卡顿分析方法、典型场景与案例
我们从可复现的场景和问题窗口入手,用 FrameTimeline(逐帧时间线) 锁定异常帧,再结合线程状态、调度、GPU 和系统合成证据建立因果关系。案例在这里只用来演示证据怎样收敛,结论要靠现场数据。
源码基线:AOSP
android-17.0.0_r1;内核android17-6.18-2026-06_r6。
⚠️ 校勘(2026-10-23):旧文把平台返回动画回调标成 API 33,并声称 AndroidX 没有进度入口;已按平台 API 参考和 AndroidX API 参考更正为 API 34、Activity 1.8.0。下文同时区分指标时长、实际执行、帧完成与显示呈现。
从异常帧到责任阶段
分析目标:把异常帧变成可复核因果链
这一节要解决的问题是:拿到 trace 之后,怎样把观察写成别人可以复核的结论。只写“主线程有一个长 slice”或“CPU 频率较低”,别人复核不了;要把结论写扎实,就得记录复现场景、目标 SurfaceFrame(某个 Surface 的一帧) 与 DisplayFrame(一次显示合成帧)、责任落在哪个阶段、关键线程或 fence(同步栅栏),以及修复后的同场景对照。
我们按下面的顺序收集和使用证据:
- 复现并固定环境;
- 检查 trace(跟踪记录) 是否已包含所需 probe(采集探针);
- 定位异常 SurfaceFrame 和对应 DisplayFrame(整屏显示帧记录);
- 按 JankType 选择 App、SurfaceFlinger、HWC(Hardware Composer,硬件合成器)/display(显示末端) 或 buffer(图形缓冲区) 路径;
- 在帧窗口内分析线程状态、Binder、GC(垃圾回收)、I/O、GPU 与 fence;
- 用相同设备状态和操作脚本验证修复。
每一步都要记下帧 token(标识)、进程、线程、layer 和时间区间;界面里位置相邻的 slice 可能属于后台事件,凭位置归组容易误归因。
抓取前先固定现场
进入采集之前,我们先固定现场。复现记录至少要包含:设备与 build、应用版本、刷新率/显示模式、温控状态、是否充电、前后台状态、页面与手势脚本、复现次数,以及首次运行还是稳态运行。涉及 SurfaceView、WebView、Camera、Video、Flutter、游戏或 Native Graphics 时,还要记录 Producer(图形内容生产者)、Surface 与 layer 结构。
“竞品不卡”是一条比较线索:两个应用可能使用不同的刷新率请求、Surface 结构、解码路径和画质,设备或系统瓶颈要先排除。问题只在低端设备上复现时,我们先把计算量、内存带宽、GPU、I/O 与温控因素分开看,再判断是不是 CPU 调度的问题。
采集时长由复现概率决定。稳定复现适合短 trace,以减少无关数据;偶发问题适合使用 ring buffer(环形缓冲区)、触发式停止或多轮采样。trace buffer(跟踪缓冲区) 的大小要覆盖目标窗口,采集结束还要检查有没有丢数据。
基础 Perfetto 配置
下面的配置用于开发和测试环境中的标准 HWUI(Android 硬件加速 UI 渲染器) 卡顿采集,包名、时长和 trace buffer 大小应按现场调整。
buffers: {
  size_kb: 65536
  fill_policy: RING_BUFFER
}

data_sources: {
  config {
    name: "linux.ftrace"
    target_buffer: 0
    ftrace_config {
      ftrace_events: "sched/sched_switch"
      ftrace_events: "sched/sched_waking"
      ftrace_events: "sched/sched_blocked_reason"
      ftrace_events: "power/cpu_frequency"
      ftrace_events: "power/cpu_idle"
      ftrace_events: "binder/binder_transaction"
      ftrace_events: "binder/binder_transaction_received"
      ftrace_events: "binder/binder_return"

      atrace_categories: "gfx"
      atrace_categories: "view"
      atrace_categories: "input"
      atrace_categories: "wm"
      atrace_categories: "am"
      atrace_categories: "dalvik"
      atrace_apps: "com.example.app"
    }
  }
}

data_sources: {
  config {
    name: "android.surfaceflinger.frametimeline"
    target_buffer: 0
  }
}

duration_ms: 15000
该配置提供 FrameTimeline、应用/系统 atrace(Android 跟踪标记)、调度、blocked reason(阻塞原因)、CPU 频率和 Binder 基线。GPU render stages(GPU 渲染阶段)、memory counters(内存计数器)、heapprofd(堆分析数据源)、thermal 或厂商图形数据源,需要根据设备支持情况和问题类型追加;一次加入所有高频 probe 会增加采集开销并缩短有效窗口。
采集结束后要检查 traced / traced_probes 错误、数据源是否启动、目标 App 是否出现在 atrace 中、FrameTimeline 表是否有记录,以及 trace buffer 是否发生 overwrite(旧数据被覆盖)。某项数据缺失时,先检查数据源支持、采集配置、目标时间窗口、过滤条件,以及该路径是否在工具覆盖范围内;现场也可能没有触发相应事件。空轨道只说明这一列没有数据;结论里应写清哪些证据暂时拿不到,以及下一步补采什么。
帧级定位:Expected、Actual 与两类 token(帧标识)
在 Perfetto 里圈定异常帧,Android 12 / API 31 起的标准入口是 FrameTimeline。应用的 SurfaceFrame 和 SurfaceFlinger 的 DisplayFrame 各有一对 expected/actual timeline(预期/实际时间线);Perfetto 通过 flow(跨轨道关联线) 把两者关联起来。surface_frame_token 与 display_frame_token 是不同标识,一个 DisplayFrame 可以合成多个 layer frame。
选择应用 Actual Timeline slice 后,依次记录:
Layer Name与Is Buffer;surface_frame_token与display_frame_token;On time finish、Present Type、Jank Type;- 对应的 expected window(预期时间窗口);
- flow 指向的 DisplayFrame,以及 SF(SurfaceFlinger) 侧的 GPU composition(GPU 合成) 与 present(呈现) 状态。
颜色只用于导航。红色、黄色或浅绿色都只是界面提示,我们读取的是字段本身:JankType 是位标志,同一帧可能有多个原因。分析 BufferStuffing、Dropped、PredictionError 和显示模式切换时,还要读取相邻帧。
SurfaceView、视频 overlay(硬件叠加层)、Camera 和某些引擎路径可能没有完整的 App FrameTimeline。这时我们改从目标 layer、buffer update、acquire fence(等待生产完成的同步栅栏)、SF latch(锁定本帧 buffer)、composition type(合成类型)、present fence(显示呈现栅栏)与 release fence(buffer 可复用栅栏)组织证据。这几个对象各管一段:acquire fence(缓冲区可读栅栏)等的是生产完成,SF latch 把本帧 buffer 锁定下来。present fence 按 HWC 接口定义,常见物理屏上对应本帧开始扫描显示、或开始向面板内存传送的 VSync,全屏扫描在这之后才结束;虚拟显示则对应输出 buffer 写完。release fence 表示相应消费者已读完 buffer,随后才可安全重写,实际仍要遵守缓冲队列的所有权规则。接口语义见 HWC 基线头文件。出图类型识别参见 渲染管线总览。
从帧回到线程与系统
帧记录把责任指向某个阶段之后,我们回到线程和系统侧收集证据:先看应用侧的 MainThread 与 RenderThread,再看 SurfaceFlinger 与显示末端,最后是 CPU 调度与等待状态。
MainThread 与 RenderThread(渲染线程)
Choreographer#doFrame 是应用帧调度入口,常见 callback(回调) 顺序为 Input(输入)、Animation(动画)、Insets Animation(系统栏等区域的动画)、Traversal(测量、布局和绘制遍历)、Commit(提交),其中 Traversal 覆盖测量、布局和绘制,Commit 处理 traversal 之后的 post-draw 回调,并可能校正回调可见的 frame time,是应用侧帧工作的收尾阶段。GPU 提交与显示 present 是否完成,要另外确认。DrawFrame 位于 RenderThread,覆盖 HWUI 的渲染准备与提交工作。这两个 slice 适合作为回溯的起点,帧的完成与呈现结论仍要看 FrameTimeline。
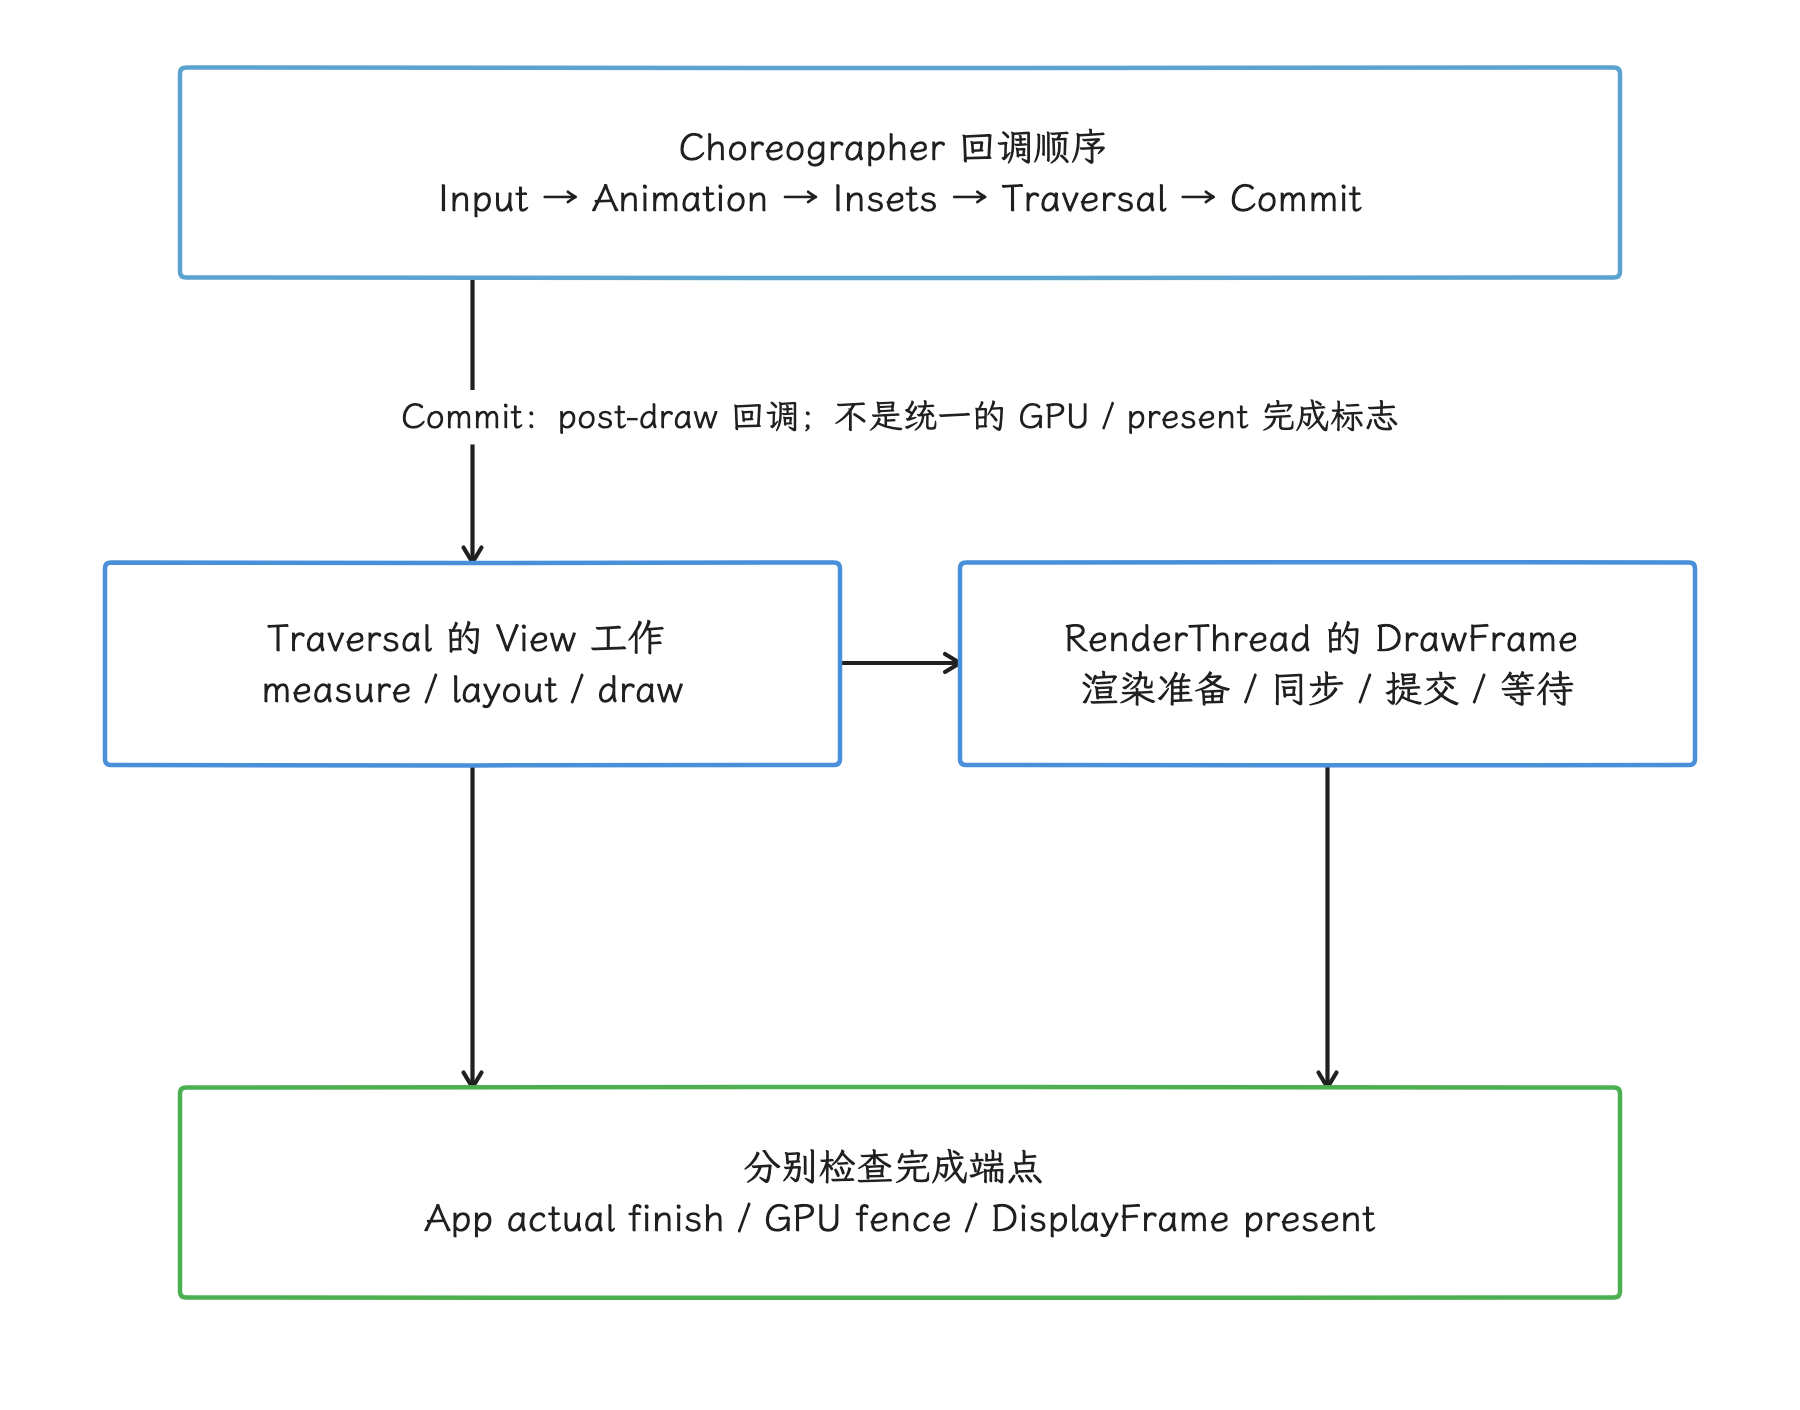
图:Commit 是 traversal 后的回调阶段;GPU 完成、App actual 结束和显示 present 要从各自的轨道或 fence 判断。主线程、RenderThread 与 GPU 可以流水重叠。
主线程 doFrame 开始较晚时,我们先检查前序 Looper(消息循环) 消息、同步 Binder、锁、I/O 和 wakeup(唤醒) latency(唤醒延迟)。doFrame 内部耗时较长时,再分别检查 callback 与业务 slice。MainThread 在 syncFrameState 附近等待,可能是与 RenderThread 的预期同步,也可能被前一帧、纹理上传或 buffer backpressure(缓冲区背压) 放大;这时沿 wait 的唤醒源继续追。
RenderThread 的 DrawFrame 较长时,我们先分清时间去了哪里:Running(运行中) 是正在执行,Runnable(可运行但未获得 CPU) 是可运行但还没拿到 CPU,buffer/fence wait(等待) 是在等缓冲或栅栏,GPU completion(GPU 完成时间) 要看 GPU 侧何时完成。DrawFrame 的 slice 长度是该记录区间的 wall time,实际 CPU 执行还要从 Running 区间统计。整帧与 GPU 是否按时完成,要核对 FrameTimeline 的 finish、GPU track(轨道)与 acquire fence。
SurfaceFlinger 与显示末端
遇到 SurfaceFlingerCpuDeadlineMissed,我们检查 SF 主线程、transaction(图层状态事务)、layer snapshot(图层快照)、composition strategy(合成策略) 和 HWC validate(能力校验)/present(验证合成方案/提交显示)。遇到 SurfaceFlingerGpuDeadlineMissed(SF GPU 合成错过截止时间),检查 RenderEngine、client target(客户端合成目标) 和 GPU fence(同步栅栏)。遇到 DisplayHAL,继续检查 Composer HAL、present fence、显示模式与驱动。
onMessageReceived 是旧版和底层 trace 中常见的 SF 工作入口,但 slice 名称、拆分方式和厂商插桩都会变化。现代分析优先依赖 DisplayFrame、flow 与明确的 SF/HWC 事件;SF 有没有做合成,以 DisplayFrame 与 flow 为准,slice 名称只作参考。
CPU 调度与等待状态
线程状态要放回 Linux 调度语义里解释,我们逐个状态给出对应的动作(Perfetto 调度文档、基线状态编码):
| 状态 | 含义 | 分析动作 |
|---|---|---|
| Running | 正在某个 CPU 上执行 | 检查调用栈、slice、核心与频率 |
Runnable (R) | 可运行但尚未获得 CPU | 量化 wakeup-to-running(从唤醒到运行)的时长,检查竞争者与调度组 |
Sleeping (S) | 可中断等待 | 查找等待对象、Binder flow、锁 owner(持有者)或唤醒源 |
Uninterruptible Sleep (D) | 内核不可中断等待 | 结合 io_wait、blocked_function 与内核事件 |
Runnable(可运行但尚未获得 CPU) duration(持续时间)量的是等待 CPU 的时间,要测它就用 thread_state 的 Runnable 区间,必要时结合 sched_waking 的唤醒关系;前一条 sched_slice 的 dur 量的是上一次在 CPU 上的运行。sched_slice.end_state = R 或 R+ 表示线程离开 CPU 时仍可运行,适合解释它为何被切出,后续的等待时长则回到 Runnable 区间读。
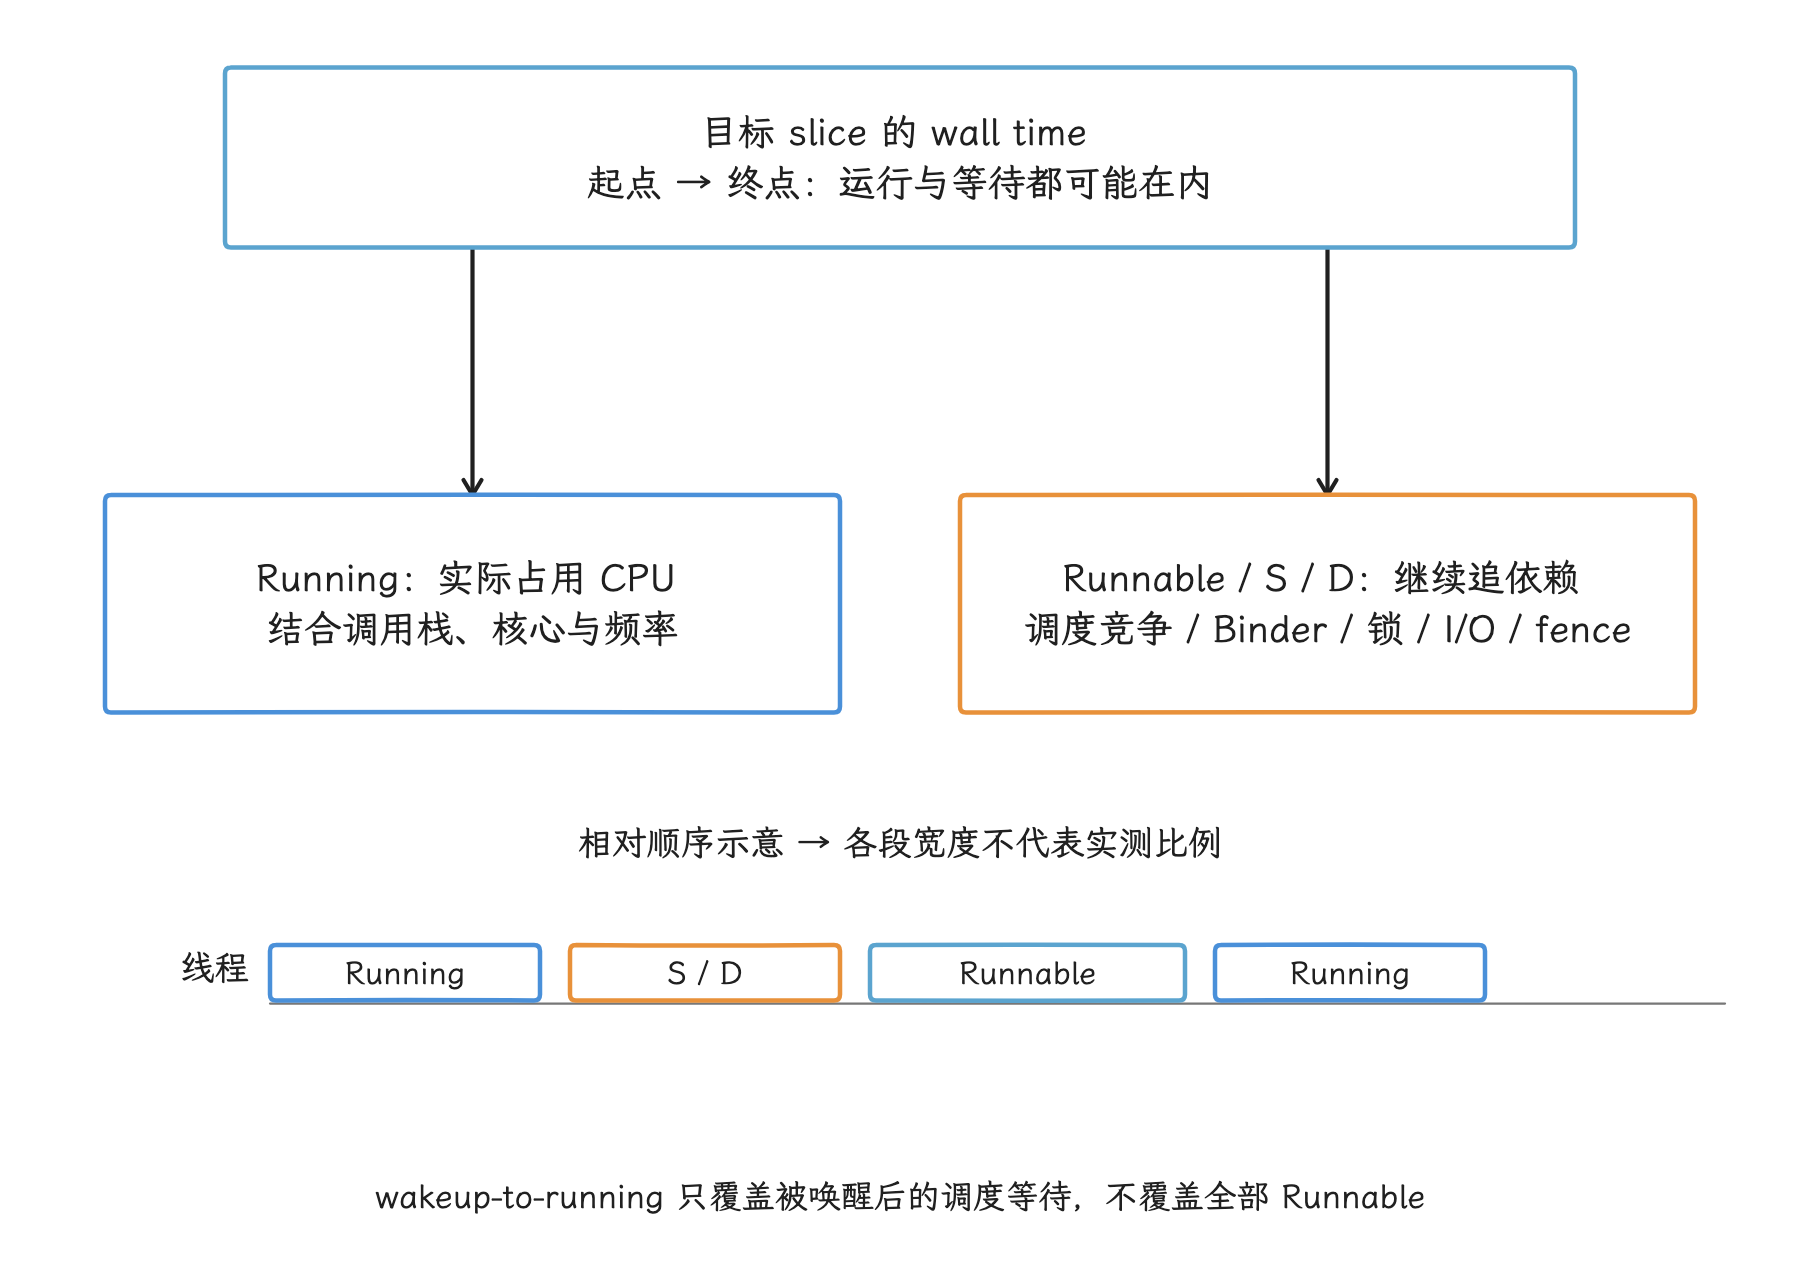
图:统计线程 Running 区间才得到 CPU 执行;Runnable 区间反映等待调度,D/S 需要继续找等待对象。sched_slice.end_state 说明的是线程离开 CPU 时的状态;后续等待了多久,要回到对应状态区间去读。
D 状态的范围比存储 I/O 宽:fence、驱动、页错误和其他内核 wait queue(等待队列) 都可能形成不可中断等待。具体在等什么资源,要有 blocked_function、io_wait 与相邻事件共同支持才写得上去。
FrameMetrics 与 JankStats(应用内卡顿监测库) 的线上角色
Window.OnFrameMetricsAvailableListener 从 API 24 起提供 HWUI 窗口的逐帧指标。listener(监听器) 会在指定 Handler(消息处理器) 上回调,处理过慢会产生 dropCountSinceLastInvocation;这个 drop count 表示指标回调丢失,和显示帧被 SurfaceFlinger 丢弃是两回事。跨线程保存数据时应复制 FrameMetrics,避免后续回调复用同一对象带来数据变化。
| 指标 | API 边界 | 解释 |
|---|---|---|
INPUT_HANDLING_DURATION、ANIMATION_DURATION、LAYOUT_MEASURE_DURATION、DRAW_DURATION | API 24 | App UI / View 阶段耗时 |
SYNC_DURATION、COMMAND_ISSUE_DURATION、SWAP_BUFFERS_DURATION、TOTAL_DURATION | API 24 | HWUI 同步、提交和总时长 |
INTENDED_VSYNC_TIMESTAMP、VSYNC_TIMESTAMP | API 26 | 计划与采用的 VSync 时间 |
GPU_DURATION、DEADLINE | API 31 | GPU 工作时长与该应用帧获分配的时长预算(单位均为 ns) |
FRAME_TIMELINE_VSYNC_ID | API 36 | 把 HWUI frame 与 compositor timeline(合成器时间线)关联 |
TOTAL_DURATION 里部分阶段可能并行执行,各阶段耗时简单相加未必等于总数。API 31 及更高版本可以用 TOTAL_DURATION < DEADLINE 判断应用是否满足该帧预算;这仍是 HWUI 窗口视角,独立 Surface 的像素生产和显示末端要另找证据。
JankStats 在 FrameMetrics 和平台计时数据上增加启发式 jank 判断和 UI state(界面状态)。它适合回答“哪个页面或交互经常出问题”;Perfetto 用于解释具体帧的跨进程原因。线上数据按设备、刷新率、场景和版本聚合,不同 API 级别的精度要分开对待。
第三方应用的 Perfetto SDK 主要提供进程内 Track Event(轨道事件) 和受支持的 tracing session(跟踪会话);要读取任意 ftrace(Linux 内核跟踪)、SurfaceFlinger 或其他进程的数据,需要平台权限。开发环境可以通过 adb/Android Studio 采集系统 trace;生产环境要使用平台允许的 profiling API(性能分析接口)、设备策略或应用内指标,并清楚记录缺少哪些数据源。
Perfetto SQL:从表结构开始
这一节的 SQL 查询都运行在 Trace Processor(跟踪数据处理器)上:它导入并分析 trace;SQL 模块和表结构取决于分析时使用的 Trace Processor 版本,不由采集设备的 Android 版本单独决定。AOSP(Android 开源项目) 参考实现位于 platform/external/perfetto 的 android.frames.timeline、android.binder 与 android.binder_breakdown 模块。字段或模块不存在时,先核对查询与分析器的兼容性;数据源未采到或现场没有对应事件时,表也可能只是空表。SQL 报错和零行结果,我们分别排查。
本文三段查询已用 Perfetto v58.2 在官方测试 trace上运行校验,并分别检查内置标准库与上述 r1 SQL 模块。此校验确认的是示例的执行与区间筛选语义;换一份 trace,数据覆盖要重新确认。
查询异常 SurfaceFrame
下面的查询使用 android_frames_layers 提供的 actual/expected id(实际/预期记录标识) 配对,避免根据 slice 名称或 track_id 猜测帧关系。
INCLUDE PERFETTO MODULE android.frames.timeline;

SELECT DISTINCT
  f.process_name,
  f.upid,
  a.id AS actual_slice_id,
  f.frame_id,
  f.layer_name,
  a.surface_frame_token,
  a.display_frame_token,
  a.ts,
  a.dur / 1e6 AS actual_ms,
  e.dur / 1e6 AS expected_ms,
  ((a.ts + a.dur) - (e.ts + e.dur)) / 1e6 AS finish_delta_ms,
  a.on_time_finish,
  a.present_type,
  a.jank_type
FROM android_frames_layers AS f
JOIN actual_frame_timeline_slice AS a
  ON a.id = f.actual_frame_timeline_id
LEFT JOIN expected_frame_timeline_slice AS e
  ON e.id = f.expected_frame_timeline_id AND e.dur >= 0
WHERE a.dur >= 0
  AND (a.on_time_finish = 0
       OR a.jank_type != 'None'
       OR a.present_type != 'On-time Present')
ORDER BY a.ts;
finish_delta_ms 比较的是 actual end(实际结束时间) 与 expected end(预期结束时间),只表示该 SurfaceFrame 的窗口偏差;最终责任仍以 jank_type、DisplayFrame 和 flow 为准。android_frames_layers 适合分析关联到 HWUI doFrame/DrawFrame 的逐 layer 记录,android_frames 则按进程与 frame 聚合;两者覆盖的都是加工后的视角,全部 producer 的原始 FrameTimeline 数据,要回到未聚合的 timeline 记录去看。基线模块对 DrawFrame 与 layer 的匹配仍有 TODO,同一 actual slice 可能因多个 DrawFrame 重复出现。上述查询按 actual slice 身份去重;缺少 expected 或有效配对时,偏差为 NULL,读作缺失,别补成 0。
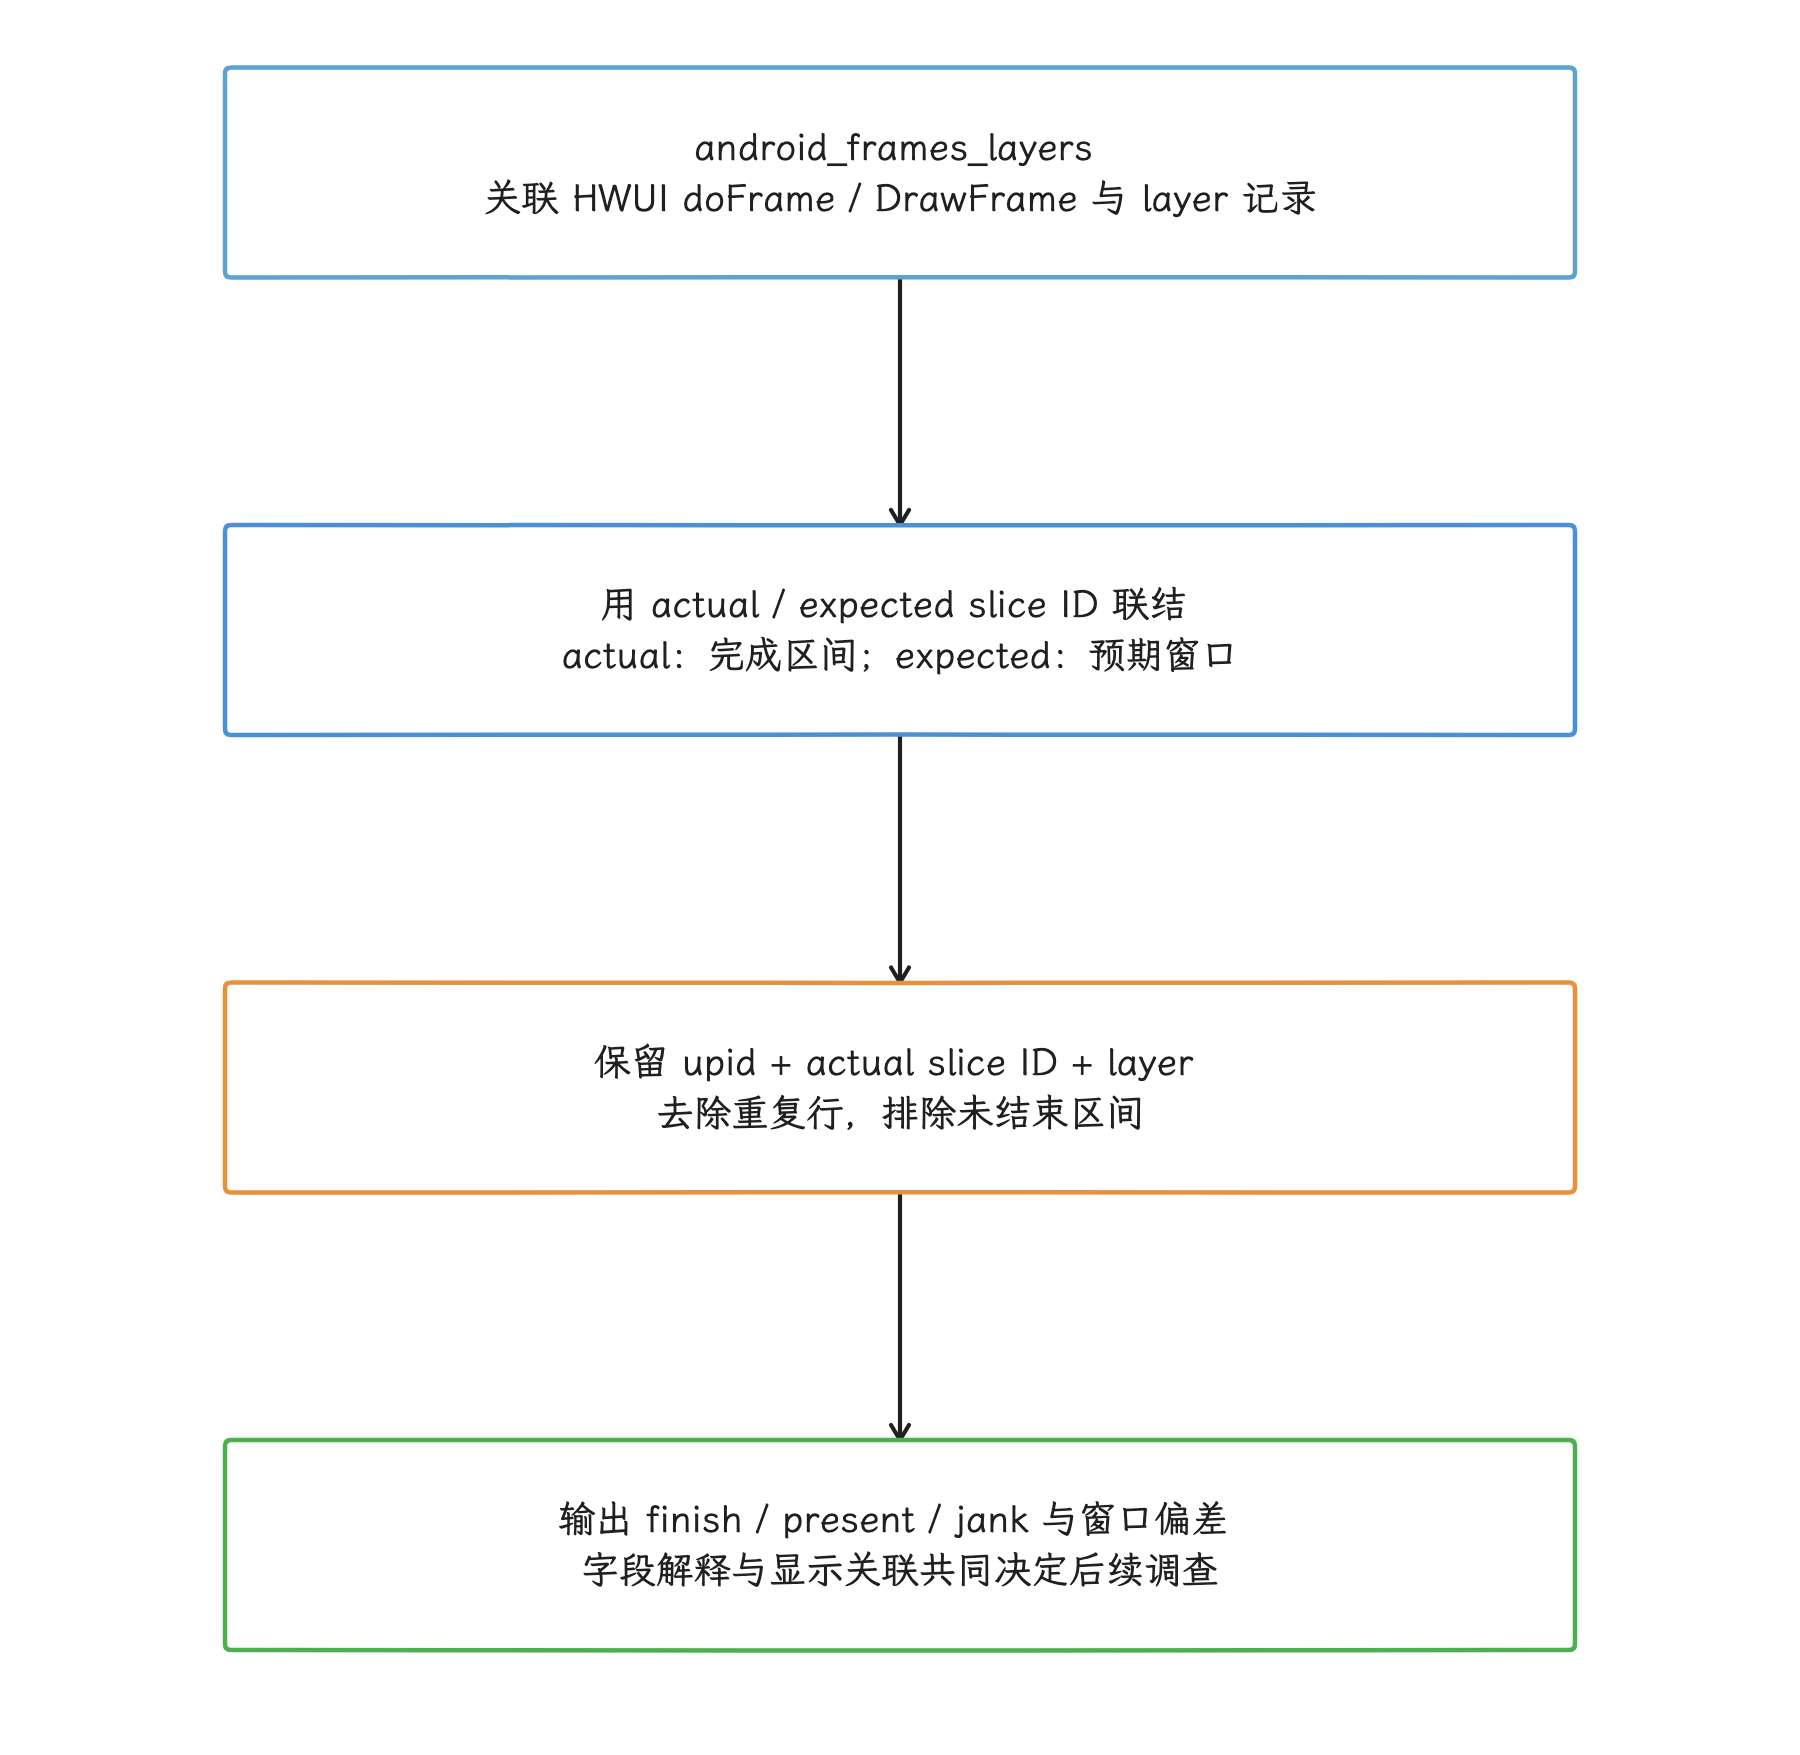
图:先包含模块并检查分析器版本,再由模块提供的 ID 连接 actual/expected。多 DrawFrame 可能使同一 actual slice 重复出现;缺少 expected 时保留 NULL,缺失照实记,不补成零。
查询主线程与 RenderThread 的等待
下面的查询列出目标进程关键线程中最长的 Runnable 与不可中断等待,包名需要替换。
WITH params(process_name) AS (
  VALUES ('com.example.app')
)
SELECT
  p.name AS process_name,
  t.name AS thread_name,
  s.ts,
  s.dur / 1e6 AS wait_ms,
  s.state,
  s.io_wait,
  s.blocked_function
FROM thread_state AS s
JOIN thread AS t USING (utid)
JOIN process AS p USING (upid)
JOIN params ON params.process_name = p.name
WHERE (t.is_main_thread = 1 OR t.name = 'RenderThread')
  AND (s.state IN ('R', 'R+') OR s.state GLOB 'D*')
  AND s.dur > 0
ORDER BY s.dur DESC
LIMIT 100;
R / R+ 行的 duration 是等待调度的时长,R+ 表示被抢占后仍可运行;以 D 开头的状态可能组合 K 等标志,仍需结合 io_wait 和 blocked_function 解释。查询没有限制帧窗口,适合初步筛选;形成单帧结论时,再与目标 frame 的 [ts, ts + dur) 半开时间区间计算重叠——包含起点、不包含终点。
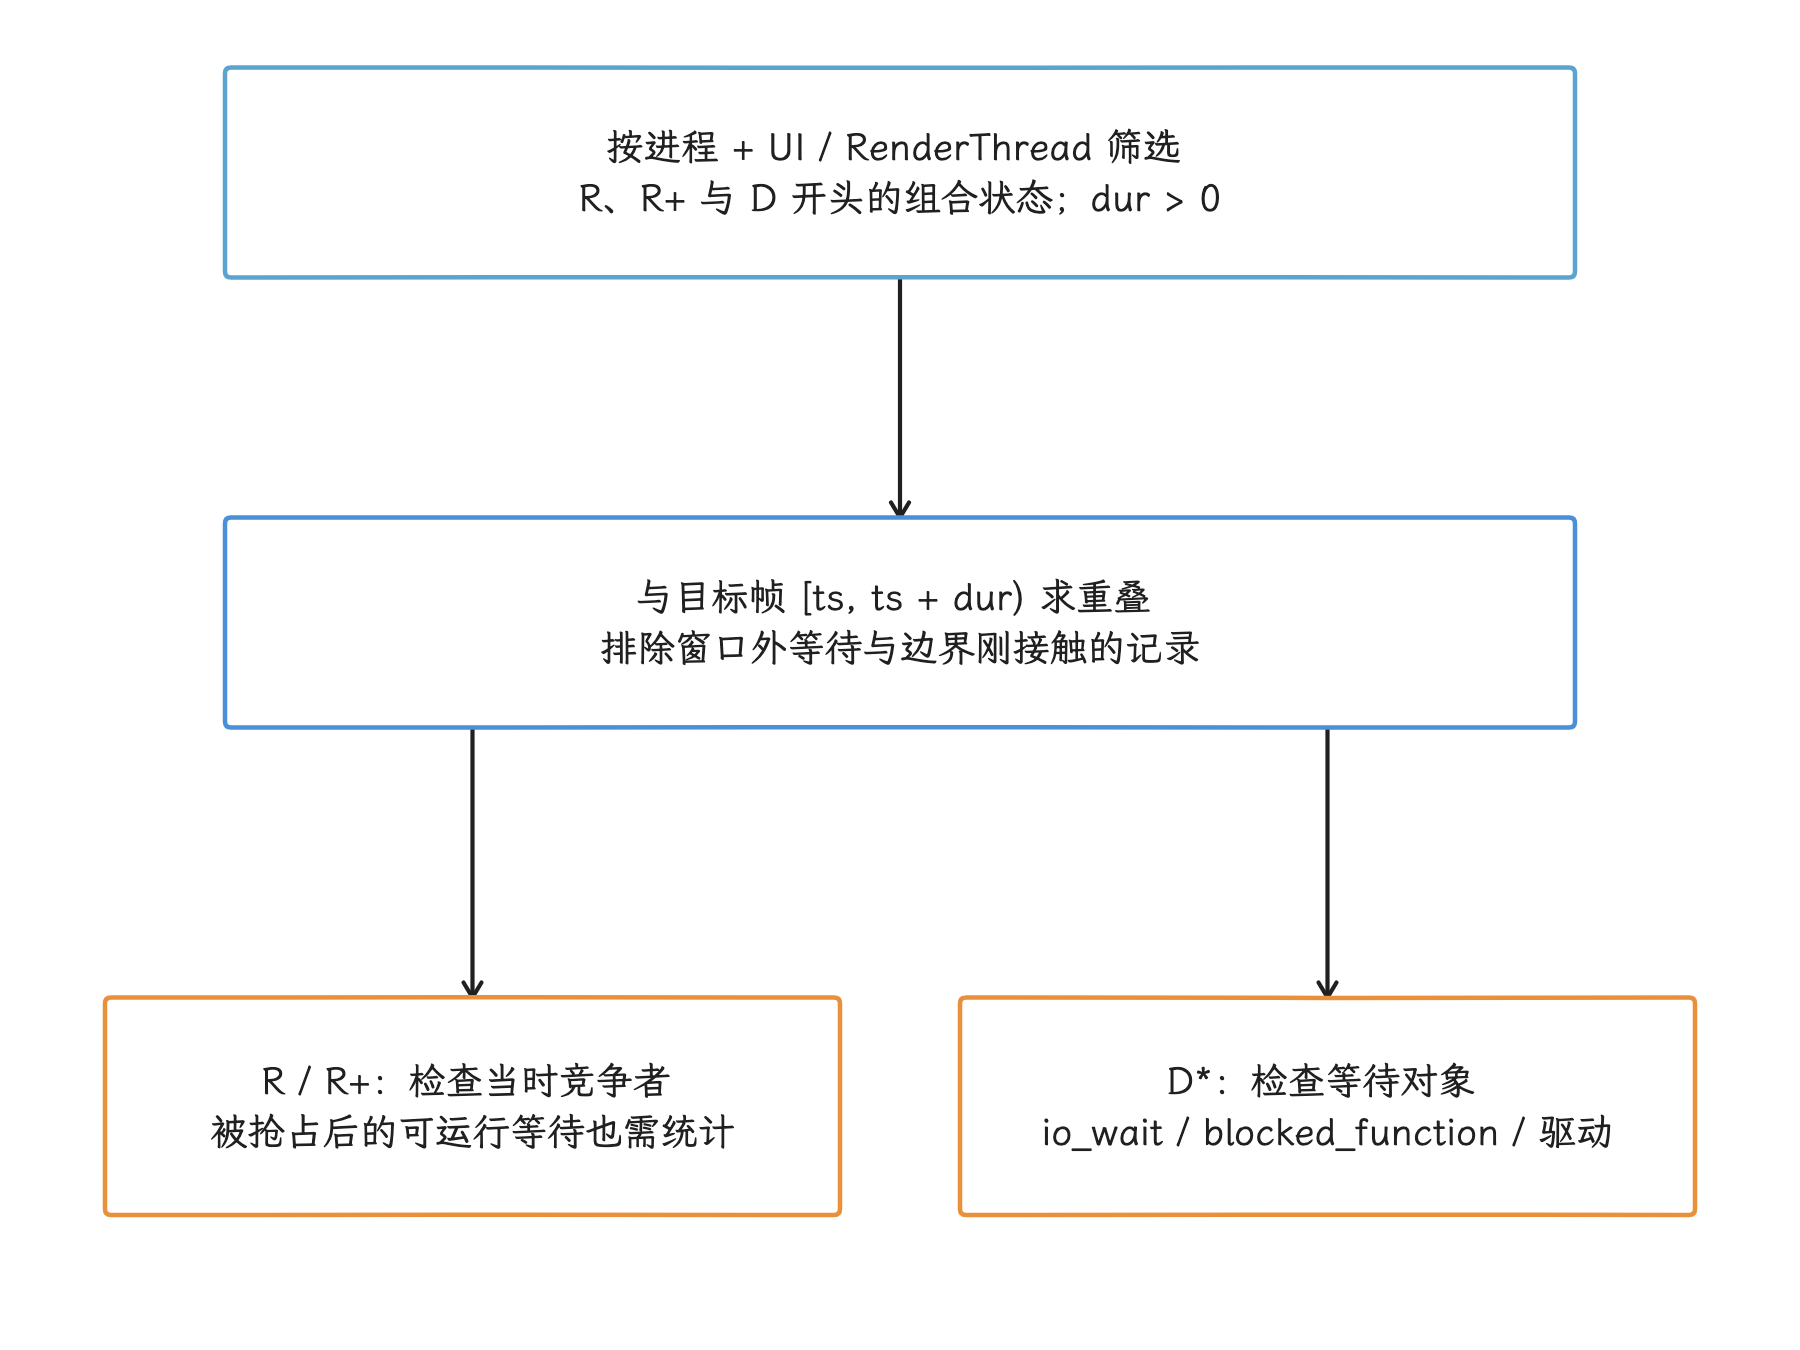
图:全局 Top 等待只用于筛选。形成单帧结论前,要保留线程身份,与实际帧半开区间计算重叠,再补等待对象、调度竞争或驱动证据。
把 Binder 限制在 AppDeadlineMissed 帧内
下面的查询只保留目标应用 UI/RenderThread 与 App Deadline Missed 实际帧窗口有重叠的同步 Binder,包括窗口之前发起、窗口内仍未返回的事务;它用来找依赖候选;从全局慢事务走到帧责任,中间要经过这道帧窗口重叠。
INCLUDE PERFETTO MODULE android.frames.timeline;
INCLUDE PERFETTO MODULE android.binder;

WITH params(process_name) AS (
  VALUES ('com.example.app')
),
janky_frames AS (
  SELECT DISTINCT
    f.frame_id,
    a.id AS actual_slice_id,
    f.layer_name,
    a.ts,
    a.dur,
    f.upid,
    f.ui_thread_utid,
    f.render_thread_utid
  FROM android_frames_layers AS f
  JOIN actual_frame_timeline_slice AS a
    ON a.id = f.actual_frame_timeline_id
  JOIN params ON params.process_name = f.process_name
  WHERE a.jank_type GLOB '*App Deadline Missed*'
    AND a.dur > 0
)
SELECT
  jf.frame_id,
  jf.actual_slice_id,
  jf.layer_name,
  b.binder_txn_id,
  b.aidl_name,
  b.method_name,
  b.client_thread,
  b.server_process,
  b.server_thread,
  b.client_dur / 1e6 AS client_ms,
  (MIN(b.client_ts + b.client_dur, jf.ts + jf.dur)
   - MAX(b.client_ts, jf.ts)) / 1e6 AS overlap_ms,
  b.server_dur / 1e6 AS server_ms
FROM janky_frames AS jf
JOIN android_binder_txns AS b
  ON b.client_upid = jf.upid
 AND (b.client_utid = jf.ui_thread_utid
      OR b.client_utid = jf.render_thread_utid)
 AND b.client_ts < jf.ts + jf.dur
 AND b.client_ts + b.client_dur > jf.ts
WHERE b.is_sync = 1 AND b.client_dur > 0
ORDER BY b.client_dur DESC;
查询结果只能证明 Binder 与责任线程的帧窗口重叠。要解释延迟来源,还要包含 android.binder_breakdown,按 binder_txn_id 汇总 android_binder_client_breakdown 和 android_binder_server_breakdown 中的 reason。server_ts - client_ts 比较客户端事务 slice 与服务端处理 slice 的起点;这段差值可能含传输和调度等阶段,线程池排队时间、服务线程首次获得 CPU 的时刻,都要从其他证据里读。判断线程池是否饱和,看服务端 worker(工作线程)、Runnable、嵌套 Binder 与队列证据;固定毫秒阈值替代不了它们。
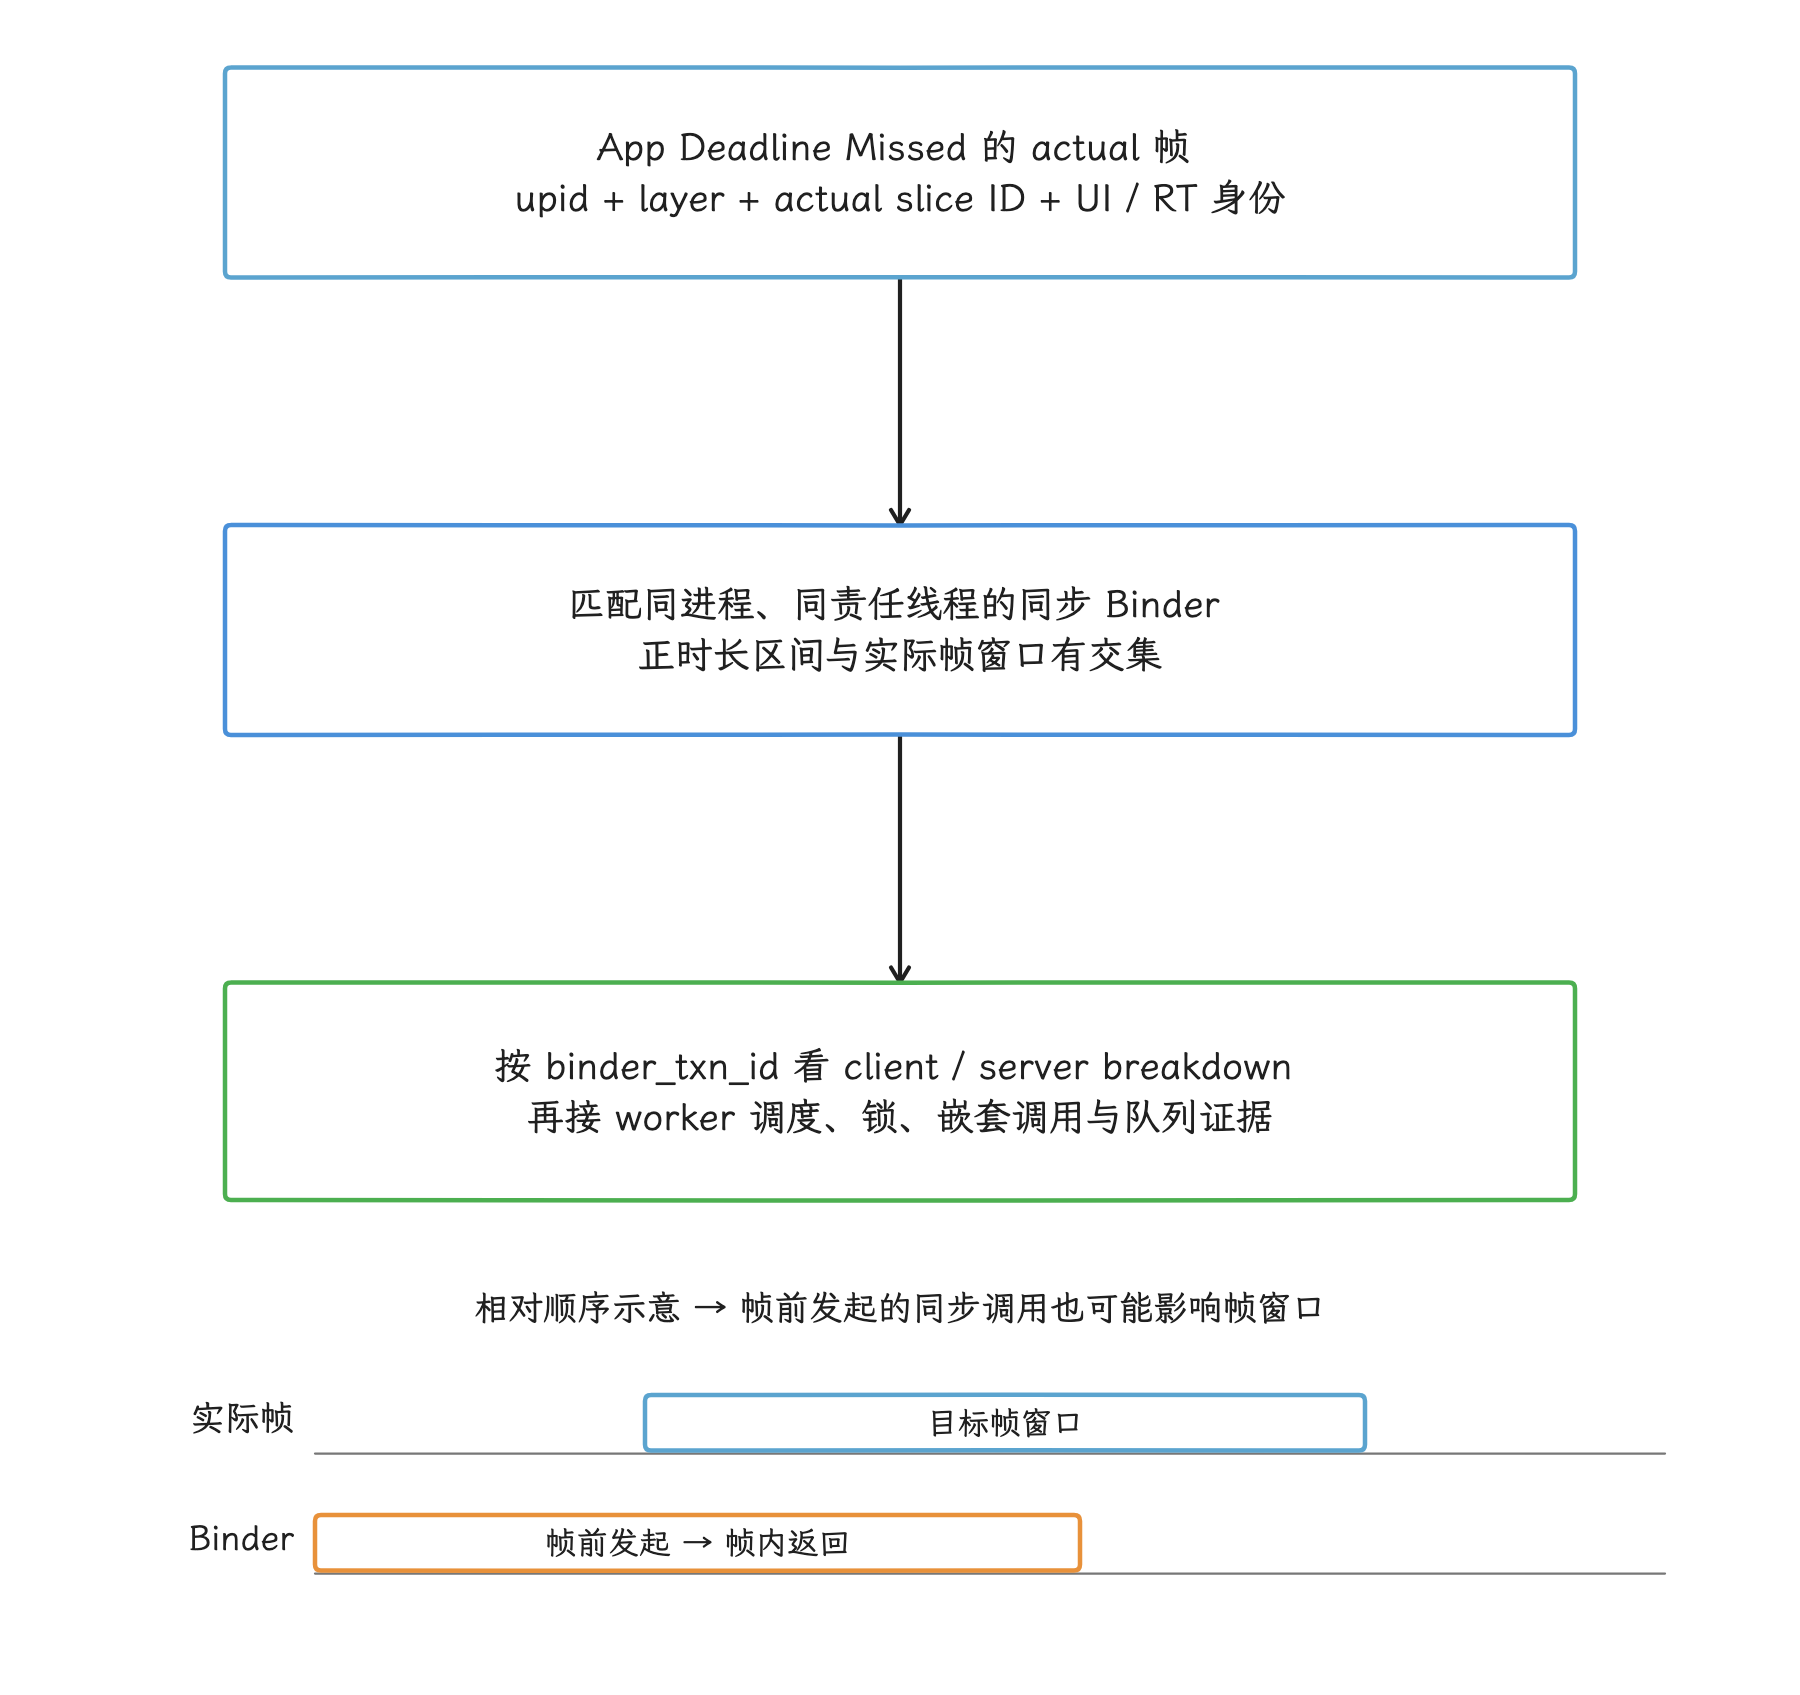
图:重叠筛选会包含帧开始前发起、帧内仍未返回的同步 Binder。它只建立候选依赖;线程池是否饱和,要看服务端分解、线程状态和嵌套事务,固定时间差给不出这个结论。
大型 trace
分析大型 trace 时,我们先用时间窗口、进程/线程条件和 LIMIT 缩小查询范围,再考虑使用 MATERIALIZED CTE(物化公共表表达式)或临时表。命令行 trace_processor_shell trace.pb --query-file analysis.sql 适合离线批处理;SQL 文件与 trace、Trace Processor 版本和查询参数一起归档,结果才可以重放。
标准化分析检查清单
现场与 trace 完整性
- 记录设备、build、应用版本、刷新率、thermal 和操作脚本;
- 标出目标问题的开始、结束和复现次数;
- 确认 FrameTimeline、sched、atrace 和所需专项 probe 有数据;
- 检查 buffer overwrite、数据丢失与 tracing 开销;
- 确认 Producer、Surface、layer 和合成路径。
帧与责任边界
- 记录 SurfaceFrame token、DisplayFrame token、layer name;
- 读取 expected / actual、finish、present 与 JankType;
- 沿 flow 找到对应 DisplayFrame;
- 检查相邻帧是否存在 stuffing(帧堆积)、drop、mode/power transition(显示或电源模式切换);
- 按 App、SF CPU、SF GPU、Display 或 buffer 选择分支。
线程与依赖
- App 分支拆 MainThread、RenderThread、应用 GPU 和 buffer;
- SF 分支拆主线程、RenderEngine、HWC 与 present;
-
对长等待区分 Runnable、Sleeping(睡眠)、
D、Binder、锁和 fence; - GC 只计算与目标线程重叠的 pause(暂停),不把并发阶段全算作停顿;
- thermal、频率、内存压力和后台负载保留为需要时序验证的系统因素。
结论与验证
- 写出异常帧、责任方、关键路径事件和排除项;
- 区分直接证据、组合证据与相关现象;
- 修复前后使用同一设备状态、场景和 trace 配置;
- 比较 jank 类型、帧间隔分布、关键 slice/wait(执行区间/等待) 和业务指标;
- 结论复现不出来时,保留不确定性和下一轮采集项。
常见失误
| 失误 | 修正 |
|---|---|
| 看到红色 slice 就写根因 | 读取 token、字段、flow 与责任线程 |
| 用固定 16.67 ms 处理所有设备 | 使用该帧 expected / deadline 和当时显示模式 |
doFrame 短便排除 App | 继续检查 RenderThread、应用 GPU、buffer 与独立 Surface |
| 主线程 Sleeping 便认定 App 无责 | 找等待对象、服务端、owner 或 fence |
D 状态都算磁盘 I/O | 检查 blocked_function、io_wait 与驱动事件 |
| Binder dispatch 超过某阈值便认定线程池耗尽 | 检查 server worker、调度、锁、嵌套事务和 breakdown(分段耗时) |
| FrameMetrics listener drop 当作显示掉帧 | 它表示指标回调丢失 |
| App 启动 Perfetto SDK 就能拿系统 trace | 区分进程内 Track Event 与受权限保护的系统数据源 |
| trace 越长越有价值 | 选择能覆盖复现且数据完整的最小窗口 |
平台与内核基线
- Platform(平台层):FrameTimeline、FrameMetrics、HWUI、SurfaceFlinger 和 Perfetto stdlib(标准库)的机制以文首的源码基线为准。
- Kernel(内核):调度、Binder、blocked reason、dma-fence(设备缓冲同步栅栏)、PSI 与内存回收同样以文首的内核基线为准。
- 版本演进:Android 12 前没有 FrameTimeline;API 24 起有 FrameMetrics,API 31 增加
GPU_DURATION/DEADLINE,API 36 增加FRAME_TIMELINE_VSYNC_ID。历史工具可保留,分析时优先使用现代字段。
滚动、动画、启动与交互场景
这一节按场景展开:滚动、动画、启动与页面切换的帧生产方式不同,起止点和关键轨道也不同,我们逐个场景列出要看的对象和检查顺序。
从场景名到渲染链路
“列表卡”“转场卡”“通知栏卡”说的是用户看到了什么,排查的第一步是把它翻译成“哪条渲染链路迟到”。同一个列表里可以同时出现普通 View、SurfaceView 视频和 TextureView 地图;一次页面切换又可能包含应用窗口的 buffer、Shell transition(系统窗口过渡) 的 leash(用于统一控制窗口动画的临时图层)变换、壁纸、IME 与 SurfaceFlinger 合成。如果我们从场景名称直接跳到某个线程,很容易把证据落到错误的对象上。
定位顺序如下:
- 记录发生卡顿的交互阶段、显示屏、刷新率和时间区间。
- 列出屏幕上的内容生产者,以及各自产出的 Surface、BufferQueue(连接内容生产者和消费者的缓冲队列) 和 SurfaceFlinger layer(图层)。
- 从 FrameTimeline 的异常 SurfaceFrame/DisplayFrame,或目标 layer 的异常 present 反查。
- 沿 token、frame number(帧序号)、transaction、buffer 与 fence 找到最早迟到的阶段。
- 回到责任线程,检查执行时间、Runnable 等待、锁、Binder、I/O、GC、GPU 和温控状态。
60 Hz 的名义刷新间隔约为 16.67 ms,120 Hz 约为 8.33 ms,但它们只是参考值,直接拿来当任意线程的固定预算会出错:Choreographer 回调相位、应用 deadline(截止时间)、BufferQueue 状态、SurfaceFlinger 调度和显示模式都会改变一帧的可用时间。诊断目标应写成“该帧相对 expected timeline(预期时间线) 在哪里开始偏离”,避免写成“整条管线必须在一个 VSync(垂直同步) 间隔内全部结束”。
一张场景取证表
每次复现都建议先把这张表填好。缺了哪一列,结论就少覆盖哪一块。
| 维度 | 需要记录的内容 | 常用证据 |
|---|---|---|
| 交互 | 手指拖动、fling(惯性滑动)、点击、返回进度、窗口进入、通知更新 | input event(输入事件)、应用 marker(跟踪标记)、CUJ(Critical User Journey,关键用户操作流程) |
| 显示 | display id(显示屏标识)、刷新率、分辨率、显示模式 | SurfaceFlinger/Winscope、Perfetto |
| 窗口 | App Window、Dialog、Splash、IME、壁纸、transition leash | WindowManager、Shell Transitions |
| 内容生产者 | UI/RenderThread、MediaCodec、GL/Vulkan、WebView renderer、地图引擎 | 线程、进程、SDK/provider(实现提供方)版本 |
| 提交对象 | ViewRoot buffer、SurfaceView child layer(子图层)、TextureView 输入、task snapshot(任务快照) | BufferQueue、Layer、transaction |
| 帧结果 | expected/actual(预期/实际)、present type(呈现类型)、jank type(卡顿类型)、dropped/duplicated(丢弃/重复) | FrameTimeline、FrameTracer、fence |
| 责任边界 | 应用、SystemUI、Launcher、system_server、SF/HWC(SurfaceFlinger/Hardware Composer,系统合成服务/硬件合成器)、内核/驱动 | sched(调度)、Binder、GPU/HWC、kernel trace(内核跟踪) |
列表滑动:先区分拖动与 fling
列表滑动至少有两段不同的驱动方式。
- 手指按住并拖动时,输入分发和应用消费决定滚动位置何时更新。检查 MotionEvent(触摸事件) 到主线程处理的间隔、输入回调耗时,以及同一帧的 traversal(测量、布局和绘制遍历)。
- 手指抬起进入 fling 后,滚动由动画时钟和 RecyclerView/ScrollView 的滚动计算继续推进。此时没有持续的触摸移动事件;要检查动画回调是否及时,以及每帧滚动工作是否稳定。
- 两个阶段都可能受 RenderThread、GPU、BufferQueue 或显示合成影响。主线程短只排除了部分应用 CPU 工作。
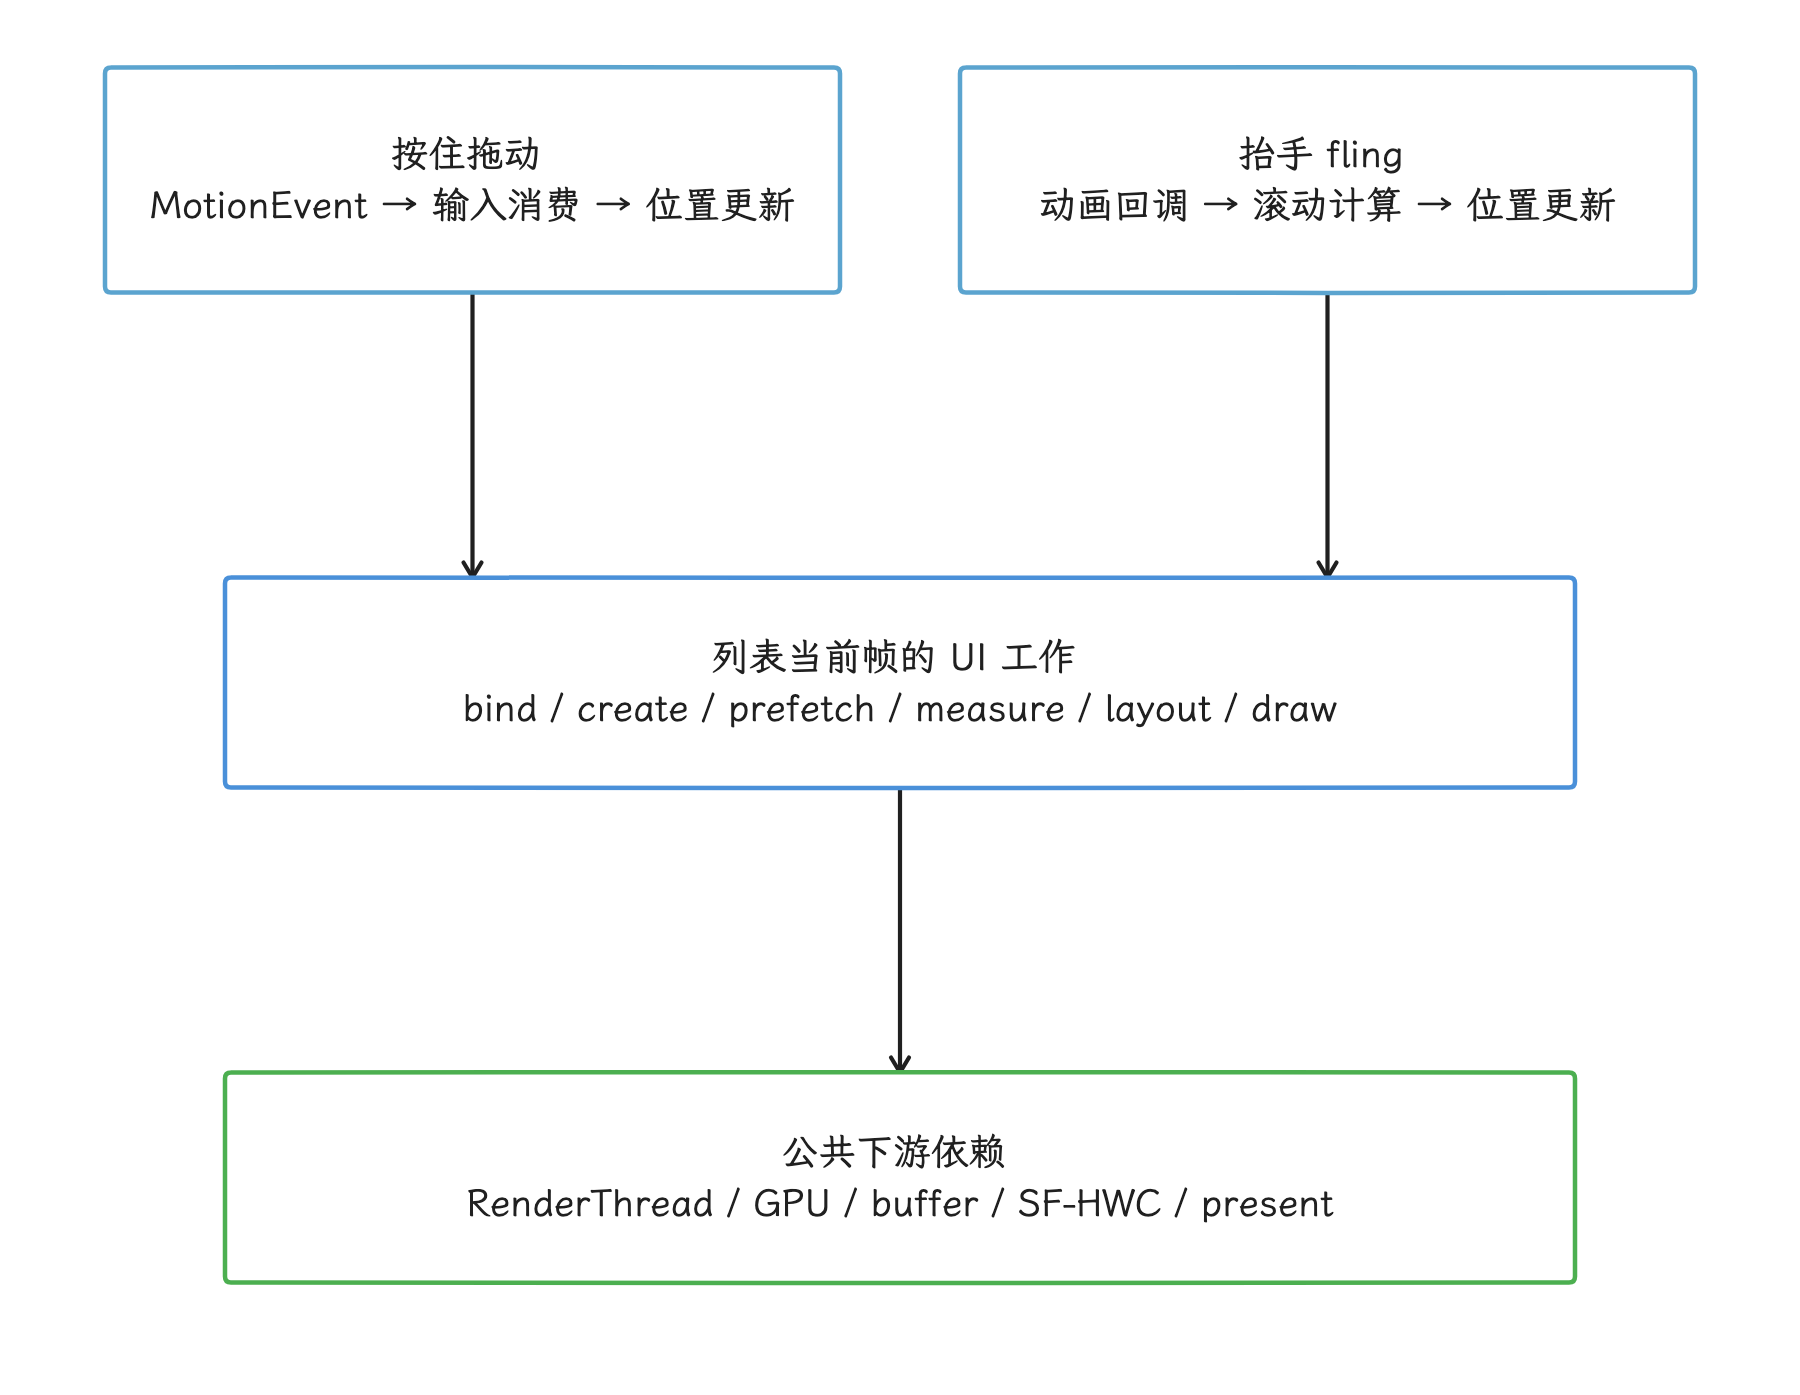
图:拖动时重点看输入分发、消费与位置更新;fling 时重点看动画时钟和滚动计算。两者都可能受后续 bind/layout、RenderThread、GPU、buffer 与显示链影响。
FrameTimeline 可以先圈定异常帧。随后我们把异常帧与正常帧放在一起比较,查看 UI Thread(主线程)、RenderThread、对应的 App Window buffer 和 DisplayFrame。对照相邻的正常帧,稳定存在的初始化或后台任务往往就能从嫌疑里排除;只盯一个长 slice,常会把它们误判成根因。
RecyclerView 的三组内建线索
AndroidX RecyclerView 在系统跟踪中留下了自己的一组 slice;不同库版本的名称可能略有差别,官方慢帧文档常用以下三组线索:
| 线索 | 代表的工作 | 常见原因 | 处理方向 |
|---|---|---|---|
RV OnBindView | 把数据绑定到已有 ViewHolder | 格式化、同步读取、复杂 span、监听器反复创建 | 把纯数据准备移出 bind,缓存稳定结果 |
RV CreateView | inflate 并创建 ViewHolder | item 树过深、View 类型多、复用不足 | 简化高频 item,按 viewType 检查创建频率 |
RV Prefetch | GapWorker 执行预取 | 嵌套列表、预取量不合适、共享池边界错误 | 按真实滚动方向和嵌套关系调整参数 |
onBindViewHolder() 运行在主线程,但它不一定嵌在名为 measure 或 layout 的 slice 里。判断 bind 是否拖慢一帧,我们直接看 RecyclerView slice 或应用自定义 marker,再观察它与 Choreographer#doFrame、traversal(界面遍历) 的时间关系。
onCreateViewHolder() 偶尔出现是正常行为。只有它在用户可感知的滚动区间反复出现、并与异常帧对齐,创建或复用才需要处理。盲目增大 RecycledViewPool 会增加常驻 View 的数量,也可能错误共享配置或语义不同的 ViewHolder;缓存大小由 viewType 分布、窗口尺寸、嵌套列表结构和内存实验共同决定。
布局容器没有固定的性能排名。ConstraintLayout 可以减少某些嵌套,也可能因约束求解、helper(辅助对象) 或频繁变化增加工作。我们优化时依据的是目标 item 的 measure/layout 次数和耗时,先把这个量出来,再谈选哪个容器。
图片完成后仍可能影响三条路径
成熟的图片库通常会把网络请求和解码移到后台线程,但显示阶段仍会回到用户可见的渲染链路:
- 结果回调在主线程更新 ImageView;
- 尺寸或 drawable(可绘制对象) 状态改变可能触发
invalidate()或requestLayout(); - 首次使用纹理时,RenderThread/GPU 可能产生上传与采样成本。
列表图片应在绑定前确定稳定的目标尺寸或宽高比。复用 ViewHolder 时,要取消或替换旧请求,并确认回调仍属于当前绑定项。图片预取要结合缓存命中率、解码尺寸和内存占用评估,只追求更早加载并不划算。
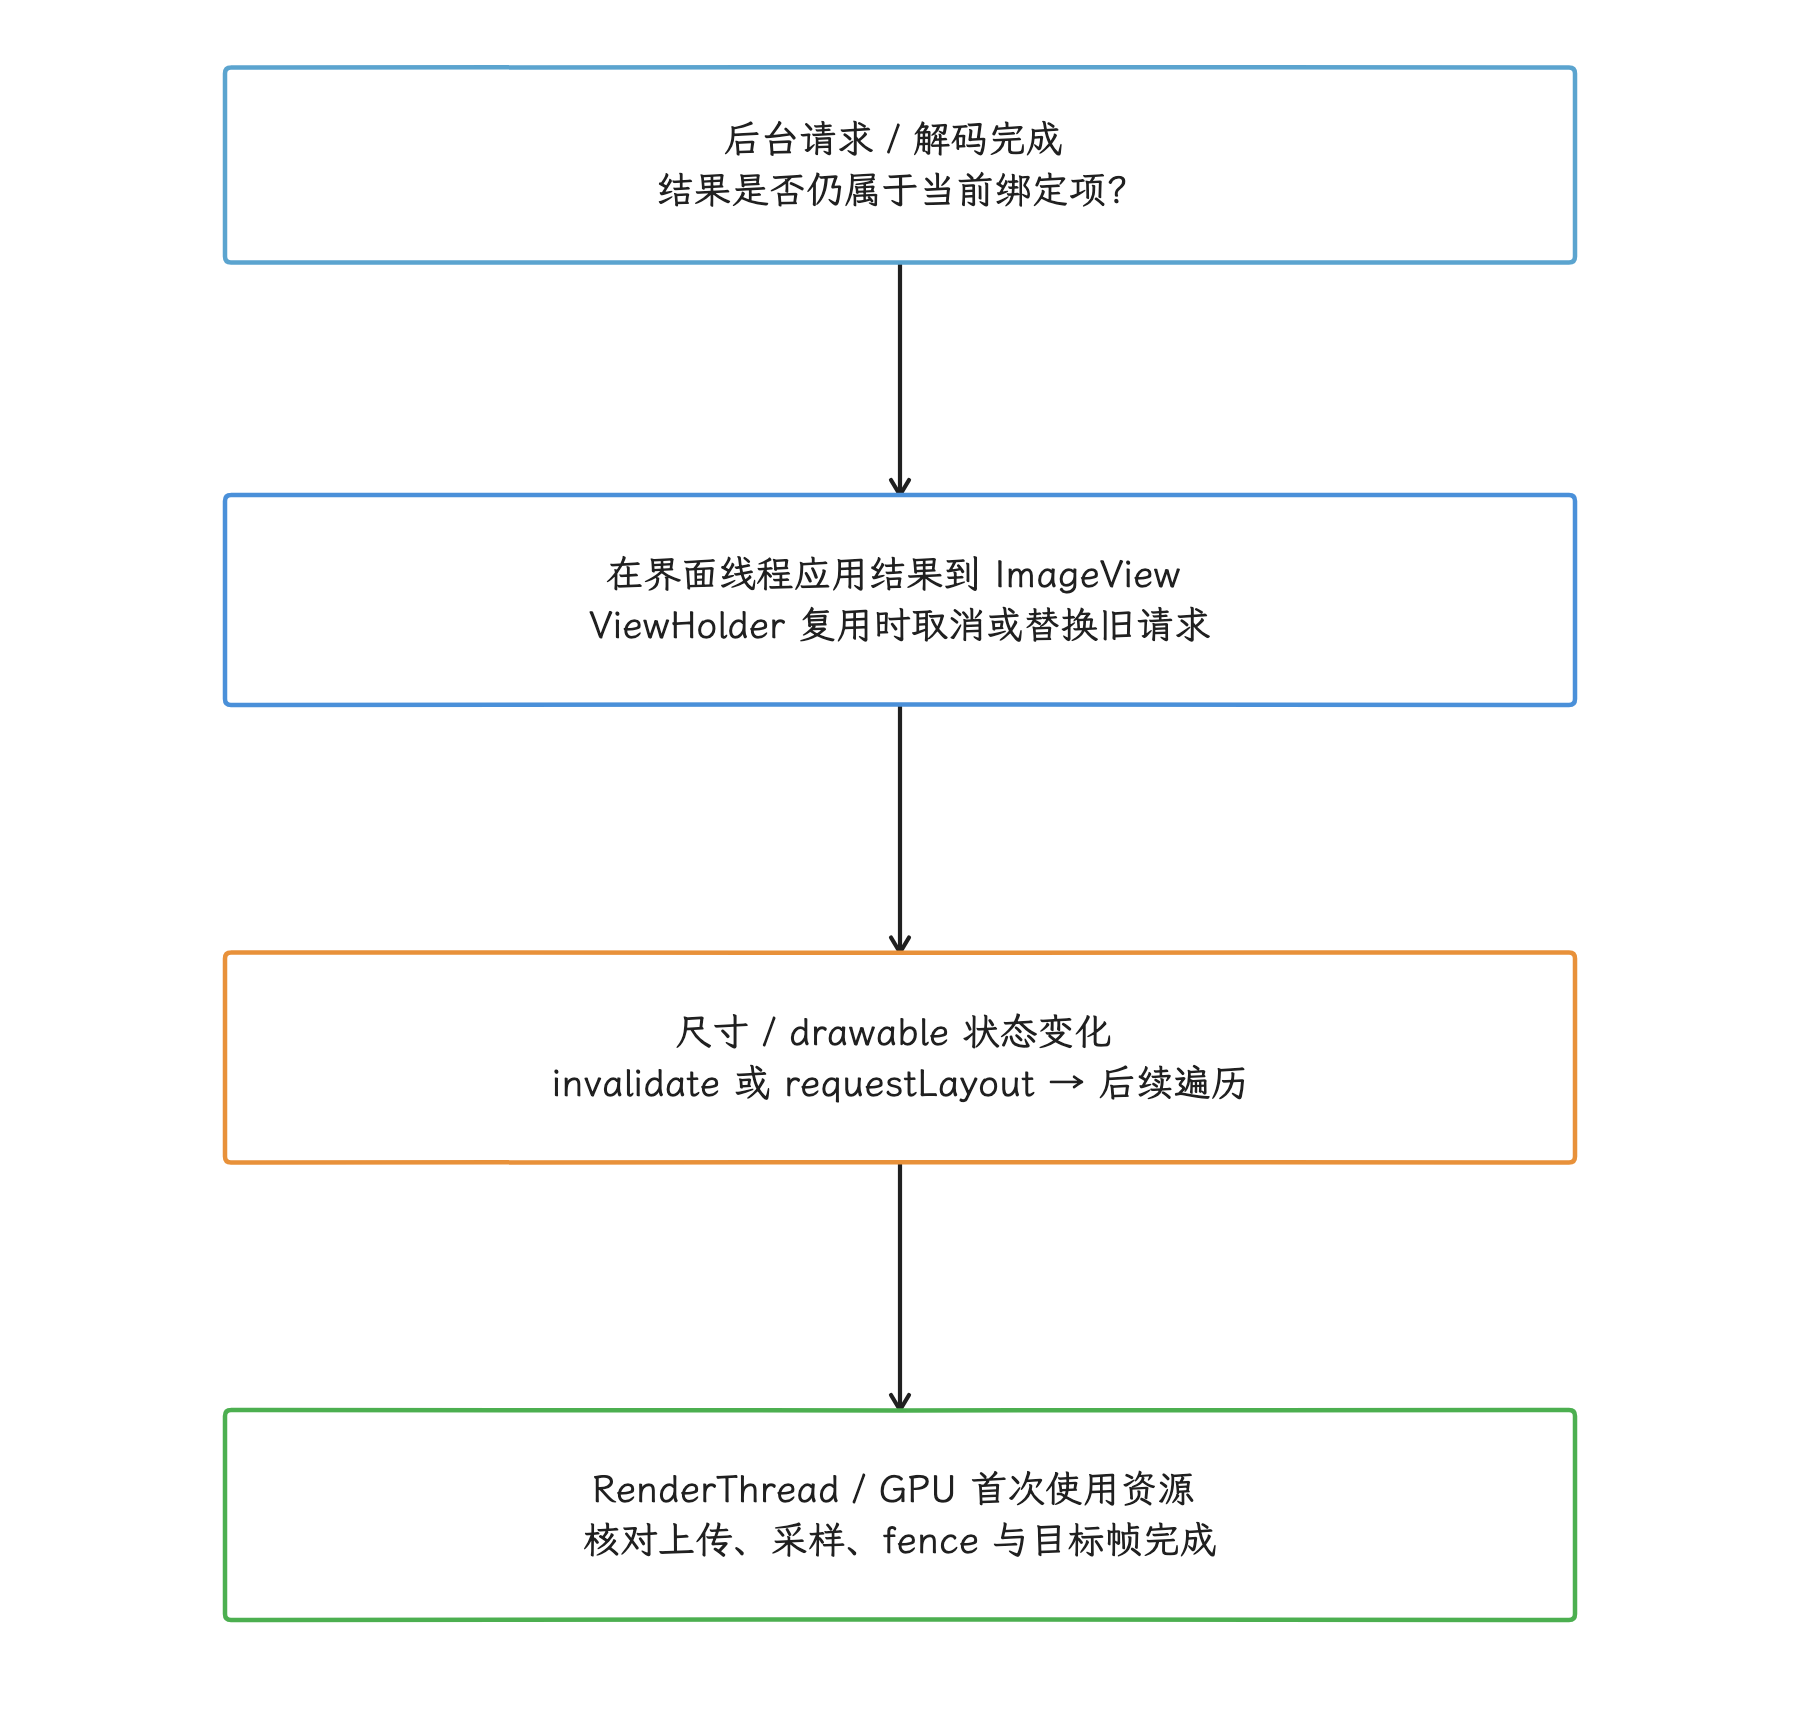
图:后台下载或解码完成后,图片应用到 View 仍可能触发布局、绘制和纹理成本。稳定尺寸、绑定身份和取消旧请求分别解决不同问题,fixed-size 覆盖不了这些检查,仍要逐项做。
RecyclerView.setHasFixedSize(true) 表达的是 RecyclerView 自身尺寸不受 adapter(列表数据适配器) 内容变化影响;bind 照常执行,子项也可能继续请求布局。RecyclerView 1.4.0 会据此选择部分测量和 adapter 更新处理路径,效果仍要按实际布局次数验证。
小核、频率与调度结论
RenderThread 在某一帧运行于低容量 CPU,只能说明“当时在哪里执行”。要确认调度因素,需要同时检查:
- wakeup 到 Running(开始运行) 的等待时间;
- 线程的调度策略、优先级、uclamp(CPU 利用率约束) 与 task group(任务组);
- CPU capacity(算力容量)、频率、idle(空闲状态) 退出和迁核;
- 同核更高优先级任务的抢占;
- thermal throttling(温控降频) 与持续复现下的变化;
- 相同工作量在正常帧和异常帧上的执行时间。
应用侧据此要求线程固定运行在某个大核,通常行不通;系统或厂商团队若要修改调度策略,还需在 android17-6.18-2026-06_r6 对应的设备内核和 SoC(片上系统) 调度实现上验证。通用内核提供调度、CPU 拓扑和 CPUFreq 等机制;设备的实际拓扑、频率/容量映射以及 GPU/HWC 可观测事件,还取决于 SoC、驱动、固件与构建配置。
页面切换:拆开内容准备、窗口事务与显示
Activity transition
Activity 跳转可能发生在同一进程,也可能拉起已有进程或新进程。诊断前我们先区分热启动、温启动和冷启动,并记录目标页面的 TTID(Time to Initial Display,首次显示时间)与 TTFD(Time to Full Display,完全显示时间)以及第一帧。把所有跳转都写成“两个应用进程协同”,会漏掉同进程场景,也会掩盖冷启动中的进程创建和类加载。
现代窗口过渡需要同时观察三条线:
- 应用侧:源/目标 Activity 生命周期、inflate、首个 traversal、RenderThread 和窗口 buffer;
- 窗口侧:WindowManager Shell transition、参与者、sync、SurfaceControl leash 与几何事务;
- 显示侧:目标 layers 的 buffer/transaction、SurfaceFlinger composition(合成)和 display present。
源窗口和目标窗口的内容提交与 leash 动画可以来自不同线程、不同进程。应用首帧准备较晚时,Shell 可能继续显示 starting window(启动占位窗口)、snapshot(任务快照)或旧 Surface;应用侧按时而整屏仍迟到时,应查看 SurfaceFlinger/HWC。Winscope(窗口与图层分析工具) 的 Shell Transitions、Window Manager、SurfaceFlinger Layers 和 Transactions 可以复原窗口关系,Perfetto 更适合比较线程调度、buffer 与帧时间。
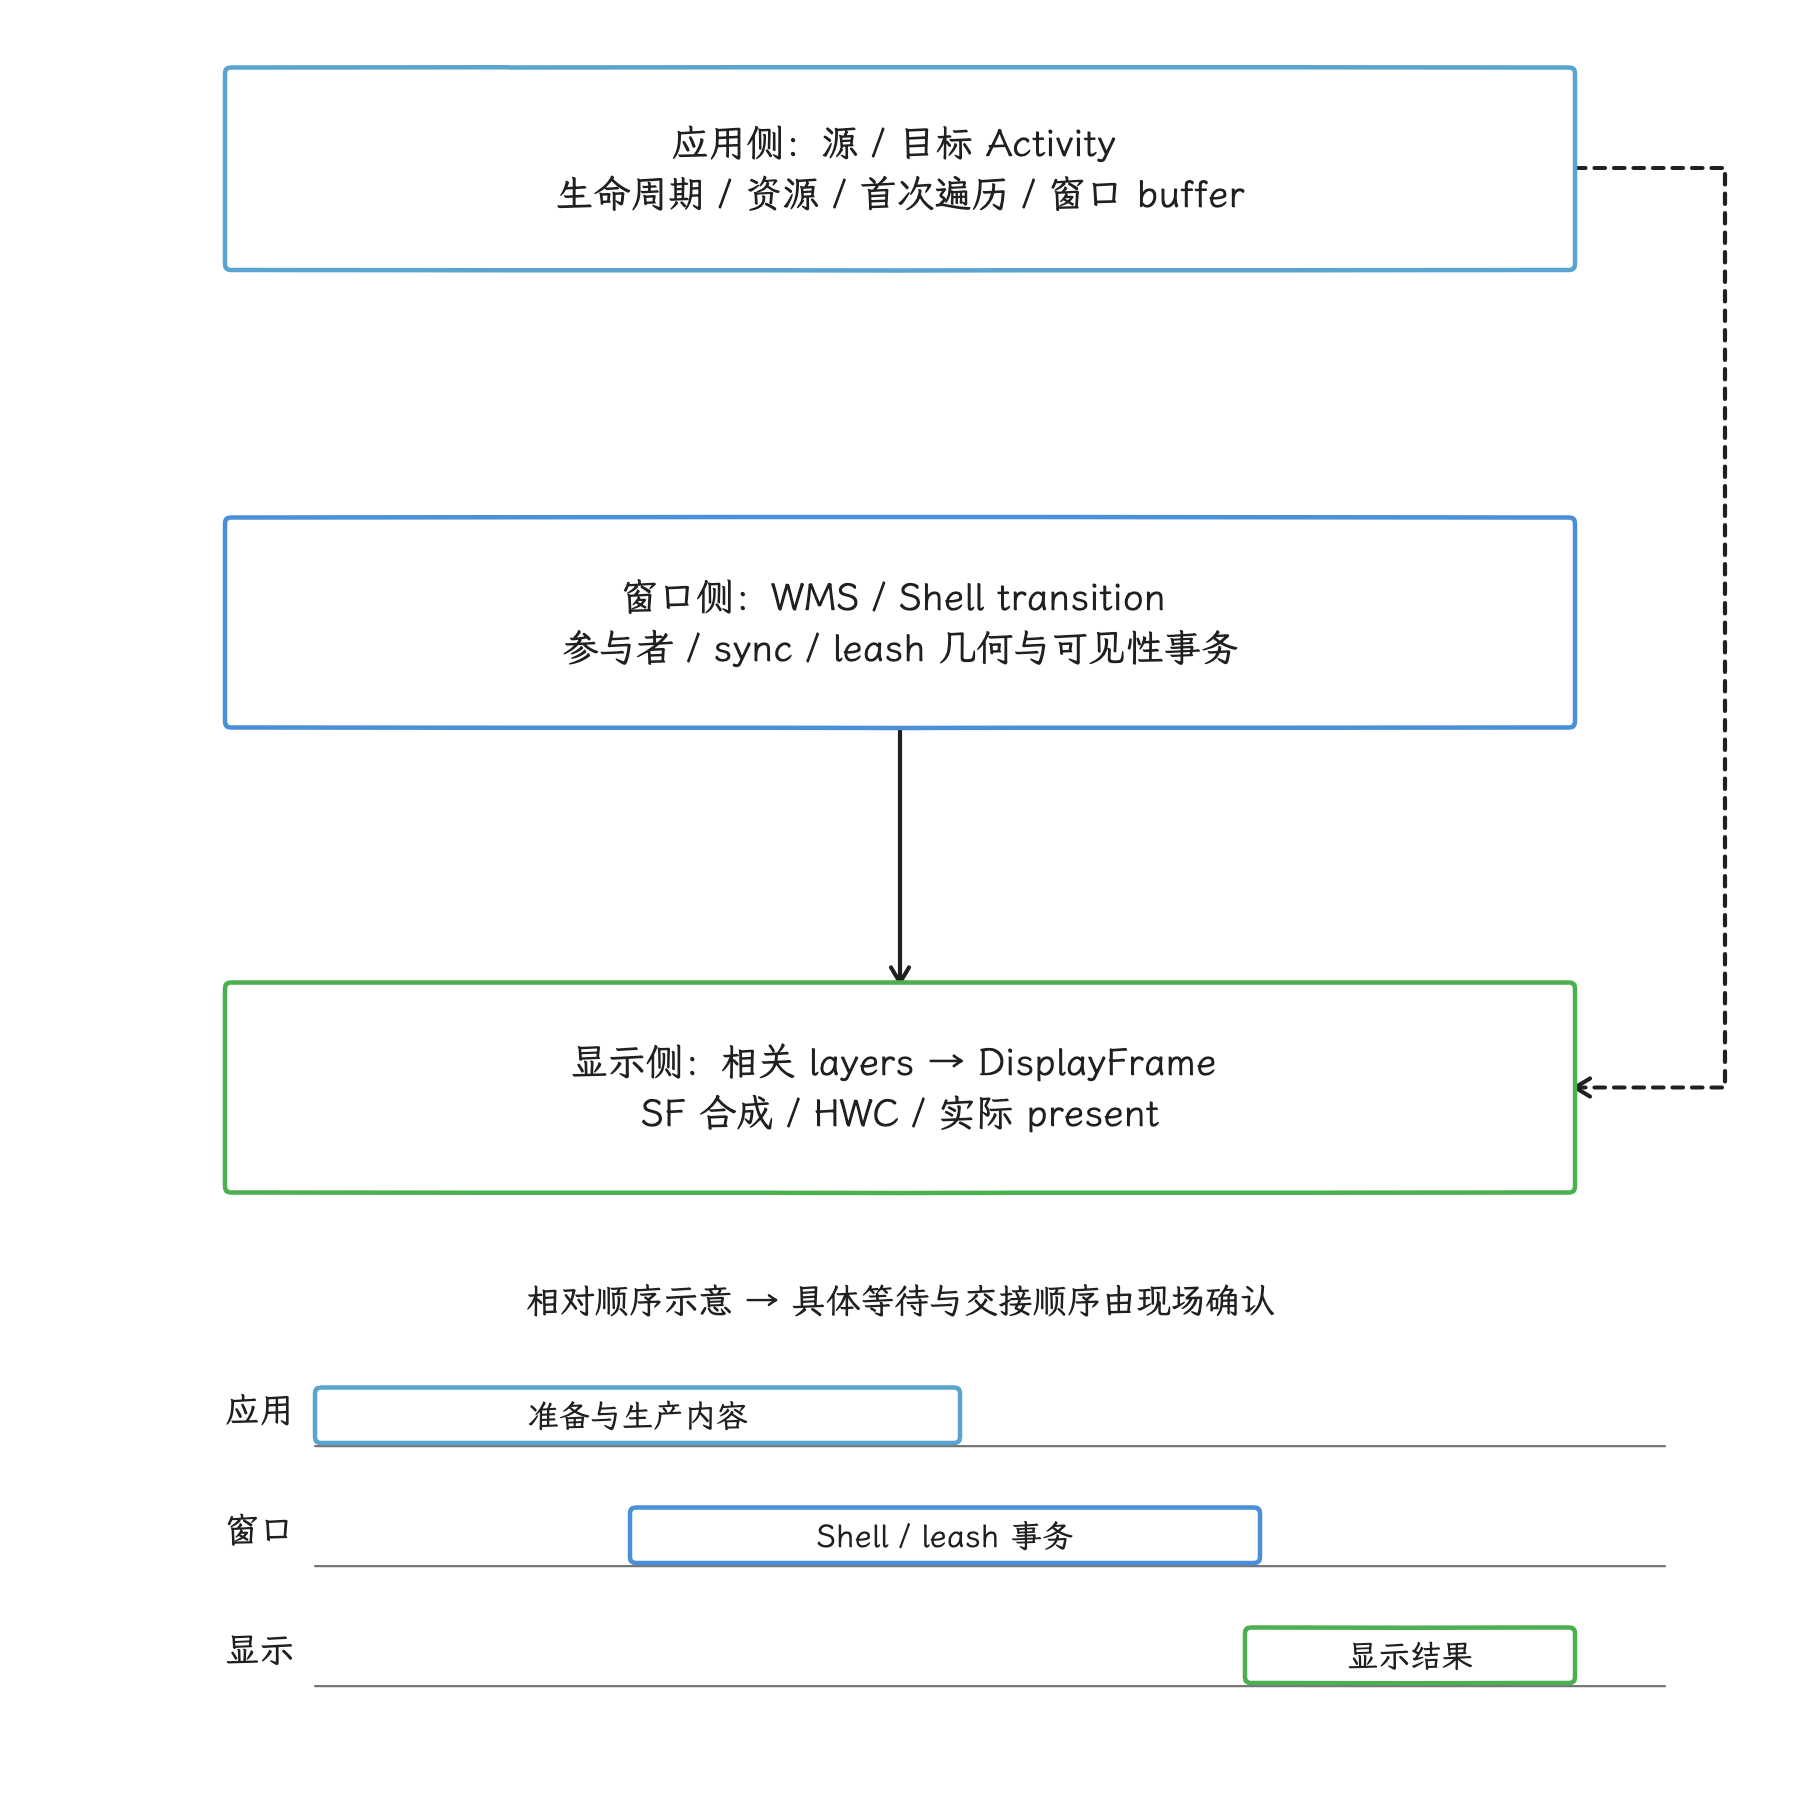
图:先区分同进程/跨进程与冷、温、热启动。应用内容提交、Shell leash 事务和显示 present 是不同边界;Winscope 查参与者与图层,Perfetto 对齐线程和帧依赖。
Fragment transaction
AndroidX Fragment 的 commit() 会把事务加入 FragmentManager 队列:它经 enqueueAction() / scheduleCommit(),通过宿主的 Handler 调用 post,投递一个 mExecCommit,随后由宿主主线程执行 pending actions(待处理操作)。mExecCommit 与 Choreographer 帧回调共享同一个主 Looper,实际执行顺序取决于主 MessageQueue(消息队列) 中已有消息、同步屏障、异步 Choreographer 消息,以及 commit() 的发生时刻。这条链路与 VSync 之间同样没有对齐承诺,“execPendingActions() 必定早于或晚于某次 doFrame”的固定顺序并不存在。
使用 commitNow() 会把工作放进当前调用栈,改变这一相对位置。一次切换可能把 Fragment 状态推进、View 创建/移除、SpecialEffectsController(转场与动画效果控制器)、measure/layout 和动画准备集中到相邻几帧。
几个 API 的边界需要分清:
commit()异步排队;返回时事务通常尚未执行。commitNow()在调用线程同步执行,要求主线程,也不支持与addToBackStack()组合。它会把工作提前到当前调用点,当通用的流畅度开关用并不合适。executePendingTransactions()会执行当前待处理事务,影响范围可能超过某一次提交。setReorderingAllowed(true)允许 FragmentManager 优化同一批操作的状态变化,并改善 transition/lifecycle(转场/生命周期) 语义。布局、业务初始化或 GPU 工作仍要另行处理。commitAllowingStateLoss()改变的是保存状态后的提交约束,用它规避卡顿会引入状态丢失风险。
取证时可以分别标记“发起 commit”“pending actions 开始/结束”“目标 Fragment 首次可见”和“第一帧 present”。卡点在 onCreateView()、onViewCreated() 或首个 layout,说明要处理页面构建;App buffer 已经按时提交,我们就继续查 transition transaction 和 display frame。更完整的源码链路见 22.11 Fragment、Predictive Back 与 Navigation Compose 页面切换。
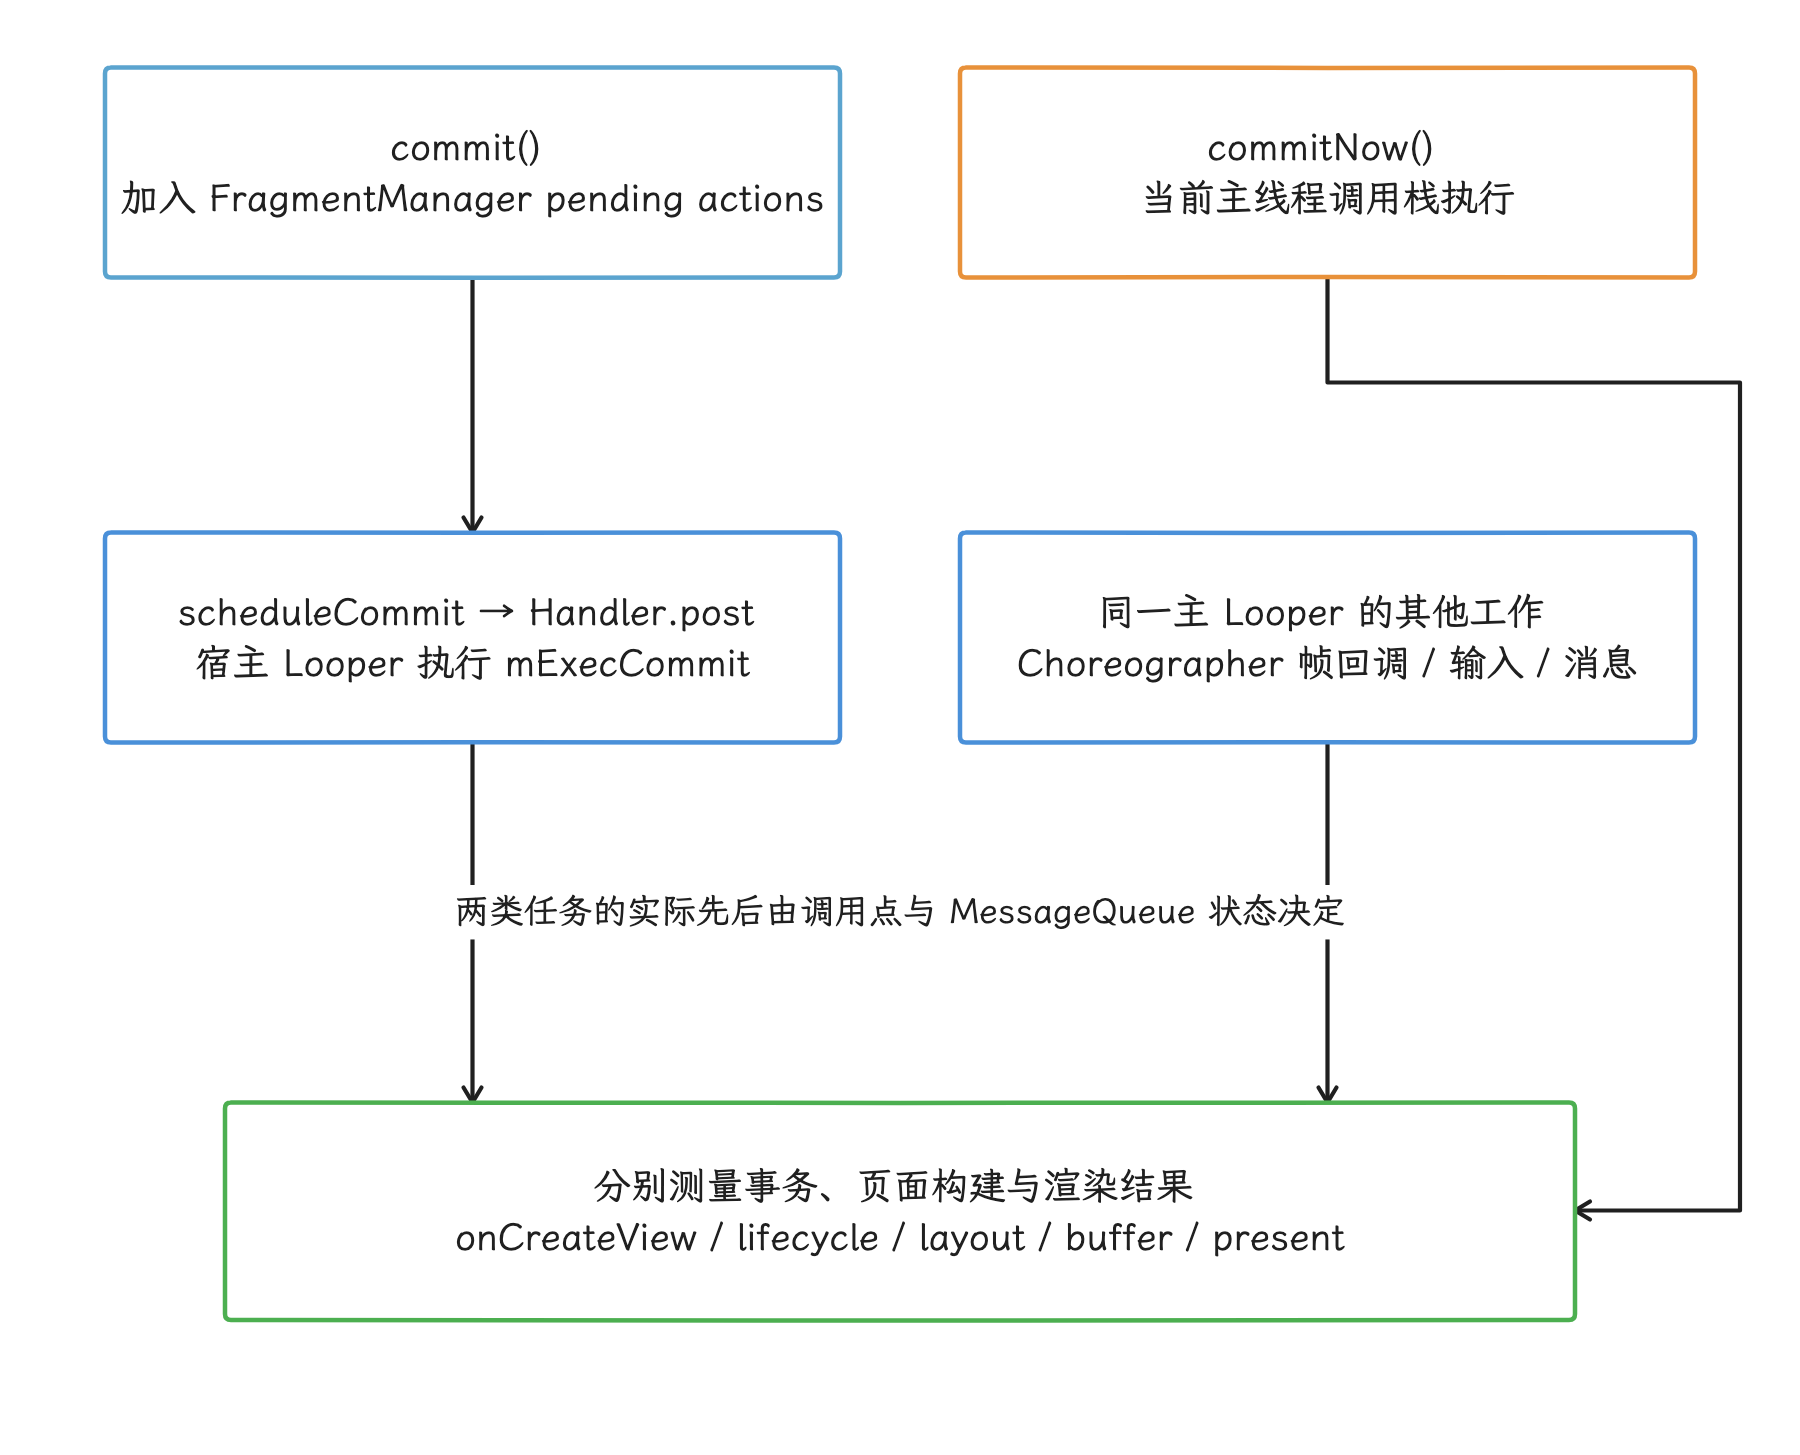
图:以 Fragment 1.8.9 源码核对异步提交路径。commit 经宿主 Handler 排队,commitNow 在当前主线程调用点执行;它们都可能产生构建、布局和转场工作,和某次 doFrame 没有固定前后关系。
Shared element
共享元素转场的成本取决于具体实现和元素类型,可能涉及源/目标 View 的名称匹配、布局坐标捕获、overlay(覆盖层)/ghost(叠加层/临时镜像视图)、snapshot、图片资源准备、matrix/clip(变换矩阵/裁剪) 更新,以及两个窗口的可见性协调。把所有共享元素都概括为“复制一张 bitmap(位图)”,会漏掉大部分工作。
常见的断点包括:
- 目标元素尚未完成布局,终点 bounds(边界) 不稳定;
- 大图在转场开始后才解码或上传;
- 元素层级在转场期间触发额外 layout;
- 源窗口、目标窗口与 transition leash 的时序没有对齐;
- alpha(透明度)、圆角、模糊或遮罩改变了合成条件。
应同时记录元素准备回调、目标页首个 traversal、窗口 transition 和对应 layer present。源窗口迟到或显示合成迟到时,优化目标 Activity 的 XML 覆盖不到这两处,要把排查范围扩到源窗口和显示端。
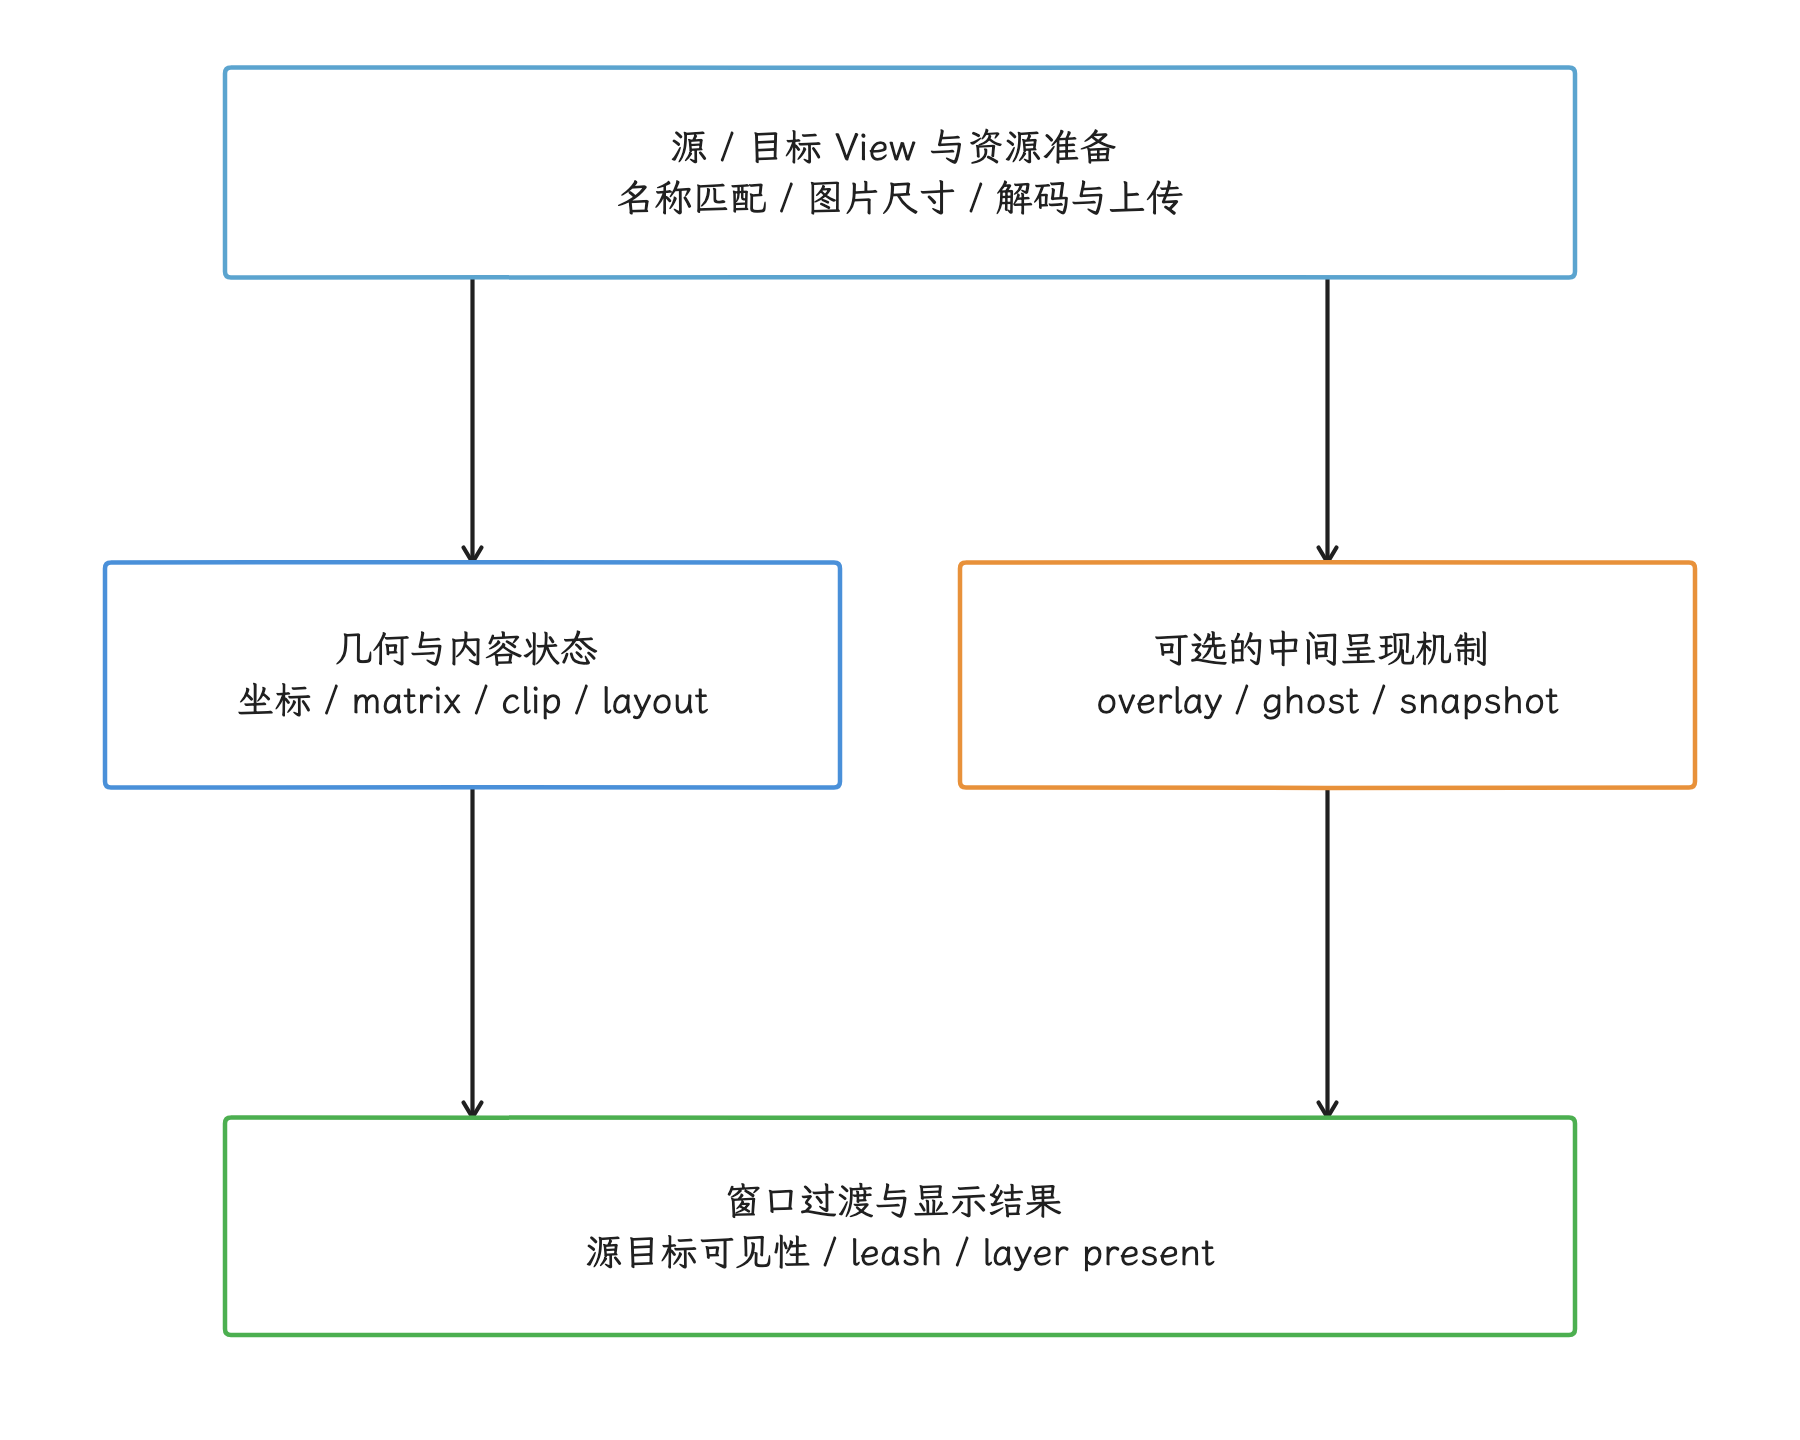
图:共享元素成本随实现而变。资源就绪、坐标/状态捕获和窗口可见性需要协调;目标页 XML 优化只能覆盖其中部分,显示合成仍须单独核验。
窗口动画:Splash、返回手势与浮层
SplashScreen 与 starting window
Android 12(API 31)起,系统 SplashScreen API 为冷启动和温启动提供统一的启动画面,热启动通常不会显示该画面。Splash screen(启动画面) 是一个独立窗口,会在应用可以绘制前覆盖目标窗口,并在应用第一帧就绪前后退出。
一次“启动时闪顿”应分别记录以下边界:
- 启动请求进入 ActivityTaskManager(Activity 与任务管理服务);
- starting/splash window(启动占位窗口/启动画面)可见;
- 应用目标窗口提交第一块可用 buffer;
- 目标窗口相关 DisplayFrame 的 present;
- splash 退出动画结束/移除的时刻。present 时刻和 splash 退出时刻要分开记;交接期间,目标内容可能在 splash 仍存在时先参与合成。
若第 2 到第 3 个时间点间隔很长,应检查进程启动、Application/Activity 主线程、资源和首帧。若应用 buffer 已经到达而交接仍然抖动,我们检查 splash exit listener(启动画面退出监听器)、Shell/WMS transaction(Shell/WindowManagerService 窗口事务)、目标 layer 和 SurfaceFlinger。自定义退出动画完成后还要移除 splash view;持续保留它会延长交接窗口。
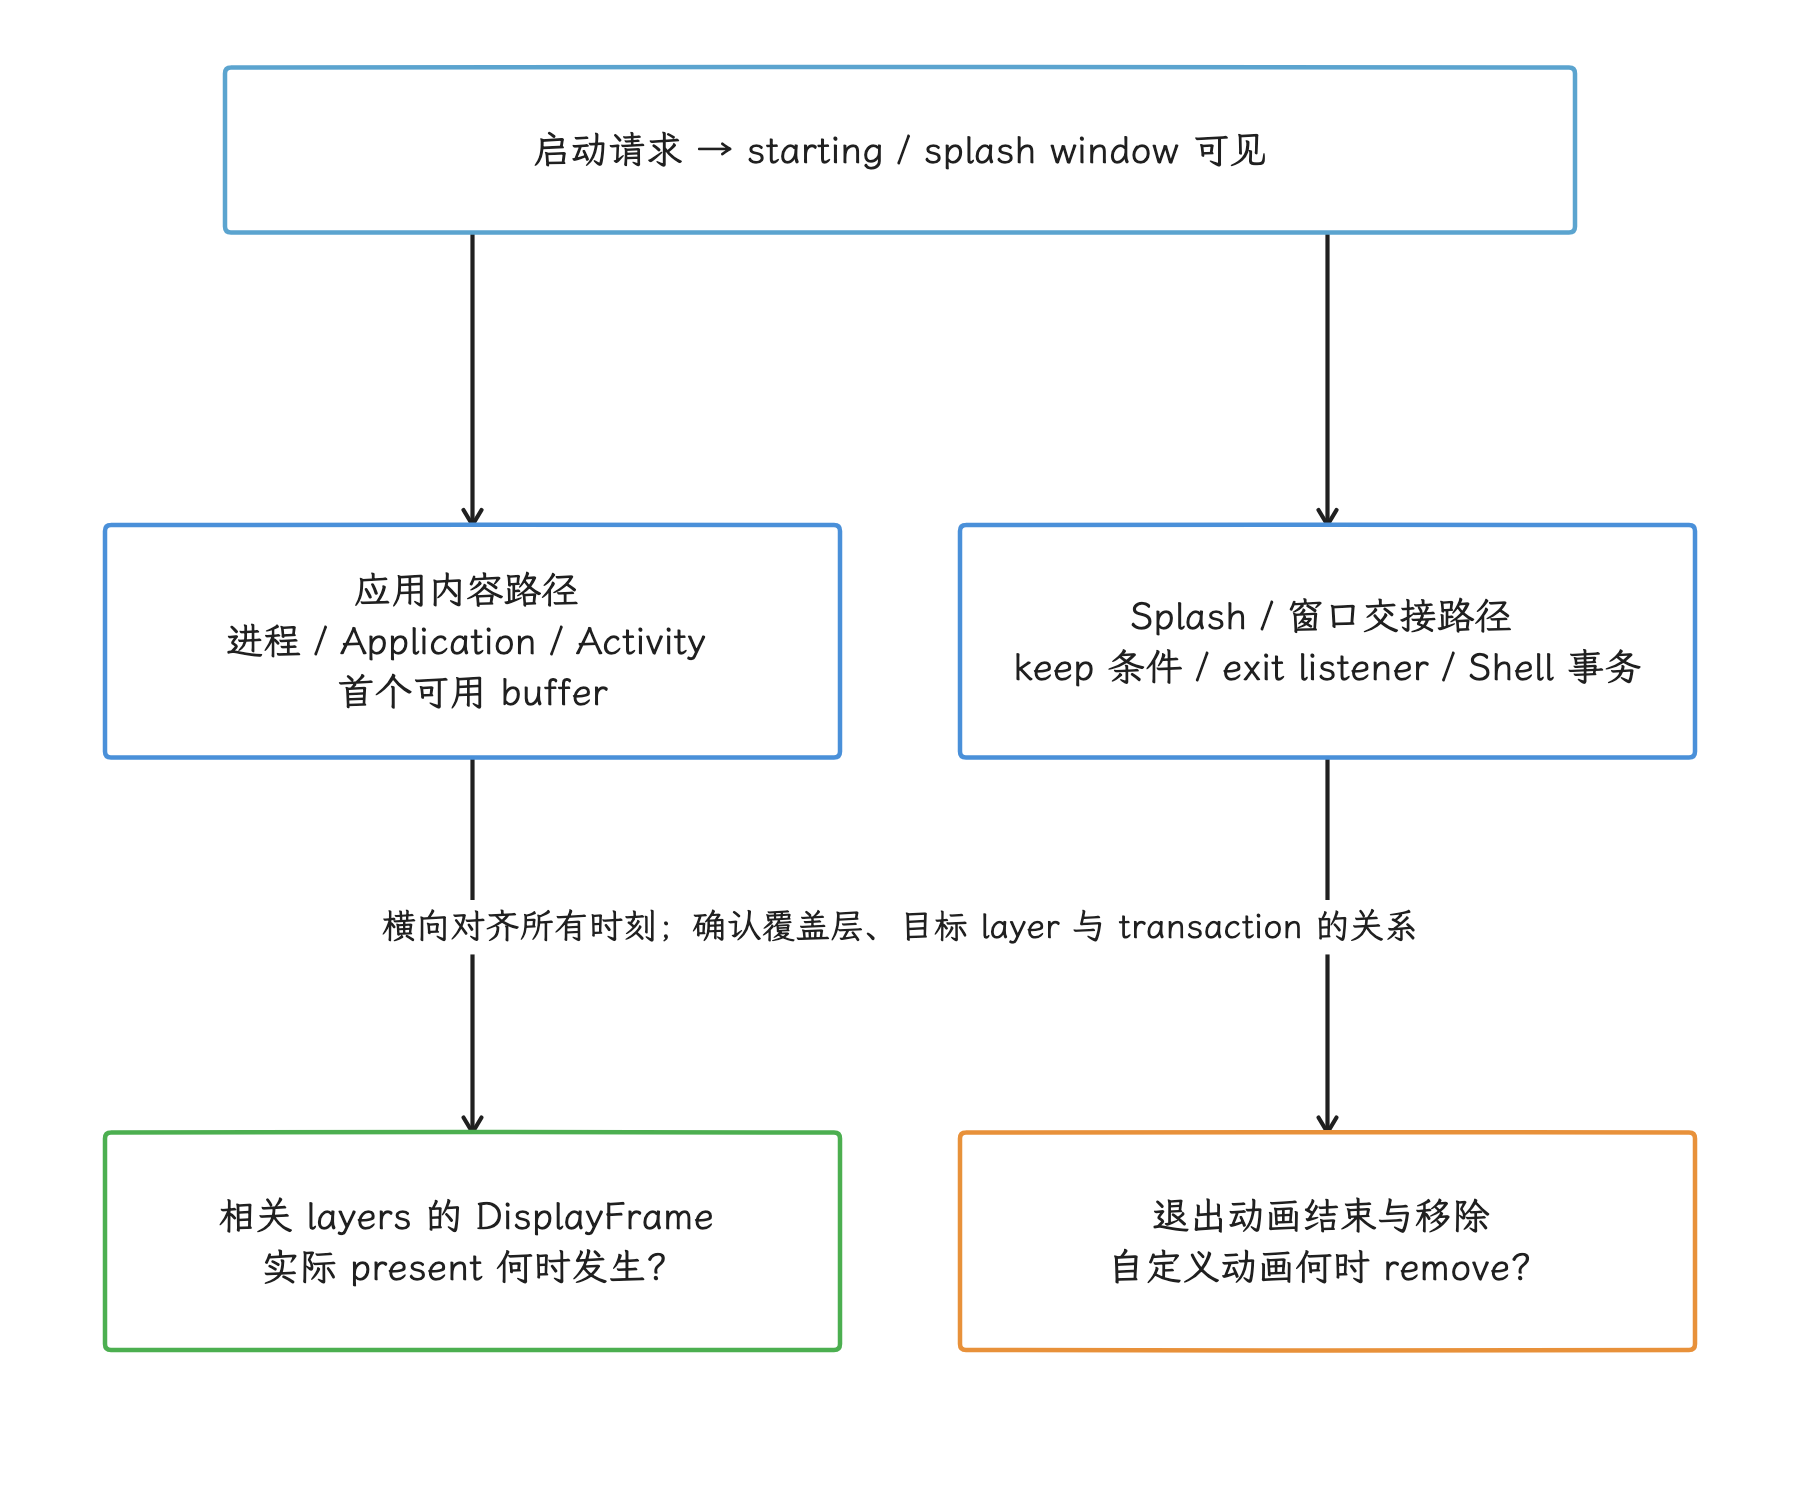
图:启动请求、splash 可见、目标 buffer 可用、相关 DisplayFrame 的 present,以及退出动画结束/移除,都应分别打点。交接期间各阶段可能重叠,一条首帧 slice 解释不了全部闪顿。
Predictive Back
Android 15 移除了预测性返回的开发者选项。应用完成 opt-in(显式启用) 后,系统可以提供返回桌面、跨 Activity 和跨任务的预测动画;具体效果仍受导航结构、回调类型和系统实现影响。相关的平台与 AndroidX 回调接口需要分清,三者语义不同,要分开使用:
OnBackPressedCallback(AndroidX Activity):handleOnBackPressed()处理返回提交;Activity 1.8.0 增加handleOnBackStarted(BackEventCompat)、handleOnBackProgressed(BackEventCompat)和handleOnBackCancelled()。系统框架只在 API 34 及更高版本分发这些进度回调;低版本仍可使用提交回调。OnBackInvokedCallback(平台,API 33 及更高版本):只有onBackInvoked(),在返回“提交”时回调。它同样没有 started/progressed/cancelled(开始/进行/取消) 的进度语义。OnBackAnimationCallback(平台,API 34 及更高版本):在启用预测性返回的窗口上提供onBackStarted(BackEvent)、onBackProgressed(BackEvent)、onBackCancelled()和继承的onBackInvoked()。应用可以直接注册平台接口,也可以通过 AndroidX Activity 1.8.0 及更高版本的上述回调处理进度。
诊断要同时检查三个问题:
- 平台或 AndroidX 手势进度回调是否短小、连续,取消路径(
onBackCancelled/handleOnBackCancelled)能否恢复界面状态; - 当前回调是否消费了系统返回,让系统预测动画失去运行机会;
- 当前窗口、目标窗口或 home/task surface(桌面/任务 Surface) 的 leash 与 display frame 是否按时。
不要预设现场存在名为 predictive_back_progress 的标准 counter。返回手势的输入、进度和参与者可沿 SystemUI EdgeBackGestureHandler、WindowManager Shell transition 与 Winscope 的相关记录追踪;Perfetto 中可见的事件取决于平台版本、插桩和已启用的数据源。
需要验证 progress 回调时序时,用应用自身插桩(例如 Trace.beginSection("onBackProgressed"))或 Winscope 的 Shell 参与者。
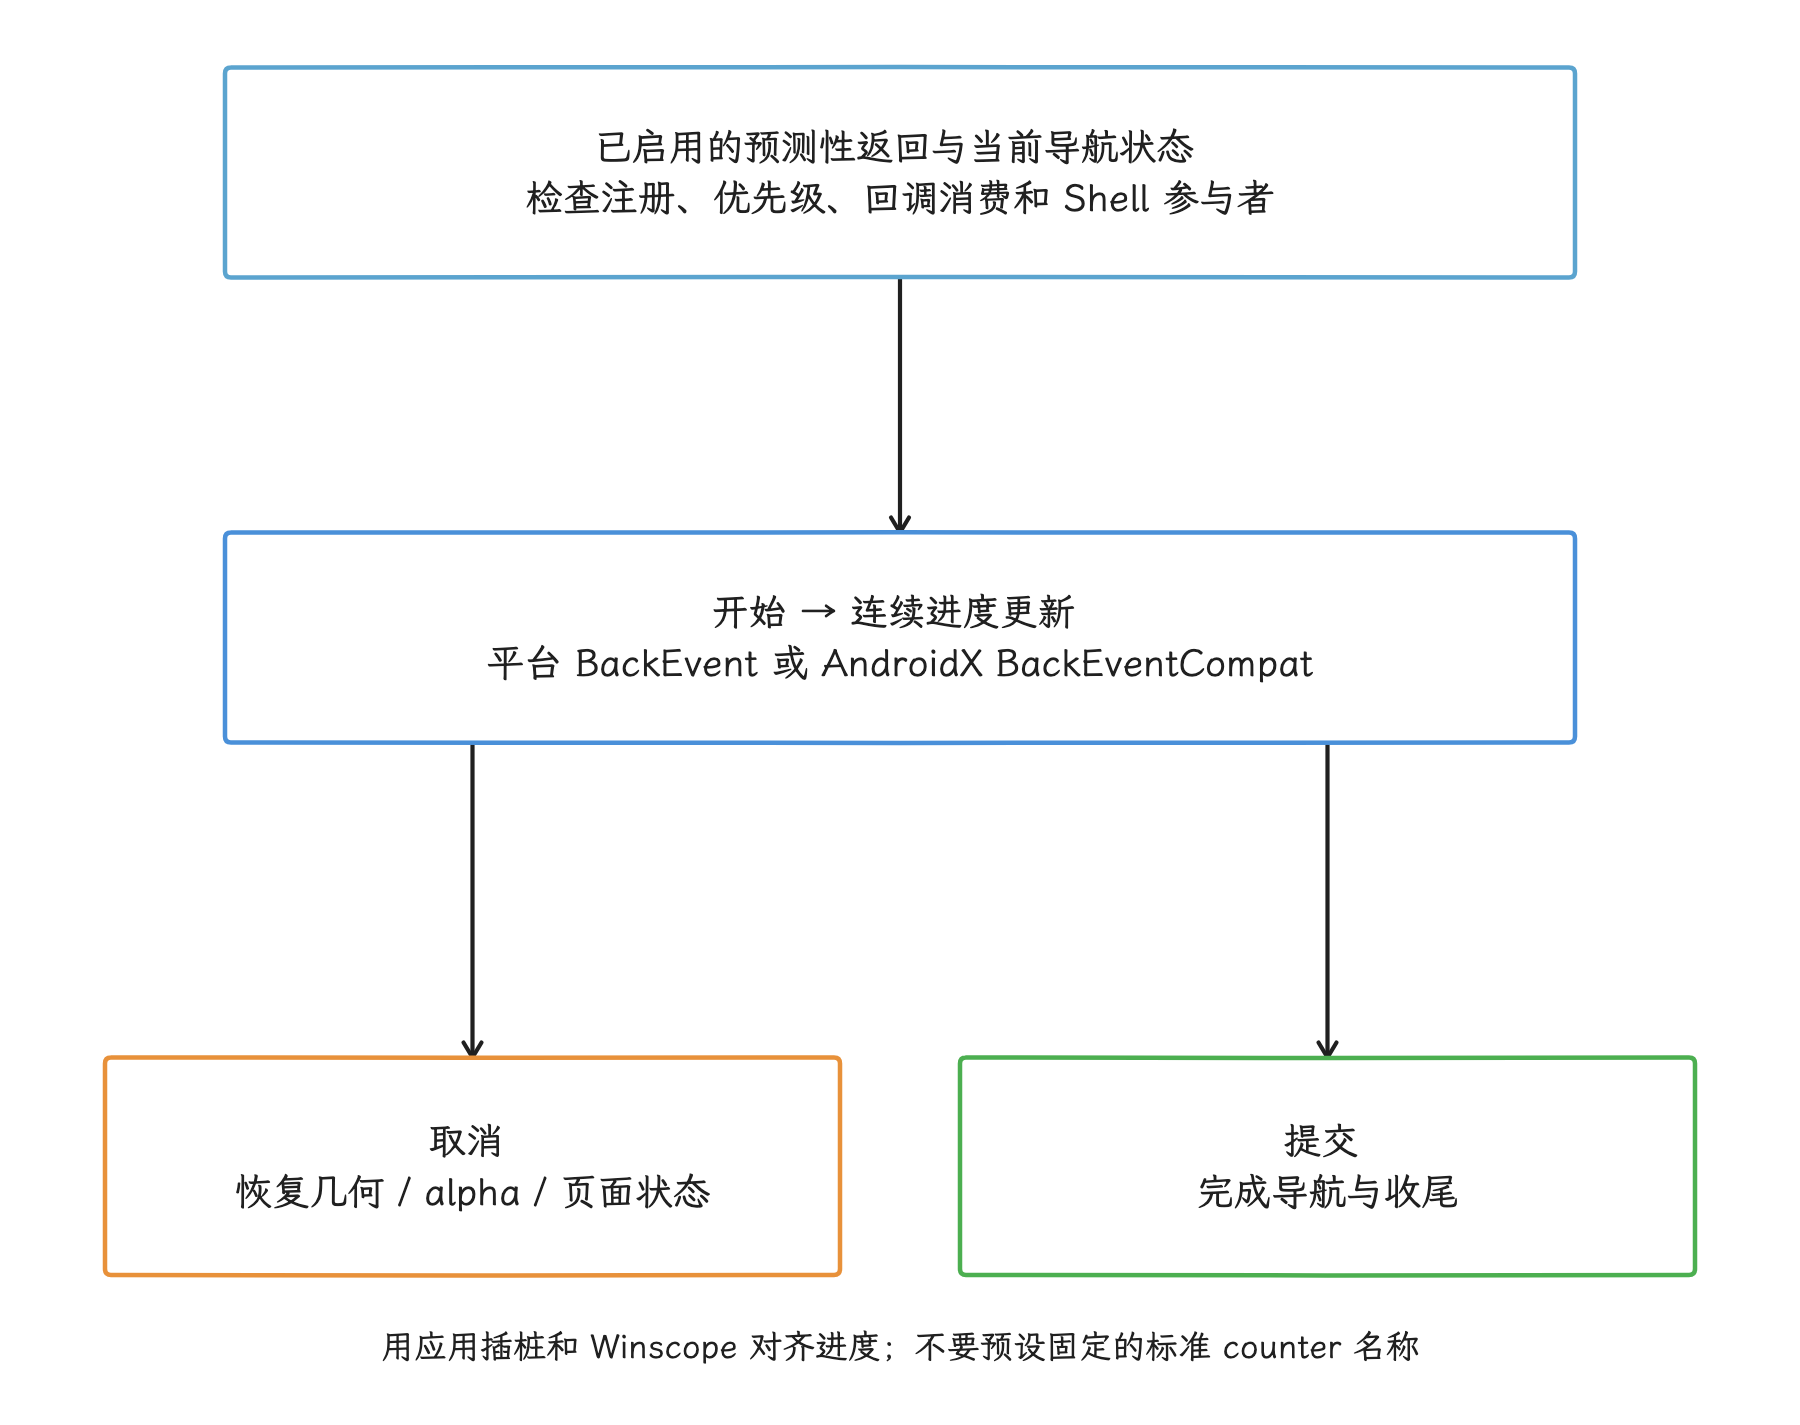
图:开始和进度回调要保持短小,取消时恢复状态,提交时执行导航。先查启用与消费规则,再查参与 surfaces 的帧证据;预测动画缺失与渲染掉帧是两类问题,要分开判断。
Android 16(API 36)起,可以使用 PRIORITY_SYSTEM_NAVIGATION_OBSERVER 观察系统导航而不消费返回,Android 17 继续保留这一能力。默认优先级或 overlay(硬件叠加平面) 优先级回调会参与消费决策。注册方式错误时可能出现“没有预测动画”,这与渲染掉帧属于两类问题。
返回预览的内容要从现场确认:跨 Activity、跨任务和返回桌面时,参与的 surfaces 由导航状态与 Shell transition 决定,我们以 Winscope 的参与者和 layer tree(图层树) 为准。
Dialog 与 PopupWindow
Dialog 和 PopupWindow 都会向 WindowManager 增加窗口对象,并拥有各自的 ViewRoot 与 Surface;它们可以与宿主处于同一进程和同一 UI Looper(界面消息循环)。弹出时的成本可能来自:
- 首次 inflate、measure/layout 和窗口首帧;
- 同一主线程上宿主窗口与浮层窗口的 traversal 排队;
- IME/Insets(输入法与系统栏等占用区域) 变化;
- dim(背景变暗)、blur(模糊)、圆角、阴影和动画;
- 新 layer 加入后,HWC 的 DEVICE(显示硬件合成)/CLIENT(GPU 客户端合成) 分配变化;
- GPU 带宽、client target(GPU 合成后的整屏目标缓冲区) 或 present fence 延迟。
“出现额外 layer”离“走 GPU client composition(客户端合成)”还差一步:HWC 是否使用 overlay,要看整组 layers 的格式、变换、混合、保护属性、硬件资源和厂商能力。我们把弹出前后的 layer composition type(合成类型)、client target、GPU 时长与 present 结果放在一起比较。深入案例见 HWC Overlay Plane 与合成降级排查。
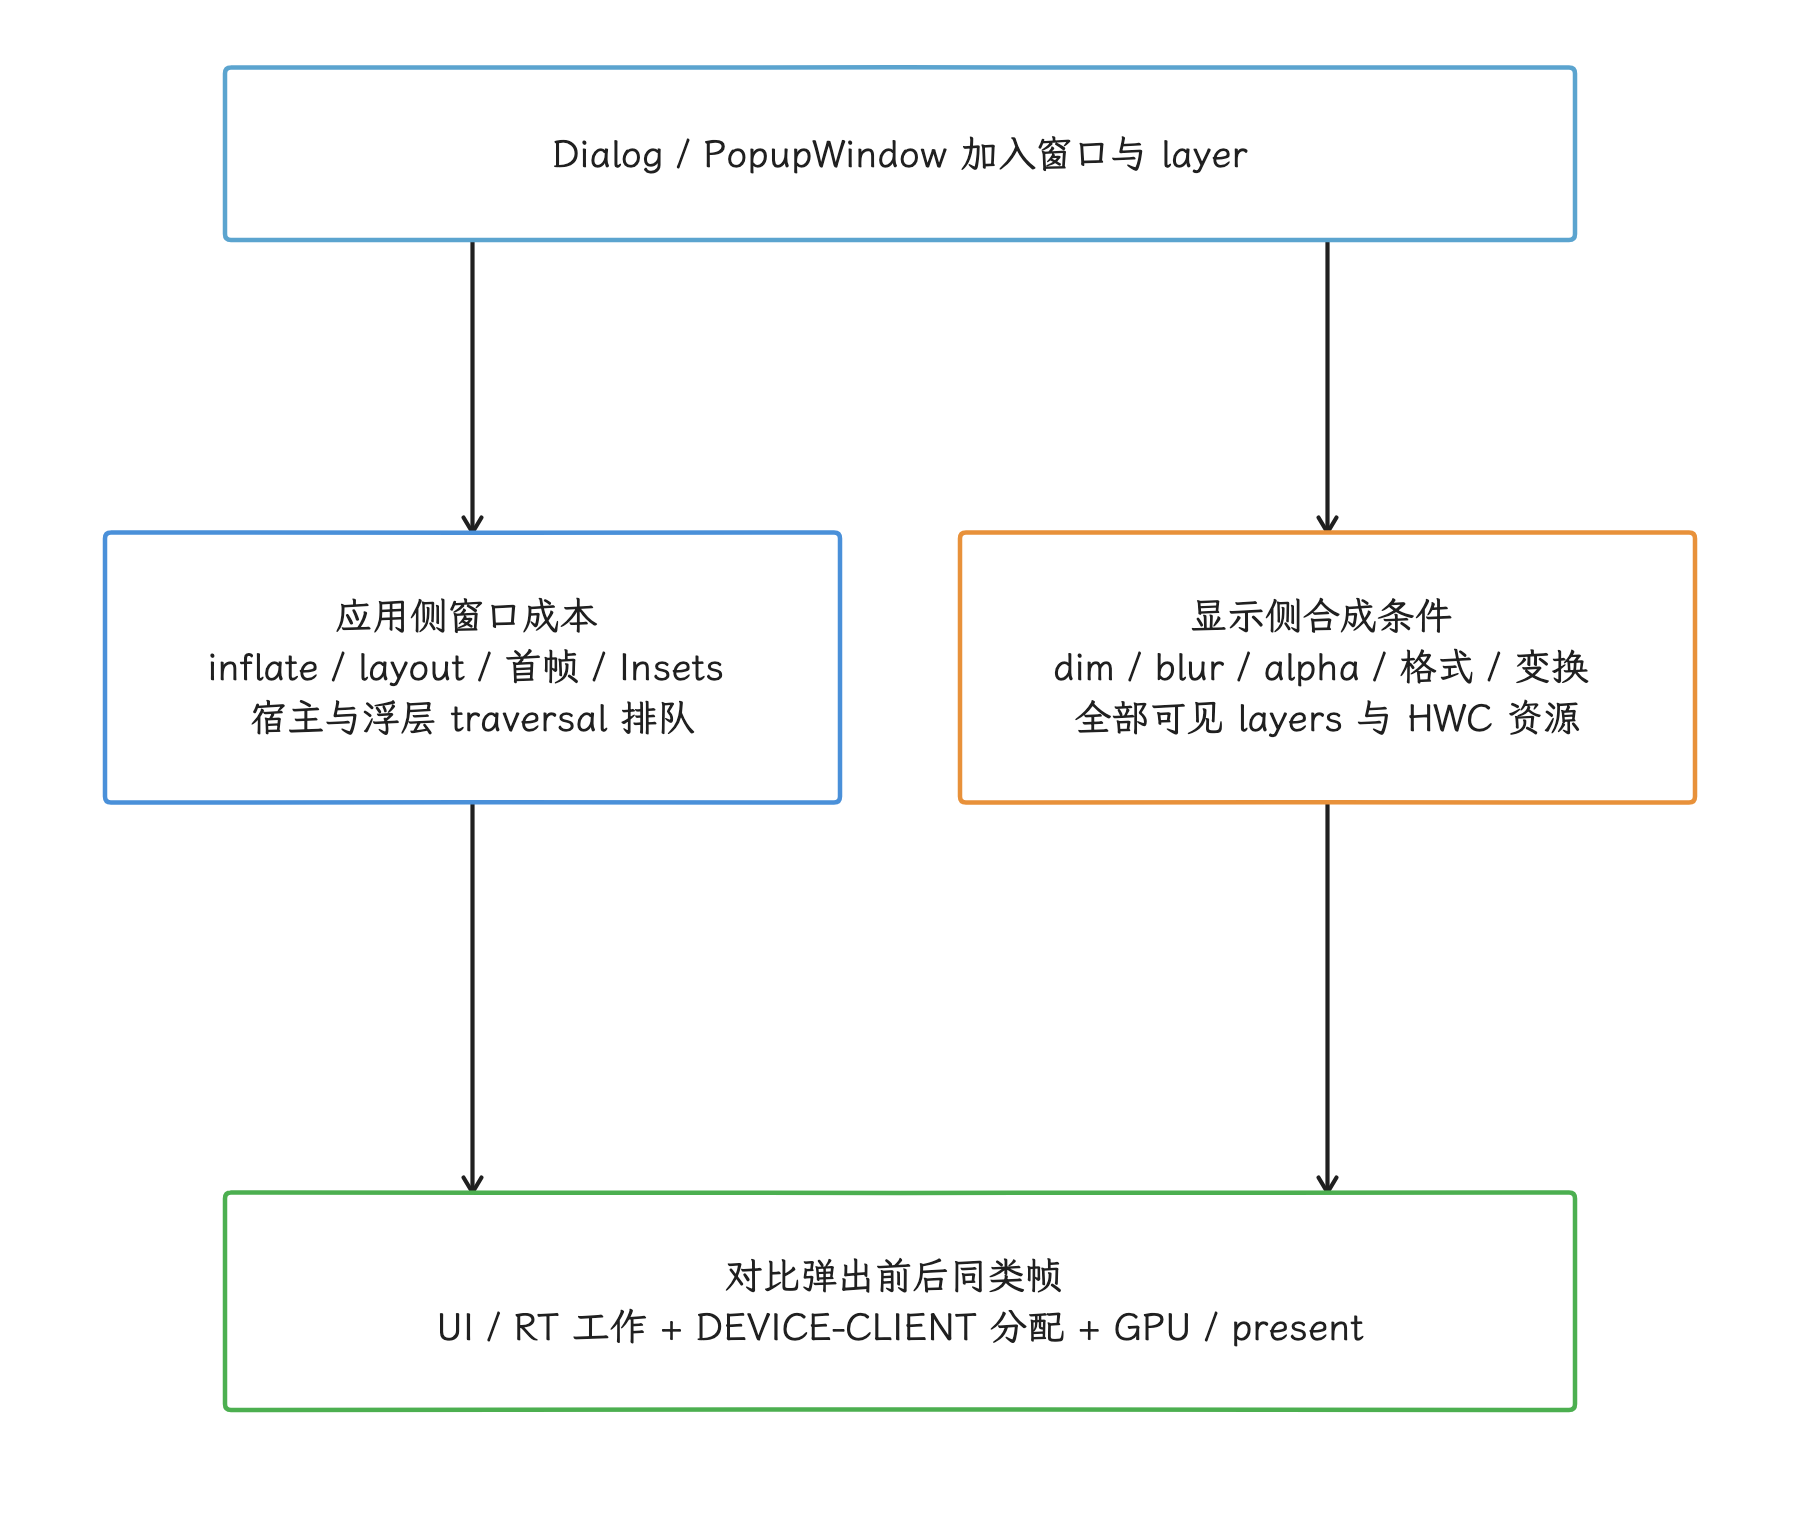
图:Dialog / PopupWindow 的新 ViewRoot 通常仍与宿主共用 UI Looper。新 layer 既可能增加主线程与渲染工作,也可能改变 HWC 分配;是否 CLIENT 必须看实际合成类型和显示结果。
Notification 展开与折叠:责任进程在 SystemUI
通知面板的展开、折叠、分组和 Quick Settings(快捷设置) 动画,主要由 SystemUI 生成 UI 帧。普通应用在发布或更新通知时通过 Binder 提交 Notification;动画期间如果通知内容没有更新,应用进程可能完全不在关键路径上,关键路径基本落在 SystemUI 一侧。
需要分别检查:
| 阶段 | 责任对象 | 典型证据 |
|---|---|---|
| 发布/更新通知 | 应用、system_server、SystemUI | Binder、NotificationManagerService、SystemUI pipeline(处理管线) |
| 应用 RemoteViews/模板 | SystemUI 主线程 | inflate/reapply(创建/重新应用视图)、图片/图标、measure/layout |
| Shade(通知面板)动画 | SystemUI UI Thread/RenderThread | FrameTimeline、CUJ、traversal、DrawFrame |
| 整屏合成 | SurfaceFlinger/HWC | visible layers(可见图层)、composition type、present |
频繁更新进度、反复改变通知布局或提交大图片,会增加跨进程传输和 SystemUI 的处理成本。RemoteViews(可跨进程应用的视图描述) 更新时,可能复用已有 View,也可能需要重新应用布局;每次 notify() 到底走哪条路,以 trace 和通知差异为准。
以 Android 12(API 31)及更高版本为目标的应用,自定义通知会被系统放入标准模板,以保持图标、展开区域和操作的一致性。自定义内容的处理成本仍然存在:复杂 RemoteViews、图片尺寸、更新频率和分组规模依旧作用在 SystemUI 上。
如果 SystemUI 的 SurfaceFrame 按时而 DisplayFrame 迟到,我们再检查遮罩、壁纸、状态栏、导航栏、当前 App 和通知面板的合成。应用自己的 App FrameTimeline 代表不了通知面板。
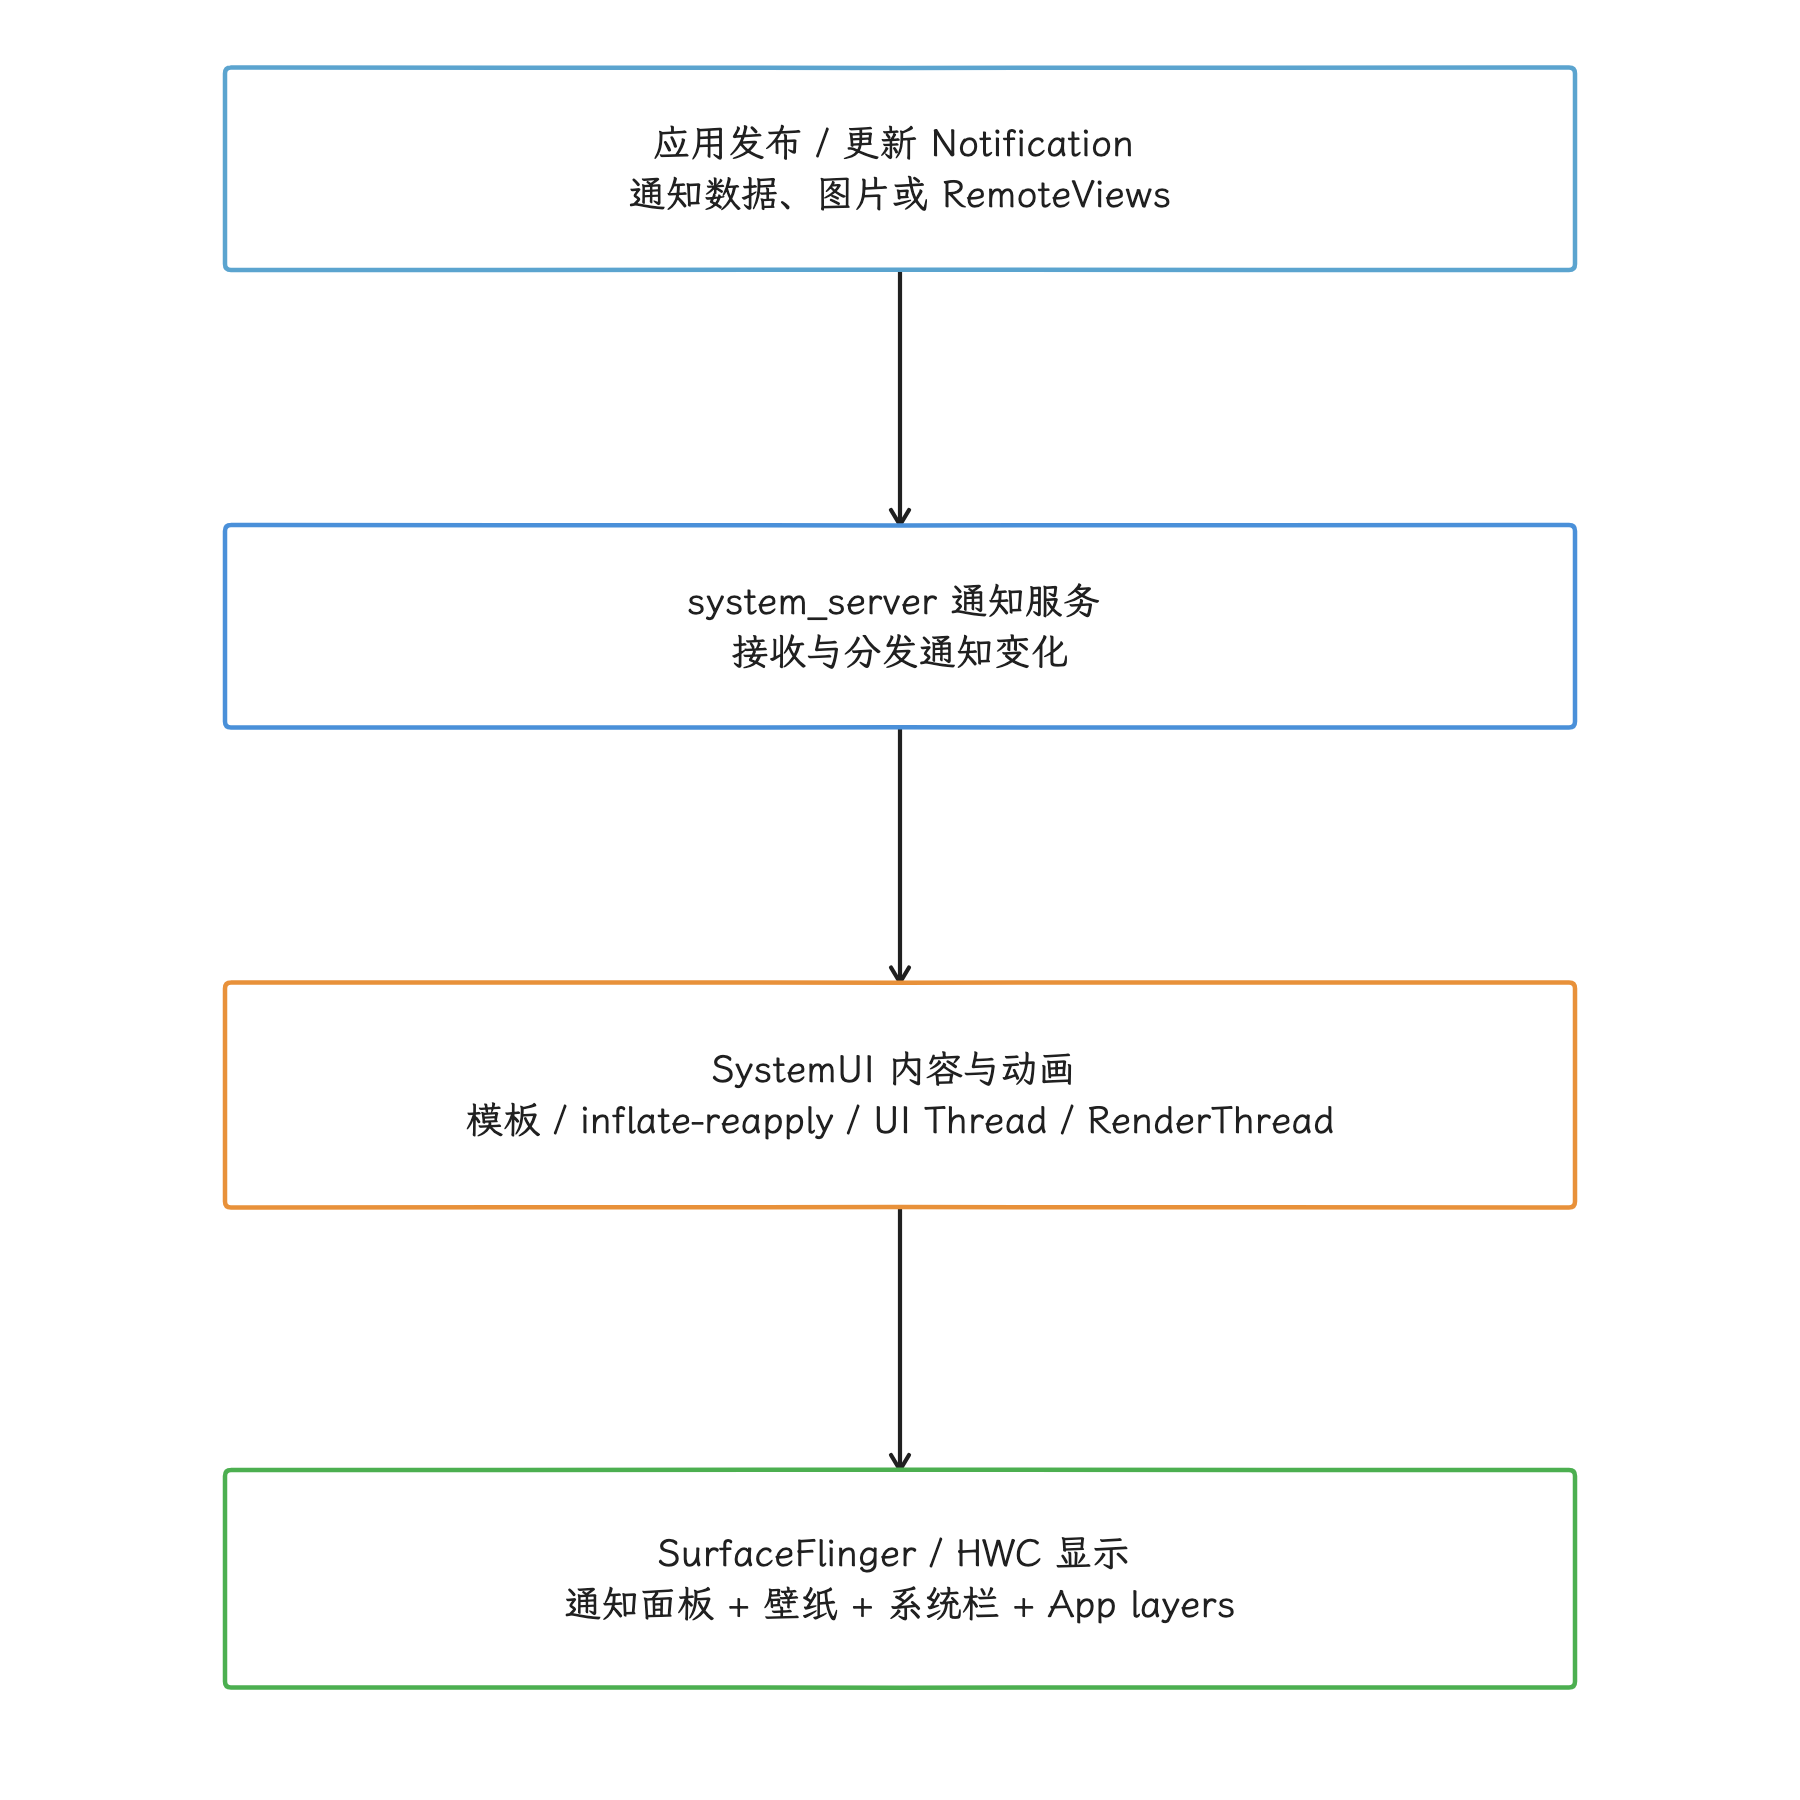
图:应用提交通知数据,SystemUI 负责面板内容应用与动画。通知未更新时,普通应用可能不在展开动画的关键路径上;应看 SystemUI 的帧以及整屏合成。
桌面滑动与多任务切换:以 OEM(设备厂商) 现场为准
Launcher 桌面
AOSP 的 Launcher3 提供 Workspace、CellLayout、Widget 与 Quickstep(手势导航和最近任务组件) 的参考实现,量产设备可能替换 Launcher 或修改动画。桌面滑动常见的内容包括图标、文件夹、AppWidget、壁纸和搜索/推荐区域;其中 Widget 更新、动态壁纸和 Launcher 帧可能来自不同的内容生产者。
诊断顺序可按对象展开:
- Launcher 主线程的输入、动画和 traversal;
- Launcher RenderThread/GPU;
- AppWidget 更新是否在同一时间进入 Launcher;
- 壁纸 layer 或 WallpaperService 是否更新;
- SurfaceFlinger 的可见 layers、composition 与 present;
- sched、CPU frequency、thermal 和 GPU 证据。
发现 RenderThread 位于小核时,还要继续验证唤醒等待、CPU capacity、频率与同帧工作量。单凭一帧的 CPU 编号,还撑不起“调度器导致卡顿”的结论。
Recents / Overview
AOSP Quickstep 由 Launcher3 实现,窗口组织和动画还依赖 WindowManager Shell、ActivityTaskManager、SurfaceControl transactions(图层事务) 与 SurfaceFlinger。OEM 可以更换参与者或动画实现,因此进程名和 slice 名称应从目标设备采集。
多任务手势可能操作以下对象:
- 当前任务的 live surface(实时任务画面) 与 transition leash;
- 其他任务的 snapshot;
- Launcher 的 Recents UI;
- 壁纸、系统栏和手势相关 surfaces;
- 即将恢复的目标任务窗口。
Task snapshot 通过 TaskSnapshot 携带 HardwareBuffer(硬件图形缓冲区)、色彩空间、方向和裁剪等信息。Launcher 采样硬件 buffer,与执行普通图片文件解码是两回事;压力更多来自 snapshot 获取时机、卡片数量、纹理采样、显存/带宽和整屏合成。某些阶段会继续使用 live task surface(实时任务 Surface),把每张卡片都解释成静态截图会出错。
在 Winscope 中,应检查 Shell transition 的参与者、WindowManager 状态、SurfaceFlinger layers 和 transactions;再在 Perfetto 中对齐 Launcher/SystemUI/system_server 的线程、输入、snapshot 相关 Binder、GPU 与 DisplayFrame。若动画卡片移动正常而内容停住,需要辨别当前看到的是 snapshot、旧 buffer 还是 live surface。
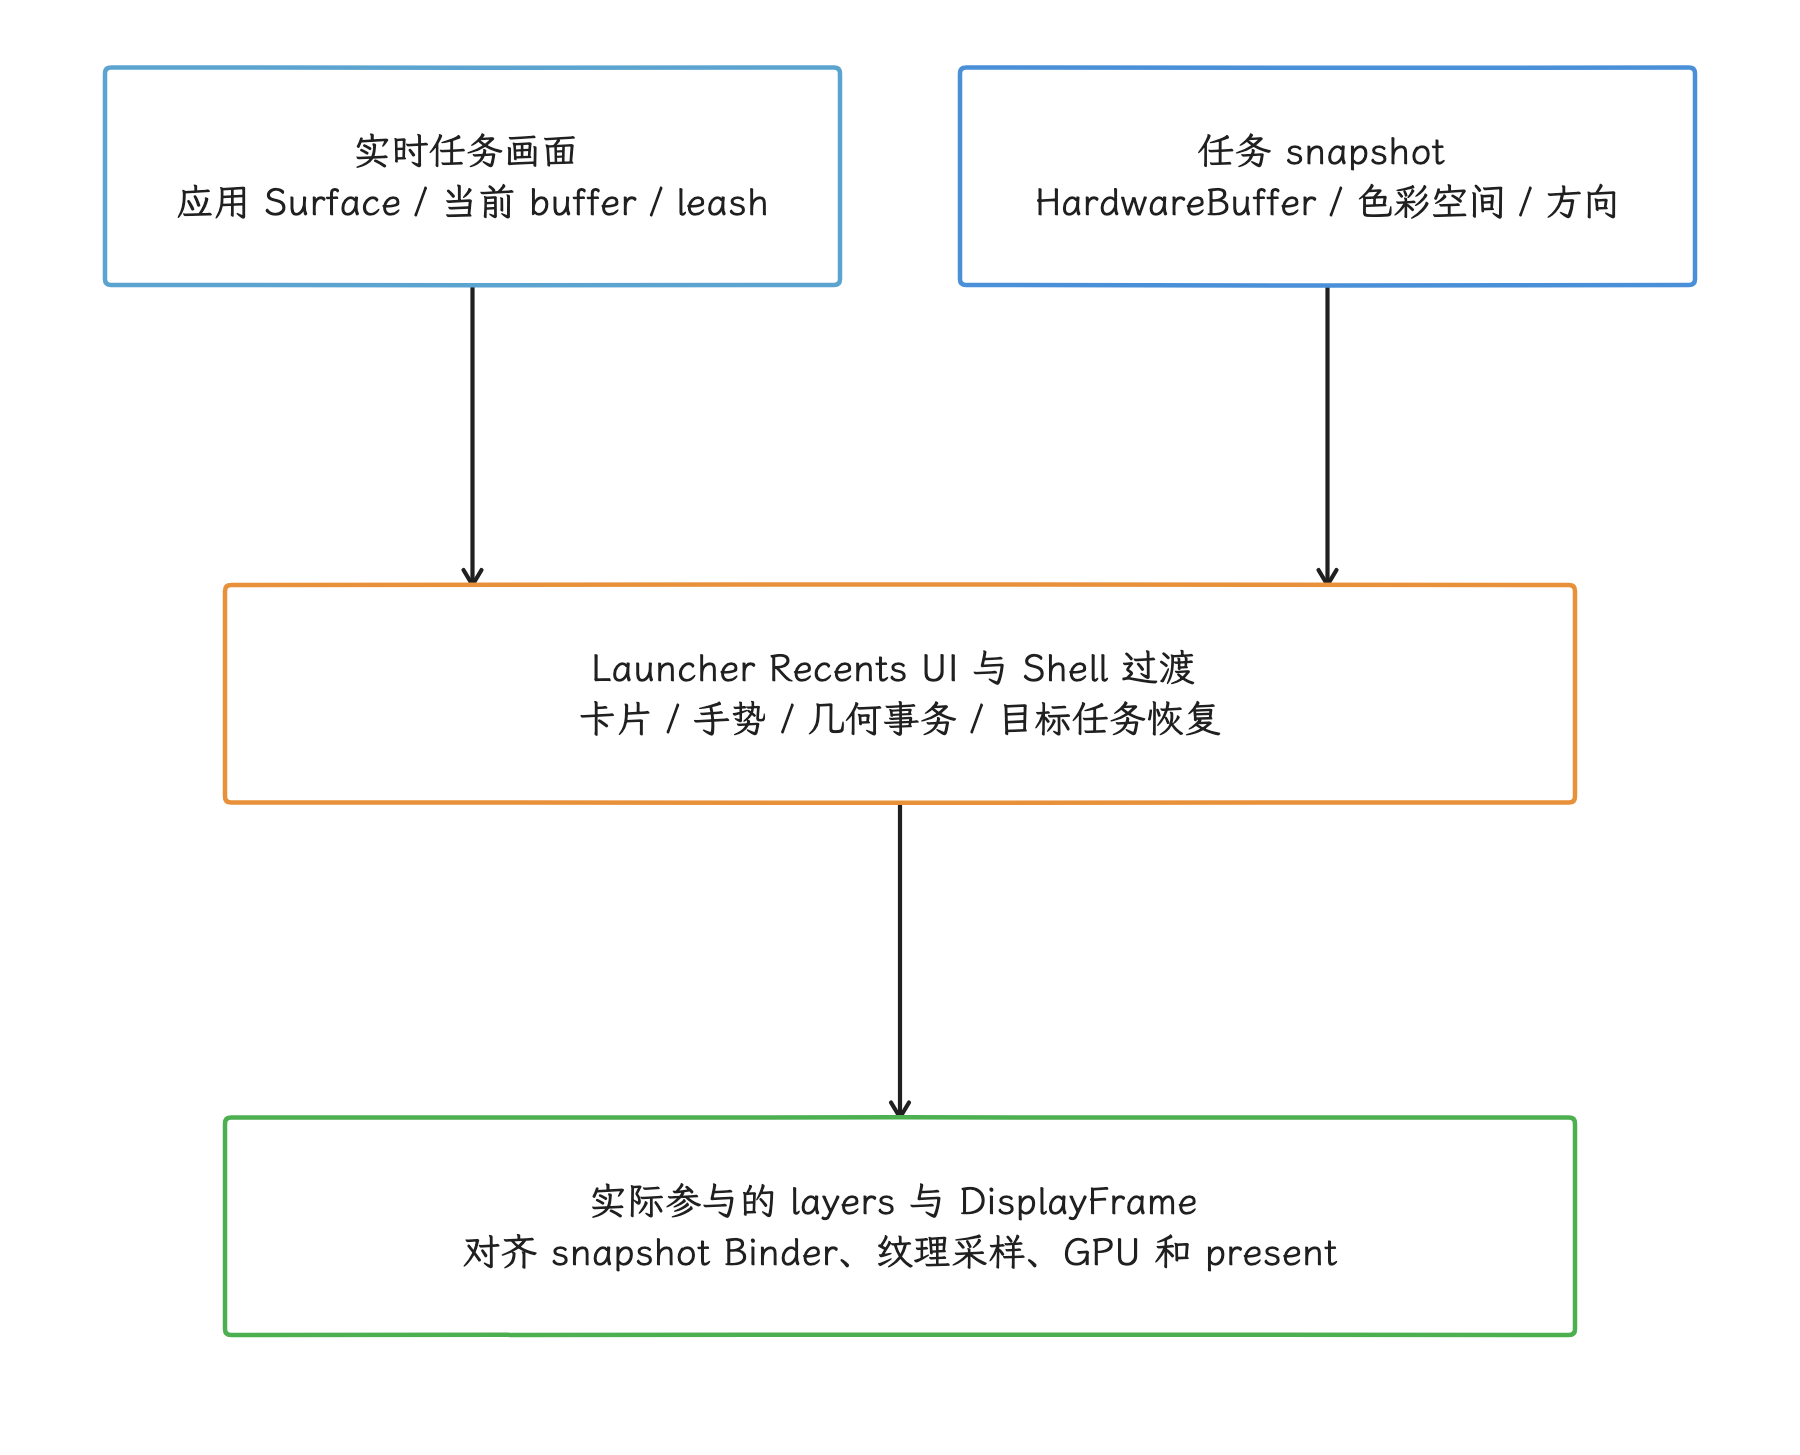
图:TaskSnapshot 携带 HardwareBuffer 等信息;卡片内容也可能来自 live task surface。移动正常而内容停住时,先辨别 snapshot、旧 buffer 或实时内容,再查各自更新和合成。
视频:UI 帧与视频帧
视频通常由 MediaCodec 或播放器渲染器向 Surface 输出 buffer。使用 SurfaceView 时,视频通常拥有独立的 child layer(子图层);使用 TextureView 时,视频 buffer 先进入 SurfaceTexture,再由宿主 HWUI 在 App Window 中采样。两条路径的责任线程、buffer 数量和 FrameTimeline 覆盖范围不同。
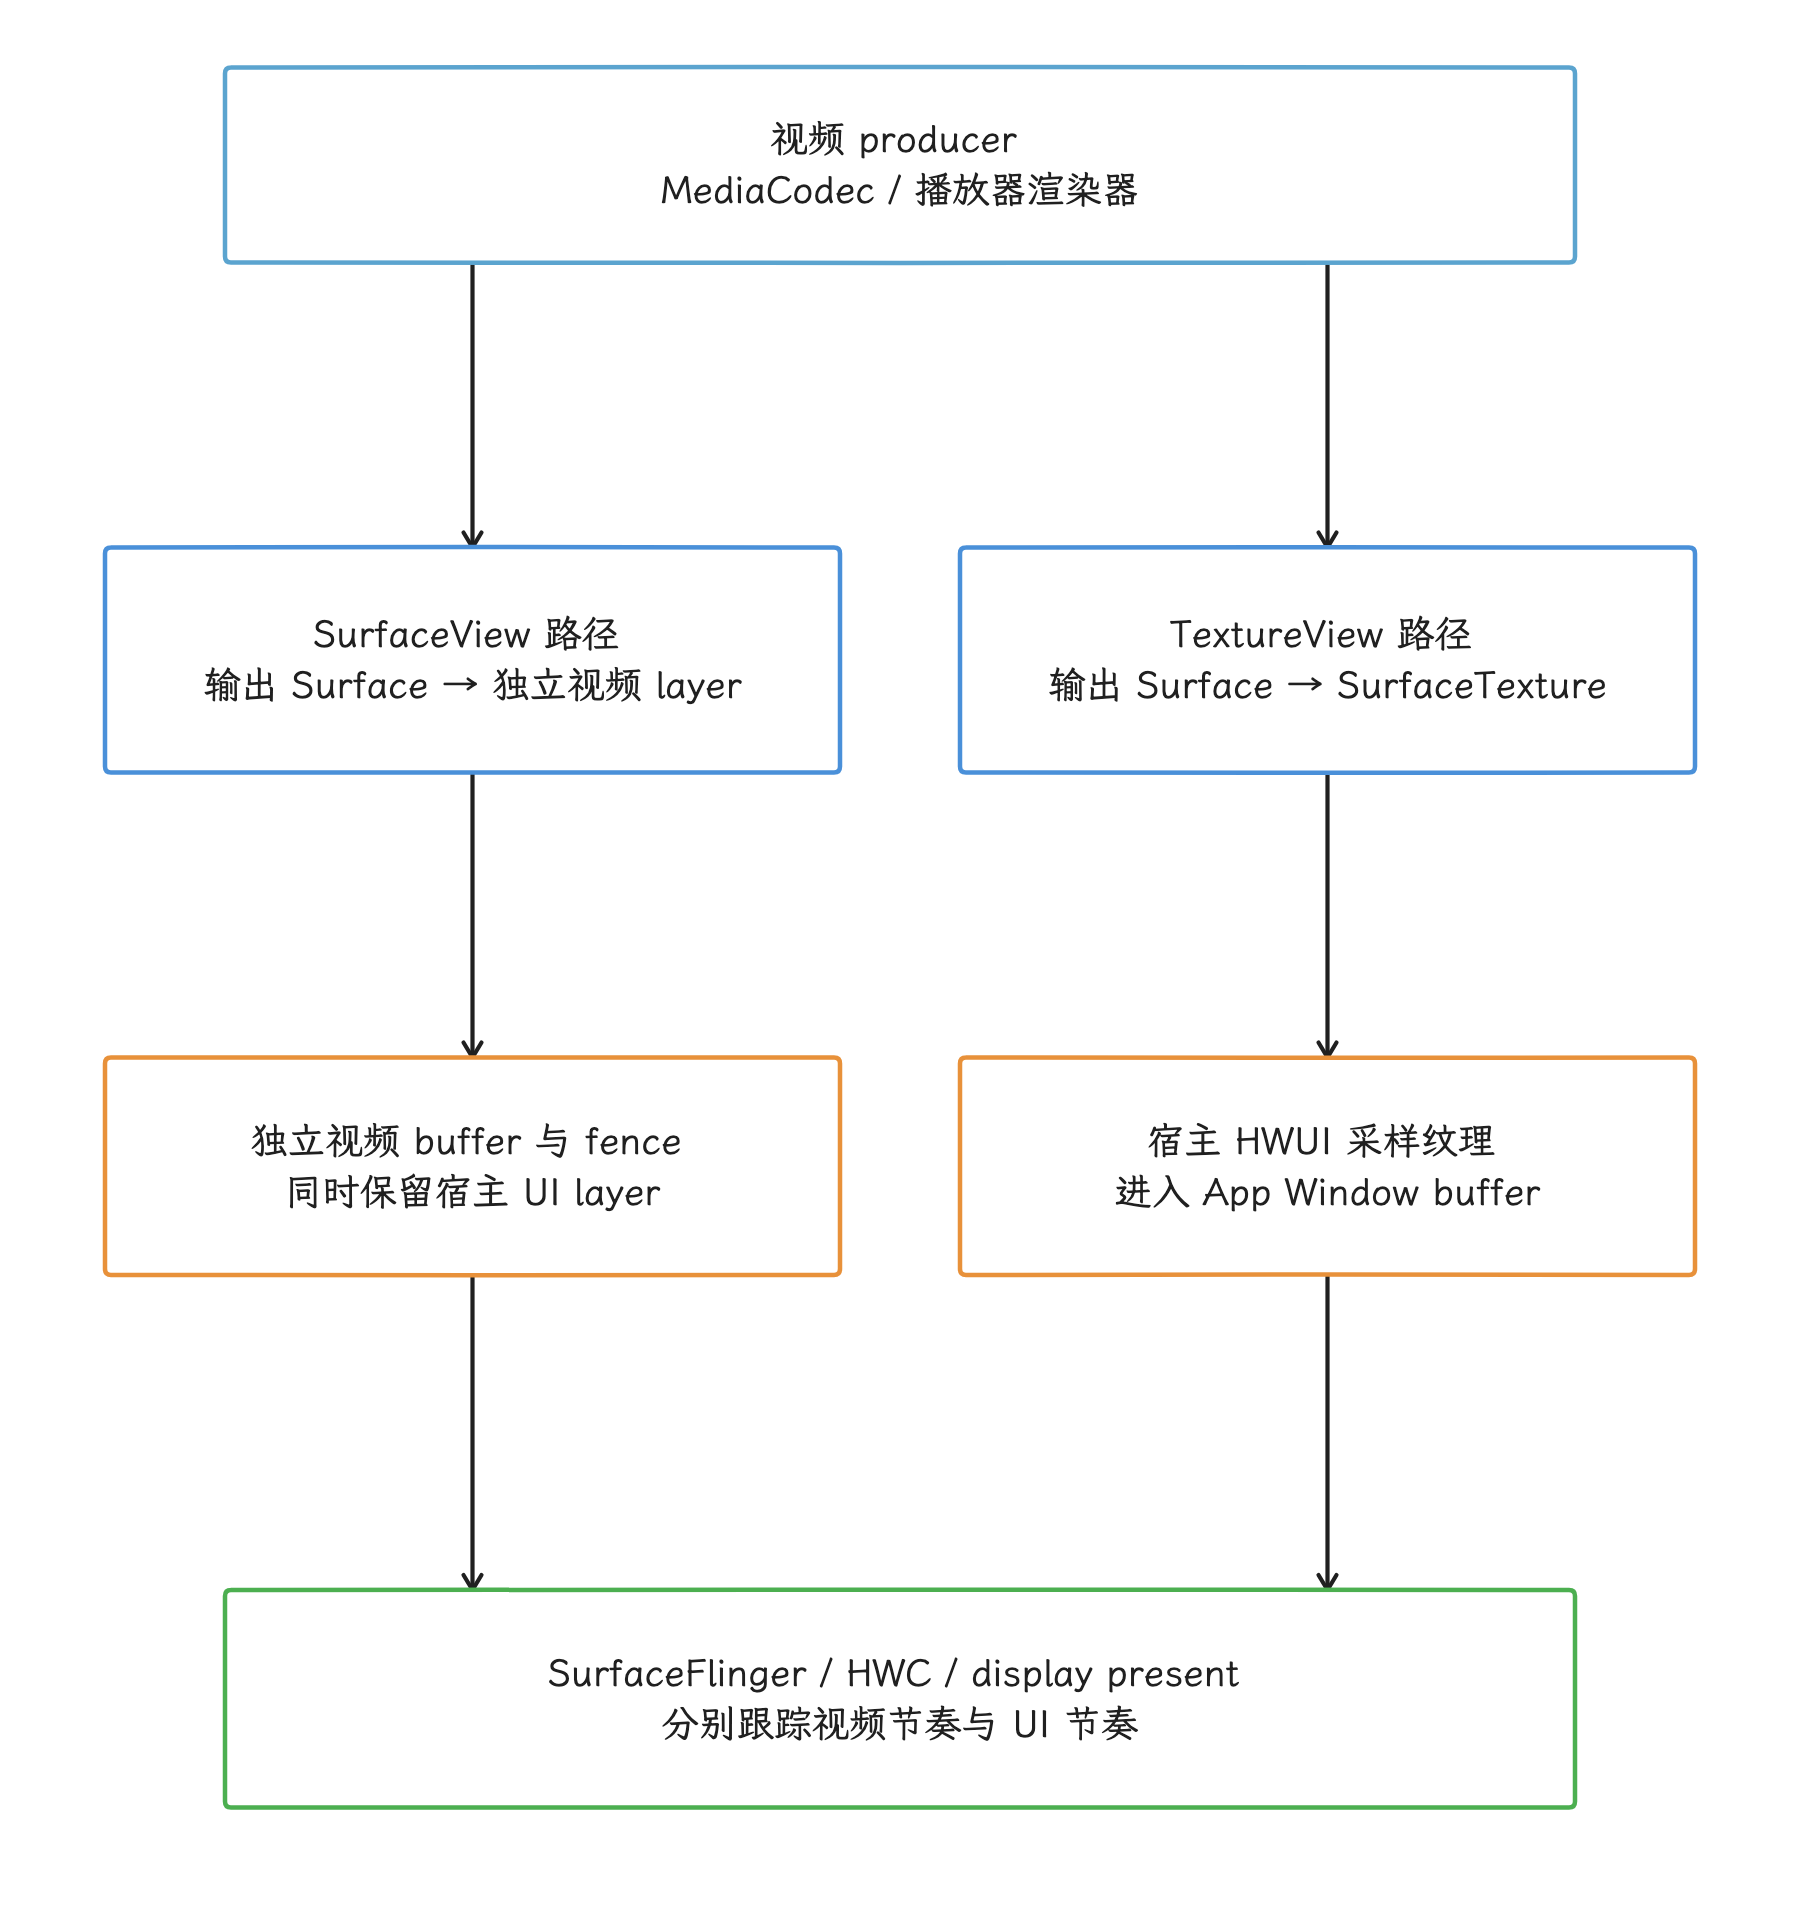
图:SurfaceView 通常以独立视频 layer 进入 SF;TextureView 经 SurfaceTexture 由宿主 HWUI 采样到 App Window。目标 layer 是否使用 DEVICE/overlay,还要看现场 HWC 分配。
视频“卡”的含义至少有三种:
- 解码器没有按节奏产出可用 buffer;
- buffer 已 queue(入队),但 fence、latch、合成或显示时刻迟到;
- 播放器主动丢帧或重复帧,以维持音视频同步。
应记录媒体 presentation timestamp(PTS,呈现时间戳)、解码输入/输出、目标 Surface 的 frame number、queue/acquire/release(入队/获取/释放)、display present 和音频时钟。UI 的 App FrameTimeline 正常时,独立视频 layer 未必在连续更新;视频连续时,控制栏动画也未必流畅,两条线要分别核对。
HWC overlay 能减少 GPU 合成压力,但是否可用取决于格式、缩放、旋转、HDR(高动态范围)、受保护内容、其他 layers 与硬件资源。我们检查目标 layer 的实际 composition type,不依据 SurfaceView 或 MediaCodec 名称推断 overlay。详见视频 Overlay、Media3 与专业编解码管线。
地图与 WebView 的承载方式
地图 SDK
地图 SDK 可能使用 SurfaceView、TextureView、GLSurfaceView、自建 SurfaceControl,或把部分内容画进宿主窗口。瓦片下载、矢量解析、标注布局和 GL/Vulkan 提交也可能分属不同线程。要把“地图卡顿”归到固定的 GL 线程,先得拿到 SDK 版本、实际 View 类型和 layer tree。
排查时先确认:
- 地图主体是独立 layer,还是作为纹理合入 App Window;
- 相机移动由手势线程、主线程还是渲染线程驱动;
- 瓦片 I/O/解码是否阻塞渲染依赖;
- shader/pipeline(着色器/图形管线) 创建、纹理上传和 GPU 执行是否与异常帧对齐;
- 独立 layer 与宿主控件的更新是否落在同一 display frame。
SurfaceView 与 TextureView 的差别参见SurfaceView 与 TextureView 渲染管线。
WebView
标准硬件加速 WebView 的网页主体通常经 Chromium renderer(渲染进程)、compositor/GPU 服务和 WebView functor(连接 Chromium 与 Android HWUI 的绘制桥接对象) 合入宿主 App Window。视频、受保护内容、provider overlay(WebView 实现提供方添加的叠加层) 或定制内核可能增加独立的 SurfaceControl layer。网页主体与媒体 overlay 需要分开追踪。
WebView 是可以独立更新的组件。平台源码可以锚定 android-17.0.0_r1,分析 Chromium 行为时还必须记录设备上的 WebView provider 包名、版本与 revision(修订版本)。某个 Chromium slice 名称或进程结构,要从这些 provider 信息里确认,平台版本标签只覆盖平台那一半。
| 现象 | 优先查看 |
|---|---|
| JS 长任务后页面不动 | renderer main thread(渲染进程主线程)、V8(JavaScript 引擎)、DOM/layout(文档对象模型处理/布局)依赖 |
| 页面 paint/raster(绘制/栅格化)晚 | Blink paint(网页绘制)、compositor、raster/GPU service(栅格化/GPU 服务) |
| 宿主控件和网页一起晚 | App UI Thread、HWUI functor、host RenderThread(宿主渲染线程) |
| 视频晚而页面滚动正常 | 独立媒体 layer、codec(编解码器)、fence、HWC |
| host buffer(宿主缓冲区)已提交但屏幕晚 | SurfaceFlinger/HWC、DisplayFrame |
Renderer 退出应结合进程生命周期、LMK(低内存终止)/OOM(内存不足) 证据与 WebViewClient.onRenderProcessGone() 判断。除非应用自行插桩,别预设 trace 中存在名为 render_process_gone 的 slice。完整结构见 WebView 渲染管线 和 WebView 性能优化实战。
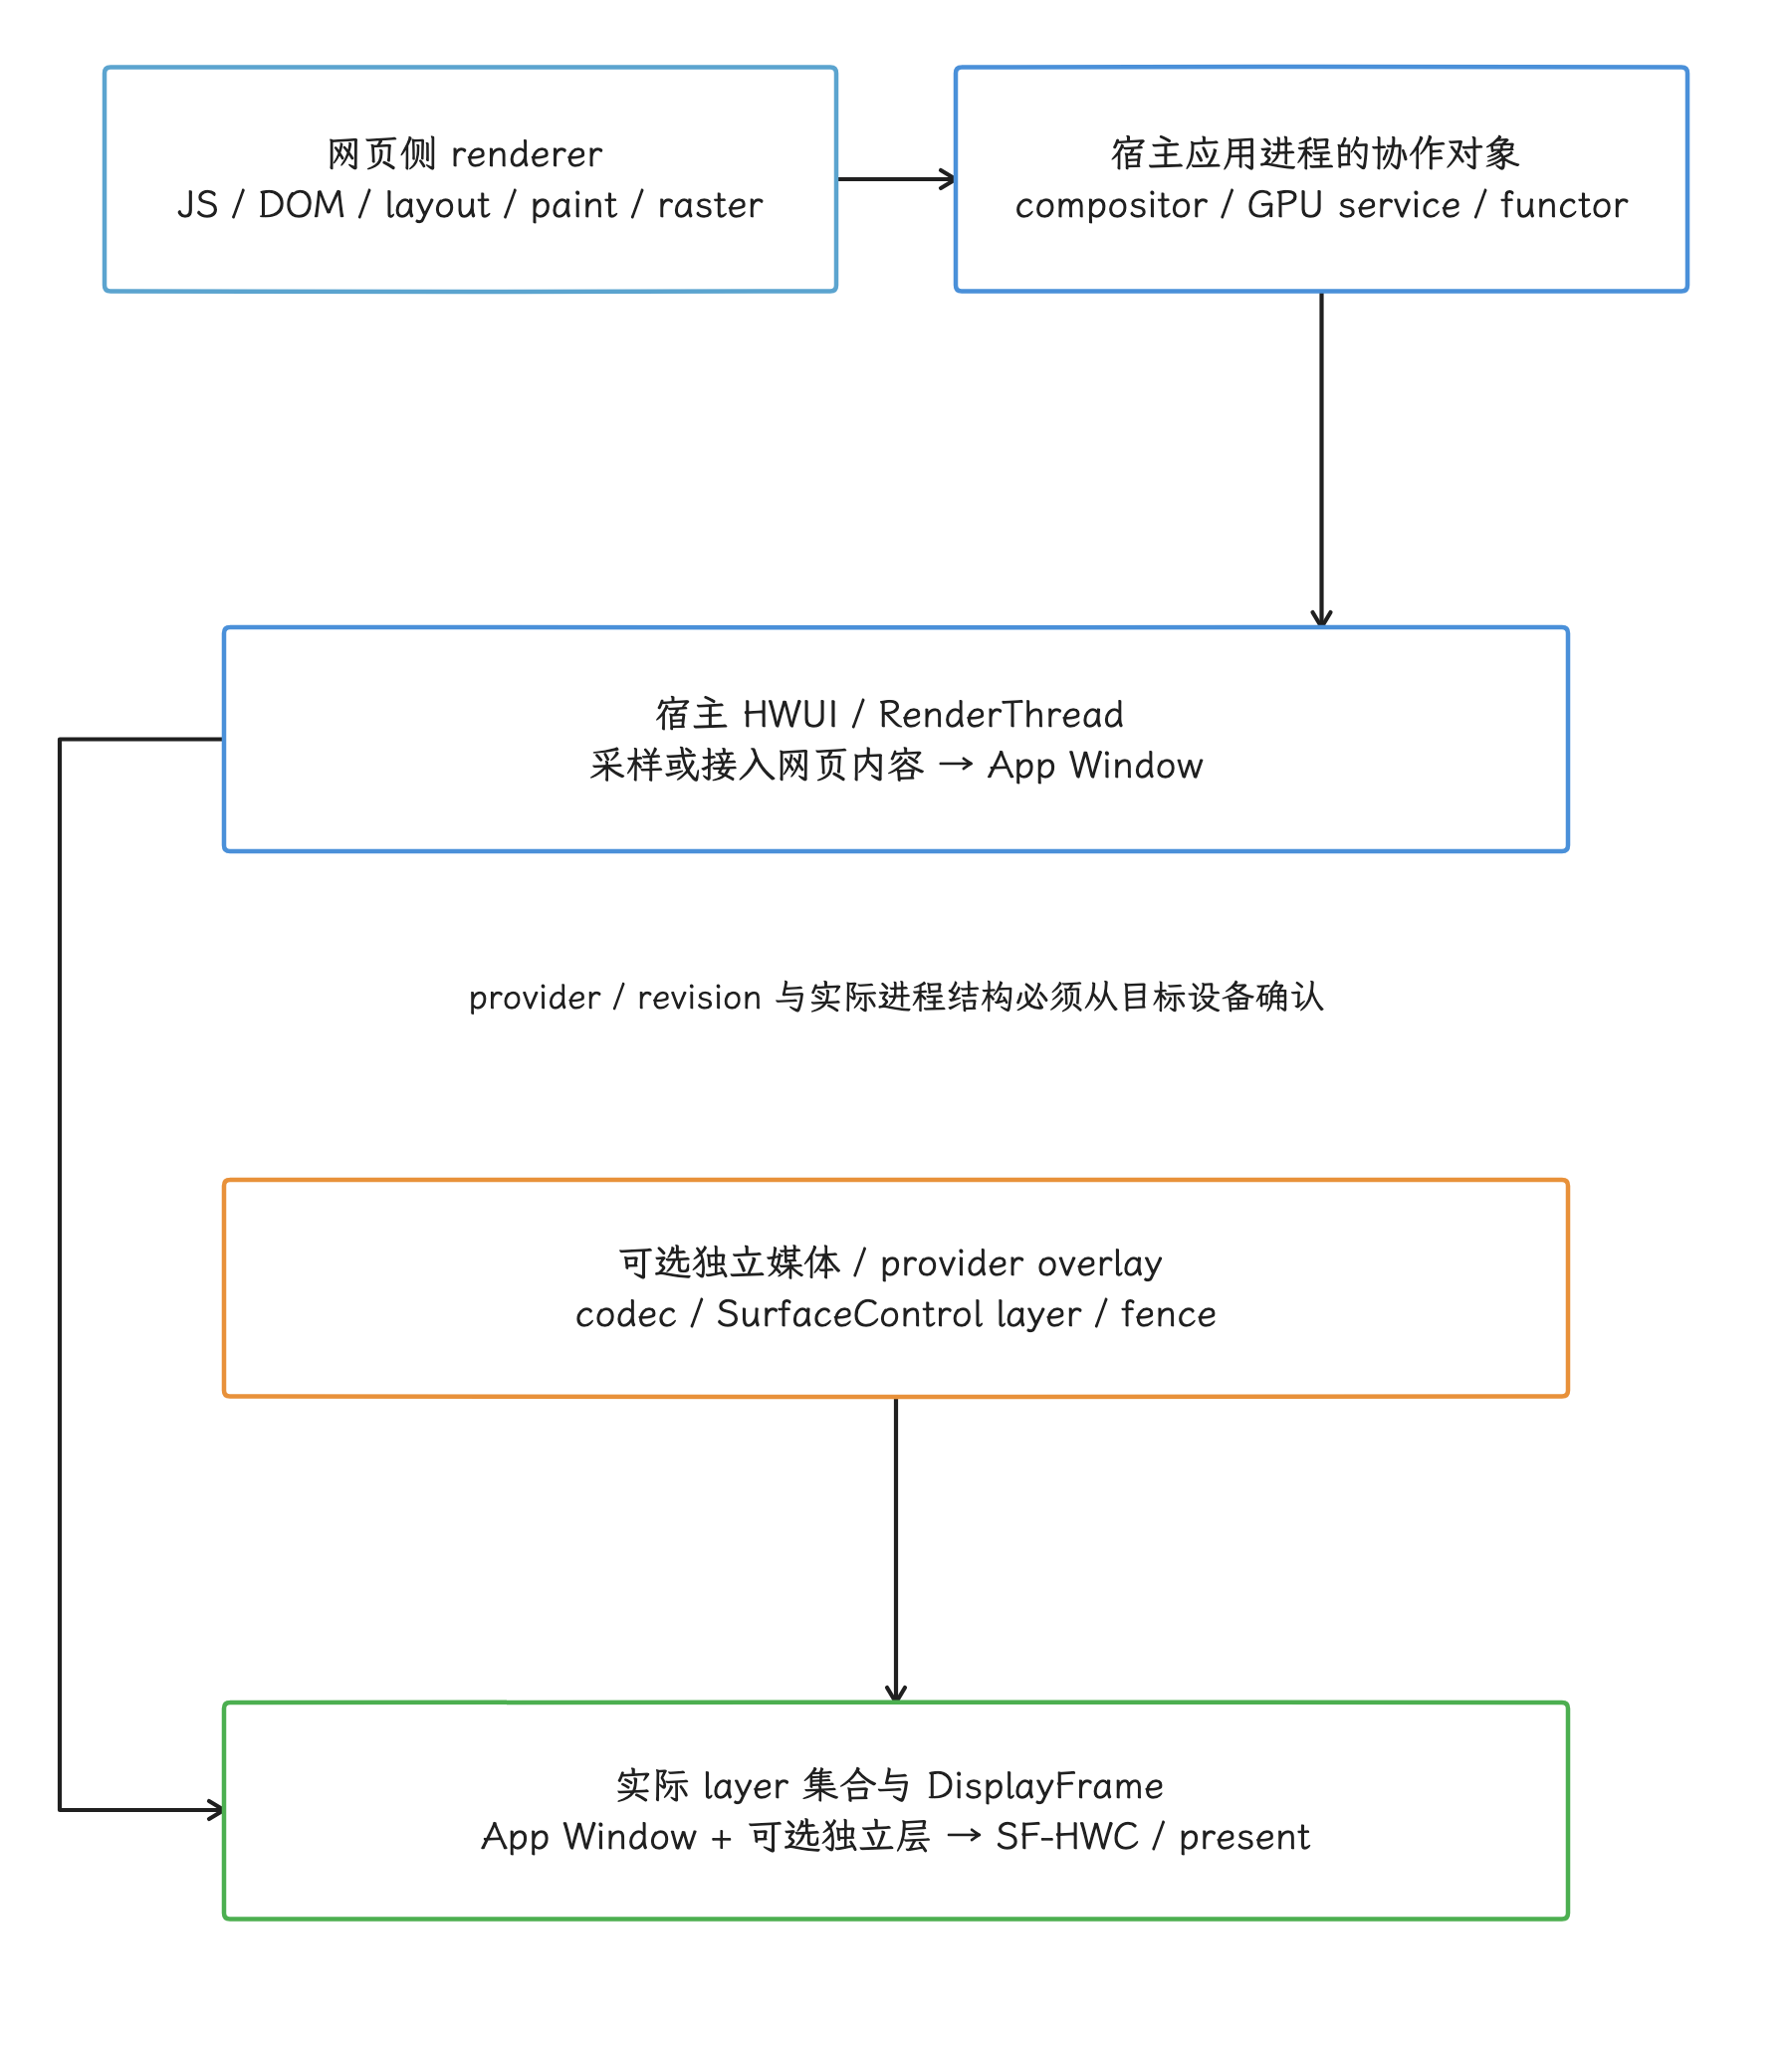
图:典型硬件加速路径中,网页经 renderer、compositor/GPU 服务和 functor 接入宿主 HWUI;GPU 服务通常在宿主进程。独立视频或 provider overlay 要另追 layer,分析时同时记录 provider 版本。
从症状到证据的速查表
我们把上面的场景对应关系压成一张速查表:先按症状找到第一组对象,再沿“继续验证”一列深入,最后一列提醒每行最容易踩的判断坑。
| 场景症状 | 第一组对象 | 继续验证 | 容易误判的结论 |
|---|---|---|---|
| 列表拖动立即跟手差 | input、UI Thread、RecyclerView | RenderThread、App Window、DisplayFrame | “一定是 onBind” |
| fling 周期性顿挫 | animation、RV bind/create/prefetch | 图片回调、GC、sched、GPU | “每帧都必须少于刷新间隔” |
| Activity 切换开头停顿 | 目标首帧、启动类型 | Shell transition、source/target layers(源/目标图层) | “总有两个进程” |
| Fragment 切换卡 | pending actions、生命周期、layout | SpecialEffectsController、RenderThread | “改用 commitNow 就会快” |
| Splash 退场抖动 | splash 与目标窗口交接 | exit listener(退出监听器)、transaction、present | “只有 Application 启动慢” |
| 返回动画缺失 | opt-in、callback 消费 | Shell 参与者 | “缺失就是掉帧” |
| Dialog 出现后整屏变慢 | 新 ViewRoot/layer、dim/blur | HWC composition、GPU/present | “多一个 layer 必走 CLIENT” |
| 通知栏卡 | SystemUI FrameTimeline | RemoteViews、SF/HWC | “发布通知的 App 在画 Shade” |
| Recents 卡片内容停住 | snapshot/live surface | Quickstep/Shell、SF transaction | “所有卡片都是 bitmap 解码” |
| 视频停顿、控件流畅 | codec producer(编解码器生产者)、视频 layer | PTS、fence、HWC/present | “App FrameTimeline 正常就没掉视频帧” |
| WebView 页面卡 | provider renderer/compositor | host HWUI、媒体 overlay、SF | “只查宿主主线程” |
版本记录与厂商差异
RecyclerView、Fragment、WebView provider 和地图 SDK 都可以独立更新,复现报告要相应记录它们的版本。厂商 Launcher、SystemUI、HWC、GPU 驱动与调度策略也可能偏离 AOSP 参考实现。
内核侧的通用证据包括 sched wakeup/switch(调度唤醒/切换)、CPU frequency/idle(频率/空闲状态)、thermal、dma-buf(设备间共享缓冲区) 与 dma-fence;设备可见的 GPU、display、HWC 和厂商调度事件由 SoC 与构建配置决定。缺少某个厂商 tracepoint 时,就承认“不足以继续归因”,线程名称或 CPU 编号补不出这个结论。
复盘模板
一份可复核的场景结论至少回答以下问题:
- 哪次交互、哪块显示屏、哪个刷新率下复现?
- 用户感知对应哪个 SurfaceFrame、DisplayFrame 或目标 layer present?
- 画面由哪些 producer(内容生产者)、Window、Surface 和 layer 构成?
- 最早偏离 expected timeline 的事件是什么?
- 迟到线程当时处于 Running、Runnable、Sleeping、Blocked(阻塞) 还是 fence wait(栅栏等待)?
- 应用 buffer、窗口几何 transaction 与 display present 分别何时完成?
- 修复改变了哪项可测量证据,相邻正常帧和异常帧是否收敛?
- 结论依赖的平台、AndroidX、WebView provider、OEM 和 kernel 版本是什么?
场景归类的作用是减少待检查对象;归因仍要依靠源码、trace 和对照实验。证据到 Surface、进程或显示边界为止时,结论也停在当前层级。
案例:从现场证据到修复判断
场景模板帮我们提出假设;案例则要回答两件事:哪条证据排除了其他原因,修复后哪项指标发生了变化。
案例证据怎样使用
以下五个公开工程案例覆盖主线程、GC/内存、调度、SurfaceFlinger 合成和温控。案例来源分成三类:
- 腾讯音乐技术团队的 WeSing 复盘给出了设备、测试动作、版本差异和若干 trace 数据;
- AndroidPerformance 的系统案例给出了 Systrace(旧版 Android 系统跟踪工具) 截图和对照数据,但仓库没有原始 trace 文件;
- 温控案例采用 Android Developers 发布的 Netmarble ADPF(Android Dynamic Performance Framework,Android 动态性能框架)案例,保留官方披露的效果数字。
截图只能证明作者当时观察到的现象;可以逐项查询、按时间核对的原始 trace 才算数。下面每个案例都把“公开材料中的事实”“Android 17 下的解释”和“仍缺少的证据”分开说明。历史数据不作为 android-17.0.0_r1 的实测结果;Android 17 源码只用于校正机制和工具入口。
统一复盘格式
| 字段 | 要回答的问题 |
|---|---|
| 现场 | 哪台设备、哪个 build(系统构建版本)、什么动作、持续多久 |
| 用户结果 | 哪一帧、哪个 CUJ(Critical User Journey,关键用户操作流程)或哪段启动变差 |
| 关键证据 | 线程状态、slice(时间区间)、counter(计数轨道)、heap(堆内存)、layer(图层)、fence(同步栅栏)、thermal(温控)状态 |
| 排除项 | 哪些相似原因已经排除 |
| 根因 | 哪条因果关系有对照实验支持 |
| 修复 | 改了哪一段工作或资源配置 |
| 效果 | 同条件下哪些指标发生变化 |
| 证据缺口 | 缺少原始 trace、样本量、设备覆盖或统计定义中的哪一项 |
案例一:WeSing 歌房进房的一条主线程消息过重
现场与公开数据
腾讯音乐技术团队在 WeSing 歌房进房场景做过两轮优化。公开测试条件是 OnePlus 10 Pro、Android 12、进程冷启动,点击进房后等待 8 秒让 UI 稳定。原文报告,在 5.65 与 5.70 两轮优化后,PerfDog(移动端性能测试工具)统计的卡顿率改善接近 50%。
其中一条主线程消息集中创建微服务(可独立初始化的应用服务模块),并派发 Activity、Fragment 和音视频组件的生命周期事件。原文文字报告服务实例创建时间为 312 ms;同一复盘还记录了 40 ms 的生命周期分发、115 ms 的音视频 SDK 初始化、103 ms 的 bitmap 模糊和 18 ms 的日志参数拼接。
图:来源截图展示服务实例创建映射代码;312 ms 来自原文文字报告,图内没有耗时时间轴。
这些数字只适用于该团队的设备、版本,以及 PerfDog 的指标定义和计算方式,直接换算成 Android vitals(Play Console 的应用性能指标) 或其他应用的收益并不可靠。
从现象到根因
“主线程有一个 312 ms 长任务”只是起点。团队接着把这条消息里的各项工作拆了开来:
- 微服务框架允许 lazy(按需) 初始化,但业务不断把服务标成进房预加载;
- 多项工作集中在同一条 Looper message(消息循环中的一条消息) 里,首批 UI 更新只能排在它们之后;
- 部分工作有严格的 UI 或生命周期顺序,全部丢到线程池行不通;
- bitmap 处理、配置 JSON 和部分 SDK 初始化可以脱离主线程;
- 日志方法即使最终不输出,调用前的字符串拼接和序列化已经发生。
所以根因除了“单个方法很慢”,还有进房依赖没有分类:立即完成、可以延后、适合预热和可以异步的工作混在了同一条消息中。
修复
公开复盘采用了五组动作:
- 删除不必要的预加载,把服务默认改为 lazy;
- 将不依赖 UI 的解析、bitmap 处理等移到工作线程;
- 对进房后立即使用且类加载昂贵的组件做有条件预热,即预计会使用时提前加载;
- 把必须在主线程执行的生命周期工作拆成小段,并保持业务顺序;
- 避免关闭日志后仍构造昂贵参数。
原案例为了控制消息顺序使用过 postAtFrontOfQueue()。这个 API 会把消息插到队首,可能延迟输入、traversal 和其他消息。迁移到新项目时,我们把依赖写成明确的状态机(用状态及其转换表达执行顺序)或阶段队列,并为每段工作设置时间预算和取消条件;“插到队首”这一实现细节不适合直接复制。
效果与证据边界
原文披露了两项结果:整体 PerfDog 卡顿率接近减半;有条件预热让线上进房平均耗时减少 250 ms。由于没有公开完整样本量、分位数和全部修改前后 trace,这两项数据只描述 WeSing 当时的发布结果。
复验同类修改时,应同时核对:
- 目标 CUJ 的 FrameTimeline 与进房 marker;
- 每条主线程 message 的 wall time(从开始到结束的实际经过时间)、Running 与 Runnable 时间;
- 冷启动类加载/JIT(即时编译)、后台预热占用的 CPU 和内存;
- 第一帧、内容稳定时刻与用户可交互时刻;
- 拆分后是否出现时序错误或首次点击延迟。
来源:Android 深入卡顿分析与实践(QQ 音乐技术团队)。
案例二:反复进退房后的内存增长与 GC
现场与公开数据
同一篇 WeSing 复盘记录了“开始流畅,反复进退歌房后越来越卡”的问题。Profiler(性能分析工具) 显示房间退出后仍有对象存活,其中一个根因是弹窗关闭后动画没有停止,引用链继续持有页面对象。原文还记录了内存紧张时进房更容易触发频繁 GC。
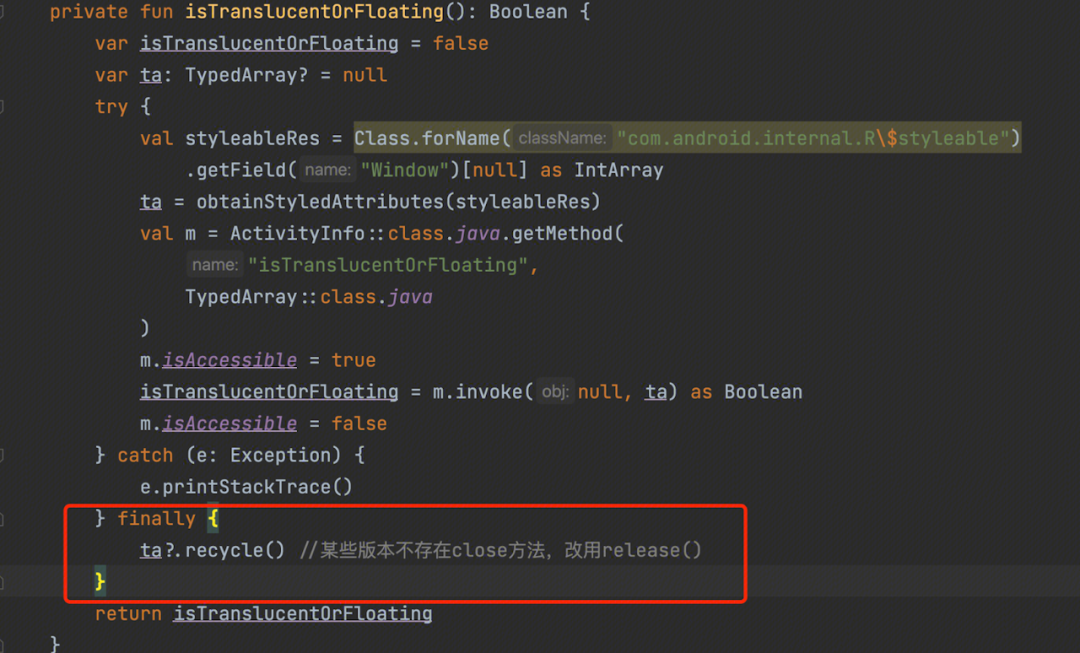
图:原文另列的 TypedArray 回收问题,截图展示 finally 中补充 recycle() 的处理;图内未展示内存增长曲线或动画泄漏引用链。
公开材料没有给出该泄漏修复前后的 GC pause(垃圾回收暂停) 分位值或 JankStats 对照。因此这里只保留“修复引用链与生命周期”这一结论,该动画泄漏修复前后的堆大小、GC 次数和卡顿率缺少对应公开数据,不采用。
从现象到根因
“使用一段时间后变慢,重启恢复”可能由多种因素造成:Java/native(Java 堆/原生内存) 泄漏、图片/GPU 缓存、线程增长、热限制、系统内存压力或存储 I/O。把下面四组证据放在一起,可以构建“泄漏或缓存增长 → 分配/回收压力 → 异常帧”的强证据链;短期分配高峰在没有泄漏时也可能触发停顿,这类停顿另有来源:
- 相同操作循环下,Java/native/graphics(原生/图形) 内存或存活对象持续增长;
- ART(Android Runtime,Android 运行时) GC 的 pause 或 allocation(内存分配) stall(分配停顿) 更频繁,并与异常帧相交;
- Heap dump(堆转储)、heapprofd(原生堆分析器) 或引用分析指向释放不掉的对象;
- 修掉引用或限制缓存后,内存曲线、GC 事件和耗时较长的尾部帧同步改善。
ART 的并发 GC 仍包含暂停阶段,但整个 Concurrent GC slice(并发回收区间)里,属于主线程 Stop-The-World(所有线程暂停)时间的只是其中一部分。我们查看 trace 中明确的 pause、线程状态和分配等待。不同 Android/ART 版本的事件名称会变化,只搜索固定名称 GC For Alloc 容易漏掉其他事件。
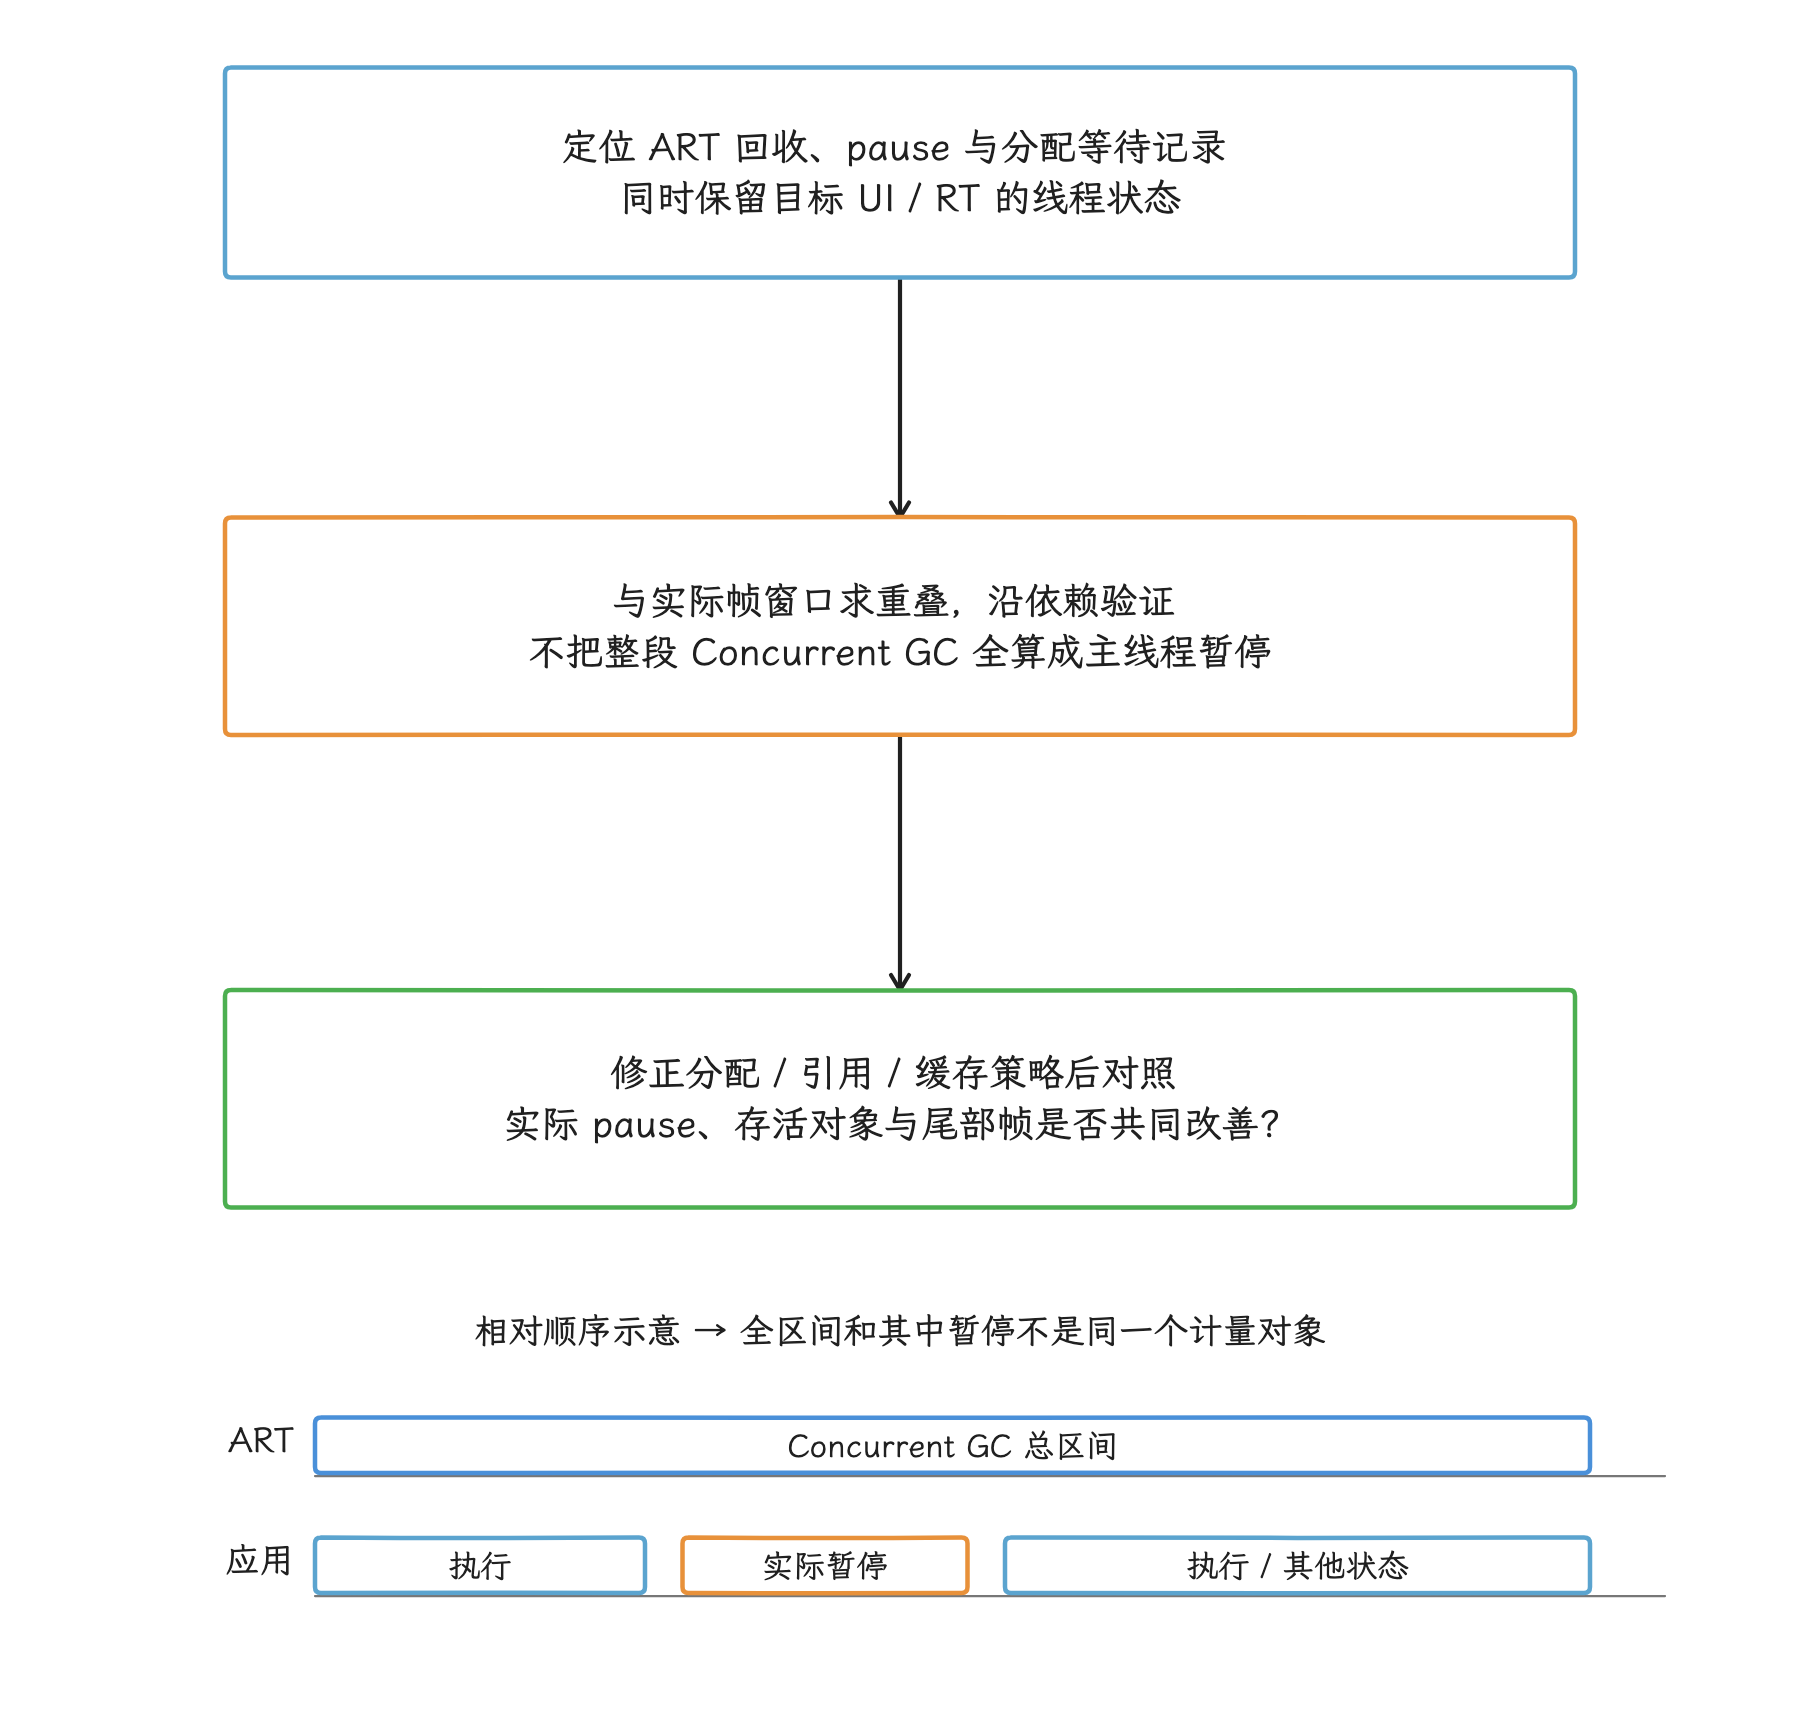
图:并发 GC 的整体区间可与应用工作重叠;真正影响本帧的暂停和 allocation stall 要按目标线程、时间重叠及唤醒关系核验。图中轨道是概念示意,不代表某种收集器的固定暂停阶段。
原案例中“弹窗关闭后动画仍持有页面”的引用链能解释对象为何存活。修复动作是结束动画、移除回调或监听器,并释放与页面生命周期绑定的对象。缓存问题还要分别统计 Java heap(Java 堆)、native allocation(原生内存分配)、GraphicBuffer/dma-buf(图形缓冲区/设备间共享缓冲区) 和 GPU 资源。
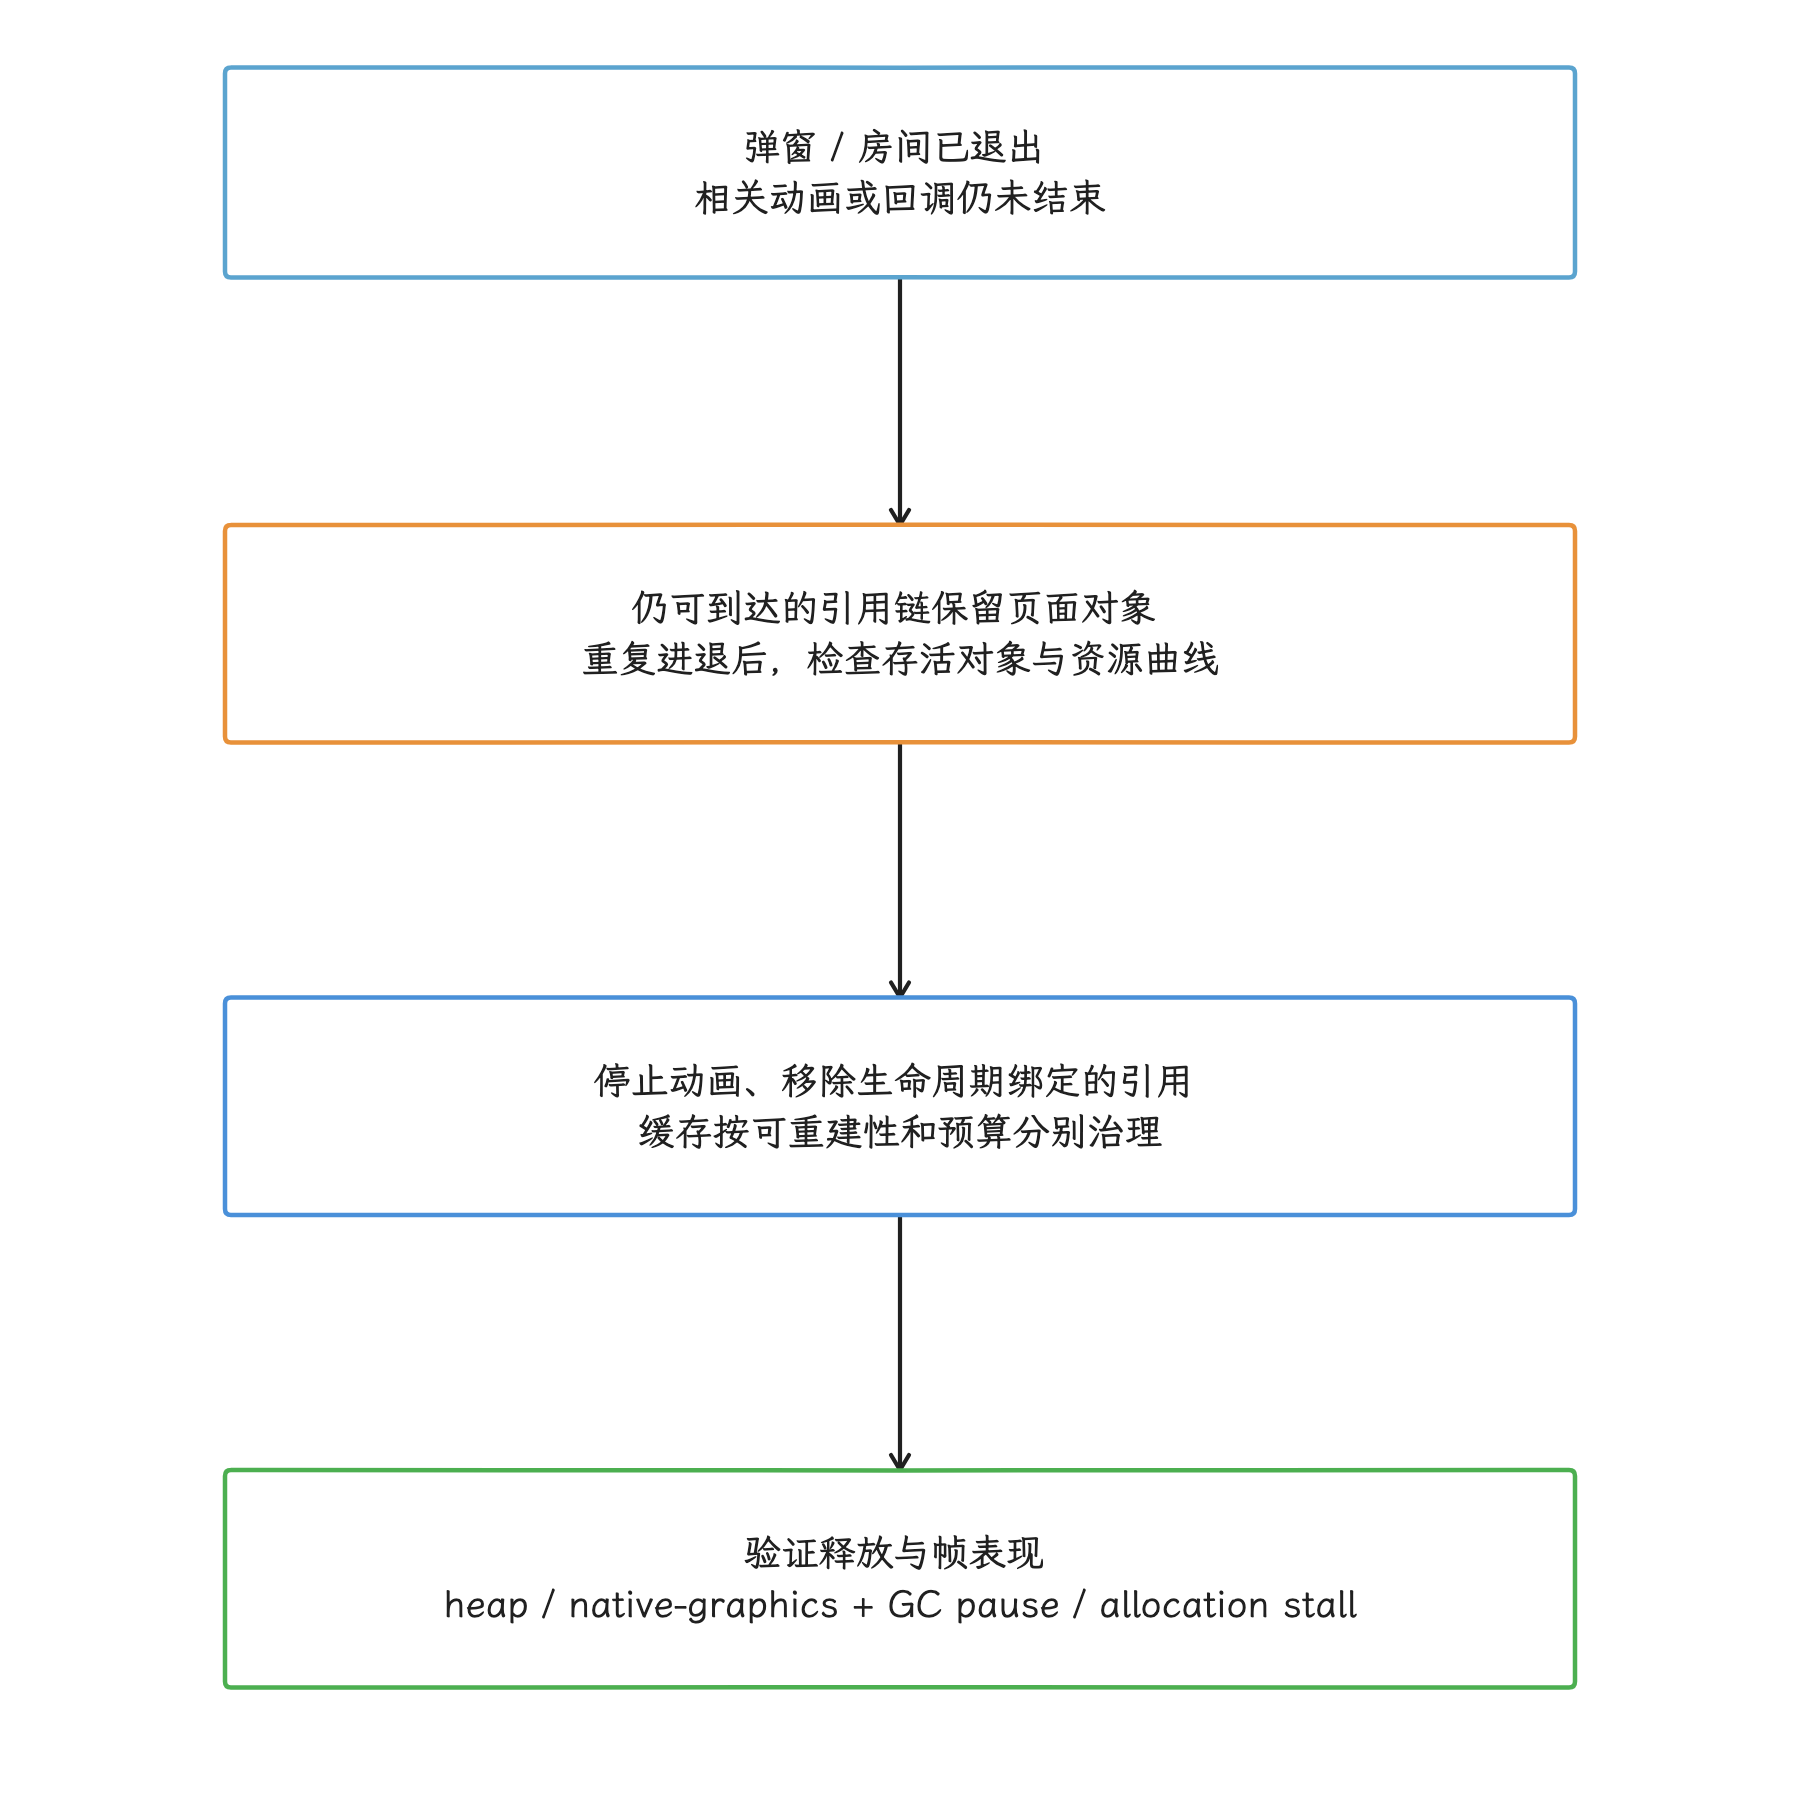
图:原案例确认弹窗关闭后动画仍持有页面对象。结束动画、移除回调/监听器和释放页面资源针对这条引用链;GC 暂停与异常帧是否相关,仍需实际 pause、分配等待和前后 trace。
整机低内存对照
AndroidPerformance 还公开过一组整机低内存冷启动对照:
| 条件 | bindApplication 到第一帧 | Block I/O 与 Uninterruptible Sleep/WakeKill | Running |
|---|---|---|---|
| 低内存 | 约 2.0 s | 约 750 ms | 约 600–682 ms |
| 正常内存 | 约 1.22 s | 约 130 ms | 约 624 ms |
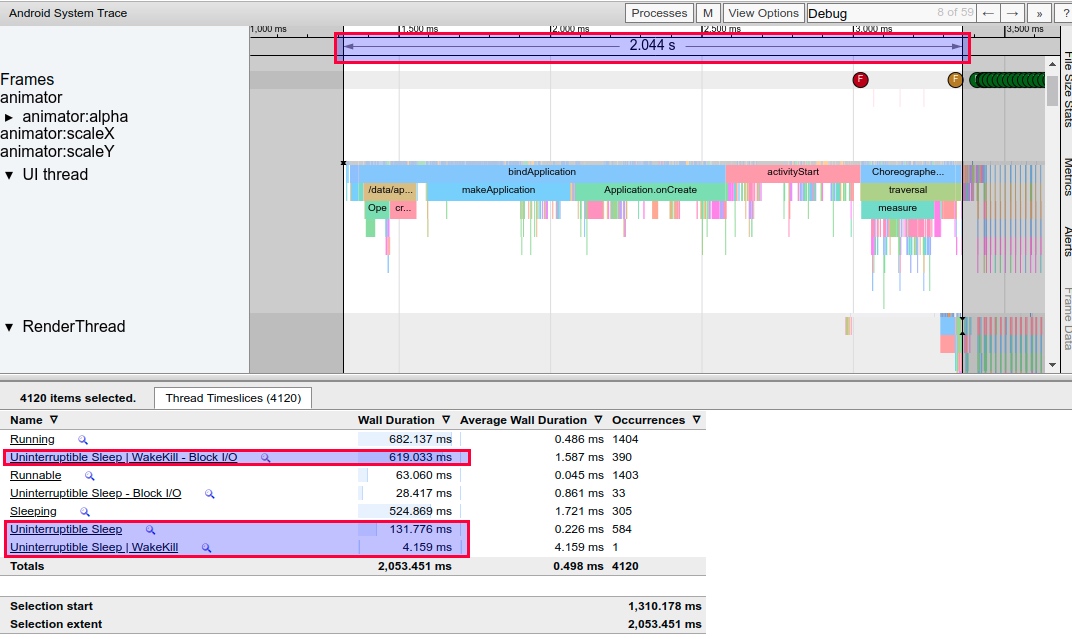
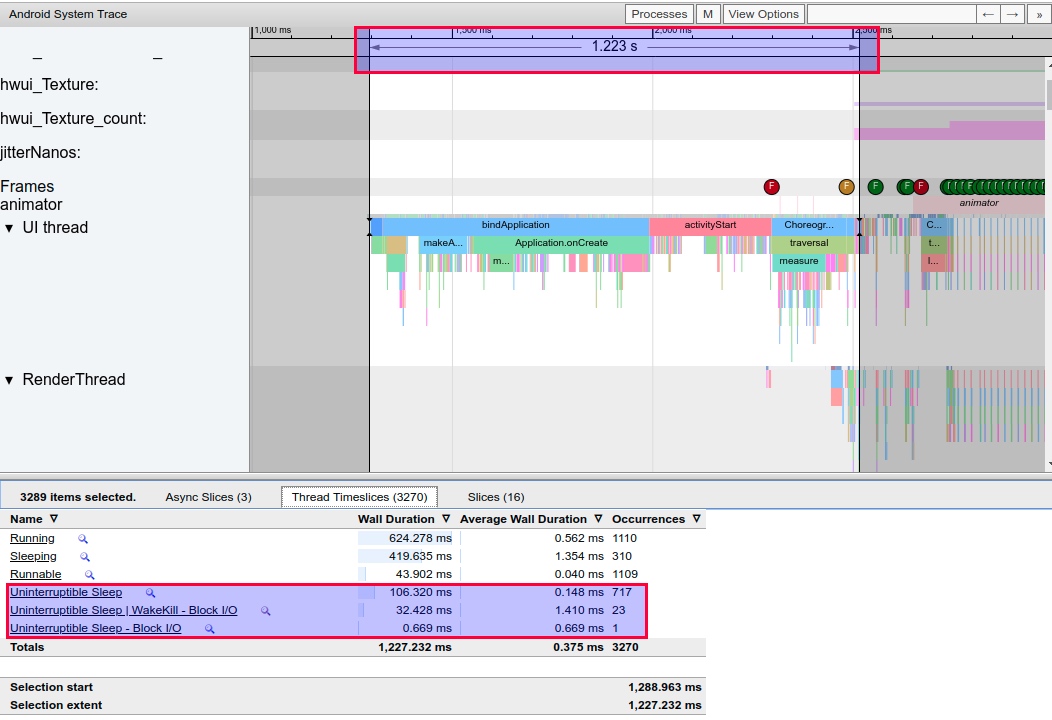
表中原文把两个等待类别合计:Uninterruptible Sleep | WakeKill - Block I/O 与普通 Uninterruptible Sleep。其中 D 表示不可中断等待,组合 K 才含“可被致命信号唤醒”的标志;解释 D 状态要按这些标志拆开,WakeKill 和存储 I/O 只是其中的可能项。Running 是线程实际执行时间;原文在低内存一节分别写了 682 ms 与约 600 ms,因此表格保留该来源差异。两次 Running 时间接近,提示优先排查额外等待与内存活动;要把调用路径、频率或计算量的变化一并排除,还需调用栈与同条件对照。
整机内存的证据链上,我们查看 PSI memory(内存压力指标)、direct reclaim(内存回收)、kswapd(内核后台回收线程)、swap/zram(压缩内存交换区) I/O(交换空间/压缩内存读写)、major fault(需要从存储读取数据的主缺页)、lmkd(低内存终止守护进程) 事件和前台线程状态。现代 lmkd 主要依据 PSI 与进程优先级工作,旧内核中的 lowmemorykiller 日志和固定 minfree 阈值方案直接套用行不通。
修复与效果
应用泄漏路径的修复目标是让房间退出后对象可以回收,并限制可重建缓存。整机低内存路径则需要减少前后台常驻对象、避免前台线程直接回收内存或等待 I/O,并由系统团队在目标设备上调校 lmkd、zram、内存回收和存储策略。
Android 14 起,应用不再收到部分旧的 TRIM_MEMORY_RUNNING_*(运行中内存压力) 回调;对应常量在 API 35 被弃用。应用仍可结合 TRIM_MEMORY_UI_HIDDEN(界面进入后台)、后台状态和自身内存预算释放可重建资源;旧式“运行中低内存”通知在当前版本已经收不到,释放时机由应用自己掌握。
验收至少包含重复进退房的 heap 曲线、GC pause、FrameTimeline、native/graphics 内存、PSI 和热状态。只看到 Java heap 下降,还证明不了 GPU buffer(图形缓冲区) 或整机内存压力已经改善。
来源:WeSing 复盘、Android 低内存案例、ComponentCallbacks2。
案例三:SDK 升级增加线程后,主线程获得 CPU 变慢
现场与关键数据
WeSing 5.68 的版本对比发现:
- 相比上个版本,进程增加近 30 个线程;
- file descriptor(文件描述符,简称 FD)增加约 250 个;
- 团队使用的卡顿率从 15% 上升到 20%;
- 增量线程在退出歌房后仍未减少;
- APK/版本二分(在版本区间中反复折半定位变化)把问题定位到 TRTC SDK 升级;
- Perfetto SQL 统计显示,升级后名为 DefaultDispatch 的线程 CPU 时间超过 UI Thread 和 RenderThread。
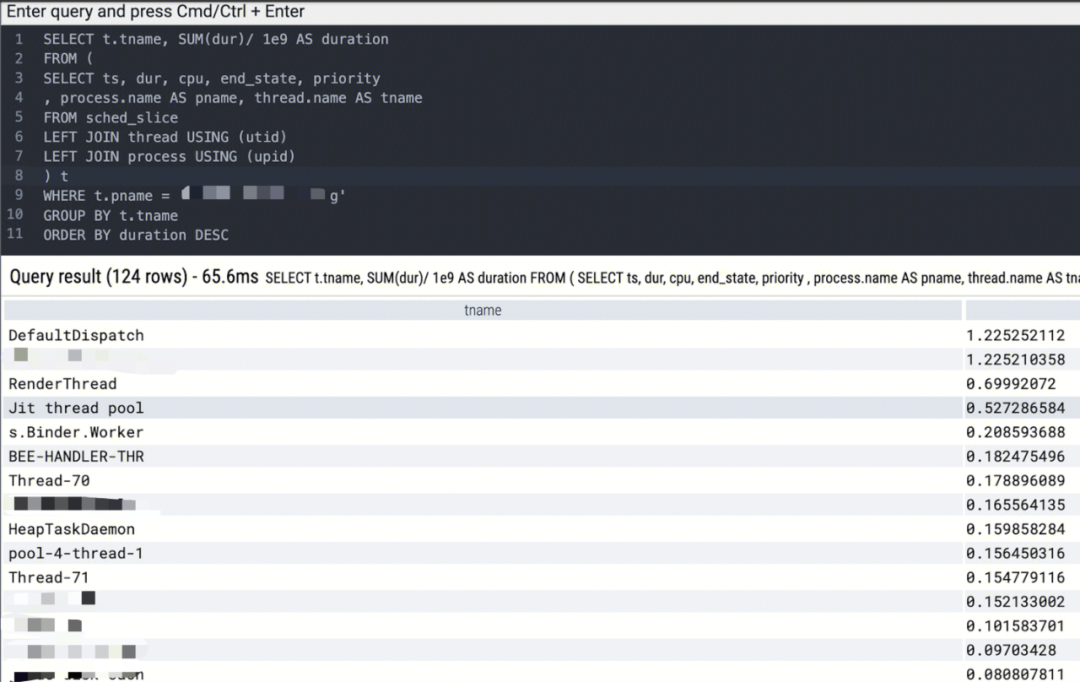
图:来源截图按线程名汇总一次采集中的 CPU 时间;升级前后差异来自原文复测叙述,截图本身只显示一组查询结果。
从相关性到根因
线程数增加本身还只是间接现象;这个案例的证据价值来自版本二分、线程来源定位和 CPU 时间汇总——SDK 方移除与业务无关的功能后,相关指标恢复。
在 Android 17 上,还应补两项证据:
- 异常帧里 UI Thread/RenderThread 是否长时间处于 Runnable,wakeup 到 Running 的等待是否增加;
- 新线程在同一时间是否处于 Running,占用了哪些 CPU,是否带来频率、迁核、thermal、内存或 GC 变化。
如果新增线程多数处于 Sleeping,调度影响可能很小;如果一个新增 CPU worker(工作线程) 长时间处于 Running,即使线程总数不高,也可能推迟交互线程获得 CPU。文件描述符增加说明的是资源占用发生了变化;CPU 调度的结论,要从线程状态和 CPU 时间里找。
修复
团队把问题提交给 SDK 方,去掉升级时引入但当前业务不需要的功能。通用处理包括:
- 为 SDK 和业务线程提供稳定、可聚合的名字;
- 对线程池设置有界并发、队列和取消;
- 页面退出时停止会话与 worker;
- 用版本开关或依赖回退完成 A/B(对照实验);
- 分开统计线程数、CPU time(CPU 执行时间)、Runnable latency(可运行等待时间)、RSS/PSS(进程实际占用/按比例分摊的内存) 和 FD。
手动把 UI Thread 或 RenderThread 固定到某个“大核”,会把 SoC 拓扑、热状态和厂商调度差异固化到代码中;无效工作本身仍要移除。
效果与证据边界
原文只写了“修复后各项指标正常”,没有披露修复后的卡顿率、线程数和 FD 数。因此可复核的结论到此为止:SDK 升级稳定复现了资源占用和卡顿指标的退化,二分和 CPU 统计指向新增 worker,SDK 修复消除了这些变化。“20% 回到某个百分比”这类说法,我们不自行补造。
案例四:SurfaceFlinger CLIENT 合成与显示链迟到
⚠️ 校勘:旧文将这组截图直接解释为“GPU 合成很慢”。原图展示的是 CLIENT 标记、missed frame 与 SF/HWC 处理区间;下文据此保留候选机制,GPU 执行时间需另行补证。
公开 trace 观察
AndroidPerformance 的系统案例展示了 hasClientComposition、FrameMissed 和较长的 SurfaceFlinger 处理区间;放大截图还把 HWC service 执行时间列为线索。独立 GPU 执行轨道和 App 侧的完整排除,都超出了这份旧现场的范围,要靠后面的重建步骤补齐。原始 Systrace 图片仍可访问:
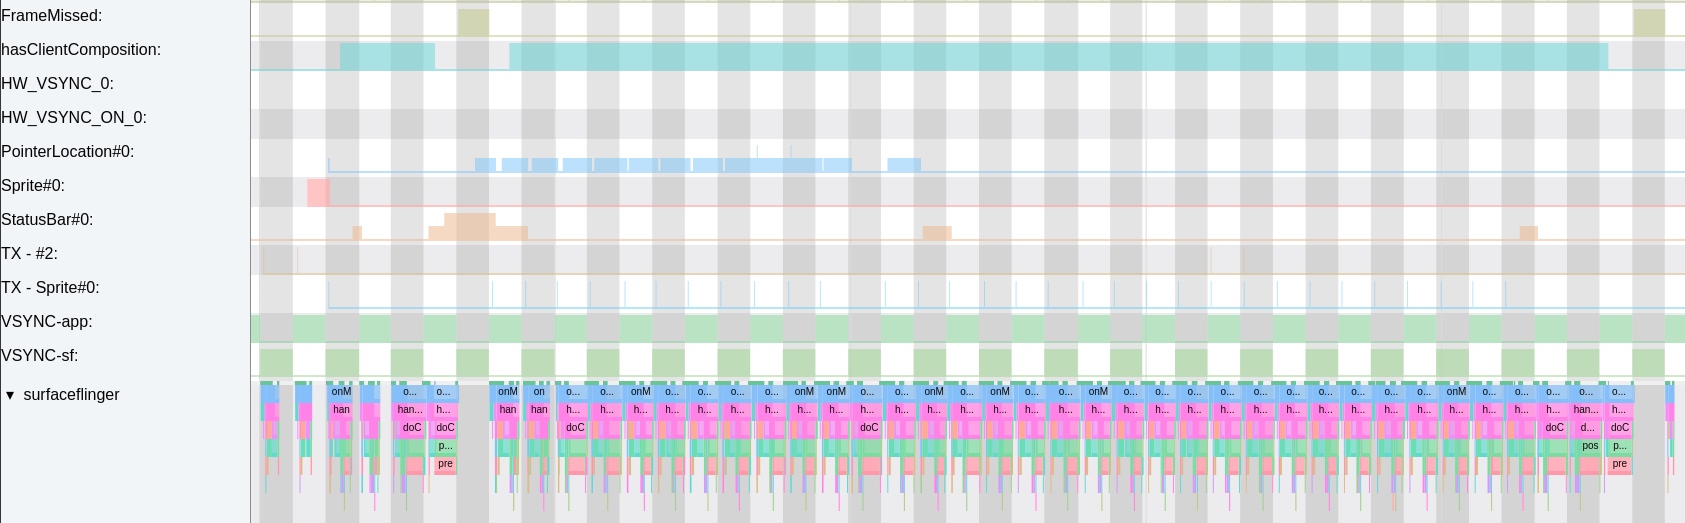
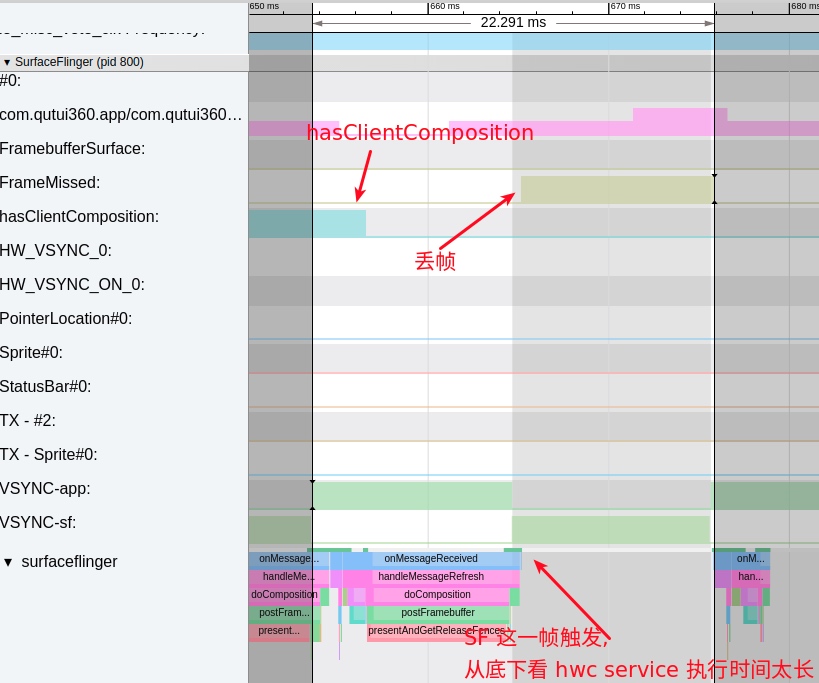
这是一份早于 FrameTimeline 的旧版 Systrace 现场。图片支持“CLIENT 合成参与时伴有 missed frame 与 SF/HWC 处理延迟”的观察;GPU 是否为最早瓶颈,以及 jank type、完整 layer 属性和 HWC validate/present 结果,需要当前平台的完整 trace 补齐。
Android 17 下怎样重建证据
在现代设备上,我们从目标 DisplayFrame 反查:
- App SurfaceFrame(应用 Surface 的帧记录) 是否按时提交;
- SurfaceFlinger 的
SurfaceFlingerCpuDeadlineMissed或SurfaceFlingerGpuDeadlineMissed是否与用户看到的帧对应; - HWC validate 后,哪些 layers 使用 DEVICE composition(显示硬件合成),哪些进入 CLIENT composition(SurfaceFlinger 使用 GPU 合成);
- CLIENT 帧中的
CompositionEngine/RenderEngine::drawLayers()和 GPU fence 等待是否变长; - 同一时刻的可见 layer 集合、格式、alpha、transform(变换)、crop(裁剪区域)、dataspace(颜色空间描述)、保护属性、刷新率和 display mode(显示模式);
- present fence 何时 signal(发出完成信号)。
CLIENT composition 只表示 SurfaceFlinger 需要把相关 layers 渲染进 client target,本身是正常且受支持的路径。CLIENT 分配变化、RenderEngine/GPU 时长和 missed DisplayFrame(错过截止时间的显示帧)在时间上相互对应,可形成合成压力的候选证据;还需沿 fence、线程状态和 HWC 调用定位最早迟到依赖,并用受控修改验证原因。
“屏幕上有五层、硬件只有四个 plane”这类观察离根因还有一段距离。plane 是显示硬件可独立处理的合成平面;AOSP 没有向普通应用提供固定的 overlay plane(硬件叠加平面) 数量查询接口。HWC 决策还受格式、缩放、旋转、混合、带宽和厂商策略影响。
修复
公开旧案例没有披露对应产品的代码改动和前后数据,这里不补造修复结果。针对同类现场,可验证的候选动作包括:
- 减少不必要的独立 Surface/Window;
- 避免让可合成 layer 带上没有视觉收益的 alpha、复杂 transform 或大面积 blur;
- 对视频/相机检查 SurfaceView、TextureView 和 overlay 的实际选择;
- 系统侧检查 HWC capability(硬件合成能力)、validate/present(能力校验/显示提交)、client target 和驱动 fence;
- 固定亮度、分辨率、刷新率与 layer 集后做前后 trace。
成功标准是目标设备上的 CLIENT/DEVICE 分配或 GPU 工作发生预期变化,同时 SurfaceFlinger jank type 和 present 的高分位耗时改善;App 主线程变短之外,还要看到显示侧指标的收敛。
Android 17 源码锚点是 SurfaceFlinger.cpp、CompositionEngine 的 Output.cpp、RenderEngine 和 HWComposer.cpp。详细步骤见 HWC Overlay Plane 与合成降级排查。
来源:Android 系统平台性能案例、Hardware Composer HAL。
案例五:Netmarble 根据热反馈维持持续帧率
现场与公开结果
Android Developers 的 Netmarble 案例介绍了《Game of Thrones: Kingsroad》在长时间高负载后出现热限制和帧率波动。团队逐项测量画质设置,发现动态分辨率比阴影、纹理等选项更适合承担主要的降负载任务;随后根据 ADPF Thermal API(温控接口) 同时调整分辨率和目标帧率。
官方案例披露的结果为:
- 平均 thermal headroom(预测热状态接近严重限温阈值程度的指标) 从 1.04 降到 0.92,降幅 11%;
- 未接入该策略时,热限制区间的帧率会在约 40–56 FPS 波动;
- 接入后,持续帧率通常保持在约 50–60 FPS;
- 动态目标帧率最低可降到 30 FPS,以避免不可持续的高负载。
这些数值来自官方开发者案例,页面没有完整列出设备覆盖、环境温度和样本分布;要用到其他游戏的 SLA(服务等级协议)上,需要按目标设备重新验证。
从现象到根因
温度升高和频率下降同时出现,还只是并存现象;要坐实 thermal 是最早原因,我们需要下面这些证据:
- 相同内容和输入下,frame time(单帧耗时) 随会话时间变差;
- thermal status/headroom(温控等级/热余量) 或 cooling state(冷却状态) 同期变化;
- CPU/GPU 可用容量减少或频率上限降低;
- 内存泄漏、后台负载、亮度和充电条件已记录;
- 冷却或降低工作量后,持续 frame time 恢复。
Netmarble 先测量不同画质项对热负载的影响,再选择动态分辨率,从而明确收到热信号后应该减少哪项工作。
修复
Thermal API 提供 thermal status 与 headroom。应用需要自行决定降低哪些负载,例如 render scale(渲染分辨率比例)、阴影、后处理、粒子、视距、模拟频率或 target FPS(目标帧率)。调整策略应加入滞回(升档和降档使用不同阈值),并设置最短保持时间,防止系统在阈值附近反复重建资源。
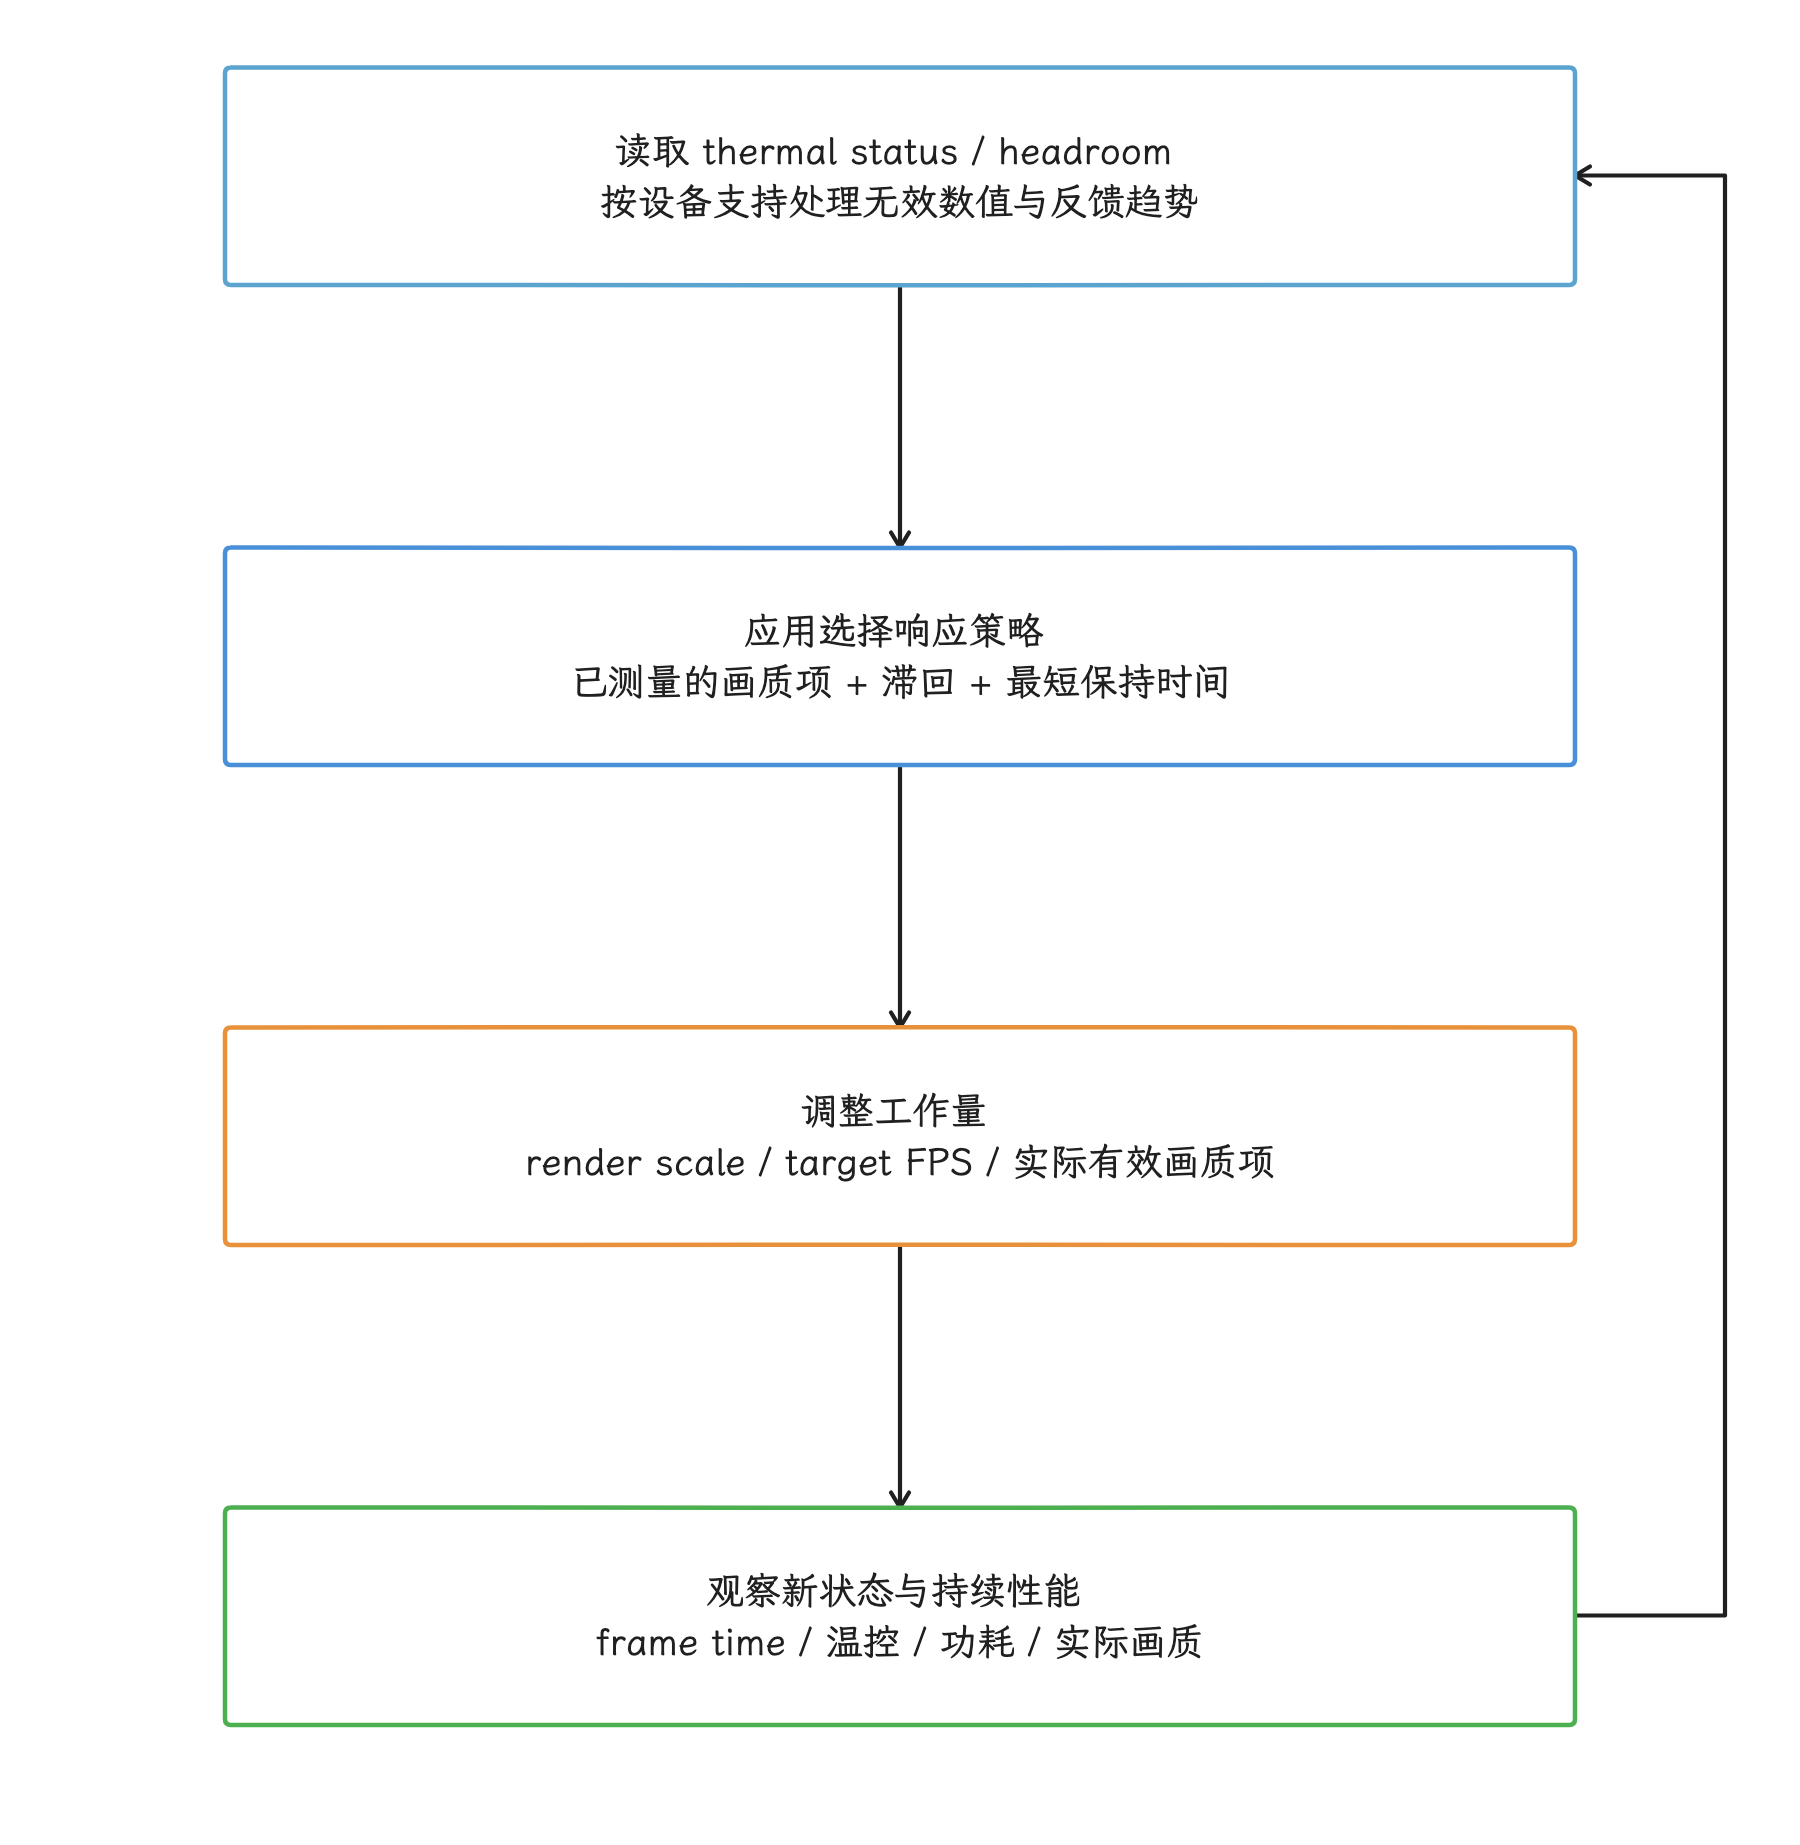
图:应用根据热反馈主动调整实际工作量,并用滞回和保持时间稳定档位。Performance Hint 是调度提示;持续帧率还取决于负载、设备容量和热保护,频率与绑核由系统侧决定,提示本身给不了这个保证。
ADPF Performance Hint Session(性能提示会话) 可以报告参与周期性工作的一组线程,以及 target duration(目标耗时) 和 actual duration(实际耗时)。它向系统提供的是调度提示;频率是否锁定或提高、CPU 是否绑定,都由系统侧决定,热保护仍可能限制性能。
官方最佳实践建议进行长时间运行测试,至少覆盖 15 分钟,以观察温度和性能趋于稳定后的状态。测试还要固定亮度、充电状态、环境温度、网络和游戏内容。
效果与 Android 17 边界
这个案例的收益来自提前降低长期维持不住的负载,画质和目标帧率本身也发生了变化。比较时要同时报告画质档位、实际 render scale、目标/显示/提交帧率、功耗和 thermal headroom,只比较平均 FPS 会漏掉关键差异。
Android 17 / API 37 继续提供 Thermal API、ADPF 与 CPU/GPU headroom 相关能力。设备支持和厂商映射仍有差异;getThermalHeadroom() 返回 NaN(无有效数值) 时,要考虑调用间隔或设备不支持。相同的热状态等级也换算不成统一的 CPU/GPU 频率。
来源:Netmarble ADPF 案例、ADPF Thermal API、ADPF 最佳实践。
五个案例放在一张责任表里
| 案例 | 用户侧结果 | 最早异常证据 | 责任边界 | 修复类型 |
|---|---|---|---|---|
| WeSing 进房 | 进入阶段多次长停顿 | 一条 UI message 聚集 312 ms 创建及其他任务 | 应用主线程与初始化架构 | lazy、异步、预热、按依赖分阶段 |
| 进退房内存 | 使用时间越长越卡 | 对象无法释放、GC/分配压力 | 应用生命周期;另查整机内存 | 断引用、停动画、限制缓存 |
| SDK 线程退化 | 新版本卡顿率上升 | +30 个线程、+250 个 FD、worker CPU 上升 | SDK 并发与调度竞争 | 移除无关功能、有界线程池 |
| SF CLIENT/显示链 | 历史截图含 missed frame | hasClientComposition、SF/HWC 长区间;GPU 尚需补证 | SurfaceFlinger/HWC/GPU | 按最早依赖验证 layer 条件或 HWC/驱动 |
| Netmarble 热限制 | 长会话帧率波动 | thermal headroom 与持续性能 | 应用负载、Power/Thermal HAL(功耗/温控硬件抽象层)、SoC | 动态分辨率与目标帧率 |
表中的“责任边界”不表示团队归属。应用 layer 属性可能增加显示侧成本,系统内存压力也会放大应用 I/O;这个字段表示下一步需要哪类证据和修改权限。
Android 17 复现实验清单
App 主线程、GC 与调度
- FrameTimeline、目标 CUJ 和应用 marker;
- UI Thread、RenderThread、Binder、sched wakeup/switch;
- ART GC pause、allocation、HeapTaskDaemon(ART 堆任务线程);
- Java/native/graphics memory(Java/原生/图形内存)、heapprofd、PSI;
- 线程 CPU time、Runnable latency、FD 与任务队列。
SurfaceFlinger 与 HWC
- SurfaceFlinger FrameTimeline、layers、transactions;
- target layer(目标图层) 的 buffer/frame number(缓冲区/帧序号) 与 acquire fence;
- DEVICE/CLIENT composition、client target;
- RenderEngine/GPU 与 present fence;
- display id(显示屏标识)、刷新率、亮度和分辨率。
Thermal
- thermal status/headroom、CPU/GPU headroom;
- CPU/GPU frequency(频率)、idle、调度与 ADPF session(会话);
- 实际画质、render scale、target FPS 与提交节奏;
- 环境温度、充电、亮度和至少覆盖热稳定点的测试时长。
ART、AndroidX、WebView、游戏引擎、GPU/HWC 与 OEM 策略还要记录各自版本。旧 Systrace 案例可以帮助识别现象,当前结论必须由目标 build 的 Perfetto、Winscope 或厂商数据重新验证。
相关章节
- 卡顿原因
- MainThread、RenderThread 与 Hardware Layer
- FrameTimeline Perfetto 分析
- Perfetto SQL Cookbook
- BufferQueue 阻塞分析
- 多窗口渲染
- 优化策略
- 热节流适配与性能降级治理
- 系统内存压力与 lmkd
- Android Thermal
- ADPF
- 视频 Overlay 与 HWC
参考资料
分析方法
- Perfetto FrameTimeline
- Perfetto CPU scheduling events
- Perfetto trace configuration
- PerfettoSQL standard library
- Perfetto trace processor
- Perfetto SDK
- Android FrameMetrics API
- Android JankStats
- AOSP Android 17 FrameMetrics.java
- AOSP Android 17 FrameTimeline.cpp
- AOSP Android 17 frames/timeline.sql
- AOSP Android 17 binder.sql
- Android 17 kernel Binder tracepoints
典型场景
- Slow rendering:RecyclerView trace labels 与常见处理
- AndroidX Fragment transactions
- SplashScreen API
- Predictive Back gesture
- Create a custom notification layout
- Winscope overview
- Winscope tables and Shell transitions
- Frame pacing
- SurfaceFlinger and WindowManager
- Hardware Composer HAL
- AOSP Android 17 Choreographer
- AOSP Android 17 FrameTimeline
- AOSP Android 17 Shell transitions
- AOSP Android 17 TaskSnapshotController
- Android common kernel sched tracepoints
- Android common kernel dma-fence
案例来源
- Android 深入卡顿分析与实践
- Android App 自身导致的卡顿案例
- Android 系统平台导致的卡顿案例
- Android 低内存案例
- ComponentCallbacks2
- Netmarble ADPF 案例
- ADPF Thermal API
- ADPF 最佳实践
- AOSP Android 17 SurfaceFlinger
- AOSP Android 17 CompositionEngine Output
- AOSP Android 17 HWComposer
- AOSP Android 17 PowerManager
- Android common kernel PSI
- Android common kernel reclaim