ADPF 自适应性能框架
Android 动态性能框架(Android Dynamic Performance Framework,ADPF)是一套应用与系统之间的反馈接口:应用上报周期性工作的目标和实际耗时,读出设备的热状态和容量余量,据此驱动降级策略,再用帧时间、能耗与温升复测系统是否做出了更合适的调度。对应用来说,它是一条表达需求的通道,而非固定升频开关。
为什么需要 ADPF
移动设备的峰值性能同时受 SoC、供电和散热限制,而应用负载一直在变:游戏可能在多人对战、粒子效果集中出现或资源流式加载时突然变重,地图、相机和视频编辑也有类似的周期性负载。内核侧已经有利用率估计、UClamp 这些需求信号,它们做的事也比被动回看历史要多;只是应用下一周期的完整工作量与业务期限,只有应用自己清楚,ADPF 补上的正是这块应用侧信息。
高刷新率会放大这段响应延迟。120 Hz(每秒 120 次) 的显示周期约为 8.33 ms,而这一段要分给输入处理、应用逻辑、RenderThread(渲染线程)、GPU、SurfaceFlinger(系统合成服务) 和最终的显示提交,一次渲染独占不了整个周期。某个线程组突然多出几毫秒工作,当前帧可能就已经错过显示时限。
ADPF 在应用与系统之间增加了两类信号:
- 性能提示接口(Performance Hint API):应用报告周期性工作的目标时长、实际时长和线程集合(thread set),系统据此尝试调整这些线程的调度与性能。
- 热状态接口(Thermal API)与 CPU / GPU 余量接口(Headroom API):应用读取设备约束,提前降低分辨率、特效、帧率或后台负载。
应用持续报告结果,系统调整后续周期,新的结果再继续修正策略,这就是 ADPF 的反馈回路。Game Mode 和 Game State 在这之上补充用户偏好与当前游戏阶段。
这些信号表达的是应用侧需求,系统这边的承诺很有限:具体的运行频率、哪颗 CPU 核、多快提频,都留给平台自己决定——Android 17 的电源 AIDL 契约就明确允许平台按自身策略实现,框架通过 Power HAL 这个硬件抽象层访问到的,是设备自己的电源策略实现。
所以接入时我们要留好退路:设备可能不支持 ADPF、只支持其中部分能力,热约束也可能优先于性能请求。
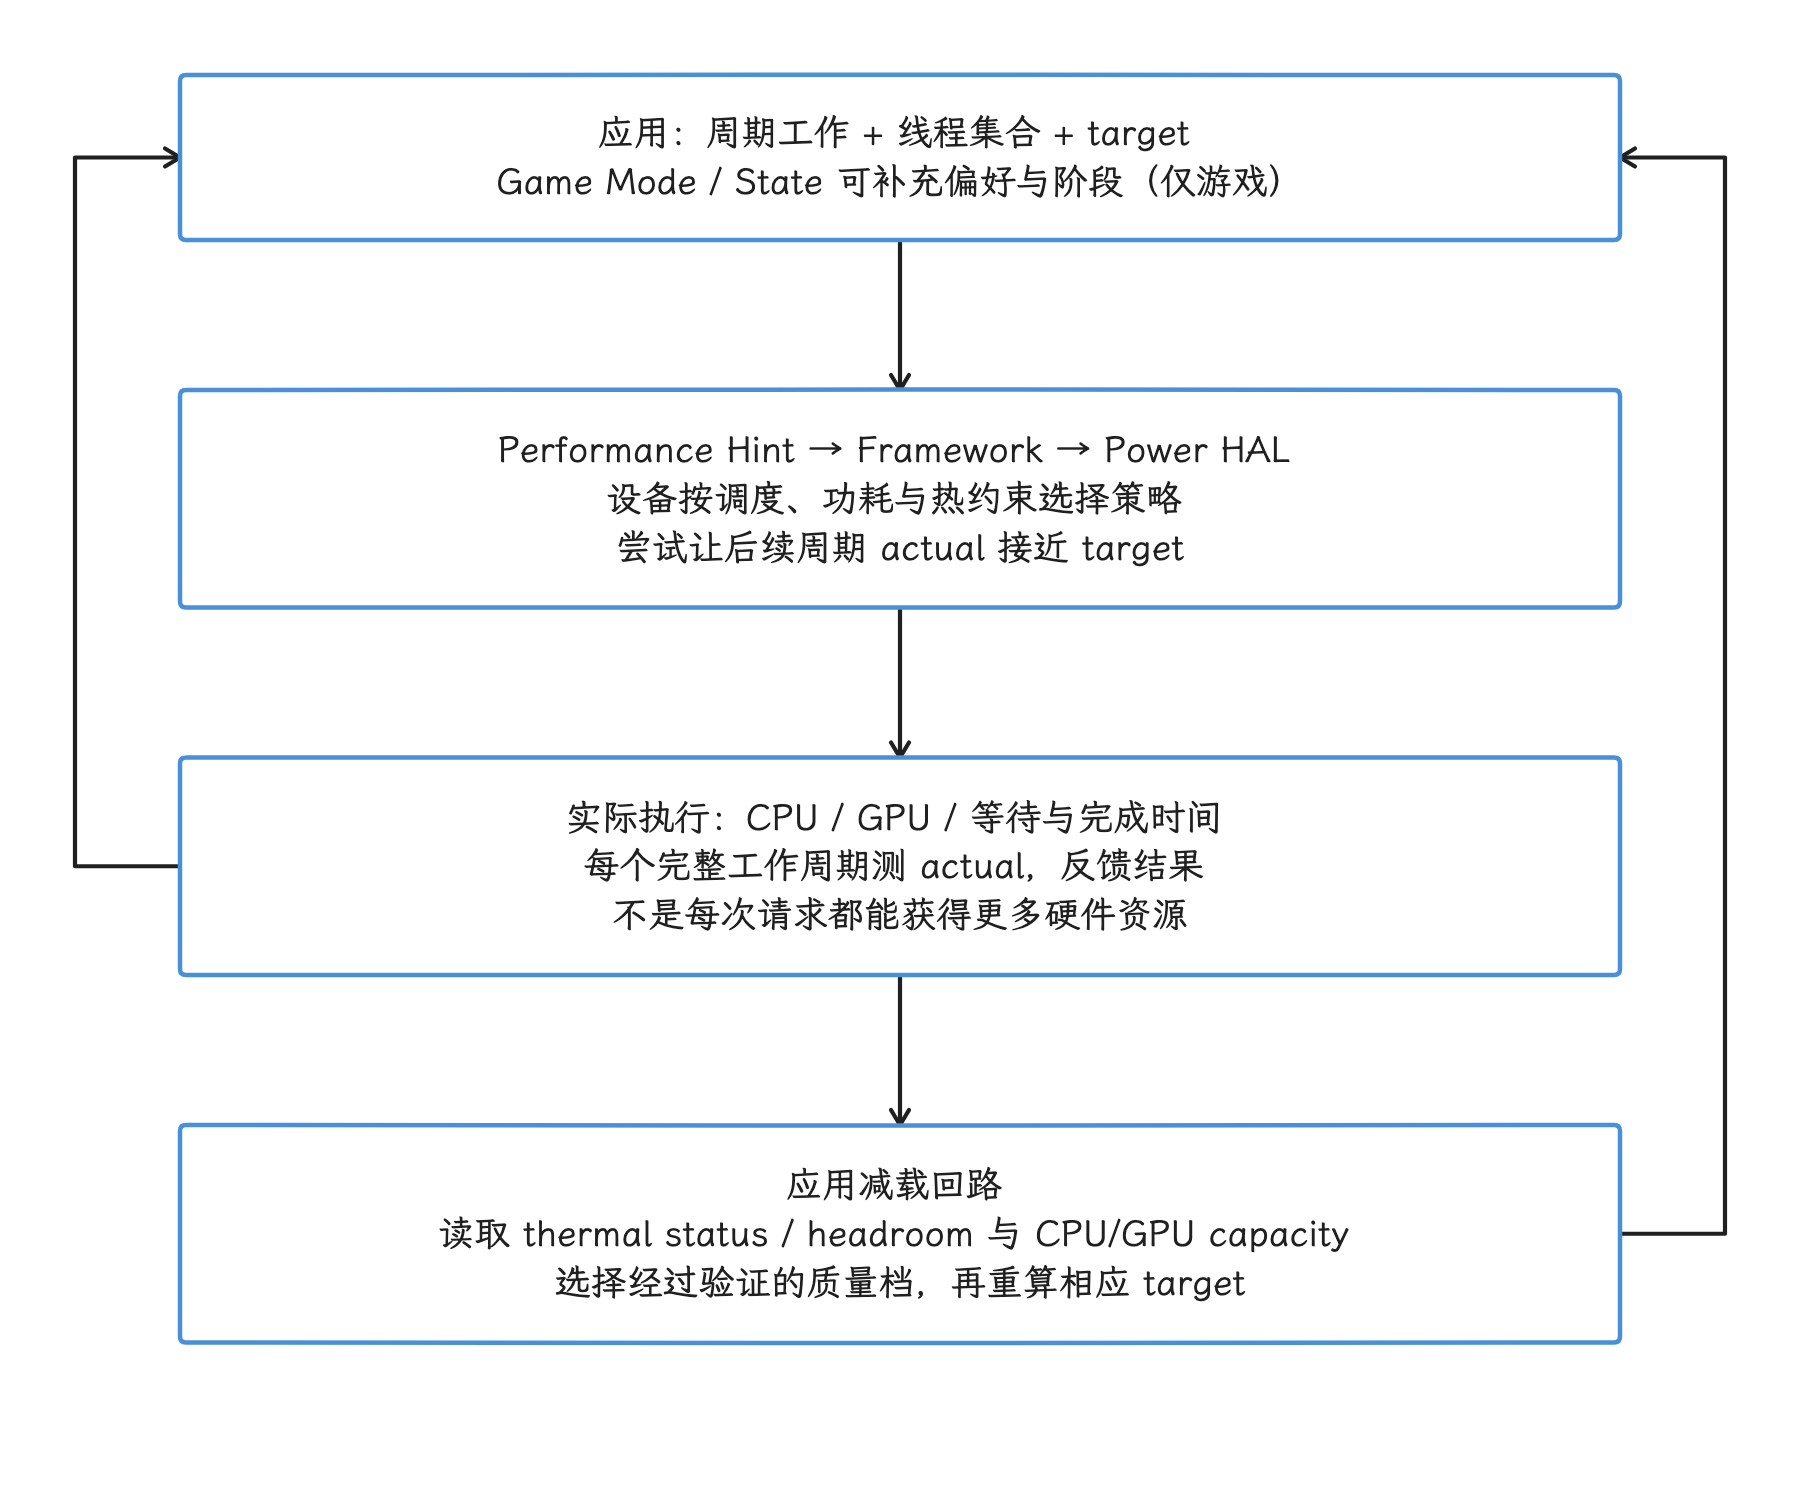
图:应用向 HintSession 提交线程集合、目标和实际工作时长,系统尝试为后续周期调整资源;应用同时读取容量与热约束,决定减少哪些工作。前者反馈实际结果,后者改变工作需求,两者需要共同验证。公开契约里没有频点、CPU 核或响应时间的保证,已经错过的帧也补不回来。
Performance Hint API:周期性工作的反馈回路
这一节我们按“建 session、定 target、报 actual”的顺序,把反馈回路的每一环走一遍。
HintSession、target duration 与 actual duration
Java 入口是 PerformanceHintManager.Session:一个 session(会话)绑定一组线程,替它们保存周期性的性能目标。我们先看创建:传入这组线程的 Linux 线程 ID(TID)和初始目标工作时长(target work duration),返回 null 可能表示设备不支持 HintSession、TID 校验失败或创建链路失败,要结合参数和系统日志定位;参数错误则更直接,空数组和非正 target 会在 Java 层抛出 IllegalArgumentException。放进 session 的线程,应当关系紧密、生命周期较长、周期性执行。
target work duration 表示这组线程希望在每个周期内完成工作的时长,通常小于完整显示周期。我们拿 60 Hz 渲染算一下:显示周期约 16.67 ms,如果 session 里的线程只负责其中 6 ms 的 CPU 工作,target 就应接近 6 ms;直接填 16.67 ms,系统会高估这组线程的时间余量。Android 17 的 IPower.createHintSession*() 注释用的也是“60 Hz 渲染、目标工作时长 6 ms”这个例子。
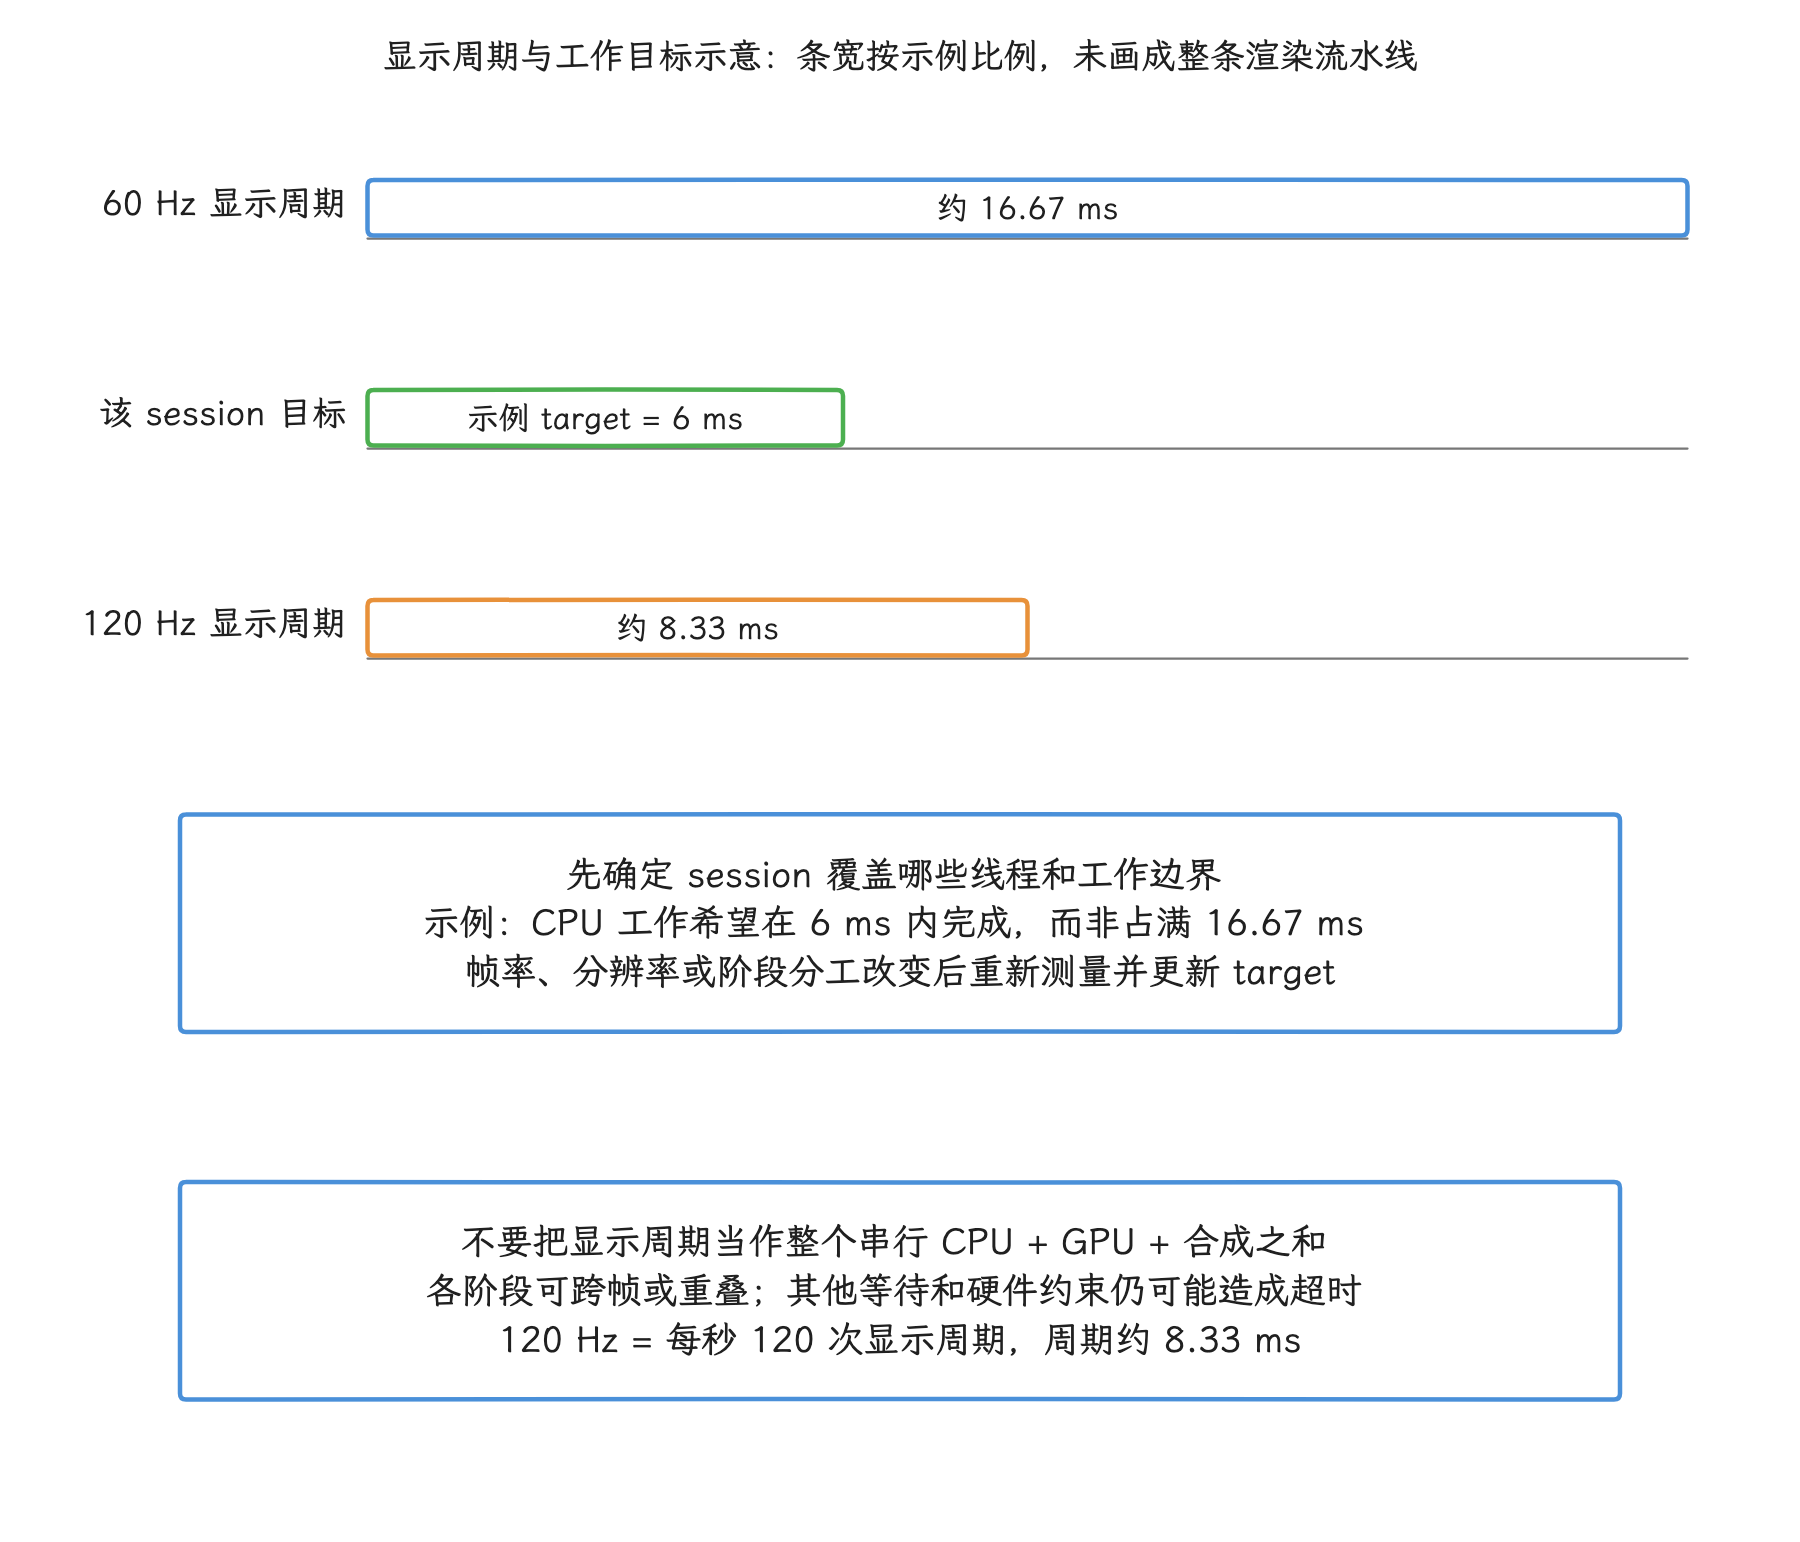
图:60 Hz 的显示周期约 16.67 ms,示例 session 的 CPU 工作目标只有 6 ms;120 Hz 的显示周期约 8.33 ms。target 应从这组线程对应的工作预算中得到,而非机械填写整帧周期。GPU、合成和显示提交还有自己的期限,流水线也可能重叠或跨帧,图中的条宽只是预算示例。
下面的代码走一个基本反馈周期:创建 HintSession,渲染一帧,再上报实际工作时长(actual duration)。renderTid 要在实际执行工作的线程里取得,或由应用自己的线程管理器提供;Java Thread.getId() 与 Linux TID 是两套编号,这里要的是后者。
// API 31+;在场景开始时创建,并在场景结束时释放。
// 本例中所有 Session 调用都在同一个受控线程串行执行。
PerformanceHintManager manager =
        getSystemService(PerformanceHintManager.class);
int renderTid = android.os.Process.myTid(); // 当前执行 CPU 工作的 Linux TID
long targetWorkNanos = 6_000_000L;
PerformanceHintManager.Session session = manager == null ? null :
        manager.createHintSession(new int[] {renderTid}, targetWorkNanos);

try {
    while (renderer.hasNextFrame()) { // 应用自己的场景循环
        long start = System.nanoTime();
        renderer.renderCpuPhase(); // 只测与该 target 对应的 CPU 工作段
        long actual = System.nanoTime() - start;
        if (session != null && actual > 0) {
            session.reportActualWorkDuration(actual);
        }
    }
} finally {
    if (session != null) {
        session.close();
    }
}
这段代码在同一场景内复用 session,每个 CPU 工作周期完成后才上报;创建失败仍正常渲染,结束时显式关闭。API 31 以下直接走没有 session 的渲染路径。系统拿 actual 与 target 比较,尝试调整这组线程跑在哪些 CPU 核上、以什么频率运行,让后续周期接近目标。
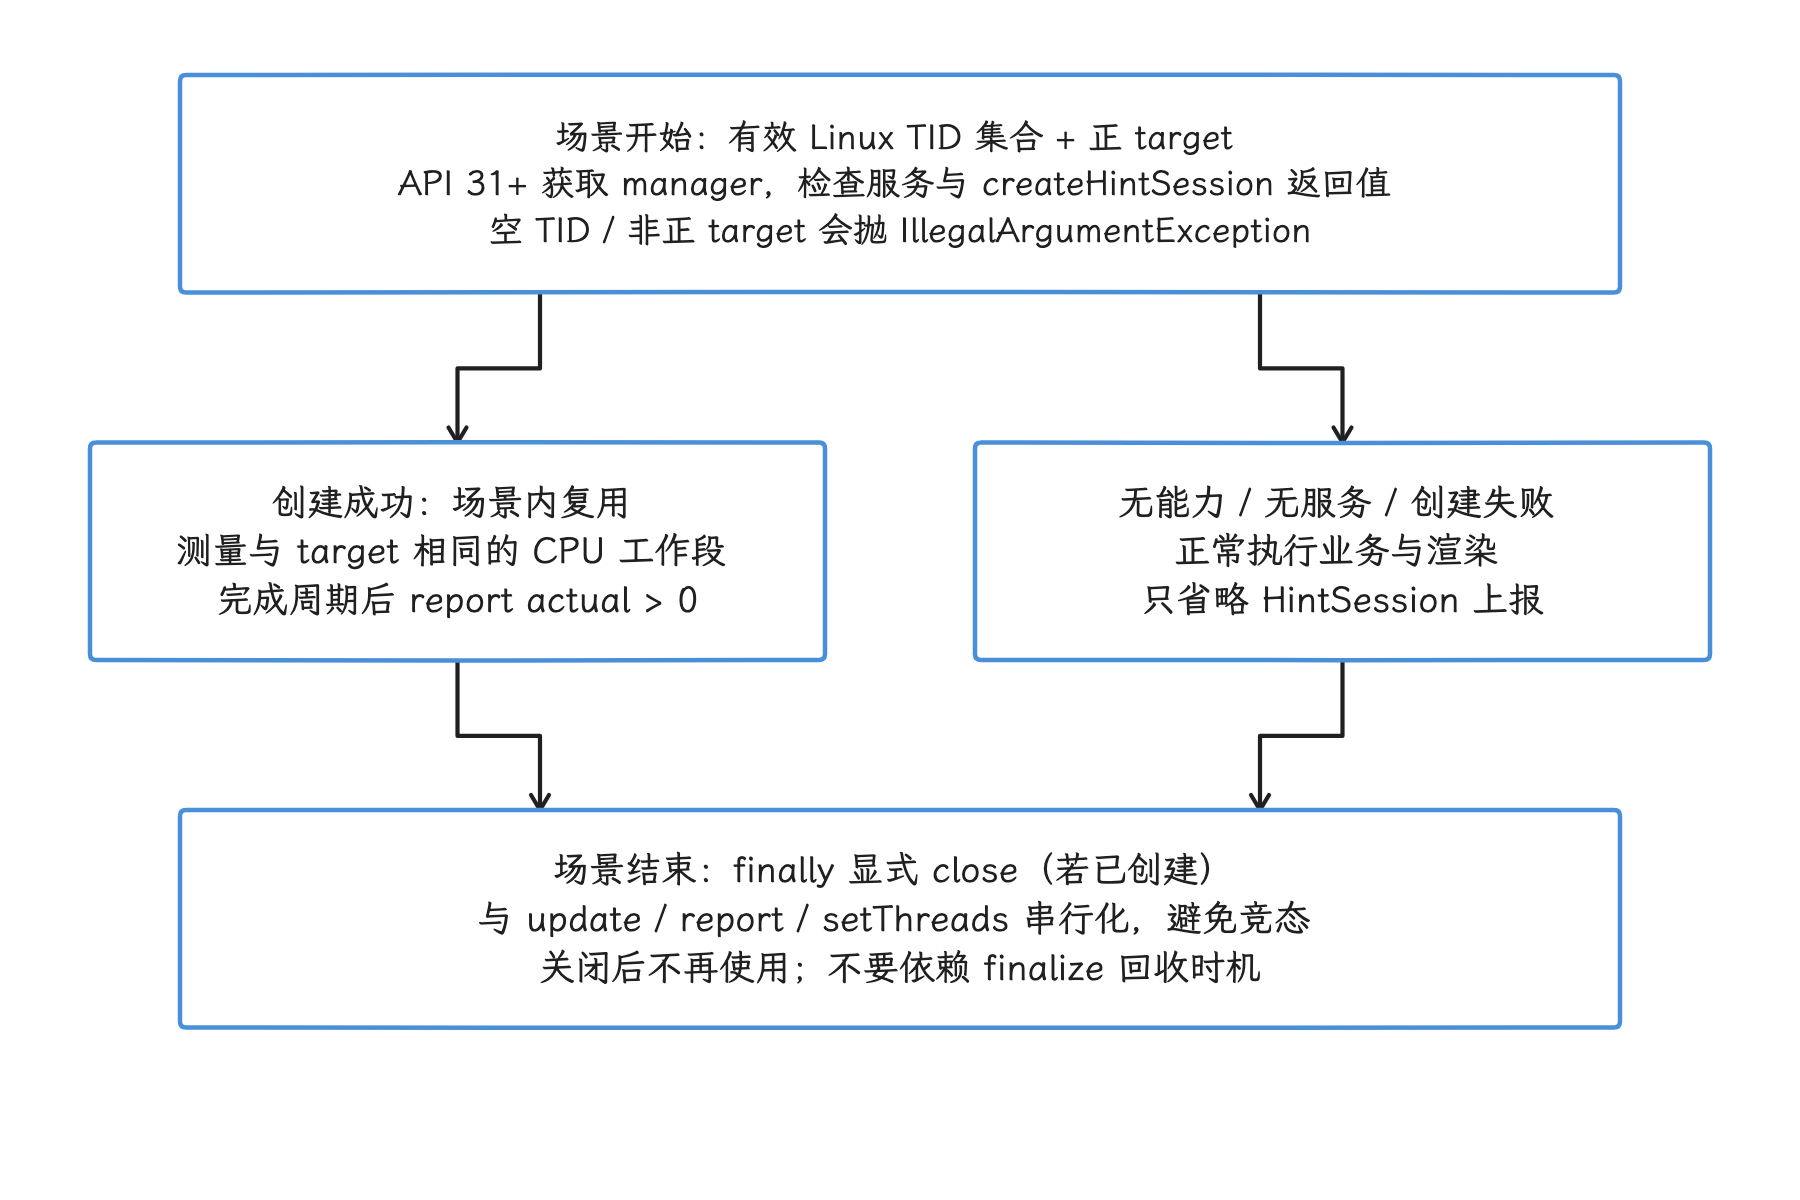
图:在场景开始时用实际执行线程的 Linux TID 和正 target 创建 session,成功后在多个周期中复用。无服务、无能力或创建失败时仍执行业务,只省略提示上报;参数错误要记录并修正。结束时显式 close,更新、上报与关闭由同一受控序列处理,会话按场景复用,逐帧新建或关闭后继续使用都属于误用。
事后上报救不回已经超时的工作。负载突增如果可以预测,应用要提前调整自身策略;用 NDK 的应用还可以发送 Android 16 新增的工作负载提示(workload hint)。
目标改变时就调用 updateTargetWorkDuration()。帧率、渲染比例或流水线(pipeline)分工一变,这组线程可用的工作预算就要重新测量;1000 / fps 算出的是整帧周期,直接拿来生成固定数值,就会重复前面高估余量的问题。
TID、协程与 setThreads()
HintSession 绑定的是 Linux TID(Thread ID,线程 ID),协程 ID、Java Thread.getId() 和任务 ID 都替代不了它。Kotlin 协程可能在 Dispatchers.Default 或 Dispatchers.IO 的不同工作线程之间迁移,而原 session 保存的线程集合不会自动跟着更新——session 里留的还是创建时的旧线程。
实践中可以这样做:
- 周期性性能任务用受控的固定线程或自有线程池,TID 从实际执行工作的线程上取。
- Android 14(API 34)以后用
Session#setThreads(int[])替换线程集合。 - API 31—33 上线程集合已经失真时,关闭旧 session,再用当前 TID 创建新 session。
setThreads() 同步执行 IHintManager.setHintSessionThreads(),校验 TID 并替换线程集合;API 文档列出了空数组、TID 归属和前后台状态这些异常情况。r1 服务端在 UID 不允许更新时会暂存新 TID,等恢复后再提交,因此调用返回也不证明 HAL 已立即更新。只在线程组成或场景变化时更新,不要每次协程调度都调用。Session 的更新、上报和 close() 还必须由应用串行化;Java 与 NDK 文档都没有承诺会话方法线程安全。
从 Java API 到 Power HAL 的调用链
以 android-17.0.0_r1 为准,Java API 要经过本地代码、系统服务和 Power HAL,才到达设备实现:
PerformanceHintManager.Session
  → android_os_PerformanceHintManager.cpp
  → libandroid.so / performance_hint.cpp
  → Binder 服务 IHintManager(performance_hint)
  → HintManagerService
  → IPower / IPowerHintSession AIDL
  → 设备 Power HAL 实现
其中 JNI 文件通过 dlopen("libandroid.so") 动态加载库,再用 dlsym() 查找 APerformanceHint_* 函数符号;NDK 实现随后连接名为 performance_hint 的 Binder 系统服务。
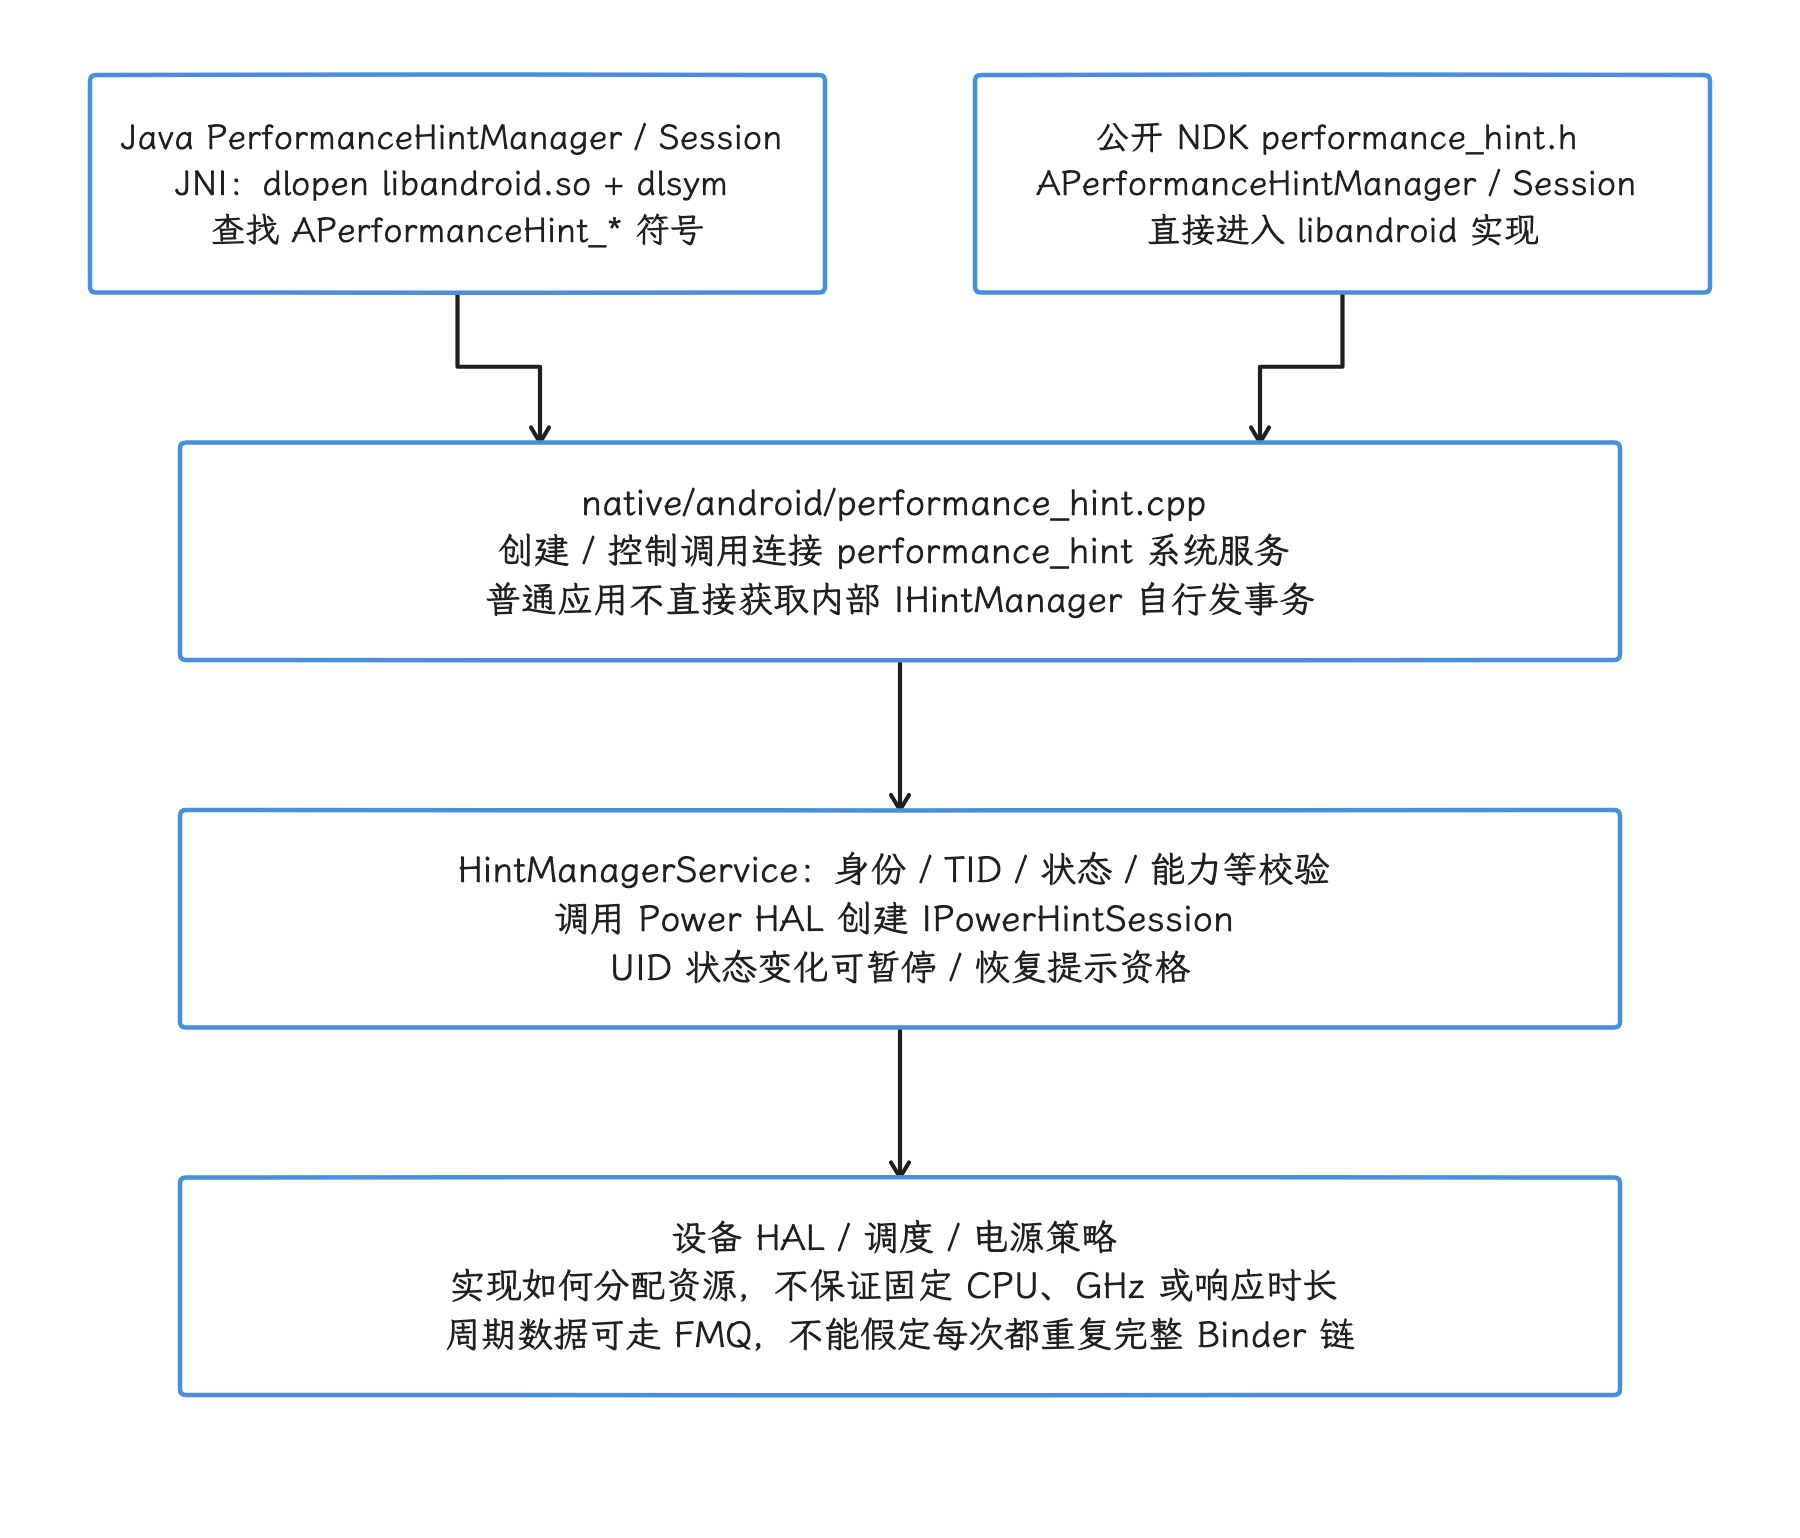
图:Java Session 经 JNI 动态查找 libandroid 的 APerformanceHint 符号,NDK 可直接使用这些 native 入口。创建、线程更新等控制操作连接 performance_hint 服务,由 HintManagerService 校验并创建 HAL 会话;设备策略才决定实际资源响应。IHintManager 是内部 Binder 接口,普通应用使用公开 Java 或 NDK API。
创建 session 后,周期性更新可以走快速消息队列(Fast Message Queue,FMQ);FMQ 不可用时,退回 IHintSession 的 oneway Binder 调用。排查这条链路时,我们可以分三层看:
- 应用是否创建了有效 session,TID、target 和 actual 填得对不对。
- framework 是否接收、校验并保持住了 session,应用的 UID 是否仍处于允许状态。
- 设备的 Power HAL 是否支持 HintSession,收到信号后如何响应。
无论上报路径走 FMQ 还是 oneway Binder,应用侧代码都要经过 JNI、锁、参数校验和客户端批处理。合适的调用频率是“每帧或每个任务周期一次”,为每个很小的子任务单独创建 session 或反复上报并不划算。
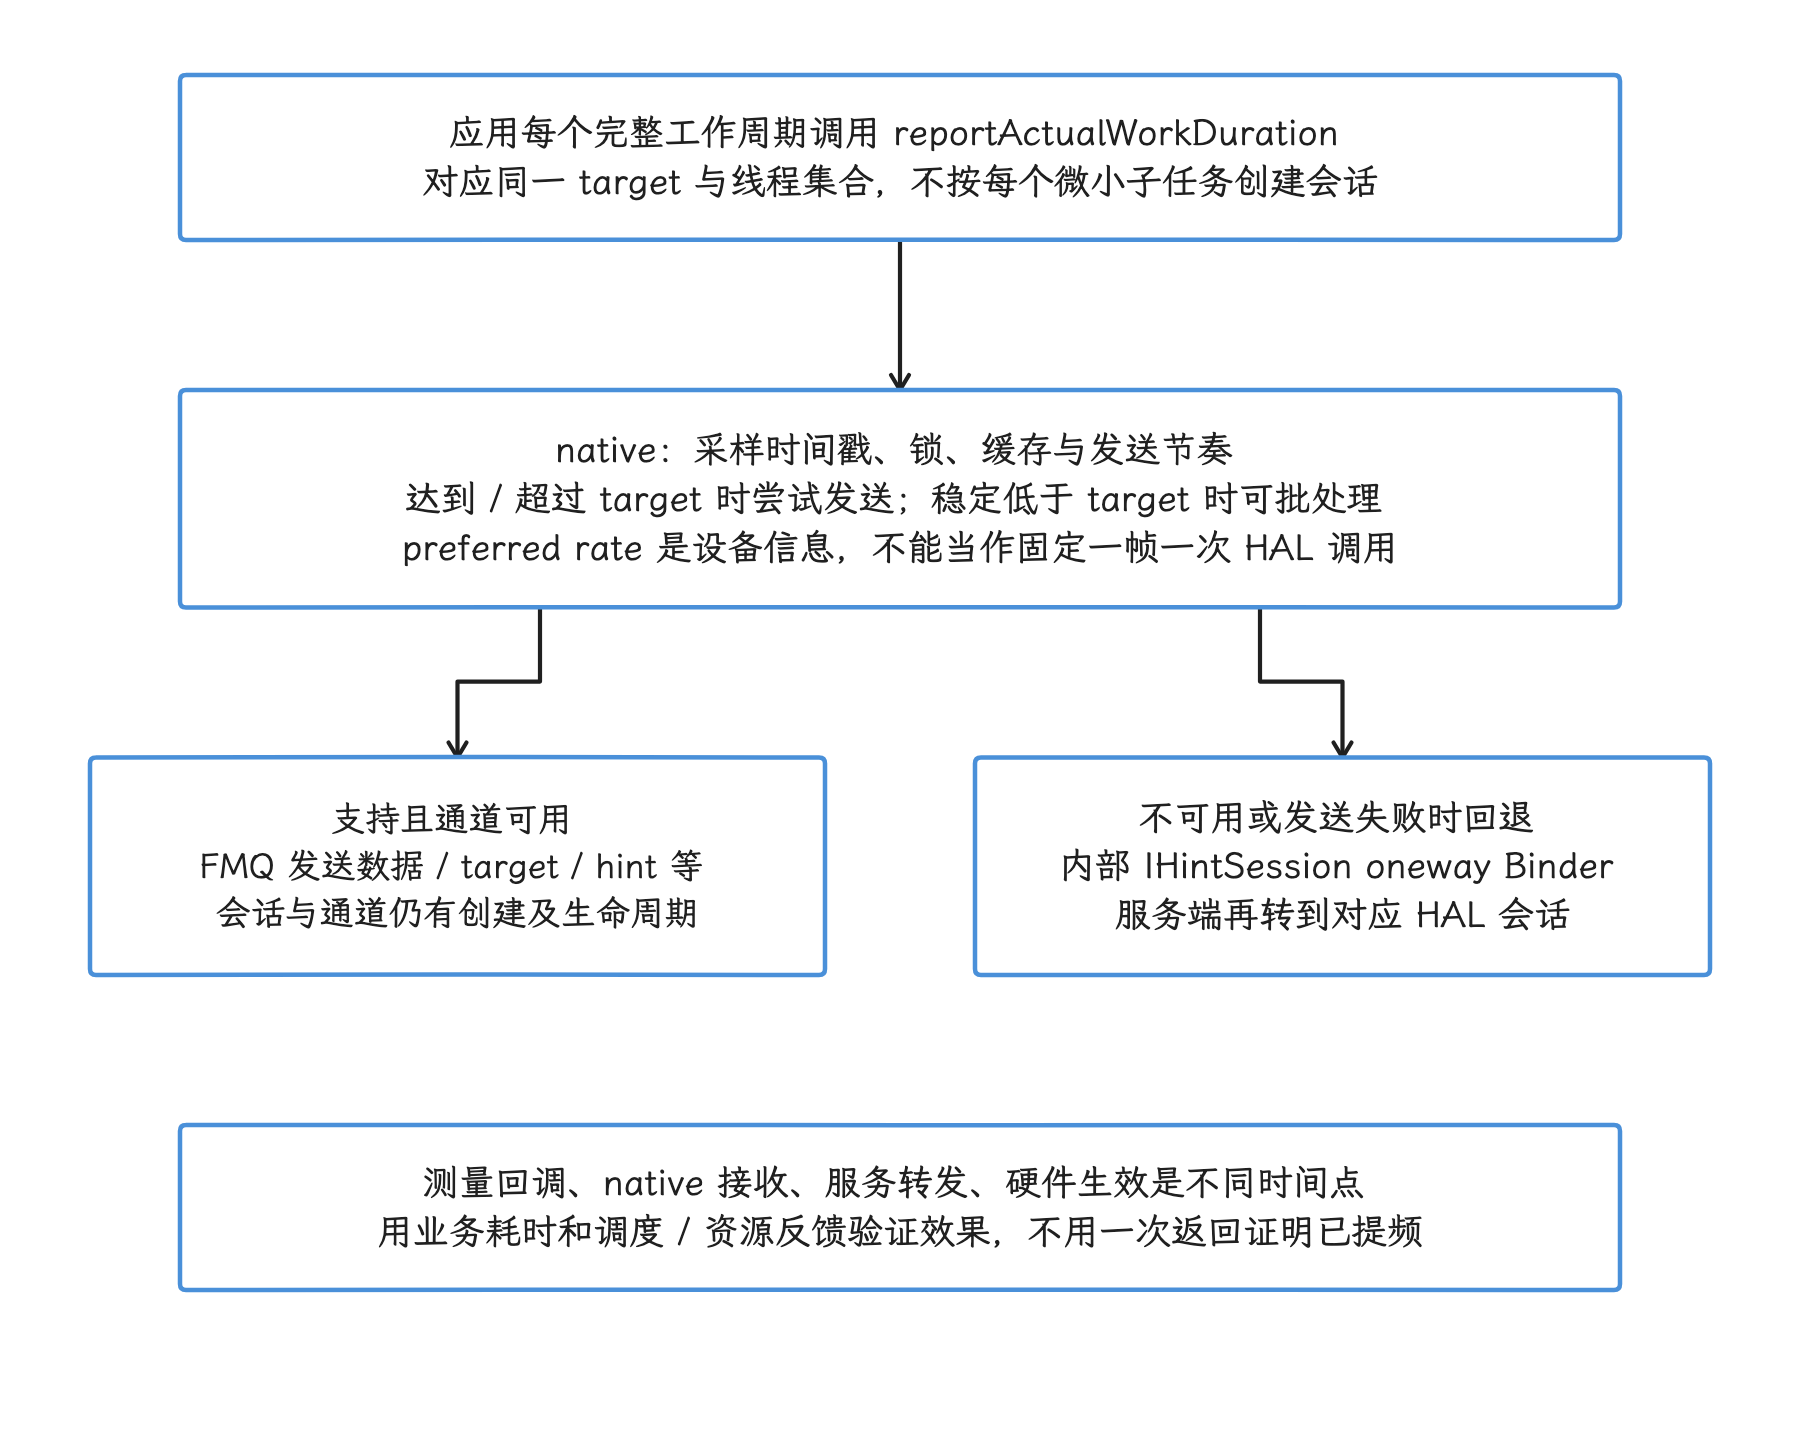
图:应用每个周期测量并调用 report,native 客户端可按目标是否达到及 preferred rate 缓存样本,再批量发送。符合条件时使用 FMQ,否则退回 IHintSession 的异步 Binder 路径。通道减少跨层成本,但参数校验、锁和批处理仍在;oneway 也不保证无阻塞、无开销或立即执行。
WorkDuration:拆分 CPU 与 GPU 工作
要把一个周期里 CPU 和 GPU 各占多少分开看,就要用 Android 15(API 35)公开的 reportActualWorkDuration(WorkDuration)。WorkDuration 把一个工作周期拆成工作周期开始时间、总墙钟时长(wall time)、CPU wall time 和 GPU wall time,系统据此区分 CPU-bound、GPU-bound,以及 CPU/GPU 阶段重叠的流水线。上报接口本身是公开能力;设备能否据此产生明显收益,仍取决于系统和 Power HAL 支持。
这组字段的时间基准与 SystemClock.uptimeNanos() 一致。开始时间和总时长必须大于 0,CPU / GPU 时长取非负值,且两者至少有一个大于 0。下面的代码分别填写这四项数据并完成一次上报:
// API 35+
WorkDuration duration = new WorkDuration();
duration.setWorkPeriodStartTimestampNanos(workStartNanos);
duration.setActualTotalDurationNanos(totalWallTimeNanos);
duration.setActualCpuDurationNanos(cpuWallTimeNanos);
duration.setActualGpuDurationNanos(gpuWallTimeNanos);
session.reportActualWorkDuration(duration);
这段代码要求调用方先测得同一工作周期的开始时间和各项时长。GPU 工作段的起止点测不准的应用,继续使用 reportActualWorkDuration(long),比填写猜测值更可靠。
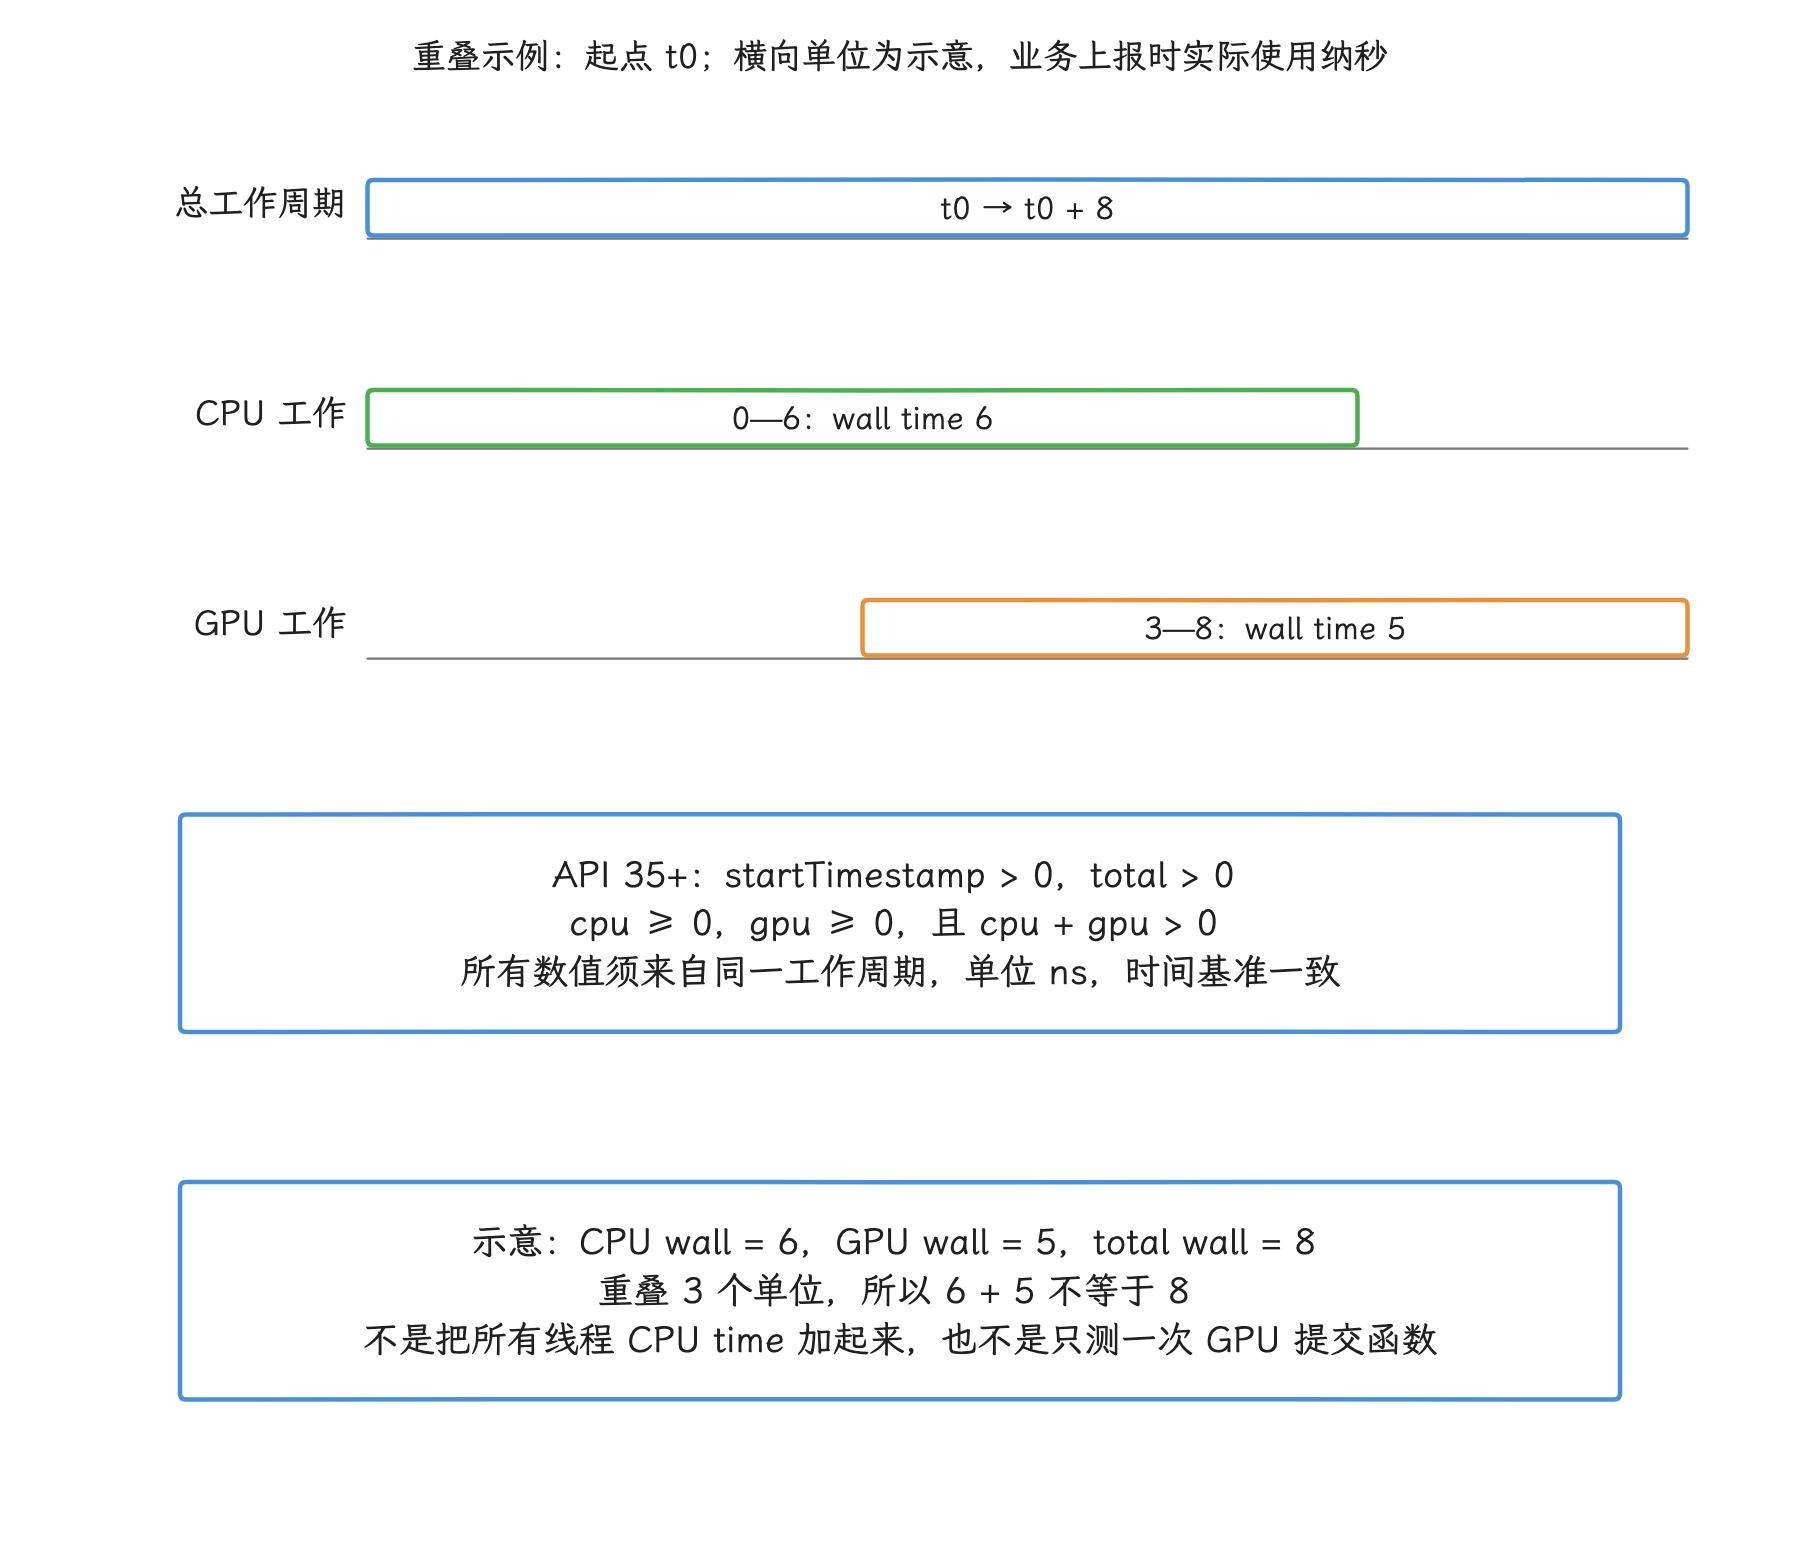
图:WorkDuration 使用 uptime/CLOCK_MONOTONIC 时间基准,记录同一周期的起点、总 wall time 与 CPU/GPU wall time。CPU 和 GPU 阶段可以重叠,因此两者之和不一定等于 total,也不是线程 CPU time 的简单累加。起点和总时长须为正,CPU/GPU 非负且至少一项为正;GPU 边界测不准时应保留可靠的 CPU 周期报告。
能效模式:Session#setPreferPowerEfficiency()
除了上报时长,session 还能声明节能偏好:Session#setPreferPowerEfficiency(boolean) 从 API 35 起公开。开启后表示这组线程可以优先采用节能调度,工作完成得稍慢也能接受。它适合周期明确、允许延长完成时间的任务;视频处理、同步或推理是否适用,要按产品的延迟目标判断,业务名称本身说明不了问题。
Android 16 workload hint
周期性的 target / actual 之外,突发负载也有专门的信号:NDK performance_hint.h 在 API 36 增加三组公开函数:
APerformanceHint_notifyWorkloadIncrease():预计下一周期 CPU、GPU 或两者负载显著增加时提前发送。APerformanceHint_notifyWorkloadReset():工作即将开始或负载特征完全改变时,通知系统不再沿用此前的负载判断。APerformanceHint_notifyWorkloadSpike():标记一次性的高开销周期,告诉系统别把它当成长期负载。
系统对这些 hint 的发送频率有按应用计的限制;设备不支持的 hint 可能被静默忽略;调用仍需检查返回码,限流可返回 EBUSY,服务通信失败可返回 EPIPE,CPU 与 GPU 同时请求按两条 hint 计数。这些提示应在工作周期开始前或尽早发送,晚到时可能被理解为下一周期;它们适合原因明确的大幅变化,持续高负载仍应通过 target / actual 反馈表达。
Java sendHint() 及 CPU_LOAD_*、GPU_LOAD_* 常量属于测试 API(@TestApi)或隐藏接口,普通应用不要依赖它们。
Headroom API:CPU/GPU 容量余量
报完了需求,接下来看怎么读约束。Android 16(API 36)的 SystemHealthManager#getCpuHeadroom() 与 getGpuHeadroom() 返回 0—100 的容量余量(headroom):0 表示在所选计算窗口与参数下没有更多可授予的对应资源;暂时不可用可返回 Float.NaN,设备不支持时则抛出 UnsupportedOperationException。这两项接口回答“当前计算资源还有多少余量”,和 Thermal Headroom 回答的是两个问题。
传入 null 表示使用默认参数。每次有效调用至少包含一次同步 Binder 往返,应用要停下来等系统服务返回结果;官方文档提示这一趟可能超过 1 ms,第一次调用或使用非默认参数时还可能更慢。所以我们要把查询放在工作线程里做,并遵守 getCpuHeadroomMinIntervalMillis() 与 getGpuHeadroomMinIntervalMillis() 给出的最小间隔。
调用间隔过短时可能拿到缓存值。要指定计算窗口或 CPU TID,先查询设备支持的窗口范围,再处理参数、TID 归属和 CPU 亲和性(affinity,即线程允许运行在哪些 CPU 上)校验的异常。CPU / GPU Headroom 适合在场景切换时或以较低频率调整质量,不适合放进渲染关键路径。
Thermal API:先读懂状态,再决定降级
Thermal Status 的语义
Headroom 读的是余量,Thermal API 给的是系统当前的热状态。应用侧 Java 入口位于 PowerManager:getCurrentThermalStatus() 直接返回当前等级,addThermalStatusListener() 在等级变化时回调。等级描述平台报告的热严重程度;r1 的普通应用整体 status 主要取 SKIN 传感器的最严重状态,各 CPU/GPU 域的限制情况,未必都完整反映在这一个等级里;NONE 之下某个芯片域也可能已经受限。源码里这些等级的定义如下:
| 状态 | 平台语义 | 应用侧常见处理 |
|---|---|---|
NONE | 未处于 thermal throttling | 维持当前策略 |
LIGHT | 轻度限制,用户体验尚未受影响 | 记录趋势,减少可延后工作 |
MODERATE | 中度限制,体验尚未受到大幅影响 | 逐步降低高功耗选项 |
SEVERE | 严重限制,体验会明显受影响 | 立即切入经过验证的保守配置 |
CRITICAL | 平台已尽力降低功耗 | 保留关键交互与数据完整性 |
EMERGENCY | 关键组件因热状态开始关闭,设备能力受限 | 尽快保存状态,停止非必要工作 |
SHUTDOWN | 设备需要立即关机 | 不再假设后续工作能够完成 |
表中最后一列的常见处理只是工程起点。画质、帧率、相机能力或推理负载具体降多少,我们要经过设备实测,并配上滞回(hysteresis,升档和降档用不同阈值)与最短冷却时间,免得状态在阈值附近波动时频繁切换。
Thermal Headroom 的数值与采样
PowerManager#getThermalHeadroom(int forecastSeconds) 主要使用设备外壳表面温度等变化较慢的传感器,参数范围是 0—60 秒。返回值 1.0 表示当前或预测将达到 THERMAL_STATUS_SEVERE;值可以大于 1.0,但 1.0 以上没有固定的状态映射,0.0 也不对应某个绝对温度。
API 文档给出的使用限制是:
- 采样频率高于约 1 Hz 没有收益,明显更快时可能返回
NaN。 - 初次采样后的几秒内样本不足,接口可能只返回当前 headroom,暂不提供有效预测。
- 预测越远,不确定性越高。
NaN也可能表示设备不支持该能力。
游戏开发指南建议约每 10 秒采样一次,适合大多数持续负载。下面的代码在独立线程中定期读取 10 秒预测值和当前 Thermal Status,并把无效预测保留为未知值:
ScheduledExecutorService thermalWorker =
        Executors.newSingleThreadScheduledExecutor();

thermalWorker.scheduleWithFixedDelay(() -> {
    float forecast = powerManager.getThermalHeadroom(10);
    int status = powerManager.getCurrentThermalStatus();
    // 即使 forecast 为 NaN,仍要处理 SEVERE 等当前状态。
    applyThermalPolicy(status, forecast);
}, 0, 10, TimeUnit.SECONDS);
applyThermalPolicy() 必须始终处理当前 status,把 NaN 预测当作未知而不是正常或零值;策略动作应提交到相应的渲染或 UI 线程。它还需实现滞回、冷却时间和设备标定,场景结束时关闭 executor,避免遗留轮询。
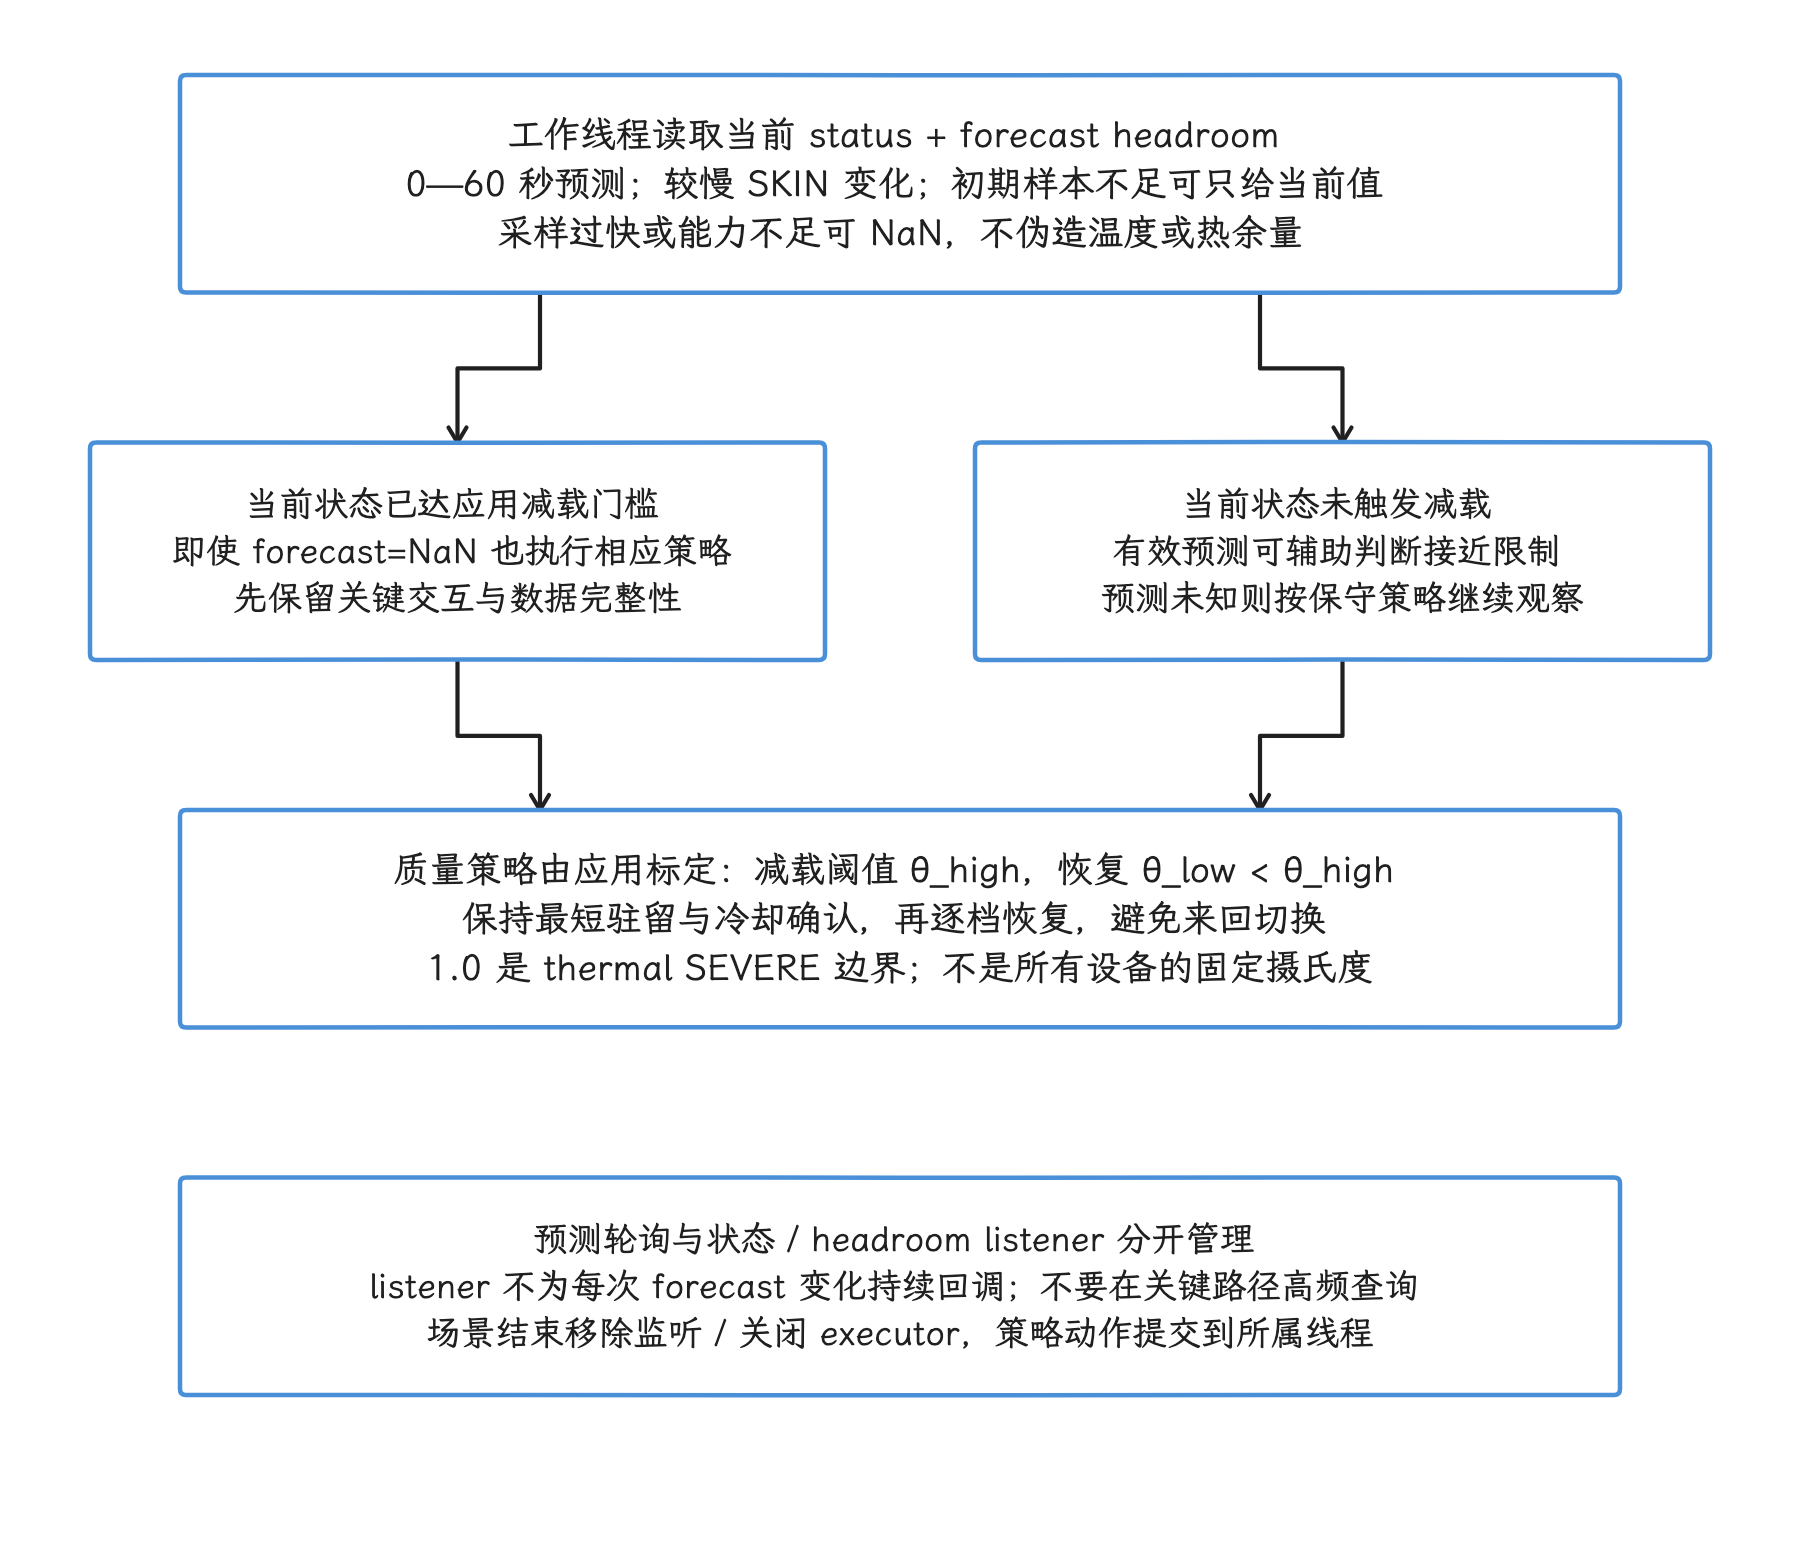
图:采样时始终处理当前 thermal status。预测为 NaN 时保留未知状态,SEVERE 等当前等级照常处理,NaN 也保持未知而非填成零。有效预测可辅助提前减载;恢复应使用更低阈值、冷却确认和逐档策略。10 秒轮询只是指南起点,策略动作需交给所属工作线程执行。
API 35 的 getThermalHeadroomThresholds() 返回设备定义的状态阈值。Android 16 起,这张阈值表可能在运行期间变化;Java addThermalHeadroomListener() 与 NDK AThermal_registerThermalHeadroomListener() 可以接收 headroom 或阈值的显著变化。不过监听器(listener)不会仅因预测值变化就持续回调,主动预测还是要靠低频轮询。
Thermal、CPU/GPU Headroom 与 Performance Hint 的分工
三类信号回答不同问题:
- Performance Hint:这组线程希望在多长时间内完成周期性工作。
- CPU/GPU Headroom:当前计算资源还有多少可授予容量。
- Thermal Status/Headroom:设备已经进入什么热限制,以及接近严重限制的趋势。
CPU 频率没有上升,未必是 HintSession 失效:当前资源可能已经足够,设备也可能受 GPU、内存带宽、功耗或热限制约束。我们要做的,是在同一时间范围内对照工作时长、调度、频率和 thermal 数据。
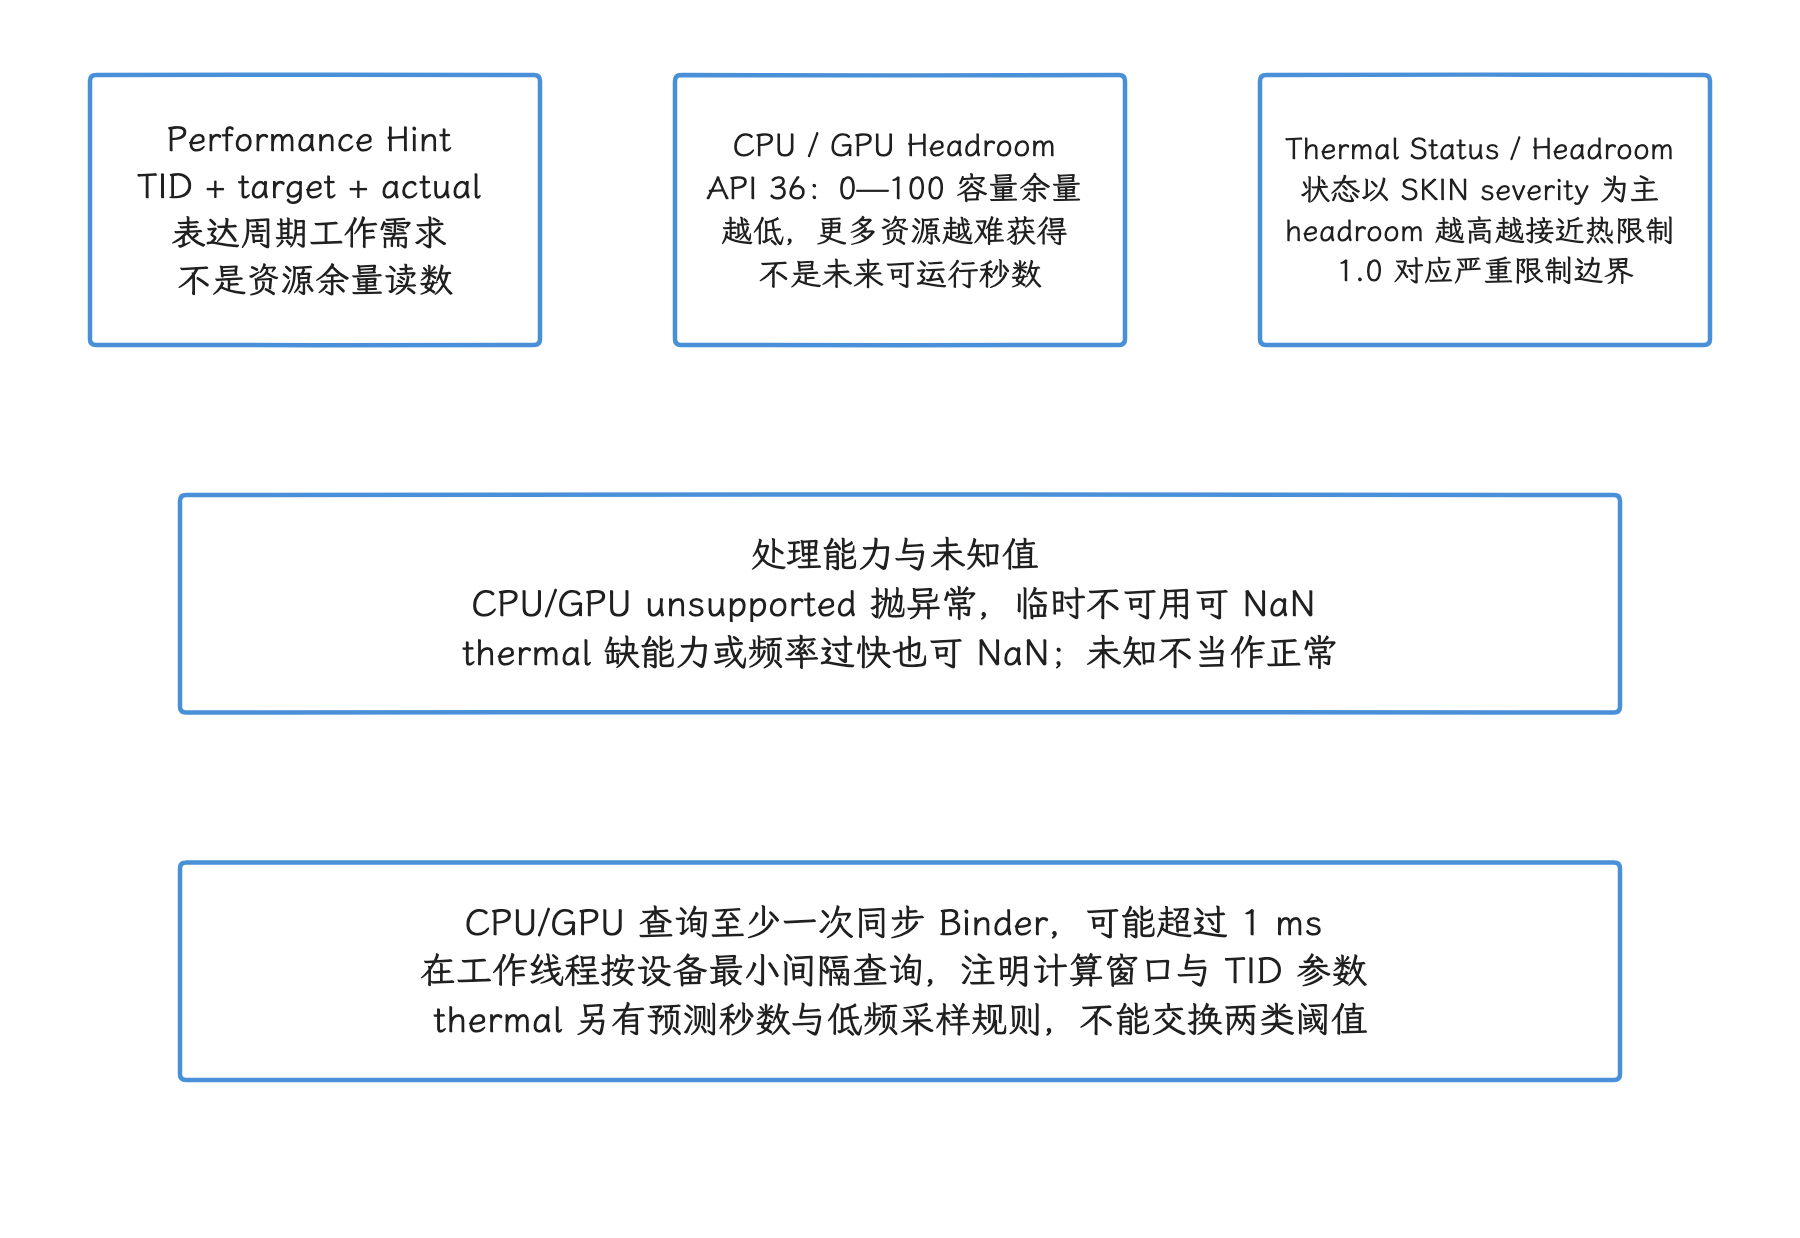
图:Performance Hint 表达完成期限,CPU/GPU Headroom 表达所选计算窗口与参数下的容量余量,Thermal Headroom 表达接近严重热限制的程度。CPU/GPU 值低意味着容量更紧,thermal 值高意味着更接近限制。热状态正常时 GPU 仍可能满载,计算尚有余量时机身也可能已接近继续升温的上限,应结合实际周期表现判断。
Game Mode 与 Game State
Game Mode 表达用户想要什么,Game State 表达游戏正在哪个阶段。
Game Mode 表达用户偏好
GameManager#getGameMode() 从 Android 12(API 31)起公开,首批只覆盖部分设备;Android 13 及以后设备提供更一致的可用范围。应用需要声明为游戏(game),并在每次 onResume() 后重新查询模式。部分设备类型可能不提供 GameManager 服务,拿到系统服务后仍要检查返回值是否为空。
模式值表达用户偏好或平台状态,不对应一套固定的画质参数:
GAME_MODE_STANDARD:使用游戏默认策略。GAME_MODE_PERFORMANCE:优先低延迟和稳定高帧率,通常要在帧率与单帧画质之间重新取舍。GAME_MODE_BATTERY:优先续航,可降低目标刷新率、帧率或部分画质。GAME_MODE_UNSUPPORTED:当前应用或设备不支持。GAME_MODE_CUSTOM:Android 14 起由平台处理用户自定义配置;目标 SDK 较旧时还存在兼容返回规则。
Performance 模式直接固定为 120 FPS 和最高画质并不可取:较高帧率往往需要降低每帧渲染成本。应用应切换到预先测试过的配置档(profile),并同步更新帧呈现节奏(frame pacing)、渲染配置和 HintSession target。下面的示例在 Activity 恢复时查询模式,并选择对应配置档:
@Override
protected void onResume() {
    super.onResume();
    GameManager gameManager = getSystemService(GameManager.class);
    if (gameManager == null) {
        applyGameProfile(GameProfile.DEFAULT);
        return;
    }
    switch (gameManager.getGameMode()) {
        case GameManager.GAME_MODE_PERFORMANCE:
            applyGameProfile(GameProfile.HIGH_FRAME_RATE);
            break;
        case GameManager.GAME_MODE_BATTERY:
            applyGameProfile(GameProfile.LONG_PLAY);
            break;
        default:
            applyGameProfile(GameProfile.DEFAULT);
    }
}
这段代码处理了设备不提供 GameManager 的情况,API 31 以下仍应直接使用默认配置。游戏声明支持 Performance / Battery Game Mode 时,要自行实现相应调整,平台会优先采用游戏优化。把 supportsPerformanceGameMode / supportsBatteryGameMode 设为 false,含义是本游戏不自行实现该模式,平台可以评估 OEM 干预;它和显式禁用某项 intervention 的配置是两回事,别当成同一个“退出”开关。FPS throttling、backbuffer resize 等动作仍应按设备和配置分别验证。
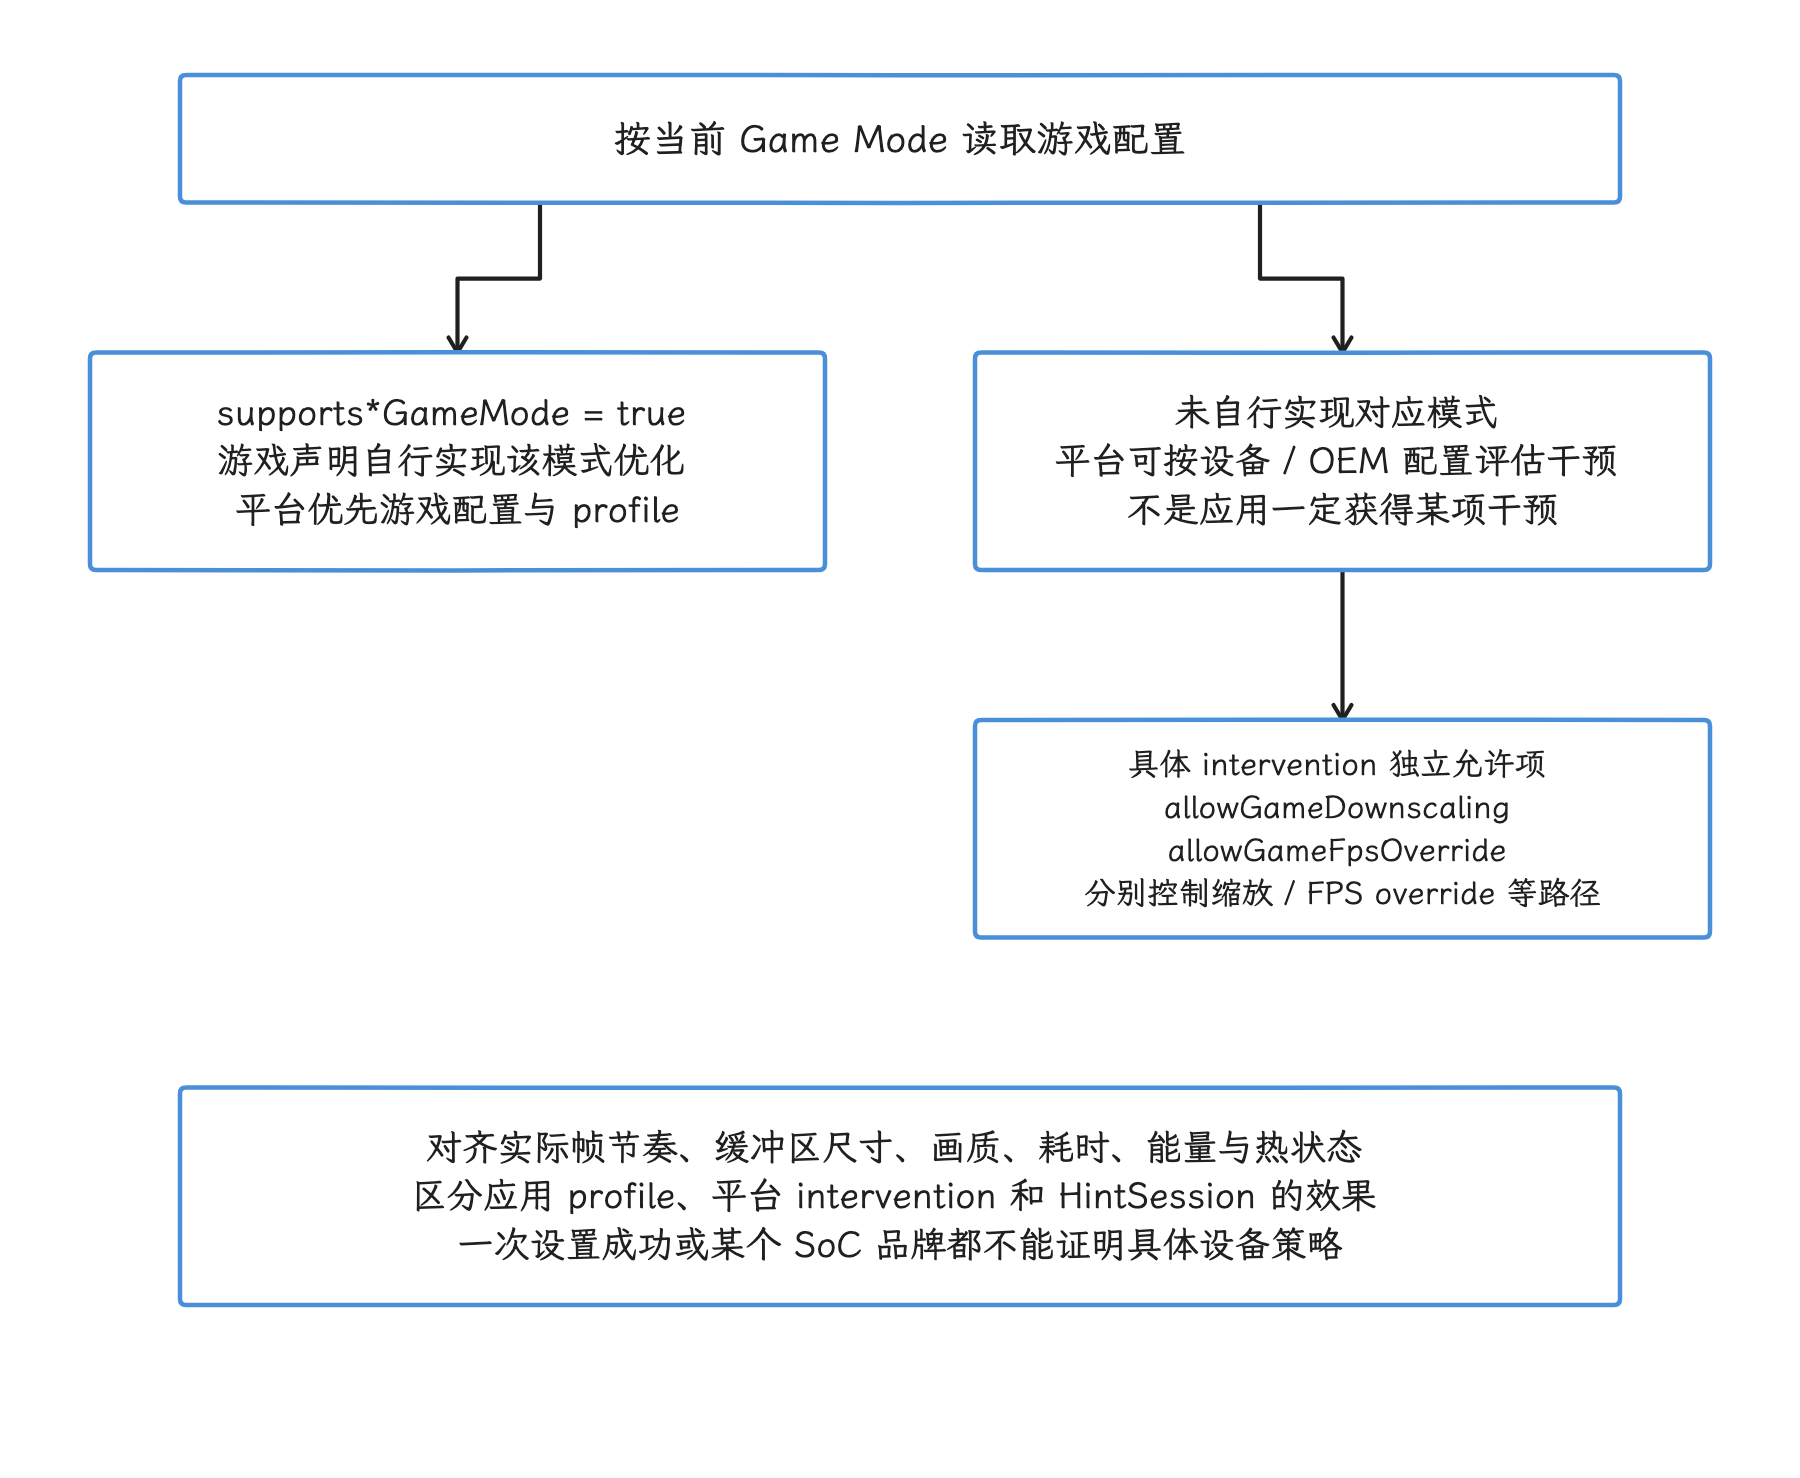
图:声明支持某 Game Mode 时,游戏应实现该模式优化,平台优先采用游戏策略。supportsPerformanceGameMode 或 supportsBatteryGameMode 为 false,表示未自行实现,可让平台评估 OEM 干预;它与 allowGameDownscaling、allowGameFpsOverride 等具体允许项不同。最终效果要在目标设备核对,各开关含义不同,统称“退出模式”会掩盖差异。
Game State 表达当前阶段
Android 13(API 33)增加 GameManager#setGameState(GameState)。GameState 包含:
isLoading:是否处于加载阶段。mode:菜单 / 非活动、可中断 gameplay、不可中断 gameplay 或内容展示。label、quality:可选的开发者自定义整数标识。
下面的代码将当前阶段上报为不可中断的实时对战:
GameState state = new GameState(
        false,
        GameState.MODE_GAMEPLAY_UNINTERRUPTIBLE);
gameManager.setGameState(state);
MODE_CONTENT 用于游戏内广告、网页、文字或视频等非 gameplay 内容;普通视频、地图或相机应用没有游戏语义,直接使用 Performance Hint 与 Headroom API 就好。
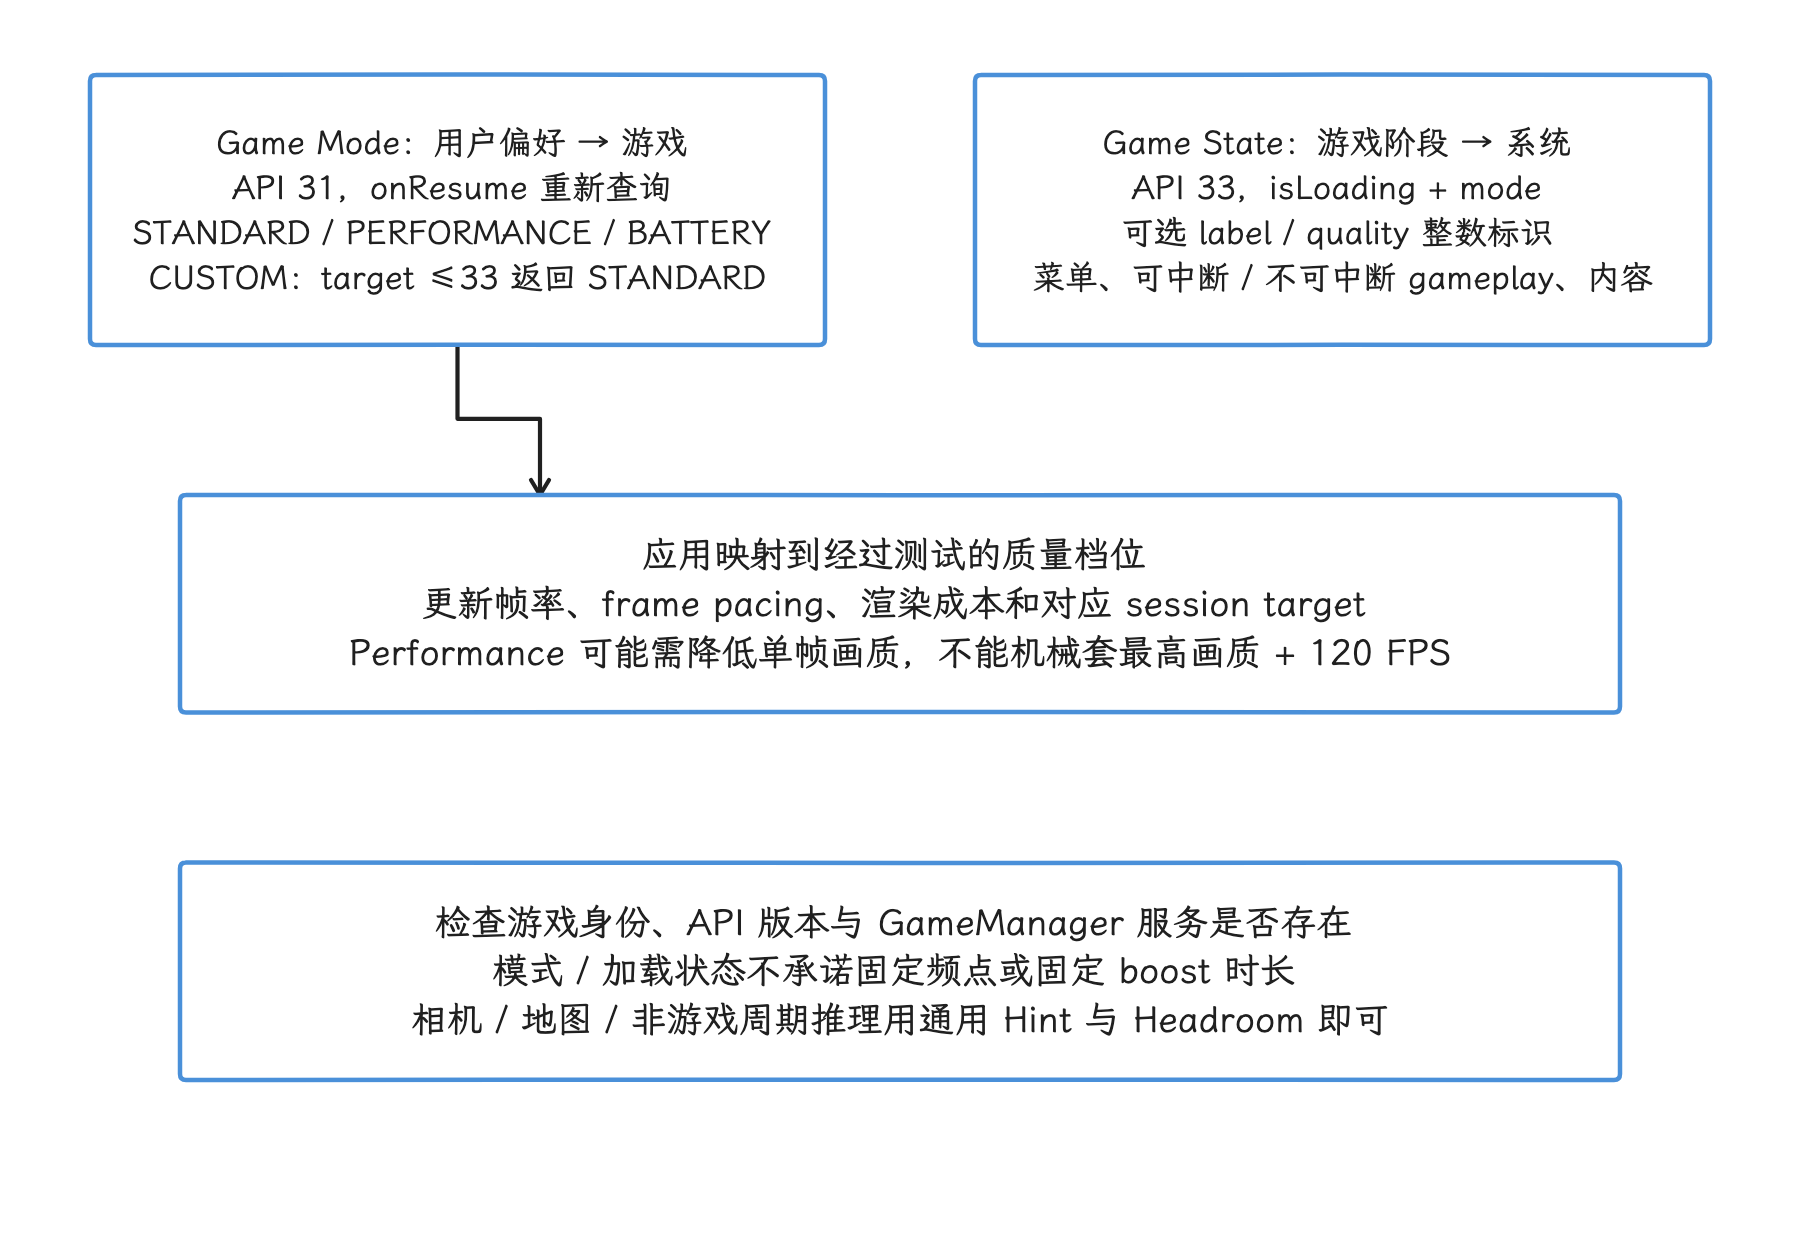
图:Game Mode 用于读取用户的性能或续航偏好,游戏恢复时重新查询,再选择经过验证的配置并更新 pacing 与 session target。Game State 则上报加载、菜单、gameplay 或内容展示等当前阶段。两者方向和语义不同,不是固定 boost;非游戏应用可直接使用 Performance Hint 与 Headroom。
一套可验证的接入流程
把前面的能力串起来,我们可以按下面这套流程接入:
- 建立基线:在固定设备、环境温度、电量区间和运行时长下,记录未启用 ADPF 时的帧时间、功耗和热状态。
- 选择工作单元:找出周期稳定、线程生命周期较长的渲染、音视频或计算任务,并确认 Linux TID。
- 定义 target:从整个流水线预算中分配该线程组的工作时长,用 actual duration 的第 50、90、95 百分位数(P50 / P90 / P95)检查目标能否稳定达到。
- 持续反馈:每个工作周期上报 actual duration;场景或帧率改变后更新 target。
- 读取约束:在工作线程中低频读取 Thermal、CPU / GPU Headroom,并处理
NaN、能力不支持和调用异常。 - 平滑降级:用滞回、每档最短保持时间和逐级配置档(profile)避免频繁切换。
- 处理生命周期:前后台切换后校验 session 和 TID;不再使用时显式
close()。 - 同机 A/B 对照:在同一设备上分别启用和关闭方案,比较达到同一体验目标时的掉帧、功耗和持续稳定时间,避免只看瞬时最高频率。
在 Perfetto 中验证
接入有没有效果,我们最终要回到 Perfetto 里验证。
采集什么
ADPF 没有向所有设备承诺提供固定名为 power.hint_session 或 power.thermal 的界面轨道(UI track)。厂商实现、trace(性能跟踪) 配置和 Perfetto 版本都会影响可见数据。我们至少采集这些:
- FrameTimeline(系统记录的预期帧与实际帧时间线)或应用自己的帧边界,用于对照 deadline 与实际完成时间。
sched_switch、sched_wakeup等调度事件,观察 session 线程运行在哪些 CPU 上。- CPU frequency 与可用的 GPU frequency / counter(随时间变化的数值轨道),用于观察资源状态。
- thermal 相关 counter,或应用自行记录的 thermal status / headroom。
- 应用自定义 trace slice(带开始和结束时间的事件区间),用于标出 target 更新、actual 上报和质量 profile 切换。
自定义 slice 用于对齐事件时间;Power HAL 在同一时刻采取了什么具体动作,从这里推断不出来。
怎样判断结果
先确定 session 覆盖的 TID 和工作周期,再从掉帧区间向外看:
- actual duration 是持续超过 target,还是只有一次性尖峰(spike)。
- 关键线程是否获得更及时的运行机会,CPU/GPU 是否已经够用。
- thermal status/headroom 是否在同一阶段恶化。
- 质量或帧率策略调整得是否及时,调整后是否出现新的流水线瓶颈。
成功不一定表现为更高频率。如果帧时间稳定,同时平均频率或功耗下降,系统也可能作出了更合适的决策。判断因果关系需要在同一设备上做多轮 A/B 对照,并保持初始温度和测试场景接近;单次 trace 只能提供线索。
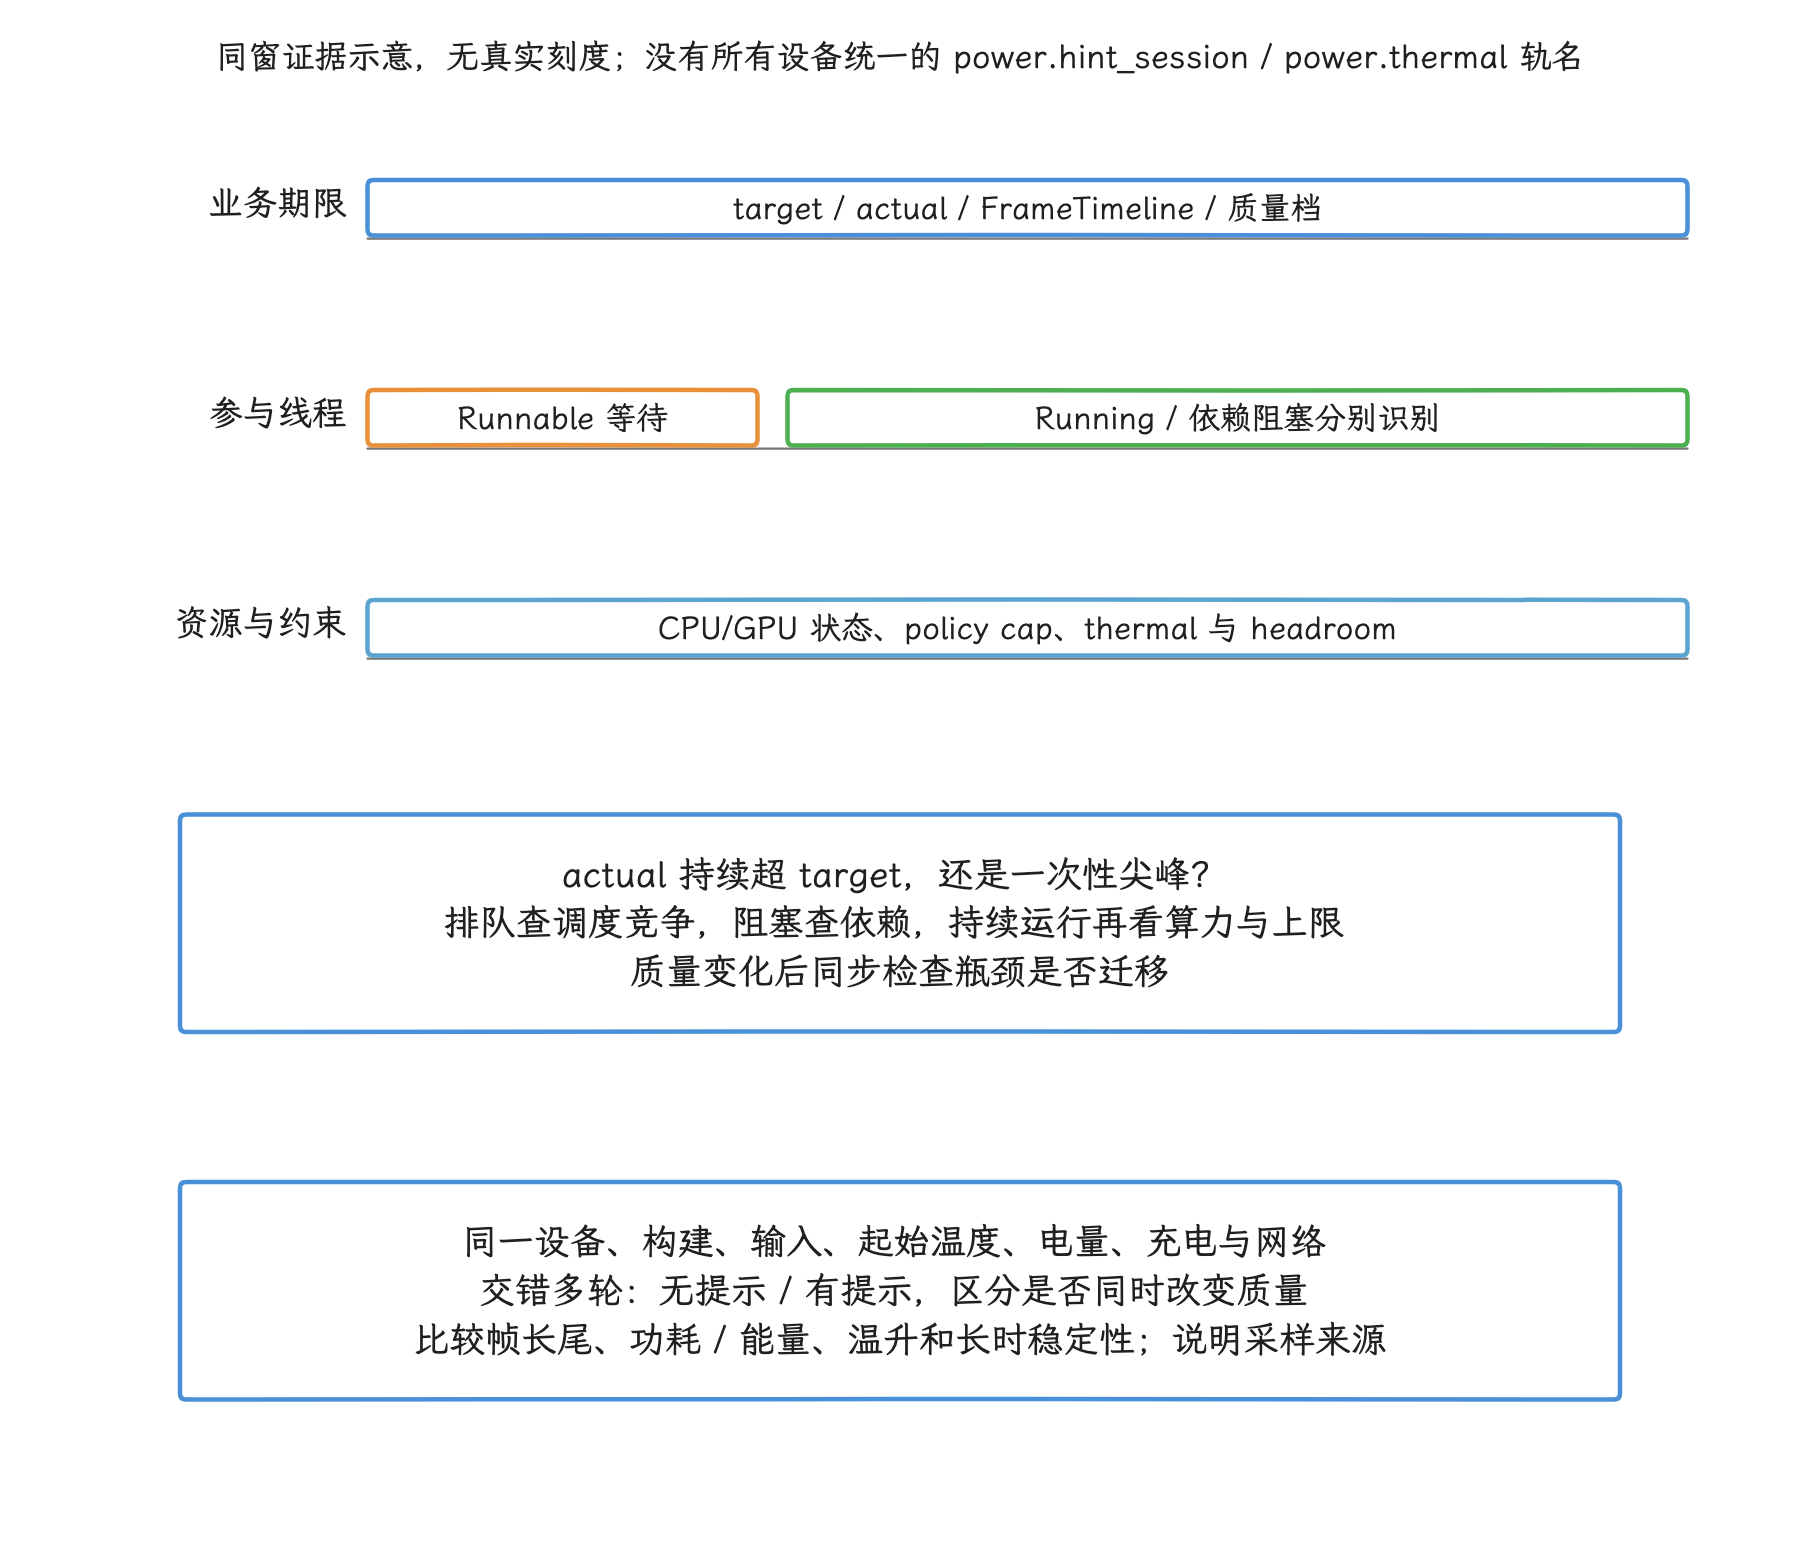
图:先对齐 target、actual 与帧 deadline,再区分线程 Running、Runnable 等待和依赖阻塞,核对频率、容量与热状态。提示上报、策略兑现和业务结果不是一个时间点;低频也可能代表需求已经满足。用同机交错 A/B 比较相同体验目标下的掉帧、完成时间、能量和持续稳定性,单看峰值 GHz 容易得出错误结论。
版本演进与 Android 17 的公开能力
| 版本 | 公开能力 |
|---|---|
| Android 10(API 29) | Java Thermal Status 查询与 listener |
| Android 11(API 30) | Java PowerManager#getThermalHeadroom() 与 NDK thermal manager 基础接口 |
| Android 12(API 31) | Java PerformanceHintManager、GameManager;NDK AThermal_getThermalHeadroom() |
| Android 13(API 33) | GameManager#setGameState(GameState);NDK APerformanceHintManager/Session |
| Android 14(API 34) | Java/NDK setThreads();GAME_MODE_CUSTOM |
| Android 15(API 35) | WorkDuration 上报、setPreferPowerEfficiency()、Thermal Headroom thresholds |
| Android 16(API 36) | CPU / GPU Headroom;Java / NDK Thermal Headroom listener;NDK workload hint、会话配置(session config)与图形流水线关联能力 |
| Android 17(API 37) | android-17.0.0_r1 公开的 Java Session API 仍包括 reportActualWorkDuration、setPreferPowerEfficiency、setThreads、updateTargetWorkDuration 和生命周期接口;公开 Java / NDK API 中没有 setPreferIdle(boolean) |
API 37 的 core/api/current.txt 以及 NDK performance_hint.h 都没有 setPreferIdle(boolean)。预览版 SDK(preview SDK)、厂商 SDK 或内部接口都不算 Android 17 的公共能力;Java sendHint() 也仍属于测试或隐藏接口。
常见误区
下面几个误解在接入 ADPF 时常见。
HintSession 会把 CPU 拉到最高频率
公开契约只说明系统会“尝试”调整线程所运行的 CPU 核或运行频率,也可能同时调整两者,使 actual 接近 target。系统可能维持当前频率、改变线程的 CPU 分配、采用厂商内部策略,也可能因热或功耗约束拿不出更多资源。
target duration 等于整帧周期
target 只对应 session 覆盖的工作,显示周期还要容纳流水线的其他阶段。把 16.67 ms 直接交给只负责 6 ms 渲染工作的线程组,会使系统高估这组线程的时间余量。
掉帧后上报能够修复当前帧
actual duration 是事后反馈,主要影响后续周期。可以预测的大幅负载变化,通过 NDK 发送 workload hint,并同步减少应用自身的峰值工作;一次性且不可预测的尖峰仍可能导致掉帧。
Thermal Headroom 和 CPU/GPU Headroom 可以互换
Thermal Headroom 表示接近严重热限制的程度;CPU/GPU Headroom 表示当前可授予的计算容量。设备可能热余量尚可但 GPU 已满,也可能 CPU 有余量却因皮肤温度接近阈值而需要降级。
ADPF 只适用于游戏
Performance Hint API 可服务相机预览、视频编辑、AR、地图和周期性推理等前台工作。Game Mode / Game State 只面向游戏;非游戏应用无需借用游戏语义。
游戏引擎接入
Unity 和 Unreal 都有官方接入件,我们先看它们各自提供什么。
Unity 官方 Android provider(平台适配组件) 支持 Unity 2021.3 及以上、Adaptive Performance 5.0 及以上;Unity 2021 / 2022 的包管理器可能默认安装 4.0,需要手动升级。官方还建议使用较新的 Android provider 1.2;1.0 只在 Pixel 设备上启用。provider 会逐帧上报 target 和 CPU / GPU actual duration;项目仍要根据自身内容调校分辨率、细节层级(LOD)、阴影和帧率调节器(scaler)。
Android Developers 提供 Unreal ADPF 插件(plugin);当前引擎支持表列出 Unreal Engine 4.25 及以上。插件分别为游戏线程(game thread)与渲染 / RHI 线程建立 hint session,并结合 thermal 信号调整 Unreal 的可扩展画质系统(Scalability)。默认设置只适合作为起点,项目应保留同机基线和自定义质量档位。
引擎自动接入之后,TID、target、热策略和 trace 验证仍要我们自己来。引擎升级、渲染线程模型变化后,应重新核对 session 覆盖范围。
OEM 差异应怎样验证
到 Android 17 为止,普通应用能依赖的公共约定是 Java / NDK API;IHintManager 是 Framework 内部 Binder 接口,android.hardware.power AIDL 是系统与设备 HAL 之间的契约,两者都在普通应用的调用范围之外。IPowerHintSession 提供 target、actual、线程集合、会话模式(session mode)等接口,这些信号如何映射到调度器、CPU / GPU 策略或厂商控制器,公共 API 没有给出保证。
单看 SoC 品牌,推断不出设备会用 PerfLock(部分厂商的私有性能锁机制)、某个私有服务还是固定的响应时间。我们跨设备测试时至少记录:
createHintSession()是否返回有效 session。- 同一 target/actual 序列下的帧时间和关键线程调度。
- 初始温度、电量、充电状态和持续运行时间。
- CPU / GPU / thermal 变化,以及未启用 ADPF 时的对照结果。
- 前后台切换、刷新率变化、线程重建后的行为。
具备系统权限或使用工程机时,可以结合系统服务诊断命令 dumpsys performance_hint、Power HAL 日志和厂商 trace 进一步定位;普通应用应以公开 API 返回值和可观测性能为准。
与其他章节的关系
- 5.2 DVFS、Thermal 与 Android 功耗管理:解释 EAS/DVFS、应用侧 Thermal API、Thermal HAL 与系统功耗约束怎样共同影响性能请求。
- 7.2 卡顿分析方法、典型场景与案例:动态画质、帧率和负载分级的验证方法。
- 14.7 Perfetto SQL、SPAN_JOIN 与 Jank CUJ:用关键用户操作流程(Critical User Journey,CUJ)查询帧、调度与 counter 数据。
参考资料
- Android Dynamic Performance Framework
- PerformanceHintManager.Session API reference
- PowerManager Thermal API reference
- SystemHealthManager API reference
- Game Mode API
- Game State API
- Game Mode interventions
- Unity Adaptive Performance and Android provider
- ADPF Unreal Engine plugin
- AOSP
PerformanceHintManager.java(android-17.0.0_r1) - AOSP
android_os_PerformanceHintManager.cpp(android-17.0.0_r1) - AOSP
performance_hint.cpp(android-17.0.0_r1) - AOSP
HintManagerService.java(android-17.0.0_r1) - AOSP NDK
performance_hint.h(android-17.0.0_r1) - AOSP 电源 AIDL
IPower.aidl(android-17.0.0_r1) - AOSP 电源 AIDL
IPowerHintSession.aidl(android-17.0.0_r1)