DVFS、Thermal 与 Android 功耗管理
源码基线:AOSP
android-17.0.0_r1(Android 17 / API 37);内核android17-6.18-2026-06_r6。厂商可替换 CPUFreq 驱动、固件与 HAL 策略,通用机制、Android 接口与设备实现要分开看。
排查掉帧、发热或耗电问题时,我们最后多半会落到这条链路上:调度器决定任务在哪个 CPU 上运行,DVFS 决定运行频率和电压,Thermal 在温度超限时收紧可用能力,Android Power HAL 则把交互、场景和厂商提示传入控制环。本章按“调频—温控—系统状态”的顺序把这三层拆开。
频率、电压与调频控制环
先分清两个问题:完成得多快,以及消耗多少能量
动手分析时,我们先分清两个问题:这件事完成得多快,以及它消耗多少能量。调度器决定任务何时运行、跑在哪个 CPU 上;动态电压与频率调节(DVFS)决定一个共享电压和频率的硬件域用哪个性能档位。DVFS 的全称是 Dynamic Voltage and Frequency Scaling。这两件事互相影响:
- 同一段 CPU 指令在高频下通常更早完成,但瞬时功率往往更高。
- 任务更早完成后,CPU 可能更早进入空闲态,整段工作的能量未必更高。
- 多个 CPU 共享一个频率策略时,一个繁忙 CPU 的需求可能抬高整个策略域(policy)的频率。
- 温控、电池电流限制或固件约束可以压低可用上限(cap),即使调度器希望继续升频。
所以看到掉帧附近出现低频,我们先把它当成“低频可能影响帧耗时”的假设,再往下确认:任务是否在运行、是否在等锁或 I/O、是否被迁移,以及设备报告的是软件请求档位还是硬件实测频率。
DVFS 的物理基础
动态功耗、漏电功耗与能量
CMOS(Complementary Metal-Oxide-Semiconductor,互补金属氧化物半导体) 电路的动态功耗常用下面的近似式说明:
P_dynamic ≈ α × C × V² × f
其中:
α是电路的翻转活动因子;C是等效开关电容;V是供电电压;f是时钟频率。
这个式子适合解释趋势:其他条件近似不变时,电压对动态功耗呈平方关系,频率呈一次关系。拿它预测整颗 SoC 或整机功耗就过头了——芯片还有漏电功耗,并随工艺、电压和温度变化;GPU、内存、显示与电源转换损耗也都不在式子里。
讨论续航时还要从功率走到能量:
E = ∫ P(t) dt
低频降低了单位时间内的动态功率,也延长了任务执行时间。对短任务来说,先用高性能档位快速完成、随后进入更深空闲态,可能比长时间低速运行更省能,也就是常说的 race to idle。我们比较续航时,要看同一工作量下的能量与完成时间,单看某个瞬时频点是不够的。
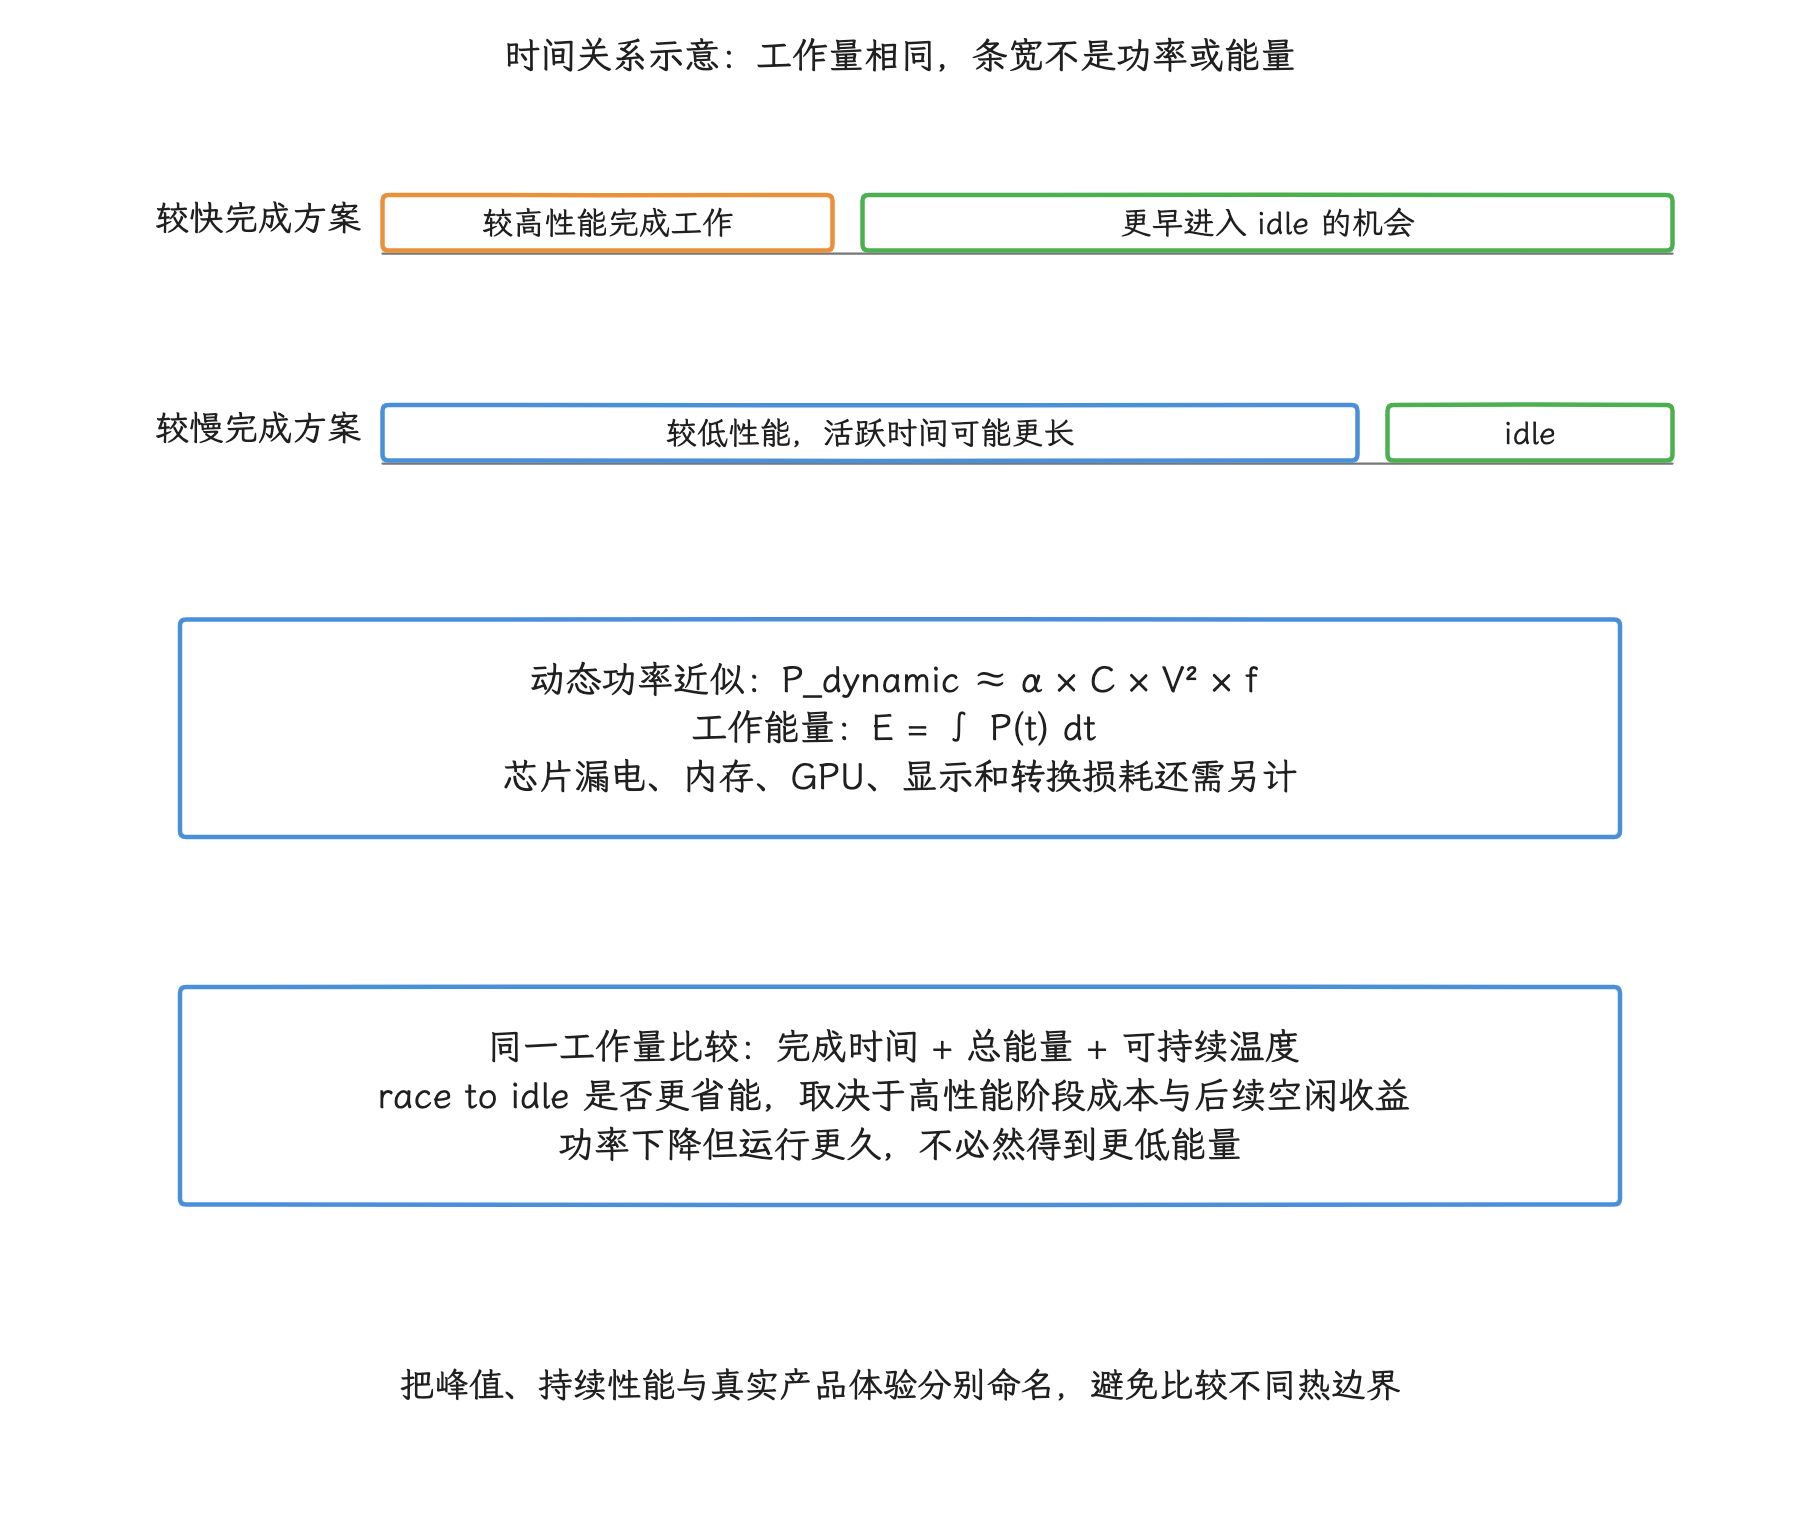
图:动态功率近似 αCV²f,整项工作能量则是功率对时间的积分。高频可能更早完成并进入 idle,也可能付出更多能量;低频降低瞬时功率,也可能延长活跃时间。判断续航要把同一工作量的完成时间、活跃与空闲成本及整机其他资源放在一起测量,GHz 数字和电压公式都替代不了这一步。
为什么频率与电压通常一起变化
时钟频率越高,组合逻辑完成一次传播的时间就越短;信号要在时钟边沿前稳定下来,还得在目标温度和芯片个体差异下留够时序裕量(让信号能在时钟边沿前稳定下来),所以较高频率通常需要较高电压。SoC 厂商会表征芯片,为每个性能域给出一组经过验证的频率—电压组合。
把频率和电压放在一起看,可以得到三条更严谨的判断:
- 降低频率常常允许同时降低电压,因此节能幅度可能大于单独降低频率。
- 电压受平台认可的工作档位约束。随意降到额定值以下做欠压,可能破坏时序稳定性,通用 Android 接口也不承诺支持欠压。
- 高频端的能效通常会变差,但拐点、幅度和可持续时间都依赖具体芯片、温度与封装,一个固定 GHz 数字概括不了。
OPP:离散的工作档位
工作性能点(Operating Performance Point,OPP)描述一个设备域能采用哪些性能状态(P-state):典型内容是频率和电压,也可以附带电流、功耗或硬件版本等约束。下面的表只用来说明离散档位,不对应任何量产 SoC:
| 示例档位 | 频率 | 电压 | 含义 |
|---|---|---|---|
| OPP 0 | 500 MHz | 650 mV | 低负载档 |
| OPP 1 | 1.2 GHz | 780 mV | 中间档 |
| OPP 2 | 2.0 GHz | 950 mV | 高性能档 |
Linux OPP 库位于 drivers/opp/。OPP 可以来自设备树(Device Tree),也可以由驱动或固件在运行时提供;平台还能根据芯片分档、温控状态等条件启用或禁用某些档位。于是一条实际的选频链是:
- governor 计算出的通常是性能需求或目标频率;
- CPUFreq 驱动把目标解析到 policy 允许且硬件支持的档位;
- 固件、电源控制器和热管理还可能进一步约束最终状态;
- 用户空间未必能看到完整的电压表,
scaling_available_frequencies也未必每台设备都有。
在使用 SCMI(System Control and Management Interface)、ACPI 的 CPPC(Collaborative Processor Performance Control)或厂商固件的系统上,Linux 可能提交抽象的性能等级。这个等级怎样映射到时钟、电压与电源域由平台定义;我们查到的只是一次等级,离独立测到物理时钟还隔着一层映射。
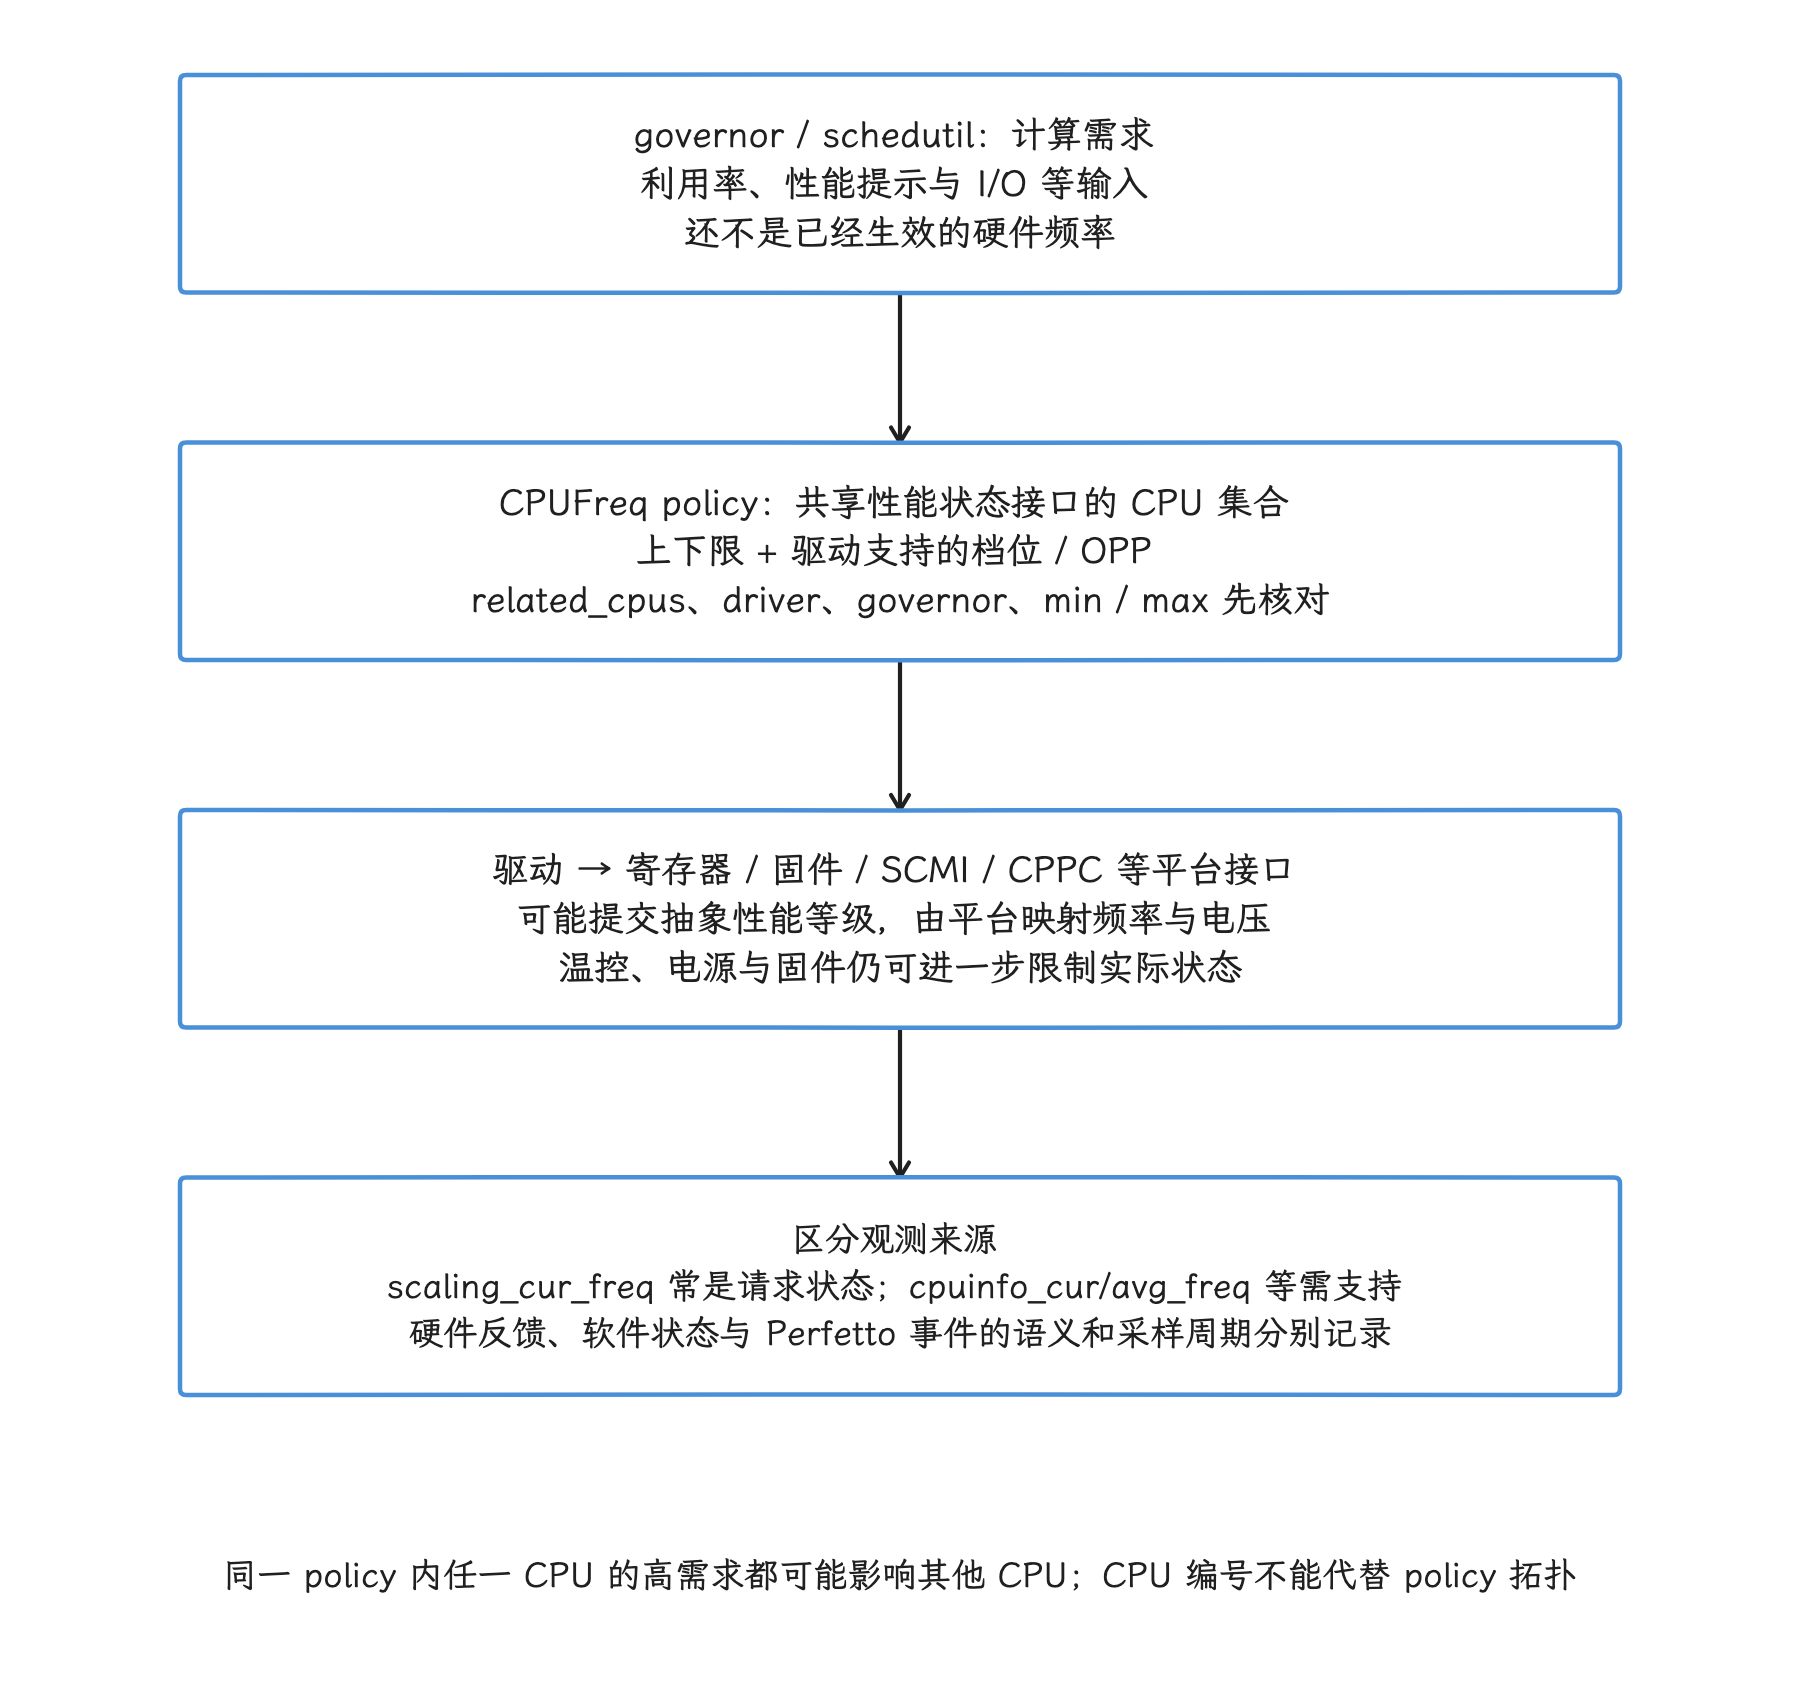
图:governor 给性能需求或目标频率,CPUFreq 在 policy 允许范围内解析受支持档位,驱动再通过寄存器、固件或抽象性能状态接口执行。OPP 是设备支持的离散组合,上限还受热、电流与平台策略限制。scaling_cur_freq 通常接近请求状态;硬件反馈节点需设备明确支持,某个读数算不算瞬时物理时钟,要看它来自哪一类节点。
CPUFreq:核心层、governor 与驱动
Linux CPUFreq 可以分成三层理解:
| 层次 | 主要职责 |
|---|---|
| CPUFreq 核心层(core) | 维护 policy、频率上下限和 governor/driver 的公共接口 |
| 调频策略(governor) | 根据负载或用户策略计算性能需求 |
| 调频驱动(scaling driver) | 将需求提交给硬件寄存器、固件或性能状态接口 |
policy 与 CPU 的对应关系
/sys/devices/system/cpu/cpufreq/policyN/ 是一个 CPUFreq policy,里面可以包含多个共享性能状态接口的 CPU。这个 sysfs(Linux 向用户空间暴露设备和内核对象状态的虚拟文件系统)目录就是内核开放给用户空间的一类入口。分析前我们可以读取:
related_cpus:属于该 policy 的 CPU;scaling_driver:当前驱动;scaling_governor:当前 governor;scaling_min_freq/scaling_max_freq:策略允许范围;cpuinfo_min_freq/cpuinfo_max_freq:驱动报告的硬件范围;cpuinfo_transition_latency:驱动能够提供时才有意义;scaling_cur_freq:通常是最近请求的 P-state 对应频率,不保证是物理时钟读数;cpuinfo_cur_freq或cpuinfo_avg_freq:驱动和硬件支持反馈时,才可能提供当前值或平均值。
这些节点是否存在、权限如何,由驱动、内核配置及设备策略决定。写入频率上下限会改变系统行为:需要 root 或调试权限,还可能破坏温控与性能策略。所以通用排障我们先做只读采集;限频 A/B 对照实验只放在可恢复的工程设备上做,并记录温度、电量和工作负载。
schedutil:按利用率选频的 governor
schedutil 是按调度器利用率选择性能需求的 CPUFreq governor。android17-6.18-2026-06_r6 的主要实现位于 kernel/sched/cpufreq_schedutil.c。
利用率信号来自哪里
CFS(Completely Fair Scheduler,完全公平调度器) 任务的利用率主要由 PELT(Per-Entity Load Tracking,按调度实体跟踪负载)维护。PELT 以 1024 微秒为周期衰减,半衰期约 32 毫秒;它是一个持续衰减的信号,和“每隔固定毫秒统计一次”的滑动窗口是两回事。在这之上,内核还会结合或约束多类信号:
- CFS 利用率与短期利用率估计
util_est; - runqueue 上利用率钳制(Utilization Clamping,UClamp)的最小值和最大值;
- I/O 等待增强(I/O wait boost);
- RT、DL 和 IRQ 对可用 CPU 调度容量(capacity,即内核估算的相对算力)的占用;
- 温控压力(thermal pressure)等 capacity 修正;
- sched_ext(可扩展调度器框架)启用时提供的 CPU 性能目标(performance target)。
这个内核分支的 sugov_get_util() 会读取 scx_cpuperf_target();没有把全部任务切到 sched_ext 时,还会加上 CFS boost(对 fair 类利用率的增强值),再经 effective_cpu_util() 和 DVFS 余量(headroom) 处理。所以拿“CPU 百分比 × 最高频率”来描述当前实现,会漏掉好几个输入。
Android 公共内核 6.18 允许 sched_ext 用 scx_bpf_cpuperf_set() 提交 CPU 性能目标。该入口与 CFS/PELT 路径会在 schedutil 中汇合,随后仍受 policy 上下限、驱动、固件与 thermal pressure 约束。
BPF 是 Linux 内核中可验证、可加载的程序机制,BPF kfunc 是内核向这类程序开放的函数接口。内核有这个入口,离“Android 17 使用 BPF 直接控频”的结论还很远;下结论前要在目标设备上确认 sched_ext 状态、已加载的 BPF 程序与 CPUFreq 路径。
从利用率映射到支持的频率
省略锁、缓存与边界处理后,主要计算关系可写为以下伪代码:
util, min_perf, max_perf = effective_cpu_util(...)
util = max(util, iowait_boost)
perf = max(min_perf, min(add_dvfs_headroom(util), max_perf))

raw_frequency = reference_frequency * perf / capacity
next_frequency = resolve_to_driver_supported_frequency(raw_frequency)
伪代码中的 perf 是综合 UClamp、IRQ、DL 带宽等上下界后的性能需求,capacity 是当前 CPU 的相对算力尺度。源码会根据频率不变性能力和架构反馈选择参考频率;约 1.25 倍的 DVFS 余量已在 add_dvfs_headroom() 所代表的 map_util_perf() 步骤施加,后续频率换算直接沿用这个结果,再乘一次等于把余量加了两遍。最终频点由 CPUFreq 驱动在 policy 限制内解析,通常选择不低于目标的受支持频点。这个 headroom 属于调频算法自身的余量,应用能从中获得多少性能提升并没有固定比例。
若一个 policy 覆盖多个 CPU,共享策略路径会遍历 policy->cpus,使用能够代表最高性能需求的利用率与 capacity 组合。我们看到某个 CPU 负载不高时,也要回头检查同一 policy 中的其他 CPU。
提交目标有三条主要路径
schedutil 提交目标走哪条路径,要看驱动的能力;“每次都排队给内核线程(kthread)”只是其中一种可能:
- policy 开启快速切换(fast switch)时,频率路径可调用
cpufreq_driver_fast_switch(); - 驱动支持性能参数调整(adjust-perf)且满足频率不变性条件时,可调用
cpufreq_driver_adjust_perf()传递性能参数; - 快速切换条件不具备时,schedutil 通过中断工作机制
irq_work和内核线程工作(kthread work)延后执行,最终进入__cpufreq_driver_target()。
具体设备走哪条路径,由 CPUFreq 驱动能力与 policy 配置决定。Perfetto 的频率事件本身分不清这次调用走的是 fast switch、固件消息通道(mailbox),还是延后执行的内核线程。
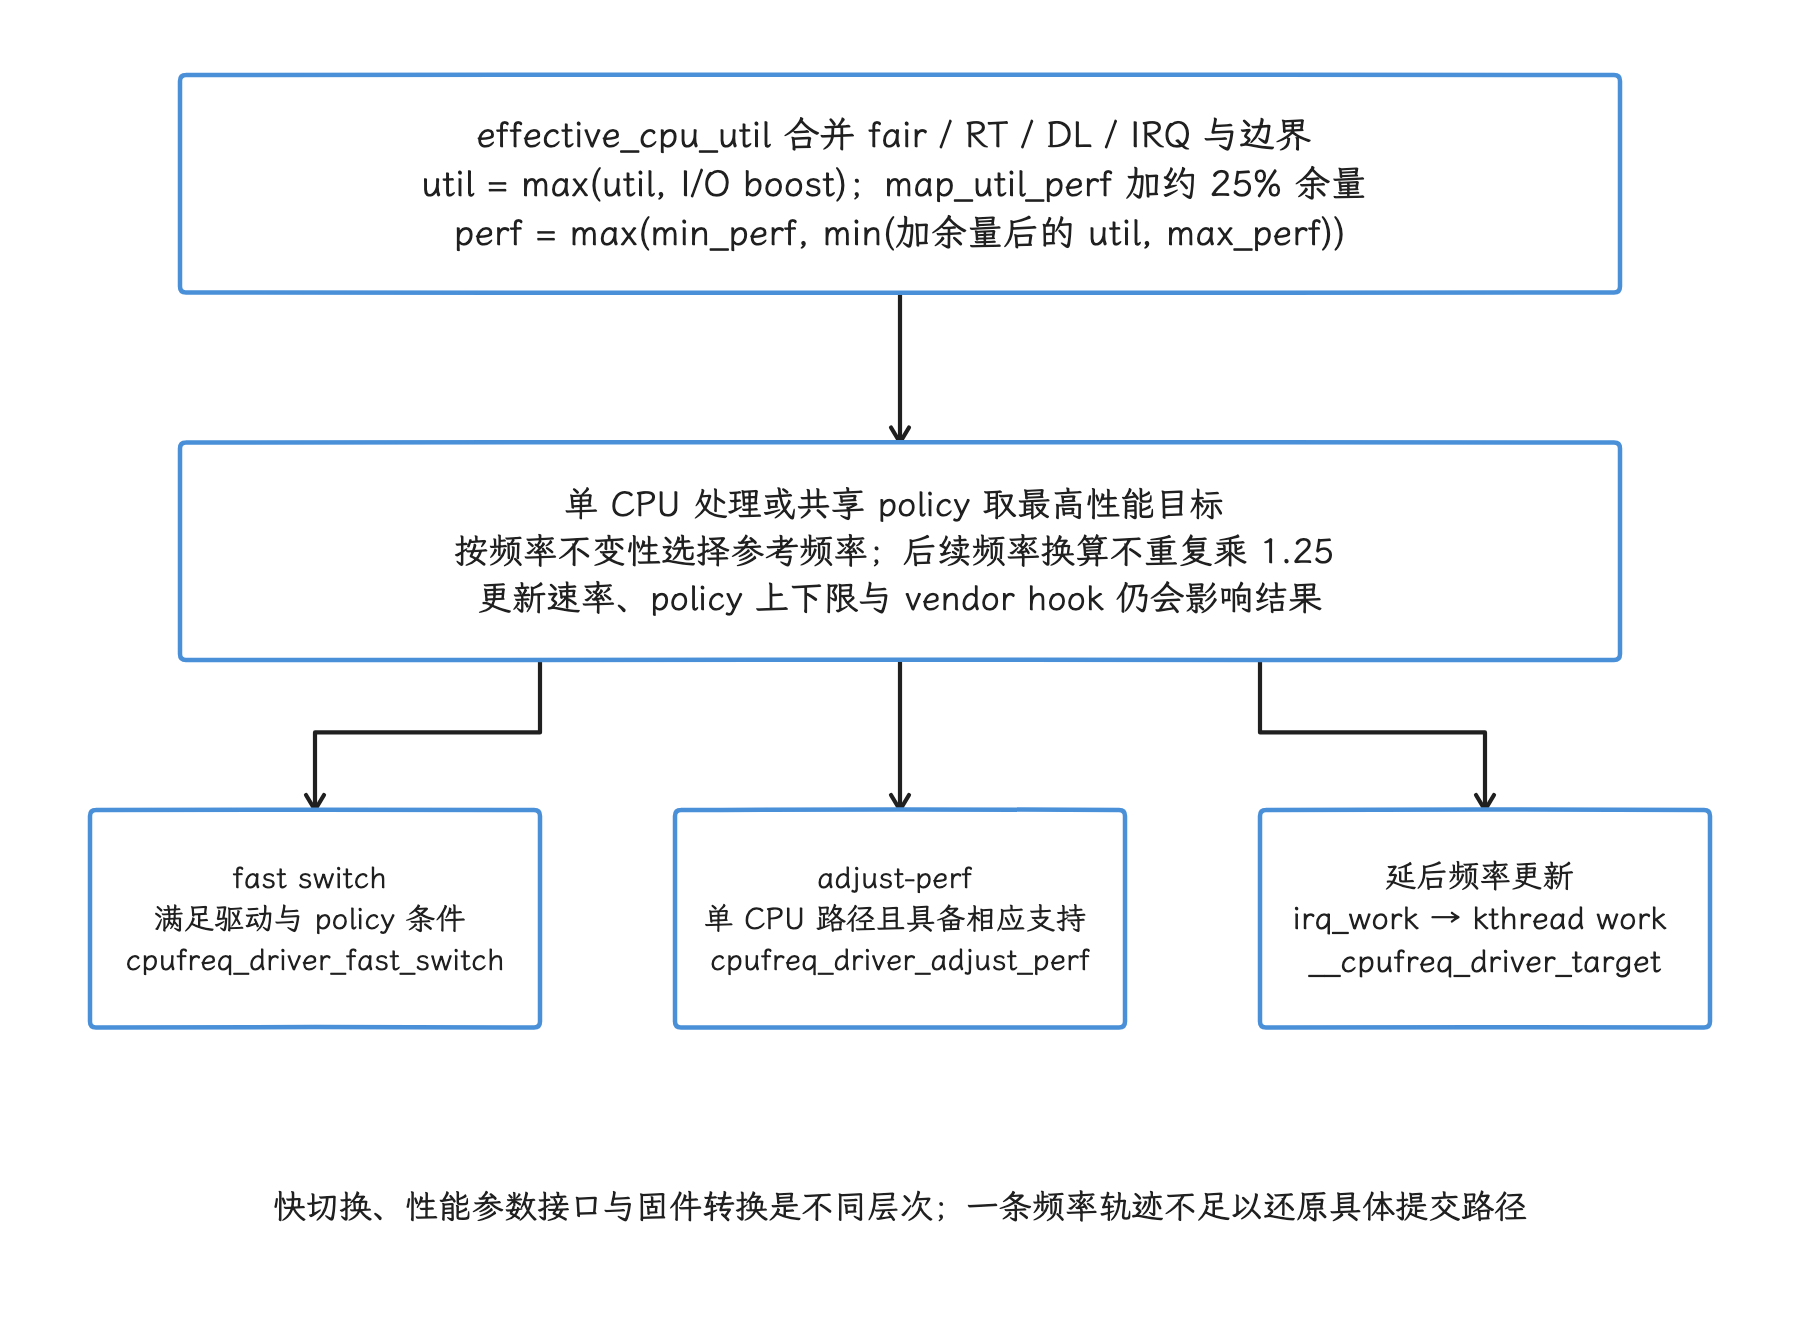
图:r6 将实际 util、I/O boost 与综合性能上下界组合,先用 map_util_perf 加约 25% 余量,再按 max(min_perf,min(actual,max_perf)) 求目标;共享 policy 汇总最高目标。支持条件不同,可走 fast switch、单 CPU adjust-perf,或 irq_work 加 kthread 延后提交。rate_limit_us 和转换延迟都来自设备,要按具体设备的值来看。
更新速率限制与 I/O wait boost
schedutil 的更新速率限制 rate_limit_us 初值来自 cpufreq_policy_transition_delay_us(policy),不是 Android 统一规定的固定毫秒值。它限制连续调频更新的节奏,设备和驱动可能提供不同的转换延迟。
I/O wait boost 用来响应刚从 I/O 等待中唤醒的任务。在这个内核版本里,增强值从 capacity 的八分之一起步,连续的 I/O 唤醒可以让它逐步增大;超过一个 tick 没有更新就重置,没有新的增强请求还会衰减。它换来了突发响应,也可能多花能量,我们分析时要结合唤醒来源与持续时间。
为什么“升频晚了”会影响一帧
一帧的关键 CPU 工作从唤醒到完成,可能经历以下路径:
- 线程被唤醒并进入可运行等待态(runnable);
- 调度器选择 CPU,任务开始消耗执行时间;
- PELT、
util_est、UClamp 或提示会形成新的性能需求; - schedutil 通过更新速率限制和 policy 共享逻辑计算目标;
- 驱动或固件接受请求,时钟和电源域完成转换;
- 温控与电源预算决定该档位是否可用、能维持多久。
其中每一步都可能受设备实现影响,所以给不出适用于所有手机的固定“升频耗时”。PELT 的 32 毫秒半衰期同样只能当参考:util_est、UClamp、I/O wait boost 和平台提示都可能让需求更早抬升。
判断低频是否导致掉帧
我们把下列观测放到同一时间窗口里:
- 应用主线程、RenderThread 或工作线程何时进入 runnable、何时开始 running;
- 运行 CPU 与该 CPU 所属 policy;
- CPU 频率事件、CPU 空闲(idle)状态和调度切片;
- 帧截止时间 deadline、关键 slice 和锁或 I/O 等待;
- UClamp、thermal throttling、CPU capacity 或厂商电源轨轨迹(power rail trace)(若设备提供);
- 同一场景多次复现时,低频与超时是否稳定共现。
如果关键线程大部分时间在睡眠或等锁,升频通常帮不上忙。如果线程持续运行、指令工作量相近,而且低频区间与 deadline miss 反复对齐,我们就有较强理由继续调查 governor、UClamp、驱动响应或温控限制。
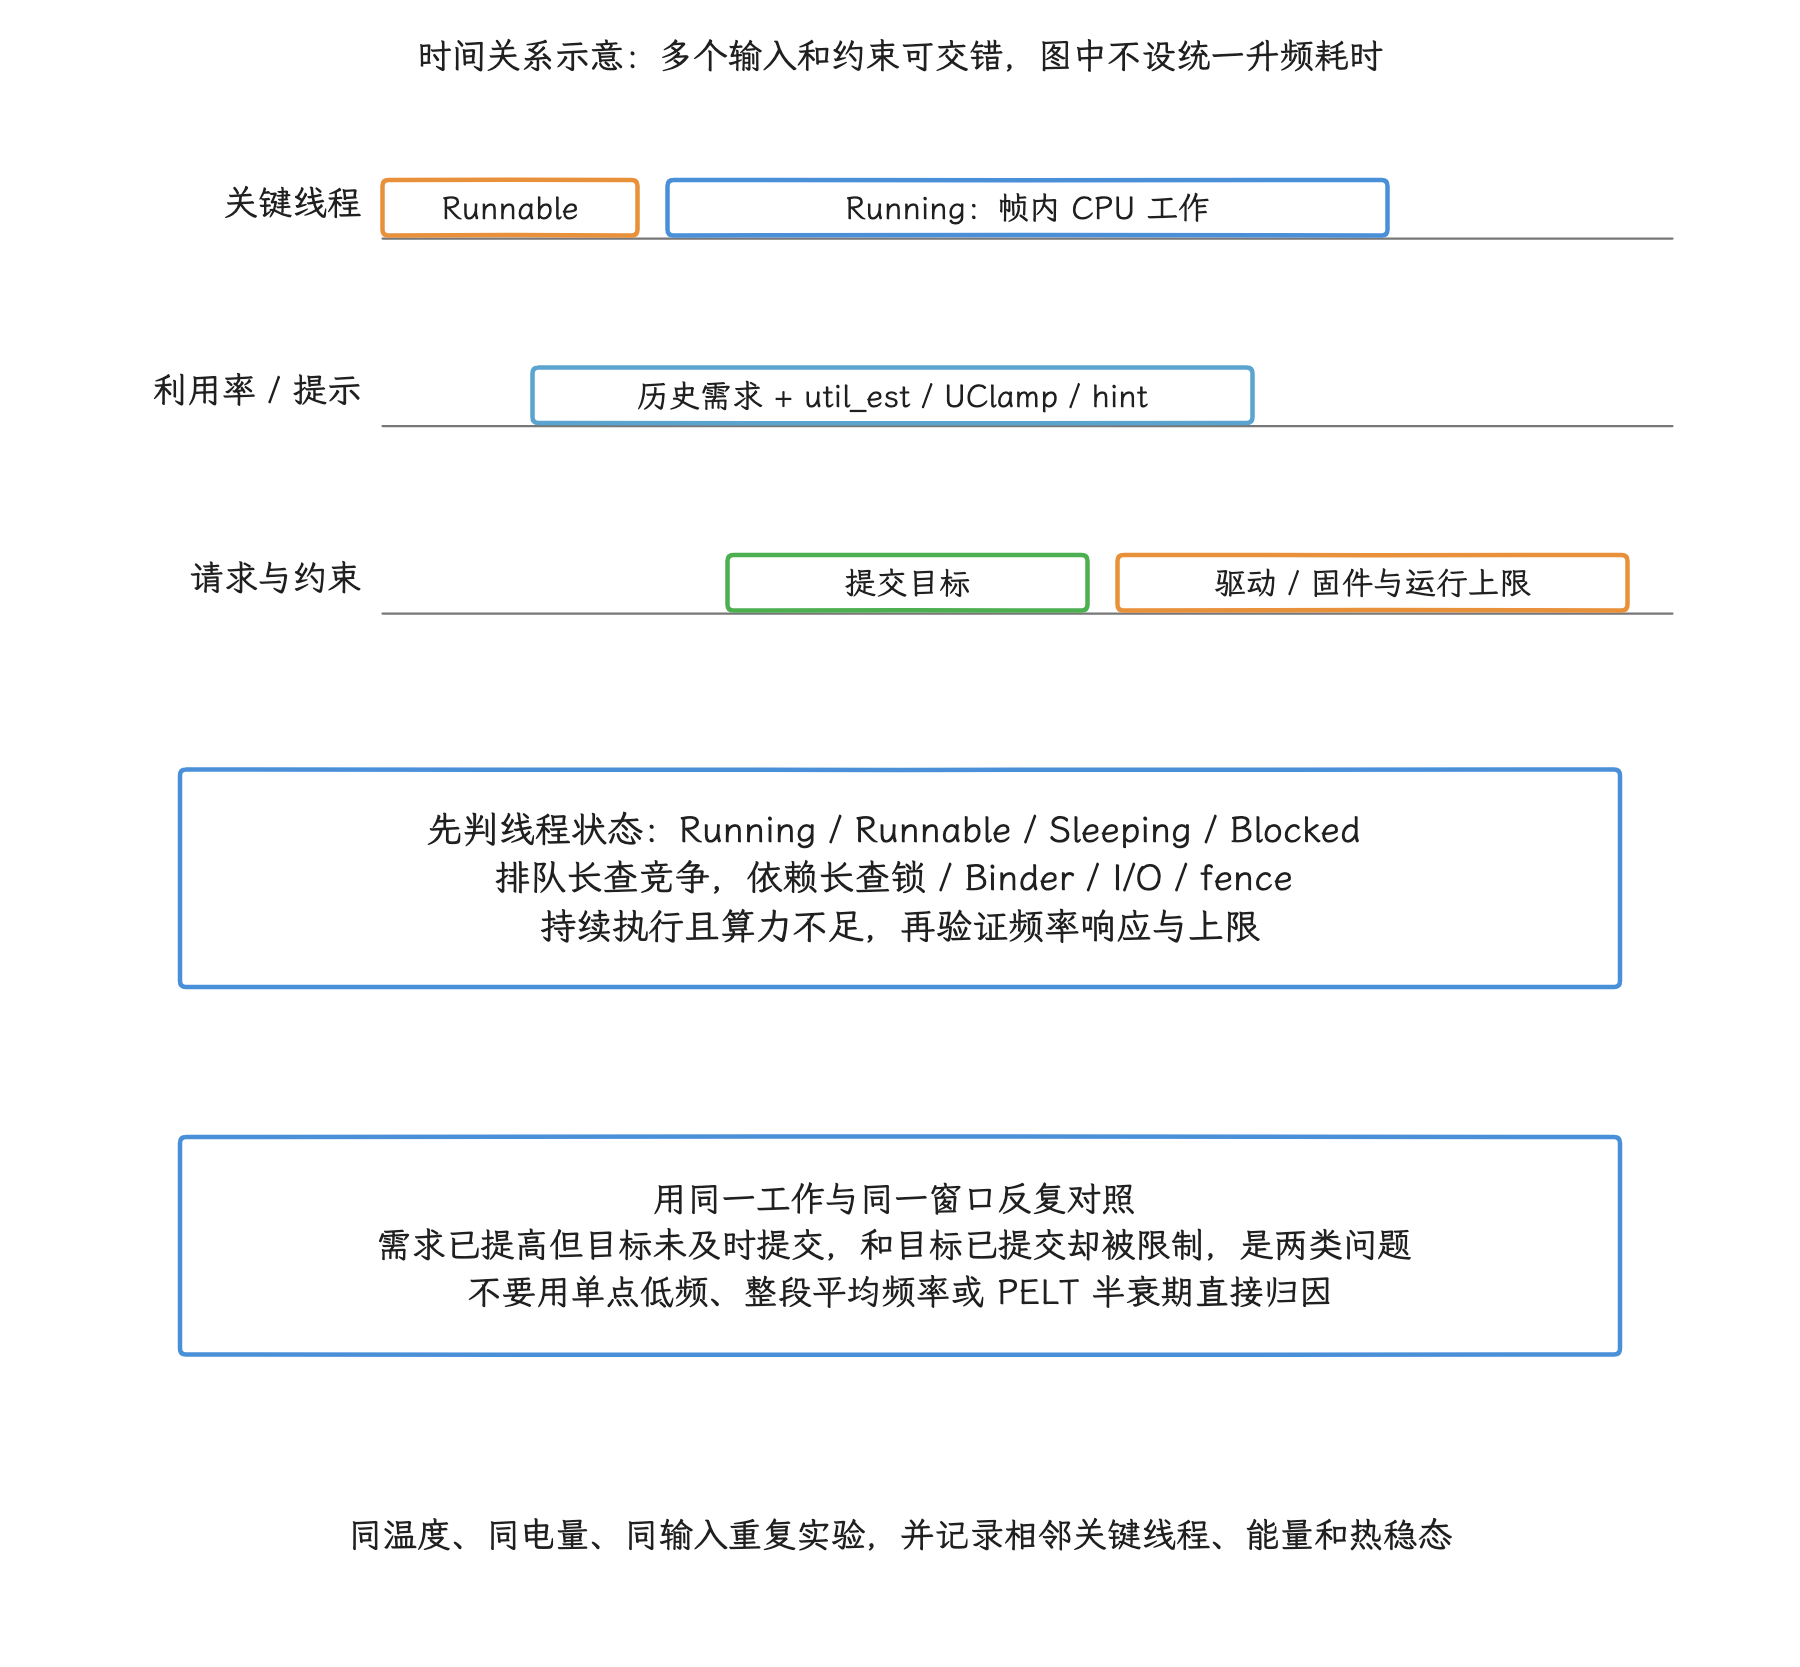
图:同一帧内先分清 Runnable 排队和实际 Running,再对齐利用率或提示、目标提交、报告频率与硬件上限。需求可由 util_est、UClamp、I/O boost 或场景提示提前抬高,PELT 的半衰期不是固定升频耗时。只有关键线程在执行、工作量可比且低性能与超时稳定相关时,才继续查响应或限制来源。
Android 怎样向性能策略表达需求
应用到系统之间隔着一层策略:应用和 Android Framework 通常只表达工作特征或时限,CPU、GPU 和内存资源怎样分配由系统及厂商策略决定,这些接口也不向应用承诺某个具体频率。
任务配置(Task Profiles)与 UClamp
Android 可以借助 task profile、cpuset(限制线程可运行的 CPU 集合)和 UClamp 调整线程的放置范围与性能提示:UClamp min 给 schedutil 一个利用率下界,适合短时拉高响应能力;UClamp max 则限制性能需求。它们仍受 policy 上限、CPU capacity、thermal pressure 和厂商实现约束。
把 UClamp min 长时间设得很高会增加功耗和温度,也可能挤占其他任务可获得的性能资源。我们应围绕关键线程和关键阶段使用,并用帧时间与能量数据验证效果。
ADPF 性能提示会话(Performance Hint Session)
ADPF(Android Dynamic Performance Framework)的 PerformanceHintManager 允许应用创建 hint session:
- 设置目标工作时长;
- 报告每轮工作的实际时长;
- 更新参与该会话的线程;
- 在受支持的 API 中报告
WorkDuration,其中可以包含工作周期起点、总时长、CPU 时长和 GPU 时长。
这些反馈让平台知道“工作有没有赶上目标”,厂商的 Power HAL 再据此调整资源。会话受前台状态、线程所有权和 HAL 支持等条件约束;它对 CPU 进哪个 OPP 没有承诺,锁等待、算法复杂度和 GPU 瓶颈也还要另行分析。
Power HAL 的 Mode、Boost 与提示会话
Power HAL 的 AIDL(Android Interface Definition Language,Android 接口定义语言)接口 android.hardware.power.IPower 提供三类相关能力:
setMode():表达持续或阶段性模式,例如INTERACTIVE、GAME、GAME_LOADING;setBoost():表达短时 boost,例如INTERACTION、DISPLAY_UPDATE_IMMINENT;- 性能提示会话(performance hint session):根据目标与实际工作时长持续反馈。
isModeSupported() 和 isBoostSupported() 用于查询支持情况;即使接口存在,厂商也可以不支持或忽略某个提示。HAL 内部把它们映射到 UClamp、CPUFreq、设备调频框架 devfreq、内存带宽还是固件参数,AOSP 没有统一规定。
游戏管理服务 GameManagerService 在游戏前台状态变化时控制 Mode.GAME;setGameState() 和 notifyGraphicsEnvironmentSetup() 可触发 Mode.GAME_LOADING,源码还为加载模式设置了最长 5 秒的限制。setGameMode() 改的主要是用户选择与配置,和一次固定时长的升频是两回事。
WakeLock(Userspace Wakelock) 的职责是约束系统挂起或相关电源状态。AOSP 里没有“每次 acquire WakeLock 都调用 Boost.INTERACTION 200 毫秒”的通用链路,排障时我们别把两者混为一谈。
Framework 提示与频率请求的关系
Power HAL 是场景提示与厂商策略的接口,schedutil 是 Linux 内核的 CPUFreq governor,两者之间隔着整个厂商实现。setMode()、setBoost() 与提示会话进入厂商 HAL 后,可能被实现成 UClamp、cpuset、devfreq、固件投票(向固件提交性能需求)或其他私有策略;AOSP 没有规定它们要写入哪个 schedutil 参数。
IPowerStats 负责观测能量消费者(energy consumer)、meter 计量值(meter)和 residency 驻留时间等数据;它只做观测,不会反过来决定 governor 行为。
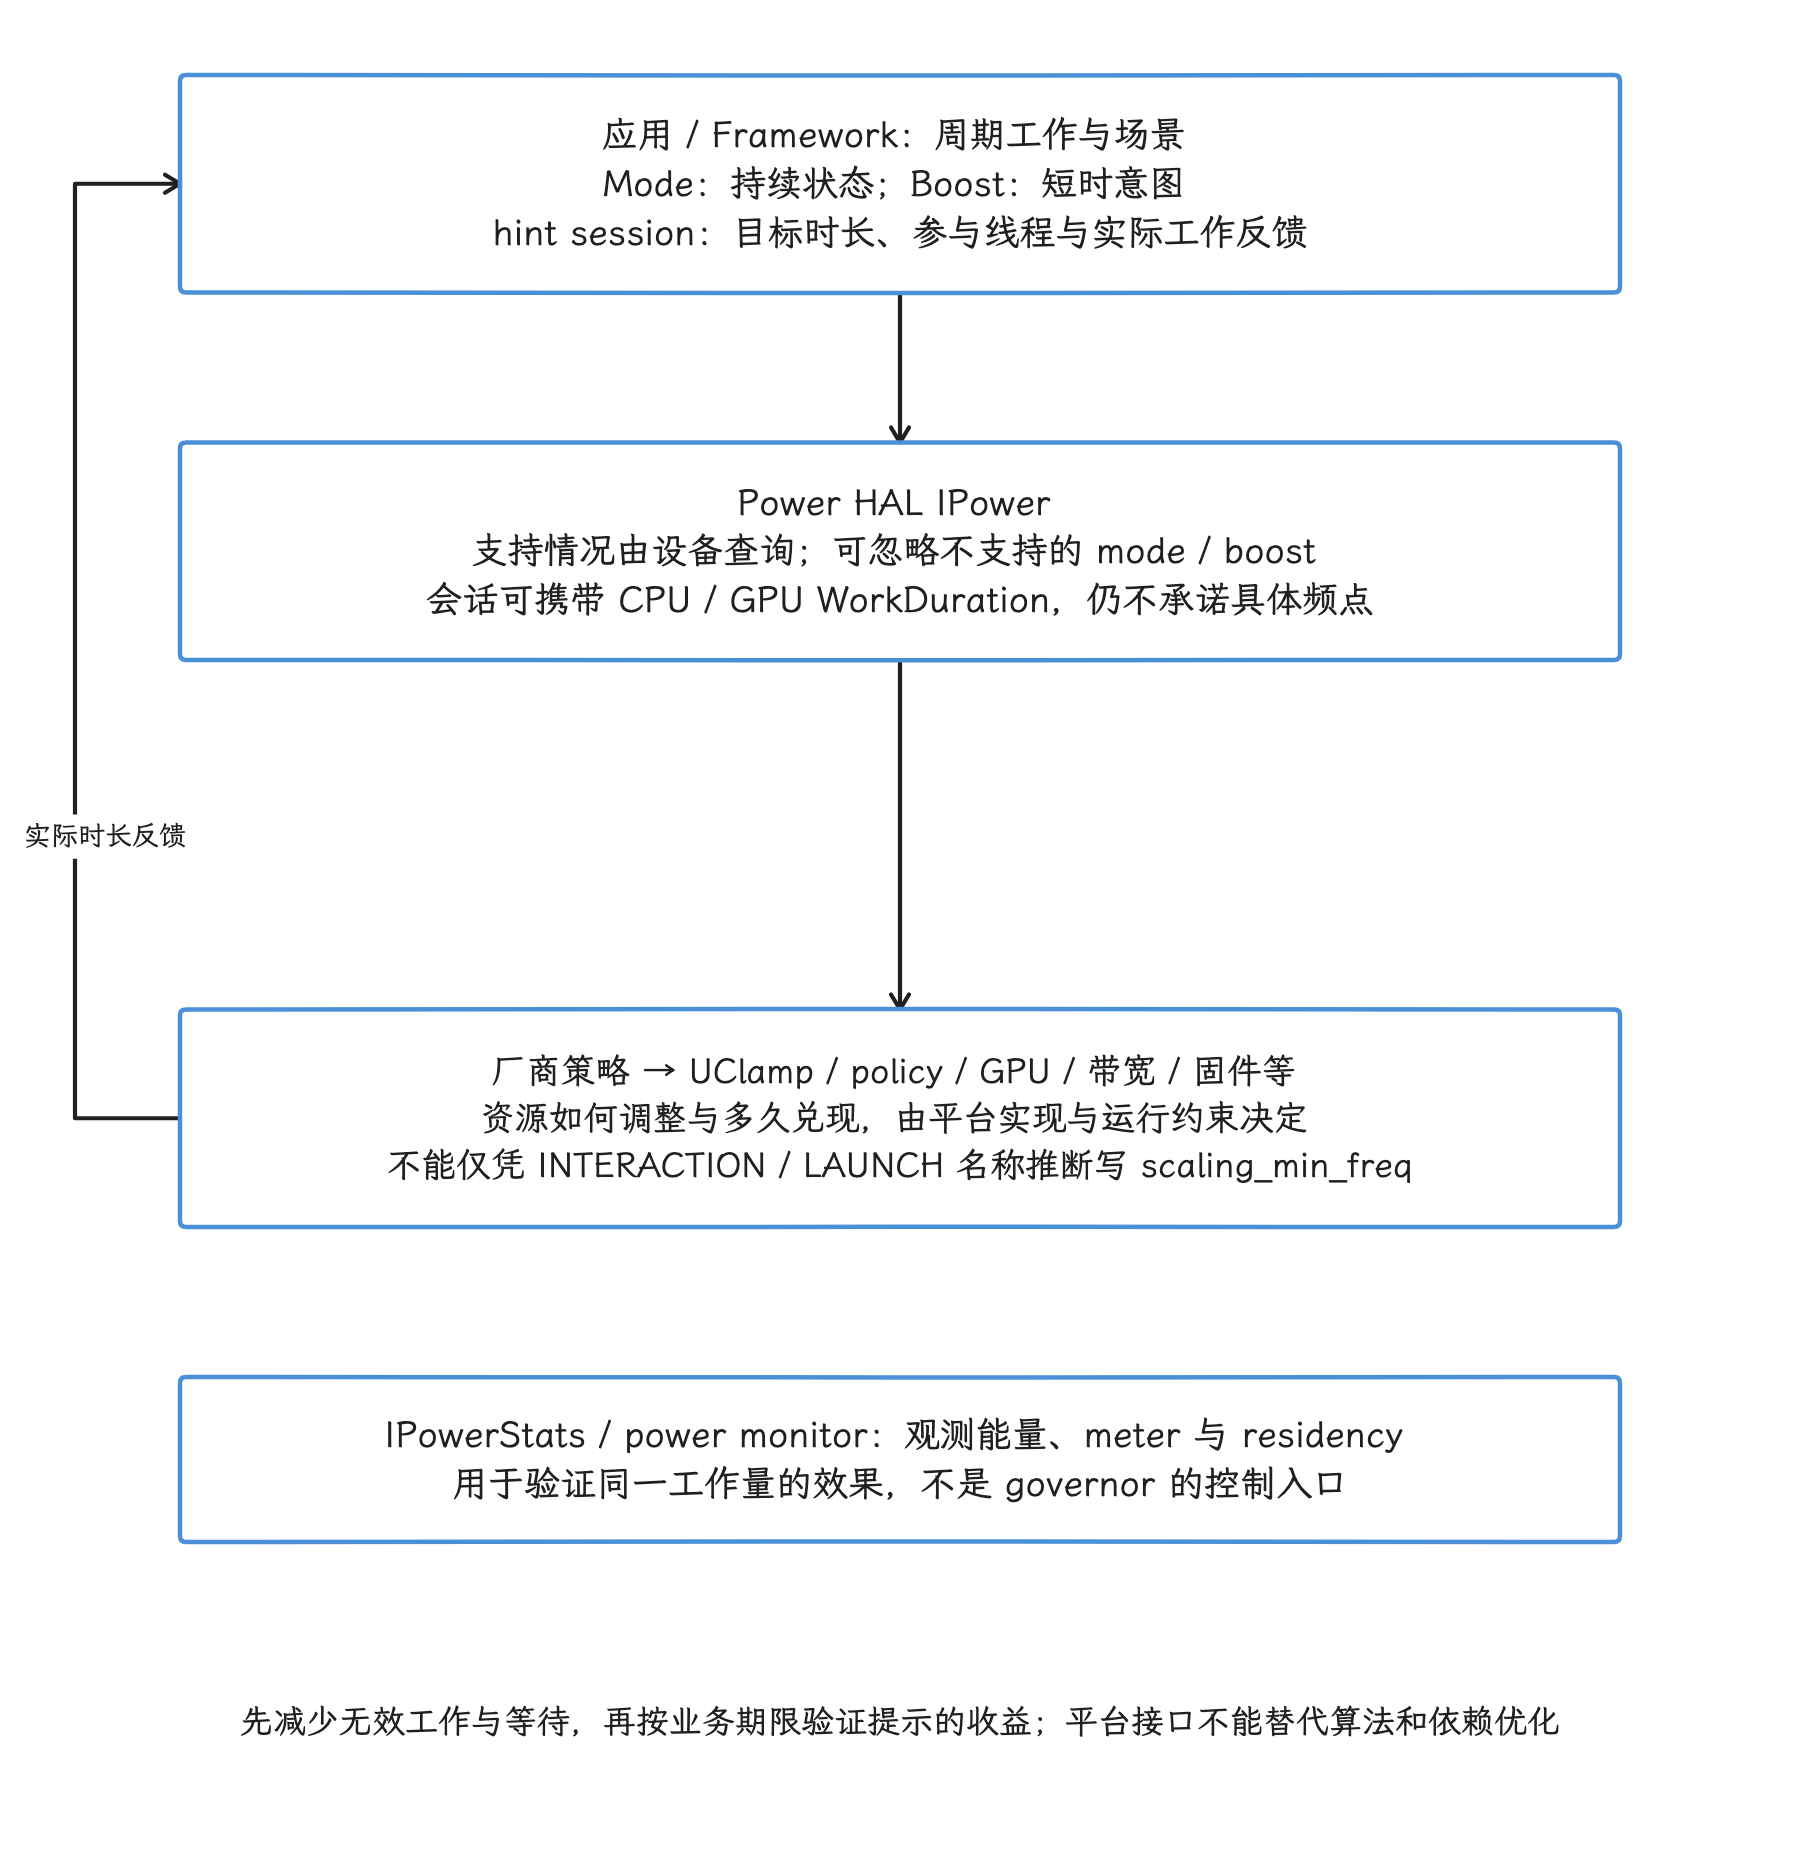
图:应用或 Framework 提交 Mode、Boost 或提示会话,表达场景与周期工作期限;会话报告实际时长,形成反馈。厂商 HAL 可把它们映射到 UClamp、CPU/GPU、带宽或固件策略,也可不支持某些提示。IPowerStats 提供能量与驻留观测,和直接控制资源的接口分开,普通 WakeLock acquire 也不等同固定升频提示。
用 Perfetto 观察 CPU DVFS
频率轨迹表示什么
Perfetto 标准库(stdlib)模块 linux.cpu.frequency 提供 cpu_frequency_counters,包含:
ts:频率状态开始时间;dur:持续时长;cpu:逻辑 CPU 编号;freq:kHz。
这类轨迹来自 Linux 内核的 cpufreq 事件,适合观察内核报告的频率状态与驻留时间。它通常接近 CPUFreq 的请求或状态通知,离片上计数器测到的瞬时物理时钟还有距离。需要硬件反馈时,去找设备支持的 cpuinfo_cur_freq、cpuinfo_avg_freq、固件计数器或厂商遥测,并说明数据语义与采样周期。
先算频率驻留,再与调度切片关联
下面的 SQL 用于汇总每个 CPU 在各频点的驻留时长:
INCLUDE PERFETTO MODULE linux.cpu.frequency;

SELECT
  cpu,
  freq,
  ROUND(SUM(dur) / 1e6, 3) AS residency_ms
FROM cpu_frequency_counters
WHERE dur > 0
GROUP BY cpu, freq
ORDER BY cpu, freq;
查询结果回答的是“内核报告在某频点停留多久”。下一步,我们把目标时间窗与 sched_slice、应用切片和帧时间相交,确认关键线程在低频区间内处于 running 状态;只统计整段 Trace 的平均频率,结果容易被空闲时间稀释。
CPU idle 的值要按设备解释
Perfetto 标准库 linux.cpu.idle 中的 cpu_idle_counters 使用 idle = -1 表示 CPU 处于活跃状态(active);非负值是平台报告的空闲状态 ID。较大的编号通常对应更深的状态,但状态名称、退出延迟和编号映射由设备决定,应结合 /sys/devices/system/cpu/cpuN/cpuidle/state*/ 或平台文档核对。
“低频”与“深 idle”也要分开:
- 低频表示 CPU 在活跃执行时采用较低性能状态;
- idle 表示 CPU 当时没有执行普通任务,并进入空闲状态;
- 从深度空闲状态唤醒与随后升频可能同时出现在启动阶段,但二者有不同的控制路径和延迟来源。
GPU DVFS 与内存调频
GPU 是独立的性能域
GPU 通常有自己的时钟、电压域、利用率统计和 governor 或固件策略。Linux 平台可能通过 devfreq 管理 GPU,也可能交给厂商驱动;CPU 的 schedutil 不直接决定 GPU 频率。
我们分析 GPU 卡顿时,应同时看:
- GPU queue、fence 和完成时间;
- GPU 频率或性能等级轨迹(设备提供时);
- 温控与功率限制;
- CPU 是否及时提交了 GPU 工作。
ADPF 的 WorkDuration 可以携带 CPU 和 GPU 的实际工作时长,给平台更完整的反馈;它也不会把 CPUFreq governor 变成 GPU governor。Perfetto 是否显示 GPU 频率、轨迹叫什么、数值是请求等级还是硬件反馈,都取决于 GPU 驱动和数据源。
CPU/GPU headroom API 按所选计算窗口估计可用性能余量(headroom),应用可以据此降低画质或并发量;它和 GPU 利用率、频率或硬件忙碌时间是不同的量。SurfaceFlinger 的 PowerAdvisor 也会围绕显示合成工作向 Power HAL 建立提示会话,但这条系统侧反馈链和应用读取 GPU headroom 之间没有固定的直接调用关系。设备有没有把两者映射到同一套 GPU/devfreq 策略,要用厂商 Trace、HAL 实现和 GPU 计数器共同证明。
DDR/LPDDR 调频要关注带宽、延迟与竞争
DDR/LPDDR 内存的控制器与互连,也可能采用动态频率或带宽投票,由各组件向平台申报带宽需求。CPU 和 GPU 同时访问内存时,瓶颈可能出现在:
- 可用带宽不足;
- 内存访问延迟上升;
- 多个发起内存访问的主设备(master)相互争用;
- 热或功率预算限制内存域;
- CPU 缓存未命中(cache miss)增多,使核心频率上升但吞吐没有同比增加。
单看 DDR 频率高低,说明不了内存有没有瓶颈。我们优先用设备提供的内存带宽计数器、LLC 相关计数器、缓存未命中与停顿事件、GPU 计数器和互连轨迹,并核对采样单位。AOSP 也不统一规定厂商的 DDR governor、节点名称或 Perfetto track。
一套可复现的 DVFS 排障顺序
界定超时工作
标出掉帧、启动或交互的截止时间,找到关键线程和耗时最长的切片。我们先把四个状态分开:running 是在跑,runnable 是在等 CPU,sleeping 是在睡,blocked 是被阻塞。
确定 CPU 与 policy
记录线程运行过的 CPU,再读取 policy 的 related_cpus、驱动、governor 和频率上下限。不要用“CPU 0~3 一定是小核”之类的固定编号推断拓扑。
对齐请求、执行和限制
把 schedutil 输入线索、频率事件、idle 状态、温控压力、capacity 与关键切片(slice)对齐。设备若提供硬件频率反馈,再把“内核请求”和“硬件反馈”分开比较。
建立对照
保持工作负载、温度、电量、屏幕刷新率和网络条件尽量一致,重复采集。工程设备上的 UClamp、提示会话或受控频率上限实验可以帮助验证因果,但每次只改变一个变量,并在实验后恢复策略。
架构活动监控单元(Activity Monitors Unit,AMU)、性能监控单元(Performance Monitoring Unit,PMU)和厂商 counter 可以帮助解释“同频不同效”:AMU 反映架构活动周期与参考周期,PMU 提供指令数、周期数、cache miss 和 stall 等事件。它们是反馈或诊断来源,AOSP 并没有拿它们做统一的升频仲裁。比较“提频有没有收益”时,我们要在相同 workload 下同时报告完成时间、指令数与周期数、内存停顿、温度和能量,别只凭利用率或频率轨迹下结论。
选择对应修复
- 线程长期处于 running 状态且算力不足:先优化工作量,再评估性能提示、UClamp 和调频响应;
- 线程处于 runnable 状态却没有获得 CPU:处理调度竞争、优先级或 CPU 放置;
- 线程处于 sleeping 或 blocked 状态:处理锁、Binder、I/O 或生产者依赖;
- 频率请求很高但硬件反馈偏低:调查温控、电源预算、固件或驱动;
- GPU/内存受限:转到对应性能域,避免只调 CPU。
版本边界与源码索引
| 主题 | Android 17 / 6.18 锚点 | 边界 |
|---|---|---|
| schedutil | kernel/sched/cpufreq_schedutil.c | 精确到 android17-6.18-2026-06_r6;其他内核分支可能不同 |
| OPP | drivers/opp/、Documentation/power/opp.rst | OPP 来源和可见性由平台决定 |
| CPUFreq | Documentation/admin-guide/pm/cpufreq.rst | 驱动决定 fast switch、反馈节点和固件接口 |
| ADPF | android.os.PerformanceHintManager | API 可用性、会话权限和 HAL 支持需在运行时确认 |
| Power HAL | hardware/interfaces/power/aidl/android/hardware/power/ | Mode/Boost 到资源策略的映射由厂商实现 |
| 游戏模式 | GameManagerService | GAME/GAME_LOADING 调用点应以当前版本标签(tag)的源码为准 |
| Perfetto | linux.cpu.frequency、linux.cpu.idle | GPU、DDR 和硬件实频轨迹不具备跨设备统一性 |
常见误区
“CPU 利用率不高,就没有升频需求”
平均利用率会掩盖短时突发负载(burst),也会把不同 CPU 和时间段的数据混在一起。schedutil 还会考虑 util_est、UClamp、I/O 等待、RT/DL/IRQ 和 capacity 约束,我们该看的是关键 policy 在目标时间窗口内的需求。
“固定最高频率可以解决卡顿”
锁等待、I/O、GPU fence 和调度竞争不会因为 CPU 固定在最高频率而消失。持续最高频还会提高温度,随后可能触发更强的温控降频(thermal throttling)。限频或定频适合作为受控实验,不是通用产品方案。
“scaling_cur_freq 就是硬件实频”
Linux CPUFreq 文档明确区分了请求状态和硬件反馈。scaling_cur_freq 在多数驱动上代表最近请求的 P-state;cpuinfo_cur_freq、cpuinfo_avg_freq 也只有在驱动与硬件支持时才存在。报告数据时,要写清 sysfs 节点或 tracepoint 的语义。
“看到频率晚升,就能判定 governor 有问题”
任务可能刚从深度空闲唤醒,也可能正在等依赖;温控或 policy 上限也会压着目标。所以要先确认关键任务正在运行、性能需求已经抬高,而目标仍长时间没有提交或兑现,这时候才轮到我们去找 governor、驱动或固件的问题。
温度预算与降频约束
跑性能测试时常见的一幕是:前几分钟一切正常,随后帧时间慢慢拉长。DVFS 按负载调整频率,Thermal 则根据温度和设备策略限制频率、功率或功能(feature);温度阈值、传感器布局、降载幅度和恢复曲线都是设备配置,AOSP 推导不出某款手机的具体行为。持续负载下,我们要同时观察请求频率与实际可用频率。
温控改变的是可持续性能
CPU、GPU、显示、充电和无线子系统消耗的电能,最终会有一部分变成热。散热速度赶不上产热速度时,设备只好减少功率或关闭部分功能,来满足芯片、电池和用户接触面的安全约束。
于是有了我们熟悉的性能曲线:还没升温的冷机阶段性能较高,温度上来之后可用 CPU/GPU capacity(系统估算的可用算力)逐步减小,帧时间或任务时长跟着拉长。这里有两个容易混淆的目标:
- 峰值性能关注短时间能跑多快。
- 可持续性能关注达到热平衡后还能保持多少吞吐。
持续负载测试如果只报告开头几分钟,通常代表不了用户长时间使用的性能。反过来也一样:看到频率降低就归因于温控为时尚早,正常的 DVFS 调频、任务等待、电池电流限制和固件策略都可能画出相似的曲线。
从传感器到降载:两条相互关联的路径
手机温控常被画成“传感器 → HAL → Framework → 限频”的单一链路。这个图便于入门,拿它去排源码就会走偏。Android 设备上通常同时有控制平面与报告平面:前者直接执行降温措施,后者把热状态上报给系统和应用。
控制平面:直接约束发热源
控制平面可以位于硬件、固件、Linux 温控核心(thermal core)或厂商进程中:
温度/电流传感器
    → 硬件或固件保护
    → thermal zone / vendor thermal policy
    → cooling device、频率上限、功率预算、充电或功能限制
这条路径的目标是及时降温,不必等 ThermalManagerService 来执行限频。量产设备可以组合多种机制;AOSP 也不规定厂商必须用某个名为 thermal-engine 的后台守护进程或某个固定配置文件路径。
报告平面:把状态交给 Framework 与应用
报告平面把设备状态转换成 Android 定义的类型和严重程度:
传感器与设备温控策略
    → Thermal HAL
    → ThermalManagerService
    → 系统监听者与 PowerManager API
    → 应用按状态主动减载
报告平面让 Framework 和应用知道设备正在接近或已经进入热限制(throttling)。它装不下厂商控制算法的全部细节,一次 severity 变化对应哪个频率上限也没有固定答案。
Linux thermal core
热区、触发点与冷却设备
Linux thermal core 位于 drivers/thermal/。三个基本对象分别负责不同职责:
| 对象 | 含义 |
|---|---|
| 热区(thermal zone) | 一个可观测的热区域或传感器模型 |
| 温度触发点(trip point) | 该热区的温度条件及类型 |
| 冷却设备(cooling device) | 可以提供若干冷却状态(cooling state)的执行对象 |
冷却设备的 state 是抽象等级。对 CPU 调频冷却设备(cpufreq cooling)来说,更高的 cooling state 通常映射到更低的最高频率;其他 cooling device 可以控制 devfreq、风扇或平台自定义资源。state 编号和温度是两个量,与 Android ThrottlingSeverity 也没有一一对应的保证。
在允许访问的设备上,/sys/class/thermal/thermal_zone*/ 可以提供 type、temp 和 trip 等信息;温控节点的温度通常以毫摄氏度表示。
节点是否存在、是否允许 adb shell 读取、zone 名称怎样解释,都由内核配置与 SELinux(Security-Enhanced Linux)策略决定。分析时我们先把 type 和 temp 配对再下结论,按目录编号猜 CPU、GPU 或电池容易猜错。
thermal governor 决定怎样调整 cooling state
Linux 6.18 提供 step_wise、power_allocator、fair_share、bang_bang 和 user_space 等温控策略(governor)。设备用的是哪一个,我们读 thermal zone 的 policy 或检查内核配置来确认,别假定 Android 默认用 step_wise。
以当前版本标签(tag)中的 drivers/thermal/gov_step_wise.c 为例:
- 温度达到触发阈值(trip threshold)后,算法结合升温或降温趋势计算目标 state;
- 升温且需要 throttle 时,目标通常增加一级;
- 降温时,目标可以逐级减少,受 thermal instance(热区与冷却设备的绑定实例)上下界约束;
HOT和CRITICAL类型的 trip 不走这段普通 cooling-state 管理逻辑。
这可以解释某些设备上逐级降低上限的曲线。不过 Perfetto 里出现阶梯状频率,还证明不了设备在跑 step_wise:OPP 本身就是离散的,schedutil 与固件也会画出阶梯。
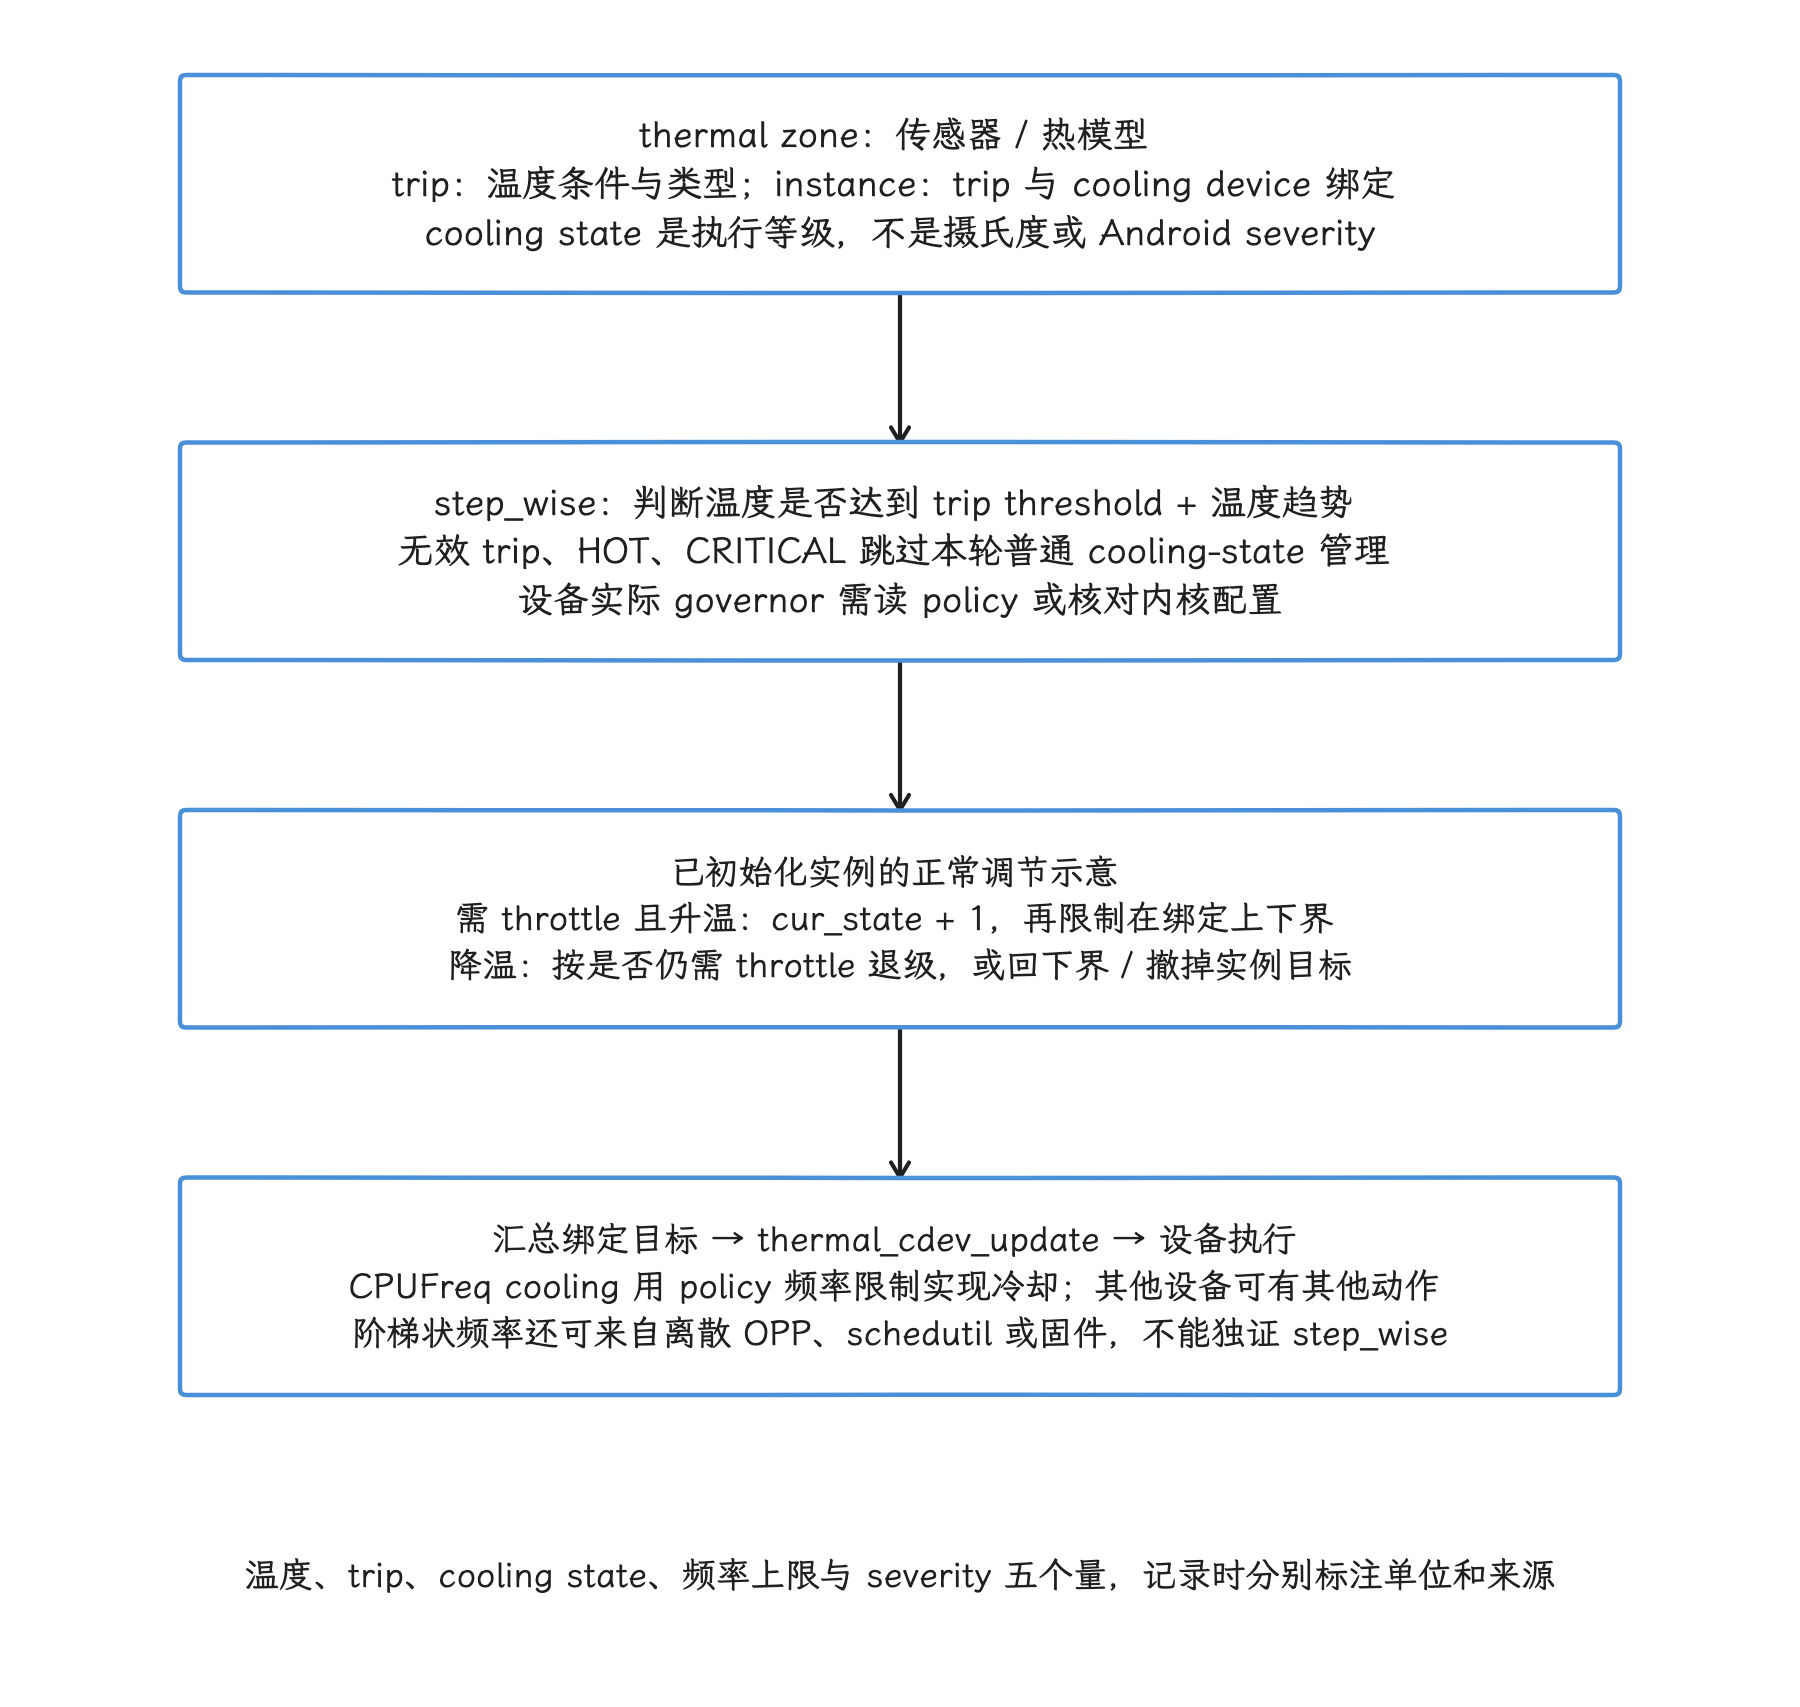
图:thermal zone 提供温度或模型,trip 定义触发条件,thermal instance 绑定 cooling device 与上下界。r6 step_wise 结合温度趋势和是否超过当前阈值计算目标:升温可加一级,仍需降温时按界限退一级,低于阈值并降温时可回到下界或撤掉实例目标。HOT/CRITICAL trip 走另外的保护逻辑,解释它们要换一条路径。
限频只是冷却动作的一种
drivers/thermal/cpufreq_cooling.c 将 cooling state 映射为 CPUFreq 的 policy 限制。设备还可以限制 GPU/devfreq,进行 CPU 热插拔(hotplug)或隔离(isolation),调低显示功耗,或者限制充电和无线功能。
“限核”并不是所有 Android 设备到了某个 severity 必然执行的步骤。CPUFreq、hotplug、固件功率预算和厂商策略可能各自独立工作,先后顺序也没有跨设备保证。
Thermal HAL 与 ThermalManagerService
稳定的 AIDL Thermal HAL 位于 hardware/interfaces/thermal/aidl/android/hardware/thermal/。关键类型包括:
Temperature:类型、名称、当前读数和throttlingStatus;TemperatureThreshold:各 severity 的热阈值和冷阈值,缺失项用非数值标记NaN;CoolingDevice:冷却设备类型、名称和当前值;ThrottlingSeverity:NONE到SHUTDOWN七个等级。
IThermal 支持读取温度、阈值和 cooling device,也支持注册温度状态变化回调。它还定义了可选的机身表面温度(SKIN)预测接口 forecastSkinTemperature()。
AIDL 注释明确了一件事:getTemperatureThresholds() 返回静态参考值,而设备的热缓解(mitigation)算法可能包含动态模型、迟滞和多传感器关系。想用静态阈值自行重建准确的 throttling 状态是行不通的,要以 Temperature.throttlingStatus 或 HAL 回调为准。
ThermalManagerService 位于:
frameworks/base/services/core/java/com/android/server/power/thermal/
    ThermalManagerService.java
服务启动时优先连接 AIDL Thermal HAL,失败后仍保留 HIDL(HAL Interface Definition Language) 2.0、1.1 和 1.0 的兼容回退。兼容路径说明旧 HAL 还可能出现在升级设备上;新设备以 VINTF(Vendor Interface,厂商接口兼容性机制) 与 HAL 声明为准。
ThermalManagerService 做什么
源码中的主要职责包括:
- 缓存 HAL 上报的
Temperature; - 把传感器状态变化发给内部温控事件监听器(thermal event listener);
- 维护面向公开 API 的整体温控状态(thermal status);
- 为温控余量(thermal headroom)收集 SKIN 温度和阈值;
- 对 CPU、GPU、NPU、SKIN 或 BATTERY 的
SHUTDOWN状态发起相应关机流程。
整体 status 由 SKIN 类型传感器的最高 severity 计算。PowerManager.getCurrentThermalStatus() 表达的是面向用户体验的设备热状态;要看“所有芯片传感器中的最高温度”或“CPU 正被限制到几 GHz”,得另找域级数据。
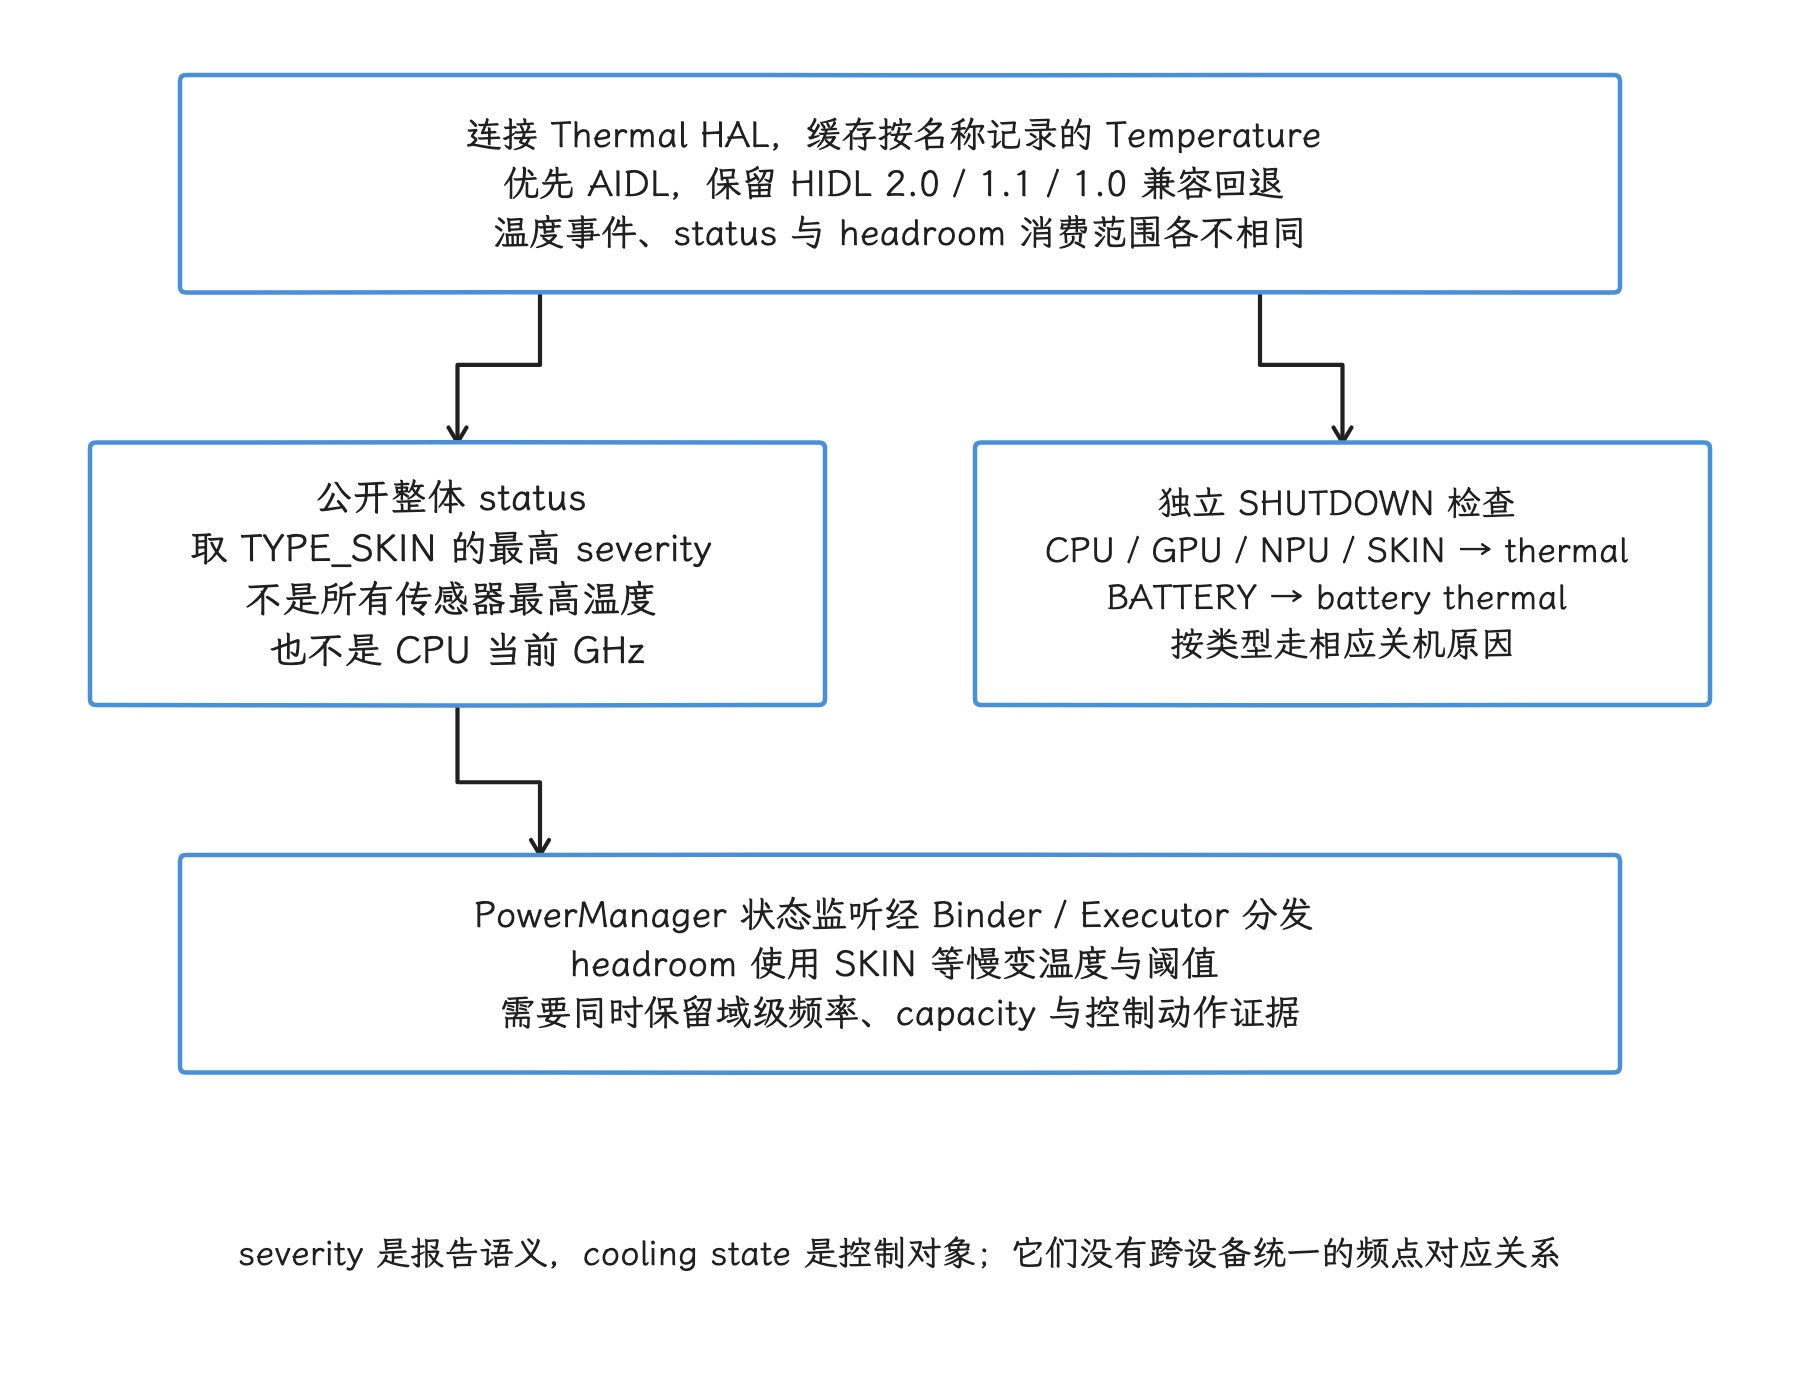
图:ThermalManagerService 缓存 HAL 温度并分发事件。公开整体 status 按 SKIN 传感器的最高严重度聚合,默认不是所有芯片传感器的最大温度或最大 severity。CPU/GPU/NPU/SKIN 的 SHUTDOWN 另走 thermal 关机原因,BATTERY 使用电池热关机原因;公开状态为 NONE 时,某个性能域仍可能已经受限。
Framework 聚合状态与后台任务限制是两条使用路径
ThermalManagerService 把 HAL 的温度回调聚合成公开的 thermal status 与 headroom;其他系统服务可以独立使用温控状态。JobScheduler 会在设备温控压力上升时减少可运行的后台作业,但某个作业是否停止,还要看它的优先级、当前执行阶段与其他约束。应用看到作业因温控原因(thermal reason)挂起,说明的是调度政策正在降载,推不出具体是哪个 thermal zone、cooling device 或 CPU 频点。
排查时我们把两条线分开查:一条是 HAL 温度与状态 → Framework 状态与 headroom;另一条是 cooling device、CPU/GPU 上限、JobScheduler 等使用方的实际动作。这两条线在时间上对齐之后,才说得清某次性能下降由哪项 mitigation 造成。
PowerManager Thermal API
当前状态与回调
公开状态从 NONE 到 SHUTDOWN,数值与 HAL severity 对齐:
| 状态 | 平台语义 |
|---|---|
NONE | 未处于温控限制(thermal throttling) |
LIGHT | 轻度限制,用户体验预期不受影响 |
MODERATE | 中度限制,用户体验预期不会受到很大影响 |
SEVERE | 严重限制,用户体验会受到明显影响 |
CRITICAL | 平台已采用其可用的主要降功率措施 |
EMERGENCY | 关键组件开始关闭,设备功能受限 |
SHUTDOWN | 需要立即关机 |
这些状态只描述严重程度,不是固定的动作表:SEVERE 不承诺一定关闭大核,EMERGENCY 也不承诺每台设备关闭同一组无线组件。
下面的代码用于监听状态并在组件停止时注销监听:
private final PowerManager.OnThermalStatusChangedListener thermalListener =
        status -> adaptWorkload(status);

@Override
protected void onStart() {
    super.onStart();
    PowerManager pm = getSystemService(PowerManager.class);
    pm.addThermalStatusListener(getMainExecutor(), thermalListener);
}

@Override
protected void onStop() {
    getSystemService(PowerManager.class)
            .removeThermalStatusListener(thermalListener);
    super.onStop();
}
adaptWorkload() 应根据业务选择可逆的降载动作,例如降低内部渲染分辨率、减少特效、降低编码复杂度或延后非关键工作。回调经 Binder 和指定的 Executor 分发,平台没有承诺“几百毫秒以内”这类固定延迟。
Thermal headroom
getThermalHeadroom(forecastSeconds) 返回非负浮点数,表示慢变化传感器距离 SEVERE 阈值的相对位置。这里的 headroom 是温控余量,别当成剩余 CPU 百分比:
1.0对应SEVERE阈值;- 数值可以大于
1.0,但1.0以上没有固定 severity 映射; 0.0不对应固定温度或NONE;- 不支持、调用过密等情况下可能返回
NaN; forecastSeconds的公开参数范围是 0~60 秒。
该 API 主要跟踪 SKIN 一类慢变化传感器。源码文档建议不必高于约每秒一次;系统积累足够样本前,即使请求未来预测,也可能只返回当前 headroom。
下面的代码演示怎样处理 NaN 和阈值边界:
float forecast = powerManager.getThermalHeadroom(10);
if (!Float.isNaN(forecast)) {
    if (forecast >= 1.0f) {
        reduceWorkloadImmediately();
    } else if (forecast >= 0.8f) {
        prepareAReversibleQualityStep();
    }
}
0.8f 是应用自己的策略示例,不是 Android 定义的系统阈值。产品应根据帧时间、业务质量和设备实验调整,并使用迟滞避免画质在临界值附近反复切换。
Headroom 阈值
设备支持这一组 API 时,getThermalHeadroomThresholds() 返回 thermal status 到 headroom 阈值的映射,只有厂商定义了相应阈值的状态才会出现在结果中。源码还说明:
- 旧设备存在多个 SKIN 传感器时,Framework 会采用较保守的阈值;
- 当前 headroom 越过某阈值,不保证当前 status 已同步达到该等级;
- 阈值可以随调用变化;
- 功能未启用会抛出
UnsupportedOperationException,服务未就绪会抛出IllegalStateException。
status 适合响应已经发生的状态变化;预测 headroom 与阈值适合提前准备降载,两类数据我们分开记录。
CPU/GPU headroom 与 thermal headroom 的区别
Android 16 增加了公开的 CPU/GPU headroom API;Android 17 源码中的实现位于系统健康管理类 android.os.health.SystemHealthManager,支持情况仍由设备能力决定:
getCpuHeadroom(CpuHeadroomParams)估算可继续提供的 CPU 容量;getGpuHeadroom(GpuHeadroomParams)估算可继续提供的 GPU 容量;- 有效值范围为 0~100,越低表示可增加的容量越少;
- 暂时计算不出结果时可以返回
Float.NaN; - 不支持时抛出
UnsupportedOperationException; - 这是同步 Binder 调用,源码提示可能耗时超过 1 毫秒,要避开关键线程。
查询频率应遵守 getCpuHeadroomMinIntervalMillis() 和 getGpuHeadroomMinIntervalMillis() 返回的最短间隔。这两个 API 估算的余量,可以帮我们判断工作是否接近 CPU/GPU capacity 的上限;但 capacity 不足未必是温度造成的,thermal headroom 也指不出瓶颈在 CPU 还是 GPU。
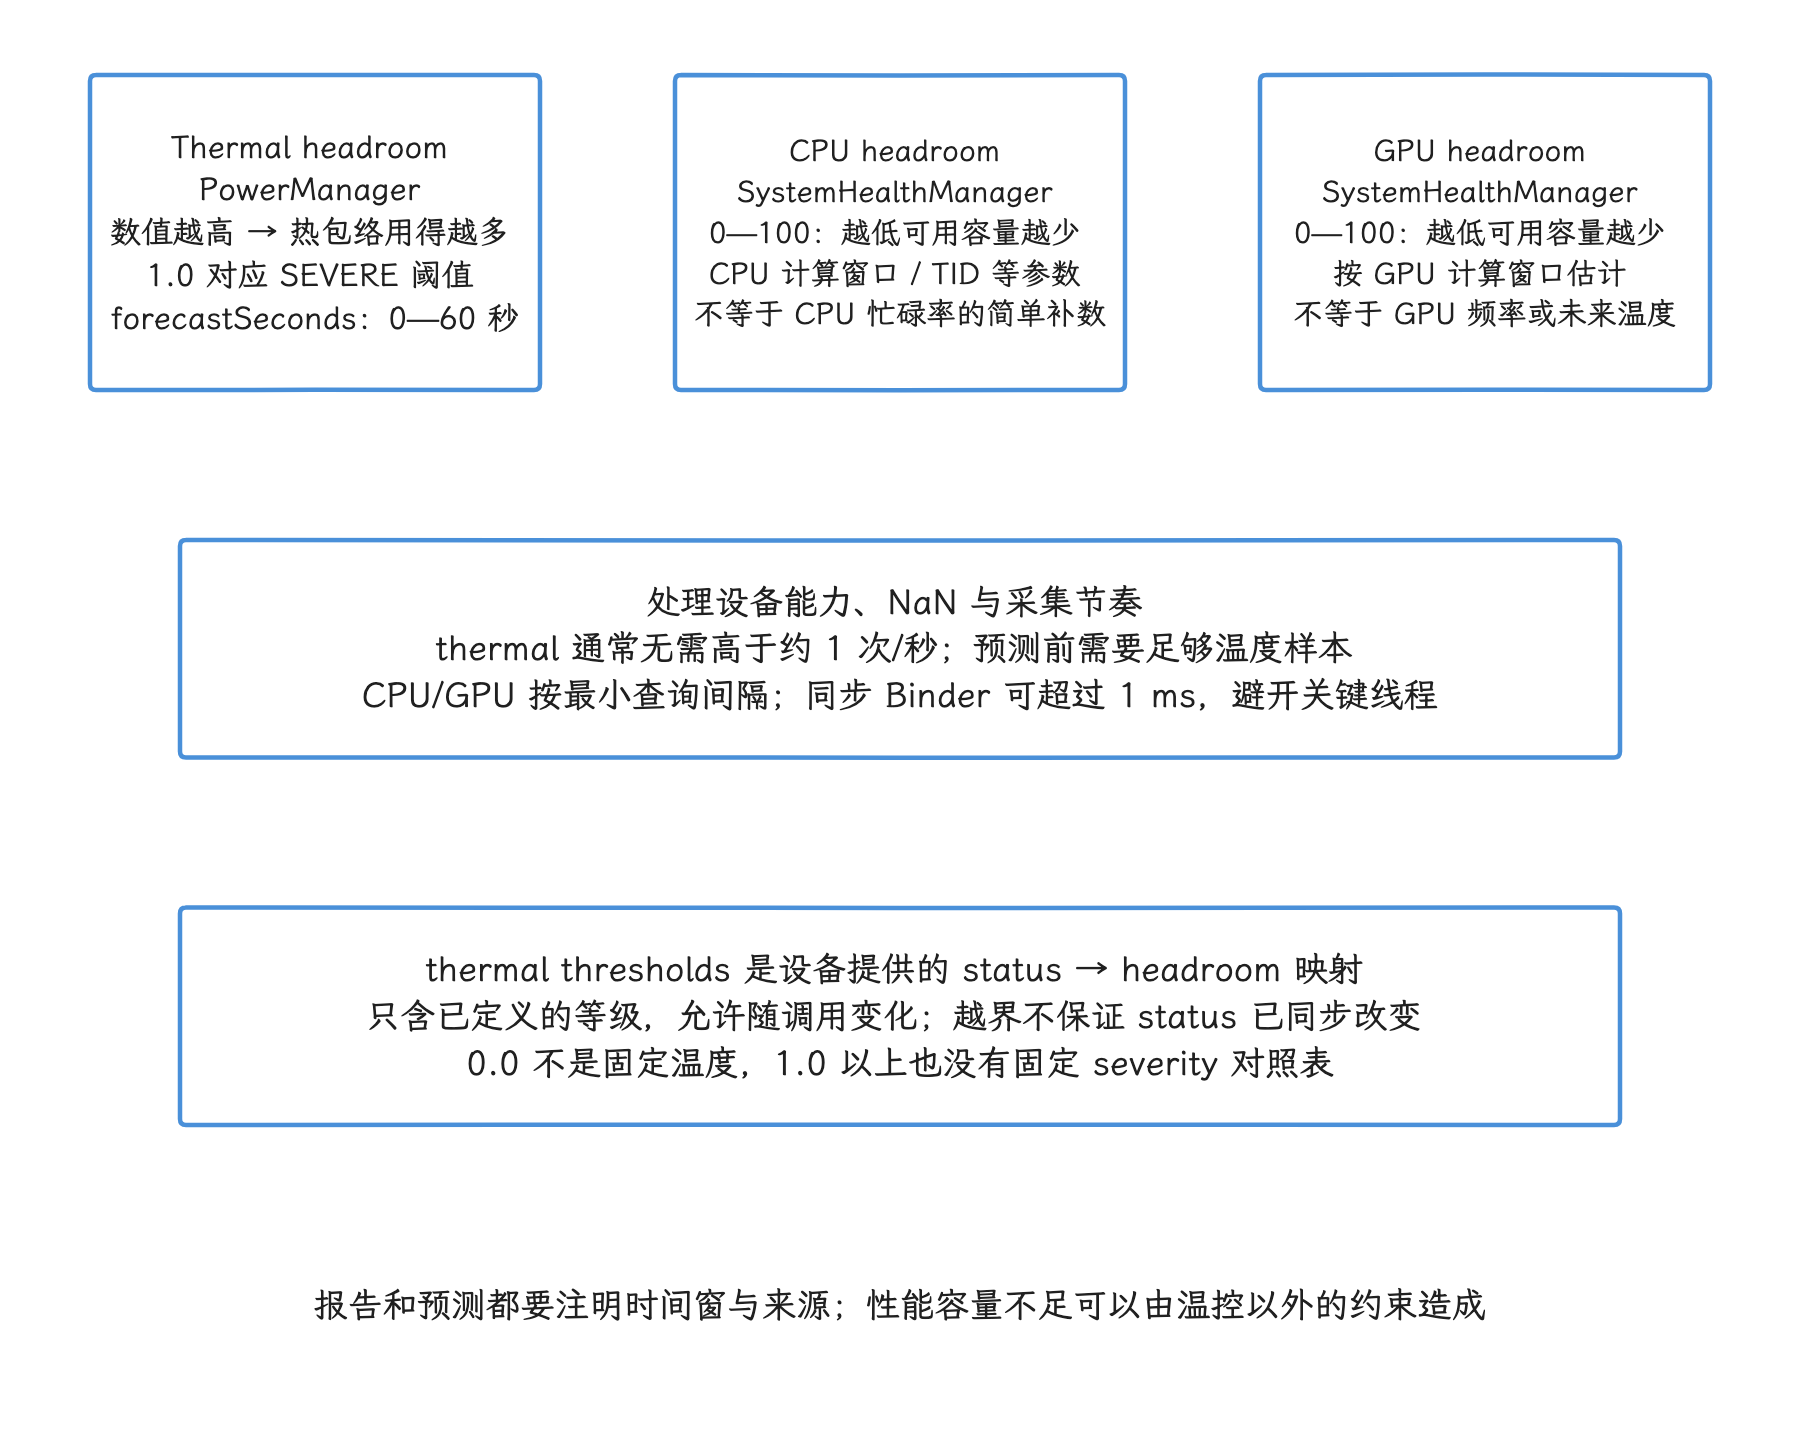
图:thermal headroom 表示热包络已使用的相对程度,值升向 1.0 意味接近 SEVERE;forecastSeconds 取 0—60 秒,过密调用或缺少能力可得 NaN。CPU/GPU headroom 表示可用容量,0—100 中越低越缺余量,参数是计算窗口而非相同的未来预测秒数。后两者有同步 Binder 成本,应按最小查询间隔在非关键线程调用。
温控怎样影响性能
频率、容量与并行度都会变化
温控可能降低 CPUFreq policy 上限、GPU 性能等级、内存带宽或可用 CPU 数量,也可能把功率预算转移给另一个硬件域。应用可能观察到:
- 同一 CPU 工作量执行时间增长;
- GPU 队列(queue)或同步栅栏(fence)完成变慢;
- 主线程或 Android 渲染线程(RenderThread)更容易错过帧截止时间(deadline);
- 编码、推理和编译吞吐随时间下降;
- 系统为了降低显示功耗而改变亮度或刷新相关策略。
热限制通常带迟滞:达到阈值后开始降载,温度回落到更低位置才逐步恢复。测试要同时观察限制生效与恢复两个过程,只记录一次最高温度是不够的。
高负载与低频共现时的证据链
我们把下面这些观测放到同一时间窗里,“性能下降来自 thermal throttling”的判断就更可信:
- 关键工作在目标 CPU/GPU 上持续繁忙;
- thermal status、SKIN headroom、thermal zone 或 cooling state 同期变化;
- policy 频率上限降低、capacity 下降,或设备功率约束增强;
- 请求频率受上限限制,任务时长或帧时间随之恶化;
- 设备冷却、策略恢复后,同一负载受到的限制解除。
如果手头只有“CPU 利用率高、频率低”,我们还要接着排查共享 policy、功率限制、任务迁移、调频驱动和频率数据语义。
用 Perfetto 建立证据链
建议采集的数据
Perfetto 的 linux.sys_stats 数据源支持轮询 thermal zone 和 cpufreq sysfs。下面的配置片段用于每秒采样一次:
data_sources: {
  config {
    name: "linux.sys_stats"
    sys_stats_config {
      thermal_period_ms: 1000
      cpufreq_period_ms: 1000
    }
  }
}
这段配置适合观察分钟级热趋势。采样周期会影响时间精度,节点访问失败时也可能缺少相应轨道(track)。
Linux 6.18 定义了 thermal/thermal_temperature、thermal/thermal_zone_trip 和 power/cpu_frequency 等 ftrace 内核跟踪事件。下面的配置用于观察这些事件的发生顺序:
data_sources: {
  config {
    name: "linux.ftrace"
    ftrace_config {
      ftrace_events: "thermal/thermal_temperature"
      ftrace_events: "thermal/thermal_zone_trip"
      ftrace_events: "power/cpu_frequency"
      ftrace_events: "sched/sched_switch"
      atrace_categories: "power"
    }
  }
}
设备内核可能关闭某个跟踪点(tracepoint),厂商也可能提供自己的 cooling、thermal pressure 或功率轨迹。采集后先确认轨迹里确实有数据,再下判断。
阅读顺序
- 用 Frame Timeline、业务 slice 或任务完成时间标记性能下降点;
- 检查
ThermalManagerService.status、thermal zone 温度与 trip 事件; - 检查 cooling state、CPUFreq policy 上限、CPU capacity、thermal pressure 和 GPU 限制轨迹;
- 对齐目标线程的 running、runnable 时间及 CPU 频率;
- 把进入 throttling、稳态和冷却恢复三个阶段分开统计。
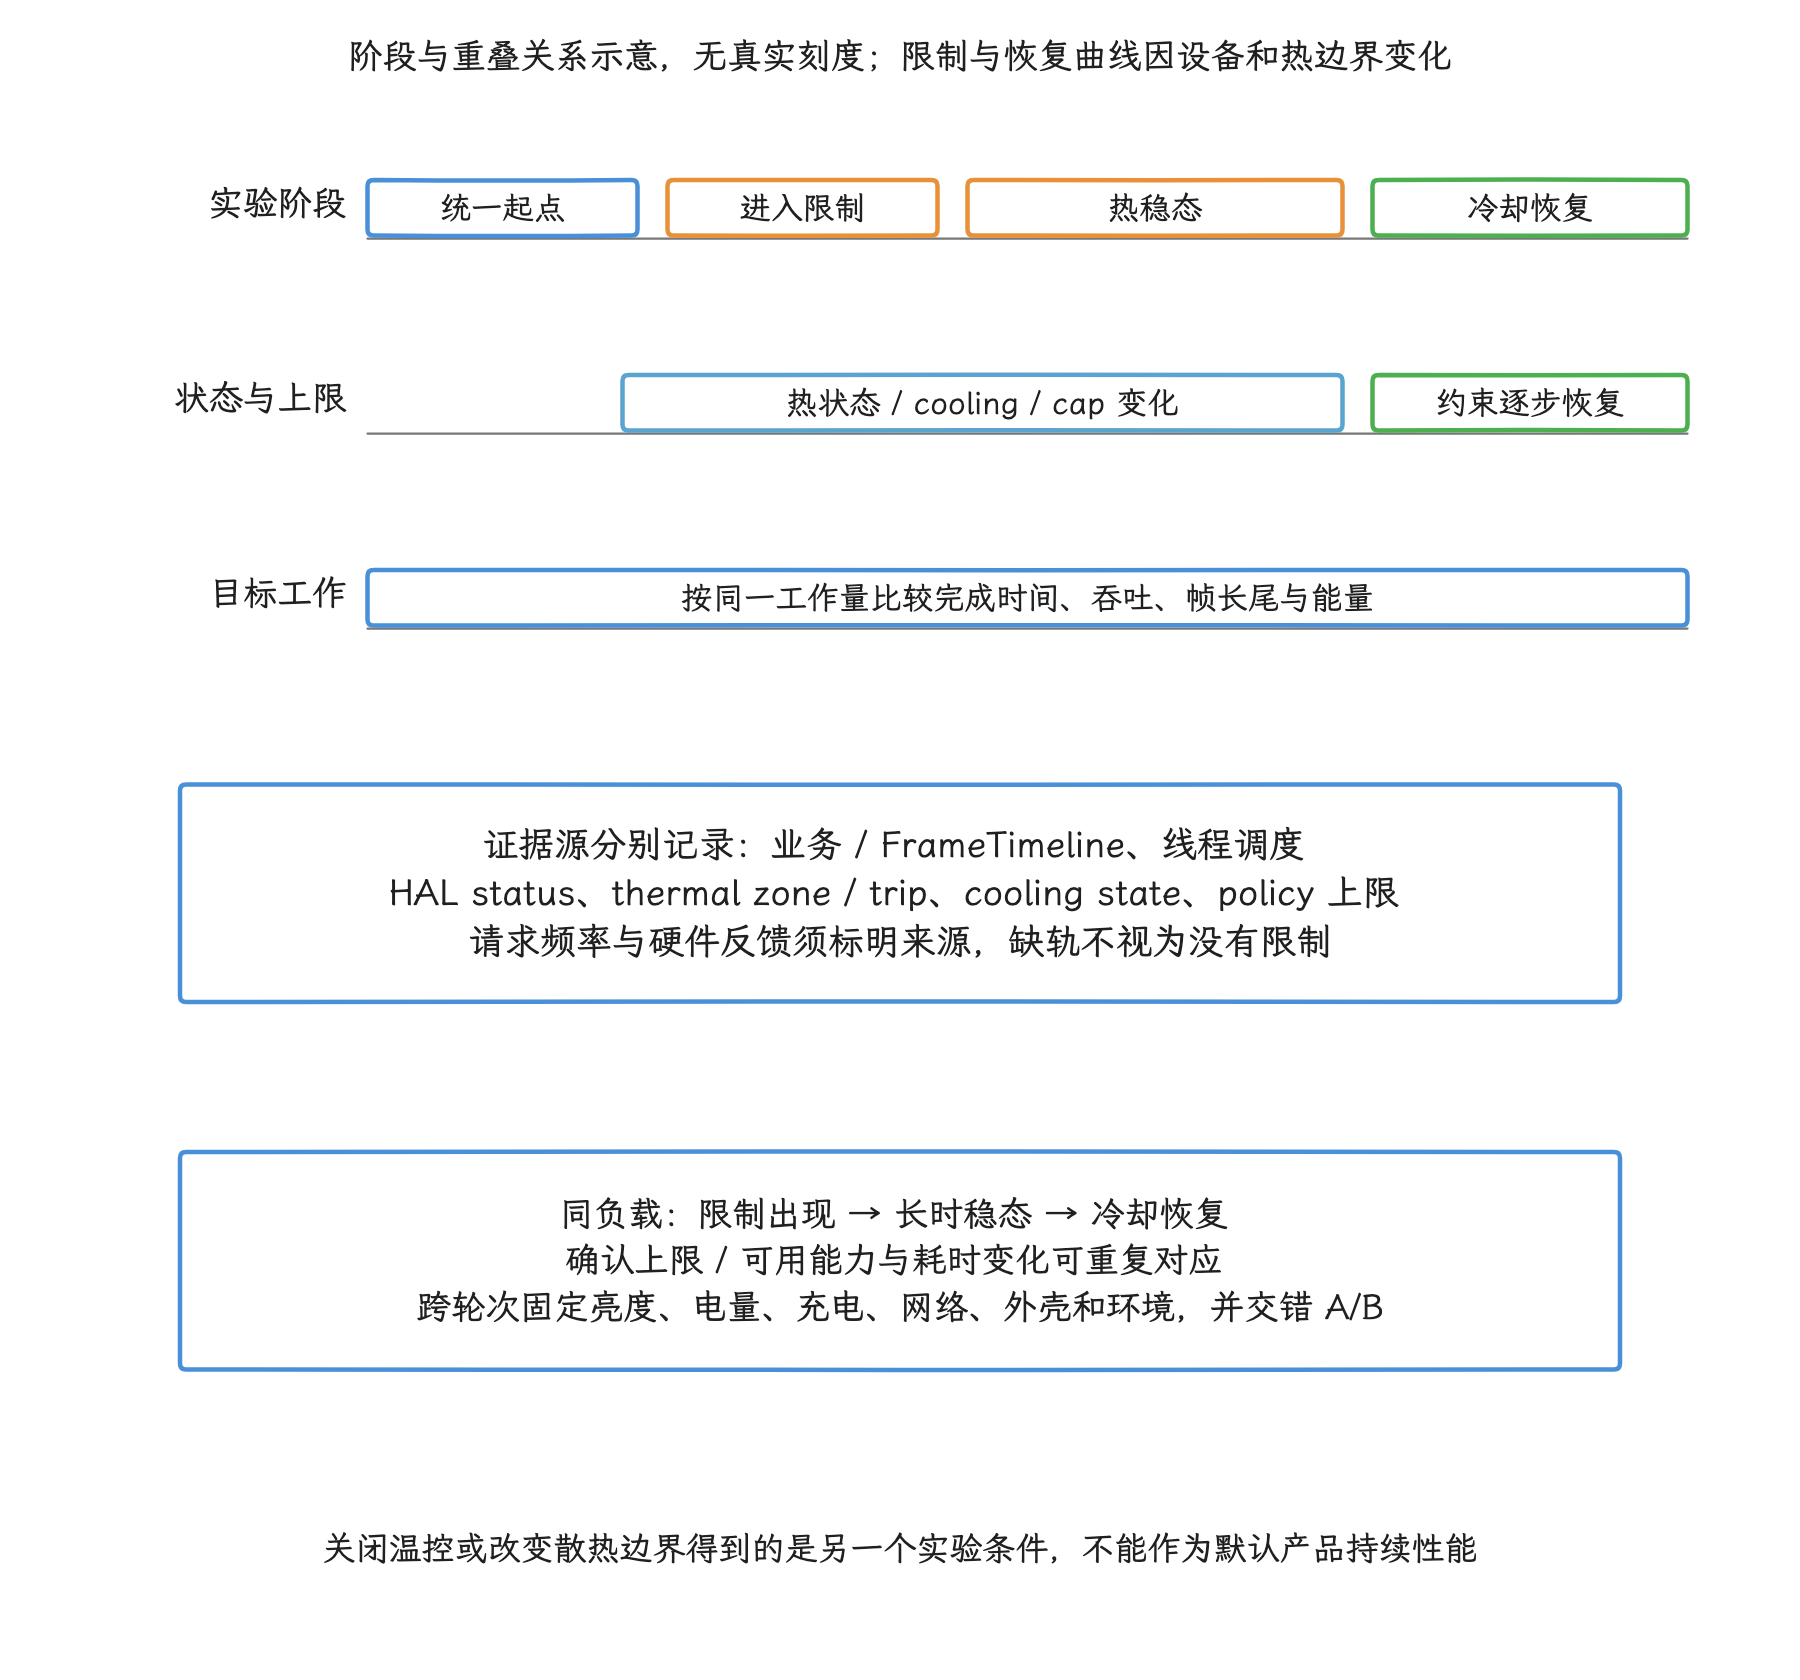
图:用业务期限先确定性能下降,再对齐温度或 status、headroom、cooling state 和实际 policy/硬件限制。持续负载下的限制出现、热稳态与冷却恢复应分别统计;只有高 util 与低频两个点,仍需排查省电、电流预算、共享 policy 与驱动语义。图中跨度仅示意,不提供固定升温分钟数或温度阈值。
power/cpu_frequency 或轮询到的 scaling_cur_freq 可能接近 CPUFreq 请求状态,先别直接当成片上计数器测到的物理实频。
常见的温控缓解手段(Thermal Mitigation)
| 手段 | 直接效果 | 应用侧可能看到的现象 |
|---|---|---|
| CPU/GPU 限频或功率上限 | 降低计算域功率 | CPU/GPU 工作时长增加 |
| CPU 热插拔或隔离(hotplug/isolation) | 减少可用并行度或高功耗核心 | runnable 等待、吞吐下降 |
| 降低显示亮度或刷新策略 | 降低显示与合成相关功率 | 亮度受限、帧率目标改变 |
| 限制充电 | 减少电池与充电集成电路(IC)发热 | 充电速度下降或暂停 |
| 限制相机、无线或其他功能 | 降低对应子系统功率 | 功能降级或暂时不可用 |
| 应用主动降载 | 提前减少产热 | 质量下降较平滑,避免被动超时 |
表中列出的是可选动作,severity 到动作并没有标准映射。具体设备要结合 Thermal HAL 状态、厂商配置、系统日志和实机 Trace 确认。
应用如何主动降载
降载动作应满足三点:
- 可逆:温度回落后能够逐步恢复;
- 有迟滞:进入和退出使用不同阈值,避免频繁切换;
- 按瓶颈选择:GPU 受限时优先减像素和特效,CPU 受限时减少模拟、脚本或编码复杂度。
可以按阶段设计:
LIGHT:停止预取、遥测数据处理和非关键后台任务。MODERATE:降低渲染分辨率、特效、相机处理或编码档位。SEVERE及以上:降低帧率目标,暂停高成本功能,优先保障交互和数据安全。
这些是应用策略示例:每个等级的动作要由产品质量要求和实测结果决定,别把示例当成平台规范。
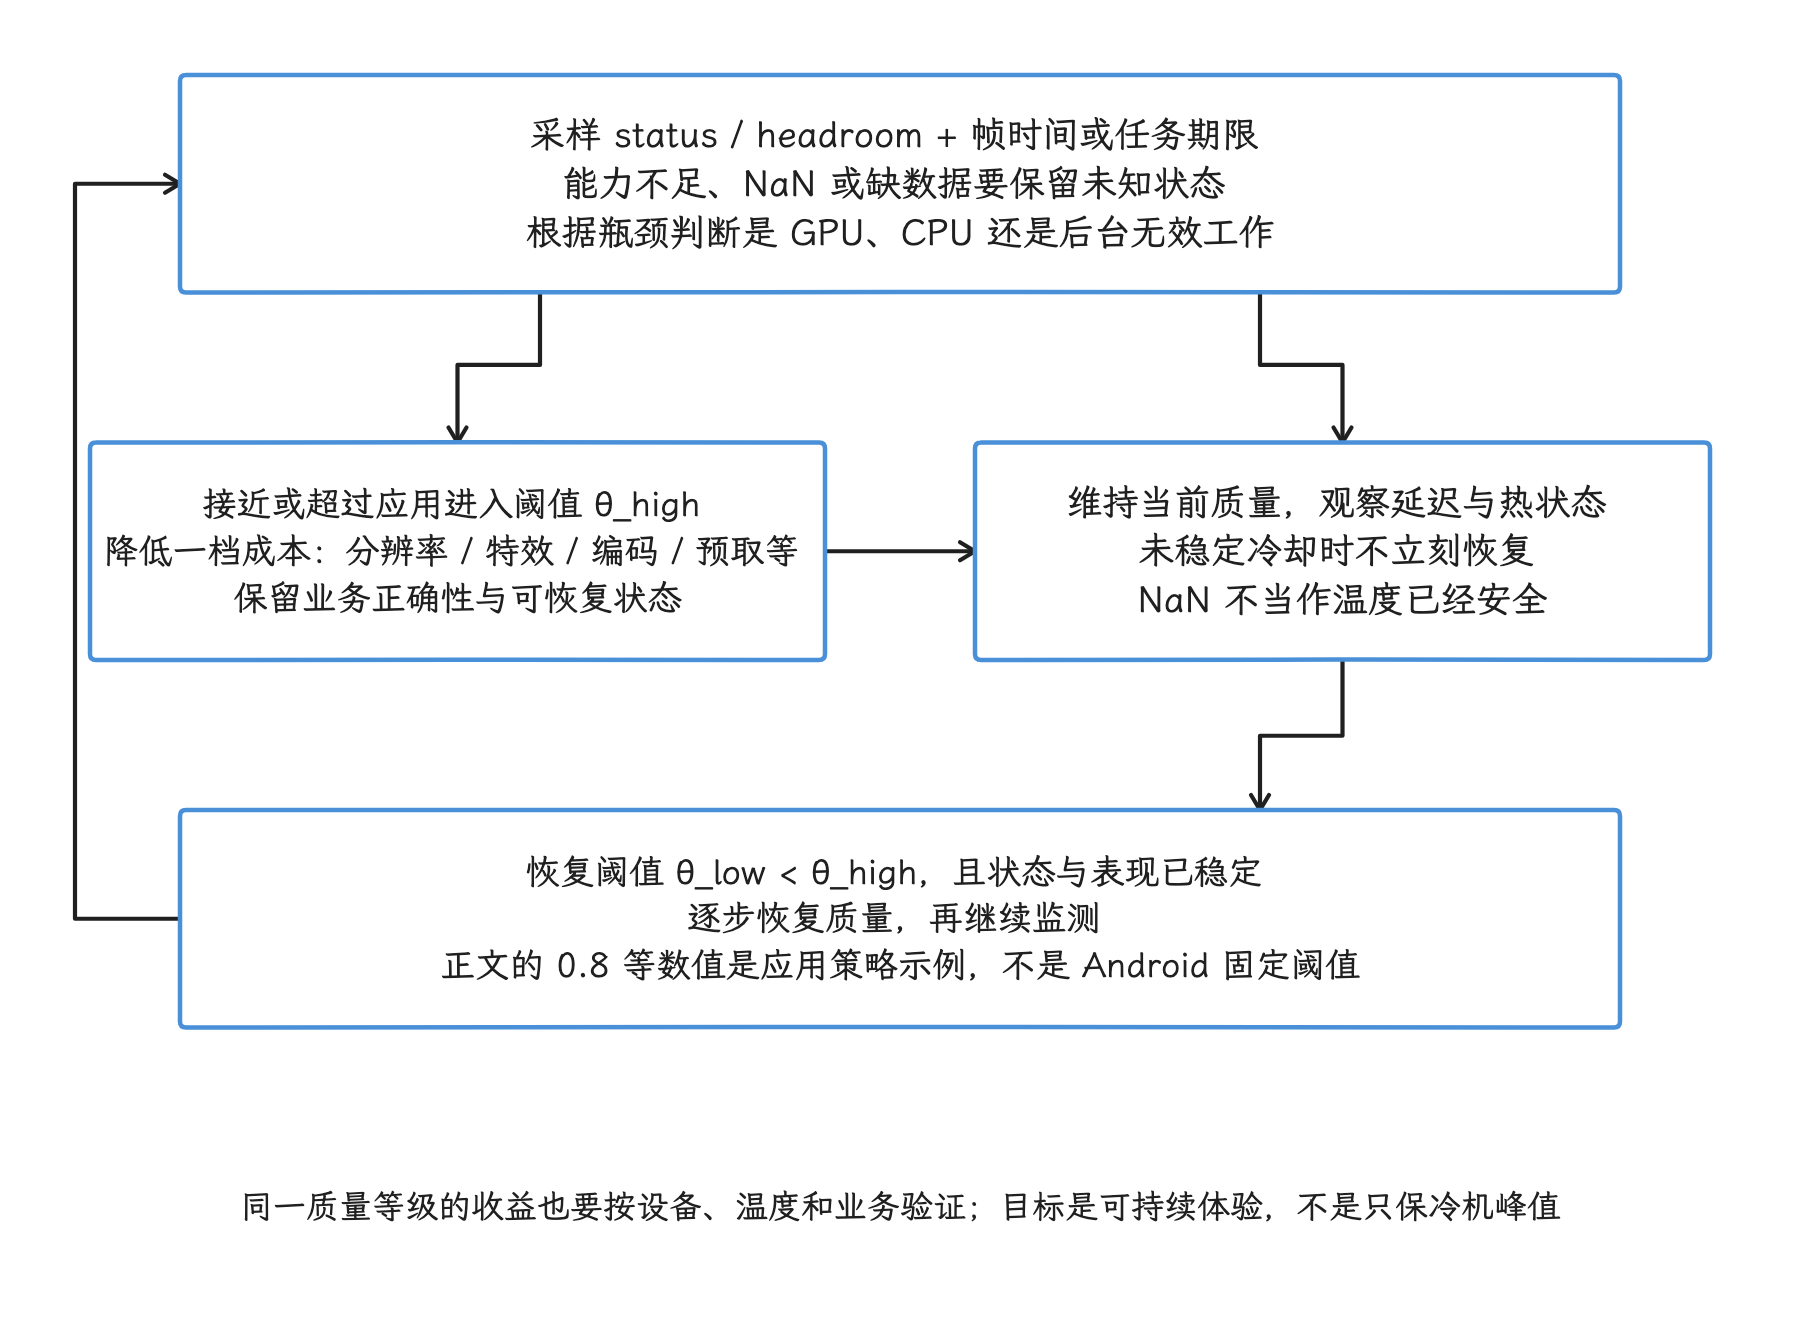
图:应用同时参考 thermal status、预测 headroom 与实际帧或任务表现;无效数据先按异常处理。进入降载使用较高阈值,恢复使用更低阈值并确认冷却稳定,避免质量在临界区间反复切换。GPU 受限可减像素和特效,CPU 受限可减模拟或编码复杂度;数值和动作属于应用实验策略,各 severity 的平台动作由系统另行决定。
持续性能模式与固定性能模式
持续性能模式(Sustained Performance Mode)
Android 7.0 提供持续性能模式。应用先用 PowerManager.isSustainedPerformanceModeSupported() 检查设备是否支持,再通过 Window.setSustainedPerformanceMode(true) 请求适合长时工作的性能策略。
下面的代码用于受支持设备上的长负载窗口:
PowerManager pm = getSystemService(PowerManager.class);
if (pm.isSustainedPerformanceModeSupported()) {
    getWindow().setSustainedPerformanceMode(true);
}
Power HAL AIDL 中仍有 Mode.SUSTAINED_PERFORMANCE。厂商可以通过 CPU、GPU 或其他资源策略提供较稳定的长期性能,平台接口不规定固定频率,也不承诺某个 30 分钟波动百分比。这个模式关不掉温控保护;设备继续升温时仍可进一步降载。
固定性能模式(Fixed Performance Mode)
adb shell cmd power set-fixed-performance-mode-enabled true 是面向测试的系统命令,用来减少动态性能变化,方便在同一设备上比较实现差异。设备不支持时命令可能失败;温控、功率和安全限制仍然有效,所以别期待“fixed”意味着观测频率绝对不变。
实验结束后要恢复:
adb shell cmd power set-fixed-performance-mode-enabled false
普通应用不要把这个命令当成产品能力,也不要把固定性能模式与 ADPF 的性能提示会话混成同一个接口。
如何控制性能测试中的热变量
先定义测试目标
- 测峰值:规定统一的起始温度和短测试窗口。
- 测持续性能:运行到热稳态,报告稳定阶段的吞吐与波动。
- 测真实体验:保留产品外壳、默认温控策略、亮度、网络和充电状态。
三种数据回答的问题不同,应分别命名,别混在一张排行榜里。
记录环境与设备状态
每轮至少记录:
- 机型、系统构建、内核、应用版本;
- 环境温度、外壳和散热附件;
- 电量、是否充电、充电功率;
- 亮度、刷新率、网络和无线状态;
getCurrentThermalStatus()、headroom 和关键 thermal zone;- CPU/GPU policy 上限以及测试开始/结束时间。
静置时间和“允许开始”的温度应来自该设备的预实验。写成固定的 5~10 分钟或环境温度 ±2°C,未必适合不同机身和传感器。
使用可复现的实验顺序
- 预热应用与数据,排除首次编译、缓存和网络差异;
- 等待设备回到预先定义的起始条件;
- 随机或交错执行 A/B 对照,避免方案 A 总在冷机、方案 B 总在热机;
- 重复多轮,分别报告中位数、离散程度和 thermal 状态;
- 持续性能测试要覆盖进入 throttling 和热稳态;
- 物理风冷只用于明确标记的实验条件;它改变了产品散热边界。
不要关闭 thermal protection,也不要放宽 CRITICAL / SHUTDOWN 阈值:这会改变安全条件,测试结果也就失去了产品意义。
厂商差异与散热硬件
AOSP 统一了 Thermal HAL 与应用 API,没有统一以下内容:
- 传感器的位置和热模型;
- SKIN 与内部热点之间的估算方式;
- trip、迟滞和控制周期;
- CPU/GPU/DDR/显示/充电之间的功率预算;
- severity 到 mitigation 动作的映射;
- 均热板(Vapor Chamber,VC)、石墨片、机身结构和外接散热器的效果。
VC、热管和石墨材料主要改变热扩散与热容量,最终效果还受接触热阻、面积、机身材料和环境对流影响。只有材料名称或面积推不出持续帧率;“导热效率是铜的固定倍数”也没法跨产品比较。
跨设备测试时,我们把硬件散热和厂商策略视为被测系统的一部分。两台设备即便用同一颗 SoC,仅凭 SoC 型号也解释不了持续性能差异。
版本边界与源码索引
| Android 版本 | 关键变化 | 分析方式 |
|---|---|---|
| Android 7 / API 24 | Sustained Performance Mode | 设备声明支持后使用 |
| Android 10 / API 29 | Thermal HAL 2.0 与公开 thermal status API | 状态监听成为应用减载入口 |
| Android 11 / API 30 | getThermalHeadroom() | 0~60 秒 SKIN 趋势预测 |
| Android 14 / API 34 | 稳定版 AIDL Thermal HAL | Android 17 优先连接的 HAL |
| Android 15 / API 35 | thermal headroom thresholds API 进入平台 API | 在运行时处理缺失阈值与不支持的情况 |
| Android 16 / API 36 | CPU/GPU headroom 与 thermal headroom 回调 | 先检查设备支持,再避开关键线程调用 |
| Android 17 / API 37 | ThermalManagerService 位于 server/power/thermal/ | 以 android-17.0.0_r1 源码为锚点 |
| 层次 | 精确源码 |
|---|---|
| Framework | frameworks/base/services/core/java/com/android/server/power/thermal/ThermalManagerService.java |
| 应用 API | frameworks/base/core/java/android/os/PowerManager.java、android/os/health/SystemHealthManager.java |
| Thermal HAL | hardware/interfaces/thermal/aidl/android/hardware/thermal/ |
| Linux 内核 | drivers/thermal/、Documentation/driver-api/thermal/sysfs-api.rst |
| Perfetto | SysStatsConfig.thermal_period_ms、SysStatsConfig.cpufreq_period_ms |
常见误区
“手机发热就表示应用有缺陷”
高负载必然产热。可疑的信号是超出业务需要的持续工作,比如忙循环、异常重试、频繁唤醒、无效的 GPU 重复绘制(overdraw)或后台定位。我们用 Trace 和功耗数据定位多余工作,再判断能否优化。
“取得 Root 权限后关闭温控可以保持峰值性能”
硬件、固件和内核可能有多层保护,关掉其中一层也未必保得住峰值。绕过 thermal protection 还会带来安全和寿命风险,测出来的也不是量产体验。
“Thermal status 为 NONE 就没有热限制”
公开 status 以 SKIN severity 为主。芯片、充电或电源预算可能已经在限制某个性能域,整体 status 却仍是 NONE。排障要结合域级频率、capacity、温度和厂商数据。
“Sustained Performance Mode 会固定频率”
它表达长期稳定性能需求,资源策略由厂商决定。固定性能模式也仍受温控和安全上限约束。这两个模式都替代不了温控证据采集。
Power HAL、系统状态与应用约束
耗电问题排查到最后,经常从“芯片干了多少活”转到“系统让不让它跑、什么时候跑”:内核控制频率和温度,Android Framework 还通过 Power HAL、Doze、后台限制和电量统计影响工作何时发生。这一层的 Doze 时序、App Standby Buckets、功率模型与厂商 Power HAL 策略都允许设备配置,所以我们不拿固定分钟数或固定频率来描述通用行为。
功耗排障先回答三个问题
一次“耗电高”的报表背后,可能是完全不同的机制。我们开始分析前先把三个问题分开:
- 谁在消耗能量:CPU、GPU、显示、蜂窝、Wi-Fi、GNSS、相机或充电电路;
- 系统为什么没有休眠:应用 WakeLock、内核 wakeup source、定时器、中断或系统恢复流程;
- 工作为什么在这个时间发生:前台业务、Alarm、JobScheduler、WorkManager、推送、Doze 维护窗口或后台限制豁免。
WakeLock 主要回答第二个问题:它解释不了 CPU 为什么繁忙,也覆盖不了显示或无线射频的全部能量。可靠的判断通常要把系统状态、组件活动和能量数据放到同一时间轴上。
从 PowerManagerService 到系统挂起
四个不同层次
功耗主路径可以分为四层:
| 层次 | 主要对象 | 职责 |
|---|---|---|
| 应用/Framework API | PowerManager.WakeLock、屏幕标志(screen flags)、Job/Alarm API | 表达“暂时保持某种运行条件” |
system_server | PowerManagerService(PMS) | 汇总 WakeLock、显示、唤醒状态(wakefulness)和用户活动,维护挂起阻止器(suspend blocker) |
| 原生层/系统服务 | PMS 的 JNI、ISystemSuspend、挂起控制服务 | 开关自动挂起(autosuspend),获取或释放原生 suspend blocker |
| Linux 内核/平台 | wakeup source、系统挂起(system suspend)、设备驱动、固件 | 冻结用户空间、挂起设备、进入平台支持的睡眠状态并处理唤醒 |
应用 WakeLock 与内核 wakeup source 有关联,却是两个对象:PMS 把满足条件的 Framework WakeLock 汇总到名为 PowerManagerService.WakeLocks 的 suspend blocker,硬件驱动也可以独立注册 wakeup source。
PMS 到原生挂起控制的调用链
PowerManagerService.java 中可以定位到:
mWakeLockSuspendBlocker、mDisplaySuspendBlocker和启动阶段 blocker(boot blocker);nativeAcquireSuspendBlocker()/nativeReleaseSuspendBlocker();nativeSetAutoSuspend();nativeSetPowerMode()。
JNI(Java Native Interface,Java 原生接口) 文件 com_android_server_power_PowerManagerService.cpp 连接 ISystemSuspend 与挂起控制服务(suspend control service)。启用 autosuspend 后,SystemSuspend 在有效 blocker 解除、唤醒计数校验等条件满足时,才尝试写入 /sys/power/state。r1 支持用户空间 suspend counter 与按名称写内核 WakeLock 节点两种实现;它们都不绕过驱动 wakeup source 和内核挂起检查。
PMS 还会用 Mode.INTERACTIVE 向 AIDL Power HAL 通知交互状态。这个模式由厂商映射到自己的电源策略;一次普通的 WakeLock acquire 也不会直接命令 schedutil 升到某个频点。
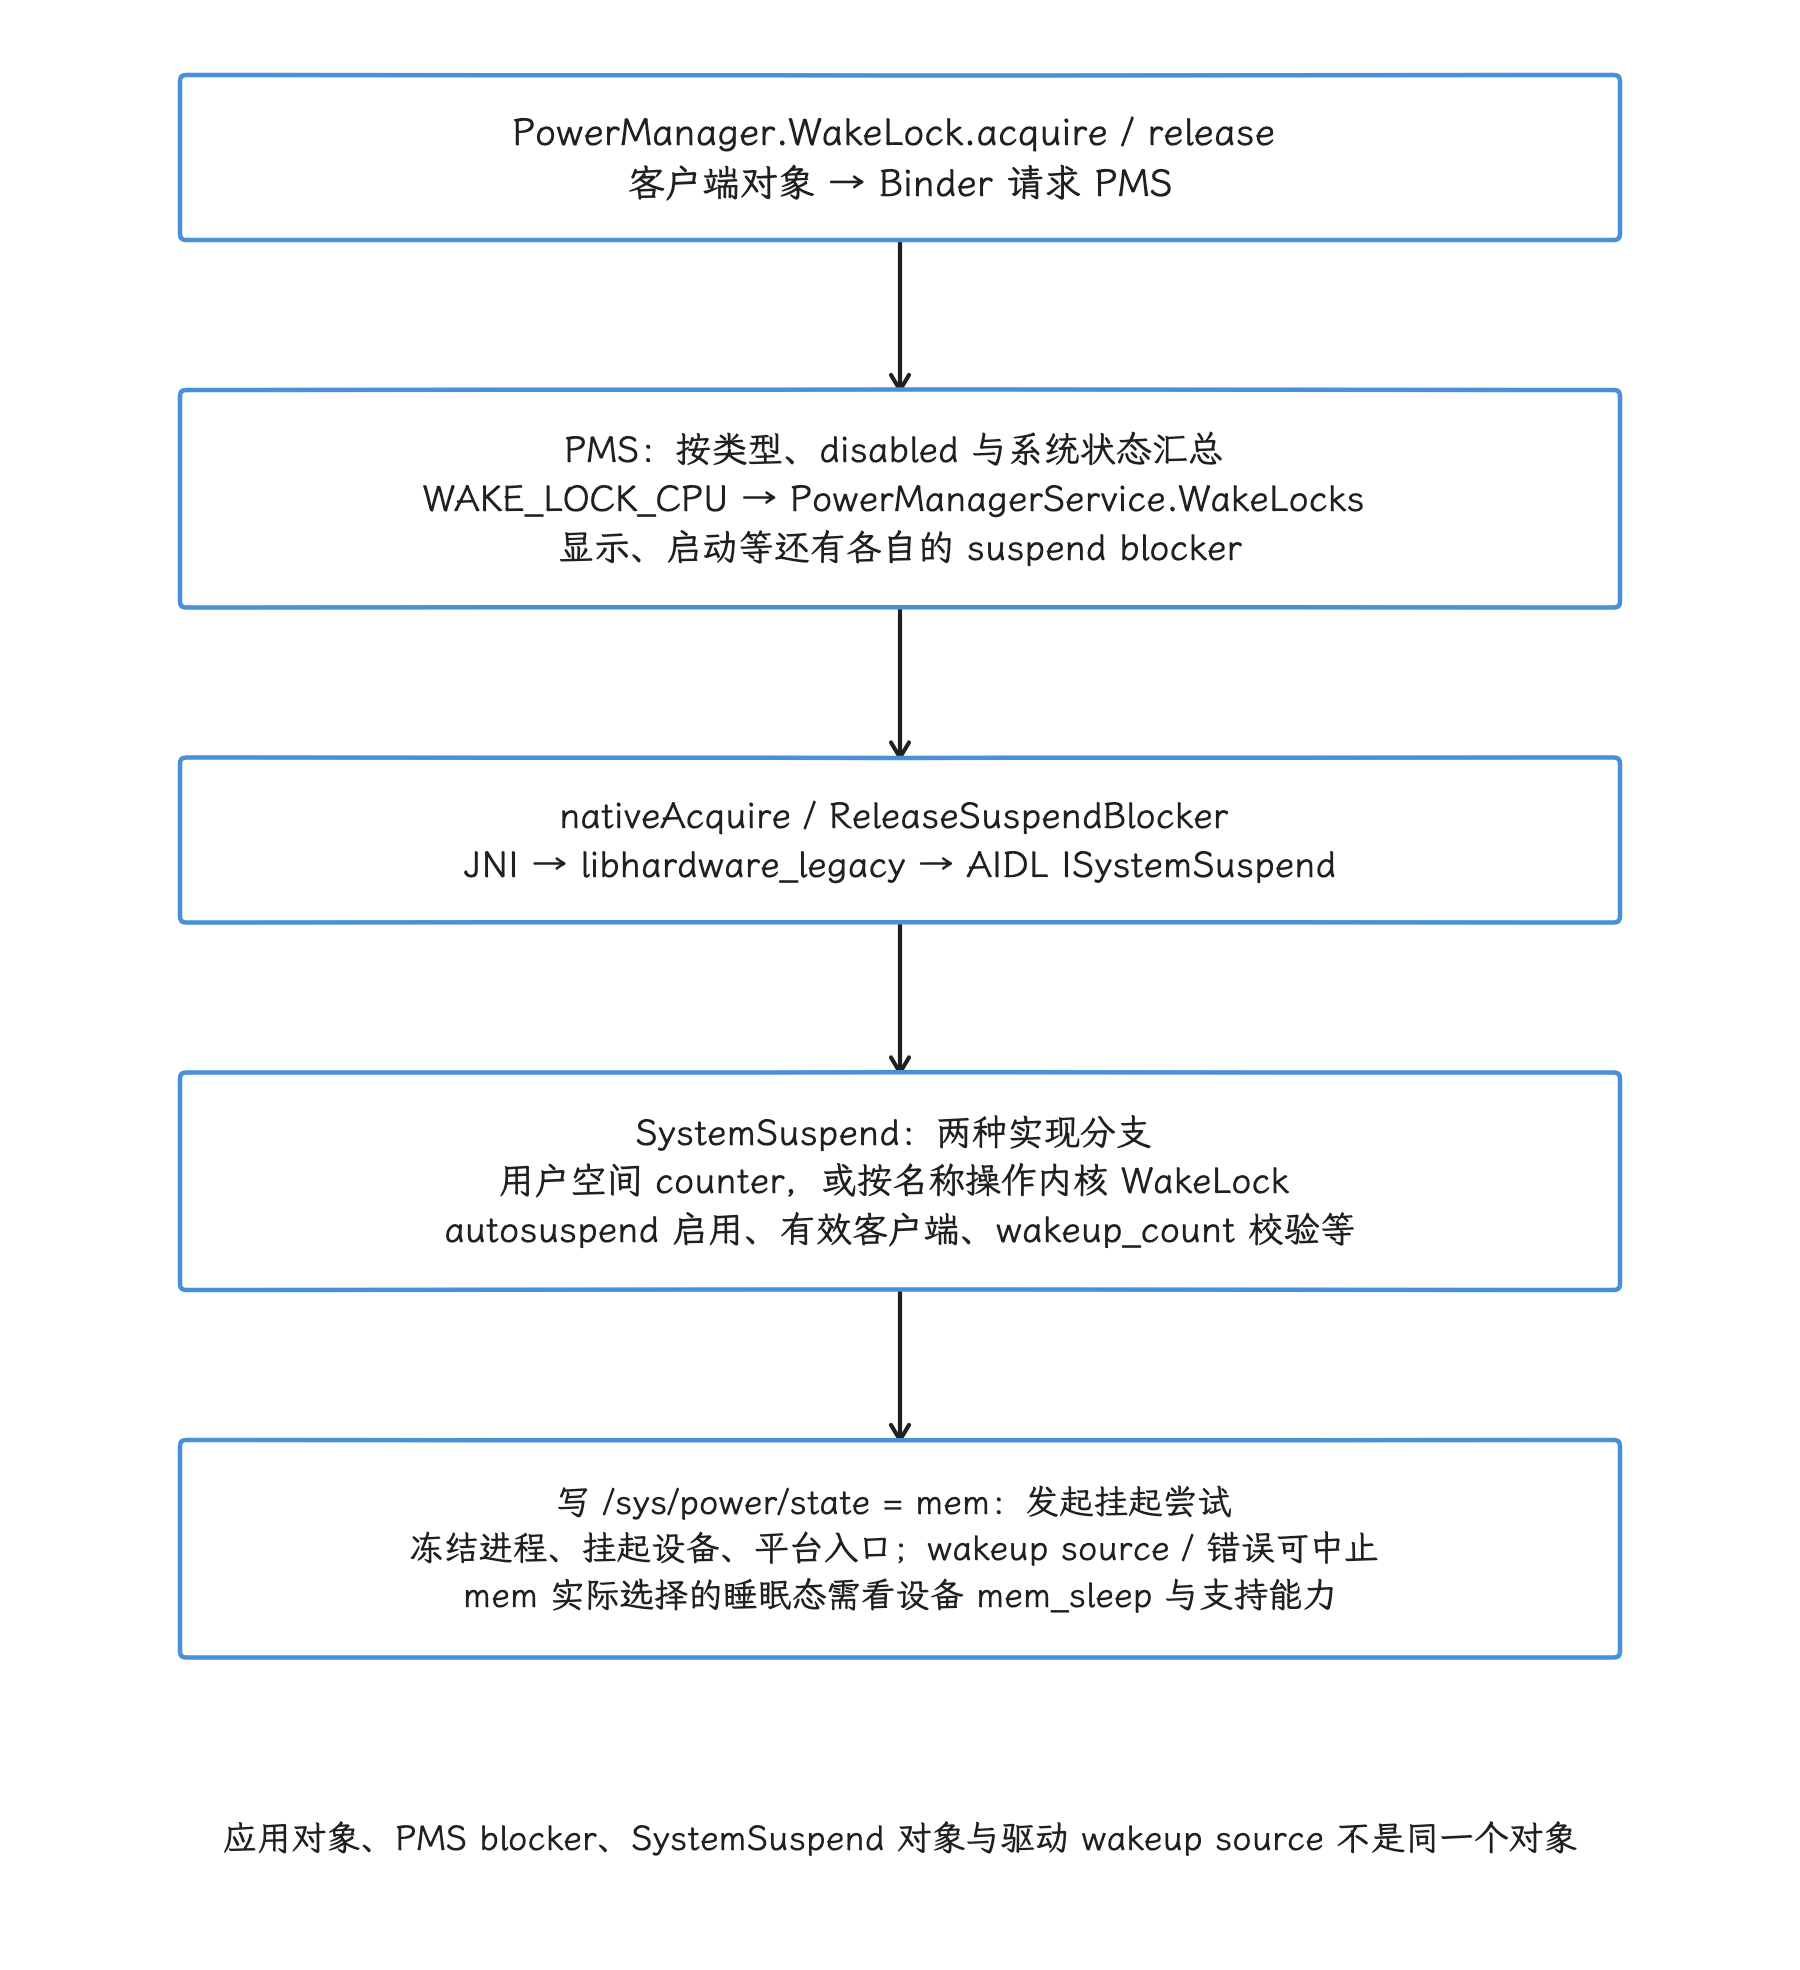
图:PMS 按锁类型、UID 状态和策略判断锁是否有效,汇总为 suspend blocker。JNI 经 libhardware_legacy 调用 AIDL SystemSuspend;后者可使用用户空间 counter 或内核命名 WakeLock。自动挂起还要校验 wakeup_count 等条件,内核和驱动仍可中止,持锁也不会直接指定 CPU 频点。
CPU 空闲与系统挂起
这两个状态必须分开:
- CPU 空闲(CPU idle):某个 CPU 暂时没有可运行任务,进入一个 cpuidle 状态;其他 CPU 和用户空间仍可能继续工作。
- 系统挂起(system suspend):全系统进入低功耗状态,用户空间被冻结,设备被挂起,CPU 由平台的 suspend 流程处理。
- 挂起到空闲(suspend-to-idle,s2idle):一种较轻的 system suspend;CPU 可以停留在深度空闲状态,但仍要经过冻结用户空间和挂起设备的系统流程。
- 挂起到内存(suspend-to-RAM):平台支持时可以进入更深状态,内存自刷新,更多设备与总线断电或进入低功耗状态。
“CPU idle 比例接近 100%”只描述各核心的空闲状态,系统是否挂起要另看挂起流程记录;Trace 里没有调度 slice 也可能只是采集缺失。power/suspend_resume 能标记挂起流程的阶段,但事件成对出现也不证明平台已经成功进入低功耗状态;设备挂起失败或新的唤醒请求都可能让流程中止。要结合挂起结果、失败原因、系统挂起时间,以及设备可提供的平台驻留统计确认。
CPUIdle 与 schedutil 分别处理空闲和运行需求
cpuidle governor(空闲状态选择策略)只在 CPU 没有 runnable 任务、准备进入 idle 时选择空闲状态;schedutil 则在 CPU 执行或负载变化时,把利用率需求映射成 CPUFreq 请求。PMS 能通过交互状态、suspend blocker 与 Power HAL mode 改变外部条件,替内核逐 CPU 选 idle state 或频率的工作它不做。
一次唤醒中常会同时出现退出 idle、任务进入 runnable、升频和 Framework 交互提示;这些事件时间上挨着,未必构成一条固定的 PMS → cpuidle → schedutil 调用链。
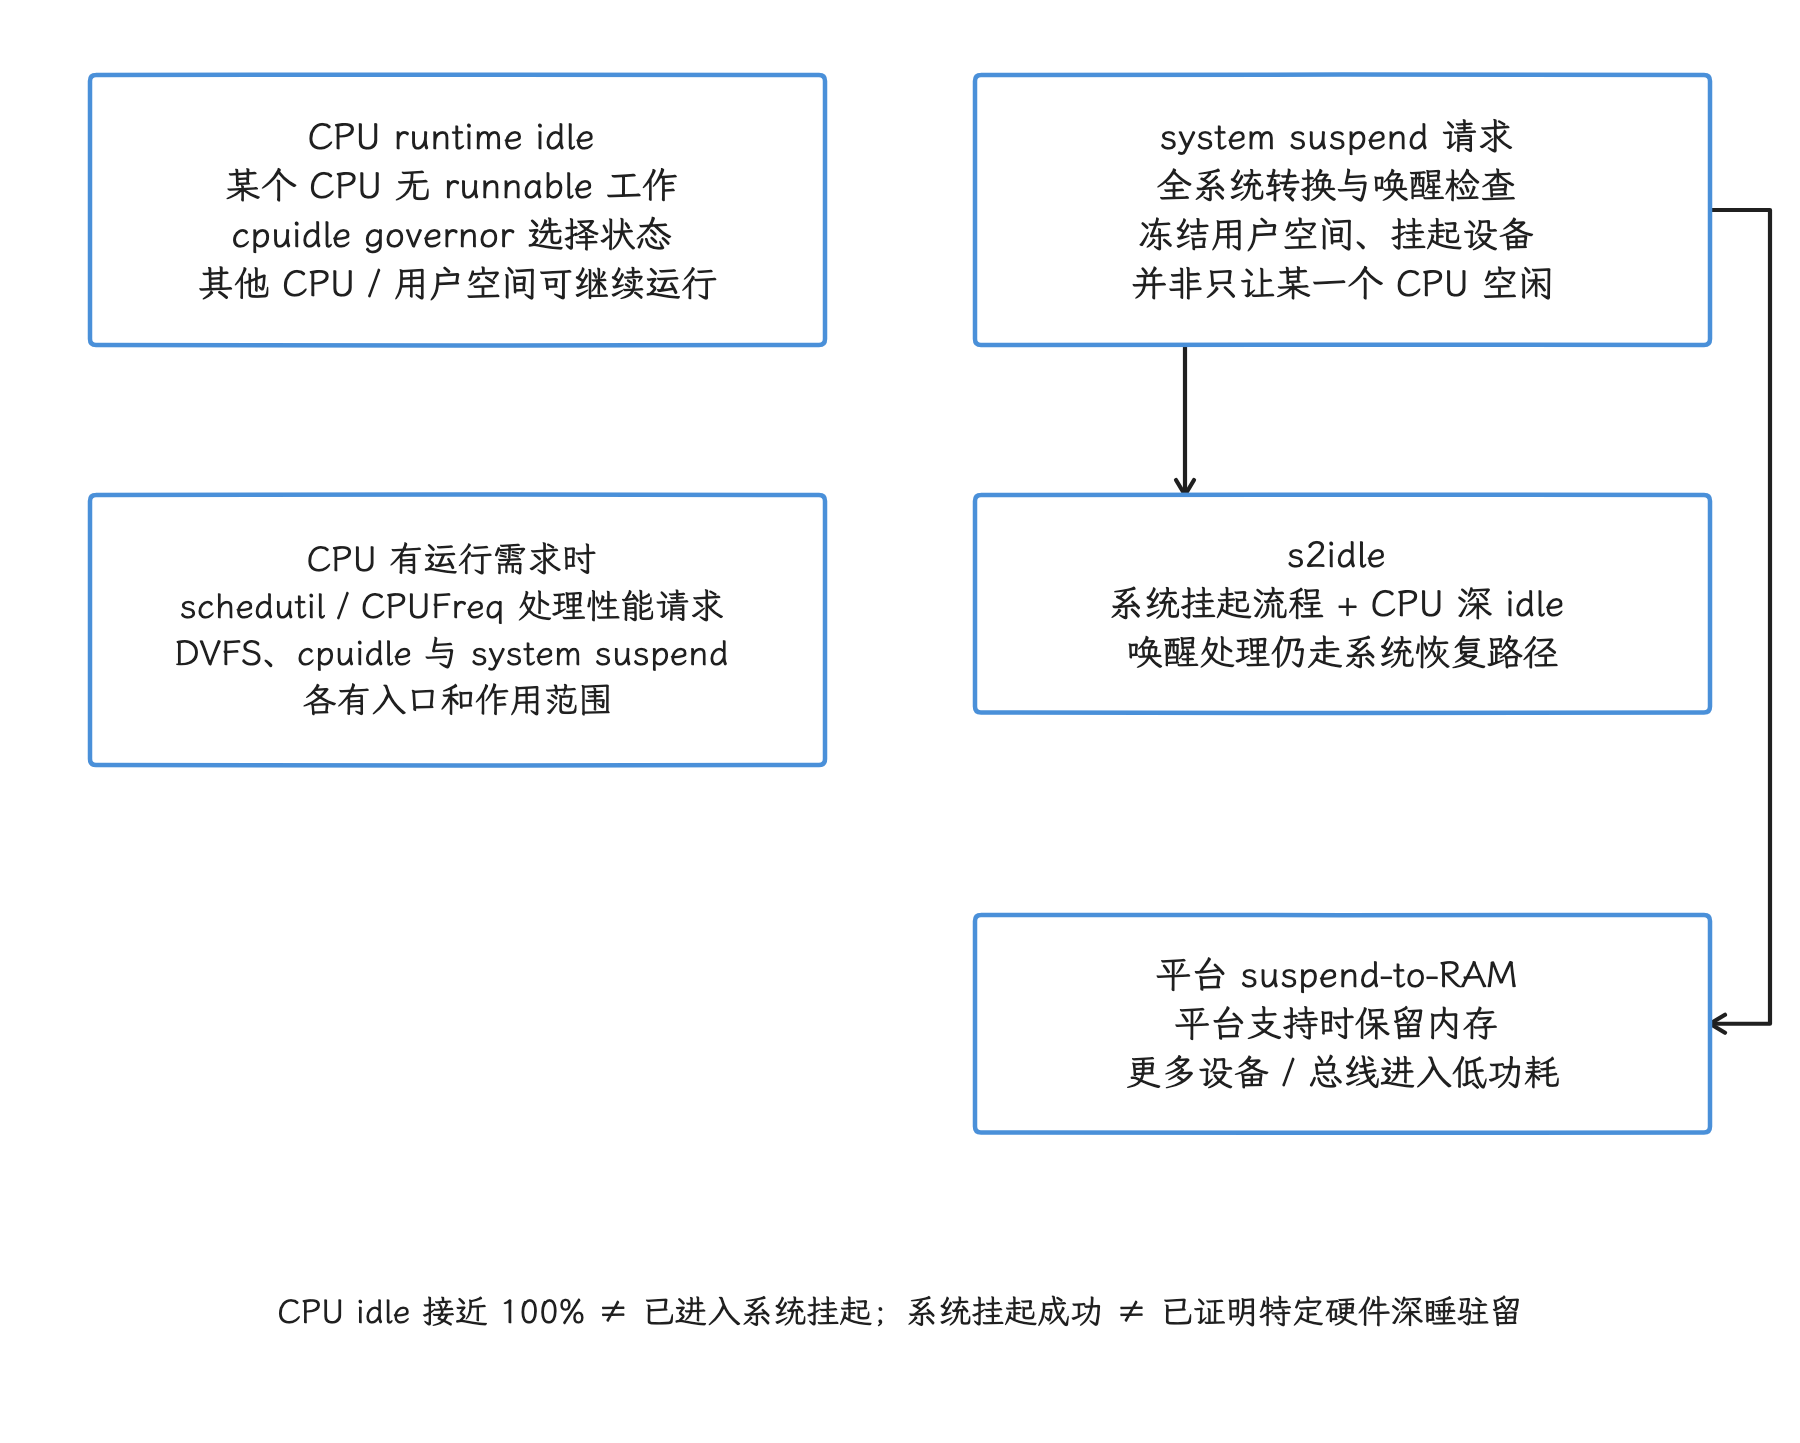
图:cpuidle 在单个 CPU 无 runnable 工作时选择空闲状态,其他 CPU 或用户空间仍可运行。system suspend 要经历全系统冻结和设备挂起,再按设备支持进入 s2idle 或平台 suspend-to-RAM。schedutil 处理运行需求,三者之间没有固定的调用链;没有调度活动同样说明不了深睡。
WakeLock:类型、语义与责任
普通应用最常用的是 PARTIAL_WAKE_LOCK
PowerManager 定义的主要 WakeLock 等级(level)包括:
| 等级 | 语义 | 普通应用建议 |
|---|---|---|
PARTIAL_WAKE_LOCK | 保持 CPU 执行,屏幕可以关闭 | 仅在没有更合适 API 时短时使用 |
SCREEN_DIM_WAKE_LOCK | 保持屏幕点亮,可变暗 | 已废弃,使用 FLAG_KEEP_SCREEN_ON |
SCREEN_BRIGHT_WAKE_LOCK | 保持屏幕高亮 | 已废弃 |
FULL_WAKE_LOCK | 保持屏幕和键盘背光 | 已废弃 |
PROXIMITY_SCREEN_OFF_WAKE_LOCK | 由接近传感器控制屏幕 | 先检查设备支持,典型用于通话 |
DOZE_WAKE_LOCK / DRAW_WAKE_LOCK | 系统内部用途 | 普通应用不可按公共能力依赖 |
PowerManager.newWakeLock() 只创建客户端对象;调用 acquire() 后,请求才会经 Binder 送到 PMS。ACQUIRE_CAUSES_WAKEUP 也已废弃;需要点亮屏幕的 Activity 应使用 setTurnScreenOn() 或清单属性等面向窗口的 API。
安全的持锁写法
下面的示例只用于屏幕关闭后仍有必要完成的一小段进程内工作:
val powerManager = getSystemService(PowerManager::class.java)
val wakeLock = powerManager.newWakeLock(
    PowerManager.PARTIAL_WAKE_LOCK,
    "$packageName:UploadFinalize"
)

wakeLock.acquire(30_000L)
try {
    finishLocalCommit()
} finally {
    wakeLock.release()
}
代码申请 30 秒后超时释放;r1 通过客户端 Handler.postDelayed() 执行,实际释放时点受消息处理和调度影响,它也不会替业务工作设置执行期限。这个示例独占持锁对象,finally 始终配对一次显式 release():即使超时已经解除系统持锁,默认引用计数下仍需平衡外部 acquire/release 计数。应用仍需声明 android.permission.WAKE_LOCK。如果工作可以交给 WorkManager、JobScheduler、媒体播放、位置或下载框架,就让对应 API 管理 WakeLock 和系统约束,少手工持锁。
还要注意引用计数:WakeLock 默认按 acquire 和 release 次数配对。调用 setReferenceCounted(false) 后,一次 release 可以结束多次 acquire 的效果;两种计数规则混用,很容易提前释放或泄漏锁。
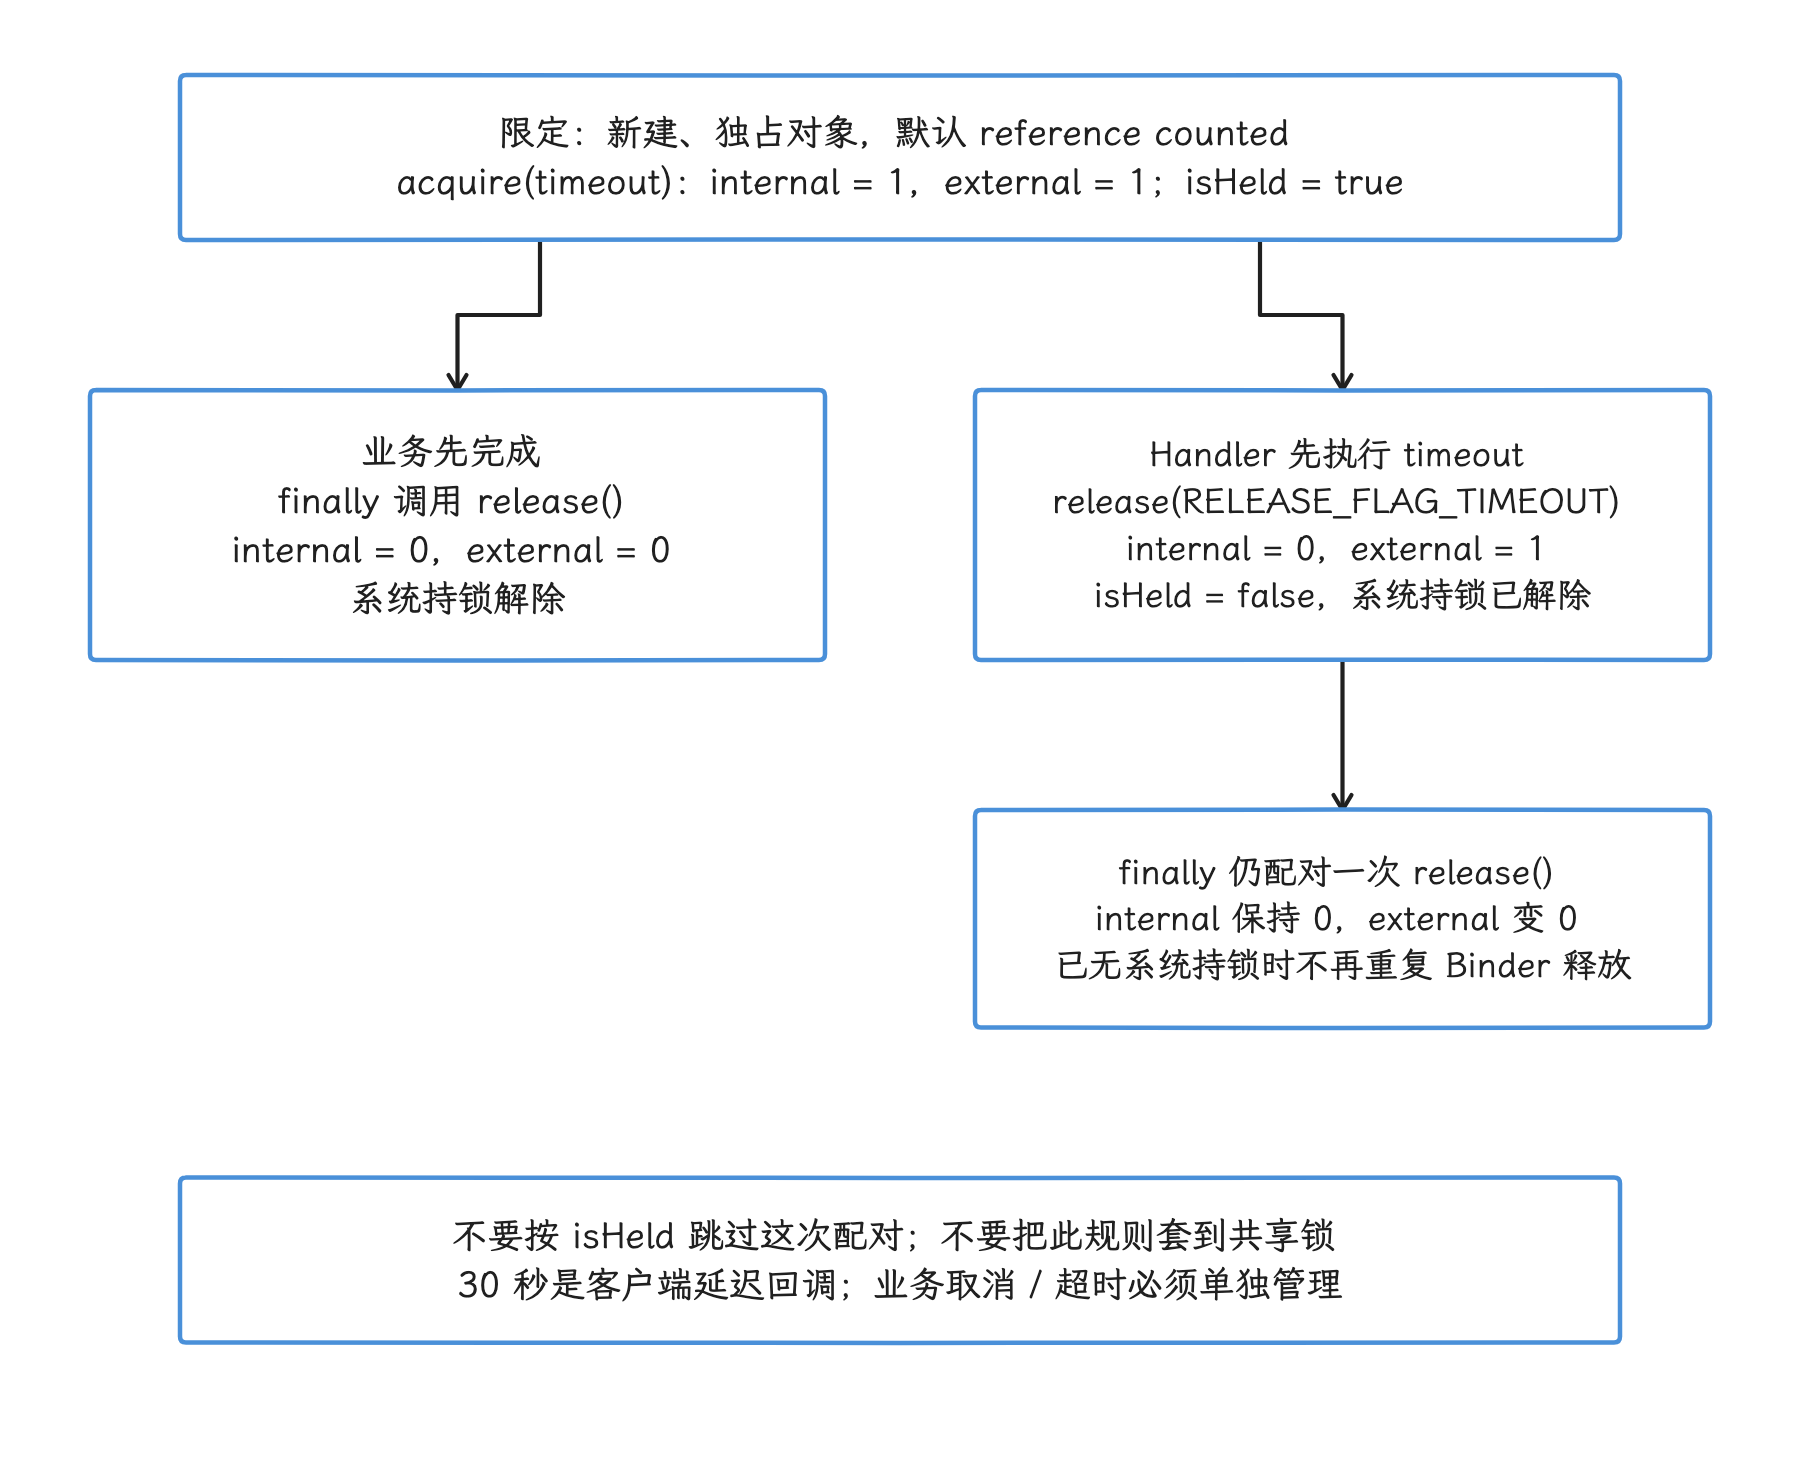
图:正文示例使用新建、独占且默认引用计数的对象。一次 acquire 后,业务先完成就由 finally 释放;若客户端 Handler 先执行超时,系统持锁解除,但外部计数仍需这次显式 release 配平。Handler 延迟不是精确业务期限;isHeld 只表示客户端持有状态,锁是否仍有系统效力要另行确认。
WorkSource 负责归因
系统服务代表其他 UID 工作时,可以用 WorkSource 把 WakeLock 成本归因给实际请求者。普通应用没法用它把自身功耗随意归到别处;权限和来源链由系统校验。排障时我们同时记录 tag、持有者 UID 与 WorkSource,别只按持锁进程判断责任。
缓存进程的 WakeLock 可能被禁用
PMS 有 no_cached_wake_locks 等配置与缓存进程(cached process)判断,可以把某些 WakeLock 标记为禁用(disabled)。具体条件还涉及 UID 状态、豁免、锁类型和设备配置。
应用不该把 PARTIAL_WAKE_LOCK 当作后台永久运行的承诺。即使应用内的对象仍显示 isHeld,系统也不会因此保证后台能力、网络或 Job 调度不受限制。
WakeLock 怎样进入 Batterystats
这条记账路径可以从源码追到:
PowerManager.WakeLock.acquire()
  → IPowerManager.acquireWakeLock()
  → PowerManagerService.acquireWakeLockInternal()
  → notifyWakeLockAcquiredLocked()
  → Notifier.onWakeLockAcquired()
  → IBatteryStats.noteStartWakelock*()
  → BatteryStatsService / BatteryStatsImpl
释放路径使用 noteStopWakelock*()。WorkSource、历史标签(history tag)、UID、进程 ID(PID)和锁标志(lock flags)都会影响归因。
Batterystats 是 Android 的功耗记账系统,适合回答“某 UID 在多长时间内持有哪些锁、触发哪些 Job、Alarm 或网络活动”。它和物理电表是两回事:记账时长与模型估算不会自动换算成精确焦耳,只靠 WakeLock 时长也推不出屏幕、射频或 GPU 的能量。
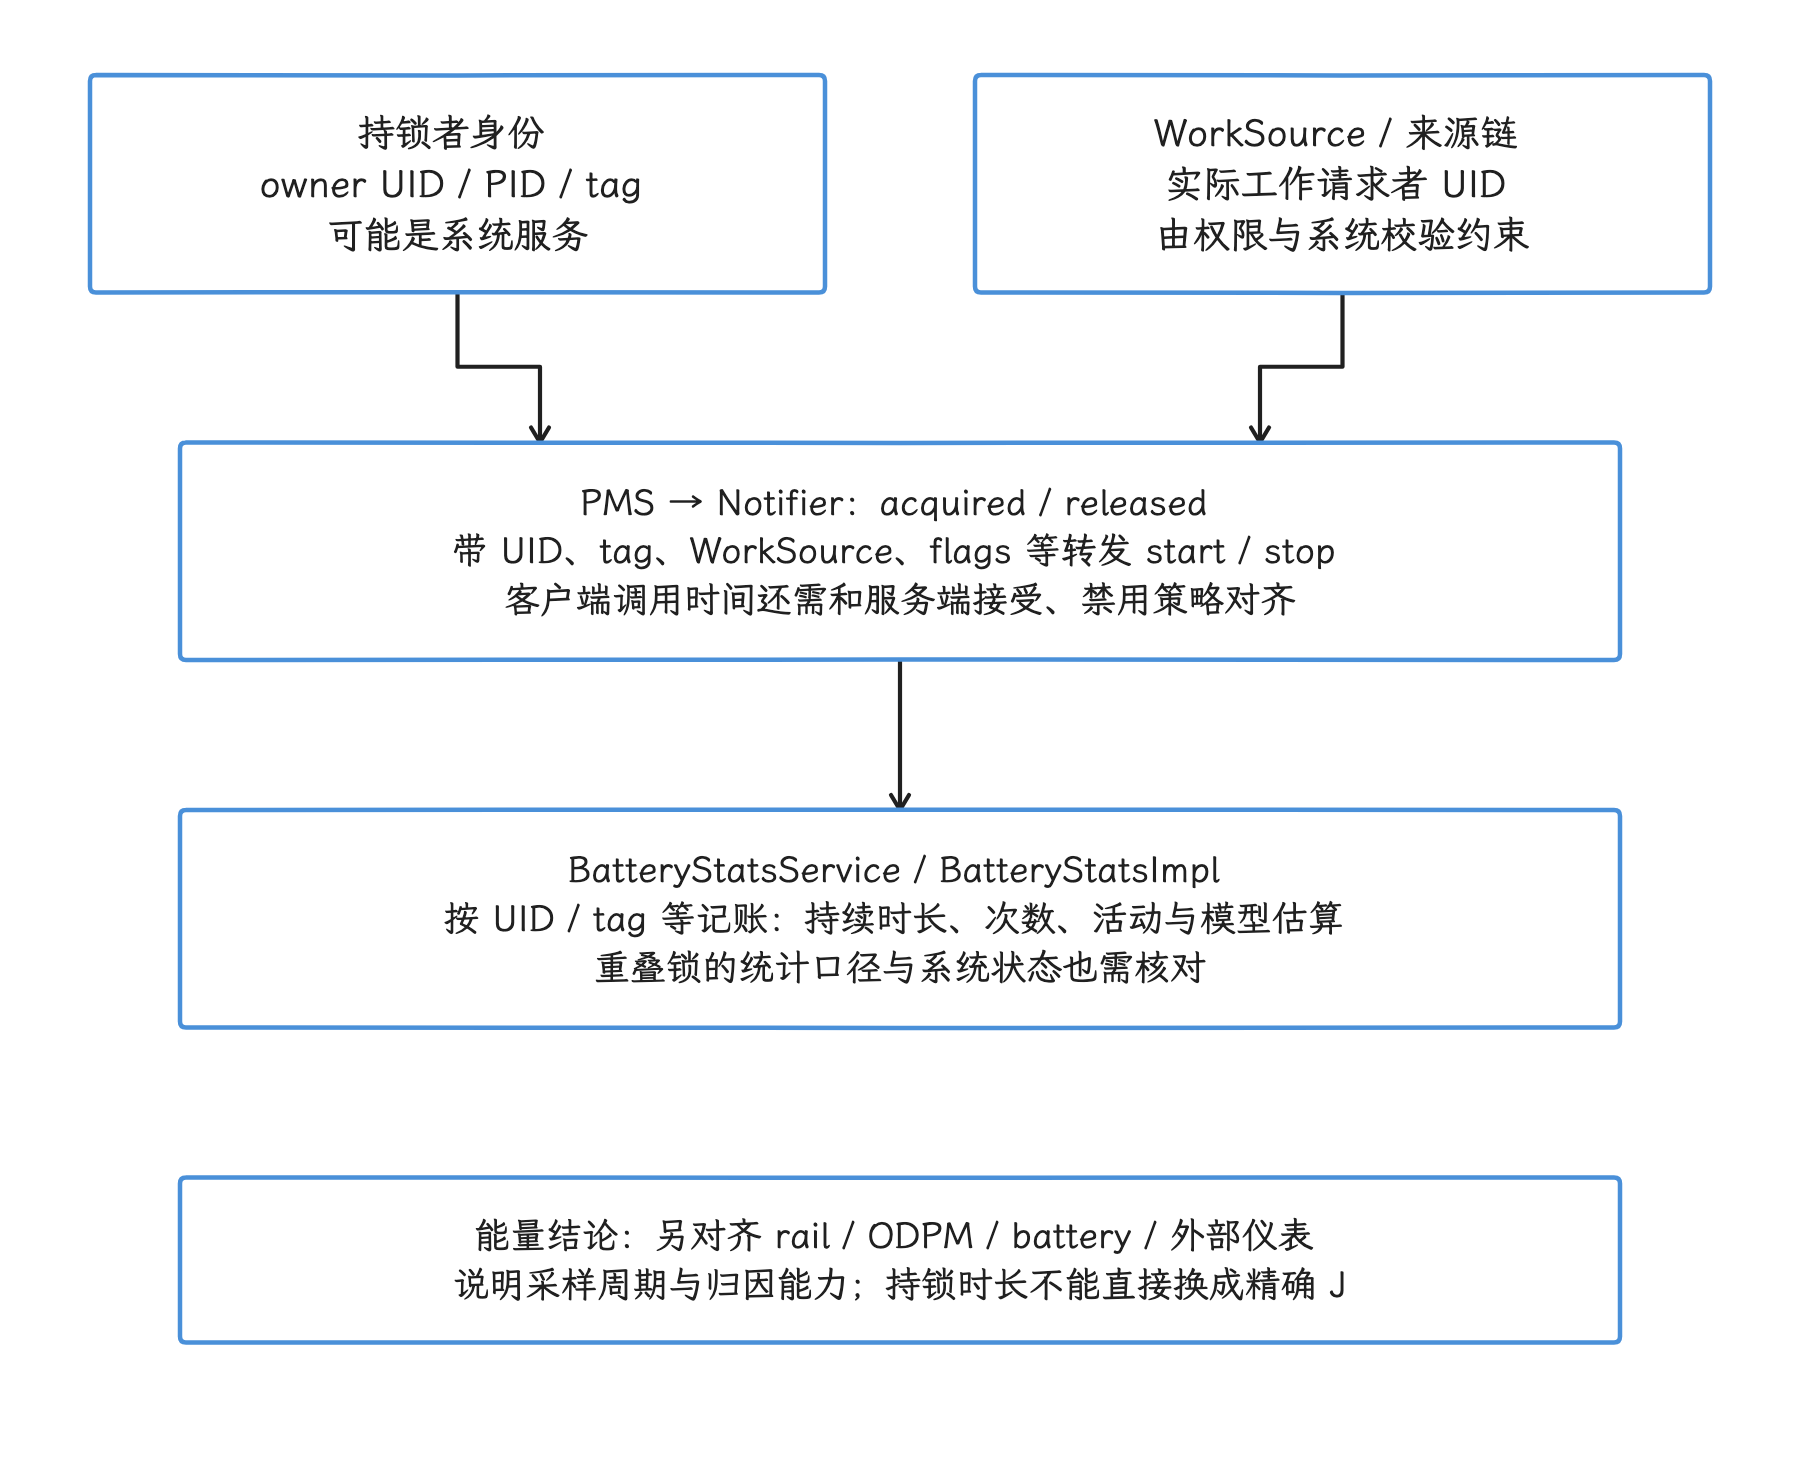
图:PMS 接收持锁者 UID、PID、tag 及经权限校验的 WorkSource,Notifier 转发 start/stop 记账。系统服务可能代表应用持锁,应同时追持有者和实际请求者。Batterystats 能解释时间、归因与模型估算;要报告焦耳或整机节能,还需注明硬件计量或外部仪表来源。
Doze、App Standby 与其他省电状态
几种省电机制各自的范围
| 机制 | 作用范围 | 主要触发依据 | 典型影响 |
|---|---|---|---|
| 省电模式(Battery Saver) | 全设备 | 用户或系统省电策略 | 系统可能降低性能、限制网络访问、减少动画并延后后台任务 |
| 低电耗模式(Doze) | 全设备空闲状态 | 灭屏、未充电、静止或空闲等设备条件 | 网络、Job、同步(Sync)和普通 Alarm 延后,WakeLock 被忽略 |
| 应用待机(App Standby) | 单个应用 | 用户近期是否使用该应用 | 后台网络、Job 和 Alarm 受限 |
| 应用待机分桶(App Standby Buckets) | 单个应用 | 使用频率、预测与系统策略 | 不同待机桶(bucket)获得不同预算 |
| 后台受限(Background restricted) | 单个应用的用户或系统限制 | 用户设置或系统提示后的选择 | 后台执行可受到更强限制 |
| 低功耗待机(Low Power Standby) | 设备非交互后的更深策略 | 平台支持、配置与豁免(exemptions) | 网络和 WakeLock 等能力进一步受限 |
这些机制可以叠加。一次 Job 延迟可能同时受到 Doze、standby bucket、后台限制、配额(quota)、网络约束和温控状态影响。
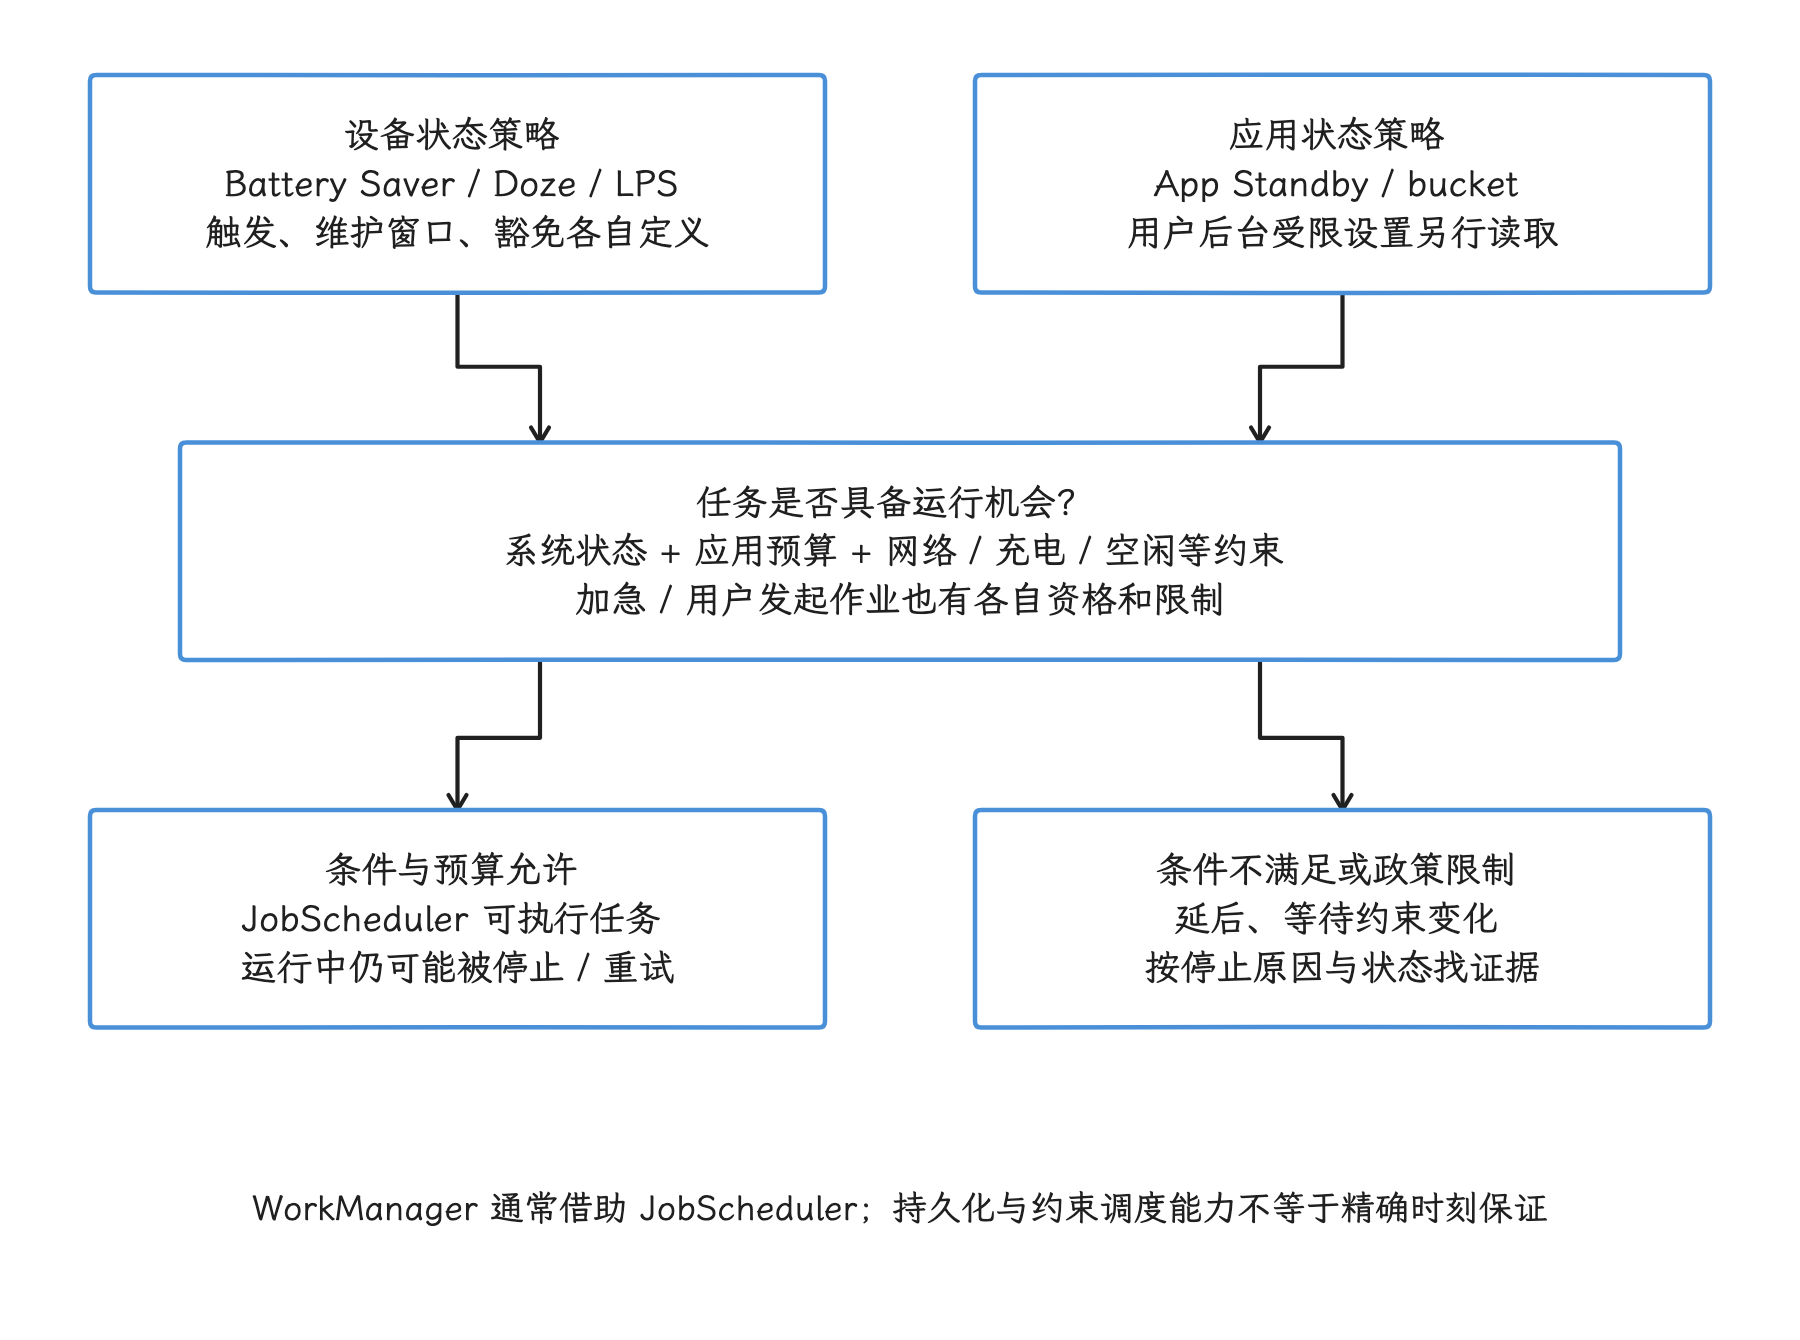
图:Doze、Battery Saver 与 LPS 根据设备状态施加策略,standby bucket 和后台受限设置影响单个应用;任务本身还有网络、充电、配额和温控等条件。它们可以叠加,允许名单也各有范围。WorkManager 提交的工作仍需通过调度评估,精确执行时刻由当时的系统状态决定。
Doze 的行为
设备满足平台定义的空闲条件后进入 Doze。Android 不向应用承诺“灭屏 30 分钟后进入”这类固定时间;浅度和深度 Doze(Light/Deep)的状态机延迟、维护窗口与运动检测都可以由系统配置。
Doze 期间,普通应用通常会遇到:
- 网络访问暂停;
- 未获豁免应用的
PARTIAL_WAKE_LOCK被忽略; - JobScheduler、WorkManager 和 Sync 延后;
- 普通 Alarm 延后到维护窗口;
- Wi-Fi 扫描等高成本操作受限。
setAndAllowWhileIdle()、setExactAndAllowWhileIdle() 和闹钟提醒(alarm clock)有特定例外,但调用频率与权限仍受限制。FCM 高优先级消息适合会产生用户可见通知的时效消息;用它维持静默心跳可能被降级,还会增加功耗。
Doze 会周期性进入维护窗口,批量执行部分待处理工作。窗口间隔随空闲延长而变化,没有可依赖的固定分钟数,应用要按“间隔可变”来设计。
电池优化豁免是部分豁免
豁免名单中的应用可以在 Doze 或 App Standby 中使用网络并持有 PARTIAL_WAKE_LOCK,但 Alarm、Job、Sync、后台启动与平台政策仍在。Google Play 对直接申请豁免也有适用场景限制。
应用可以用 PowerManager.isIgnoringBatteryOptimizations() 查询自身状态。大多数业务应先采用 FCM、JobScheduler、WorkManager、前台服务或专用系统 API;只有核心功能在 Doze 下没法工作、且符合政策时,再引导用户查看豁免设置。
App Standby Buckets
Android 17 仍使用以下主要待机桶:
ACTIVEWORKING_SETFREQUENTRARERESTRICTED- 另有从未运行等特殊状态。
待机桶会影响 Job、Alarm 和后台网络预算。系统可以依据近期使用情况分配,也可以由预装预测组件用机器学习判断未来使用概率;OEM 可以调整非 ACTIVE 应用的分配标准。应用不该尝试操纵待机桶,要做的是保证功能在各个桶里都能恢复。
UsageStatsManager.getAppStandbyBucket() 可以查询当前 bucket。测试设备可用下面的命令改变和读取状态:
adb shell am set-standby-bucket com.example.app rare
adb shell am get-standby-bucket com.example.app
测试结束后我们恢复原待机桶。待机桶只是一个变量,Doze、充电状态、后台限制和 Job 约束仍要分别记录。
RESTRICTED bucket 与“后台受限”设置
当前官方文档对 RESTRICTED bucket 给出的是严格预算:通常把 Job 集中到每天一次、最长约 10 分钟的批处理会话,Alarm 也大幅受限;充电时限制可能仍在,只在特定的充电、空闲和非计量网络条件组合下放宽。
这些是 Android 当前的高层行为,设备厂商仍可决定分桶条件和部分限制细节。device owner、profile owner、VPN、默认拨号应用(dialer)、持久系统应用(persistent app)和用户设为“不受限制”的应用等,可能获得豁免;“正在运行任意前台服务”并不是通用的 RESTRICTED bucket 豁免条件。
系统设置里的“Restricted/后台受限”是用户明确禁止后台活动,与预测得到的 standby bucket 是两个状态。两者都可能让 Job、Alarm、网络和前台服务启动受限,排障时我们分别读取。
Adaptive Battery 的能力与限制
Adaptive Battery 可以借助预测结果影响 standby bucket 和后台资源分配。AOSP 和官方 API 里没有“Adaptive Battery 2.0”这个公共技术名称,也没有跨设备固定的 ML 模型、输入特征或省电百分比。
可以确认的是:应用所在的 bucket 会动态变化,OEM 可以提供预测组件;应用应使用系统调度 API,并正确处理延迟、停止和重试。
Low Power Standby 在非交互期间限制网络与 WakeLock 效力
Low Power Standby(LPS)与 Doze、App Standby、应用休眠是不同的状态机。Android 13 起,设备进入非交互状态、超过配置的超时时间,默认不在 device-idle 维护窗口内时,LPS 可以启用(mActiveDuringMaintenance 配置也可允许它在维护窗口保持生效);启用后应用的网络访问被禁用,持有的 WakeLock 被忽略,跑前台服务的应用也在限制范围内。Framework 主要把策略交给两个使用方:网络策略限制部分后台 UID 的联网能力,PowerManagerService 让不在允许范围内的 WakeLock 不再阻止低功耗状态。
LPS 不会删除 WakeLock,也不会取消 Job。设备恢复交互,或应用符合 package、feature、allowed reason 等豁免条件后,限制可以解除。Android 14 / API 34 增加了 isExemptFromLowPowerStandby() 与 isAllowedInLowPowerStandby(),用于查询当前策略下的豁免和允许能力。这些查询只描述 Low Power Standby,代替不了 Doze 允许名单(allowlist)、standby bucket 或用户后台限制检查。
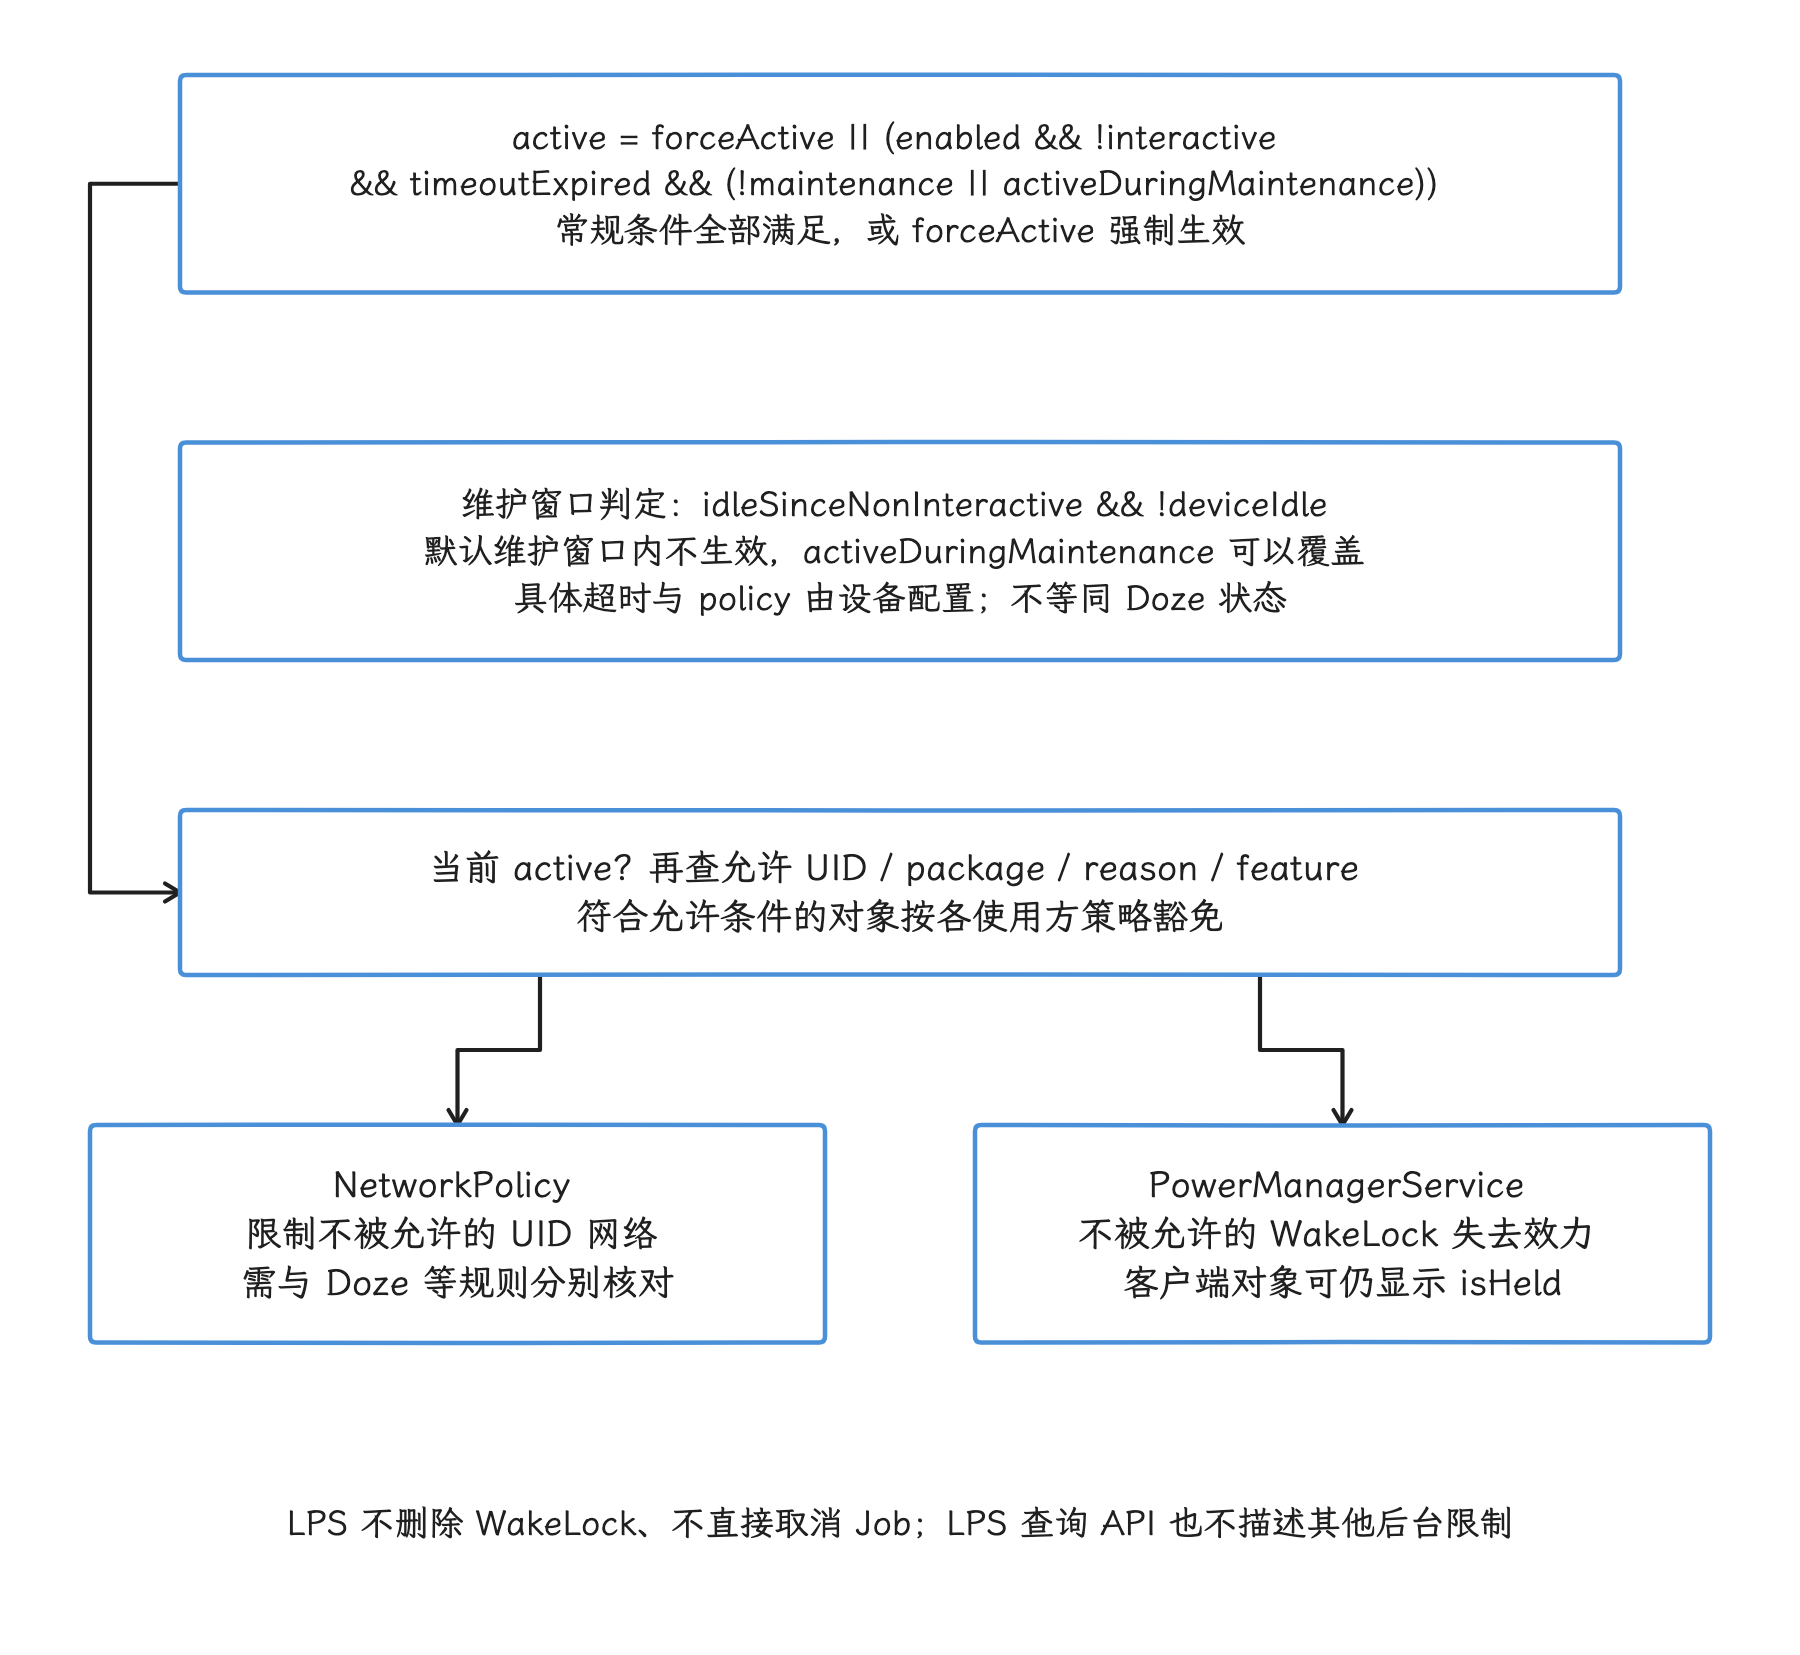
图:常规 LPS 生效需要 enabled、非交互、超过配置超时,以及维护窗口条件。维护窗口通常不生效,但 activeDuringMaintenance 可改变这一点;forceActive 是独立的强制状态。生效后按允许 UID、reason、feature 等策略限制网络和 WakeLock 效力,客户端锁并未被删除,Job 也未被直接取消。
验证时我们读取 dumpsys power 中的 Low Power Standby 状态与 policy,并同时观察网络访问、WakeLock、suspend blocker 和 power/suspend_resume;只看到一次请求超时,还分不清是 LPS、Doze、待机桶还是网络故障。
JobScheduler 与 WorkManager
为什么它们通常比手工 WakeLock 合适
JobScheduler 能根据充电、网络、空闲、存储和配额等条件,批量执行多个应用的可延期工作,省掉大量频繁唤醒和无线电重复建链。WorkManager 在现代 Android 上通常借助 JobScheduler 执行任务,并提供持久化、任务依赖关系和跨版本适配。
它们不承诺精确执行时间,也不会解开 Doze、App Standby、温控或配额限制。详细的 JobScheduler 机制见 5.3 后台执行、任务调度与 App Hibernation。
选择 API
| 需求 | 首选方向 |
|---|---|
| 可延期且需要可靠完成 | WorkManager |
| 平台或系统组件按条件运行的后台任务 | JobScheduler |
| 用户刚发起且可见的大文件传输 | 用户发起的数据传输作业(User-initiated data transfer job) |
| 用户可感知、需要持续运行的工作 | 符合类型与权限要求的前台服务(foreground service) |
| 精确的用户提醒 | AlarmManager,按精确闹钟(exact alarm)政策使用 |
| 进程存活期内的短异步工作 | 协程或执行器(coroutine/executor),不需要持久化调度器 |
别为了“早点运行”同时叠加 WakeLock、exact alarm、foreground service 和加急工作(expedited work)。每种机制都有独立成本与政策,我们按业务语义选择够用的最小集合。
检测 WakeLock 与 suspend 问题
看当前状态
dumpsys power 能显示 PMS 当前的 wakefulness、suspend blocker 和 WakeLock。下面的命令只读取状态:
adb shell dumpsys power
adb shell cat /sys/kernel/debug/wakeup_sources
第二个节点需要相应的内核配置、权限和 SELinux 许可,量产设备上可能读不到。输出中的 active count、event count、active time 和 wakeup count,具体语义由内核 wakeup-source 统计决定。
抓取系统 Trace
Linux 6.18 的 include/trace/events/power.h 定义了以下 ftrace 内核跟踪事件:
power/suspend_resumepower/wakeup_source_activatepower/wakeup_source_deactivatepower/cpu_idle
下面的 Perfetto 配置用于观察系统挂起、wakeup source、CPU idle 和调度活动:
data_sources: {
  config {
    name: "linux.ftrace"
    ftrace_config {
      ftrace_events: "power/suspend_resume"
      ftrace_events: "power/wakeup_source_activate"
      ftrace_events: "power/wakeup_source_deactivate"
      ftrace_events: "power/cpu_idle"
      ftrace_events: "sched/sched_switch"
      atrace_categories: "power"
    }
  }
}
PMS 还会在 SuspendBlockers 轨道中写入异步 Trace。我们可以按以下顺序分析:
- 标记屏幕和交互(interactive)状态变化;
- 检查
PowerManagerService.WakeLocks与显示挂起阻止器(Display blocker)何时释放; - 检查 wakeup source 是否持续处于活跃状态;
- 用
suspend_resume定位流程阶段,再对照 success/fail、错误或唤醒原因及 suspend time;平台深睡还需对应的驻留统计,一次尝试是否成功要分开判断; - 恢复后查看第一批硬件中断(IRQ)、唤醒原因(wakeup reason)、线程和硬件活动;
- 把周期性唤醒与 Alarm、Job、网络、GNSS 或厂商驱动关联。
“某应用有 WakeLock”与“该锁阻止了本次 system suspend”之间,还要看两者在时间上是否重叠。系统服务可能代表应用持锁,硬件 wakeup source 上也可能没有对应的应用标签。
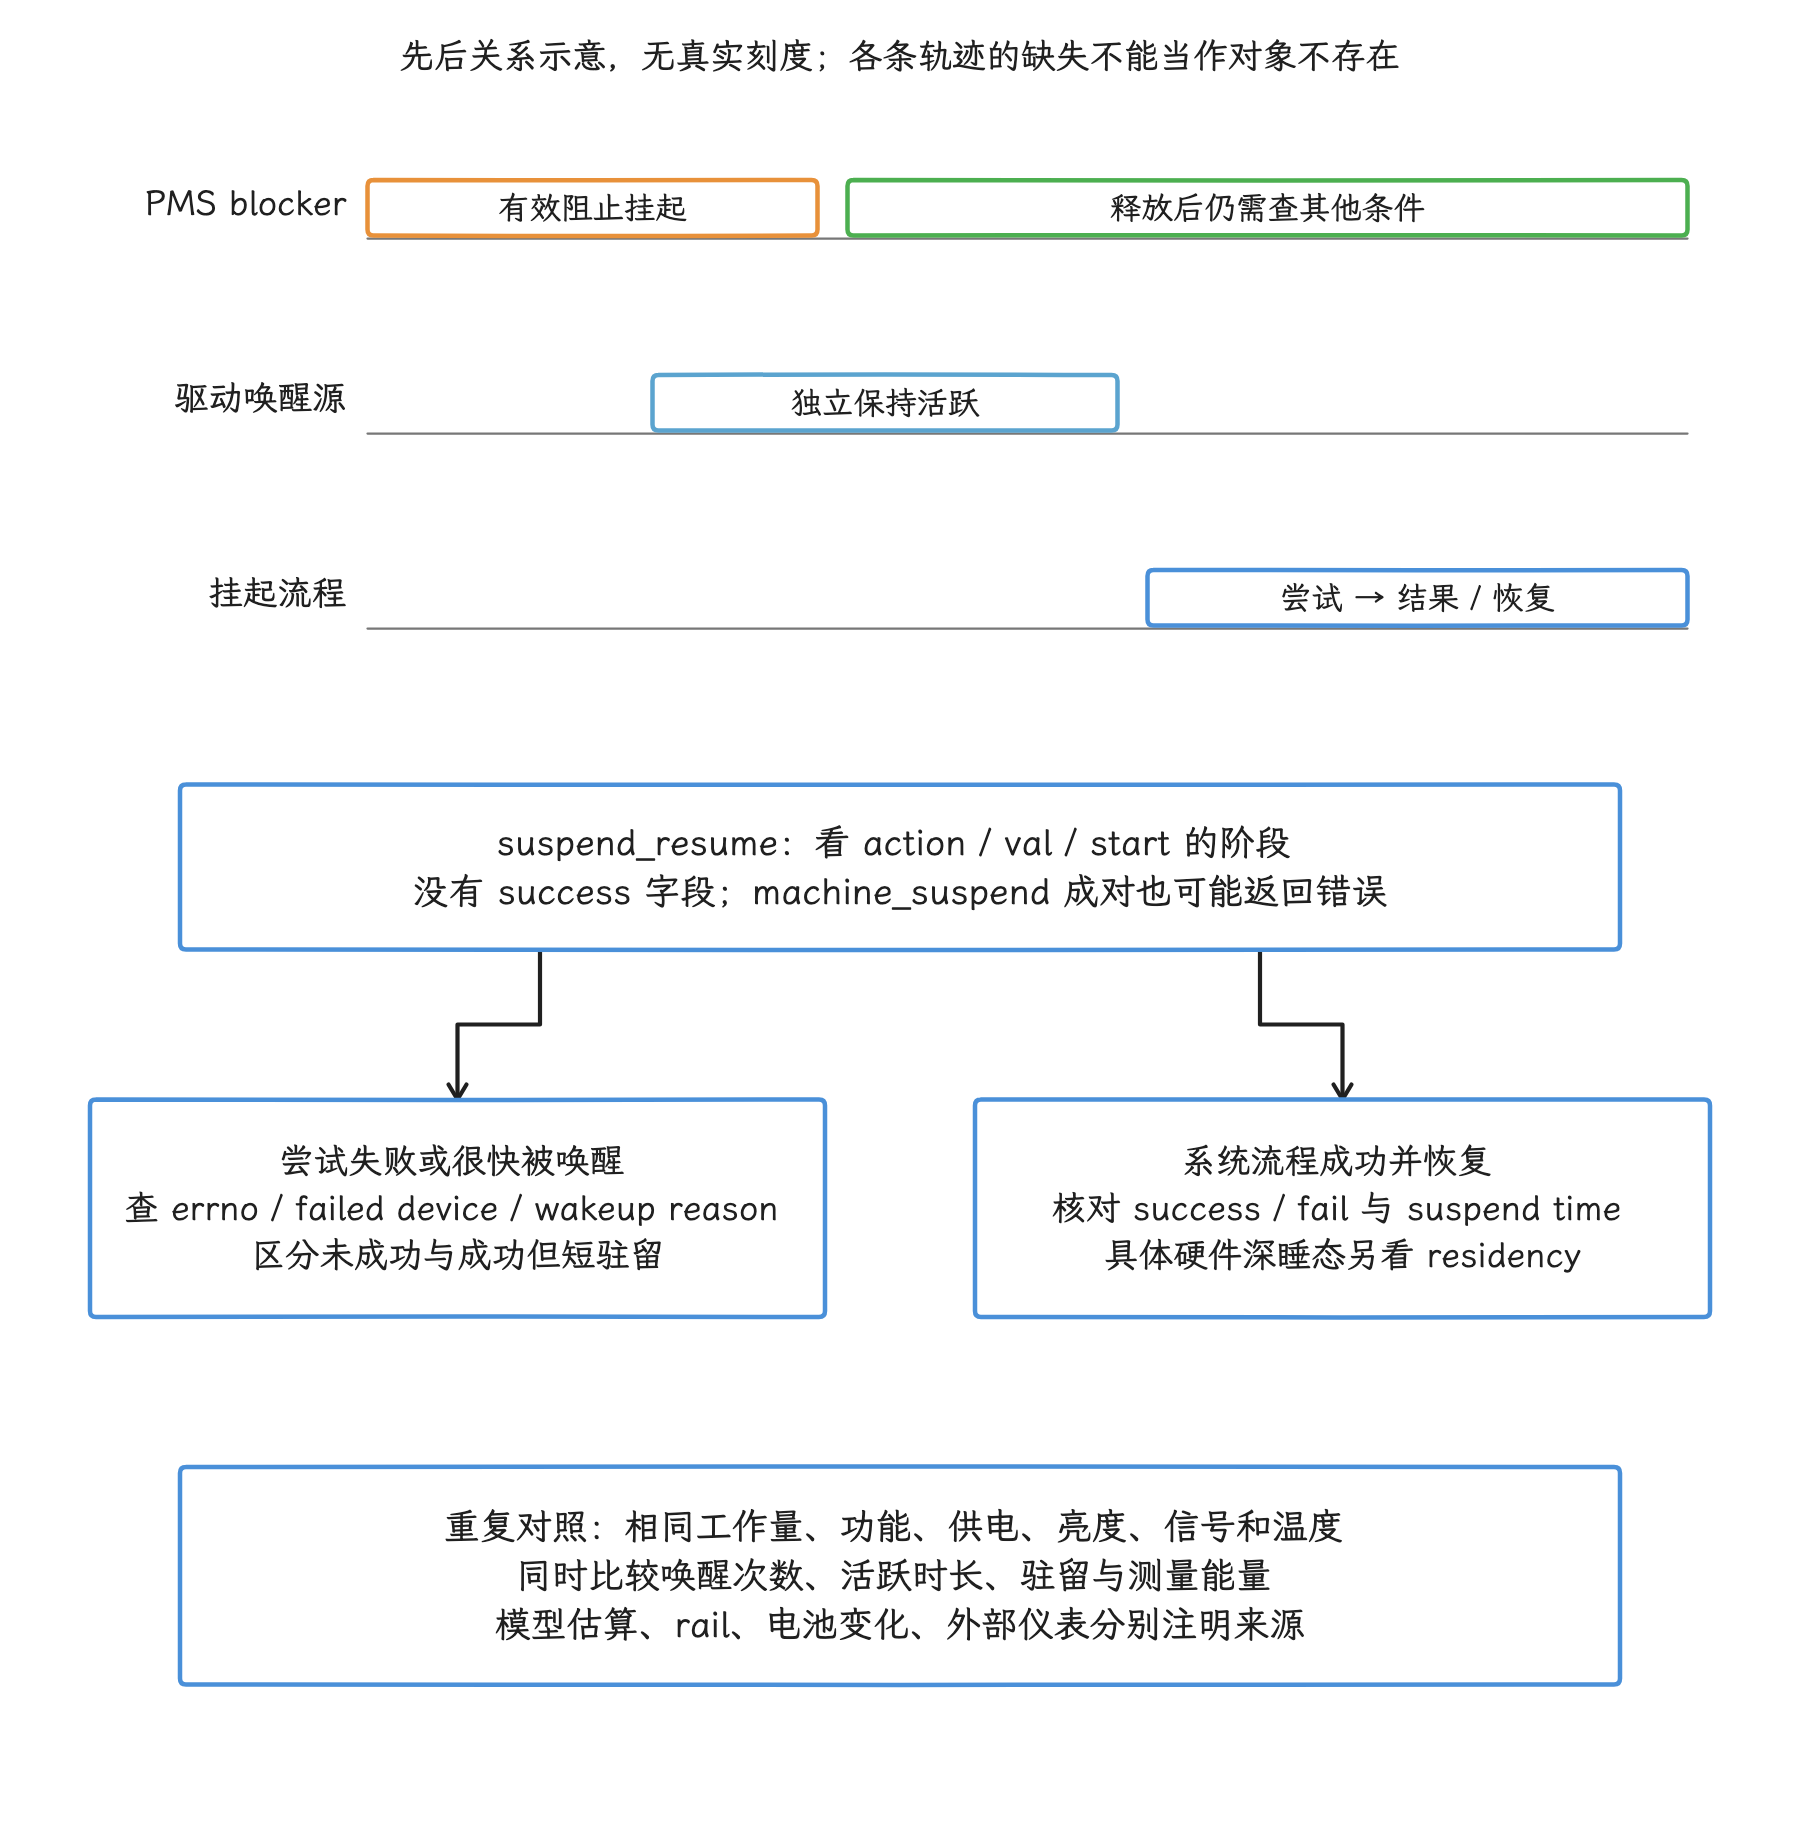
图:先把交互状态、PMS blocker、驱动 wakeup source 与挂起流程放在同一时间窗。suspend_resume 只标记阶段:后续可能中止,也可能完成并恢复。需要对照错误、成功失败统计和 suspend time;要证明某个平台深睡态,还需该状态的驻留数据。轨道只示意先后关系,不表示实测时长。
看长时间统计
Batterystats 可用于跨数小时或一天观察 UID 归因。下面的命令先清空旧统计并启用完整 WakeLock 历史,然后在复现场景后生成 bugreport:
adb shell dumpsys batterystats --reset
adb shell dumpsys batterystats --enable full-wake-history
# 复现场景后
adb bugreport /path/to/output/bugreport.zip
重置会清除旧统计,只应在受控测试开始前执行。测试时应断开 USB 或固定供电条件,并记录亮度、网络、信号、电量、温度和场景时间。
Battery Historian 可以读取 bugreport,显示用户空间 WakeLock、JobScheduler、同步管理器(SyncManager)和进程状态等长时间线。但官方已注明该工具不再积极维护;能用系统跟踪、Macrobenchmark 功耗指标(power metric)或 Android Studio Power Profiler 时,优先用这些工具。Historian 适合查看历史关联,当精确能量仪表用就不合适了。
验证能量
要判断优化是否省电,应保持工作量和环境一致,比较:
- 完成时间与成功率;
- system suspend 驻留时间(residency)与唤醒次数;
- CPU/GPU/网络/GNSS 活动;
- 设备提供的电源轨或片上功耗监测(ODPM)数据;
- 电池电流/电量统计;
- 条件允许时的外部电源仪表。
Perfetto 能量消费者、Power Profiler 或电源轨数据是否存在,取决于设备 HAL 和硬件。AOSP 不保证靠 RAPL 或静态能量模型(Energy Model)就能拿到每个进程的真实能耗。
WakeLock 滥用模式
忘记释放或异常路径泄漏
典型表现是业务结束后,WakeLock 标签仍长时间处于活跃状态。修复时我们缩小持锁作用域,用 try/finally 和超时,并分别测试错误、取消与进程生命周期路径。
锁粒度过大
把整个网络请求、重试等待和解析流程包进同一个 WakeLock,等于把不可控的等待也计入了持锁区间。能交给系统调度器的工作就移交给相应 API;必须手工持锁时,只把锁压在必须拦住 system suspend 的那几个阶段上。
高频短锁导致反复唤醒
单次持锁很短也可能有问题:频繁的 Alarm、轮询或推送重试会反复唤醒 SoC 和无线电。除了按标签汇总总时长,我们还要统计 acquire 次数、间隔及其与硬件活动的关系。
隐式 WakeLock
音频、位置、下载和 JobScheduler 等系统 API 可能代表应用持锁。看到陌生标签,先查 WorkSource、UID 与发起 API,别只在代码库里搜 newWakeLock。
Android vitals 口径
截至 2026 年的 Android vitals 文档,非豁免的 partial WakeLock 在 24 小时内累计达到 2 小时,会被报告为过度使用(excessive);这里只统计应用处于后台或运行前台服务(foreground service)时的持锁时长。如果 28 天窗口内受影响的会话超过 5%,从 2026 年 3 月 1 日起可能影响应用在 Google Play 中的可见性。音频、位置和 JobScheduler 用户发起(user-initiated) API 等用户收益明确的场景有统计豁免。
这是 Google Play 的质量政策指标,可能会更新,也不等同于系统强制释放 WakeLock 的阈值。应用内部应采用更严格、与业务时限匹配的预算。
一套可复现的排障方法
先做时间线归因
- 记录用户操作、屏幕状态和问题区间;
- 确认系统有没有进入 system suspend;没有的话,找出持续存在的 suspend blocker 或 wakeup source;
- 如果系统反复唤醒,按唤醒间隔和 wakeup reason 分组;
- 对齐应用 Alarm、Job、网络、GNSS、音频和推送;
- 找到造成无效工作或阻止休眠的最小代码路径。
再做 A/B 对照
- 保持设备、系统构建、环境温度、亮度、信号和电量区间一致;
- 让测试包含足够长的灭屏或后台阶段;
- 交错执行基线与候选版本,避免热机和冷机偏差;
- 同时比较功能正确性;省电若以漏同步或丢通知为代价,结果也就失去了意义;
- 在报告中区分模型估算能量(modeled energy)、电源轨测量(rail measurement)、电池电量变化(battery delta)与外部仪表结果。
最终选择修复层
| 证据 | 优先修复 |
|---|---|
| 手工 WakeLock 覆盖过大 | 缩小作用域或交给系统调度器 |
| 周期性 Alarm 唤醒 | 合并、延后或改用 Job/WorkManager |
| 网络建链过于频繁 | 批量传输、推送触发、退避 |
| GNSS/传感器持续活跃 | 调整请求频率、批处理(batching)和生命周期 |
| Job 在不合适的条件下运行 | 补充真实约束(constraints),拆分可中断批次 |
| 内核 wakeup source 异常 | 在驱动或固件侧调查,不要归因给应用 WakeLock |
| 屏幕/刷新持续高功率 | 到显示与渲染章节分析亮度、刷新和合成 |
Android 17 / Linux 6.18 源码索引
| 主题 | 精确路径 |
|---|---|
| PMS | frameworks/base/services/core/java/com/android/server/power/PowerManagerService.java |
| WakeLock API | frameworks/base/core/java/android/os/PowerManager.java |
| PMS JNI | frameworks/base/services/core/jni/com_android_server_power_PowerManagerService.cpp |
| 统计转发 | frameworks/base/services/core/java/com/android/server/power/Notifier.java |
| Batterystats | frameworks/base/services/core/java/com/android/server/am/BatteryStatsService.java、services/core/java/com/android/server/power/stats/BatteryStatsImpl.java |
| Power HAL | hardware/interfaces/power/aidl/android/hardware/power/IPower.aidl |
| JobScheduler | frameworks/base/apex/jobscheduler/ |
| Linux 内核休眠 | Documentation/admin-guide/pm/sleep-states.rst、include/trace/events/power.h |
常见误区
“代码没调用 newWakeLock,就不会阻止休眠”
系统 API 可以代表应用持锁;Alarm、网络、音频、GNSS 和驱动 wakeup source 也能让设备保持活跃或反复唤醒。我们顺着 UID、WorkSource 和时间线追到发起的 API。
“持有 PARTIAL_WAKE_LOCK 就能绕过 Doze”
Doze 会忽略普通应用的 WakeLock,并限制网络、Job、Sync 和 Alarm;部分豁免也解不开全部后台政策。
“WorkManager 保证指定时刻执行”
WorkManager 提供持久化和按约束调度的能力;执行时间仍受系统状态影响。精确的用户提醒要走符合政策的 Alarm API。
“CPU idle 等于 system suspend”
cpuidle 是单个 CPU 的运行时空闲,system suspend 是全系统状态转换。判断系统休眠,要结合 suspend_resume 阶段、blocker、wakeup source、挂起结果与驻留数据。
“Batterystats 的耗电百分比就是实测能量”
Batterystats 里是记账和模型估算。硬件电源轨、采样周期和归因能力因设备而异;要给精确能量结论,先说明测量来源。
版本与实现边界
| Android 版本 | 主要变化 | 说明 |
|---|---|---|
| Android 5 / API 21 | JobScheduler | 把可延期后台工作交给系统批处理 |
| Android 6 / API 23 | Doze、App Standby | 设备级与应用级后台限制 |
| Android 7 / API 24 | Light Doze、后台广播优化 | 灭屏后更早限制更多活动 |
| Android 8 / API 26 | 后台执行与前台服务限制 | 长期后台服务受到更强约束 |
| Android 9 / API 28 | App Standby Buckets、Adaptive Battery | bucket 可由使用历史或预测影响 |
| Android 12 / API 31 | RESTRICTED bucket | 增加更严格的应用级资源限制 |
| Android 13 / API 33 | Low Power Standby、RESTRICTED bucket 规则更新 | 非交互阶段可进一步限制网络和 WakeLock;受限行为仍需按设备核对 |
| Android 14 / API 34 | Low Power Standby policy 查询 | 增加豁免、allowed reason 与 allowed feature 查询 |
| Android 16 / API 36 | ACTIVE bucket 的 Job 运行时配额等规则调整 | WorkManager/DownloadManager 也受平台 Job 配额影响 |
| Android 17 / API 37 | 以 android-17.0.0_r1 PMS、SystemSuspend、JobScheduler APEX 模块为准 | 不假设新的固定 Doze 时序或厂商策略 |
小结
- schedutil、CPUFreq 驱动与固件共同把调度利用率转换成性能状态;请求频率、
scaling_cur_freq和硬件实频要分开看。 - Thermal 框架通过温度传感器、严重级别和 cooling device 约束可用性能。频率降低只是缓解方式之一,Thermal Status/Headroom 也当不成绝对温度。
- Power HAL 表达系统场景,CPUIdle 管理无任务时的核心空闲,system suspend、WakeLock、Doze、Standby 与后台任务政策各有各的范围。
- 排障时先确定线程是算力不足、Runnable 等待还是阻塞,再对齐频率请求/反馈、温控上限、空闲/挂起和长期能量证据。
参考资料
-
Linux 内核
android17-6.18-2026-06_r6:kernel/sched/cpufreq_schedutil.c -
Linux 内核:
Documentation/admin-guide/pm/cpufreq.rst -
Linux 内核:
Documentation/scheduler/schedutil.rst -
Linux 内核:
Documentation/power/opp.rst与drivers/opp/ -
AOSP
android-17.0.0_r1:frameworks/base/core/java/android/os/PerformanceHintManager.java -
AOSP
android-17.0.0_r1:frameworks/base/services/core/java/com/android/server/app/GameManagerService.java -
AOSP
android-17.0.0_r1:hardware/interfaces/power/aidl/android/hardware/power/IPower.aidl、Mode.aidl、Boost.aidl -
Perfetto SQL 标准库:
linux.cpu.frequency、linux.cpu.idle -
AOSP
android-17.0.0_r1:PowerManager.java、SystemHealthManager.java -
AOSP
android-17.0.0_r1:services/core/java/com/android/server/power/thermal/ThermalManagerService.java -
AOSP
android-17.0.0_r1:hardware/interfaces/thermal/aidl/android/hardware/thermal/IThermal.aidl、Temperature.aidl、TemperatureThreshold.aidl、ThrottlingSeverity.aidl -
Linux 内核
android17-6.18-2026-06_r6:drivers/thermal/gov_step_wise.c、drivers/thermal/cpufreq_cooling.c -
Linux 内核:
Documentation/driver-api/thermal/sysfs-api.rst -
Perfetto
android-17.0.0_r1:protos/perfetto/config/sys_stats/sys_stats_config.proto -
AOSP
android-17.0.0_r1:上述 Framework、SystemSuspend 与 Power HAL 源码 -
Linux 内核
android17-6.18-2026-06_r6:系统休眠文档与 power 跟踪点(tracepoints)