SurfaceView 与 TextureView 渲染管线
SurfaceView 拥有独立 Surface 和 layer,TextureView 把外部纹理合入宿主 View。这一节我们把两条管线各走一遍:前者利于独立合成,后者便于 View 变换;代价分别落在窗口同步和宿主 GPU 合成。
SurfaceView 的独立 Layer 与同步
为什么需要 SurfaceView
SurfaceView 让主体内容无须先画进宿主窗口的 buffer。这里的宿主窗口,指包含 SurfaceView 和其他普通 View 的 App Window;视频解码器、Camera 或 EGL/Vulkan 渲染线程等 Producer(内容生产方)向另一条独立的 buffer 队列提交内容,控制条、遮罩等普通 View 则仍由宿主窗口的主线程与 RenderThread 生成。我们用下面的简图区分这两条内容生产线:
宿主窗口:Choreographer → UI Thread → RenderThread → Host BufferQueue
主体内容:Codec / Camera / EGL / Vulkan Producer → SurfaceView BufferQueue
                                                    ↓
                                      SurfaceFlinger → HWC → Display
这张简图划分的是像素归属,并以现代硬件加速宿主为例,宿主普通 View 由 UI 线程和 RenderThread/HWUI 组织绘制。SurfaceView 本身不要求宿主必须硬件加速,软件宿主可由 CPU 生成 host buffer。这里的“独立”指主体像素拥有自己的 Surface、BufferQueue 和 SF layer;View 与几何仍由 ViewRoot 管理,内容 Producer 也可能就在应用进程内。
这套结构带来三项直接收益:
- 主体内容可以采用与宿主 UI 不同的帧率。低帧率视频无须迫使宿主窗口按同样节奏重画,宿主窗口刷新时也不要求视频每轮都提供新 buffer。
- 主体内容不经过宿主 RenderThread 的纹理采样。对视频、相机等大面积内容,这可能减少 GPU 工作和内存带宽。
- SurfaceFlinger 能把主体作为独立 layer 交给 HWC(Hardware Composer,硬件合成器) 评估。设备条件满足时可使用 DEVICE composition,由显示硬件直接参与合成;条件不满足时则可能进入 CLIENT composition,由 RenderEngine 先生成整屏合成所需的 client target。
这些收益各有适用范围。回到 trace 上,主线程卡住时,已有视频帧仍可能继续更新,但 SurfaceView 的布局、裁剪、透明洞、控制条和生命周期处理可能停在旧状态;独立 layer 拿到的也只是被 HWC 单独评估的机会,Overlay(硬件叠加层)是否用得上、功耗和时延是否更低,都要看设备的具体条件。所以分析时我们分别回答三个问题:内容是否继续生产、宿主几何是否更新、本轮采用何种合成方式。
SurfaceView 适合主体像素由独立 Producer 持续提供的场景,例如:
- MediaCodec 或 Codec2 的视频输出;
- Camera preview stream(相机预览流);
- 游戏、地图或可视化引擎的 EGL/Vulkan 输出;
- 需要 secure 防截取策略或 protected buffer 保护链路的内容;
- 通过
SurfaceControlViewHost嵌入的远端 View 层级。
反过来,内容需要频繁参与普通 View 的旋转、复杂裁剪、着色器效果或父子透明度动画时,TextureView 往往更容易实现。选型时我们回到三件事:像素归属、变换需求和目标设备的合成能力;“视频用 SurfaceView、动画用 TextureView”这类口诀,当作固定规则会出错。
独立 Surface 与挖洞机制
SurfaceView 的对象层次
SurfaceView.createBlastSurfaceControls() 维护的主要对象如下:
ViewRootImpl bounds layer
  └─ mSurfaceControl:SurfaceView container
       ├─ mBlastSurfaceControl:BLAST buffer layer
       └─ mBackgroundControl:background color layer
这张层次图要区分组织层和内容层。mSurfaceControl 本身不携带像素,它作为 container 负责 SurfaceView 子树的位置、变换、裁剪、相对层级和部分视觉状态;承载 Producer buffer 的是 mBlastSurfaceControl 内容层;mBackgroundControl 是同一 container 下的纯色背景 child,并通过相对宿主窗口的层级配置放到背景位置。图中的 parent-child 关系与屏幕 Z 顺序是两种关系。
背景层的显隐有一条明确的条件链:updateBackgroundVisibility() 要求 mSubLayer < 0(内容位于宿主下方)、内容层带 OPAQUE(不透明) 标志且背景层未被禁用,同时满足才显示;mBlastBufferQueue 再通过 update() 把内容层的尺寸、格式与生产端 Surface 关联起来。
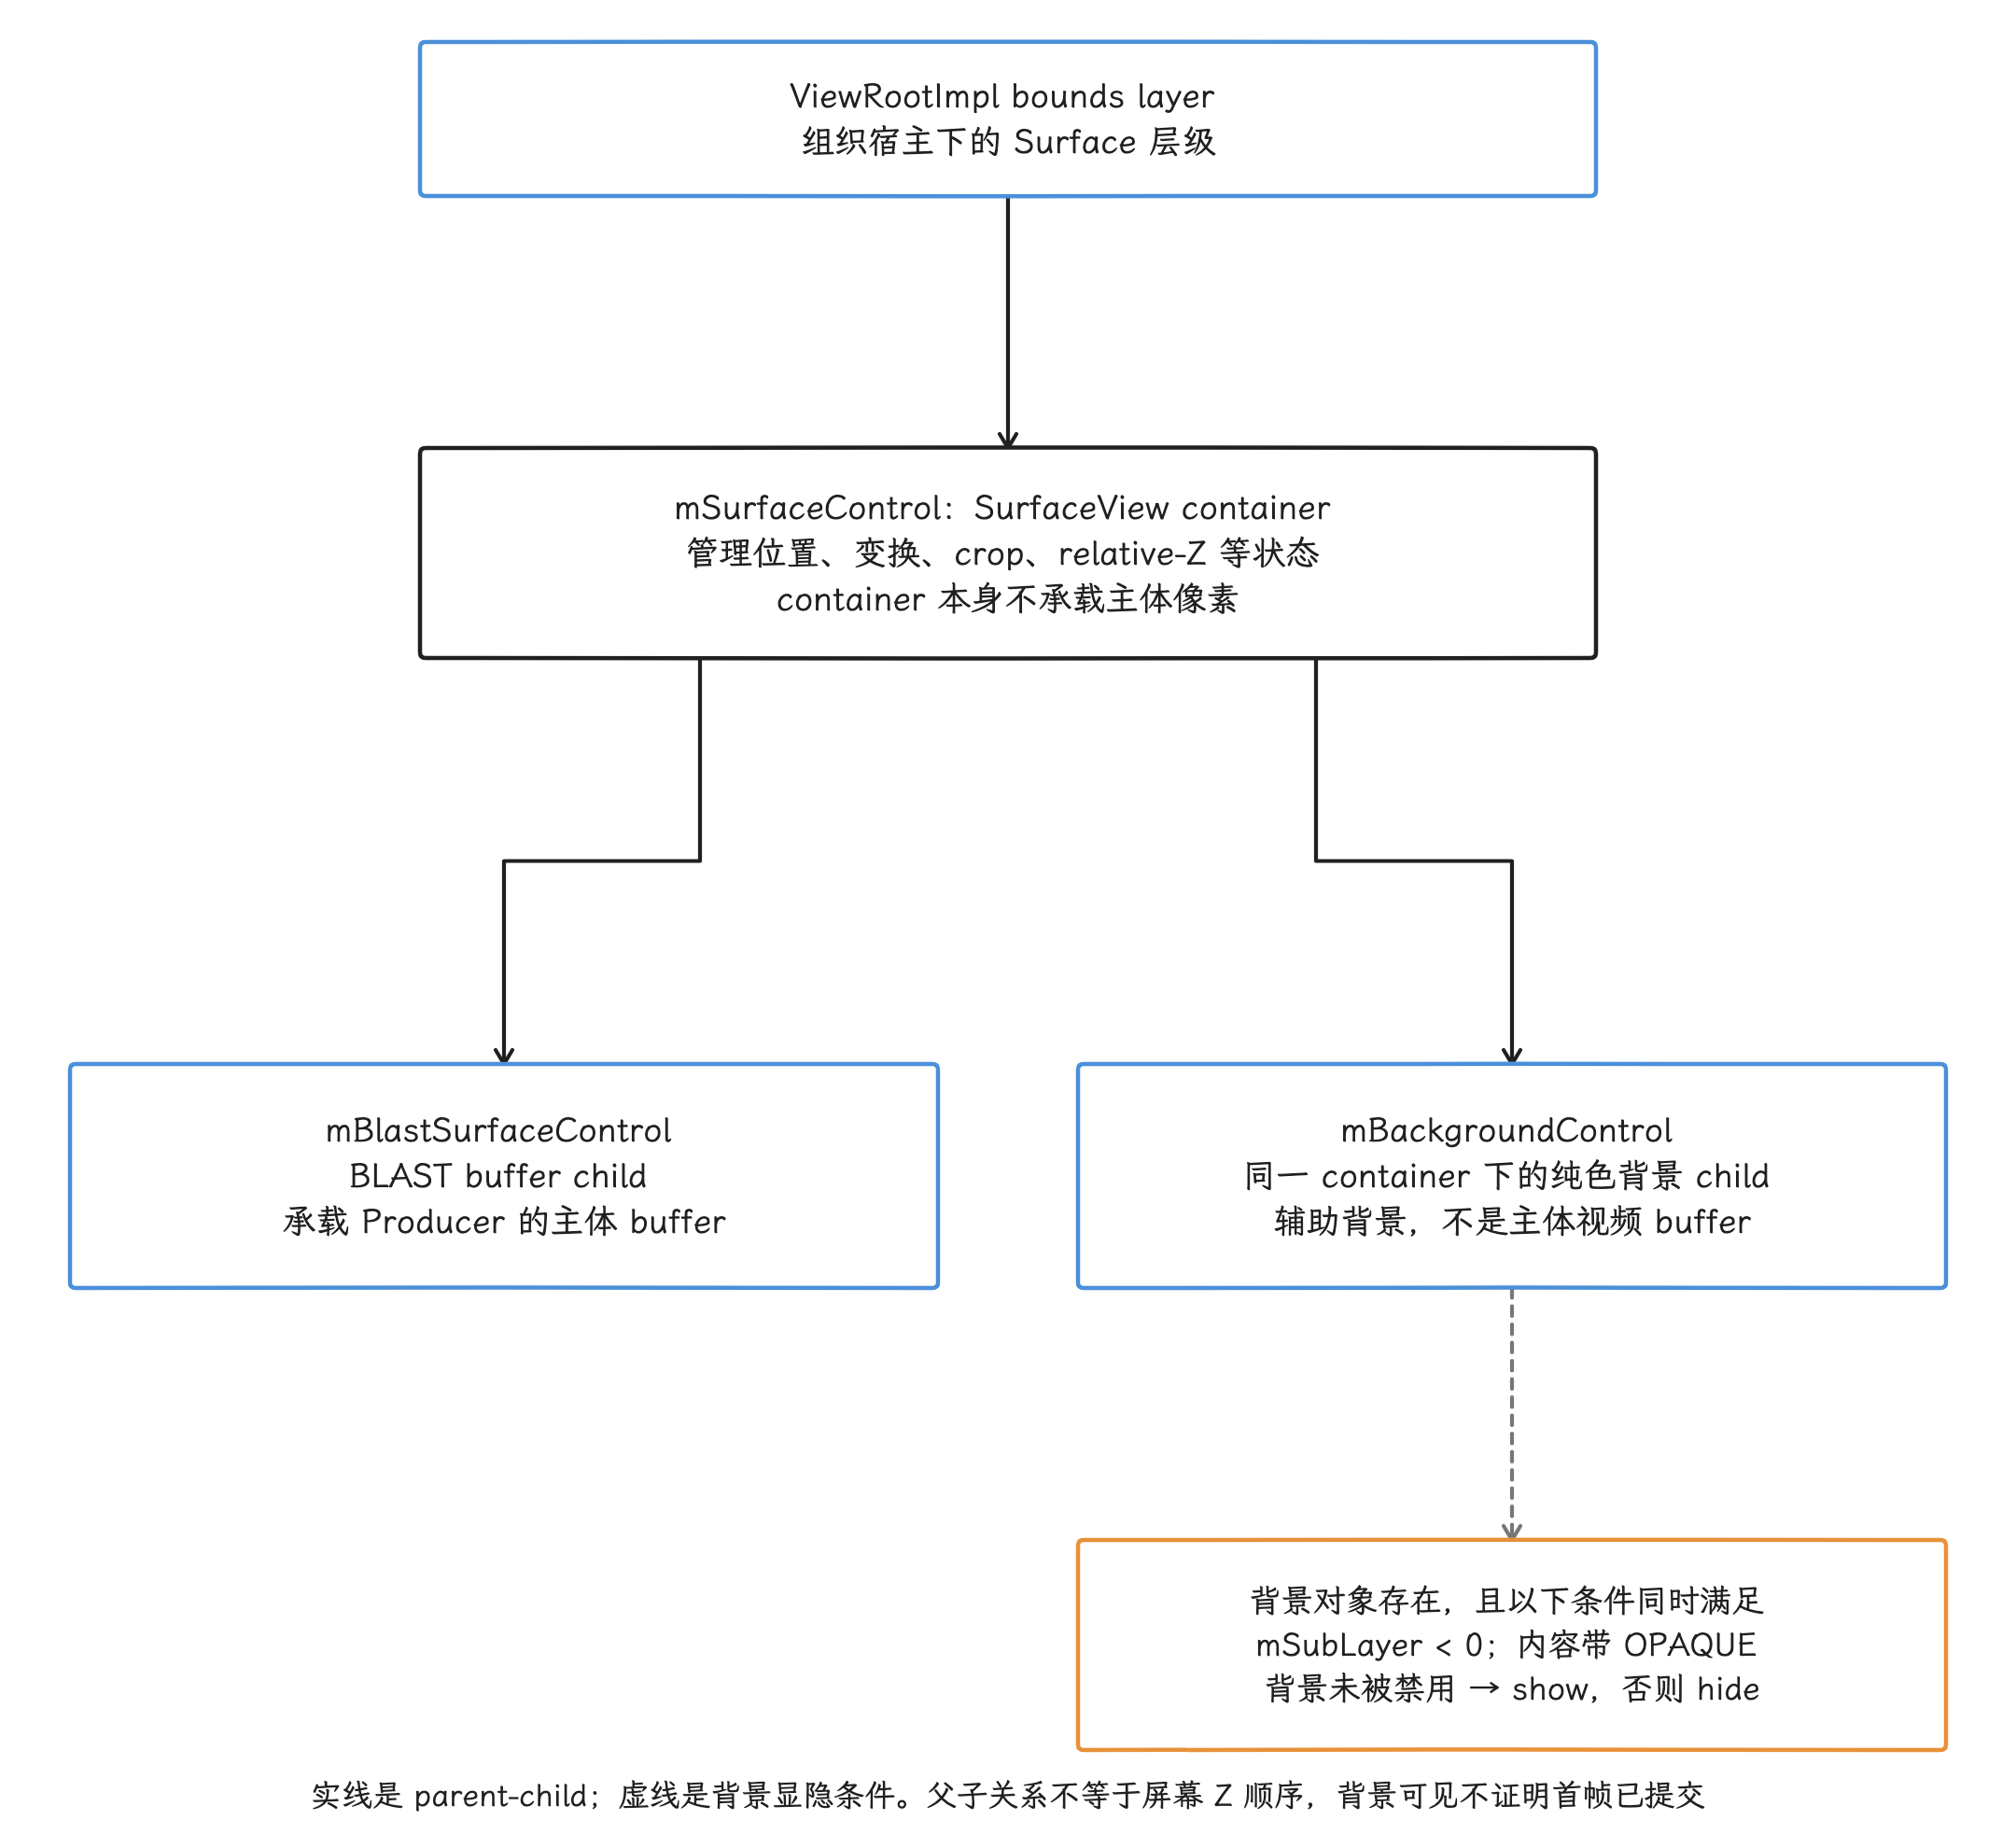
图:对象层级与背景显隐合图。mSurfaceControl只管理几何和层级,mBlastSurfaceControl承载Producerbuffer,mBackgroundControl是同container下的辅助纯色child。实线为父子关系,虚线仅表示对已有background的条件控制:mSubLayer负、内容带OPAQUE且背景未禁用,才show,否则hide。父子关系不同于相对宿主Z;背景显示也不证明主体首buffer已经提交或present。
Java SurfaceView 位于应用进程,但 buffer 填充者不一定也在该进程:应用内游戏线程可以直接使用 Surface,MediaCodec、Camera 或嵌入式层级也可能由系统服务和厂商组件参与生产。确认 Producer 身份时,我们沿目标 BufferQueue 的 connect、dequeue(取出)、queue(放回待消费队列)、fence 和 layer id 回溯;拿常见进程名当依据,只是猜测。
默认 Z-below 与透明洞
SurfaceView 默认采用 Z-below,即内容层位于宿主窗口下方。宿主窗口若仍在同一矩形内绘制不透明像素,下面的内容就会被遮住,所以 HWUI 要在宿主 buffer 中留出透明区域,也就是 hole-punch(挖洞)。关键实现包括:
gatherTransparentRegion()把 SurfaceView 的可见矩形加入宿主窗口的透明区域;draw()或dispatchDraw()在mDrawFinished && !isAboveParent()时调用clearSurfaceViewPort();clearSurfaceViewPort()使用Canvas.punchHole()清理对应像素,并把圆角、clip bounds 与 alpha 纳入透明区域参数;mDrawFinished为false时不会打洞;surfaceRedrawNeededAsync要求的所有重绘回调结束后,该字段才会变为true。
“挖洞”既没有创建一个黑色 View,也没有把视频像素复制到宿主窗口;它只是在宿主 buffer 的对应区域保留透明度,剩下的交给 SurfaceFlinger 按 layer 层级合成宿主与 SurfaceView 内容。
mDrawFinished 能证明的只有一点:framework 认为 redraw callback 阶段已经结束。至于 Producer 是否已 queue 第一块 buffer、SurfaceFlinger 是否已经 latch(为本次合成选中)该 buffer、HWC 是否已 present,要另行确认;我们分析首帧时,依次检查 Producer connection、第一笔 buffer transaction、acquire fence、layer 可见性和目标 Display 的 present。
Z-above 时,SurfaceView 位于宿主窗口之上,无须在宿主 buffer 中打洞;相应地,宿主窗口里的普通 View 也盖不到它上面。API 36 起可用 setCompositionOrder(int) 表达层叠关系:负数位于宿主下方,非负数位于宿主上方;同级 SurfaceView 数值越大越靠上,数值相同的顺序未定义。android-16.0.0_r1 和当前 r1 源码仍有 surface_view_set_composition_order 的 @FlaggedApi 注解。旧 setZOrderMediaOverlay() / setZOrderOnTop() 在这些源码中带 @Deprecated 及 deprecate_surface_view_z_order_apis 注解,但当前公开 API 页未把它们列成已弃用,不能把源码注解写成所有 SDK/设备统一的弃用状态。
alpha、HDR、composition order 与 blur
Android 12 到 Android 17 的现代主线可按下表理解:
| 平台 | SurfaceView 相关变化 | 分析含义 |
|---|---|---|
| Android 12 / API 31 | 固定 r1 的 BLAST 分支已有 container、BLAST child、background 与 RenderNode 位置同步;同文件也保留非 BLAST 创建分支 | 先确认设备走哪条分支,几何 transaction 与内容 buffer 按不同对象观察 |
| Android 13 / API 33 | 主体结构延续 | 设备差异仍要核对厂商 Composer、gralloc(图形内存分配器)与 Producer,不能预设 AOSP 拓扑已经换代 |
| Android 14 / API 34 | 支持 0—1 范围内的 alpha;公开 setSurfaceLifecycle() 与 applyTransactionToFrame() | Z-below 的 alpha 调节透明洞的混合比例,Z-above 的 alpha 作用于 Surface 内容;生命周期可以跟随 visibility 或 attachment |
| Android 15 / API 35 | 增加 setDesiredHdrHeadroom();Android 16 固定 r1 仍带 limited_hdr 注解 | 表达期望的 HDR/SDR 白点比,不是绝对 nits;需核对版本/flag,结果受面板、位深、环境和策略约束 |
| Android 16 / API 36 | 增加 setCompositionOrder();固定 r1 有 surface_view_set_composition_order 注解 | 多 SurfaceView 用整数层级;相同 order 顺序未定义,需核对 SDK/flag/设备 |
| Android 17 / API 37 | 增加 setBlurRegions();当前 r1 带 surface_view_set_blur_regions 注解 | blur 坐标相对 SurfaceView bounds;尺寸改变后调用方更新,还需核对 flag/设备与几何状态 |
Z-below 的 alpha 作用于宿主透明洞与内容层之间的混合比例,内容 buffer 中的 alpha 通道保持原样。多个位于宿主下方的 SurfaceView 相互重叠时,混合结果也和普通 View 按父子顺序逐层混合不同。所以排查叠加异常时,我们同时记录 composition order、宿主 hole-punch、内容层 alpha 与 HWC composition type(DEVICE 或 CLIENT 等合成类型)。
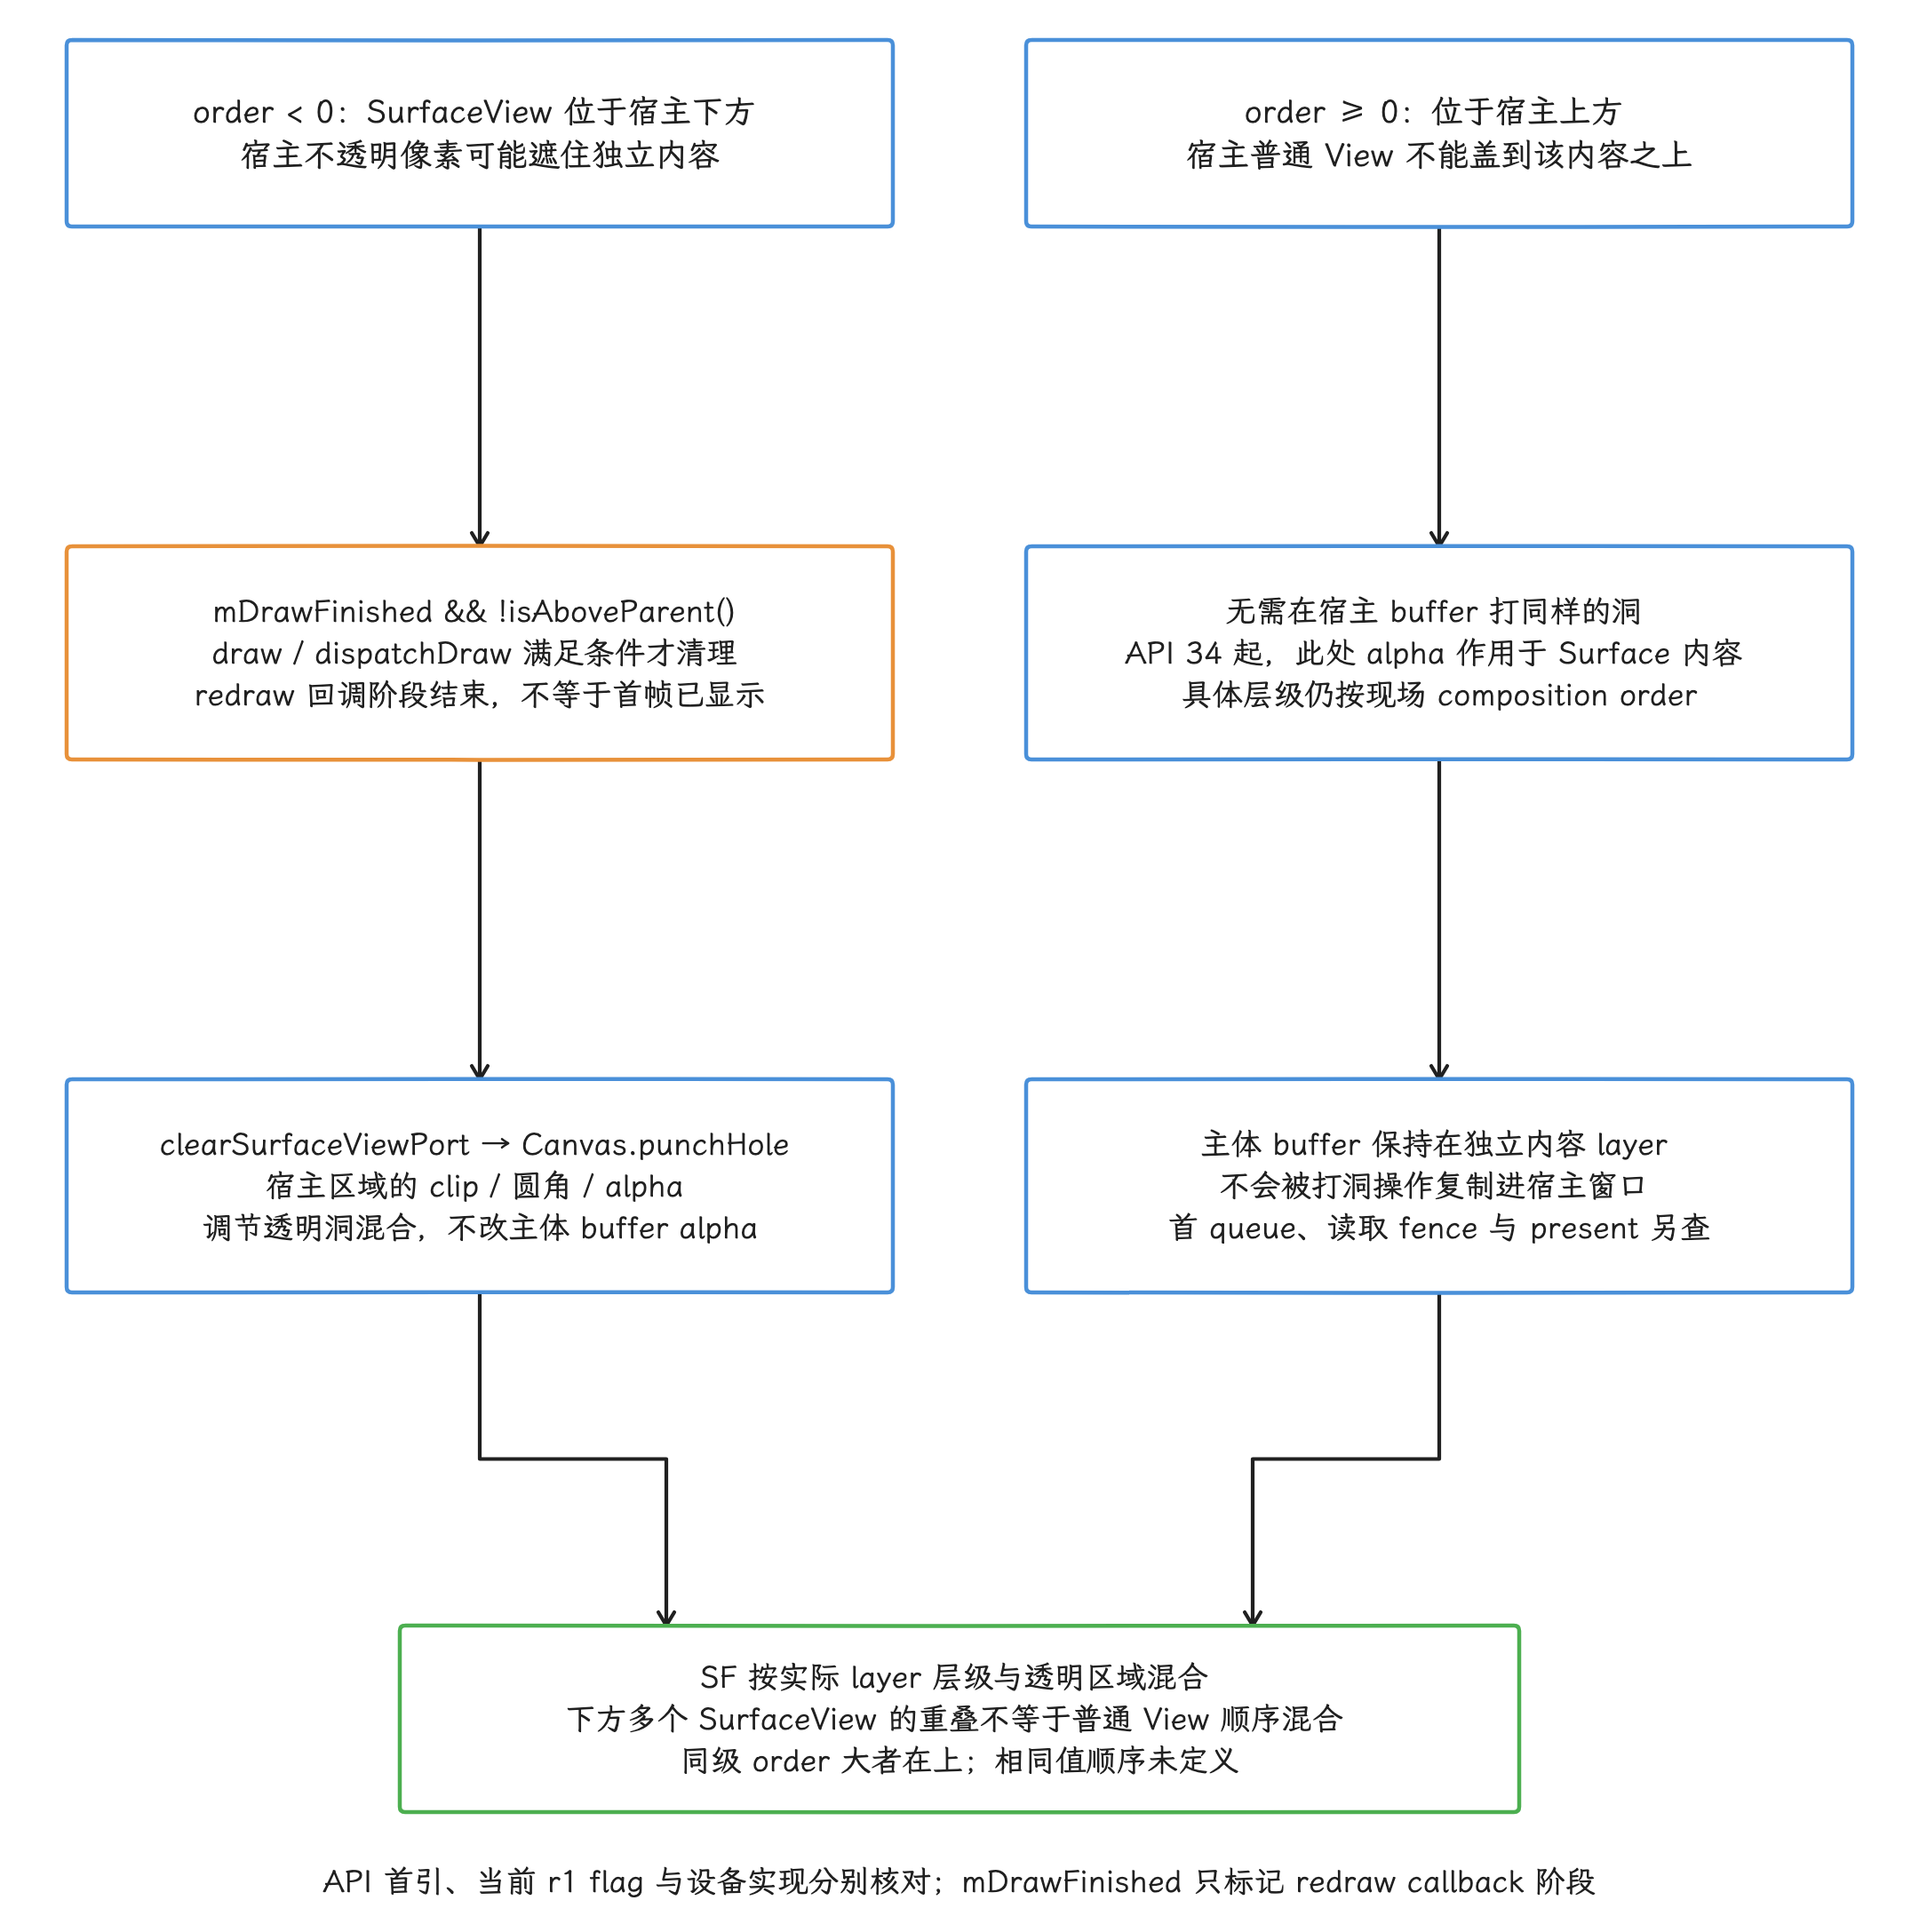
图:相对宿主Z、打洞和alpha合图:order负在host下,draw/dispatchDraw仅在mDrawFinished且非above时经clearSurfaceViewPort/punchHole清理宿主clip/圆角/alpha区域;不把主体像素复制进host。非负在上,不打同样的host洞,宿主普通View也盖不到其上。API34alpha在下方调hole混合、在上方作用Surface内容,不改bufferalpha;下方重叠SV不等普通View逐层混合。peer order大在上、同值未定义,API36/当前flag另核。mDrawFinished只标redrawcallback结束,首queue、读前acquire和present仍分别证明。
生命周期是 Producer 的硬边界
我们先把三个状态分开:Activity 可见、View 已 attach(接入 View 层级)、底层 Surface 有效。Producer 只能在 surfaceCreated() 到 surfaceDestroyed() 之间使用当前 Surface;surfaceDestroyed() 返回后,渲染线程必须停止访问它。Producer 若位于工作线程或远端服务,销毁回调就要等到旧连接停止使用 Surface 再返回,只异步发送一条 stop 消息是不够的。
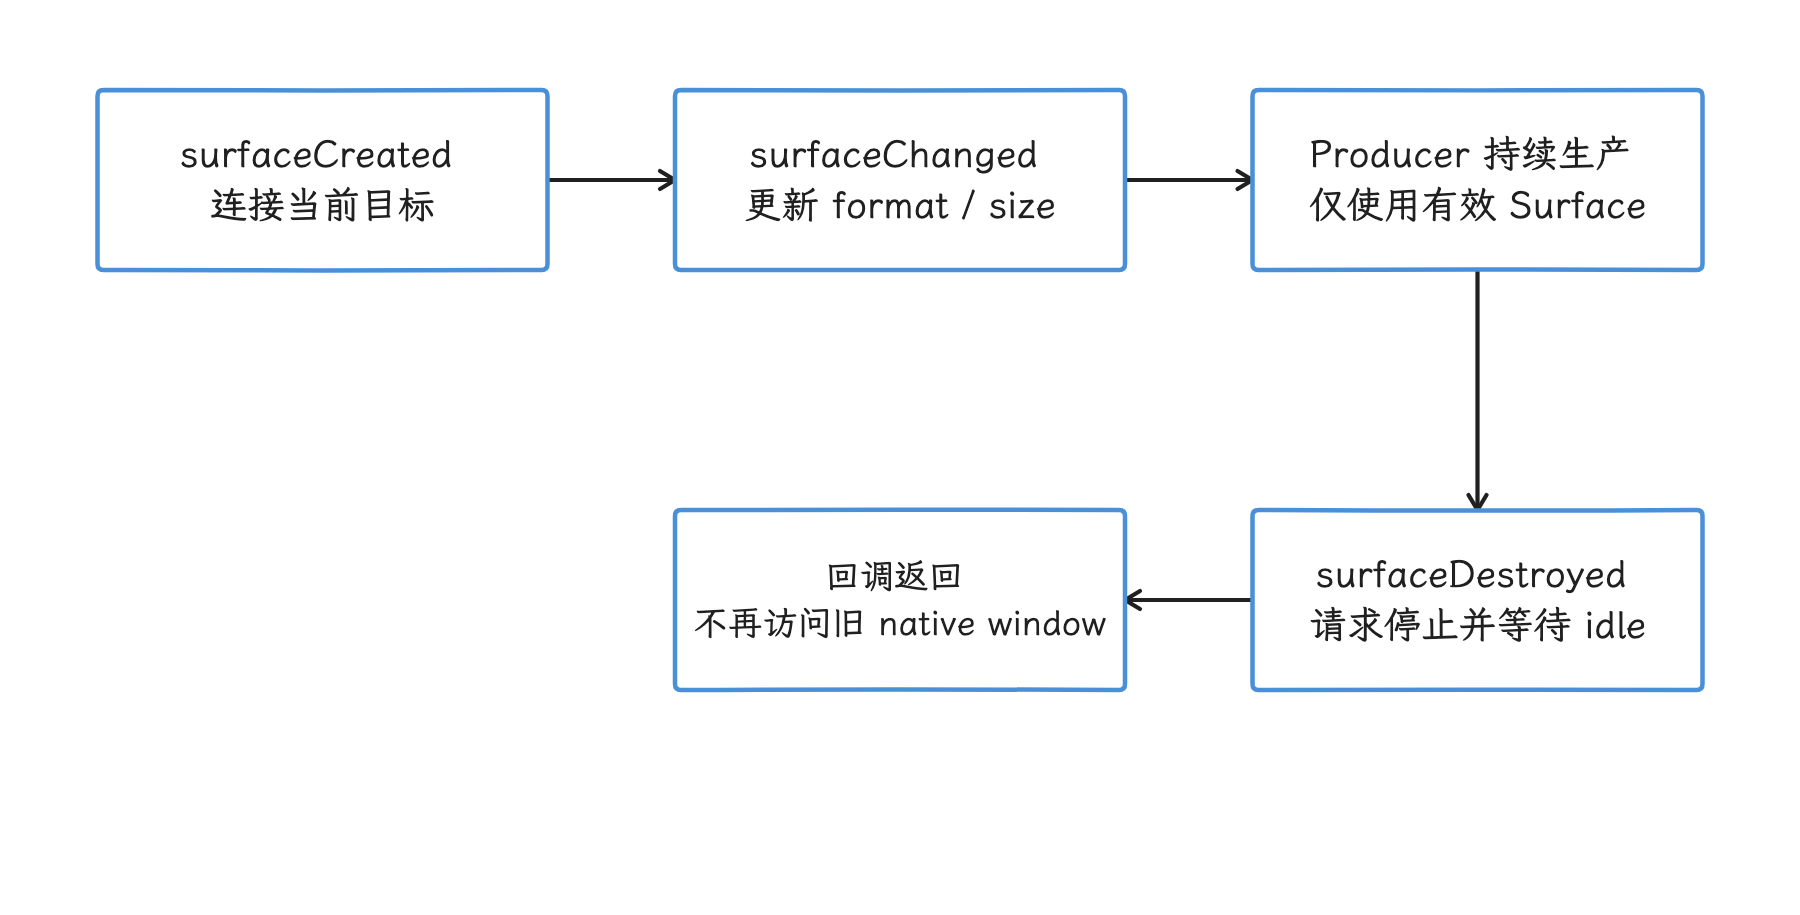
图:Producer 使用当前 Surface 的有效期由 created/destroyed 回调限定。 Activity 可见、View attach 与 Surface 有效是三个状态;销毁回调返回前停止旧目标访问。
下面的代码用应用自有接口表达所有权划分,FrameProducer 不是 Android SDK 类型:
private interface FrameProducer {
    fun attach(surface: Surface)
    fun resize(width: Int, height: Int, format: Int)
    fun detachAndWaitUntilIdle()
}

surfaceView.holder.addCallback(object : SurfaceHolder.Callback {
    override fun surfaceCreated(holder: SurfaceHolder) {
        producer.attach(holder.surface)
    }

    override fun surfaceChanged(
        holder: SurfaceHolder,
        format: Int,
        width: Int,
        height: Int,
    ) {
        producer.resize(width, height, format)
    }

    override fun surfaceDestroyed(holder: SurfaceHolder) {
        producer.detachAndWaitUntilIdle()
    }
})
这段骨架强调 detachAndWaitUntilIdle() 必须同步等到旧 Surface 不再被使用:EGL/Vulkan 线程停止对旧 native window 的 swap/present,MediaCodec 或 Camera 撤销旧 output,具体停止 API 取决于 Producer。Android 14 的 attachment 生命周期策略允许 Surface 在 View 暂时不可见时继续存在,代价是 buffer、连接和硬件资源的持有时间也被拉长。
完整渲染路径
从 Producer 到显示设备
一块 SurfaceView 内容 buffer 会依次经过以下阶段:
- Producer 从目标 Surface 对应的 BufferQueue
dequeue一个候选 slot/buffer,并取得约束旧内容复用的 release fence;真正开始写入前仍须满足这项依赖。 - Codec、Camera、CPU、GLES 或 Vulkan 填充内容,并生成描述写入完成条件的 fence。
- Producer 把 buffer
queue回待消费队列,同时提交时间戳、crop、transform、dataspace(颜色空间等解释信息)和 HDR metadata。 - BLAST consumer 取得描述该帧的
BufferItem,在BLASTBufferQueue::acquireNextBufferLocked()周围把 buffer、acquire fence、frame number 与 layer 状态写入SurfaceComposerClient::Transaction。 - SurfaceFlinger 接收 transaction,更新 FrontEnd 的 requested state(请求状态)、layer hierarchy 与 snapshot,再根据当前 latch 条件选用新 buffer 或继续使用旧 buffer。
- CompositionEngine 为目标 Display 组织可见输出;HWC 按条件走
validate()或presentOrValidate()。后者可直接 present 成功;需要 CLIENT 时才先由 RenderEngine 生成 client target,再走显示提交。 - HWC 提供目标 Display 的 present/release 反馈;SF 的 layer release 依赖还可能合并 RenderEngine/client target 的 GPU 完成条件,再沿 BLAST/BufferQueue 返回 Producer。归还的是对应旧 buffer,收到归还通知后仍须满足有效 release fence 才能重写。
下面的时序图把宿主几何和内容提交画在两条线上:
sequenceDiagram
    participant Host as "Host UI / RenderThread"
    participant Producer as "Codec / Camera / EGL / Vulkan"
    participant BLAST as "SurfaceView BLAST"
    participant SF as "SurfaceFlinger / CompositionEngine"
    participant RE as "RenderEngine"
    participant HWC as "Composer / Display"

    par 宿主更新(独立节奏)
        Host->>SF: "宿主 buffer / hole-punch + 对齐的几何事务"
    and 主体更新(独立节奏)
        Producer->>BLAST: "queueBuffer(buffer, acquire fence)"
        BLAST->>SF: "主体 buffer transaction"
    end
    SF->>SF: "readiness / 状态与新旧 buffer 选择"
    alt presentOrValidate 直接 present 成功
        SF->>HWC: "presentOrValidate(满足跳过 validate 条件)"
        HWC-->>SF: "present / release 反馈"
    else validate 或 presentOrValidate 返回 validated
        SF->>HWC: "validate,或组合调用的 validated 结果"
        opt 本轮需要 CLIENT composition
            SF->>RE: "绘制 client target(遵守 acquire fence)"
            RE-->>SF: "client target + GPU 完成依赖"
            SF->>HWC: "setClientTarget"
        end
        SF->>HWC: "present"
        HWC-->>SF: "present / release 反馈"
    end
    SF-->>BLAST: "对应旧主体 buffer 的 release(可合并 GPU 依赖)"
    BLAST-->>Producer: "归还旧 buffer;满足有效 fence 后才能写"
图中列举的宿主 buffer、container 几何和主体 buffer 各有独立节奏,不要求一次 display frame 三者都更新;宿主几何可与对应宿主 buffer 合并。各队列 frame number 也不共享命名空间。分析时要确认目标 Display present 使用了哪组新旧内容与几何,图里的返回箭头不表示当前新 buffer 一经显示就立即归还。
内容节奏的时钟来源
内容从哪套时钟来,各家 Producer 各有答案:MediaCodec 可以按媒体时间戳释放输出帧,Camera 受 sensor 与 HAL stream 节奏约束,游戏线程可能由 Choreographer、AChoreographer、Swappy 或引擎时钟驱动。SurfaceView 对 Producer 走不走宿主的 ViewRootImpl#doTraversal() 也没有要求;某个 Producer 是否跟随 VSync 或 Choreographer,取决于它用哪套 pacing(供帧节奏控制)机制。
宿主刷新率与内容帧率不同很常见。看到多个 DisplayFrame 使用同一块视频 buffer,我们先别急着判丢帧:要确认的是新内容是否在目标 present deadline 前可用、旧 buffer 是否符合媒体节奏,以及控制层与主体是否使用相容的几何状态。
几何 transaction 与内容 transaction
常见的对齐方式至少有三种:
SurfaceViewPositionUpdateListener从记录 View 绘制属性的 RenderNode 取得宿主 frame number,再通过ViewRootImpl.mergeWithNextTransaction(),把 container 的 position、matrix、crop 等状态与对应的宿主 buffer transaction 合并。- UI 线程发起的部分状态更新通过
ViewRootImpl.applyTransactionOnDraw(),绑定到宿主窗口的下一次 draw。 - 公共 API
applyTransactionToFrame()通过mBlastBufferQueue.mergeWithNextTransaction(),把 transaction 绑定到 SurfaceView 的下一块内容 buffer。
第三种方式从 API 34 起公开。只有调用前暂停 SurfaceView 渲染,才能把目标明确为调用后的下一帧;持续渲染时对应哪帧未定义,没有新内容时甚至可能不应用。当前 BLAST 若已 acquire 目标 frame number,会直接 apply 事务,否则保存为 pending 合并。因此它表达帧绑定,不能推导每次调用都固定等待一次 dequeue/queue。位置和裁剪通常跟随宿主帧;必须与某块主体 buffer 同时生效的 child transaction 才评估内容帧绑定。
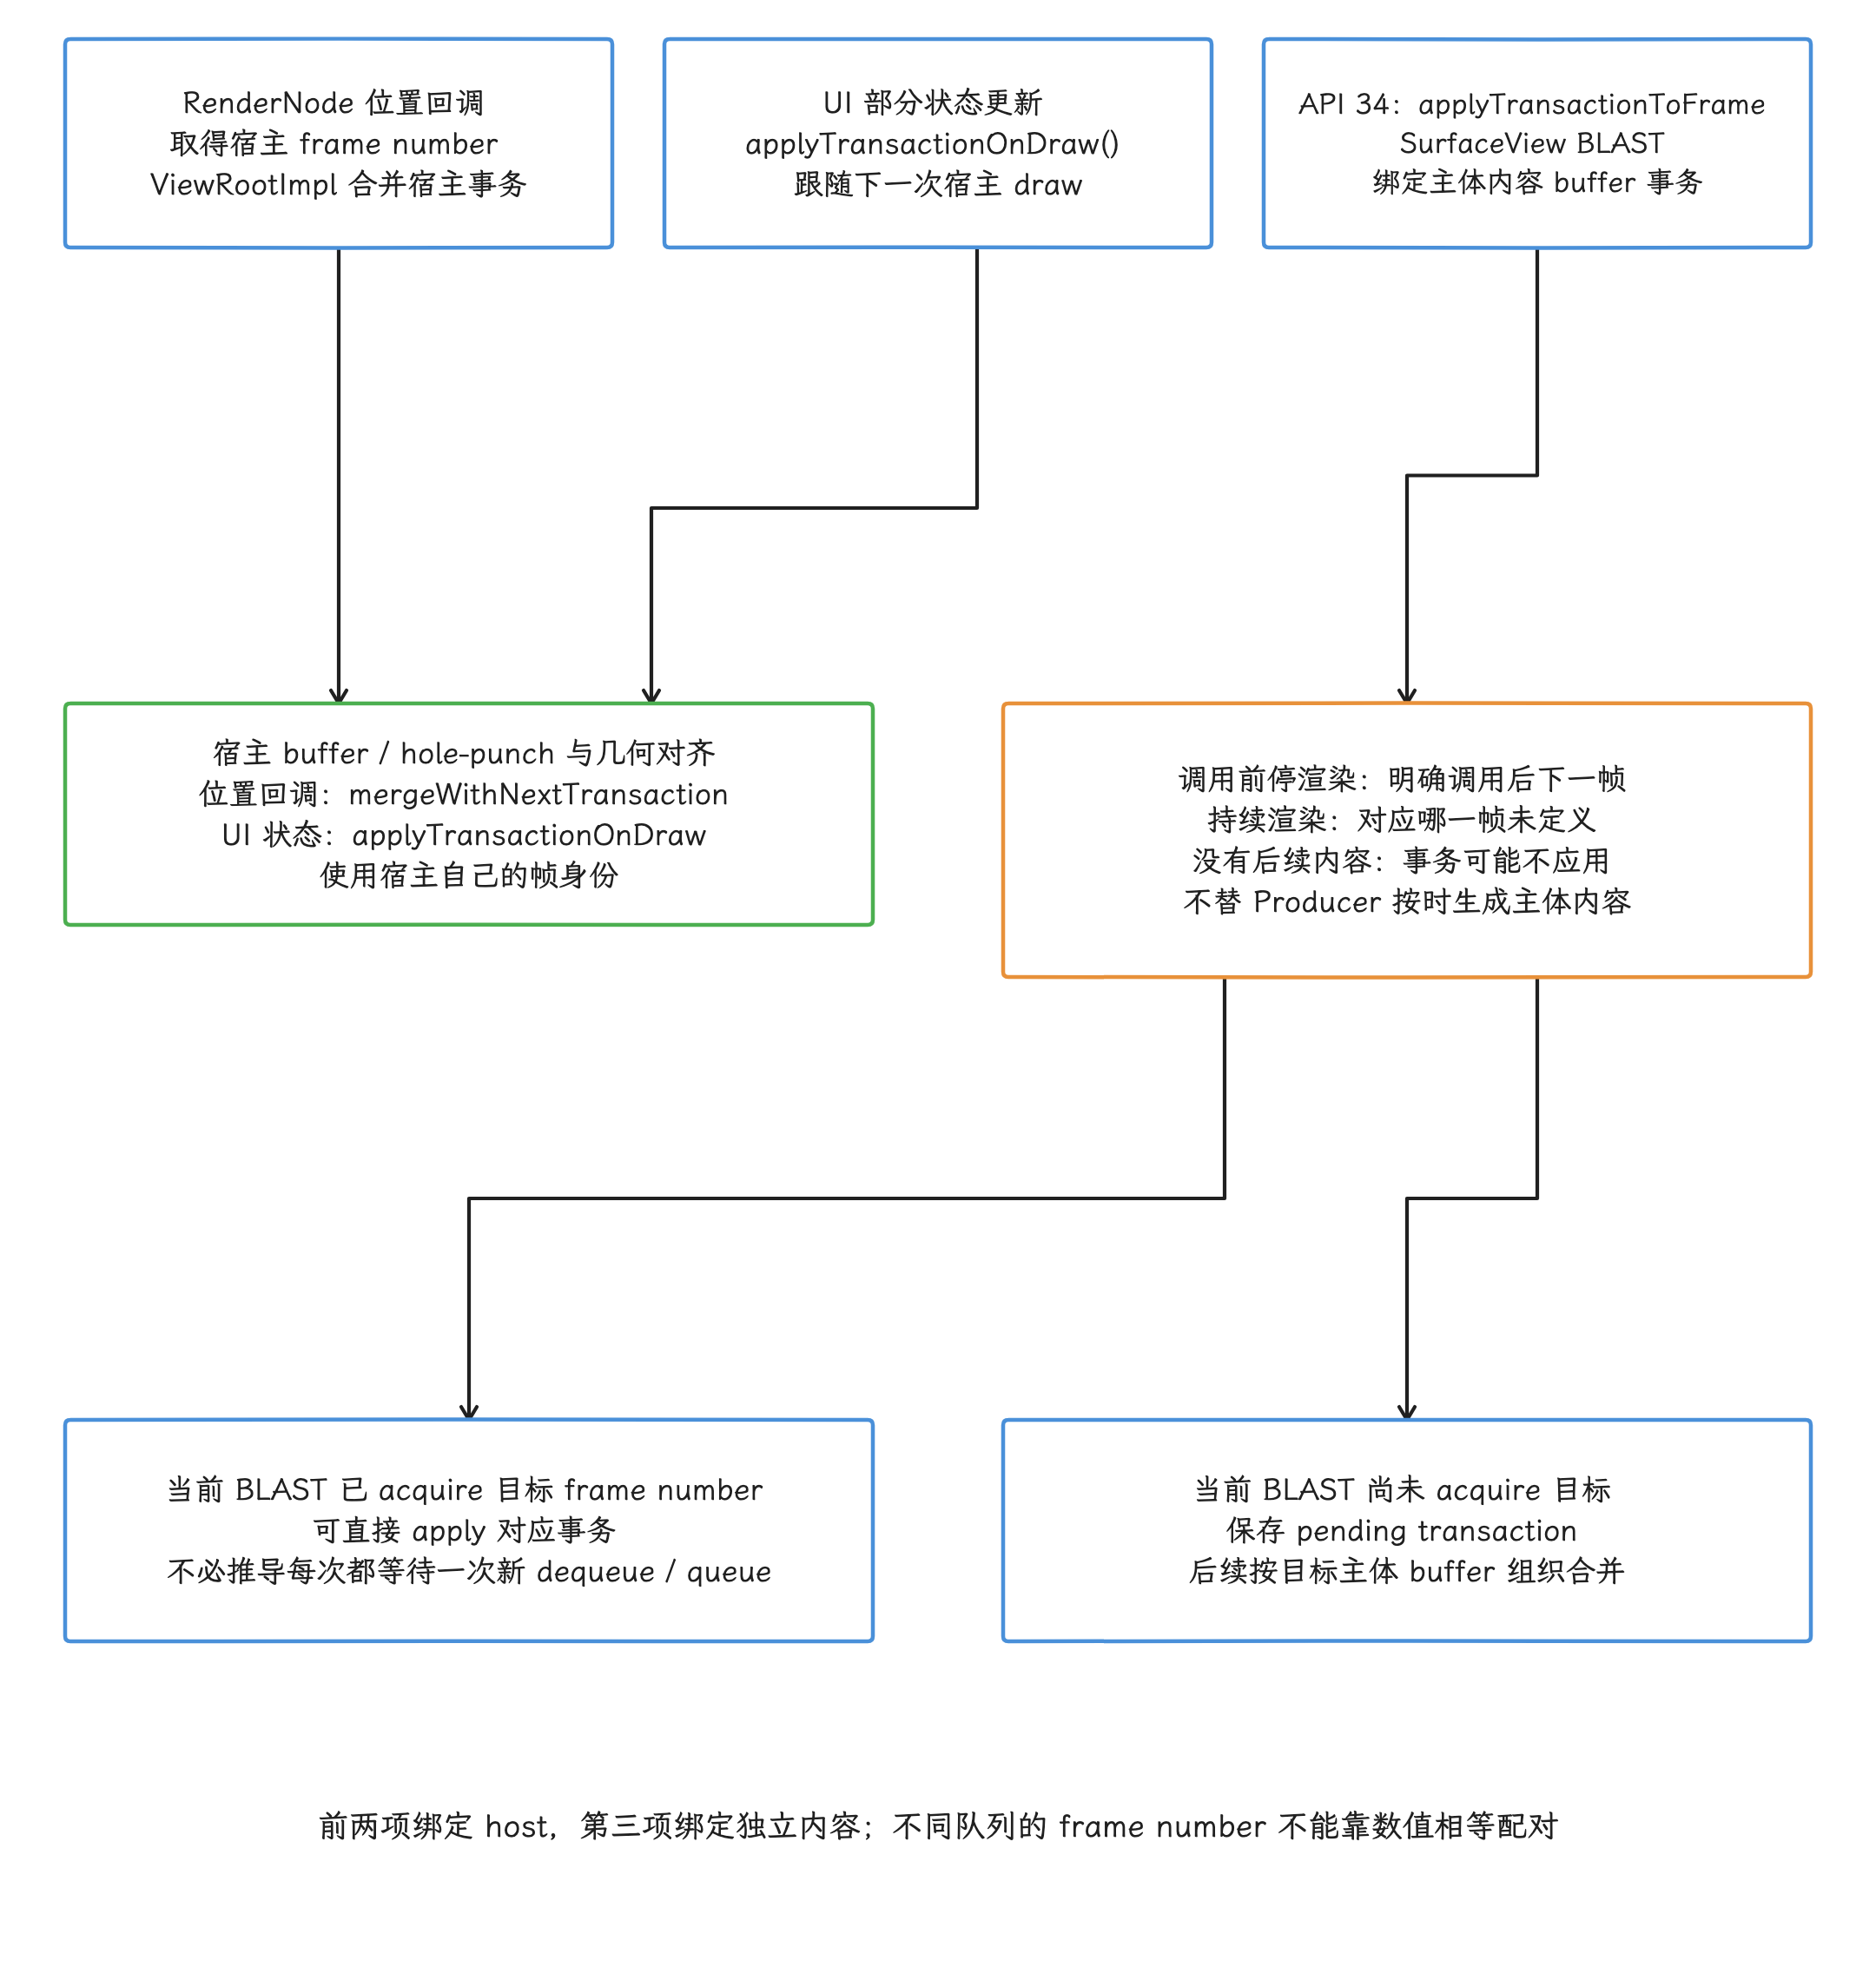
图:宿主帧与内容帧绑定合图:framework位置回调取得hostframe并由ViewRoot.mergeWithNextTransaction合宿主事务,部分UI状态经applyTransactionOnDraw绑下次hostdraw。API34公开applyTransactionToFrame则合SV内容:调用前停渲染才明确调用后下一帧,持续生产哪帧未定义,无后续内容可能不apply;当前BLAST目标已acquire时可直接apply,否则保存pending。不同队列framenumber不共命名空间;绑定不替Producer产出新尺寸内容,也不保证每次固定等一次dequeue/queue。
fence:fd、依赖与所有权
queueBuffer() 返回时,像素未必已经可读:Producer 可以随 buffer 提交一个尚未 signal(触发) 的完成 fence,从 BLAST 或 SurfaceFlinger 的角度看,这就是 acquire fence。SurfaceFlinger 使用 buffer 前必须先满足该依赖;即使启用了允许 unsignaled latch 的受限优化,开始硬件读取前 fence 仍要满足。
我们把这三类 fence 分开看,它们各管一段同步边界:
- acquire fence:说明上游 Producer 何时写完这块内容 buffer,消费者何时可以读取;
- per-layer release fence:说明 HWC 或合成路径何时用完某个 layer buffer,Producer 何时可以复用;
- present fence:标记一次 Display present 的同步完成边界,用于显示时序反馈;面板光学扫描何时完成,要另找测量手段。
在内核基线 android17-6.18-2026-06_r6 中,drivers/dma-buf/sync_file.c 负责把 fence 暴露为 fd(文件描述符),drivers/dma-buf/dma-fence.c 提供 signal、callback 与 wait 等基础语义。这两个文件讲清的是同步机制本身;GPU、codec、camera 或 DPU(Display Processing Unit,显示处理单元)中的哪项工作延迟了 signal,要结合用户空间 Producer、厂商 HAL、驱动 timeline 与调度轨迹才能定位。
BufferQueue 行为与 Triple Buffering
“Triple Buffering”标题沿用目录名称;Android 17 没有适用于所有 SurfaceView 场景的固定三槽模型。
BufferQueueCore 维护 slot 与 GraphicBuffer 的所有权;mMaxDequeuedBufferCount、mMaxAcquiredBufferCount、async/cannot-block 和配置上限共同决定可用数量。当前 r1 的槽表按 BufferQueueDefs::NUM_BUFFER_SLOTS 初始化,默认禁止扩展;Consumer 允许 mAllowExtendedSlotCount 后,Producer 的 extendSlotCount() 可增大槽表,不能把该常量写成所有连接的绝对最大容量。槽表容量、已分配 buffer、queued/acquired/dequeued 数量也不同;看到三块活跃 buffer,只能描述这次连接当时的三缓冲表现。
状态与背压
通用状态流如下:
FREE → DEQUEUED → QUEUED → ACQUIRED → FREE
          Producer          Consumer
这个状态图描述普通非 shared-buffer 路径的主要所有权周转,省略了 cancel、丢弃/释放 queued buffer、detach/attach 等分支。Producer dequeue 后再满足返回的 release fence,才可写入;Consumer release 让所有权可回收,也不保证 fence 已 signal。shared-buffer 模式中的并存状态不能套用这一条独占状态环。
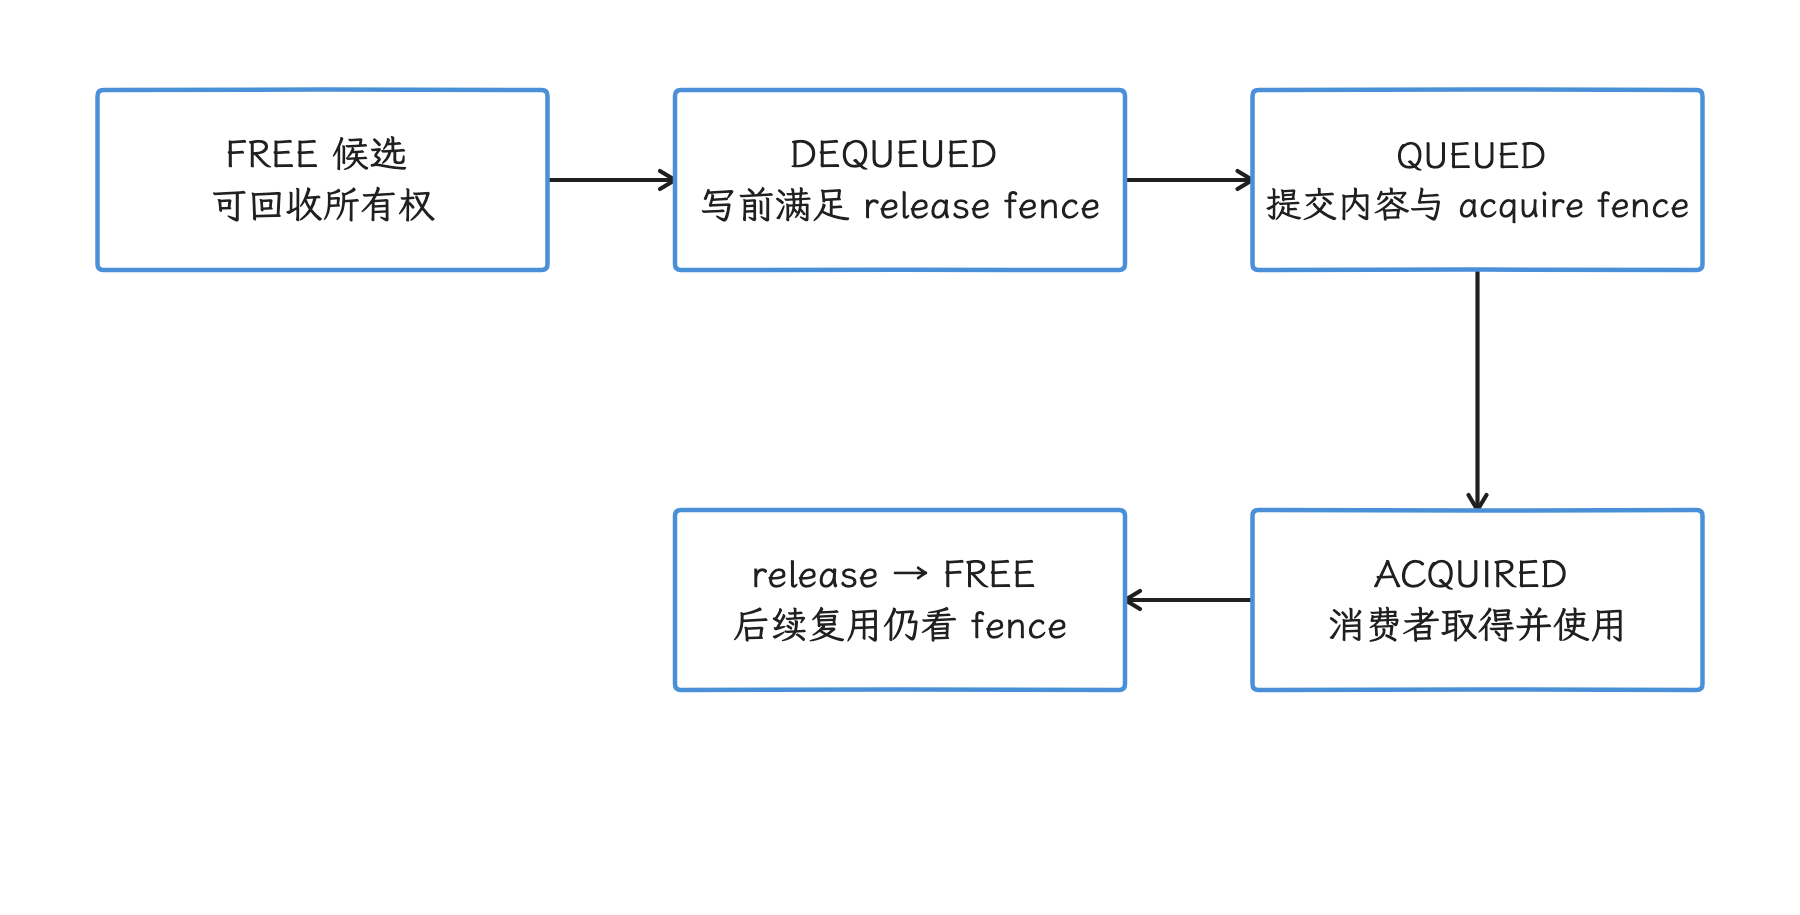
图:主要非 shared-buffer 路径按 dequeue、queue、acquire、release 周转。 省略 cancel、drop、detach/attach;FREE 或已 release 不自动表示有效 fence 已完成。
Producer 的 dequeueBuffer() 变长可能来自没有候选 slot、分配及兼容实现中的等待;普通 native release fence 通常随 slot 返回,再由 Producer 的 EGL/Vulkan/CPU 写入路径满足,不能把长 dequeue 一律当成该 fence 的 CPU wait。无槽时还可能超时或按 cannot-block 条件失败,达到最大 dequeued 数也可能报错,而非必定等待。应结合下面的原因与实际调用栈核对:
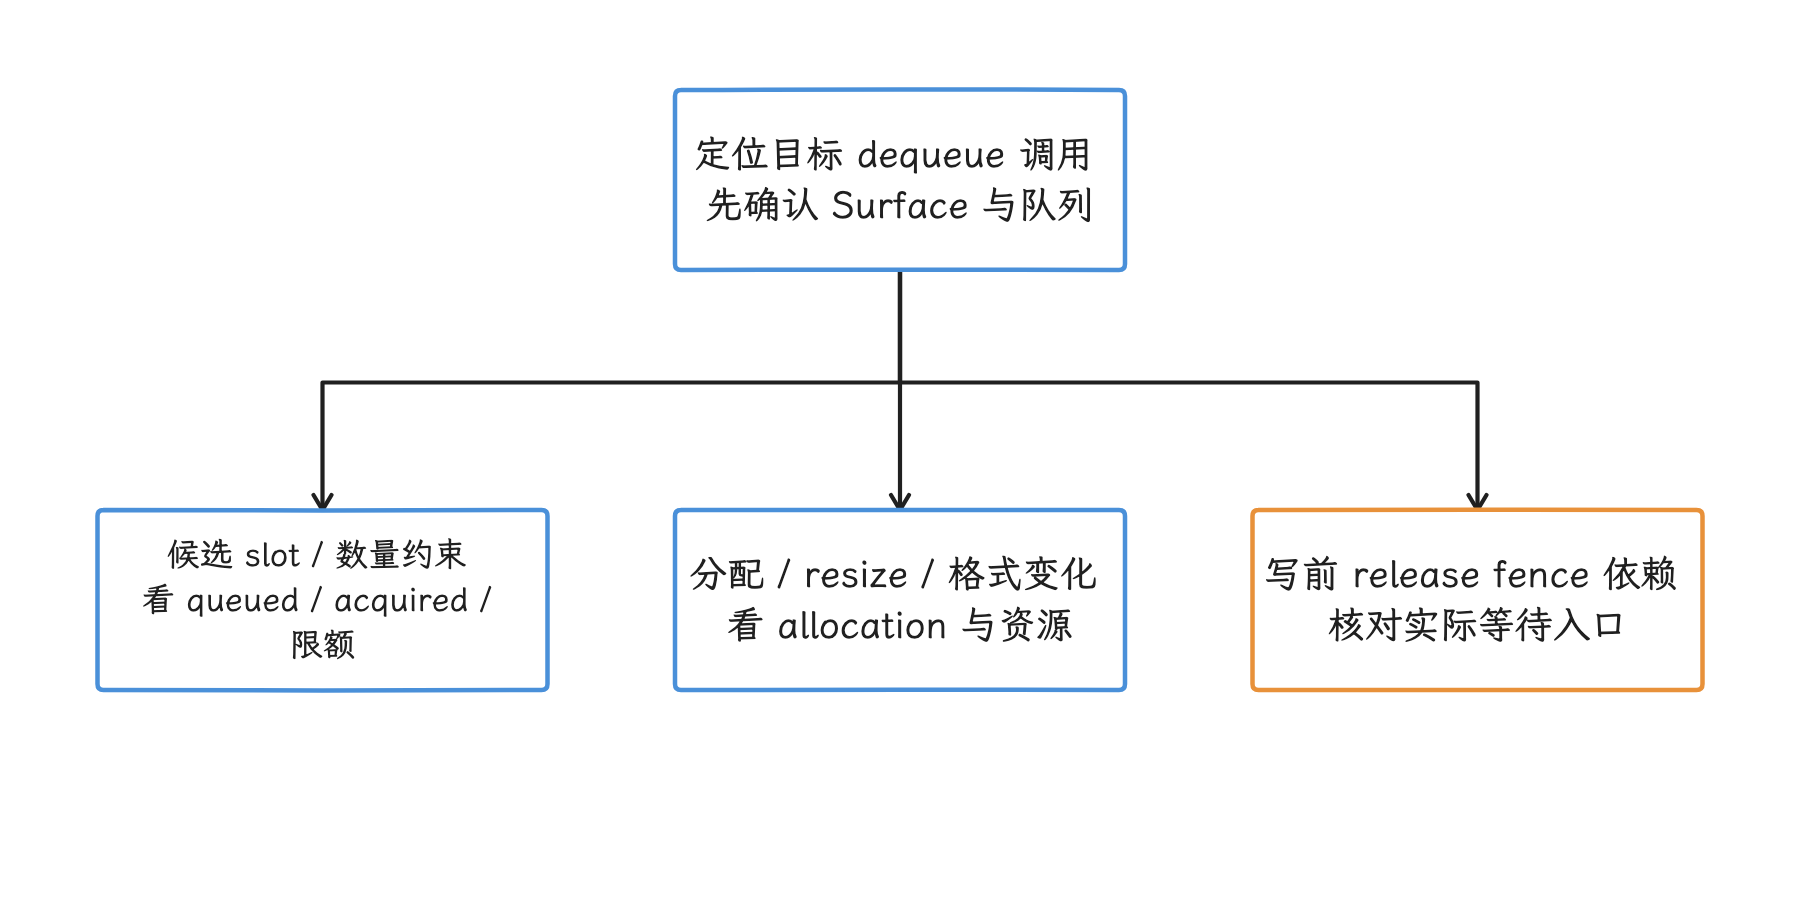
图:候选 slot 等待、分配与写前 fence 依赖必须按调用栈区分。 无槽可等待、超时或失败;max-dequeued 违规也可能报错,不能只增加深度。
- Consumer/HWC 仍在使用 buffer,release fence 迟到;
- GPU、codec 或 camera 的前序工作使队列周转变慢;
- Producer 生成速度长期高于 Display/Consumer 的消费能力;
- resize、格式变化或重新分配期间出现额外等待;
- queue 要求保留帧顺序,旧帧走不了异步丢弃这条路。
看到一条较长的 dequeueBuffer slice,先别直接归因于“队列深度太小”;下结论前,我们要核对目标 layer 的 queued/acquired 状态、release fence、Consumer 消费节奏、Producer timestamp,以及当时是否正在分配 buffer。
两套队列独立,但仍共享设备资源
宿主窗口与 SurfaceView 内容拥有各自的 Producer/Consumer 状态和 release fence 返回路径。宿主 dequeueBuffer() 发生等待时,SurfaceView 队列仍可以照常流转;SurfaceView Producer 遭遇背压,即生产速度受消费速度限制,宿主按钮也仍可以照常刷新。
当然,两条队列仍共享系统资源:CPU 调度、GPU、内存带宽、SurfaceFlinger、HWC plane/scaler、Display deadline 与功耗策略都可能相互影响。所以这句话要分两半说:队列所有权和背压状态相互独立,资源竞争与最终合成仍然相关。
增加可用 buffer 数量可能降低 Producer 阻塞概率,也可能增加内存占用和排队时延。实时交互更关注旧帧是否堆积,离线处理更关注 Producer 是否会被短暂抖动打断。调整 buffer count 或 async 行为前,要先确定业务优先保障吞吐、时延还是逐帧顺序。
SurfaceView vs TextureView
两者都能向 Producer 提供 Surface,但入口不同:SurfaceView 通过 holder.surface 提供;TextureView 公开的是 SurfaceTexture,应用通常用 Surface(surfaceTexture) 构造并负责释放包装对象。主要差异是由谁消费内容流,以及主体像素最终落在哪个 buffer:
SurfaceView:
Producer → SurfaceView BufferQueue → BLAST buffer transaction
         → SurfaceFlinger 独立 layer → HWC / Display

TextureView:
Producer → SurfaceTexture BufferQueue → App RenderThread 纹理采样
         → Host Window BufferQueue → SurfaceFlinger 宿主 layer → HWC / Display
TextureView 路径的附加工作,是应用 RenderThread 组织输入 image 的获取与宿主绘制,再由 GPU 采样并写入宿主 buffer;RenderThread 这个 CPU 线程本身不执行 GPU 纹理采样。通常也不是 CPU 逐像素拷贝,成本取决于分辨率、变换、格式、刷新率和 GPU 实现。
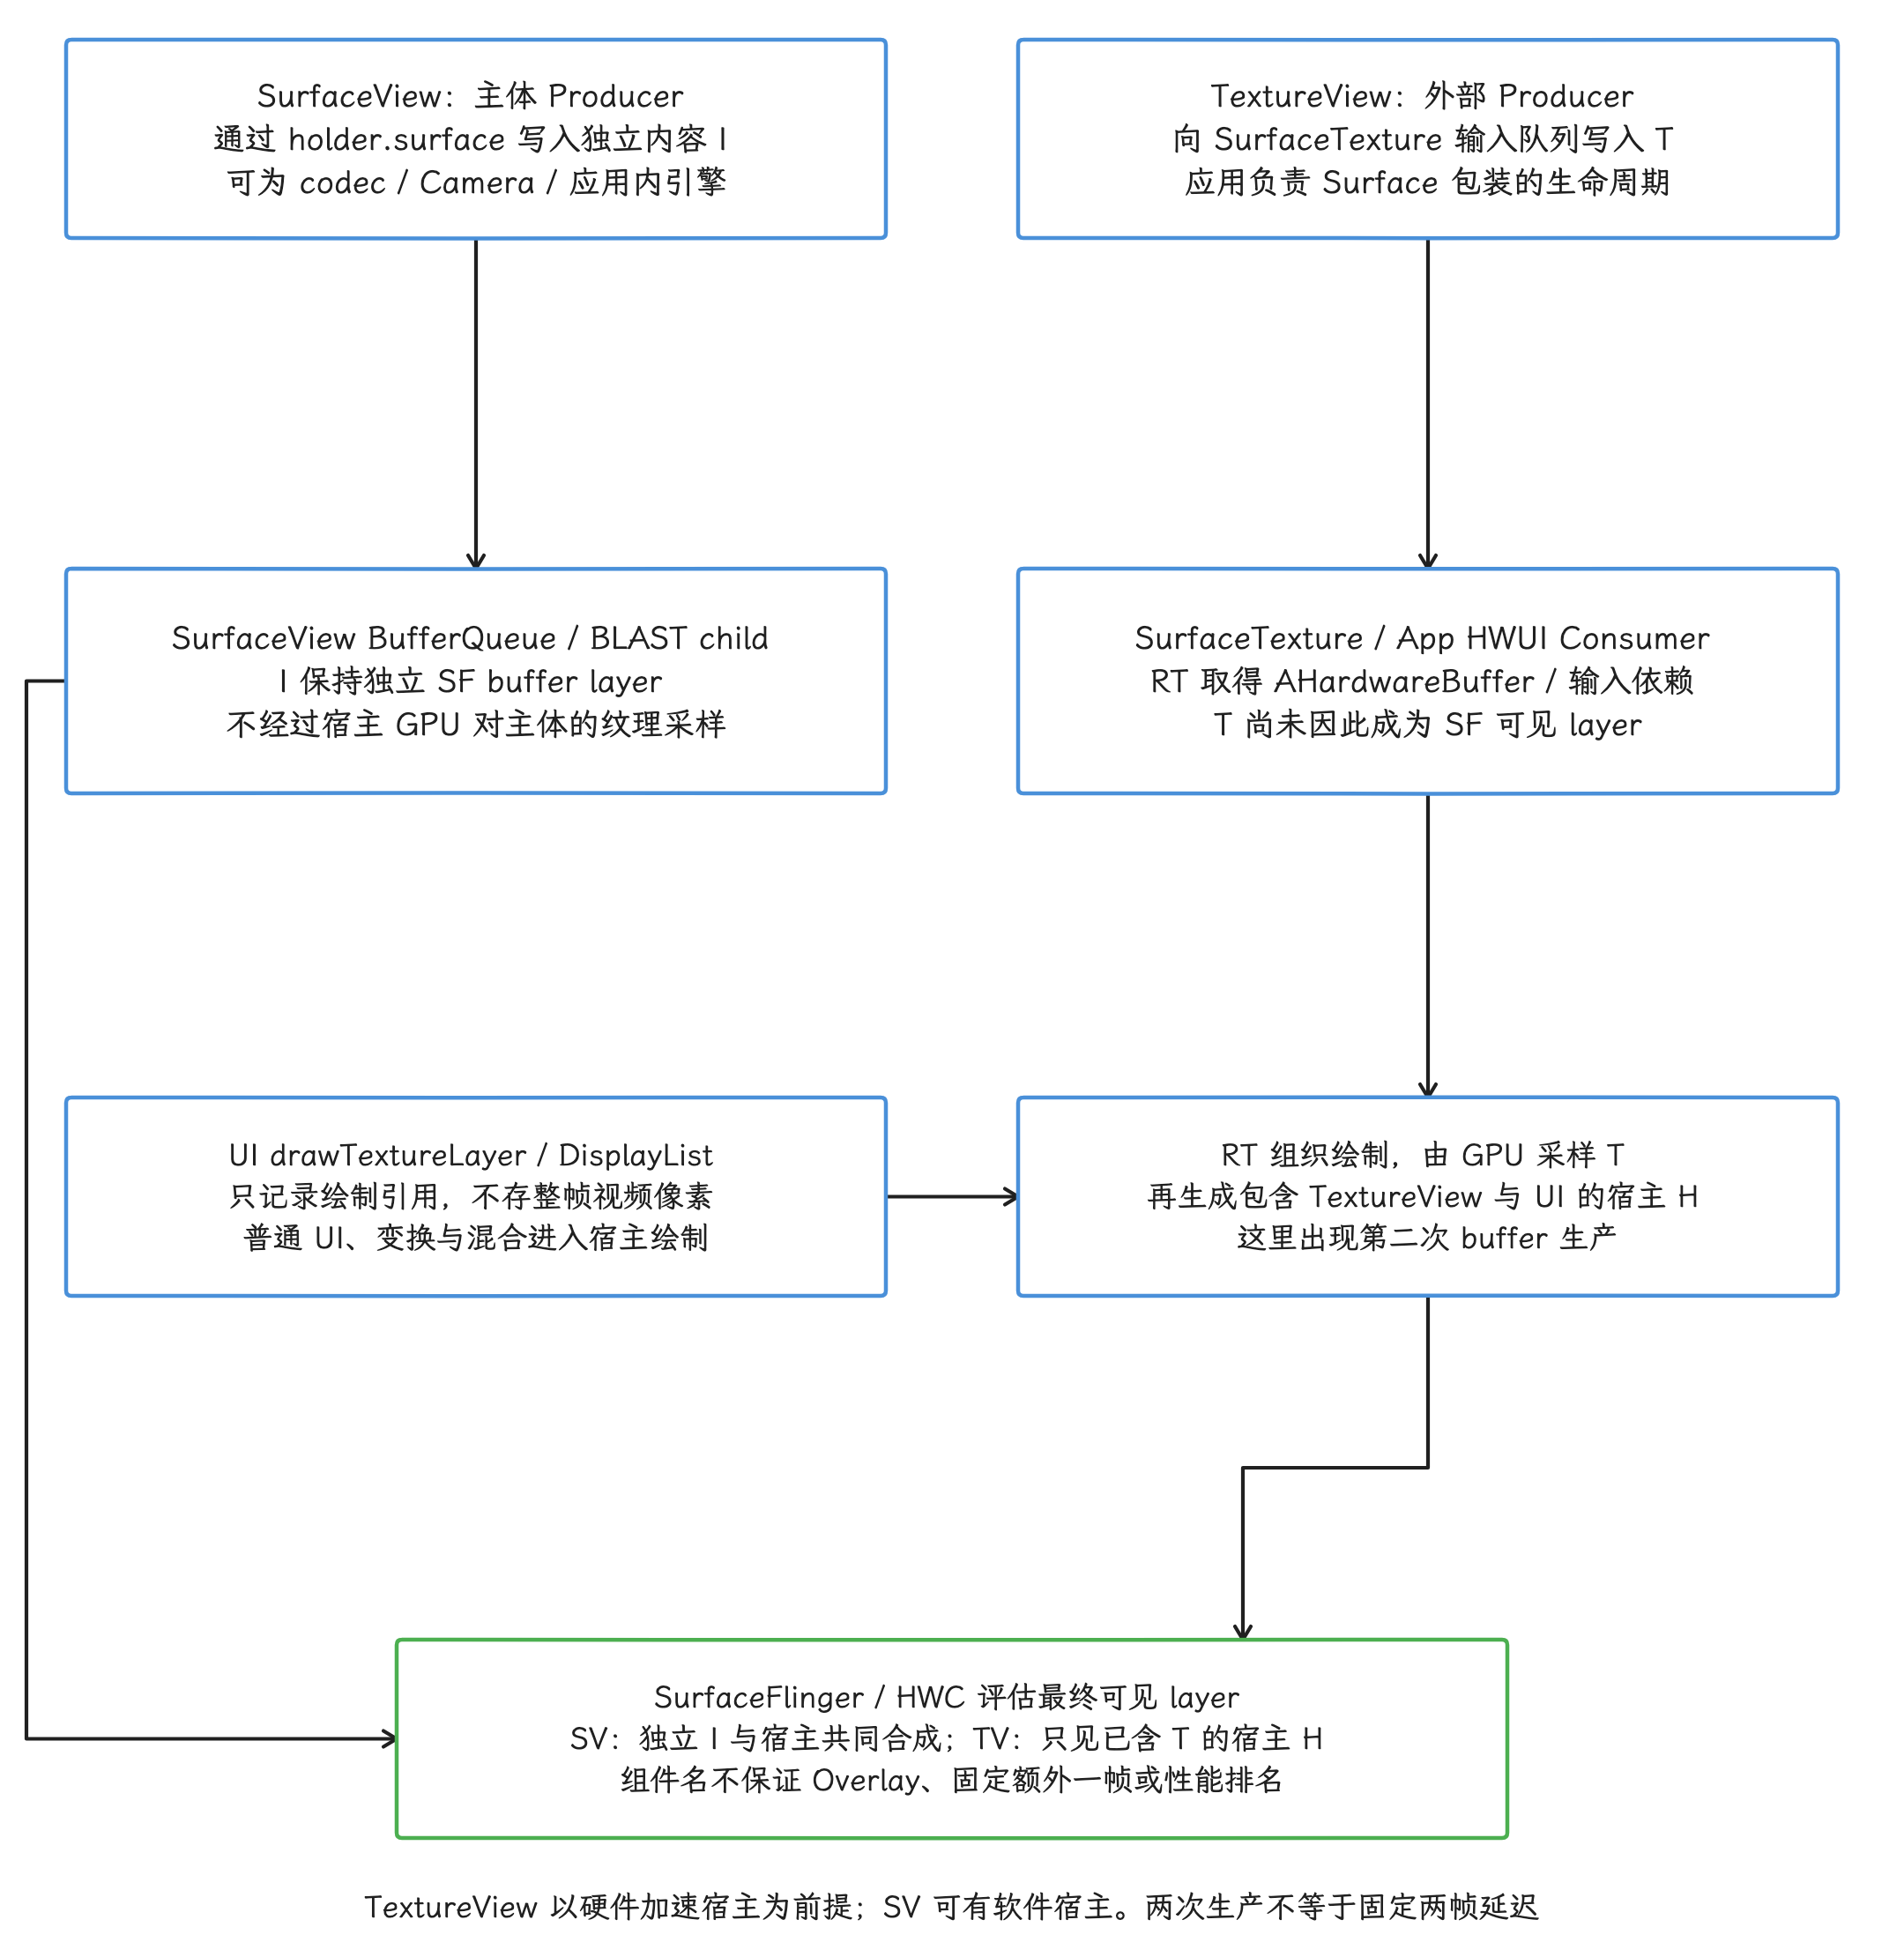
图:两种最终像素拓扑与绘制记录合图。SV主体I保留独立BLASTchild,在SF与host汇合;TV先由外部生成输入T,应用RT取得image并组织绘制,再由GPU采样T生成宿主H,SF通常只见包含T的H。DisplayList记录TextureLayer引用,不存整帧视频像素;RT是CPU组织/提交者,采样由GPU执行。TV以硬件加速host为前提,SV可有软件host。独立layer非DEVICE保证,host DEVICE不给内部TV矩形独立overlay,两次生产非固定两帧延迟。
| 维度 | SurfaceView | TextureView |
|---|---|---|
| 主体像素的最终位置 | 独立的 BLAST child layer | 通常进入宿主窗口 buffer |
| 宿主 RenderThread | 不采样主体内容;仍负责普通 View 和几何相关工作 | 消费 SurfaceTexture,并把它作为 TextureLayer 参与宿主绘制 |
| 帧节奏 | 内容可与宿主不同;SF 可复用旧内容 buffer | 新内容要经过宿主 draw 才能出现在新的宿主 buffer 中 |
| 变换与混合 | 受 SurfaceControl、composition order、crop 和 hole-punch 语义约束 | 作为 View/纹理参与父层变换、alpha、clip 和效果 |
| HWC 视角 | 主体 layer 可独立判断 DEVICE/CLIENT | HWC 通常只看到已包含主体像素的宿主窗口 layer |
| secure/protected 内容 | 可以建立独立的受保护显示链路 | 受宿主纹理采样和保护能力限制,不能假定两者等价 |
| trace 重点 | host、container、BLAST child、两套 buffer 与 fence | Producer queue、SurfaceTexture 更新、RenderThread 和 host buffer |
选型时我们按下面的顺序判断:
- 主体是否必须成为独立 secure layer,或者是否希望 HWC 单独评估大面积视频/相机内容?优先评估 SurfaceView。
- 是否需要普通 View 语义下的连续旋转、复杂裁剪、shader 效果或父子透明度?评估 TextureView。
- 主体更新能否接受等待宿主 RenderThread?等不起时,SurfaceView 的独立内容流更合适。
- 页面是否大量依赖普通 View 覆盖内容?SurfaceView 的 Z-below 允许宿主 View 覆盖,但要验证 hole-punch、alpha 与设备合成代价;Z-above 会让宿主 View 盖不到内容上方。
- 是否已有目标设备 trace 和功耗数据?数据到手前,“SurfaceView 一定省电”或“TextureView 一定卡”都只是预设。
HWC Overlay 与合成策略
SurfaceView 提供独立 layer,HWC 因此可以单独评估其 buffer;这只代表该 layer 拿到了使用硬件 Overlay plane 的机会,最终用不用由整屏条件决定。HWC 的 validate 面向整屏可见 layer 集合,判断会受以下条件共同影响:
- buffer format、内存布局 modifier、用途标志 usage、颜色解释 dataspace 与 HDR metadata;
- source crop(源裁剪区域)、destination frame(屏幕目标区域)、缩放、旋转、alpha 与 blending;
- secure/protected 要求和外接显示保护状态;
- 同屏其他 layer 对 plane、scaler、bandwidth 和颜色处理单元的占用;
- Display mode、刷新率、面板能力与厂商 Composer 限制。
YUV 内容经常适合硬件视频 plane,但格式本身定不了 HWC 的最终选择。SurfaceView 上方存在控制条,同样不必然导致 CLIENT composition:有些硬件可以叠加多个 plane,某些变换或混合条件则会让部分 layer 进入 client target。Overlay plane 的数量和能力属于设备实现细节,写死“三到四个”没有依据。
普通 layer 用不上 DEVICE composition 时,SurfaceFlinger 可以让 RenderEngine 先把 CLIENT layers 合成到 client target,再交给 HWC。protected buffer 没有普通 RGBA 内容那种无条件改走非保护 GPU 路径的选项;设备建立合规保护链路失败时,可能黑屏、拒绝显示或播放失败。
SF 侧入口集中在 HWComposer::getDeviceCompositionChanges() 周围。当前 r1 仅在无 CLIENT、且 Composer 能处理 expected-present time 或已到 earliest-present 边界时尝试 presentOrValidate();直接 present 成功就保存 fence,后续不再重复 present;否则按 validated 结果继续,或先独立 validate()。ComposerHal 对应组合、validate 与 present 接口。HAL 返回与 fence 创建不证明面板物理扫描已经完成。
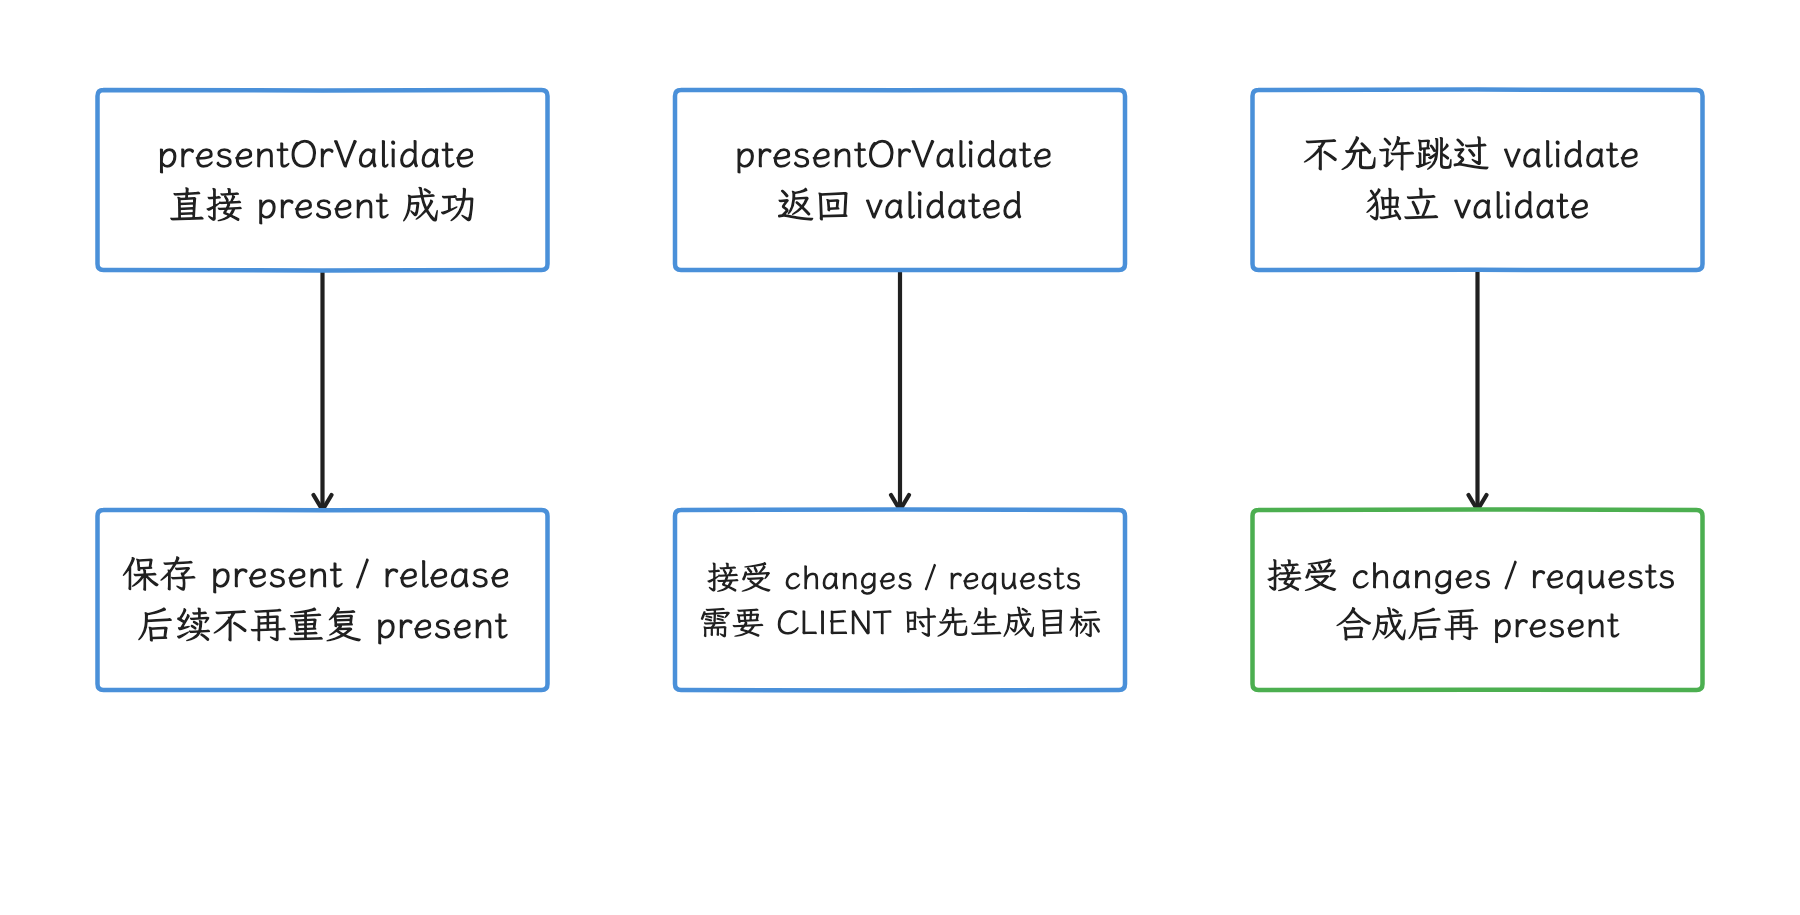
图:无 CLIENT 且时间条件允许时,组合调用可直接完成 HAL present。 直接成功后不重复 present;HAL 返回或 fence 创建不证明面板扫描完成。
怎样验证 composition type
一次 dumpsys SurfaceFlinger 只能给出采样时刻的状态,适合快速确认 layer 树和 composition type;分析动画或瞬时回退时,应使用 layer trace/HWC 轨迹。下面的命令先在设备上保存完整输出,再拉到主机,避免用硬编码 layer 名的 grep 漏掉 BLAST child:
adb shell 'dumpsys SurfaceFlinger > /data/local/tmp/sf.txt'
adb pull /data/local/tmp/sf.txt
第一行的单引号让 > 交给设备端 shell 处理;第二行把设备文件复制到主机当前目录。主机与设备端 shell 会分别解释命令参数,引用规则见 ADB shell 文档。
在输出中应先根据 parent-child 关系、buffer 尺寸、dataspace 和 layer id 确认目标 mBlastSurfaceControl,再读取 DEVICE、CLIENT 或 SOLID_COLOR 等类型。composition type 发生变化时,我们要比较同一 DisplayFrame 的整屏 layer 条件;只比较 SurfaceView 自身属性,会漏掉整屏条件的变化。
Trace 视角
采集前提与支持边界
我们建议同时采集应用 gfx/view 事件、线程调度、SurfaceFlinger transactions/layers、FrameTimeline、sync/fence,以及与场景对应的 GPU、codec、camera、Binder 或厂商数据源。Perfetto 官方文档明确注明 SurfaceView 尚不在支持范围;trace 里缺少主体内容独立的 App FrameTimeline slice 时,先别断定 Producer 没有提交新帧。
主体内容的时间线要通过 layer trace、目标 BufferQueue/BLAST、Producer queue、acquire fence、SurfaceFlinger 状态和 Display present 共同复原。宿主窗口和 SurfaceFlinger 的 FrameTimeline 仍可用来定位宿主帧与最终显示帧。
建立 layer 身份表
trace 分析应先记录对象身份:
| 对象 | 建议记录 | 用途 |
|---|---|---|
| Host App Window | layer id、name、buffer layer、parent | 对齐普通 View、hole-punch 与宿主 buffer |
| SurfaceView container | layer id、parent、relative-Z(相对层级)、position、crop | 对齐布局和几何 transaction |
| SurfaceView BLAST child | layer id、parent、buffer size、dataspace、composition type | 对齐主体 buffer 与 Producer |
| background/embedded child | layer id、parent、visible region | 避免把辅助层误认为主体 |
layer 名可能包含 Java tag、(BLAST)、SurfaceFlinger 分配的序号或 transaction 前缀;不同 trace 配置下,slice 名也可能变化。识别对象时,我们依赖的是 parent-child 关系、buffer 属性、Producer connection、frame number 和 transaction id;固定字符串在这里算不上稳定 API。
分开观察宿主组和内容组
宿主组关注:
Choreographer#doFrame、Input/Animation/Traversal;syncAndDrawFrame、RenderThread 与宿主 GPU work;- 宿主窗口的 buffer transaction;
- SurfaceView position/crop transaction;
- 包含 hole-punch 的宿主 buffer。
内容组关注:
- Codec、Camera、EGL/Vulkan 或其他 Producer 的工作;
- 目标 Surface 的 connect、dequeue 与 queue;
- BLAST child 的 buffer transaction;
- buffer frame number、timestamp、dataspace、crop、transform;
- acquire fence 与对应 layer 的 release fence。
宿主与视频内容按相同帧号配对并不可靠,因为视频、相机和宿主刷新可能处于不同节奏。分析一次异常显示帧时,我们至少要确认:宿主使用哪块 buffer、container 使用哪组几何、主体使用哪块 buffer、对应 acquire fence 何时 ready,以及 HWC 选择了哪种 composition type。
常见证据模式
| 现象 | 需要对照的证据 | 容易误判的点 |
|---|---|---|
| 控制条卡,视频继续更新 | main/RenderThread、宿主 BufferTX、SV BufferTX | 视频流畅不代表布局与 hole-punch 也在更新 |
| 视频卡,按钮流畅 | Producer queue、SV acquire fence、BLAST child buffer | 主线程空闲无法排除 codec、camera、GPU、SF 或 HWC 问题 |
| resize 时错位 | Traversal bounds、PositionUpdateListener frame、宿主透明洞、container transaction、内容 buffer | Android 7 以前的异步窗口模型不能解释所有现代错位 |
| Producer 长时间 dequeue | 目标队列状态、release fence、HWC/Consumer 节奏 | 较长的 slice 无法证明固定三槽数量不够 |
| 功耗升高 | 每层的 DEVICE/CLIENT、RenderEngine、client target 面积和 Display mode | composition type 变化是结果,还要查明触发条件 |
| 首帧黑屏 | SurfaceHolder callbacks、Producer connect、first queue/fence、layer show、background | surfaceCreated() 只代表 Surface 有效,不代表已有可显示 buffer |
fence wait 的读法
遇到 sync_wait 或 fence timeline 时,应依次确认:
- 等待者属于哪个线程和 layer;
- fence 是内容 acquire、client target acquire、per-layer release,还是 Display present;
- fence 创建者来自 GPU、codec、camera、RenderEngine,还是显示设备;
- signal 时刻是否越过目标 present deadline;
- 同期 CPU 线程是正在 running(正在运行)、runnable(可运行但在等 CPU) 等 CPU,还是 blocked(等待依赖) 等依赖。
“线程在等 fence”只说明它依赖上游工作完成,责任归属要靠下面的对照来定:内容 acquire fence 迟到,指向 Producer 或其上游工作没有及时完成;HWC release fence 迟到,则会延后 Producer 复用旧 buffer。两者都可能让画面或 Producer 变慢,排查方向却不同。
常见性能问题与优化
主线程卡住,内容仍动
这种现象说明主体内容这条生产线没被宿主 draw 卡住;我们还要逐项检查页面状态:宿主控制层是否停止更新、container 是否还在使用旧几何、hole-punch 是否匹配当前位置。此时通常要优化的是主线程工作、宿主 RenderThread 或布局更新;视频还在播,交互卡顿也还在。
Producer 阻塞或主体掉帧
先确认阻塞发生在目标 SurfaceView 队列,排除宿主窗口队列。随后对齐 dequeueBuffer()、queue timestamp、acquire/release fence、BLAST child 是否采用新 buffer,以及 HWC present 周期。降低 Producer 帧率、减少 GPU/codec 工作或调整队列行为都可能有效,选哪一种要看上面的对照结果;盲目增加 buffer 数量,可能用更高的显示时延换取较少的阻塞。
resize、滚动和转场错位
把以下三个对象放到同一时间轴上:
- 宿主 buffer 中透明洞的新位置;
- container 的 position/matrix/crop transaction;
- BLAST child 的新 buffer 和 destination frame。
BLAST 提供 transaction 同步能力;Producer 是否按时给出新尺寸内容、各状态是否绑定到同一帧,仍要调用方自己保证。频繁 resize 时,应减少没有实际作用的尺寸往返,明确 Producer 切换 buffer size 的时刻,并用宿主 frame number 验证几何 transaction 与哪一帧合并。
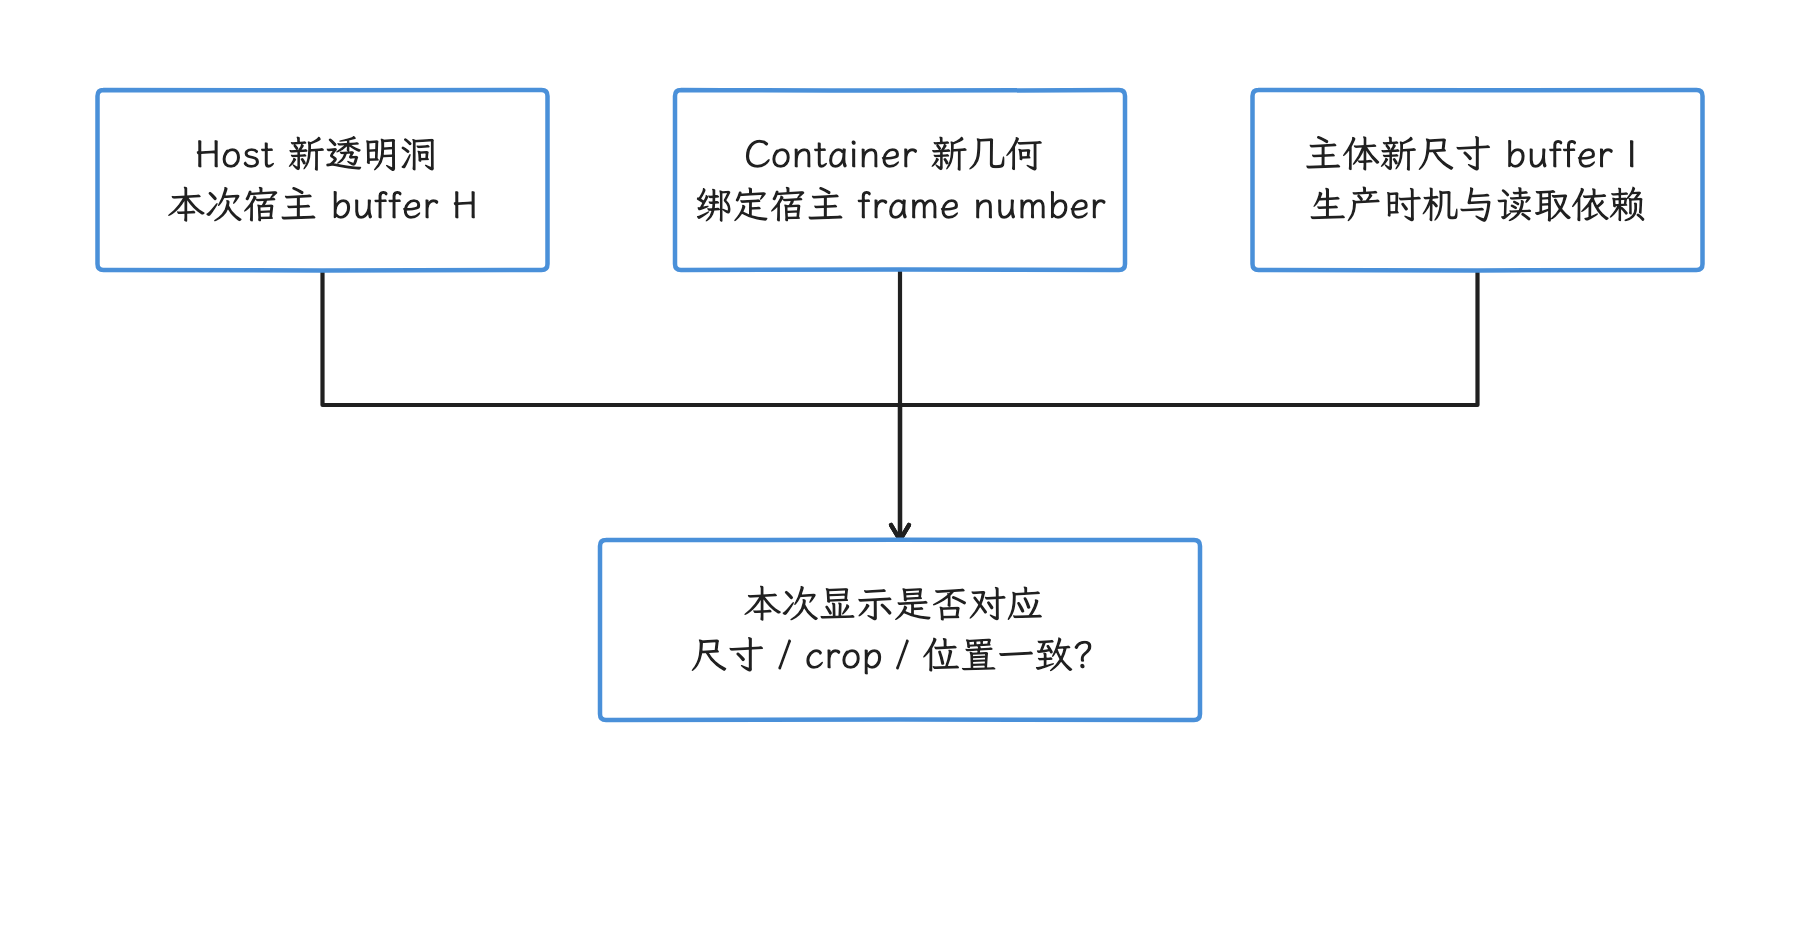
图:透明洞、container 几何与新尺寸内容要按具体宿主帧关联。 BLAST 不替 Producer 按时生成新尺寸内容,也不创建业务层跨队列帧号。
首帧延迟和生命周期竞态
Android 12—17 的 SurfaceView 首帧会经过以下阶段:
ViewRoot/bounds layer 就绪
→ SurfaceControl 与 BLASTBufferQueue 创建
→ SurfaceHolder callback
→ Producer connect
→ 第一块 buffer queue / 对应事务到达
→ layer 状态与 buffer 采纳(受限路径可先采纳未 signal buffer)
→ 真正读取前满足 acquire fence,再进入目标 display present
这条路径用于定位首帧耗时。应分别测量每个阶段,避免把整段时间都归给 surfaceCreated() 或 SurfaceFlinger。surfaceDestroyed() 后仍向旧 Surface 提交、重建后复用旧 EGLSurface/ANativeWindow,或者只在 onResume() 启动 Producer,都可能造成生命周期竞态:回调顺序与异步生产线程的实际状态不一致。
Z-order、alpha、圆角与 blur 异常
先记录 composition order 的正负和值,再判断 alpha 作用于内容层还是 hole-punch。圆角和 clip 同时涉及宿主透明洞与 container crop;API 37 的 blur region 还要随 SurfaceView bounds 更新。setZOrderOnTop(true) 会让宿主普通 View 盖不住内容,算不上通用的性能修复。
DEVICE 变成 CLIENT
对比变化前后的整屏 layer 集合、buffer format/dataspace、alpha、crop、scale、rotation、HDR、secure flag、Display mode 和厂商 HWC 日志。弹幕、圆角或 YUV 这类单一条件,单独哪一个都证明不了原因。业务允许时,可以尝试减小 client target 面积、降低混合复杂度或调整层级结构;是否值得采用,要根据目标设备的 GPU、带宽、功耗和视觉要求验证。
protected 内容黑屏
分别检查 layer 的 SECURE 策略、buffer 的 protected usage、目标 Display 保护能力、HDCP/外接屏状态和厂商错误。SurfaceView.setSecure() 设置的是 layer flag,不会自动把普通 buffer 转成受保护分配,也不替代 DRM/codec 的输出配置。普通非保护 CLIENT 路径不能规避保护要求;内屏正常而外接屏黑屏时,要先核对目标显示设备与系统策略。
输入延迟
SurfaceView 改变的是内容生产和合成拓扑,不会绕过 InputDispatcher 到应用窗口的输入路径。端到端输入时延应分为:
- InputDispatcher 到应用主线程;
- 主线程把输入状态交给内容 Producer;
- Producer 生成并 queue 下一块受影响的 buffer;
- acquire fence 满足、SF latch、HWC present,直至画面可见。
游戏或地图的 Producer 可能受 frame pacing 约束;视频和 Camera 的内容节奏通常不会因一次触摸而改变。完整的输入到显示时延,要回到上面几段分别看,doFrame 或 queueBuffer 的单段耗时只覆盖其中一段。
复核清单
每次分析至少回答这些问题:
- 主体像素是否位于独立 BLAST child,而非宿主 buffer?
- Producer 是谁,在哪个线程或服务填充 buffer?
- 当前 Surface 的有效期由哪套 callback 与 lifecycle strategy 控制?
- 宿主 hole-punch 在哪里形成,何时随 draw 更新?
- container 的 parent、position、crop 与 composition order 是什么?
- 几何跟宿主 frame 对齐,还是绑定到下一块内容 buffer?
- acquire、release 与 present fence 分别属于哪个对象?
- SurfaceFlinger 本轮采用新 buffer 还是复用旧 buffer?
- HWC 把主体判为 DEVICE 还是 CLIENT,前后条件有何变化?
- 用户看到的异常对应哪次 display present?
这些问题都有源码或 trace 佐证后,才能把“SurfaceView 卡了一帧”定位到 Producer、宿主、BLAST/SF、HWC 或显示设备中的具体环节。
Android 17 源码锚点
源码以平台版本 android-17.0.0_r1 和内核版本 android17-6.18-2026-06_r6 为准:
SurfaceView.java:hole-punch、container/BLAST/background 创建、生命周期、位置回调、composition order、blur 和 transaction 对齐;BLASTBufferQueue.cpp:buffer acquire、buffer transaction、mergeWithNextTransaction()与 release callback;BufferQueueCore.cpp、BufferQueueProducer.cpp:队列容量计算、dequeue 与背压;SurfaceFlinger.cpp与FrontEnd:transaction、layer state、snapshot 与 hierarchy;HWComposer.cpp、HWC2.cpp:validate、present、composition type 与 fences;sync_file.c、dma-fence.c:内核 fence fd(文件描述符) 与等待语义;- Perfetto FrameTimeline:SurfaceView 支持范围;
- Android Graphics Architecture 与 BufferQueue/Gralloc:平台图形模型。
相关章节:
- 13.4 OpenGL ES、EGL 与 ANGLE
- 13.5 Vulkan 原生管线与 HWUI 多队列
- 2.8 BufferQueue、Gralloc 与 Sync Fence
- 2.9 SurfaceFlinger 合成、FrontEnd 与事务队列
TextureView 的 SurfaceTexture 与宿主合成
SurfaceView 的 buffer 作为独立 layer 的内容提交;TextureView 的宿主 DisplayList 记录 TextureLayer 绘制引用,输入像素随后由 HWUI/GPU 采样写入宿主 buffer,不是把整帧像素塞进 DisplayList。把两者放在一起比较时,我们看的是变换需求、延迟和合成方式。
为什么要理解 TextureView 的链路
TextureView 参与普通 View 的布局与绘制顺序,可以跟随父布局应用 alpha、scale、rotation、clip 和 transition,也能与兄弟 View 混合。不过,它显示的主体像素不由普通 onDraw() 直接生成:Camera、MediaCodec、EGL/Vulkan 或其他 Producer 先向 SurfaceTexture 背后的 BufferQueue 提交 buffer,宿主 HWUI 再把选中的输入作为纹理采样,绘入 App Window buffer。
因此,一次可见更新包含两次 buffer 生产:外部 Producer 生成输入内容,宿主 HWUI 再生成包含该内容的最终窗口 buffer。
外部内容:Producer → SurfaceTexture BufferQueue
宿主窗口:SurfaceTexture → HWUI / RenderThread → App Window BufferQueue
这张简图区分了两套队列,两个同名调用含义并不相同:外部的 queueBuffer() 表示内容进入应用侧 Consumer 的输入队列,宿主的 queueBuffer() 表示最终窗口 buffer 已交给 SurfaceFlinger。从外部 queue 到用户看到新内容,中间还要经过宿主帧调度、输入 acquire fence、HWUI 采样、宿主 GPU 绘制、SurfaceFlinger/HWC 合成和 Display present。
TextureView 的价值是让外部内容遵循普通 View 的合成语义。业务需要连续旋转、父级裁剪、交叉淡入淡出、滤镜,或者要把内容与 UI 一起截图时,这种结构比独立 Surface 更直接。相应成本也来自这条宿主合成链路:
- 新内容需要等待宿主 View 帧把 TextureLayer 更新送到 RenderThread;
- 宿主 GPU 要读取外部 image,再写出包含 TextureView 的窗口 buffer;
- SurfaceFlinger 只能看到最终的 App Window layer,其中的 TextureView 区域再也分不出独立 video overlay(视频硬件叠加层);
- 输入队列与宿主窗口队列各有 fence、slot 和背压,任一段迟到都可能导致旧内容被复用,或者整个窗口延迟提交。
所以这两种组件没有固定的性能排名:小尺寸、低帧率 TextureView 的采样成本可能很低,SurfaceView 也可能因为整屏 layer 条件复杂而进入 CLIENT composition。选型时我们比较目标分辨率、帧率、视觉变换、protected 内容要求、功耗,以及设备的 HWC/GPU 能力。
硬件加速是前提
TextureView 只能在硬件加速窗口中显示内容。onAttachedToWindow() 会在硬件加速关闭时记录警告,draw() 也只在 canvas.isHardwareAccelerated() 返回 true 时创建并绘制 TextureLayer。
即使 TextureView 显示不出来,外部 Producer 仍可能继续 queue,“Camera/codec 正常输出”排除不了 TextureView 黑屏。排查时我们同时确认这几项:Window/ViewRoot 是否启用硬件加速、SurfaceTexture 是否处于有效生命周期、Producer 是否正确连接,以及宿主窗口是否绘制。
三阶段链路详解
第一阶段:外部 Producer
Producer 可以是 Camera、codec、GLES、Vulkan、Canvas 或业务引擎。它从 SurfaceTexture 背后的 BufferQueue 取得可写 buffer,填充内容,再随时间戳、crop、transform、dataspace、HDR metadata 和完成 fence 一起提交。从应用侧 Consumer 的角度看,这个说明写入何时完成的同步条件就是输入 acquire fence。
Producer 没有统一的线程或进程模式。MediaCodec、Camera 的生产链路可能跨越应用、系统服务、provider/HAL 和厂商组件;EGL/Vulkan Producer 也可能就在应用进程内。识别责任对象时,我们沿目标 BufferQueue、frame number 和 fence 回溯;固定进程名当不了依据。
第二阶段:TextureView 与宿主 HWUI
消费过程分两段,UI 线程记录更新,RenderThread 实际取得并绘制输入:
- 新 buffer 触发
SurfaceTexture.OnFrameAvailableListener。 TextureView把 listener 绑定到mAttachInfo.mHandler,也就是宿主 ViewRoot 所在线程的消息处理器。- listener 调用
updateLayer()与invalidate():前者设置mUpdateLayer待更新标志,后者把 View 标记为需要重绘。 - 宿主
Choreographer#doFrame()进入 traversal;TextureView.draw()在硬件 Canvas 上执行applyUpdate()。 TextureLayer.updateSurfaceTexture()通过HardwareRenderer.pushLayerUpdate(),把 native updater 加入 RenderThread 的 pending layer updates(待处理 layer 更新) 列表。DrawFrameTask::syncFrameState()处理待更新对象;DeferredLayerUpdater::apply()只在初次取得 Consumer ownership 或mUpdateTexImage标志置位时调用ASurfaceTexture_dequeueBuffer()。后者可返回输入AHardwareBuffer,没有新输入时可沿用旧内容,出错也可返回空,并非每次 apply 都取到新帧。- HWUI 按 slot 建立或复用
SkImage,应用 crop、transform、dataspace、HDR metadata、alpha 和过滤,再把内容与其他 View 一起绘入 App Window buffer。
这里有两个容易混淆的入口。公共 SurfaceTexture.updateTexImage() 适用于应用自行管理 GLConsumer 的路径;Android 12—17 中,HWUI TextureView 的主要消费入口则是 DeferredLayerUpdater::apply() 与 ASurfaceTexture_dequeueBuffer()。onSurfaceTextureUpdated() 发生在 UI 线程执行 applyUpdate() 之后,到那时 RenderThread 未必已经取得新 buffer,用户有没有看到新帧,从这一刻也判断不出来。
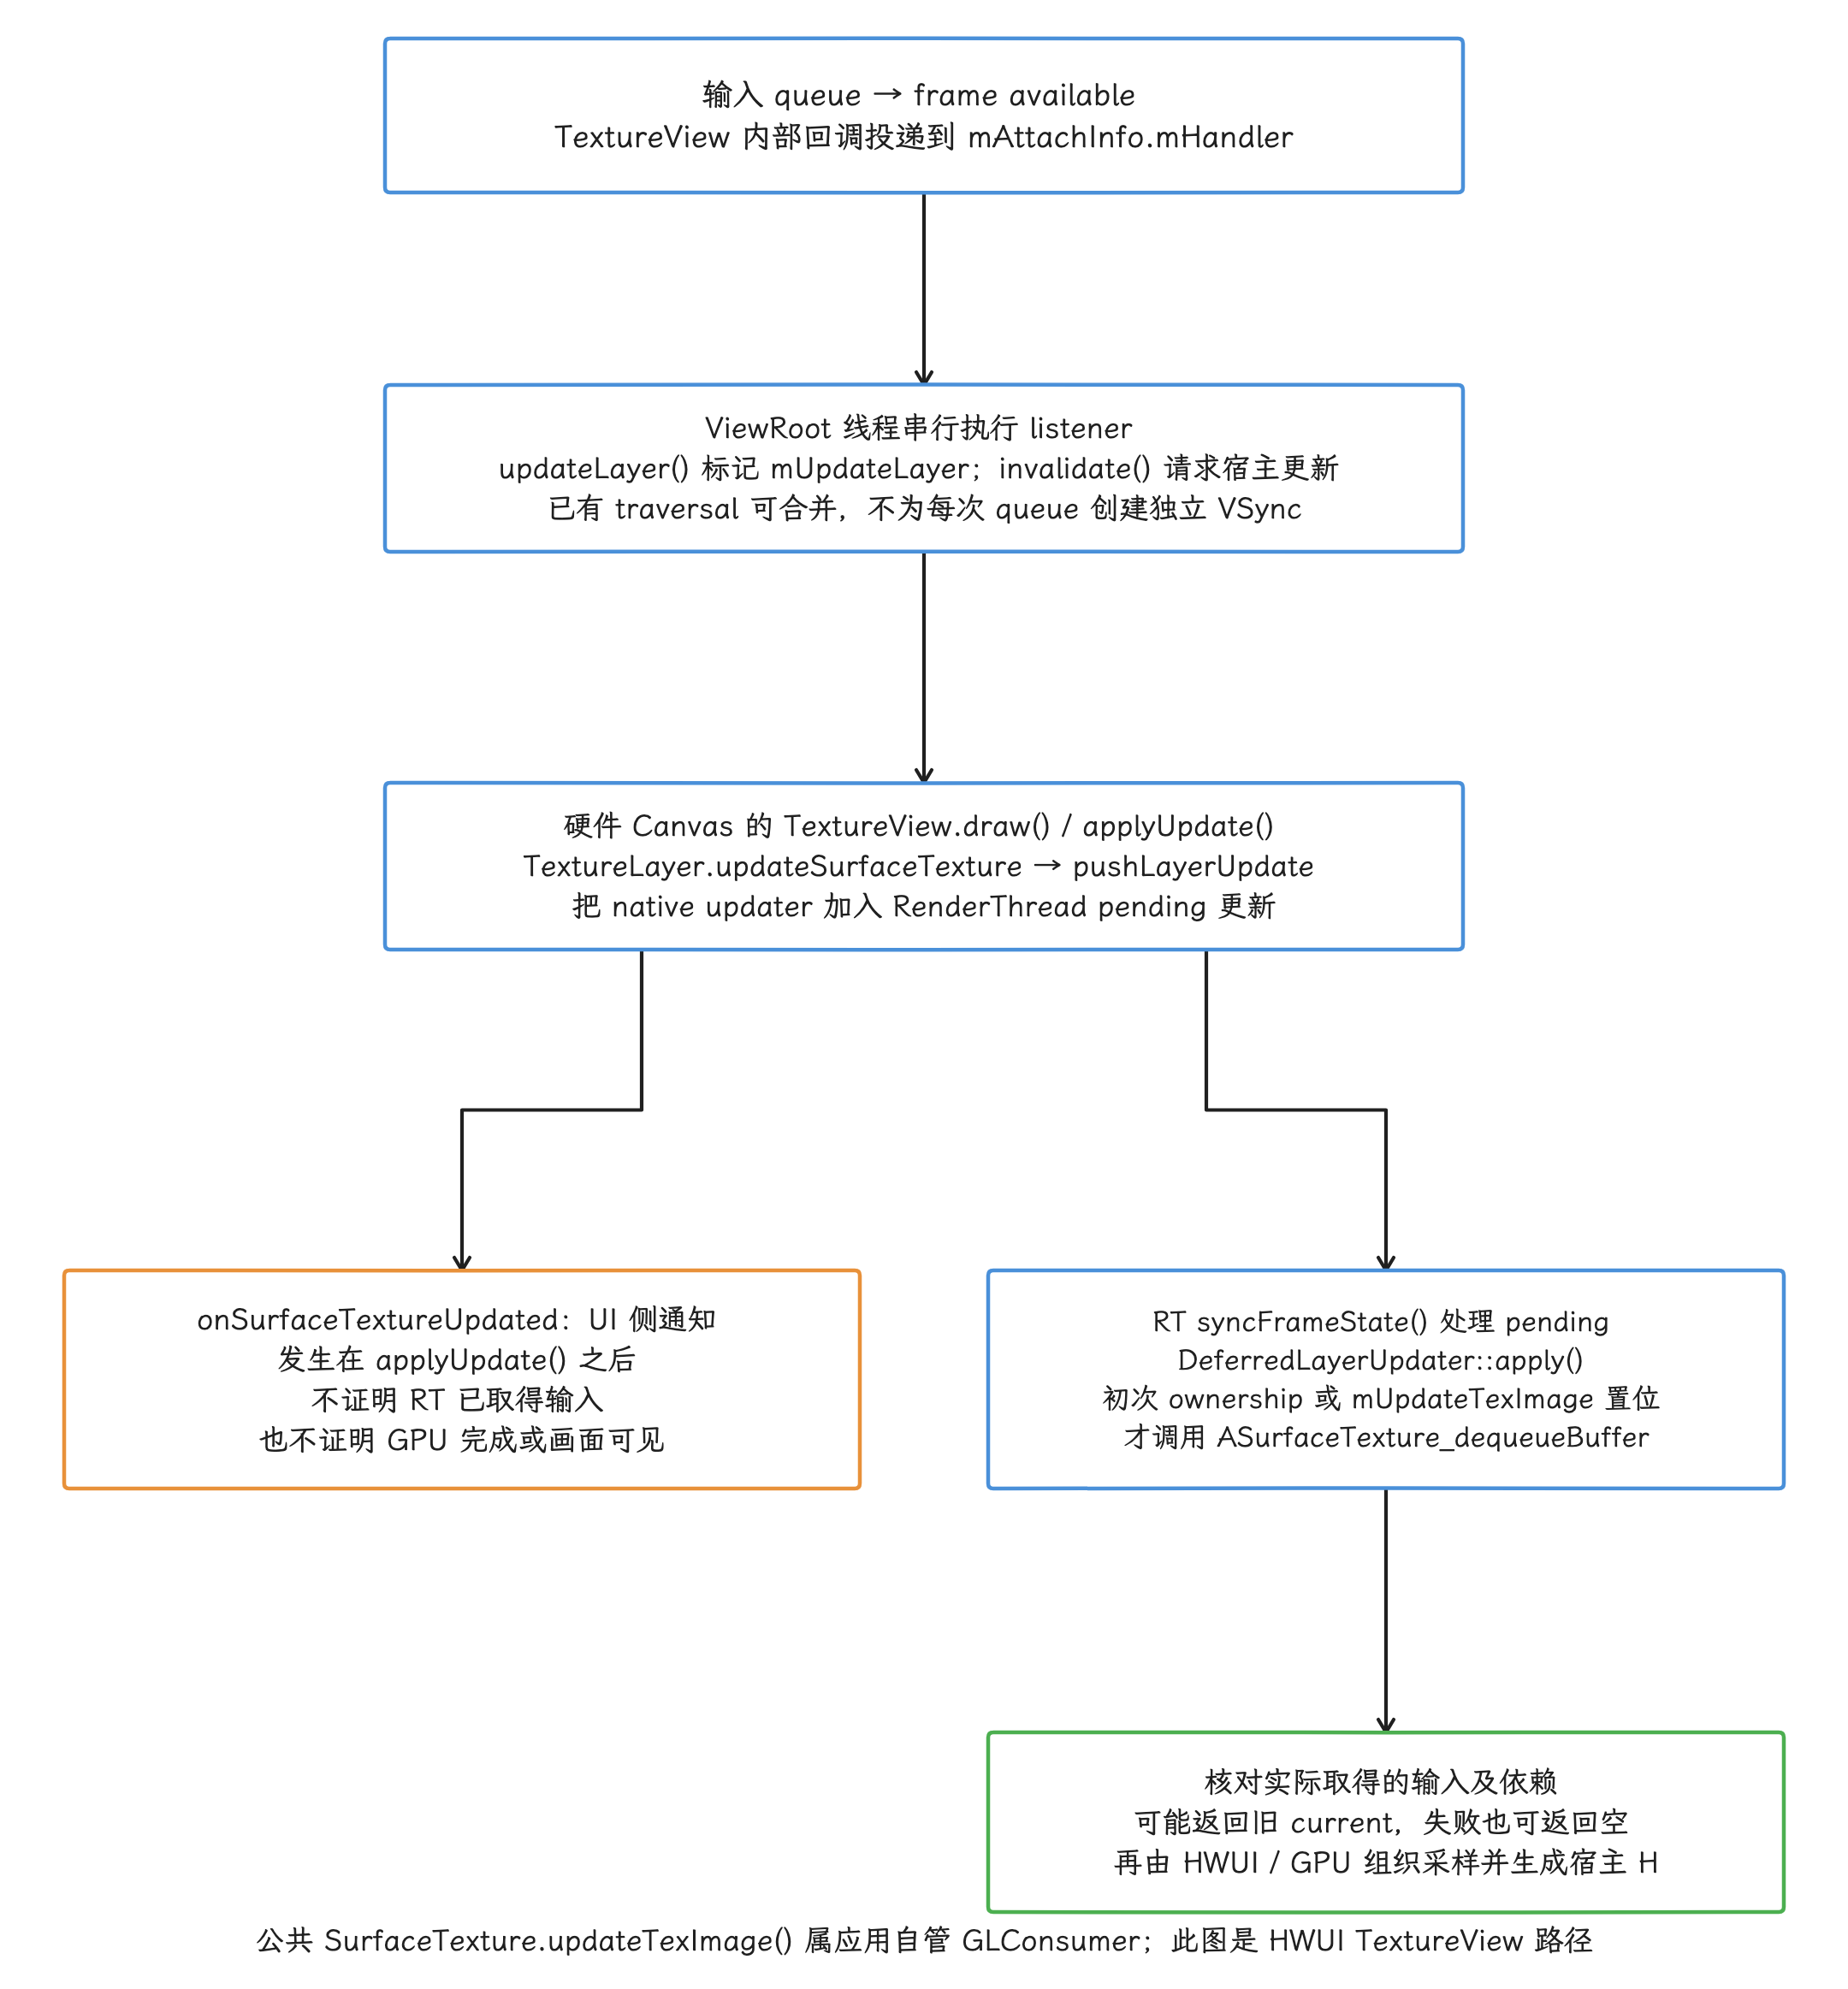
图:内部通知、UI请求和RT消费合图:frameavailable投mAttachInfo.mHandler,listener在ViewRoot线程updateLayer/invalidate并可合并traversal。硬件Canvas draw/applyUpdate经TextureLayer.updateSurfaceTexture/pushLayerUpdate送nativeupdater到RTpending;UI后的onSurfaceTextureUpdated不证明RT已acquire、GPU完成或已显示。RTsyncFrameState处理pending,DeferredLayerUpdater仅初次ownership或mUpdateTexImage置位时经ASurfaceTexture取输入,可能沿用current或失败空。公共updateTexImage是应用自管GLConsumer入口;通知、输入frame和VSync不一一对应。
第三阶段:宿主 BLAST、SurfaceFlinger 与 HWC
RenderThread 把宿主 GPU 绘制工作提交后,可在 GPU 尚未完成时将 App Window buffer 与完成 fence 经宿主 BLAST 交出。SF 收到宿主 layer 的 buffer transaction,真正读取前仍须满足宿主 acquire fence;外部 SurfaceTexture stream 在应用内消费,没有因此成为独立可见的 SF layer。
SurfaceFlinger 更新 FrontEnd layer state 和 snapshot,再选择宿主的新 buffer,或者继续使用旧 buffer,随后由 CompositionEngine/HWC 处理整屏 layer 集合。HWC 可以把整个 App Window layer 判为 DEVICE 或 CLIENT composition,却没法只为窗口内部的 TextureView 矩形分配独立 Overlay plane。
下面的时序图把外部提交和宿主提交放在同一条时间线上:
sequenceDiagram
    participant P as "External Producer"
    participant ST as "SurfaceTexture Consumer"
    participant UI as "Host UI / TextureView"
    participant RT as "Host RenderThread / HWUI"
    participant SF as "SurfaceFlinger / CompositionEngine"
    participant HWC as "Composer / Display"

    P->>ST: "queueBuffer(input + completion fence)"
    ST-->>UI: "frame available on ViewRoot handler"
    UI->>UI: "updateLayer + invalidate / traversal / applyUpdate"
    UI->>RT: "syncAndDrawFrame + pending TextureLayer update"
    RT->>ST: "ASurfaceTexture_dequeueBuffer(更新标志置位时)"
    opt 切换旧输入(以 Legacy 路径示意)
        ST->>RT: "createReleaseFence,约束旧输入的未完成读取"
        RT-->>ST: "旧输入 release 依赖"
        ST-->>P: "归还旧输入;有效 fence 满足后才可重写"
    end
    ST-->>RT: "选中的 AHardwareBuffer / 输入依赖与属性"
    Note over ST,RT: 输入回收与当前宿主 display present 无固定先后关系
    RT->>RT: "组织 GPU 采样与宿主绘制,遵守输入依赖"
    RT->>SF: "host BLAST buffer transaction + GPU 完成 fence"
    alt presentOrValidate 直接 present 成功
        SF->>HWC: "presentOrValidate"
        HWC-->>SF: "present / release 反馈"
    else 先获得 validated 结果
        SF->>HWC: "validate 或组合调用的 validated 结果"
        SF->>SF: "需要时生成 CLIENT target,再交给 HWC"
        SF->>HWC: "present"
        HWC-->>SF: "present / release 反馈"
    end
图中的 onFrameAvailable()、RenderThread acquire 和宿主 buffer transaction 是三个不同的检查点。通知先由 UI applyUpdate() 提交为待消费更新,RenderThread 随后从输入队列取帧。判断新内容能否进入当前宿主帧,我们分别核对 UI 提交更新和 RenderThread 取帧的时刻。
SurfaceTexture 机制深入
两套 Producer/Consumer
TextureView 页面至少有两套 buffer 周转:
External Producer
  → SurfaceTexture BufferQueue
  → app-process HWUI Consumer / DeferredLayerUpdater
  → GPU image sampling
  → App Window buffer Producer
  → host BLASTBufferQueue
  → SurfaceFlinger / HWC
第一套队列由应用进程中的 HWUI 消费,第二套队列负责把宿主窗口交给显示系统,两套队列各有自己的 frame number、slot、acquire/release fence 和背压状态。也正因为独立,两边要分开读:宿主 BufferTX 回答的是宿主队列的状况,SurfaceTexture 输入队列是否堆积要另行检查;外部 Producer 的 dequeueBuffer() 出现等待,也只说明第一套队列在背压,宿主 BLAST 是否缺可写 buffer 另查。
TextureView 链路的对象分工
TextureView:管理 View 生命周期、dirty(待重绘)状态、listener、opaque(不透明)、内容变换和绘制入口。SurfaceTexture:向 Producer 提供 BufferQueue 的生产端,并向应用发送 frame-available 通知。TextureLayer:Java 层的 HWUI 对象,持有 nativeDeferredLayerUpdater,通过pushLayerUpdate()把更新交给 RenderThread。DeferredLayerUpdater:取得输入AHardwareBuffer,按 slot 维护对应的SkImage包装,并处理 crop、transform、dataspace、buffer format 和 HDR 最大亮度。- App Window
Surface/BLAST:接收宿主 HWUI 生成的最终 buffer,再把宿主 layer 提交给 SurfaceFlinger。
HWUI TextureLayer 属于应用内的绘制对象,SurfaceFlinger layer 则属于系统合成树。两者名称都含有 “layer”,位置却在不同进程和 Consumer 体系里;所以我们写 trace 报告时,注明对象属于应用 HWUI 还是系统合成。
最新帧选择
取帧的目标是尽量显示较新的输入。DeferredLayerUpdater::apply() 在更新标志置位时调用 ASurfaceTexture_dequeueBuffer();循环位于后者内部,反复调用 Consumer 的取帧接口,尝试跳过旧 pending frame,调用方不需要先判断同步/异步模式。队列暂空而已有 current buffer 时还可能返回旧内容。
取帧循环还受 acquire fence 限制:Consumer 遇到未 signal fence 时把 outQueueEmpty 设为 true,再调用后端 fenceWait() 建立或等待读取依赖;成功返回后外层即停止追新,不保证 CPU 已等到 GPU 工作完成。这是停止循环的保护信号,不是队列物理为空的证明;取帧失败返回空也会终止循环。因此一次调用不保证拿到返回时队列中最新的 buffer。当前 r1 的 wb_surfacetexture 构建开关会选择 SurfaceTexture/ImageConsumer 或 LegacySurfaceTexture/LegacyImageConsumer:前者按 GraphicBuffer 建立 image-slot 映射,后者使用 BufferQueue slot 索引,不能把两者编号混用。
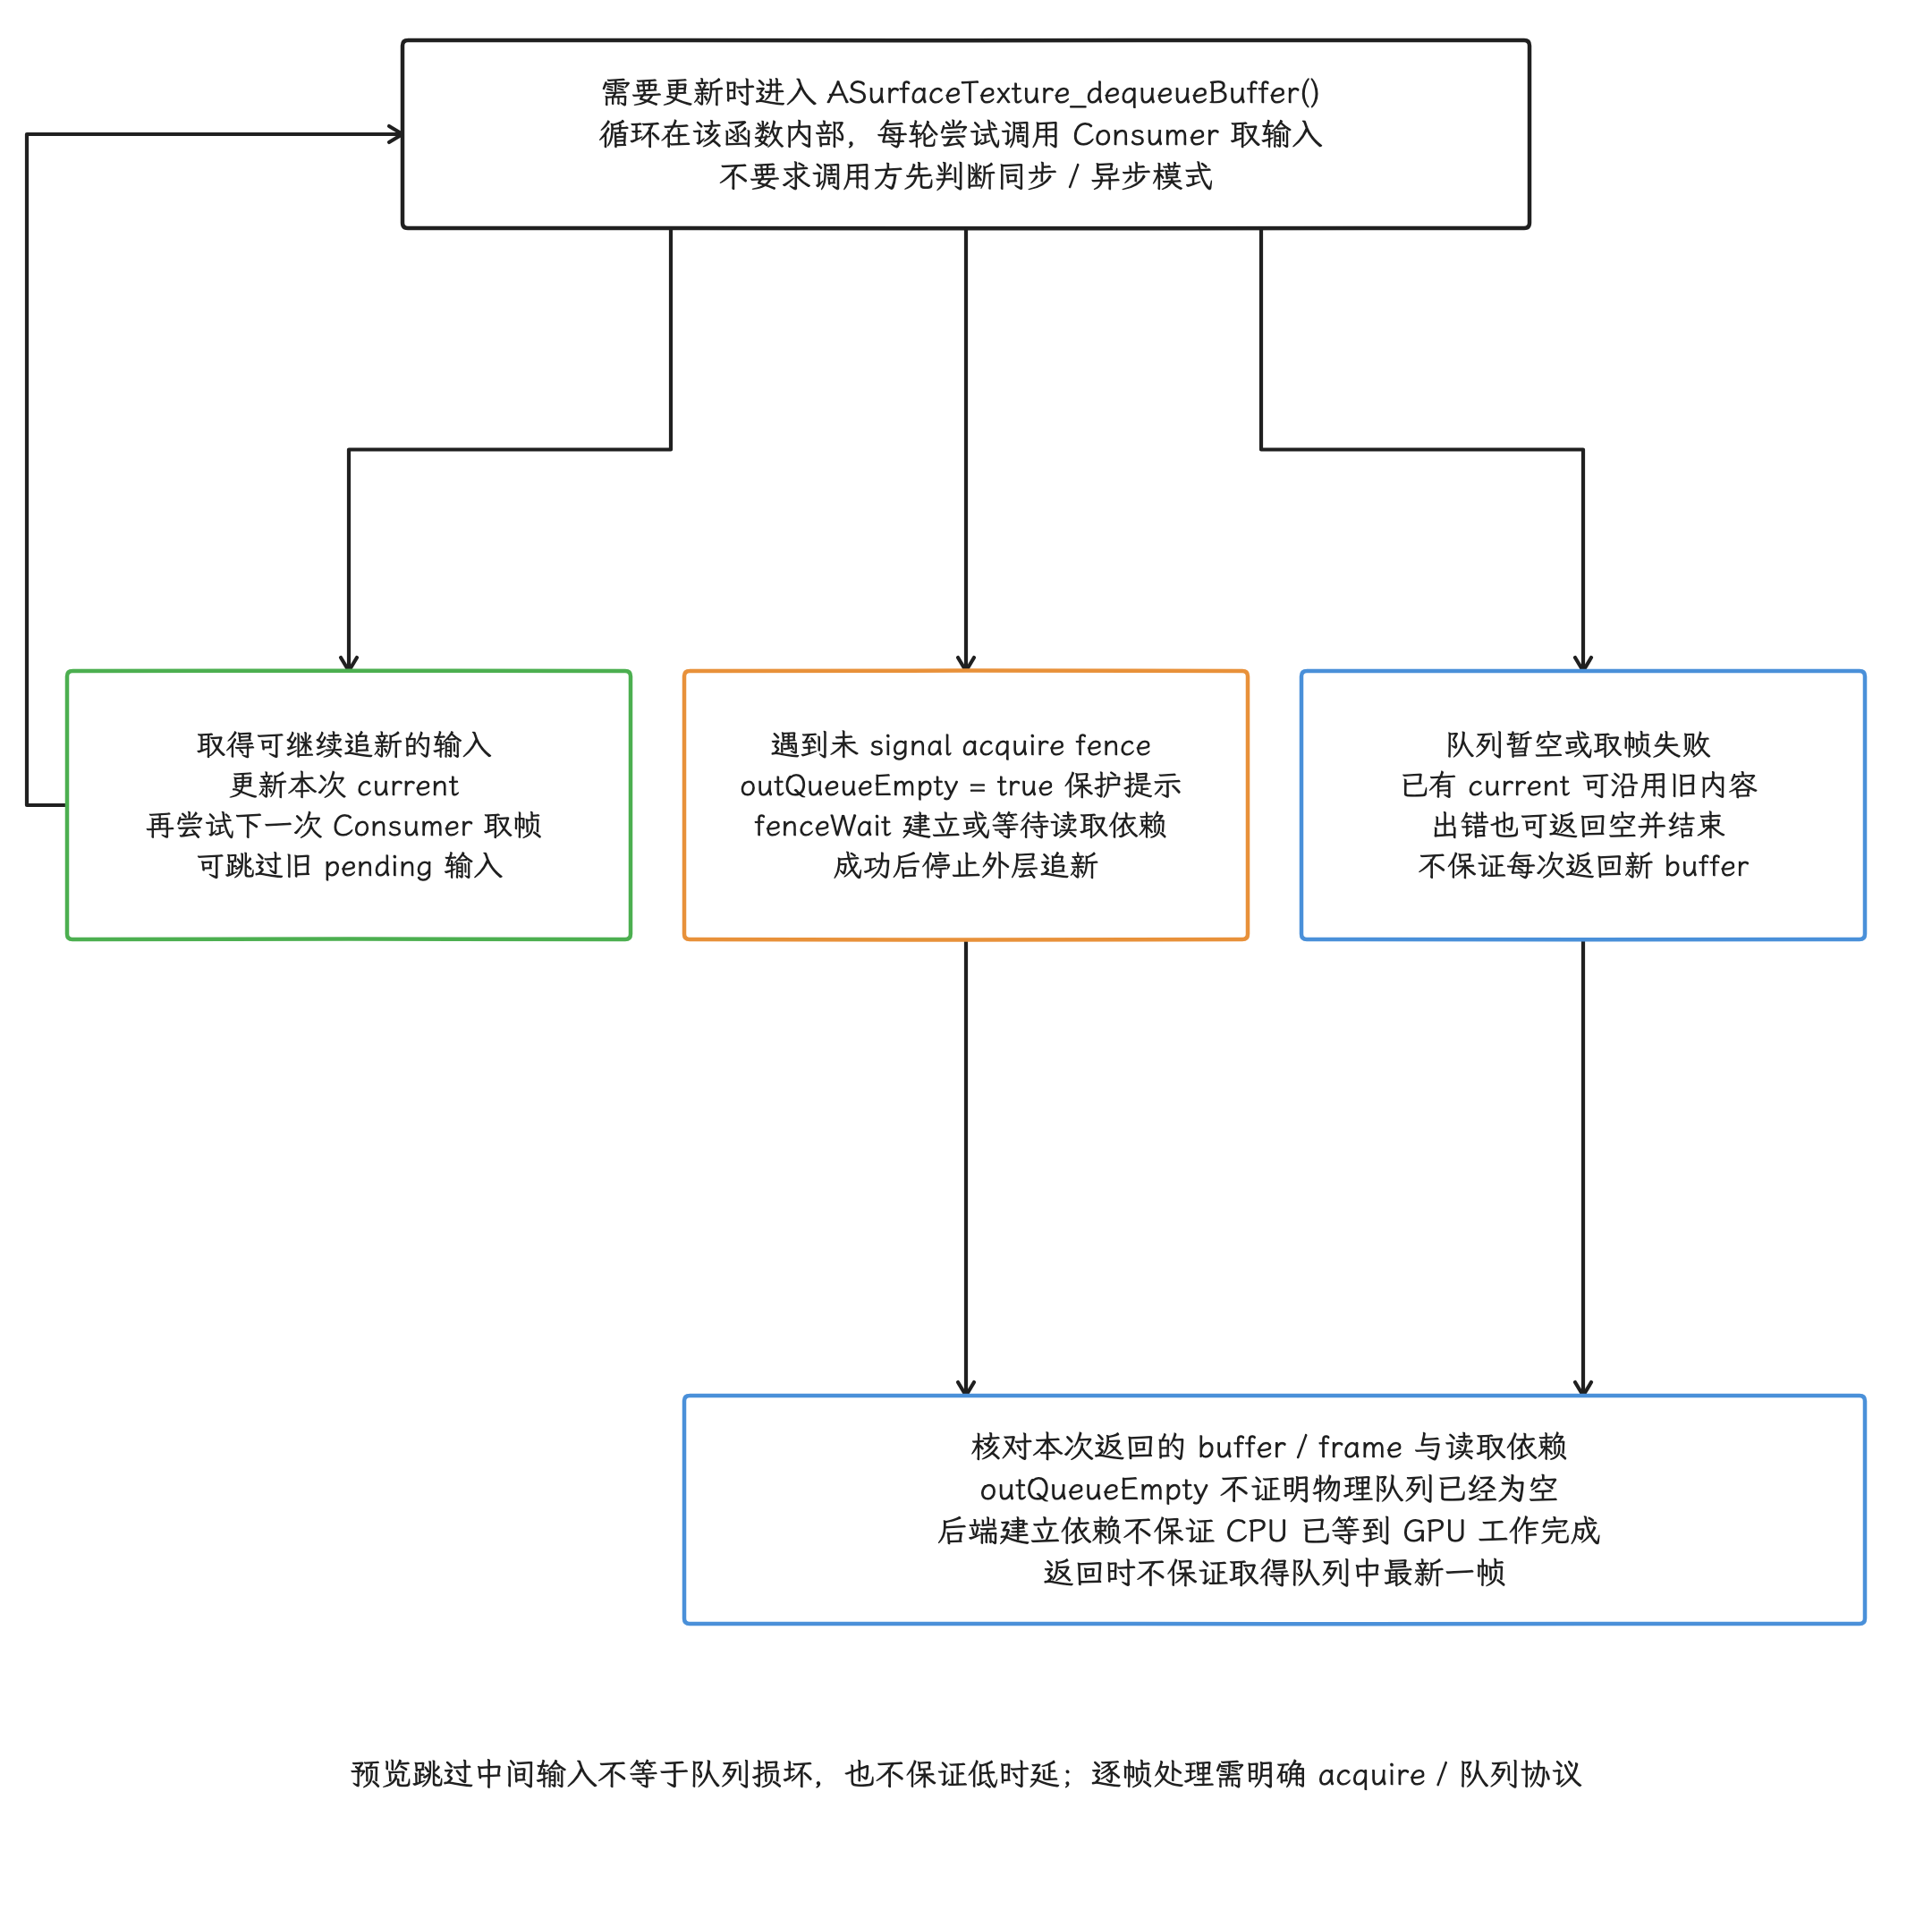
图:ASurfaceTexture内部循环与预览跳帧边界合图:按更新条件进入后,可继续时更新current再取,跳过旧pending;未signalacquire令outQueueEmpty成为停止保护提示,经后端fenceWait建立或等待读取依赖,成功返回后外层停止追新,不保证CPU已等GPU完成或物理队列为空。暂空已有current可沿用旧内容,失败可返回空。返回时不保证最新;预览跳中间帧不等队列坏,逐帧处理需明确acquire/队列协议而非预览回调。
以下环节仍可能增加延迟:
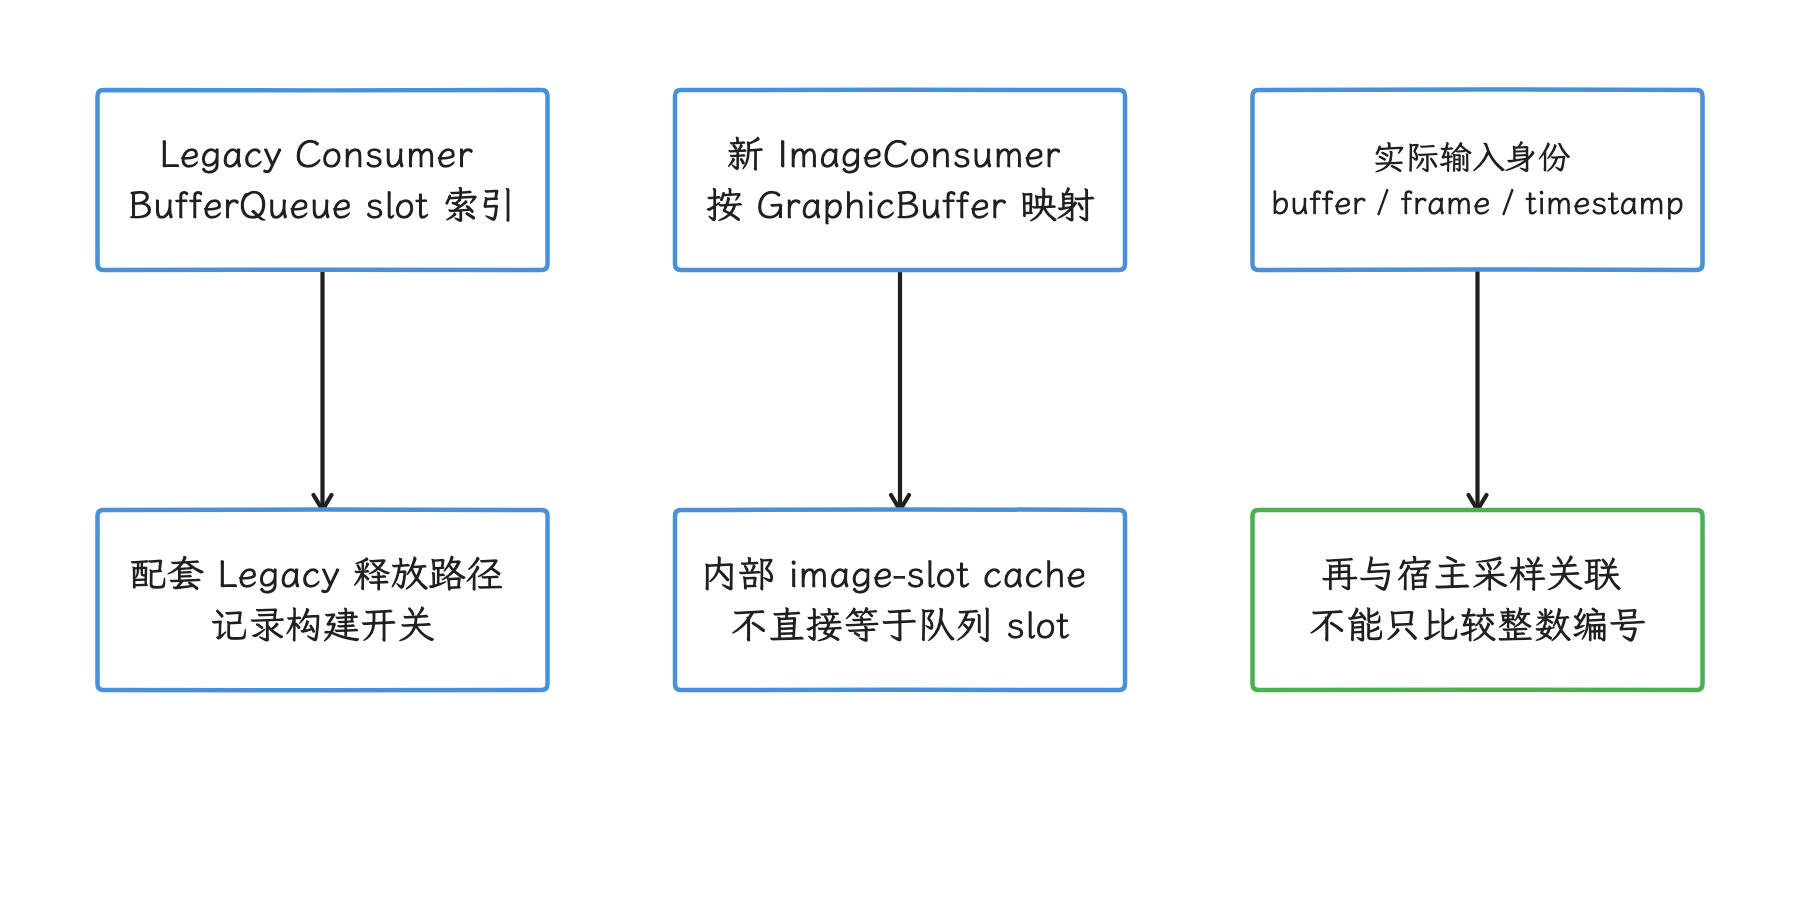
图:比较输入时必须记录构建分支、buffer 身份及实际 frame。 wb_surfacetexture 选择新旧 Consumer;image cache 编号不能与另一分支的 BQ slot 混用。
- Producer 在目标时间之后才 queue;
- frame-available 回调被宿主线程上的其他工作延迟;
- 通知晚于 UI
applyUpdate(),且此前没有其他待消费更新; - 输入 acquire fence 迟到;
- image import(把硬件 buffer 映射为 GPU 可采样图像)、颜色处理、缩放或宿主 GPU 过载;
- App Window BLAST/HWC 尚未释放宿主 buffer;
- Display present 使用了上一块宿主 buffer。
丢弃旧 pending frame 的行为也说明了它适合什么任务:TextureView 的目标是显示最新内容。需要每一输入帧都被显示或处理的任务,应选择具有明确 acquire 语义的 ImageReader、MediaCodec buffer 模式或应用自管队列。
image import、GL 与 Vulkan
输入 buffer 通常通过 AHardwareBuffer 导入为 GPU 可采样 image,从而避免 CPU 逐像素复制整帧。DeferredLayerUpdater 同时支持 SkiaGL 与 SkiaVulkan:
- SkiaGL 分支通过
EglManager建立 wait/release fence; - SkiaVulkan 分支通过
VulkanManager建立 wait/release fence,并管理 image 的 queue ownership(队列所有权); - 两条分支最终都把输入 image 交给 HWUI layer,再写入宿主窗口。
所以 TextureView 没有固定的 OES/SkiaGL 后端。应用自行管理 SurfaceTexture.updateTexImage() 时常用 GL_TEXTURE_EXTERNAL_OES;HWUI 路径更准确的描述是 ASurfaceTexture_dequeueBuffer()、AHardwareBuffer、Skia image 和当前 RenderPipelineType。切换 GL/Vulkan backend 不会消除宿主采样这项结构成本,但会改变 image import、同步、shader/颜色处理和驱动行为。
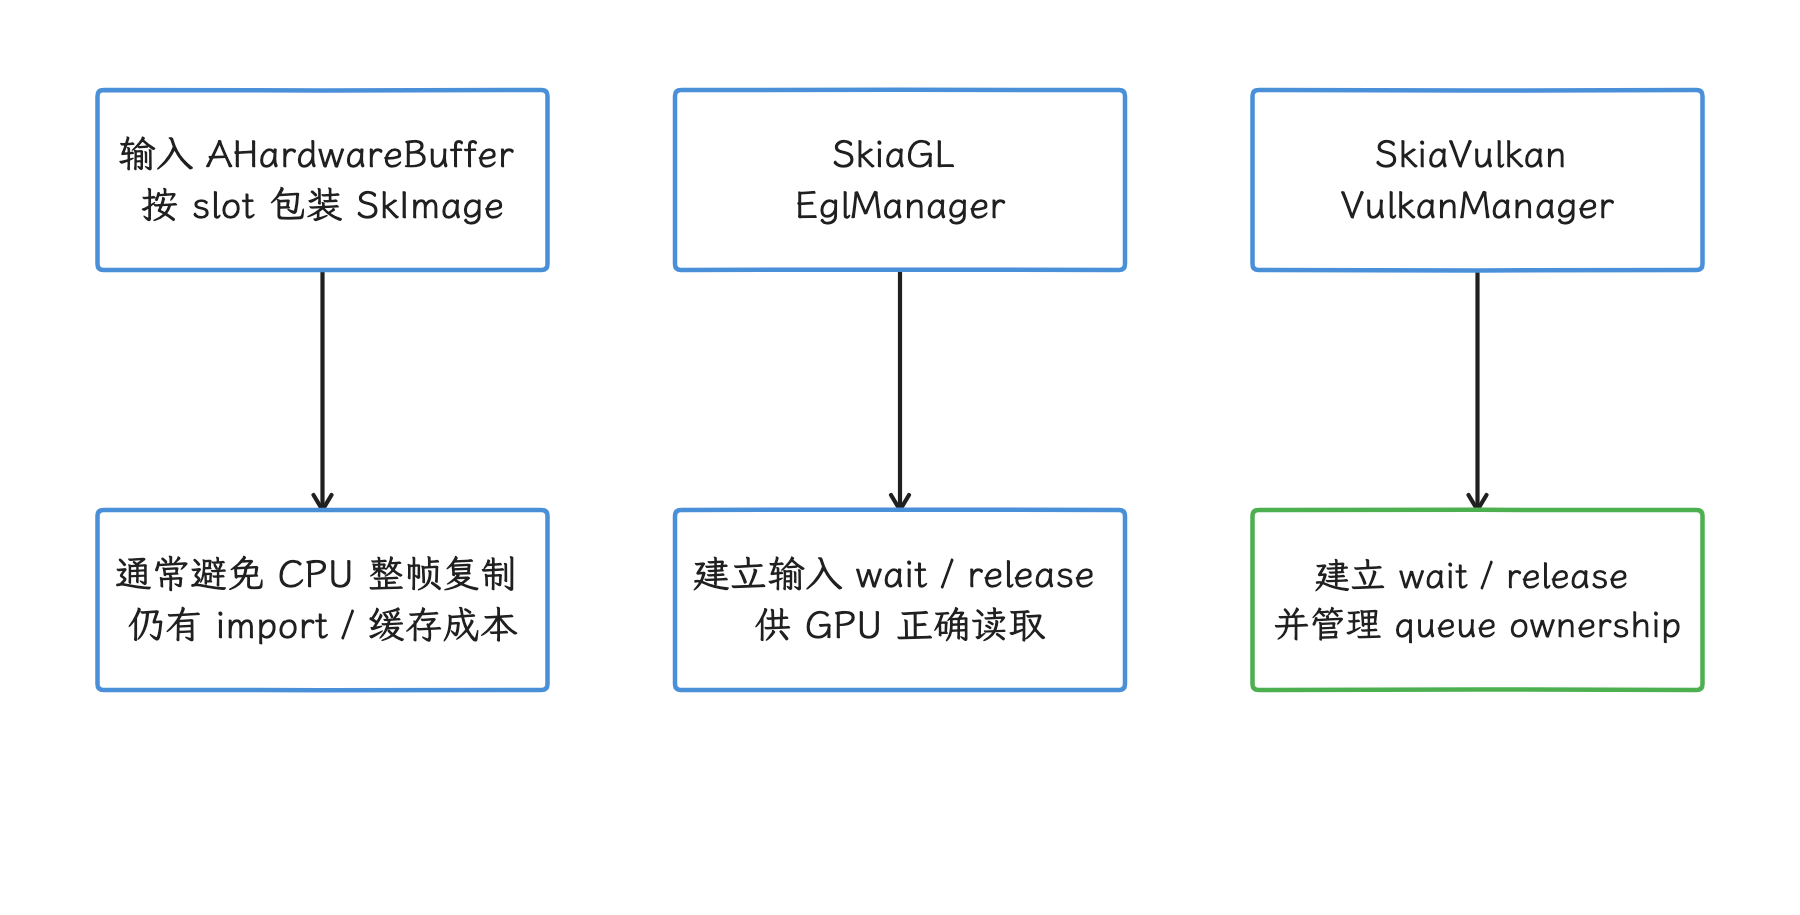
图:当前 RenderPipelineType 决定 image、wait 和 release 的后端实现。 改变后端不消除宿主 GPU 采样和最终 buffer 写出。
生命周期与所有权
TextureView.SurfaceTextureListener 是应用可用的生命周期边界:
| 回调 | 含义 | 应用责任 |
|---|---|---|
onSurfaceTextureAvailable() | 当前 SurfaceTexture 及其尺寸可用 | 创建并保存 Surface,连接一个 Producer |
onSurfaceTextureSizeChanged() | View 尺寸改变,默认 buffer size 已更新 | 更新输出尺寸、viewport、crop 或内容变换 |
onSurfaceTextureUpdated() | UI 线程已把 TextureLayer update 加入宿主流程 | 只能作为更新请求通知,不能当作 acquire、GPU 完成或画面可见时刻 |
onSurfaceTextureDestroyed() | TextureView 将放弃当前 SurfaceTexture | 返回 true 时由 TextureView release;返回 false 时由调用方接管并负责 release |
同一个 TextureView 在同一时刻只连接一个 Producer;Camera preview、MediaCodec output 和 lockCanvas() 也要串行使用同一 SurfaceTexture。
下面的代码用应用自有接口表达停止与资源释放,FrameProducer 不是 Android SDK 类型:
private interface FrameProducer {
    fun attach(surface: Surface, width: Int, height: Int)
    fun resize(width: Int, height: Int)
    fun detachAndWaitUntilIdle()
}

private var producerSurface: Surface? = null

textureView.surfaceTextureListener = object : TextureView.SurfaceTextureListener {
    override fun onSurfaceTextureAvailable(st: SurfaceTexture, width: Int, height: Int) {
        producerSurface = Surface(st).also {
            frameProducer.attach(it, width, height)
        }
    }

    override fun onSurfaceTextureSizeChanged(st: SurfaceTexture, width: Int, height: Int) {
        frameProducer.resize(width, height)
    }

    override fun onSurfaceTextureUpdated(st: SurfaceTexture) = Unit

    override fun onSurfaceTextureDestroyed(st: SurfaceTexture): Boolean {
        frameProducer.detachAndWaitUntilIdle()
        producerSurface?.release()
        producerSurface = null
        return true
    }
}
本例返回 true:调用方先等 Producer 停止访问,再释放自建 Surface 包装,TextureView 随后释放 SurfaceTexture。若 destroyed 返回 false,TextureView 不释放 SurfaceTexture;应用可按自管协议继续持有/使用,但必须在不再使用时停止 Producer 并自行 release。不能把 View 放弃对象等同于底层队列已销毁。
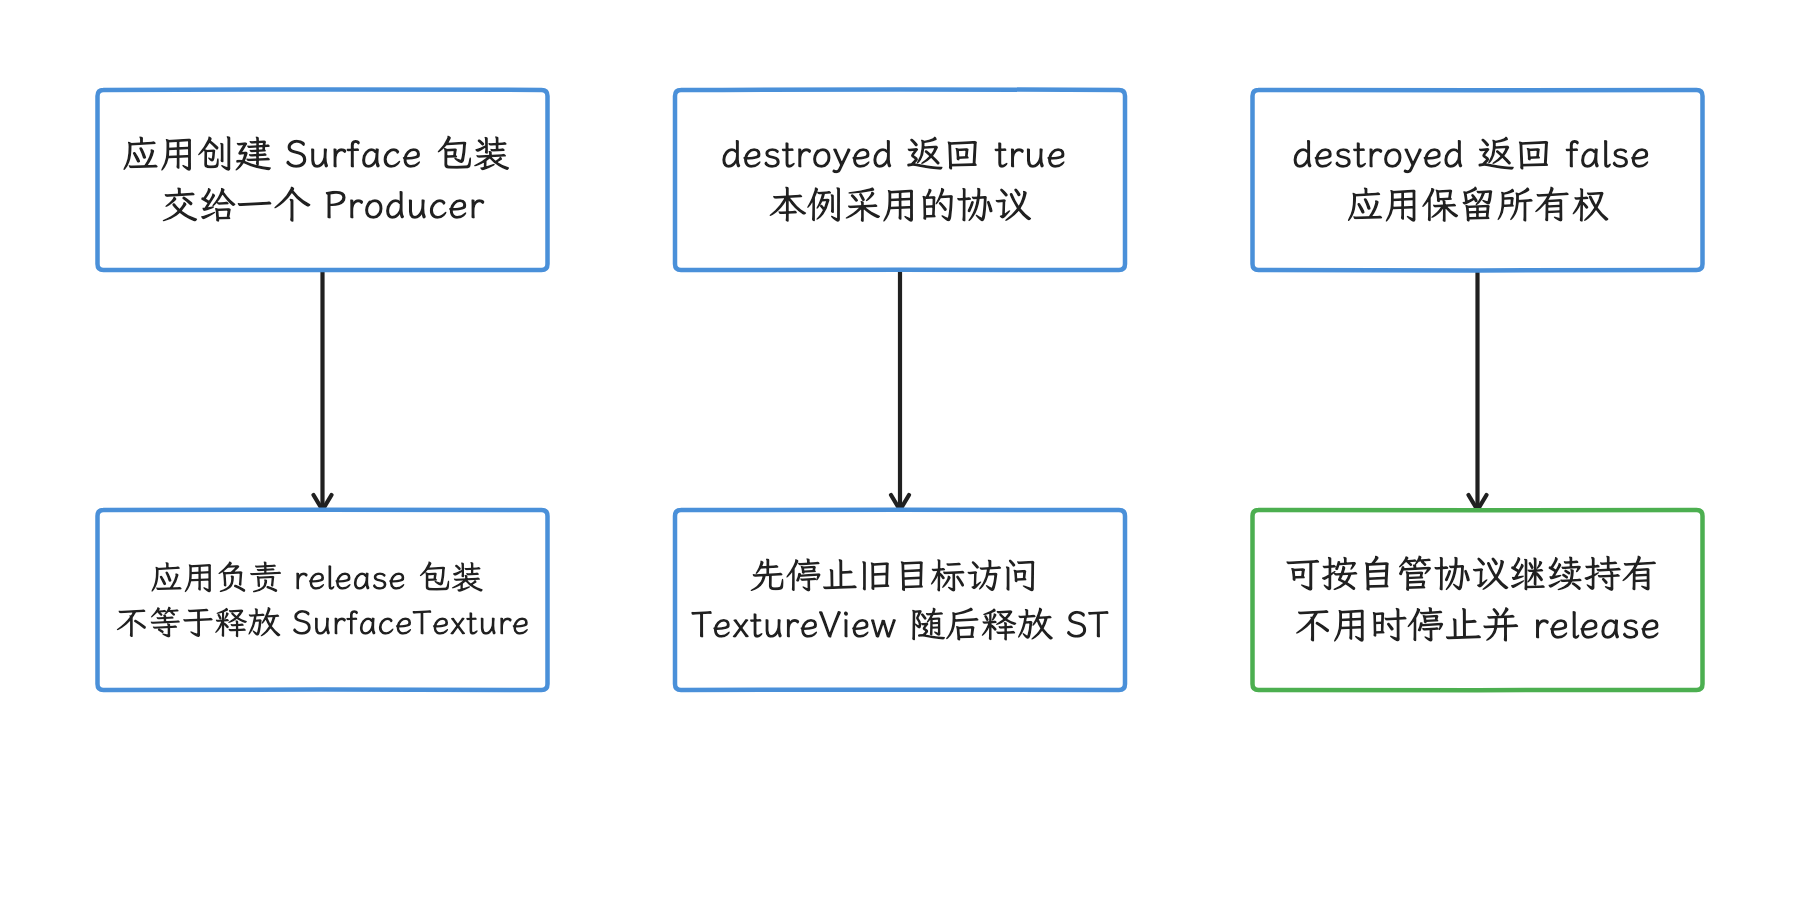
图:返回 true 走停止 Producer 后由 TextureView 释放,false 则应用接管。 应用自建 Surface 包装另行负责释放;接管后仍须自管停止和最终 release。
setSurfaceTexture(newTexture) 是另一个容易出现所有权错误的入口:TextureView 会立即 release 旧对象,也不会为旧对象调用 onSurfaceTextureDestroyed();传入的新对象同样不会触发 onSurfaceTextureAvailable()。调用前,新对象必须从所有 GL context detach,旧 Producer 也要先停止使用旧目标。
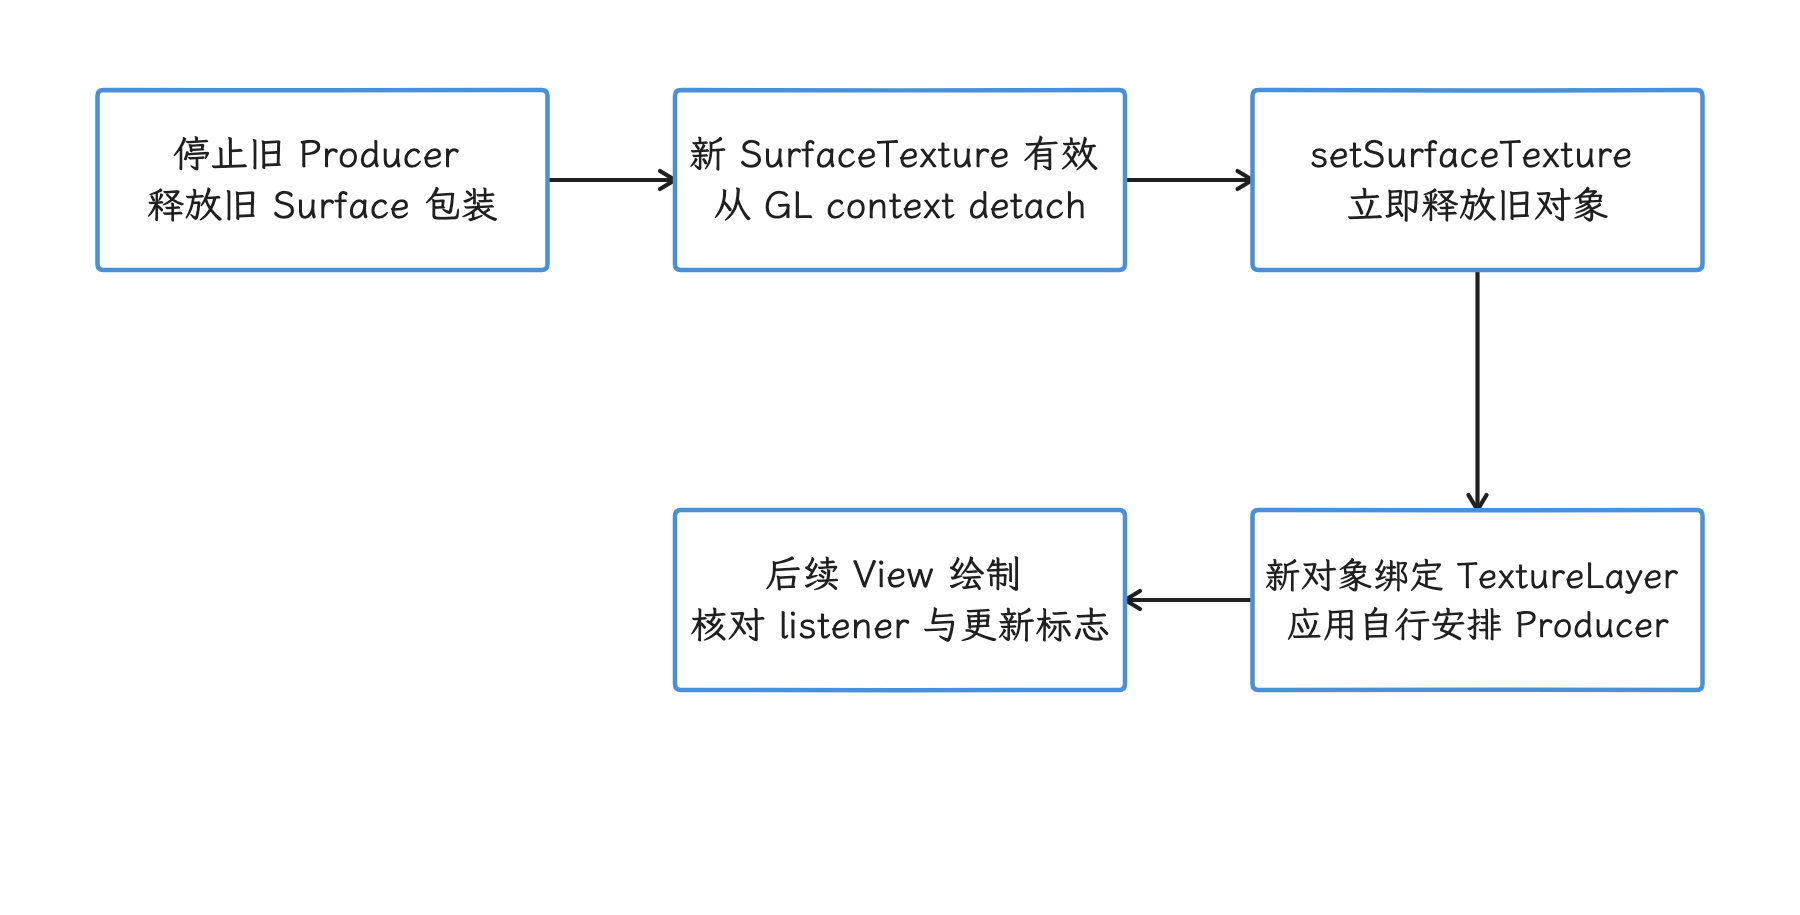
图:替换前停止旧目标并准备 detached 的新对象,替换后自行管理新连接。 旧对象立即 release;不调用旧 destroyed,也不调用新 available。
TextureView 不可见时,onVisibilityChanged() 会移除内部 frame-available listener;重新可见时再注册,并调用 updateLayerAndInvalidate()。Producer 在不可见期间继续 queue,宿主未必跟着持续消费。Tab、RecyclerView 或前后台切换后卡在旧帧时,应同时检查 listener 是否恢复、SurfaceTexture 是否被替换、Producer 是否重连,以及队列中的最新 buffer。
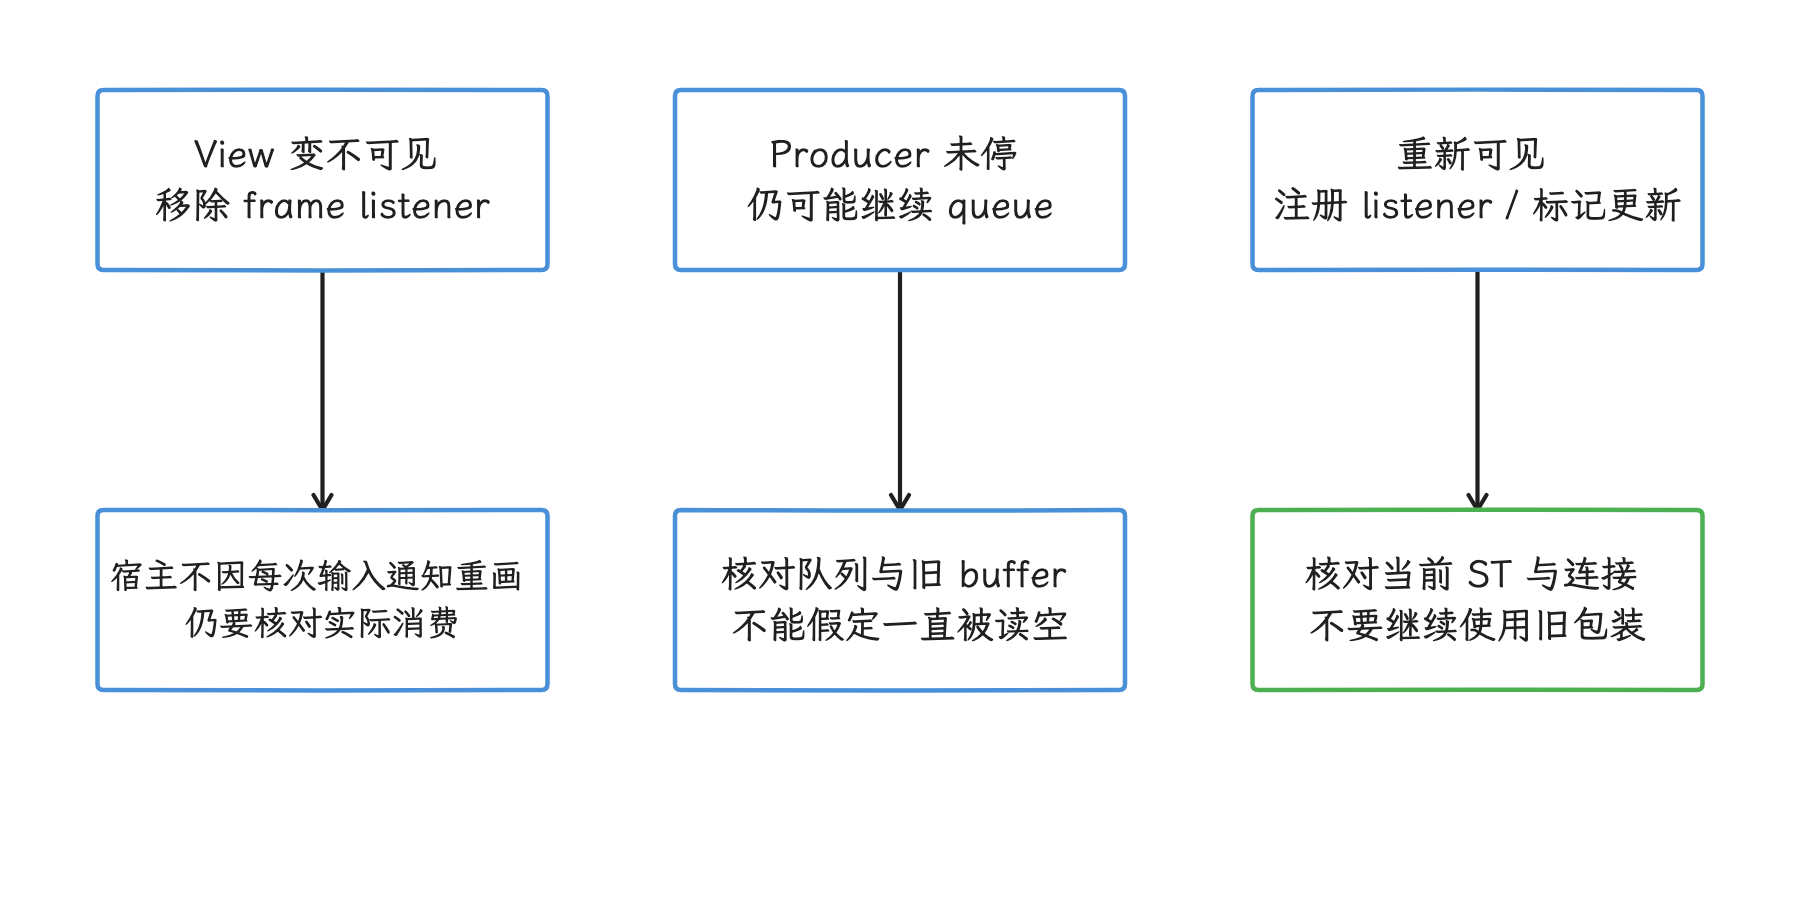
图:可见性控制内部 frame-available listener 与后续更新请求。 不可见不等于 Producer 自动停止,继续供帧可能背压或丢帧。
额外纹理采样的性能代价
采样与宿主 render pass
TextureView 的额外成本通常不是 CPU 把整块像素 memcpy 到宿主窗口。常见路径会把 AHardwareBuffer 导入为 GPU image,再由 HWUI 采样,成本主要来自:
- image import、缓存和所有权转换;
- 输入 acquire fence 等待;
- 纹理过滤、缩放、rotation、crop 和其他内容变换;
- buffer format/dataspace 相关的颜色转换;
- alpha、blend、clip、color filter 和其他 View 的组合;
- 高分辨率输入的读取带宽;
- 宿主 App Window render pass(一次渲染过程)和最终 buffer 写出。
这条路径的形态随输入而变:可能是多平面 external format、RGBA 或驱动支持的其他形式;队列中的 buffer 数量、宿主尺寸、像素格式、保留策略和 GPU 缓存都会改变内存占用。所以估算时我们直接读取目标设备上的实际 buffer format、尺寸、slot 状态和 gfx/meminfo 数据,“每帧上传 YUV”“内存翻倍”这类固定描述都靠不住。
宿主调度门槛
我们从 onFrameAvailable() 看起:它只会设置待更新标记并调用 invalidate()。宿主已有 pending traversal(待执行的遍历) 时,请求可以合并;没有的话,ViewRoot 会申请下一次 VSync。通知驱动的更新要先赶上 UI applyUpdate(),把待更新对象送入 RenderThread;随后由 ASurfaceTexture_dequeueBuffer() 从输入队列取帧。
DrawFrameTask::syncFrameState() 处理待更新对象后才可能提前解除 UI 同步等待;若不能提前解除,等待可延续到 draw/flush 之后。正常消息循环中,内部 listener 与 traversal 在同一 ViewRoot 线程串行,UI 等待 RT 时不能执行新的 listener。外部 Producer 则可继续并发 queue;updater 已有待消费更新时,RenderThread 可能取得比触发通知的那一帧更新的 buffer。
TextureView 增加的等待有多长,取决于通知与取帧的相对时机:通知及时触发 UI 更新、输入又赶上当前 RenderThread 取帧时,额外等待可能小于一个刷新周期;本次没有待消费更新,或新输入在取帧结束后才入队时,新内容就要等待后续宿主 draw。
两套同步与背压
四类 fence 各管一段同步,需要分开读:
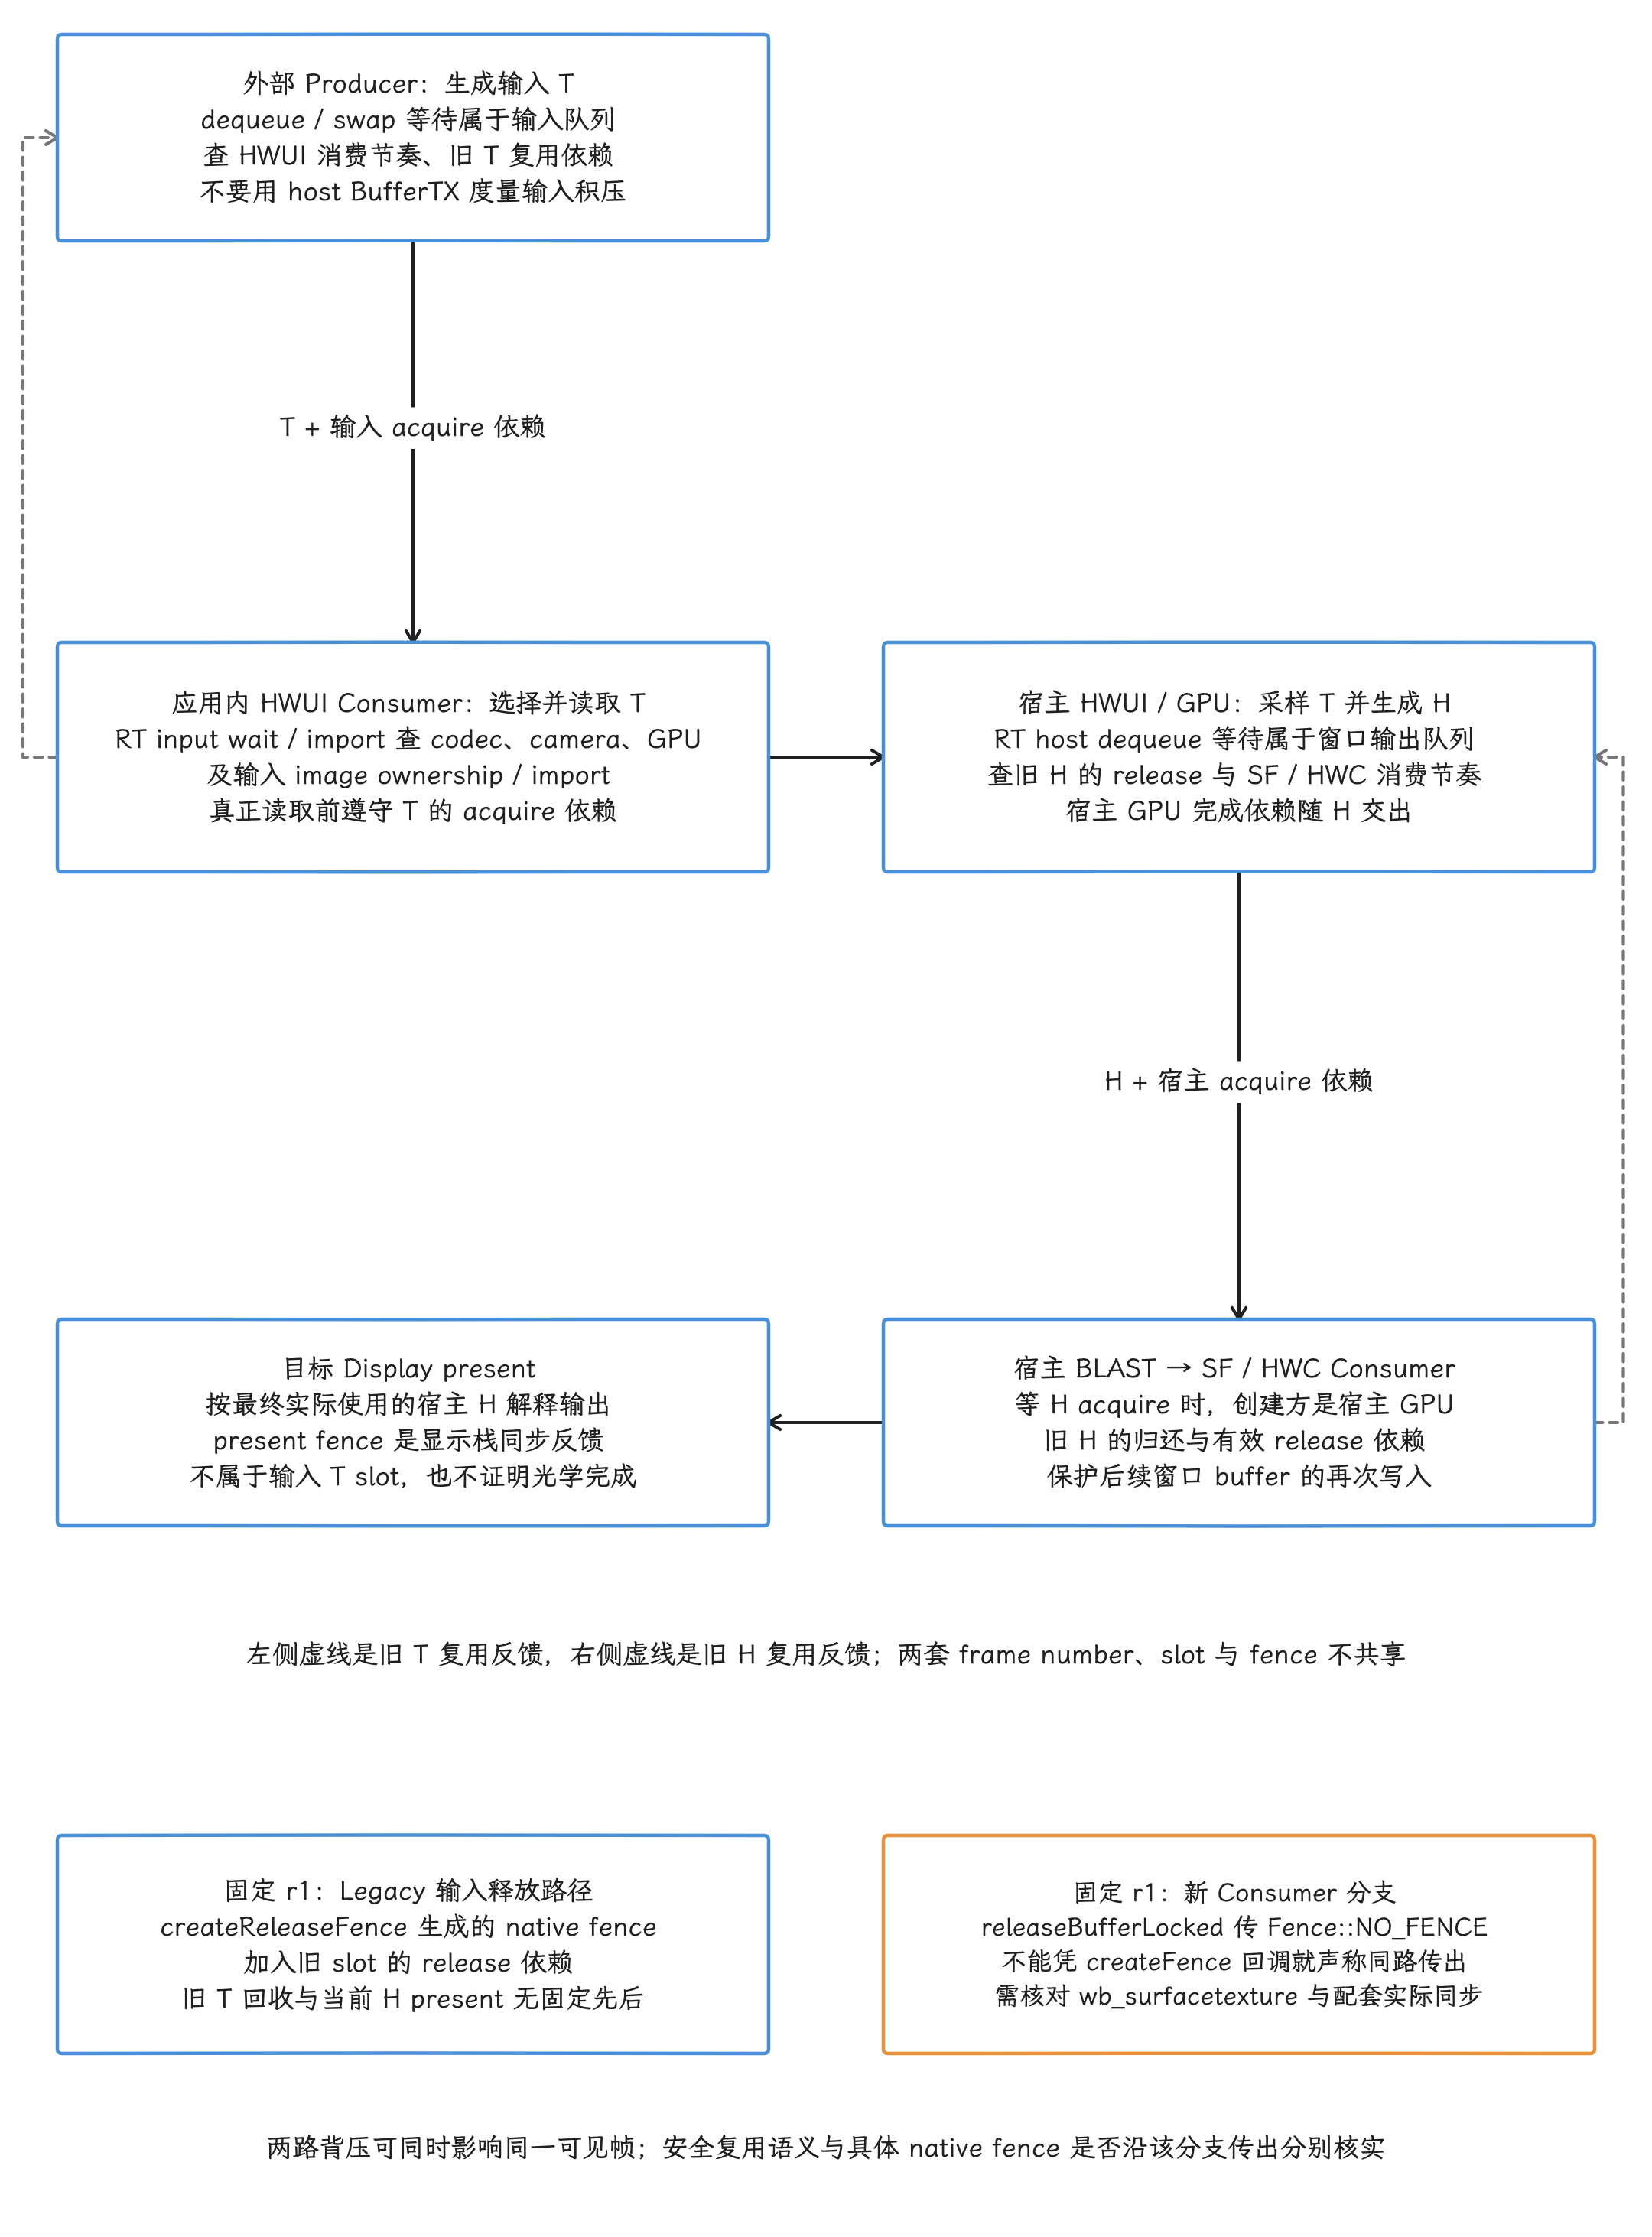
图:三类fence与T/H两个反馈回路合图。T由外部写、HWUI读,H由hostGPU写、SF/HWC读,各自frame/slot/acquire/release独立;hostBufferTX不能度量输入积压。外部dequeue查旧T与HWUI消费,RTinputwait/import查输入创建方及ownership,hostdequeue查旧H归还,SF等Hacquire查宿主GPU。present属于Display,不属于Tslot,旧T回收与当前Hpresent无固定先后。虚线只表达安全复用需求:固定r1 Legacy把createReleaseFence的nativefence加入旧slot;新releaseBufferLocked传NO_FENCE,须核wb_surfacetexture、配套实现与实际同步,不能凭createFence回调声称同路已传出,也不能仅据静态代码断言数据竞争。SV内容同样分acquire/release,CLIENTrelease还可合并GPU条件。
- 输入 acquire fence:外部 Producer 何时完成当前内容 buffer;
- 输入 release fence:HWUI 何时不再读取旧输入 slot,Producer 何时可以复用;
- 宿主 acquire/release fence:宿主 GPU 何时写完 App Window buffer,以及 SF/HWC 何时不再读取;
- present fence:一次 Display present 的显示栈同步边界,属于 Display,不属于某个 TextureView 输入 slot。
同一可见帧可能先等待外部 acquire fence,又受到宿主 GPU 和 App Window release 返回路径的约束。所以我们写报告时,把等待者、创建者和对应队列的所有权一并写清,责任才定位得下来;只写一句“GPU fence 慢”,这些信息就都丢了。
⚠️ 源码分支边界:安全复用条件不等于每个实现分支都以同样方式传递 fence。当前 r1 的 LegacyImageConsumer 会把 createReleaseFence 产生的 native fence 加入旧 slot 的 release 依赖;新 SurfaceTexture::releaseBufferLocked() 则向 BufferItemConsumer::releaseBuffer() 传 Fence::NO_FENCE。因此本节时序图的输入归还按 Legacy 路径说明,不能仅凭新 ImageConsumer 存在 createFence 回调就断言 native fence 已沿同一路径交给 Producer,也不能从这段静态代码直接断言目标设备发生数据竞争;现场需核对 wb_surfacetexture 构建选择、配套同步实现与实际 fence。
这一层仍是内核里那两个文件:drivers/dma-buf/sync_file.c 提供 fence fd 接口,drivers/dma-buf/dma-fence.c 提供 signal、callback 和 wait 语义,讲的只是同步机制本身;某台设备上的 GPU、codec、camera 或 Display fence 为何迟到,还要结合驱动 timeline、vendor service 和硬件轨迹才能回答。
Android 12—17 的版本边界
| 平台 | 已核实变化 | 分析含义 |
|---|---|---|
| Android 12 / API 31 | DeferredLayerUpdater 已使用 ASurfaceTexture_dequeueBuffer()、AHardwareBuffer 与 SkImage | Android 12 已是当前 HWUI 消费模型的基线,不能只用旧 updateTexImage() 名称描述 |
| Android 13 / API 33 | 增加 CTA-861.3 / SMPTE 2086 HDR metadata 读取 | HDR 分析还要检查 dataspace、metadata、宿主颜色策略和 Display 能力 |
| Android 14 / API 34 | listener→TextureLayer→DeferredLayerUpdater→App Window 主拓扑延续 | SurfaceView 的 API 34 alpha/lifecycle 变化不能套到 TextureView |
| Android 15 / API 35 | flag 启用后,OnSetFrameRateListener 可把输入流请求传给 View requested frame rate | 这是传递刷新率提示的桥梁,不保证系统切换到指定刷新率 |
| Android 16 / API 36 | AHardwareBuffer/SkImage 消费与 frame-rate bridge 延续 | 跨版本差异应核对应用、Skia backend、驱动和刷新率策略 |
| Android 17 / API 37 | 当前实现继续处理 crop、transform、dataspace、HDR 和 slot image cache | 现有机制延续到 API 37,不代表它们都在 API 37 新增 |
链路级对比:SurfaceView vs TextureView
两者都能向 Producer 提供 Surface,差异在于谁消费主体像素,以及它们何时进入 SF layer:
SurfaceView:
Producer → independent BufferQueue/BLAST child → SurfaceFlinger → HWC

TextureView:
Producer → SurfaceTexture → app HWUI sampling → host App Window
         → SurfaceFlinger → HWC
这张对比图表明,TextureView 增加的是应用内 Consumer 与宿主采样阶段,通常不会增加一次 CPU 逐像素拷贝。SurfaceView 的主体保持为独立 layer,TextureView 的主体则进入宿主窗口 buffer。
| 维度 | SurfaceView | TextureView |
|---|---|---|
| 主体最终可见对象 | 独立 BLAST child layer | 宿主 App Window buffer 中的一部分 |
| 宿主 RenderThread | 不采样主体;仍处理普通 View 与几何相关工作 | acquire 输入 image,并与其他 View 一起绘制 |
| View 变换 | 受 SurfaceControl、composition order、crop 和 hole-punch 语义约束 | 支持普通 View 的 transform、alpha、clip 与绘制顺序 |
| 帧节奏 | 内容可与宿主 UI 不同 | 新内容要经过一次宿主 HWUI frame |
| HWC | 可以独立评估主体采用 DEVICE 或 CLIENT composition | 只能评估整个宿主 layer |
| protected 内容 | 可建立 secure/protected 独立路径 | 普通 HWUI Consumer 通常不适合读取受保护 buffer |
| 队列 | 内容队列与宿主队列在 SF 汇合 | 输入队列先由应用消费,再生成宿主队列 |
| trace 重点 | host、container、BLAST child、HWC | 输入 queue、listener、TextureLayer、RT acquire、host BufferTX |
SurfaceView 不一定更快,TextureView 的额外等待也随时机浮动。迁移前应回答:
- 是否需要普通 View 级的旋转、裁剪、滤镜和交叉混合?
- 是否要求 protected/secure 内容?
- 主体分辨率和更新频率带来的宿主 GPU/带宽成本能否接受?
- 页面是否需要主体内容绕开宿主 UI 卡顿继续更新?
- 目标设备上的 SurfaceView 能否满足层级和动画要求,HWC composition type 是否稳定?
游戏引擎、WebView、Flutter、React Native 或地图框架的名称,说明不了渲染路径:它们可能使用 TextureView、SurfaceView、普通 App Window 或嵌入式 SurfaceControl。我们先确认 layer/BufferQueue 拓扑,再分析引擎线程。
onFrameAvailable 回调模型
内部 listener 骨架如下:
SurfaceTexture.setOnFrameAvailableListener(mUpdateListener, mAttachInfo.mHandler)

mUpdateListener.onFrameAvailable(surfaceTexture)
  updateLayer()   // mUpdateLayer = true
  invalidate()    // mark TextureView dirty
这段结构说明回调会投递到宿主 ViewRoot 的 handler。回调到达只代表通知到了 UI 侧,RenderThread 是否已 acquire 输入、系统是否产生了独立的 VSync 回调,都要另行确认。应用直接使用裸 SurfaceTexture 时可以自行选择 listener handler;讨论 TextureView 内部行为时,则以 mAttachInfo.mHandler 为准。
invalidate 的合并
invalidate() 把 dirty region(待重绘区域)交给 ViewRoot。已有 traversal 时,新请求可以并入该帧;没有 pending frame 时,scheduleTraversals() 会注册 traversal 回调,再由 Choreographer 申请下一次 VSync。一次外部 queue 不会产生一条独立的 vsync-app。
常见时序如下:
- 通知先于 UI
applyUpdate(),更新被送入 RenderThread,取帧时输入已入队,本轮可能采到新内容; - 通知晚于 UI
applyUpdate(),且此前没有其他待消费更新,本轮继续使用旧输入,等待后续宿主 draw; - 已有待消费更新时,Producer 在 RenderThread 取帧期间又 queue 新 buffer,消费者可能选择更新的输入;通知与输入 frame number 不保证一一对应;
- 宿主当时没有 pending frame,回调触发下一次宿主帧。
判断新输入能否赶上当前宿主帧,要先确认待更新对象已进入本次 syncFrameState(),再核对 ASurfaceTexture_dequeueBuffer() 取得的 frame number。queueBuffer()、回调到达或 Choreographer#doFrame() 的单个时间点,都替代不了这两项检查。
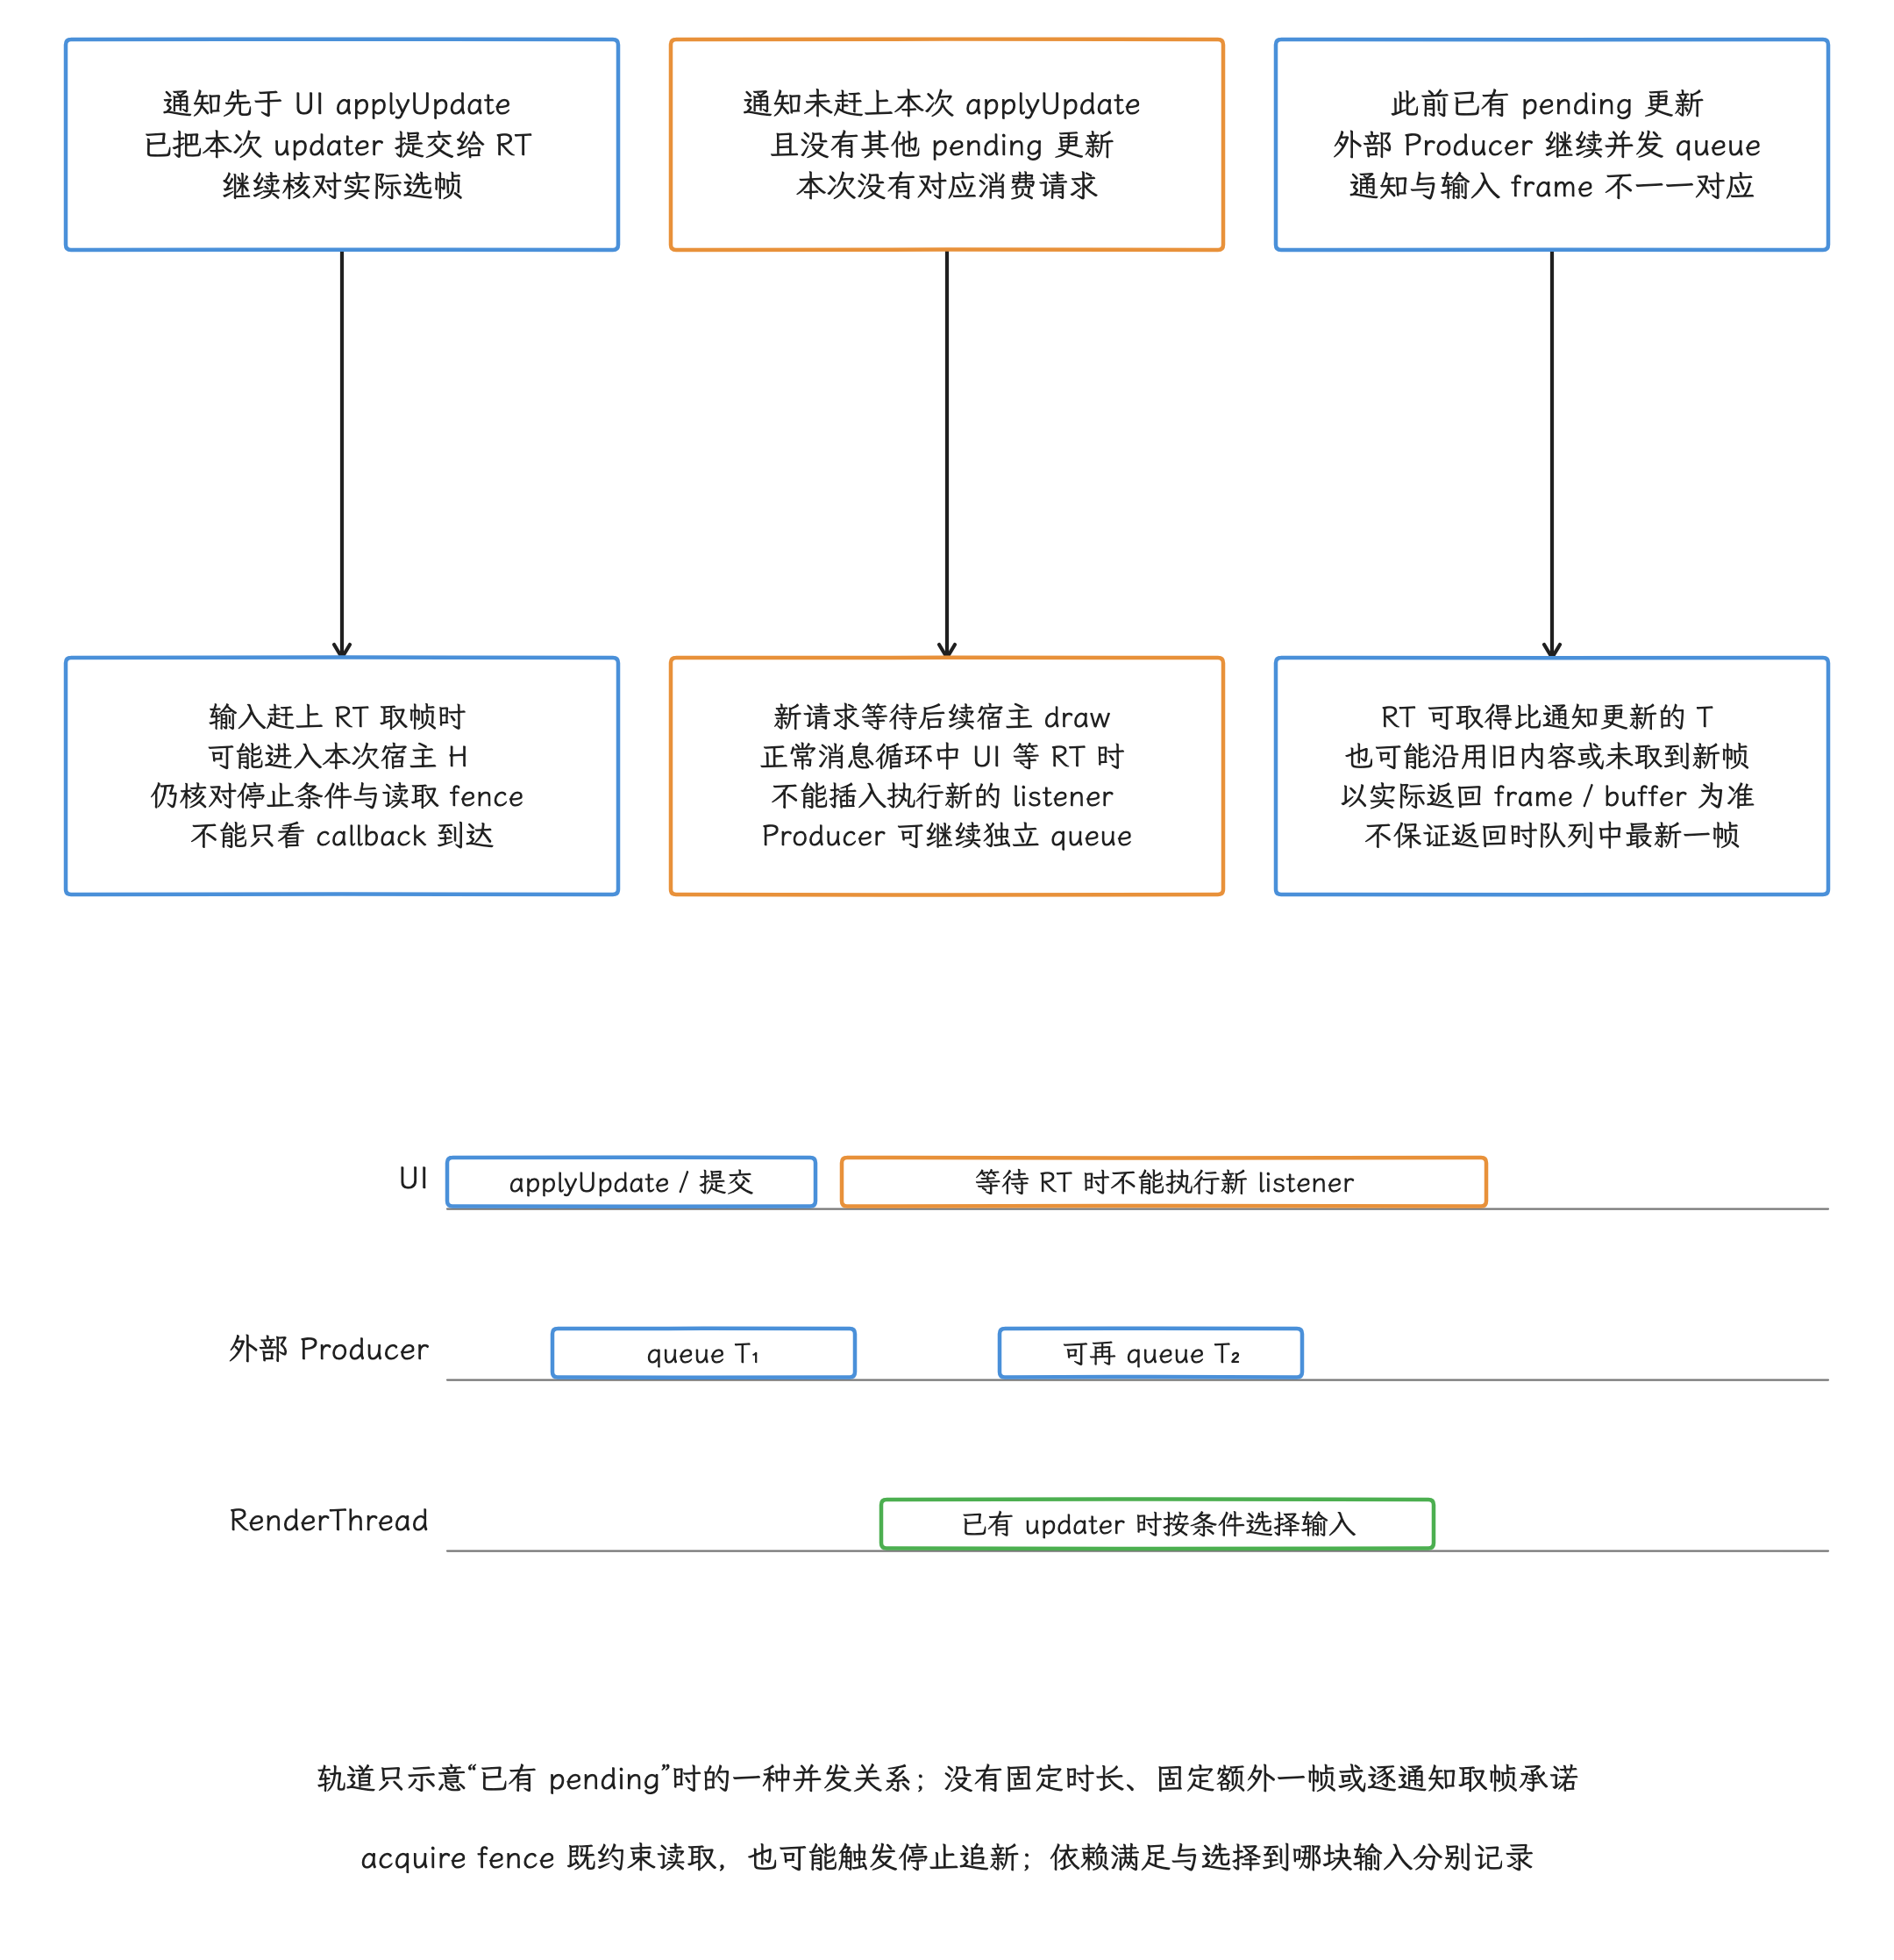
图:两个门槛与通知合并合图,轨道非实测。通知赶上UIapplyUpdate且updater进入本次sync,输入还须赶上RT实际选帧并满足读取依赖;晚于UI且没有其他pending时等后续hostdraw。已有pending时外部Producer仍可并发queue,RT可能选到比通知更新的T,也可能旧/空,不保证返回时最新。正常消息循环中UI等RT时不能执行新listener。acquire未signal可触发停止追新,依赖满足与实际选中输入分别记;没有固定额外一帧或逐通知取帧承诺。
尺寸、opaque 与 transform
onSizeChanged() 会调用 SurfaceTexture.setDefaultBufferSize()、标记 layer 更新,并通知 onSurfaceTextureSizeChanged()。这只能设置 BufferQueue 建议使用的默认 buffer size;Producer 仍需按自身 API 更新输出,避免长期生成与 View bounds 相差很大的 buffer。
TextureView 默认假设内容 opaque。setOpaque(false) 会改变 HWUI 的 blending 方式,但不会替 Producer 生成正确的 alpha 通道。setTransform() 只改变内容在 TextureView bounds 内的采样变换,不改变 View layout 或触摸命中区域;Camera 方向、镜像、center-crop 和触摸坐标应使用同一套映射关系。
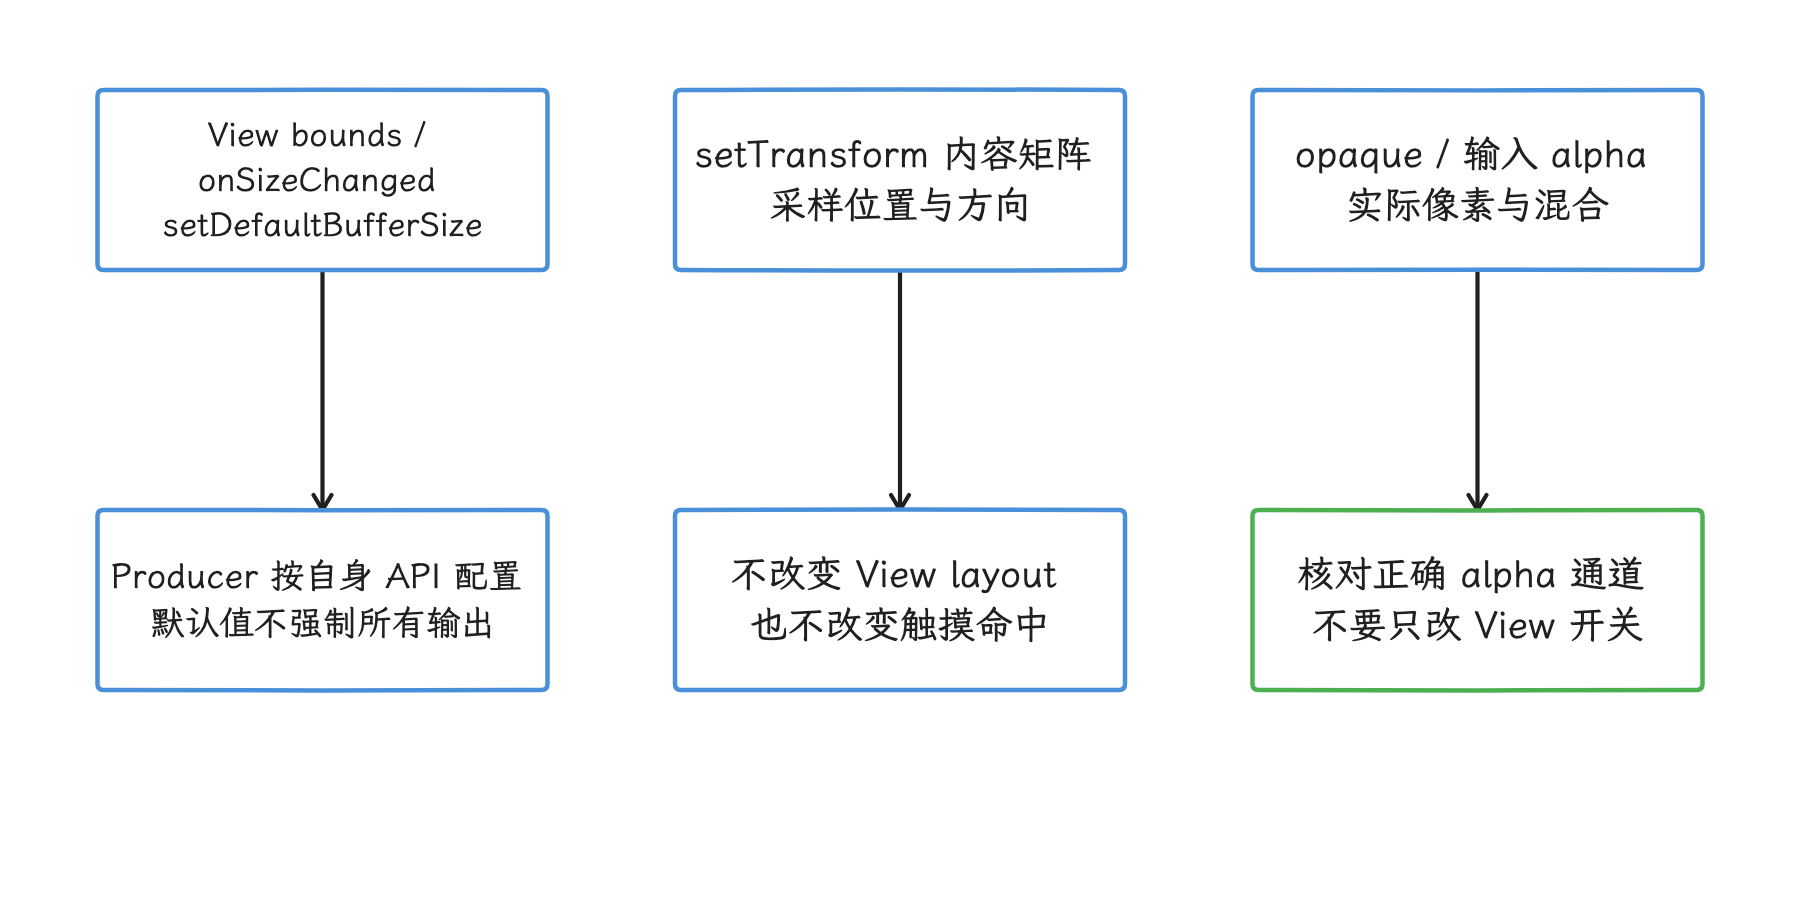
图:默认 buffer size 是建议值,内容 transform 不改变 View 的布局和命中区域。 opaque=false 不替 Producer 生成 alpha;方向、crop 与触摸应共用映射依据。
frame-rate hint
Android 15—17 在相关 flag 开启时会注册 SurfaceTexture.OnSetFrameRateListener,把输入流的 frame-rate 请求转换为 TextureView 的 requested frame rate 与 compatibility。该机制只向系统刷新率策略提供提示,不保证 Display mode 会切换到请求值。我们在 trace 里同时检查 flag、Producer 请求、Window requested rate、FrameRateOverride、Display mode 和其他 layer 的请求。
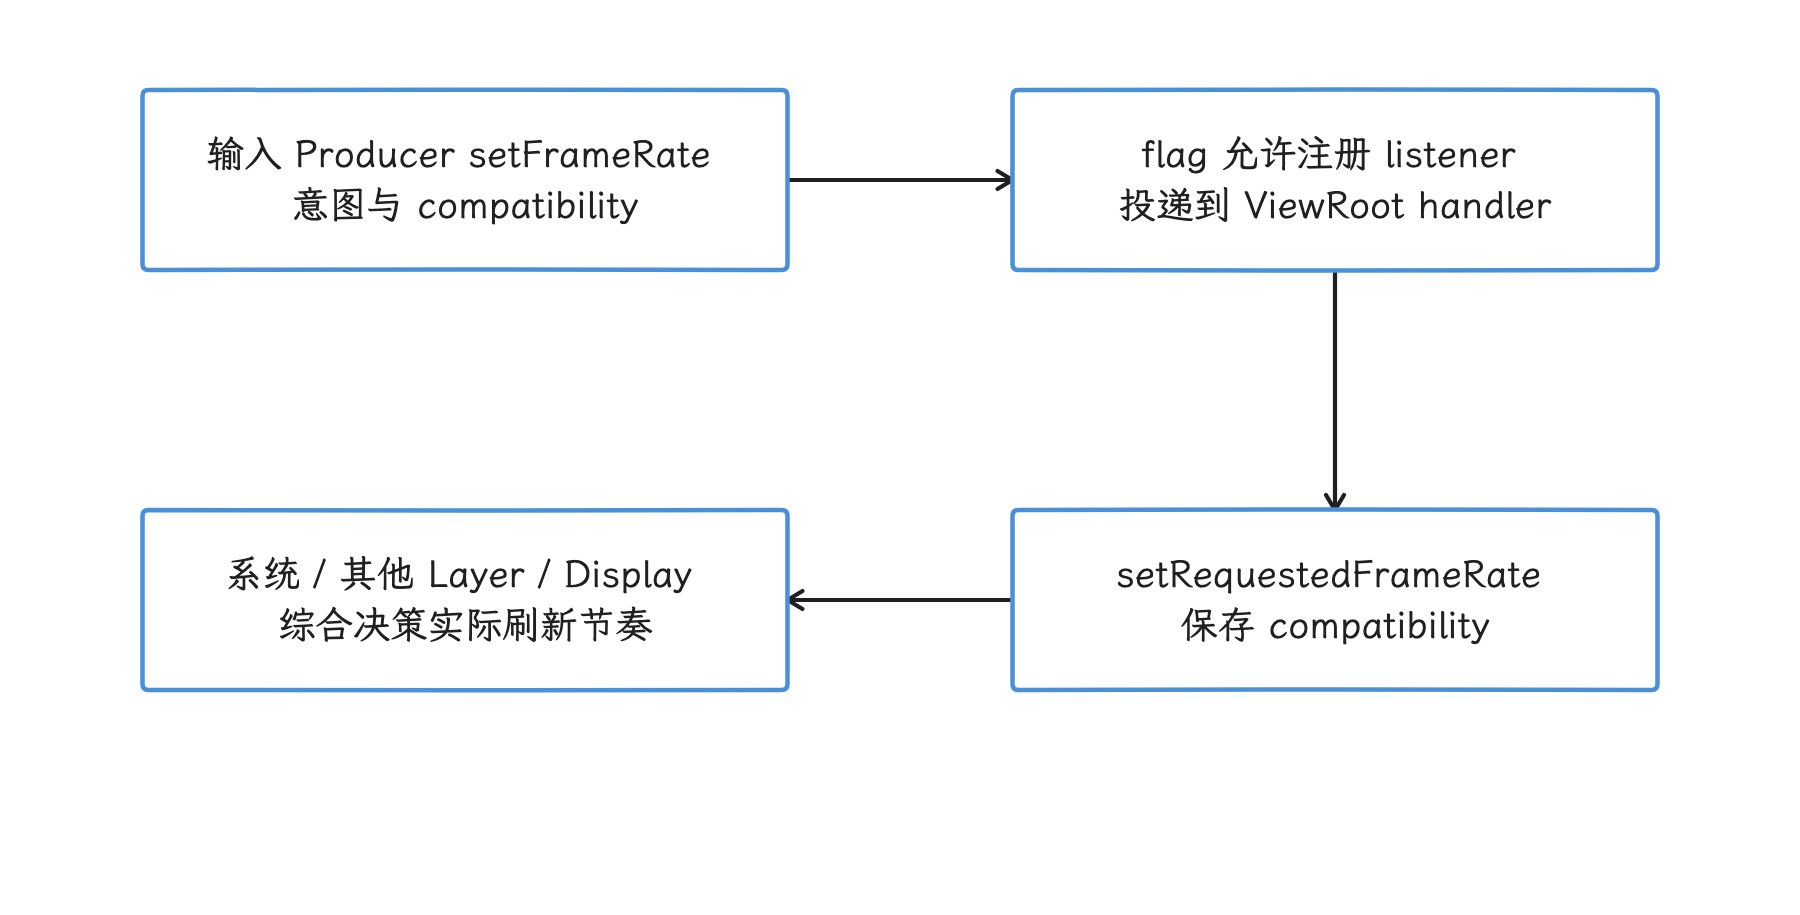
图:输入流的请求被桥接到 View requested rate,再由系统做刷新率决策。 toolkitSetFrameRateReadOnly 为注册条件;请求不是目标 Display mode 的承诺。
Trace 视角
证明 TextureView 拓扑
要确认实际用的是 TextureView 宿主合成链路,下面几项要组合起来看:
- 外部 Producer 的目标是 SurfaceTexture 或由它创建的
Surface; - 应用 HWUI 中存在
TextureView、TextureLayer、pending layer update 或DeferredLayerUpdater相关行为; - 新输入沿
onFrameAvailable → updateLayer/invalidate → 宿主 frame传播; - RenderThread 取得输入 image,再提交宿主 App Window buffer;
- SurfaceFlinger layer tree 中没有与该输入 stream 对应的独立可见 buffer layer。
单独出现 SurfaceTexture、EGL swap、MediaCodec、Camera 或宿主 GPU 繁忙,确认不了这条拓扑:普通 HWUI 页面也可能只有一个 App Window layer,应用自行管理的 GLConsumer 同样会使用 SurfaceTexture。
建立对象与时间表
| 对象 | 身份字段 | 时间点 |
|---|---|---|
| 外部 Producer | 进程/线程、目标 queue、frame number | dequeue、填充、queue 和 completion fence |
| SurfaceTexture 队列 | Producer/Consumer、slot、queued/acquired | frame available、实际 acquire 的 frame 和 release old |
| TextureView/TextureLayer | ViewRoot、handler、updater | callback、invalidate、applyUpdate、pending update |
| Host App Window | layer id/name、BLAST queue | doFrame、DrawFrame、宿主 queue、BufferTX 和 latch |
| DisplayFrame | Display token、composition | validate、client target、present/release fence |
SurfaceFlinger layer tree 通常只能帮助确认宿主窗口,列不出应用内的 SurfaceTexture slot。第一套队列要从应用/Producer trace、BufferQueue 名、frame callback 或业务 instrumentation(插桩记录)中回溯。
对齐两次生产
把以下时间点放在同一条时间轴上:
- 外部 Producer queue;
- frame-available callback;
invalidate()/scheduleTraversals();- 宿主
Choreographer#doFrame(); - UI
TextureView.draw()/applyUpdate(); - RenderThread
syncFrameState()与 pending layer apply; ASurfaceTexture_dequeueBuffer()选择的输入 frame;- 宿主 GPU draw 与 host queue;
- 宿主 BufferTX、SF/HWC 与 Display present。
回调较早到达时,仍要检查待更新对象是否进入目标宿主帧,以及取帧循环实际返回了哪个输入 frame。acquire fence 决定已取得的 buffer 何时可读;尚未 signal 的 fence 还会触发取帧循环的停止条件,应把等待依赖和选择输入分开记录。通知晚于 UI applyUpdate()、且该帧没有其他待消费更新时,新请求要等后续宿主 draw。
分开等待位置
| 等待位置 | 所属队列 | 常见上游 |
|---|---|---|
| 外部 Producer dequeue/swap | SurfaceTexture 输入队列 | HWUI 消费较慢、旧 slot release fence 未完成、Producer 生产过快 |
| RenderThread input wait/import | SurfaceTexture 输入队列 | codec/camera/GPU 未完成、driver ownership/import |
| 宿主 RenderThread dequeue | App Window BLAST 队列 | SF/HWC 未释放宿主 buffer、Display 消费形成背压 |
| SF/HWC 等宿主 acquire fence | App Window BLAST 队列 | 宿主 GPU 尚未完成 TextureView 与 UI 绘制 |
报告“卡在 dequeueBuffer()”时,必须注明目标队列和 layer;报告“等待 fence”时,必须注明 acquire/release/present 类型和创建者。两套背压可以在同一个可见帧中同时出现。
FrameTimeline 与 HWC
FrameTimeline 主要覆盖宿主 App Window 与 SurfaceFlinger DisplayFrame。它能回答宿主帧是否 late、是否出现 buffer stuffing(提交过多帧造成排队),以及哪个 surface_frame_token 对应哪个 display_frame_token。外部 SurfaceTexture 输入 frame 仍要用 queue frame number、timestamp、回调和 fence 关联。
TextureView 没有独立的 composition type。宿主 DEVICE 只说明整个窗口 layer 被 HWC 处理,已混入窗口 buffer 的视频矩形没有因此获得独立 Overlay plane。当前 HWComposer.cpp 用 state == 1 注释为 present succeeded;这个 HAL 返回和保存的 fence 不证明面板完成扫描,也不证明某块外部输入已赶上宿主帧。
常见性能问题与优化
Producer 已 queue,画面仍旧
依次检查回调是否进入宿主 handler、View 是否可见、invalidate() 是否并入目标 traversal、UI 是否执行 applyUpdate()、RenderThread 选择了哪个输入 frame,以及输入 acquire fence 何时 ready。Producer 按时 queue,只能证明第一套队列已经收到内容。
主线程或宿主帧迟到
TextureView 的新内容要经过宿主帧,因此主线程 I/O、锁竞争、GC 和复杂布局都会延迟 listener 与 traversal。优化时应先定位具体的主线程工作;如果业务不需要 View 级混合,也可以根据目标设备数据评估 SurfaceView。doFrame 的预算不是固定的 16 ms:高刷新率与动态刷新率设备具有不同 deadline,应使用 FrameTimeline 的 expected/actual 时间判断。
RenderThread 或输入 fence 慢
先区分 CPU slice、GPU wait 和 driver queue。DeferredLayerUpdater::fenceWait() 会根据 SkiaGL/SkiaVulkan 使用不同的 manager;等待可能直接出现在 CPU 上,也可能表现为 GPU-side dependency(GPU 任务间依赖)。随后沿 fence 创建方继续检查 codec、camera、外部 GPU 或 image import;只优化 TextureView draw,覆盖不了这些来源。
外部 Producer dequeue 变长
检查 SurfaceTexture 输入 slot、旧 buffer 的 release fence 和 HWUI 消费节奏。宿主不可见时,内部 listener 会被移除;Producer 继续全速输出,可能改变输入队列的阻塞或丢帧行为。盲目增加 buffer 数量会增加内存占用或旧帧排队,应先确定业务更重视吞吐还是时延。
宿主窗口背压
如果宿主 RenderThread 卡在 App Window dequeue,问题位于第二套队列。应检查宿主 release fence、SF/HWC composition、Display mode、buffer stuffing(应用持续提交过多帧造成排队) 和其他窗口;此时外部输入队列可能完全正常。
高分辨率内容导致 GPU/带宽上升
读取输入 buffer 的尺寸、format、dataspace、缩放比例和宿主刷新率,并结合 GPU counter(硬件性能计数器)与功耗测量判断。减少无效超采样、按 View 尺寸配置 Producer、降低不必要的 alpha/滤镜,或迁移到独立 Surface,都可能有效。固定的“1080p 每帧多少 MB × 三缓冲”估算,代替不了设备上的实测数据。
黑屏、旧帧与生命周期泄漏
黑屏时优先检查硬件加速、SurfaceTexture available/destroyed 状态、Producer connection、Surface 是否已 release、View visibility 和 protected usage。destroyed 返回 false 后一直没有 release,会保留 native 队列与 GraphicBuffer;调用 setSurfaceTexture() 前未停止旧 Producer,则可能留下无效连接或引发生命周期竞态。
普通 HWUI TextureView Consumer 通常不适合读取 protected DRM buffer。播放器可能拒绝配置、显示黑屏,或者切换到 secure SurfaceView;具体行为取决于 DRM、codec、gralloc 和设备能力,没有统一的错误表现。
预览跳帧但交互延迟较低
核对 ASurfaceTexture_dequeueBuffer() 是否持续选择最新 frame,以及 Producer 供帧频率是否高于宿主消费频率。对于显示预览,这可能是主动丢弃过时内容;对于逐帧处理,则说明 API 选型不合适。中间 frame 没有显示,不足以证明 BufferQueue 损坏。
HDR、折叠与坐标错位
HDR 要同时检查 buffer format、dataspace、CTA-861.3/SMPTE 2086 metadata、宿主 Window color mode、Skia backend 和 Display policy。折叠、多窗口或 cutout(屏幕挖孔) 不会为 TextureView 增加专用渲染路径;Window bounds 变化仍通过普通 View layout 与 onSizeChanged() 传播。排查画面方向、crop 和触摸坐标时,要一起核对 View layout、TextureView content transform 与 Producer transform。
复核清单
- TextureView 是否处于硬件加速窗口?
- 谁创建 SurfaceTexture、谁创建并 release
Surface? - destroyed 返回值与资源所有权是否一致?
- 同一时刻是否只有一个 Producer?
- 输入 buffer 尺寸、format、dataspace、crop 与 View bounds 是否匹配?
- frame-available 投递到哪个 Looper,是否被宿主线程延迟?
- 输入 frame 是否赶上目标 RenderThread layer apply?
- 输入、宿主与 display 三类 fence 分别属于谁?
- HWC 看到哪个宿主 layer,是否有人把它误称为 TextureView Overlay?
- 结论是否限定到具体 Android、应用和 vendor 版本,并有源码或 trace 佐证?
Android 17 源码锚点
TextureView 部分沿用同一组平台与内核版本锚点,重点查阅以下对象:
TextureView.java:硬件加速、listener、lifecycle、draw/applyUpdate、visibility 和 frame-rate bridge;SurfaceTexture.java:公共 Producer/Consumer、callback、release 和应用自管 GLConsumer 的语义;TextureLayer.java:native updater、pushLayerUpdate()与 SurfaceTexture 绑定;DeferredLayerUpdater.cpp:输入 buffer、AHardwareBuffer/SkImage、SkiaGL/SkiaVulkan fence、crop、transform、dataspace 和 HDR;surface_texture.cpp、ImageConsumer.cpp、LegacyImageConsumer.cpp:循环取帧、acquire fence 与停止条件;DrawFrameTask.cpp、CanvasContext.cpp:pending layer updates、prepareTree、draw 和宿主 swap;BufferQueueProducer.cpp、BufferQueueConsumer.cpp:输入队列 slot、acquire/release 与背压;BLASTBufferQueue.cpp、SurfaceFlinger FrontEnd、HWComposer.cpp:宿主 BufferTX、layer state、validate/present 和 fence;sync_file.c、dma-fence.c:内核 fence fd 与等待语义;- Perfetto FrameTimeline:宿主 SurfaceFrame、DisplayFrame、expected/actual 与 jank 字段。
相关章节:
- 13.4 OpenGL ES、EGL 与 ANGLE
- 2.8 BufferQueue、Gralloc 与 Sync Fence
- 2.9 SurfaceFlinger 合成、FrontEnd 与事务队列
小结
SurfaceView 让主体内容保留独立 BufferQueue 和 SurfaceFlinger layer,TextureView 则让外部内容先经 SurfaceTexture 被宿主 HWUI 采样。前者的关键在内容 buffer、container 几何与 hole-punch 的同步,后者的关键在输入队列、宿主帧与第二次 buffer 提交。
选型时我们先确认 protected/secure、View 级变换、独立节奏和目标设备 HWC 能力;诊断时分别对齐 Producer、两套队列、acquire/release fence、宿主或独立 layer 与 display present。组件名直接推断不出 Overlay、固定延迟或性能高低。