Android 17 游戏引擎渲染链路
游戏的一帧要依次经过输入采样、模拟、渲染提交、Surface 队列和显示合成,把帧间隔做稳和把延迟压低,两个目标还可能互相牵制。这篇文章沿这条链路讲游戏渲染:线程按什么识别、每一环的等待和 fence 说明什么、Swappy 到 Game Mode 这些机制各自管到哪一段。识别线程时,我们以职责和依赖为准,引擎版本的线程名只作辅助。
源码基线(2026-10-24 核对):AOSP
android-17.0.0_r1;内核android17-6.18-2026-06_r6为通用内核研究样本,设备可能使用其他内核分支。Unity、Unreal 和 Swappy 的公开文档用于解释角色与契约,具体线程、模式、扩展与 flag 仍须按实际引擎构建和设备核对;本文没有把源码审阅当作设备实测。
普通 Android View 页面通常由事件触发:输入、动画或数据变化引起 invalidate(),Choreographer 再在 VSync 节点驱动 ViewRootImpl 和 HWUI。游戏同样要处理 Activity 生命周期、窗口和输入事件,但画面通常由引擎自己的 game loop(持续执行的游戏主循环)主动生产。
这一区别决定了分析的起点。普通页面常从 UI Thread 的 doFrame() 向后追踪;游戏要先确定某一次输入被哪一轮 simulation(物理、玩法等世界状态更新)读取,我们再顺着 Render / RHI、GPU、swapchain、BufferQueue、SurfaceFlinger 一路追到显示 present。
Unity、Unreal、Cocos、自研引擎、Swappy 和 GPU driver 都有自己的版本变化;我们采集数据时,应同时记录引擎版本、graphics API、渲染后端、frame pacing 配置、Game Mode 和设备 build fingerprint。
Game Loop 与事件驱动 UI 有什么不同
下面这段伪代码用来说明职责和节奏,各引擎都有自己的实现:
while (running) {
    pollLifecycleAndInput();

    accumulator += elapsedTime();
    while (accumulator >= fixedStep) {
        simulatePhysicsAndGameplay(fixedStep);
        accumulator -= fixedStep;
    }

    buildRenderSnapshot(accumulator / fixedStep);
    recordAndSubmitGpuCommands();
    presentWithFramePacing();
}
很多引擎用固定时间步长更新物理,再用可变步长或插值生成 render snapshot(供渲染线程读取的一帧世界状态);输入则可能在 game thread 开头、VSync 附近或更靠近提交时采样。所以只知道“游戏 60 FPS”,我们既推不出 simulation 每秒也运行 60 次,也推不出触控到显示只经历一帧。
| 对比维度 | 普通 View 页面 | 游戏引擎 |
|---|---|---|
| 主要驱动力 | View 失效、输入、动画、数据变化 | 自有 game loop 持续执行 |
| 逻辑更新 | UI Thread 上的回调与状态更新 | Game / Logic thread 的 simulation、脚本、物理、动画 |
| 渲染准备 | HWUI 在 UI Thread / RenderThread 协作 | Render / RHI thread、task workers、引擎 render graph |
| 提交接口 | HWUI 通过 Skia / RenderThread 输出 | GLES eglSwapBuffers() 或 Vulkan vkQueuePresentKHR() |
| 节奏控制 | Choreographer 与系统帧调度 | Swappy、自研 pacer、引擎 limiter、Frame Rate API |
| 重点延迟 | 输入到 App FrameTimeline | 输入采样到对应游戏帧 present 的完整链路 |
游戏仍然运行在 Android 窗口系统里:引擎自有 game loop,最终画面仍要经过 SurfaceFlinger 合成;把 swap/present 做成阻塞式,也代替不了完整的线程协作与 GPU 同步设计。
一帧的完整路径
下面的图展示常见独立 SurfaceView 游戏的依赖关系,省略错误、共享 present mode 和 presentOrValidate 快路径;它不是按比例的实测时间线。pacer 可以在一帧多处等待,图上只标记提交控制关系。
flowchart TD
    Input["Input dispatch + engine input sampling"]
    Game["Game / Logic: script + physics + animation"]
    Workers["Workers: parallel jobs and dependencies"]
    Render["Render: culling + render graph + draw preparation"]
    RHI["RHI / graphics: command recording"]
    API["GLES / Vulkan: submit GPU work"]
    GPU["GPU asynchronous writes + completion fence"]
    Pacer["Swappy / engine pacer: target + in-flight control"]
    Swap["swap / present request"]
    BQ["ANativeWindow / BufferQueue: buffer + write fence"]
    BLAST["Client BLAST: acquire + setBuffer transaction"]
    SF["SF: transaction readiness + snapshot / latch"]
    HWC["Layer state to HWC + validate composition"]
    RE["Optional CLIENT: RenderEngine + client target"]
    Driver["HWC present submission + display driver"]
    Present["Display presentation feedback"]
    Input --> Game
    Workers --> Game
    Workers --> Render
    Game --> Render --> RHI --> API
    API --> GPU
    API --> Swap --> BQ --> BLAST --> SF --> HWC
    Pacer -. controls submission timing .-> Swap
    HWC -->|CLIENT layers| RE --> Driver
    HWC -->|DEVICE layers| Driver
    GPU -. complete before reading .-> RE
    GPU -. complete before device reads .-> Driver
    Driver --> Present
    Present -. timing feedback .-> Pacer
    Driver -. prior buffer release dependency .-> BLAST
CPU 的提交调用返回时,GPU 往往还在异步执行,buffer 也可能已经携带未 signal 的写完成 fence 入队。BLAST 可以先取得 BufferItem 并发送事务;SF 在策略允许时也可能先 latch,真正的 RenderEngine/HWC 读取仍必须遵守 acquire 依赖。HWC 新一轮返回的 device-layer release fence 通常对应上一帧的旧 buffer,SF 还会按合成路径合并其他访问依赖;slot 归还与下一次可安全写入是两件事。present timing / present fence 则描述显示栈的呈现边界,三者要分别判读。
五段职责
- Input 与 Game / Logic:读取输入,更新脚本、AI、物理、动画和世界状态。
- Render preparation:完成可见性裁剪、LOD(Level of Detail,细节层级)、render graph、draw item 与资源依赖准备。
- RHI / graphics submission:RHI(Rendering Hardware Interface,渲染硬件抽象层)把引擎命令转换成 GLES/Vulkan 调用,录制并提交 GPU command buffer。
- GPU 与 swapchain:应用提交 GPU 写入并请求 swap/present,把 image 与完成依赖交给 Android native window;CPU 提交返回不要求 GPU 已写完。普通 swapchain image 在渲染与显示间轮换,共享 present mode 等特殊模式需另查。
- Android display:常见 SurfaceView 路径由 BufferQueue 的客户端 BLAST Consumer 组织 buffer 事务,再接 SurfaceFlinger readiness/latch、HWC/可选 RenderEngine、Composer HAL 与显示驱动。
这些阶段可以跨帧并行:Game thread 在准备 N+1 帧时,Render thread 可能正在处理 N 帧,GPU 还在执行 N-1 帧。这样的并行可以提高吞吐量,也可能让输入多等待一到两轮。已经进入 CPU/GPU/显示流水线、尚未完成 present 的帧,我们称为 in-flight frame;分析时要同时记录每秒完成帧数,以及同一输入跨越的在途帧数量。
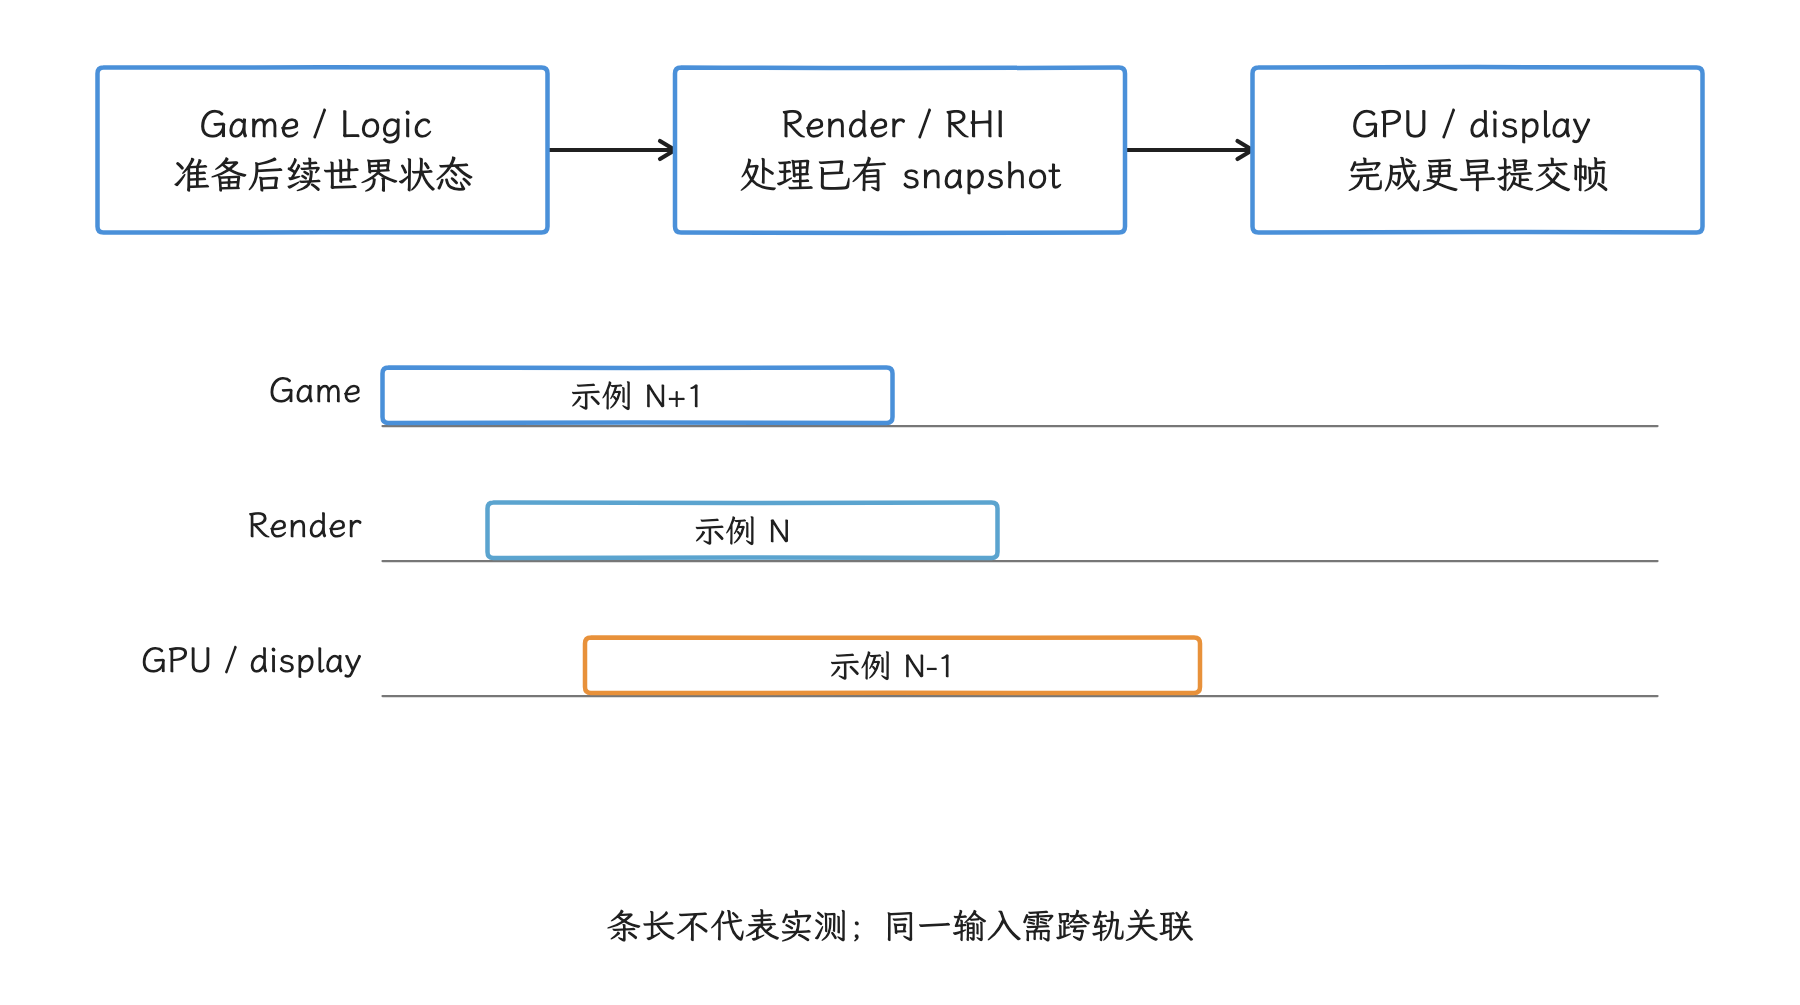
图:提高流水线吞吐时还要控制同一输入的在途等待。 N+1/N/N−1 只展示一种可能重叠,不是固定引擎帧差。
多线程架构:职责比线程名更可靠
引擎会随版本、graphics job、渲染后端和构建选项改变线程数量,所以我们先按职责识别线程,再用线程名辅助确认:
| 角色 | 常见工作 | 过载或阻塞时的表现 |
|---|---|---|
| Game / Logic thread | input、script、physics、animation、world tick | GPU 队列出现空洞,Render thread 等新命令 |
| Render thread | culling、draw preparation、render graph | Game thread 可能在帧边界等 Render thread |
| RHI / graphics thread | API command、driver 调用、queue submit | CPU submit 晚,GPU 开工也晚 |
| Worker threads | jobs、animation、visibility、streaming | 主线程在 barrier / future(等待并行任务完成的同步点)等待 worker |
| GPU queue | vertex、fragment、compute、copy | producer fence 晚,swapchain image 回收慢 |
| SurfaceFlinger / display | latch、composition、present | buffer 已 ready,仍错过目标 present |
Unity 的典型结构与证据边界
Unity 的 main thread 运行 PlayerLoop,脚本 Update / FixedUpdate / LateUpdate 等阶段位于其下。启用多线程渲染后,render thread 处理图形命令,Job System worker 处理可并行任务。具体线程和 marker 会随 Unity 版本、渲染后端及 Player 设置变化。
Unity Profiler 中常用的 marker 包括:
PlayerLoop:播放器主循环;Gfx.ProcessCommands:render thread 处理图形命令;Gfx.WaitForCommands:render thread 等 main thread 产生新命令;Gfx.PresentFrame:渲染线程上的 present/GPU/VSync 相关等待;Gfx.WaitForPresentOnGfxThread则在主线程,表示主线程等渲染线程完成相应 present 等待。名字里的 GfxThread 不是该 marker 所在的线程;旧版名称与具体嵌套以对应 Unity 版本为准;- Job worker 上的任务与 idle 区间。
这些名称属于 Unity Profiler 的 marker,Perfetto 默认并不保证显示它们;Perfetto 通常能看到的是进程、Linux 线程、调度状态、futex、binder、图形和 GPU/SurfaceFlinger 信息。要把 Unity 内部阶段与系统帧准确对应,我们应同时采集 Unity Profiler,或在关键阶段写入 ATrace / Perfetto TrackEvent,并携带统一 frame id。
看到 Gfx.WaitForPresentOnGfxThread 变长,还不能就此判定 GPU bound:等待可能来自 VSync、frame pacer、swapchain back-pressure(下游未及时释放 image)或 GPU 本身,要结合 GPU 完成时间和 BufferQueue 深度一起判断。
Unreal 的典型结构与证据边界
Unreal 常见 Game Thread、Rendering Thread、可选 RHI Thread 与 Task Graph workers。Epic 的线程渲染文档说明 Rendering Thread 可能落后 Game Thread 一到两帧,Game Thread 会在帧边界限制自己的领先距离。
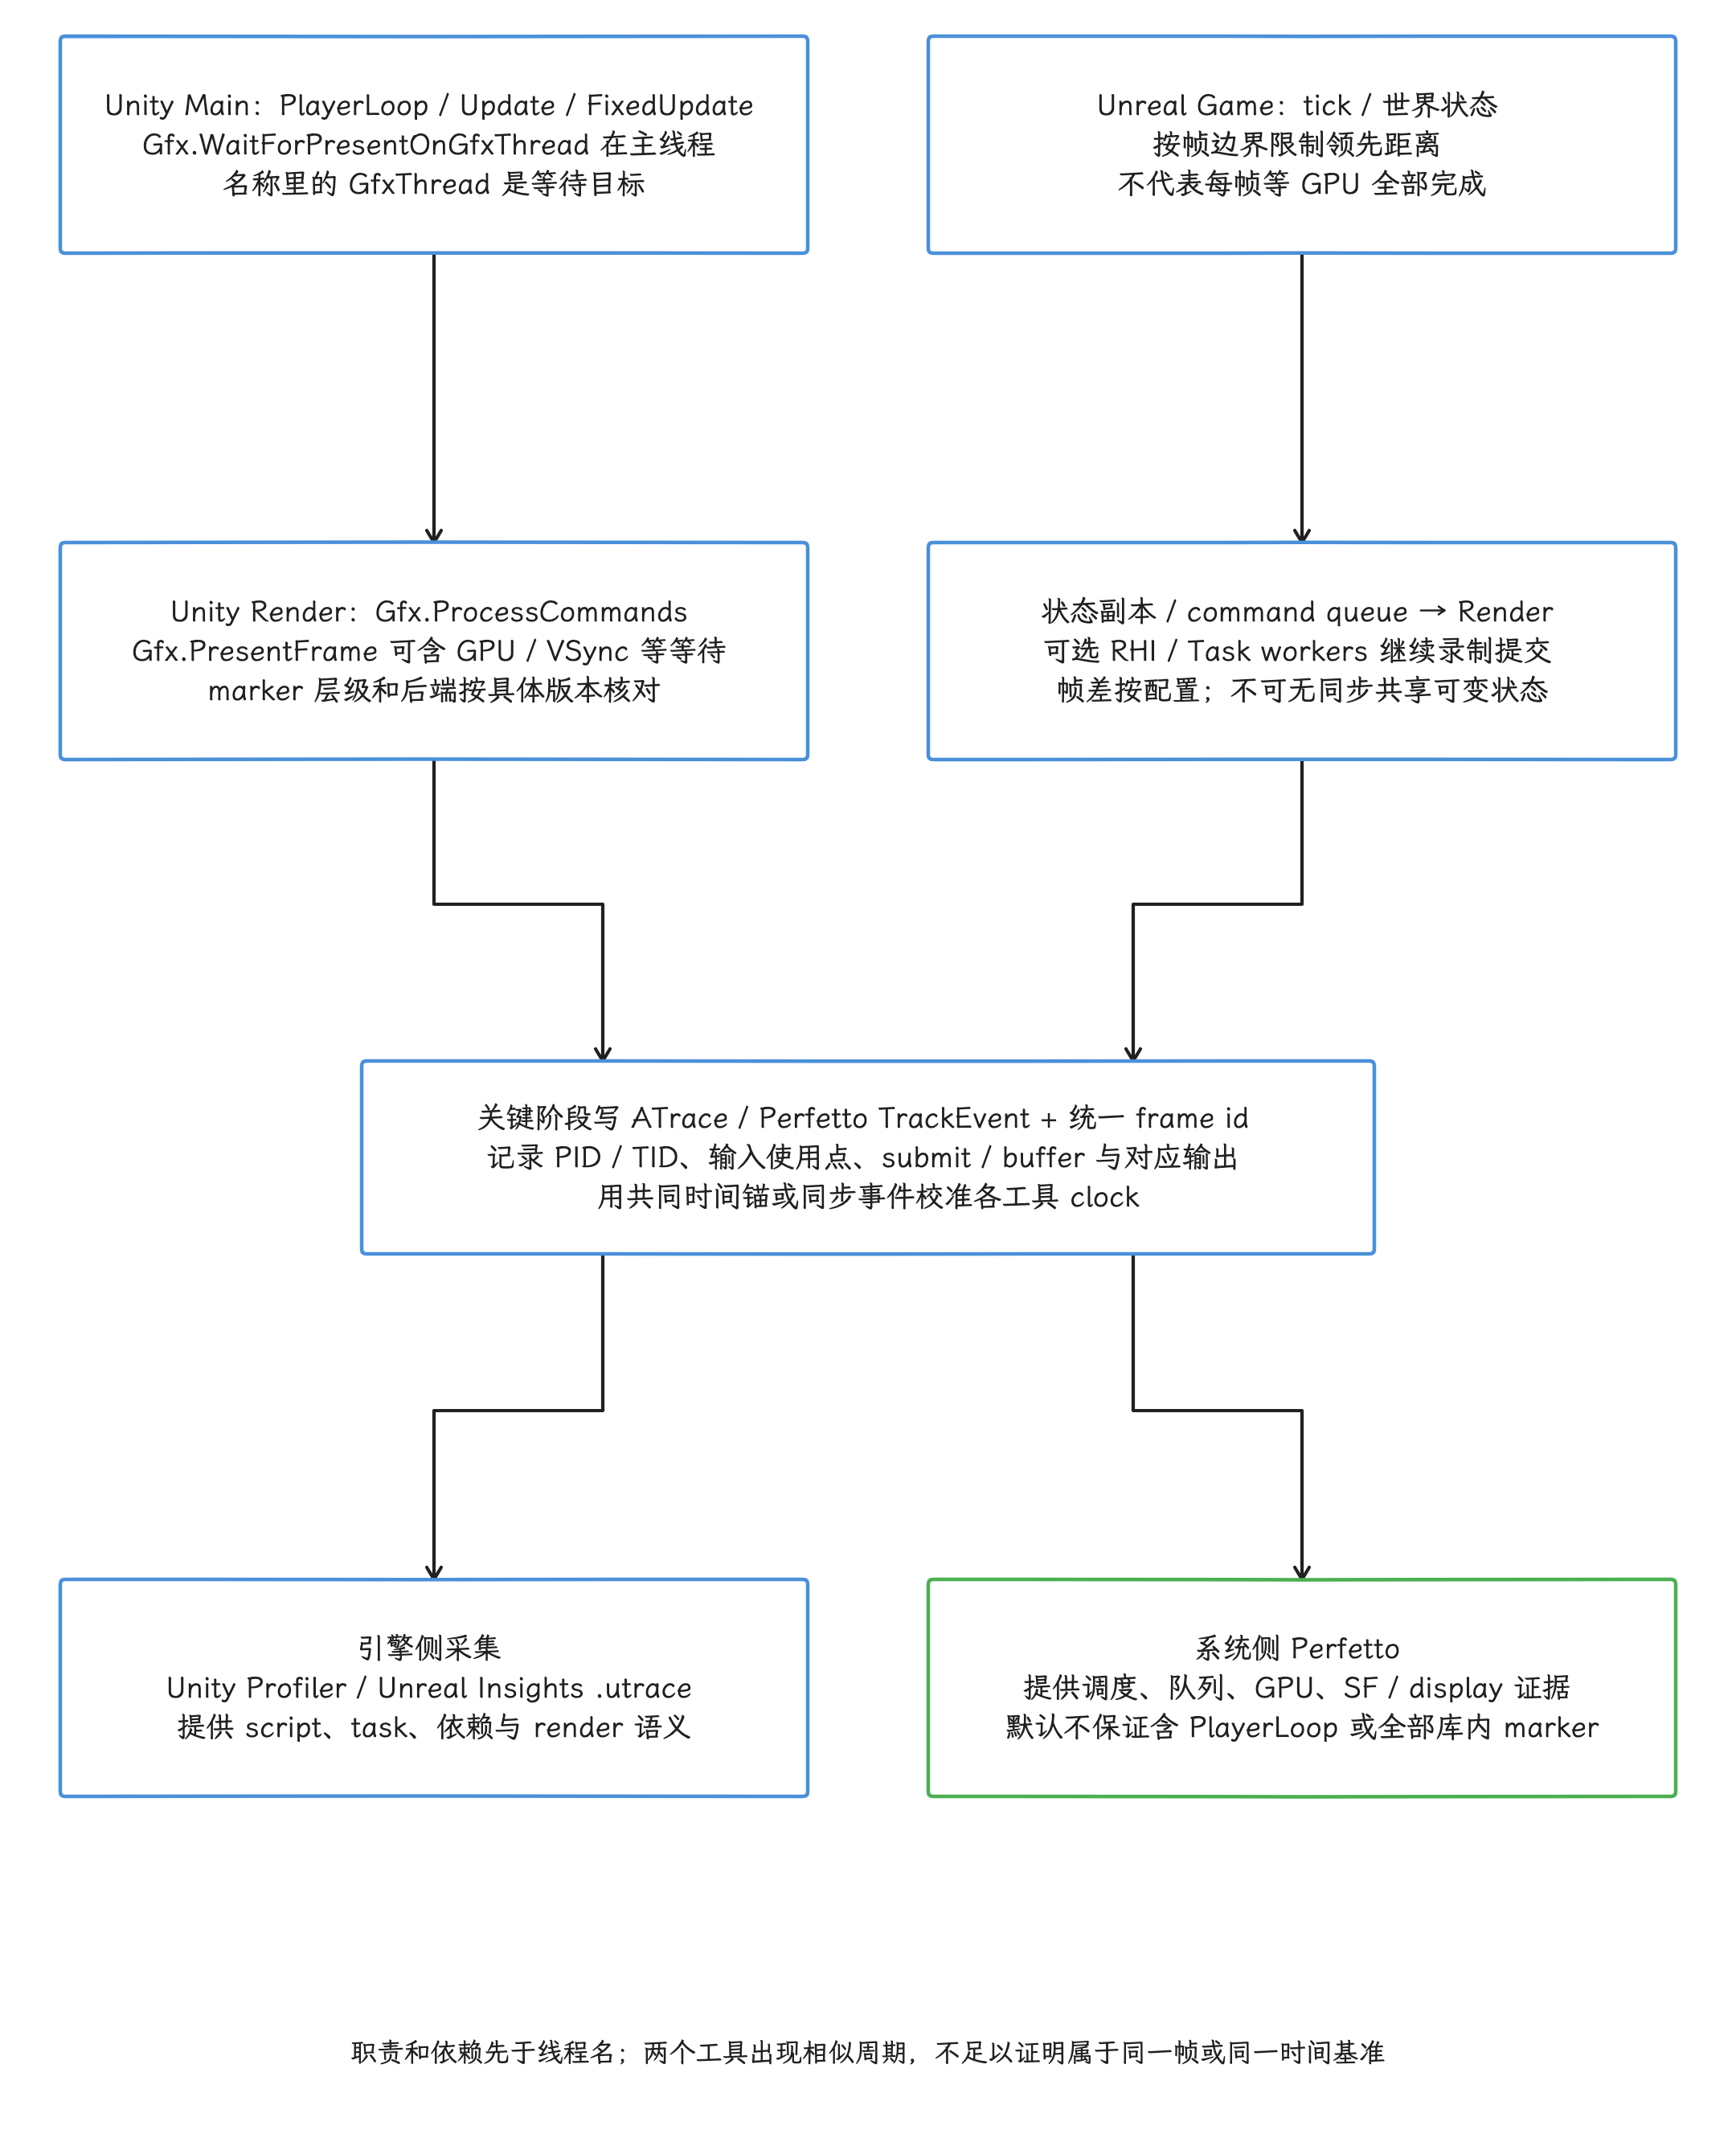
图:Unity Main PlayerLoop包含Update/FixedUpdate等,Gfx.WaitForPresentOnGfxThread在Main,名称描述等待Render目标;Render包含Gfx.ProcessCommands/Gfx.PresentFrame,具体嵌套按版本。Unreal Game通过状态副本/command queue交Render与可选RHI/Task,不能无同步共享可变状态,Game帧边界限制领先但不是每帧等GPU全部完成。采集Unity Profiler/Insights及Perfetto,关键阶段ATrace/TrackEvent带统一frame id并校准时钟;默认OS trace不保证有引擎marker,统一id也不消除clock偏移。
在 Perfetto 里,我们通常能按 OS 线程名找到 Game、Render、RHI 和 worker 轨道;名称会受引擎版本、平台封装和 Linux 线程名长度影响。GameThread::Tick、render pass、RHI command 这些细节属于 Unreal 的引擎 trace 语义,完整证据通常来自 Unreal Insights 的 .utrace。建议同时保留:
- Perfetto:系统调度、频率、GPU、BufferQueue、SurfaceFlinger 和 display;
- Unreal Insights:引擎 task、Game/Render/RHI dependency、asset loading 和自定义事件;
- 统一帧号:把同一 frame id 写入两边的自定义 marker。
线程等待怎样解读
我们看到等待,先别急着定性:Render thread 等 Game thread,可能说明逻辑慢;Game thread 等 Render thread,可能说明渲染准备积压;Swappy 或 acquire 上的短等待,也可能是在主动限制 in-flight 深度。判断时查看等待对象、前驱 fence、目标帧率,以及后续阶段有没有按预算启动。
游戏 Surface、SurfaceView 与 BLAST
看游戏渲染问题时,我们先确认画面由哪个 Surface 承载:大多数 Android 游戏把最终画面输出到独立 Surface。常见入口有:
GameActivity:官方文档说明它渲染到SurfaceView,并把ANativeWindow生命周期回调给 C/C++;- Unity / Unreal 的 Android Player Activity:通常持有供引擎渲染的 Surface 或 native window,具体封装随版本变化;
- 自研 Native 游戏:从
SurfaceView、NativeActivity或GameActivity获得ANativeWindow。
入口确认后,再看常听到的“游戏普遍使用 SurfaceView + BLAST”:它描述的是一种常见承载结构——现代 Android 的独立 SurfaceView 生产链,通常由 BLASTBufferQueue 配合 SurfaceControl transaction 协调 buffer 与几何更新。引擎多数只是经由这套链路提交画面;会不会直接调用 BLAST、拿到哪种封装,要按引擎版本和设备核对,平台并未把它写成对所有引擎的 API 保证。
Android 17 的 SurfaceView 路径
android-17.0.0_r1 的 SurfaceView.java 直接持有 BLASTBufferQueue、mBlastSurfaceControl 和 SurfaceControl.Transaction。Surface 的创建与 resize、destination frame(目标显示区域)、crop、z-order 和窗口同步都由这套 SurfaceControl/BLAST 路径处理;游戏像素本身仍由引擎生成。
稳态游戏帧仍由引擎通过 ANativeWindow 生产。以 Vulkan WSI(Window System Integration,窗口系统集成)为例,vulkan/libvulkan/swapchain.cpp 会:
- 用 native window 查询
NATIVE_WINDOW_MIN_UNDEQUEUED_BUFFERS等能力; - 按 swapchain 配置设置 buffer format、dimensions、dataspace 和 transform;
- 在 acquire 路径调用
dequeueBuffer(); - 在 present 路径把 GPU release fence 随
queueBuffer()交给 BufferQueue。
acquire 方向还要把 Android fence 接入 Vulkan 同步对象。普通非 shared swapchain 的 vkAcquireNextImageKHR() 对应实现从 dequeueBuffer() 取得 ANativeWindowBuffer 和 native fence fd(文件描述符),随后调用 driver 的 AcquireImageANDROID(),把该 fence 的复制 fd 导入应用提供的 Vulkan semaphore / fence;acquire 同步对象满足之后,应用才能安全改写这块 image。 shared present mode 使用另一分支,不会每帧重复 dequeue;这时即使拿到了 image index,写 image 之前仍要先满足 acquire semaphore/fence 的访问同步。
present 方向则把链路接回 BufferQueue:vkQueuePresentKHR() 或 SwappyVk_queuePresent() 最终进入 PresentOneSwapchain(),平台先调用 QueueSignalReleaseImageANDROID(),把 Vulkan wait semaphore 转换成代表 GPU 完成的 sync fd,再把 buffer 与该 fd 一起交给 ANativeWindow::queueBuffer()。Vulkan swapchain image 与 Android BufferQueue buffer 由此建立明确的映射。我们还要留意,present 调用走完这条路径时,该帧可能尚未被 SurfaceFlinger latch,后面仍有显示呈现和像素响应等阶段。 这里函数名中的 release image fence 对下游读取方起的是 acquire 依赖的作用;显示端稍后释放旧 buffer 的 release fence 属于显示尾链那一环,两个名字相近的信号各管一段。
游戏 Layer 仍要经过 SurfaceFlinger
独立 Surface 可以避开 App 的 HWUI RenderThread,但下一站仍是 SurfaceFlinger:它为游戏建立 Layer snapshot,并与 HWC 协商 CLIENT / DEVICE composition。
即使游戏 Layer 被 HWC 判为 DEVICE,游戏场景本身也已经由 GLES/Vulkan 在 GPU 中渲染完成;DEVICE 省掉的只是显示合成阶段 RenderEngine 对该 Layer 的再采样,游戏自身的 GPU 渲染成本仍然存在。
显示尾链可以沿下面几组调用核对:
- 常规路径先由
Output::writeCompositionState()/OutputLayer::writeStateToHWC()写入 Layer buffer、acquire fence、几何和请求类型;C++ Layer 入口为HWC2::Layer::setBuffer(),Composer3 命令入口为AidlComposer::setLayerBuffer()。 - 再由
Display::chooseCompositionStrategy()/HWComposer::getDeviceCompositionChanges()协商类型与 display requests;无 CLIENT 且满足时间条件时,presentOrValidate可直接成功提交并缓存 fences,后续不应重复 present。 - 普通 validate 后仍需要
CLIENT时,由 RenderEngine 生成 client target,setClientTarget()连同写完成依赖交给 HWC;DEVICELayer 直接由显示硬件读取。预测合成还可能与协商并行,这份顺序只是主要路径的简化。 Display::presentFrame()/presentAndGetReleaseFences()取得或沿用 display present fence 和各 Layer release fence,SF 再按 buffer 使用关系安排归还。
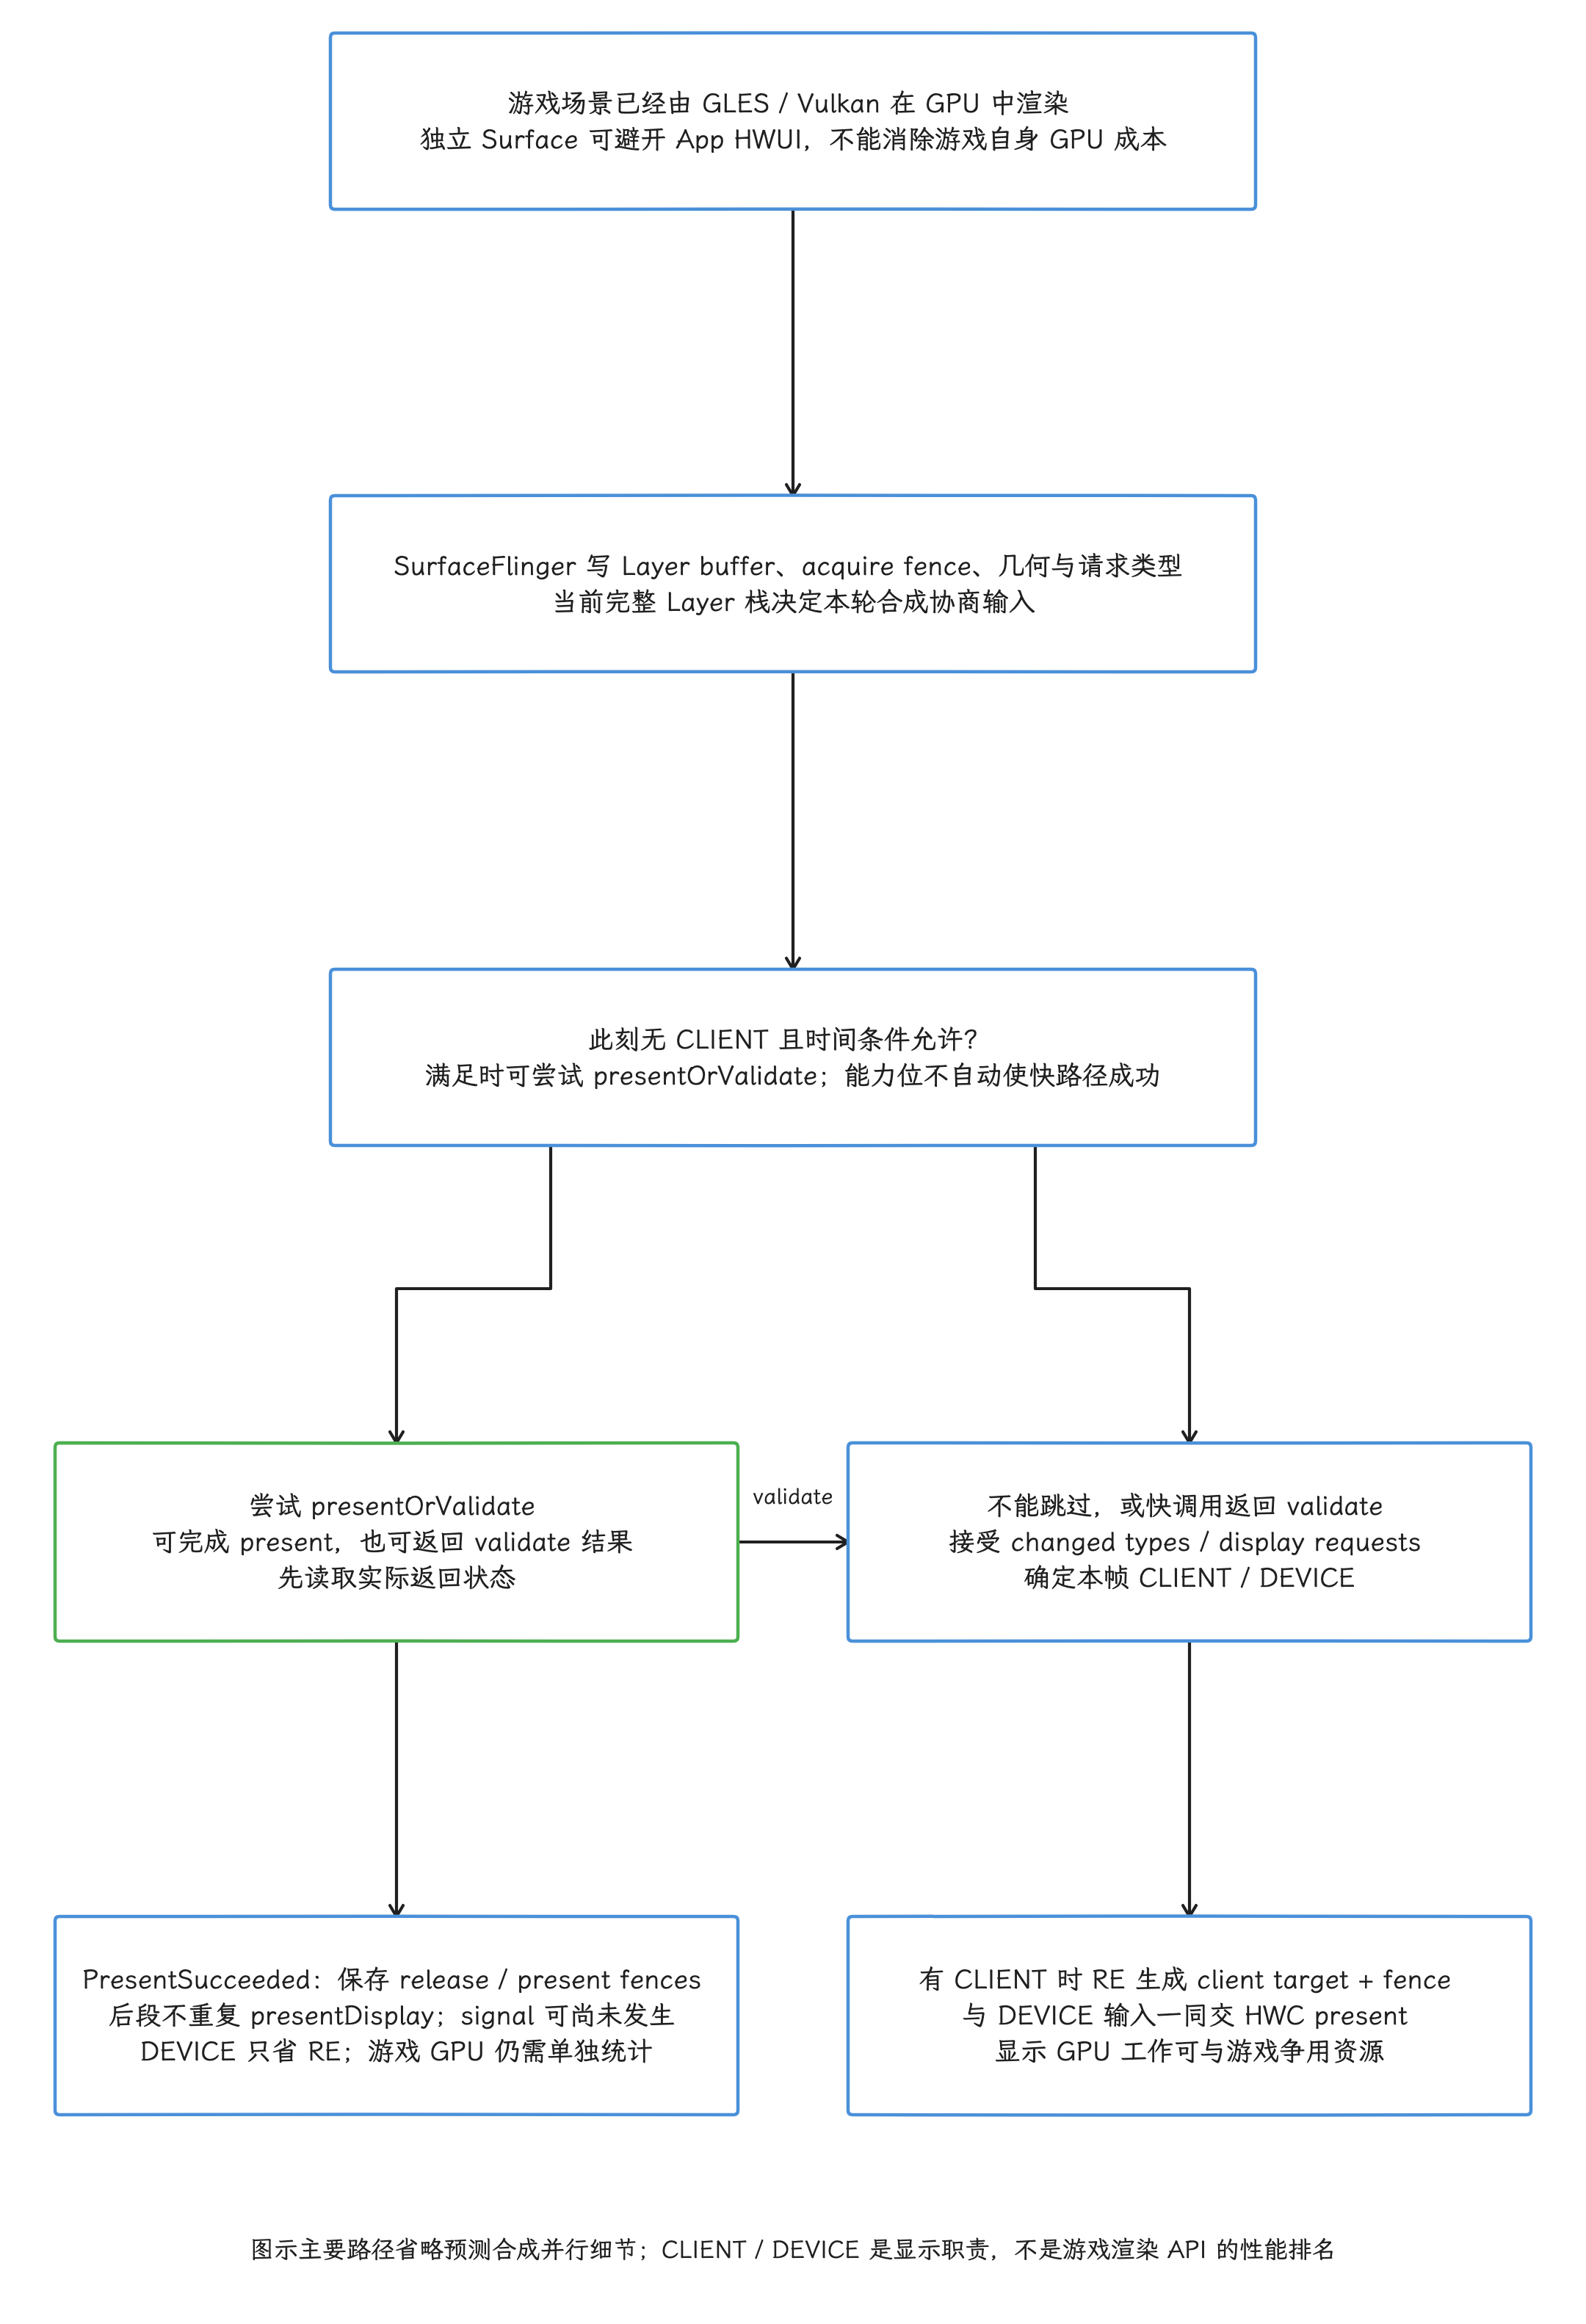
图:游戏GLES/Vulkan产生场景像素,SurfaceView可以绕过AppHWUI但仍经SF/HWC。游戏LayerDEVICE只省该Layer被RenderEngine再采样,其他CLIENT和游戏自身GPU仍存在。SF写buffer/acquire/几何/请求类型后协商;无CLIENT且时间允许才可presentOrValidate,成功保存fences后不重复present,返回validate继续changedtypes与clienttarget;常规CLIENT时RE生成target交HWC。预测合成可能并行,此为主要依赖简化,CPU返回非signal或面板发光。
函数返回时间只能说明调用结束,vblank 与 fence signal 要以 fence 对象为准。物理显示的 present fence 契约通常指画面开始出现(video mode)或开始传入面板内存(command mode)的 VSync;虚拟显示则指输出写完,面板此后的扫描与像素响应都在这份契约之外。HWC 的旧 buffer release 与 SF 合并的最终访问依赖满足后,下一次写入才安全;FREE slot 里也可能带着尚未 signal 的 release fence。
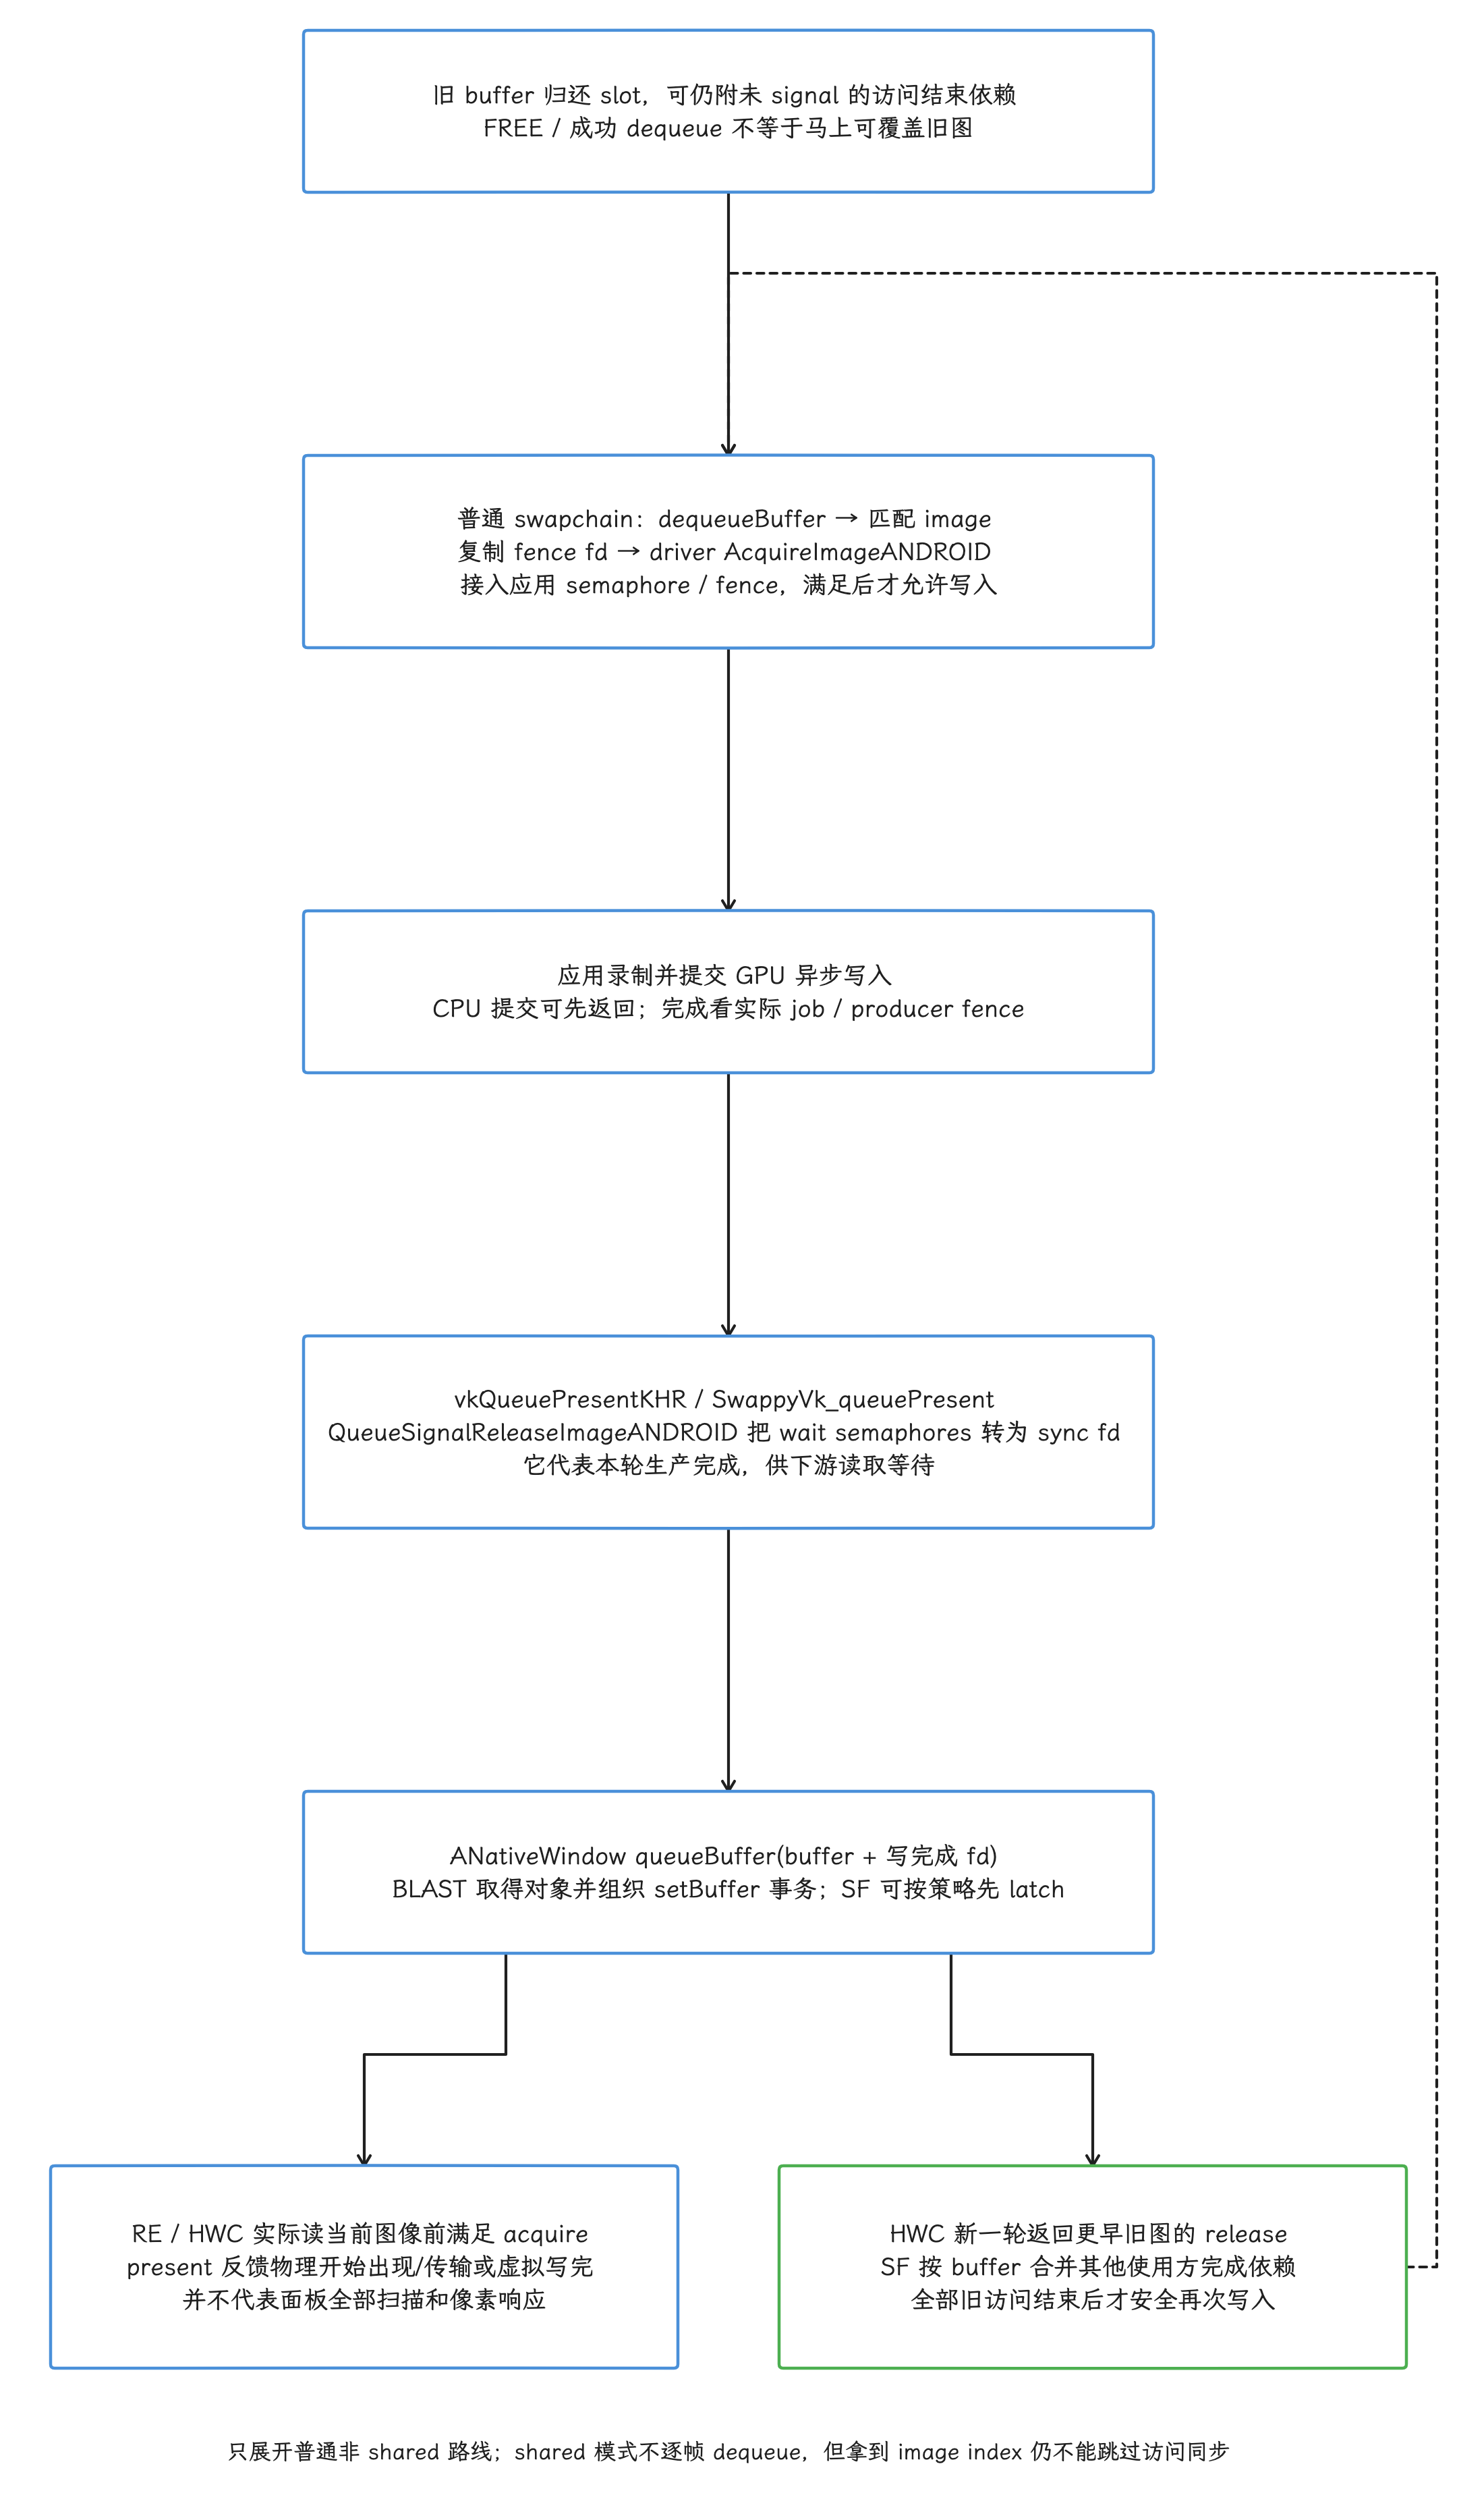
图:普通非shared swapchain dequeue取得native buffer和旧访问fence,匹配image后复制fd给driver AcquireImageANDROID,导入应用semaphore/fence,满足后才可写image。GPU异步写入后present的QueueSignalReleaseImageANDROID把wait semaphore转sync fd,与buffer queue到BLAST;这里release-image是下游acquire依赖,不是显示旧buffer release。BLAST可先acquire/SF可先latch,实际RE/HWC读前满足写完成。HWC本轮device-layer release通常对应更早的旧buffer,SF合并其他使用方依赖,FREE slot仍可未signal;display present物理开始出现/传输、虚拟输出写完,不等面板扫描响应。shared mode不每帧dequeue,仍需访问同步。
生命周期和 resize
GameActivity 的 onNativeWindowDestroyed 契约要求:回调返回前,其他渲染线程必须停止访问该 window。旋转、分屏、折叠、自由窗口或 Surface 重建时,应按引擎规范停止提交,等待必要的 GPU 使用结束,销毁或重建 EGLSurface/Vulkan swapchain,再开始使用新 window。
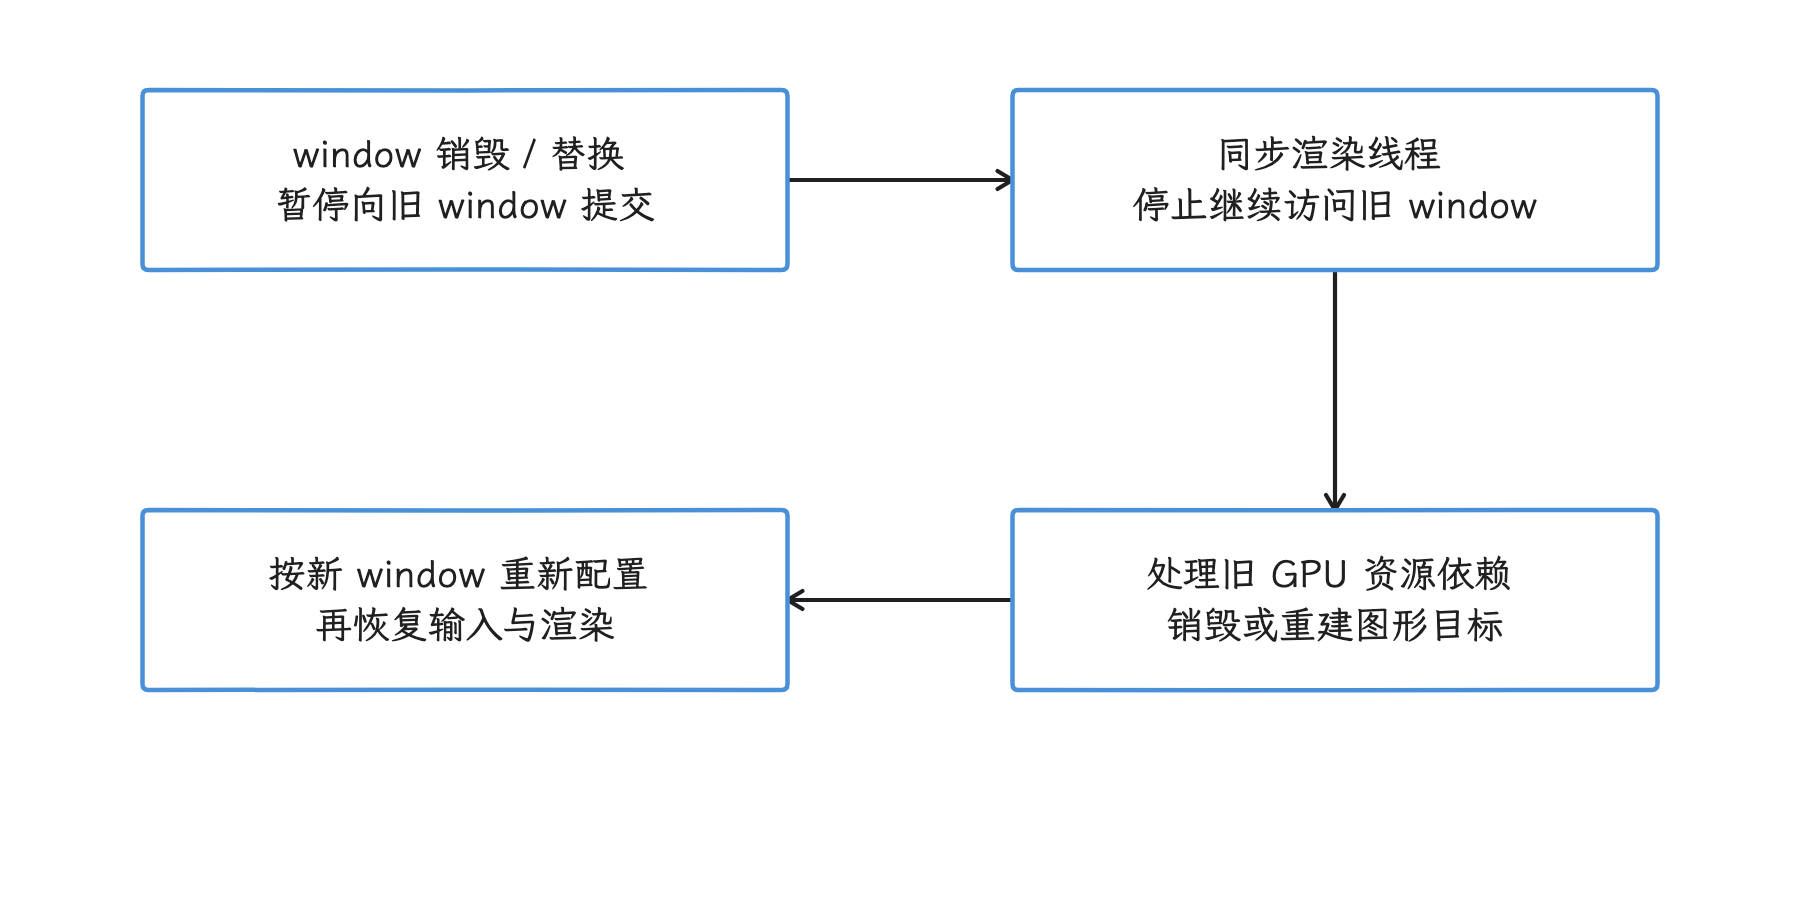
图:销毁回调返回前,其他线程必须停止访问该 window。 GPU 使用与资源释放按 API 和引擎依赖处理,错误名本身不证明全部根因。
如果旧 swapchain 继续向已经销毁的 window 提交,就可能出现 VK_ERROR_OUT_OF_DATE_KHR、VK_ERROR_SURFACE_LOST_KHR、黑帧或 native crash。排查这些现象时,我们先核查 Surface/swapchain 生命周期、返回码和旧资源依赖;黑帧或某个错误名只是入口线索,渲染、资源或驱动问题还要逐项排除。
Frame pacing:稳定间隔与低延迟要一起看
先看一个典型场景:游戏在 60 Hz 屏幕上只能产出约 40 FPS,提交节奏又未经控制。于是某些帧只显示一个刷新周期,另一些帧显示两个刷新周期,形成明显的 16.7 ms / 33.3 ms 交替;即使平均 FPS 接近目标,present-to-present(相邻两次显示提交之间)的间隔仍不均匀,玩家的顿挫感就来自这里。
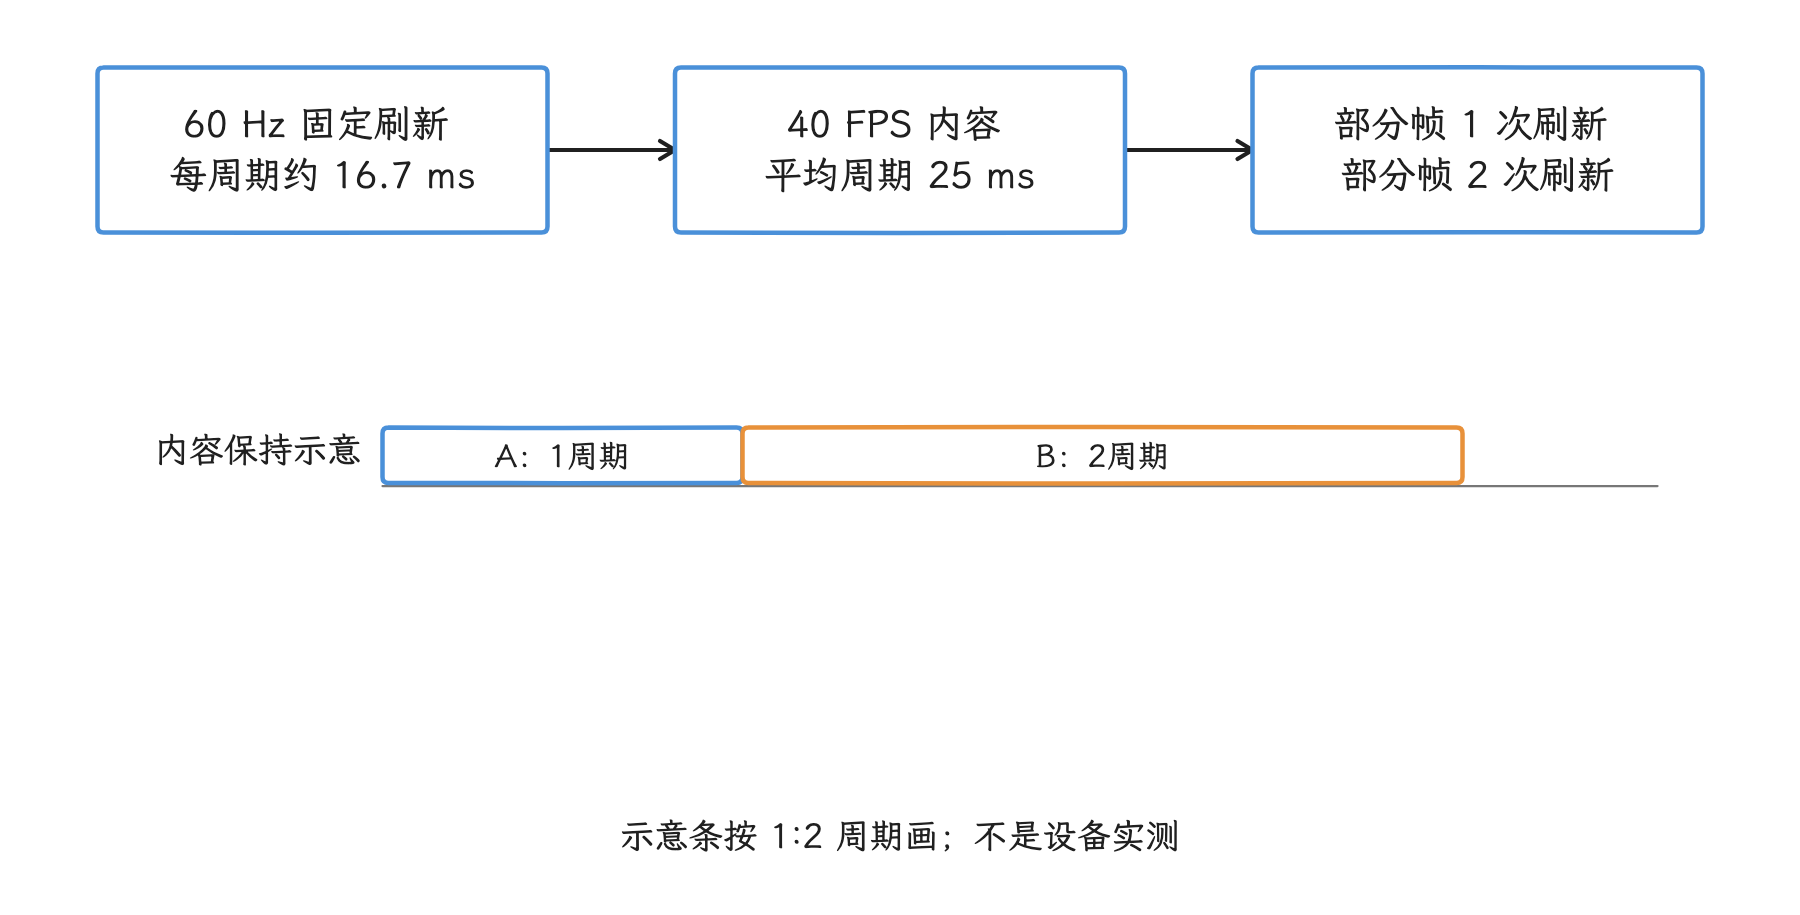
图:60 Hz 固定刷新下,40 个均匀内容帧也无法全按整数相同周期保持。 16.7/33.3 ms 是理想量化示意,真实抖动还需测 requested/actual timing。
Queue-stuffing 为什么会增加延迟
游戏持续以最快速度 present,display pipeline 里的 buffer 会逐渐占满,这种状态称为 queue-stuffing。队列没有空位之后,render thread 会在 acquire、swap 或 present 附近阻塞,看起来像系统在自动限速;而输入可能早在前面的逻辑帧中就完成了采样,玩家看到结果之前,还要先等队列里的旧帧走完,输入延迟随之增加。
swap 调用阻塞时,GPU 慢只是候选原因之一,下面这些因素同样常见:
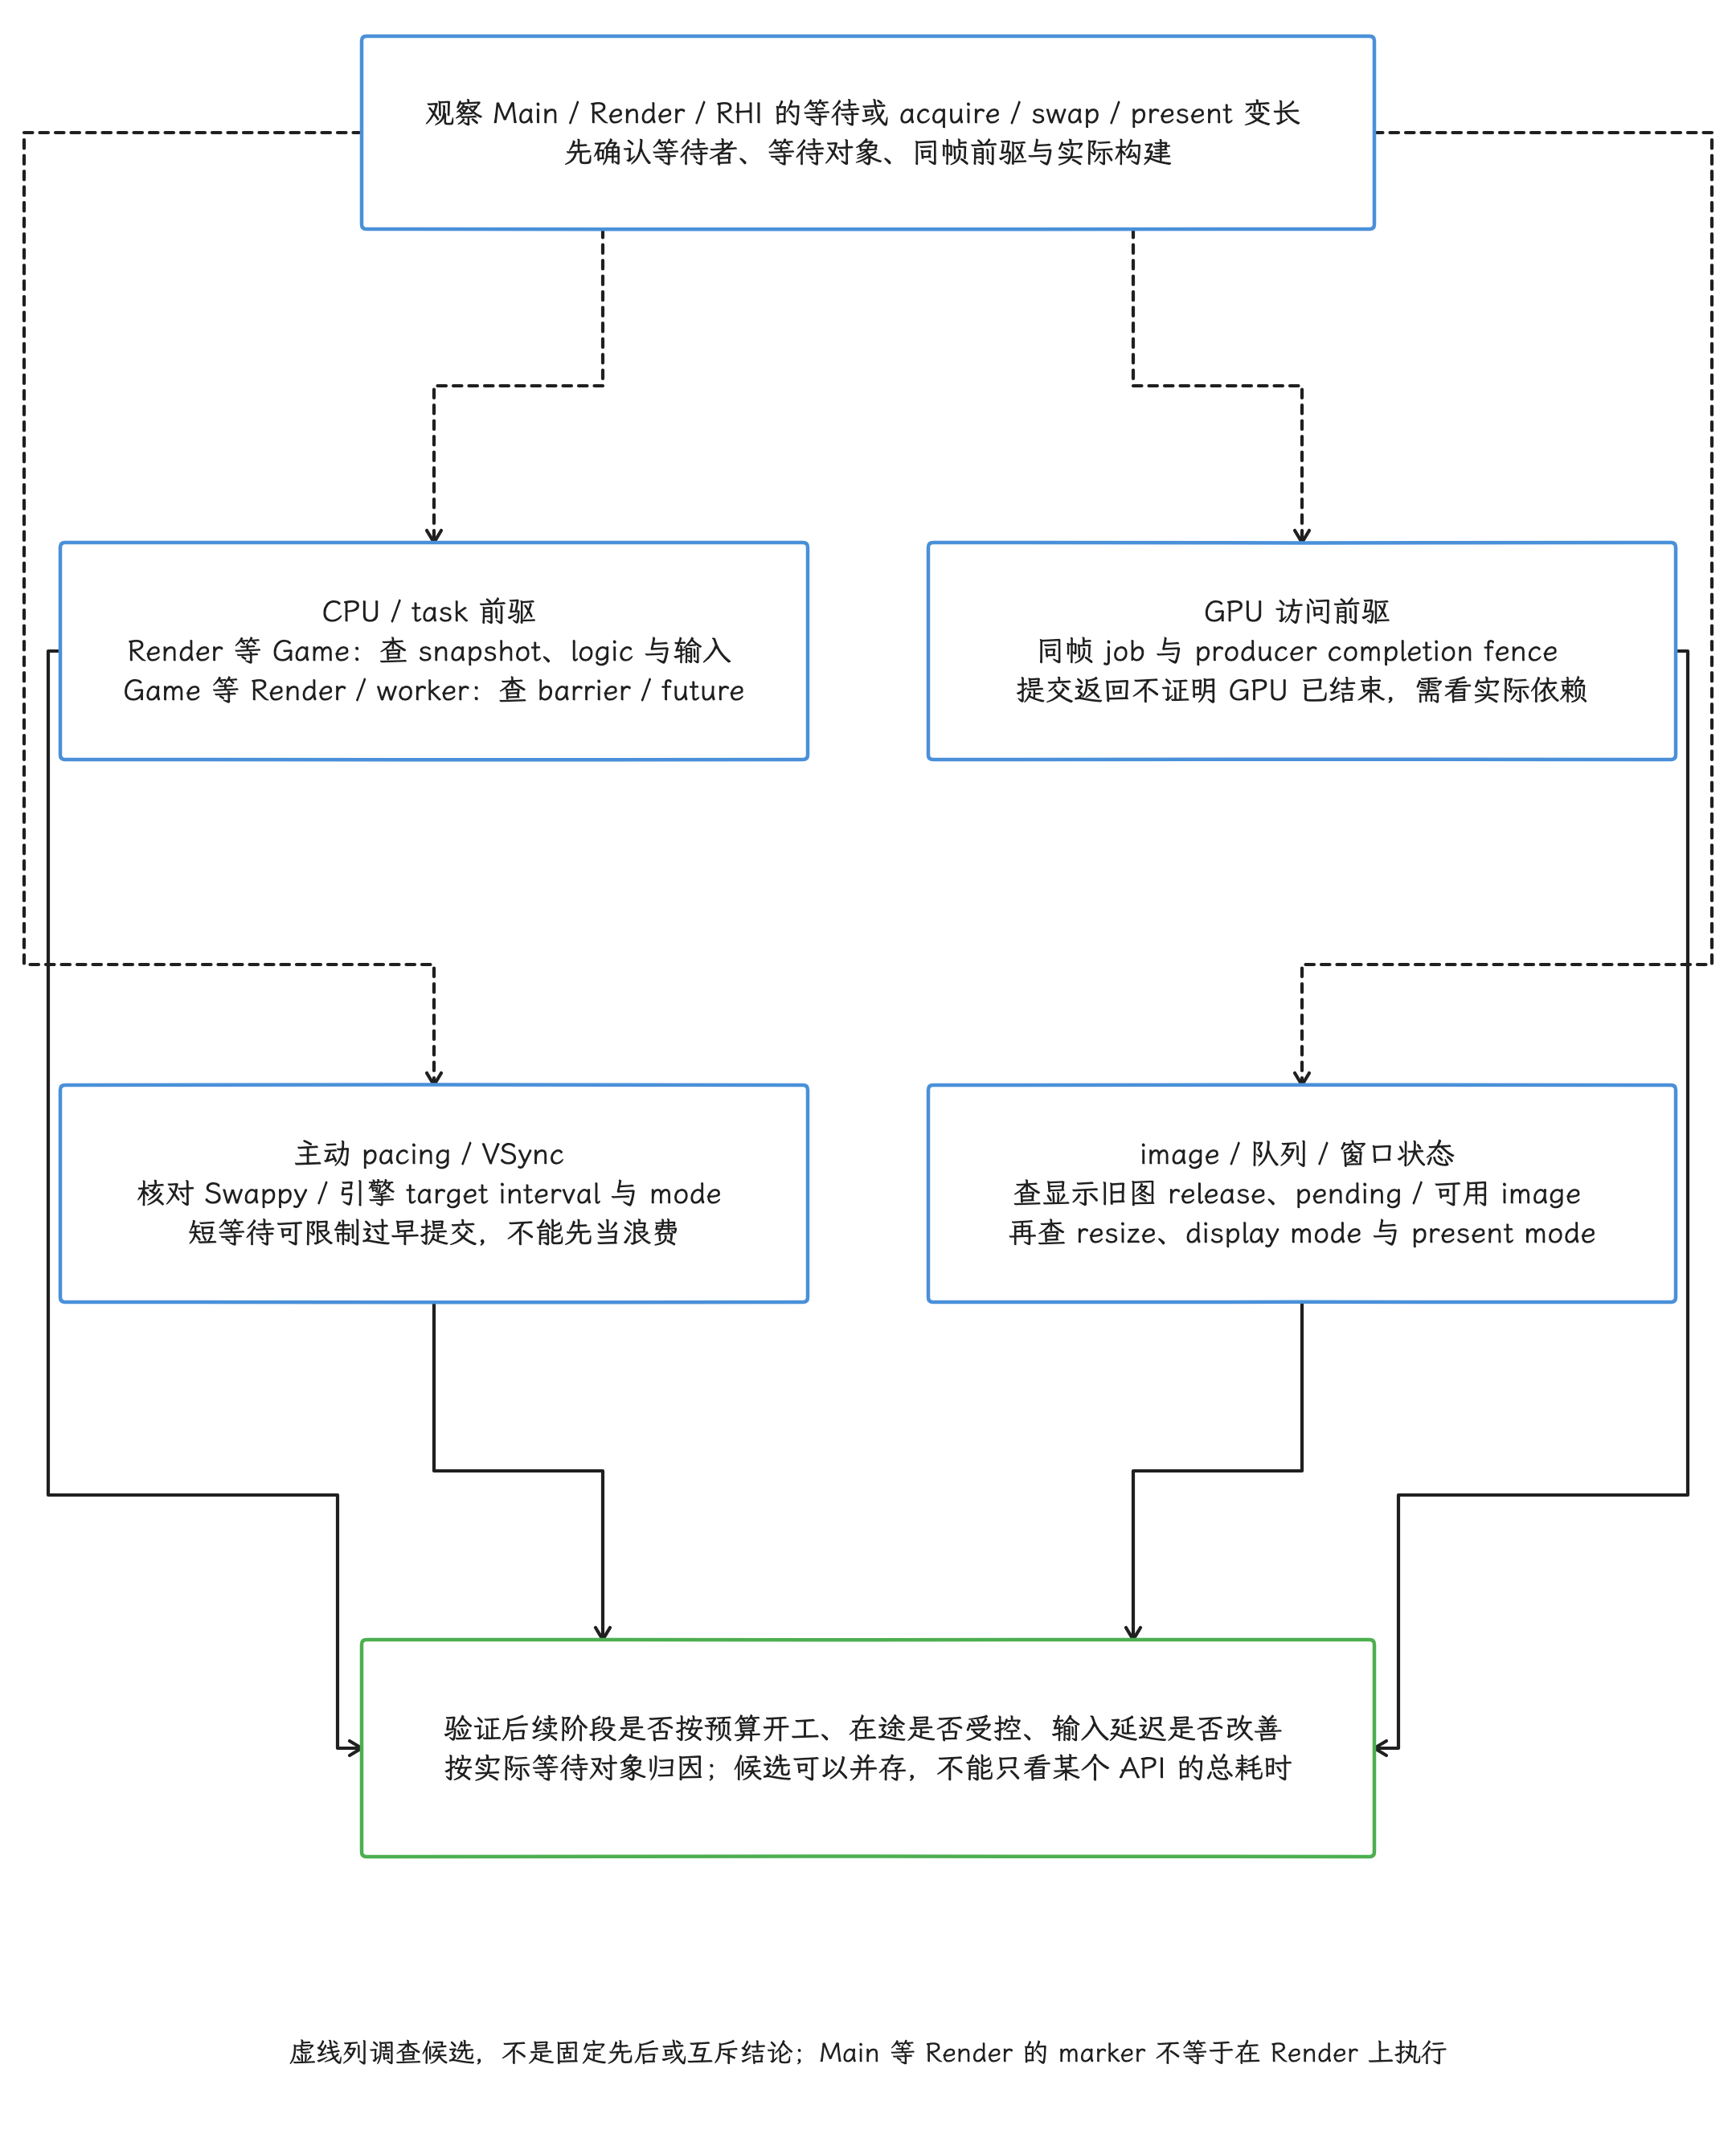
图:等待候选可并存,单个marker或swap耗时不证明GPU bound。Render等Game先查snapshot和logic,Game等Render/worker查barrier/future;GPU前驱查producer fence/job;Swappy/VSync主动等待看targetinterval和inflight;image仍被显示使用、queue满、resize/mode/present mode查release和生命周期。确认后续是否按预算开工,正常主动控制可降低输入延迟,不能盲删所有wait。
- Swappy 或引擎 pacer 主动等待目标时刻;
- swapchain image 仍被显示端使用;
- BufferQueue 已满;
- GPU producer fence 还未完成;
- resize / display mode change;
- Vulkan present mode 与 driver 行为。
Swappy 做了什么
Swappy 是 AGDK 提供的 Frame Pacing library,用于安排帧提交时机和限制队列深度:
- GLES 使用
SwappyGL_swap()包装eglSwapBuffers(); - Vulkan 使用
SwappyVk_queuePresent(),它会代为调用vkQueuePresentKHR(); - 库利用 Choreographer、presentation timestamp 和 sync fence 控制 swap interval(提交间隔)与 pipeline mode;
- GLES 侧可使用
EGL_ANDROID_presentation_time,Vulkan 侧可使用VK_GOOGLE_display_timing等能力; - 目标是避免帧过早 present 和 queue-stuffing,同时兼顾不同刷新率。
Swappy 里的 wait 可能就是主动 pacing,是库在正常工作。我们分析这段等待时,要检查目标 interval 是否正确、队列里有几帧、输入到 present 的延迟有没有缩短;如果只想着消除 wait slice,队列可能再次进入 queue-stuffing。
Pipeline 与 non-pipeline
Pipeline mode 允许 CPU 和 GPU 跨 VSync 并行,通常能稳住吞吐,代价是可能多出一轮 in-flight latency;Non-pipeline mode 适合 CPU 与 GPU 工作总量能在一个 interval 内完成的轻负载场景,可缩短输入到显示的等待。Swappy 的 auto pipeline mode 会根据工作量调整。我们评价模式选择时,要把帧间隔和输入延迟放在一起看,平均 FPS 只能作参考。
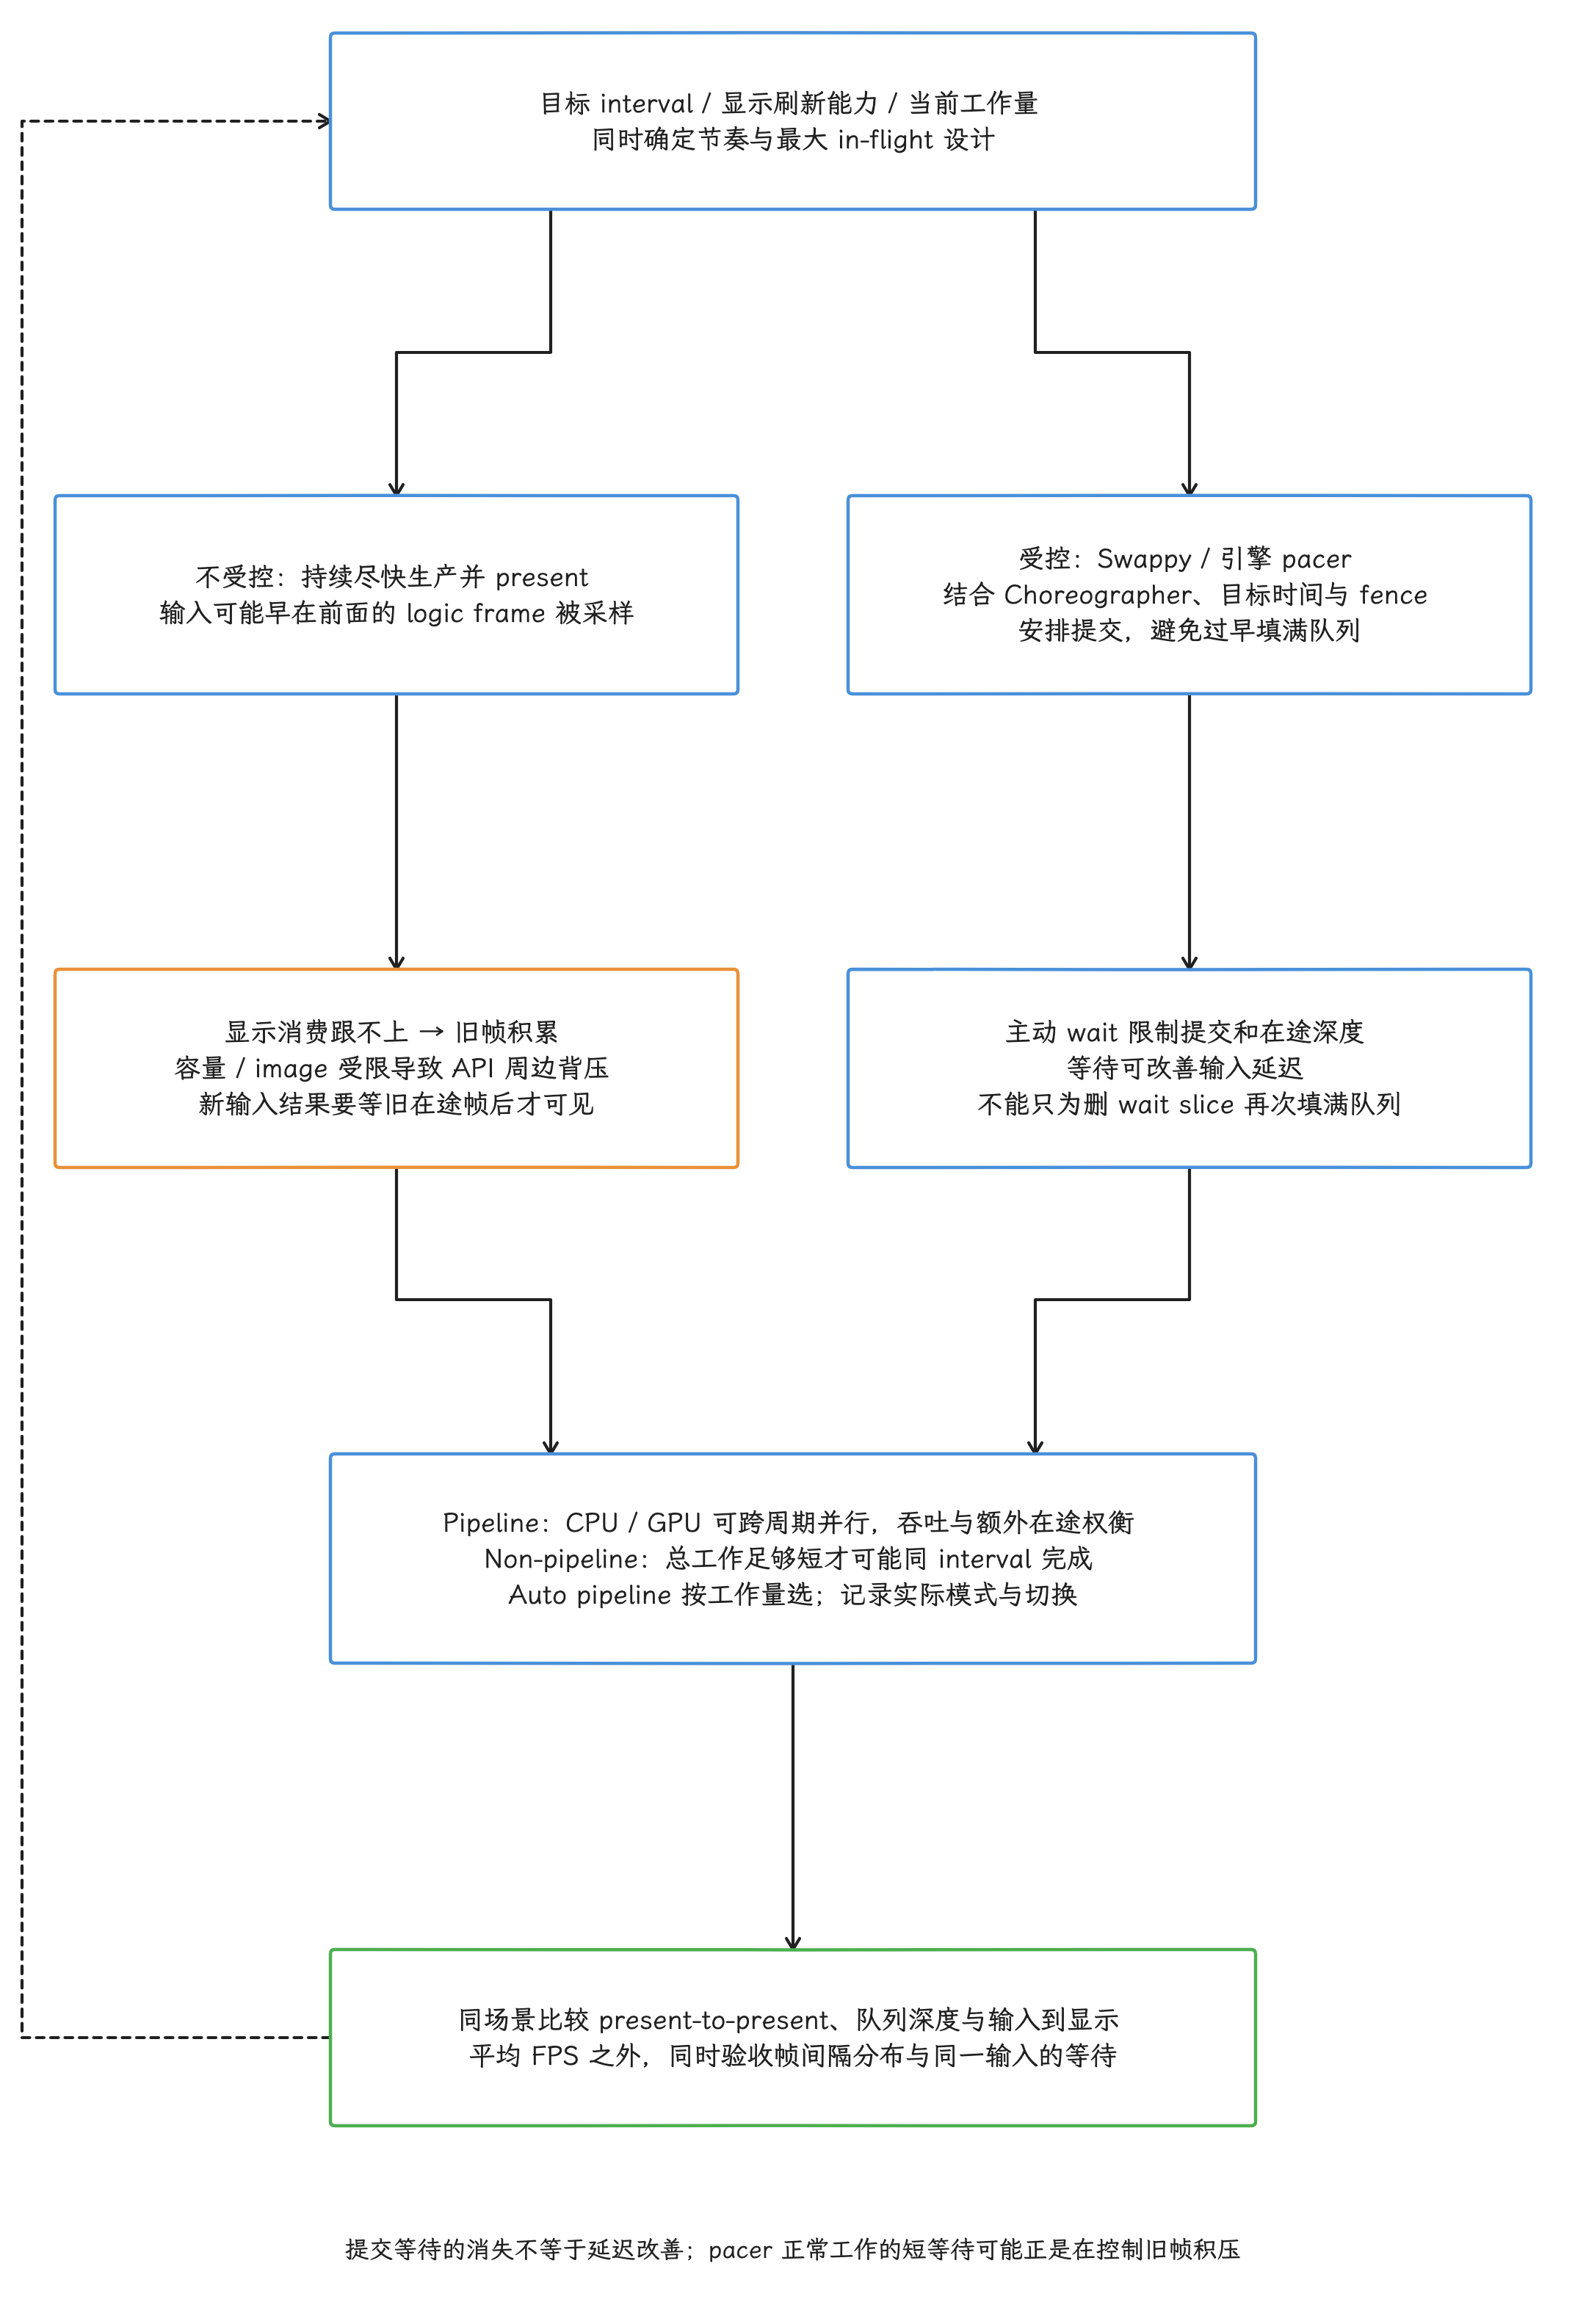
图:尽快present可积累旧帧,input早采样后等这些在途帧,容量/image受限时在acquire/swap/present附近背压。Swappy用目标interval、Choreographer、timestamp/fence反馈限制过早提交与深度,wait可正常改善延迟。pipeline允许CPU/GPU跨周期并行提高吞吐但可能多一轮在途,nonpipeline适合CPU+GPU总量可在interval内完成轻负载,auto依工作量选。实际模式、present间隔与同输入延迟一起验收,条长和固定帧差均非承诺。
Choreographer 与 Swappy 的分工
游戏可以直接用 Choreographer 对齐显示节拍,只是回调偏移会随设备变化,长帧之下也可能继续 queue-stuffing;Swappy 在 Choreographer 之外,还结合 presentation timestamp 与 fence 一起控制提交。
Perfetto 默认不保证存在名为 Swappy 的 track;想看到 preWait、postWait、preSwapBuffers 这些库内阶段,需要通过 Swappy tracer 回调写入 ATrace/TrackEvent。未加自定义埋点的系统 trace,则更适合观察 present 调用点、FrameTimeline、BufferQueue、GPU 和 SurfaceFlinger。
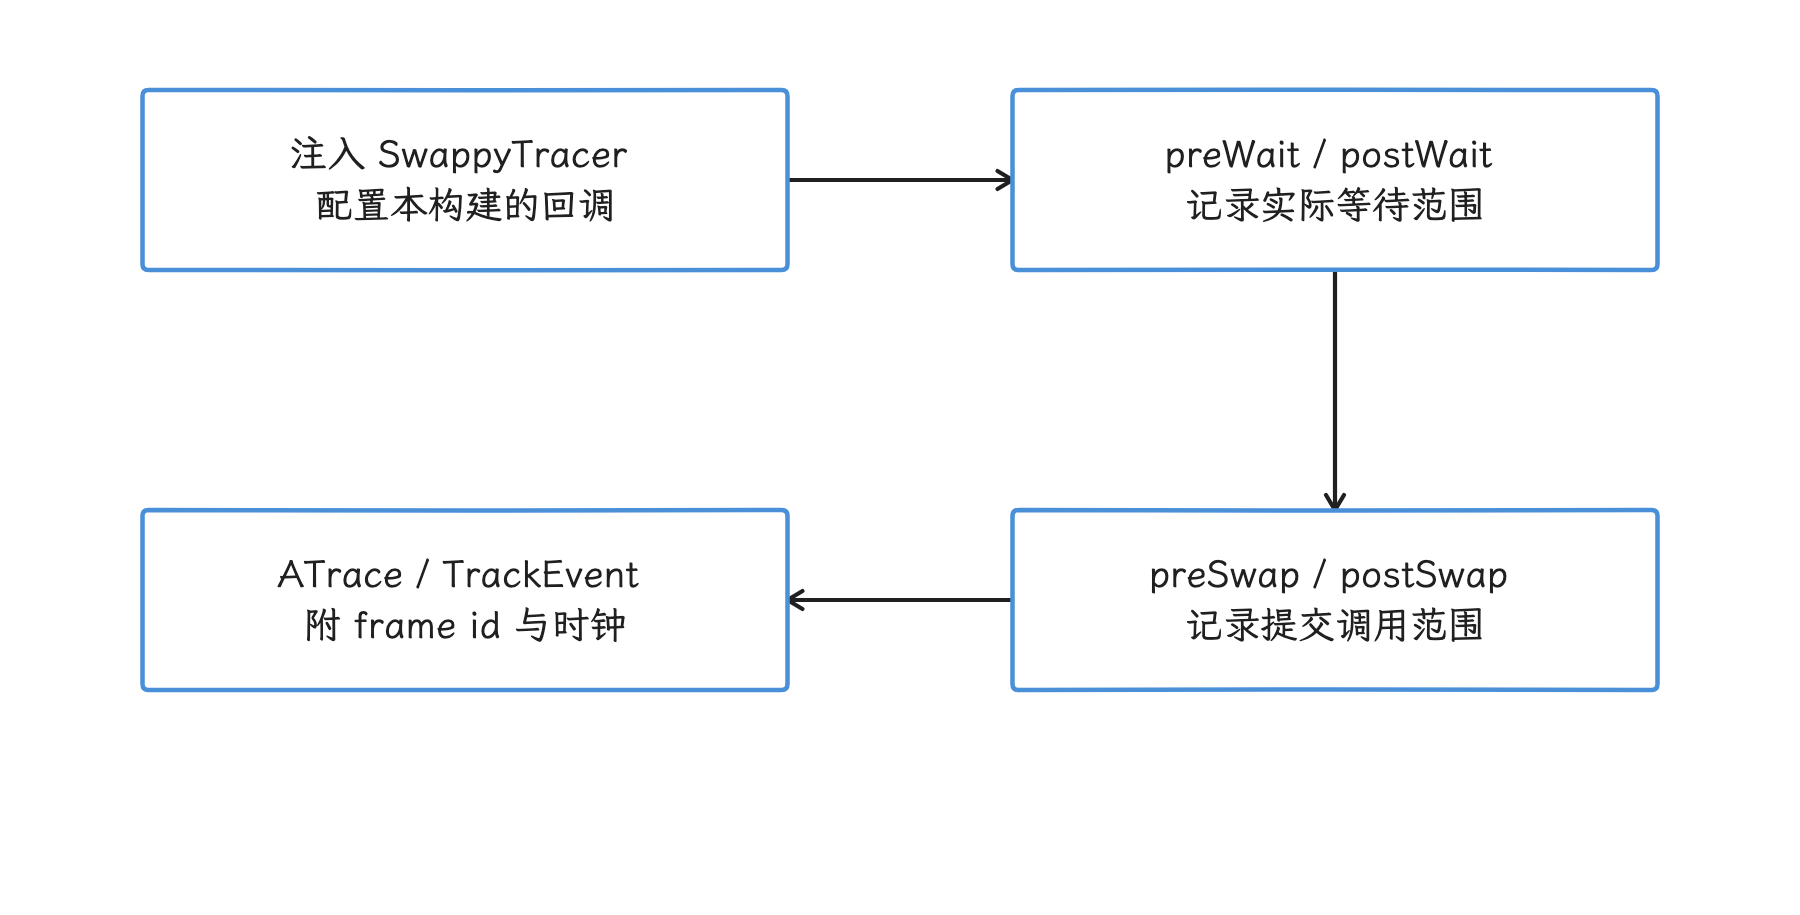
图:tracer 回调可把库内等待和提交阶段接入系统 trace。 默认 OS 轨道不能凭名称还原全部 Swappy 逻辑。
Android 17 的 present timing 与 producer throttling
前面的 swap/present 等待,大多能归到队列深度、fence 依赖和 pacer 行为上;Android 17 又在这附近补了两个更细的控制点——Vulkan 侧的 present timing 反馈,以及 Surface 侧的 producer throttling 开关。我们先看 Vulkan 扩展。
VK_EXT_present_timing
Android 17 支持 VK_EXT_present_timing,自研 Vulkan pacer 可以请求 target present time,并查询多个 present stage:queue operations end 表示相关队列操作结束,request dequeued 表示显示请求从队列取出,first pixel out / visible 则描述显示输出和可见阶段。该扩展依赖 VK_KHR_present_id2;应用还须在创建 device 和 swapchain 前枚举 extension、feature 与相关 flag。
平台侧,swapchain.cpp 已解析 VkPresentTimingsInfoEXT 和 VkPresentId2KHR,并从 native window timestamp 填充 past presentation timing。系统版本达到 Android 17 只是第一道门槛,我们仍要逐设备检查驱动和 swapchain 的能力;扩展拿不到时,可退回 VK_GOOGLE_display_timing 或 Swappy。 固定 r1 的 surface capabilities 分支在 present_timing_ext flag 下声明的是绝对时间能力,相对时间未在其列;写时间参数前,我们先查询本 Surface 的 timing capabilities,再参考文档示例。该实现把 queue-operations-end 映射为 render-complete、request-dequeued 映射为 composition-latch,两个 first-pixel stage 都取同一个 actual-present 时间;无有效时间时可返回 0。四个 stage 名称在这里对应的是时间来源映射,与两路独立光学传感器的读数是两回事。
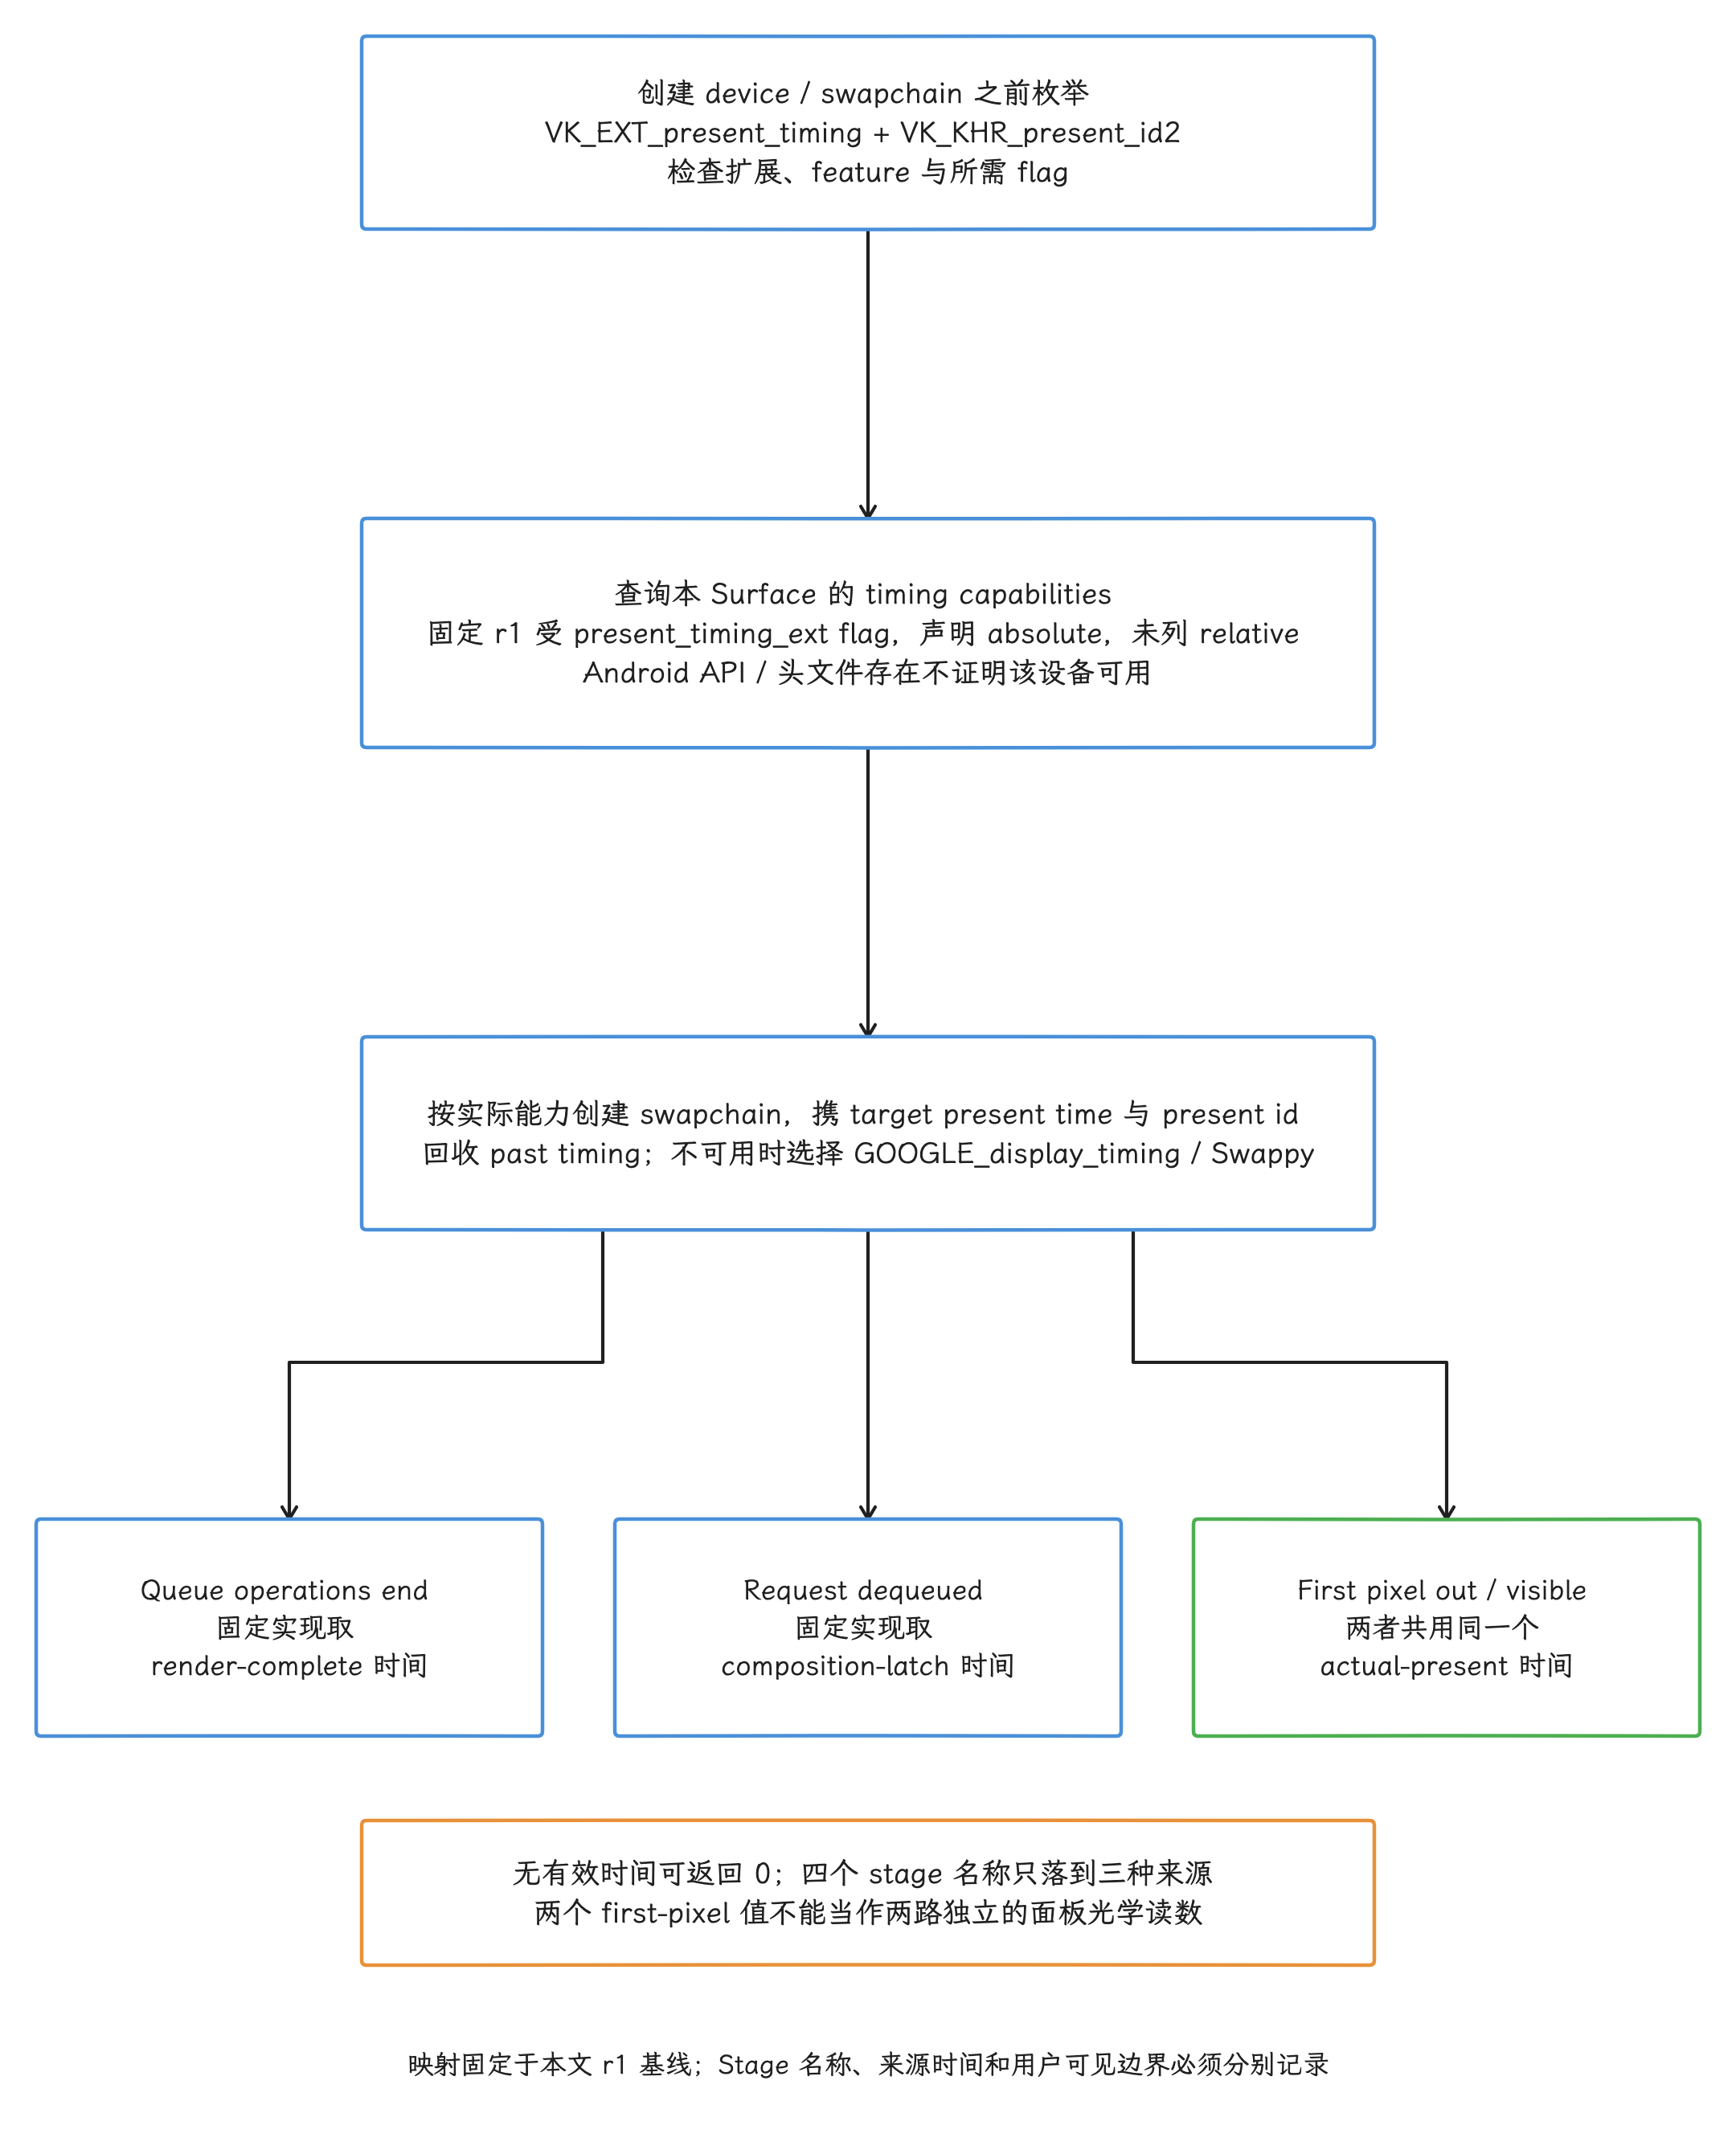
图:VK_EXT_present_timing依赖present_id2,创建device/swapchain前枚举扩展feature并查询Surface timing能力和flags;固定r1受present_timing_ext flag,surface声明absolute不列relative。应用请求target/presentid并取pasttiming,不支持可退GOOGLE_display_timing/Swappy。固定映射queue operations end→render complete、request dequeued→composition latch、firstpixelout与visible共用actualpresent,无有效值可0,不等独立光学测量。
Surface.setProducerThrottlingEnabled()
API 37 新增的 Surface.setProducerThrottlingEnabled(boolean) 默认开启:Vulkan/EGL producer 正在 queue 新 buffer、consumer 还在处理上一帧时,系统会对 producer 施加 CPU back-pressure(隐式 queue 侧等待),阻塞可能出现在 eglSwapBuffers() 或 Vulkan present 附近。这个 API 对 asynchronous mode 无效,该模式下 throttling 总是开启。 这项控制与队列容量等待、GPU 显式同步是不同层次;源码还有平台 flag 边界。
平台的 API 文档建议 Vulkan 应用关闭这类隐式 throttling,改用正确的显式同步。关闭之后,如果生产速度超过 GPU 或显示消费速度,等待通常会转移到 vkAcquireNextImageKHR() / dequeue 一侧。接入现成引擎时,我们先确认引擎版本已适配该 API,并具备完整的 semaphore、fence、in-flight frame 上限和 frame pacer 设计,避免绕过引擎直接修改 Surface。
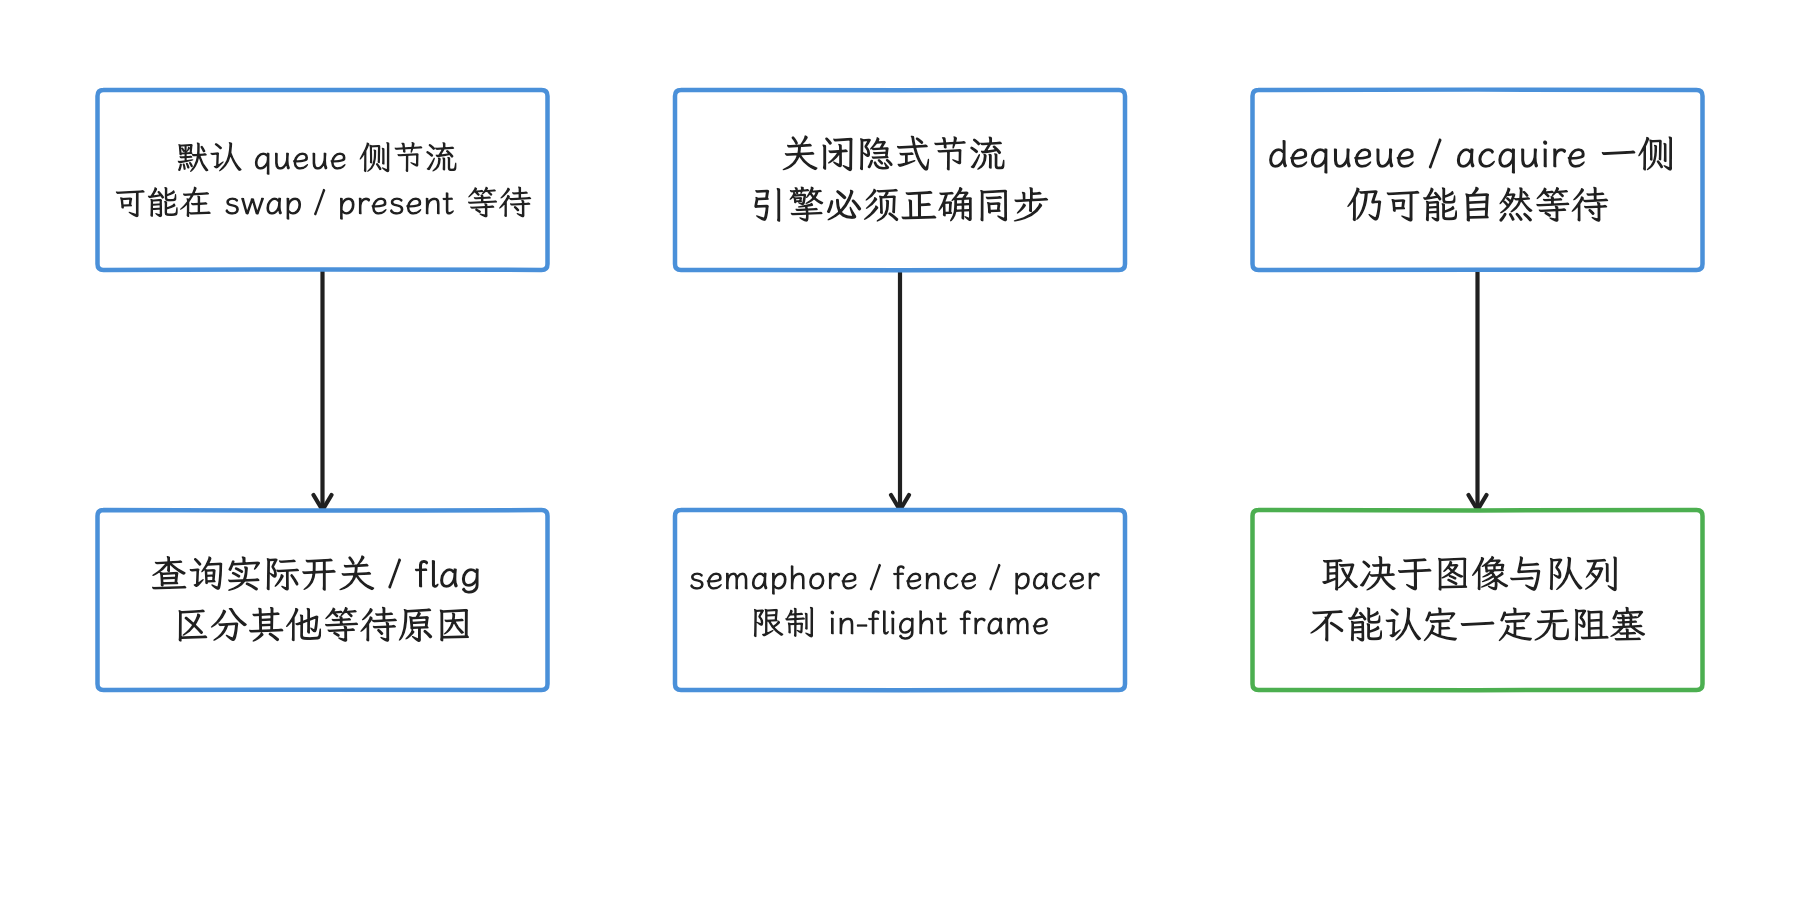
图:关闭隐式 queue throttling 后仍要控制资源和在途帧。 异步模式设置无效;关闭不会消除容量、fence 或设备约束。
BufferQueue 计数、分辨率切换与显存预算
android-17.0.0_r1 的 BufferQueueCore 构造函数把 mMaxAcquiredBufferCount 和 mMaxDequeuedBufferCount 都初始化为 1,再用 getMaxBufferCountLocked() 按 acquired + dequeued + async / non-blocking 额外项计算当前队列上限,结果受 mMaxBufferCount 限制;构造函数据此把起始 free slot 放入 mFreeSlots。这组默认值描述的是新建 BufferQueue 的锁内约束,平台并没有给过“所有游戏 swapchain 最终固定两张图像”的 API 保证。[来源: DeepResearch/2026-07-17-game-engine-resolution-memory-allocation.md; 已验证: android-17.0.0_r1 frameworks/native/libs/gui/BufferQueueCore.cpp:120-149, 238-266]
Surface::setBufferCount(N) 在 N>0 时先查询 NATIVE_WINDOW_MIN_UNDEQUEUED_BUFFERS,再把参数转换成 setMaxDequeuedBufferCount(N - minUndequeued);N=0 是把 max-dequeued 恢复为 1 的分支。BufferQueueProducer::setMaxDequeuedBufferCount() 会检查当前已 dequeued 的 buffer 数、最小 slot 数和总上限,不满足就返回 BAD_VALUE。所以在 resize、折叠/分屏切换或 Surface 重建期间,如果旧 image 仍被 producer / GPU / HWC 使用,直接反复改队列深度,可能只是在制造新的拒绝路径和额外重建工作。[来源: DeepResearch/2026-07-17-game-engine-resolution-memory-allocation.md; 已验证: android-17.0.0_r1 frameworks/native/libs/gui/Surface.cpp:2601-2624, frameworks/native/libs/gui/BufferQueueProducer.cpp:183-271]
分辨率调整先区分内部 render scale 与输出 Surface/swapchain 尺寸。只改变离屏渲染区域时,native window 与 swapchain image count 都可以维持原状;Unity 6.0 的公开动态分辨率实现甚至继续保留完整尺寸 render target、只使用其中一部分,降低 render scale 也就未必伴随显存释放。实际呈现尺寸或 image count 需要改变时,再交给引擎处理旧资源依赖,按 WSI/EGL 协议调整或按需重建目标。来源:Unity 动态分辨率、Android Vulkan WSI。
以 1080p RGBA8 为例,单张 color buffer 的裸像素是 1920×1080×4 = 8,294,400 bytes(约 7.91 MiB);真实分配还含 gralloc 对齐、metadata、depth/MSAA attachment 和实现开销,并需按真实 allocation 去重。要不要减少一张 image,须同时用 allocator 统计、queue/事务、fence 和显示节奏验证,不能只按像素尺寸推断内存收益。来源:Surface 数量协商、WSI image count。
slot 上限与实际 image 数量
BufferQueueDefs::NUM_BUFFER_SLOTS 的默认值 64 与初始 mMaxBufferCount 描述的是默认 slot 配置,已分配 image 数要另行确认。固定 r1 另有 Consumer 在连接前启用 allowUnlimitedSlots()、Producer 再执行 extendSlotCount() 的受控扩展路径,64 在这里只是默认配置,离所有队列的绝对上限还有距离。普通游戏还必须遵守自己的 WSI capabilities;实际在途数量与可 dequeue 数、consumer 保留数、present mode、引擎 frame 上限和设备实现有关。
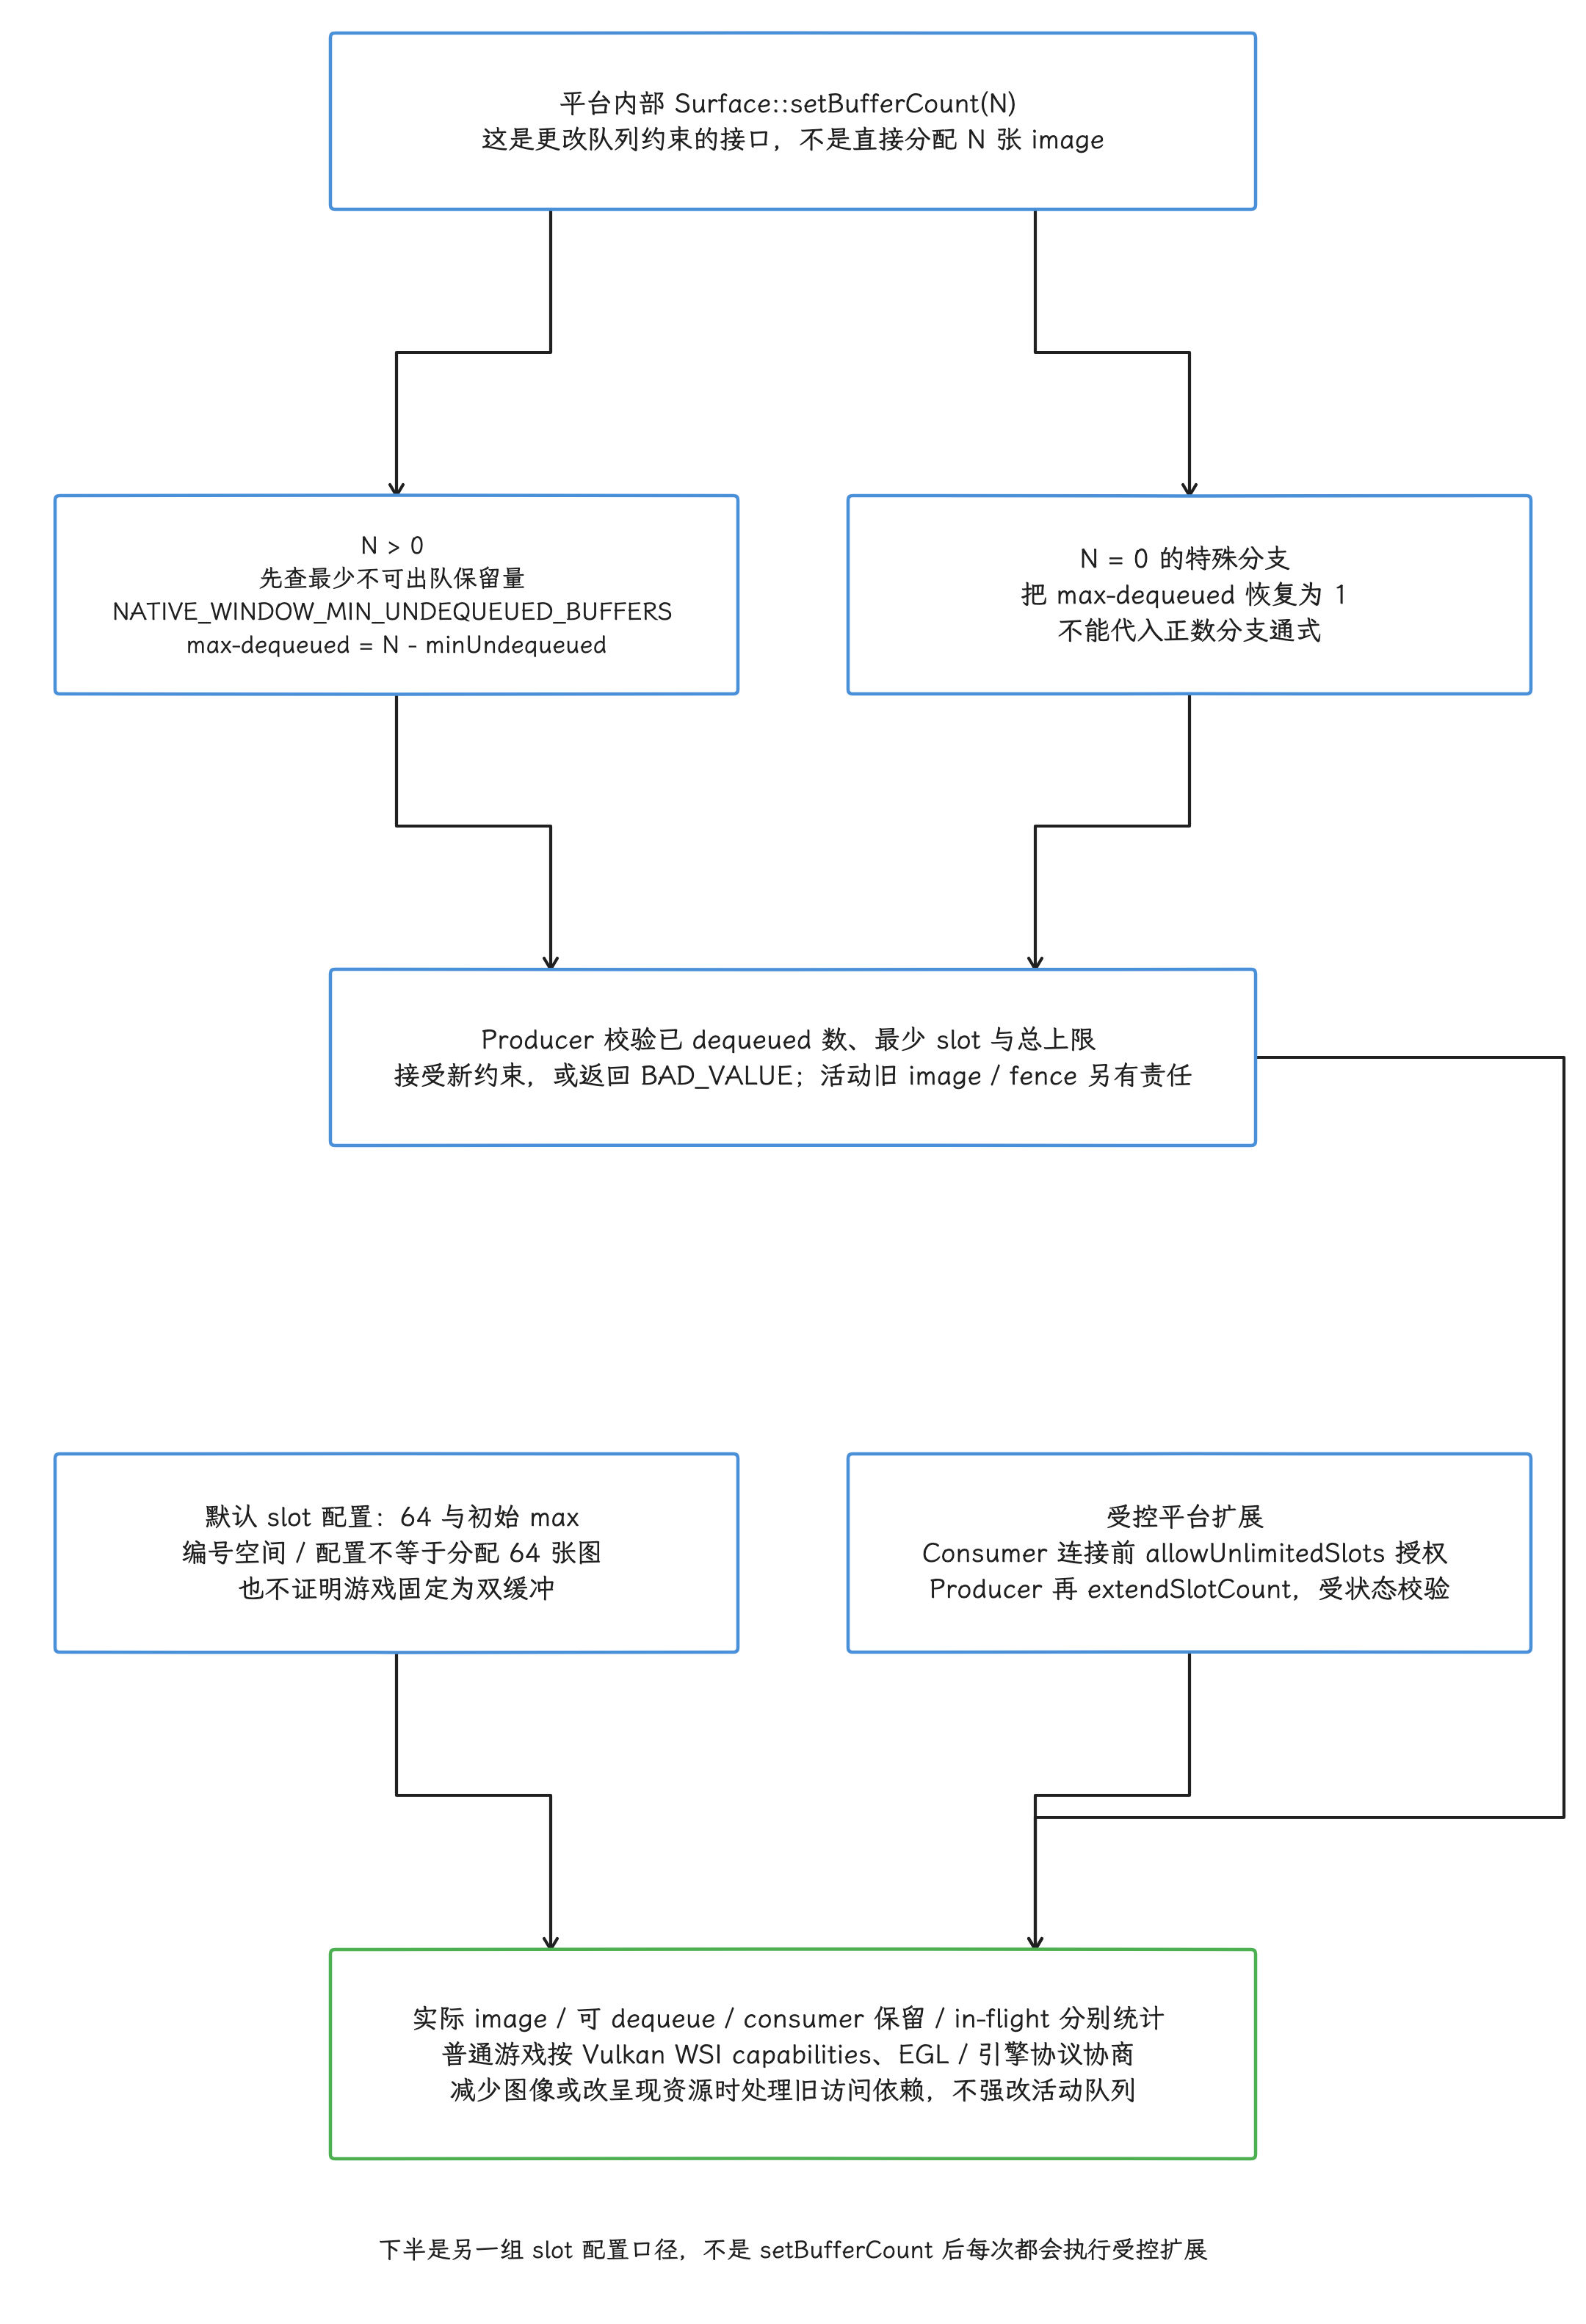
图:内部Surface::setBufferCount N>0查询minundequeued,转N-min;N0恢复maxdequeued1不是通式。Producer校验当前已dequeued、最小slots与总上限,可能BADVALUE,不是直接分配N张。默认slot64/初始max是配置非所有队列硬上限或实际图数;Consumer连接前allowUnlimitedSlots授权,Producer extendSlotCount受控扩展。普通游戏仍按VkSurfaceCapabilities/EGL/引擎协商imagecount,resize/减少image需处理旧访问依赖,不直接用隐藏setter改活动队列。
普通应用要调整 image 数量,同样应交给协议和引擎:Vulkan 按 VkSurfaceCapabilitiesKHR 协商 swapchain image count,GLES 遵循 EGL/ANativeWindow 协议与引擎管理;绕开协议直接用隐藏的 Surface::setBufferCount() 强改活动队列,得到的多半是上一段说的拒绝路径。低内存、resize 或模式切换需要减少 image count 时,走引擎的 swapchain 重建流程,并确认旧 image 和 fence 已经退出使用。
几组系统调优机制各管什么
Swappy、Frame Rate、ADPF、Game Mode 和 Game State 这几个名字经常一起出现,容易看起来像一套东西;我们先把它们各自表达的信息和控制范围分开,再逐个展开:
| 机制 | 表达的内容 | 不负责什么 |
|---|---|---|
| Swappy / engine pacer | 每帧何时提交、swap interval、in-flight 深度 | 不保证 CPU/GPU 资源,也不决定用户画质偏好 |
| Frame Rate API | Surface 希望显示系统采用什么刷新节奏 | 不是强制刷新率,也不安排每一帧的 CPU/GPU 工作 |
| Performance Hint Session | 一组周期性线程的 target / actual work duration(目标与实际工作时长) | 不能锁核、锁频或绕过 thermal |
| Game Mode | 用户选择 PERFORMANCE / BATTERY / STANDARD 等目标 | 不规定各 OEM 必须使用同一套 intervention |
| Game State | 当前是否 loading、是否 gameplay 及业务标签 | 不等同于 Game Mode |
ADPF Performance Hint Session
PerformanceHintManager 从 API 31 开始提供 Hint Session,思路是用周期性的工作时长反馈,帮助系统安排 CPU 资源。使用时要满足以下契约:
- session 关联同一进程中一组长期存在、工作相关的线程;
- 创建时给出正数 target duration;
- 每个周期调用
reportActualWorkDuration(),报告这组线程完成上一轮工作的实际时长; - 目标 FPS 或工作预算改变时调用
updateTargetWorkDuration(); - API 34 可用
setThreads()替换线程集合; - API 35 可用
WorkDuration报告 CPU/GPU 分量,并可用setPreferPowerEfficiency()表示这些线程可偏向能效调度; - session 不受支持时,
createHintSession()可以返回null。
这类 hint 影响的是系统的线程放置和 CPU 频率决策,至于是否用到大核、固定频率或某个 GPU 档位,决定权在系统和 thermal 策略。target、线程集合或 actual duration 要认真填:填错了,系统收到的负载反馈就会失真。 Session 的 Java 方法会修改内部状态,调用方应负责线程安全;WorkDuration 的 start 与 total 必须大于 0,CPU/GPU 分量各自非负且要避免同时为 0,时间域按 uptimeNanos() 契约。两个分量允许重叠,total wall time 与二者之和是两个口径。
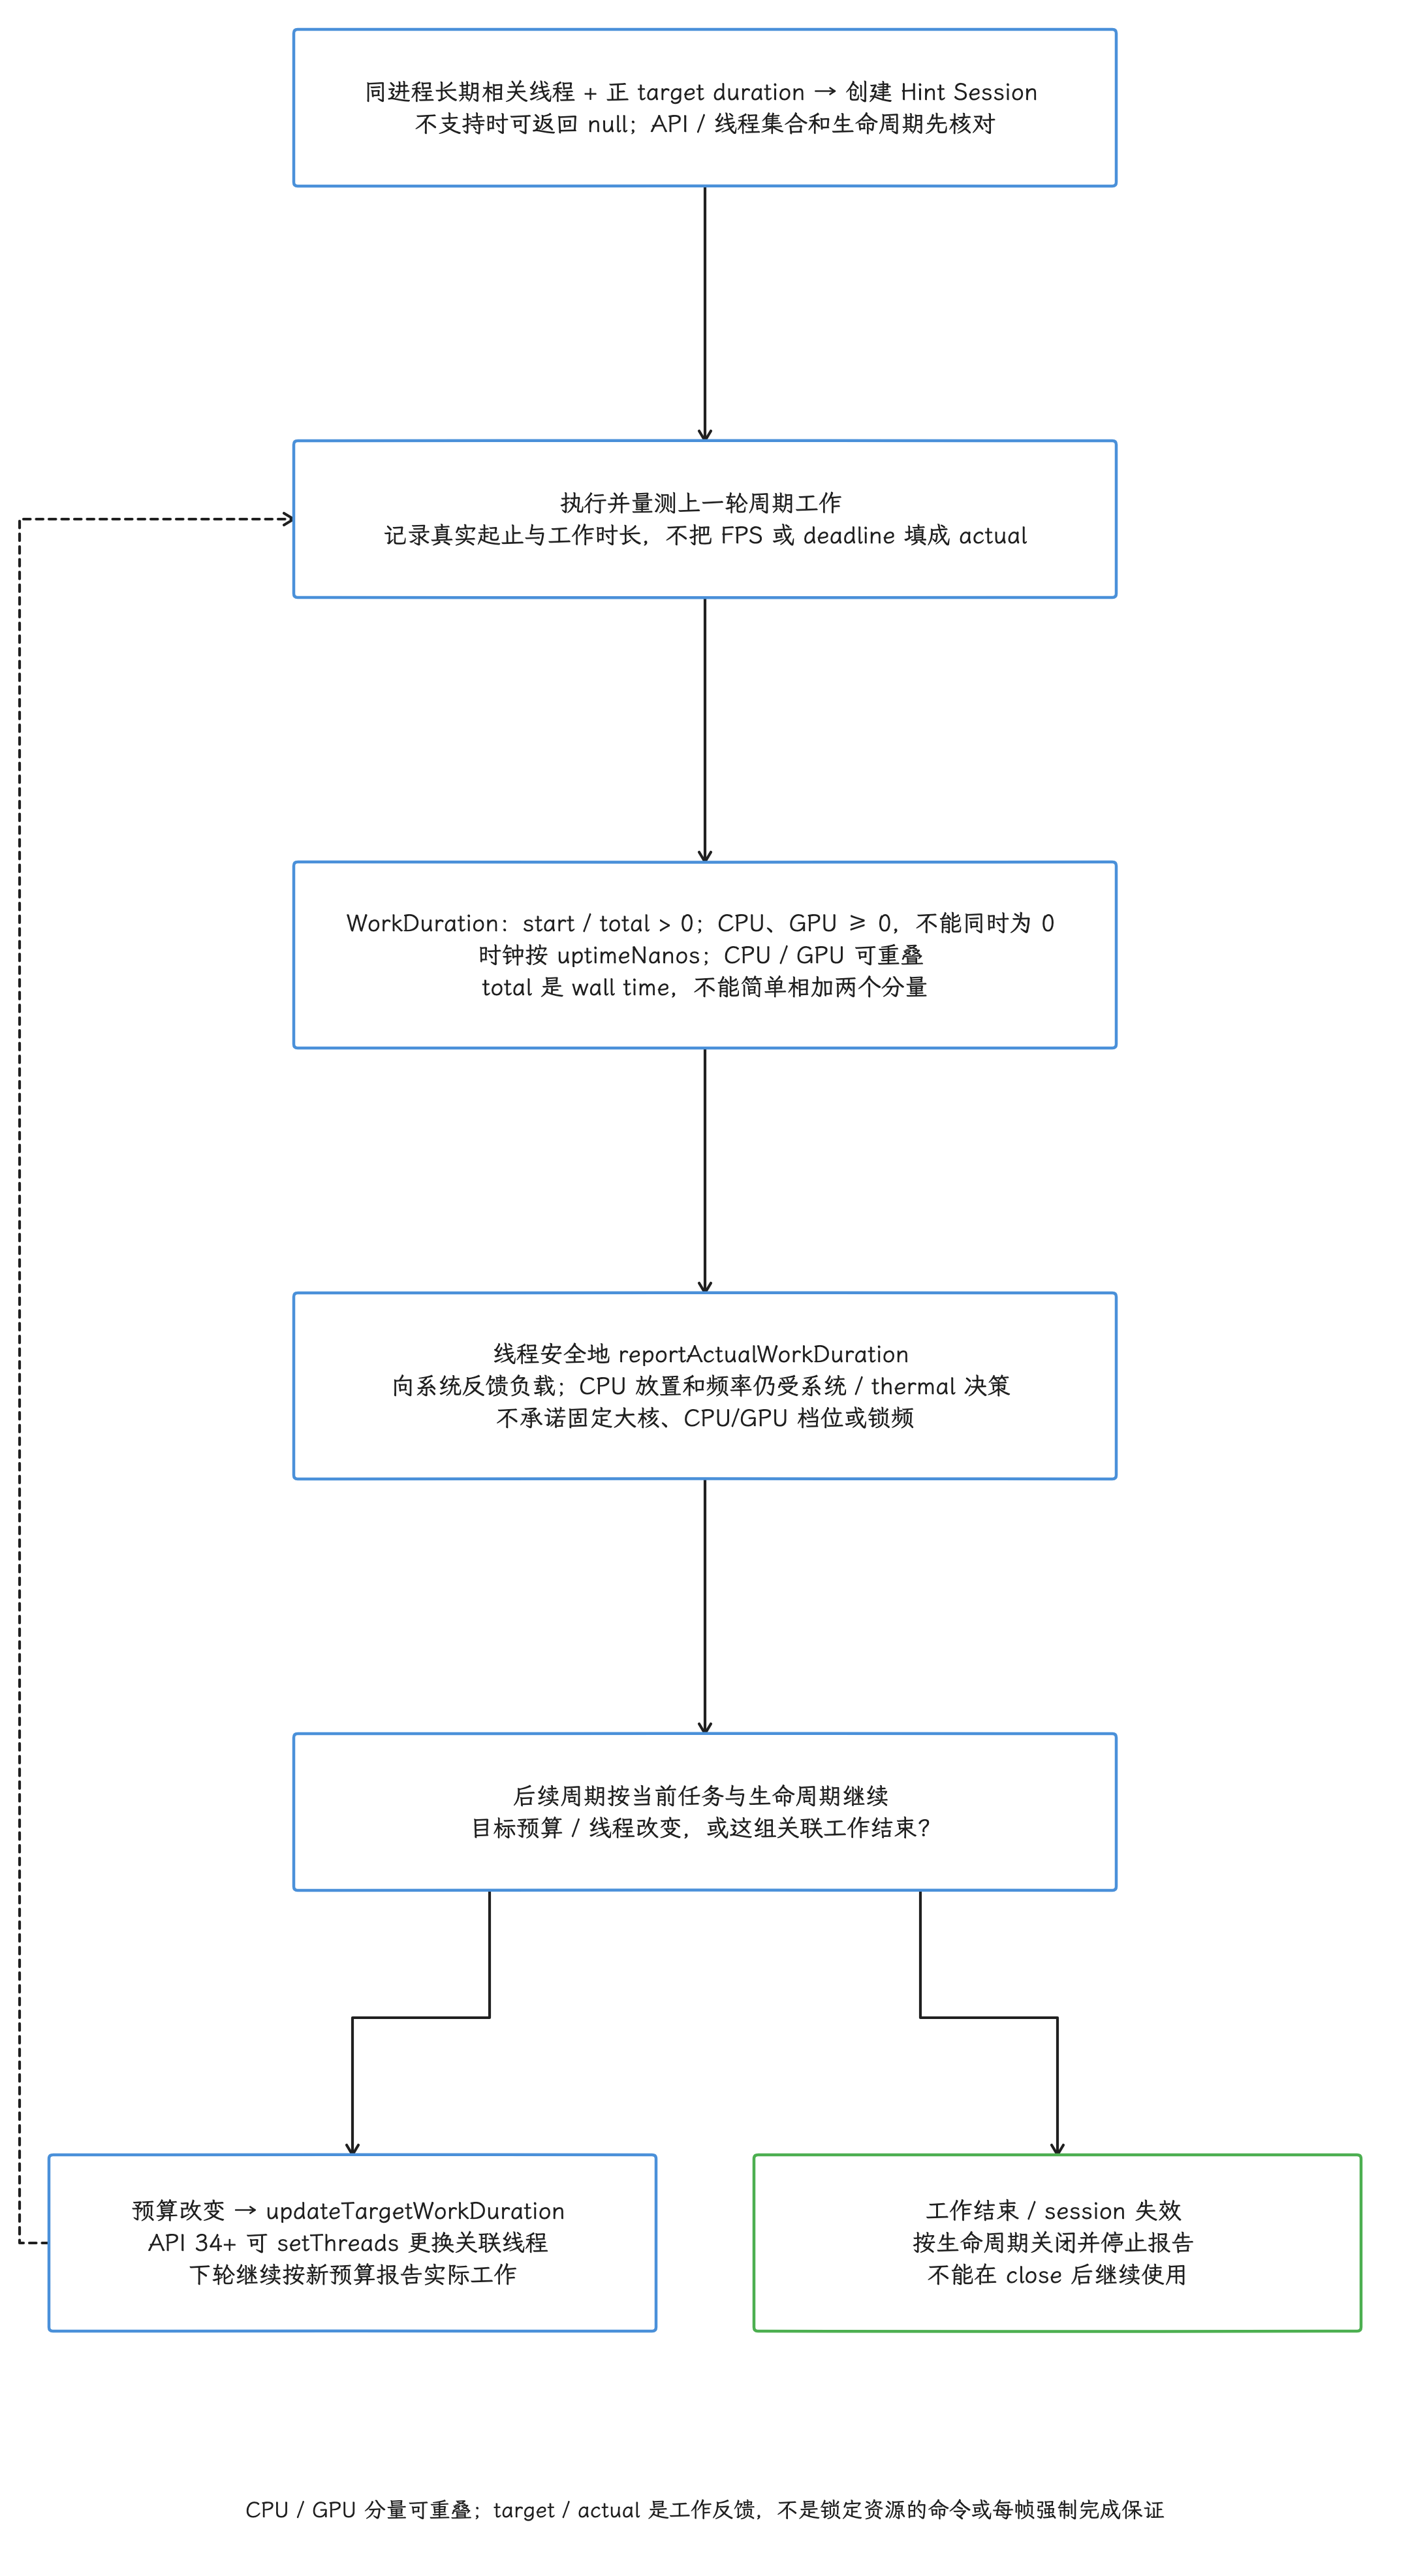
图:API31 HintSession关联同进程长期相关线程与正target,create可null;每周期actual报告上一轮工作,target变化update、API34setThreads,API35WorkDuration含CPU/GPU分量。start/total>0,CPU/GPU各>=0且不能同时0,按uptimeNanos;分量可重叠,total walltime不等二者和。Java session有内部状态,调用方自保线程安全,close后不继续使用。hint帮助CPU放置/频率,系统与thermal仍决定资源,不能锁核锁频。
持续性能还要结合 Thermal API。画质调节应分别评估 render scale、阴影、后处理、粒子、LOD 和目标 FPS,并加入滞回区间与最短保持时间。滞回指升档和降档使用不同阈值,可避免热状态在边界附近反复切换,进而触发资源重建和 frame-time 尖峰。
Frame Rate API
Android 11 / API 30 起,Java 侧可调用 Surface.setFrameRate(),Native 侧可调用 ANativeWindow_setFrameRate(),API 31 又增加了 change strategy。游戏内容应使用 FRAME_RATE_COMPATIBILITY_DEFAULT;FIXED_SOURCE 面向固定帧率视频,AT_LEAST 明确不适合游戏。
⚠️ 文档矛盾(本次核对仍存在):游戏专用的“Optimize refresh rates”页面示例传入 FIXED_SOURCE,而 Surface API 契约和通用 Frame Rate 指南明确把 FIXED_SOURCE 限定给视频,游戏应传 DEFAULT。实现时以公开 API 契约和通用指南为准,那个示例不宜直接照抄。
我们还要清楚 Frame Rate API 提交的是刷新率偏好,系统最终可能因 thermal、battery、其他可见 Surface 或 display mode 能力选择不同刷新率。Android 15 起,游戏默认刷新率策略更偏向 60 Hz,希望使用 90/120 Hz 的游戏要显式申请,并继续通过 Swappy 或自研 pacer 控制提交节奏。
目标帧率改变时需要同时更新:
- display frame-rate vote;
- Swappy swap interval 或引擎 pacer;
- Performance Hint Session target duration;
- render scale / quality budget。
只更新其中一项,常会出现“屏幕 120 Hz、游戏仍按 60 FPS 提交”,或“pacer 已降到 45 FPS、ADPF 还按 120 FPS 预算申请资源”这样的矛盾配置。
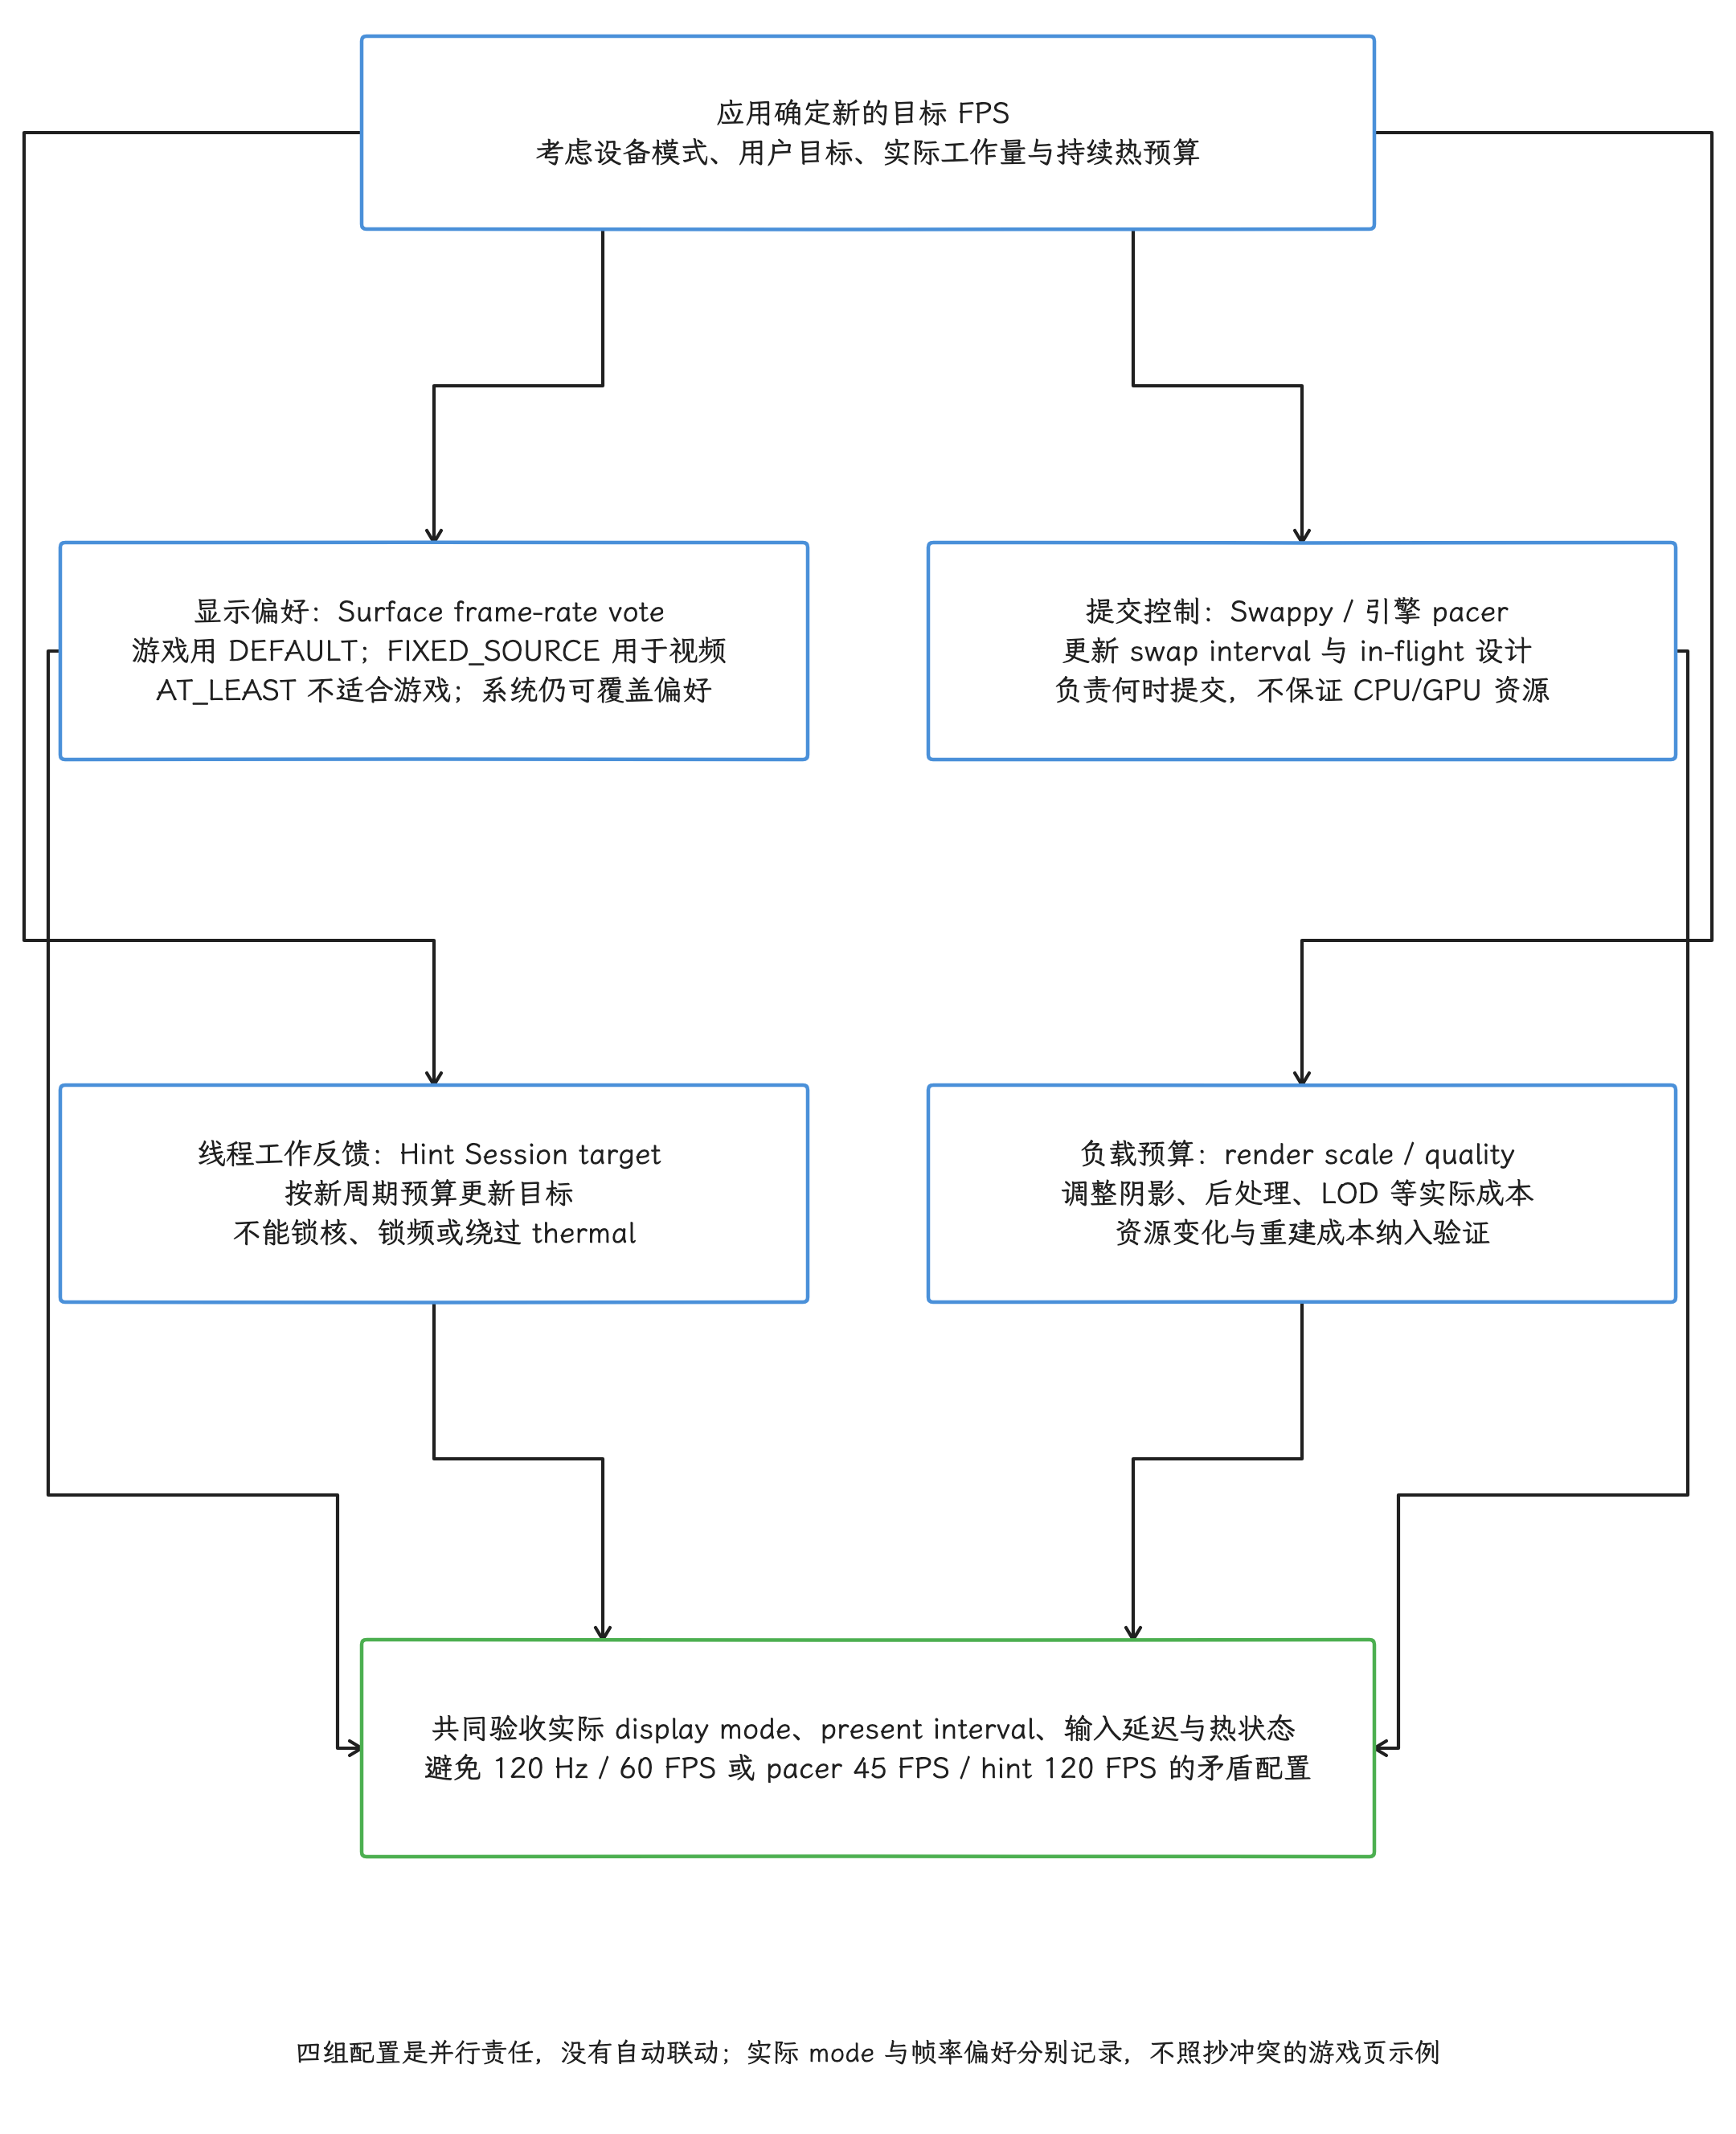
图:新的目标FPS应协调Surface frame-rate vote、Swappy/引擎interval、HintSessiontarget和qualitybudget。游戏按Surface公开契约DEFAULT,FIXED_SOURCE面向视频且AT_LEAST不适合游戏;专用优化页相反例子不直接照抄。vote是偏好系统可覆盖,pacer管每帧提交和inflight,hint管关联线程工作反馈不锁资源,quality管负载;四API不自动联动。只改部分会产生120Hz仍60FPS或45FPS但hint120预算冲突,须验收真实mode/interval/latency/热。
Game Mode 与 Game State
GameManager.getGameMode() 从 API 31 提供 STANDARD、PERFORMANCE、BATTERY 和 UNSUPPORTED;API 34 增加 CUSTOM。官方要求游戏在每次 onResume() 重新查询,因为用户可能在暂停期间改变模式。
PERFORMANCE 表达的是用户的高性能偏好,游戏要自己决定怎么兑现:为了保持高帧率稳定,可能需要适当降低高成本特效;BATTERY 则可以降低帧率、刷新率或分辨率。OEM 还可能为未主动适配的游戏配置 Game Mode intervention(系统侧干预规则)。Android 13+ 的 FPS throttling intervention 只能限制帧率,把 60 FPS 提升到 120 FPS 超出它的作用范围。
API 33 的 GameManager.setGameState(GameState) 用于报告 loading、MODE_GAMEPLAY_INTERRUPTIBLE、MODE_GAMEPLAY_UNINTERRUPTIBLE、MODE_CONTENT 等状态。isLoading 与 mode 是两个独立维度,仍在 gameplay 时也可能并行加载资源;这里的后台加载说的是资源加载,与应用进入操作系统后台是两个概念。系统如何使用这些信号取决于 OEM 实现。
Power HAL mode 还要与面向用户的 Game Mode 分开。Android 13 的 GameState.isLoading 可经系统服务触发 GAME_LOADING,Android 14 起前台游戏可触发 GAME;Android 17 的 Mode.aidl 同时保留这两个枚举。它们只向 Power HAL 描述场景,具体 boost、持续时间、CPU/GPU 策略和 thermal 约束由 OEM 实现。
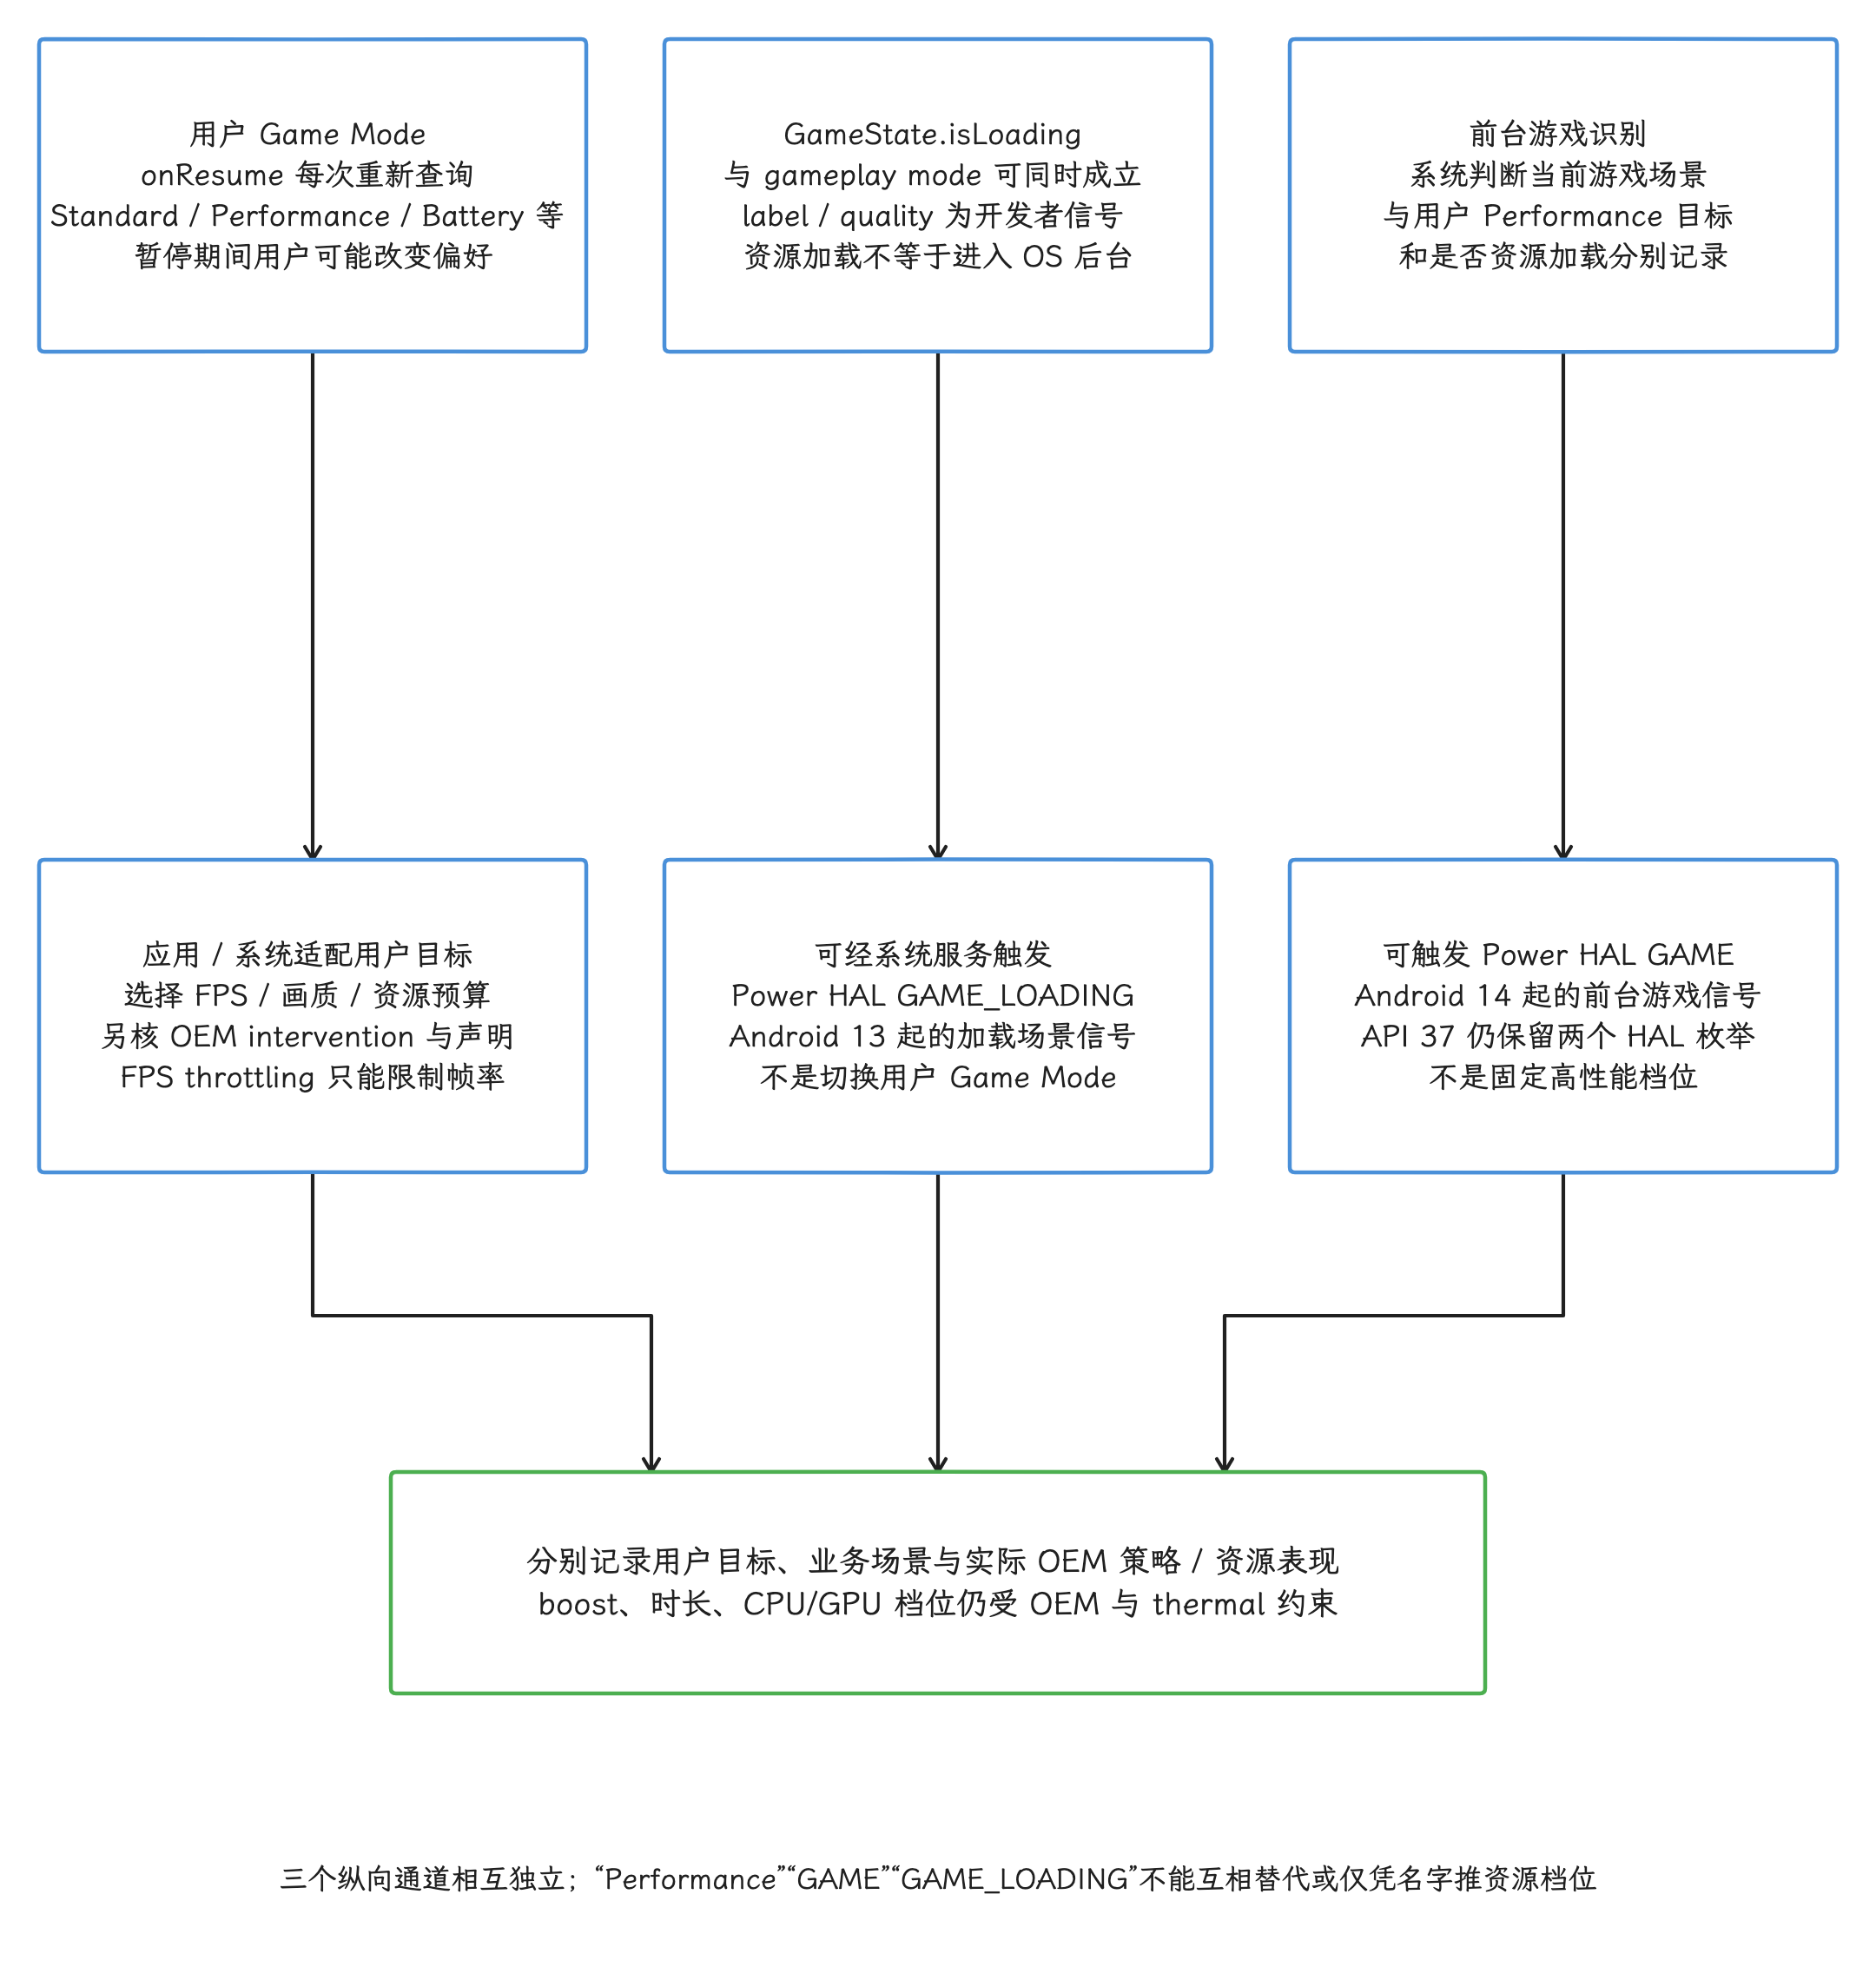
图:GameManager用户GameMode每次onResume重查,应用据Standard/Performance/Battery等调整FPS/quality;OEMintervention与声明另核,FPSthrottle只限不提升。GameState isLoading与gameplaymode独立可并存,label/quality开发者值,资源后台加载非App进入OS后台。isLoading可经服务触发Android13GAME_LOADING,前台游戏可触发Android14GAME,API37Mode均保留;这些PowerHALmode非用户GameMode,boost时长/档位/thermal由OEM决定,不承诺固定提升。
排查时看到稳定的 30、40、45、60 或 90 FPS 上限,我们先查询 Game Mode、intervention 和 frame-rate vote,再检查引擎 limiter,不要一上来就归因于 GPU。
CPU/GPU headroom 进入低频控制回路
Android 16 / API 36 起,支持设备可以通过 SystemHealthManager.getCpuHeadroom() 和 getGpuHeadroom() 返回 0~100 的余量估计;暂时算不出来时可能返回 NaN,设备未实现时可能抛出 UnsupportedOperationException。这次查询至少要走一次同步 Binder,渲染关键线程上不适合直接等待:应用应读取平台给出的最小查询间隔,在独立执行器里低频采样并缓存结果。 有效值 0 表示相应资源已无可授予的余量;NaN 表示暂不可用,要与 0 区分开。最小间隔内重复调用可能只拿到缓存值,采样按平台给的最小间隔安排即可。
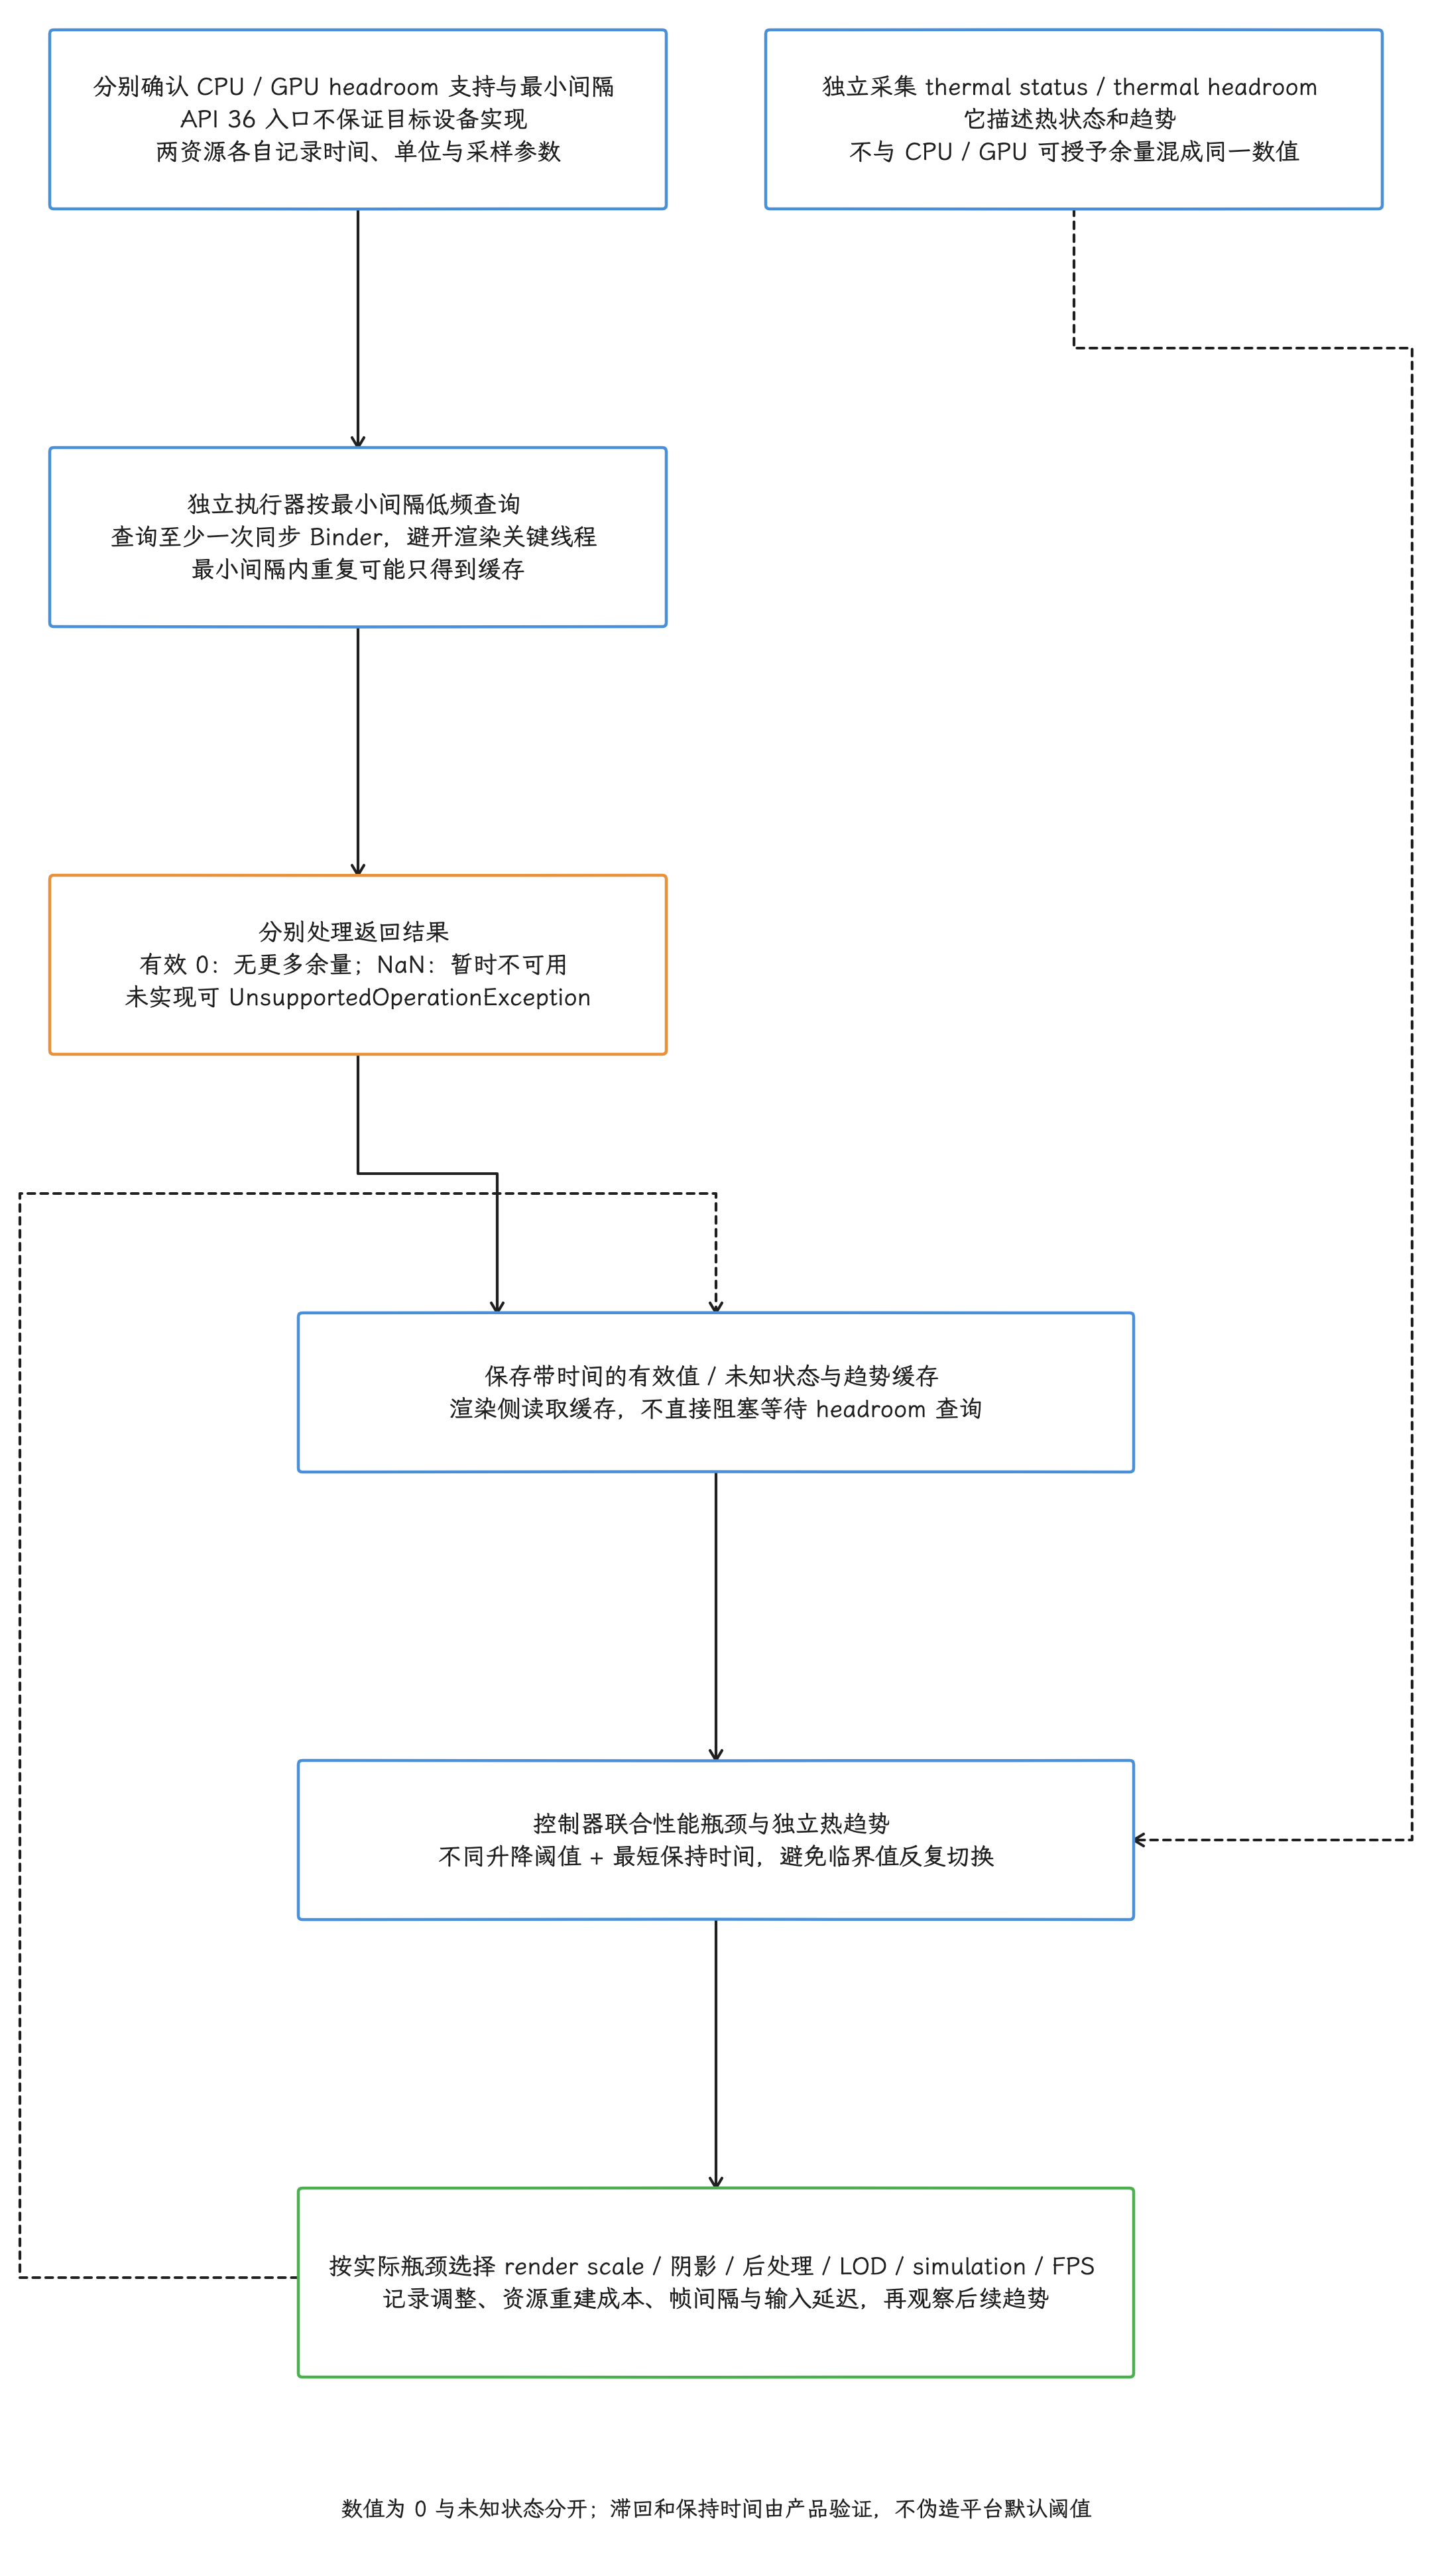
图:API36支持设备CPU/GPU headroom0..100,有效0为无可授予余量;NaN暂不可用,未实现可UnsupportedOperationException。读取平台最小查询间隔,独立执行器低频同步Binder并缓存;间隔内重复可得缓存,不在关键渲染线程等。thermalheadroom描述热趋势,是独立口径。控制器看持续趋势,按瓶颈调scale/阴影/后处理/LOD/simulation/FPS,设不同升降阈值、最短保持时间,记录资源重建和帧尖峰,平台不规定固定阈值或自动降档。
headroom 适合让画质控制器判断一段时间内的资源余量趋势,单次采样只作参考。动态分辨率、阴影、后处理、simulation rate 和目标 FPS 都要设置滞回区间与最短保持时间;thermal headroom 描述的是热趋势,与当前 CPU/GPU 可用余量是两回事,要单独采集。
把用户模式、系统 intervention 与 OEM 面板拆开实验
同一场景我们至少测四组条件:游戏自身的 Standard 基线、只切换 Game Mode、只修改 game_overlay intervention、最后再打开 OEM 游戏面板。每轮固定温度、亮度、刷新率、电源、场景和输入脚本,并记录游戏内部 target FPS / render scale、实际 present interval、频率、thermal 与 headroom。
cmd game mode 只改变用户模式;device_config 里的 game_overlay 可能改变 downscale 或 FPS throttling,通常还需要重启进程。实验前保存原值,结束后恢复。若游戏已经声明自行处理某种模式,系统可能跳过相应 intervention;测试构建要把这项声明记录下来,免得把预期的“不生效”误判为设备缺陷。
Draw call、Batching 与 GPU 成本
每个 draw call(一次绘制命令)都带着 CPU 侧的命令准备、状态检查和 driver 成本;我们把数量降下来,GPU 未必更快,还要看用的是哪种手段:
- Mesh batching:把可合并几何放入较少的提交,减少 draw call,代价是更新、内存和 culling(可见性裁剪)粒度可能变粗;
- GPU instancing:用一次或少量 draw 描述多个共享网格与材质的实例;
- 状态排序:减少 pipeline、descriptor、texture 和 render target 切换;
- Indirect / GPU-driven draw:让 GPU 根据缓冲区中的参数发起绘制,把部分可见性判断与提交工作移向 GPU;
- 缓存 render state:减少 CPU 重建成本,不一定减少 draw call 数。
Unity SRP Batcher 的主要作用是降低使用同一 shader variant 的兼容材质的 CPU 状态设置成本,把它概括成“把 Mesh 合成一次 DrawCall”就偏了;Unreal Mesh Draw Commands 还包含缓存、排序和可能的 dynamic instancing,与传统静态合批是两种不同的机制。 这两项要分别查对应引擎版本的兼容规则;启用开关本身说明不了某一帧 draw 数的变化,结论要从 trace 里拿。
“每帧超过 1000 draw call 就有问题”这类阈值没有跨设备意义,判断要看下面这组证据:
- Render / RHI thread 花在 draw preparation 和 driver 的时间;
- pipeline / shader 是否在游戏过程中同步创建;
- GPU vertex、fragment、compute、texture、tile memory 和带宽;
- pass 数、阴影级联、透明 overdraw、分辨率和 MSAA;
- 降低 draw call 后 CPU、GPU 与画面质量是否得到预期变化。
这两类瓶颈在 trace 里的样子正好相反:CPU draw-call bound 通常是 Render/RHI 提交晚、GPU 队列出现空闲区间;fragment 或带宽 bound 则常表现为 CPU 已较早提交、GPU producer fence 仍然很晚。前者优先减少 CPU 提交成本,后者去查像素处理、overdraw 与内存带宽。
Perfetto:建立逐帧证据
采集前记录配置
至少记录这些变量:
- 引擎及版本、GLES/Vulkan、renderer / RHI、Swappy 或自研 pacer;
- SurfaceView / GameActivity / native window 结构;
- display refresh rate、游戏目标 FPS、frame-rate vote;
- Game Mode、intervention、充电状态、亮度和温度;
- render scale、HDR、画质档、最大 in-flight frame 数;
- 场景、相机路径、网络状态和输入脚本。
缺了这些信息,同一台设备的两份 trace 也可能没法比较。
一次基础系统 trace
下面的命令用于采集图形、调度、频率、窗口和输入相关的基础数据:
adb shell perfetto \
  -o /data/misc/perfetto-traces/game.perfetto-trace \
  -t 20s -b 256mb \
  gfx view sched freq idle am wm input binder_driver
adb pull /data/misc/perfetto-traces/game.perfetto-trace
命令先把 20 秒 trace 写进设备,再通过 adb pull 取回本机。GPU stage、counter 和 Vulkan API 细节取决于设备数据源和权限;Perfetto 数据不足时,用 AGI、GPU 厂商 profiler、Unity Profiler 或 Unreal Insights 补充。单个含义模糊的 GPU completion slice 离全部 GPU 阶段还很远。 android.surfaceflinger.layers 或游戏独立 Surface 的完整 App FrameTimeline 是否启用,同样要在采集前确认:先验证目标 Layer 的覆盖,再选择 queue/事务、fence 与引擎 marker 补证。
连续三到五帧要标什么
| 节点 | 要找的证据 | 常见误读 |
|---|---|---|
| Input | event time、dispatch、游戏采样点 | dispatch 到达就代表本帧已经使用该输入 |
| Game | tick start/end、physics、script、worker dependency | 把主线程全部 Running 时间都算作有效游戏工作 |
| Render/RHI | draw preparation、command recording、submit | draw call 多就一定是瓶颈 |
| GPU | queue submit、job、producer fence | vkQueueSubmit() 返回就代表 GPU 完成 |
| Swapchain | acquire、swap/present、queueBuffer、in-flight depth | 所有 wait 都来自 GPU 慢 |
| SurfaceFlinger | latch、FrameTimeline、composition type | SF 沿用旧帧就代表 SF 计算慢 |
| Display | requested/actual present、present fence | fence 一定对应精确的首像素可见时刻 |
我们给同一输入和同一游戏帧分配稳定 ID,把 ID 写进 Game、Render、submit 和 present marker;这样某次触控最终对应哪一帧就有据可查,省得只凭几条相似的周期曲线猜关联。 关联 Unity/Insights 与系统 trace 时还要记录时钟域,并用共同时间锚或同步事件校准;统一 ID 解决的是关联问题,不同工具时间基准的偏移要靠这一步校准来消除。
Unity 与 Unreal 的 trace 组合
| 引擎 | Perfetto 默认侧重 | 引擎工具侧重 | 推荐关联方式 |
|---|---|---|---|
| Unity | OS 线程、调度、GPU/显示、SurfaceFlinger | PlayerLoop、script、render marker、Job System | 自定义 frame id + Unity Profiler timestamp |
| Unreal | OS 线程、调度、GPU/显示、SurfaceFlinger | Game/Render/RHI task、asset loading、render events | 自定义 frame id + .utrace |
Perfetto 里看不到 PlayerLoop,只说明系统 trace 缺这个 marker,Unity main thread 是否仍在工作要另行确认;名为 RenderThread 的线程也可能属于其他进程。我们同时核对进程包名、线程周期、调用栈、引擎 marker 和 frame id,再下判断。
常见瓶颈怎样区分
证据集齐之后,瓶颈归类就是把这些证据对号入座。下面几类瓶颈在 trace 里的特征各有差异,我们按 CPU、GPU、queue/pacing、display 与稳态 thermal 依次过一遍。
CPU bound
CPU bound 指 Game、Render 或 RHI 等 CPU 阶段超过帧预算,常伴随 GPU 队列出现空闲区间。原因包括 script、physics、animation、draw preparation、同步 shader/pipeline creation、资源上传、JNI、锁和 worker barrier。
降低分辨率对纯 CPU draw-call bound 帮助有限;降低对象数、pass、状态切换或并行任务依赖更有针对性。
GPU bound
GPU bound 指 CPU 已较早完成提交,但 GPU 持续忙碌且 producer fence 很晚。需要用 GPU stage/counter 区分 vertex、fragment、compute、texture、overdraw、tile memory、带宽、同步 bubble(依赖造成的 GPU 空闲间隙)和频率限制。
动态分辨率主要缓解像素与带宽成本;如果瓶颈是 vertex、compute 或同步,降低 render scale 可能几乎没有改善。
Queue / pacing bound
Queue / pacing bound 表现为 acquire、swap、present 或 Swappy wait 周期性变长,下一步检查 pending buffer、release fence、目标 interval、pipeline mode 和 producer throttling。主动 pacing wait 可以保持较低的队列深度,我们看到的 CPU idle 正是它正常工作的表现,别当成浪费删掉。
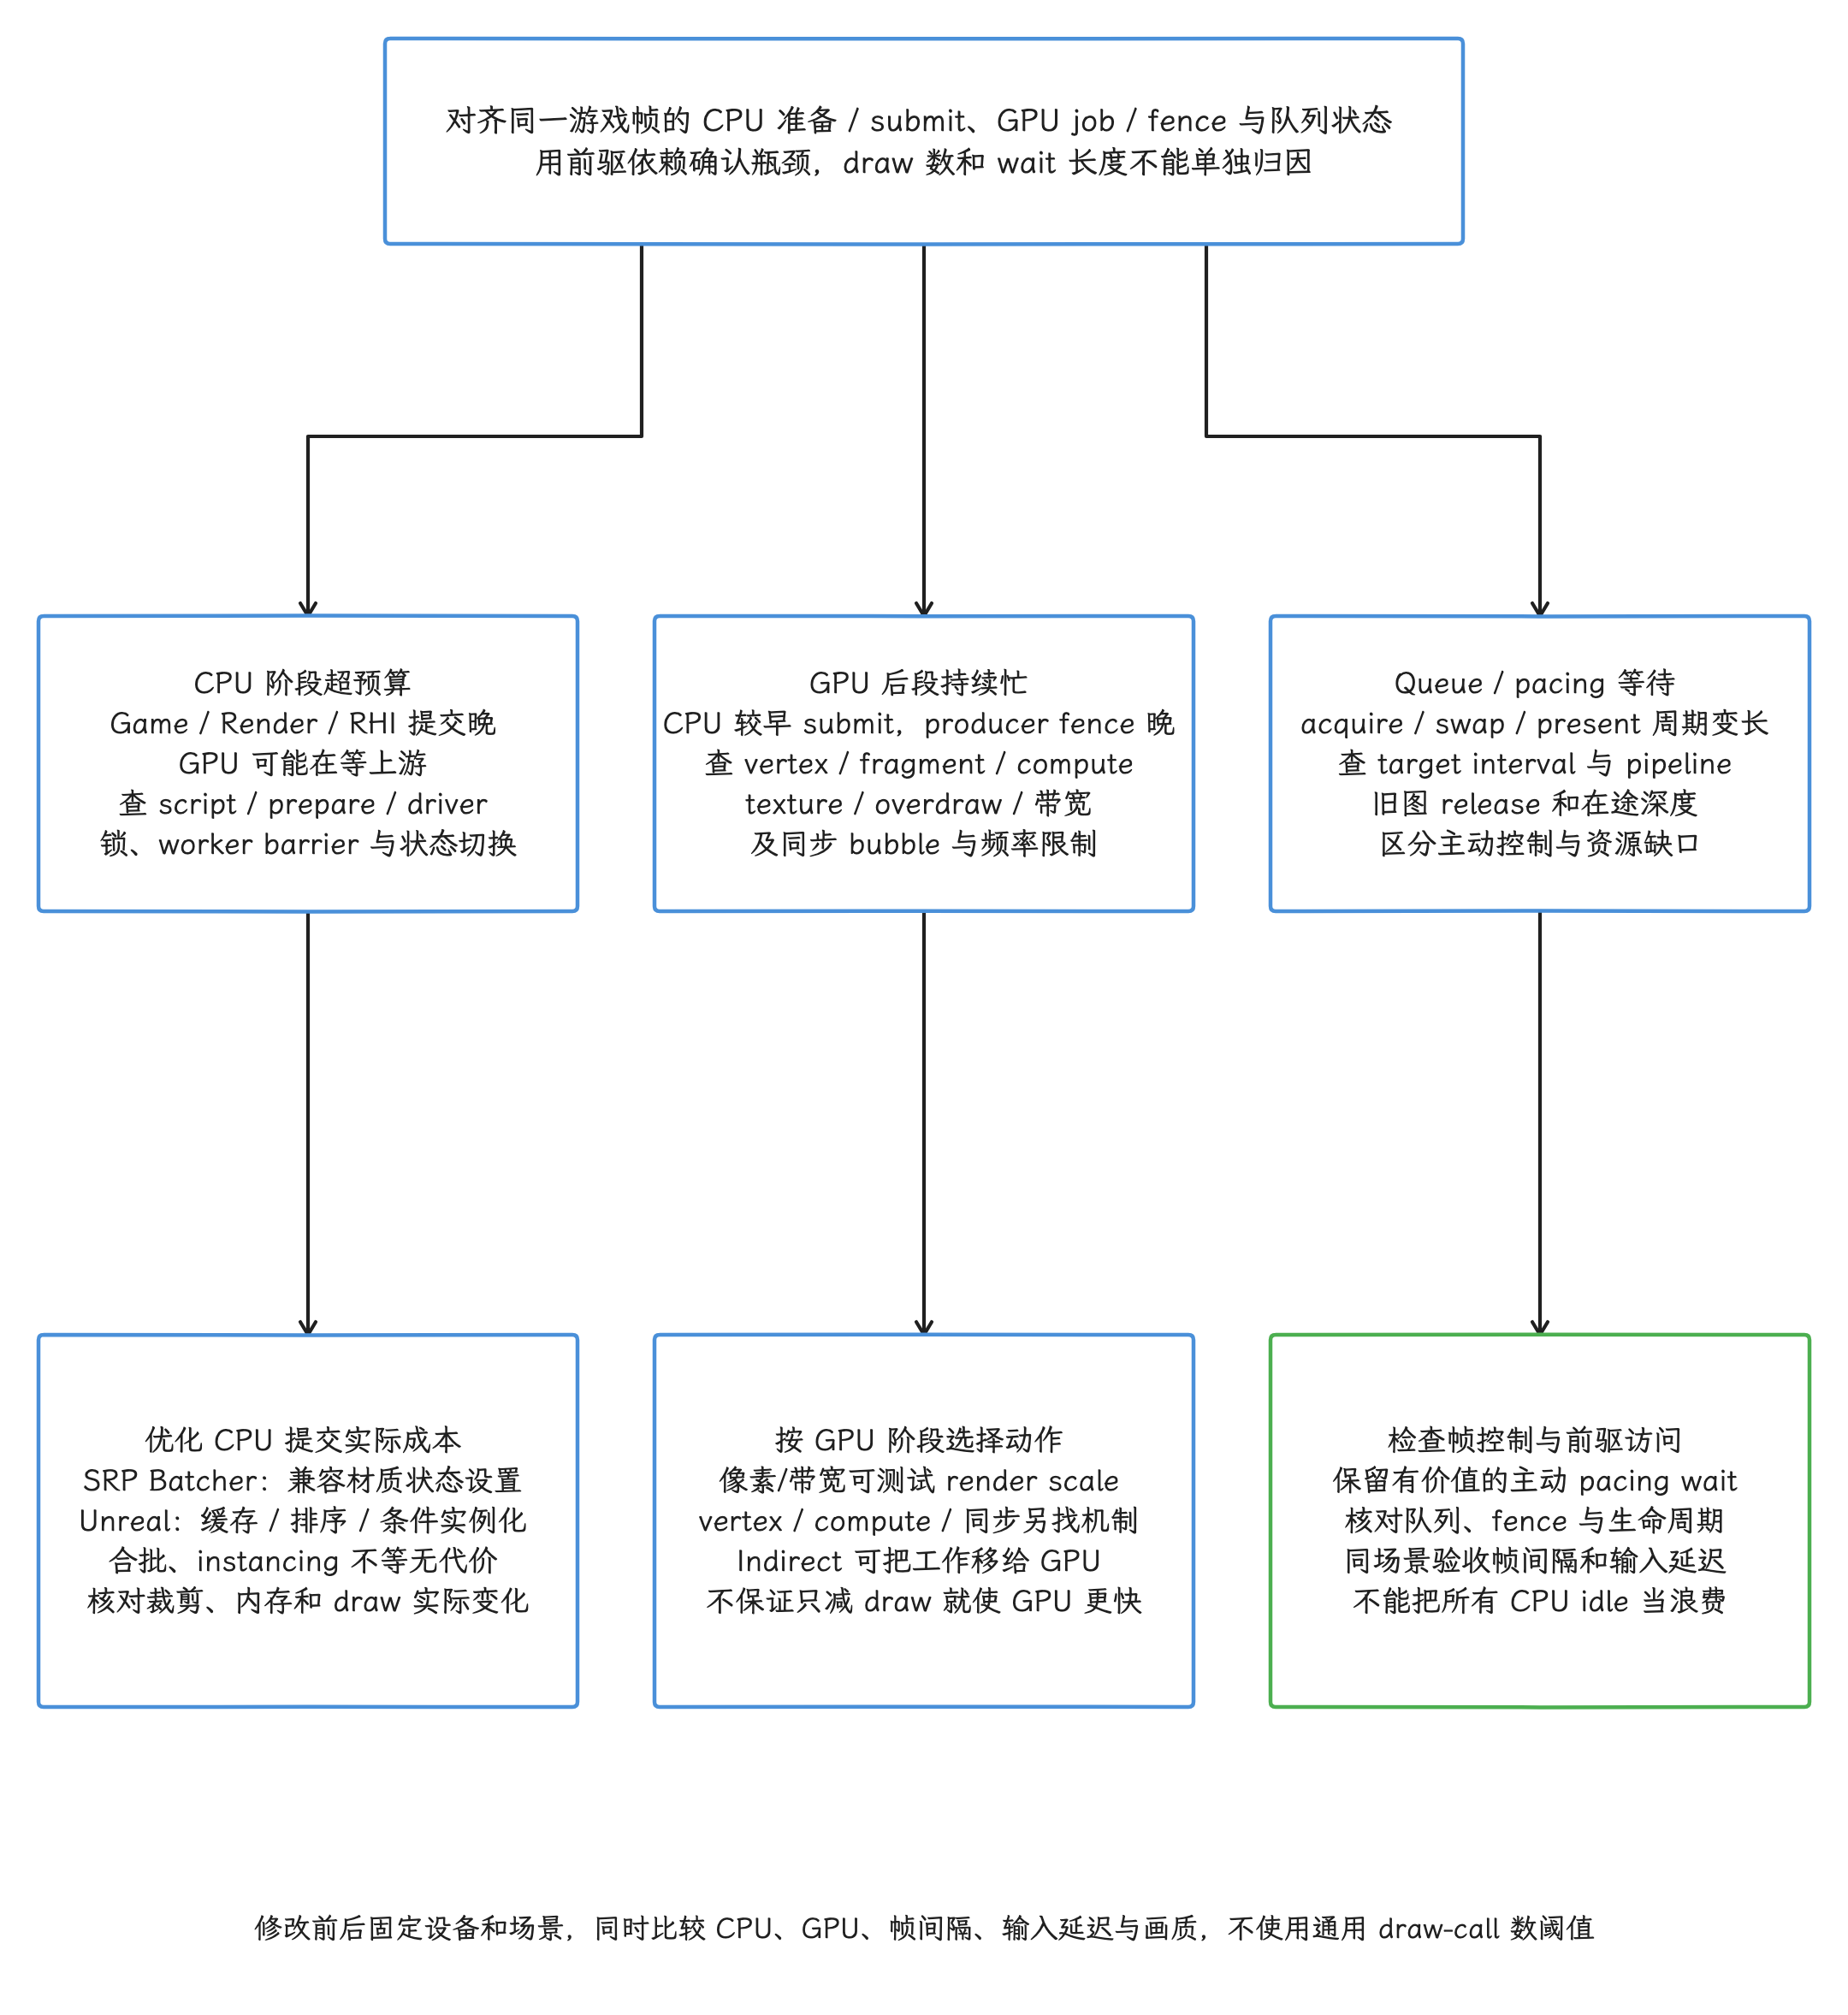
图:CPU Game/Render/RHI超预算且GPU等上游可查script/prepare/driver/锁/worker,合批instancing减少部分提交但粗culling/内存成本另算;UnitySRPBatcher降低同shader variant兼容材质CPU状态,不等合mesh一次draw,UnrealMeshDrawCommands含缓存排序和条件动态实例化。GPU CPU较早submit后job/producerfence晚需stagecounter区分fragment/vertex/compute/带宽/同步,降render scale不解所有GPU瓶颈。Queue/pacingwait要查interval、release/inflight和主动pacer,不能先删wait。默认draw数阈值无跨设备意义,改变后同时看CPU/GPU和画质。
Display bound
Display bound 指游戏 buffer 已 ready,SurfaceFlinger 却错过目标 latch,或显示端 present 变晚。应检查 desired present、FrameTimeline、HWC CLIENT composition、display mode change 和 Composer / driver fence。游戏 Layer 自身 GPU 负载很高时,额外的 RenderEngine client composition 还会与游戏竞争 GPU 和带宽。
稳态 thermal bound
稳态 thermal bound 常表现为首分钟正常,运行十分钟后 CPU/GPU 频率、内存带宽或可用功耗预算下降,frame time 持续恶化。测试需要覆盖足够长的会话,并同时记录 thermal status / headroom、频率、亮度、充电状态和环境温度。
平均 FPS 会掩盖连续长帧,我们至少还要统计 frame-time 分布、P90/P99、1% low(需声明采用最慢 1% 帧平均时长的倒数,还是其他工具算法;不能直接与 P99 倒数混用)、present-to-present 间隔和输入到显示延迟。
Android 12 到 Android 17 的关键演进
| 版本 | 与游戏渲染直接相关的变化 |
|---|---|
| Android 12 / API 31 | Game Mode 与 Performance Hint Manager 公布;三参数 setFrameRate() 可带 change strategy;FrameTimeline 成为系统分析基线 |
| Android 13 / API 33 | GameState / setGameState() 与 Power HAL GAME_LOADING 公布;FPS throttling intervention 可在平台侧限制游戏帧率 |
| Android 14 / API 34 | GAME_MODE_CUSTOM、Hint Session setThreads() 与 Power HAL GAME;SurfaceView alpha 能力扩展,但 z-order 语义仍需区分 |
| Android 15 / API 35 | WorkDuration 和 setPreferPowerEfficiency();游戏需要显式请求高于默认策略的刷新率 |
| Android 16 / API 36 | 支持设备可提供更丰富的 ARR / headroom 能力,游戏仍需按设备检查并做反馈控制 |
| Android 17 / API 37 | VK_EXT_present_timing 与 Surface.setProducerThrottlingEnabled() 提供更细的 present 反馈和 producer back-pressure 控制 |
平台版本升级并不会统一引擎和 GPU driver 的线程模型;落到具体设备上,我们仍要记录 Unity / Unreal 版本、Swappy 版本、Vulkan extension 和设备 driver。
小游戏、云游戏、AR 与 XR 的边界
这些场景只能在本地 game loop 与显示阶段复用本节方法,端到端的责任划分各不相同:
- 小游戏:还要区分 JS/runtime、bridge(脚本运行时与原生宿主之间的调用层)及宿主
SurfaceView/TextureView。 - 云游戏:要把云端排队、渲染、编码和网络遥测关联到本地解码与 present。
- 手机 AR:要统一 Camera、IMU/pose、render target 与 present 的时钟。
- 头显 XR:由 OpenXR runtime/compositor 负责 predicted display(预测显示时间)、reprojection(依据最新姿态修正已渲染画面)与最终显示交接,不保证经过普通 App
queueBuffer()。
四套场景的完整链路不在本节展开:TextureView 的消费语义见 13.3 SurfaceView 与 TextureView 渲染管线,云游戏本地视频与 sideband 见 13.11 视频 Overlay、Media3 与专业编解码管线,XR runtime/compositor 见 13.13 Android 17 / Android XR 空间 UI 与环境资产渲染性能。进入对应专题前,我们先确认最终 buffer Producer、输出 carrier(承载方式)、时钟域和 present 责任方。
内核和驱动侧
Android 通用内核提供 dma-buf、dma-fence 和 sync_file:dma-buf 用于跨设备共享 buffer,dma-fence 表示异步硬件任务的完成依赖,sync_file 则把 fence 封装成可跨进程传递的 fd。GPU scheduler、devfreq、thermal、IOMMU fault、memory reclaim 和 display driver tracepoint 多由设备实现提供。
在 android17-6.18-2026-06_r6 中可从以下入口核对通用语义:
drivers/dma-buf/dma-buf.c:buffer attachment 与跨设备共享;drivers/dma-buf/dma-fence.c、include/linux/dma-fence.h:GPU / HWC 等异步任务的 fence signal、callback、wait 与公共同步接口;drivers/dma-buf/sync_file.c:把 fence 封装成跨进程 fd。
vendor GPU job 变长、GPU 频率低和 producer fence 晚,我们要在同一帧内关联起来看;Render / RHI 线程处于睡眠状态只说明它在等,GPU scheduler 是否异常要靠这些同帧证据来下结论。
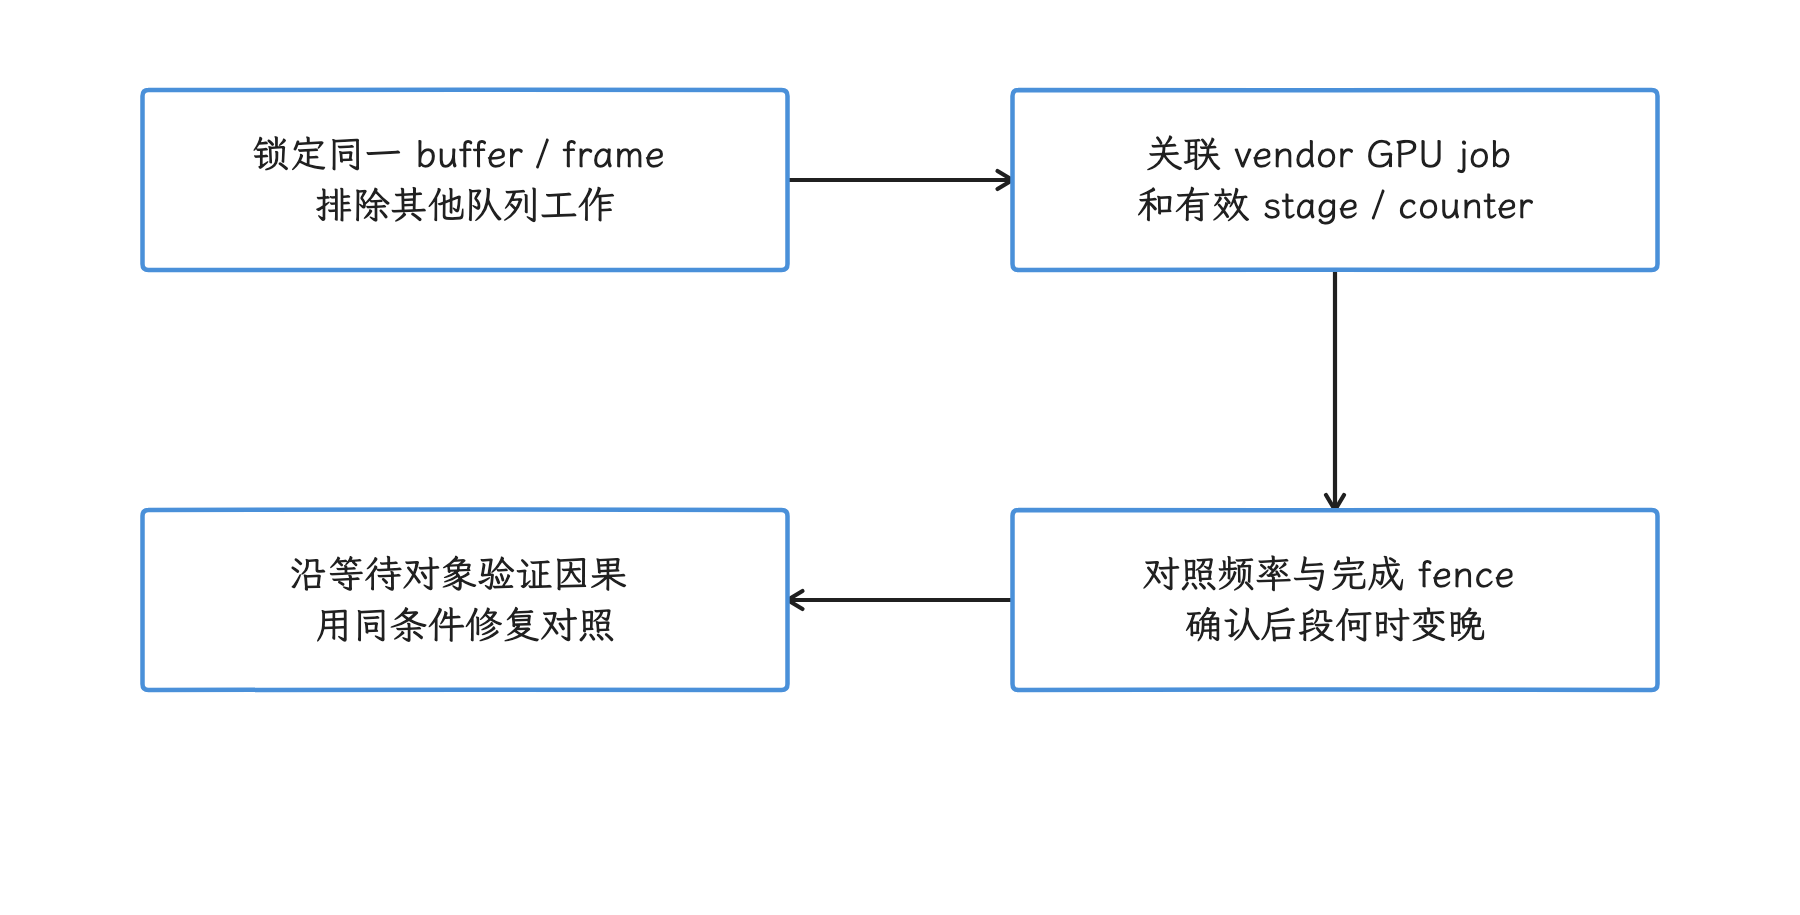
图:把 job、频率和写完成 fence 放到同一帧内验证。 Render/RHI 睡眠只说明等待,不能独立证明 GPU scheduler 异常。
常见误判
“FPS 高,输入延迟就低”
FPS 衡量吞吐量,不能直接代表单次输入的端到端延迟。队列中可能已有多帧,输入也可能在很早的阶段采样;应对齐 input、frame id、in-flight depth 与 display present。
“vkQueueSubmit() 返回,GPU 已完成”
该调用只把工作提交到 GPU queue,执行是异步的。完成时间要看 GPU job 和 producer fence。
“vkQueuePresentKHR() 慢,说明 Vulkan driver 差”
present 附近可能包含 Swappy 主动等待、BufferQueue back-pressure、GPU fence、resize 或 display mode change。需要沿等待对象和 fence 依赖继续追踪。
“Unity/Unreal 的 marker 在 Perfetto 里默认都有”
引擎 profiler、Unreal Insights 与 Perfetto 是不同数据源。未显式写入系统 trace 时,Perfetto 可能只显示线程和系统事件。
“Vulkan 一定比 GLES 快”
Vulkan 把更多调度和同步责任交给引擎,较低层级的控制并不会自动转化成更高性能。结果取决于 render graph、driver、pipeline、资源管理和 workload。
“ADPF 可以锁大核或锁频”
Hint Session 提供 target / actual workload 信息,CPU 放置、频率等资源决策仍由系统与 thermal 策略完成。
“Game Mode Performance 会自动提高 FPS”
OEM 策略、画质、thermal、frame-rate vote 与引擎上限都可能限制结果。Performance mode 也可能降低部分画质,以换取更稳定的帧率。
“BufferQueue 有 64 个 slot,所以游戏要手工改成三缓冲”
64 是默认 slot 配置,已分配数和当前在途数要分别确认;受控扩展面向平台内的 Consumer/Producer 路径,普通游戏要走自己的协商。swapchain image count 应通过 EGL / Vulkan 和 native window 协议协商,应用侧不应调用隐藏接口强制修改活动队列。
与其他章节的关系
- 2.3 VSync、Choreographer 与 SurfaceFlinger 调度:VSync、回调与帧调度。
- 5.4 ADPF 自适应性能框架:Hint Session、Game Mode / State、headroom 与 thermal 反馈。
- 13.3 SurfaceView 与 TextureView 渲染管线:独立 Surface、BLAST 与生命周期。
- 13.4 OpenGL ES、EGL 与 ANGLE:EGL window surface 和 GLES 提交。
- 13.5 Vulkan 原生管线与 HWUI 多队列:Android Vulkan swapchain 与显式同步。
- 13.11 视频 Overlay、Media3 与专业编解码管线:云游戏视频 carrier、CLIENT / DEVICE 与 tunneled sideband。
- 2.2 帧率、刷新率与显示模式选择:frame-rate vote、ARR 和 display mode。
- 13.13 Android 17 / Android XR 空间 UI 与环境资产渲染性能:OpenXR runtime、compositor 与显示边界。
Android 17 源码核对清单
平台
SurfaceView.java、Surface.java:BLAST / SurfaceControl、Frame Rate API 与 API 37 producer throttling。PerformanceHintManager.java、SystemHealthManager.java、GameManager.java、GameState.java:Hint Session、CPU/GPU headroom、Game Mode 与 Game State。TextureView.java、TextureLayer.java、HardwareRenderer.java:小游戏 TextureView 的 frame available、宿主 invalidation 与 pending layer update。DeferredLayerUpdater.cpp、DrawFrameTask.cpp:RenderThread 获取最新 SurfaceTexture buffer。swapchain.cpp、BufferQueueCore.cpp、BufferQueueProducer.cpp、Surface.cpp:Vulkan WSI 到 ANativeWindow / BufferQueue、buffer count 校验、present timing 与 producer throttling。SurfaceFlinger.cpp、Display.cpp、Output.cpp:Layer snapshot、composition strategy、RenderEngine client target 与 present。OutputLayer.cpp、HWComposer.cpp、AidlComposerHal.cpp:Layer buffer、client target、Composer3 validate / present 与 fence。- Power HAL
Mode.aidl:GAME与GAME_LOADING。
通用内核
本轮配图补充依据
- BLASTBufferQueue.cpp、HWC2 fence 契约:客户端事务、安全读取、旧 buffer 释放与物理/虚拟 present。
- BufferQueueConsumer.cpp、BufferQueueCore.cpp、BufferQueueProducer.cpp:连接前扩展授权、slot 扩展与数量校验。
- WorkDuration.java、Hint Session 契约:参数校验、时间域与线程安全。
- Vulkan timing surface capabilities、固定 WSI 实现:absolute/relative 能力与 stage 时间实际映射。
- SwappyTracer、Unity SRP Batcher、Unreal mesh drawing:库内事件与两种引擎提交优化。
- FrameTimeline 覆盖、Perfetto 时钟映射:独立 Surface 的采集缺口和跨工具时间校准。
官方文档
- AGDK Frame Pacing / Swappy
- Swappy Vulkan API
- Vulkan frame pacing extensions
- Vulkan native engine support
- GameActivity
- Frame Rate API
- ADPF
- PerformanceHintManager.Session
- SystemHealthManager
- Game Mode API
- Game State API
- Performance boost for games
- Optimize refresh rates
- Unity Profiler markers
- Unreal threaded rendering
- Unreal Insights
- OpenXR 1.1 specification
小结
- 游戏由自有 game loop 持续推进,性能分析要从输入采样追到对应帧 present。
- Game、Render、RHI、worker 和 GPU 可以跨帧并行;提高吞吐量的同时,也要限制在途帧带来的输入延迟。
- Unity Profiler、Unreal Insights 和 Perfetto 各自覆盖不同层级,统一 frame id 比猜线程名可靠。
- 游戏常使用独立 SurfaceView / GameActivity 路径;现代 SurfaceView 由 BLAST 和 SurfaceControl 协调,游戏 buffer 仍要经过 SurfaceFlinger。
- Vulkan WSI 把 acquire fence 接入
AcquireImageANDROID,并把 GPU release fence 随queueBuffer()送入 BufferQueue;display present fence 与 Layer release fence 需要分开判读。 - Swappy 控制提交节奏和队列深度,Frame Rate API 表达刷新率偏好,ADPF 报告 workload,Game Mode 表达用户选择。
- 小游戏 TextureView、云游戏视频 carrier、手机 AR 与 OpenXR runtime 各有不同的 producer、时钟域和 present 责任方。
- Android 17 新增 present timing 与 producer throttling 控制,但显式同步、extension 检查和设备验证仍由引擎负责。
- BufferQueue 默认 slot 配置、受控扩展和游戏 swapchain capabilities 要分别检查:slot 数只是配置,当前分配数要另查,二缓冲还是三缓冲交给 EGL / Vulkan 协商决定。