Vulkan 原生管线与 HWUI 多队列
Vulkan 把资源、命令和同步的管理责任交给应用,但 Android 的显示后半段仍然存在。App 要通过 VK_KHR_android_surface 把代表显示目标的 VkSurfaceKHR 连接到 ANativeWindow;swapchain image(循环用于渲染和显示的图像) 仍映射到 Android GraphicBuffer/BufferQueue,提交之后还要经过 SurfaceFlinger、HWC 和 Display present。
源码基线:AOSP
android-17.0.0_r1的 Android WSI(窗口系统集成层)与 SurfaceFlinger/RenderEngine;内核android17-6.18-2026-06_r6的 dma-buf/dma-fence。Vulkan 驱动和 GPU job scheduler 由设备厂商实现,AOSP 只能说明接口与所有权;GPU 工作何时完成,要在目标设备上确认。
Vulkan 应用自行管理实例、设备、交换链、命令缓冲区和同步;HWUI 的 Vulkan 后端则由 framework 组织这些对象。HWUI 多队列提供分开的提交入口,是否硬件并行需测量。其窗口路径通过 VulkanSurface 直接管理 ANativeWindow buffer 与 Skia 包装,不是调用应用版 vkAcquireNextImageKHR()/vkQueuePresentKHR() 的 VkSwapchainKHR 循环;两条路径最终都交接 Android buffer 和 fence。我们先看原生 Vulkan 这条路径,再看 HWUI 内部的多队列,两条线最后都收束到 BufferQueue、SurfaceFlinger 与 present。
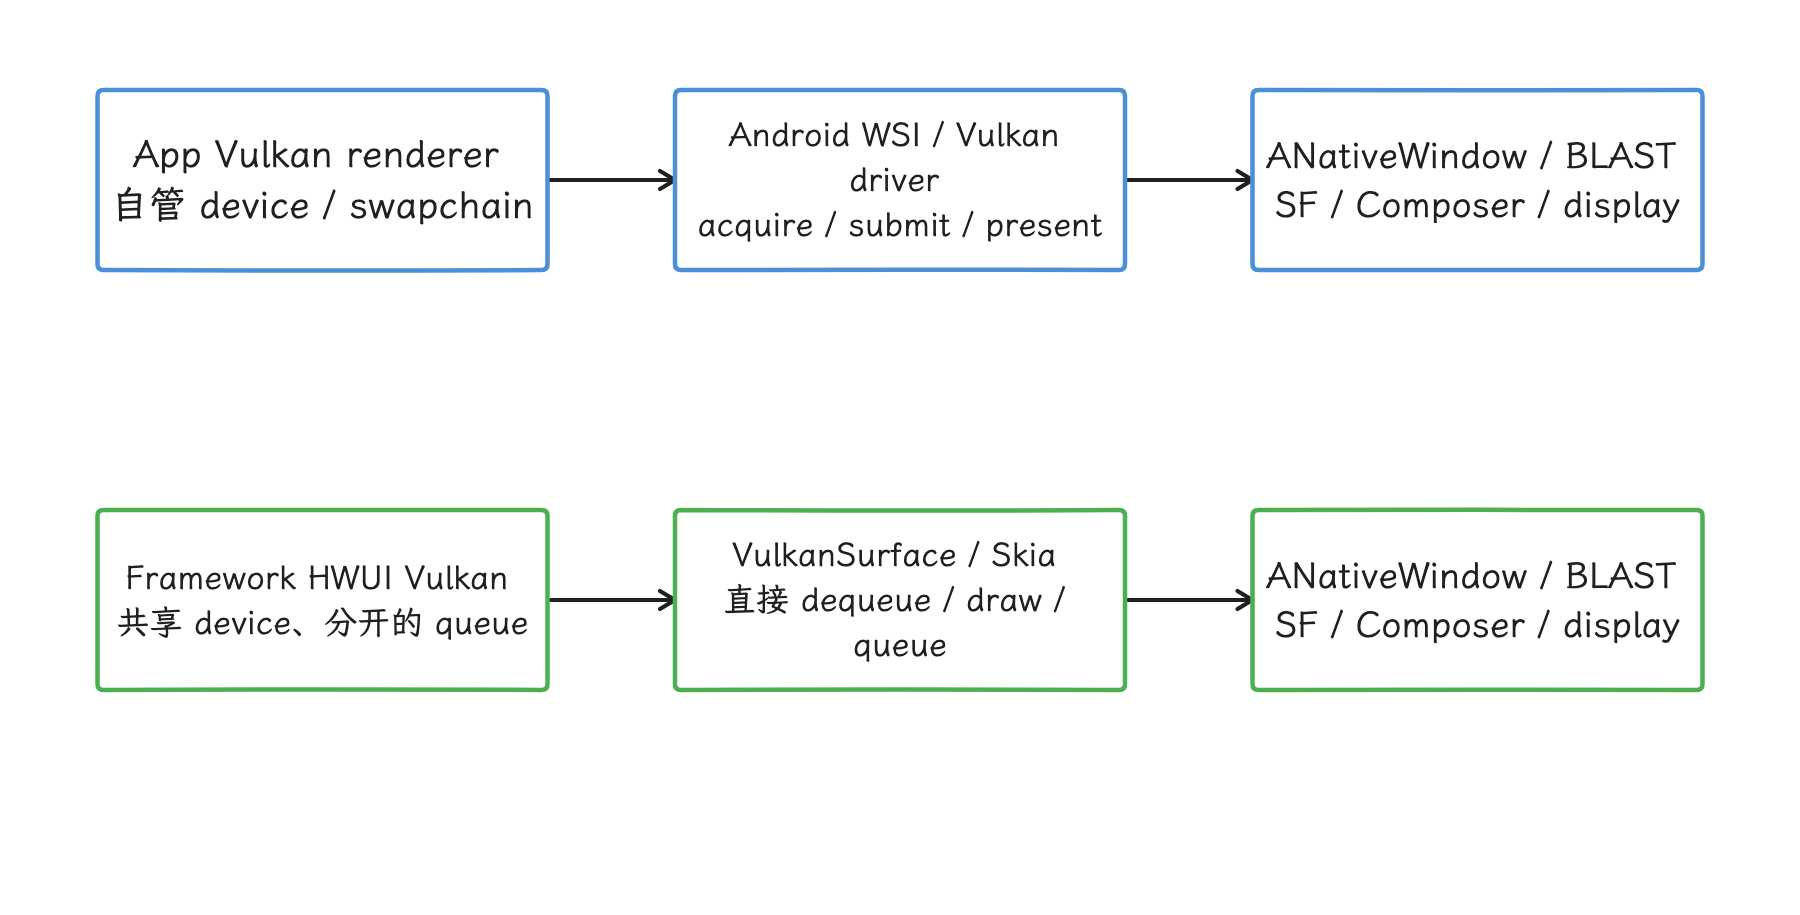
图:原生应用使用 VkSwapchainKHR,HWUI VulkanSurface 直接管理窗口 buffer。 两条路径最终都交出 Android buffer/fence;HWUI 双 queue 不证明 GPU 硬件并行。
交换链、命令提交与呈现
我们先从应用为什么选择 Vulkan 讲起,再沿 acquire、record/submit、present 把一帧走完;同步对象、present mode、pacing 和 trace 归因放在后面几节。
为什么选择 Vulkan
显式控制带来的价值
我们先看价值从哪来。OpenGL ES 把较多状态验证、资源转换和同步决策放在驱动中;Vulkan 则要求应用预先描述 pipeline(固定功能与着色器状态组合)、descriptor(着色器访问资源的绑定)、resource usage、command buffer 和执行依赖。组织得当时,Vulkan 可以:
- 降低高 draw-call 场景中的 CPU 驱动开销;
- 把 shader/pipeline 创建从关键帧移到加载或缓存阶段;
- 用多个 command pool(命令缓冲分配池)并行准备命令;
- 精确表达执行依赖、内存可见性和 image layout(图像当前用途对应的状态);
- 让帧内 GPU 工作和错误更容易通过 Validation Layer/AGI(Android GPU Inspector)定位。
这些能力要兑换成性能收益,前提是引擎把它们用好。引擎如果频繁创建 pipeline、把提交切得过碎、设置过度保守的 barrier,或者积压太多 in-flight frame(已提交但尚未完成显示的帧),Vulkan 同样会产生较高 CPU 开销、GPU bubble(依赖导致的硬件空闲间隙)和输入延迟。我们比较 GLES 与 Vulkan 时,要保持内容、分辨率、pacing 和设备温度一致。
应用侧的责任
| 领域 | 应用需要管理的内容 |
|---|---|
| 资源 | 内存 allocation/binding、生命周期、aliasing(内存复用)和预算 |
| 命令 | command pool/buffer、record/reset 和 queue submit |
| 同步 | semaphore、fence、stage/access mask 和 queue ownership |
| 图像 | format、usage、layout、subresource(图像的 mip/layer 子范围)和 compression |
| 窗口 | surface capabilities、swapchain、resize、rotation、present mode |
| 节奏 | 输入采样、目标 present、in-flight 数量和刷新率提示 |
| 恢复 | OUT_OF_DATE、SUBOPTIMAL、surface lost、device lost |
Validation Layer 能发现许多 API、同步和对象生命周期误用;性能是否达标、跨帧业务所有权是否正确,还要靠 Release 构建上的 trace、GPU counter、内存预算和长时间温度测试来验证。
Vulkan 与承载结构是两个维度
Vulkan 描述 Producer(buffer 生产方) 如何生成内容。它可以绘制到 SurfaceView/GameActivity/NativeActivity 提供的独立 Surface,也可以写入 TextureView 的输入 Surface 或离屏 AHardwareBuffer(可跨系统组件共享的图形缓冲区)。SurfaceFlinger 能否看到独立 layer,取决于目标 ANativeWindow 连接到哪个 Consumer(buffer 消费方);API 名本身给不出这个答案。
常见游戏页面会同时包含 Vulkan 主体 Surface、宿主 HWUI、系统栏和弹窗。如果引擎 HUD(抬头显示界面) 已经画入同一个 swapchain image,SurfaceFlinger 看到的仍只有一个主体 buffer layer;画面里出现按钮,同样推不出额外的 SF layer。
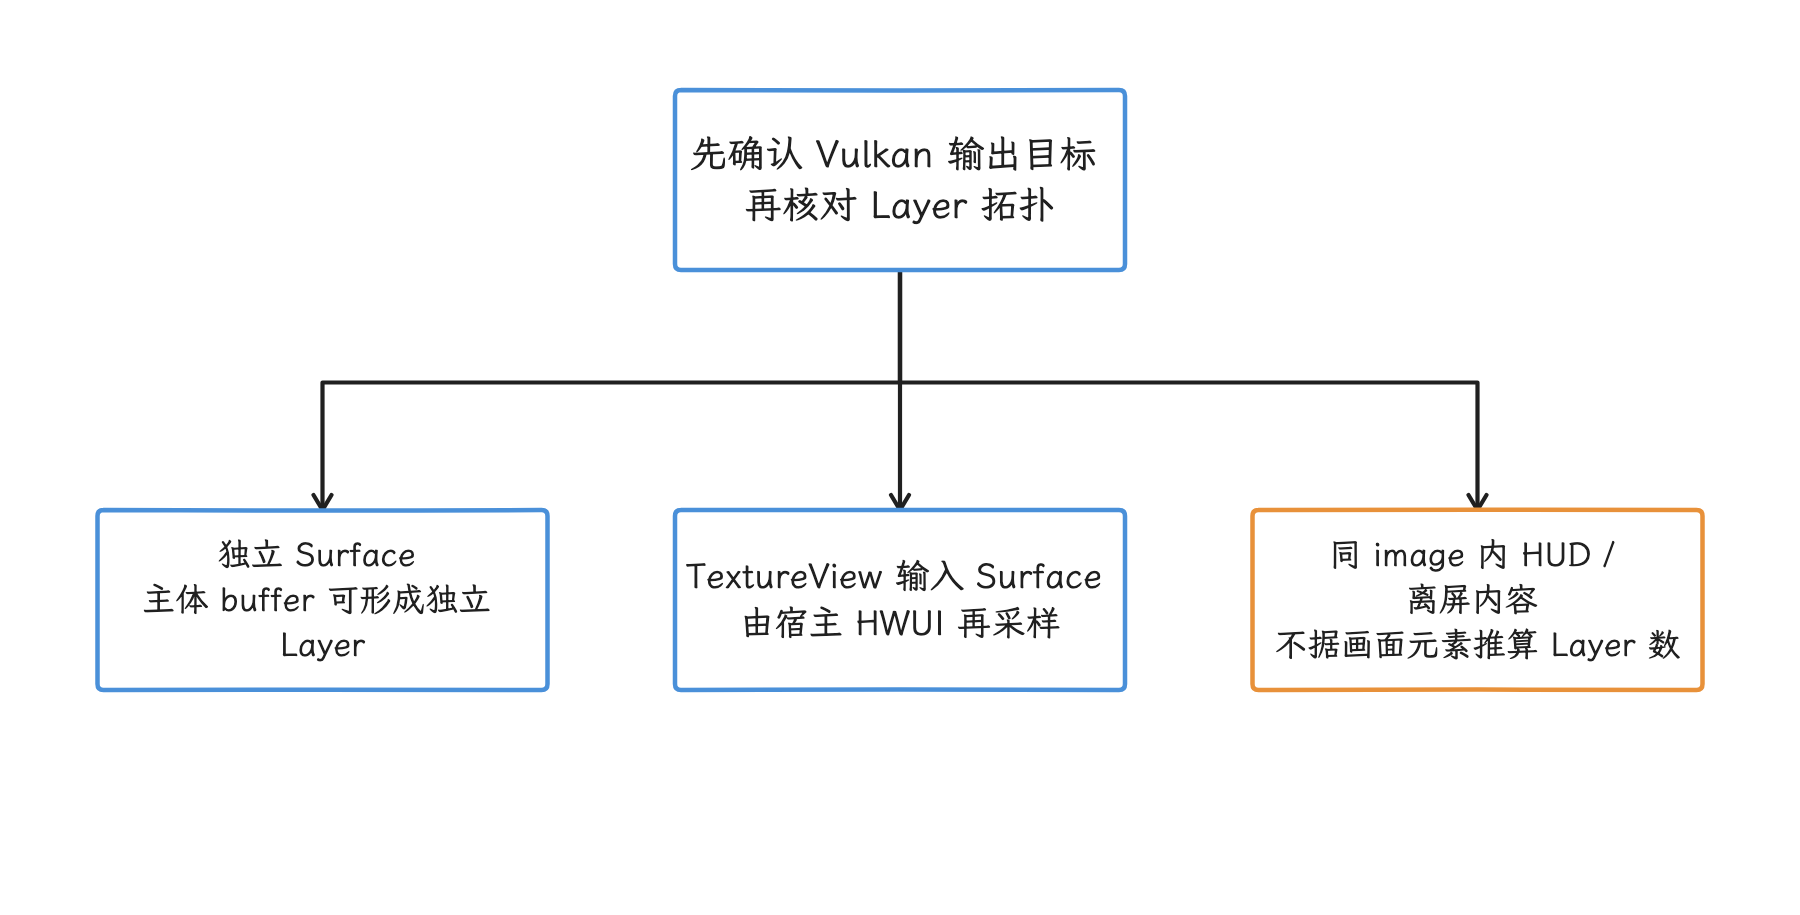
图:同一 swapchain 中的 HUD 不自动成为独立 SF layer。 目标 native window 的 Consumer 决定拓扑,离屏内容未必直接显示。
Android Vulkan Profile (AVP)
Vulkan Profile 是一组可以由工具检查的 extension、feature、property、format 和 limit,工程可以用它表达所需的能力集合。至于具体设备的 GPU 能力,仍要在运行时查询里确认:安装同一 Android 版本的设备,GPU 能力也未必相同。
兼容性 profile 与要求 profile
这里要区分两类 profile:面向存量设备的兼容性 profile,和面向新芯片的要求 profile。
VP_ANDROID_vulkan_profile_2025:Android Vulkan Profile 2025,面向广泛的现役设备能力,延续原 Android Baseline Profile 的兼容性用途。VP_ANDROID_17_requirements:由android-17.0.0_r1中vulkan/vkprofiles/profiles/VP_ANDROID_17_requirements.json定义,也称 VRA17;其 label 为 “Vulkan Minimum Requirements for Android 17”,面向随 Android 17 发布或续期 Google Requirements Freeze 的芯片。
VP_ANDROID_17_requirements 的 api-version 是 Vulkan 1.4.335,并以 VP_ANDROID_vulkan_profile_2025 为父 profile。它包含 VK_KHR_present_id2、VK_KHR_present_wait2、VK_EXT_present_timing 和 VK_EXT_present_mode_fifo_latest_ready 等要求。该文件约束的是相应的新芯片档位;升级到 Android 17 的旧设备支持多少,仍以运行时查询结果为准。
工程使用方式
我们建议把能力分三层:
- 用目标市场的兼容性 profile 定义广覆盖的能力下限;
- 对 Android 17 新芯片档位检查
VP_ANDROID_17_requirements; - 继续在运行时查询应用必需的 extension/feature/format/limit,并为缺失能力设计 fallback(降级路径) 或明确拒绝启动。
Profile 检查通过,说明的只是能力集合这一层;具体某个 surface、format、present mode 或 protected 路径可用与否,属于物理设备与 VkSurfaceKHR 的组合,仍要调用 surface capability/format/present-mode query 获取运行时结果。
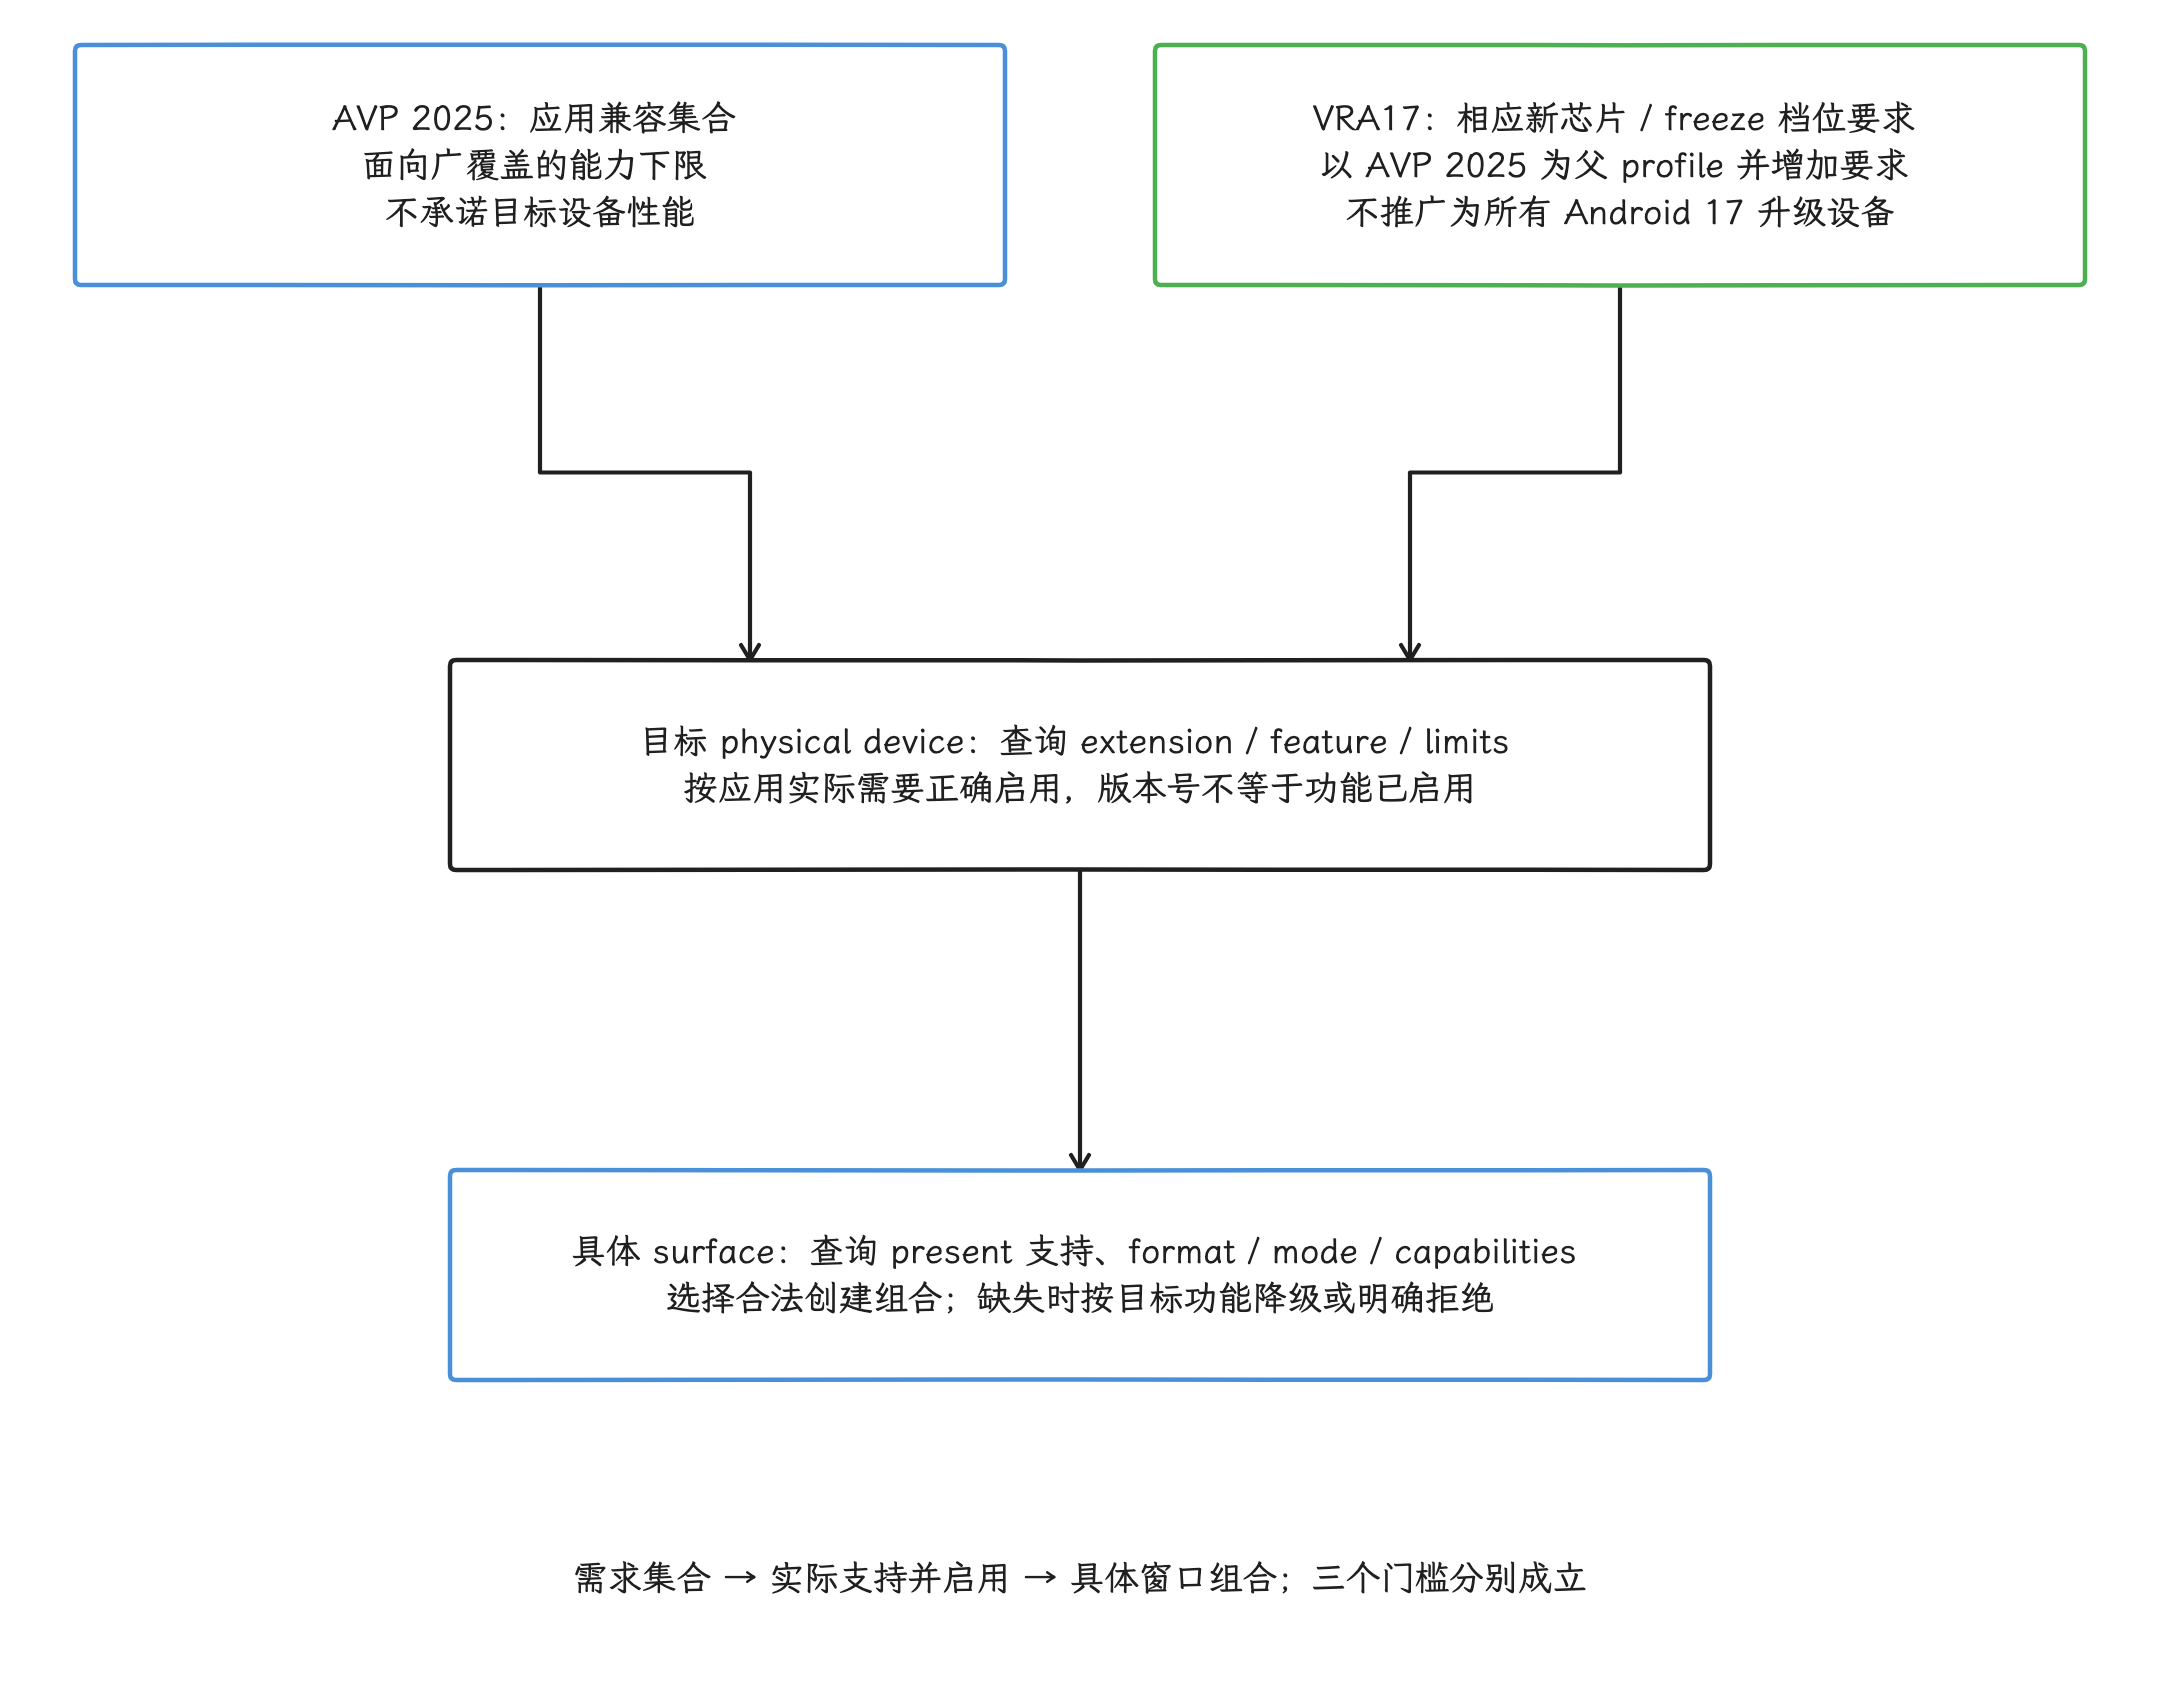
图:AVP2025兼容集合与VRA17相应新芯片/freeze要求的适用范围不同,VRA17以AVP2025为父profile并增加规范要求,适用范围限于相应新芯片,存量升级设备另以运行时查询为准。profile/version不是目标设备已启用某feature或窗口支持某组合的证明,DynamicRendering等仍须查支持并正确启用,再查询具体surface的format/mode/capabilities。箭头是能力核对关系,不表示性能因果。
Dynamic Rendering(无须预先创建 RenderPass/Framebuffer 的渲染方式) 例子
对带有独立 feature bit 的可选能力,核心版本号只说明规范已收录这项能力,应用侧还要显式启用它。以 Dynamic Rendering 为例,它免去预先创建 RenderPass/Framebuffer 的步骤,但应用仍要通过 VkPhysicalDeviceVulkan13Features 或对应 extension feature 查询 dynamicRendering,并在 device creation feature chain 中显式打开。Profile JSON 是否要求该 bit,以实际文件为准;API version 单独给不出这个答案。
渲染流程详解
创建 surface 与 swapchain
进入帧循环前,应用至少要完成以下初始化:
- 用
VK_KHR_android_surface从ANativeWindow创建VkSurfaceKHR; - 查询 queue family(具有相同能力/属性的一组队列接口,不等于物理 GPU 引擎)是否支持向该 surface present;
- 查询 surface capabilities、formats 和 present modes;
- 选择 extent(图像尺寸)、format/colorspace、usage、preTransform、compositeAlpha 和 image count;
- 创建 swapchain 并取得 images;
- 为每个 in-flight frame 准备 command buffer、binary acquire semaphore 和 submit fence;present 所等待的 binary render-finished semaphore 应使用独立的安全复用方案,例如按 swapchain
imageIndex配置一份,而不是仅随 frame slot 循环。submit fence 完成不证明 presentation operation 已消费该 semaphore;也可在支持时使用 swapchain-maintenance 等扩展提供的 present fence 方案。
创建参数 VkSwapchainCreateInfoKHR::minImageCount 至少为 surface capabilities 的下限;若 capabilities 的 maxImageCount 非零,上限就以它为准。这个参数只是请求的最少数量,创建后应再查询实际 image 数;maxImageCount == 0 表示规范未给出显式上限,实际数量仍由实现决定。Android WSI(Window System Integration,Vulkan 与窗口系统的连接层) 还受 native window 的 min-undequeued/max-buffer-count 约束,swapchain 具体几个 buffer,要按设备和 surface 的实际约束来定,双缓冲、三缓冲这类固定说法套不上。
第一阶段:Acquire
典型调用通过 semaphore 或 fence 接收 image 可用信号:
VkResult result = vkAcquireNextImageKHR(
    device,
    swapchain,
    timeoutNs,
    imageAvailableSemaphore,
    VK_NULL_HANDLE,
    &imageIndex
);
只有返回 VK_SUCCESS 或规范允许的 VK_SUBOPTIMAL_KHR 等成功状态时,才继续使用本次取得的 imageIndex;VK_NOT_READY/VK_TIMEOUT/错误时,本次输出索引按无效值处理。即使调用成功,CPU 返回也不保证 image 的旧使用已完成,后续访问仍须等待 acquire semaphore/fence。timeoutNs == 0 时可返回 VK_NOT_READY,有限 timeout 可返回 VK_TIMEOUT,窗口/交换链失效还可能返回 VK_ERROR_OUT_OF_DATE_KHR。固定 r1 普通 Android WSI 的成功 acquire 返回 VK_SUCCESS,SUBOPTIMAL 主要在 present 的 transform 检查产生。
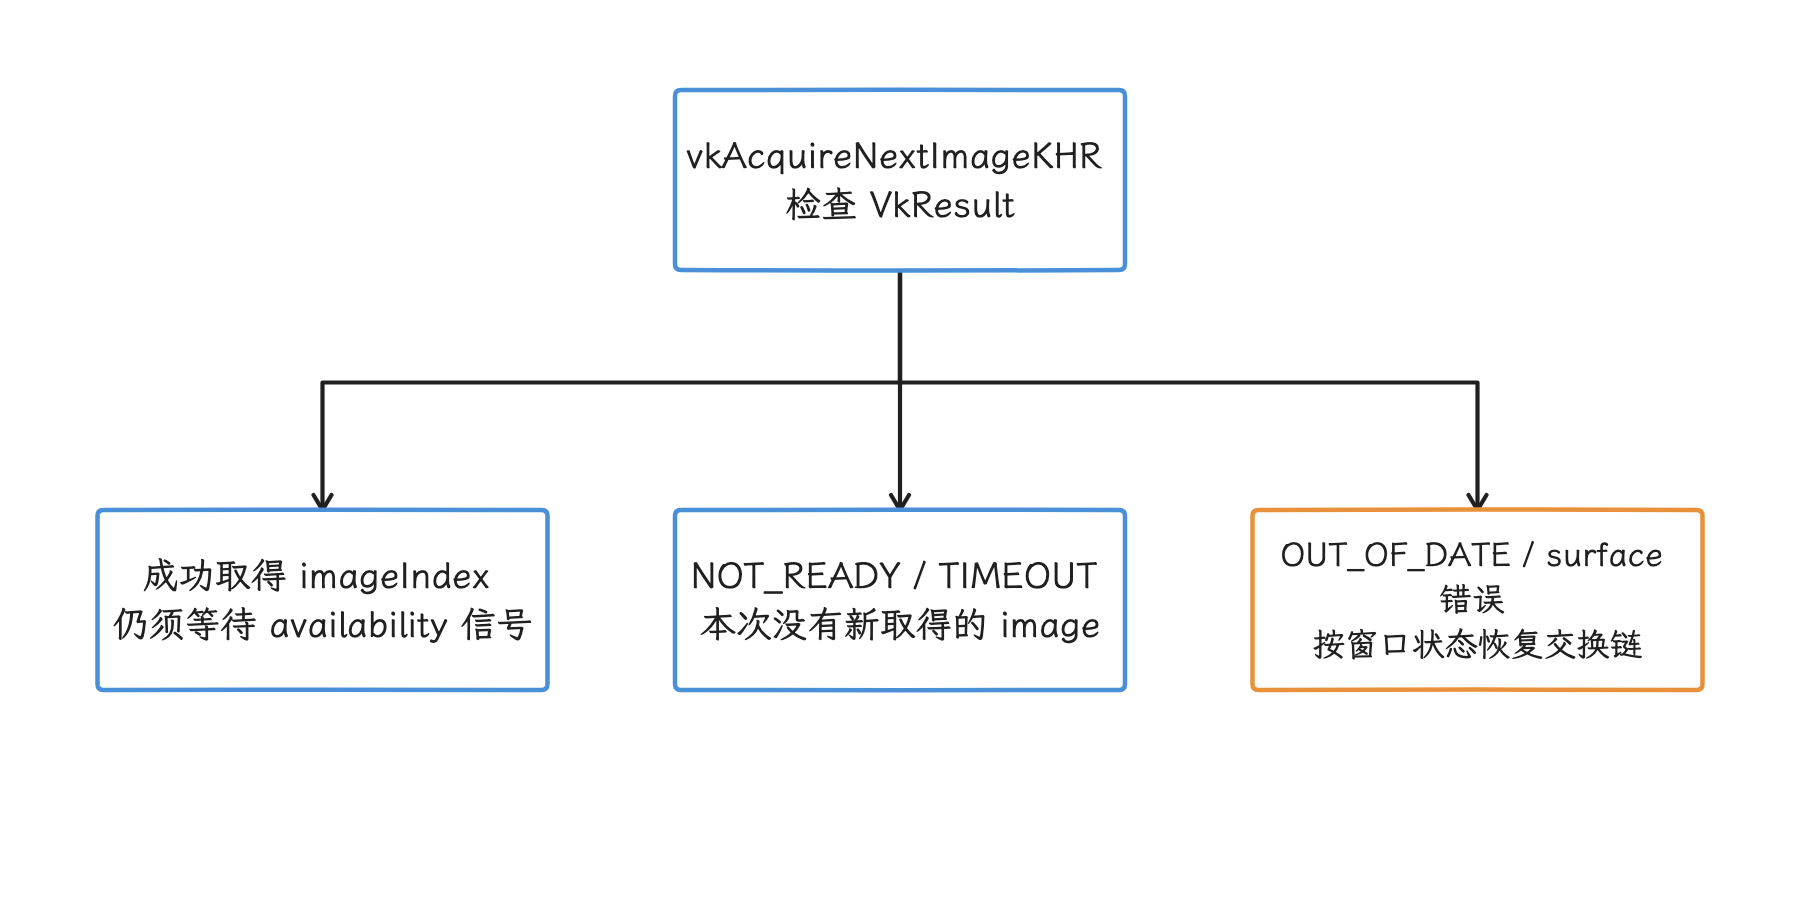
图:先判断返回码,成功返回后旧使用可能仍未完成。 后续访问必须遵守 acquire semaphore/fence,失败时不得使用本次未取得的索引。
普通 swapchain 的 AcquireNextImageKHR() 在 WSI 内部会:
- 把 Vulkan timeout 映射为 native window 的 dequeue timeout;
- 调用
ANativeWindow::dequeueBuffer(),取得 buffer 和 dequeue fence fd; - 找到或绑定对应 swapchain image;
- 把 fence fd 的副本交给驱动私有入口
AcquireImageANDROID(); - 由驱动把该依赖连接到应用提供的 semaphore/fence。
AcquireImageANDROID() 是 loader 与驱动间的私有集成入口。WSI 复制 dequeue fence fd,再交给驱动把依赖接到应用提供的 semaphore/fence:导入全程发生在 WSI 与驱动之间,应用只提供同步对象,loader 调用也只到这个入口为止。若 dup 失败,当前实现先在 CPU sync_wait();失败路径还按私有契约处理 fd 与 cancel。这项依赖已经处理过,同一次 WSI acquire 里应用不要再导入一次。
Acquire 耗时较长,可能因为没有可用 image、native window release 较慢、FIFO 节拍限制、surface 正在重新配置,或者驱动内部处理。dequeue fence 来自该 buffer 的前序 Consumer 完成依赖,但 vkAcquireNextImageKHR() 的 wall time 里还叠着其他因素。我们观察时把两件事分开:dequeue 调用本身是否阻塞,以及返回后 fence/GPU 依赖何时满足。
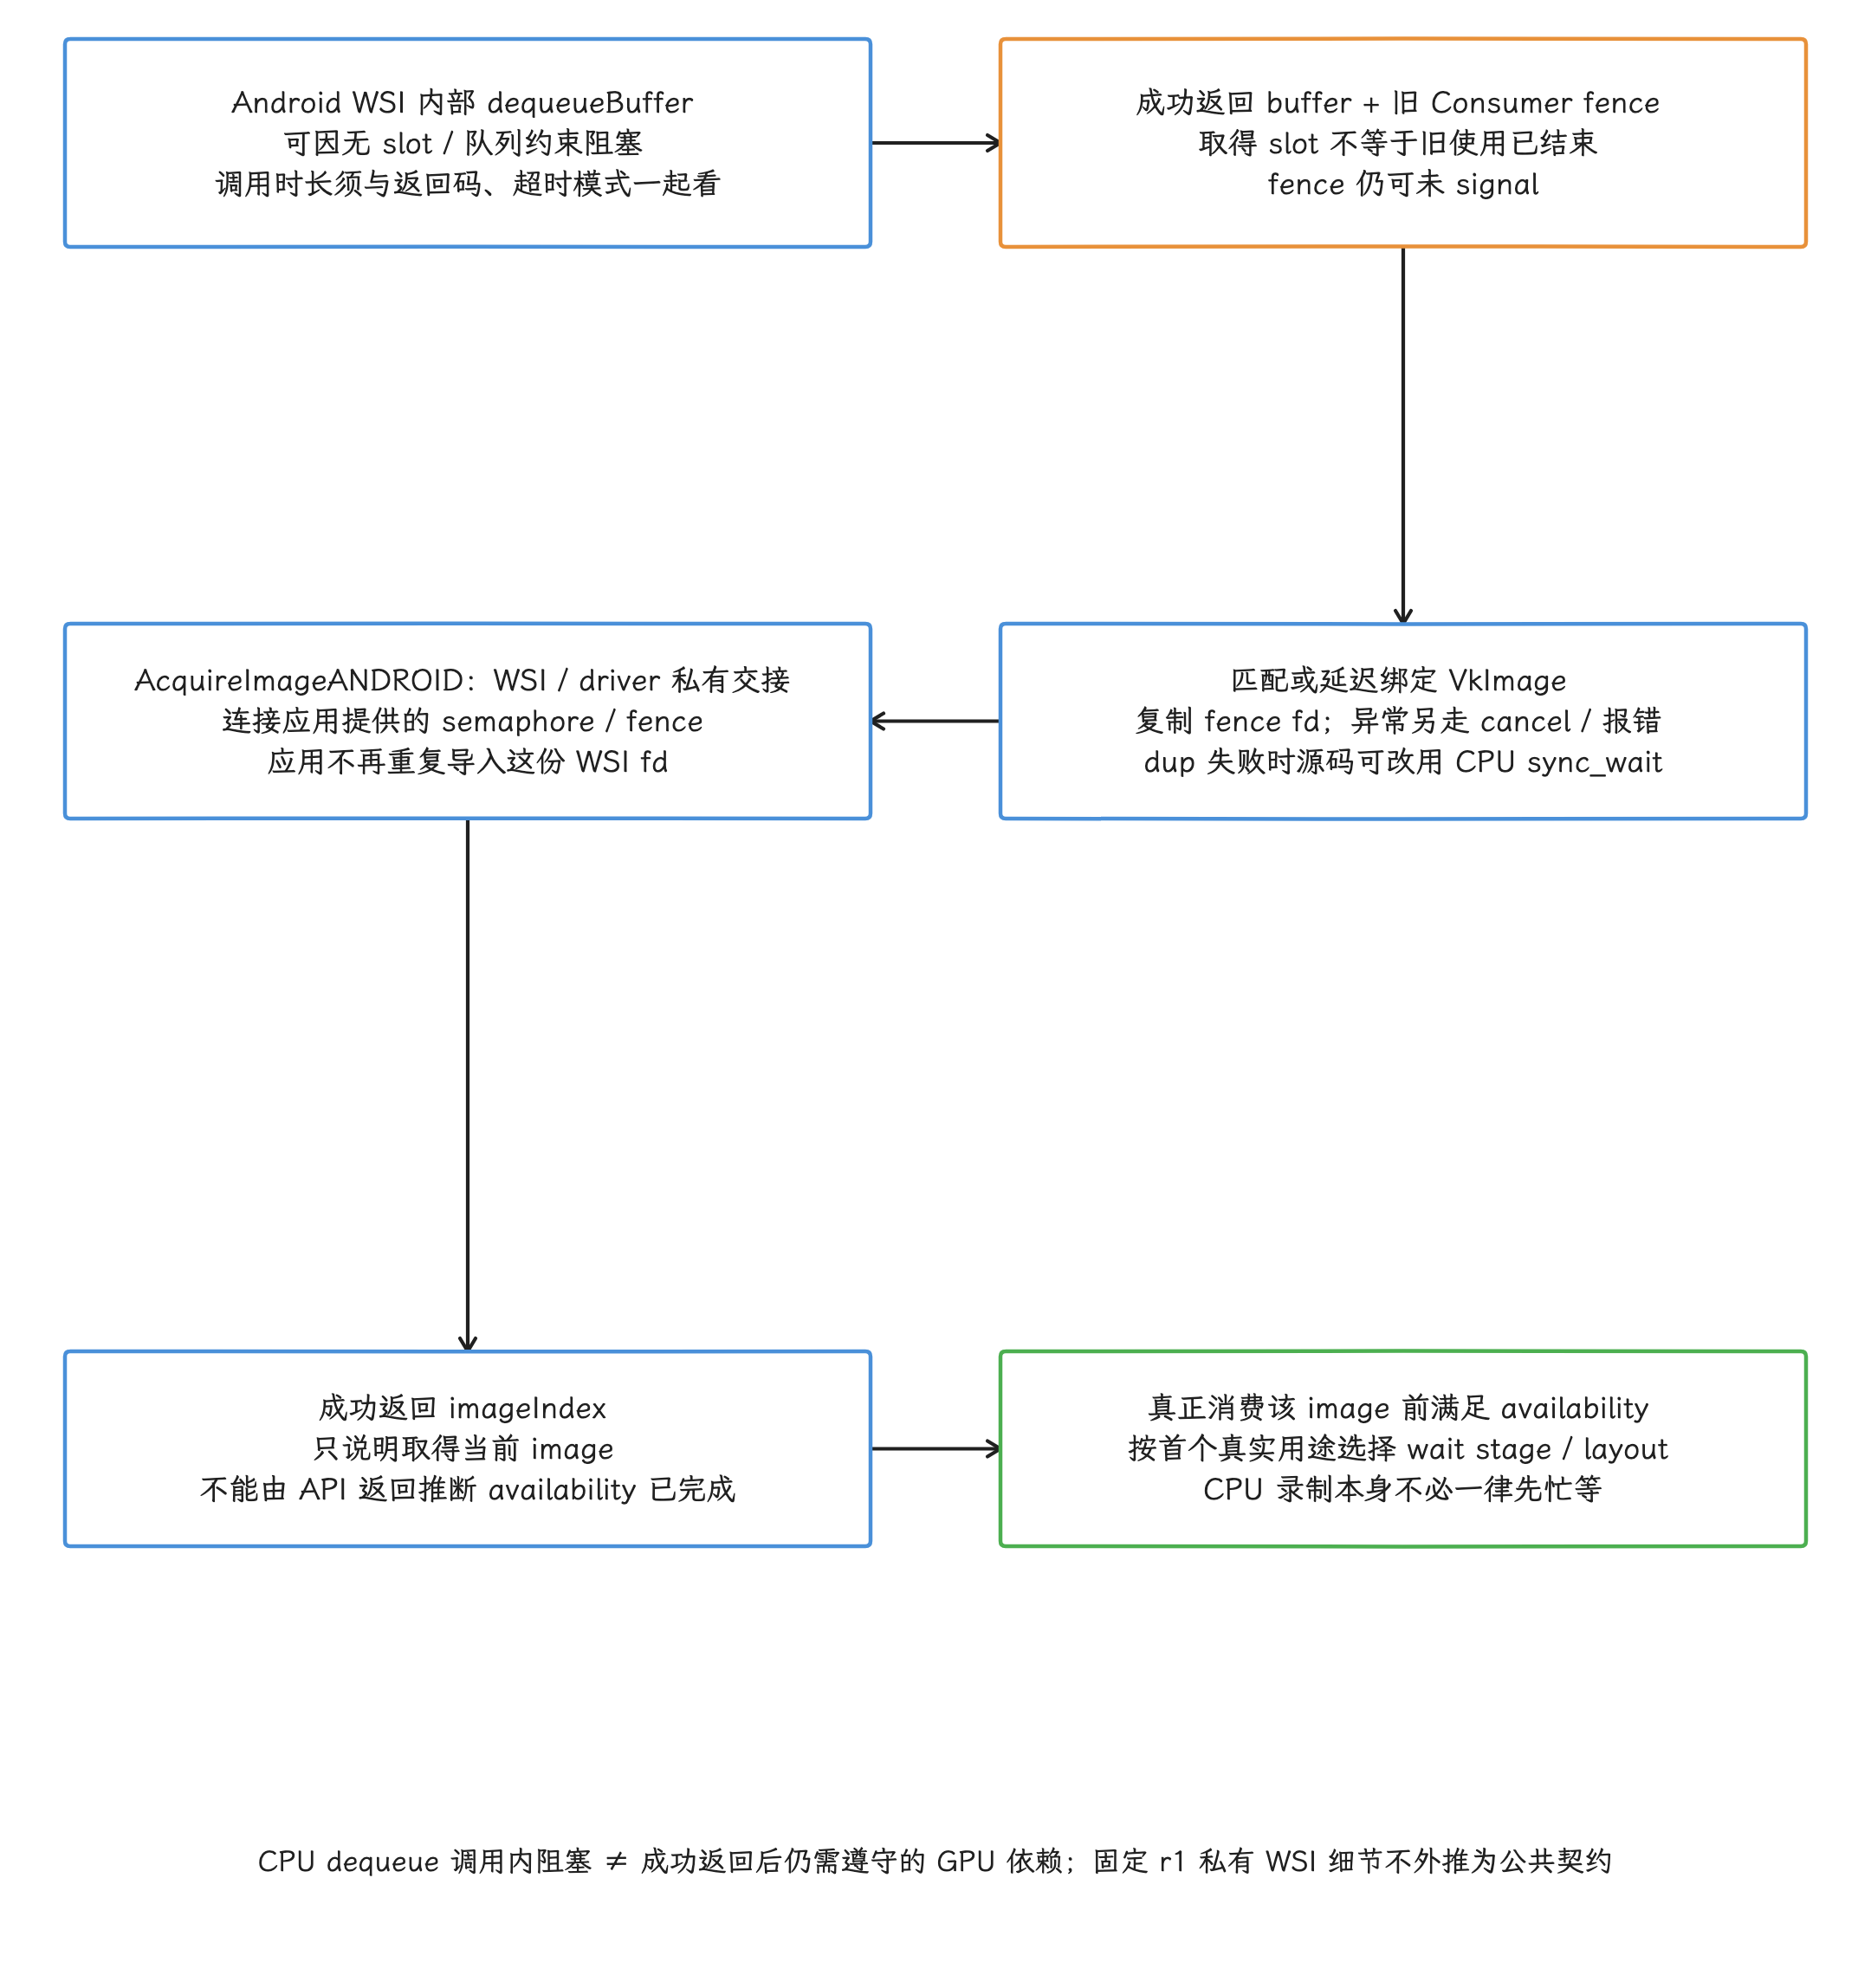
图:固定r1内部NativeWindowDequeue可因slot/队列约束等待,成功返回可带未signal旧Consumer fence。WSI匹配或延迟绑定VkImage,dupfd交私有AcquireImageANDROID由driver连接应用semaphore/fence;dup失败可CPUsync_wait,异常可cancel/报错。成功imageIndex不证明已安全访问,应用在正确stage遵守availability,不重复导入WSI已处理的fd。这里只画正常链和关键等待边界,不是公有API替代实现。
第二阶段:Record 与 Submit
Command Buffer recording 是 host 侧的 CPU 工作,只负责记录命令和对象引用,此时 GPU 还没有执行这些命令。并行录制时要遵守 Vulkan 的 external synchronization(由应用负责的线程同步)规则:
- 并发访问的 recording worker 使用各自的
VkCommandPool;要共享 pool 就用外部锁串行访问; - 同一
VkCommandBuffer的 begin/record/end/reset 不得并发; - 对需要 external synchronization 的同一
VkQueuehost 操作串行保护;新扩展VK_KHR_internally_synchronized_queues的内部同步创建标志是有条件例外,例外范围也仅限该标志,其他对象与 GPU 资源依赖照常成立;本文 HWUI queue 的创建 flags 为 0; - descriptor pool、query pool 和其他标记为 externally synchronized 的对象也要按规范加锁或分离所有权。
下面是需启用 synchronization2 feature 的片段:按 Vulkan 1.3 core 入口书写,较低版本使用对应 KHR 扩展/入口并查询支持。假设 image 第一次被颜色附件阶段使用,acquire→附件的 layout barrier 也使用与该 wait 相容的 stage;若先 transfer/compute,wait stage 必须随真实最早访问调整。renderFinishedSemaphore 取自本次 imageIndex 的安全复用资源,frameFence 已按上一轮 submit 完成状态管理为可用的 unsignaled fence。片段省略对象创建、acquire layout transition 与错误恢复。
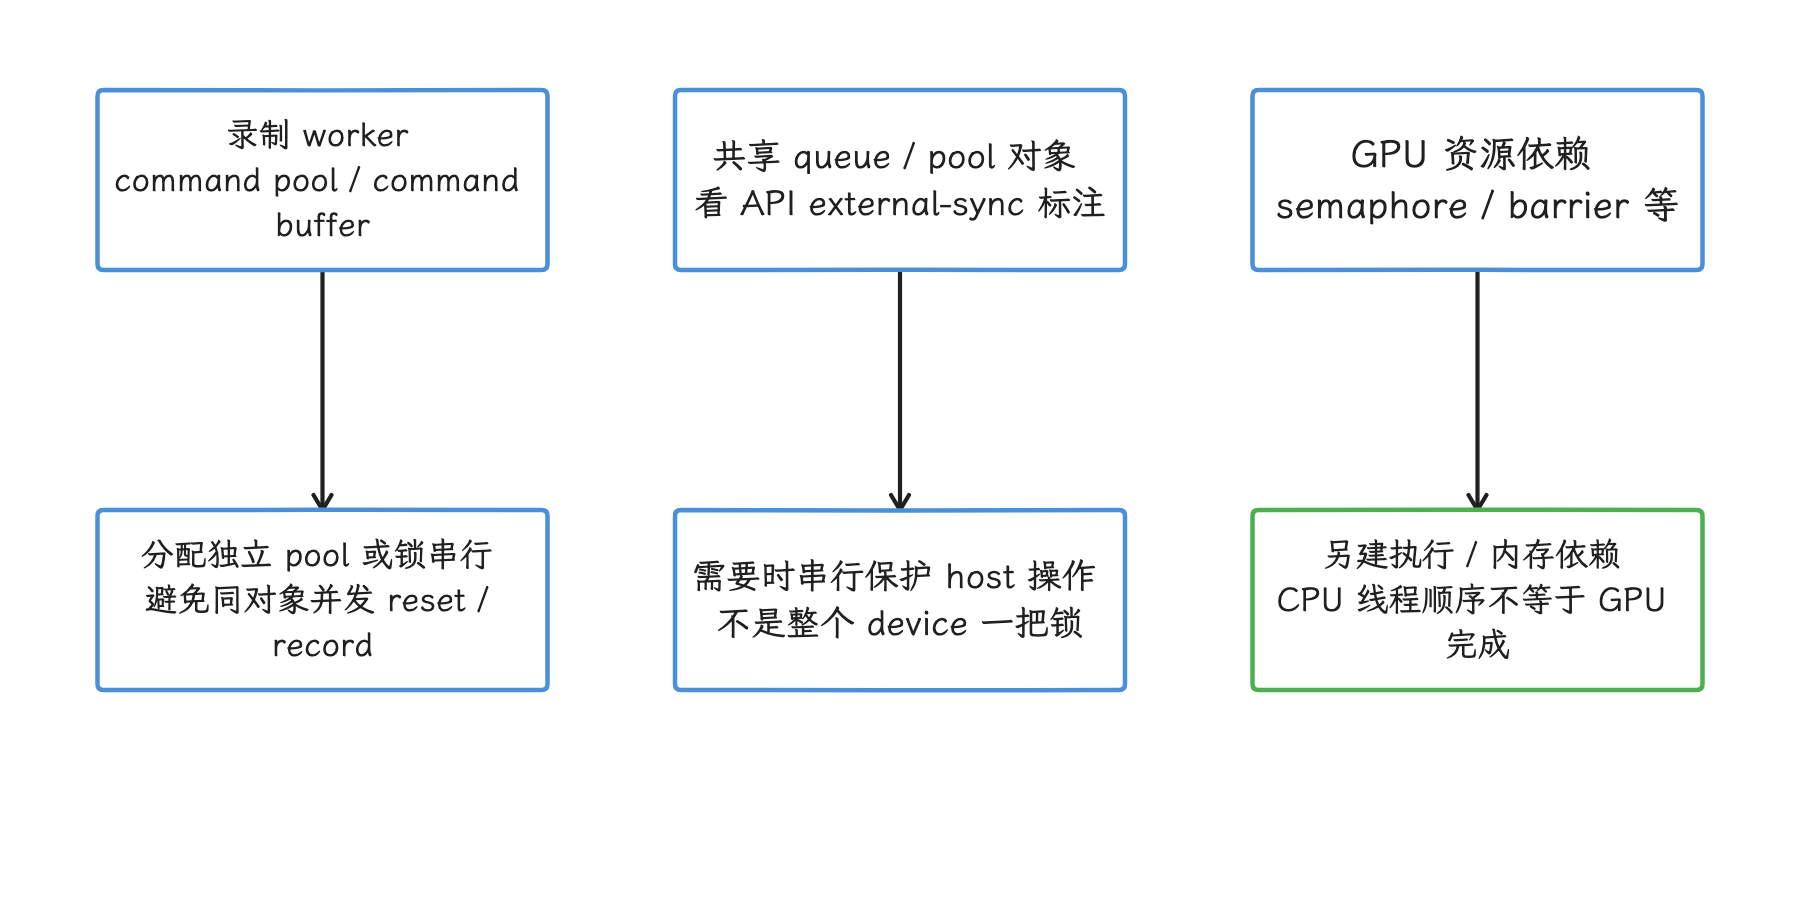
图:并行录制采用独立 pool 或外部锁,队列和对象按各 API 同步要求访问。 内部同步 queue 扩展是条件例外;本文 HWUI queue flags=0,且 host 同步不代替 GPU 依赖。
VkSemaphoreSubmitInfo acquireWait = {
    .sType = VK_STRUCTURE_TYPE_SEMAPHORE_SUBMIT_INFO,
    .semaphore = imageAvailableSemaphore,
    .stageMask = VK_PIPELINE_STAGE_2_COLOR_ATTACHMENT_OUTPUT_BIT,
};

VkCommandBufferSubmitInfo commandInfo = {
    .sType = VK_STRUCTURE_TYPE_COMMAND_BUFFER_SUBMIT_INFO,
    .commandBuffer = commandBuffer,
};

VkSemaphoreSubmitInfo renderSignal = {
    .sType = VK_STRUCTURE_TYPE_SEMAPHORE_SUBMIT_INFO,
    .semaphore = renderFinishedSemaphore,
    .stageMask = VK_PIPELINE_STAGE_2_ALL_COMMANDS_BIT,
};

VkSubmitInfo2 submit = {
    .sType = VK_STRUCTURE_TYPE_SUBMIT_INFO_2,
    .waitSemaphoreInfoCount = 1,
    .pWaitSemaphoreInfos = &acquireWait,
    .commandBufferInfoCount = 1,
    .pCommandBufferInfos = &commandInfo,
    .signalSemaphoreInfoCount = 1,
    .pSignalSemaphoreInfos = &renderSignal,
};

VkResult submitResult = vkQueueSubmit2(graphicsQueue, 1, &submit, frameFence);
// 只有提交成功才进入对应 present;失败由调用方恢复,不能继续假定 fence 会 signal。
这段代码只展示依赖关系,还称不上完整的 renderer。frameFence 让 CPU 判断本次 submit 何时完成,以便安全复用这一帧的 command/descriptor 资源;renderFinishedSemaphore 则让 present engine 等待 GPU 渲染完成。前者跟踪本次 submit 的资源复用,后者约束 present 对 image 的使用。等待 frameFence 不保证 present 已用完 renderFinishedSemaphore;frame slot 与 image index 也不是同一个编号。只在成功 acquire 且准备执行实际 submit 后安排 fence reset,避免重建分支未 submit 却继续等待已 reset 的 fence。
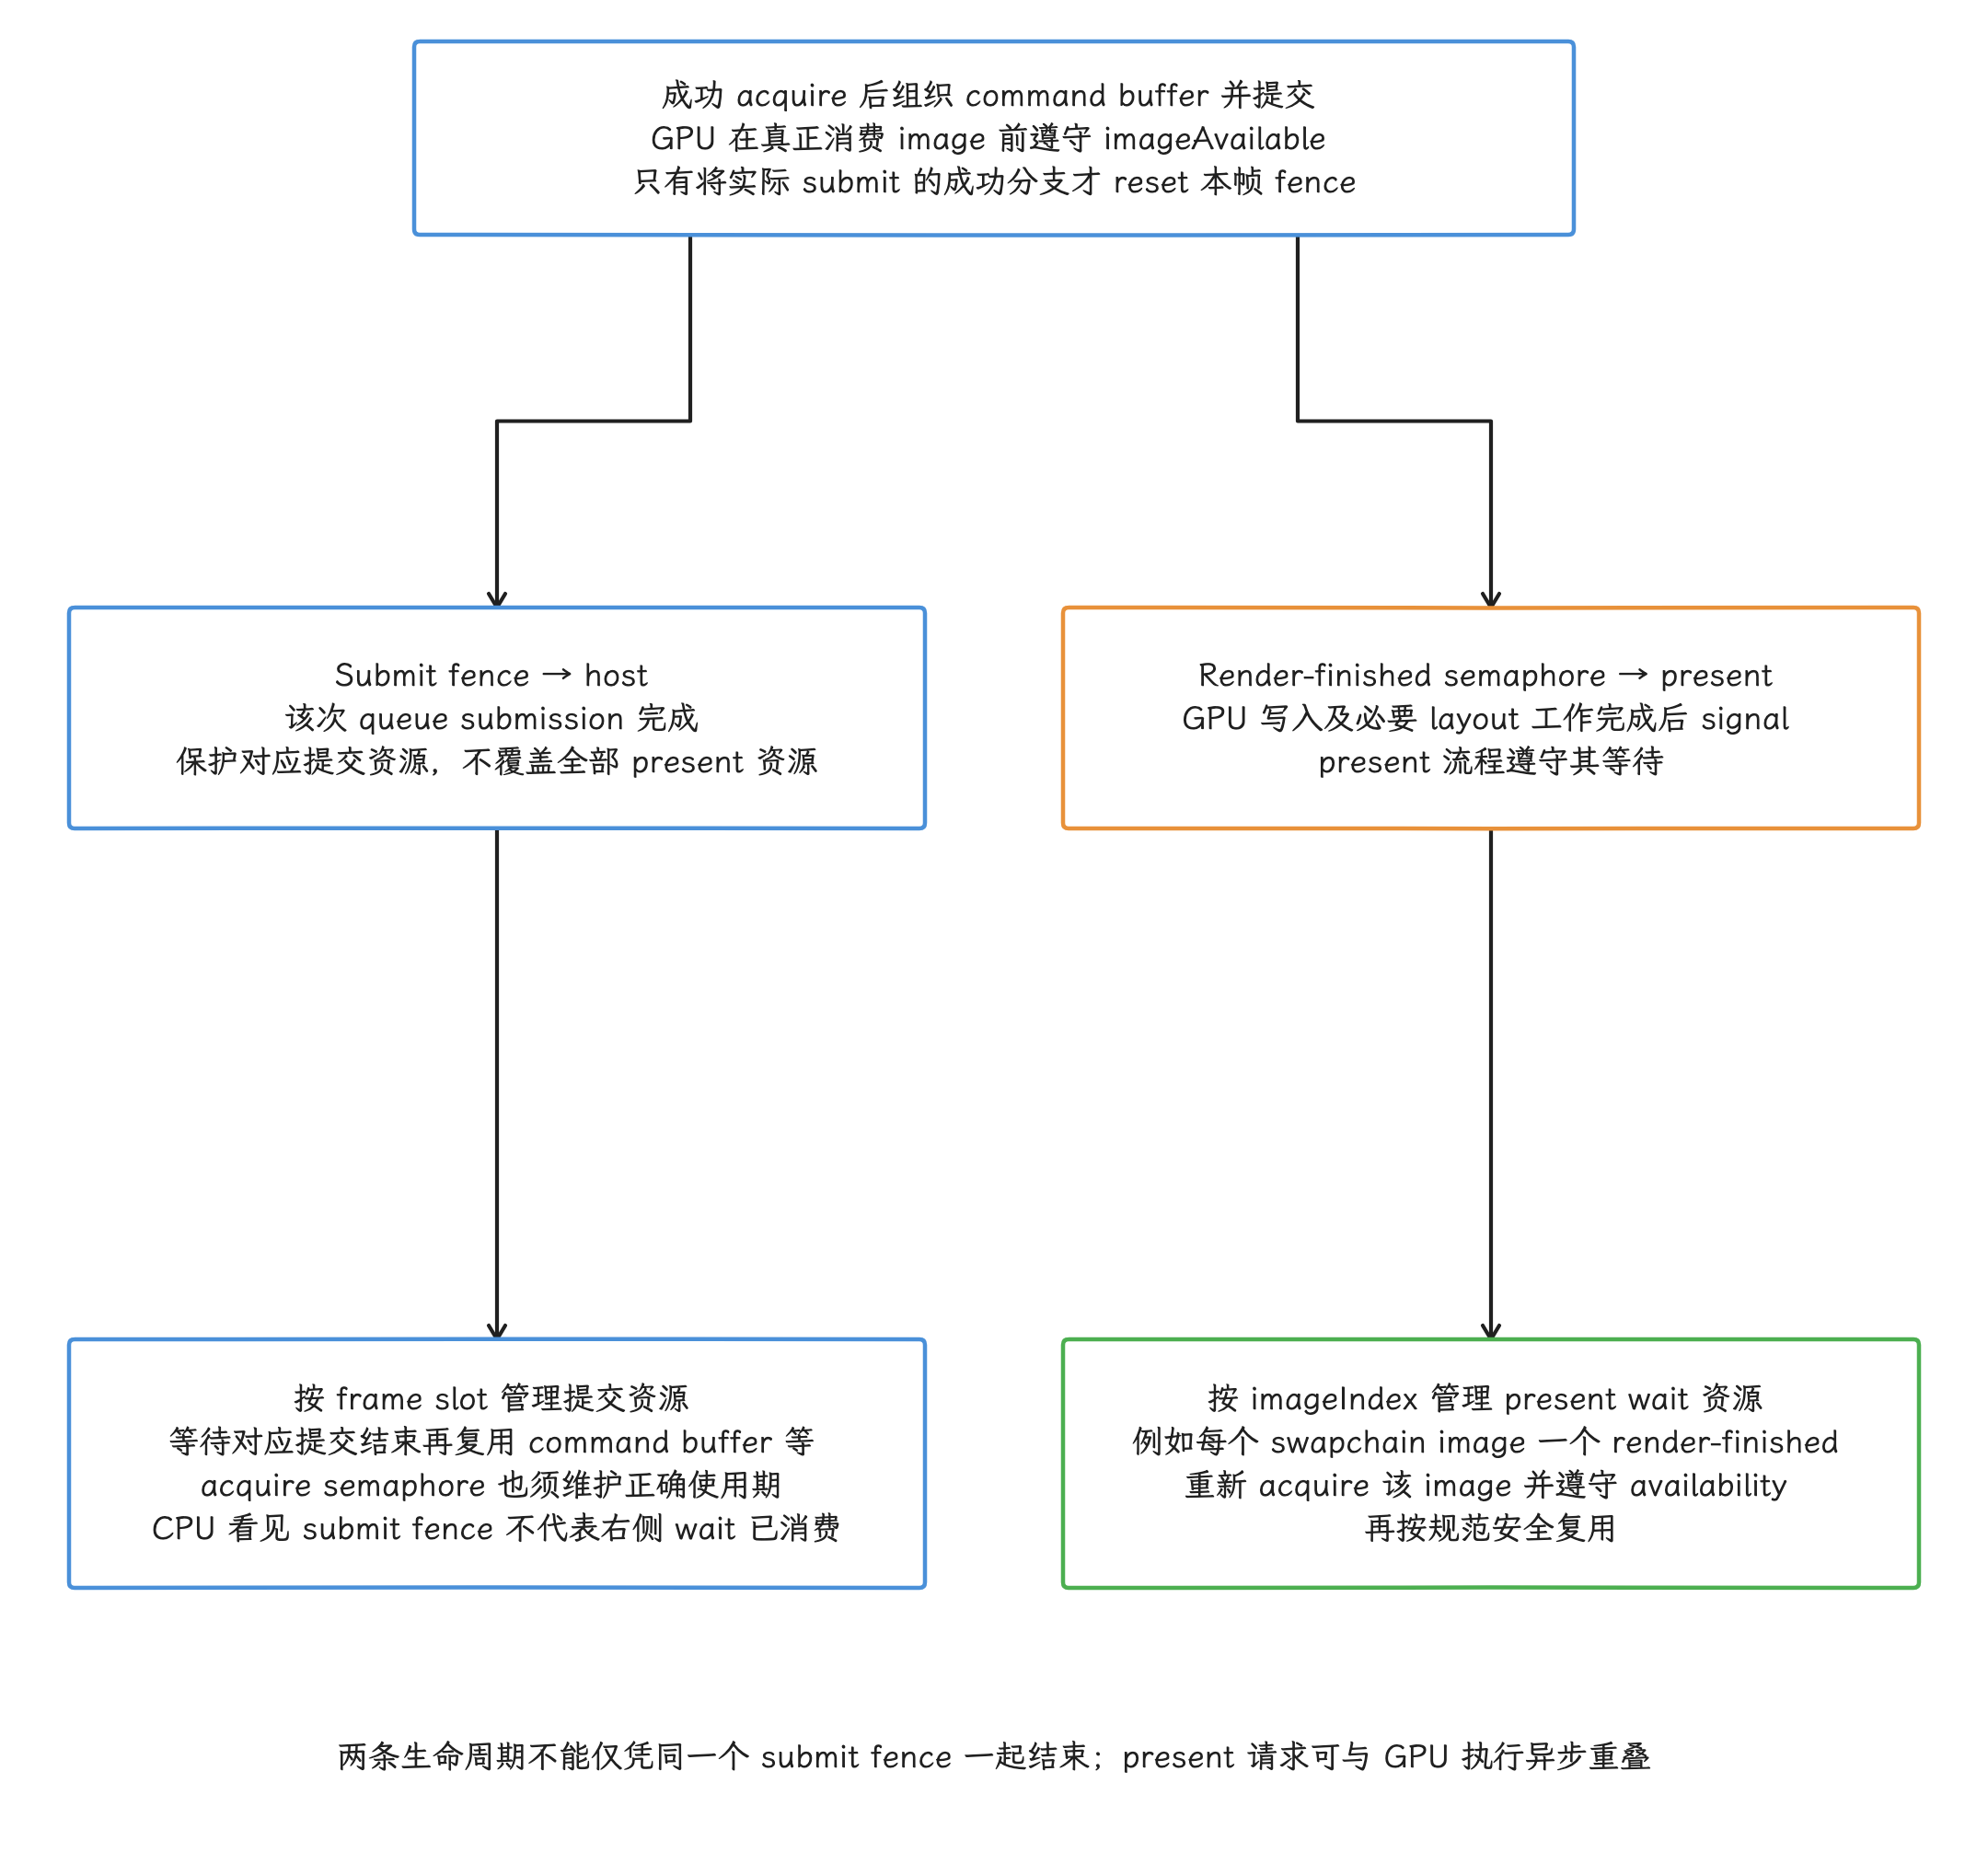
图:frame slot可管理commandbuffer/acquiresemaphore等提交资源,frame submit fence仅证明该提交完成,不证明present已消费renderFinished。renderFinished安全生命周期可按swapchain imageIndex管理,重新acquire对应image并遵守availability依赖后安全复用。resetframefence只放在成功acquire且将实际submit的分支,任何acquire失败后都避免无条件reset。箭头为同步对象及复用保护关系,非CPU先等待整个GPU再调用present。
第三阶段:Present
Present 把 image index 和需要等待的 semaphore 交给 presentation engine(负责把 swapchain image 送入窗口系统的实现),由它把 swapchain image 送入窗口系统:
VkPresentInfoKHR present = {
    .sType = VK_STRUCTURE_TYPE_PRESENT_INFO_KHR,
    .waitSemaphoreCount = 1,
    .pWaitSemaphores = &renderFinishedSemaphore,
    .swapchainCount = 1,
    .pSwapchains = &swapchain,
    .pImageIndices = &imageIndex,
};

VkResult presentResult = vkQueuePresentKHR(presentQueue, &present);
PresentOneSwapchain() 会调用驱动的 QueueSignalReleaseImageANDROID(),把 present waits 转换为 producer completion fence;随后设置 damage/timing 等 native window 状态,并由 CPU 调用 queueBuffer(buffer, fence)。queueBuffer() 接管 fence fd 的所有权,SurfaceFlinger/BLAST 再把它作为 buffer acquire dependency,等待 Producer 完成写入。
vkQueuePresentKHR() 返回时,用户通常还没有看到画面。应用仍需处理 VK_ERROR_OUT_OF_DATE_KHR、VK_SUBOPTIMAL_KHR 和 surface lost;显示时序还要继续追踪 SF latch、HWC validate/present 和 Display fence。固定 r1 PresentOneSwapchain() 仅在 window transform hint 与 swapchain pre-transform 不同的检查中产生 VK_SUBOPTIMAL_KHR;源码明确不因 extent 变化产生这个返回值。应用仍须处理其他失效返回码,并根据实际窗口尺寸管理重建。
完整时序
下面的图按 CPU API、GPU 依赖和 Android queue 三条线描述一帧:
sequenceDiagram
    participant App as "App / RHI thread"
    participant WSI as "Android Vulkan WSI"
    participant BQ as "ANativeWindow / BufferQueue / BLAST"
    participant Driver as "Vulkan driver"
    participant GPU as "GPU execution"
    participant SF as "SF / CompositionEngine"
    participant HWC as "Composer / Display"
    App->>WSI: "vkAcquireNextImageKHR"
    WSI->>BQ: "dequeueBuffer"
    BQ-->>WSI: "buffer + dequeue/release fence"
    WSI->>Driver: "AcquireImageANDROID(duplicated fd, semaphore/fence)"
    WSI-->>App: "successful imageIndex#59; availability signal may be pending"
    App->>App: "record commands#59; layout and access dependencies"
    App->>Driver: "submit(wait acquire, signal renderFinished)"
    Driver->>GPU: "asynchronous GPU work"
    App->>WSI: "present request(wait renderFinished)"
    WSI->>Driver: "QueueSignalReleaseImageANDROID"
    Driver-->>WSI: "write-completion fence fd (may be unsignaled)"
    WSI->>BQ: "CPU queueBuffer(buffer, fence)"
    BQ->>SF: "BLAST buffer transaction + acquire dependency"
    Note over GPU,SF: queue and constrained latch may precede GPU completion#59; actual read obeys acquire fence
    alt presentOrValidate presents directly
        SF->>HWC: "presentOrValidate"
        HWC-->>SF: "present / release feedback"
    else validated result
        SF->>HWC: "validate or validated result"
        SF->>SF: "optional CLIENT composition#59; respect read dependency"
        SF->>HWC: "present"
        HWC-->>SF: "present / release feedback"
    end
    SF-->>BQ: "old buffer release#59; may merge CLIENT GPU dependency"
图中 WSI 调用驱动取得 fence 后,再由 CPU 调用 queueBuffer()。GPU 通过 semaphore/fence 表达完成依赖,CPU 负责发起 API 调用和转移 fd 所有权;queueBuffer() 不是 GPU 自行执行的操作。
Pipeline Barrier 与 Image Layout
三种同步对象解决不同问题
- Semaphore:连接 queue submit、acquire 和 present 等 GPU/WSI 执行依赖;
- Fence:把某次 queue 工作的完成状态暴露给 host(CPU);
- Pipeline barrier/event:在 command stream 内定义执行顺序、内存可见性、image layout 和 queue-family ownership。
Semaphore 的 signal/wait 可以建立执行与内存依赖,但不会自动执行 image layout transition 或 queue-family ownership transfer;barrier 也代替不了 present 对 render-finished semaphore 的等待。分析同步时我们要同时看三件事:execution dependency(谁先执行)、memory dependency(写入何时对读取可见)、resource state(资源处于哪种 layout/ownership)。
acquired image 的 layout
swapchain image 会被循环复用。第一次使用且应用明确丢弃旧内容时,可以从 VK_IMAGE_LAYOUT_UNDEFINED 转换到颜色附件 layout;后续若保留旧内容,应从已知的 VK_IMAGE_LAYOUT_PRESENT_SRC_KHR 等实际旧 layout 转到渲染所需状态;若完全丢弃内容,也可依法继续用 UNDEFINED,不限于首次。把 oldLayout 设为 UNDEFINED 的前提,是旧内容允许完全丢弃且符合规范与渲染设计;满足这个前提,每帧照写才是规范允许的用法。
一次常见的 layout 序列是:
acquire
PRESENT_SRC_KHR(保留旧内容)或 UNDEFINED(允许丢弃)
→ COLOR_ATTACHMENT_OPTIMAL
→ PRESENT_SRC_KHR
present
这条序列只覆盖最简状态变化;MSAA resolve、transfer、compute post-process 或多 queue ownership 涉及进来时,还要增加对应的 layout transition 与 queue-family transfer。
synchronization2 barrier
下面的 barrier 把颜色附件写入收束到 present layout:
VkImageMemoryBarrier2 toPresent = {
    .sType = VK_STRUCTURE_TYPE_IMAGE_MEMORY_BARRIER_2,
    .srcStageMask = VK_PIPELINE_STAGE_2_COLOR_ATTACHMENT_OUTPUT_BIT,
    .srcAccessMask = VK_ACCESS_2_COLOR_ATTACHMENT_WRITE_BIT,
    .dstStageMask = VK_PIPELINE_STAGE_2_NONE,
    .dstAccessMask = 0,
    .oldLayout = VK_IMAGE_LAYOUT_COLOR_ATTACHMENT_OPTIMAL,
    .newLayout = VK_IMAGE_LAYOUT_PRESENT_SRC_KHR,
    .srcQueueFamilyIndex = VK_QUEUE_FAMILY_IGNORED,
    .dstQueueFamilyIndex = VK_QUEUE_FAMILY_IGNORED,
    .image = swapchainImages[imageIndex],
    .subresourceRange = {
        VK_IMAGE_ASPECT_COLOR_BIT, 0, 1, 0, 1
    },
};

VkDependencyInfo dependency = {
    .sType = VK_STRUCTURE_TYPE_DEPENDENCY_INFO,
    .imageMemoryBarrierCount = 1,
    .pImageMemoryBarriers = &toPresent,
};

vkCmdPipelineBarrier2(commandBuffer, &dependency);
这段示例适用于 graphics/present 使用同一 queue family,并且颜色附件写入是最后一项操作的简化场景。如果两类 queue family 不同,应按 surface sharing mode 和 ownership transfer 设计;如果后续还有 transfer/compute,srcStageMask 和 srcAccessMask 必须覆盖真正的最后一次写入。Validation Layer 只能发现其覆盖到的误用;同步问题需启用并检查 synchronization validation,GPU-assisted validation 则针对另一类 GPU 执行期访问问题。二者按需使用,并保留目标设备测试,各自覆盖一类问题。
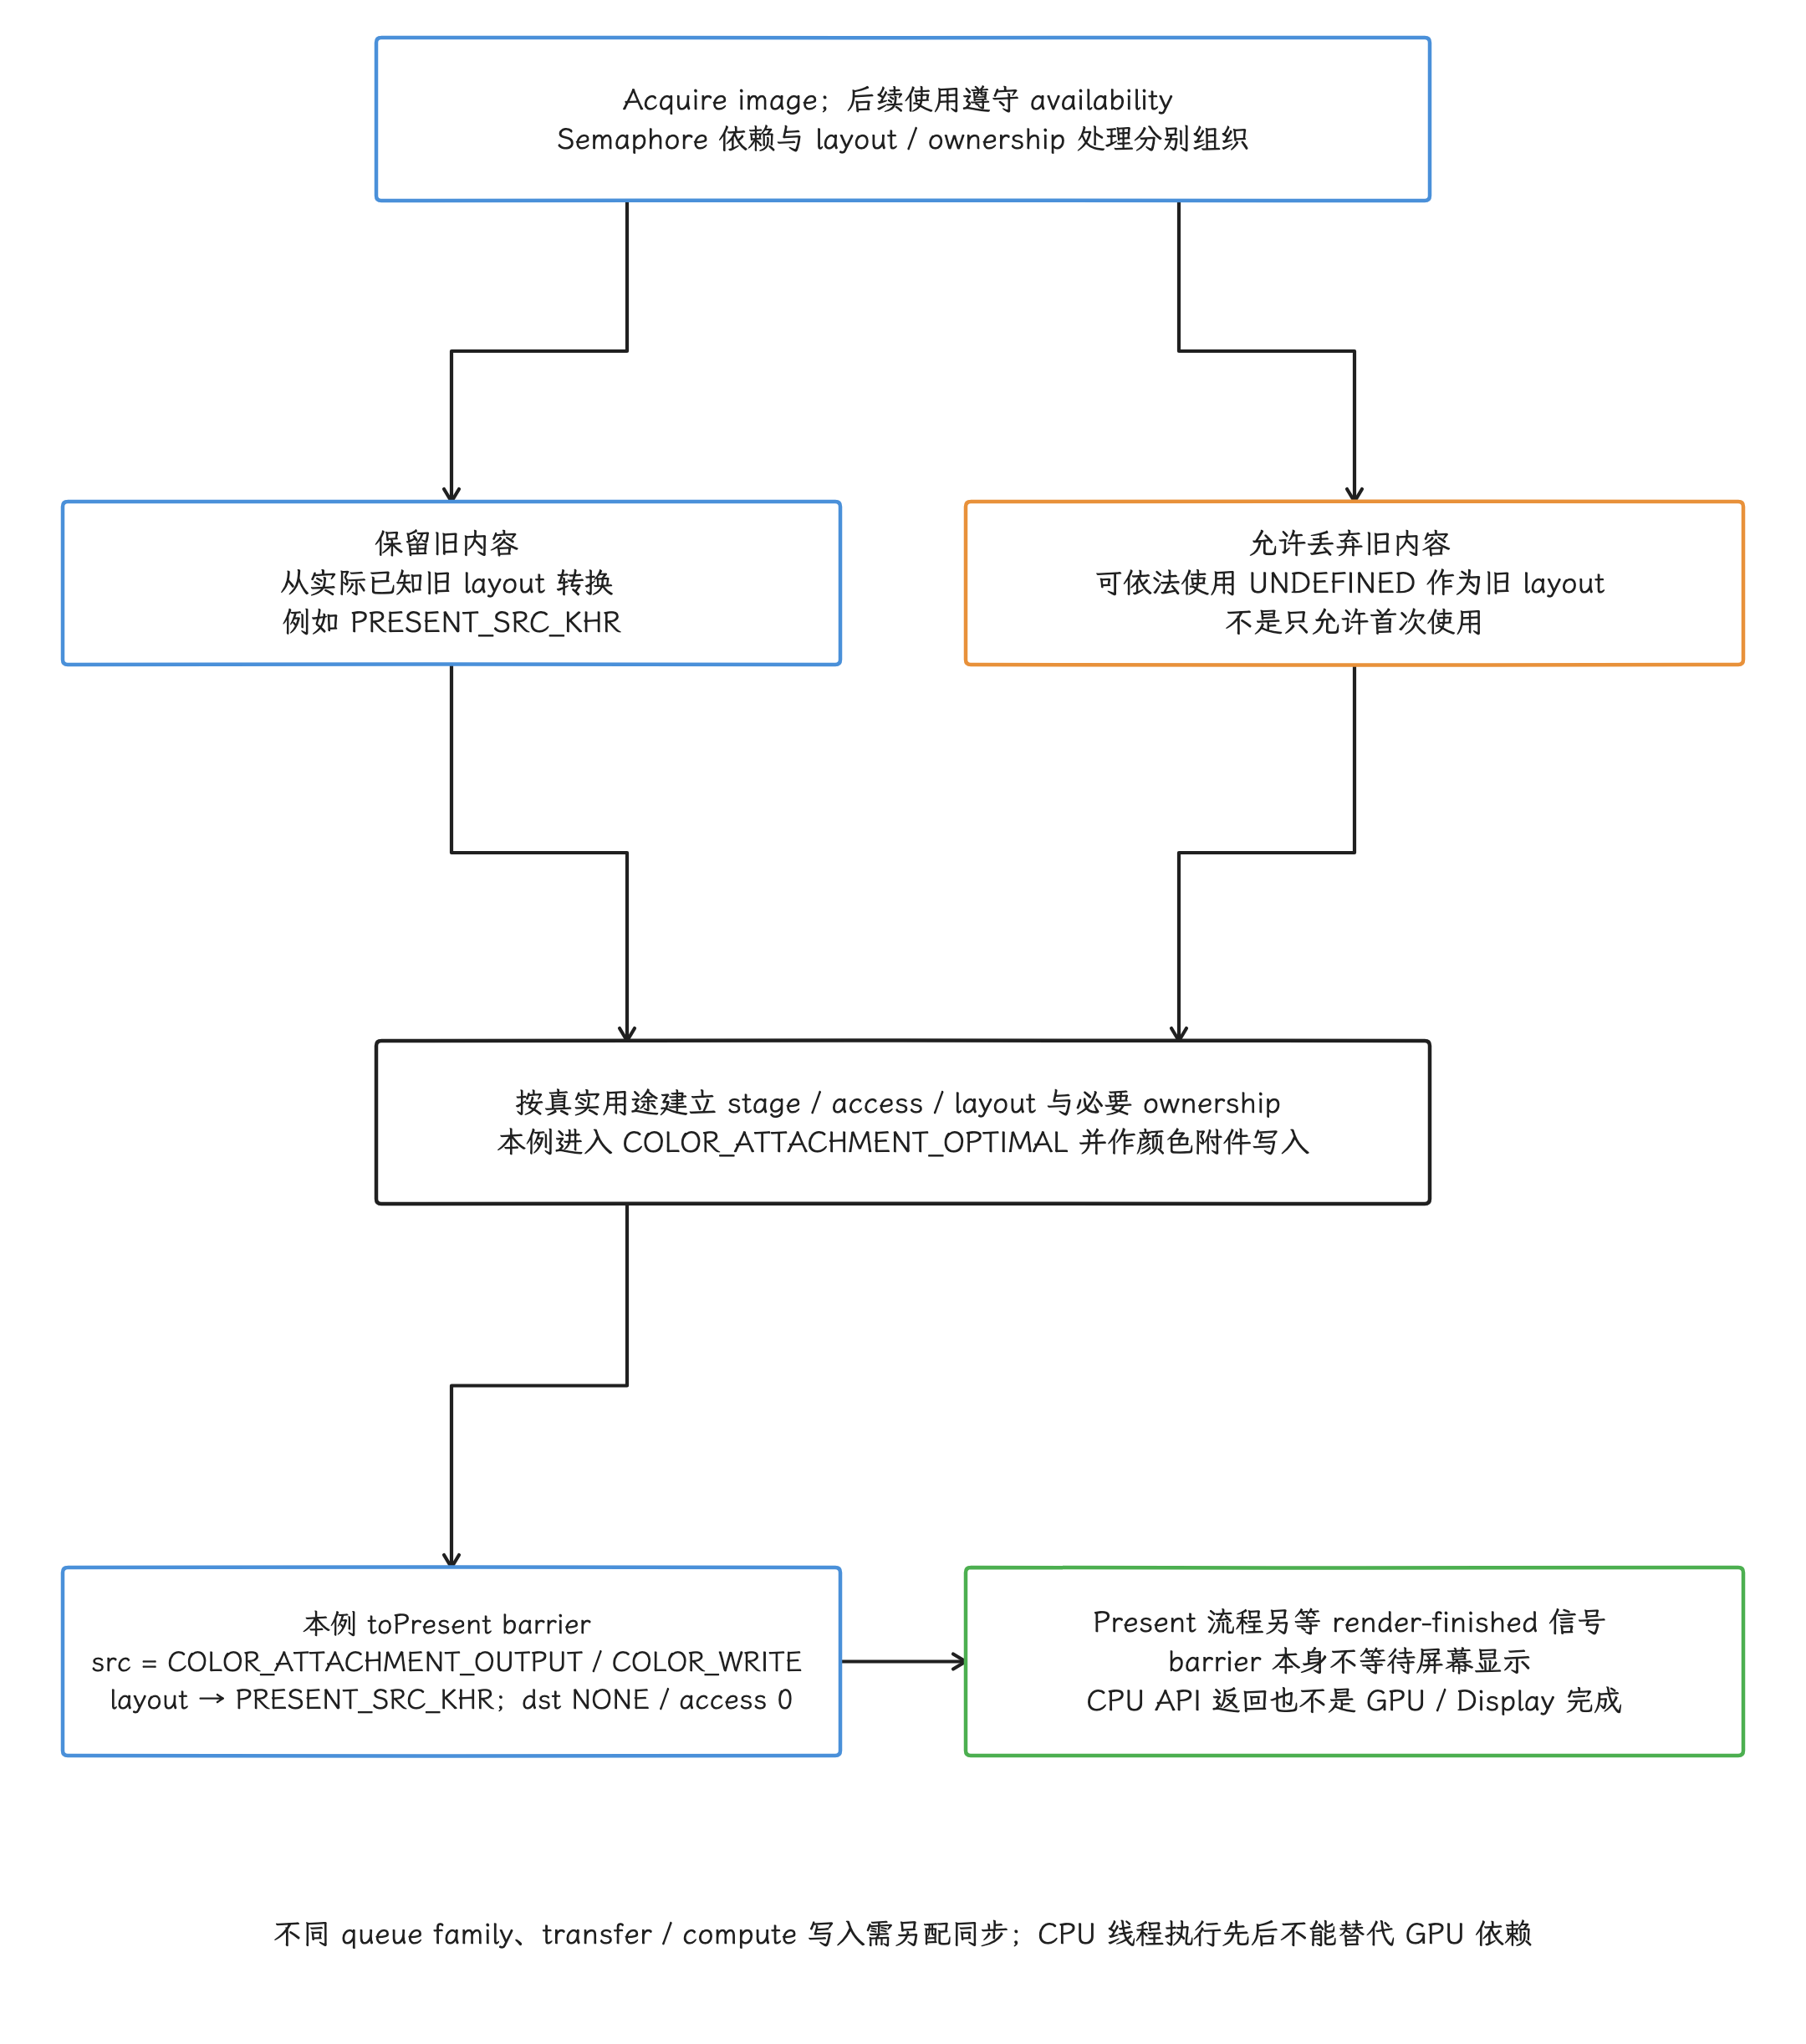
图:semaphore的signal/wait建立规范作用域内执行与内存依赖,不自动做layout或queue-family ownership转移。成功acquire并遵守availability之后,保留旧内容须用实际已知layout,允许丢弃时任意帧可依法用UNDEFINED。图中toPresent只针对最后访问为颜色附件写入且不需family转移的例子;transfer/compute或不同family须另配,按真实访问另设mask后再用。present仍等待renderFinished,barrier不是CPU等待显示,syncvalidation与GPUassisted覆盖范围不同。
过度同步
不分依赖范围地使用宽 stage/access mask、频繁 queue idle、每个 pass 都提交后由 CPU 等 fence,或制造无意义的小 submit,可能增加等待、提交成本或减少有效重叠。仅仅在提交里附带一个 fence,还推不出 CPU 已阻塞;阻塞要看应用实际的等待行为,是否造成 GPU bubble,还要看实际依赖和调度。优化时按下面的步骤走:
- 画出资源的生产者和消费者;
- 找到必须等待该资源的最早 Consumer stage;
- 让 access mask 只覆盖真实的写入和读取;
- 合并无意义的小 submit;
- 用 GPU trace 验证 bubble 是否减少。
Presentation Mode
Vulkan 规范定义了多种 present mode,但应用只能使用 vkGetPhysicalDeviceSurfacePresentModesKHR() 为当前 surface 实际枚举出的模式。
AOSP native WSI 的普通 surface 路径如下:
| Mode | Android 17 返回条件 | 语义与边界 |
|---|---|---|
FIFO_KHR | 始终加入返回集合 | 按顺序显示队列中的 image;Vulkan 规范要求支持 |
MAILBOX_KHR | min_undequeued_buffers + 1 < max_buffer_count | 新 image 可以替换尚未显示的旧 image;仍需评估 pacing、功耗与 in-flight 数量 |
FIFO_LATEST_READY_EXT | present_mode_fifo_latest_ready_ext2 flag 开启 | 按 FIFO 规则消费已 ready 的连续请求并使用较新的结果,可能丢弃中间结果;不是任意越过未 ready 请求挑帧,须以实际枚举与实现为准 |
SHARED_DEMAND_REFRESH_KHR / SHARED_CONTINUOUS_REFRESH_KHR | physical-device presentation properties 报告 sharedImage | 使用共享 image 的专用模式,生命周期不同于普通 swapchain |
普通 Android Surface 路径返回的集合里没有 IMMEDIATE_KHR 和 FIFO_RELAXED_KHR,桌面 Vulkan 的常见选型建议要经枚举确认后才能搬到 Android。
运行时选择
我们的选择流程包括:
- 枚举 modes;
- 结合业务目标选择 FIFO、MAILBOX 或 FIFO latest ready;
- 用 surface capabilities 选择合法 image count;
- 记录 swap interval/present mode 和 Display refresh mode;
- 在目标设备测量 input-to-present、帧间隔、功耗和丢帧;
- surface 重建后重新查询,不要一直沿用上一窗口的能力结果。
MAILBOX 未必带来最低时延,更多可用 image 也未必更流畅:应用过早采样输入并持续积压工作时,即使 presentation engine 丢弃旧帧,CPU/GPU 仍然会为这些帧付出成本。
Android 17 present timing
android-17.0.0_r1 增加了 VK_EXT_present_timing 平台支持,并把它列入 VP_ANDROID_17_requirements。AOSP WSI 可以查询 queue-operations-end、request-dequeued、image-first-pixel-out 和 image-first-pixel-visible 等显示阶段时间。应用还要完成以下步骤:
- 枚举并启用 extension;
- 查询
VkPhysicalDevicePresentTimingFeaturesEXT; - 按规范启用
VK_KHR_present_id2等依赖; - 查询具体 surface 的 timing capabilities;
- 创建 swapchain 时设置
VK_SWAPCHAIN_CREATE_PRESENT_TIMING_BIT_EXT; - 处理 timing queue full 和查询结果延迟到达。
该扩展提供的是 Android 显示链路中的阶段反馈;用户实际看到的光学显示时间,仍要靠外部仪器测量。旧设备可以继续评估 VK_GOOGLE_display_timing;两套 API 的阶段/标识与时间域模型不同,应按各自契约使用;Android 官方文档指出两者相关时间戳均使用 CLOCK_MONOTONIC,据此把两者说成 Android 上不同的实际时钟,缺少依据。
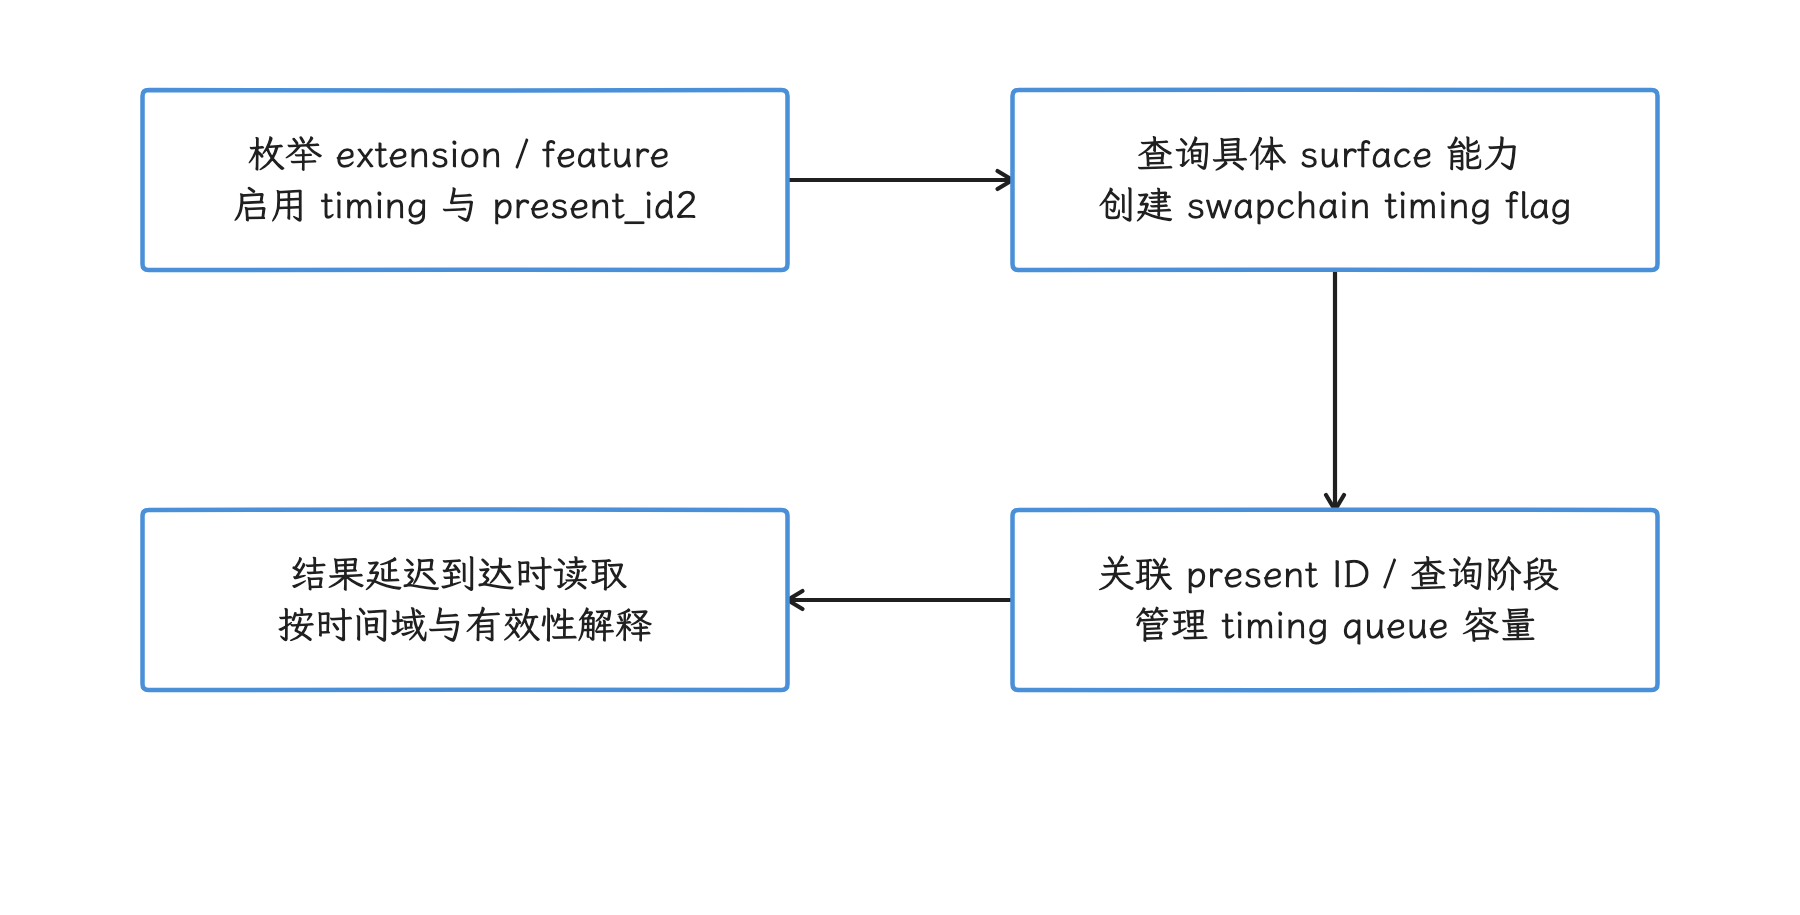
图:扩展、feature、依赖与 swapchain flag 都满足后,按实际 timing 能力查询反馈。 Android 两套 timing 的相关时间戳使用 CLOCK_MONOTONIC;光学指标仍以外部仪器为准。
Swappy Frame Pacing
Swappy 是 Android Game Development Kit(AGDK)中的帧节奏库,不属于平台源码 android-17.0.0_r1。应用打包的 Swappy 版本、初始化结果和运行时配置都会影响行为,因此记录系统版本时还要单独记录库版本。
它解决什么
Swappy Vulkan 接口包装 vkQueuePresentKHR(),结合 Display refresh、presentation timestamp、Choreographer 和 sync fence 调整提交节奏。它主要用于:
- 避免 Producer 持续过早提交造成 queue-stuffing(待显示帧长期积压);
- 让目标帧率与显示周期形成稳定关系;
- 在需要时调整 pipeline mode 和 swap interval;
- 为多刷新率设备提供可复用的 pacing 机制。
Swappy 中出现等待,不一定代表卡顿。如果它在合适的位置暂停 render thread,减少 in-flight frame 并推迟输入采样,端到端时延反而可能下降。判断时我们比较等待前后的 present 间隔、missed frame、queue depth、GPU idle 和 input-to-present 时延。
接入要点
每个 swapchain 都要单独完成 Swappy 初始化,并在重建时更新对应状态。SwappyVk_queuePresent() 仍会返回 VkResult,应用必须处理 OUT_OF_DATE/SUBOPTIMAL;初始化失败时,也要切换到自研 pacing 或明确的降级策略。
下面的骨架只展示调用位置,具体签名与配置以应用锁定的 AGDK 版本为准:
create swapchain
  → initialize Swappy for this swapchain
  → configure target swap interval / auto mode

per frame
  acquire → record → submit
  → SwappyVk_queuePresent(...)

swapchain recreate
  → destroy/reinitialize Swappy state
这份骨架只标出 present 包装入口;Swappy 在一帧中的其余 hook、等待与统计,以应用锁定版本的文档为准。resource barrier、command buffer fence 和业务线程同步,仍由应用自己管理。
自研 pacing 与 Swappy
Vulkan 应用可以使用 VK_EXT_present_timing、VK_GOOGLE_display_timing、present id/wait、frame-rate hint 和引擎时钟自行实现 pacing。同一个 swapchain 最好只交给一套 pacing 控制器调度;接入 Swappy 后,要明确由谁决定目标时间、由谁等待,以及由谁统计历史 present。
Trace 视角
建立逐帧证据
做帧归因时,我们从目标 Surface 和 Producer tid 开始,每帧至少记录:
CPU: input / update / recording(先后按引擎组织)→ successful acquire → submit → present request / queue
GPU: acquire wait → rendering / layout work → producer completion signal
Display: buffer transaction / readiness / latch → strategy → optional CLIENT → present feedback
Reuse: old buffer release / fence → future acquire → safe rewrite
(queue may precede GPU completion; actual pixel read still obeys acquire dependency)
我们用这条时间线把 CPU API、GPU execution 和显示阶段分开。带有调用名的 slice 可能来自应用 marker、Vulkan layer、AGI 或驱动数据源;没有标准 slice 时,可以用 present id、buffer/frame number、fence 和 FrameTimeline token 补齐关联。
等待归因
| 现象 | 候选原因 | 证据 |
|---|---|---|
vkAcquireNextImageKHR() 耗时长 | 没有 available image、FIFO cadence、Consumer release 较晚、surface resize | image count、BufferQueue state、dequeue/release fence 和返回码 |
| command recording 迟到 | logic/RHI/worker 依赖、pipeline 编译、CPU 调度 | worker slice、Runnable latency(可运行线程等待 CPU 的时间)和 pipeline cache |
vkQueueSubmit*() host 调用耗时长 | queue 外部同步竞争、驱动工作、过多小 submit | host mutex、调用栈和 submit 数量 |
| submit 较早但 GPU fence 迟到 | shader、overdraw、带宽、barrier bubble、温控/频率 | GPU stages/counters、job queue 和 fence signal |
vkQueuePresentKHR() 耗时长 | 驱动/WSI、present waits、window queue;计时包住外层 Swappy 时另含库侧等待 | Swappy marker、QueueSignalReleaseImage 和 BufferQueue queue |
| buffer 已 queue 但 SF 使用旧帧 | Producer fence 未 ready、目标显示时刻未到、visibility/transaction 条件 | layer trace、fence 和 present timing |
| SF 已选新帧但 present 仍晚 | CLIENT composition、HWC/Display 资源竞争 | RenderEngine、composition type 和 HWC/present fence |
vkAcquireNextImageKHR() 和 vkQueuePresentKHR() 管理的是 swapchain image 的取得与交付;业务线程同步和通用 GPU 同步要另选原语。它们的阻塞行为会随驱动、present mode 和 presentation engine 状态变化。
queue-stuffing
在 trace 里看到 pending/in-flight 数量长期高位、应用仍按最大速度 acquire/submit/present、随后周期性等待 available image,而帧率接近目标、input-to-present 时延持续上升,就是 queue-stuffing 的典型形态。修复方向包括:
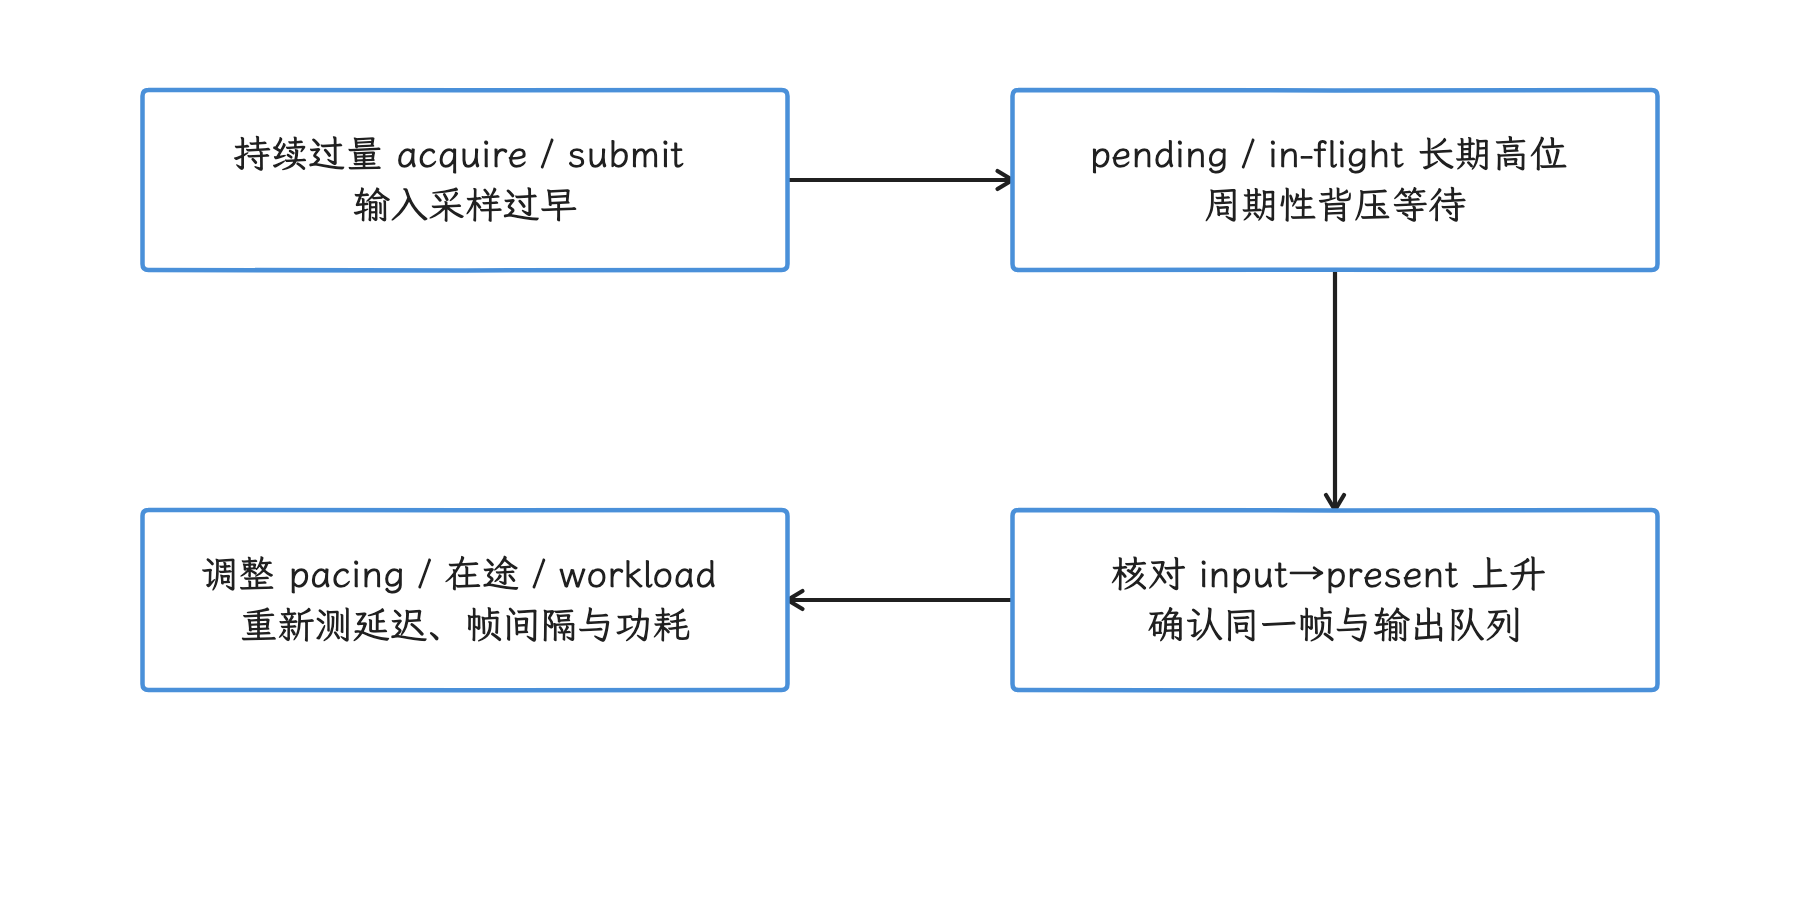
图:用同队列在途数量、等待与输入时延证明过量超前,再调整节奏。 候选形态不代替根因验证,GPU workload 过重与显示约束也要排查。
- 用 Swappy 或自研 timing 控制 submit;
- 降低 in-flight frame 数;
- 把输入采样推迟到更靠近目标帧;
- 减少 GPU workload,确保 Producer fence 在 deadline 前 ready;
- 选择经设备验证的 present mode/image count。
FrameTimeline、present timing 与光学时间
FrameTimeline 可帮助对齐受支持路径的 App SurfaceFrame 与 SF DisplayFrame;官方文档明确列出 SurfaceView 尚未支持;独立 SurfaceView 是否有完整 expected/actual,要看该路径的实际支持情况,仅凭 native Producer 传递 token/desired-present 还不足以判断。还要记录 Producer、系统与采集配置。VK_EXT_present_timing 提供 WSI/显示阶段反馈,present fence 是显示栈的呈现时间基准;光学响应时间仍以外部仪器测量为准。
SurfaceFlinger Graphite 不属于 App WSI
SurfaceFlinger RenderEngine 包含可选的 Graphite Vulkan backend;RenderEngineCreationArgs::Builder 的 backend 字段默认 Ganesh,实际 SF 调用方仍可覆盖;是否启用 Graphite 取决于 flag、property 和 OEM 配置。RenderEngineThreaded 尝试应用 SFRenderEnginePolicy;setSchedFifo(true) 仅在 disable_sched_fifo_re 未开启时请求 SCHED_FIFO priority 2,否则选择 SCHED_OTHER。设置还可能失败;primeCache task 在发起预热调用前后尝试切换普通/原策略;源码里的请求与现场线程的实际调度状态,要分开确认。
这条 Vulkan 工作只在 SurfaceFlinger 需要 RenderEngine 生成 client target、blur、tone-map 等内容时出现。它属于 SF 的另一套 device/context/queue/线程对象,与 App 侧对象分开管理;两者仍可能竞争同一物理 GPU、带宽和显示资源。如果主体 layer 使用 HWC DEVICE composition,SF 未必会通过 RenderEngine 重绘它。我们 trace 分组时把 App queue、REThreaded::drawLayers、Graphite/Ganesh submit 和 HWC present 分开看,SF Graphite 的时间要留在 App command recording 之外。
Graphite 的 flushAndSubmit() 使用 Recording、wait/signal backend semaphores 和导出的 sync fd 表达 RenderEngine GPU 何时完成。这是 SF RenderEngine 输出工作的一项完成依赖,正常 CLIENT 路径用它保护 client target 后续读取;与 App submit 的 VkFence 是不同对象,但可能处于同一帧的前后依赖链中,分析时要放进同一条链里看。
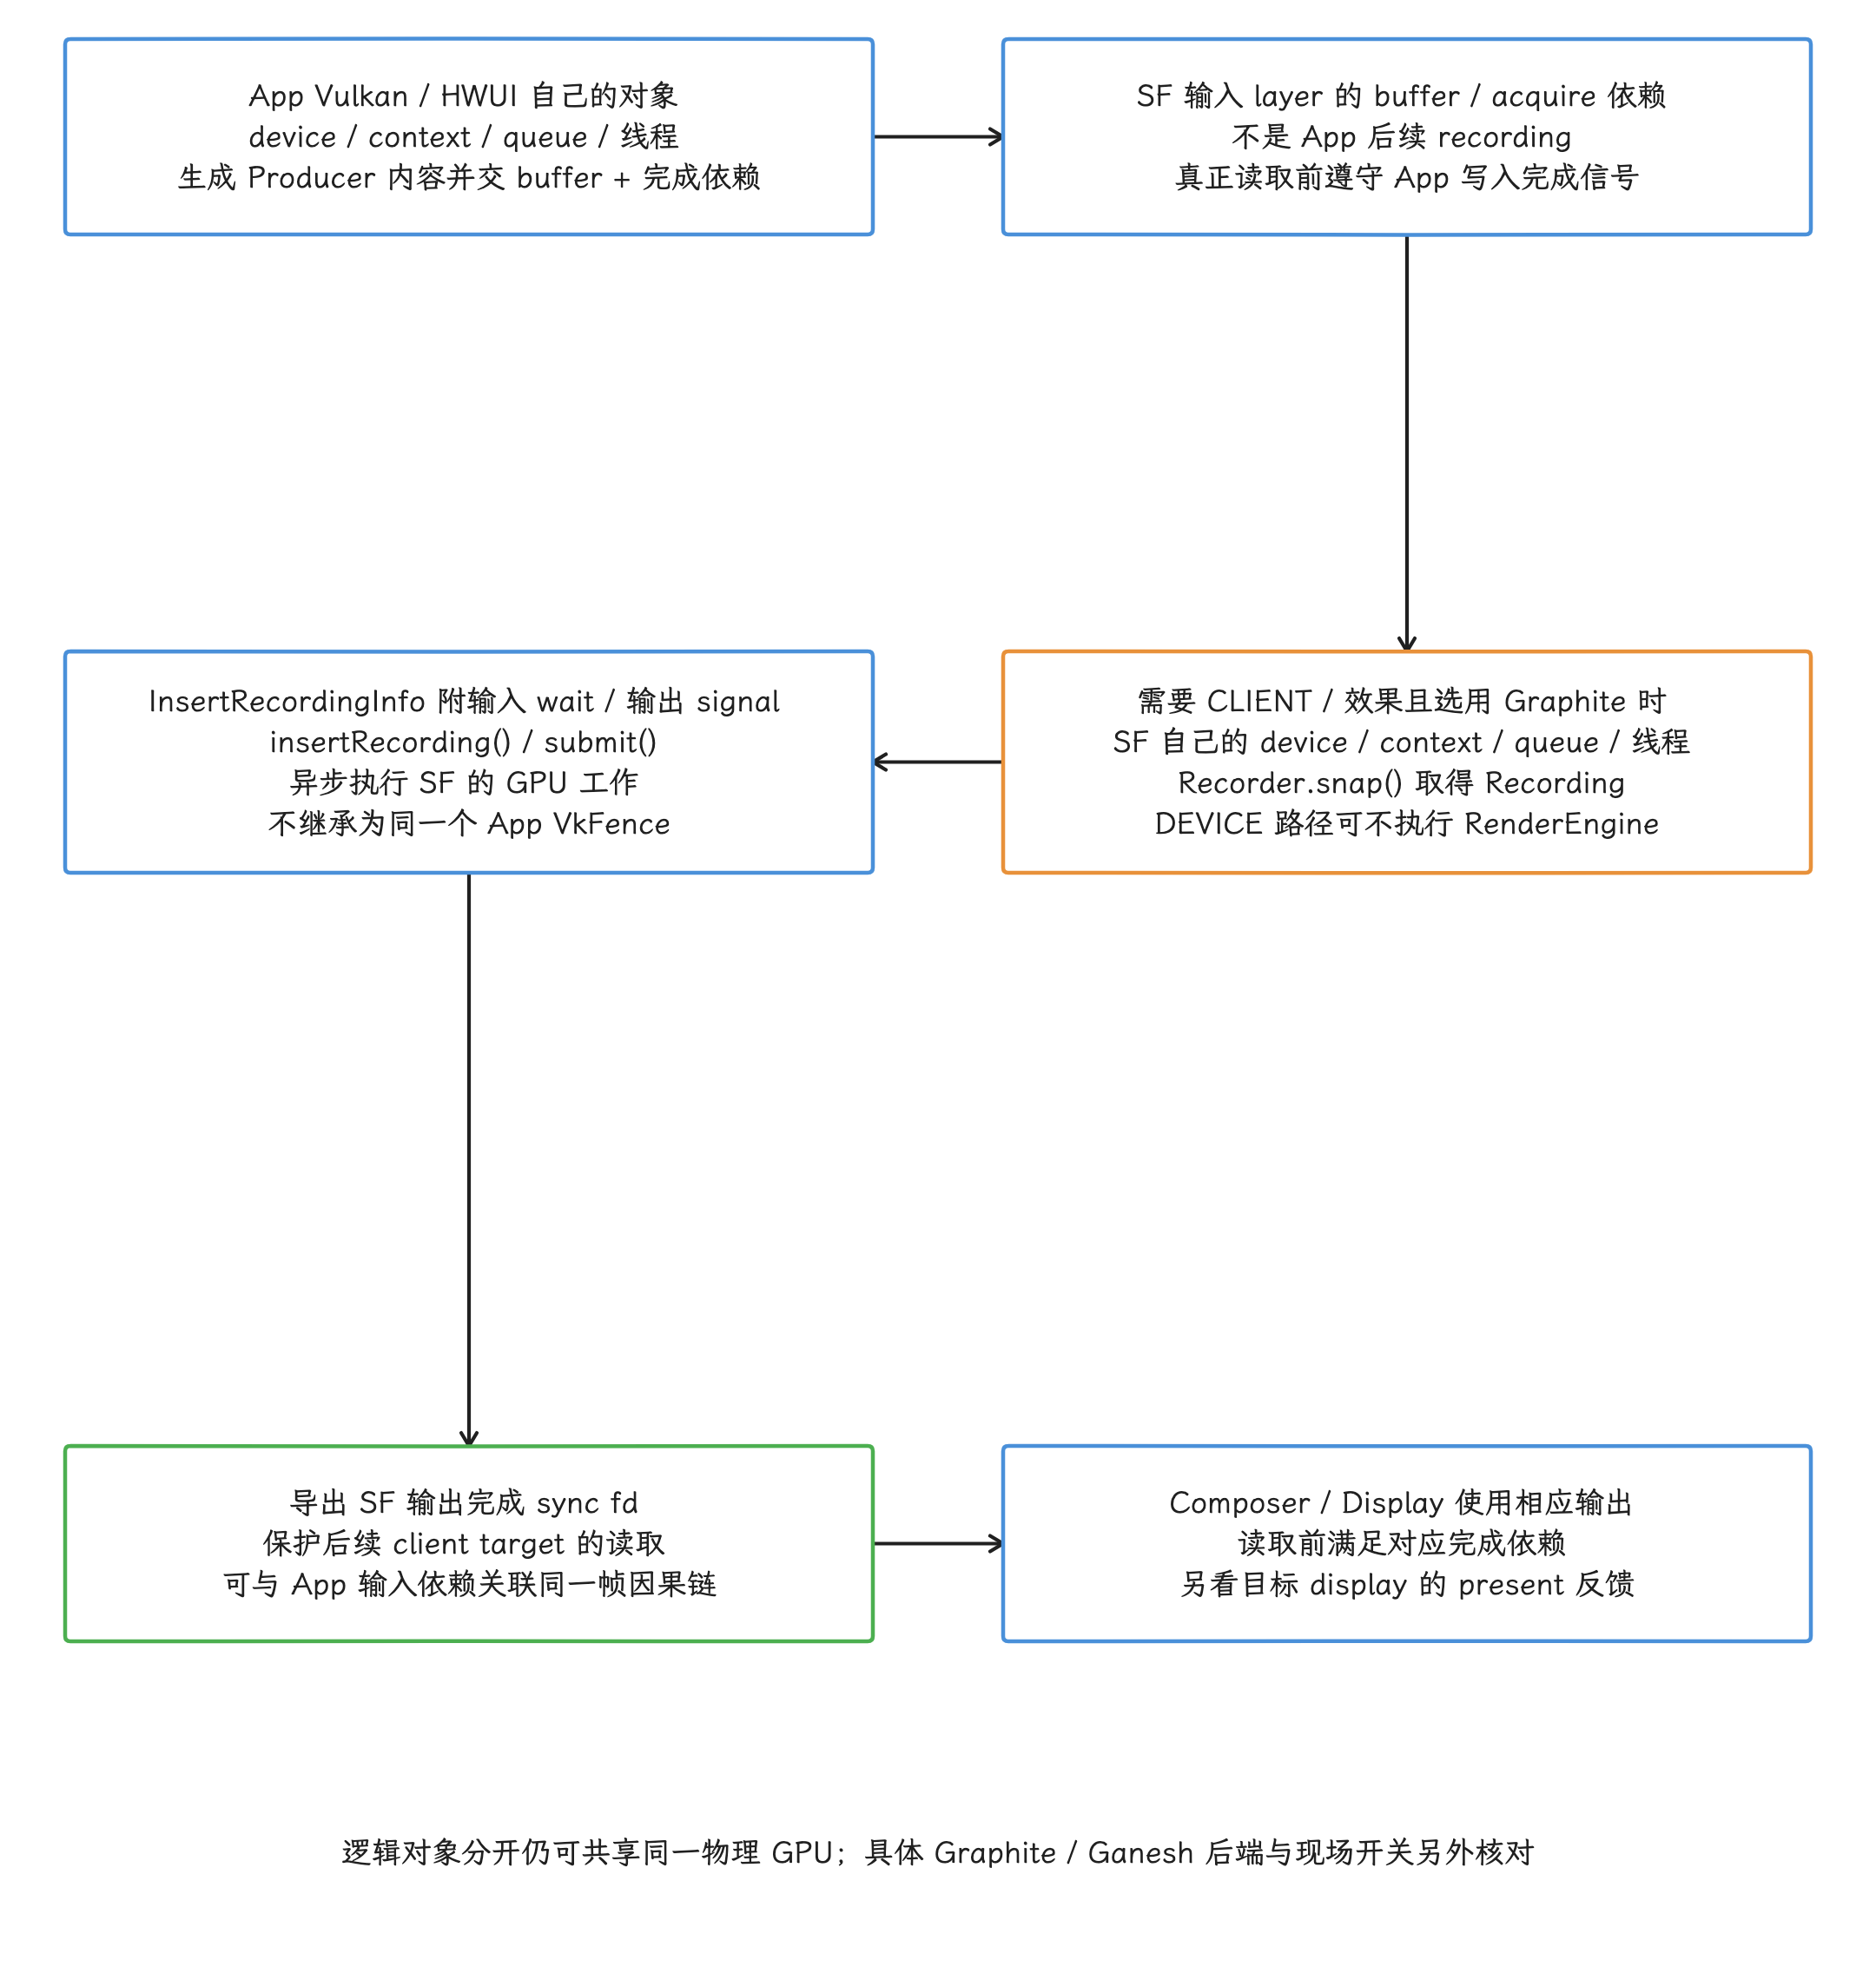
图:App原生Vulkan/HWUI与SFRenderEngine不是同一device/context/queue/线程,仍可争用同一物理GPU。SF可用Graphite或Ganesh,DEVICE可不执行RenderEngine;图中仅展开需要CLIENT/效果且选择Graphite的条件分支。Recorder snap得Recording,InsertRecordingInfo附输入wait和输出signal,经insertRecording/submit异步执行,输出syncfd保护后续clienttarget读取。此fd不同于AppVkFence,却可关联同一帧因果链。
Validation 与工具
- Validation Layers:在开发构建中检查 API、同步和对象生命周期;按 Android 官方 GPU debug layers 流程打包和启用,不使用未经版本核实的全局属性片段。
- AGI:关联 Vulkan API、GPU queue、counter 和 frame capture。
- RenderDoc:在目标设备和构建支持时,检查单帧资源与 DrawCall。
- Perfetto:关联线程调度、BufferQueue、SurfaceFlinger、FrameTimeline、fence 和 HWC。
这些工具会改变 CPU/GPU 成本。确定性能基线时,应关闭 validation/capture 后重新测量。
Android 12—17 版本对照
| 平台 | 变化 | 分析重点 |
|---|---|---|
| Android 12 / API 31 | BLAST 与 FrameTimeline 形成现代显示诊断基线 | 区分 App submit、SF latch 和 Display present |
| Android 13 / API 33 | HWC HAL 从此提供 AIDL、旧 HIDL deprecated;不能假定所有升级设备已迁移;Game Mode/FPS intervention 可能改变游戏帧率 | 判断目标 cadence 时要包含系统 intervention(干预) |
| Android 14 / API 34 | Android WSI acquire/queue 主结构延续 | 不要虚构 API 34 专属 present 流程 |
| Android 15 / API 35 | Vulkan requirements/profile 体系继续演进;AOSP 从 Android 15 支持 16 KB 页设备,应用需按目标设备验证 native 库兼容 | 能力 profile 与应用可运行性要分开验证 |
| Android 16 / API 36 | ADPF(Android Dynamic Performance Framework)、性能 headroom 与 ARR(Adaptive Refresh Rate)能力扩展,Vulkan 主链不变 | workload 自适应无法替代正确的 pacing |
| Android 17 / API 37 | 增加 VP_ANDROID_17_requirements、VK_EXT_present_timing 和有条件支持的 FIFO latest ready;SF 包含可选 Graphite backend | 运行时查询 surface/feature,并把 App WSI 与 SF RenderEngine 分组分析 |
Android 17 源码锚点
swapchain.cpp:surface capabilities、present modes、AcquireImageANDROID、QueueSignalReleaseImageANDROID、queueBuffer 和 present timing;VP_ANDROID_17_requirements.json:Android 17 芯片要求 profile 和 Vulkan 1.4.335 能力集合;Surface.cpp、BufferQueueProducer.cpp:dequeue/queue、slot、fence 和 buffer age;SurfaceFlinger.cpp、HWComposer.cpp:buffer selection、composition 和 present;RenderEngine.h、GraphiteVkRenderEngine.cpp、RenderEngineThreaded.cpp:SF 可选 Graphite、threaded task 和 client-target fence;dma-buf.c、sync_file.c、dma-fence.c:共享 buffer 和 fence fd;- Android Vulkan Profiles、Native/proprietary engine Vulkan guide、Android Frame Pacing:profile、WSI 同步和 Swappy 的官方边界。
相关章节:
- 13.4 OpenGL ES、EGL 与 ANGLE
- 13.6 SurfaceControl 与 HardwareBufferRenderer
- 2.8 BufferQueue、Gralloc 与 Sync Fence
- 2.7 GPU 渲染与图形 API 选型
HWUI Vulkan 多队列与帧边界
原生 Vulkan 由应用显式管理队列,HWUI 多队列由框架在渲染任务之间分配并行度。我们诊断时先分清:哪些是应用自己的队列,哪些是 HWUI 内部队列。
HWUI 的 Vulkan 后端会从同一个 graphics queue family 取得两条 VkQueue。queue 0 服务 RenderThread 的窗口绘制,queue 1 服务 HardwareBitmapUploader 的 AHardwareBuffer 上传。二者共享同一个逻辑设备 VkDevice,并分别绑定一个 Skia GrDirectContext;后者是 Skia 管理 GPU 资源与提交工作的上下文。
源码能证明 HWUI 创建了两条 queue,也能证明 CPU 线程可以分别向它们执行 host submission(主机侧命令提交);GPU 是否并行执行这些命令,由驱动与硬件决定,GPU 引擎、依赖、内存带宽、频率和调度策略都可能让工作交错或串行。我们分析时把结论分成三层:接口保证、由源码推导的结论,以及仍需 trace 验证的硬件行为。
对 android-14.0.0_r1 至 android-17.0.0_r1 的 VulkanManager.cpp 做标签对比后,可以确认双 queue 在 Android 14 基线中已经存在。本文源码取 Android 17,只是跟随当前平台版本;这些对照证明的是下限:至少在 Android 14 r1 已有双 queue;首次引入日期要另查开发分支与 Git history,标成 Android 17 新增就会与对照结果冲突。
复核基线
| 层级 | 基线 | 负责内容 |
|---|---|---|
| Android 平台 | Android 17 / API 37 / android-17.0.0_r1 | HWUI、VulkanManager、SkiaVulkanPipeline、ANativeWindow、FrameTimeline |
| Android 内核 | android17-6.18-2026-06_r6 | CPU 线程调度、dma-buf、dma-fence 与 sync_file;厂商 GPU 调度仍由具体驱动实现,内核不包含 VulkanManager 或 Skia 逻辑 |
| 历史对照 | android-14.0.0_r1、android-15.0.0_r1、android-16.0.0_r1 | 判断双 queue 与 frame-boundary 代码何时已出现 |
分析范围限定为 HWUI 选择 SkiaVulkan 的应用进程。应用自行创建的 Vulkan device/queue、SurfaceFlinger 的 RenderEngine Vulkan 上下文,以及厂商 GPU 服务,都不属于这里的 VulkanManager 实例。
完整路径
下面的流程图标出两条 queue 在 HWUI 以及窗口显示路径中的位置:
flowchart LR
    UI["UI 线程 / RenderNode display list"] --> RT["RenderThread / SkiaVulkanPipeline"]
    DEC["CPU bitmap pixels / decode"] --> UP["GrallocUploadThread / VkUploader task"]
    subgraph DEV["同一 VkDevice / graphics queue family;不同 GrDirectContext"]
        Q0["queue 0 / mGraphicsQueue"]
        Q1["queue 1 / mAHBUploadQueue"]
    end
    RT --> Q0
    UP --> Q1
    Q1 -->|上传并由 CPU 等待完成| HBM["Hardware Bitmap AHardwareBuffer"]
    HBM -->|后续帧纹理采样| RT
    RT -->|CPU 交出窗口 buffer + fence| ANW["VulkanSurface / ANativeWindow queueBuffer"]
    Q0 -.->|写入完成依赖;queue 可先发生| ANW
    ANW --> BLAST["BufferQueue / BLAST transaction"]
    BLAST --> SF["SF readiness / latch / composition strategy"]
    SF --> OUT["可选 CLIENT / HWC 分支 / display present"]
应用进程生产窗口 buffer,SurfaceFlinger 负责 latch(选定本轮合成使用的 buffer)与合成决策,HWC/显示设备完成 present。图中只展开应用进程内的 HWUI Vulkan 双 queue,后半段仍沿用 BufferQueue、SurfaceFlinger 与显示路径。
queue 1 负责把 CPU 侧 bitmap 像素复制进新分配的 AHardwareBuffer,窗口帧仍由 queue 0 生成。上传完成的 hardware bitmap 后续可以作为纹理由 queue 0 采样;两条 queue 不会共同 present 同一个 App Window 帧。
VulkanManager:共享 device,分别持有 Skia context
VulkanManager 通过进程内弱引用缓存,让 RenderThread 与上传线程复用仍然存活的 Vulkan device。弱引用不延长对象生命周期,但可以在对象仍存活时取得它。下面的代码展示实例获取规则:
static wp<VulkanManager> sWeakInstance = nullptr;
static std::mutex sLock;

sp<VulkanManager> VulkanManager::getInstance() {
    std::lock_guard _lock{sLock};
    sp<VulkanManager> manager = sWeakInstance.promote();
    if (!manager.get()) {
        manager = new VulkanManager();
        sWeakInstance = manager;
    }
    return manager;
}
RenderThread、VkUploader 以及各 GrDirectContext 会持有强引用,确保使用期间 manager 不被销毁;createContext() 还通过 context delete callback 增减 VulkanManager 的强引用。只要上传 context 仍存活,RenderThread 即使释放自己的引用,也不会另建一份 manager。所有强引用都释放后,下一次 getInstance() 才会创建新实例。
共享范围包括:
VkInstance;VkPhysicalDevice;VkDevice;- graphics queue family index;
- 已启用的 Vulkan extension 与 feature 信息。
隔离范围包括:
- RenderThread 和 UploadThread 各自的
GrDirectContext; - 两个 context 各自创建的 Skia Vulkan memory allocator(GPU 内存分配器);
- device-lost(Vulkan 设备不可继续使用)回调中的上下文标签;
- queue 0 与 queue 1 各自的提交顺序。
每次 createContext() 都调用 SkiaVMA::Make(),这才是两个 context 各建 allocator 的代码依据;.fThreadSafe=false 只关闭该 allocator 自身的线程安全保障,device 层面并未因此多出一把全局锁。调用方按每个 API 的外部同步要求管理共享对象,并维护跨 queue 的 GPU 依赖。共享 Vulkan 对象、queue 和跨 queue 资源依赖仍要遵守 external synchronization(由调用方避免并发访问同一对象) 规则,并使用 semaphore 或 fence 表达执行依赖。
两条 graphics queue 如何创建
同一 queue family,两个 queue index
setupDevice() 选中第一个带 VK_QUEUE_GRAPHICS_BIT 的 family,并要求该 family 至少提供两个 queue。下面合并 setupDevice() 与 initialize() 的关键关系,省略设备创建和其他错误处理,只用于说明关键关系,独立编译或照抄运行前要另行补全。queueInfo.sType 等必填字段照常填写,“缩写”仅服务本文叙述:
constexpr uint32_t kRequestedQueueCount = 2;

for (uint32_t i = 0; i < queueFamilyCount; i++) {
    if (queueProps[i].queueFamilyProperties.queueFlags & VK_QUEUE_GRAPHICS_BIT) {
        mGraphicsQueueIndex = i;
        LOG_ALWAYS_FATAL_IF(
            queueProps[i].queueFamilyProperties.queueCount < kRequestedQueueCount);
        break;
    }
}

float queuePriorities[kRequestedQueueCount] = {0.0f, 0.0f};
VkDeviceQueueCreateInfo queueInfo{
    .sType = VK_STRUCTURE_TYPE_DEVICE_QUEUE_CREATE_INFO,
    .pNext = queueNextPtr,  // 已按能力决定是否附加 global-priority 请求
    .flags = 0,
    .queueFamilyIndex = mGraphicsQueueIndex,
    .queueCount = kRequestedQueueCount,
    .pQueuePriorities = queuePriorities,
};

mGetDeviceQueue(mDevice, mGraphicsQueueIndex, 0, &mGraphicsQueue);
mGetDeviceQueue(mDevice, mGraphicsQueueIndex, 1, &mAHBUploadQueue);
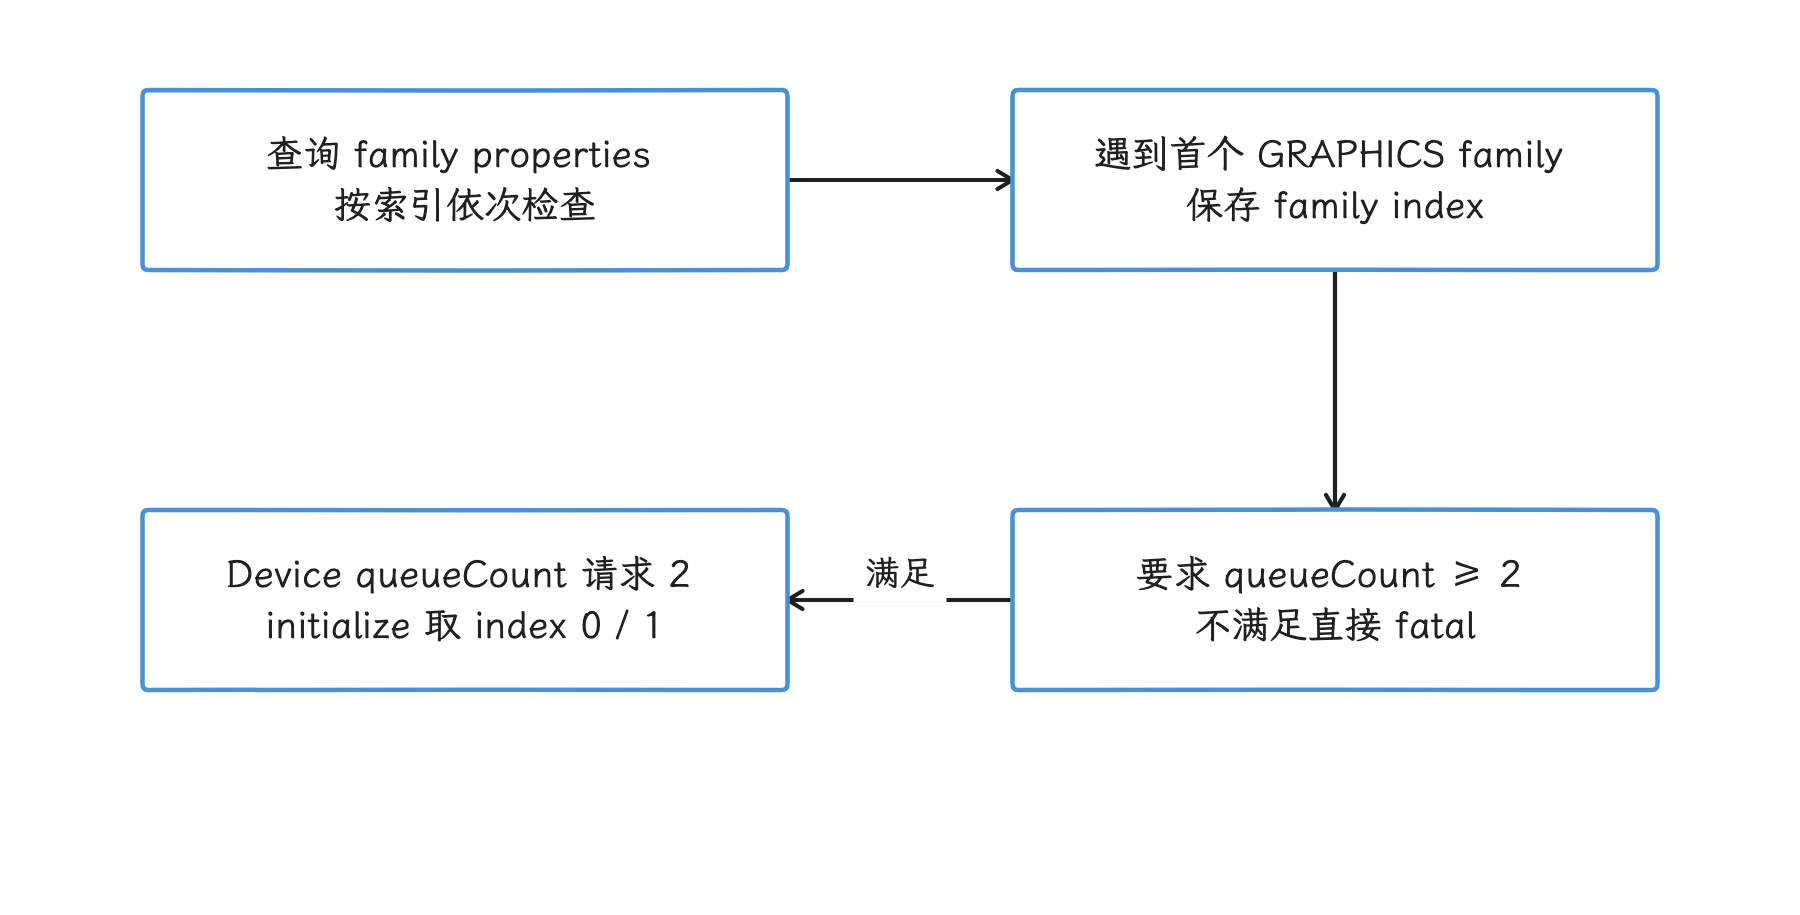
图:第一个具备 GRAPHICS 能力的 family 还必须满足 queueCount 至少为 2。 不满足会 fatal;这里没有尝试另一个 family 或复用 queue 0 的降级分支。
两条 queue 具有相同 capability 和同一个 family index,仅在这两条同 family queue 之间传递普通资源时,不需要彼此的 queue-family ownership 转移;仍需执行/内存依赖。AHardwareBuffer 的外部/foreign ownership 或其他 family 的互操作须另按规则处理。setupDevice() 里也没有 queue 数量不足时复用 queue 0 的分支;HWUI 一旦进入这段 Vulkan device 初始化,能力不满足就会触发 fatal 并中止进程。至于某台设备是否运行 Vulkan HWUI,由更上层的设备配置与进程策略决定,这段代码能回答的只有初始化要求。
两个 Skia context 绑定不同 queue
createContext(ContextType) 把同一组 device 信息交给 Skia,只替换 fQueue:
kRenderThread→mGraphicsQueue;kUploadThread→mAHBUploadQueue。
直接效果是把主机侧提交顺序分开:硬件位图上传不会进入 RenderThread 所用 queue 的顺序链。实际性能收益仍取决于驱动和硬件:
- GPU 有可重叠的 copy/graphics 执行资源时,上传可能与窗口绘制部分重叠;
- 两条 queue 争用内存带宽、cache 或同一图形引擎时,驱动可能交错甚至串行;
- AHardwareBuffer 上传涉及的分配、页映射和 cache 维护也可能拖慢窗口渲染;
- 两条 queue 使用同一个 global priority 请求,queue 1 没有天然的低优先级。
双 queue 分开的是 host 提交入口和 submission order;一个 queue 内的命令在硬件上未必逐条串行,执行与内存先后仍由同步规则约束。两条 queue 之间的资源依赖要应用自己建立,硬件是否并行由驱动与硬件决定,上传争用带宽或图形引擎时,窗口渲染仍会受影响。
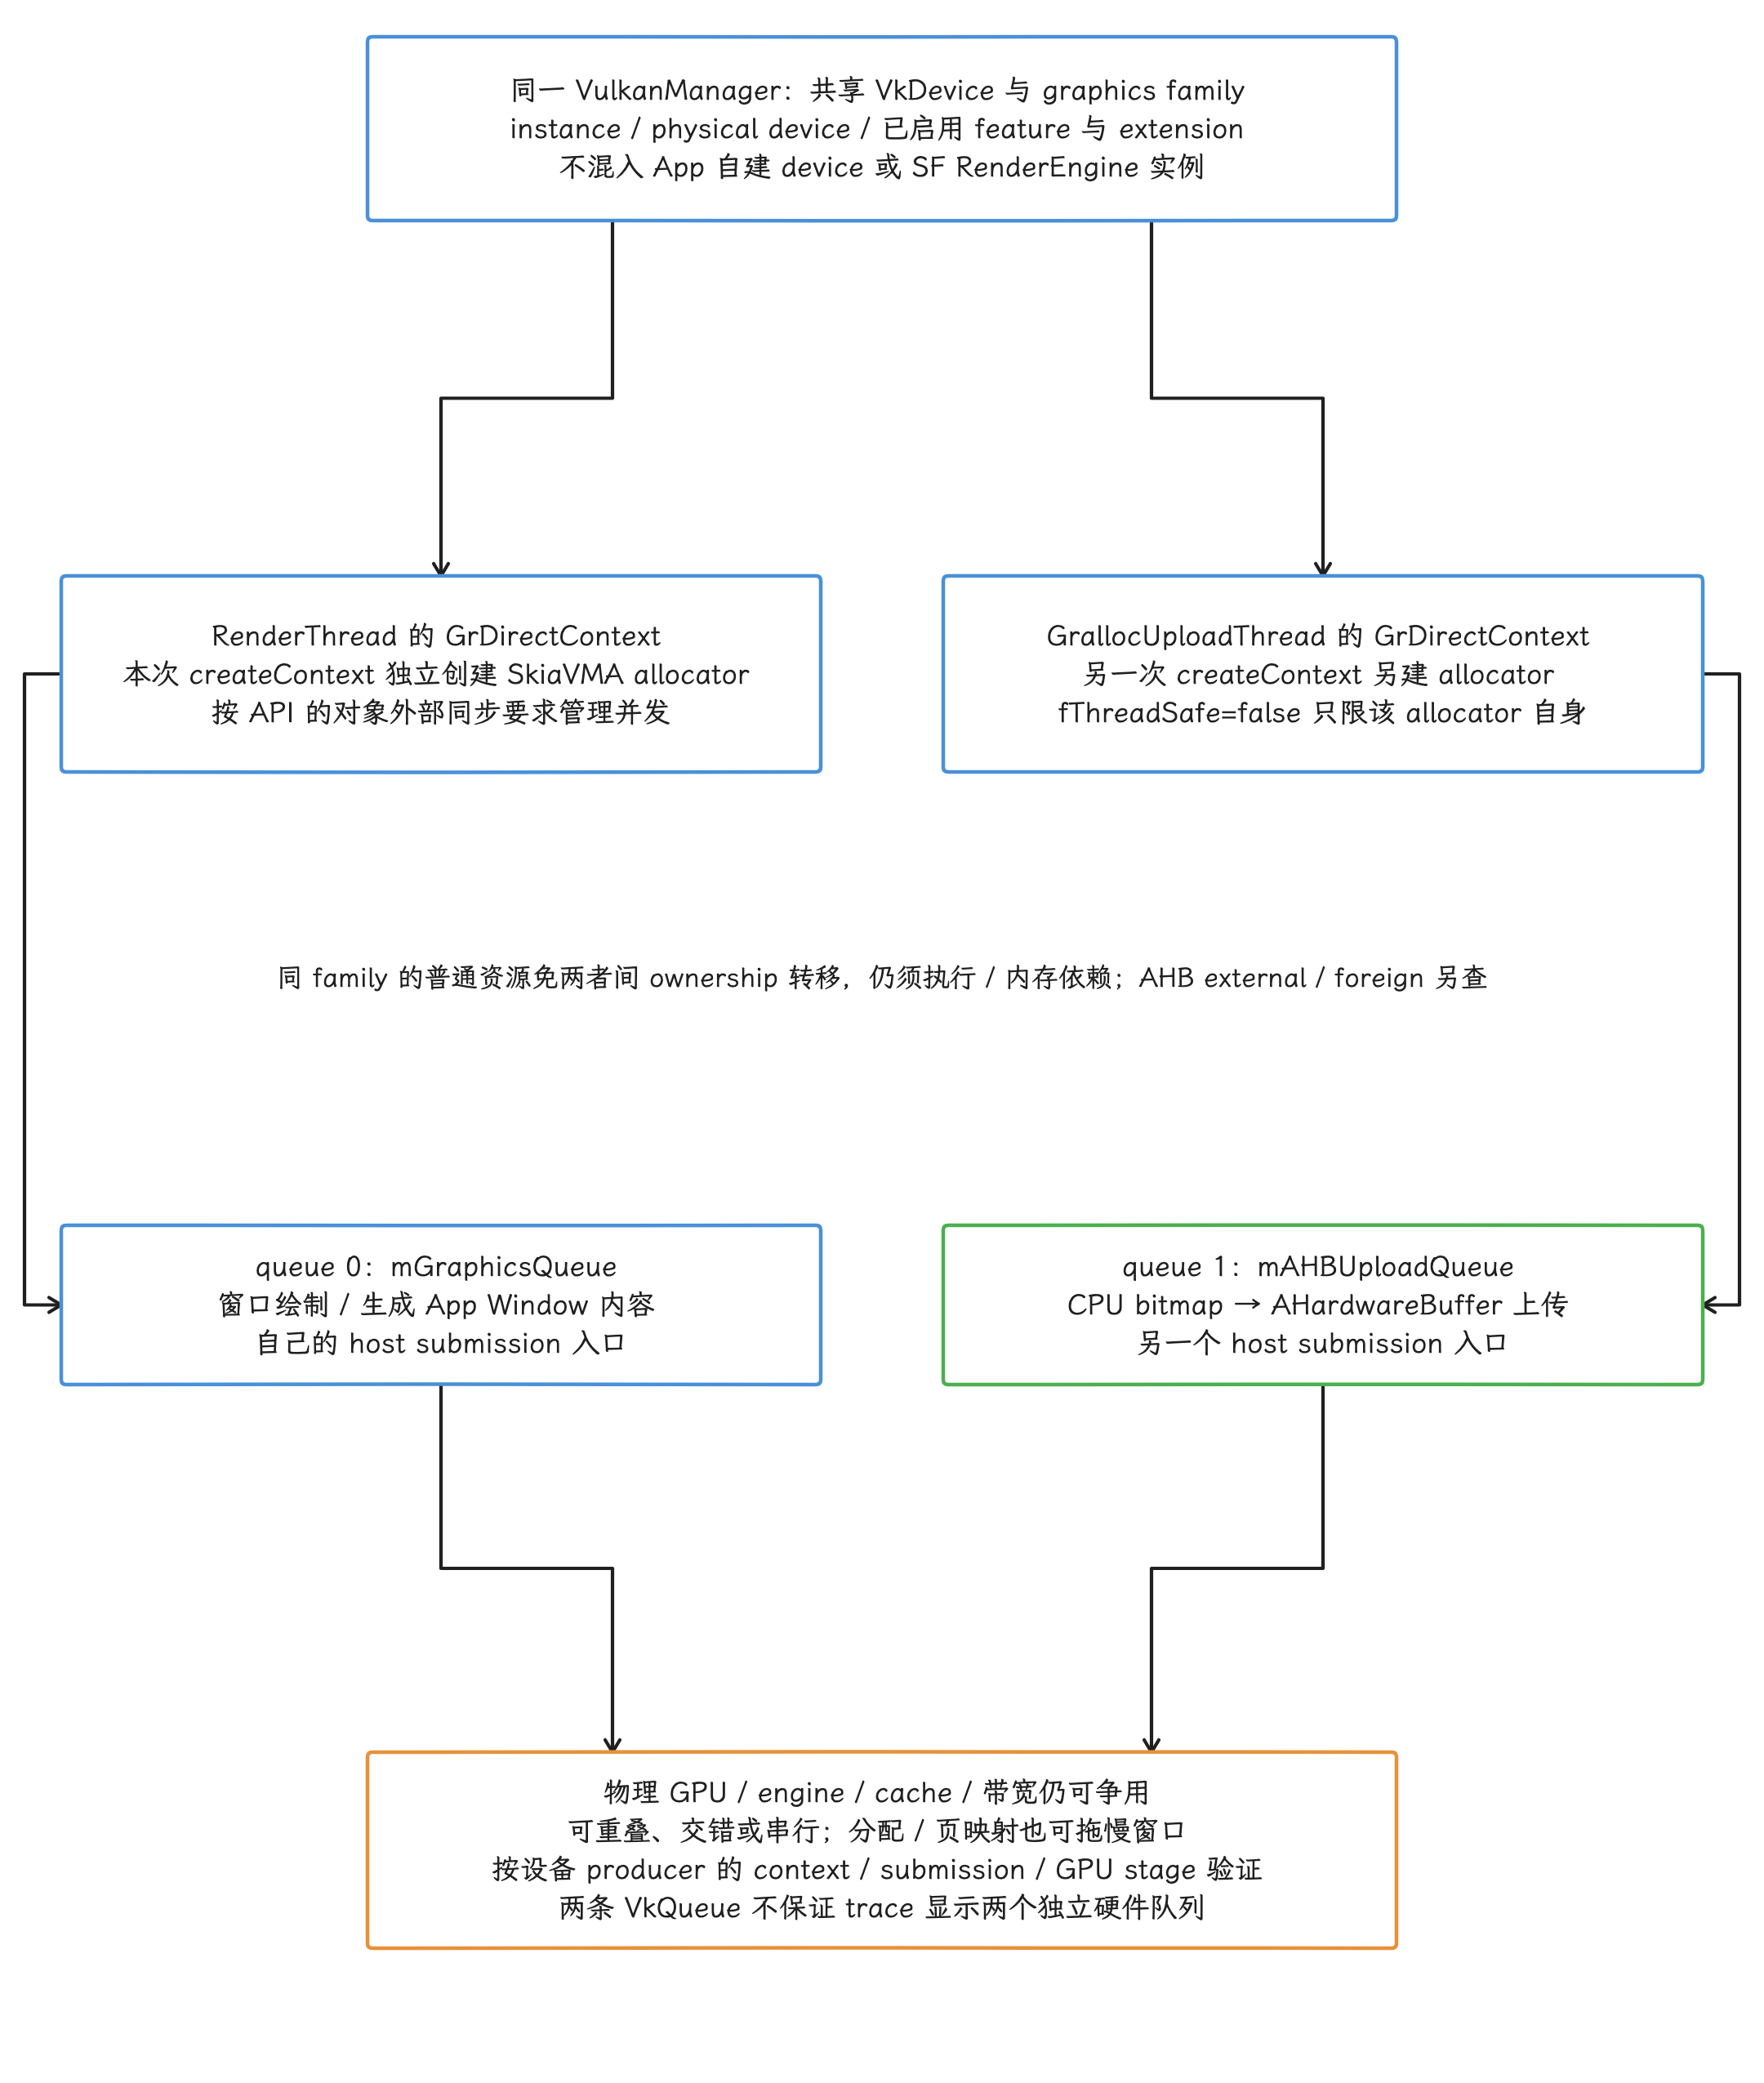
图:同VulkanManager共享instance/physicaldevice/device/family/features/extensions;每次createContext各建GrDirectContext和SkiaVMA allocator,fThreadSafe=false不意味整个device所有API一把锁。queue0RT窗口/queue1上传都是同family graphicsqueue;普通资源仅在两者间不需familyownershiptransfer,但执行/内存依赖仍需建立,AHBexternal/foreign另查。队列接口数、host并发和物理执行重叠三者不同;APIqueue不保证对应独立hw_queue_iid,按设备producercontext/submission/stage/counter取证,两queue请求同一globalpriority,上传与窗口提交在请求上同级。
HardwareBitmapUploader 的上传路径与等待
CPU 像素会被复制
Bitmap.Config.HARDWARE 的这条创建路径先分配带 AHARDWAREBUFFER_USAGE_GPU_SAMPLED_IMAGE 的 AHardwareBuffer,再调用 SkImages::TextureFromAHardwareBufferWithData() 把 SkPixmap 数据写入。Bitmap.cpp 也明确把 allocateHardwareBitmap() 描述为复制 bitmap contents。
因此,这条创建路径会把已有 CPU 像素传输到新分配的 gralloc/AHardwareBuffer;格式不受支持时,makeHwCompatible() 还可能先做 CPU 转换。AHardwareBuffer 统一承载后续图形共享与采样,对“零复制”、恰好一次内部搬运或完全没有临时 staging 存储并无承诺;具体拷贝与带宽由 Skia/驱动实现和格式决定。
GrallocUploadThread 与调用方等待
Vulkan 上传在 GrallocUploadThread 上执行:
- 取得或创建共享
VulkanManager; - 创建绑定 queue 1 的
GrDirectContext; - 调用
TextureFromAHardwareBufferWithData()记录上传; - 执行
mGrContext->submit(GrSyncCpu::kYes); runSync()返回后,uploadHardwareBitmap()才把结果交回调用方。
GrSyncCpu::kYes 表示上传线程会等待 GPU 完成。这样可以保证返回的 hardware bitmap 已经写完,但调用仍是同步的。主线程若同步创建大图,仍可能依次等待解码、AHB(AHardwareBuffer)分配、上传和 GPU 完成。
queue 1 与 queue 0 在这段时间可以分别提交工作;GPU 资源争用有没有拉长 RenderThread 的 queue 0 工作,我们仍要通过 trace 验证。
60 秒闲置回收
HardwareBitmapUploader.cpp 把 kThreadTimeout 设为 60000 ms。没有 pending upload(待处理上传)且空闲时间超过该值后,VkUploader::onIdle() 会释放上传 GrDirectContext 与 manager 强引用;下一次上传再按需重建。
源码能证明的是上传 context 及其持有资源被释放;具体回收多少 GPU 内存,还取决于驱动、Skia cache、AHardwareBuffer 的其他持有者和设备内存策略,这里没有固定数值可给。
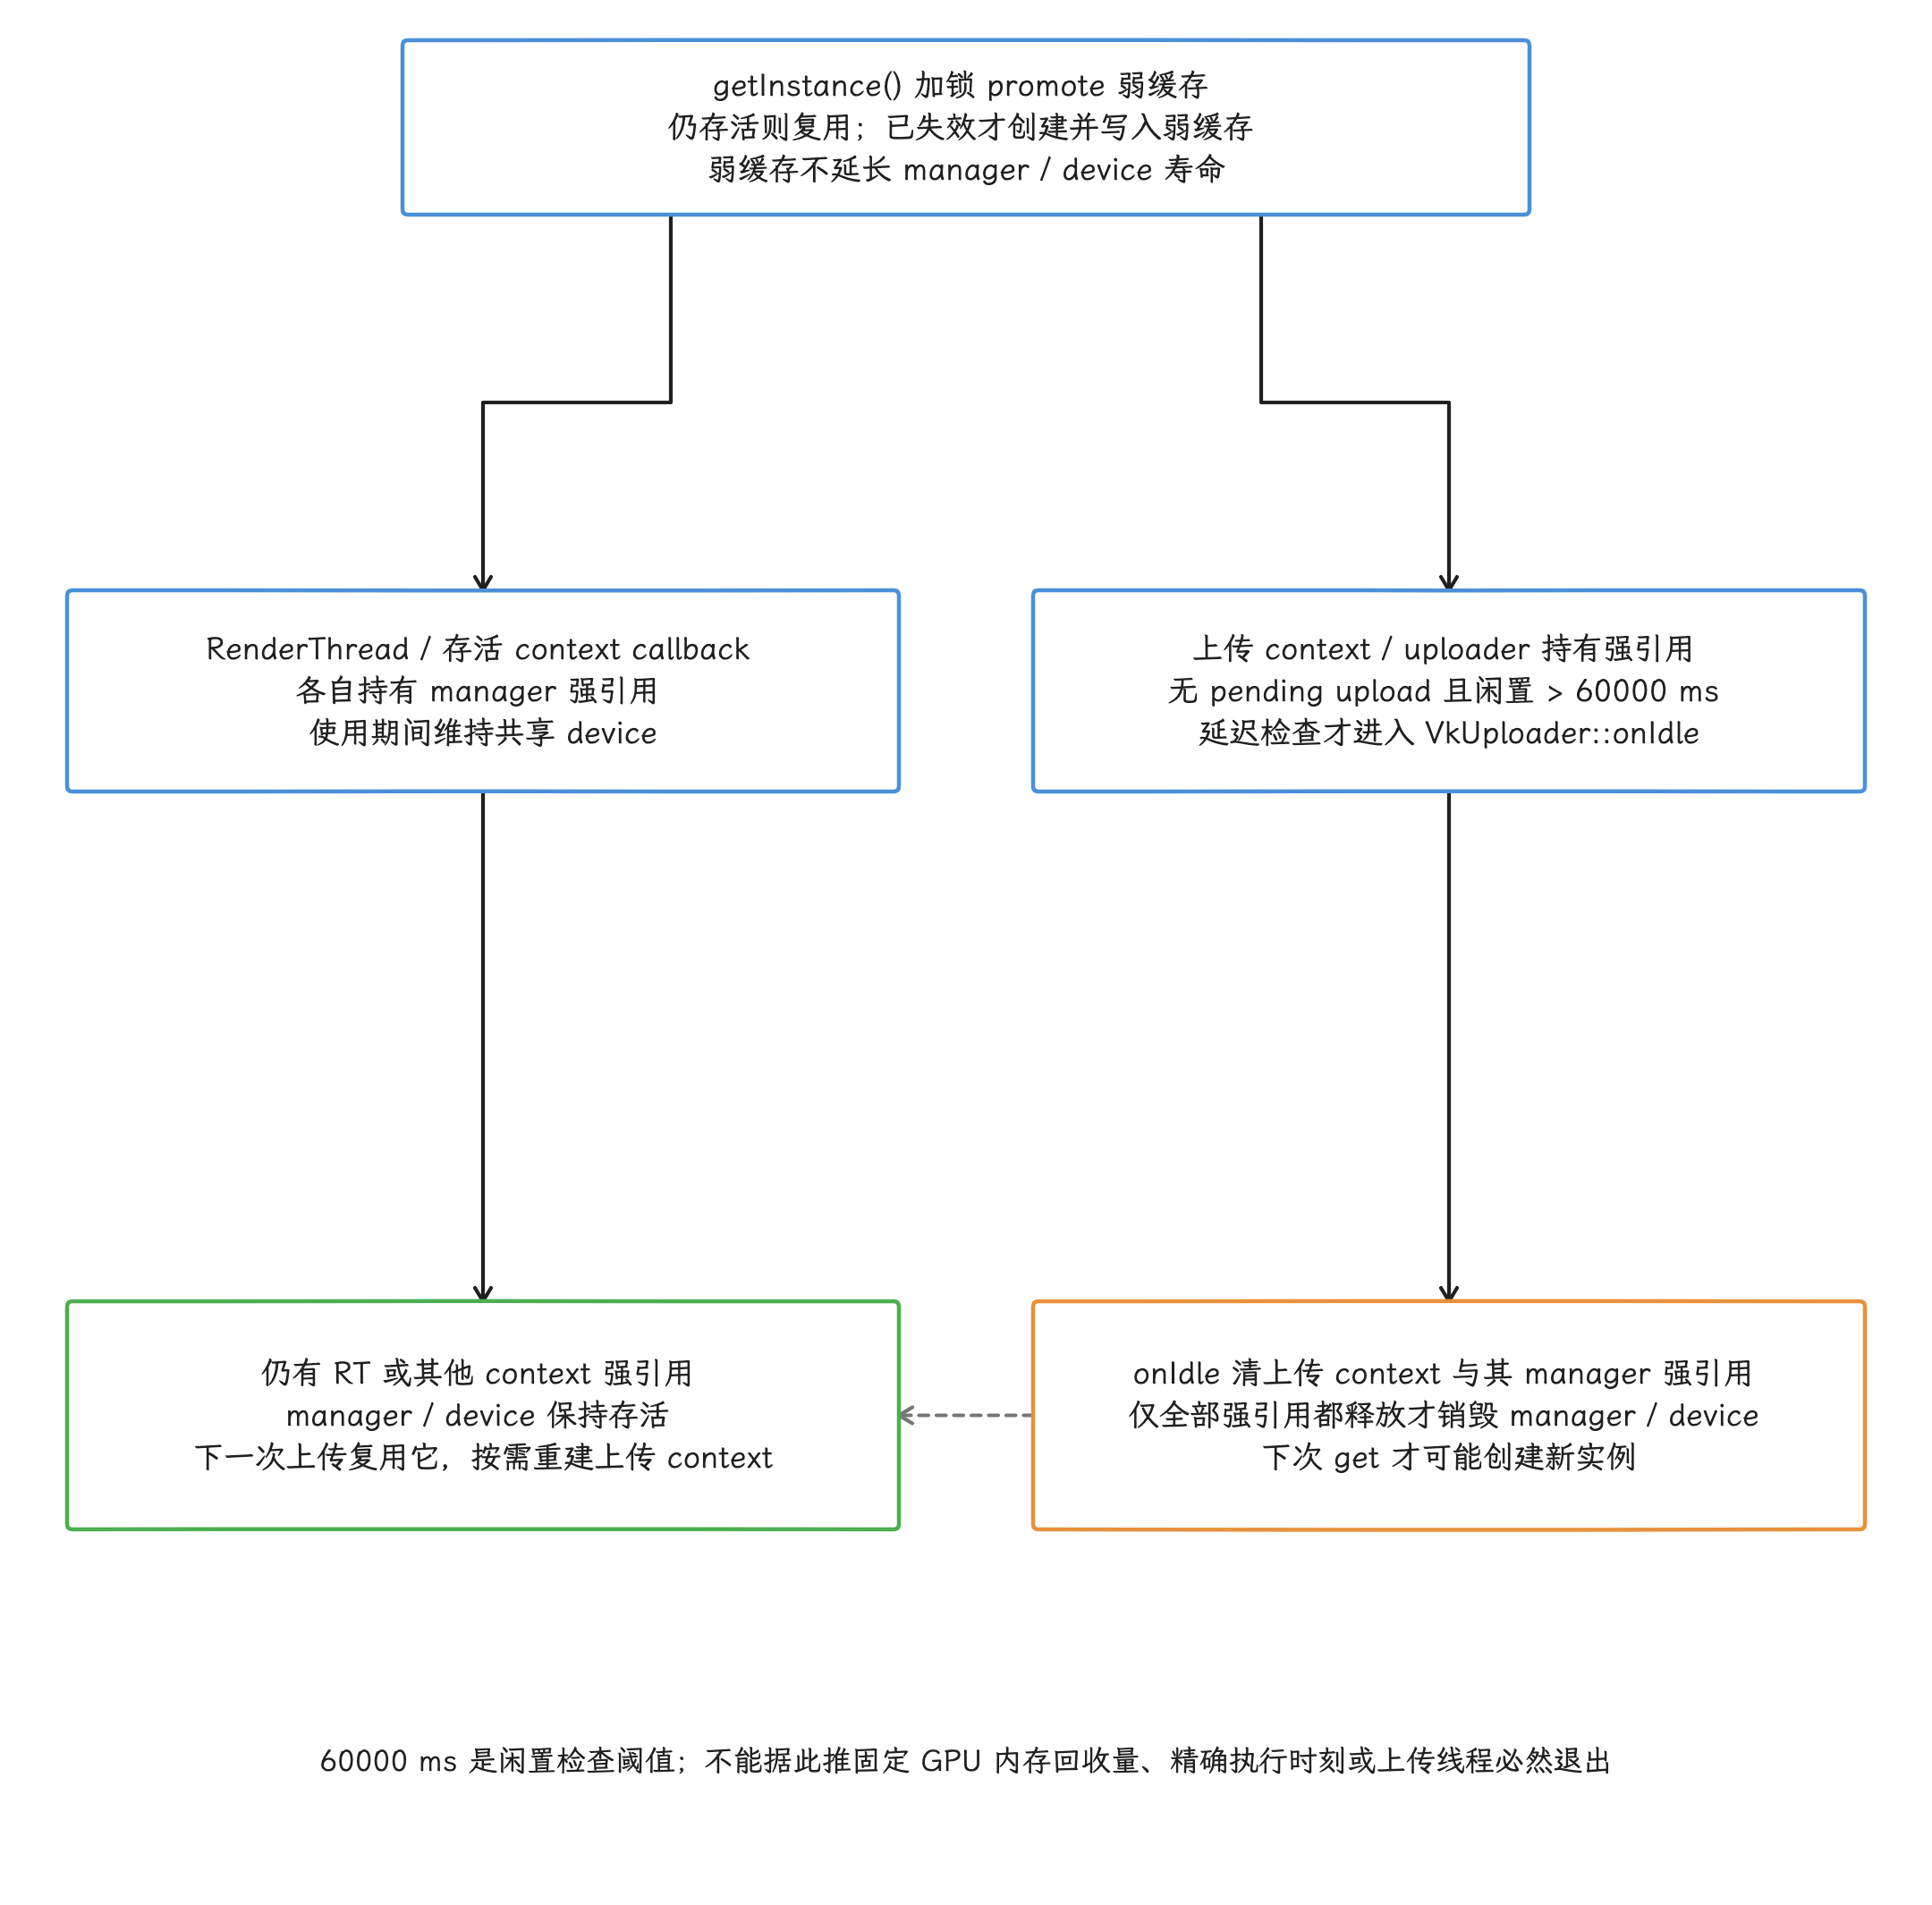
图:getInstance加锁promote弱缓存,存活则复用,否则新建。RT/uploader/各contextcallback持有强引用,弱缓存本身不延寿。无pendingupload且空闲超过60000ms后延迟检查可onIdle清上传context及manager强引用,线程是否退出、何时回收与回收多少,都由现场状态决定。只有全部强引用释放才销毁manager及device;RT仍持有时下次upload复用同manager重建上传context。
Global priority 的请求语义
Properties::contextPriority 默认值为 0。通过隐藏的 HardwareRenderer.setContextPriority()/JNI 等平台内部入口在 device 初始化前设置 EGL priority 常量后,VulkanManager 才会尝试映射到:
VK_QUEUE_GLOBAL_PRIORITY_LOW_EXT;VK_QUEUE_GLOBAL_PRIORITY_MEDIUM_EXT;VK_QUEUE_GLOBAL_PRIORITY_HIGH_EXT。
源码仅在 contextPriority != 0 且识别到 VK_EXT_global_priority v2 时附加 VkDeviceQueueGlobalPriorityCreateInfoEXT。如果 global-priority query 可用,代码会先确认选中的 queue family 是否报告了目标档位;query 明确不支持时丢弃该 priority 请求并 warning,再按无此附加请求创建 device;query 不可用时仍可能尝试目标 priority。vkCreateDevice() 若报错,当前代码会 fatal;失败后并不会都降档到低优先级重试。
还要注意三点:
mAPIVersion固定为 Vulkan 1.1;源码检查VK_API_VERSION_1_4,从这一点推不出 HWUI 在用 Vulkan 1.4 core priority;- 两条 queue 来自同一个
VkDeviceQueueCreateInfo,global priority 请求对这次创建的两条 queue 一起生效; - global priority 是提交给驱动的队列调度请求,还受系统权限控制。它与 Linux 线程实时优先级无关,也不承诺具体的 GPU 抢占时延。
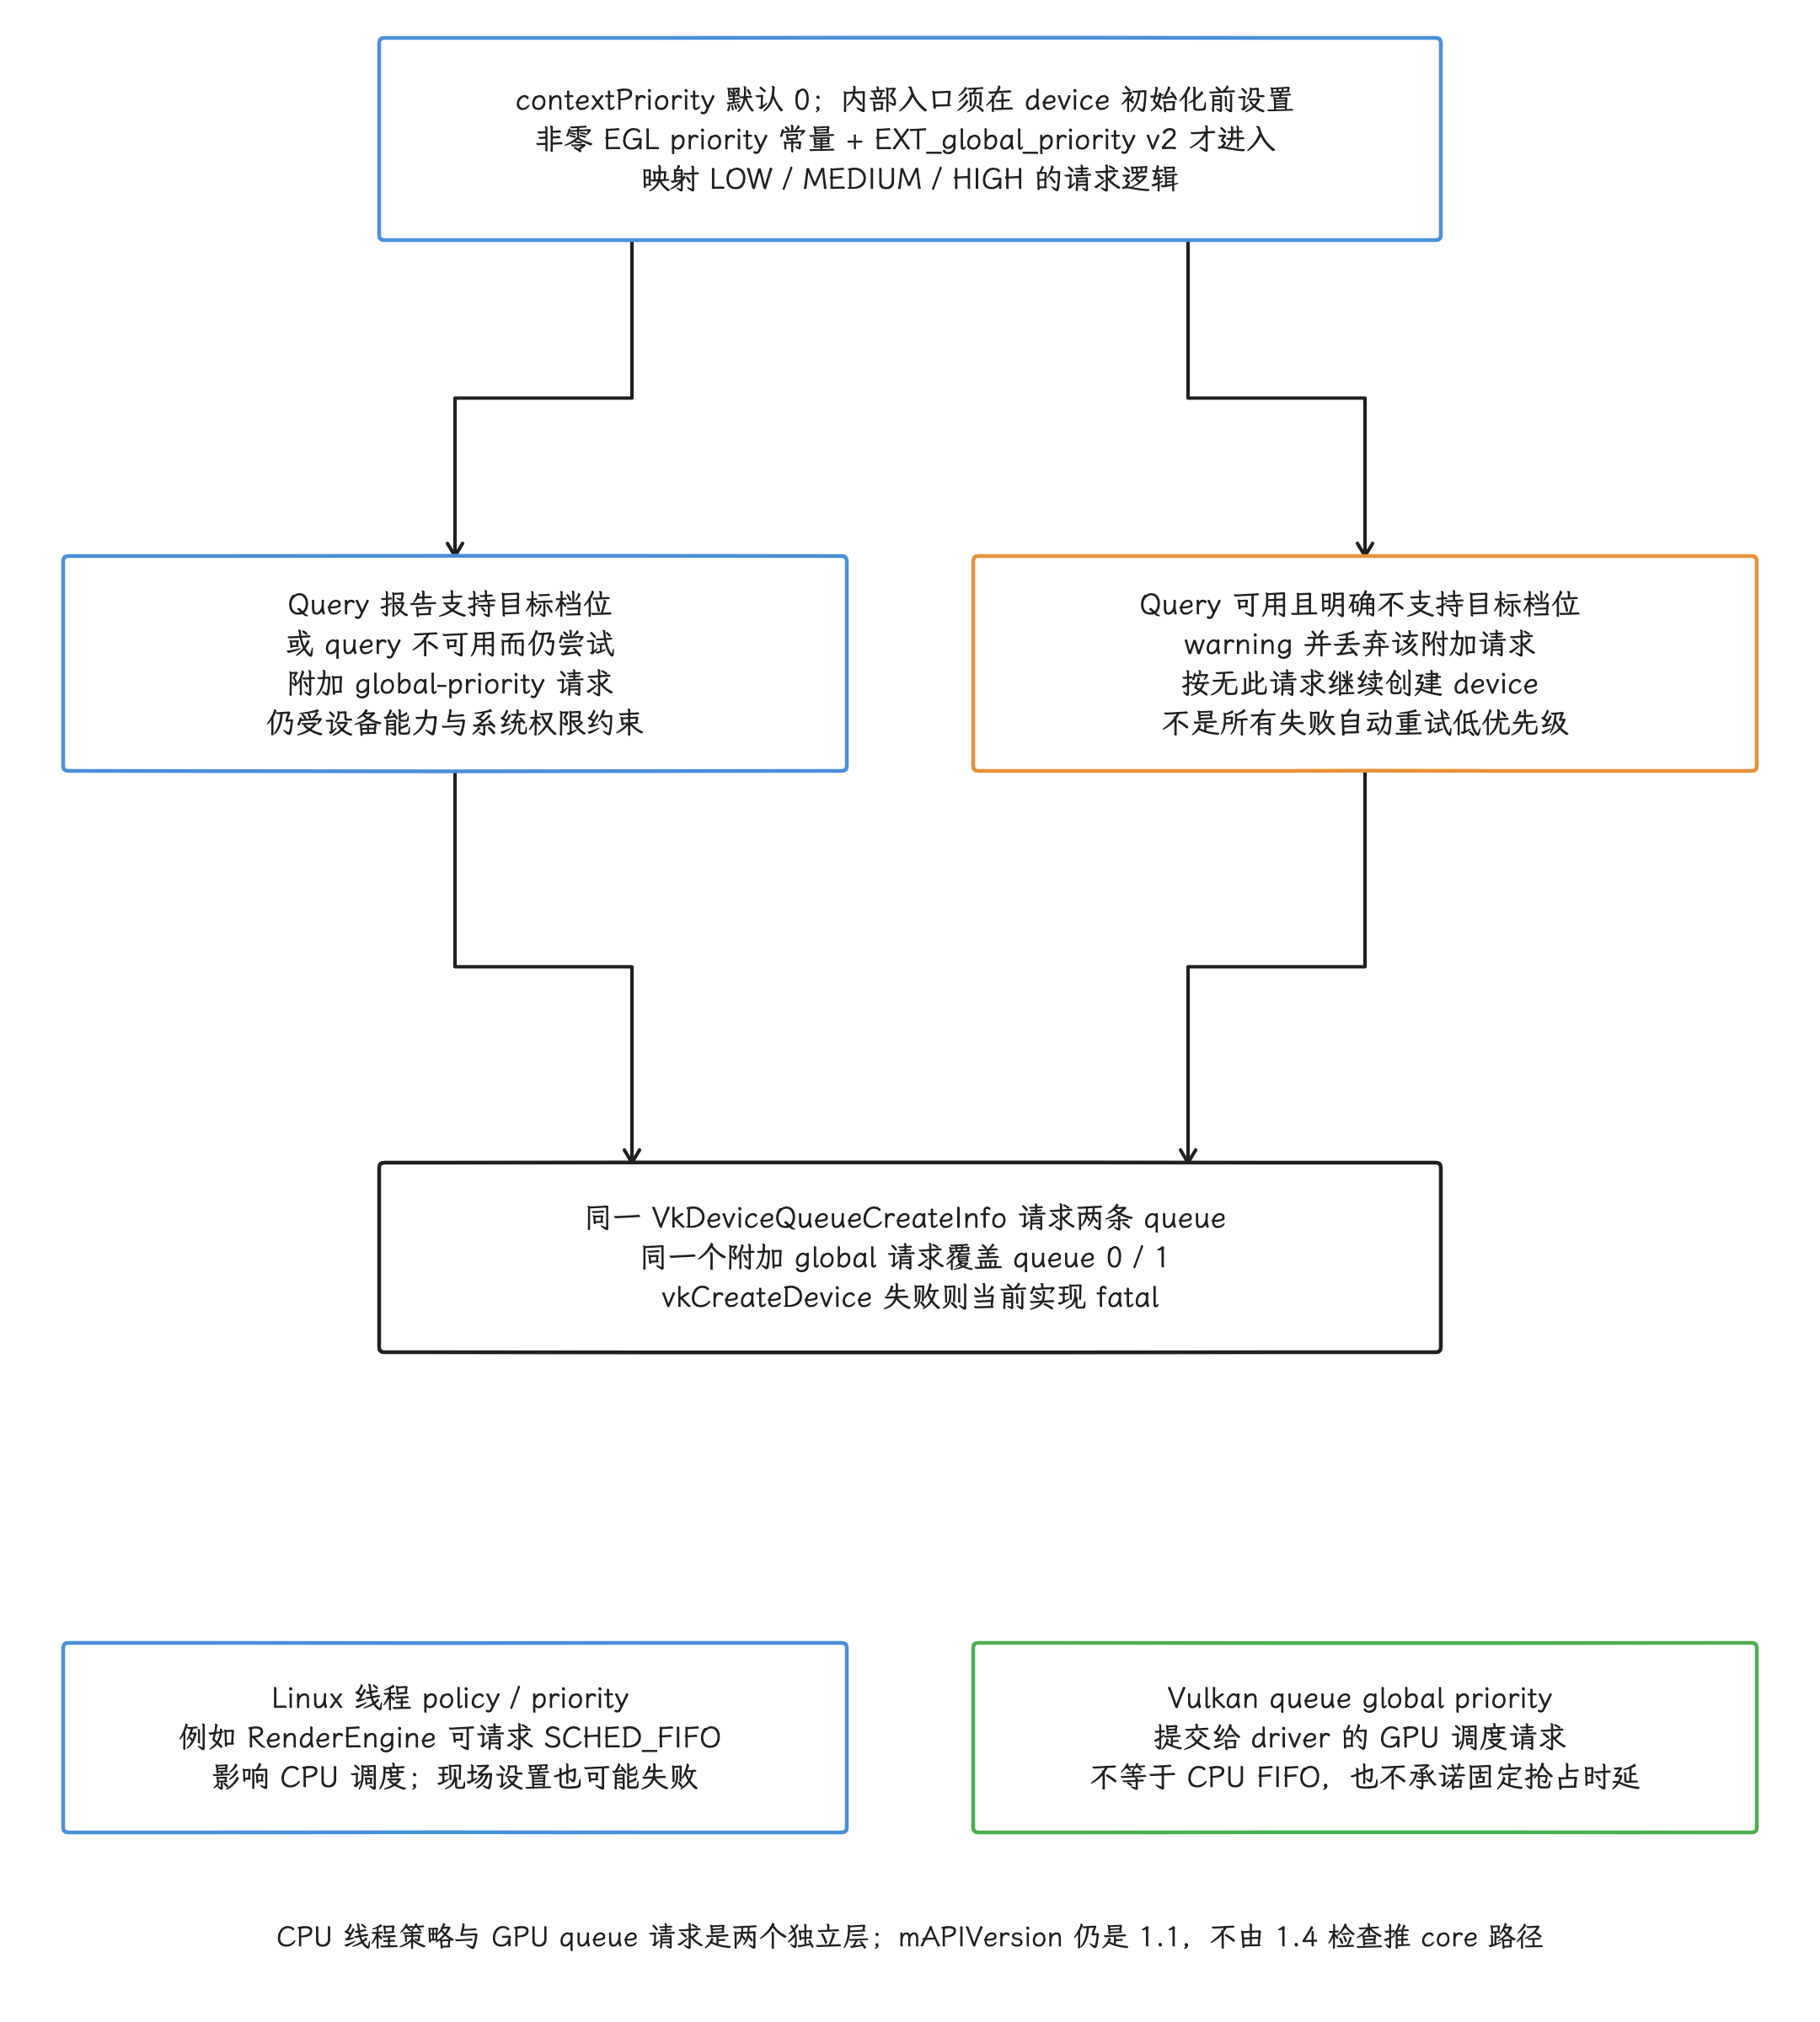
图:contextPriority默认0;初始化前内部入口设置非零EGLpriority常量且识别EXTglobalpriorityv2才映射LOW/MEDIUM/HIGH并进入请求逻辑。query可用且支持目标档位或query不可用时可能尝试请求;query明确不支持时warning并丢弃附加请求。两queue同queueInfo接同globalpriority请求,不保证设备权限允许;createDevice失败fatal非所有失败重试低档。mAPIVersion1.1不因检查1.4推正在走1.4core。Linux线程policy与Vulkanqueuepriority不同,两者不承诺硬件并行或抢占时延。
两种“帧边界”记录不同对象
Vulkan frame-boundary 的用途
finishFrame() 在提交 Skia 工作时有两条帧标记路径:
- AGI capture layer 提供私有
VK_ANDROID_frame_boundary时,HWUI 把本帧的 signal semaphore(GPU 完成后置位的同步对象)和 render-target image 传给vkFrameBoundaryANDROID(); - 该私有入口不存在时,HWUI 设置
GrSubmitInfo.fMarkBoundary = Yes与进程内递增的fFrameID,由 Skia 和可用的VK_EXT_frame_boundary支持向工具描述 frame boundary。
Khronos VK_EXT_frame_boundary 给 queue submission 附加应用定义的 frame ID、结果 image/buffer 和工具 tag。它是给分析工具看的标注:新的执行依赖不会因它产生,present semaphore 的等待也仍由 present 流程承担。
VK_ANDROID_frame_boundary 在 AOSP 头文件中被明确描述为 AGI 专用扩展,由 AGI Vulkan capture layer 在抓帧时提供。普通运行时查不到该 proc pointer(Vulkan 函数入口指针)属于预期情况。
FrameTimeline 的窗口时间线
再看 FrameTimeline 的 vsyncId,它走的是另一条路径。CanvasContext::draw() 取得 FrameTimelineVsyncId,构造 ANativeWindowFrameTimelineInfo,再由 render pipeline 在 queueBuffer() 前设置给 ANativeWindow。SurfaceFlinger 用它关联 App SurfaceFrame 和显示 DisplayFrame 的 expected/actual 时间线。
两类 ID 的差异如下:
| 对象 | 生成位置 | 主要消费者 | 是否直接表示 expected present |
|---|---|---|---|
Vulkan currentFrameID | HWUI VulkanManager::finishFrame() 的进程内计数器 | Skia、Vulkan 工具、AGI capture | 否 |
FrameTimeline vsyncId | Choreographer / 平台帧时间线传入 HWUI | ANativeWindow、SurfaceFlinger、Perfetto FrameTimeline | 用于关联预测信息;ID 本身不是 expected-present 时间戳 |
| BufferQueue frame number | Producer queue 次序 | BLAST、SurfaceFlinger、transaction/trace | 不单独表示 |
AOSP 没有把 currentFrameID 赋值为 FrameTimelineVsyncId。工具可以根据时间、submission、render target 或其他元数据关联两者;两个数值本身,要当作相互独立对待。
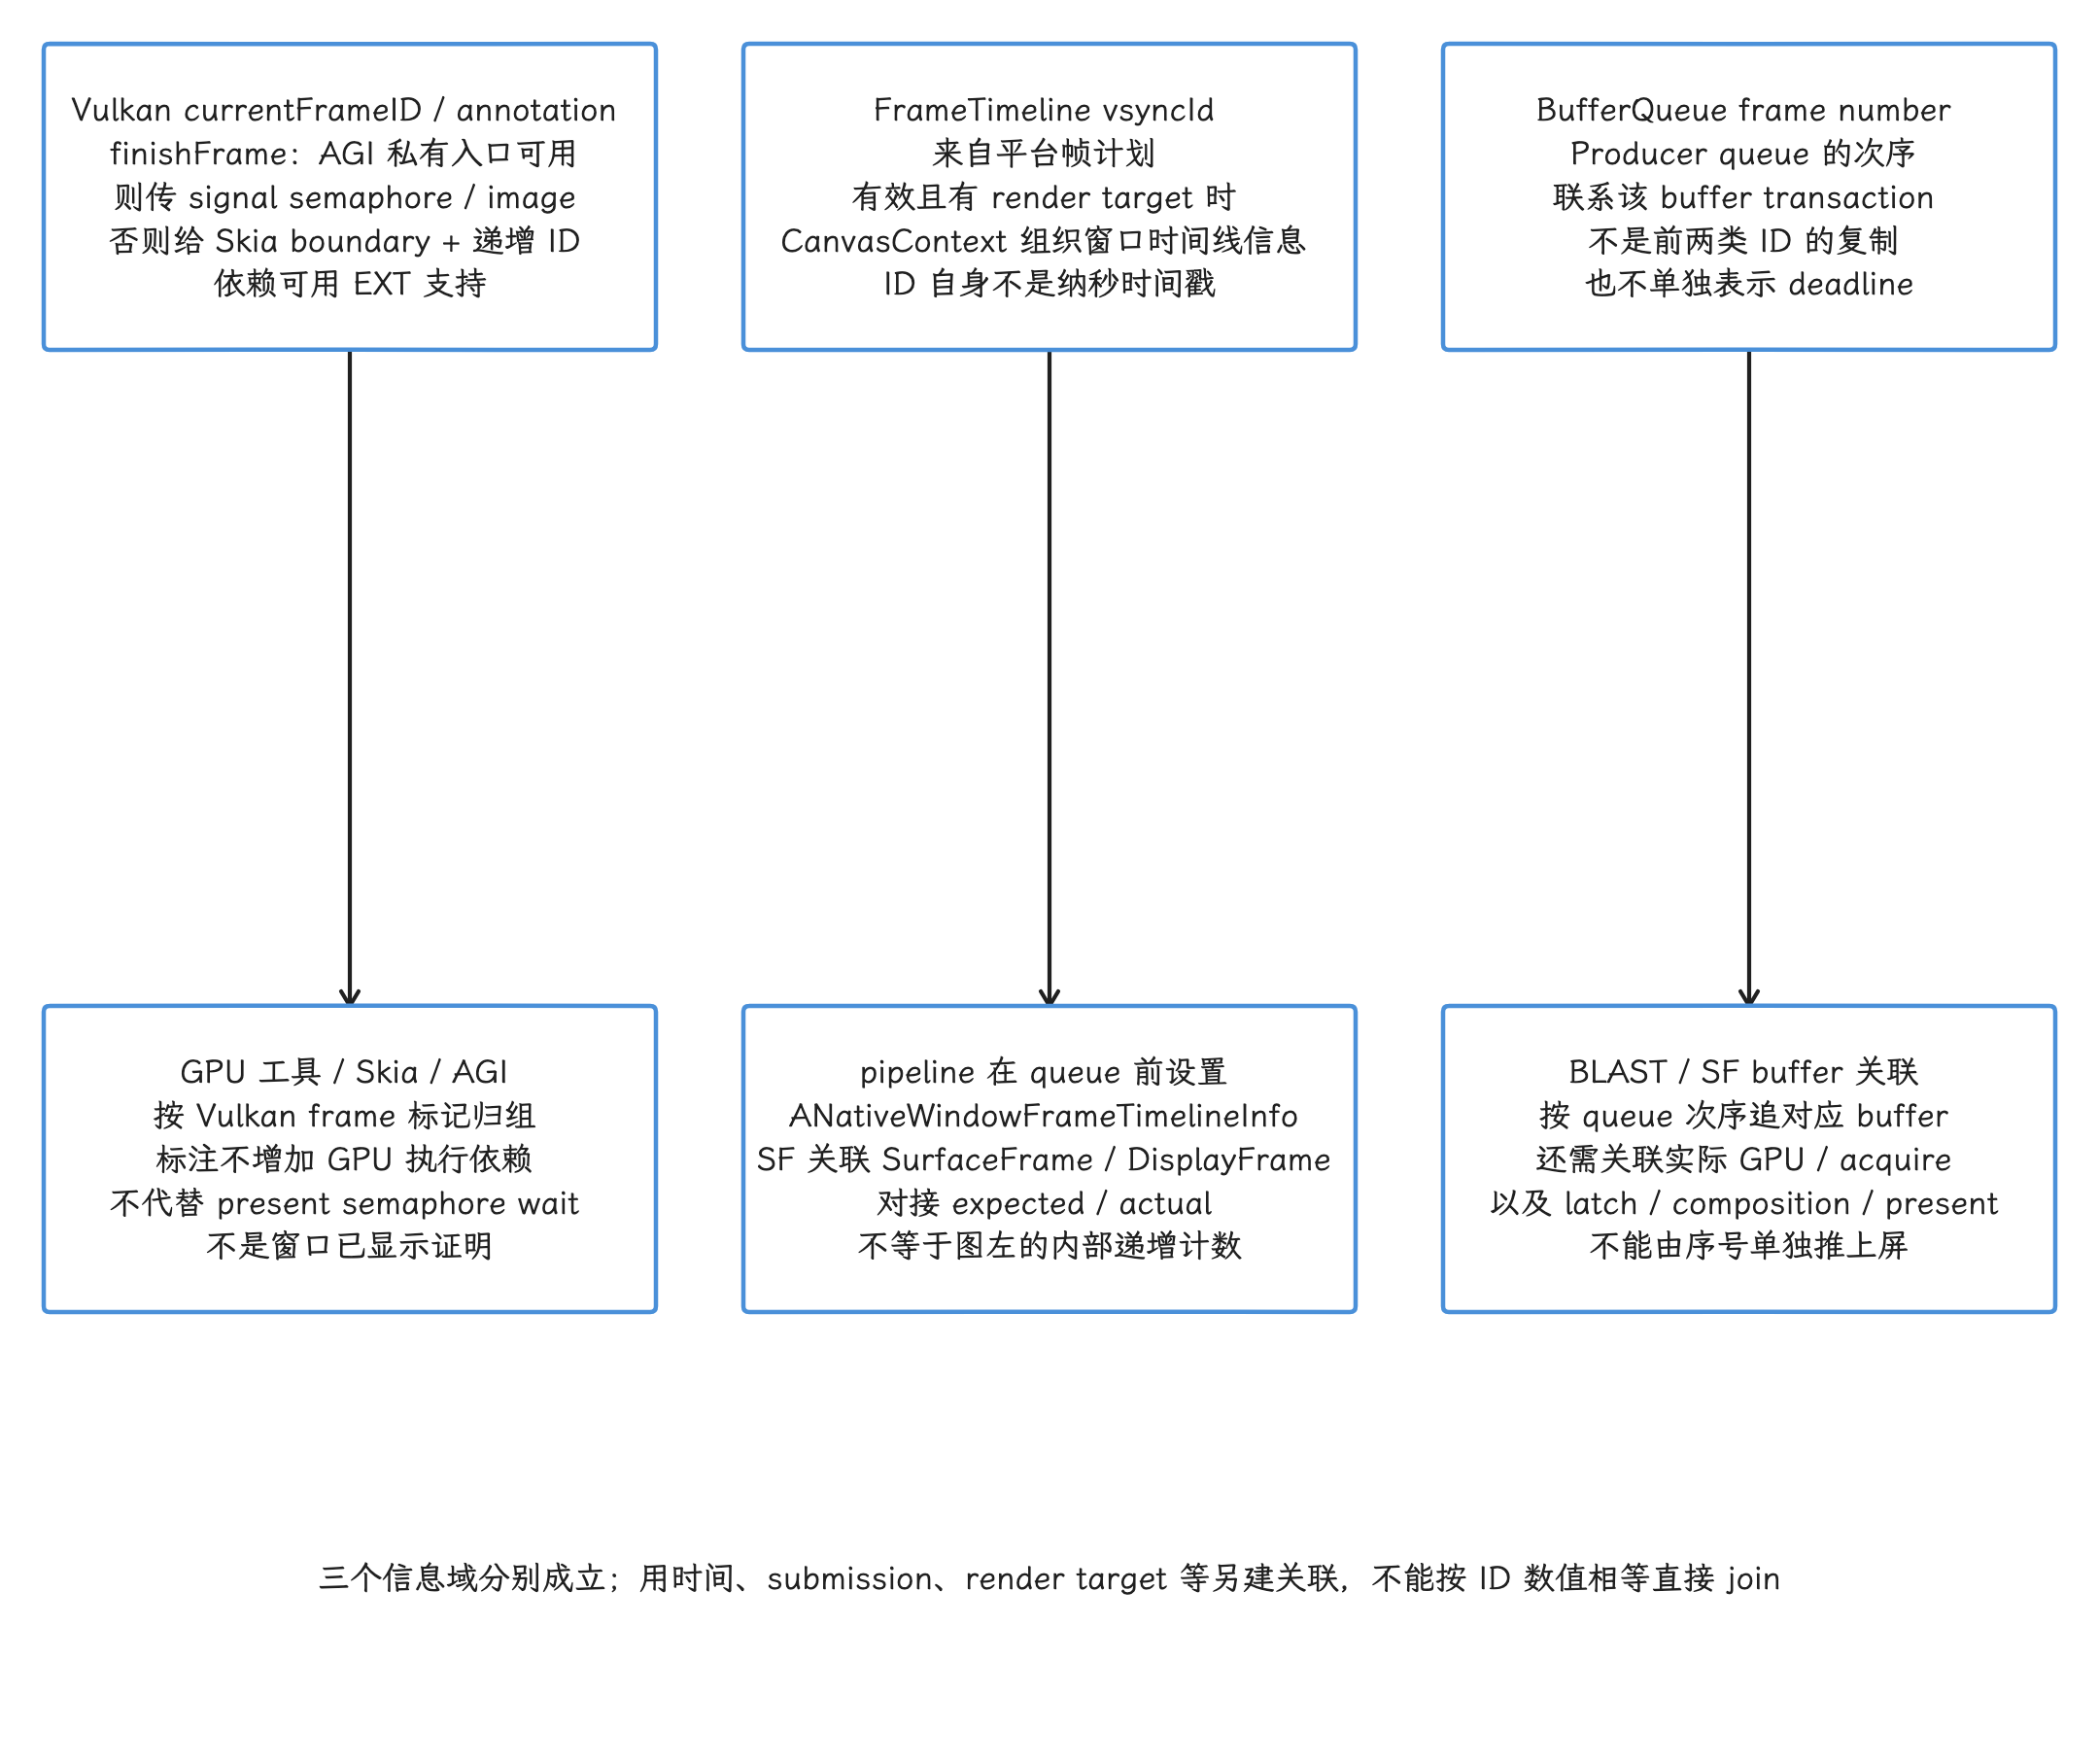
图:HWUIfinishFrame存在私有vkFrameBoundaryANDROID指针时传signalSemaphore/renderimage,普通运行缺私有AGIproc属预期;否则给SkiafMarkBoundaryYes及内部递增frameID,依赖可用EXT支持。frameannotation不新建执行依赖,不替代presentwait。FrameTimelinevsyncId由平台帧计划传入,有效且存在目标时CanvasContext组织ANativeWindowFrameTimelineInfo经pipeline在queue前设置,再由SF关联expected/actual;token不是时间戳。BQframenumber是Producerqueue次序,三者无同值赋值保证,关联要按时间/target/submission等另行建立。
Frame boundary 到 present 的距离
Vulkan frame-boundary 标记发生在 queue submission 附近,离屏幕显示仍有以下步骤:
- CPU 提交/导出完成 fence,并可在 GPU 尚未写完时调用
ANativeWindow::queueBuffer(); - BLAST buffer transaction 与 SF readiness/latch;受限策略可先 latch 未 signal buffer;
- 真正读取像素前满足 acquire fence,组织 DEVICE 或必要的 CLIENT 路径;
- HWC 的快 present 或 validated 后 present,以及后续 display 呈现反馈。
GPU 工具把 draw call 归到某帧,回答的只是这些 GPU 命令属于哪组提交工作;用户何时看到结果,我们仍要结合 FrameTimeline 与 present fence 判断。
dequeue fence 与 producer completion fence
dequeue fence:等待旧消费者释放 buffer
VulkanSurface::dequeueNativeBuffer() 从 App Window 的 ANativeWindow 取得 buffer 和 dequeue fence。该 fence 表示 Consumer 何时结束对这块旧 buffer 的使用;Producer 要等它 signal 后才能安全复用并写入。
固定 r1 仅在 fd 有效、sync_file_info() 查询成功且 status != 1 的分支尝试以下导入:
dup()fence fd;- 创建
VkSemaphore; - 以
VK_EXTERNAL_SEMAPHORE_HANDLE_TYPE_SYNC_FD_BIT和VK_SEMAPHORE_IMPORT_TEMPORARY_BIT把 fd 临时导入 semaphore; - 让 Skia surface 的后续 GPU 工作等待该 semaphore;
- 调用
FlushAndSubmit()及时提交 wait;源码把它注明为 workaround/TODO,调用返回不表示 CPU 等到了 GPU 完成。
dup、创建 semaphore 或导入失败时,源码改由 CPU 调用 sync_wait()。若 sync_file_info() 查询失败,当前函数不会进入上述 pending 分支;“没有 wait slice”单独出现时,fence 状态仍要另行确认。成功导入的副本 fd 归 Vulkan,原 dequeue fd 仍由 buffer 记录持有。这条 fence 的方向是 Consumer/HWC 把旧 buffer 释放给 App Producer 复用,与“SurfaceFlinger 作为 Producer 通知 App 新内容就绪”的方向正好相反。
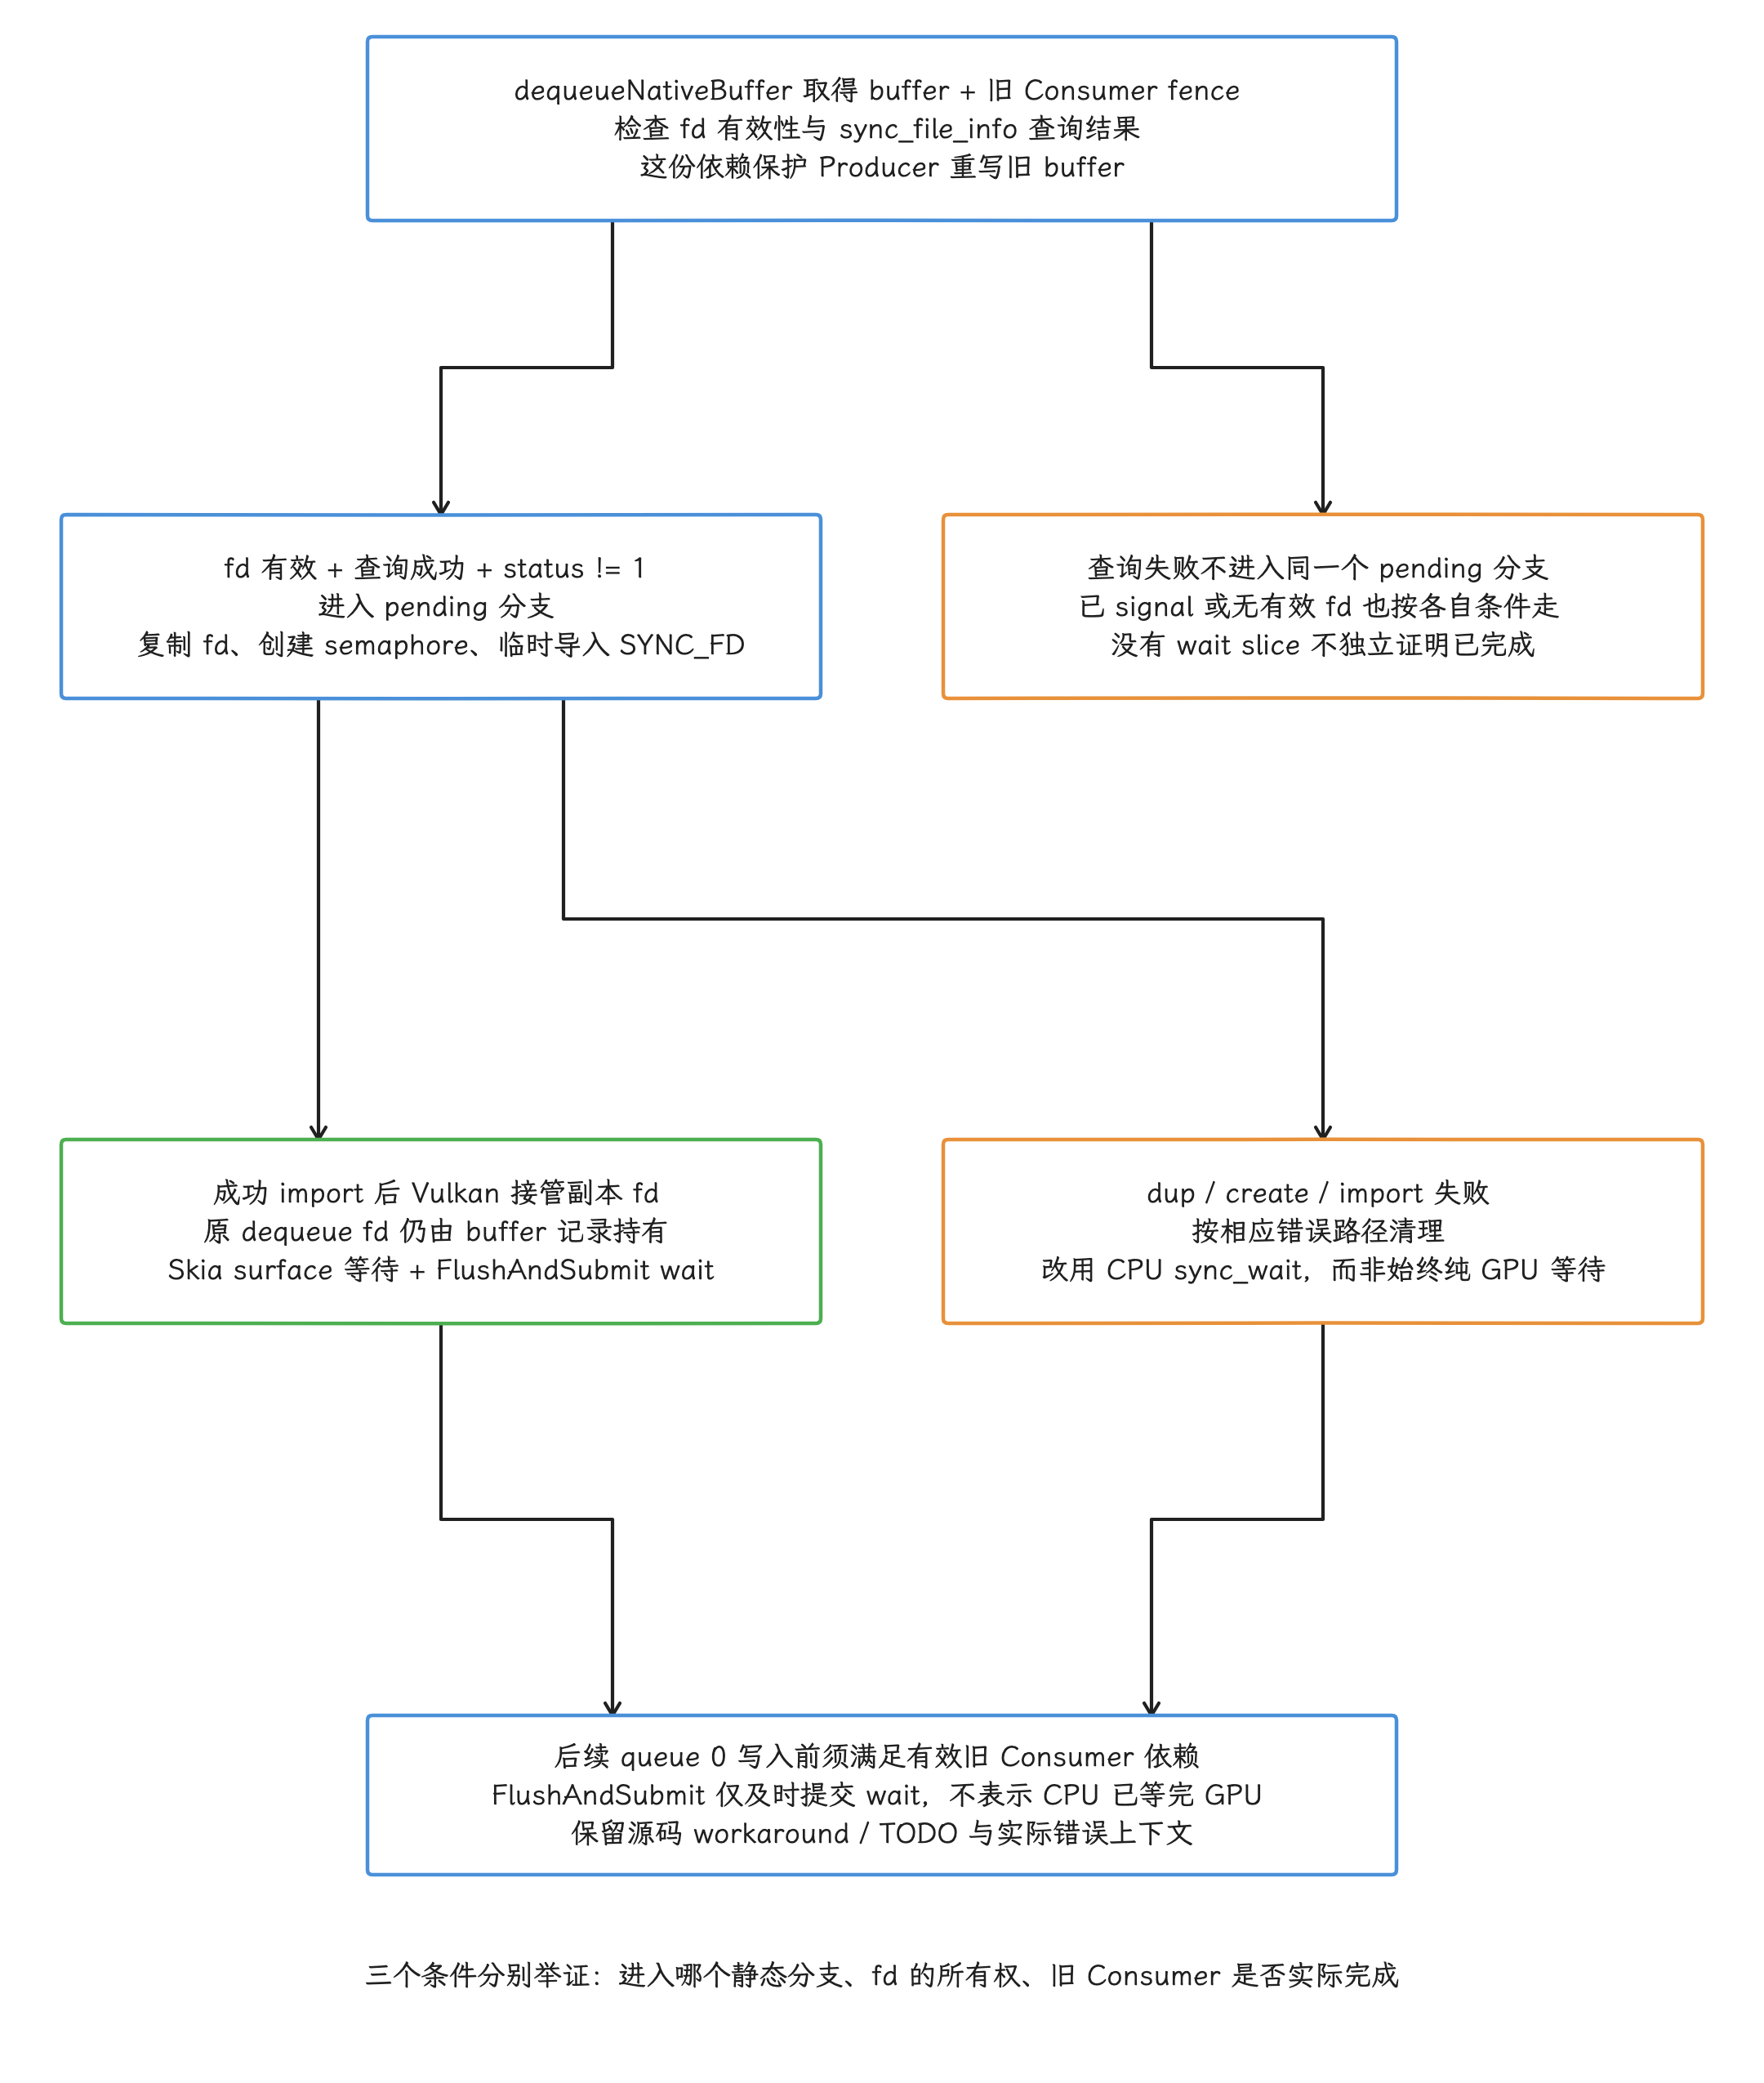
图:仅fd有效、sync_file_info查询成功且status!=1分支dupfd/createbinarysemaphore/TEMPORARYSYNCFDimport;成功Vulkan接管副本,原dequeuefd仍由buffer记录持有。Skiasurfacewait后FlushAndSubmit及时交GPU等待,源码workaround不证明CPU等GPU结束。dup/create/import失败走清理和CPUsync_wait;sync_file_info查询失败不进入同一pending分支。缺少waitslice不是fence已signal独立证明;新Producer写前仍须满足旧Consumer依赖。
finishFrame:导出本轮 GPU 完成 fence
queue 0 的窗口绘制工作准备提交时,finishFrame() 创建可导出为 sync-fd 的 semaphore,并把它放入 GrFlushInfo.fSignalSemaphores。flush/submit 后,代码通过 vkGetSemaphoreFdKHR() 取得 fd。sync-fd 是用户空间传递内核 dma_fence 的文件描述符封装。VulkanSurface::presentCurrentBuffer() 再把这个 fd 传给 ANativeWindow::queueBuffer()。
这个 fd 在 BufferQueue 消费侧成为当前 buffer 的 acquire fence。SurfaceFlinger 可以先接收 buffer 元数据,但读取像素前必须等待 fence signal,确认 GPU 已经写完。presentCurrentBuffer() 的函数名容易误导;这里执行的是 queue buffer,屏幕 present 还在后面的链路里。
创建可导出 semaphore 失败、导致 sharedSemaphore 为空时,finishFrame() 会调用 mQueueWaitIdle(mGraphicsQueue),保守地等待 queue 0 空闲;若 GPU 已成功提交、但后续 vkGetSemaphoreFdKHR() 导出 fd 失败,源码只记录错误并返回无效 fd。这两类失败各有各的处理,没有共用的 fallback。正常路径下,RenderThread 无需先在 CPU 等整帧 GPU 完成;但 swapBuffers() 的 Properties::waitForGpuCompletion 调试分支会执行 mDeviceWaitIdle(),可能同时等待该 device 的上传工作,排查异常串行时要核对它。 VulkanSurface::presentCurrentBuffer() 收到无效导出 fd 时会改用原 dequeue fence 交给 queue;这份旧 Consumer 依赖与本轮新写入是否完成,要结合此前是否 idle、submit 是否成功和错误上下文分别判断,该 fd 分支也就谈不上统一可靠的 Producer 完成 fallback。
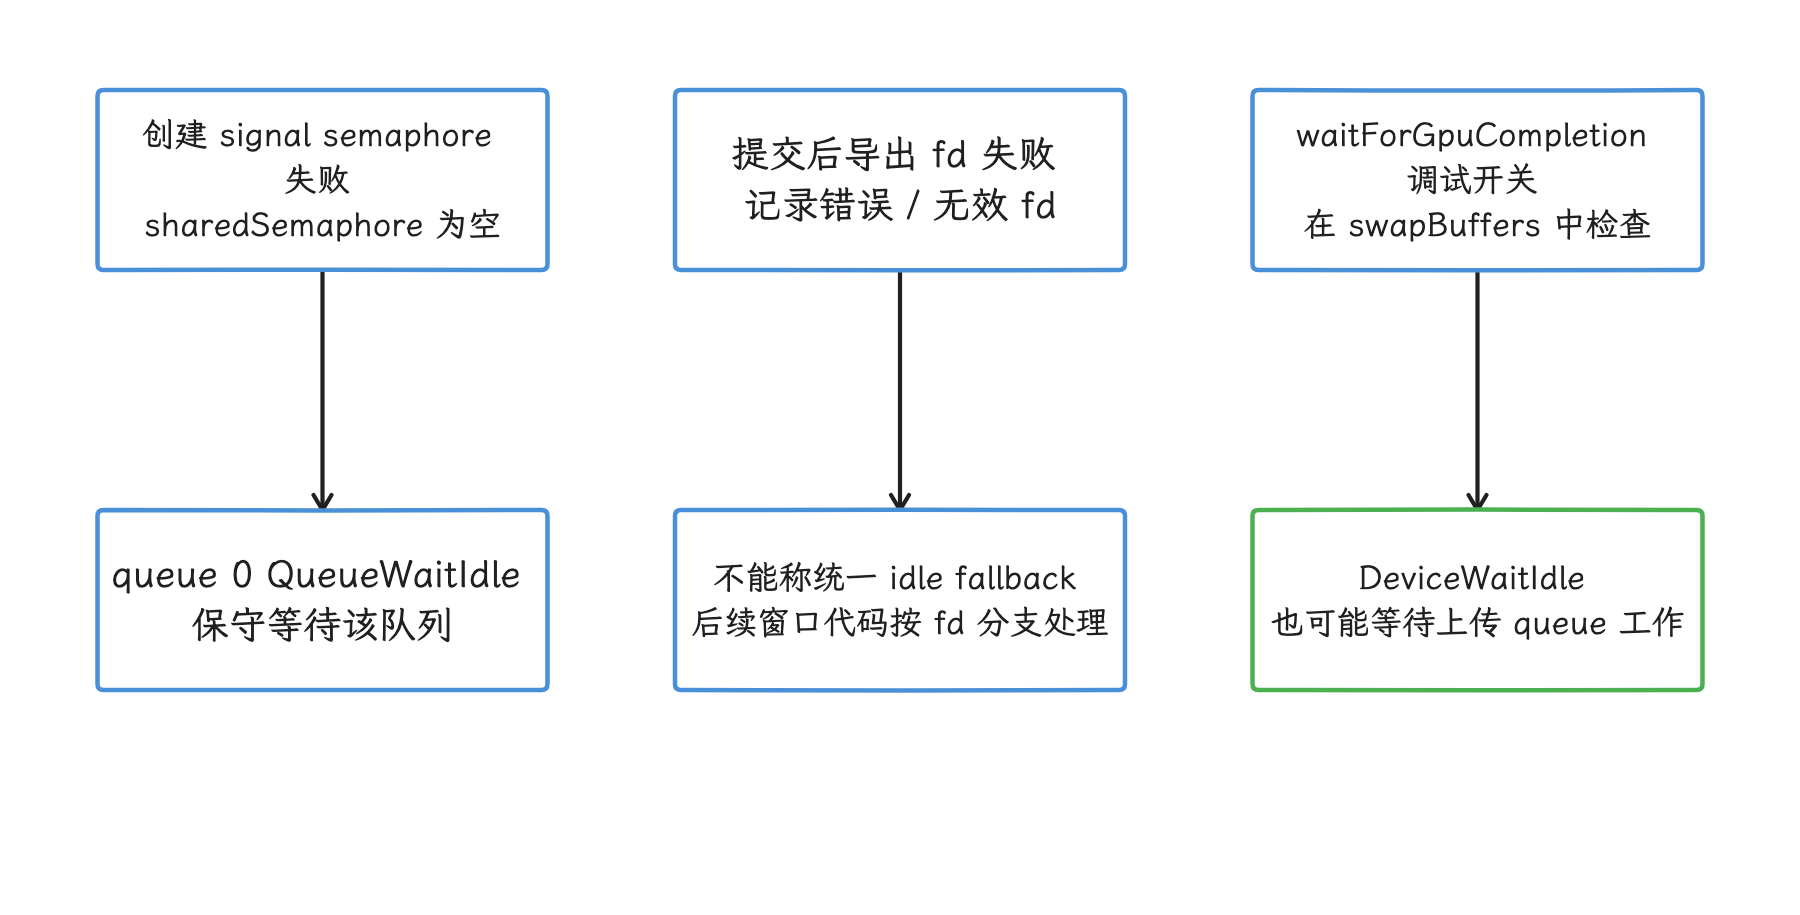
图:无 signal semaphore、导出 fd 失败和调试 waitIdle 是三种不同情况。 无效 fd 不自动证明写入完成;固定 r1 没有为所有失败统一补 CPU 等待。
下面的时序图按 buffer 所有权变化标出 fence 方向:
sequenceDiagram
    participant BQ as "ANativeWindow / BufferQueue / BLAST"
    participant RT as "RenderThread / VulkanManager"
    participant Vk as "Vulkan / Skia CPU API"
    participant GPU as "GPU queue 0 work"
    participant SF as "SF / CompositionEngine"
    participant HWC as "Composer / Display"
    BQ-->>RT: "dequeue buffer + old-consumer release fence"
    RT->>Vk: "pending branch: import dup fd#59; surface wait + FlushAndSubmit"
    RT->>Vk: "Skia draw / flush + signal exportable semaphore"
    Vk->>GPU: "asynchronous work#59; obey old-consumer dependency"
    Vk-->>RT: "export producer completion sync fd"
    RT->>BQ: "CPU queueBuffer(buffer, sync fd)"
    BQ->>SF: "BLAST buffer transaction + acquire dependency"
    Note over GPU,SF: queue / constrained latch can precede signal#59; actual read obeys acquire
    alt presentOrValidate presents directly
        SF->>HWC: "presentOrValidate"
        HWC-->>SF: "present / release feedback"
    else validated result
        SF->>HWC: "validate or validated result"
        SF->>SF: "optional CLIENT composition"
        SF->>HWC: "present"
        HWC-->>SF: "present / release feedback"
    end
    SF-->>BQ: "old buffer release#59; may include CLIENT GPU dependency"
由此可以解释两个现象:queueBuffer() 可以在 GPU 完成前返回;下一次 dequeue 可能因无合适 slot 或队列约束而等待;也可能先返回 slot + 未 signal 的 release fence,再由 Producer 在写入前遵守这项依赖。违反最大 dequeued 等约束还可能直接报错;旧 buffer 使用期有多种表现,dequeue 内的 CPU 阻塞只是其中之一。
Buffer age 与 partial update
当 Properties::enablePartialUpdates 和 Properties::useBufferAge 同时开启时,VulkanManager 使用 SwapBehavior::BufferAge。buffer age 表示一块 buffer 距离上次成功入队经历了多少次窗口提交。VulkanSurface 根据本进程的 present count 与该 buffer 上次成功入队时的 count 计算 age;新 buffer、内容无效或 transform 改变时返回 0。
CanvasContext::computeDirtyRect() 先保存本帧窗口变化区域 windowDirty,再把绘制修复区域 dirty 与 age−1 帧历史 damage 合并;age 为 0 或历史不足则完整绘制。SkiaVulkanPipeline::draw() 用修复后的 dirty 绘制,而 swap 把 windowDirty 交给 presentCurrentBuffer()/native_window_set_surface_damage()。所以 back-buffer 修复 damage 与提交给窗口的 surface damage,要按两个矩形分开对待。这里有三个限制:
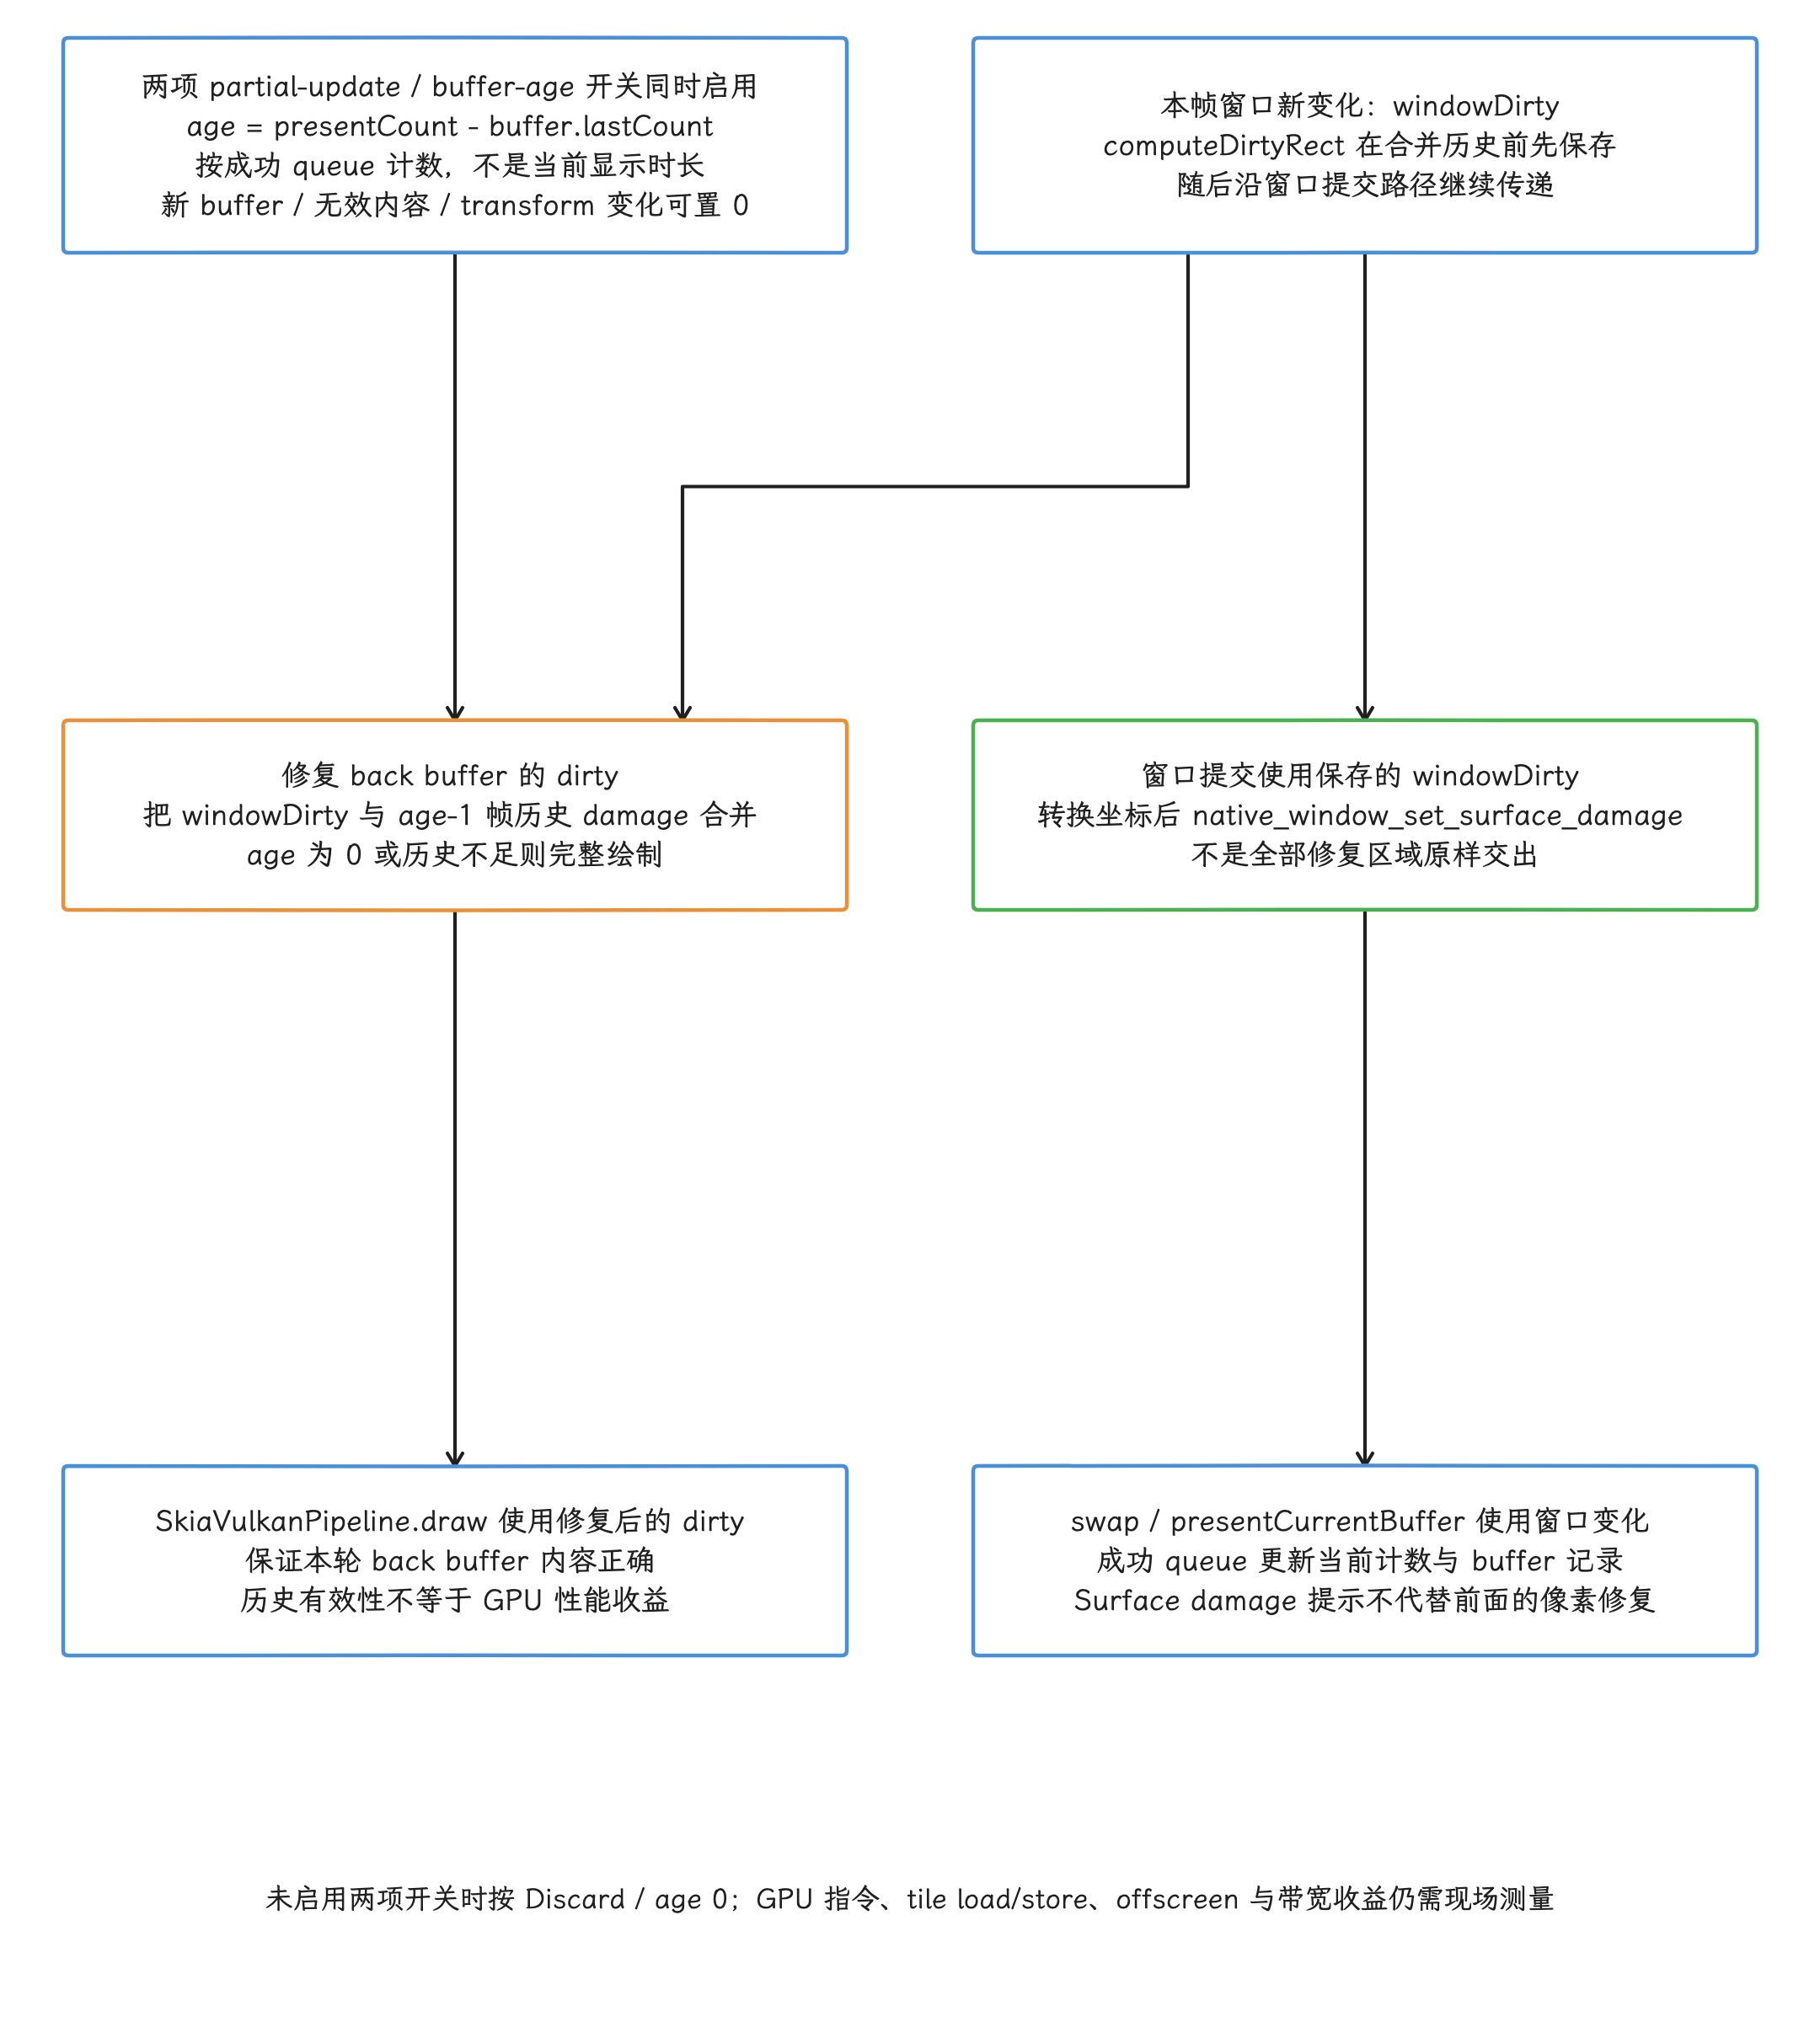
图:enablePartialUpdates与useBufferAge同时开才选择BufferAge,否则Discard/age0。age由进程成功queue计数减buffer上次成功queue计数,不是当前显示时长;新建/内容无效/transform变化age0。computeDirtyRect先保存本帧windowDirty,再修复dirty合age-1历史damage,age0或历史不足全绘制。SkiaVulkanPipelinedraw用修复dirty,而swap/native_window_set_surface_damage传windowDirty,二者可不同。damage提示不保证所有GPU仅执行该矩形,性能收益另测GPU/带宽/功耗。
- buffer age 只表示内容可复用历史,脏矩形之外的 GPU 指令是否省掉由实现决定;
- age 为 0 时需要按完整内容处理;
- driver、tile 架构、offscreen layer、blend 和 SurfaceFlinger 合成仍会影响最终带宽。
因此,partial update 的收益要结合 GPU counter、render stage 与功耗数据评估。bufferAge != 0 本身证明不了 fill rate(每秒实际填充的像素量)已按 damage 面积同比例下降。
VkFunctor 与 WebView 私有互操作
getVkFunctorInitParams() 会向 HWUI 的 WebView Vulkan functor 回调提供 VkInstance、VkPhysicalDevice、VkDevice、queue 0、queue family index 和已启用的 feature/extension。这里的 functor 是 WebView 与 HWUI 之间的私有绘制回调对象;VkFunctorDrawable 明确持有 WebViewFunctor::Handle,并在 RenderThread 上调用它。
它只服务于 WebView 与 HWUI 之间的私有互操作;SurfaceView 的自定义渲染复用不到这套 device,普通 native renderer 也拿不到。应用自己的 instance、device、queue 与同步对象,应通过公开 Vulkan/ANativeWindow API 管理。
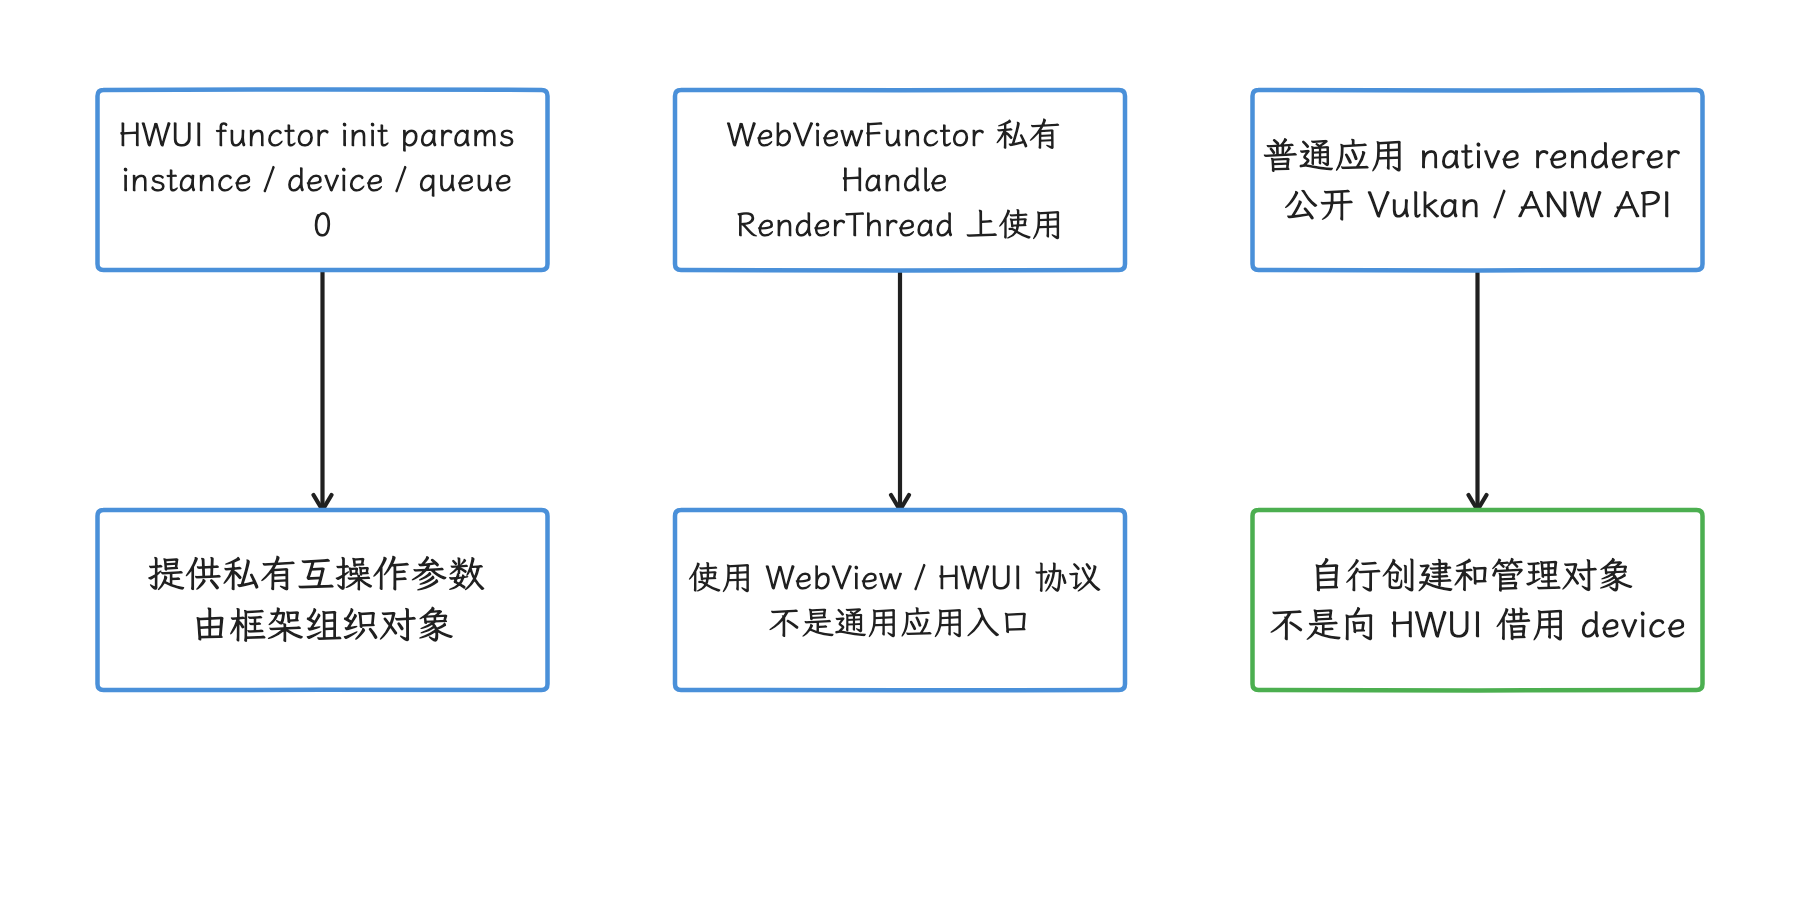
图:HWUI 向 WebView 私有回调提供 queue 0 等对象,普通 native renderer 自建公开对象。 此私有互操作不是通用应用获取 HWUI device 的公开 API。
与 SkiaGL 的对比
我们常听到一种误解:SkiaGL 只有一个 context,因此 hardware bitmap 上传必然与 RenderThread 串行。但 GL 路径同样使用独立的 EGLUploader、GrallocUploadThread 与 EGL context:GL 上传命令在 upload thread 的 runSync() task 内执行并返回 fence,随后 eglClientWaitSyncKHR() 位于调用方线程。它有 2 秒超时且这里只记录异常后继续:等待有界、位置在调用方线程,上传是否完成以每次等待的结果为准。
两种后端的可观察差异如下:
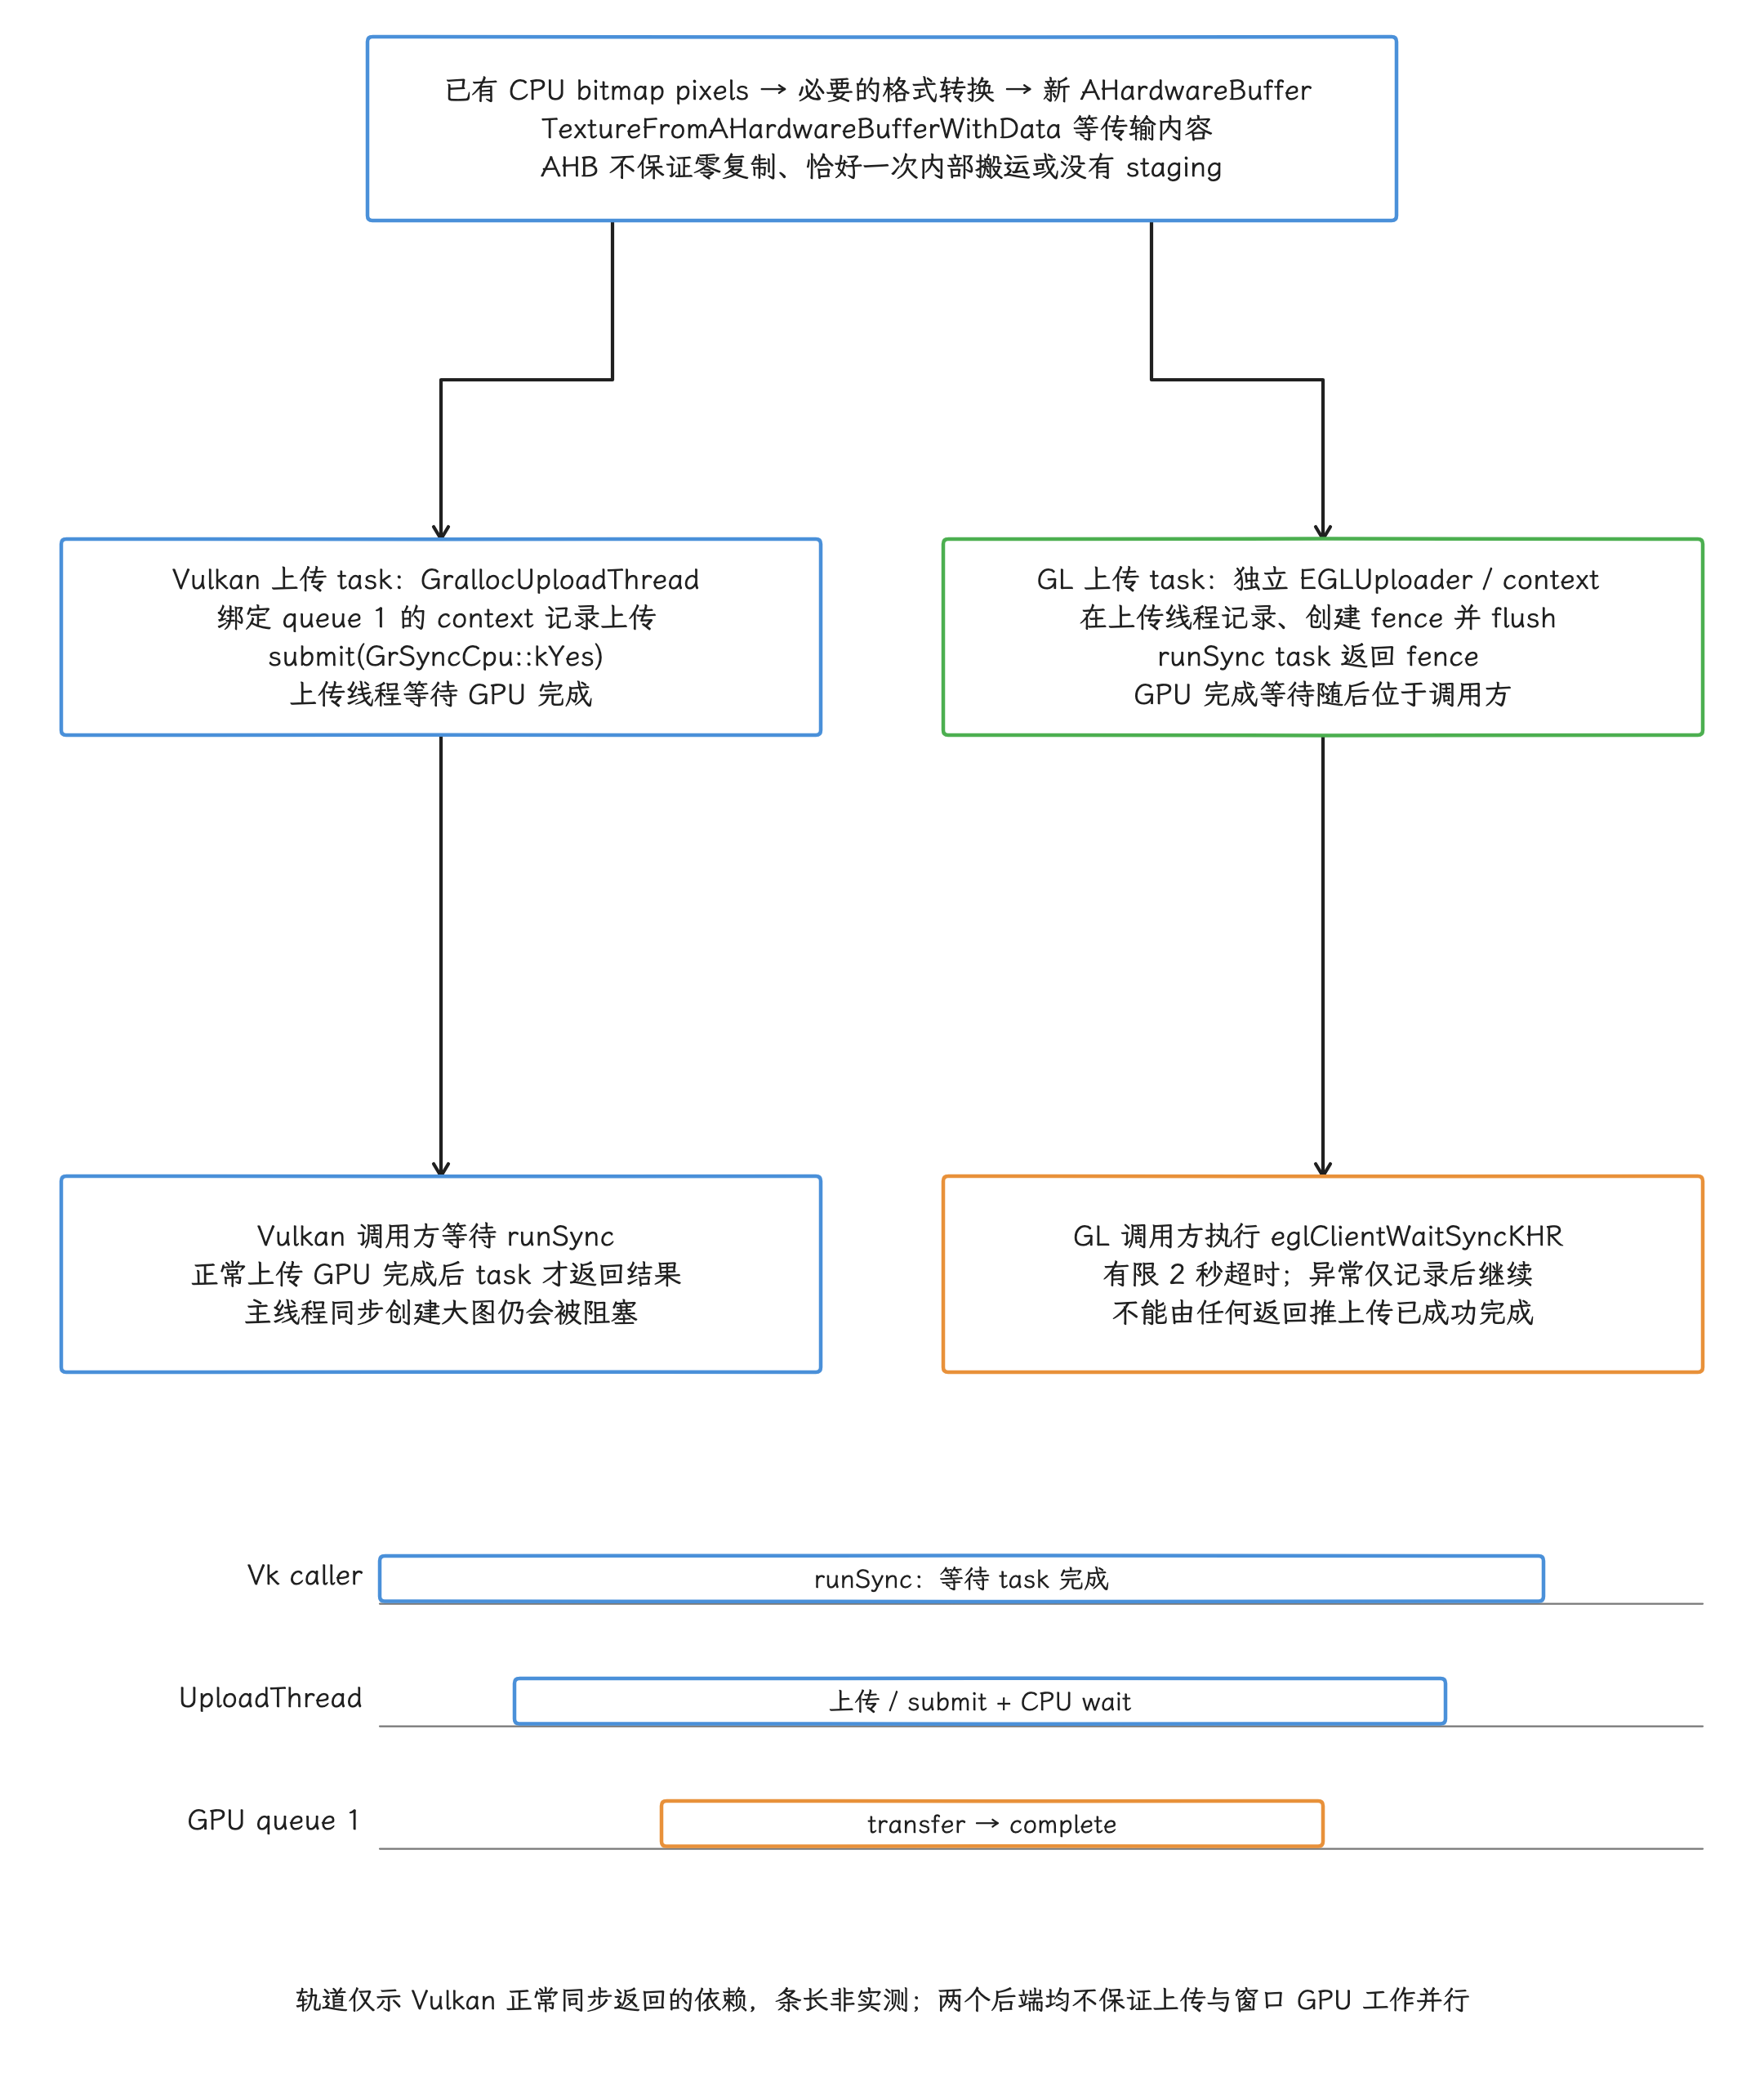
图:CPU像素可能先makeHwCompatible转换,分配带sampledusage的新AHB后TextureFromAHardwareBufferWithData传输;AHB不保证零复制/恰一次搬运/无staging。Vulkan上传在GrallocUploadThreadqueue1且submitGrSyncCpuYes,runSync正常返回后调用方才获写完结果。GL上传task记录/flush并返回fence,runSync后由调用方eglClientWaitSyncKHR,2秒有限超时且异常只记录后继续,上传是否完成以等待结果为准。两种后端都有上传线程,不保证与窗口GPU工作同时执行。轨道只示Vulkan正常同步返回的关系,非时长测量。
| 维度 | SkiaVulkan | SkiaGL |
|---|---|---|
| HWUI 明确管理的提交对象 | 同一 VkDevice 上两条 graphics VkQueue | RenderThread 与 uploader 各自的 EGL/GL context;驱动内部 queue 拓扑不可由 GL API 直接得知 |
| AHB 上传完成等待 | UploadThread GrSyncCpu::kYes | 上传 task 返回 fence 后,由调用方 eglClientWaitSyncKHR()(有限超时) |
| 窗口完成 fence | Vulkan semaphore 导出 sync fd | EGL/GL native fence 路径 |
| GPU frame annotation | 可使用 VK_EXT_frame_boundary 或 AGI 私有扩展 | 依赖 GL/驱动/工具支持,不能概括成“无分析能力” |
| 是否保证上传与绘制并行 | 否 | 否 |
Vulkan API 会显式表达 queue、semaphore 与外部句柄之间的关系,便于建立同步证据,但同一负载不会因此自动变快。做性能对比时,我们仍要固定设备、内容、刷新率与热状态。
性能观测:分清 queue、GPU 与 present
Perfetto
我们建议同时采集以下证据,并用 submission ID、时间区间和 frame token(关联同一帧的标识)串起各数据源:
- Main thread 与 RenderThread 调度、
syncAndDrawFrame、Vulkan finish frame、flush commands; GrallocUploadThread的 hardware bitmap 上传 slice;dequeueBuffer/queueBufferduration;- FrameTimeline expected/actual 与 jank type;
gpu.renderstages:设备 producer 支持时,可以通过hw_queue_iid、context、submission ID 与 render stage 查看 GPU 活动;gpu.counters:设备支持时查看频率、busy、带宽、cache 等计数器;- GPU/DRM ftrace 与 dma-buf/fence 事件:用来判断驱动调度和 fence 等待。
Perfetto 的 GPU data source 由设备或驱动侧 producer(向 Perfetto 写入 trace 数据的组件)提供,名称可能带 .adreno、.mali 等后缀,可用字段也因设备而异。HWUI 创建两条 VkQueue,不保证 trace 会显示两条可独立命名的硬件 queue。
AGI
AGI frame profiling 可以检查单帧中的 Vulkan API call、render pass、shader、texture、pipeline state 与资源。抓取 HWUI 渲染时,VK_ANDROID_frame_boundary 由 AGI capture layer 注入,用于帮助工具划分窗口帧。
AGI 适合解释单帧 GPU 命令做了什么;系统层面的 FrameTimeline、BufferQueue、SurfaceFlinger、HWC 与 present timing,仍要通过 Perfetto、dumpsys 或厂商显示工具观察。
常见症状与证据
| 症状 | 先看 | 避免的误判 |
|---|---|---|
| hardware bitmap 创建卡住调用线程 | decode、AHB allocation、GrallocUploadThread、GrSyncCpu wait | 看到 queue 1 就认定调用异步返回 |
| RenderThread 慢且 upload 同期发生 | queue 0/1 submission、GPU busy、带宽、频率、调度 | 把两个 queue 直接当成两套 GPU 引擎 |
dequeueBuffer 长等待 | 上一轮 release fence、buffer 数量、SF/HWC/GPU 使用期 | 直接归因于 Vulkan command recording |
queueBuffer 按时但帧晚 | acquire fence、SF latch、composition、present | 把 queue 时间当上屏时间 |
| AGI 有清晰 frame boundary,Perfetto token 对不上 | Vulkan frame ID 与 FrameTimeline vsyncId 分开对齐 | 假设两个 ID 数值相同 |
| partial update 开启但 GPU 仍重 | buffer age、damage、offscreen layer、overdraw、tile load/store | 认为 surface damage 会裁掉所有上游工作 |
源码核对索引
VulkanManager.cpp/VulkanManager.h:device、两条 queue、context、global priority、frame boundary、fence 导入导出;HardwareBitmapUploader.cpp/Bitmap.cpp:GL/Vulkan 上传线程、首次内容复制、CPU 等待与 60 秒 idle timeout;SkiaVulkanPipeline.cpp:dequeue、draw、finishFrame、swapBuffers 的调用关系;VulkanSurface.cpp:ANativeWindow buffer、dequeue fence、buffer age、surface damage 与 queueBuffer;CanvasContext.cpp:FrameTimeline info、damage history、dequeue/queue duration;- 历史标签:
android-14.0.0_r1、android-15.0.0_r1、android-16.0.0_r1:双 queue、frame-boundary 与 global-priority query 的版本对照; - Khronos
VkFrameBoundaryEXT:Vulkan frame annotation 的规范语义; - 内核
dma-fence.c/sync_file.c:android17-6.18-2026-06_r6的 fence 与 sync-file 边界; - Perfetto GPU data sources:GPU counter、render stage 与设备 producer 的观察口径;
- Perfetto FrameTimeline:expected/actual 时间线与 jank 分类;
- AGI Frame Profiler:单帧 Vulkan/GL 调用和 GPU 资源分析。
版本与实现边界
双 queue 与 frame-boundary、global priority 代码从哪个版本开始存在,固定 release tag 的对照能给出一部分答案;下表陈述的就是这种对照能够证明的结果:
| 平台标签 | 双 graphics queue | frame-boundary 相关代码 | global-priority 相关代码 |
|---|---|---|---|
android-14.0.0_r1 | 已有 queue 0 + AHB upload queue 1 | 已有 AGI 私有 VK_ANDROID_frame_boundary 调用;未见当前 EXT fallback / fFrameID 形态 | 已有 VK_EXT_global_priority 请求 |
android-15.0.0_r1 | 保持双 queue | 保持 AGI 私有 boundary;未见当前 EXT fallback / fFrameID 形态 | 保持 extension 请求 |
android-16.0.0_r1 | 保持双 queue | 已有 VK_EXT_frame_boundary、AGI 私有扩展与 fFrameID | 增加 global-priority query/KHR 相关处理 |
android-17.0.0_r1 | 保持双 queue | 保持两条 boundary 路径 | 保持 query 与不支持时的降级处理 |
这张表能说明 Android 17 固定 tag 中有哪些实现,也能证明双 queue 至少在 Android 14 基线已经存在。若要定位某个提交首次进入主线,还需继续检查相关开发分支与 Git history,仅凭四个 release tag 推断不出精确日期。
结论
原生 Vulkan 与 HWUI Vulkan 的显示后半段最终都收束到 Android buffer/fence、SurfaceFlinger 与 Display present。原生路径由应用管理 swapchain、submit、barrier 和 pacing;HWUI 路径则由 framework 管理窗口 buffer、Skia context 与内部队列。两条路径上,API 返回、GPU frame boundary 或 queueBuffer() 都还称不上已经上屏。
HWUI Vulkan 的双 queue 架构可以概括为四点:
- queue 0 供 RenderThread 生成 App Window 帧,queue 1 供 GrallocUploadThread 上传 hardware bitmap;
- 两条 queue 共享 VkDevice,但使用独立 Skia context 与 allocator,可以独立提交,硬件同时执行没有保证;
- Vulkan frame-boundary 是 GPU 工具标记,FrameTimeline
vsyncId才关联窗口的 expected/actual present; - dequeue fence 保护旧 buffer 的安全复用,
queueBuffer()携带的 producer completion fence 保护 SurfaceFlinger 的安全读取,二者方向相反。
分析问题时,我们把 RenderThread、GrallocUploadThread、两条 queue、GPU completion fence、BufferQueue、FrameTimeline 与 present 放进同一时间区间。queue 数量说明的只是可独立提交的接口结构;硬件并行度、卡顿原因或用户看到帧的时刻,要靠这些证据一起回答。