文件系统与 I/O 调度
应用 I/O 从系统调用进入 VFS、页缓存和具体文件系统;缓存未满足或需要回写、同步时,才可能继续由块层和设备队列提交给存储。这一篇我们讲两件事:文件系统解释数据怎样组织和持久化,I/O 调度解释多个请求如何排序、合并与限流。
源码基线:Android 17 / API 37,AOSP
android-17.0.0_r1;Android Common Kernelandroid17-6.18-2026-06_r6。
VFS、页缓存与文件系统语义
VFS 与 Page Cache(页缓存):统一接口之下的差异
VFS(Virtual File System,虚拟文件系统)通过 super_block、inode(索引节点)、dentry 和 file 等内核对象向上提供统一接口:它们分别描述挂载的文件系统、文件元数据、目录项和已打开文件。App 调用同一套 open()、read()、write() 和 fsync(),VFS 再把操作分发到具体文件系统的 file_operations、address_space_operations 等实现。接口统一,行为各不相同,这也是我们分析 I/O 问题时总要落到具体文件系统上的原因。
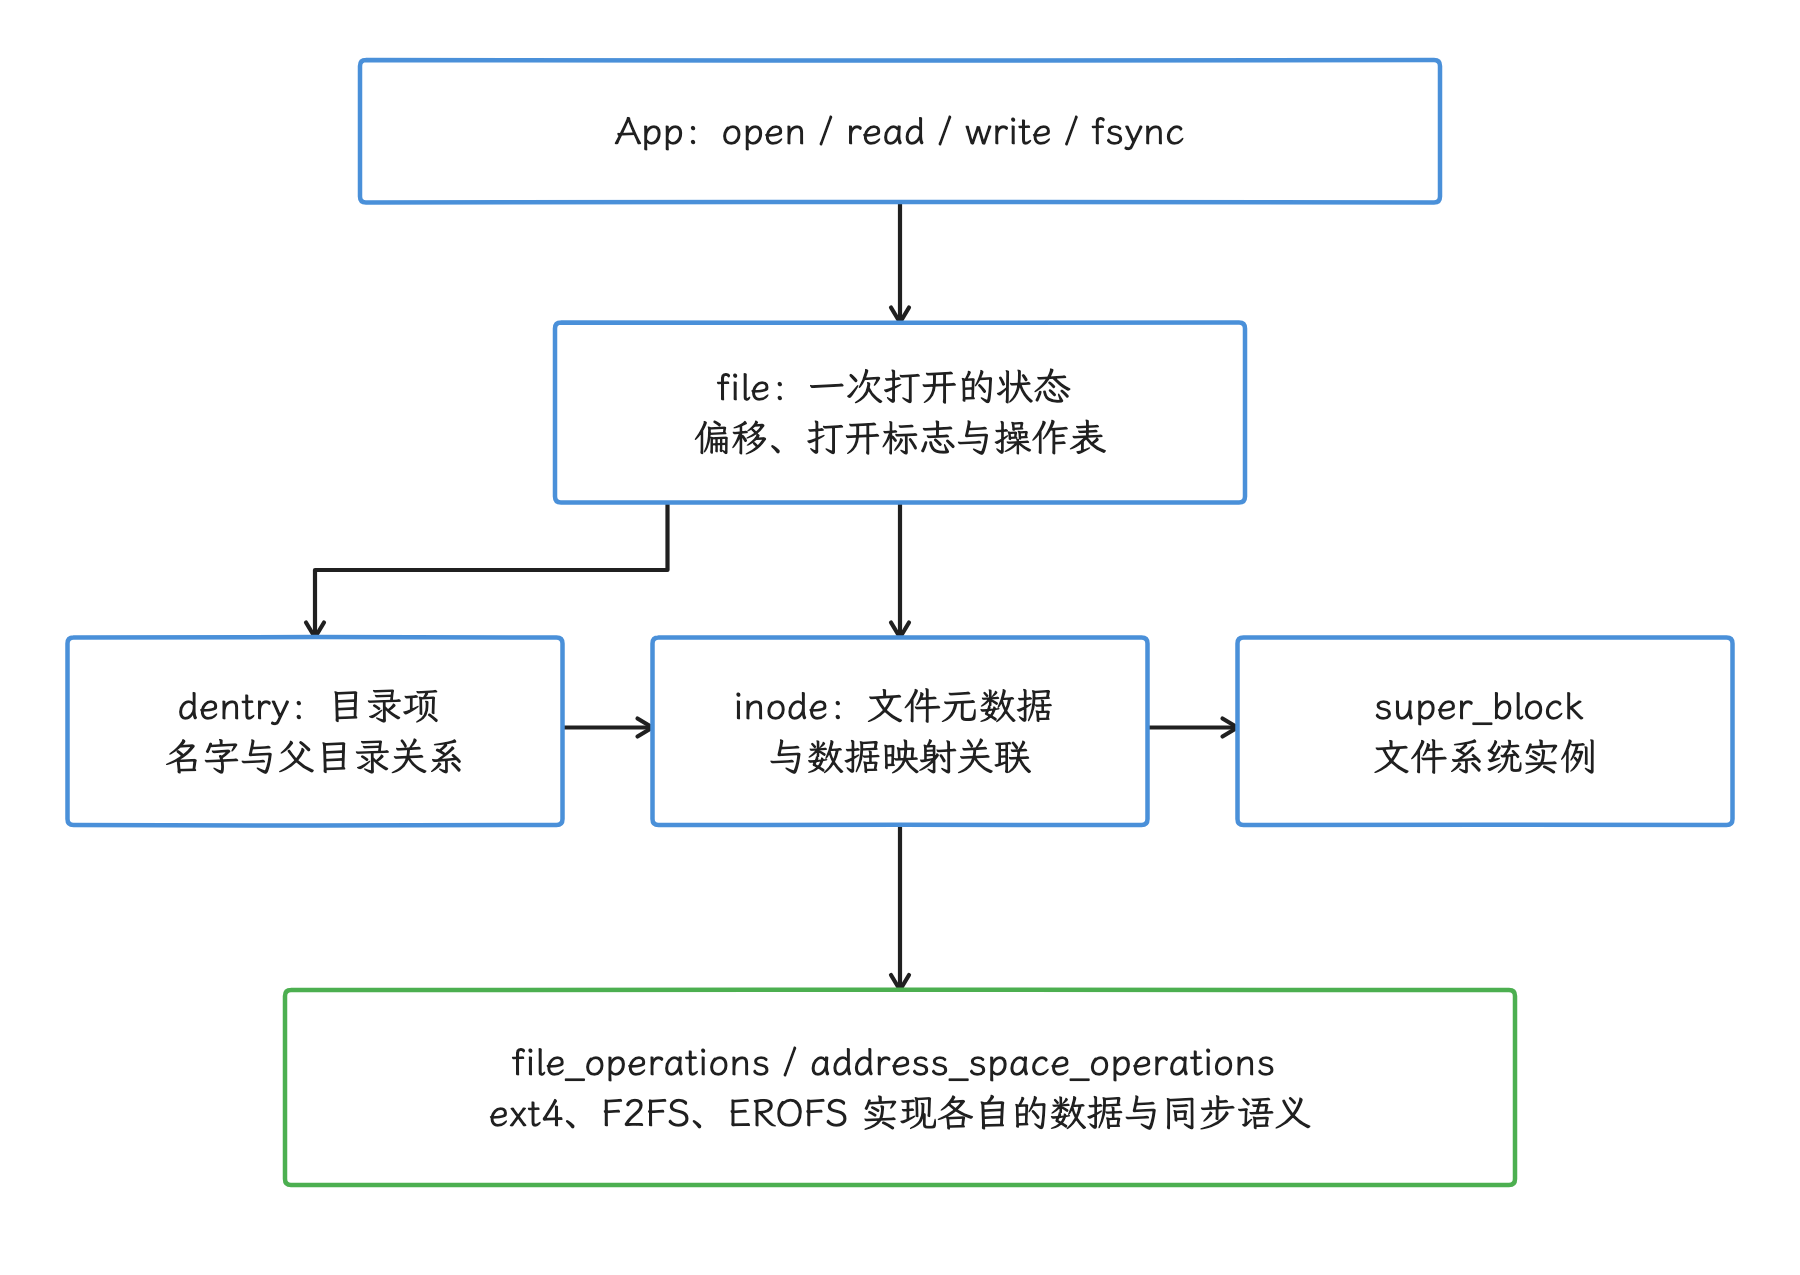
图:dentry 表示名字关系,inode 表示文件本体,file 表示一次打开;VFS 按操作接口分发到具体实现。
普通缓冲 I/O 的 write() 通常先修改 Page Cache,页面随后被标记为 dirty。内核回写线程可以异步提交这些页面;fsync() 则要求指定文件在相应范围内达到持久化语义,因此调用者可能需要等待:
- 文件数据写回;
- 影响文件可读性的元数据更新;
- journal(事务日志)、F2FS node 或 checkpoint 等恢复信息;
- 块设备 cache flush(缓存刷写)。
Page Cache 命中会掩盖很多读取差异。分析随机读时,我们先区分缓存命中、page fault(缺页) 触发的读取和落到存储设备上的读取,就不会把内存访问的速度算到文件系统名下。
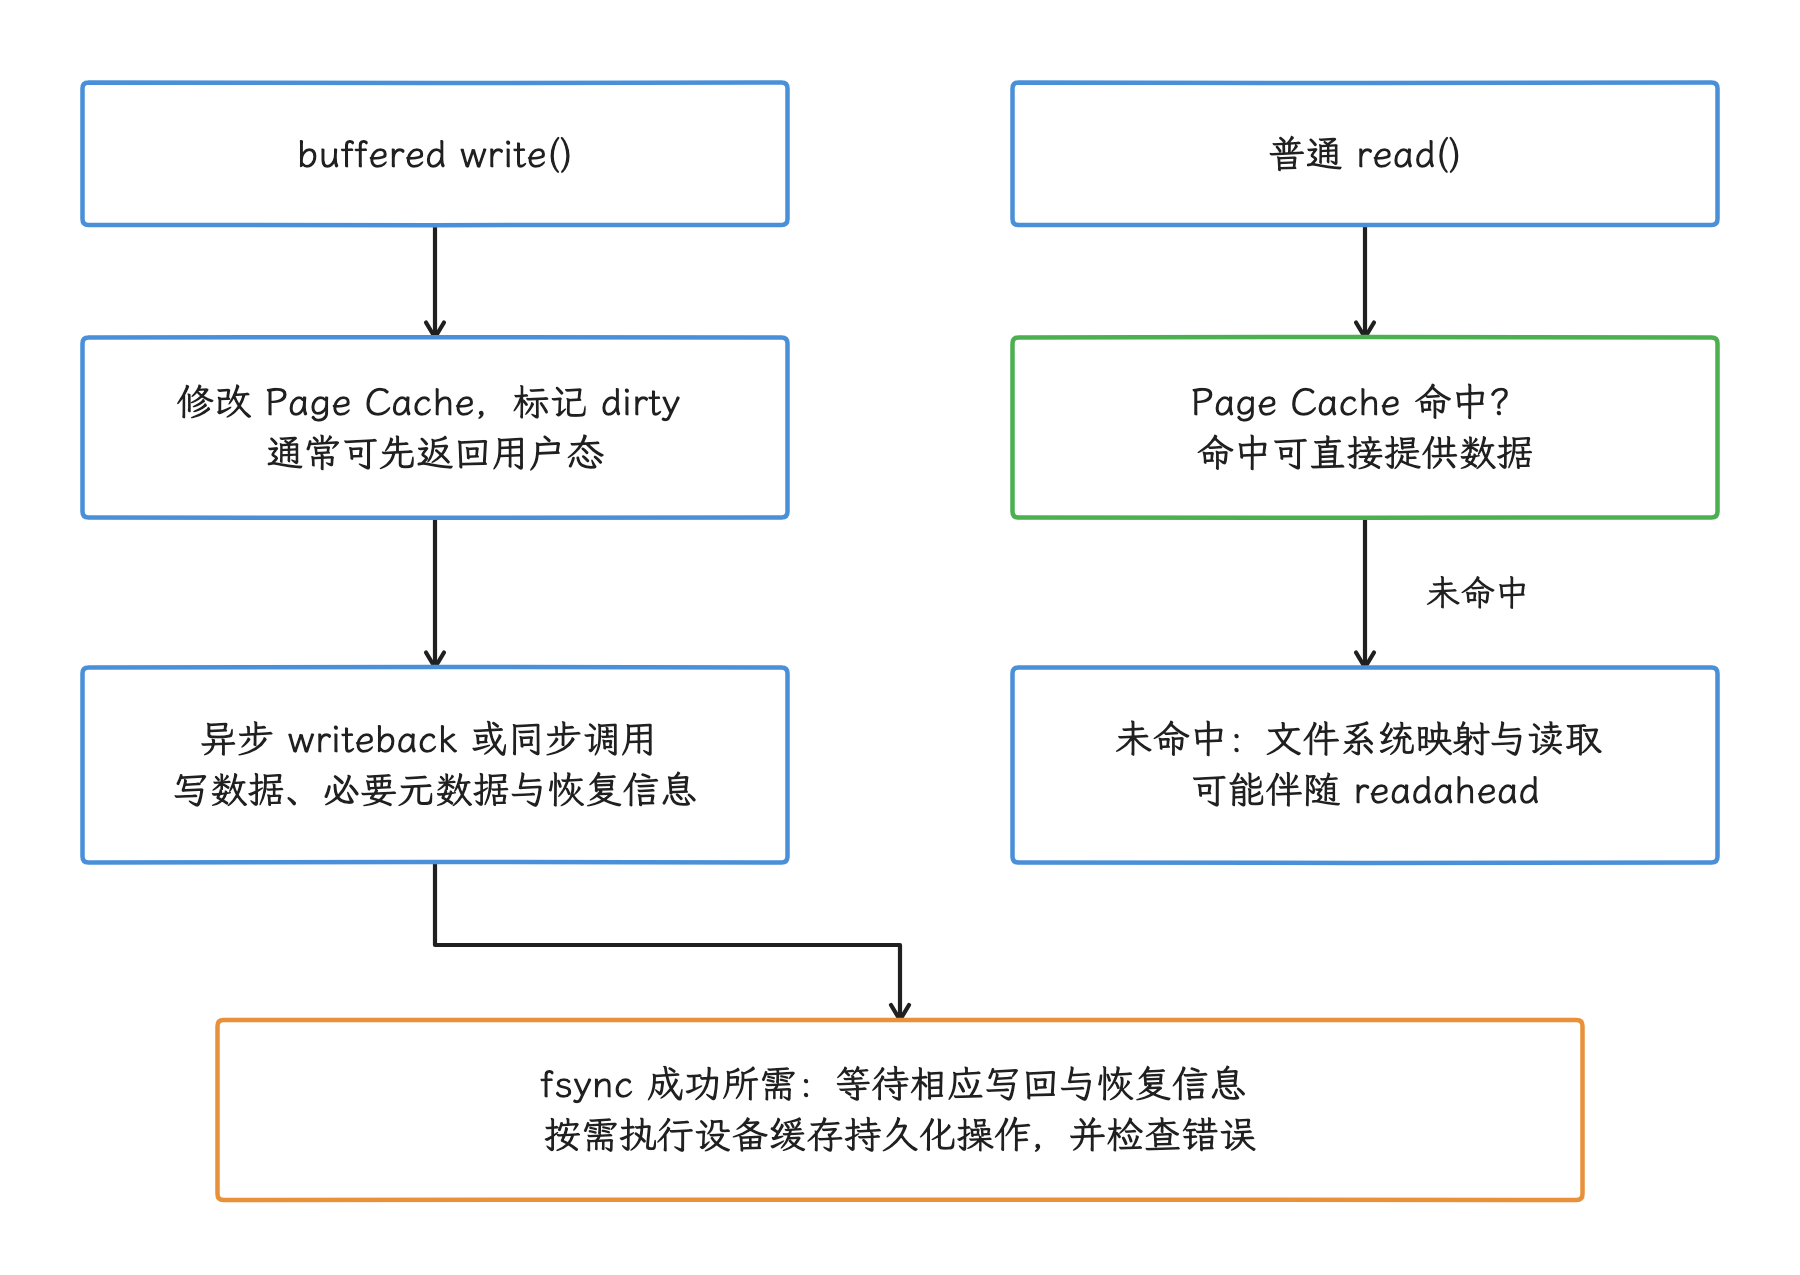
图:write 返回通常只表示数据进入缓存;fsync 要等待对应持久化工作,flush/FUA 的使用由文件系统与块层条件决定。
先把 fsync 卡顿放回完整 I/O 路径
在 Perfetto 里,我们偶尔会看到主线程进入一段不可中断睡眠,调用栈停在 fsync()、fdatasync() 或文件关闭附近。这是持久化相关等待的一条线索,仍需调用栈和事件确认;文件关闭本身不等同于一次 fsync,不可中断等待也可能来自其他内核资源。要判断问题出在哪一层,得把这一次同步写放回完整的 I/O 路径。它可能经过这些层次:
- App 或数据库提交修改。
- VFS 把脏页交给 ext4 或 F2FS;脏页就是内存中已修改、还没写回存储的数据页。
- 文件系统写数据、必要的元数据和恢复信息。
- 块层处理请求合并、调度、加密与 device-mapper(设备映射层) 映射。
- UFS 控制器和设备内部 FTL 完成写入与缓存刷新。
fsync() 的返回语义还受挂载参数和写屏障影响;存储设备怎样实现 flush(刷新设备写缓存)与 FUA(Force Unit Access,要求本次写入到达非易失介质),同样会改变它。文件系统能改变这条路径上的一部分成本;器件尾延迟、温度降频、磨损控制和队列拥塞,它消除不了。
SQLite 的同步次数同样要看条件:事务边界、journal 模式、PRAGMA synchronous、是否发生 cache spill(缓存页提前写出),以及文件系统是否提供 SQLite 能识别的原子批写能力,一起决定一次修改要同步几次;“每执行一条 SQL 就调用一次 fsync()”这样的固定对应,在这里套不上。
SharedPreferences 的 apply() 会先更新内存并把磁盘写入排到后台;它减少了调用线程的直接等待,但排队写入仍可能在组件生命周期切换时参与 ANR(应用无响应)。
ext4:成熟的通用读写文件系统
ext4 解决了哪些问题
ext4 在 arm64 GKI(Generic Kernel Image,通用内核镜像)中仍为内建能力:CONFIG_EXT4_FS=y。
它依赖的几个重要机制如下:
- extent(区段):用连续区间描述物理块,降低大文件块映射的元数据量。
- delayed allocation(延迟分配):缓冲写入阶段可以暂缓物理块分配,给多块分配器更多机会形成连续布局。
- multiblock allocator(多块分配器):批量选择连续空闲块。
- jbd2 journal:记录维持一致性所需的文件系统修改。常见
data=ordered模式主要记录元数据,并要求相关数据先于元数据提交完成。 - fast commit(快速提交):条件允许时只记录较小的增量;遇到不支持的操作会回退到完整 journal commit。
“就地更新”说的是 ext4 在逻辑块分配上的倾向。NAND 的物理擦除、搬移和磨损均衡由 UFS/eMMC 内部的 FTL(闪存转换层)处理,固定的 NAND erase block(擦除块)只出现在 FTL 内部,ext4 面对的是逻辑块。把每次 ext4 小写入都描述成一次固定大小的“读—改—擦—写”,就把逻辑写入和 NAND 物理操作绑得太死了。
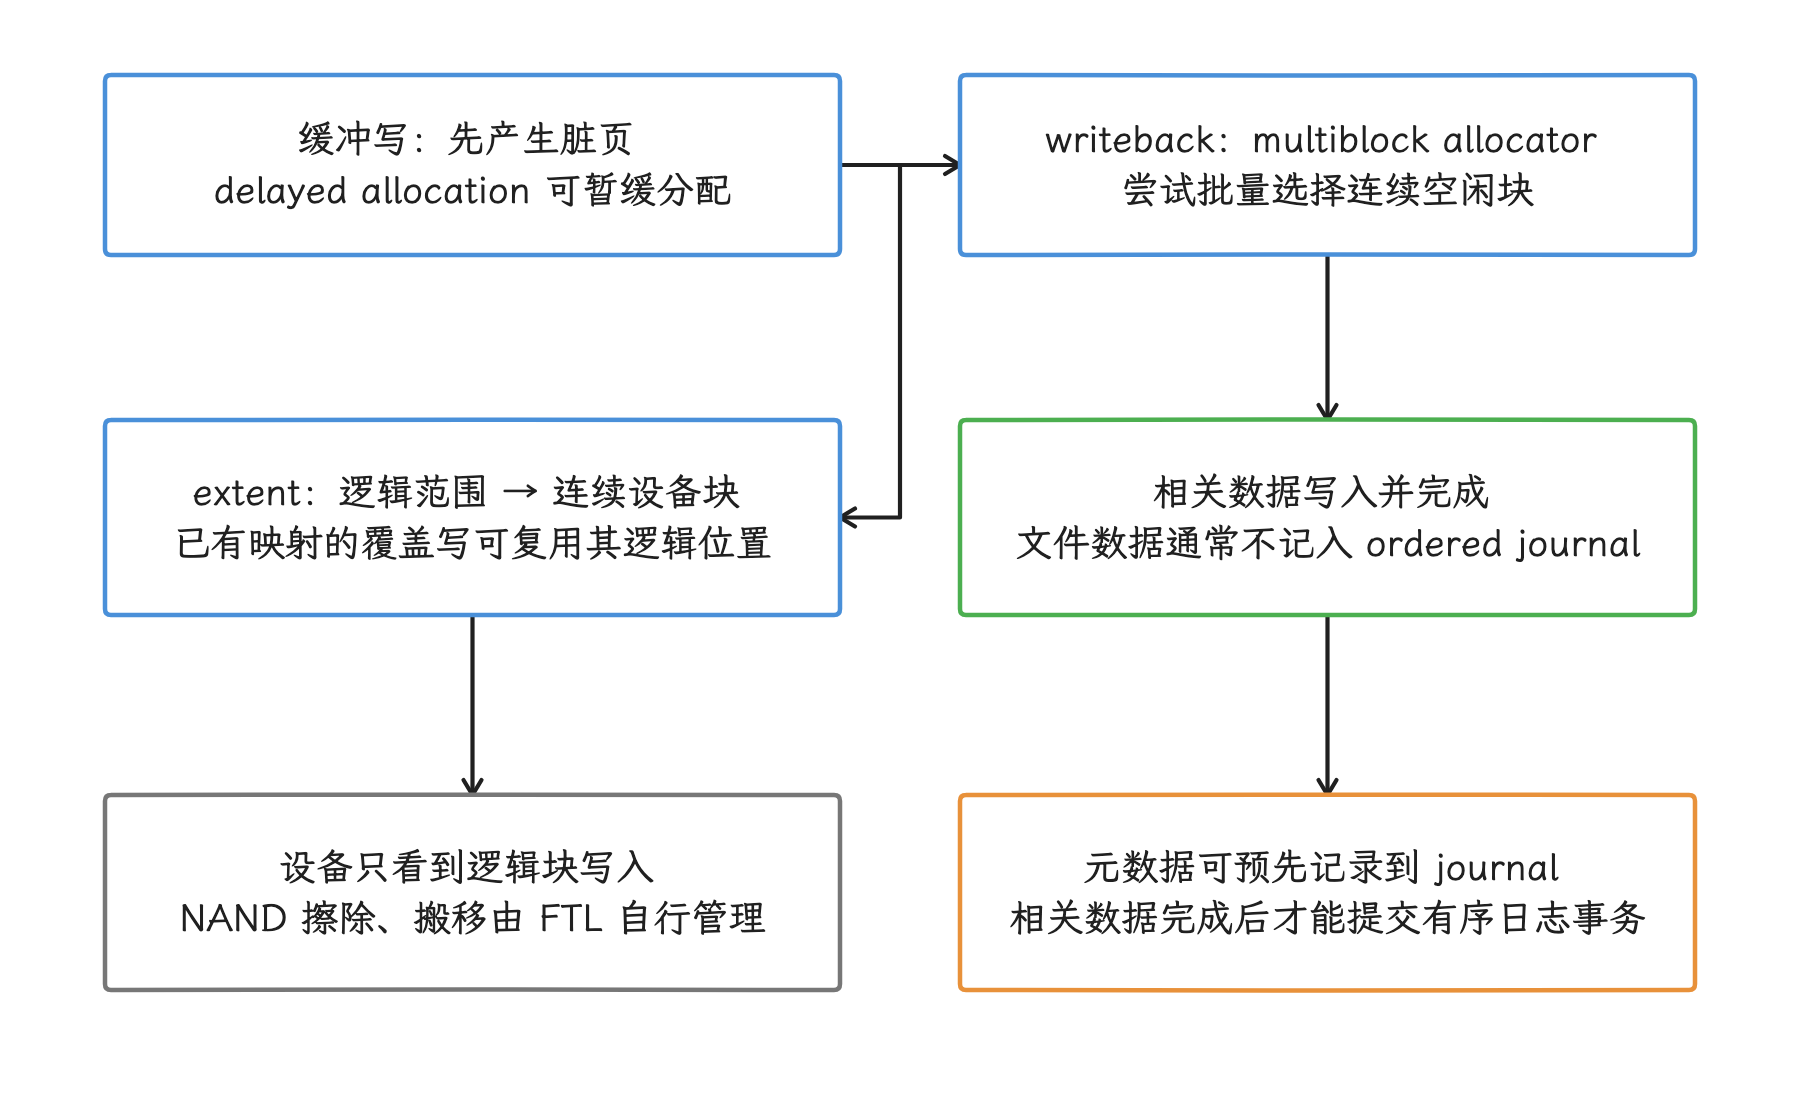
图:extent 合并连续逻辑映射,延迟分配为批量布局提供机会;data=ordered 约束相关数据先于元数据日志提交完成。
ext4 今天仍是 Android 设备的候选之一:分区职责、升级方案、故障恢复经验和性能目标,都会影响一台设备是否选择它。
ext4 fsync 的等待路径
下面的源码摘自 fs/ext4/fsync.c,可以看到 ext4 同步文件时等待了哪些对象:
ret = file_write_and_wait_range(file, start, end);
if (ret)
        goto out;

ret = ext4_fsync_journal(inode, datasync, &needs_barrier);

if (needs_barrier)
        err = blkdev_issue_flush(inode->i_sb->s_bdev);
这条路径先提交并等待目标文件范围的数据,再等待对应的 journal transaction(日志事务);需要写屏障时还会发出块设备 flush。ext4_fsync_journal() 会对普通文件尝试 ext4_fc_commit(),能否走 fast commit 由文件系统特性和本次修改类型共同决定。
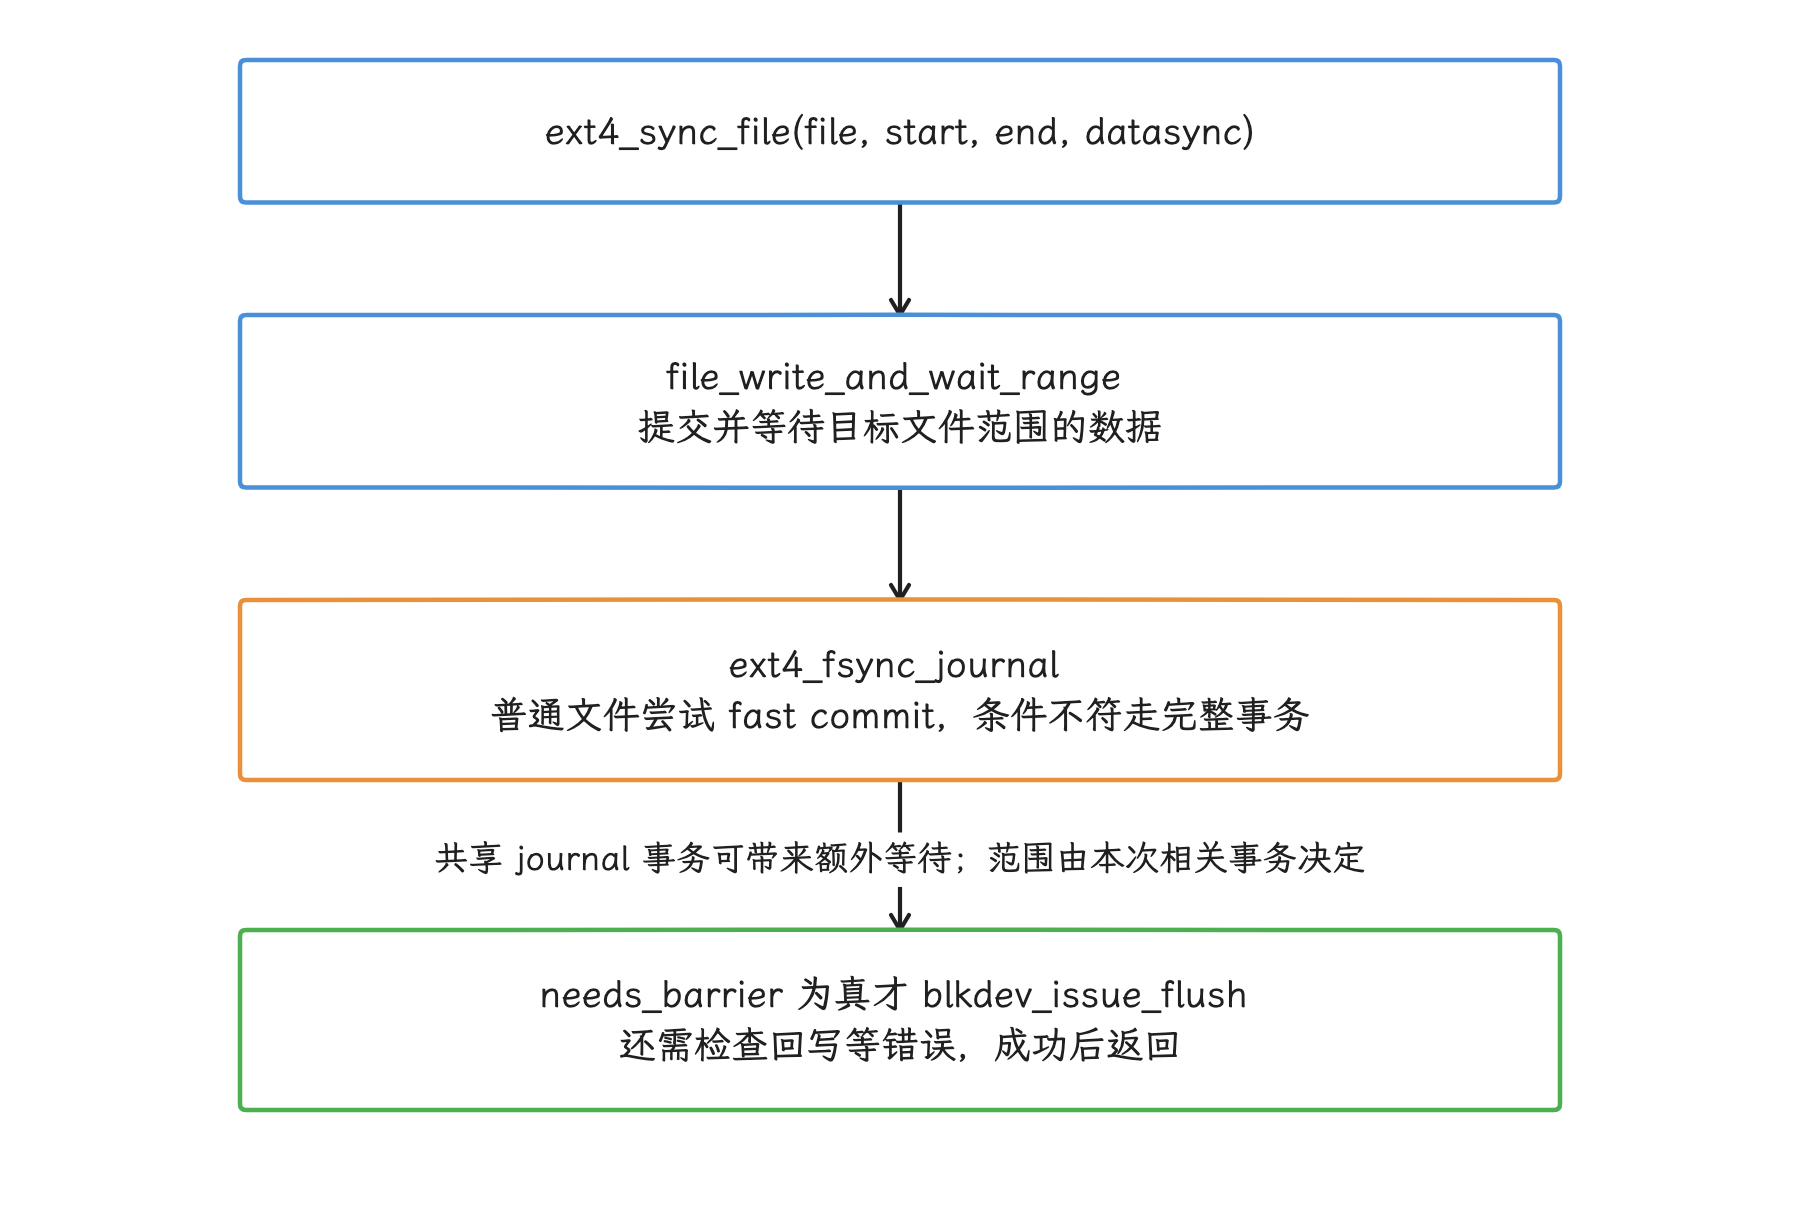
图:fsync 先等待目标文件数据,再等待相关 journal/fast commit;同一日志事务可能包含其他工作,最终按需 flush 并报告错误。
因此我们会看到,ext4 的一次 fsync() 可能捎带等待同一 journal transaction 中的其他工作;把它扩写成“等待所有进程的脏数据”或“每次都做完整 checkpoint”就过度了。诊断时应同时查看 ext4_sync_file_enter/exit、jbd2 commit 和块层事件。
F2FS:围绕闪存负载组织写入
LFS 思路与 F2FS 的修正
F2FS 借鉴 LFS(Log-Structured File System,日志结构文件系统)的思路,目标是减少随机覆盖写,同时控制经典 LFS 的两大成本:wandering tree(更新叶节点后逐级改写索引节点)与空间清理。arm64 GKI 启用了:
CONFIG_F2FS_FS=yCONFIG_F2FS_FS_COMPRESSION=yCONFIG_F2FS_FS_SECURITY=y
F2FS 的空间分配单位是 segment,默认含 512 个 block;一个 section 由一个或多个 segment 组成。它的关键磁盘结构可以这样理解:
- NAT(Node Address Table):把
nid(节点编号) 映射到最新 node block 的物理地址。inode、direct node 和 indirect node 都属于 node。 - SIT(Segment Information Table):记录 segment 中有效块数量、有效位图和类型信息,供分配与 GC(垃圾回收) 使用。
- SSA(Segment Summary Area):保存 segment 内块的归属摘要,GC 可据此回查块是否仍有效。
- Checkpoint:保存一组可恢复的一致状态。双 checkpoint pack 让挂载恢复可以选择有效版本。
- 多路 active logs(活跃日志):按 node/data、冷热等类别分配写入,尽量降低 GC 搬移有效块的成本。
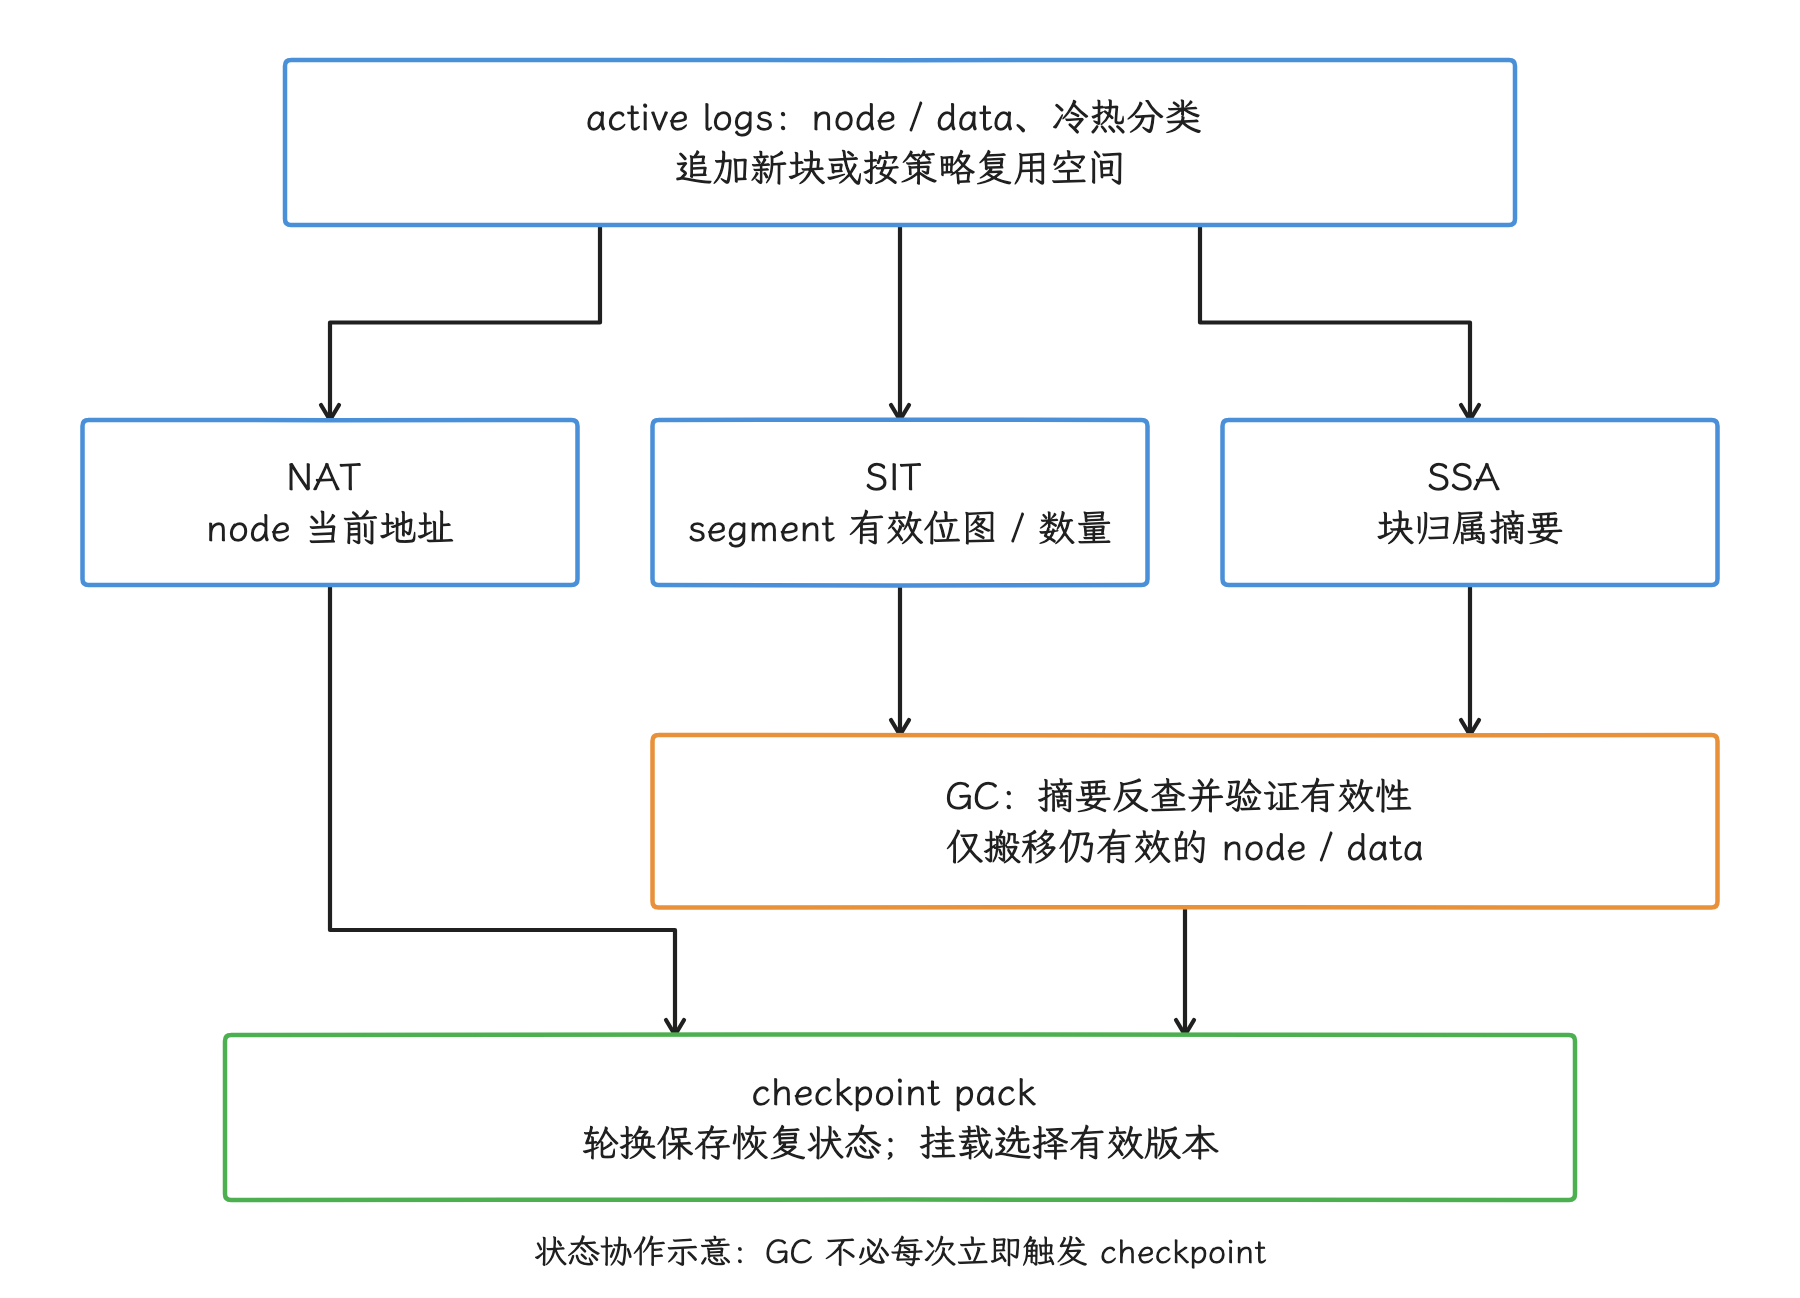
图:active logs 分流 node/data 与冷热写入;NAT 定位 node,SIT 记录有效块,SSA 提供归属摘要,checkpoint 固化可恢复状态。 箭头表示状态协作,不代表每次 GC 后立即 checkpoint。
容易搞错的是 NAT 的分工:NAT 只负责 nid → node block address,文件数据块地址放在 inode 或其他 node 的地址数组里。要是把 NAT 说成“文件逻辑块到数据块的直接映射”,就漏掉了 F2FS 解决 wandering tree 的关键一层。
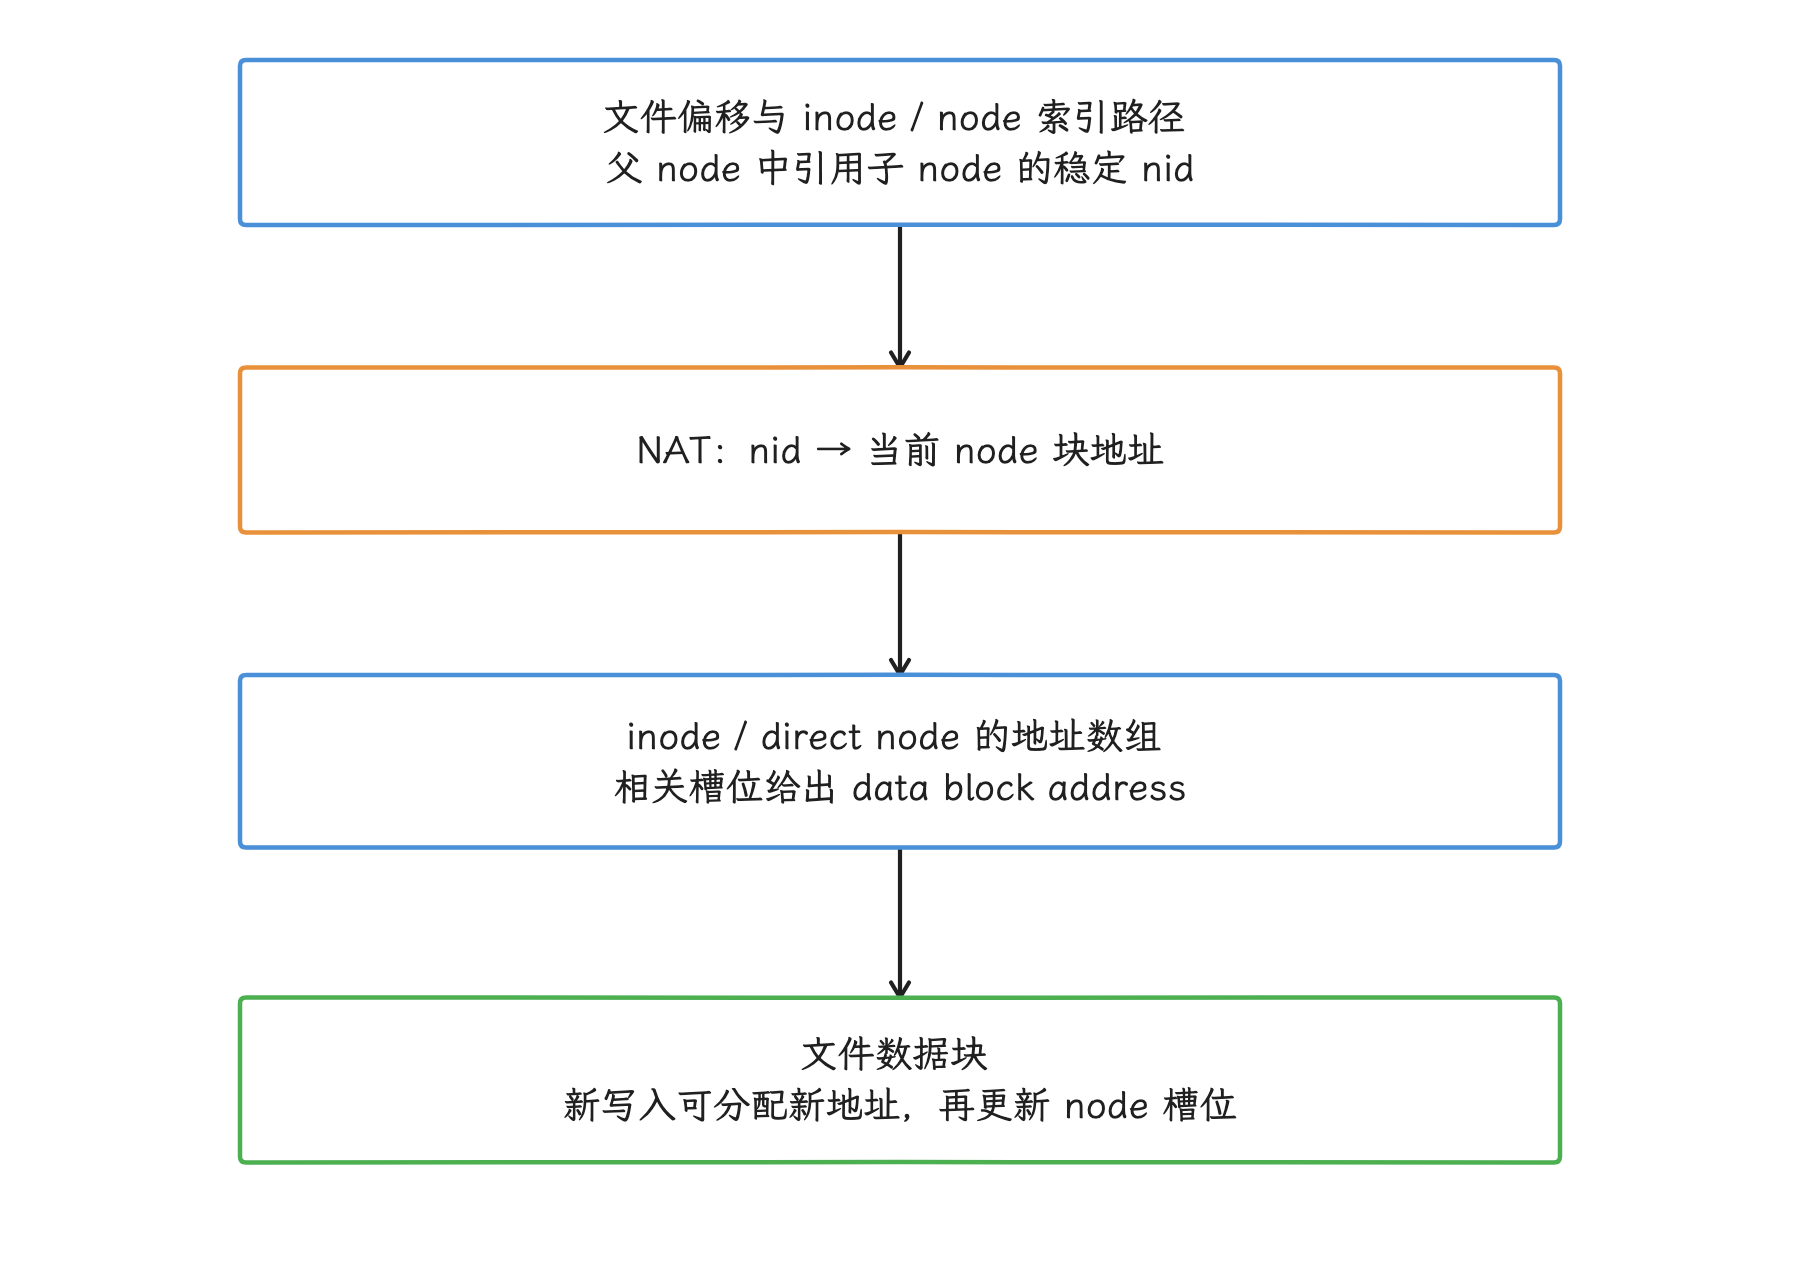
图:NAT 解析 node 的当前位置,node 的地址数组再解析文件数据块;node 搬移时更新 NAT,父节点仍可引用稳定 nid。
SSR 与 IPU:追加式写入的例外
追加式写入是 F2FS 的默认倾向,但也有例外。默认的 adaptive(自适应) 模式会在 LFS 分配与 SSR(Selective Segment Reuse,选择性复用分段)之间选择:空间宽裕时,out-of-place update(异地更新)更容易保持追加式写入;空间紧张时,SSR 可以复用已用 segment 中的空洞。挂载为 mode=lfs 时,主区域不采用随机覆盖分配,代价是需要更多连续空闲空间。
F2FS 还存在 IPU(in-place update,就地更新)路径。内核的 f2fs_do_sync_file() 会在 fdatasync() 或脏页较少时设置 FI_NEED_IPU,随后执行范围写回。所以,“F2FS 的每一次数据修改都是 CoW(写时复制)”属于过度简化。
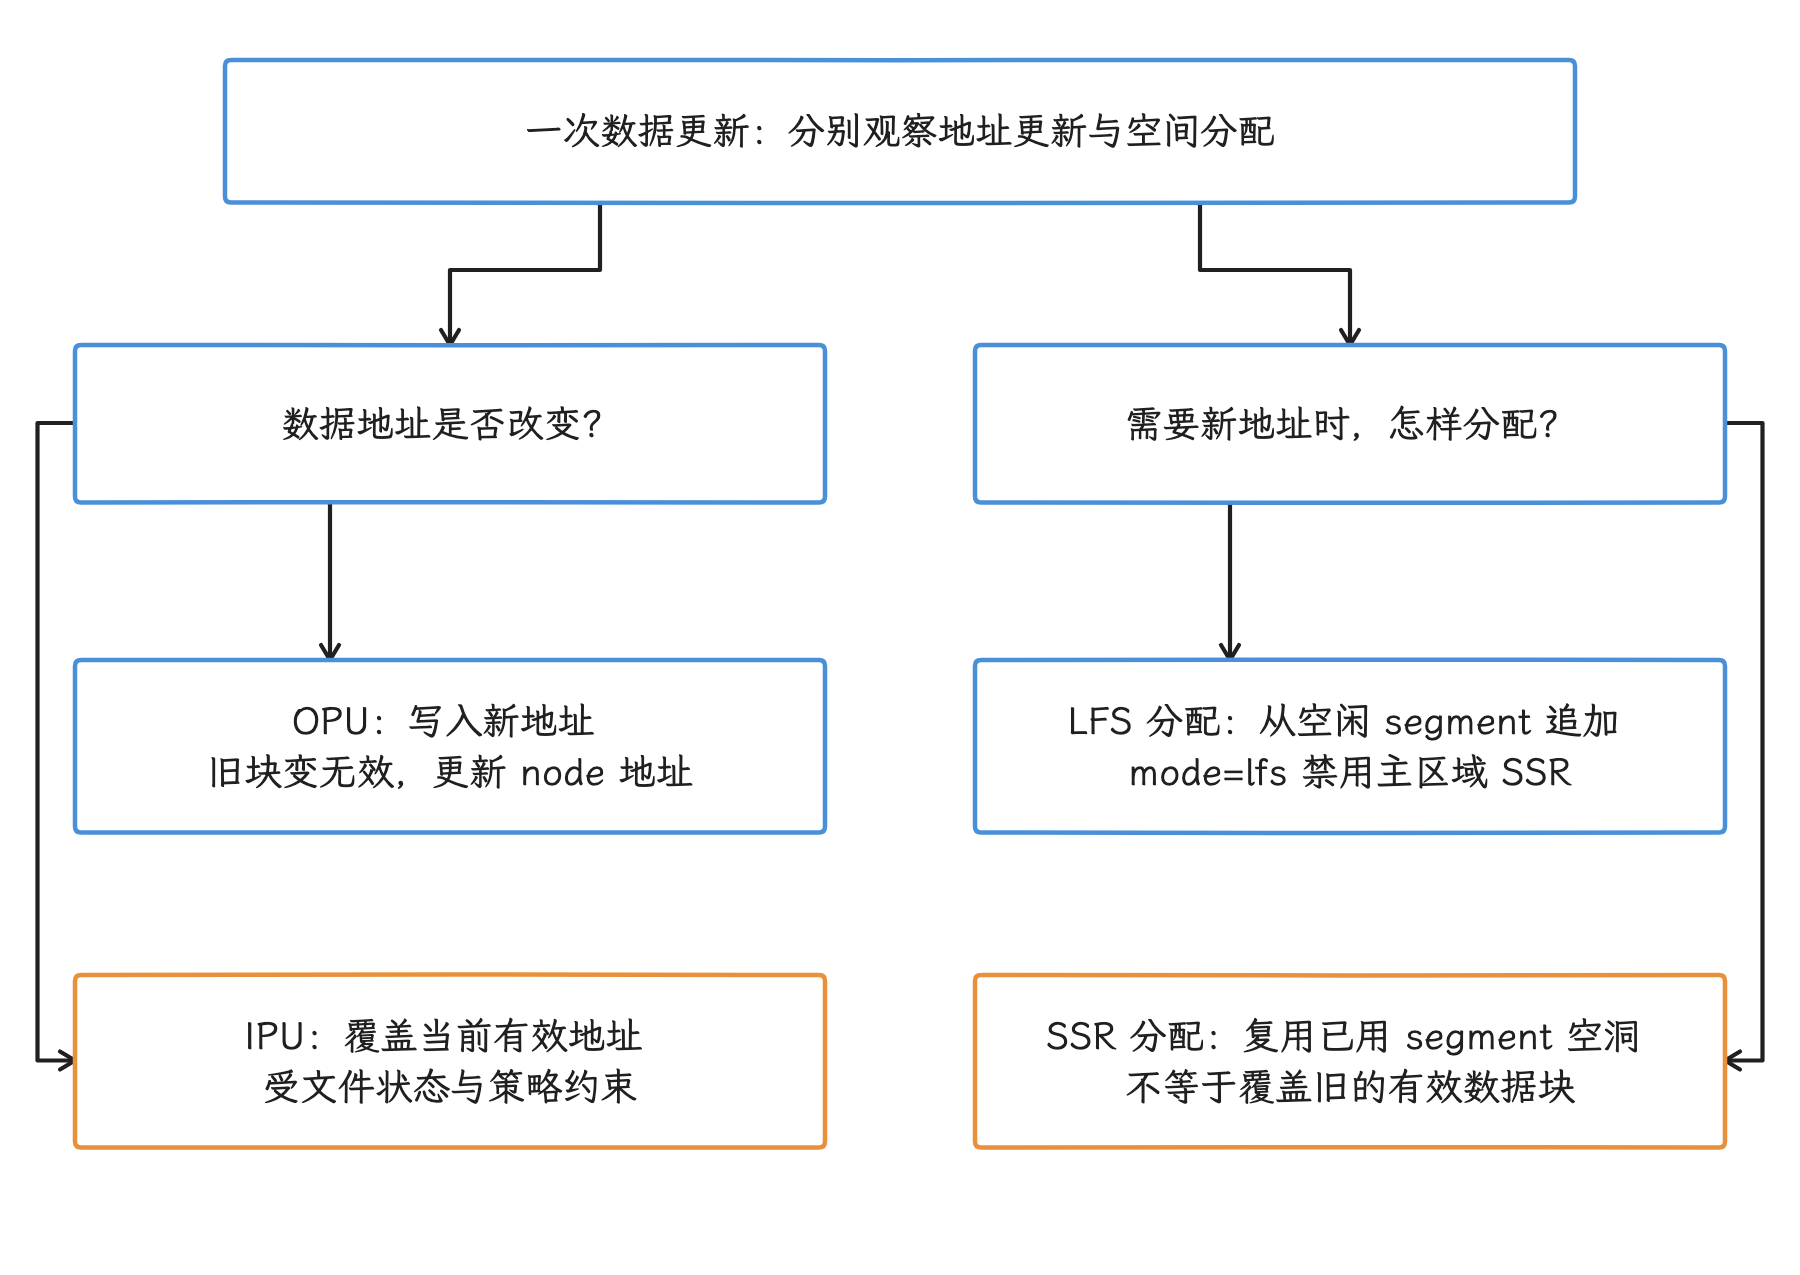
图:F2FS 既要决定数据地址是否变化,也要决定新地址如何分配;SSR 复用的是 segment 空洞,IPU 则覆盖当前有效数据块地址。
当前 f2fs_need_SSR() 的判断条件很清晰,我们逐条看:
mode=lfs直接禁用 SSR;GC_URGENT_HIGH或 checkpoint disabled 状态需要 SSR;- 常规模式比较 free sections 与 dirty node/dentry/inode metadata、
min_ssr_sections、reserved sections 的需求。
这些阈值来自运行时状态和格式化参数,没有一份适用于所有设备的固定百分比;排查时直接读现场状态,比背一个百分比可靠。
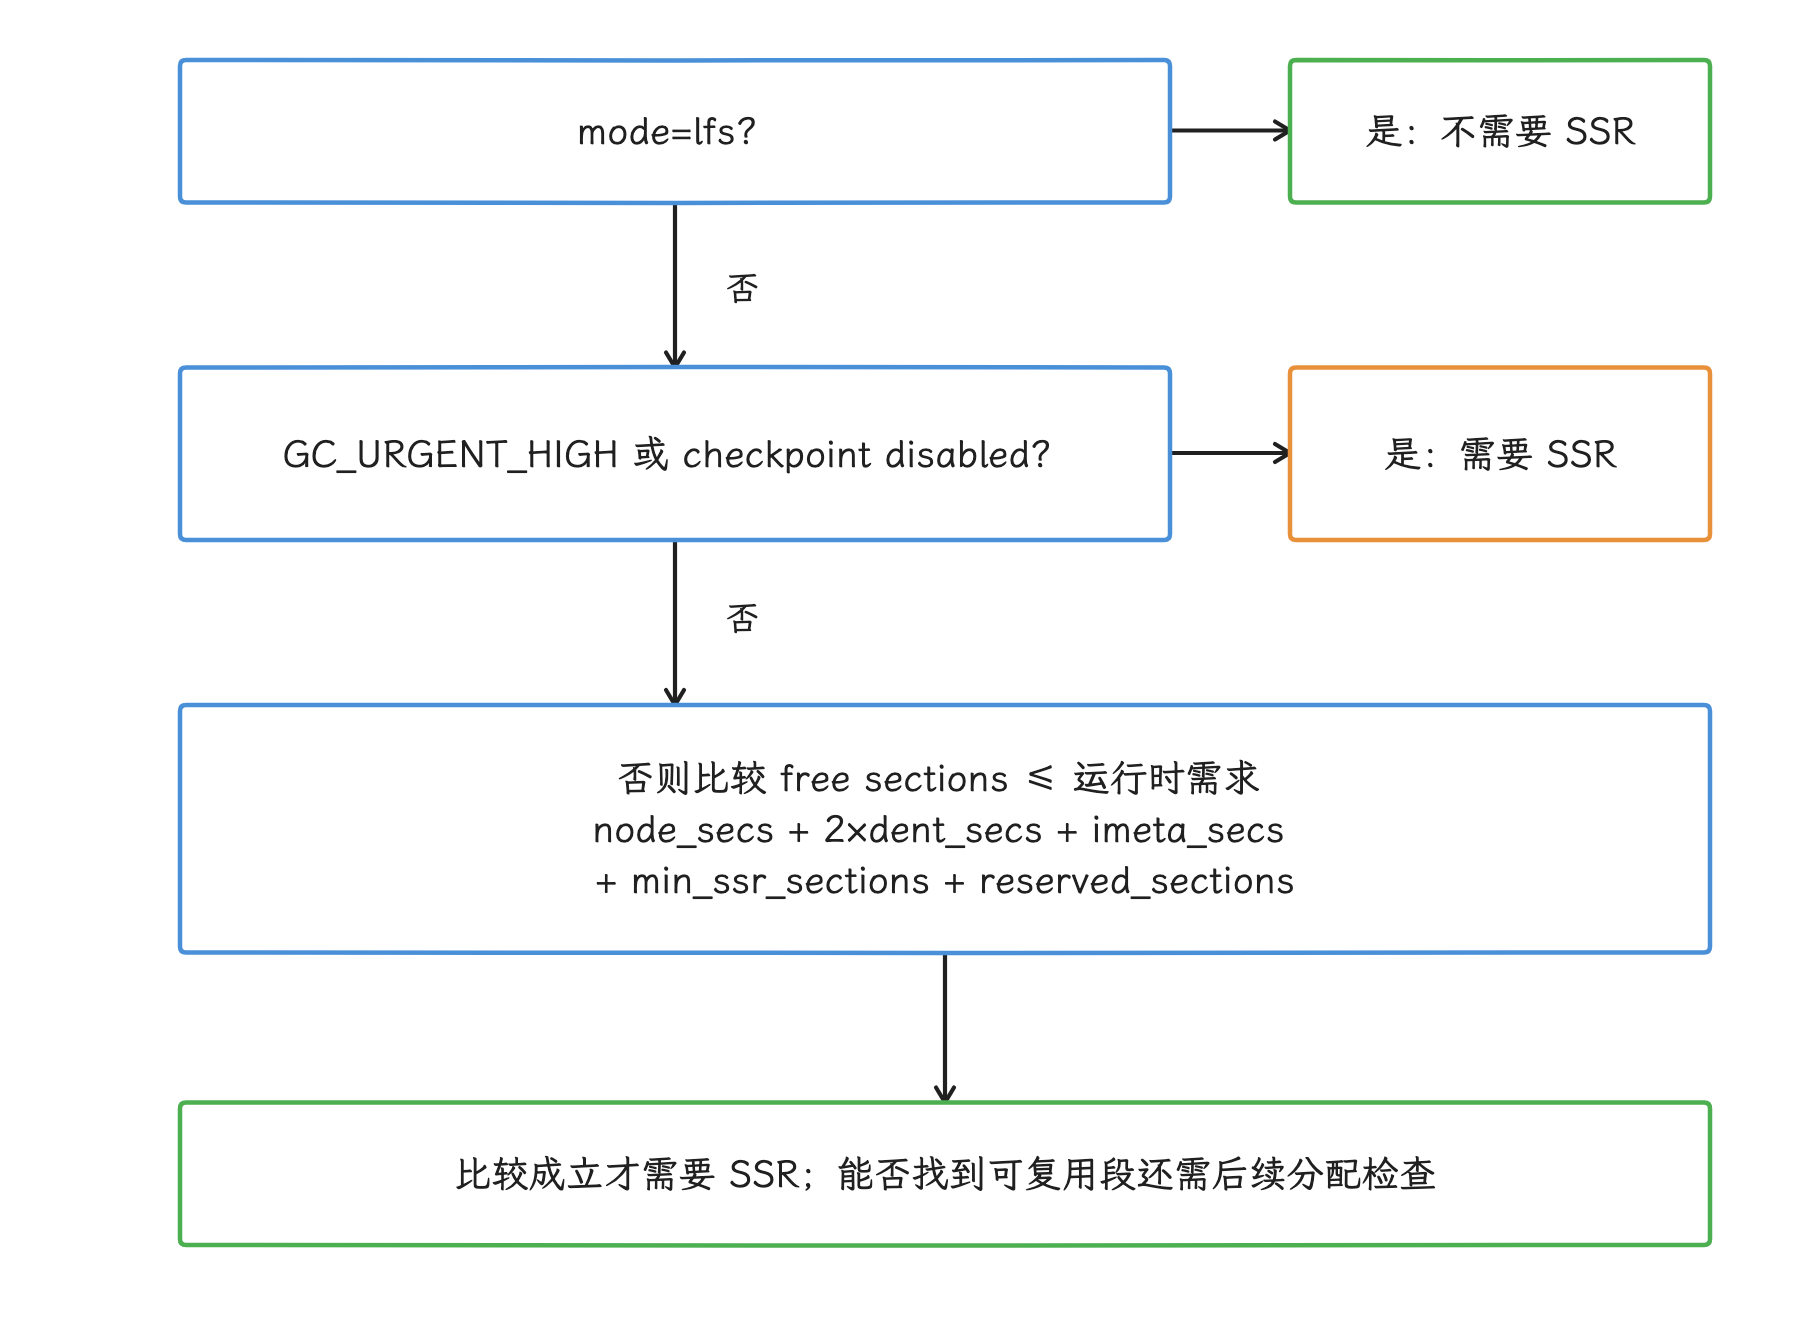
图:先检查 mode=lfs;只有未被它排除时,urgent/禁用 checkpoint 或空间阈值才可能要求 SSR。
fsync、roll-forward 与 checkpoint
我们跟着一次普通的 fsync() 走:F2FS 会先写回目标文件数据,再判断是否需要 checkpoint。普通、可 roll-forward(通过重放 fsync node 恢复)的情况,会写入带 fsync 标记的 node 链并发出必要的 flush;非普通文件、压缩文件、硬链接或超级块明确要求 checkpoint 等情况,则可能转入完整 checkpoint。
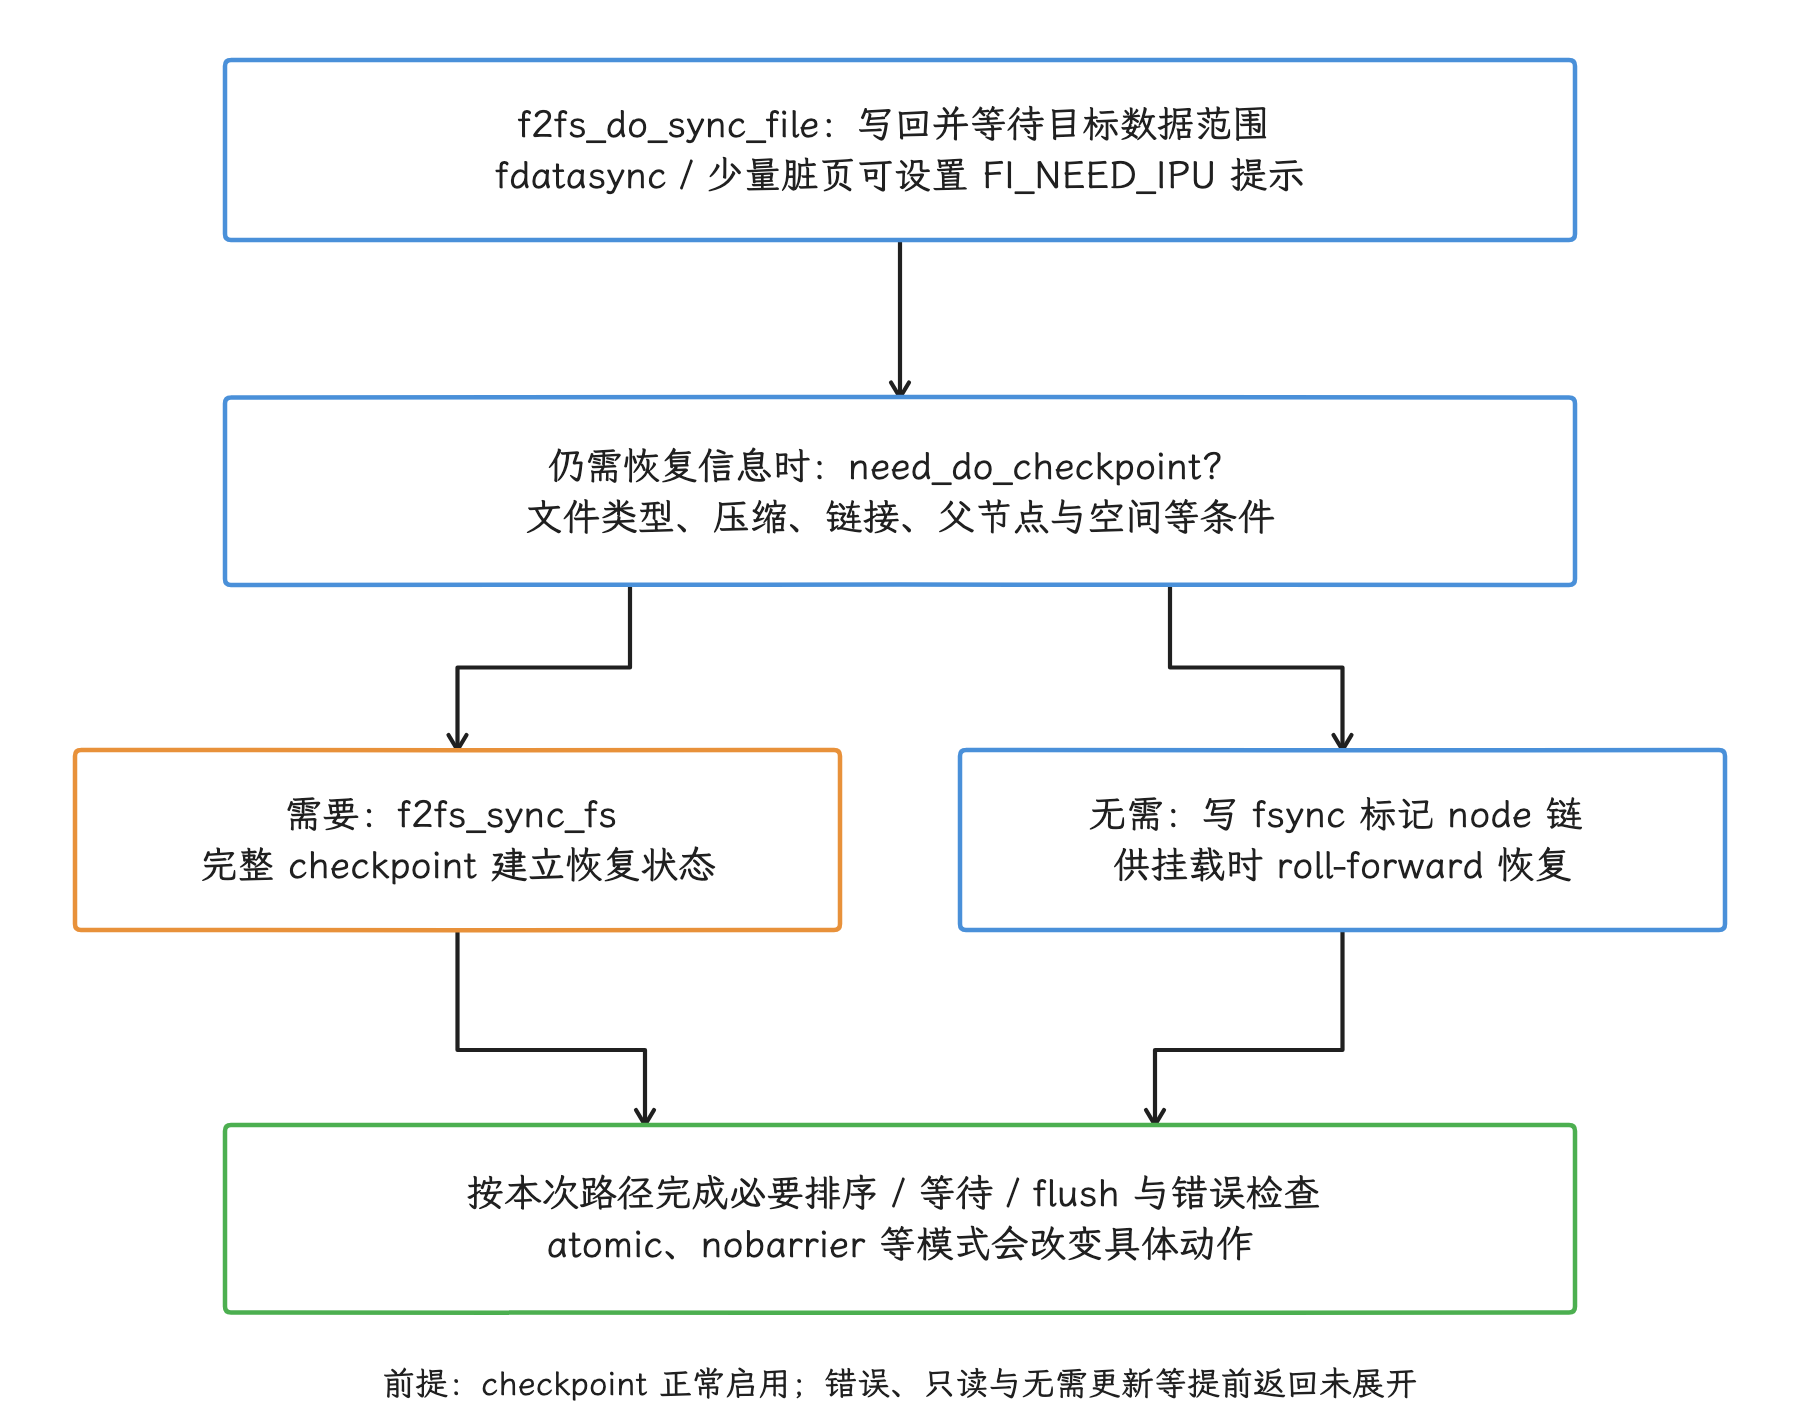
图:正常启用 checkpoint 的路径先写数据,再按恢复条件选择完整 checkpoint 或 fsync node;没有新增修改时还可能提前结束。
以上描述针对正常启用 checkpoint 的可写文件系统;checkpoint disabled 时,f2fs_do_sync_file() 在范围写回后会提前返回,不能沿用普通 checkpoint/roll-forward 的持久化推断。没有新增修改等情况也可能跳过恢复信息写入。较短的 roll-forward 路径可以减少恢复信息和等待范围,但仍需满足掉电恢复语义。设备 cache flush、node writeback(节点回写)、checkpoint 以及 GC 都可能成为尾延迟来源,所以“F2FS 上的 fsync() 没有成本”是错误结论。
原子文件写与 Android SQLite
内核在 include/uapi/linux/f2fs.h 中定义了:
F2FS_IOC_START_ATOMIC_WRITEF2FS_IOC_COMMIT_ATOMIC_WRITEF2FS_IOC_ABORT_ATOMIC_WRITEF2FS_IOC_START_ATOMIC_REPLACE
f2fs_ioc_start_atomic_write() 会为普通文件准备 COW(写时复制) inode;commit 路径调用 f2fs_commit_atomic_write(),随后按 atomic 语义同步文件,失败或结束后再清理原子写状态。这里的“原子”指一批文件页修改在崩溃恢复时要么全部可见,要么全部不可见,写入本身仍可能有 I/O 等待。
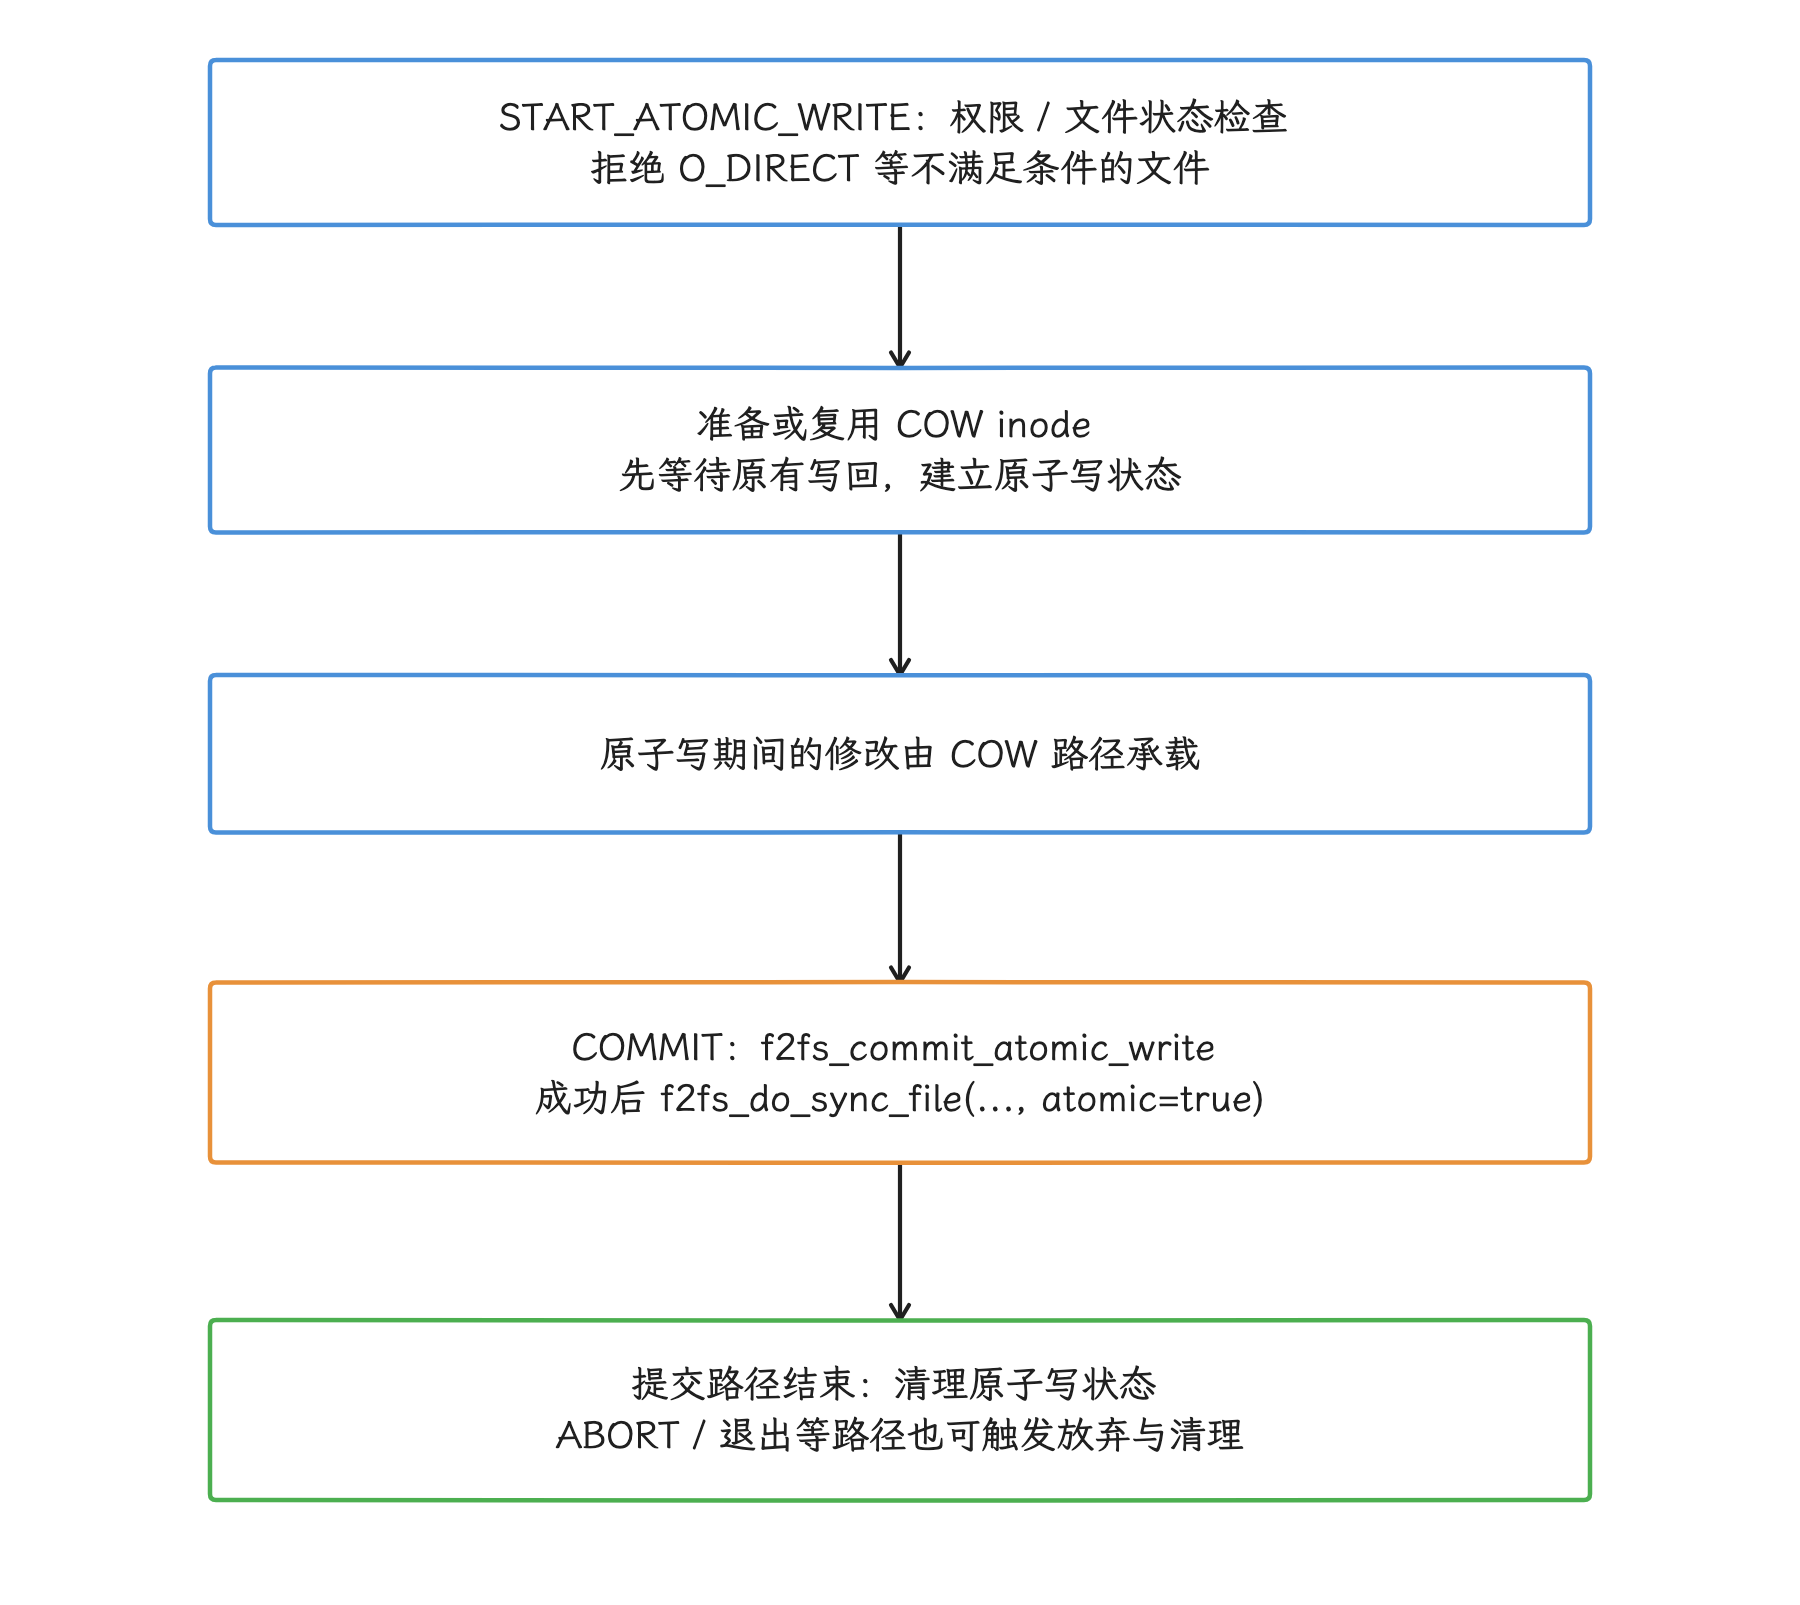
图:START 为普通可写文件准备 COW inode;COMMIT 安装修改并执行 atomic 同步,随后清理原子状态。
AOSP SQLite 在 external/sqlite/dist/Android.bp 中启用了 SQLITE_ENABLE_BATCH_ATOMIC_WRITE,编译期开关提供了使用机会。但 Unix VFS(Unix 平台的虚拟文件系统适配层)先用 F2FS_IOC_GET_FEATURES 查询 F2FS_FEATURE_ATOMIC_WRITE,成功且包含该位时才报告 SQLITE_IOCAP_BATCH_ATOMIC;实际开始批写时才发出 F2FS_IOC_START_ATOMIC_WRITE。SQLite pager(页面缓存与事务管理模块)还会检查数据库状态和事务条件——要断言一个事务真的走了 F2FS 原子写,这几层都要确认。
在这个 r1 pager 中,WAL 走独立分支;batch atomic 的候选提交要求没有 super-journal、VFS 报告能力、未关闭同步,而且 journal 仍在内存中。条件满足后才尝试 BEGIN / 写页 / COMMIT;执行出错还可能回退到普通 journal 或向上报告错误。编译宏、文件系统类型和事务实际路径不能画等号。
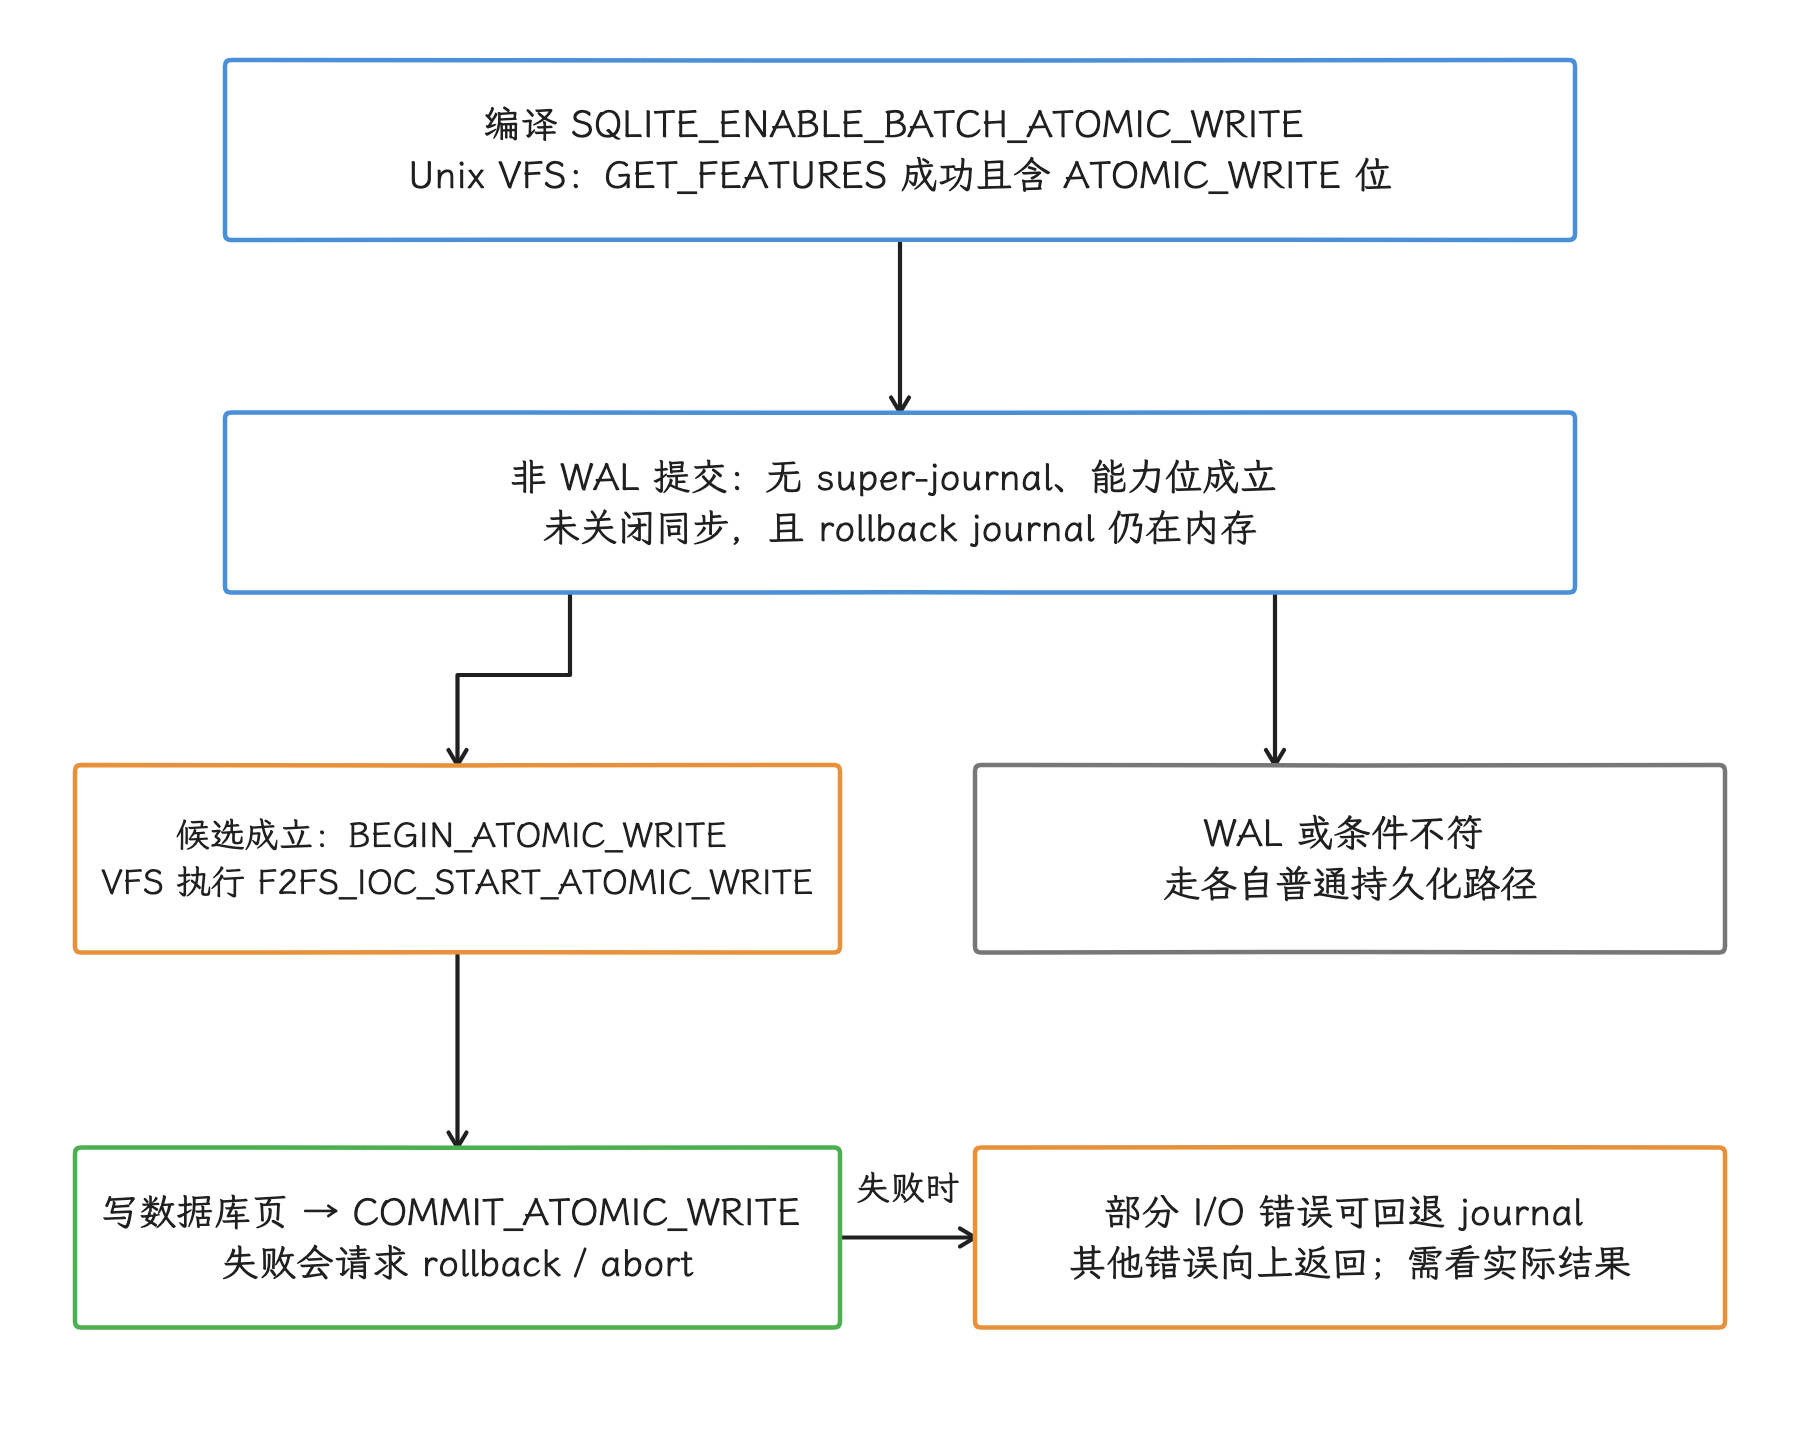
图:编译开关、GET_FEATURES 能力位、非 WAL pager 条件和实际 ioctl 执行逐层成立,才有本次 batch atomic 提交。
GC:空间紧张时为什么会抬高尾延迟
前面反复出现的 out-of-place update 会留下无效块,回收它们是 GC 的职责:选择 victim segment(待回收分段),核对其中仍有效的数据与 node,再搬移有效块来释放 segment。后台 GC 可以利用空闲窗口;可用 section 不足时,写入路径上的请求线程可能直接参与空间回收,或等待回收完成。
空间是否紧张的判定已经不同于旧版 kernel 6.6 的 lower/upper 阈值写法。下面的摘录来自 fs/f2fs/segment.h,固定了当前 6.18 源码中的比较对象:
free_secs = free_sections(sbi) + freed;
required_secs = needed + reserved_sections(sbi) +
                __get_secs_required(sbi);

return free_secs < required_secs;
__get_secs_required() 会把 dirty node、dentry、inode metadata,以及特定模式下的 dirty data,换算为所需 section。f2fs_balance_fs() 在空间足够时直接返回;空间不足时,它可以唤醒启用了 gc_merge 的 GC 线程并等待,也可以调用 f2fs_gc() 释放 section。默认策略下,后台 GC 使用 cost-benefit(成本收益)或启用 ATGC 时的 age-threshold(年龄阈值),前台 GC 使用 greedy(贪心);gc_mode 的 idle/urgent 模式还可以覆盖这个选择。
这也解释了“剩余容量尚未显示为 0,写入已经变慢”的现象:文件系统要保留可完成写回、checkpoint 和 GC 搬移的工作空间;UFS 自身也需要预留块进行 FTL 回收。两层空间压力可能同时出现。
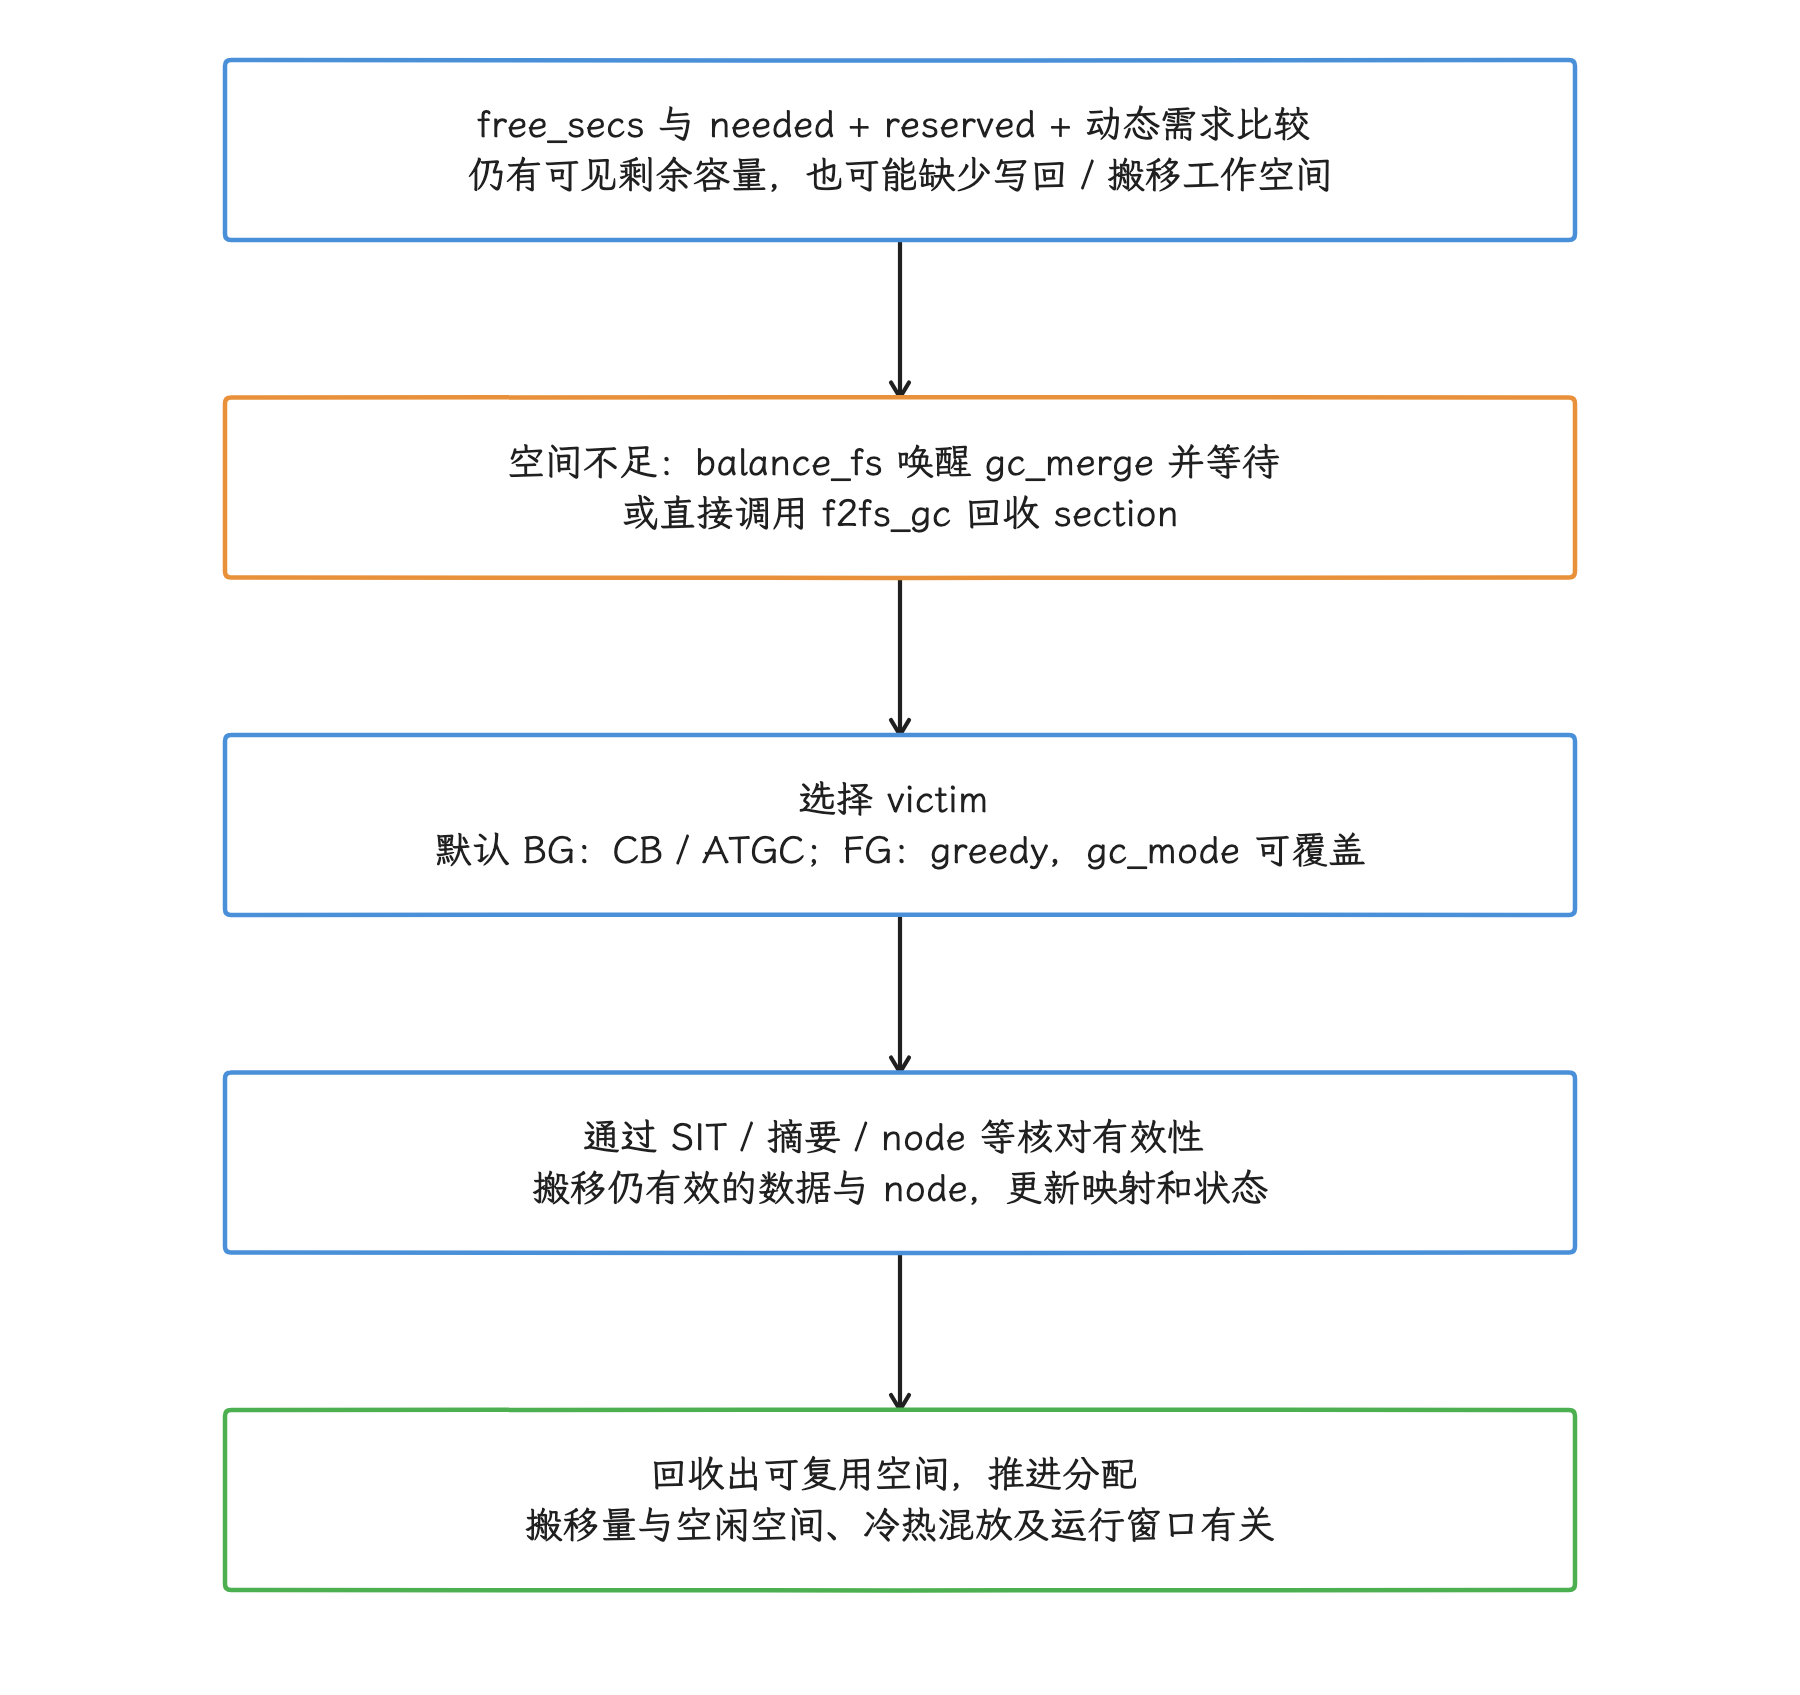
图:GC 需要把 victim 中仍有效的块搬到别处,才能释放可复用空间;空闲 section 不足会让前台参与或等待。
4 KB 与 16 KB 页大小
Android 15 开始支持 16 KB page size(页大小),Android 17 继续支持 4 KB 与 16 KB 设备。ELF(Executable and Linkable Format,可执行与可链接格式)的 16 KB 对齐兼容性和 F2FS 磁盘格式,是两件不同的事:
- AOSP 用户空间可以构建为 page-size agnostic(不依赖固定页大小),ELF 以 16 KB 对齐后可在 4 KB/16 KB kernel 上运行。
android17-6.18-2026-06_r6的include/linux/f2fs_fs.h明确规定F2FS_BLKSIZE == PAGE_SIZE。- 同一源码中的默认 segment 仍含 512 个 block,因此 4 KB 页时默认 segment 为 2 MiB,16 KB 页时为 8 MiB。
16 KB kernel 使用的 F2FS 格式参数需要按 16 KB block 生成。设备升级后能否保留 /data,取决于 OEM 的分区、迁移和升级方案;App 的 ELF 兼容结论回答的是另一件事,“旧 4 KB /data 可原样挂载”这样的推断要从设备实现里找答案。App 工程师要做的是修复 native library 对页大小的硬编码;格式化与用户数据迁移则由设备实现负责。
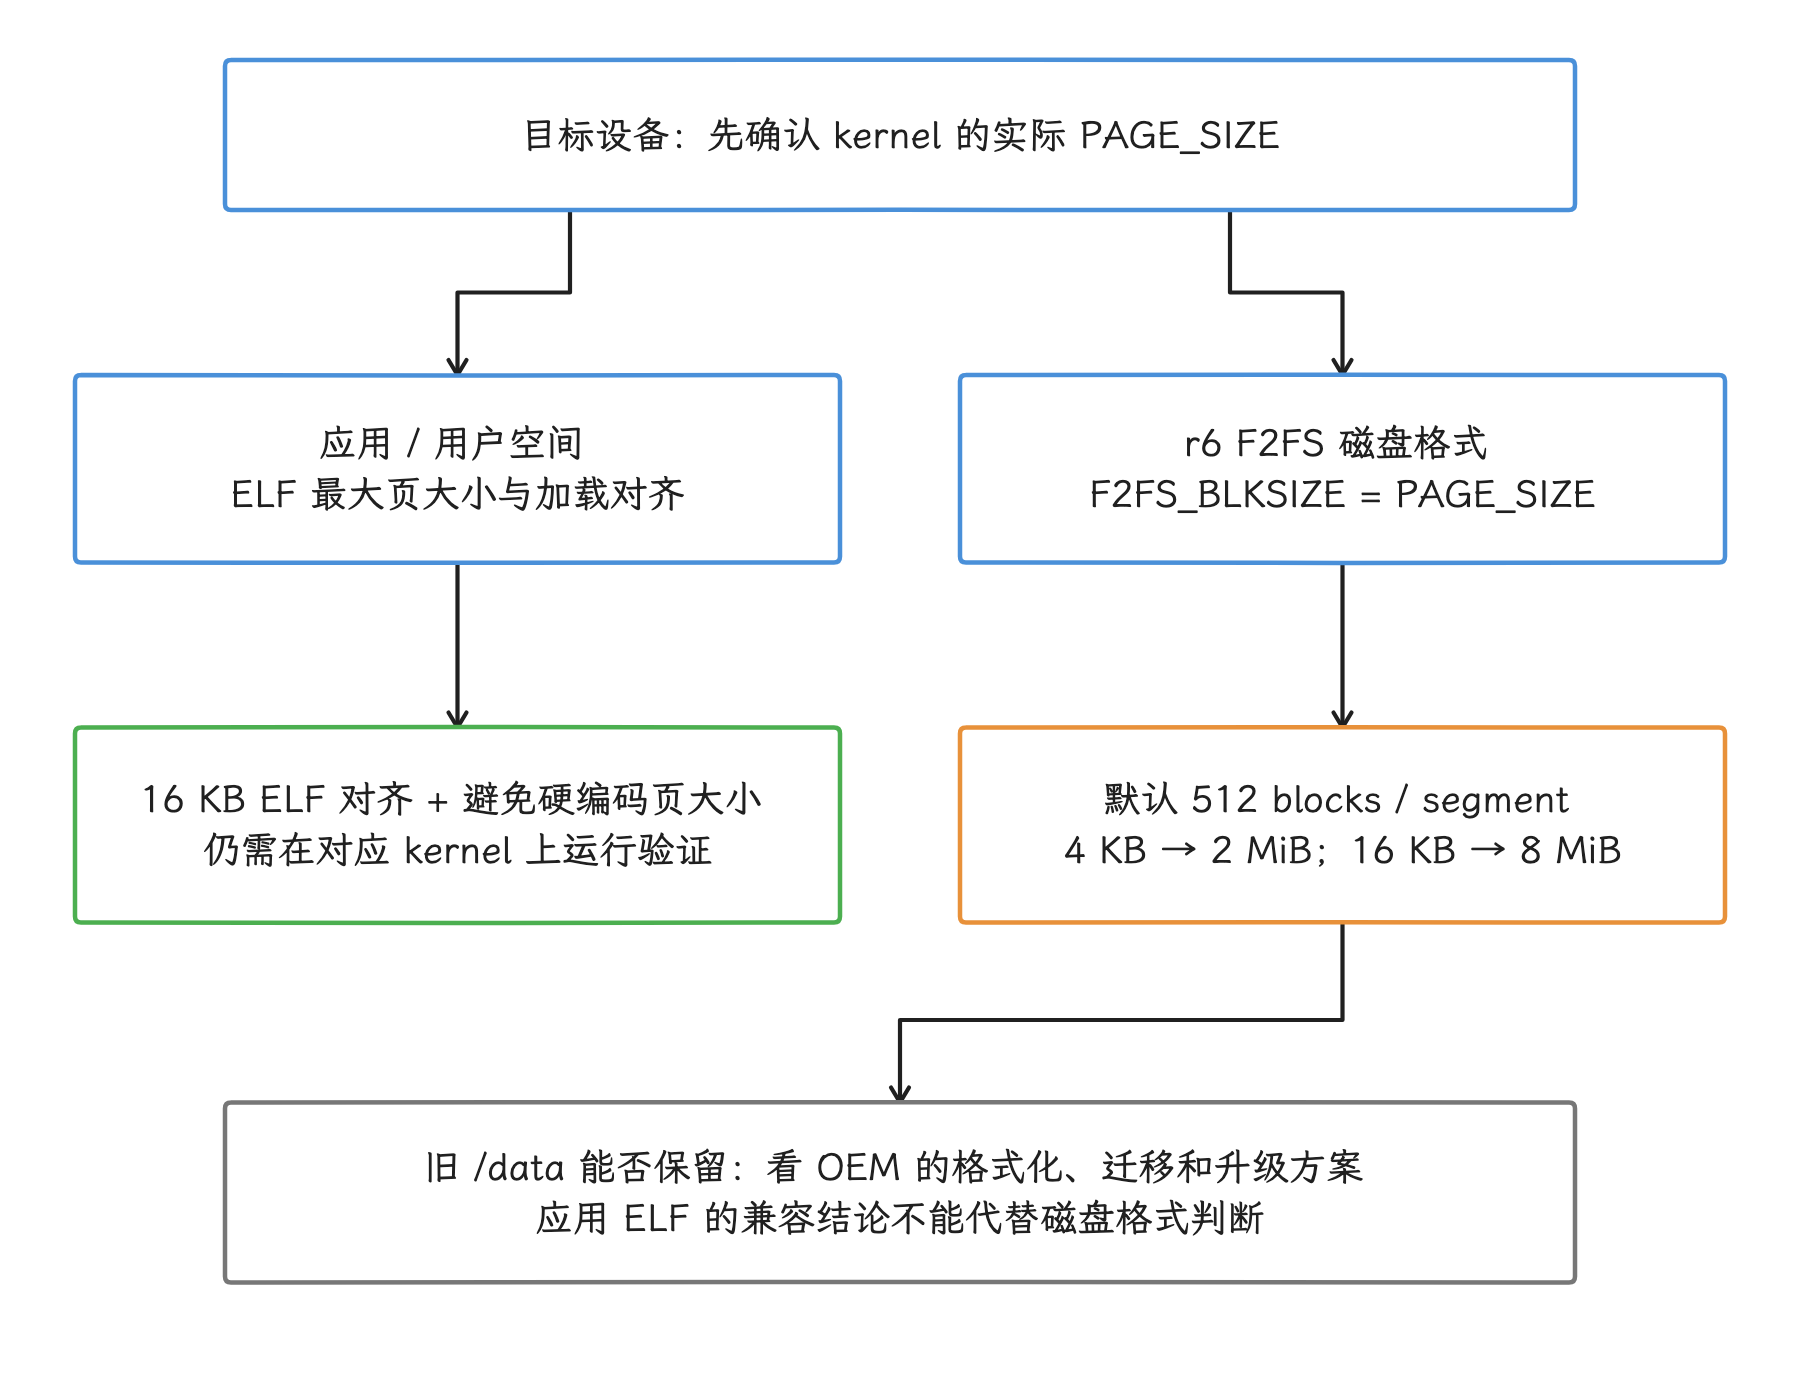
图:16 KB ELF 对齐解决用户空间兼容的一部分;该 r6 的 F2FS block 等于 PAGE_SIZE,磁盘格式与迁移还需设备方案。
quota、casefold 与 fscrypt
F2FS 和 ext4 都可以承载 Android 所需的配额、大小写无关目录与文件加密能力,但可用性取决于内核配置、文件系统 feature、格式化参数和挂载参数:
- project quota(项目配额) 可以帮助系统按目录项目统计或限制空间;
CONFIG_QUOTA=y(配额支持) 只是内核能力,目标分区有没有启用prjquota,还要看格式化与挂载配置。 - casefold 使用 Unicode 规则进行不区分大小写的查找;只有文件系统具备相应 feature,且目录被设置为 casefold 时才生效。
- fscrypt 提供文件级加密策略,Android 的 FBE 在其上组织 DE/CE 密钥域。
- inline encryption(内联加密) 可以把数据加解密交给存储控制器,但文件系统仍负责密钥上下文与
bio(块 I/O 描述结构) 标记。
检查设备行为时,我们要读的是实际的 superblock feature(超级块特性)、mount options(挂载选项) 和内核配置;这些细节都藏在里面,文件系统类型只给出一个起点。
EROFS:面向不可变镜像的只读文件系统
适用场景
EROFS(Enhanced Read-Only File System)没有运行时写入、journal 和空闲块分配路径,适合在构建期生成、启动后只读的镜像,例如 system、vendor、product 和 system_ext。/data 需要创建和修改文件,这部分分区继续由 ext4 或 F2FS 负责。
AOSP 的 EROFS 文档给出了 BoardConfig、fstab、压缩和 Virtual A/B 配置。文档中的示例允许为 /system 同时保留 EROFS 与只读 ext4 的 fstab 条目,以便测试 ext4 GSI(Generic System Image,通用系统镜像)。这类配置表明 Android 为两者提供了完整支持,具体分区采用哪一种格式仍由产品配置决定。
EROFS 的核心能力包括:
- compact/extended inode(紧凑/扩展索引节点) 布局与 tail packing(尾部数据内联);
- 可选透明压缩;
- in-place decompression(就地解压),减少额外解压缓冲与 Page Cache 抖动;
- chunk-based 与 rolling-hash(滚动哈希) 压缩数据去重;
- 面向随机访问的索引设计。
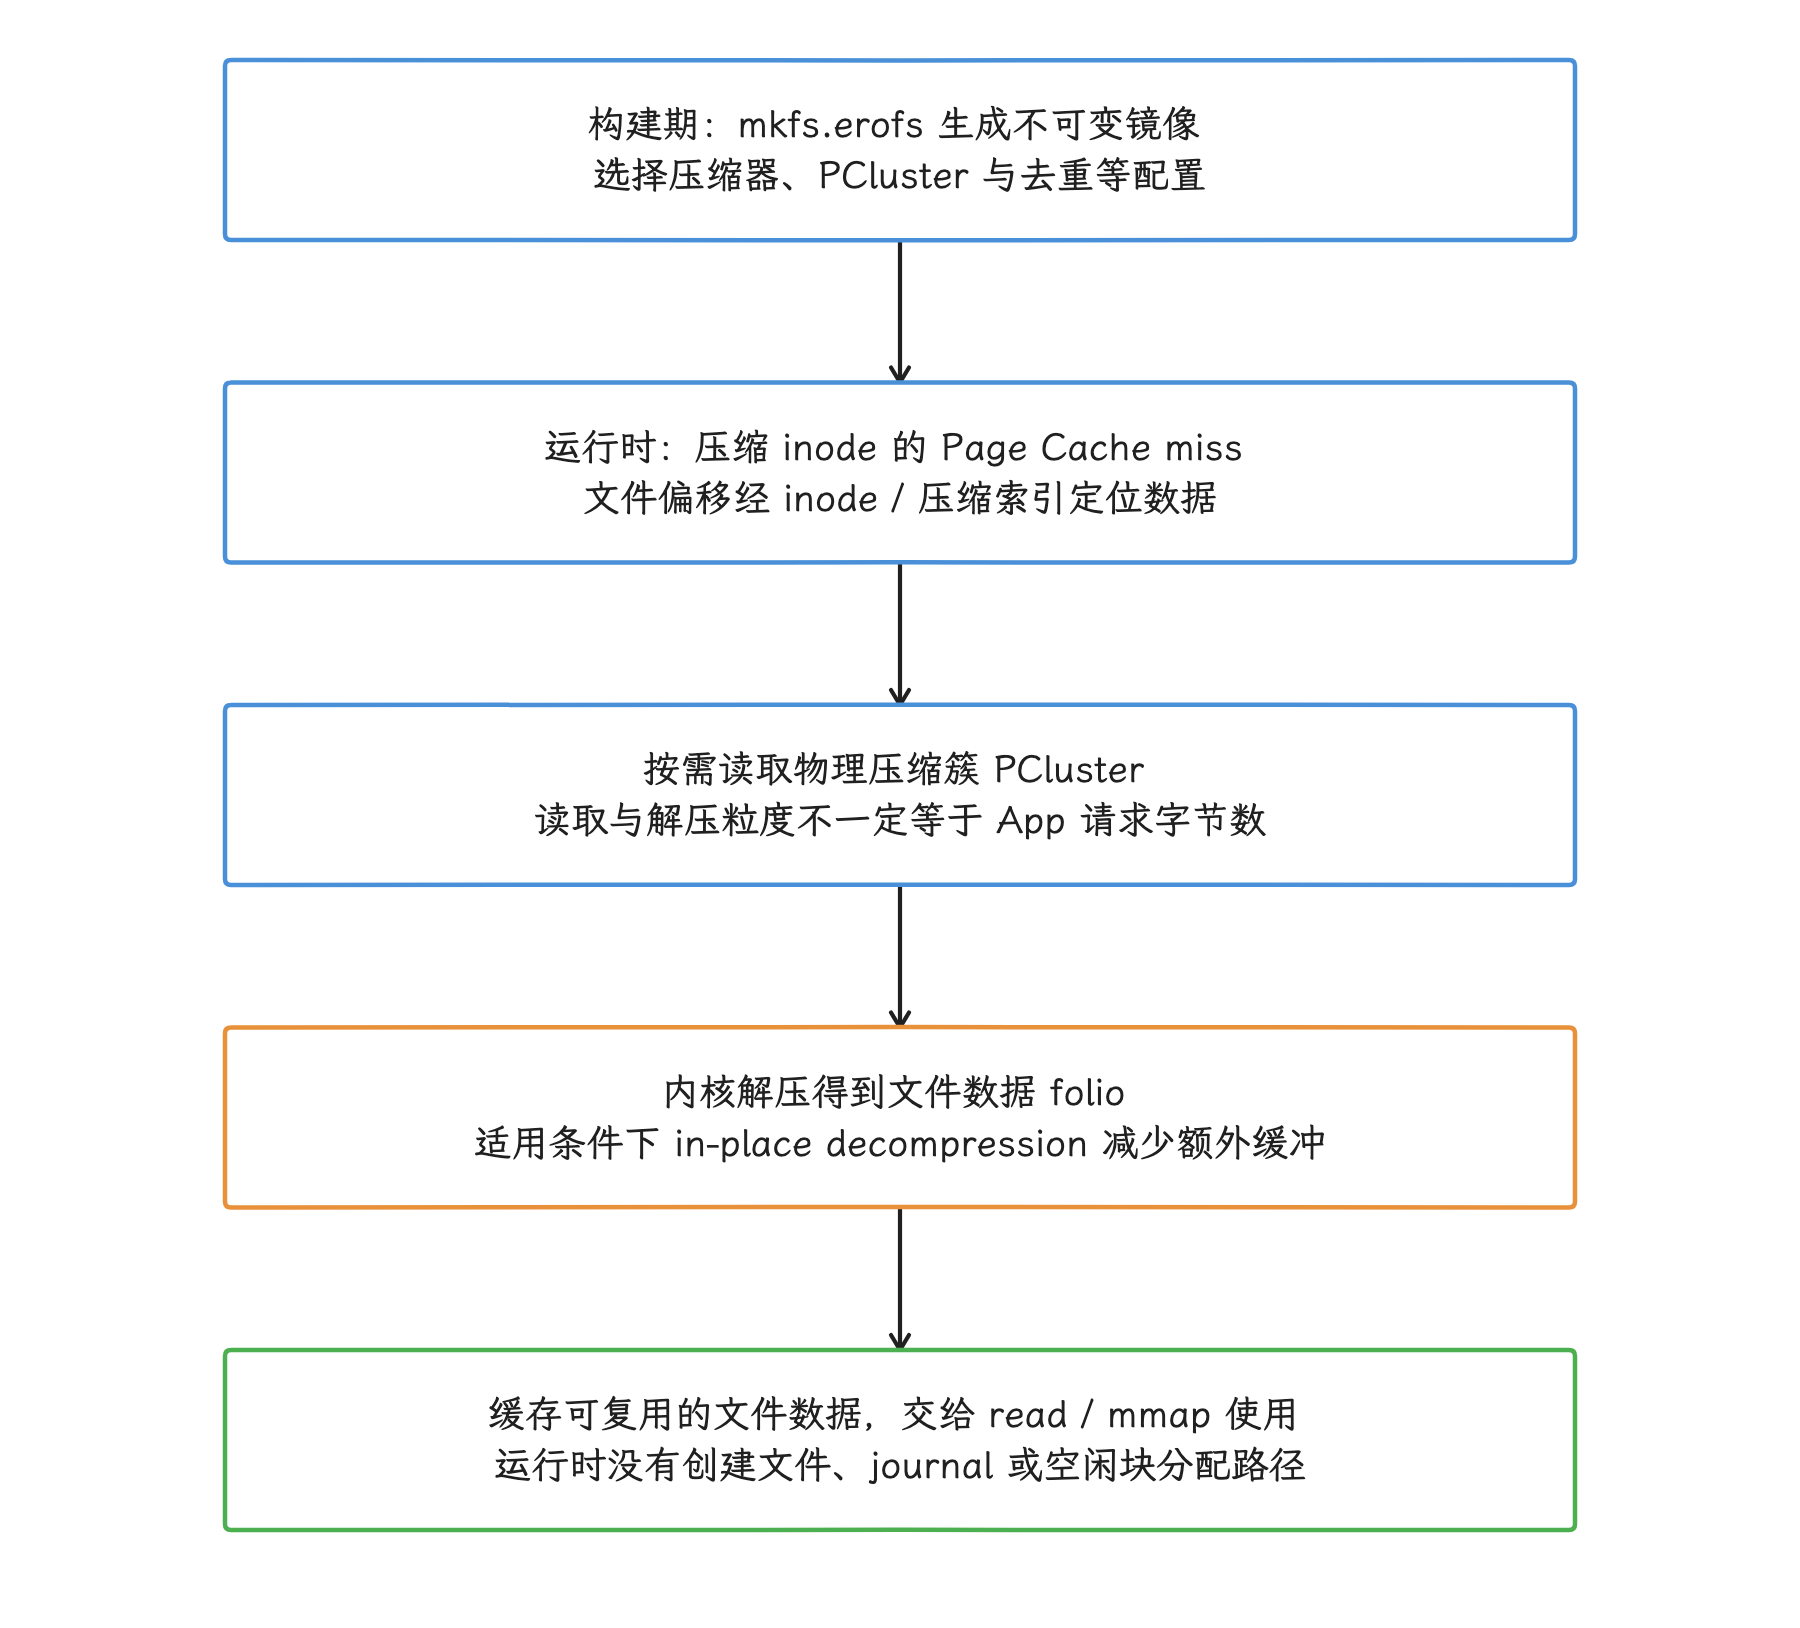
图:EROFS 在构建期生成只读镜像;压缩文件 cache miss 时按索引读取 PCluster,再解压得到文件数据。
AOSP 当前构建文档的默认 compressor(压缩器) 是 lz4hc,也允许禁用压缩和调整 PCluster(物理压缩簇) 大小。官方给出的镜像体积数据是平均约缩小 25%,高压缩配置可到约 45%;这组数字描述的是文档中的测试范围,拿来推算任意设备的启动耗时,就超出了它的适用范围。
6.18 arm64 GKI 已启用 CONFIG_EROFS_FS=y、CONFIG_EROFS_FS_ZIP_ZSTD=y 和 CONFIG_EROFS_FS_PCPU_KTHREAD=y,ZSTD 因此具备内核解压支持;镜像是否使用 ZSTD 仍由产品构建配置决定,而且 6.18 Kconfig 仍把该能力标记为 experimental(实验性)。LZ4HC 依然是 AOSP EROFS 构建文档中的默认选择。
EROFS、dm-verity(块设备完整性校验机制) 与 Virtual A/B
EROFS 负责解释只读文件和压缩数据;dm-verity 负责校验块完整性;AVB(Android Verified Boot)/vbmeta 提供可信的根摘要与签名信息。正常挂载时,常见的简化层次如下:
super物理分区;dm-linear映射出的动态逻辑分区;dm-verity校验设备;- EROFS 或只读 ext4;
/system等挂载点。
dm-verity 会按需读取哈希树并验证数据,挂载时并不会重新计算整棵树。哈希算法、数据块大小和错误策略来自 AVB descriptor(描述符) 与设备配置,把它们固定写成“所有设备每块都用 4 KB SHA-256”是行不通的。
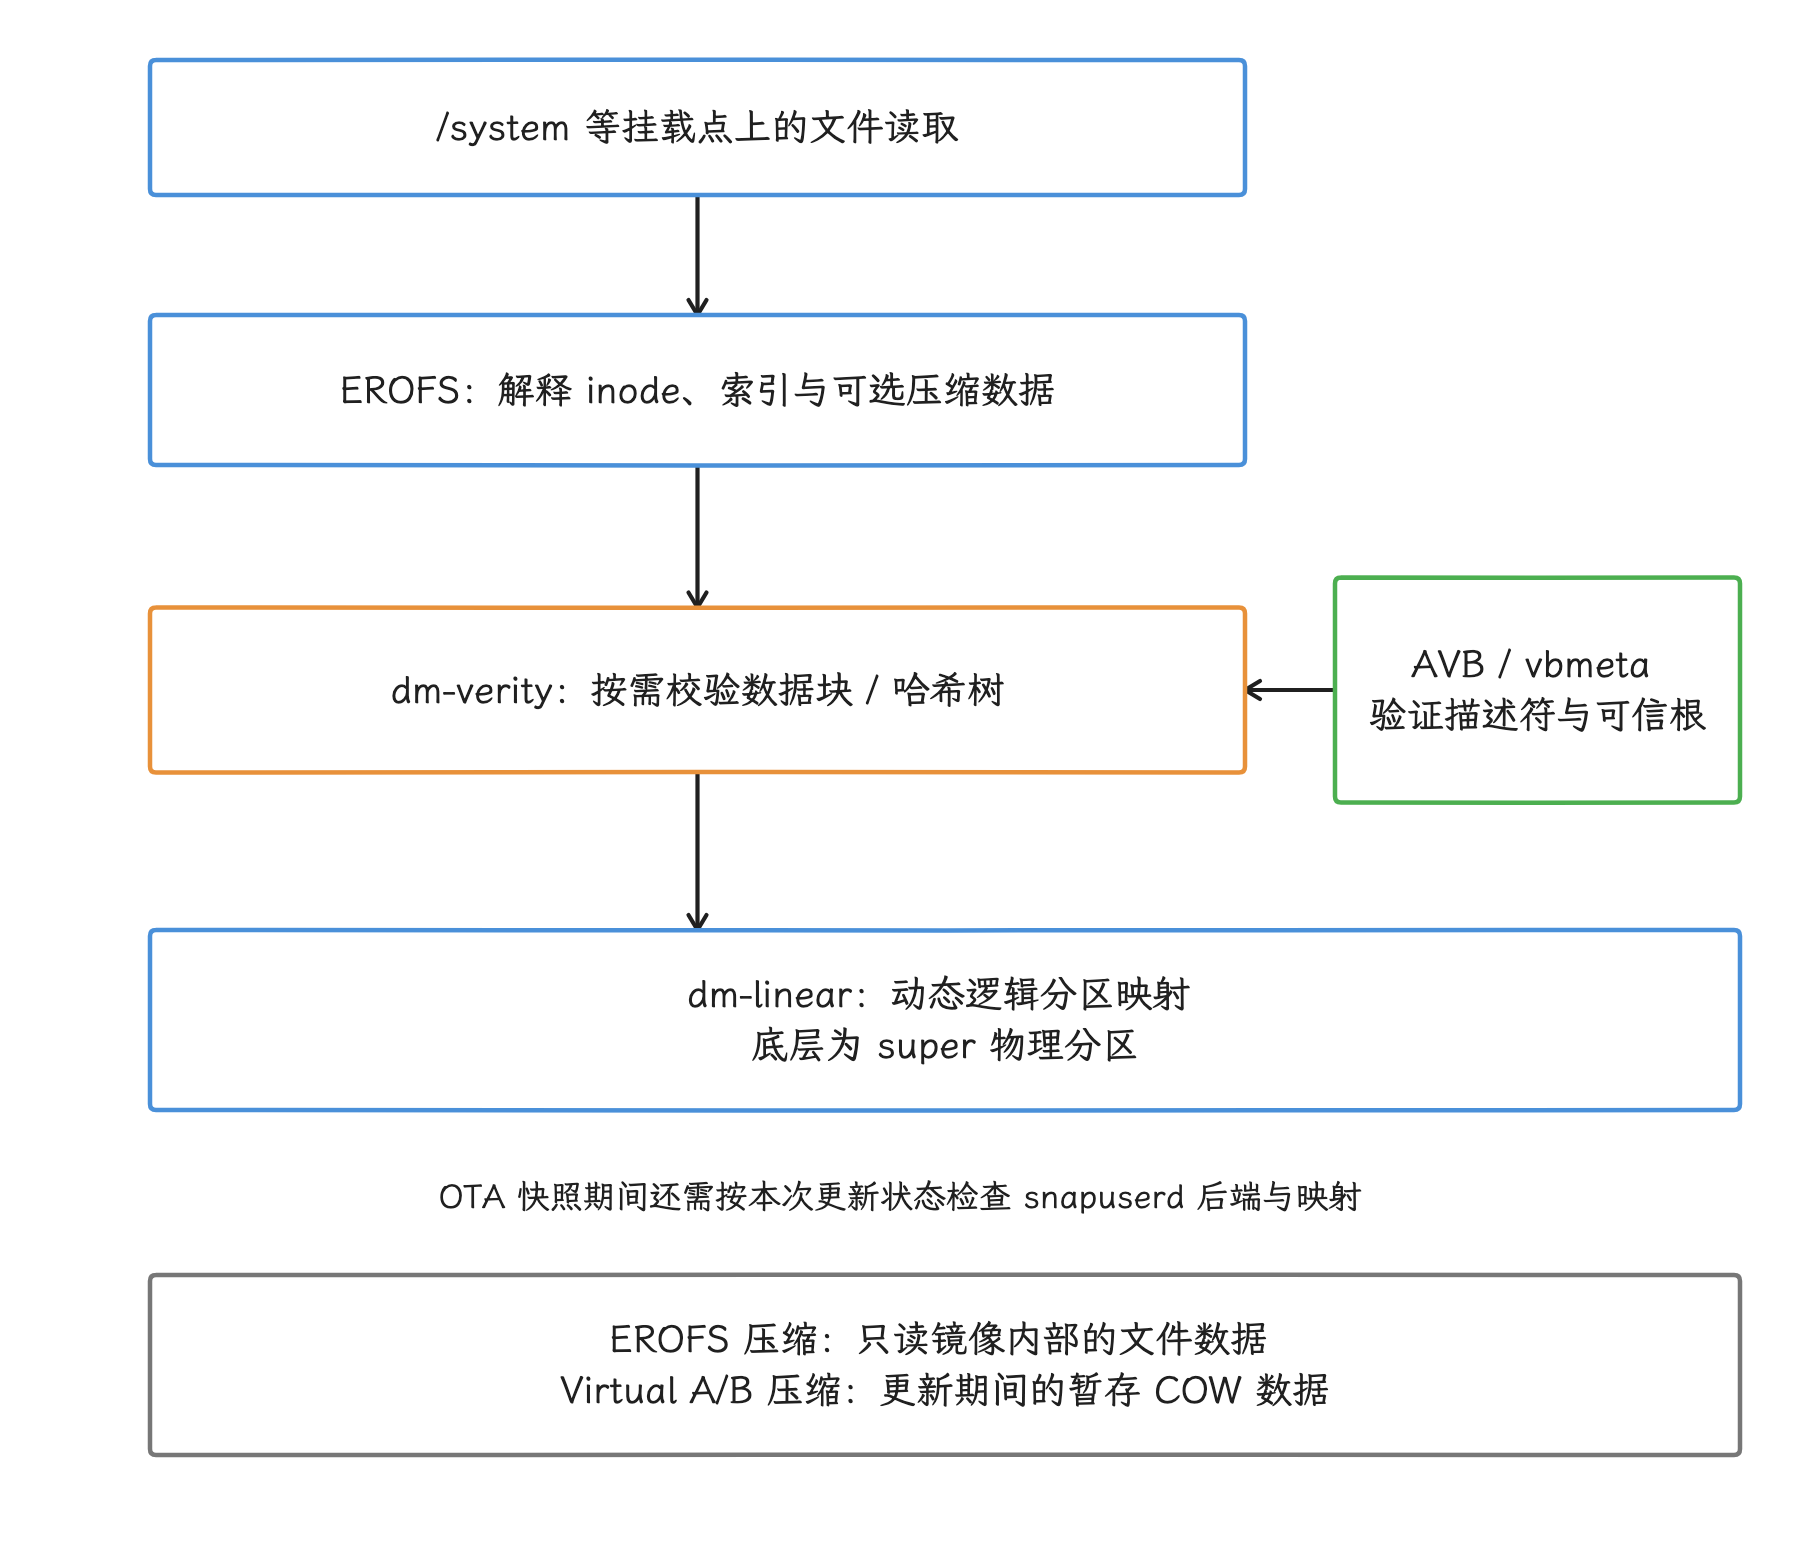
图:读取从文件系统经 dm-verity、逻辑分区映射到 super;AVB 提供可信校验根,文件系统压缩和 OTA COW 压缩处于不同层。
Virtual A/B OTA 的 snapshot(快照)读取与合并阶段还可能插入 snapuserd 服务的用户态后端;Android 17 r1 支持按条件选择 dm-user 或 ublk,实际以本次更新状态为准,后端选择见 6.1。AOSP 从 Android 13 起完整支持 EROFS 与 Virtual A/B,并能在生成增量 OTA 时处理 LZ4 数据流。这里容易混淆的是两个“压缩”:EROFS 镜像压缩缩小只读文件系统镜像,Virtual A/B snapshot 压缩缩小更新期间暂存的 COW 数据,属于不同层次。
文件系统如何影响随机 I/O
下表比较的是机制与风险点,不是脱离设备和负载的性能排名:
| 场景 | ext4 | F2FS | EROFS |
|---|---|---|---|
| 缓冲随机读 | Page Cache + extent 映射 | Page Cache + node/NAT 映射 | Page Cache + 压缩索引与解压 |
| 随机写 | delayed allocation、extent 分配、journal | OPU(out-of-place update)/IPU、LFS/SSR、node 更新 | 不支持 |
| 同步提交 | 数据写回 + journal/fast commit + 必要 flush | 数据写回 + roll-forward node 或 checkpoint + 必要 flush | 不支持写入 |
| 空间回收 | 空闲 extent 管理、discard(向块设备告知可回收范围) | segment GC、SSR、discard | 构建期生成镜像 |
| 主要尾延迟来源 | journal 竞争、块分配、flush、器件延迟 | GC/checkpoint、flush、器件延迟 | cache miss、压缩块读取与解压、verity、器件延迟 |
随机写成本来自多个层次。文件系统决定逻辑块如何分配,块层决定请求如何提交,FTL 决定 NAND 页如何搬移与回收。F2FS 尝试向 FTL 提供更有规律的写入并分离冷热数据,但文件系统和 FTL 的双层日志式管理也可能叠加写入放大。要判断哪种文件系统更快,我们得在同机型、同镜像、同挂载参数和同工作集下测量 P50/P95/P99(第 50/95/99 百分位)延迟。
fsync() 与 fdatasync():差别在持久化范围
POSIX(可移植操作系统接口)语义可以简化为:
fsync(fd):同步文件数据,以及恢复该文件状态所需的元数据。fdatasync(fd):可以跳过不影响后续数据读取的元数据,例如仅修改时间戳;文件大小变化仍需持久化。
“fdatasync() 固定少一次元数据写”是常见的预期,实际两者最终走到哪些写回和 flush,取决于文件修改类型与文件系统实现。F2FS 甚至会在 fdatasync() 路径设置 FI_NEED_IPU——前面我们已经见过这个标志——单看 syscall(系统调用) 名称,估不出一次调用的成本。
SQLite 在 rollback journal、WAL 和不同 synchronous 配置下会安排不同的同步操作。要求断电恢复的安全配置需要保留相应同步保证;修改 PRAGMA 来换取性能前,必须先定义允许丢失多少数据,以及是否允许数据库损坏。业务层更稳妥的优化通常是减少事务数量和主线程等待,而非关闭同步保证。
App 侧能做的事
- 批量提交数据库修改:把同一业务动作的多条写入放在一个明确事务中,避免在循环内反复提交。Room 可以用
@Transaction或批量 DAO(数据访问对象)方法表达边界。 - 谨慎选择 WAL:WAL 通常可以改善读写并发,但仍有 WAL sync、checkpoint 和文件增长成本。收益要用目标 workload(真实工作负载) 验证;同步保证该留的还得留,WAL 换不来“免同步”。
- 避免主线程等待持久化:文件写、数据库事务和
SharedPreferences.commit()要避开 UI 关键路径。 - 理解
SharedPreferences.apply()的限制:它会立即更新进程内视图并异步写磁盘;连续apply()仍产生磁盘工作,生命周期切换可能等待排队任务。 - 合并小文件更新:频繁创建、rename(重命名) 和删除小文件,会增加目录与 inode 元数据修改。可以在保持崩溃一致性的前提下降低更新频率。
如何定位
下面的命令用于确认目标挂载点的文件系统与关键挂载参数:
adb shell cat /proc/mounts
adb shell stat -f -c '%T %S' /data
adb shell getconf PAGE_SIZE
第一条显示实际 mount options,第二条用 Toybox 的 %T %S 显示 /data 的文件系统类型和基本块大小(%s 是最佳传输大小),第三条确认运行内核的页大小。stat 的输出只能当第一条线索,完整的判断要落到 F2FS on-disk feature(磁盘格式特性) 上。
Perfetto/ftrace(内核跟踪) 可以按设备开放情况观察:
ext4_sync_file_enter/ext4_sync_file_exitf2fs_sync_file_enter/f2fs_sync_file_exit- F2FS GC 与 checkpoint 事件
block_rq_issue/block_rq_complete- UFS host(主机控制器) controller(控制器)、device-mapper 和 writeback(回写) 事件
我们先用 sync_file 的 enter/exit 事件确认文件系统层的等待区间,再看时间消耗在 writeback、journal/checkpoint、GC、块队列,还是设备完成阶段。判定时不要用统一的 10 ms 阈值,应与同机型正常场景的分位数比较。
厂商选型:以设备事实为准
AOSP 和 GKI 在两边都提供了能力:/data 可以落在 ext4 或 F2FS 上,只读动态分区也是 EROFS 与只读 ext4 并存;最终用哪一种,是产品结合以下因素做的决定:
- launch/upgrade(首发/升级) 路径与 Virtual A/B 方案;
- UFS 特性、容量与 FTL 行为;
- 4 KB/16 KB kernel 选择;
- FBE、metadata encryption、quota 和 casefold 需求;
- 故障恢复、量产工具和售后升级成本;
- 厂商内核的补丁回移植与测试覆盖。
同一品牌的不同 SoC、地区版本和产品代际也可能采用不同配置。文章或发布会信息只能作为线索;现场问题以 /proc/mounts、fstab、superblock 与 build config(构建配置) 为准。
碎片化与长期性能变化
ext4 和 F2FS 都会出现布局不连续,只是形成方式和维护机制不同。
ext4 的空闲空间可能随着文件创建、扩展、截断和删除而逐渐分散。extent 与 delayed allocation 能缓解碎片,长期使用后文件还连不连续,就要看设备的写入历史了。闪存没有机械寻道,碎片仍可能增加 bio 数量、削弱 readahead(预读)和请求合并效果。
F2FS 的更新会产生旧的无效块,GC 随后搬移 victim 中仍然有效的块。冷热数据混放、空闲 section 少或后台 GC 缺少运行窗口时,需要搬移的有效数据会增多,前台分配也更容易等待。F2FS 同样可能把一个文件的逻辑块映射到分散的物理地址,因此“F2FS 没有文件碎片”并不成立。
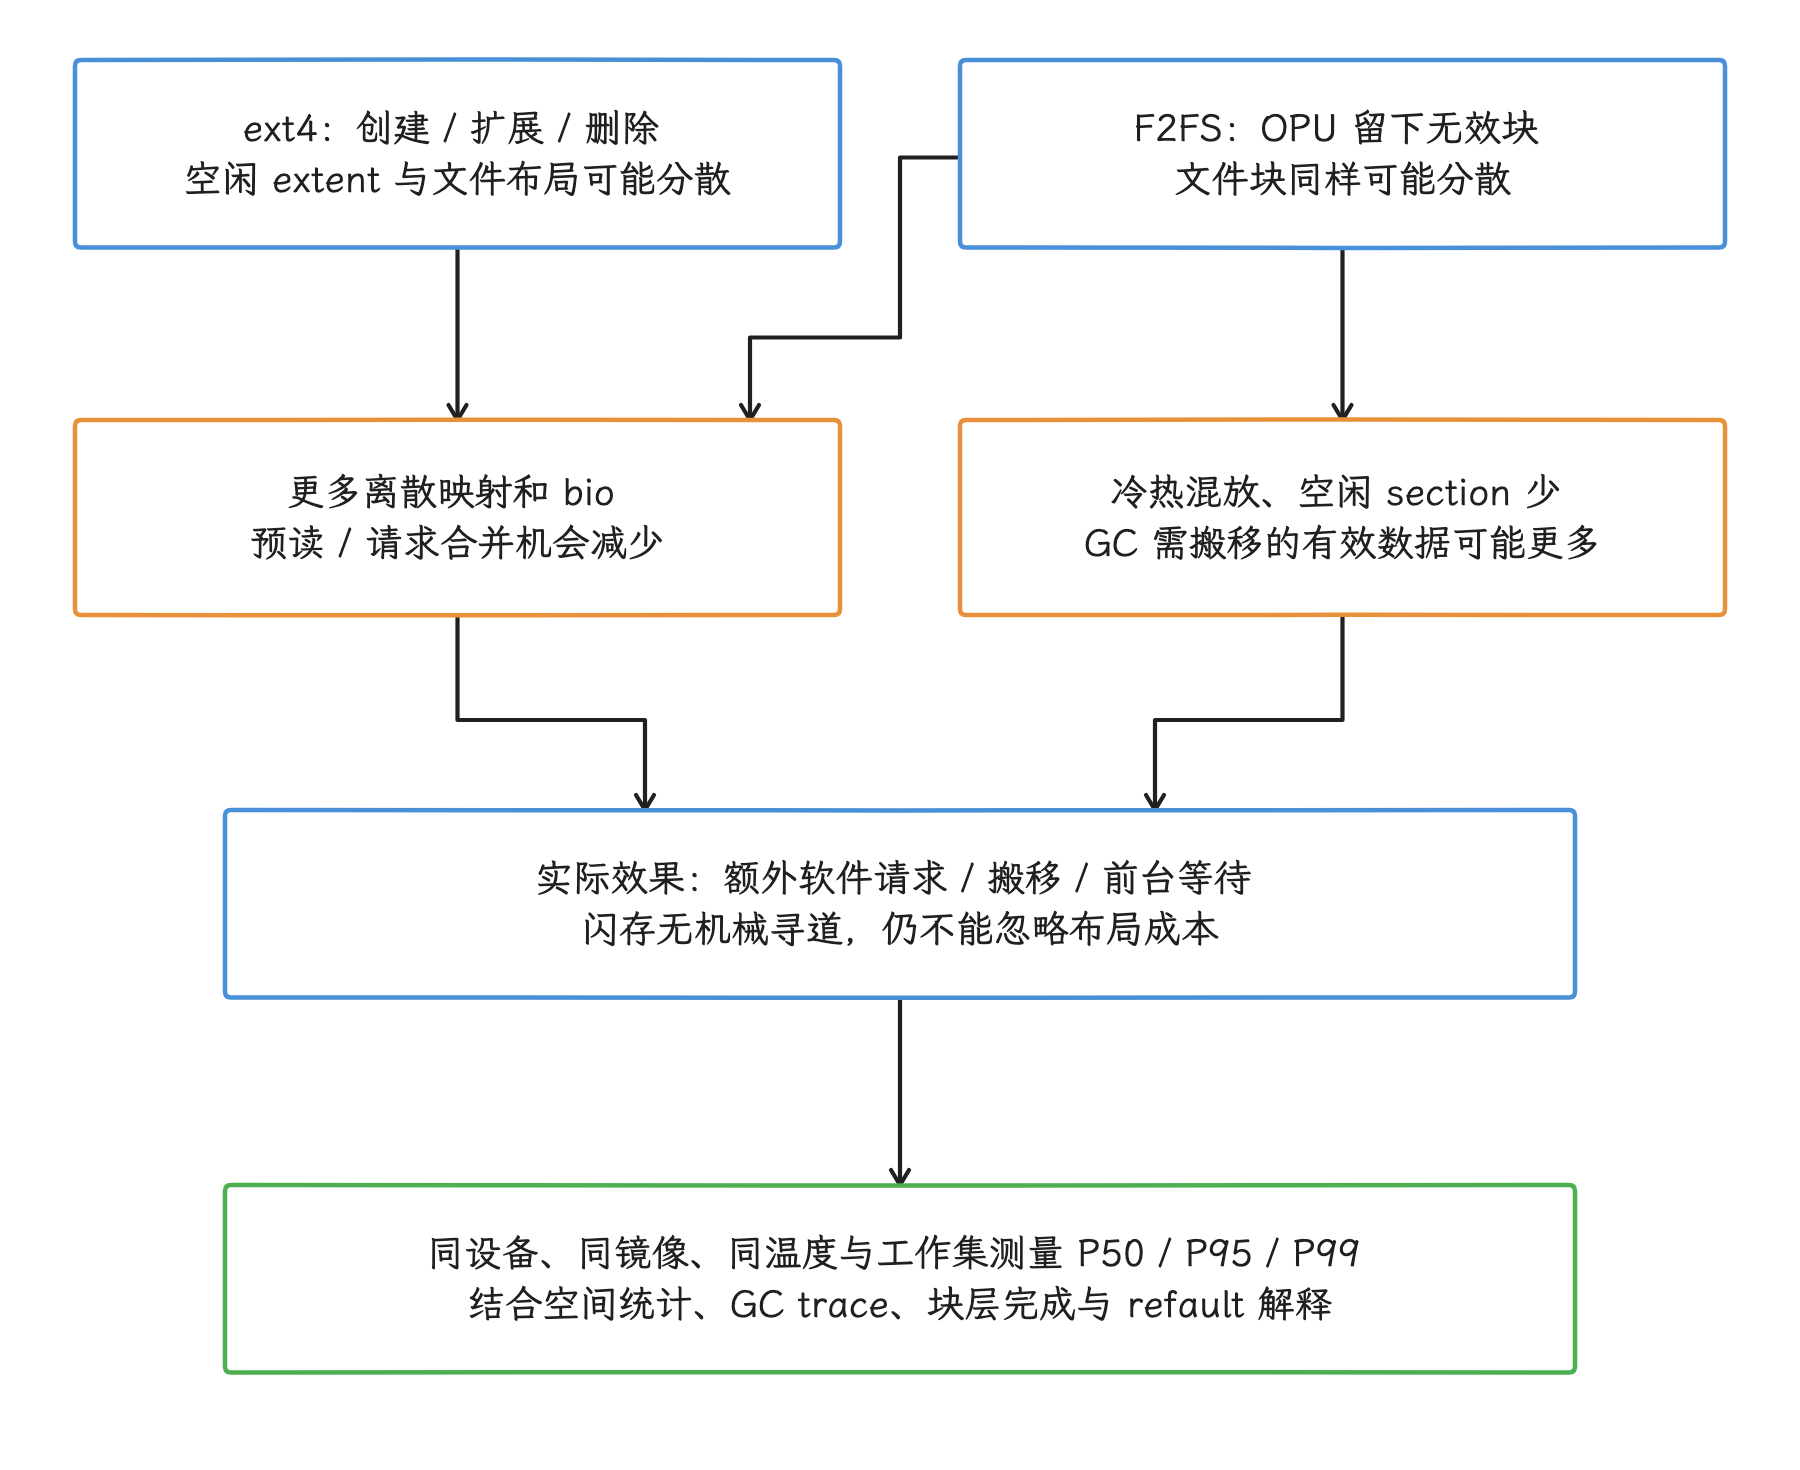
图:布局不连续可能削弱请求合并与预读;F2FS 还需为 GC 搬移有效块,空闲空间和冷热混放会改变成本。
保留一定空闲空间通常有利于文件系统和 FTL 回收;具体保留多少,系统开发者应结合 /sys/fs/f2fs/<dev>/ 统计、GC trace、块层延迟和产品容量策略建立阈值,“至少 10%”这类跨设备的统一数字只适合当参考。普通 App 要避免用 root 工具对用户设备定期强制 defrag(碎片整理)。
恢复出厂设置会重建或清空用户数据,短期内改变空间与布局状态。持续制造高频小写、无边界缓存或过多事务提交的业务模式如果继续存在,重置后的空间与布局收益仍可能逐渐消失;恢复出厂设置不能根治这种负载来源。
版本脉络:AOSP 能力与设备事实
| 版本阶段 | 可确认的变化 |
|---|---|
| 早期 Android | 设备曾使用 YAFFS2、ext4 等多种格式;“Android 从诞生起所有分区都用 ext4”不成立。 |
| Android 8–12 | F2FS 原子写 ioctl(设备控制命令)与 SQLite 适配进入 Android 设备软件栈;是否使用仍需运行时探测并满足事务条件。 |
| Android 10–12 | F2FS、ext4 继续用于可写分区;动态分区与 Virtual A/B 改变系统镜像的映射和更新方式。 |
| Android 13 | AOSP 文档明确 EROFS 完整支持 Virtual A/B,EROFS 成为只读分区的产品选项。 |
| Android 15 | AOSP 支持 16 KB page size;文件系统格式、kernel page size 与 native ELF 对齐需要分别检查。 |
| Android 16 | AOSP 增加预编译 ELF 最大页大小检查等迁移工具,16 KB 兼容要求继续变严。 |
| Android 17 | 平台锚点为 API 37 / android-17.0.0_r1;6.18 arm64 GKI 同时启用 ext4、F2FS、EROFS,并启用 EROFS ZSTD 解压能力。 |
这条时间线描述的是 AOSP 能力;具体某台设备在某个版本用什么格式,还要结合它属于 launch 还是 upgrade 路径,以及 vendor kernel(厂商内核) 和产品配置来判断。
文件系统源码锚点
Android 17 / kernel 6.18 源码
kernel/common/fs/ext4/fsync.c:ext4_sync_file()、fast commit 与 flush。kernel/common/fs/f2fs/file.c:f2fs_do_sync_file()、atomic write ioctls。kernel/common/fs/f2fs/segment.h:__get_secs_required()、has_not_enough_free_secs()。kernel/common/fs/f2fs/segment.c:f2fs_need_SSR()、f2fs_balance_fs()。kernel/common/fs/f2fs/gc.c:BG/FG GC 与 victim policy。kernel/common/include/linux/f2fs_fs.h:F2FS block/page、NAT、SIT 磁盘结构。kernel/common/include/uapi/linux/f2fs.h:F2FS ioctl ABI。kernel/common/fs/erofs/、kernel/common/fs/erofs/Kconfig:EROFS 与压缩算法支持。kernel/common/arch/arm64/configs/gki_defconfig:Android 17 arm64 GKI 文件系统配置。external/sqlite/dist/Android.bp与dist/sqlite-autoconf-*/sqlite3.c:SQLite batch atomic write 编译选项与 F2FS 探测。
官方文档
- AOSP EROFS
- AOSP 16 KB page size
- AOSP Virtual A/B
- Android SharedPreferences.Editor
- Linux F2FS documentation
- Linux ext4 documentation
- Linux EROFS documentation
- Linux VFS documentation
- SQLite Atomic Commit
文件系统选型的判断依据
遇到同步写卡顿时,我们可以依次回答四个问题:
- 谁发起了同步,事务或配置更新是否过于频繁?
/data使用 ext4 还是 F2FS,页大小和挂载参数是什么?- 时间消耗在数据回写、journal/fast commit、F2FS node/checkpoint/GC,还是块设备 flush?
- 问题属于 App 调用方式、系统服务、文件系统策略,还是 UFS/FTL 尾延迟?
ext4 是成熟的通用读写文件系统;F2FS 使用 segment、NAT/SIT、冷热日志和 GC 适配闪存更新负载;EROFS 服务于构建期生成的只读镜像。三者的职责与代价不同。对应的内核能力在当前基线里都保留着,具体分析哪一条路径,由产品配置和现场读数决定。
文件系统生成的 bio 如何变成设备请求,见后文「块层队列、调度与延迟分析」一节。
块层队列、调度与延迟分析
上一节结束时,文件系统已经把读写请求交给了块层;这一节要解决的是合并、优先级和设备队列。我们在这段路上关心的两个量——吞吐和尾延迟——都要结合请求大小、同步方式和存储介质来判断。
D 状态:I/O 排查的起点
我们在 Perfetto 里看到主线程出现一段 D(uninterruptible sleep,不可中断睡眠)状态时,I/O 是头号嫌疑,但离定案还早:D 只说明线程睡在不可中断的等待点上,等的也可能是驱动、内存回收或其他内核资源。要缩小范围,可以接着看 thread_state.io_wait=1、sched_blocked_reason、文件系统 tracepoint(内核跟踪点) 和 block 事件。
即便调用栈落在 read() 或 fsync(),延迟也可能来自不同位置:
- Page Cache miss(页缓存未命中) 或脏页回写。
- ext4 journal(日志)、F2FS checkpoint(检查点)/GC 等文件系统工作。
- request(块层请求) 进入块层后等待 scheduler dispatch(调度器派发)。
- device-mapper、inline crypto(内联加密)、UFS host 与设备内部队列。
- UFS 固件的 cache flush、FTL GC、磨损控制和温度策略。
I/O scheduler(I/O 调度器) 管的是块层请求进入设备前的一段路径:请求顺序、带宽份额和队列深度它都能影响;已经发给设备的命令它抢不回来,主线程上设计不当的同步写,也还是要回到 App 侧去改。
blk-mq 与 I/O scheduler 的位置
先看清块层自己的形状:现代 Linux 块层使用 blk-mq(多队列块层),软件提交队列把请求分发到一个或多个硬件队列,驱动再把命令交给控制器。可选的 elevator(块 I/O 调度器) 挂在 request queue(请求队列) 上,负责合并、排序或限流尚未 dispatch 的请求——后面讨论的每一种调度器,都工作在这个位置上。
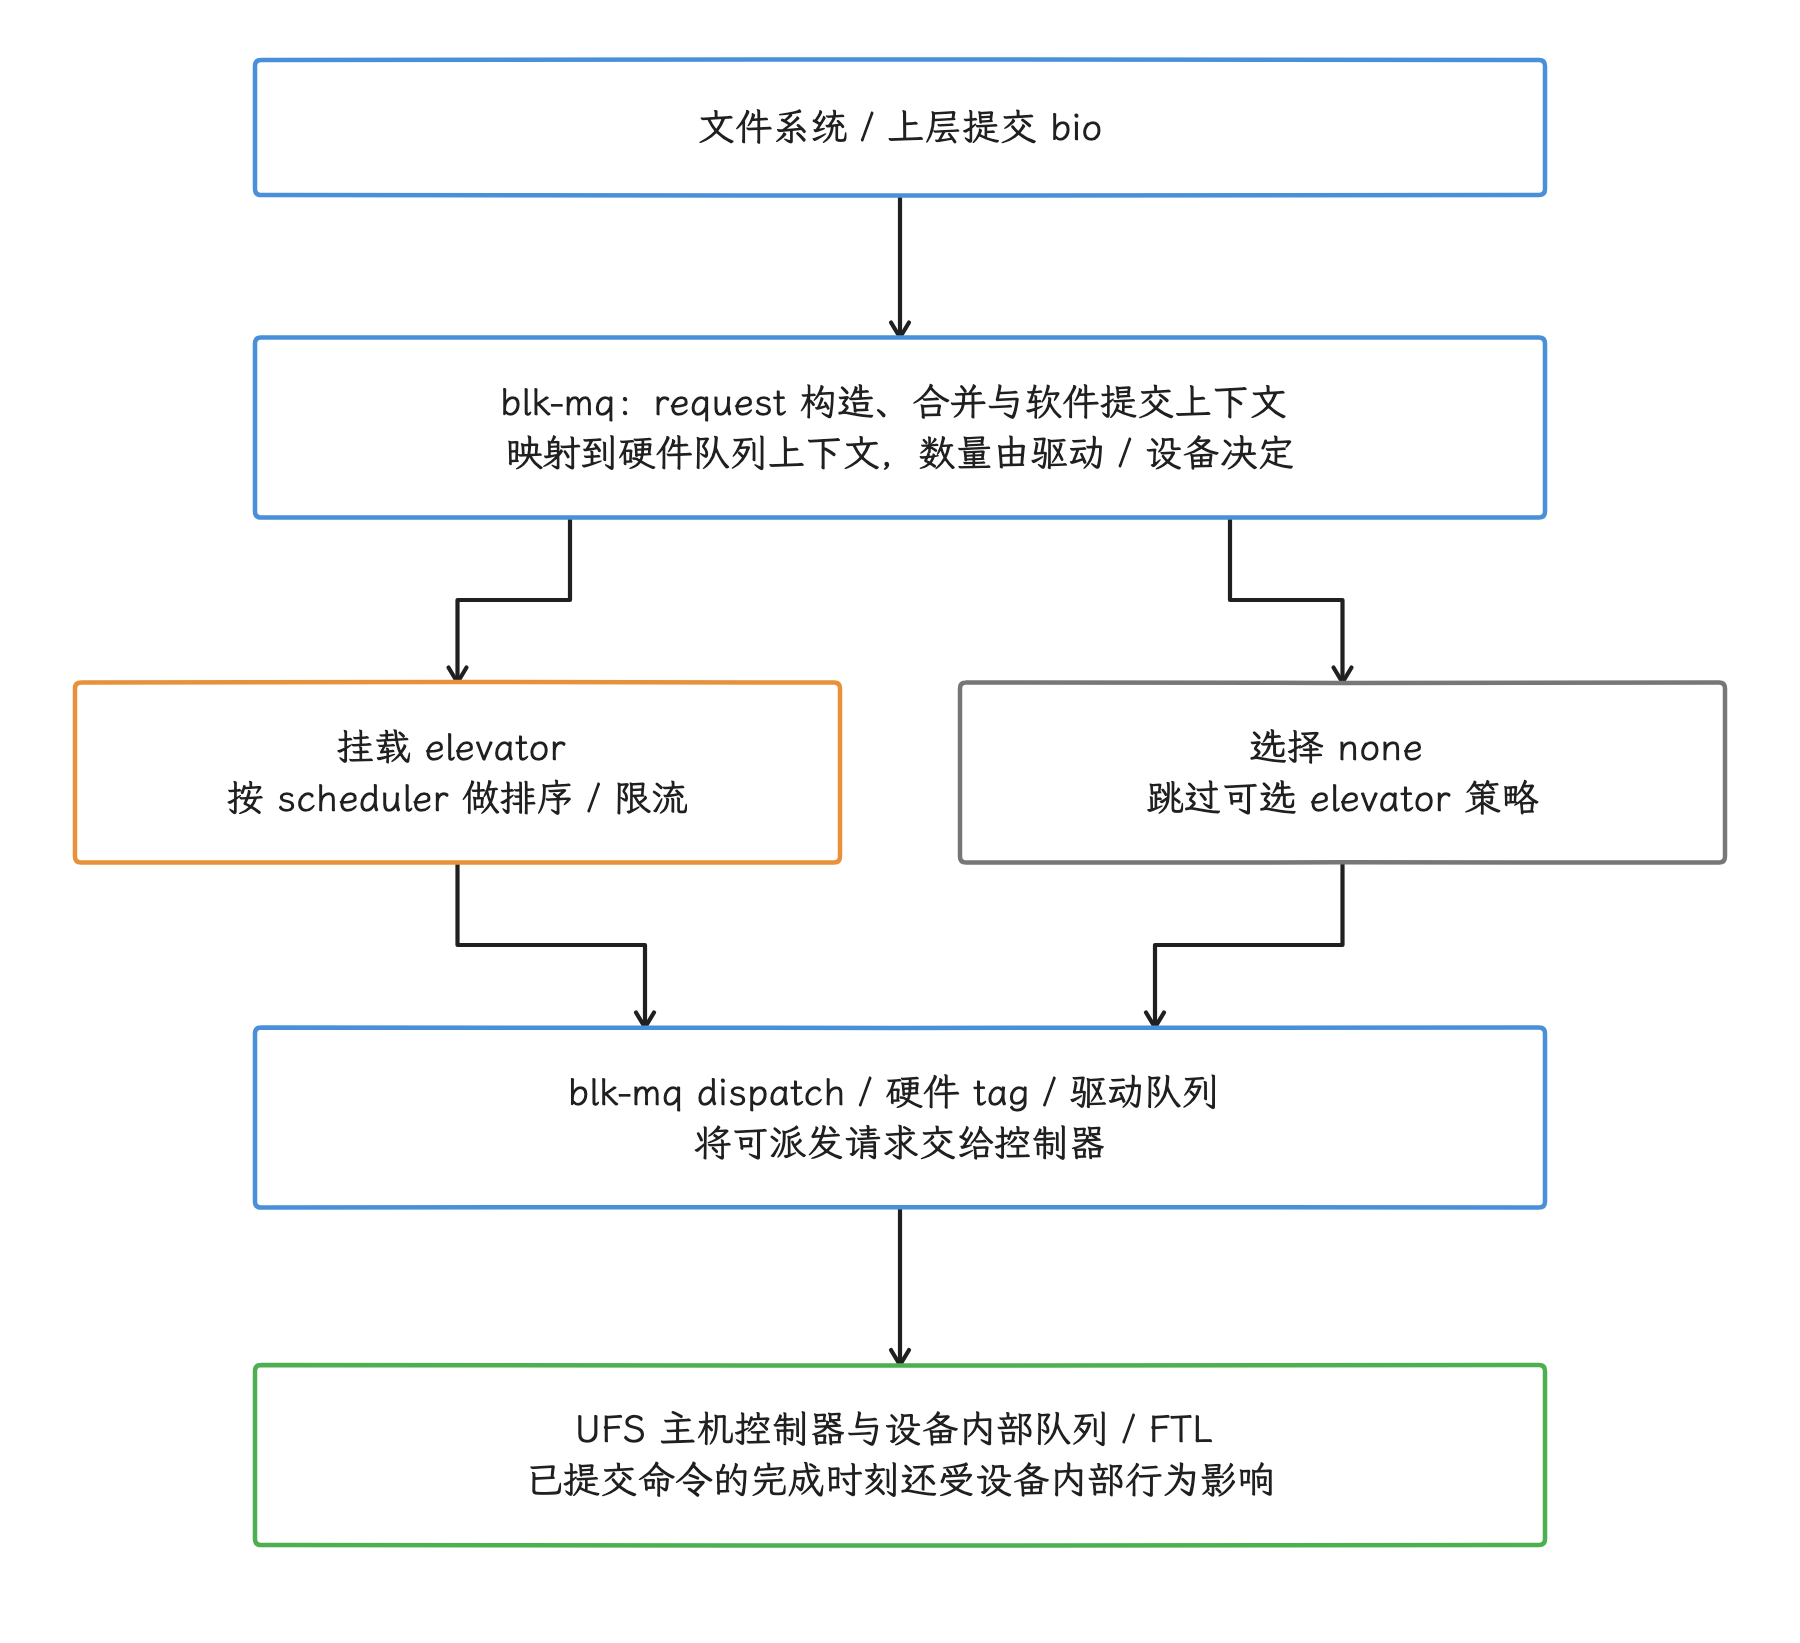
图:elevator 管理尚未派发的请求;none 跳过可选策略,软件上下文、硬件队列、tag 与驱动仍然存在。
UFS 没有机械磁头,但 scheduler 仍可能有价值:
- 读与同步写对交互延迟敏感,后台顺序写更重视吞吐。
- 设备队列过深会增加排队时间;过浅又可能浪费并行度。
- 多个进程或 cgroup(控制组) 需要隔离。
- 相邻请求合并可减少软件和设备命令开销。
“闪存随机访问很快”推不出“请求顺序不再重要”:UFS 的读写不对称、SLC cache(以单层单元模式工作)、内部并行单元与 FTL 回收,都会让尾延迟随队列形态变化。
CFQ、BFQ、mq-deadline、Kyber 与 none
先把这串调度器名称放回各自的位置:CFQ 属于旧 single-queue(单队列) 块层,BFQ、mq-deadline 和 Kyber 都可以工作在 blk-mq 上,none 表示目标 request queue 没有挂载可选 elevator。把它们拼成一张固定的 Android 版本替换表,是排查时最容易踩的坑;Android 版本、GKI 能力、vendor kernel 配置与块设备的最终选择,要分开判断。
CFQ:历史背景
CFQ(Completely Fair Queuing,完全公平排队)为每个 I/O context(I/O 上下文) 管理队列,并通过时间片和优先级分配设备服务。它曾是通用 Linux 配置中的重要调度器,但没有进入当前 6.18 的 blk-mq scheduler 集合。
CFQ 本身支持 I/O class(优先级类别) 与 priority,“所有进程完全相同”的简化说法丢掉了这些调节手段。它退出当前内核,主要背景是块层迁移到 blk-mq;单个 Android 前后台场景解释不了这件事。
BFQ:按 budget 分配服务
BFQ(Budget Fair Queueing,预算公平排队)按照权重和 budget(一次获准处理的数据量)为队列分配服务,目标是在吞吐、公平性和交互延迟之间取得平衡。启用 CONFIG_BFQ_GROUP_IOSCHED 后,它还能进行 cgroup 层级调度。
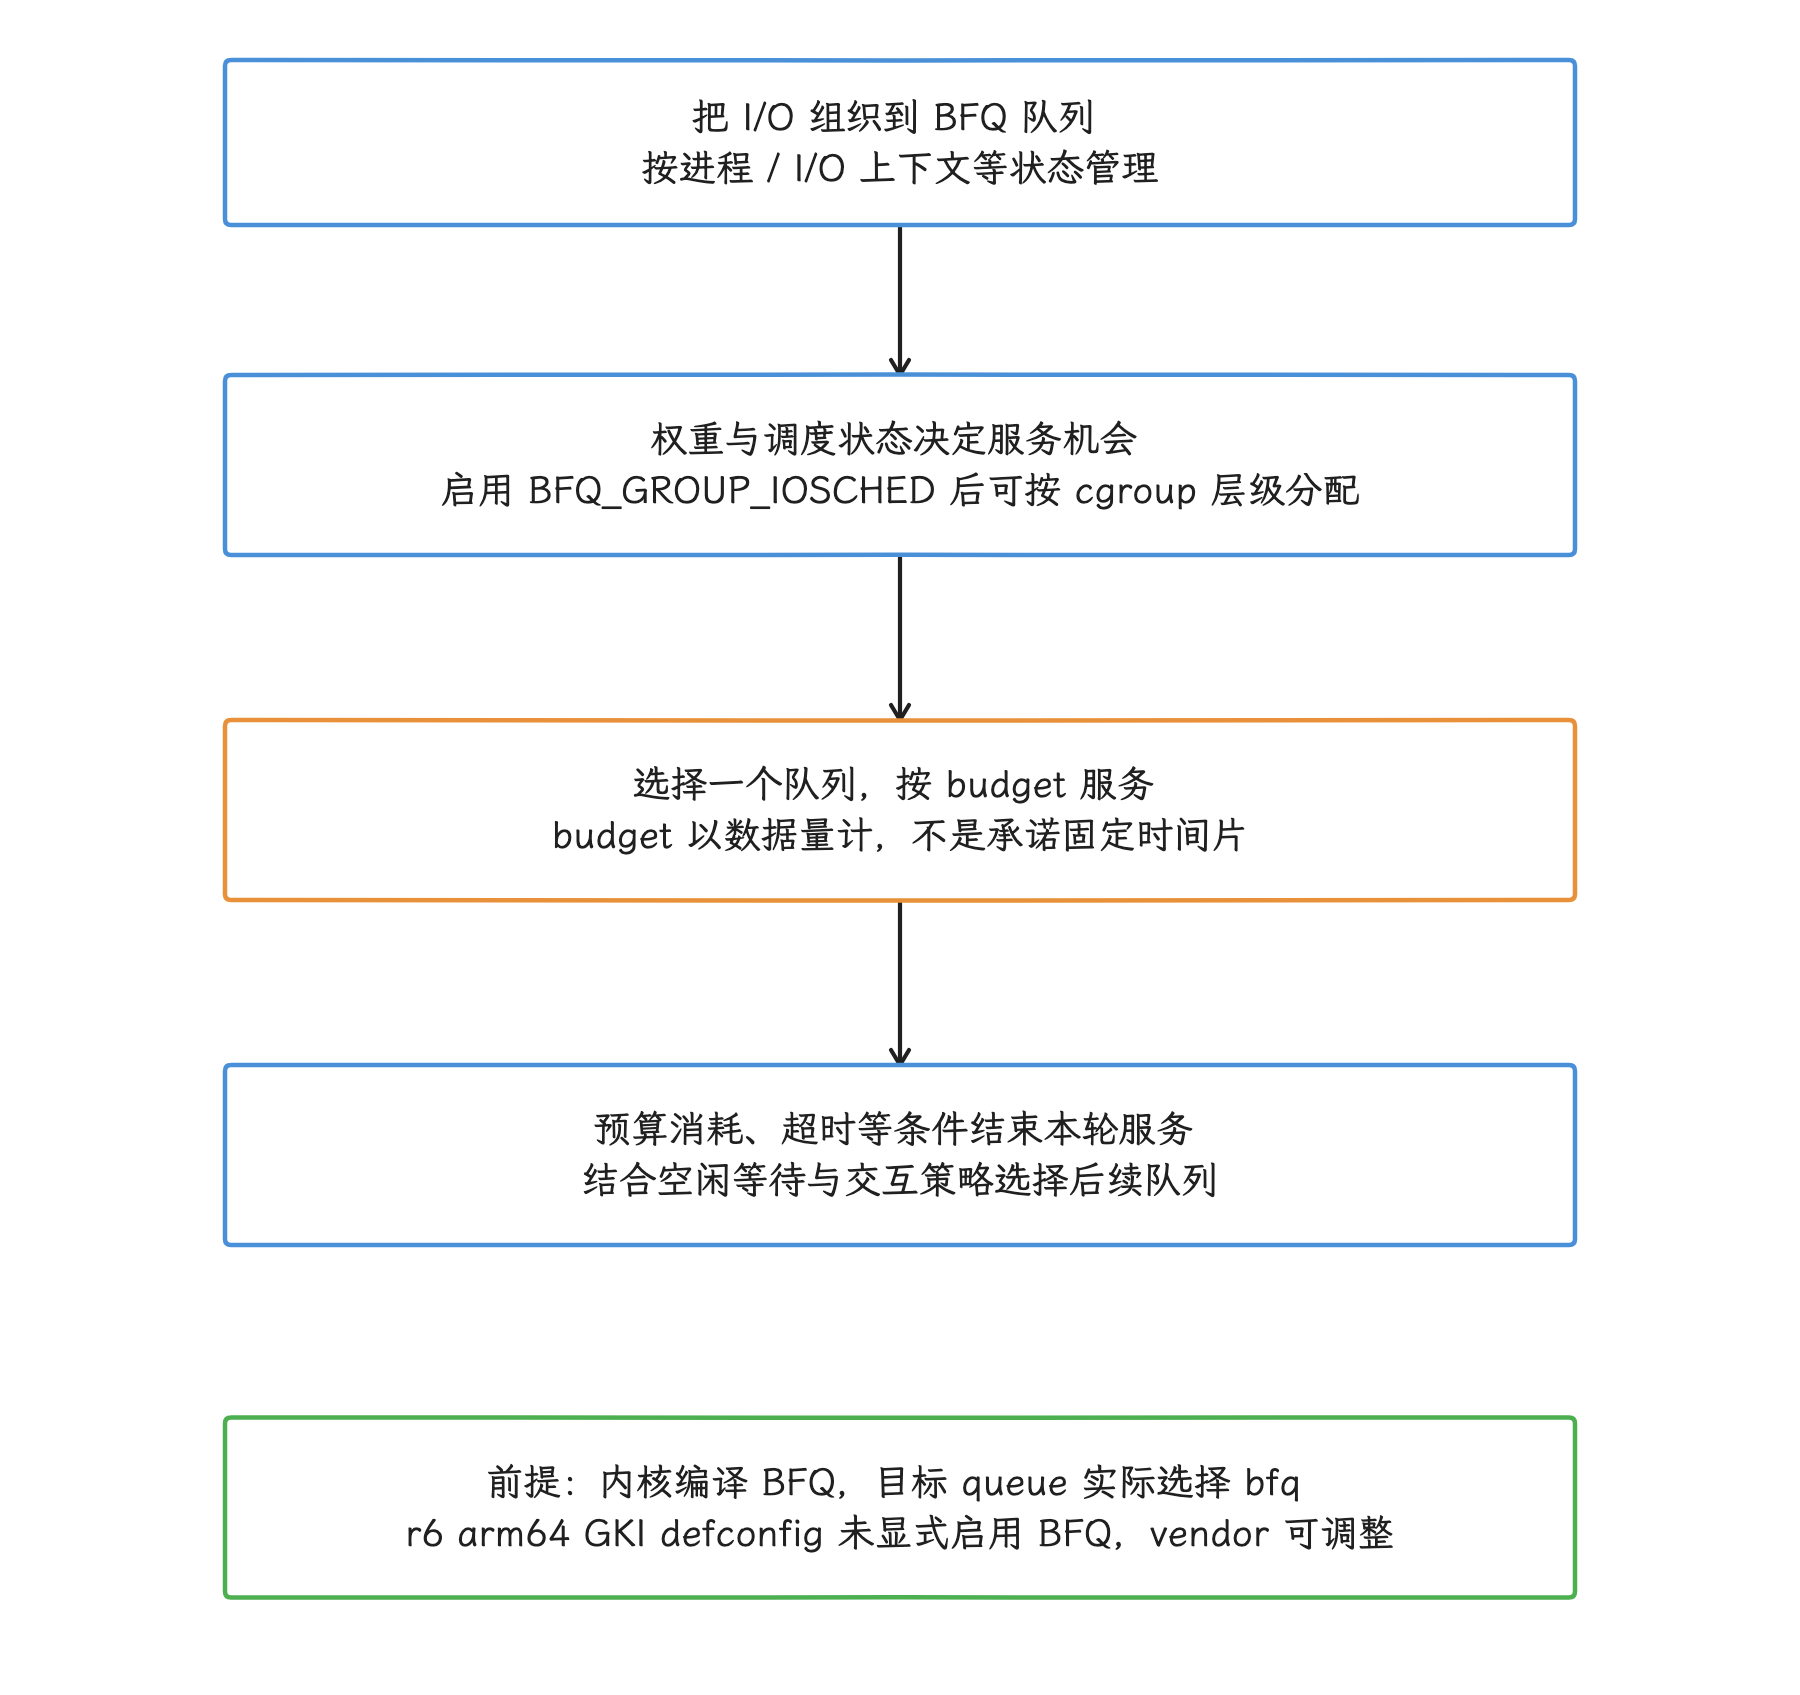
图:BFQ 为队列分配以数据量计的 budget,并结合权重和交互策略分配服务;组间比例调度还需 GROUP_IOSCHED 支持。
BFQ 的 per-request(逐请求) 处理和队列管理比 mq-deadline 更复杂。在较慢设备、需要比例带宽或交互保障的负载上,这份成本可能值得;在高 IOPS(每秒 I/O 操作次数) 设备上,额外调度工作也可能限制吞吐。“BFQ 的最低延迟一定是 mq-deadline 的数倍”并不适用于所有设备。
6.18 的 Kconfig.iosched 把 BFQ 保留为可选项,但 arm64 GKI defconfig(默认内核配置) 没有显式启用 CONFIG_IOSCHED_BFQ。vendor 可以改变配置,所以实机上会不会出现 bfq,仍以 sysfs(内核导出的运行时属性接口) 为准。
mq-deadline:位置队列、FIFO(先进先出队列) 与 I/O class
mq-deadline 为 RT、BE、IDLE 三种 I/O class 分别维护读写队列。每个请求会同时进入按 sector(扇区位置) 排序的红黑树和按到期时间排列的 FIFO;调度器通常沿 sector 顺序批量 dispatch,并在两批之间处理超期请求。
下面的源码常量给出了内核的默认软期限,摘自 block/mq-deadline.c:
static const int read_expire = HZ / 2;
static const int write_expire = 5 * HZ;
static const int prio_aging_expire = 10 * HZ;
static const int writes_starved = 2;
static const int fifo_batch = 16;
read_expire=500ms 和 write_expire=5s 是 FIFO 防饥饿检查所用的软到期时间,请求可以在到期之前正常 dispatch;它们既不是最短等待时间,也不是设备完成期限。设备完成延迟要用另一条时间线衡量。writes_starved=2 表示连续优先处理一定次数的读批次后要照顾写队列,讲的是批次的交替节奏;“读写 2:1”带宽比例是另一个概念,从这里读不出来。
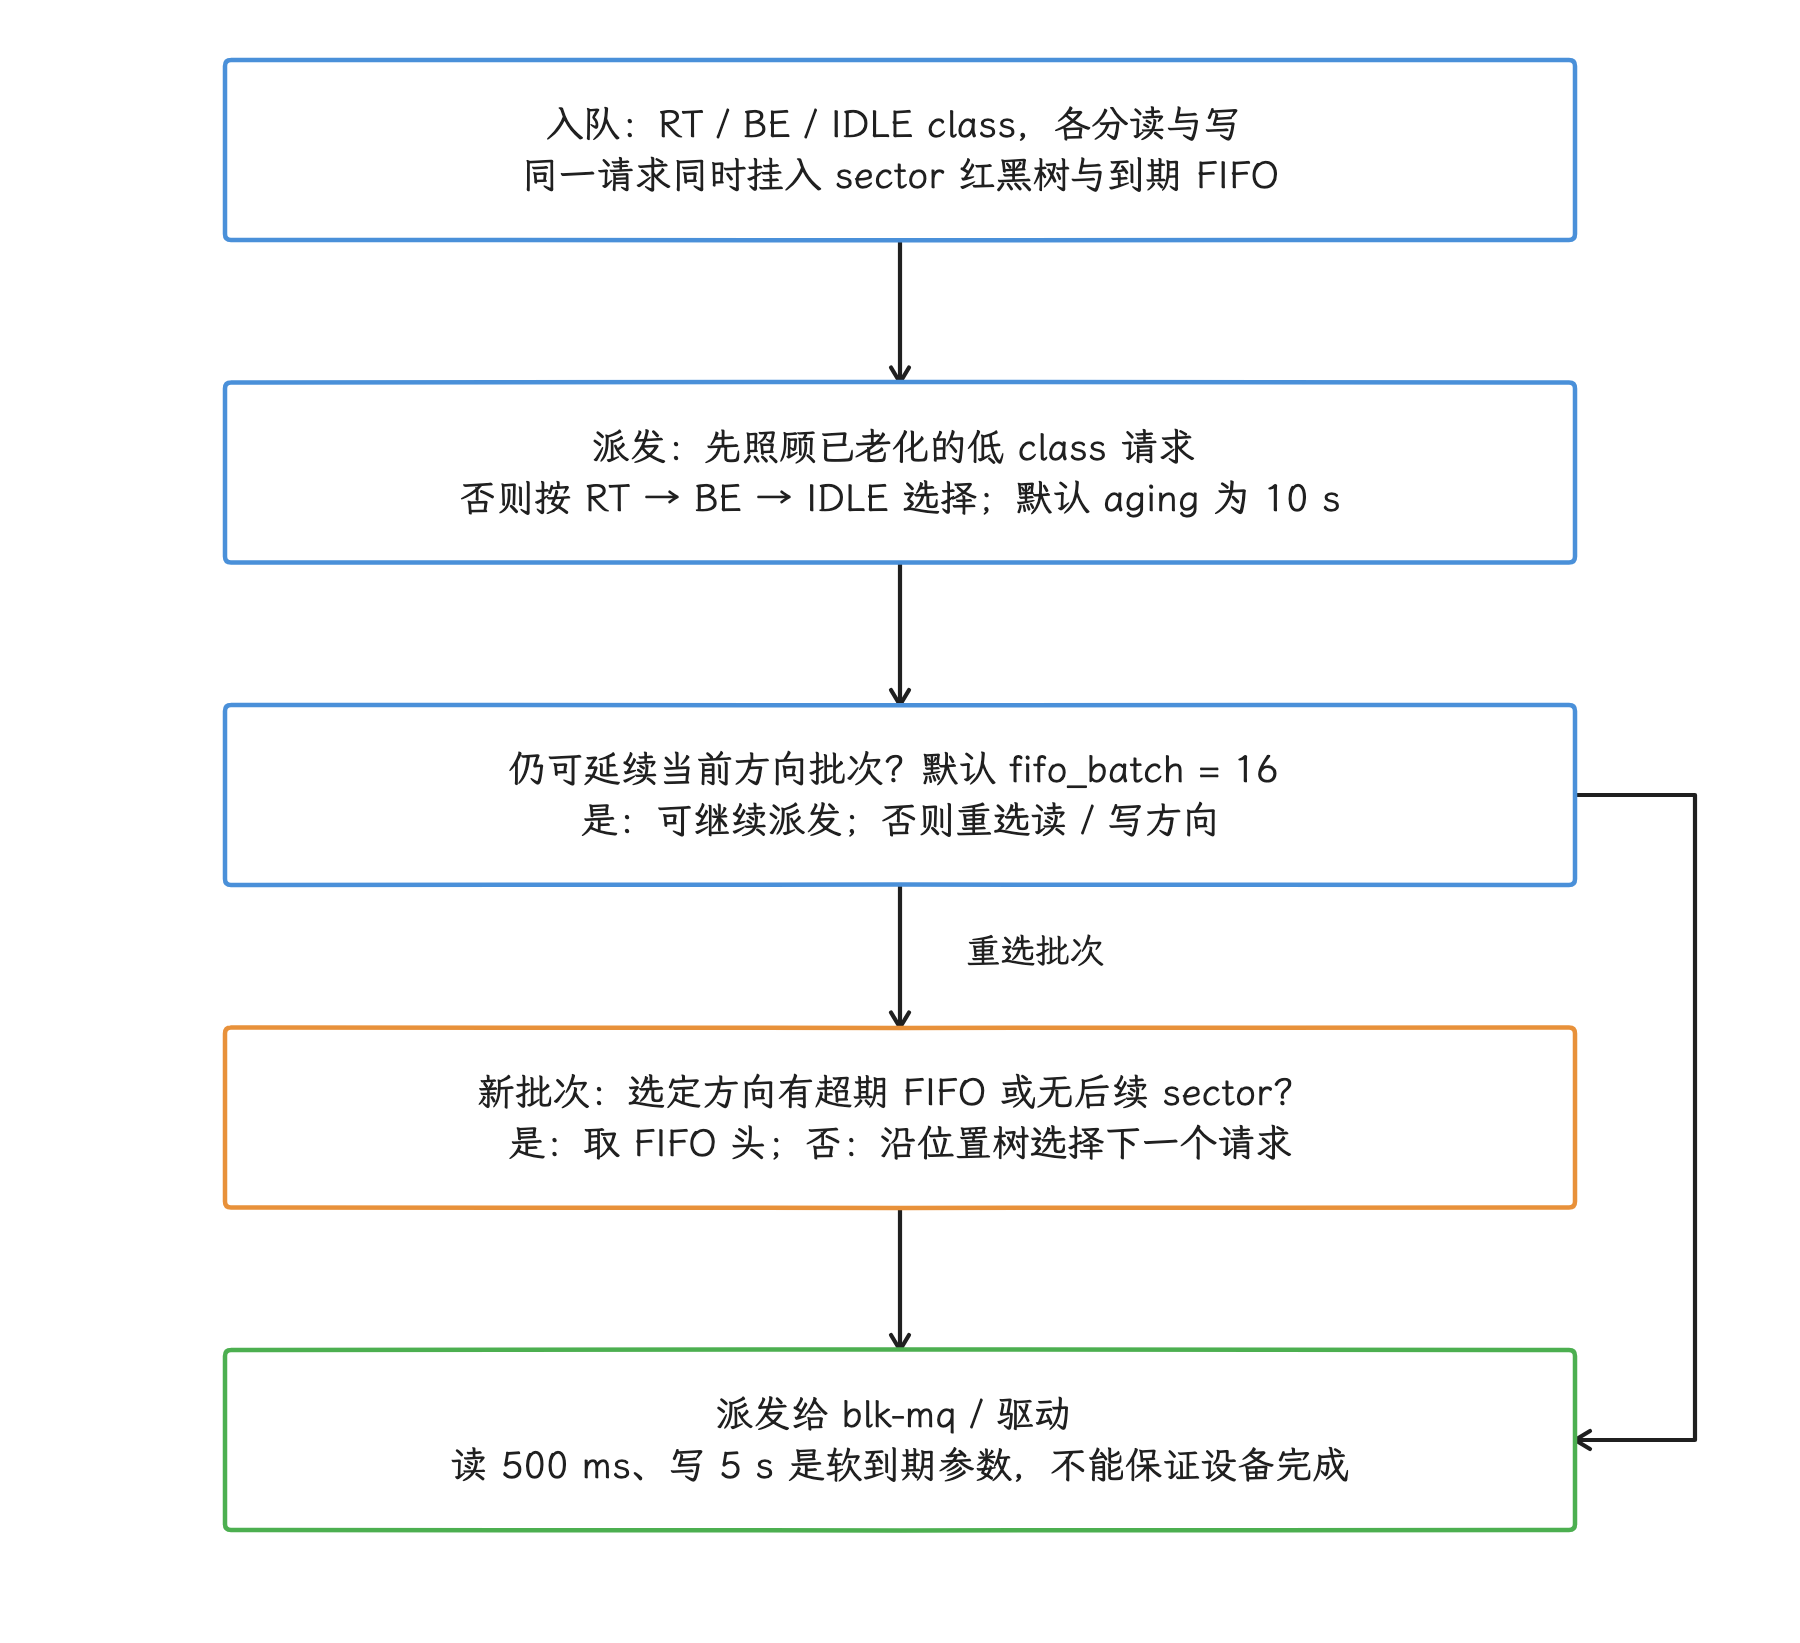
图:每个 class 内同时维护位置树与 FIFO;正常批次可在到期前派发,新批次再按方向、超期和位置选择请求。
6.18 实现会把 IOPRIO_CLASS_NONE 映射到 BE,并识别 RT/BE/IDLE class。优先级 class 可以影响 dispatch;class 内的 0–7 level(等级) 是否生效要看 scheduler 消费与否,ionice 命令返回成功与最终效果之间还隔着这一层。
Kyber:用 token(令牌) 控制队列深度
Kyber 把请求分成 READ、WRITE、DISCARD 和 OTHER 域,用 token 限制各域同时在途的请求数,并根据延迟直方图动态调整。6.18 源码中的默认 target 是读 2 ms、写 10 ms、discard 5 s;这些值用于内部控制,并不承诺每个请求都在目标时间内完成。
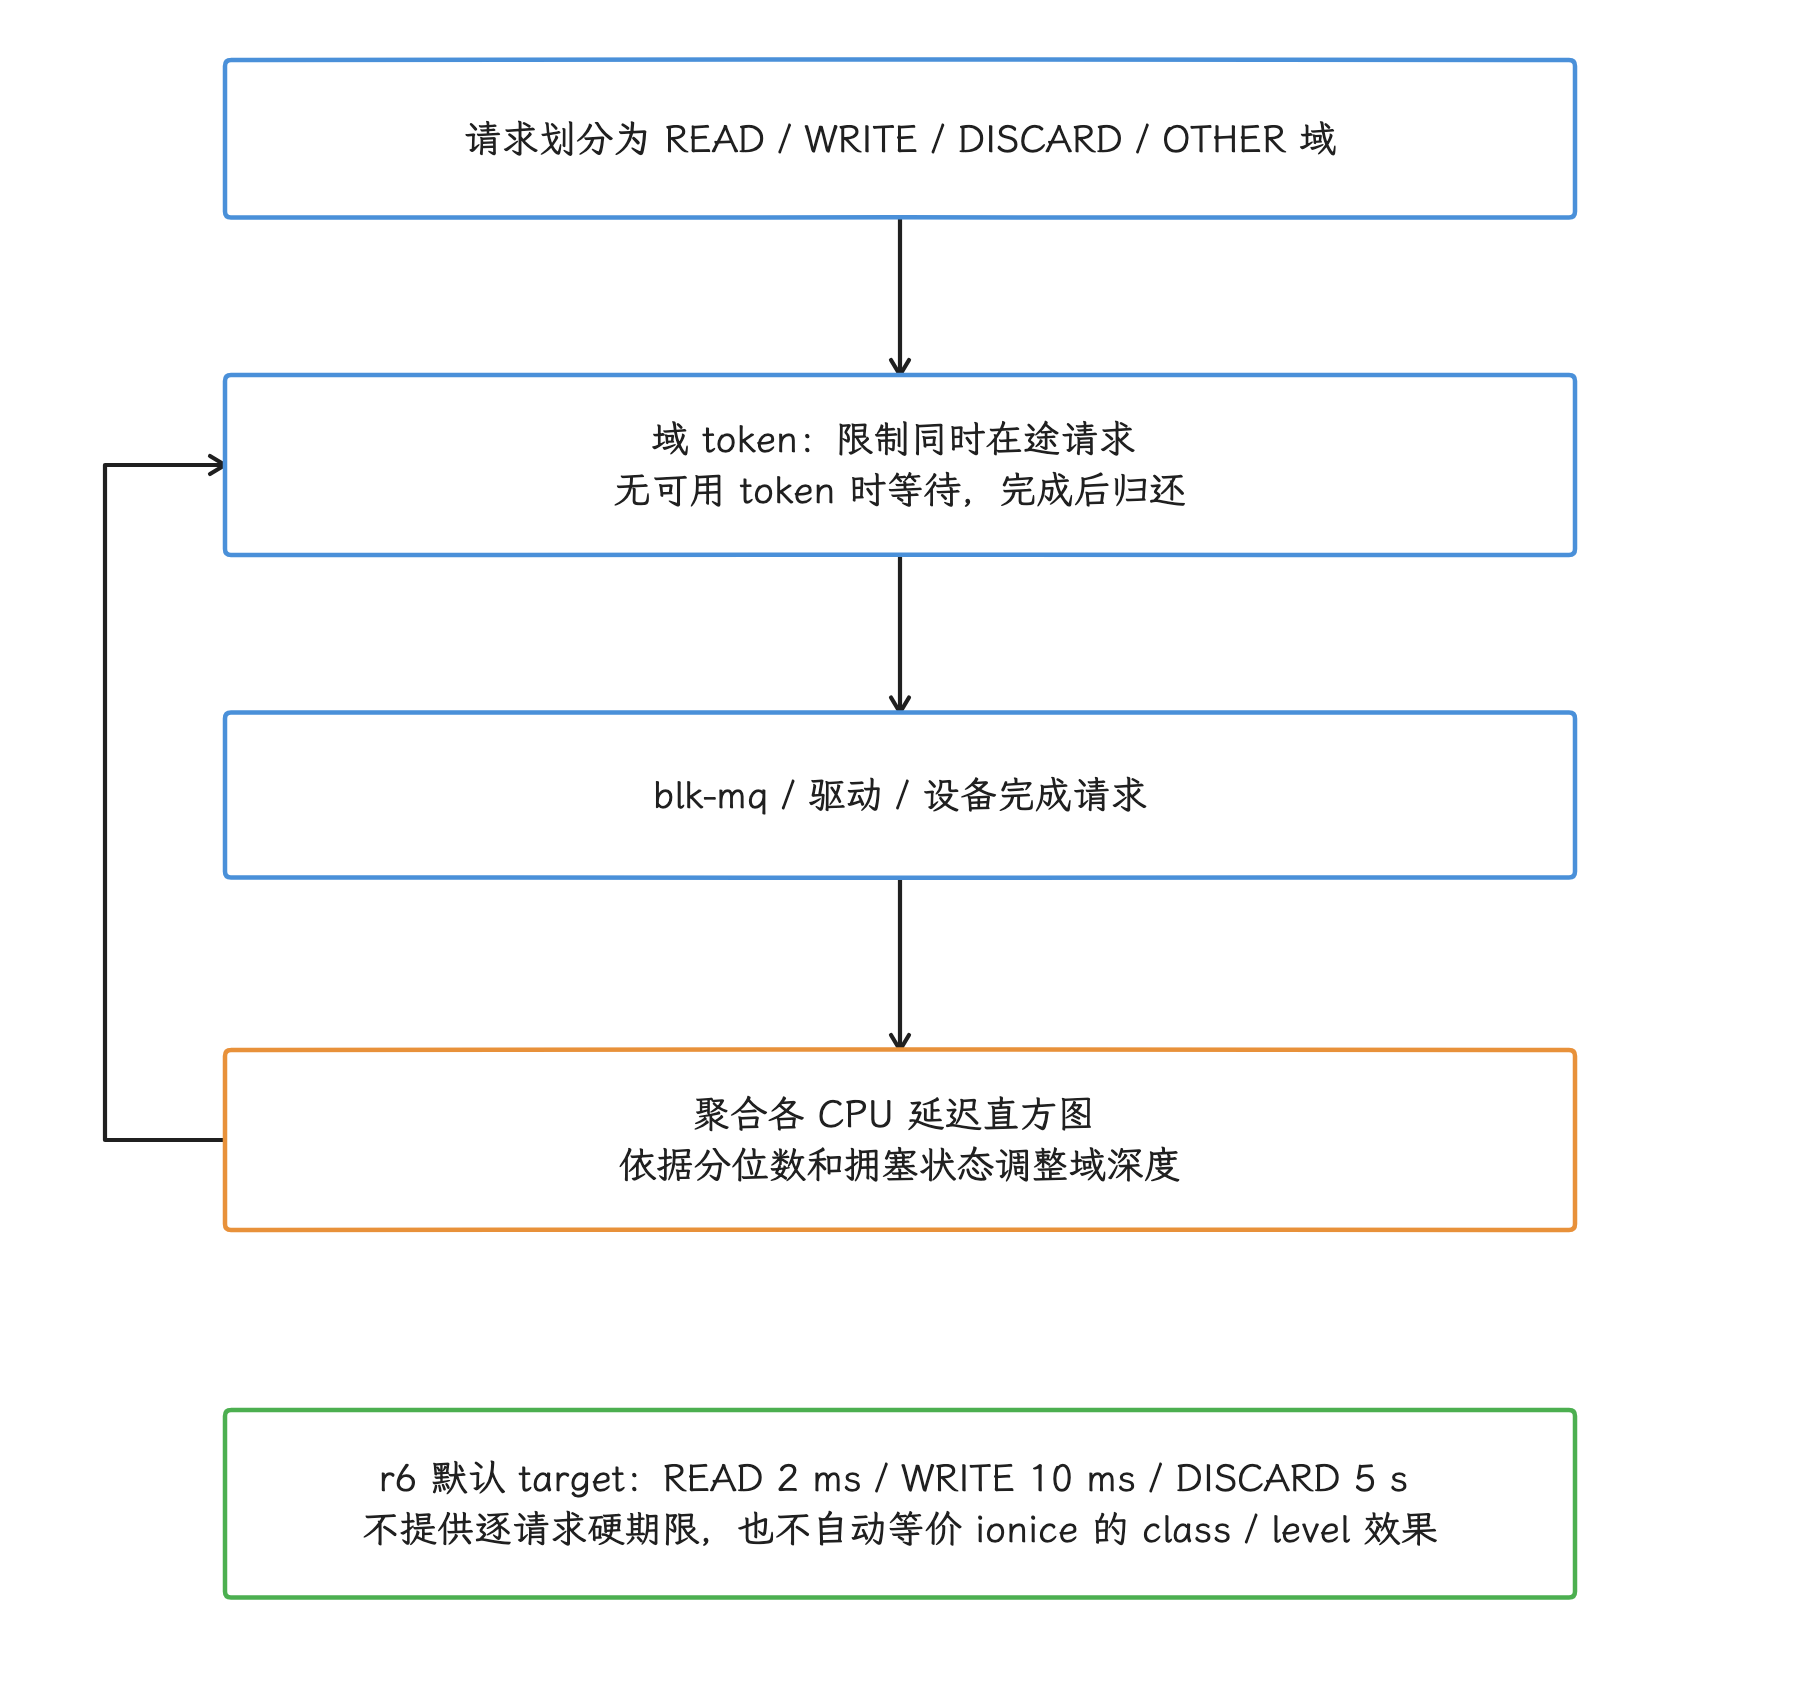
图:Kyber 用域 token 控制在途深度,再根据完成延迟直方图调整;target 是控制目标,不能当作每个请求的完成保证。
Linux 的通用 I/O priority 文档把 BFQ 和 mq-deadline 列为支持者;需要 ionice 或 cgroup I/O class 时,Kyber 能否提供相同效果要单独确认。
none:不挂 elevator
none 跳过的是可选 scheduler 的排序和 QoS(服务质量) 策略;blk-mq、plugging(暂存请求以便批量提交)、request 构造、硬件 tag(队列槽位标识) 与驱动队列都还在,部分合并也可能发生。把 none 说成“完全没有块层处理”,会误导排查方向。
平台提供什么,设备选择什么
6.18 的 Kconfig.iosched 默认提供 mq-deadline 与 Kyber,BFQ 是可选配置。设备的动态分区可能显示为 dm-*,直接承载请求的 UFS LUN(逻辑单元)则对应另一个 request queue;我们应沿 device-mapper 映射找到叶子块设备,再读取它的 scheduler。
下面的命令用于列出设备上所有可见 request queue 的当前与候选 scheduler:
adb shell 'for q in /sys/block/*/queue/scheduler; do
  printf "%s: " "$q"
  cat "$q"
done'
方括号包围的名称是当前选择。某个设备只显示 [none],可能源于驱动能力、queue 类型或内核配置;要谈“Android 17 的统一默认值”,得先把多台设备的读数摆在一起。
I/O priority:先问谁消费它
Linux 的 ioprio_set() 和 ionice 使用三种通用 I/O priority class:
- RT(Real Time):高于 BE/IDLE,持续高负载可能使低 class 长时间得不到服务。
- BE(Best Effort):普通的尽力服务类别,level 范围为 0–7。
- IDLE:有其他工作时延后。
下面的示例只用于调试受控进程的 class,不建议把普通前台 App 任意设成 RT:
adb shell su 0 ionice -c 3 -p <pid>
adb shell su 0 ionice -c 2 -n 4 -p <pid>
第一条把进程设为 IDLE class,第二条设为 BE level 4。命令通常需要足够权限;如果 scheduler 不读取相应的 class/level,即使命令设置成功,也未必改变请求派发。
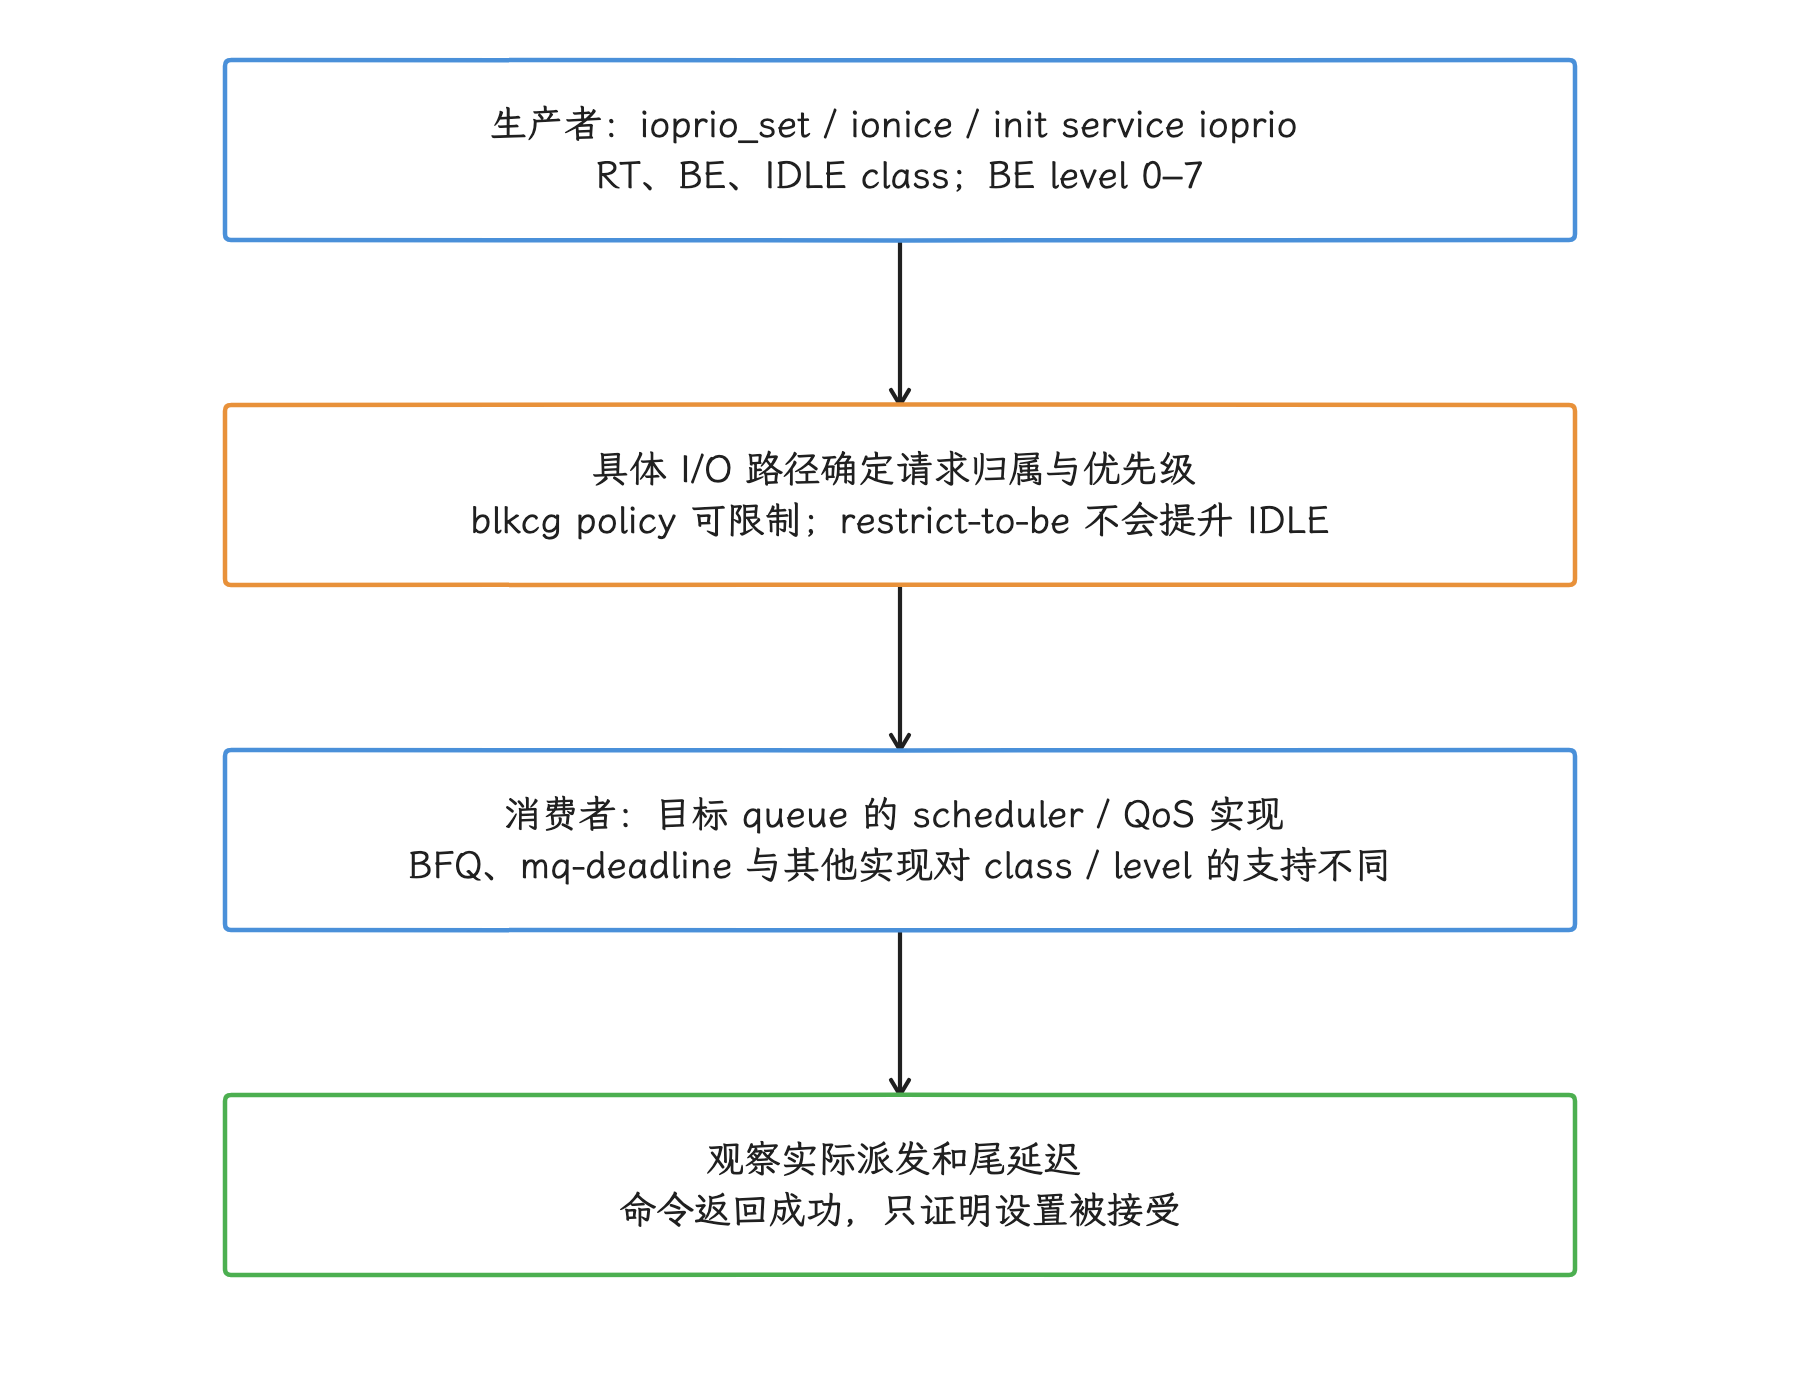
图:ionice/init 设置的 class/level 经具体 I/O 路径和 blkcg 策略进入请求;scheduler 是否读取它决定实际效果。
Android init service 还支持 ioprio <rt|be|idle> <0-7>,最终通过 SYS_ioprio_set 设置服务进程。但 Android App 的前后台保障并不是由 ActivityManager 为每个前台进程调用一次 ionice RT 实现的。
AOSP 的 blkio task profile
AOSP tag 中的基线
android-17.0.0_r1 的 system/core/libprocessgroup/profiles/cgroups.json 仍把 blkio 配置为 cgroup v1,并挂载在 /dev/blkio。同一份文件的 cgroup v2 基线只列出 freezer(进程冻结控制器) 和可选的 memory controller(内存控制器),因此“Android 17 已把 I/O 全部迁到 cgroup v2”与这个版本标签不符。
task_profiles.json 的关键动作是:
LowIoPriority:加入/dev/blkio/background。NormalIoPriority、HighIoPriority、MaxIoPriority:加入 blkio 根组。SCHED_SP_BACKGROUND:包含LowIoPriority。SCHED_SP_FOREGROUND:包含HighIoPriority。SCHED_SP_TOP_APP:包含MaxIoPriority。
这些名称容易让人望文生义:AOSP 的 HighIoPriority 和 MaxIoPriority 都只是把任务移回 blkio 根组,本身没有设置 RT class;前台收益主要来自避开 background 组的降权和 class 限制。
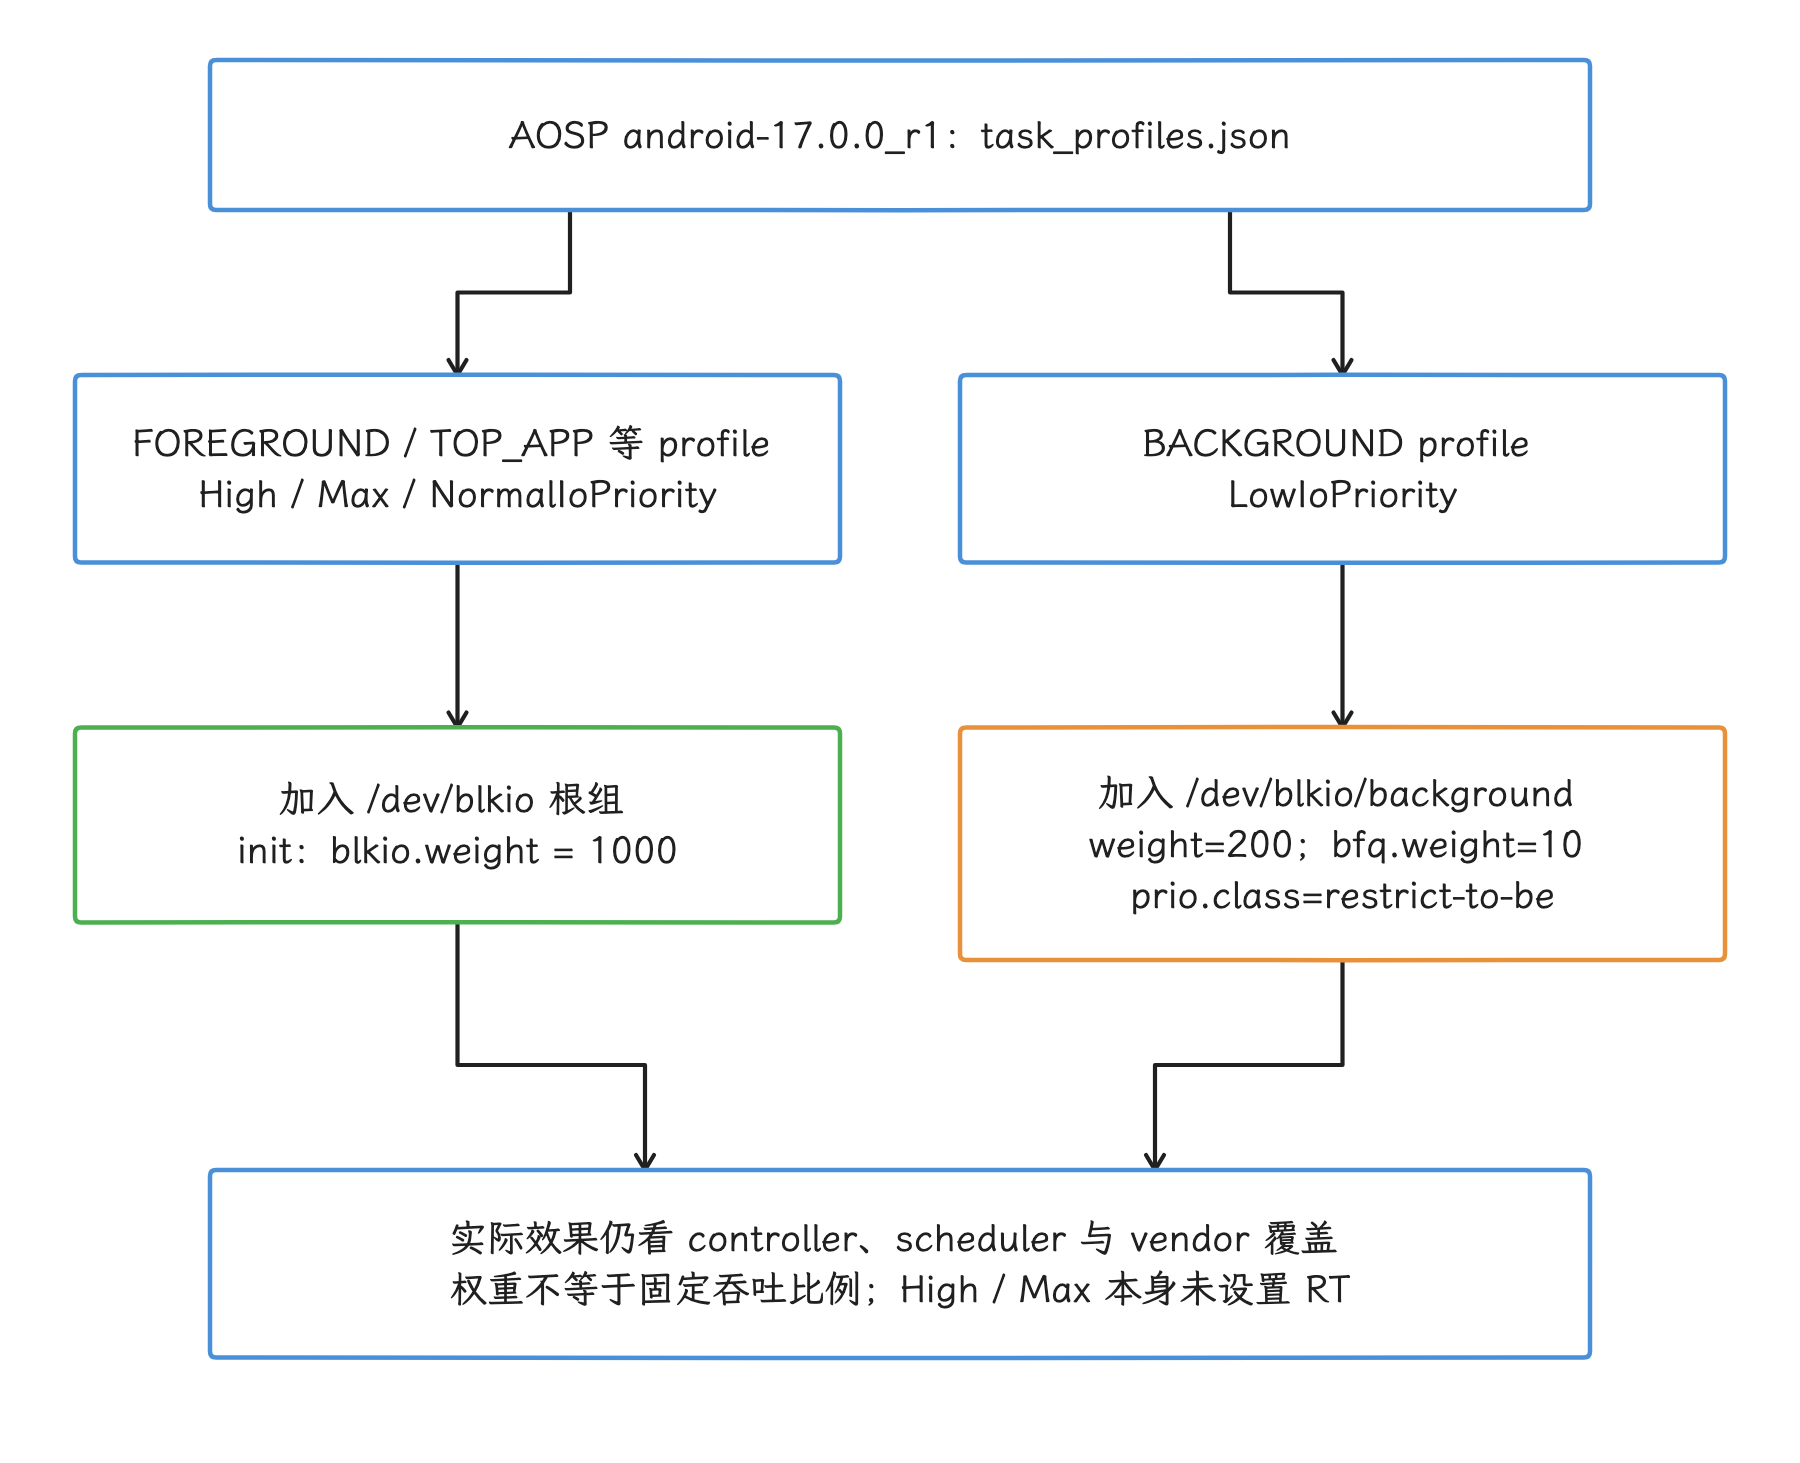
图:r1 的 Normal/High/MaxIoPriority 都加入根组;LowIoPriority 进入 background,不能按名字推断设置了 RT 或不同前台 I/O 层级。
下面的 init 配置摘录固定了 AOSP 对后台 blkio 组的初始设置,来自 system/core/rootdir/init.rc:
write /dev/blkio/blkio.weight 1000
write /dev/blkio/background/blkio.weight 200
write /dev/blkio/background/blkio.bfq.weight 10
write /dev/blkio/background/blkio.prio.class restrict-to-be
根组与后台组配置了不同权重;只有内核和目标 queue 使用 BFQ 时,BFQ 专用权重才会生效。restrict-to-be 来自 blk-cgroup I/O priority policy,它把 NONE/RT 请求降到 BE,保留原本更低的 IDLE 等优先级,并能作用于支持 cgroup writeback(按控制组归属回写) 的缓冲写。
从内核能力到产品配置
arm64 GKI 开启了 CONFIG_BLK_CGROUP、CONFIG_BLK_DEV_THROTTLING、CONFIG_BLK_CGROUP_IOCOST 和 CONFIG_BLK_CGROUP_IOPRIO。这些选项只说明内核具备相应控制器能力;产品还需要正确挂载 controller、创建层级、设置参数,并选择能够读取这些策略的 scheduler。
Android 允许 API-level 和 vendor 文件覆盖默认 cgroups.json / task_profiles.json。因此排查实机时要读取:
/proc/cgroups、/proc/<pid>/cgroup与/proc/mounts;/system/etc/task_profiles/和/vendor/etc/task_profiles.json;/dev/blkio/或/sys/fs/cgroup/下实际存在的控制文件;- 叶子块设备的
/sys/block/<dev>/queue/scheduler。
不要混用 blkio v1 的 blkio.* 示例和 cgroup v2 的 io.* 示例。应先确认层级版本,再解释 blkio.weight、io.weight、io.max、io.prio.class 或 io.pressure。
Buffered I/O、Page Cache 与 cgroup writeback
读路径
普通 read() 会先查询 Page Cache:命中时不访问存储;未命中时,文件系统读取 folio(由内核管理的一组连续内存页),并可能触发 readahead。App 冷启动中的 DEX、资源和数据库读取是否命中缓存,会显著改变耗时;“同一文件第二次读更快”这样的观察,衡量的是缓存行为,而非 UFS 性能。
Page Cache 属于可回收的 file-backed memory(有文件作为后备的数据页)。内存压力出现时,内核会在文件页与匿名页之间选择回收对象,并考虑 swap(交换空间)成本;该 6.18 GKI 基线还启用了 MGLRU(多代 LRU),不能只按经典活跃/非活跃两条 file LRU 链表解释所有设备;后台大范围扫描可能挤出前台仍需使用的数据,增加 refault(回收后很快再次缺页)。回收决策还受 memcg(内存控制组) 保护、访问频率、working set(工作集) 检测和 swap 成本影响。
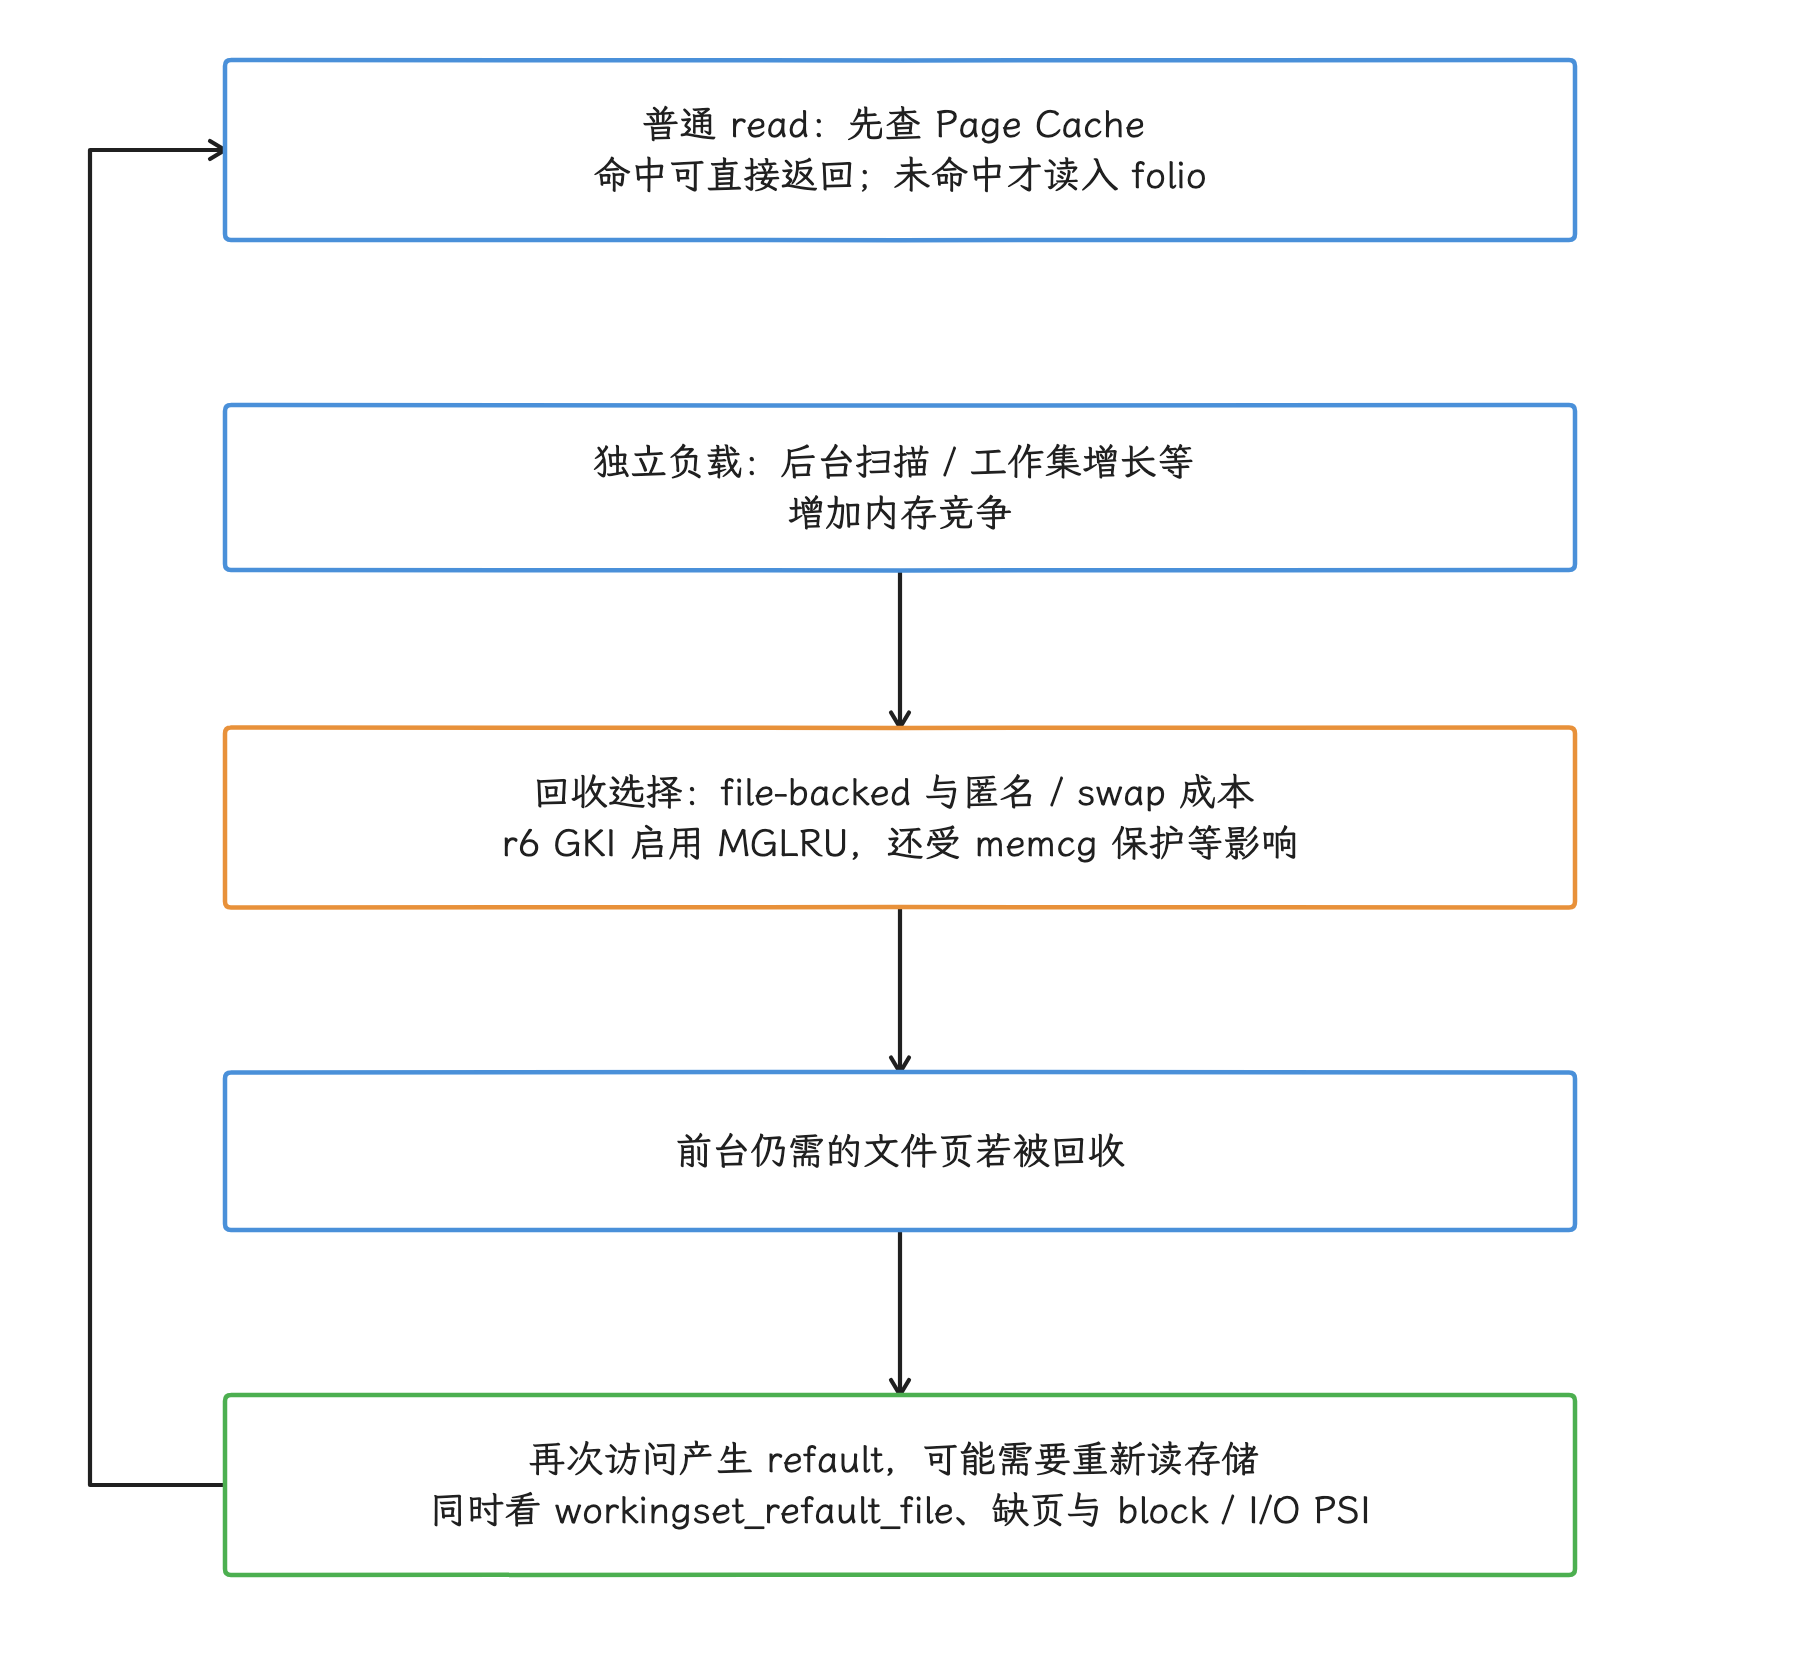
图:缓存命中无需读盘;内存压力下回收文件页会影响后续命中,refault 与块层延迟需要一起观察。
写路径
Buffered write(缓冲写) 会先把 folio 标为 dirty,writeback 随后把数据转换成 bio/request。脏页控制横跨 memory 与 I/O:
- memory controller 决定脏内存在哪个 memory domain(内存记账域) 统计和限速;
- I/O controller 决定 writeback
bio归到哪个 blkcg(块 I/O 控制组); - 文件系统需要支持 cgroup writeback,ext4 与 F2FS 均支持;
- inode 的 writeback owner(回写归属者) 会根据持续写入来源调整;把每个回写请求都归因于当时运行的 flush 线程,会归错账。
缓冲写转交给后台线程后,原进程的 cgroup 信息并不一定丢失。支持 cgroup writeback 的路径会把 bio 关联到 inode owner 所属的 blkcg。
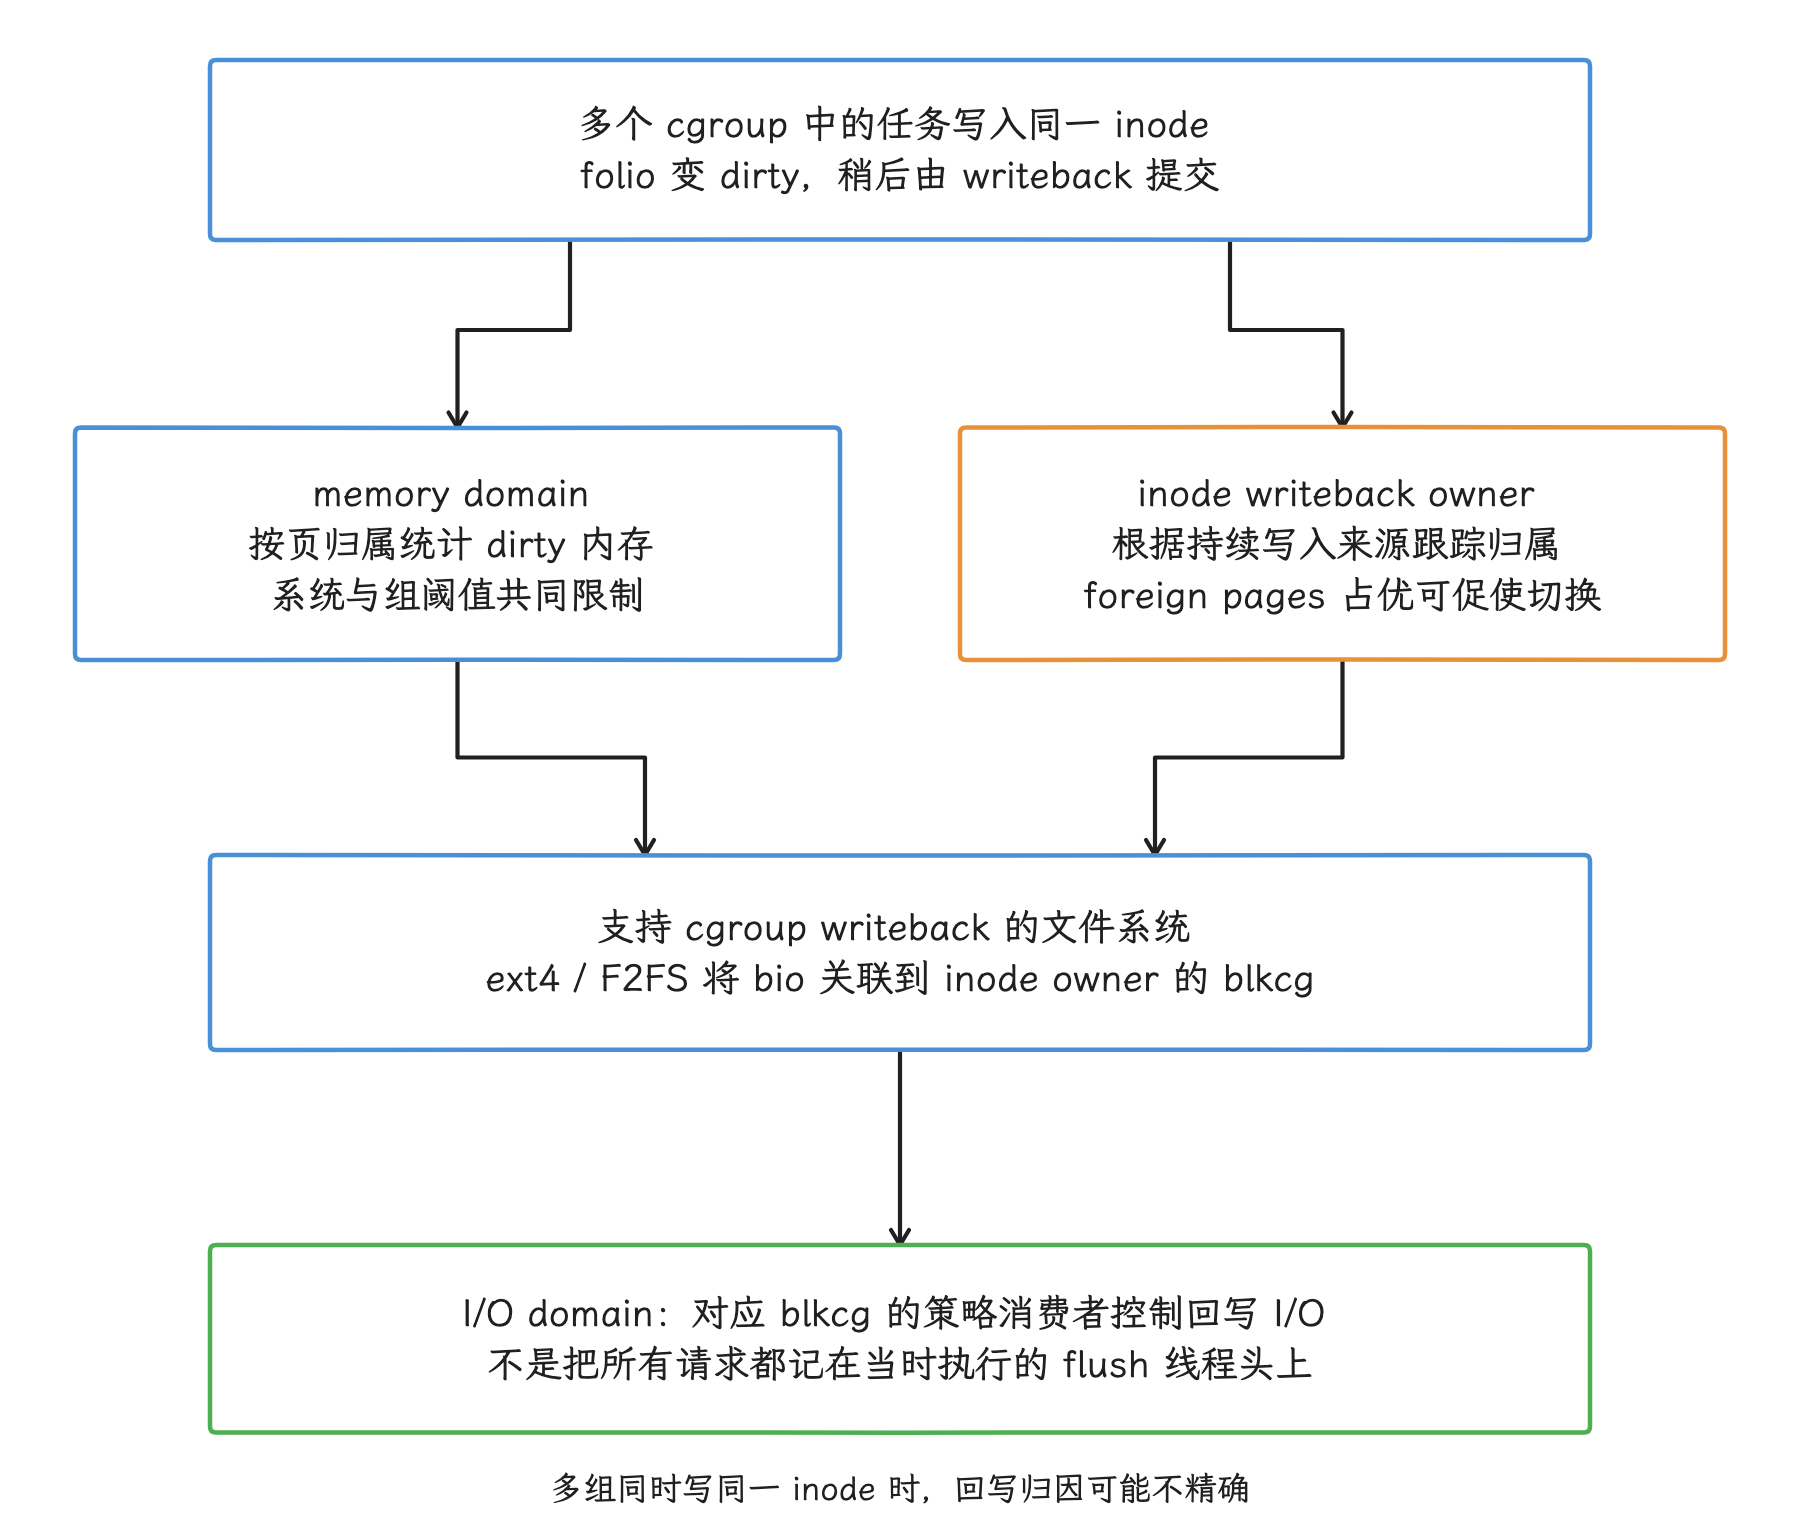
图:内存按页归属,回写按 inode owner 关联 blkcg;回写线程身份不能直接替代原始写入归属。
dirty sysctl 与 swappiness
dirty_background_ratio、dirty_ratio、对应的 *_bytes、dirty_expire_centisecs 和 dirty_writeback_centisecs 会影响回写触发条件与节奏。它们可以被产品 init 配置覆盖,也会与 backing device(后备存储设备)、memcg 阈值共同作用;Linux 的常见默认值,直接搬到 Android 设备上是靠不住的。
AOSP 只在 low-RAM(低内存) 或 batteryless(无电池) 等特定条件下写入部分参数,例如 low-RAM 分支把 dirty_background_ratio 设为 5。某台设备用不用 5,取决于它是否命中这些条件。
swappiness 描述 swap I/O 与 filesystem paging(文件页换入换出) 的相对成本,范围为 0–200,100 表示两者成本相同。它影响匿名页与 file-backed page 的回收权衡,并不表示 Page Cache 的最大占比。Android 通常使用 zram(内存压缩交换设备),合适的取值仍要结合压缩成本、refault 和产品内存容量测量。
下面的命令用于采集现场内存与 I/O 控制参数:
adb shell 'for f in \
  dirty_background_bytes dirty_background_ratio \
  dirty_bytes dirty_ratio swappiness; do
  printf "%s=" "$f"
  cat "/proc/sys/vm/$f"
done'
adb shell cat /proc/pressure/io
第一组输出应与设备 init 配置一起解释;PSI(Pressure Stall Information,资源压力停顿信息)中的 some/full 表示部分任务或所有非 idle 任务因 I/O 停顿的时间比例,比一个孤立的 CPU iowait 百分比更适合描述系统压力。
Direct I/O 与 Buffered I/O
Buffered I/O 适合多数 App
Page Cache 可以合并小写、提供 readahead,并让热点数据复用,数据库、配置、资源和代码文件普遍依赖这些能力。写入先返回到用户态,这本身说明不了持久化已经完成:崩溃一致性仍由事务、fsync() 和文件系统语义保证。
O_DIRECT 的适用条件
O_DIRECT 尝试让文件数据 I/O 绕过 Page Cache。它适合自身管理缓存、访问模式明确、能够满足对齐约束的系统软件。Linux 6.18 可以通过 statx(..., STATX_DIOALIGN) 请求文件系统报告 direct-I/O 对齐要求;还要检查返回的 stx_mask 是否包含该位,再解释 stx_dio_mem_align 和 stx_dio_offset_align。接口存在不保证每种文件系统都返回这组信息。
使用时要记住几个限制:
- buffer 地址、长度和文件 offset 常有对齐要求;
- 绕过 Page Cache 会失去普通 readahead 和缓存复用;
O_DIRECT不提供持久化保证,必要时仍要fsync();- 同一文件混用 buffered 与 direct I/O 会增加一致性和失效处理难度;
- inline encryption、device-mapper 或驱动可能增加 bounce buffer(中转缓冲)、请求拆分等成本。
AOSP SQLite 的 Unix VFS 以普通缓冲文件 I/O 为基线,F2FS batch atomic write(批量原子写) 则属于另一套 ioctl 能力。“Android SQLite 的 WAL(Write-Ahead Logging,预写式日志)默认使用 Direct I/O”这个说法,目前在源码里还找不到对应实现。
Perfetto:从线程等待走到块设备
录制数据要够
要分析这条路径,trace 至少需要 scheduler 数据;进一步定位还要按设备开放情况加入:
sched_switch、sched_wakeup、sched_blocked_reason;block_rq_insert、block_rq_issue、block_rq_complete;writeback:*;ext4:*或f2fs:*中的 sync、writeback、checkpoint、GC 事件;- UFS、device-mapper 与 PSI 数据。
sched_blocked_reason 在不同 build type(系统构建类型) 和内核配置上的可用性不同。缺了它,thread_state.io_wait 可能为 NULL,把所有 D 状态都记成 I/O 等待,排查范围就会偏大。
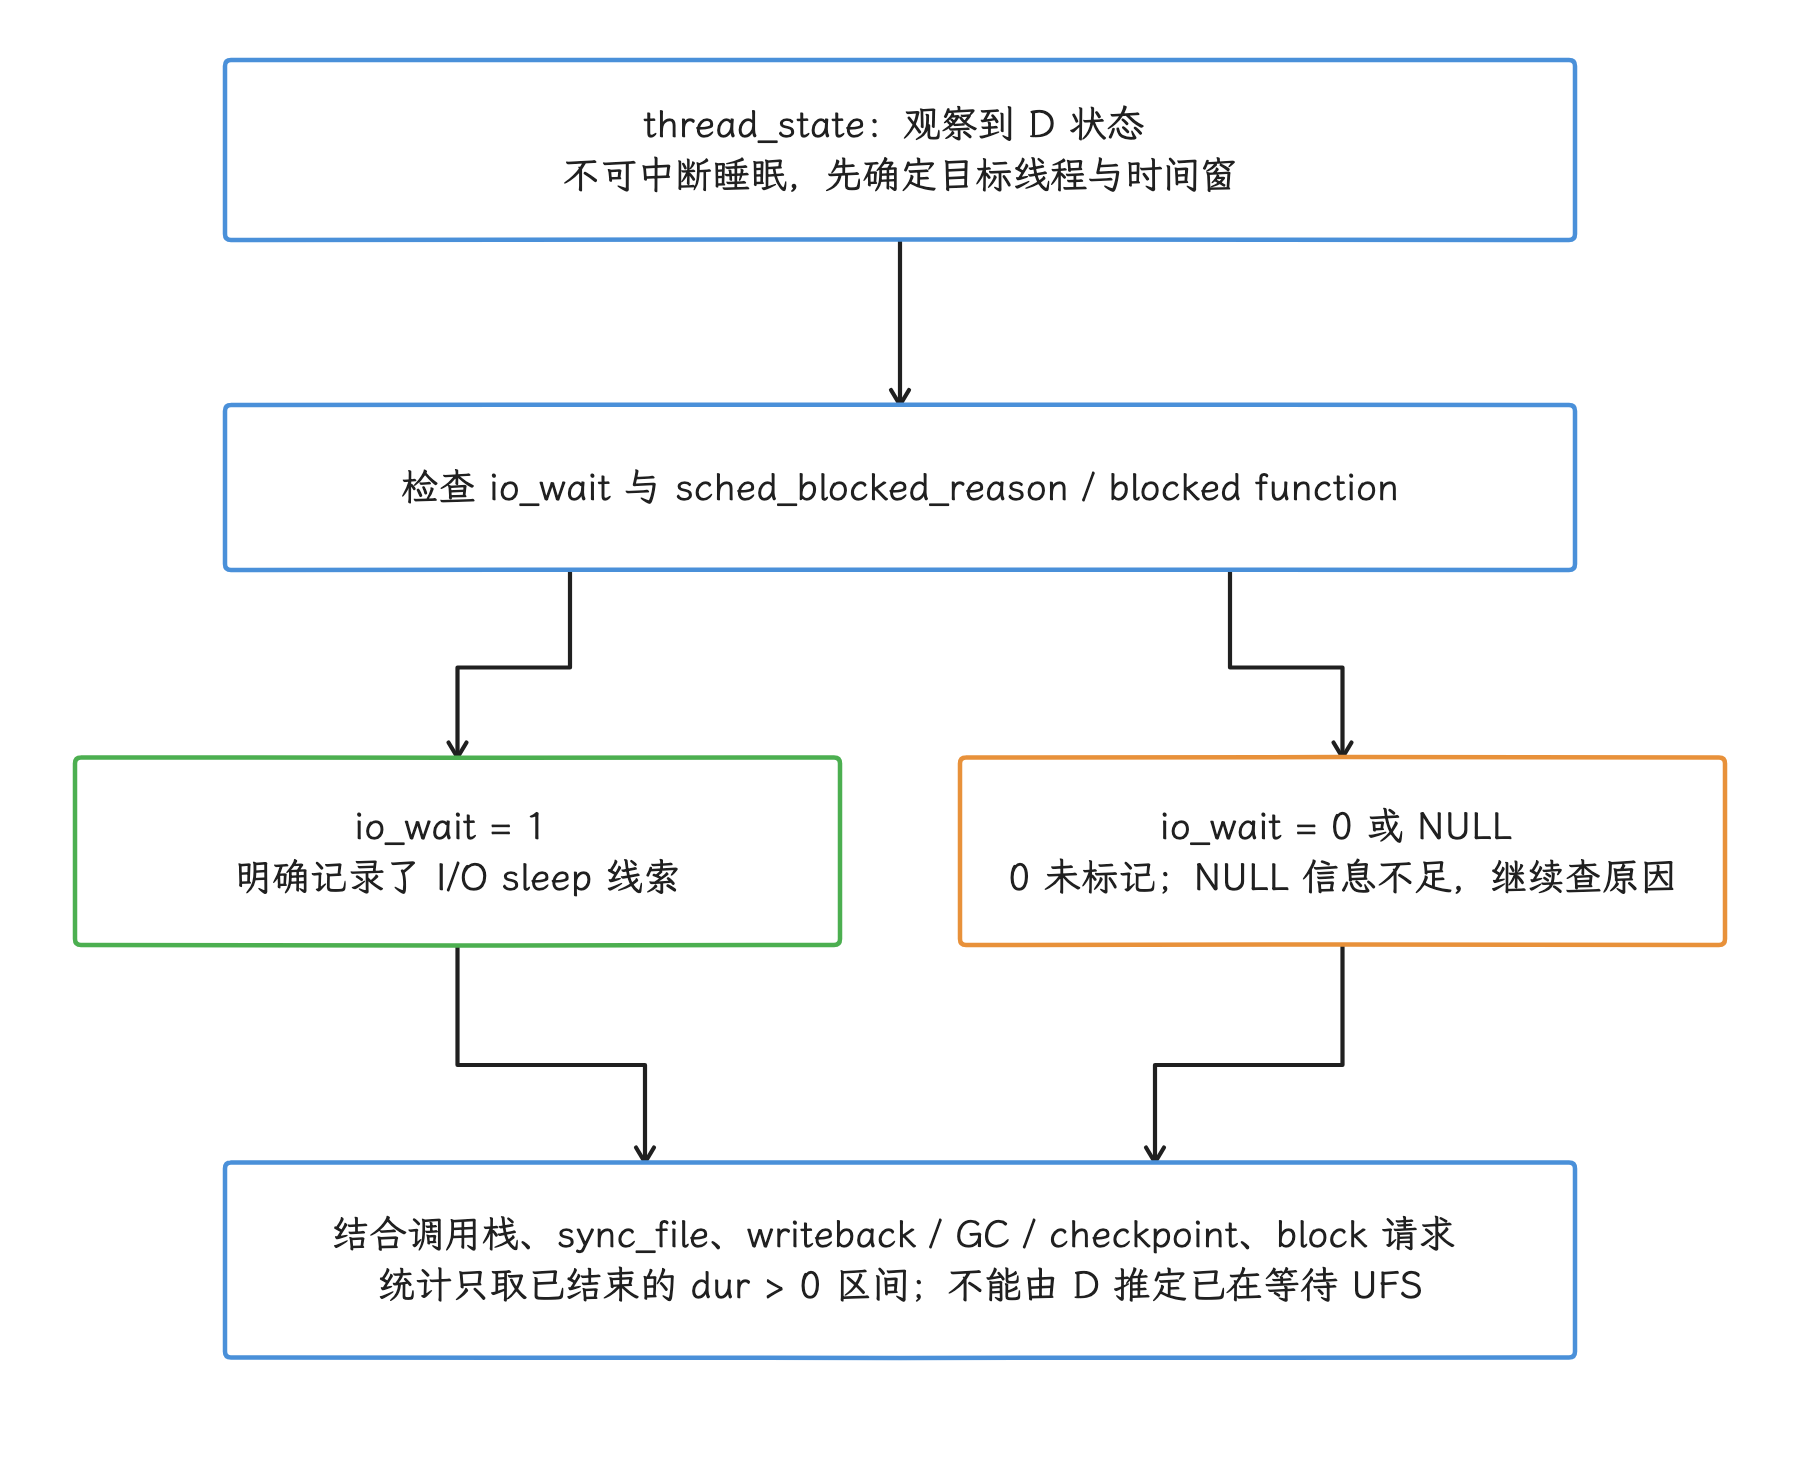
图:D 只说明不可中断等待;io_wait=1 缩小到 I/O 等待线索,仍需调用栈、文件系统与 block 事件定位具体对象。
第一问:哪些线程在 I/O sleep(睡眠等待)
下面的 PerfettoSQL 用于聚合明确标记为 io_wait=1 的 D 状态,兼容当前的 thread_state schema(表结构):
SELECT
  COALESCE(process.name, '[kernel]') AS process_name,
  thread.name AS thread_name,
  ROUND(SUM(thread_state.dur) / 1e6, 2) AS iowait_ms,
  ROUND(MAX(thread_state.dur) / 1e6, 2) AS max_wait_ms
FROM thread_state
JOIN thread USING (utid)
LEFT JOIN process USING (upid)
WHERE thread_state.state = 'D'
  AND thread_state.io_wait = 1
  AND thread_state.dur > 0
GROUP BY thread.utid, process.name, thread.name
ORDER BY iowait_ms DESC
LIMIT 20;
查询只汇总已结束的正时长区间,排除了 dur=-1 等不完整状态;结果给出录制范围内可确认的线程等待总量和单次最大值;至于线程正在等哪个文件、哪块设备,要回到对应时间窗,检查调用栈、文件系统 slice(事件区间) 和 block 请求。
第二问:块设备队列是否积压
下面的查询用于统计 trace 中各 block device 的最大和平均在队列/设备中的操作数:
INCLUDE PERFETTO MODULE linux.block_io;

WITH io_intervals AS (
  SELECT
    dev,
    ops_in_queue_or_device,
    LEAD(ts, 1, (SELECT end_ts FROM trace_bounds)) OVER (
      PARTITION BY dev ORDER BY ts
    ) - ts AS dur
  FROM linux_active_block_io_operations_by_device
)
SELECT
  dev,
  MAX(ops_in_queue_or_device) AS max_ops,
  ROUND(
    SUM(1.0 * ops_in_queue_or_device * dur) /
    NULLIF((SELECT end_ts - start_ts FROM trace_bounds), 0),
    2
  ) AS time_avg_ops
FROM io_intervals
WHERE dur > 0
GROUP BY dev
ORDER BY max_ops DESC;
这个 stdlib view(Perfetto 标准库视图) 输出计数变化的时间点,而不是等间隔采样,因此查询先用 LEAD 得到每个计数持续多久,再计算整个 trace 时间窗的加权均值;未出现 I/O 的时间按零贡献处理,不能直接 AVG 这些变化点。它基于 track.type='block_io' 的 slice,事件缺失或不完整时,队列深度统计也可能不完整。录制中没有 block issue/complete 数据时,查询不会凭空生成结果;device id 还要映射到实机的 major:minor(主/次设备号) 和 device-mapper 层。
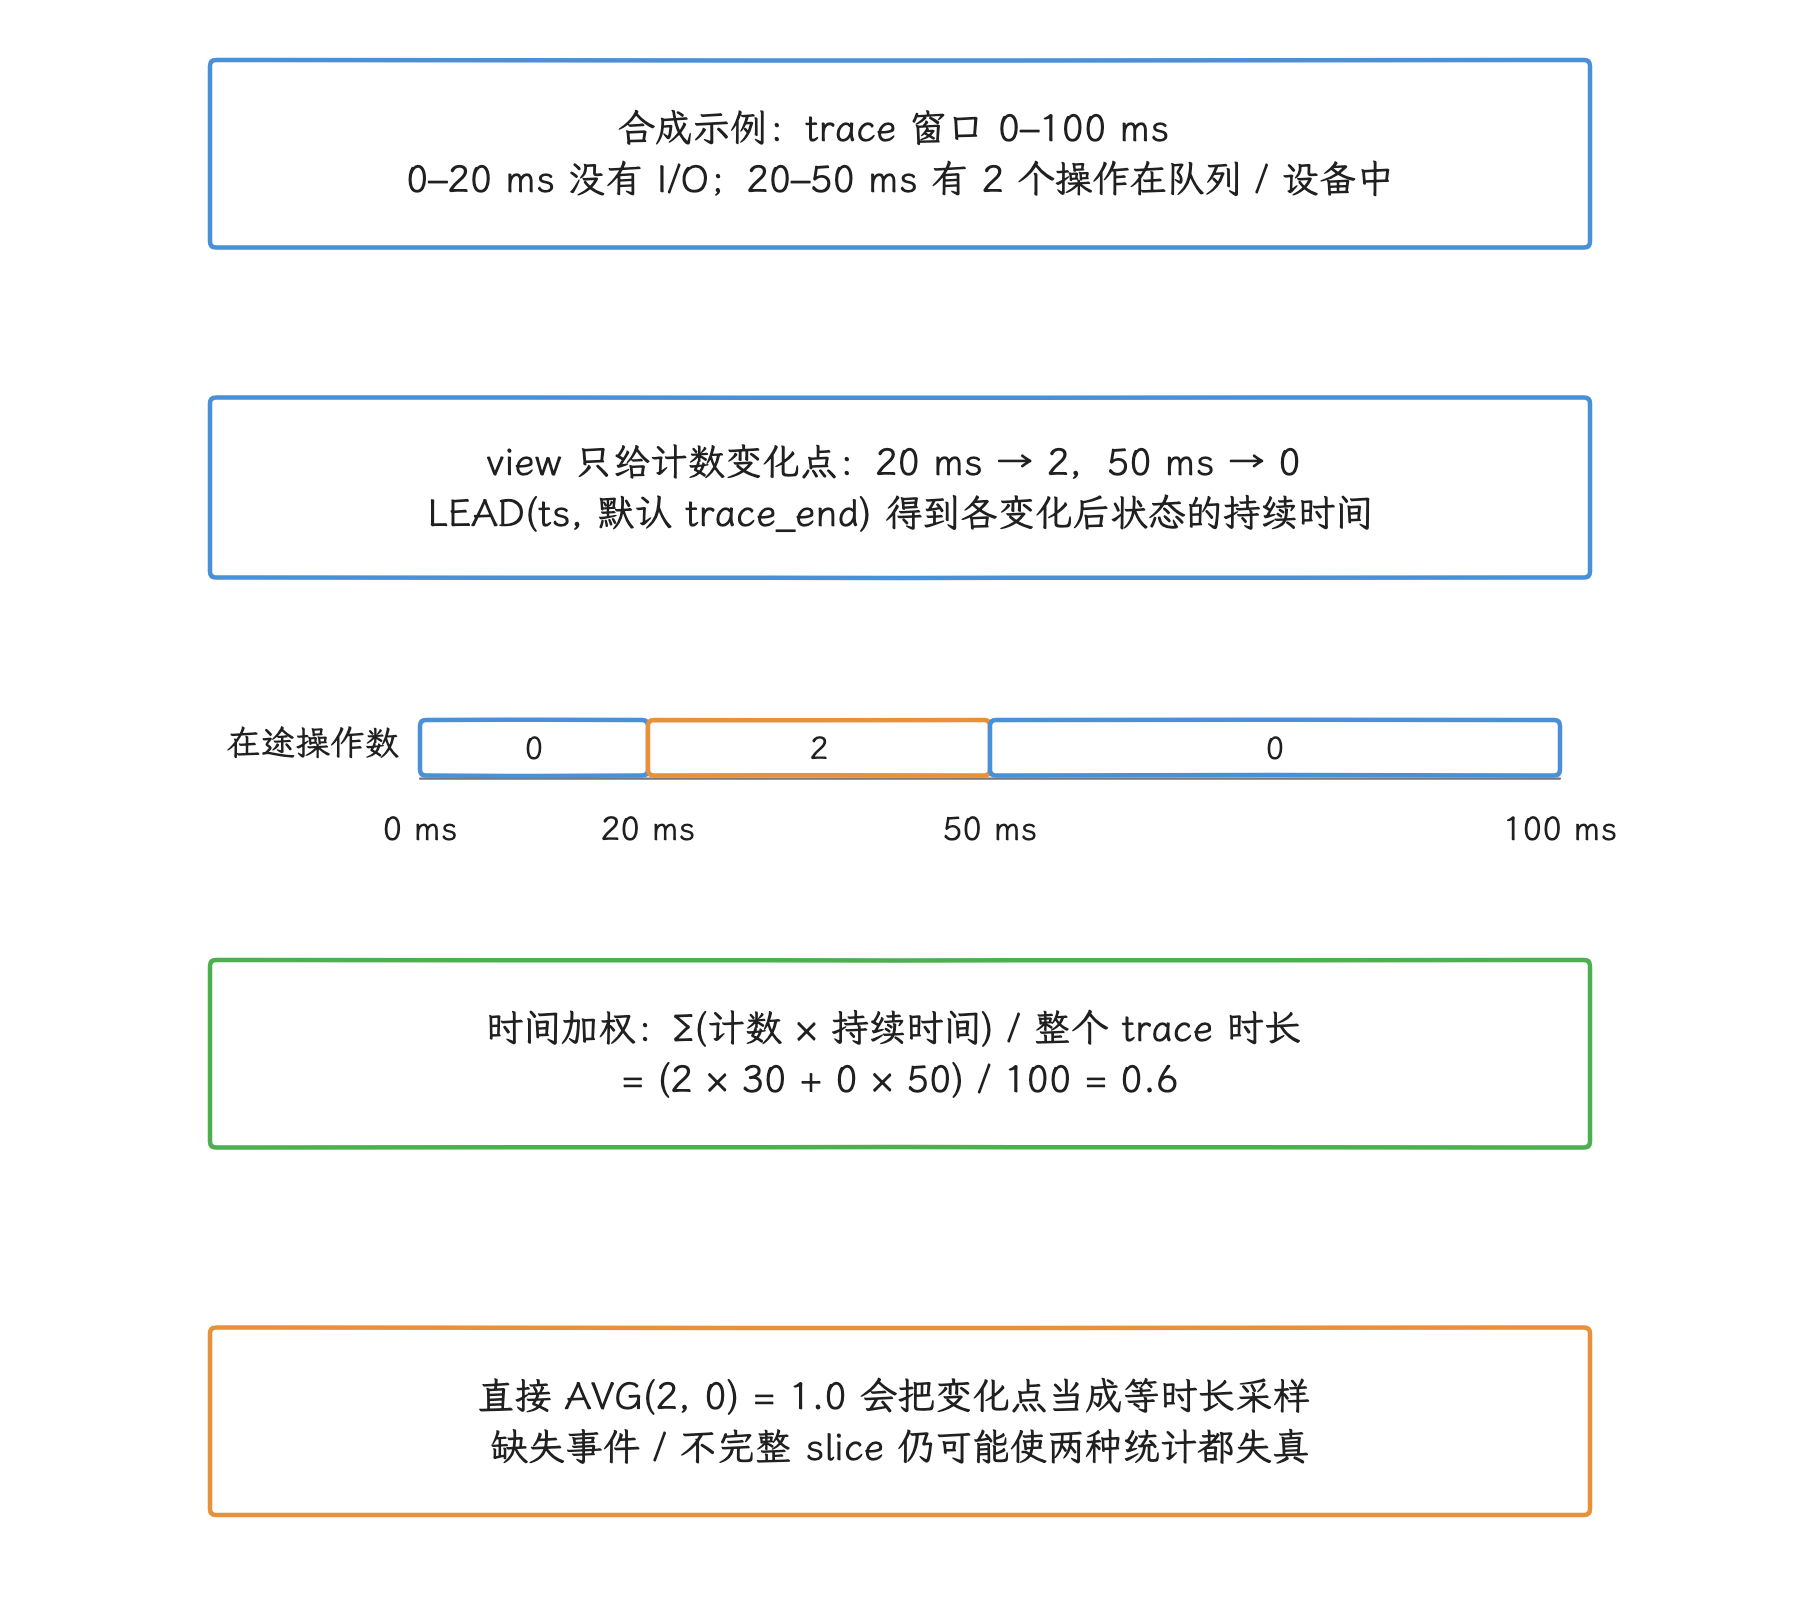
图:示例 trace 共 100 ms,只有 20–50 ms 处于 2 个在途操作;时间均值是 0.6,变化点数值均值会得到 1.0。
第三问:等待发生在哪一层
然后把同一时间窗内的线索对齐:
sync_file_enter/exit区间很长,但 block queue 不深:关注 journal/checkpoint、锁、writeback 或 flush。- 从 issue 到 complete 的时间很长:关注设备排队、UFS、加密、dm 层和器件状态。
D状态很长,但io_wait不明确,block 事件也没有活动:检查 blocked function(阻塞函数)、reclaim(内存回收) 以及 Binder/驱动等待。- 后台
wbytes/wios(写入字节数/写操作数) 上升,且前台 refault/major fault(需要存储读取的缺页) 增多:同时检查 blkio、memcg 和 Page Cache 竞争。 - I/O PSI 的
full持续上升:在对应统计范围内,曾有所有非 idle 任务同时因 I/O 停顿的时间;/proc/pressure/io统计系统,cgroup 的io.pressure只统计该组。还需结合 CPU、内存和块层判断原因。
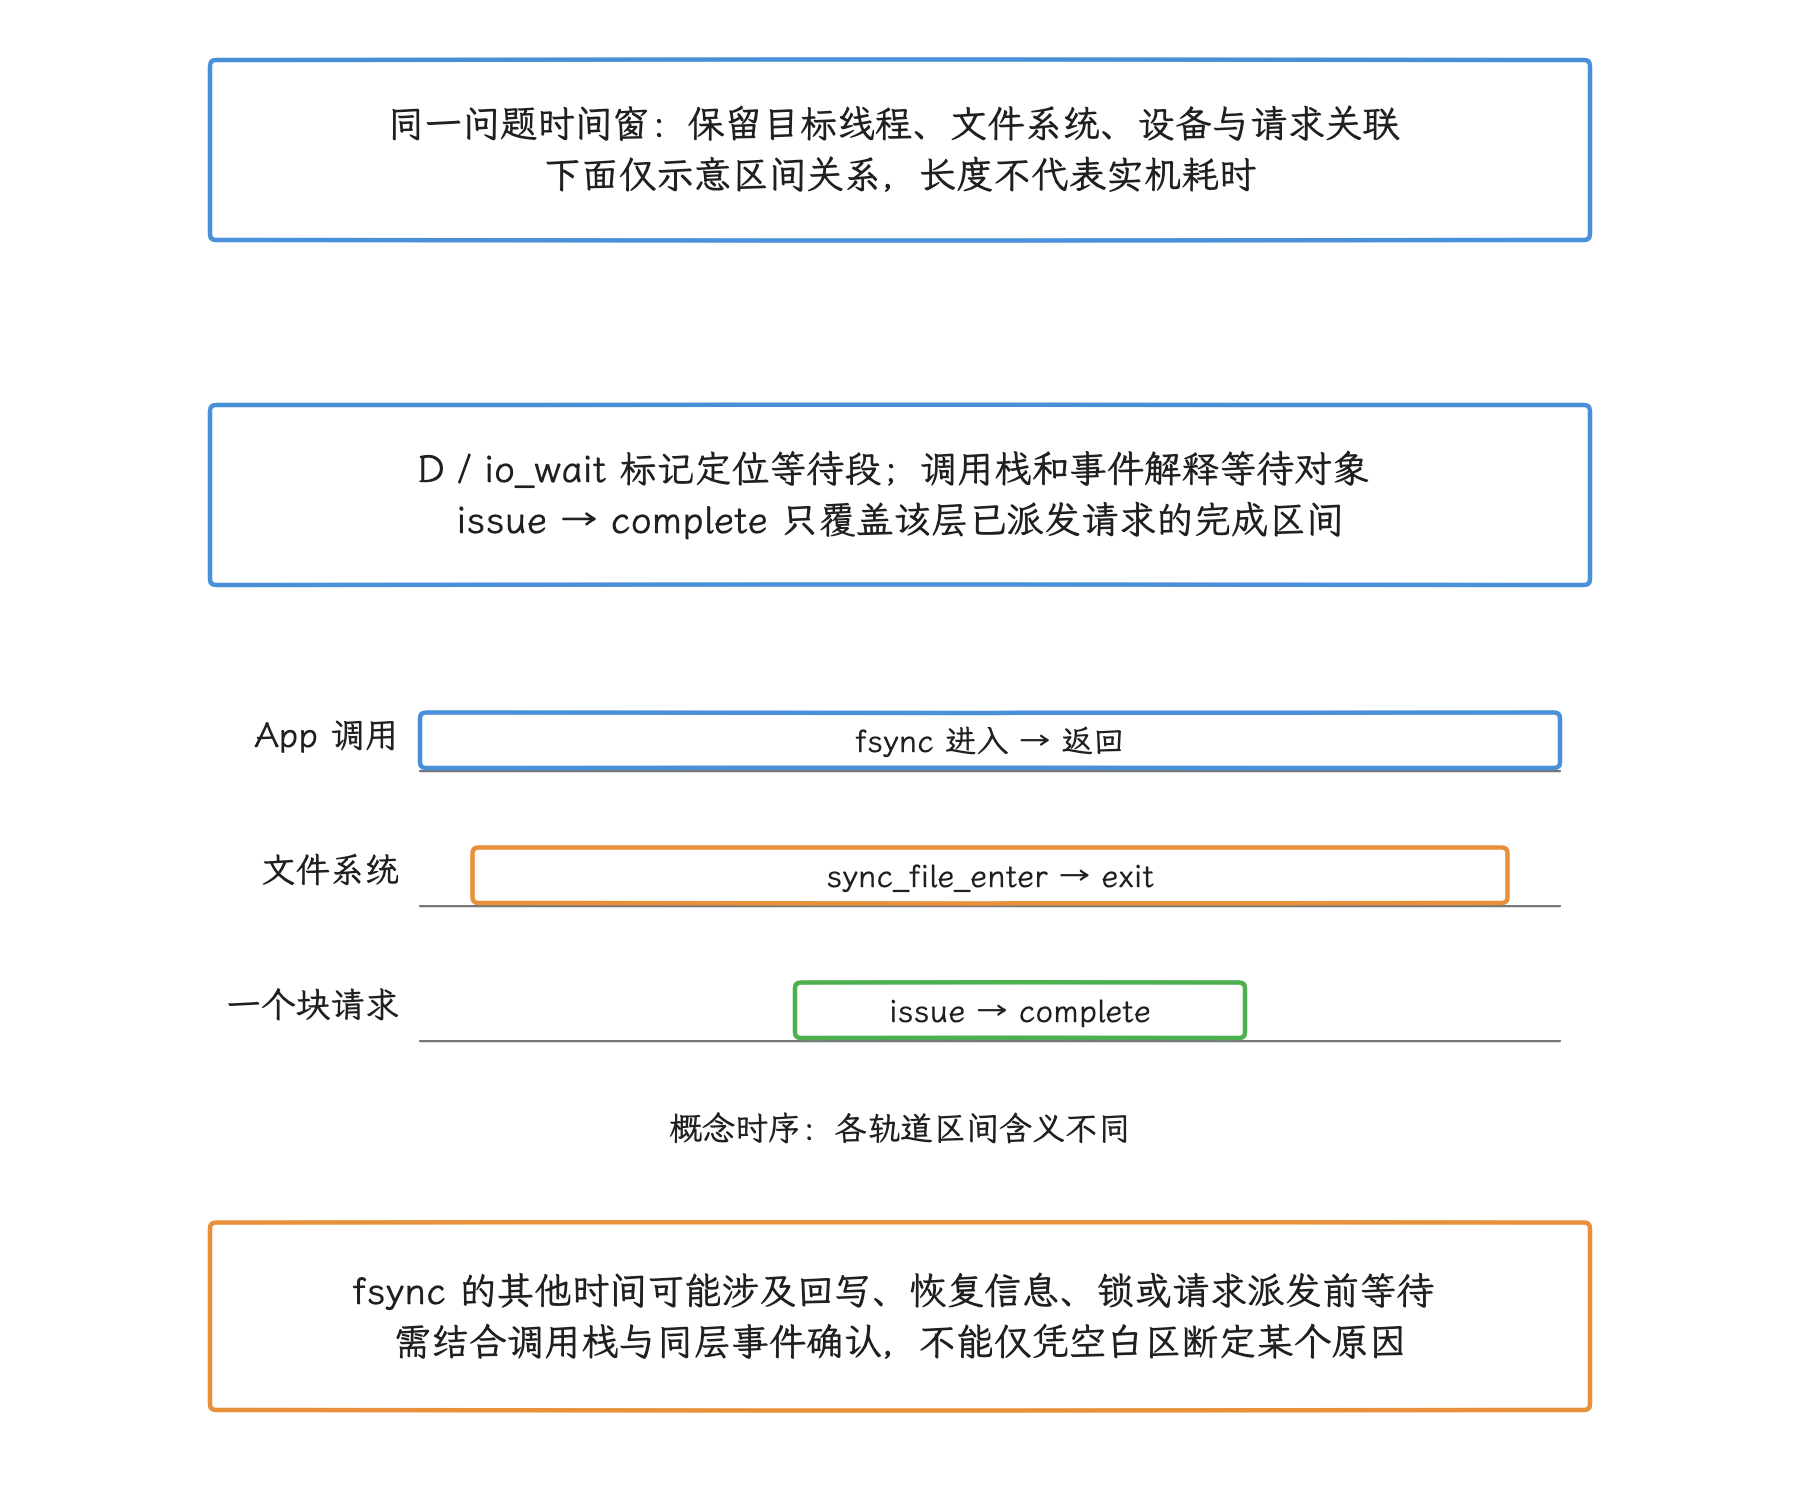
图:先对齐同一时间窗,再区分调用区间、文件系统同步区间与单个 block 请求区间;相邻或重叠不能单独证明归因。
跨设备固定的“fsync 超过 5 ms”“随机读超过 1 ms”“iowait 超过 5%”这类异常线,我们都不要用。UFS 代际、容量、温度、文件系统、队列深度和 trace 开销都会改变分布;更可靠的基线来自同机型、同镜像、同电量与温度,以及相同 workload(工作负载) 下的 P50/P95/P99。
CPU iowait 的含义
CPU iowait 是 CPU idle 记账中的一个状态,记的是 CPU 的时间,叠加不出各线程的 I/O 等待,也切分不到单个 App 头上。异步 writeback 可能让设备很忙而 CPU iowait 很低;一个线程等 I/O 时,其他 runnable(可运行) 线程也可能让 CPU 保持忙碌。
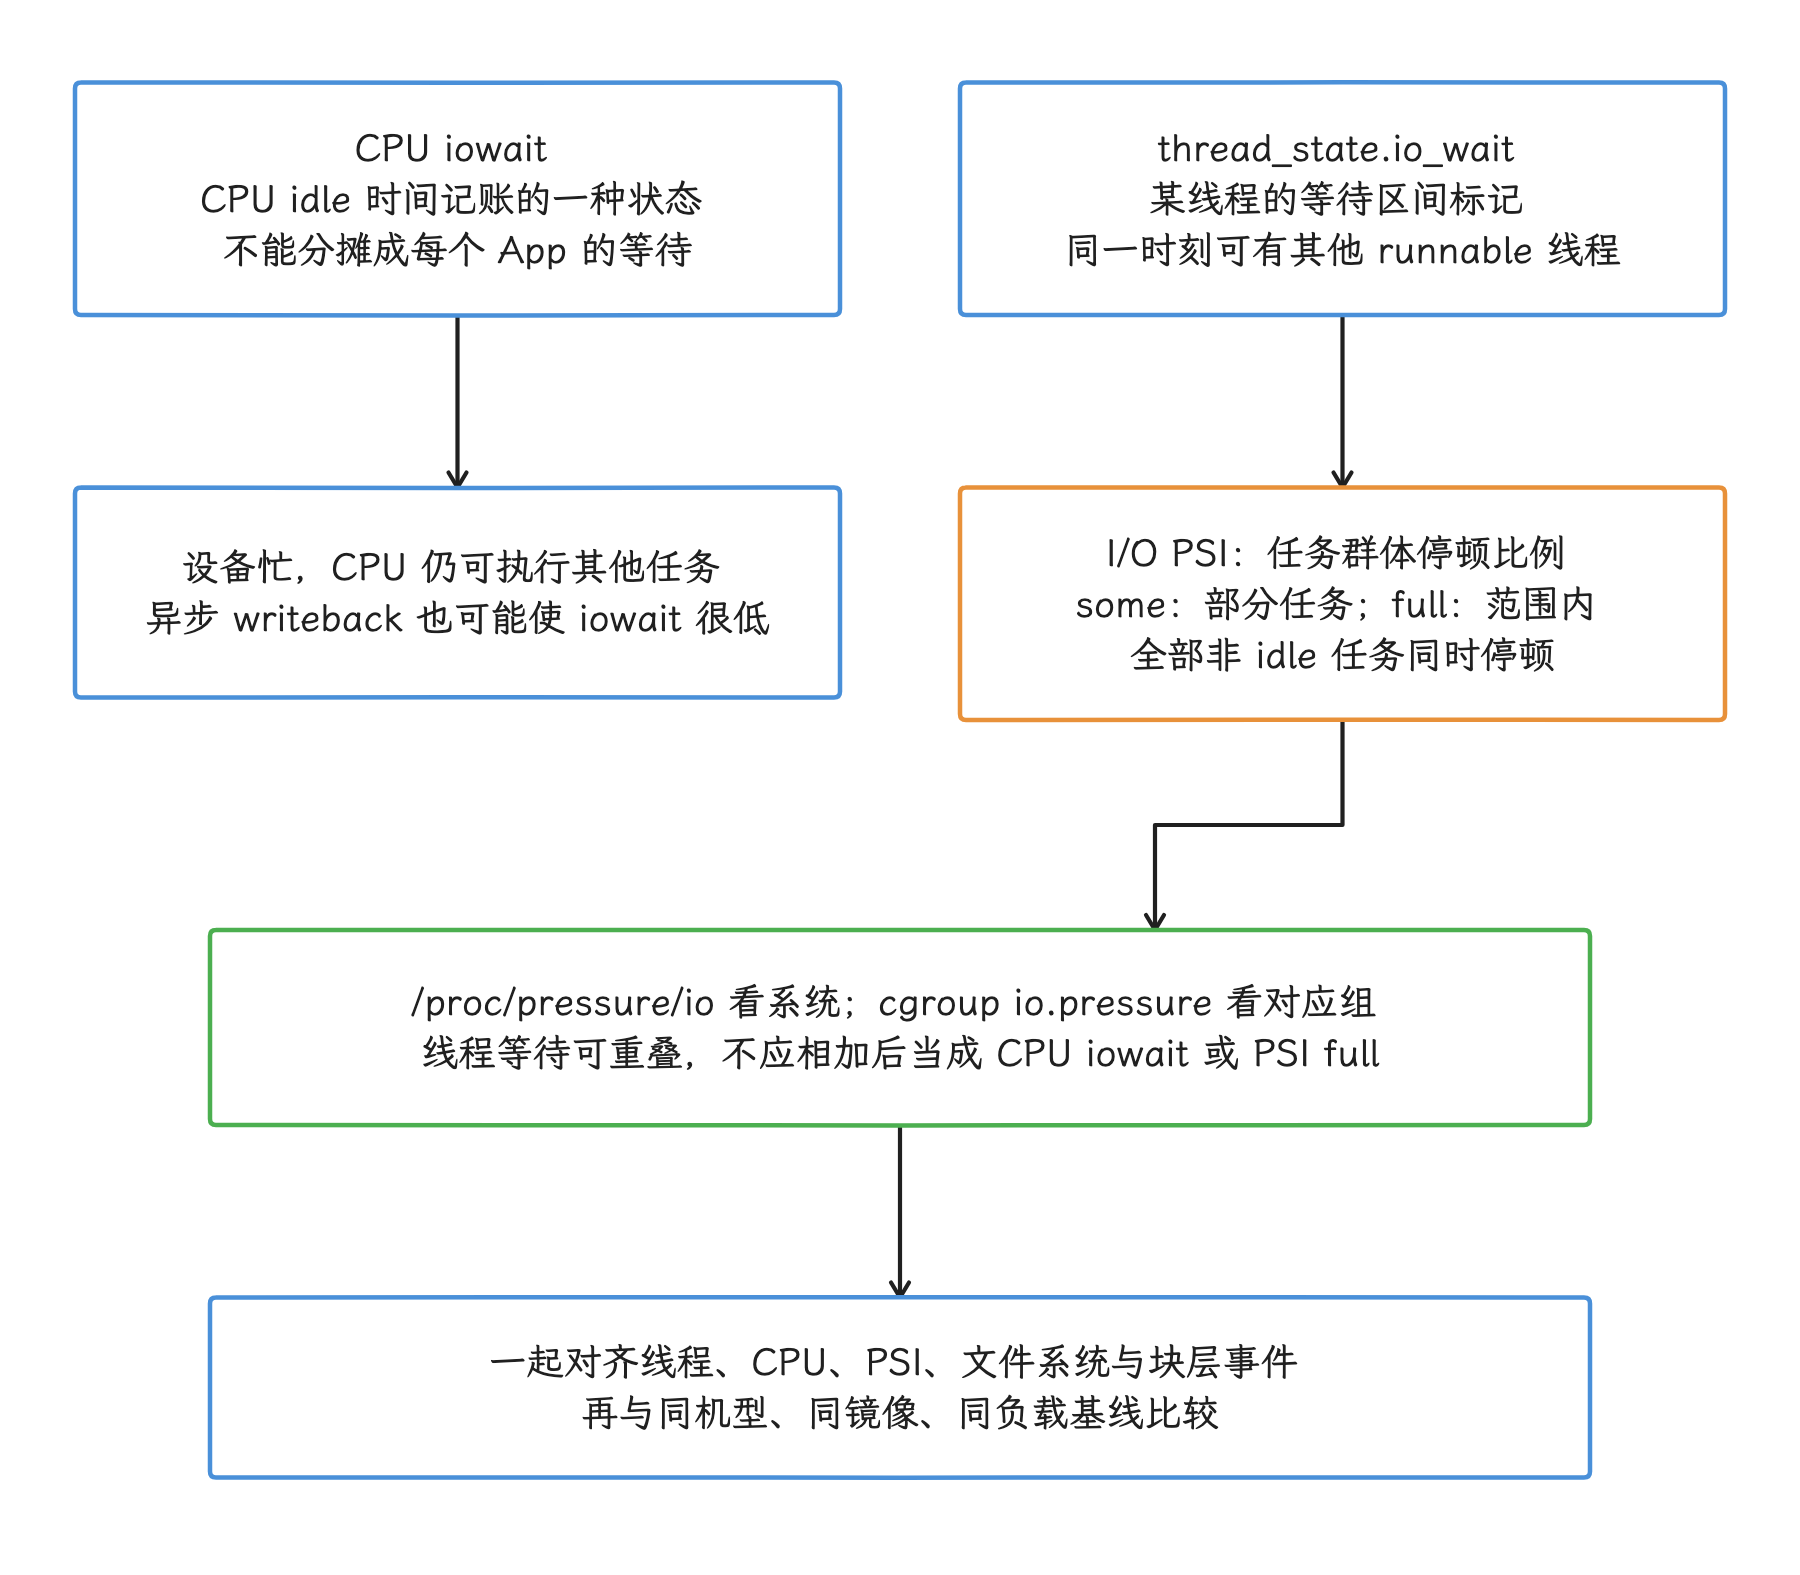
图:CPU 时间、单线程等待和任务群体停顿属于不同统计口径;结合使用才能解释系统与交互压力。
CPU iowait 因此适合作为系统级线索;定位时还要结合线程 io_wait、I/O PSI、block queue、文件系统事件和应用调用栈。
SQLite、Room 与 SharedPreferences:优先减少同步工作
调度策略能减轻竞争,但一次本就多余的主线程事务,还是要回到 App 侧解决。优先检查:
- 事务边界:把同一业务动作的多条数据库修改放在一个事务中,避免循环自动提交。
- 线程边界:Room 默认拒绝主线程数据库访问;应使用
suspend、Flow、RxJava 或 executor(任务执行器) 等异步 DAO,不要开启allowMainThreadQueries()绕过限制。 - WAL 条件:WAL 常能改善读写并发,但仍有 WAL sync、checkpoint、文件增长和多进程边界。应按真实 workload 验证。
- SharedPreferences:
apply()把磁盘写排到后台,连续调用仍制造 I/O,生命周期切换也可能等待排队任务。 - 开发期检查:StrictMode 可以发现主线程磁盘访问;release(发布版本) 的性能仍需通过 Perfetto、数据库统计和现场分位数验证。
AOSP SQLite 编译了 F2FS batch atomic write 支持,运行时还要由 Unix VFS 探测文件系统 ioctl,并满足 pager 的条件。它可以减少部分 journal 工作;剩下的同步与块层竞争,还要靠事务本身的安排来压低。
io_uring(Linux 异步 I/O 接口) 与 FUSE:能力与实际使用
6.18 Kconfig 默认提供 IO_URING,GKI 也启用了 FUSE(Filesystem in Userspace,用户空间文件系统)和 FUSE BPF(借助内核可编程机制处理部分 FUSE 操作)。由此只能确认内核具备相关能力;若要声称 Android 17 的某条 MediaProvider、外部存储或 OTA 路径用上了 io_uring,需要找到对应的 AOSP 调用点、进程权限、设备配置与 trace 事件。
“io_uring 让 FUSE 快 40%”“dm-verity 并行哈希让冷读快 35%”这类数字都缺少可迁移到所有 Android 17 设备的前提,当不了平台结论。
现场检查清单
| 问题 | 证据 |
|---|---|
| 请求落到哪个叶子块设备? | /proc/mounts、ls -l /sys/dev/block/<major>:<minor>、dm 映射 |
| 当前 elevator 是什么? | /sys/block/<dev>/queue/scheduler |
| 线程在哪个 I/O cgroup? | /proc/<tid>/cgroup |
| v1 还是 v2,参数是否存在? | /proc/cgroups、/proc/mounts、/dev/blkio、/sys/fs/cgroup |
| Page Cache 是否反复失效? | major fault、workingset_refault_file、memcg memory.stat |
| 脏页是否在回写或限速? | file_dirty、file_writeback、writeback:* |
| 系统是否普遍被 I/O 阻塞? | /proc/pressure/io 或 cgroup io.pressure |
| 延迟在文件系统还是设备? | *_sync_file_*、checkpoint/GC、block_rq_*、UFS trace |
块层与调度源码锚点
Android 17 / kernel 6.18 源码
kernel/common/block/Kconfig.iosched:mq-deadline、Kyber、BFQ 配置边界。kernel/common/block/mq-deadline.c:deadline 队列、软期限与 I/O class。kernel/common/block/kyber-iosched.c:调度域、token 与 latency target。kernel/common/block/blk-ioprio.c:cgroup I/O priority policy 与prio.class。kernel/common/Documentation/admin-guide/cgroup-v2.rst:I/O controller 与 cgroup writeback。kernel/common/arch/arm64/configs/gki_defconfig:Android 17 arm64 GKI blk-cgroup 能力。system/core/libprocessgroup/profiles/cgroups.json:Android 17 controller 基线。system/core/libprocessgroup/profiles/task_profiles.json:前后台 I/O profiles。system/core/rootdir/init.rc:blkio 根组与 background 组参数。system/core/init/service_parser.cpp:init service 的ioprio解析。external/perfetto/src/trace_processor/perfetto_sql/stdlib/linux/block_io.sql:block I/O stdlib view。
官方文档
- AOSP cgroup abstraction layer
- Linux block I/O priorities
- Linux mq-deadline
- Linux BFQ
- Linux cgroup v2
- Linux VM sysctl
- PerfettoSQL standard library
- Perfetto CPU scheduling events
块层诊断的四个问题
排查 Android I/O 卡顿时,我们可以按顺序回答四个问题:
- 线程是否处于明确的 I/O sleep,还是另一种不可中断等待?
- 延迟在 Page Cache/回写、文件系统、块层 scheduler,还是设备完成阶段?
- 实机使用哪一个 scheduler,线程在哪个 task profile 与 blkio/io cgroup?
- App 能否通过减少事务、主线程磁盘访问和无效小写降低同步压力?
GKI 提供 mq-deadline、Kyber 和多种 blk-cgroup QoS 能力,BFQ 仍是可选项;AOSP task profile 基线继续使用 blkio v1 区分 background 与根组。vendor 可以覆盖这些配置,所以“Android 17 默认 scheduler”这类结论,都要回到实机上验证。
应用配置持久化的同步边界见 6.3,MediaProvider/FUSE 共享存储路径见 6.4。
常见误区
“F2FS 一定比 ext4 快”
F2FS 针对闪存随机更新做了专门设计,但空间紧张时可能付出更高的 GC 和 checkpoint 成本。ext4 的 journal 可能抬高同步提交延迟,fast commit、工作集和设备 flush 行为也会改变结果。文件系统名称只能帮助建立假设,结论必须来自相同条件下的测量。
“EROFS 自带 dm-verity”
EROFS 提供只读文件系统语义和压缩访问;dm-verity 是独立的 device-mapper 完整性层。Android 常把两者叠加使用,EROFS 镜像也可以在没有 dm-verity 的其他 Linux 场景挂载。
“apply() 已经消除了 SharedPreferences I/O”
apply() 只是把磁盘阶段移出当前调用点,写入仍会发生。Android API 文档明确提醒,排队写入可能在组件生命周期切换时引发 ANR。高频配置更新应先合并并限制频率。
“fsync() 慢就换文件系统”
把 /data 从 ext4 换成 F2FS,属于设备级的格式化、升级和数据迁移设计,运行时的 App 改写不了它。发现同步操作缓慢后,我们先确认调用者、事务边界、文件系统内部等待和设备 I/O,再判断应该修改 App、framework、kernel 还是产品分区配置。