SharedPreferences 与 DataStore:I/O、ANR(Application Not Responding,应用无响应) 与多进程一致性
SharedPreferences.apply() 调用返回得快,但写盘工作和主线程生命周期仍然绑在一起,跨进程一致性也从来不在它的承诺范围内。我们选 SharedPreferences(下文简称 SP)还是 DataStore,要同时考虑首次加载、写入收尾、序列化成本和数据所有权。
源码基线:平台为 Android 17 / API 37,AOSP
android-17.0.0_r1;Jetpack 实现为 AndroidX(Jetpack 库集合) DataStore 1.2.1。手机升级到 Android 17 不会替 App 自动升级 DataStore,最终行为由应用依赖的 AndroidX 版本决定。
版本范围:SP 接口始于 API 1;本文 DataStore 1.2.1 的 Android 实现 datastore-core-android 在官方 AAR 的 Manifest 中声明 minSdkVersion=23,对应 Android 6.0 / API 23 及以上。
apply() 返回后的写盘与主线程关系
先回答一个问题:apply() 是异步的,ANR 是怎么找上门的?SP 适合少量、低频、单进程的配置,它的风险来自两层:XML 的读写速度,以及 API 语义本身。
- 首次加载由后台线程执行,但调用方第一次读取可能在
awaitLoadedLocked()等待。 apply()先更新内存,不等待本次写盘结果便可返回;调用中仍有加锁、映射复制和部分监听器执行成本。- Android 框架会在部分组件收尾点排空
QueuedWork,主线程可能执行尚未开始的写盘,也可能等待已经开始的写盘。 - 实际需要写盘时会序列化整份键值映射,SP 没有按 key 增量更新文件的能力;已有文件的过时异步中间状态可以被跳过。
- 平台接口层面没有可靠的跨进程一致性。
SharedPreferences 的接口文档已经明确建议:新的小型数据存储需求优先考虑 Jetpack DataStore,关系型数据和较大数据集则使用 Room。
SP 对象与首次加载
同一进程会缓存同一份 SP 实例
要看 SP 的 I/O 行为,得先从对象创建和文件加载说起。ContextImpl 使用静态的 sSharedPrefsCache,先按包名、再按文件路径缓存 SharedPreferencesImpl;同一进程中用相同的 Context/文件名反复获取,通常拿到同一个对象,框架也不会为每次 getSharedPreferences() 重新创建加载任务。
这个缓存只解决进程内的对象复用。不同进程各有一份内存 map(键值映射),变更通知也没有跨进程的可靠协议。MODE_MULTI_PROCESS 已废弃,留下的实现只在文件变化时尝试重新加载,事务和一致性都谈不上。
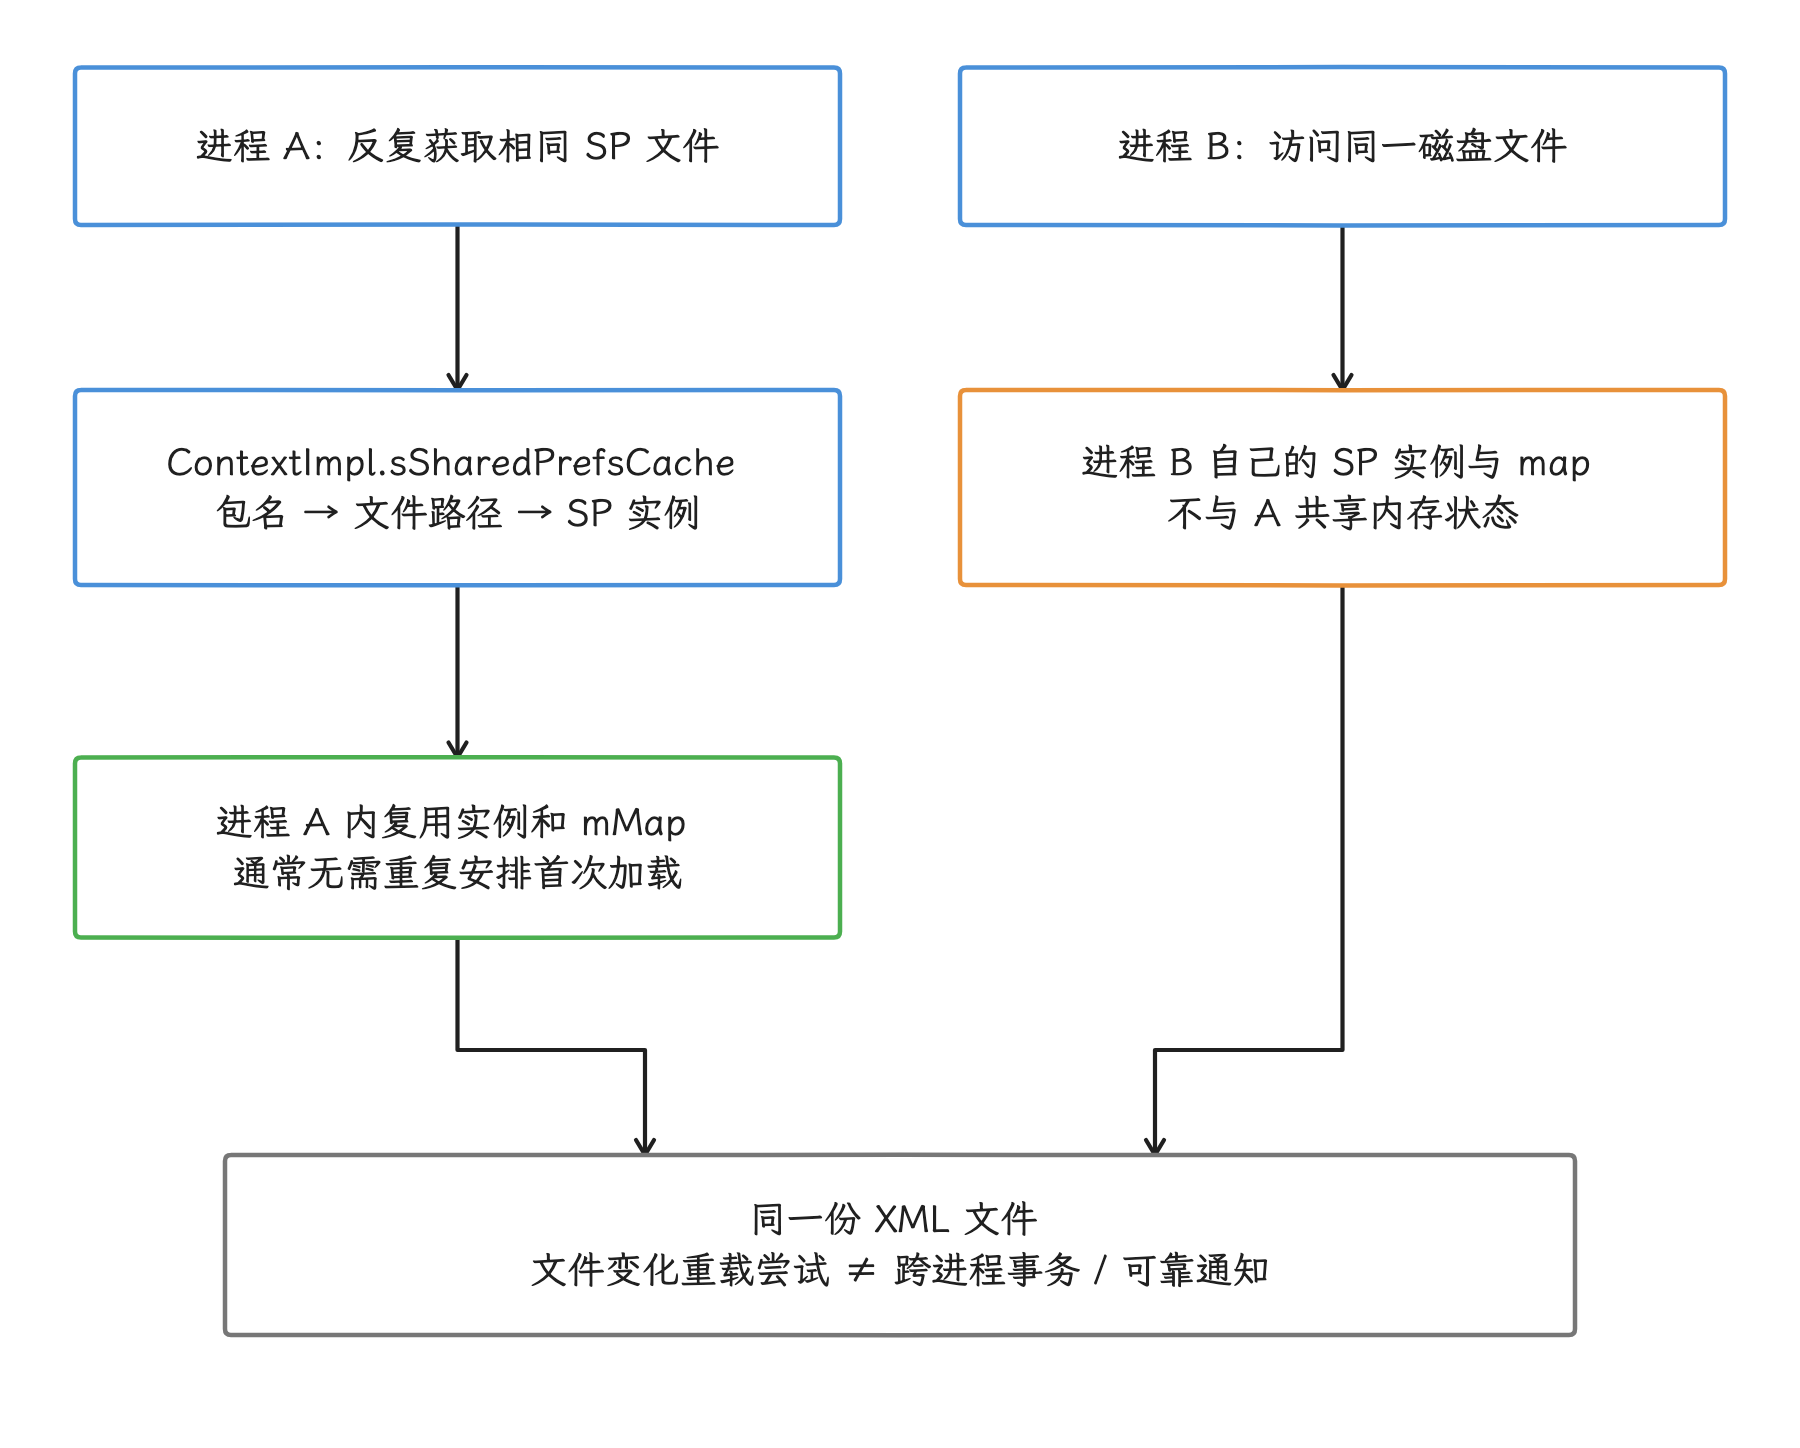
图:同一进程按包名与文件路径复用 SP 实例;不同进程各有内存 map,MODE_MULTI_PROCESS 不提供可靠事务协议。
startLoadFromDisk() 异步,getXxx() 仍可能同步等待
下面的源码片段给出加载执行器与线程名的定义:
private static final ThreadPoolExecutor sLoadExecutor =
        new ThreadPoolExecutor(
                0, 1, 10L, TimeUnit.SECONDS,
                new LinkedBlockingQueue<Runnable>(),
                new SharedPreferencesThreadFactory());

private static final class SharedPreferencesThreadFactory implements ThreadFactory {
    @Override
    public Thread newThread(Runnable runnable) {
        Thread thread = Executors.defaultThreadFactory().newThread(runnable);
        thread.setName("SharedPreferences");
        return thread;
    }
}
corePoolSize=0、maximumPoolSize=1 意味着同一进程的 SP 加载任务在单个工作线程上依次执行。我们要找的稳定观察点,就是名为 SharedPreferences 的线程;旧版本或厂商修改版仍要以现场线程和调用栈为准。
对象构造后,startLoadFromDisk() 把 loadFromDisk() 交给这个执行器。加载线程负责 .bak 备份恢复、文件 stat(读取文件元数据) 和 XML 解析,完成后设置 mLoaded 并唤醒等待者。
下面的等待循环解释了为什么“后台读盘”仍会卡住主线程:
@GuardedBy("mLock")
private void awaitLoadedLocked() {
    if (!mLoaded) {
        BlockGuard.getThreadPolicy().onReadFromDisk();
    }
    while (!mLoaded) {
        try {
            mLock.wait();
        } catch (InterruptedException unused) {
        }
    }
    if (mThrowable != null) {
        throw new IllegalStateException(mThrowable);
    }
}
getString()、getInt()、contains()、getAll(),甚至 edit() 都会先走这里。后台线程可能还在读盘,主线程已经停在 mLock.wait()。即使文件 I/O 发生在另一条线程上,这次调用也会按调用线程的 StrictMode(线程违规检测工具) 策略上报一次磁盘读取。
首次等待通常被以下因素放大:
- XML 文件较大或 key 数量很多。
- 同一进程同时首次打开多份 SP,而加载执行器只有一个工作线程。
- 冷启动阶段还有 DEX(Android 字节码)、资源和数据库等 I/O 在竞争。
/data正在脏页回写或 F2FS GC(垃圾回收),块设备本身也在延迟抖动。- 常见 XML 读取/解析异常会记日志并回退到空 map,未必抛给调用方;记录到 mThrowable 的其他失败才会在等待结束后转成 IllegalStateException。
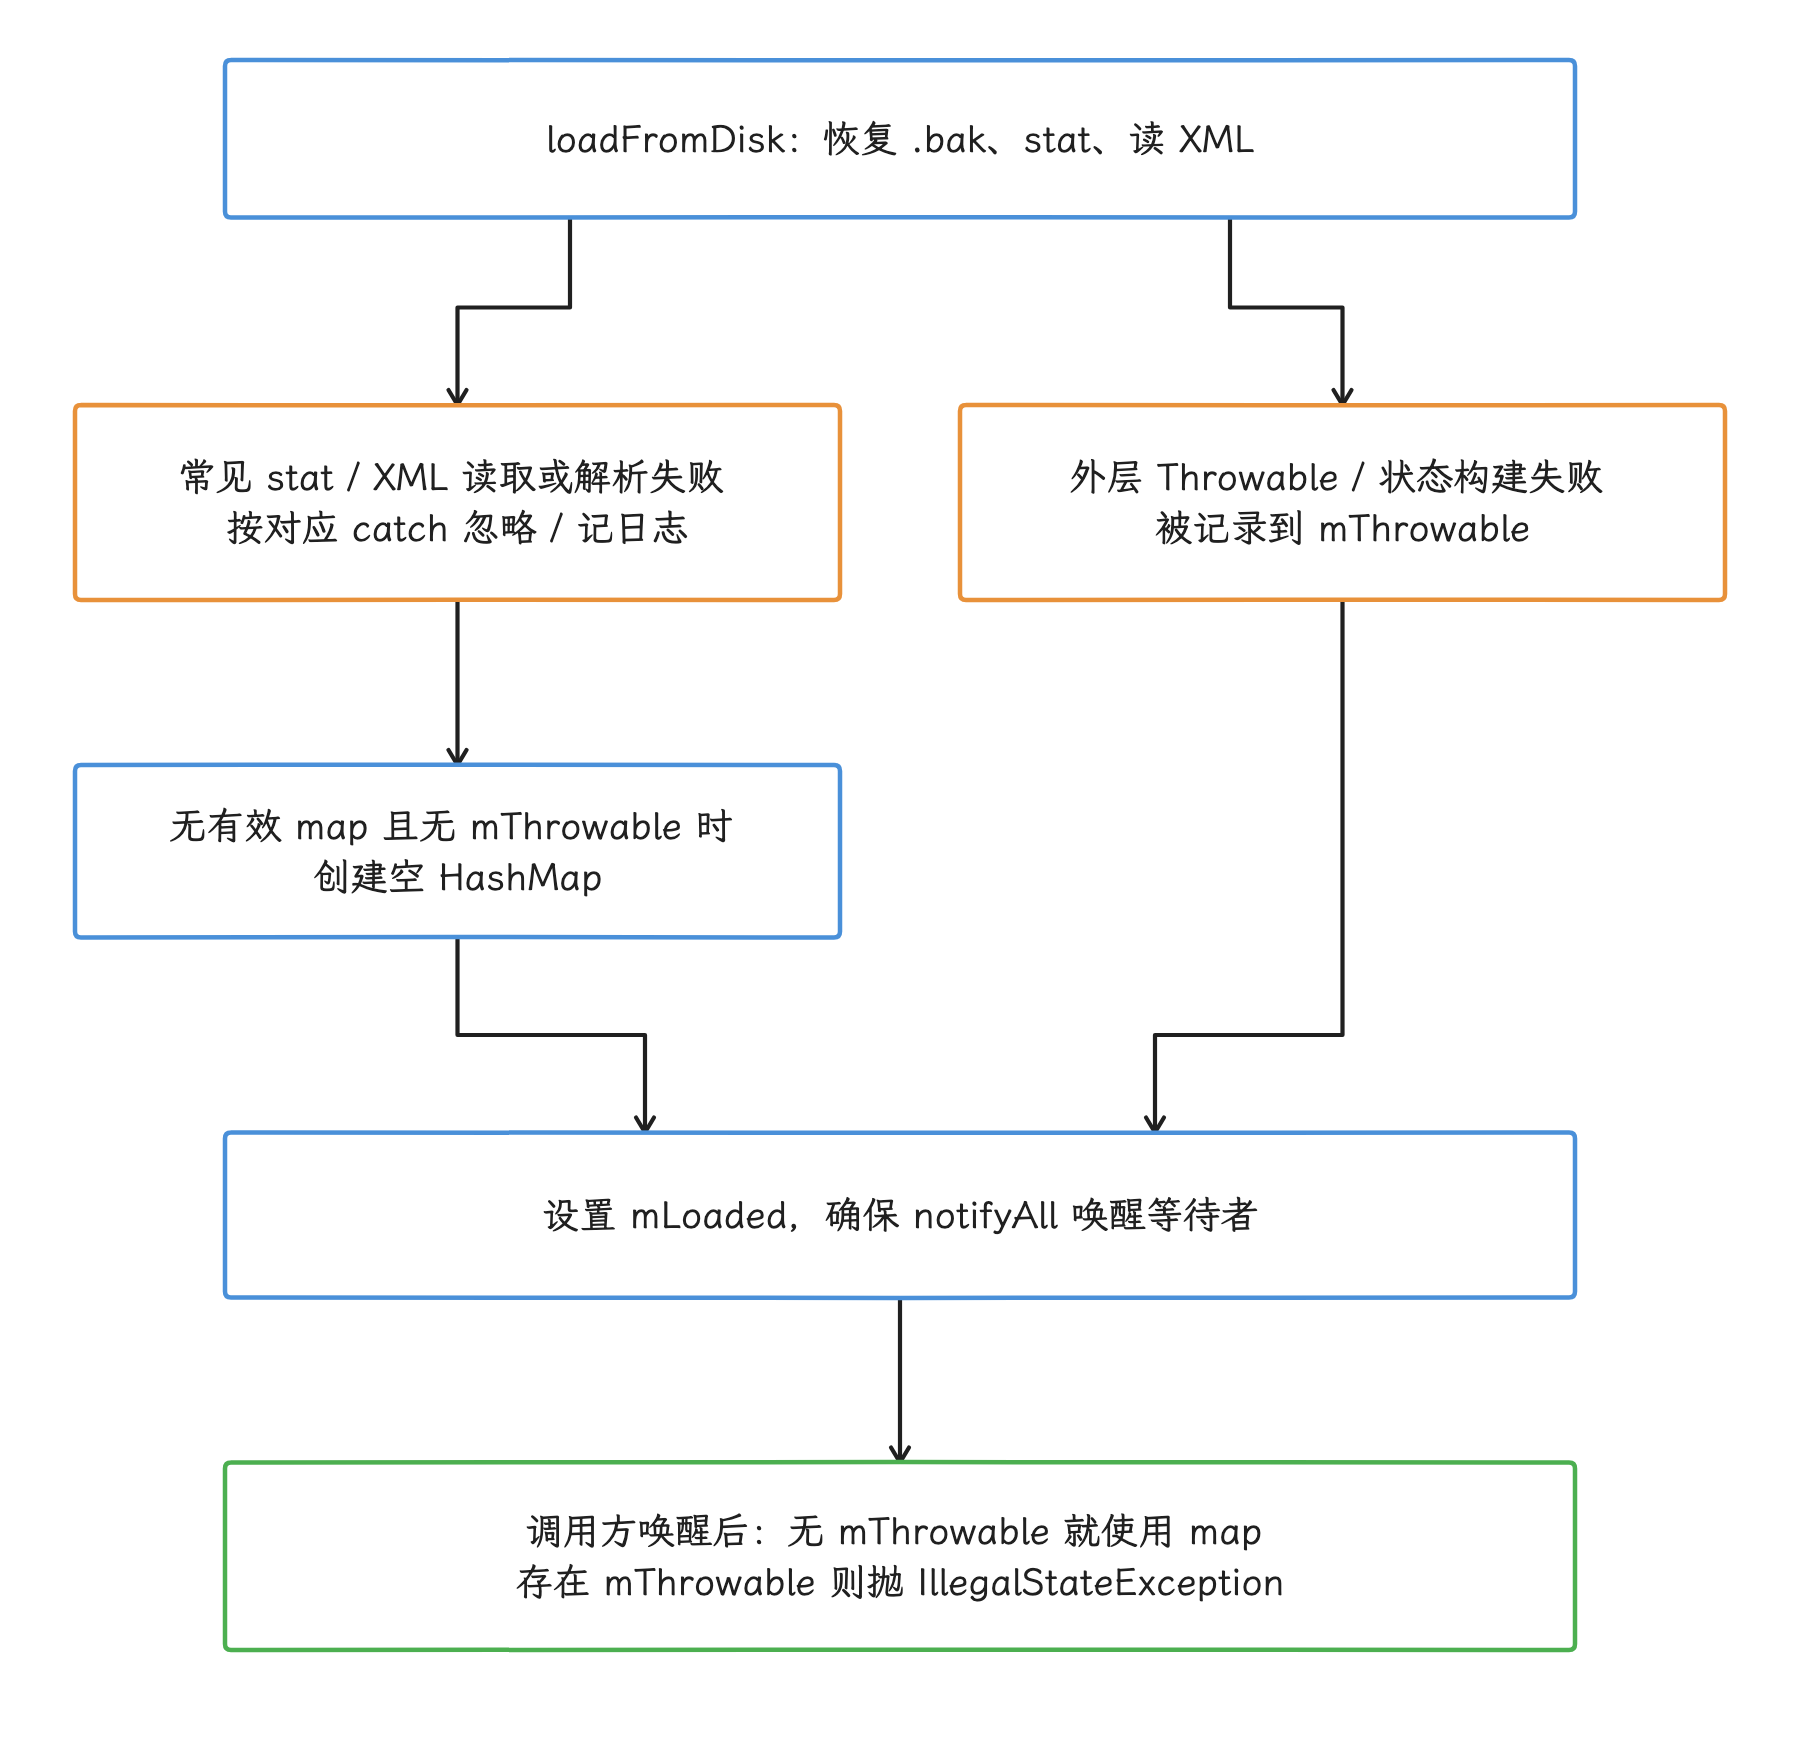
图:常见读取/解析异常可能回退为空 map;被记录到 mThrowable 的失败则在 awaitLoadedLocked 结束后抛出 IllegalStateException。
“在 Application 中提前调用 getSharedPreferences()”只是提前创建对象、提前安排加载;紧接着就读 key 的话,仍可能进入等待。要降低首帧风险,要把首次使用挪到有余量的阶段,再用 trace 验证加载有没有在关键路径前完成。
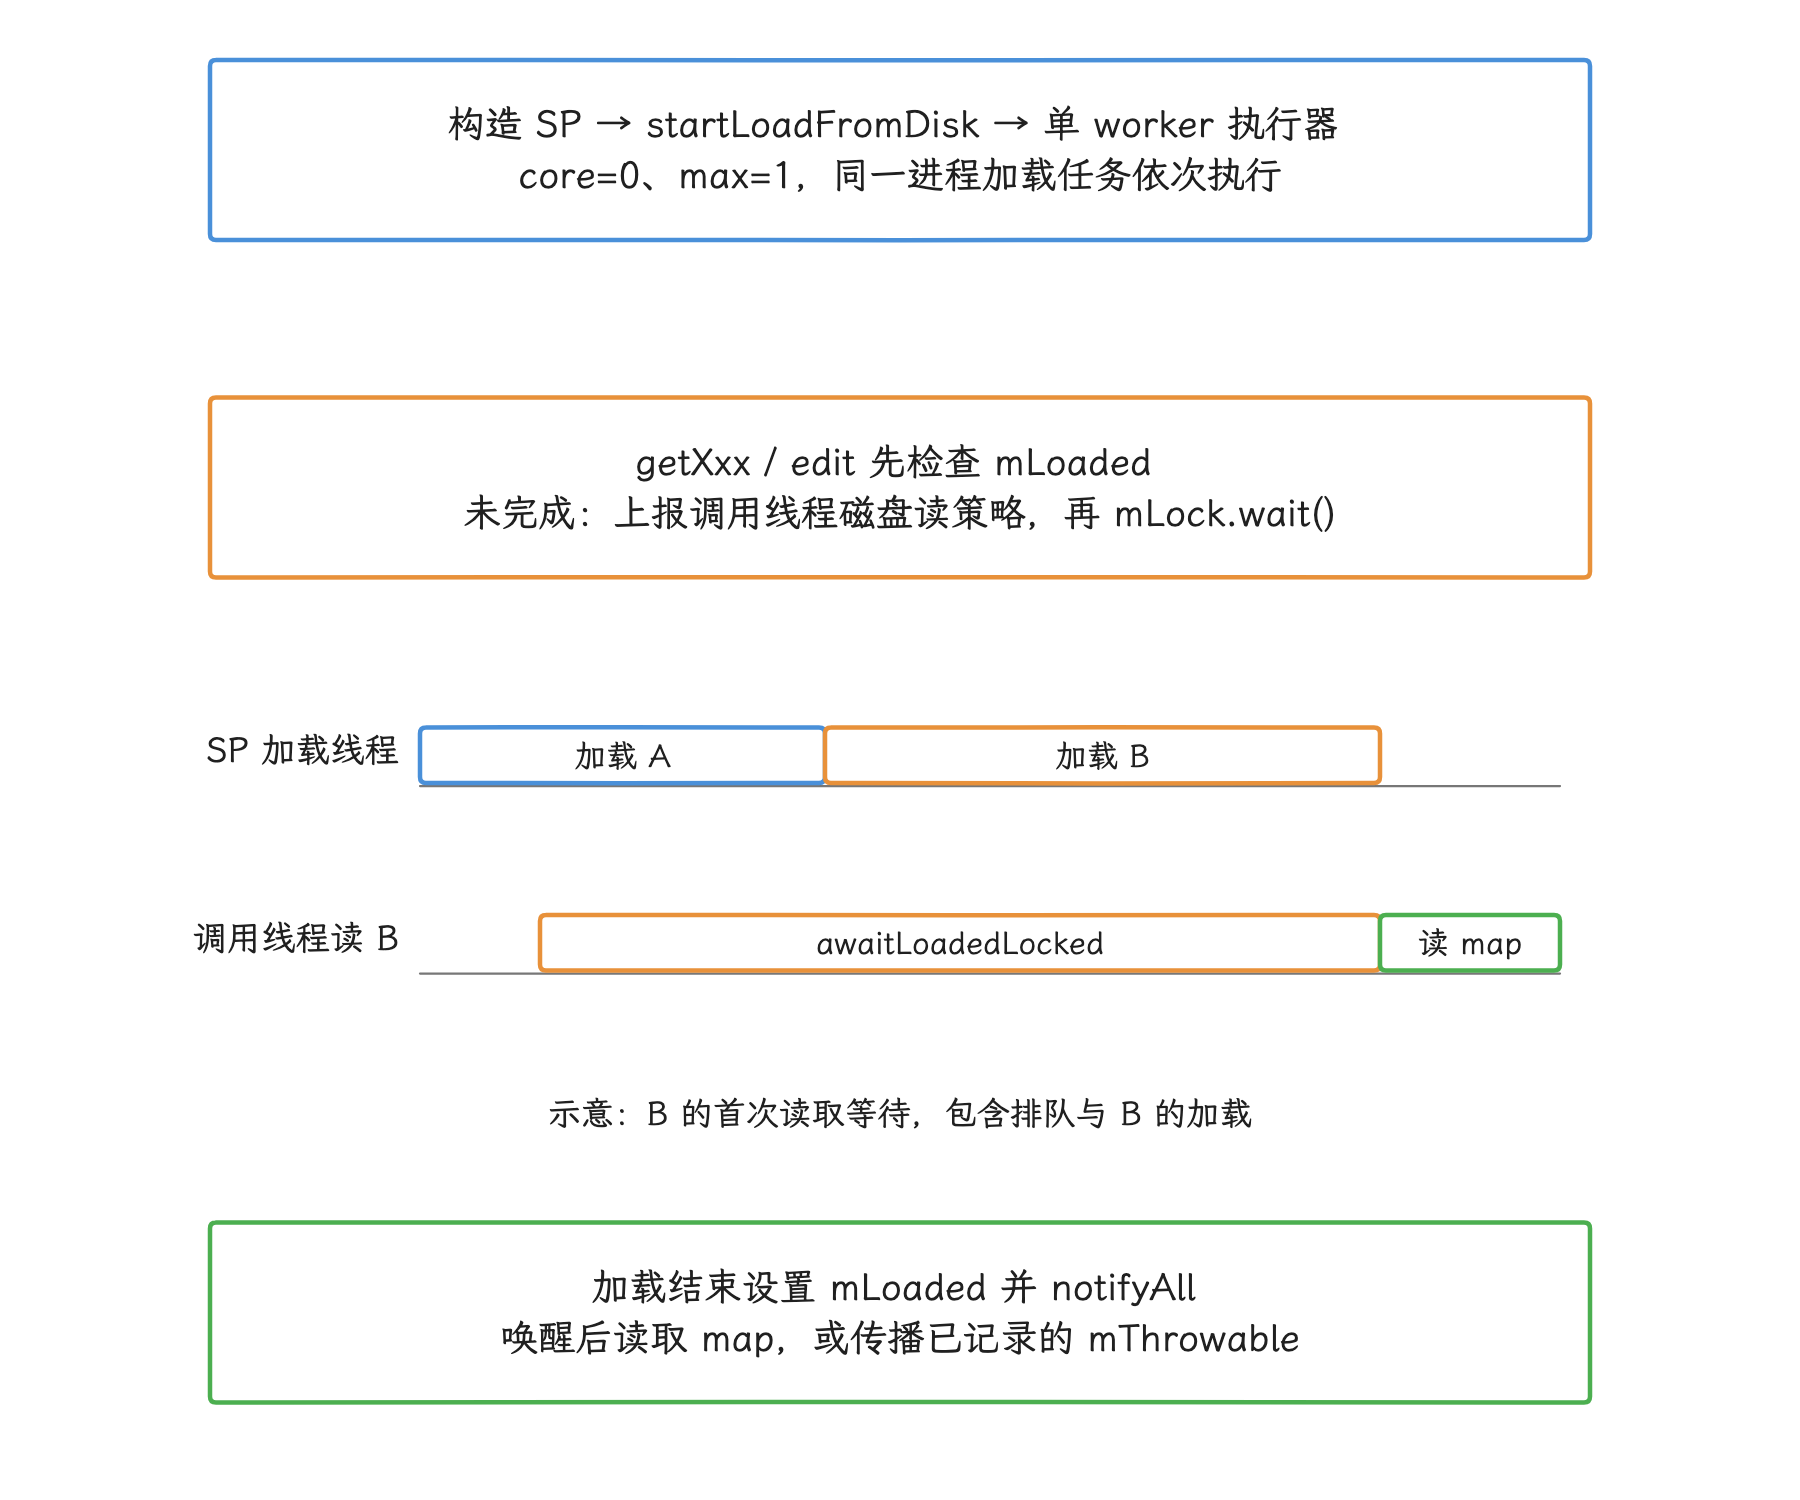
图:getSharedPreferences 提前安排加载;getXxx/edit 首次使用仍可能在 awaitLoadedLocked 等待,等待也可能包含前一份文件的加载。
从 edit() 到 fsync():SP 写入的完整路径
一次写入从 edit() 到 fsync(),要经过内存提交、finisher 排队、线程选择和整文件重写四步。我们按发生顺序把这四步走完,后面看 ANR 栈时,每一段都能对回这里的位置。
第一步:commitToMemory() 修改内存状态
无论 apply() 还是 commit(),第一步都是 commitToMemory():在锁内把 Editor(编辑器对象)的修改合入 mMap。mDiskWritesInFlight 在提交路径中加一,不以实际值变化为条件;只有发生实际变化时才递增内存状态版本号。受影响的 key 和监听器按本次修改及监听注册状态记录。
如果已有写盘正在使用旧 map,代码会先复制一份再修改,避免写盘序列化期间改动同一个对象。这里的“提交”只覆盖进程内状态;文件有没有落盘,要等写盘结束才知道。
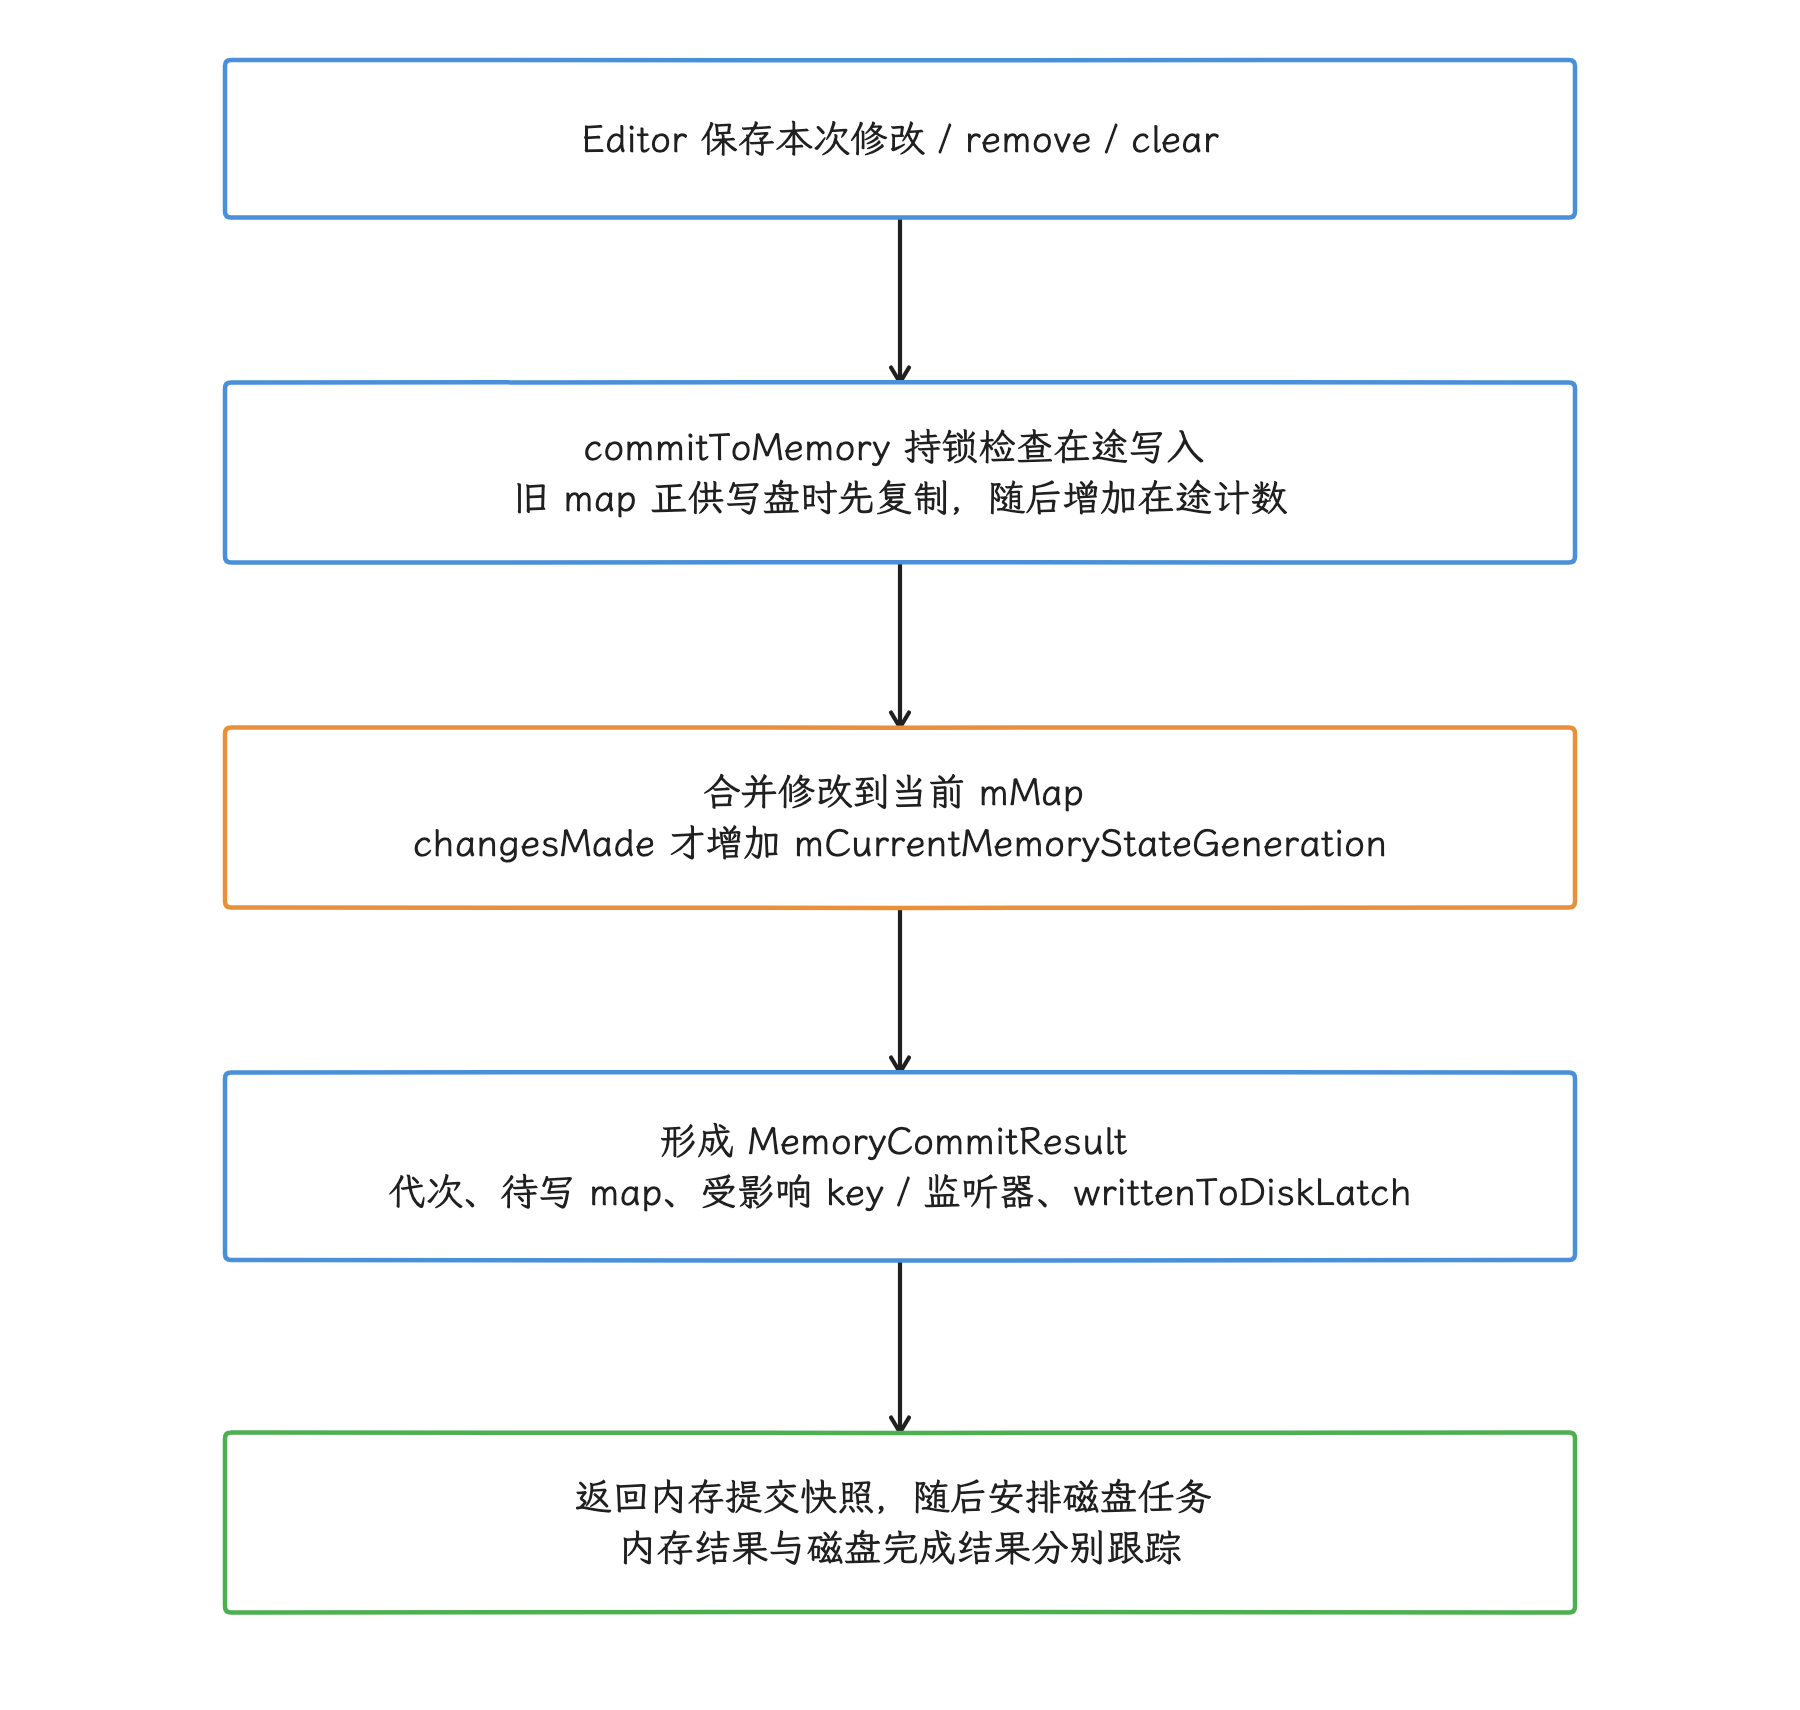
图:apply 和 commit 都先合并内存;已有写入使用旧 map 时先复制,有实际变化才递增内存代次,磁盘结果随后单独完成。
第二步:apply() 注册 finisher 并排队
下面的精简片段用于说明 apply() 与 QueuedWork 的关系:
public void apply() {
    final MemoryCommitResult mcr = commitToMemory();
    final Runnable awaitCommit = () -> {
        try {
            mcr.writtenToDiskLatch.await();
        } catch (InterruptedException ignored) {
        }
    };

    QueuedWork.addFinisher(awaitCommit);
    Runnable postWriteRunnable = () -> {
        awaitCommit.run();
        QueuedWork.removeFinisher(awaitCommit);
    };

    enqueueDiskWrite(mcr, postWriteRunnable);
    notifyListeners(mcr);
}
确定的顺序是先更新内存、再安排写盘并调用通知逻辑。调用线程是主线程时,监听器在这里直接执行;其他线程调用时,通知会 post 到主线程,可能在 apply() 返回后才发生。监听器观察的只是内存变化;磁盘结果如何,要等写盘结束才知道。awaitCommit 作为 finisher(收尾任务)留在 QueuedWork.sFinishers 里,直到写盘结束后由 postWriteRunnable(可执行任务) 移除,或者被框架的收尾逻辑取出来执行。
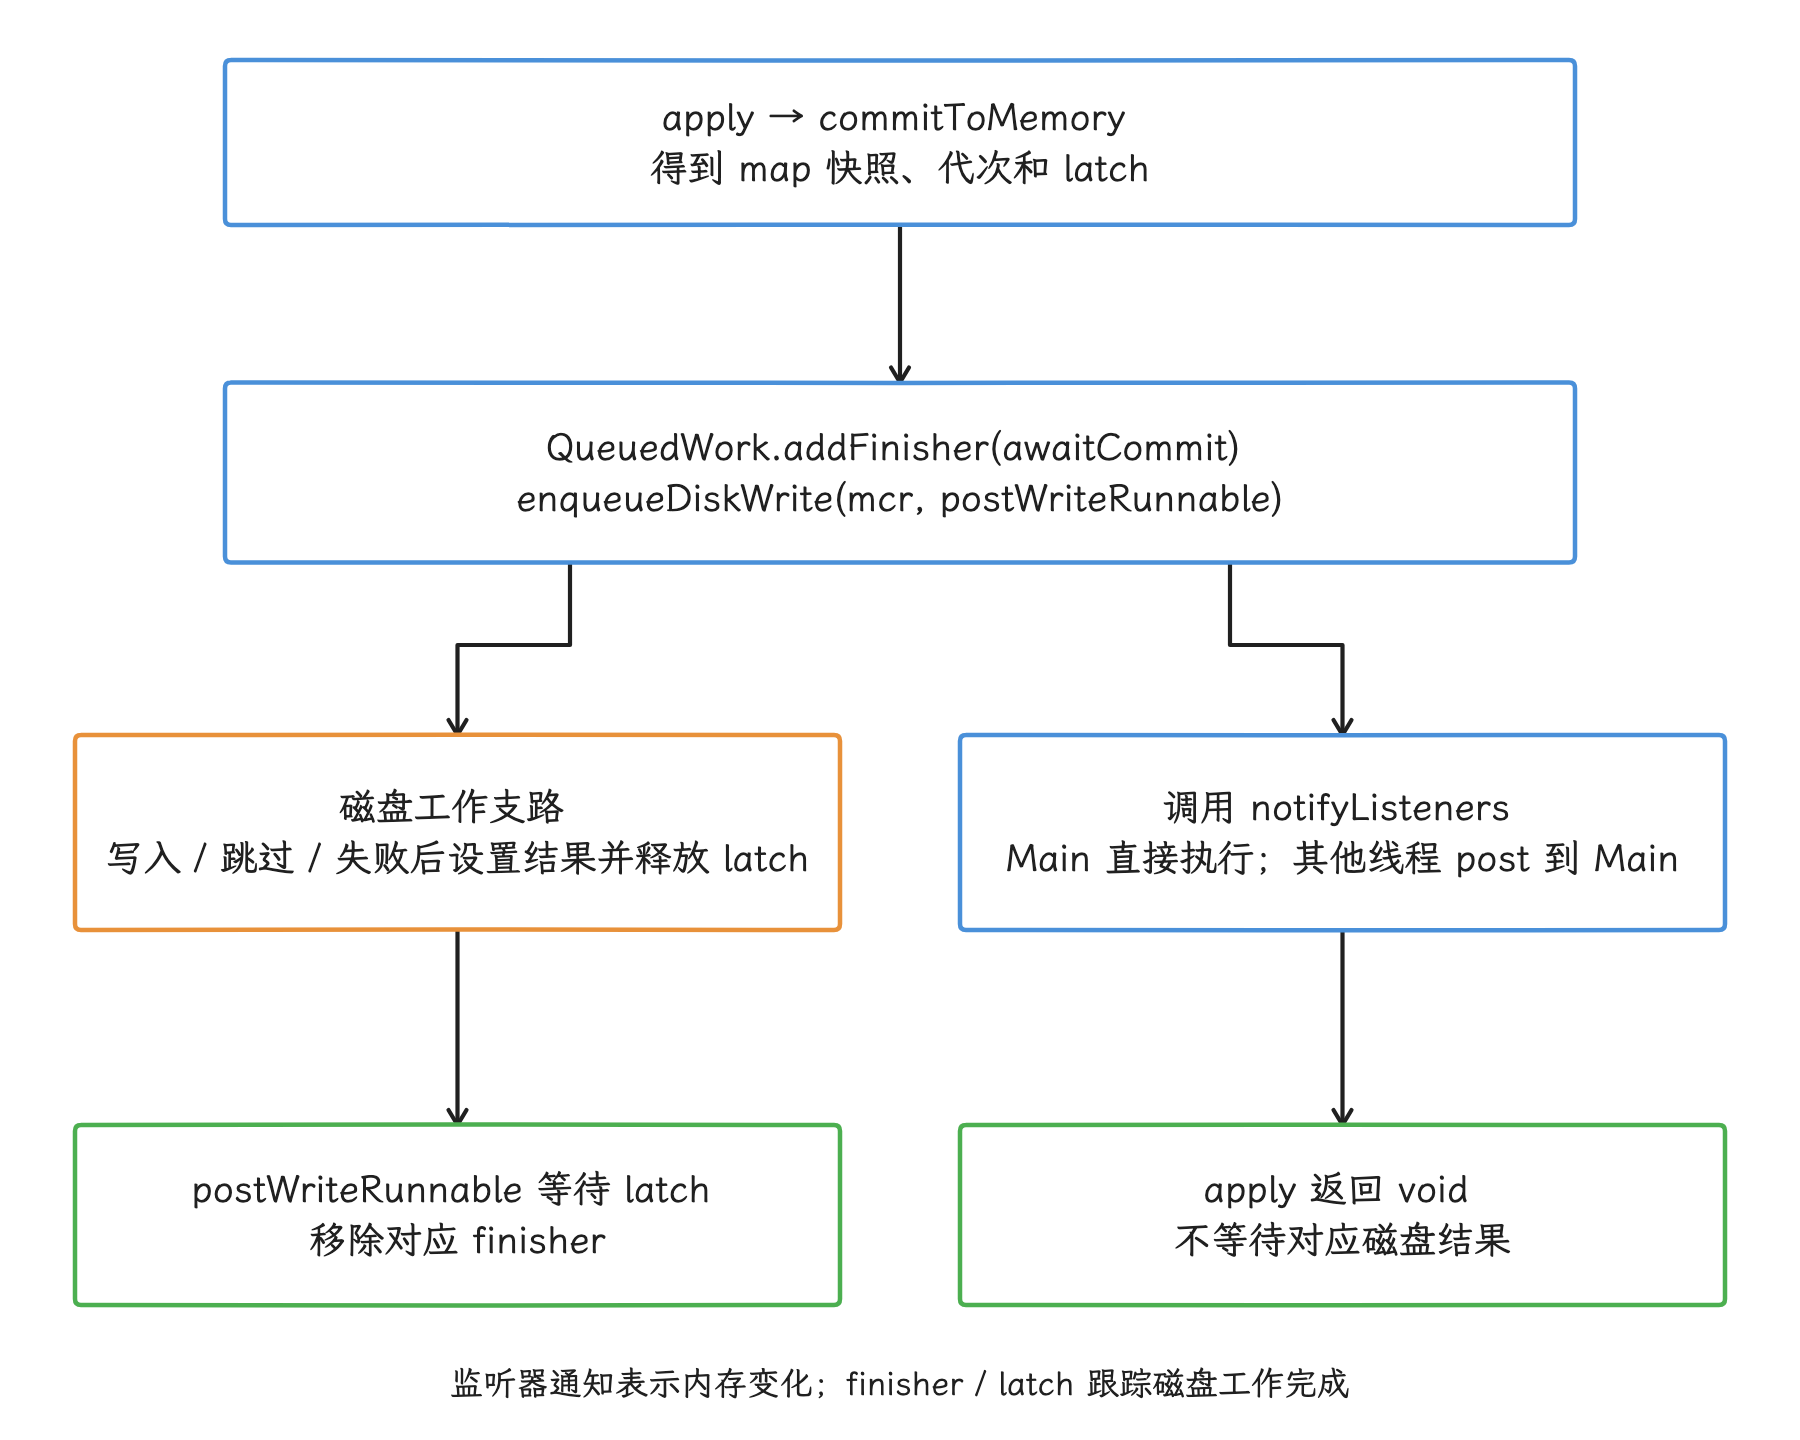
图:apply 注册 finisher 并排队写盘,再触发内存变更通知;监听器是否同步执行取决于调用线程,返回无需等待磁盘结果。
apply() 没有返回值,序列化、fsync() 还是重命名失败了,调用方都拿不到信号。所以写重要安全状态、或必须确认数据已持久化时,我们的判断依据是写盘结果本身;只凭“内存已经读到新值”认定成功,是不够的。
第三步:enqueueDiskWrite() 决定在哪条线程写
enqueueDiskWrite() 把文件写入封装成 writeToDiskRunnable(可运行)。这个 Runnable 拿着 mWritingToDiskLock 串行执行 writeToFile(),结束后把 mDiskWritesInFlight 减一,再运行 postWriteRunnable。
commit() 与 apply() 的关键差异如下:
| 维度 | apply() | commit() |
|---|---|---|
| 返回 | 不等待本次写盘结果,返回 void | 等待对应写盘结果,返回 boolean |
| 内存可见 | commitToMemory() 后立即可见 | 同样先更新内存 |
| 常规写盘安排 | 进入 QueuedWork,默认可延迟 100 ms | 若当前写是唯一在途写,可由调用线程直接执行 |
| 已有写盘时 | 排队 | 同样排队,随后调用线程等待 latch(同步闩锁) |
| 监听器 | 写盘完成前即可通知 | 等待本次写盘后通知 |
| 错误信息 | 无磁盘结果 | 只有布尔结果,没有详细失败原因 |
| 生命周期收尾 | pending work(待处理任务)/finisher(收尾任务)可能被框架等待 | 调用点已经同步等待 |
两种常见说法都站不住:“commit() 总在当前线程写”和“apply() 总在 queued-work-looper 写”——commit() 可能先排队再等待,apply() 的任务也可能被随后调用 waitToFinish() 的线程取走执行。
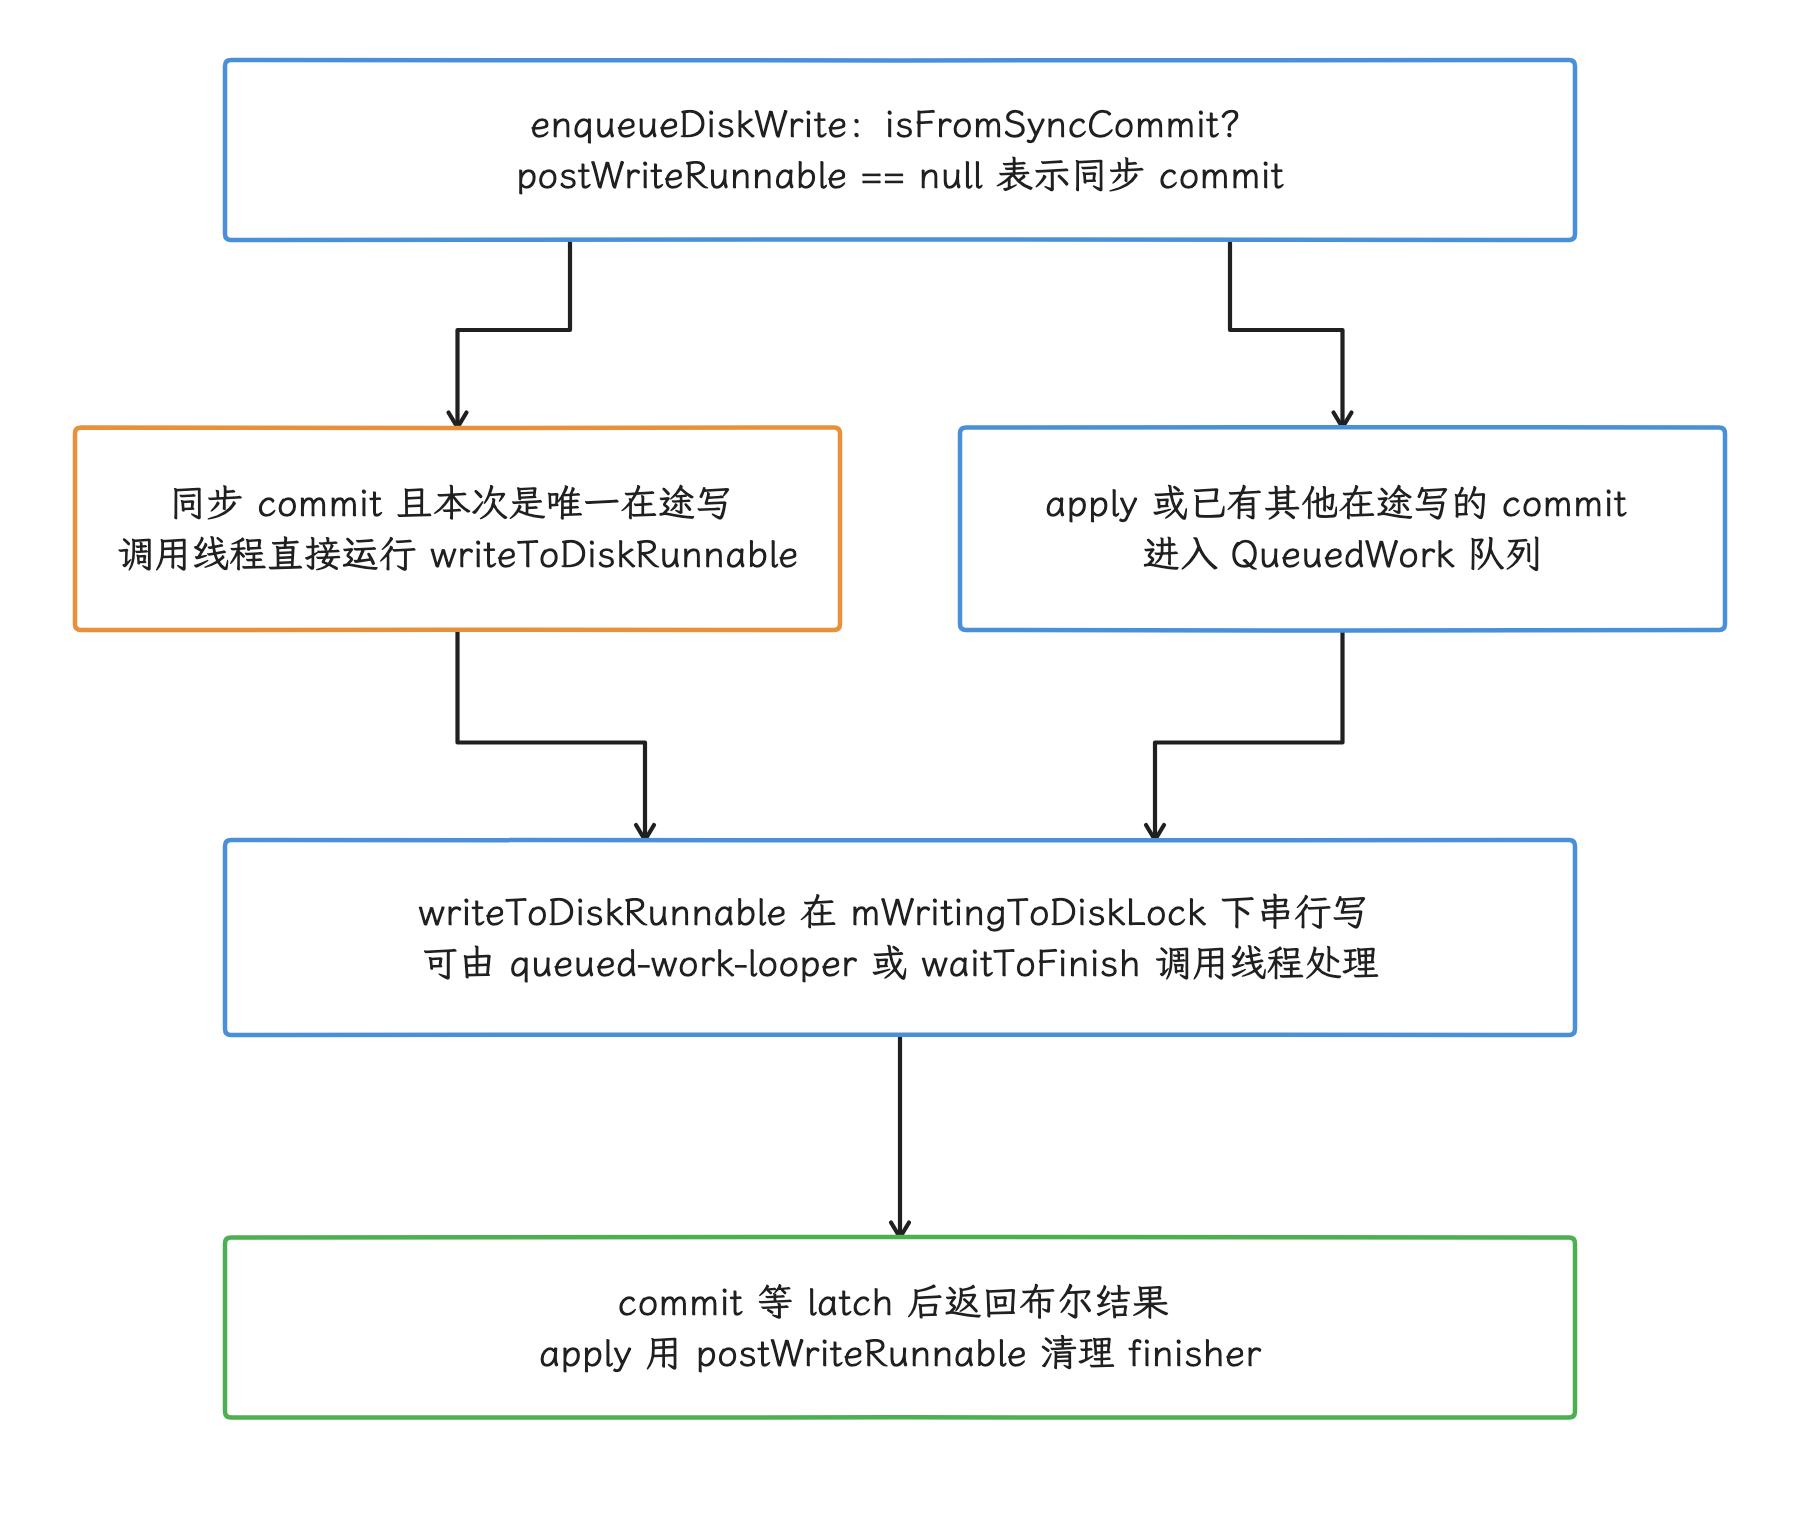
图:唯一在途的同步 commit 可直接在调用线程写;其他情况排入 QueuedWork,后续工作也可能被 waitToFinish 调用线程取走。
第四步:writeToFile() 重写整份 XML
我们把一次有效写入的步骤完整走一遍:
- 原文件存在时比较磁盘代次:已覆盖本次代次则跳过;异步 apply 的中间代次若已被更新状态替代也可跳过。只有需要写时才继续;这组跳过判断只适用于已有文件,新建文件另算。
- 若原文件存在且没有备份,把原文件重命名为
.bak。 - 创建新的 XML 文件,把
mapToWriteToDisk整体序列化。 - 调用 FileUtils.sync(str) 尝试同步文件;这个 r1 实现没有检查它的布尔返回值。
- 更新权限、时间戳和文件大小记录。
- 成功后删除
.bak,更新磁盘代数并释放writtenToDiskLatch。 - 失败时删除不完整的新文件,保留备份供下次加载恢复。
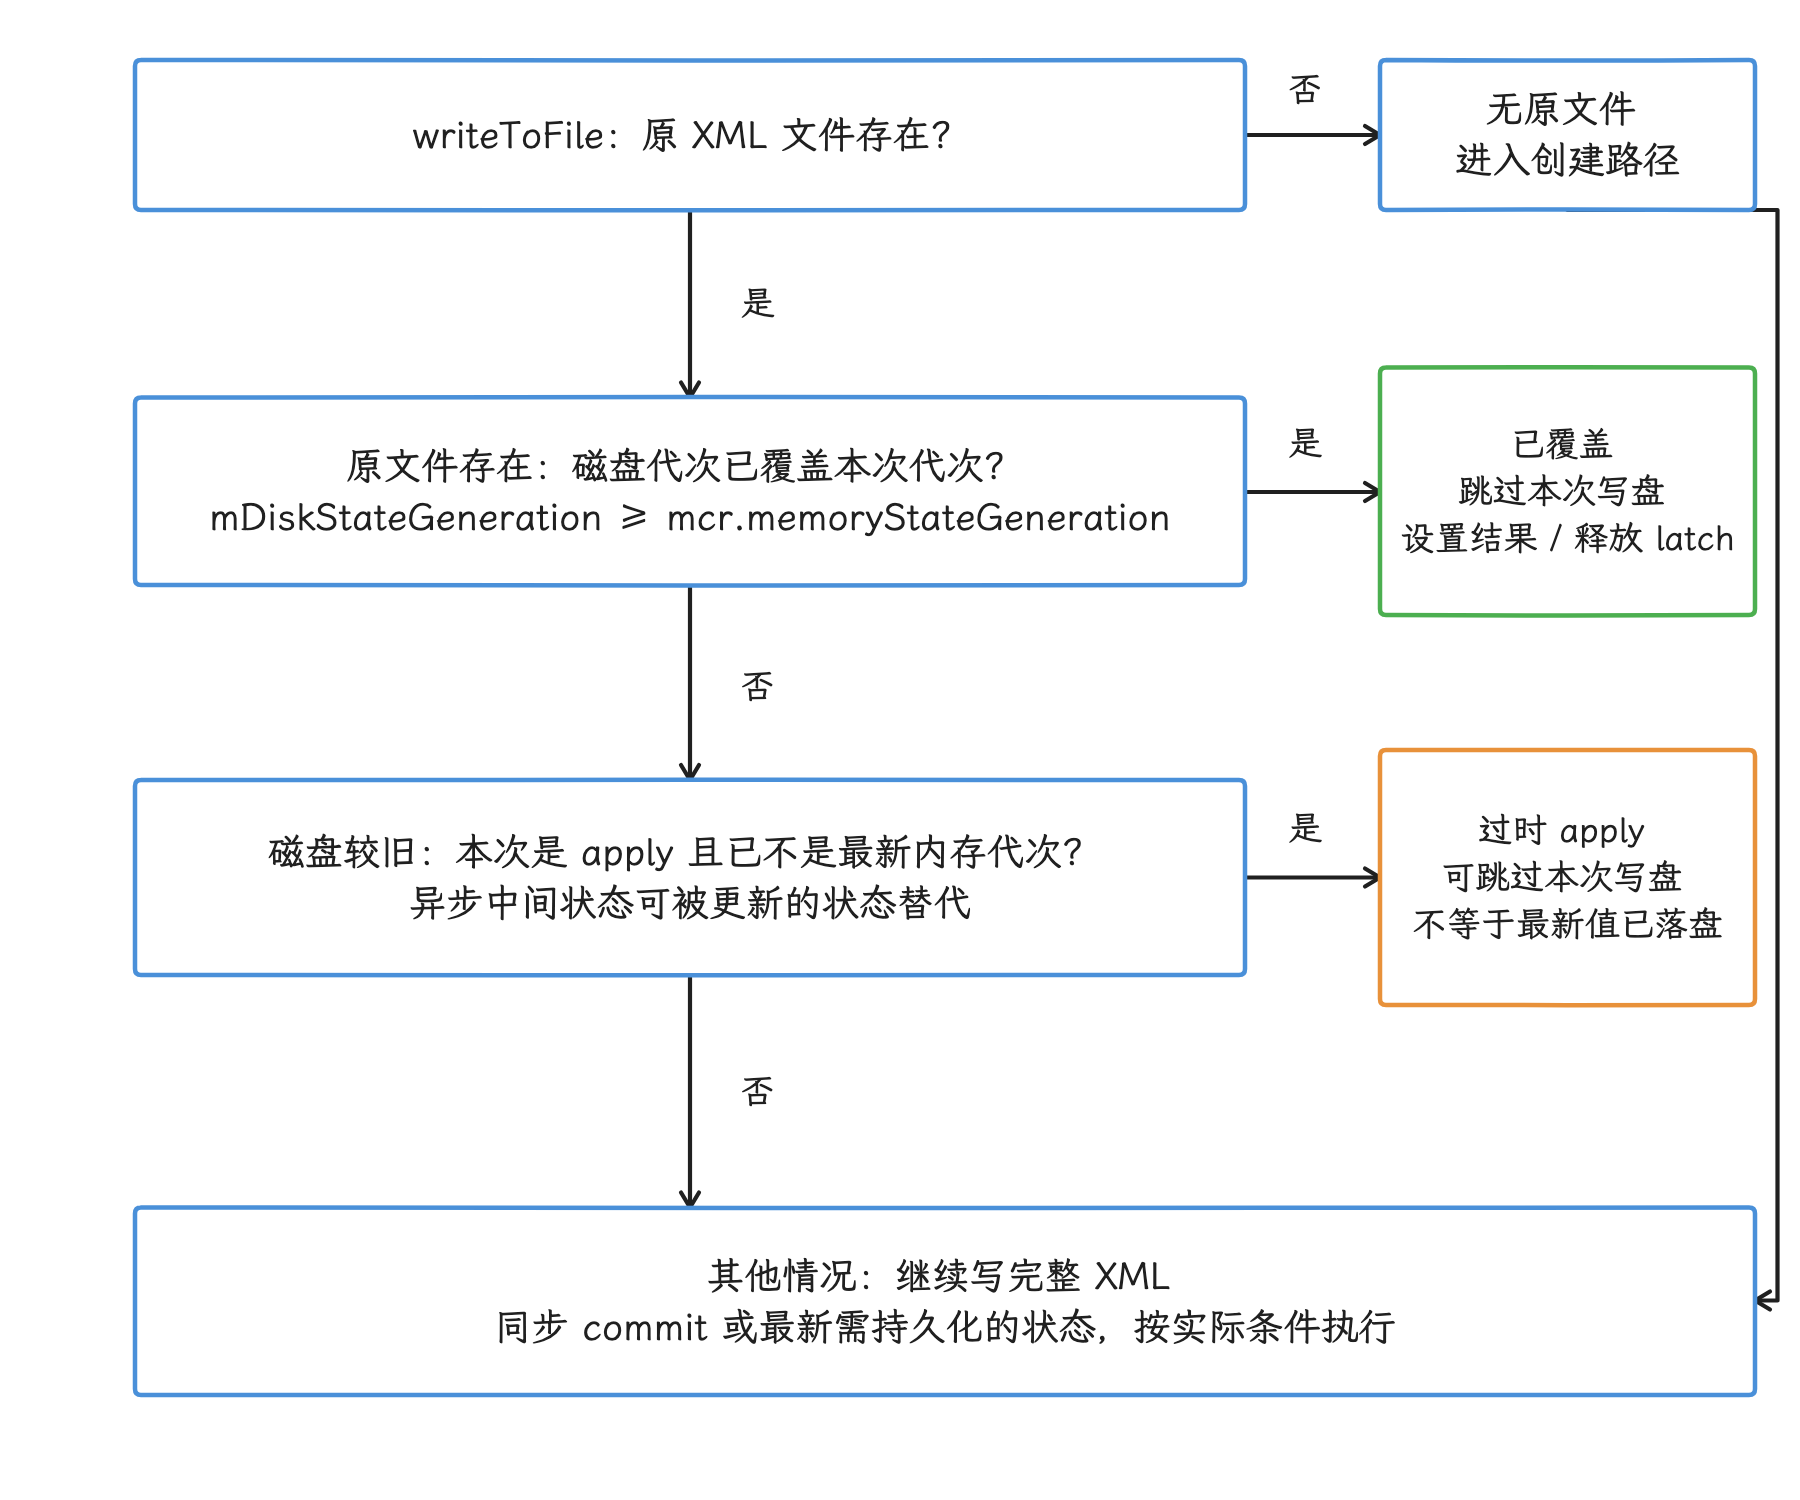
图:已有文件时,磁盘已覆盖该代次或异步中间状态已过时,都可以跳过;新建文件与需要持久化的最新状态走写入路径。
还有一个错误传播上的缺口要交代:r1 的 FileUtils.sync() 捕获同步 IOException 后返回 false,writeToFile() 却没有使用这个返回值。因此 commit() 的布尔值覆盖不了全部底层同步失败,true 也证明不了每种故障下的独立断电持久性。
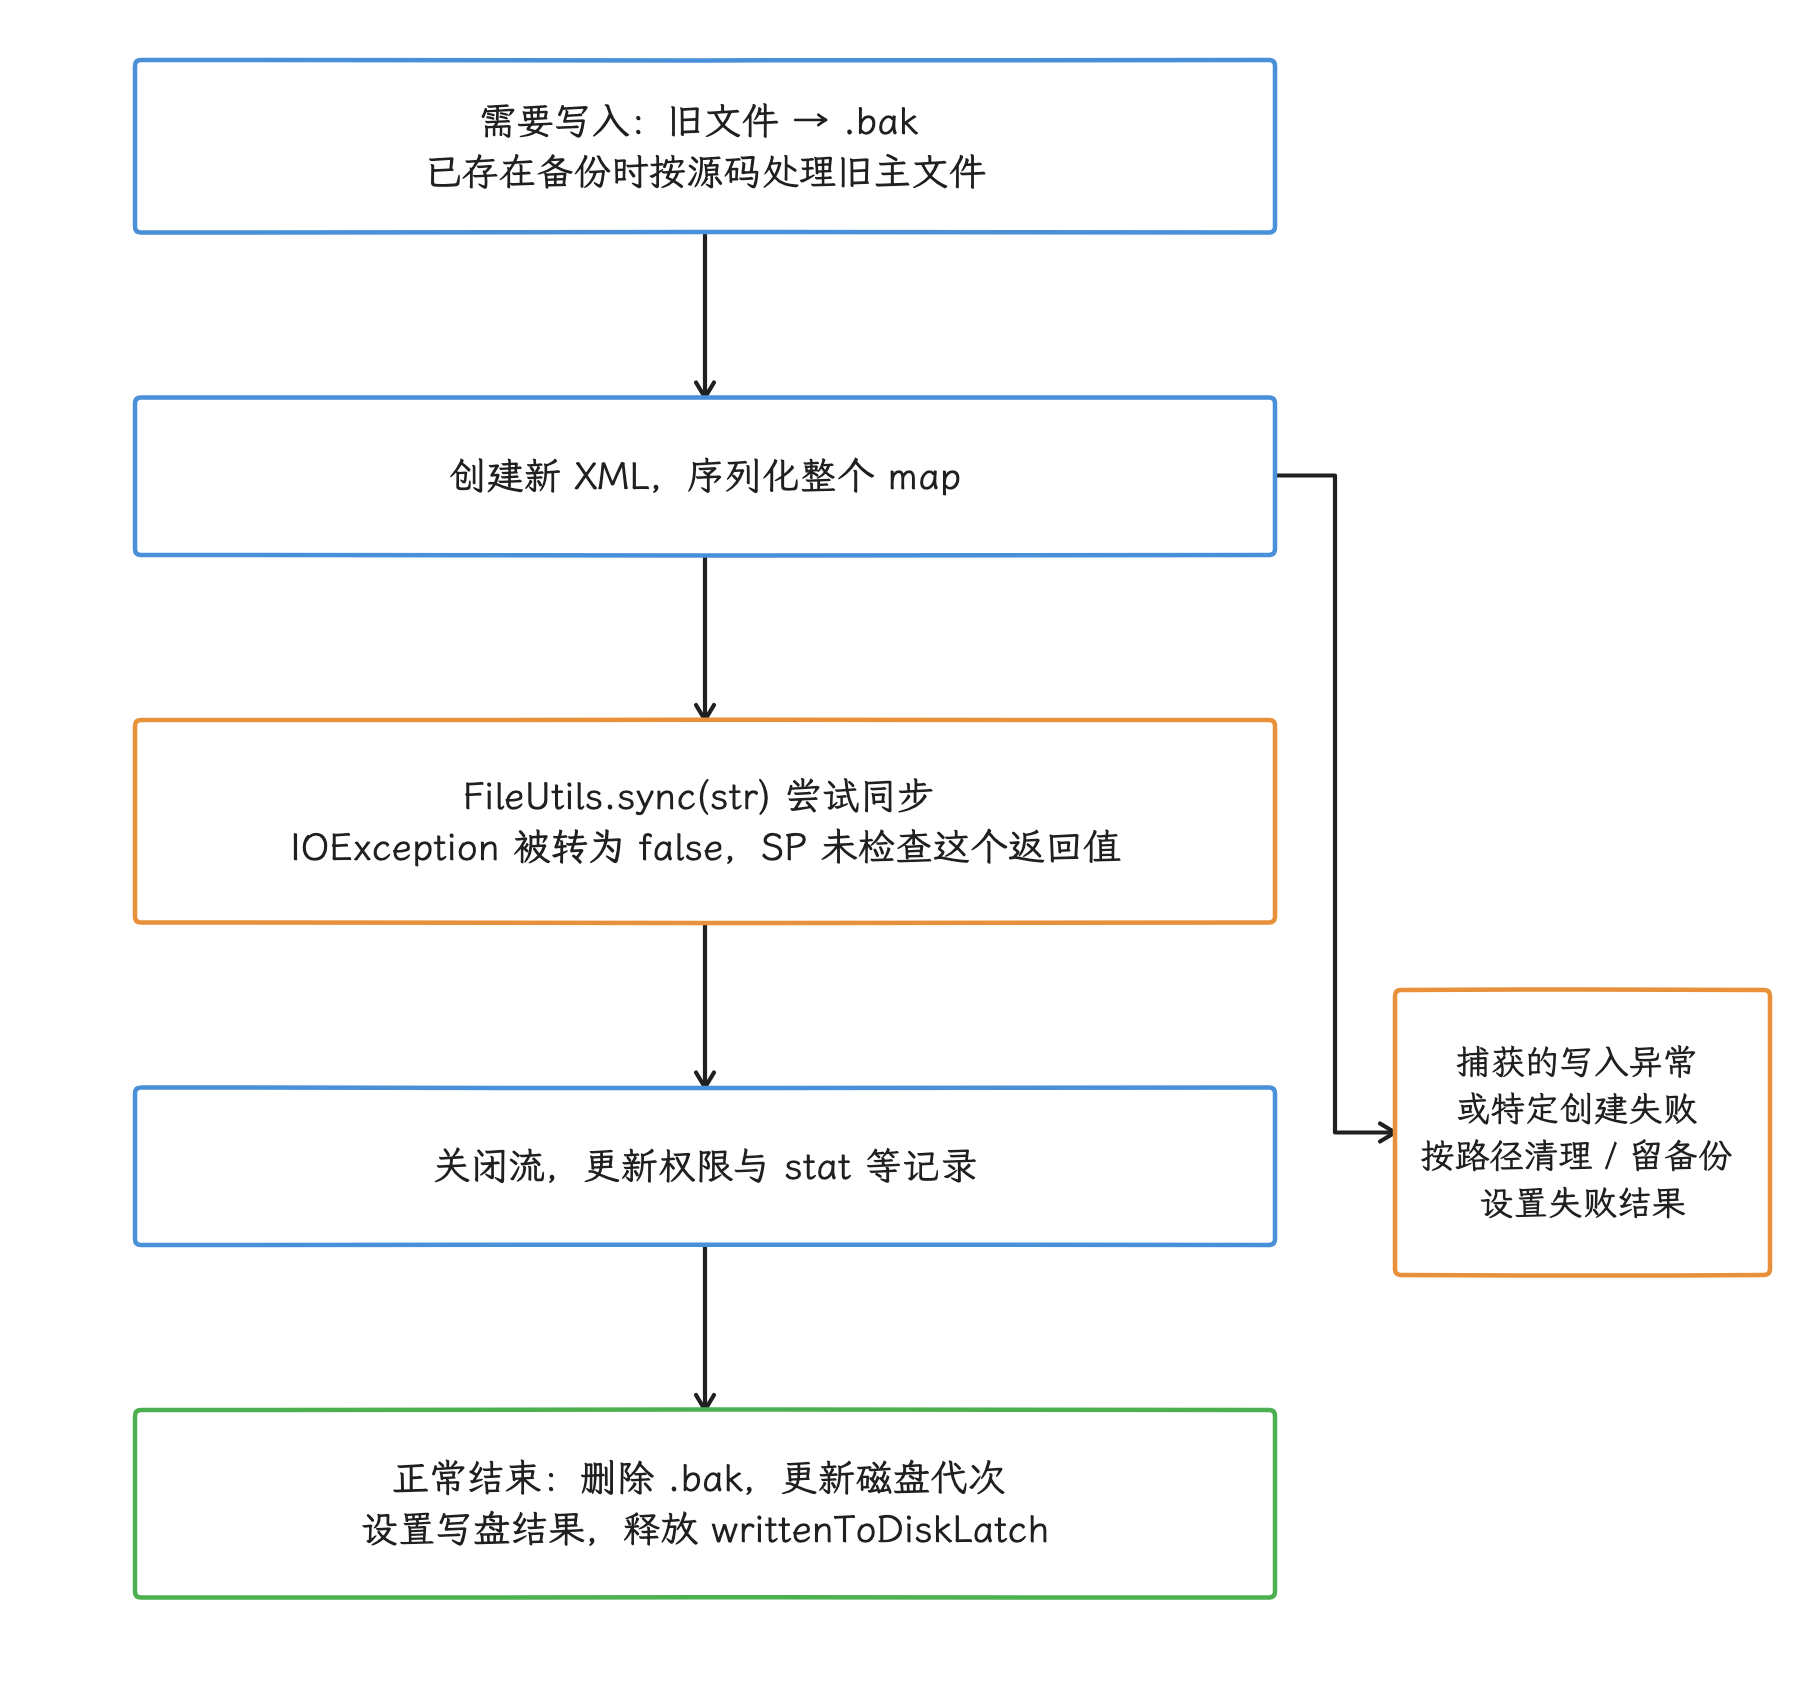
图:SP 先保留旧文件备份,再写新 XML;r1 忽略 FileUtils.sync 的布尔值,commit 的 true 覆盖不到这层同步失败。
这套备份协议降低了进程在写入中途退出时留下半份 XML 的风险,也仅止于此:源码没有在每次替换后同步父目录,文件系统、内核与存储设备仍会影响最终的持久性语义。
SP 没有按 key 更新磁盘文件的能力,改一个布尔值也可能重写整份 map。所以一次写盘的耗时,由文件大小、序列化成本、fsync() 延迟和前序队列长度共同决定。
两个内部观测阈值
平台保留了两个内部观测阈值:
SharedPreferencesImpl.MAX_FSYNC_DURATION_MILLIS = 256:单次fsync超过 256 ms 时输出累计直方图;每 1024 次同步也会输出。QueuedWork.MAX_WAIT_TIME_MILLIS = 512:waitToFinish()超过 512 ms 时输出等待直方图;每 1024 次等待也会输出。
这两个阈值只做观测,既取消不了写盘,也拦不住 ANR,也没有面向普通 App 的公开调参接口。256 ms 和 512 ms 只是日志观测线,我们别把它们当成系统超时线。
apply() 如何进入组件收尾路径
SP 的写盘只是被延后,框架会在组件收尾的几个固定位置把它捡回来。我们先看 waitToFinish() 内部做了什么,再看有哪些调用点。
waitToFinish() 可能让主线程写盘
下面的源码片段用于说明收尾时做了哪些工作:
public static void waitToFinish() {
    synchronized (sLock) {
        handlerRemoveMessages(QueuedWorkHandler.MSG_RUN);
        sCanDelay = false;
    }

    StrictMode.ThreadPolicy oldPolicy = StrictMode.allowThreadDiskWrites();
    try {
        processPendingWork();
    } finally {
        StrictMode.setThreadPolicy(oldPolicy);
    }

    try {
        while (true) {
            final Runnable finisher;
            synchronized (sLock) {
                finisher = sFinishers.poll();
            }
            if (finisher == null) break;
            finisher.run();
        }
    } finally {
        sCanDelay = true;
    }
}
processPendingWork() 先获取覆盖整批处理的 sProcessingWork monitor,再取走 sWork 中的任务并在当前线程逐个运行。若后台已持有这个 monitor,主线程会先阻塞在锁入口,尚未走到 finisher 的 latch 等待。若主线程调用 waitToFinish(),尚未开始的 SP 写盘就可能直接在主线程执行。完成这批处理后它再运行 finisher;若仍有对应写入未完成,finisher 可以在 writtenToDiskLatch.await() 等待。monitor 等待、主线程直接写盘和 latch 等待是不同位置。
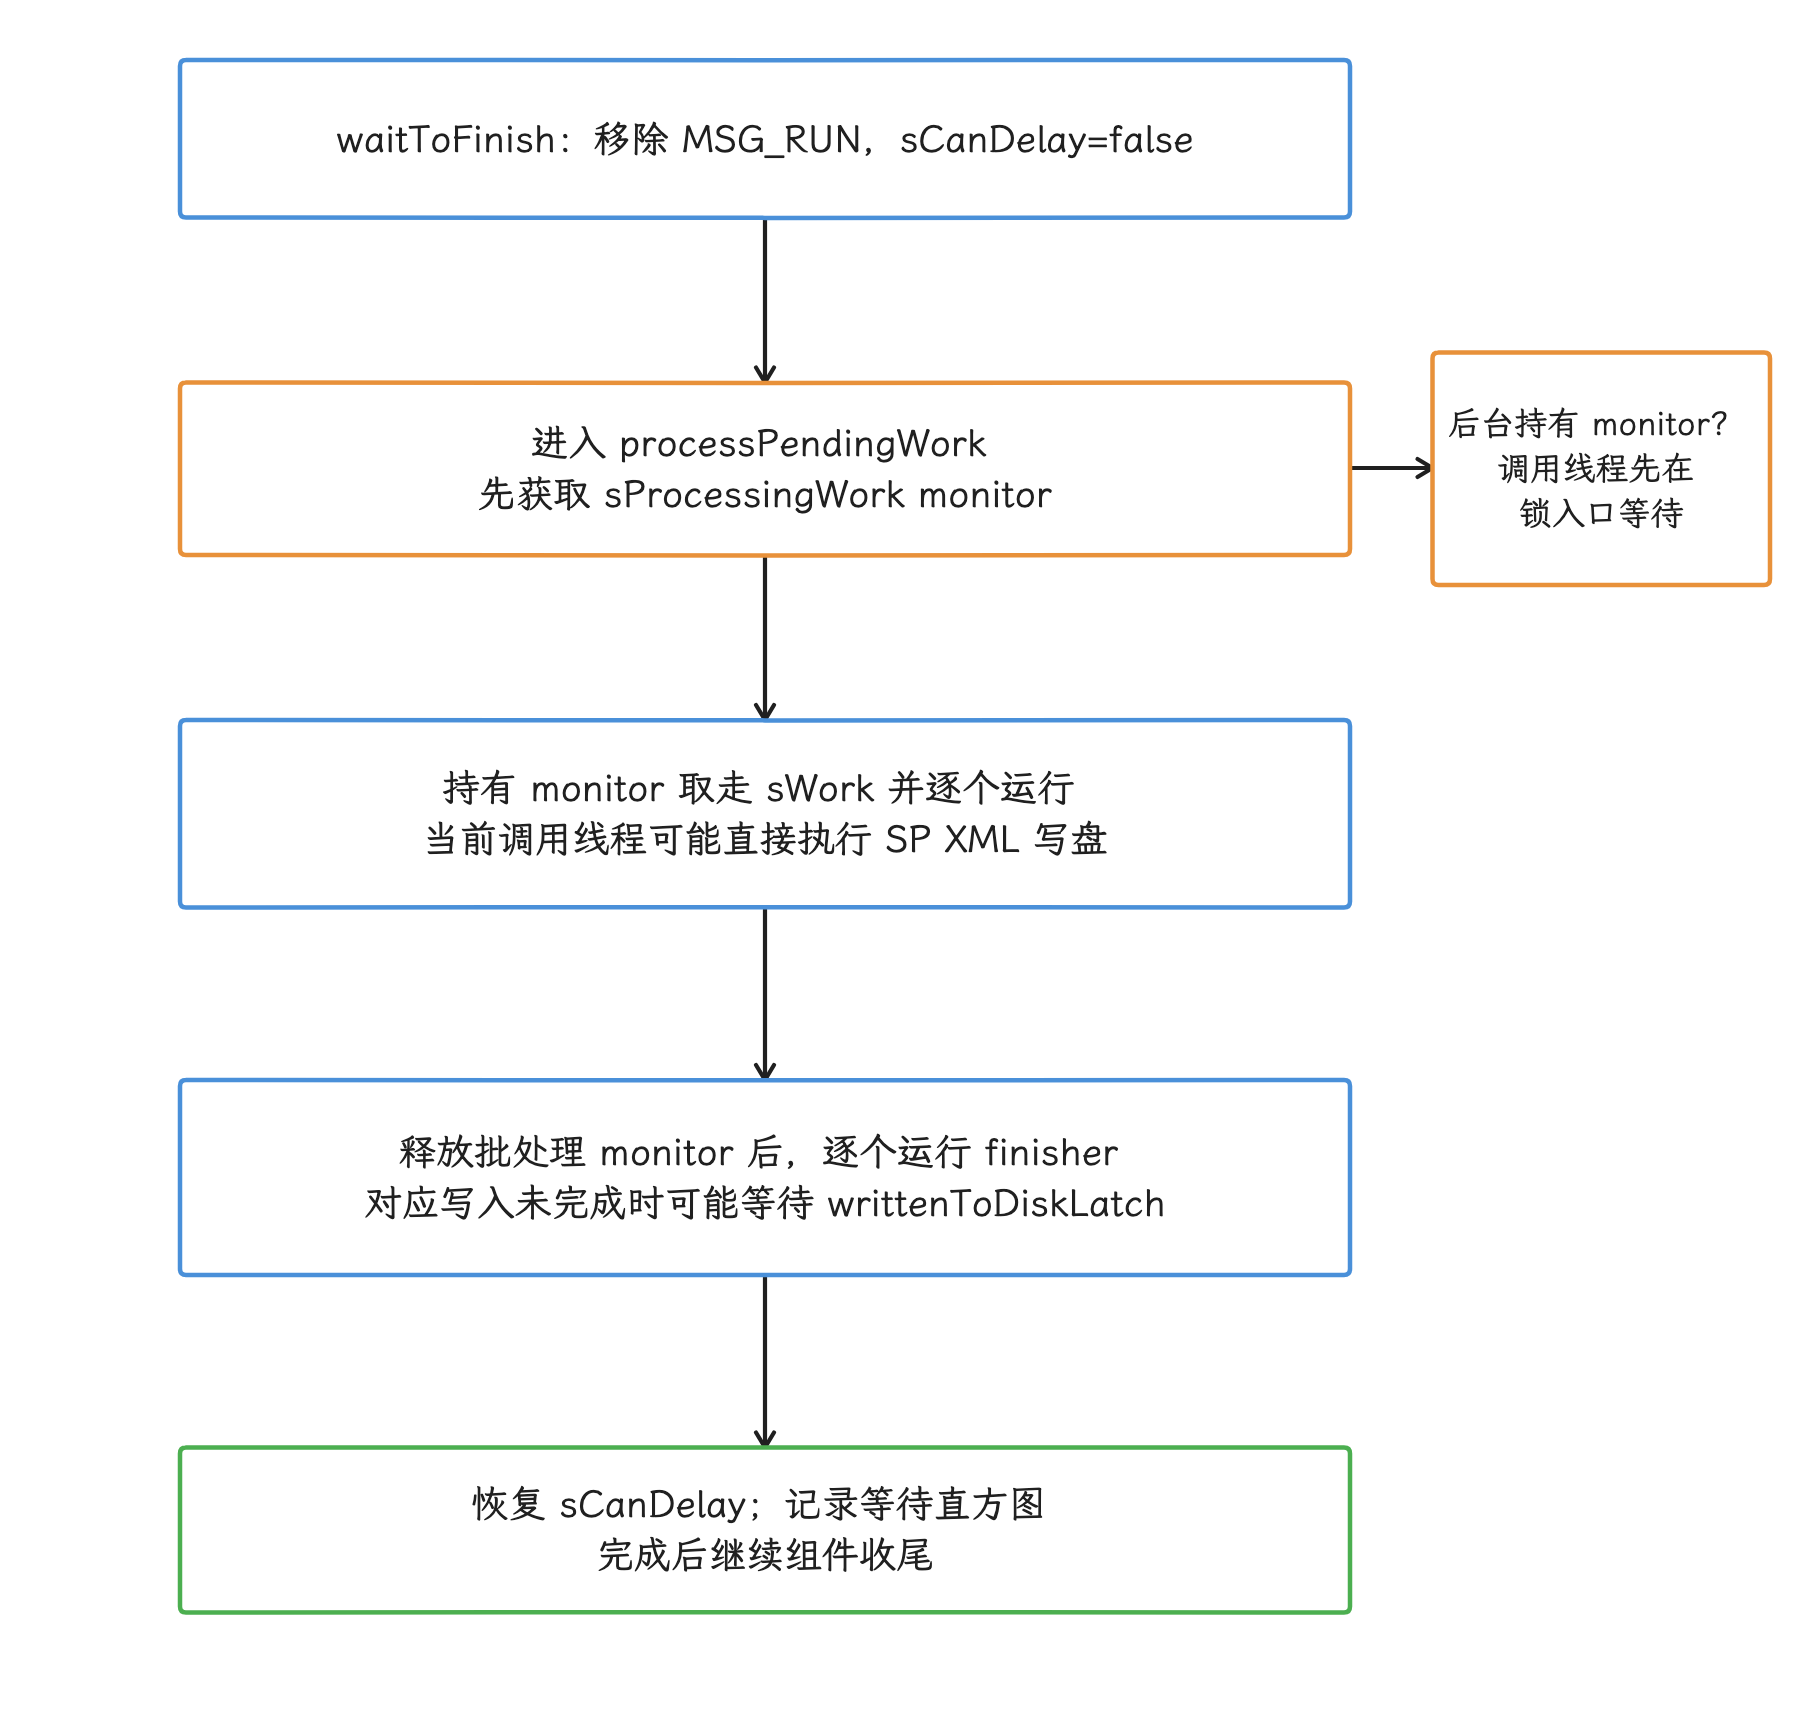
图:waitToFinish 先禁止延迟、处理待运行任务,再运行 finishers;锁竞争、直接写盘和 latch 等待是三个不同位置。
StrictMode.allowThreadDiskWrites() 会临时放宽这一段的磁盘写策略,所以只靠 StrictMode,可能漏掉生命周期收尾阶段由主线程执行的写盘。
组件收尾的四类调用点
组件收尾的等待点分四类:
-
现代 Activity:
handleStopActivity()在 Activity 停止时调用QueuedWork.waitToFinish()。 -
pre-Honeycomb Activity:面向 Android 3.0(API 11)之前行为的兼容路径仍在
handlePauseActivity()调用;现代 App 的主路径要按handleStopActivity()理解,不要写成onPause()。 -
Service:
handleServiceArgs()在命令处理后等待,handleStopService()在销毁清理后等待。 -
BroadcastReceiver:
PendingResult.finish()不直接调用waitToFinish()。仅 TYPE_COMPONENT 分支在 hasPendingWork() 为真时把 sendFinished() 排在队尾;其他类型或没有 pending work 时直接发送。这个检查只看尚在 sWork 中的任务,不等同于统计所有 in-flight 写盘。排队分支会使 AMS(ActivityManagerService,系统的 Activity 管理服务) 收到完成回执的时间随之推迟。
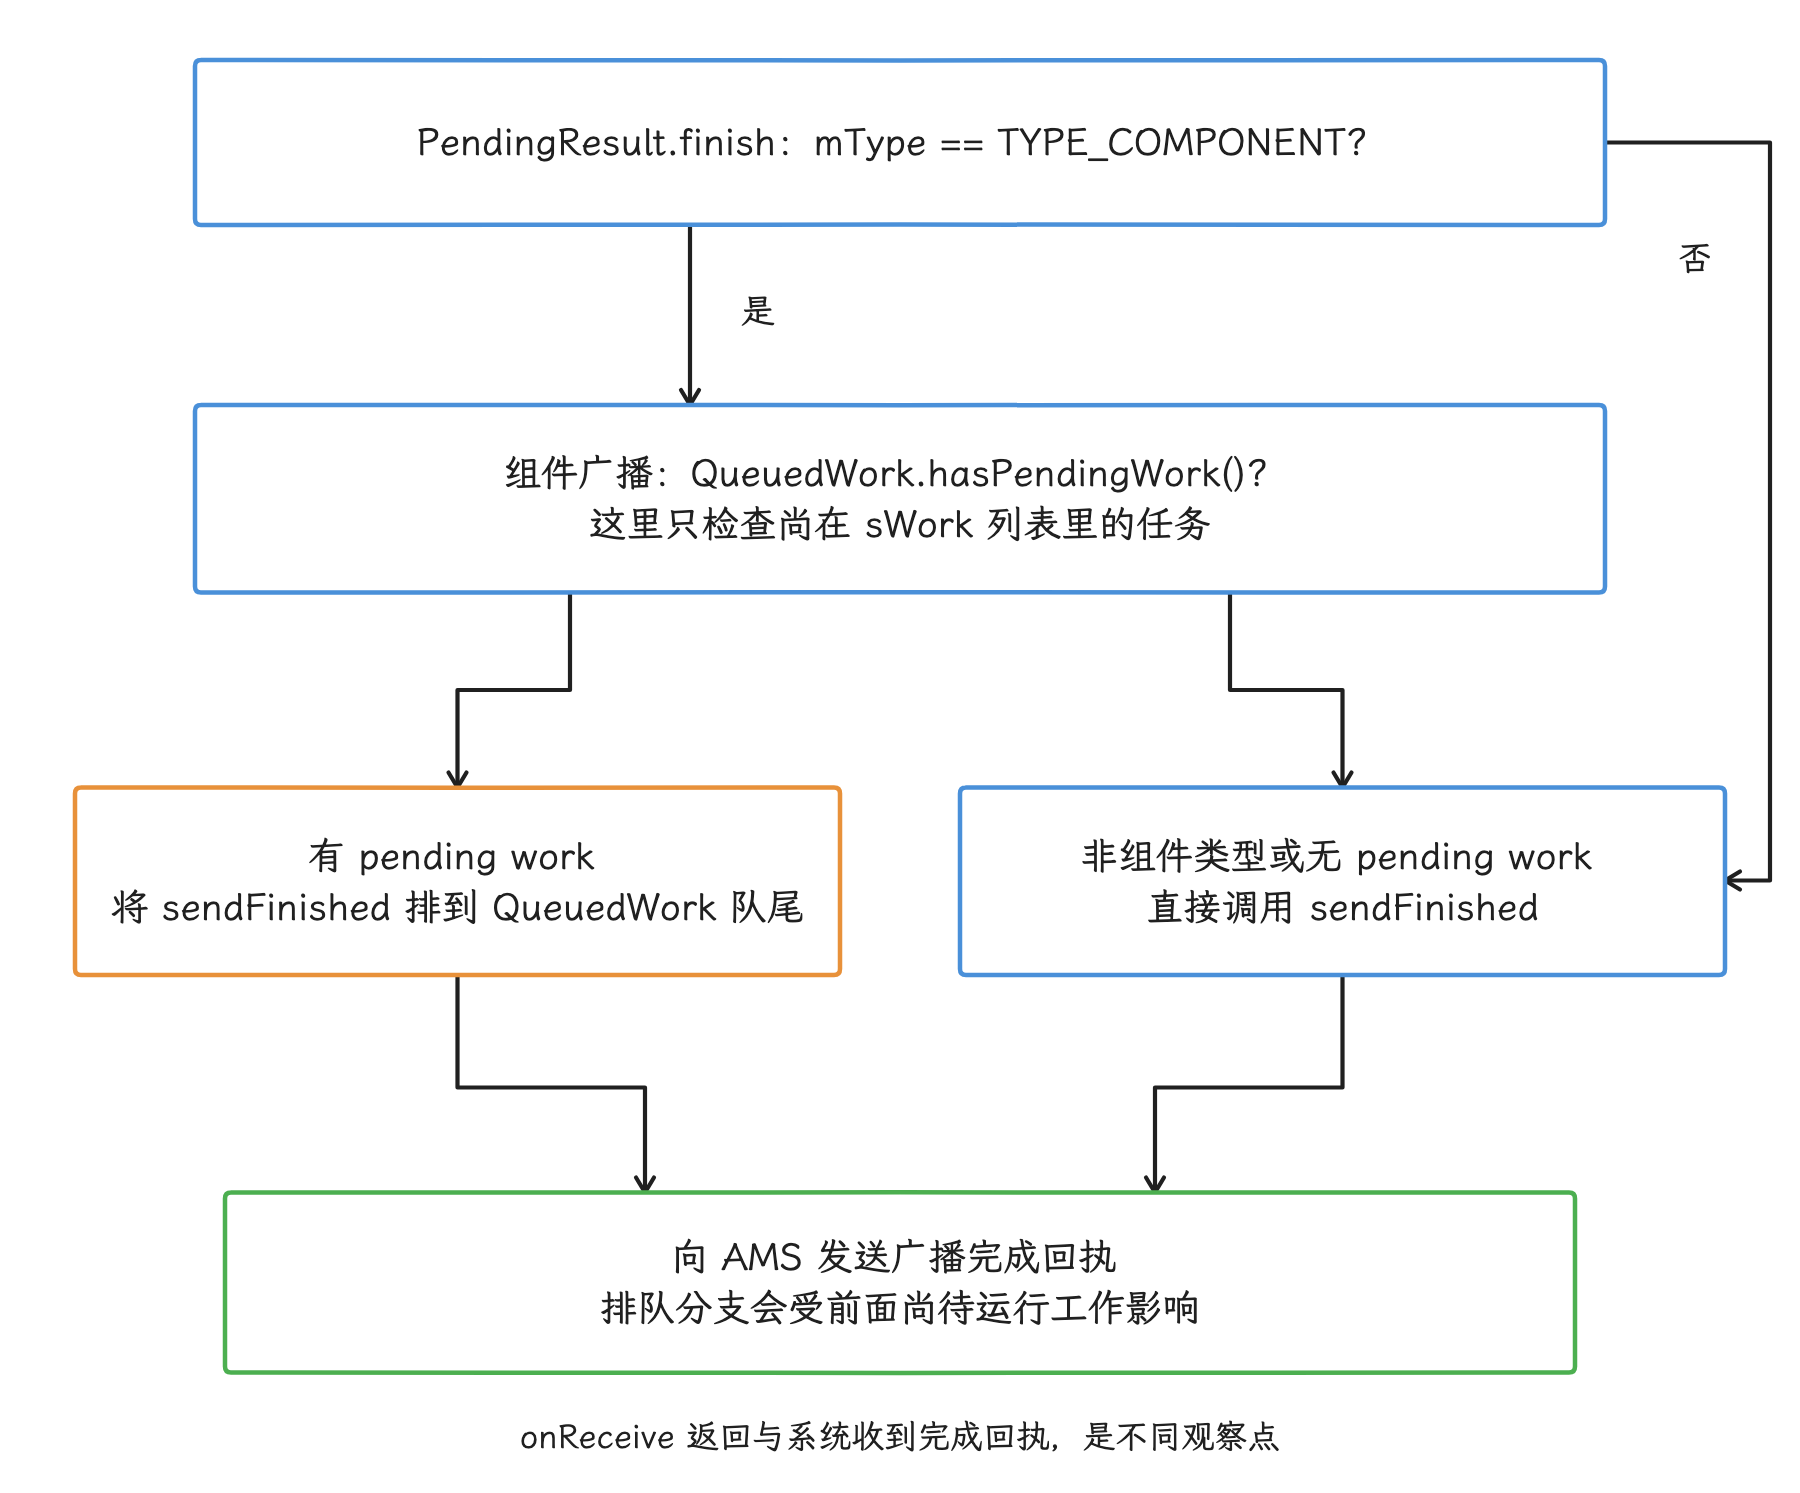
图:PendingResult.finish 只有在组件广播且 sWork 仍有 pending work 时排队 sendFinished;其他分支直接发送回执。
BroadcastReceiver 的 Java onReceive() 返回,只说明应用侧代码执行完了;系统什么时候收到完成回执,要看队列里 SP 写盘的进度,写盘过慢时广播超时风险随之上升。
组件的 ANR 窗口随组件类型、前后台状态和系统版本变化,统一套用“超过 5 秒必定 ANR”会误判。框架等待点的作用,是把原本延后的持久化成本重新带回组件时限内。
用 ANR traces 与 Perfetto 定位 SP
先从 ANR 栈判断阻塞类型
拿到一份 ANR trace,我们先看主线程卡在哪一类 SP 栈上。下面的示例区分四种常见形态,行号会随源码版本改变:
# A. 首次加载等待
java.lang.Object.wait
android.app.SharedPreferencesImpl.awaitLoadedLocked
android.app.SharedPreferencesImpl.getString

# B. 生命周期收尾时等待后台写盘
java.util.concurrent.CountDownLatch.await
android.app.SharedPreferencesImpl$EditorImpl.lambda$apply$0
android.app.QueuedWork.waitToFinish
android.app.ActivityThread.handleStopActivity

# B2. 生命周期收尾时等待后台批处理锁
- waiting to lock <sProcessingWork monitor>
android.app.QueuedWork.processPendingWork
android.app.QueuedWork.waitToFinish

# C. 生命周期收尾时由主线程执行写盘
android.system.Os.fsync
android.app.SharedPreferencesImpl.writeToFile
android.app.QueuedWork.processPendingWork
android.app.QueuedWork.waitToFinish
A 类要关联 SharedPreferences 加载线程与 XML 解析;B 类区分 writtenToDiskLatch 等待与 B2 的 sProcessingWork monitor 竞争,并找到后台工作线程;C 类的文件 I/O 已经在主线程上。我们先把阻塞类型分对再谈优化——类型分错,很容易只移动耗时而没有消除等待。
Service 栈可能以 handleServiceArgs() 或 handleStopService() 结尾。BroadcastReceiver 常见的是完成回执延后,未必出现主线程停在 waitToFinish() 的相同栈形态。
Perfetto 中看什么
Perfetto 默认并不会给每个 Java 方法生成名为 QueuedWork 的 slice(时间区间)。采集配置里如果没有 Java 调用栈或应用自定义 trace,只搜方法名很可能一无所获。我们把几类信息放在一起看:
- 主线程在组件收尾区间处于 Running(运行中)、Runnable 还是 Sleeping(睡眠) 状态。
SharedPreferences与queued-work-looper线程的调度和 CPU 活动。- ART(Android Runtime,Android 运行时)/Java 调用栈采样里是否出现
awaitLoadedLocked()、writeToFile()、processPendingWork()。 - 文件系统与块 I/O 事件是否和等待区间重合。
- logcat 日志中
SharedPreferencesImpl的慢fsync直方图、QueuedWork的慢等待直方图。 - App 自己记录的 SP 文件名、key 数、文件字节数、在途写次数和调用场景;不要记录敏感值。
只看到主线程停在 futex(快速用户态互斥锁) 等待还不够:Java monitor(对象监视器)、CountDownLatch、Binder 和许多其他同步原语都可能落到 futex 上,等待对象要靠调用栈来确定。
DataStore 的异步模型
换了存储库,异步模型完全不同。我们先看 DataStore 的一次更新在什么意义上算“完成”,再看它的序列化成本和单例约束。
非阻塞 API 的完成时序
DataStore 的 data 是 Flow<T>(异步数据流),edit()/updateData() 是挂起 API。默认工厂的协程作用域使用 Dispatchers.IO + SupervisorJob(),内部 I/O 与 actor 任务使用该作用域,但 transform 会通过 withContext(callerContext) 回到调用方协程上下文;把它当成自动迁移到 IO 的任意计算,属于误用。SupervisorJob 隔离子任务失败;自定义作用域还需按实际配置判断。调用方线程不会像 SP commit() 那样同步执行文件 I/O,但调用方协程会挂起;挂起期间不占用当前线程,直到更新完成或异常抛出。
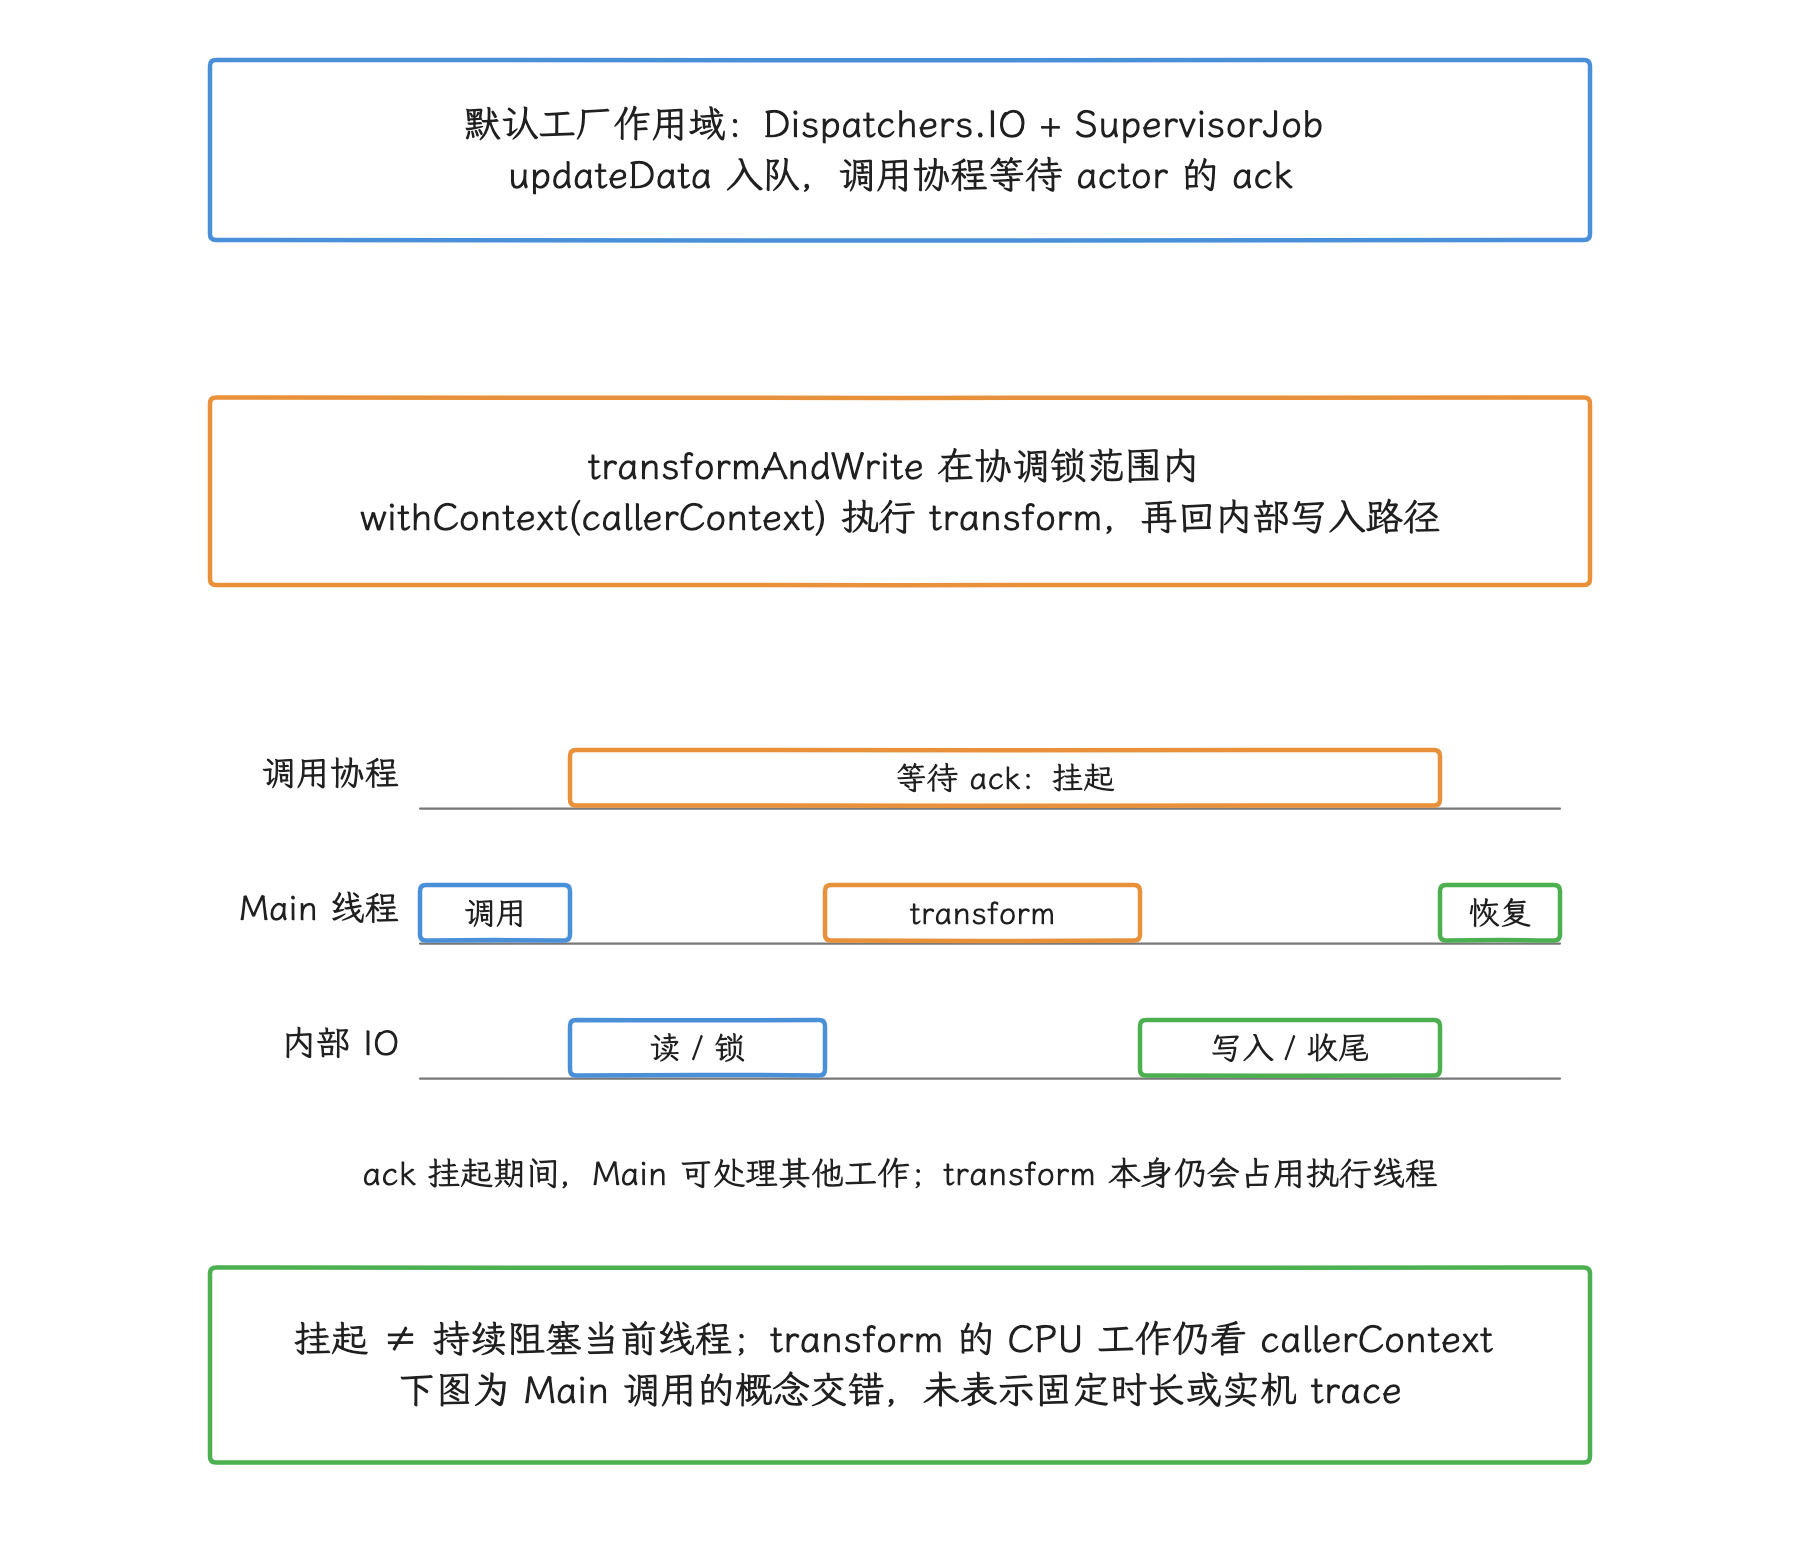
图:默认内部作用域使用 IO;transform 会回到 callerContext,若从 Main 调用,耗时计算仍可能占用 Main。调用协程等待 ack 时会挂起。
下面的代码用于展示 Preferences DataStore 的基本读写语义:
val Context.settingsDataStore by preferencesDataStore(name = "settings")

val nightMode: Flow<Boolean> =
    context.settingsDataStore.data.map { prefs ->
        prefs[booleanPreferencesKey("night_mode")] ?: false
    }

suspend fun setNightMode(enabled: Boolean) {
    context.settingsDataStore.edit { prefs ->
        prefs[booleanPreferencesKey("night_mode")] = enabled
    }
}
setNightMode() 返回时,这次更新已经走完 DataStore 的串行更新与持久化路径;写入失败的话,异常会回到挂起调用方。重试、提示用户还是保留旧状态,由调用者决定——launch 启动协程后立刻把业务操作标记为永久成功,等于放弃了失败信号。
官方 API 对 DataStore 的承诺包括线程安全、非阻塞和事务化更新。普通读取可以走缓存或尝试锁路径,通知触发的刷新仍可能等待协调锁;非阻塞 API 不承诺零等待。第一次收集还需要完成初始化、迁移和首次读盘;初始化失败会通过 Flow 或更新调用传播。
DataStore 的全量序列化
DataStore 没有字段级磁盘更新。官方 API 文档明确说明:新旧对象不相等、实际执行写入时,整个对象会被序列化并持久化;updateData() 的 transform 若返回与旧值相等的新值,1.2.1 会跳过 writeData()。Preferences DataStore 把键值集合编码为 protobuf(Protocol Buffers 二进制格式),Proto DataStore 使用应用定义的 protobuf schema(数据结构定义);通用的 typed DataStore
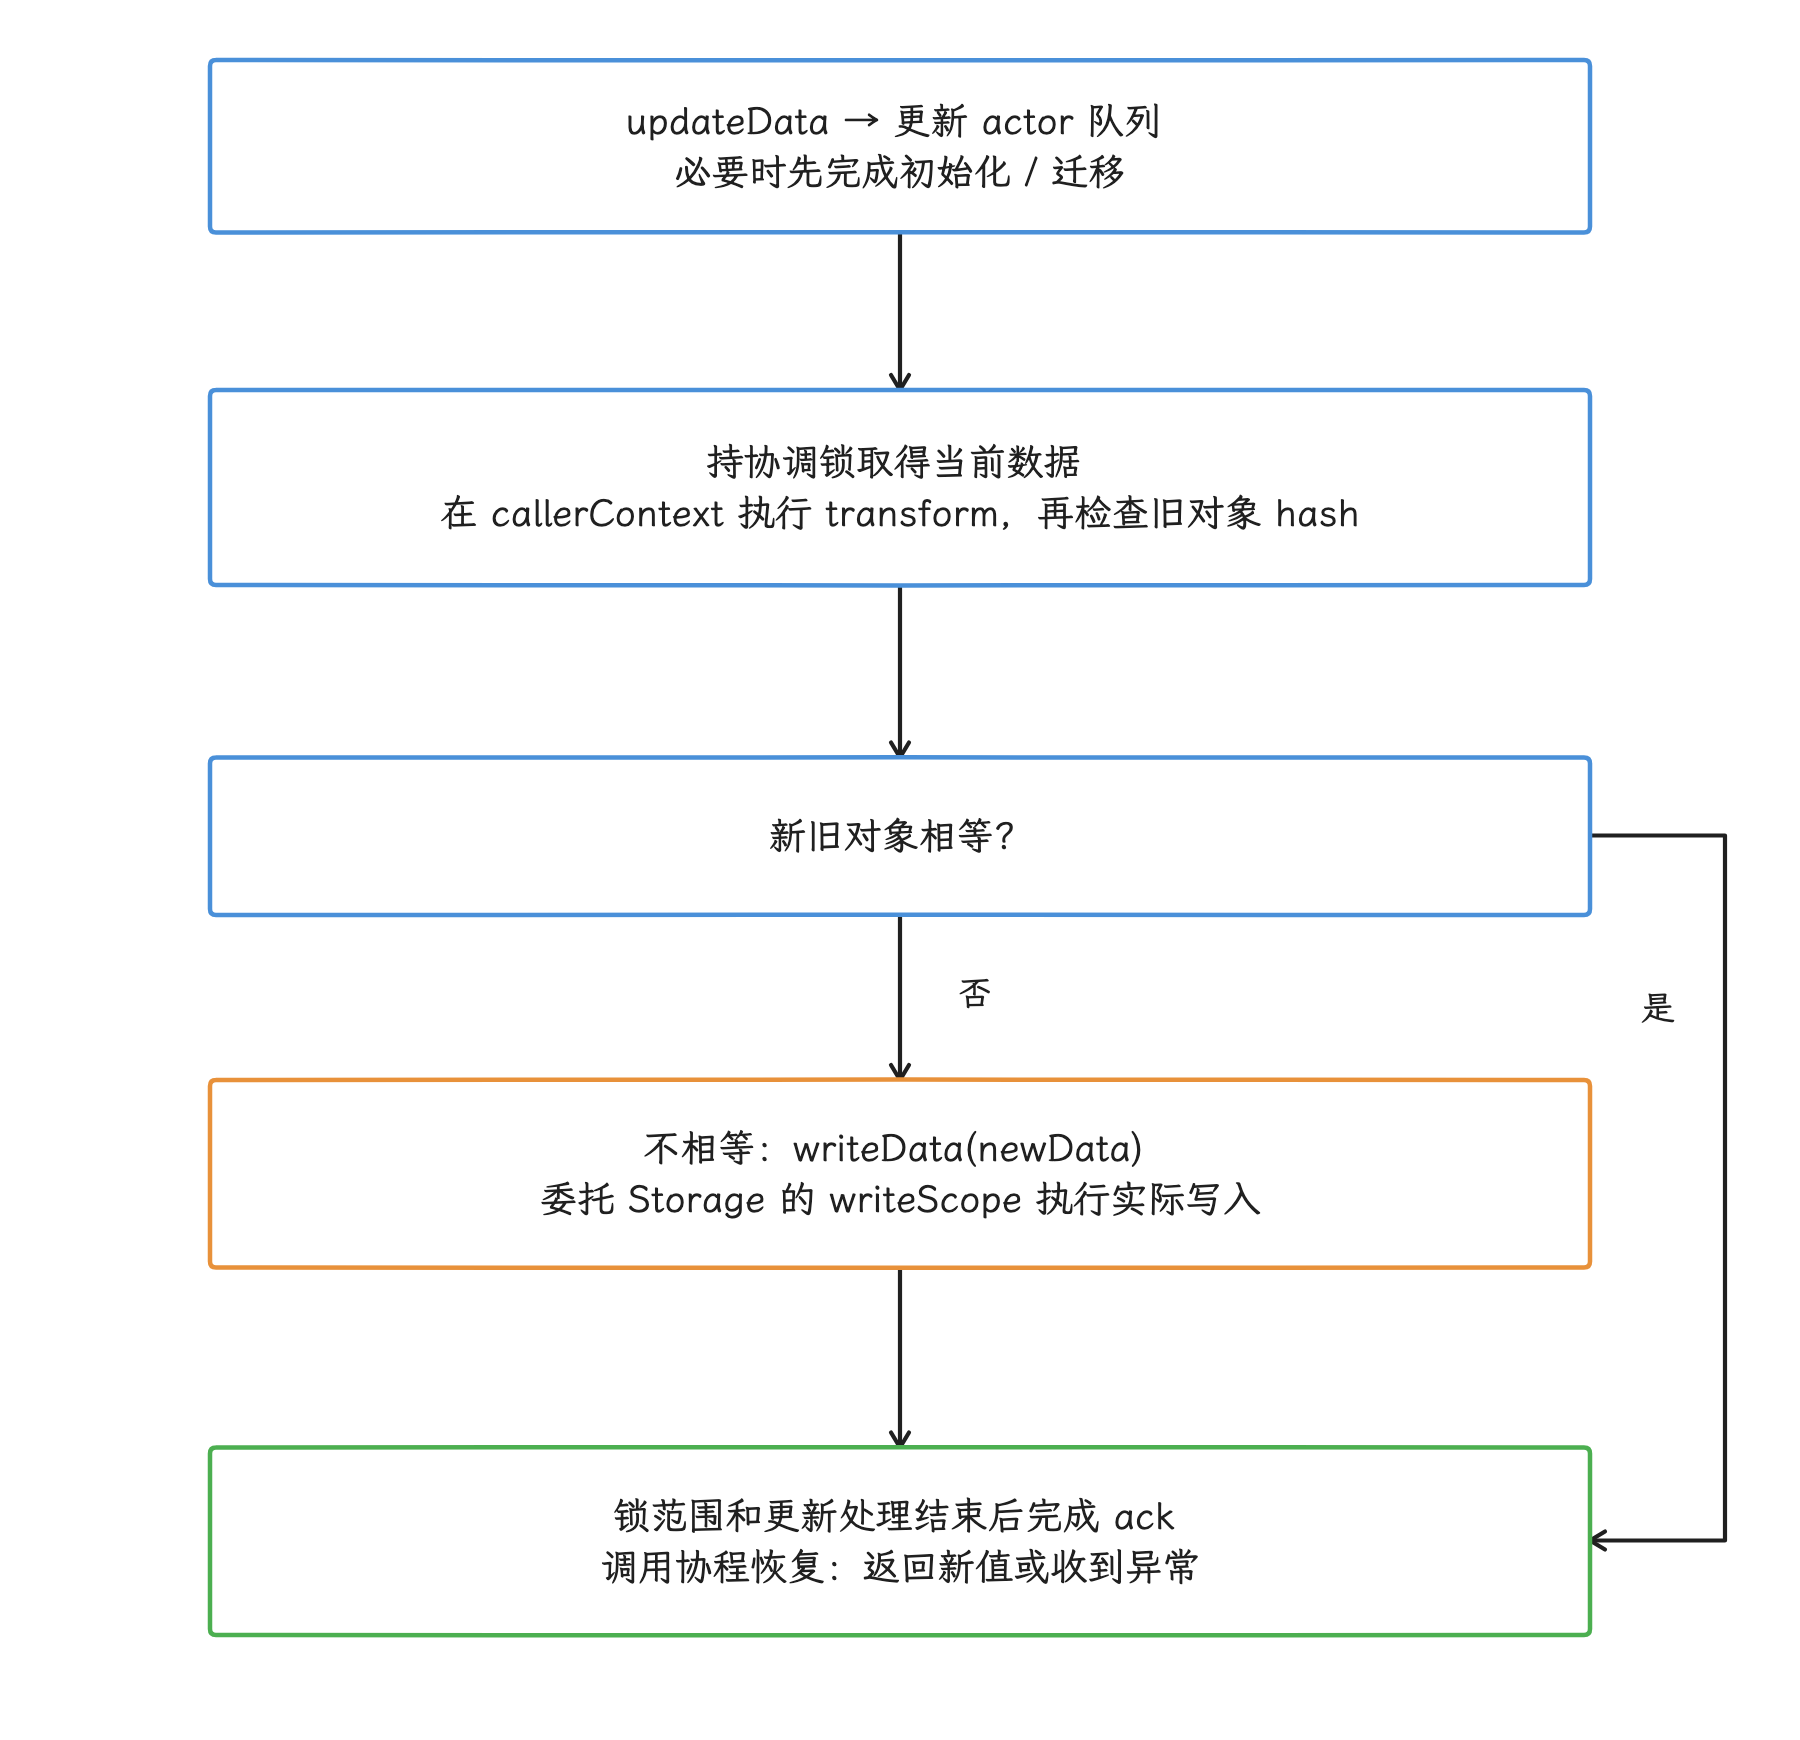
图:actor 串行处理更新,在协调锁内读当前值、执行 transform 和检查不变性;新旧值不相等才写入,成功或错误通过 ack 返回调用方。
以下流程限定 AndroidX DataStore 1.2.1 的 FileStorage 后端:preferencesDataStore 所调用的 Preferences 默认工厂,以及 DataStoreFactory.create(serializer, produceFile) 使用它。普通 typed dataStore 委托在这个版本使用 OkioStorage,自定义 Storage 也可改变底层实现;分析具体调用时,应先确认后端。
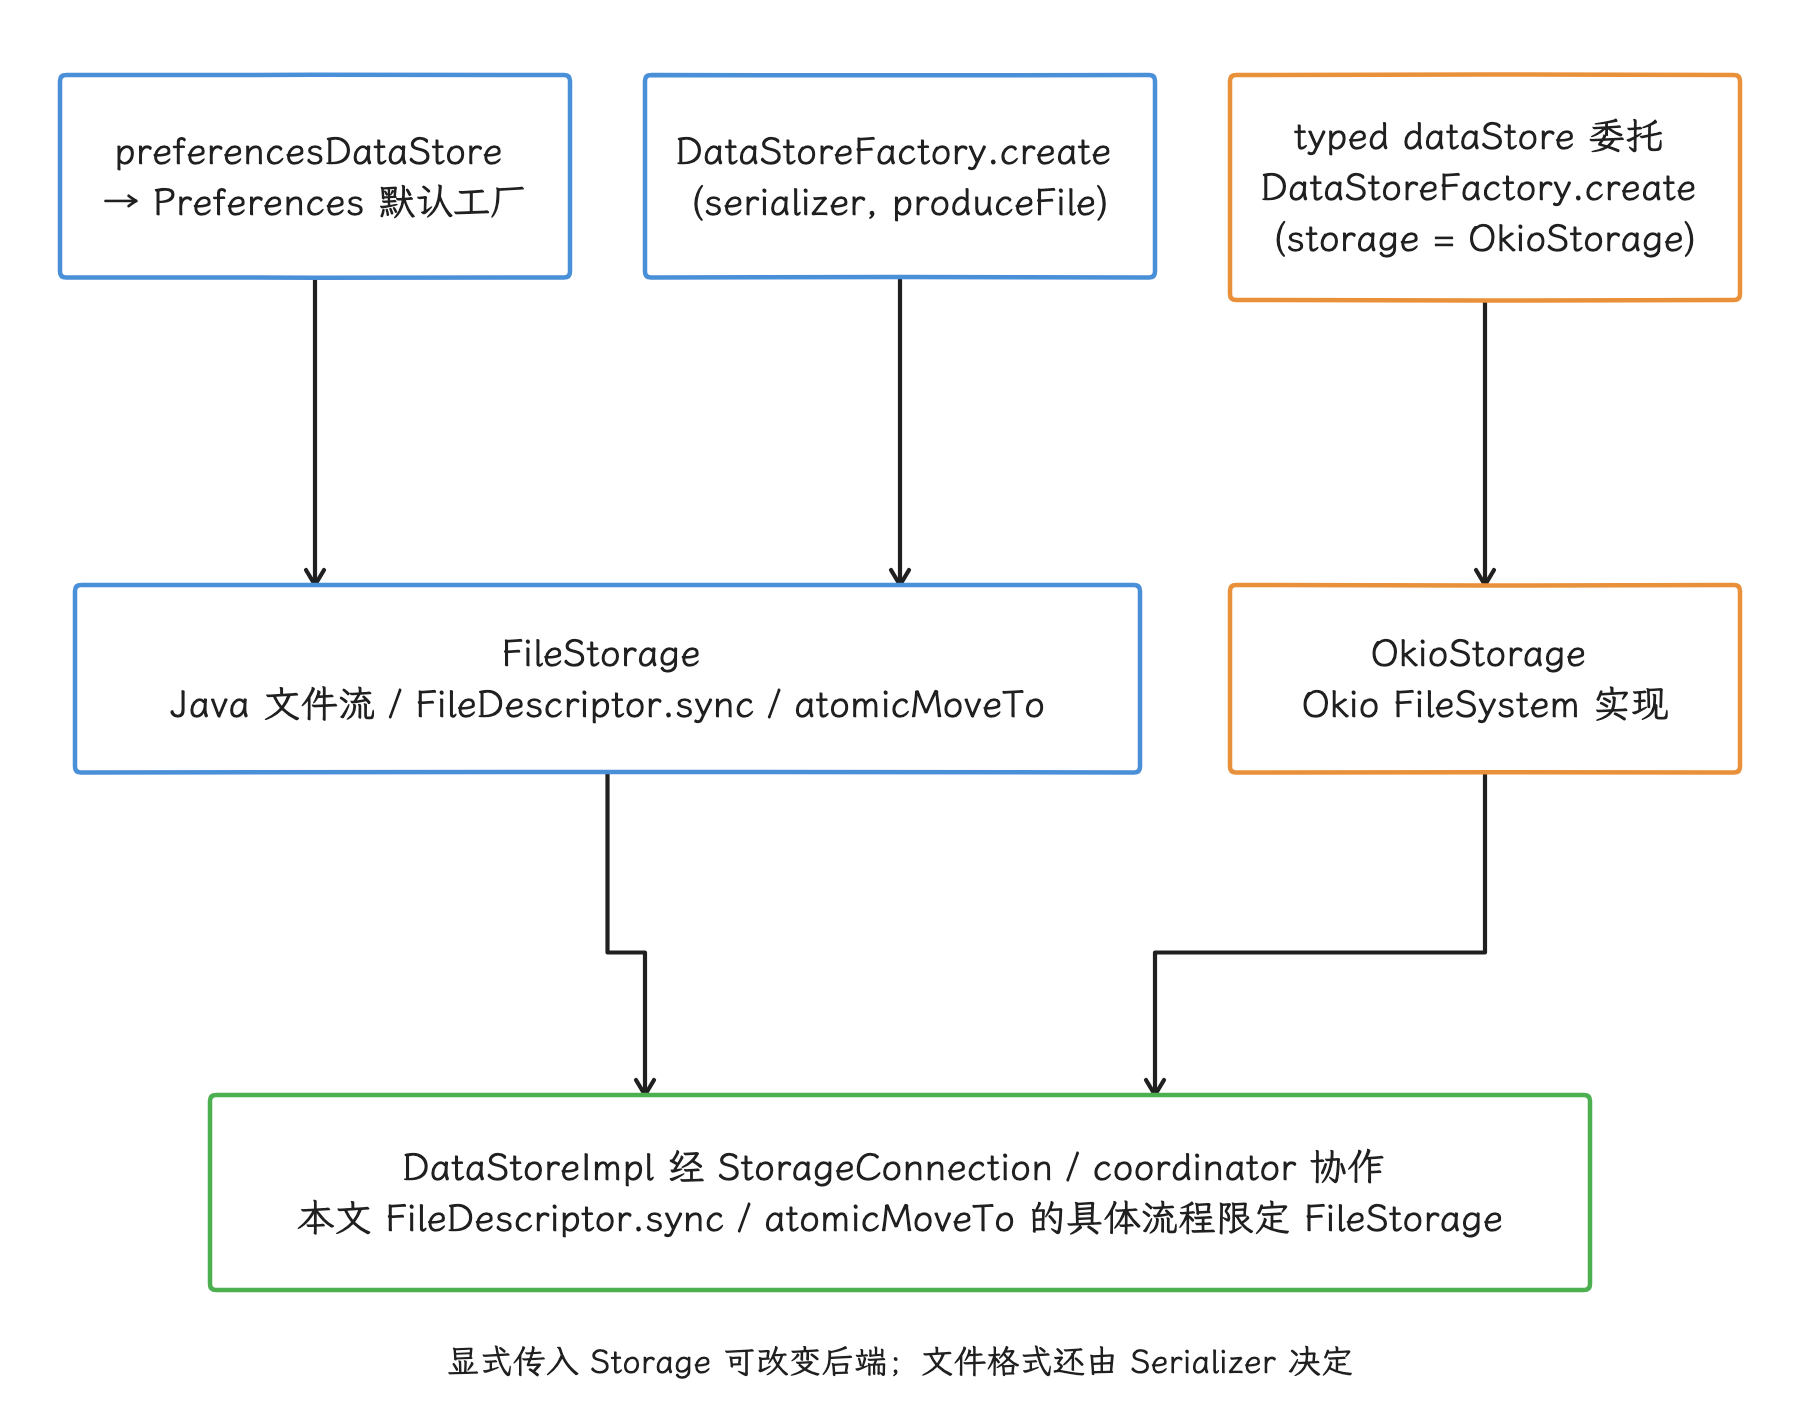
图:Preferences 默认工厂和 serializer/file 工厂选择 FileStorage;typed dataStore 委托选择 OkioStorage,显式 Storage 可进一步改变后端。
FileStorage 的实际写入路径是:
- 在更新序列中获得当前数据。
- 执行 transform(更新函数),得到不可变的新值;新旧值相等时可跳过后续磁盘写入。
- 在受协调锁保护的
writeScope(受协调锁保护的写入作用域) 中递增协调器版本。 - 将新值完整序列化到
<file>.tmp。 - 对临时文件执行
FileDescriptor.sync()。 writeScope的写入代码结束后,FileStorage把临时文件原子移动到目标路径。- 整个
writeScope成功返回后,串行处理更新的写入 actor(串行处理更新的内部任务) 才唤醒等待该更新的调用方。
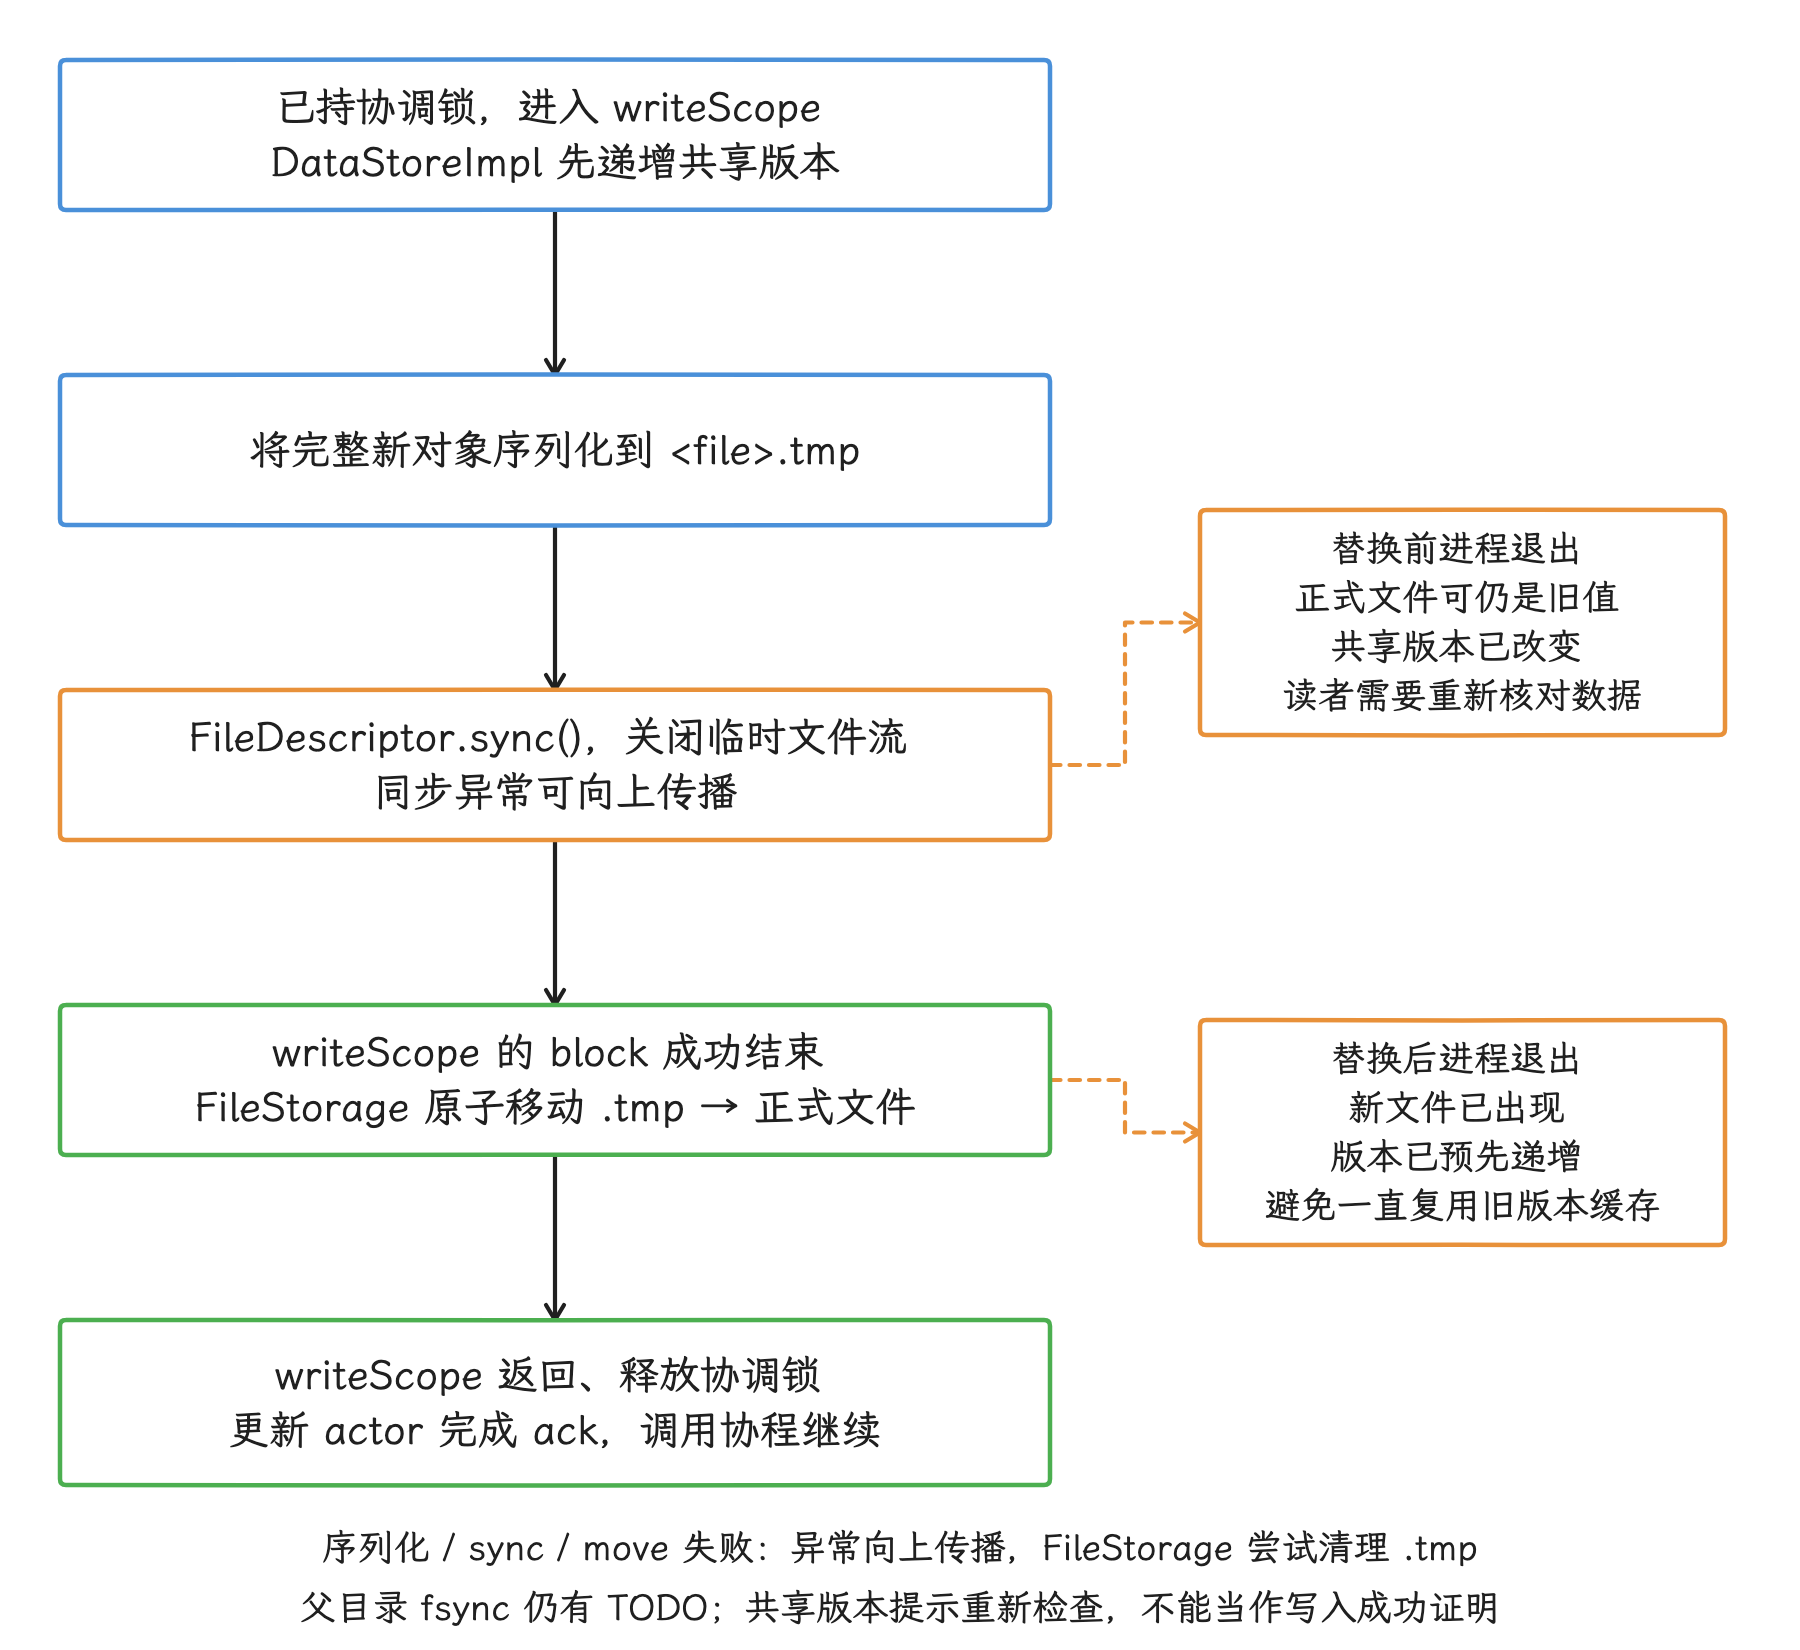
图:限定 DataStore 1.2.1 的 FileStorage 实际写入:持协调锁先递增版本,再全量写 .tmp、同步并原子替换正式文件,writeScope 返回并释放协调锁后由 actor 完成 ack。替换前退出时正式文件可仍旧,但版本已变化;替换后也不会留下新文件存在而版本尚未递增的顺序窗口。版本是重查信号;异常向上传播并尝试清理 .tmp,父目录 fsync 仍有 TODO,断电持久性另行验证。
源码里仍留着“同步父目录”的待办注释,掉电窗口下的回退风险因此还在。DataStore 的 API 一致性和错误传播显著强于 SP,但存储硬件与文件系统对持久性的影响,任何上层 API 都消不掉。
Preferences 与 Proto 怎么选
| 需求 | 建议 |
|---|---|
| 少量、无固定 schema 的键值配置 | Preferences DataStore |
| 有明确字段、枚举、默认值和版本演进 | Proto DataStore |
| 关系查询、局部更新、索引、分页、大集合 | Room |
| 缓存,可丢失且需要容量淘汰 | 专用缓存方案 |
Proto DataStore 的 schema 更利于审查和演进,但业务迁移仍要应用自己做:字段编号不可复用,删除字段要保留编号;加密、备份排除和敏感数据生命周期也由应用设计。
单例是文件级约束
同一进程、同一路径应只有一个活跃 DataStore 实例。标准 FileStorage 在首次建立读写连接时,按 canonical path 的 activeFiles 登记检查重复并抛出 IllegalStateException;自定义或不同 Storage 也必须遵守唯一实例约束;某个后端自带的检查,当不成跨后端的全局文件锁。顶层 by preferencesDataStore 属性是一种方便的单例组织方式,但指向同一文件创建多个 delegate(属性委托) 依旧是错的。
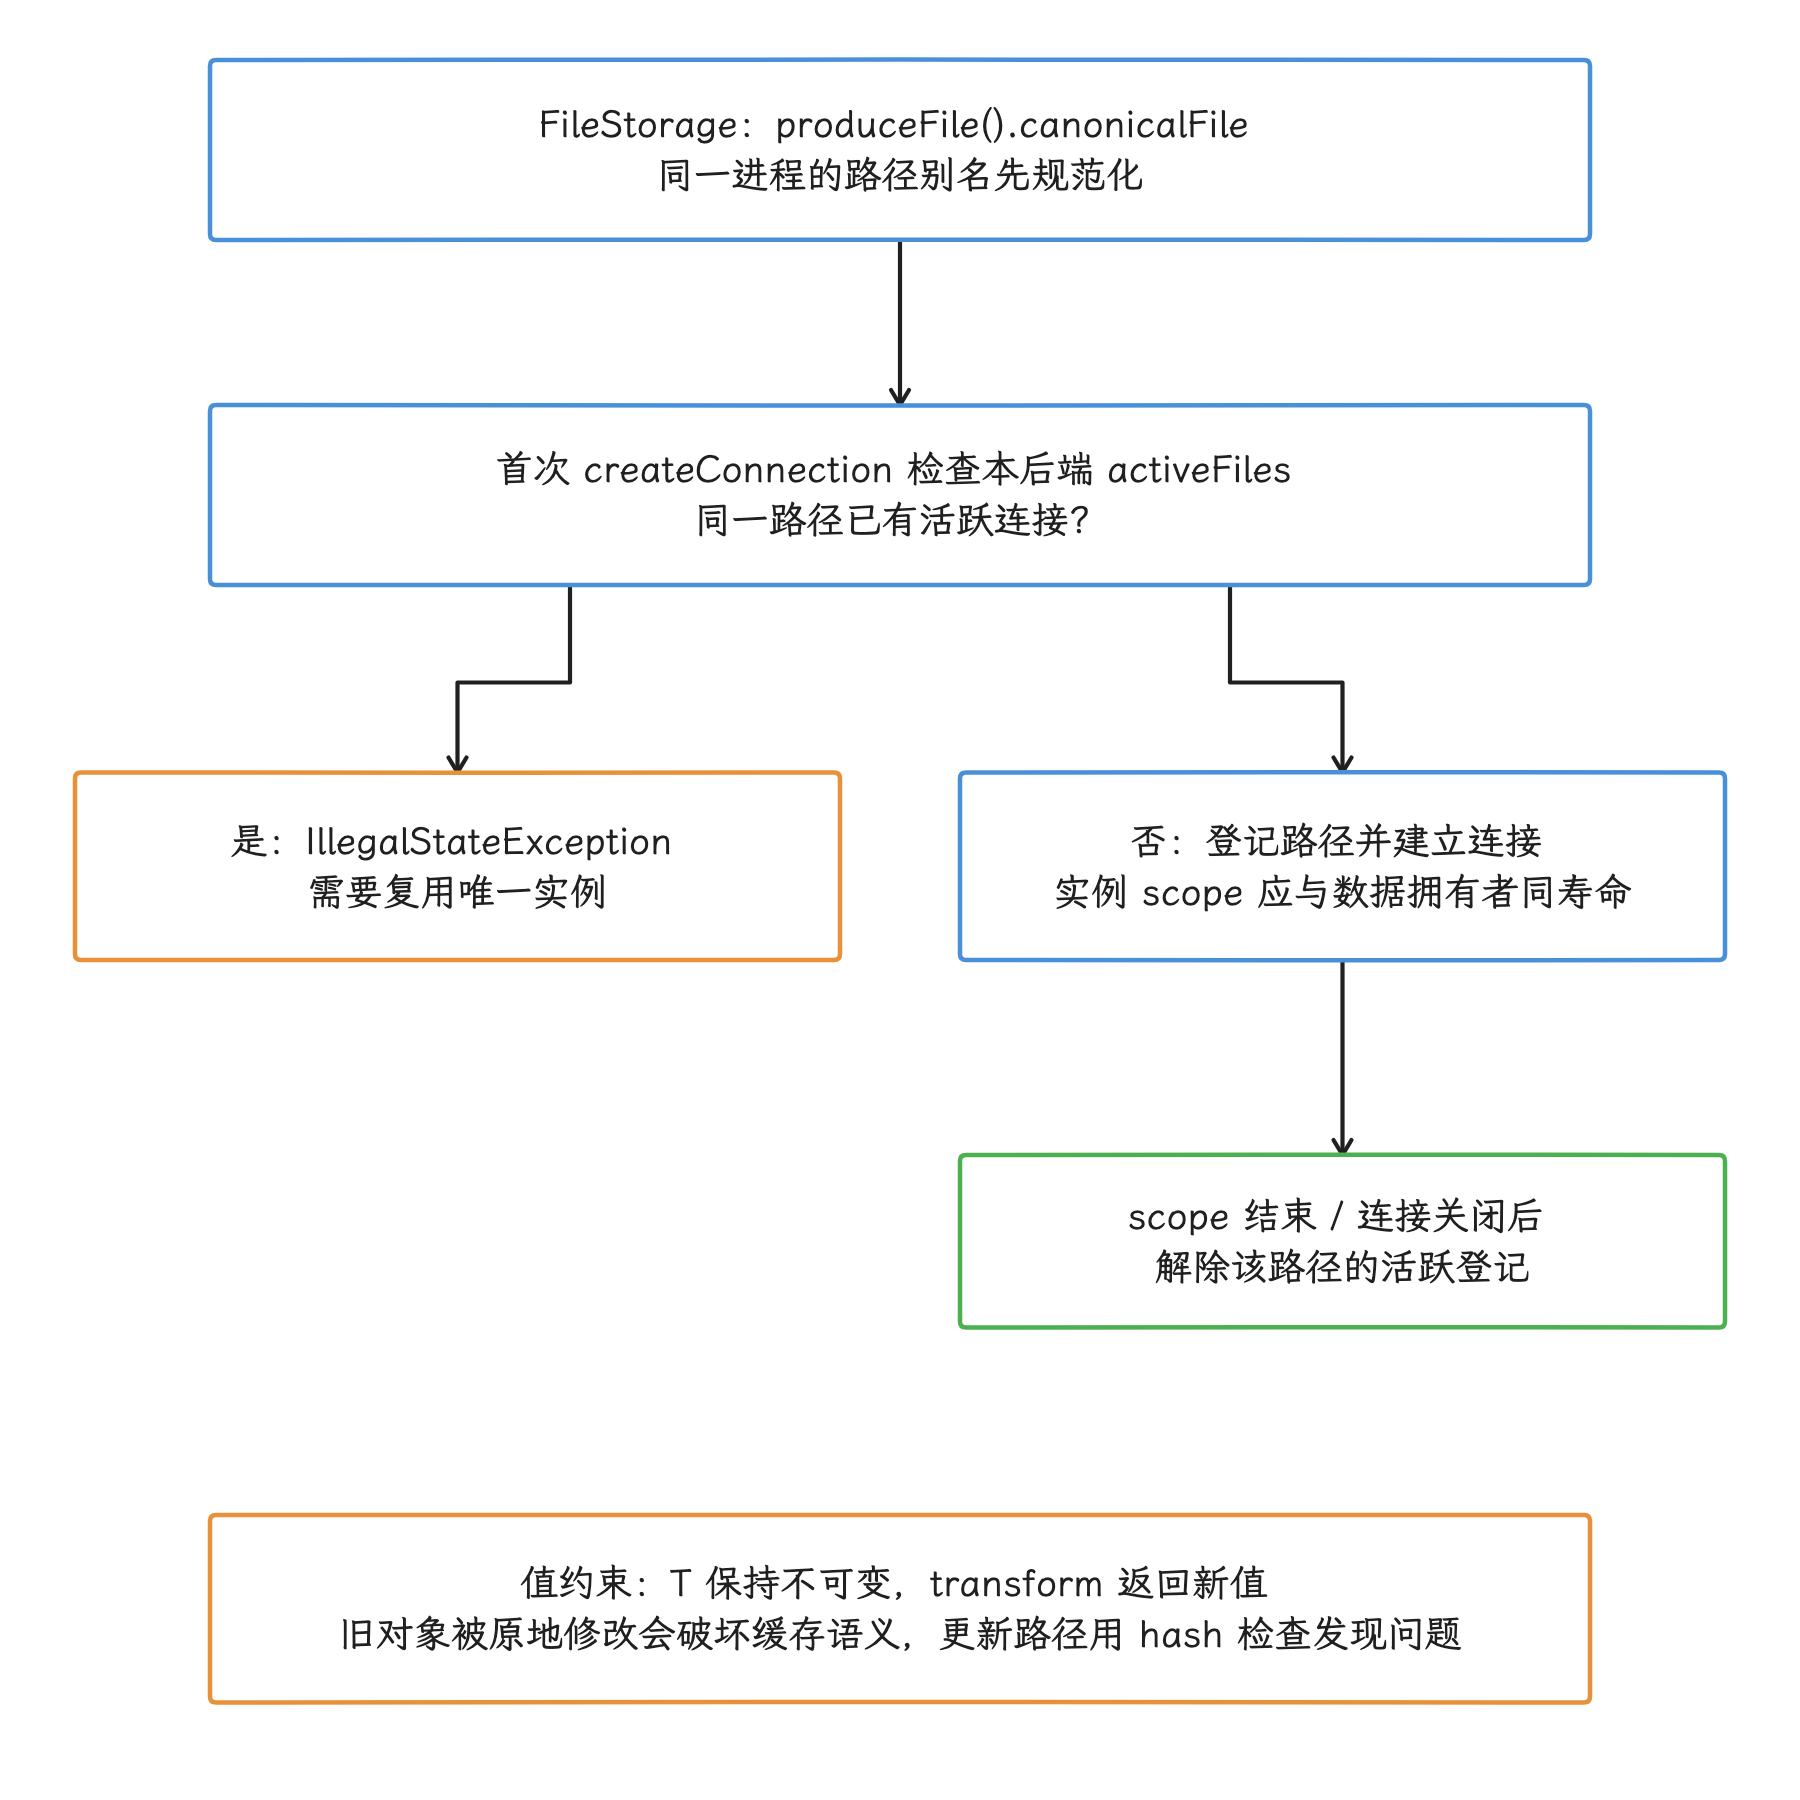
图:FileStorage 首次建连接时以 canonical path 登记活跃文件;重复会报错,关闭连接后解除登记。唯一实例和不可变值都是使用约束。
自建 DataStoreFactory 时,传入的协程作用域应与应用级数据拥有者同寿命。Activity、Fragment 或一次请求里都不要重复创建实例,produceFile 也不要每次返回不同路径。
多进程场景的实例与路径要求、单进程与多进程工厂的选择,见后文 MultiProcess DataStore 一节。路径要先规范化,transform 返回的数据对象必须保持不可变,否则进程内缓存的 hash(哈希) 校验就失去了意义。
错误与损坏要分开处理
下面的代码用于给 Preferences DataStore 的读流提供 I/O 失败降级:
val safeSettings: Flow<Preferences> =
    context.settingsDataStore.data.catch { error ->
        if (error is CorruptionException) {
            throw error
        } else if (error is IOException) {
            emit(emptyPreferences())
        } else {
            throw error
        }
    }
这段代码先排除 CorruptionException,再把其他 IOException 映射为空配置,适合“默认值可接受”的场景。catch 发出默认值后,这次收集会正常结束,不会自动恢复监听后续更新;若需要恢复,应明确设计 retryWhen 或重新收集策略。若数据影响登录、安全或付费状态,静默回退可能产生更严重的问题,应由业务定义恢复策略。
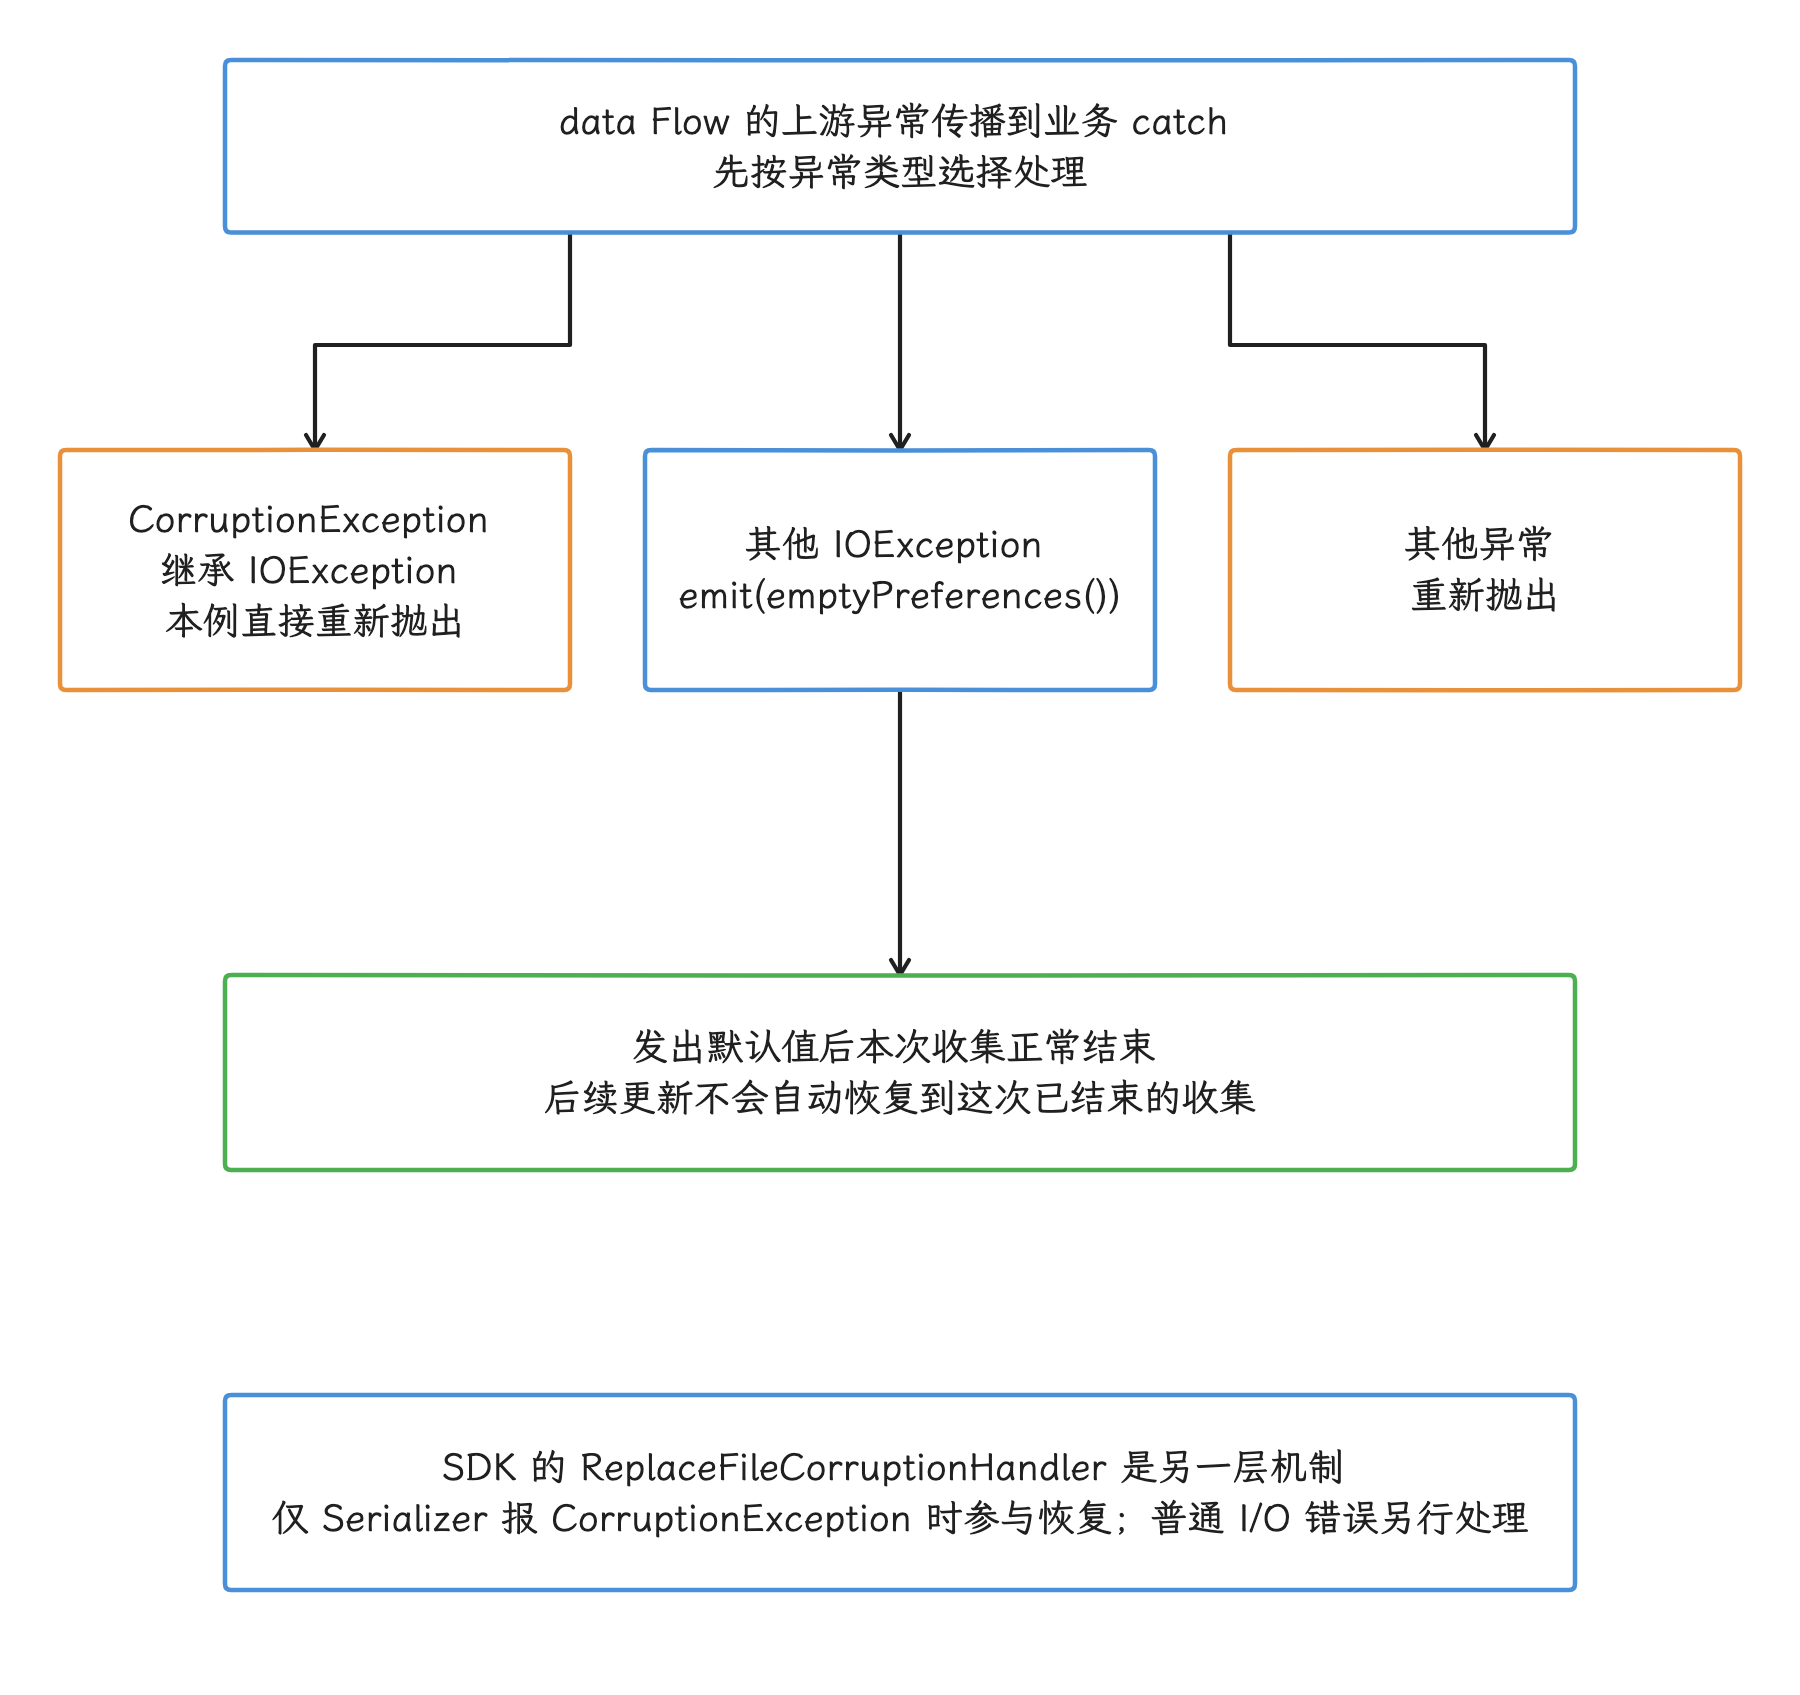
图:此示例先保留损坏异常,再对其他 IOException 发出默认配置;fallback 发出后本次收集结束,需要恢复时应显式重试或重新收集。
ReplaceFileCorruptionHandler 只在 Serializer 抛出 CorruptionException 时参与恢复;权限不足、磁盘空间不够等其他 I/O 错误,要走业务自己的恢复策略,恢复值也要满足业务的安全要求。
从 SP 迁移到 DataStore
迁移要解决的事情很具体:把旧 key 搬进 DataStore、清理旧文件,并保证迁移重跑安全。我们先看官方迁移组件怎么用,再按数据所有权安排迁移顺序。
使用 SharedPreferencesMigration
下面的示例用于迁移指定的基础类型 key:
val Context.settingsDataStore: DataStore<Preferences> by preferencesDataStore(
    name = "settings",
    produceMigrations = { context ->
        listOf(
            SharedPreferencesMigration(
                context = context,
                sharedPreferencesName = "legacy_settings",
                keysToMigrate = setOf("theme", "font_scale"),
            )
        )
    },
)
迁移任务在 DataStore 首次可访问之前执行。shouldMigrate() 返回 false 的迁移会跳过,也不会登记该次 cleanUp();参与迁移的结果成功写入(新旧值相等时可复用原值)后,才执行已登记的清理步骤,从旧 SP 删除所选 key;使用 Context/文件名构造器且旧 SP 已空时,还会尝试删除旧文件。迁移或持久化一旦失败,后续访问可能再次执行相关步骤,所以迁移函数必须幂等——重复执行也要得到一致结果。
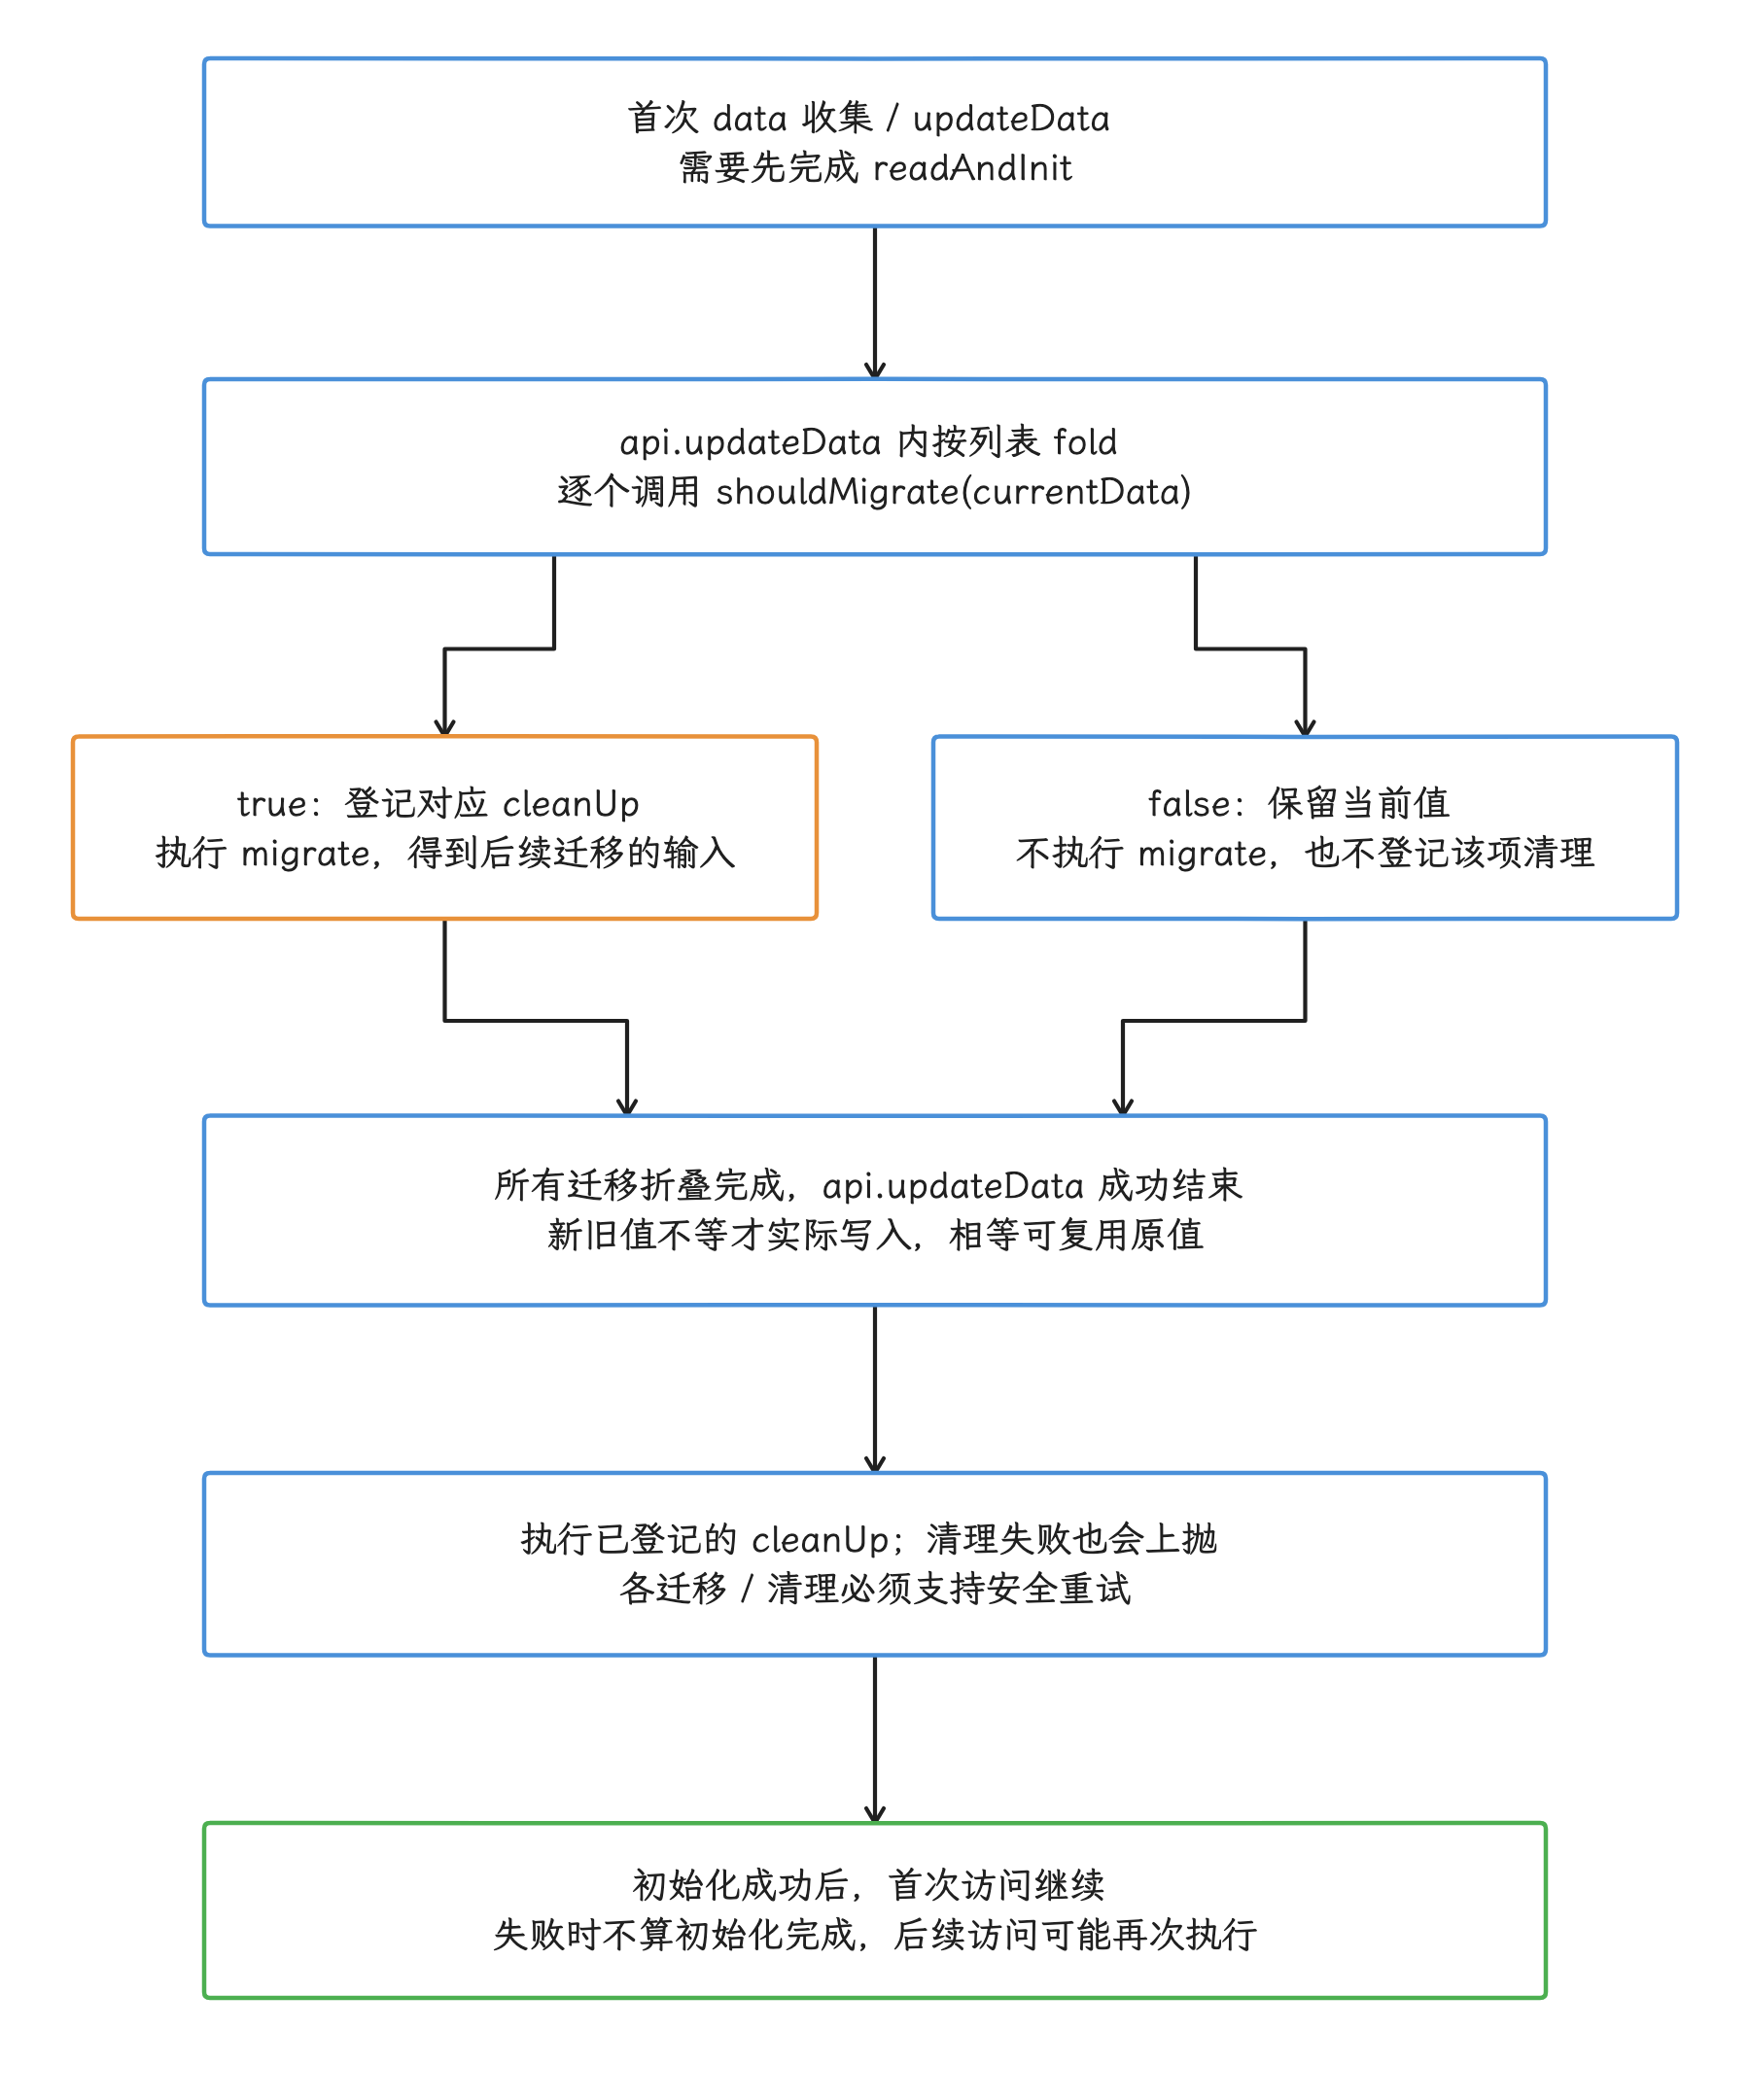
图:初始化在 api.updateData 中折叠迁移列表;参与迁移才登记清理,结果更新成功后执行已登记的 cleanUp,再开放数据访问。
另外几点要留心:
- 内置 Preferences 迁移只支持 SP 的 boolean、float、int、long、string 和 string set(字符串集合)。
- 指定
keysToMigrate后只能访问这些 key;省略时迁移全部受支持 key。 - DataStore 中已经存在的同名 Preferences key 不会被旧 SP 反复覆盖。
- 迁移尚未完成时,
data.first()和更新调用都会等待初始化。 - 迁移完成后继续让旧代码写 SP,会形成两份来源;DataStore 不负责持续双向同步。
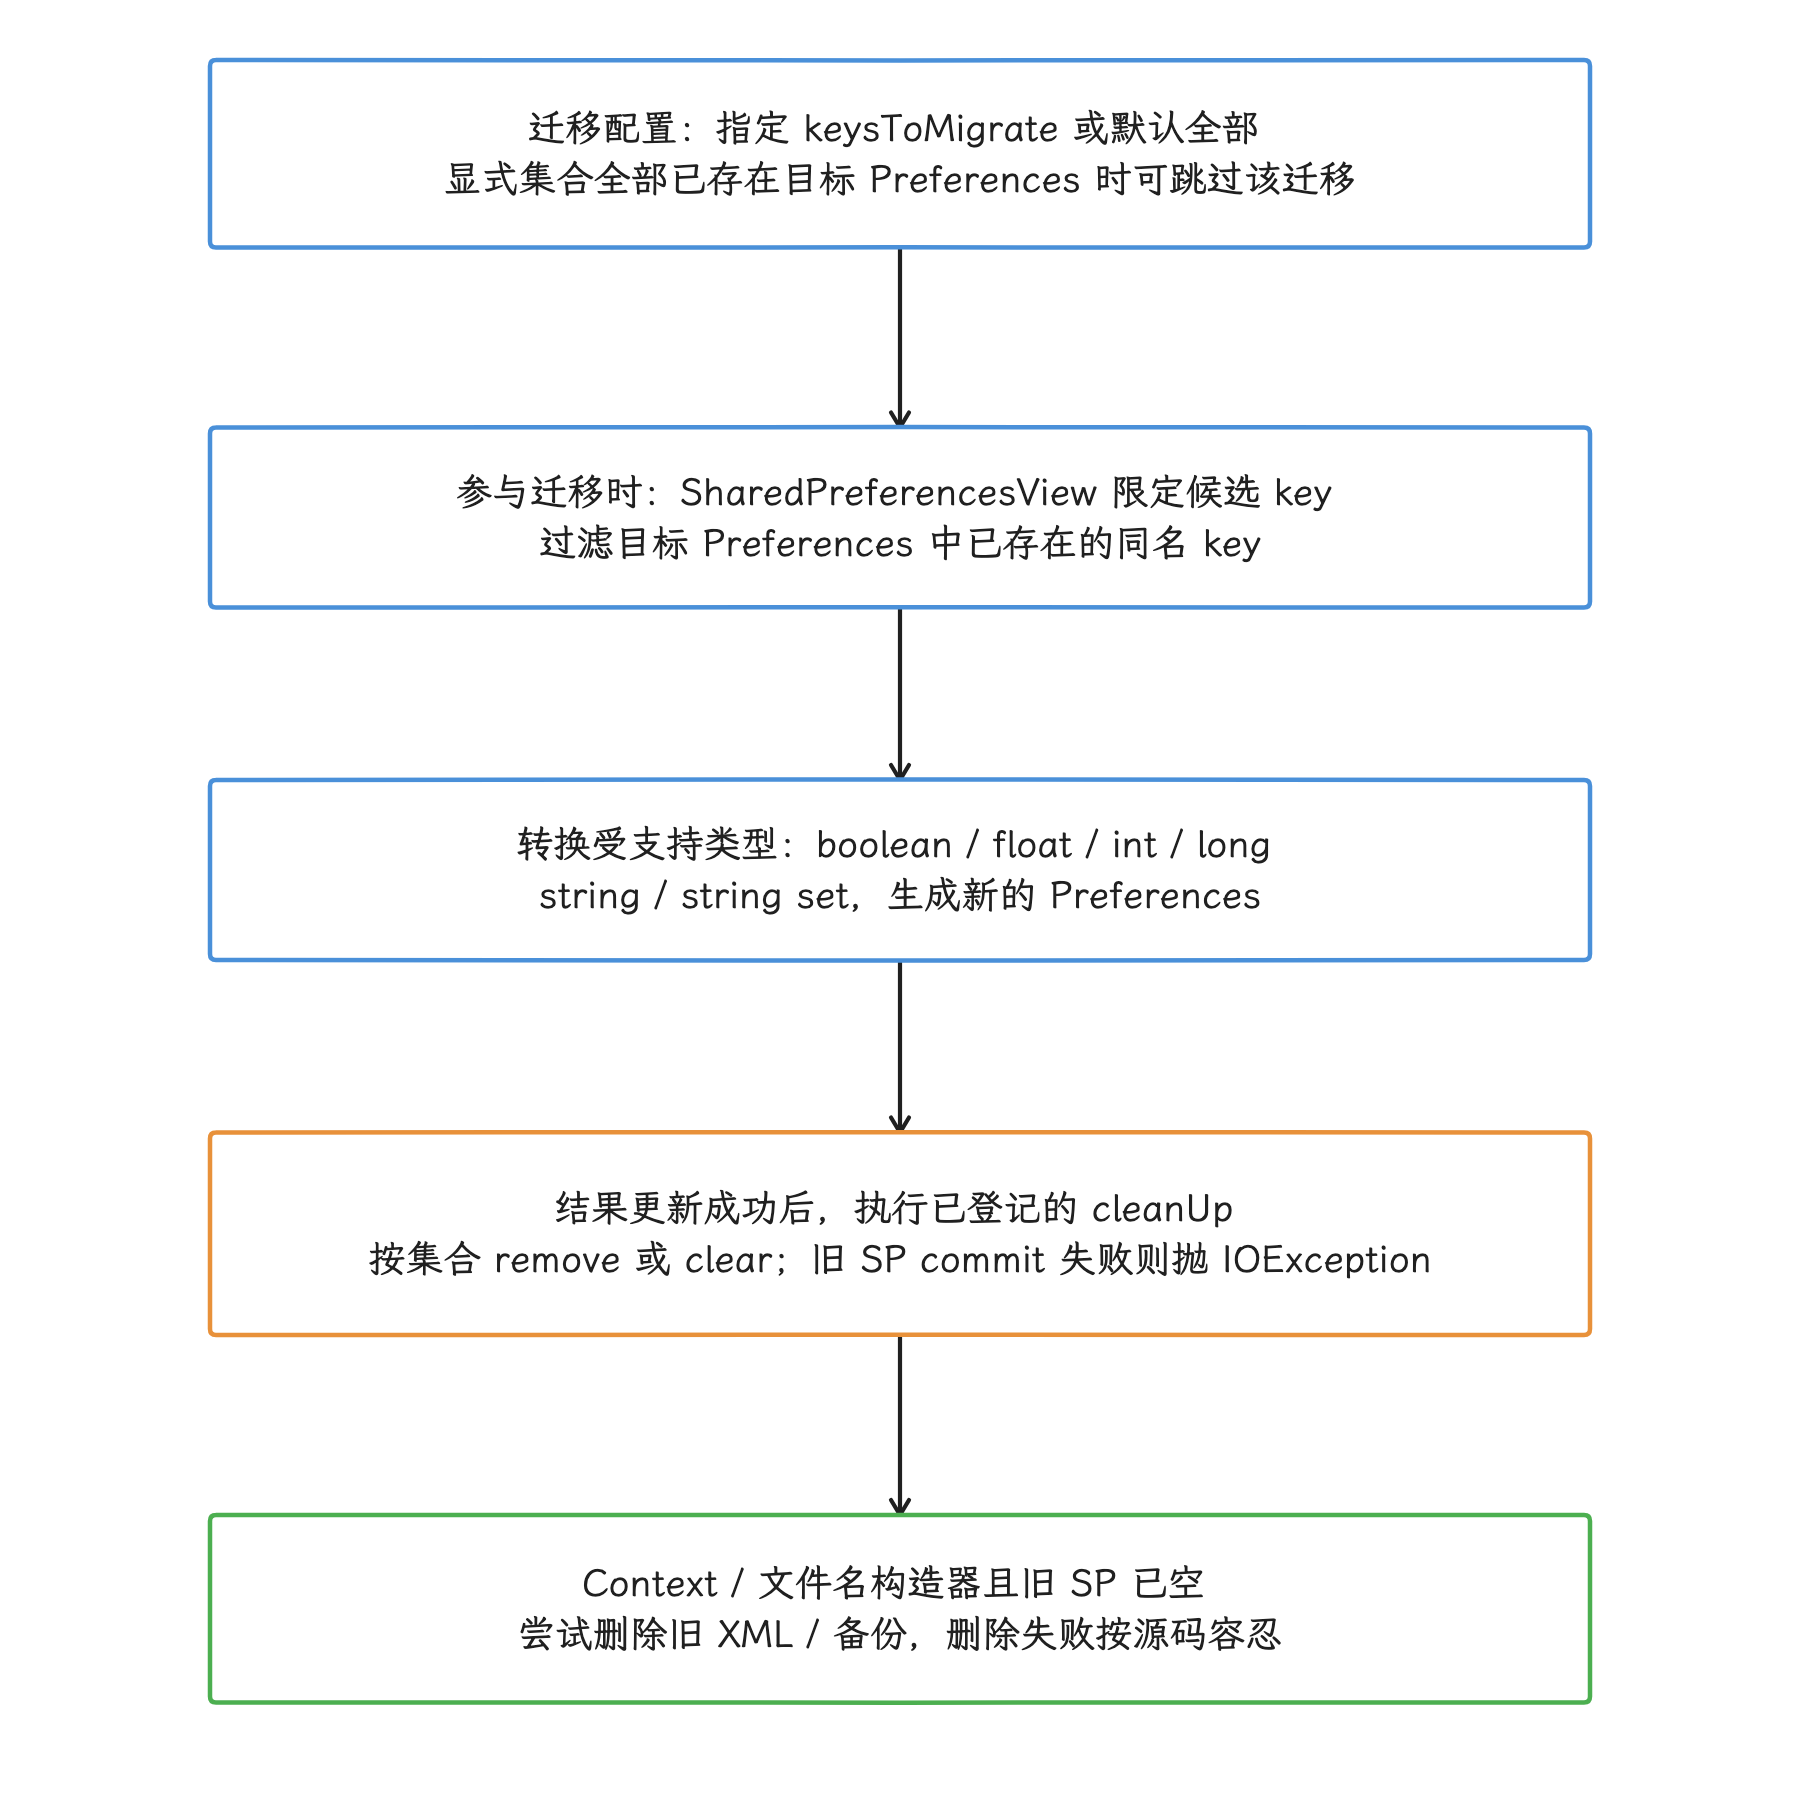
图:显式 key 集合限定可见范围,已有同名目标 key 不覆盖;迁移更新成功后才清理所选旧 key,并按条件尝试删除空 SP 文件。
迁移按数据所有权推进
我们把一次可靠迁移分成四步:
- 盘点:列出每个 SP 文件的拥有模块、key 类型、读写频率、跨进程使用、备份策略和回滚要求。
- 确定唯一写入方:为每组配置指定一个数据接口,禁止业务代码绕过它直接拿 SP。
- 迁移并观测:先迁高风险写入和大文件;记录迁移失败、初始化耗时、DataStore 文件大小和更新延迟。
- 删除旧路径:确认活跃版本和独立进程都切换后,移除旧读写。需要支持版本回退时,要提前定义旧版本如何处理已删除的 SP key。
“SP 超过 50 KB 就必须迁移”这样的通用阈值并不存在。文件大小只是一个维度,key 数、启动位置、写频率、设备分布和等待分位数同样要看;按线上 trace 和 ANR 聚类(按相似调用栈归组)确定优先级,更可靠。
MultiProcess DataStore 的实现边界
多进程一致性靠一套协作协议维持。我们从工厂选择看起,再看 1.2.1 的协调机制和测试要求。
所有进程必须使用多进程工厂
从 DataStore 1.1.0 起,MultiProcessDataStoreFactory 提供正式的多进程支持。若 App 进程和独立 Service 进程共享一个文件,两边都应使用多进程工厂,并指向完全相同的路径。单进程 DataStore 与多进程 DataStore 混用同一文件不受支持。
每个进程仍应只保留一个指向该文件的活跃实例。配置对象必须不可变,迁移也必须能够安全地重复执行。
1.2.1 的三类协调机制
AndroidX DataStore 1.2.1 的 Android 实现包含:
<file>.lock:用FileChannel文件锁协调跨进程读写;进程内再叠一层协程Mutex(互斥锁),避免同一进程自己跟自己冲突。<file>.version:JNI(Java Native Interface,Java 本地接口) 把共享计数器映射到多个进程,用原子整数记录版本。FileObserver(MOVED_TO):观察目标文件被临时文件替换的事件,提醒其他进程检查版本并刷新。
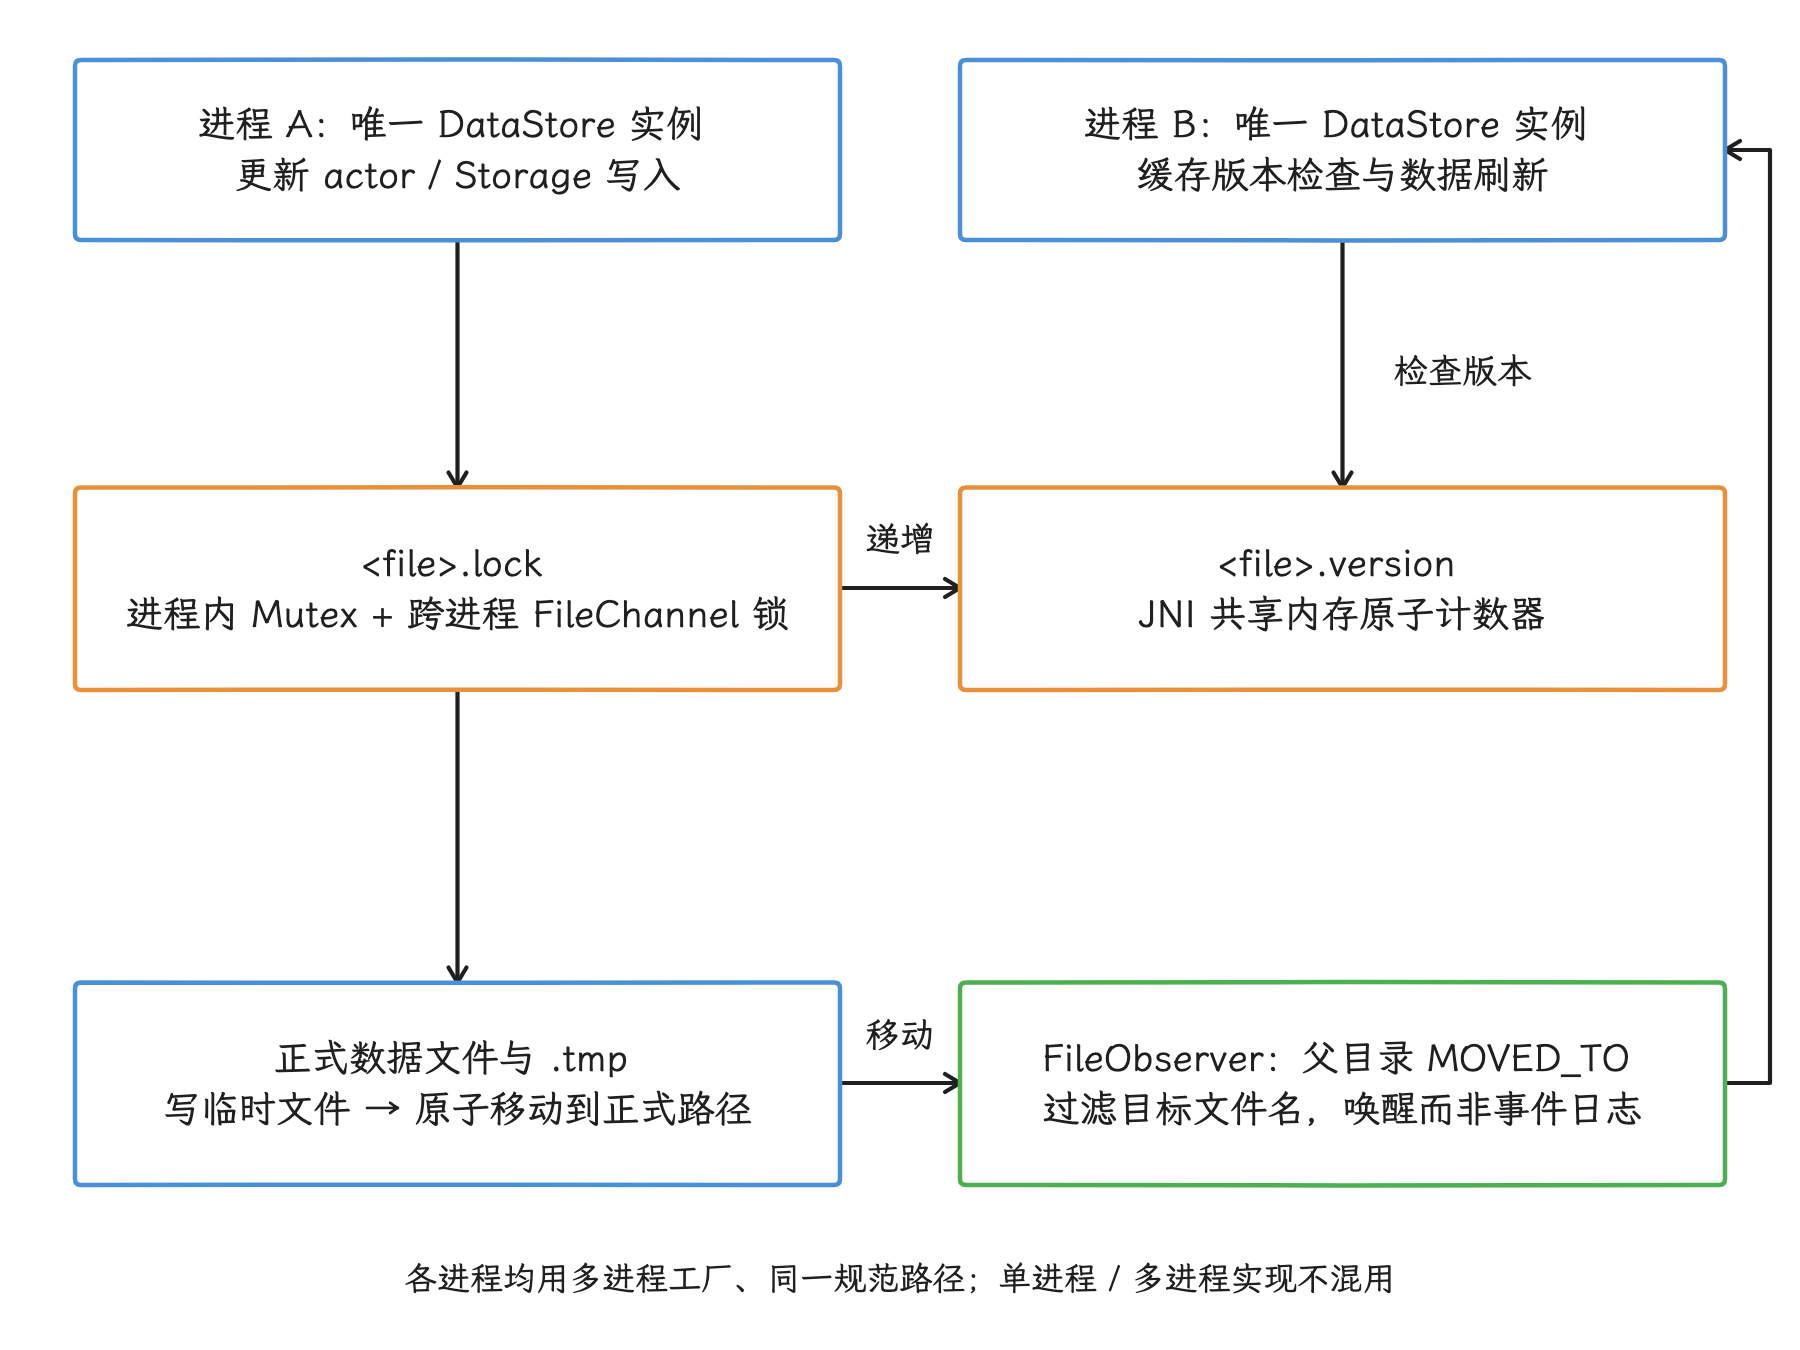
图:写方持协调锁、递增共享版本并替换数据文件;读方检查版本,文件移动通知在有收集者时唤醒刷新。所有访问方必须遵守协议。
下面的精简片段对应这三个机制:
override val updateNotifications: Flow<Unit> =
    MulticastFileObserver.observe(file)

override suspend fun <T> lock(block: suspend () -> T): T =
    inMemoryMutex.withLock {
        FileOutputStream(lockFile).use { stream ->
            stream.channel.lock(0L, Long.MAX_VALUE, false).use {
                block()
            }
        }
    }

override suspend fun incrementAndGetVersion(): Int =
    withLazyCounter { it.incrementAndGetValue() }
实际源码在文件锁报告死锁错误时还会退避重试,共享读锁也有兼容处理;上面的精简代码只作示意,读真实实现以库为准。
允许尝试锁的读路径(requireLock=false)拿不到进程内 mutex 或共享文件锁时,仍可读取当前正式文件,但不会把这次无锁结果提交为稳定缓存。通知触发的刷新则使用 requireLock=true,会等待协调锁;读取等不等写锁,取决于走哪条读路径。后续再通过共享版本和通知校准缓存,读取也不会直接消费正在生成的 .tmp 文件。
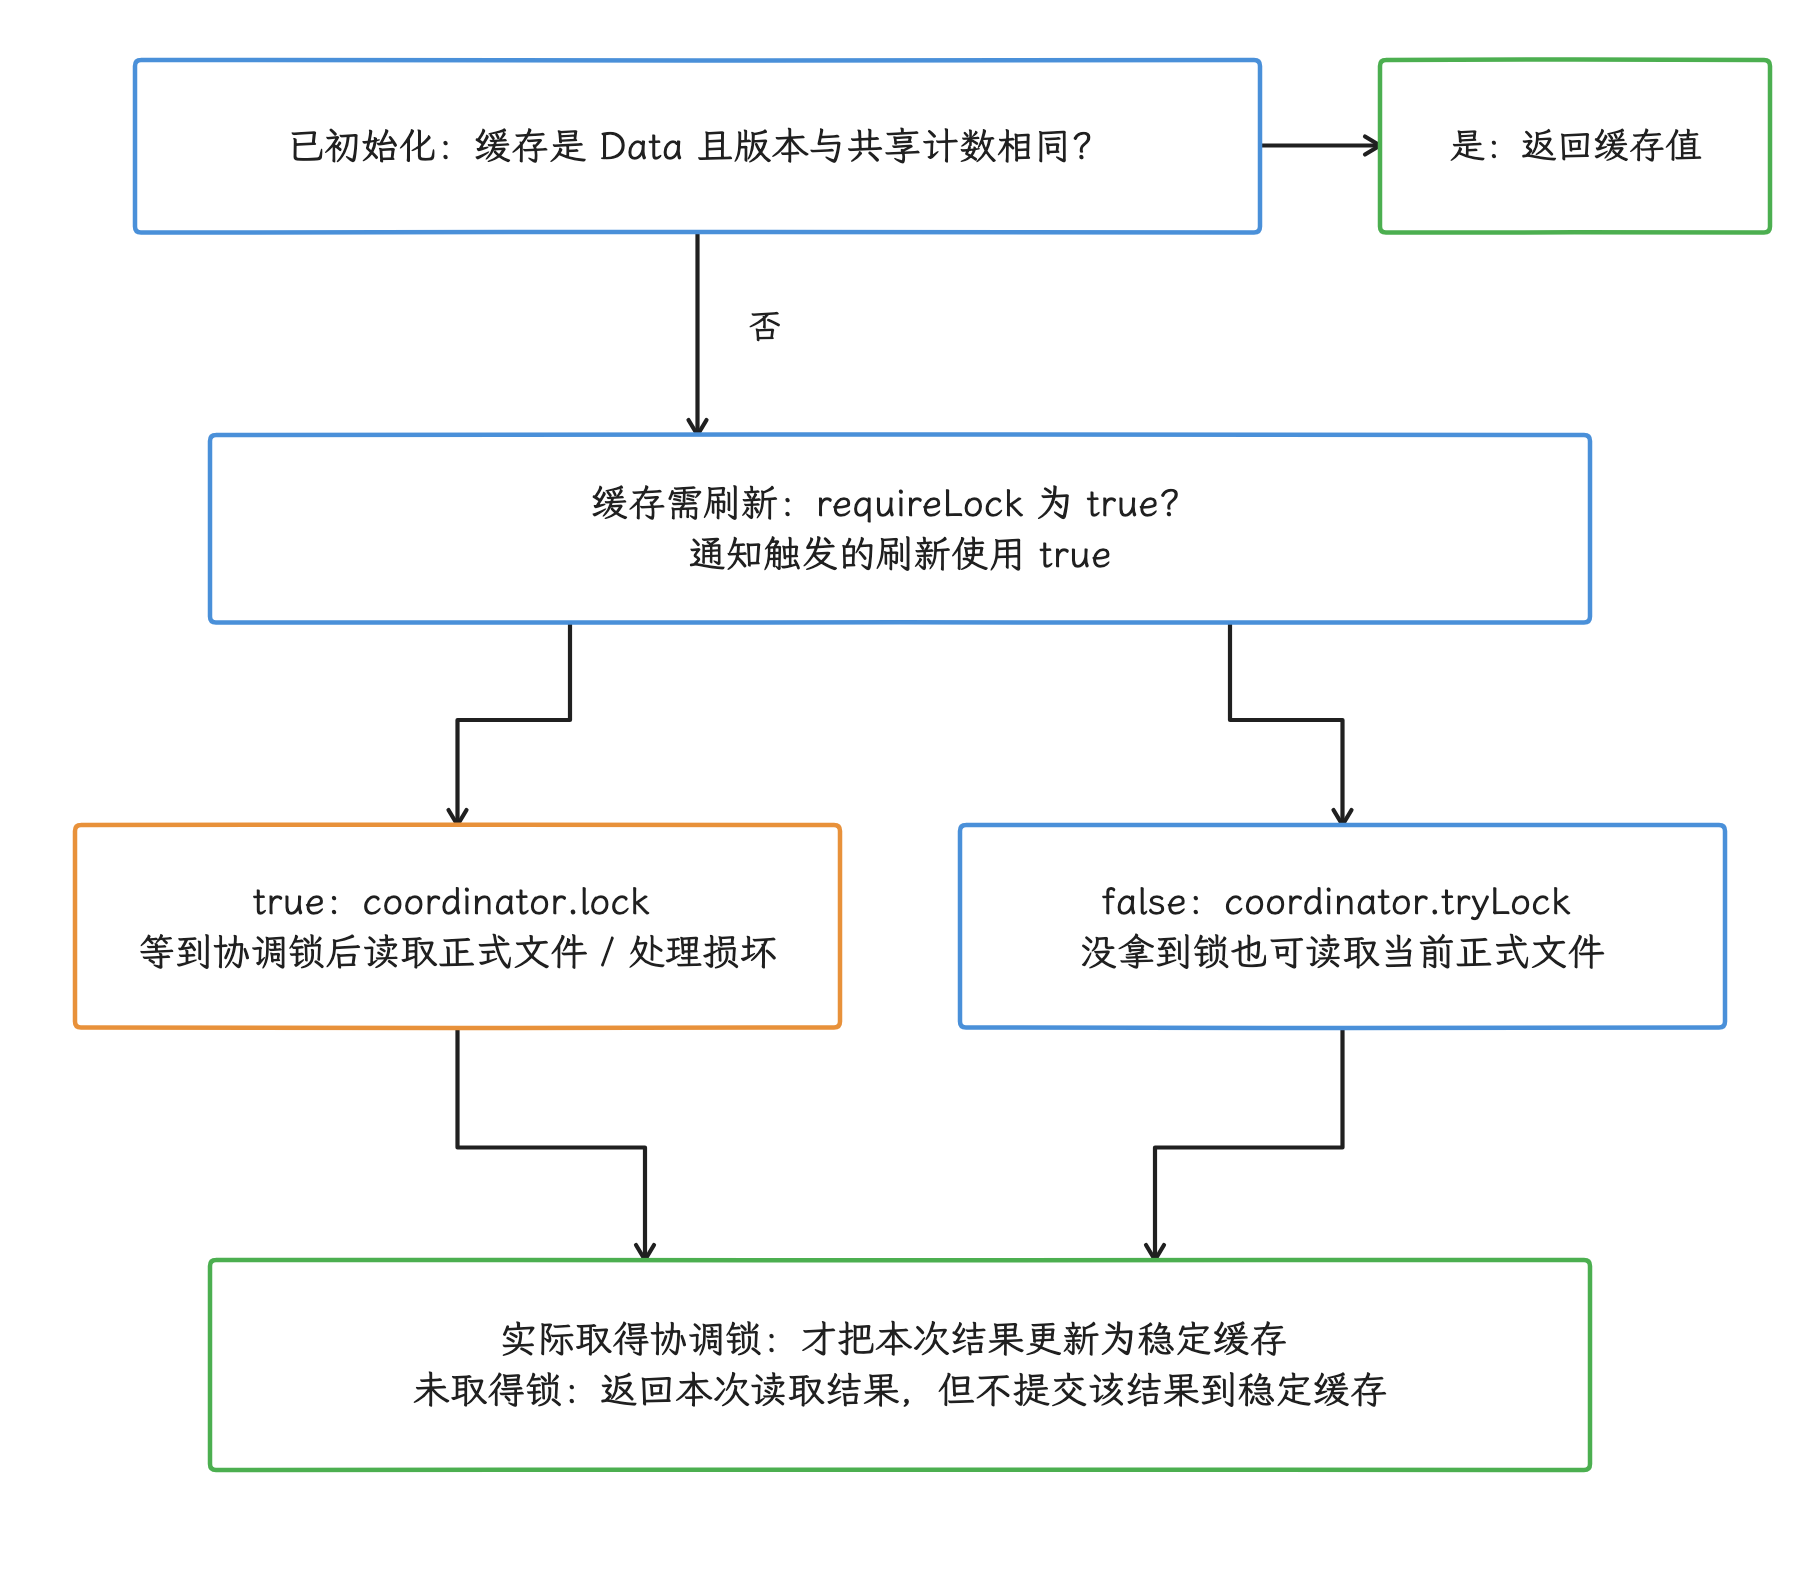
图:已初始化后先比较共享版本;版本不一致时,强制刷新等锁,尝试锁路径可无锁读取正式文件,但只有拿到协调锁才提交稳定缓存。
写入顺序与版本递增
1.2.1 的 DataStoreImpl.writeData() 在持有协调锁和 writeScope 时,先递增共享版本,再把新对象写入临时文件。临时文件完成 sync() 后,FileStorage 才把它原子移动到目标文件;该移动会触发 MOVED_TO 通知。
版本先递增是刻意设计:如果先替换文件,随后进程在递增版本前退出,其他进程可能长时间认为缓存仍是最新。版本、锁与文件观察器要一起工作,单拿出任何一个机制都撑不起跨进程事务。
updateData() 的 transform 位于跨进程独占锁范围内,应保持短小、确定且无副作用;网络请求、长计算或另一把业务锁会延长所有进程的写等待。DataStore 的事务覆盖一个完整对象,多文件原子提交、字段级更新和历史版本回滚都超出它的能力。
FileObserver(MOVED_TO) 只在目标进程还有活跃的 data Flow 收集者时用来唤醒刷新;收集者数量回到零后,观察任务随之停止。下一次读取仍会比较共享版本,所以这种通知只是尽力唤醒,别当作必达的事件日志。
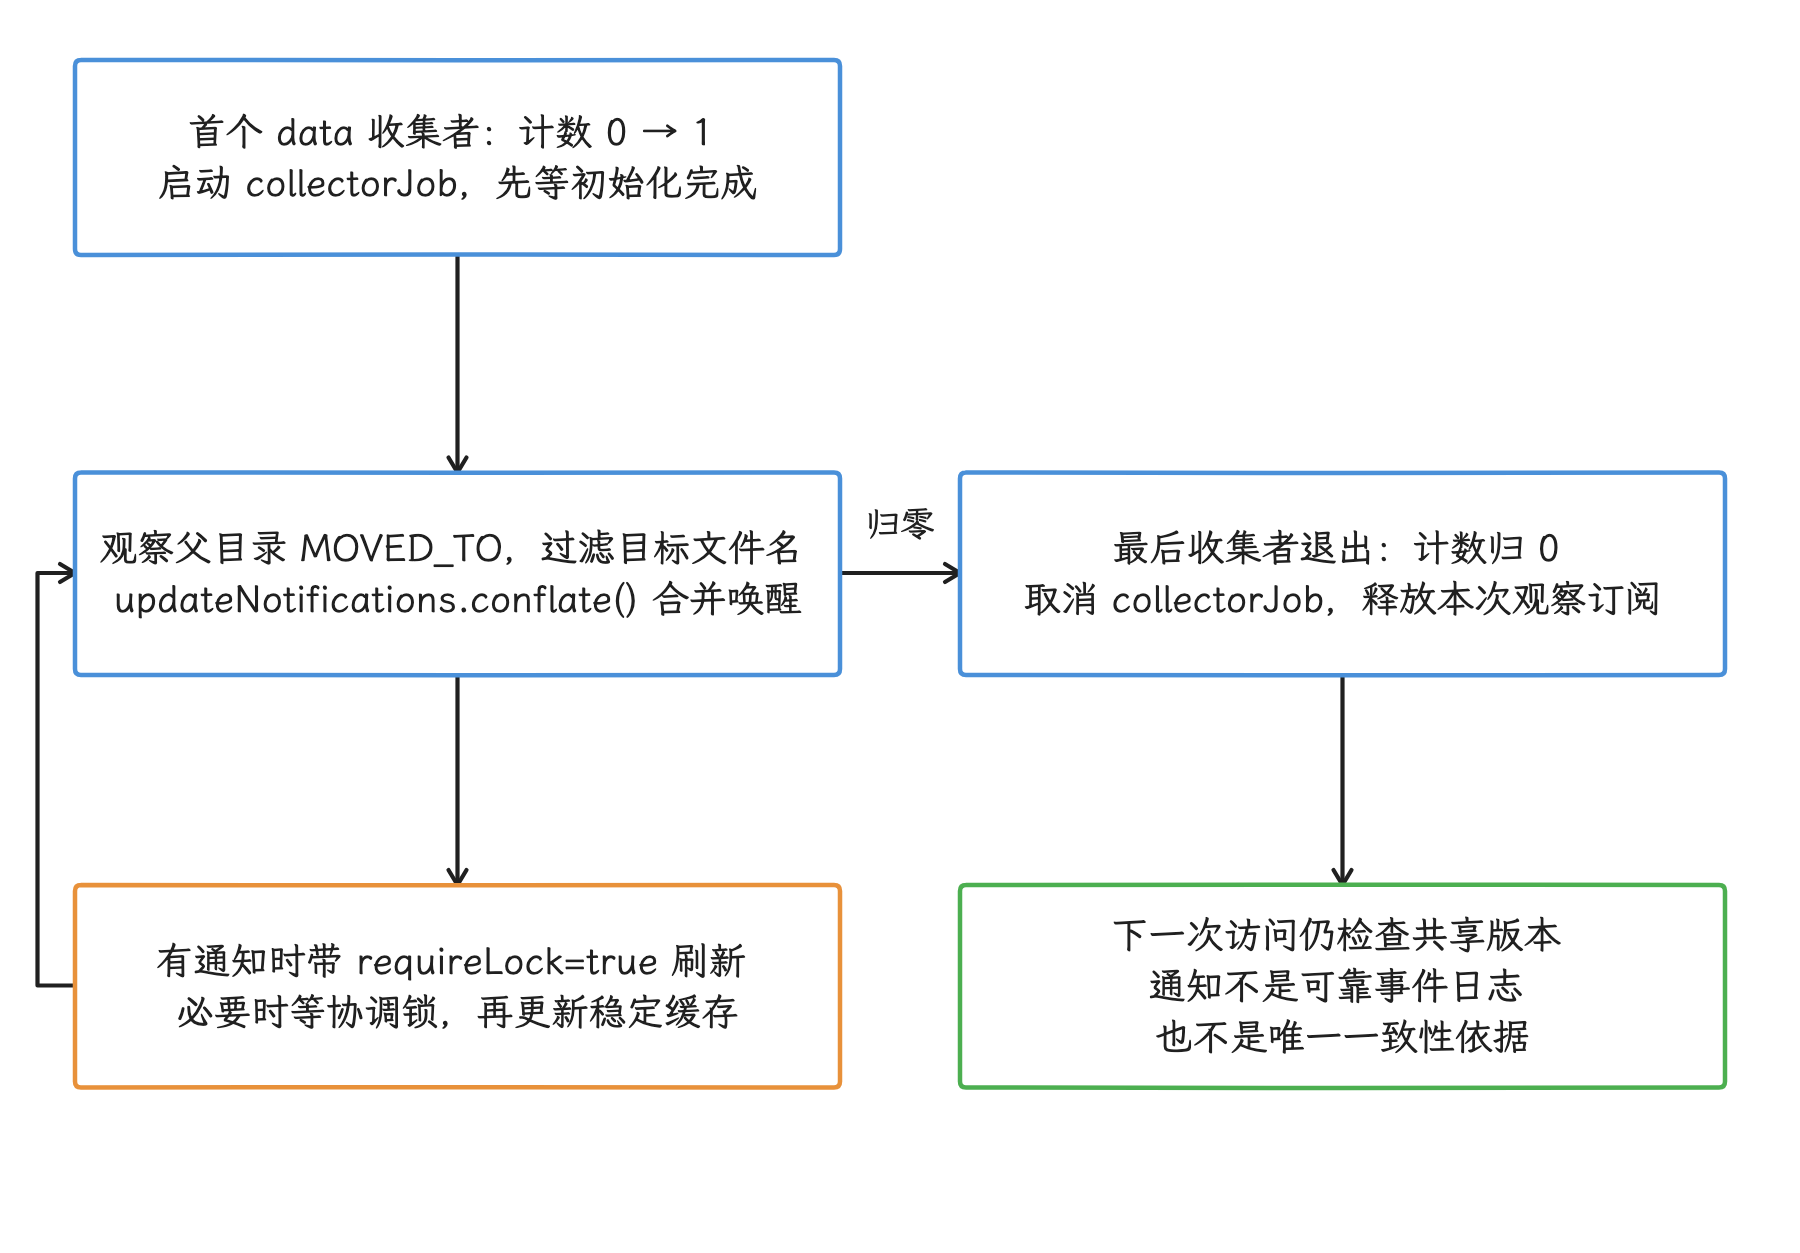
图:首个 data 收集者启动通知观察任务,移动事件唤醒带锁刷新;最后收集者退出会取消该任务,之后访问仍检查共享版本。
不要直接修改 .preferences_pb、.lock、.version 或 .tmp。文件锁属于协作式协议,绕过 DataStore 的直接文件写入会破坏版本和通知关系。
本地库与测试边界
1.2.1 的 datastore-core-android AAR(Android 库归档) 为 arm64-v8a、armeabi-v7a、x86 和 x86_64 打包了 libdatastore_shared_counter.so,Android 运行时加载失败会抛错。主机测试不在 Android 运行时里执行,可以用进程内 shadow counter(替代计数器) 顶替;跨进程 mmap(内存映射) 的语义,还是要到模拟器或真机上验证。
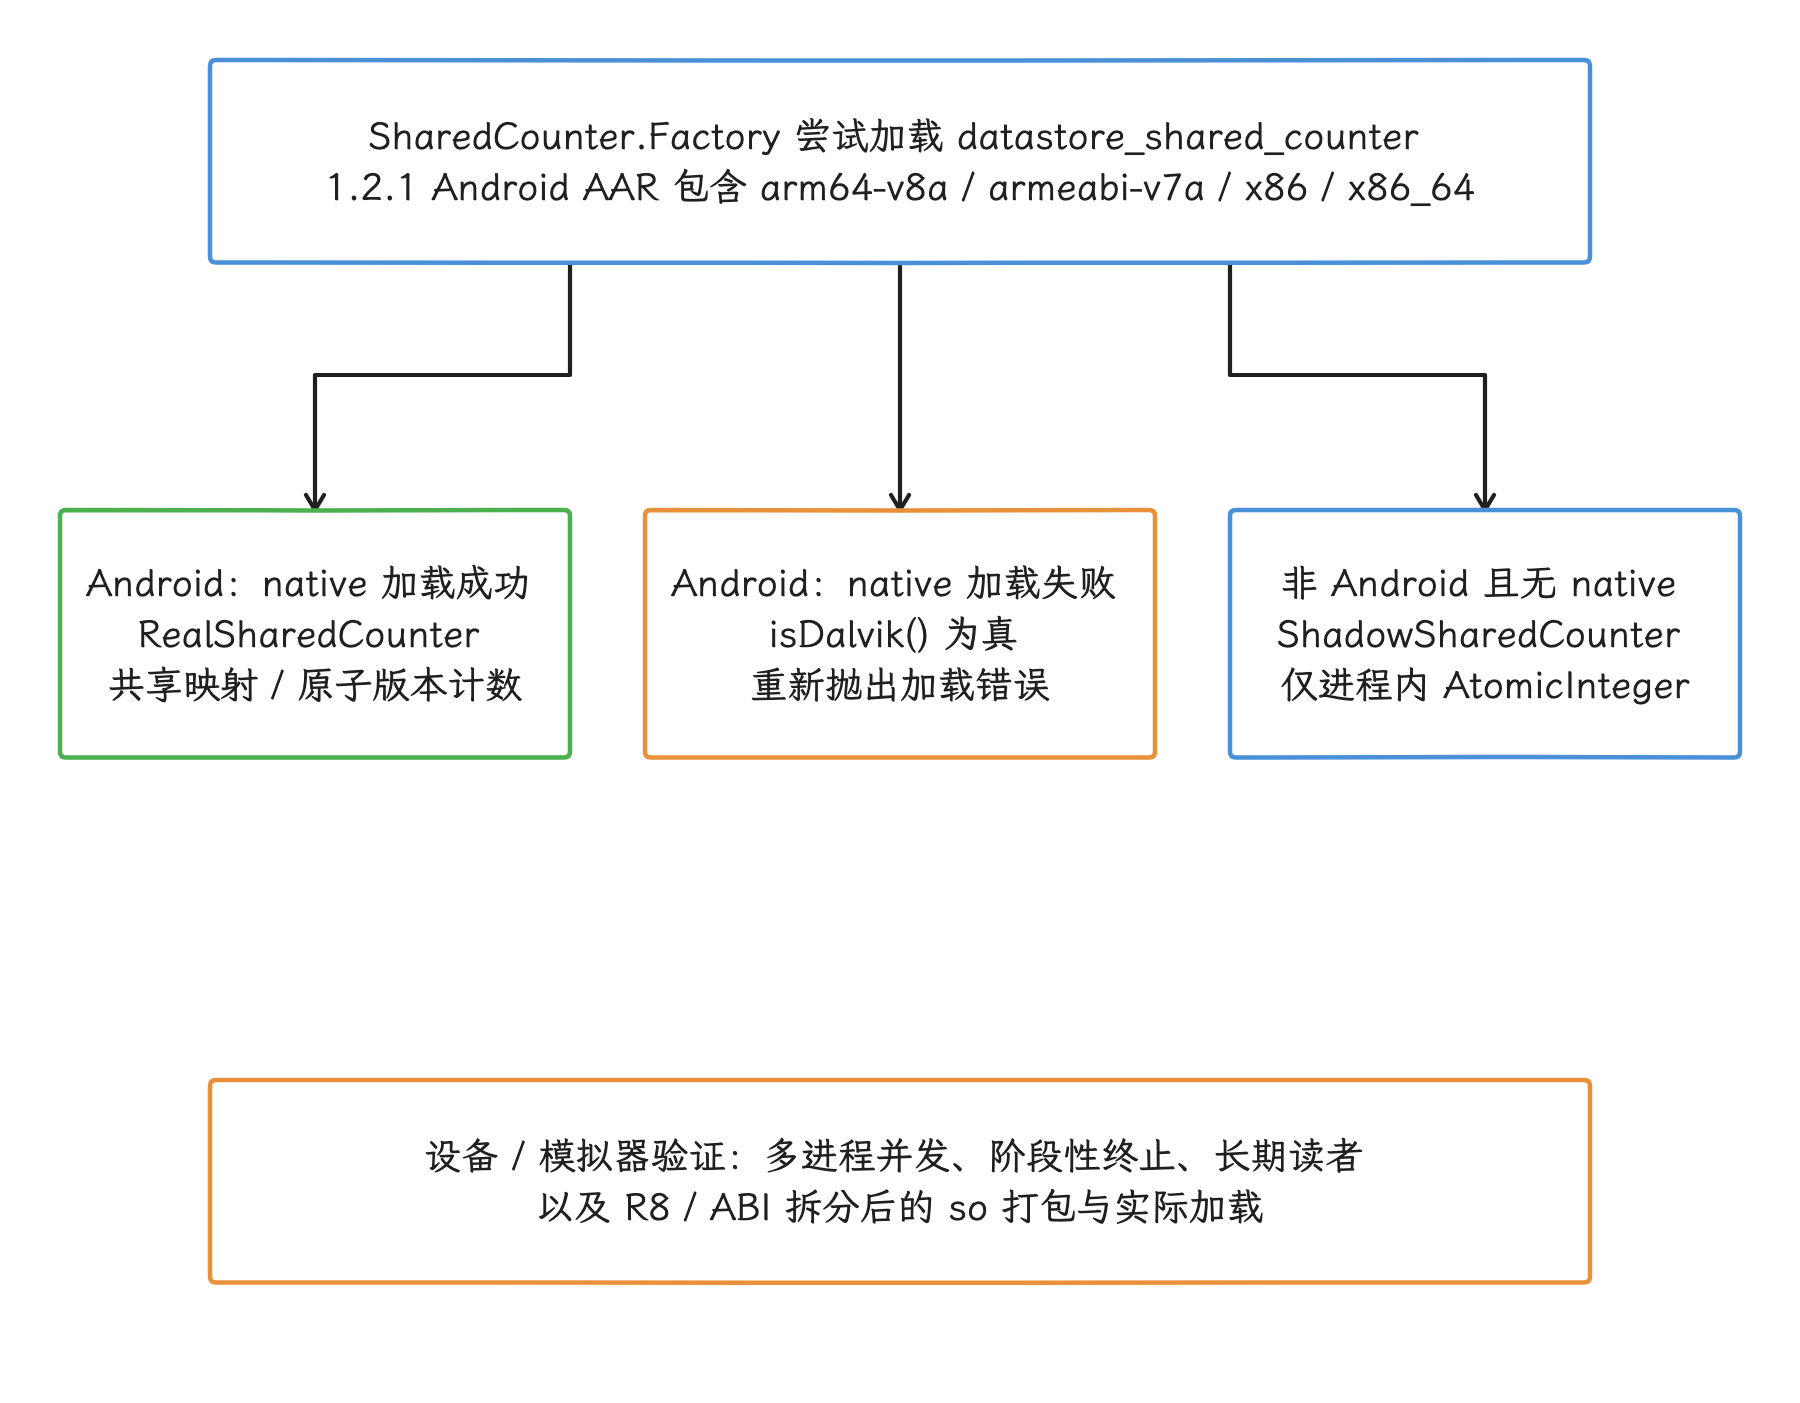
图:Android 真实计数器依赖本地库与共享映射;非 Android 主机测试可回退进程内 shadow,跨进程一致性仍以真机验证为准。
所以,多进程路径至少要在模拟器或真机 instrumentation 测试里覆盖以下场景:
- 两个进程并发更新同一个 key。
- 写入进程在不同阶段被终止。
- 读取进程长期存活时能否看到新值。
- APK/AAB 经过 R8(代码压缩与优化工具) 处理和 ABI(应用二进制接口) 拆分后,是否仍包含这一本地库。
- Direct Boot 与凭据解锁前后的文件位置是否符合预期。
DataStore 1.2.0 起增加了 Direct Boot 支持 API;本文 1.2.1 的 createInDeviceProtectedStorage() / deviceProtectedDataStore() 要求 Android 7.0 / API 24 及以上。这与库本身最低 API 23 的声明是两个不同的版本要求。Direct Boot 允许部分组件在用户解锁前访问特定存储;只有确需在这一阶段读取的数据才应放进 device-protected storage(设备保护存储区),并且要避开依赖用户凭据保护的敏感内容。
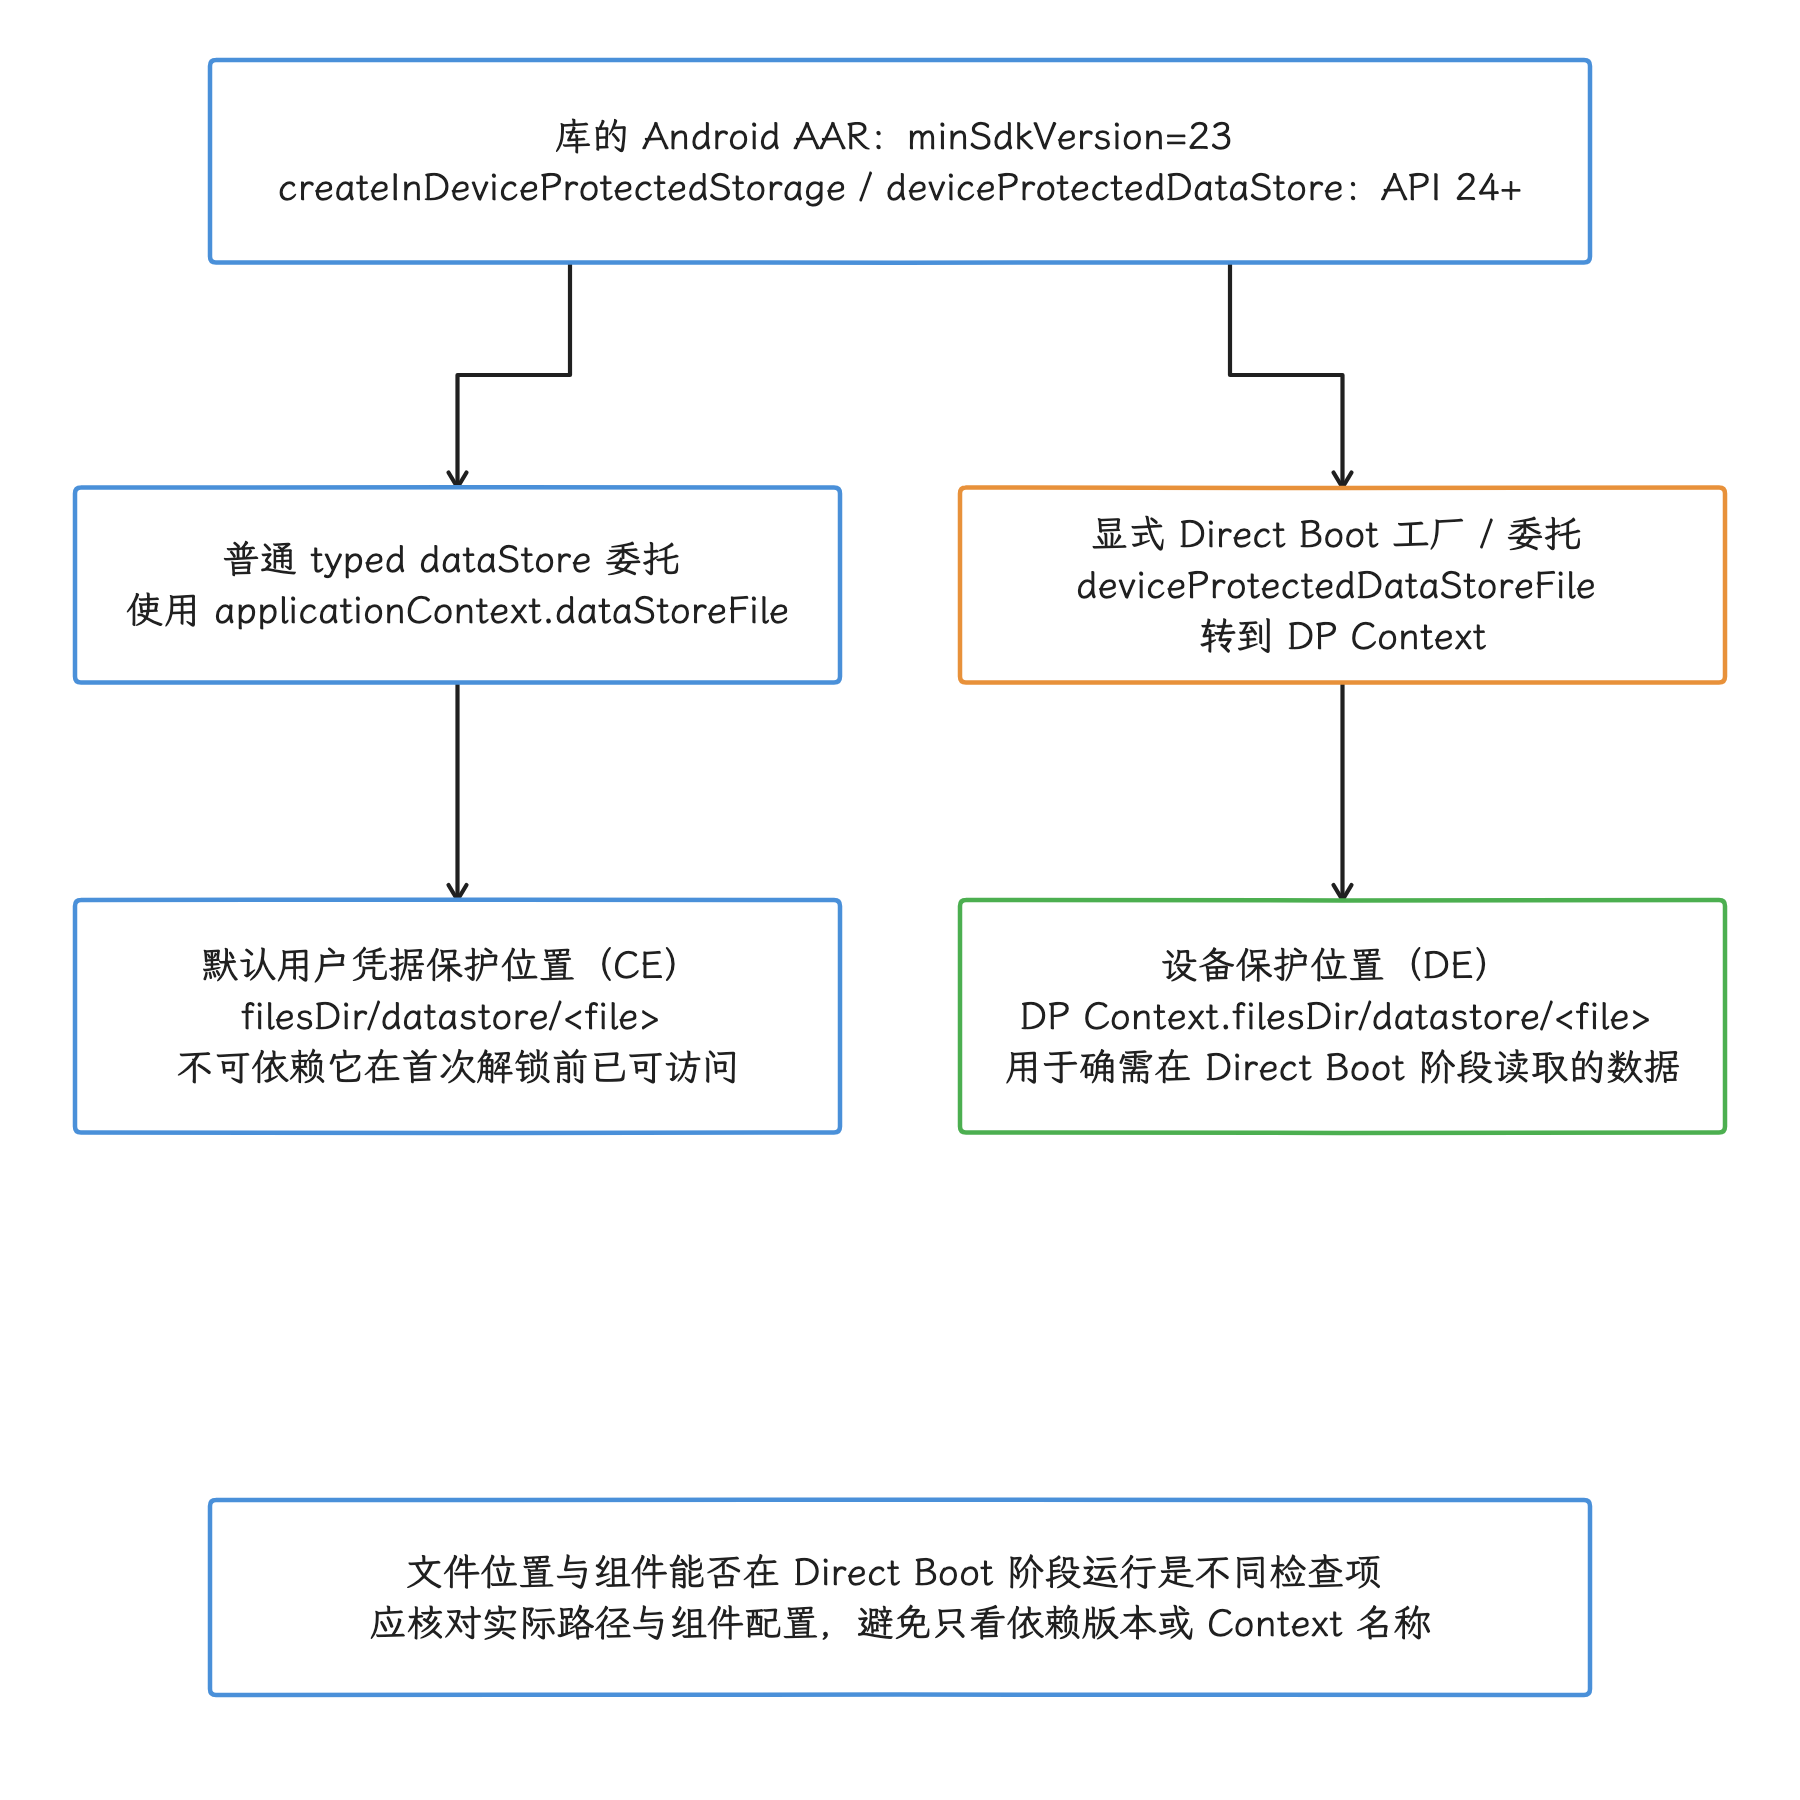
图:1.2.1 库最低 API 23,Direct Boot 专用工厂/委托要求 API 24;是否在首次用户解锁前可用,还取决于文件实际放在 CE 还是 DE。
仍需保留 SP 时的规则
存量工程一次迁不完,我们可以先约束风险:
- 不在主线程调用
commit()。 - 不在 Activity 即将 stop、Service 命令收尾或 BroadcastReceiver 返回前集中
apply()。 - 同一批 key 使用一个 Editor 和一次提交,减少整文件重写次数。
- 不把列表、日志、埋点队列或不断增长的业务对象放进 SP。
- 复制
getStringSet()的结果后再修改,返回集合本身要保持原样。 - 监控每个文件的字节数、key 数、写频率、慢
fsync和组件收尾等待。 - 跨进程数据停止使用
MODE_MULTI_PROCESS;选择 MultiProcess DataStore、Room + ContentProvider 或其他有明确一致性协议的方案。 - 敏感状态要定义持久化失败时的处理,仅靠
apply()的内存可见性是不够的。
拆分 SP 文件可以缩小单次序列化与解析的范围,也会增加首次打开任务和管理成本。加载执行器只有单线程,拆成大量小文件并不会带来并行加载;文件应按数据拥有者和访问阶段划分,避免按 key 随意分文件。
DataStore、MMKV 与 Room 的选型
| 场景 | 优先评估 | 需要额外验证 |
|---|---|---|
| 官方 Jetpack、协程、少量单进程配置 | DataStore | 首次初始化、全量序列化、错误处理 |
| 少量多进程配置 | MultiProcess DataStore | 文件锁竞争、本地库打包、进程终止 |
| 高频 KV(键值)读写,已有 MMKV 基础设施 | MMKV | 持久性、多进程、升级兼容、备份与安全 |
| 复杂查询、局部更新、事务、大集合 | Room | schema、索引、WAL(Write-Ahead Logging,预写式日志)、迁移 |
| 跨进程统一数据服务 | Room + ContentProvider 或专用 Binder 服务 | IPC(进程间通信)权限、并发、进程生命周期 |
MMKV 是用 mmap 与自定义编码格式的第三方键值存储库,在部分高频键值工作负载下可能优于 XML SP。mmap 路径仍会发生缺页、脏页回写和持久化操作,性能优势和掉电语义都要在目标设备上实测。选型时还要评估格式演进、加密配置、崩溃恢复和维护成本。
用 ContentProvider 包一层 SP,得到的只是统一入口,SP 整体 XML 写入和 QueuedWork 语义都保持原样。既然已经需要复杂的跨进程访问,底层数据模型也应一起调整。
给挂起写入添加正确的 Trace(性能跟踪)
DataStore 的更新是挂起调用,给它加 trace 时要处理线程切换的问题。同步 Trace.beginSection()/endSection() 要求在同一线程配对;协程可能在挂起后切换线程,所以普通的同步 trace 区间不要跨越 DataStore.edit() 调用。
下面的代码用异步 trace 区间记录一次可跨线程的 DataStore 更新:
private val nextTraceCookie = AtomicInteger()

suspend fun updateNightMode(enabled: Boolean) {
    val traceName = "DataStore.updateNightMode"
    val cookie = nextTraceCookie.incrementAndGet()
    Trace.beginAsyncSection(traceName, cookie)
    try {
        context.settingsDataStore.edit { prefs ->
            prefs[booleanPreferencesKey("night_mode")] = enabled
        }
    } finally {
        Trace.endAsyncSection(traceName, cookie)
    }
}
这里的 Trace 可以用 androidx.tracing.Trace;并发请求要使用不同的 cookie(配对异步区间的整数标识),也就是配对 begin/end 的那对整数标识。当前 androidx.tracing 版本若支持挂起函数 traceAsync,直接用它包装调用也可以。Trace 名称里不要出现用户值或其他敏感信息。
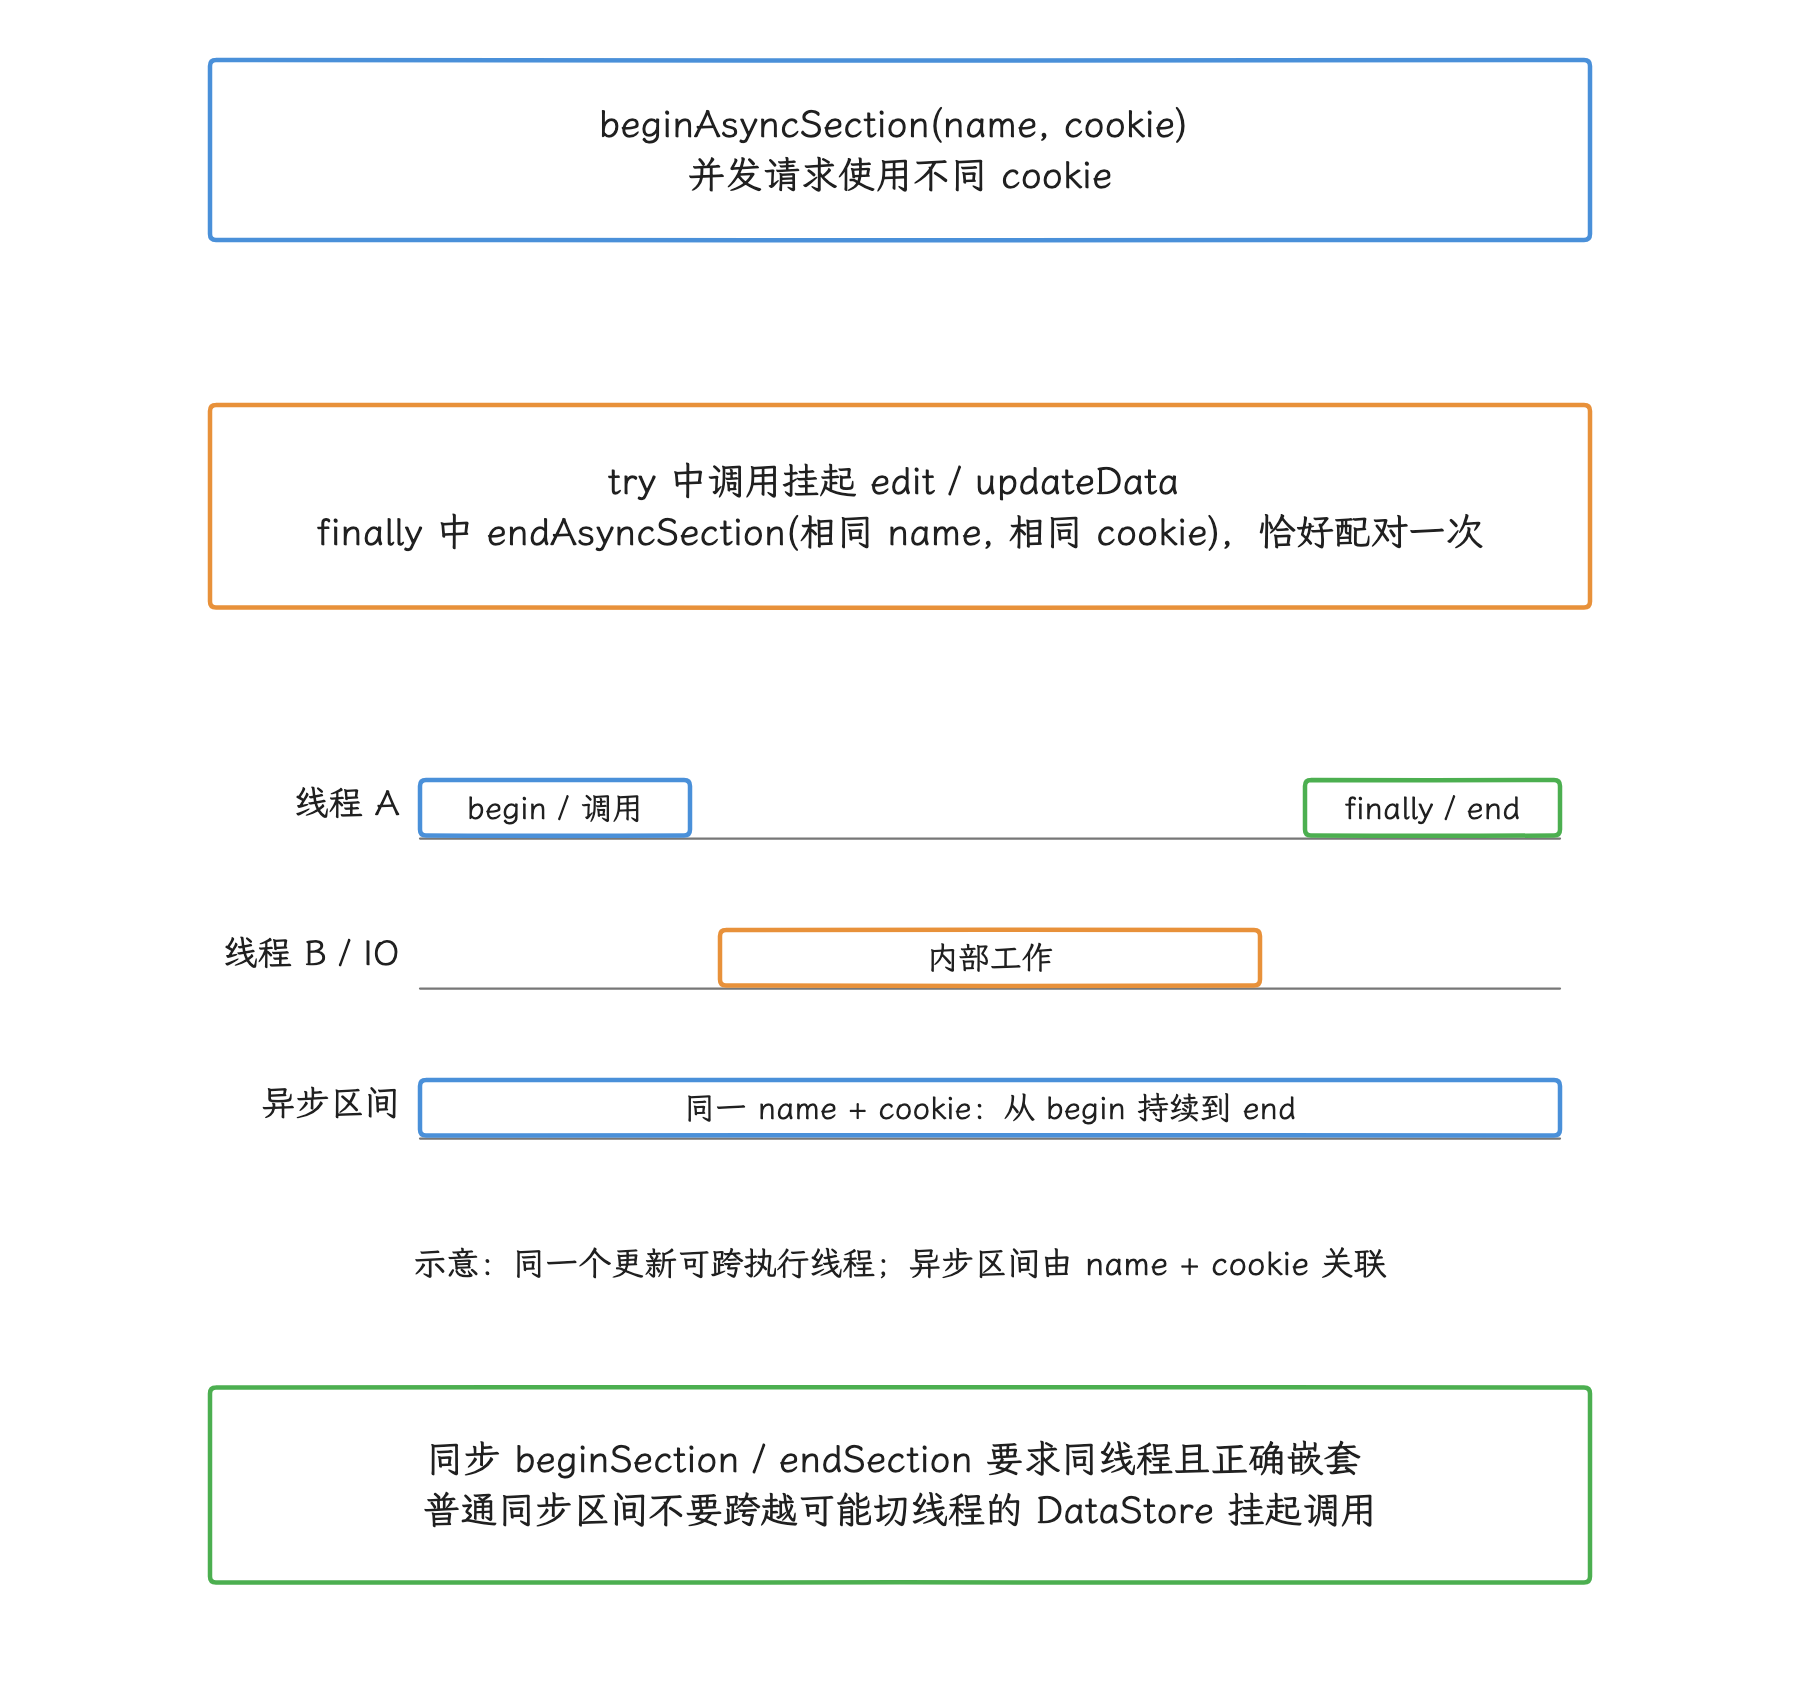
图:异步 Trace 用同一 name/cookie 配对 begin/end;edit 可挂起并切换执行线程,finally 收尾覆盖成功、异常和取消路径。
除了时长,建议记录成功、异常类型和调用场景计数。单次 DataStore 更新慢可能来自首次迁移、transform 执行过久、文件同步、跨进程锁竞争或设备 I/O,只有一个总 slice 的话,慢在哪里仍定位不到。
常见误区
“apply() 已异步,不会引起 ANR”
apply() 的调用点通常很快返回,但 pending work 会在 Activity/Service 收尾时被 waitToFinish() 处理,BroadcastReceiver 的完成回执也可能排在它后面。
“现代 Activity 在 onPause() 等待 SP”
Android 17 的现代 Activity 主路径在 handleStopActivity()。handlePauseActivity() 中的等待只服务于 pre-Honeycomb 兼容路径。
“DataStore 不会重写整个文件”
DataStore 不支持部分更新。它会完整序列化当前对象到临时文件并替换目标文件,优势来自非阻塞 API、事务化更新、错误传播和一致性语义。
“调用 edit() 后可以立即忽略结果”
DataStore edit() 是挂起函数。它成功返回表示更新完成;异常需要调用方处理。把它放进无人管理的协程作用域会失去失败信号,也可能在作用域取消时丢掉尚未完成的任务。
“多进程 DataStore 只靠文件锁”
当前 Android 实现同时使用文件锁、共享版本计数器和文件移动通知。所有进程都必须遵守同一协议。
“换成 MMKV 就不再有磁盘问题”
MMKV 改变编码和访问路径,但脏页持久化、设备抖动、数据损坏与多进程协调仍要处理。
小结
SP ANR 的关键链条可以压缩成一句话:
apply() 先更新内存并把持久化任务延后;需要写入的代次会序列化整份 XML;组件收尾时,框架又要求这些 pending work 完成,于是主线程可能执行写盘或等待写盘。
排查时,我们把首次加载等待、主线程写盘、批处理 monitor 竞争、latch 等待和 BroadcastReceiver 回执延迟分开识别。迁到 DataStore 后,线程阻塞和错误语义得到改善,全量序列化、首次初始化、文件同步与多进程锁竞争依然要测量。
Android 17 平台源码负责解释 SP;DataStore 行为应以 App 锁定的 AndroidX 版本为准。对新项目,少量配置优先 DataStore,关系数据与较大集合使用 Room;存量 SP 则按数据所有权分批迁移,并给失败、回滚和跨进程访问留下明确方案。
参考资料
- AOSP SharedPreferencesImpl.java(android-17.0.0_r1)
- AOSP QueuedWork.java(android-17.0.0_r1)
- AOSP ActivityThread.java(android-17.0.0_r1)
- AOSP BroadcastReceiver.java(android-17.0.0_r1)
- AOSP SharedPreferences.java(android-17.0.0_r1)
- AOSP ContextImpl.java(android-17.0.0_r1)
- AOSP FileUtils.sync(android-17.0.0_r1)
- DataStore guide
- DataStore API
- DataStore release notes
- SharedPreferencesMigration API
- MultiProcessDataStoreFactory API
- AndroidX tracing 顶层 traceAsync API
- AndroidX Trace 异步区间
- AndroidX DataStore 1.2.1 官方源码包:datastore-core、datastore-core-android、datastore-android、datastore-preferences-android
- Preferences 默认 FileStorage 工厂源码(1.2.1)
- OkioStorage 源码(1.2.1)
- AOSP Trace.java(android-17.0.0_r1)
- Tencent MMKV 官方实现与说明
- Protobuf 字段删除与 reserved
- Kotlin Flow.catch:异常、降级与重试边界
- 今日头条 ANR 优化实践:告别 SharedPreference 等待