Android 存储架构
一次应用 I/O 可能涉及 API、文件系统、页缓存、块层和存储器件,也可能命中缓存后提前返回;没有命中缓存时,路径上的等待又可能把短请求放大成长尾。这一章我们把这条链路从头到尾走一遍,把“磁盘慢”拆成可观测的缓存命中、回写、排队、同步和介质延迟。
源码基线:AOSP
android-17.0.0_r1,Android 17 / API 37;内核 Android Common Kernelandroid17-6.18-2026-06_r6。
设备厂商可以定制分区表、文件系统、UFS(Universal Flash Storage) 控制器和 vendor kernel(厂商内核),涉及具体机型的性能结论仍要以运行时信息为准。
从一个卡顿现象说起
在 Perfetto 里追主线程卡顿,我们常会遇到这样的片段:线程调用 SQLite、SharedPreferences 或普通文件 API 后进入睡眠,直到数据回写、日志提交或设备请求完成才重新运行。SQLite 事务和 SharedPreferences 写盘是两条独立的实现路径,判断 fsync() 来自哪一条,要靠调用栈、文件名、文件系统事件和 block trace(块 I/O 跟踪记录)一起定位。
这类问题有时伴随大量 CPU 工作,有时主要耗在 I/O wait(等待输入/输出完成)。Android 的一次文件访问可能依次经过 VFS(统一文件系统接口)、具体文件系统、fscrypt(文件级加密框架)、device-mapper(块设备映射层)、块层、主机控制器和闪存;共享存储还可能经过 MediaProvider/FUSE。我们要做的,是把等待时间对应到具体层级,再判断延迟来自同步点设计、文件系统回写、设备排队、加密准备,还是共享存储的权限检查路径。
存储栈全景:从闪存芯片到应用 API
Android 存储栈按职责分为应用与 framework、VFS 与文件系统、块设备映射与调度、主机控制器和闪存器件几层。ext4、f2fs、FUSE、fscrypt 和 device-mapper 各居一层,我们分析 I/O 问题时会把它们分别对待,把笼统的“文件系统开销”落到具体一层。
下面的简图用于标出常见读写路径;括号中的层只在相应场景出现。
Application / native library
    ↓  Java File API、SQLite、MediaStore 或 POSIX I/O
Android framework / ContentProvider(按 API 路径)
    ↓
MediaProvider + FUSE(共享外部存储路径)
    ↓
VFS → ext4 / f2fs(集成 fscrypt;buffered I/O 使用 page cache)
    ↓
device-mapper(dm-linear、dm-verity、dm-default-key、snapshot,按卷配置)
    ↓
Block multi-queue / I/O scheduler
    ↓
UFS 或 eMMC host controller → storage device
同一次访问只经过图中的一部分路径:应用内部文件不经过 MediaProvider/FUSE;只读动态分区通常经过 dm-linear 与 dm-verity;/data 则可能叠加 dm-default-key 和 fscrypt。这张图帮助我们定位各层分工,具体设备采用什么映射,以该机的实际配置为准。
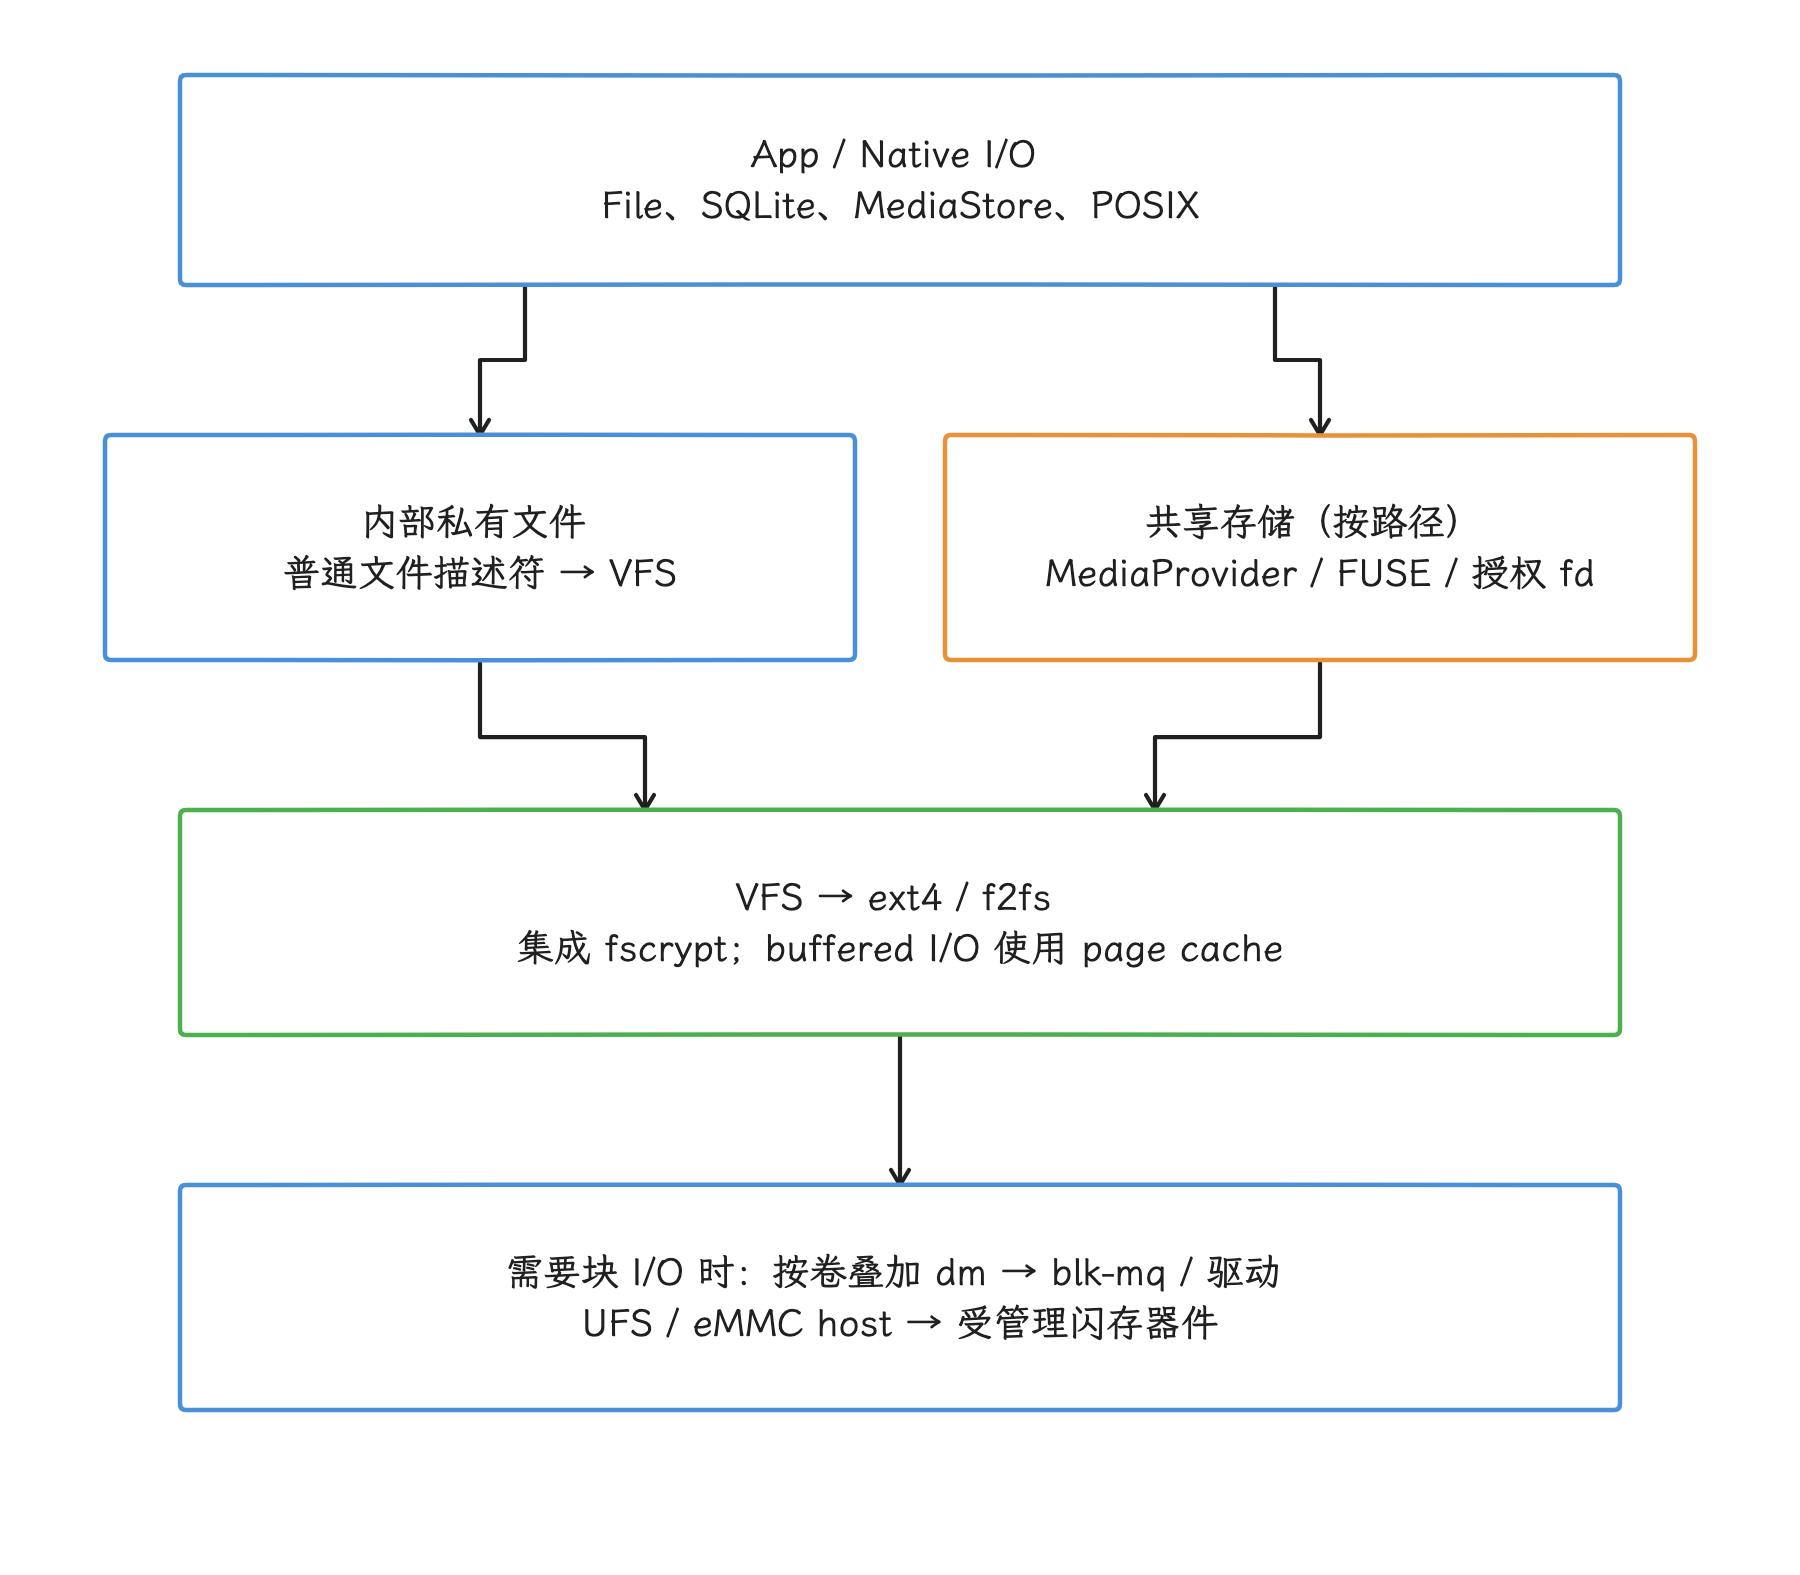
图:本图按职责压缩层级,不是每次 I/O 都经过所有节点。内部文件不经共享存储 FUSE;授权 fd、直接路径、passthrough 可能不同,缓存命中也可能提前返回。dm 目标及叠加顺序按卷和更新状态核对。
先看最底层的物理存储器件。
物理存储器件:UFS 与 eMMC(embedded MultiMediaCard) 的差异
总线、并发和软件栈
eMMC 和 UFS 都是管理型闪存器件,封装里包含 NAND 闪存、控制器和 FTL(Flash Translation Layer,闪存转换层)。FTL 把主机看到的逻辑块地址映射到 NAND 物理位置。两类器件都向 Linux 暴露块设备,差别集中在主机接口和并发能力上。
eMMC 使用并行总线,数据传输为半双工。旧式 eMMC 请求模型的并发能力有限,但 eMMC 5.1 已经定义了 Command Queuing(命令排队),控制器同一时刻能排几个命令,要看主机驱动、器件是否支持 CQE(Command Queue Engine)、队列深度和固件质量。
UFS 使用 MIPI M-PHY 差分串行链路和 UniPro 协议,UTP 负责承载 UFS Command Set。链路是全双工的,协议和主机控制器也支持同时挂多个 outstanding request(尚未完成的请求)。更高的链路速率、队列并发度和控制器并行度可以改善吞吐与尾延迟,但应用实际感受到的性能,仍受 NAND 类型、SLC cache(单层单元高速缓存)、温度、容量占用和固件影响。
下面这张图按层列出 UFS 协议,以及每层承载的规范。
┌─────────────────────────┐
│     Application Layer    │  ← UCS(基于 SCSI 的命令集)
├─────────────────────────┤
│     Transport Layer      │  ← UTP (UFS Transport Protocol)
├─────────────────────────┤
│     Interconnect Layer   │  ← UniPro(含传输、网络与数据链路)
├─────────────────────────┤
│     Physical Layer       │  ← M-PHY (差分串行)
└─────────────────────────┘
应用调用 read() 时,请求并不会直接变成 UFS Command Set 命令:文件系统与块层先把文件偏移翻译成块请求,按需要合并或拆分,最后由 UFS host driver(主机驱动) 把请求映射为 UTP transfer request。
版本号与实际性能
JEDEC 版本规定的是接口能力,同一版本的量产器件,实际 MB/s 和 IOPS(每秒输入/输出操作次数) 可以差很远。建基线要以自己设备的实测数据为准,比较时我们区分以下维度:
| 维度 | eMMC 5.1 | UFS 3.x / 4.x |
|---|---|---|
| 主机链路 | 并行、半双工 | M-PHY 串行、全双工 |
| 多请求能力 | 可有 CQE,设备实现差异大 | 原生支持多个 transfer request |
| Linux 驱动栈 | MMC block / CQHCI(命令队列主机控制器接口,按设备能力) | SCSI/UFSHCD(UFS 主机控制器驱动) |
| 多硬件队列 | 取决于主控和 CQE | 支持 MCQ 的 UFSHCI 主控可建立多组 submission/completion queue(提交/完成队列) |
| 常见性能特征 | 链路与并发上限较低 | 更高带宽与并发潜力,尾延迟仍由器件和负载决定 |
MCQ(Multi-Circular Queue,多循环队列)是 UFS Host Controller Interface 的能力,长在主控一侧;设备标称的 “UFS 4.0” 说的是器件接口,两者要分开看。android17-6.18-2026-06_r6 的 drivers/ufs/core/ufs-mcq.c 会根据主控能力配置读写队列、专用读队列和 polling queue(轮询队列),默认读写队列数还会参考 CPU 数量。要确认设备是否启用了 MCQ,我们还需检查 host controller capability(主机控制器能力)、驱动日志和 /sys 队列信息。
验证器件差异
发现 I/O 延迟异常时,我们先记录器件型号、UFS/eMMC 版本、文件系统、可用空间、温度与当前后台负载,再为这台设备建立冷启动、随机读写和 fsync() 基线。Perfetto 的 block request 延迟能说明请求在块设备路径上等待了多久;正常与否,对照这台设备自己的基线来判断。
块设备层:设备映射与 I/O 调度
请求离开文件系统之后、到达器件之前,中间还有映射和调度两站。文件系统把一段或多段内存页组织成 bio(描述一组块 I/O 的内核结构) 提交给块层;device-mapper 可以先改写目标设备和扇区,块层再合并或拆分 bio,形成 request,交给 blk-mq(多队列块层) 与设备驱动。映射和调度谁先谁后,取决于具体的 device-mapper 叠加方式,配置不同,同一段 I/O 走的路径也不同。
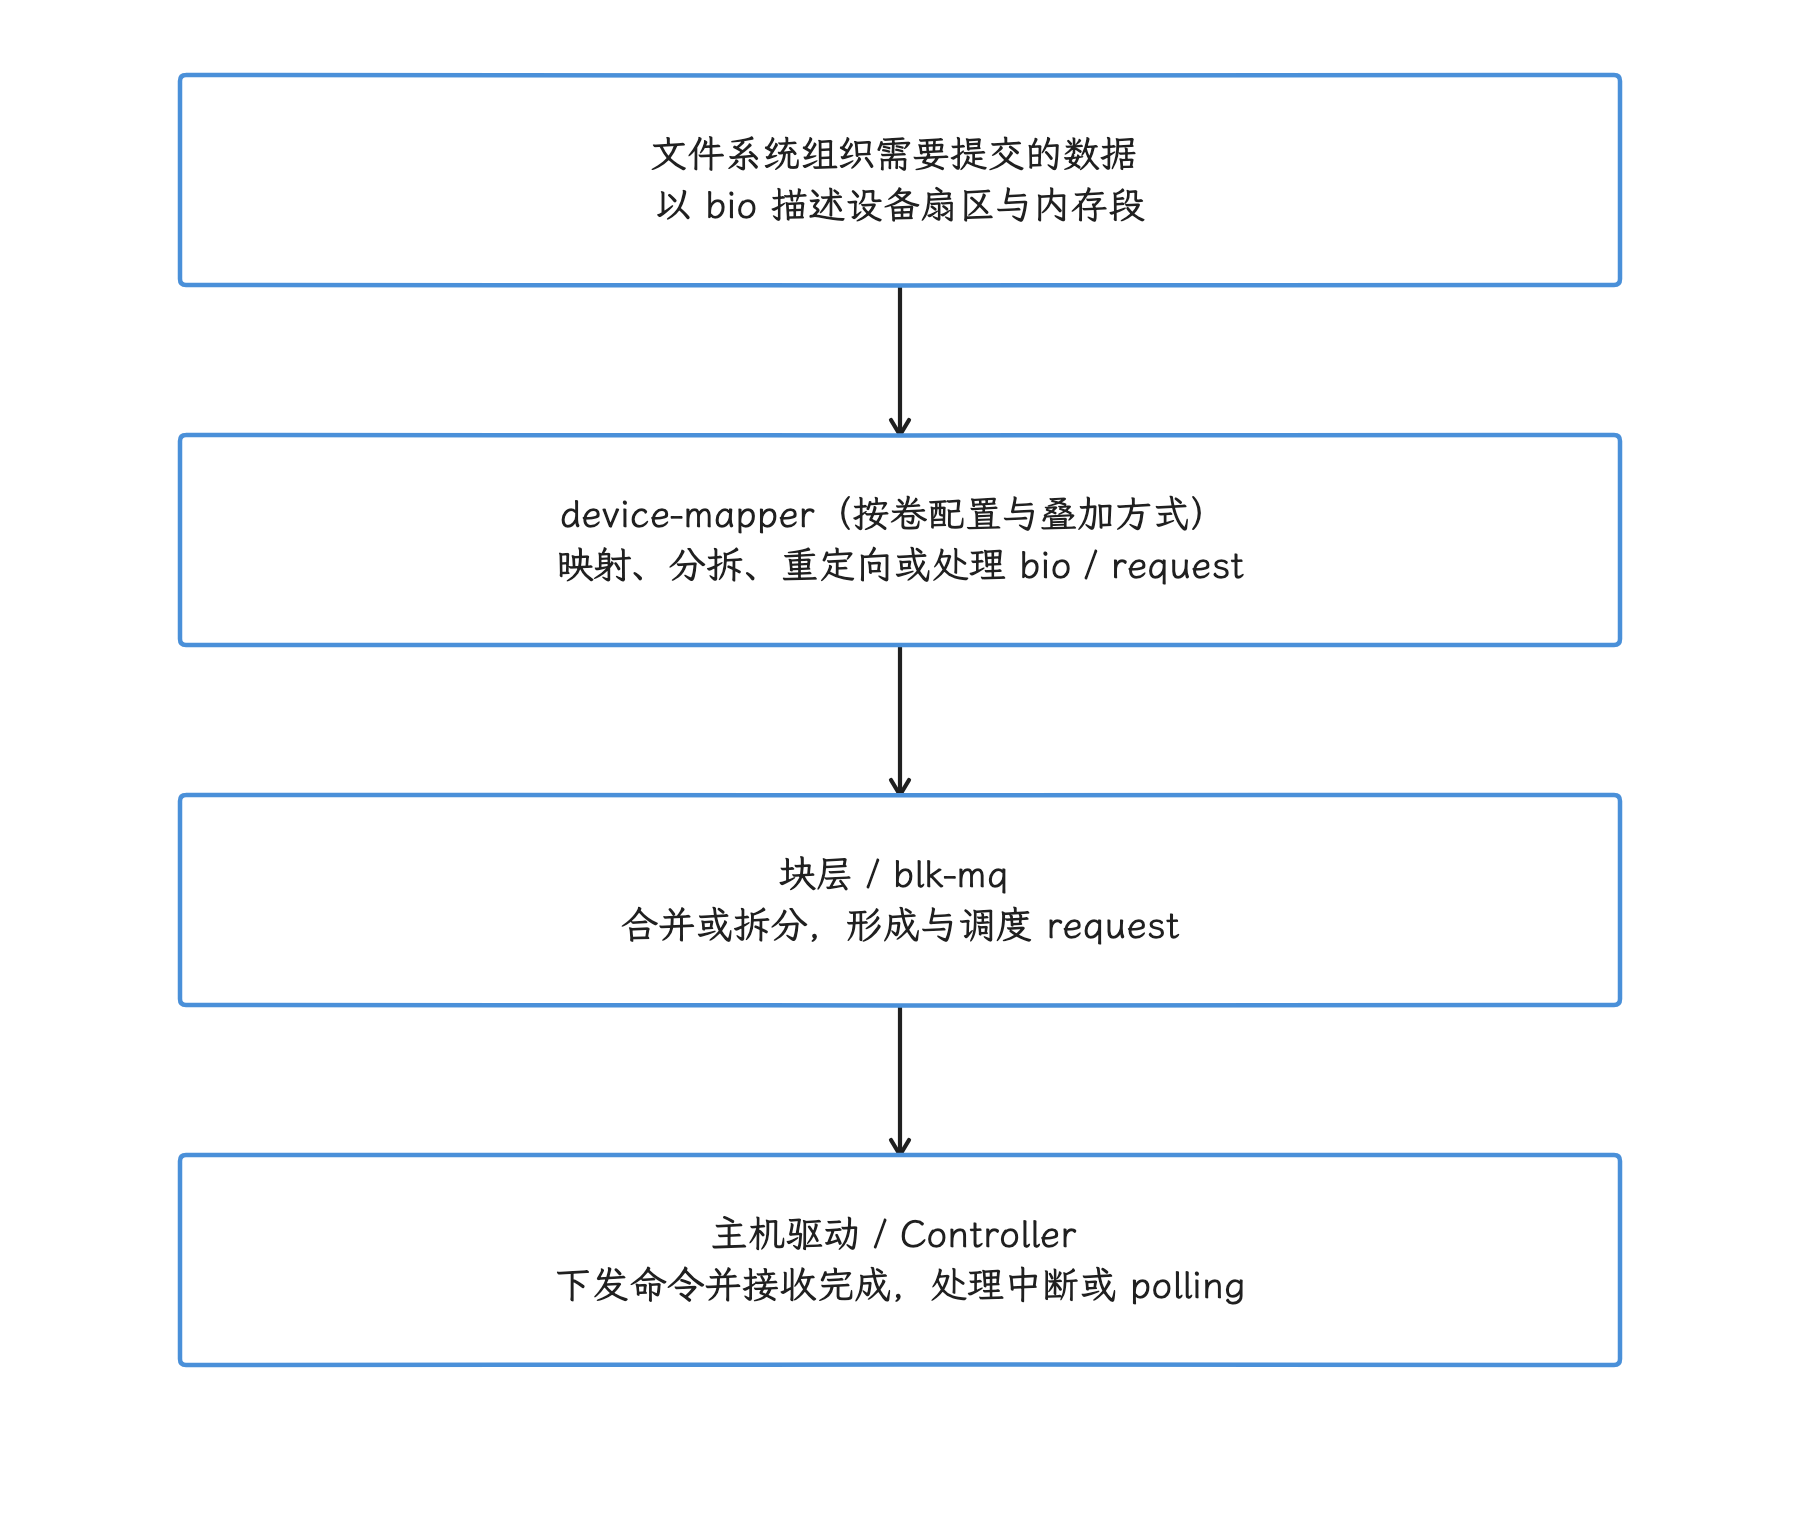
图:本图是职责顺序示意,不保证每个 dm target 都是相同的 bio-based 实现;映射层可以多次重入底层块路径,合并、拆分和下发也不是简单一对一。
device-mapper:虚拟块设备映射层
device-mapper(简称 dm)是 Linux 内核提供的通用块设备映射框架,可以把一个或多个底层块设备映射成新的虚拟块设备。Android 用它实现分区管理、完整性校验和加密等功能。
device-mapper 有三个基本概念:
- 映射设备(Mapped Device):对上层可见的虚拟块设备,例如
/dev/block/dm-0; - 映射表(Mapping Table):定义虚拟设备的每段扇区范围对应哪个底层设备的哪些扇区;
- 目标设备(Target Device):映射表指向的底层块设备。
Android 常用的 dm target(映射目标类型) 包括:
- dm-linear:把一个连续扇区范围线性映射到另一个设备的连续扇区。它是 Dynamic Partition 的基础,
system、vendor等逻辑分区通过 dm-linear 从super物理分区中映射出来。 - dm-verity:通过预先计算的 hash tree(哈希树) 校验只读分区(如
system)的完整性,检测数据是否被篡改。 - dm-snapshot / dm-user:用于 Virtual A/B 的快照路径,但具体职责要按 Android 版本区分:Android 11 使用
dm-snapshot和 kernel COW;Android 12 compressed snapshots 引入 Android COW format 与snapuserd,但仍需转换到 kernel COW /dm-snapshot;Android 13+ 的 userspace merge 才移除对 kernel COW 和dm-snapshot的依赖。 - dm-default-key:用于 metadata encryption,在
data分区的块设备层执行加密。
这些 dm 目标可以叠加,形成 Android 的分区布局。各分区的职责、挂载方式和性能影响需要分别分析。
I/O 调度器
I/O 调度器负责块 request 的排序、合并与派发。Android 设备可能选择 mq-deadline、BFQ(Budget Fair Queueing)或 none,UFS MCQ 与设备厂商配置都会影响最终选择。mq-deadline 同时维护排序队列和 FIFO(先进先出) 到期约束;BFQ 根据预算和权重分配设备服务时间,启用相应 cgroup(控制组) 支持时可以体现组级权重。调度器名字只是起点,前台请求是否真的优先,取决于后面的分组配置。
手机上经常出现前台随机读与后台顺序写竞争。AOSP android-17.0.0_r1 的 libprocessgroup/profiles/cgroups.json 仍把 v1 blkio(块 I/O 控制组)挂载到 /dev/blkio;在 task_profiles.json 中,LowIoPriority 进入 blkio/background,SCHED_SP_FOREGROUND 与 SCHED_SP_TOP_APP 分别组合 HighIoPriority、MaxIoPriority。这个基线的 HighIoPriority 与 MaxIoPriority 都加入 blkio 根组,单看名字分不出两个 I/O 优先级档位。我们把这些 profile 理解为用户空间的分组意图;它要转化为实际的设备服务差异,还取决于 active scheduler(当前启用的调度器)、内核 cgroup 支持和厂商的 blkio 属性。
核对时我们可以结合 /sys/block/<dev>/queue/scheduler、/proc/cgroups、/dev/blkio 与设备配置。
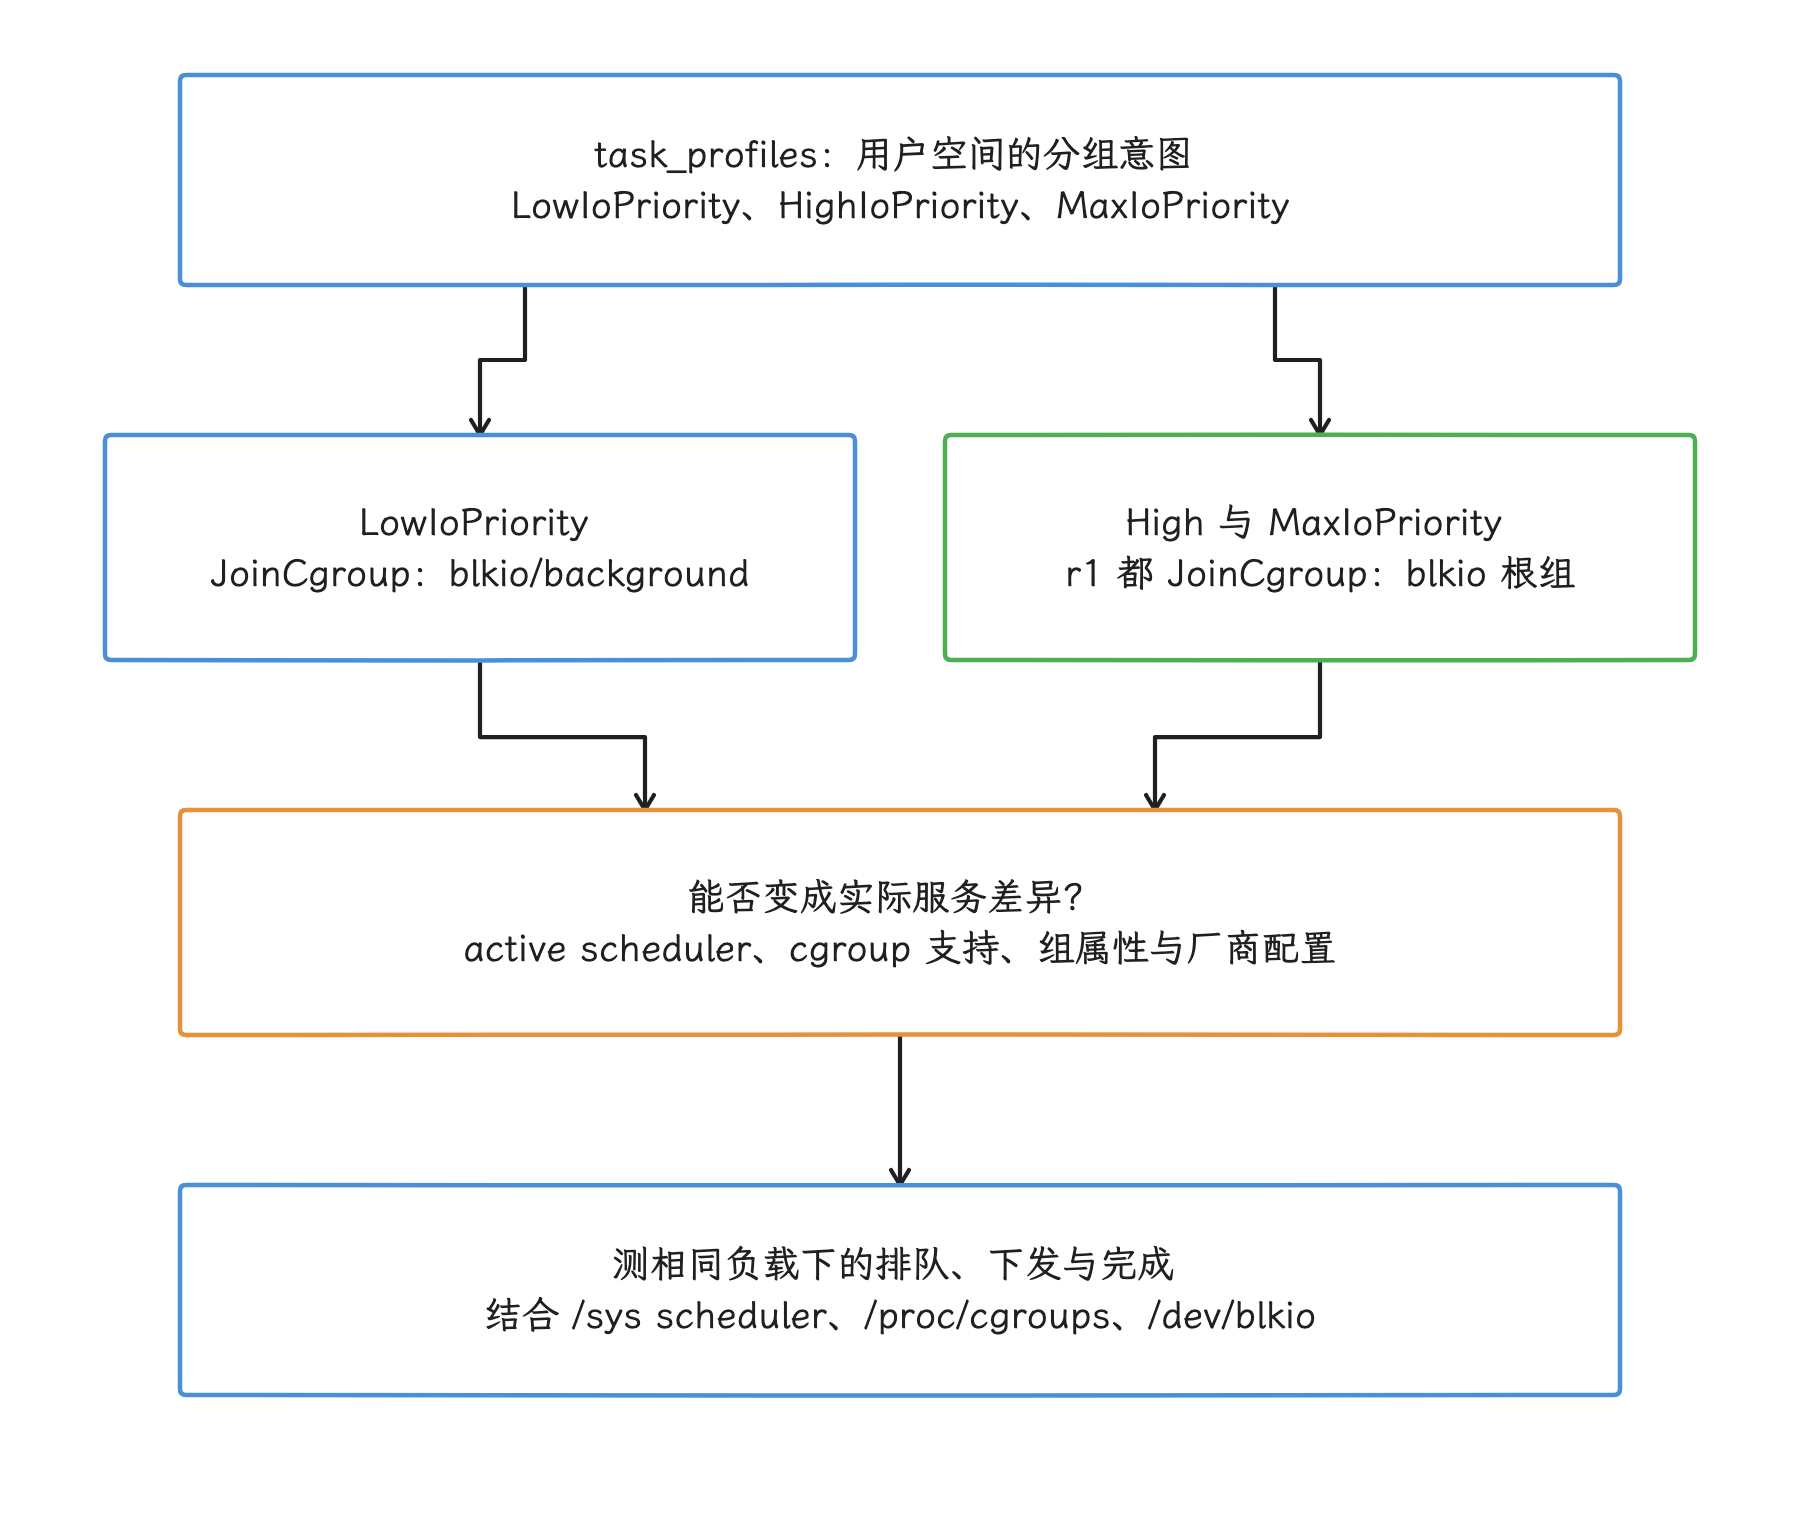
图:r1 的 High/MaxIoPriority 组路径相同,单看名字证明不了两个设备优先级档位。mq-deadline、BFQ 或 none 的选择要落到前台是否更快,还需核对内核与设备配置。
分区布局:system、vendor、data 与 metadata
传统分区与 Dynamic Partition
早期 Android 使用固定大小的分区。system、vendor、cache 等分区在出厂时就确定容量,写入分区表后便固定下来。如果 system 空间不足而 vendor 仍有空余,这部分空间也挪不过去给 system 用。
Android 10 引入 Dynamic Partition(动态分区)。设备可以把 system、vendor、product、odm 等适合动态化的只读分区放入 super,再通过 dm-linear 映射成逻辑分区。boot、dtbo、vbmeta 等 bootloader(引导加载程序) 需要直接读取的分区通常仍是物理分区,留在 super 之外。
下面的图说明 super 与逻辑分区的映射关系,分区在介质上的实际排列以设备为准。
Physical Partition: super
┌──────────┬──────────┬──────────┬──────────┐
│  system  │  vendor  │ product  │   odm    │
│ (logical)│ (logical)│ (logical)│ (logical)│
└──────────┴──────────┴──────────┴──────────┘
         mapped via dm-linear
借助这种布局,OTA 升级可以动态调整各逻辑分区的大小,不再完全受固定分区表约束。
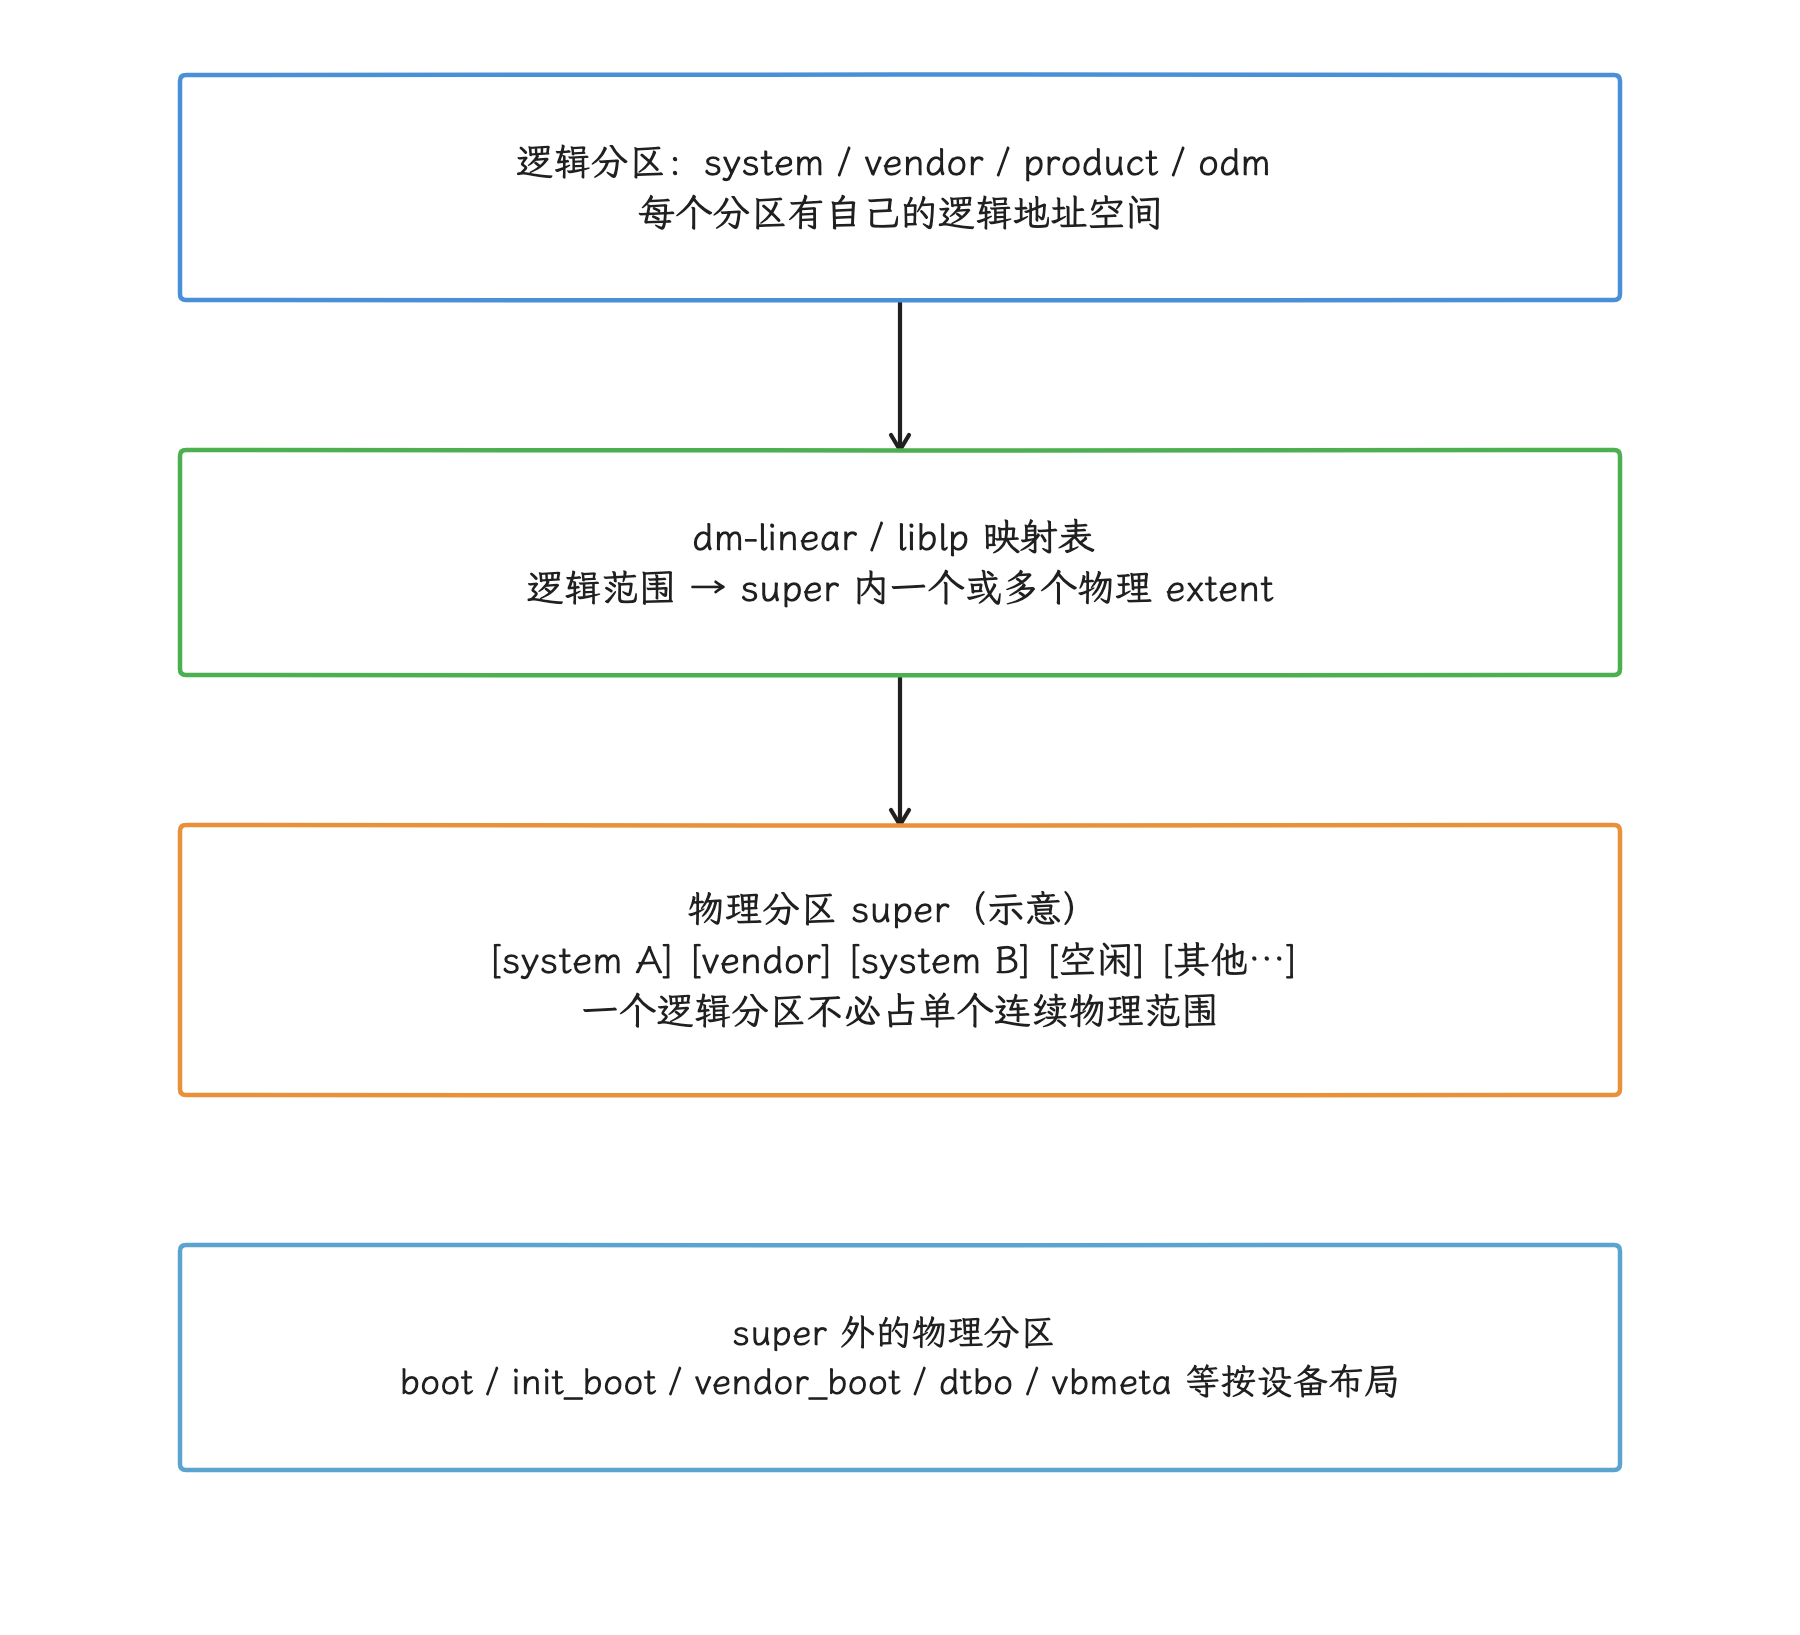
图:super 本身是分区容器,挂载的是映射后设备上的文件系统。逻辑分区可以有多个 extent,具体排列、空闲区和 OTA 期间的 COW 占用以本机 metadata 为准。
各分区的职责
system 分区:包含 Android framework、系统库和系统应用,在正常 Verified Boot(验证启动) 流程中以只读方式使用。Android 9 首发设备采用当时的 system-as-root:rootfs(根文件系统) 内容合入 system.img,由内核直接挂载为根。Android 10 仍采用 system-as-root 的分区布局,但启动方式变了:设备必须带 ramdisk,first-stage init 解析 super metadata、创建 dm-linear 逻辑设备,并挂载 system、vendor、product 等分区,不再沿用 Android 9 的 no-ramdisk、kernel-direct-mount(挂载) 路径。受保护的只读分区继续由 AVB(Android Verified Boot)/ dm-verity 验证。
vendor 分区:包含 HAL(硬件抽象层) 实现、固件和厂商定制配置。Project Treble 借助这条分区界线把 vendor 实现与 Android framework 分开,framework 升级因此不必与全部厂商实现同步更新。vendor 分区同样以只读方式使用,并受 dm-verity 保护。
data 分区:这是主要的大容量可写分区,承载安装包(/data/app/)、应用私有数据(/data/user/<user_id>/)、共享媒体的底层存储(/data/media/)以及系统数据库等。设备还可能有 metadata、persist 等小型可写分区。应用日常持久化流量主要集中在 /data,我们做 I/O 性能分析时,重点也在这里。
metadata 分区:这是启动早期即可使用的独立小分区,AOSP metadata encryption 文档建议容量为 16 MB,通常挂载到 /metadata。它保存用于保护 metadata encryption key 的 KeyMint blobs(由 KeyMint 保护的密钥数据),也可能承载 vold(Volume Daemon,存储卷守护进程)、checkpoint(检查点)、Virtual A/B 等功能在 /data 挂载前必须访问的少量状态。系统先挂载 /metadata 取得 key material(密钥材料),随后建立 /data 的 metadata-encrypted block device(元数据加密块设备):取密钥和建加密设备是先后两步,分析时分开看。
挂载流程:从 bootloader 到用户空间
Android 10+ 设备的常见启动链远比“bootloader 挂分区”复杂。bootloader 完成 Verified Boot 和硬件初始化后,加载 kernel 与启动所需的 ramdisk。首发 Android 13+ 的 GKI 设备把 generic ramdisk 放入独立的 init_boot,vendor ramdisk 则来自 vendor_boot;核对 ramdisk 位置时别只盯着 boot.img。
内核启动后进入 ramdisk 中的 first-stage init;first-stage init 解析 super 分区 metadata,创建 dm-linear 逻辑设备,并挂载 system、vendor、product 等 first_stage_mount 分区。
到 early-fs 阶段,系统先启动 vold,提前做 metadata encryption 的准备工作;到 late-fs 阶段,init 先执行 wait_for_keymaster,再通过 mount_all 挂载 /data。解析 super、建立逻辑设备并挂载相应文件系统,以及挂载 /data,都由内核和用户空间协作完成,vold 负责 /data 挂载前的密钥准备和设备映射。
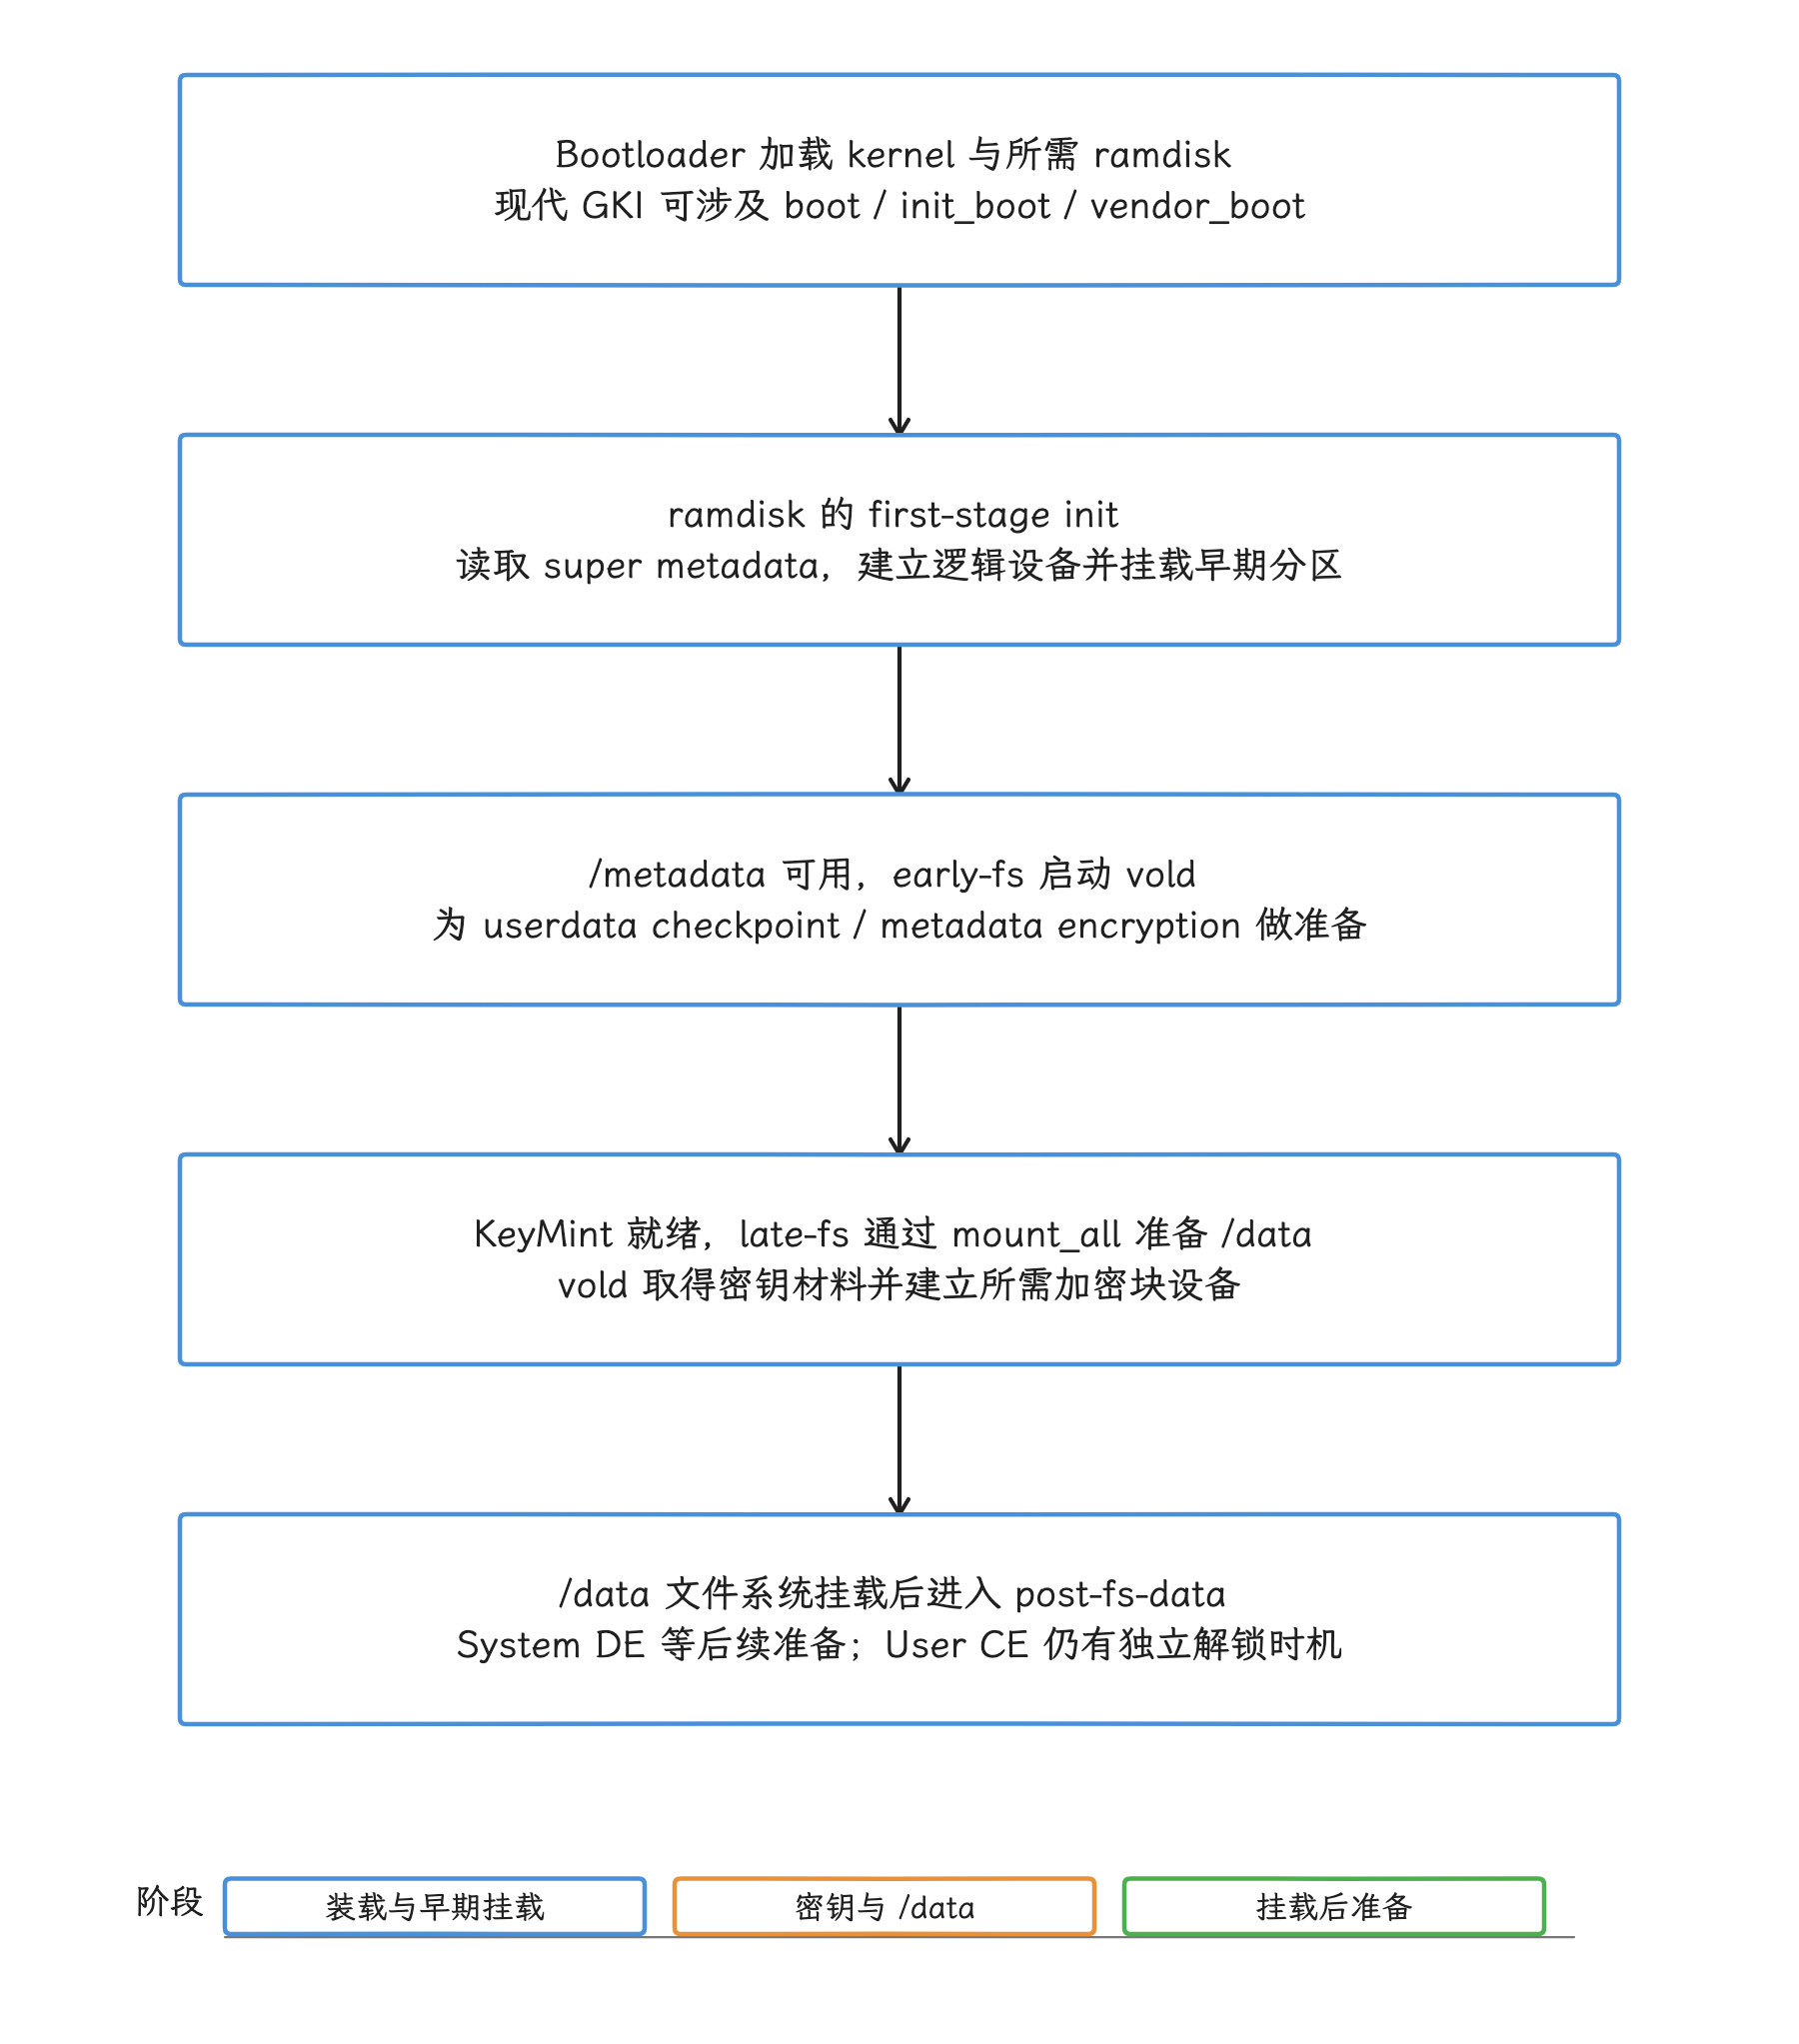
图:这是常见配置的依赖链,init 具体动作由设备 rc/fstab 决定。Android 13+ 首发 GKI 的 generic ramdisk 位于 init_boot;super 是映射容器,不是 bootloader 直接挂载的文件系统。
文件系统:ext4 与 f2fs
ext4 的同步写成本
ext4 和 f2fs 都是 Android 17 GKI(Generic Kernel Image,通用内核镜像)支持的文件系统,量产设备可以选择其中之一作为 userdata。ext4 在 Android 上仍是现役方案,它的日志、一致性保证与同步写时机,要结合应用的事务模型来分析。
应用的普通 buffered I/O(缓冲 I/O) 会先进入 page cache(页缓存),落盘的时机则常由 SQLite、SharedPreferences、文件下载器或系统服务调用 fsync() / fdatasync() 决定。手机还同时面对进程频繁启动、后台回写、突然掉电保护、热约束和共享闪存队列竞争,这些因素都可能放大一次同步写的尾延迟。
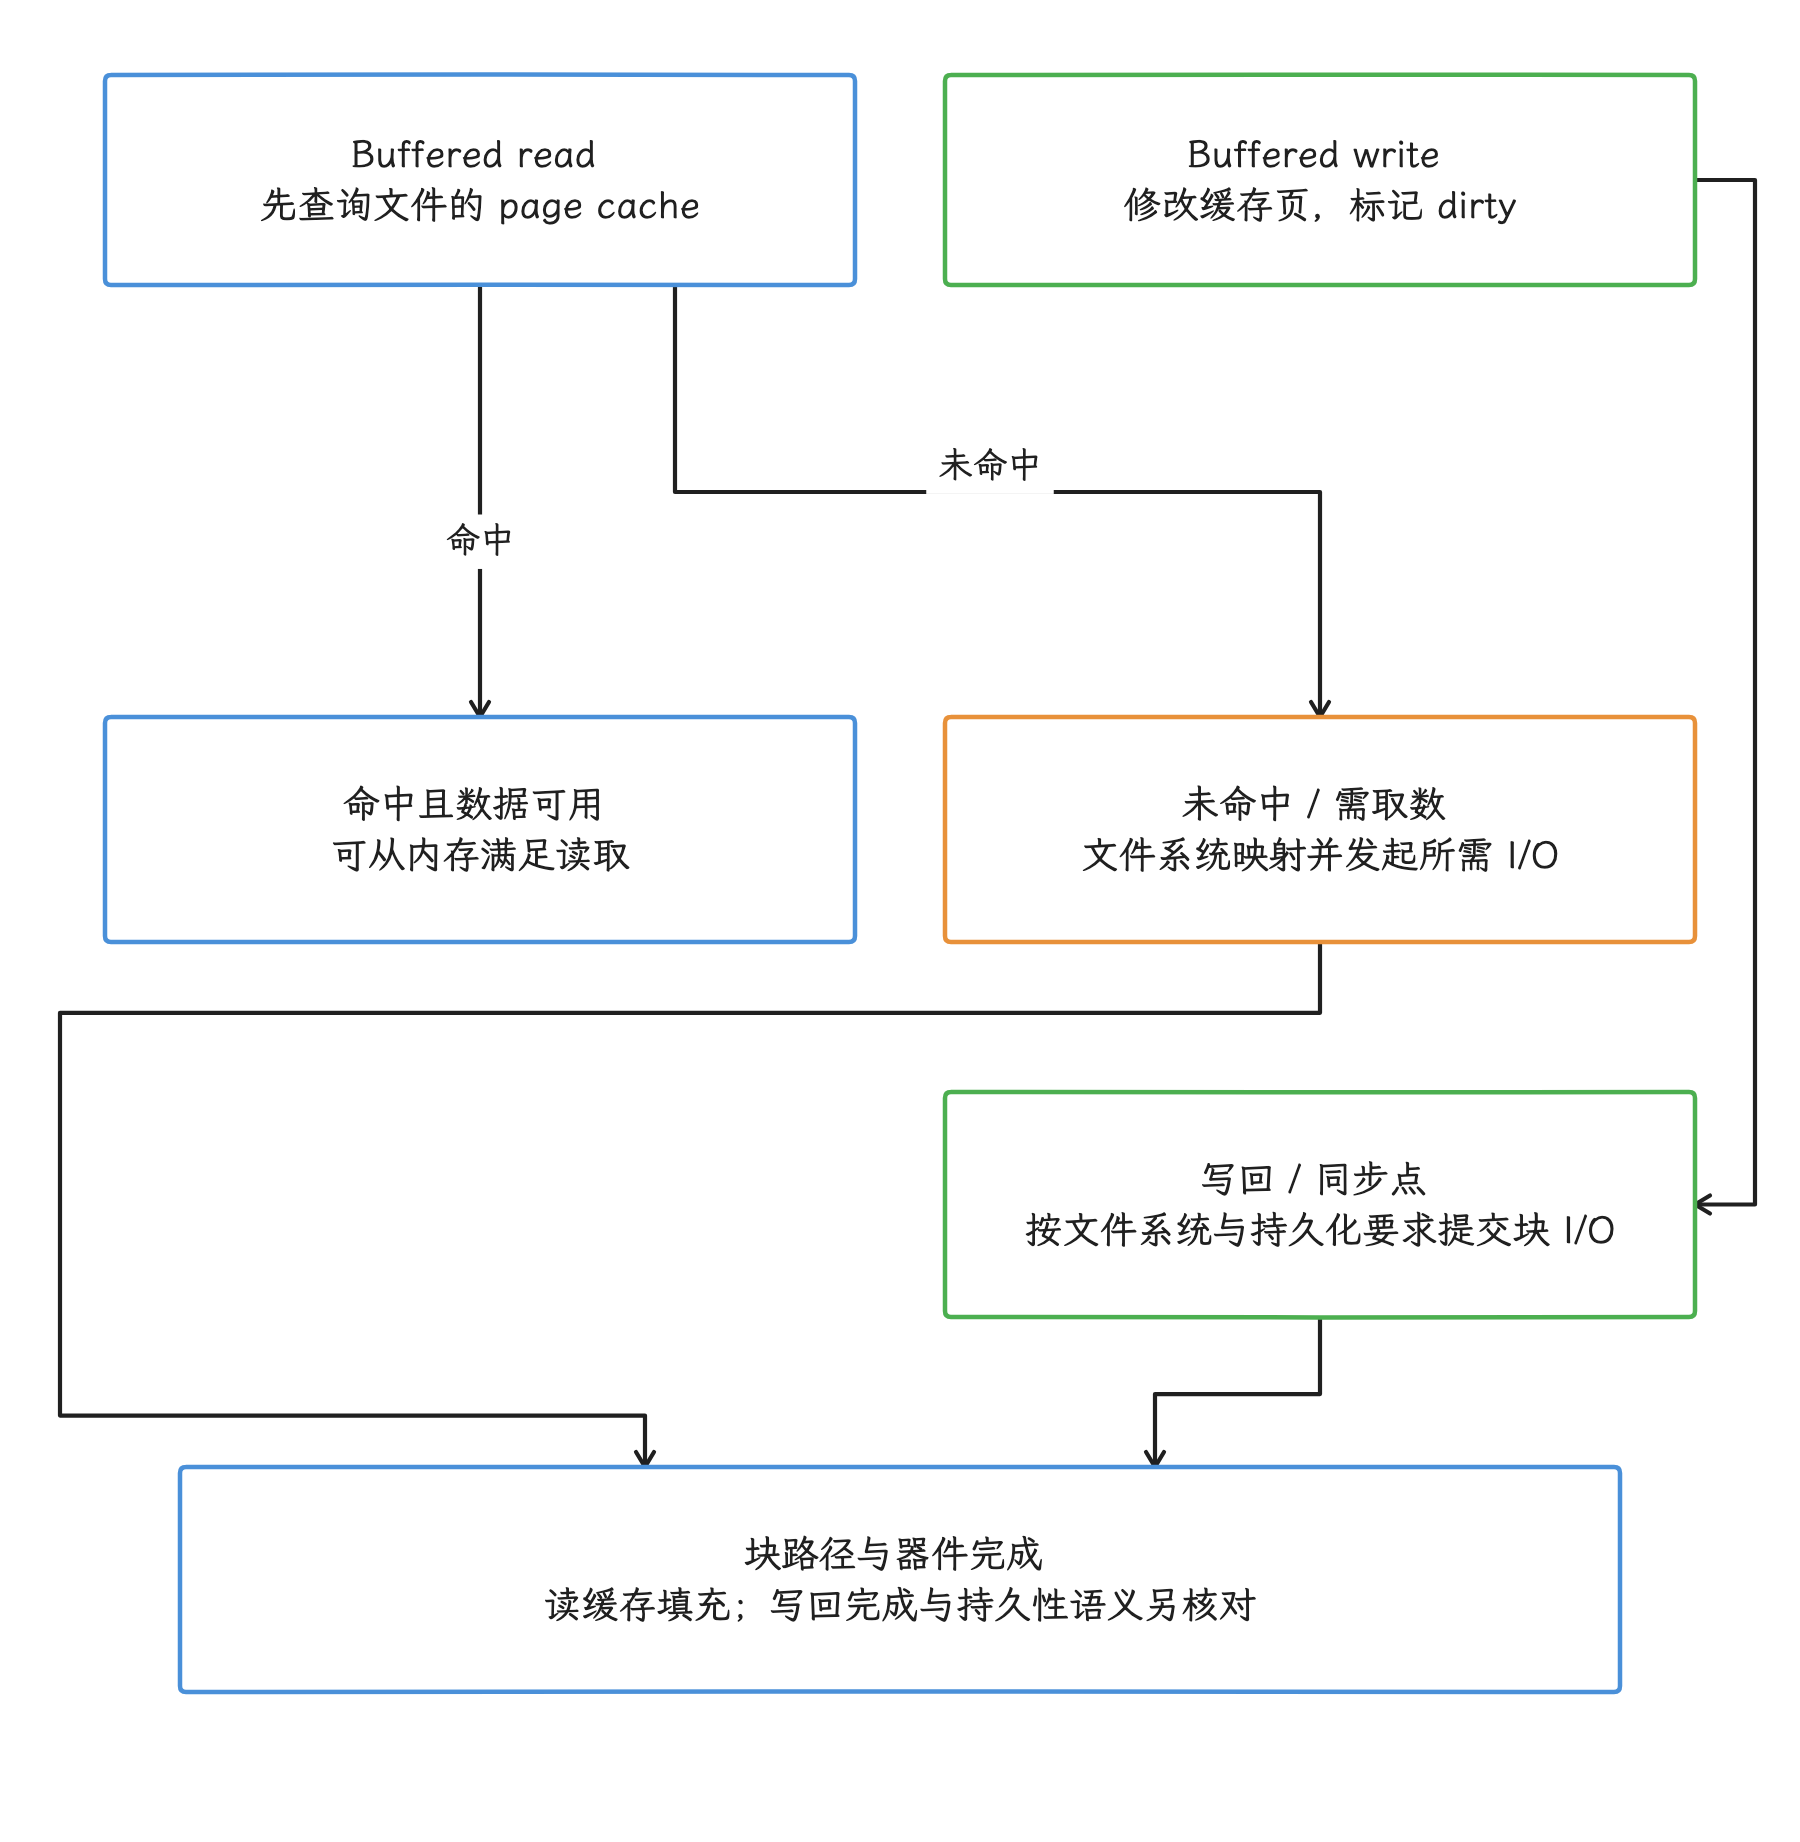
图:图示普通 buffered 文件 I/O,省略 readahead、mmap 与错误路径。write 返回可仅表示数据进入缓存;fsync/数据库提交的持久化要求还受日志模式、文件系统、flush/FUA 与设备语义影响。
SQLite 可以使用 rollback journal(回滚日志)或 WAL(Write-Ahead Logging,预写日志)。一次提交会发出哪些同步操作,取决于 journal mode、synchronous 级别、checkpoint 状态和 Android SQLite 配置。以 WAL 为例,事务记录通常追加到 -wal 文件,再由 checkpoint 回写主库;估算一次事务的同步成本,就从这两段入手。
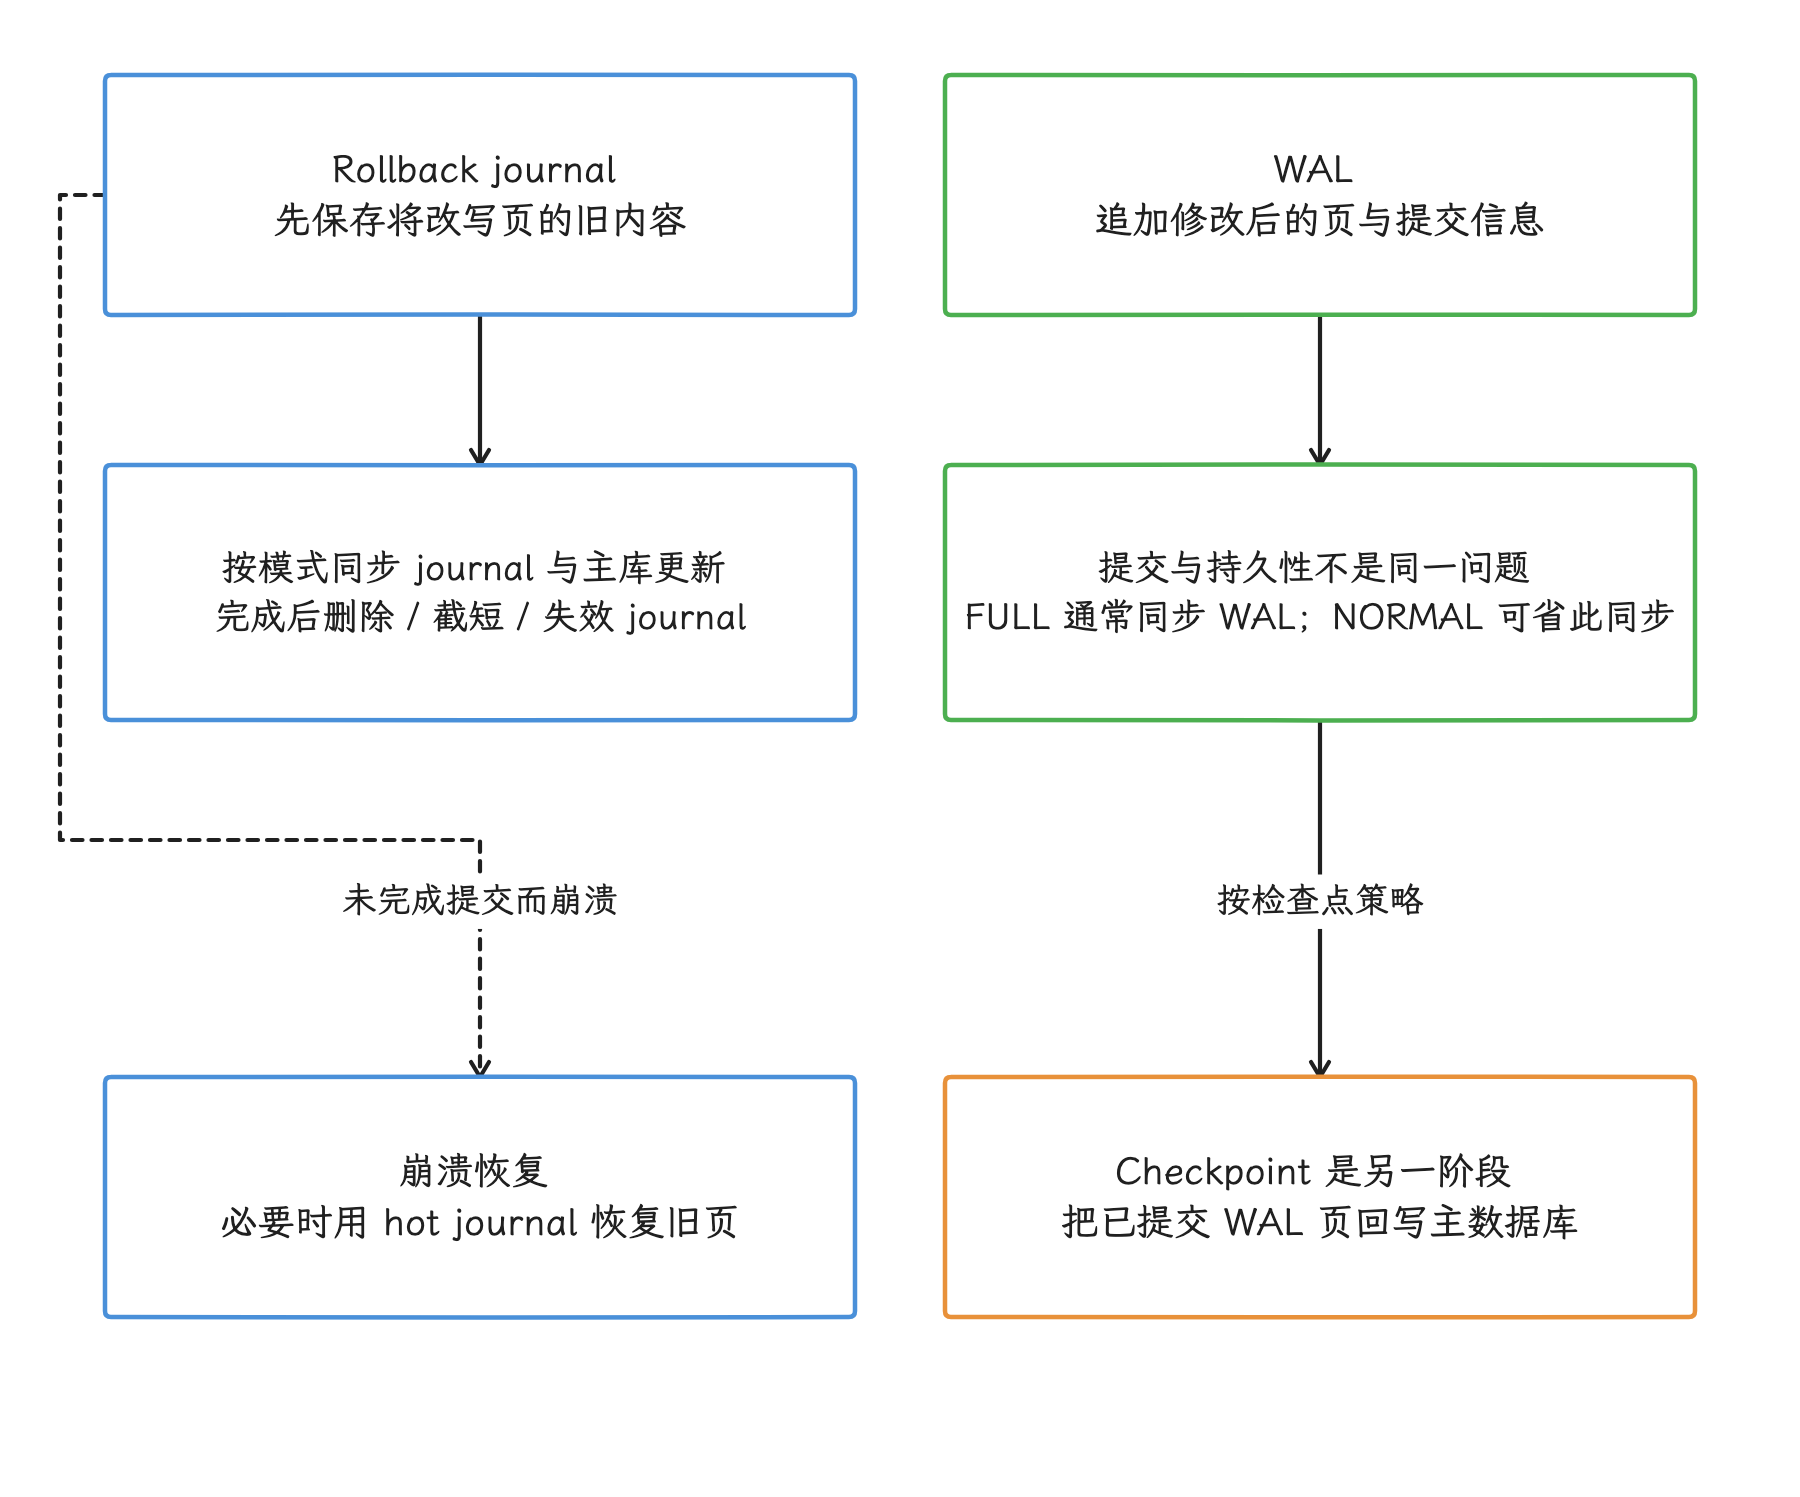
图:这是机制对照,不是每次事务固定发相同数量的 fsync。WAL commit 与 checkpoint 是不同阶段;实际同步由 synchronous、自动 checkpoint、文件系统和 Android 配置共同决定。
在 ext4 常见的 data=ordered 配置下,fsync() 需要协调目标文件的脏数据、必要的 jbd2 metadata transaction(文件系统日志事务) 和设备 flush。延迟分配可能把块分配推到回写或同步阶段,后台写入也可能占据设备队列,所以我们要靠具体 trace 判断耗时落在哪一步。
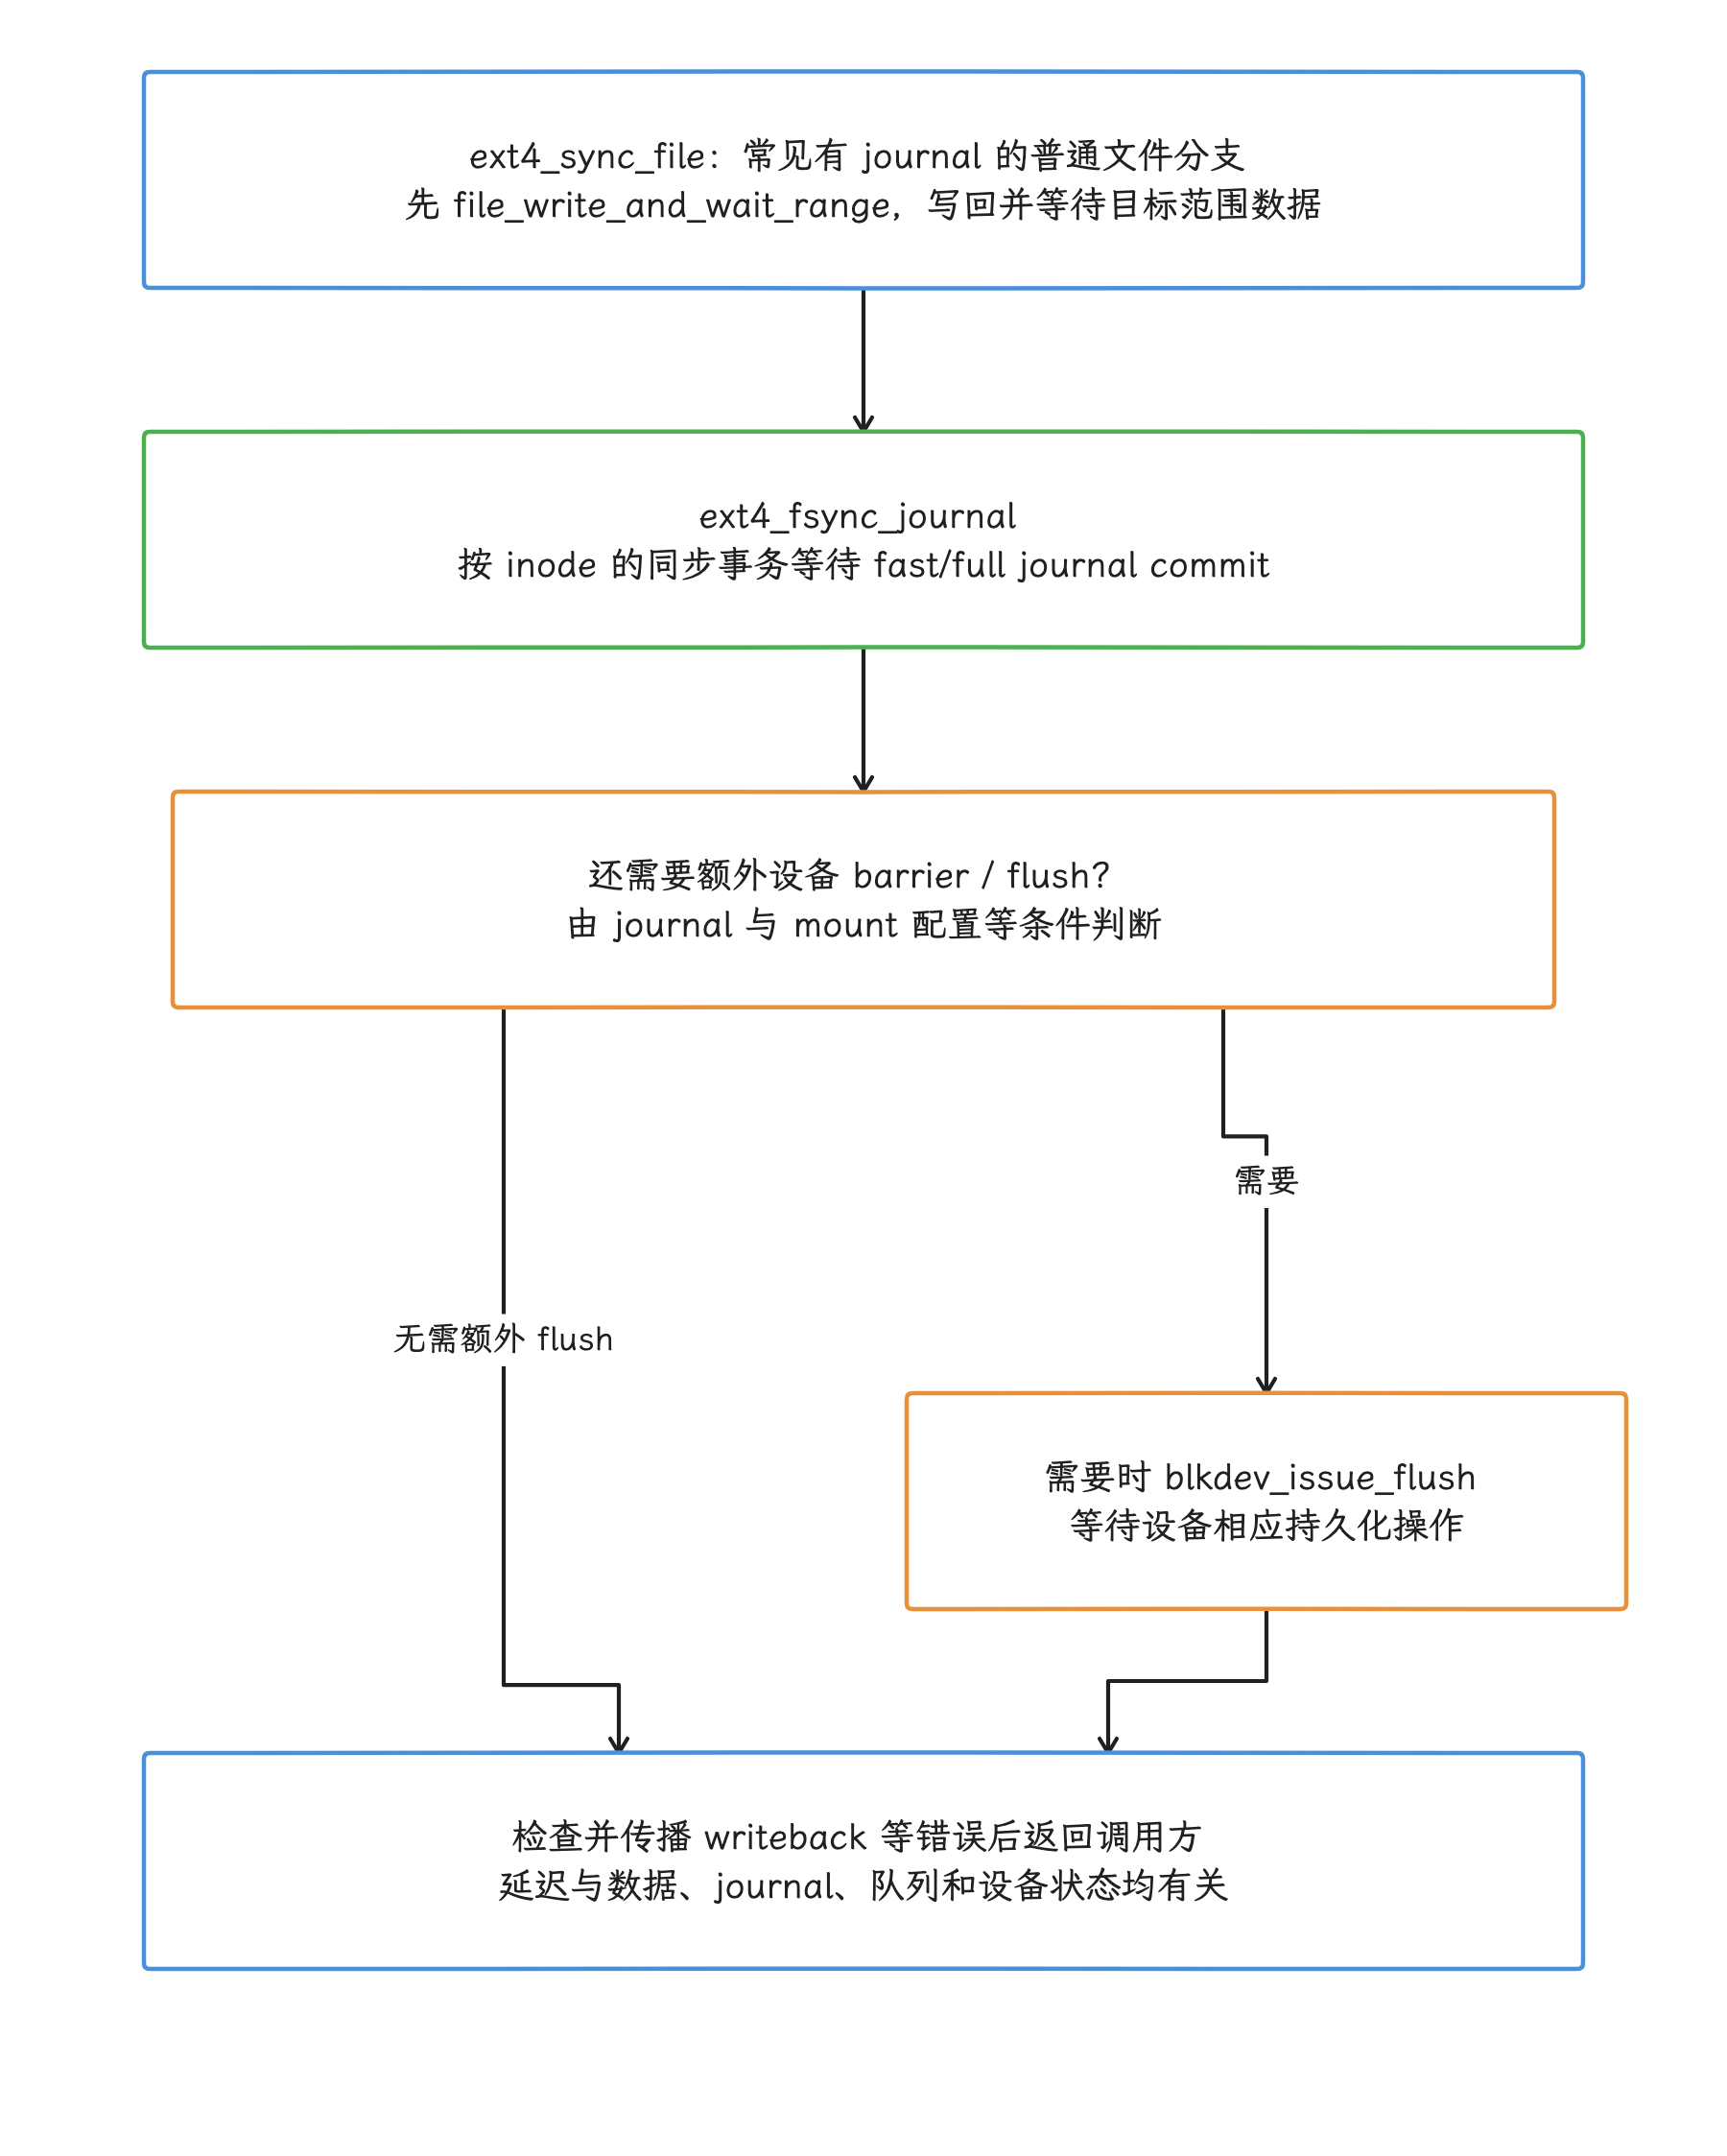
图:图限定常见有 journal、非 data=journal 的路径;无 journal、错误和特殊模式另有分支。journal 同步是否伴随额外设备 flush,要按这条路径的实际条件确认;延迟分配与后台写入也可能影响等待。
f2fs:为闪存优化的文件系统
f2fs(Flash-Friendly File System)是 Android 设备可选的 userdata 文件系统。它采用 log-structured(日志结构) 设计,把主机侧更新写入新的逻辑块,再通过 segment(分段)、checkpoint 和 GC(垃圾回收) 管理空间。Android 也没有统一要求把 /data 从 ext4 迁移到 f2fs。
f2fs 的关键设计包括:
Out-of-place update(异地更新):f2fs 通常把修改后的数据写入新逻辑块,再更新元数据。它可以把主机侧的随机更新整理到 segment 中,降低文件系统层的覆盖写与碎片压力。不过 NAND 的物理擦除、有效页搬移和写入放大仍有器件 FTL 参与,一次 4 KiB 更新在闪存内部产生多少写入,要由 FTL 的实际行为决定。
冷热数据分离:f2fs 会根据更新模式给数据与 node 标记不同温度,尽量把更新频率相近的数据放入相应 segment。这样可以降低 GC 搬移仍然有效的冷数据的概率。这种分类属于启发式策略,热写入仍有可能影响冷数据。
SQLite batch atomic write(批量原子写):android-17.0.0_r1 的 external/sqlite/dist/Android.bp 明确定义了 SQLITE_ENABLE_BATCH_ATOMIC_WRITE。只有当 VFS 与文件系统报告相应能力、事务满足限制且采用 rollback-journal 相关路径时,SQLite 才可能通过 batch atomic write 减少 journal 工作。WAL 有自己的追加与 checkpoint 语义,用不上这项优化;设备文件系统和运行时 journal mode 都需要单独确认。
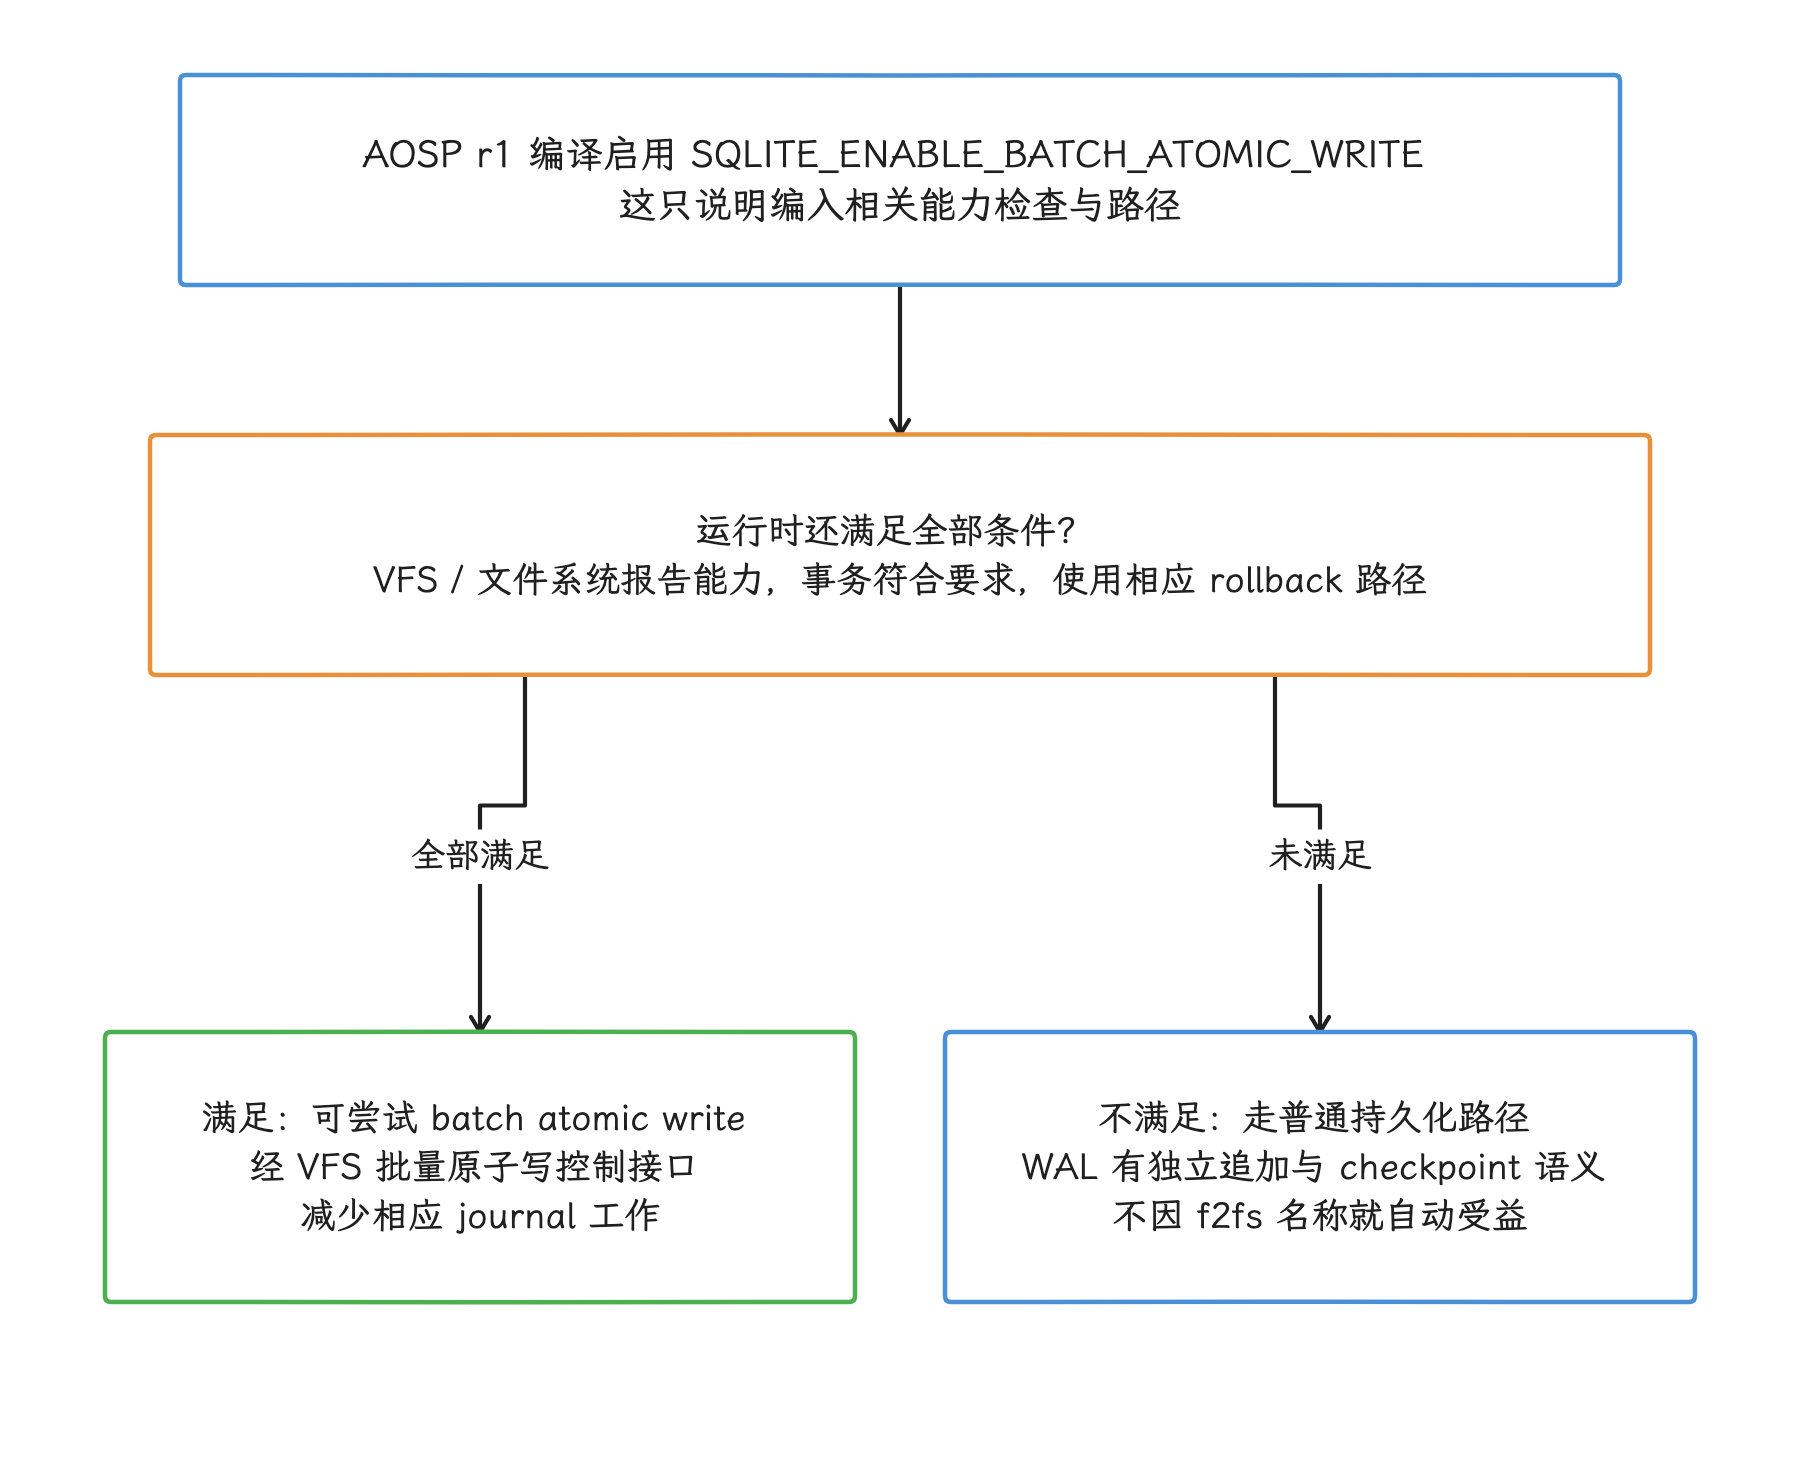
图:编译选项不代表每笔 SQLite 事务都减少日志。先确认运行时 journal mode、VFS/device characteristics 和实际原子写支持,再比较同步次数、延迟与写入量。
在 Perfetto 里看到 data partition 上大量 fsync() 延迟时,我们先确认 filesystem type(文件系统类型)。分析 ext4,要关注 jbd2(ext4 日志线程)和 ext4_sync_file_* 等同步写路径;分析 f2fs,则要检查 writeback(脏页回写)、checkpoint 或 GC 是否与 foreground I/O 争用 device queue(设备队列)。f2fs 的 GC 多数时间在后台完成,但可用空间紧张时也会拖慢前台读写。
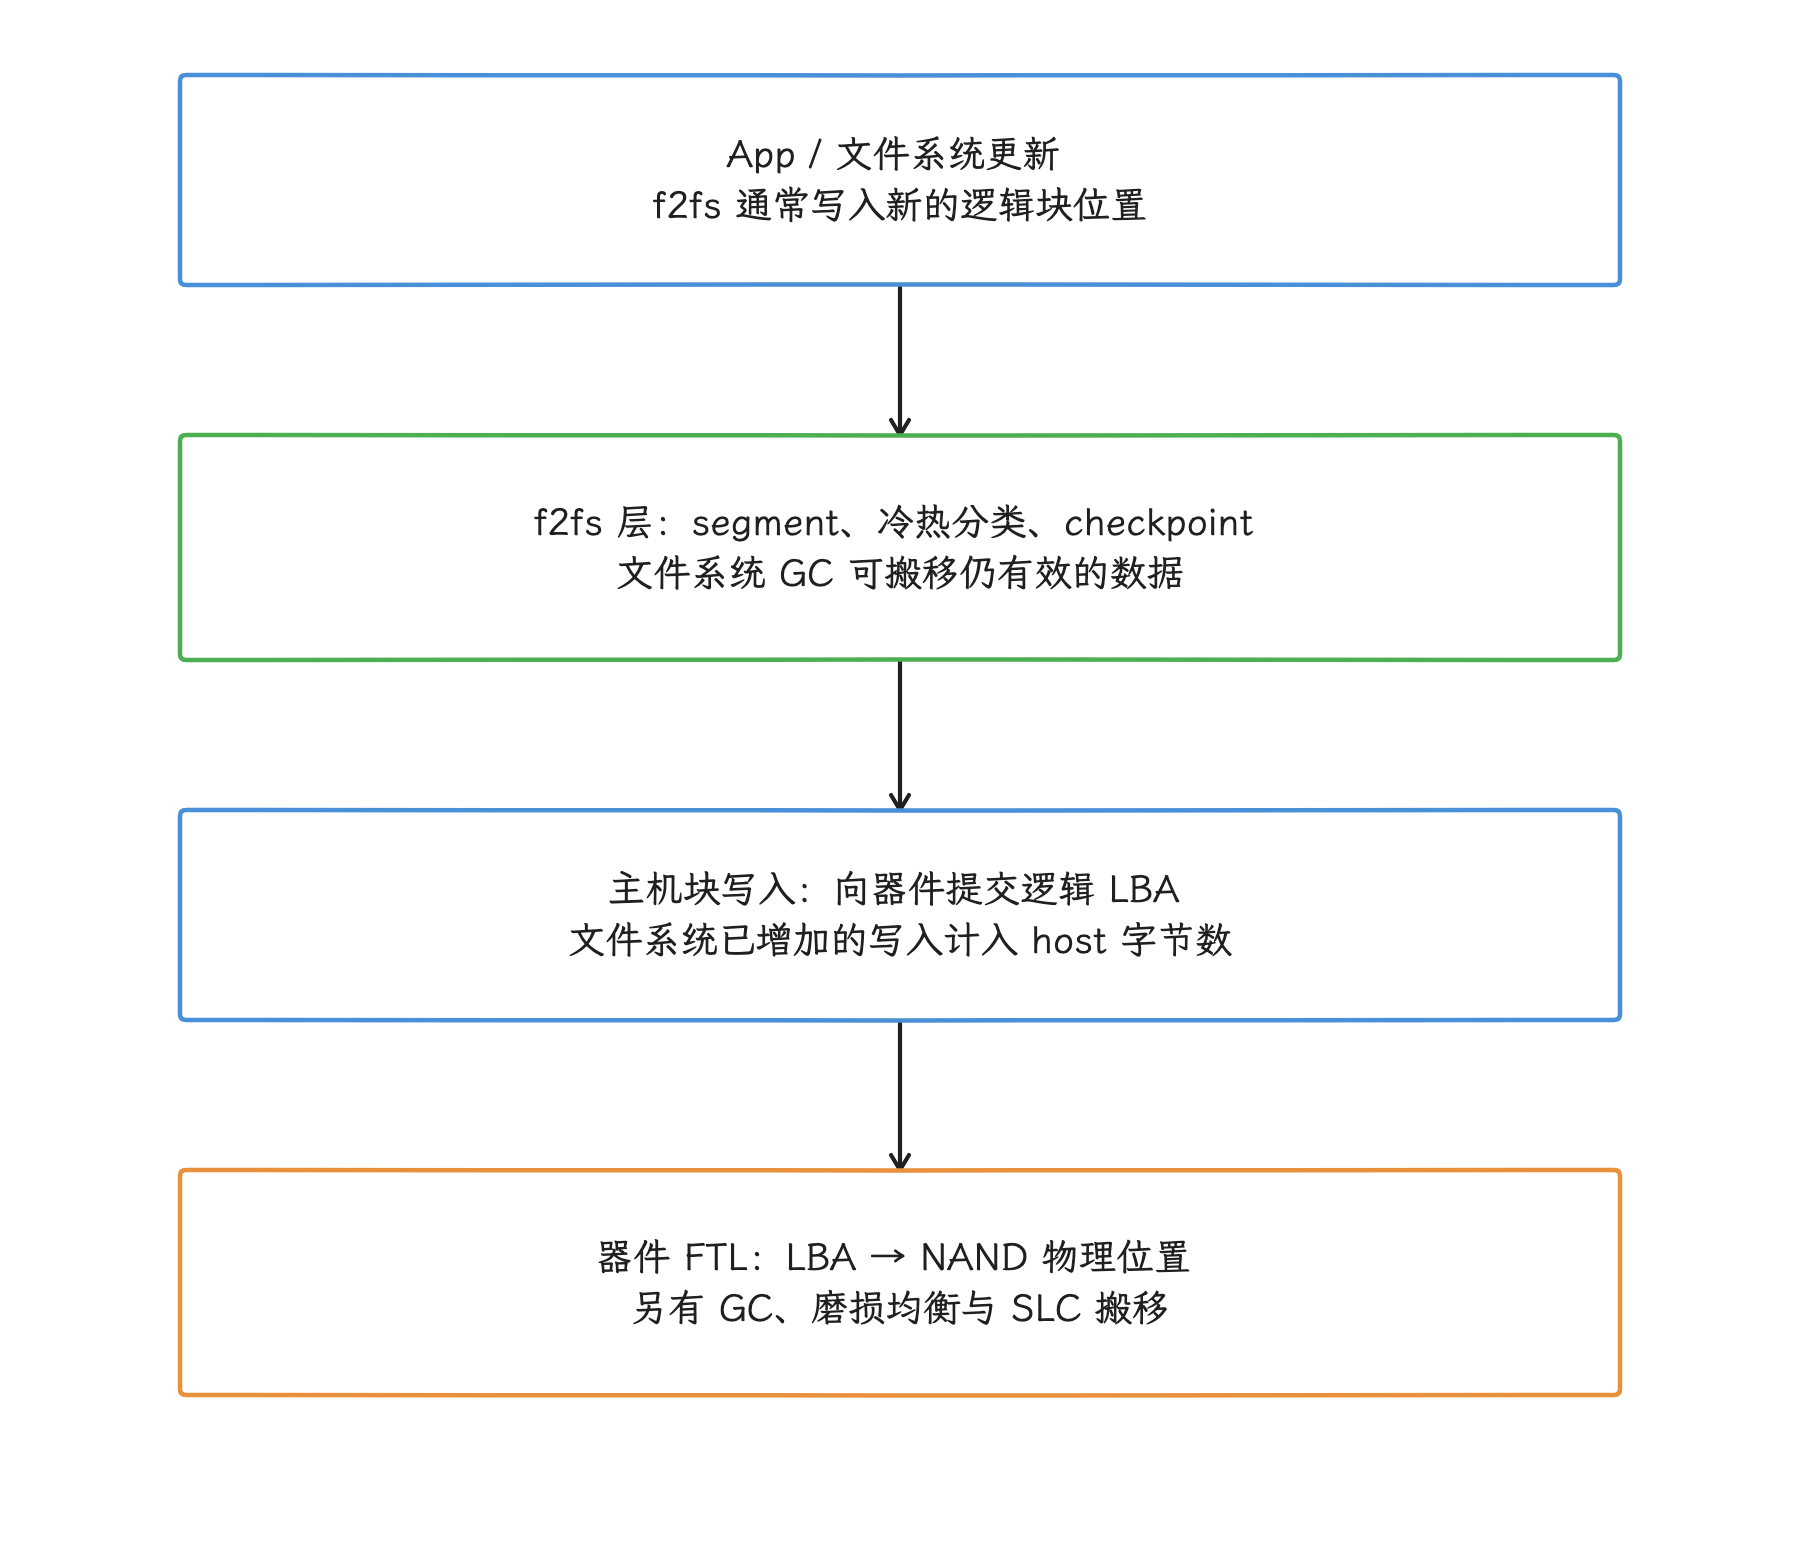
图:f2fs 的异地更新和冷热分离作用于主机逻辑块,NAND 页怎么搬移、何时擦除由器件 FTL 决定。两个 GC 层都可能有成本;空间紧张与后台写入影响尾延迟,需要分别观测。
Scoped Storage:权限模型与 I/O 路径变化
为什么需要 Scoped Storage
共享存储的权限模型在 Android 10 前后被重新设计,我们先从旧模型的问题看起。Android 10 之前,App 只要拿到 READ_EXTERNAL_STORAGE 或 WRITE_EXTERNAL_STORAGE,就可以访问共享存储(/sdcard)中的大部分内容。用户照片、文档和下载内容缺少按媒体集合与创建者划分的细粒度隔离,这种权限模型暴露了过多用户数据。
Android 10 引入 Scoped Storage(分区存储),并允许应用通过兼容机制暂缓迁移;从 Android 11 开始,target API(应用声明的目标 API 级别)为 30 及以上的应用必须遵循 scoped storage。主要变化包括:
- App 可以直接访问自己的专属目录(
Android/data/<package_name>/和Android/media/<package_name>/),不需要申请存储权限; - 共享媒体通常先通过 MediaStore 查询和定位,再按 Android 版本取得媒体权限或用户选择授权;Android 11+ 获得访问权后,也可以用直接路径的 File / fopen() 访问媒体;
- 访问用户的 PDF、文档等任意文件时,通常通过 Storage Access Framework(SAF,存储访问框架)让用户选择;应用自己的专属目录,以及自己通过 MediaStore.Downloads 创建的文件,按相应规则访问;
- 遵循 scoped storage 的普通 App 写共享存储应使用相应媒体集合、SAF 或自己的专属目录,
/sdcard根路径没有留任意直接写的入口;特殊的 All Files access 另有权限边界。
FUSE 层的性能开销
共享存储的权限策略需要一个执行点,Android 11 重新引入 FUSE 来承担:MediaProvider 充当 userspace FUSE handler(用户态 FUSE 处理程序),可以允许、拒绝或按策略对文件访问结果脱敏。首发搭载 Android 11 且使用 5.4 及以上内核的设备改用了 FUSE 路径,不再有 SDCardFS;从旧版本升级的设备则可能在 SDCardFS 上叠加 FUSE。应用内部目录 /data/user/<user_id>/<package>/ 走的是另一条路径,不经由共享存储的 FUSE 挂载。
Android 11 新增了 shared media 的 direct file paths(直接文件路径)访问方式。取得相应权限后,App 可以继续使用 File API 或 fopen() 访问媒体文件,从而兼容大量第三方媒体库。它解决的是 API 兼容问题,本身没有承诺绕过 FUSE。官方文档指出,顺序读取时 direct file path 与 MediaStore 的性能接近;随机读写时,direct file path 的耗时反而可能接近 MediaStore 的 2 倍,此类场景更适合继续使用 MediaStore。
Android 12 增加了 FUSE passthrough(直通路径),设备需要匹配的 official kernel、MediaProvider 实现与产品属性。文件通过权限与 redaction(内容脱敏)检查后,FUSE driver 可以在 open() 之后把后续读写直接转发到 lower file system(底层文件系统)。android-17.0.0_r1 的 MediaProvider/jni/FuseDaemon.cpp 仍会检查 persist.sys.fuse.passthrough.enable、内核 capability(能力支持) 以及文件是否需要 redaction/transform,再决定能否启用 passthrough;源码里还有 FUSE BPF(通过内核 BPF 程序处理部分 FUSE 操作) 路径,由内核 BPF 程序处理部分 FUSE 操作。MediaStore API、Android 11 direct file path、FUSE passthrough 和 FUSE BPF 分属四个不同层次,我们分析共享存储性能时,先要弄清请求落在哪一层。
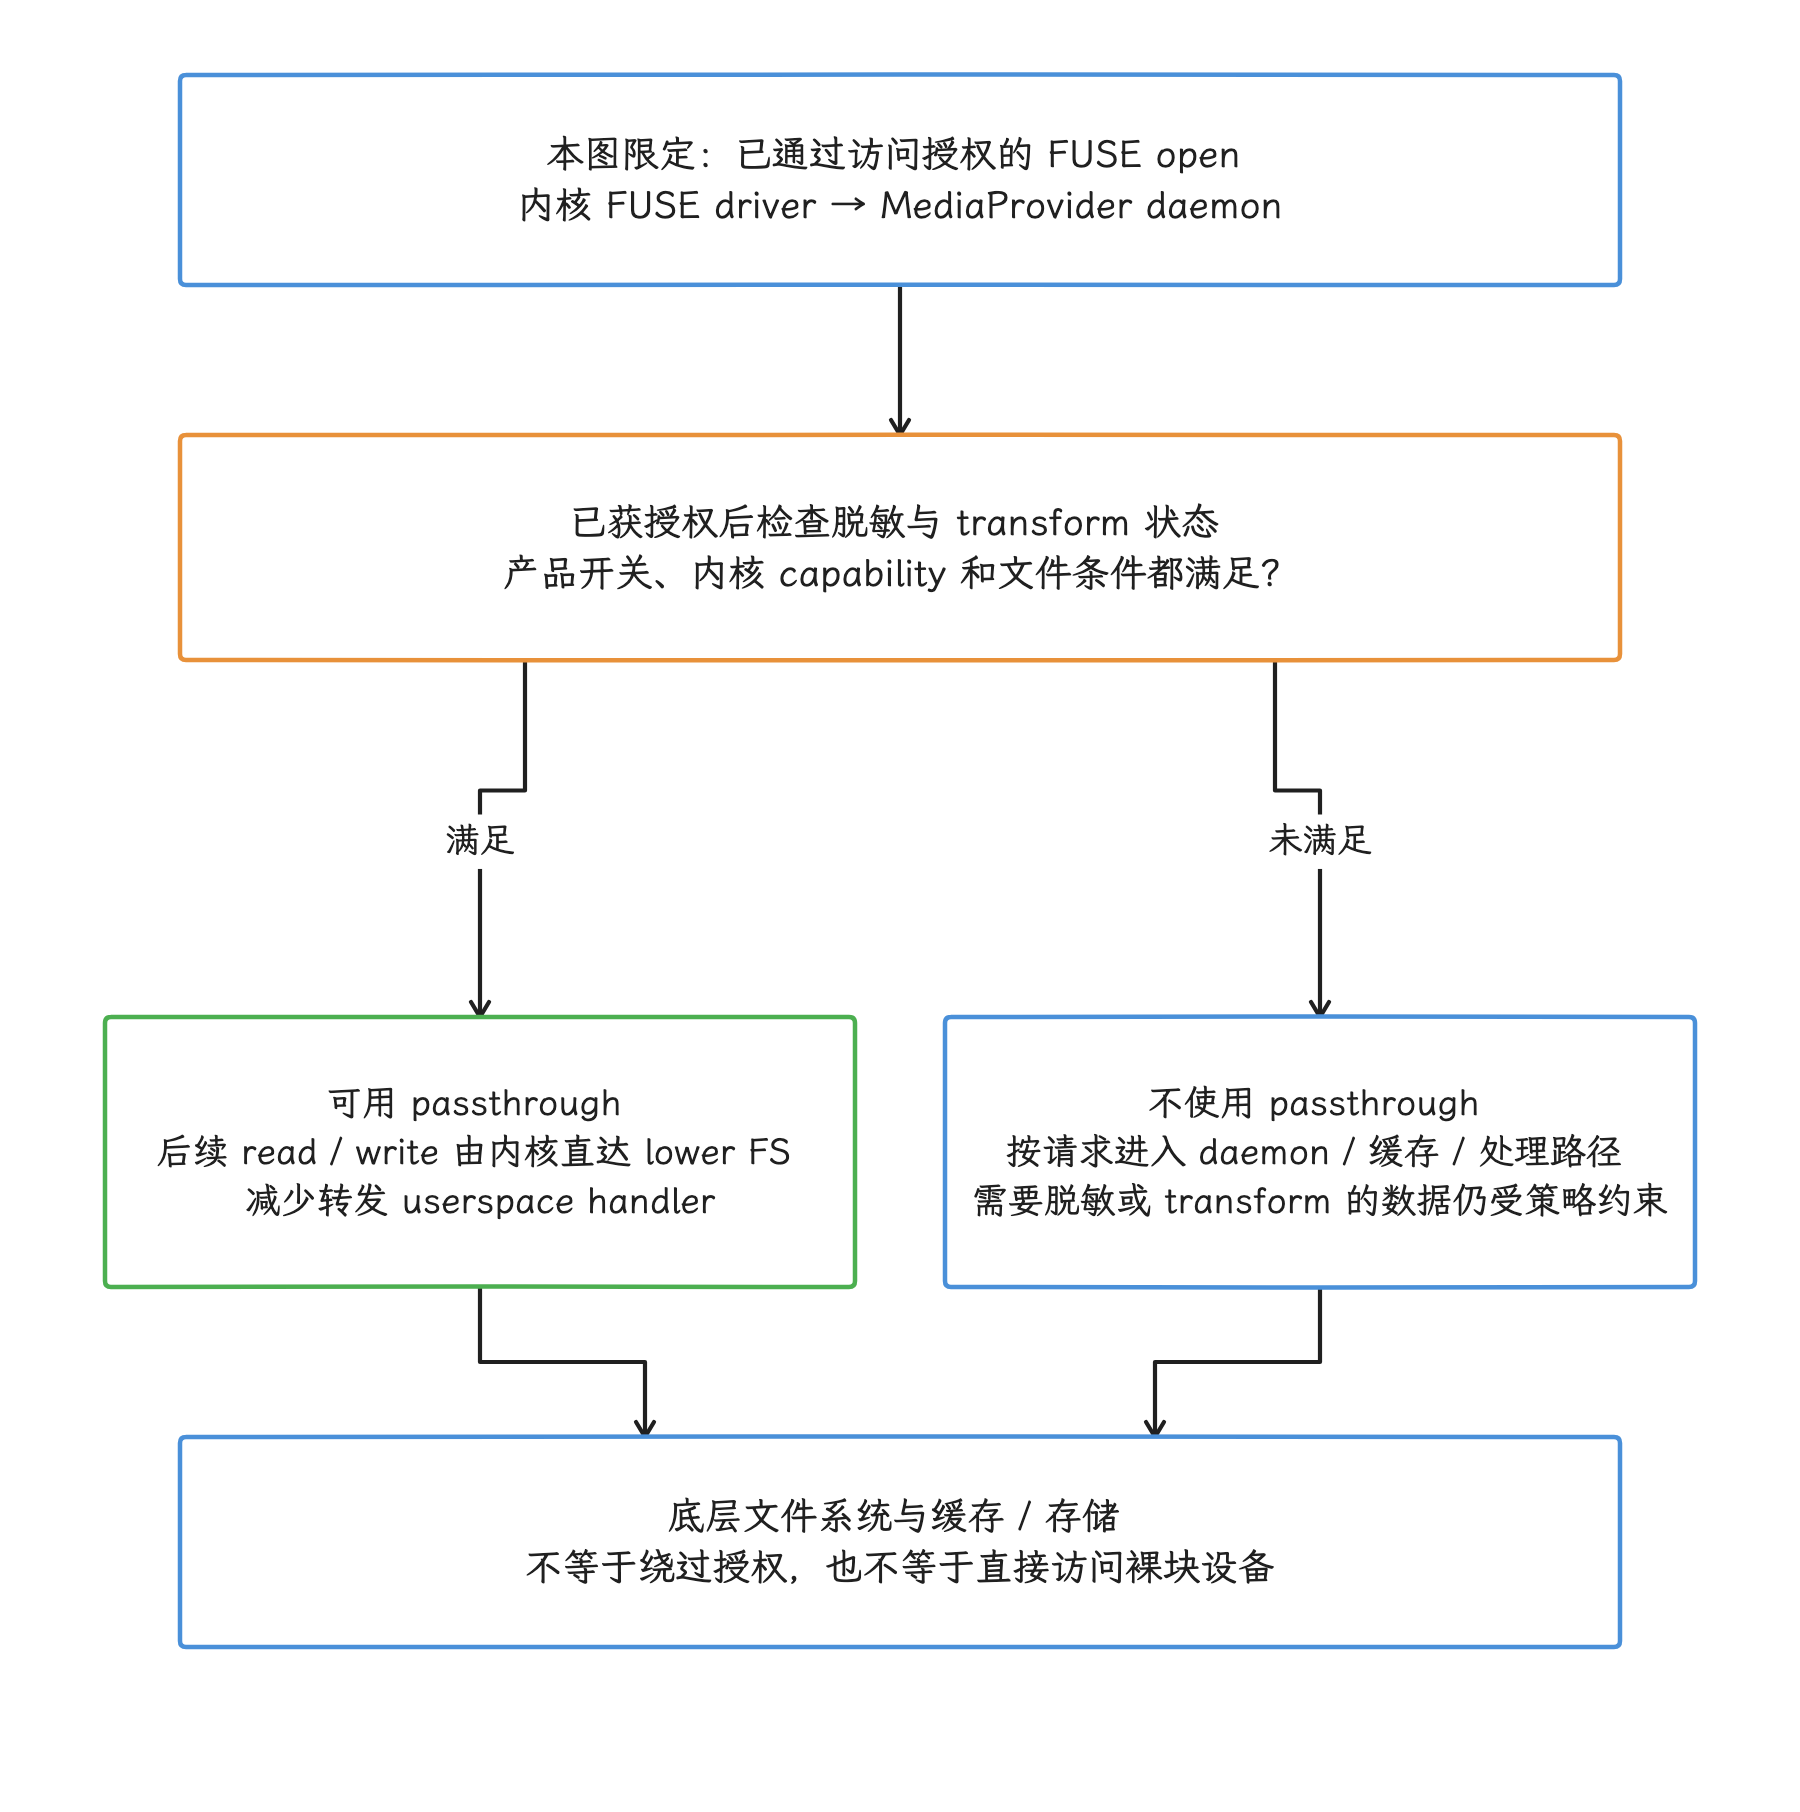
图:r1 create_handle_for_node 要求无需 redaction 且 transform 已完成,才能在允许的路径上启用 passthrough;首次读才做转码时不能直接返回尚未转换的数据。MediaStore API、直接路径、passthrough 与 FUSE BPF 不是同一开关。 未获授权的 open 会失败,不进入这两条数据读写分支。
对 App I/O 行为的实际影响
落到 App 开发和性能分析上,我们关心三件事:接口怎么选、数据放哪里、版本差异怎么处理。
访问共享媒体时,先按访问模式选择接口:目录扫描、批量查询和随机读写等场景,优先使用 MediaStore 完成索引与权限判定;需要兼容旧库或 native 媒体栈时,再考虑 Android 11 的 direct file paths。
应用私有数据优先放内部存储:只在 App 内部使用的数据,放在内部存储 /data/user/0/<package>/ 最直接。如果必须放入 external app-specific directory(外部存储中的应用专属目录),分析时也要把它与共享媒体访问分开,按两条 I/O 路径分别建模。
先确认版本再下结论:同样是“共享媒体访问慢”,Android 10 要区分 MediaProvider API 与当时的 SDCardFS/设备存储模拟路径;Android 11 才由 MediaProvider FUSE 支持 direct file path;Android 12+ 设备还可能启用 passthrough。分析时先确认首发版本、MediaProvider 模块、设备内核和产品属性。
在 Perfetto trace 中,未使用 passthrough 的 FUSE 请求可能表现为 App 线程等待,并与 MediaProvider 的 FUSE worker(工作线程) 活动对齐;采用 passthrough 后,后续数据读写可能不再唤醒 userspace handler。要判断一个请求是否经过 FUSE,我们要看 MediaProvider 日志、产品属性、内核 capability 和调用路径;App 侧的 I/O wait 只是指路的线索。
版本断点速查
| Android 版本 | system / 挂载模型 | shared storage 入口 | FUSE 行为 | App 侧建议 |
|---|---|---|---|---|
| Android 9 | system-as-root 成为首发设备基线,rootfs 合入 system.img | 传统 external storage 模型 | 设备存储模拟常用 SDCardFS,也存在升级和厂商差异 | 旧项目以路径访问为主,但要为后续访问权限减少做准备 |
| Android 10 | dynamic partitions + first-stage init 成为新设备主路径 | Scoped Storage 引入,可通过兼容机制暂缓 | MediaProvider 执行 scoped policy;设备存储模拟仍常见 SDCardFS,direct file path 受限 | 新代码优先 MediaStore / SAF,少依赖裸路径 |
| Android 11 | /data 挂载流程继续沿用 Android 10 | shared media 支持 direct file paths、File API、fopen() | MediaProvider 成为 FUSE handler;升级设备可叠加 SDCardFS | 媒体库兼容可以用 direct file paths,重度随机访问优先比较 MediaStore |
| Android 12 | 挂载模型基本稳定 | API 入口与 Android 11 接近 | 首发设备配合 official kernel 可启用 FUSE passthrough | 先确认设备是否支持 passthrough,再判断瓶颈位置 |
| Android 15-17 | 挂载与共享存储主要模型延续 Android 12+ | MediaStore / direct file path 共存 | FUSE passthrough 仍取决于内核与 MediaProvider 模块版本 | 大量枚举和跨媒体库访问仍优先使用 MediaStore,模块侧优化按设备实测确认 |
FBE:文件级加密的存储影响
从全盘加密到文件级加密
Android 的存储加密经历了从全盘加密(Full-Disk Encryption,FDE)到文件级加密(File-Based Encryption,FBE)的演进。FDE 在块设备层用一套 volume key(卷密钥) 保护 userdata,早期密码启动流程会把整卷解锁与用户凭据绑定。FBE 则通过 fscrypt policy(文件系统加密策略) 把不同目录树归入可以独立解锁的加密类,由此形成 DE(Device Encrypted,设备加密)与 CE(Credential Encrypted,凭据加密)存储。内容密钥是否按文件派生,还取决于 policy 版本和 inlinecrypt 优化模式。
DE 存储:class key(加密类密钥)不依赖用户凭据解锁,但仍受 KeyMint、Verified Boot 与硬件信任根保护。系统完成 Direct Boot(用户解锁前启动)所需准备后,direct-boot-aware 组件就可以访问 DE 数据。
CE 存储:class key 受用户解锁凭据和 Android 密钥保护机制约束,只有在用户解锁后才能安装。应用默认存储、用户媒体和大部分隐私数据都属于 CE。
所有首发 Android 10 及以上版本的设备都必须使用 FBE。
metadata encryption、FBE 与 /metadata 的分工
我们把“存储加密”拆成三个容易混淆的层级看。/metadata 是独立小分区,用于保存保护 metadata encryption key 的 KeyMint blobs。
metadata encryption 工作在 userdata block device 层,保护目录项、inode(索引节点)、文件长度等文件系统 metadata,现代设备上的常见实现是 dm-default-key 配合 inline crypto / blk-crypto。
FBE 由 ext4/f2fs 集成的 fscrypt 实现,保护文件内容与文件名;vold 在 /data 可以挂载后管理和安装相应密钥,并为目录设置策略。System DE、User DE 和 User CE 的准备时机各不相同,画密钥安装时序时要分开标注。
按启动顺序观察会更清楚:系统先挂载 /metadata,让 vold 取得保护 metadata encryption key 的 key material;随后 wait_for_keymaster 与 mount_all 协作,使 /data 进入可挂载状态;文件系统可用后,vold 才继续安装 System DE、User DE 和 User CE key。dm-default-key 负责 /data block device 的 metadata 保护,与 FBE 分属两个层级。
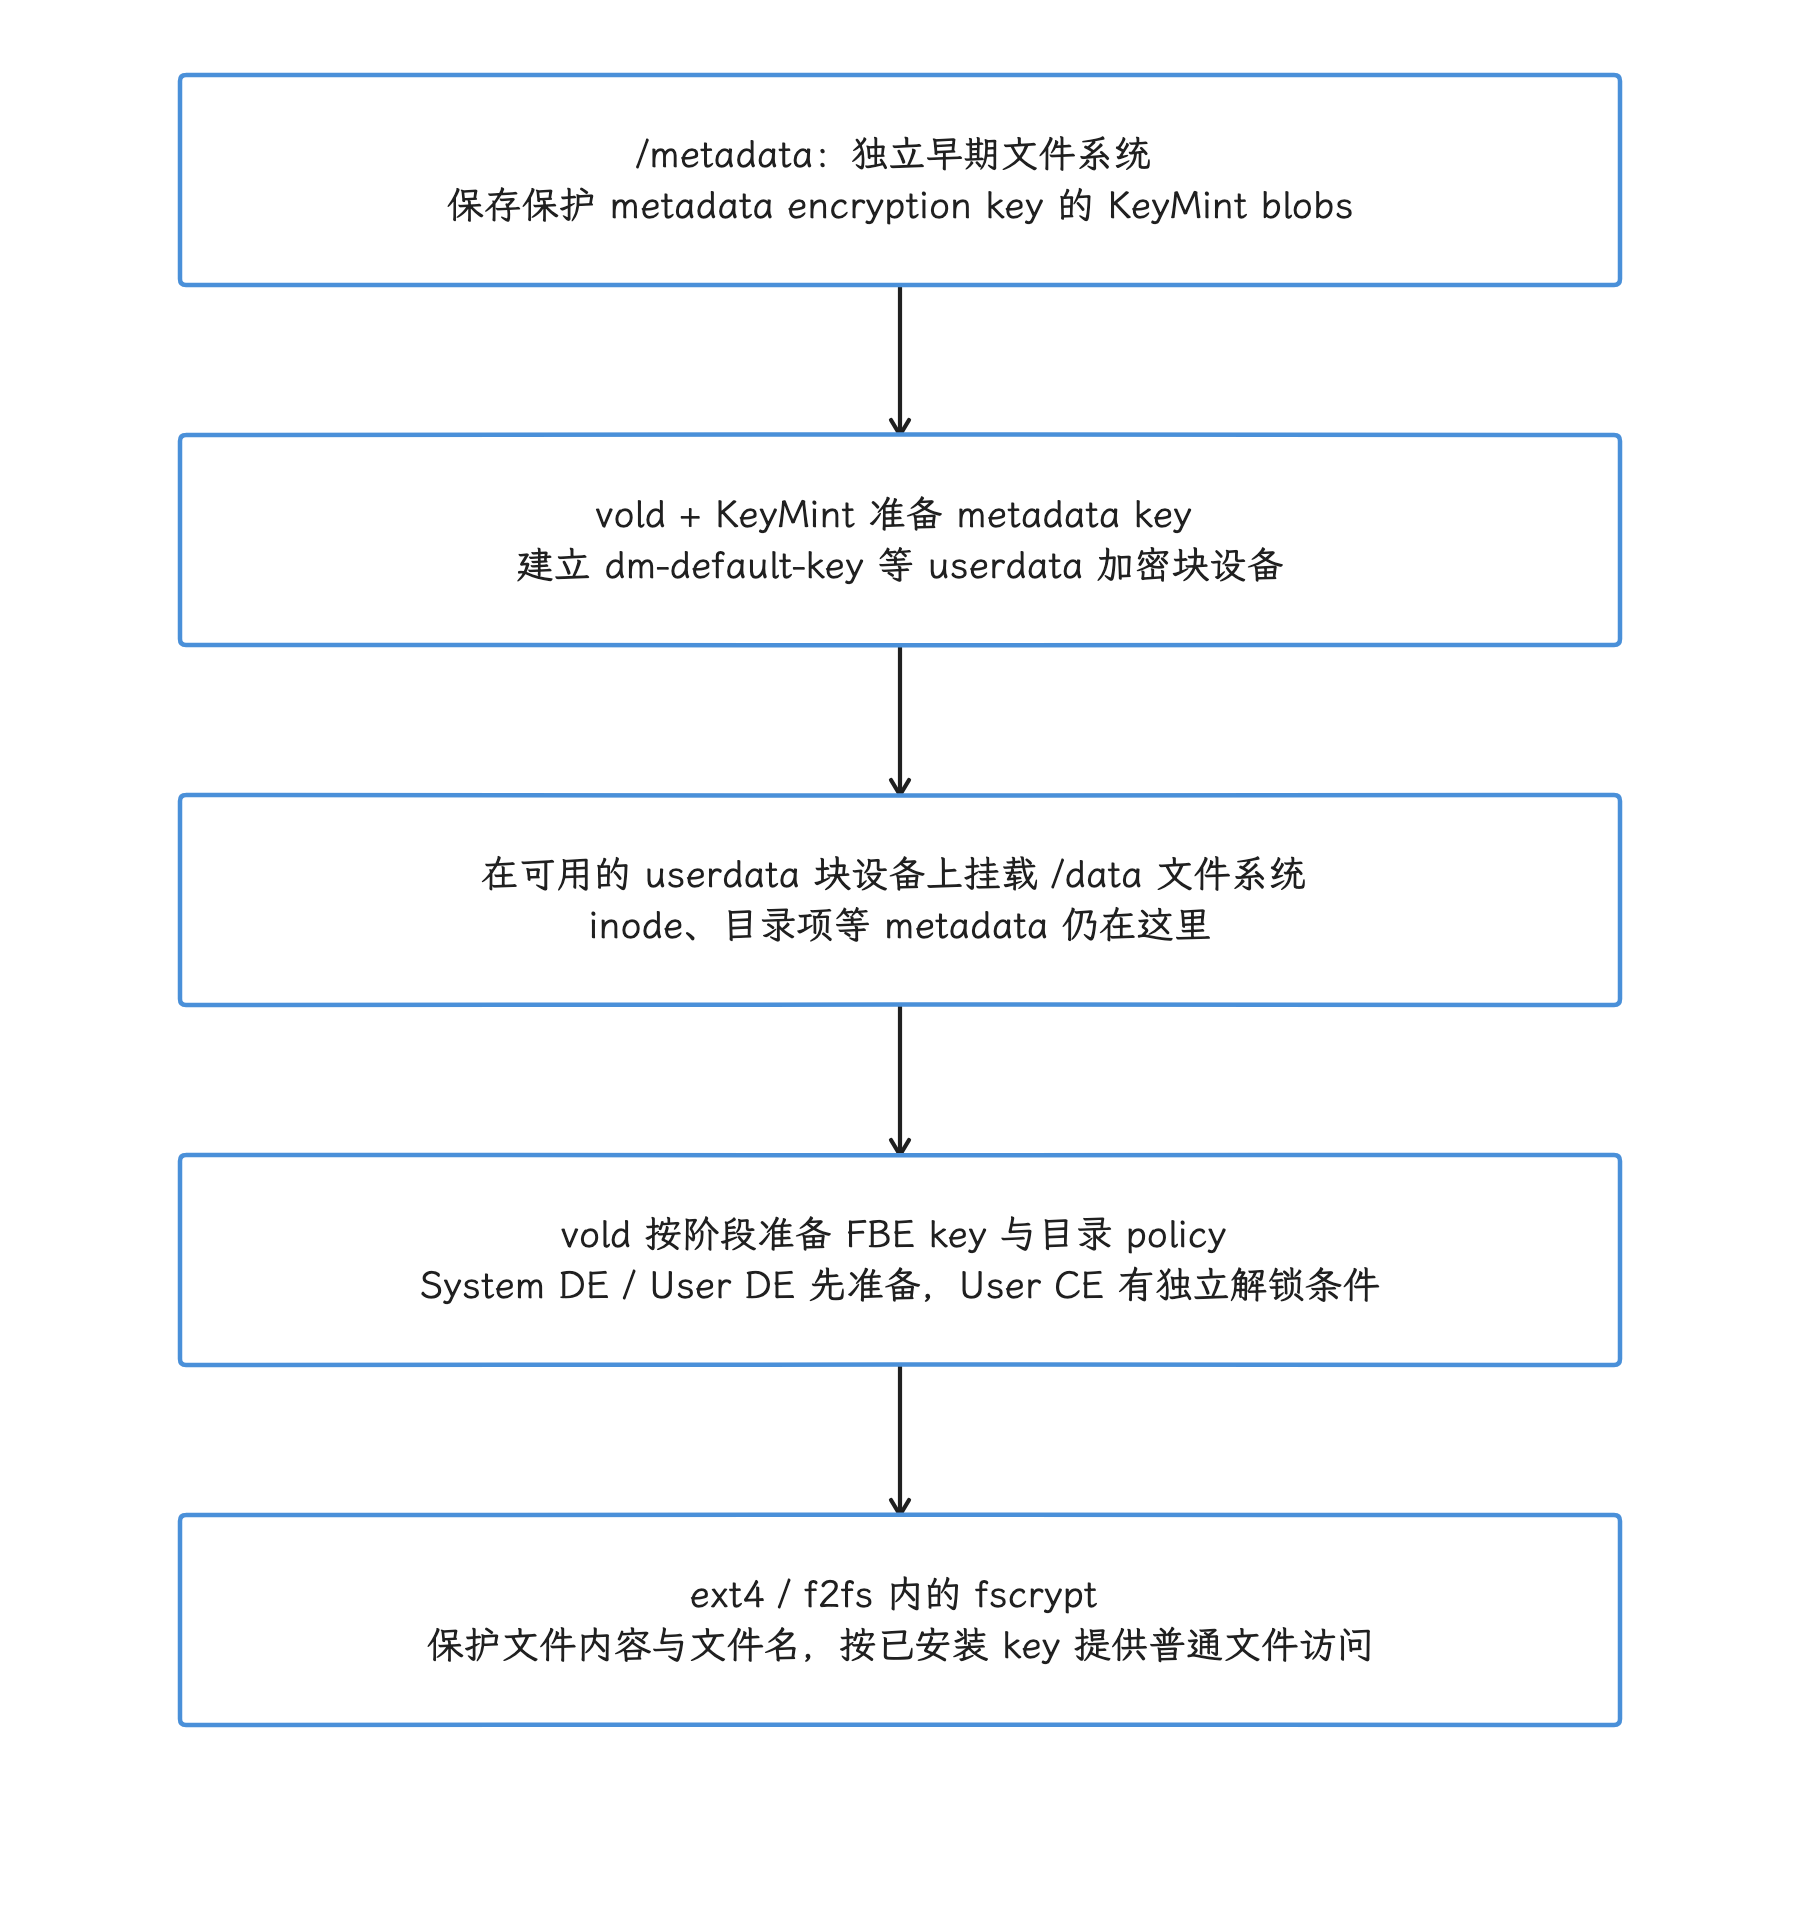
图:dm-default-key 工作在块设备层;fscrypt 集成于文件系统,按目录策略使用 DE/CE 等密钥。/metadata 存放早期密钥材料,不是把 userdata 的全部文件系统 metadata 搬到另一个分区。
FBE 的密钥层次
FBE 的密钥管理由 vold 负责。密钥层次如下:
- System DE Key:系统级 DE key 在启动早期安装,保护
/data/app、/data/misc、/data/system、/data/vendor等不属于某个用户 DE/CE 类的顶层数据。 - User DE Key:每个用户各有 User DE class key,用于 Direct Boot 数据,对应
/data/misc_de/<user_id>/、/data/system_de/<user_id>/、/data/user_de/<user_id>/、/data/vendor_de/<user_id>/等。 - User CE Key:每个用户的 CE class key 在用户解锁认证成功后解封并安装,用于绝大多数 App 数据,对应
/data/user/<user_id>/,也包括/data/misc_ce/、/data/system_ce/、/data/vendor_ce/等。
AOSP android-17.0.0_r1 中的关键实现路径如下:
system/vold/FsCrypt.cpp:fscrypt_prepare_user_storage()准备 DE/CE 目录并应用 fscrypt policy;system/vold/Utils.cpp:BuildDataSystemDePath()、BuildDataMiscDePath()、BuildDataUserDePath()生成/data/system_de/<user>、/data/misc_de/<user>、/data/user_de/<user>等路径。
fscrypt policy 设置在加密目录上,并保存在文件系统 metadata 中。新建的子文件或子目录会继承父目录的加密上下文,内核再从已经安装的 master key(主密钥) 派生或选择相应的内容密钥与文件名密钥。应用看到的仍是普通文件 API,一份文件此时是否可访问,取决于对应的 DE/CE class key 是否已经安装好。
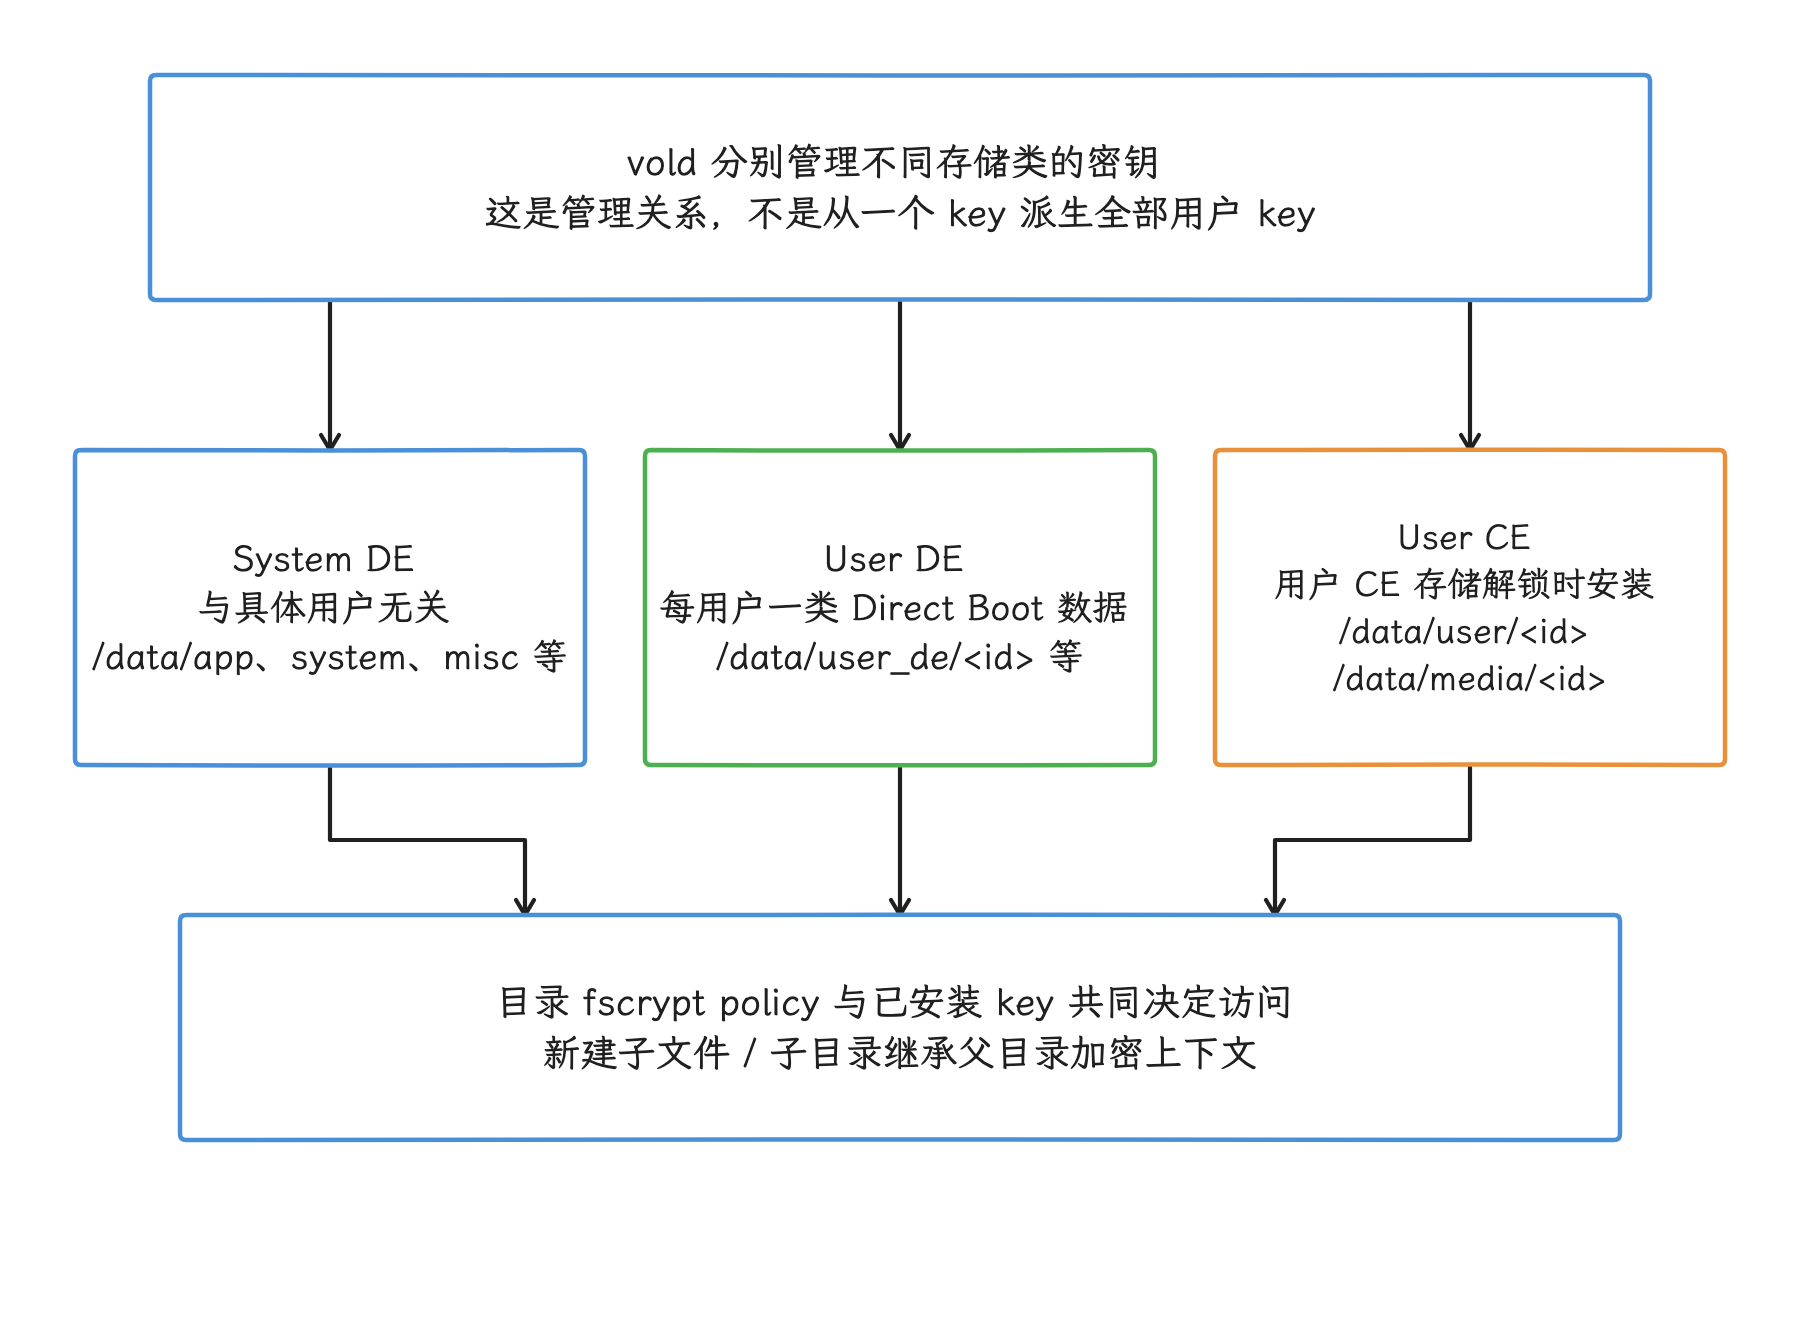
图:图不是密码学派生树,也不把 /data/user 父目录本身当某个用户的 CE。各类 key 的落盘保护和安装时机不同;文件内容密钥是否按文件派生,还受 policy、inlinecrypt 优化模式与 key 类型影响。
加密的 I/O 性能影响
加密路径会增加密钥准备、crypto mapping(加密映射) 和数据加解密工作,成本取决于设备是否具备 CPU crypto acceleration(加密指令加速)、inline crypto、hardware-wrapped key(硬件封装密钥)以及匹配的驱动。
inline encryption hardware(内联加密硬件) 通常由 UFS 或 eMMC host controller 实现,在数据往返存储器件的路径上执行块加解密。android17-6.18-2026-06_r6 的 arm64 GKI 打开了 CONFIG_BLK_INLINE_ENCRYPTION、CONFIG_FS_ENCRYPTION_INLINE_CRYPT、CONFIG_DM_DEFAULT_KEY、CONFIG_SCSI_UFS_CRYPTO,也打开了 CONFIG_BLK_INLINE_ENCRYPTION_FALLBACK。这些配置说明内核具备相应接口与软件 fallback(回退实现),实际能否使用还取决于密钥类型、算法、设备驱动和 fstab(文件系统挂载配置)。blk-crypto-fallback 不支持 hardware-wrapped keys;选择这类密钥而硬件不匹配时,实际走 CPU 还是别的路径,要按设备确认。
Android 17 还把当前版 hardware-wrapped keys 命名为 wrappedkey,与旧版 wrappedkey_v0 区分。前者使用 android17 内核的 blk-crypto key generate/import/prepare 接口,并与 mainline Linux 方向兼容。是否启用,可从 userdata 的 fstab fileencryption= 选项、内核日志和加密测试确认。
性能分析时,我们先把加密路径确认一遍:软件 fallback 可能增加 CPU 时间;inline crypto 也会受 keyslot(硬件密钥槽)编程、host reset、队列和内存带宽影响。最小验证应包含 fstab、dmctl table userdata、内核配置和 vts_kernel_encryption_test,再把 CPU 活动与 block trace 对齐。
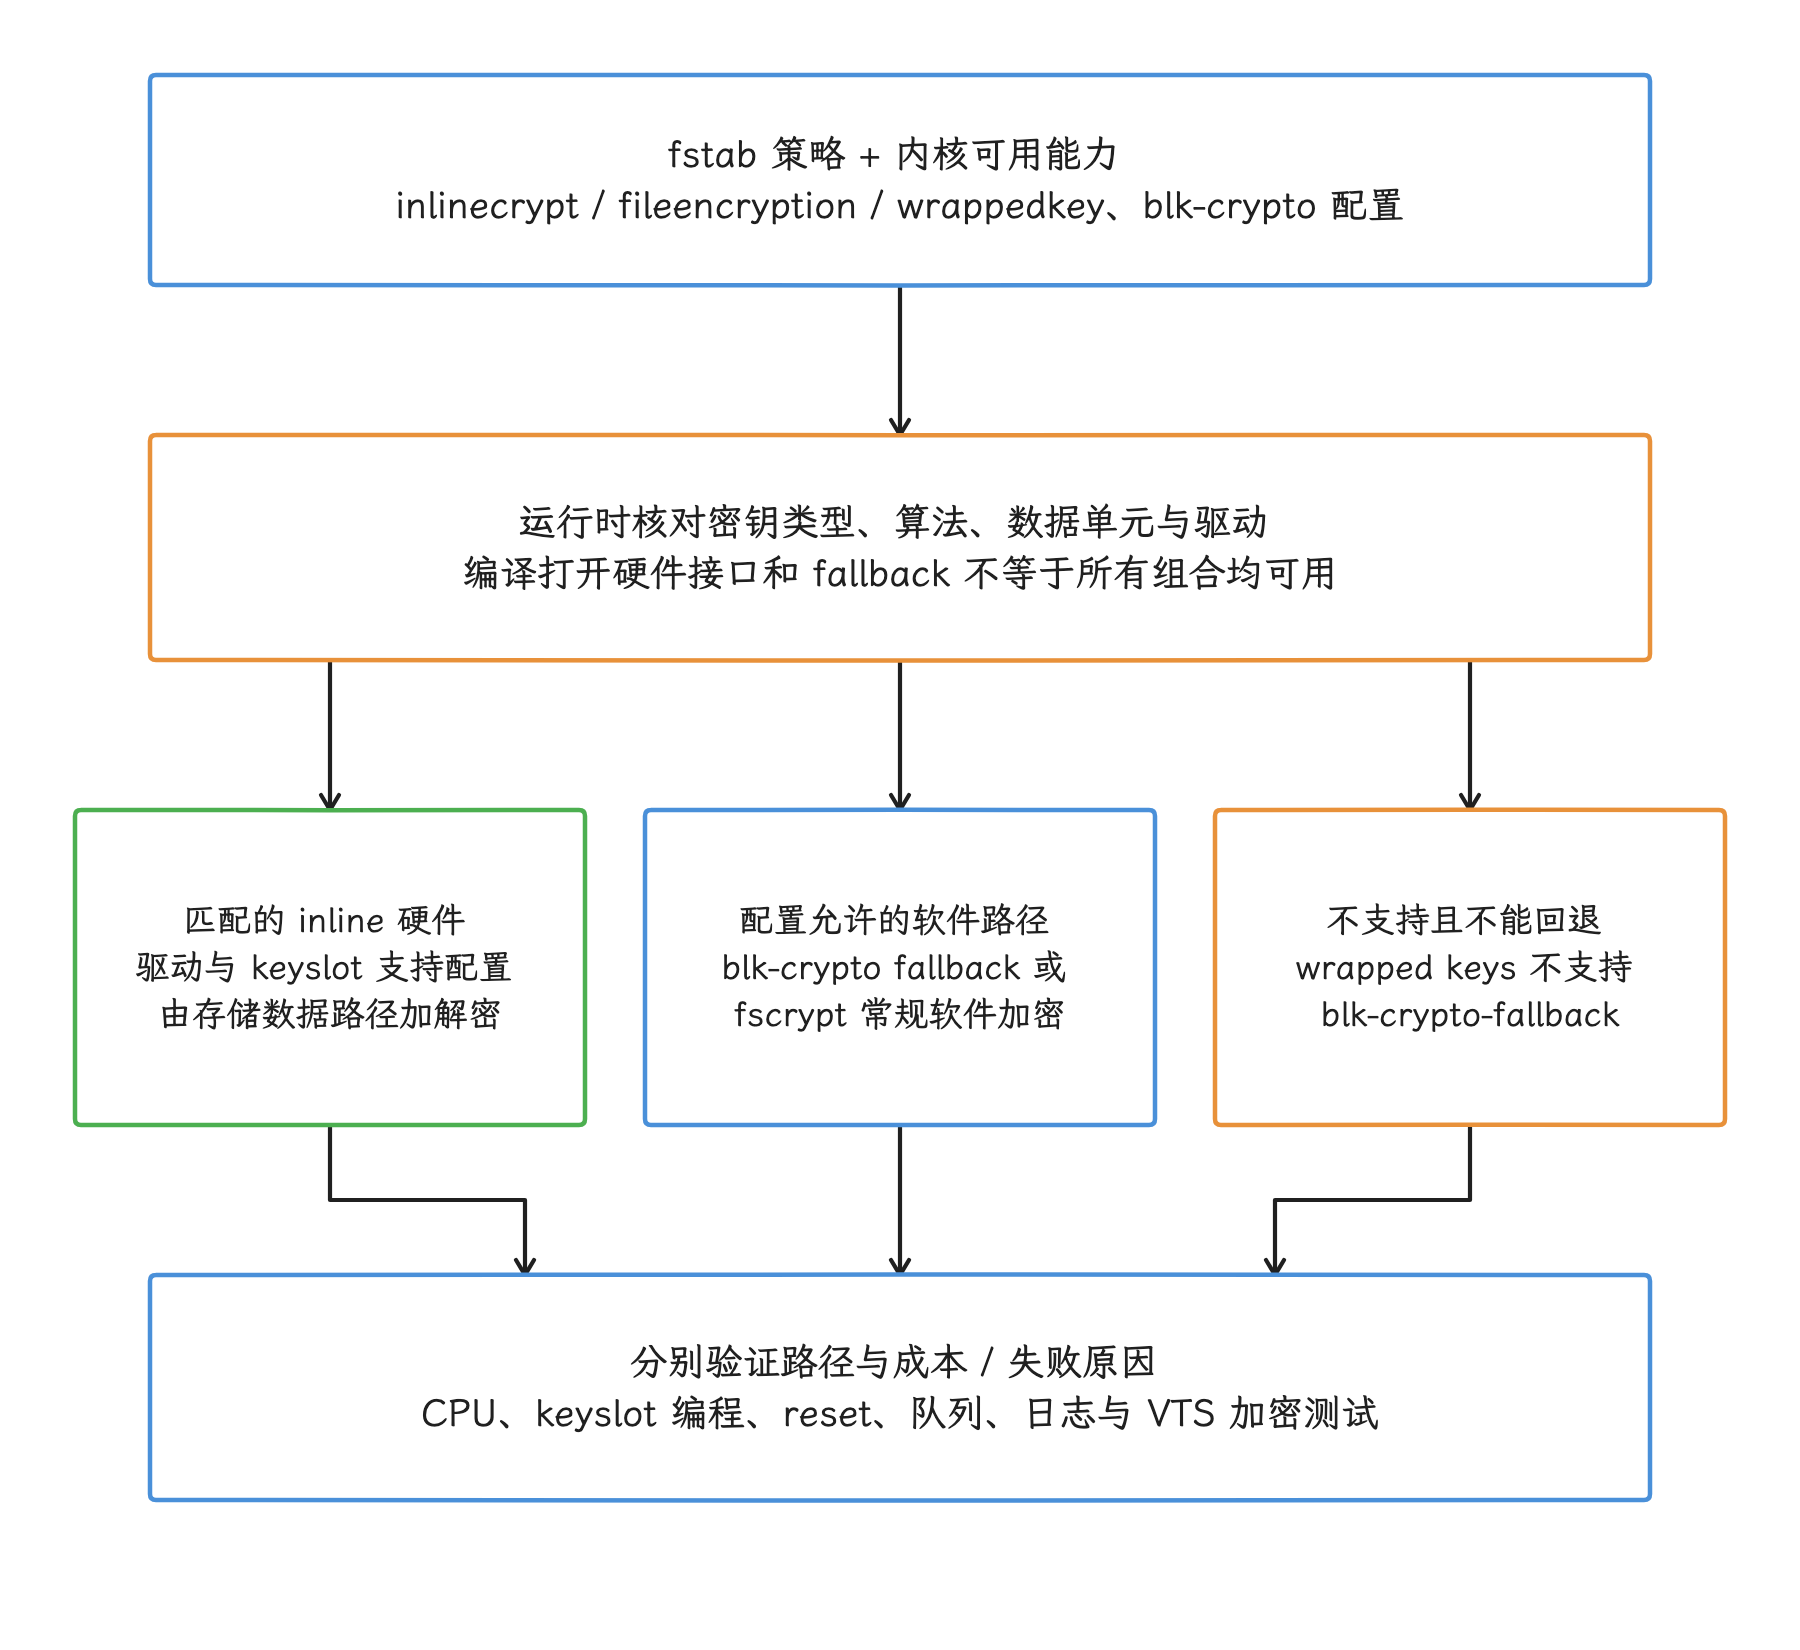
图:r6 GKI 同时启用 inline 接口与 fallback;实际路径还要看 fstab 和驱动。blk-crypto-fallback 不支持 hardware-wrapped keys,没有匹配硬件时的实际路径要按设备确认;dm-default-key 单独证明不了 FBE 已硬件卸载。
Dynamic Partition 与 Virtual A/B 的存储布局
Dynamic Partition 通过 super 物理分区和 dm-linear 在运行时映射出逻辑分区,解决的是“逻辑分区如何划分”。另一部分是 Virtual A/B,负责 OTA 升级期间如何安全更新这些逻辑分区、差异数据存在哪里,以及由谁合并。
传统 A/B 会为需要无缝升级的分区保留 A/B slot(槽位)。Virtual A/B 仍会复制 bootloader 必须直接读取的物理分区,但动态分区不再常驻一套完整副本;OTA 期间只为变更部分创建 snapshot(快照),成功启动后再执行 merge(合并)。snapshot 的格式、存放位置和 merge 执行者,都要按 Android 版本区分,下面我们按三个版本分别看。
Android 11:kernel COW
Android 11 引入了 Virtual A/B 的早期形态。更新差异使用 kernel COW(Copy-on-Write,写时复制)format,并由 dm-snapshot 提供 base partition(基础分区) 与 COW 数据的组合视图。COW 数据会占用 OTA 期间的临时空间。Android 11 的 PartitionCowCreator 先使用当前与目标分区布局中都空闲的 super 区间,不足部分由 /data 上的 COW image 补足;r1 的分配器仍区分 cow_partition_size 与 cow_file_size。所以画 COW 的落点时,super 和 /data 两侧都要留位置;换来的是动态分区确实无须常驻一套完整 B 槽。确认新 slot 后,再把变化合并进 base device。一次请求是否产生额外读写,取决于具体操作和 merge 阶段,要按阶段实测来看。
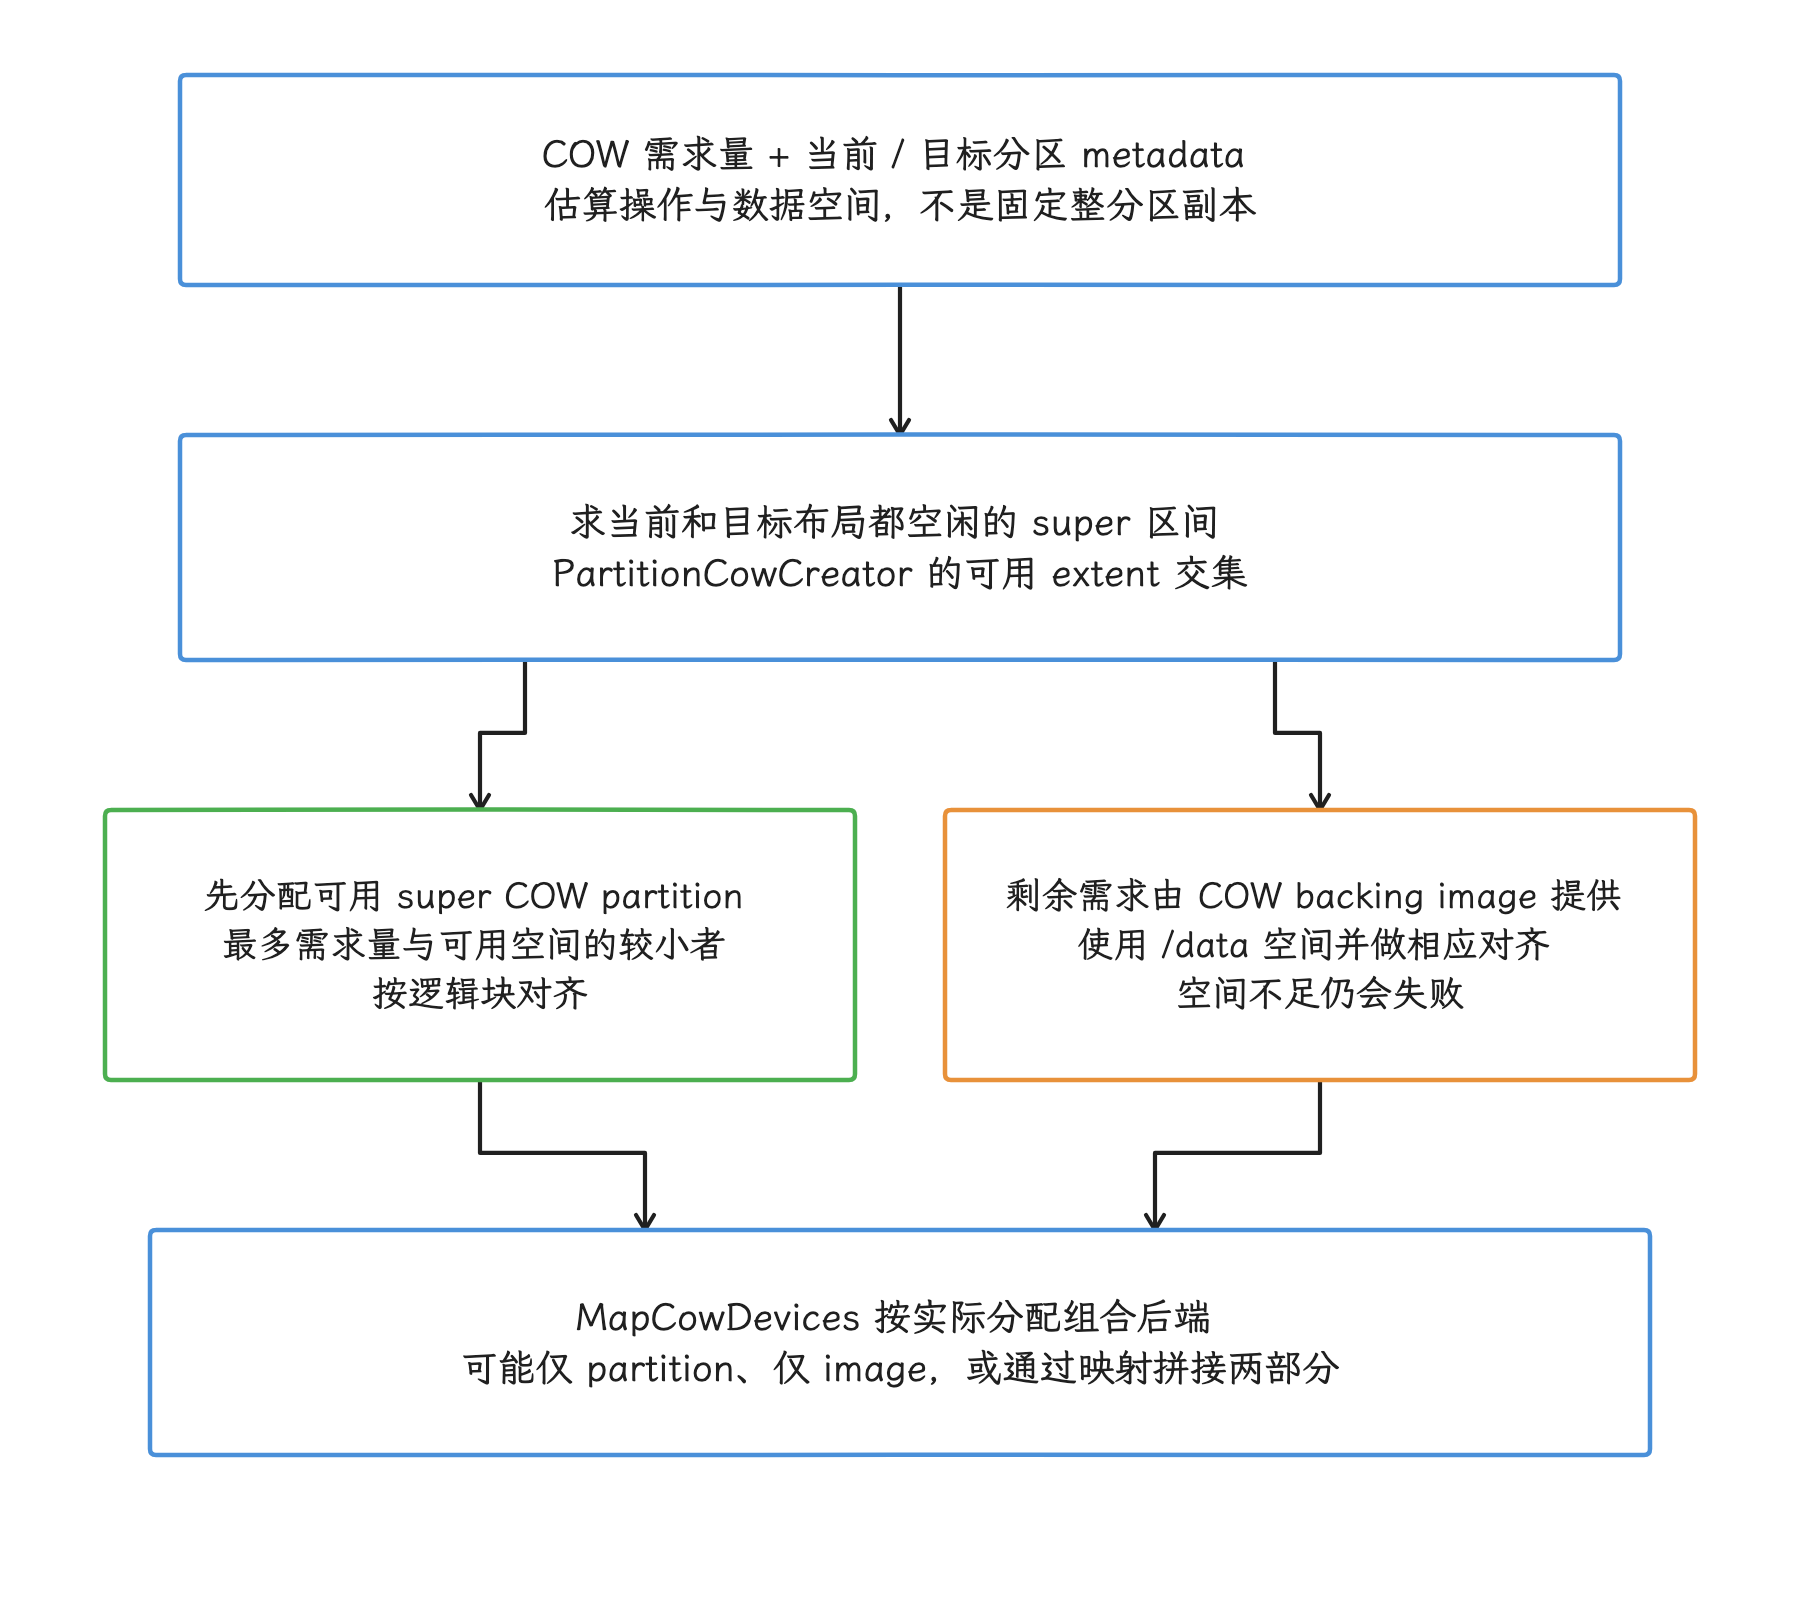
图:Android 11 与 r1 分配器都区分 cow_partition_size 和 cow_file_size。图概括空间分配,两处是否同时占用、压缩 COW 以哪侧为主,都以本次 update metadata 和 backing image 为准。
Android 12:compressed snapshots 与 dm-snapshot 过渡期
从 Android 12 开始,Virtual A/B 可以启用 compressed snapshots(压缩快照)。这一版本引入 Android COW format 和 snapuserd,压缩 COW 也可能使用 super 空闲区与 /data backing image,实际分配比例由空间与更新布局决定,dm-user 让用户态组件可以处理块设备读写。不过 Android 12 还没有走到纯 userspace merge:Android COW 仍需转换为 kernel COW format,snapshot merge 仍会用到 dm-snapshot。我们分析 Android 12 设备时,要同时观察 snapuserd、dm-user 和 dm-snapshot。
Android 13+:userspace merge
Android 13 把 compressed snapshot 的 mount 与 merge 移入用户态的 snapuserd,移除了对 kernel COW format 和 dm-snapshot 的依赖。首发搭载 Android 13 及以上版本的设备默认启用 userspace merge;从旧版本升级的设备则需要显式启用。Android 17 延续 userspace merge,但 r1 还提供 dm-user 与 ublk 两种 snapshot 后端,snapuserd 挂在哪一侧由后面的条件决定。IsUblkEnabled() 同时检查 ro.virtual_ab.ublk.enabled、vabc_with_ublk_support flag 和内核版本门槛(6.6+),测试模式可覆盖属性;更新 manifest 还可禁用 ublk。实际还须具备内核驱动及相应设备节点。新 slot 确认成功后才启动合并;进入 merge 后,回退到未修改旧系统的承诺不再有效,合并中断则会在后续启动恢复。
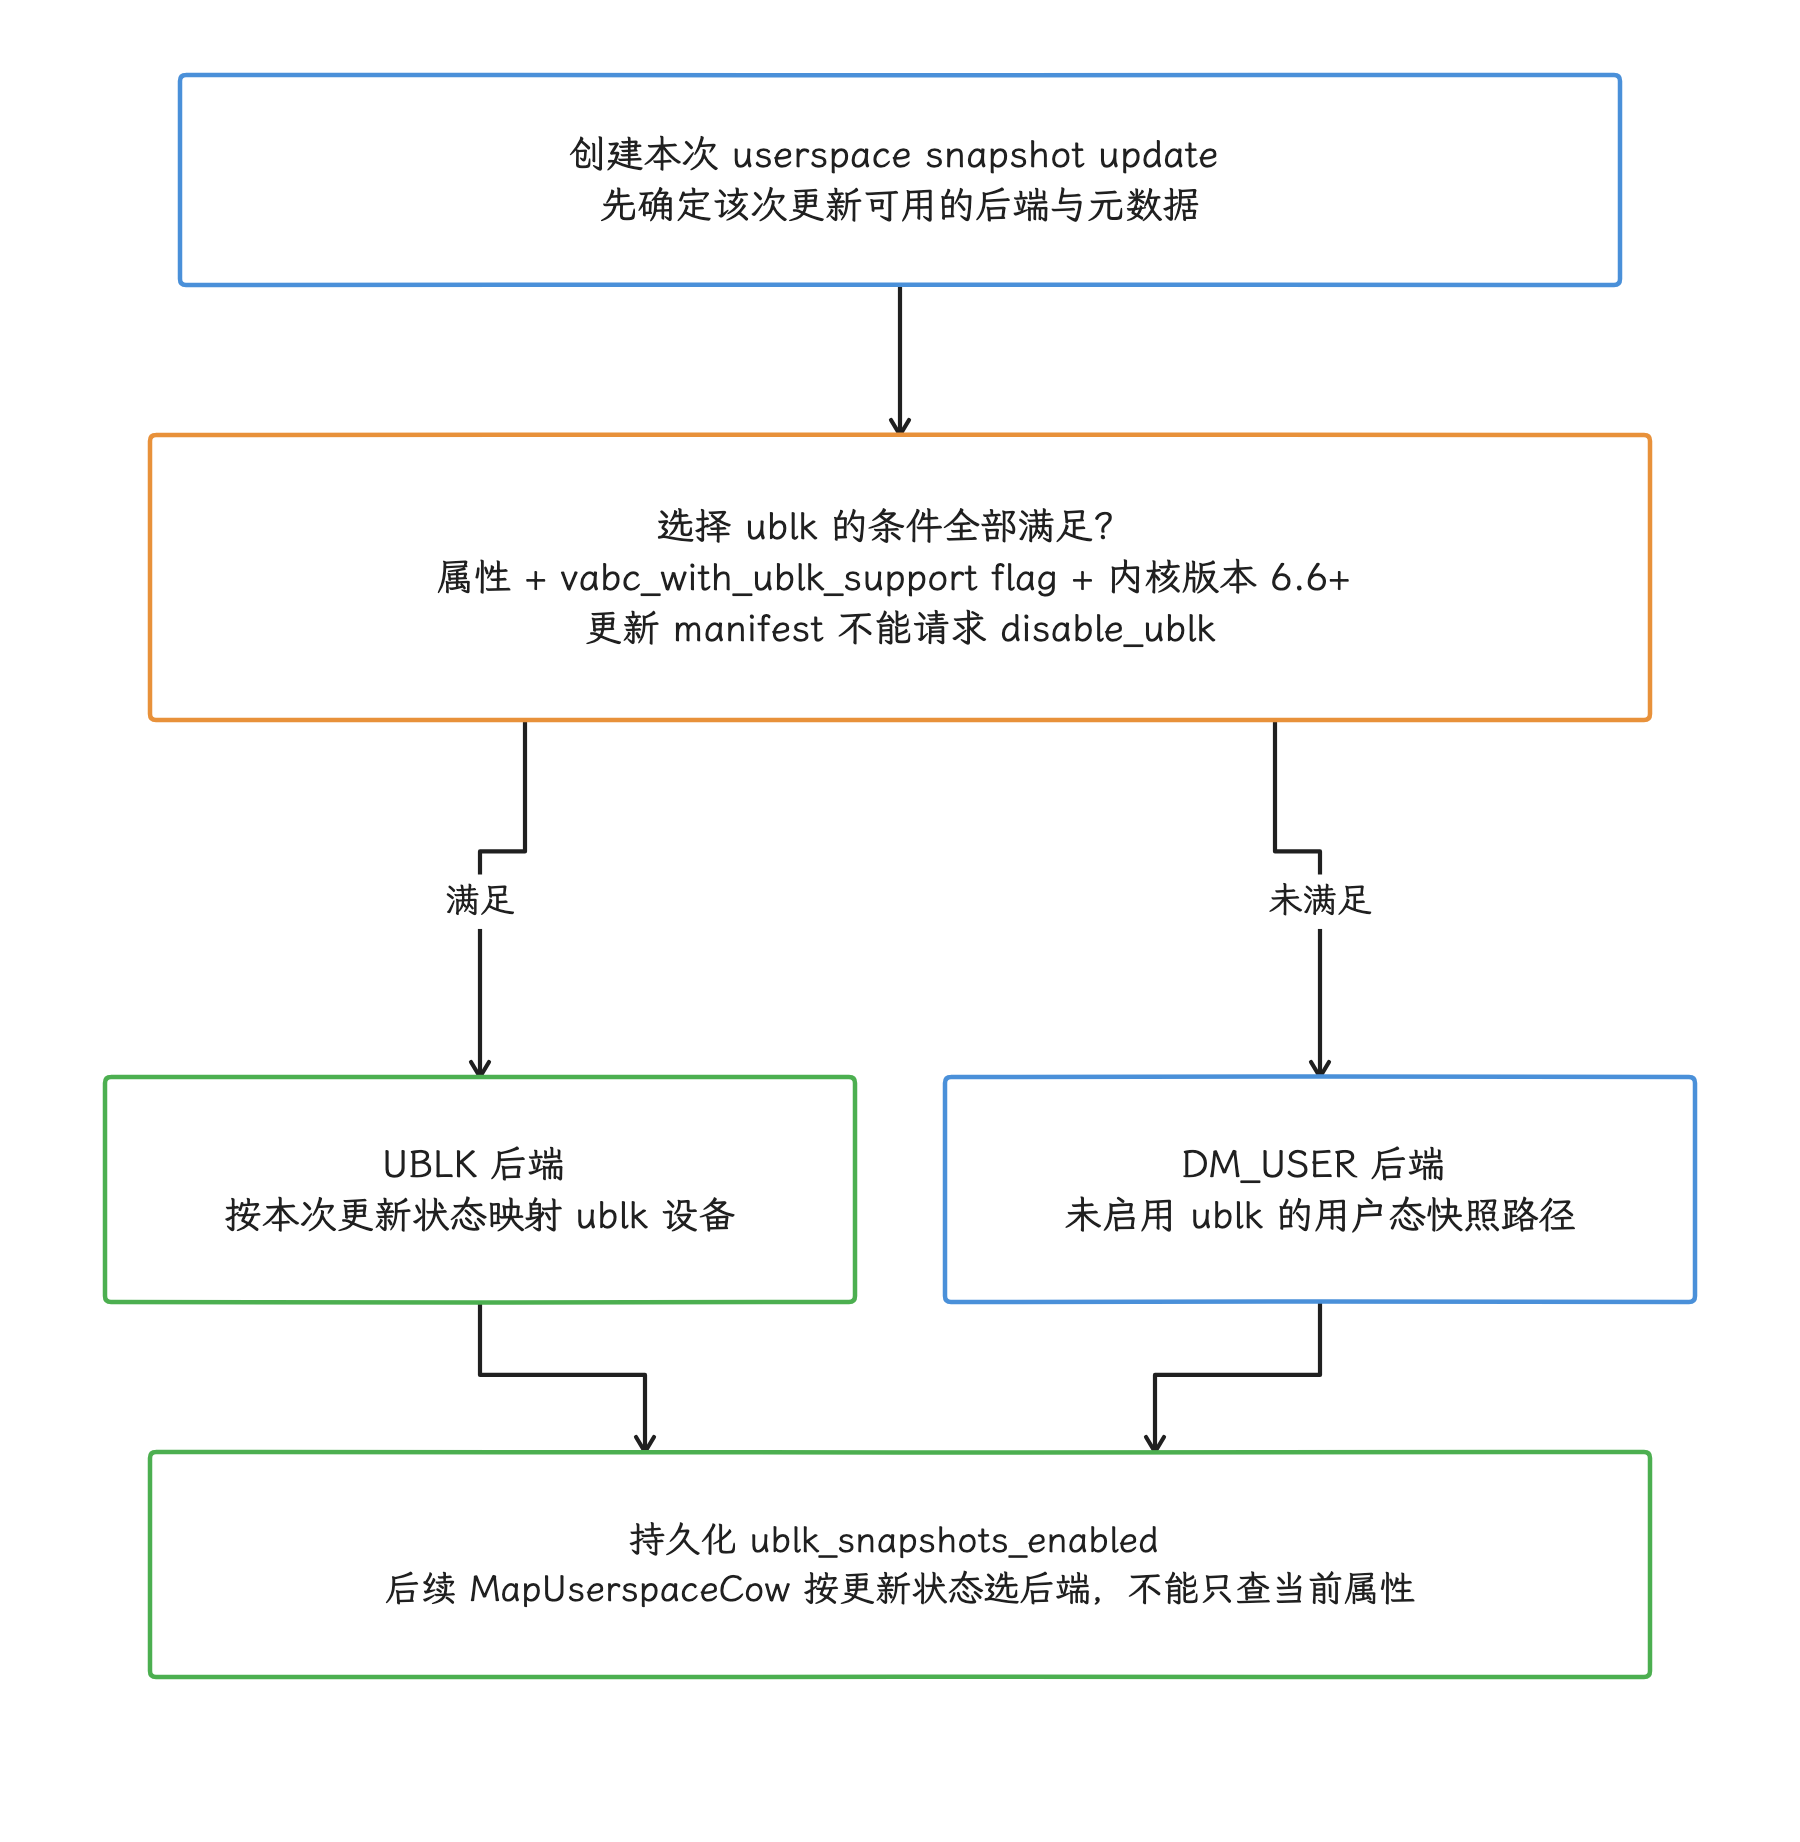
图:IsUblkEnabled 的测试 force_mode 可覆盖属性;真正映射 ublk 还需内核驱动、/dev/ublk-control 等节点就绪,节点缺失可使建立失败,自动回退与否取决于具体条件。此图限定已经采用 userspace snapshot 的更新。
下面的简图用于对比三个关键版本的 COW 与 merge 路径。
Virtual A/B 存储模型演进:

Android 11(kernel COW):
  snapshot delta → dm-snapshot COW → super 空闲区 + 按需 /data backing image

Android 12(compressed snapshots 过渡期):
  snapshot delta → Android COW(super / /data)→ dm-user + snapuserd → kernel COW / dm-snapshot merge

Android 13+(userspace merge):
  snapshot mount / merge 由 snapuserd 执行,移除 kernel COW / dm-snapshot 依赖
  Android 17 r1 后端按条件选择 dm-user 或 ublk
图中 Android 12 这一行是格式转换的过渡期,读它时按混合路径来;Android 13+ 才有的 userspace merge,在这一版还没有出现。compressed snapshots 会使用 /data 的临时空间,升级完成并合并后可以回收;安装阶段的 COW 写入以及 merge 期间的底层设备流量,都可能与前台 I/O 竞争。
在 Perfetto trace 中,OTA 升级期间的 Virtual A/B 活动主要集中在三组进程:
| 进程 | 角色 | Trace 特征 |
|---|---|---|
update_engine | 下载/应用更新、协调 COW 与 merge 状态 | 安装期间有下载与 COW 写入;不能由守护进程存在与否判断 merge 是否活跃 |
snapuserd | Android 12 compressed snapshots 的 COW 处理;Android 13+ 的 userspace merge | 按 snapshot 读视图与 merge 阶段产生 CPU、COW 和 base device I/O;r1 后端可能为 dm-user 或 ublk |
| 前台 App | 受影响方 | 主线程 fsync() / read() 延迟明显增加,时间与 snapuserd / update_engine 活动对齐 |
Android 13+ 的 userspace merge 大多在后台完成;Android 12 设备还要单独分析 dm-snapshot merge 路径。存储空间紧张或后台写入密集时,snapuserd 的 COW/base I/O 与 App 数据 I/O 可能落到同一物理器件并争用带宽、队列和 CPU,即使逻辑分区不同也会相互影响;是否拉长前台等待,要结合实际 trace 与对照负载确认。
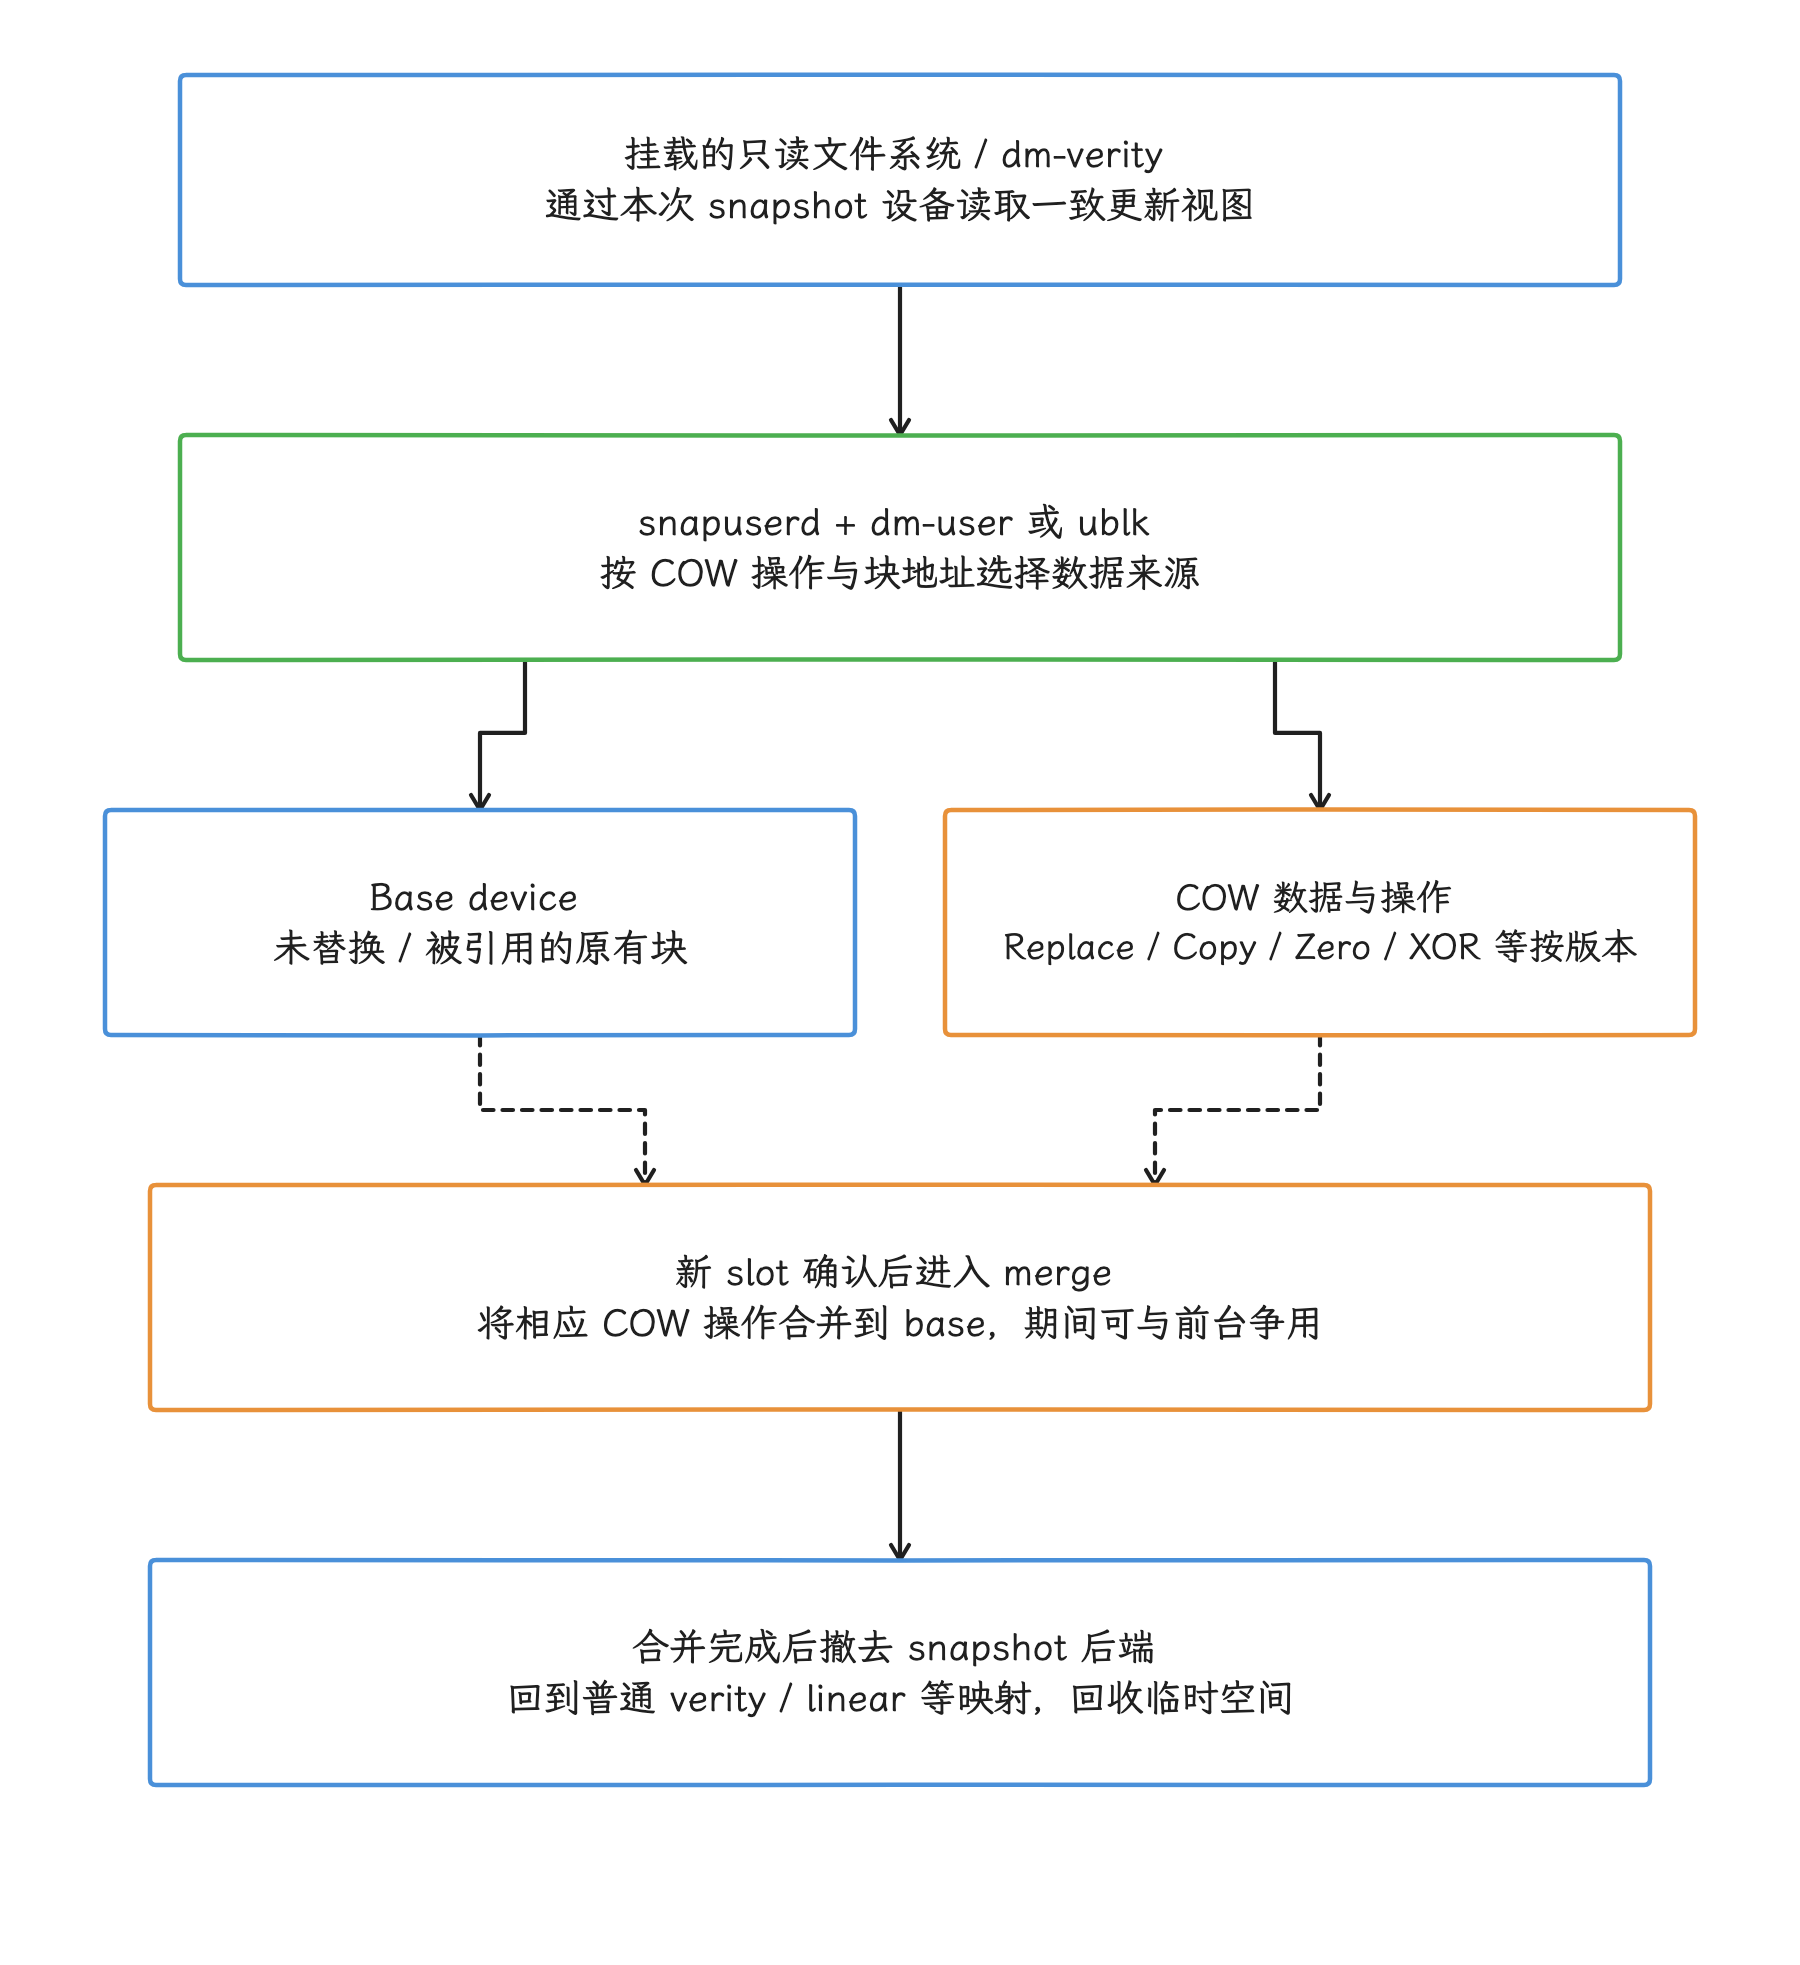
图:实线概括读视图依赖,虚线表示后续合并阶段,并不是每次读都立刻 merge。进入 merge 后 base 已开始改变,完整回滚的承诺就此失效;中断后会恢复合并。不同逻辑分区也可能争用同一存储器件。
存储寿命与写入放大
谈存储寿命,我们先从“一次应用写入最终落到 NAND 多少字节”这个问题入手。NAND 闪存单元只能承受有限次数的 program/erase cycle(编程/擦除循环)。SLC、MLC、TLC、QLC 每个单元存储的位数不同,耐久度趋势也不同;同一类型还会因工艺、纠错、预留空间和厂商分级产生很大差异。手机存储器件还常使用动态 SLC cache(用单层单元模式提供的高速缓存)、磨损均衡和 over-provisioning(预留空间),寿命估算要落到具体器件的规格上。
**写入放大(Write Amplification Factor,WAF)**的测量先把两段路径分开。器件 WAF 是 NAND 实际写入字节数除以主机提交给器件的写入字节数;数据库日志、文件系统 metadata 与 F2FS GC 放大的是前一段“应用有效写入 → 主机块写入”,这些额外字节已经算进器件 WAF 的分母;FTL GC、磨损均衡、SLC 数据搬移影响的则是后一段“主机块写入 → NAND program”。所以算这个比值,我们要分别取得主机与 NAND 两侧的计数:应用写入的 4 KiB 处在主机侧放大之前,固定 erase block(擦除块)大小也推算不出它。
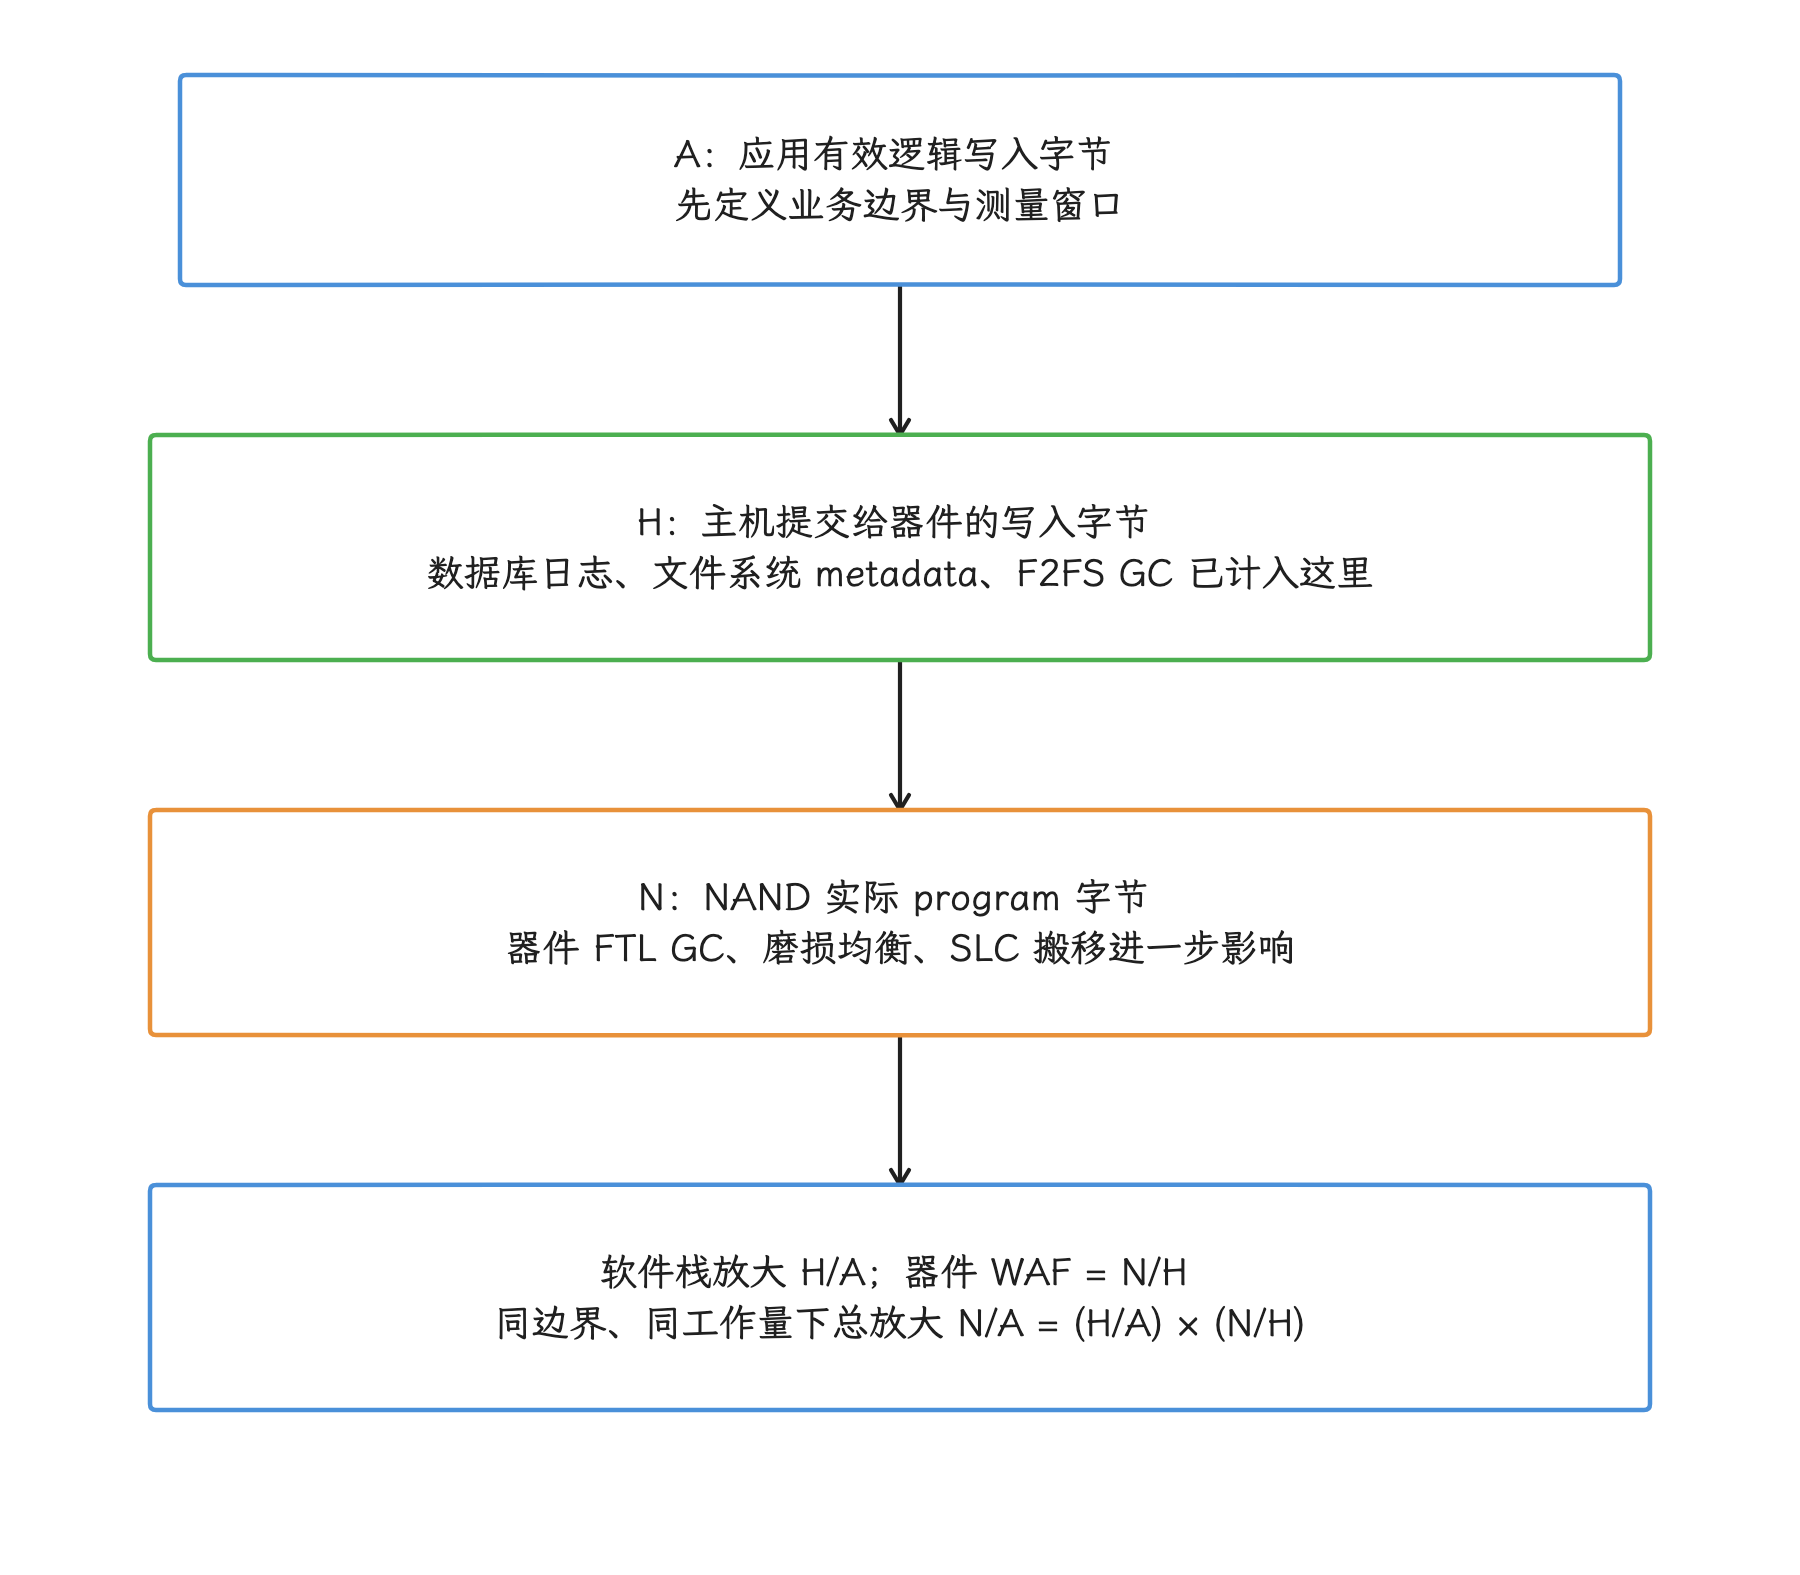
图:公式适用于相同且非零的工作量对比,需处理缓存延迟、后台写入和计数窗口。减少应用重写可减少总写入,器件 N/H 比值是否随之下降要另行测量;一次应用 4 KiB 只覆盖主机侧,单独当设备 WAF 分母会把比值算错。
写入放大的常见来源包括:
- 垃圾回收(GC):NAND 没有就地覆盖写,必须先擦除再写。当空闲 block 不足时,控制器需要把仍然有效的数据从一个 block 搬到另一个 block,再擦除旧 block,这些搬移都会产生额外写入。
- 磨损均衡(Wear Leveling):控制器会尽量让各个 block 的擦写次数均匀分布,避免部分 block 过早失效;这一过程也可能搬移数据。
- 文件系统与应用写入模式:小事务、频繁 checkpoint、临时文件重写和文件系统 GC 会改变 host request 形态,FTL 再把逻辑地址映射到物理 NAND。
可用空间下降时,文件系统和 FTL 可选择的空闲区域减少,GC 更容易进入前台路径,尾延迟和 WAF 都可能上升。设备使用时间只是相关变量,应用数据增长、温度、后台任务、OTA merge、器件固件和电池策略也会改变性能;排查“用久变慢”时,我们把这些变量一起过一遍再下结论。
应用侧可以合并状态更新、避免无变化重写、控制日志与缓存规模,并把持久化移出关键交互路径。SharedPreferences.apply() 先更新内存再排队持久化,并不保证每次调用都对应一次完整 XML 写盘。r1 的 writeToFile() 会跳过磁盘已有的代次,也可能略过已被更新状态取代的异步中间代次;真正持久化最新状态时仍需写 XML 和同步,生命周期切换还可能等待 queued work(排队写入)。若目标是降低总写入与磨损,应先减少逻辑重写,再分别测量主机写入量与器件 WAF;异步 API 本身不保证更少写入。
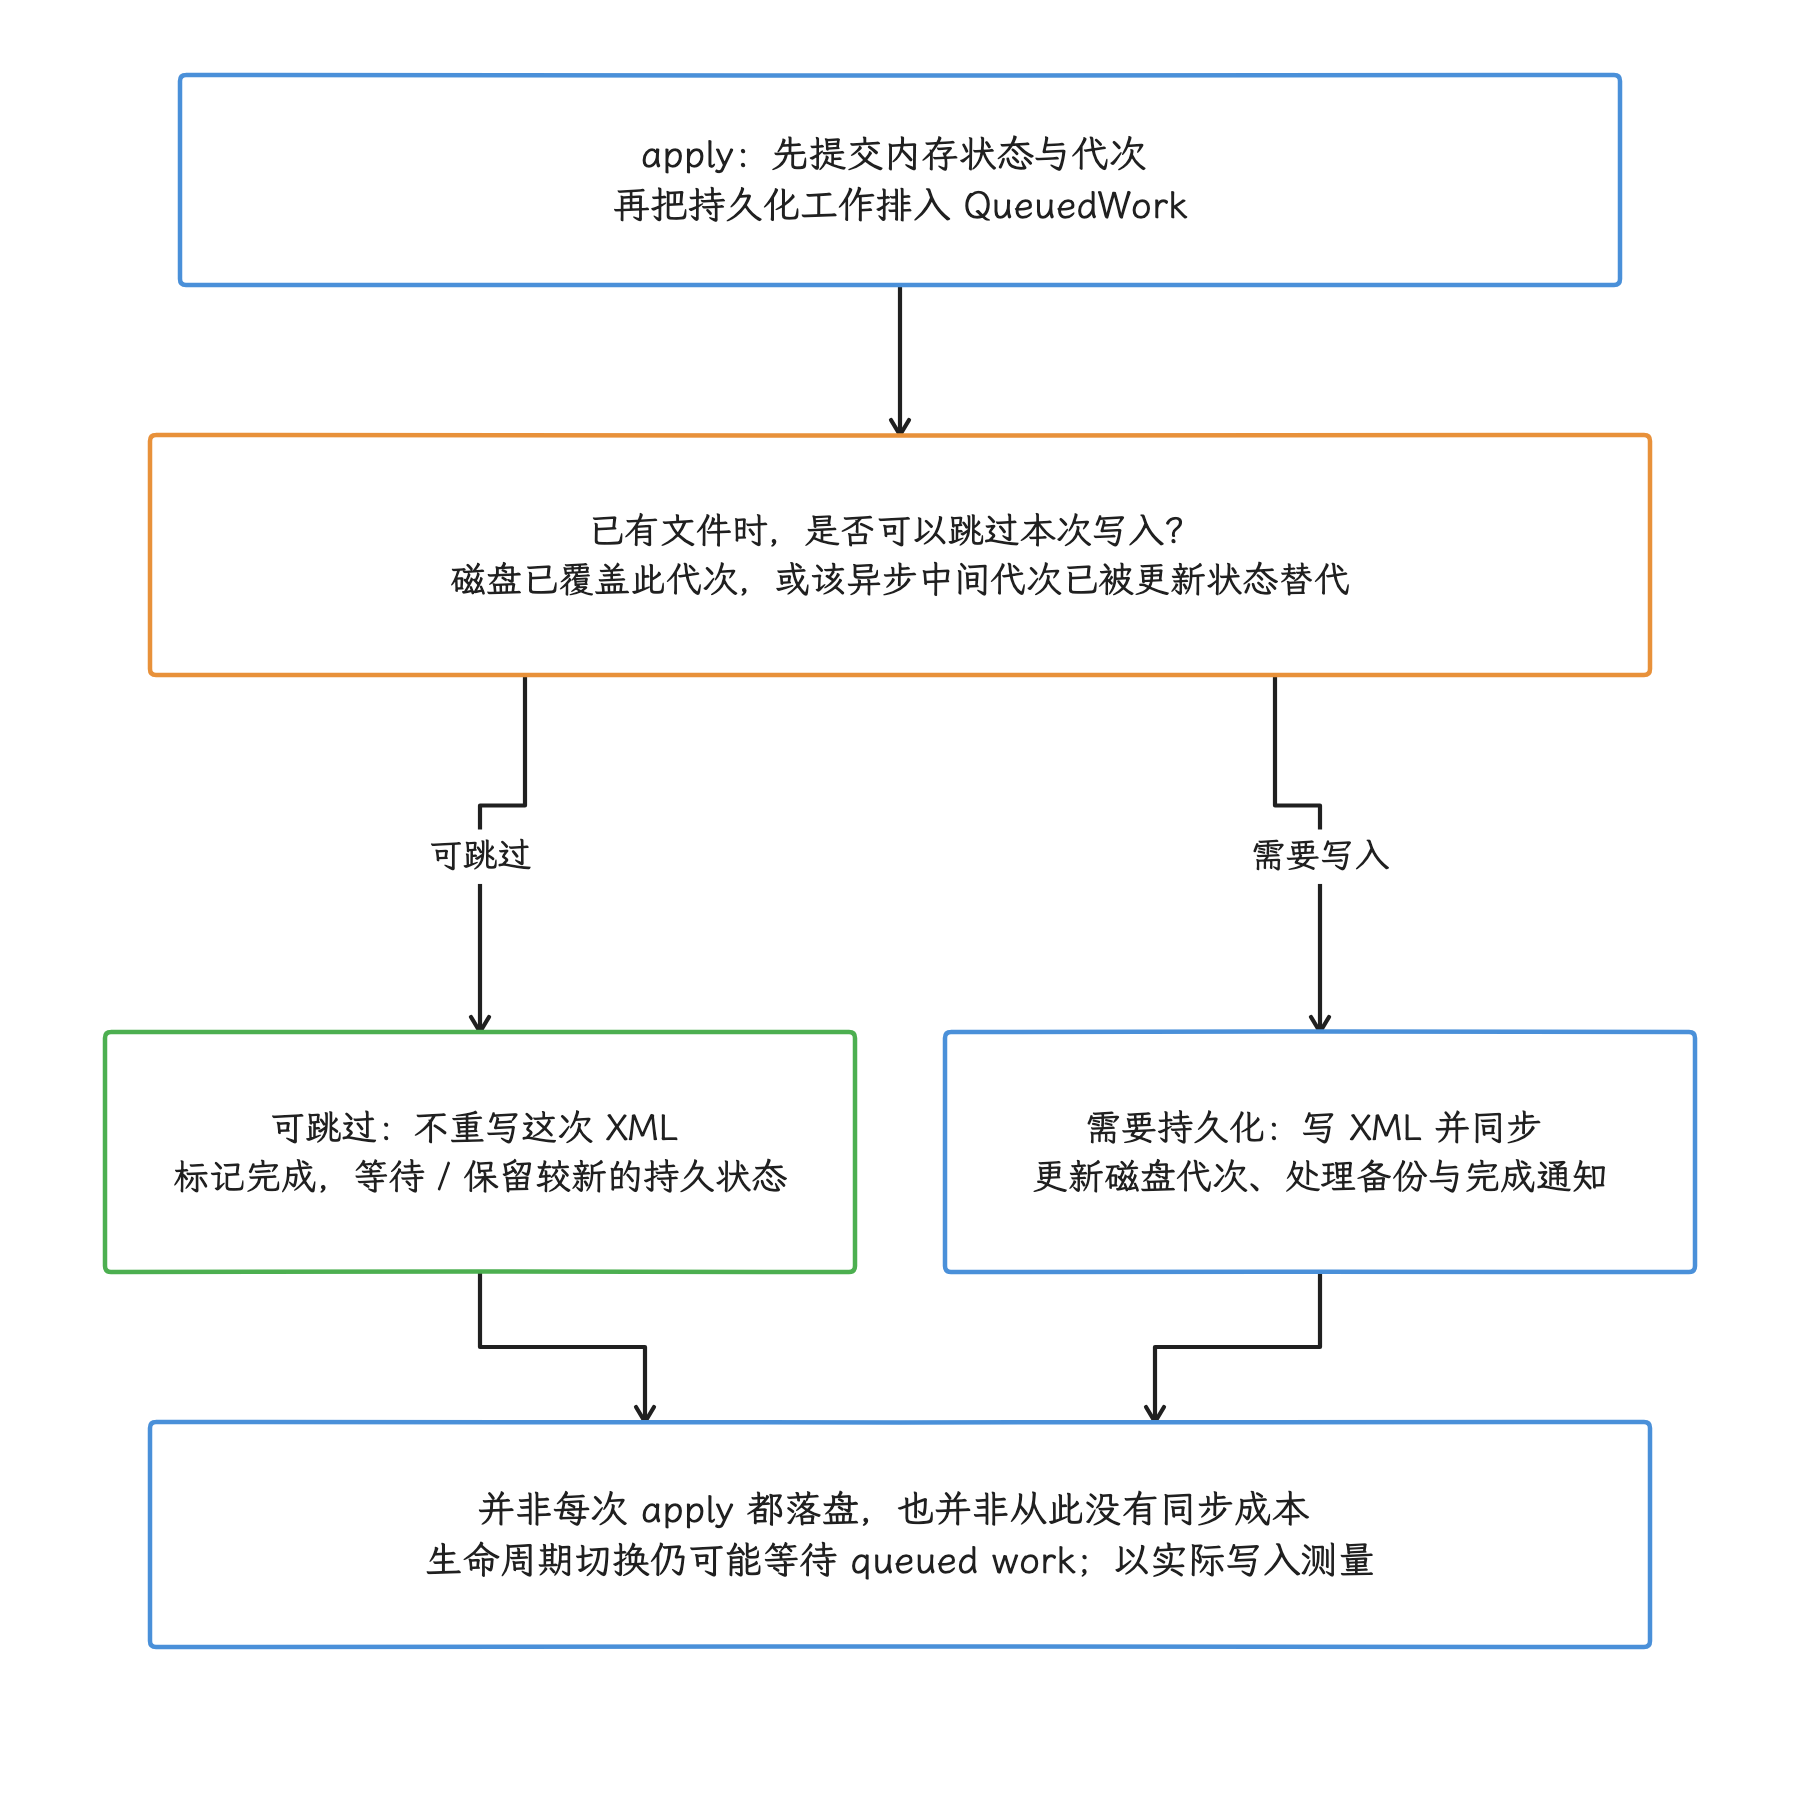
图:图限定 r1 的 apply 异步路径与已有文件代次检查。磁盘已有此代次、过时异步中间状态可被跳过;最新需持久状态仍会写 XML 并同步。新文件创建等路径按各自条件判断是否跳过。
常见问题与误区
“手机变慢是因为闪存老化了吗?”
回答这个问题,要同时查看可用空间、器件寿命指标、后台写入、温度、文件系统 GC、I/O 错误与同机型基线。闪存磨损可能参与性能下降,也可能只是应用数据和并发负载增加。
“f2fs 一定比 ext4 快吗?”
答案要落到具体负载和机型上。f2fs 的 out-of-place update、冷热分离和 segment 管理适合部分闪存工作负载,ext4 的成熟日志与分配策略也可能在另一些负载上更稳定。两者都受 mount option(挂载选项)、内核版本、可用空间、GC、checkpoint、设备 cache 与 flush 语义影响。结论应来自目标机型的 p50/p95/p99(第 50/95/99 百分位)延迟、吞吐、CPU 和写入量,“低于 80%”一类阈值并没有源码依据。
“FBE 加密会拖慢存储性能吗?”
在支持 inline encryption 的设备上,FBE 额外带来的 CPU 成本通常不大;如果设备缺少这类硬件能力,软件加密会让 CPU 承担一部分加解密工作。排查 FBE 要检查 fstab 的 fileencryption=、inlinecrypt、fscrypt/blk-crypto 能力与驱动实际路径;dm-default-key 只说明 metadata encryption,FBE 是否使用硬件加密要由这些检查来回答。再结合 vold / kernel 日志、CPU 活动与块层等待分析具体成本。
存储问题观测地图
做 I/O 诊断,我们至少要覆盖以下五层,让结论越过“看起来像 I/O 慢”的直觉判断。
| 关注面 | 推荐抓取点 | 重点看什么 | 异常形态 |
|---|---|---|---|
| Block layer | Perfetto 的 ftrace(内核跟踪)事件 block_rq_issue、block_rq_complete | 单次请求从 issue 到 complete 的时延、队列是否堆积 | 前台线程卡在 fsync() / read(),同时块请求完成时延持续增加 |
| ext4 / f2fs | ext4_sync_file_*、f2fs_sync_file_*、内核回写线程 | 同步写是否集中出现在事务提交或 checkpoint 前后 | fsync() 时间长,并伴随 jbd2、f2fs checkpoint 或 GC 活动 |
| Shared storage / FUSE | App 线程、MediaProvider、fuse 相关进程或线程 | App I/O wait 是否与用户态转发、权限检查同时发生 | 目录扫描或批量访问媒体时,App 与 MediaProvider 的 CPU 和 I/O 等待同时增加 |
| Mount / encryption | 开机阶段的 init、vold、wait_for_keymaster 日志与 trace slice(事件区间) | /metadata 是否已挂载、vold 是否提前启动、mount_all 是否卡住 | 开机早期反复重试 KeyMint,/data 长时间无法挂载,后续 I/O 全部受到影响 |
| OTA merge | update_engine、snapuserd、Virtual A/B merge 相关后台写入 | OTA 后台 merge 是否仍在持续、前台 I/O 是否受到挤压 | 重启后长时间存在稳定写入流量,前台 App 随机 I/O 延迟异常 |
block_rq_issue 到 block_rq_complete 只覆盖请求下发后的区间,不包含全部用户态、文件系统或下发前排队等待,一次 fsync() / read() 的总耗时要把调用区间另算进去。缓存命中可能不产生 block 事件;要分析调度器中的排队,还需相应的 insert/requeue 等事件与调用区间。
除 Perfetto 外,还应结合 logcat、dmesg、mount、getprop 交叉验证。存储问题经常横跨内核、init、vold、MediaProvider 和 App 线程,把这几层串起来看,结论才站得住。
从存储架构定位性能问题
主线程卡在 fsync() 上时,我们可以按以下顺序收敛:
- 调用层:确认谁调用了
fsync()、同步的是哪个文件,以及这一同步点是否必须位于主线程。 - 文件系统层:确认 ext4/f2fs、mount option,并检查 jbd2、checkpoint、writeback 或 GC 是否与等待区间重合。
- 块设备层:检查 active I/O scheduler、request issue-to-complete(请求下发到完成)延迟、队列堆积和后台写入。
- 映射与加密层:读取 device-mapper table 与 fstab,确认 dm-default-key、snapshot、inline crypto 或软件 fallback。
- 共享存储层:涉及
/storage/emulated时,核对 MediaProvider/FUSE、passthrough、权限检查与 redaction。 - 器件层:记录 UFS/eMMC 型号、MCQ、可用空间、温度和设备健康信息,用同机型基线解释数据。
按这套顺序走下来,Perfetto 里的“I/O wait”才能落到同步点、文件系统、块队列、共享存储或器件层面的可验证原因上。
第 6.2 节继续分析文件系统选择、I/O 调度和调优;存储与内存压力共同放大卡顿的案例见第 7.2 节。
参考资料
- 手机 Android 存储性能优化架构分析 - Linux 阅码场,系统梳理了 Android 存储 I/O 路径和 ext4/f2fs 的性能差异
- 手机主流存储器件的分析与发展 - OPPO 内核工匠,介绍 eMMC/UFS 架构对比与 UFS 4.0 MCQ 特性
- Android 分区挂载原理介绍 - OPPO 内核工匠,介绍 Dynamic Partition、dm-linear 与 FBE 密钥层次
- Partition layout | AOSP - Android 9/10 system-as-root 语义与 first-stage init 的分工
- Scoped storage | AOSP - Android 11 MediaProvider/FUSE、direct file path 与性能特征
- FUSE passthrough | AOSP - Android 12+ passthrough 的内核、产品属性和验证方式
- JEDEC UFS 4.0 Standard (JESD220F) - UFS 设备接口与协议能力;MCQ 还需结合 UFS Host Controller Interface 规范和主控实现
- Android Common Kernel
android17-6.18-2026-06_r6-drivers/ufs/core/ufs-mcq.c、arm64 GKI defconfig、ext4/f2fs、blk-crypto 与 dm-default-key 实现 - AOSP
android-17.0.0_r1-system/core/libprocessgroup/profiles/、system/vold/FsCrypt.cpp、packages/providers/MediaProvider/jni/FuseDaemon.cpp、external/sqlite/dist/Android.bp - Virtual A/B overview | AOSP - Android 11 kernel COW、Android 12 格式转换、Android 13+ userspace merge 的官方版本划分
- File-based encryption | AOSP / Metadata encryption | AOSP - DE/CE、KeyMint、
dm-default-key、inline encryption 与/metadata启动依赖 - KIOXIA managed flash protocol analysis:UFS 3.1/4.0/4.1 与 JEDEC 规范编号对应表。
- MIPI UniPro:UFS 互连层与 M-PHY 的分工。
- Android 17 snapshot.cpp / capabilities.cpp:dm-user/ublk 选择、更新 manifest 与 merge 状态。
- Android 11 COW 分配 / Android 17 COW 分配:super 空闲区与 data backing image。
- Android 17 SharedPreferencesImpl:异步中间代次跳过与实际持久化。
- KIOXIA logical-to-physical address translation:器件 WAF 的 NAND/host 字节边界。