Android 端侧 AI Runtime 与 NPU 性能边界
端侧推理进入相机、OCR、语音、搜索和生成式功能之后,模型执行时间就成了前台交互预算的一部分。一次推理可能同时占用 CPU 时间、GPU 带宽、专用加速器(AI accelerator)、文件映射的内存页和匿名内存,持续执行还会推高温度、触发降频。所以实验室里测得更快的执行后端(实际承担计算的 CPU、GPU 或加速器实现),放进真实页面后未必换来更稳的帧时间。
源码基线:Android 17 / API 37 / AOSP
android-17.0.0_r1。
本文讨论三个工程问题:
- 应用发起的一次推理,经过哪些准备和执行阶段;
- CPU、GPU、NPU 与 AICore 分别属于哪条路径;
- 如何用可复现的测试和系统侧观测判断瓶颈,避免只看一组平均耗时。
端侧推理性能由模型、张量布局、运行时、加速器(accelerator)和内存传输共同决定。应用自管 LiteRT 管线、平台提供的 ML Runtime 和系统托管 GenAI 服务(AICore),三者的设备访问与资源隔离并不相同。
模型执行、委托与数据搬运
先把四条软件路径分开
Android 上的“端侧 AI”包含多套职责不同的组件。排查性能问题前,我们先确认产品使用的是哪一条软件路径。
| 路径 | 应用面对的接口 | 模型与运行时(runtime)由谁管理 | 常见执行设备 |
|---|---|---|---|
| LiteRT 自带运行时 | Interpreter、委托后端(delegate),或新的 CompiledModel API | 应用及其依赖 | CPU、GPU、NPU |
| LiteRT in Google Play services | Play services 提供的 LiteRT 接口 | Play services 更新运行时,应用管理模型 | CPU、GPU,具体能力看接口与设备 |
| AICore / ML Kit GenAI | ML Kit GenAI 等高层 API | AICore 管理 Gemini Nano、请求和安全能力 | 由受支持设备的系统实现决定 |
| NNAPI | 原生开发套件(Native Development Kit,NDK)的 Neural Networks API,或 NNAPI delegate | Android NNAPI runtime 与厂商驱动 | CPU、GPU、数字信号处理器(DSP)、NPU,取决于驱动 |
这四条路径可以同时出现在一台设备上,而应用能控制的部分各不相同:CompiledModel 属于 LiteRT,AICore 是系统服务(service),Android 17 的 NPU 调度组件只管直接访问 NPU 的资格和调度信息。排查时先把层次分开再画调用图;混进同一张图里,初始化成本、内存归属和失败后的处理方式都容易看错。
为什么端侧推理容易变成性能问题
一次完整推理通常包含以下阶段,从输入采集一直到界面更新:
输入采集
  → 解码 / 缩放 / 归一化 / 分词
  → 模型与运行时初始化
  → delegate 分区或模型编译
  → 输入传输与 tensor 准备
  → 加速器执行
  → 输出读取与后处理
  → UI 更新
用户感知的是从输入到 UI 更新的端到端延迟(latency),而运行时报告的 kernel 时间只覆盖其中一段。常见成本包括:
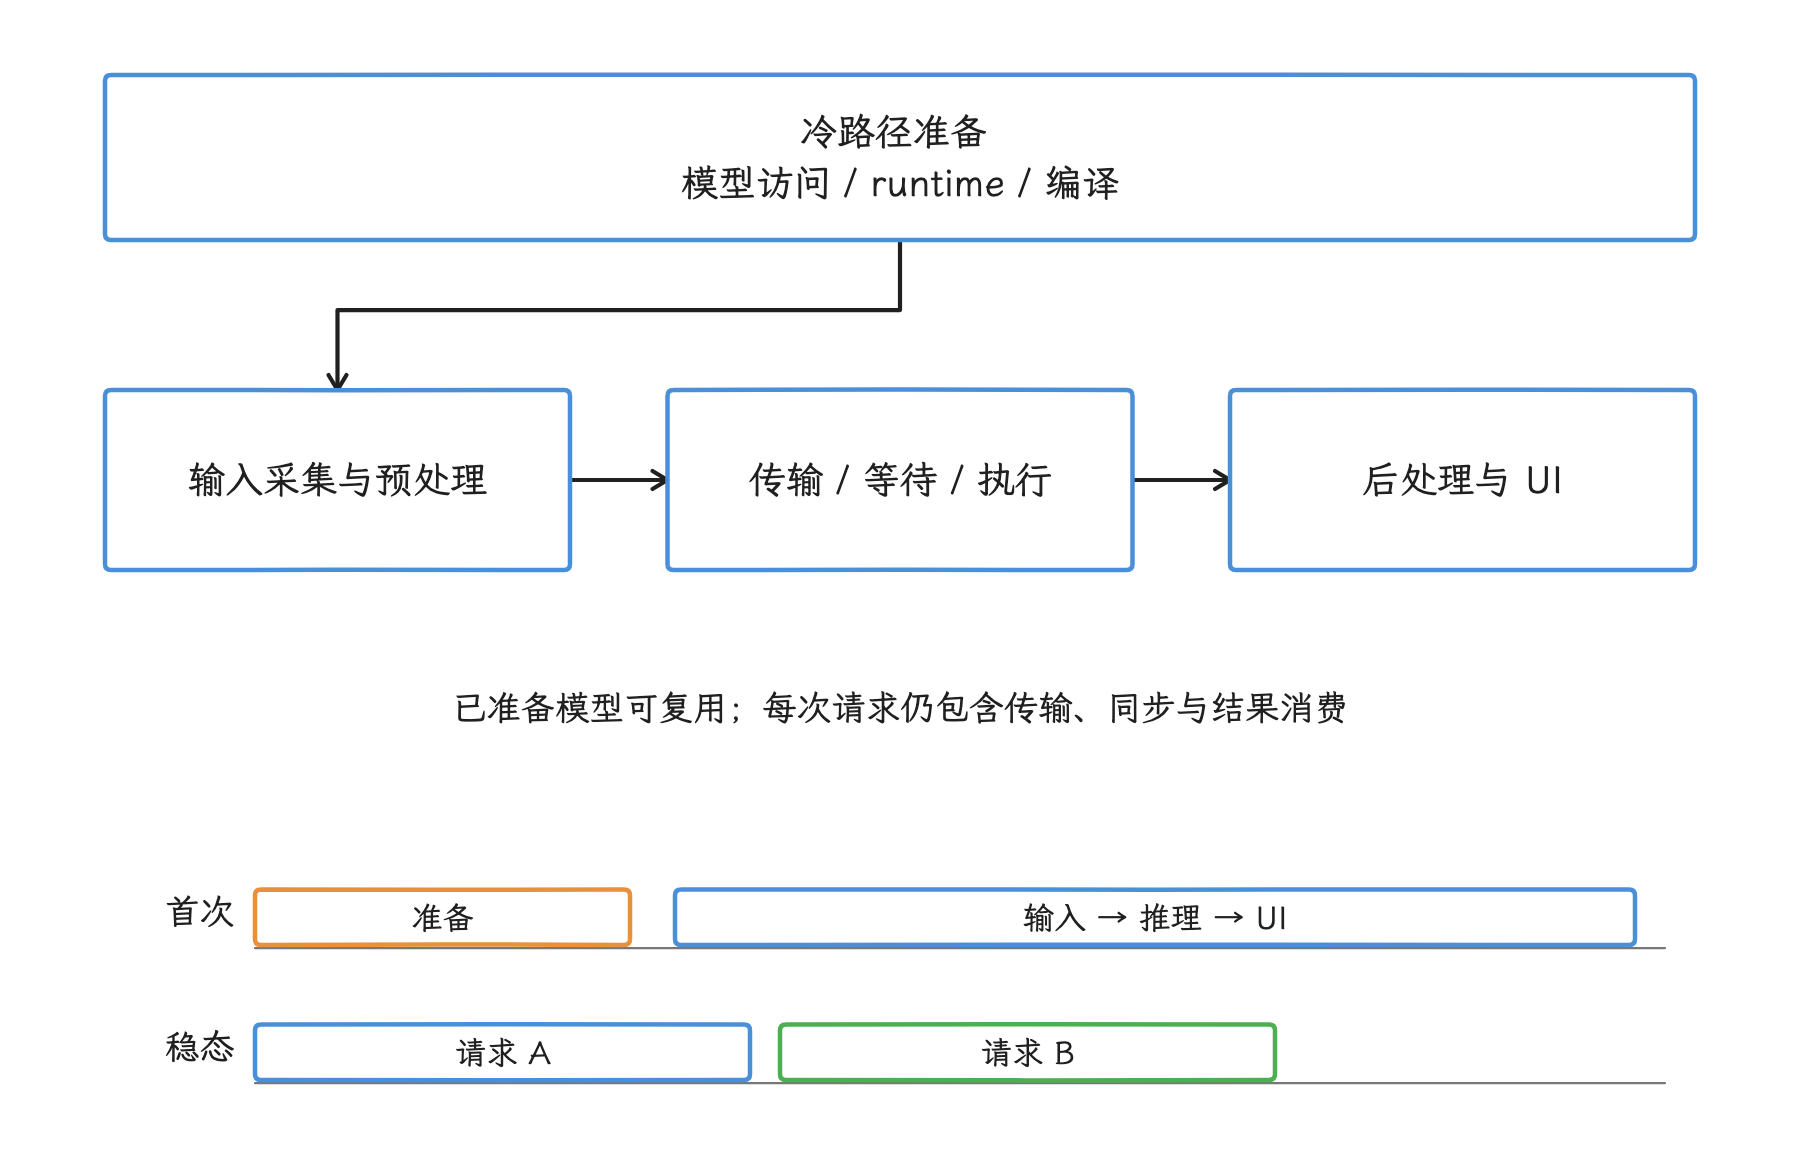
图:示意时序不按实际耗时比例绘制。准备可以提前完成,稳态请求复用已准备模型;不能把调用或等待区间全部记为 kernel 时间。
- 首次准备:打开模型、映射文件、创建运行时、分配张量(tensor)、加载 delegate、编译(prepare / compile)子图;
- 稳态执行:算子(operation,op)计算、输入输出传输、同步等待和后处理;
- 并发干扰:GPU 推理与渲染、相机或视频处理争用带宽和执行时间;
- 内存压力:权重、tensor arena、delegate 临时工作区(workspace)、硬件缓冲区(buffer)和编译缓存同时驻留;
- 热衰减:连续推理几分钟后,CPU、GPU 或 NPU 频率受热策略(policy)限制;
- 队列延迟:请求排队、跨进程调用、系统服务或厂商运行时调度。
这条管线依次经过预处理、模型执行和后处理,每个 buffer 的所有权和同步点都要明确记录。CPU 预处理、GPU / NPU 执行与 CPU 后处理交接时,还可能出现 tensor 重排、cache flush / invalidate、AHardwareBuffer / dmabuf 导入和 fence 等待。
零拷贝要求数据格式、内存布局、allocator、生命周期和执行后端都兼容;共享同一个 buffer 对象,驱动内部的数据复制未必因此消失。我们测量时至少要分开记录提交、排队、执行、fence wait 与数据转换,免得把 CPU 的等待时间误算成加速器的计算时间。
优化目标应写成可测量的产品预算,例如“相机预览期间,P95 端到端延迟低于一帧、没有新增卡顿,连续运行十分钟后的温度等级仍可接受”。单次最短推理耗时不足以代表用户体验。
CPU、GPU、NPU 与 DSP 的选择
CPU:兼容性基线
CPU 路径适合建立同机型对照基线,也适合小模型、dynamic shape、多分支控制流和加速器覆盖不足的模型。LiteRT 的 CPU 后端会使用针对移动 CPU 优化的 kernel;合适的线程数仍需实测。
增加线程数并不保证端到端延迟更低。前台页面还需要主线程、RenderThread(渲染线程)、Binder 通信线程和系统合成线程;推理线程占满高性能 CPU 核之后,单独测得的模型耗时可能下降,页面帧时间和整机功耗却可能恶化。所以基准测试要同时记录线程数、CPU 调度、帧时间与温度。
GPU:吞吐与图形争用
LiteRT 在 Android 上公开的 GPU 路径主要使用 OpenCL 和 OpenGL 两类接口,适合并行度高、算子覆盖良好且输入规模足够大的模型。输入过小、频繁创建 delegate,或 CPU 与 GPU 之间多次传输数据时,提交与同步成本可能抵消计算收益。
重点检查三件事:
- 旧式
InterpreterGPU delegate 对创建线程与调用线程有约束,跨线程调用要按文档来; TensorBuffer、OpenGL buffer 或AHardwareBuffer只有在格式、布局、生命周期和后端均兼容时,才可能减少复制;- GPU 与 RenderThread(负责提交渲染工作的线程)、SurfaceFlinger、相机和视频管线共享资源,GPU 推理耗时下降,页面未必跟着更流畅。
GPU 频率变化只说明设备切换了频率点;要判断利用率有没有提高、模型有没有完整交给 GPU,还要结合 GPU work period、驱动 slice、帧时间、delegate 日志和 CPU 等待状态。
NPU:模型覆盖与运行时版本
NPU 适合卷积、大规模张量乘加、attention 等计算。Android 设备上的 NPU 没有一套供普通应用通用的模型图执行 ABI,LiteRT NPU delegate 和厂商 SDK 仍需适配具体片上系统(SoC)与运行时。
评估 NPU 时至少回答以下问题:
- 当前设备、ABI、系统与运行时版本是否受支持;
- 模型中的哪些子图能进入 NPU,哪些会留在 CPU 或 GPU;
- 首次编译或加载缓存需要多久;
- 输入输出是否发生额外复制或格式转换;
- 连续运行后的延迟、温度和功耗怎样变化;
- delegate 失败时,产品是否配置了明确的回退(fallback)顺序,即失败后依次尝试哪些其他执行后端。
DSP:旧设备与厂商栈
DSP 擅长低功耗信号处理,也曾是许多 Android 设备的神经网络加速资源。新设备的产品资料更常使用 NPU、APU 或 AI 加速器等名称,但厂商内部实现仍可能组合 DSP 与专用张量单元。delegate 覆盖率要看运行时兼容列表和本机执行结果,营销名称帮不上忙。
NNAPI 的源码保留与迁移方向
NNAPI(Neural Networks API)在 Android 8.1 / API 27 引入,允许框架构造计算图,再由系统运行时(runtime)和厂商驱动选择设备并准备执行。Android 15 / API 35 起,官方将 NNAPI 标记为弃用(deprecated),并建议性能敏感的应用迁移。
Android 17 源码没有删除 NNAPI。当前版本仍包含:
packages/modules/NeuralNetworks/runtime/include/NeuralNetworks.h:NDK API 带有 API 35 弃用标记;packages/modules/NeuralNetworks/runtime/:NNAPI runtime;hardware/interfaces/neuralnetworks/1.3/:HIDL(HAL Interface Definition Language,HAL 接口定义语言)旧版硬件抽象层;hardware/interfaces/neuralnetworks/aidl/:AIDL(Android Interface Definition Language,Android 接口定义语言)版 NNAPI HAL。
“deprecated”的含义是新项目别再把它当长期入口;它并不表示 Android 17 上所有既有 NNAPI 应用会立即失效。迁移期间我们仍要保留旧设备回归测试,直到产品支持的最低版本和设备范围允许移除旧路径。
分区与回退的实际执行计划
框架或 delegate 可以把受支持的连续节点组成分区,其余节点留给 CPU;设备选择、分区数量,以及编译或执行失败后的处理,还受 API 调用方式与运行时配置影响。所以“任一算子不支持,整张图就无提示地回到 CPU”和“每个不支持的算子都会自动逐个回退”这两种说法,都当不成 NNAPI 的通用行为;实际怎么分区,按执行计划验证。
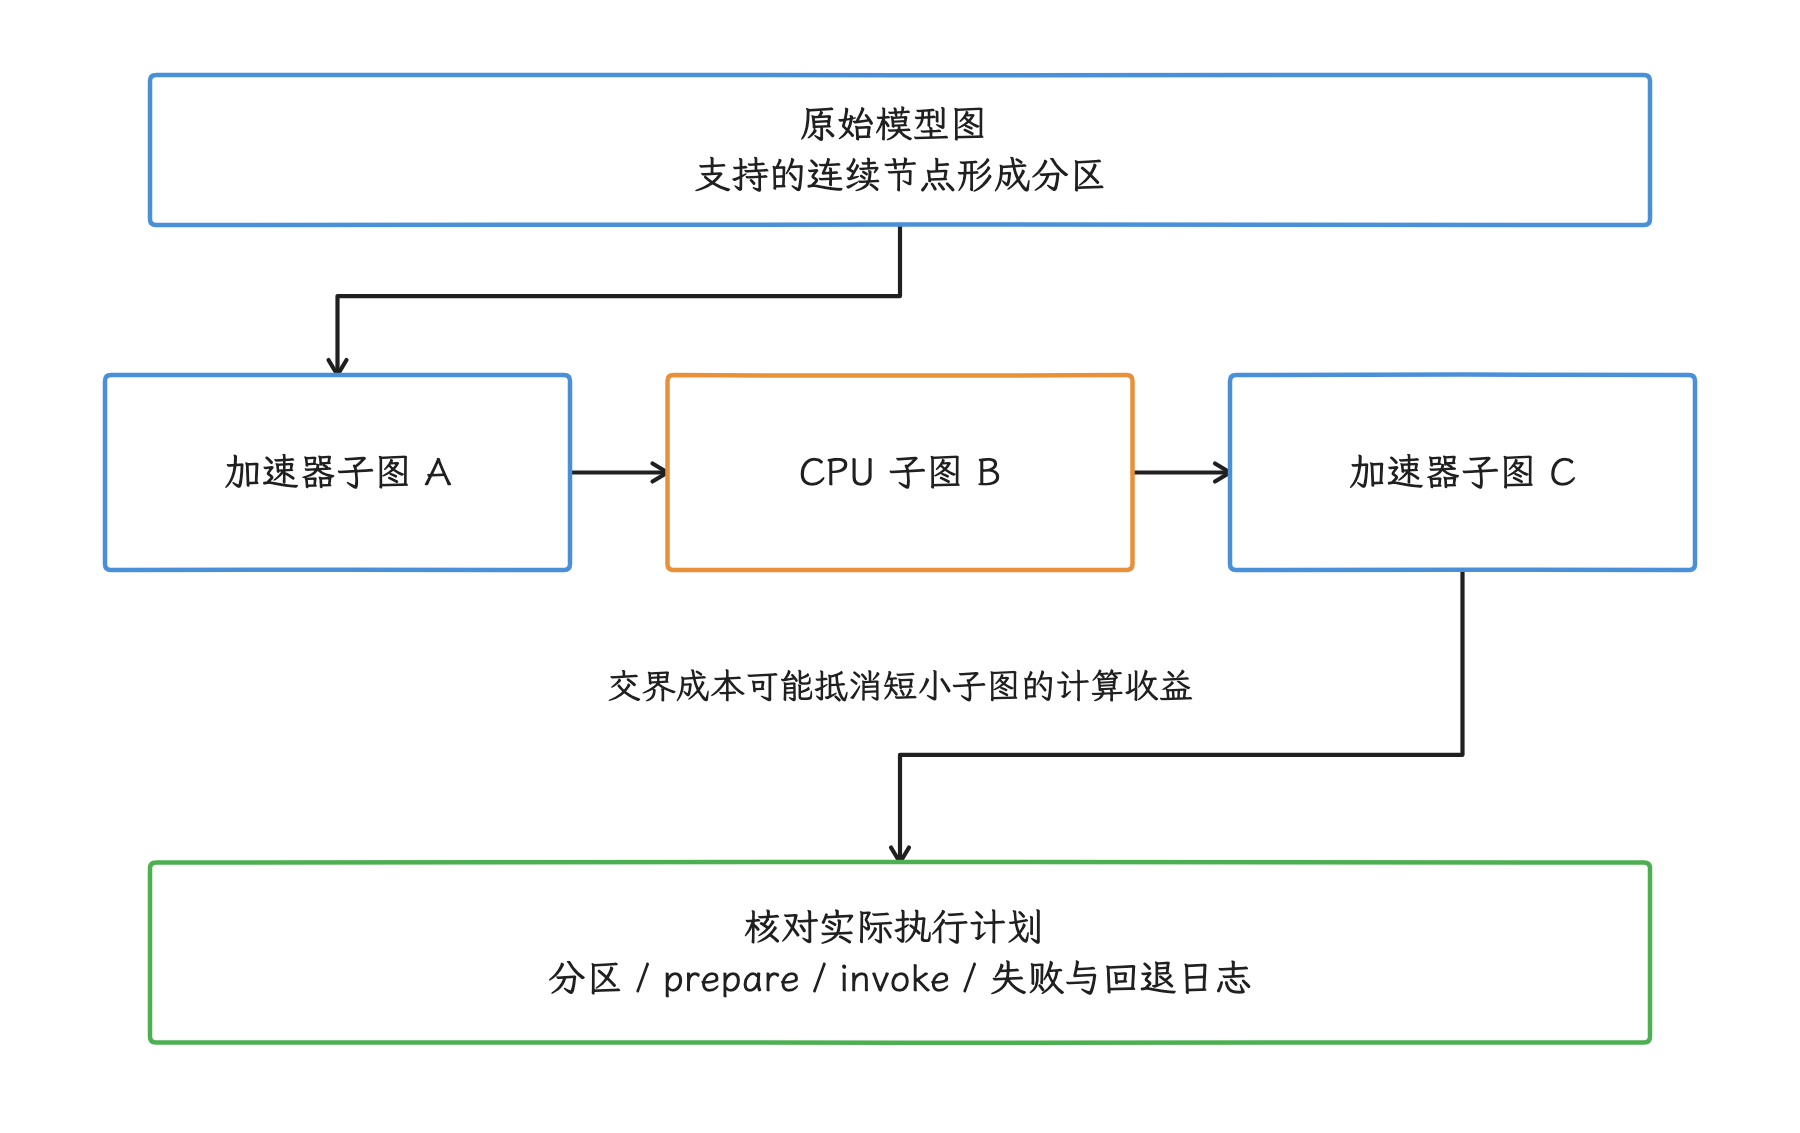
图:A→CPU→C 是一种可能的分区计划。交界可能发生复制、布局转换和 fence 等待;失败后的整图回退由 API 与运行时配置决定。
分区数量过多且每个分区很小时,即使部分算子进入加速器,跨分区同步和 tensor 转换也可能增加总耗时。验证时应记录:
- 实际委托的节点或子图数量;
- CPU 与加速器之间的交界数量;
- prepare / compile 是否成功;
- 执行失败后是否触发应用配置的回退;
- 回退后的结果正确性与延迟。
迁移选择
官方 NNAPI 迁移指南(Migration Guide)给出的主要方向是:
- 普通自定义模型:迁移到 LiteRT,可选择应用自带运行时或 Google Play services 路径;
- 适合 GPU 的模型:评估 LiteRT GPU delegate;
- 基础模型能力:在受支持设备上评估 AICore 上层 API。
没有 Google Play services 的设备需要独立部署方案。即便使用 Play services,模型、delegate、加速器支持和版本回退策略仍应在应用侧明确测试。
LiteRT / TFLite 的准备与执行管线
LiteRT 是 TensorFlow Lite 之后启用的名称,运行时本身也在继续演进。旧项目仍大量使用 Interpreter 和 delegate,新的 LiteRT API 提供 CompiledModel 与 TensorBuffer。两代接口可以共存,分析时先确认应用实际打包的 artifact 及其版本。
Interpreter 路径
典型的 Interpreter 工作可以按下面五项拆开测量;这不是所有 API 的固定调用顺序。delegate 可能在解释器构造期间应用,张量分配也可能随 shape 变化在执行前自动触发:
- 模型访问:读取或内存映射
.tflite的 FlatBuffer(二进制序列化格式); - 解释器创建:解析模型元数据,注册 kernel;
- tensor 准备:确定 shape,规划并分配 arena;
- delegate prepare:检查算子支持情况、进行分区、编译或创建后端资源;
- 执行(invoke):填充输入、执行子图、读取并后处理输出。
内存映射可以减少把整份模型复制进 Java 堆的开销,但保证不了整条推理管线都不复制数据:delegate 可能转换权重、生成编译产物,输入图像也可能经历颜色转换、布局变换和硬件缓冲区导入。
CPU、GPU 或其他 delegate 的收益要比较完整管线才能看出来。只测量 invoke() 的调用时长,会遗漏首次 allocateTensors()、delegate prepare 和输入转换。
CompiledModel 路径
CompiledModel 以优先使用加速器的方式创建可执行模型,并用 TensorBuffer 表达输入输出。它将模型创建与后续多次执行分开,同时支持同步和异步执行;可用的加速器与具体接口以项目所用 LiteRT 版本为准。
这里有三件事要弄清楚:
- 创建
CompiledModel仍可能触发图检查、编译、权重转换与资源分配,要避开主线程; - “compiled”不保证得到可跨设备复用的本地二进制文件,产物格式和缓存能力由后端决定;
CompiledModel仍属于 LiteRT 模型执行路径,不会因此变成 AICore 客户端。
适合新接口的项目可以直接评估 CompiledModel;已有 Interpreter 的项目,要通过同一模型、输入和设备的对照测试确认迁移收益,仅换接口换不来性能结论。
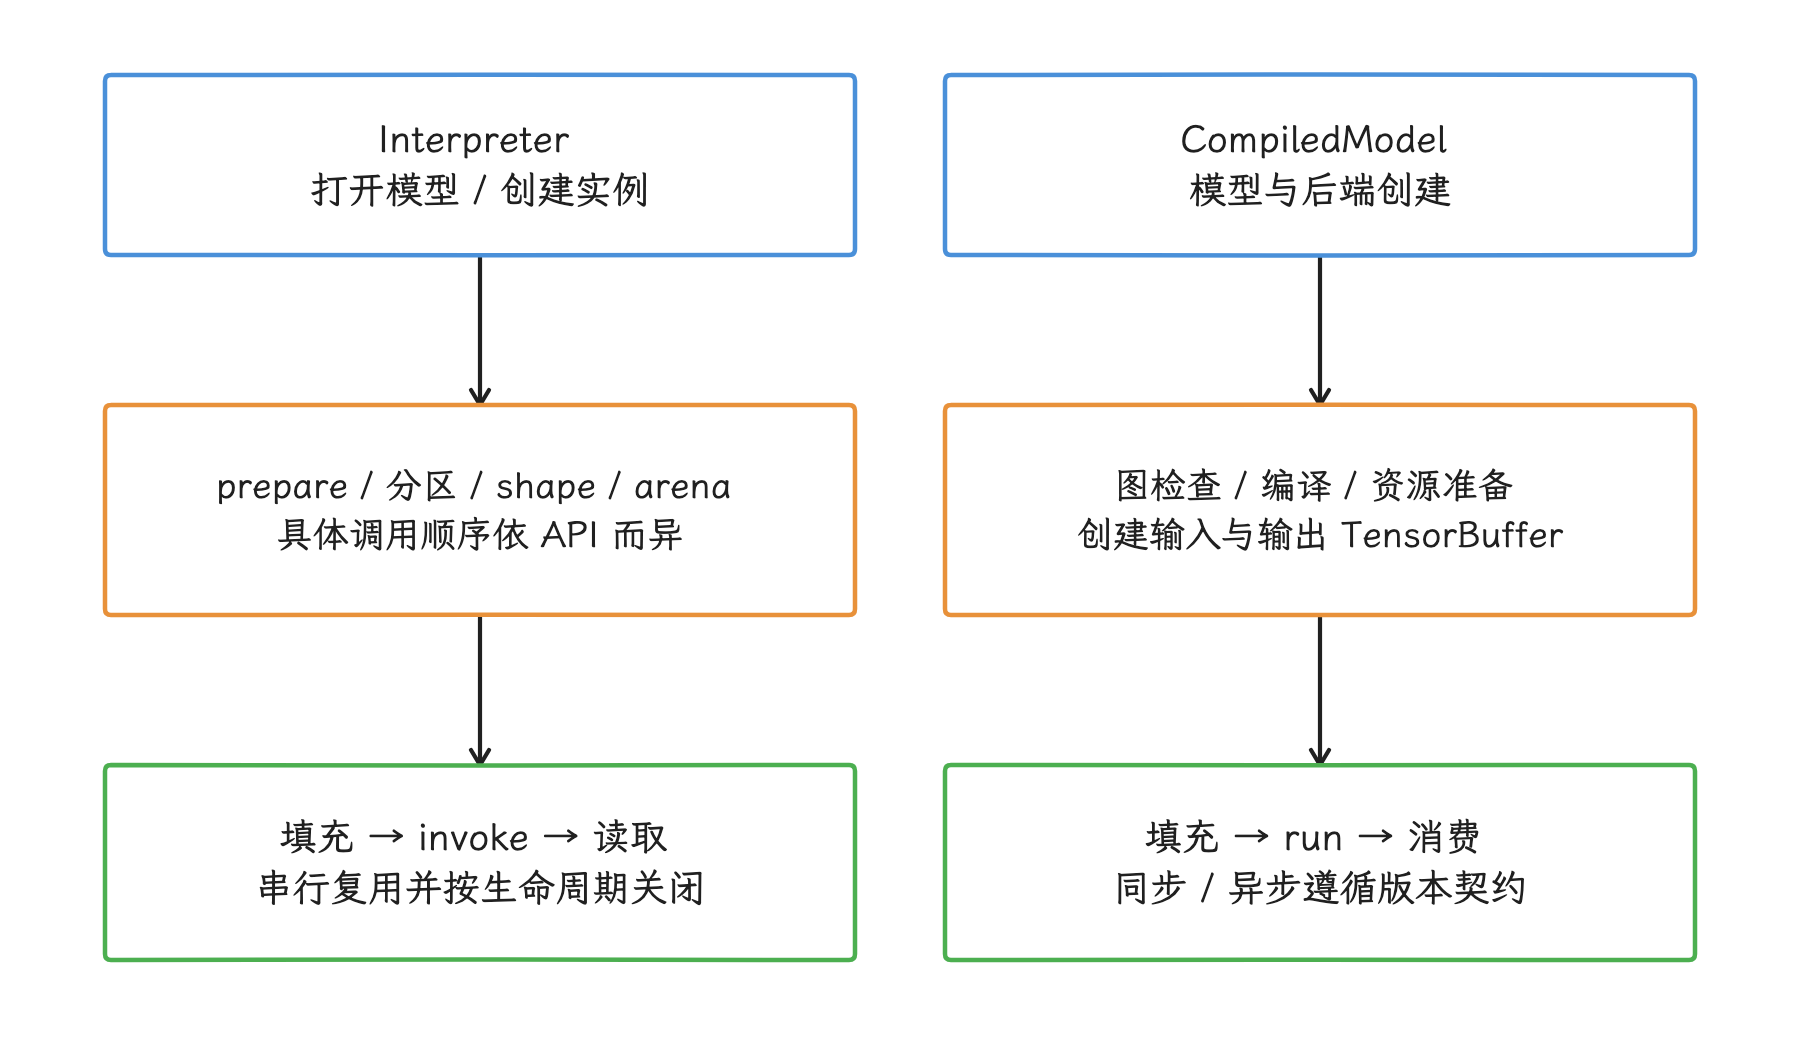
图:模型创建与稳态执行应分别测量。Interpreter 可能隐式调整张量分配;compiled 名称不保证产物可以跨设备复用。
AOT、JIT 与冷启动
LiteRT NPU 文档把部署分成提前编译(Ahead-of-Time,AOT)和即时编译(Just-in-Time,JIT)两类。AOT 在目标 SoC 已知时预先生成设备相关产物,把部分设备端编译工作提前到分发阶段,可以减少设备端首次准备,通常更适合模型固定、目标 SoC 已知且首次响应敏感的场景。JIT 在设备上完成编译,分发更灵活,适合设备范围广或模型动态更新的场景,但第一次创建模型时可能产生额外编译成本。
跨设备通用的“500 ms 降到 50 ms”这类承诺,AOT 给不了。准备时间取决于模型、厂商编译器、固件、缓存命中、存储状态和进程生命周期,验证时分别测量:
- 无缓存的首次创建;
- 同版本缓存命中的再次创建;
- 进程重启后的创建;
- 系统或驱动升级后的缓存失效;
- AOT 产物带来的下载体积和驻留内存;
- 数值精度与模型输出是否保持在允许范围。
当前 LiteRT NPU 文档显示,不同厂商对 AOT 与 JIT 的支持各不相同,支持范围还随 LiteRT 版本变化,某一家芯片的测试结果推广不到所有 Android 设备。发布前应固定 LiteRT artifact、目标设备清单、SoC / 驱动版本和模型版本。
Android 17:直接访问 NPU 需要 feature 声明
Android 17 的这项变化落在平台控制面:以 API 37 为目标版本且需要直接访问 NPU 的应用,必须在 manifest 中声明 android.hardware.npu,系统据此决定这个 UID(应用身份编号) 能否直接提交 NPU 工作。声明写法、required 对安装过滤的影响,以及运行时的能力检测见「android.hardware.npu:声明、安装过滤与能力检测」。
排查时我们注意两件事:
- 声明和设备能力检测只解决访问资格。后续仍需处理 delegate 创建失败、模型不兼容、资源繁忙和执行错误;直接访问路径包括 LiteRT NPU delegate、厂商 SDK 与已弃用的 NNAPI 等,把推理放到工作线程并不会绕过 Android 17 的访问检查。
- NPU 调度层不定义模型计算。Android 17 的 AOSP 新增
NpuManager模块与hardware/interfaces/npu/aidl/,两者只描述资格、优先级和工作状态,推理仍由 LiteRT 或厂商 runtime 负责;PriorityManager读取目标 SDK、manifest feature 和 UID 重要性,对targetSdkVersion >= 37且缺少声明的应用可置hasDirectAccess = false,而NpuManager的 Java 接口是受权限保护的系统 API(@SystemApi),普通应用把它当公共 SDK 调用是行不通的。
在支持并启用该服务的 Android 17 系统镜像上,dumpsys npu 可以检查服务状态;量产设备是否开放详细信息取决于系统构建与权限。拿不到这些信息时,先看应用的 delegate 日志和厂商工具。
AICore / Gemini Nano:系统服务路径
Android 官方将 Gemini Nano 的设备内运行环境描述为 AICore 系统服务,应用通常通过 ML Kit GenAI 等高层 API 请求能力。AICore 负责模型可用性、下载更新、请求处理和相关安全机制;模型经 Private Compute Services(负责隐私计算相关网络交互的系统组件)下载,AICore 本身不直接访问互联网。
这条路径与应用自带 .tflite 模型不同:
- 应用要按“模型可能尚未下载”来设计;
- 首次请求可能包含能力检查、模型准备(preparation)或下载等待;
- 设备、地区、系统版本和具体 API 会影响可用性;
- 系统服务可以复用模型资源,但请求上下文与并发策略由服务管理;
- 应用应按 API 契约处理忙碌、取消、超时与不可用状态。
AICore 文档没有将其定义为 CompiledModel 的调度器,也未公开承诺内部必须经过 NNAPI。分析 AICore 时,我们就以高层 API、系统服务和官方设备支持范围为准;内部执行后端,不要根据论坛描述去推断。
AICore 的内存应怎样观察
跨进程推理会把内存分散到调用方、AICore、Private Compute Services、驱动和共享缓冲区。PSS(Proportional Set Size,比例集大小)按比例分摊共享内存页,RSS(Resident Set Size,常驻集大小)统计进程当前映射并驻留在物理内存中的页面;要用它们回答“这次请求的内存归到哪个应用”,还差一层业务归属的换算。
公开文档没有给出 AICore 全部 PSS/RSS 回算到调用方的保证。排查内存峰值时,应同时观察:
- 调用方的 Java 堆、native heap、graphics 和总 PSS;
- AICore 与相关系统进程的变化;
dmabuf共享缓冲区、GPU 或厂商驱动分配;- 请求结束后缓存是否保留,以及内存能否在压力下回收。
不同系统版本的进程名和权限可能变化,脚本里写死单一进程名是靠不住的,先通过包名、系统服务和进程列表确认本机实现。
一次推理的内存由哪些部分组成
“模型文件只有 100 MB,所以推理最多占 100 MB”是常见误判。运行时内存大致包括以下部分:
| 类别 | 典型内容 | 观察提示 |
|---|---|---|
| 模型映射 | FlatBuffer、权重文件页 | 区分由文件映射的(file-backed)RSS / PSS 与匿名内存 |
| 权重转换 | delegate 打包、重排、量化展开或编译缓存 | 首次 prepare 后可能持续驻留 |
| tensor | 输入、输出、中间激活、键值缓存(Key-Value cache,KV cache) | shape、批大小(batch)、序列长度会改变峰值 |
| workspace | CPU 临时内存(scratch)、GPU / NPU 临时缓冲区 | 可能位于 native heap、驱动(driver)或 dmabuf |
| 输入输出(I/O)管线 | Bitmap、YUV / RGB 图像格式、纹理、HardwareBuffer | 重复格式转换会产生额外峰值 |
| 服务进程 | AICore 或其他跨进程 runtime | 不会全部出现在应用自身 heap |
测量时要标记模型生命周期的各个时间点:模型打开前、runtime 创建后、第一次执行后、稳定运行后、释放后,以及系统出现内存压力时。只截取一次 dumpsys meminfo 输出,很难区分一次性准备、可回收缓存和持续泄漏。
模型与管线优化
先优化端到端管线
推理要离开主线程,但换到工作线程只解决了最基本的一层。还要避免:
- 每次进入页面都重新创建 interpreter 或 delegate;
- 相机每帧积压,旧帧还没处理完又提交新帧;
- 输入在
Bitmap、数组、ByteBuffer和纹理间反复转换; - 推理结束后在主线程做重型排序、解码或文本处理;
- 多个模型各自占满线程池或加速器队列。
实时场景通常更适合使用有长度上限的队列,或只保留最新输入。双缓冲可以让准备和执行阶段重叠,但必须限制已提交、尚未完成的请求数量,防止内存占用和延迟随队列持续增长。
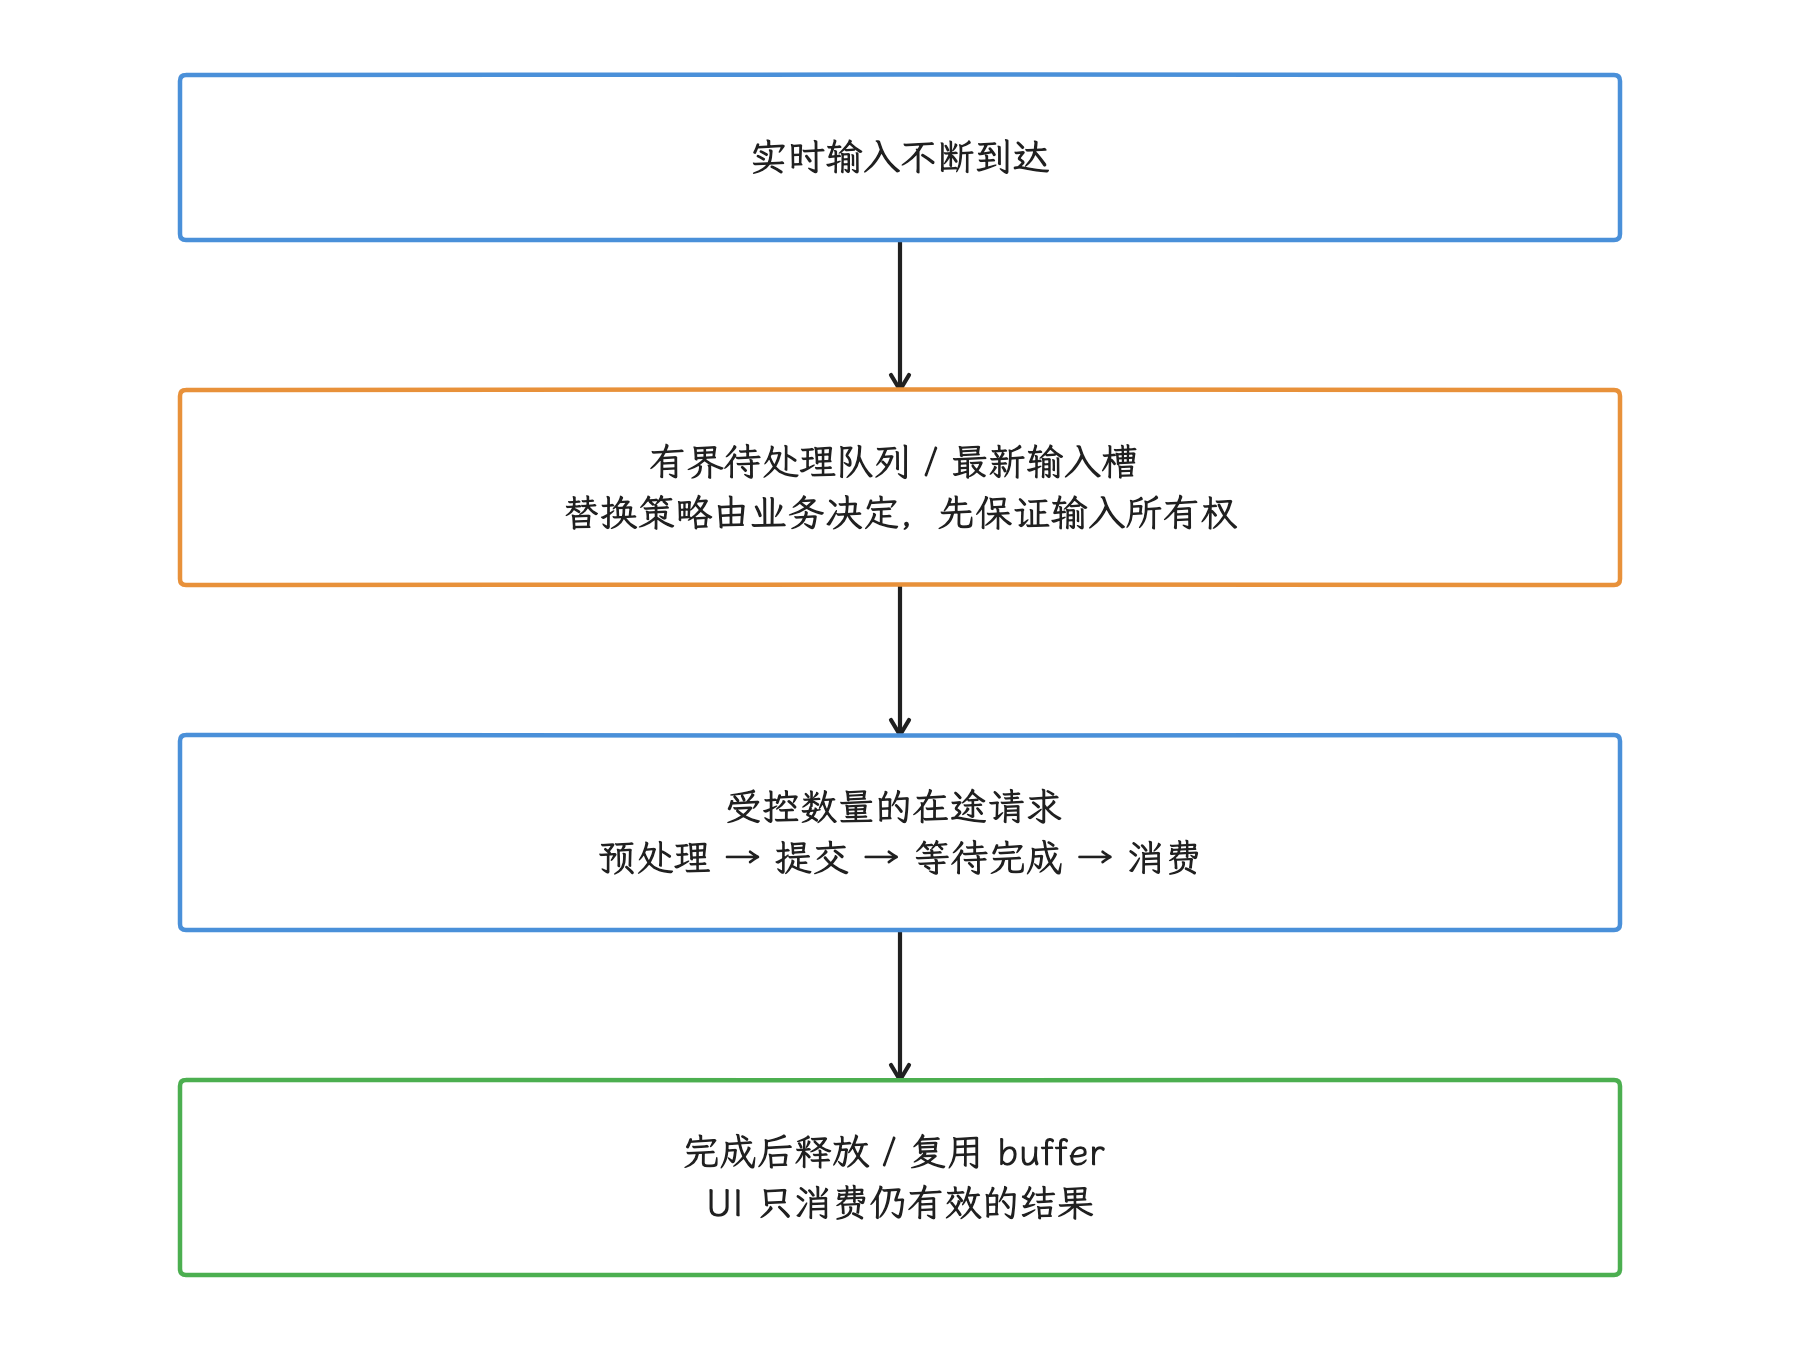
图:队列有界还不够,已提交但未完成的工作也要有上限。相机缓冲区必须在消费者完成后归还,不能覆盖仍被加速器读取的数据。
量化的精度与后端覆盖
INT8(8 位整数)、FP16(16 位浮点)等量化方式可以减少模型体积、内存带宽和计算量,但收益依赖目标后端的 kernel 支持。训练后量化(Post-Training Quantization)接入较快;量化感知训练(Quantization-Aware Training)可以改善部分模型的精度保持,但会增加训练成本。
每次量化都应同时验证:
- 业务数据集上的准确率、召回率或生成质量;
- delegate 覆盖率是否提高或下降;
- 初始化、首次和稳态延迟;
- 峰值内存、能耗与持续运行后的温度;
- 不支持设备上的 CPU 回退质量与速度。
裁剪、稀疏与蒸馏
稀疏化会让模型中的一部分权重变为零。非结构化稀疏不会自动在移动加速器上获得等比例加速;只有运行时和硬件支持相应稀疏格式时,减少的参数才可能转化为执行收益。
结构化裁剪会按通道或模块等规则减少参数,更容易改变张量尺寸;知识蒸馏则让较小的学生模型学习较大教师模型的输出,以增加训练成本换取更小模型。两种方法都要在目标 delegate 和真实输入上重新测量。
预热、缓存和批处理(batching)
预热可以提前触发内存规划、JIT 编译和 kernel 选择,但也会把 CPU、内存和热成本移到更早的时刻,所以要避开首帧、启动 I/O 和页面动画这些关键资源。
编译缓存的键应包含模型、运行时、设备和驱动版本,并处理缓存失效与磁盘空间不足。批处理可以让多项输入共同承担一次固定调度成本,却会增加等待时间和 tensor 内存;交互式请求通常需要较小的 batch。
建立可复现的 benchmark(基准测试)
benchmark 要记录完整的环境和指标,结果才可复现。一次可靠测试至少应报告:
- runtime、delegate、模型、量化方式、输入 shape、batch 和线程数;
- 设备、SoC、Android build、驱动与电量状态;
- 模型创建时间、第一次执行时间、预热次数;
- 稳态第 50、95、99 百分位数(P50 / P95 / P99)与吞吐;
- 端到端延迟,以及预处理、执行、后处理的分段时间;
- 峰值 PSS / RSS、native heap、
dmabuf或 GPU 内存; - 连续运行后的温度、频率、功耗和降频点;
- 交给加速后端执行的节点比例、回退路径和输出正确性。
建议至少设置以下四组对照:
- CPU 基线;
- 目标 delegate,无缓存首次创建;
- 目标 delegate,缓存命中与预热后;
- 与真实 UI、相机或音频负载并发。
LiteRT 的 benchmark_model 工具可以测量初始化、预热和稳态执行,但工具参数会随 runtime 版本与 delegate 改变。我们先用 --help 确认当前二进制文件支持的选项,再把完整命令、模型校验值和测试环境写入记录。
用 Perfetto 建立证据
默认的系统 trace(性能跟踪记录) 主要回答“线程何时运行、CPU / GPU 频率如何变化、内存和温度发生了什么”;模型算子、delegate 分区和 NPU 内部阶段,通常要靠运行时、应用或厂商额外记录跟踪事件。
应用记录分段事件
为了区分输入、推理和输出,我们可以用下面的代码为关键阶段添加 trace section(带开始和结束时间的跟踪区间):
Trace.beginSection("ml/preprocess")
try {
    preprocess()
} finally {
    Trace.endSection()
}

Trace.beginSection("ml/inference")
try {
    runInference()
} finally {
    Trace.endSection()
}
这段示例会生成 ml/preprocess 和 ml/inference 两类 slice,便于与 UI 帧、线程调度、频率和内存事件对齐。名称要保持稳定并带上必要的请求类型;用户内容、文件名和提示词都不要写进 trace。
LiteRT 内部 tracing
LiteRT 的性能测量文档说明,interpreter internal tracing 从 LiteRT v2.4 起提供。只有应用使用的 runtime 达到相应版本时,下面的系统属性开关才会产生预期效果:
adb shell setprop debug.tflite.trace 1
# 录制目标场景
adb shell setprop debug.tflite.trace 0
第一条命令打开 LiteRT 内部跟踪,第二条在目标场景录制完成后把它关掉,免得影响后续测试。部署版本较旧时,就依靠应用记录的分段事件、benchmark 工具和 delegate 日志,系统并不会自动显示每个模型算子。
不同后端的观测重点
| 后端 | Perfetto 中常见证据 | 还需要什么 |
|---|---|---|
| CPU | 工作线程(worker)的长 slice、运行队列(run queue)、CPU 频率、线程迁核 | 线程数、CPU 后端配置、算子性能记录(profile) |
| GPU | GPU 工作、频率、CPU 提交 / 等待、FrameTimeline(预期帧与实际帧时间线) | GPU delegate 日志、驱动计数器、渲染并发对照 |
| NPU | 应用提交 / 等待、NpuManager 控制事件、温度与系统调度 | LiteRT / 厂商日志、NPU 性能分析器(profiler)、模型委托比例 |
| AICore | Binder(Android 进程间通信机制)等待、调用方 slice、系统进程 CPU / 内存变化 | ML Kit 状态、模型准备事件、服务侧可见日志 |
Android 17 AOSP 的 NpuManager 带有 constructor、model load / unload、policy 和 UID 重要性等 trace section。它们能帮我们确认调度控制面是否在活动,但逐算子的 NPU 时间还是要靠 delegate 或厂商侧的记录。
GPU 频率上升、CPU 利用率下降或 NPU feature 存在,都只是间接信号。要确认模型确实用上了加速器,至少要有一项直接记录,例如 delegate 的成功分区记录、厂商 profiler、编译日志或运行时统计。
常见问题的定位顺序
首次请求慢
先分别测量模型下载、文件打开、runtime 创建、delegate prepare、编译、第一次执行和后处理,再比较进程重启、缓存命中和系统升级后的差异。一次总耗时说明不了 AOT 或 JIT 各自的作用。
平均延迟正常,但页面掉帧
将 ml/* slice 与 FrameTimeline 对齐,检查主线程阻塞、高性能 CPU 核占用、GPU 推理与渲染重叠、内存回收和后处理。降低推理线程数或限制提交频率,有时会使模型平均耗时略有上升,但交互 P95 可能更稳定。
标称启用 NPU,CPU 仍然很忙
CPU 还要负责预处理、后处理、图中未交给加速器的节点和提交等待。检查 Android 17 feature 声明、设备能力、delegate 创建结果、分区日志与模型支持列表,再判断这是正常的混合执行,还是已经回退到 CPU。
连续运行越来越慢
同时观察 thermal severity、CPU / GPU 频率、NPU 或厂商状态、帧时间和功耗。固定散热条件,分别记录设备未升温、温度上升和温度稳定三个阶段;增加预热次数解决不了热降频。
释放模型后内存没有立刻下降
区分分配器(allocator)保留空间、文件页缓存、delegate 缓存、驱动分配和仍被引用的 tensor。重复执行“创建—运行—释放—施加内存压力”的周期,观察内存占用是否持续无上限增长;进程 RSS 没有立即回到初始值,本身说明不了泄漏。
Android 版本边界
| 版本 | 与端侧推理相关的变化 |
|---|---|
| Android 8.1 / API 27 | 引入 NNAPI |
| Android 14 代设备 | AICore / Gemini Nano 开始面向部分设备提供系统级能力 |
| Android 15 / API 35 | NNAPI 标记为 deprecated,官方给出迁移指南 |
| Android 17 / API 37 | 加入 FEATURE_NEURAL_PROCESSING_UNIT;以 Android 17 为目标版本且直接访问 NPU 的应用需要 manifest 声明;AOSP 增加 NpuManager 与 NPU 调度(scheduling)AIDL |
版本表圈定的是平台 API 范围;某台设备到底有没有 NPU、AICore 或同一套 LiteRT delegate,还要看设备 feature、Google Play services、厂商组件和模型兼容性。
源码核对位置
以下路径均对应 android-17.0.0_r1:
| 组件 | 路径 | 用途 |
|---|---|---|
| NPU feature 常量 | frameworks/base/core/java/android/content/pm/PackageManager.java | FEATURE_NEURAL_PROCESSING_UNIT |
| NPU service 名称 | frameworks/base/core/java/android/content/Context.java | NPU_SERVICE = "npu" |
| NPU feature 检查与 UID 优先级 | packages/modules/NpuManager/service/java/com/android/server/npumanager/PriorityManager.java | 直接访问(direct-access)判定 |
| NPU flags | packages/modules/NpuManager/flags/npumanager_flags.aconfig | Android 17 功能开关(feature gate) |
| NPU scheduling AIDL | hardware/interfaces/npu/aidl/android/hardware/npu/ | 调度配置与工作回调 |
| NNAPI NDK 头文件 | packages/modules/NeuralNetworks/runtime/include/NeuralNetworks.h | API 35 弃用标记 |
| NNAPI runtime | packages/modules/NeuralNetworks/runtime/ | 既有 NNAPI 执行层 |
| NNAPI HAL | hardware/interfaces/neuralnetworks/1.3/、hardware/interfaces/neuralnetworks/aidl/ | 既有厂商驱动接口 |
hardware/interfaces/npu/aidl/ 与 hardware/interfaces/neuralnetworks/ 的职责不同:前者是 Android 17 的 NPU 调度控制接口,后者属于 NNAPI 推理 HAL。两者在项目中同时存在,只说明各管各的对象;由共存推断新的 NPU AIDL 已经替代所有模型执行接口,就推断过头了。
LiteRT 是独立演进的 Google AI Edge 项目。API、artifact 和 delegate 支持应以应用实际依赖的 LiteRT 版本为准,平台 AOSP 标签(tag)推不出它的最新版本。
官方资料
- NNAPI overview
- NNAPI Migration Guide
- Android 17 release notes
FEATURE_NEURAL_PROCESSING_UNIT- LiteRT for Android with
CompiledModel - LiteRT NPU acceleration
- LiteRT GPU acceleration
- LiteRT performance measurement
- Gemini Nano and AICore
ML Runtime、驱动与 NPU 能力
应用层的 delegate 只有通过运行时和驱动才能使用 NPU:算子支持、内存共享、编译缓存和回退路径,决定加速最终是否生效。上一节我们讲了执行路径与测量方法;这一节沿同一基线往下走,看这些路径落到平台、驱动和厂商后端上的样子——从 NPU 访问资格与调度接口,到 LiteRT CompiledModel、AOT / JIT 和 Neural Networks HAL。
Android 17 在这里增加了明确的系统控制层:以 API 37 为目标版本的应用要直接访问 NPU,必须先声明 android.hardware.npu。这层控制决定的是某个 UID 能否直接提交工作、系统如何把应用优先级传给 NPU 调度层;普通应用并没有因此多出一个能“执行任意模型”的通用 framework API。
通用推理性能分析见上一节;LLM 的 TTFT、TPOT、DVFS 与能效测量见 5.6 节。
android.hardware.npu:声明、安装过滤与能力检测
Android 17 release notes 的要求很具体:以 Android 17 为目标版本的应用需要直接访问 NPU 时,必须声明 NPU 硬件 feature。这里的 feature 是写在 manifest 里的设备能力声明。API 37 在 PackageManager 中新增以下常量:
public static final String FEATURE_NEURAL_PROCESSING_UNIT =
        "android.hardware.npu";
这段代码定义了 feature 对应的字符串。应用清单通常这样声明该 feature:
<uses-feature
    android:name="android.hardware.npu"
    android:required="false" />
这段 XML 将 NPU 声明为可选能力。需要区分两个维度:
- 是否存在
<uses-feature>,决定目标 API 为 37 的应用能否获得直接访问资格; android:required供 Google Play 等分发渠道判断是否过滤缺少该 feature 的设备。Android 系统安装过程本身不会普遍执行这种 feature 匹配检查,其他渠道的处理要分别确认。
大多数同时提供 CPU / GPU 路径的应用应使用 required="false":既保留了 NPU 声明,让 Android 17 能识别应用请求 NPU 能力,又避免 Google Play 仅因缺少 NPU 而过滤设备,使产品可以改用 CPU 或 GPU。只有核心功能在其他后端上跑不起来时,才适合使用 required="true"。
Android 17 源码也体现了这一区别。packages/modules/NpuManager 中的 PriorityManager.doesPackageUseNpuFeature() 遍历 PackageInfo.reqFeatures(应用请求的 feature 列表),检查名称是否等于 FEATURE_NEURAL_PROCESSING_UNIT;直接访问资格与 required 标志无关,required 影响的是分发渠道的设备兼容性过滤,而非这段直接访问检查。
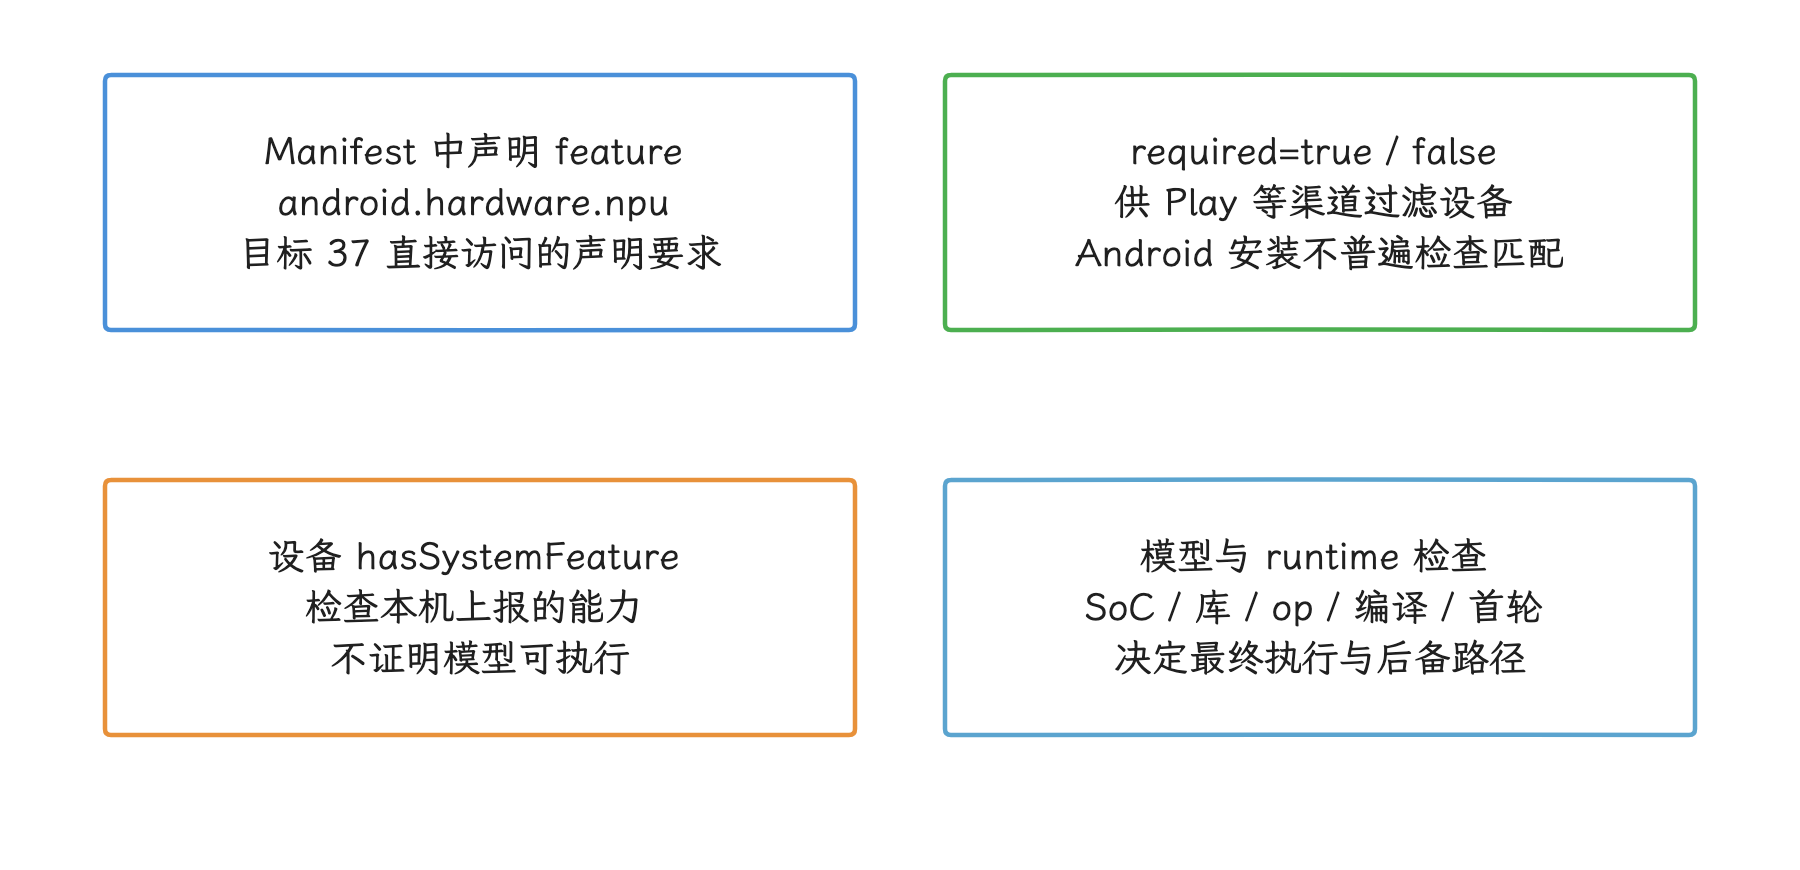
图:required=false 保留 feature 声明并避免 Google Play 仅因无 NPU 而过滤设备;它不决定 PriorityManager 的直接访问检查。
下面的代码在运行时检测设备是否声明该 feature:
val hasNpuFeature = context.packageManager.hasSystemFeature(
    PackageManager.FEATURE_NEURAL_PROCESSING_UNIT
)
返回 true 只说明设备声明了 NPU 或类似的 AI 加速硬件,下面这些问题它一个都回答不了:
- LiteRT NPU 运行时(runtime)和厂商库是否已安装;
- 当前 SoC 是否在所用 LiteRT 版本的兼容范围内;
- 模型能否编译;
- 算子、数据类型、动态形状(dynamic shape)和量化格式是否受支持;
- 运行时最终使用 NPU、部分回退,还是完全改用其他后端;
- NPU 路径是否比 CPU/GPU 更快或更省电。
因此,hasSystemFeature() 只是访问前置条件之一;模型兼容性要靠所选运行时的兼容性 API 来查,模型编译、buffer 创建和首轮执行失败也要分别处理。
使用低于 37 的编译 SDK(compileSdk)时,清单仍可写字符串 android.hardware.npu;Java / Kotlin 代码还引用不到 API 37 常量,可以暂时使用同一字符串。项目升级到 API 37 后改用常量,IDE、lint 和 API 检查就能协助维护。
Android 17 如何阻断未声明的直接访问
Android 17 的检查链跨越 framework 的 feature 信息、NpuManager 模块和新的 NPU 调度 HAL(scheduling HAL),声明信息沿以下环节成为厂商 NPU 调度实现可以使用的配置:
PackageManager.FEATURE_NEURAL_PROCESSING_UNIT
                    │
                    ▼
packages/modules/NpuManager
  PriorityManager 读取 targetSdk 与 reqFeatures
                    │
                    ▼
android.hardware.npu.SchedulingConfig
  uid / priority / hasDirectAccess / canAttributeOtherUid
                    │
                    ▼
android.hardware.npu.IScheduling
  setSchedulingConfigs() / updateSchedulingConfigs()
                    │
                    ▼
厂商 NPU 调度实现
在这条流程中,SchedulingConfig 同时携带身份、优先级和直接访问资格。在 android-17.0.0_r1 中,PriorityManager.createPriorityInfo() 会对 targetSdkVersion >= Build.VERSION_CODES.CINNAMON_BUN 的应用检查 NPU feature;相应 feature flag 启用时,缺少声明会使 SchedulingConfig.hasDirectAccess 变为 false。应用包更新后,onPackageModified() 还会重新判断目标 SDK 与 feature,并更新直接访问状态。
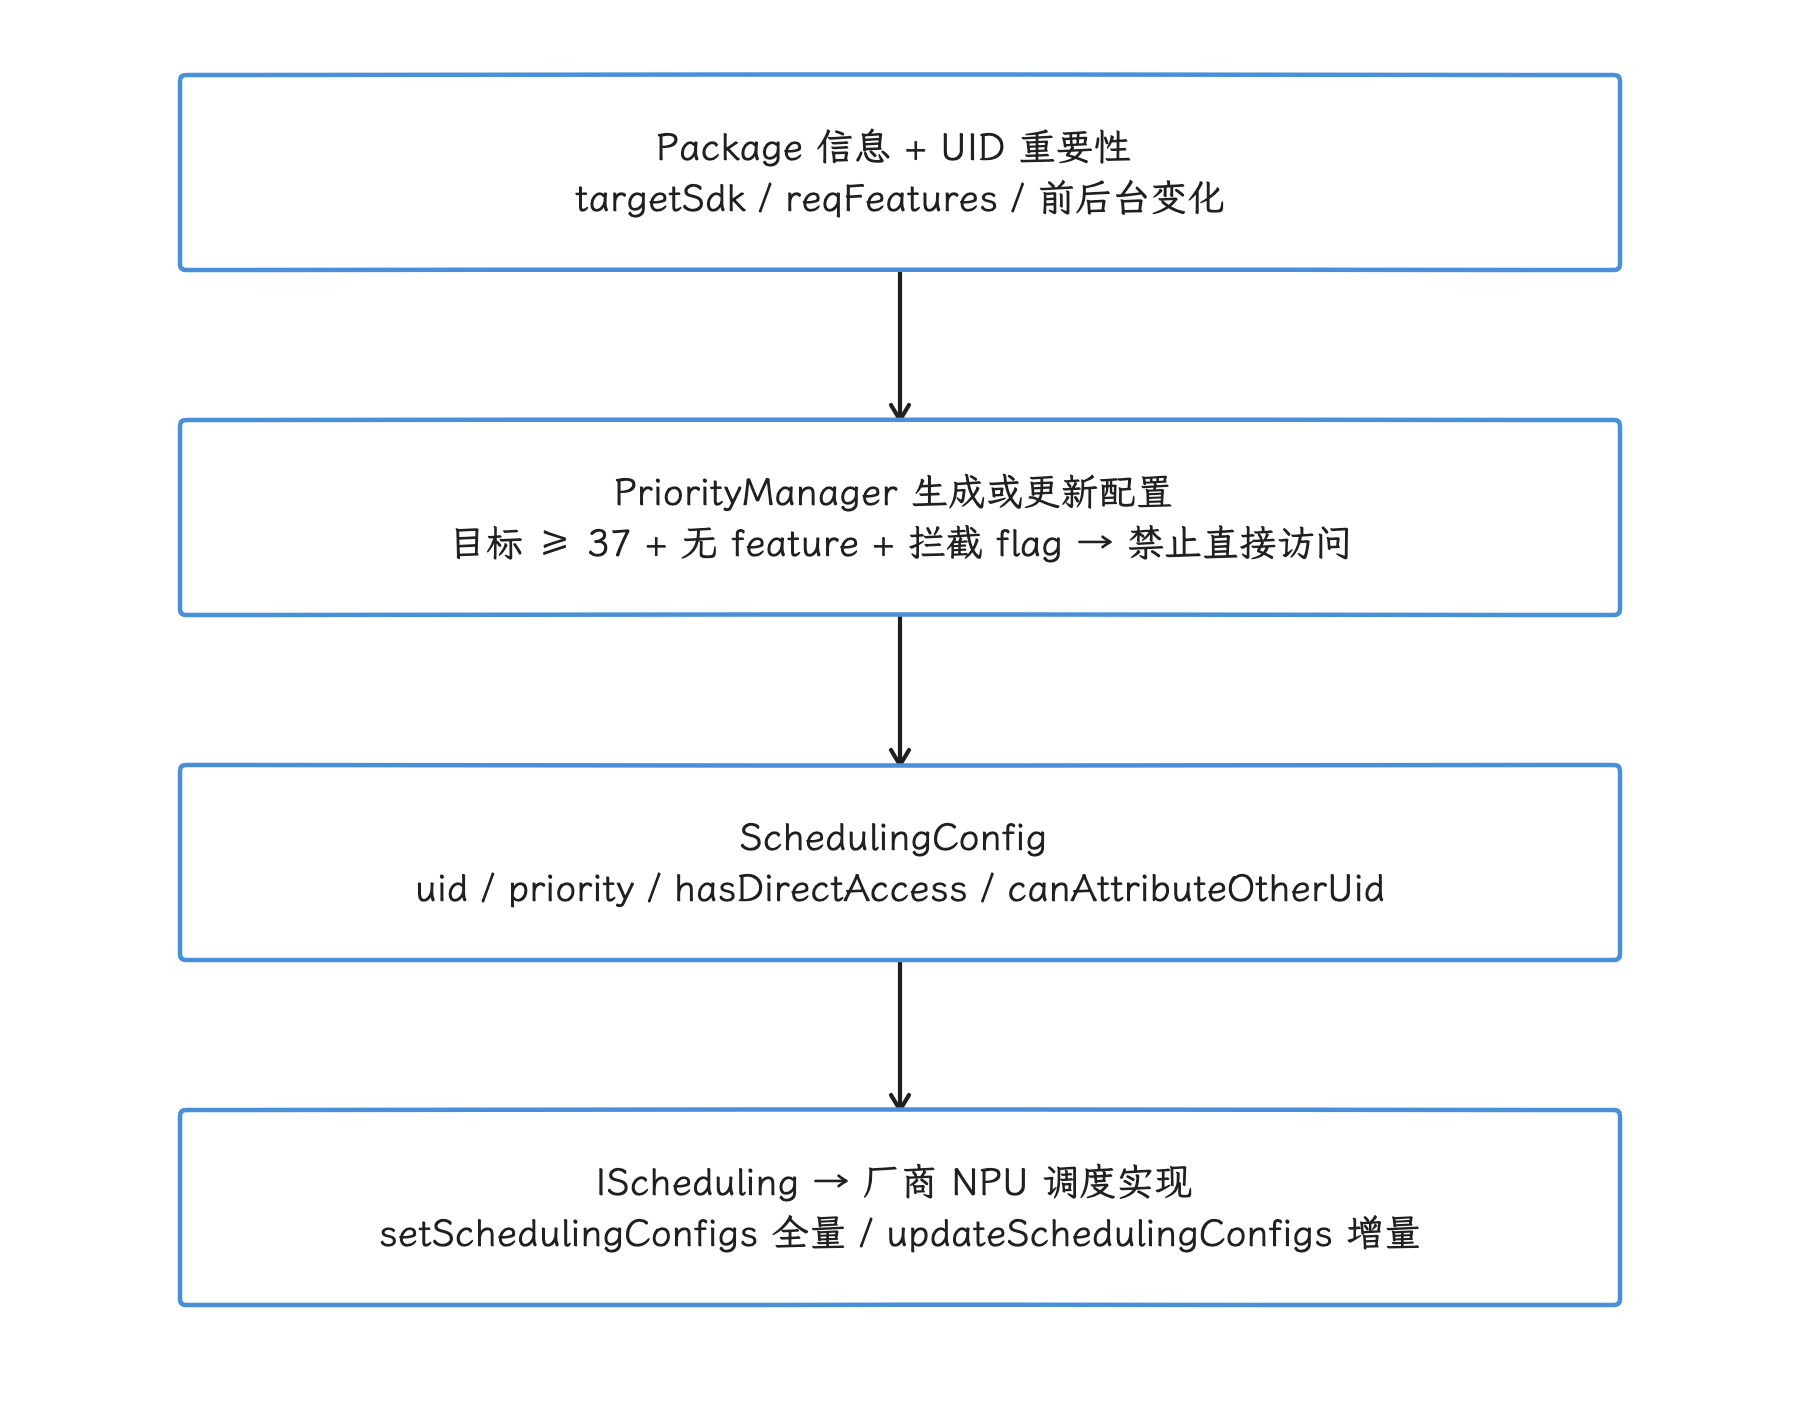
图:图中是 android-17.0.0_r1 的控制路径。服务、拦截开关及 HAL 实现参与生效;priority 数字越小越高,但只是尽力调度,不保证固定延迟或独占时间片。
hardware/interfaces/npu/aidl/android/hardware/npu/SchedulingConfig.aidl 定义了四个关键字段:
uid:应用的 Linux UID;priority:UID 级优先级,数值越小优先级越高;hasDirectAccess:该 UID 能否直接在 NPU 上执行;canAttributeOtherUid:中介服务能否将工作归因到另一个 UID。
IScheduling 以完整表格或增量更新的方式将配置交给 NPU,还可以注册调度事件回调。HAL 文档要求厂商尽力遵循优先级,但硬件能力仍可能限制实际执行顺序。该接口不向应用承诺固定延迟或专属 NPU 时间片。
SchedulingConfig 还明确区分直接访问与中介访问:hasDirectAccess=false 的应用失去直接执行 NPU 工作的资格,但仍可能通过获准的中介服务请求能力,这与 release notes 使用的“directly access”一致。调用系统托管的 AI 服务和在应用进程内加载厂商 NPU runtime 是两种访问方式,各自遵循各自文档,manifest 里得出的结论照搬过去会出错。
Android 17 的兼容性测试套件(Compatibility Test Suite,CTS)为 NpuManager 提供了两类缺少 feature 的测试:
- 通过 NNAPI 路径运行推理应失败;
- 通过测试用 LiteRT / 厂商 delegate 路径直接运行推理也应失败。
这些测试证明系统控制层覆盖多种直接访问路径;至于上层库会抛哪种异常、会不会自动改用 CPU / GPU,规范里并没有规定,应用仍要按运行时文档配置 fallback,并记录最终选中的加速器。
NpuManager 的系统管理职责边界
packages/modules/NpuManager/framework/java/android/npumanager/NpuManager.java 容易因名称而被误认为应用侧推理入口。Android 17 的 API 签名显示:
NpuManager是受功能开关控制的系统 API(flagged@SystemApi);- 模型装载请求受
ACCESS_NPU_MODEL_MANAGER_API权限保护; - 接口用于协调模型能否加载、卸载(model load / unload)通知、模型大小和加载策略;
- 公共 SDK 没有借此获得提交张量或执行模型的通用接口。
NpuManager 的模型加载策略用于管理共享 NPU 资源:它可以根据普通 / 后台优先级、模型大小和预算,决定某个模型当前能否加载,或请求已经加载的模型释放资源。普通应用把这些 @SystemApi 当公共 SDK 调用是行不通的。
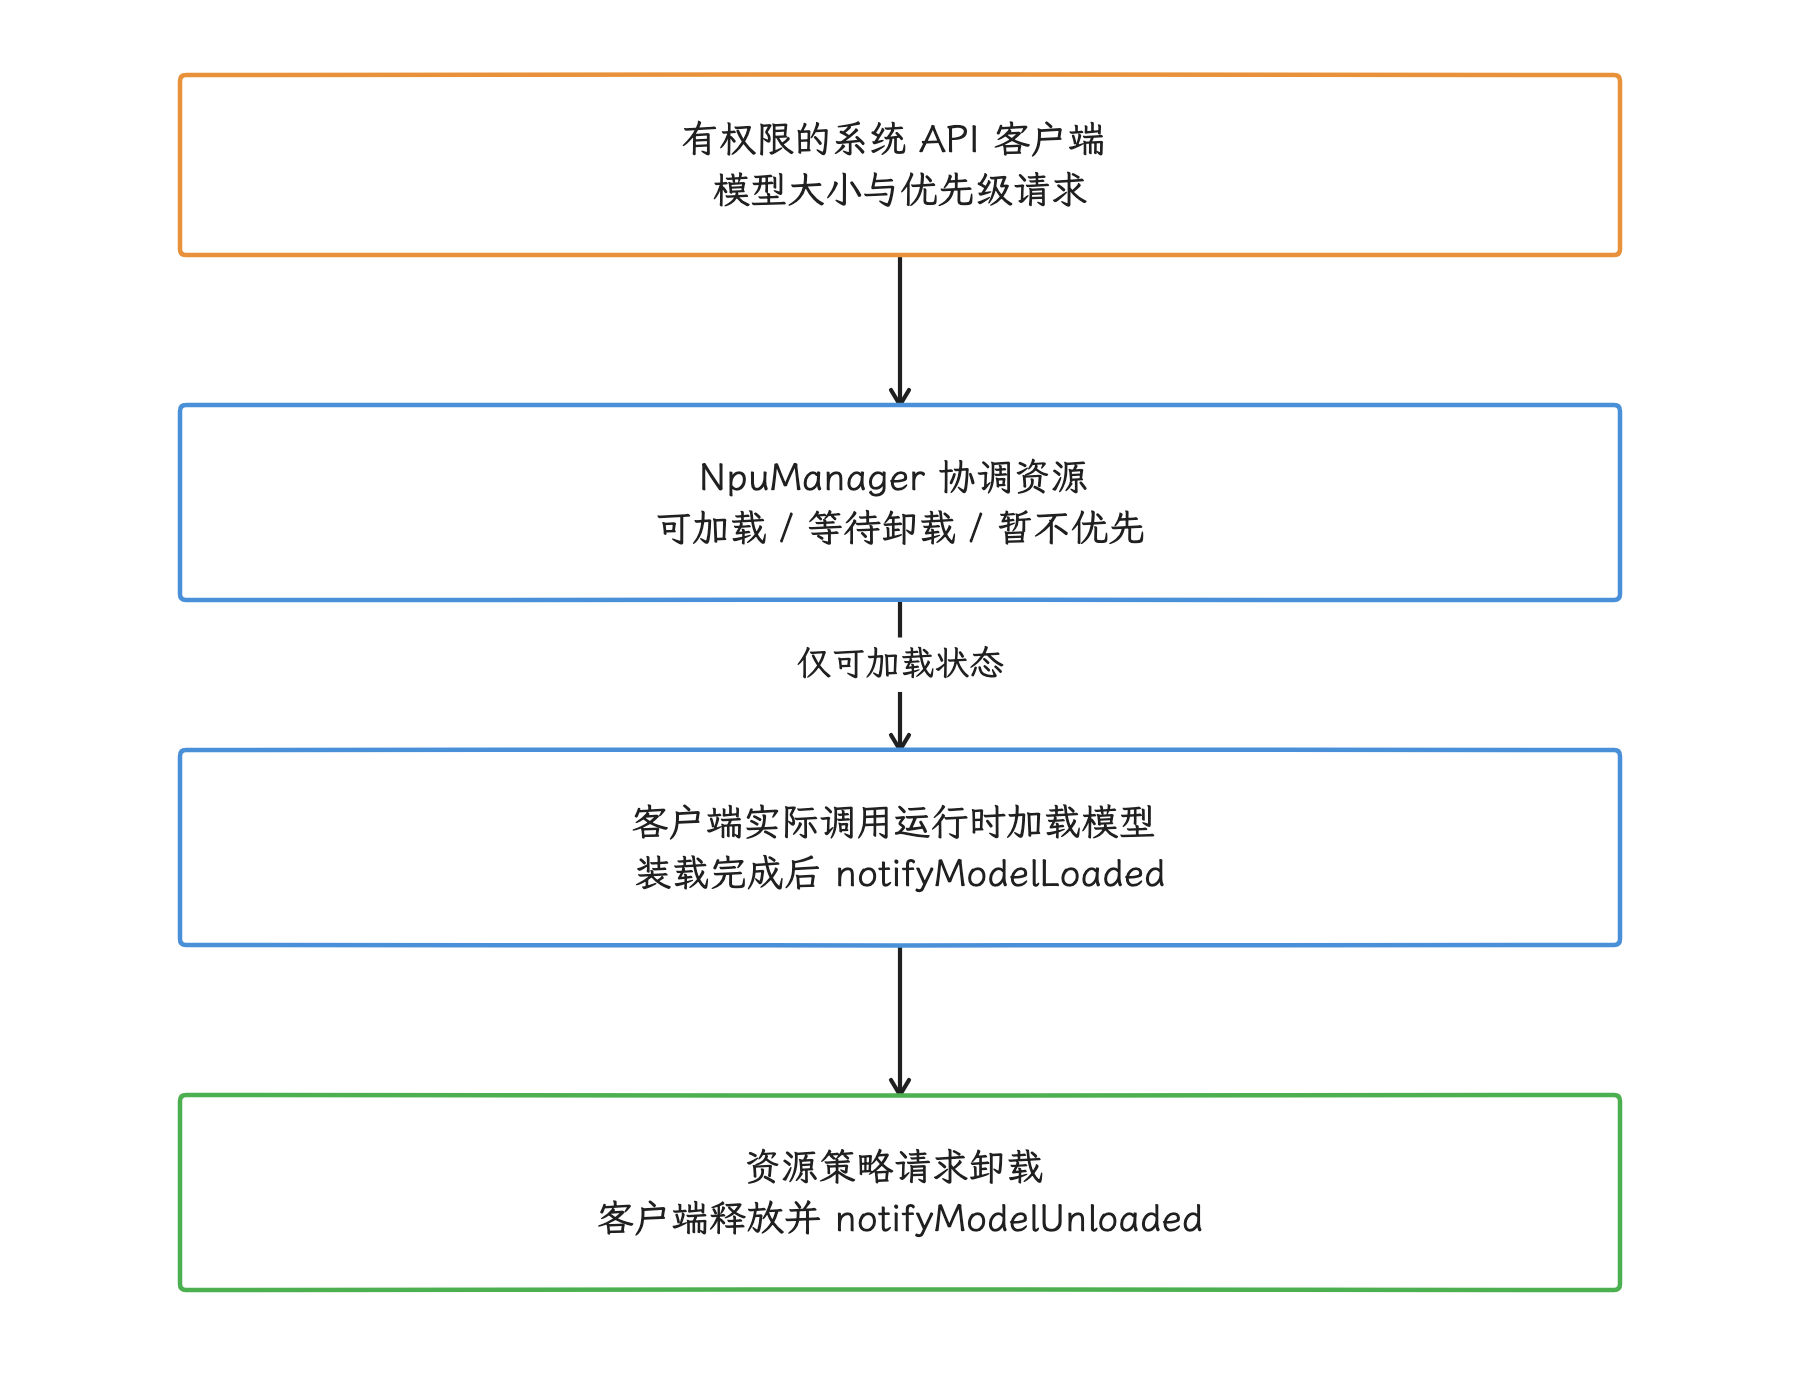
图:NpuManager 是受 flag 和权限保护的 @SystemApi。状态回调协调是否装载与何时释放,模型加载和执行仍由客户端运行时完成。
同样,android.hardware.npu.IScheduling 是系统与 NPU 实现之间的稳定 AIDL HAL。普通应用既配置不了 UID 优先级,也注册不了该 HAL 的调度回调;应用可见的稳定入口仍来自 LiteRT、厂商公开 SDK 或系统服务文档。
LiteRT CompiledModel 的执行边界
LiteRT 由 Google AI Edge 独立发布,版本与 AOSP 的 android-17.0.0_r1 并不固定在一起。当前官方文档将 CompiledModel 作为 Android 上面向 CPU、GPU、NPU 的现代推理 API,Interpreter 继续承担兼容路径。工程记录里,下面这些版本要逐项固定:
- Android build 与目标 / 编译 SDK;
- LiteRT Maven/C++ 版本;
- 模型文件哈希和量化格式;
- NPU compiler plugin、dispatch library 和厂商 runtime 版本;
- 设备 SoC、固件和驱动版本。
创建模型前先选择可用产物
使用 NPU 不只是把 Accelerator.CPU 改成 Accelerator.NPU:官方示例先按 SoC 兼容性选择模型产物和 runtime,再创建 CompiledModel。这两个决定的先后顺序如下:
设备 feature 与 NPU compatibility
              │
              ├─ 选择 AOT AI Pack 中匹配的模型
              │
              └─ 或选择设备侧编译使用的原始模型
                         │
                         ▼
Environment + NPU runtime/compiler libraries
                         │
                         ▼
CompiledModel.Options(NPU, fallback...)
                         │
                         ▼
createInputBuffers / createOutputBuffers / run
流程中的 ModelSelector、AiPackModelProvider 和 NpuCompatibilityChecker 负责匹配模型产物与设备;CompiledModel.Options 描述候选 accelerator。模型产物选择与执行后端选择虽然相邻,仍是两个不同决定,需要分别记录。
Fallback 的配置与验证
LiteRT NPU 文档支持在 CompiledModel.Options 中同时给出 NPU 与 CPU / GPU,使 NPU 不可用时可以选择后备硬件;AOT 模型也支持后备路径。官方还说明,不受 NPU 支持的子图可以部分交给 CPU / GPU 执行。
回退未必保得住精度和性能。需要验证:
- fallback 模型产物是否包含 CPU / GPU 可执行部分;
- 候选 accelerator 的次序与当前 LiteRT 版本语义;
- NPU 子图与 CPU / GPU 子图之间有多少同步和复制;
- NPU 编译失败、runtime 库缺失、执行失败分别会走哪条路径;
- fallback 后的精度、延迟、内存和温度是否仍满足要求。
为了让线上数据可以解释,至少要记录“请求的 accelerator 集合”和“最终使用的后端 / 子图分布”;只记一个 hasNpuFeature=true,说明不了一次请求真的在 NPU 上完成。
Buffer 与零复制
CompiledModel 会根据模型和后端创建输入输出缓冲区 TensorBuffer,官方 NPU 文档还给出基于 AHardwareBuffer 的零复制示例。零复制要求数据生产者、消费者、数据布局、同步 fence 和执行后端都支持同一种 buffer;将 Java 数组写入 NPU buffer,执行后再由 CPU 读回,数据传输仍然发生。
相机、GPU 预处理与 NPU 依次连接时,应测量完整管线,包括容易遗漏的缓冲区获取、同步和释放阶段:
camera / GPU producer
        → buffer acquire 与 fence wait
        → NPU inference
        → output consumer
        → buffer release
这条管线表明,只报告 NPU kernel 时间会遗漏格式转换、cache 维护、同步和 CPU 后处理。
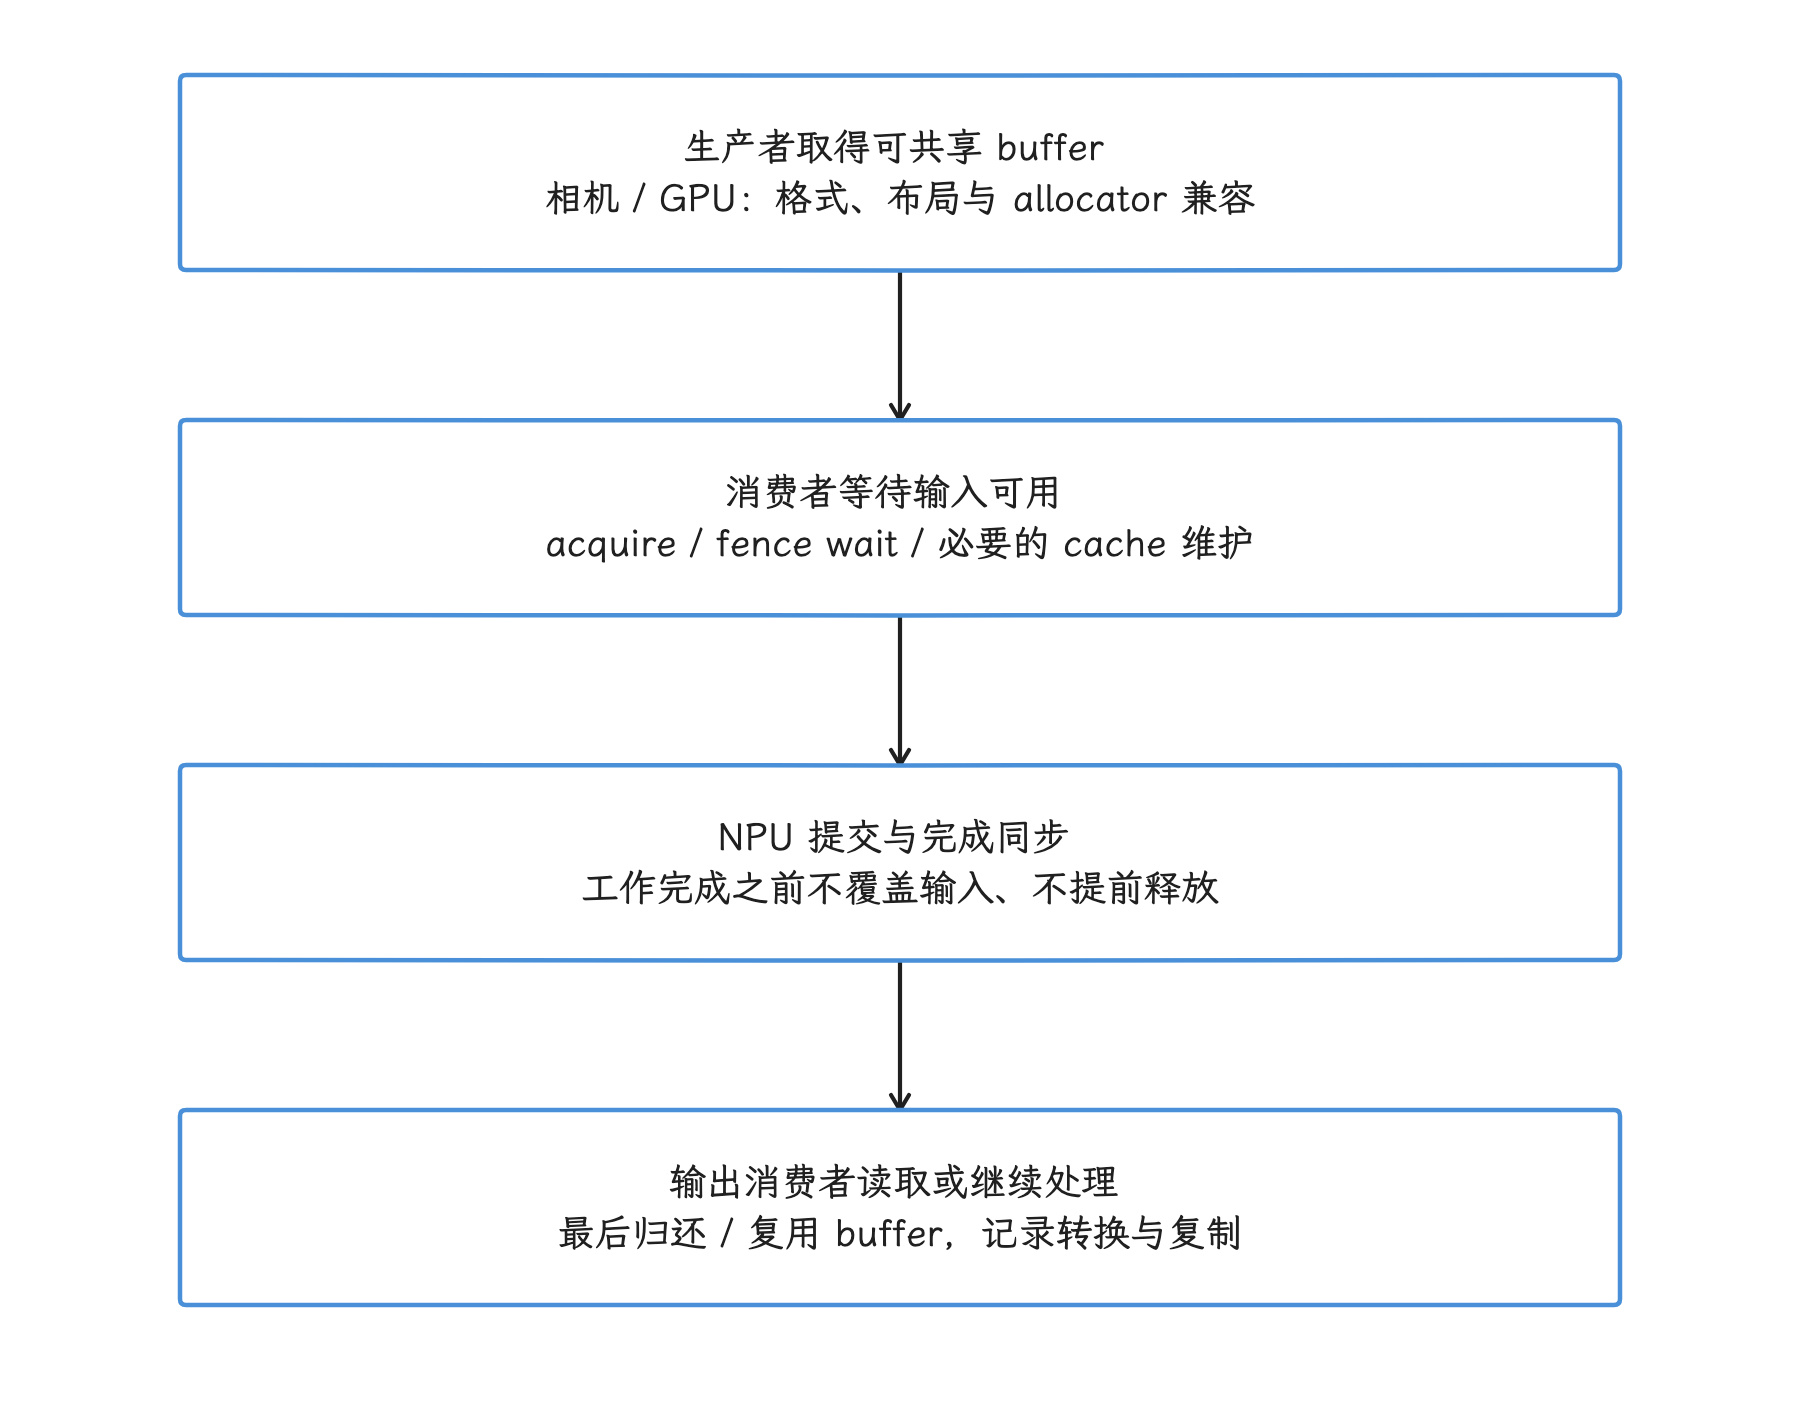
图:同一 buffer 对象不保证驱动内部无复制。CPU 数组写入或读回仍有数据传输,完整成本还包含获取、等待、转换和释放。
AOT、设备侧编译与分发
LiteRT NPU 文档将编译分成 AOT 和设备侧 JIT 两类:
| 路径 | 适用条件 | 首次运行成本 | 分发成本 |
|---|---|---|---|
| AOT / 离线编译(offline compilation) | 目标 SoC 已知,模型较大或初始化预算紧 | 可跳过大部分设备侧编译 | 要为不同 SoC / 版本准备匹配产物 |
| 设备侧 / JIT 编译(on-device / JIT compilation) | 希望分发较通用的原始模型,设备后端支持 JIT | 首次初始化会消耗时间与内存 | 产物准备较少,但需携带编译器 / 运行时(compiler / runtime) |
| JIT 编译缓存(compilation cache) | 模型、compiler、系统构建指纹(build fingerprint)和选项稳定 | 命中时减少重复编译 | 需要应用私有可写目录和缓存失效管理 |
官方文档指出,AOT 更适合目标 SoC 已知的大模型,可以降低启动时的编译成本和内存压力。AOT 仍可能需要读取模型文件、校验产物、加载 runtime、分配 buffer 和执行首轮预热,把它描述成“无需初始化”并不成立。
设备侧编译的缓存键至少会受到模型、厂商 compiler plugin、Android build fingerprint(精确标识系统构建的字符串) 和编译选项影响。应用升级、系统 OTA 或模型替换后出现新的编译峰值,可能是缓存正常失效;要把 cache miss 的原因写进诊断日志。
Play AI Pack(按设备交付 AI 模型的资源包) 与 runtime library 是两类产物
当前官方流程将它们分开:
- AOT 编译模型可导出为 Play AI Pack(按设备交付模型的资源包),由 Google Play 向目标设备交付匹配模型;
- NPU runtime library 通过 Play Feature Delivery(按需交付功能模块)分发;
- 按当前文档,LiteRT 2.3.0 起 NPU 库以 Maven 包提供;旧的
litert_npu_runtime_libraries.zip只适用于 2.3.0 之前的 release。Maven 解决构建依赖,PFD 解决设备侧模块交付,两者不是替代关系; - JIT 路径将原始
.tflite放入应用,并提供对应 compiler / runtime library。
AI Pack 可以采用 install-time、fast-follow 或 on-demand 等交付方式,具体能力以 Play for On-device AI 文档为准。on-demand 可以减小首次安装下载量,但会增加首次进入功能时的网络等待和失败路径;应用应把“模型尚未下载”与“NPU 编译或执行失败”区分呈现。
Google Play 交付不覆盖所有渠道。没有 GMS 的设备或其他应用商店需要独立方案,例如:
- 在 APK / App Bundle 中携带适配产物;
- 自有下载服务按设备安全交付;
- 设备侧编译;
- 回退到可随应用分发的 CPU/GPU 路径。
多渠道方案还要检查模型许可、厂商 runtime 再分发条款、动态代码 / 原生库政策、完整性校验和磁盘配额。
各 NPU 后端的公开支持
当前 LiteRT NPU 文档列出的能力各不相同,一句话“Android NPU 都支持 AOT 和 JIT”概括不了它们:
| 后端 | CompiledModel 文档能力 | 需要额外确认 |
|---|---|---|
| Google Tensor | AOT 执行;Google Tensor SDK 处于 Beta,当前公开页只列 AOT,未把 Google Tensor 写入设备侧编译支持项 | 支持的 Tensor 代际、模型产物和 AI Pack |
| Qualcomm AI Engine Direct | AOT 与设备侧编译 | Qualcomm Neural Network(QNN)/ Hexagon Tensor Processor(HTP)版本、支持的 SoC 与算子 |
| MediaTek NeuroPilot | AOT 与设备侧编译 | 支持的 Dimensity SoC、runtime 与算子 |
| Samsung Exynos AI LiteCore | AOT 与设备侧编译 | 公开兼容列表和 runtime 版本 |
| Intel OpenVINO | AOT 与设备侧编译 | Android / 目标平台覆盖和模型限制 |
这些列表会随 LiteRT release 更新,Android 17 平台版本替代不了它。发布前应保存所用文档日期或 release、兼容性查询结果和测试设备信息。
Google Tensor 的逐层验证
对于 Google Tensor 设备,当前可核实的公开结论是:LiteRT NPU 文档支持通过 CompiledModel 执行 AOT 产物,并提供使用 NpuCompatibilityChecker.GoogleTensor 匹配设备的示例;设备侧编译没有出现在 Google Tensor 当前公开支持项中。
仍需按下面四层逐项验证:
- 设备是否声明
android.hardware.npu; - LiteRT compatibility checker 是否接受该设备;
- AI Pack 是否已交付适配相应 Tensor 代际的模型产物;
- 运行时是否成功加载 NPU 调度分发库(dispatch library) / 运行时(dispatch / runtime),并按预期执行或回退。
芯片名称、营销材料和 hasSystemFeature() 都顶替不了这四项检查。AICore 或其他系统托管模型服务也有独立的设备、地区、模型与更新条件,与应用内嵌 LiteRT 的 NPU 后端并不是一回事。
NNAPI、Neural Networks HAL 与 NPU scheduling HAL
Android 17 里同时存在名字相近、职责不同的接口,我们把它们逐个分开看。
NNAPI NDK API 已进入弃用期
NNAPI 的 NDK API 从 Android 15 起标记为弃用(deprecated):新项目别再把它当作长期主路径,但 Android 17 并未删除 NNAPI,已发布应用也不会立即失效(背景、源码保留情况和迁移方向见「NNAPI 的源码保留与迁移方向」一节)。
这里要分的是层次:NNAPI NDK API 是应用通过 NDK 调用的 C API,而下面两套 HAL 分别面向 NNAPI Runtime / 厂商驱动和系统 NPU 调度,都不面向普通应用。
迁移时应保留旧设备的对照基线,并验证 LiteRT 在 CPU、GPU、NPU 上的结果与精度;只替换 API 名称是不够的。
Neural Networks HAL 继续存在
官方 NNAPI Runtime 文档明确说明:
- Android 11 及以下使用 HIDL 定义的 HAL 版本;
- Android 12 及以上的 NNAPI HAL 修订版(revision)使用 AIDL;
- NNAPI NDK API 弃用不影响 Neural Networks HAL 和驱动支持。
在 android-17.0.0_r1 中:
- 历史 HIDL 1.3 位于
hardware/interfaces/neuralnetworks/1.3/; - 当前 AIDL 位于
hardware/interfaces/neuralnetworks/aidl/; - 冻结 AIDL API 目录包含版本 1~4;
- 当前接口仍有
IDevice.getSupportedOperations()、模型 preparation、compilation cache、device buffer、同步 / 围栏执行; - AIDL v4 还包含
ExecutionConfig、IExecution和接收 config 的执行入口。
这些接口面向 NNAPI Runtime 与厂商驱动(vendor driver),普通应用不要把 AIDL IDevice 当公共 SDK 用。
NPU scheduling HAL 的调度身份与生命周期
Android 17 新增的 hardware/interfaces/npu/aidl/ 提供 IScheduling、SchedulingConfig、WorkInfo 和回调。它传递 UID 优先级、直接访问资格、归因和工作开始 / 结束事件,但不定义模型图、tensor、算子或编译。
下面的对照概括两套 HAL 分别管理的对象:
Neural Networks HAL
  关注:model / operation / prepared model / execution / buffer

NPU scheduling HAL
  关注:UID / priority / direct access / attribution / work lifecycle
这段对照可以这样记:Neural Networks HAL 管理模型执行对象,NPU scheduling HAL 管理身份和工作生命周期。LiteRT NPU 还可能使用厂商 compiler plugin、dispatch library 和 runtime,不保证经过 Neural Networks HAL;但只要直接向受 Android 17 控制的 NPU 提交工作,仍需满足 android.hardware.npu 声明要求。
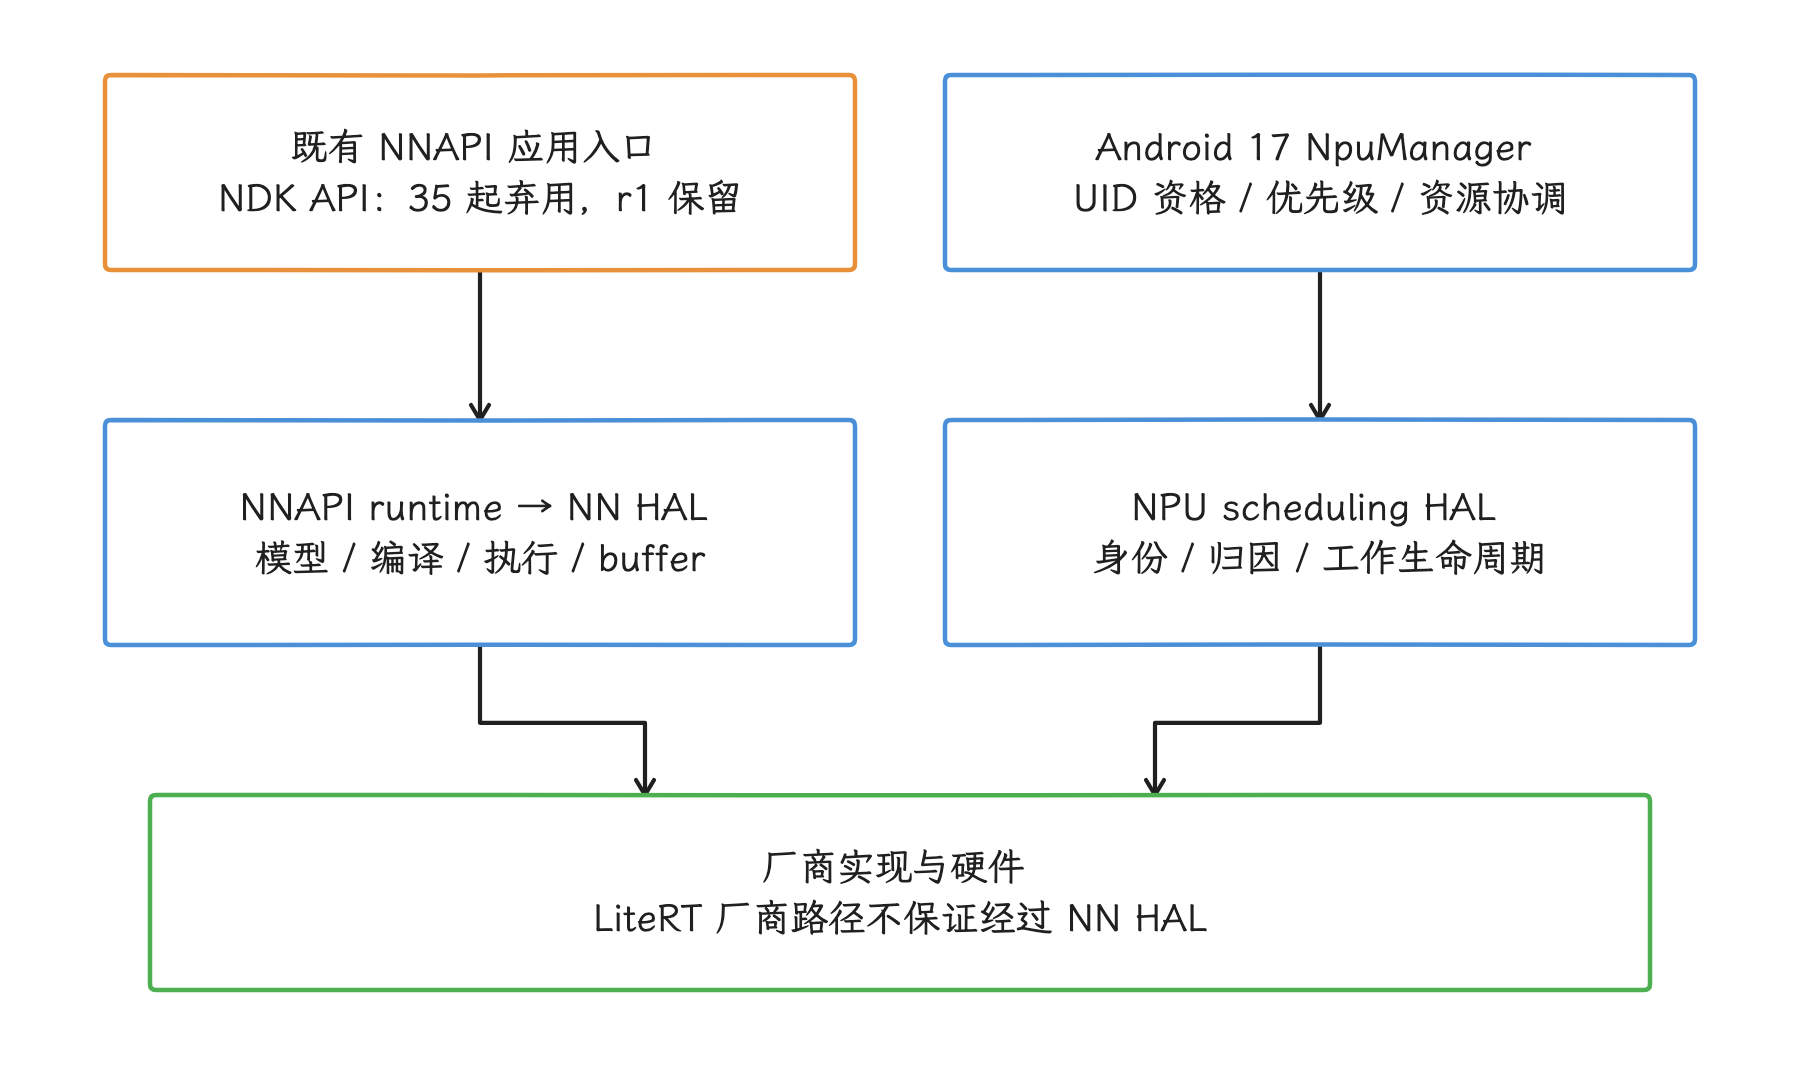
图:NNAPI NDK 弃用没有删除 NN HAL;新 NPU scheduling HAL 传递 UID 与工作状态,没有模型图或张量执行入口。两条链可在设备上并存。
部分委托(Partial delegation)的收益与代价
LiteRT 官方 NPU 路径支持将未被 NPU 接收的子图交给 CPU / GPU。部分委托(partial delegation)可以提高模型兼容性,也会增加不同后端交界处的成本:
- 子图切换需要调度与同步;
- 不同后端的 tensor layout 可能触发转换;
- 中间 buffer 可能在 CPU、GPU、NPU 可访问的内存之间复制;
- 短小 NPU 子图的加速时间可能小于切换成本;
- CPU / GPU fallback 会重新占用原本希望节省的功耗与散热预算。
评估时至少记录:
- NPU、GPU、CPU 各自执行的子图或算子数;
- 编译警告与不支持的算子;
- 中间 buffer 大小和复制次数;
- 端到端延迟,而非单个 NPU 子图时间;
- fallback 发生率和触发原因;
- 结果精度与确定性。
如果运行时没有公开子图分布,结论就写到“请求 NPU 并成功完成”为止,再用运行时日志和系统信号补充推断依据;“模型完整运行在 NPU”这样的表述,等拿到直接记录再写不迟。
性能、内存与功耗验证
只有端到端指标改善,模型使用 NPU 才具有产品价值。建议将实验分成初始化和稳态两部分。
| 指标 | 测量边界 | 常见问题 |
|---|---|---|
| 模型可用时间 | 请求下载到产物可加载 | AI Pack 未交付、磁盘不足、校验失败 |
| 编译 / 加载时间 | 创建运行环境(environment)到 CompiledModel 可用 | JIT 未命中缓存(cache miss)、runtime 加载、AOT 不匹配 |
| 首次推理 | buffer 准备到第一份结果 | 首轮预热、内存页、后端初始化 |
| 稳态延迟 | 固定输入、多次执行 | 调度波动、复制、partial delegation |
| LLM TTFT / TPOT | 按 5.6 节的 token 边界 | prefill / decode 后端不同、KV cache 增长 |
| 峰值内存 | 初始化和执行阶段分别采集 | 编译器工作区(compiler workspace)、tensor、cache、重复模型 |
| 请求能量 | 同一供电与屏幕条件下积分 | 整机基线、USB 充电、后台任务 |
| 持续性能 | 运行到温度和频率趋于稳定 | 热限制(thermal clamp)、共享 NPU 竞争 |
Trace 能看到什么
Perfetto 通常可以稳定采集应用 slice、CPU 调度、CPU 频率、进程内存与部分电源 / 温度信号。GPU、NPU、互连和内存频率轨道(track)依赖设备与厂商数据源;没有 NPU track 时,可以联合观察:
- 应用标注的编译 / 运行(compile / run)slice;
- LiteRT 或厂商 runtime 日志;
- CPU/GPU 执行时间与频率;
- PowerStats 可用的能量消费者或 power rail;
- thermal status / headroom;
- 输出回调时间。
这些信号可以支撑推断,但要断言“模型在用 NPU”,还要有直接记录;“CPU 利用率下降”单独当依据太弱,整机电流也当不了 NPU 部件功耗。
稳态测试与共享资源
NPU 可能由系统模型服务、相机、语音或其他应用共享,测试应包含单请求、并发请求、前后台切换和持续运行。Android 17 的 scheduling HAL 支持 UID 级优先级和工作生命周期回调,第三方应用想借它自行设置最高优先级,这条路走不通。
持续测试需要运行到 token / 帧延迟、温度和频率上限呈现稳定趋势,并按时间窗口报告。固定写“运行 3 分钟”或“运行 10 分钟”覆盖不了所有设备;终止条件和环境温度应写入报告。
后台执行边界
NPU feature 只描述设备能力与访问资格,不会授予应用额外的后台执行机会。JobScheduler、WorkManager、前台服务、Doze、App Standby 和电池策略仍会决定任务何时运行、能运行多久。
按用户意图选择执行方式:
- 用户正在等待的即时推理,应与可见界面和取消操作绑定;
- 允许延迟的摘要、索引或批处理,使用 JobScheduler / WorkManager 约束;
- 体积大的模型下载交给合适的下载和存储管理组件;
- 高温、低电量或后台受限时,减少并发、缩小模型或推迟非必要任务。
系统中介服务能否代应用访问 NPU,取决于该服务的公共 API 约定、配额和归因规则。不要因为 SchedulingConfig 包含 canAttributeOtherUid,就推断任意应用都能借 Binder 服务绕过 feature 要求。
从 TFLite / NNAPI 迁移到 LiteRT
迁移前先保存可比较的旧路径基线:
| 检查项 | 迁移前要记录 | LiteRT 路径要验证 |
|---|---|---|
| 模型 | 文件哈希、输入形状、量化 | 转换后精度和支持的 op |
| CPU | 线程数、XNNPACK(LiteRT 的优化 CPU 后端)、CPU 亲和性 | CompiledModel CPU 基线 |
| GPU | delegate 配置、缓存、精度 | GPU 后端(backend)与渲染竞争 |
| NNAPI | 设备选择、fallback、缓存 | NPU / CPU / GPU 候选和失败处理 |
| 冷启动 | 加载、编译、预热 | AOT / JIT / cache 分段 |
| 内存 | 权重、工作区(workspace)、tensor | 编译器(compiler)峰值与 buffer 生命周期 |
| 分发 | APK、动态模块、渠道 | AI Pack、Play Feature Delivery(PFD)与非 Play 方案 |
| 可观测性 | 旧日志和 trace | 最终 accelerator、子图分布、错误码 |
推荐按以下顺序迁移:
- 用 LiteRT CPU 路径复现旧 CPU 路径的正确性和性能;
- 加入 GPU,验证算子覆盖、精度和 UI 渲染竞争;
- 对兼容设备加入 NPU feature、runtime 与模型产物;
- 明确配置
CompiledModel.Options的 fallback; - 分开测 AOT、JIT 首次编译和缓存命中;
- 做持续功耗、温控、后台与并发测试;
- 最终决定哪些设备启用 NPU,哪些设备保留 GPU / CPU。
如果目标是缩短首次结果等待时间,就重点比较模型交付、编译和预热;如果目标是降低持续功耗,就比较稳态下的请求能量、温度和吞吐。单个平均延迟值回答不了这两个问题。
发布前检查清单
-
目标 API 37 的直接 NPU 访问路径声明了
android.hardware.npu; -
required与产品的安装范围一致; - 运行时同时检查设备 feature、SoC 兼容性和模型编译结果;
- Android build、LiteRT、runtime、compiler、模型与 SoC 版本均可追溯;
-
NpuManager没有被写成普通应用推理 API; - NPU scheduling HAL 与 Neural Networks HAL 的职责已分开;
- AOT、JIT 和缓存命中的初始化时间分别记录;
- AI Pack 与 NPU runtime library 的分发方式分别记录;
- Google Tensor、Qualcomm、MediaTek 等后端按各自文档写清适用范围;
- fallback 与 partial delegation 有运行时记录;
- 端到端 latency 包含复制、同步、预处理和后处理;
- 功耗结论包含供电、屏幕、温度与持续时间;
- 无 GMS 或非 Play 渠道有替代模型 / runtime 交付方案;
- NNAPI 弃用没有被写成 HAL 或驱动已删除。
Android 17 源码索引
以下路径均已逐一复核:
frameworks/base/core/java/android/content/pm/PackageManager.javaFEATURE_NEURAL_PROCESSING_UNIT
packages/modules/NpuManager/service/java/com/android/server/npumanager/PriorityManager.javacreatePriorityInfo()doesPackageUseNpuFeature()onPackageModified()
packages/modules/NpuManager/framework/java/android/npumanager/NpuManager.java- flagged
@SystemApi模型加载协调接口
- flagged
packages/modules/NpuManager/tests/cts/cts_npu_manager_test.py- 有 / 无 NPU feature 时的 NNAPI 与 delegate 访问测试
hardware/interfaces/npu/aidl/android/hardware/npu/IScheduling.aidlSchedulingConfig.aidlWorkInfo.aidlISchedulingCallback.aidl
hardware/interfaces/neuralnetworks/aidl/android/hardware/neuralnetworks/IDevice.aidlIPreparedModel.aidlIExecution.aidlExecutionConfig.aidl
hardware/interfaces/neuralnetworks/1.3/- Android 11 及以下 HIDL 历史接口
系统托管 GenAI 与资源竞争
系统托管模型把下载、调度和隔离进一步交给平台服务;我们设计功能时要按公开能力和配额准备降级,独占 NPU、内存或温度预算的设想在这条路径上站不住脚。
在 Android 17 / API 37 上讨论端侧 GenAI(生成式 AI),先要分清“平台版本”和“模型服务版本”:Android 17 决定 App 可以使用哪些系统 API,AICore、Gemini Nano 模型和 ML Kit GenAI 库仍可独立更新,同一台设备上的模型版本、支持能力和下载状态都可能变化。因此,SDK_INT >= 37 替代不了运行时能力检测。
当前面向应用的入口是 ML Kit GenAI APIs:摘要、校对、改写、图片描述和语音识别等场景优先使用专用 API,需要自定义文本或多模态提示词时使用 Prompt API,这些 API 通过 AICore 调用 Gemini Nano。旧版 com.google.ai.edge.aicore 示例套不到当前 ML Kit API 上;早期公开资料使用的“Google Intelligence API”也不是现在的入口名称。
AICore 和 Gemini Nano 不随 Android 17 的 AOSP 标签发布,涉及它们的结论以公开 API 契约为准。进程名、Binder 次数、加速器选择、队列策略和 OOM 优先级这些公开文档没有说明的细节,一律当作实现细节看待。
先选清楚执行架构
端侧生成式 AI 常见的两条路径,资源归属和可控范围差别很大:
| 维度 | ML Kit GenAI + AICore | App 内 LiteRT-LM |
|---|---|---|
| 模型 | 系统管理并供多个 App 共享的 Gemini Nano | App 选择并管理的 .litertlm 模型文件 |
| 可用性 | 受设备、模型版本、功能配置和下载状态共同影响 | 受模型文件、ABI(应用二进制接口)、运行时和所选执行后端影响 |
| 硬件控制 | AICore 隐藏底层硬件接口,App 不指定具体 NPU/GPU 路径 | App 在运行时支持范围内选择 CPU、GPU 或 NPU 后端 |
| 存储与模型生命周期 | AICore 负责模型分发和更新 | App 负责下载、校验、存储、初始化与释放 |
| 内存观测 | App 进程指标只覆盖调用端分配,不能代表系统总开销 | 权重、KV cache(复用历史 token 注意力状态的缓存)、工作区等主要计入 App 进程或驱动分配 |
| 适合场景 | 支持设备上的标准能力、低接入成本、共享系统模型 | 自选模型、离线模型版本控制、专用后端和自定义推理流程 |
两条路径都在设备上执行,但工程责任并不相同。走 AICore 路径,我们要围绕“状态、配额、前台限制和端到端延迟”设计;走 LiteRT-LM 路径,还要自己负责模型文件、内存峰值、后端兼容,以及引擎关闭等资源生命周期工作。
Android 17 还包含受权限保护的 OnDeviceIntelligence(ODI)framework。ODI 由 OEM(设备厂商)提供管理 service 和隔离的推理 service,并通过 Feature、prepare/process/streaming request、数据补充回调与 InferenceInfo 组织系统级能力。它属于 @SystemApi 和特权应用的集成接口,普通 App 拿它替代 ML Kit GenAI 是行不通的;AICore 的模型、配额和设备支持契约也套不到 OEM 的 ODI provider 上。
ODI 的 system_server 逻辑会根据调用 UID 的前台 importance(进程重要性),建立带 BIND_SCHEDULE_LIKE_TOP_APP 标志的高优先级连接。这可以提高被绑定服务的进程调度地位,但由此推导不出一套按模型、token 或 deadline 排序的统一推理队列,也不会直接控制 NPU 频率。InferenceInfo 只记录 UID、开始/结束时间与暂停时长,不包含能量或加速器类型;OEM 要分析功耗归属,还要结合 runtime 和 SoC counter(硬件计数器)。
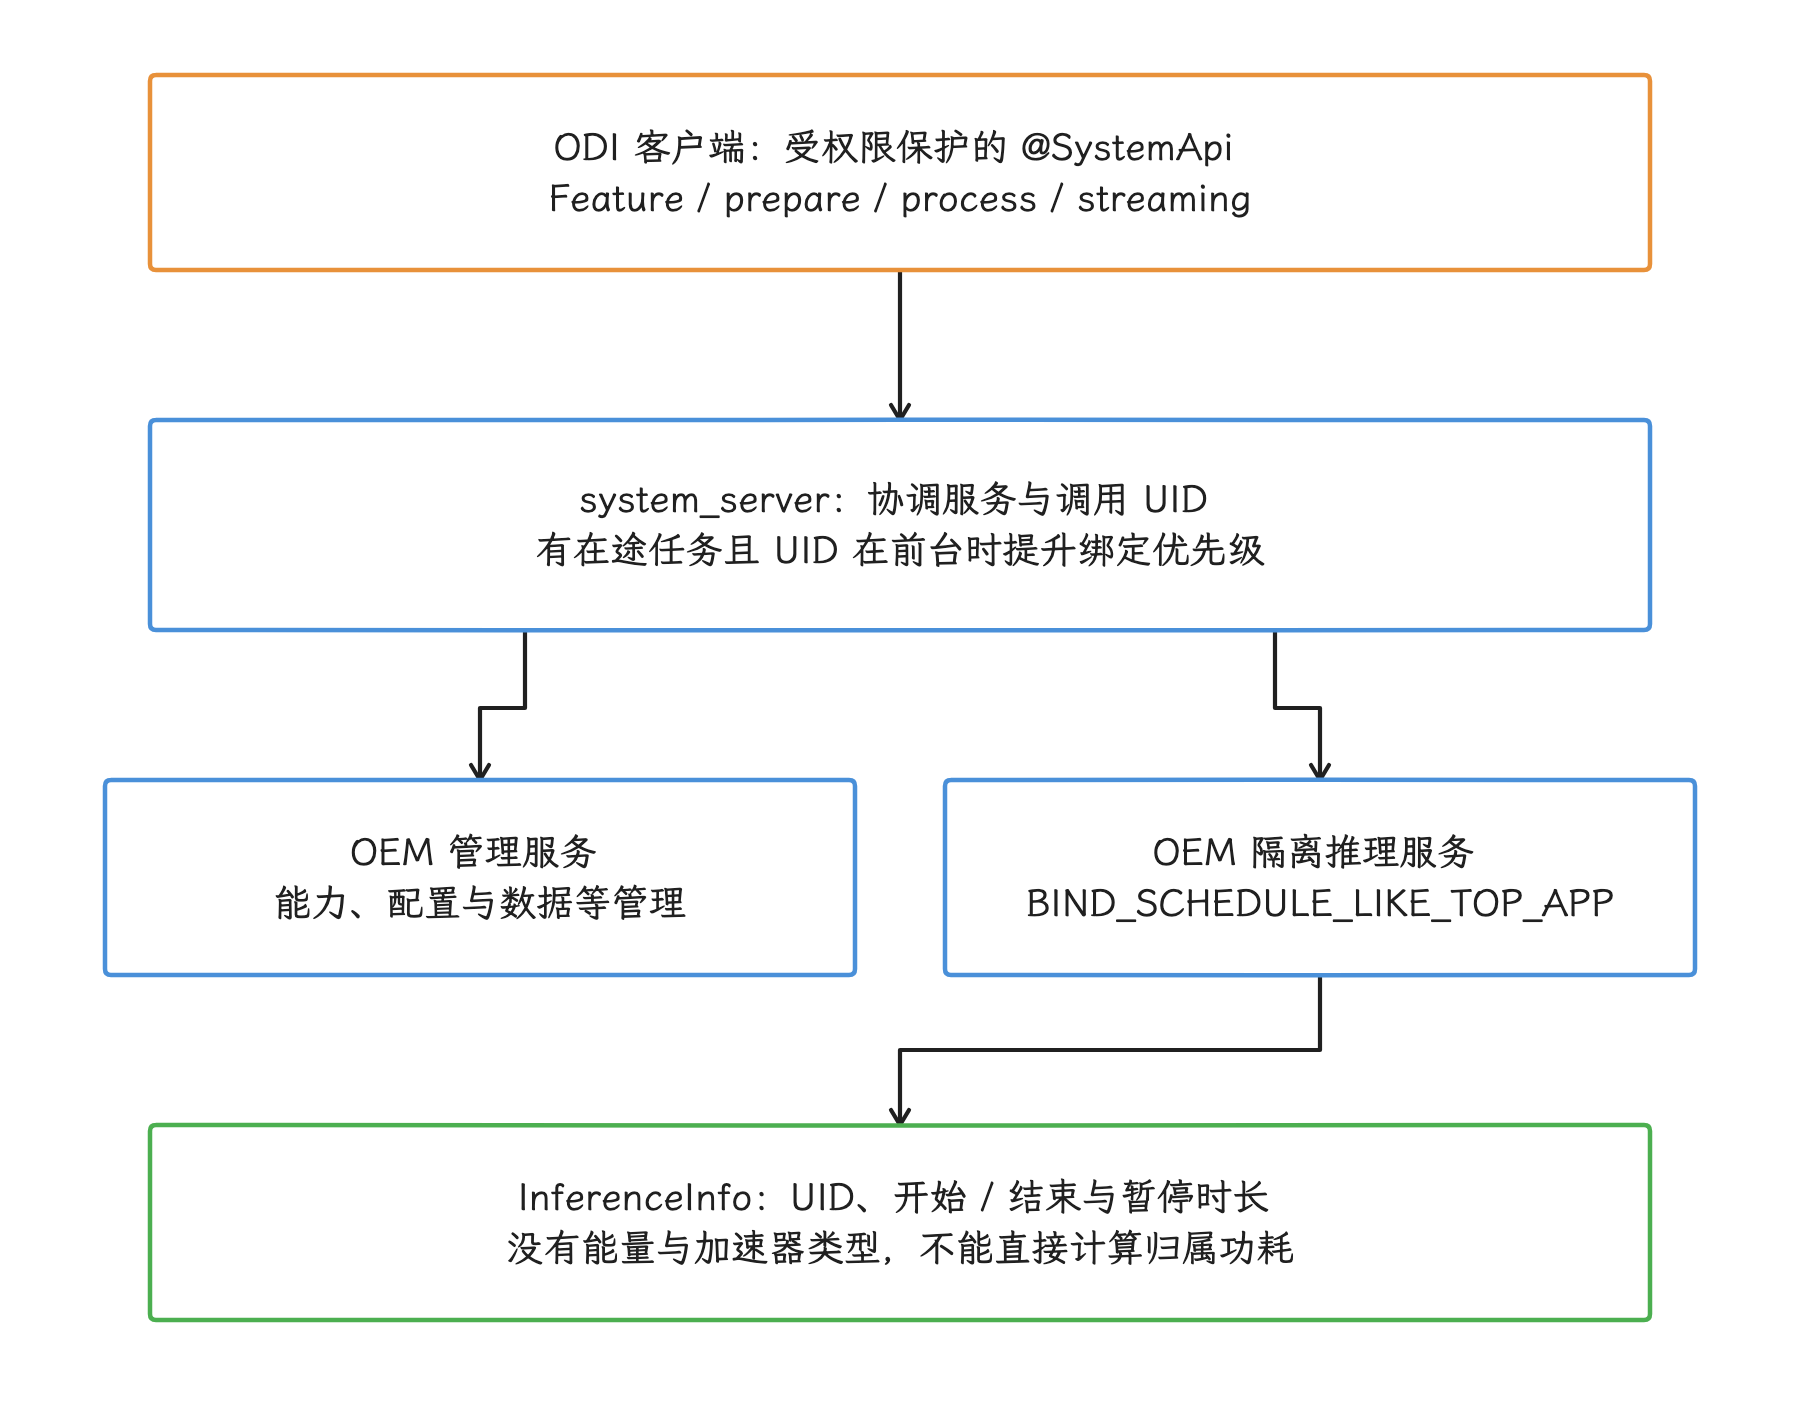
图:ODI 是受权限保护的系统集成框架。前台 UID 的在途任务可触发高优先级服务绑定,这不定义 token 队列、NPU 频率或功耗归属。
AICore 公开保证了什么
官方文档对 AICore 给出的公开保证包括:
- AICore 是 Android 的系统级服务,负责运行 Gemini Nano、管理模型分发与更新,并利用设备硬件加速推理。
- ML Kit GenAI 在 AICore 之上提供高阶接口。同一设备上的 App 可以复用系统已有的 Gemini Nano,避免每个 App 重复保存模型。
- 提示词、推理和输出在设备本地处理。AICore 不直接访问互联网;包括模型下载在内的网络请求经 Private Compute Services 处理。
- AICore 隔离各次请求,处理结束后不保存输入和输出记录。
下图只表达公开文档能支持的层级关系,不把内部调用拆成未经公开保证的 Binder 事务或固定 HAL:
App
  └─ ML Kit GenAI API
       └─ AICore 系统服务
            ├─ Gemini Nano、功能配置与安全处理
            ├─ 设备选择的硬件加速路径
            └─ Private Compute Services(模型下载等网络请求)
这条链路说明了控制权的分界:App 可以控制请求内容、调用时机和结果消费方式,AICore 负责模型、运行时和底层硬件。即使某台设备的 trace 里看到特定包名、Binder 调用或 GPU/NPU 活动,也只是该设备、该版本当时的观测结果。
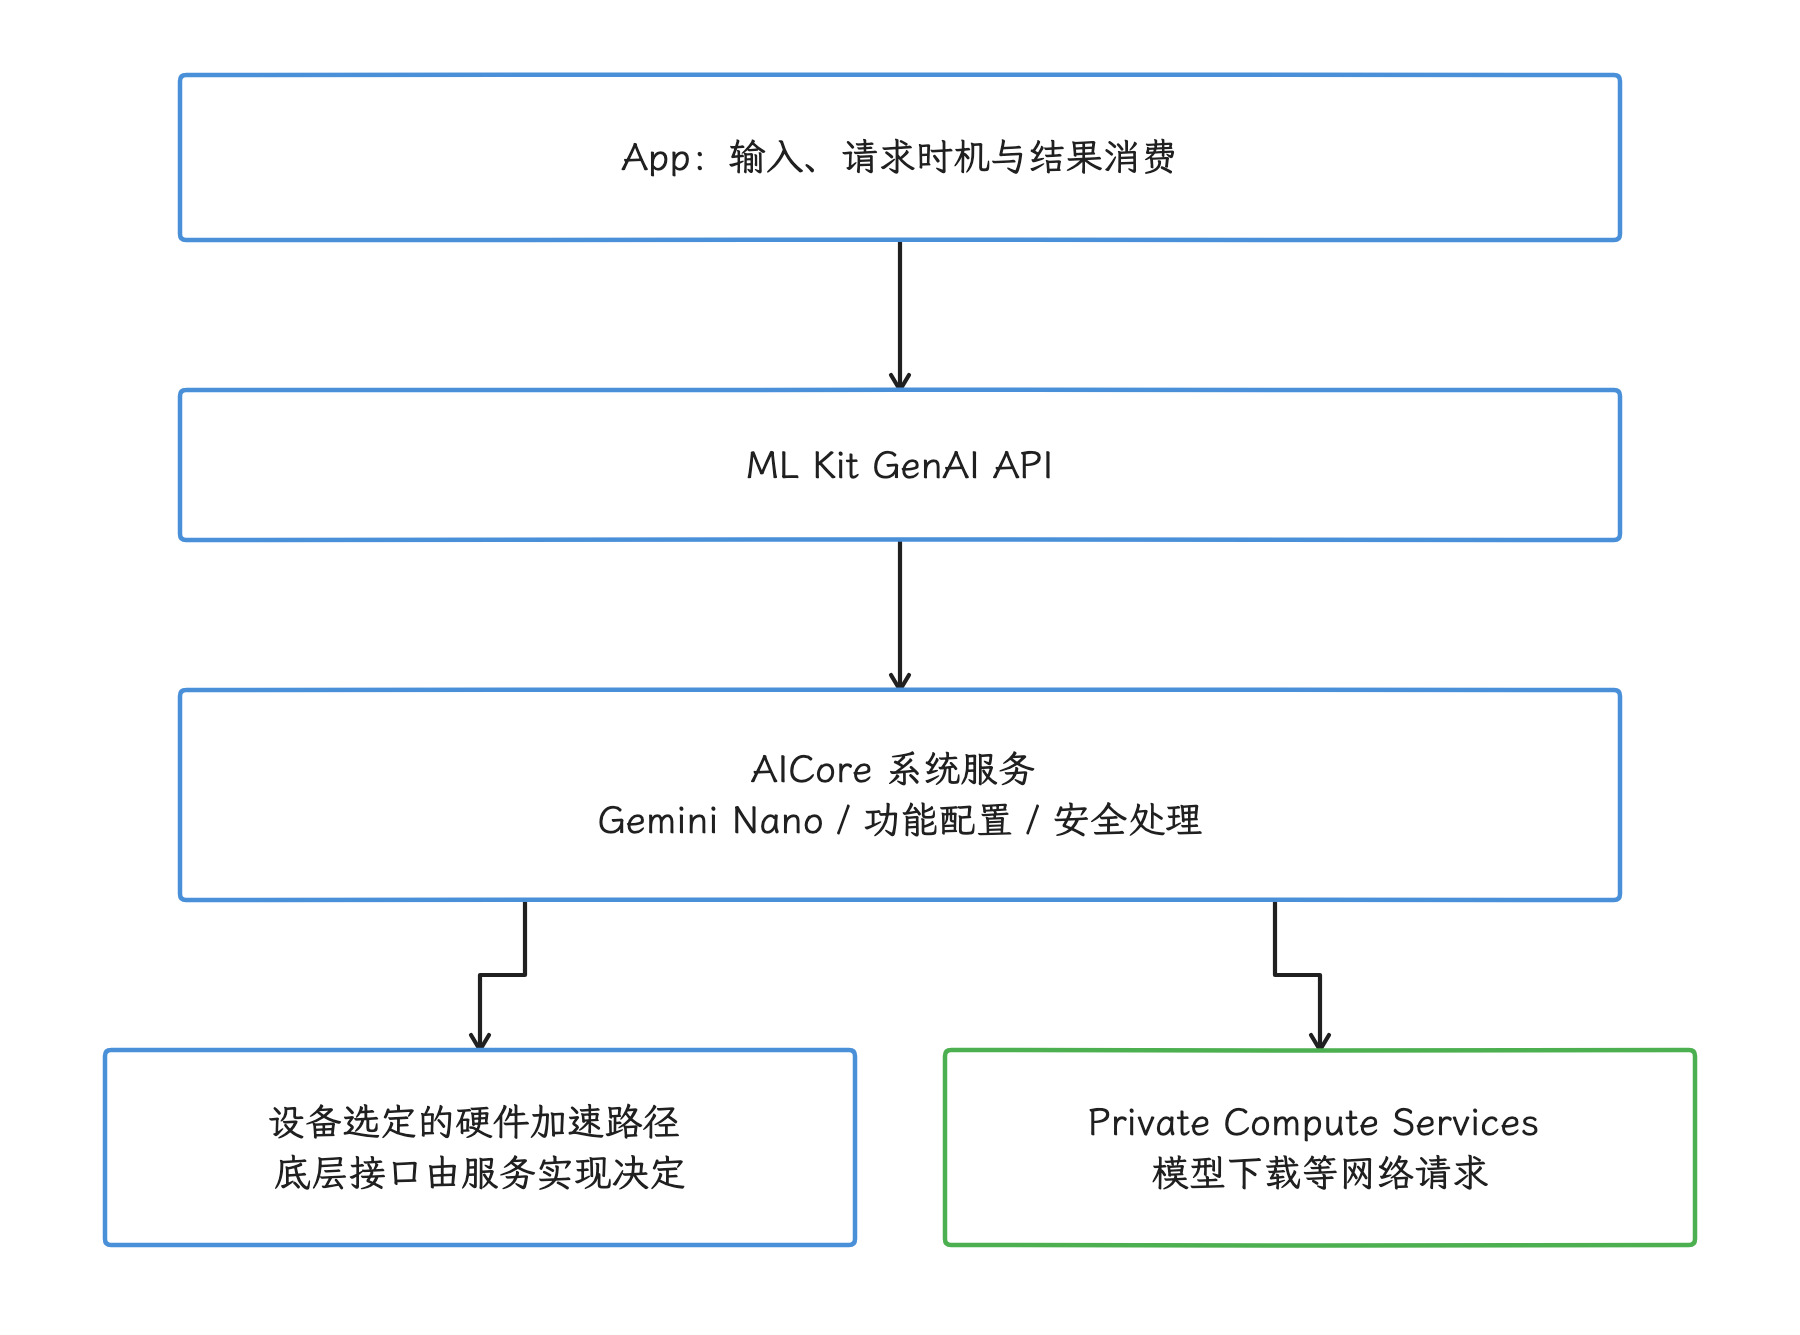
图:推理输入和输出在本地处理。AICore 不直接联网,模型下载等经 PCS;公开架构不规定固定 Binder 次数、包名或 NNAPI/NPU 后端。
公开契约之外的内部细节
以下推论都超出了公开契约:
- 固定 AICore 包名或进程名;
- 每个请求固定发生两次 Binder 事务;
- 一定经过 NNAPI HAL,或一定使用 NPU/GPU;
- 回调一定运行在 Binder 线程池;
- AICore 对前后台 App 使用某种确定的排队或时间片策略;
- AICore 拥有固定的
oom_score_adj(内核选择 OOM 终止目标时使用的分数调节值),内存压力时一定先终止其他 App。
这些实现可能随设备厂商、AICore 模块和模型版本变化,应用代码只依赖公开契约就好;性能报告则要写清设备、系统构建、AICore/ML Kit 版本、基础模型名,以及测试时的热状态。
ML Kit GenAI 的准备状态机
Prompt API 的可用性至少由设备支持、AICore 配置和模型下载状态共同决定。当前公开 API 使用四个明确的具名状态常量:
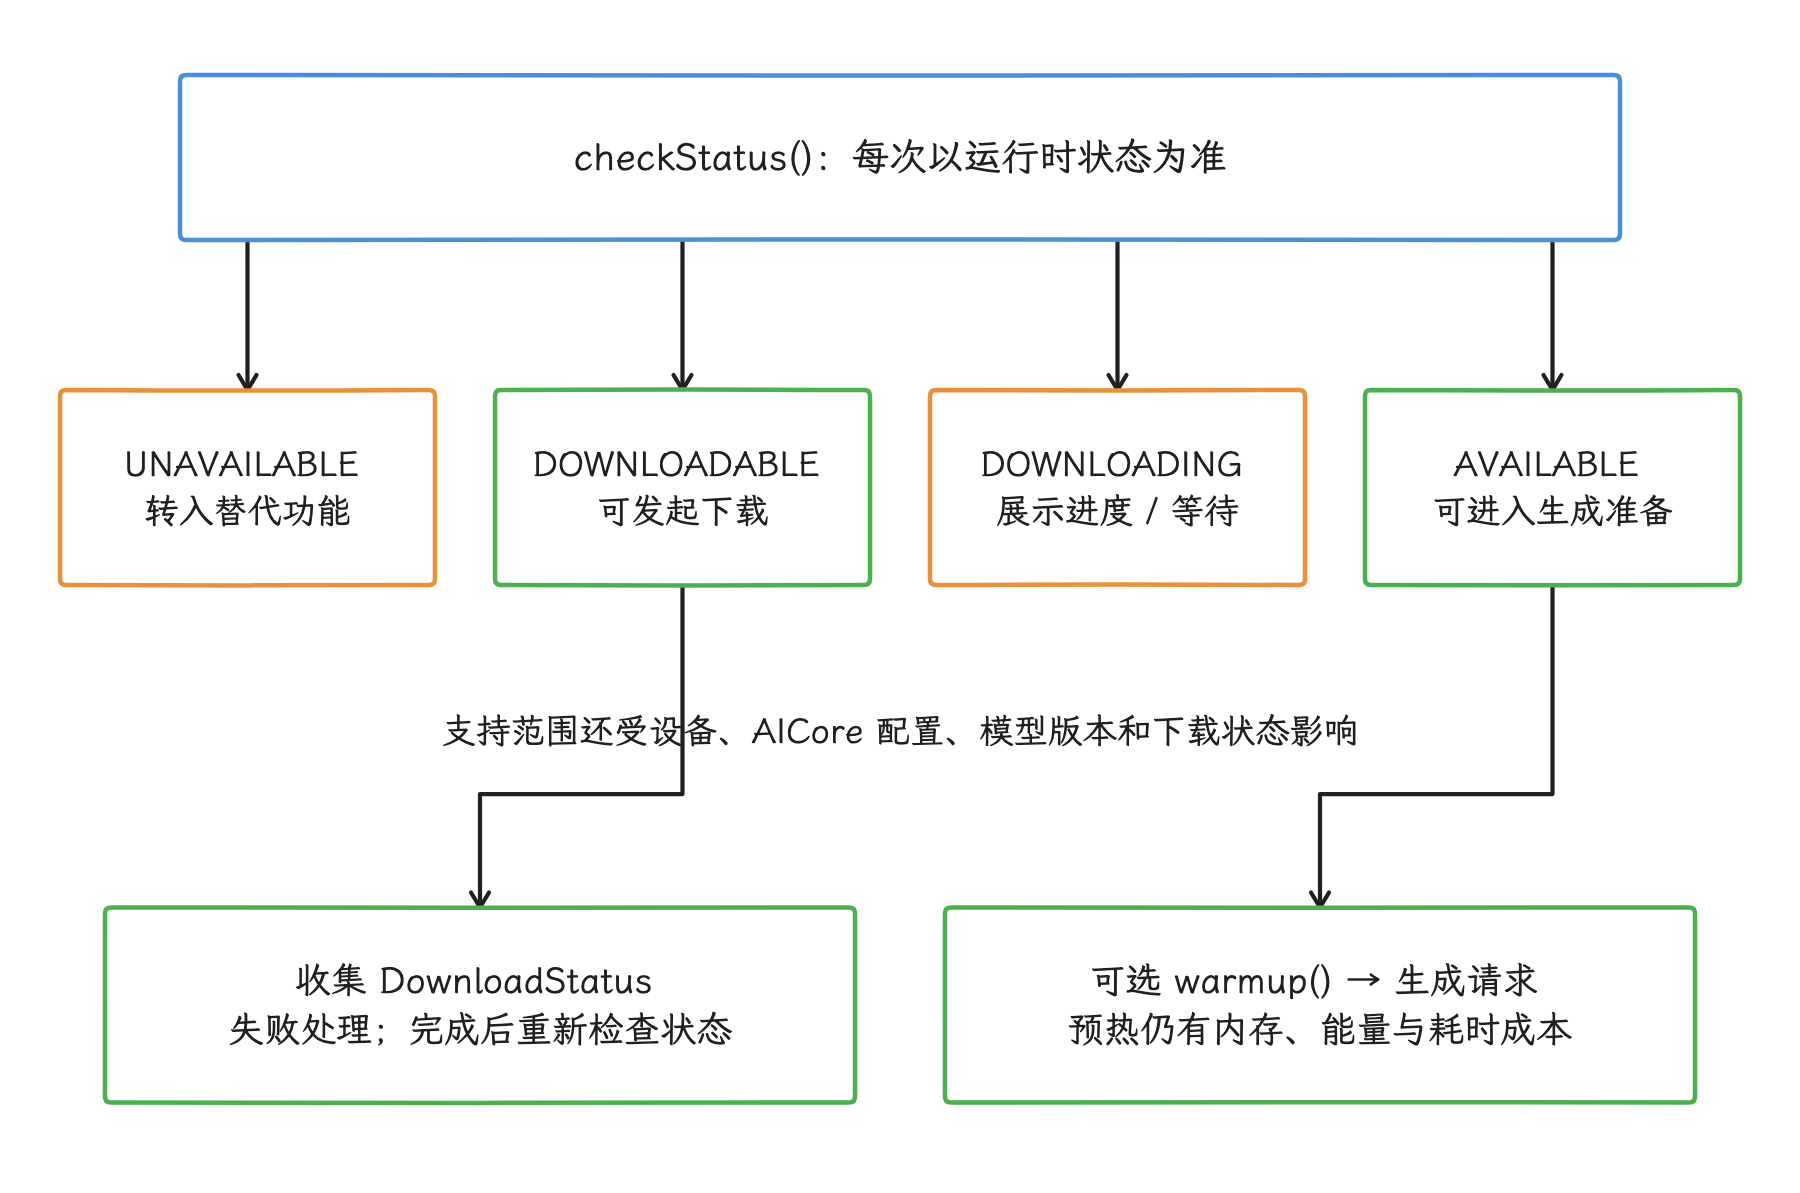
图:UNAVAILABLE 和 DOWNLOADING 不进入生成分支。下载状态变化后重新检查;warmup 可提前准备模型,但不保证后续请求一定成功。
FeatureStatus.UNAVAILABLE:设备不支持,或设备尚未取得可用配置;FeatureStatus.DOWNLOADABLE:支持该能力,但模型尚未下载;FeatureStatus.DOWNLOADING:下载正在进行;FeatureStatus.AVAILABLE:当前可以使用。
这段代码展示状态判断、下载和可选预热的顺序,使用具名状态常量,不使用来源不明的整数值:
private val generativeModel by lazy { Generation.getClient() }

suspend fun preparePromptModel(warmUpForInteractiveUse: Boolean): Boolean {
    when (generativeModel.checkStatus()) {
        FeatureStatus.AVAILABLE -> Unit

        FeatureStatus.DOWNLOADABLE -> {
            var completed = false
            generativeModel.download().collect { event ->
                when (event) {
                    DownloadStatus.DownloadCompleted -> completed = true
                    is DownloadStatus.DownloadFailed -> throw event.e
                    else -> Unit // DownloadStarted 或 DownloadProgress
                }
            }
            if (!completed) return false
        }

        FeatureStatus.DOWNLOADING,
        FeatureStatus.UNAVAILABLE -> return false

        else -> return false
    }

    if (warmUpForInteractiveUse) {
        generativeModel.warmup()
    }
    return true
}
这段代码只负责判断“本次是否可以进入推理”。DOWNLOADING 应映射成用户可以理解的 UI 状态,并在下载状态变化后重新检查;UNAVAILABLE 应转入产品预先设计的替代功能。warmup() 会把 Gemini Nano 加载进内存并初始化运行时组件,可能改善第一次推理的延迟,也会提前产生时间、内存和能耗开销。它适合在用户即将进入交互式生成场景时调用,不适合在每次任务开始前无条件重复执行。
生成长响应时,流式接口能更早把内容交给 UI。它改善的是用户感知到的首段响应时间,总计算量未必随之下降。消费 Flow 时仍需控制文本累计、Markdown 解析和 UI 刷新频率,避免每个很小的分片都触发一次完整的 Compose 重组或 View 布局。
SDK_INT 与运行时状态
官方支持列表会随模型和设备扩展,专用 GenAI API 与 Prompt API 的设备列表也不相同。运行时还要考虑以下情况:
- 同一 API 在不同设备上可能使用不同 Gemini Nano 版本;
getBaseModelName()可用于记录当前基础模型名;- 相同提示词在不同模型版本上可能得到不同输出;
- 解锁 bootloader 的设备不支持当前 ML Kit GenAI API;
- AICore 刚初始化、清除数据或重新安装后,配置同步可能尚未完成。
因此,是否显示 UI 入口、是否提示下载,以及是否启用功能,都应由 API 的实时状态决定。SDK 版本只适合检查最低平台 API;模型是否可用,要交给运行时状态去回答。
前台限制与配额
ML Kit GenAI 当前只允许 top foreground application,即此刻位于最前方并与用户交互的 App,执行推理。App 离开前台后,即使保留前台服务,调用仍会收到 ErrorCode.BACKGROUND_USE_BLOCKED。因此,下面两种设计都会直接失败:
- 把 AICore 推理放进 WorkManager,期待离开页面后继续完成;
- 用前台服务绕过前台限制。
页面切到后台时,应停止提交新请求,取消已经不需要的结果收集,并把 UI 标记为可恢复状态。回到前台后重新检查能力和业务上下文,不要假设旧请求仍会完成。
AICore 还按 App 执行推理配额:
- 短时间请求过多可能返回
ErrorCode.BUSY;官方建议采用指数退避,即每次失败后逐步延长等待时间; - 长时间累计使用可能返回
ErrorCode.PER_APP_BATTERY_USE_QUOTA_EXCEEDED。
指数退避必须设置最大重试次数,并提供用户可见的终止状态。交互页面中的无限重试会同时增加耗电、发热和排队时间。App 内还应合并重复请求并限制并发数;这些措施属于调用方的流量控制,别把它说成 AICore 在多个 App 之间采用的调度规则。
线程、取消与 UI 更新
Kotlin 的 Prompt API 通过挂起函数和 Flow 表达异步工作,Java 包装层则使用 ListenableFuture 和显式 Executor。调用方应遵循所选 API 的线程契约,不要假定回调来自 Binder 线程。
工程上可以按三段拆开:
- 在 App 自己的工作线程中完成图片缩放、文本整理、token 数量预算和业务数据读取;
- 通过 ML Kit 发起请求,不在主线程同步等待 Java
Future.get(); - 对流式结果做节流和增量渲染,把必须操作 View 的工作切回主线程。
取消行为也要按产品语义设计。用户修改输入、离开页面或开始新请求时,旧结果通常已经失去价值,停止收集输出可以避免继续更新 UI。至于“调用端停止收集”会不会立即停止设备侧计算,要以具体 API 版本的取消契约和实测为准。
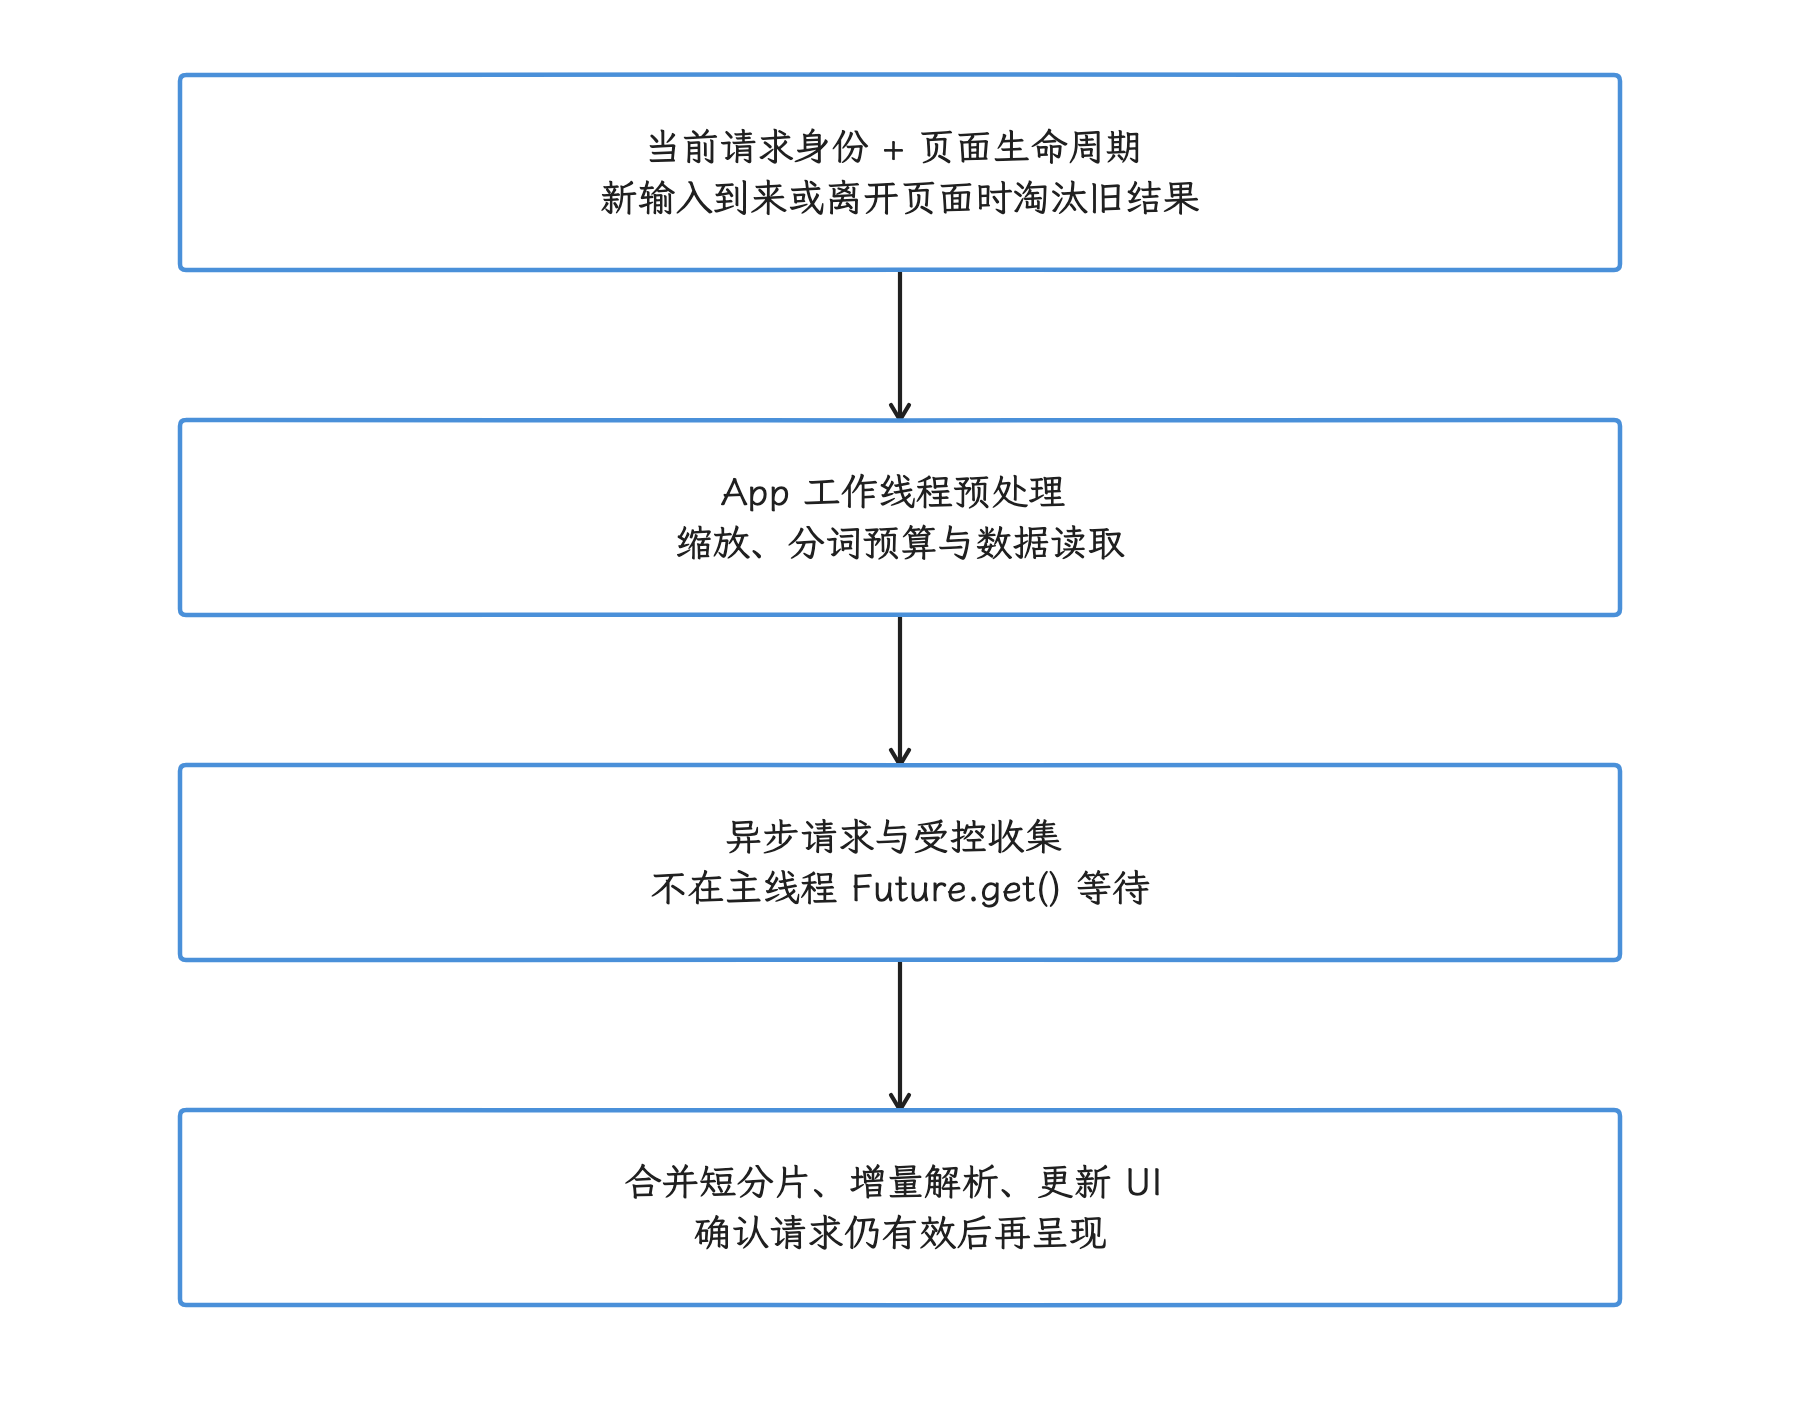
图:停止收集可以防止过期结果更新 UI,设备侧计算是否立即停止要按具体 API 契约验证。刷新窗口和字符阈值由目标设备帧时间决定。
内存归属与系统总成本
AICore 管理共享模型,使 App 不必把 Gemini Nano 放进自己的 APK、数据目录和模型运行时预算。但调用方仍会产生内存开销:
- Prompt 字符串、输入图片及其缩放副本属于 App;
- 请求构造、结果对象、流式文本累计和 UI 富文本缓存属于 App;
- AICore 管理的模型权重、运行时与服务侧工作不在 App 的 Java/Kotlin heap(堆内存) 中;
- 驱动共享缓冲区和硬件工作区的归属还会受设备实现与统计口径影响。
所以,Debug.getMemoryInfo() 或针对 App 单进程执行 dumpsys meminfo,只能回答“调用端增长了多少”,回答不了“这项功能给整机增加了多少内存压力”;公开文档也没有给出适用于所有设备的 Gemini Nano RSS/PSS 数字。
建议分层观测:
| 层级 | 记录内容 | 能回答的问题 |
|---|---|---|
| App | Java/native/graphics 内存、输入图片大小、结果累计长度 | 调用端是否有泄漏、重复位图或无界文本缓存 |
| 相关系统组件 | 在可观测的测试设备上记录服务进程 PSS/RSS、启动与下载阶段 | 模型准备或推理期间,服务侧内存是否明显变化 |
| 整机 | MemAvailable、PSI(内存压力停顿指标)、lmkd 事件、后台进程回收 | 功能是否让设备持续处于内存压力下 |
| 业务 | 请求成功率、页面重建、进程死亡与恢复 | 内存压力是否已经影响用户流程 |
不要根据“系统服务”身份猜测 LMK(Low Memory Killer,低内存回收机制)的回收顺序,调用方进程终止后推理是否继续,同样没有保证。若要分析回收原因,应把 lmkd 事件、进程状态、PSI 和请求时间线放在一起。§4.3 说明了 Android 17 的 LMK 机制,§5.8 说明了 Cache 与内存统计的层级。
渲染、CPU 与共享硬件资源
AICore 隐藏具体加速器,但推理仍会消耗 CPU、内存带宽和某类硬件执行资源。App 侧还会负责预处理、结果解析与 UI 更新。因此,生成期间出现掉帧有多种可能:
- 主线程对输入图片做缩放或格式转换;
- 每个流式分片都触发 Compose 重组、Markdown 全量解析或 RecyclerView 列表更新;
- App 的工作线程挤占主线程和 RenderThread 所需的 CPU 时间;
- 服务侧工作与渲染在内存带宽、功耗或设备选定的加速器上相互影响;
- 持续生成使设备进入更强的热限制。
GPU 频率上升单独证明不了 AICore 正在使用 GPU,CPU 频率上升也可能来自输入处理、安全处理或 UI。更可靠的方法是做成对实验:保持页面、输入和初始热状态相同,分别关闭和开启推理,多次比较帧时间、首段延迟、总延迟、CPU 调度和热状态。
流式输出的 UI 更新建议按时间窗口或字符量批处理。例如每 50~100 ms 合并一次短分片,再更新可见文本。这个数值是 UI 调度策略的起点,需要用目标设备的帧时间验证,不是 AICore 的性能保证。
ADPF 的作用范围
Android 17 的 PerformanceHintManager.createHintSession() 要求线程 ID 属于调用进程的线程组;Session.setThreads() 遇到不属于该 App 的线程时会抛出 SecurityException。setPreferPowerEfficiency(true) 描述的也只是该 hint session(性能提示会话) 内线程的调度偏好。
App 可以为自己长期存在的预处理、后处理或渲染线程建立 ADPF 会话,但 AICore 内部线程加不进会话,也借它指定不了 AICore 的 NPU/GPU 频率。把 setPreferPowerEfficiency(true) 写在 checkStatus() 和 generateContent() 之间,并不会自动把推理切换到所谓的“能效 NPU 模式”。
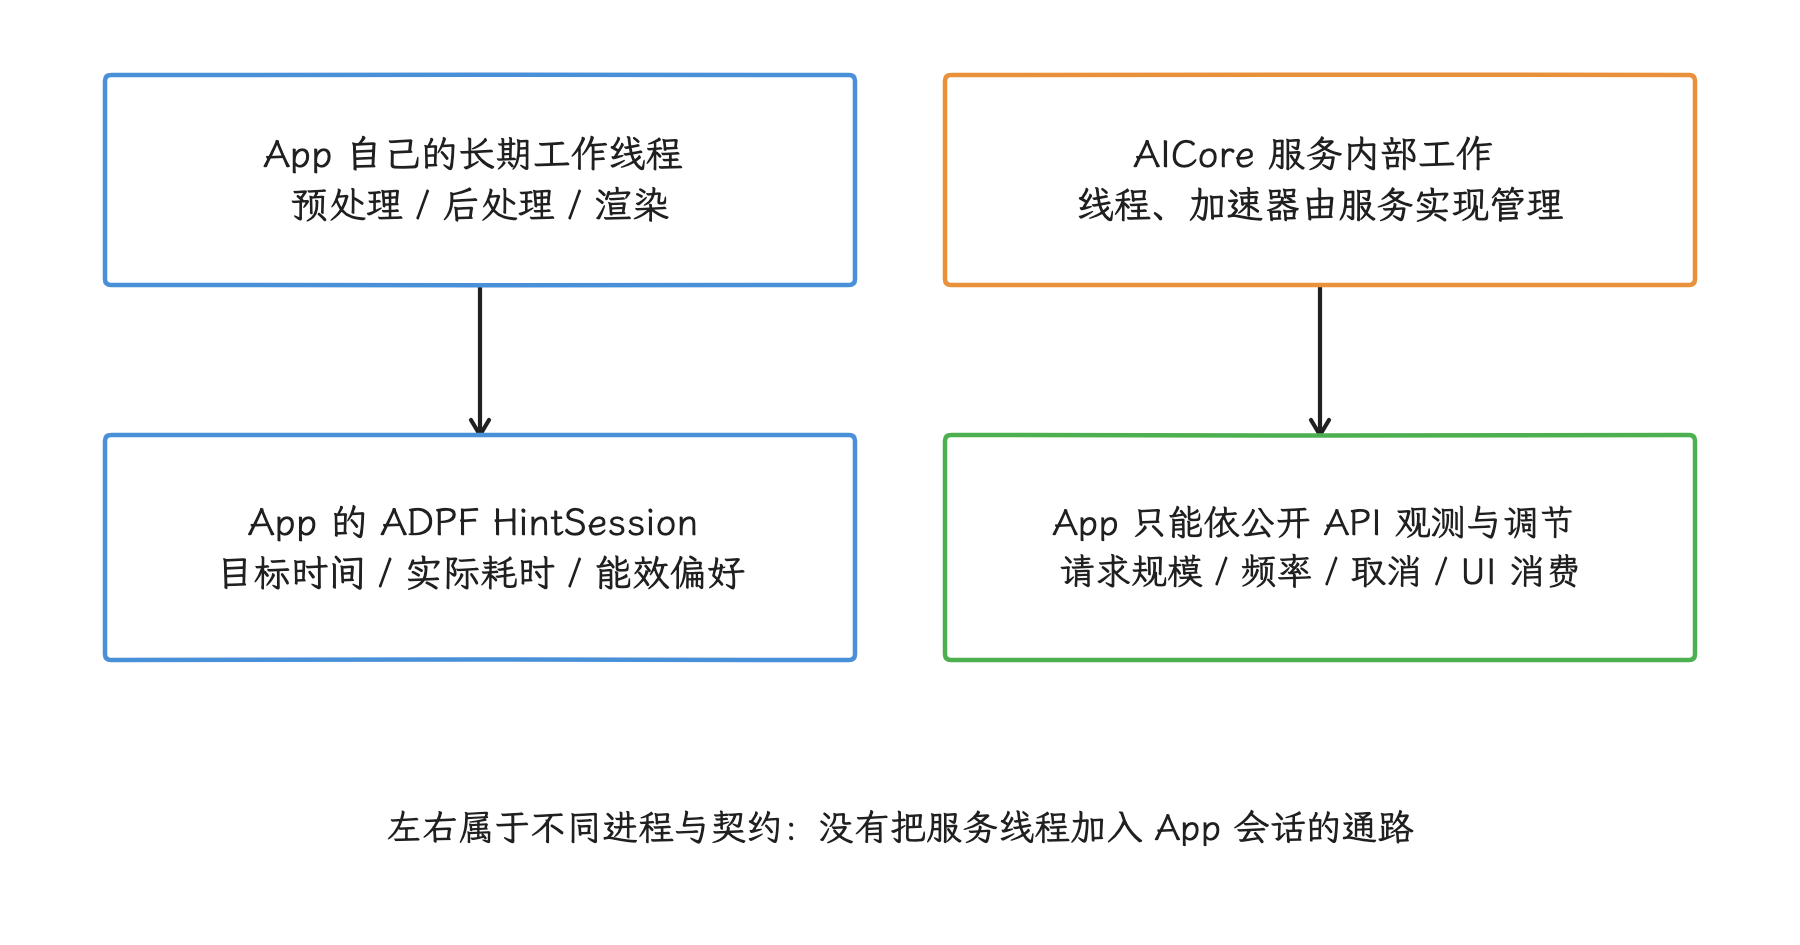
图:App 的 hint session 不能包含 AICore 内部线程。preferPowerEfficiency 是本会话调度偏好,不是切换 AICore/NPU 能效模式的命令。
对于持续时间短、到达时间又不固定的请求,也不要为了“用了 ADPF”临时创建线程和会话。AOSP 源码要求 hint session 面向一组相互关联、长期存在的线程;周期性工作应报告目标时间和实际工作时间。具体用法见 §5.4。
热状态与降级
Android 的 PowerManager.addThermalStatusListener() 可以通知设备当前的整体热限制级别。该状态适合作为产品降级信号,但它的粒度较粗,含义随设备实现而变,换算不出固定的 NPU 频率或 token/s(每秒生成的 token 数)。
“持续 30~60 秒后从 200 ms 上升到 500~1000 ms”没有跨设备依据。性能数据应按机型测量以下指标:
- cold start(无可复用状态)、warm start(部分状态可复用)和主动预热后的首段延迟;
- prefill(处理输入上下文)时间、首 token 时间、decode token/s(持续生成速度) 和完整请求时间;
- 连续请求中的 P50、P95、P99 及随时间的变化;
- 请求期间的 thermal status、thermal headroom(热限制余量)、帧时间与电量消耗;
BUSY、电量配额、后台阻止、下载失败和模型不可用的比例。
降级策略可以包括缩短输入、限制最大输出、降低连续请求频率、暂停非必要生成,或切换到规则功能/云端服务。是否从 THERMAL_STATUS_MODERATE 开始降级,要由功能的交互要求和目标设备测试决定;写成所有 App 共用的阈值就错了。
需要自选模型时:LiteRT-LM
如果产品需要固定模型版本、自行管理上下文、选择执行后端,或目标设备不在 AICore 支持列表中,可以评估 LiteRT-LM。当前官方 Kotlin API 支持 Android,并提供 CPU、GPU 和 NPU 后端;Engine.initialize() 可能耗时较长,官方要求在后台线程或协程中调用,并在使用结束后关闭 Conversation 与 Engine。
下面的代码用于说明资源生命周期。生产代码还要补上版本固定、模型校验、设备能力探测和可观测的错误处理:
withContext(Dispatchers.IO) {
    val config = EngineConfig(
        modelPath = modelPath,
        backend = Backend.GPU(),
        cacheDir = context.cacheDir.path,
    )

    Engine(config).use { engine ->
        engine.initialize()
        engine.createConversation().use { conversation ->
            conversation.sendMessageAsync(prompt).collect { message ->
                consumeIncrementally(message)
            }
        }
    }
}
这里的 GPU 只是显式选择后端的示例,算不上所有 Android 设备的默认答案。使用 GPU 时,需要在清单中声明相应的 native library,NPU 还可能需要厂商库目录。初始化失败时应记录后端、设备和模型信息,再按照目标设备上验证过的策略回退;“GPU → 多模态 CPU → 纯文本 CPU”的固定三级顺序不是 LiteRT-LM 的通用要求,捕获所有 Throwable 后静默继续执行也是要避免的。
LiteRT-LM 把更多控制权交给 App,也让 App 承担模型存储、进程内内存、引擎初始化、会话并发和资源关闭责任。它与 AICore 采用不同的资源模型,只比单次请求的平均延迟是不够的。
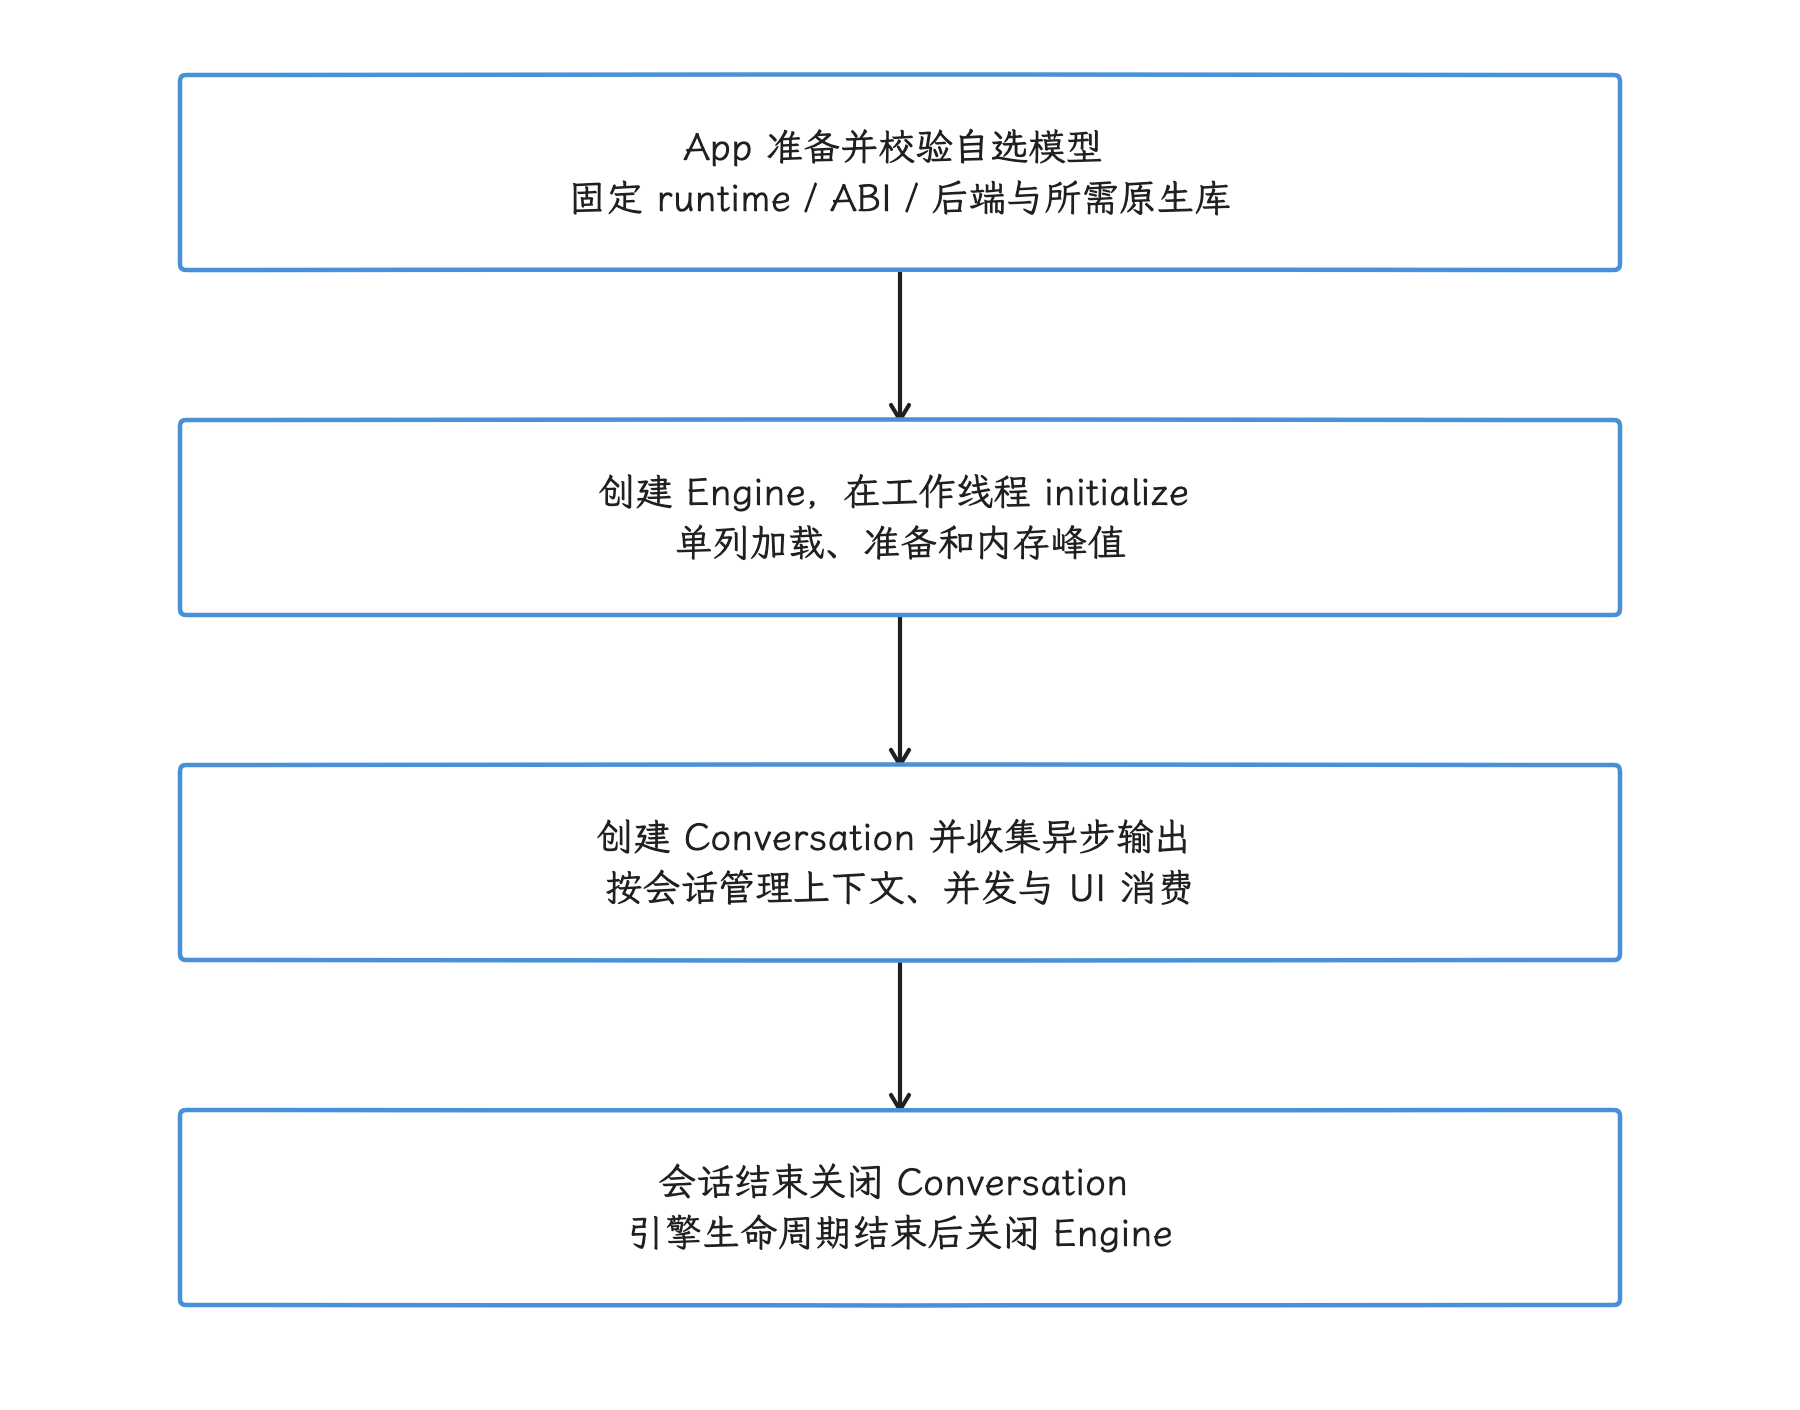
图:Engine 可以服务合适作用域内的会话,避免无意义重复初始化;模型、库与后端不兼容要显式处理,关闭前应结束相关工作。
AppFunctions 的职责范围
AppFunctions 从 Android 16 起提供 Android 平台 API 和 Jetpack 库,让 App 把自身操作注册成设备上的工具;调用者必须拥有 EXECUTE_APP_FUNCTIONS 权限。它与 MCP(Model Context Protocol,模型上下文协议)的概念相近,解决的是“获得授权的调用者如何发现并执行 App 能力”。
截至 Android 17,官方仍把 AppFunctions 标为 experimental preview(实验性预览);截至 2026 年 5 月,与 Gemini 的集成仍是 private preview(小范围预览)。AppFunctions 没有承诺由 AICore 执行模型,也没有给出“支持 8 小时 agent(智能体)”的运行保证。agent 可以使用 AICore、云端模型或其他本地运行时来决定调用哪个工具,这与 AppFunction 本身的执行协议是两个独立问题。
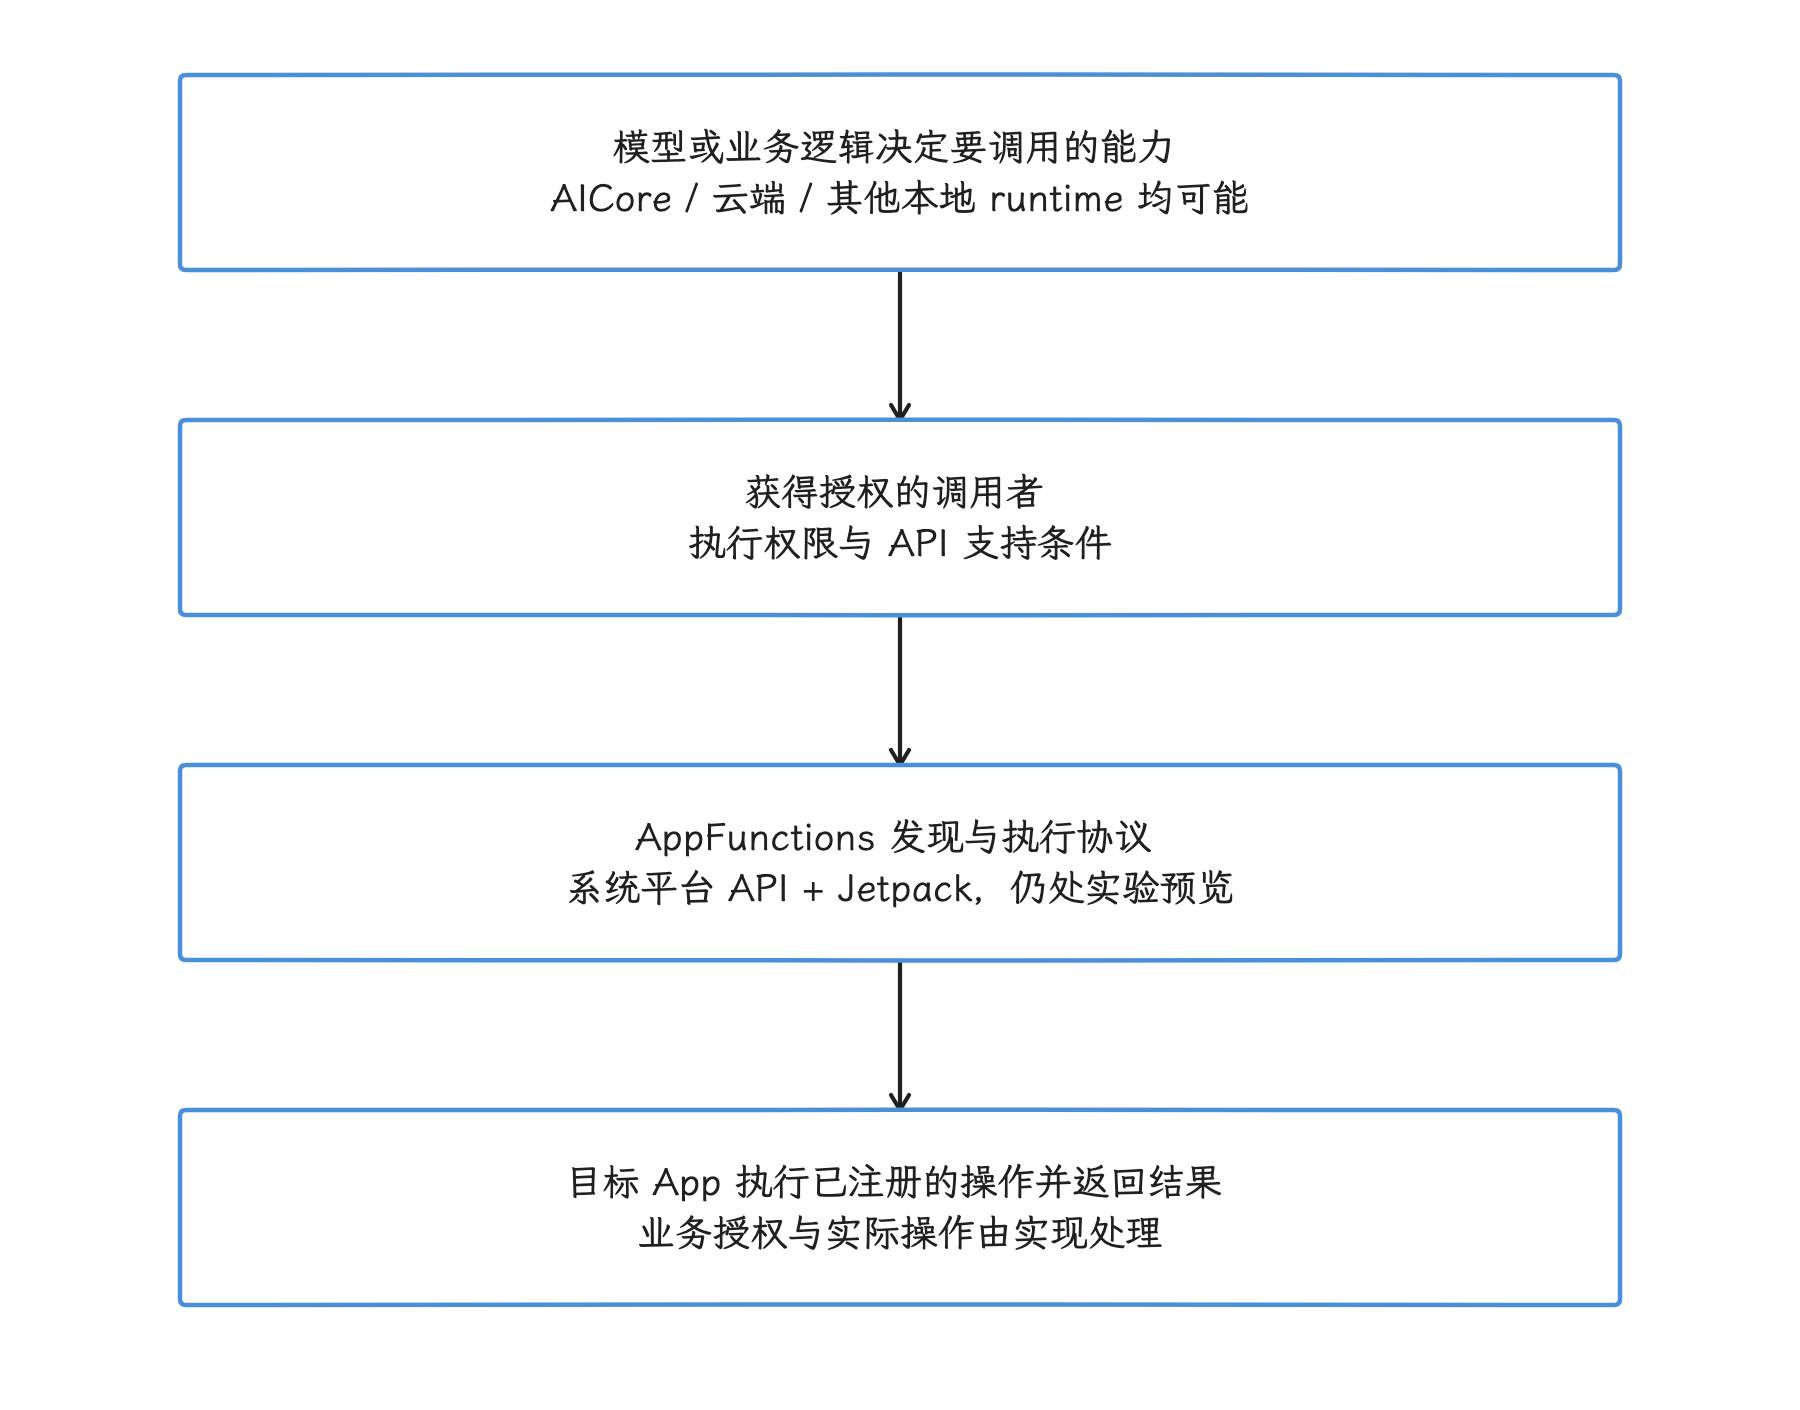
图:AppFunctions 提供 App 能力的注册与调用协议,不规定模型由 AICore 执行,也不授予任意后台执行时长。调用者权限和预览支持范围需核实。
性能测量清单
每个请求都记录
- 设备型号、Android build fingerprint、App/ML Kit 版本;
getBaseModelName()、checkStatus()结果、是否发生下载和预热;- 输入类型、输入 token 数或图片尺寸、
maxOutputTokens; - 请求开始、首分片、最终分片、取消和失败时间;
- 错误码、前后台状态、当前 thermal status;
- 同一页面的帧时间和流式 UI 更新次数。
Prompt API 当前要求输入少于 4000 token,并建议避免生成超过 4K token 的长输出。把 token 数写入性能记录,才能区分“模型变慢”和“请求规模变大”。
把一次请求拆成阶段
| 阶段 | 计时边界 | 常见问题 |
|---|---|---|
| 能力检查 | 调用 checkStatus() 到返回 | 配置未完成、服务连接、设备不支持 |
| 下载 | DownloadStarted 到 DownloadCompleted | 网络、磁盘、配置与模型分发 |
| 预热 | warmup() 开始到返回 | 模型装载与运行时初始化 |
| 首段 | 发起生成到收到第一段 | 冷启动、prefill、排队、热限制 |
| 持续生成 | 第一段到最终一段 | decode(逐 token 生成)速度、配额、热限制 |
| UI 消费 | 收到分片到画面呈现 | 主线程、解析、重组与布局 |
如果只记录“点击到完整文本出现”的总时间,就判断不出该优化模型准备、请求规模还是 UI。把 wall-clock time(从开始到结束的实际经过时间)直接命名为 Binder 延迟、NPU 时间或 AICore 排队时间也要慎重,除非 trace 中有支持这种分解的设备级记录。
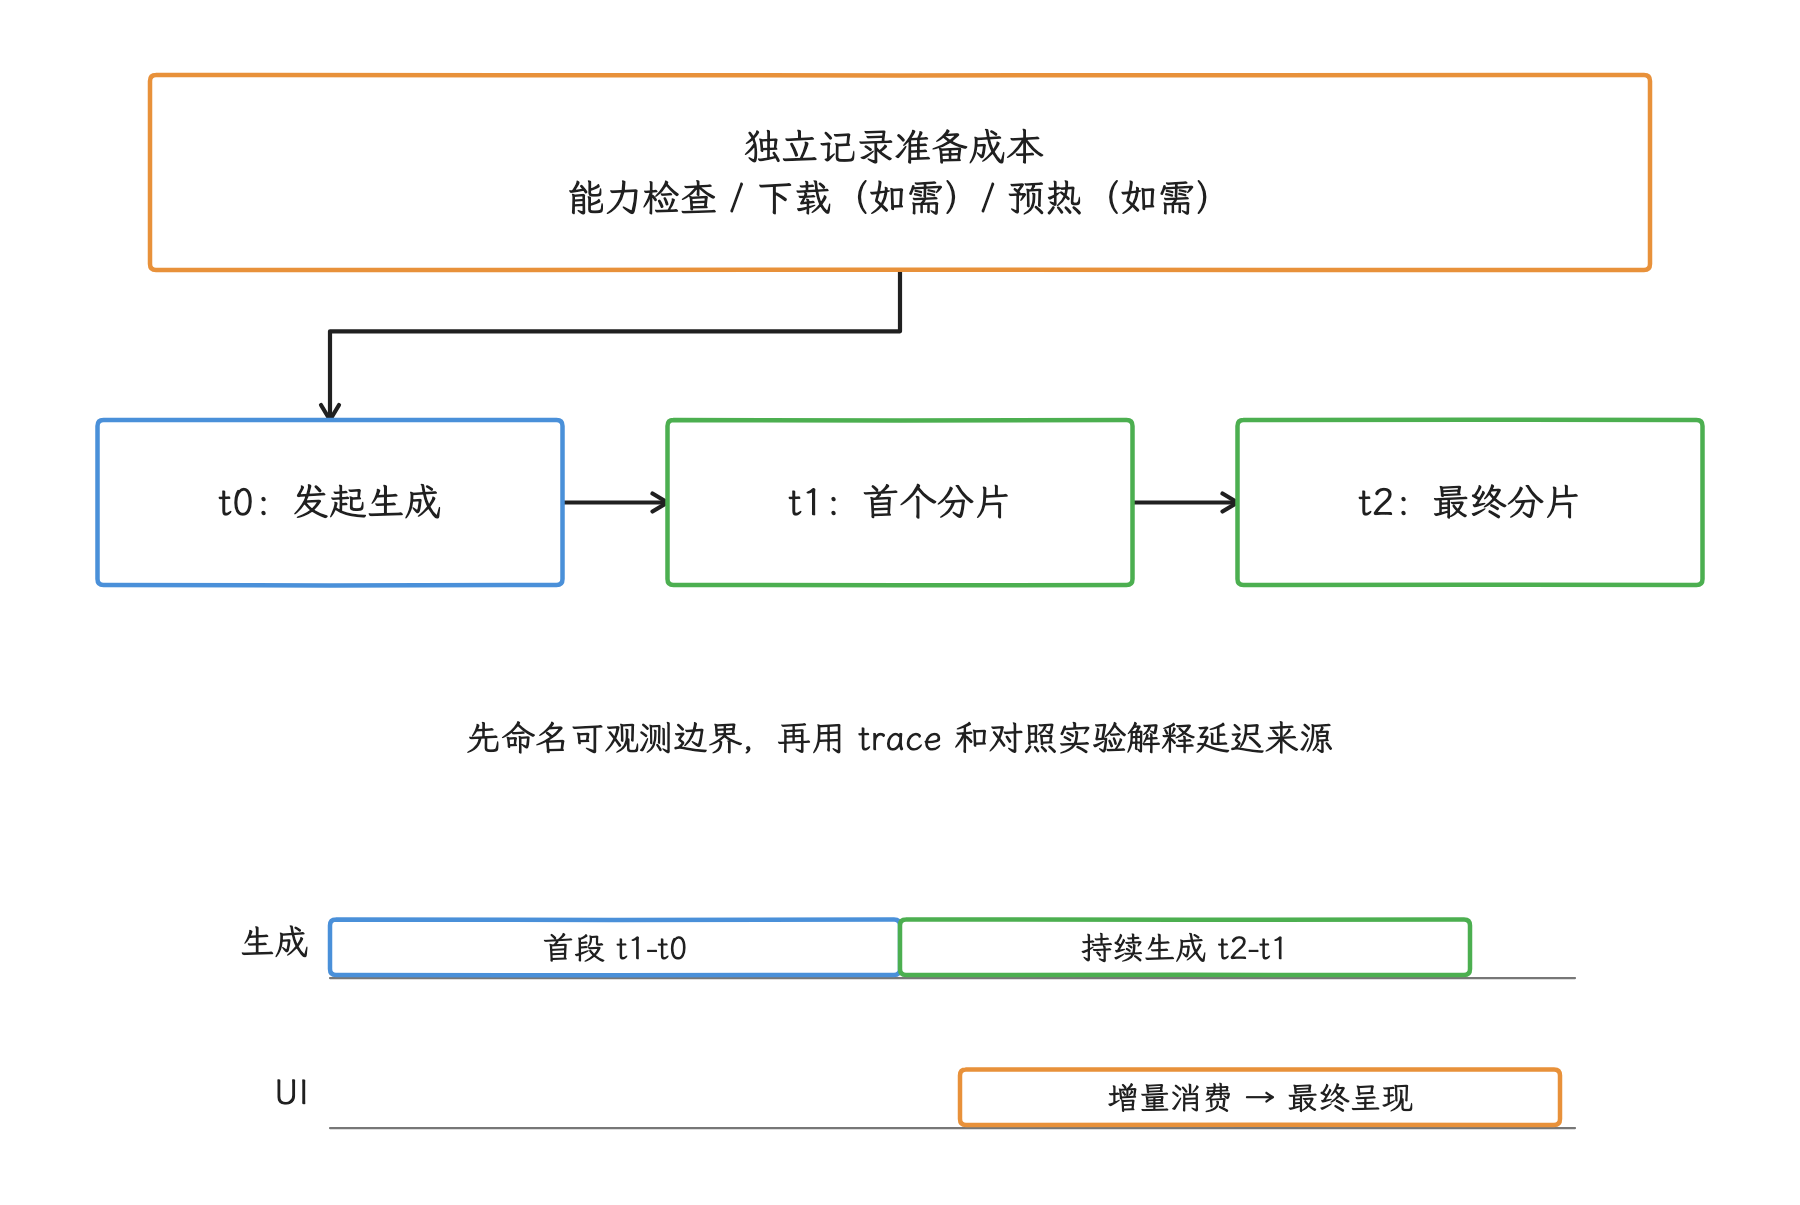
图:首段延迟为 t1−t0,完整生成耗时为 t2−t0。UI 消费可能与生成重叠,最终画面呈现可晚于 t2;内部排队或计算分解仍需直接记录。
Perfetto 的正确用途
App 应为状态检查、下载、预热、推理请求、首分片和结束点增加自定义 trace 标记。Perfetto 可以用这些标记对齐:
- App 主线程、工作线程和 RenderThread 调度;
- 帧时间、CPU 频率、设备支持时的 GPU counter(设备支持时);
- 内存计数器、PSI、lmkd 和 thermal 事件;
- 可见的 Binder 与系统服务活动。
Perfetto 中的时间重叠只能说明两个事件相关。要证明某种资源竞争导致了延迟,还需要关闭推理的对照组、重复实验,以及目标设备上粒度更细的指标。
与其他章节的关联
- 5.6 移动端 LLM 推理的 DVFS 与能效边界:prefill、decode 与持续负载测量。
- 5.4 ADPF 自适应性能框架:本进程工作线程的 HintSession 用法。
- 5.8 CPU Cache 友好代码与数据布局优化:Cache 与内存统计的层级边界。
- 4.3 lmkd、Cached App Freezer 与内存压力治理:lmkd、PSI 与进程状态。
- 2.4 MainThread、RenderThread 与 Hardware Layer:流式结果更新与帧时间。
- 15.1 Android Studio Profiler:应用侧 CPU 和内存分析。
常见误区
| 错误写法 | 可验证的改写 |
|---|---|
| Android 17 设备都支持 Gemini Nano | Android 版本只是条件之一,以支持列表和运行时状态为准 |
| AICore 固定运行在某个进程名 | 进程名是设备实现细节,应用只依赖公开 API |
| 每次生成固定两次 Binder | IPC 形态和流式回调属于实现细节,不把次数写成契约 |
| AICore 一定走 NPU | 官方只保证使用设备硬件加速并隐藏底层接口 |
| App PSS 正常说明推理内存正常 | App PSS 只覆盖调用端,需结合相关组件和整机压力 |
| ADPF 可以调 AICore/NPU 频率 | App 的 hint session 只包含本进程线程 |
| 前台服务可以继续生成 | 当前 ML Kit GenAI 要求 App 是 top foreground |
| AppFunctions 由 AICore 提供推理 | AppFunctions 提供工具注册与调用协议,不规定模型运行时 |
小结
- 先确认模型执行发生在应用内运行时、厂商后端还是系统托管服务,再分别测量模型准备、编译、数据搬运、硬件执行、回退和结果消费。
- Android 17 的 NPU feature 与调度接口控制直接访问资格和优先级,不提供一个能执行任意模型的通用 Framework 推理 API;设备支持仍取决于运行时、驱动、模型和产品配置。
- 系统托管 GenAI 还包含模型下载、服务排队、前台限制、配额和跨进程内存。调用端 PSS 和端到端墙钟时间各有各的含义,直接标成 NPU 时间属于误标。
- 性能优化要以冷/热路径、后端覆盖、复制次数、内存压力、帧时间和温控的同机对照为依据,凭“NPU”或“AICore”标签推断收益是站不住的。
参考资料
- Android 17 release notes:https://developer.android.com/about/versions/17/release-notes
PackageManagerAPI 37 reference:https://developer.android.com/reference/android/content/pm/PackageManager- NNAPI Runtime:https://source.android.com/docs/core/ota/modular-system/nnapi
- NNAPI migration guide:https://developer.android.com/ndk/guides/neuralnetworks/migration-guide
- LiteRT Android:https://developers.google.com/edge/litert/android
- LiteRT NPU acceleration:https://developers.google.com/edge/litert/next/npu
- Qualcomm NPU:https://developers.google.com/edge/litert/next/qualcomm
- MediaTek NPU:https://developers.google.com/edge/litert/next/mediatek
LiteRT、Play for On-device AI 和厂商兼容列表会独立更新。使用这些资料时应记录 runtime release 和查询日期,只记 Android 17 平台版本是不够的。
- Gemini Nano 与 AICore 架构:AICore 的系统服务定位、隐私边界、Private Compute Services、模型管理与硬件加速。
uses-feature声明与 Google Play 过滤:required的分发语义及系统安装检查边界。- ML Kit GenAI APIs 概览:共享模型、设备支持、模型版本、配额和前台限制。
- Prompt API Android 入门:
FeatureStatus、下载、生成、流式输出、warmup()与输入限制。 - LiteRT-LM Android Kotlin API:
Engine、后端选择、初始化、会话和资源关闭。 - AppFunctions 概览:Android 16+、实验状态、权限与工具协议边界。
- PerformanceHintManager.java(android-17.0.0_r1):hint session 的线程归属和能效偏好。
- PowerManager.java(android-17.0.0_r1):thermal status 与监听器。