移动端 LLM 推理的 DVFS 与能效边界
端侧 LLM 推理会同时占用 CPU、GPU 或 NPU 与内存带宽,还要消耗设备的散热余量。计算方式随阶段变化:prefill 一次处理输入上下文,decode 持续生成输出;模型加载、后端编译、采样(sampling)和 KV cache 管理又会在这两段计算之外引入额外开销。
只看平均 CPU 利用率或某一次 tokens/s,通常解释不了用户感受到的等待、速度波动和发热。本文围绕四个工程问题展开:
源码基线:平台
android-17.0.0_r1(Android 17 / API 37),内核android17-6.18-2026-06_r6。设备可能使用其他内核分支。
- 首个 token 等待时间(Time to First Token,TTFT)、每个输出 token 的平均时间(Time per Output Token,TPOT)与单 token 能耗(energy per token)应该如何定义和测量;
- EAS、CPUFreq、GPU / 内存 DVFS、ADPF(Android Dynamic Performance Framework)和温控分别负责什么;
- 普通应用能调节哪些负载参数,哪些操作只属于系统、厂商或取得最高系统权限的 root 实验;
- 如何判断一次优化确实节能,还是只是把耗电和热限频推迟到下一轮请求。
这些机制的基础分属不同章节:EAS 见 5.1 节,CPUFreq 与温控见 5.2 节,ADPF 见 5.4 节,端侧 AI 后端见 5.5 节。本文把它们放到同一条 LLM 请求时间线上观察。
先把指标定义清楚
LLM 的性能指标只有在起止点一致时才有可比性。我们建议在应用侧为每个请求分配一个标识符(ID),并记录下列时间戳:
t_request:请求进入推理 API;t_prefill_start、t_prefill_end:后端开始和结束处理输入;t_first_token:第一个可交付 token(模型处理文本时使用的基本单位)到达应用;t_i:第i个输出 token 到达应用;t_done:生成结束、取消或报错。
本文采用的 TTFT、TPOT 和单请求每输出 token 能耗定义如下:
TTFT = t_first_token - t_request

TPOT = (t_last_token - t_first_token) / (N_output - 1)
       仅在 N_output > 1 时定义

request_energy_per_output_token
    = (E_done - E_request) / N_output
      仅在 N_output > 0 时定义;E 为同一口径的累计消耗能量
按这套定义,TTFT 覆盖请求进入 API 后到首个 token 交付前发生的工作,可能包括分词、排队和冷启动;若模型创建或分词在 t_request 之前完成,就不会计入该 TTFT。点击到首个可见结果还需另计调用前处理和 UI 呈现。如果还要分析执行后端,我们另外报告 t_prefill_end - t_prefill_start,并分别测量模型文件读取、权重映射、delegate 初始化、计算图编译和首轮 kernel 预热。预热之后量到的后端时间属于热身后的稳态数据,报告里要与冷启动 TTFT 分开列。
TPOT 是整段 decode 的平均值,容易掩盖个别 token 的停顿,工程报告还应给出相邻 token 延迟(inter-token latency)的第 50、95 百分位数(P50、P95)、最大值和随时间变化的曲线。在采用推测解码(speculative decoding)、并行解码(decode)或一次提交多个 token 的运行时里,输出回调与硬件 kernel 可能不再一一对应;这时 token 到达间隔仍能描述用户体验,要推断每个 token 在硬件上的执行周期,还需要另找依据。
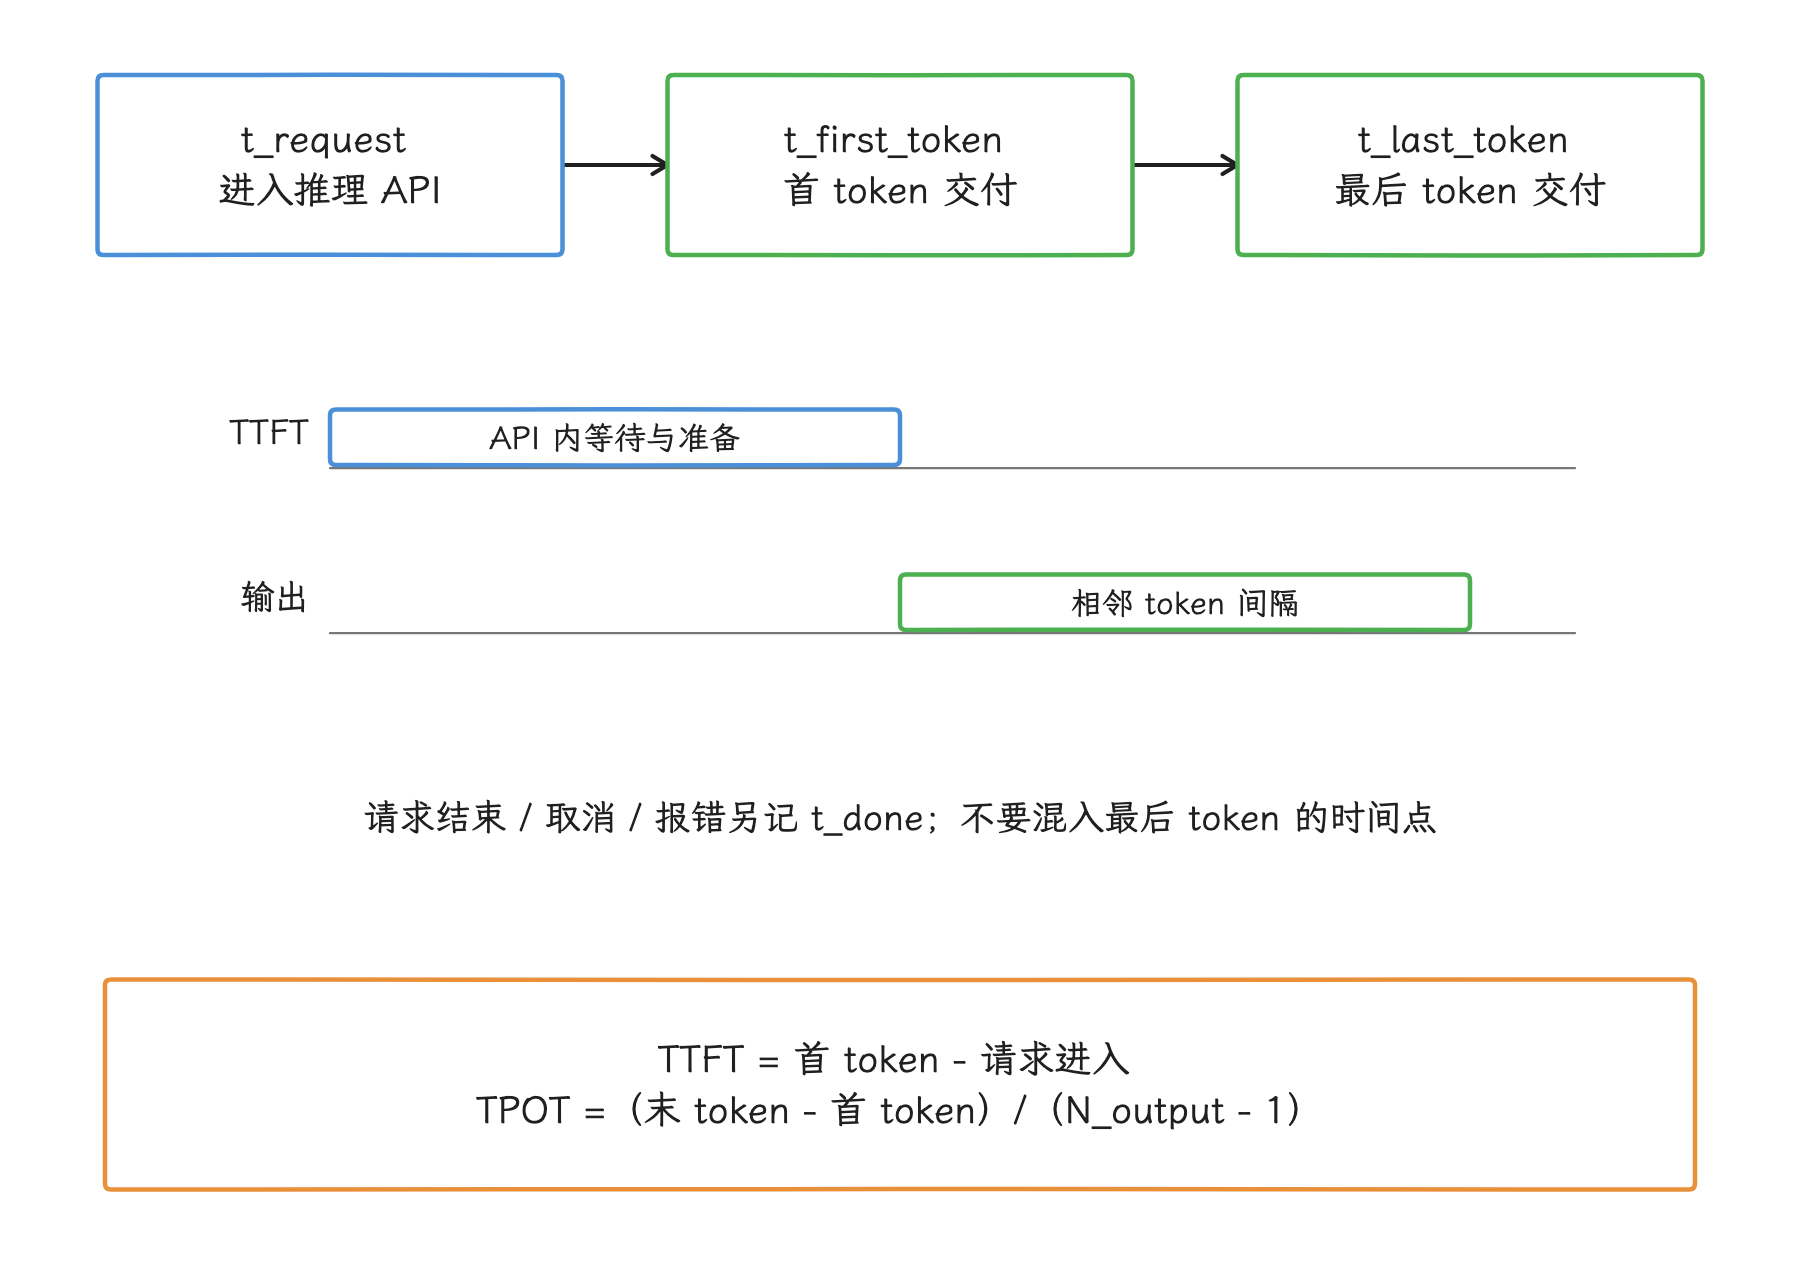
图:TPOT 仅在输出 token 数大于 1 时定义,并配合 P95 相邻 token 延迟。API 仅交付文本分片时,应改报分片指标,不能还原逐 token 时刻。
能耗同样要写清分母:
prefill_energy / input_token反映长输入 prompt 的处理成本;decode_energy / output_token适合比较连续生成;request_energy / output_token包含加载、prefill、decode 和应用开销;joules / successful_request以焦耳 / 成功请求为单位,还能反映取消、超时与失败造成的能量浪费。
这几组指标可以同时报告。横向比较之前,先确认两边用的是同一个分母,再谈“模型能效”的高下。如果 API 只交付文本分片而不暴露逐 token 时间,应报告首分片与分片间隔;按 tokenizer 统计分片里的 token 数,并不能还原各 token 的真实到达时刻。零输出的失败或取消请求保留在请求能量和成功率统计中。
一次请求经过哪些硬件
一次端侧推理请求会穿过多个执行层,每层都有一部分容易被漏看的成本;具体分工由模型格式、运行时和 delegate 决定。我们先用下表建立一个排查用的层次视图:
| 层级 | 常见工作 | 容易漏看的成本 |
|---|---|---|
| 应用与 tokenizer | 文本预处理、分词(tokenize)、流式回调、用户界面(UI)更新 | Java / Kotlin 对象分配、日志、频繁跨语言调用 |
| CPU 运行时 | 图调度、采样、算子补位、GPU/NPU 命令提交 | 单线程串行段、线程迁移、锁与唤醒 |
| GPU | 张量乘加、向量算子、部分注意力计算(attention)与后处理 | 短 kernel 间隙、命令提交等待、频率从低档升到高档所需的时间 |
| NPU | 支持范围内的编译图与加速算子 | 图切分、回退、编译缓存、厂商驱动约束 |
| 动态随机存取内存(DRAM)/ 系统缓存 | 读取权重和 KV cache,交换各后端数据 | 带宽竞争、容量压力、数据布局转换 |
| 存储 | 首次读取模型与编译产物 | 尚未进入内存缓存的文件页(冷页)、解压、校验、存储空间不足 |
| 显示、网络及其他进程 | 展示流式文本、下载上下文、系统并发任务 | 全机功耗与模型功耗混在一起 |
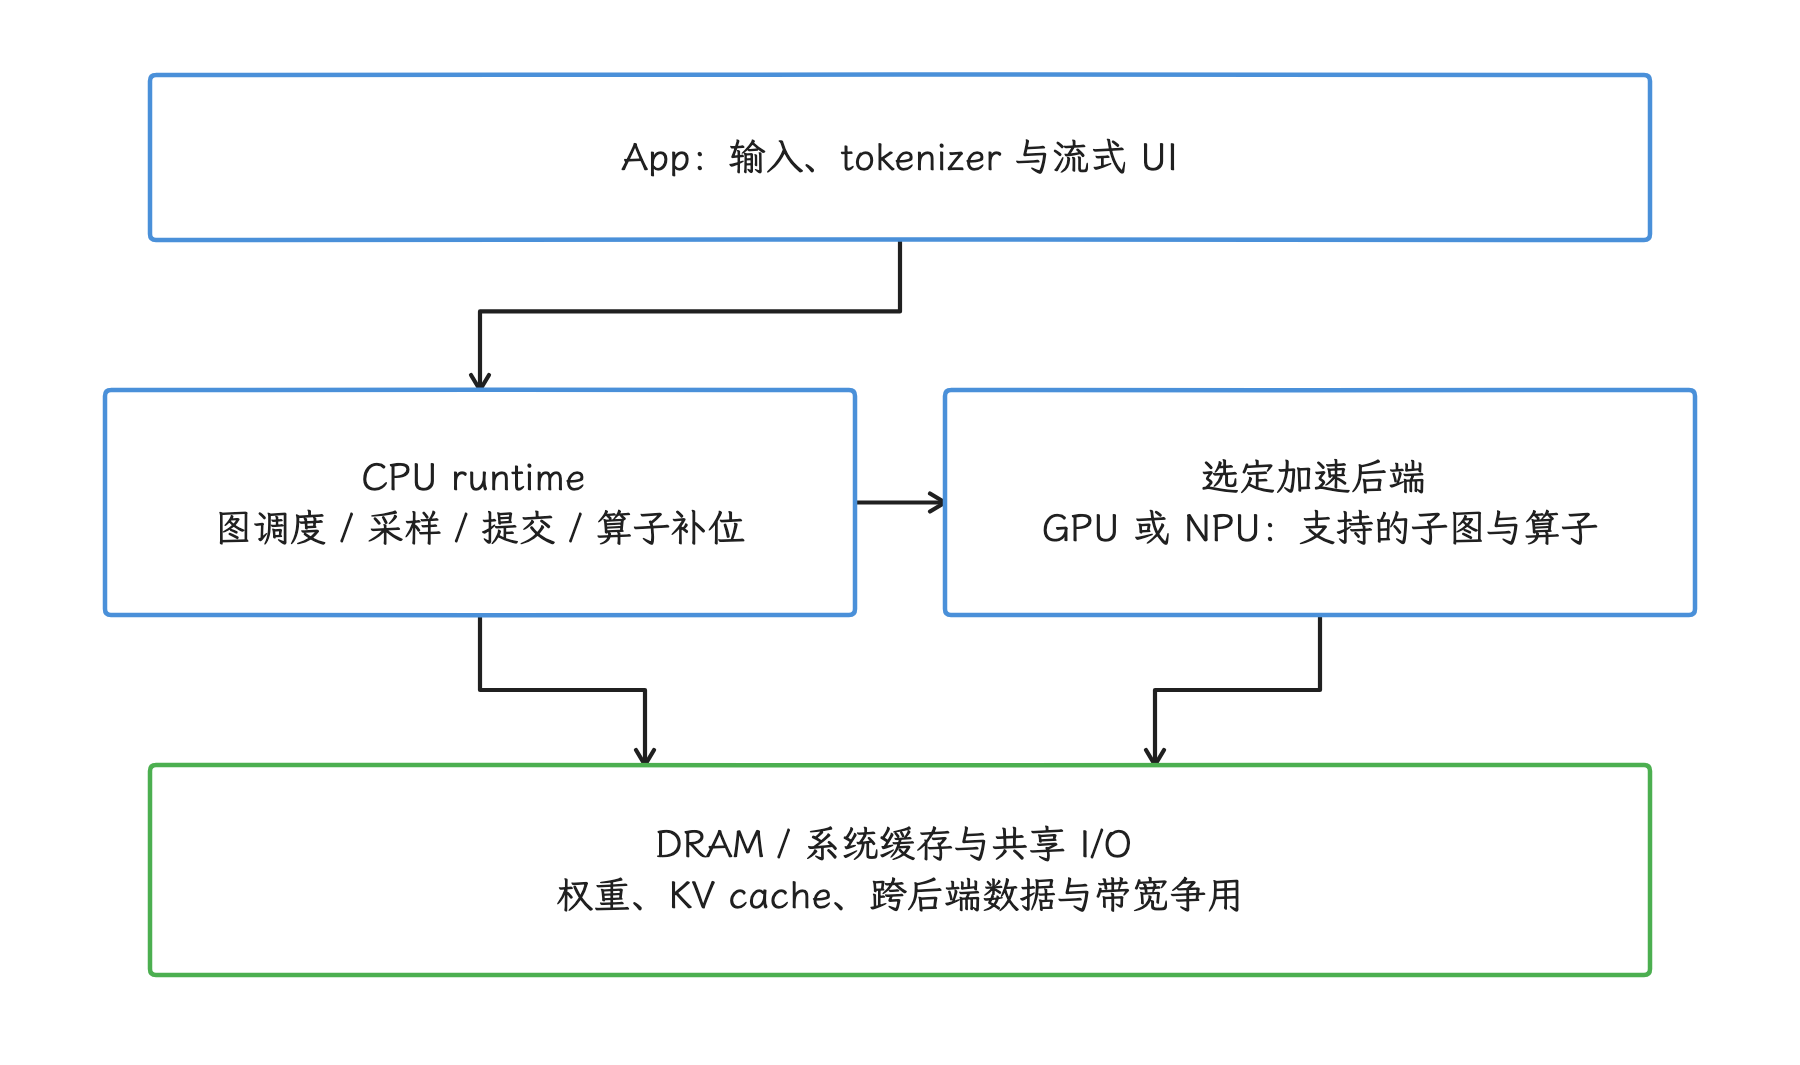
图:图为常见混合执行关系。模型加载还涉及存储,屏幕、网络与其他进程会进入整机能量;具体算子分工由模型、runtime 和 delegate 决定。
Prefill 与 Decode 的负载特征
prefill 和 decode 对硬件的压力形态差别很大,我们分开看这两段。
Prefill 的负载形态
Prefill 一次处理较长的输入序列,张量运算容易组织成批量工作,这是它与 decode 最直接的差别。随着 prompt 增长,计算量、权重读取、attention 中间数据和 KV cache 写入都可能增加。所以我们在 trace 里看到 GPU 或 NPU 利用率很高时,先别急着把瓶颈定在计算单元上:内存带宽、计算图分区、首次编译和 CPU 提交,都可能拖长 TTFT。
Decode 的负载形态
传统自回归 decode 每轮根据已有上下文生成后续 token,各轮之间存在数据依赖,可批量并行的工作通常少于 prefill。分工上,CPU 可能负责采样、运行时调度与命令提交,加速器则读取权重和不断增长的 KV cache。token 周期还会受采样策略、停止条件、上下文长度、计算图回退和系统抢占影响。
所以在 trace 上,decode 常呈现“CPU 短暂工作—提交—等待加速器—读取结果—采样”的交替节奏。某个硬件在一个采样窗口内利用率不高,它的运行频率仍可能影响端到端的 token 间隔。
调度与频率控制的分层
动态电压频率调节(Dynamic Voltage and Frequency Scaling,DVFS)按负载与约束调整硬件电压和频率。在这条链路上,EAS、CPUFreq governor、GPU / 内存策略和 Power HAL 各管一段,我们按层拆开看:EAS 决定任务放在哪个 CPU,schedutil 与 CPUFreq 决定 CPU 频率,GPU 与内存频率多由厂商实现,Power HAL、ADPF 与温控构成约束和提示层。
EAS 负责 CPU 放置
在 android17-6.18-2026-06_r6 中,kernel/sched/fair.c 的 find_energy_efficient_cpu() 会调用 compute_energy(),借助能耗模型(Energy Model)估算把刚唤醒的任务放到不同 CPU 之后的能量变化,回答的问题是“这个任务放在哪个可用 CPU 上更合适”。
注意 Energy Model 的用途:它服务于调度选择,量不了整机功耗。估算结果受任务利用率、CPU 容量、调度域、CPU 空闲状态、uclamp 和厂商扩展影响;它不知道一次 LLM 请求的 token deadline,也不直接控制 GPU 或内存频率。
schedutil 与 CPUFreq 负责 CPU 频率
同一内核版本里,kernel/sched/cpufreq_schedutil.c 的 schedutil governor 根据调度器利用率计算下一个目标频率:get_next_freq() 经过 map_util_freq() 等映射,并考虑策略容量、I/O wait boost、更新速率等条件;厂商可以通过 android_vh_map_util_freq 这个 vendor hook 调整映射。
最终频率还要叠加 CPUFreq policy 的最低 / 最高值、freq_qos 请求、热限制和硬件可用频点约束。
选核、选频与最终硬件频点的关系如下:
任务唤醒
  ├─ EAS / fair scheduler:选择可运行的 CPU
  └─ scheduler utilization → schedutil / vendor policy
                         → CPUFreq target
                         → policy、QoS、thermal clamp
                         → 硬件频点
这段流程里选核与选频会互相影响:任务落到哪个 CPU 核簇(cluster)会改变可用容量和频点,频率又会影响执行时间。所以两条路径要分开观察:任务迁核后变快,未必是 governor 升频的功劳;看到 cpu_frequency 变化,也未必说明 EAS 改变了放置决策。
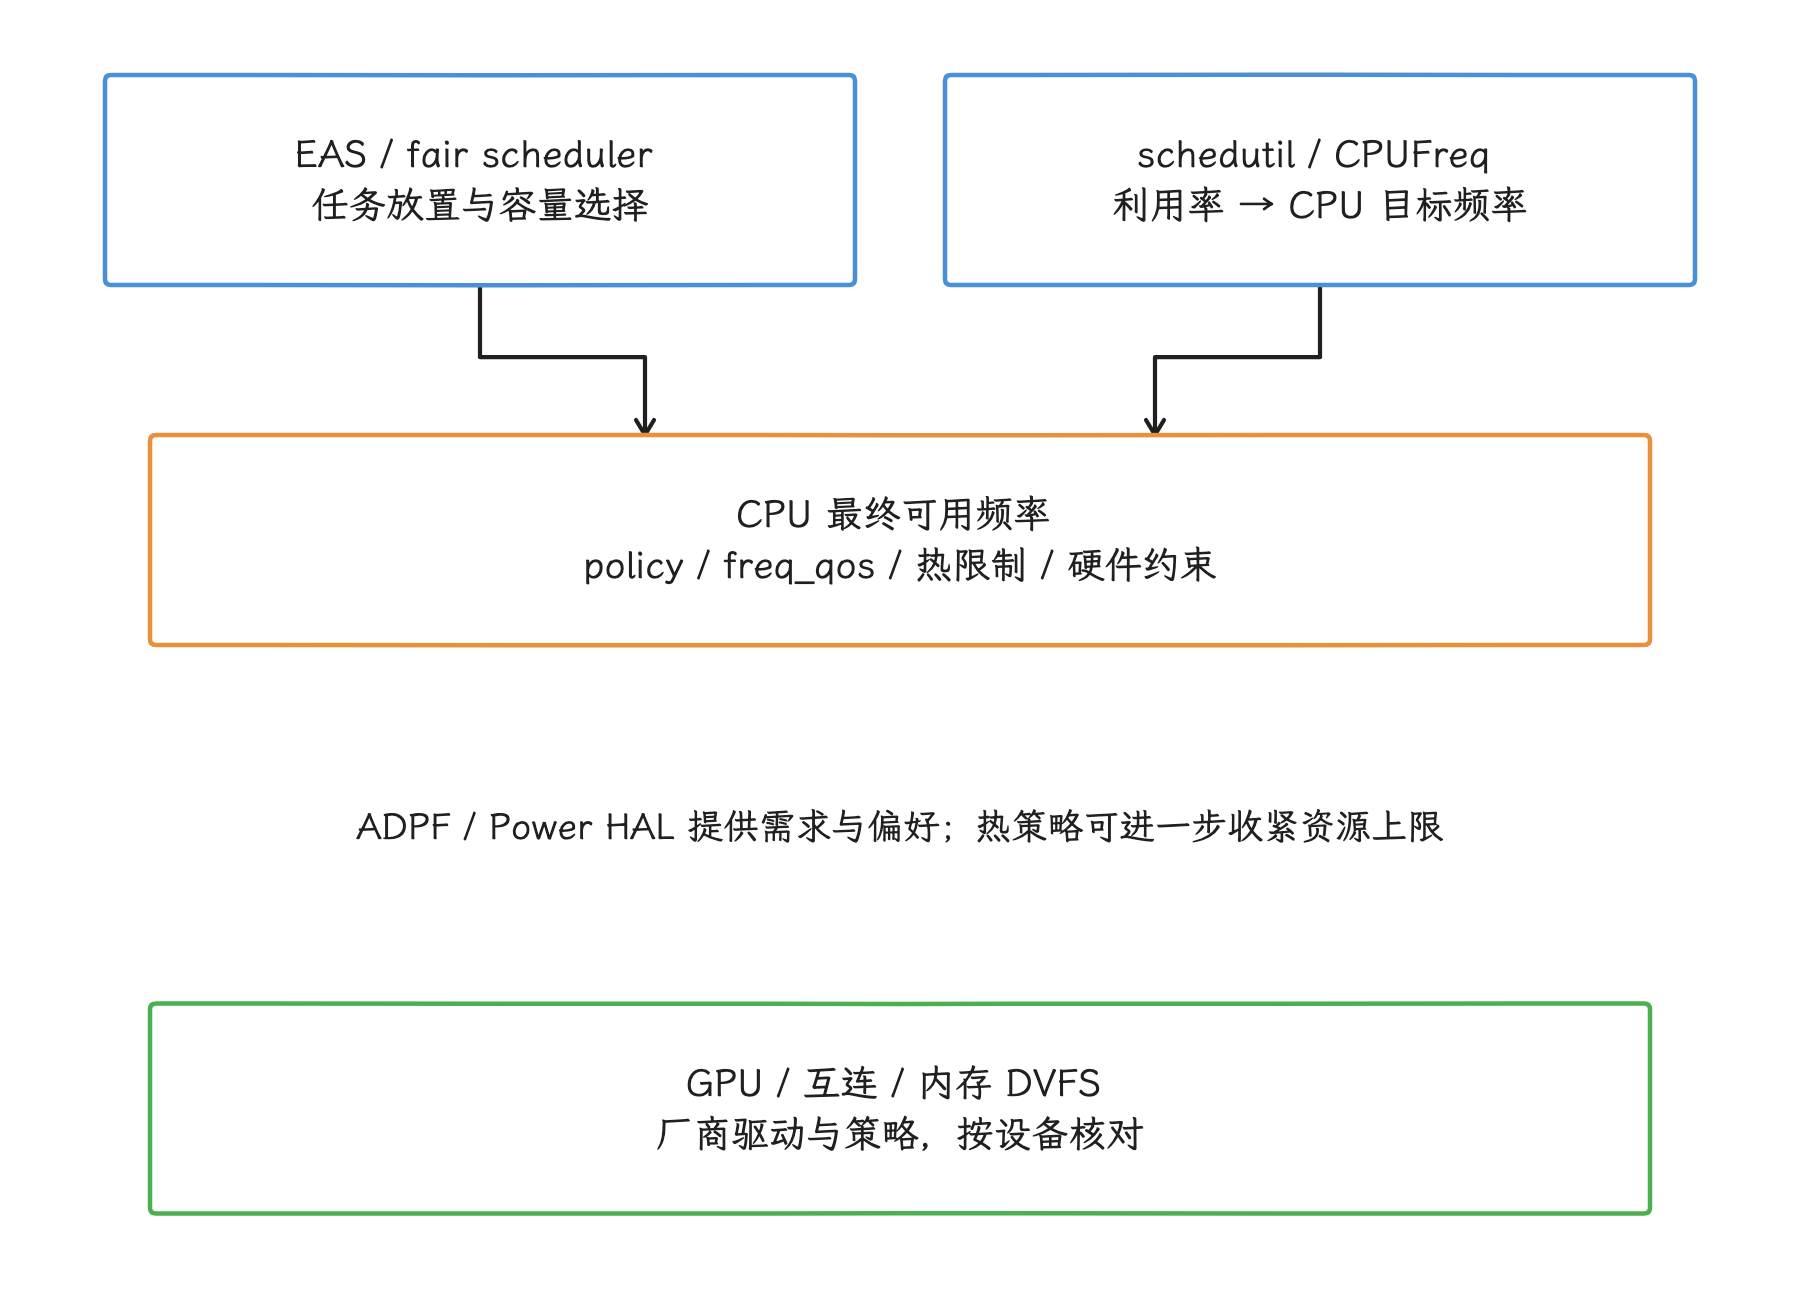
图:EAS 的能耗模型用于比较放置方案,不是整机功耗计。CPU 目标频率还受 QoS、温控与硬件限制;GPU/内存另有设备策略。
GPU 与内存 DVFS 多由厂商实现
Linux 提供了 devfreq 框架和通用 governor,但 Android 设备的 GPU、片上互连和内存控制器多由 SoC 厂商的驱动与策略管理,带宽请求和相关遥测数据(telemetry)也是。
AOSP 没有给普通应用提供指定 GPU 或 DRAM 频点的统一 API。某台设备上存在的 sysfs(内核向用户空间暴露状态和控制项的虚拟文件系统) 节点、tracepoint 或频率表,换一台设备就未必还在。
GPU delegate、NPU delegate 或厂商运行时可以通过驱动提交工作,间接触发性能状态变化;是否升频、升到哪里、维持多久,取决于厂商实现、系统功耗模式和热预算。
Power HAL、ADPF 与温控约束
AIDL 接口 IPower 支持创建性能提示会话(hint session)。Framework 把应用线程组、目标工作时长和实际工作时长交给 Power HAL,系统和厂商可以据此调整调度、频率或其他策略,也可以在不支持相应能力时忽略提示。对应用来说,性能提示是一个影响系统决策的输入,换不来保证的 CPU / GPU 频点。
温度达到限制后,thermal cooling device、CPUFreq / Devfreq 限制、Power HAL 和厂商策略都可能压低性能上限。这时再增加负载、增加线程数或反复发送性能提示,可能只是增加排队与功耗,突破不了热限制。
decode 阶段的利用率盲区
利用率驱动的策略本身没有问题,它看到的只是局部信号;LLM decode 又恰好容易让局部信号与端到端目标脱节。我们把容易出错的情形列出来:
- 串行依赖:CPU 必须等待加速器结果后才能采样并发起下一轮,任一侧空闲都可能表示正在等待前一阶段;
- 短时突发(burst):短 kernel 的利用率会在采样窗口内被平均;频率尚未稳定升高,工作可能已经结束;
- 跨设备交接:CPU 提交慢会让 GPU 暂时没有工作,GPU 执行慢又会让 CPU 休眠,两边的平均利用率都可能不高;
- 状态切换成本:升降频、唤醒 cluster、加载计算图和恢复缓存都需要时间;
- 带宽瓶颈:计算单元频率提高后,如果权重或 KV cache 受带宽限制,延迟改善会很小;
- 热与功率上限:观测到的低频可能来自 thermal clamp 或平台功率预算,不一定是 governor 低估了利用率;
- 后台竞争:相机、显示、网络、系统服务和其他应用会共同消耗 CPU、内存带宽与热余量。
所以诊断要从 token 时间线开始,再关联 CPU 放置、CPU / GPU 频率、调度、内存、功耗和温度。单张利用率(utilization)截图说明不了升频策略的问题。
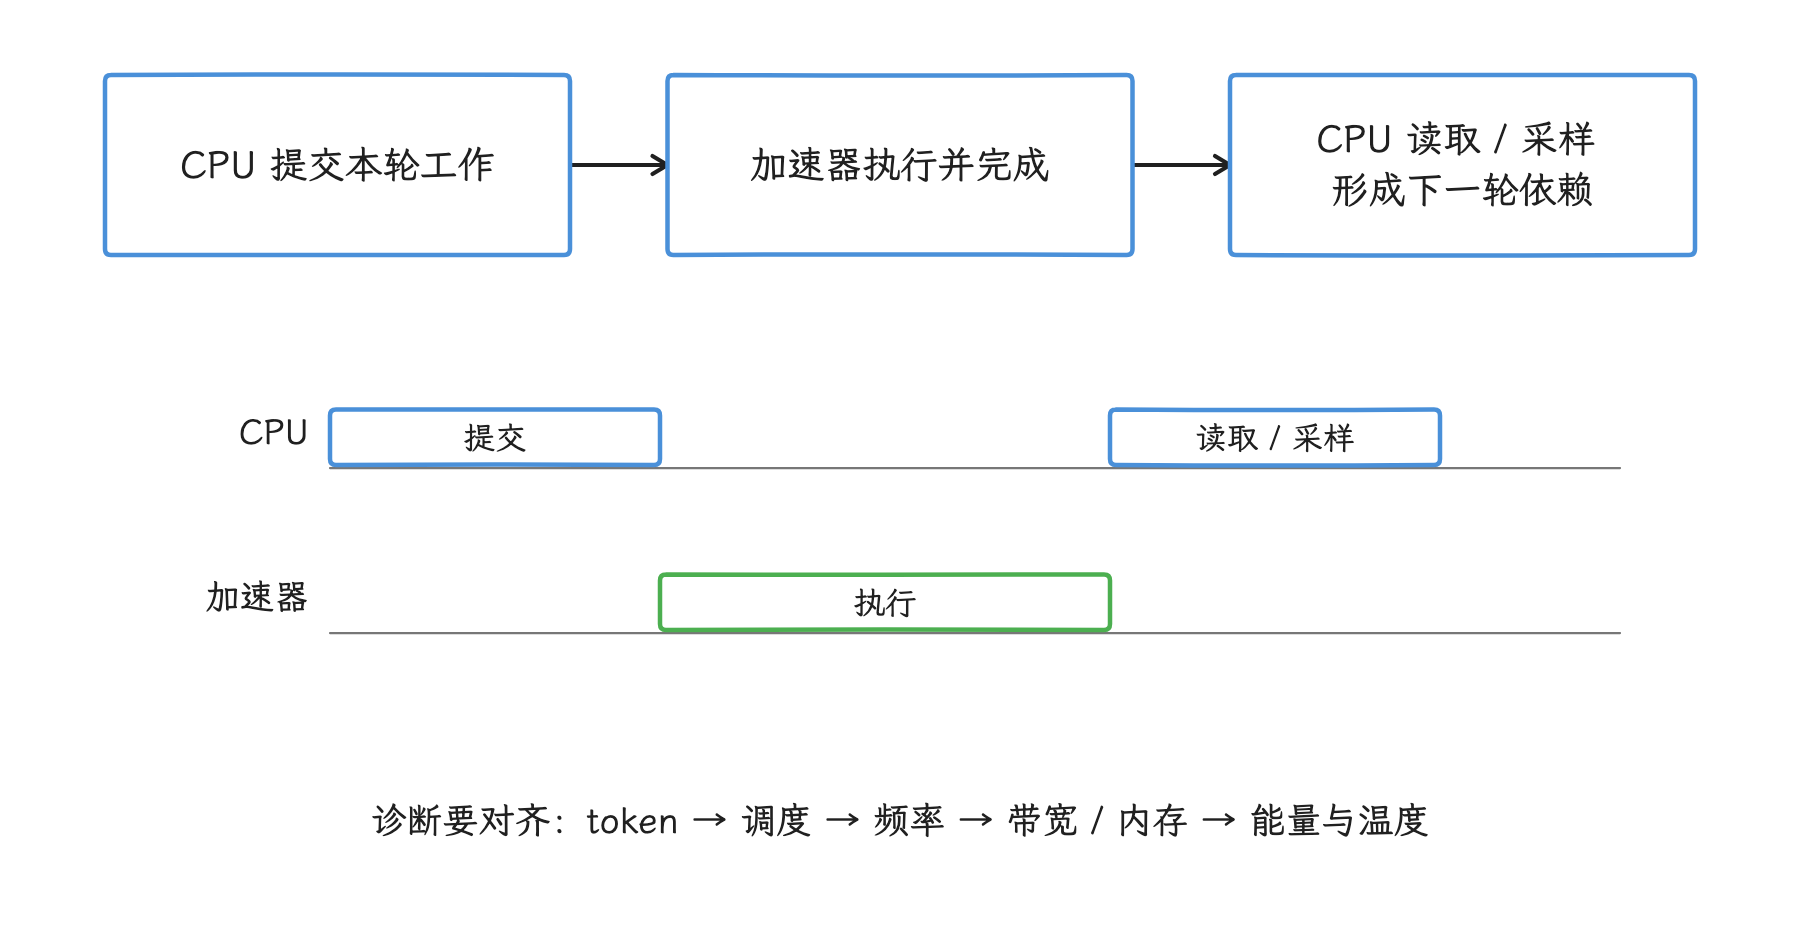
图:示意一个依赖周期,长度不代表实测时间。CPU 或加速器空闲可能是在等待另一侧,带宽与热限制也会拉长周期;低利用率本身不证明 governor 失效。
FUSE 论文:Pixel 7 上的频点组合实验
论文 Dissecting the Impact of Mobile DVFS Governors on LLM Inference Performance and Energy Efficiency(arXiv:2507.02135)研究的问题很具体:各 governor 独立选出的频率组合,可能偏离某个 LLM 请求在给定能耗预算下的低延迟组合。FUSE 是论文提出并评估的联合频率选择原型。
我们先看实验条件,它们决定了结论能用到哪里:
- 设备为已取得 root 权限的 Pixel 7 / Pixel 7 Pro,片上系统(SoC)是 Tensor G2,GPU 是 Mali-G710 MP7;
- 系统为 Android 13,CPU 使用论文所述
sched-pixel/ EAS 配置,GPU governor 为quickstep,内存策略为interactive; - 推理运行时为带 OpenCL / CLBlast 计算后端的 llama.cpp,论文原型基于 llama.cpp
b2202; - 设备经过拆机并绕过电池供电,屏幕关闭,Monsoon 外置功耗仪以 0.2 ms 间隔采样;
- 实验通过 root 接口将最低 / 最高频率设为同一值,从而固定频率;
- FUSE 评估包含 4-bit 模型和 ShareGPT 请求子集,prompt 与输出长度受到论文设定限制。
在这些条件下,论文报告了以下代表性现象:
| 场景 | governor 观测值 | 固定频率实验 | 论文报告的 TPOT 变化 |
|---|---|---|---|
| TinyLlama decode / GPU | 约 424.4 MHz | 848 MHz | 降低 41.0% |
| StableLM decode / GPU | 约 411.4 MHz | 762 MHz | 降低 34.6% |
| TinyLlama decode / CPU | 约 1130.8 MHz | 2252 MHz | 降低 13.2% |
| StableLM decode / CPU | 约 1038.8 MHz | 2401 MHz | 降低 13.4% |
这些表格行来自隔离单个 governor 的实验:测 GPU 时固定 CPU/内存,测 CPU 时固定其他部件,并非每行都表示整机所有 governor 同时默认运行。以 TinyLlama 的 GPU 案例为例:论文给出默认 governor 下 TPOT 为 215.1 ms、单 token 能耗为 402.7 mJ(毫焦耳);固定 GPU 848 MHz 后,TPOT 为 126.9 ms、单 token 能耗为 396.5 mJ。在这台设备与这一请求上,提高 GPU 频率缩短了执行时间,单 token 能耗仍与默认 governor 相近。这条数据支持的是这一个组合上的观察,还撑不起“GPU 总应保持高频”这样的普遍结论。
论文的前期测量枚举 CPU、GPU、内存频率组合;FUSE 原型的高效搜索则先选 GPU 候选频点,再搜索 CPU 频点,内存保留默认 governor。运行时按 prefill/decode 阶段和输入长度范围选择已测配置。论文的 TTFT 按其 prefill 计时、不包含输入排队,与本文 API 进入到 token 交付的边界应区分。论文在其工作负载上报告:单 token 能耗相同时,TTFT 平均改善 7.0%~16.9%,TPOT 平均改善 25.4%~36.8%。
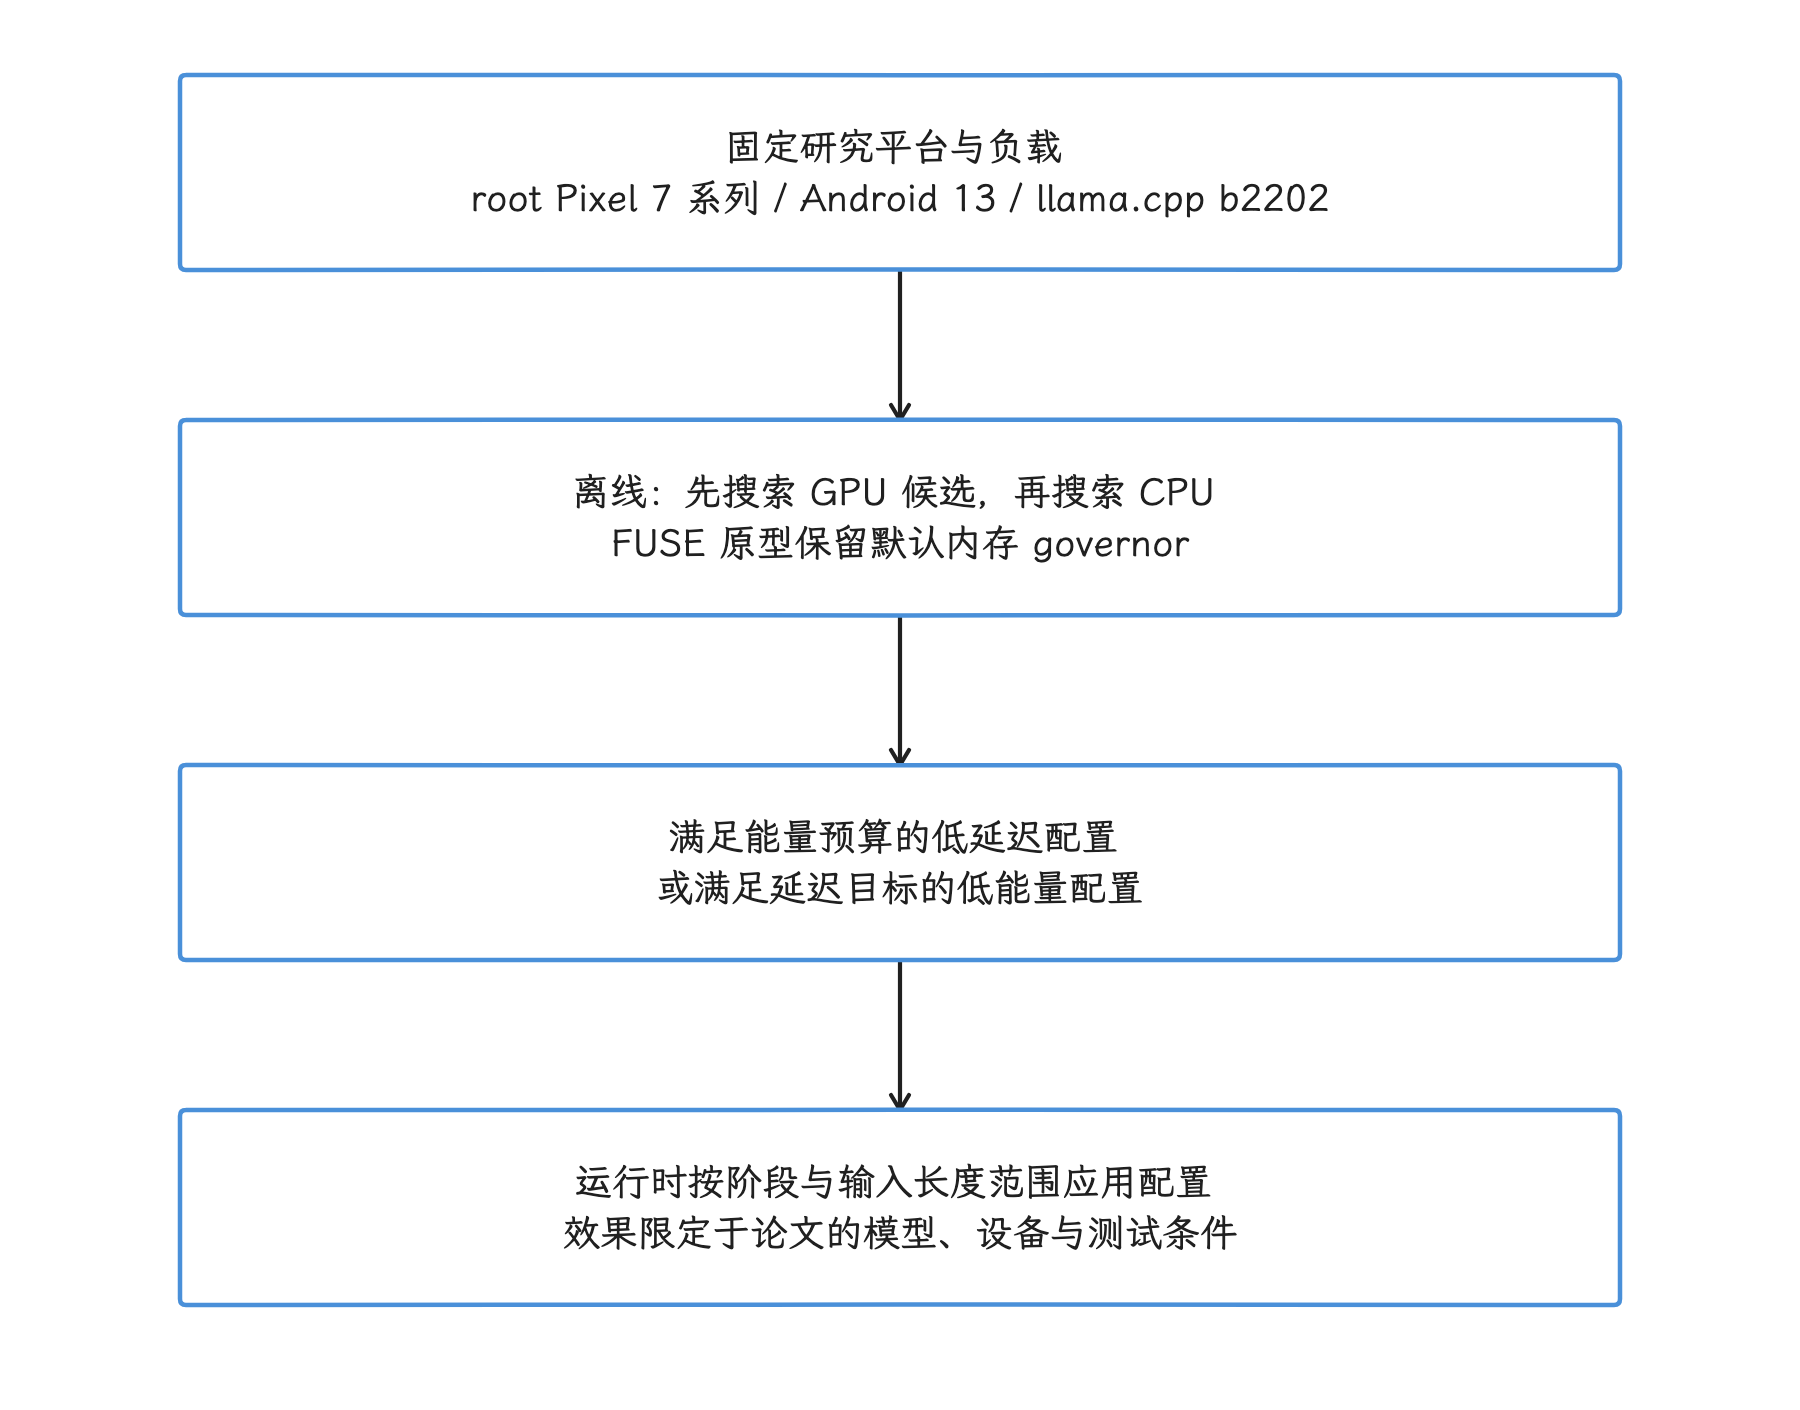
图:FUSE 并未在其高效搜索中枚举内存频点。论文设备拆机、旁路电池、关屏,用外置功耗仪测量;结果不能直接外推到 Android 17 量产 App 或 NPU。
这项研究能支持的工程判断是:CPU、GPU、内存和请求阶段要联合测量,各自独立的利用率策略可能错过更好的组合。把结果外推之前,先对照这份清单:
- Android 17 的调度器和厂商策略;
- Snapdragon、MediaTek 或其他 Tensor 代际;
- 当前 LiteRT-LM、其他 llama.cpp 版本或不同算子后端;
- NPU delegate;
- 未 root 的量产应用;
- 屏幕点亮、联网、边充边测等不同整机条件。
复现这篇论文时,我们把它当作 root 实验机上的机制验证:固定频率脚本依赖 root 接口,普通量产应用没有对应入口,它会改变默认 governor 的选频行为,但只写最小 / 最大频率并不保证绕过热限制、QoS 或硬件约束;是否另改温控必须单独记录。
普通应用、系统组件与 root 实验各能做什么
能用的手段取决于代码运行的位置。下表按普通应用、系统 / 厂商组件与 root 实验机分列:
| 能力 | 普通应用 | 系统 / 厂商组件 | root 实验机 |
|---|---|---|---|
| 选择模型、量化、上下文长度、采样参数 | 可以 | 可以 | 可以 |
| 选择运行时公开的 CPU/GPU/NPU 后端 | 可以,受设备支持限制 | 可以 | 可以 |
| 调整线程数、批次与请求队列 | 可以 | 可以 | 可以 |
| 创建 ADPF hint session | API 与设备支持时可以 | 可以 | 可以 |
| 查询公开 thermal status / thermal headroom | API 支持时可以 | 可以访问更多内部信号 | 可以 |
| 调用 AIDL Power HAL | 不可以直接调用 | 可以按平台权限和架构调用 | 可实验,不代表应用接口 |
| 固定 CPU/GPU/内存频率 | 不可以 | 厂商策略可管理 | 常可通过调试接口(debug)/ sysfs 实验 |
| 修改 governor、调度器或 thermal 配置 | 不可以 | 平台集成阶段可以 | 可实验 |
| 读取原始 PowerStats / 厂商能量通道 | 通常受权限限制 | 可以按权限获取 | 常可获取 |
普通应用应通过模型、上下文长度、线程数和请求队列等参数改变工作负载,并向系统描述时间目标;指定硬件频率这件事不在应用侧。Power HAL、调度参数、GPU / 内存策略和 thermal 配置适合由系统团队评估。两类结论需要分开记录,避免把 root 实验结果写成 SDK 能力。
用 ADPF 描述周期工作
我们可以用 android.os.PerformanceHintManager 为一组相互关联、长期存在的线程创建性能提示 Session。下面示例只为应用自管的稳定 CPU 工作段建立会话;target 与 actual 都对应这个 CPU 工作段,并在场景内复用会话:
// API 31+;在负责该 CPU 工作段的长期线程中串行执行。
PerformanceHintManager manager =
        context.getSystemService(PerformanceHintManager.class);
long targetNanos = decodeCpuTargetNanos; // 产品分配给本 CPU 段的预算
PerformanceHintManager.Session session = manager == null ? null :
        manager.createHintSession(
                new int[] {android.os.Process.myTid()}, targetNanos);
try {
    while (decoder.hasNextStep()) { // 应用自己的场景循环
        long start = System.nanoTime();
        decoder.runDecodeCpuPhase(); // 不包含 UI 消费或设备侧完成等待
        long actual = System.nanoTime() - start;
        if (session != null && actual > 0) {
            session.reportActualWorkDuration(actual);
        }
    }
} finally {
    if (session != null) session.close();
}
这段代码表达“这些线程会周期性完成一轮工作,并希望在目标时间内结束”。createHintSession() 可能返回 null,所以应用必须保留没有 hint session 时仍可正确执行的路径。线程 ID 应来自被度量 CPU 工作的长期 worker;示例用 Process.myTid() 取得 Linux TID,不能用 Java Thread.getId()。同一 Session 的更新、上报和关闭要串行化;只有公共 API 明确支持且边界匹配时,才使用 WorkDuration 分别报告 CPU/GPU 工作,不能把整个服务请求等待直接当成本进程 CPU 工作。
这个 Session 的主要操作包括:
updateTargetWorkDuration(long):目标发生变化时更新期限;reportActualWorkDuration(long):每个周期报告实际时长;setThreads(int[]):长期 worker 集合变化时更新线程;setPreferPowerEfficiency(boolean):在相应的 flagged API(功能开关(flag)控制可用性)可用时表达能效偏好;reportActualWorkDuration(WorkDuration):在相应 flagged API(由平台功能开关控制是否可用的 API) 可用时报告总时长及 CPU / GPU 时长;close():工作结束后释放 session。
LLM decode 具有周期性,可以把一个稳定的 token 生成过程或一组 token 作为工作周期,但要满足三个条件:
- session 覆盖长期 worker,避免每生成一个 token 就创建和销毁 session;
- target 来自产品可接受的 token 周期或吞吐目标,避免长期填一个达不到的极小值;
- actual duration 的起止点固定,避免这轮只量 GPU、下一轮又把采样与 UI 回调计入。
Prefill 往往是一段较长的批量工作。如果运行时没有稳定、可重复的 prefill 分块(chunk)周期,把整段 prefill 硬当作一个高频次重复的周期上报,信号会难以解释。我们可以为起止点明确的 prefill chunk 单独建 session,也可以只为 decode 建立 session,用 trace 另行评估 TTFT。
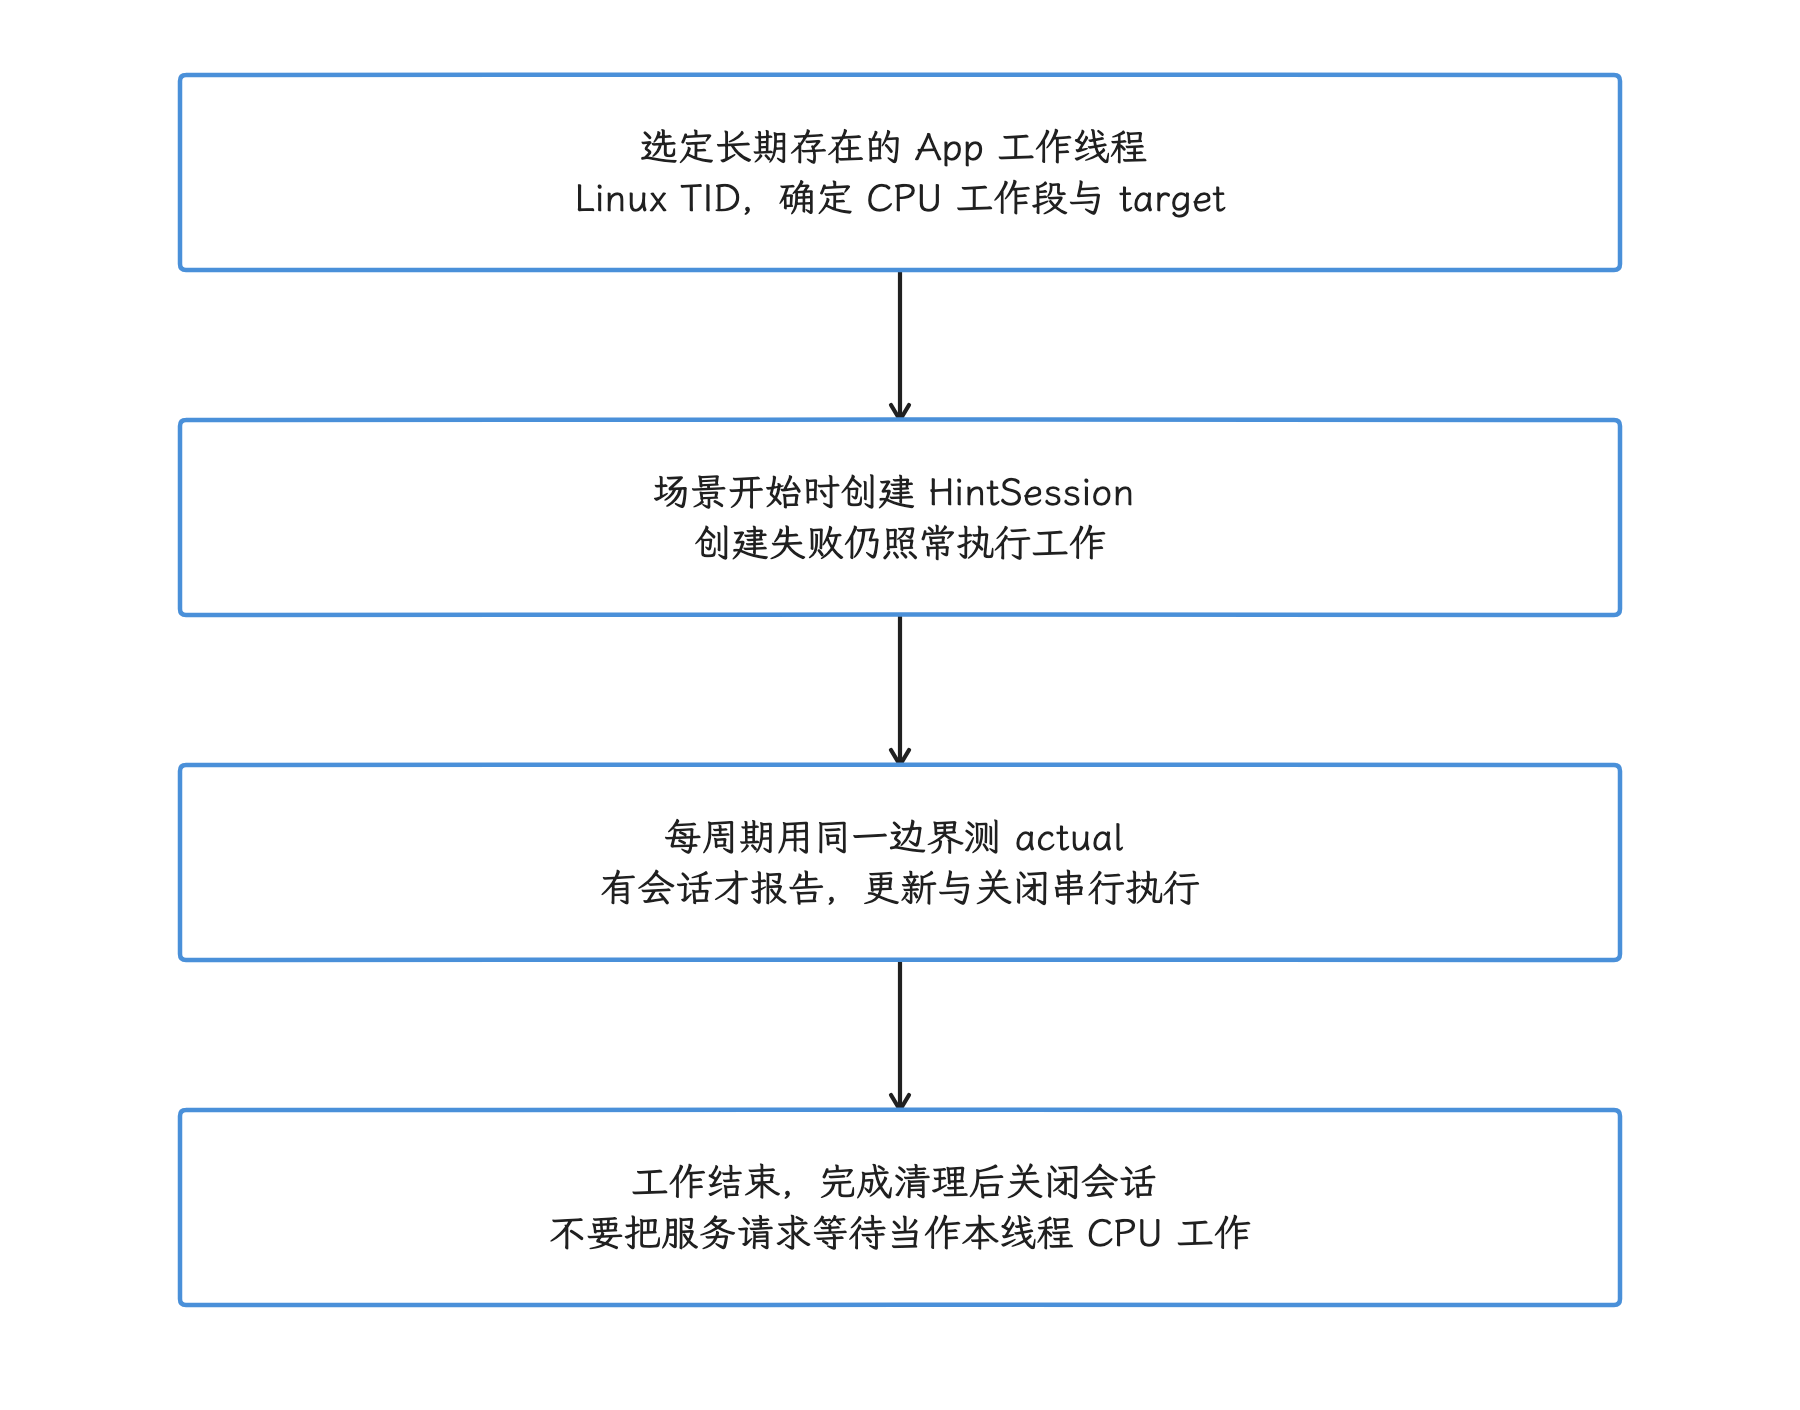
图:target 与 actual 必须对应同一工作范围。ADPF 只提供提示;GPU 细分报告需遵循 WorkDuration 契约,不控制 AICore 服务或保证频率。
目标时长也不是越短越好。如果产品只要求稳定达到某个 token 速率,可以将 target 设在体验预算附近,并在温度升高、电量策略变化或应用进入后台时适当放宽。setPreferPowerEfficiency(true) 只表达偏好,最终选择仍由平台决定;调用前检查当前 SDK、flag 和设备能力。
直接调用 IPower.createHintSession() 是系统侧的用法:Framework API 负责身份、权限、生命周期与版本兼容处理,AIDL HAL 则是系统与厂商实现之间的接口,普通应用通过 Framework API 使用 hint session。
从模型和运行时减少无效工作
频率策略只能在既定工作量上做取舍。对普通应用而言,先把每个请求必须完成的计算和数据传输降下来,通常比寻找某个固定频点更稳定。
量化与模型尺寸
降低权重位宽,也就是用更少的二进制位表示权重,通常能减小模型体积和权重带宽需求,但收益取决于后端是否有相应的高效 kernel。某种量化格式的文件更小,设备上的 delegate 未必更快。选择时要同时检查:
- 后端是否原生支持该位宽与分组方式;
- 不支持的算子是否回退 CPU;
- 反量化(将低位宽数值转换为计算所需格式)是否增加临时内存和计算;
- 精度、输出稳定性和安全评测是否仍满足产品要求。
KV cache 与上下文长度
未压缩 KV cache 的主体容量可以粗略估算为:
KV bytes ≈ 2 × layers × tokens
           × num_kv_heads × head_dim × bytes_per_element
该式假定单条序列、各层 KV 形状一致且 key/value 维度相同,系数 2 对应 key 和 value。相同长度的 batch 还要乘 batch size;不同序列长度则逐条求和,并另计对齐、分页、预分配和元数据开销。分组查询注意力(GQA)、多查询注意力(MQA)、分页 cache、量化 cache、滑动窗口或特殊布局,都会让公式参数和额外元数据发生变化。
上下文越长,cache 容量与访问成本通常越高,也更容易触发内存压力。我们应记录运行时真实分配、RSS 和 PSS,只按模型配置推算是靠不住的。
产品可以控制历史消息长度、检索片段数量、system prompt 大小和最大输出 token 数。截断规则要与语义评测一起验证,避免以明显降低回答质量为代价换取更高的 tokens/s。
后端选择与图切分
选定 CPU、GPU 或 NPU 后端,整张计算图未必都在相应硬件上执行。我们通过运行时日志、delegate 诊断或厂商工具确认:
- 哪些算子被加速后端接收;
- 是否发生 CPU 回退,即不受加速器支持的部分转由 CPU 执行,以及是否存在频繁同步;
- 权重格式是否匹配目标后端;
- 编译缓存是否命中;
- 首次请求和后续请求是否使用同一路径。
切换后端前,需要按设备型号、模型和版本建立对照基线。GPU 在某台设备上更快,在短 prompt、低电量或持续受温控限制时未必仍然更省电。
模型与 session 生命周期
如果内存预算允许,应复用模型映射、已编译计算图、tokenizer 和长期运行的 session,避免每次对话都重复加载与编译。复用时还需处理:
- 前后台生命周期与进程回收;
- 多会话 KV cache 的容量上限和淘汰策略;
- 模型升级后的缓存失效;
- 取消请求后 worker、缓冲区(buffer)和 hint session 的清理;
- 低内存回调和设备热状态变化。
建立可复现的能效实验
这一节按五个环节搭建能效实验:固定负载、标记阶段、采集频率、区分功耗、积分与重复试验。我们从固定工作负载开始。
1. 固定工作负载组合
能效实验要能被别人复现,第一步是把工作负载钉死。至少记录以下维度:
- 设备型号、SoC、系统构建版本(build)、内核 build;
- 模型名称、精度、量化格式和文件哈希;
- 运行时、delegate、驱动版本;
- prompt token 数、目标输出 token 数和采样参数;
- CPU 线程数、CPU 亲和性(affinity)或运行时调度选项;
- 冷启动、热启动、首轮预热(warm-up)是否计入;
- 屏幕亮度、网络、充电状态、后台进程;
- 环境温度、测试开始时的电池温度和热状态(thermal status)。
结果要按这些维度分组。将 32-token prompt 和 2K-token prompt 的 TTFT 混合求平均,所得数值很难用于指导优化。
2. 用应用 trace 标记请求阶段
我们为请求、prefill、decode、采样、回调和模型加载添加 Perfetto slice,token 事件应包含请求 ID 与序号,避免并发请求互相覆盖。事件只打在阶段边界上;给每个很小的函数都生成大量 trace 事件,测量本身就会改变 token 周期。
3. 同时采集 CPU 频率变化与轮询值
采集频率时要留意两套数据来源:Perfetto 的 power/cpu_frequency tracepoint 只在频率变化时产生事件,trace 开始时不保证给出初始频率;linux.sys_stats 的 cpufreq_period_ms 可以补上周期性读取的频率值。这份精简配置同时采集频率变化、CPU 空闲、调度事件和 100 ms 频率轮询:
buffers {
  size_kb: 65536
  fill_policy: RING_BUFFER
}

data_sources {
  config {
    name: "linux.ftrace"
    ftrace_config {
      ftrace_events: "power/cpu_frequency"
      ftrace_events: "power/cpu_idle"
      ftrace_events: "sched/sched_switch"
      ftrace_events: "sched/sched_wakeup"
    }
  }
}

data_sources {
  config {
    name: "linux.sys_stats"
    sys_stats_config {
      cpufreq_period_ms: 100
    }
  }
}
这段配置使用 ring buffer,数据写满后会覆盖旧数据。100 ms 适合作为观察长期趋势的起点,解析单个很短的 kernel 就不够用了。分析短周期时,我们把频率变化事件、调度 slice 和应用 token 标记放在一起看,同时评估 trace 本身的开销。
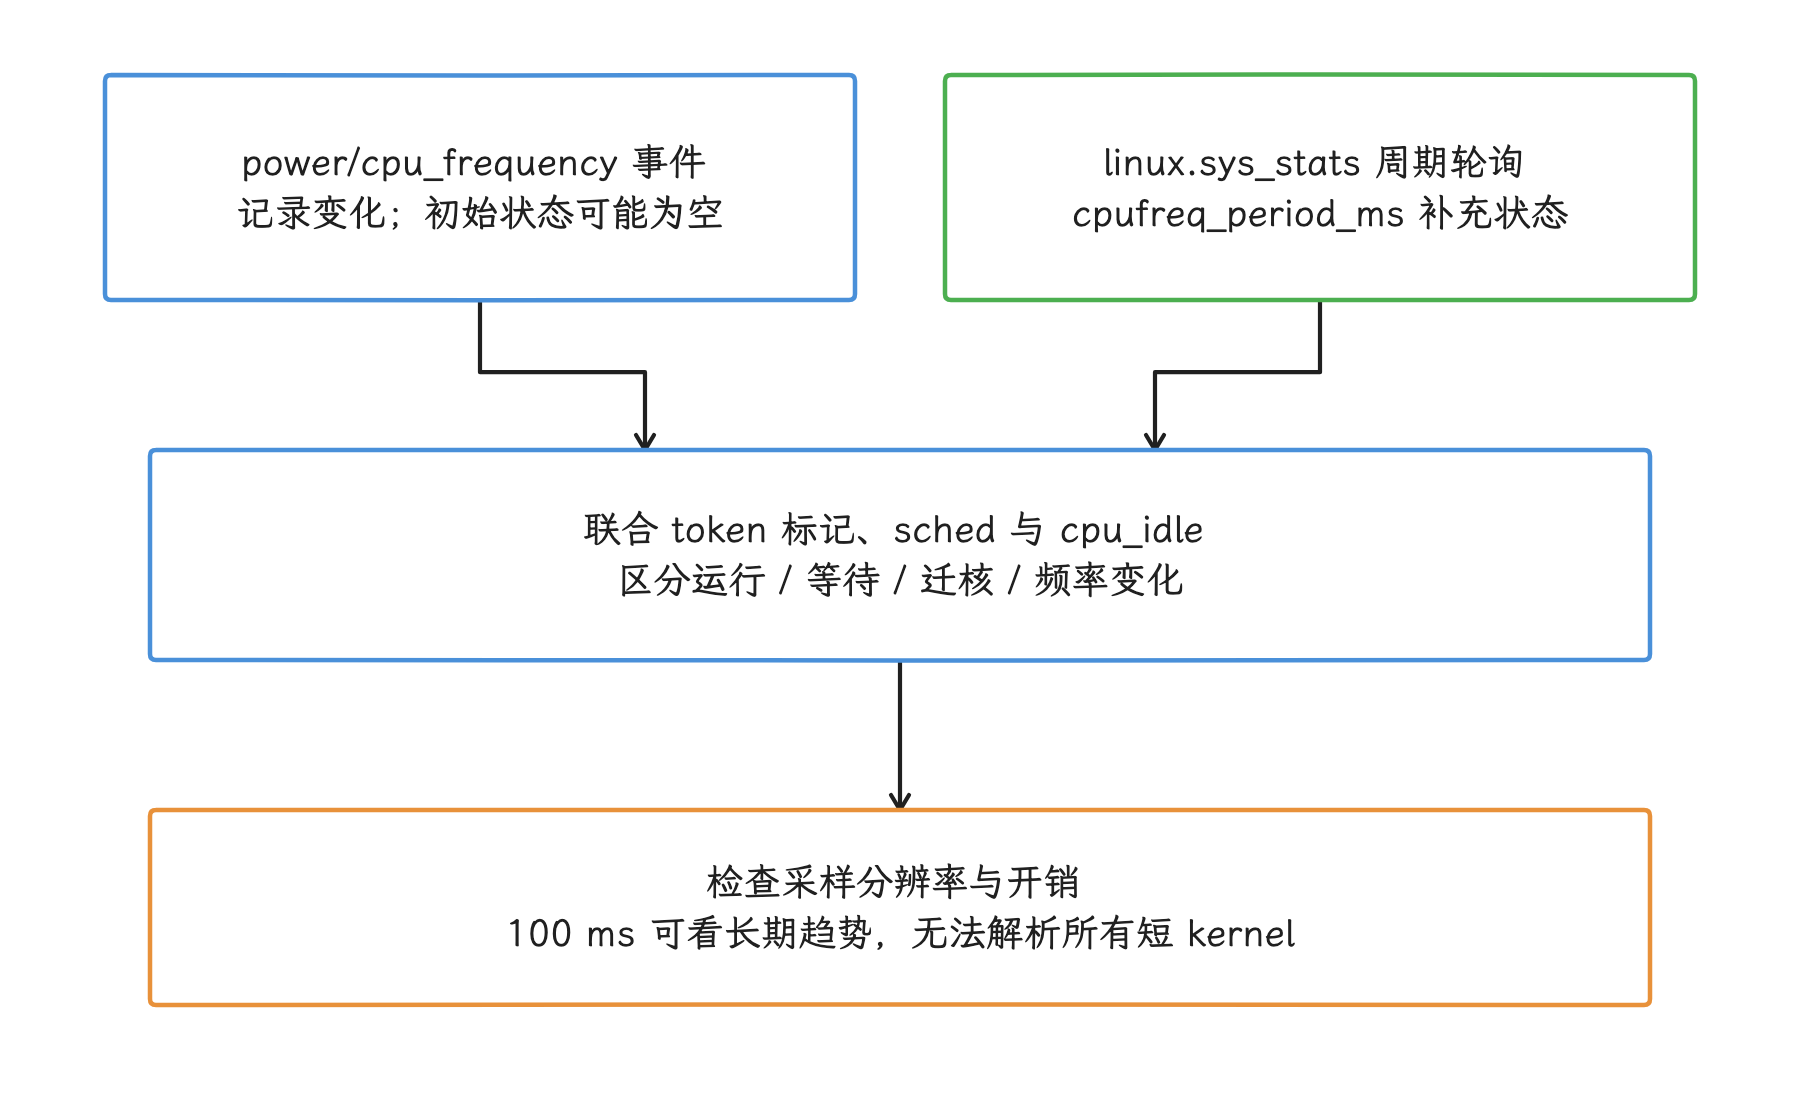
图:变化事件与轮询提供不同证据。CPUFreq 通常按 policy/簇共享,读到的频率及支持情况依设备实现解释;GPU/NPU/内存轨道另行确认。
GPU、NPU、互连和内存频率数据源依赖设备,采集前要确认 counter 的名称、单位和更新含义。
4. 区分整机功耗与部件能量
这段 Perfetto android.power 配置每 250 ms 采集电量百分比、电流、电压等电池计数器,并请求采集部件能量轨道(power rails):
data_sources {
  config {
    name: "android.power"
    android_power_config {
      battery_poll_ms: 250
      battery_counters: BATTERY_COUNTER_CHARGE
      battery_counters: BATTERY_COUNTER_CAPACITY_PERCENT
      battery_counters: BATTERY_COUNTER_CURRENT
      battery_counters: BATTERY_COUNTER_VOLTAGE
      collect_power_rails: true
    }
  }
}
这份配置里的电池电流和电压代表整机,屏幕、调制解调器与后台任务都计在结果里。USB 充电会改变电池计数器的含义,边充电边测到的数据要与放电测试分开比较。collect_power_rails 依赖设备的 IPowerStats 实现,很多量产设备不提供可用的 rail;拿不到 rail 数据时就如实报告“不可用”,别用估算值填补。
IPowerStats 把 energy consumer 与 energy meter 作为厂商定义的数据返回,累计能量以微瓦秒等明确单位计量;调用方还要处理结果暂不可用、缺少按 UID 归因,以及通道名称因设备而异等情况。原始 HAL 数据通常不在普通应用的权限范围内。
使用外置功耗仪时,要记录供电路径、采样频率、电压设置、电池是否被旁路、屏幕状态与 ADB 连接状态。外置仪器能提高采样一致性,但拆机并旁路电池后的结论仍只适用于相应实验条件,与正常电池供电的数据要分开存放、分开比较。
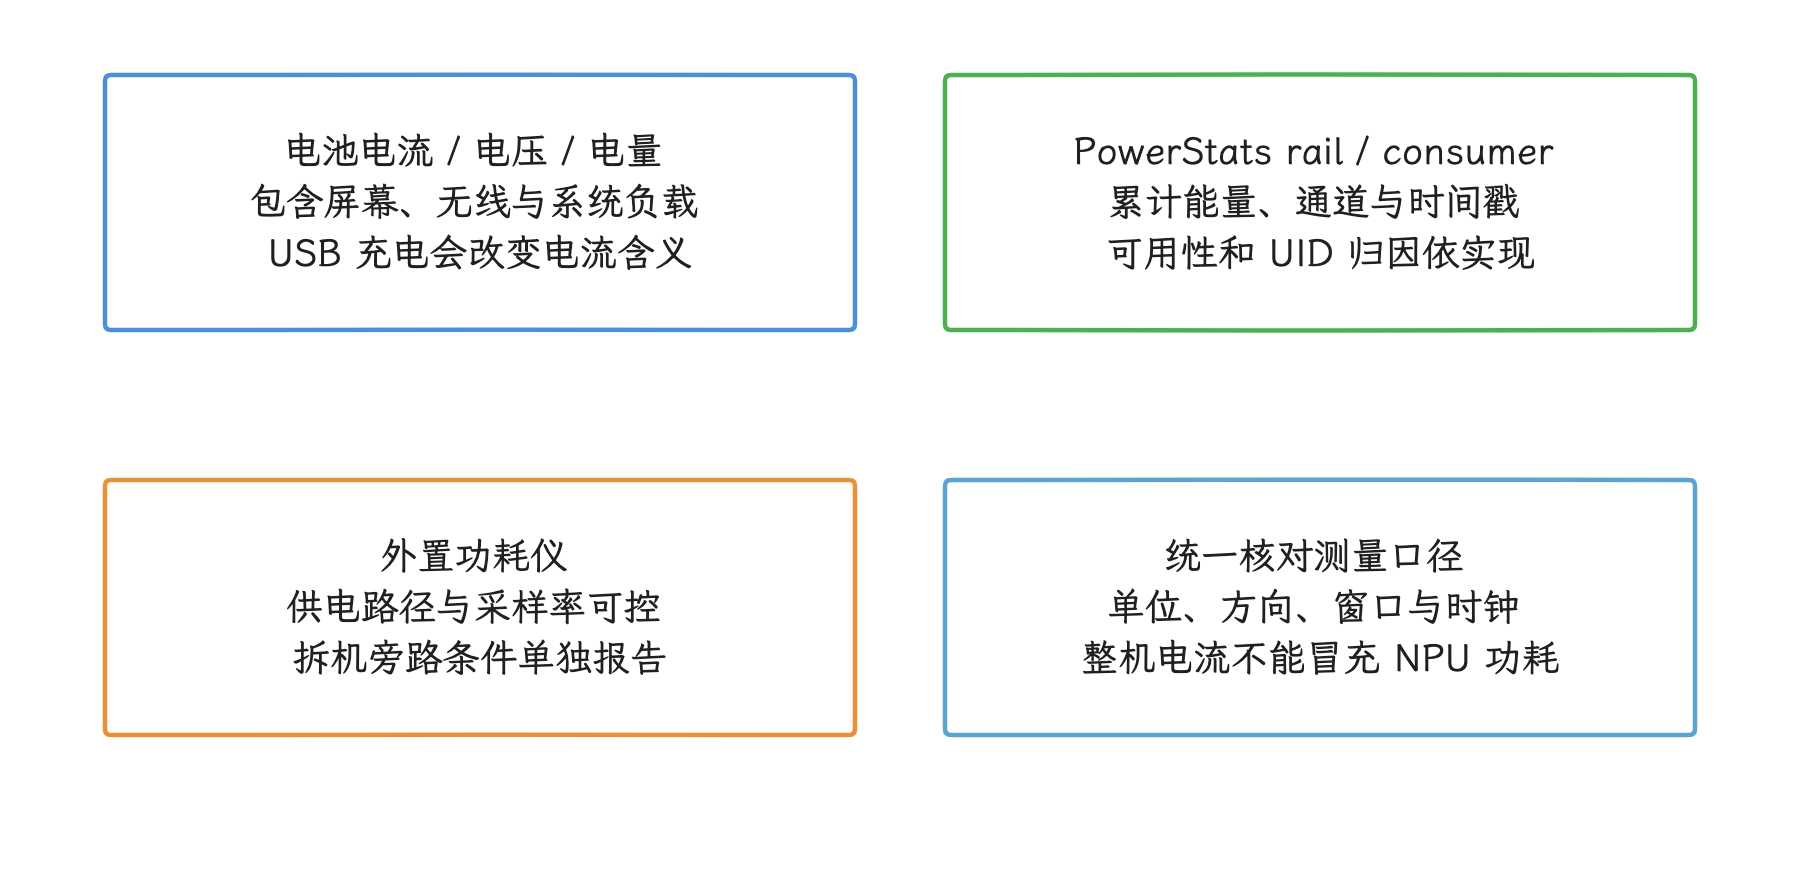
图:电池计数描述电池侧整机流量;power rail/consumer 是设备定义的子系统口径,可能缺失。外置测量需记录电池旁路、屏幕与 ADB 条件。
5. 积分、基线与重复试验
若测得随时间变化的电压 V(t) 和电流 I(t),请求窗口能量可以积分近似为:
E_request = ∫ V(t) × I(t) dt
也就是把每个时刻的功率 V(t) × I(t) 按时间累加。电流正负方向由数据源定义,积分前必须核对。如果要扣除 idle baseline,应使用相同的屏幕、网络、温度和采样配置,在相近时间测量,并同时保留未扣除的整机能量;基线扣除(baseline subtraction)会放大短请求的误差。
每组配置都需要多次重复,并随机安排测试顺序,免得所有“高性能配置”都赶在设备尚未升温时运行,而“节能配置”全在设备已经升温后运行。至少报告样本数、中心趋势、离散程度和失败请求;长时间测试还应按时间窗口分别展示结果。
把温控纳入性能结论
短时间 benchmark 往往让激进升频策略表现更好,连续对话则更容易暴露热约束。一个完整测试应包含:
- 一组从相同初始温度开始的短请求,用于分析 TTFT 和单轮 decode;
- 持续多轮或固定时长的稳态(steady-state)测试;
- thermal status、thermal headroom、CPU / GPU 频率上限和 token 延迟的同一时间轴记录;
- 进入限制前、限制发生时、限制后的分段统计;
- 冷却后复测,排除后台任务与偶发驱动错误。
“尽快完成后进入空闲”(race to idle)只有在更高瞬时功率被更短执行时间抵消,并且没有提前触发温控或占用其他部件预算时,才有能效优势。判断依据是请求总能量、持续 TPOT、热状态和恢复时间,别只看峰值频率。
应用可以按产品目标采取降载措施:
- 缩短允许的上下文或输出上限;
- 降低并发请求数;
- 切换更小模型或更低成本后端;
- 放宽 token 速率目标;
- 在后台或高温时暂停非必要 prefill;
- 提前向用户展示“设备较热,生成速度可能下降”,并支持取消。
热余量(thermal headroom)是预测信号,其数值方向和可用性要按 API 文档处理。它适合辅助选择负载档位,但保证不了未来某一时刻仍有固定的频率预算。相关 API 与阈值含义见 5.2 节。
常见现象的排查顺序
把前面各节的机制压缩成一张排查表:先按现象定位方向,再做后续验证。
| 现象 | 先检查 | 后续验证 |
|---|---|---|
| 冷启动 TTFT 高,热启动正常 | 模型读取、权重映射、计算图编译、缓存(cache)命中 | 分开测量输入输出(I/O)、编译(compile)和首轮 kernel slice |
| 冷热 TTFT 都高 | prompt 长度、prefill 后端、CPU 回退 | 固定输入,比较后端覆盖和频率 / 带宽 |
| 平均 TPOT 尚可,偶发停顿明显 | P95 inter-token latency、线程抢占、垃圾回收(GC)、回调阻塞 | 对齐 sched_switch、GC 与 token 事件 |
| CPU / GPU 利用率都不高但 TPOT 高 | 跨设备等待、短 burst、单线程采样 | 查看线程状态、提交间隙和频率变化 |
| 频率提高后速度不变 | 内存带宽、计算图回退、串行阶段、thermal clamp | 比较算子时间与 CPU / GPU 上限 |
| 前几轮快,随后持续变慢 | 温度、频率上限、系统 thermal status | 冷却复测并观察限制发生点 |
| tokens/s 提高但能量明显增加 | 请求总时长、瞬时功率与任务结束后的空闲尾部功耗(idle tail) | 比较焦耳 / 请求(joules/request)和焦耳 / token(joules/token) |
| 更换 NPU 后端反而慢 | 计算图分区、编译、数据转换、CPU 回退(fallback) | 查看后端日志和冷 / 热启动差异 |
| 并发吞吐提高但单请求体验变差 | 队列等待、带宽竞争、热预算 | 分开报告吞吐、TTFT、TPOT 和公平性 |
我们排查时每轮只改变一个主要变量。同时更换模型、delegate、线程数和系统版本,就算结果改善,也说不清是哪项变化起了作用。
发布前检查清单
-
Android 平台结论已按
android-17.0.0_r1复核; -
内核调度与 CPUFreq 结论已按
android17-6.18-2026-06_r6复核; - EAS 选核与 schedutil / CPUFreq 选频已分开解释;
- GPU、NPU、内存频率数据标明设备和厂商差异;
- TTFT 的冷 / 热启动统计范围明确;
- TPOT 同时提供 P50 / P95 或时间曲线;
- 能耗分母和采样窗口明确;
- prompt、输出长度、模型、运行时与 delegate 固定;
- root 固频实验没有写成普通应用能力;
- ADPF session 使用长期 worker,target 与 actual 起止点一致;
- Power rail 不可用时,没有用估算值冒充部件能量;
- 持续测试包含 thermal status/headroom 与频率上限;
- 性能收益通过回答质量、失败率和取消路径验证。
版本边界与源码索引
Android 17 平台
frameworks/base/core/java/android/os/PerformanceHintManager.javacreateHintSession()Session.updateTargetWorkDuration()Session.reportActualWorkDuration()Session.setThreads()- flagged
Session.setPreferPowerEfficiency() - flagged
Session.reportActualWorkDuration(WorkDuration)
hardware/interfaces/power/aidl/android/hardware/power/IPower.aidlcreateHintSession()createHintSessionWithConfig()- hint session 通道(channel)与支持信息
hardware/interfaces/power/stats/aidl/android/hardware/power/stats/IPowerStats.aidl- 能量消费者(energy consumer)、能量计量器(energy meter)与驻留时间(residency)接口
上述平台路径按 android-17.0.0_r1 复核。
Android 17 内核
kernel/sched/fair.cfind_energy_efficient_cpu()compute_energy()
kernel/sched/cpufreq_schedutil.cget_next_freq()map_util_freq()- Android 厂商钩子(vendor hook)
android_vh_map_util_freq
drivers/cpufreq/cpufreq.c- CPUFreq policy 与服务质量(Quality of Service,QoS)约束
drivers/devfreq/- 通用 devfreq 框架;具体 GPU/内存实现需继续查看设备内核
上述内核路径按 android17-6.18-2026-06_r6 复核。
LiteRT-LM 的版本边界
LiteRT-LM 是 Google AI Edge 在 AOSP 之外维护的端侧生成式 AI 运行时项目。其公开仓库提供 Kotlin / C++ 接口、.litertlm 模型格式,以及 CPU、GPU、NPU 后端支持说明;具体硬件覆盖受版本、模型和设备影响。应用应固定经过验证的 LiteRT-LM 版本和模型产物,并保存运行时日志。
android-17.0.0_r1 能确定的是 Android 平台 API、Framework 与 HAL 的版本;LiteRT-LM 仓库版本要单独查证,AOSP 源码和 LiteRT-LM 发布版本(release)必须分别记录。系统服务提供的模型能力也不等同于应用内嵌 LiteRT-LM,二者的模型、权限、更新和资源管理互不相同,详见 5.5 节。
外部运行时与研究
- LiteRT-LM:https://github.com/google-ai-edge/LiteRT-LM
- FUSE 论文:https://arxiv.org/abs/2507.02135
- FUSE 论文全文 §3、§5、§6:实验计时口径、隔离单个 governor 的实验,以及保留默认内存 governor 的两步搜索。
- KV cache 策略:动态、静态、滑窗和量化缓存的容量与执行成本差异。
- CPUFreq cooling(固定内核基线):通过频率 QoS 上限实施热限制。
- Perfetto CPU frequency:https://perfetto.dev/docs/data-sources/cpu-freq
- Perfetto battery counters:https://perfetto.dev/docs/data-sources/battery-counters
- Android Performance Hint API:https://source.android.com/docs/core/perf/performance-hint-api
FUSE 论文同样使用独立版本,不会随 android-17.0.0_r1 标签固定在同一版本。