CPU Cache 友好代码与数据布局优化
Cache 优化要解决两个问题:让经常一起使用的数据在时间和地址上靠近;让被不同 CPU 频繁写入的数据各自分开,避免挤在同一条 cache line(缓存行,即硬件成块传输和维护的一段连续数据)上。动手之前,我们先要证明当前负载确实受内存层级限制,再让数据布局去匹配访问模式;停在“顺序数组比链表快”这类经验判断上,很容易把力气花错地方。
这里的内存层级,包括各级 cache、地址转换缓存和 DRAM。不同移动 SoC(系统级芯片)的 CPU 核心、频率、cache 容量、共享层级和可用的 PMU(Performance Monitoring Unit,性能监控单元)事件都不一样,在一个机型上成立的结论换个 SoC 未必成立;没有测量支撑的 padding(填充)、prefetch(预取)或对象池,常常只是增加了内存占用,延迟却没有改善。
源码基线:Android 17 / API 37,AOSP
android-17.0.0_r1;内核android17-6.18-2026-06_r6。设备可能使用其他内核分支。
本文的分析范围包括 Kotlin/Java、NDK C/C++、DEX 布局和系统源码中的局部性设计。调度、EAS 与大小核见 5.1,Baseline Profile 见 21.4,启动测量见 21.1。
先建立准确的 cache 模型
动手优化之前,先把我们要依赖的 cache 模型建立对:层级结构是什么样的、每层的容量和延迟由什么决定。模型错了,后面每个判断都会跟着错。
现代移动 CPU 通常有每核私有的 L1 指令 cache 和数据 cache、每核或小组共享的 L2,以及 cluster(核心簇)或 SoC 级共享 cache。具体容量、组相联路数、上下级是否互相包含、访问延迟,都由 CPU 与 SoC 实现决定:Cortex-A510、A710、A715 等核心本身就允许采用多种 L1/L2 配置,芯片厂商还可以加入系统级 cache。
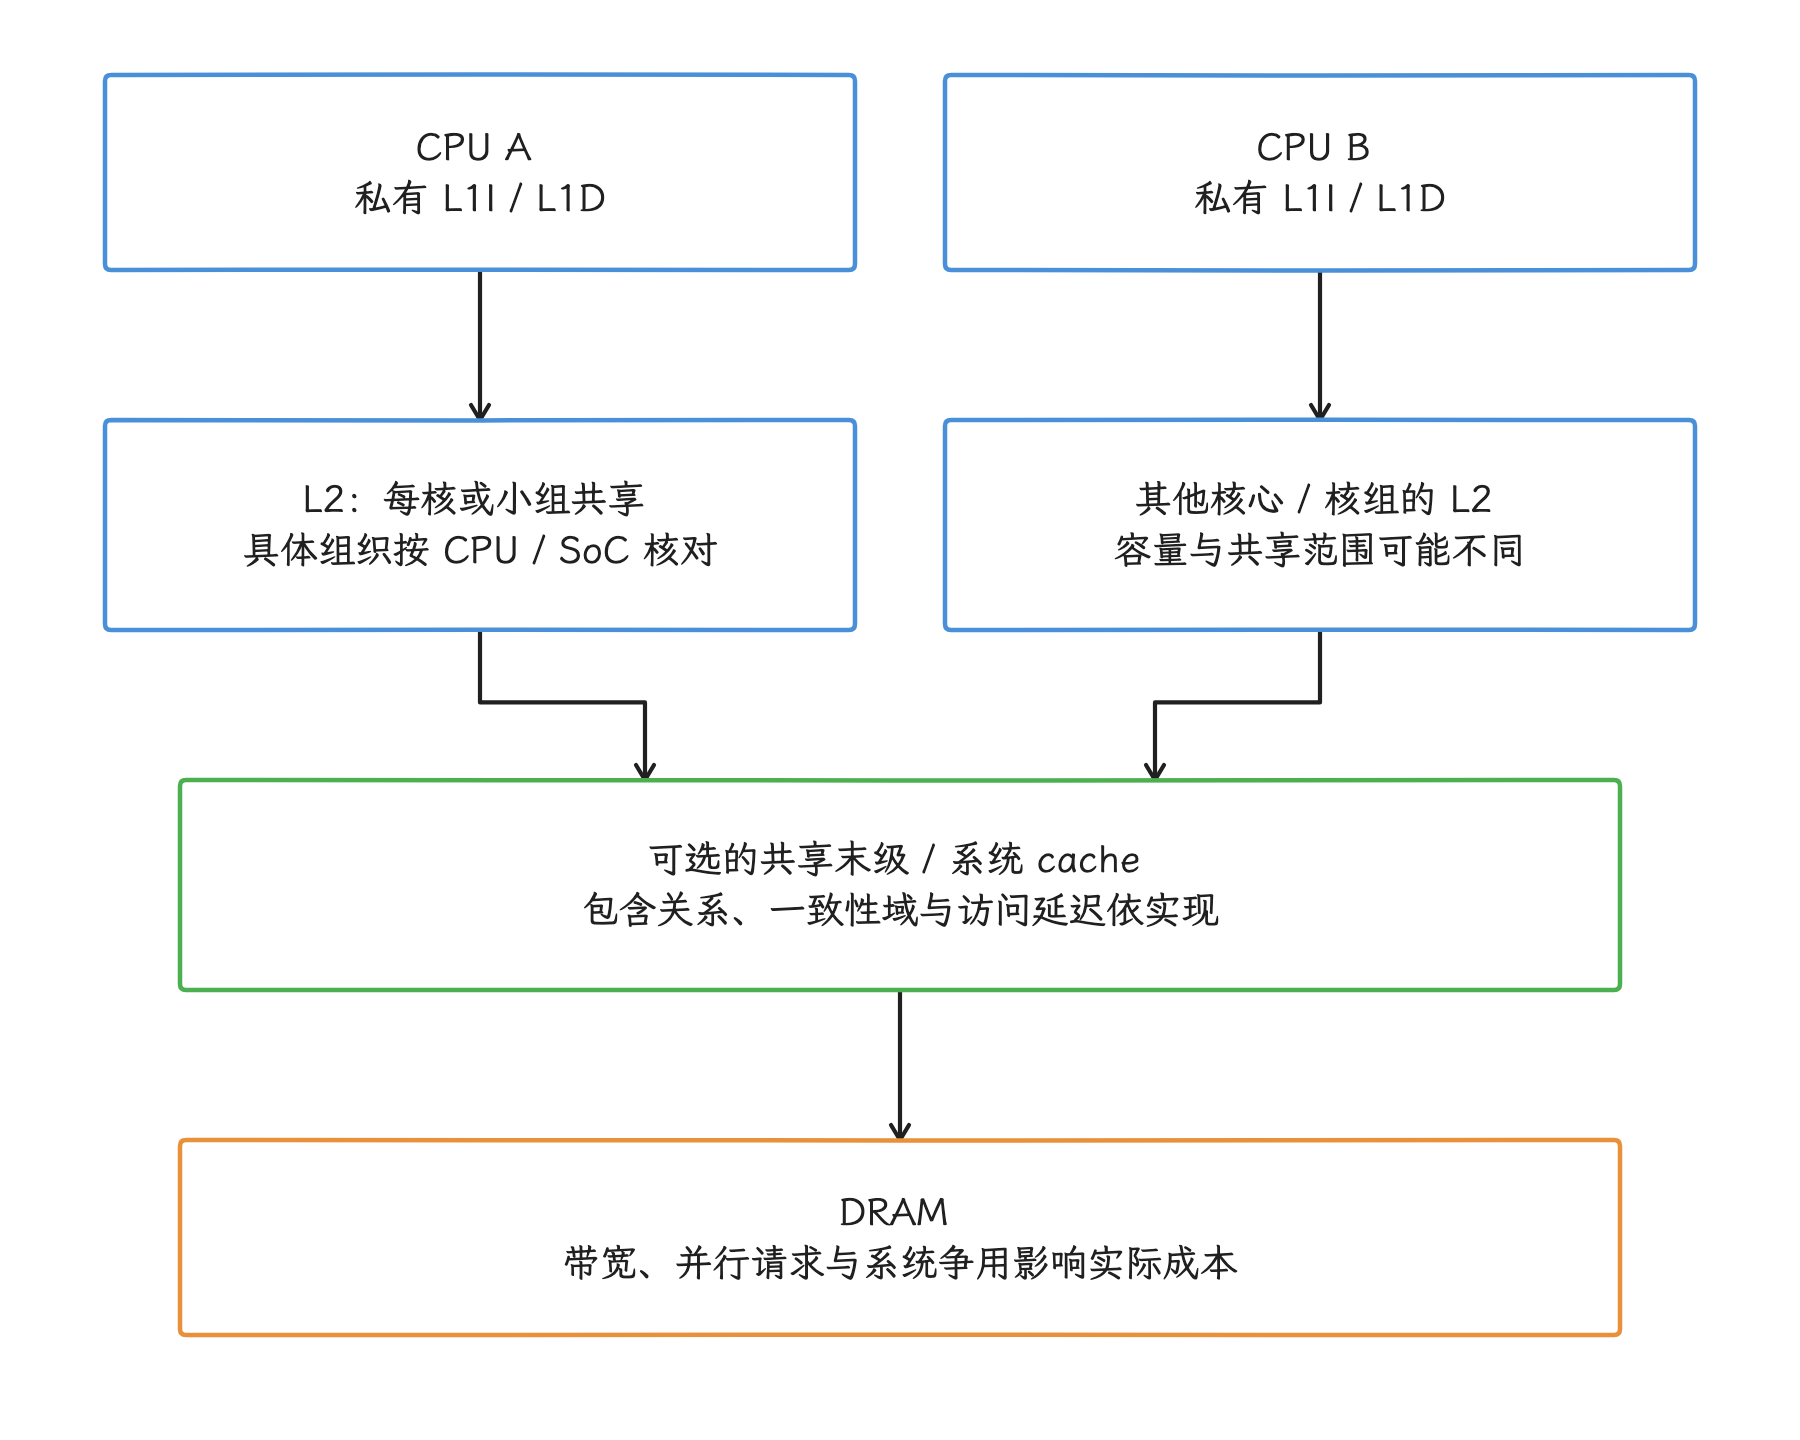
图:图是排查模型,未画出每种 SoC 的全部旁路和一致性路径。L2 组织、共享末级 cache 和包含关系均须查目标设备;不使用跨设备固定周期表。
所以,一张“L1 2 周期、L2 10 周期、主存 200 周期”的表,只能当数量级参考;把它当作所有 Android 设备的通用参数,从第一步就会走偏。实际延迟还要受频率、尚未完成的访存请求数、预取、TLB(Translation Lookaside Buffer,地址转换缓存)、DRAM 状态和资源争用影响。工程上更有参考价值的是数量级与相对关系:
- 靠近执行核心的层级通常容量小、延迟低;
- 访问逐渐落到共享 cache 和 DRAM 时,延迟和能耗会上升;
- 连续、可预测的访问更容易利用 cache line 和硬件预取;
- 频繁写入共享 cache line 会增加硬件一致性协议的通信量;
- 工作集(近期反复访问的数据集合)超过有效 cache 容量时,命中率会下降。
64 字节的适用范围
Android common kernel android17-6.18-2026-06_r6 的 arm64 arch/arm64/include/asm/cache.h 定义:
#define L1_CACHE_SHIFT  6
#define L1_CACHE_BYTES  (1 << L1_CACHE_SHIFT)
这个内核基线按 64 字节 L1 cache line 构建。同一文件还从 CTR_EL0.CWG 读取 cache 写回粒度,并把 arm64 的 ARCH_DMA_MINALIGN 设为 128 字节。也就是说,CPU L1 cache line、DMA 安全对齐、跨 CPU 避免互相干扰所需的间隔,是三件不同的事,各有各的常量。
应用代码可以把 64 字节当作当前常见设备的实验起点;至于 Armv8/Armv9 规范保证,它给不了。涉及共享库、DMA 或多代设备时,我们还要结合目标 ABI、设备资料和测量来决定布局。
线程迁移对 cache 的影响
线程从一个 CPU 迁移到另一个 CPU 后,新核心的私有 cache 里可能还没有该线程最近使用的数据,需要从共享层级或同一硬件一致性域内的其他 cache 获取。原核心的全部 L1/L2 也不会因此被软件统一失效,硬件一致性协议继续负责维护共享数据的可见性。
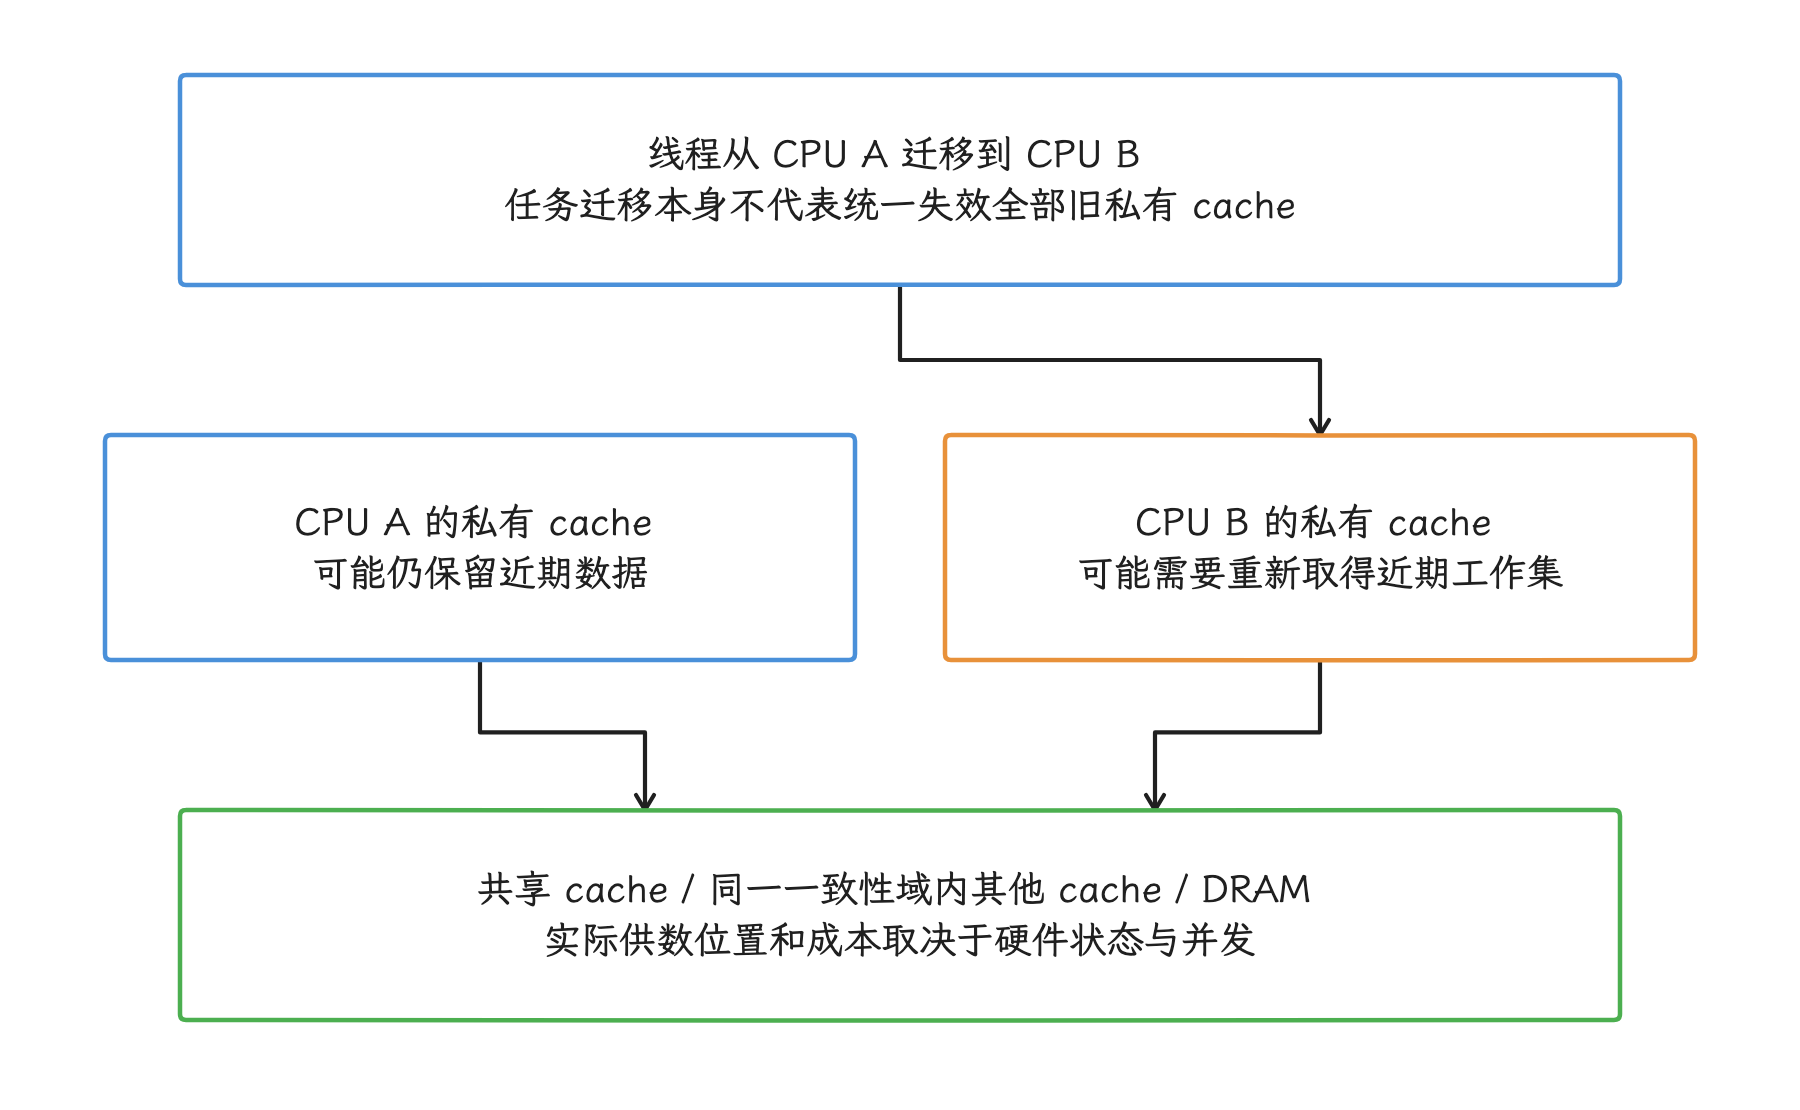
图:cpu-migrations 增加只是线索。需联看实际核心、周期、refill 与端到端时间,工作集仍在共享层级时迁移未必带来很大访存成本。
迁移的实际成本,取决于这几件事:
- 工作集是否仍在共享 cache;
- 数据是否能从同一 cluster 的其他 cache 获取;
- 两个核心是否跨 cluster;
- 迁移间隔与工作集大小;
- 迁移前后 CPU 的微架构和频率;
- 同期内存带宽与其他任务。
所以 cpu-migrations 上升只是一条线索;要判断迁移有没有真的破坏局部性,还要同时比较 CPU time、周期数、cache refill(从较低层级重新填入)、实际运行的核心和端到端延迟。
Hardware cache、ART inline cache 与软件缓存
这一节里说的 L1/L2/L3 是硬件 cache。ART 的 inline cache(内联缓存)记录某个调用点出现过的接收者类型,用来优化虚调用;业务代码里的 LruCache 保存可复用的计算结果。它们都叫 cache,机制和存储层级各不相同。业务缓存的容量、淘汰和加载去重见 4.4 App 内存优化与诊断。
inline cache 的影响是间接的:它可能让编译器生成更直接的调用路径,从而改变取指、译码等指令前端工作和数据访问。我们拿它当“某个对象进入过 L1”的证据还差得远;多态调用的开销,也还有 L1 miss 之外的部分。
局部性的两个方向
空间局部性
空间局部性指相邻地址在接近的时间被访问。CPU 以 cache line 为单位传输数据,顺序遍历连续数组通常能吃满一次 refill,预取器也能提前请求后续 cache line。
以 C++ 为例,std::vector<float> 的元素连续,链表节点通常分散分配,批量求和时数组一般更有利。不过“链表每个节点必 miss、数组每 line 只 miss 一次”只是最坏与理想这两种模型,分配器复用、节点大小、预取器和 cache 容量都会改变实际结果。
在 Java/Kotlin 里,我们还要分清容器实际保存的内容:
IntArray连续保存基本类型值;Array<Int>/List<Int>保存引用,并涉及装箱对象;Array<MyObject>连续保存对象引用,对象本体仍分散在堆中;ByteArray/FloatArray适合紧凑的批量处理;- Java 多维数组是“数组的数组”,每一行是独立对象。
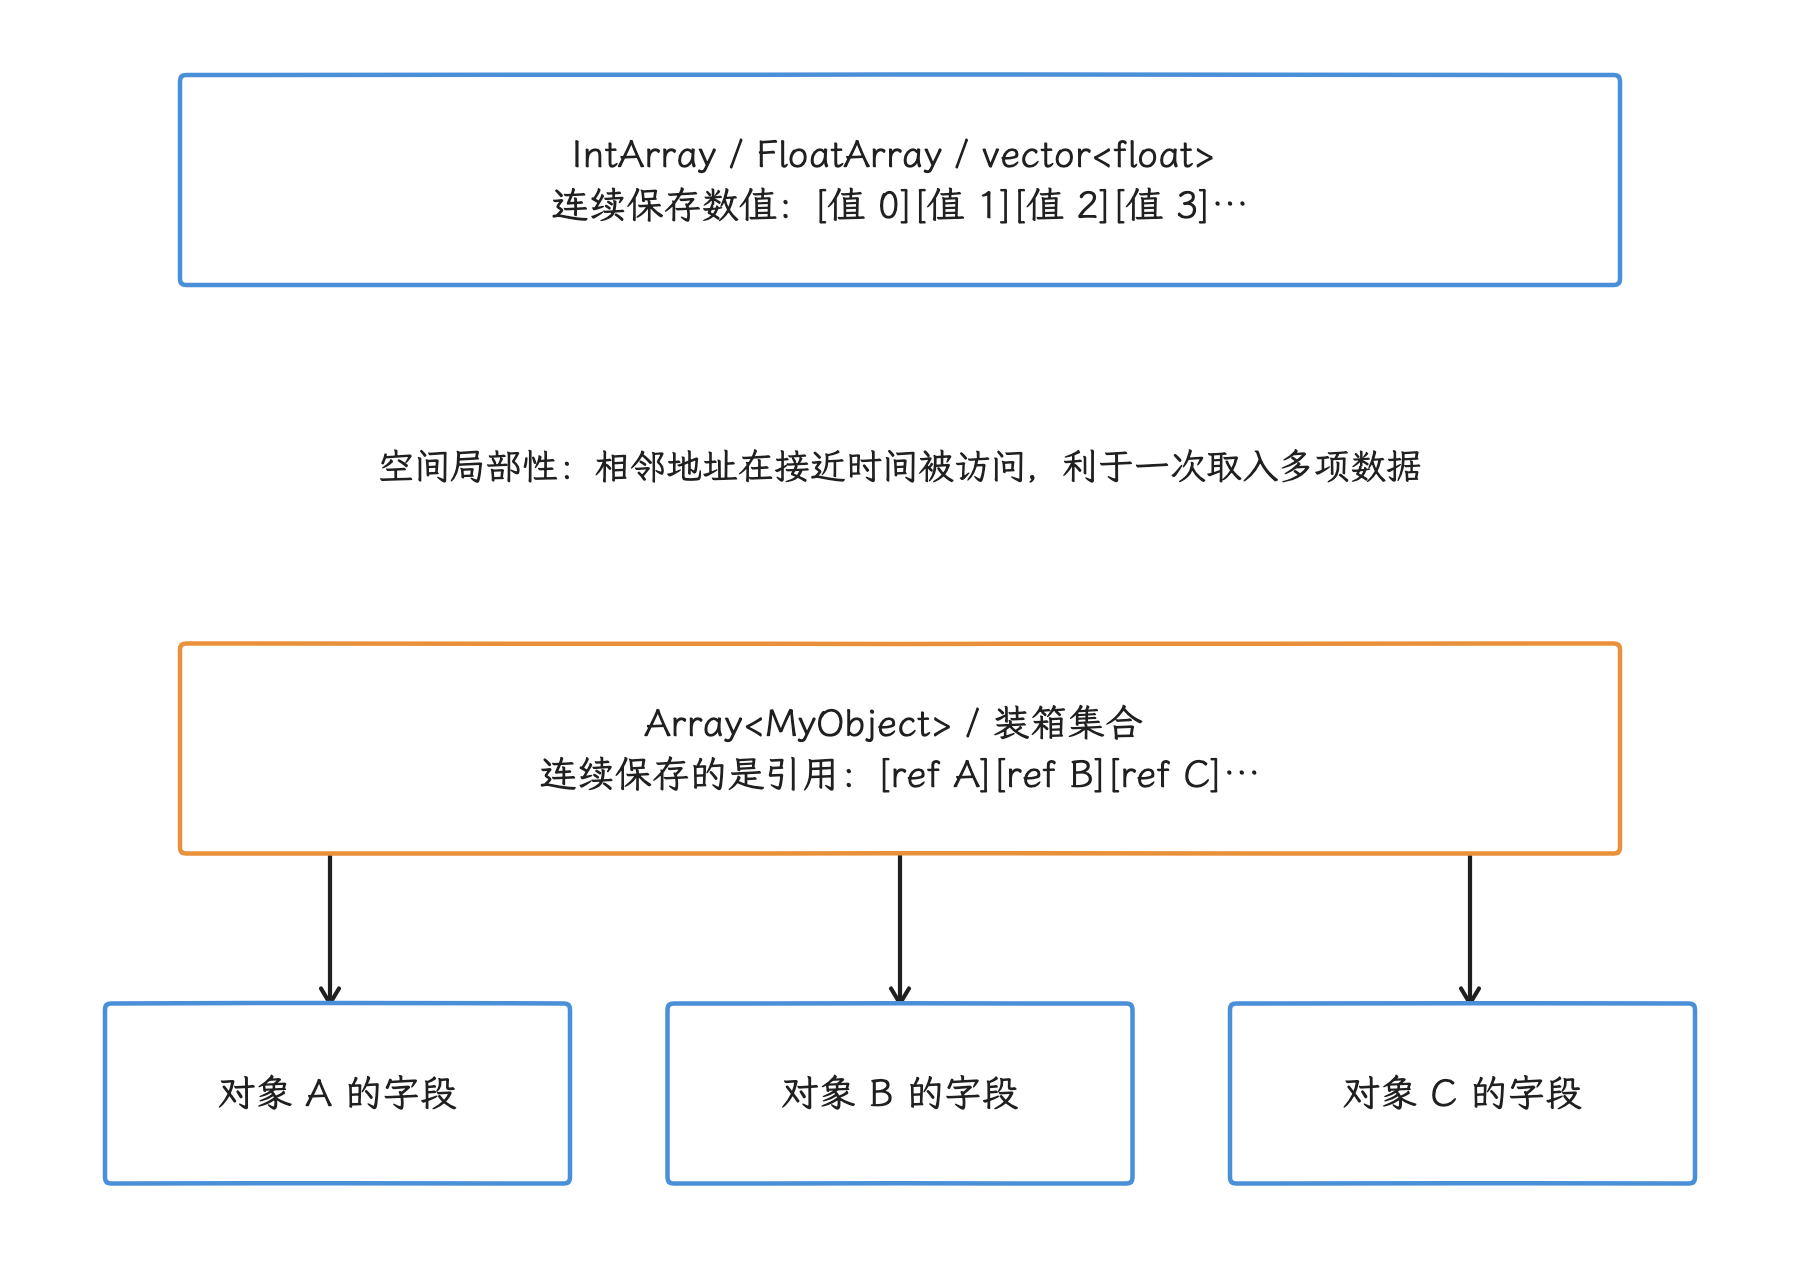
图:对象引用连续不代表对象本体连续。改用基本类型数组的收益还可能来自减少装箱与分配;不能把全部差异算成 cache miss。
把热循环从装箱集合改成 primitive(基本类型)array(基本类型数组),收益可能同时来自减少装箱、减少分配和改善局部性。写报告时我们要把这几个因素都列出来,别把全部收益都归给 cache。
时间局部性
时间局部性指数据在短时间内被重复使用。一个工作块趁它还在 cache 里时完成多次计算,通常比每轮扫描整个大数据集更有效。
二维数值计算、图片卷积和张量预处理常用 tiling(分块):把输入拆成能放入目标 cache 的小块,在块内完成多个操作后再进入下一块。tile 大小要靠基准测试确定——代码、栈、其他数组和并发线程也在占用 cache,只按“L1 容量除以元素大小”估算,会低估这部分占用。
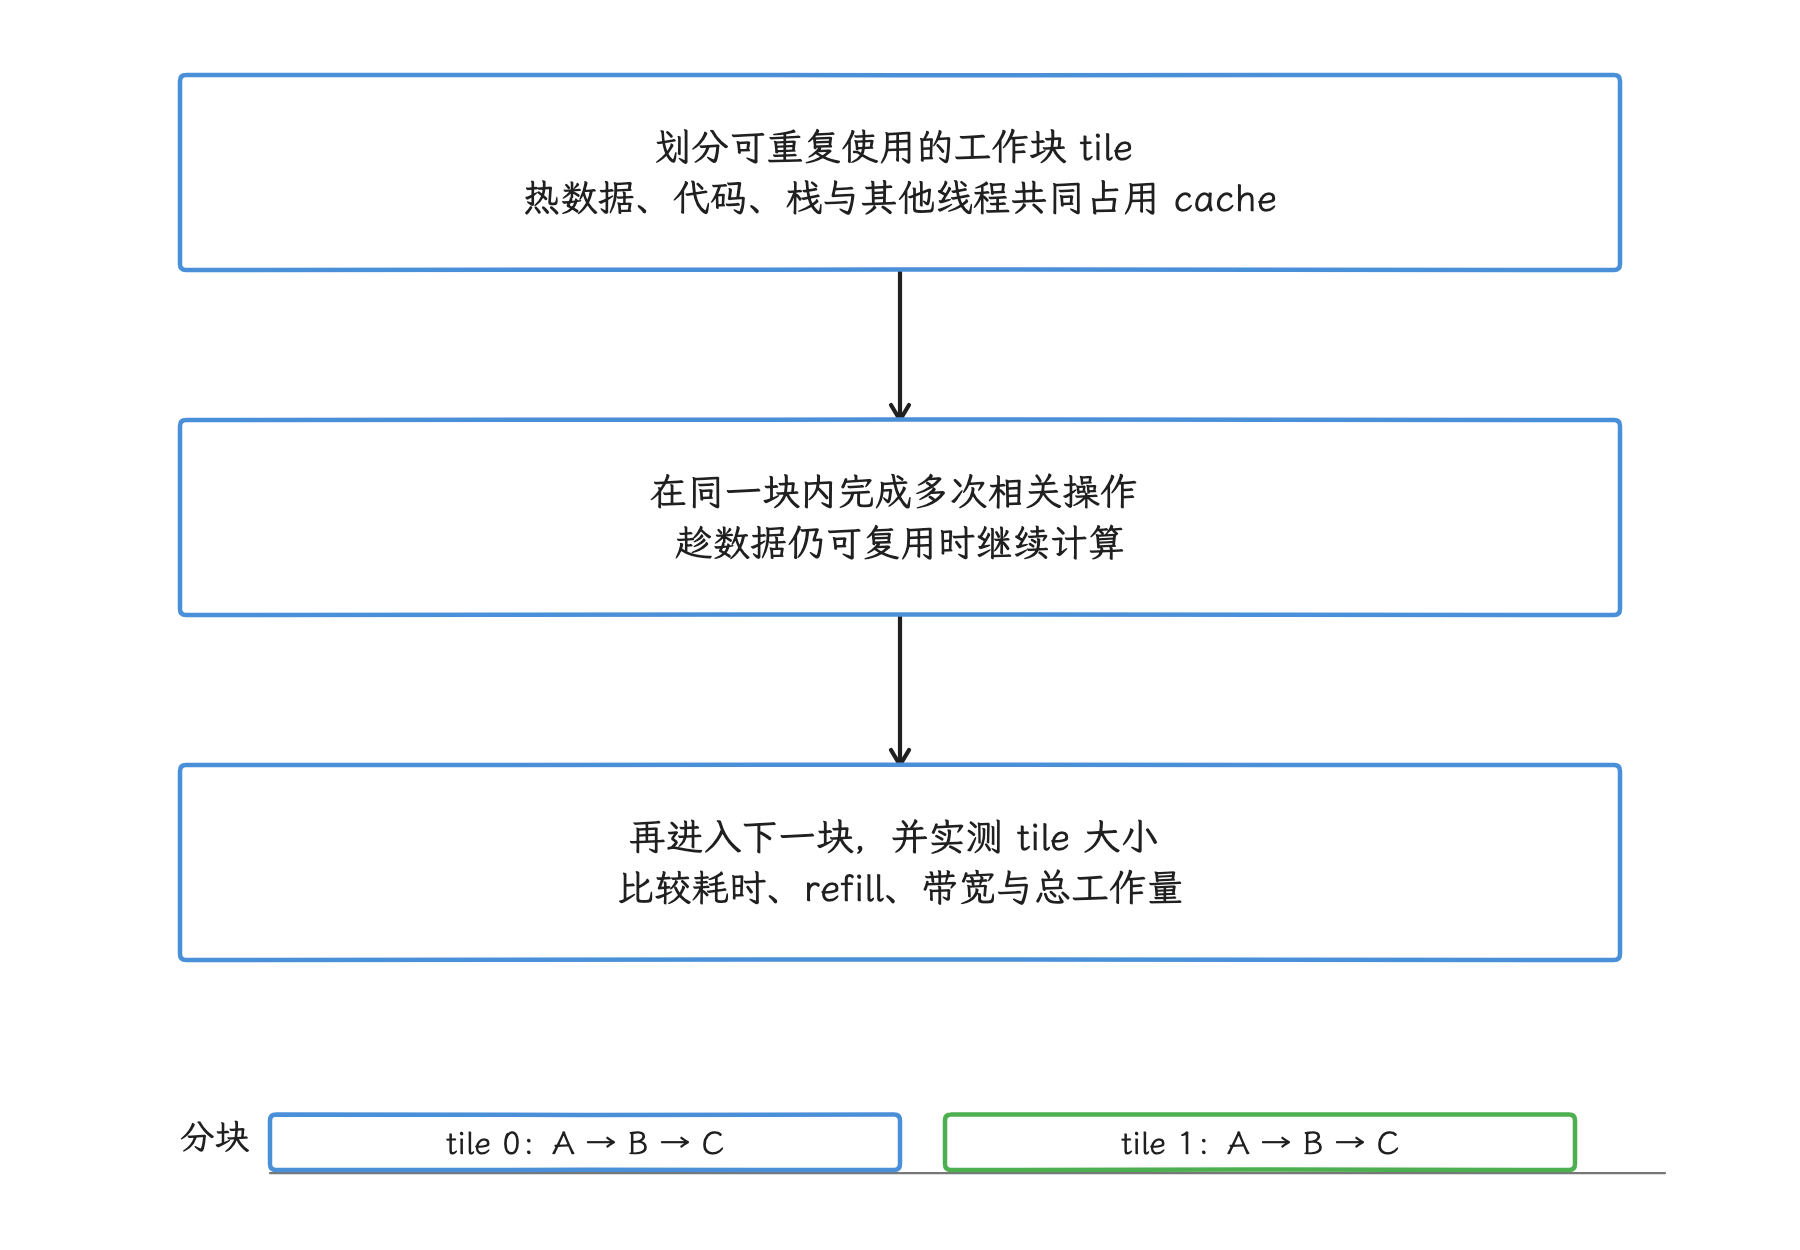
图:图示把每块的相关操作靠近执行;tile 并不等于 cache 容量除以元素大小,还需容纳代码、栈、并发与其他数组。
False sharing(伪共享):不同字段,共用一条 cache line
当多个 CPU 并发访问同一 cache line,且至少一个 CPU 在写入,一致性协议就要转移数据,或让其他核心上的副本失效。如果几个线程操作的是不同字段,却因为这些字段落在同一条 cache line 上而产生大量一致性通信,这就是 false sharing。这里的“共享”发生在硬件用来维护一致性的 cache line 上,业务数据本身并没有被多个线程共同修改。
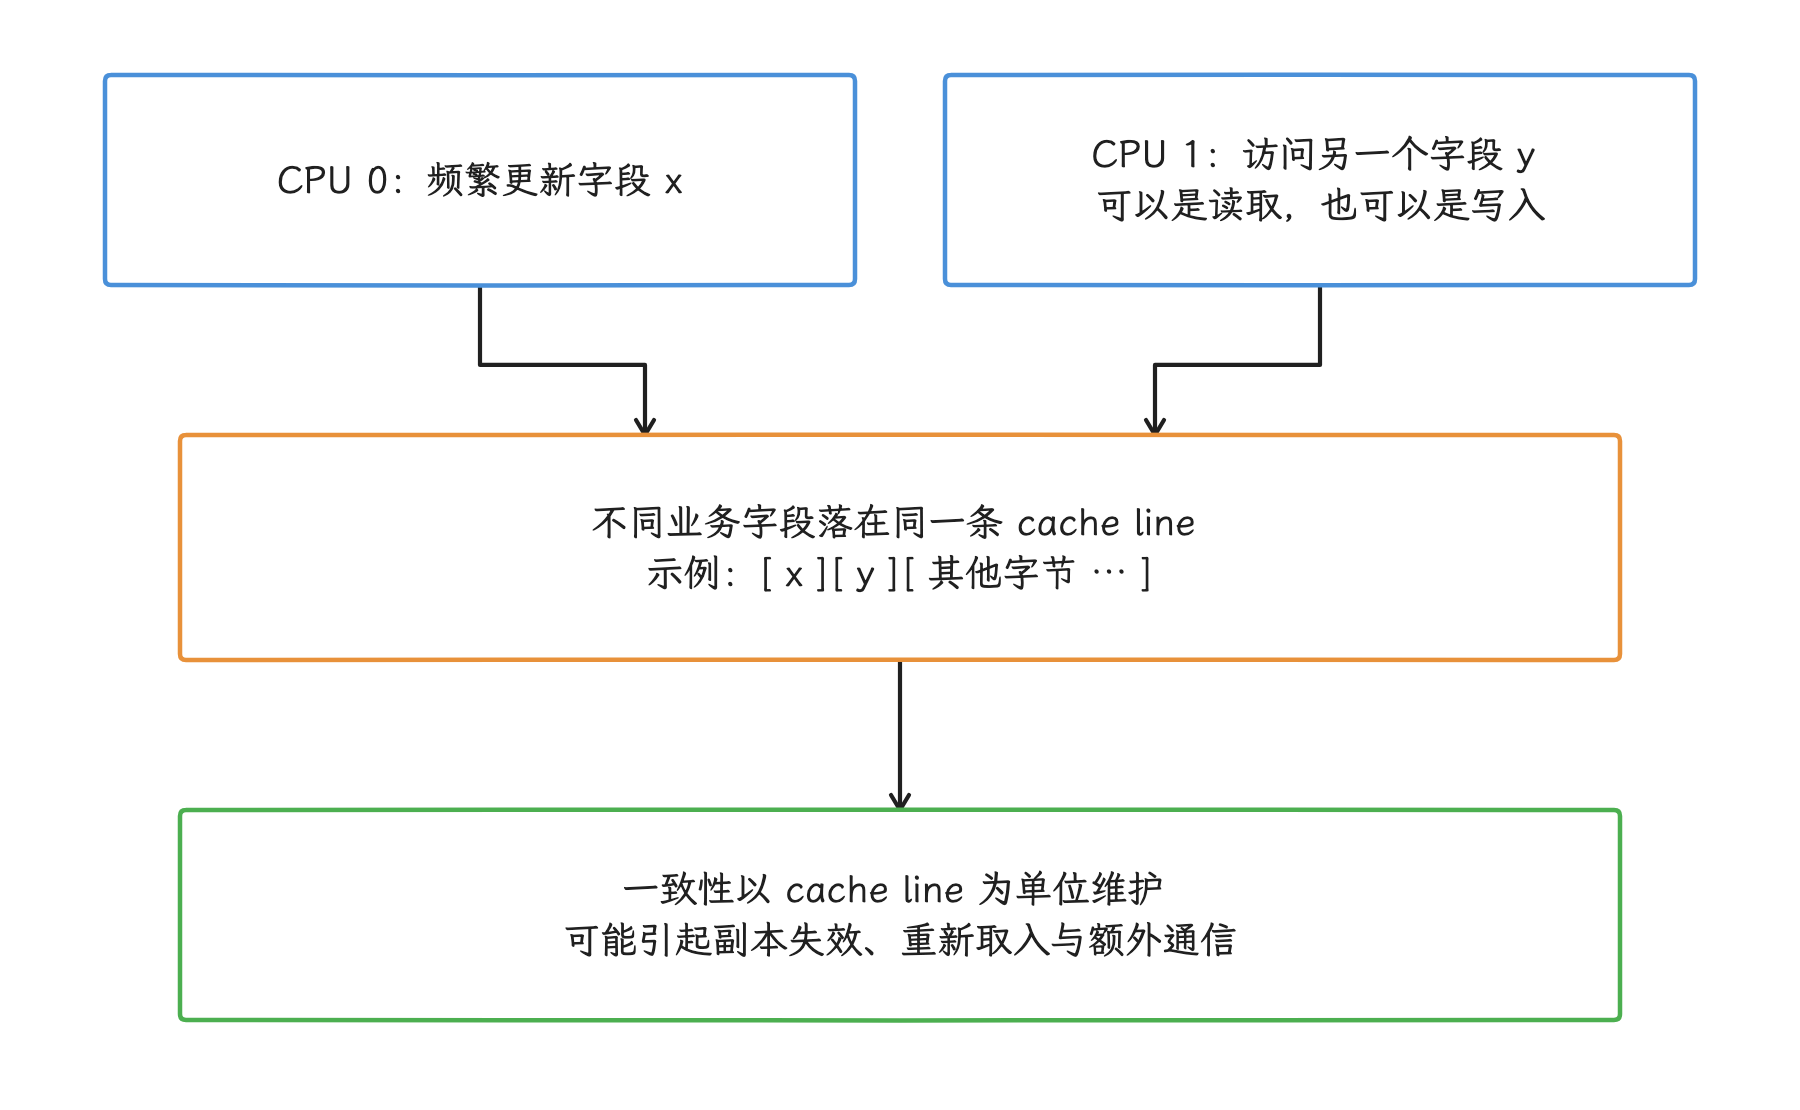
图:有害伪共享需要多个 CPU 并发访问同一行且至少一方写入。图不代表每次访问必然产生一次总线事务;仍需区分锁、atomic 重试与真实共享。
典型模式包括:
- 多线程分别更新数组中的相邻计数器;
- 一个线程频繁写状态,其他线程频繁读取同一 cache line 中的配置;
- 锁与被其他 CPU 高频读取的数据挤在同一 cache line;
- 多生产者把各自的 head/tail(读写位置)或统计字段放得过近。
看到这类模式先别急着定性:锁竞争、atomic(原子操作)重试、调度和内存带宽不足,都会产生相似的症状,要靠后面的测量把它们分开。
先调整并发模型,再考虑 padding
缓解 false sharing 时,我们通常按以下顺序排查:
- 减少共享写入,例如每线程 / 每 CPU 累积后批量归并;
- 避免无条件写相同值;
- 把一起读取、一起更新的字段分组;
- 将高频写字段与高频只读字段分开;
- 最后才为已经证实的热点增加对齐或 padding,让高频字段落入不同的 cache line。
顺序之所以如此,是因为 padding 本身有代价:它增加对象大小、cache/TLB 占用和内存流量,也可能把竞争转移到相邻字段。Linux 6.18 的 false-sharing 文档同样要求根据性能证据权衡空间成本。
NDK 与 Java/Kotlin 的布局控制差别
C++ 可用 alignas 明确对齐,并用 sizeof / offsetof 验证构建结果。下面的结构用于实验性隔离两个高频计数器:
struct alignas(64) CounterSlot {
    std::atomic<int64_t> value{0};
    std::byte padding[64 - sizeof(std::atomic<int64_t>)];
};

static_assert(sizeof(CounterSlot) == 64);
它保证的是 C++ 对象布局满足本次构建的 64 字节设计。目标硬件若采用更大的一致性维护粒度,或数组起始地址、allocator(内存分配器)、ABI 发生变化,就要重新验证。原子操作也必须采用符合算法要求的 memory order(内存序);至于 data race(数据竞争),那是 padding 管不了的问题。
Java/Kotlin 的对象布局属于 ART 实现细节,靠添加若干 long 字段保证不了字段独占 cache line;@Contended 也不是 Android 公共 SDK 契约。应用层更稳的路线是减少共享可变对象、分片计数、批量提交,再以基准测试验证。
MessageQueue 案例
MessageQueue 有 Legacy、Combined 与 CombinedDeli 等实现变体,字段布局还要再经过一层 ART 对象布局。mPtr 与 mMessages 在源码中相邻,只说明源码里相邻;它们是否落在同一条 cache line,要看到实际布局才算数,“引发了可测 false sharing”又是更远的一步。
enqueueMessage() 与队列消费里还混着锁、native 层的 poll/wake 等待唤醒(poll/wake)和主线程调度。所以在没有 PMU、地址级采样和对照布局的时候,这个例子适合当作共享队列案例来分析;要标成“framework 已经存在 false sharing”,证据还不够。
C/C++ 数据布局:AoS、SoA 与 hot/cold split(冷热字段拆分)
AoS 与 SoA 的选择由访问模式决定
Array of Structures(AoS,结构体数组)把一个元素的所有字段放在一起:
struct Particle {
    float x, y, z;
    float vx, vy, vz;
    float r, g, b, a;
};
std::vector<Particle> particles;
这个结构每个元素为 40 字节(忽略额外对齐)。若循环只读 x/y/z,位置字段的有效字节占结构体字段字节的 12/40,即 30%,这不是实测的缓存行利用率或总线流量比例;18.75%(12/64)是把对象流和 cache line 都理想化之后算出来的数,实际的 cache line 还可能跨越两个对象,边界与数组起始地址有关。
Structure of Arrays(SoA,分字段数组)把同类字段拆成连续数组:
struct ParticleBatch {
    std::vector<float> x, y, z;
    std::vector<float> vx, vy, vz;
    std::vector<float> r, g, b, a;
};
只更新位置时,SoA 能避免把颜色与速度数据一并载入 cache;处理一个粒子的全部字段时,AoS 可能更紧凑。两者之间还可以采用 Array of Structures of Arrays(AoSoA,分块结构体数组),按 SIMD(单指令多数据)宽度或 tile 分组,在向量化与单元素访问之间折中。
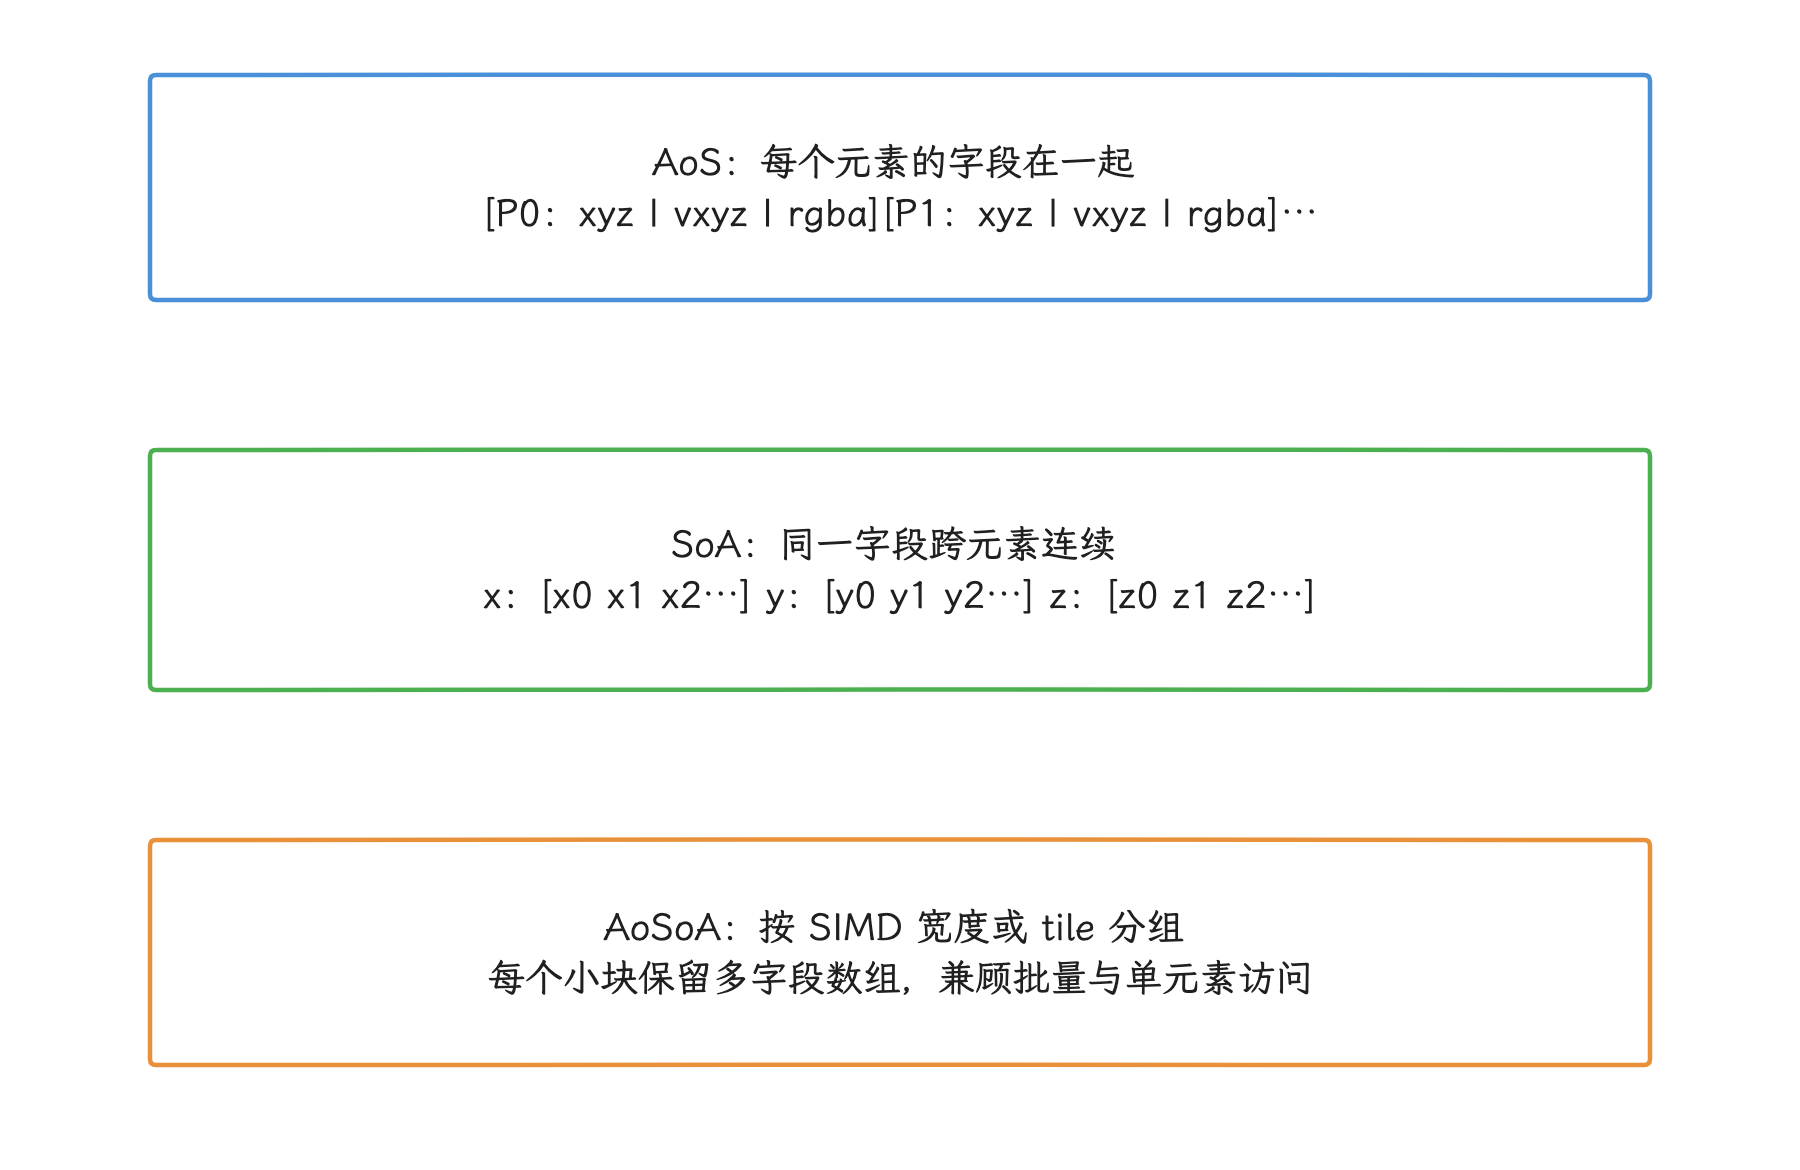
图:正文 Particle 的字段有效字节为 xyz 12/总40,30% 是字段占比,不能直接当缓存行利用率或总线流量。只用位置常适合 SoA,常用全部字段则需对照 AoS。
选择时我们测量以下指标:
- 目标循环端到端耗时;
- bytes processed / item(每个元素读写的字节数);
- L1D refill、LLC(last-level cache,末级 cache)miss 与 TLB miss;
- 向量化报告和生成代码;
- 内存占用与构造成本。
hot/cold split 还要考虑对象生命周期
hot/cold split 把每次迭代都读取的字段放入紧凑的热结构,把调试字符串、低频统计和错误信息放到 cold side(冷数据区),以此缩小热工作集。常见形式是:
struct RenderItemHot {
    float transform[16];
    uint32_t flags;
    uint32_t resourceIndex;
};

struct RenderItemCold {
    std::string debugName;
    uint64_t createdAt;
};
热结构可以连续存入 vector,cold 数据通过稳定索引关联。代价是多一层索引、两套生命周期和更复杂的更新逻辑;若 cold 字段在常见路径也频繁访问,拆分反而增加一次间接访问。
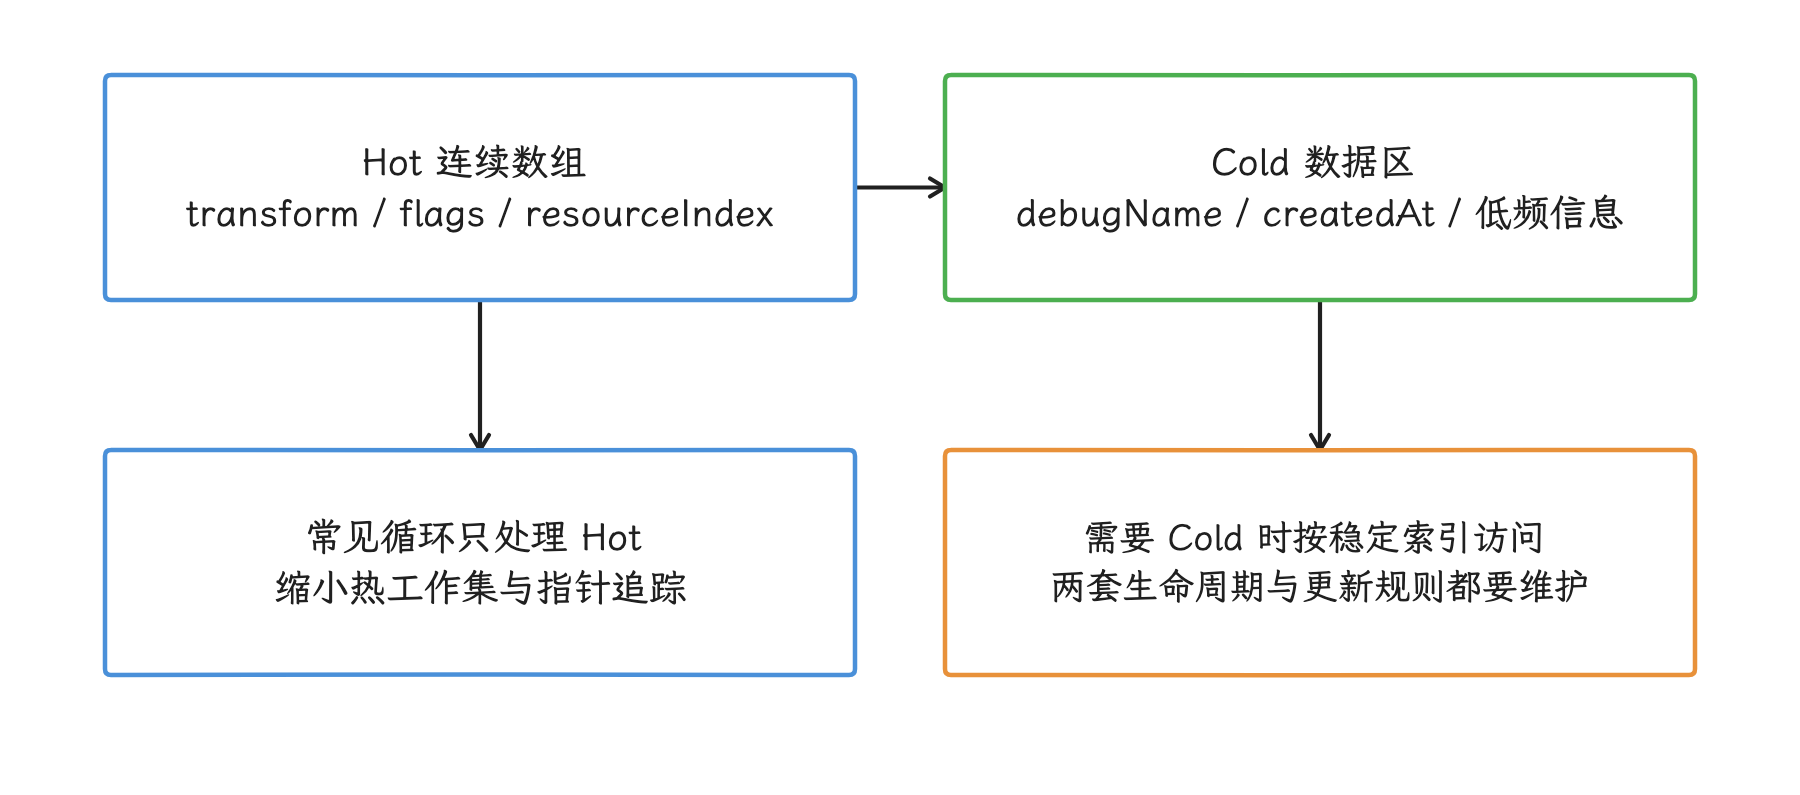
图:拆分适合常见路径很少使用 Cold 的场景。若两部分总是一起读取,间接访问和维护成本可能抵消收益;以真实结构布局与 workload 验证。
拿想象中的 RenderNode 布局来论证方案没有意义。对我们自己的结构运行 sizeof / offsetof,查看编译器输出的布局 dump,再执行能代表真实负载的 workload benchmark,这三步都要做。
连续内存也有扩容与复制成本
std::vector 和 Binder Parcel 使用连续缓冲区,顺序读写的空间局部性很好,但容量增长可能触发重新分配和复制。已知大小时合理调用 reserve() 可以减少扩容,过度预留会扩大容器保留容量,并可能增加实际触页后的 RSS(常驻内存);容量、已初始化元素数与驻留页数不能直接画等号。
frameworks/native/libs/binder/Parcel.cpp 中,mData、mDataSize、mDataCapacity 和 mDataPos 管理连续数据区,写入按 4 字节 padding,增长路径使用 realloc 或分配并复制。Parcel 另有对象偏移数组,读取时也可以调整 data position,所以“Parcel 只能从头顺序读”这个说法并不成立。Parcel 字段与增长路径的完整说明见本章「Binder Parcel:连续数据与独立对象表」。
Parcel 的布局主要服务于 Binder 传输格式(wire format)、安全检查和对象管理,cache 局部性只是连续数据区顺带带来的性质。要回答“Parcel 是不是总比 JSON 快”,得把序列化格式、数据规模、解析器和 IPC(Inter-Process Communication,进程间通信)拷贝都放进比较。
应用层热路径:先减少工作,再谈对象池
应用层能控制的布局手段比 NDK 少:对象布局由 ART 和分配器决定,可改的主要是“少做工作”和“少引入额外机制”。本节按这个顺序展开:先去装箱和指针追踪,再判断对象池是否划算,最后单独评估分支预测和软件 prefetch——后两者与 cache miss 属于不同机制。
避免装箱和指针追踪
在图像、音频、统计和几何运算中,可以优先评估 primitive array、紧凑 buffer 或专用 collection。List<Float> 的每个元素访问都要先走对象引用、再走装箱对象,这种逐级追踪引用的访问方式称为 pointer chasing,数据密度通常低于 FloatArray。
业务层的所有模型也不必都改成数组。对不在热点的代码,可读性与正确性更重要;常见做法是保留清晰的业务对象,只在性能分析确认是热点的计算环节,把数据转换为批量 buffer。
谨慎复用可变对象
ART 的线程局部分配路径很快,存活时间短的对象也能在 GC 年轻代中高效回收。对象池则要背上这些成本:
- 状态重置不完整;
- 生命周期和线程安全更复杂;
- 池保留对象,扩大 live set(仍存活、无法被 GC 回收的对象集合);
- 旧对象未必仍在目标 CPU 的 cache;
- 池自身产生锁竞争或共享写入。
Message.obtain() 的回收池只说明 framework 在这个场景采用了特定复用策略,推广到“所有临时对象都适合池化”就过了。先用 allocation profiler(分配分析器)、GC pause(垃圾回收停顿)、CPU 和内存数据确认分配成本,再比较“直接分配”“批量分配”“复用”三种方案。
分支与 cache 要分开归因
分支预测错误会使错误路径上的推测执行指令被丢弃,并重新从正确路径取指;难预测的分支只是更容易发生这种情况,不能把每次分支都等同于一次 pipeline flush。间接跳转的目标预测也会影响取指和译码。这些与 data-cache miss 属于不同机制。三元表达式未必生成无分支指令,__builtin_expect 也只是向编译器提供分支概率提示。
优化分支时,我们要把 branch-misses、生成后的机器码和端到端时间放在一起看。把错误路径移出热函数可能改善指令布局,但函数内联、LTO(链接时优化)和 PGO(运行数据驱动的优化)会再次改变代码,源码排列直接代表不了最终的 instruction-cache 布局。
是否手动 prefetch
__builtin_prefetch() 是提示,编译器和硬件可以按各自规则处理。预取目标无效不意味着可以非法计算地址表达式:例如 p->next 的求值仍要求 p 有效;提示本身也不提供线程同步或数据可见性保证。线性数组通常已有硬件预取兜底;链表、树或多流访问有时能从软件 prefetch 获益。
prefetch 距离太近,数据可能来不及到达;距离太远,又可能提前挤出仍在使用的 cache line。目标地址不在页表中时,还可能增加地址转换工作。把改动放进通用库之前,我们至少要在两类核心、冷/热数据和有/无并发负载下比较,并检查能耗;单次 microbenchmark(微基准)的 p50(中位数)结果撑不起这个决定。
DEX 局部性:Startup Profile 与构建配置
DEX 标识符与类定义受格式排序约束,和“按源码出现顺序排列”是两回事;ART 的 AOT(Ahead-of-Time,预先编译)和 JIT(Just-in-Time,即时编译)产物也不会机械复制 DEX 顺序。
Android 当前的官方工具链让两类 profile 各管一段:
- Baseline Profile 供 ART 对常用方法进行 AOT 编译;
- Startup Profile 在构建期指导 R8/D8 优化 DEX 中启动代码的布局。
Startup Profile 让启动关键类和方法更集中,并尽量放入首个 classes.dex,从而减少启动阶段需要触及的代码页。收益可能同时来自 DEX page locality(代码页局部性)、page fault(缺页)减少、解压或映射过程变化,以及编译产物布局变化;把它们全归到 instruction-cache miss 头上,是立不住的。
当前构建要求
官方文档给出的版本要求:
- DEX layout optimization 从 AGP 8.1 可用;
- AGP 8.1–8.2 需要在 Baseline Profile 配置中启用;
- AGP 8.3 起默认启用;
- release 构建需要开启 R8、minification 和完整优化;
- startup journey(启动场景基准流程)通过
includeInStartupProfile = true进入 Startup Profile。
Startup Profile 只包含应用自己定义的启动测试生成的规则,库不能像提供 Baseline Profile 那样贡献 Startup Profile。AGP 8.2 不支持为每个构建变体(variant)保留独立的 Startup Profile;使用 AGP 8.2 时,Baseline Profile Gradle 插件需为 1.2.3 或更高版本,以自动合并各变体的规则。需要按变体区分规则时,应升级到 AGP 8.3 或更高版本。
dexOptions.reorderClassesWithProfiling 不是对应的公开 AGP 配置,示例里不要用它。
生成、验证、A/B 测量
Startup Profile 应覆盖 launcher、常见 deep link(直接打开应用内指定页面的链接)、通知入口等真实启动路径,也要避免让大量与启动无关的 journey 占满首个 DEX。
验证分四步:
- 用 APK Analyzer 查看 startup 类和方法是否进入预期 DEX;
- AGP 8.8 及以上可检查 AAB 内
BUNDLE-METADATA/com.android.tools/r8.json是否至少有一个 DEX 条目标记为"startup": true,并将各条目的checksum与 AAB 中对应 DEX 的 SHA-256 核对; - 用 Macrobenchmark 分别测冷启动、温启动和多个入口;
- 固定 APK、编译状态、设备温度和系统版本。
应用或依赖库使用 desugared API(脱糖后由兼容实现提供的 API)时,这些兼容实现始终位于最后一个 DEX,该 DEX 不参与布局优化,核验时要单独识别。官方的 AAB 元数据核验流程仅在 Linux 上测试过;这项测试范围限制不代表其他主机系统无法读取元数据。
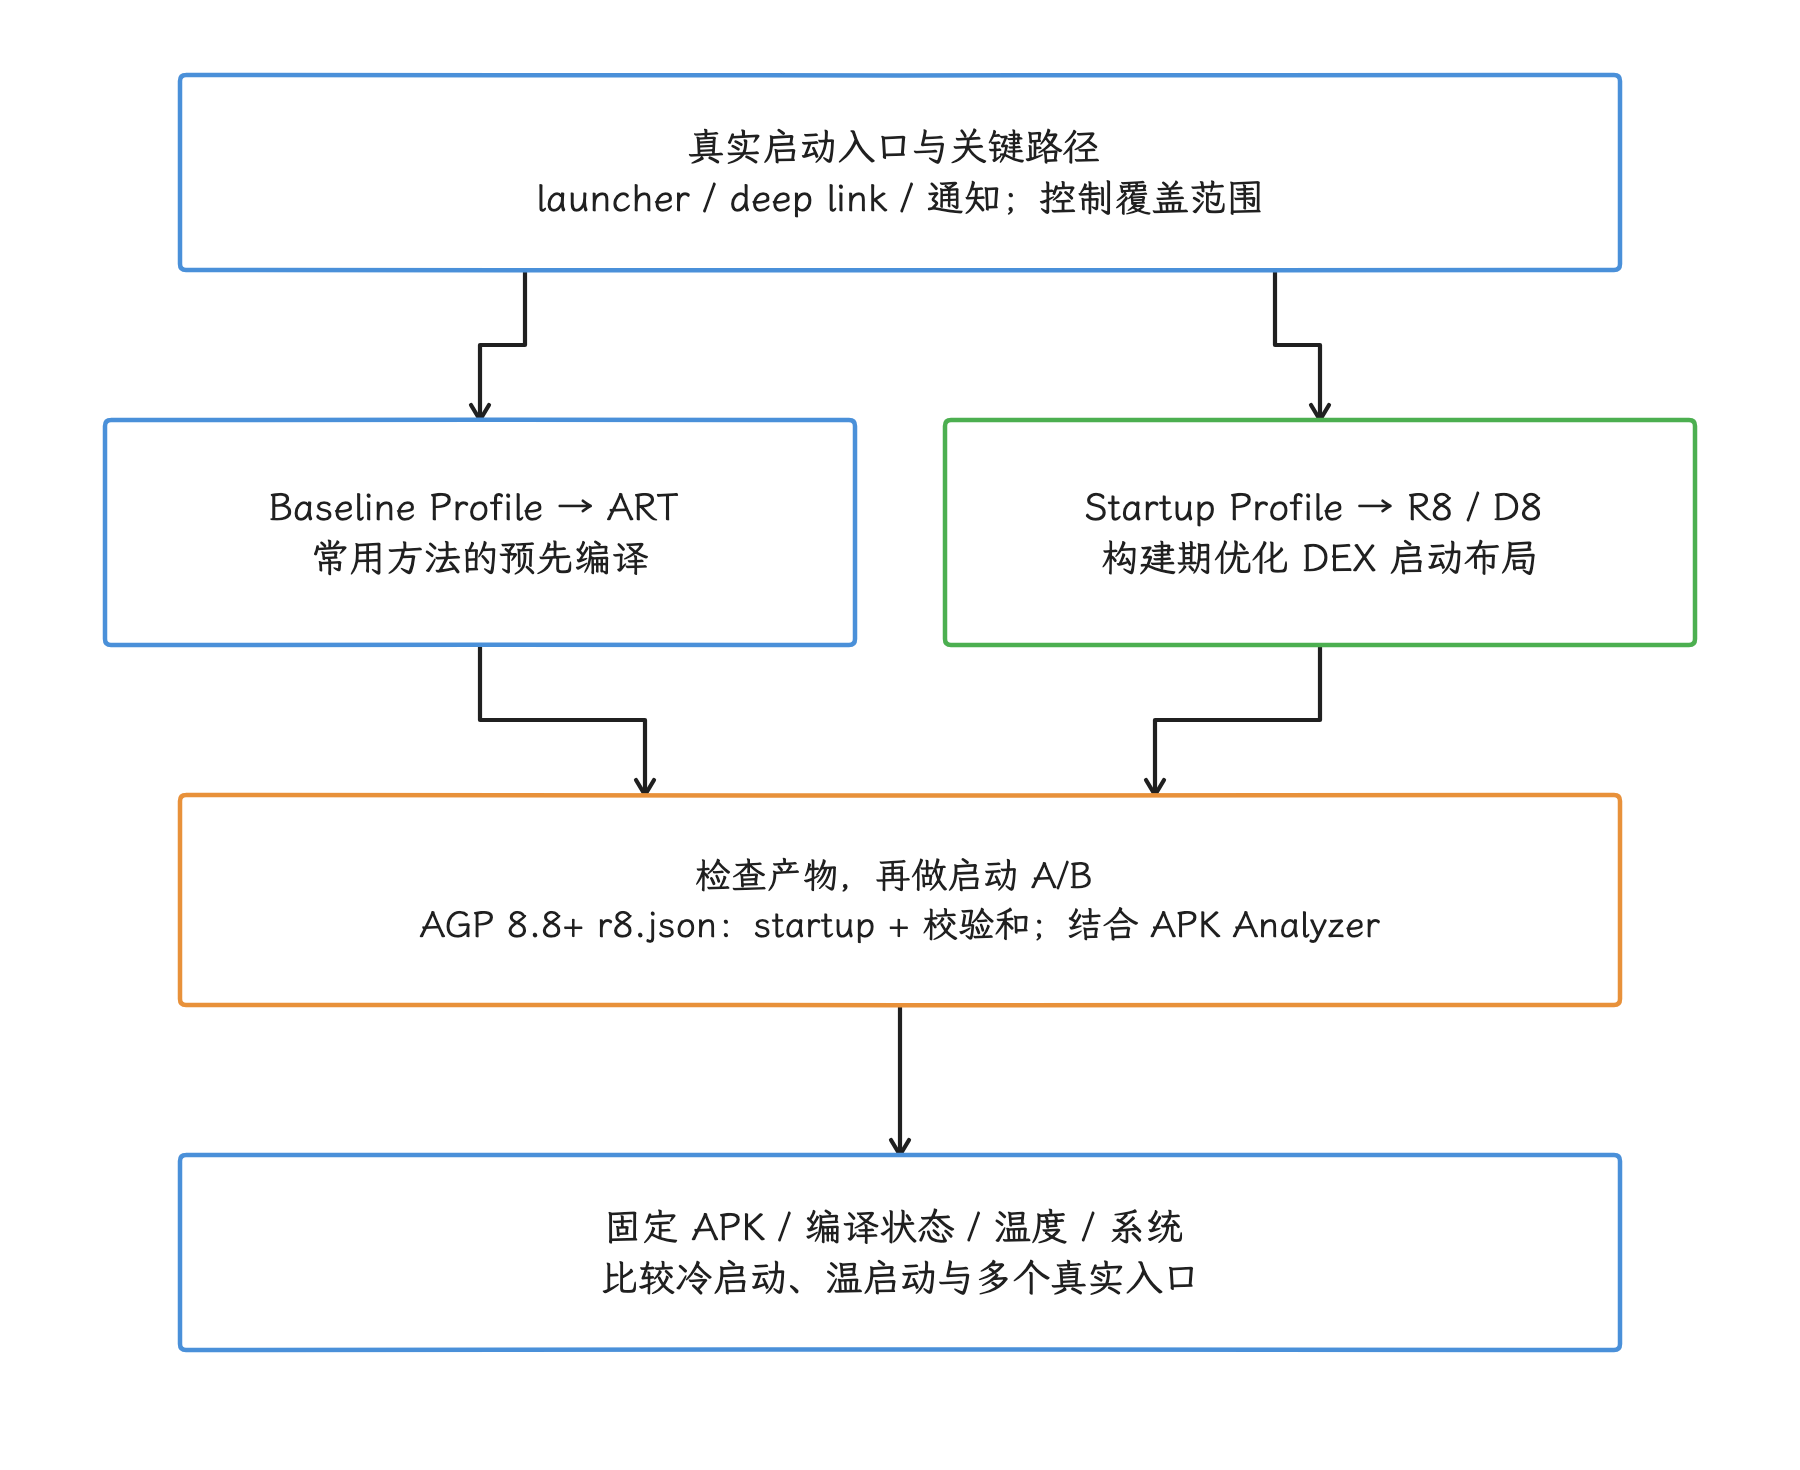
图:DEX 布局优化从 AGP 8.1 可用,8.1–8.2 需启用,8.3 起默认启用;release 还须开启 R8 优化。r8.json 的 startup 状态要与对应 DEX 校验和一起核对,端到端收益不能全部归因于 I-cache miss。
与当前应用、构建链无关的 Redex 百分比,引用来当预期收益没有意义;官方给出的经验范围只够用来决定要不要实验,发布结论应来自我们自己的 A/B 数据。
Simpleperf:从症状到证据
Simpleperf 能提供的证据有强弱之分。这一节我们先确认设备支持哪些 PMU 事件,再用分组计数和热点采样定位到符号,然后说清低 IPC、cache miss 与 false sharing 各自能被证明到什么程度,最后看内存统计类的数据为什么顶替不了这些证据。
先查看设备支持哪些 PMU 事件
PMU 事件是硬件提供的计数项,用来统计周期、指令、cache miss 等微架构行为;事件名和可用性取决于 CPU PMU、内核及权限。动手采集前,我们先在自己这台设备上跑:
simpleperf list
simpleperf list raw
simpleperf stat --print-hw-counter
第一条列出内核封装的事件,第二条列出工具为本机 CPU 匹配并探测的 raw event(原始硬件事件);r1 还会区分 supported 与 may supported 的 CPU,后者不表示已经观测到非零计数。第三条显示可用硬件 counter(计数器)数量。raw-l2-dcache-refill 未必每台设备都支持,某个 Cortex 文档中的 event number 也未必适用于另一款 SoC,先确认自己这台设备有什么。
先做分组计数
如果设备支持通用事件,可以先比较周期、指令和 cache 事件:
simpleperf stat \
  --group cpu-cycles,instructions \
  --group cache-references,cache-misses \
  -p <pid> --duration 10
同组事件会尽量同时调度,适合计算 IPC(instructions per cycle,每周期指令数)或 miss ratio(未命中比例)。硬件 counter 不足时会发生 multiplexing(分时复用);引用输出时要连 enabled/running 时间和警告一起保留。不同 cluster 可能使用不同 PMU,线程迁移也会影响结果解释。
“cache miss 超过 10% 就该优化”这样的通用阈值并不存在。miss 的种类、每次 miss 的代价、内存访问并行度和业务 deadline(截止时间)都会影响结果。更有用的做法是比较相同工作量下的前后变化,并确认延迟或吞吐也随之改善。
再做热点采样
确认 cache 事件与慢样本相关后,再定位符号:
simpleperf record \
  -e cache-misses:u \
  -p <pid> --duration 10 --call-graph dwarf
simpleperf report --sort dso,symbol
设备是否支持该事件采样、用户态过滤和 DWARF 调用栈还原,要通过 simpleperf list 与设备能力确认。采样结果能定位事件出现在哪些指令附近;被访问的数据地址未必包含在内,单靠它也定不下 false sharing。
标记为 debuggable 或 profileable 的应用可以使用 Simpleperf 的应用分析流程。setenforce 0 这类关闭 SELinux 强制模式的操作属于特殊调试手段,普通开发步骤里不该出现;量产设备的 PMU 与 tracing 权限由系统安全策略决定。
低 IPC 与 memory-bound 的判断
IPC 低的原因不止 memory-bound(主要受内存访问限制)一种:
- branch miss 或 instruction-cache / TLB 压力;
- 长依赖链;
- 锁等待附近的短运行片段;
- 指令前端或执行后端的 stall(停顿);
- 不同核心宽度与频率;
- PMU multiplexing 或统计窗口错误。
要判断负载是否真的受内存访问限制,我们至少要结合以下几类信息中的一部分:cache/TLB refill、backend stall(执行后端停顿)、内存带宽或访问延迟采样;同时通过改变数据布局或工作集做可控实验,看指标是否随之移动。
Perfetto 的 sched、CPU frequency、thread state 和应用 slice(带起止时间的自定义事件区间)可以提供时间上下文。默认 trace 不会自动产生每线程 instructions/cycles,也没有一段可以直接套用的通用 SQL,能把任意 counter 按线程换算成 IPC。可以用相同 workload 的时间窗口关联 Simpleperf 与 Perfetto,但需注明数据来自两次采集还是同一次采集。
False sharing 需要地址级证据
普通 cache-miss 采样只能提示热点。要定位 false sharing,通常需要:
- 支持 Arm SPE(Statistical Profiling Extension,统计分析扩展)的设备;
- 内核提供的 perf data-source(访存来源)信息;
perf c2c(cache-to-cache 分析)或等价的厂商工具;- 带符号信息的 binary(二进制文件);
- 结构体布局信息,例如
pahole/offsetof。
这些条件在量产 Android 手机上经常凑不齐。可行的替代实验是固定线程和工作量,只改变计数器分片或字段间距,同时比较吞吐量、atomic retry、cache event 与功耗。拿不到地址级证据时,结论就写到“现象与共享 cache line 竞争一致”为止,别声称已经定位到某个字段。
内存统计与 cache 证据的分工
PSS(按共享比例折算的进程内存)中的 Dalvik/native/other 分类用于内存归因;要看 CPU cache(高速缓存,下文保留 cache)的数据布局或访问局部性,得换成 cache 事件的视角。anon_huge_pages、file_pmd_mapped 等 smaps 字段反映的是大页映射状态。这两类都是内存统计和 TLB/页表侧的数据,false sharing 的证据还是要回到 cache 事件与地址级采样上来。
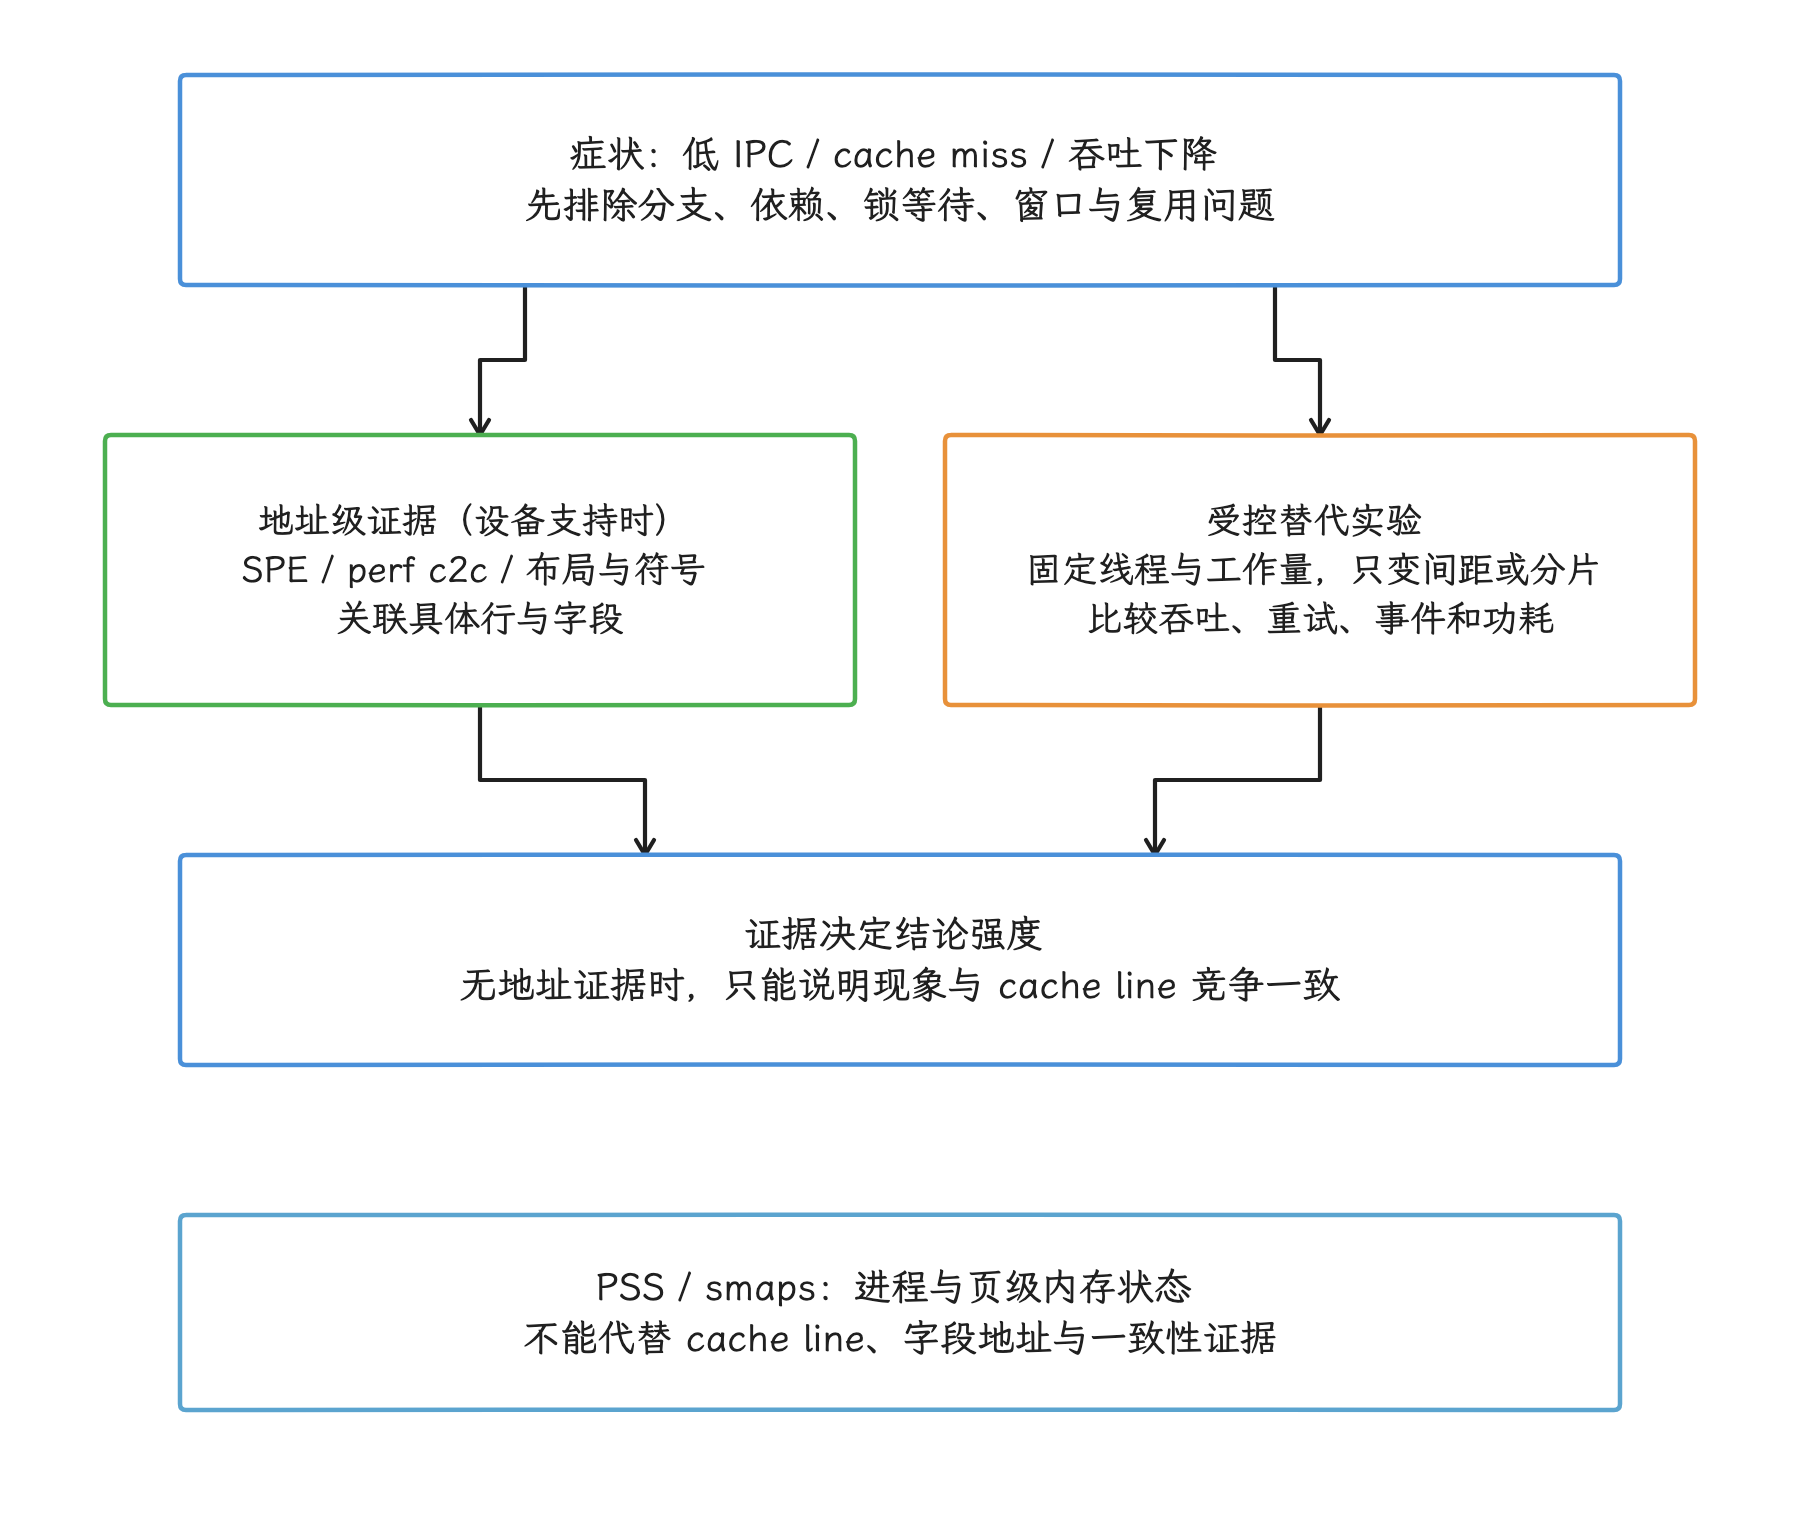
图:低 IPC 或普通 cache miss 不能单独证明 false sharing。SPE、perf c2c 与数据来源信息在设备上未必可用;PSS 与 smaps 可帮助理解内存或页表状态,但无法直接证明两个字段正在争用同一行。
同样,Linux 的 SLUB slab allocator(小对象分配器)并不会把所有对象统一向上取整到 cache-line 大小的整数倍;具体 alignment(对齐方式)取决于架构、cache flags、对象大小和创建参数。16 KiB page 对 slab order(一个 slab 占用的连续页阶数)、内存碎片和 TLB 的影响,也需要单独测量。
系统源码中的局部性设计
本节看三类能从源码直接核对的布局设计:ART 卡表的偏置基地址、Binder Parcel 的连续数据区、内核的 cache 对齐宏。每一类我们先给可以确认的事实,再说清哪些性能结论从这些常量推不出来。
ART CardTable:一字节表示 1 KiB 堆区间
ART 的 CardTable(卡表)定义 kCardShift = 10,卡表里每个 byte 对应 1 KiB 堆区间。对象引用的 write barrier(写屏障)会把对应 byte 标为 kCardDirty,GC 可以在相应的卡表扫描阶段重点处理这些 dirty card(脏卡)覆盖的堆区间;整个垃圾收集仍有根扫描、对象遍历等其他工作,不能概括为只扫描脏卡。
CardTable::Create() 为表额外分配 256 字节,并调整 biased_begin(带偏置的基地址),使其地址低字节等于 kCardDirty。源码注释说明,这样 JIT 生成的写屏障不必另行构造或加载 dirty 常量,可以减少生成代码中的指令。
可以确认的事实:
- card granularity 是 1 KiB heap(堆内存)/ 1 byte table;
biased_begin用于高效计算 card 地址并写入 dirty 状态;- dirty、aged、aged2 是 GC 状态。
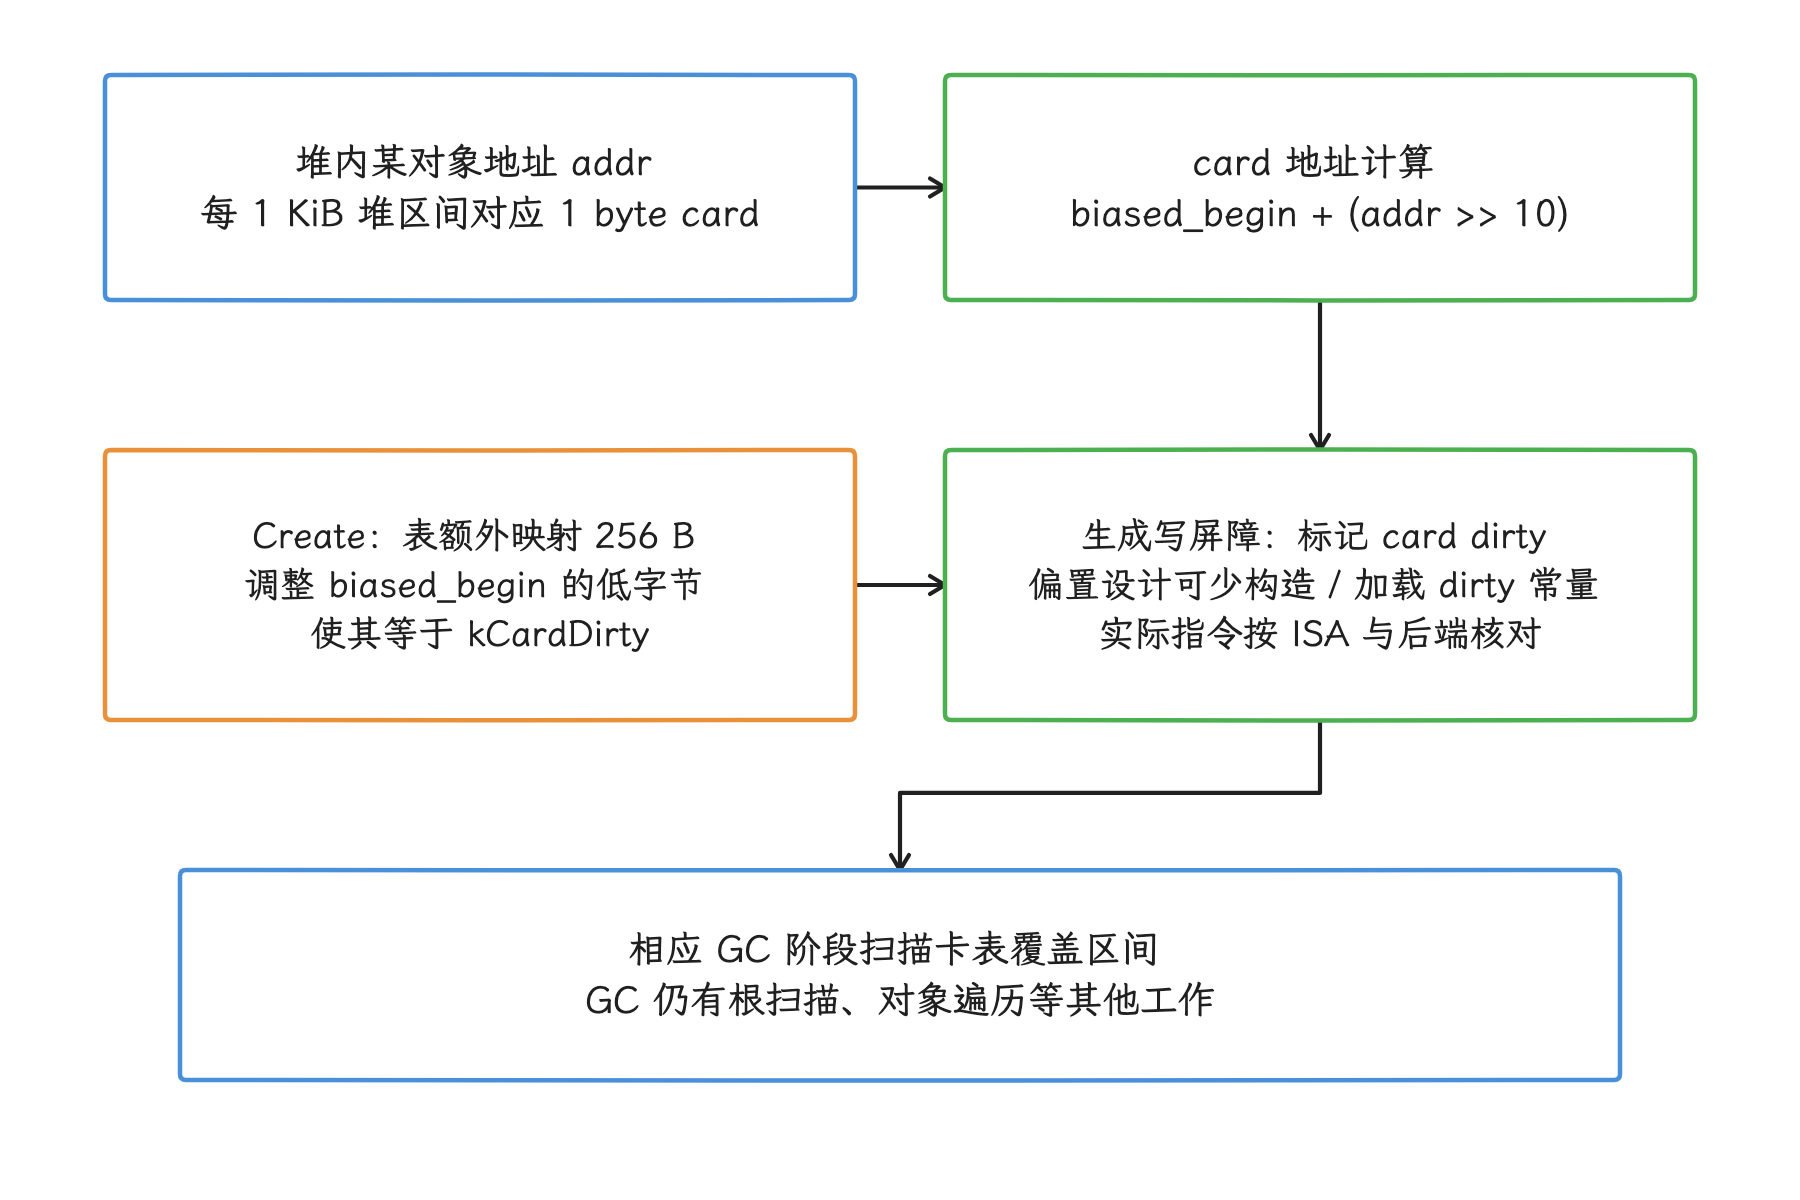
图:kCardShift = 10 表达 1 KiB heap / 1 byte table,与 CPU cache line 不是同一粒度。额外 256 B 用于基地址调整,不能推导“每次写屏障节省一条 cache line”或固定性能比例。
“每次写屏障节省一条 cache line”或固定的性能百分比,从这些常量是推不出来的:实际指令序列取决于 ISA(指令集架构)、编译器后端和运行模式;多个 mutator(并发修改堆的应用线程)写入相邻的 card byte,离观测到 false sharing 也还差一步。
Binder Parcel:连续数据与独立对象表
Parcel 的普通数据存储在 mData 连续缓冲区,通过 mDataPos 顺序写入,并按 4 字节边界 padding。容量不足时 growData() 扩大缓冲区,continueWrite() 负责所有权与复制;Binder 对象位置另存于 mObjects 或 RPC object-position 容器。
这套布局方便顺序序列化和内核 Binder 处理,也能减少普通字段的指针追踪。代价同样存在:扩容、对象验证、FD 复制和大块二进制数据仍可能成为主要成本。源码结构只解释数据放在哪里,性能结论还要靠具体 transaction 测量。
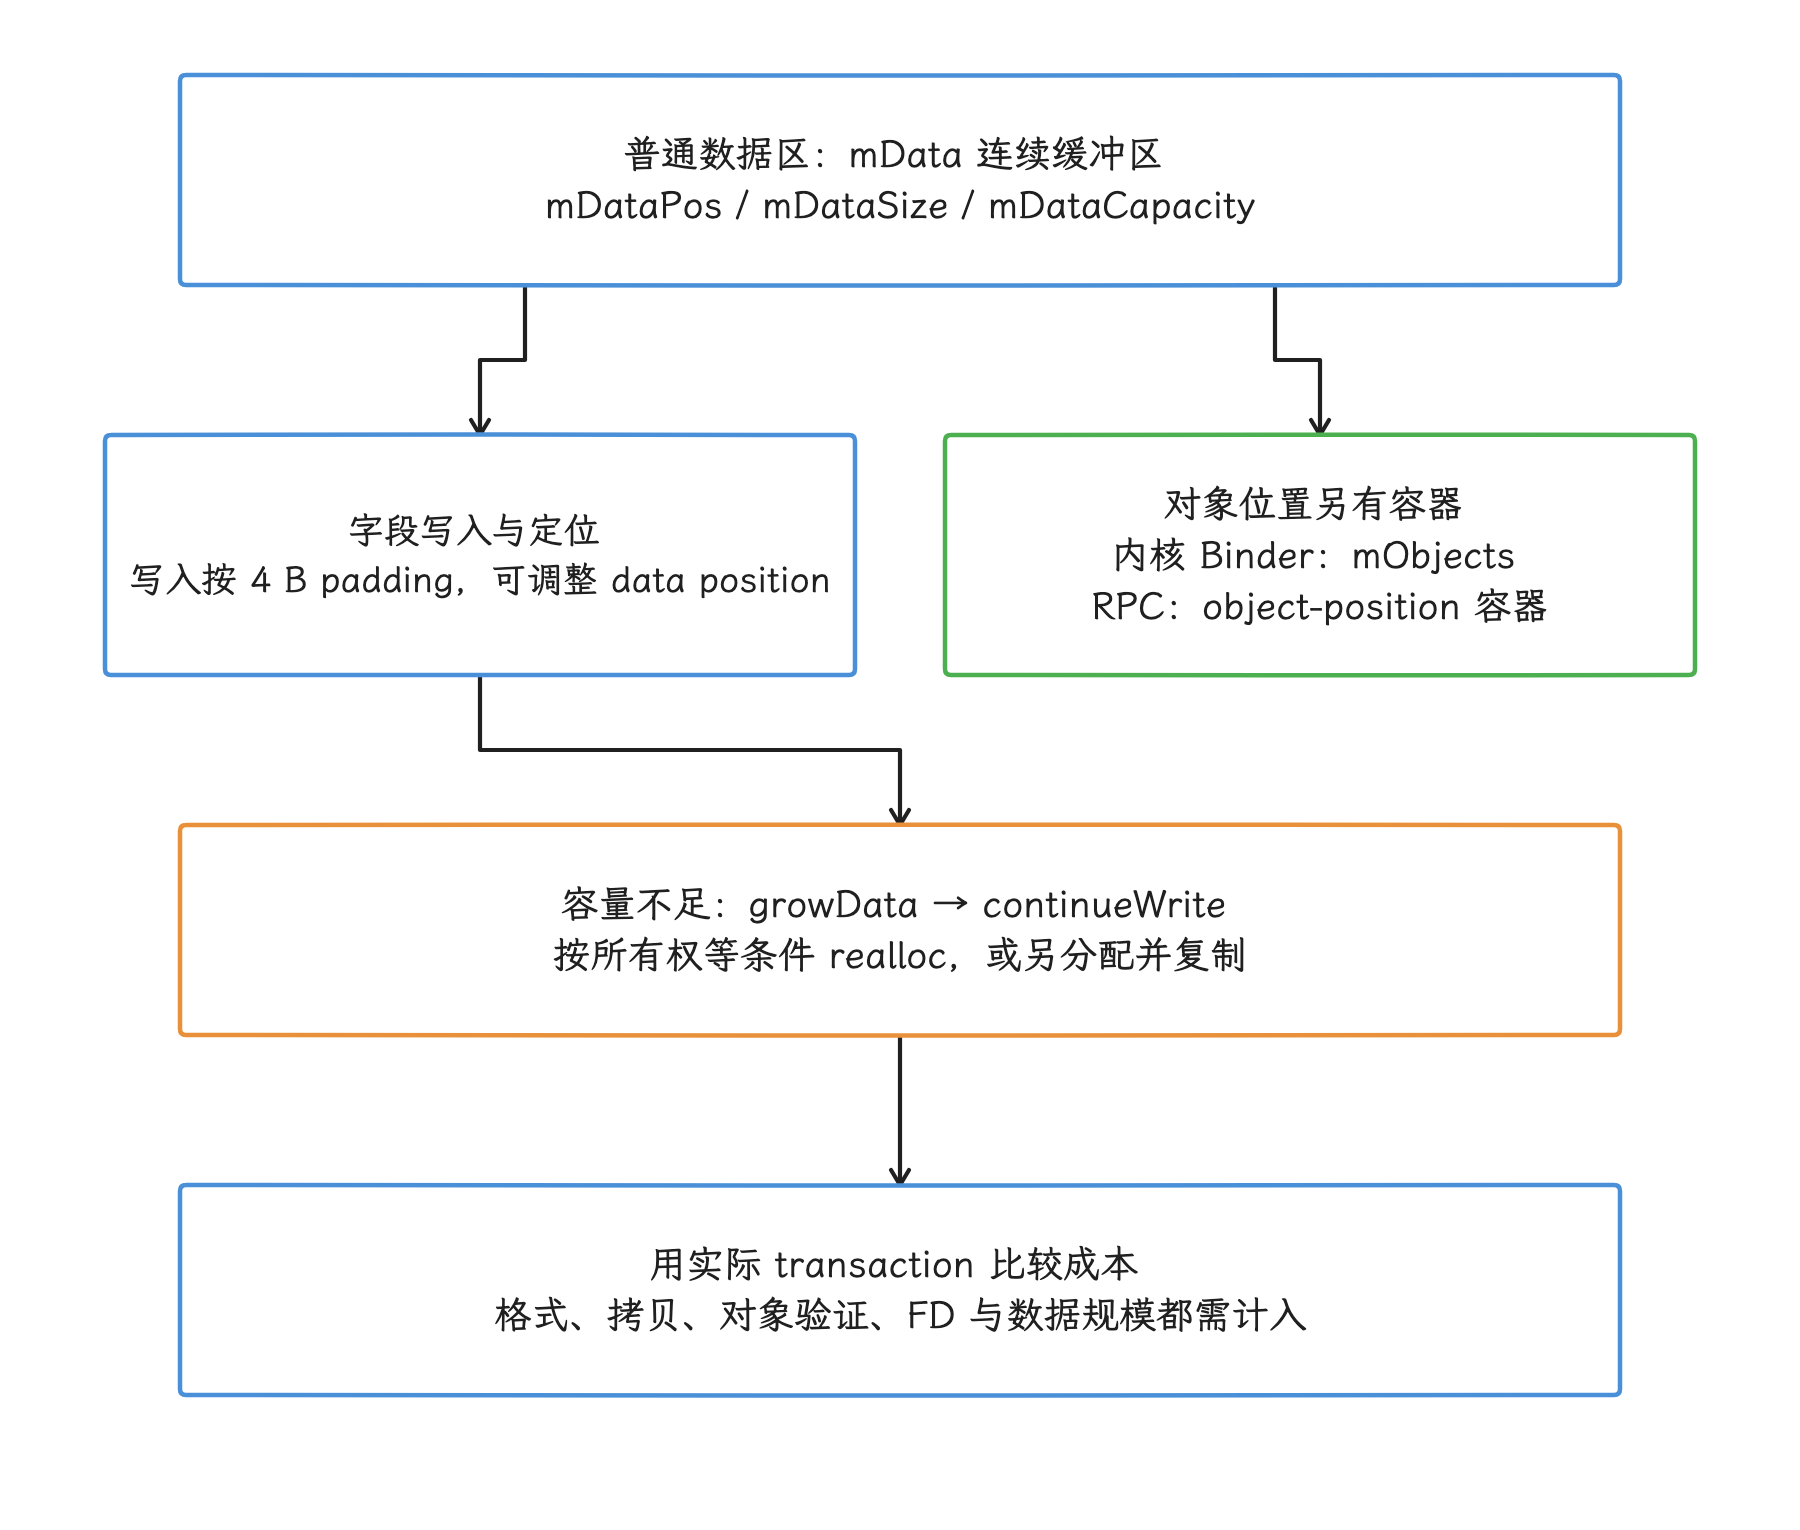
图:Parcel 不是只能从头顺序读取,也不是所有内容都挤在一个数组里。连续 mData 有局部性,但 Binder wire format、所有权、安全检查与 FD 管理同样决定性能。
Linux cache 对齐宏表达了取舍
内核 6.18 的 include/linux/cache.h 提供:
__read_mostly,把热路径会读取、但很少修改的数据集中到特定区域;__cacheline_aligned/____cacheline_aligned_in_smp;- cacheline group begin/end;
cache_line_size()。
文件注释明确要求谨慎使用 __read_mostly,并根据性能分析结果决定是否采用。紧凑排列可以减少读取的 cache line 数,对齐隔离则会增加空间占用,这是一对取舍。应用层可以借鉴这套决策顺序,内核宏本身没法直接搬,也不该让所有结构都独占一条 cache line。
一套可执行的优化流程
1. 固定业务指标
先选择用户可感知或系统必须满足的指标:帧耗时、启动时间、音频 deadline、每秒处理量、单次能量。cache counter 是用来解释现象的硬件计数,业务指标才是验收标准。
2. 找到 CPU 热点
用 Perfetto 确认线程何时在运行、是否被抢占或迁移;用 Simpleperf 的 cycles / instructions 找 CPU 热点。若线程多数时间阻塞,先查锁、I/O 或 Binder。
3. 验证 memory hierarchy 假设
在设备支持范围内加入 cache、TLB 和 stall 事件。改变工作集大小、遍历顺序或字段布局,观察硬件事件与业务耗时是否出现可重复、方向一致的变化。
4. 一次只改一个主要变量
分别比较:
- primitive array 与 boxed collection(装箱元素集合);
- AoS、SoA、AoSoA;
- 每线程分片与共享 atomic;
- 有无 reserve;
- 有无 Startup Profile;
- 有无 prefetch / 不同 tile。
一次同时改算法、线程数、数据结构和编译选项,收益就解释不清了。
5. 覆盖大小核与热状态
至少要在目标机型的常见调度状态下重复实验。为了 cache 实验把生产代码永久绑核是不可取的;可以在受控 benchmark 中记录实际运行的 CPU,并分别观察性能核和能效核。长时间负载还要记录温度、热限制状态和频率,免得把降频差异误认为 cache 收益。
6. 检查代价
布局优化可能增加:
- RSS 与 allocator 产生的内存碎片;
- TLB miss;
- 初始化和转换成本;
- 代码复杂度;
- 低端设备上的工作集;
- 多份数据的一致性维护。
业务指标在代表性设备和输入上稳定改善了,改动才值得保留。
结论
Cache 友好代码要让“经常一起使用的数据”在时间和地址上靠近,也要让被不同 CPU 频繁写入的数据分开,各占一条 cache line。落到各语言层,做法分别是:
- Kotlin/Java 优先减少装箱、指针追踪和共享可变状态;
- NDK 使用连续容器、hot/cold split、SoA/AoSoA 和经过验证的对齐;
- 启动代码通过 Startup Profile 交给 R8/D8 做 DEX layout;
- 系统级问题通过 PMU、地址级采样和源码布局核对。
所有规则都有反例。数组可能因转换成本输给对象模型,padding 可能因内存膨胀变慢,prefetch 可能污染 L1,Startup Profile 也可能因为覆盖错误入口而收益很小。先测量,再做最小改动,最终回到端到端指标验收。
源码核对索引
art/runtime/gc/accounting/card_table.hkCardShift、card 状态和biased_begin字段。
art/runtime/gc/accounting/card_table.cc- 额外 256 字节映射与
biased_begin计算。
- 额外 256 字节映射与
frameworks/native/libs/binder/Parcel.cpp- 连续
mData、4 字节 padding、增长与对象位置管理。
- 连续
kernel/arch/arm64/include/asm/cache.h- 64 字节 L1 基线、
CTR_EL0.CWG与 DMA alignment。
- 64 字节 L1 基线、
kernel/include/linux/cache.h- read-mostly、cacheline alignment 与 group 宏。
kernel/Documentation/kernel-hacking/false-sharing.rst- 检测条件、
perf c2c与缓解原则。
- 检测条件、
参考资料
- Android Simpleperf documentation
- Arm cache hierarchy:cache 层级、组相联和预取概念;其中服务器示例的数值不作为 Android 通用参数。
- Arm AoS/SoA 布局示例:按热循环字段选择数据布局。
- GCC prefetch 与分支提示:编译器提示及地址表达式边界。
- AOSP Simpleperf command reference
- Baseline Profiles overview
- Startup Profiles overview
- Create Startup Profiles and optimize DEX layout
- Confirm Startup Profile optimization
- AOSP Android 17 ART CardTable
- AOSP Android 17 Binder Parcel
- Android common kernel 6.18 arm64 cache definitions
- Android common kernel 6.18 cache helpers
- Android common kernel 6.18 false-sharing guide
- Arm Cortex-A processor comparison