Native 与虚拟内存管理优化
源码基线:Android 17 / API 37 / AOSP
android-17.0.0_r1;内核android17-6.18-2026-06_r6。旧版本只用于说明能力的引入时间,不作为当前实现依据。
Native 内存治理分两步:先把分配器、对象所有者和释放路径找清楚,再进入虚拟地址映射、页驻留、缺页和回收。malloc 数字、RSS 和 PSS 描述的是不同层面的事,我们先分清它们各自回答什么问题,后面每一节都建立在这个区分上。
分配器、所有权与资源生命周期
原生内存为什么需要单独排查
Java 堆没有持续增长,进程的内存占用也可能在涨。只要应用里有 JNI、音视频 SDK、地图 SDK、游戏引擎、图片库或加密库,原生堆(Native Heap)、匿名 mmap、共享库映射和图形缓冲都可能推高 PSS;涨上去的后果,轻则后台进程更早被系统回收,重则前台内存压力或原生崩溃。
所以我们先确认增长落在哪一种系统统计里,再按问题类型挑工具:heapprofd(Android 原生堆采样器)、libmemunreachable、malloc_debug、ASan、HWASan、GWP-ASan 或 MTE。容量问题和非法访问要看的东西不同:前者看分配栈和存活量,后者看越界、释放后访问这些错误现场。内存模型见 4.1 Android 与 Linux 内存管理全景,工具使用见 15.3 内存分析、HPROF 与 Heap Dump 工具,应用进程统计见 10.1 App 内存分析与案例。
文中术语含义如下:
| 术语 | 本文含义 |
|---|---|
JNI / .so / ELF | JNI 是 Java/Kotlin 与 C/C++ 代码之间的调用接口;ELF 是 Android 原生二进制文件采用的格式,.so 是其中的共享库文件。 |
| RSS / PSS / Private Dirty | RSS 是驻留物理页总量;PSS 按共享者数量分摊共享页;Private Dirty 是当前进程独占且已写入的页面。Shared Clean 是未被写脏的共享页,Private Clean 是未被写脏的私有页。 |
VMA / mmap | VMA(虚拟内存区域)描述一段连续地址范围及其权限和来源;mmap 用于建立匿名或文件映射。 |
| allocator / arena / chunk / quarantine | allocator(内存分配器)管理申请与释放;arena 是其成组管理的内存区域;chunk 是单个分配块;quarantine(隔离区)会延迟复用已释放块。 |
memtrack / dma-buf | memtrack 是 Android 汇总图形等设备内存的接口;dma-buf 是内核中供设备和进程共享缓冲区的机制。 |
| Graphics / GL / Code / Unknown | 这些是 dumpsys meminfo 的分类标签:Graphics 和 GL 通常覆盖图形缓冲与 OpenGL 驱动分配,Code 统计映射的程序及安装包文件,Unknown 收纳未归入其他分类的页面;具体边界受平台和驱动实现影响。 |
| UID / SELinux / root | UID 是 Linux 用来区分进程身份的用户编号;SELinux 是 Android 的强制访问控制机制;root 表示系统管理员权限。 |
| user / userdebug / eng | user 是量产构建;userdebug 和 eng 提供更多调试权限。debuggable、profileable 是应用清单或构建配置声明的可调试、可分析属性。 |
| Bionic / Scudo / jemalloc | Bionic 是 Android 的 C 标准库;Scudo 和 jemalloc 是系统可采用的原生内存分配器。 |
| sanitizer / instrumentation | sanitizer 是检测内存错误的运行时;instrumentation(插桩)是在构建时加入检测代码。 |
| tombstone / fault address | tombstone 是 Android 原生崩溃转储;fault address 是触发异常访问的地址。Build ID 用于匹配二进制和符号,ABI 表示应用二进制接口。 |
| HPROF | Java 堆快照的数据格式和分析路径,用于查看 Java 对象,不等同于 heapprofd 记录的原生堆分配。 |
| producer / client | 在 heapprofd 中,producer 是写入 Perfetto 数据的组件,client 是目标进程内接收配置并记录分配的组件。 |
全文的操作主线就是这两步:先按系统统计分区,再选工具。
原生内存包含哪些部分
把所有非 Java 堆的增长都归到 malloc,是讨论原生内存时的常见误区。我们排查时至少区分四类:
- 原生堆:C/C++ 代码通过
malloc、calloc、realloc、new申请的堆内存,常见来源是 JNI 层业务代码、第三方.so、音视频编解码、图片库和加密库。 - 匿名
mmap区域:代码直接用mmap申请的私有匿名映射,或者分配器向内核申请的大块 arena。/proc/<pid>/smaps中可能显示为[anon:libc_malloc]、[anon:scudo:*]或业务自定义名称。 .so/ ELF 映射:.so文件被动态链接器映射到进程地址空间后,会产生代码段、只读数据、可写数据和重定位相关页面。共享只读页面通常按 PSS 分摊,可写脏页计入当前进程。- 图形与硬件缓冲:Bitmap 像素、OpenGL/Vulkan 纹理、Surface buffer(界面缓冲)、
dma-buf等资源可能出现在原生堆、Graphics、GL 或 memtrack 统计中。统计位置受分配方式、驱动和厂商实现影响,VMA(virtual memory area,虚拟内存区域) 名称只能当线索用,资源类型还要结合分配路径确认。图片内存见 23.4 Bitmap 与图片内存优化。
这些分类在系统侧有明确的实现位置:android_os_Debug.cpp 的 android_os_Debug_getDirtyPagesPid() 调用 libmeminfo 的 ExtractAndroidHeapStats() 取得按 VMA 分类的统计,再把 memtrack 返回的图形数据计入相应字段。VMA 分类规则位于 androidprocheaps.cpp:[heap]、[anon:libc_malloc]、[anon:scudo:] 和 [anon:GWP-ASan] 等名称归入原生堆,.so 归入共享库,.jar、.apk 等归入对应的代码分类。Graphics 数值还可能来自 memtrack,所以 dma-buf 的归类要以具体实现为准。
另外,VMA 分类和总量统计走的是两条读取路径:androidprocheaps.cpp 必须扫描详细的 /proc/<pid>/smaps,因为分类依赖每个 VMA 的名字;而 ProcMemInfo::SmapsOrRollup() 用于计算 PSS、RSS 等聚合值,内核提供 smaps_rollup 时读取汇总文件,否则改读 smaps。汇总文件里没有逐 VMA 名称,这两条路径各有用途。
[源码锚点: AOSP android-17.0.0_r1, frameworks/base/core/jni/android_os_Debug.cpp, system/memory/libmeminfo/androidprocheaps.cpp, system/memory/libmeminfo/procmeminfo.cpp]
四类内存对应的诊断动作也各不相同:原生堆看分配栈;.so 映射看装载范围、重定位和脏页;图形缓冲看图像、渲染资源与 memtrack;匿名 mmap 要追踪调用方或业务设置的 VMA 名称。把它们合成一个“原生内存”数字固然省事,定位要用的线索也就跟着丢了。
排查入口:先看趋势,再记录调用栈
拿到一条原生内存曲线后,我们先看它属于哪种形状:一次性峰值过高,还是存活内存随操作次数持续增长。前者多见于大图、模型、音视频缓冲和一次性解压;后者要继续检查泄漏、缓存失控或对象池未回收。
这三组命令用于建立第一次快照。dumpsys meminfo 适合先看系统分类;读取 smaps 适合检查 VMA,但在量产设备上可能受到 UID、SELinux 和 /proc 访问限制,需要 root、userdebug 或目标进程具备相应调试条件。
# 大写名称是符号占位符,使用前替换为目标包名、数字PID或进程名。
# 1. 看系统口径的进程内存分类
adb shell dumpsys meminfo PACKAGE_OR_PID

# 2. 在权限允许时保存 VMA 级明细
adb shell cat /proc/PID/smaps > smaps.txt

# 3. 从系统分类中单独观察 Native Heap
adb shell dumpsys meminfo PID | grep -A 20 "Native Heap"
这类快照只能说明“哪一类在变”;要进一步定位,就要在相同设备、相同构建和相同操作序列下,对比进入场景前、场景稳定后、退出并等待回收后的数据。走向也随分类而变:原生堆持续增长就采 heapprofd;Graphics、GL 或 memtrack 相关值增长就转到图片和渲染资源路径;.so 的私有脏页异常,再去查动态库装载、初始化写入和重定位。
heapprofd:原生堆分配的首选分析入口
heapprofd 是 Perfetto 的原生堆采样分析器,从 Android 10 开始可用,适合回答两个问题:哪条调用栈的累计分配量高,哪条调用栈在快照时仍有较多存活分配。user 构建只能分析满足系统权限规则的 debuggable 或 profileable 应用;系统进程和更深的诊断通常需要 userdebug 或 eng 环境。
中央服务默认禁用,由采集请求按需启动
heapprofd.rc 把 heapprofd 服务声明为 disabled:persist.heapprofd.enable=1 或 traced.lazy.heapprofd=1 时,init(Android 启动后负责管理系统服务的进程) 才启动服务;两个属性都清空后,服务随之停止。默认配置支持按需拉起,但 persist.heapprofd.enable=1 也能独立启动并保持服务;disabled 不足以证明任意设备上服务都未运行,服务运行也不等于正在持续采集。
服务启动后,heapprofd.cc::StartCentralHeapprofd() 从 init 进程传入的 socket(本地通信端点) 取得监听端,建立 HeapprofdProducer,接收目标进程中分析 client 的连接。应用进程这一侧,malloc_interceptor_bionic_hooks.cc 中的 Bionic(Android 的 C 标准库与系统基础库) MallocDispatch 拦截 malloc、free、calloc、realloc 等入口,并通过 AHeapProfile_registerHeap 注册要分析的堆;这条路径不依赖 LD_PRELOAD。
这套接口属于 heapprofd 与系统分配器的内部协作面,没有对外提供应用 SDK 的公共 malloc 拦截 API;源码里的 heapprofd_get_malloc_leak_info 和 heapprofd_write_malloc_leak_info 就是显式的空实现,所以它们当不了 LeakCanary 或其他原生泄漏 SDK 的基础接口。
[源码锚点: Perfetto android-17.0.0_r1, heapprofd.rc, src/profiling/memory/heapprofd.cc, src/profiling/memory/malloc_interceptor_bionic_hooks.cc]
采集配置与采样语义
这段配置演示如何采集一个指定进程。size_kb 和 dump_interval_ms 是诊断示例值,需要根据复现时长和设备负载调整;sampling_interval_bytes 决定采样密度。
buffers: {
  size_kb: 65536
}
data_sources: {
  config {
    name: "android.heapprofd"
    heapprofd_config {
      process_cmdline: "com.example.app"
      sampling_interval_bytes: 4096
      continuous_dump_config {
        dump_interval_ms: 10000
      }
    }
  }
}
Perfetto 官方文档把 4096 字节作为默认采样间隔。Sampler::SampleSize() 对小于间隔的分配使用按字节推进的概率采样,含义是长期期望每 N 字节产生一个样本;单次分配大于或等于间隔时绕过该概率路径,记录这次分配的原始大小。估算“某个对象被记了几次”要回到这套采样语义上算,固定换算比例给不出来;CPU 开销也一样,脱离设备、调用栈展开成本和负载,给不出固定百分比。
采集完成后,我们到 Perfetto UI 的 Heap Profile(堆分配视图) 中看结果,火焰图按调用栈层级汇总分配。分析泄漏时,比较多个时间点仍然存活的分配及其调用栈;分析频繁申请和释放造成的分配抖动时,看累计分配量与分配频率。采样间隔越小,小分配的细节越多,事件量与运行开销也越高,所以先在目标设备上把开销测出来,再定复现窗口和采样间隔。
[源码锚点: Perfetto android-17.0.0_r1, src/profiling/memory/sampler.h, src/profiling/memory/sampler.cc]
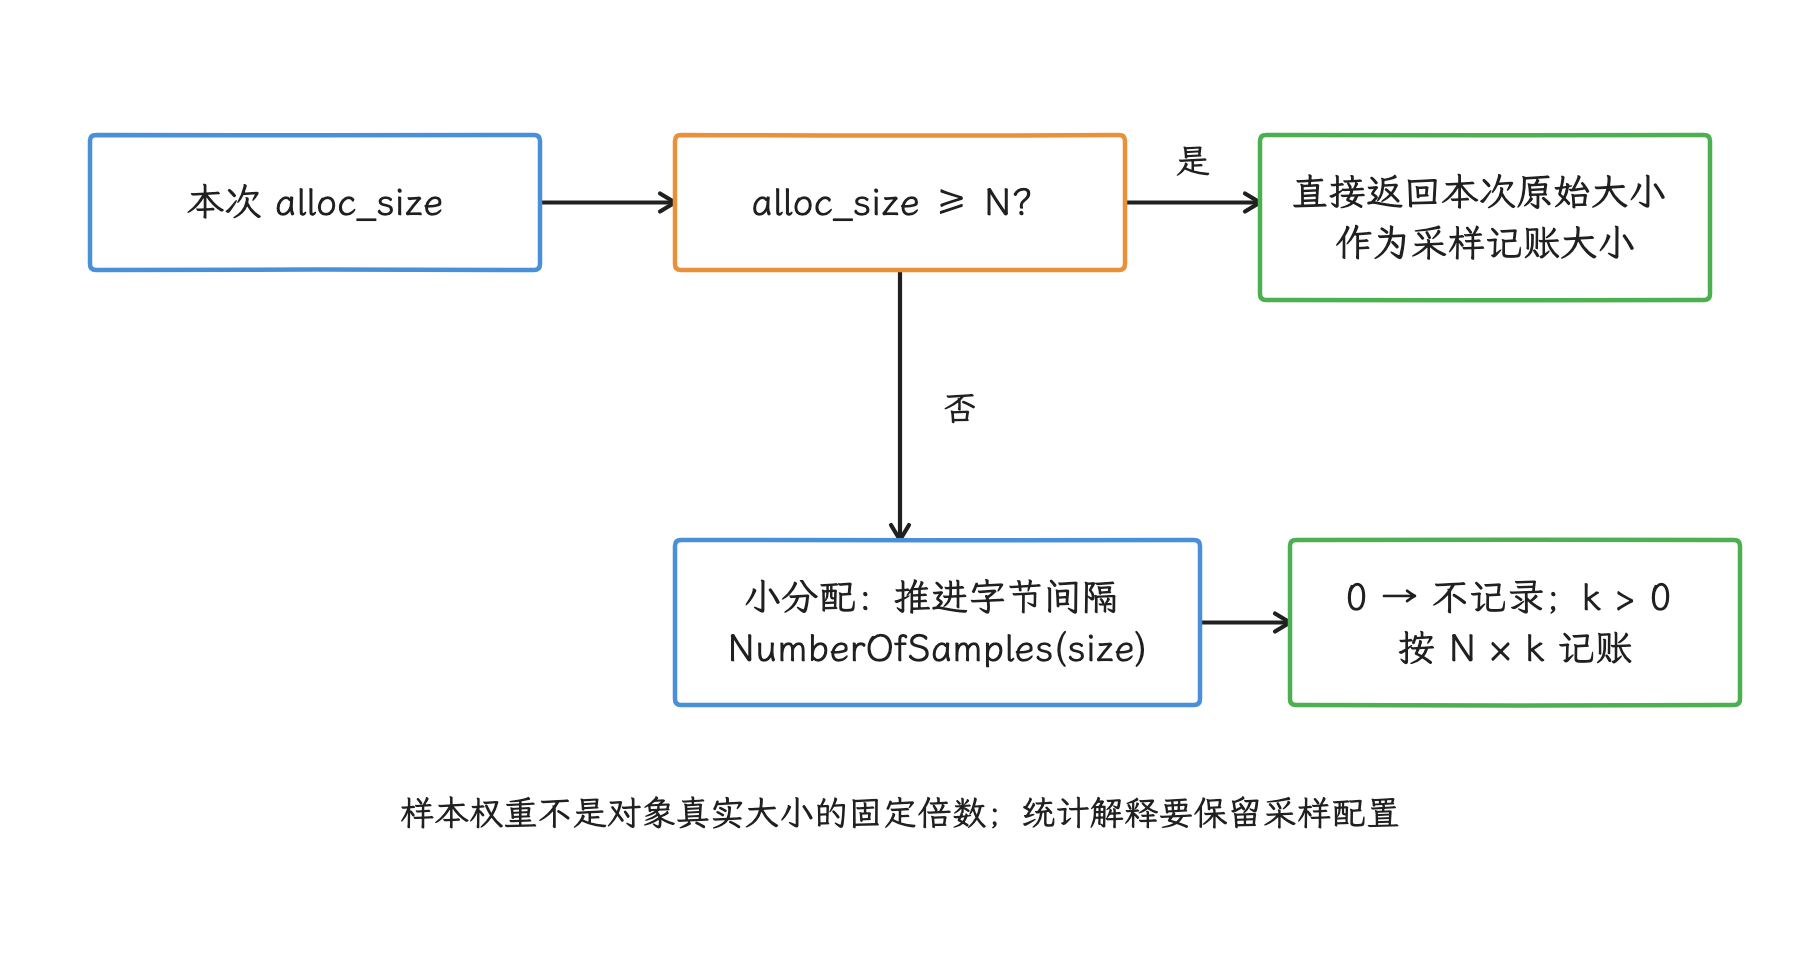
图:小分配使用按字节推进的随机采样,可跨多个间隔;累计估计与单个对象是否被记录是不同问题。降低间隔后需重新测开销。
原生堆与 Java HPROF 是两条独立路径
Perfetto 源码为原生 heapprofd 使用 __SIGRTMIN + 4,为 Java HPROF 使用 __SIGRTMIN + 6;Java HPROF producer 在发送信号前还会通过 CanProfile() 检查目标进程是否允许分析。这里的 Java HPROF 指 Perfetto 的 android.java_hprof / JavaHprofProducer 路径,其 ART 插件输出 trace 内的 HeapGraph,并不先落盘为完整 .hprof 文件。独立完整 HPROF 仍由 Debug.dumpHprofData()、有权限的 am dumpheap 或 Studio 等入口生成,详见 23.2 的产物区分。原生 heapprofd 与 Java HeapGraph 使用不同的数据源、信号与权限路径;某种转储命令能运行,另一条路径仍要单独验证。
[源码锚点: Perfetto android-17.0.0_r1, src/profiling/memory/heapprofd_producer.cc, src/profiling/memory/java_hprof_producer.cc]
libmemunreachable 与 malloc_debug:本地复现时补充泄漏证据
libmemunreachable 在请求发生时扫描原生分配器,找出从可达根走不到的分配块。默认模式不为每次分配记录回溯,运行期开销低,代价是报告只能提供地址、大小上界和部分内容;启用 malloc_debug backtrace(分配回溯栈) 后,报告可以附带分配栈,代价换成明显的运行时开销。
固定标签下,面向应用的流程位于独立仓库 platform/system/memory/libmemunreachable;malloc_debug 实现则从旧目录 libc/malloc_debug 移到了 Bionic 的 libc/memory/malloc_debug。下面这组命令用于userdebug设备上的单个应用,PROCESS_NAME替换为进程名;PACKAGE_OR_PID替换为包名或PID,路径中的PID替换为数字PID,设置属性后必须终止并重新启动进程。
# 大写名称是符号占位符,使用前替换为目标包名、数字PID或进程名。
adb root
adb shell setprop libc.debug.malloc.program app_process
adb shell setprop wrap.PROCESS_NAME "\$\@"
adb shell setprop libc.debug.malloc.options backtrace=4

# 重启目标进程并复现问题后执行
adb shell dumpsys -t 600 meminfo --unreachable PROCESS_NAME
--unreachable 报告的是扫描时从可达根走不到的分配块,离语言层意义上的确定泄漏还有一步:保守扫描可能把某些整数误认成指针,第三方分配器或自管理内存也可能不在它的观察范围内。所以下结论要结合可重复的增长趋势、分配栈和资源生命周期一起做。
Bionic README 还记录了 Android 12 起的一个 wrap.<APP> 问题。属性未生效时,可在受控测试设备上按 README 设置 dalvik.vm.force-java-zygote-fork-loop=true,再重启 Zygote(应用进程的模板进程);这会影响设备进程启动方式,别在量产设备上尝试。
完成诊断后要清除三个属性并重启进程,避免后续测试继续承受 backtrace 开销:
# 大写名称是符号占位符,使用前替换为目标包名、数字PID或进程名。
adb shell setprop libc.debug.malloc.options "''"
adb shell setprop libc.debug.malloc.program "''"
adb shell setprop wrap.PROCESS_NAME "''"
收尾的清理命令只撤销本次 malloc_debug 配置,不会修改应用数据。量产 user 设备通常不具备这套流程所需的 root、属性和 SELinux 权限,所以它只适合在可控环境里复现问题。
怎样选择 ASan、HWASan、GWP-ASan 与 MTE
原生内存问题不只有泄漏。越界写、use-after-free 和 double free(重复释放) 可能先表现为偶发崩溃、数据损坏或 UI 异常,再在内存统计里留下噪声。检测工具按使用场景选择:
| 工具 | 适合场景 | 代价与边界 |
|---|---|---|
| ASan | HWASan 无法使用时,调试旧设备上的越界访问和 use-after-free | 已弃用且不再积极维护;需要重新编译插桩,内存和运行时开销高 |
| HWASan | 测试阶段检测 64 位 Arm 设备上的内存错误 | 当前 NDK 文档推荐的测试期首选;需要支持的系统镜像和编译配置 |
| GWP-ASan | 在较低开销下抽样捕获原生堆 use-after-free(释放后使用)和 heap-buffer-overflow(堆缓冲区越界) | 抽样检测,不保证每次问题都命中 |
| MTE | Arm Memory Tagging Extension(内存标记扩展),用硬件标签检测越界和释放后访问 | 依赖硬件、系统版本、应用清单与系统配置;模式不同会影响性能与报错时机 |
HWASan 适合测试构建,ASan 只在 HWASan 不可用时作为兼容方案,GWP-ASan 和 MTE 则在较低开销下扩大检测样本。这些工具和 heapprofd 是分工关系:heapprofd 说明哪些调用栈分配得多,sanitizer 说明哪次访问越界或访问了已释放内存,前者管容量、后者管安全错误,互相替代不了。
应用清单可请求的启用模式是 sync 和 async,asymm 不是 android:memtagMode 的取值;ASYMM 是 Arm v8.7-A 提供的平台模式,读取按同步方式检查,写入按异步方式检查。设备可以通过每个 CPU 的 mte_tcf_preferred,把应用请求的 ASYNC 静默升级为 ASYMM 或 SYNC,所以应用记录的只是请求模式,设备的有效模式还要看平台配置。
.so 库内存优化从三个维度入手
.so 库相关内存,我们拆成装载成本、运行时分配和可写脏页三块来看,三者对应不同动作。
装载成本:少装、晚装、按需装
.so 加载后,代码段、只读数据、重定位表和符号相关页面会进入进程地址空间。APK 体积和运行时内存是两回事,排查时我们要看的是进程 maps / smaps 中对应 .so 的 RSS、PSS 和 Private Dirty。
可执行动作:
- 只在测量表明
dlopen数量或重复元数据造成显著成本时,评估合并小型原生模块;合并后若低频代码被一并加载,也可能增加常驻映射; - 把低频功能的
.so延后到功能入口加载; - 清理未使用 ABI(应用二进制接口,决定指令集和数据布局)、未使用架构和重复打包的
.so,这主要减少安装包与安装占用;只有相关文件原本会被映射时,才会影响运行时 RSS/PSS; - 把发布构建的符号文件作为独立产物保存,供 tombstone、Perfetto 和地址回溯使用;从 App 内移除调试段主要减少文件体积,运行时内存收益要另行评估。
运行时分配:把大块分配变成可解释事件
第三方 .so 分配异常时,单靠 dumpsys meminfo 只能看到原生堆变大,要把分配归到调用栈,还得靠 heapprofd 或 malloc 拦截;符号文件保留完整的话,还能还原到函数名和源码行。
工程上可以为可控的原生大对象建立统一分配入口,例如模型缓冲、音视频帧缓冲、解码输出池和压缩临时缓冲:封装层记录大小、用途、生命周期与调用位置,生产环境只上报有界的聚合数据,本地再使用 heapprofd 或 malloc_debug 取得完整分配栈。遇到改不动的第三方库,就以分析工具的输出为准,别只凭库名归因。
可写脏页:少改共享映射,少做启动期全量初始化
.so 的只读文件页可以在多个进程间共享。具有写权限的 MAP_PRIVATE 文件映射被写入时,会通过 COW 形成当前进程的私有脏页;只读映射不能不经权限变更就直接写入。常见来源有全局可变数据、启动期大表初始化、懒加载缓存写入和重定位后的可写段。
排查时对比同一 .so 的 Shared Clean、Private Dirty、Private Clean:某个库的 Private Dirty 远高于同类模块时,我们就要检查它是否在启动期写入大块全局状态,或者把可延迟的数据提前初始化了。
原生内存监控方案
设计生产监控时,我们先记住目标差异:用户设备上要的是发现趋势、定位版本和场景,完整调用栈在那里做不了长期记录。
本节只定义 Native Heap、映射和内存安全错误的原生侧信号;跨 Java、Native、图形与系统回收的统一监控见 23.7 内存监控与线上治理。
一套可控方案可以分三层:
- 基础指标层:定时采集 PSS、RSS、Native Heap Alloc(原生堆已分配量)、Graphics、GL、线程数、文件描述符(FD(file descriptor,文件描述符))数量,并按页面、业务场景、前后台状态和设备可用内存分组。采集频率按场景设定,避免常驻高频轮询。
- 异常判定层:在同一会话内观察增长斜率,例如进入页面前后、按确定脚本重复操作后、播放或上传结束后。单点阈值容易把合理的高占用当成异常。
- 诊断触发层:命中抽样诊断规则后,对少量 debuggable 或 profileable 包触发 heapprofd、系统 meminfo 快照或业务侧原生分配摘要。普通发布包只上报聚合指标和场景标签。
指标上报要区分“占用高”和“泄漏”:缓存命中带来的短时原生堆增长不一定是问题;退出场景、收到 onTrimMemory() 或完成任务后仍不回落,也只是进一步分析的信号,要坐实原因还得靠分配栈与对象生命周期。反过来,分配器可能保留空闲页,PSS 没有立刻下降,说明不了对象仍然存活。
Scudo 与原生堆的统计边界
Android 应用通常不直接选择系统分配器,但分配器会影响碎片、页归还、错误检测和 smaps 命名。Android 11 起常规设备使用 Scudo,低内存设备仍可能使用 jemalloc;设备上到底是哪一个,以构建、VMA 名称和 tombstone 为准。
四种数值的用途分工
| 口径 | 数据来源 | 适合回答的问题 | 覆盖不到的部分 |
|---|---|---|---|
Debug.getNativeHeapAllocatedSize() | mallinfo().uordblks | 分配器当前记为已分配的字节 | 任意 mmap()、线程栈、共享库、Graphics |
dumpsys meminfo 的 Native Heap | 原生堆 VMA 的 PSS/RSS 分类 | 原生堆对物理内存的贡献 | 具体分配调用栈 |
/proc/$pid/smaps / showmap | 内核 VMA 与页统计 | 匿名映射、文件映射、栈和 .so 分别占多少 | 每次 malloc() 的调用者 |
heapprofd / Native Allocations | 录制窗口内的分配、释放与栈 | 哪些路径分配、哪些样本仍存活 | 录制前分配和绕过分配器的映射 |
android_os_Debug.cpp 直接把 mallinfo().uordblks 返回为 getNativeHeapAllocatedSize();libmeminfo 则把 [heap]、[anon:libc_malloc]、[anon:scudo:*] 和 [anon:GWP-ASan*] 等 VMA 归到 Native Heap,并按页面计算 PSS/RSS。两条统计路径不同,所以分配器记录的已分配量降下来之后,原生堆 PSS 未必要同步下降。
free() 后的 RSS 回落时机
业务调用 free() 后,chunk 对外已经不可再访问,但分配器可以把它放进 quarantine、线程缓存或空闲结构,等待复用或批量归还操作系统。启用 quarantine 时,隔离策略会延迟复用已释放块;小块隔离和 secondary 映射缓存的配置并不相同。固定标签的 standalone flags.inc 把小块隔离相关默认值设为 0,是否生效仍须结合构建选项与目标进程配置。release interval 用于限制或调节向系统归还空闲页的尝试,不是保证到点完成归还或 RSS 下降的定时器;两者会影响安全检查、锁竞争、复用速度与 RSS 回落。这类系统配置交由平台管理就好,应用侧不要通过 SCUDO_OPTIONS 或 __scudo_default_options 把它当常规省内存开关。
判断泄漏,还是要同时满足可重复增长和对象归因:固定场景中已分配量持续上升,heapprofd 的未释放样本集中在稳定调用栈,业务缓存过期后仍不回落,并且 Graphics、线程栈、文件映射等其他分区解释不了增量。
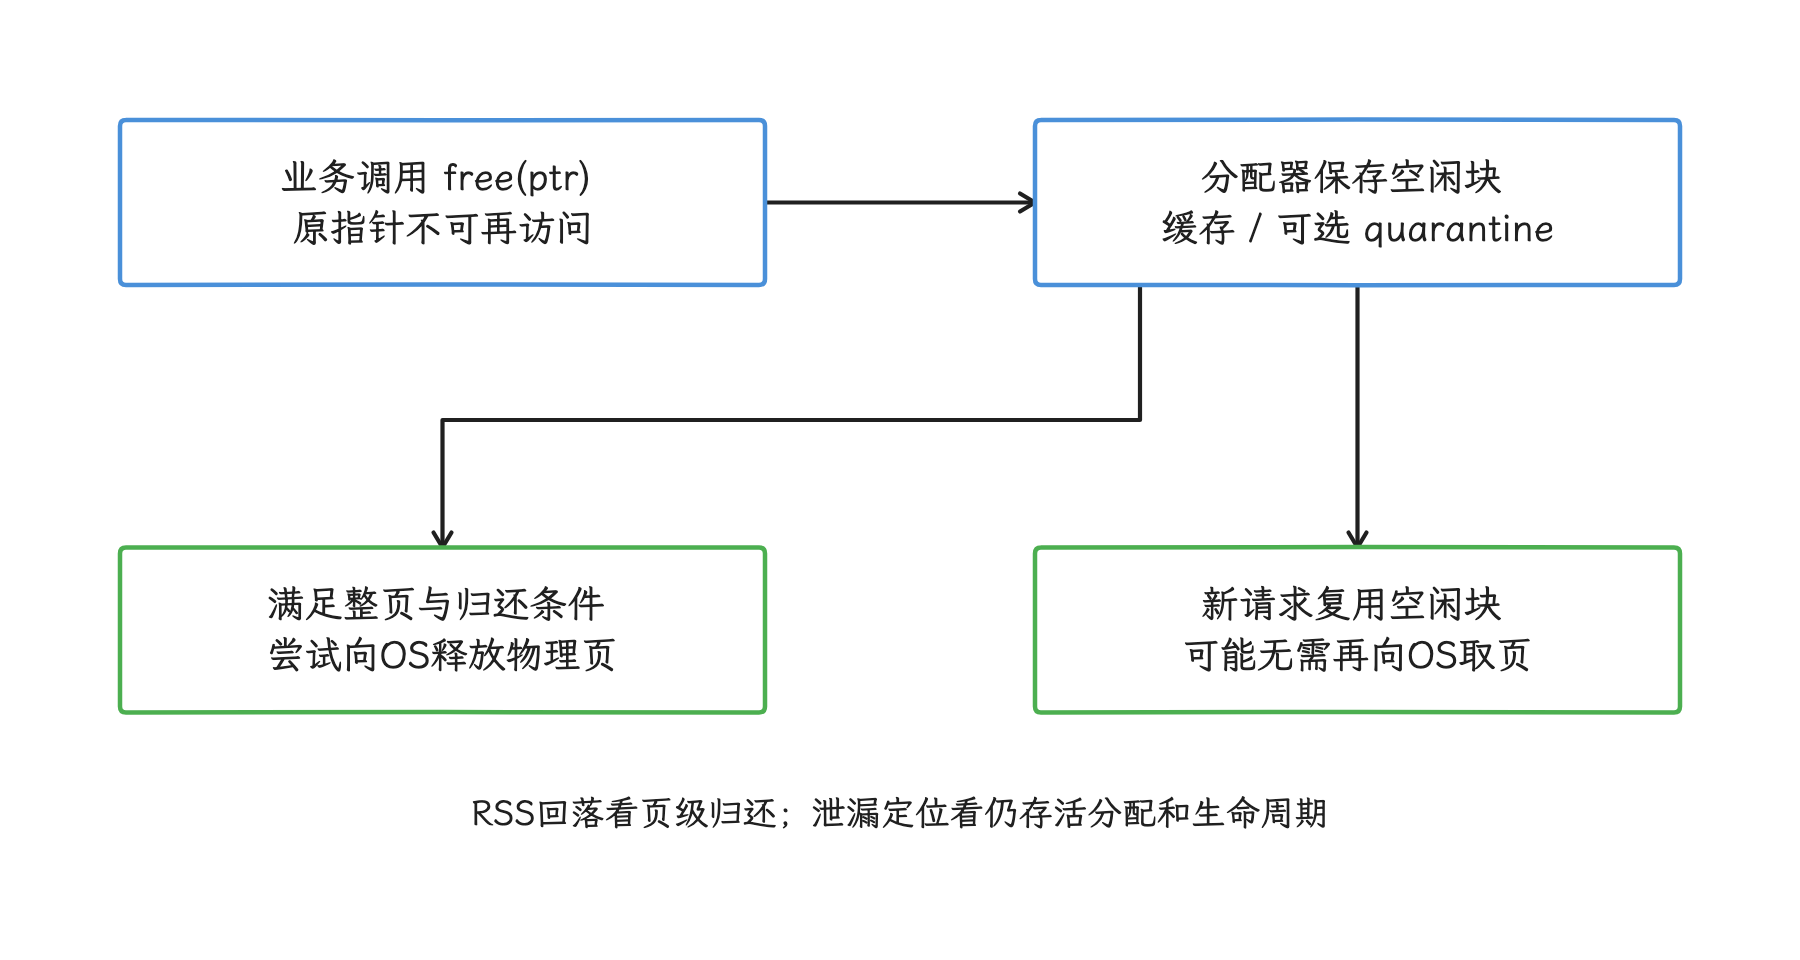
图:allocator已分配字节下降后,Native Heap的RSS/PSS仍可暂时不变;这与对象仍被业务持有是不同证据。
Scudo ERROR 与破坏现场
Scudo 发现 corrupted chunk header、invalid chunk state、misaligned pointer、allocation type mismatch 或 invalid sized delete 等异常时会终止进程。这些是日志里的原始错误标签,其中 chunk header 是分配器保存大小、状态等信息的元数据。
比如线程 B 在 free() 时发现 header 已损坏,越界写可能早已发生在线程 A。所以排查要保留完整 tombstone、错误文本、fault address、Build ID、ABI、相关线程和匹配的未剥离符号,再借助 GWP-ASan、MTE 或 HWASan 补上分配、释放与访问位置的信息。
GWP-ASan 是抽样检测,Recoverable(可恢复上报) 模式写出 tombstone 后继续运行,也说明不了进程已经恢复正确状态;MTE 的 SYNC、ASYNC 和平台 ASYMM 模式在定位精度与成本上各有取舍,应用清单请求还受设备硬件和系统配置约束。
16 KiB 页与三方 so
16 KiB 页改变的是 ELF 加载段对齐、APK 中未压缩 .so 的 ZIP 起始位置对齐、mmap()(建立内存映射的系统调用) 参数约束以及分配器管理区域的页面粒度;它既不会让每个小对象都占一个独立 16 KiB,也没法从 PSS 增量直接反推出 malloc() 对象数。含原生代码的应用应检查所有 ABI,运行时通过 getconf PAGE_SIZE 获取实际页大小,清理动态链接器和第三方库中写死的 4096 字节假设。
Android 15 起支持 16 KiB 页面设备。按 2026-08-15 的 Google Play 规则,面向 Android 15(API 35)及以上的应用更新需要在 64 位设备上支持 16 KiB 页面;从 2027-02-01 起,不兼容的更新会被拒绝发布。兼容性检查要 ELF 加载段和 APK 内未压缩 .so 的 ZIP 对齐两边都做,在 4 KiB 设备上运行一次就判定通过是不够的。
给第三方 .so 提报告时,至少保存 SDK 版本、.so Build ID、ABI、输入与并发、设备页大小、heapprofd 样本和相同场景的 meminfo。Build ID 缺失时,同名 .so 可能来自不同二进制,聚合出来的调用栈没有可比性。
[源码锚点: AOSP android-17.0.0_r1, frameworks/base/core/jni/android_os_Debug.cpp, system/memory/libmeminfo/androidprocheaps.cpp, platform/bionic/libc/bionic/malloc_common.cpp, platform/external/scudo]
排查清单
dumpsys meminfo中增长的是 Native Heap、Graphics/GL、Code,还是 Unknown?- 使用确定的操作脚本重复场景后,内存曲线是趋于稳定、随次数增长,还是只出现一次峰值?
- heapprofd 的存活分配火焰图中,最大路径是否来自业务 JNI、第三方 SDK、图片库或音视频库?
- 原生崩溃是否带有 ASan、HWASan、GWP-ASan、MTE 相关标记?
- 相关
.so是否有符号文件可用于地址还原? smaps里同一.so的Private Dirty是否异常偏高?- 生产环境是否只采集聚合指标,避免在用户设备上长期开启高开销调试能力?
分配器与原生堆小结
到这里把第一部分收个尾。原生内存调查先用系统分类确认增长属于分配器、映射、代码还是图形缓冲,再用 heapprofd 或本地检测工具拿到对应的信息。容量增长、内存安全错误和 free 后 RSS 暂未下降是三类不同的问题,各有各的结论,共用一个“泄漏”就把区别抹平了。
mmap、页驻留、缺页与回收
对象释放解决的是逻辑所有权;虚拟内存这一侧——地址空间、文件映射、匿名页和 page fault(页故障,例如按需分配、文件读入、写时复制或权限异常)——是另一条线:调用 free() 后的内存也可能暂时留在进程 RSS,原因要到后面几节里找。
虚拟内存问题经常和 Java heap OOM(ART 托管对象堆耗尽)、native heap(C/C++ 分配使用的堆) 耗尽、线程资源耗尽混在一起。所以我们排查的第一步,是确认失败到底来自地址空间、物理内存、VMA 数量还是线程资源。
VMA 是内核记录的一段连续地址范围,同一 VMA 具有一致的权限和映射来源。只看一个很大的 VSS 数字,容易把正常的地址空间预留(reservation)误判成泄漏。对象持有关系可参阅 23.2 内存泄漏检测与治理,Native Heap 的分配与所有权则见本文前一部分。
Android 10—16 的历史行为只用于解释存量设备,实际诊断仍以目标设备为准。
1. VSS 先看语义,再看数值
这一节从四个指标的分工讲起:同一个进程,VSS、RSS、PSS 各自回答的是不同问题,先分清它们,后面的判断才有依据。
1.1 四个指标回答不同问题
| 指标 | 常见来源 | 回答的问题 | 不能单独证明什么 |
|---|---|---|---|
VSS(Virtual Set Size)/ VmSize | /proc/<pid>/status | 所有 VMA 长度之和,也就是进程映射了多少虚拟地址 | 已消耗多少 RAM、是否正在泄漏 |
RSS(Resident Set Size)/ VmRSS | /proc/<pid>/status、smaps_rollup | 当前驻留在 RAM 的页有多少 | 共享页应全部归属于该进程 |
| PSS(Proportional Set Size) | dumpsys meminfo、smaps | 共享页按使用进程数分摊后的物理内存 | 地址空间是否碎片化 |
| Private Dirty / Private Clean | dumpsys meminfo、smaps | 进程独占页按当前 dirty / clean 状态分类;能否从文件恢复还要看映射来源 | 单次快照中的增长原因 |
地址空间预留会先占用一段虚拟地址,常用 PROT_NONE 禁止访问,等后续加载或提交时再改变映射。它与文件映射、尚未访问的匿名页都会计入 VSS,其中一部分还没有对应的物理页。所以 64 位进程出现数 GiB VSS 很常见,这个数字要结合 ABI、地址空间空洞、线程数、VMA 数量和失败现场才参与判断。
1.2 32 位与 64 位的风险差异
32 位进程的用户态地址空间小于 4 GiB,具体布局受内核、ABI、ASLR(地址空间布局随机化)、链接器和厂商配置影响,“3 GiB 用户态 + 1 GiB 内核态”的统一写法套不到所有设备上。真正卡住分配的往往是连续空洞:未映射地址的总量看起来还够,大块 mmap() 仍可能因找不到连续区间而返回 ENOMEM(内核拒绝了这次内存或地址空间请求)。
64 位进程的可用用户态地址范围由架构和内核配置决定,128 GiB、256 GiB、256 TiB 这些常见数字都只是特定配置的结果,具体以目标设备的 maps 边界和内核配置为准。64 位地址耗尽很少见,但 VMA 数量、物理内存、commit charge(内核对匿名内存可兑现容量的提交记账)、资源限制和错误的超大地址空间预留仍可能让映射失败。
常见故障信号如下:
| 信号 | 优先检查 |
|---|---|
pthread_create (... stack) failed | 线程数、每线程栈、native 内存、进程资源限制、VMA 数量 |
mmap failed: ENOMEM | ABI、请求长度、最大连续空洞、VMA 数量、RLIMIT_AS(进程虚拟地址空间资源上限)、系统内存压力 |
std::bad_alloc / native OOM | native allocator(C/C++ 内存分配器)、RSS/PSS、碎片、申请尺寸;VSS 只作辅助 |
Java OutOfMemoryError | ART 托管堆上限、对象存活关系与 GC;同时确认错误消息是否指向线程创建 |
| LMKD 杀进程 | PSS/RSS、进程状态和系统压力;VSS 不是 LMKD(low memory killer daemon,低内存终止守护进程)的直接排序指标 |
错误类型决定排查入口:线程创建失败先看线程和栈,映射失败先看连续地址与资源限制,进程被终止则先看物理内存压力。VSS 在这里是辅助,现场信号才是入口。
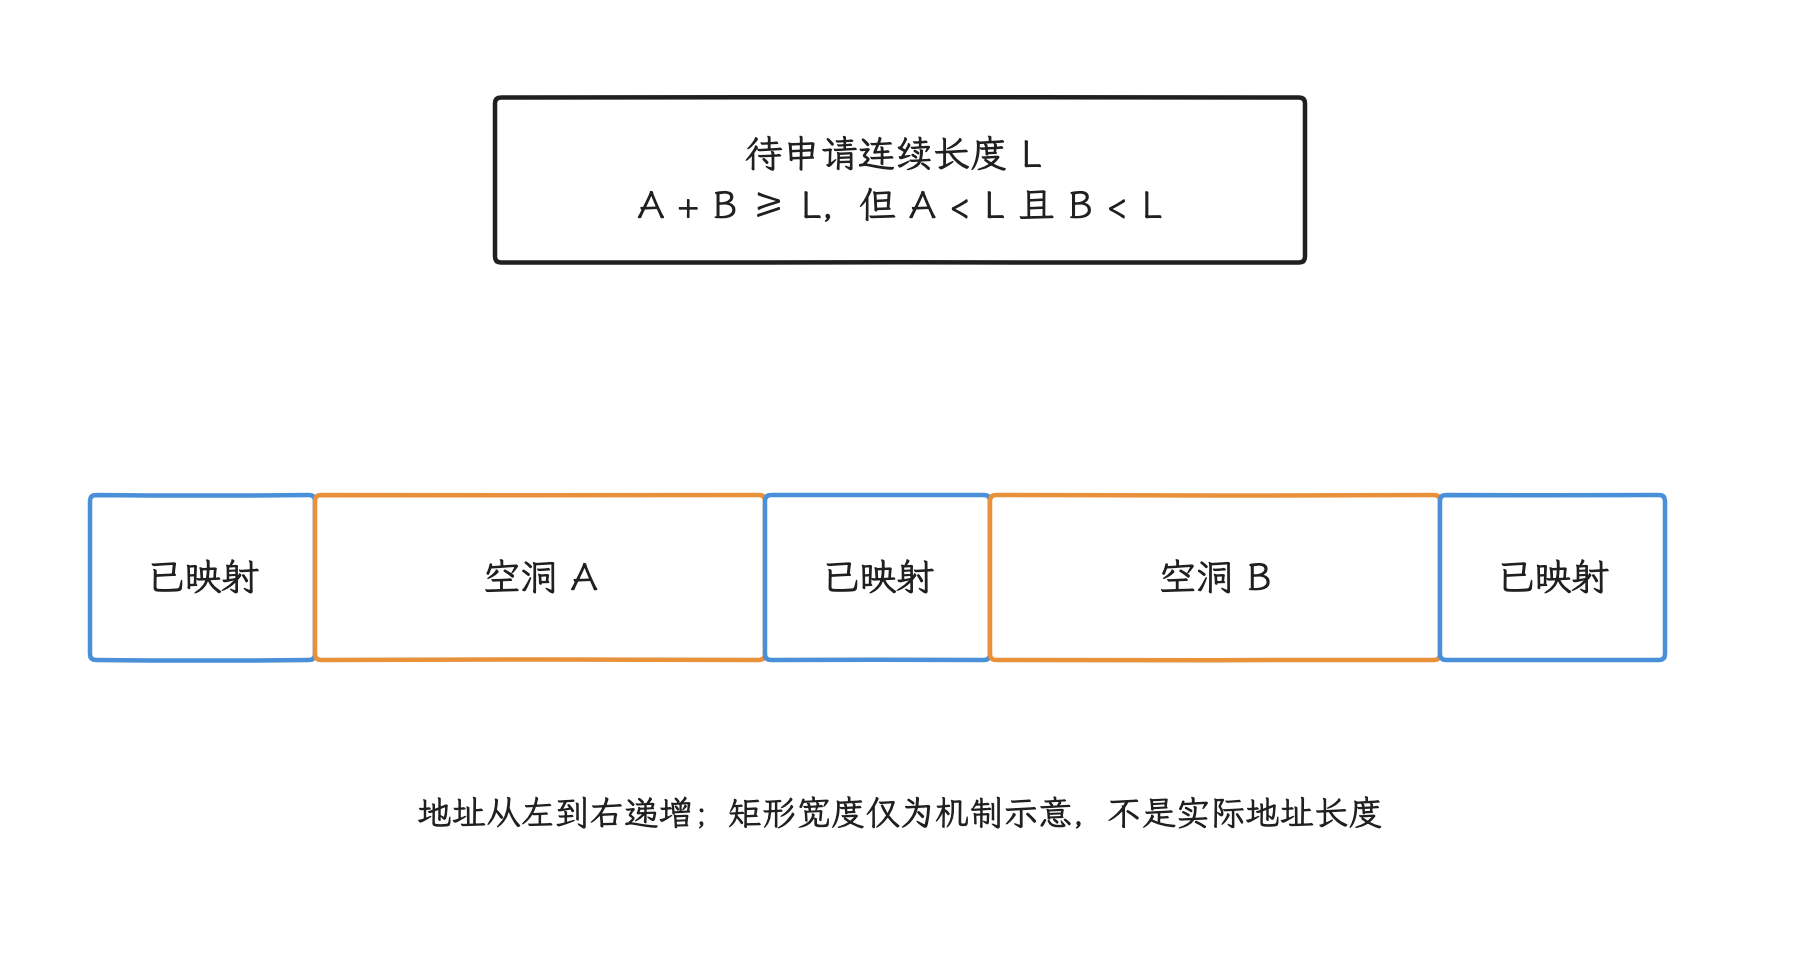
图:虚拟地址必须为同一次映射找到足够连续的区间。总可用地址长度并不能替代最大连续空洞;ENOMEM还要结合VMA数量、RLIMIT_AS和系统压力。
1.3 VmSwap 的记账语义
内核 proc.rst 把 VmSwap 定义为匿名私有数据使用的 swap(换出空间),不包含 shared(共享映射) memory(共享内存) 的换出量。页被换出后,原虚拟地址仍在 VMA 中,所以该页仍计入 VmSize;VmSwap 是记账量,不是可以再加到 VSS 上的独立地址空间。
Android 17 及以上还支持内存管理守护进程 mmd:mmd_setup 负责配置 ZRAM(在 RAM 中保存压缩换出页的块设备),mmd 再执行重压缩和可选的 writeback(把冷页写到后备存储)。应用从 VmSwap 只能看到按页核算的换出量,ZRAM 里压缩后占多少字节、页面此刻在 ZRAM 还是后备存储,都推不出来。分析卡顿时,应同时查看 VmSwap 增长、major fault(需要存储 I/O 才能完成的主缺页)、PSI(Pressure Stall Information,资源压力导致的任务停顿统计)、lmkd 事件和业务时间线。
这套内核还包含 Multi-Gen LRU(按访问时间把可回收页划分为多代的 LRU 实现),它按访问新旧程度把可回收页划分成多代、参与页回收选择,VSS、RSS、PSS 的定义保持原样;目标设备是否启用仍取决于内核与产品配置。应用侧要做的是减少实际工作集、改善访问局部性;某个 VMA 能否手动解除仍取决于它自身的来源,Multi-Gen LRU 改变不了这一点。
2. 建立可复现的地址空间快照
2.1 设备侧基础采集
判断地址空间问题要靠可复现的快照,我们先在同一轮里采集页大小、VSS、RSS、线程数和 maps。调用时显式传入包名与输出目录,避免把示例包名误用于现场:
#!/usr/bin/env bash
set -euo pipefail

if (( $# != 2 )); then
  echo "usage: $0 <package-name> <output-directory>" >&2
  exit 2
fi

package_name="$1"
output_directory="$2"
pid="$(adb shell pidof -s "$package_name" | tr -d '\r')"

if [[ -z "$pid" ]]; then
  echo "process not found: $package_name" >&2
  exit 1
fi

mkdir -p "$output_directory"
adb shell getconf PAGE_SIZE | tr -d '\r' > "$output_directory/page-size.txt"
adb shell cat "/proc/$pid/status" > "$output_directory/status.txt"
adb shell "ls /proc/$pid/task | wc -l" > "$output_directory/task-count.txt"
adb shell "wc -l /proc/$pid/maps" > "$output_directory/vma-count.txt"
adb shell cat "/proc/$pid/maps" > "$output_directory/maps.txt"
adb shell dumpsys meminfo "$package_name" > "$output_directory/meminfo.txt"

grep -E '^(Name|VmPeak|VmSize|VmRSS|RssAnon|RssFile|VmSwap|Threads):' \
  "$output_directory/status.txt"
拿到输出后先做两个校验:VmSize 应与 maps 中各 VMA 长度之和接近——它算的是各段长度之和,两段 VMA 之间的空洞不计入;Threads 应与 /proc/<pid>/task 数量一致。脚本中的命令按顺序执行,各条命令之间有时间差,得到的是跨越一段时间的快照;进程变化较快时要缩短采集间隔或连续采两轮验证。pidof -s 只选择一个 PID,多进程应用要对每个目标进程分别采集。dumpsys meminfo 补充 PSS、RSS 和堆分类;部分量产设备会限制 showmap 或 smaps,权限失败要记录下来,作为观测上的缺口。
采集点至少覆盖:
- 冷启动完成(基线);
- 进入目标业务前(场景起点);
- 业务稳定运行(稳态);
- 业务退出并等待缓存回收(确认是否回落);
- 异常前后(保留失败现场)。
只有一张峰值快照时,一次性预留、可复用缓存和持续泄漏是分不开的。
2.2 /proc/<pid>/maps 怎样读
这一行展示 maps 的字段布局:
70000000-78000000 ---p 00000000 00:00 0 [anon:libwebview reservation]
地址范围给出 VMA 起止位置;rwx 是读、写、执行权限;第四个字符 p 或 s 表示私有映射或共享映射;其后依次是文件偏移、设备号、inode(文件系统中的对象编号) 与可选名称。---p 只是说明当前没有读、写、执行权限,这块区域是否归应用释放,是另一个问题。
系统侧 android_os_Debug.cpp 通过 meminfo 解析器读取进程映射并按堆类型汇总。我们要自建分类器时,别假设标签在所有厂商版本上都完全一致。
这段离线脚本按 pathname(maps 末列的映射名称或文件路径)汇总 VSS,并统计没有 pathname 的匿名 VMA。参数是设备侧脚本生成的 maps.txt:
from collections import defaultdict
from pathlib import Path
import sys

if len(sys.argv) != 2:
    raise SystemExit(f"usage: {sys.argv[0]} <maps-file>")

groups = defaultdict(lambda: {"bytes": 0, "vmas": 0})
maps_path = Path(sys.argv[1])

for line in maps_path.read_text(encoding="utf-8").splitlines():
    fields = line.split(maxsplit=5)
    if len(fields) < 5:
        continue
    start, end = (int(value, 16) for value in fields[0].split("-", 1))
    name = fields[5] if len(fields) == 6 else "[anonymous]"
    key = name if name.startswith("[") else Path(name).name
    groups[key]["bytes"] += end - start
    groups[key]["vmas"] += 1

for name, stat in sorted(
        groups.items(), key=lambda item: item[1]["bytes"], reverse=True):
    mib = stat["bytes"] / 1024 / 1024
    print(f"{mib:10.1f} MiB  {stat['vmas']:6d} VMAs  {name}")
汇总结果适合查找大块地址空间预留、线程栈、重复 .so 库和 VMA 数量异常。有两点要先说清楚:脚本按文件名而非完整路径聚合,同名但不同路径的库会被合并;同一路径的多个 segment(映射分段) 也可能分别承载代码、只读数据和可写数据。汇总值表示的是虚拟地址长度,离私有物理内存还有距离。
2.3 16 KiB 页设备
getconf PAGE_SIZE 返回 16384 时,VMA 边界、guard page(用于捕获越界访问的不可访问保护页) 和 ART 对齐都以 16 KiB 页大小计算。小对象仍可由分配器在页内切分,maps 只展示页级映射。
自研 native 组件需要遵守运行时页大小,Android 的 16 KiB 页适配指南 要求清理写死的 4096、0x1000 或 4 KiB 对齐。解析 start/end 的十六进制差值不受页大小影响;调用 mmap()、mprotect()、munmap() 时,则要分别遵守接口对地址、offset(偏移量) 和 length(长度) 的约束。
每个系统调用的对齐要求不同:文件映射的 mmap() offset 必须按页对齐,内核会把实际映射范围向上取整到包含 length 的完整页;MAP_FIXED 地址、mprotect() 起始地址和 munmap() 起始地址也有页对齐要求。“所有参数都必须页对齐”并不是统一规则,具体要看调用使用的 flags(控制映射行为的标志) 和接口文档。
3. 线程栈:先控制线程数量
每个线程都要占用一段栈地址空间,线程一多,VSS 和 VMA 数量跟着涨。这一节先把栈的预留大小算清楚,再谈控制数量。
3.1 Java 线程栈的预留大小计算
thread.cc 内的静态辅助函数 FixStackSize() 按以下顺序计算栈预留大小:
- 传入
0时改用 ART 的默认栈大小; - 增加 1 MiB,以兼容依赖 Dalvik 较大 native stack 的应用;
- 启用内存检测工具的构建保证至少 2 MiB;
- 保证不小于
PTHREAD_STACK_MIN; - 根据隐式栈溢出检查配置,增加不可访问保护区和运行时保留区,或只增加保留区;
- 向运行时页大小取整;
- 把结果交给
pthread_attr_setstacksize()和pthread_create()。
所以“每个 Java 线程固定占 1 MiB”并不准确:最终地址空间预留还受 ART 默认值、保护区、保留区、页对齐和构建配置影响。maps 中的 [anon:stack_and_tls:<tid>] 是 Bionic 为线程栈与 TLS(thread-local storage,线程局部存储) 合并映射使用的标签;线程 dump 可以把线程名与 TID(线程 ID) 对应起来,映射大小仍应从 maps 读取。
线程栈通常按需分配物理页,VSS 增长因此早于 RSS 增长。32 位进程中,大量线程还会带来 VMA 数量、调度开销、TLS 和运行时线程元数据的额外负担。
3.2 有界线程池
这个 Java 工厂方法展示有界队列、固定工作线程数和线程命名。调用方必须传入经过压测的工作线程数与队列容量,示例不内置设备无关的固定阈值:
static ThreadPoolExecutor newBoundedExecutor(
        String threadNamePrefix,
        int workerCount,
        int queueCapacity,
        RejectedExecutionHandler rejectedExecutionHandler) {
    if (workerCount <= 0 || queueCapacity <= 0) {
        throw new IllegalArgumentException("workerCount and queueCapacity must be positive");
    }
    Objects.requireNonNull(threadNamePrefix);
    Objects.requireNonNull(rejectedExecutionHandler);

    AtomicInteger sequence = new AtomicInteger();
    ThreadFactory factory = runnable -> {
        Thread thread = new Thread(runnable);
        thread.setName(threadNamePrefix + "-" + sequence.incrementAndGet());
        return thread;
    };

    return new ThreadPoolExecutor(
            workerCount,
            workerCount,
            0L,
            TimeUnit.MILLISECONDS,
            new ArrayBlockingQueue<>(queueCapacity),
            factory,
            rejectedExecutionHandler);
}
固定上限的价值在于挡住突发任务把线程数无限顶上去。workerCount 要结合 CPU/I/O 比例和任务驻留内存确定,queueCapacity 要结合可接受的排队时延确定。拒绝策略也由调用方显式选择:CallerRunsPolicy 会让提交线程执行任务,提交方可能是主线程时,就换成合并、拒绝或异步重试这些符合业务语义的处理。
线程数量常从这些位置失控:
Executors.newCachedThreadPool()的无限最大线程数;- 每个 SDK 各建一套线程池;
- 定时任务每次创建新线程;
- 协程调度器或 RxJava Scheduler 配置不当;
- native SDK 内部的
pthread_create(); - 业务结束后仍在
Looper.loop()中等待消息的 HandlerThread,或未关闭且保留工作线程的线程池。
任务执行完后,线程池中的工作线程仍可能存活;长寿命工作线程中的 ThreadLocal 值也可能继续持有业务对象。业务退出时要分别确认工作线程是否结束、排队任务是否取消;任务作用域内设置的 ThreadLocal 值应在使用结束后调用 remove() 清理。
ART 为 Java 平台线程创建的是 detached(分离状态、退出后自动回收底层资源)pthread;Bionic 在线程退出时拆除其自管栈映射。已经终止的 Thread 对象即使仍有 Java 引用,也不会因此继续占用对应的 TID 和原生栈,这类对象持有应从 Java 堆排查。直接创建的 native joinable(可等待回收)线程则要通过 pthread_join() 或 pthread_detach() 处理退出后保留的资源。
底层回收路径见 Thread::CreateNativeThread() 和 pthread_exit();工作线程与线程局部值的生命周期见 ThreadPoolExecutor 和 ThreadLocal。
CPU 密集任务的并发度可以从 CPU 核数起步;I/O 任务没有通用的“64—128 线程”答案,要看服务端并发限制、文件描述符、尾延迟和内存预算再定。
3.3 栈大小与函数拦截的边界
Thread(ThreadGroup, Runnable, String, long) 把 stack size(期望栈大小) 定义为平台相关的建议值。Thread.java 会原样保存该构造器传入的负数,JNI 桥接再把 jlong 交给接收 size_t 的 Thread::CreateNativeThread()。
于是就有了那条回绕路径:特定负数可能在无符号转换和增加 1 MiB 时回绕成较小值,例如 -512 KiB 会在增加 1 MiB 后得到 512 KiB,再叠加 ART 保留区并按页取整;Thread.Builder.OfPlatform.stackSize() 则明确拒绝负数。这条路径属于实现细节,构建变化后可能得到超大栈、pthread_attr_setstacksize() 失败或进程异常,生产方案不要依赖它。
对 pthread_create() 做 PLT hook(通过 Procedure Linkage Table 拦截动态库函数调用) 也覆盖不了所有线程来源,还会改变系统库与三方库的栈假设。诊断时可以在可调试构建中记录调用栈和 pthread_attr_t 属性;真要改栈大小,必须按 ABI、4/16 KiB 页、递归深度、JNI 栈帧大小和极端调用链做压力测试。生产环境里,减少线程数量仍然是第一优先级。
3.4 虚拟线程的可用条件
android-17.0.0_r1 的 libcore 已包含 Thread.ofVirtual()、startVirtualThread() 和 VirtualThread 实现,但 api/current.txt 给创建入口标记了 com.android.libcore.virtual_thread_api_v1 FlaggedApi,表示公开可用性受功能标志控制。ThreadBuilders.newVirtualThread() 会检查 ContinuationSupport.isSupported():支持时创建由 continuation(可暂停并恢复执行状态的运行时机制)驱动的 VirtualThread;不支持且调用方没有指定自定义 scheduler(任务调度器)时,创建一对一绑定平台线程的 BoundVirtualThread。
所以“虚拟线程一定不创建 pthread、每个任务都省下 1 MiB”当不了通用结论。产品采用前,要确认目标镜像是否开放该 API、运行时是否支持 continuation,以及 pinning(虚拟线程因特定阻塞或同步操作而无法暂时脱离承载线程) 的行为、调试工具和关键库兼容性。面向 Android 10—17 的通用实现,仍应以协程、有界线程池和结构化取消为主。
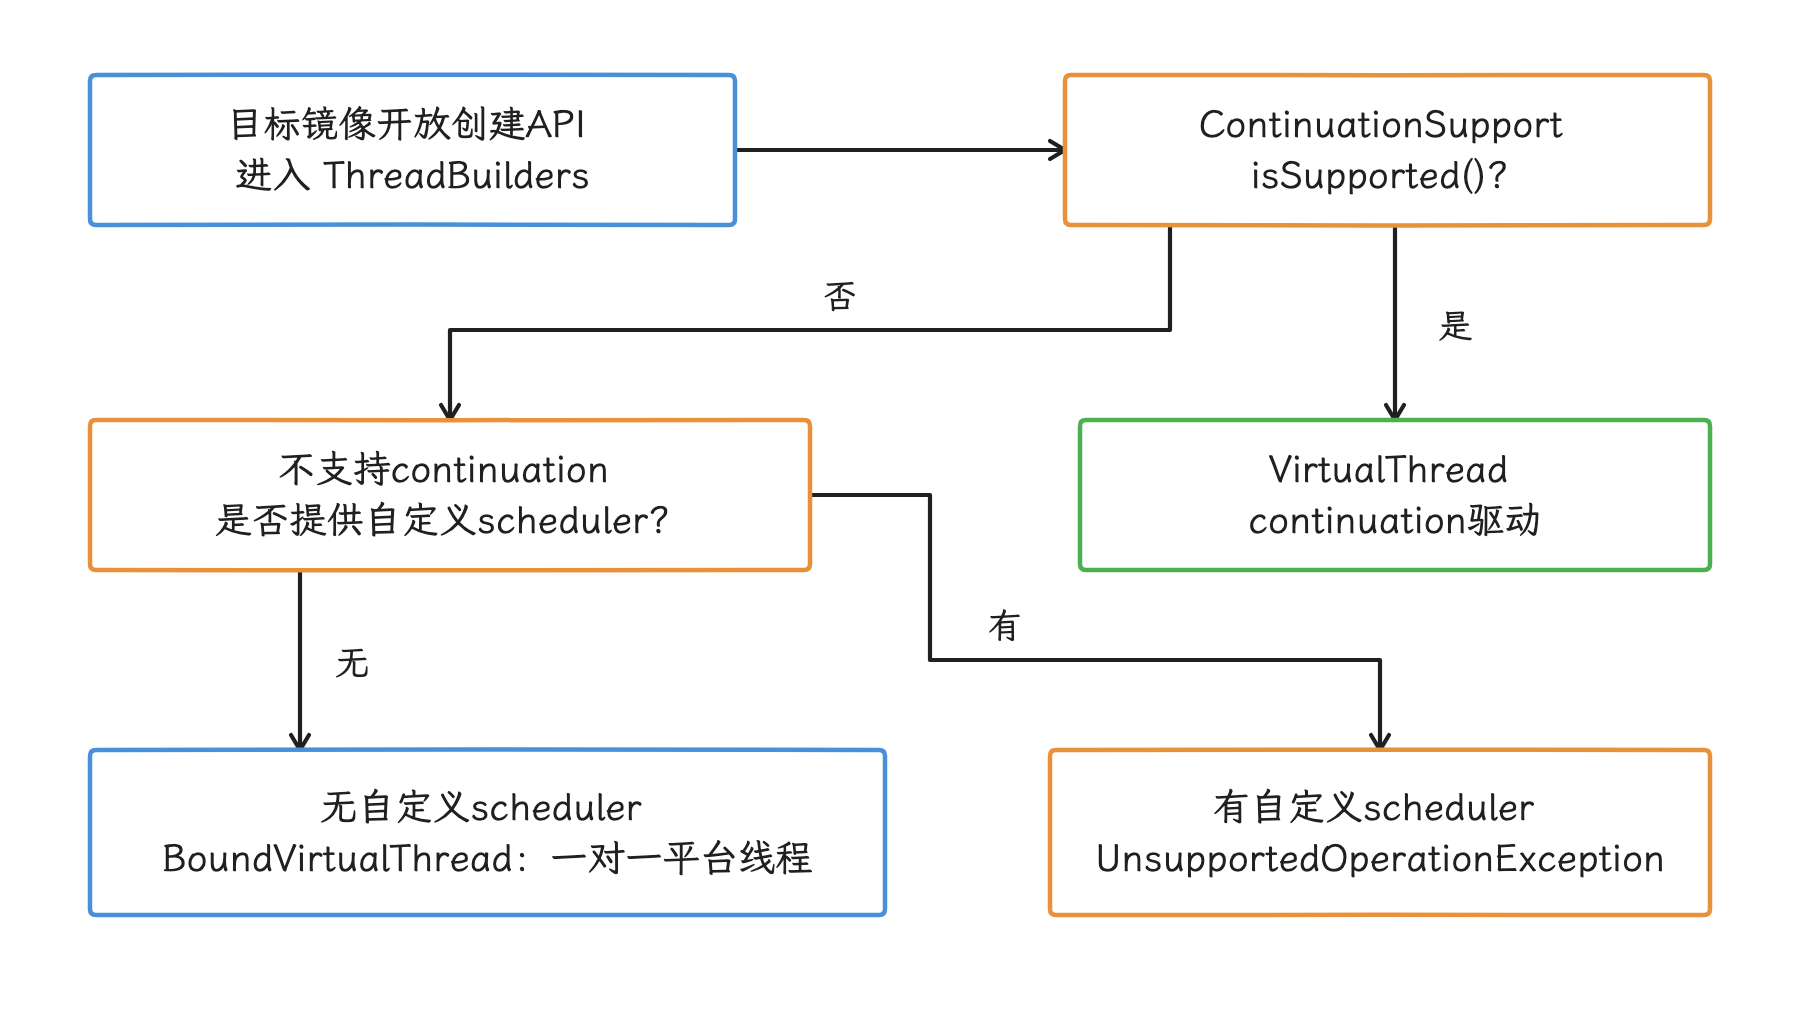
图:源码支持、公开API开关和真正continuation能力分别验收。不能承诺每个虚拟任务都省一个固定大小的平台栈。
线程泄漏的完整治理方法参阅 20.8 线程与协程泄漏治理。
4. WebView 地址空间预留
在 maps 里看到名为 [anon:libwebview reservation] 的大块区域时,先别急着处理,这一节讲它是怎么来的、该怎么对待。
4.1 固定标签中的预留
Android 17 的 WebViewLibraryLoader.reserveAddressSpaceInZygote() 选择以下地址空间大小:
| 进程 ABI | 地址空间预留 |
|---|---|
| 64 位 | 1 GiB |
| 32 位 ARM | 130 MiB |
| 其他 32 位 ABI | 190 MiB |
loader.cpp::DoReserveAddressSpace() 使用 mmap(PROT_NONE, MAP_PRIVATE | MAP_ANONYMOUS) 创建地址空间预留,并让全局变量 gReservedAddress、gReservedSize 记录其地址和大小。maps 中的名称是 [anon:libwebview reservation]。
这块预留会增加 VSS,但未访问的 PROT_NONE 地址不会按预留大小消耗 RSS,64 位进程看到 1 GiB VSS 增量时,别写成“WebView 已消耗 1 GiB RAM”。表中的常量解释的是 Android 17 固定标签源码,其他系统版本仍应按对应标签核对。
4.2 这块预留为什么归加载器管
WebView 加载器随后把 gReservedAddress 和 gReservedSize 交给 android_dlopen_ext(),在这段固定预留中加载 provider(提供 WebView 实现的系统组件) 原生库和共享 RELRO(重定位完成后设为只读、可供进程共享的数据)。应用私自调用 munmap() 之后,加载器的全局状态没有同步清零,该地址还可能被其他映射占用,稍后任何 WebView 初始化都可能加载失败或破坏进程地址空间——这是 4.1 节那两个全局变量真正的用途。
有人会想绕开加载器:用函数拦截取得 android_dlopen_ext() 的地址、反射隐藏的 nativeLoadWithRelroFile(),或按 maps 标签解除映射。这些做法都依赖隐藏实现,而且即使当前进程暂时不用 WebView,广告、登录、支付、帮助页、SDK 和系统组件也可能在后续触发 provider。
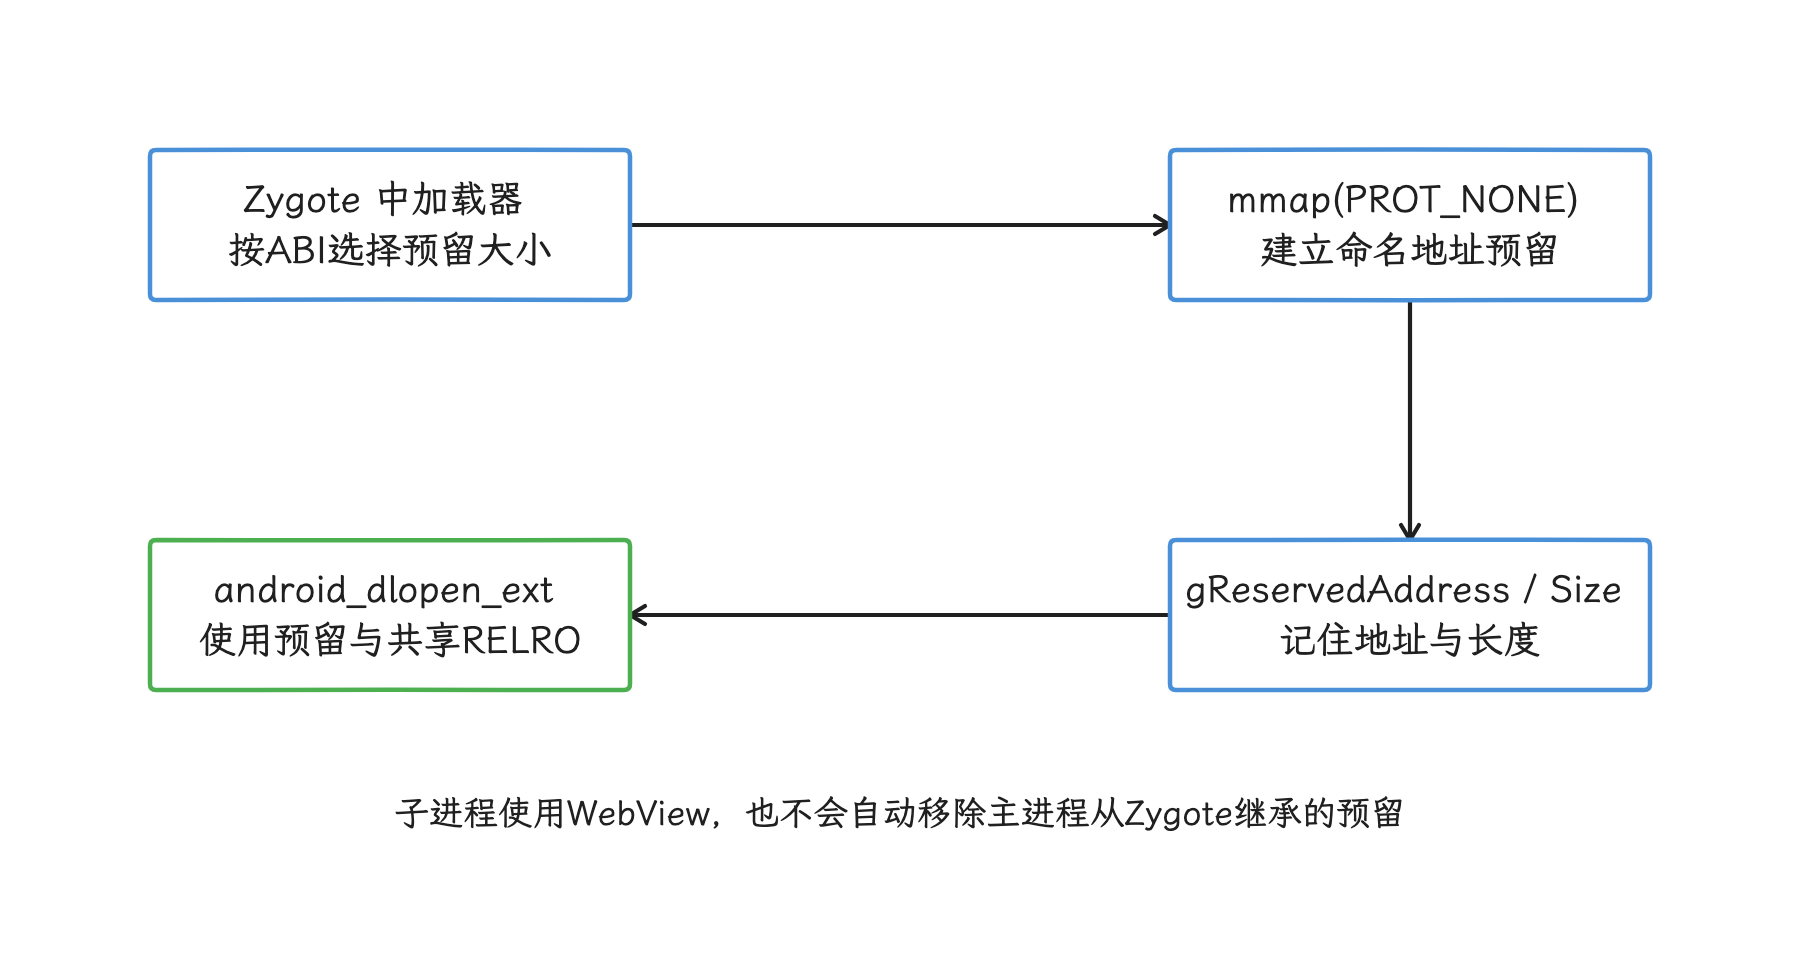
图:未提交的预留不按完整大小消耗RSS;私自munmap会使加载器全局状态与真实映射不一致,后续provider初始化可能失败或破坏地址空间。
安全策略只有两类:
- 业务不需要 WebView 时,避免初始化 provider 和相关 SDK,接受从 Zygote(用于孵化应用进程的模板进程)继承的预留仍计入 VSS;
- 需要隔离 WebView 时,按产品架构放入受控进程,管理该进程生命周期,并测量总 PSS、启动时延和 Binder(Android 进程间通信机制)代价。
把 WebView Activity 放到子进程不会自动移除主进程继承的预留;子进程方案的收益主要来自已提交页、WebView 对象与故障边界的隔离。
5. ART 托管堆:运行时内存区域归谁管
应用进程里还有一大块内存归 ART 自己管——托管堆的各个 Space。这一节先看 HSC 的适用条件,再看 JNI 临界区这类应用侧要守的约束。
5.1 Homogeneous Space Compact 的适用条件
HSC(Homogeneous Space Compact,同构空间压缩) 把主分配空间中的存活对象复制到备用空间,以整理碎片。Heap::SupportHomogeneousSpaceCompactAndCollectorTransitions() 要求同时存在 main_space_backup_、main_space_,且前台垃圾回收器为 CMS(Concurrent Mark Sweep,并发标记清扫);PerformHomogeneousSpaceCompact() 还会在 moving GC(会移动存活对象的垃圾回收) 已被禁用、当前回收器本身会移动对象,或主空间不允许移动对象时拒绝执行。
同一文件的 Heap 构造路径会对 CC(Concurrent Copying,并发复制) 和 CMC(Concurrent Mark Compact,并发标记压缩) 关闭 use_homogeneous_space_compaction_for_oom_。所以 HSC 是受回收器与 Space 布局约束的兼容路径,只有满足上面这些条件的进程才会走到;至于“每个应用都有两块固定 512 MiB MainSpace”,ART 实际会按回收器、heap growth limit(托管堆允许增长到的上限)、设备配置和进程类型建立不同 Space,这个说法立不住。
这些 Space 各管一摊:RegionSpace 用分区支持移动回收,zygote space 保存进程孵化前已有的对象,large object space 管理大对象,image space 映射启动镜像,JIT 代码映射保存即时编译生成的机器码,用途和生命周期互不相同。
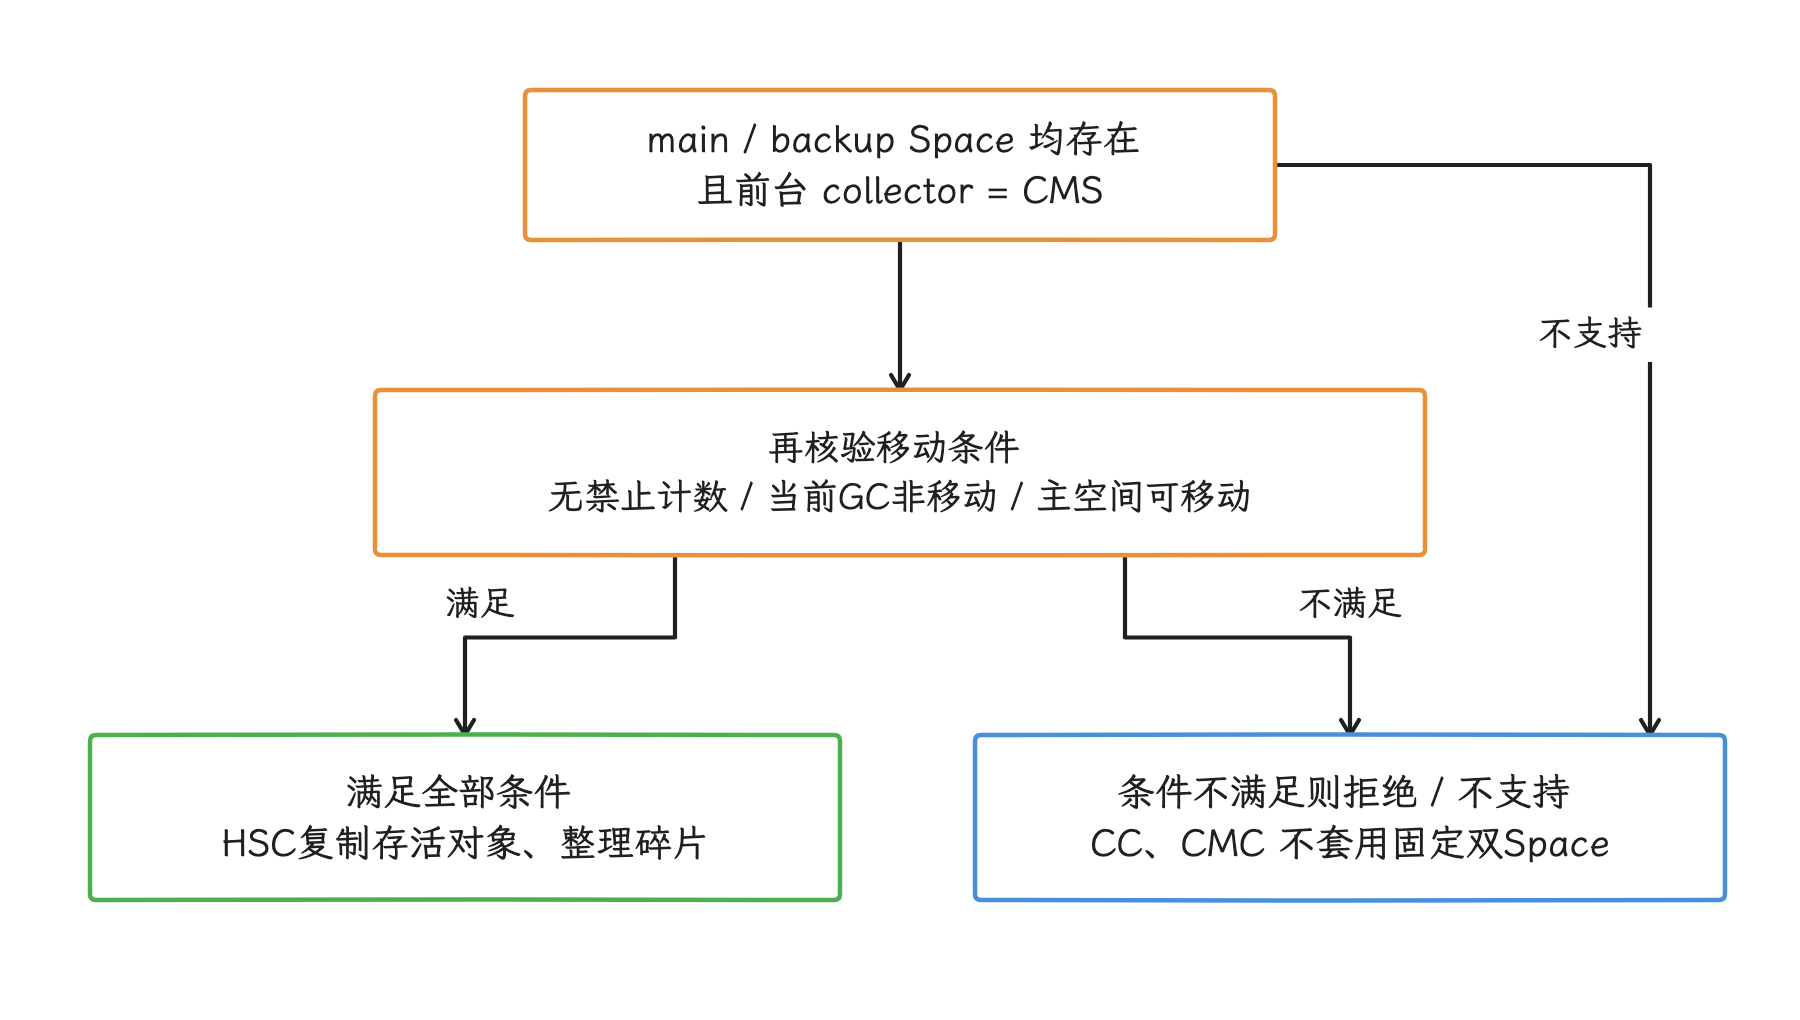
图:只有匹配配置才可能执行HSC,CC/CMC构造路径会关闭相应OOM压缩选项。源码有此函数不代表应用可释放“备用512MiB空间”。
5.2 JNI 临界区必须成对释放
Android JNI tips 对 GetPrimitiveArrayCritical() 的约束是:ART 可以返回指向数组的直接指针,也可以返回副本。取得指针到执行 ReleasePrimitiveArrayCritical() 之间称为 JNI 临界区;期间 native 代码要避免长时间阻塞和任意调用 JNI,完成访问后必须成对释放。
长期保留临界区指针可能延迟或限制 GC,具体影响取决于 ART 返回直接指针还是副本,以及当前垃圾回收器的实现;两种路径都要求临界区尽快结束,否则可能增加分配等待和线程停顿。对任一 dalvik-* 区域调用 munmap() 还会破坏 ART 的分配器、card table(记录哪些堆区域可能包含跨区引用的表)、对象位图和引用关系。“禁用 moving GC 后释放备用 Space”走不通,这不是应用能安全使用的方案。
应用侧能控制的是对象生命周期和分配形态:
- 取消不再需要的任务与回调;
- 对缓存设置容量和生命周期;
- 按各自资源协议释放 Bitmap、媒体缓冲区与 native peer(Java 对象对应的原生侧实例);DirectByteBuffer 没有通用公开
close(),应缩短引用生命周期;JNI 自管的底层 buffer 则由其原生所有者配对释放,并确保不存在仍访问它的 ByteBuffer 视图; - 用 heap dump(堆转储)、Perfetto、heapprofd 和对象分配记录找到长期持有者;
- 避免在内存压力回调中同步制造大量临时对象。
6. 多进程:改变故障边界,也增加固定成本
每个 Android 进程都有独立的虚拟地址空间、ART 运行时、Binder 状态和原生内存分配器。把模块移入子进程,主进程中的已提交页与对象数量会降下来,但整个应用的总 PSS 可能上升。进程隔离的完整取舍可参阅 23.5 大内存与多进程策略。
这段 AndroidManifest.xml 配置展示私有进程声明:
<activity
    android:name=".WebContainerActivity"
    android:process=":web" />

<service
    android:name=".CodecService"
    android:process=":codec"
    android:exported="false" />
冒号前缀创建应用私有进程。是否值得拆分,要同时测主进程 PSS、子进程 PSS、启动时延、Binder 流量、冷启动次数和低内存下的恢复体验,再下结论。
适合评估隔离的模块通常具备这些特征:
- 生命周期清晰,结束后允许整个进程退出;
- 原生代码崩溃风险较高,需要限制影响范围;
- 已提交内存大,主进程长期不需要保留;
- IPC(inter-process communication,进程间通信)接口较少,避免高频传输大对象;
- 被 LMKD 回收后可以恢复。
较大的数据载荷(payload)可考虑通过 SharedMemory、文件描述符或流式接口传输;传输之外仍要定义所有权、校验长度并及时关闭 FD。拿多进程规避应用整体内存预算,这条路走不通。
7. 建立面向原因的监控
快照采回来还要能回答“为什么涨”。我们先把采样字段定下来,再定阈值。
7.1 采样字段
一条可解释的虚拟内存快照至少包含:
- 时间、业务场景、进程名、PID、ABI 和页大小;
VmSize、VmPeak、VmRSS、RssAnon、RssFile、VmSwap;- 线程数、VMA 数量和 FD 数量;
Java Heap、Native Heap、Graphics、Code与Stack等dumpsys meminfo分类的 PSS;- 占用较大的 VSS 分类及其 VMA 数量,按报告容量保留排名靠前的若干类别;
- 最近一次
mmap、pthread_create或内存分配器失败信息。
采样频率按风险控制:/proc/self/status 成本较低,可在场景边界采样;读取并解析 maps、读取记录每个 VMA 物理页明细的 smaps,或抓取堆转储,都交给异常触发,避免高频磁盘读取和主线程阻塞。
7.2 阈值按设备分组
“五分钟增长 100 MiB”或“接近 2 GiB 就报警”这样的固定阈值,缺少 ABI、业务和基线条件。我们按以下维度分别统计分位数:
- 32/64 位 ABI;
- Android 版本与页大小;
- 设备内存档位;
- 进程角色;
- 冷启动、稳定态、退出后;
- 线程数与 VMA 数量。
告警要把 VmSize 增量、RSS/PSS 增量、线程/VMA 增量和错误信号组合起来看:VSS 上升后 RSS 不变、业务退出后保持稳定,通常来自地址空间预留或可复用映射;VSS、RSS、线程数一起持续上升时,调查优先级更高。
8. 常见现场如何定位
8.1 pthread_create 失败
- 保存 ART 错误中的
requested stack size(请求的栈大小)和errno(native 调用返回的错误号); - 记录
/proc/<pid>/status的Threads、VmSize和VmRSS; - 按线程名、创建调用栈和持有者聚合;
- 检查缓存线程池、HandlerThread、SDK 与 native 线程;
- 先减少线程,再评估受控线程的栈大小。
8.2 32 位进程 mmap 失败
- 记录申请长度、
flags(映射标志)、errno和调用栈; - 保存完整 maps;
- 计算最大连续空洞——地址总范围减 VSS 是不够的;
- 检查大块地址空间预留、重复库、线程栈和 VMA 数量;
- 优先提供 64 位 ABI,并减少不必要映射的创建来源。
8.3 VSS 很大但设备没有内存压力
检查大区域是否为 PROT_NONE、文件映射、ART 预留或 WebView 地址空间预留,再看 RSS/PSS 与 page fault。没有失败信号时,就不去为了缩小面板数字解除系统映射。
8.4 多进程后主进程变小、整机更卡
把所有进程的 PSS 相加,并检查进程反复冷启动、Binder 数据载荷、共享页分摊和 LMKD 回收。主进程单项下降,证明不了方案节省了整机内存。
9. 优化顺序
表中的 P0、P1、P2 表示实施优先级:P0 是先完成的基础治理,P1 需要按设备或架构验证,P2 只用于受控诊断;“禁止”项会破坏运行时所有权。
| 顺序 | 动作 | 风险 |
|---|---|---|
| P0 | 记录 ABI、页大小、VSS/RSS/PSS、线程和 VMA 的同轮快照 | 低 |
| P0 | 明确线程持有者,使用有界线程池,清理失控的 HandlerThread/SDK 线程 | 低 |
| P0 | 修复对象、原生缓冲区、Bitmap、DirectByteBuffer 和映射生命周期 | 低 |
| P1 | 评估 64 位 ABI 覆盖,针对 32 位碎片做专项测试 | 中 |
| P1 | 按总 PSS 和生命周期评估进程隔离 | 中 |
| P2 | 在可调试构建中拦截 mmap/pthread_create 做取证 | 中 |
| 禁止 | 对 WebView 地址空间预留或 ART 托管堆 Space 调用 munmap | 高 |
| 禁止 | 永久持有 JNI 临界区指针来阻止 moving GC | 高 |
| 禁止 | 用负数栈大小依赖无符号回绕 | 高 |
最后把虚拟内存这部分收个尾。虚拟内存优化要让每段地址空间都能对应到创建来源和生命周期:32 位进程优先检查连续空洞、线程栈和 VMA 数量;64 位进程优先区分地址空间预留与物理页,并把 PSS/RSS、线程和失败信号放在同一份报告中。只有主进程 VSS 下降、总 PSS 和故障数据没有改善的改动,算不上有效优化。
10. 虚拟内存源码锚点
art/runtime/thread.ccart/runtime/native/java_lang_Thread.cclibcore Thread.javalibcore ThreadBuilders.javalibcore VirtualThread.javaWebViewLibraryLoader.javaWebView loader.cppart/runtime/gc/heap.ccandroid_os_Debug.cpp- Android JNI tips
- Android 17 Memory management daemon
- Linux 6.18
/proc文档 - Linux 6.18 Multi-Gen LRU
- Android 17 common kernel tag
android17-6.18-2026-06_r6
全文小结
Native 与虚拟内存优化要把逻辑对象、分配器记录、VMA 和驻留页分开观察。先按故障类型和系统内存分区选定要看的信息,再修复所有权、线程或映射来源;固定 VSS 阈值不要用,手动解除系统预留或 ART 空间制造出来的“下降”也不要信。最终效果应同时体现在 PSS/RSS、失败信号和业务场景稳定性上。
参考资料
- Debug native memory use
- Perfetto Native Heap Profiler
- Memory error debugging and mitigation
- GWP-ASan
- Arm MTE
- AOSP Arm MTE 与 ASYMM 模式
- Scudo
- Android 16 KiB 页面兼容要求
- AOSP
android-17.0.0_r1, malloc_debug README - AOSP
android-17.0.0_r1, libmemunreachable README - AOSP
android-17.0.0_r1, android_os_Debug.cpp - AOSP
android-17.0.0_r1, androidprocheaps.cpp - AOSP
android-17.0.0_r1, procmeminfo.cpp - AOSP
android-17.0.0_r1, Bionic README - Perfetto
android-17.0.0_r1, heapprofd.rc - Perfetto
android-17.0.0_r1, heapprofd.cc - Perfetto
android-17.0.0_r1, malloc_interceptor_bionic_hooks.cc - Perfetto
android-17.0.0_r1, heapprofd_producer.cc - Perfetto
android-17.0.0_r1, java_hprof_producer.cc - Perfetto
android-17.0.0_r1, sampler.h - Perfetto
android-17.0.0_r1, sampler.cc