Android 与 Linux 内存管理全景
Android 进程看到的 Java Heap、Native Heap、图形内存和文件映射,最终都由内核以页、匿名页、文件页和 Swap 来管理。我们分析 PSS、RSS、回收和 OOM,做的就是把这两套视角对应起来:应用侧关心进程用了什么、哪一类对象在增长;内核侧看到的是页类型、回收状态和内存压力。
源码基线:AOSP
android-17.0.0_r1(Android 17 / API 37);内核android17-6.18-2026-06_r6。厂商可以调整 ZRAM、cgroup、图形驱动和进程限制,节点与数值以目标设备为准。
进程内存域与统计口径
四类内存问题与排障地图
Android 应用遇到的“内存问题”至少有四类,每一类的触发条件、取证和处理方向都不一样:
- Java 或 Kotlin 代码分配对象时,ART 满足不了请求,抛出内存不足异常
OutOfMemoryError(OOME); - 原生内存分配器、图形驱动或其他系统调用返回分配失败;
- 系统处于内存压力中,lmkd 按进程重要性和内存占用挑选终止目标;
- 部分设备启用了内存限制器(MemoryLimiter),单个应用的匿名内存与 Swap 越过厂商配置的上限。
为什么要先分类?PSS 按共享页比例分摊,只看这一个数字很难判断属于哪一类。所以我们沿着“系统是否有压力、进程用了什么、哪一类对象或映射在增长、进程怎样退出”逐层缩小范围。
排查过程涉及以下层次:
图中的箭头表示管理或记账关系:procfs 是挂载在 /proc 的虚拟文件系统,暴露进程和内核状态;cgroup v2 按进程组统计和限制资源。ART 堆、原生堆和图形内存最终都依赖内核提供的页面、映射或设备缓冲区,同一物理页还可能被多个进程和设备共享。
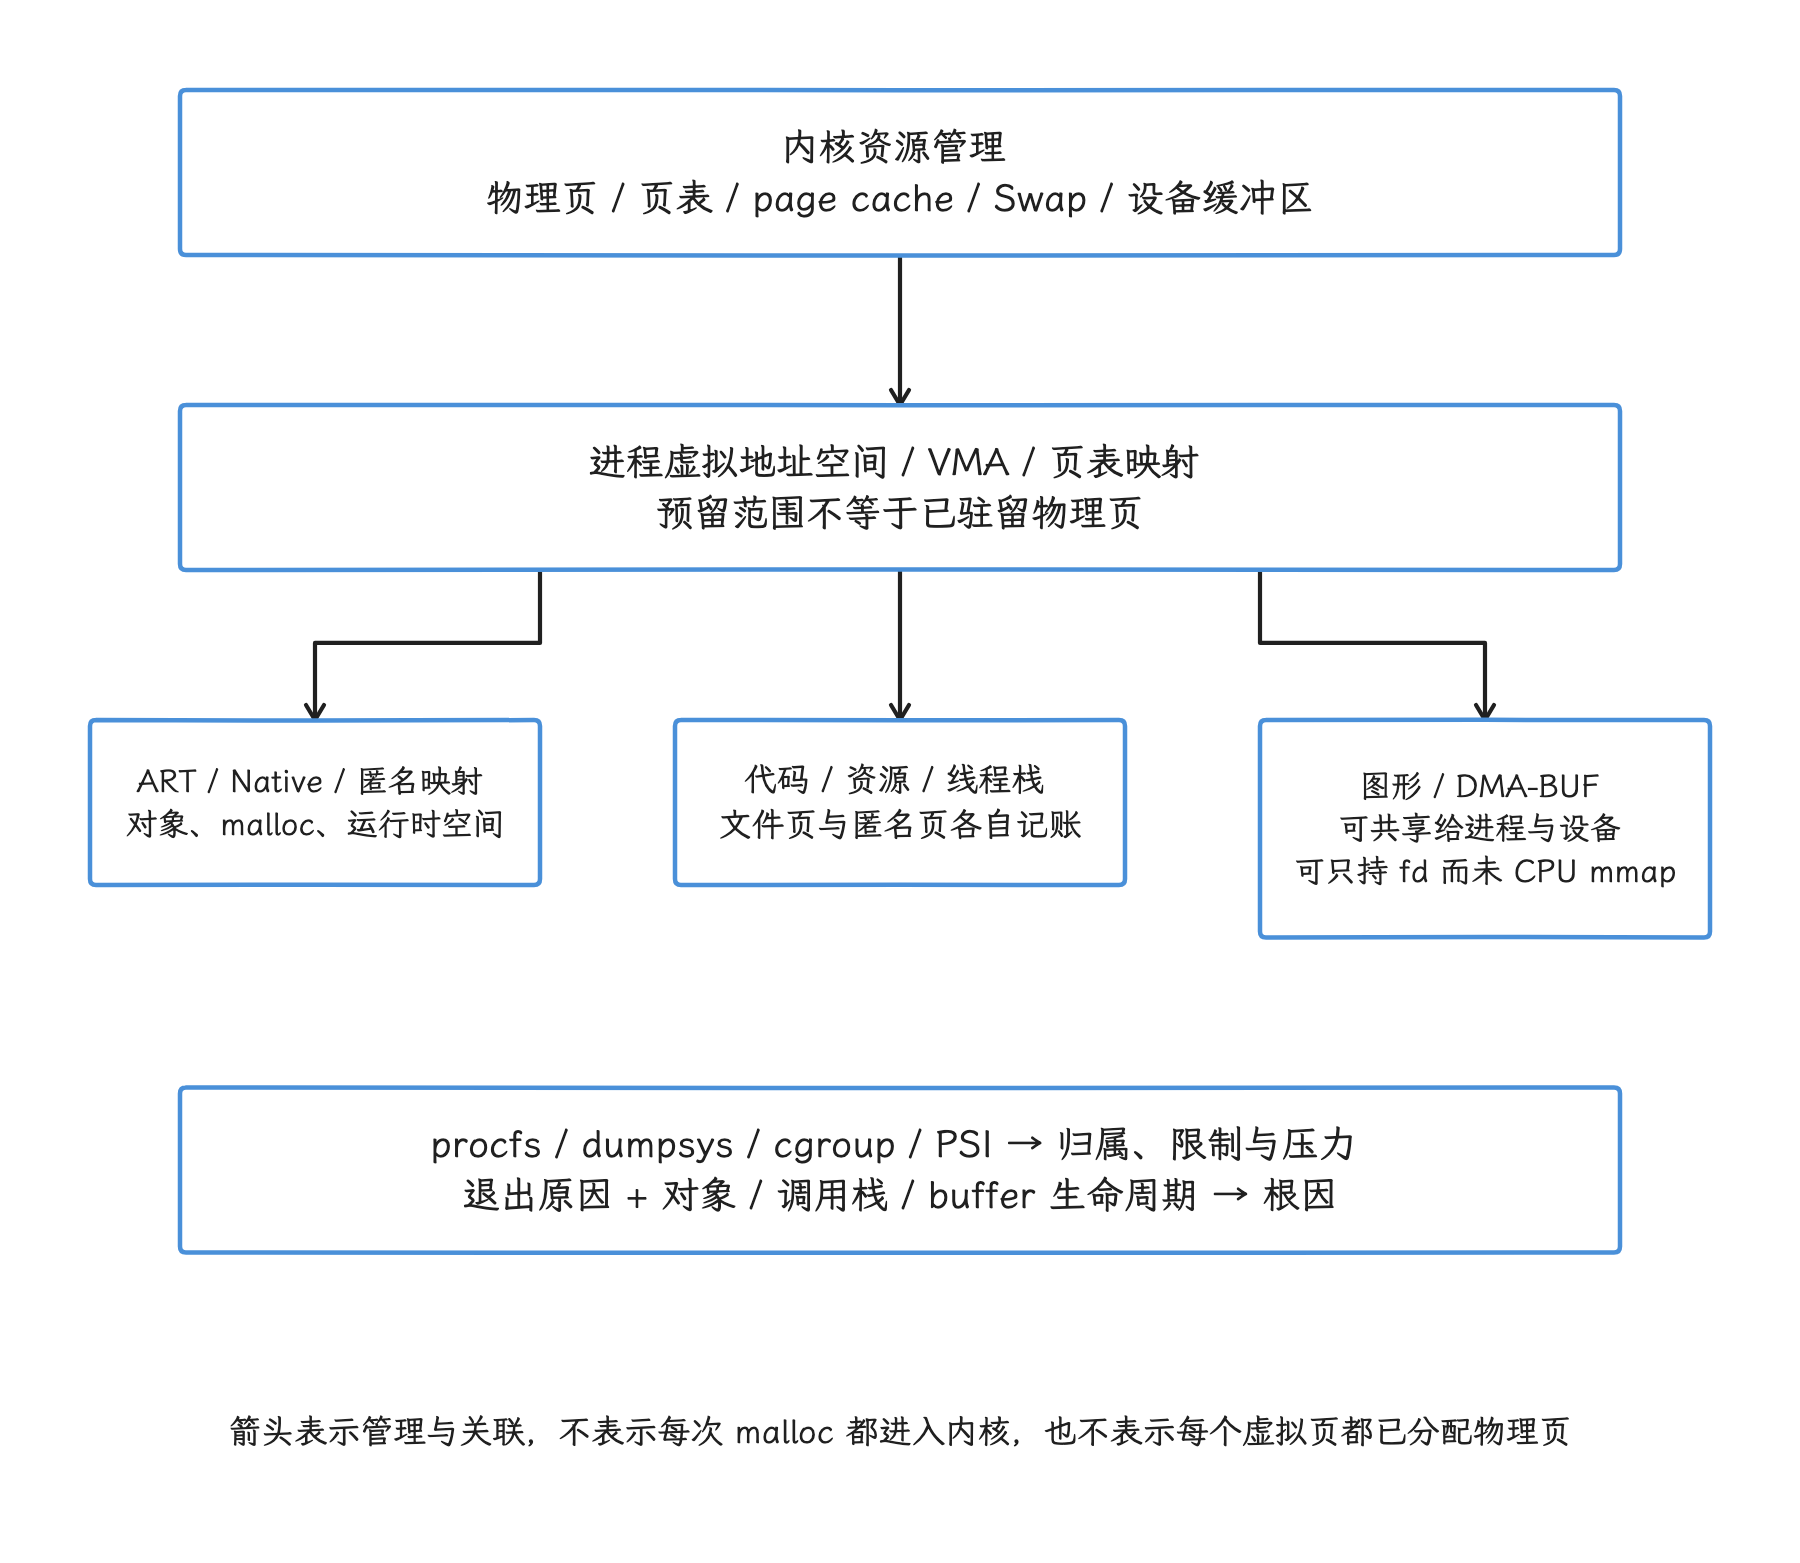
图:应用按 Java、Native、文件、栈和图形分类;内核按页、VMA、回收与设备缓冲区组织。虚拟预留可以还没有物理驻留,同一物理页也可被多个进程共享。统计用于解释归属,分配失败、ART OOME、系统压力退出与单进程限制则要分别取证。
从物理内存(RAM)到进程地址空间
物理内存与应用可用内存
设备标称的物理内存 RAM、Linux /proc/meminfo 中的 MemTotal,以及应用可以持续占用的内存,是三个不同的量。拿到一台设备,我们可以先粗算它们之间的差去了哪里:
- 固件、内核映像、页表、内核对象和硬件保留区会消耗一部分物理内存。
- 文件页缓存会占用 RAM,但其中的干净页通常可以回收。
- 匿名页可以留在 RAM,也可以在配置允许时进入 ZRAM 或其他交换后端。
- 图形、相机和编解码缓冲区可能通过 DMA-BUF 共享缓冲区机制在进程与硬件之间共享;具体记账取决于内核、驱动和 memtrack 内存跟踪接口的实现。
- Android 会保留运行系统服务和前台体验所需的余量,
MemTotal也就当不了应用的预算。
MemFree 很小时先别紧张,Linux 会主动拿空闲页做缓存。看系统还剩多少余量,MemAvailable 比 MemFree 更有参考价值;要判断压力是否已经影响任务运行,还得再看 memory PSI、回收活动和进程退出记录。
虚拟地址空间与实际驻留
64 位应用拥有很大的虚拟地址空间。mmap、加载 .so、预留线程栈或为堆保留地址范围,都会增加虚拟大小;RSS 统计其中已建立驻留映射的页面,不包含仅预留地址或已换出的页。驻留映射只说明页面已挂进页表,是否被逐页访问过要另找依据:内核的 fault-around 可以在一次文件缺页时,把周围已经就绪的文件页一并映射。 [已验证: android17-6.18-2026-06_r6 mm/memory.c do_fault_around();fs/proc/task_mmu.c smaps_account()]
一个 Android 进程常见的映射来源如下:
| 区域 | 常见来源 | 观察时要注意 |
|---|---|---|
| ART 托管堆 | Java/Kotlin 对象、对象数组、部分运行时结构 | 堆容量、已分配对象、活对象和 PSS 口径不同 |
| 原生堆 | malloc/new、Java 原生接口(JNI)、C/C++ 库 | Java HPROF 堆转储看不到原生内存分配 |
| 匿名映射 | mmap(MAP_ANONYMOUS)、运行时空间、即时编译(JIT)区域等 | 不一定归入 Native Heap |
| 代码与资源映射 | APK、.dex、.vdex、.oat、.art、.so、字体 | 干净文件页可回收,共享页会按 PSS 分摊 |
| 线程栈 | 主线程栈、POSIX 线程(pthread)/ART 创建的线程栈 | 预留地址范围和已经访问的页面差距可能很大 |
| 共享内存 | memfd、早期 Android 使用的 ashmem、Binder 进程间通信共享区域等 | 同一物理页可以出现在多个进程 |
| 图形与设备内存 | Android 图形缓冲区分配器 Gralloc、DMA-BUF、EGL/OpenGL/Vulkan 图形栈、驱动对象 | 进程映射、memtrack 与设备侧占用可能采用不同口径 |
ActivityManager.getMemoryClass() 给出的是托管堆近似容量,取值来自平台属性 dalvik.vm.heapgrowthlimit,没有该属性时回退到 dalvik.vm.heapsize;单位是 MiB,即 2^20 字节。这个值只针对托管堆:进程总内存上限、原生内存、代码映射、线程栈和图形内存都在它之外。largeHeap 对应的容量同样由设备配置决定,我们按目标设备查,别记固定值。
线程栈同样别统一记成“每线程 1 MiB 已用内存”。ART thread.cc 中的文件内静态函数 FixStackSize() 会根据请求值、运行时默认值、保护区和运行环境修正栈映射,主线程还继承进程启动时创建的栈。看栈映射时分两个量:VSS 是预留的地址范围,RSS 是当前驻留的页面大小;两者都不直接表示栈中有效数据的字节数。 [已验证: AOSP android-17.0.0_r1 art/runtime/thread.cc FixStackSize()]
VSS、RSS、PSS、USS 各回答什么问题
四个指标的定义
| 指标 | 含义 | 适合回答的问题 | 主要限制 |
|---|---|---|---|
| VSS / VmSize | 虚拟集大小(Virtual Set Size);进程虚拟地址空间中所有映射的总大小 | 地址空间是否异常、是否存在超大预留或映射 | 大量页面可能从未驻留,不能当作物理占用 |
| RSS | 驻留集大小(Resident Set Size);当前驻留映射的页面总量 | 进程当前的驻留映射规模 | 共享页会在每个映射进程中重复计算,不能据此推断逐页访问或访问频率 |
| PSS | 比例分摊集大小(Proportional Set Size);每个驻留共享页按映射者数量分摊后求和 | 多进程之间较公平的内存归因 | 共享者变化会让 PSS 波动,采集需要遍历页映射 |
| USS | 独占集大小(Unique Set Size);通常以 Private_Clean + Private_Dirty 估算私有驻留页 | 进程私有驻留规模 | 不等于终止进程后立即增加的可用内存 |
对同一时刻、同一进程和相近的工具读数,通常可以用下面的关系做直觉检查:
VSS ≥ RSS ≥ PSS ≥ USS
这条关系只用于直觉检查,具体数值仍以字段定义为准。SwapPss 是换出共享页的比例分摊值;工具是否计入 SwapPss、设备内存、显式大页(HugeTLB)或 memtrack 数据,都会改变最终的展示值。
为什么 PSS 会在代码不变时波动
假设三个进程映射了同一个 12 MiB 的驻留共享区域,每个进程先分到约 4 MiB PSS。如果其中两个进程退出,剩余进程会分到约 12 MiB。剩余进程的对象和映射没有增长,PSS 仍然可能上升。
所以判断泄漏时,应在可重复的业务阶段采样,并同时观察:
- RSS、PSS、私有脏页(
Private Dirty)、SwapPss的趋势; - Java 对象、原生内存分配或 DMA-BUF 等具体组成;
- 共享进程是否启动或退出;
- GC、页面回收和前后台切换的时间点。
看到“PSS 连续上升”,我们把它当作继续调查的信号,离泄漏结论还有一段距离。
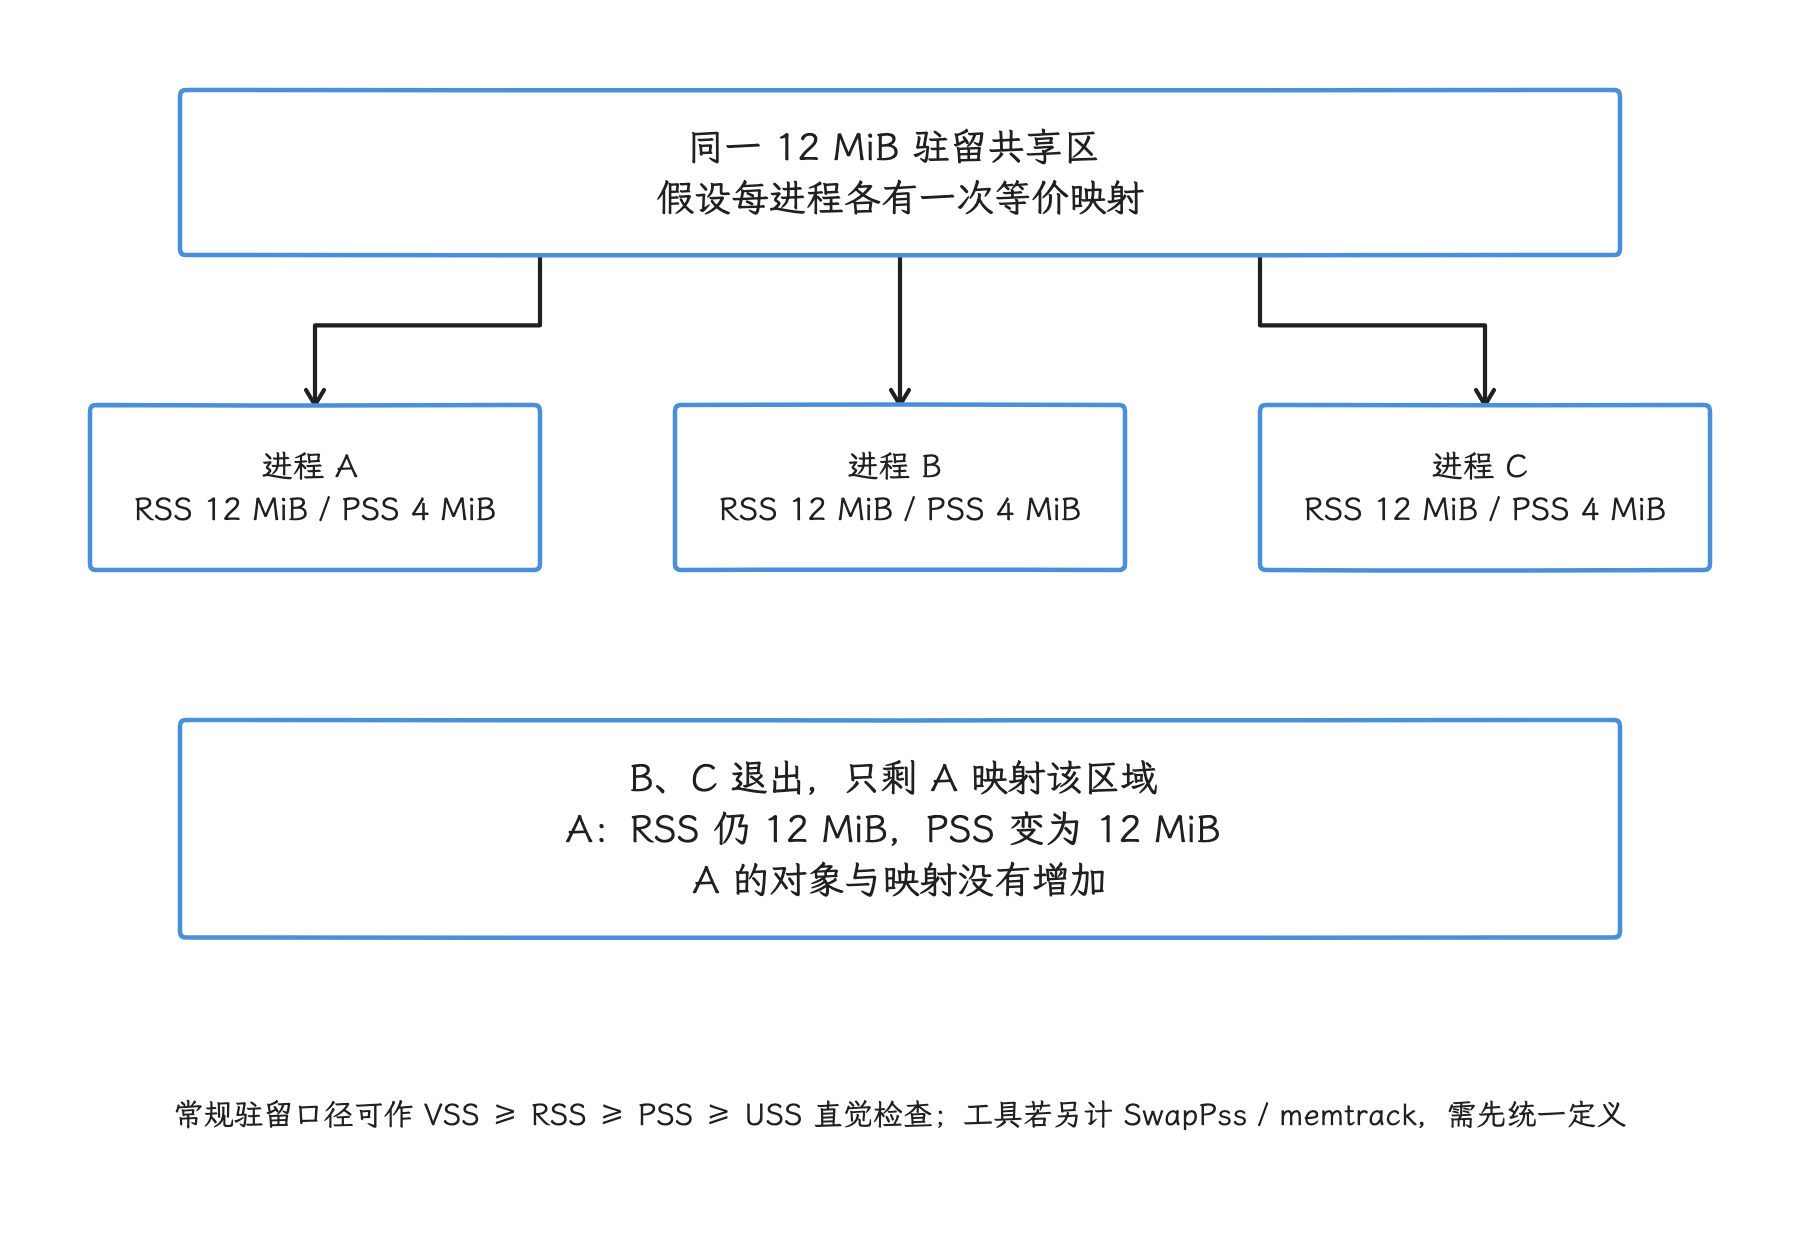
图:假设 A、B、C 各自映射一次同一 12 MiB 驻留共享区,每进程 RSS 各计 12 MiB,PSS 各分 4 MiB。B、C 退出后,A 映射的页面和对象不增加,PSS 却可变成 12 MiB。比较泄漏还需看私有页、保留对象和稳定业务状态。
USS 与进程退出后的内存释放
用 USS 预测“终止进程后能释放多少”之前,先把几类页的出路分开:私有干净页可直接丢弃,私有脏页需要回收或释放;共享页在进程退出后会重新分摊;文件描述符关联的内核对象、图形缓冲区和服务端引用也有各自生命周期。所以 USS 适合描述私有驻留规模,要精确预测进程退出后的 MemAvailable 增量,还得回到这些页各自的去向。
用 procfs 查看原始证据
/proc/meminfo:系统级快照
先采集系统总量、可用量、匿名页、文件缓存与交换空间(Swap)。下面的命令只筛选常用字段,单位由节点输出决定,通常为 kB。
adb shell 'cat /proc/meminfo | grep -E "^(MemTotal|MemFree|MemAvailable|Buffers|Cached|SReclaimable|Shmem|AnonPages|SwapTotal|SwapFree|SwapCached):"'
Cached 包含普通文件页缓存,也包含 tmpfs 与共享内存(shmem);Shmem 与它有重叠,两项直接相加会把 tmpfs 部分算两遍。Cached 大只说明页缓存多:丢弃后从磁盘重读只适用于普通文件页,tmpfs/shmem 的部分要等 Swap 可用才能释放。 [已验证: android17-6.18-2026-06_r6 Documentation/filesystems/proc.rst 的 Cached、Shmem;Documentation/filesystems/tmpfs.rst]
SwapFree 下降说明逻辑交换空间在消耗;SwapCached 统计已经换入(swap-in)、同时仍在交换空间保留副本的页面;这些页当前驻留在 RAM,同时仍占用 Swap 槽位;该值不能当作 ZRAM 压缩对象内存池的 RAM 成本,后者要按后文 ZRAM 统计另行核对。
/proc/<pid>/status:低成本进程概览
系统总量确认之后,我们再落到单个进程。下面的命令用于快速检查目标进程的地址空间、RSS 分项、交换空间与线程数。
adb shell 'pid=$(pidof com.example.app); grep -E "^(VmSize|VmRSS|RssAnon|RssFile|RssShmem|VmSwap|VmStk|Threads):" /proc/$pid/status'
VmRSS 对应驻留集概览,通常可拆分为 RssAnon、RssFile 和 RssShmem。Linux 内核文档提醒,status 中部分 RSS 统计通过异步记账获得,精确度低于 smaps 汇总。VmStk 描述主栈映射大小,主线程实际用掉的栈字节数要看别的量。
VmSwap 只统计私有匿名数据的换出量,不含 shmem 的换出页。所以它较低甚至为零时,共享内存的 Swap 占用仍可能存在;我们继续核对 shmem 映射和对应 cgroup 的统计,把这部分单独查清。 [已验证: android17-6.18-2026-06_r6 Documentation/filesystems/proc.rst 的 VmSwap 定义]
Android 的 SELinux 强制访问控制、procfs 挂载选项和 ptrace 权限会限制跨进程读取。开发机上可以根据构建类型和应用属性使用 run-as、应用自身采集或具备权限的系统工具;量产设备上,我们先默认 adb shell 读不到任意 PID(UID) 的 smaps,再逐台确认。
/proc/<pid>/smaps 与 smaps_rollup:逐映射核算
status 文件读起来便宜,但要逐映射核算,就得靠 smaps:为每个虚拟内存区域(Virtual Memory Area,VMA)提供 Size、Rss、Pss、私有/共享的干净页与脏页、Swap 等字段。smaps_rollup 在内核支持时给出进程汇总,输出更短,但仍需要内核遍历相关映射和页面。
下面的命令用于查看进程汇总:
adb shell 'pid=$(pidof com.example.app); cat /proc/$pid/smaps_rollup'
smaps_rollup 适合快速比较进程汇总值,增长来自哪一个映射要看完整的 smaps。
shmem 映射中的 Swap 还包含底层 shmem 对象在映射范围内、未被写时复制替换的换出部分,SwapPss 不包含这部分,两者对 shmem 换出页的覆盖范围不同。排查共享内存换出时,我们保留具体 VMA 的 Swap,并与系统及 cgroup 的 Swap 统计对照;VmSwap 和 SwapPss 各覆盖一部分,单看哪个都会漏。 [已验证: android17-6.18-2026-06_r6 Documentation/filesystems/proc.rst 的 smaps Swap、SwapPss 定义]
下面的命令用于定位 PSS 较大的具体映射:
adb shell 'pid=$(pidof com.example.app); cat /proc/$pid/smaps' > app.smaps
第二条命令把输出保存到主机当前目录,适合离线解析。频繁轮询 smaps 会增加 CPU 开销并扰动观测,应根据问题选择采样间隔。
4 KiB 与 16 KiB 页大小
Android 15 起,AOSP 支持使用 16 KiB 页大小的设备,排查内存时页大小要先确认。下面的命令可直接读取运行设备的页大小:
adb shell getconf PAGE_SIZE
smaps 还会列出 KernelPageSize 和 MMUPageSize。兼容映射和设备实现会影响具体输出,所以分析脚本应读取字段,把 4096 写死是靠不住的。
16 KiB 页会改变页表规模、缺页行为、对齐要求和小映射的内部碎片。官方文档只给出“平均内存可能略有增加”这类有保留的描述,没有通用的固定增幅。应用比较前后数据时,应保持 ABI、构建选项、MTE、业务负载和设备配置一致。
APK mmap:从 VMA 定位到 ZIP 条目与 DEX 结构
smaps 能指出哪段 APK 映射的 RSS 或 PSS 增长,但同一段映射可能覆盖多个 ZIP 条目。要继续定位 classes.dex、资源或原生库,可以把页的驻留状态、VMA 文件偏移和 APK 内部布局对应起来。得到的是驻留页覆盖的文件内容分布,触发驻留的函数调用仍需另找证据。 [来源: 技术文章/source/juejin-android/2026-10-14-76956227-APK_mmap_内存增长定位:page.md §3.2、§5.4、§6.4]
对文件线性映射,设 VMA 起点为 vma_start,映射头中的文件偏移为 vma_offset,页起始虚拟地址为 page_addr,设备基础页大小为 PAGE_SIZE。该页对应的 APK 文件区间为 [file_start, file_start + PAGE_SIZE),其中 file_start = vma_offset + (page_addr - vma_start)。PAGE_SIZE 应取前面 getconf PAGE_SIZE 的结果,别照搬材料示例中的 4096。 [来源: 技术文章/source/juejin-android/2026-10-14-76956227-APK_mmap_内存增长定位:page.md §3.1] [已验证: 本章“4 KiB 与 16 KiB 页大小”;android17-6.18-2026-06_r6 fs/proc/task_mmu.c pagemap_read() 的 PAGE_SHIFT 索引]
/proc/<pid>/pagemap 为每个虚拟基础页保存一个 8 字节记录,文件读取位置是 (page_addr / PAGE_SIZE) × 8。bit 63 是 present,bit 62 是 swapped,bit 0–54 才是驻留页的 PFN。只统计驻留页时,PFN 可以先放一边:r6 源码单独用 CAP_SYS_ADMIN 控制 PFN 可见性,present 位的设置另走一路,不受这个开关影响。读取文件仍受进程访问检查与 Android SELinux 策略限制;PFN 读到 0 时,驻留与否以该位为准;读取失败或数据不完整的轮次应整轮丢弃,按零增长处理会掩盖真实变化。 [已验证: android17-6.18-2026-06_r6 Documentation/admin-guide/mm/pagemap.rst;fs/proc/task_mmu.c pagemap_open()、pagemap_read()、pte_to_pagemap_entry()]
ZIP 条目的数据起点是 data_start = header_offset + 30 + name_len + extra_len,其中两个长度要从本地文件头读取;header_offset 本身不是 DEX 起点。按页文件区间与条目数据区间求交集,才能把跨条目的页分开统计。直接把交集解释为 DEX 内部字节,还要求该条目采用 ZIP_STORED,且映射内容与所采集 APK 一致;Deflate 压缩、运行时解密或另一个文件中的 DEX,需要单独处理。 [来源: 技术文章/source/juejin-android/2026-10-14-76956227-APK_mmap_内存增长定位:page.md §2.1、§5.2、§5.4]
- 在测试前后保留同一 PID、同一构建的
smaps与目标 VMA 的pagemap,记录时间和业务阶段。比较前核对文件身份、地址范围、权限与映射偏移;VMA 已变化时应单独分析,直接对旧虚拟地址集合做差会出错。 [来源: 技术文章/source/juejin-android/2026-10-14-76956227-APK_mmap_内存增长定位:page.md §1、§3.1、§5.5] [已验证: 本章“为什么 PSS 会在代码不变时波动”与“先确认命令和采样条件”] - 对稳定 VMA 按基础页读取
present,分别记录pages_t1 - pages_t0的新增驻留页与反向差集的离开驻留页。新增页数量只描述进入量;比较净 RSS 变化时还要扣除离开量,并注意smaps与pagemap不是同一时刻的原子快照。 [来源: 技术文章/source/juejin-android/2026-10-14-76956227-APK_mmap_内存增长定位:page.md §5.5、§6.2] [已验证: android17-6.18-2026-06_r6fs/proc/task_mmu.c的show_smap()与pagemap_read()独立读取路径] - 把新增页换算成文件区间,先汇总各 ZIP 条目的交集字节。ZIP 头、填充、未支持的压缩条目以及解析失败范围保留为未归因字节,避免只归一化已识别内容而隐藏遗漏。 [来源: 技术文章/source/juejin-android/2026-10-14-76956227-APK_mmap_内存增长定位:page.md §5.2、§5.4、§5.5]
- 对 DEX 条目,先校验格式版本和边界,再解析
map_list与具体项。method_ids是方法标识符表;回到方法字节码要沿class_data_item中的encoded_method.code_off找code_item。变长项必须完整解码,几个定长表的偏移代表不了全部类、方法或字符串。 [来源: 技术文章/source/juejin-android/2026-10-14-76956227-APK_mmap_内存增长定位:page.md §5.3] [已验证: AOSP DEX 格式文档method_id_item、class_data_item、encoded_method、code_item]
页内的字节占比只能说明驻留页里包含什么。一页同时覆盖方法字节码和字符串时,字符串占比高只说明它在这页里,缺页是否由它触发,还要靠别的证据;present 同样只表示驻留,访问频率要另找信号。soft-dirty 只记录写入及映射更新,只读 APK 的访问它跟踪不全。要追触发路径,我们把驻留分布与 perf/simpleperf 调用栈采样、ART 分析或业务时间线放到一起看。 [来源: 技术文章/source/juejin-android/2026-10-14-76956227-APK_mmap_内存增长定位:page.md §5.4、§6.2、§6.4] [已验证: android17-6.18-2026-06_r6 Documentation/admin-guide/mm/soft-dirty.rst]
单进程的 present 集合只覆盖驻留页,共享页的 PSS 仍要靠 smaps 实测。材料把 VMA 的 PSS 增量按已归因字节占比分摊,这依赖页间共享比例相近等假设;共享者变化、离开驻留页和未归因内容都会影响结果。报告应并列保留 smaps 实测的 RSS/PSS 差值、进入与离开页数、条目分布和未归因字节,把比例分摊值标为估算;没有归因字节时如实写未归因,避免输出伪精确的零 PSS。 [来源: 技术文章/source/juejin-android/2026-10-14-76956227-APK_mmap_内存增长定位:page.md §5.5、§6.2] [已验证: 本章“为什么 PSS 会在代码不变时波动”]
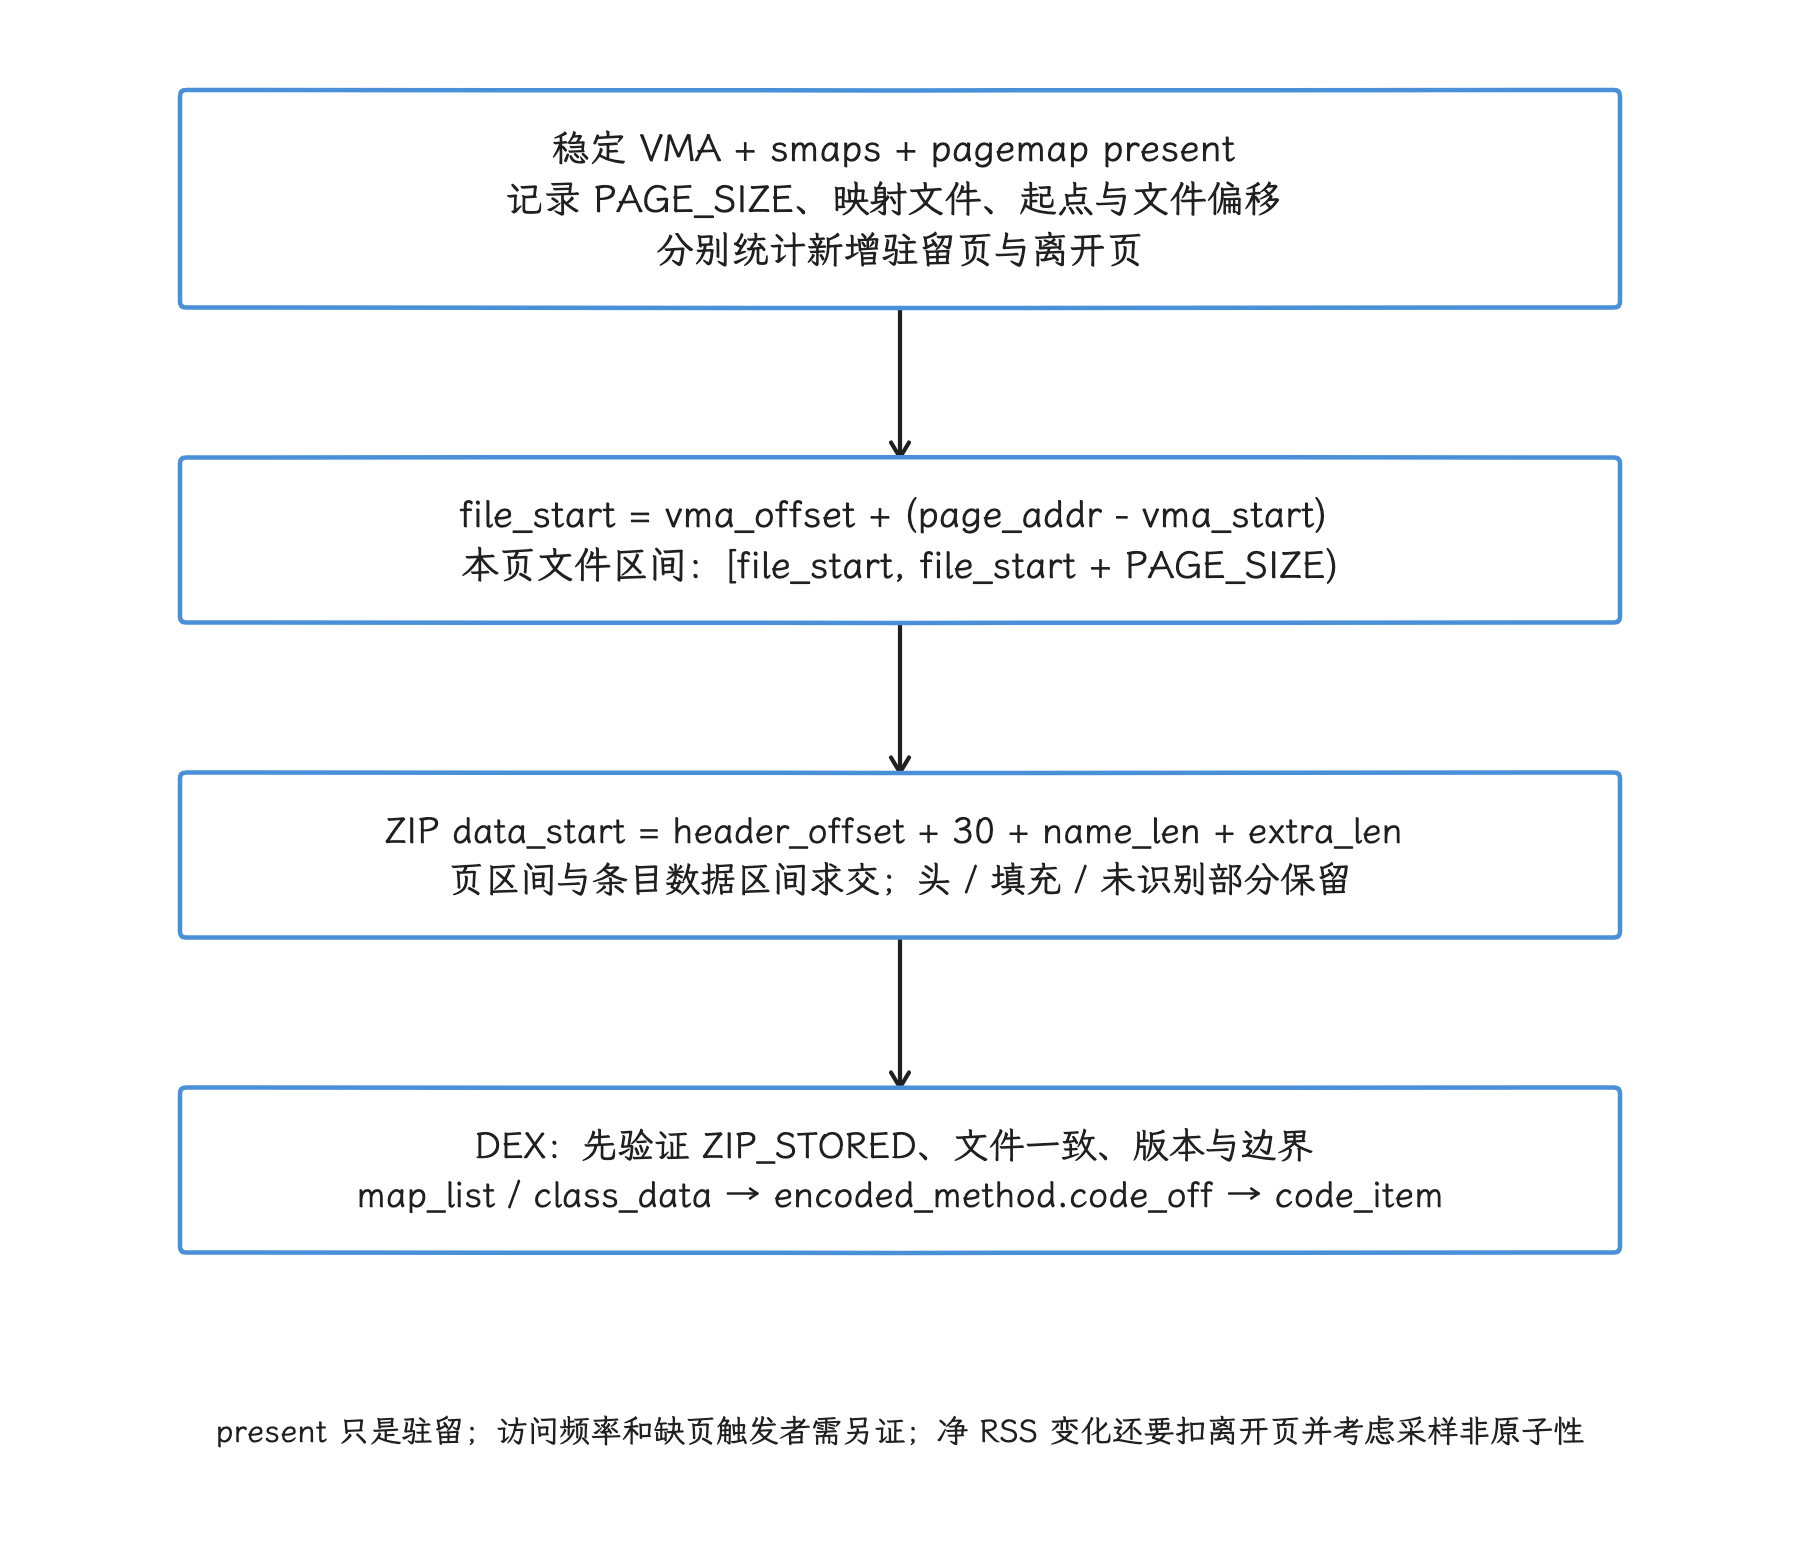
图:同 PID / 构建下先核对 VMA 与文件身份,再比较 pagemap present 集合的进入与离开。把页地址换算为 APK 文件区间,与 ZIP 条目数据区间求交;只有未压缩且文件匹配的 DEX,才继续解析内部结构。字节覆盖比例不能直接证明触发缺页的函数,也不能代替实测 PSS。
dumpsys meminfo 应该怎样读
先确认命令和采样条件
下面的命令采集指定包名对应进程的内存快照:
adb shell dumpsys meminfo com.example.app
一个包可能同时有多个进程,采集前先确认 PID、进程名、前后台状态和业务阶段;需要对比采样时,使用同一操作脚本、相近的等待时间和相同构建配置。
App Summary 是分类视图
Debug.MemoryInfo 将 App Summary 组织为以下字段:
Java Heap:dalvikPrivateDirty加.art映射的私有页;Native Heap:原生堆的私有脏页(Private Dirty);Code:.so、.jar、.apk、.ttf、.dex、.oat等映射,以及 Zygote/应用 JIT 代码缓存的私有页;Stack:栈类别的私有脏页;Graphics:Gfx dev、EGL mtrack与GL mtrack的私有页汇总;Private Other:总私有页扣除前面几项后的余量;System:getTotalPss()扣除总私有页后的余量,包含共享页的比例归因,以及内核提供的 SwapPss;TOTAL PSS:r1 的getTotalPss()返回dalvikPss + nativePss + otherPss + getTotalSwappedOutPss(),已经包含比例化 Swap;TOTAL SWAP PSS/TOTAL SWAP:前者展示比例化 Swap,内核不提供该统计时回退展示后者的未分摊 Swap 总量。
App Summary 的 TOTAL PSS 与 /proc/<pid>/smaps_rollup 的驻留 Pss 口径不同。比较两者前,应先分清 SwapPss、映射分类和 memtrack 数据;计算驻留加交换的总量时,这里的 TOTAL PSS 已包含比例化 Swap,直接用它即可,再加 TOTAL SWAP PSS 会重复计算。System 也是计算余量,内核替该应用分配的全部内存要看别的字段。 [已验证: AOSP android-17.0.0_r1 Debug.MemoryInfo.getTotalPss()、getSummarySystem()、getSummaryTotalSwapPss()]
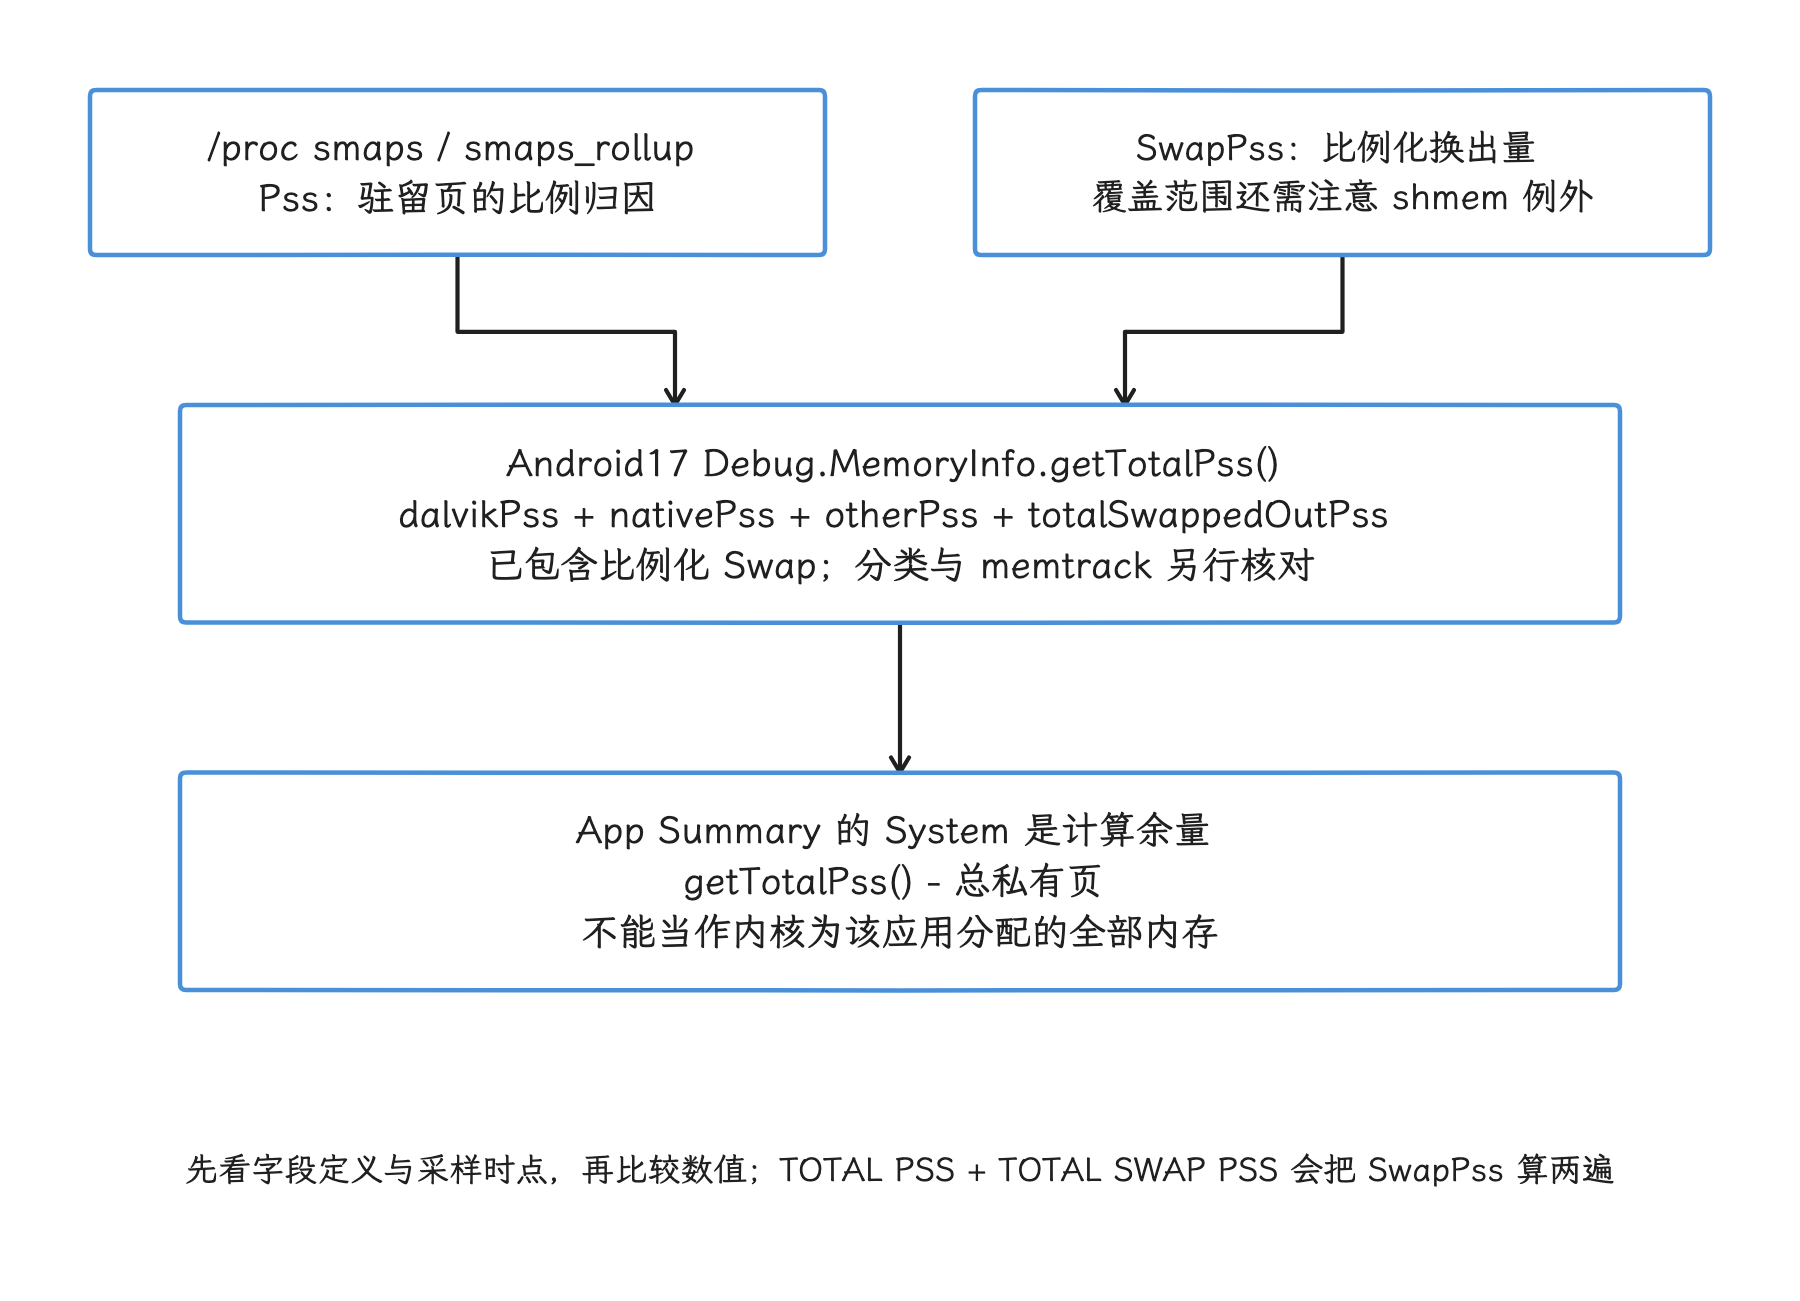
图:procfs 的 Pss 是驻留映射比例归因,SwapPss 列出相应比例化换出量。Android17 Debug.MemoryInfo.getTotalPss 把 Dalvik、Native、Other PSS 与总 SwapPss 相加;展示时还要核对 memtrack 与分类来源。该 TOTAL PSS 再加 TOTAL SWAP PSS 会重复计入交换部分。
详细表格用于解释“增长来自哪里”
详细表格中的 Dalvik Heap、Native Heap、.so mmap、.dex mmap、.art mmap、Stack、Ashmem、Memfd、EGL mtrack 等行,来自内核映射分类和 memtrack 数据。
分析两次快照时,建议按以下顺序:
- 确认 PID 和场景一致,记录采样时间与应用状态。
- 比较
TOTAL PSS、RSS、SwapPss/Swap 的总体变化。 - 找到变化最大的分类行。
- 按分类切换工具:Java HPROF、原生堆分析器、
smaps、DMA-BUF/图形工具或 Perfetto。 - 在应用回到稳定状态后重复多轮,验证增长是否可复现。
Objects 区域里的 View、Activity、Binder、Parcel 等计数适合发现异常线索。一次计数偏高只是起点,泄漏结论要结合对象保留路径、生命周期和重复场景才能下。
图形内存需要跨进程、跨驱动核对
getSummaryGraphics() 只汇总 Gfx dev、EGL mtrack 和 GL mtrack。memtrack 数据是否完整取决于设备实现。Vulkan、Gralloc、DMA-BUF 和 SurfaceFlinger 持有的缓冲区还可能在其他节点或进程中记账。
排查图形增长时可以组合使用:
dumpsys meminfo:查看进程视角的映射和 mtrack 分类;dumpsys SurfaceFlinger:查看合成层与缓冲区相关状态;/proc/<pid>/smaps:定位设备映射与共享映射;/proc/<pid>/dmabuf_rss:仅部分 Android 内核提供,且可能需要额外权限;- Perfetto 与厂商 GPU 工具:观察分配、提交、回收和进程状态的时间关系。
dumpsys gfxinfo 主要提供 UI 渲染性能、帧与部分对象统计,图形内存的整体核算要靠上面这组工具。
Ashmem、memfd 与 DMA-BUF 的职责要分开
ashmem 是 Android 早期的匿名共享内存机制,memfd 则通过文件描述符创建匿名内存对象;较新版本逐步使用 memfd 承担通用共享内存场景。DMA-BUF 面向设备之间以及设备与进程之间的缓冲区共享,常见于图形、相机和媒体。三者职责各不相同,版本变化的正确读法是“场景迁移”,而不是“DMA-BUF 取代 ashmem”。
堆转储与采样边界
Java HPROF 回答对象保留问题
需要分析 Java/Kotlin 对象、类实例数和引用链时,可以对允许调试的目标进程采集 ART 托管堆。下面的命令把 HPROF 堆转储写入设备临时目录,并在转储前请求 GC:
adb shell am dumpheap -g com.example.app /data/local/tmp/app.hprof
adb pull /data/local/tmp/app.hprof
ActivityManagerShellCommand.runDumpHeap() 把 -g 解析为 runGc=true,再交给 AMS 与应用进程执行。转储会暂停进程、遍历堆并额外消耗内存,低余量现场可能被它明显扰动,所以我们先保留退出原因、日志、PSS/RSS 和时间线,再评估是否适合抓取 HPROF。
同一命令的 -n 选择原生堆转储,-m 请求 malloc 信息;它们的输出属于另一类格式,Java 对象图的读法用不上。原生内存分配应使用 Perfetto android.heapprofd、malloc 调试或厂商工具,具体选择取决于构建与权限。
Perfetto Java 堆分析器的适用范围
Perfetto 的 android.java_hprof 从 Android 11 起可用,可把 ART 堆图写入跟踪文件,并支持按进程名或 PID 选择目标。它记录对象引用关系,不包含对象内部数据和分配调用栈,与标准 HPROF 的产物不同。连续快照会产生显著开销和较大的跟踪文件,通常先采单次快照,再根据复现窗口决定是否启用 continuous_dump_config。 [已验证: Perfetto《Memory: ART Heap Dumps for Java/Kotlin Heap》的可用性与产物说明]
Android 14 及以后还可以使用 android.java_hprof.oom 捕获 OOME 触发的堆信息;Android 17 r1 的官方案例文档与 ART 插件仍提供这条路径。能否采集目标应用,受应用可分析属性、系统配置和权限限制。 [已验证: AOSP android-17.0.0_r1 external/perfetto/docs/case-studies/android-outofmemoryerror.md;art/perfetto_hprof/perfetto_hprof.cc]
系统内存压力、控制组(cgroup)与进程退出
MemAvailable 与 PSI 描述不同维度
MemAvailable 估算在不发生交换的前提下,可供新应用使用的内存。PSI 记录任务因为等待内存资源而停顿的时间比例。下面的命令用于查看设备当前的内存压力停顿:
adb shell cat /proc/pressure/memory
some 表示至少有一个任务受影响,full 表示所有非空闲任务都因该资源同时停顿。短时尖峰和持续高压的含义不同,我们把 PSI 与 vmstat、ZRAM、页面回收、业务卡顿和 lmkd 事件放到同一时间线上看。
cgroup v2 的几个内存控制文件
控制组用于把一组进程放进共同的资源统计和限制里。Linux 6.18 的 cgroup v2 内存控制器为每个层级提供以下文件:
| 文件 | 内核语义 |
|---|---|
memory.low | 尽力保护边界;低于有效边界的内存受到较少回收 |
memory.high | 节流边界;越界任务进入直接回收并可能被节流,本身不调用内核的 OOM 进程终止机制(OOM killer) |
memory.max | 硬上限;回收无法满足时可能触发该 cgroup 内的 OOM 处理 |
memory.current | 当前 cgroup 及其所有后代的内存用量 |
memory.stat | 匿名页、文件页、共享内存(shmem)、回收等分类统计 |
memory.events | low、high、max、oom、oom_kill 等事件计数,默认包含后代事件;memory_localevents 挂载选项可改为仅本地 |
memory.events.local | 仅当前 cgroup 的事件计数,不汇总后代 |
memory.swap.current | 当前 cgroup 及其所有后代的交换空间使用量 |
memory.swap.max | 交换空间硬上限;达到后不再允许该 cgroup 继续换出匿名页 |
memory.pressure | 该 cgroup 的内存 PSI |
memory.stat 的 file 已经包含 shmem,把 anon + file + shmem 相加会把 shmem 算两遍;内核内存等其他占用也另有去处,这一求和只能当分类参考,用量以 memory.current 节点原值为准。共享页按 cgroup 所有权记账,各进程之间不做 PSS 那种比例分摊。父级节点的读数已汇总其子组用量,直接读即可;只想定位当前层级的事件,则读 memory.events.local。 [已验证: android17-6.18-2026-06_r6 Documentation/admin-guide/cgroup-v2.rst 的 Memory Interface Files 与 Memory Ownership]
Android 通过 libprocessgroup 与 task profile 管理进程所在的 cgroup。设备可以采用不同控制器和层级配置;定位时读取该构建的 cgroups.json、task_profiles.json 以及运行设备的 cgroup 文件系统,比凭版本号推断路径可靠。
Android 17 MemoryLimiter:只在部分设备生效
面向单应用的 MemoryLimiter 是 Android 17 引入的行为变化。它由 system_server 中的 Java 服务和 JNI 组件组成,用每进程 cgroup v2 监控应用进程,约束的是进程外部的 cgroup 限制,与 Runtime.maxMemory() 或 Dalvik/ART 堆大小的调整无关。Java 堆之外的原生匿名映射、WebView/Bitmap 背后占用和图形相关缓存,只要最终表现为受统计的匿名页、共享内存或 Swap 增长,也可能把进程推近限制。 [来源: 技术文章/source/juejin-android/2026-09-11-76535333-解读 Android 17 全新内存限制,有没有.md] [已验证: Android 17 Memory Limiter 官方文档;AOSP android-17.0.0_r1 MemoryLimiter.java 与 JNI]
android-17.0.0_r1 的 MemoryLimiter.Limiter.updateIsReady() 还把监控范围限定在应用 UID 空间:PID 和 UID 有效,且 UID 不小于 10000,即 Process.FIRST_APPLICATION_UID 时,进程对象才可能进入 MemoryLimiter 配置路径;如果包名命中豁免列表,源码会把它排除。低于该范围的系统 UID 不按普通应用限制处理;系统或厂商进程的内存限制要另看 PMGD、task profile 或厂商私有机制。 [来源: 技术文章/source/juejin-android/2026-10-09-76535333-解读Android17全新内存限制有没有豁免后门.md] [已验证: AOSP android-17.0.0_r1 MemoryLimiter.java Limiter.updateIsReady();Process.java FIRST_APPLICATION_UID]
在 android-17.0.0_r1 源码里,默认配置(defconfig)文件路径为 /vendor/etc/memory-limiter-config.xml;该文件可有可无,没有配置文件或没有匹配当前 RAM 的 limit set 时功能会关闭。
当前线上官方文档描述的标准配置路径是 /system/etc/memory-limiter-config.xml;这是文档的说法,固定源码标签下的 r1 结论仍以 /vendor/etc/memory-limiter-config.xml 为准。两相对照,“Android 17 应用都有固定内存上限”这个说法要打个问号,阈值以目标设备镜像和运行时 am memory-limiter status 为准。 [来源: 技术文章/source/juejin-android/2026-09-11-76535333-解读 Android 17 全新内存限制,有没有.md] [已验证: Android Memory Limiter(当前官方说明,配置路径以目标源码标签和设备镜像为准) 官方文档;AOSP android-17.0.0_r1 MemoryLimiter.java CONFIG_PATH 与 isMemoryLimiterSupported()]
Android 17 r1 源码中的关键流程如下:
- Java 层按进程状态选择
visible、not-visible、cached或unrestricted限制档位。PERSISTENT/PERSISTENT_UI为unrestricted;TOP、BOUND_TOP、IMPORTANT_FOREGROUND、TOP_SLEEPING为visible;FOREGROUND_SERVICE与BOUND_FOREGROUND_SERVICE映射为not-visible,前台服务通知和 MemoryLimiter 的可见档位是两回事。 [来源: 技术文章/source/juejin-android/2026-09-11-76535333-解读 Android 17 全新内存限制,有没有.md] [已验证: AOSP android-17.0.0_r1MemoryLimiter.java进程状态映射] - JNI 层把限制写入每进程 cgroup 的
memory.high和memory.swap.max。 [已验证: AOSP android-17.0.0_r1com_android_server_am_MemoryLimiter.cpp] - JNI 从
memory.stat读取anon与shmem,从memory.swap.current读取 Swap。 [已验证: AOSP android-17.0.0_r1com_android_server_am_MemoryLimiter.cpp] - 联合判断会比较
anon + shmem + swapCurrent与memHigh + swapMax。 [已验证: AOSP android-17.0.0_r1com_android_server_am_MemoryLimiter.cpp] - 联合上限越界后,服务解除该进程的限制;相关系统开关启用时触发异常分析事件
ProfilingTrigger.TRIGGER_TYPE_ANOMALY,并安排在 30 秒后终止进程。 [已验证: AOSP android-17.0.0_r1MemoryLimiter.java]
应用侧可用 ApplicationExitInfo 区分这类退出:原因字段(reason)为 REASON_OTHER,描述字段(description)包含 MemoryLimiter:AnonSwap。以下命令中,status 查询状态,ignore 修改忽略设置,manual 请求写入手动限制;后两者应仅用于可重启的测试进程。r1 的 manual 12345 10 会按 10 MiB 向 JNI 传递内存和 Swap 两项限制,Swap 项是否写入还受开关控制;这个数值可能导致回收停顿或进程退出,别当成 10% 用。 [已验证: AOSP android-17.0.0_r1 MemoryLimiter.java 与 ActivityManagerShellCommand.java]
adb shell am memory-limiter status
adb shell am memory-limiter ignore 10087
adb shell am memory-limiter ignore all
adb shell am memory-limiter ignore none
adb shell am memory-limiter manual 12345 10
adb shell am memory-limiter manual 12345 none
ignore 在 r1 接受 UID、none 或 all;单 UID 设置会覆盖先前值,ignore none 清除忽略设置。它让 Java 消息处理跳过该 UID 后续的启动与限制配置请求,manual 请求也会被跳过;已写入的 cgroup 限制、已有 JNI 监控和已排队的终止消息都不会因此撤销。排查时应核对 PID 的实际节点,不能把 ignore 当作现有进程的立即豁免或复位。 [已验证: AOSP android-17.0.0_r1 MemoryLimiter.java 的 MESSAGE_START、MESSAGE_CONFIG、MESSAGE_IGNORE、MESSAGE_KILL、ControllerEnabled.setManualLimit() 与 shouldIgnore()]
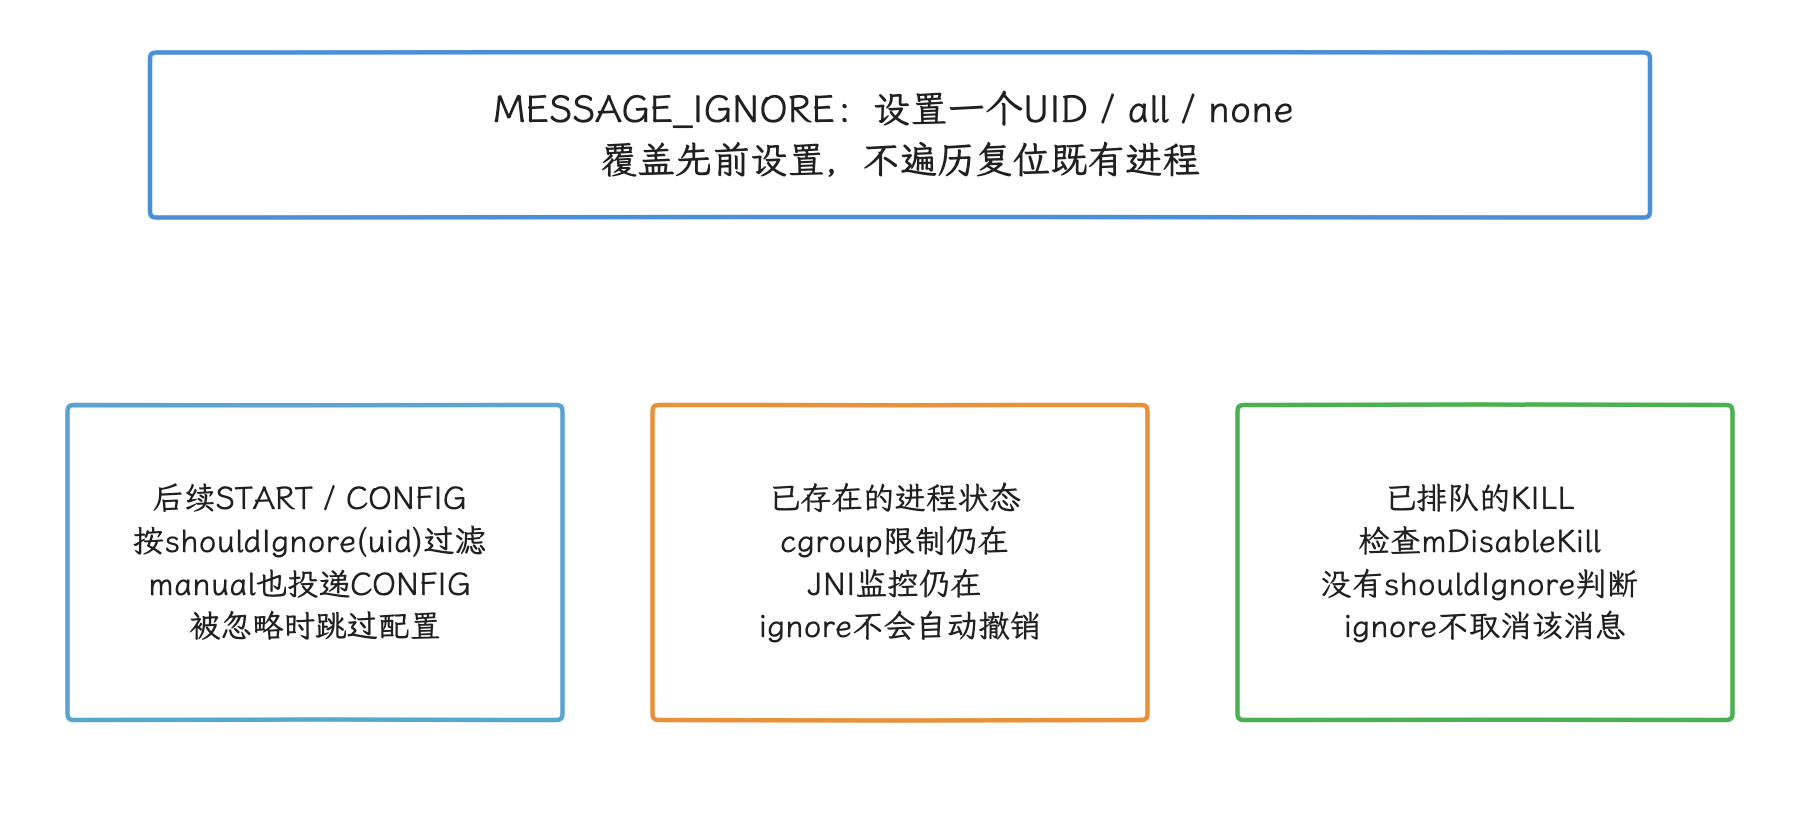
图:ignore消息覆盖被忽略UID设置,影响后续START/CONFIG(含manual)检查;既有cgroup限制和JNI监控不会自动撤销,已排队KILL只按其开关判断。
manual 接受 PID 和一个整数或 none,Java 层把整数按 MiB 转换,帮助文本仍写成 PERCENT|none。但 manual ... none 在这份实现中先变为 -1,再被乘成 -1048576,JNI 对这种值跳过节点写入,因此想撤销已写入的手动限制,靠它靠不住;测试后应重启目标进程,并重新读取该进程的 cgroup 节点确认。 [已验证: AOSP android-17.0.0_r1 ActivityManagerShellCommand.runMemoryLimiter()、MemoryLimiter.setManualLimit()、JNI Process::setLimit()]
公开二手材料可能把命令写成 <limit>|max|none,当前官方文档也给出字节数及 MB/GB 后缀写法;r1 的 shell 解析不接受 max 或这些后缀。使用前核对目标构建源码和运行结果,am help 里 r1 的单位与复位说明,单独当不了依据。 [来源: 技术文章/source/juejin-android/2026-09-11-76535333-解读 Android 17 全新内存限制,有没有.md] [已验证: Android Memory Limiter 官方文档;AOSP android-17.0.0_r1 ActivityManagerShellCommand.java 与 MemoryLimiter.java]
排查时先看 status 输出里的 enabled、limits、monitoring、killing 和 ignored,区分服务存在、限制生效、事件监控与终止开关。visibleMem、visibleSwap、notVisibleMem、notVisibleSwap 展示的是可见/不可见档位的配置模板,不保证等于某个 PID 当前节点中的值:手动配置、cached 状态和 JNI 的水位余量调整都可能让两者不同。应结合 PID 的进程状态、事件计数和实际 cgroup 节点读取;公开示例里的 14 GiB / 8192 MiB / 4096 MiB 也外推不成 Android 17 固定阈值。 [来源: 技术文章/source/juejin-android/2026-10-09-76535333-解读Android17全新内存限制有没有豁免后门.md] [已验证: AOSP android-17.0.0_r1 MemoryLimiter.java initializeMemoryLimits()、dump() 与 JNI Process::setLimit()]
MemoryLimiter 与 lmkd 的决策依据也不同。MemoryLimiter 约束单个受监控进程的匿名页、共享内存与交换空间;lmkd 在系统压力下结合进程重要性等信息选择终止目标。复盘进程消失时,应先读取 ApplicationExitInfo、系统日志和 PSI,再确定是哪条路径。 [已验证: AOSP android-17.0.0_r1 MemoryLimiter 源码;本章“MemAvailable 与 PSI 描述不同维度”段落]
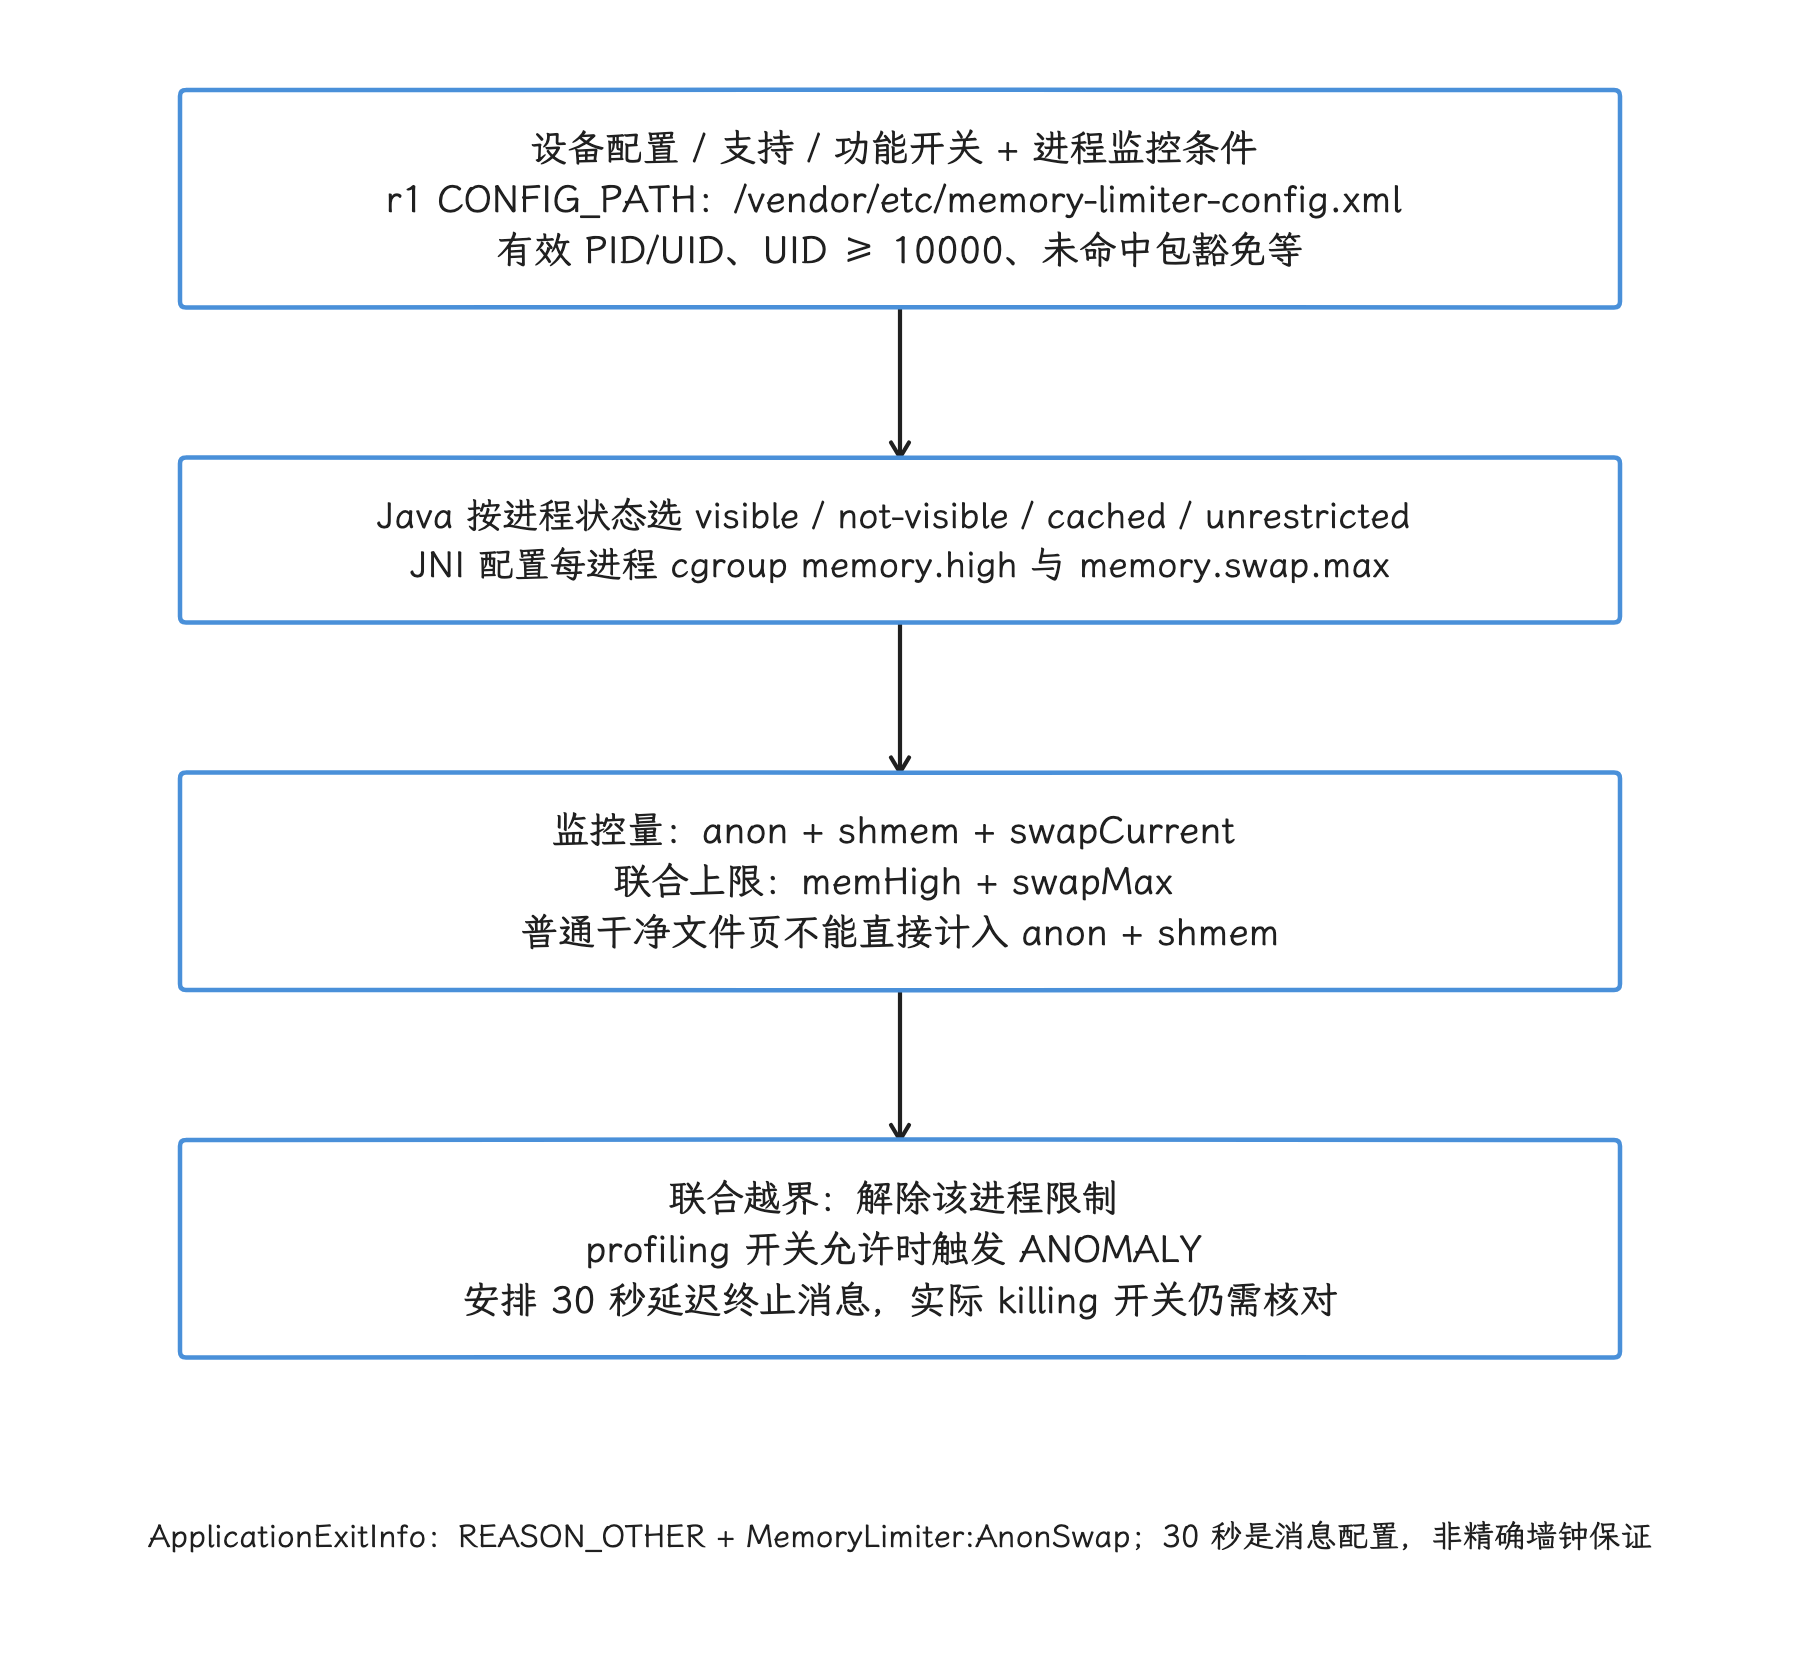
图:r1 只有设备配置匹配、服务功能开启且进程符合监控条件时才生效。Java 按进程状态选择档位,JNI 配置 cgroup memory.high / swap.max,并读取 anon、shmem、swap.current;联合量超过 memHigh + swapMax 后解除限制,按相关开关触发 profiling 与延迟终止。它不等同于 ART 托管堆上限,也不要求系统已经整体低内存。
PMGD 与 MemoryLimiter 的差别
Android 17 官方文档还描述了进程内存守护进程 PMGD(Process Memory Guardian Daemon)。MemoryLimiter 按应用 UID 与前后台状态分档;PMGD 改由 /vendor/etc/pmgd/config.json 点名目标进程,通过 cgroup task profile 设置 memory.high,通过 anon_limit_in_mb 设置匿名内存硬上限,目标可以是 system_server 这类指定进程。 [来源: 技术文章/source/juejin-android/2026-09-11-76535333-解读 Android 17 全新内存限制,有没有.md] [已验证: Android PMGD(Process Memory Guardian Daemon) 官方文档 https://source.android.com/docs/core/perf/pmgd]
PMGD 使用 inotify 监听 cgroup v2 的 memory.events。命中后,它先检查匿名内存;如果超过 anon_limit_in_mb 会立即终止目标进程。如果匿名内存未超过硬上限,PMGD 会等待 reclaim_wait_time_secs,再检查 memory.current 是否仍大于等于 memory.high,或匿名内存是否超过硬上限;仍超限时终止进程,并记录 Statsd memory atoms。 [来源: 技术文章/source/juejin-android/2026-09-11-76535333-解读 Android 17 全新内存限制,有没有.md] [已验证: Android PMGD 官方文档 https://source.android.com/docs/core/perf/pmgd]
PMGD 官方文档还规定,每个目标进程在一次设备重启周期内最多被 PMGD 终止一次,历史记录在 /data/misc/pmgd/history.json。重复实验时要核对这项限流;SELinux 未允许访问目标进程的域时,PMGD 监控不了,logcat 可能出现拒绝记录。 [已验证: Android PMGD 官方文档 System health features、SELinux configuration]
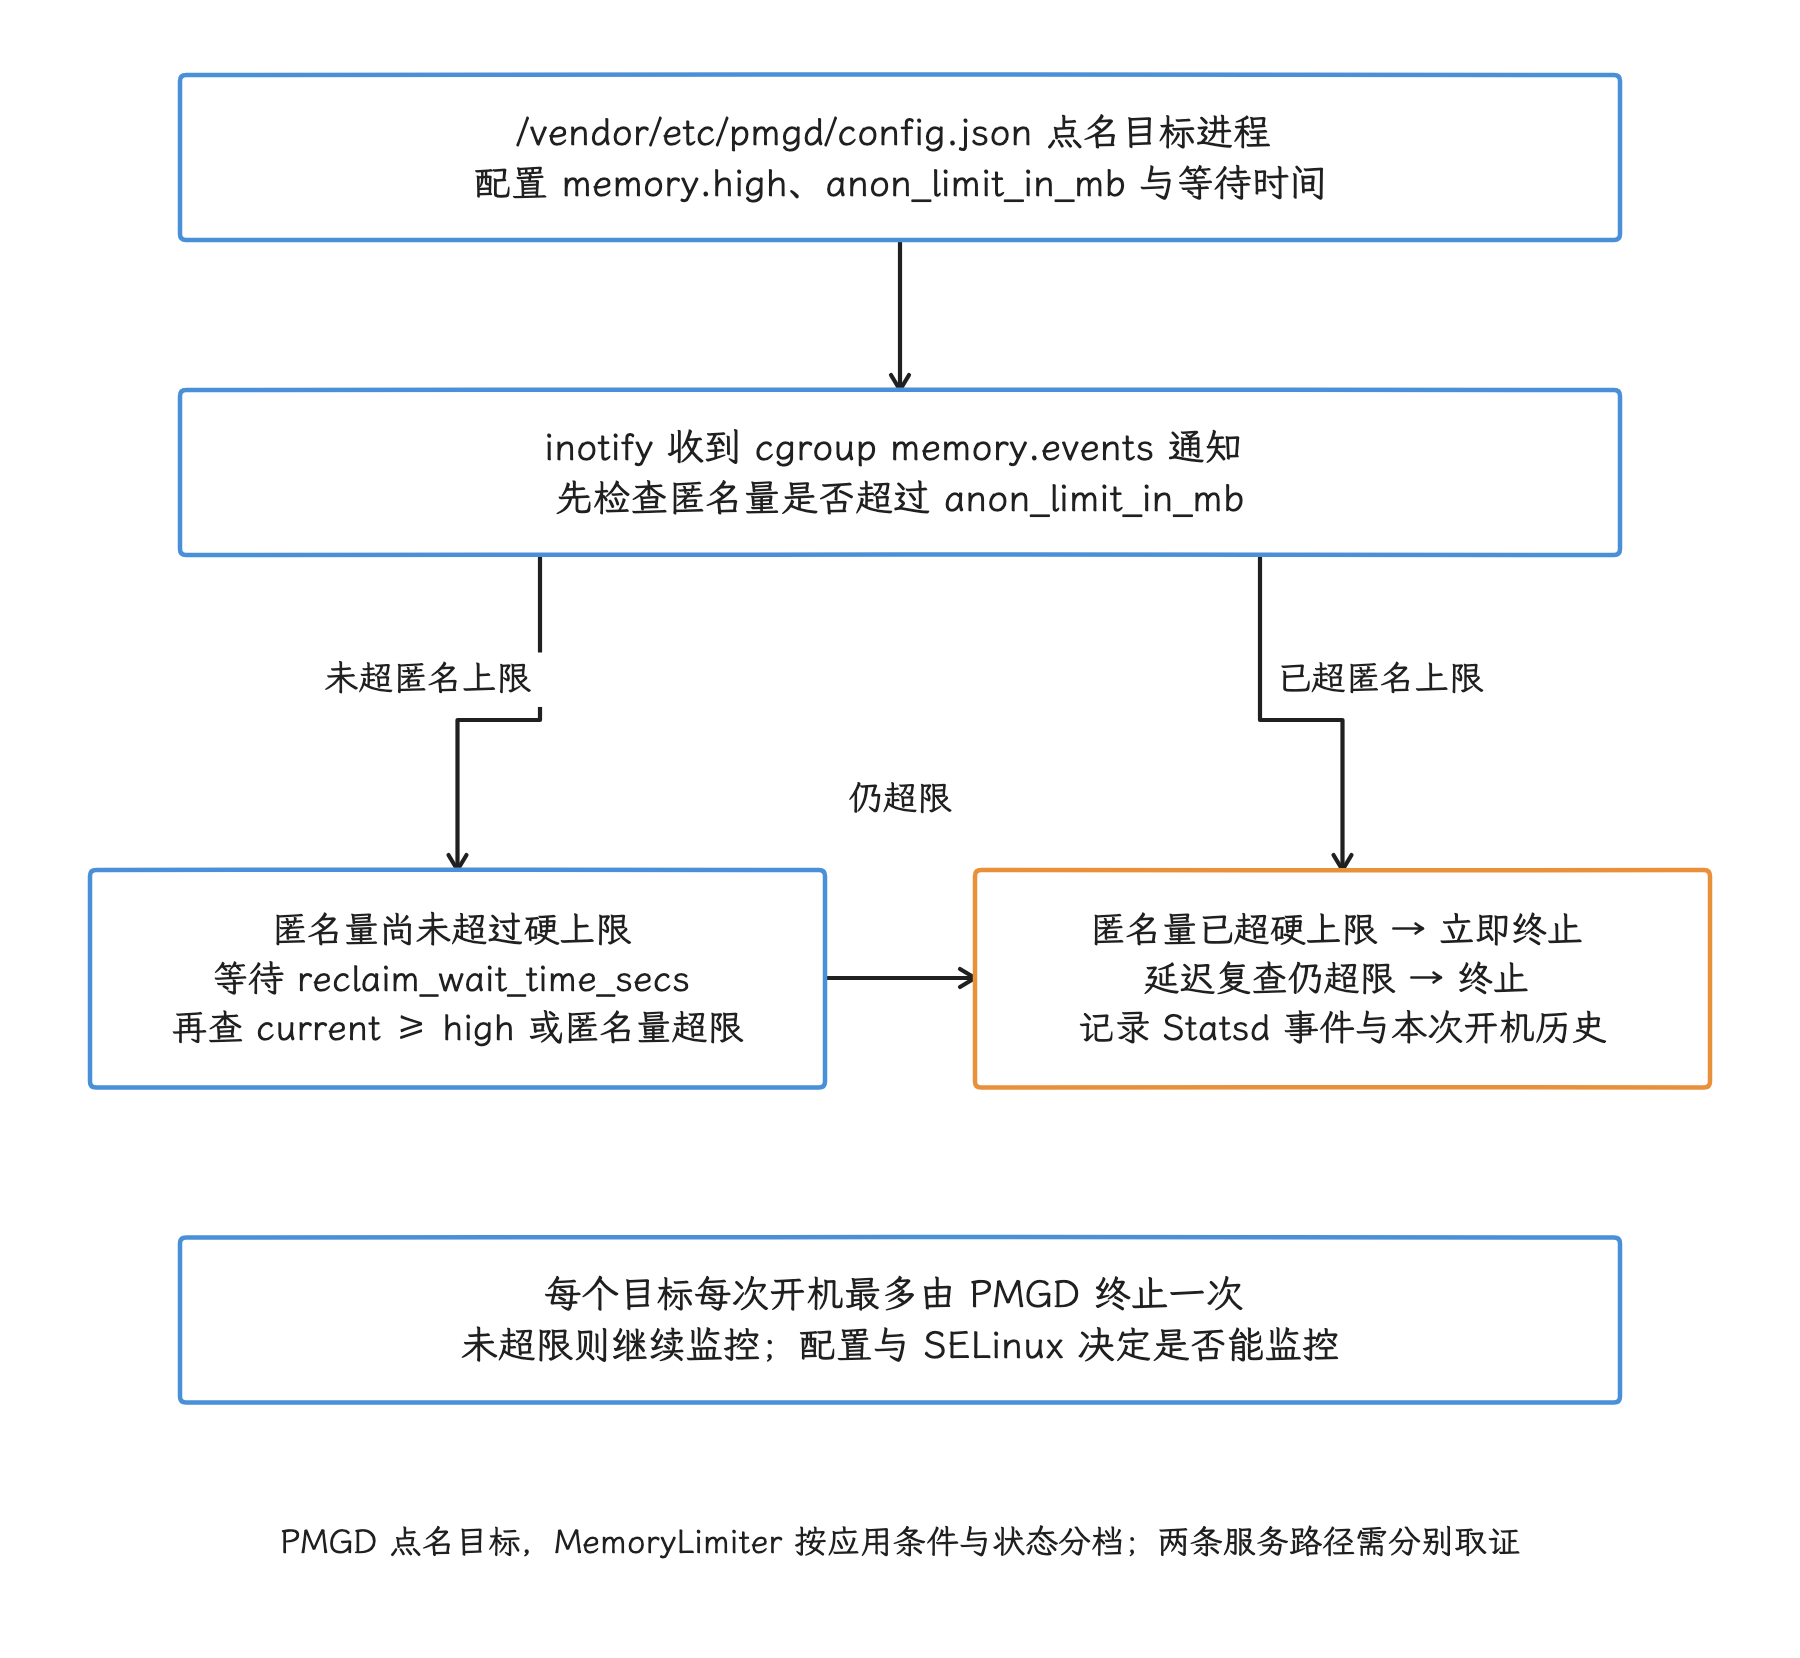
图:设备用配置点名进程并设置 cgroup high 与匿名量阈值。memory.events 通知后,匿名量已超硬上限则立即终止;否则等待配置时间再复查 current ≥ high 或匿名量超限。每个目标每次开机最多由 PMGD 终止一次,复现实验还需核对历史记录与 SELinux。
系统或厂商进程因内存被终止时,应同时确认 PMGD 配置与历史记录、SELinux 策略、memory.events/memory.current、ApplicationExitInfo、lmkd 日志与 PSI 时间线,再判断是否属于普通应用的 MemoryLimiter 路径。 [已验证: Android PMGD 官方文档;本章“MemAvailable 与 PSI 描述不同维度”段落]
应用侧对 MemoryLimiter 的应答路径
MemoryLimiter 触发“匿名页 + 共享内存 + 交换空间”越界终止后,应用拿不到常规 Java 堆栈,只能从 ApplicationExitInfo、PSI 和运行时提前注册的取证入口入手。下面三个方向对应同一份退出现场的不同时间点。
编译期:让 R8 的压缩与优化生效
R8 的保留规则写得太宽时,release 包可能留下未使用的代码和资源,或者阻止优化。安装包里保留了多少内容,直接换算不成常驻内存;把 APK 的干净文件页计入 MemoryLimiter 的 anon + shmem + swap,更是算错了账。应先区分文件驻留页与运行时对象、匿名映射等占用。 [已验证: Android Developers《Enable app optimization with R8》;本章“APK mmap:从 VMA 定位到 ZIP 条目与 DEX 结构”与 AOSP android-17.0.0_r1 com_android_server_am_MemoryLimiter.cpp 的 anon、shmem、Swap 读取路径]
沿用 minifyEnabled/shrinkResources 配置方式的工程,可以在 buildTypes.release 中检查:
isMinifyEnabled = true:启用代码压缩、优化与混淆。 [已验证: Android Developers《Enable app optimization with R8》的 Legacy DSL 示例]isShrinkResources = true:在构建阶段移除未使用的资源。 [已验证: Android Developers《Enable app optimization with R8》的 Legacy DSL 示例]proguardFiles(getDefaultProguardFile("proguard-android-optimize.txt"), "proguard-rules.pro"):使用允许优化的默认规则文件。 [已验证: Android Developers《Enable app optimization with R8》的 Legacy DSL 示例]
AGP 8.0 起 R8 完整模式默认开启;若 gradle.properties 中仍保留 android.enableR8.fullMode=false,可在补齐必要 keep 规则并测试反射等动态入口后移除。-dontoptimize、-dontshrink、-dontobfuscate 分别限制优化、压缩与混淆,应逐项核对使用理由。 [已验证: Android Developers《Enable app optimization with R8》的完整模式说明与版本行为表]
反射、序列化与三方 SDK 的 keep 规则应当收窄到具体类、字段或注解。库工程要把对外规则放在 consumer-rules.pro,把库内部为自身编译和测试保留的规则放在模块自己的 proguard-rules.pro;两者混在一起,接入方可能收到过宽的 keep,限制代码与资源压缩。 [来源: 技术文章/source/juejin-android/2026-09-23-76471867-Android17内存超限杀App排查.md] [已验证: Android Developers《Enable app optimization with R8》]
R8 对文件映射和运行时分配的影响要分开测量。对同一业务负载的 release 构建,比较 APK/DEX 大小、文件映射 RSS/PSS,以及 cgroup 的 anon、shmem 和 Swap;只有后几项的变化才能直接对应这里的 MemoryLimiter 联合上限。 [已验证: 本章“APK mmap:从 VMA 定位到 ZIP 条目与 DEX 结构”;AOSP android-17.0.0_r1 com_android_server_am_MemoryLimiter.cpp]
运行时:主动让出可重建缓存
应用退到后台后,平台可能按进程状态释放一部分内存,ComponentCallbacks2.onTrimMemory(level) 是应用主动交还可重建对象的入口。Android 14 起多个旧的 trim 常量不再继续下发,Android 15 已把若干 trim 常量标记为废弃,实际处理仍主要集中在 TRIM_MEMORY_UI_HIDDEN 和 TRIM_MEMORY_BACKGROUND 两个入口:
TRIM_MEMORY_UI_HIDDEN:UI 不再可见后清理图片缓存、视频预览 buffer、动画资源等大对象;这些对象重新进入页面时通常可以从网络或磁盘重建。TRIM_MEMORY_BACKGROUND:进程已进入后台,可一并清空搜索结果缓存、临时 buffer 池等能在下次进入页面时再生成的资源。
在 onTrimMemory 里,我们只清理可以重建的缓存;正在编辑的草稿、支付流程状态或用户选择路径等重要业务状态,应及时持久化到适当的存储。
进程死亡前后的恢复要分两套机制看:ViewModel 能跨配置变化保留内存数据,但跨不过进程死亡;保存状态机制在进程重建后恢复 ID、查询词等少量 UI 信息,大型对象或完整业务数据要走自己的持久化方案。保存状态还依赖 Activity 的停止时机:Activity 已停止后写入的内容,需要再次经过启动、停止才会保存。必须可靠恢复的数据要提前保存,别等 trim 或进程被杀前的回调。 [来源: 技术文章/source/juejin-android/2026-09-23-76471867-Android17内存超限杀App排查.md] [已验证: Android Developers《Save UI states》的进程死亡、数据大小与 Activity 停止时机说明]
onTrimMemory 按应用状态转换提示清理,并不保证在 MemoryLimiter 越界之前送达。可重建缓存应有自己的生命周期和容量管理;峰值控制要靠自己,trim 回调替代不了。 [已验证: Android Developers ComponentCallbacks2 的状态回调说明;本章 Android 17 MemoryLimiter 按进程状态选择限制档位的流程]
线上取证:用 ProfilingManager 抓被杀前的现场
MemoryLimiter 的退出标记用于确认终止路径,通常还不足以定位保留对象或分配调用栈。应用可以提前接入 ProfilingManager,但采集请求与结果交付都不保证成功。 [已验证: 本章 ApplicationExitInfo 的 MemoryLimiter 标记;AOSP android-17.0.0_r1 packages/modules/Profiling/framework/java/android/os/ProfilingManager.java]
ProfilingManager 和全局结果回调从 API 35 提供,addProfilingTriggers() 从 API 36 提供;下面两个触发类型从 Android 17 / API 37 提供: [已验证: Android Developers ProfilingManager、ProfilingTrigger API 参考]
ProfilingTrigger.TRIGGER_TYPE_OOM:应用发生 OOM 异常时请求 Java 堆转储;自定义未捕获异常处理器需要继续调用默认处理器,否则这一触发路径就走不通。 [已验证: Android DevelopersProfilingTrigger.TRIGGER_TYPE_OOM]ProfilingTrigger.TRIGGER_TYPE_ANOMALY:系统检测到应用异常行为时触发,产物类型取决于异常。MemoryLimiter 在相关系统开关启用时调度该事件,每次异常事件未必都对应 Java 堆转储。同一 UID 下有多个包注册该触发器时,系统对部分异常可能不提供产物;共享 UID 应用排查未交付结果时,还要核对同 UID 的其他注册包。 [已验证: Android DevelopersProfilingTrigger.TRIGGER_TYPE_ANOMALY的同 UID 警告;AOSP android-17.0.0_r1ProfilingTrigger.java与 MemoryLimiter 异常事件流程]
接入时应分别注册全局结果回调 registerForAllProfilingResults() 和所需的触发器 addProfilingTriggers();只注册结果回调不会订阅 OOM 或异常事件。结果可在进程存活时返回;如果回调失败,系统可能在应用以后重新注册全局回调时尝试重投递,“只在下次启动返回”或必然补齐文件都没有保证。 [已验证: AOSP android-17.0.0_r1 packages/modules/Profiling/framework/java/android/os/ProfilingManager.java addProfilingTriggers() 与 registerForAllProfilingResults()]
线上接入还要考虑限流、用户同意、文件大小、上传时机和保留时间。Java 堆转储可能包含对象引用与内容,应按敏感数据处理;ApplicationExitInfo、系统日志、tombstone、lmkd 记录与 PSI 时间线仍用于确认退出原因,分析产物用于补充对象或调用栈线索。 [来源: 技术文章/source/juejin-android/2026-09-23-76471867-Android17内存超限杀App排查.md] [已验证: Android Developers ProfilingManager 的限流说明;本章“堆转储与采样边界”]
ZRAM 与 Swap:容量、压缩数据和 RAM 成本
Android 常把 ZRAM 块设备(在 RAM 中保存压缩数据的块设备)配置为交换空间。匿名页换出后,数据通常以压缩形式保存在 RAM;内核还支持为 ZRAM 配置 backing device,把空闲或难压缩页面写回存储。是否启用、采用什么压缩算法以及容量多大,均由设备配置决定。
下面的命令用于确认 Swap 与 ZRAM 设备:
adb shell cat /proc/swaps
adb shell cat /sys/block/zram0/mm_stat
Linux 6.18 的 mm_stat 按以下顺序输出字段;大小字段以字节计,页统计以基础页为单位:
orig_data_size:已存数据按未压缩页大小计算的逻辑量,包含同值填充页和仍占用逻辑槽位的回写页;compr_data_size:当前留在 ZRAM 对象内存池中的数据大小,包含以原大小存放的难压缩页;mem_used_total:对象内存池占用的 RAM,包含池内碎片等开销;mem_limit、mem_used_max:对象内存池的 RAM 限制与历史峰值;same_pages、pages_compacted:同值填充页数量、内存池压实累计释放的页数;huge_pages、huge_pages_since:当前与自设备初始化以来累计的难压缩页数,这里的huge与 THP 无关。 [已验证: android17-6.18-2026-06_r6Documentation/admin-guide/blockdev/zram.rst;drivers/block/zram/zram_drv.cmm_stat_show()、write_same_filled_page()、write_incompressible_page()]
orig_data_size / compr_data_size 可以作为设备层面的容量比,计算前要确认分母非零。它同时受压缩算法、数据内容、同值页优化和回写影响:同值填充页只保存填充值,不分配数据对象;回写完成会释放池内对象、扣减 compr_data_size,但仍保留逻辑槽位。看到比值升高,我们先排除同值页与回写的影响,再谈压缩算法。 [已验证: android17-6.18-2026-06_r6 zram_drv.c write_same_filled_page()、zram_writeback_complete()]
mem_used_total 适合观察对象内存池的 RAM 成本,与 compr_data_size 对照可看出池内分配开销;它未计入单独分配的槽位表,不能代表整个 ZRAM 驱动的 RAM 成本。r6 的 mm_stat_show() 从 zs_get_total_pages() 取值,而 zram_meta_alloc() 另用 vzalloc() 分配槽位表。 [已验证: android17-6.18-2026-06_r6 zram_drv.c mm_stat_show()、zram_meta_alloc()]
核对回写时,可继续读取以下节点。它们依赖 CONFIG_ZRAM_WRITEBACK,访问还受设备权限限制;以下命令只读取配置与统计,不会启用回写:
adb shell cat /sys/block/zram0/backing_dev
adb shell cat /sys/block/zram0/bd_stat
backing_dev 用于确认后备设备配置,bd_stat 依次给出后备设备占用量、累计读取量和累计写入量。三项均按 4 KiB 为单位计数,换算字节时乘以 4096;即使基础页为 16 KiB,也不能改乘运行时页大小。结合前后快照,才能区分对象内存池变化与后备存储 I/O。 [已验证: android17-6.18-2026-06_r6 Documentation/admin-guide/blockdev/zram.rst bd_stat;zram_drv.c bd_stat_show() 与 FOUR_K()]
判断系统是否陷入内存抖动,还要观察 PSI、换入换出、回收扫描、CPU 压缩开销和前台延迟。单次 SwapTotal - SwapFree 或一个容量比都不足以支持这一结论。
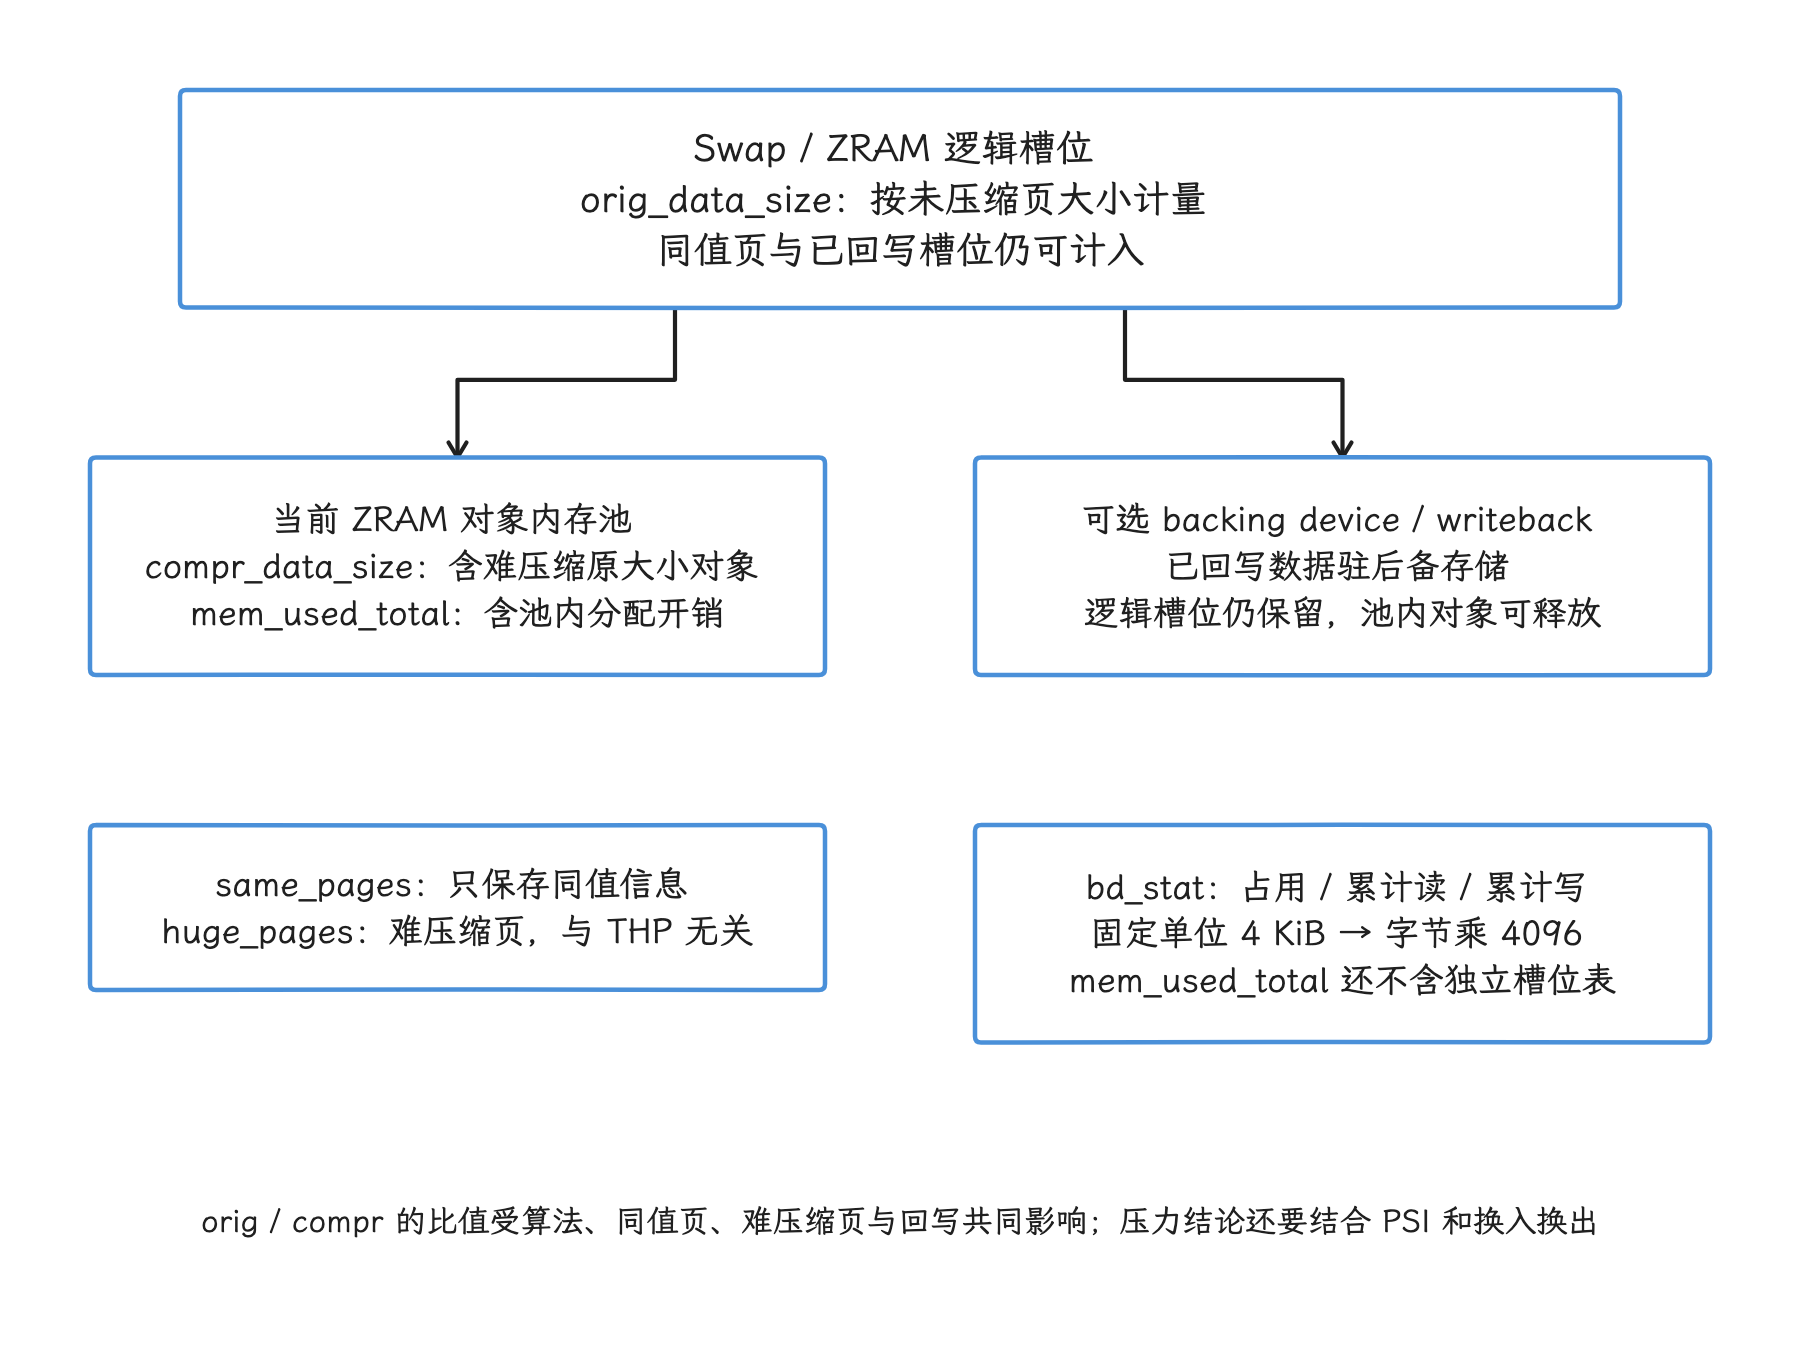
图:orig_data_size 按逻辑页大小累计;当前对象池数据用 compr_data_size 表示,池实际 RAM 用 mem_used_total 表示且不含全部驱动元数据。同值页可只存填充值,难压缩页可按原大小存放,可选回写又把对象移到 backing device;这些都会改变容量比。bd_stat 固定以 4 KiB 计数,不能改乘 16 KiB 基础页。
用 Perfetto 把“数值”变成“时间线”
进程与系统统计来自不同数据源
Perfetto 的相关数据源职责如下:
linux.process_stats:轮询/proc/<pid>/status等文件,记录 RSS 分项、交换空间、oom_score_adj等进程计数;linux.sys_stats:轮询/proc/meminfo、/proc/vmstat与/proc/pressure/*;android.java_hprof:抓取 ART 托管堆图;android.java_hprof.oom:等待 OOME 触发的托管堆采集;android.heapprofd:采样原生堆分配调用栈;linux.ftrace:通过 Linux 内核跟踪机制 ftrace 记录调度、回收、OOM、LMK 等所选内核与 Android 事件。
linux.process_stats 默认只带 status 一类的 RSS 计数;配上 scan_smaps_rollup: true 之后,它就可以采样 smaps_rollup,而分析 Android 系统守护进程通常需要 root(超级用户) 权限,并受 ptrace 与 procfs 权限限制。观察 PSS 趋势时,先确认跟踪配置和设备权限,再判断每条“进程内存”轨道统计的到底是什么。
下面给出一个低频观察系统与进程内存趋势的最小配置。它适合先定位增长窗口,随后再按分类启用堆分析器。
buffers {
  size_kb: 32768
  fill_policy: RING_BUFFER
}
duration_ms: 30000

data_sources {
  config {
    name: "linux.process_stats"
    process_stats_config {
      scan_all_processes_on_start: true
      proc_stats_poll_ms: 1000
    }
  }
}

data_sources {
  config {
    name: "linux.sys_stats"
    sys_stats_config {
      meminfo_period_ms: 1000
      vmstat_period_ms: 1000
      psi_period_ms: 1000
    }
  }
}
proc_stats_poll_ms 在 Perfetto 的 proto 配置中要求大于 100 ms,系统统计的各轮询周期要求大于 10 ms;高频采样会增加开销。示例使用 1 秒周期,适合观察秒级趋势;几毫秒的分配尖峰,它解释不了。
一条可复用的排查顺序
面对“内存不断上涨”或“进程突然消失”,我们可以按下面的顺序取证:
- 记录构建、页大小、MTE 模式、设备总内存、ZRAM 配置和复现步骤。
- 用
ApplicationExitInfo、日志与 tombstone 区分 ART OOME、原生崩溃、lmkd、MemoryLimiter 或主动退出。 - 用
/proc/meminfo、PSI 和 Perfetto 判断系统是否有持续压力。 - 用
dumpsys meminfo与smaps找出Java、Native、Code、Stack、Graphics、共享页或交换空间中的主要变化。 - 根据分类选择 Java HPROF、
heapprofd、图形/DMA-BUF 工具,或线程与映射分析。 - 回到稳定业务状态,重复多轮并比较保留量,验证修复前后的差异。
按这套顺序走,系统杀进程问题上只抓 Java HPROF、把共享页重新分摊造成的 PSS 上升误判为对象泄漏,这两类弯路都能避开。
APM OOM 黑匣子只能作为退出复盘线索
第三方 APM 的 OOM 黑匣子报告不要和 Android 平台退出原因混同。所选材料中的 Tencent OOMDetector 是 iOS 工具:运行时用 <uuid>.oom 记录前后台状态、已知崩溃、主动退出、卡死、系统版本和应用版本等字段,另用 <uuid>.mmap 按调用栈 digest 汇总超过阈值的 malloc 分配;下次启动时,再通过 UUID、app.images 与聚合堆栈合并成报告。 [来源: 技术文章/source/juejin-android/2026-09-06-76815905-APM-OOMDetector-腾讯Mars-OOM-黑匣子实现原理与落盘结构.md]
这类报告回答的是“上次退出前记录到了什么状态、哪些分配路径仍有大额聚合占用”;它离“Android 系统杀进程的直接证明”还差一步,“仍未释放的聚合分配”也还要再验证才能写成内存泄漏结论。 [来源: 技术文章/source/juejin-android/2026-09-06-76815905-APM-OOMDetector-腾讯Mars-OOM-黑匣子实现原理与落盘结构.md]
复盘进程突然消失时,仍先用 ApplicationExitInfo、系统日志、tombstone、lmkd/MemoryLimiter 记录和 PSI 时间线区分 ART OOME、原生崩溃、lmkd、MemoryLimiter 或主动退出。 [已验证: 本章“系统内存压力、控制组与进程退出”与“用 Perfetto 把‘数值’变成‘时间线’”段落,AOSP android-17.0.0_r1]
如果 Android APM 也采用类似“运行时持续记录、下次启动合并”的黑匣子设计,报告字段应作为辅助上下文接入取证链:
- 时间戳、前后台状态和业务页面:用于对齐 Perfetto/日志;
- 聚合调用栈:用于选择 Java HPROF、
heapprofd、smaps或 DMA-BUF 工具; - 符号化前的镜像地址:只能说明原始地址落在哪个模块,仍需匹配对应构建产物才能回到代码位置。 [来源: 技术文章/source/juejin-android/2026-09-06-76815905-APM-OOMDetector-腾讯Mars-OOM-黑匣子实现原理与落盘结构.md] [已验证: 本章“详细表格用于解释‘增长来自哪里’”与“一条可复用的排查顺序”段落]
MTE 与内存数据的比较条件
Arm MTE(Memory Tagging Extension,内存标签扩展)通过分配标签和指针标签检测 use-after-free、缓冲区溢出(buffer overflow)等错误。Android 应用可按设备能力与配置使用同步或异步模式。MTE 的成本来自标签存储、分配器与检查,具体多少取决于硬件、模式、分配模式和工作负载;AOSP 文档没有给出适用于所有设备的固定 RAM 百分比,我们自己测量时要把这些变量记录下来。
比较两个版本的内存数据时,我们把这几项记下来:
- MTE 是否启用以及使用哪种模式;
- 系统页大小是 4 KiB 还是 16 KiB;
- 应用二进制接口(ABI)、编译选项、调试工具与符号化配置;
- 业务数据量、页面层级、图片规格和前后台状态。
这些配置变化都会影响内存分类与采样开销,没有控制变量的 PSS 对比很难支持因果判断。
常见判断的校正
“Java 堆没满,所以不会 OOM”
进程还包括原生内存、线程栈、代码映射、图形内存与共享内存。ART 自身也可能因连续空间、堆增长策略或分配请求满足不了而抛出 OOME。应先看异常栈与退出原因,再看相应内存域。
“RSS 就是应用独占的 RAM”
RSS 会在每个进程重复计算共享驻留页。比较多个进程的归因时使用 PSS;调查单个进程当前的驻留映射规模时,RSS 仍然有用;逐页访问或访问频率,它答不上来。
“PSS 上升一定是泄漏”
共享者变化、预热、JIT、图片缓存、页面回收与交换活动都可能改变 PSS。泄漏需要稳定场景下的持续保留量和引用关系。
“代码和资源不会影响运行时内存”
APK、DEX/OAT/VDEX、.so、字体和资源会形成文件映射,代码执行与重定位还会产生私有页。精简依赖、使用 R8 做代码压缩与优化,以及按需加载,都可能同时影响安装体积、启动 I/O 与运行时内存。
低内存终端上的 U 盘升级列表是一个具体例子:所选 Android 11 / RK / 2GB 设备案例中,升级页只保存 APK 路径、大小和修改时间,不在列表阶段解析 APK 内容或读取图标;作者把 PackageManager.getPackageArchiveInfo() 解析大 APK 的代价算作可以避免的瞬时成本。 [来源: 技术文章/source/juejin-android/2026-09-15-76852071-Android 系统级设备应用踩坑实录:sharedUserId 签名.md]
这个案例也只说明该设备上的瞬时成本,外推成所有设备的固定节省量就过头了。排查类似列表页时,我们把 APK/资源读取、图标解码和列表对象分配分别放回 Java Heap、Native Heap、Code/File mmap 与 Graphics 等分类观察,再用 dumpsys meminfo、smaps 或 Perfetto 对齐列表刷新前后的变化。 [来源: 技术文章/source/juejin-android/2026-09-15-76852071-Android 系统级设备应用踩坑实录:sharedUserId 签名.md] [已验证: 本章 dumpsys meminfo、smaps 与 Perfetto 取证口径]
“ZRAM 越高,系统越危险”
ZRAM 本身是匿名页回收策略的一部分,风险主要来自持续换入换出、回收停顿、压缩 CPU 成本和前台延迟,要结合 PSI 与时间线判断。
“16 KiB 页或 MTE 会固定增加某个百分比”
两者的开销都受设备、构建和负载影响。引用固定比例前必须有同设备、同场景、同配置的测量数据。
进程内存域的源码与文档锚点
- AOSP Android 17
Debug.MemoryInfo - AOSP Android 17
ActivityManagerShellCommand - AOSP Android 17
MemoryLimiter.java - AOSP Android 17
MemoryLimiter.cpp - Android 17:所有应用的行为变更
- Android Memory Limiter 官方文档
- Android PMGD 官方文档
- 解读 Android 17 全新内存限制,有没有“豁免”后门?
- 解读 Android 17 全新内存限制,有没有“豁免”后门?(2026-10-09 抓取)
- Android 应用内存管理
- Android 图形内存管理
- 支持 16 KiB 页大小
- Arm MTE 开发指南
- Linux 6.18 cgroup v2 文档
- Linux 6.18 procfs 统计口径
- Linux 6.18 tmpfs 与 Swap 条件
- Android 17 kernel
/proc/meminfo实现 - Linux 6.18 ZRAM 文档
- Android 17 kernel ZRAM 统计与回写实现
- Perfetto
ProcessStatsConfig - Perfetto
SysStatsConfig - Perfetto
JavaHprofConfig - APK mmap 内存增长定位:pagemap 与 DEX 结构联合定位方法
- Android 17 kernel
pagemap接口文档 - Android 17 kernel soft-dirty 文档
- Android 17 kernel
fs/proc/task_mmu.c - AOSP DEX 文件格式
- AOSP Android 17
ProfilingManager - Android
ProfilingTriggerAPI 参考 - Android
ComponentCallbacks2API 参考 - Android R8 优化配置
从指标进入根因的判断顺序
Android 内存分析要先区分三件事:
- 地址空间、驻留页、共享归因和私有页的算法各不相同;
- Java、原生内存、代码、线程栈、图形与内核资源需要不同工具;
- 分配失败、系统压力杀进程与 Android 17 MemoryLimiter 是不同退出路径。
我们先用退出原因和系统压力确定问题类型,再用 dumpsys meminfo、procfs 与 Perfetto 找到增长分类,最后深入 Java 对象、原生调用栈或图形缓冲区;每一步得到的结论都应该能回到源码、配置和可重复实验中验证。
页分配、回收、缓存与 Swap
进程指标只回答“内存归谁”;决定延迟和失败的是内核页管理层的处理过程。缺页、页面回收、内存规整和 Swap 都会改变同一份进程内存的可用性和访问成本——同样大小的 PSS,在页缓存充足和内存压力很高的设备上,意义并不一样。这一节我们从应用可感知的现象出发,把这条内核路径走一遍。
这一层为什么会让应用卡住
应用线程执行 malloc() 时,分配器可能直接复用空闲块:r1 的 Scudo popBlocks() 先查空闲链表,再考虑补充映射。访问已驻留且权限满足的页面,同样不必重新进入内核;真正要进内核的,是新建映射、补充物理页、处理缺页或向驱动申请缓冲区这些事。 [已验证: AOSP android-17.0.0_r1 external/scudo/standalone/primary64.h popBlocks();android17-6.18-2026-06_r6 mm/memory.c]
进入页分配后,空闲页不足、zone 不满足水位或需要高阶连续页,可能使请求进入分配慢路径,其中包括页面回收、页面迁移和内存规整。访问已换出的页则走缺页与换入路径。这些工作有些交给后台内核线程,有些直接占用发起请求的应用线程;发生在关键帧或启动关键路径上时,就可能增加用户可感知的延迟。
物理页从分配到回收的主路径如下:
分配走哪条分支由上下文决定:GFP 分配标志、表示连续页数量级的 order、可用 zone、memcg,以及是否允许阻塞和 I/O。所以只凭 MemFree,我们推断不出一次分配会走到哪里。
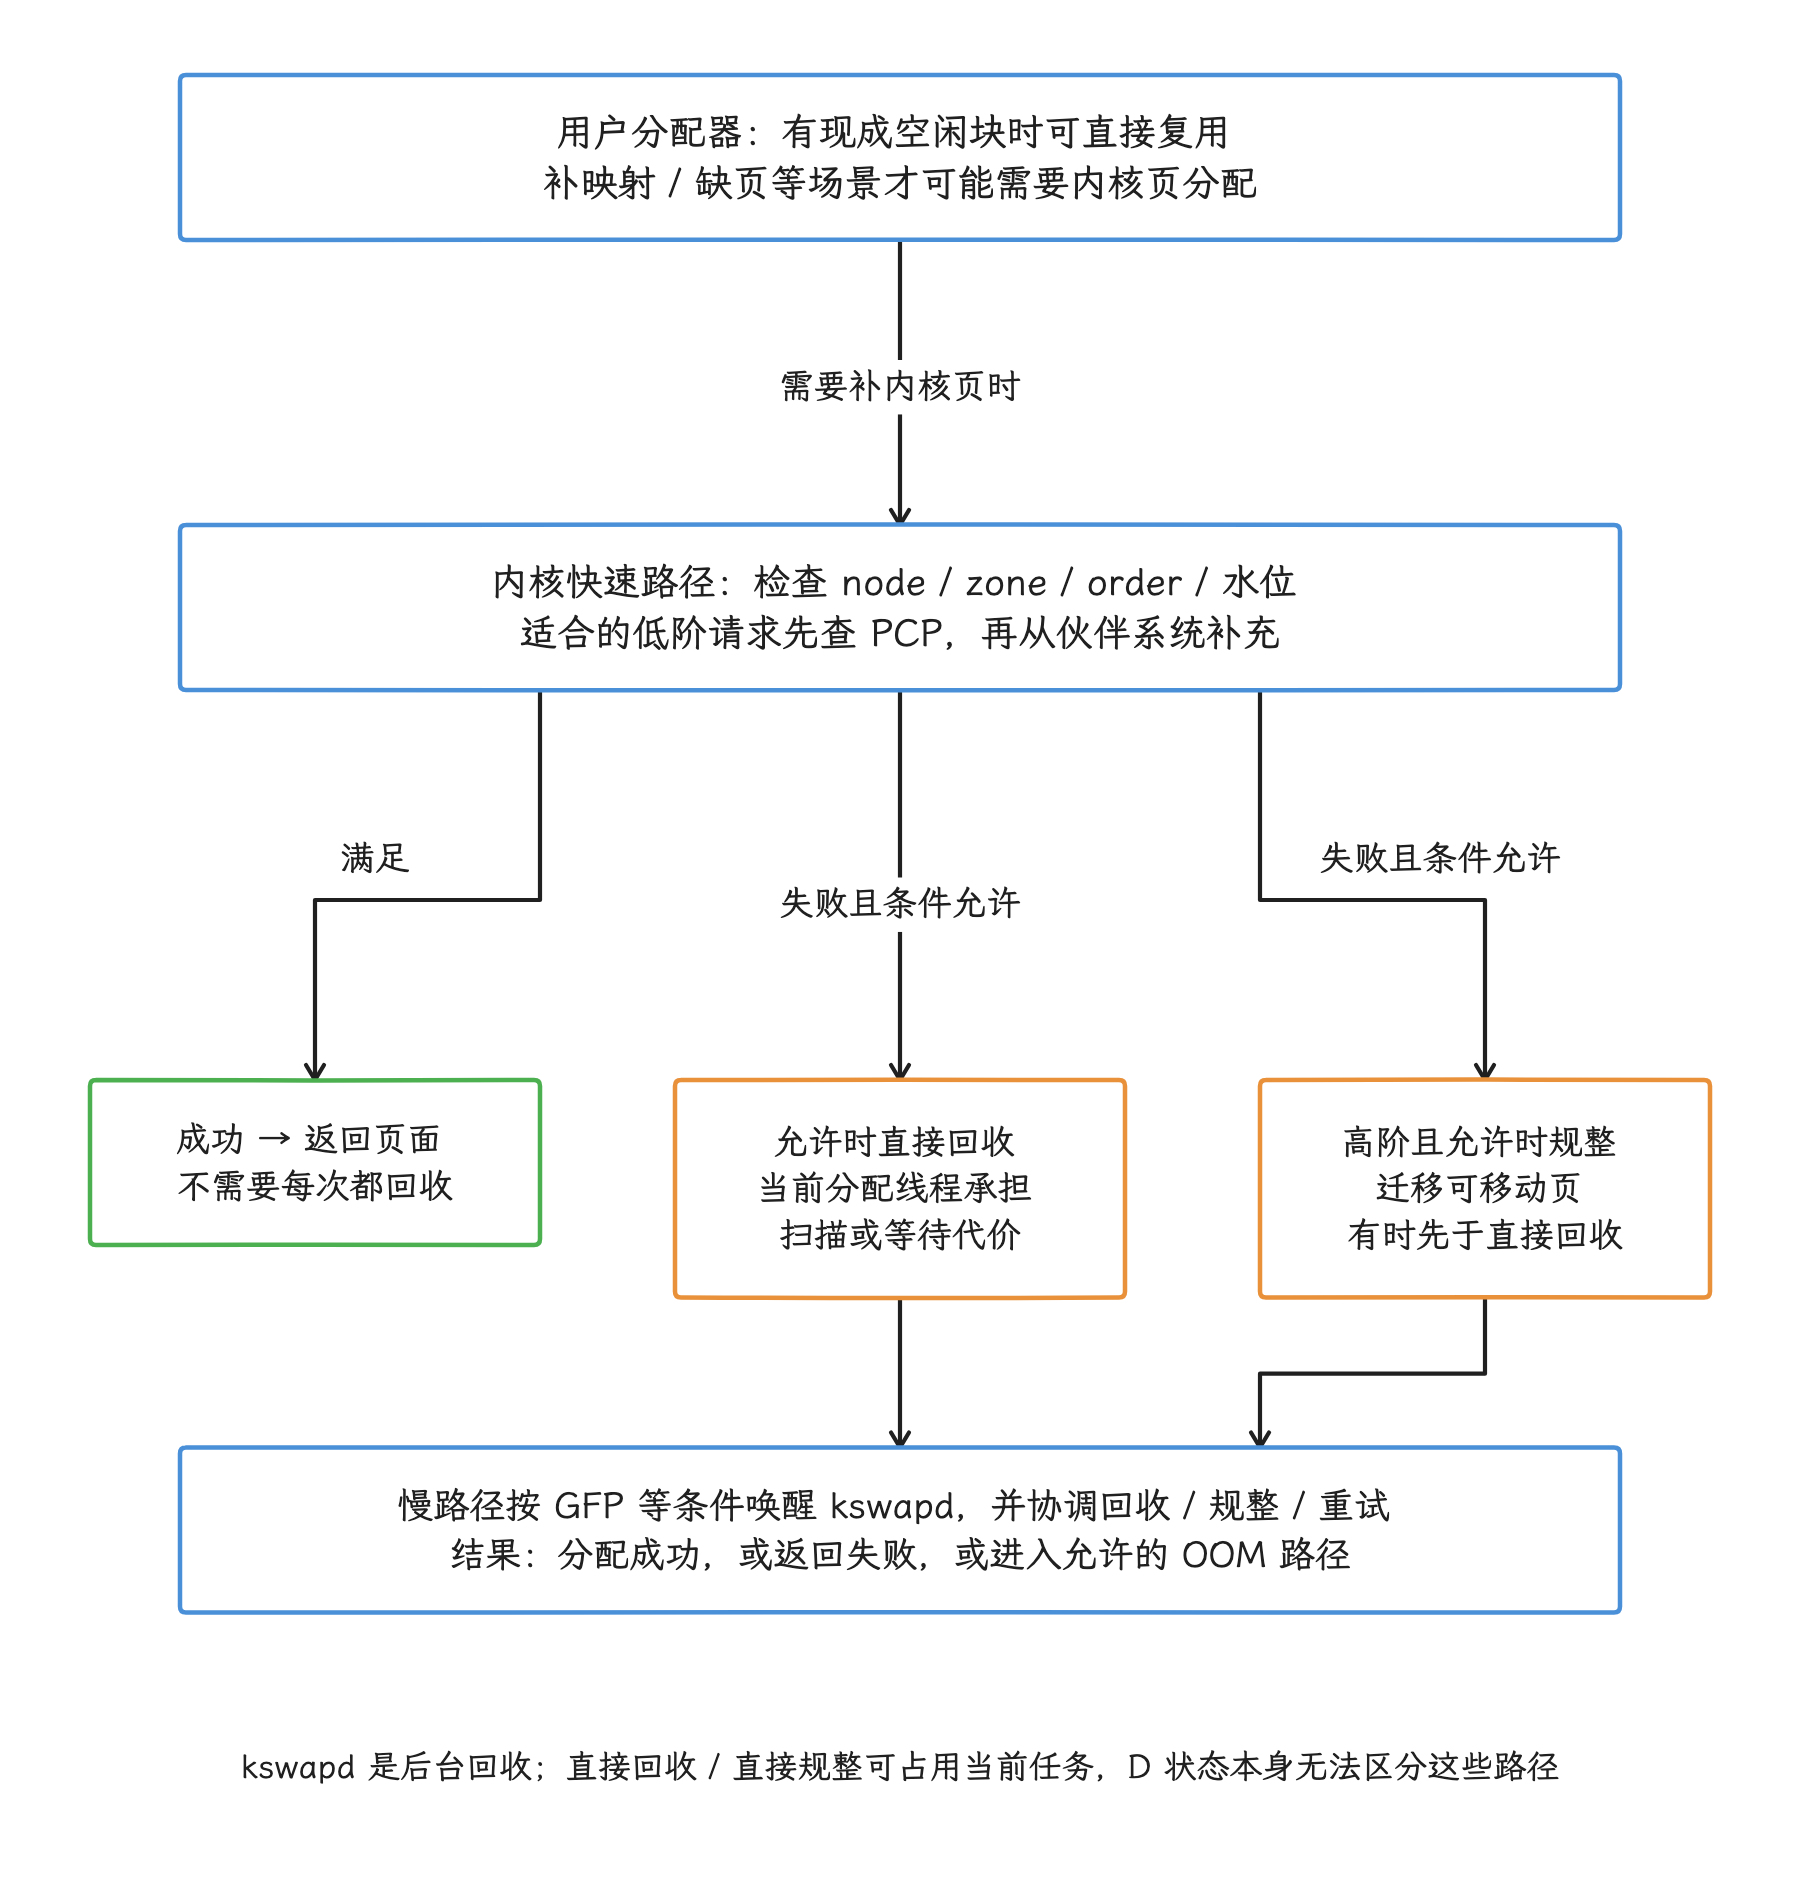
图:用户分配器先可复用已有块,补充映射或首次访问才可能需要内核工作。页分配按 node、zone、order、水位与 GFP 约束尝试快速路径;失败后按条件唤醒 kswapd、直接回收或规整并重试。高阶请求可能先规整,回收和规整也可能重复;最终可成功、失败或进入允许的 OOM 路径。
虚拟地址怎样变成物理访问
页表层级由架构配置决定
CPU 发出虚拟地址后,MMU 按页表项完成地址翻译和权限检查。Linux 用 PGD、P4D、PUD、PMD、PTE 描述从顶层页目录到末级页表项的通用结构,其中某些层级在具体架构配置中会被折叠。
ARM64 设备的页表层级要看配置:页大小、VA_BITS 和架构能力共同决定有效层级。例如内核文档给出的 4 KiB 配置可以采用三级或四级翻译表,Android 的 16 KiB 配置又有自己的层级与块大小。所以我们分析页表成本时要读运行内核的配置,不照搬某一种服务器配置。
页表项除了物理页帧号,还携带可读、可写、可执行、用户态权限,以及 accessed/young、dirty 这类访问与修改状态。内核的页面回收与 MGLRU 老化,用的就是其中一部分访问状态。
TLB 缓存地址翻译结果
逐次访问都遍历多级页表成本很高,所以 CPU 用 TLB 缓存近期的虚拟页到物理页翻译;TLB 未命中时,硬件或软件再做一次 page-table walk,逐级遍历页表。
更大的页面让同样数量的 TLB 条目覆盖更多地址空间,也减少表示同等内存所需的页表项;但收益受访问局部性、TLB 结构、CPU 缓存、页表层级和工作负载影响,换算不成固定的时钟周期或固定性能比例。
缺页异常与按需建立映射
当前页表项满足不了这次访问时,CPU 进入缺页处理。合法地址上的缺页,可能就是按需分配机制在干活:
- 首次写匿名映射:内核分配并清零物理页,再建立可写映射;
- 首次读取文件映射:页面已在页缓存(page cache)时可直接建立映射,缺失时需要读取文件;
- 写时复制(Copy-on-Write,COW):Zygote 通过
fork()创建子进程后,父子进程的私有映射可以共享物理页;写入时若原页复用不了,内核会分配并复制内容。如果匿名页已满足独占复用条件,r6 的do_wp_page()可经wp_page_reuse()恢复可写映射,无需复制页面; - 换入:匿名页已换出时,需要从 ZRAM 压缩交换设备或其他交换后端恢复;
- 权限或无效地址:修复不了时向进程发送
SIGSEGV、SIGBUS等信号。
Linux 统计把缺页分成两种:次要缺页(minor fault)通常不需要等待存储 I/O,例如零页、COW 或命中页缓存;主要缺页(major fault)表示处理被标记为 VM_FAULT_MAJOR,常见于需要等待文件或交换数据的情况。两者都可能发生在正常执行中,我们把数量放回延迟和场景里解释,才算读懂。
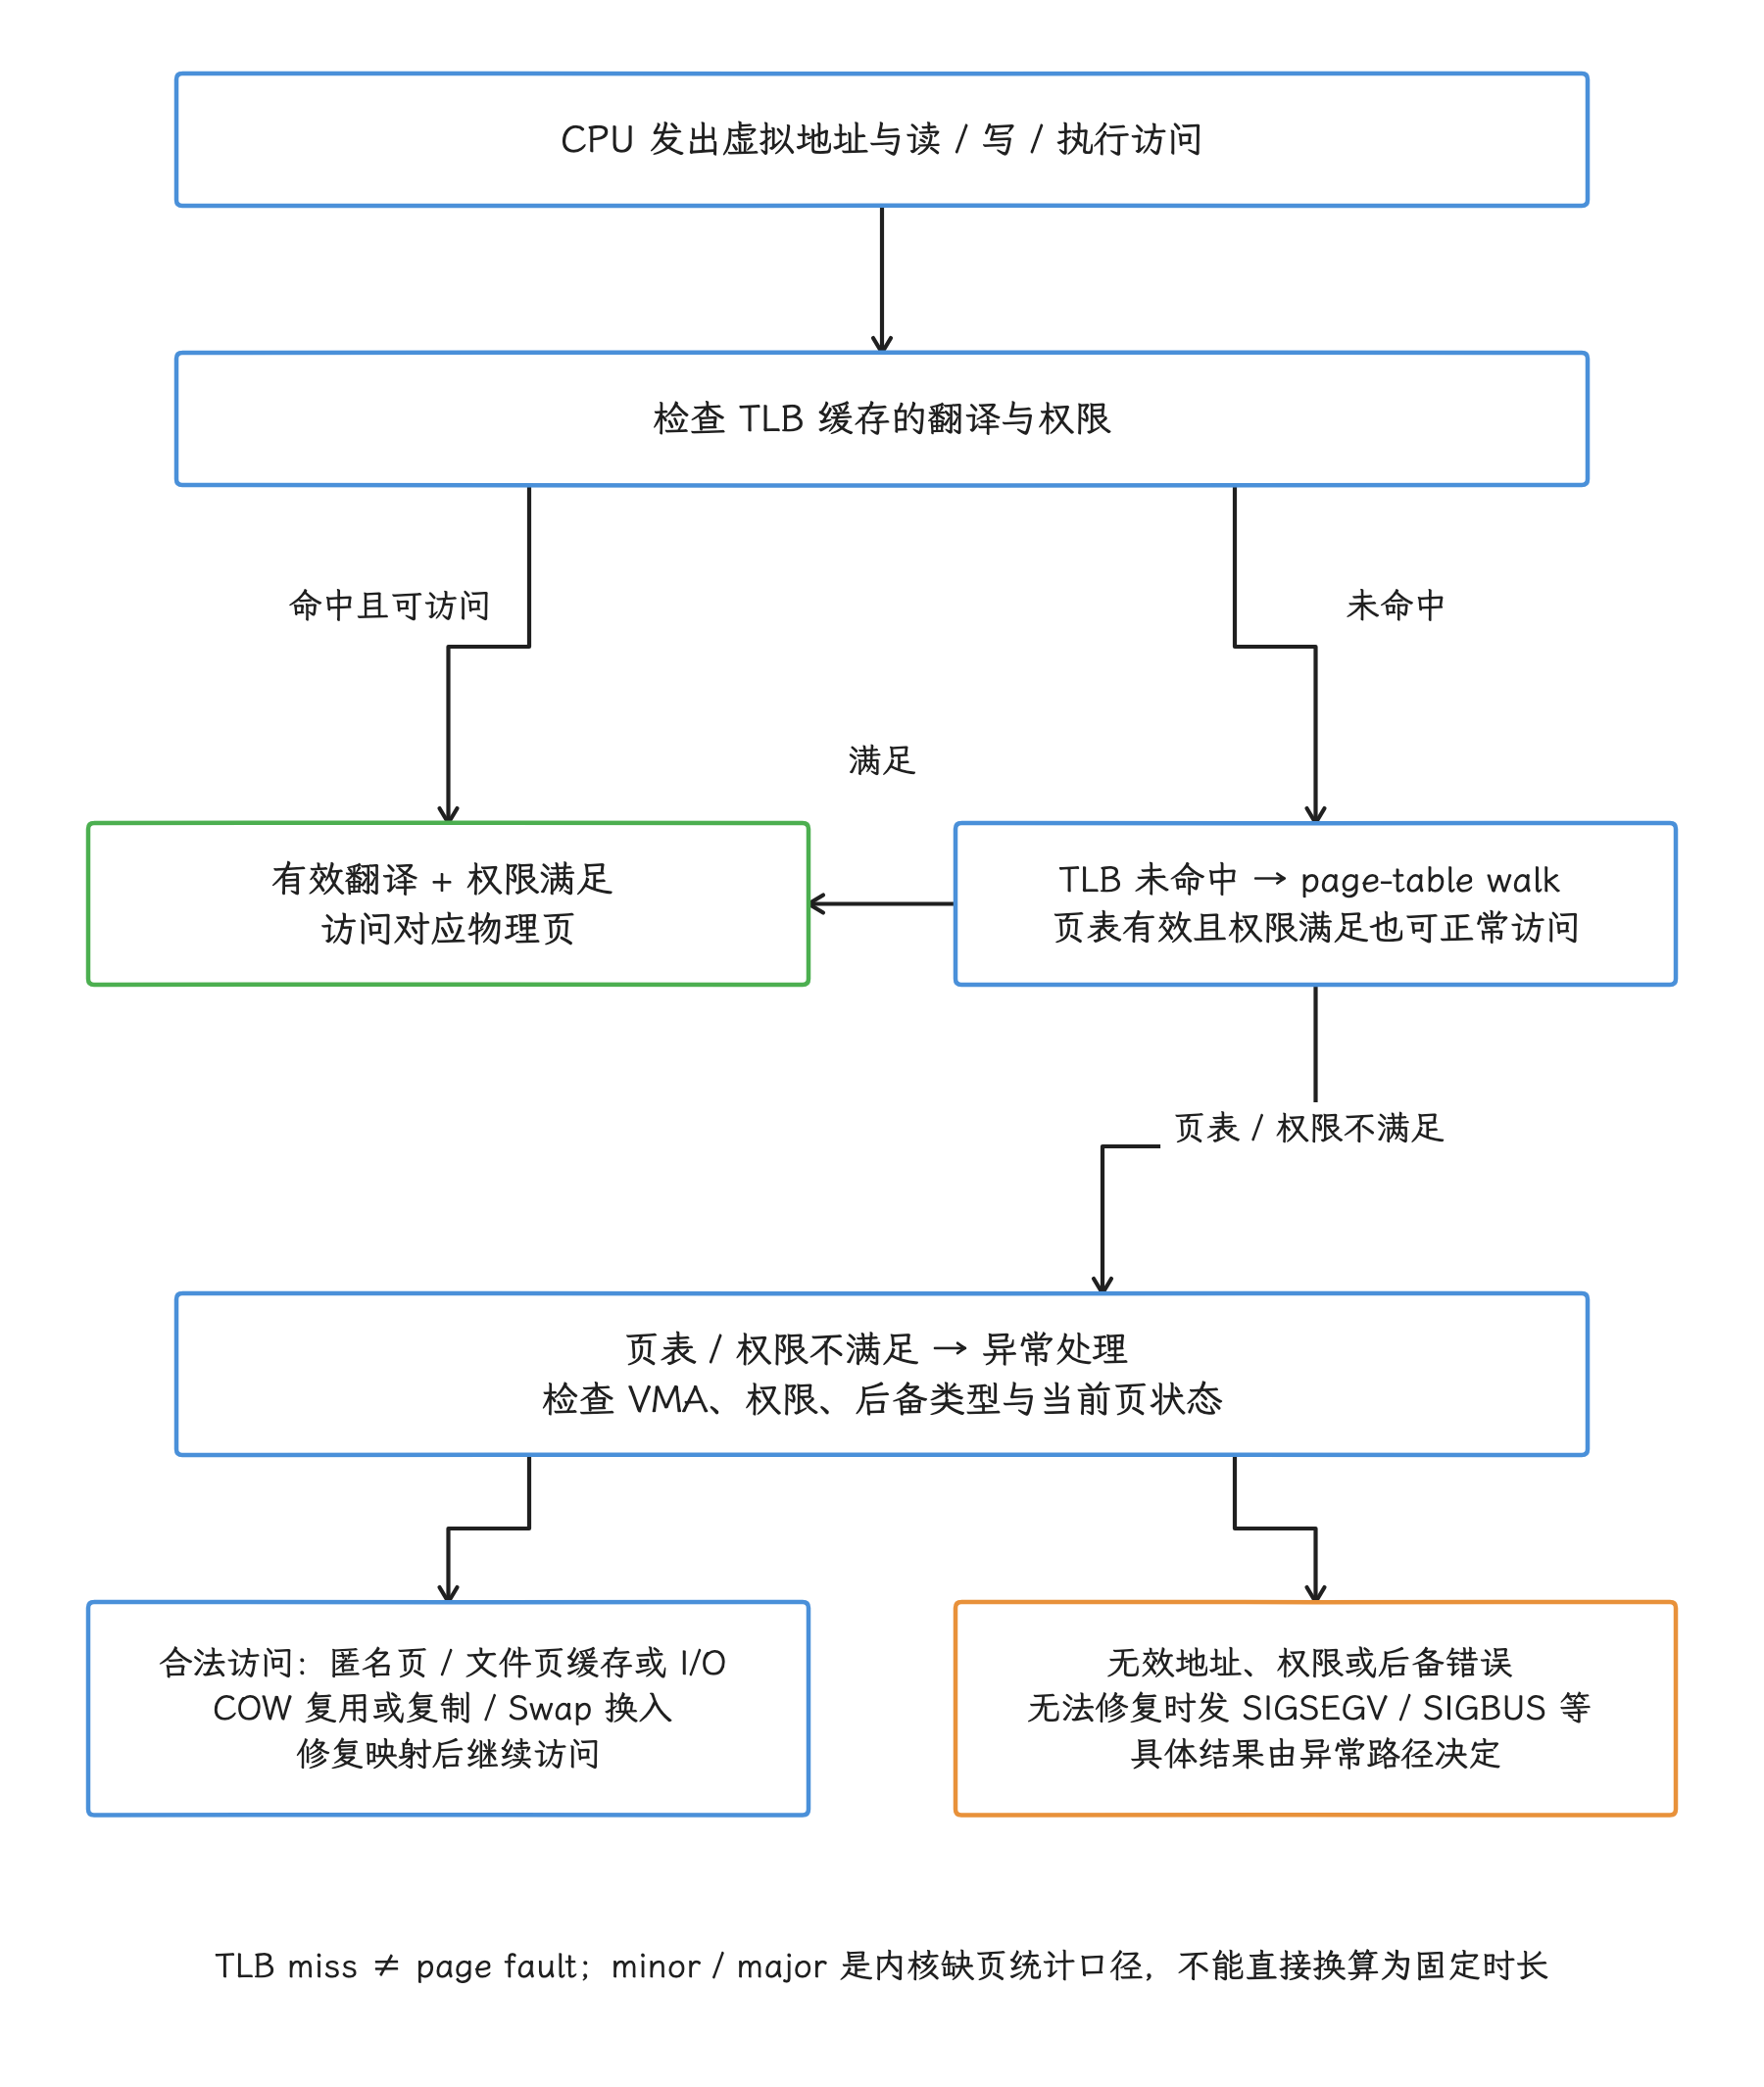
图:TLB 命中且权限满足即可完成翻译;未命中先遍历页表,页表有效时仍可直接访问。页表或权限无法满足时才进入异常处理:合法访问可能补匿名页、建立文件页映射、处理 COW 或换入;无法修复的地址或权限错误则发信号。COW 并非每次都复制,独占匿名页有条件可复用。
缺页的观察入口
想把缺页计数落到时间线上,我们有两组入口:ARM64 内核 6.18 的 arch/arm64/mm/fault.c 在合法缺页路径调用 perf_sw_event(PERF_COUNT_SW_PAGE_FAULTS, ...)。Perfetto 的 linux.perf 数据源也定义了 SW_PAGE_FAULTS、SW_PAGE_FAULTS_MIN 和 SW_PAGE_FAULTS_MAJ 软件事件。
进程累计值还可以从 /proc/<pid>/stat 的 minflt、majflt 及其子进程字段读取。下面的命令先定位 PID,再输出原始 stat;生产脚本要用可靠的解析器,进程名字段可能含空格和括号。
adb shell 'pid=$(pidof com.example.app); cat /proc/$pid/stat'
exceptions/page_fault_user、exceptions/page_fault_kernel 只有部分 ARM64 Android 内核提供。在 r6 上做通用内存跟踪,我们更常用 ftrace 里的 filemap/mm_filemap_fault、vmscan/*、kmem/* 事件,加上 perf 缺页计数;事件是否启用仍要检查 tracefs。
物理页分配:PCP、伙伴系统(Buddy)与 SLUB
从节点、内存区域到每 CPU 页集合
看完了地址翻译,我们回到物理页本身。内核先把物理内存组织成节点,再在节点内按寻址与迁移约束划分 zone;Android 手机通常按统一内存访问 UMA 的单节点模型看待,具体 SoC 仍可能有多个内存域或厂商扩展。分配请求的 GFP 标志决定可以访问的最高 zone、是否允许回收和 I/O 等条件。
常见低阶页面的分配先走每 CPU 页集合(Per-CPU Pageset,PCP)这条快速路径,省得每次分配都抢 zone 全局锁;PCP 拿不到页,再进 zone 的伙伴系统空闲区。Linux 6.18 的 physical_memory.rst 明确描述了“PCP 快速路径 → 伙伴系统”这两步。
伙伴系统与 order
伙伴系统的 order 以二次幂表示连续页数量:
order-n = 2^n × PAGE_SIZE
同一 order 在 4 KiB 和 16 KiB 内核上的字节数如下:
| order | 连续页数 | 4 KiB 基础页 | 16 KiB 基础页 |
|---|---|---|---|
| 0 | 1 | 4 KiB | 16 KiB |
| 1 | 2 | 8 KiB | 32 KiB |
| 2 | 4 | 16 KiB | 64 KiB |
| 4 | 16 | 64 KiB | 256 KiB |
| 9 | 512 | 2 MiB | 8 MiB |
| 10 | 1024 | 4 MiB | 16 MiB |
在 android17-6.18-2026-06_r6 中,未设置 CONFIG_ARCH_FORCE_MAX_ORDER 时,MAX_PAGE_ORDER 是 10,free_area 覆盖 order 0 到 10。厂商可以覆盖最大 order,所以工具应读取当前内核构建,表中最末行只是这份配置的值。
分配较小 order 时,如果对应的 free list 为空,伙伴系统可以拆分更大的内存块;释放时,地址与 order 匹配的空闲伙伴可以逐级合并。页面块还带迁移类型:Unmovable、Movable、Reclaimable 和 CMA(连续内存分配器),把不同生命周期的页面分开存放,外部碎片(extfrag)就少一些。
这里还要区分两种浪费:
- 内部碎片:获得的块大于请求,例如高阶页或对齐造成的未用空间;
- 外部碎片:空闲页总数够用,却分散到满足不了目标 order。
SLUB 服务小型内核对象
伙伴系统按页分配内存,SLUB 在这些页面上组织对象缓存,再复用相同布局的对象。task_struct、dentry 等内核对象使用各自的专用 slab 缓存,通用小块请求走 kmalloc 缓存;两类入口要分开看,对象大小也不保证小于一个基础页。folio 表示内核作为整体管理的一个或多个页面;slab 可以占用一个或多个页面。 [已验证: android17-6.18-2026-06_r6 kernel/fork.c alloc_task_struct_node()、fs/dcache.c __d_alloc();mm/slub.c kmalloc_slab()]
Linux 6.18 的内核配置文件 mm/Kconfig 将 CONFIG_SLUB 定义为默认启用;旧的 SLAB、SLOB 是历史背景,Android 17 里并列运行三种实现的说法不成立。arm64 GKI 还启用了空闲链表随机化与安全加固,并默认关闭 slab 缓存合并。
kmalloc() 对常见小分配使用 kmalloc slab 缓存;较大请求可能直接需要高阶页。返回区域在内核虚拟地址上连续,通常也满足其接口承诺的物理连续性。vmalloc() 则把离散物理页映射成连续的内核虚拟区,适合不要求物理连续的大区域,代价包括页表管理和 TLB 压力。
三个原始诊断入口
排查时我们有三个原始入口,下面的命令分别观察各 order 的空闲块、迁移类型与 slab 缓存。量产设备可能限制其中部分节点。
adb shell cat /proc/buddyinfo
adb shell cat /proc/pagetypeinfo
adb shell cat /proc/slabinfo
buddyinfo 的每一列是对应 order 的空闲块数量,换算字节乘以 2^order × PAGE_SIZE。读它时要防两个误判:低 order 空闲块多,推不出高阶请求一定成功;高 order 长期接近零,也要结合目标分配 order、CMA 和内存规整结果再下判断。
slabinfo 适合定位内核对象缓存增长。/proc/meminfo 中的 Slab、SReclaimable 和 SUnreclaim 提供系统汇总,但不会直接指出哪个缓存或驱动持有对象。
页面回收:文件页、匿名页与工作集
两类页的回收成本不同
分配在快速路径拿不到页时走慢路径,回收是慢路径上的工作之一。普通磁盘文件的干净页可以从页缓存丢弃,下次访问再读文件;仍需保留的脏文件页则要先写回,或交给相应文件系统处理。
匿名页装的是堆、栈和匿名映射的数据,背后没有可重新读取的普通文件;内核只有在存在可用交换空间或内存分层目标时,才能在保留内容的前提下回收它的物理页。Android 常用 ZRAM 充当这个交换空间,厂商也可以配置 ZRAM 回写;没有可用交换空间时,匿名页能腾挪的余地就小得多。
tmpfs/shmem 虽然计入 Cached 和 cgroup memory.stat 的 file,保留内容时却不能像磁盘文件的干净页那样丢弃后重读。它们可以使用 Swap 释放驻留页,但要有可用交换空间且相关配置允许;tmpfs 挂载为 noswap 时不能走这条路径。判断缓存能否回收,应先核对页面后备类型,再看 Shmem、对应映射和 cgroup 的 Swap 用量。 [已验证: android17-6.18-2026-06_r6 Documentation/filesystems/tmpfs.rst 的 Swap 与 noswap 说明;Documentation/filesystems/proc.rst;Documentation/admin-guide/cgroup-v2.rst]
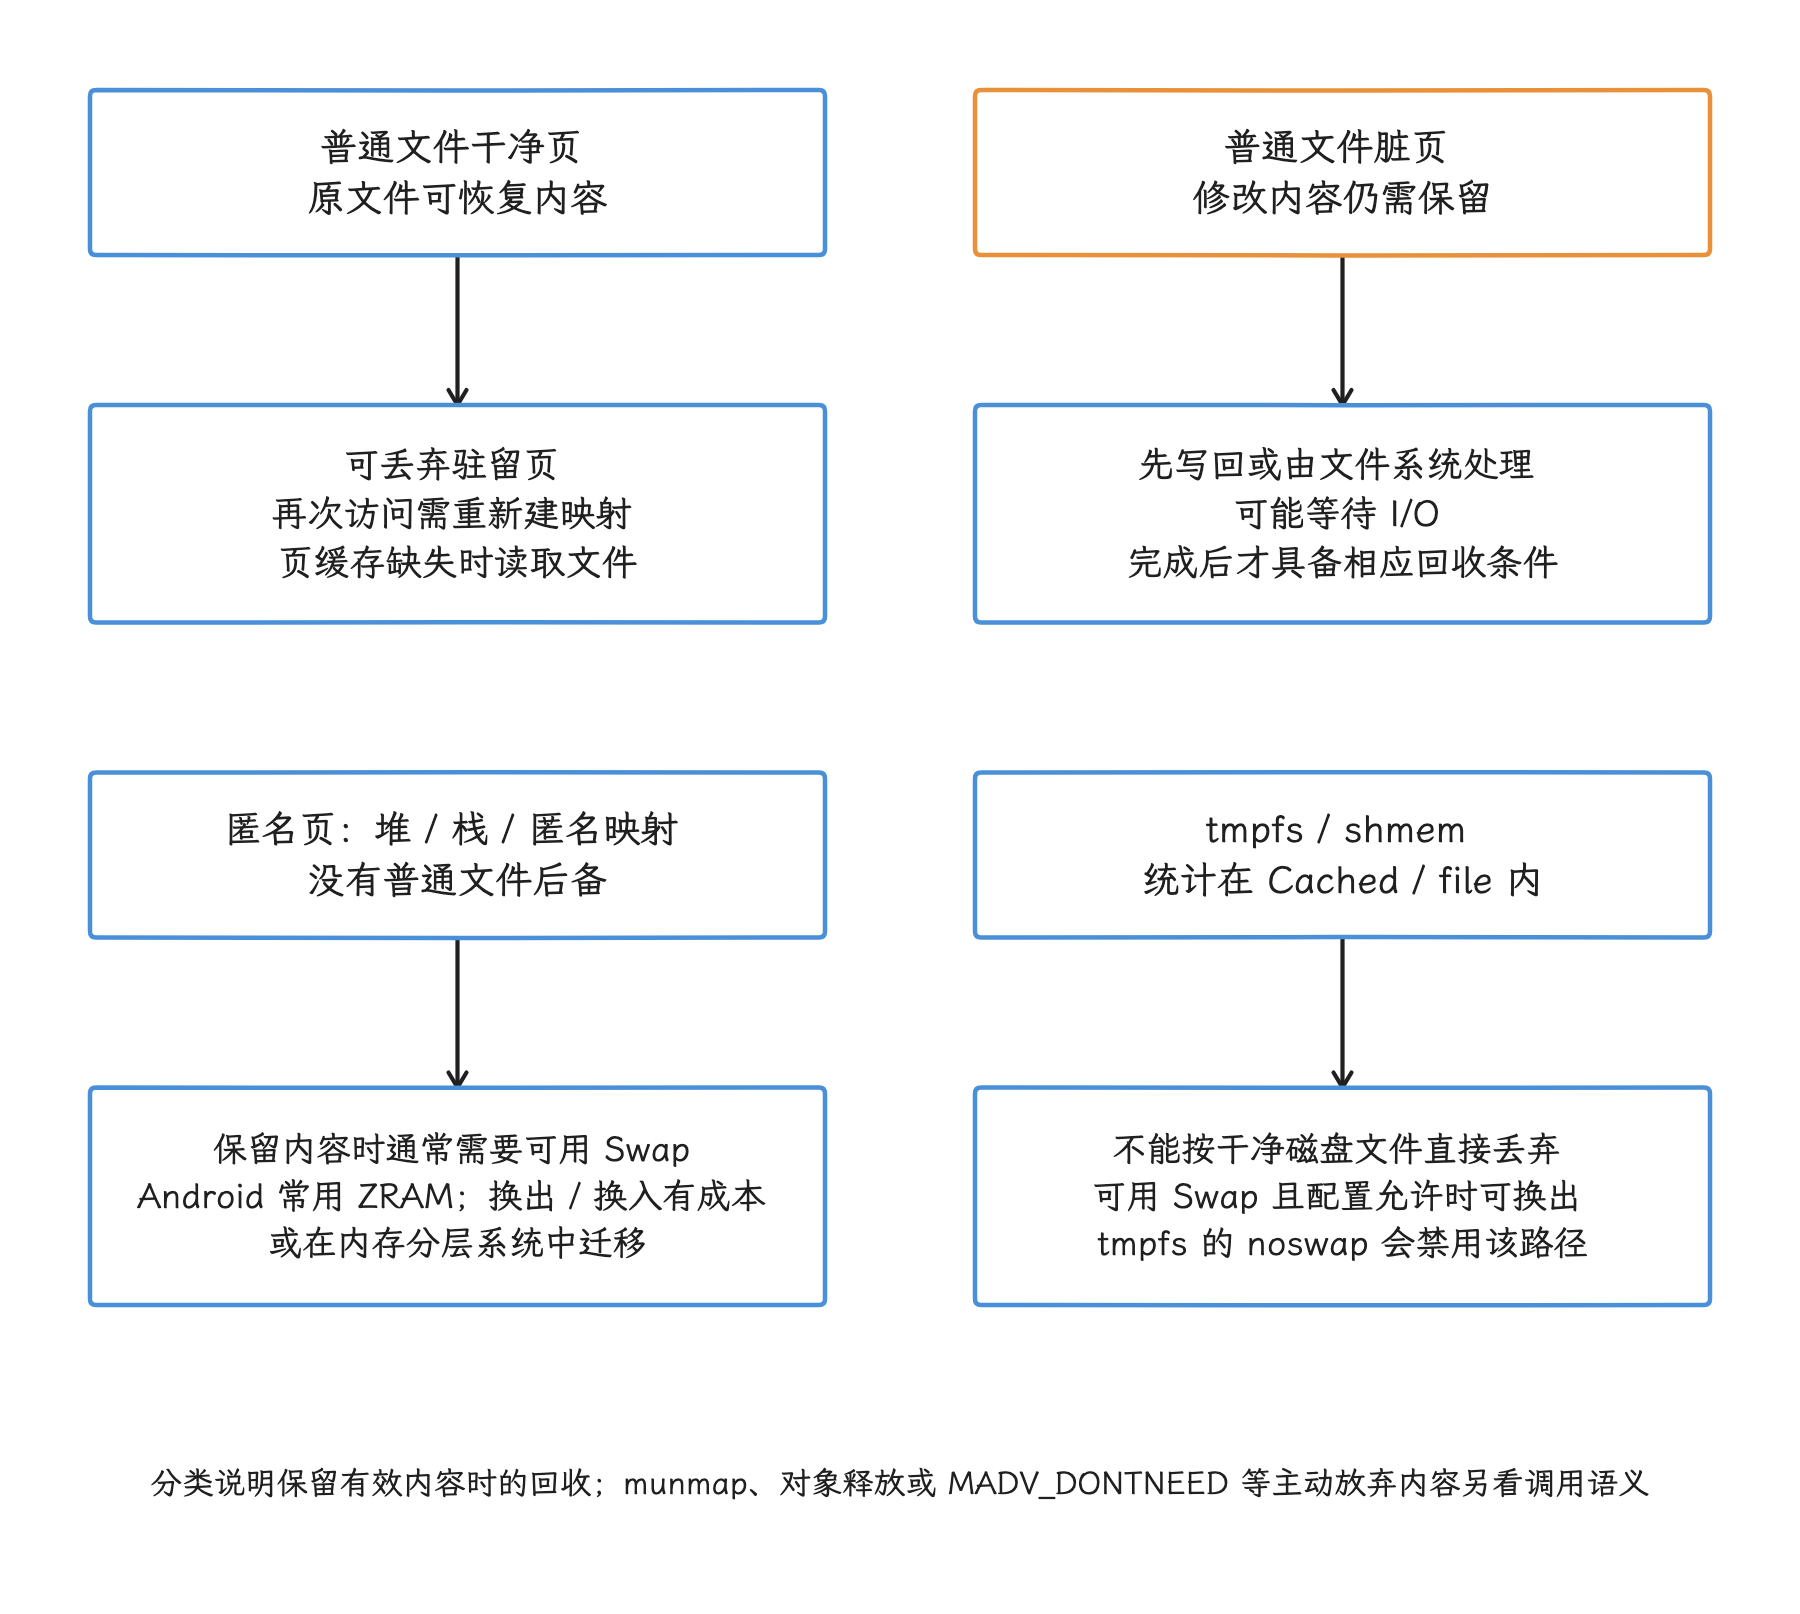
图:普通文件的干净页可丢弃后重读;需要保留内容的脏文件页先写回或交给文件系统处理。匿名页没有普通文件后备,保留内容时通常依赖可用 Swap,或迁移到其他内存层。tmpfs/shmem 虽计入 Cached/file,也不能按干净磁盘文件直接丢弃;可换出性仍受配置和 noswap 限制。
回收的目标是腾出可分配页,同时尽量保留近期工作集。代价可能来自:
- 扫描大量页却回收很少;
- 文件页被回收后再次访问(refault),触发存储读取;
- 匿名页在 RAM 与 ZRAM 之间频繁换入换出;
- 压缩与解压消耗 CPU;
- 脏页写回占用 I/O;
- 应用线程自己进入直接回收。
zone 水位与 kswapd
每个 zone 维护 min、low、high 等水位。Linux 6.18 的物理内存文档给出的主语义是:
- 空闲页低于 low 时,分配路径会唤醒该 node 的
kswapd; kswapd在后台回收,zone 回到 high 以上时通常视为平衡;- 空闲页低于 min 时,允许阻塞的分配可能进入直接回收或直接规整;
- 水位提升(watermark boost)、order、zone、保留页和 GFP 标志会改变单次判断。
“低于 min 一定进入直接回收”说得过满:原子分配、禁止 I/O 的请求、memcg 限制、高阶请求和保留页访问各有各的路径。
直接回收的执行位置
r6 的 __alloc_pages_slowpath() 先按条件唤醒 kswapd;高阶请求可能先尝试直接规整(direct compaction);允许 __GFP_DIRECT_RECLAIM 时,再调用 __alloc_pages_direct_reclaim(),随后重试分配和内存规整。
直接回收的代价落在发起请求的线程上:它可能在 CPU 上执行扫描,也可能在等写回、锁或其他资源。所以线程停在 D(不可中断睡眠)状态说明不了太多,更可靠的判据是调用栈、PSI 中的内存停顿,以及下面这些 ftrace 内核跟踪事件:
vmscan/mm_vmscan_direct_reclaim_beginvmscan/mm_vmscan_direct_reclaim_endvmscan/mm_vmscan_kswapd_wakevmscan/mm_vmscan_kswapd_sleepvmscan/mm_vmscan_lru_shrink_inactivevmscan/mm_vmscan_lru_shrink_active
/proc/vmstat 中的 pgscan_*、pgsteal_*、allocstall_*、pswpin、pswpout 还能补充累计数据。字段会随内核版本变化,分析器应按字段名读取。
MGLRU 的默认启用状态
多代最近最少使用算法(Multi-Gen Least Recently Used,MGLRU)用多代模型记录页面访问的新旧程度:老化阶段依据页表访问位等信息推进代际(generation),驱逐阶段从较老代际里挑页面;匿名页与文件页还会根据页面被回收后再次访问的反馈,调整保护与回收选择。
android17-6.18-2026-06_r6 的 arm64 GKI defconfig 默认设置了:
CONFIG_LRU_GEN=yCONFIG_LRU_GEN_ENABLED=y
这表示该 GKI 配置编译并默认启用 MGLRU。设备仍可能使用不同内核、不同配置或运行时开关。下面的命令读取稳定的运行时位掩码:
adb shell cat /sys/kernel/mm/lru_gen/enabled
主开关对应 0x0001 这一位。其他位控制批量清理叶子或非叶子页表的访问位,硬件不支持的组件即使写入也不会生效。
代际直方图也不在 /sys/kernel/mm/lru_gen/lru_gen,内核文档把实验接口放在 debugfs:
/sys/kernel/debug/lru_gen/sys/kernel/debug/lru_gen_full
lru_gen_full 提供额外调试统计;CONFIG_LRU_GEN_STATS=y 控制是否保留已驱逐代际的历史统计,不是这个节点存在的前提。r6 的 init_lru_gen() 在 MGLRU 编译路径中同时注册这两个 debugfs 文件。debugfs 通常不向量产应用开放。 [已验证: android17-6.18-2026-06_r6 Documentation/admin-guide/mm/multigen_lru.rst Experimental features;mm/vmscan.c init_lru_gen()]
普通 LRU 与 MGLRU 都在 LRU 列表容器 lruvec 的 lru_lock 下完成部分列表操作,并把开销较高的 shrink_folio_list() 放到锁外;r6 的 shrink_inactive_list() 和 evict_folios() 都能看到这种结构。所以“普通 LRU 全程持锁、MGLRU 把持锁复杂度从 O(n) 做到 O(1)”这组对比不成立,评价 MGLRU 还是看代际老化、页表扫描、页面再次访问反馈和具体设备指标。
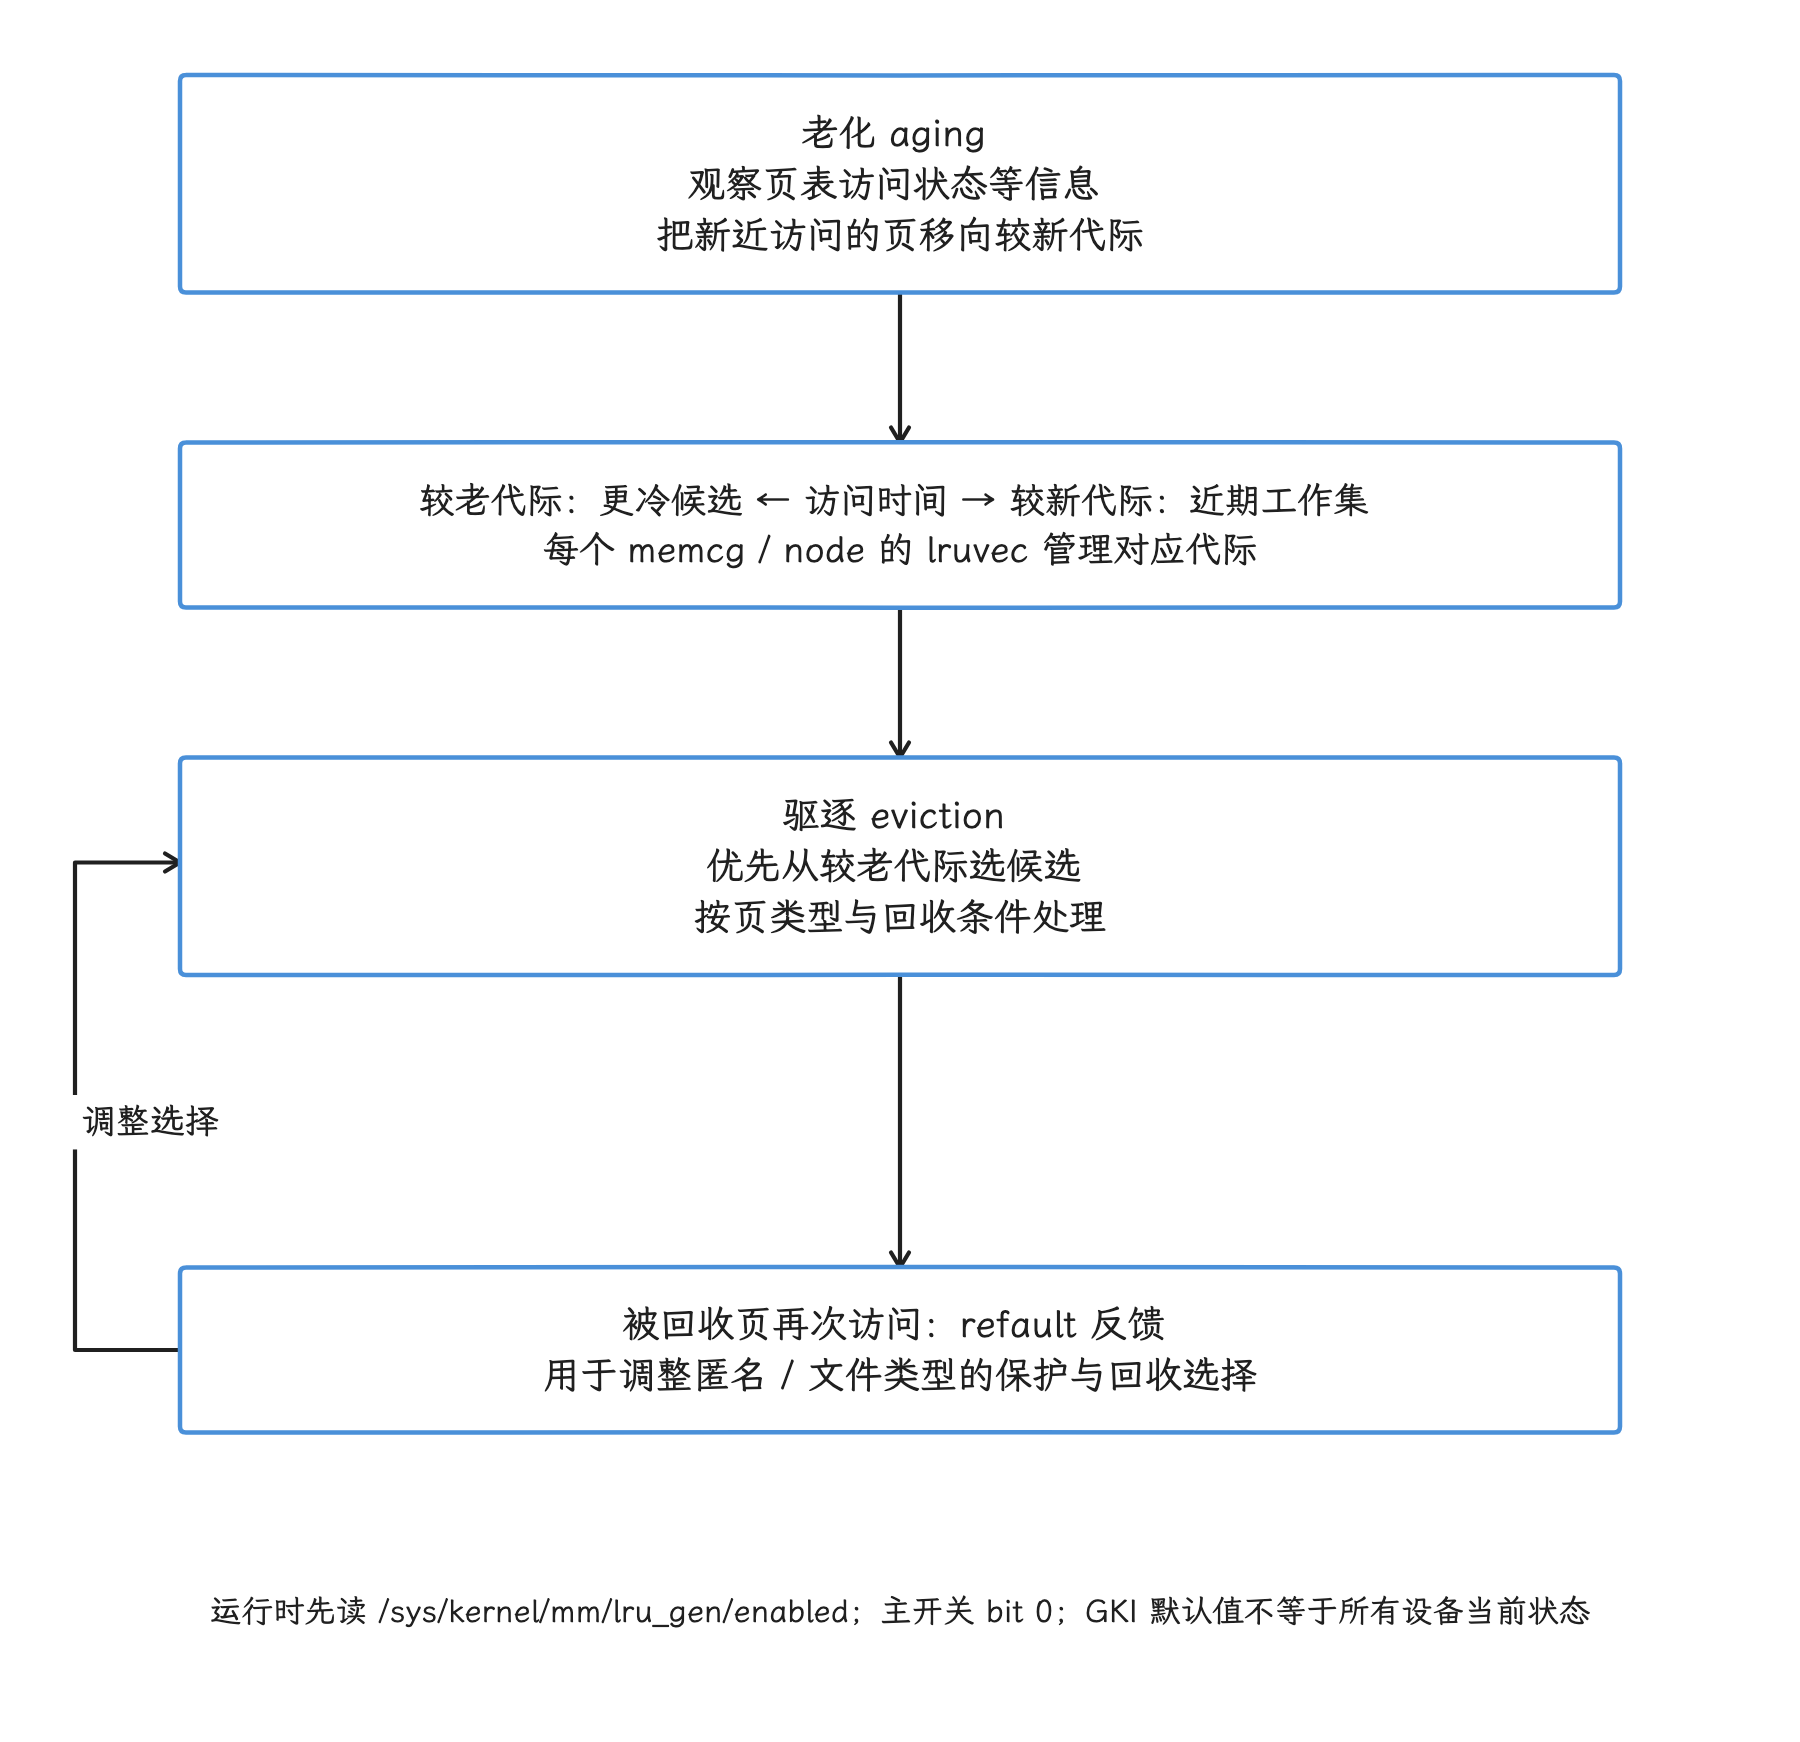
图:老化阶段依据页表访问状态等推进代际,驱逐从较老代际挑选候选;页面后来再次访问形成 refault 反馈,帮助调整匿名页与文件页的保护和回收选择。代际只是热度估计,实际回收仍受页类型、Swap、保护与权限限制,收益要用扫描效率、PSI、缺页和前台延迟验证。
内存规整与物理碎片
内存规整与连续空闲块
回收腾出的是零散页,规整要的是连续块:内存规整(memory compaction)从一端扫描可迁移页,从另一端找空闲页,把内容迁移过去,腾出更大的连续空闲范围。它做的是搬页,数据压缩是 ZRAM 那条路上的事。
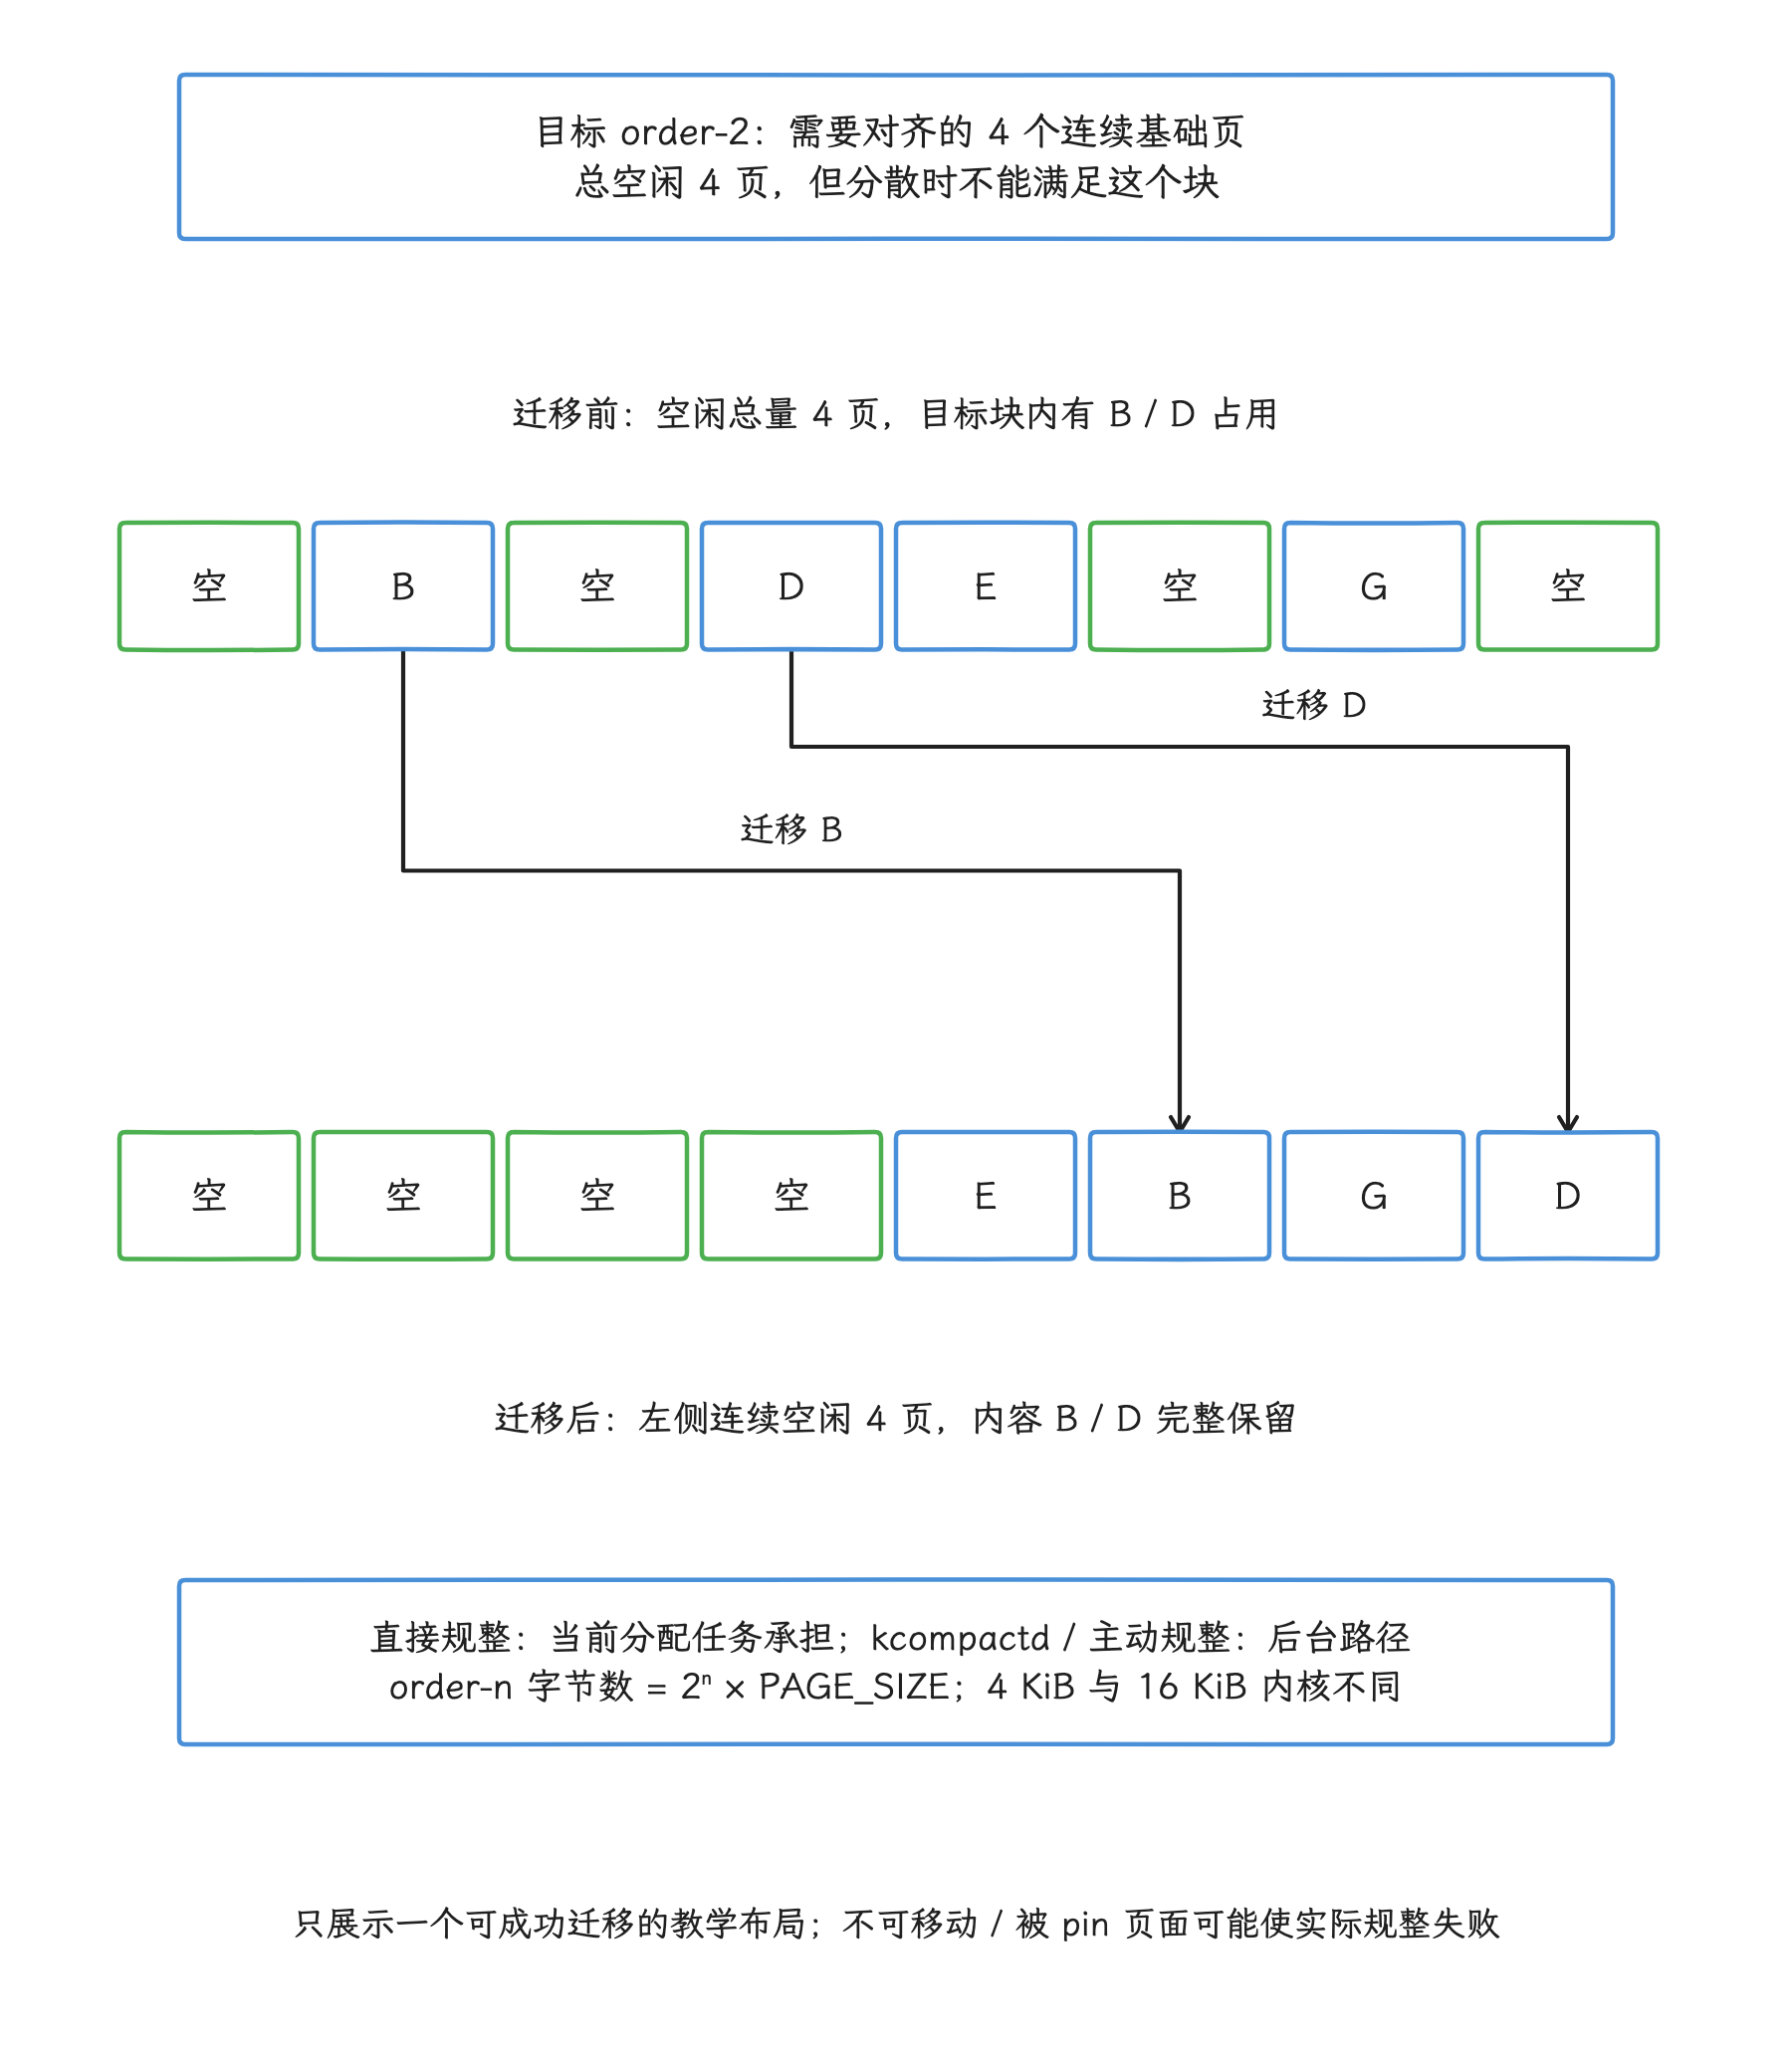
图:示意区间中,迁移前后都只有 4 个空闲基础页。把可迁移的 B、D 移到右侧空闲位置后,左半段才形成对齐的连续 4 页,可作为 order-2 候选。规整没有压缩页面,也没有增加总空闲页;真实请求还受 zone、水位、不可移动页与 CMA 条件限制。
高阶页分配在伙伴系统快速路径失败时,可能进入:
- 直接规整:由当前分配任务同步执行;
kcompactd:每个节点的后台规整线程;- 主动规整(proactive compaction):由
vm.compaction_proactiveness等机制触发,具体配置取决于设备。
r6 的 try_to_compact_pages() 是直接规整入口;kcompactd_do_work() 处理后台请求。页面迁移本身要花 CPU、锁和内存带宽,失败或反复扫描也会产生延迟。
怎样证明延迟来自内存规整
下面这些内核跟踪点(tracepoint)比“线程处于 D 状态”更直接:
compaction/mm_compaction_begincompaction/mm_compaction_endcompaction/mm_compaction_migratepagescompaction/mm_compaction_try_to_compact_pagescompaction/mm_compaction_kcompactd_wakekmem/mm_page_alloc_extfrag
还可以读取 /proc/vmstat 的 compact_*、compact_stall、compact_fail、compact_success 和迁移相关字段。一次失败可能来自目标 zone、水位、不可移动(Unmovable)页、CMA 约束或目标 order;总空闲页只是其中一个条件。 [已验证: android17-6.18-2026-06_r6 include/linux/mmzone.h enum migratetype;mm/compaction.c]
CMA 区域与可迁移页
连续内存分配器(Contiguous Memory Allocator,CMA)在启动时圈出区域:区域空闲时可以容纳可移动页,需要连续内存时再尝试把它们迁走,为 CMA 请求腾出连续范围。
启用 CMA 的设备通常在 /proc/meminfo 提供 CmaTotal 和 CmaFree。CmaFree 偏小时,先想想区域里是不是暂存着可移动页,再谈泄漏;一次 CMA 分配能否成功,还取决于这些页是否可迁移、目标大小与规整成本。
相机、编解码器和显示路径是否使用 CMA,由 DMA 能力、IOMMU、内存堆类型与驱动实现决定;图形缓冲区一律按物理连续的 CMA 内存记账,会把账算错。
ION、DMA-BUF Heaps 与共享缓冲区
分配器与共享框架的分工
图形、相机这类跨进程、跨设备的缓冲区,走的是另一套共享机制。DMA-BUF 是跨设备、跨驱动和跨进程共享缓冲区的框架:一个驱动导出 struct dma_buf,其他驱动作为 importer 通过 attachment 拿到适合自己访问的 scatter-gather 映射;用户空间通常只持有一个不暴露内部实现的 fd。
DMA-BUF Heaps 提供从指定内存堆分配 dma-buf 的用户空间接口(UAPI)。下图展示分配、导出与设备导入之间的关系:
传递 fd 时,各方共享的是同一个 dma-buf 对象,整块像素数据不用复制。至于各进程是否建立了 CPU mmap、设备怎样映射、哪一方还持着引用,要分别核对。
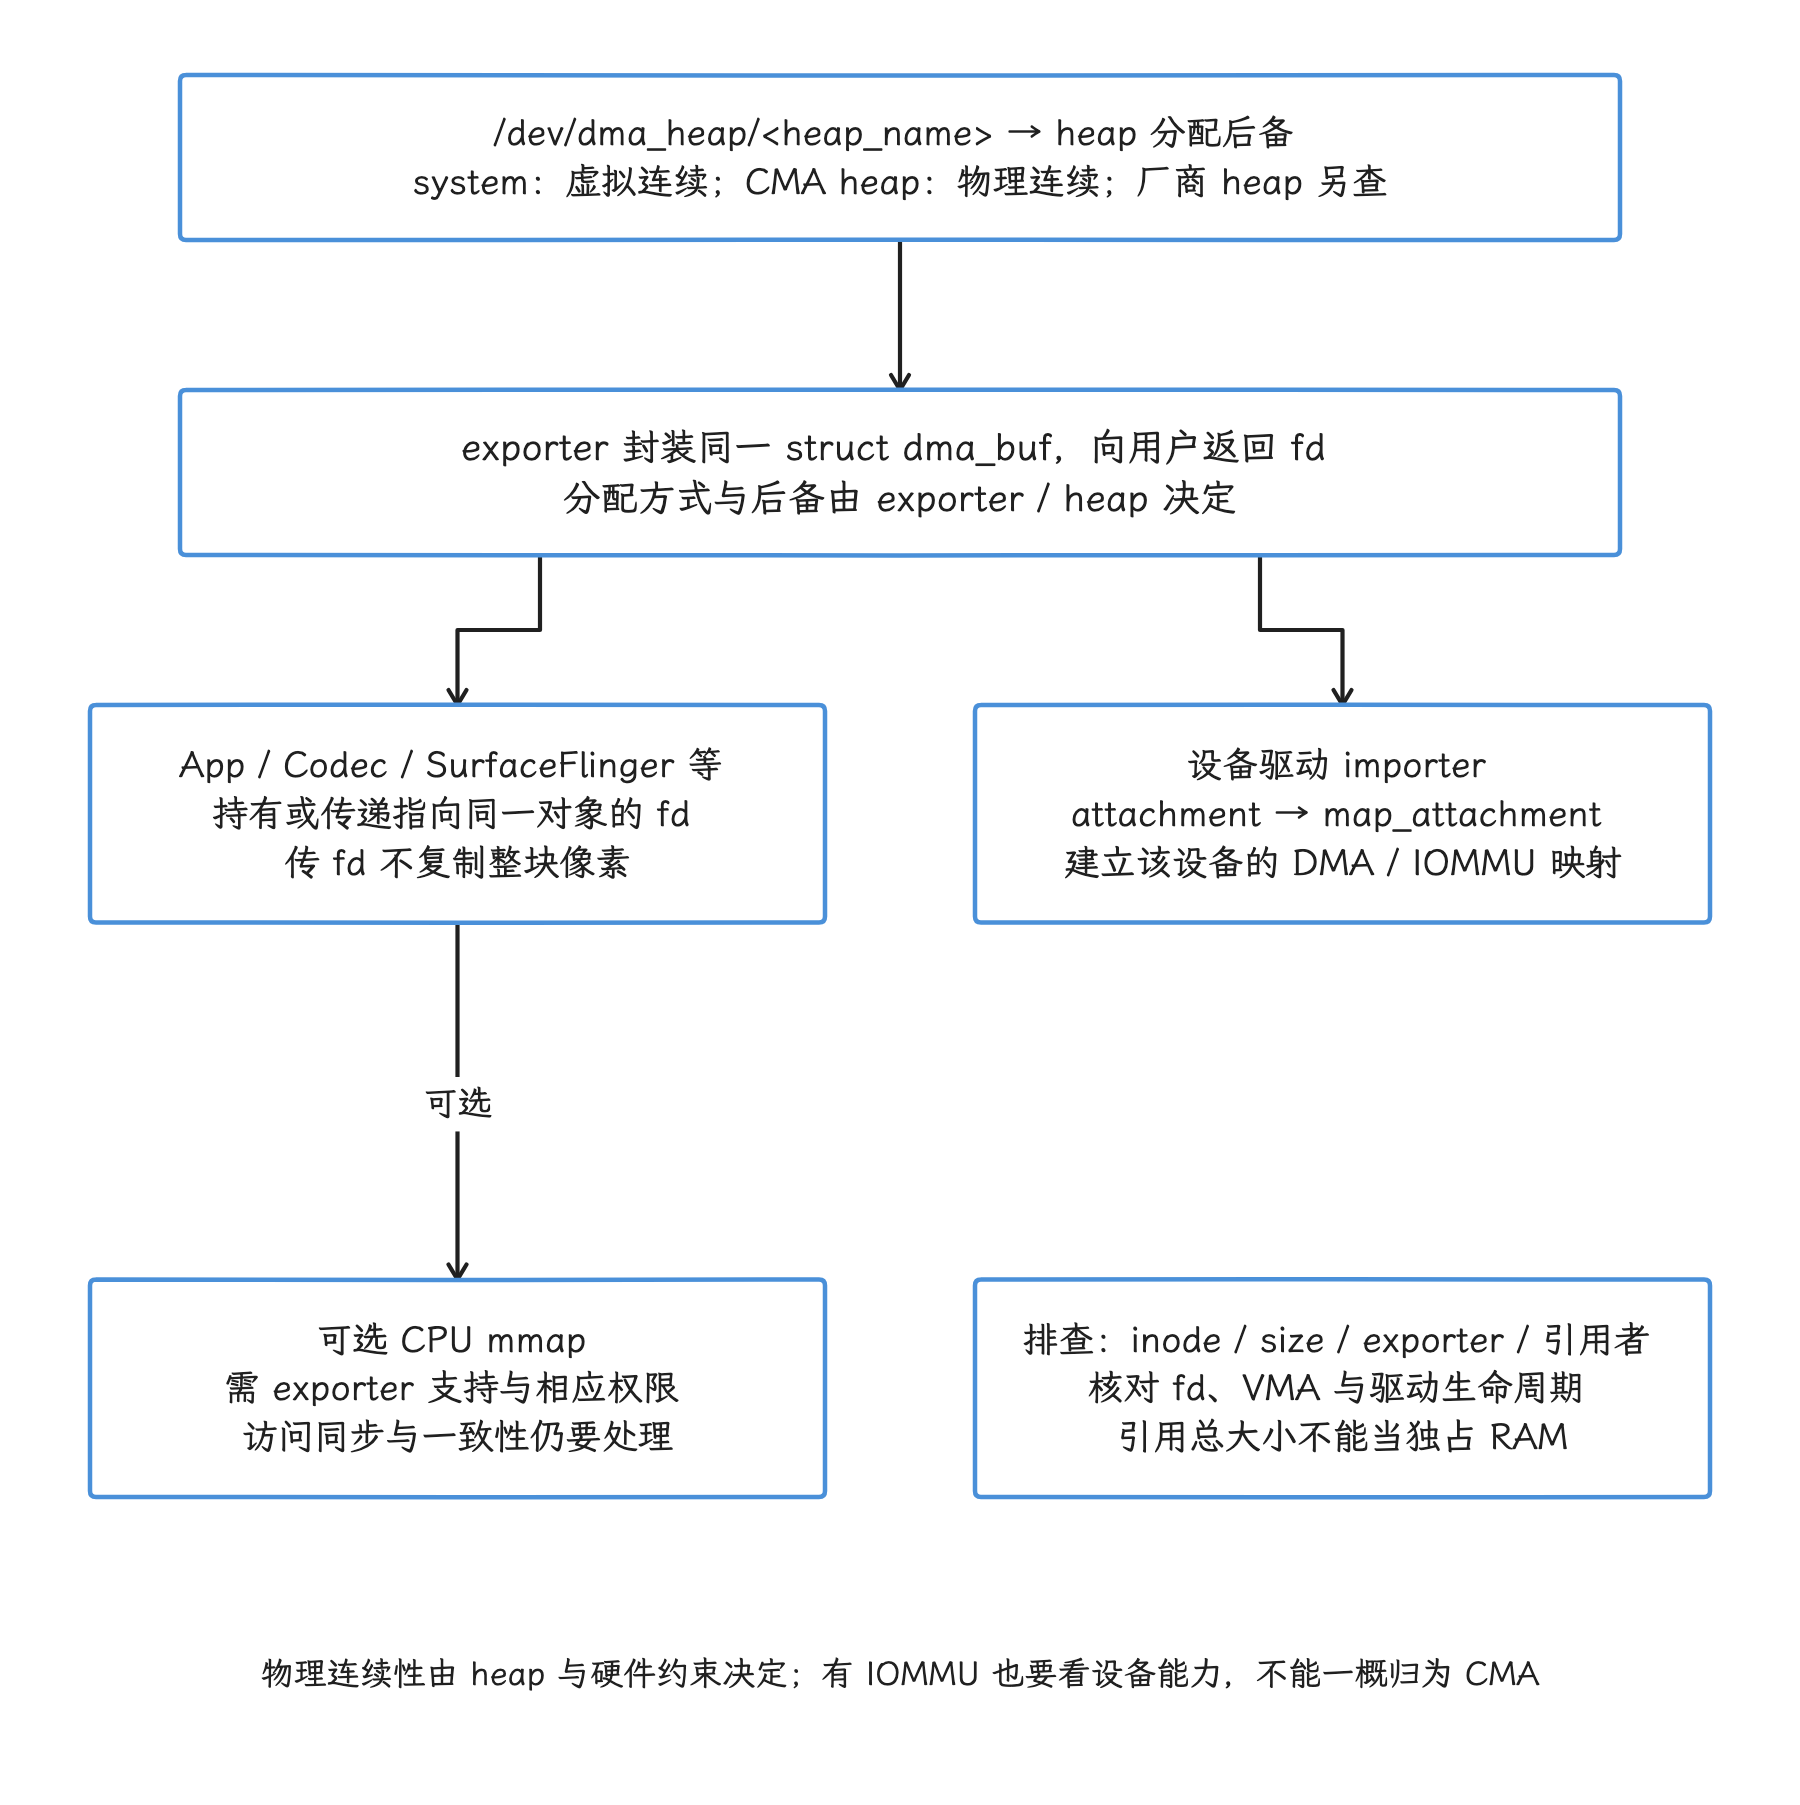
图:用户从指定 dma_heap 请求分配,导出方封装 dma_buf 并返回 fd;fd 传递使多个进程引用同一个对象。设备 importer 建立 attachment 与适合该设备的 DMA / IOMMU 映射,CPU mmap 则是另一个可选入口。引用大小不等于进程独占 RAM,同一 inode 跨持有者直接求和会重复计算。
ION 到 DMA-BUF Heaps 的版本边界
旧的 ION 分配器和 DMA-BUF Heaps 都能当 dma-buf 的导出方(exporter):ION 靠 /dev/ion、heap mask 和私有标志选择分配器;DMA-BUF Heaps 则为不同内存堆暴露独立字符设备 /dev/dma_heap/<heap_name>,换来稳定的 UAPI、测试和 SELinux 强制访问控制。
Android 12 的 GKI 2.0 以 DMA-BUF Heaps 替换 ION;AOSP 迁移页已标记为废弃,标题限定为 “5.4 kernel only”,只能用于理解历史迁移。Android 17 的接口和行为应以当前内核文档和设备节点为准。android12-5.10 通用内核已关闭 CONFIG_ION。升级设备仍可能通过 libdmabufheap 的兼容映射访问旧 ION 内存堆,因此历史代码和旧内核仍能看到 /dev/ion。 [已验证: AOSP ION 迁移页的 Deprecated 提示与版本说明;android17-6.18-2026-06_r6 Documentation/userspace-api/dma-buf-heaps.rst]
Android 17 新设备应从 DMA-BUF Heaps 视角分析,同时确认厂商提供的内存堆:
systemheap:内核文档定义为虚拟连续、可缓存缓冲区;default_cma_region:CMA 内存堆,提供物理连续、可缓存缓冲区;- 安全、非缓存或设备优化内存堆:名称、权限和语义由平台实现决定。
有 IOMMU 的设备通常能让硬件访问离散页面;缺少相应能力或受到特定硬件约束时,才需要 CMA 等物理连续来源。
DMA-BUF 统计的归属
同一个缓冲区可能同时被应用、SurfaceFlinger、GPU 和 HWC 引用:把完整大小计入每个持有者会重复计算,只看应用的 smaps 又会漏掉那些未映射进该进程、但仍由 fd 或驱动持有的缓冲区。
Linux 6.18 在启用 CONFIG_DMABUF_SYSFS_STATS 时提供:
/sys/kernel/dmabuf/buffers/<inode>/size/sys/kernel/dmabuf/buffers/<inode>/exporter_name
/proc/<pid>/fdinfo/<fd> 可以把进程 fd 与 dma-buf 的 inode、大小等导出信息关联;debugfs 的 /sys/kernel/debug/dma_buf/bufinfo 适合调试构建。生产系统更适合用 sysfs 和 procfs,权限仍由设备策略决定。
Perfetto linux.process_stats 的 record_process_dmabuf_rss 可读取 /proc/<pid>/dmabuf_rss,配置协议(proto)明确注明该节点只存在于部分 Android 内核。它统计的是进程通过 fd 或 VMA 引用的 dma-buf 总大小,属于“引用规模”:既解读不成该进程独占的物理内存,也别和常规 RSS 直接画等号。
16 KiB 基础页对上述机制的影响
Android 15 起,AOSP 支持 16 KiB 基础页,应用和原生库要同时覆盖 4 KiB 与 16 KiB 设备。第一步还是先确认页大小,用运行时 API 或下面的命令:
adb shell getconf PAGE_SIZE
页从 4 KiB 增至 16 KiB 后:
- 同等地址范围需要更少 PTE,TLB 覆盖范围增大;
- 顺序访问同等字节数时,理论上需要的基础页缺页次数减少,业务中的变化幅度取决于访问模式与映射方式;
- Buddy 的同一 order 对应四倍字节数;
- 页表、
mmap、mprotect、文件偏移量与 ELFPT_LOAD对齐需要适配; - 小映射、尾页和部分 slab 布局可能产生更多内部碎片;
- 单次回收或迁移的基本粒度增大。
Android 官方初始测试报告了应用启动、功耗、相机启动和系统启动等平均收益,也明确说明 16 KiB 设备平均会使用略多内存、设备和应用结果会变化。某个应用自己的预期收益,还是要在目标构建上量缺页、页表、RSS、启动 I/O 和帧时间,平均值代劳不了。
使用原生代码的应用还要保证 ELF LOAD 段和打包对齐,避免把 4096 写死。只使用 Java/Kotlin 的应用通常已经兼容,但仍需在 16 KiB 环境执行功能与性能测试。完整迁移要求见 4.5 节。
THP 的尺寸与运行时策略
透明大页(Transparent Huge Pages,THP)可以用大于基础页的粒度管理内存。常见 4 KiB 基础页配置下,PMD 层级的 THP 是 2 MiB,其他基础页大小与页表几何会产生不同尺寸。多尺寸透明大页(multi-size THP,mTHP)还支持小于 PMD 尺寸的匿名页分配,仍由 PTE 映射;其缺页次数和 TLB 收益取决于分配尺寸、访问模式与架构能力。 [已验证: android17-6.18-2026-06_r6 Documentation/admin-guide/mm/transhuge.rst 的 mTHP 说明]
r6 arm64 GKI 编译了 THP,顶层默认策略配置为 madvise。匿名 THP 未被启动参数覆盖时,源码将 PMD 尺寸设为 inherit,继承顶层策略,其他尺寸初始为 never;编译支持 mTHP 不代表设备已启用各个尺寸。实际行为还受运行时 sysfs、内存类型、进程/VMA 限制和调用方建议影响。 [已验证: android17-6.18-2026-06_r6 arch/arm64/configs/gki_defconfig;mm/huge_memory.c hugepage_init_sysfs()]
缺少合适的连续页时,THP 分配可能触发回收或内存规整;有现成空闲块时可直接分配。enabled 控制启用范围,defrag 另行控制分配路径中的回收与规整尝试,也可选择在失败后回退到普通页。显式 MADV_COLLAPSE 会忽略这些 sysfs 策略,仍受进程和 VMA 限制,所以就算各尺寸的 enabled 都显示 never,显式折叠出的大页仍可能存在。小而稀疏的工作集可能付出额外内存成本,应结合 TLB、缺页、内存规整与 RSS 判断收益。 [已验证: android17-6.18-2026-06_r6 Documentation/admin-guide/mm/transhuge.rst 的 Global THP controls 与 process THP controls]
下面的命令只读取可访问的 THP 策略与尺寸节点,不修改设备配置:
adb shell 'base=/sys/kernel/mm/transparent_hugepage; for p in "$base"/enabled "$base"/defrag "$base"/hpage_pmd_size "$base"/hugepages-*kB/enabled; do if [ -r "$p" ]; then printf "%s: " "$p"; cat "$p"; fi; done'
方括号标出当前策略,hpage_pmd_size 给出 PMD 大页的字节数。逐尺寸节点中的 inherit 要结合顶层 enabled 解释;节点不可读或不存在时,需继续核对内核配置和设备权限,不能当作已关闭 THP 的证据。 [已验证: android17-6.18-2026-06_r6 Documentation/admin-guide/mm/transhuge.rst;mm/huge_memory.c enabled_show()、anon_enabled_show()]
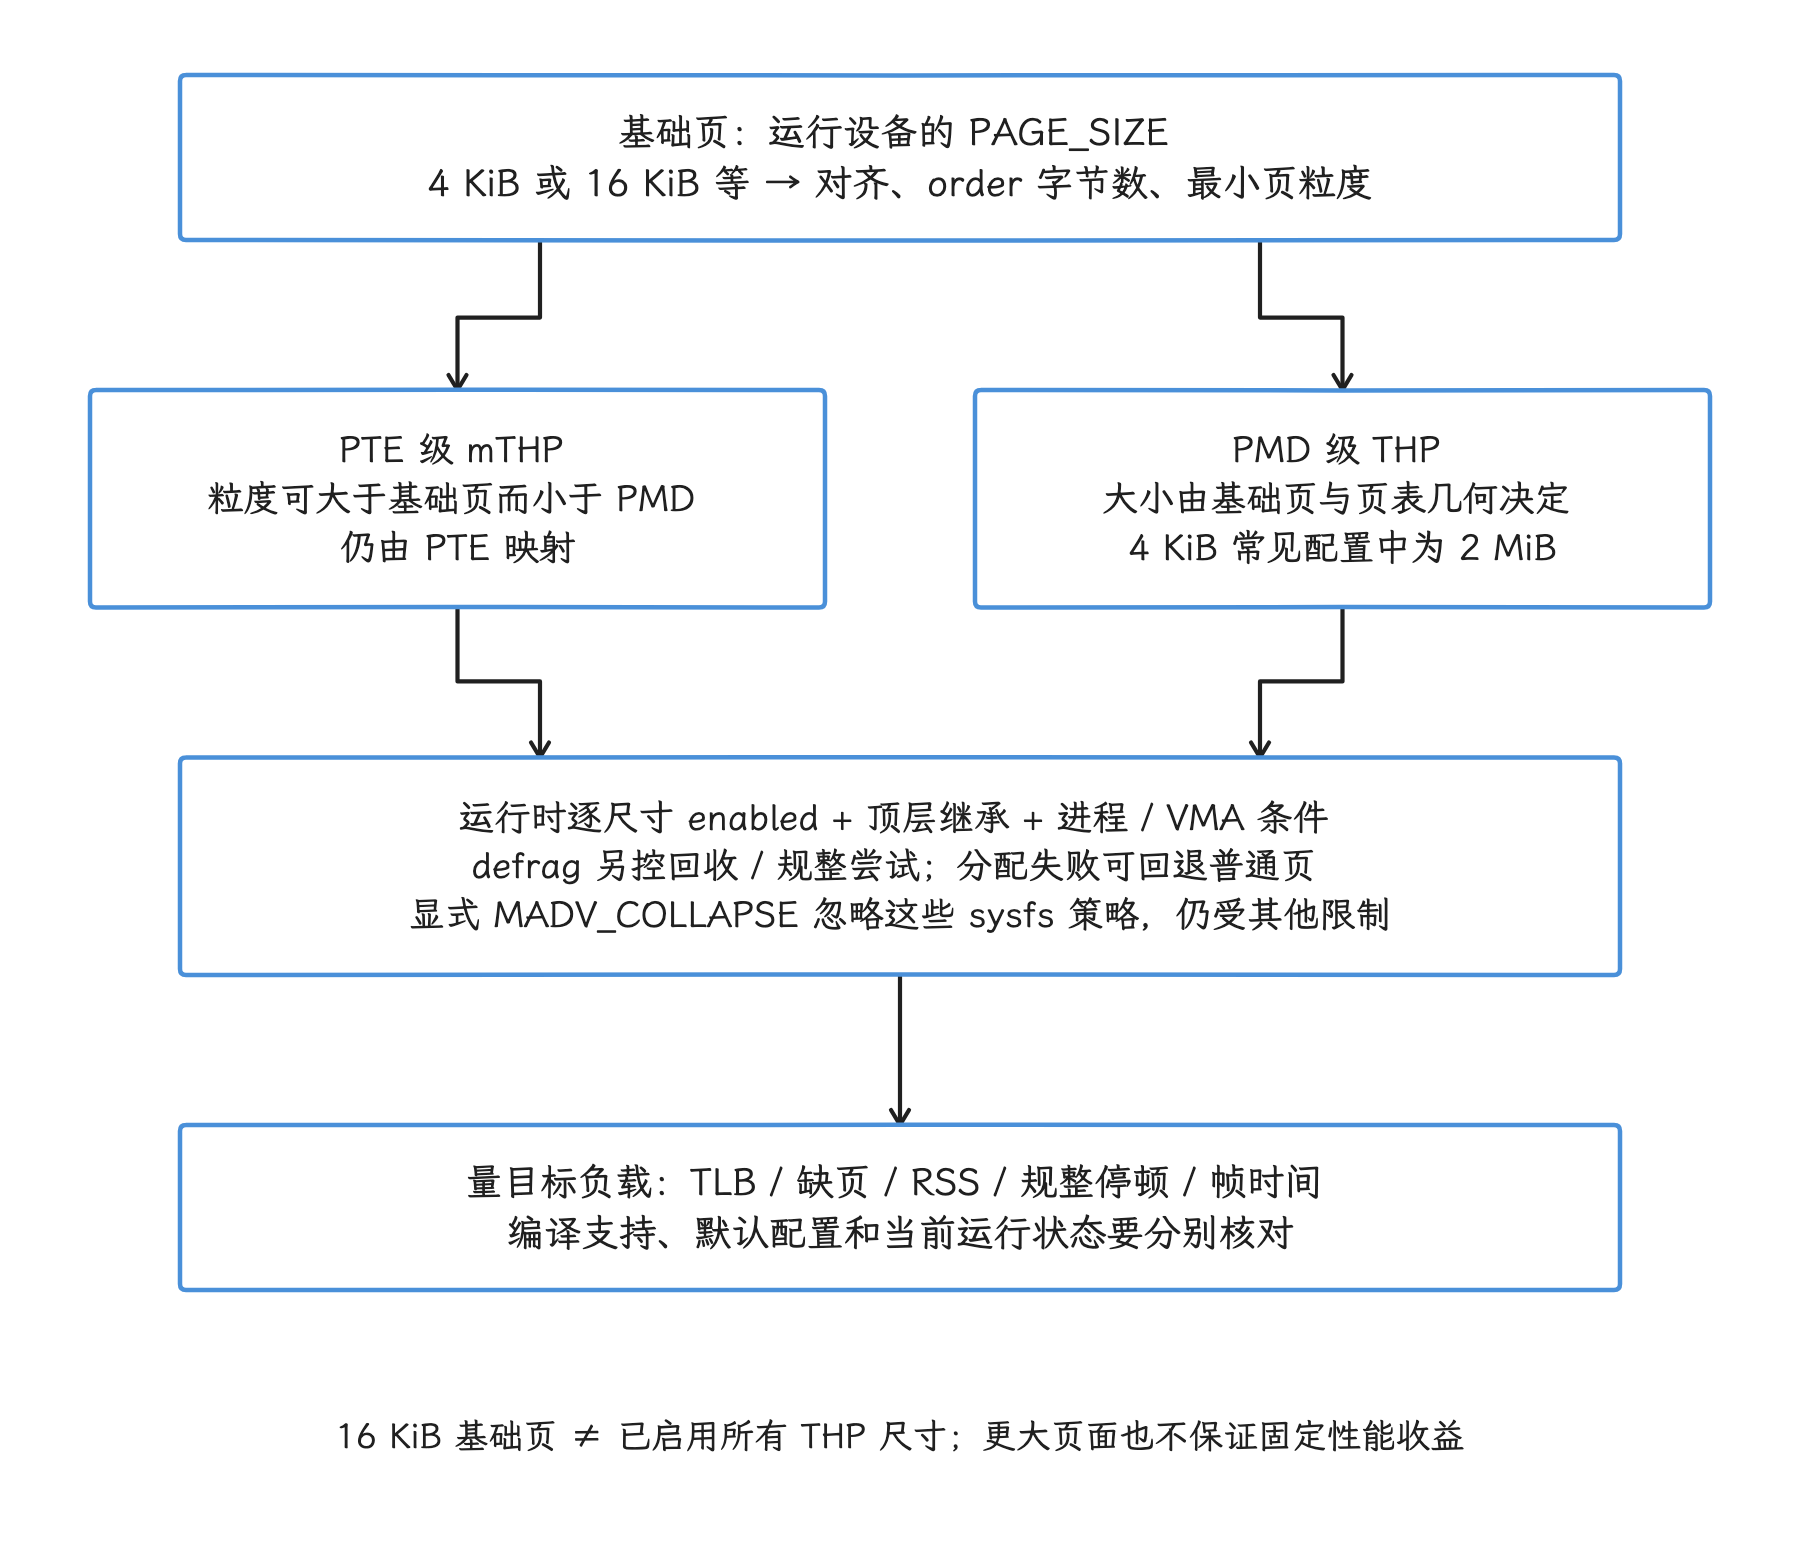
图:基础页大小由目标内核决定,直接影响 PAGE_SIZE、order 字节数、对齐与碎片。THP 是在该基础上使用更大粒度:mTHP 可仍由 PTE 映射,PMD THP 则取决于页表几何。运行时逐尺寸 enabled、顶层继承、defrag、进程和 VMA 限制共同影响自动路径;MADV_COLLAPSE 是另查的显式折叠入口。
KASAN、MTE 与版本测量
内核地址消毒器(Kernel Address Sanitizer,KASAN)检测内核内存越界和 use-after-free。软件影子内存模式和硬件标签模式的成本差异很大,调试选项、采样模式和运行硬件都会改变结果。
MTE 可以支持用户空间分配器检查,也可以支撑 KASAN 的 HW_TAGS 硬件标签模式。Android 17 r6 arm64 GKI 配置包含 KASAN/HW_TAGS 能力,运行设备是否启用、采用什么模式仍由启动参数、硬件和构建决定。
所以这里没有跨设备的固定开销比例,比较内存与性能基线时把这几项记下来:
- 内核配置与启动参数;
- 用户空间 MTE 的同步、异步或关闭状态;
- KASAN 类型与采样配置;
- 基础页大小、ABI 和同一业务负载。
ART 与内核回收的分工
ART 通过 madvise() 处理页面释放和映射预取,两者用途不同。android-17.0.0_r1 的 RegionSpace::ReleaseFreeRegions() 与 FreeListSpace::Free() 使用 MADV_DONTNEED 处理空闲页;线程栈中不再需要的页面也通过该建议处理。Runtime::MadviseFileForRange() 则用 MADV_WILLNEED 预取文件映射。 [已验证: AOSP android-17.0.0_r1 region_space.cc、large_object_space.cc、thread.cc、runtime.cc]
RegionSpace::ClearFromSpace() 经 ZeroAndProtectRegion() 调用 ZeroMemory()。Linux 下,对支持 madvise 清零的完整页范围,release_eagerly=false 且 mincore() 成功时,ZeroMemory() 按驻留状态分段:驻留段先清零,编译时存在 MADV_FREE 定义才发送该建议;非驻留段使用 MADV_DONTNEED。立即释放或 mincore() 失败时,页对齐的内部范围回退到 MADV_DONTNEED;不足一页的边缘部分直接清零,不适合 madvise 的范围也直接清零。 [已验证: AOSP android-17.0.0_r1 region_space.cc ClearFromSpace();mem_map.cc ZeroMemory()、ClearMemory()]
内核 android17-6.18-2026-06_r6 的 MADV_COLD 走另一条路径:mm/madvise.c 的 madvise_cold() 排除 VM_LOCKED、VM_PFNMAP、VM_HUGETLB 等不适用的 VMA,再对符合条件的 folio 清理访问状态并调用 folio_deactivate()。共享、非 LRU 等页面还可能被跳过;这条路径降低页面活跃度,不承诺立即回收整个范围。内核接受该参数,单独证明不了某个 ART 调用点用了它。 [已验证: android17-6.18-2026-06_r6 mm/madvise.c can_madv_lru_vma()、madvise_cold()、madvise_cold_or_pageout_pte_range()]
Silk 等研究工作讨论了对象热度与内核页热度之间的偏差。核对具体构建中的 GC 协作方案时,需要追到 ART 调用入口、建议值和内核处理,再结合回收与 PSI 观察效果。
核对 ANON_VMA_LAZY 类优化
anon_vma 为匿名页提供反向映射(reverse mapping,rmap)关系,让内核能从页找到相关 VMA;anon_vma_chain 连接 VMA 与 anon_vma,并把关系组织到区间树中。物理页按需分配与这些元数据的建立,是需要分别核对的两个时机。 [已验证: android17-6.18-2026-06_r6 include/linux/rmap.h 的结构定义与注释]
在 r6 的普通 PTE 级匿名缺页路径中,do_anonymous_page() 的读缺页可以映射共享零页;需要分配私有匿名页时,先调用 vmf_anon_prepare(),再调用 alloc_anon_folio()。准备路径已有 anon_vma 时直接复用;缺少时,__anon_vma_prepare() 尝试复用相邻 VMA 的结构或分配新结构,并在锁保护下链接 VMA 与区间树。因此,“匿名页按需分配”本身证明不了额外的 ANON_VMA_LAZY 优化,也推算不出 slab 或 fork() 的收益。 [已验证: android17-6.18-2026-06_r6 mm/memory.c do_anonymous_page()、__vmf_anon_prepare();mm/internal.h vmf_anon_prepare();mm/rmap.c __anon_vma_prepare()、anon_vma_chain_link()]
检查厂商材料中的 ANON_VMA_LAZY 或类似优化时,应同时核对:
- 内核配置、源码符号和补丁提交,只看 Android API 级别是不够的;
/proc/slabinfo中anon_vma、anon_vma_chain的数量与对象大小;- 同一负载下
fork()、VMA 数、次要缺页、rmap 相关 CPU 时间和页面迁移结果; - KSM、NUMA 页面平衡、页面迁移、COW 与进程退出等正确性压力测试。
仅看到 anon_vma slab 下降,证明不了完整提案存在;厂商也可能通过 VMA 合并、分配器调整或其他补丁得到相似结果。
一套面向性能问题的取证顺序
确认问题属于哪条慢路径
先在 Perfetto 中对齐卡顿、启动或分配失败时间:
- 应用线程是否出现
vmscan/mm_vmscan_direct_reclaim_*; kswapd是否运行,mm_vmscan_kswapd_wake/sleep是否覆盖问题窗口;- 是否出现
compaction/mm_compaction_*; filemap/mm_filemap_fault、perf 主要缺页与块 I/O 是否相关;- 内存 PSI 是否显示持续的 stall。
读取累计计数和物理布局
下面的命令一次采集常用的系统数据:
adb shell cat /proc/pressure/memory
adb shell cat /proc/vmstat
adb shell cat /proc/buddyinfo
adb shell cat /proc/meminfo
把问题前后的快照做差,比盯着单次绝对值更有意义;我们重点找扫描/回收比例、分配停顿、换入/换出、内存规整成败、CMA 与高阶空闲块的变化。
按资源类型进入专用工具
- 文件页回收后再次访问:检查文件映射、I/O、预读和缓存生命周期;
- 匿名页换入换出:检查 ZRAM、工作集、GC 后保留量与 PSI;
- slab 增长:按
/proc/slabinfo或 slab 跟踪点定位缓存; - 高阶/CMA 失败:检查目标 order、迁移类型、extfrag 外部碎片与内存规整;
- DMA-BUF 增长:按 inode、导出方、fd 持有者和 Surface/驱动生命周期分析。
常见结论的校正
“内存总量够,高阶分配就会成功”
高阶分配需要目标 zone 中的连续页。即使总空闲量充足,外部碎片、不可移动页、CMA 与水位限制仍可能让请求进入内存规整或失败。
“看到 kswapd 占 CPU,就说明它拖慢了前台”
kswapd 活跃只说明内核在后台回收,也可能来自水位提升或主动策略。要证明它拖慢了前台,得同时看到 CPU 竞争、I/O、前台访问刚被回收的文件页、PSI 或关键线程延迟。
“线程进入 D 状态就代表直接回收”
D 状态只是不可中断睡眠,来源很多,而且直接回收也可能正在 CPU 上执行;归因还是靠 vmscan 跟踪点、内核调用栈和 PSI。
“lmkd 只在内核回收失败后运行”
现代 Android 的 lmkd 运行在用户空间,监控 PSI 等压力信号,可以在内核 OOM 之前选择进程。它与 kswapd 工作在同一内存压力环境中,但两者没有严格的先后顺序。详细决策见 4.3 节。
“每个 DMA-BUF 都是物理连续内存”
分配方式由内存堆决定:system heap 给虚拟连续缓冲区,CMA heap 给物理连续缓冲区,设备还可以定义其他内存堆;硬件怎么访问,看 IOMMU 与驱动能力。
“应用持有 100 MiB DMA-BUF,就独占 100 MiB RAM”
持有 fd 或 VMA 只说明存在引用,共享者、导出方、驻留状态和设备映射仍要逐项核对。同一缓冲区被多个进程引用时,跨进程直接求和会重复计算。
页分配与回收的源码与文档锚点
- Android 17 kernel
mm/page_alloc.c - Android 17 kernel
mm/vmscan.c - Android 17 kernel
mm/compaction.c - Linux 6.18 THP/mTHP 与运行时策略
- Android 17 kernel THP 策略实现
- Android 17 kernel
mm/madvise.c - Android 17 kernel arm64 GKI defconfig
- Linux 6.18 physical memory
- Linux 6.18 Multi-Gen LRU
- Linux 6.18 DMA-BUF
- Linux 6.18 DMA-BUF Heaps
- AOSP:ION 迁移到 DMA-BUF Heaps(5.4/GKI 2.0 过渡期文档)
- Android:支持 16 KiB page size
- Perfetto
ProcessStatsConfig - Perfetto
PerfEventConfig - AOSP Android 17 ART
mem_map.cc - AOSP Android 17 ART
RegionSpace - AOSP Android 17 ART
FreeListSpace - AOSP Android 17 ART 线程栈处理
- AOSP Android 17 ART 文件映射预取
- Android 17 kernel 匿名缺页处理
- Android 17 kernel 反向映射实现
- Android 17 kernel
anon_vma与anon_vma_chain - Android 17 kernel
vmf_anon_prepare()
小结
先区分地址空间、驻留页、共享归因和私有页,再把 Java、原生、代码、线程栈、图形与内核资源放回各自的内存域。确认增长发生在哪一域后,还要继续沿内核页管理回答以下问题:
- 虚拟访问为什么触发缺页,它是次要缺页、主要缺页、COW、文件页回收后再次访问,还是交换空间换入?
- 物理页分配需要什么 zone 和 order,PCP/伙伴系统能否满足?
- 页面回收或内存规整是否进入应用线程,造成了多长停顿?
- 图形缓冲区由哪个内存堆导出,哪些进程和设备仍持有引用?
版本差异需要结合构建和设备确认:arm64 GKI 配置默认启用 MGLRU,DMA-BUF Heaps 是新设备的主要分配接口,16 KiB 基础页需要兼容;ART 释放空闲页与内核 MADV_COLD 降低页面活跃度的路径要分别核对。再把这些机制与运行设备的缺页、回收、PSI 和映射变化对应起来,才能定位具体原因。