SurfaceControl 与 HardwareBufferRenderer
ASurfaceControl 从 Android 10(API 29)起向 NDK 开放。它解决的问题很具体:组件已经有原生渲染器和硬件 buffer 池,或者需要自己管理跨进程嵌入的层级。普通 View 页面留在 HWUI 的窗口路径里就够了,一般用不到这组 API。
源码基线:AOSP
android-17.0.0_r1;内核android17-6.18-2026-06_r6。
上手 SurfaceControl,我们先把四类对象分开看:ASurfaceControl 是 Layer 节点的句柄,AHardwareBuffer 携带像素,ASurfaceTransaction 收集一批要原子应用的状态变更,fence 说明 buffer 何时可以读取或复用。这四类对象的生命周期和所有权各管各的,后面会反复回到这一点。
本文前半讲 SurfaceControl 的 Layer 树、transaction(事务) 提交和 fence 同步,后半讲 HardwareBufferRenderer(HBR)如何把 RenderNode 场景树画进调用方持有的 HardwareBuffer。两者能接起来用:HBR 产出 buffer,SurfaceControl 把它作为独立 Layer 提交给 SurfaceFlinger 合成;中间的 buffer 所有权、fence 方向和回调生命周期由应用自己维护。
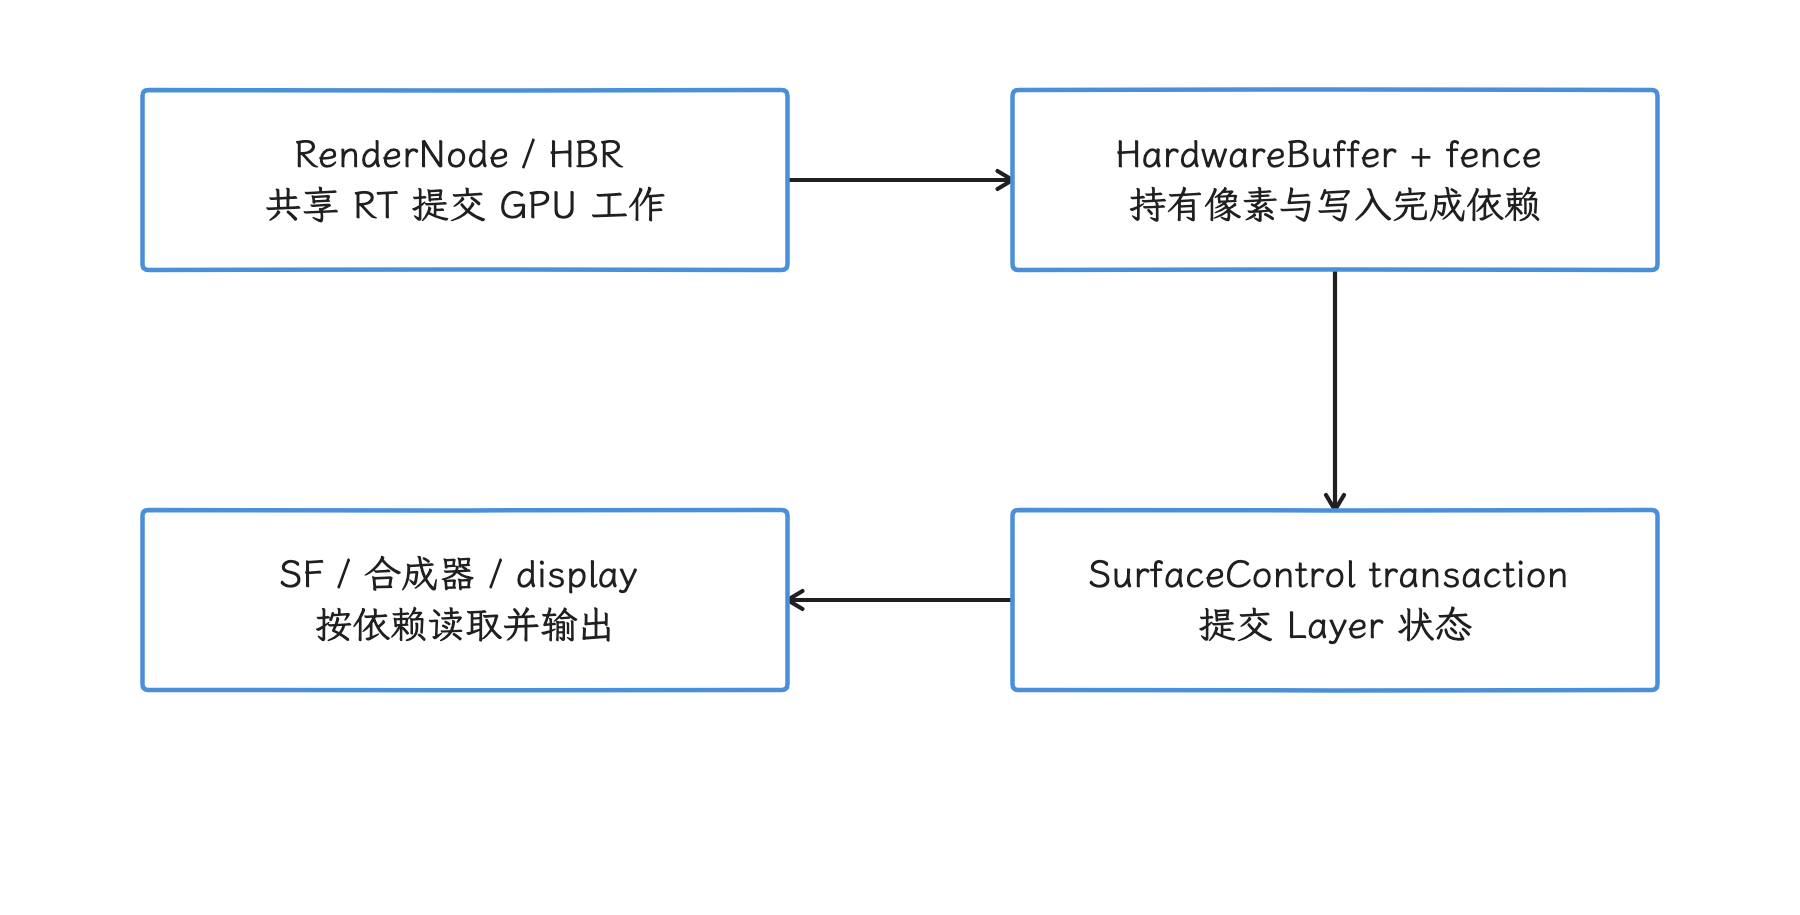
图:先把像素生产、共享存储、Layer 交付和显示消费连起来。 事务与 fence 交接由应用维护;HWC 不保证给该 Layer 分配 overlay。
Layer 创建与 SurfaceControl Transaction
这一节回答的问题是:不经过 View 树和 HWUI 窗口,一块像素怎样变成屏幕上独立合成的一个 Layer。我们按使用顺序过一遍:先分清各类对象,再创建节点、提交 transaction,最后处理 fence 与生命周期。
核心概念
五类对象各管什么
| 对象 | 职责 | 不负责什么 |
|---|---|---|
ANativeWindow | 面向 Producer 的 dequeue/queue 入口,通常由 Java Surface 桥接而来 | 不代表一个新建的 SurfaceFlinger Layer |
ASurfaceControl | 指向可由 transaction 修改的 Layer 节点 | 不提供绘制命令,也不等同于 BufferQueue |
ASurfaceTransaction | 收集一批 Layer 状态,调用 apply() 后异步提交 | 不等待该帧真正显示 |
AHardwareBuffer | 持有可在 CPU、GPU、编解码器和合成器间共享的图形内存 | 不包含 acquire/release 时序 |
| sync fence fd | 描述 Producer 写完或 Consumer 用完的同步边界 | 不会延长业务对象或回调上下文的生命周期 |
从实现上看,frameworks/base/native/android/surface_control.cpp 里公开的 ASurfaceControl* 会转换为 framework native 的 SurfaceControl*,ASurfaceTransaction* 会转换为 SurfaceComposerClient::Transaction*。我们拿到的是 opaque handle(不透明句柄):能调用的只有公开函数,内部字段随时可能变化,裸指针也当不了跨进程的 Binder 参数。
创建的是父节点下面的新 Layer
ASurfaceControl_createFromWindow(parent, name) 从 ANativeWindow 取得已有的 SurfaceControl handle,再在该节点下面创建一个新的 Layer。原来的 window 原样保留,BufferQueue 也继续归它自己用;新节点创建时带 eFXSurfaceBufferState 标志,因此可以直接接收 setBuffer() 提交的 AHardwareBuffer。
已经持有 ASurfaceControl* 时,改用 ASurfaceControl_create(parent, name),它会在同一个 SurfaceComposerClient 连接下创建子节点。两种创建函数都把新引用的所有权交给调用方:失败返回 nullptr,成功后要配对调用 ASurfaceControl_release()。
Java SurfaceControl.Builder 里 “Buffer Layer、Color Layer、Container Layer” 三分法,在 NDK 的公开 C API 里没有对应物——创建函数一律生成 buffer-state 节点,layer type 选项在这套接口里找不到。以 ASurfaceTransaction_setColor() 为例,它最终调用 setBackgroundColor(),设置的是 buffer 透明区域下方的背景色,独立的 Color Layer 并不会因此新建。一个节点哪怕只用来组织子树、一块 buffer 都不提交,身份也还是这组函数生成的 buffer-state 节点。
Java 与 NDK 句柄桥接
Android 14(API 34)增加了 android/surface_control_jni.h:
ASurfaceControl_fromJava()从有效的 JavaSurfaceControl取得一份本地强引用;用完后必须调用ASurfaceControl_release()。ASurfaceTransaction_fromJava()返回 JavaSurfaceControl.Transaction内部 transaction 的 borrowed pointer(借用指针),只在 Java 对象存活且未close()时有效;ASurfaceTransaction_delete()不适用于它。
这两个函数只解决同一进程内 Java 与 native 对象的桥接。跨进程传递仍要通过 Java SurfaceControl 的 Parcelable 能力、SurfaceControlViewHost.SurfacePackage 或系统服务完成。
Transaction 的原子性保证
一个 ASurfaceTransaction 可以同时修改多个节点。头文件保证 transaction 中的更新原子应用,SF 不会只应用其中一部分;同一线程调用 apply() 的多个 transaction 也会按提交顺序应用;同一对象的并发修改仍应由调用方串行保护。不过这些保证到 SurfaceFlinger 接收并应用状态为止,再往后的几件事都要另行确认:
apply()返回时 buffer 是否已被 latch(选入某次合成);- 事务能否赶上调用后的第一个 VSync;
- acquire fence 尚未 signal 的 buffer 能否立即读取;
- 系统是否会自动识别多个独立 Producer 提交的哪些 buffer 属于同一业务帧。
transaction 提交之后,还要经过 Binder、SurfaceFlinger 调度、buffer 就绪判断、合成策略选择和 Display present。我们定位问题时沿着这条时间线往下追,apply() 返回只是起点。
与 BLAST 的关系
BLAST 与 NDK SurfaceControl 最终都使用 SurfaceComposerClient::Transaction 向 SurfaceFlinger 交付 buffer 和 Layer 状态,但入口与 buffer 队列所有者不同。
flowchart LR
    subgraph "BLAST 窗口路径"
        P1["HWUI / native Producer"] --> BQ["BufferQueue"]
        BQ --> BLAST["BLASTBufferQueue\n消费 BufferItem"]
        BLAST --> TX1["SurfaceControl Transaction"]
    end

    subgraph "NDK 直接提交路径"
        P2["引擎 / codec / 自有 buffer pool"] --> AHB["AHardwareBuffer + acquire fence"]
        AHB --> NDK["ASurfaceTransaction_setBuffer()"]
        NDK --> TX2["SurfaceControl Transaction"]
    end

    TX1 --> SF["SurfaceFlinger FrontEnd"]
    TX2 --> SF
    SF --> CE["CompositionEngine / HWC"]
BLAST 路径通常由 Producer 先通过 BufferQueue dequeueBuffer()/queueBuffer(),再由 BLASTBufferQueue 的 Consumer 取得 BufferItem,把 buffer、acquire fence 和几何状态放进 transaction。NDK 直接提交路径不会为调用方创建公开的 BufferQueue;应用把自己管理的 AHardwareBuffer 和 fence 直接放入 transaction。
两条路径只在 transaction 层汇合。ASurfaceControl 与 BLASTBufferQueue 是不同对象,ASurfaceControl_createFromWindow() 也不会接管 parent window 的队列。排查时可以通过三个问题区分:
- Producer 是在调用
queueBuffer(),还是直接调用ASurfaceTransaction_setBuffer()? - buffer slot(buffer 池中的一项) 和 release 节奏由 BufferQueue 管理,还是由应用自己的池管理?
- Perfetto 中要查的是 BLAST queue 的 frame number,还是应用 transaction 中的独立 Layer/buffer?
同一 transaction 中的几何和 buffer 状态会一起生效,但显示时刻仍受 acquire fence 与调度目标约束。多个 Producer 各自提交 transaction 时,哪些 buffer 属于同一业务帧要靠上层同步协议说明;SurfaceControl 自身没有这套协议,跨 Producer 的时序对齐由业务完成。
典型使用流程
从 Java Surface 建立子 Layer
下面的 Java 代码只负责把当前有效的 Surface 交给 native。SurfaceView 生命周期结束或底层 Surface 被替换后,原对象可能失效,因此 native 层也要跟随 surfaceCreated、surfaceChanged 和 surfaceDestroyed 更新资源。
Surface surface = surfaceView.getHolder().getSurface();
nativeCreateChild(surface);
native 侧先取得 ANativeWindow,再在该 window 对应的 Layer 下创建子节点。下面的代码只展示引用关系,不包含 JNI 注册、回收状态机和业务回调;创建、宿主重建和销毁由上层在同一条串行生命周期中安排,释放旧 child 后将 g_child 置空。
#include <android/native_window_jni.h>
#include <android/surface_control.h>

static ASurfaceControl* g_child;

void nativeCreateChild(JNIEnv* env, jobject javaSurface) {
    // 上层串行调用;先按下文移除并释放旧 child,再为新宿主重建。
    if (g_child != NULL) {
        return;
    }
    ANativeWindow* window = ANativeWindow_fromSurface(env, javaSurface);
    if (window == NULL) {
        return;
    }

    ASurfaceControl* child =
            ASurfaceControl_createFromWindow(window, "native-overlay");
    ANativeWindow_release(window);

    if (child == NULL) {
        return;
    }
    g_child = child;
}
ANativeWindow_fromSurface() 会增加 window 引用计数,示例在创建子节点后立即释放这份引用。ASurfaceControl_createFromWindow() 返回的 child 是另一类资源:ANativeWindow_release() 只减 window 的引用,child 要用 ASurfaceControl_release() 释放。
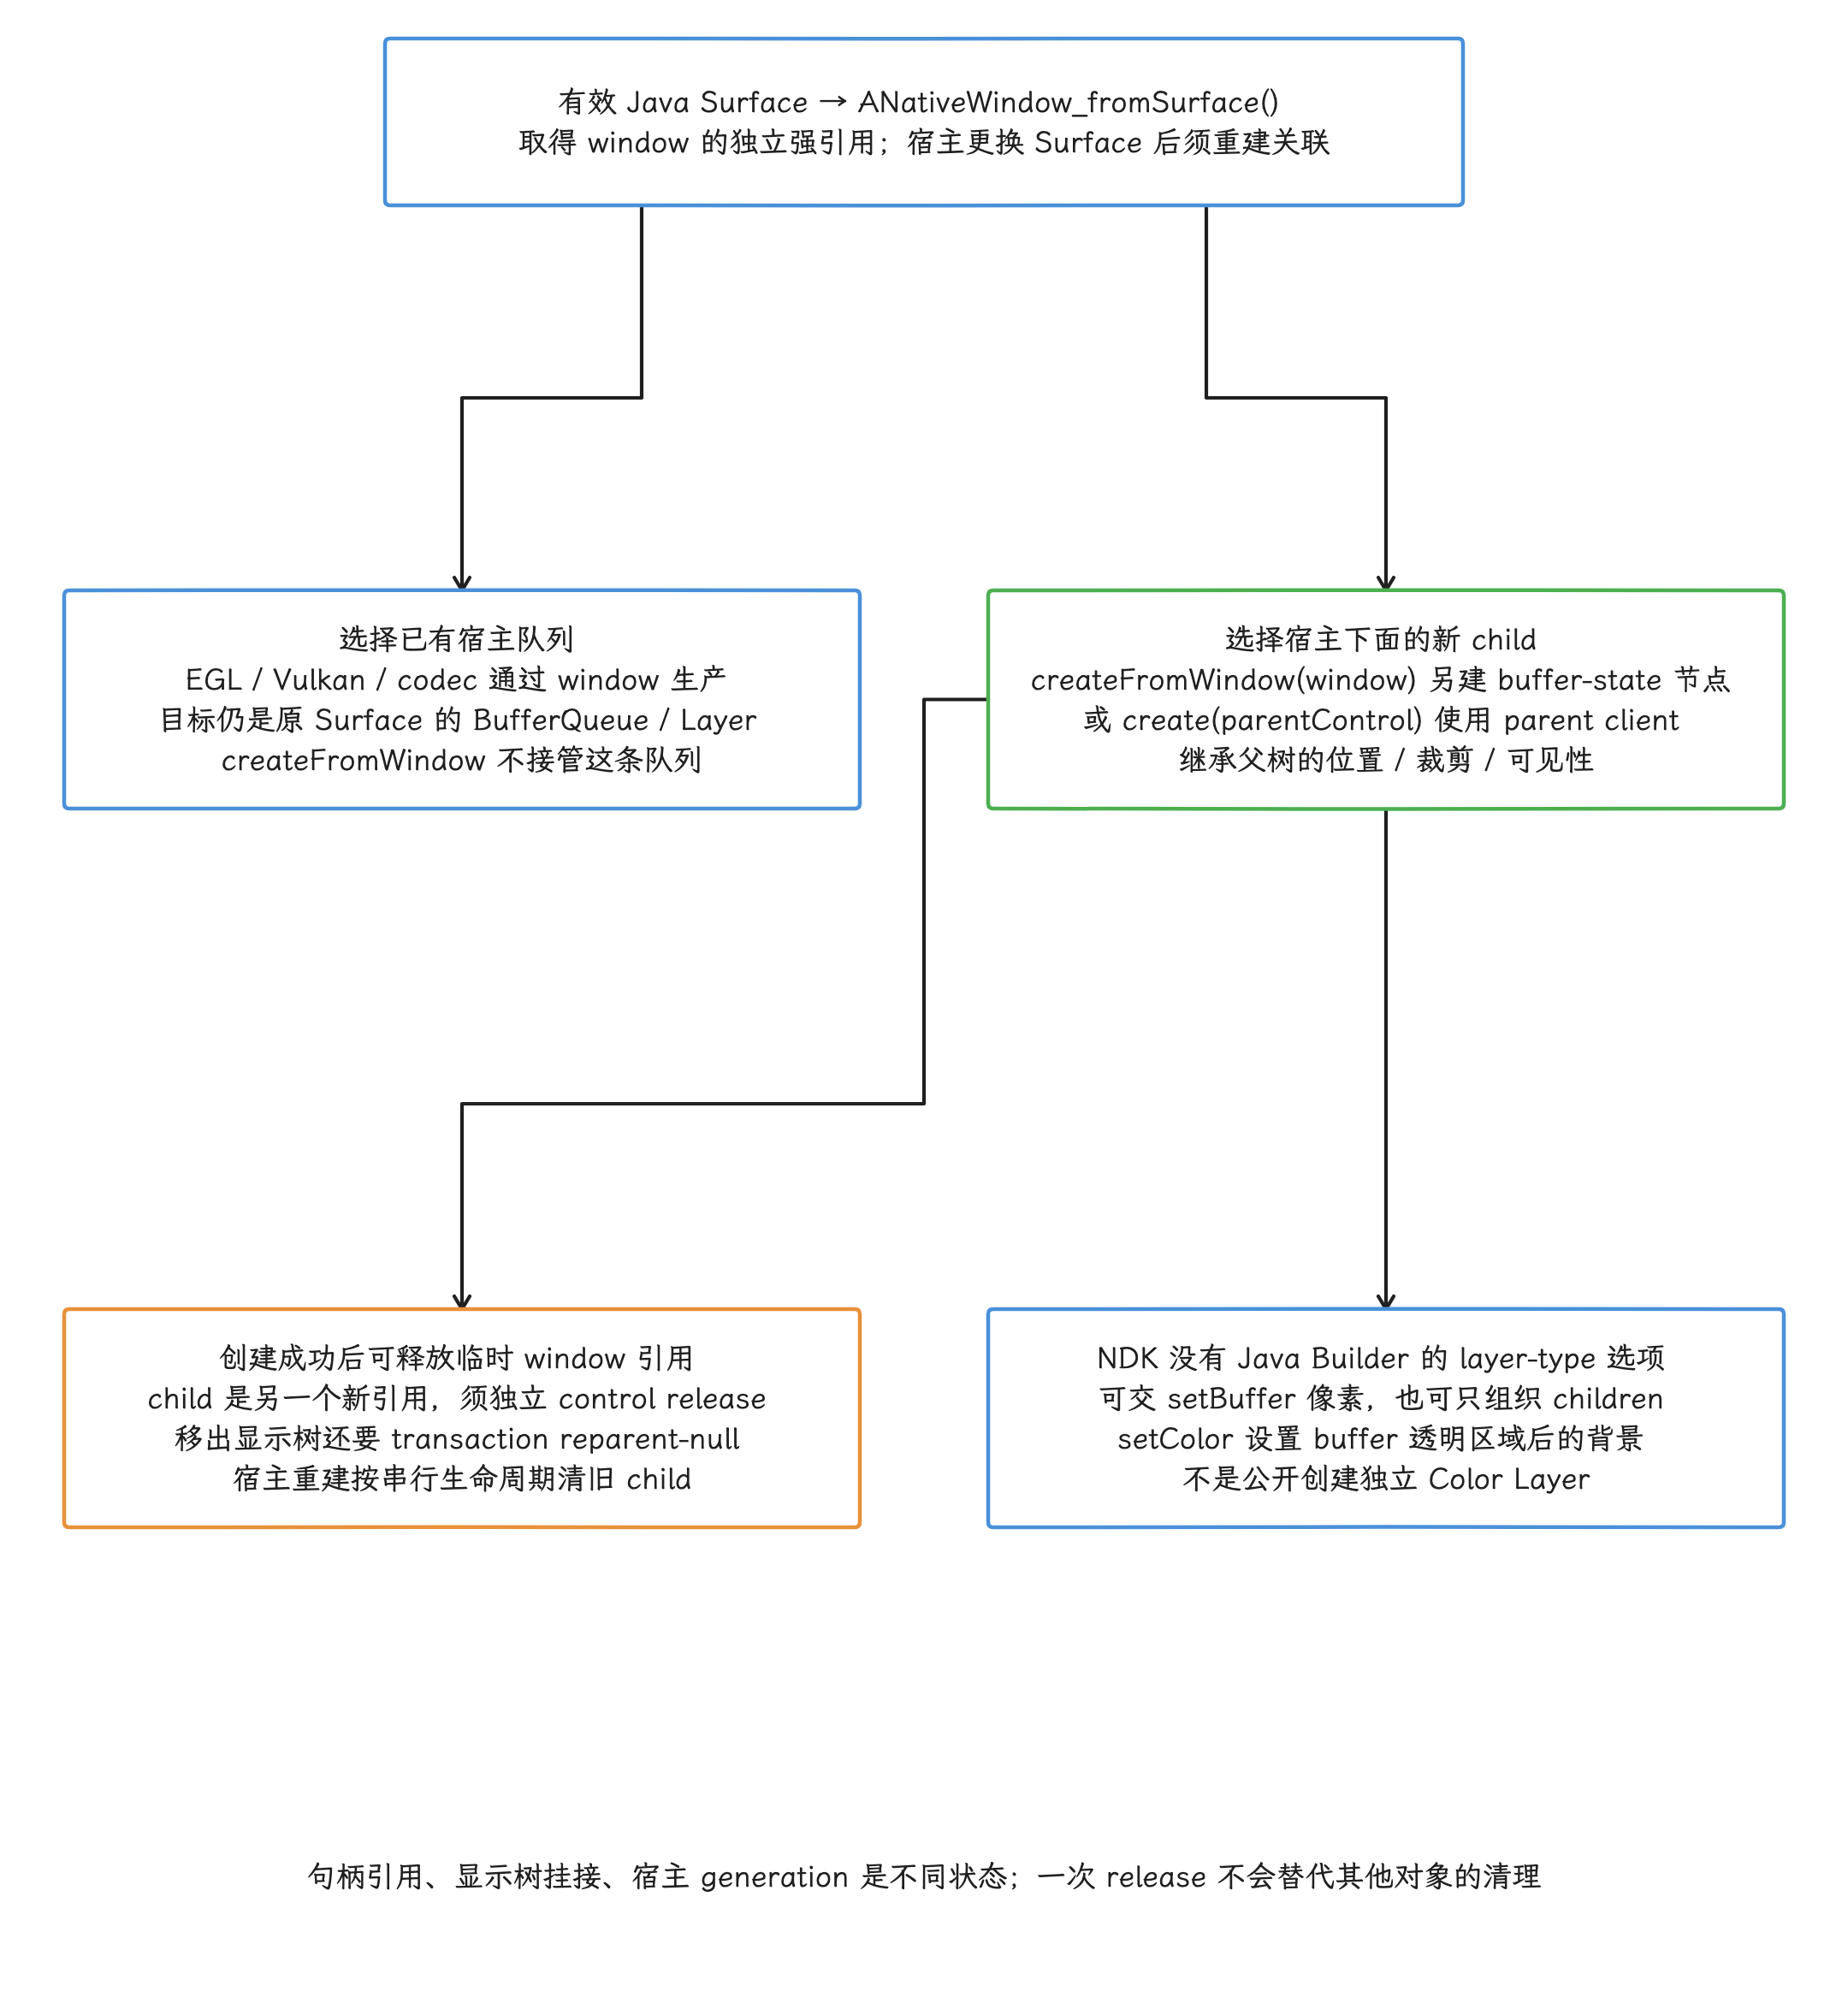
图:Java Surface 桥接增加 ANativeWindow 引用。向现有 window 的 EGL/Vulkan/codec 队列生产,与 createFromWindow 另建 child 是不同操作;后者新 client/child,create(parentControl) 使用 parent client。公开 NDK 创建 buffer-state 节点,无 Java Builder layer-type 选择;setColor 只设置透明区域后的背景,不新建 Color Layer。临时 window 引用可释放,child 新引用要另配 control release;本地 release 不等移出显示树。宿主 Surface 重建时旧 parent 不能对应新树根,须串行移除/释放旧 child 并清空句柄后重建。
提交 buffer 和几何状态
下面的 C 示例把一块 Producer 已提交写入工作、并附带完成依赖的 AHardwareBuffer 提交给 child。acquireFenceFd 为 -1 时表示没有需要等待的 fence;大于等于 0 时,setBuffer() 会把这份 fd 的所有权一并移交给 framework,后续的关闭与复用都交给 framework;这份 fd 交出去之后,调用方就别再碰它了。
void submitBuffer(
        ASurfaceControl* child,
        AHardwareBuffer* buffer,
        int acquireFenceFd,
        int32_t bufferWidth,
        int32_t bufferHeight,
        int32_t x,
        int32_t y) {
    ASurfaceTransaction* tx = ASurfaceTransaction_create();

    ARect crop = {
        .left = 0,
        .top = 0,
        .right = bufferWidth,
        .bottom = bufferHeight,
    };

    ASurfaceTransaction_setBuffer(tx, child, buffer, acquireFenceFd);
    ASurfaceTransaction_setCrop(tx, child, &crop);
    ASurfaceTransaction_setPosition(tx, child, x, y);
    ASurfaceTransaction_setVisibility(
            tx, child, ASURFACE_TRANSACTION_VISIBILITY_SHOW);

    ASurfaceTransaction_apply(tx);
    ASurfaceTransaction_delete(tx);
}
setCrop() 和 setPosition() 从 API 31 开始可用。如果 minSdk 低于 31,需要按运行系统版本选择接口,或者在 API 29—30 使用已废弃的 setGeometry() 兼容旧设备。transaction 对象在 apply() 后可以删除,但提交到显示系统的工作仍会异步继续。
AHardwareBuffer 必须包含 AHARDWAREBUFFER_USAGE_GPU_SAMPLED_IMAGE,因为 SurfaceFlinger 可能选择 GPU CLIENT composition;直接交给显示合成的 buffer 也应按完整 consumer 契约声明 composer overlay usage,Java setBuffer() 文档明确要求这两项。Producer 使用 Vulkan 写入时,还要根据图像用途增加 GPU color output 等 usage;CPU 需要 lock 这块 buffer 时,则要增加相应的 CPU read/write usage。usage 声明哪些模块可以怎样访问内存,fence 只负责访问顺序,两件事各管各的。
提交后的系统路径
下面的时序图把 apply() 异步返回、buffer 就绪、系统合成和回收通知放在同一条时间线上。
sequenceDiagram
    participant P as "Producer / pool"
    participant GPU as "Producer GPU"
    participant NDK as "ASurfaceTransaction"
    participant SF as "SurfaceFlinger"
    participant RE as "RenderEngine"
    participant HWC as "Composer / Display"
    P->>GPU: "submit writes for B#59; export completion fence"
    P->>NDK: "setBuffer B + acquire fence + geometry/timeline"
    P->>NDK: "apply"
    NDK->>SF: "enqueue Binder transaction"
    NDK-->>P: "return#59; no display completion wait"
    SF->>SF: "timeline / readiness / state application / latch"
    Note over GPU,SF: CPU submission and constrained latch may precede signal#59; actual reads obey acquire dependency
    GPU-->>SF: "write completion dependency becomes ready"
    alt fast present succeeds
        SF->>HWC: "presentOrValidate"
        HWC-->>SF: "present / per-layer release feedback"
    else validation needed
        SF->>HWC: "validate or validated result"
        SF->>RE: "optional CLIENT composition#59; obey acquire fence"
        SF->>HWC: "present client target / DEVICE layers"
        HWC-->>SF: "present / release feedback"
    end
    SF-->>P: "release previous A#59; may include CLIENT GPU dependency"
    Note over P,SF: Current B needs a later replacement/removal or early-release path#59; each callback still carries its fence
从 apply() 到 release 回调的间隔随调度和合成负载变化。一次提交 B 的 transaction completion stats 通常用于回收被替换的 A;B 自身还要等未来替换、移除或未展示的提前释放路径。API 36 的 per-buffer callback 或 API 29—35 的 previous-buffer stats 交回的是同步依赖,仍需按回调对应的提交引用和 fence 判断可复用时机。图中的相对长度只表示依赖,不是实测时长。
关键 API 详解
公开能力与版本范围
| API | 级别 | 用途与边界 |
|---|---|---|
createFromWindow() / create() | 29 | 在已有 window 或 control 下创建子节点 |
reparent() / visibility / Z | 29 | 修改树结构、子树可见性和兄弟节点相对层级 |
setBuffer() / color / alpha / dataspace / damage | 29 | 提交像素及合成属性 |
setDesiredPresentTime() | 29 | 请求 transaction 不早于给定时间展示 |
setFrameRate() | 30 | 向系统声明内容帧率,不会替应用控制产帧节奏 |
| crop / position / scale / transform | 31 | 拆分设置几何;优先于已废弃的 setGeometry() |
setOnCommit() / backpressure | 31 | transaction 节奏反馈和服务端排队策略 |
setFrameTimeline() | 33 | 把事务关联到 Choreographer 给出的 vsyncId |
fromJava() / clearFrameRate() | 34 | Java / native 桥接和清除帧率投票 |
setDesiredHdrHeadroom() | 35 | 为标准 HDR 内容声明期望 headroom |
setBufferWithRelease() / LUT | 36 | per-buffer 回收回调和显示用 Look-Up Table(查找表) |
android-17.0.0_r1 的公开头文件没有新增标记为 API 37 的 SurfaceControl C 函数;表中沿用的旧接口,签名、实现和 SurfaceFlinger 行为都按这条基线复核过。
Buffer、几何和颜色
ASurfaceTransaction_setBuffer() 把 AHardwareBuffer 与 acquire fence 一起绑定到 Layer。native transaction 在收集状态时就会持有 GraphicBuffer 引用,提交后的系统状态也按各自生命周期持有引用;应用仍要管理自己在 buffer pool(缓冲池) 中的引用,等所有 release fence 与回调都走完,这块 buffer 才能再次写入。
几何属性的坐标空间容易混淆:
setPosition()使用父节点的坐标空间;setCrop()限制该节点及其子树的可见区域;setScale()以(0, 0)为缩放中心,缩放值必须大于 0;setZOrder()只在兄弟节点之间比较,相同 Z 的顺序未定义;setBufferTransform()描述 buffer 内容的旋转或翻转,不会移动 Layer 节点本身;setDamageRegion()提示哪些内容区域发生了更新,传错可能造成显示错误,或者失去局部更新收益。
setBufferAlpha() 设置 Layer 的整体 alpha,混合按 premultiplied blending 进行;straight-alpha 像素要转换成预乘格式,这件事得 Producer 自己做。如果通过 setBufferTransparency(...OPAQUE) 声明完全不透明,buffer 范围内每个像素都要满足这个条件;把带透明像素的内容标为 OPAQUE,可能造成错误合成。
setColor() 设置背景色、alpha 和 dataspace。带 buffer 的 Layer 还应通过 setBufferDataSpace() 描述 buffer 色彩空间;HDR 内容还要按格式提供相应静态元数据或 headroom(高光亮度余量)。像素格式或色域写错了要回到 Producer 侧修,Layer 侧这些颜色接口管的是另一头。
OnCommit、OnComplete 与 release callback
| 回调 | API | 能证明什么 | 不能证明什么 |
|---|---|---|---|
ASurfaceTransaction_OnCommit | 31 | transaction 已应用,更新已进入可展示状态;后续 transaction 不会再合并进同一帧 | buffer 已释放、present fence 已可读取 |
ASurfaceTransaction_OnComplete | 29 | 包含该 transaction 更新的帧已展示,可以读取 latch/present/previous release 统计 | 所有 previous release fence 都已经 signal |
ASurfaceTransaction_OnBufferRelease | 36 | 交回本次 buffer 提交引用的 release 依赖,也可对应未显示就被替换的 buffer | 回调 fd 大于等于 0 时,fence 已经 signal;或该 buffer 一定显示过 |
OnCommit 先于 OnComplete 到达,适合用作 transaction pacing 的反馈;present fence、previous release fence 的查询和 buffer 回收,都留到 OnComplete 再做。
OnComplete 传入的 ASurfaceTransactionStats* 只在回调执行期间有效。getPresentFenceFd() 和 getPreviousReleaseFenceFd() 返回的有效 fd 归调用方所有,需要由调用方等待并关闭。getAcquireTime() 的注释已标为 deprecated,因为统计可能先于 acquire signal 到达。固定 r1 的封装遇到 fence 形式的统计时还会在 ASurfaceControlStats_getAcquireTime() 中 waitForever(),这是个可能一路阻塞的调用;排障时应保留 Producer fence 与提交时间作参照。调用 getPreviousReleaseFenceFd() 时,control 必须属于该 stats 的更新/移除列表,否则当前实现会 fatal;可用 getASurfaceControls() 枚举,并在回调内处理完后用 releaseASurfaceControls() 释放数组。
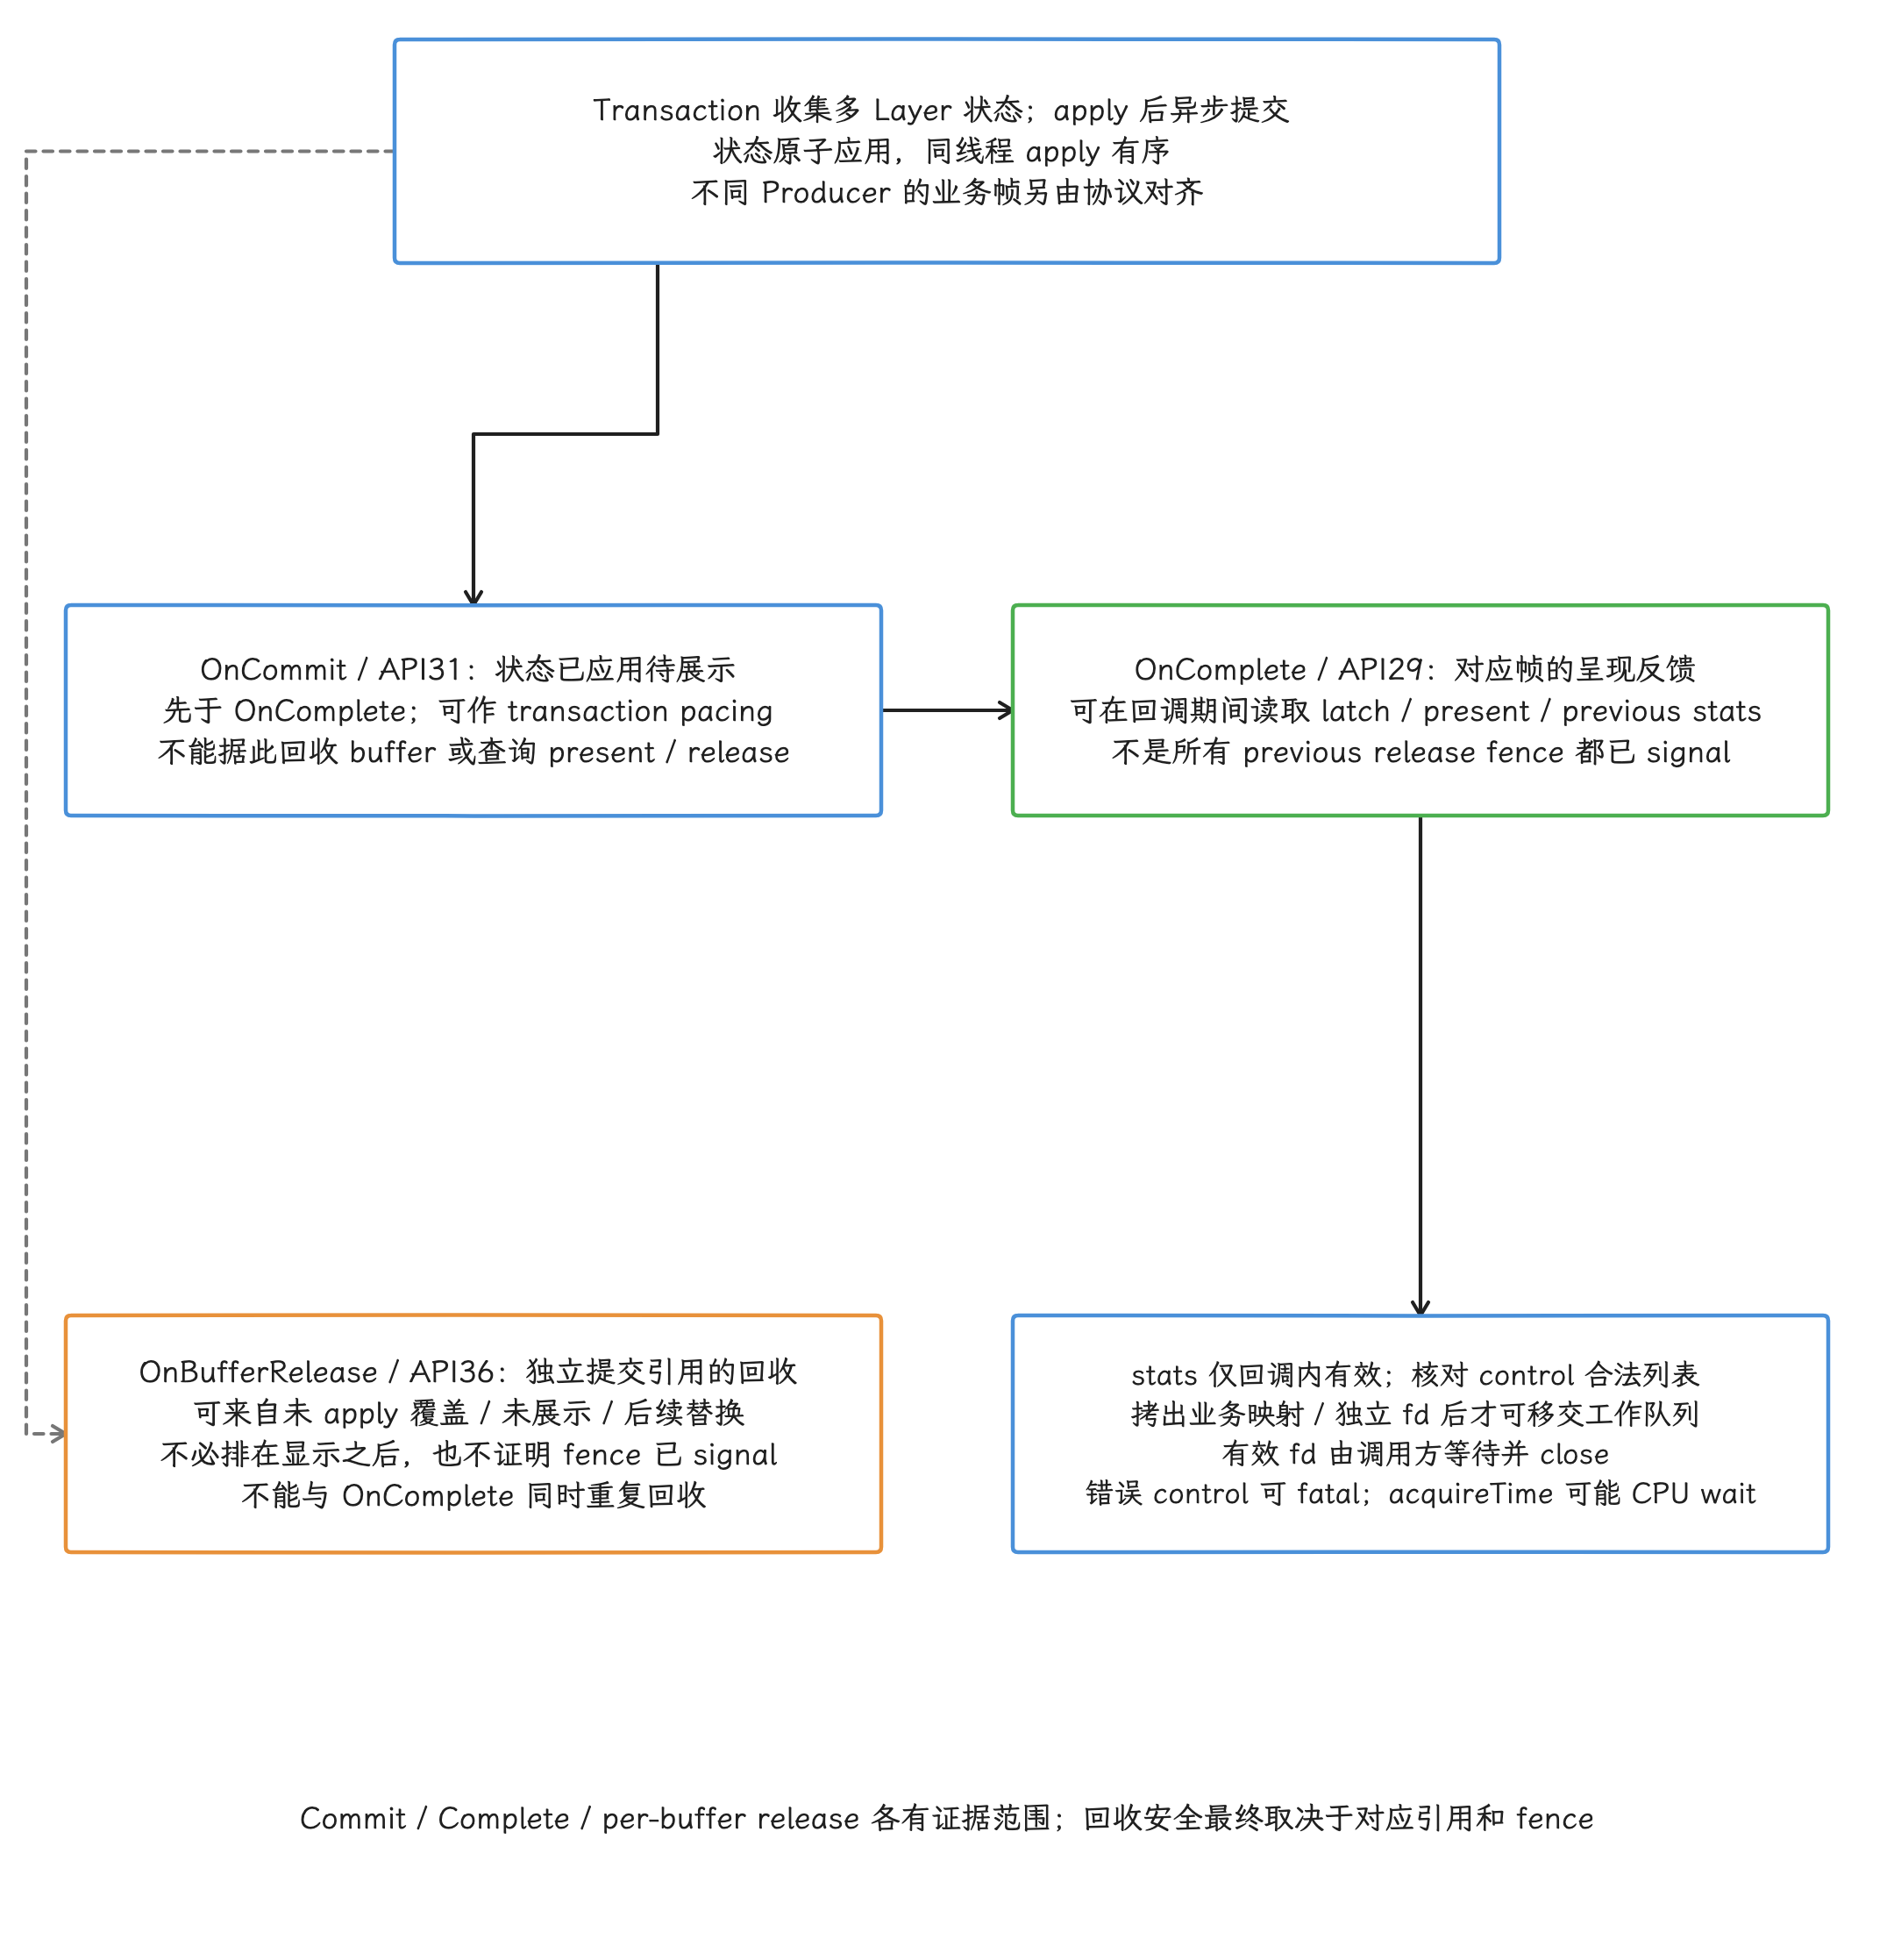
图:同 transaction 状态原子应用,同线程 apply 有序,共享 transaction 的 host 修改要串行。apply 异步返回不保证下一 VSync 或 GPU 完成;多 Producer 业务帧需上层协议。OnCommit API31 先于 OnComplete,不能查 present/previous-release;OnComplete API29 可在回调内查询 stats,stats 裸指针只在回调期间有效。control 必须是 stats 更新/移除列表成员,否则固定 r1 可 fatal;getASurfaceControls 数组须专用 release。返回有效 fd 由调用方等待/close,可移交独立 fd 与复制业务数据;deprecated acquireTime 可能 waitForever。API36 per-buffer release 可未显示即发生,回调交回 fence 也不等 signal。
API 36 起优先使用 setBufferWithRelease()。它把回收通知直接绑定到本次 buffer 提交,池状态直接从回调读,“上一块 buffer”的 transaction stats 这层反推就省掉了。同一提交采用 per-buffer callback 回收后,OnComplete 里的重复回收可以去掉;同一内存有多次提交引用时,仍须等全部引用及相应 fence 都完成。
Backpressure 与丢帧
NDK 创建的节点默认关闭 backpressure(服务端保留每次提交的策略)。在上一块 buffer 的回调到达前继续提交时,新 buffer 可能覆盖尚未展示的旧 buffer。这适合优先降低时延、允许丢弃中间帧的场景。
ASurfaceTransaction_setEnableBackPressure(..., true) 要求 buffer 在释放并交回回调前先展示;整个 SurfaceControl 被移除是明确例外,本地尚未 apply 就被覆盖的 buffer 同样在这个保证之外。服务端可能因此暂存更多提交。它可以保留帧序,也可能增加排队与内存压力。引擎已经有可靠的 N-buffer 池和 release pacing 时,看到中间帧消失先判断这些中间帧是否具有业务价值,再决定要不要开启。
Layer 层级管理
用树描述显示层级
下面的结构适合视频编辑器或自绘播放器:视频、字幕和调试信息的更新频率不同,因此各自使用少量独立 Layer。
Host Window
└── Native Container
    ├── Video Buffer Layer      Z = 0
    ├── Subtitle Buffer Layer   Z = 10
    └── Debug Buffer Layer      Z = 20
父节点的位置、裁剪和可见性会作用于整个子树。setVisibility(HIDE) 会隐藏节点及其后代;reparent(child, newParent) 更换 child 的父节点时,其原有后代仍跟随 child;reparent(child, NULL) 则让整个子树脱离显示树。
相同 Z 值的兄弟节点顺序未定义,创建先后也决定不了它。需要稳定顺序时给出不同 Z 值,并把层级变更和相关几何更新放进同一事务。
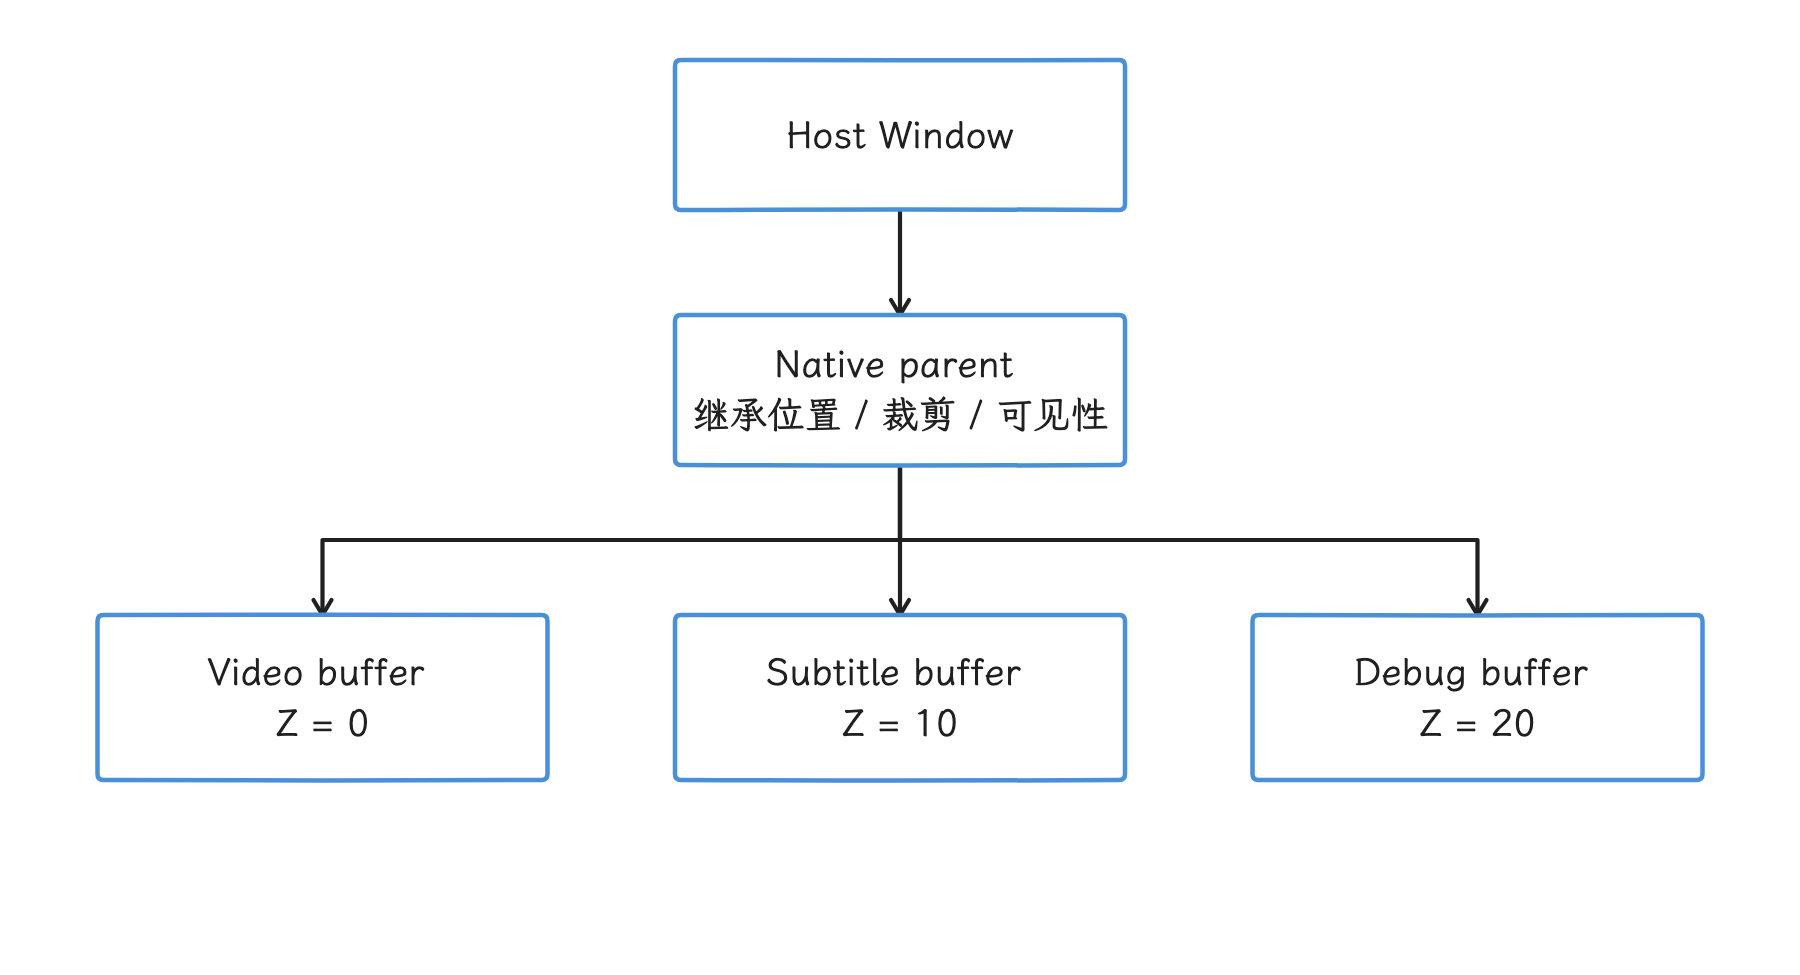
图:用父子树统一移动、裁剪和隐藏少量独立更新的 Layer。 图表示显示层级;业务对象所有权和 buffer 生命周期另行约定。
跨进程传递的路径
Java android.view.SurfaceControl 从 API 29 起实现 Parcelable,系统组件可以经 Binder 传递可恢复的句柄,再在目标进程创建本地引用。普通应用嵌入远端 View 时,更常见的公开封装包括:
- 提供方用
SurfaceControlViewHost托管远端 View; - 接收方取得封装远端 Surface 层级与输入信息的
SurfacePackage,并把它附着到SurfaceView; - API 34 起可用
SurfaceSyncGroup收集参与者的同步结果; - native 代码需要操作已经传到本进程的 Java control 时,再用
ASurfaceControl_fromJava()桥接。
公开 NDK 没有 ASurfaceControl_writeToParcel(),ASurfaceControl* 只是当前进程地址空间里的句柄,跨进程传递要走上面这些 Java 封装。跨进程双方还要约定谁创建节点、谁执行 reparent、谁在 Binder death(远端进程死亡)后清理,以及服务退出时如何让 callback context 失效。
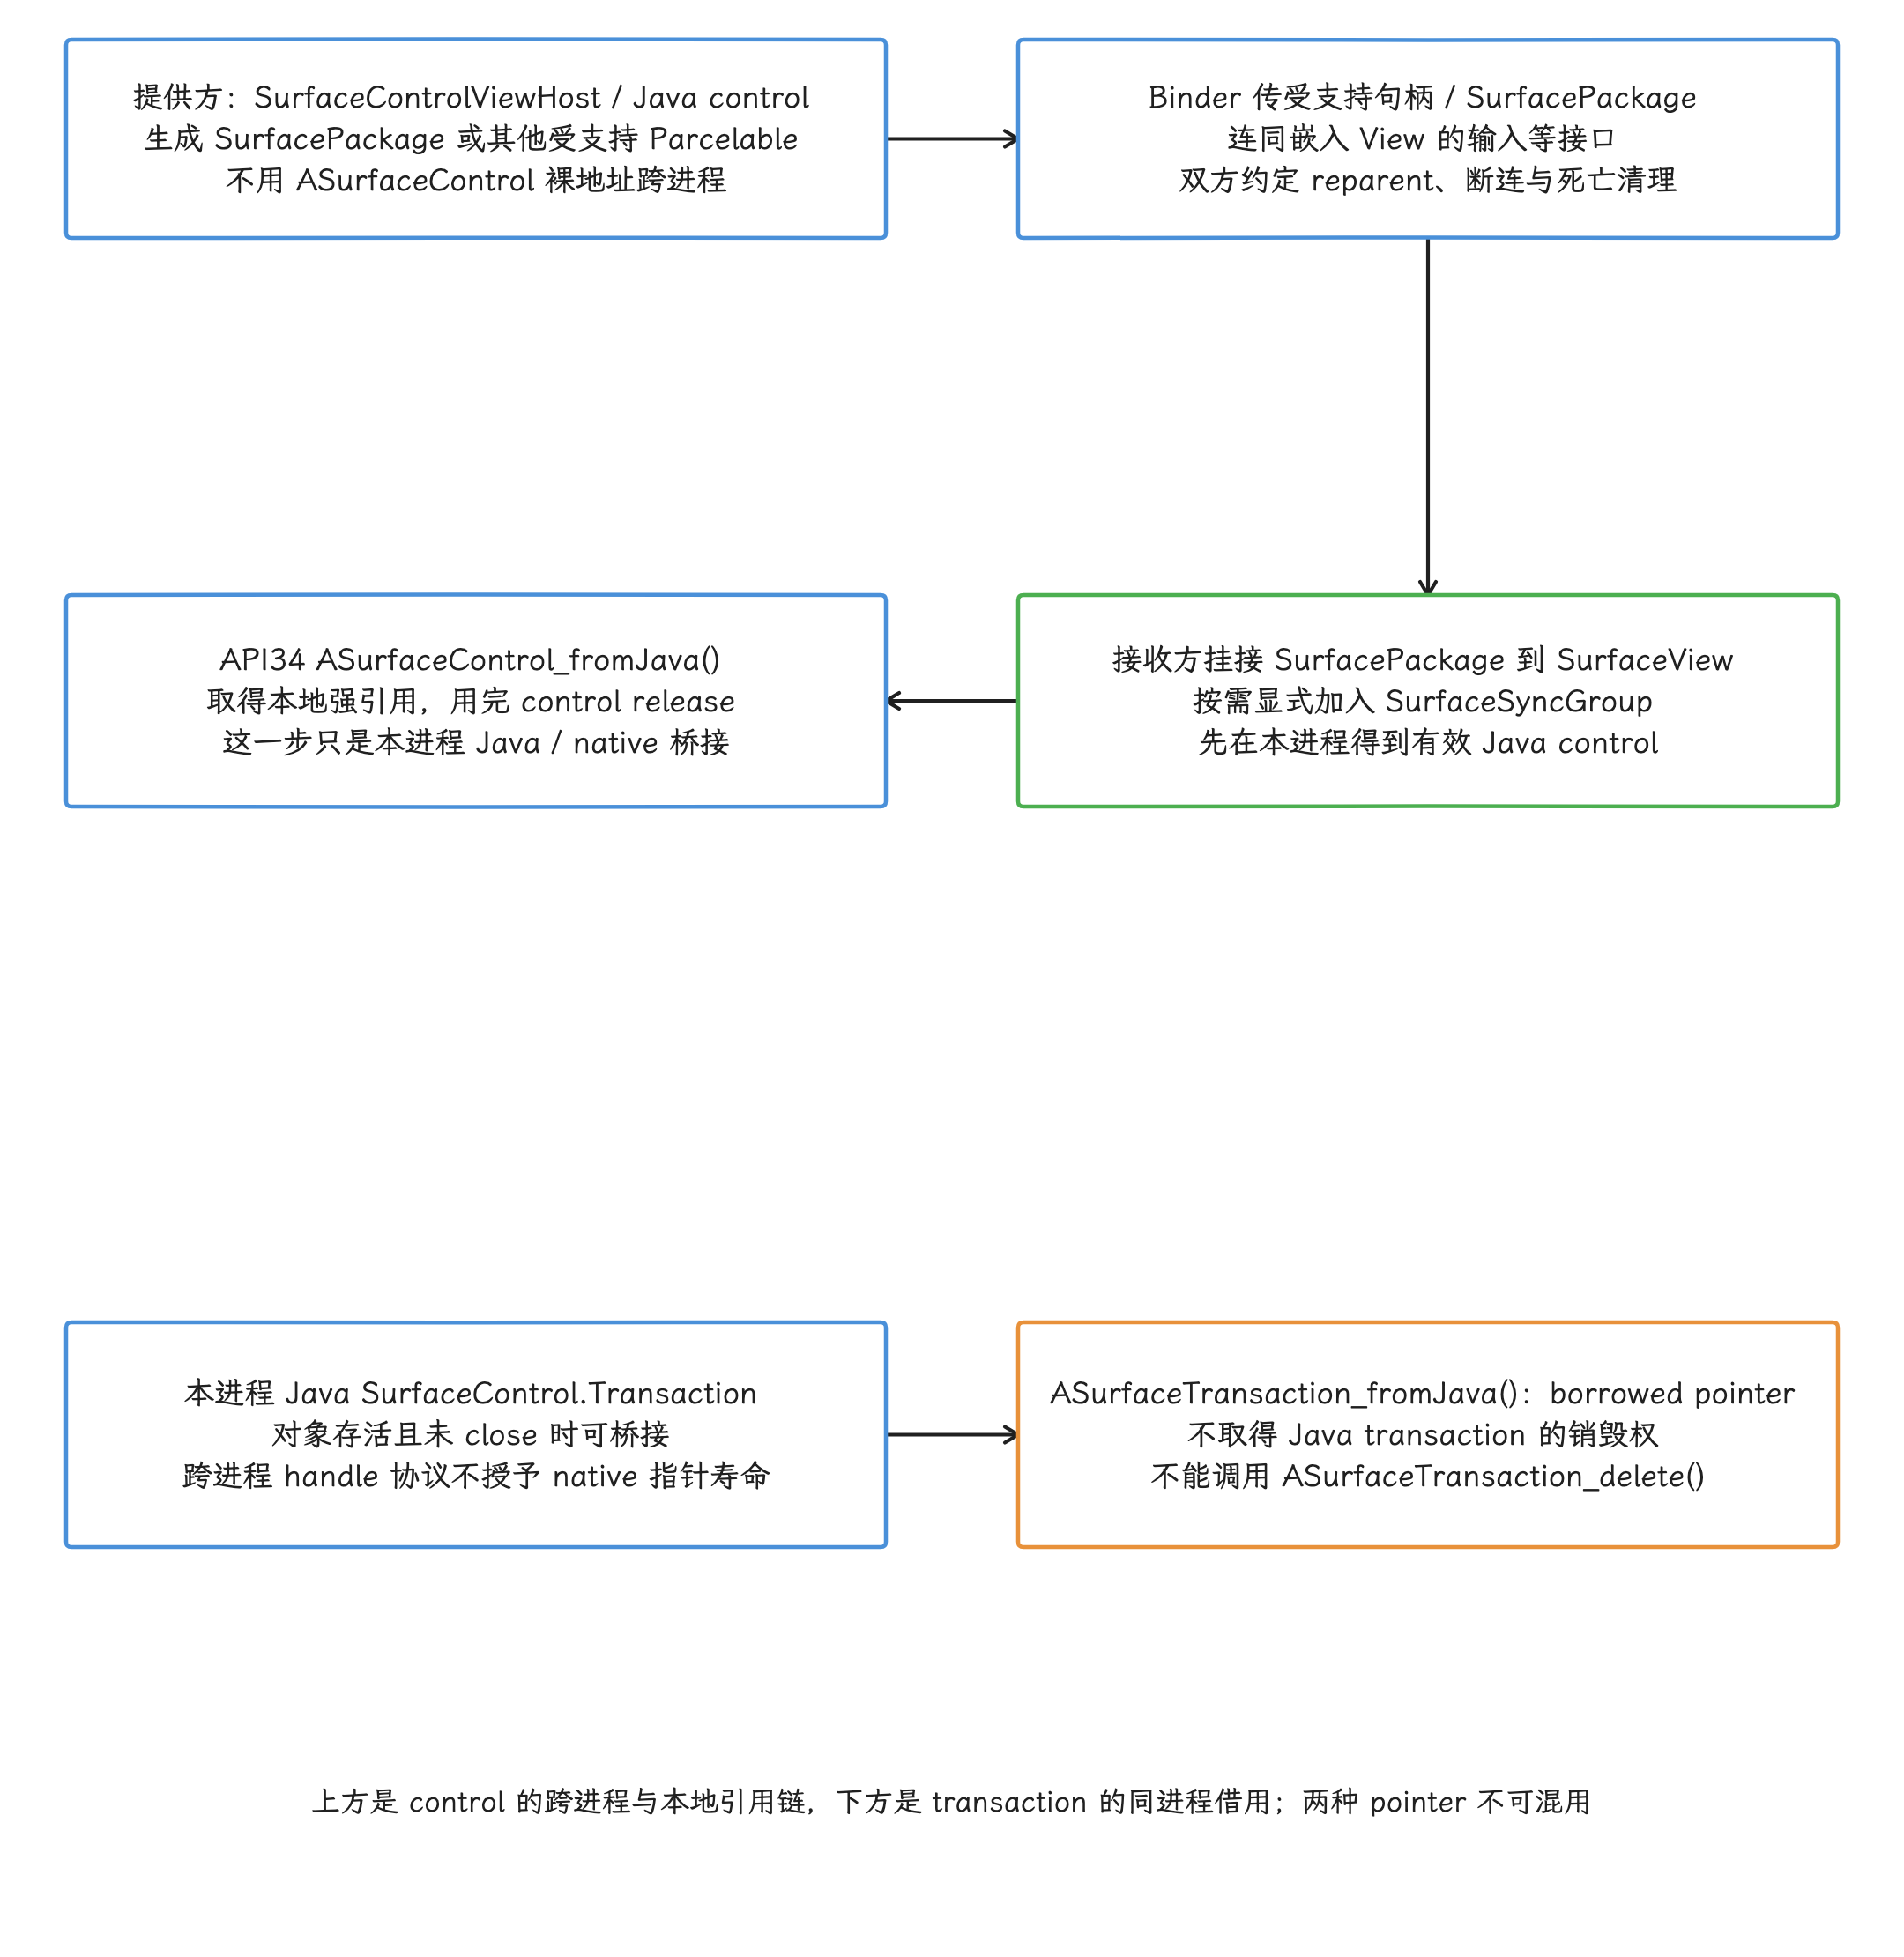
图:SurfaceControl 的 Parcelable / SurfaceControlViewHost.SurfacePackage 负责受支持的跨进程传递,接收方把 SurfacePackage 附着 SurfaceView,API34 可显式加入 SurfaceSyncGroup;公开 NDK 没有 writeToParcel,裸 control 指针仅当前地址空间有效。API34 control fromJava 取得需 release 的本地强引用;transaction fromJava 只借用 Java 内部指针,Java 对象必须存活且未 close,不可 NDK delete。Binder death、reparent 权责与 callback context 失效由协议约定,同步组参与不自动发生。
销毁分为“离开显示树”和“释放本地引用”
ASurfaceControl_release() 只减少调用方持有的本地强引用。头文件明确说明,只要父节点仍在显示树中,surface 及其 children 就仍可能留在屏幕上。
需要移除一棵子树时,可以按以下顺序处理:
- 停止新生产和新 transaction 提交,保留未完成回调所需的对象;
- 用 transaction 执行
reparent(node, NULL)移出显示树并提交;需要确认显示状态时另等OnComplete; - 处理既有提交的全部 release 通知与 fence,以及 Producer 自身尚未完成的写入;
- 最后释放本地
ASurfaceControl引用、buffer pool 和回调上下文。
这四步分别处理显示树状态、transaction 完成、像素所有权和本地引用,跳过任何一步都会留下一类清理没做。release() 只减本地引用,移出显示树要靠 reparent 完成;HIDE 只改变可见性,节点和当前 buffer 仍可保留,最后一个 buffer 的 release 未必由它触发;移除显示树之后,本地对象的销毁和 fence 的等待仍要应用自己完成。
Layer 数量的权衡
每个独立 buffer Layer 都会增加状态遍历、buffer/fence 跟踪和合成策略输入。HWC 能直接处理多少 Layer,取决于像素格式、缩放、旋转、alpha、HDR、secure 属性、分辨率和厂商硬件限制;“超过 N 层必然 GPU 合成”这样的通用阈值并不存在,结论要落到具体设备的合成数据上。
拆分 Layer 时,重点判断两个条件:内容是否需要独立更新节奏,是否需要独立生命周期。如果两个元素总是一起生产、移动和销毁,把它们绘入同一个 buffer 往往更简单。
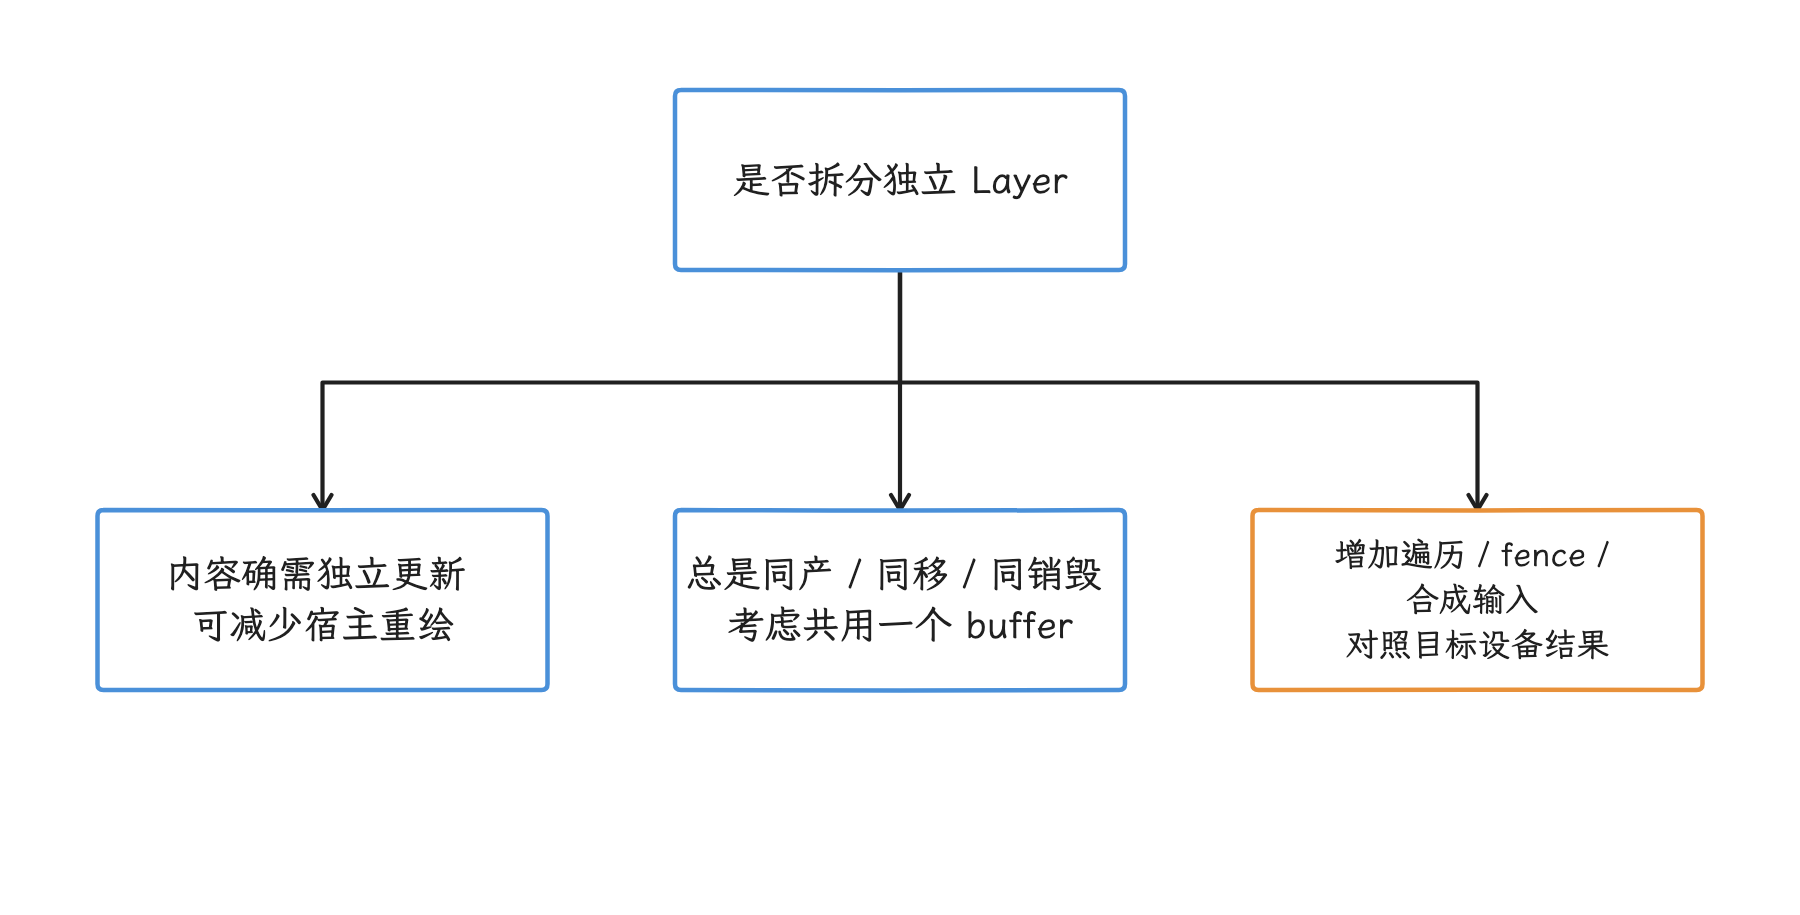
图:独立更新和生命周期有价值时,再检查合成侧新增成本。 没有跨设备通用的 Layer 数阈值;DEVICE/CLIENT 按当帧能力与资源决定。
FrameTimeline API
NDK 中的 FrameTimeline 选择流程
Android 12 引入系统侧 FrameTimeline 诊断能力;NDK 中完整的选择和绑定流程到 Android 13(API 33)才开放,包括 AChoreographer_postVsyncCallback()、AChoreographerFrameCallbackData_*() 和 ASurfaceTransaction_setFrameTimeline()。
VSync callback 会提供多条候选 timeline。每条包含:
vsyncId:用于把 transaction 与 SurfaceFlinger 目标帧关联的标识;expectedPresentationTimeNanos:预计展示时刻,也可以用于推进动画时钟;deadlineNanos:buffer 要赶上该次展示所必须满足的就绪期限。
callback data 只在回调执行期间有效,但从中取出的 AVsyncId、时间戳和索引值可以保存。选择 timeline 时,我们既看业务期望的展示时刻,也估算渲染能否赶上 deadline。
下面的示例从 preferred 及后面的候选中选取一条不早于业务目标、且 deadline 不早于预计完成时间的 timeline;挑不到时跳过本轮生产——最后一个已错过 deadline 的候选,同样算不上满足条件。所有预测完成时间和展示目标都使用绝对的 CLOCK_MONOTONIC 纳秒时间,要传的是时间点,一段 duration 在这里派不上用场。代码省略了 GPU 提交,只展示选择和事务绑定位置。
#include <android/choreographer.h>
#include <android/surface_control.h>

typedef struct FrameContext {
    AChoreographer* choreographer;
    int64_t desiredPresentTimeNanos;
    int64_t predictedReadyTimeNanos;
} FrameContext;

static size_t chooseTimeline(
        const AChoreographerFrameCallbackData* data,
        int64_t desiredPresentTimeNanos,
        int64_t predictedReadyTimeNanos) {
    size_t count =
            AChoreographerFrameCallbackData_getFrameTimelinesLength(data);
    size_t preferred =
            AChoreographerFrameCallbackData_getPreferredFrameTimelineIndex(data);

    if (preferred >= count) {
        return count;
    }
    for (size_t i = preferred; i < count; ++i) {
        int64_t expected =
                AChoreographerFrameCallbackData_getFrameTimelineExpectedPresentationTimeNanos(
                        data, i);
        int64_t deadline =
                AChoreographerFrameCallbackData_getFrameTimelineDeadlineNanos(
                        data, i);
        if (expected >= desiredPresentTimeNanos
                && deadline >= predictedReadyTimeNanos) {
            return i;
        }
    }
    return count;  // 未找到满足条件的 timeline。
}

static void onVsync(
        const AChoreographerFrameCallbackData* data,
        void* opaque) {
    FrameContext* ctx = (FrameContext*)opaque;
    size_t index = chooseTimeline(
            data,
            ctx->desiredPresentTimeNanos,
            ctx->predictedReadyTimeNanos);
    size_t count =
            AChoreographerFrameCallbackData_getFrameTimelinesLength(data);
    if (index >= count) {
        AChoreographer_postVsyncCallback(ctx->choreographer, onVsync, ctx);
        return;
    }
    AVsyncId vsyncId =
            AChoreographerFrameCallbackData_getFrameTimelineVsyncId(data, index);

    ASurfaceTransaction* tx = ASurfaceTransaction_create();
    ASurfaceTransaction_setFrameTimeline(tx, vsyncId);
    /* renderFrameAndAttachBuffer(tx, vsyncId); */
    ASurfaceTransaction_apply(tx);
    ASurfaceTransaction_delete(tx);

    AChoreographer_postVsyncCallback(
            ctx->choreographer, onVsync, ctx);
}
连续渲染时,每次 callback 都要再次注册下一帧。AChoreographer_getInstance() 必须在带有 ALooper(NDK 消息循环)的线程中调用。示例已在没有合适候选时跳过生产;工程代码还要处理上下文销毁、预测预算更新、渲染取消和 buffer 提交失败。跳帧分支也只重注册 callback,不会创建空 transaction。
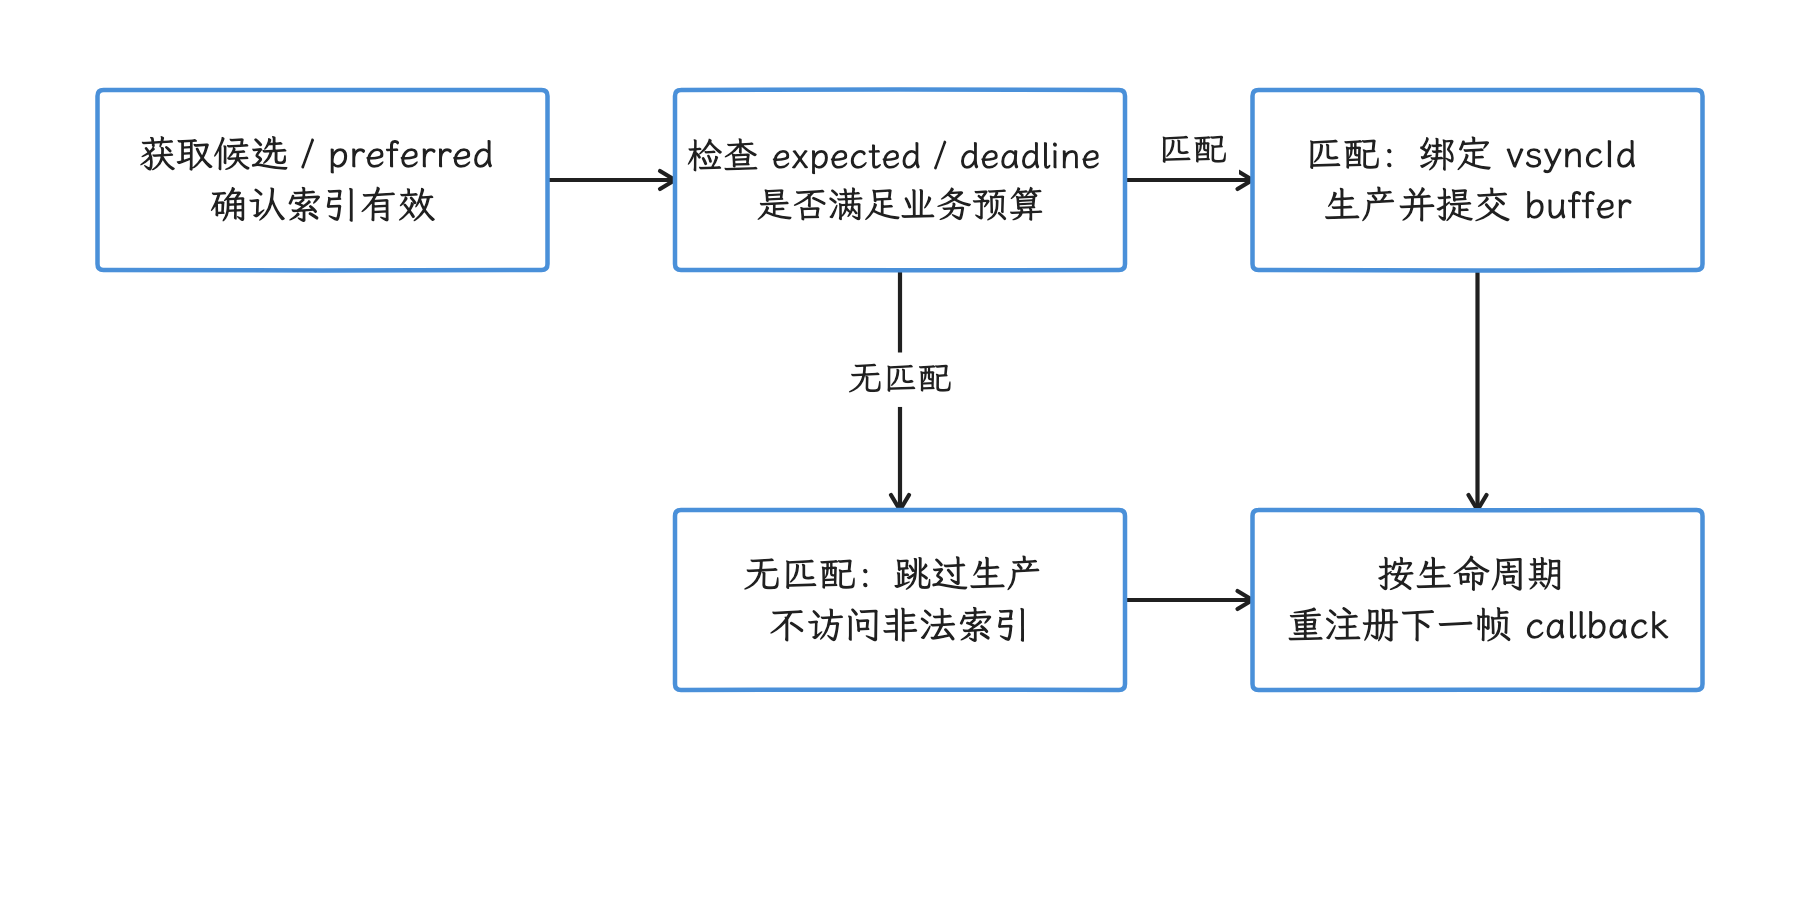
图:从 preferred 开始检查时间条件,成功才绑定 token 与 buffer。 没有可行候选时重注册并跳过;不把最后一个已错过 deadline 的候选当作满足。
setFrameTimeline() 已经把 transaction 关联到候选 timeline 的 expected presentation time 和 deadline,同一个 expected time 再填一遍 setDesiredPresentTime() 属于重复劳动。后者是 API 29 起的独立调度请求,适用于没有 vsyncId,或者业务明确要求“不早于某时刻”展示的场景。如果同时使用两个请求,应保证它们的目标一致;过期或无效的 vsyncId 会被忽略。
setFrameRate() 和 FrameTimeline 分工不同:它向系统声明内容帧率,可能影响显示刷新率选择;产帧节奏仍要靠 Choreographer、swapchain pacing 或 release callback 自己控制。
Trace 中怎样解释 FrameTimeline
FrameTimeline 提供的是“计划”和“结果”的对应关系。分析一帧时至少记录:
| 字段 | 回答的问题 |
|---|---|
| expected presentation | 应用选择的目标展示时刻 |
| deadline | buffer 最晚应在何时准备好 |
| App Actual end / Display Actual end | App 完成并交付的边界与显示栈的呈现边界分别是什么,不能把两个 slice 的结束都读成上屏 |
| present type / jank type | 平台如何归类早、准时或迟到 |
| Layer / token 映射 | 这条 timeline 对应哪个内容对象 |
vsyncId 只负责把 transaction 和目标帧关联起来,卡顿的归因还要看 actual 时间。App SurfaceFrame 的 Actual end 通常结合 queue 与 acquire signal(pending 时有源码替代路径);DisplayFrame 的 Actual 结束使用显示栈 present 时间——这两处都是系统侧记录,光学测量要另找手段。覆盖范围也要核对:Perfetto 官方说明目前不支持 SurfaceView 的完整 FrameTimeline,单独调用 setFrameTimeline() 也证明不了独立 HBR/SurfaceView 已具备完整 App Expected/Actual。缺失时用 buffer、transaction、GPU fence、latch 和 present 补证。
Fence 处理与生命周期
一块 buffer 的同步方向
下面的方向图只描述一块 buffer 的读写同步,不表示对象引用关系。
Producer 写入
    │
    ├── acquire fence ──> SurfaceFlinger / HWC 等待后读取
    │
    └── buffer 保持不可复写
                         │
                         └── release fence ──> Producer 等待后复用
acquire fence 保证 Producer 写完后 Consumer 才读取,release fence 保证 Consumer 读完后 Producer 才重新写入。两者方向相反,并且都独立于 AHardwareBuffer 的引用计数:对象引用拿在手里,只说明内存还在自己名下,同步条件要看 fence。
调用 setBuffer() 或 setBufferWithRelease() 后,framework 会接管传入的 acquire fence fd。如果调用方还要保留同一 fence 用于诊断,必须在调用前通过 dup() 创建另一份 fd;所有权转移后,原 fd 归 framework,再关闭或复用都会出错。
内核版本 android17-6.18-2026-06_r6 中,drivers/dma-buf/sync_file.c 把 dma-fence 暴露为 fd,drivers/dma-buf/dma-fence.c 提供 signal、callback 和 wait 原语。这套机制是通用的;某台设备的 GPU、codec 或 Display fence 为什么迟到,要结合厂商驱动 timeline 和目标 buffer 的所有权才能归因。
API 36:按 buffer 接收 release
release callback 可能在任意线程执行;更稳妥的做法是回调里只做移交,把 slot 和 fence fd 交给专门的回收队列处理。
static void onBufferRelease(void* opaque, int releaseFenceFd) {
    BufferSlot* slot = (BufferSlot*)opaque;
    enqueueForRecycle(slot, releaseFenceFd);
}

void attachBuffer(
        ASurfaceTransaction* tx,
        ASurfaceControl* child,
        BufferSlot* slot,
        int acquireFenceFd) {
    ASurfaceTransaction_setBufferWithRelease(
            tx,
            child,
            slot->hardwareBuffer,
            acquireFenceFd,
            slot,
            onBufferRelease);
}
回收线程看到 releaseFenceFd >= 0 时,要确认等待成功、再关闭 fd,并在该 buffer 的全部提交引用都已释放后把 slot 放回可写队列;等待失败应隔离 slot,按失败路径另行处理;值为 -1 表示 buffer 已经可以复用。回调上下文 BufferSlot* 必须存活到回调执行完毕,组件销毁时要先停止新提交,再排空未完成回调。
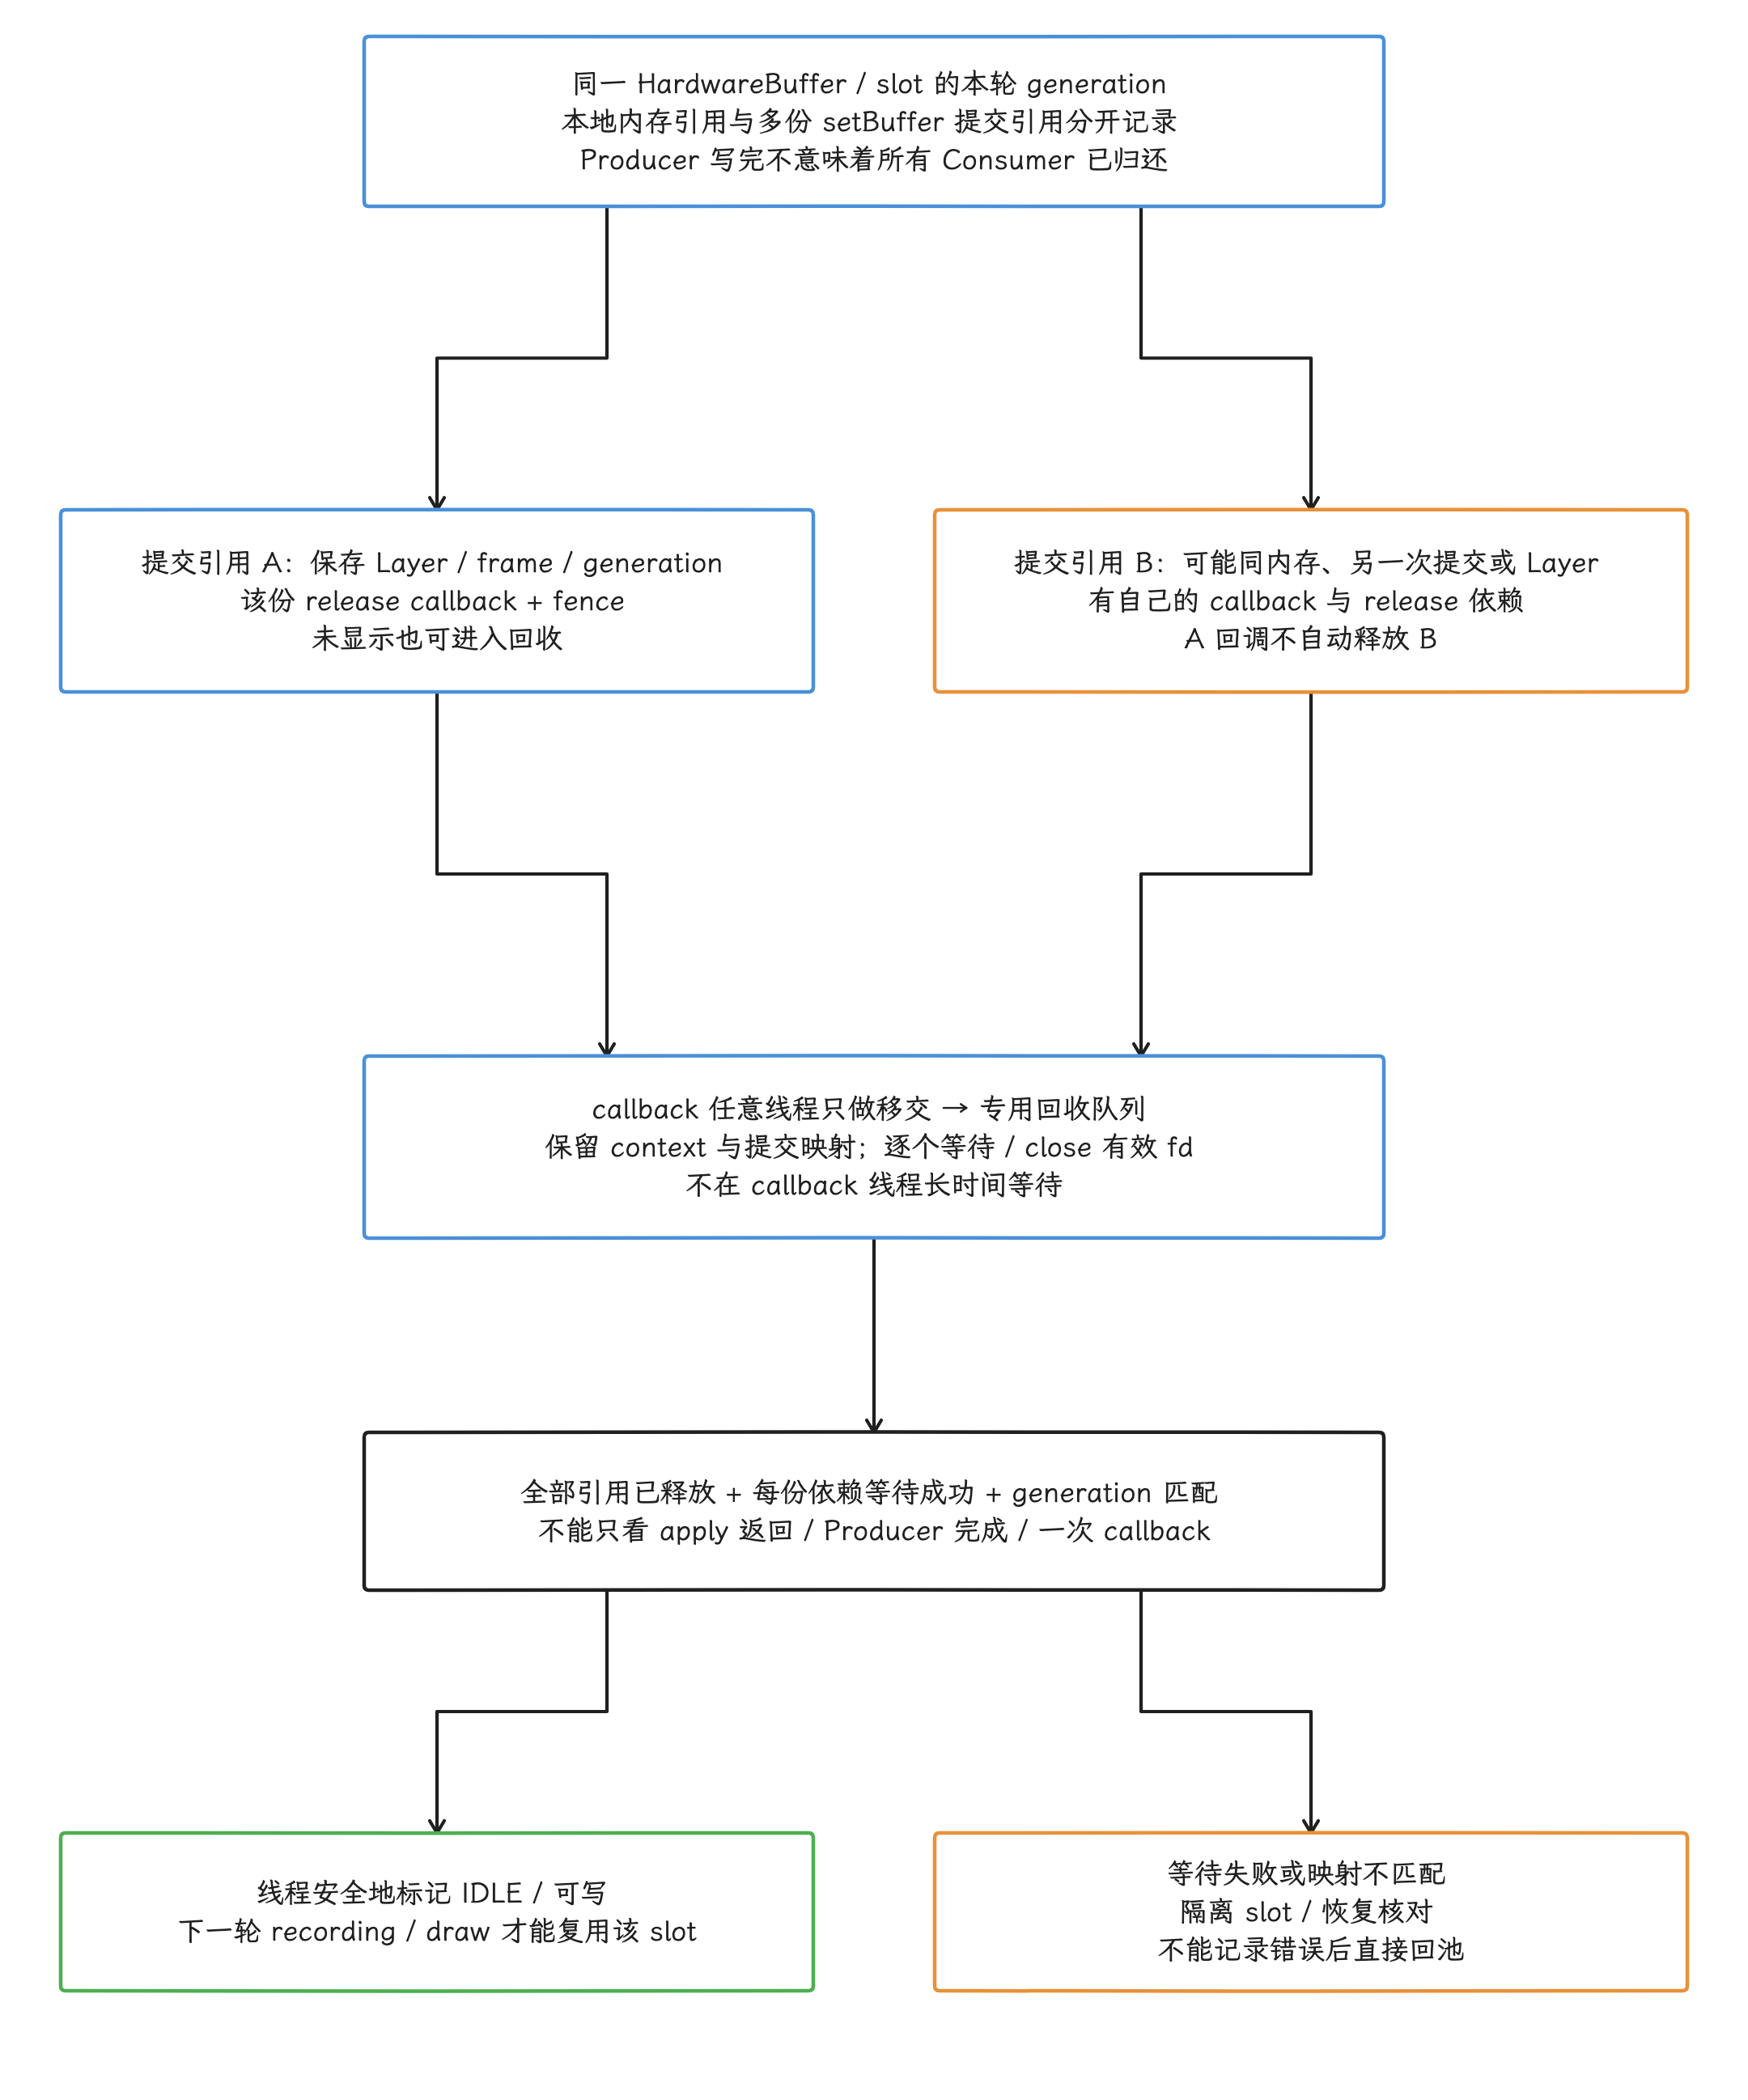
图:一块 AHardwareBuffer 可被不同 Layer 或多次 setBuffer 作为多份提交引用持有。每次 release 只归还对应提交引用,可能未显示,不是显示计数。回调任意线程只移交提交记录/generation/fd,context 覆盖回调及排队任务;非负 fd 须等待成功后 close,-1 按契约无需等待。必须全部引用释放且所有依赖成功,generation 匹配后线程安全置 IDLE;失败隔离,旧回调不能释放新一轮 slot。producer fence pending 可先提交,但 Producer 完成、apply 返回或一次 callback 都不足以重写。per-buffer 回收与 OnComplete 重复回收,二者只取其一。
头文件规定,同一 transaction 中的 buffer 在 apply() 前又被 setBuffer() 替换时,会立即进入 release 回调路径;固定 r1 的 releaseBufferIfOverwriting() 对本进程回调使用专用线程异步派发,并把旧 acquire fence 当作 release 依赖交回,所以这个 “立即” 指的是尽快安排回调:派发交给专用线程异步进行,旧 GPU 写入也可能仍在进行。正常展示后的 release 可由替换它的 transaction 的完成处理携带;backpressure 关闭、节点移除等路径也可回收未显示 buffer。池状态应按实际 callback、提交引用与 fence 维护,按显示帧数推算出来的状态靠不住。
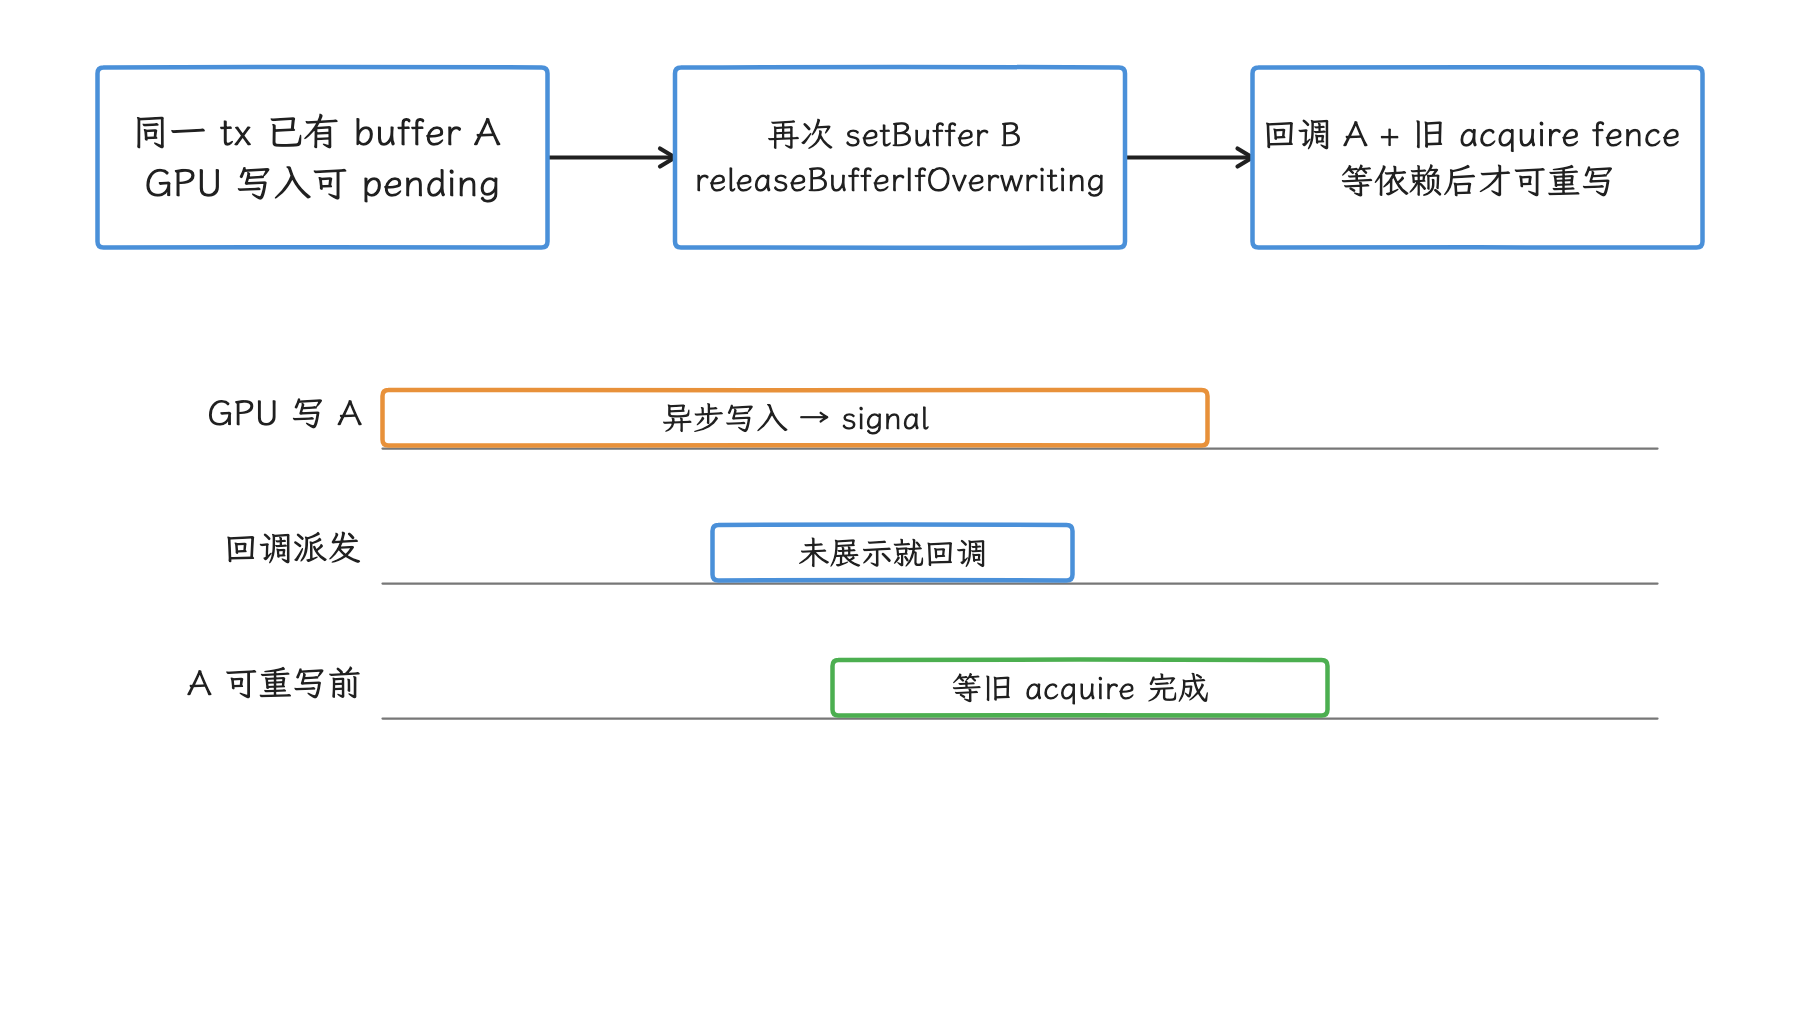
图:本地覆盖会安排 release 回调,旧 GPU 工作仍可能继续。 本进程由专用线程派发;条长仅为依赖示意,不是覆盖调用栈同步回调。
API 29—35:从完成统计取得上一块 buffer
旧系统使用 setBuffer(),并在 OnComplete 执行期间、确认 control 属于该 stats 的更新/移除列表后查询。下面的两个业务函数必须按已保存的提交记录定位上一块 buffer,不能简单把 control 的“当前 slot”回收:
int fd = ASurfaceTransactionStats_getPreviousReleaseFenceFd(stats, control);
if (fd >= 0) {
    enqueuePreviousBufferForRecycle(control, fd);
} else {
    recyclePreviousBufferNow(control);
}
该 fd 描述此 Layer 的上一块 buffer。每次把 buffer 应用到某个 surface,framework 都将其视为一次独立引用;同一个 AHardwareBuffer 被多次提交时,第一次 callback 到达只释放其中一个引用,要等所有待处理引用都释放后才能复写。
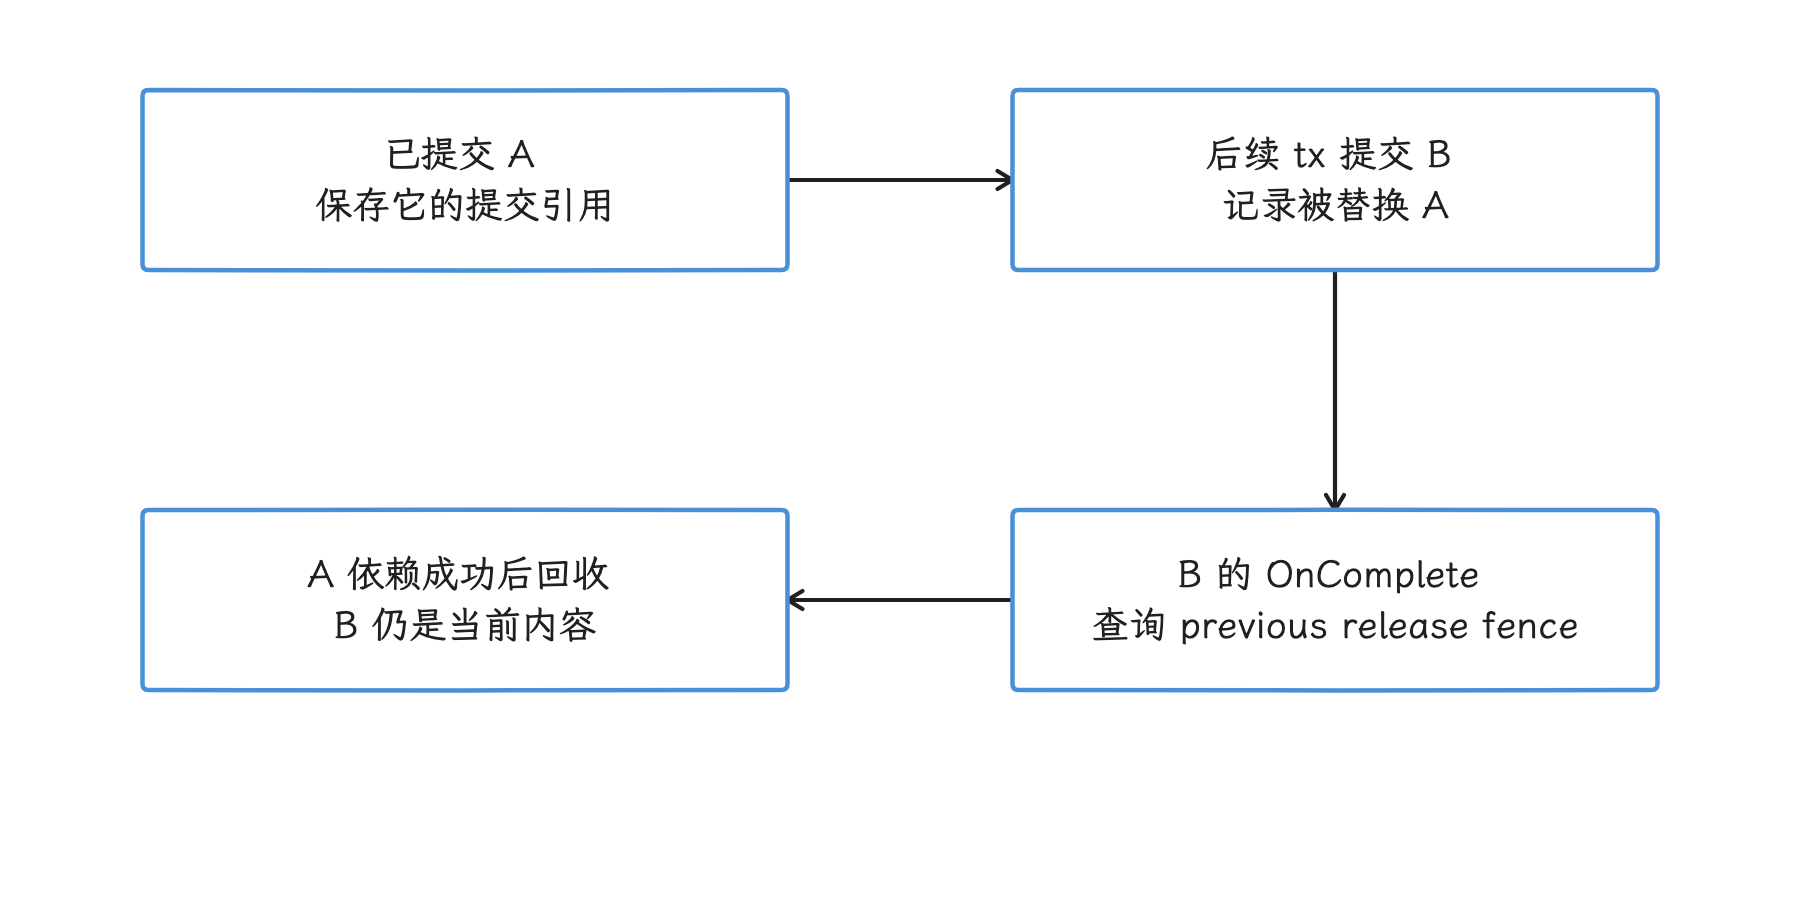
图:提交 B 时保存 A→B 映射,用 B 的完成统计回收上一提交引用 A。 当前 B 留待未来替换/移除;control 必须来自该 stats 的合法列表。
常见错误
| 错误 | 后果 | 修正 |
|---|---|---|
apply() 返回后立即复写 buffer | 撕裂、花屏或同步错误 | 等待 per-buffer callback/previous release fence |
把 acquire fd 传入后再次 close() | framework 等到无效或复用 fd | 调用前按需 dup(),明确所有权转移 |
在 OnCommit 查询 present / release fence | 查询失败 | 在 OnComplete 查询,或使用 API 36 release callback |
| callback context 提前销毁 | use-after-free(释放后继续访问) | 停止提交并排空回调后再销毁池 |
| callback 线程直接长时间等待 | 回调拥塞,后续 release 延迟 | 把 fence 移交给回收线程 |
只释放 ASurfaceControl,未移除子树 | Layer 仍可能显示 | 停新提交、reparent-null、排空 release/fence,再释放句柄;hide 仅改变可见性 |
实战场景
自绘引擎与视频编辑器
SurfaceControl 适合把更新节奏不同的少量内容拆开:主画面逐帧更新,字幕只在文本变化时更新,调试层只在采样点刷新。引擎负责生产 AHardwareBuffer、提交 acquire fence、处理 release callback;SurfaceFlinger 把这些 Layer 与其他窗口一起合成。
收益要同时用应用侧和显示侧的数据验证。App GPU 工作减少后,额外 Layer 仍可能因为缩放、alpha、HDR 或硬件限制进入 CLIENT composition;如果 App RenderThread 负载降下来,SurfaceFlinger/RenderEngine 负载却升上去,成本只是转移到了系统合成阶段。
SurfaceView 宿主
SurfaceView 提供独立 Surface 与 Layer 生命周期。native 组件可以从其 Java Surface 取得 ANativeWindow,再通过 createFromWindow() 创建受宿主裁剪和可见性影响的子节点。宿主销毁或重建 Surface 后,旧 parent handle 指向的树根已随之失效,需要重新创建。
需要直接向 SurfaceView 的 BufferQueue 渲染时,应使用该 ANativeWindow 的 EGL/Vulkan/MediaCodec Producer 路径;只有需要在宿主节点下组织额外 Layer 时,才使用 ASurfaceControl_createFromWindow()。前者向现有队列生产内容,后者创建新的子 Layer,两者是不同操作。
WebView
标准 WebView 主体通常由 Chromium 准备 compositor frame(合成器帧),再通过宿主进程的 HWUI functor 合入 App Window buffer。renderer 进程独立,说明的只是内容生产跨了进程;网页主体有没有独立的 SurfaceFlinger Layer,要另找依据。
视频、受保护内容或 provider 选择的 overlay 可能产生额外 SurfaceControl Layer。判断设备上的真实路径时,要检查 WebView provider revision、SurfaceFlinger Layer 树、宿主 RenderThread 和媒体 Producer;仅看到 Viz/Compositor 线程,离“网页已经独立合成”的结论还差着证据。
画中画与系统动画
进入 PiP 时,WindowManager Shell 通常持有任务 leash(承载过渡动画属性的临时父 Layer)和 PiP container,并通过 Java/framework transaction 修改位置、裁剪、圆角和层级。普通应用负责提交视频内容;把自己的 Layer 任意 reparent 到系统私有容器,超出了公开 NDK API 的能力范围。
分析 PiP 卡顿时,我们把问题拆开看:
- Shell / WMS 的几何事务是否按时;
- 视频 Producer 的 buffer 与 acquire fence 是否按时;
- PiP 圆角、阴影和其他窗口是否改变 HWC composition;
- transition 结束后旧 leash / Layer 是否被清理。
旧 buffer 与新几何同时生效时,可能出现拉伸或黑边。内容迟到与动画 transaction 迟到要按 token 和 Layer 分开定位。
跨进程 View 与 Flutter Platform View
分析跨进程 View 时,优先从 SurfaceControlViewHost、SurfacePackage 和 SurfaceSyncGroup 的公开生命周期入手。Flutter Platform View 可能走 hybrid composition(原生 View 与 Flutter 内容分层合成),也可能走 Texture 路径或 SurfaceProducer,实际拓扑随 Flutter engine、Android 版本和插件实现变化。框架名称本身说明不了是否存在独立 SurfaceControl Layer。
我们先把“内容 Producer → 消费位置 → 宿主 buffer 或独立 Layer → SurfaceFlinger”的对象关系画出来,再讨论优化。只按进程名或框架名判断,很容易把应用内的宿主纹理合成误写成系统 overlay。
Trace 视角
先建内容对象表
分析混合出图时,我们先按内容对象归档,再谈应用和线程。SurfaceControl 场景可以先填写这张表:
| 内容 | Producer | 提交入口 | SF Layer / parent | buffer 标识 | acquire / release | 时间线 |
|---|---|---|---|---|---|---|
| 主画面 | 引擎 RenderThread | setBufferWithRelease() | game-main/host | pool slot + frame id | GPU → SF/SF → pool | vsyncId |
| 字幕 | UI raster worker | setBuffer() | subtitle / container | subtitle generation | CPU ready / previous release | 可选 |
| 视频 | codec | queueBuffer() 或独立 bridge | video / host | codec PTS + frame number | codec → consumer | media timing |
这张表可以发现同名 Layer 已经重建、误用宿主 FrameTimeline 解释独立视频、把 release fence 归到错误 buffer 等问题。
应用侧 trace 标记
NDK 的 ASurfaceTransaction_apply() 只调用 native transaction 的 apply()。源码并没有承诺一定生成名为 ASurfaceTransaction_apply 的 trace slice;setTransactionState、latchBuffer 等内部 slice 也可能随版本和 trace 配置变化。
应用可以在提交点加入自己的稳定 marker。下面的标记只圈出 API 调用发生的位置;transaction 是否 commit、内容是否上屏,要结合系统侧数据确认。
#include <android/trace.h>

ATrace_beginSection("SC submit: subtitle frame=42");
ASurfaceTransaction_apply(tx);
ATrace_endSection();
把业务 frame id 写入自定义 marker 后,再用 transaction、Layer、buffer 和 FrameTimeline 数据源向显示端关联。marker 结束时刻是应用调用返回的时刻,present time 要从显示端取。
一次卡顿分析的最小链路
一次 SurfaceControl 卡顿分析至少覆盖五段:
- Producer 何时开始和结束写 buffer,GPU/codec fence 何时 signal;
- 应用何时提交 transaction,该提交是否被后续 transaction 覆盖;
- SurfaceFlinger 看到哪个 Layer、parent、Z、crop、buffer 和 frame token;
- 该帧目标 Layer 分别选择 DEVICE 还是 CLIENT,显示输出是否使用 client target,RenderEngine/HWC 花费多少;
- actual present 和 release fence 何时发生,buffer pool 是否及时恢复可写 slot。
下面的命令用于核对当前 Layer 名称。不同版本的详细 dump 格式可能变化,自动化脚本解析时以字段名为准,跳过固定列位置。
adb shell dumpsys SurfaceFlinger --list
adb shell dumpsys SurfaceFlinger
Perfetto 配置应包含应用 atrace、线程调度、Binder、gfx/view、SurfaceFlinger、FrameTimeline 和场景所需的 GPU 数据源。厂商 GPU/HWC counter 是否可见取决于设备;缺少 counter 时,结论里要写清哪些硬件阶段落在本次分析范围之外。
从现象到检查项
| 现象 | 优先检查 | 不要直接下的结论 |
|---|---|---|
apply() 很快,画面仍晚 | acquire fence、目标 timeline、SF/HWC present | SurfaceControl 没有生效 |
| 中间帧消失 | backpressure、连续 setBuffer()、Producer 频率 | SurfaceFlinger 随机丢帧 |
| Layer 数量上升后耗时增加 | parent 树、CLIENT/DEVICE、RenderEngine | 超过固定 Layer 数量上限 |
| WebView renderer 很忙 | renderer/functor/host/media overlay 各自路径 | 网页主体一定是独立 Layer |
| PiP 几何顺、内容卡 | codec buffer、acquire fence、视频 Layer | Shell 动画慢 |
| 内存只增不降 | 未完成 release、buffer pool、旧 Layer/callback context | 单纯 Java heap 泄漏 |
源码索引
surface_control.h:公开 API、级别、fd 所有权和 callback 语义。surface_control_jni.h:API 34 Java/native 桥接及所有权差异。surface_control.cpp:NDK 到SurfaceControl/Transaction的实现映射。SurfaceControl.java:Java Layer 树、Parcelable和 Transaction。BLASTBufferQueue.cpp:BLAST 消费 BufferQueue 并生成事务的路径。SurfaceComposerClient.cpp:transaction 状态收集和提交。SurfaceFlinger.cpp与FrameTimeline.cpp:transaction 应用、帧调度和展示结果。sync_file.c与dma-fence.c:内核 fence fd、signal、callback 和 wait 语义。
相关章节:
- 13.1 Android View 渲染管线与分析方法
- 13.3 SurfaceView 与 TextureView 渲染管线
- 13.5 Vulkan 原生管线与 HWUI 多队列
- 13.9 Android 17 WebView 渲染管线
- 2.8 BufferQueue、Gralloc 与 Sync Fence
- 2.9 SurfaceFlinger 合成、FrontEnd 与事务队列
HardwareBuffer 渲染与提交
前一半的 SurfaceControl 管 Layer 状态、transaction 提交和 fence 同步;轮到像素本身——内容由谁画进 buffer、画完交给谁——就是这一半要回答的问题。HardwareBufferRenderer 负责把内容画进调用方提供的 HardwareBuffer,两边通过一块 buffer 和它两端的 fence 交接。
HBR 解决什么问题
HBR 把一棵 RenderNode 场景树光栅化到调用方拥有的 HardwareBuffer。这块 buffer 之后交给 SurfaceControl、其他进程、GPU 还是媒体 consumer,由调用方自己决定,同步与复用也自己负责。我们记住这条分界,再看它和另外两个 Canvas API 的差别:lockCanvas() 与 lockHardwareCanvas() 都把内容写进 Surface 背后的 BufferQueue,输出目标由 Surface 侧决定。
先看基线 Surface.lockCanvas()。它让 CPU 直接绘制到 Surface:调用方从 BufferQueue 取得可写 buffer,Skia software backend 在 CPU 上完成光栅化(把矢量绘制命令转成像素),unlockCanvasAndPost() 再把 buffer 提交回队列。复杂 Path、大尺寸缩放、滤镜或高分辨率离屏内容会吃掉不少 CPU 时间,这正是 HBR 要接手的场景之一。
把 HBR 当成 lockCanvas() 的硬件加速开关是常见误会——硬件加速的 Canvas 另有入口:Surface.lockHardwareCanvas() 已经用上 HWUI/GPU,输出目标仍是 Surface。三者的分工如下:
| API | 光栅化执行者 | 输出目标 | 提交与 buffer 复用 |
|---|---|---|---|
Surface.lockCanvas() | CPU / Skia software | Surface 背后的 buffer | 由 unlockCanvasAndPost() 和 BufferQueue 协作 |
Surface.lockHardwareCanvas() | HWUI / GPU | Surface 背后的 buffer | 仍沿用 Surface / BufferQueue;每帧必须完整覆盖目标 |
HardwareBufferRenderer | HWUI RenderThread / GPU | 调用方提供的 HardwareBuffer | 调用方选择 consumer,并管理 presentation fence、release fence 和 buffer 池 |
Surface.java 明确规定,lockHardwareCanvas() 不保留前一帧内容,调用方每次都要完整覆盖。HBR 在 draw 前不会自动清空目标,未被本次绘制覆盖的像素会继续保留——这是局部更新的能力,也可能成为残留旧像素的来源。AOSP: Surface.lockHardwareCanvas() AOSP: HardwareBufferRenderer
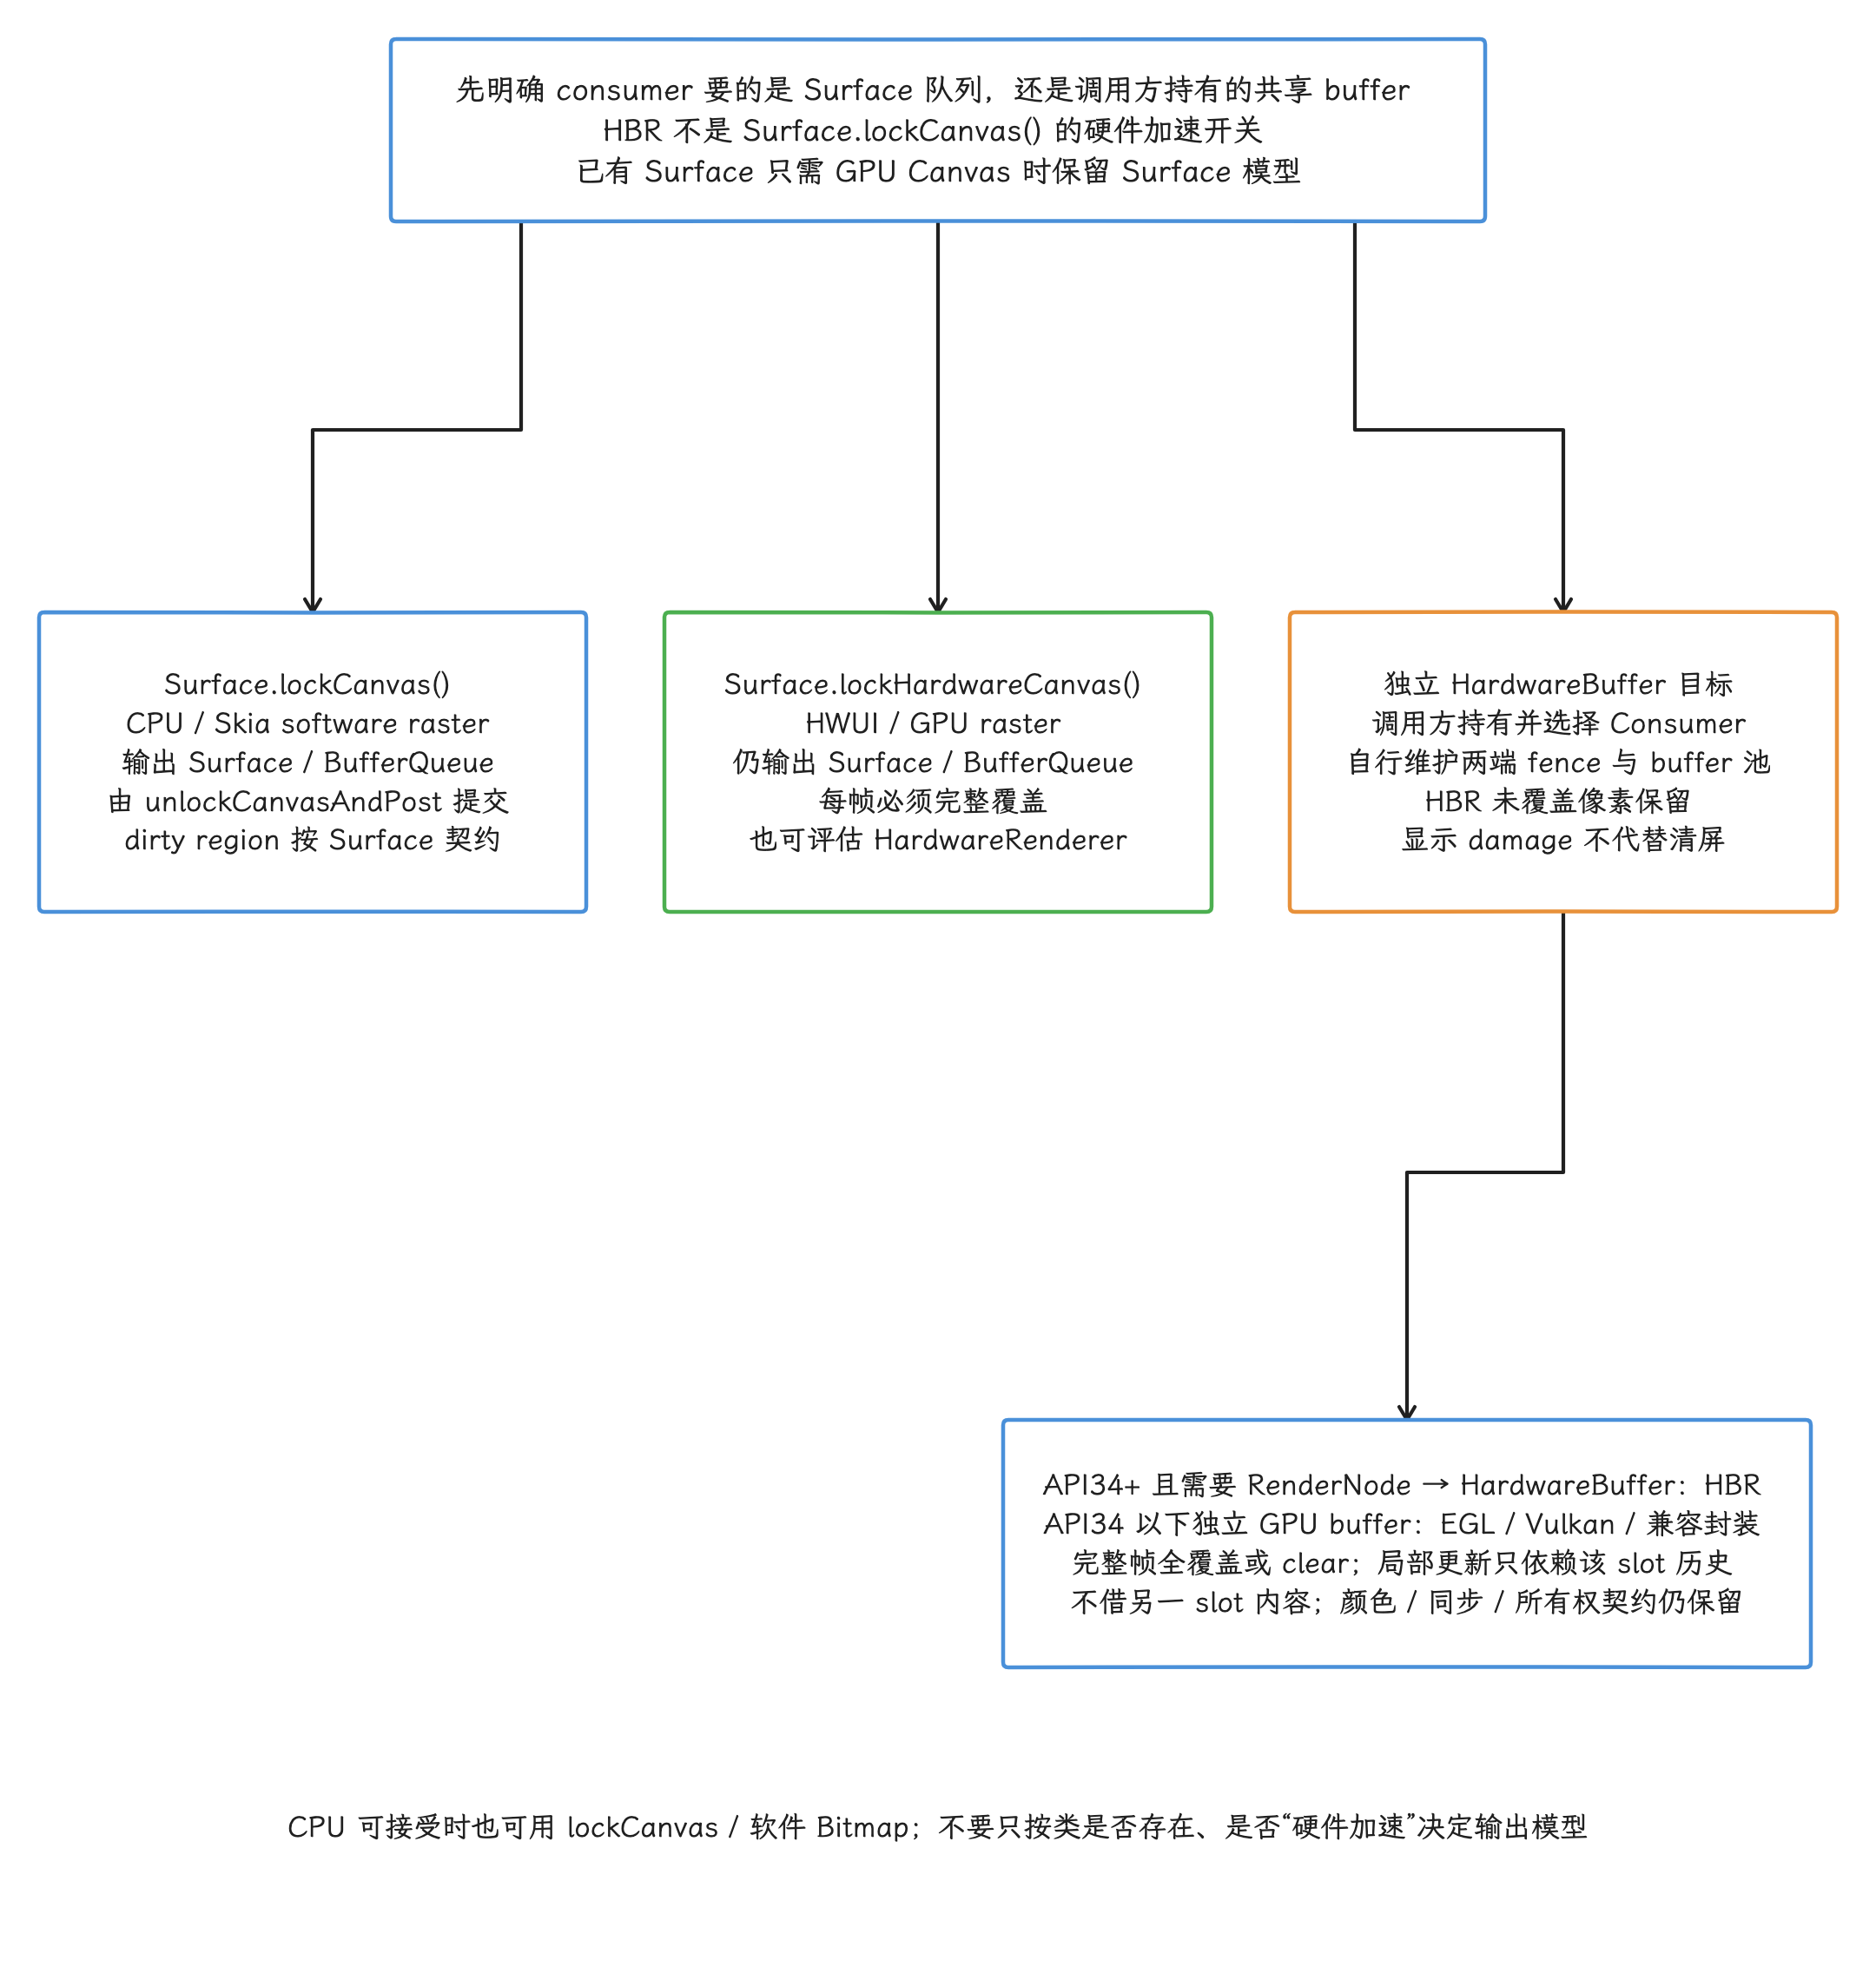
图:lockCanvas为CPUsoftware光栅到Surface的BufferQueue,dirtyregion按Surface契约;lockHardwareCanvas为HWUI/GPU写同类Surface目标,每帧完整覆盖。HBR34+把RenderNode写调用方HardwareBuffer,Consumer/同步/池自行管理,draw前不自动清空;完整帧须完整覆盖或clear,局部更新维护该slot的历史,不能借另一slot内容,surface damage不是清屏。已有Surface只需GPUCanvas可用lockHardwareCanvas/HardwareRenderer;API34以下独立GPUbuffer可EGL/Vulkan或兼容封装,CPU可接受时software。降级必须保留颜色、consumer、fence与资源所有权,NDK没有公开AHardwareBufferRenderer。
如果已经有一个正常消费的 Surface,需求只是 GPU Canvas,lockHardwareCanvas() 或面向 Surface 的 HardwareRenderer 通常更合适。
HBR 的生命周期约束
HBR 是 Android 14 / API 34 加入的 Java API。它复用 HWUI 的基础设施,没有为离屏内容另建一套渲染系统,生命周期上要遵守下面这些约束:
- 所有
HardwareBufferRenderer与HardwareRenderer共享应用进程中的 RenderThread、GPU context 和 GPU 资源。HBR 的工作量可能与普通 View 硬件渲染争用 RenderThread 和 GPU。 - 进程首次创建 HBR 时可能需要初始化 GPU context,冷启动成本要单独统计,与稳态单帧数据分开看;后续实例通常只承担较小的增量成本。
- 预期用法是每个活动中的
HardwareBuffer对应一个 HBR 实例。连续渲染若有三块 in-flight buffer,通常也维护三个 renderer/slot;把同一 renderer 临时改绑到另一块 buffer 的 API,公开接口里并不存在。 close()只释放 renderer 资源;构造时传入的HardwareBuffer要由调用方自己关闭,两个对象各有自己的所有权。setContentRoot()会让内部根节点记录一次drawRenderNode(content)。RenderNode 的 display list 保存已经录制的绘制命令;之后修改这棵树的显示列表或属性,setContentRoot()调一次就够,下一次 render request 会同步最新状态。obtainRenderRequest()返回内部复用的请求对象。每次调用都会把 color space 重置为 sRGB、transform 重置为 identity;该对象没有线程安全保证,draw()之后即视为消费完毕,继续修改或长期持有都超出了用法约定。
这些行为都能直接在 HardwareBufferRenderer.java 中核对。
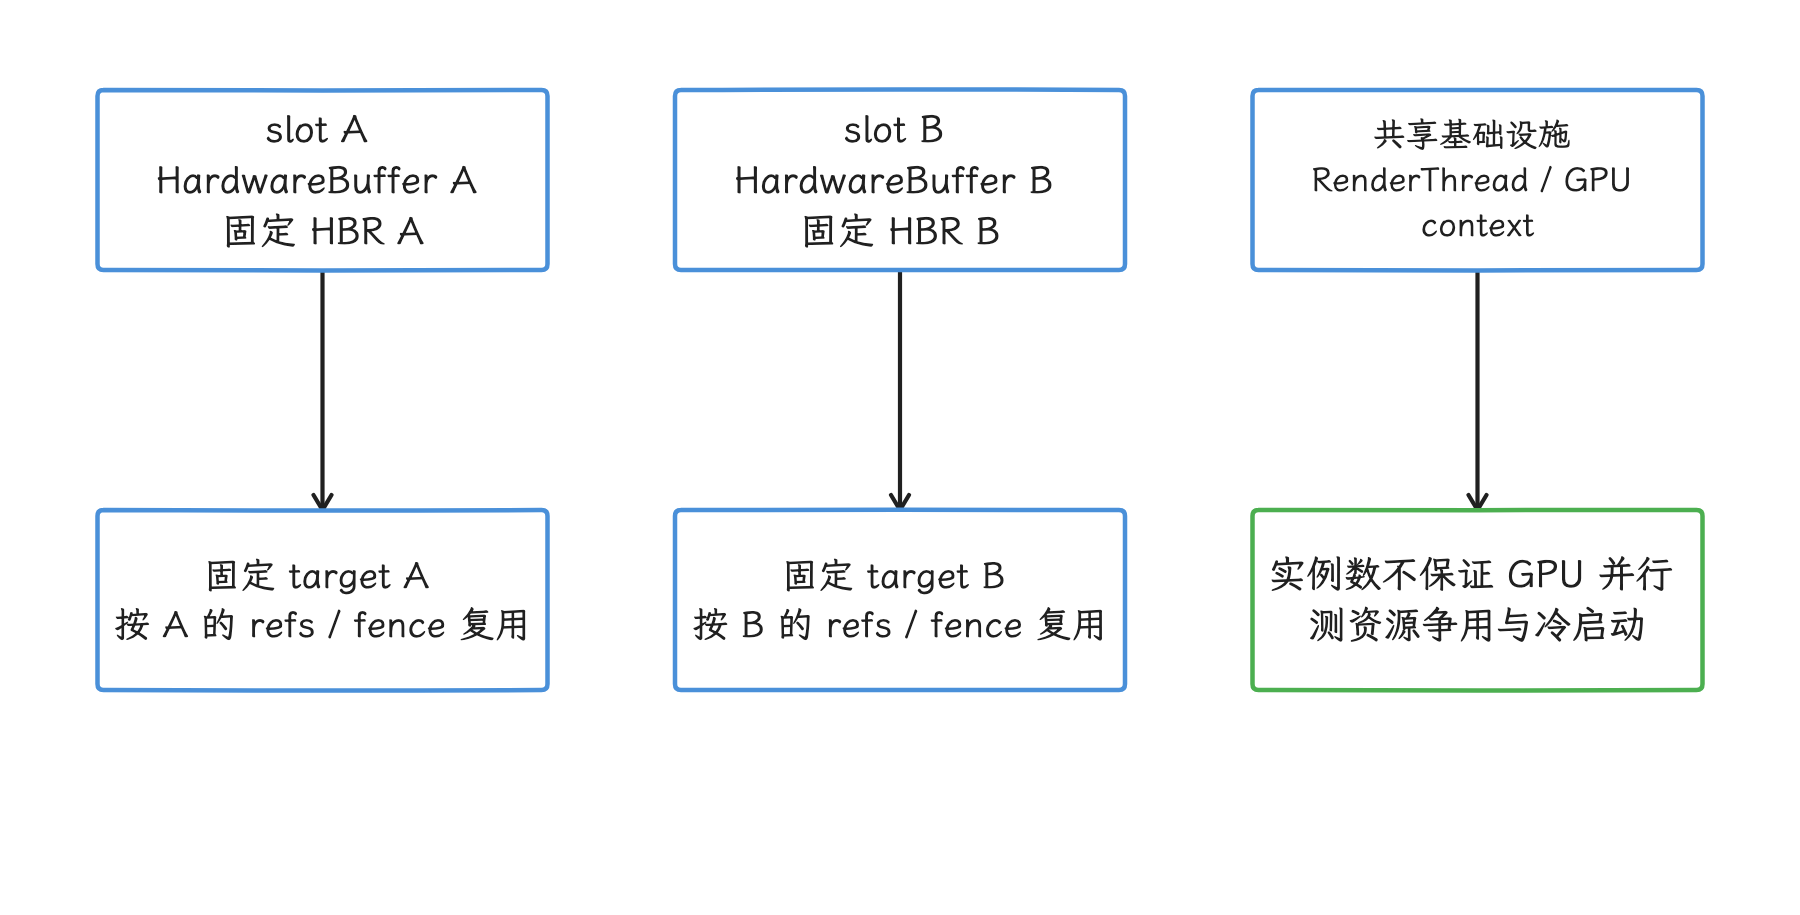
图:为每个活动 slot 保存固定目标、renderer 和同步状态。 HBR 没有公开改绑目标 API;renderer.close 不关闭传入 buffer wrapper。
draw() 之后的 native 调用链可以在 android-17.0.0_r1 中逐段对应:
RenderRequest.draw()调用nRender()。android_graphics_HardwareBufferRenderer.cpp把尺寸、旋转变换、color space 和 callback 写入HardwareBufferRenderParams,再调用RenderProxy::syncAndDrawFrame()。DrawFrameTask同步 RenderNode 树,并让 HWUI pipeline 写入构造时绑定的AHardwareBuffer。DrawFrameTask在持有 HardwareBuffer 目标时调用 pipelineflush()导出 producer fence,通过HardwareBufferRenderParams回调到 JNI;Java 将 fd adopt 成SyncFence,再经调用方提供的 executor 交付RenderResult。
draw() 自身要走 syncAndDrawFrame() 的 host 同步边界,投递后原地等同步,而非立刻返回;它可以在 RenderThread 同步完场景树后被唤醒,这时 GPU 工作可能仍在进行。
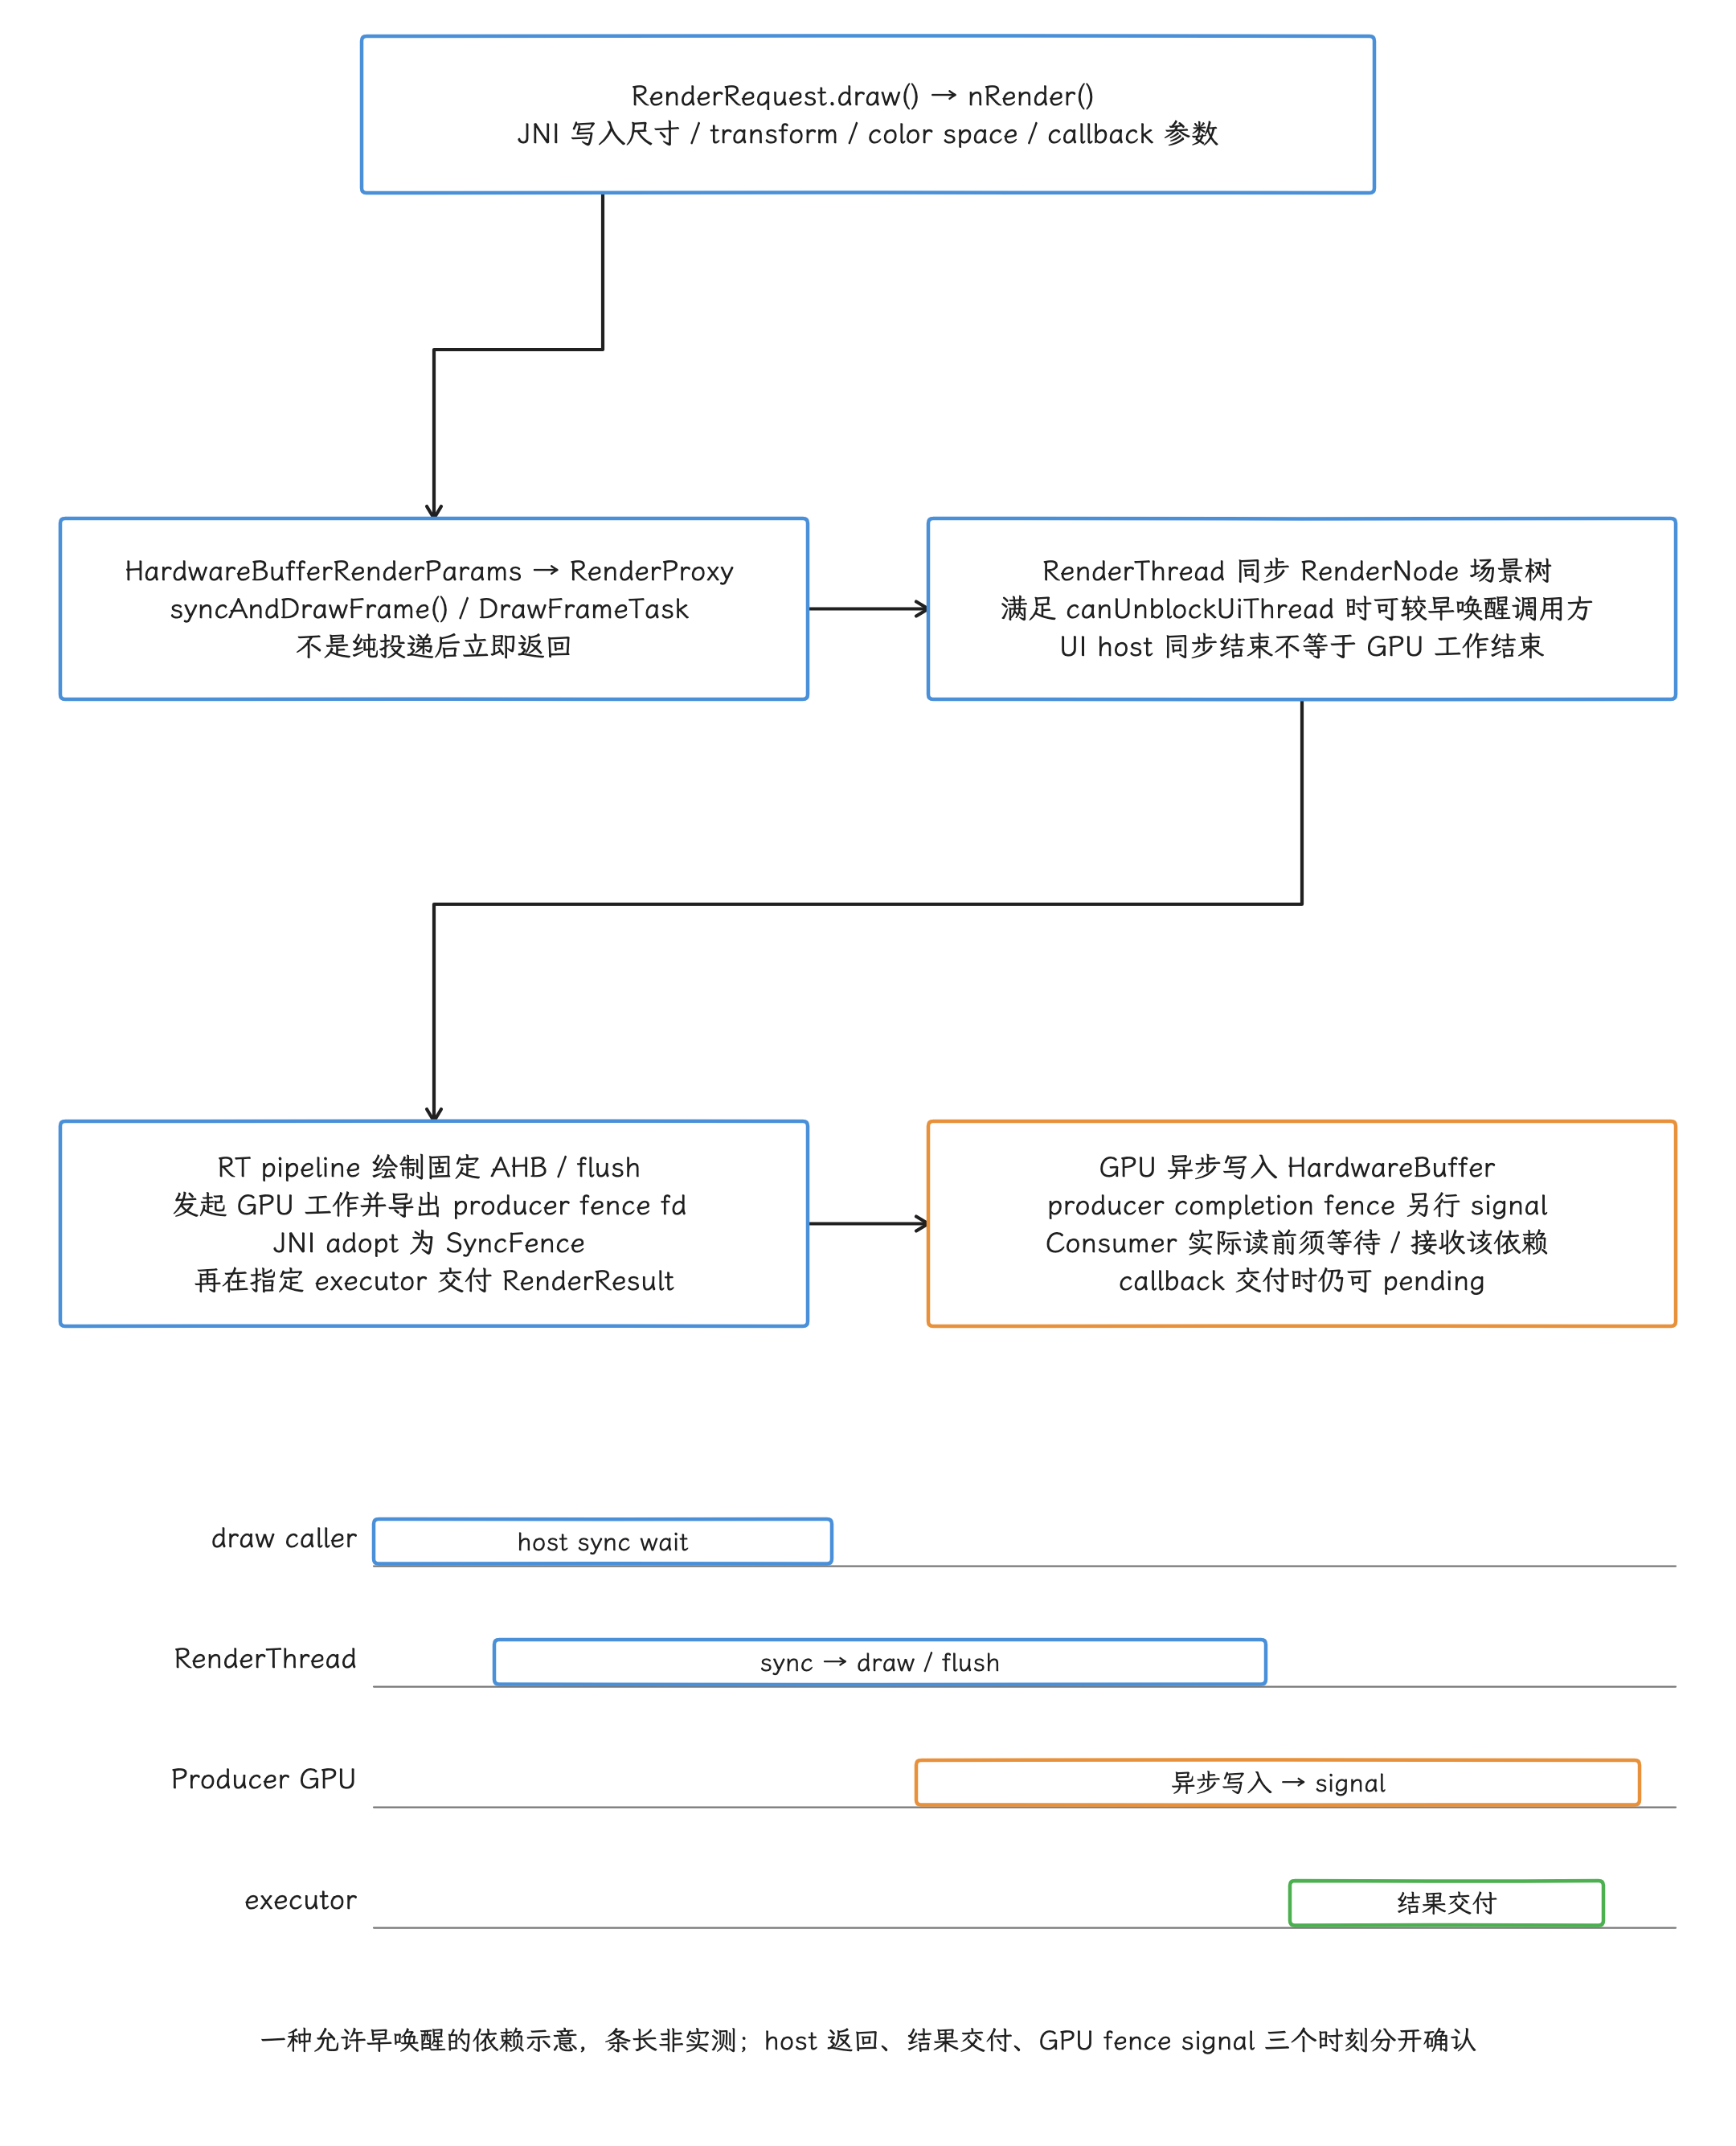
图:draw通过nRender配置HardwareBufferRenderParams尺寸/transform/color/callback,再RenderProxy.syncAndDrawFrame;DrawFrameTask同步RenderNode并写构造固定AHB,持AHB目标时pipeline.flush导Producerfd,JNI adopt为SyncFence后executor交RenderResult。draw不是纯投递立即返,host可在场景同步后较早唤醒,仍非GPU完成;callback也可早于fence signal。图中边为调用和工作发起关系,不规定callback必先于或后于GPU结束;轨道示允许提前unblock的一种正常依赖,条长非测量。
HBR 的 JNI 在构造 UiFrameInfo 时使用 INVALID_VSYNC_ID,因此一次 HBR draw 本身没有关联到有效的 App FrameTimeline VSync。若结果需要按 VSync 上屏,我们仍要通过 Choreographer 选择目标帧,并在 Java API 35+ 的 SurfaceControl.Transaction 或 NDK API 33+ transaction 上设置对应 FrameTimeline。固定 r1 的 Java setFrameTimeline() 与 setDesiredPresentTimeNanos() 还带 sdkDesiredPresentTime flag 检查,关闭时原样返回;请求是否真的被目标设备应用了,还要回到设备上确认。
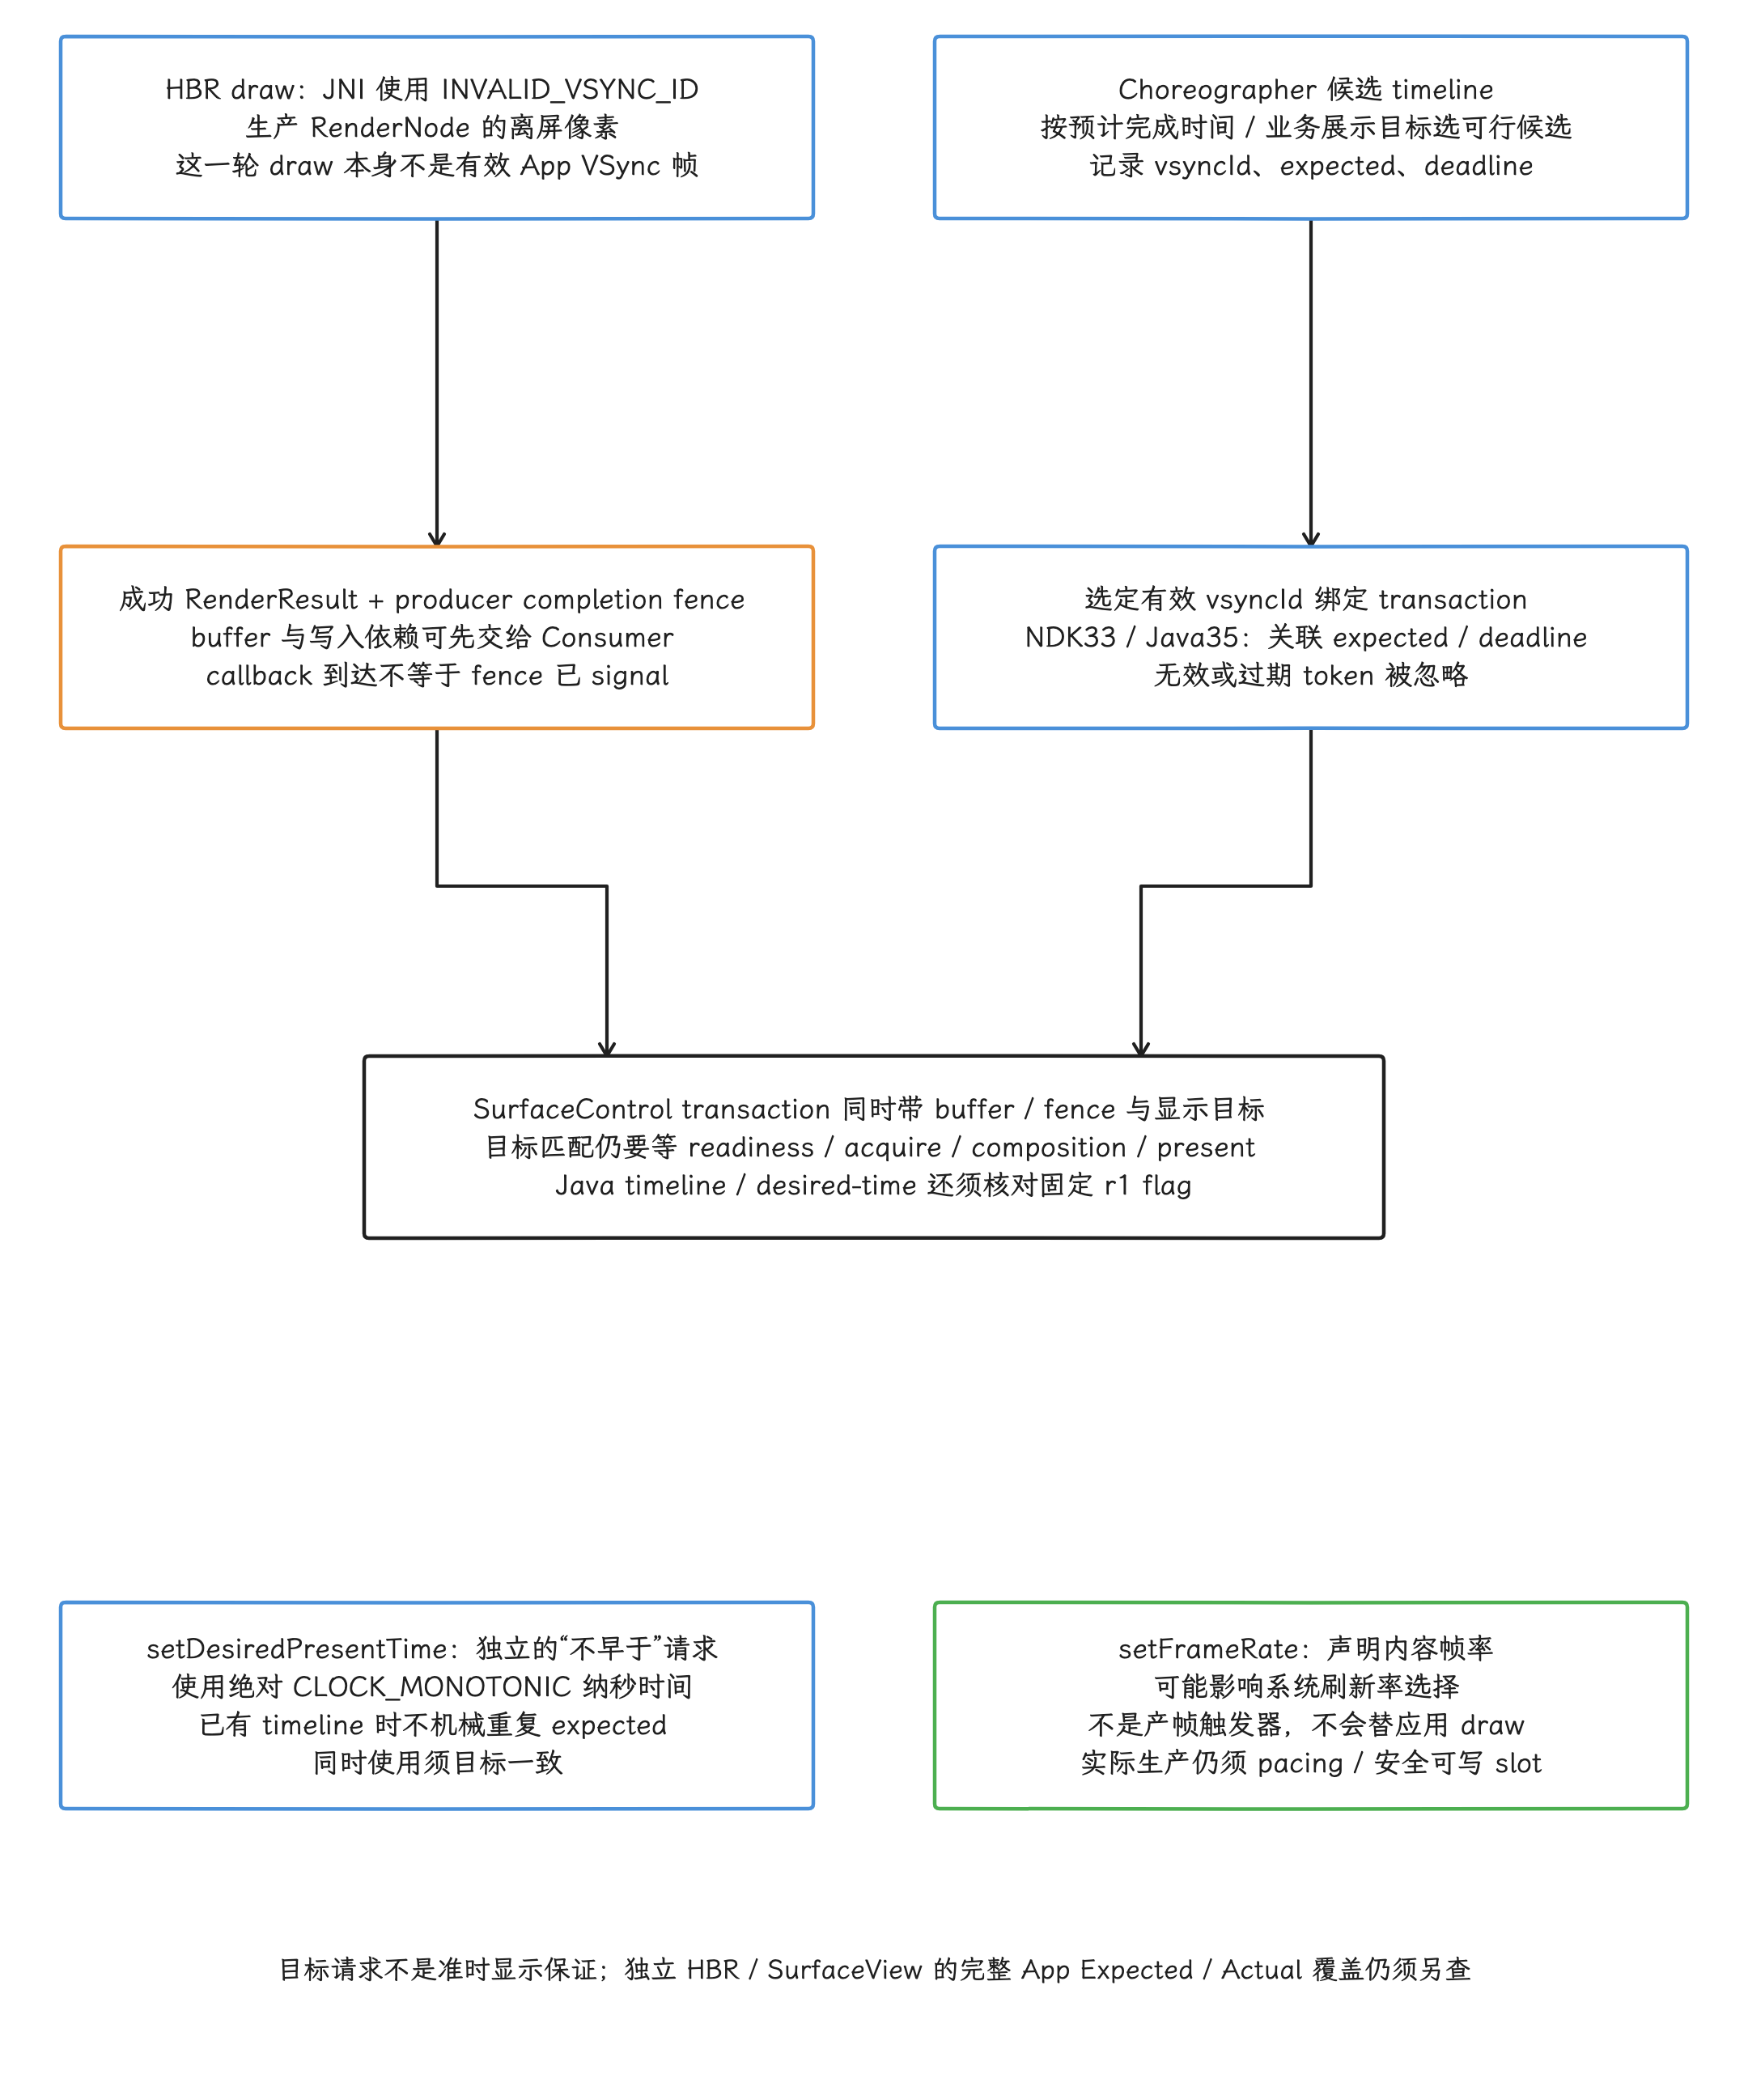
图:HBR JNI UiFrameInfo 使用 INVALID_VSYNC_ID,一次离屏draw自身不关联有效AppVSync。Choreographer选候选并按预计就绪/业务展示预算取token;无可行候选应跳过,实际选择见保留分支图。NDK33/Java35 transaction关联vsyncId,过期无效忽略;Java35timeline/desiredtime固定r1有sdkDesiredPresentTime flag关闭即返回。setFrameTimeline已含expected/deadline,不机械重复desiredtime;desiredtime是独立不早于绝对单调时间请求,两者共用时目标一致。frameRate是内容帧率投票,不触发draw,不保证实际刷新率;token不补齐独立HBR/SurfaceView完整FrameTimeline覆盖。
从 RenderNode 到屏幕的完整路径
HBR 只负责下图中间的 GPU 光栅化,buffer 分配、consumer 选择、显示提交和安全复用都由调用方管理:
flowchart LR
    A["更新 RenderNode / 取得空闲 slot"] --> B["draw: 同步场景树 / RT 提交工作"]
    B --> GPU["GPU 异步写 HardwareBuffer"]
    B --> F["callback: status + producer completion fence"]
    F --> T["成功时 setBuffer + fence / apply"]
    T --> L["SF readiness / latch: 条件允许时可早于 signal"]
    GPU --> Q["producer completion fence signal"]
    Q --> R["Consumer 实际读取前满足依赖"]
    L --> R
    R --> D["按 Layer 选择 DEVICE / 必要 CLIENT 后 present"]
    D --> X["未来替换或移除当前提交引用"]
    T --> E["未展示被覆盖 / 提前释放分支"]
    X --> C["release callback + 对应 fence"]
    E --> C
    C --> W["全部引用释放且 fence 等待成功"]
    W --> A
这里有两个名称相近、方向相反的同步点,分别保护“producer 写完后 consumer 才能读”和“consumer 读完后 producer 才能重写”:
- Presentation fence:由
RenderResult.getFence()返回,表示 producer 的 GPU 写入何时完成。consumer 在读取 buffer 前必须等待它。直接上屏时可将它传给Transaction.setBuffer(),由 SurfaceFlinger 等待,应用无须先阻塞 CPU。 - Release fence:由
setBuffer(..., releaseCallback)的 callback 参数提供,交回这次提交引用的最后使用依赖,可能涉及 HWC 读取、CLIENT GPU 读取,或被丢弃提交尚未结束的 Producer 写入。只有对应的全部引用和有效 fence 都完成后,producer 才能再次写入。
draw() 的 callback 交付 RenderResult 时,其中的 SyncFence 未必已经 signal;API 注释要求先检查 status == SUCCESS,consumer 再等待或接收该 fence。把 callback 到达时间当成 GPU 完成时间,consumer 可能与 GPU 并发访问同一块 buffer。
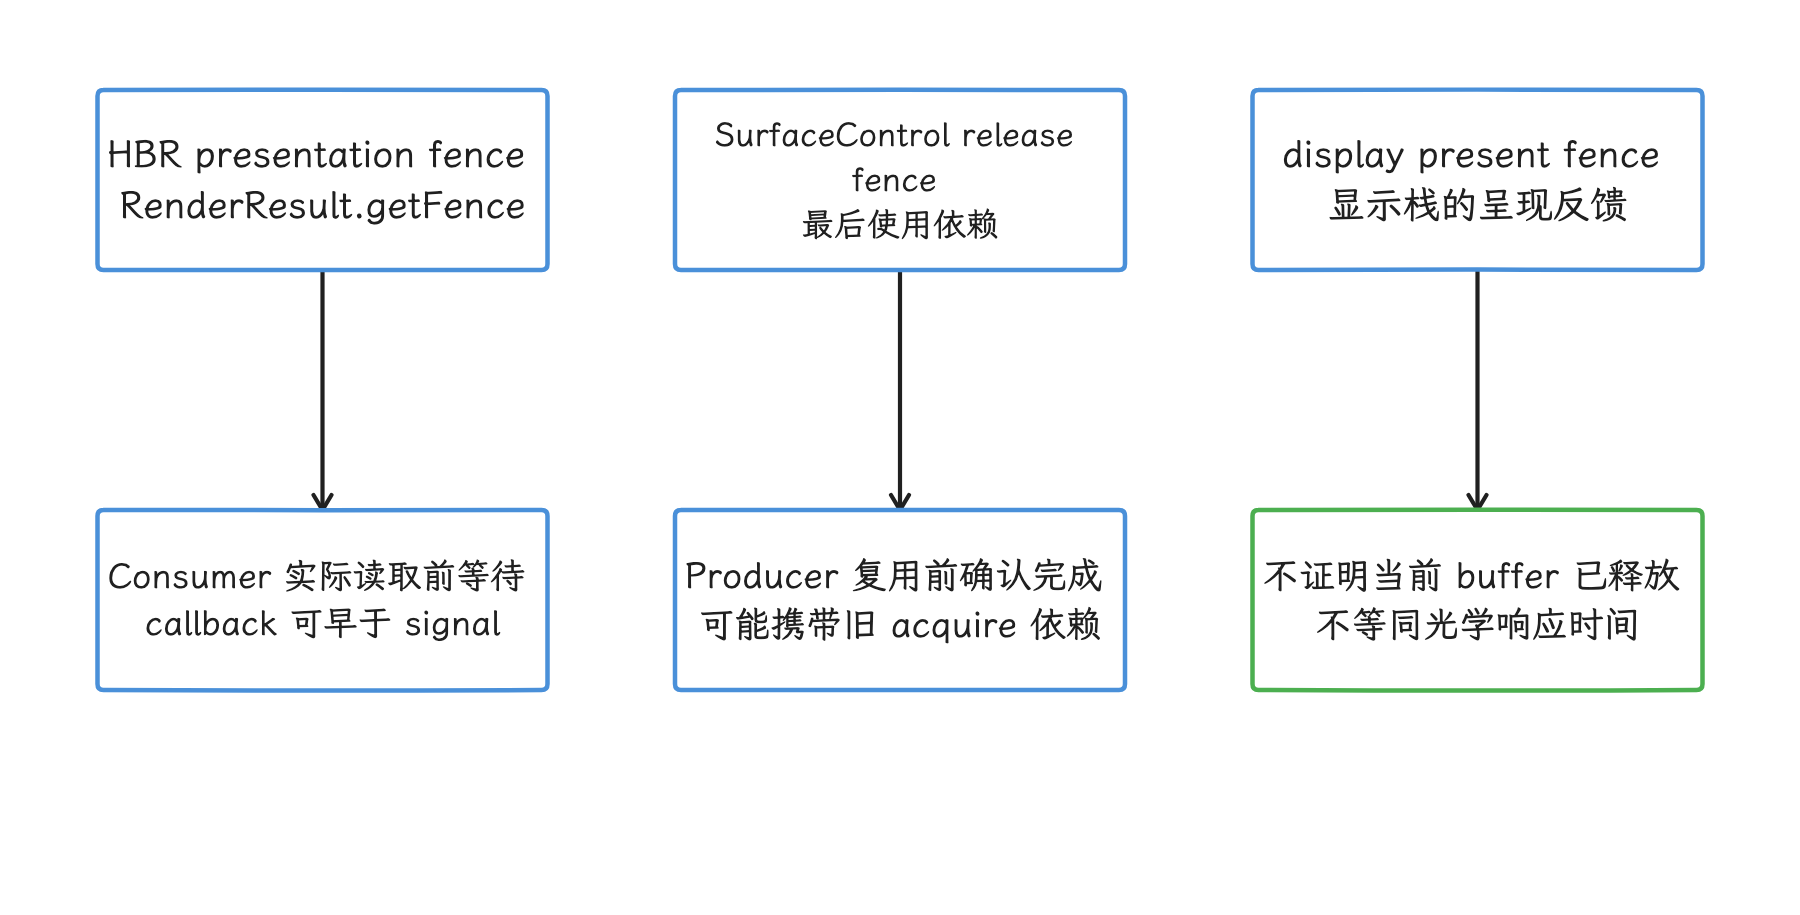
图:HBR 的 presentation fence 是 Producer 写入完成依赖,显示端 present 是另一条线。 名称相近,各管各的;release fence 才约束该提交引用再次可写。
正常保留在 Layer 上的当前 buffer,要等后续 transaction 替换、移除或节点退出显示树后才进入回收;同一 transaction 本地覆盖和未展示的提前释放是其他分支。callback 只交回 release 依赖——“收到回调”“显示过”“GPU 已结束”是三件事,谁也顶替不了谁。一块 buffer 仍作为当前内容持有时,Producer fence 完成只说明写入结束,重写要等替换、移除或提前释放把它送进回收路径。
Java API 提交骨架
下面的代码展示单个 buffer slot 的关键顺序。surfaceControl、线程池与 slot 状态机由上层持有;持续渲染时要避免只创建一个 slot 然后无条件循环覆写。
long usage = HardwareBuffer.USAGE_GPU_COLOR_OUTPUT
        | HardwareBuffer.USAGE_GPU_SAMPLED_IMAGE
        | HardwareBuffer.USAGE_COMPOSER_OVERLAY;

if (!HardwareBuffer.isSupported(
        width, height, HardwareBuffer.RGBA_8888, 1, usage)) {
    throw new IllegalArgumentException("Unsupported HardwareBuffer configuration");
}

HardwareBuffer buffer = HardwareBuffer.create(
        width, height, HardwareBuffer.RGBA_8888, 1, usage);
HardwareBufferRenderer renderer = new HardwareBufferRenderer(buffer);

RenderNode root = new RenderNode("HbrContent");
root.setPosition(0, 0, width, height); // recording viewport 不会替节点设置 bounds。
RecordingCanvas canvas = root.beginRecording(width, height);
canvas.drawColor(Color.TRANSPARENT, PorterDuff.Mode.CLEAR);
// 记录本帧需要的 drawBitmap / drawText / drawPath ...
root.endRecording();
renderer.setContentRoot(root);

HardwareBufferRenderer.RenderRequest request = renderer.obtainRenderRequest();
request.setColorSpace(ColorSpace.get(ColorSpace.Named.SRGB));
request.draw(callbackExecutor, result -> {
    SyncFence presentationFence = result.getFence();
    if (result.getStatus()
            != HardwareBufferRenderer.RenderResult.SUCCESS) {
        releaseExecutor.execute(() -> {
            try (presentationFence) {
                if (!presentationFence.awaitForever()) {
                    quarantineSlotAfterFenceFailure();
                    return;
                }
            }
            markSlotIdleAfterRenderFailure();
        });
        return;
    }

    try (SurfaceControl.Transaction transaction =
                 new SurfaceControl.Transaction()) {
        transaction
                .setDataSpace(surfaceControl, DataSpace.DATASPACE_SRGB)
                .setBuffer(
                        surfaceControl,
                        buffer,
                        presentationFence,
                        releaseFence -> releaseExecutor.execute(() -> {
                            try (releaseFence) {
                                if (!releaseFence.awaitForever()) {
                                    quarantineSlotAfterFenceFailure();
                                    return;
                                }
                            }
                            markSlotIdle();
                        }))
                .setVisibility(surfaceControl, true)
                .apply();
    } finally {
        // native transaction 已持有提交所需的 fence 引用。
        presentationFence.close();
    }
});
示例显式调用 clear,因为 HBR 不会替调用方清除旧像素。失败分支也会先处理返回的 fence,再把 slot 放回空闲队列,避免 GPU 仍在写入时复用目标。示例中的 quarantineSlotAfterFenceFailure() 会把 slot 移出可写池并交给恢复逻辑,记录错误后照常复用是行不通的;awaitForever() 的布尔结果必须检查,新返回的无效 fence 按 API 约定视为已完成,主动 close 后的无效状态则要排除在这类证据之外。若业务能保证每次记录都覆盖整个 buffer,可以省略 clear;局部更新则要自行维护未覆盖区域的正确内容。
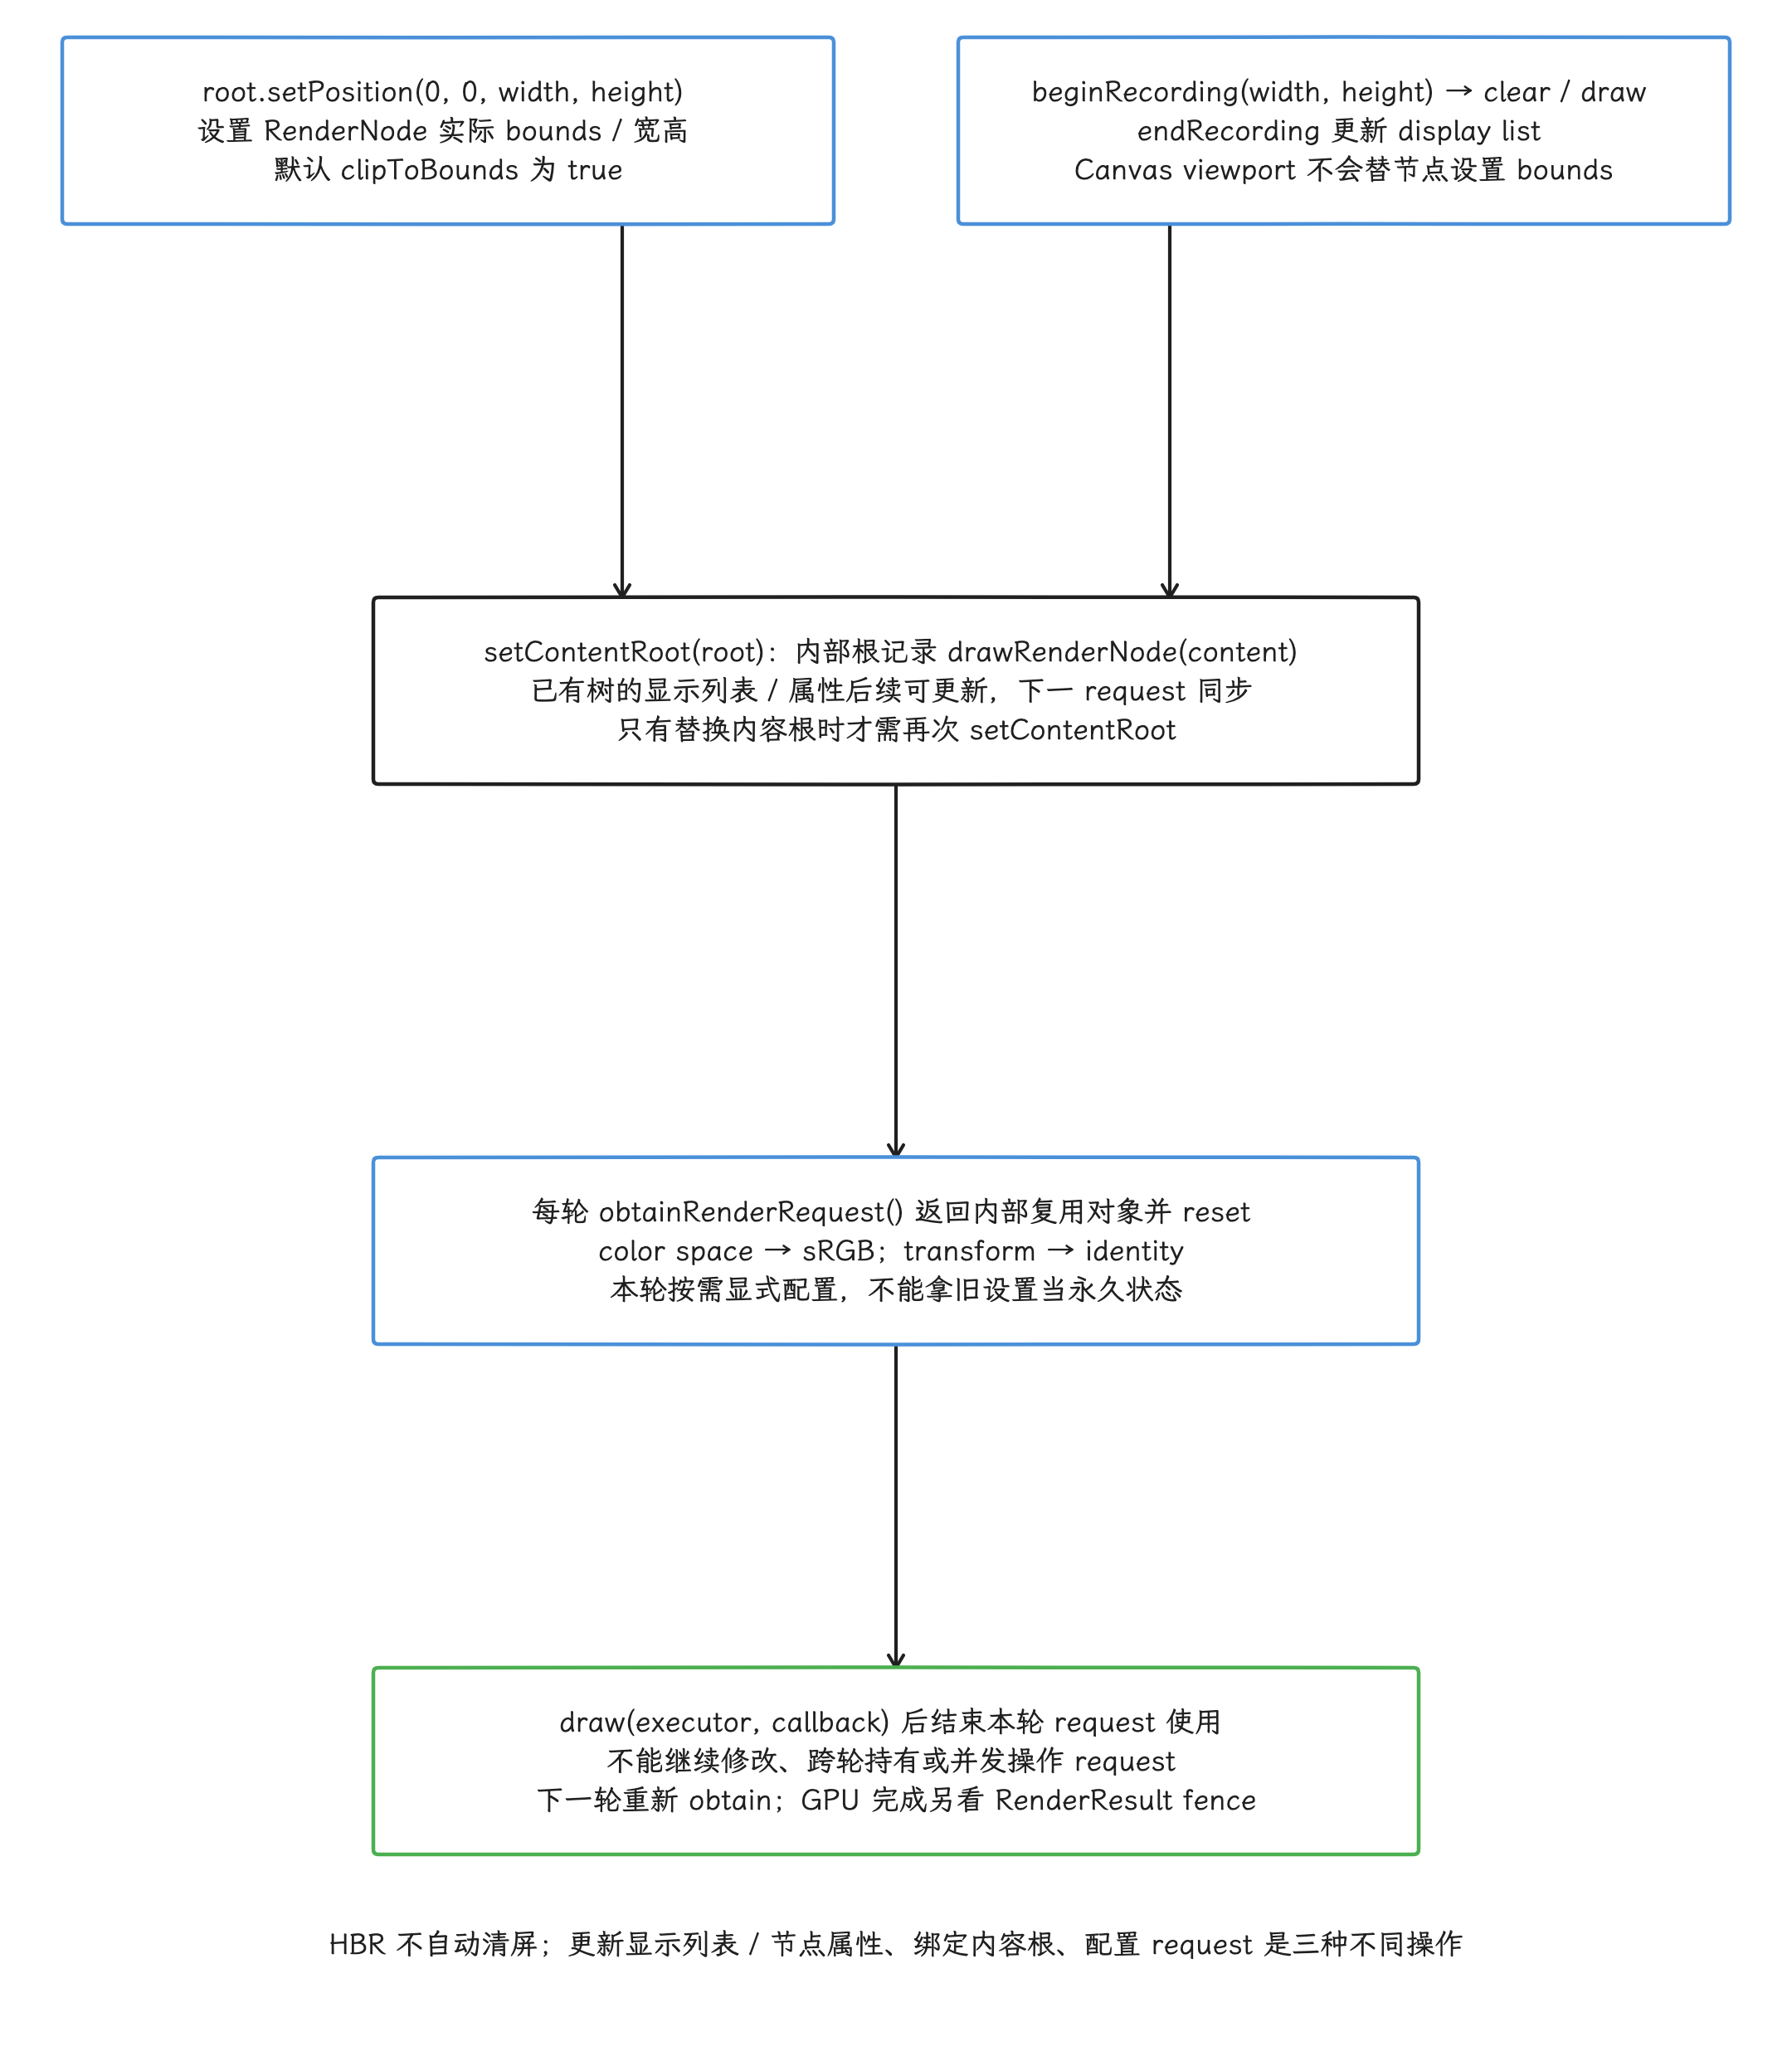
图:root.setPosition设置实际bounds/宽高,默认clipToBounds=true;beginRecording(width,height)只是录制viewport,不替节点改bounds。clear/draw/endRecording更新displaylist,setContentRoot让内部根记录drawRenderNode;之后同树displaylist或属性变更下一request同步,只有换根需再setContentRoot。obtainRenderRequest返回内部复用对象并重置sRGB/identity,逐轮显式设置所需colorSpace/transform;非线程安全,draw后不能继续修改或长期保留。HBR不自动清屏,局部更新要维护本slot历史。
android_view_SurfaceControl.cpp 会让 transaction 通过 sp<Fence> 持有 native fence 引用,所以成功分支把 presentation fence 交给 setBuffer() 后就可以关闭 Java wrapper;继续保留 wrapper 只会额外占用一个 fd / native 资源。
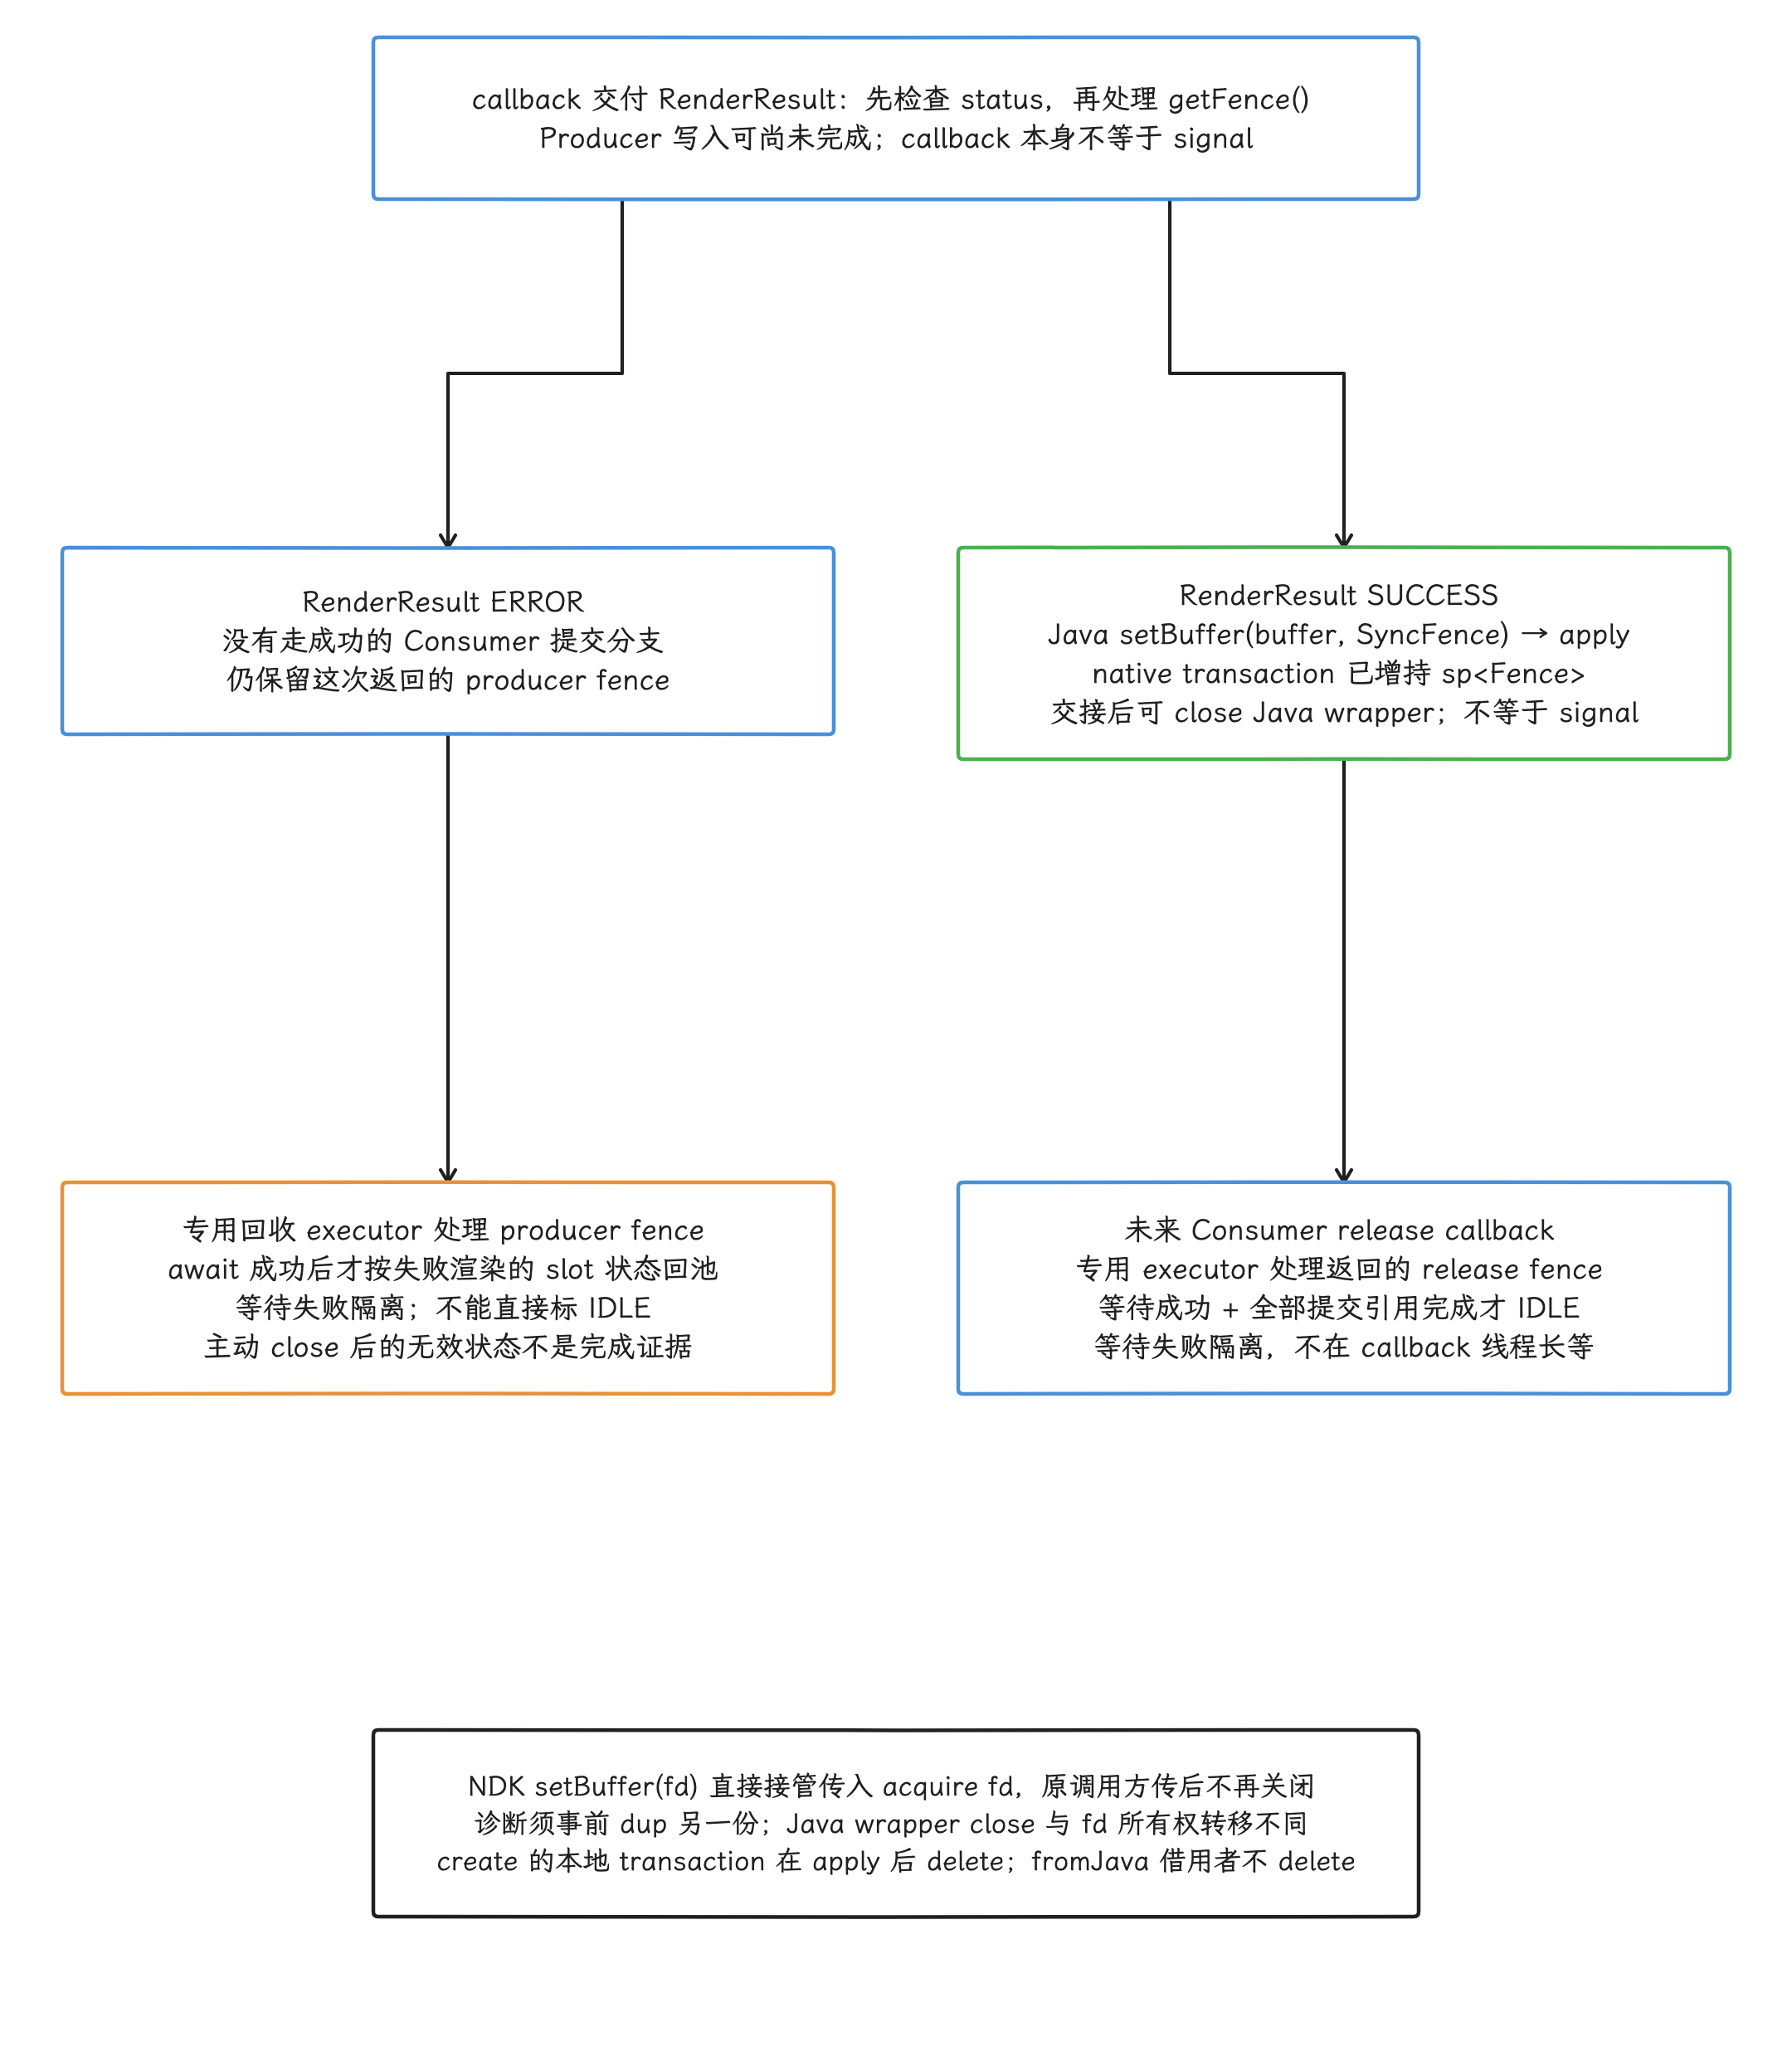
图:先检查RenderResult.status;SUCCESS才Java setBuffer(buffer,SyncFence)并apply,native transaction增持sp
三个 usage flag 声明不同的访问方式,allocator 会据此判断格式和内存配置是否可用:
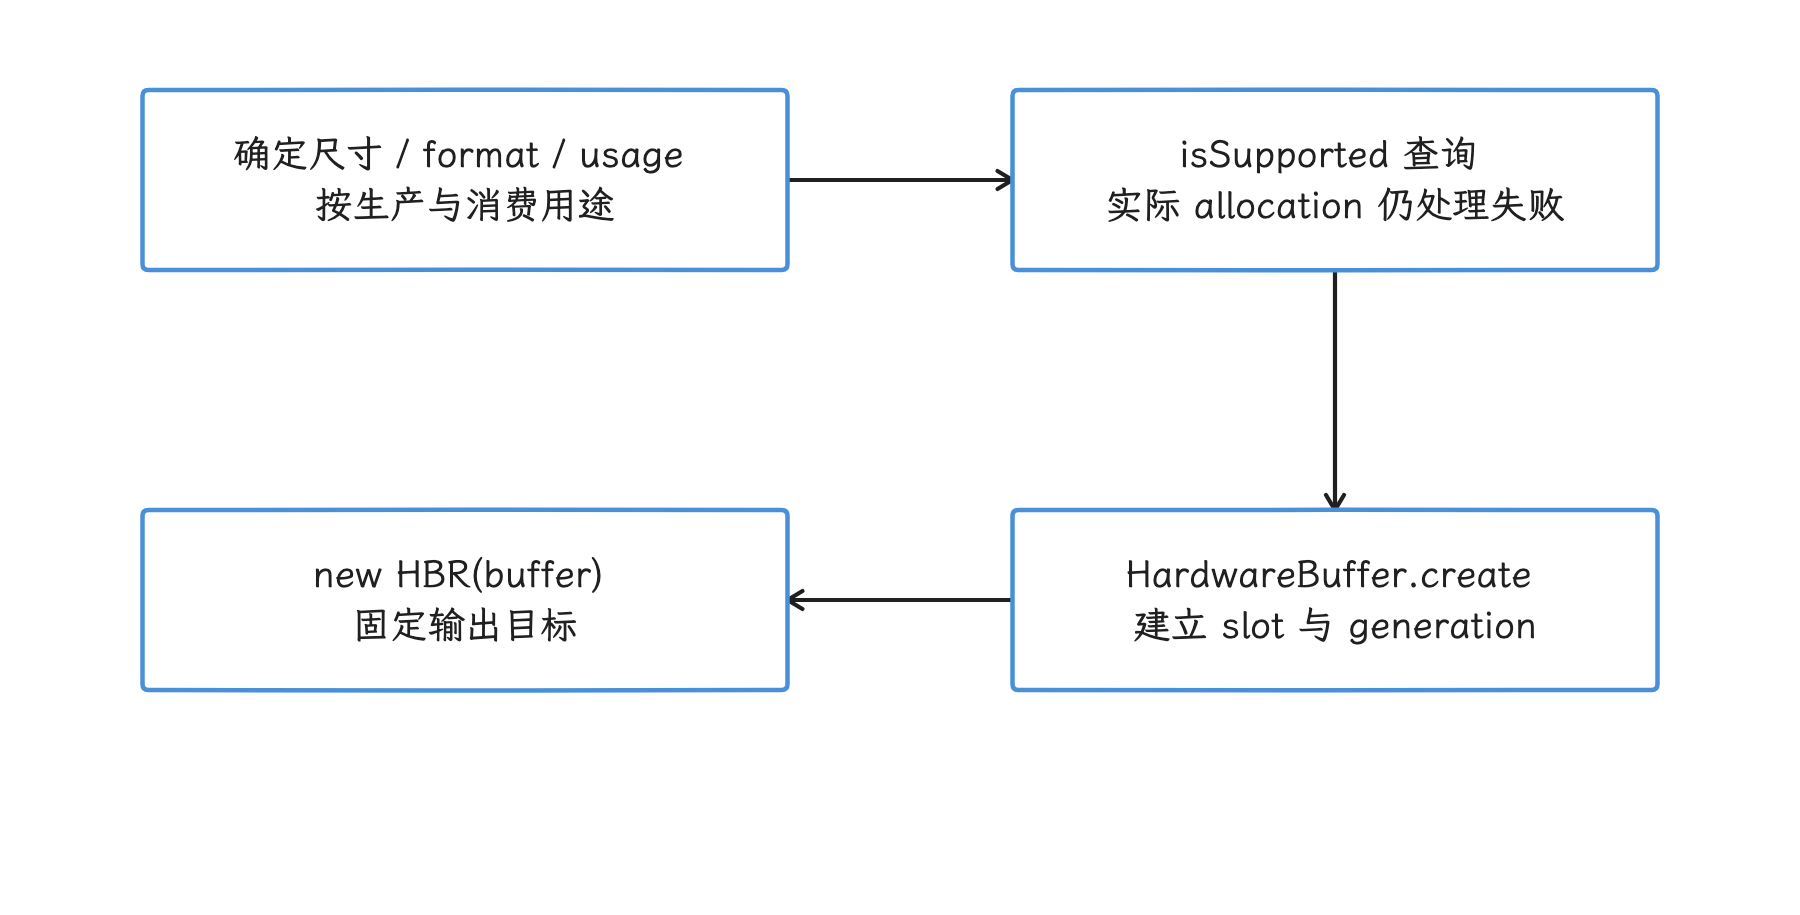
图:先匹配格式/用途,再分配 buffer 并建立对应 renderer。 isSupported 不预留内存;实际分配仍可能失败,且不保证 DEVICE。
USAGE_GPU_COLOR_OUTPUT:GPU 会把该 buffer 作为 render target 写入。USAGE_GPU_SAMPLED_IMAGE:SurfaceFlinger 可能通过 GPU 采样该 buffer 完成合成。USAGE_COMPOSER_OVERLAY:直接调用SurfaceControl.Transaction.setBuffer()时需要,HWC 也可能把该 buffer 作为 overlay layer 输入。
Java setBuffer() 文档同时要求 GPU_SAMPLED_IMAGE 和 COMPOSER_OVERLAY。gralloc(图形 buffer 分配器)会约束 format 与 usage 的组合;任意尺寸、FP16 与用途组合的支持情况因设备而异,分配前先调用 HardwareBuffer.isSupported() 查询组合支持,随后仍要处理实际 allocation 失败;支持查询不预留内存;目标显示最终选不选 DEVICE,它也回答不了。AOSP: HardwareBuffer AOSP: SurfaceControl.Transaction.setBuffer()
RenderNode 更新与阴影
内容变化时,可以重新 recording 同一个 RenderNode 的 display list,也可以只修改 translation、alpha 等 RenderNode 属性,再发起新的 request。只有替换内容根节点时,才需要再次调用 setContentRoot()。
若场景使用 elevation 阴影,还要调用 setLightSourceGeometry() 与 setLightSourceAlpha()。光源要在显示空间中保持锚定,而传入的 x/y 需换算为当前输出坐标,例如 displayWidth / 2f - windowLeft 和 0 - windowTop;窗口移动后应更新这项换算。使用 request 的直角旋转时,native 还会据该变换调整光源位置。
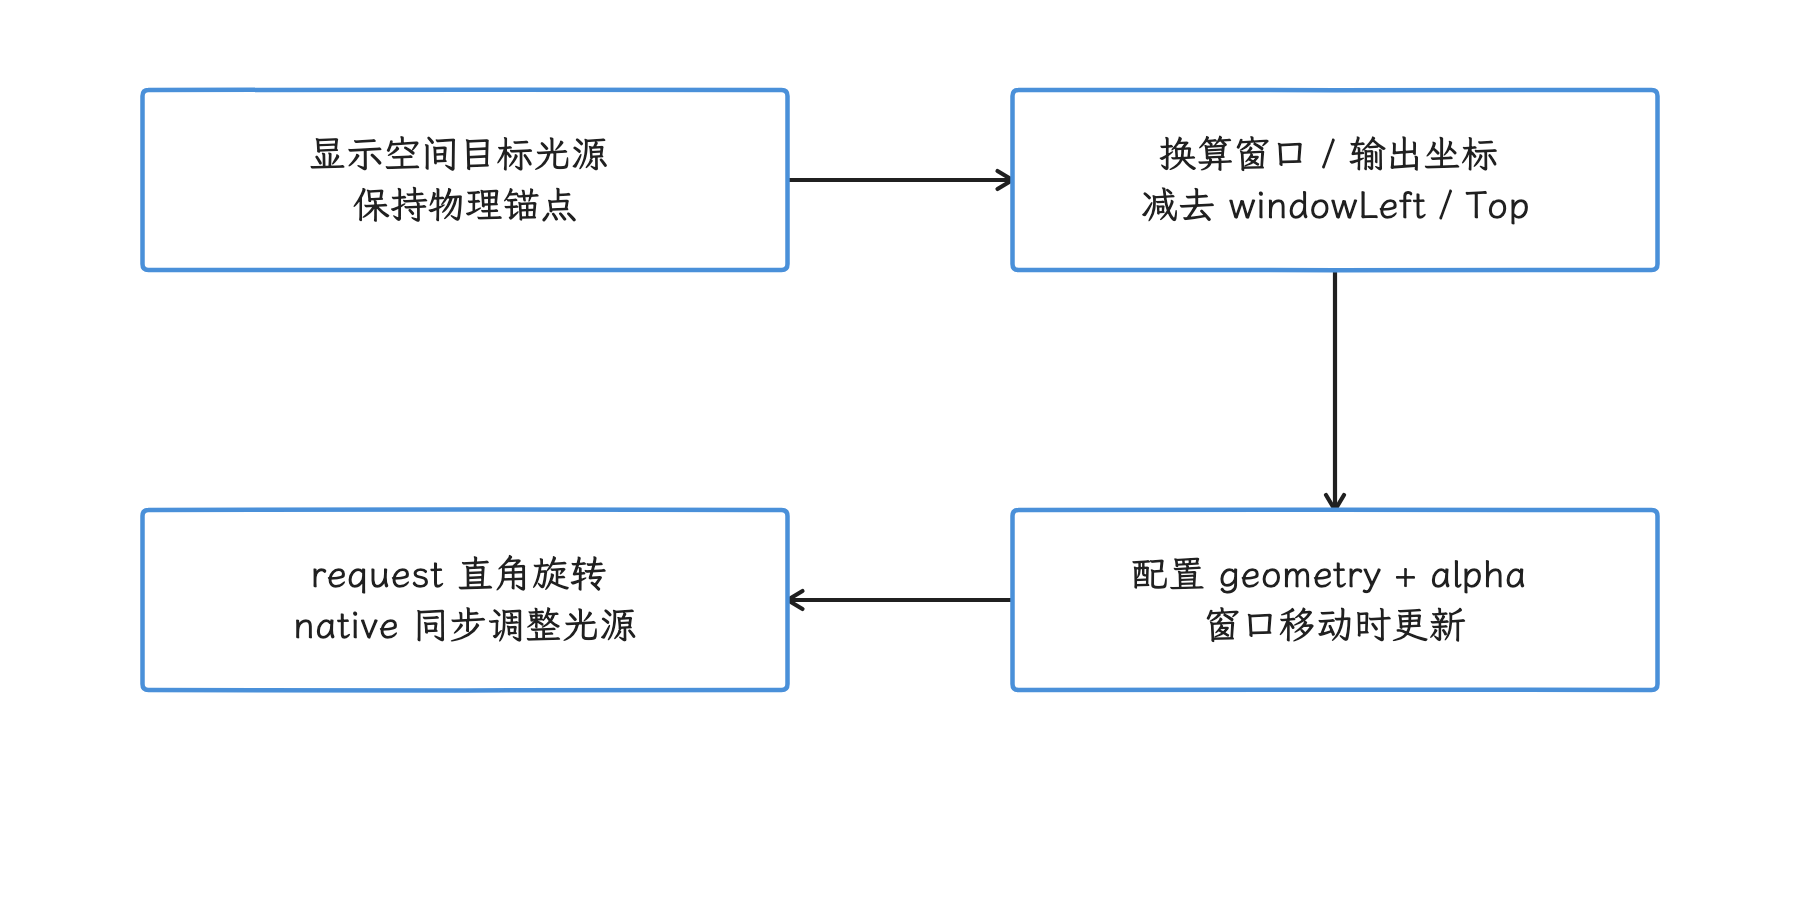
图:阴影先配置 geometry/alpha,再按窗口位置与输出旋转维护光源。 传参 x/y 是经输出坐标换算的值;显示空间锚定与直接传全局坐标是两回事。
Transform 的四种直角旋转
HBR 源码只接受 identity、90°、180°、270° 四种 BUFFER_TRANSFORM_* 值;90°/270° 时内部会交换 render width 与 height。这个 transform 用于在输出阶段预旋转 buffer,RenderNode 上的任意缩放、镜像或透视变换要另外做。
公开 RenderRequest 文档因为参数标注为通用 SurfaceControl.BufferTransform,枚举列表还包含水平/垂直镜像;HardwareBufferRenderer.java 会对镜像值抛出 IllegalArgumentException。应用面向 API 37 时以这四个实际接受值为准,文档的通用枚举列表只当参考。
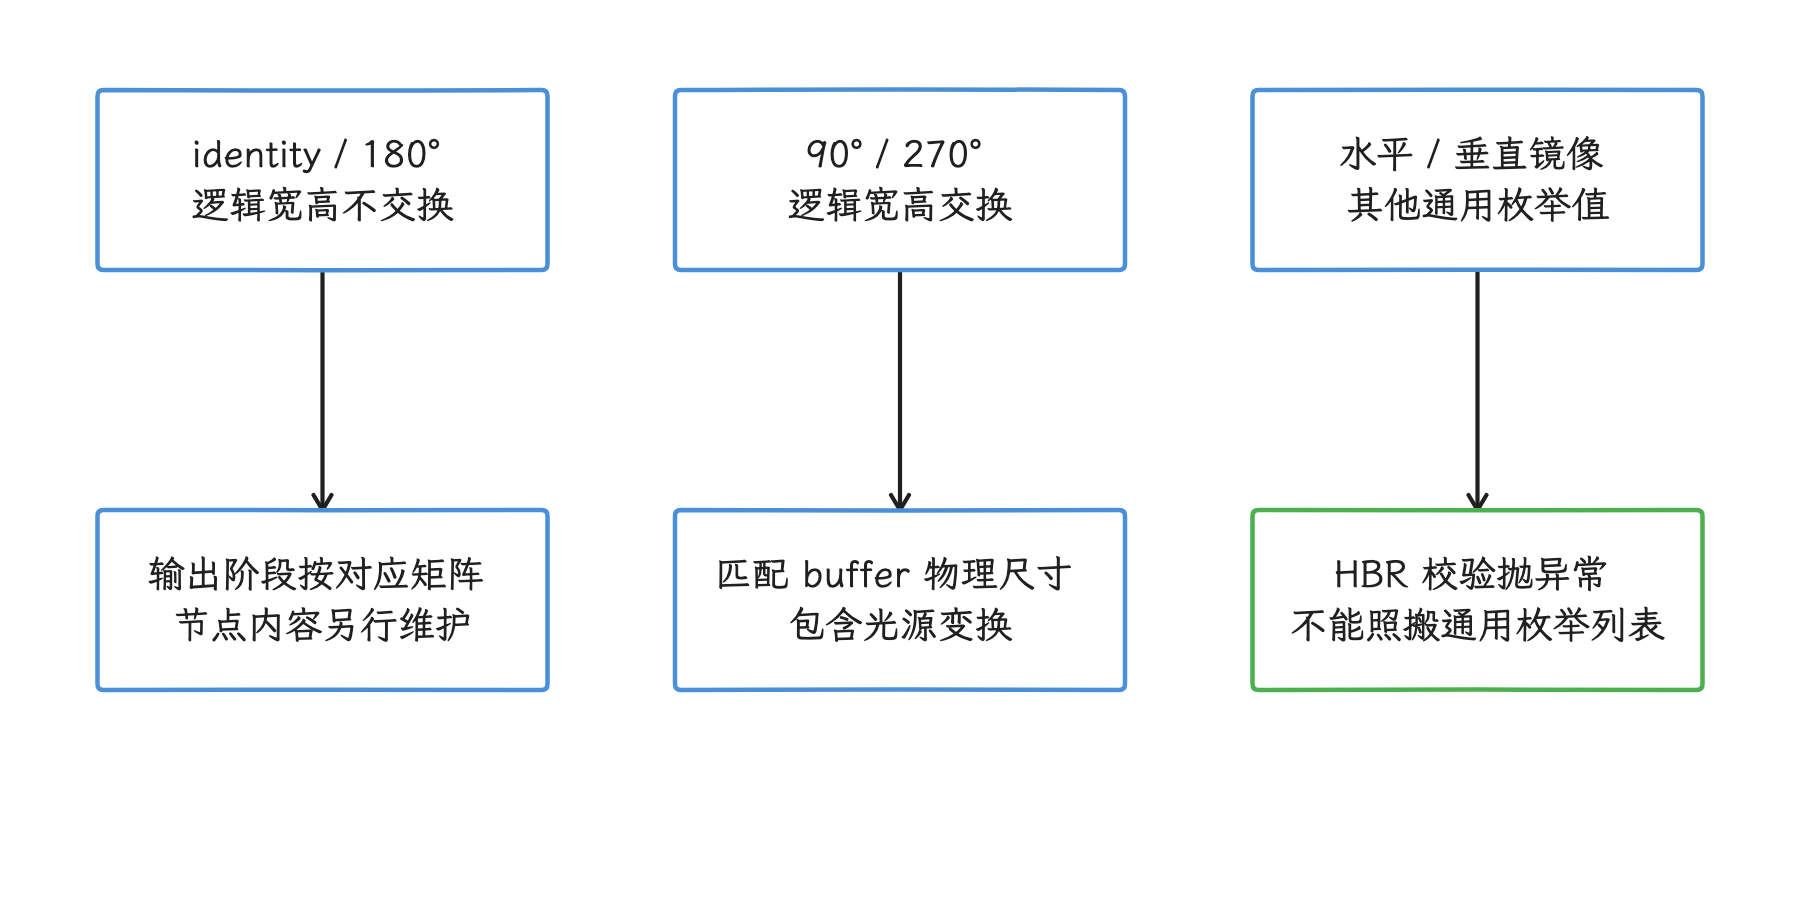
图:实际接受值由 HBR Java 校验决定,90/270 交换逻辑宽高。 通用 BufferTransform 注解里的镜像值,HBR 并不接受;其他变换放 RenderNode。
Buffer 池的复用规则
持续渲染时,“HBR 已经画完”只意味着 producer 阶段接近完成,buffer 还可能正在等待显示或被显示端读取。我们跟踪一个 slot,至少要走过后面的状态:
IDLE -> HBR_DRAW_SUBMITTED -> RESULT_WITH_PRODUCER_FENCE
  -> SUBMITTED_TO_SURFACE_CONTROL  (producer fence 仍可 pending)
  -> DISPLAY_PENDING_OR_IN_USE    (也可能未显示就被释放)
  -> RELEASE_CALLBACK_WITH_FENCE
  -> ALL_REFS_RELEASED_AND_WAIT_SUCCEEDED -> IDLE
池中使用两块还是三块 buffer,由目标帧率、GPU 时间、合成延迟和允许的排队深度决定,“高帧率必须三缓冲”这样的预设只是想当然。池太小时,producer 会频繁等待 release;池更大会增加可用内存占用;只有 Producer 实际提前填满更多待展示工作时,排队深度和延迟才随之上升。
每个 slot 建议一起保存:
HardwareBuffer- 绑定该 buffer 的
HardwareBufferRenderer - 当前 generation/frame id,用于识别回调属于哪一轮内容
- busy/idle 状态
- 尚未完成的 release fence 或 callback
release callback 可以在任意线程到达,回调线程里只做移交,把等 fence 的事交给专用 executor,再以线程安全的方式把 slot 放回空闲队列。关闭与销毁策略还要分别处理 renderer、buffer wrapper、SurfaceControl 本地引用和 callback context:context 至少活到回调及排队任务不再访问;引用关闭只结束引用,fence 完成是另一条线上的事。renderer.close() 关的只是 renderer,buffer 要另行关闭,两个对象必须分别释放。
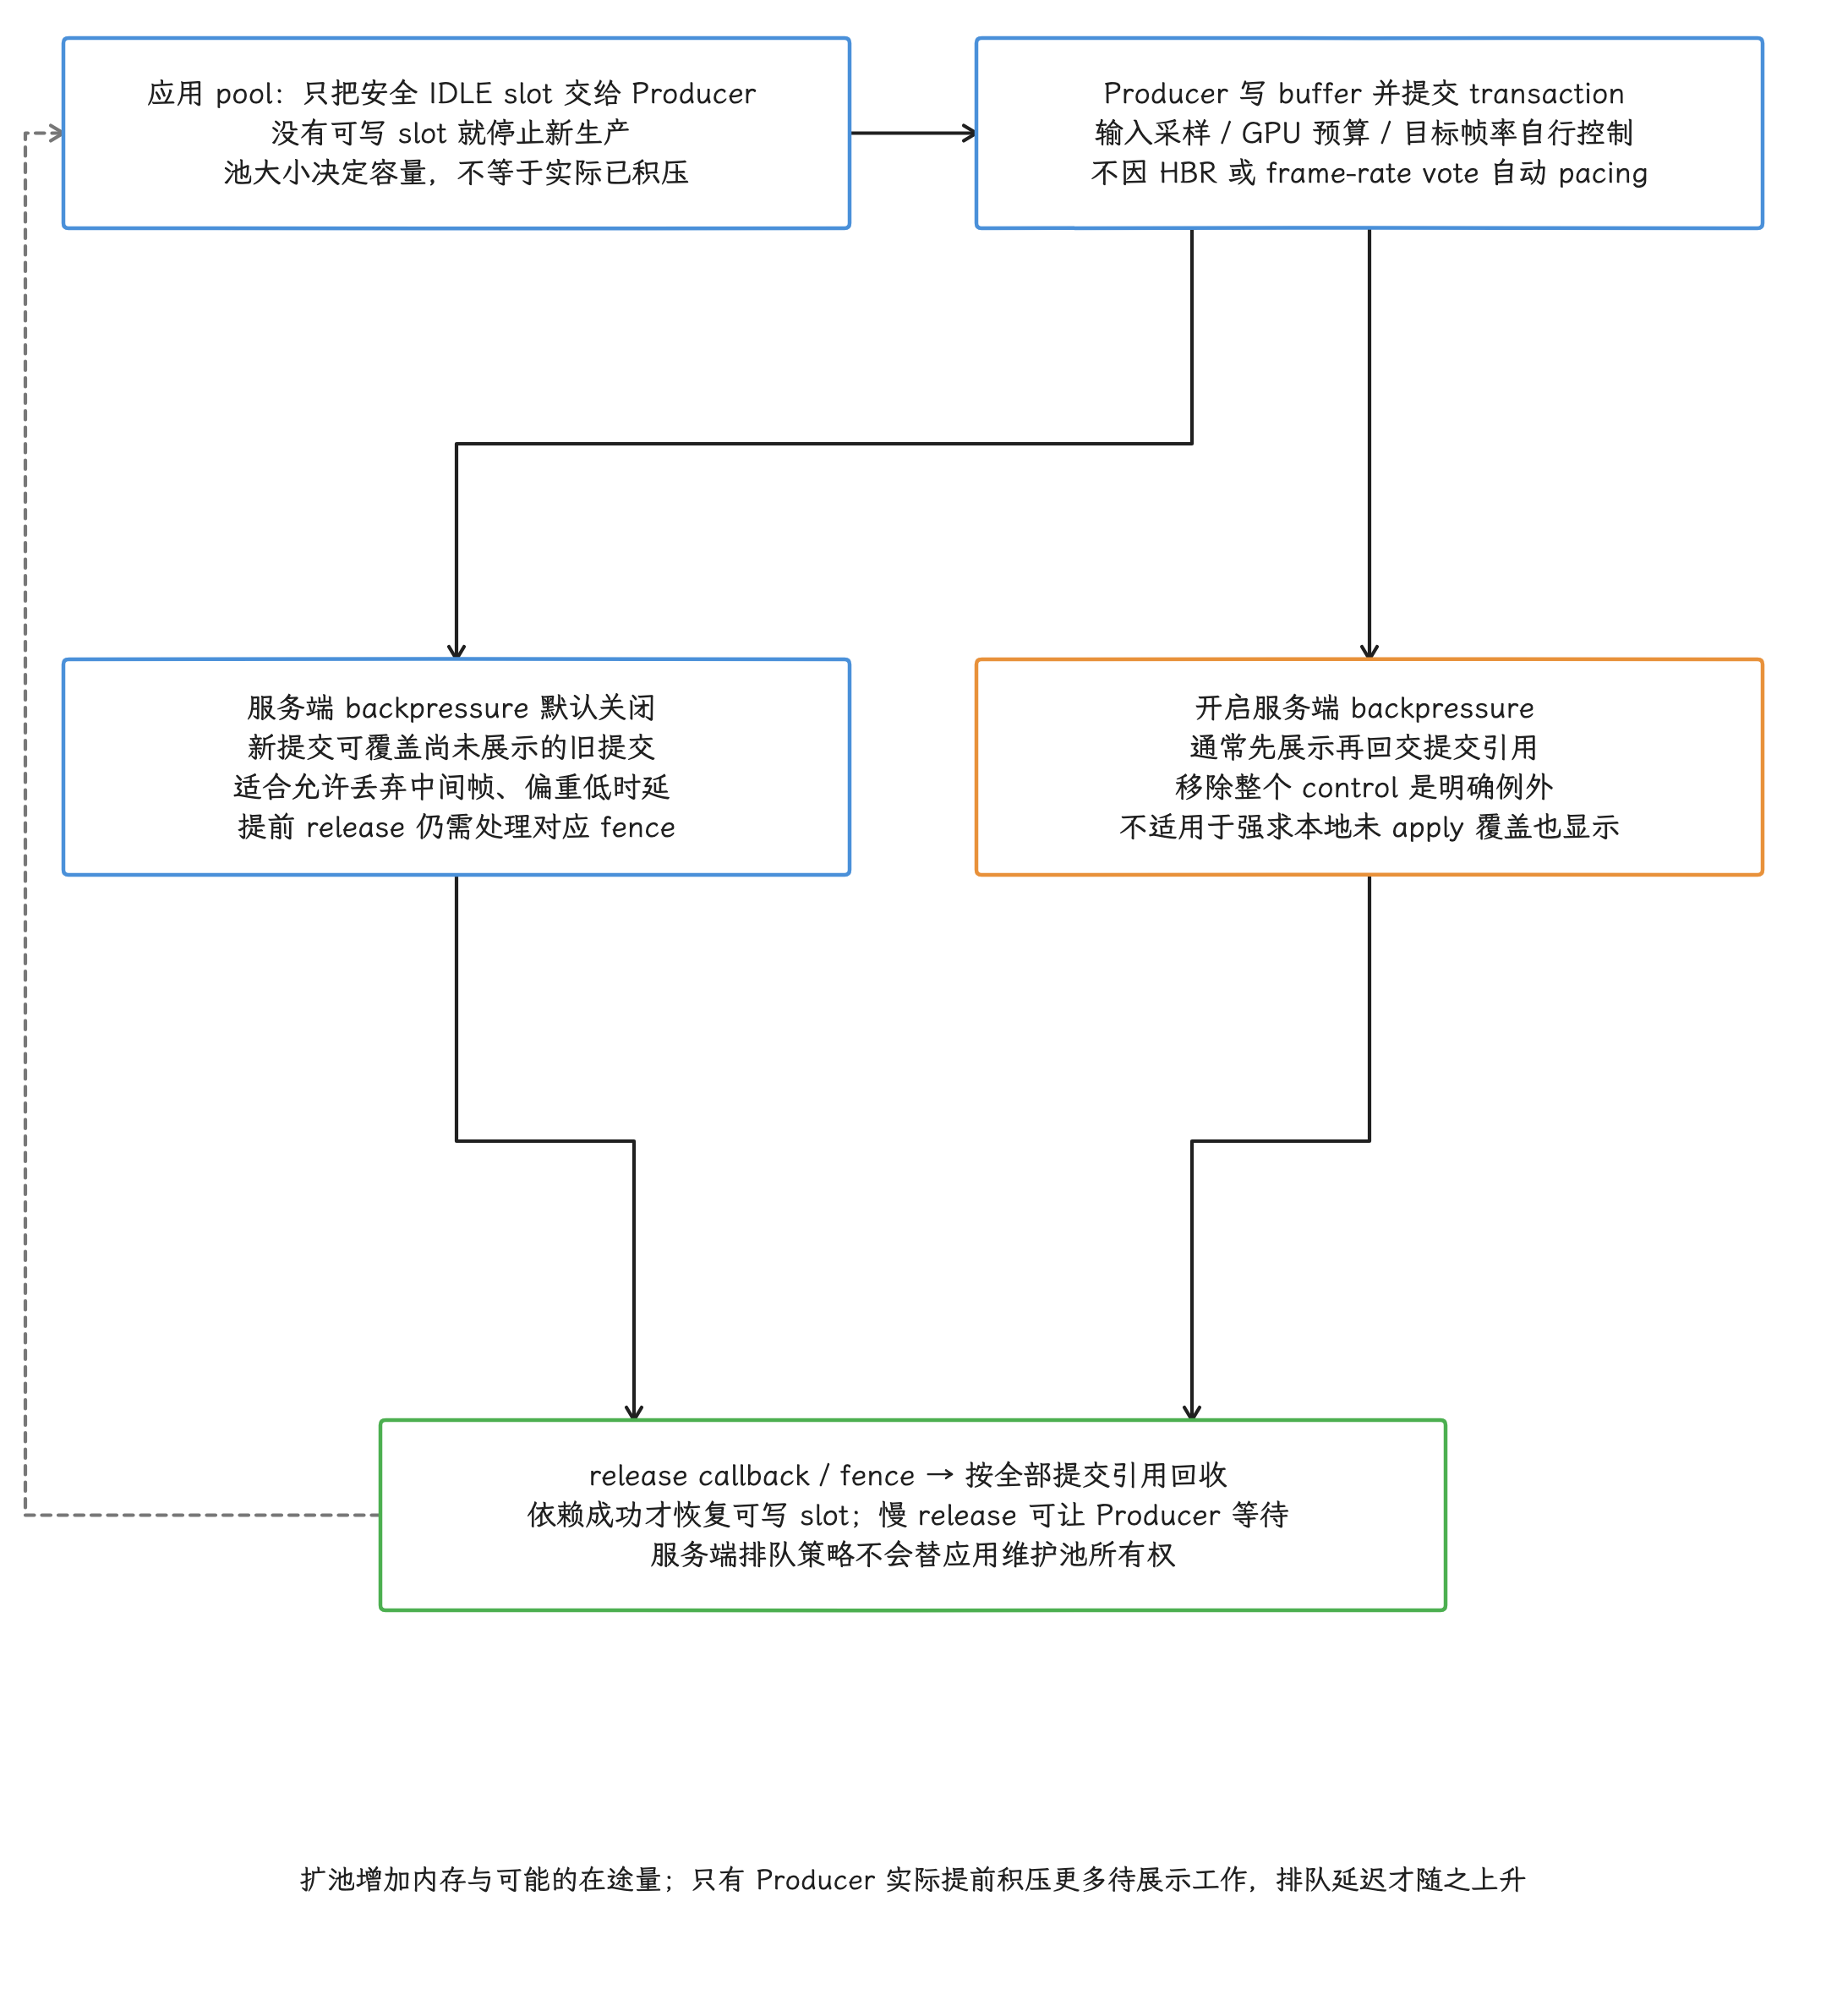
图:NDK child 默认关闭服务端 backpressure,尚未展示的旧提交可被新提交覆盖;开启通常先展示再release,但整个control移除是例外,本地未apply覆盖的buffer也拿不到这个要求。应用 buffer 池背压是无安全可写slot则停产,独立于服务端策略。池容量太小可能等待release,扩池增加内存/潜在inflight,只有实际超前积压才增加排队延迟;扩池掩盖不了下游瓶颈。每次仍按所有提交引用/fence回收,Producer频率、输入到present和功耗一起测,不由HBR或setFrameRate自动pacing。
与 NDK 的关系
公开 NDK 没有与 Java HBR 对应的 AHardwareBufferRenderer_* API。Native 代码可以把 AHardwareBuffer 导入 EGL/OpenGL ES 或 Vulkan,自行实现 GPU producer,再把结果交给 ASurfaceTransaction:
AHardwareBuffer_allocate
    -> 导入 EGLImage 或 Vulkan external memory
    -> GPU 渲染
    -> 导出 acquire/presentation fence fd
    -> ASurfaceTransaction_setBuffer*
    -> release callback/fence 后复用
这条路径仍要显式处理 acquire/presentation fence、release fence 和 transaction 所有权。头文件按 API 级别给出的对应关系如下:
| API 范围 | 提交 API | 安全复用当前 buffer 的依据 |
|---|---|---|
| API 26–28 | 有 AHardwareBuffer,没有公开的 ASurfaceTransaction buffer 提交 | 走 ANativeWindow/EGL/Vulkan 等对应 consumer 的同步规则 |
| API 29–35 | ASurfaceTransaction_setBuffer() | 在后续 transaction 的 OnComplete 中读取 previous buffer 的 release fence |
| API 36–37 | 优先 ASurfaceTransaction_setBufferWithRelease() | 与当前提交 buffer 一一对应的 ASurfaceTransaction_OnBufferRelease |
API 29–35 的 ASurfaceTransactionStats_getPreviousReleaseFenceFd() 返回被本次 transaction 替换或移除的上一块 buffer 的 fence,回收对象是上一块;本次刚提交的 buffer,要等未来某次 transaction 替换它之后,才会作为“上一块”出现在统计里。
API 36–37 的 release callback 会直接关联当前提交的 buffer。若 callback 给出非负 fd,接收方取得该 fd 的所有权,必须等待并关闭;-1 表示无需等待。传给 setBuffer*() 的 acquire fence fd 则由 framework 接管并关闭。ASurfaceTransaction_create() 返回的 transaction 仍归调用方所有,apply() 后要调用 ASurfaceTransaction_delete()。AOSP: surface_control.h
内核里的共享对象与同步原语
Java HardwareBuffer 在 native 侧映射到 AHardwareBuffer / GraphicBuffer,allocator 可通过 dma-buf 让 GPU、DPU 等设备共享同一块图形内存。SyncFence 和 NDK fence fd 通过 sync_file 跨进程传递,底层由 dma-fence 表达异步硬件任务的完成依赖。
在 android17-6.18-2026-06_r6 中,通用语义可从四个入口核对:
drivers/dma-buf/dma-buf.c:buffer attachment(设备附着关系)、map 与跨设备共享;drivers/dma-buf/dma-fence.c:signal、callback 和 wait;include/linux/dma-fence.h:dma-fence 接口、上下文与序列号;drivers/dma-buf/sync_file.c:把一个或一组 dma-fence 封装成 sync_file fd。
内核层看不到 RenderNode、HBR request 或 SurfaceControl Layer 的业务含义:内核侧记录能说明共享对象和同步依赖是否成立,而 HWUI 是否按预期绘制、Layer 是否被 HWC 选为 DEVICE、release fence signal 时像素是否已经对用户可见,还要回到上层去回答。
性能对比与实测
HBR 的收益取决于原有瓶颈。我们用下表筛选候选方案,最终要靠同设备、同内容的测量说话:
| 维度 | lockCanvas() | lockHardwareCanvas() | HardwareBufferRenderer |
|---|---|---|---|
| 光栅化 | CPU | GPU / HWUI | GPU / HWUI |
| 目标 | Surface | Surface | 调用方的 HardwareBuffer |
| 局部内容保留 | software Surface 支持 dirty region 语义 | 每帧完整覆盖 | 旧内容保留,是否 clear 由调用方决定 |
| 帧提交 | unlockCanvasAndPost() | unlockCanvasAndPost() | consumer 自定;直接显示常用 SurfaceControl.Transaction |
| 同步管理 | 多数由 Surface / BufferQueue 处理 | 多数由 Surface / BufferQueue 处理 | presentation 与 release 两端都要接好 |
| 主要风险 | CPU 光栅化占用、锁 buffer 等待 | RenderThread/GPU 争用、consumer 不及时 | 冷启动、共享 RenderThread/GPU、transaction 与 buffer 池错误 |
下面几类内容适合先用 HBR 实测:
- 大尺寸 Path、矢量场景、图片变换或复杂 RenderNode 场景,CPU software raster 已经是主要耗时。
- 结果本来就要作为独立
HardwareBuffer继续消费,避免为了得到独立 buffer 再设计一套读回路径。 - 业务已有合法、稳定的
SurfaceControllayer,需要显式控制 buffer 与原子 transaction。
简单图形、低分辨率静态内容或 GPU 已饱和的场景,HBR 可能没有收益。HBR 使用与普通 UI 共享的 RenderThread/GPU,离屏任务过重时,View 动画和窗口帧也可能受影响。直接调用 setBuffer() 只让 buffer 成为独立 Layer 输入;overlay plane 是否落在它头上,仍由 HWC 根据格式、变换、遮挡、带宽和硬件能力在 DEVICE 与 CLIENT composition 之间选择。
基准测试至少要固定设备与 GPU、Android build、buffer format/size/usage、场景内容、清屏策略、目标帧率、buffer 池大小,以及冷启动或稳态条件。测量时把 CPU recording、RenderThread、GPU、transaction 到 latch 和 release 等待分开记录;只看单个总耗时,回归来自哪个阶段的线索就断了。
适用场景与约束
CPU 软件光栅化吃紧的离屏内容
PDF 页、复杂图形卡片、自定义贴纸或缩略图生成,如果 CPU raster 已在 trace 中成为主要成本,可以评估 HBR。还要确认后续 consumer 能直接使用 HardwareBuffer;若最终仍要把结果读回 CPU,GPU readback(把 GPU 结果复制回 CPU 可访问内存)这一步可能抵消收益。
跨进程 buffer 共享
HardwareBuffer 实现了 Parcelable。Binder 传递的是 native buffer handle/reference,不会把整幅像素复制进 Parcel。跨进程协议仍要同时定义:
- width、height、format、usage、color space/dataspace;
- producer 完成写入的 fence;
- consumer 用完后的 release 反馈;
- buffer id/generation,用于防止迟到的旧回调释放已经重新分配的 slot;
- 进程死亡和 binder 断连时的引用清理。
如果只传 HardwareBuffer、没有同时传递同步关系,consumer 可能读到尚未完成的 GPU 输出,producer 也可能在 consumer 使用期间覆写同一块内存。
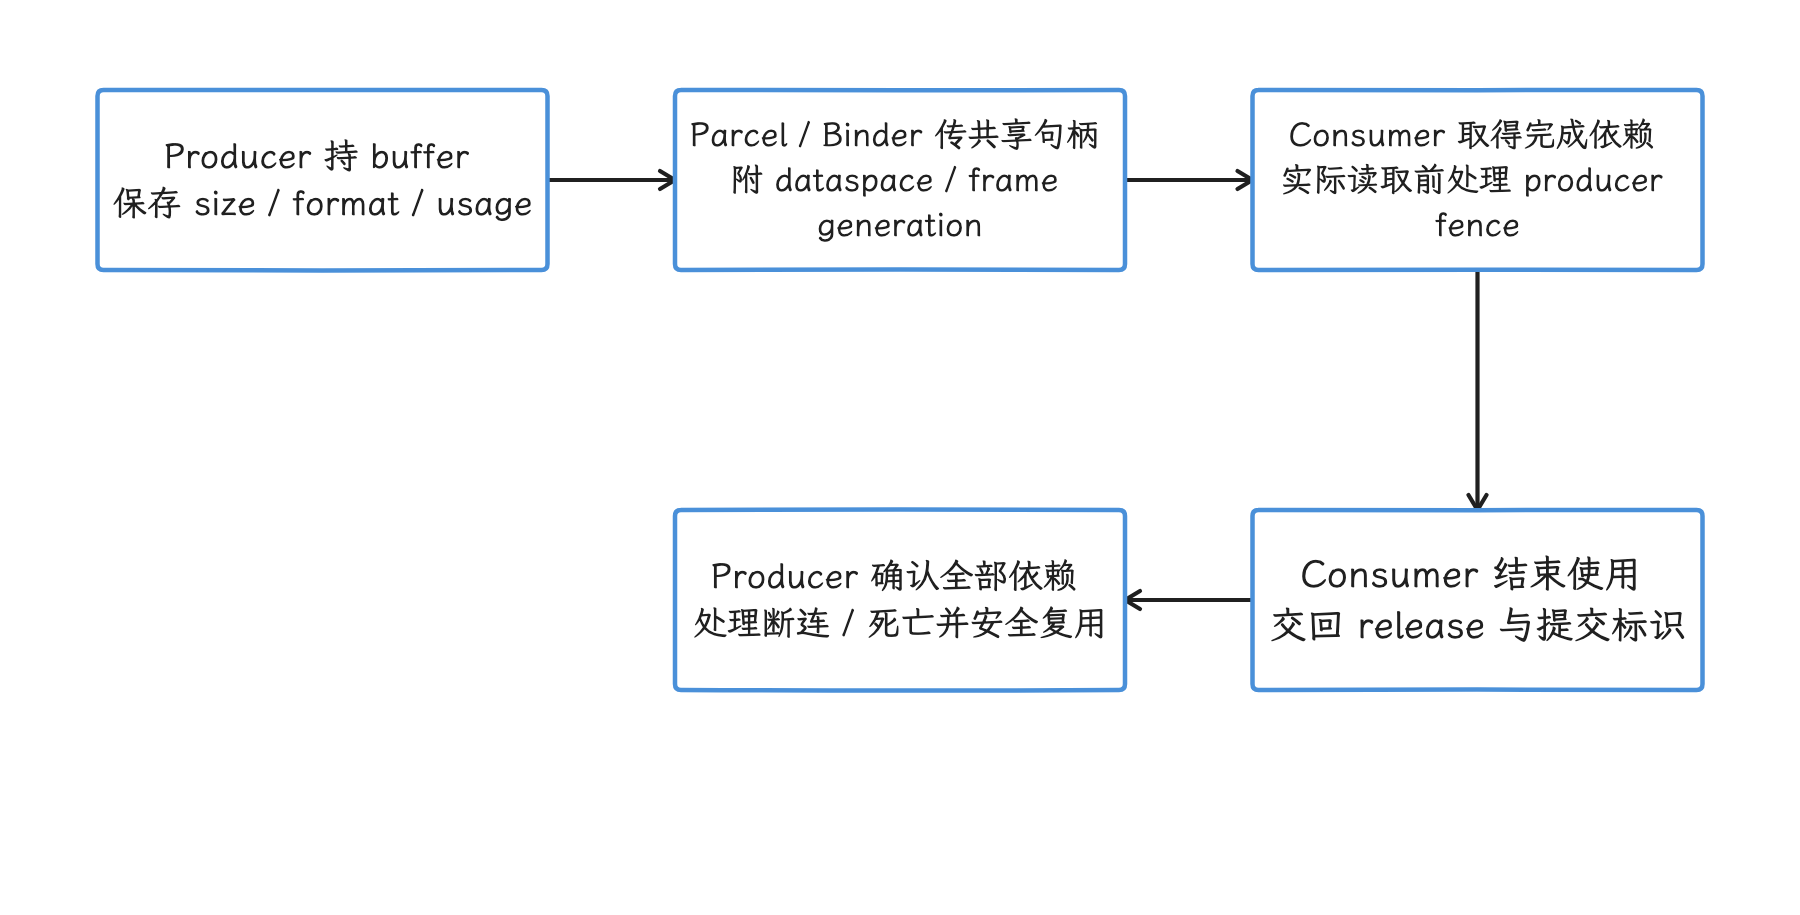
图:共享句柄只传存储引用,读写同步和回收反馈另由协议定义。 Parcel 不复制整幅像素;没有 fence / generation 协议仍可发生并发访问或错回收。
Wide color 与 HDR
RGBA_FP16 说的只是每个 RGBA 分量使用 16-bit 浮点存储;内容要成为 HDR,靠的是下面这整条颜色契约:
- 用
RenderRequest.setColorSpace()告诉 HBR 如何解释和生成像素;跳过这一步时每次 request 都回到 sRGB。 - 用
Transaction.setDataSpace()告诉 SurfaceFlinger layer 中像素的编码含义。 - 确认 buffer format/usage 组合由设备支持。
- 确认显示、SurfaceFlinger 与 HWC 支持目标色域和传递函数,并准备 tone mapping(色调映射)或 SDR 回退。
- HDR 内容可在 API 35–37 使用
setDesiredHdrHeadroom()表达期望的 HDR/SDR 亮度比;它是合成 hint,显示能力的保证要从显示端另行核实。
DISPLAY_P3 描述 wide color gamut(广色域),和 HDR 是两回事。FP16 是存储格式,P3 是色域,HLG/PQ 是 HDR 传递函数,HDR headroom 是亮度比提示;setDesiredHdrHeadroom() 接受有限的 0(交给系统)或 >= 1,(0, 1) 会被 Java 参数校验拒绝;扩展范围亮度用 setExtendedRangeBrightness() 时还需描述 buffer 当前 HDR/SDR 比,两项按后调用者覆盖;把它们混成一个开关,可能出现 buffer 精度足够、显示端解释却不正确的问题。Android API: setDesiredHdrHeadroom()
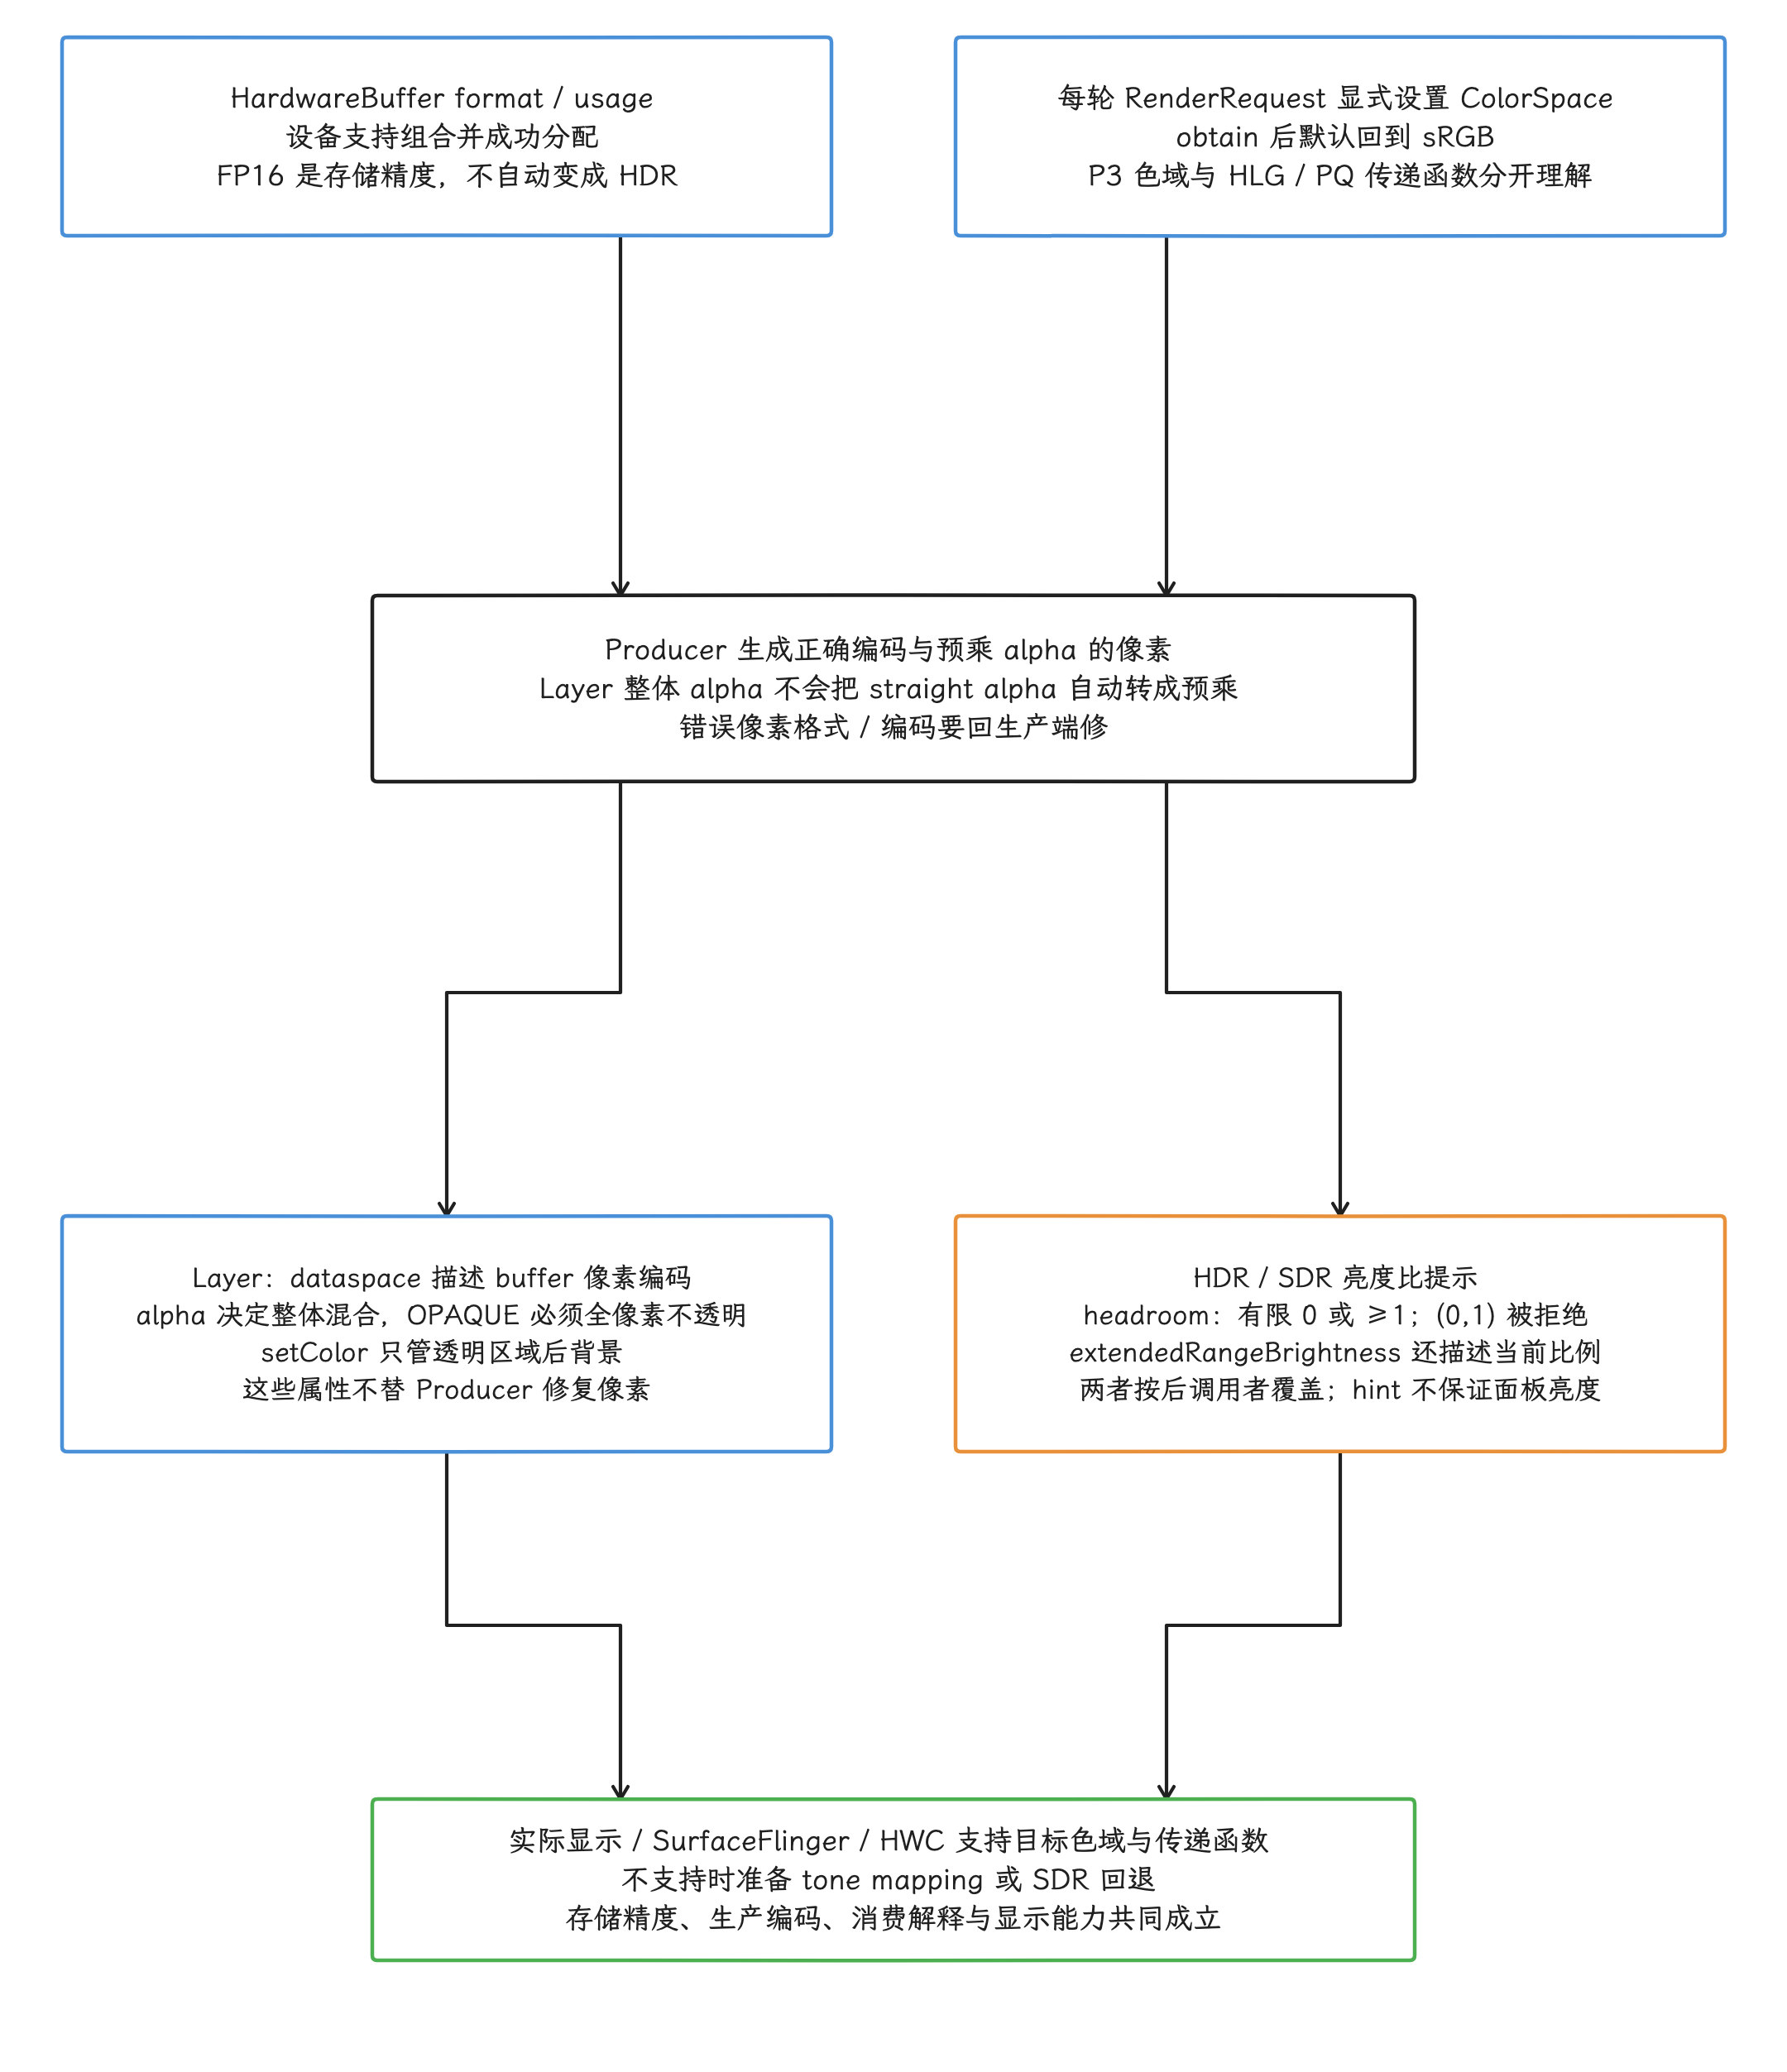
图:格式和 usage 要设备支持并处理实际分配失败;RGBA_FP16 仅是存储精度,P3 是色域,HLG/PQ 是传递函数,彼此不等同 HDR。每轮 request obtain 会 reset sRGB,须显式 ColorSpace,Producer 正确编码并做预乘;Layer alpha 不替像素预乘,OPAQUE 要全像素不透明。setColor 是透明区域后背景,与 setBufferDataSpace 的 buffer 编码不同。headroom 是有限 0 或 >=1,0 交系统;(0,1) 被 Java 拒绝,与 extendedRangeBrightness 后调用者覆盖。显示/SF/HWC 支持目标编码并准备 tone-map/SDR,hint 不保证亮度。
高帧率直接 layer 提交
HBR 允许应用按自己的节奏生成 buffer;接入 Choreographer、FrameTimeline 和显示刷新率策略,这些仍要自己做。高帧率场景还要处理:
- 基于 VSync 的生产节奏;
Transaction.setFrameTimeline()或系统提供的 frame timeline token;- layer frame-rate vote 与显示模式切换;
- buffer 池背压,防止 producer 无限领先;
- GPU 预算与 UI 渲染争用。
单靠选择 HBR,刷新率改不了,显示管线也缩短不了;这些都要靠上面列出的工作自己实现。
Perfetto:按阶段定位
HBR 没有承诺跨版本、跨厂商一致的 trace slice 名。排查前我们可以在 draw()、transaction apply() 和 release callback 三处加入应用自己的 trace section,再按 frame id 与时间关联以下阶段:
- 调用线程:RenderNode recording 与
RenderRequest.draw()发起时间。 - 应用 RenderThread:场景树同步和 HWUI 工作;它与普通 View 渲染共享。
- GPU queue:对应离屏 raster 的 GPU 工作,以及 presentation fence signal 时间。
- SurfaceFlinger layer / transaction:目标 layer 何时收到 buffer、是否在等 presentation fence、何时 latch。
- HWC / present fence:目标显示的合成与呈现反馈;与 HBR 的 producer completion fence 名称分开,外部光学响应测量要另行安排。
- release callback:release fence 何时交回、slot 何时能再次进入 producer。
| 现象 | 更可能的证据 |
|---|---|
draw() 发起很晚 | recording、业务调度或空闲 slot 获取慢 |
| callback 很快,layer 却很晚 latch | presentation fence 长时间未 signal,或 transaction 提交较晚 |
| GPU 忙而 CPU 很轻 | 离屏 raster 或系统其他 GPU 工作成为瓶颈 |
| producer 周期性停顿 | buffer 池耗尽,等待 release |
| HBR 任务与 UI 帧同时恶化 | 共享 RenderThread/GPU 出现争用 |
我们看到 BufferQueue/BLAST 轨道时,先确认它属于哪条路径:HBR API 只写目标 HardwareBuffer,BufferQueue 事件来自应用另外选择的 Surface consumer 路径。
常见错误
把 draw callback 当成 GPU fence 已 signal
callback 只交付 RenderResult,consumer 仍要处理 getFence()。另一个 GPU/CPU consumer 若跳过接收或等待该 fence 直接读取 buffer,就会与 HBR 的 GPU 写入发生未同步的并发访问。
用 presentation fence 判断 buffer 可写
presentation fence 约束 consumer 何时可读,release fence 约束 producer 何时可再次写。两者方向相反,各管一头。
一块 buffer 连续提交
同一块 buffer 还在 layer 上显示时又发起 HBR draw,会让 producer 与 consumer 同时访问它。单 buffer 必须等 release fence signal 后才能再次写入;连续动画应维护带 backpressure(无空闲 slot 时停止生产)的 buffer 池。
忘记 clear,或把旧内容当成完整帧缓存
HBR 会保留未覆盖像素。这允许调用方自行实现局部更新,也可能留下意外的旧内容;透明背景尤其需要明确清屏策略。
一个 renderer 轮流“绑定”多块 buffer
HBR 在构造时固定输出 buffer,没有更换 target 的 API。buffer 池应让每个 slot 持有对应 renderer;如果 buffer 已经不再活动,应先安全关闭旧 renderer,再按需重建。
只关闭 renderer
HardwareBufferRenderer.close() 不会关闭传入的 HardwareBuffer。HBR 后续 draw() 仍会向该 Java wrapper 读取 width/height,因此计划继续 draw 时应保持它开放;关闭 wrapper 也不等于所有 native 引用消失。已经 setBuffer() 的 native transaction 会持有 GraphicBuffer 引用,Java wrapper 关闭之后,这份提交的底层内存要等这些 native 引用逐一释放。应用仍须独立排空回调和 fence,分别定义 renderer、wrapper、native 引用及 slot 的关闭与复用时机。
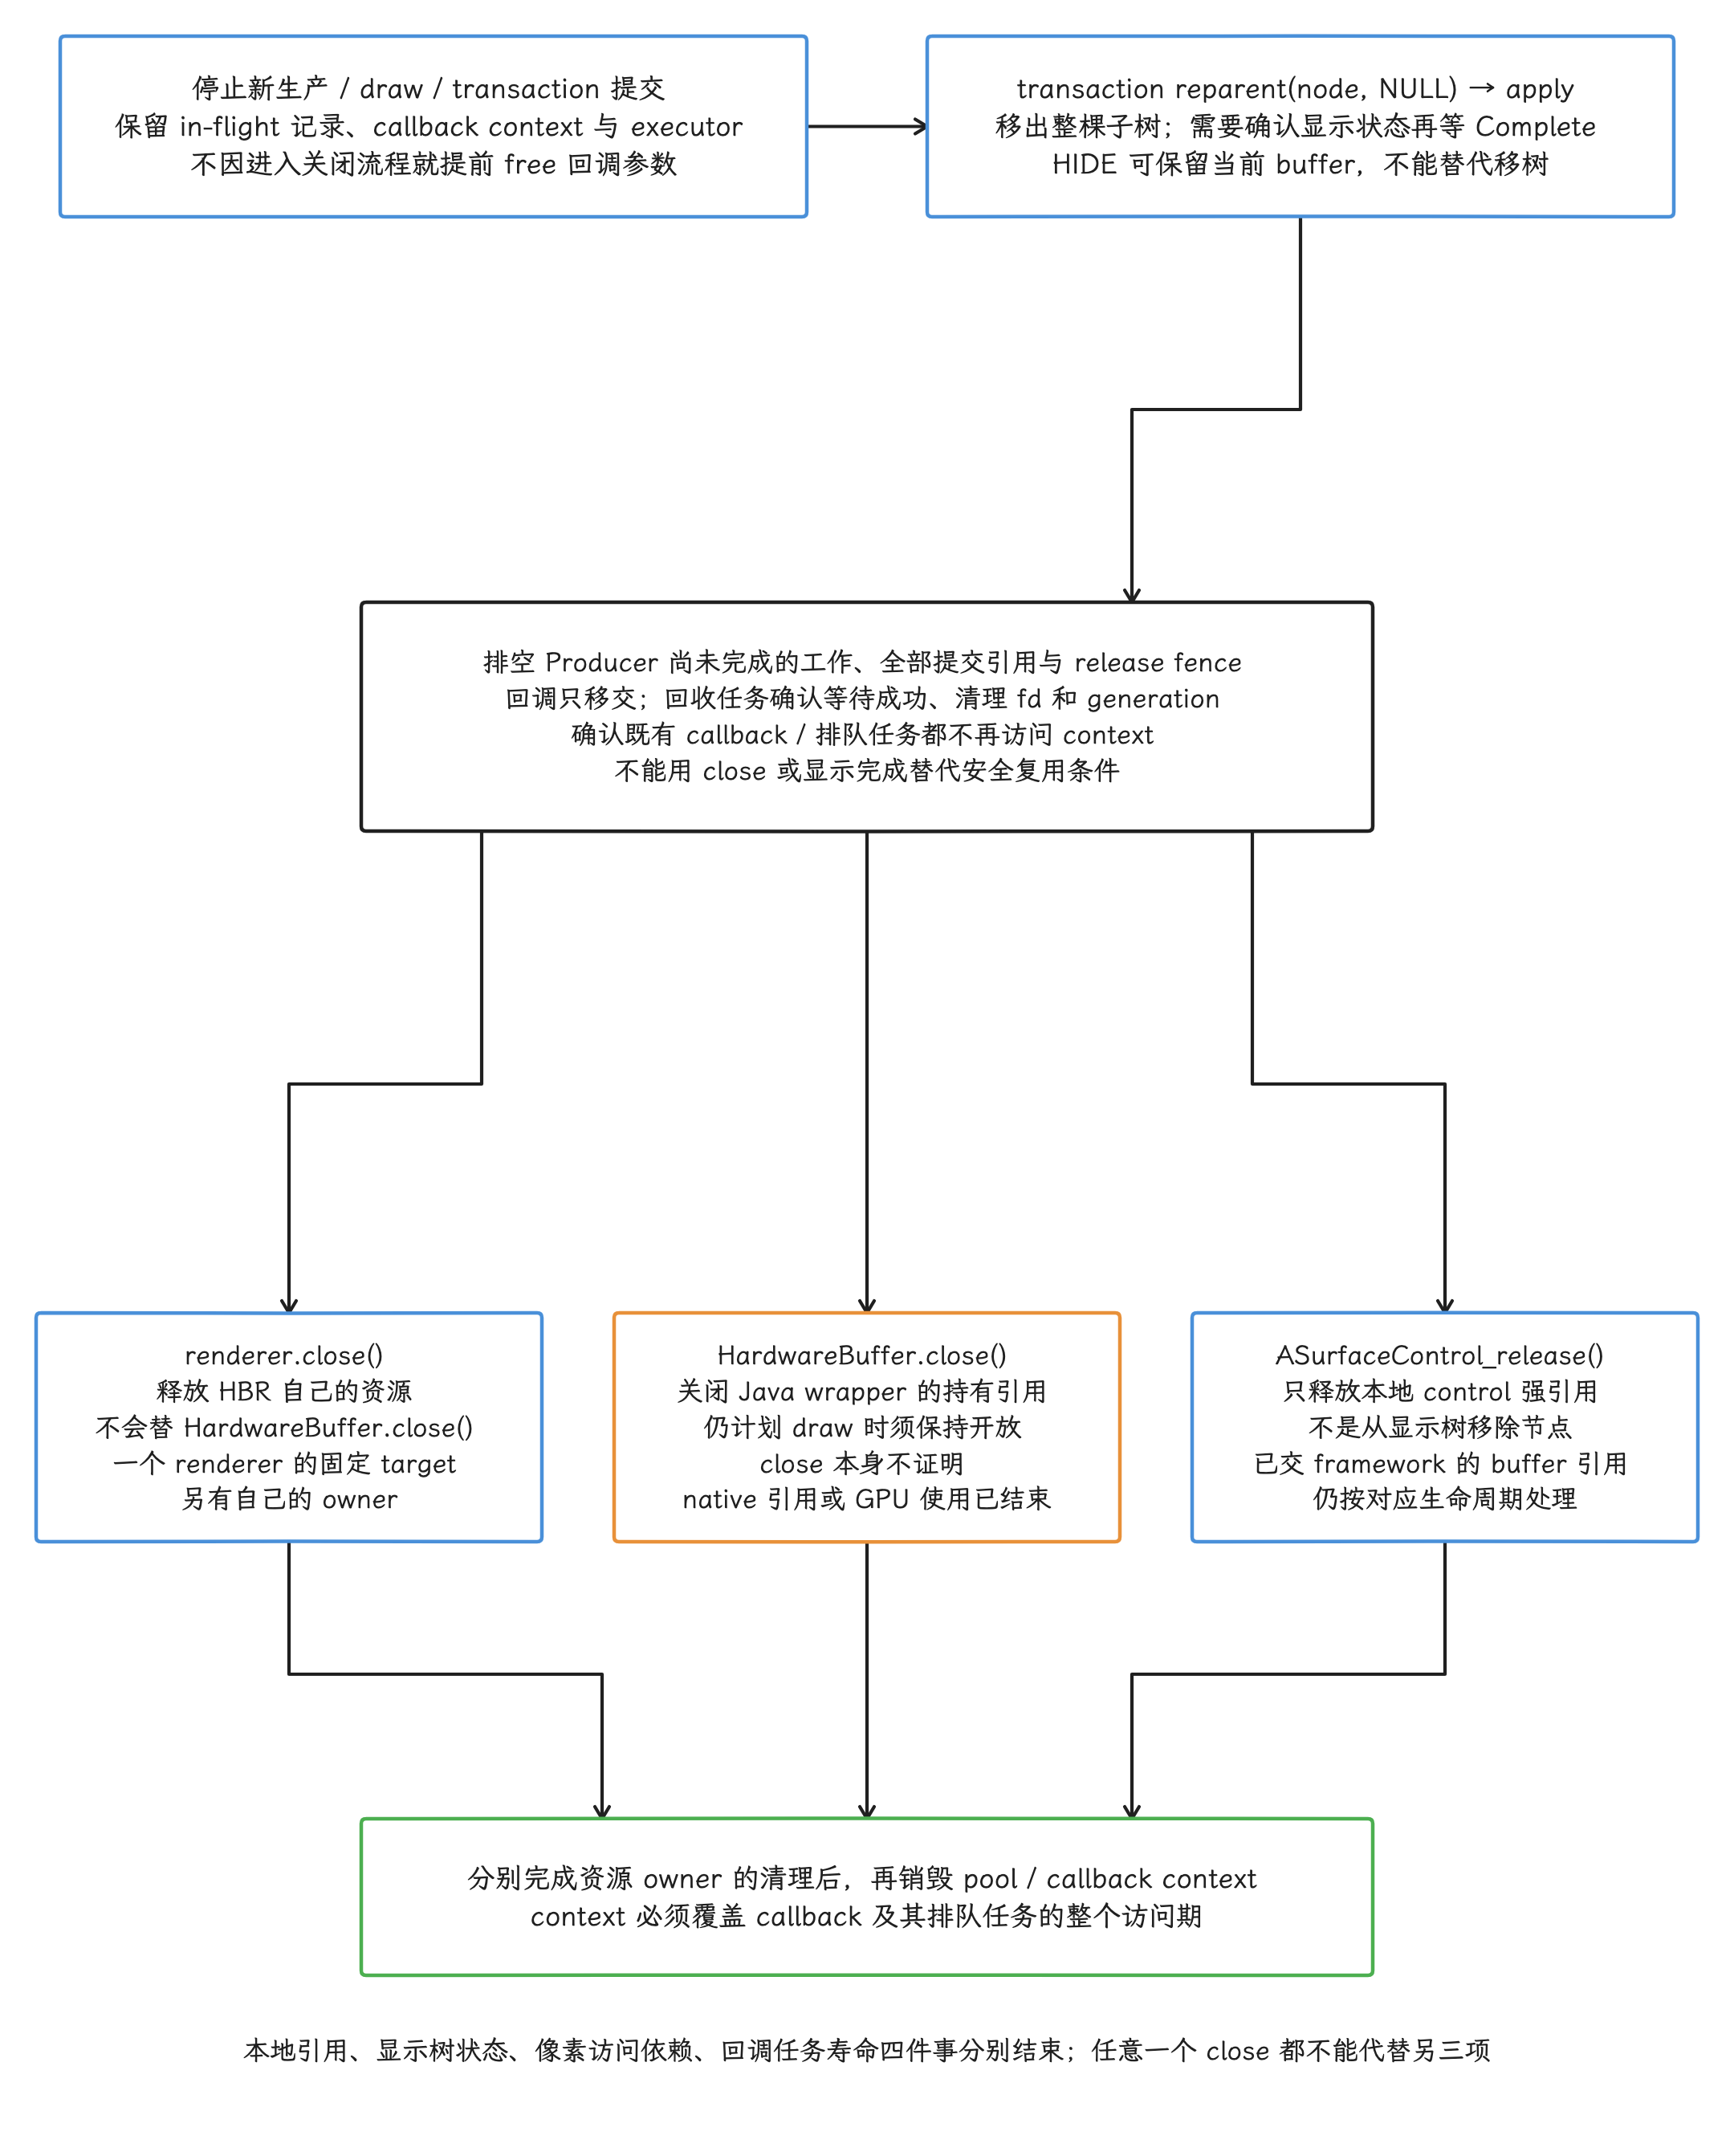
图:图示一种安全关闭流程,不将各对象close当同一事件。先停新生产/transaction并保持context/executor,reparent-null apply移出显示树;要证显示状态另等OnComplete,HIDE可保留节点/当前buffer,control release仅减本地引用不移树。再排空Producer工作、所有提交引用/release fence、回调和排队回收任务,最后分别释放renderer、HardwareBuffer wrapper、localcontrol及context。HBR close不关闭buffer,计划继续draw时buffer wrapper必须保持开放(后续读取宽高);wrapper close不等nativeGraphicBuffer引用消失或硬件已完成。context要活到回调和任务都不再访问。
把 SurfaceControl.Transaction.setBuffer() 当成任意应用窗口入口
调用方必须拥有一个生命周期有效、已经正确挂入 layer tree 的 SurfaceControl。很多场景里,SurfaceView、AttachedSurfaceControl、HardwareRenderer 或 AndroidX Graphics 是更合适的选择;普通 View 业务单为用上 HBR 就绕开既有窗口渲染,通常并不划算。
从 Android 13 到 Android 17 的公开能力
| 版本 | 与 HBR 直接相关的公开能力 |
|---|---|
| Android 13 / API 33 | Java SyncFence;SurfaceControl.Transaction.setBuffer(HardwareBuffer, SyncFence, releaseCallback) 提供 direct Layer 的 producer / consumer 同步 |
| Android 14 / API 34 | HardwareBufferRenderer、RenderRequest 与 RenderResult 公开,支持 RenderNode 到调用方 HardwareBuffer |
| Android 15 / API 35 | Java Transaction.setFrameTimeline()、setDesiredPresentTimeNanos() 与 setDesiredHdrHeadroom() 公开;前两项在固定 r1 还检查 sdkDesiredPresentTime flag |
| Android 16 / API 36 | NDK ASurfaceTransaction_setBufferWithRelease() 和逐 buffer release callback 公开 |
| Android 17 / API 37 | HBR 没有新增公开方法;按 android-17.0.0_r1 核对 request reset、四种直角旋转、JNI fence 和 SurfaceControl 提交语义 |
读这张表时注意方向:API 33 已具备 HardwareBuffer direct Layer 和 fence 基础能力,Java HardwareBufferRenderer 类仍要到 API 34 才能使用;旧版本上 HBR 的有无以 API 34 这条线为准,API 33 的能力清单回答的是另一个问题。
Android 14 以下的降级
版本判断只能回答类是否存在,降级方案还要根据业务所需的输出目标和 consumer 选择:
if (Build.VERSION.SDK_INT >= Build.VERSION_CODES.UPSIDE_DOWN_CAKE) {
    // API 34+: RenderNode -> HardwareBufferRenderer -> consumer
} else {
    // 已有 Surface:lockHardwareCanvas() 或 HardwareRenderer
    // 独立 GPU buffer:EGL/Vulkan + HardwareBuffer/平台兼容层
    // CPU 可接受:lockCanvas() 或软件 Bitmap
}
若目标只是绘制到 Surface,应优先保留 Surface 模型;若协议必须输出独立共享 buffer,再评估 EGL/Vulkan 或 AndroidX Graphics 的兼容封装。降级路径要保持 color space、同步和资源所有权语义,只替换类名只算完成了最表面的一步。
复核清单
- 已确认需要的是“RenderNode → 独立 HardwareBuffer”,不只是 GPU Canvas
-
用
HardwareBuffer.isSupported()验证 format、尺寸和 usage - 每个活动 buffer 有对应 renderer/slot
- 每次 request 都显式设置需要的 color space/transform
-
检查
RenderResult.getStatus() - presentation fence 已传给 consumer 或被正确等待
- 全部提交引用释放且 fence 等待成功后才把 slot 标为空闲;失败则隔离
- 已定义全量覆盖或显式 clear 策略
- renderer、buffer、transaction、fence 都有清晰的关闭方
- 高帧率 producer 有 VSync pacing 和 buffer 池背压
- HDR 同时校验 format、color space、dataspace、headroom 与显示能力
- Perfetto 中把 app、RenderThread、GPU、SurfaceFlinger 和 release 串成同一帧
结论
- SurfaceControl 负责 Layer 树、buffer 状态和 transaction,HardwareBufferRenderer 负责把 RenderNode 内容写入调用方持有的 HardwareBuffer;二者通过 production/presentation fence 与 release fence 组成完整交接。
- Transaction 的原子应用、commit、complete 和 display present 各是独立阶段。直接提交 buffer 的应用还必须自行维护池、回收回调、FrameTimeline 与对象生命周期。
- HBR 把 RenderNode 场景树写入调用方拥有的
HardwareBuffer;若目标是现成Surface,应同时比较lockHardwareCanvas()和HardwareRenderer。 - HBR 与普通 UI 共享应用 RenderThread 和 GPU context,离屏任务会与窗口渲染争用资源。
RenderResult的 presentation fence 约束 consumer 读取,SurfaceControl release fence 约束 producer 复用,两类 fence 方向相反、各管一段。- 持续渲染需要按 slot 配置 buffer、renderer、generation 和 release 状态,池大小由 GPU 与显示延迟实测决定。
- Java HBR 从 API 34 开始提供;NDK 需要使用 AHardwareBuffer 加 EGL / Vulkan,并按 API 29–35 与 API 36–37 的不同 release 契约实现。
- HDR 需要同时匹配 format、color space、dataspace、headroom 与显示能力,单凭
RGBA_FP16说明不了内容是 HDR。 - 源码只接受 identity 与三种直角旋转;公开文档列出的镜像 transform 落到 HBR request 上会被拒绝。
参考资料
- Android API:HardwareBufferRenderer(API 34)
- Android API:HardwareBufferRenderer.RenderRequest
- Android API:HardwareBuffer
- Android API:SyncFence
- Android API:SurfaceControl.Transaction
- AndroidX Graphics:CanvasBufferedRenderer
- Android 17 AOSP:HardwareBufferRenderer.java 与 JNI
- Android 17 AOSP:DrawFrameTask.cpp
- Android 17 AOSP:HardwareBuffer.java
- Android 17 AOSP:Surface.java
- Android 17 AOSP:SurfaceControl.java 与 JNI
- Android 17 AOSP:NDK surface_control.h
- Kernel android17-6.18:dma-buf.c、dma-fence.c、dma-fence.h、sync_file.c