A/B Test 与性能回归防护
性能改动最终要过发布这一关。平均值涨跌只是第一层答案:长尾用户、低端设备、被牵连的业务指标,都可能藏在均值下面。这一篇讲发布阶段的纪律——预先定义随机化单位、样本比例、护栏和回归阈值,把异常归因也做在同一版本与场景之内。
源码基线:AOSP
android-17.0.0_r1,Android 17 / API 37;相关判断不依赖内核专有实现,不附加内核版本标签(kernel tag)。
发布阶段需要回答的问题
性能治理进入发布阶段后,我们要回答的都是风险问题:新版本能否继续扩大灰度,某个配置是否适合放量,启动优化有没有伤到资源受限设备,页面改版有没有推高慢帧率。回答这些问题靠两套机制:A/B Test 用随机对照估计方案的因果影响;性能回归指新改动让既有指标变差,回归防护负责在代码合入、候选包和生产灰度阶段把这种劣化找出来。两套机制相关,给出的证据等级不同。
26.1 节已经讲过性能指标采集与上报,这一篇接着处理实验(A/B Test)设计、回归检测、CI/CD 门禁和劣化归因,重点是让实验室基准测试、生产环境分流实验、灰度监控和发布决策共用同一套判断流程。
版本只影响其中一部分。实验统计与 CI 策略属于应用和数据平台的设计;Android 版本主要决定两件事:Macrobenchmark 各项指标是否可用,以及 ApplicationExitInfo 能提供哪些退出证据。
性能 A/B Test 的设计与统计方法
设计一个性能 A/B Test,我们先要承认一件事:启动、渲染、内存和功耗往往带长尾,同一方案还可能对不同设备群产生相反影响,只比较“新方案平均耗时”问不出完整答案。所以实验开始前,我们要把一串决定预先写清:估计目标 estimand(希望用数据回答的具体效应)、随机化单元、主指标、护栏指标、关键分群、最小可检测效应、样本量方法和停止规则。护栏指标管的是其中一类风险:实验用稳定性或业务损伤换取主指标收益。
| 设计项 | 推荐做法 | 风险 |
|---|---|---|
| 随机化单元 | 按账号、安装或设备选择与产品语义一致的稳定单元;分析时保留分桶版本 | 按请求随机会让同一用户反复切换;更换哈希函数(hash)或分桶盐值(salt)会造成重新分桶 |
| 暴露定义 | 分别记录实验分配(assignment)、配置拉取(fetch)、配置激活(activate)和功能实际使用 | 只分析成功激活者会引入处理后选择偏差 |
| 主指标 | 每个决策指定一个主指标,并写清是每用户均值、事件分位值还是用户违约率 | 同名指标的聚合单元不同,估计的问题也不同 |
| 护栏指标 | 同时观察崩溃(Crash)、应用无响应(ANR)、内存、功耗、数据上报健康度和关键业务路径 | 性能收益可能伴随稳定性或业务损伤 |
| 分群维度 | 预先指定设备档位、Android 版本、刷新率、网络与入口等少量关键分群 | 事后遍历大量分群容易挑出偶然差异 |
| 停止规则 | 固定观察终点,或使用预注册的有效序贯方法 | 反复查看普通 p 值并随时停止会抬高假阳性率;p 值是在零假设成立时,观察到同等或更极端结果的概率 |
随机化单元和统计单元必须一致——上表第一行要落到分析里,就是这一条。按用户分桶时,同一用户的多次启动、帧或会话是相关观测,统计时要当成一个整体:常见做法是先在用户级聚合再比较两组;必须保留事件级模型时,就用按随机化单元聚类的标准误,或按该单元做 bootstrap。少了这层处理,活跃用户贡献的更多事件会把置信区间压得过窄。
落到工具上,Firebase A/B Testing 的 Remote Config 实验可以配置目标人群、基线与变体、权重和指标。官方文档里有两个容易忽略的点:若配置了可选激活事件(activation event),结果只纳入触发该事件的目标用户;其他命中条件的用户仍可能收到实验值。不要把这个条件说成每个实验都必须配置激活事件;实验一旦开始,变体权重也就固定了。
自建平台应把“被分配”“成功获取”“成功激活”“使用功能”“成功上报”拆成一个漏斗来监控。主分析优先遵循预先指定的实验分配口径;按激活者做补充分析时,要说明这份数据可能受网络、启动成功率和变体自身崩溃的影响。
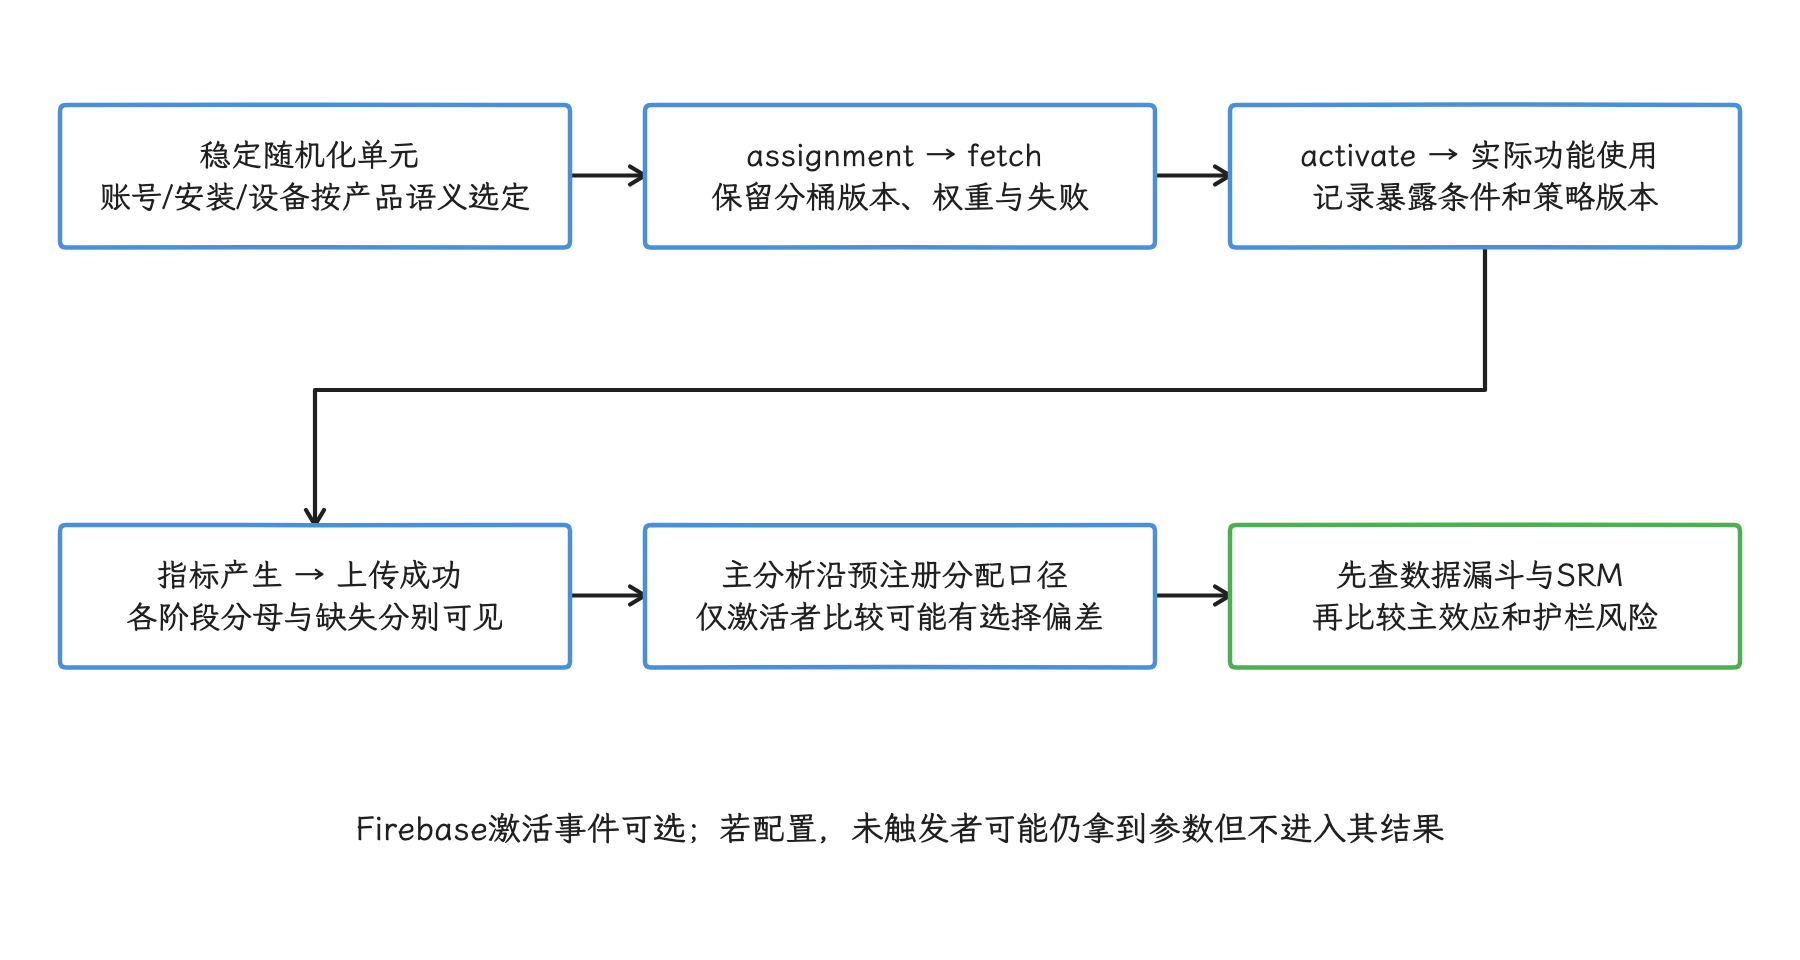
图:配置拉取、激活与成功上报不是随机分配本身;某变体提前崩溃会改变进入分析的人群。
指标类型决定估计方法,我们逐个看:
- 连续指标:例如用户级平均启动耗时。样本量计算需要历史方差、最小可检测效应、显著性水平、统计功效与分配比例,只填一个基线均值算不出结果。
- 二元指标:例如“用户当天是否遇到 Crash”或“是否越过体验阈值”。用用户级比例及其置信区间;同一用户的多次事件要先合并成一个用户,再进统计。
- 比率指标:例如慢帧数 / 总帧数。先明确聚合方式——“分子总和除以分母总和”还是“先算每用户比率再取均值”——再选与之匹配的误差估计:Delta method(一阶近似方差)、bootstrap 或聚类模型。
- P90/P99:这两个是 90 和 99 分位值,属于非线性秩统计量,均值那套公式在这里派不上用场。要估计它们,可以按随机化单元 bootstrap 分位差,也可以把 SLO 转成用户级或会话级违约率;两种结果回答的问题不同。
最小可检测效应(MDE)来自产品决策,定义为实验希望可靠识别的最小业务差异,与“统计上能测到的最小数字”是两回事。关键分群需要单独检查统计功效;样本不足时,我们报告“方向与不确定区间”,收益结论留到证据够了再下。设备群过细时,可先用实验室基准测试排除确定性风险,再积累生产环境证据。
A/A Test 给两组下发同一方案,用来检查分桶、曝光、上报和统计任务是否校准。它检验的是校准本身,给不出“平台永远无偏”的结论;判断校准要看长期假阳性率、置信区间覆盖率和样本比例失衡(Sample Ratio Mismatch,SRM),单次指标差异则允许围绕零波动。
SRM 检查要覆盖全量与预注册关键分群,并沿“实验分配 → 配置拉取 → 配置激活 → 指标产生 → 上传成功”这条链路逐层定位丢失。多项主张、多分群或多次查看结果时,应预先选好多重比较或序贯控制方法;固定终点检验则留给按固定终点执行的实验。
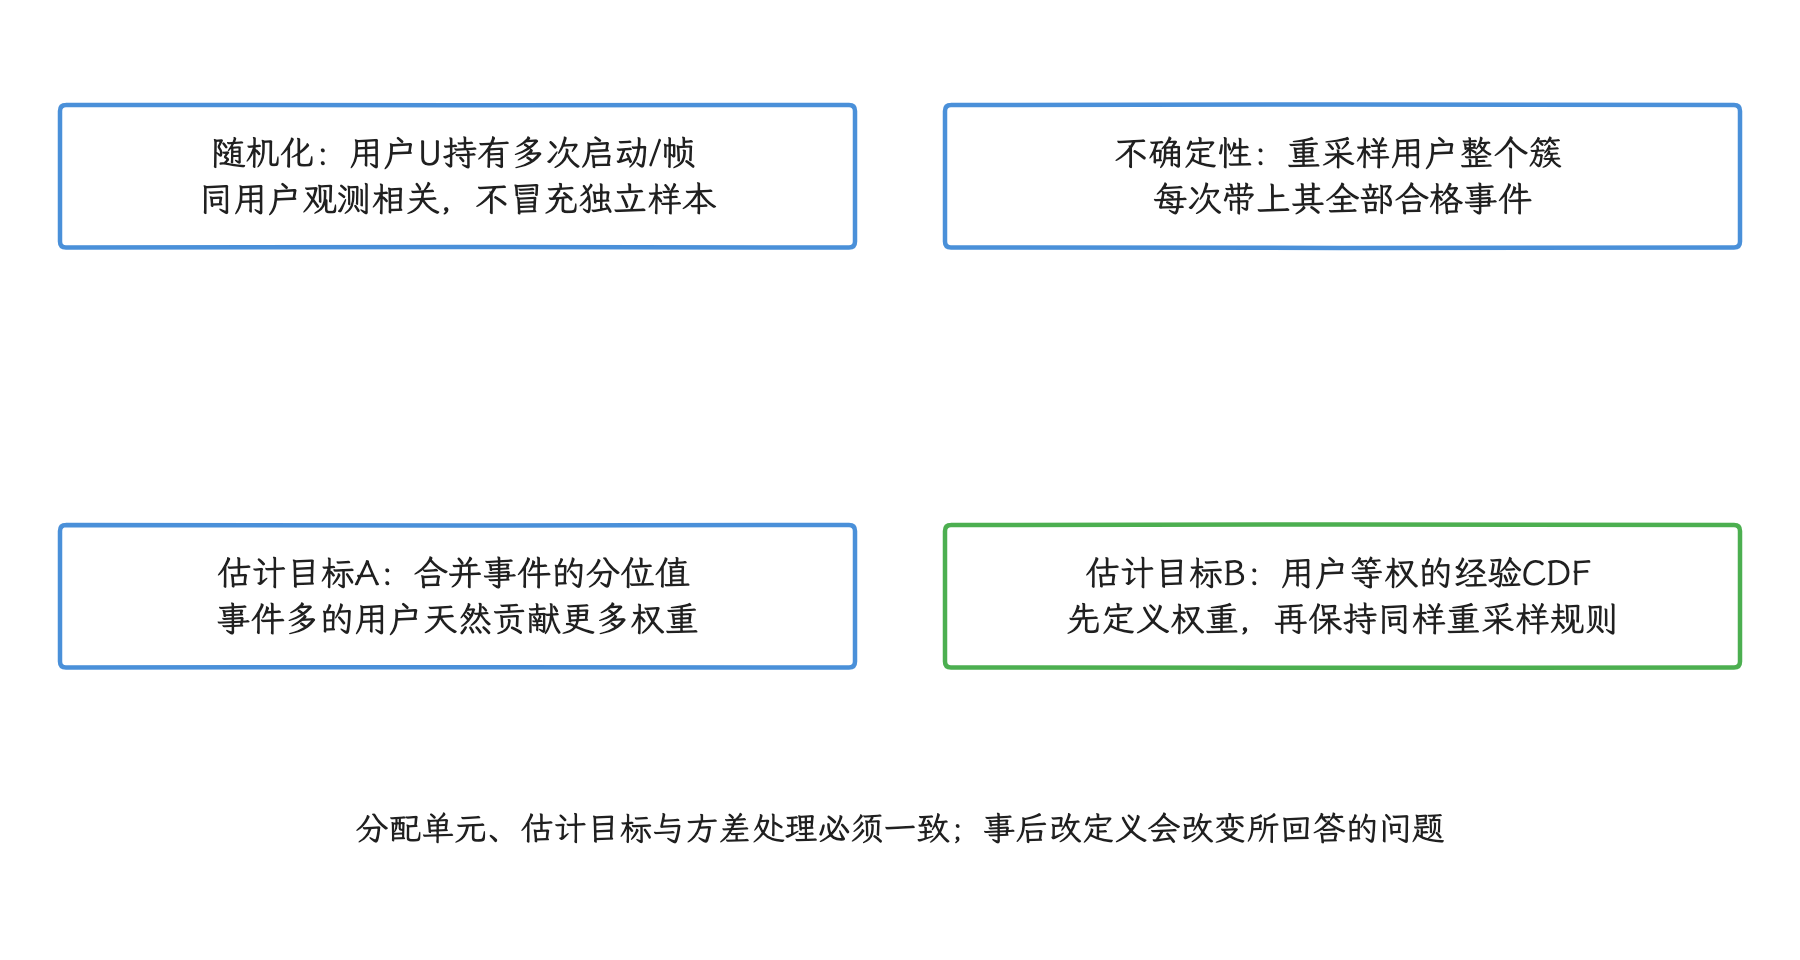
图:聚类bootstrap保护单元内相关性,不会自动改变事件加权目标;样本量也要报告独立实验单元数。
长尾指标的判定协议
P90/P99 的主效应要直接定义为 Qτ(variant) - Qτ(baseline):Qτ 是分位点函数,τ 取 0.90 或 0.99,variant 与 baseline 分别是实验组和基线组。区间也按同样的定义,直接为两组分位差构造;两组各自的分位值区间是否重叠,回答的是另一个问题,顶替不了差值区间。按用户或安装分桶时,聚类 bootstrap 必须按随机化单元重采样,并让被抽中的单元携带其全部合格事件;改成独立按帧、启动或请求重采样会破坏单元内相关性。还要另定估计目标:合并全部事件的分位值本来就按事件数让高活跃单元贡献更多权重;若要等用户权重,应明确定义用户加权经验CDF等目标,并在每次单元重采样中保持同一权重规则。聚类重采样本身不会把事件分位值自动变成用户等权分位值。
尾部报告要给的比一个 P99 多:预先登记体验阈值 L,报告 P(X > L) 的违约率、超过阈值的时长(excess duration)、独立实验单元数和每单元事件分布。若区间同时包含可接受改善和不可接受退化,结论就记为证据不足 inconclusive;此时正确的做法是呈现不确定性本身,单点方向替代不了它。
分群分位值同样绕不开混合分布。总体分布写作 F(x) = Σg wgFg(x),wg 是分群权重,Fg(x) 是该群的累积分布函数;总体分位值是混合 CDF 的逆函数,各群分位值的加权和替代不了它。归因时我们要分开回答两个问题:人群构成是否变化,相同分群内部的分布是否变化。需要标准化时,把两组重加权到同一参考构成,再重新计算经验分布;跳过这一步直接算“样本量 × P90 差值”,得不出可用的结果。
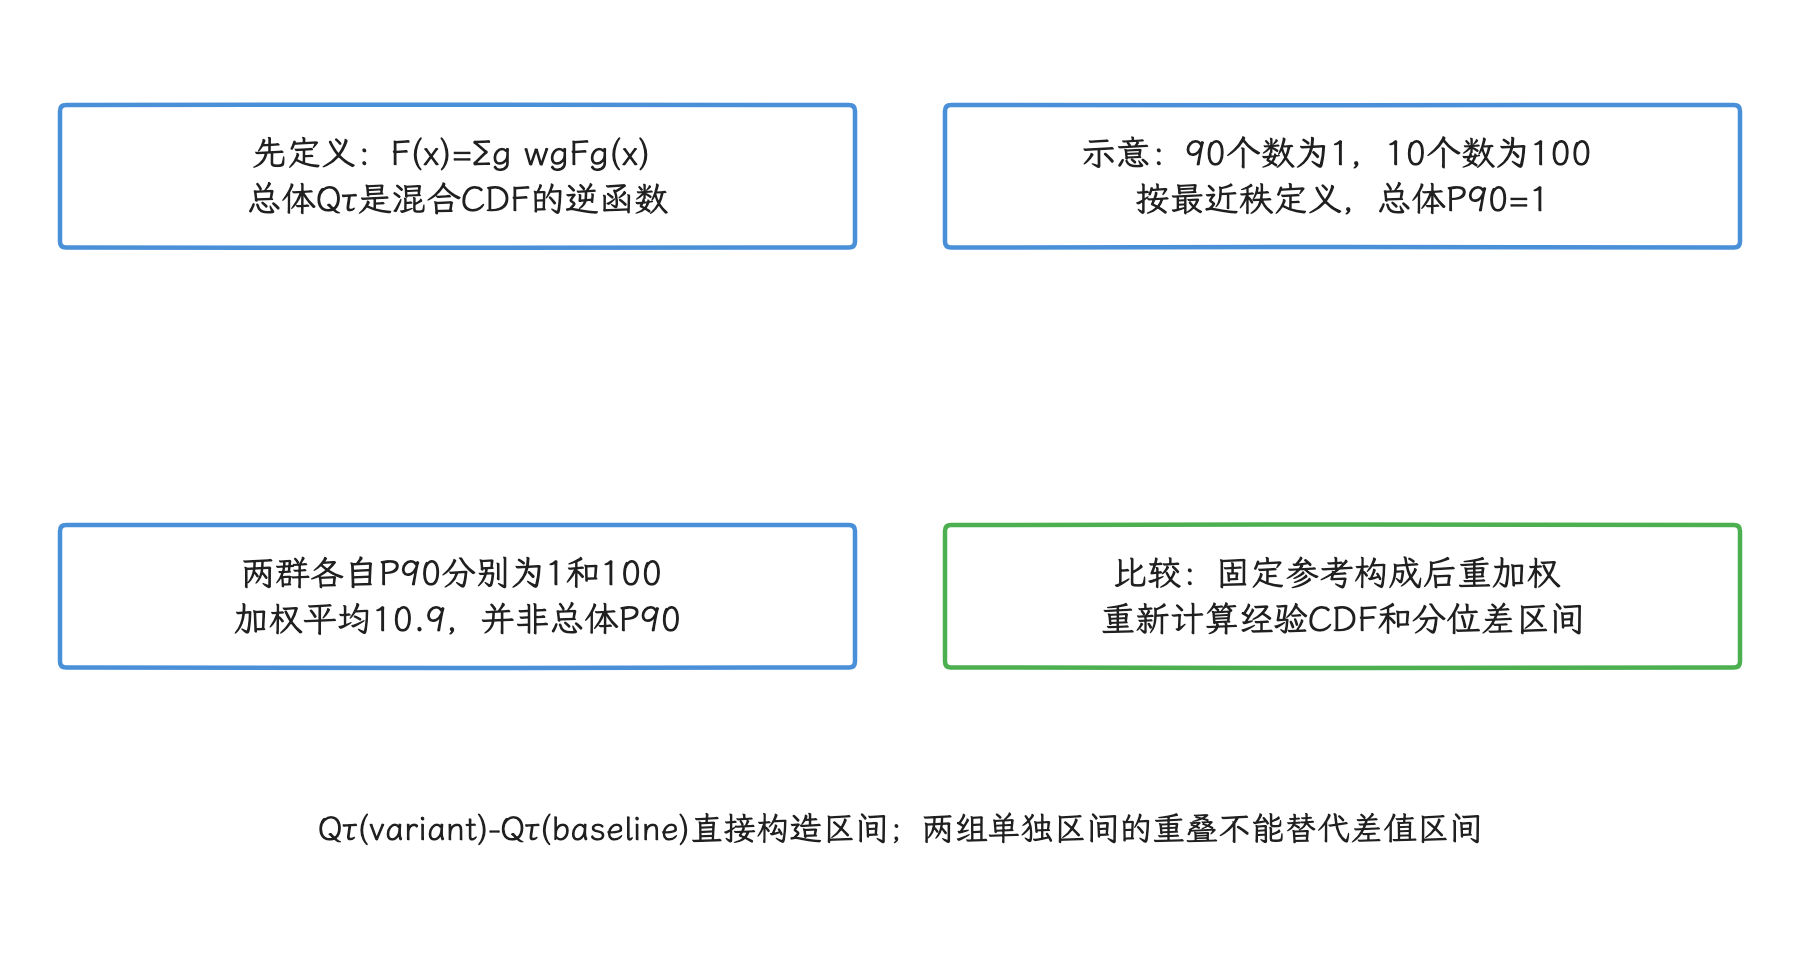
图:数值是人为构造的无量纲反例;人口结构变化和群内分布变化分开分析。
查看频率、多重比较与异常值
看结果的频率本身就会影响结论:每天查看一次普通固定终点 p 值,又在第一次越过显著性阈值时就停止,假阳性率会被抬高。所以平台要在实验登记时就选好查看方式——固定终点 fixed horizon,或带 alpha spending 的有限次分组序贯检验,把一类错误预算预先分配给每次查看;经过校准、允许按规则随时查看的 anytime-valid inference 是第三条路。Crash、ANR、数据损坏和严重性能伤害可以触发安全停止;安全停止的含义是及时止损,方案本身有效与否还要另行判断。
多个确认性主张要控制家族错误率(family-wise error),即多项判断中至少出现一次假阳性的概率;大量设备、场景和时间分群只能标为探索性(exploratory),发现之后再进入复现实验。
数据清洗的规则同样要在揭盲前登记。可以判无效的是负耗时、时钟混用、重复事件和错误的 join;低端机、热降频、冷缓存与弱网造成的真实慢样本属于用户体验,数值再极端也要保留。缩尾 winsorization 和截尾均值 trimmed mean(前者把极端值替换为边界值,后者去掉两端样本后求均值)可以作为敏感性分析的补充,主结果仍然是原始分位值与违约率。
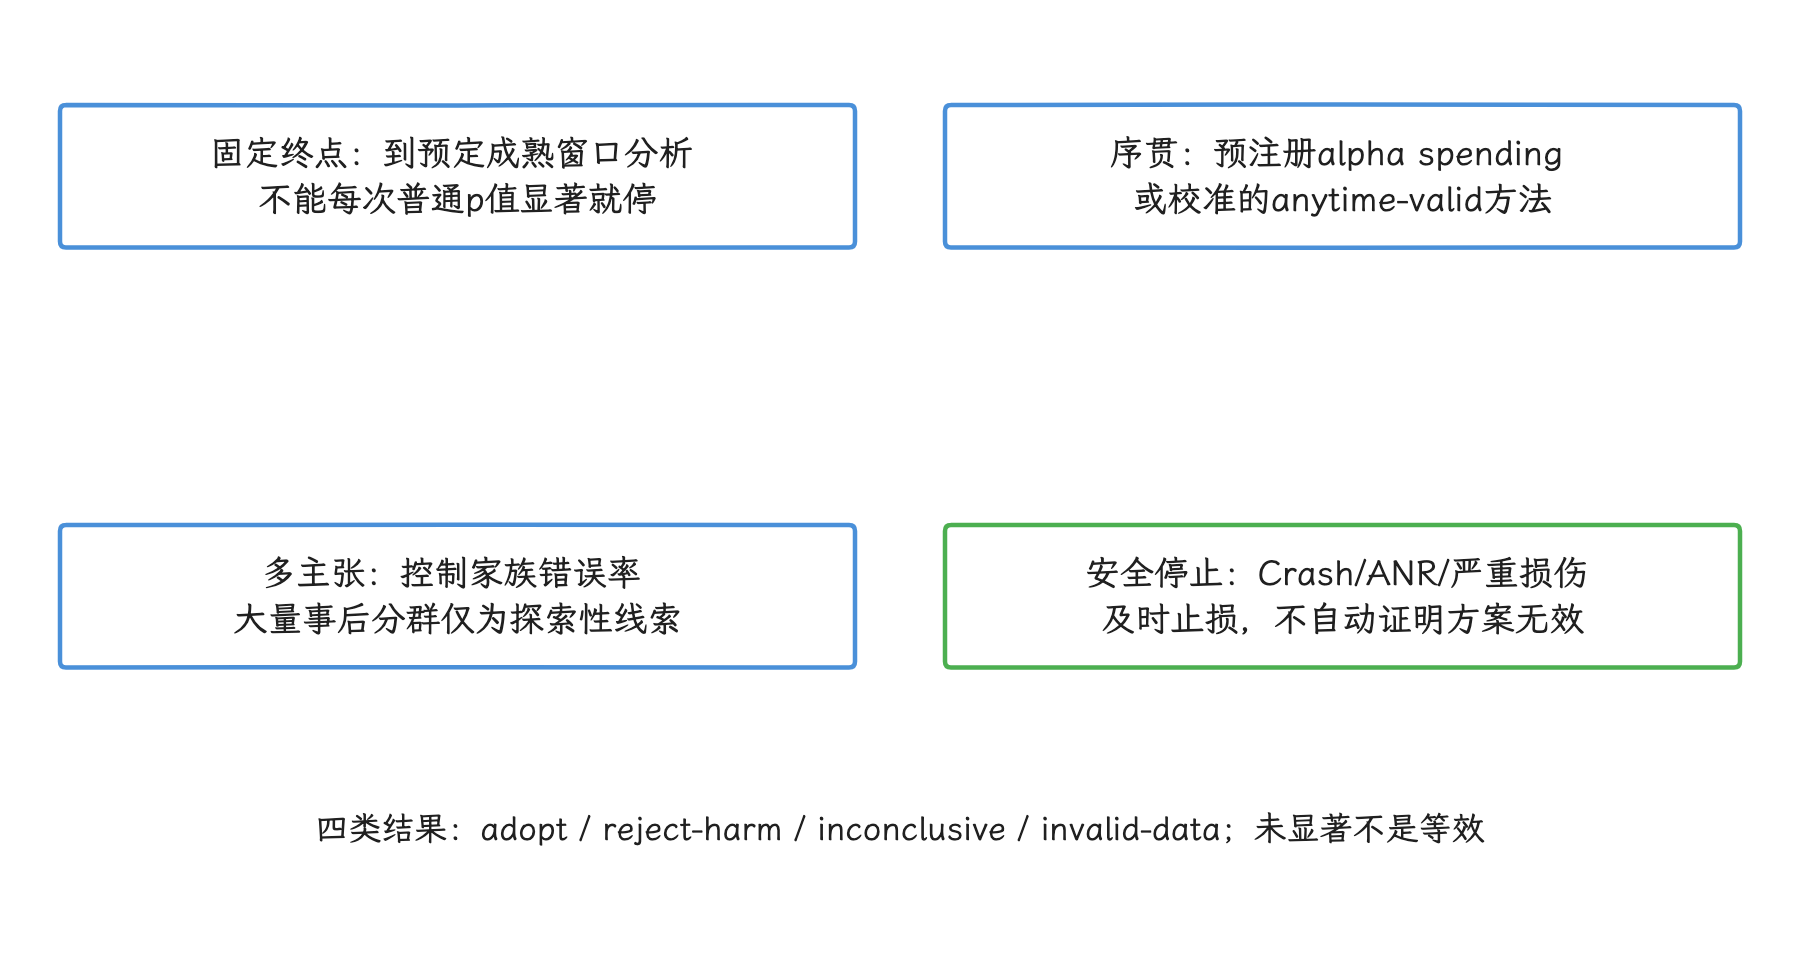
图:主指标、MDE、护栏、缺数、SRM、停止规则和数据成熟窗口都应在实验开始前登记。
实验登记与决策结果
一份可审计的实验登记至少保存这些字段:处理方案 treatment 与作用路径、入组条件(eligibility)、分配单元(assignment unit)、暴露定义(exposure)、主估计目标、护栏指标、聚类单位、MDE、业务可行动差异、伤害线、置信区间 CI 方法、分配比例、数据成熟窗口、SRM 与缺失数据规则、预注册分群、停止规则和数据结构版本。
结果只归入四类之一:采用(adopt)、拒绝或有害(reject/harm)、证据不足(inconclusive)、数据无效(invalid-data)。判为“未显著”,说明的只是这轮证据还确认不了差异,差异本身可能仍在;数据漏斗或 SRM 已损坏时,收益比较要先停下来。
性能回归自动检测
性能回归检测有两条线:实验室基线和线上分布,对应 Android 官方文档里的 local testing 与 field testing。实验室基线在代码合入、候选包、发版前运行,我们用基准测试库在可控设备上复现用户流程,抓确定性退化;线上分布观察真实用户环境,负责长尾问题。两条线各管一段,合起来才完整。
这条线的第一步是把环境留痕:CI 应保存设备、系统镜像、构建配置、编译模式、测试数据与测量产物。环境信息缺失时,趋势变化可能只是设备温度、后台负载或构建配置漂移的结果。
回归检测适合采用三类规则组合:
| 规则 | 判定依据 | 适合发现的问题 | 处理动作 |
|---|---|---|---|
| 相对变化 | 相对固定已知良好基线(green baseline)的效应与不确定区间 | 稳定、可复现的中等幅度退化 | 重跑确认后阻断候选包或暂停灰度 |
| 产品阈值 | 由用户体验 SLO、历史分布和业务风险共同定义 | 已越过可接受体验范围的问题 | 进入发布风险评审 |
| 分群异常 | 预注册关键分群相对自身基线的变化 | 全量指标掩盖的设备或版本问题 | 限制受影响分群并派发诊断 |
Macrobenchmark 适合承担实验室基线,前提是基准设备用物理设备、目标包尽量接近发布版:保持不可调试,通过 profileable 允许测试工具采集性能剖析信息,并尽量开启与生产环境一致的优化。固定设备只固定了型号,温度、后台负载这些环境因素仍在变,所以每次仍要记录电量、温控等待、后台干扰、系统构建指纹(build fingerprint)、CompilationMode 编译模式和 App 数据准备方式。官方明确不建议用模拟器数值代表用户设备。
挑指标时,版本和语义的差别也要留心:
StartupTimingMetric.timeToInitialDisplayMs测到首帧,对应 TTID;timeToFullDisplayMs依赖 App 调用reportFullyDrawn(),对应 TTFD,在 Android 10 / API 29 之前的版本可能不可用。App 未正确上报完全显示信号时,TTFD 门禁本身就没有业务意义。FrameTimingMetric.frameDurationCpuMs表示 UI 主线程与 RenderThread 生产一帧所用的 CPU 时间;frameOverrunMs还考虑帧 deadline,但只在 Android 12 / API 31 及以上可用。两个指标的阈值要分别标定,直接互换会出错。TraceSectionMetric仍是实验性 API。当前 AndroidX 1.3.0+ 构造器默认targetPackageOnly = true,只读目标包的 trace section;默认Mode.Sum会累计所有匹配实例。我们要首个实例、平均值、最大值或次数时,应显式选择对应模式,并验证它是否符合测试场景。PowerMetric也是实验性 API,测的是系统级功率或能量,不能直接归因于单个 App;官方支持物理 Pixel 6、Pixel 6 Pro 及后续设备,测试时还要减少其他进程干扰。
门禁的数据结构应保存 metric_name、metric_available_api、设备与系统指纹、场景、编译模式、基线来源、样本数、效应区间和处理动作。Benchmark 库会输出 JSON,并为每个 Macrobenchmark 测量迭代保存 Perfetto trace;两类产物 CI 都要归档,这样聚合数据出现异常后,我们仍能回到单次 Trace 查原因。
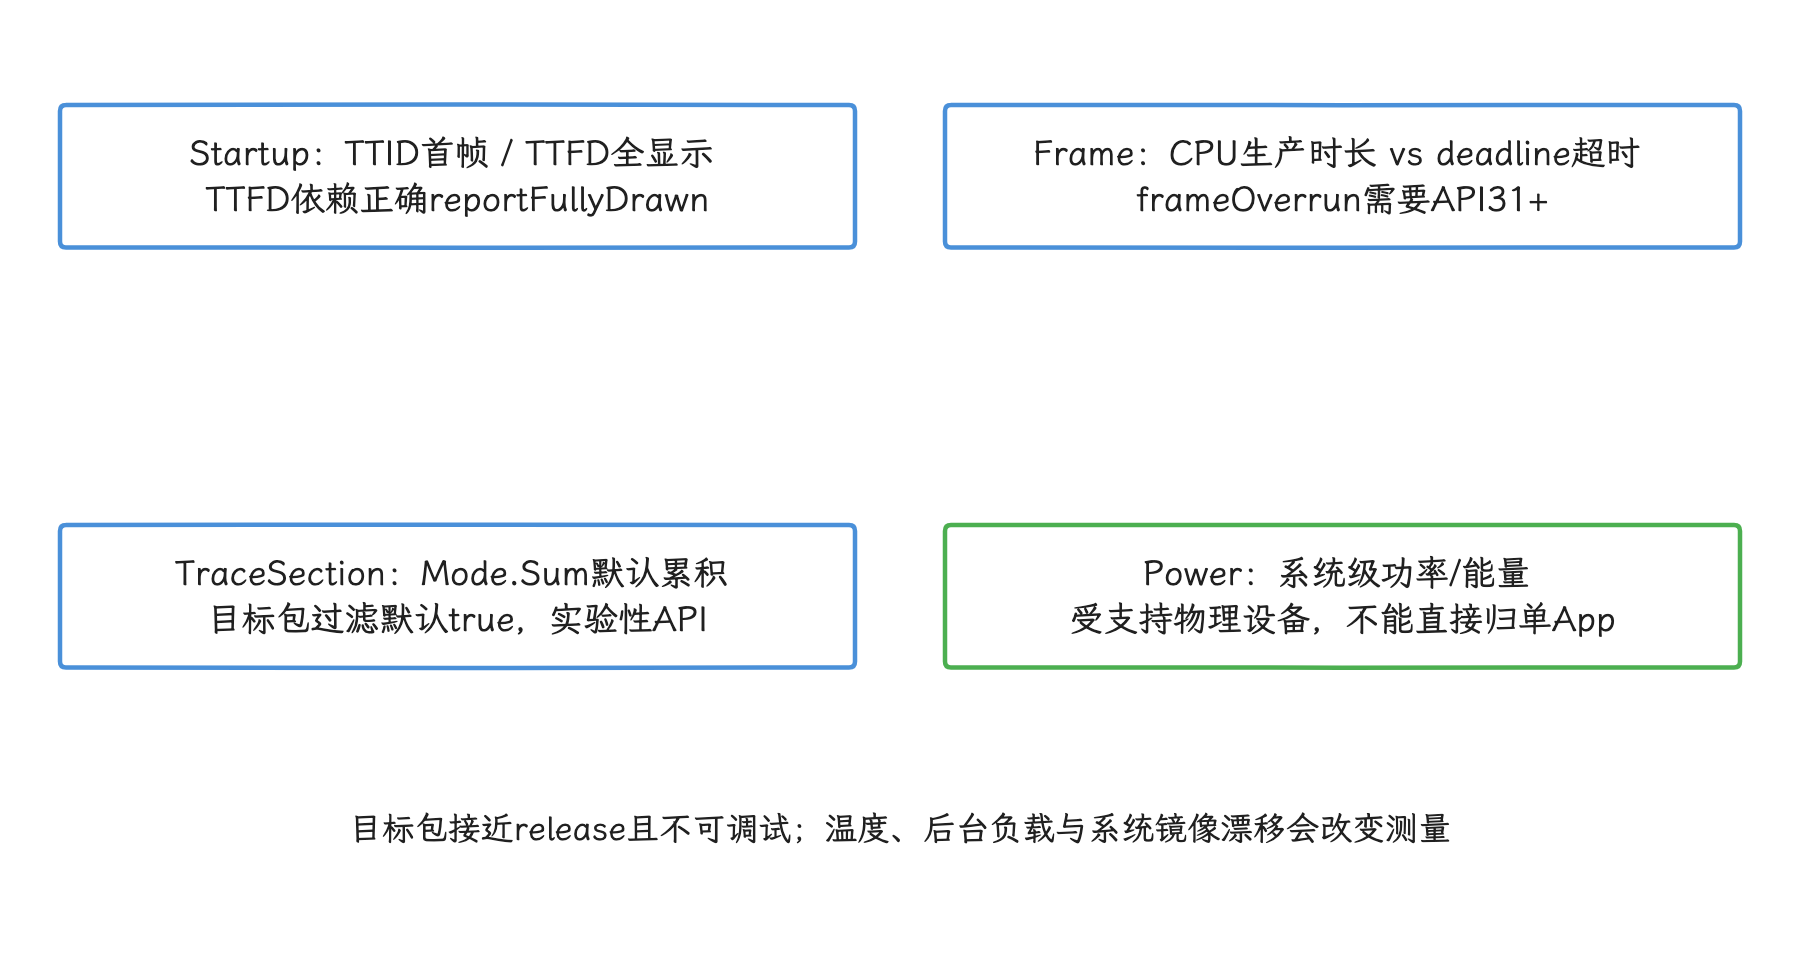
图:保存metric、可用版本、设备、编译模式、样本量和效应区间;JSON与逐次Perfetto trace都归档。
再看线上这条线。线上回归检测沿用 26.1 节的分位值和采样字段,检测任务至少按 metric_name、scene_id、app_version、experiment_id、variant_id、device_tier、android_version 分桶;不分桶的 P90 读的是混合分布,支撑不了版本决策。
线上告警要同时处理不确定性和数据新鲜度。样本量不足时只记录风险;服务端故障、活动流量、配置切换和采样策略更新要标成外部事件。连续窗口之间没有天然的独立性,“连续命中次数”也就冒充不了统计置信度;更稳的做法是固定观察窗口,报告效应区间与数据延迟,并把重复告警合并到同一事件。
Android vitals 可以作为外部校验源。它与自建 APM 在安装来源、设备集合、聚合窗口、用户定义与数据延迟上都不同,所以发布报告要保留每个指标的分子、分母、窗口和过滤条件:Play 的每日活跃用户和内部会话是两套统计口径,直接相减得不出有效结论;尚未更新的 vitals 也当不了实时放量信号。
CI/CD 集成性能门禁
CI/CD 里的性能门禁要分层。把所有基准测试塞进每个 PR 是行不通的:每次提交都跑完整启动、滚动、功耗和弱网测试,队列很快排满;反过来完全不跑,回归又会拖到灰度阶段才暴露。
所以我们把门禁拆成三档:
| 阶段 | 运行内容 | 失败动作 | 产物 |
|---|---|---|---|
| PR 快检 | 基准测试编译、只验证流程可运行的 dry run、关键场景可执行性 | 测试基础设施失败时阻断合入 | 测试日志、环境信息 |
| 主干定时任务 | 固定物理设备上的启动、滚动与稳定 trace section,多轮测量 | 创建回归事件,达到团队风险线时限制主干 | JSON、每次迭代 Trace、趋势 |
| 发布候选 | 代表性设备档位、目标系统版本和核心用户路径 | 阻断发包或缩小灰度 | 候选包、设备覆盖表、门禁结论 |
官方 CI 文档里,Macrobenchmark 需要分别构建目标 APK 和测试 APK,再通过 Android instrumentation 运行;使用 Gradle 时,JSON 与 Trace 会自动复制到构建主机的 additional output 目录。CI 系统要按 commit、分支(branch)、设备、系统镜像、基准测试名称和迭代编号归档,后端才能做同环境趋势对比。
门禁配置要把“测什么、和谁比、证据够不够、命中后做什么”写成可审计字段:
| 字段组 | 必备内容 |
|---|---|
| 测量身份 | 场景、metric、API 可用范围、设备组、系统与构建指纹 |
| 比较基线 | 固定已知良好版本(pinned green release)、滚动稳定基线,以及基线更新时间 |
| 判断证据 | 产品阈值、最小可检测效应、样本数、估计值与不确定区间 |
| 环境有效性 | 温控、低电量、后台干扰、失败迭代与异常值处理规则 |
| 处置 | 阻断、重跑、缩小灰度、责任模块与豁免流程 |
baseline 别总指向上一轮测试:上一轮本身可能已经退化,逐次比较会放过累积变化。报告里可以同时展示固定已知良好版本与滚动稳定基线,并写明哪一个用于门禁。更新固定基线是发布决策;测试任务在结果变差后自动完成这一步,门禁就失去了参照。
性能门禁可以允许人工豁免。测试环境异常要先标记为无效运行;它和业务豁免是两类事,混记会让豁免记录失真。有效豁免需记录批准人、证据、适用构建、到期条件、用户影响和补偿计划;豁免是临时手段,到期即恢复门禁。
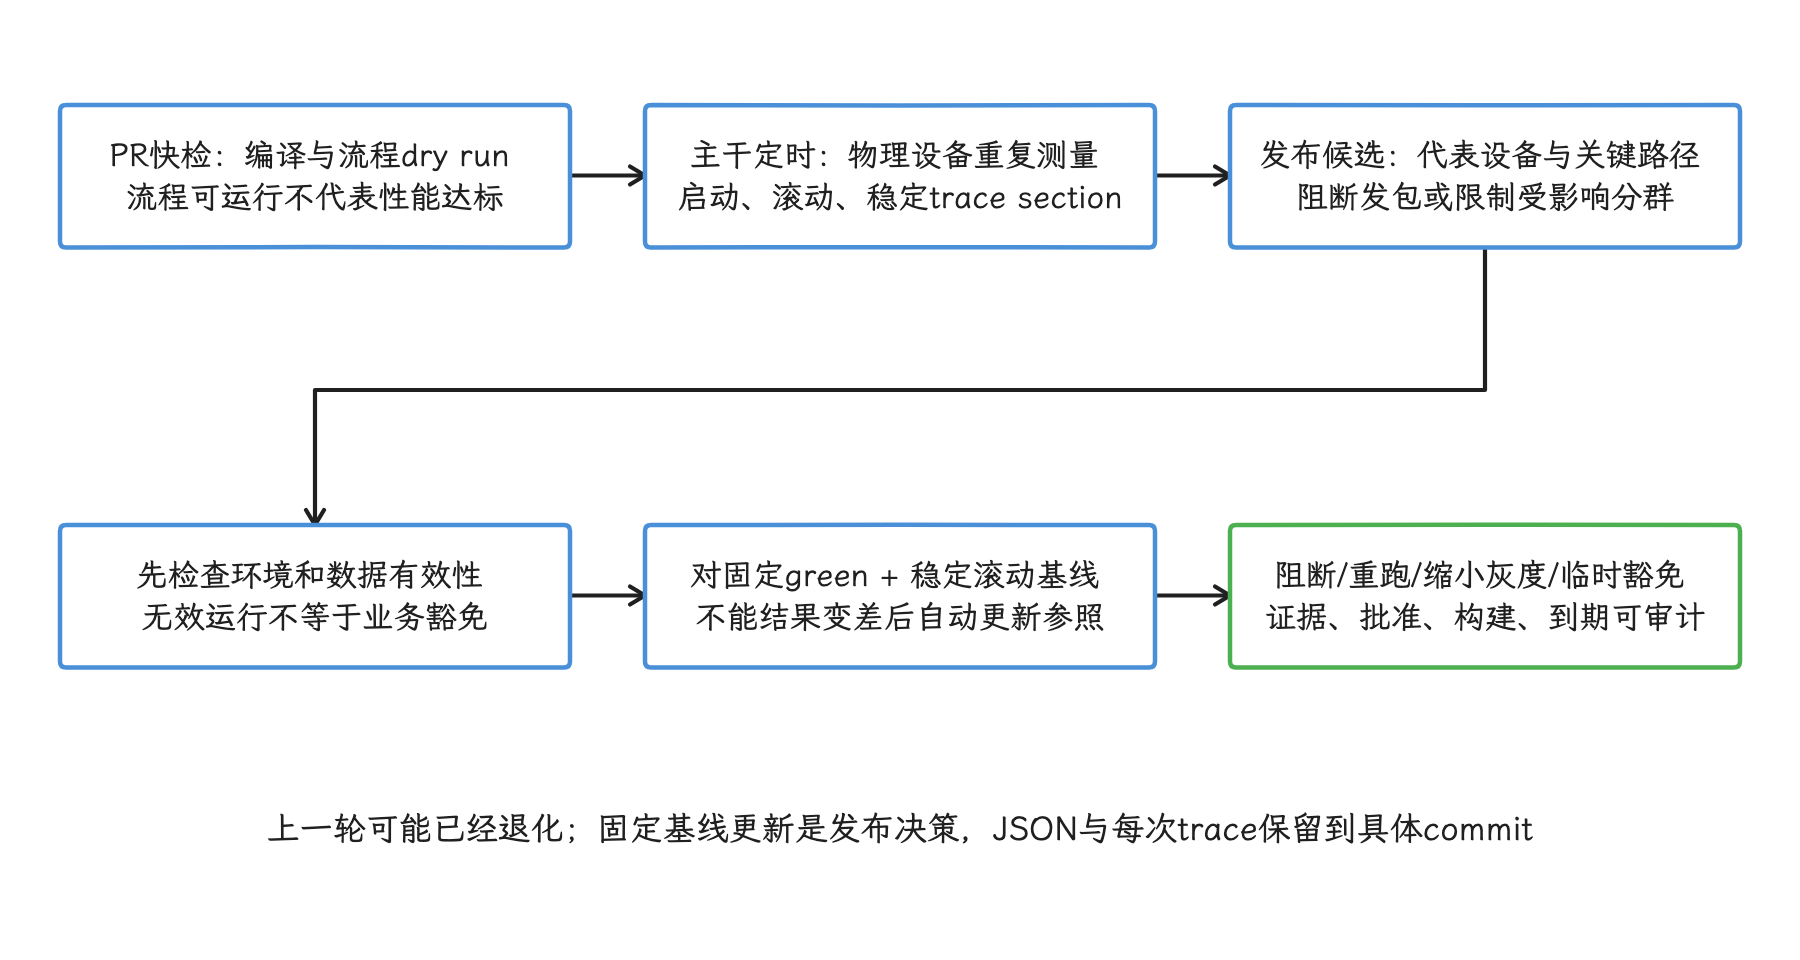
图:图中为分层治理流程;实际任务可并行运行,流程层级不表示PR测量是完整发布覆盖。
性能劣化的自动归因
自动归因的职责是把排查范围缩小到一批可验证的候选:相关性只是线索,根因裁定留给验证环节。性能告警应该携带版本、实验、场景、设备分群、变更记录、trace section 与原始样本索引,排查人据此提出并验证假设。
归因输入建议固定成五类字段:
| 字段组 | 典型字段 | 用途 |
|---|---|---|
| 发布字段 | App 版本、构建编号、Git 提交号、渠道、灰度批次 | 判断是否由包体或代码变化引入 |
| 实验字段 | 实验 ID、变体 ID、参数快照、命中时间 | 判断是否由配置或功能开关引入 |
| 场景字段 | 场景 ID、入口、启动类型、页面、业务阶段 | 判断是否集中在某条用户路径 |
| 设备字段 | 机型、SoC(片上系统)、内存档位、Android 版本、刷新率、国家 / 地区 | 判断是否是兼容性或性能档位问题 |
| 证据字段 | trace section(追踪区段)、慢帧样本、日志摘要、网络错误码、Crash / ANR 组 | 支持工程团队复现和定位 |
给候选排序可以交给算法,前提是我们让算法和指标类型匹配:
- 均值或比例:先把两组标准化到同一设备与入口分布,再分解“分群内部变化”和“人群构成变化”。只计算样本量乘分群差值,会把流量结构变化混入代码效应。
- 比率:分子、分母分别做贡献分解,并保留分母变化(denominator shift)。慢帧率上升可能来自慢帧数增加,也可能来自总帧数或会话长度变化。
- P90/P99:各分群分位值做不了线性加权。可按固定体验阈值比较违约样本数与超阈值分布,也可移除某分群后重算全量分位值,作为排查优先级;“移除后变化”属于描述性敏感度分析,与因果效应是两回事。
- 时间线证据:版本、配置和服务端变更与指标拐点相邻,只说明相关。要提升根因置信度,我们还需要对照组、回滚/再现、代码路径或 Trace 证据。
TraceSectionMetric 和业务 trace 的名称要提前统一。实验室基准测试里 home.bind_data 变慢、生产环境同名摘要也变慢时,归因系统就能把告警直接指到首页数据绑定阶段;反过来,实验室叫 HomeBind、生产环境叫 feed_first_render,后端就只能靠人工判断。26.1 节已经建议自定义 Trace 和生产环境摘要使用同名阶段,这里直接复用该规则。
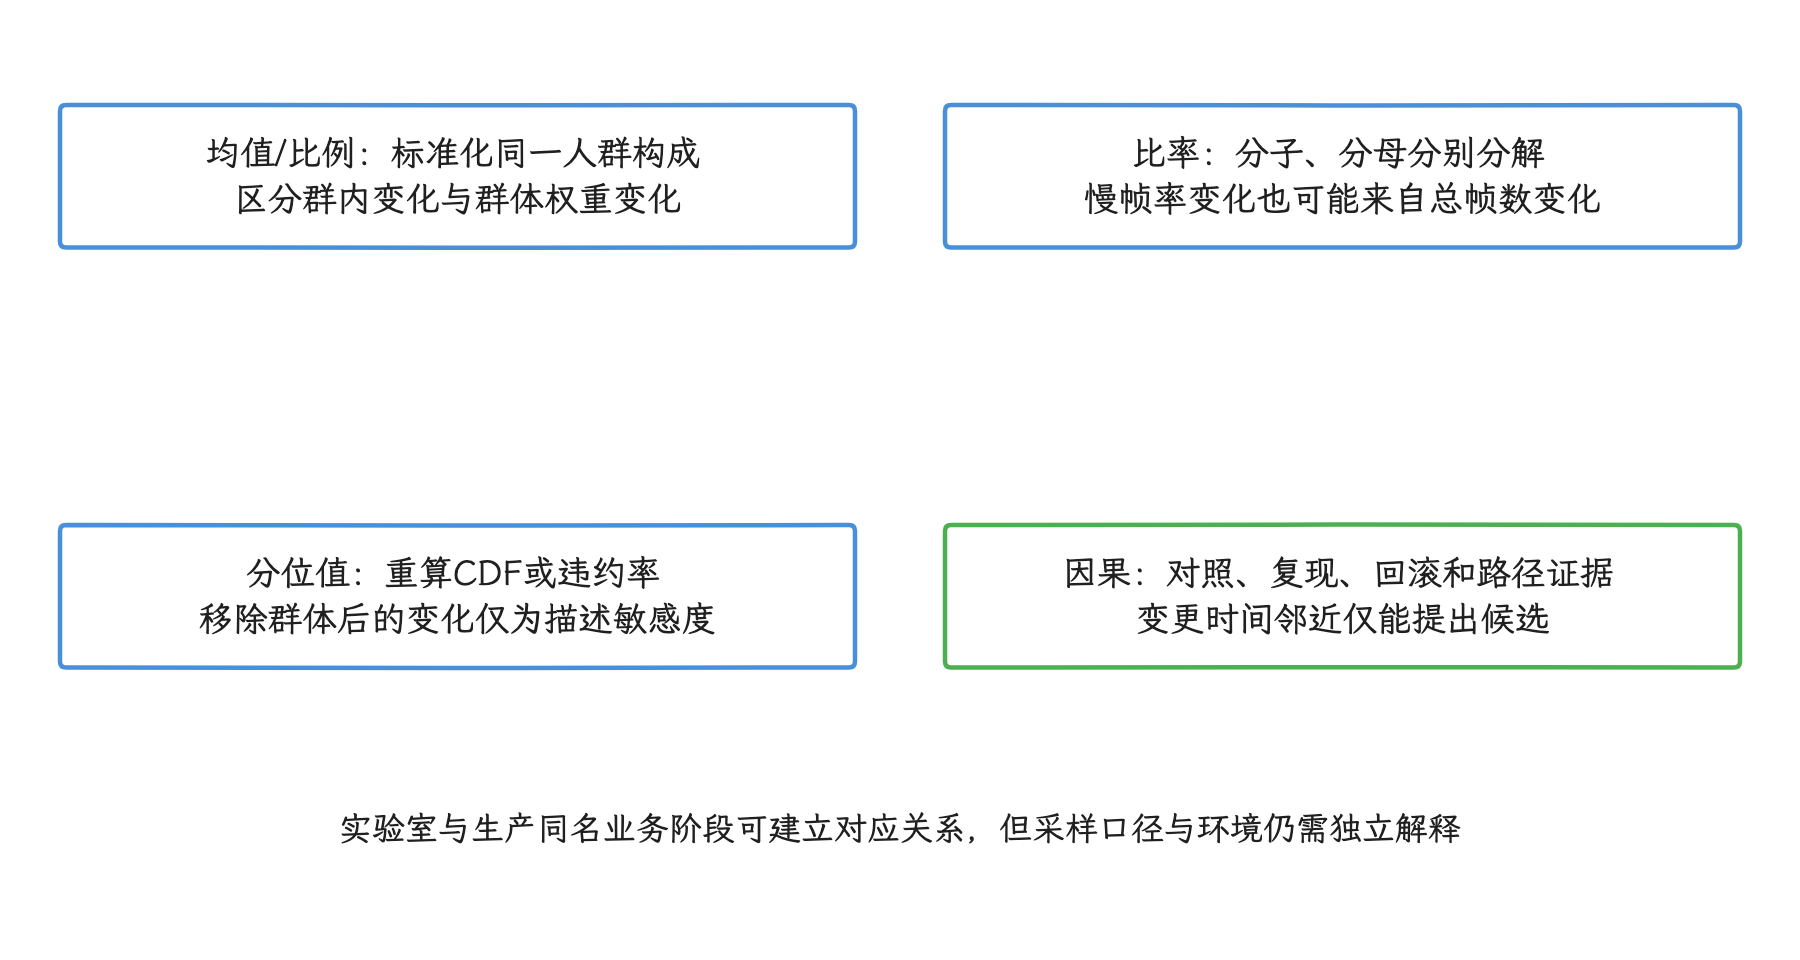
图:发布、实验、场景、设备和原始样本身份共同进入候选清单,算法排序不代替根因验证。
自动归因可以按固定流程输出候选:
- 比对实验组和对照组,确认退化是否只出现在某个变体。
- 比对新版本和固定已知良好版本,确认退化是否随包体发布出现。
- 按设备档位和 Android 版本排序贡献度,确认是否只影响特定设备群。
- 拉取耗时最高的一组代表性样本,查看 trace section、启动入口、网络错误和日志摘要。
- 如果 Trace 指向业务阶段,派给业务模块;如果指向系统阶段,关联到 14.1、16.5、21.x、22.x、23.x 对应章节做实验室复现。
这套流程代替不了人工分析,但能省掉每次告警都在群里问“最近谁改了”的环节;工程团队拿到的是一份可复核的候选清单,下一步往哪查由人来决定。
样本比例失衡与实验污染
性能 A/B Test 要持续监控 SRM。实际分配数量与预设权重的差异一旦超出随机波动能解释的范围,实验数据就应暂停用于决策。常见原因包括分桶哈希函数或盐值变更、安装 ID 重置、目标条件实现不一致、埋点丢失,以及某个变体在配置激活或上报之前崩溃。
我们先做 SRM 检查,再做性能指标判断。大样本且期望频数足够时可以使用卡方检验,小样本或稀疏分群则选择精确方法;检验阈值和查看频率也要预注册。实验平台应输出实验分配、配置拉取、配置激活、指标产生和上传成功率。实验分配已经均衡、激活之后才失衡,问题就出在处理之后的环节;此时只过滤“成功用户”,Crash、ANR 或启动失败造成的损伤会被藏起来。
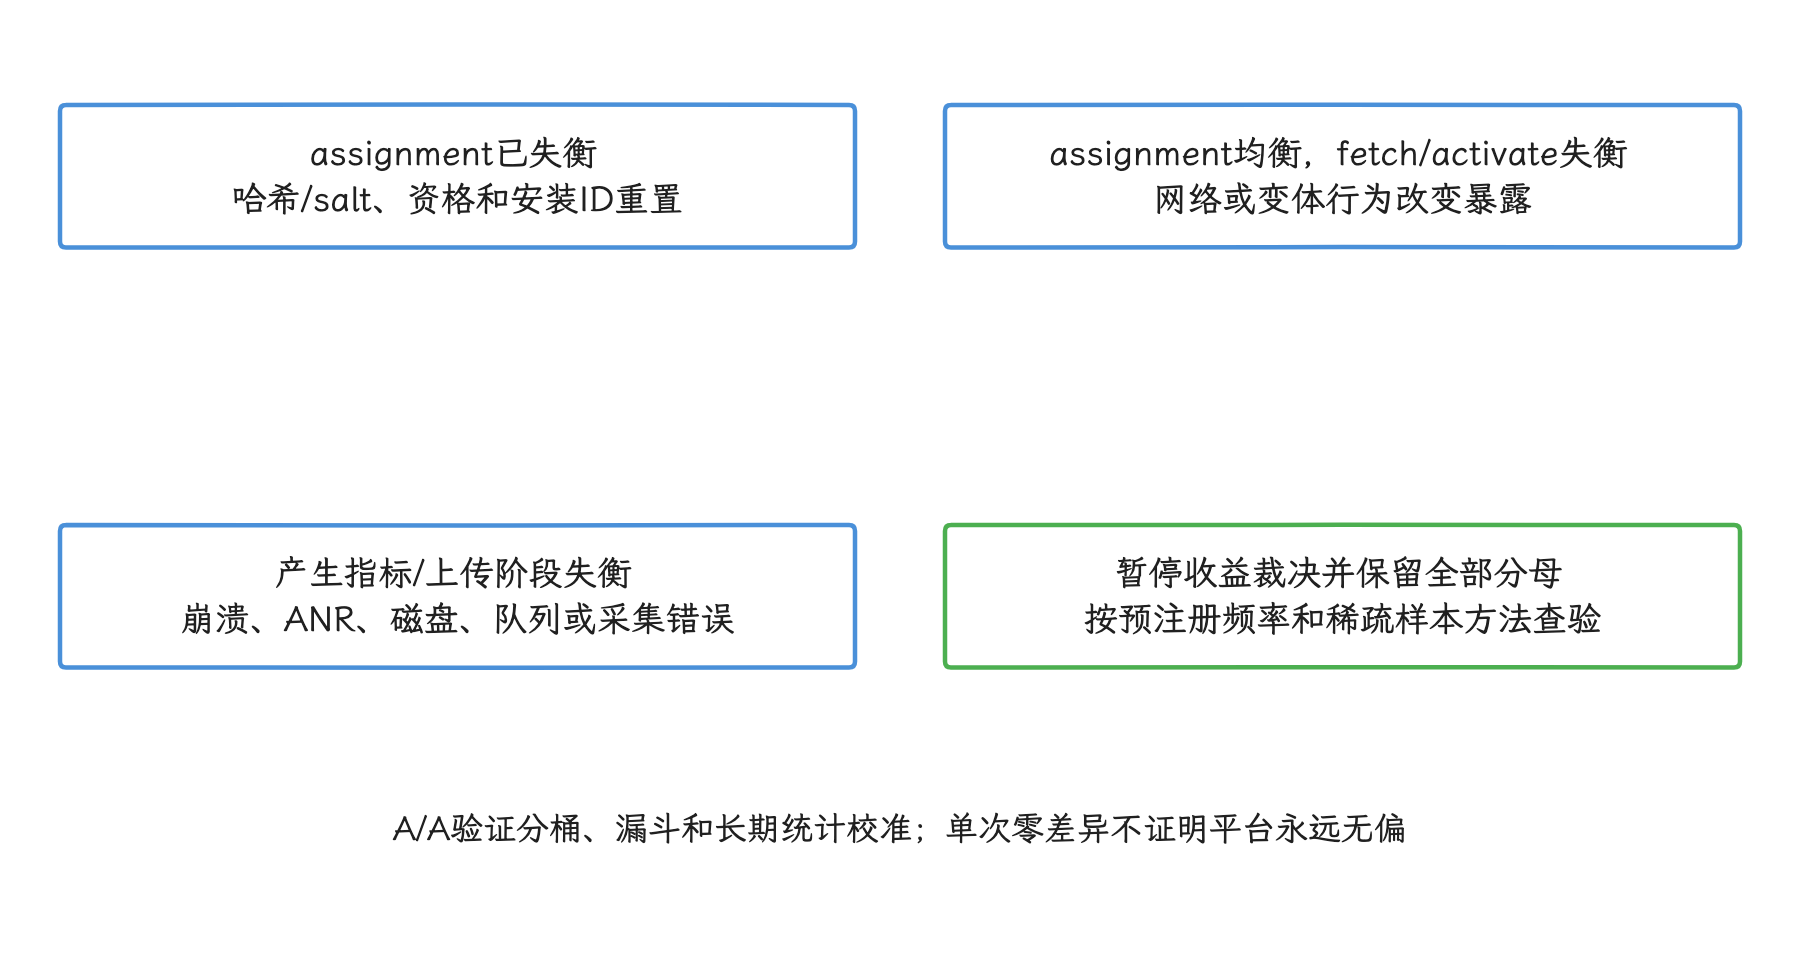
图:处理后失衡可能来自真实损伤,不能只筛成功者“修复”样本;定位后按原估计目标重新判断。
实验平台自身也要设护栏
实验平台、Remote Config、灰度平台都可能制造性能事故:一个错误配置可能让启动阶段多拉接口、打开高频日志、扩大图片预加载、调整线程池参数。所以平台自身要支持配置审计、灰度放量、紧急关闭和指标回看。
Firebase Remote Config 实验会在变体中修改参数;官方文档说明,实验开始后变体权重固定不可改,非均匀权重也会延长数据收集。自建平台也一样,我们要记录不可变的实验与版本编号、参数结构版本、权重、分桶盐值与发布时间。紧急关闭应生成新的配置版本并保留旧快照,让历史值始终可回看。
系统进程死亡证据:ApplicationExitInfo
线上退出排查里,有一类证据常被忽略:客户端来不及上报的 Crash、ANR、低内存与其他系统终止,系统侧仍有记录。Android 11 / API 30 起,App 可以用 ActivityManager.getHistoricalProcessExitReasons() 查询自己的近期进程退出记录,把这块证据补回来。这份历史列表有界、字段可能缺失,PID 也会复用;实验报表应保留 processName、timestamp、reason、status、importance 和可用的 processStateSummary,把 PSS/RSS 为 0、trace 为空等情况显式标为不可用。
Android 17 / API 37 的 ApplicationExitInfo.getAnrInfo() 可在 REASON_ANR 记录中提供结构化的 ANR ID、类型、系统等待时限和用户可感知标记。description 仍只适合人工阅读,getTraceInputStream() 也可能为空或附带较早的 ANR 现场;非空 trace 改变不了记录里的实际退出原因。查询参数、历史容量、Native tombstone、去重和版本回退的完整说明见 26.6,本节只保留实验归属所需的字段。
接入 A/B 平台时可这样处理:
- 进程获得运行机会后在后台重扫当前仍保留的记录。对时间戳、PID/UID、进程名和原因/状态等身份字段作带版本的无歧义编码,建立尽力去重指纹;可缺失、稍后补充或失效的trace/状态摘要作为附件,不加入必须稳定的身份键。PID会复用,指纹也不是平台保证唯一的事件ID。
- 已落盘待传与已ACK项都参与去重,记录和索引以唯一约束原子提交;ACK后才推进可回收状态。重扫允许重叠,不以严格最大wall-clock时间戳作为唯一游标,避免漏同毫秒或校时后的记录。系统历史有界,低频轮询不能找回已被覆盖的事件。
- 按
reason、ANR 类型和变体分桶聚合,description只进入受控明细;PSS/RSS 为 0 时标记为不可用,不做插值。 - 发现 trace 后立即在字节上限内复制到应用私有目录并关闭流。
REASON_CRASH_NATIVE在 API 31 及以上对应前述 Protocol Buffers 格式 tombstone,其他reason也可能附带较早的 ANR trace;保留实际reason与 trace 类型两个字段,每个非空流按自身格式处理,统一当文本或统一标为 ANR 都会引入错误。 setProcessStateSummary()只在变体或关键场景变化时更新,并捕获限流异常。服务端实验分配日志仍是实验归属的主记录,进程状态摘要只在进程死亡时作补充证据。- Android 17 的
AnrInfo可进入结构化维度;Android 11-16 手里只有reason、trace 和业务现场,从description反解析不出等价字段。
我们最后回到归因:ApplicationExitInfo 补的是 App 上报中断后的那部分进程退出信息,某个变体是否导致退出,它证明不了。有效归因仍需检查实验分配是否随机、各组退出记录的缺失机制是否一致,并结合对照组、代码变更、复现或 Trace。系统证据提高的是事件分类质量,相关性到因果这一步,仍要靠上面的验证手段完成。
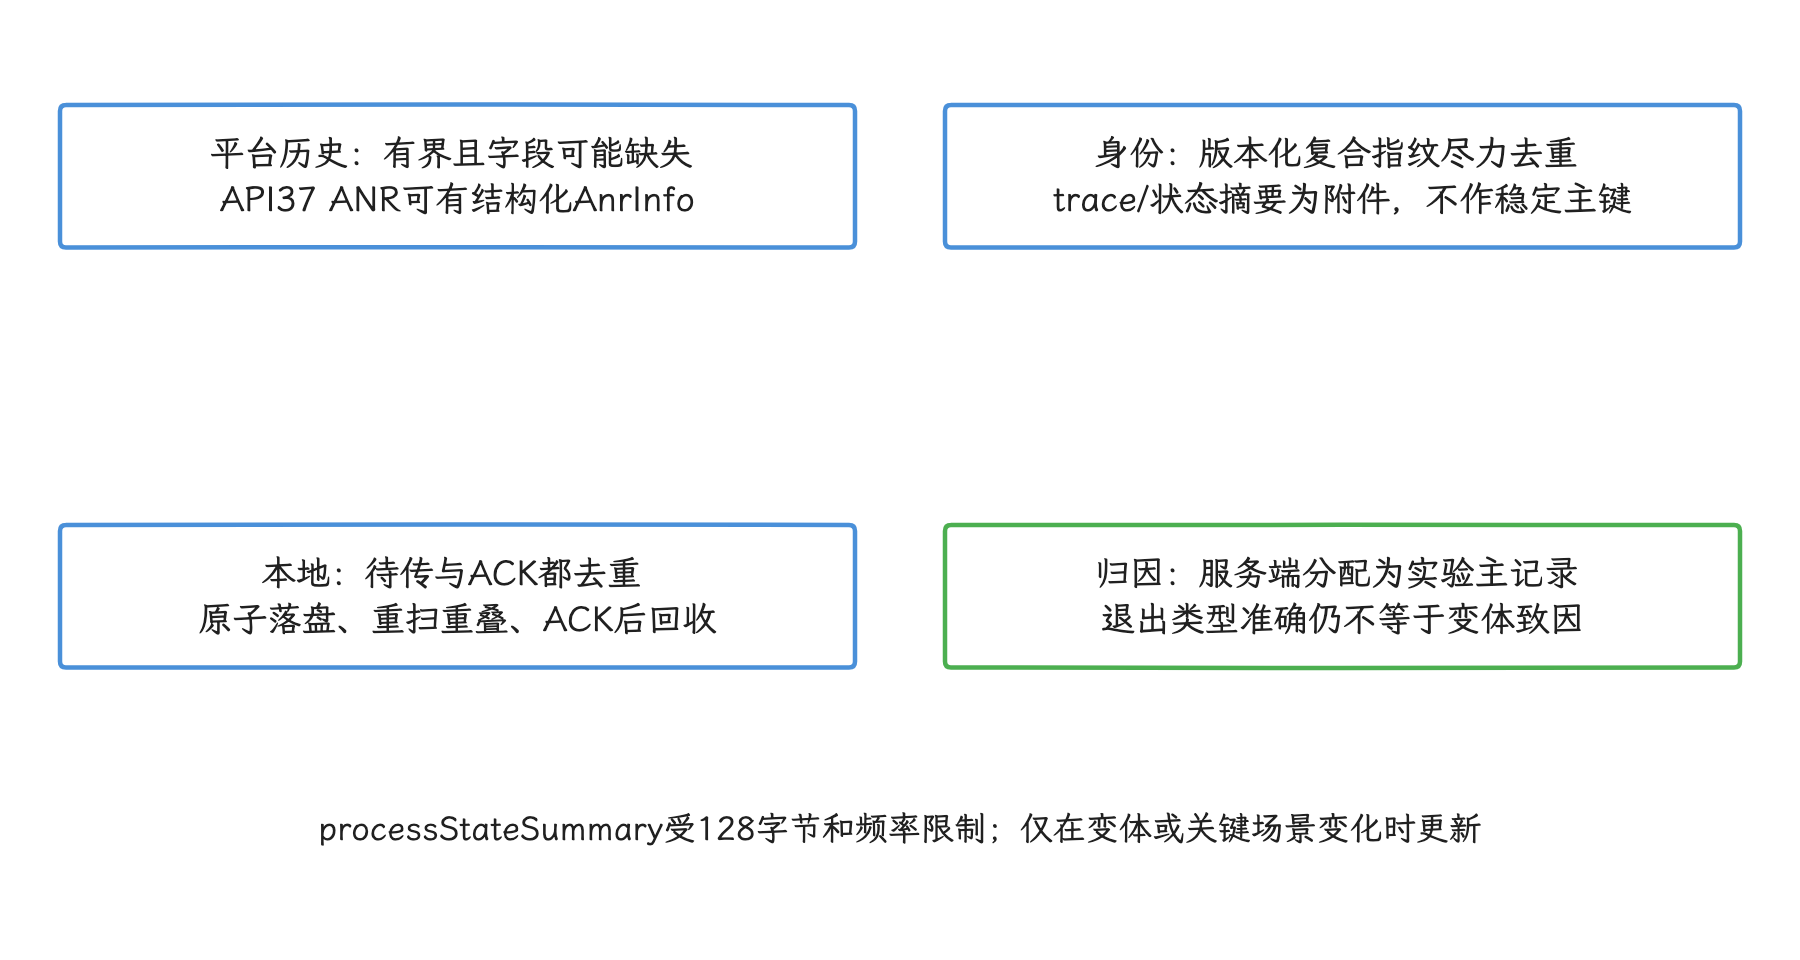
图:PSS/RSS为零标不可用,非空trace不改reason;各组退出缺失机制和系统覆盖窗口都进入解释。
全文小结
我们把这一篇的规则收拢一下:性能 A/B Test 从随机化单元、暴露漏斗和估计目标开始设计;重复会话不能冒充独立样本,分群分位值回到混合分布再算,SRM 与缺失数据的检查先于收益判断。CI 用接近发布版的目标包和物理设备建立可复现基线,生产环境实验覆盖真实设备与长尾分布;告警系统输出带证据强度的候选,因果结论仍需对照、复现或回滚验证。
26.5 会继续处理发版质量门禁,把回归检测结果放进发布前检查清单、灰度放量和回滚决策。
参考资料
- 在 CI 中运行 Android Benchmark
- Macrobenchmark 指标
FrameTimingMetricAPI- Firebase Remote Config A/B Testing
- Android vitals
ActivityManager.getHistoricalProcessExitReasons()与setProcessStateSummary()ApplicationExitInfoAPIApplicationExitInfo.AnrInfoAPI 37- AOSP Android 17:
AppExitInfoTracker - AOSP Android 17:退出历史容量配置