线上排障、诊断通道与非 Play ROM(系统固件) 适配
线上排障先用指标和版本缩小影响面,再通过受控日志、Trace(追踪记录) 或诊断命令获取增量证据。非Play安装可能不进入Play质量报表;ROM是否提供某项公共API、系统服务或厂商报表,应按设备版本和实际能力检查。提前设计自己的证据回传与分发路径,不能从渠道名称推断平台API缺失。
源码基线:AOSP
android-17.0.0_r1,平台能力上界为 Android 17 / API 37;相关结论不依赖内核专有实现,因此不附加内核版本标签(kernel tag);设备可能使用其他内核分支。
影响面、假设、证据与止损
线上问题排查流程
线上排障处理的是复现概率低、现场容易丢、影响范围会变化的问题。所以我们把排障效率拆成三件事来建设:事发前准备好必要的记录,事发时能按用户、版本、设备和时间把证据聚合起来,事发后把风险限制在小范围内。
26.1 节已经说明指标(Metrics)、日志(Logs)和追踪(Traces)的分工,16.3 节覆盖生产环境性能监控,14.1 节说明 Perfetto 抓取方式;远程日志、用户反馈与灰度控制属于应用架构,可以自己建设。落到排障实战,我们要做的是四个动作:接到反馈后收集证据、复现问题、打开临时日志或诊断开关、用灰度环境缩小影响范围。灰度指只向一部分用户发布版本或配置,再根据观测结果逐步扩大范围。
一次线上事件可以按以下顺序推进:
- 建立事件编号,记录用户可见现象、首次发生时间、影响版本和当前影响面。
- 先做安全处置:暂停扩大灰度,必要时关闭可疑功能;保留已知证据,避免重启服务或清除缓存后现场消失。
- 建立时间线。优先使用单调时间,也就是只随设备运行递增、不受校时影响的时钟;跨设备关联时改用带时区并经过校准的墙钟时间(wall clock)。我们把客户端日志、服务端追踪标识(traceId)、Crash / ANR、配置变更和发布记录放进同一时间线。
- 列出证据缺口,想清楚还缺哪些材料才能验证当前假设,再选择动态日志、端侧性能剖析(profiling)、用户协助生成系统诊断包(bug report),或在测试环境复现。采集动作本身也要限时、限量并可撤销。
- 修复或隔离后,沿用相同的用户分桶和操作路径验证指标是否恢复;同时记录哪些证据能够支持结论,哪些只能说明时间或分组相关。
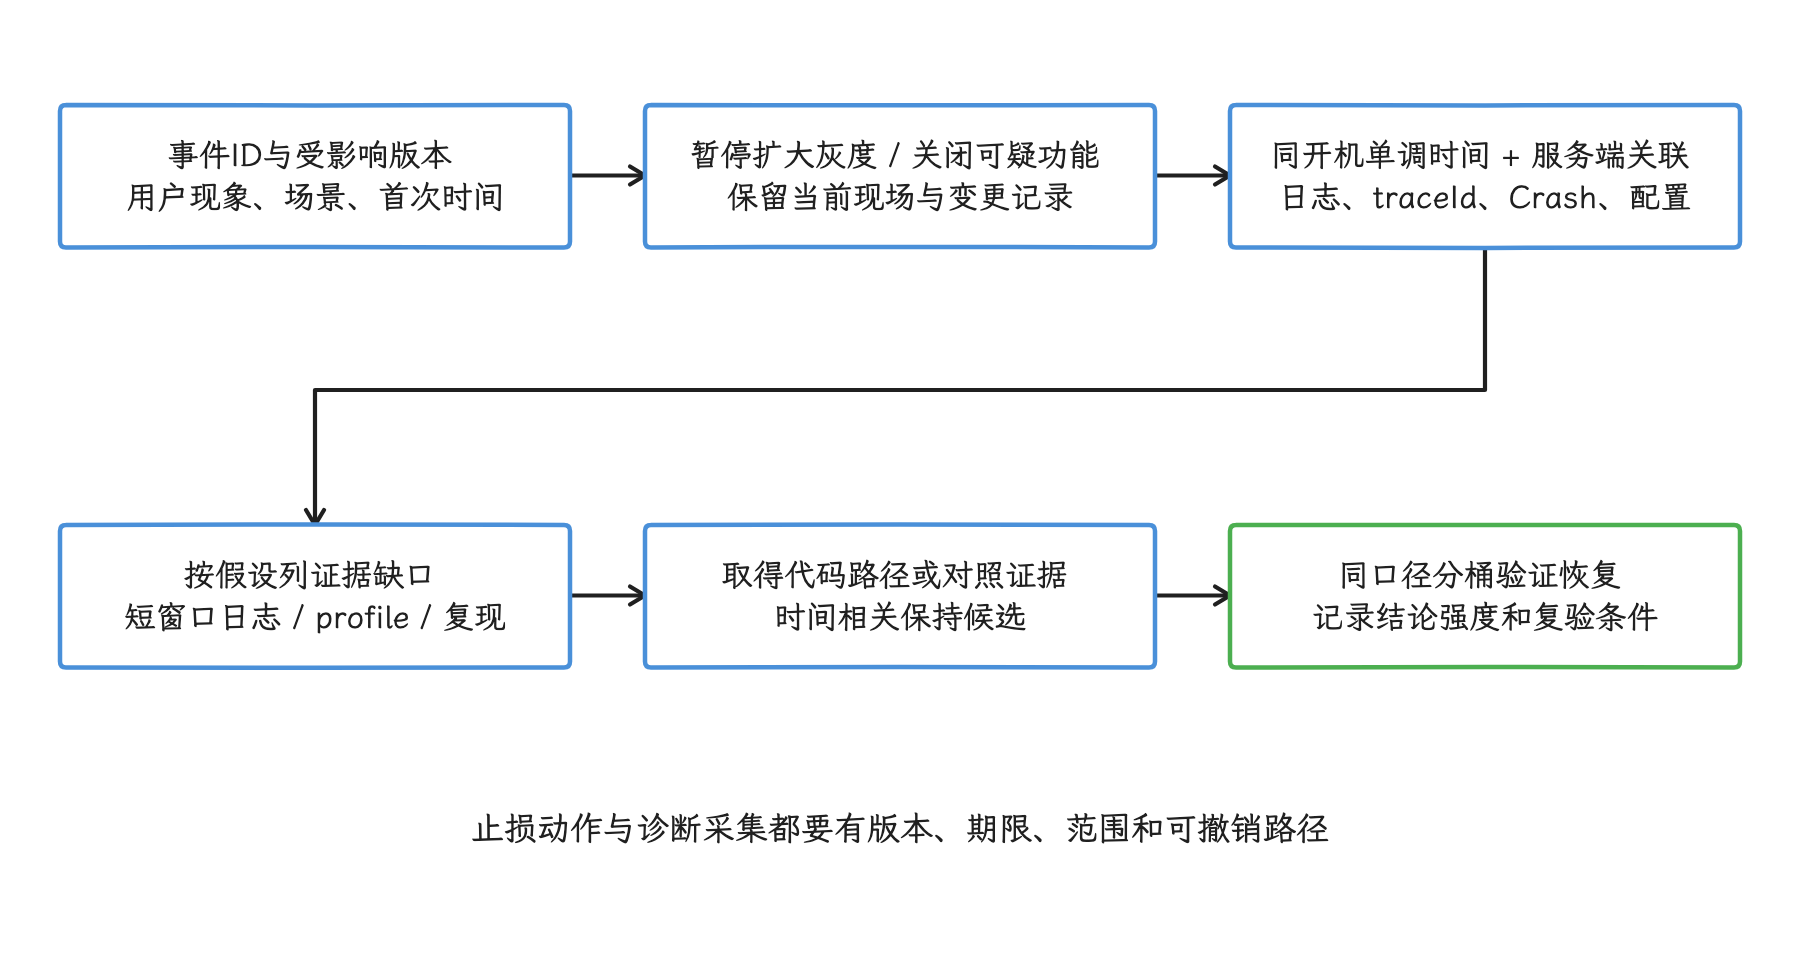
图:事故流程同时管理影响面、证据缺口和推断强度,不以新增日志数量代替验证。
远程日志与动态日志级别
远程日志要解决的问题是,只靠线上已有的安装包,把一次会话的必要现场留下来。线上设备始终是用户的设备,我们按生产环境对待,别当成远程开发机。动手设计前先回答四个问题:这是谁的设备、发生在哪个版本、当时走过哪些业务步骤、失败点附近有哪些系统状态。
一套可用的远程日志方案通常分成四层:
- 本地写入层:把应用(App)自有日志写入 App 私有目录,按时间、字节和会话滚动,设置总容量与保留期限。多进程 App 可按进程分文件,上传前再按单调时间和进程名合并,避免多个进程竞争同一个文件。
- 采样与开关层:发布版保留日常诊断需要的低成本事件;对目标用户、机型、版本或实验组临时增加字段与采样。
log.tag.<TAG>/Log.isLoggable()中的 tag 是日志分类标签,这组机制更适合使用 adb 调试设备、系统组件或本地构建。普通 App 应使用自己的类型化配置,远端下发的字符串只作为配置字段解释,不得当成系统属性或任意命令执行。 - 隐私与合规层:密码、验证码、完整 token(令牌,例如登录凭据)、支付凭据、输入文本和联系人内容不得进入日志。关联请求使用服务端生成的随机 ID 或经过密钥保护的令牌化标识;可枚举字段即使经过简单哈希(hash)仍可能被反推,要达到匿名化还需要更强的处理。字段在产生处分类,写盘与上传两处校验,App 私有目录本身也不构成采集敏感数据的理由。
- 拉取与主动上报层:经用户同意的反馈、Crash、ANR 或严重业务失败可以触发受控上报。远程诊断任务必须使用有限动作集合,并携带目标范围、配置版本、过期时间、重放保护(防止旧指令再次生效)、总字节上限和网络条件;禁止下发 shell 命令、任意反射调用或任意文件路径。
工程上我们不必一开始就建设完整日志平台:先让会话 ID、请求 ID、页面路径、关键业务状态、错误码、设备、系统和版本字段齐全,就已经能覆盖大量偶发问题;等现有证据定位不了,再增加动态诊断能力。
动态日志级别要控制三类成本。CPU 成本来自字符串构造、序列化和压缩;I/O 成本来自频繁写文件与同步落盘;流量成本来自批量上传。开关应按日志标签或结构化事件类型生效,只覆盖明确的用户分组,并由服务端到期时间和客户端累计预算共同终止。每次下发、命中、续期和撤销都写审计记录;客户端一旦验证不了签名、版本或有效期,就退回安全的默认级别。
用户反馈与问题复现
用户反馈如果只收一句"打不开",排障就无从下手。我们要把反馈入口的产出做成可检索的证据包,也就是围绕同一事件收集的一组日志、时间线和环境信息。最小字段包括:事件编号、经过授权的用户或会话标识、App 版本、安装渠道、设备型号、Android 版本、发生时间与时区、网络类型、页面或功能入口、操作步骤、错误提示,以及可用的请求 ID。
截图和录屏要提醒用户检查通知、账号、聊天内容等屏幕隐私。
Android bug report 包含系统服务诊断输出、负责汇总设备状态的 dumpstate 产物,以及系统日志工具 logcat 的记录。普通用户需要启用开发者选项并主动生成、分享,App 没有静默读取它的生产环境接口。文件可能包含设备与其他应用信息,接收方应提示风险、取得同意、限制访问并按事件保留期删除。
Crashlytics 一类平台的自定义键值字段(custom keys)与自定义日志适合附加 App 内现场信息,但仍受字段数量、大小和隐私规则约束。两类材料分工明确:bug report 偏系统现场,崩溃(Crash)平台偏应用内状态。
复现时先把问题分成四类:
- 强复现问题:固定步骤能稳定触发。直接准备本地环境、打开 DEBUG 级别日志和 Perfetto,按 14.1 节流程抓取 Trace。
- 弱复现问题:同一用户或同一机型偶尔触发。保留用户现场数据,按设备型号、系统版本、区域、网络、渠道分组,找重复出现的组合。
- 数据依赖问题:只在某些账号、缓存、配置或服务端返回下触发。复现包要保存配置版本、接口返回摘要、数据库结构版本和迁移状态。
- 时序依赖问题:只在启动、切后台、网络切换、进程恢复、灰度切换时触发。复现时要保留时间线,单条错误日志通常不够。
反馈处理从列出证据缺口开始:缺少关联键就补会话或请求标识,缺少时间线就补有限时长和容量的日志窗口,缺少业务状态就补经过审核的自定义字段;怀疑系统状态、且用户愿意配合时,再请求 bug report。bug report 成本较高,留作后备手段,别把它变成每次反馈的默认要求。证据补齐后再决定是否启用临时诊断、下发运行期开关或发布修复版本。
线上 Trace 抓取与分析
Trace 适合回答两个问题:时间花在哪里,线程为什么没有运行。它和日志分工明确:日志描述业务状态,Trace 描述线程、调度、锁、Binder 跨进程调用(IPC)、渲染和 I/O 的时间分布,两者要用同一套会话 ID 和时间戳关联。
在用户设备上,发布版 App 能抓到什么 Trace,取决于系统给出的路径。Android 9 起设备提供 System Tracing(系统追踪) 应用,Android 10 起以 Perfetto 格式保存记录,这条路径需要用户或测试人员亲手操作。
Android 15 新增的 ProfilingManager 为普通 App 提供受系统约束的程序化性能剖析:返回的数据经过裁剪或脱敏、只与请求进程相关,和 adb 条件下的全设备 Trace 是两回事。表中的36.1是Android 16的次要API发布版本;它与独立更新模块使用的SDK Extensions不是同一编号体系。
Android 线上诊断能力按版本分层:
| 平台版本 | 普通 App 可用能力 | 需要记住的边界 |
|---|---|---|
| Android 10 / API 29 | System Tracing、bug report、App 内 trace section(追踪区段) | 系统 Trace 依赖用户或 adb;尚无 ApplicationExitInfo |
| Android 11 / API 30 | getHistoricalProcessExitReasons()、getTraceInputStream() | 查询退出历史;trace 可能为空或被系统环形缓冲区覆盖 |
| Android 12-14 / API 31-34 | 延续退出历史;API 31 起原生崩溃(Native crash)可返回 Protocol Buffers 格式的 tombstone(崩溃转储) | 按 reason(退出原因)区分 ANR trace 与 Native tombstone |
| Android 15 / API 35 | ProfilingManager.requestProfiling() | 请求可能延迟、失败或被限流;持续采集类型应提前开始,并用 CancellationSignal 取消信号停止 |
| Android 16 / API 36 | ProfilingTrigger、addProfilingTriggers() | 系统触发结果只投递给全局监听器(listener),不保证每次触发都有文件 |
| Android 16次要版本36.1 | requestRunningSystemTrace()、addAllProfilingTriggers() | 先注册对应触发器;后台trace快照还依赖系统当时正在录制 |
| Android 17 / API 37 | OOM、冷启动、异常行为、兼容性等新增触发类型 | 各常量有不同采集产物;OOM为Java heap dump,不一律依赖后台trace快照 |
Android 15 的 requestProfiling() 支持 system trace(系统追踪)、Java heap dump(Java 堆转储)、heap profile(堆分配剖析) 和 stack sampling(调用栈采样) 四种类型。请求必须配好接收结果的监听器和执行回调的 executor;系统会同时按应用和全局预算限流,成功、失败还是被限流,要看回调里的 ProfilingResult。结果文件交付到应用数据目录后,容量、保留期和上传策略仍由应用自己执行。
Android 16 的 ProfilingTrigger 支持注册 ANR、APP_FULLY_DRAWN 等事件。Android 16次要版本36.1增加了 requestRunningSystemTrace() 和 TRIGGER_TYPE_APP_REQUEST_RUNNING_TRACE,这个 API 请求的是系统正在后台采集的 trace 快照,系统不会为调用方临时启动不受约束的全局 Trace。Android 17 / API 37 又增加了一批触发类型:OOM(内存不足)、冷启动、异常行为、兼容性问题,以及因过量占用 CPU 被终止。不同类型返回 system trace、stack sample、heap dump 或与异常类型对应的产物。客户端按成员的引入版本检查运行时能力:主API看SDK_INT,36.1成员应先确认API≥36,再用SDK_INT_FULL >= Build.VERSION_CODES_FULL.BAKLAVA_1判断。targetSdk不是能力探测;完整版本常量与版本判断说明给出了次要版本规则。详细 API 用法见 26.6 节。
生产环境方案仍要把能力分成三个等级:
- 常驻轻量标记:在启动、页面切换、列表刷新、图片加载、数据库迁移和网络请求等位置写入
Trace.beginSection()/Trace.endSection()或 AndroidX Tracing section,并用独立指标记录耗时。section 只有在 Trace 被采集时才会出现,常驻指标仍要单独记。 - 触发式 App 内证据:对少量目标用户打开函数耗时、主线程卡顿、请求耗时、I/O 摘要、锁等待摘要。只保留聚合结果和短窗口明细,避免把每次方法调用都上报。
- 人工协助系统 Trace:当问题影响面大、复现路径清楚、用户或测试设备可配合时,再引导抓取 bug report 或 Perfetto Trace。文件要带采集时间、场景说明、App 版本和会话 ID。
归档 Trace 前,我们先统一指标含义:P90、P95、P99 分别是 90、95、99 分位数;jank rate 是卡顿帧占比;TTFB(Time to First Byte)是从请求开始到收到首字节的时间;DNS 是域名解析,TLS 是加密连接协议。生产环境 Trace 可按同一张表归档:
| 场景 | 触发条件 | 必带轨道或字段 | 关联章节 |
|---|---|---|---|
| 慢启动 | 冷启动 P90/P99 突然上升 | 进程启动时间、主线程、RenderThread、Binder、磁盘 I/O、首屏业务阶段名 | 21.x、14.2 |
| 页面卡顿 | jank rate 或慢帧上升 | Choreographer、RenderThread、SurfaceFlinger、主线程长任务、GC | 22.x、14.2 |
| 网络疑难 | 请求超时或 5xx 集中出现 | traceId、DNS、连接建立、TLS 握手、TTFB、服务端日志索引 | 24.x、26.1 |
| ANR / 卡死 | 前台 ANR 或长时间无响应 | 主线程堆栈、Binder 等待、锁等待、CPU 调度、输入事件时间线 | 20.4、9.2、14.2 |
如果团队已经有 traceId 或 requestId,Trace section 名称不要写高基数值。高基数表示字段有大量不同取值,例如把每个用户 ID 都当成一个类别。section 只写稳定阶段名,高基数字段放日志或事件属性里,否则 Perfetto 视图和聚合统计会被大量唯一名称污染。
灰度环境与问题隔离
灰度环境用于限制风险范围,并让诊断配置与功能开关能够撤销。它同时服务发版和线上排障:给小范围用户增加日志、下发诊断配置、关闭可疑功能或恢复旧配置,都应经过同一套授权、发布、监控和审计规则。
隔离策略按影响面从小到大排列:
- 单用户隔离:经用户同意后,对反馈会话开启受控日志、诊断动作或备用配置。适合弱复现问题。
- 同类设备隔离:按设备型号、系统版本、ABI(应用二进制接口)、渠道、地区、网络类型圈定。适合厂商 ROM、SoC(片上系统) 或网络环境相关问题。
- 版本隔离:按 App 版本、配置版本、资源版本、热修复版本切分。适合发版后指标异常或配置下发事故。
- 功能隔离:用远程配置关闭可疑功能、切回旧实现、降采样、降低图片质量、停用高风险实验。适合一时发不了版、但可以止损的场景。
Google Play 分阶段发布(staged rollout)可以暂停继续分发,但已经收到该版本的用户仍停留在该版本;修复通常需要发布 versionCode 更高的新版本。halt 只停止新增分发,起不到远程降级已安装 APK 的作用。
Firebase Remote Config rollout 支持编辑或回滚灰度配置;客户端只有在后续成功拉取(fetch)并激活(activate)配置后才会应用新值,离线设备和仍使用缓存的客户端不会即时切换。两条路径的生效时延不同,事故预案要分别准备"停止新增曝光""运行期关闭功能"和"发布修复版本"。
远程开关也有失败模式。旧客户端可能不认识新字段,设备可能离线,配置缓存可能尚未刷新,服务端也可能误下发。关键功能应给出向后兼容默认值、配置结构版本和本地有效期;关闭功能的开关要提前演练,别等到事故发生才第一次验证客户端会不会执行。
灰度期间,崩溃率只是起点。Android vitals 会评估用户感知崩溃率(user-perceived crash rate)、用户感知 ANR 率(user-perceived ANR rate)、启动、慢渲染、耗电、LMK(Low Memory Killer,低内存终止) 等质量指标;业务侧还要看登录、支付、播放、下载等操作路径指标。我们同时盯两条线:技术指标止住恶化势头,用户操作指标没有冒出新异常。
扩展:证据包模板
每个线上疑难问题可以按同一份模板建单,避免排障过程散在聊天记录里:
- 现象:用户看到的结果、错误文案、截图或录屏。
- 范围:影响用户数、版本、设备、系统、渠道、地区、网络。
- 时间线:首报时间、指标开始异常时间、最近一次发版或配置变更时间。
- 证据:日志文件、Crash / ANR 报告、bug report、Trace、服务端日志索引、用户反馈单。Android 11+ 补充
ApplicationExitInfo退出记录,包括进程名、reason(退出原因)、status(状态码)、时间戳、importance(进程重要性),以及可用时的 trace。PSS 是按共享内存比例折算后的进程内存,RSS 是进程当前驻留在物理内存中的页总量;这里记录的是系统最近一次采样值,可能为 0,也不是进程死亡瞬间的精确快照。这些退出记录与 SDK 事件可按进程名、时间窗、退出原因、会话编号(session_id)和 trace 摘要做概率关联,关联结果要保留置信标记。 - 变更:App 发版、热修复、远程配置、服务端发布、运营活动、第三方 SDK 版本。
- 处置:已打开的日志开关、灰度策略、回滚动作、下一次观察窗口。
- 结论:定位到的模块、修复方式、验证方式、后续防复发项。
这个模板用于减少遗漏。排障人员拿到单子后,可以直接判断缺哪类证据。结论栏要区分"已由复现实验或代码路径证明""由时间与分桶相关性支持""证据仍不充分",避免把同时发生的变更直接写成根因。
从症状到证据的案例索引
常见事故不需要各自维护一篇独立案例文档。把症状拆成阶段,再按同一份证据包推进,既能复用排障流程,也能避免"常见原因"被写成既定根因。
| 用户症状 | 需要拆分的阶段 | 必须关联的证据 | 典型止损动作 |
|---|---|---|---|
| 下载卡在 99% | 正文接收、文件缓冲区写盘(flush)、校验、解压、原子改名(rename)、数据库更新、UI 状态 | DNS / 连接建立 / TLS / TTFB、断点续传头 Range / Content-Range、期望与已写字节、剩余空间、校验结果、状态转换、request ID | 暂停有问题的断点续传或收尾路径,保留失败批次 |
| 低端机启动 P95 上升 | 进程创建、Application、ContentProvider 初始化、首帧、业务可用 | 启动类型、设备档位、本地数据量、编译状态、磁盘 I/O、类加载、初始化 Trace、构建与配置版本 | 缩小灰度,对受影响设备关闭可选初始化 |
| 支付页卡约 3 秒 | UI 主线程、Binder、网络、锁、服务端等待、超时重试 | 页面阶段名、线程状态、请求 ID、DNS / TLS / TTFB、服务端日志、配置版本、代表性 Trace | 关闭可疑实验或重试策略,切换受支持的备用处理路径 |
| 后台耗电无法复现 | 任务调度、唤醒锁(wakelock)、网络批次、前台服务、进程状态 | 任务入队 / 开始 / 停止、调度约束、省电与热状态、wakelock、网络、Battery Historian / Perfetto 时间线 | 停止高频任务或诊断采集,启用更严格的后台约束 |
这些案例共用一套处理顺序:确认指标和状态定义,检查数据采集路径是否完整;按版本、设备、渠道和场景圈定影响范围;查找同一时间窗内的发布、配置和服务端变更;抽取代表样本补充日志或 Trace;执行可撤销的止损;再用原来的统计口径验证是否恢复。若只有时间相关性,结论保持为候选,直到代码路径、对照实验、回滚或可重复 Trace 提供更强证据。
处置手册(runbook)至少要固定负责人、告警入口、证据查询、权限申请、止损开关、升级路径、恢复判定和复盘动作。每次演练还应覆盖队列满、上传失败、数据结构版本不兼容、时钟偏差和诊断开关下发失败,避免只验证事故处理流程的成功分支。
平台与 OEM 补充:StatsD 的权限边界
StatsD 是 Android 平台的统计框架,服务对象是 Android 系统、设备厂商(OEM)和具备相应权限的系统组件,为他们提供长期聚合数据,普通第三方 App 拿不到通用的生产环境查询入口。它的调用路径是:StatsManagerService 通过 Binder 与本地 statsd 守护进程通信,StatsCompanionService 负责部分系统协作;这段配置/报告控制链通过Binder,不应画成固定JNI三层。事件写入另有StatsLog等入口及native实现,不能据此断言StatsD所有路径都不经过JNI。
权限决定了适用对象:
| 操作 | Android 17 平台权限 | 对普通第三方 App 的含义 |
|---|---|---|
| 注册 pull atom callback | REGISTER_STATS_PULL_ATOM,`signature | privileged` |
| 读取受限指标 | READ_RESTRICTED_STATS,`internal | privileged` |
| 配置或读取 statsd 数据 | 服务端检查 DUMP、PACKAGE_USAGE_STATS 与 usage-stats AppOp | AppOp 是系统对具体操作的授权检查;DUMP 明确不供第三方应用使用 |
signature|privileged 由 signature 基础类型和 privileged 标志组成,具体授予取决于应用签名、安装位置与适用的许可清单;internal|privileged 还带有平台内部使用约束。这两种权限普通 App 在运行时弹窗里申请不到。
因此,面向 Play 发布的普通 App 应使用自有指标、Android vitals、ApplicationExitInfo 和 ProfilingManager。平台或 OEM 项目如果已经通过合规审查导出 StatsD 聚合结果,可以把 atom ID(统计事件编号)、config key / version、elapsed timestamp(单调时间戳)、聚合窗口和缺失状态放入证据包,再与 Perfetto 时间线对照。没有权限时明确记录"不可用",也不要建议用户去授予所谓"特殊权限",更不要把虚构的业务字段称为系统 atom。
Android 17:StatsD 重启后的注册恢复
这一段只适用于平台、OEM 或具备权限的系统组件。android-17.0.0_r1 已公开,StatsD 模块位于 platform/packages/modules/StatsD/,我们直接按这一版源码讲,不必再用 Android 16 源码推测 Android 17 行为。
StatsManagerService.registerPullAtomCallback() 会先把 PullerKey 与回调参数写入 mPullers,再通过 getStatsdNonblocking() 尝试通知本地守护进程。statsd 暂时不可用时,服务保留 Java 侧注册;后续 statsdReady() 更新 mStatsd、唤醒等待者,并由 sayHiToStatsd() 重新注册拉取器(puller)和 PendingIntent 回调订阅。各 registerAll*() 方法在锁内复制容器,释放锁后再执行 Binder 跨进程调用,避免持有 mLock 调用另一个进程。
数据读取路径使用 waitForStatsd(),STATSD_TIMEOUT_MILLIS 为 5000 毫秒。这个常量只限制单次等待守护进程连接的时长;停机期间缺不缺数据,还要看事件入口、队列、配置恢复时点和数据源本身。
排查平台侧 StatsD 时,可以据此区分三类状态:
- 注册调用已返回、守护进程当时不可用:检查
statsdReady()之后系统有没有完成重新注册;重新注册由服务端自己收尾,调用方不必无限重复。 - 读取或配置调用失败:记录具体 API、config key、调用者 UID(Linux 用户标识)、权限 / AppOp 结果和连接超时,重试必须沿用同一配置键,并设置次数或时长上限。
- 指标时间线有空洞:Java 缓存还在,说明不了停机期间的 atom 已经保存,要同时核对 statsd 生命周期、配置生效时间和 atom 数据源。
本地 statsd 在 main.cpp 中仍创建容量上限为 50000 条且不预先分配内存的 LogEventQueue,随后启动本地套接字监听器(socket listener)、注册 Binder 服务并与 StatsCompanionService 建立联系。这个条数上限说的是队列能攒多少条事件;要换算 RSS 或判断 OOM 根因,还得靠其他证据。
日志缓冲、命令授权与结果回传
影响面圈定之后,接下来的问题是怎么从用户设备上安全地拿到证据。诊断通道只执行白名单、限时、可审计的采集动作,高开销 Trace 与敏感字段必须受配置控制。
这一节处理的始终是同一类现场:问题发生在用户设备上,常规监控只看得到结果,我们手里缺的是复现路径、运行状态和时间线。讨论范围是普通 App 用公开 API 和应用沙箱能建设的能力;排障流程见前文,26.6 节介绍 ApplicationExitInfo、ProfilingManager 与 ProfilingTrigger 的版本适用范围。
我们说一条日志通道"高可用",指的是证据在进程被杀、断网或磁盘异常后仍尽量得到保存和恢复。它提高的是证据可得性;每次故障能拿到多少材料,还受三件事约束:进程可能在缓冲区刷新前被杀,设备可能没有剩余空间,用户也可能清除数据或卸载 App。所以验收目标要写成可度量的丢失窗口、上传时限和隐私边界。
日志、Trace、诊断命令的分工
动手之前先分清三类材料各自回答什么问题。业务日志保存连续的业务状态;性能 Trace 按时间记录线程与系统事件,profile 通过采样或快照保存调用栈、内存等性能信息;诊断命令则在限定对象和时间窗内补采状态。三者成本、权限和保留周期不同,我们给它们分别设计文件格式与审批策略,避免混用。
| 能力 | 适合回答的问题 | 端侧成本 | 典型触发 | 主要风险 |
|---|---|---|---|---|
| 常规业务日志 | 用户进行到哪一步、状态怎样变化、请求在哪一阶段失败 | 低到中 | 常开采集、用户反馈、Crash/ANR 后恢复上传 | 敏感字段泄露、关键路径缺字段、写入过量 |
| 性能 Trace / profile | 线程为什么等待,Binder、锁、I/O、渲染和 CPU 时间花在哪里 | 中到高 | 一次性请求、系统触发、受控实验 | 文件较大、系统限流、方法名与内存对象泄露 |
| 诊断命令 | 配置、网络、缓存和文件元数据是否符合预期 | 中 | 工单、线上告警、受控设备排查 | 越权、重放、重复执行、误操作 |
| 动态采集规则 | 现有字段不足时,临时提高既有观察点的详细度 | 中到高 | 限定版本、设备和时间窗 | 性能回退、范围扩散、配置未及时失效 |
先说读取权限:普通第三方 App 读不到全设备 logcat。Android 的 logging 说明明确把全设备日志访问限定给 OEM App,并受 READ_LOGS、前后台状态等条件约束;第三方 App 读取自身日志的规则不受影响。
Android 安全文档仍建议生产环境使用应用内部、可治理的日志设施,并避免把敏感数据写进 logcat,参见日志信息泄露风险。
所以 App 自建日志要自己完成字段约束、脱敏、持久化、上传和删除;bug report、系统日志与 Perfetto 文件属于补充材料,业务状态仍由应用自己的结构化事件说明。
高可用日志通道的五个目标
"数据不丢"适合当方向;我们把验收落到可执行的指标上:高优先级事件允许丢失的时间窗或记录数、本地保存时限、网络恢复后的上传时限,以及超出预算后的降级行为。
- 丢失窗口有上限:关键记录尽快从内存缓冲写入带边界校验的文件。同步写入或
fsync(要求操作系统把缓冲数据提交给存储设备)会增加延迟和闪存写放大——少量逻辑数据引起更多物理写入。这类操作只用于少数经测量确认的事件,普通日志接受明确的缓冲丢失窗口。 - 写入开销可控:主线程与渲染路径不执行压缩、网络发送和大型对象序列化。调用方提交小型结构化字段,后台线程完成组块、压缩等工作。
- 中断后可恢复:上传失败保留可重试文件,进程重新启动或持久后台任务运行时重新扫描。磁盘满、数据损坏、清除数据和卸载等情形必须记录为能力边界。
- 时间线可关联:记录
session_id、匿名主体标识、App 版本、进程、线程、wall clock(可被校时的日历时间)、单调时钟(只向前递增,适合计算时长)和请求标识。匿名标识要可轮换,且不要为了排障额外建立长期跨场景跟踪。 - 敏感字段可治理:写入 API 使用字段 allowlist(只接受预先登记的字段)、类型约束、保留期和采集目的。原始 URL、查询参数(query)、请求头(header)、请求体(body)、凭据(token)、手机号、精确位置、联系人以及未经检查的异常消息均不得直接进入线上日志。
常开字段只保存最少的排障信息。临时字段由带版本和期限的策略开启,并受设备范围、文件预算、流量预算与用户政策约束。关闭策略还要说明已有文件是继续上传、仅保留高优先级部分,还是立即删除。
采样、存储、上报三层架构
服务端开关表达的只是采集意图;写入成本、崩溃一致性、文件生命周期、后台执行限制和重试语义都落在端侧,因此采样、存储与上报各自拥有独立策略和指标。
采样层:保留可解释的时间线
采样层决定采集对象、事件范围和有效时长。
- 稳定分桶:同一匿名标识在策略有效期内始终落入相同样本组,避免一条时间线内反复进入和退出样本。哈希输入、盐值(与标识组合以降低反推风险)或密钥版本、分桶算法、配置版本和命中概率都要随事件保存。
- 避免长期跟踪:未登录标识设置轮换周期和用途边界。跨设备、跨账号或跨产品关联需要另行评估,这一步已经超出"稳定采样"的范围。
- 事件分级:Crash、ANR、数据一致性故障等可获得更高持久化和上传优先级;具体业务事件的等级由影响与隐私风险共同决定,别只凭名称硬编码。
- 临时窗口:指定设备或用户的诊断策略包含生效时间、失效时间、最大记录数、最大文件量、网络预算、命令 ID 和审批 ID。过期后端侧自行恢复默认配置。
- 未知状态显式化:配置尚未拉取、匿名标识不可用或策略版本认不出来时,记录
unknown或使用保守默认值,不把未知误写成未命中。
逐事件独立随机采样容易切断事件连续性。若业务必须采用这种方式,事件要携带纳入概率,分析端再做加权,并把缺失片段视为采样结果:没抽到只说明采样没命中,别读成业务没有发生。
存储层:用记录边界处理崩溃恢复
应用日志通常位于 App 私有目录,并按进程、优先级与时间窗口切分。文件名只放非敏感的文件 ID、时间片和进程代号;账号、手机号、完整 URL 等信息不得出现在文件名中,因为文件名也会进入诊断和运维记录。
| 方案 | 优点 | 主要代价 | 适用范围 |
|---|---|---|---|
| 直接追加文件 | 实现和人工检查简单 | 系统调用较多,结构约束弱 | 低频业务事件 |
| 内存组块后写文件 | 可合并写入并集中编码 | 崩溃前尚未刷出的组块会丢失 | 中低频结构化日志 |
| mmap(内存映射)/ 环形文件 | 高频写入路径可控,可限制最大占用 | 崩溃恢复、并发协议和持久化语义复杂 | 经压测证明有需要的日志基础库 |
mmap 让进程通过虚拟内存页访问文件,它只改变访问方式,映射可写不等于已经持久化。记录长度/序号/校验用于恢复时识别完整记录;掉电持久性还取决于同步策略、文件系统和设备,不能由校验通过倒推出。无论采用哪种方案,记录都应具有长度、schema(字段与编码结构)版本、序号和校验信息;读取端碰到半条记录时停止在上一条完整边界。关键元数据还要有独立的小型状态记录,别只凭文件名猜测上传状态。
应用私有目录提供的是进程与普通应用之间的沙箱隔离;业务需要的保密性、完整性和可恢复性要另行设计。是否额外加密取决于威胁模型,即要保护什么、攻击者是谁、攻击者拥有哪些权限。密钥与密文都由同一已被攻陷的进程访问时,应用层加密挡不住该进程读取明文。
上报层:持久调度与幂等恢复
Android 不保证某个应用进程长期存活。各进程可以写自己的文件,上传交给满足约束的持久后台任务调度——持久任务会把调度状态保存下来,App 退出或设备重启后重新安排执行。例如 WorkManager 持久工作适合表达网络、充电和重试约束,但执行时间仍由系统决定。每次进程启动和每次任务运行都应重新扫描状态,别指望"保活进程"持续监听。
上传任务至少处理以下边界:
- 网络与电量:高优先级小包可以在允许的计量网络上传——计量网络是系统认为可能按流量收费的网络。大文件是否等待非计量网络由产品时效与用户成本决定。网络条件满足只说明任务具备运行条件,系统仍可能延后任务。
- 文件年龄与空间预算:按优先级、创建时间和总字节数淘汰。达到硬上限时优先保留短小的故障索引,再按既定策略删除低优先级正文。
- 错误分类:超时、连接中断和部分服务器错误可退避重试——让连续重试的间隔逐步增加;鉴权失败、格式不支持和服务端明确拒收需要停止盲目重试,并记录终止原因。
- 幂等语义:文件或证据包携带
file_id、内容摘要、schema 版本、命令 ID 和分片序号。服务端用稳定幂等键去重,同一证据重传多次也只生成一份业务结果;客户端在确认服务端接收后才转入可清理状态。 - 状态恢复:状态至少区分待处理、上传中、已确认、待删除和永久失败。进程在任一步骤退出后,新任务都能从持久状态继续;租约是带过期时间的执行权记录,过期后允许其他执行者重新处理。
- 触发审计:用户操作、故障恢复、自动策略和人工命令分别记录触发来源、策略版本与审批信息。
队列可能在采样、编码、落盘、调度、上传、服务端解析或隐私检查任一阶段失败。每个阶段都需要低基数字段——取值种类有限、便于聚合的字段——并配套稳定错误码,避免仅记录一句"上传失败"。
多进程写入与单进程上报
主进程、应用声明的WebView宿主进程、播放器进程和推送进程同时写入一个 Binder(Android 跨进程调用机制)服务,会把日志压力转成 IPC(跨进程通信)队列压力;每个进程独立上传又会增加连接、退避和状态竞争。常用边界是每进程独立写文件,由任一取得上传租约的执行者统一扫描和传输。
这里的"单执行者"描述并发协议,不绑定固定进程身份:
- 每个进程只修改自身正在写入的文件。切片完成后,在同一文件系统内 rename 到待上传目录。
- 同一文件系统内成功rename提供名称切换原子性;记录长度、序号和校验值用于恢复完整边界,不能证明此前数据已持久化。需要抗掉电时另行设计文件同步及所需的目录同步/提交顺序,并验证具体文件系统;同步失败必须留在失败状态。
FileObserver是 Android 的文件与目录变更通知 API,这里只把它作为唤醒提示。观察者未运行、进程死亡或监听范围不完整时可能没有事件,而且目录监听不会自动递归覆盖所有子目录。进程启动、后台任务运行和上传完成后均要全量重扫索引目录。- 上传执行者使用跨进程文件锁或带过期时间的租约。持有者退出后其他进程可以接管;即便出现双执行者,服务端幂等键也应避免产生两份业务结果。
- WorkManager 的 unique work 会按唯一名称和既定冲突策略处理重复入队,可限制同一调度数据库里的重复工作,但它不是任意多进程代码的锁。多进程初始化方式、实际运行进程和数据库访问策略必须在目标 App 中验证。
进程退出时,正在写入的文件可能没有切片。恢复扫描应识别所有进程的遗留文件,校验完整记录,给恢复动作写入 recovered_by 与恢复原因,再进入待上传状态。磁盘满时,恢复逻辑可能连新的状态文件都建不了,因此要预留小额应急空间或采用可原地更新的固定大小索引,并在故障注入测试中验证。
事件排序同时保存 wall clock 与 elapsedRealtime。后者只在同一次开机周期内可比较,因此还要记录开机会话标识;跨设备或跨重启排序依赖服务端接收时间及已知的时钟偏差,直接按客户端 wall clock 合并会出错。
如果已有应用性能监控(APM)SDK,可以和它共享会话 ID、请求 ID、设备维度和调度能力。聚合指标与可读日志仍需不同的 schema、采样和保留策略,否则任一侧的字段变更都可能破坏另一侧分析。
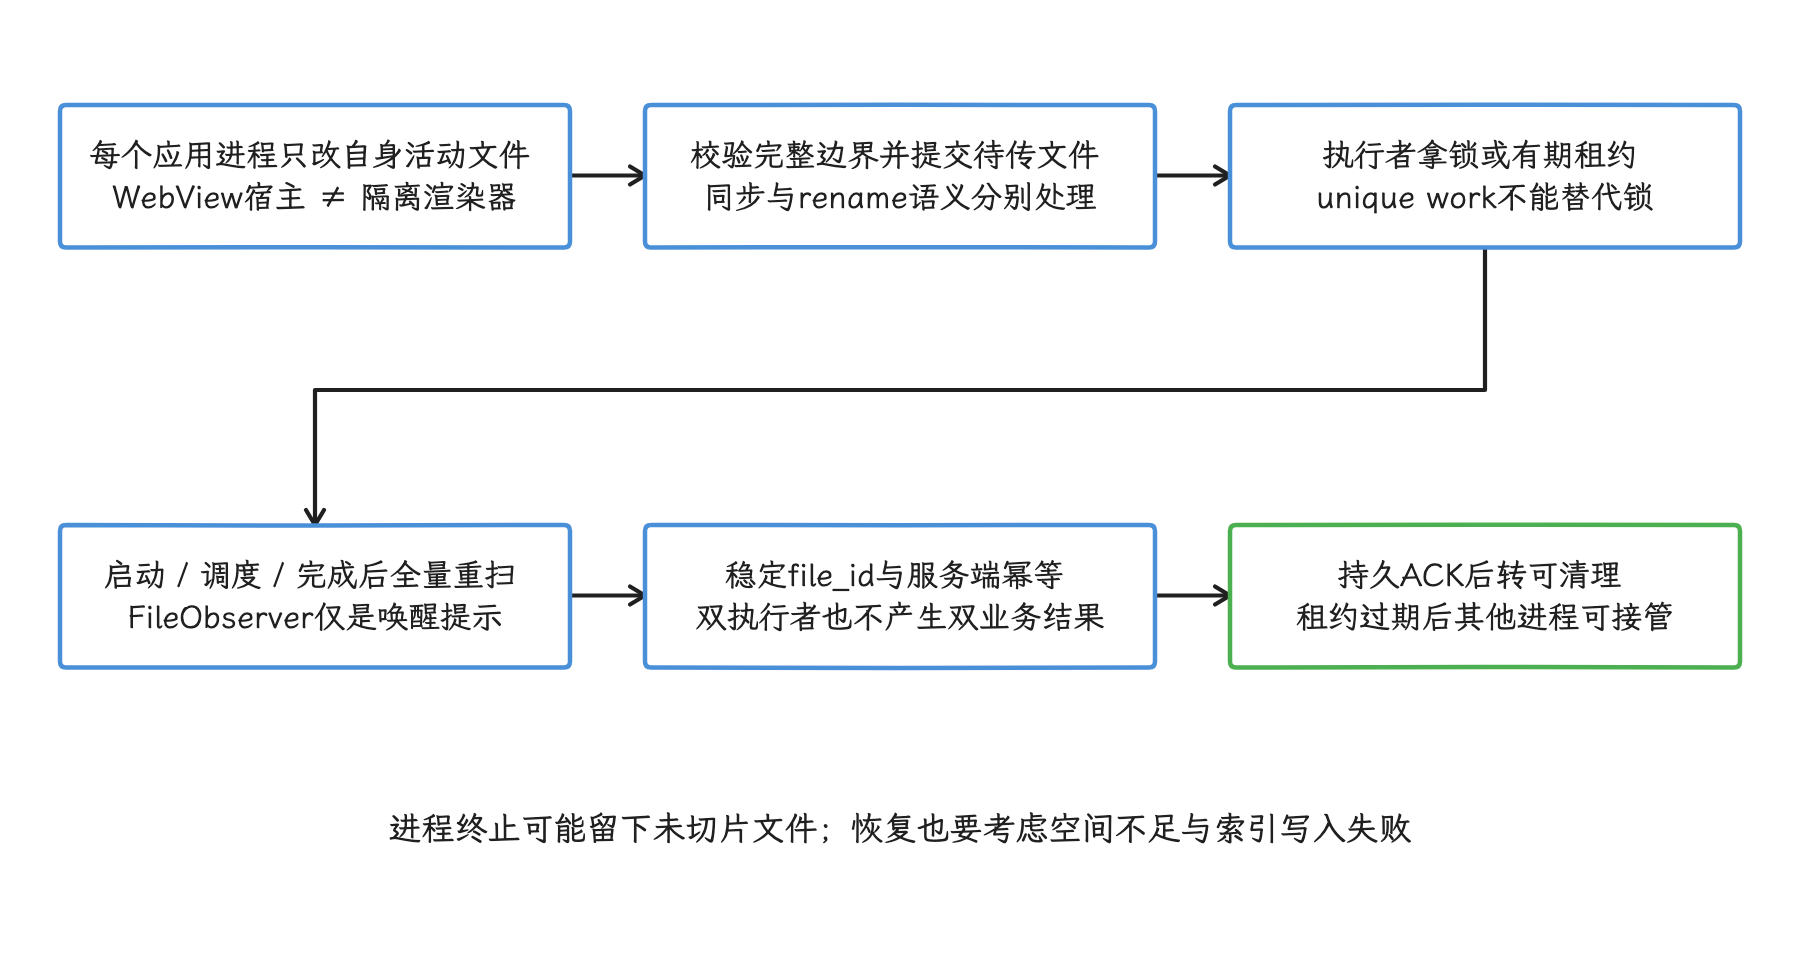
图:单执行者描述并发协议,不绑定主进程;监听事件丢失时靠索引重扫恢复。
诊断命令通道
诊断命令让端侧在限定范围内执行一次预定义动作。它属于远程控制面——服务端下发并约束管理动作的协议,安全级别应高于普通远程配置。
命令信封是包在命令正文外的元数据与安全字段,至少包含:
command_id、命令类型、参数 schema 版本和策略版本;- 目标包名、签名或渠道、App 版本、API level、设备或匿名主体范围;
- 签发时间、过期时间、nonce(每条命令唯一的随机值)或单调序列、最大执行次数;
- 允许的网络、文件与时长预算,结果字段 allowlist;
- 审批 ID、签名算法、签名密钥 ID,以及用于密钥轮换的版本信息。
端侧先验证签名、受众、版本、期限、nonce 和本地政策,再写入持久执行记录。设备 wall clock 不可信时,服务端时间锚点、短有效期与本地单调时间可共同缩小重放窗口;有效期确认不了时,采用拒绝或最低权限策略。command_id 和 nonce 存入有限期防重放表,服务端也要用同一命令 ID 幂等接收结果。
| 命令类型 | 端侧动作 | 返回证据 | 风险控制 |
|---|---|---|---|
| 拉取日志 | 选择限定会话或时间窗的既有文件 | 文件索引、日志包、脱敏统计 | 字节上限、字段策略、授权与保留期 |
| 网络诊断 | 执行固定 DNS、连接、TLS、HTTP 探测 | 阶段耗时、错误码、请求标识 | 固定端点、固定 payload(请求内容)、频率与流量限制 |
| 文件状态检查 | 读取白名单目录中指定类型的元数据 | 大小、mtime(最近修改时间)、摘要、schema 版本 | 规范化路径、防目录穿越(利用 ../ 等越过白名单目录)、禁止任意内容读取 |
| 配置快照 | 输出允许回传的配置元数据 | 配置版本、规则 ID、分桶结果 | 敏感值不回传,保留命中依据 |
| 一次性 profile | 请求 ProfilingManager 或写入 App Trace 标记 | 系统结果、文件接收与上传状态 | 平台检查、系统配额、短时采集、敏感级别审批 |
服务端和端侧应分别记录 issued、delivered、validated、started、result_created、uploaded、expired、blocked_by_policy 与失败阶段。命令没送达端侧,不计入执行失败;结果文件已生成但未上传,也不计入 profiling 失败。
线上协议只暴露经过代码评审的命令类型。任意 Java、Lua、shell、反射、文件读取或网络请求能力会把诊断服务变成远程代码执行入口,因此被排除在普通用户路径之外。熔断开关用于紧急停用某类命令,应能按命令类型、版本、区域和签名密钥缩小范围,并在客户端离线时依靠命令过期自行生效。
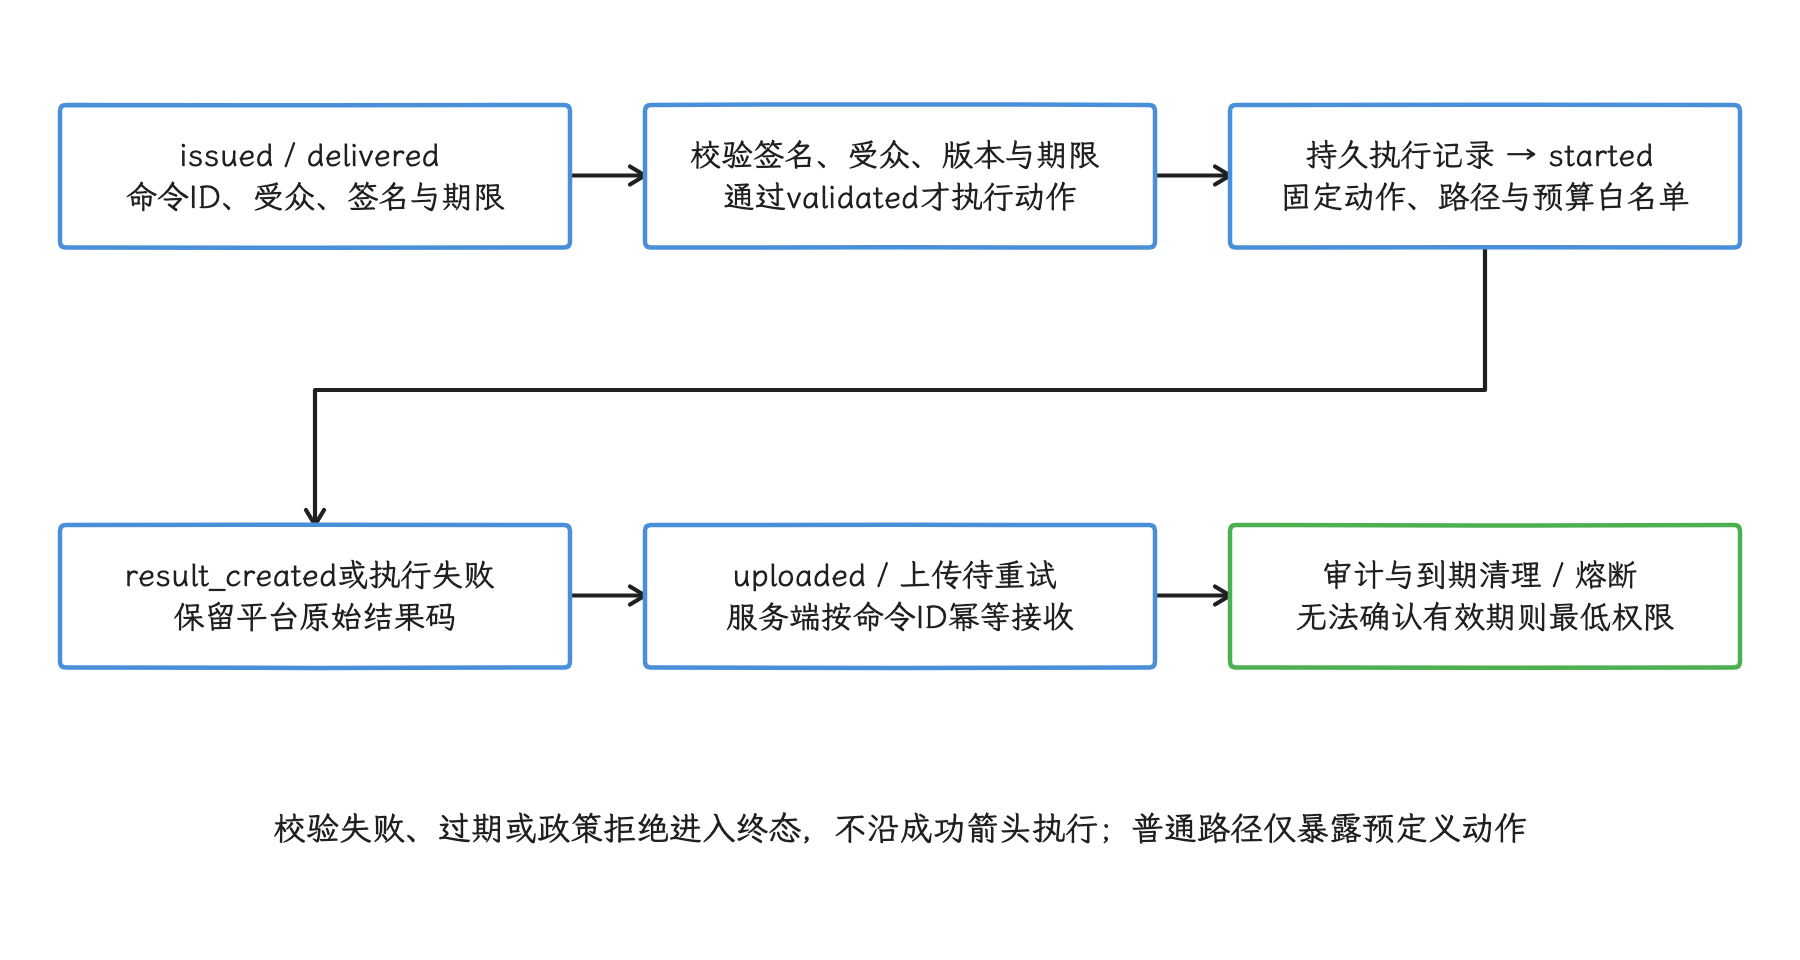
图:未送达不是执行失败,文件未上传不是profiling失败;防重放表和结果状态都需要持久化。
与 ProfilingManager / Perfetto 的边界
Android 15 / API 35 引入 ProfilingManager,Android 17 的实现见 ProfilingManager 源码。
requestProfiling() 的公开类型覆盖 system trace、Java heap dump(Java 堆对象快照)、heap profile(按采样统计内存分配)和 stack sampling(周期性采集调用栈)。它是受系统配额与脱敏规则控制的一次性 profiling 入口,不提供持续业务日志。
官方当前建议多数场景优先使用 AndroidX 高层封装来构造请求,以减少参数组合错误。无论使用哪层封装,系统配额与 ProfilingResult 的结果语义都不变。
版本差异还要细分:API 36 加入系统触发器注册;Android 16次要版本36.1加入requestRunningSystemTrace()和addAllProfilingTriggers()。App 必须先通过 addProfilingTriggers() 或 addAllProfilingTriggers() 注册 TRIGGER_TYPE_APP_REQUEST_RUNNING_TRACE,该方法才会请求系统当前后台 trace 的快照。
调用方能否拿到结果,取决于系统当时是否在运行后台 trace、配额是否充足、请求是否被执行;结果只通过全局监听器投递。这项 API 给不了普通 App 任意启动全设备追踪的能力。
官方采集指南给出的几个边界需要进入命令协议:
- 请求会被系统限流,也可能因为另一项 profiling 正在执行、磁盘空间不足、请求无效或执行失败而没有文件;提交了请求,系统也未必生成结果。
- 请求需要成对提供
Executor(决定回调在哪个执行线程运行)与结果监听器,或者提前注册全局结果监听器。没有可投递的监听器时,请求没有可靠的结果出口。 - 未提供
CancellationSignal(取消信号)且未设置时长时,系统使用默认时长;两者都存在时,先到达的结束条件生效。 - 公开 API 只暴露 Perfetto 配置的一部分。需要任意 Perfetto 配置、设备范围系统追踪或调试构建能力时,应使用受控测试设备上的 Perfetto 工具路径。
ProfilingResult在 Android 17 定义以下结果码:
| 结果码 | 含义 |
|---|---|
ERROR_NONE | 系统生成了可用结果 |
ERROR_FAILED_RATE_LIMIT_SYSTEM | 系统级配额限制 |
ERROR_FAILED_RATE_LIMIT_PROCESS | 请求进程配额限制 |
ERROR_FAILED_PROFILING_IN_PROGRESS | 已有 profiling 正在进行 |
ERROR_FAILED_EXECUTING | 采集执行失败 |
ERROR_FAILED_POST_PROCESSING | 结果后处理失败 |
ERROR_FAILED_NO_DISK_SPACE | 可用磁盘空间不足 |
ERROR_FAILED_INVALID_REQUEST | 请求参数无效 |
ERROR_UNKNOWN | 未归入上述类型的失败 |
只有 error_code == ERROR_NONE 时才使用 getResultFilePath();错误结果的路径可为空。文件位于请求 App 的数据目录,App 负责读取、上传、保留和删除,路径必须来自回调,别按固定目录拼接。
系统 trace 会按平台规则脱敏,其他进程的 CPU 活动只合并显示在 OtherProcesses 中,以隐藏进程身份和具体行为;脱敏之后的文件仍要按敏感材料保管。Java heap dump 仍可能包含对象内容、token 和用户数据,应采用最高敏感级别。
结果获取说明还规定了进程死亡后的行为:若 App 在结果投递前退出,系统会在 App 下次启动并注册全局监听器后尝试投递。端侧必须尽早注册该监听器,同时接受结果因配额、进程生命周期或文件问题而缺失的可能性。
需要历史system trace的触发类型,依赖系统当时有抽样后台trace及可用配额;不能将这个前提推广到所有触发器。例如API37的TRIGGER_TYPE_OOM请求Java heap dump。按各触发器契约解释产物;结果依赖全局监听器,并区分“触发已登记”“系统产生结果”“结果已上传”。进程不在时的重投递也只是平台尝试。
命令回执保存请求参数、平台版本、结果码、错误消息、结果文件 ID 和上传状态。rate_limited 这类根据结果码归纳出的字段替代不了原始 error_code;请求时长或缓冲设置也应标为 requested_*,表示这是请求值,除非系统 API 明确返回实际采用值。
Perfetto 解释线程、调度、Binder、锁、I/O、渲染与 CPU 时间,App 日志解释业务状态、配置和用户操作。两类文件通过 command_id、trace_session_id、请求 ID 和单调时间窗关联,且各自保持独立的权限与保留期。
网络诊断命令与 traceId 协同
网络诊断要把 DNS、连接、TLS、HTTP、CDN(内容分发网络)、网关和业务服务的证据按一次尝试关联起来。trace_id 可表示分布式调用,客户端还应区分逻辑请求 request_id 与每次重试 attempt_id,否则多个地址、协议或连接复用会被误合并。
24.5、26.10 说明网络质量与请求归因;这里规定诊断命令如何安全触发和回传。命令可执行以下受限动作:
- 对业务控制的诊断域名解析,回传解析耗时、IP 版本、A /AAAA(IPv6 地址) 记录数量和分类错误码。DNS 服务器地址与原始结果列表通常没有必要上传。
- 向固定探测端点建立 TCP / TLS 连接,回传阶段耗时、协议和错误类别,不上传证书正文、请求 header 或 body。
- 向专用 GET 或 HEAD 端点发送固定请求。HEAD 可能未被服务端支持,也可能具有不同缓存行为,因此协议要约定允许的方法与预期响应。
- 读取最近一次业务请求的脱敏摘要,回传 URL 模板 ID、请求 ID、attempt ID、状态与重试原因。
- 记录当时的网络能力快照及回调时间。网络状态会变化,快照说明不了整个请求期间始终使用同一网络。
主机名(host)、CDN 节点、代理、VPN、DNS 与 IP 可能暴露用户位置或网络环境。服务端优先接收内部端点 ID、分类结果和阶段耗时;确需原值时采用更高审批等级、短保留期和严格访问控制。
动态部署与远程调试的风险边界
诊断命令不得分发可执行代码。Android 的动态代码加载安全指南指出,从远程来源加载代码会增加代码注入与篡改风险,许多远程动态加载形式还可能违反 Google Play 政策。补日志可以通过预埋观察点、结构化配置和签名命令调整采集级别,无需下载新的 Java、DEX、native 或脚本代码。
如果产品另有经过授权的更新或补丁系统,它应作为独立安全系统设计:代码签名、版本约束、回滚保护、兼容性测试、发布审批和分发政策都不得借用诊断命令的较低权限。App 商店与设备管理政策也需要单独核对。
JDWP(Java Debug Wire Protocol,用于调试器与虚拟机通信)、远程调试和高权限脚本只适合明确登记的测试设备、企业受管设备或用户主动参与的专项会话。生产账号和普通用户设备上的诊断命令保持预定义、无任意文件访问、无任意网络目标、无反射调用、无长期驻留。
数据自监控与质量指标
日志通道失效时,服务端天然看不到端侧未送达的数据。我们看任何"到达率",都要先问分母来源、覆盖率和未知量;拿服务端已收到的记录反推全部端侧生成量,是推不出来的。
| 指标 | 定义与边界 | 诊断价值 |
|---|---|---|
| 写入结果 | 成功、缓冲丢弃、编码失败、磁盘满等本地计数 | 定位采集与持久化问题 |
| 可对账到达率 | 服务端收到数 / 以后成功送达的端侧持久计数 | 估算传输损失;尚未回传的计数保持未知 |
| 上传延迟 | 文件完成时间到服务端确认时间的分布 | 区分调度等待、网络传输和服务端处理 |
| 本地积压 | 分优先级的文件数、字节数与最老年龄 | 发现调度、网络、拒收或清理异常 |
| 丢弃原因 | 缓冲溢出、空间预算、TTL(存活期限,过期后清理)、隐私拦截、格式拒收等 | 判断缺失发生的阶段 |
| 命令阶段转化 | delivered → validated → started → result_created → uploaded | 区分送达、安全策略、执行和上传失败 |
| 隐私阻断 | 按政策版本和字段类型统计,避免记录敏感值 | 发现规则误配或业务越界 |
| 用户成本 | 分计量网络与非计量网络的上传字节、CPU 和电量样本 | 约束诊断对用户体验的影响 |
本地生成计数应足够小且独立持久化,并在主通道恢复后延迟对账。低频健康探针(health ping)是只报告通道是否还能工作的轻量请求,可以使用更小的 payload、独立优先级或独立端点。它仍可能遭遇同一网络、DNS、进程和证书故障,因此只提供额外观察面。看板要标注存活偏差:能上报健康信息的设备通常也是通道状况较好的设备。
隐私、合规与灰度开关
日志 SDK 要在数据进入文件前完成约束。服务端脱敏只能补救已上传的数据,本地文件、系统备份、崩溃材料或传输过程中的暴露仍然存在。
- 结构化 allowlist:字段包含类型、最大长度、采集目的、敏感级别和保留期。自由文本只允许用于经审查的低风险内容;异常
message、URL 和序列化对象也按不可信输入处理。 - 分级审批:普通状态日志、system trace、stack sample、网络诊断与 heap dump 采用不同审批级别。heap dump 可包含完整对象,应限制到明确授权的受控场景。
- 本地与服务端期限:命令、采集开关、文件、索引和备份分别设置 TTL,并验证删除任务。用户撤回授权或政策变更时,要有停止采集与处理遗留文件的规则。
- 加密按威胁模型设计:传输使用现代 TLS;落盘加密需定义要防护的攻击者、密钥来源、锁屏状态和轮换策略。字段最小化与访问控制不可省略,加密替代不了它们。
- 地区与主体政策:地区、渠道、企业设备、未成年人账号和用户授权状态可能对应不同规则。端侧在执行命令前再次判断,拒绝时只回传必要的政策错误码。
- 审计最小化:审计记录包含操作者、审批 ID、目标范围、命令摘要和证据文件 ID,不复制原始敏感内容。
Android 的日志安全建议明确要求避免记录凭据和 PII(可识别个人身份的信息)。App 私有存储与受限服务端权限只能减少暴露面,仍需配合数据最小化、保留期、访问审计和删除验证。
Xlog、Logan、Holmes 类方案的结构对比
这里把 Xlog、Logan、Holmes 作为三类架构原型,不据此断言某个当前版本的具体实现、安全算法或维护状态。选型时仍要检查正在采用的版本、许可证、ABI(应用二进制接口,决定 native 库面向的 CPU 架构) 兼容性(native 库面向的 CPU 架构)、加密协议、崩溃恢复和服务端组件。
| 方案类型 | 主要价值 | 工程成本 | 适用条件 |
|---|---|---|---|
| 高性能本地日志 | 高频路径保留可恢复的时间线 | native / mmap、文件协议、加密和恢复较复杂 | Java/Kotlin 写入已被测量为显著成本 |
| 统一日志平台 | 按匿名主体、会话和请求组织多种证据 | 索引、权限、检索、删除与成本治理较重 | 多业务线、多日志源且排障入口分散 |
| 动态日志插桩(在预定位置插入采集逻辑) | 在已有可审查观察点上临时增加细节 | 插桩兼容性、包体、性能和误触风险较高 | 受控版本、受控对象、短期专项排查 |
较稳妥的演进顺序是:统一结构化写入 API 与隐私规则,增加私有目录持久化和幂等上传,再建设受签名保护的诊断命令。只有压测和线上指标证明现有写入路径不足时,才增加 mmap、native 库或插桩系统的复杂度。
实施清单
一套可上线的最小版本可按以下顺序推进:
- 定义威胁模型、数据分类、丢失预算、上传时限、空间预算和删除期限。
- 统一结构化日志 API:字段 allowlist、长度限制、敏感级别、会话 ID、请求 ID、进程与线程信息。
- 建立每进程文件协议:记录长度、序号、schema、校验、切片状态和损坏恢复。
- 建立持久上传任务:网络约束、退避、跨进程租约、服务端幂等、确认后删除。
- 上线签名命令协议:期限、nonce、受众绑定、最大执行次数、审批与分阶段回执。
- 接入 API 35+ profiling:全局监听器、完整错误码、结果路径校验、敏感级别和文件清理。
- 建立自监控:本地持久计数、阶段转化、积压年龄、未知量、用户资源成本和隐私阻断。
- 做故障注入,即主动制造可控失败:让进程在每个状态转换点退出,并覆盖磁盘满、文件尾损坏、锁过期、重复上传、断网、超时、服务端拒收、命令过期、签名篡改和重放。
- 做隐私验证:字段模糊测试(用随机、超长和异常格式输入验证约束)、路径穿越测试、日志与 heap dump 人工抽检、权限审计、TTL 与删除结果核验。
完成这些基础项后,团队获得的是一条可度量、可恢复、可审计的证据通道。它减少线上问题对偶然复现的依赖,同时把系统配额、进程生命周期、网络失败和隐私风险保留为明确边界。
渠道差异、ROM 能力与替代方案
标准通道不可用时,我们要按应用商店、系统权限、后台限制和厂商服务逐项降级,替代方案仍要保持相同事件口径。
非 Play 分发的观测缺口
Android Vitals 的数据来自选择共享使用情况与诊断信息的部分用户和设备。官方说明明确排除未通过 Google Play 安装的应用版本,以及未通过认证的设备型号。
APK 是 Android 应用安装包。同一个 APK 即使同时发布到 Play 与其他市场,非 Play 安装产生的问题也不会自动进入同一份 Vitals 数据。
这里的 ROM 指设备厂商基于 Android 定制的系统构建,沿用的是行业叫法,与"只读存储器"的硬件含义不同;渠道则指应用的分发来源或构建变体,例如 Google Play、厂商市场或企业分发;渠道字段适合分组,单独使用时说明不了性能原因。
国内 ROM 仍可能提供诊断能力,应用市场也可能有自己的质量报表,但二者的覆盖条件与 Vitals 各有前提,直接视为等价物行不通。可靠的做法是把平台公共 API、应用自身事件与服务端统计组成可审计的数据路径,再把厂商和渠道作为分析维度。
APM 是 Application Performance Monitoring 的缩写,指持续采集应用性能与稳定性信号的一类系统;厂商控制台、应用市场报表和第三方 APM 都可以补充自建数据,而确认具体版本、场景和采集质量,靠的还是应用侧自己的记录。
端云数据路径
数据路径上,非 Play 场景仍要把指标、崩溃事件和 trace 分开处理:指标是可聚合的数值,崩溃事件描述一次离散故障,trace 保存一段时间内的细粒度事件与时间戳。三者体积、采样方式、隐私风险和服务端查询方式各不相同,塞进同一种日志,容量与上传限额很容易失控。
三类采集各有schema与预算,先经过有界持久队列,再机会式批量上传;服务端按类型分库,并关联准确构建与符号文件。
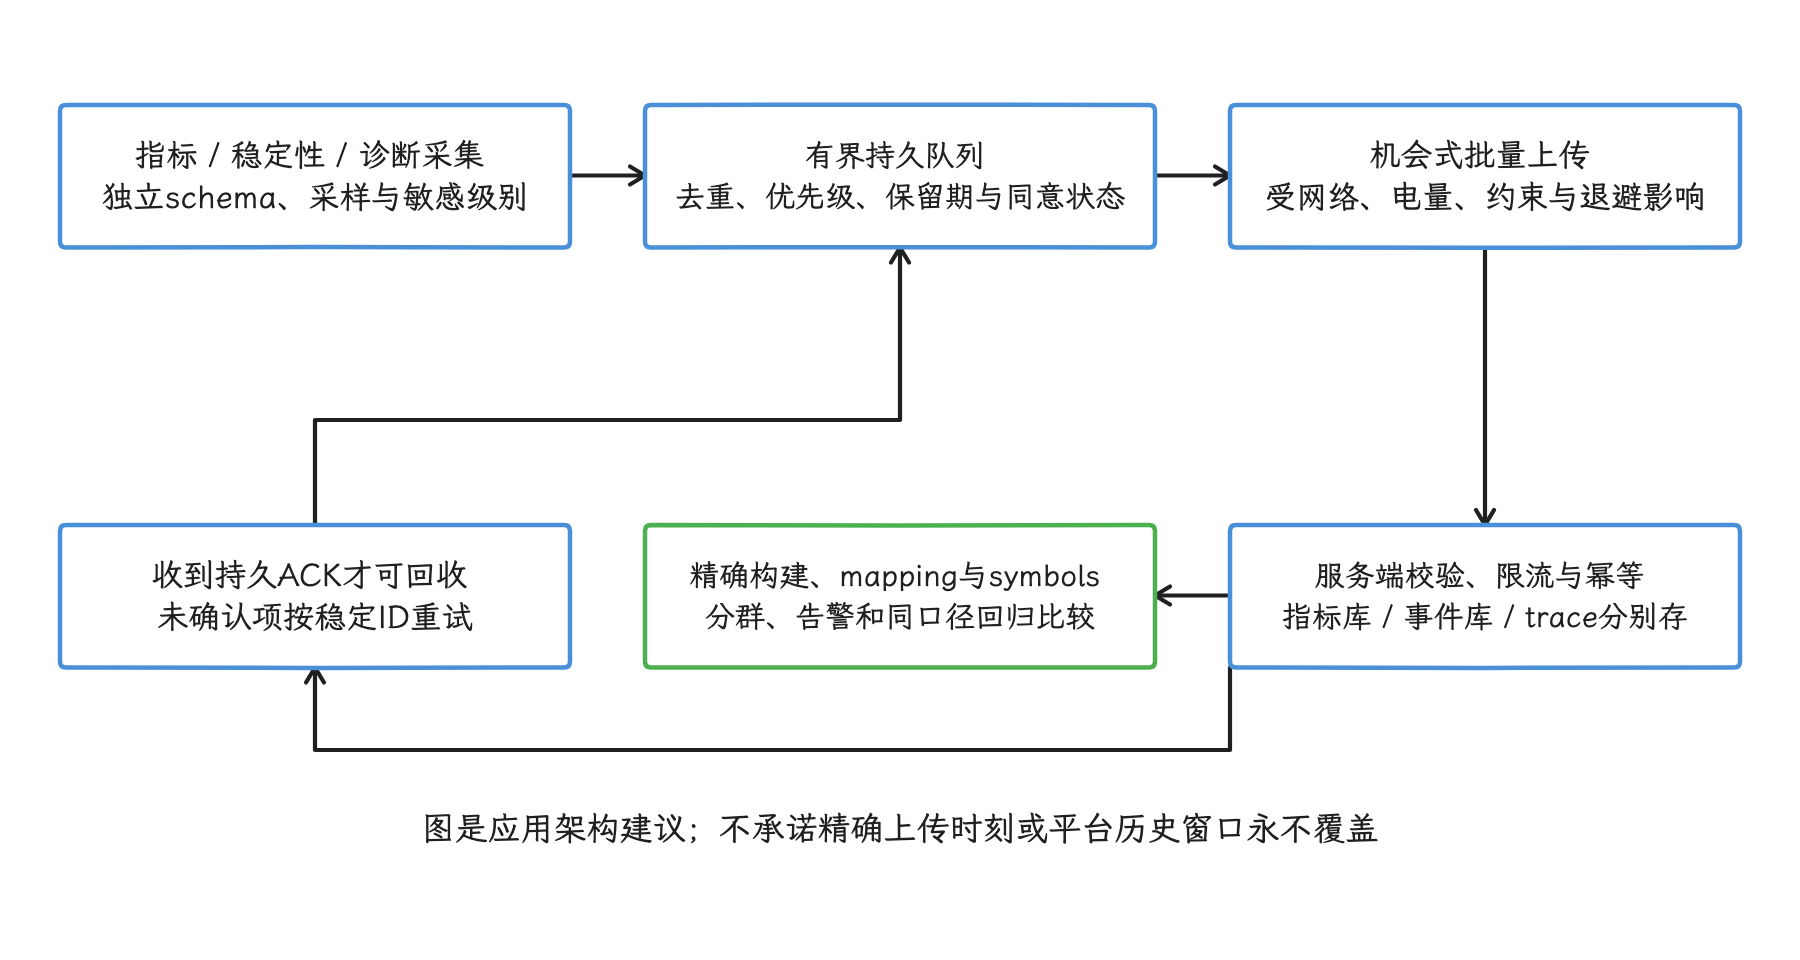
图:没有收到事件与指标值为零分开;进程可能在回传前退出,本地状态需跨进程恢复。
"机会式"表示满足网络、电量和调度条件时才尝试上传,不承诺精确执行时刻。进程也可能在上传前结束,因此本地队列要限制容量与保存期限,写入要能抵抗进程中断;收到服务端确认后再删除对应批次。
服务端要区分"没有收到事件"和"指标值为零"。前者可能表示进程、调度、网络或队列出了问题;若把两种情况合并,后台限制较强的设备会从统计中消失。
每条事件至少需要以下几组字段:
| 字段组 | 建议内容 | 用途与边界 |
|---|---|---|
| 事件身份 | schema 版本、事件 ID、会话 ID、事件类型 | 会话 ID 不应包含账号或设备标识 |
| 时间 | wall clock、elapsed realtime、进程启动时刻 | wall clock 便于服务端对齐;单调时钟用于进程内耗时 |
| 应用构建 | versionCode、versionName、构建 ID、签名证书摘要、base/split 摘要 | 摘要用于确认是否为同一产物,不上传证书原文 |
| 分发 | 应用内声明的渠道、installing package、initiating package | 安装来源可能为空或发生变化,不能代替构建渠道 |
| 平台 | API、release、安全补丁、构建增量、fingerprint 的受控表示 | fingerprint 基数很高,应按隐私策略归一化或哈希 |
| 硬件群组 | manufacturer、model、device、ABI、page size、低内存设备标记 | 用于群组统计,不应拼成持久用户身份 |
| 运行状态 | 前后台、进程 importance、省电、热状态、刷新率、后台限制、standby bucket | 状态必须和被测事件尽量同时记录 |
| 采集质量 | collector 版本、采样原因、丢弃计数、队列年龄、上传重试状态 | 用于判断缺数和采集器自身回归 |
时间字段的分工是:wall clock 是可能被用户或网络校时调整的日历时间,便于服务端按日期对齐;elapsed realtime 从设备启动起单调递增,适合计算同一设备、同一次开机区间内的耗时;跨重启须另存开机区间标识。跨设备比较前,仍要先转换到共同时间基准。
进程 importance 由 ActivityManager 分类,例如是否承载前台界面或用户可感知工作;它会随组件生命周期变化,所以记录时要保留原始常量和 API 版本。
构建 ID 与证书、APK 摘要用来回答“事件对应哪份产物”。摘要是原数据经过散列函数得到的固定长度值,可用于一致性比较,但散列本身不会自动消除隐私风险。
fingerprint 是系统构建指纹,通常包含产品、版本和构建标识,属于高基数字段——可能出现大量不同取值。原样 fingerprint 或仅做散列都可能形成很小的设备群组,所以服务端要归一化字段并设置最小样本门槛。
collector 是执行采集的客户端模块;把它的版本、丢弃计数和队列年龄记下来,我们才能区分业务指标的变化与采集器自身的回归。
ANR是Application Not Responding(应用无响应),表示主线程等关键响应路径在系统规定时间内没有完成。Native 崩溃指 C/C++ 等本地代码触发的进程故障。
PackageManager.getInstallSourceInfo() 从 API 30 开始提供安装来源信息。逐字段语义见 InstallSourceInfo。
installingPackageName 是当前登记的安装器名称,可以被更改;initiatingPackageName 指请求安装或更新的包,来源不可用或该包已经卸载时可能为空。originatingPackageName 由发起安装的一方提供且未经框架验证,调用方缺少 INSTALL_PACKAGES 权限时拿不到。
应用还应保留编译或分包阶段写入的明确渠道字段。平台字段与自有渠道不一致时记录差异,并把结果标为待解释,避免擅自选一个字段回答"用户来自哪个市场"。
采集公共能力快照
Kotlin 示例用于在 Android 12 至 Android 17 上读取当前应用可见的公共信号。它不读取设备标识,也不调用隐藏 API。
import android.app.ActivityManager
import android.app.usage.UsageStatsManager
import android.content.Context
import android.os.Build
import android.os.PowerManager
import android.os.SystemClock
import android.system.Os
import android.system.OsConstants

data class Readout<T>(val value: T?, val error: String? = null)

fun <T> observe(read: () -> T): Readout<T> = try {
    Readout(read())
} catch (e: Exception) {
    Readout(null, e.javaClass.simpleName)
}

fun <T, R> Readout<T>.mapRead(read: (T) -> R): Readout<R> =
    if (error != null) Readout(null, error)
    else observe { read(requireNotNull(value)) }

data class RuntimeCapabilitySnapshot(
    val readStartedElapsedMillis: Long,
    val readFinishedElapsedMillis: Long,
    val sdkInt: Int,
    val release: String,
    val securityPatch: String,
    val manufacturer: String,
    val model: String,
    val supportedAbis: List<String>,
    val pageSizeBytes: Readout<Long>,
    val lowRamDevice: Readout<Boolean>,
    val backgroundRestricted: Readout<Boolean>,
    val standbyBucket: Readout<Int>,
    val powerSaveMode: Readout<Boolean>,
    val thermalStatus: Readout<Int>,
    val ignoringBatteryOptimizations: Readout<Boolean>,
    val installingPackage: Readout<String?>,
    val initiatingPackage: Readout<String?>
)

fun readRuntimeCapabilitySnapshot(context: Context): RuntimeCapabilitySnapshot {
    val started = SystemClock.elapsedRealtime()
    val am = observe { requireNotNull(context.getSystemService(ActivityManager::class.java)) }
    val usage = observe { requireNotNull(context.getSystemService(UsageStatsManager::class.java)) }
    val power = observe { requireNotNull(context.getSystemService(PowerManager::class.java)) }
    val source = observe {
        context.packageManager.getInstallSourceInfo(context.packageName)
    }
    val pageSize = observe {
        Os.sysconf(OsConstants._SC_PAGESIZE).also { check(it > 0) }
    }
    val lowRam = am.mapRead { it.isLowRamDevice }
    val restricted = am.mapRead { it.isBackgroundRestricted }
    val bucket = usage.mapRead { it.appStandbyBucket }
    val powerSave = power.mapRead { it.isPowerSaveMode }
    val thermal = power.mapRead { it.currentThermalStatus }
    val exempt = power.mapRead { it.isIgnoringBatteryOptimizations(context.packageName) }
    val installing = source.mapRead { it.installingPackageName }
    val initiating = source.mapRead { it.initiatingPackageName }
    return RuntimeCapabilitySnapshot(
        readStartedElapsedMillis = started,
        readFinishedElapsedMillis = SystemClock.elapsedRealtime(),
        sdkInt = Build.VERSION.SDK_INT,
        release = Build.VERSION.RELEASE,
        securityPatch = Build.VERSION.SECURITY_PATCH,
        manufacturer = Build.MANUFACTURER,
        model = Build.MODEL,
        supportedAbis = Build.SUPPORTED_ABIS.toList(),
        pageSizeBytes = pageSize,
        lowRamDevice = lowRam,
        backgroundRestricted = restricted,
        standbyBucket = bucket,
        powerSaveMode = powerSave,
        thermalStatus = thermal,
        ignoringBatteryOptimizations = exempt,
        installingPackage = installing,
        initiatingPackage = initiating
    )
}
示例保留同次开机内的读取开始/结束时间,表示一个观测窗口,不声称多个服务状态原子一致。每个Readout的error != null表示读取失败;error == null && value == null可表示安装来源正常不可得。异常只记类别,不直接上传异常消息;不要捕获并吞掉Error。省电、热状态、standby bucket和后台限制会变化,首次启动快照解释不了几天后的任务延迟。
standby bucket(应用待机分组)是系统按近期使用情况给应用划分的活跃程度类别,并据此调整后台资源;热状态则是 PowerManager 报告的设备热压力等级。存储这些整数值时还要记录 API 与采集器版本,服务端按对应版本的常量解释;读取失败或值不可用时写"未知",别用零代替。
示例只查询当前包,因此 getAppStandbyBucket() 不需要 PACKAGE_USAGE_STATS。服务端还需归并 Build.MANUFACTURER 与 Build.MODEL 的别名,并按隐私策略限制原始值的保存期限和访问范围。
ActivityManager.isBackgroundRestricted() 的文档给出了明确语义。返回 true 时,系统至少会阻止作业和闹钟执行,并在应用不处于前台时阻止其启动前台服务;这项用户施加的限制在充电时仍然有效。该值只能证明系统报告了限制状态,具体设置页面、策略模块或厂商组件,要另外排查。
UsageStatsManager.getAppStandbyBucket() 查询的是调用应用当前所在的待机分组。系统可随时调整分组,越受限的分组通常获得越少后台运行机会。它适合解释采集时刻附近的任务等待,别当作稳定的用户属性。
isIgnoringBatteryOptimizations() 只说明应用当前是否在电池优化豁免名单中。普通应用要改善统计完整度,也别去诱导用户豁免;豁免之后,也换不来后台常驻承诺。
进程退出:用 ApplicationExitInfo 记录事实
Android 11 / API 30 引入 ApplicationExitInfo。
ApplicationExitInfo.java 定义了退出原因、状态码、进程重要性、时间戳、PSS、RSS、描述和可选 trace 流。
getHistoricalProcessExitReasons() 返回的是系统仍保留的近期记录,更近的退出可能把它覆盖掉。应用要在下次获得运行机会时尽早读取、限量写入本地队列并上传;可选 trace 也可能为空。
示例重扫系统仍保留的受限历史窗口,先过滤已经落盘或ACK的记录,再按调用方的批量上限选取最旧未处理项。它复用上文Readout和observe,应在受控后台执行器上调用。
import android.app.ActivityManager
import android.app.ApplicationExitInfo
import android.content.Context
import java.io.ByteArrayOutputStream
import java.io.DataOutputStream
import java.security.MessageDigest

data class ExitRecord(
    val key: String,
    val timestampMillis: Long,
    val pid: Int,
    val realUid: Int,
    val packageUid: Int,
    val processName: String?,
    val reason: Int,
    val status: Int,
    val importance: Int,
    val pssKilobytes: Long,
    val rssKilobytes: Long,
    val description: String?
)

fun exitRecordKey(info: ApplicationExitInfo): String {
    val bytes = ByteArrayOutputStream()
    DataOutputStream(bytes).use { out ->
        out.writeInt(1) // 本地身份编码版本
        out.writeLong(info.timestamp)
        out.writeInt(info.pid)
        out.writeInt(info.realUid)
        out.writeInt(info.packageUid)
        out.writeInt(info.reason)
        out.writeInt(info.status)
        val name = info.processName?.toByteArray(Charsets.UTF_8)
        out.writeInt(name?.size ?: -1) // null 与空串不同
        if (name != null) out.write(name)
    }
    return MessageDigest.getInstance("SHA-256")
        .digest(bytes.toByteArray())
        .joinToString("") { "%02x".format(it.toInt() and 0xff) }
}

// 使用上文 Readout / observe;查询失败与成功但无记录分开表示。
fun readUnseenExitRecords(
    context: Context,
    batchLimit: Int,
    isPersistedOrAcked: (String) -> Boolean
): Readout<List<ExitRecord>> {
    require(batchLimit > 0)
    return observe {
        val am = requireNotNull(context.getSystemService(ActivityManager::class.java))
        // maxNum=0 返回系统当前仍保留的全部记录,并非无限历史。
        // 最旧记录先入队,避免最新的已处理记录反复占满查询上限。
        am.getHistoricalProcessExitReasons(context.packageName, 0, 0)
            .asReversed().asSequence()
            .map { info ->
                ExitRecord(
                    key = exitRecordKey(info),
                    timestampMillis = info.timestamp,
                    pid = info.pid,
                    realUid = info.realUid,
                    packageUid = info.packageUid,
                    processName = info.processName,
                    reason = info.reason,
                    status = info.status,
                    importance = info.importance,
                    pssKilobytes = info.pss,
                    rssKilobytes = info.rss,
                    description = info.description
                )
            }
            .distinctBy { it.key }
            .filterNot { isPersistedOrAcked(it.key) }
            .take(batchLimit).toList()
    }
}
示例没有读取 trace 内容,因为 trace 的体积、I/O、脱敏和保存策略应由独立采样流程控制。ANR 进程若恢复后因其他原因退出,记录里仍可能带有较早的 ANR trace。
从 API 31 开始,Native 崩溃还可能提供 protobuf 格式的 tombstone。tombstone 是系统保存的 Native 崩溃诊断记录,protobuf 是 Protocol Buffers 的二进制编码格式。消费方必须同时检查退出原因和 trace 类型,有 trace,并不说明本次退出由 ANR 引起。
示例对带版本的字段元组做长度前缀编码,再取SHA-256;它是本地尽力去重指纹,不是平台保证唯一的事件ID,也不会自动匿名化。isPersistedOrAcked查询已落盘待上传或已确认索引;调用方必须把记录与唯一键原子提交后才视为已持久化,并在ACK后变更状态。并发扫描以存储唯一约束兜底,保留重复/冲突计数。历史会淘汰,任何重扫策略都不能恢复已被平台覆盖的记录;不要只保存最大时间戳。
PSS 是 proportional set size(比例集大小),会把共享内存页按共享进程数折算后计入;RSS 是 resident set size(常驻集大小),统计当前驻留在物理内存中的页面,共享页会在每个进程的 RSS 中出现。pss 与 rss 的单位均为 kB,字段保存的是系统最近一次采样值,可能早于退出时刻;系统没有样本时还会返回零。两者适合辅助分组;要把一次退出归因到内存,还需要其他证据支持。
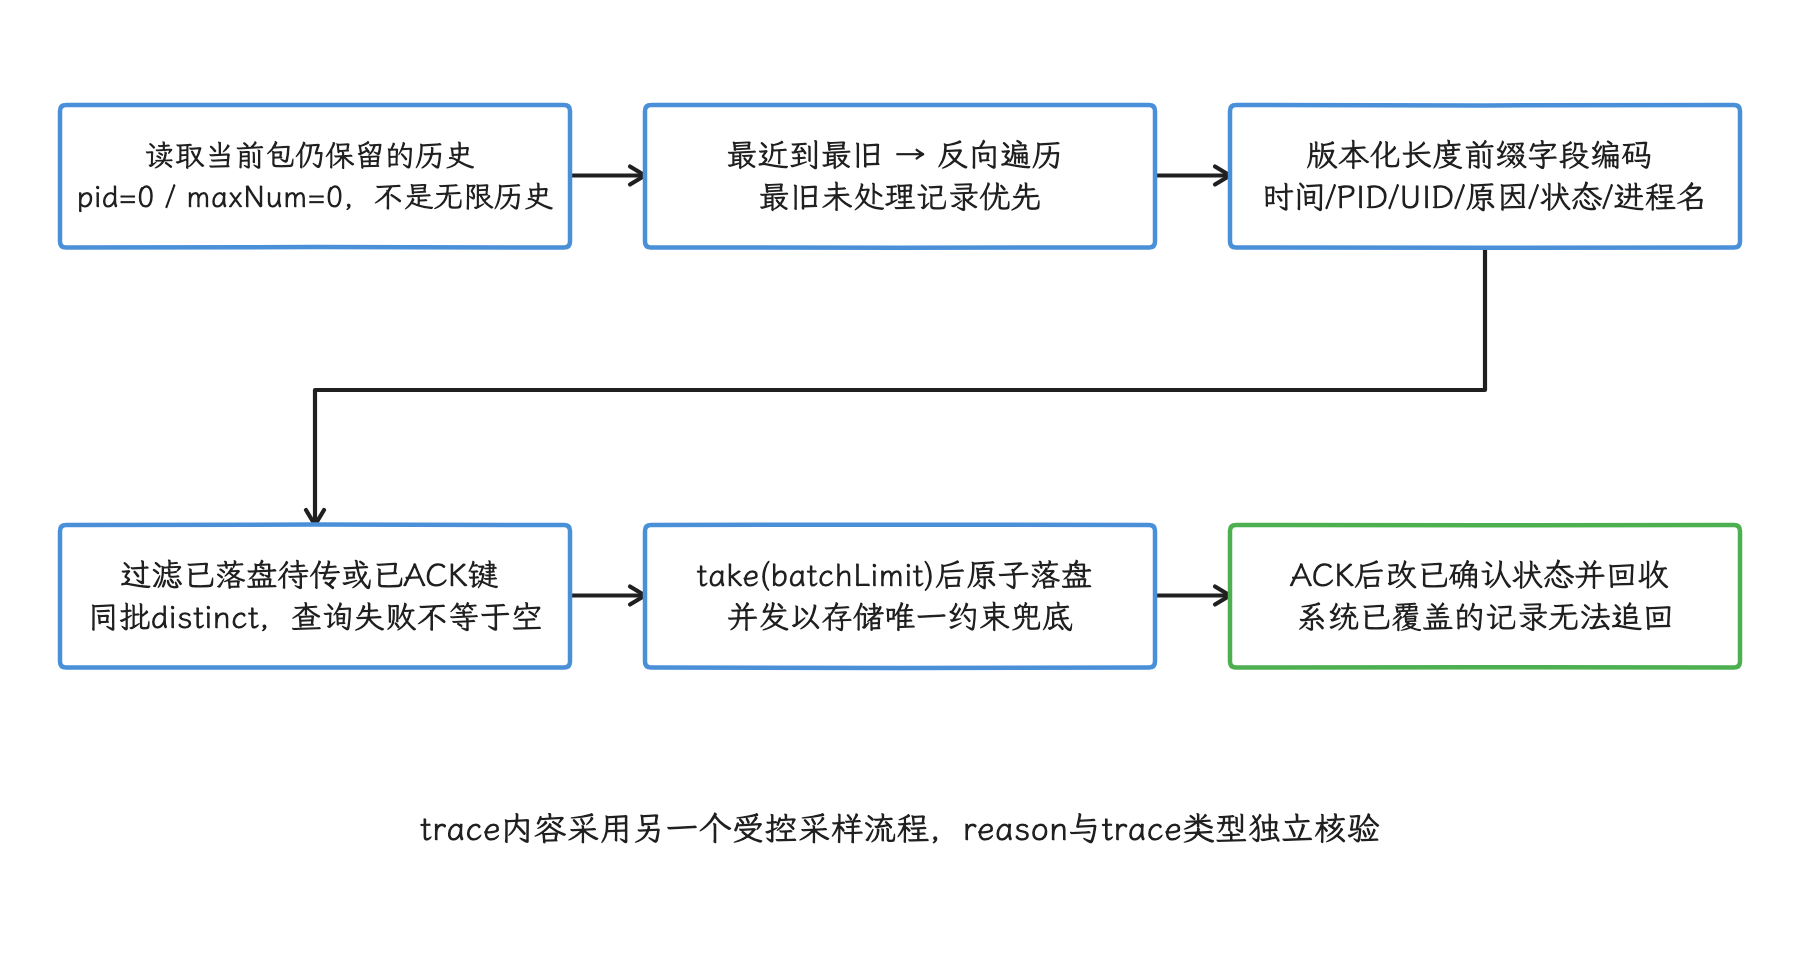
图:只查batchLimit条再过滤已处理项可能漏掉窗口中的旧项;去重指纹是尽力身份,不是平台事件ID。
解释退出原因时,有几处容易读错的地方:
REASON_CRASH、REASON_CRASH_NATIVE、REASON_ANR、REASON_USER_REQUESTED、REASON_PACKAGE_UPDATED等是平台给出的分类,可作为直接信号;REASON_USER_REQUESTED覆盖多种用户发起的停止动作,原因码本身区分不了"设置中的强行停止"和"从最近任务移除"等具体入口;- 部分设备不支持可靠报告
REASON_LOW_MEMORY。先查ActivityManager.isLowMemoryKillReportSupported();不支持时,低内存终止可能只表现为REASON_SIGNALED与SIGKILL; REASON_FREEZER表示系统 freezer 相关退出。freezer 是让目标进程暂停执行的一种系统机制,该原因码用于命名某个厂商的后台管理功能并不合适;REASON_UNKNOWN或一般的REASON_SIGNALED信息不足,不要自动标记为"被安全中心杀死";- subreason 是比公开 reason 更细的原因码,在平台源码中属于隐藏信息,普通应用别通过反射建立依赖。
可以用 ActivityManager.setProcessStateSummary() 写入少量、无敏感信息的当前业务阶段,帮助下一次启动解释退出发生前的应用状态。参数最多 128 字节;系统可能限制调用频率,调用过多还可能抛出 RuntimeException。这份数据适合版本化的稳定枚举;UI 恢复用不上,URL、搜索词、账号和自由文本也不要放进来。
缺失数据也要有语义
APM 事件中断只说明服务端没有继续收到数据。以下情况都可能产生相似表象:
- 进程正常或异常退出;
- 作业尚未获得运行机会,或者约束未满足;
- 网络不可用、服务器拒绝请求或本地队列已满;
- 用户关闭后台运行、撤回采集同意或清除应用数据;
- 用户对应用执行强行停止;在用户再次显式启动前,作业和闹钟不会恢复正常触发;
- 应用被卸载,此后不会再有"下次启动"上传退出记录。
因此,服务端应把会话结束、最近一次成功上传时刻、队列年龄和下一次启动时的退出补记放在一起看。若一直没有下次启动,系统没有提供一个让应用进程自行说明原因的机会。周期性心跳也同样受进程、调度和网络条件约束,改变不了这一点。
以下 A—D 分级是本文采用的工程约定,Android API 没有定义这套等级。时间相关或群组相关只表示两个现象一起变化;要说明因果关系,还需要控制其他条件、重复实验,并找到符合 API 契约的作用机制。
| 等级 | 含义 | 可写出的结论 |
|---|---|---|
| A:平台直接信号 | 公共 API、系统回调、退出记录或明确异常 | “系统报告后台受限”“退出原因为 ANR” |
| B:时间相关 | 状态变化与问题在同一时间窗出现 | “问题与进入省电状态同时出现” |
| C:群组相关 | 某机型、版本或渠道的比率显著不同 | “该群组异常率较高,待对照实验” |
| D:用户描述 | 截图、客服反馈或复现叙述 | “用户报告开启某设置后恢复” |
A 级证据可以按字段原义陈述平台报告的事实,扩写则以公共 API 提供的细节为限。B、C、D 级证据用于提出和筛选假设,改写成"该厂商会执行某策略"就越界了。
后台任务与前台服务怎么记录
JobScheduler 是 Android 平台的作业调度服务,WorkManager 是 Jetpack 提供的可延后后台工作调度库。enqueue(入队)指把任务及其约束交给调度器等待执行;worker 是 WorkManager 中实际运行任务逻辑的组件。两套接口都不承诺精确启动时刻。观察一项后台任务时,至少记录:
- enqueue、计划条件和唯一工作名称;
- 系统契约允许的最早运行条件,不写自行计算的"应当启动"时刻;
- worker 实际开始、结束、重试次数和输出状态;
- 当时的网络、充电、存储、standby bucket、后台限制与省电状态;
- WorkManager 或 JobScheduler 暴露的停止原因;
- 前台服务启动请求、异常类型、
onStartCommand()和onDestroy()时刻。
一个任务晚于业务期望启动,可能仍符合 API 契约。只有在同一应用构建、相同约束和受控设备设置下做对照实验,才能判断某个系统版本是否引入了额外差异。不要把固定延迟值写成某个 ROM 的默认规则。
Android 14 / API 34 起,JobScheduler 可以返回任务仍在等待的原因。Android 17 / API 37 的 getPendingJobReasonStats(jobId) 进一步按原因汇总等待时长。
多个约束可能同时成立,因此各项时长相加可以超过总等待时间。这些统计不会跨设备重启保存,任务成功完成或取消时会被清空。查询不对应待执行任务的 ID 会抛出 IllegalArgumentException。
FGS 是 foreground service(前台服务)的常用缩写,指执行用户可感知工作并按平台规则关联通知的服务。应用要按 Android 版本处理服务类型、启动窗口和权限。记录 ForegroundServiceStartNotAllowedException 等公共异常,适合发布版本的线上统计;厂商日志仅作为实验室取证,别当成应用依赖的稳定协议。
ADPF:能力协商与效果验证
ADPF 是 Android Dynamic Performance Framework,中文可理解为 Android 动态性能框架。它允许应用描述工作负载和性能目标,由系统结合热状态、功耗与硬件能力做调度决策。
PerformanceHintManager 是 ADPF 的公共入口。
hint session(性能提示会话)把一组应用线程、目标工作时长和后续实际工作时长关联起来。SoC 是 system-on-chip(片上系统),即集成 CPU、GPU 等部件的主芯片。
createHintSession() 在设备不支持 hint session 或线程不属于调用应用等情况下可以返回 null;空线程列表、非正目标时长等错误参数会抛出 IllegalArgumentException。应用应按服务和 session 的实际结果协商能力,别维护"某品牌或某 SoC 必然支持"的静态表。
一次可分析的 hint session 应记录:
- manager 是否可取得、session 是否创建成功和失败类型;
- 目标工作时长及每次上报的实际工作时长;前者表示应用希望在多久内完成,后者表示一次工作已经花费多久;
- 参与线程集合变更;
- session 对应的渲染或计算阶段;
- 同场景下的帧、CPU time、热状态、功耗代理指标和质量级别。
ADPF 是向系统表达负载意图的控制接口,API 返回值只说明能力与请求结果。体验是否改善,要用帧耗时、任务时长、热状态和功耗代理指标验证。若该能力不可用,应用应回到自身已有的质量分级、工作量控制和线程模型,继续记录结果;不要私自写 CPU 频率,也不要把提升线程优先级当成通用替代方案。
ProfilingManager 的请求与结果
ProfilingManager 从 Android 15 / API 35 开始提供面向应用的性能采样请求。profile 在这里指一份用于定位性能问题的采样产物,四种类型各自回答不同问题:
- system trace 记录进程、线程、调度、CPU 运行和系统或应用事件的时间关系,适合分析延迟与卡顿;
- Java heap dump 保存某一时刻 Java 堆中的对象及引用关系,适合查找重复对象和内存泄漏;
- heap profile 在发生内存分配时抽样并关联调用位置,适合观察分配热点和内存抖动;
- stack sampling 按固定频率抽取正在 CPU 上运行的调用栈,适合定位 CPU 热点和代码执行路径。
系统 trace、heap profile 与 stack sampling 是持续一段时间的采集,开始请求和实际开始采集之间可能有延迟;Java heap dump 更接近时点快照。请求会受频率限制,也不保证执行。调用 requestProfiling() 时必须成对提供 executor 与 listener,或者事先注册成对的全局 executor 与 listener;两处都没有有效组合时,请求会被丢弃且没有回调。
executor 决定在哪个执行环境处理回调,listener 接收 ProfilingResult。结果写入请求应用的数据目录,经过脱敏,只包含请求进程的特定信息,其他进程的任意内容读不到。
Android 16 / API 36 增加 ProfilingTrigger。Android 17 / API 37 又增加异常行为、应用兼容问题、冷启动、因 CPU 使用过多而终止及 OOM 等触发类型。OOM 是 Out of Memory,指内存不足异常。
具体常量按 ProfilingTrigger 和 Android 17 功能说明 适配,别从主线源码预览推定发布版本行为。
系统触发的结果只投递给 registerForAllProfilingResults() 注册的全局 listener。它按 UID 生效;UID 是系统为应用分配的 Linux 用户标识。系统触发同样可能受限而没有产物,进程在采集期间被杀后,系统也可能在应用重新注册全局 listener 时尝试再次投递。
遇到"请求没有结果",我们先把它记成未知状态,可能原因包括版本不支持、参数错误、缺少有效回调组合、频率限制、系统资源状态、进程生命周期或实现问题。处理办法是记录请求类型、请求时刻、回调结果和超时状态,再在目标设备上复现。
API 35 以下没有 ProfilingManager,可使用适合该版本的公共指标、Android Studio、Perfetto 或 Simpleperf 完成实验室诊断。Perfetto 用于记录和查询系统 trace,Simpleperf 用于采样 CPU 性能数据。
读取受保护的 ftrace 内核跟踪节点,或通过 hook 拦截平台私有实现,都不适合作为线上降级方案。hook 在这里指替换或截获函数调用的非公开做法。profile 的查询与脱敏边界可参考官方的 ProfilingManager profile 查询说明。
帧、CPU 与系统状态
FrameMetrics 提供窗口帧各阶段的耗时字段,AndroidX JankStats 在兼容不同 Android 版本的同时标记卡顿帧,Choreographer 则按显示垂直同步节奏安排应用回调。三者和应用内 trace 都只能观察各自覆盖的事件,厂商策略的原因要另行取证。
进入省电、热限制或刷新率切换后,帧节奏和预算可能变化,所以事件旁边要记录显示模式、刷新率、热状态和省电状态。没有公开证据表明某品牌会系统性修改 FrameMetrics 的"精度";采样差异要写成厂商结论,还需要更多证据支持。
CPU time 表示进程或线程实际占用处理器运行的累计时间。ProcessCpuTracker 属于 framework 内部实现,第三方应用没有受支持的公共 API 契约。线上应用可使用:
Process.getElapsedCpuTime()观察本进程累计 CPU time;/proc/self/stat或/proc/self/task/<tid>/stat读取当前进程可见计数,并按内核时钟频率换算;/proc是内核暴露运行状态的伪文件系统,内容由内核动态生成,磁盘不会持久保存;- ProfilingManager、Perfetto 或 Simpleperf 在各自允许的环境中做采样分析。
/proc 可见性、字段解析和采样开销应按 26.13 heapprofd、procfs CPU 与 Page Fault 分析 的边界处理。某个节点不可读时记录能力缺失,不要通过扩大权限或扫描其他进程规避。
渠道性能比较如何避免误判
渠道通常和厂商、型号、地区、系统版本、应用产物、ABI、签名、安装时间及用户群一起变化。与渠道同时变化、又会影响性能结果的因素称为混杂因素。直接比较"渠道 A 平均启动时长"和"渠道 B 平均启动时长",很容易把设备结构差异误写成安装市场影响。
实验室比较应满足这些条件:
- 使用同一源码和等价构建参数,记录 base APK、split APK、签名与 Native 库摘要;split APK 是按 ABI、语言或功能等条件拆出的安装分包;
- 明确安装方式、首次安装或覆盖安装、应用数据状态和编译状态;
- 在相同设备与系统镜像上交叉安装,重复冷启动和热启动;
- 记录 ABI、page size、存储余量、温度、充电状态和网络条件;ABI 是应用二进制与处理器约定的接口,page size 是系统管理虚拟内存的基本页大小;
- 把安装完成到首次启动的系统日志作为辅助证据。
线上分析则按应用版本、产物摘要、API、厂商、型号、系统构建、ABI、page size、地区、安装来源和明确渠道分层,并报告样本量、分位数和置信区间。置信区间给出统计估计在既定假设下的不确定范围,样本偏差仍要另行控制。
跨群组比较时,可用匹配让两组样本在已知特征上更接近,或用回归模型估计并控制这些特征的影响。没有记录或建模不了的那些差异属于未观测混杂,结论中要明确保留这一限制。
dexopt 是 Android 对 dex 字节码进行校验、优化或编译的一组处理。启动变慢推不出"应用商店没有执行 dexopt",启动变快也证明不了市场执行了预优化;要验证编译因素,就得在受控设备上检查 package 编译状态、安装会话和用于编译决策的运行时 profile,并保持 APK 与数据状态一致。
厂商安全中心与用户引导
不要把"加入白名单"设计成所有用户第一次启动时的必做步骤。更合适的触发条件是:
- 公共 API 已显示后台受限,或多次任务记录显示约束满足后仍未运行;
- 该功能依赖及时后台执行,延迟会给用户带来可解释的影响;
- 当前机型和系统版本的页面路径经过验证;
- UI 说明用户将改变什么设置、可能增加什么耗电,以及如何恢复。
Intent 是 Android 用于描述要执行的操作及目标数据的消息对象。设置页面和厂商说明会变化,应用应使用当前官方文档和受支持的 Intent;打开失败时停留在系统通用设置,不要扫描已安装包寻找安全中心,也不要为监控申请与功能无关的广泛权限。
"白名单"是用户和厂商文档中常见的统称,各设备上的实际开关可能分别控制电池优化、后台启动或任务清理,没有统一公共 API 语义。
所谓"厂商行为库"应保存证据,传闻不进入结论。每条记录至少包含机型、系统构建、应用构建、复现步骤、观察信号、对照组、证据等级和失效日期。系统升级后重新验证,别沿用旧 ROM 结论。
自建与第三方 APM 的选型
产品名单、套餐和厂商支持会变化,静态营销对照表维护不住。选型时,我们用同一组样例事件和目标设备验证以下项目:
| 维度 | 需要验证的问题 |
|---|---|
| 信号覆盖 | Java/Native 崩溃、ANR、ApplicationExitInfo、启动、帧、网络、trace 分别如何采集 |
| 符号化 | R8 mapping、native symbol、build ID、split 和动态特性如何对应 |
| 离线能力 | 队列容量、过期、断点续传、进程中断后的写入一致性 |
| 采集开销 | 不同事件密度下的 CPU、内存、I/O、包体和网络变化 |
| 数据质量 | 采样率、丢弃计数、重复事件、时钟和 schema 升级是否可见 |
| 隐私与安全 | 同意、字段脱敏、传输与存储加密、数据驻留、删除和访问审计 |
| 数据控制 | 原始数据能否导出、保存周期、查询接口、SDK 与后端是否可替换 |
| 运维 | 限流、告警、符号上传、版本回滚和 SDK 自身故障如何处理 |
符号化是把混淆后的类名或机器地址还原为可定位的源码位置。R8 mapping 用于还原 Java/Kotlin 混淆名称,Native symbol 用于解析 Native 地址,build ID 则把崩溃事件与生成该二进制的符号文件对应起来;三者都必须和具体构建严格配对。动态特性指按需交付的 dynamic feature 模块,也需要登记所属分包与构建标识。
Tinker 是热修复框架,职责是下发代码补丁,与持续采集和分析性能信号的 APM 范围不同。厂商控制台或应用市场若提供性能报告,也要确认它覆盖哪些安装、设备和采样人群,再决定它能否补充自建数据。
排障顺序
遇到"某渠道、某 ROM 数据少或性能差"时,可以按以下顺序推进:
- 核对事件 schema、采样、限流、队列和服务端接收,排除采集器回归。
- 核对应用构建、签名、split、ABI、安装来源和明确渠道,确认比较对象。
- 查看后台限制、standby bucket、省电、热状态、网络与任务生命周期。
- 在下次启动补记
ApplicationExitInfo,区分已知退出与未知中断。 - 按机型、系统构建和应用版本分群,检查样本量与置信区间。
- 用同一设备、同一产物和受控状态复现,并保存系统 trace 或 profiler 证据。
- 只有在直接证据支持时,才形成厂商或系统版本级结论,并设置复验日期。
这套顺序要求每个判断都能回到记录、API 契约或可重复实验。非 Play 可观测性的难点在于明确数据覆盖范围,以及每个归因所依据的证据等级。
全文小结
线上排障的主线,是用最小必要采集得到可验证证据。远程日志保存业务状态,用户反馈给出复现入口,Trace 解释线程与调度时间线,灰度和运行期开关限制新增影响;诊断通道则负责让这些材料在进程退出、断网和多进程环境下可恢复、可授权、可审计。
非 Play 与 OEM 场景继续复用相同事件口径,并把安装来源、系统能力、后台状态和采集缺口作为分层维度,而不是凭品牌或渠道直接推断根因。
profiling 与退出记录始终运行在权限、配额和结果缺失的约束里;所有结论都应标明证据强度,并用同口径指标或受控实验验证。
参考资料
- Android 日志信息泄露风险
- 抓取和阅读 bug report
- 设备端系统 Trace
ApplicationExitInfoAPIProfilingManagerAPIProfilingTriggerAPI- 基于触发器采集 profiling 数据
- Google Play staged rollout
- Firebase Remote Config rollout
- AOSP Android 17:平台权限声明
- Android 权限保护级别
- 特权权限许可清单
- AOSP Android 17:
StatsManagerService - AOSP Android 17:
statsd启动入口