WakeLock、Alarm(系统定时通知) 与 WorkManager 调度
WakeLock 阻止设备进入部分休眠状态,Alarm 安排未来的时间通知,只有唤醒型 Alarm 才请求唤醒设备,WorkManager 在系统约束下安排可延迟的工作。三者搭配出错的代价,就是频繁唤醒、锁未释放和任务积压。
唤醒锁、定时器与系统休眠
两类机制的职责
WakeLock(唤醒锁)和 Alarm(定时通知)解决两个不同阶段的问题。我们按「工作是否已经开始」把它们分开看:
- WakeLock 表示工作已经开始,设备暂时保持清醒,避免进入会中断这段工作的休眠状态。
- Alarm 表示工作尚未开始,系统到达约定时刻后通知应用。
这两个接口常被误当作进程保活接口,但它们各管一段:WakeLock 只管阻止休眠,进程存活和后台启动资格要交给其他机制;Alarm 回调只完成短小的分发工作,耗时任务要另行调度。
搭配出问题时,代价落在三处:持锁范围过大,会阻止系统进入低功耗状态;唤醒型 Alarm 过密,会增加设备被唤醒的次数;精确 Alarm 若未满足权限条件,调用时会抛出 SecurityException。
系统电源(power)状态机见 §5.2 和 §11.3,后台任务分类见 §25.2,WorkManager 实践见「约束任务、重试与执行窗口」。这里我们只讨论应用侧的选择、生命周期、权限和诊断。
源码中的调用边界
这张关系图把应用接口、系统服务和内核的职责放在同一视图里。
WakeLock 的休眠阻止与 Alarm 的未来投递经不同系统路径管理;系统共享锁只保护有界投递。
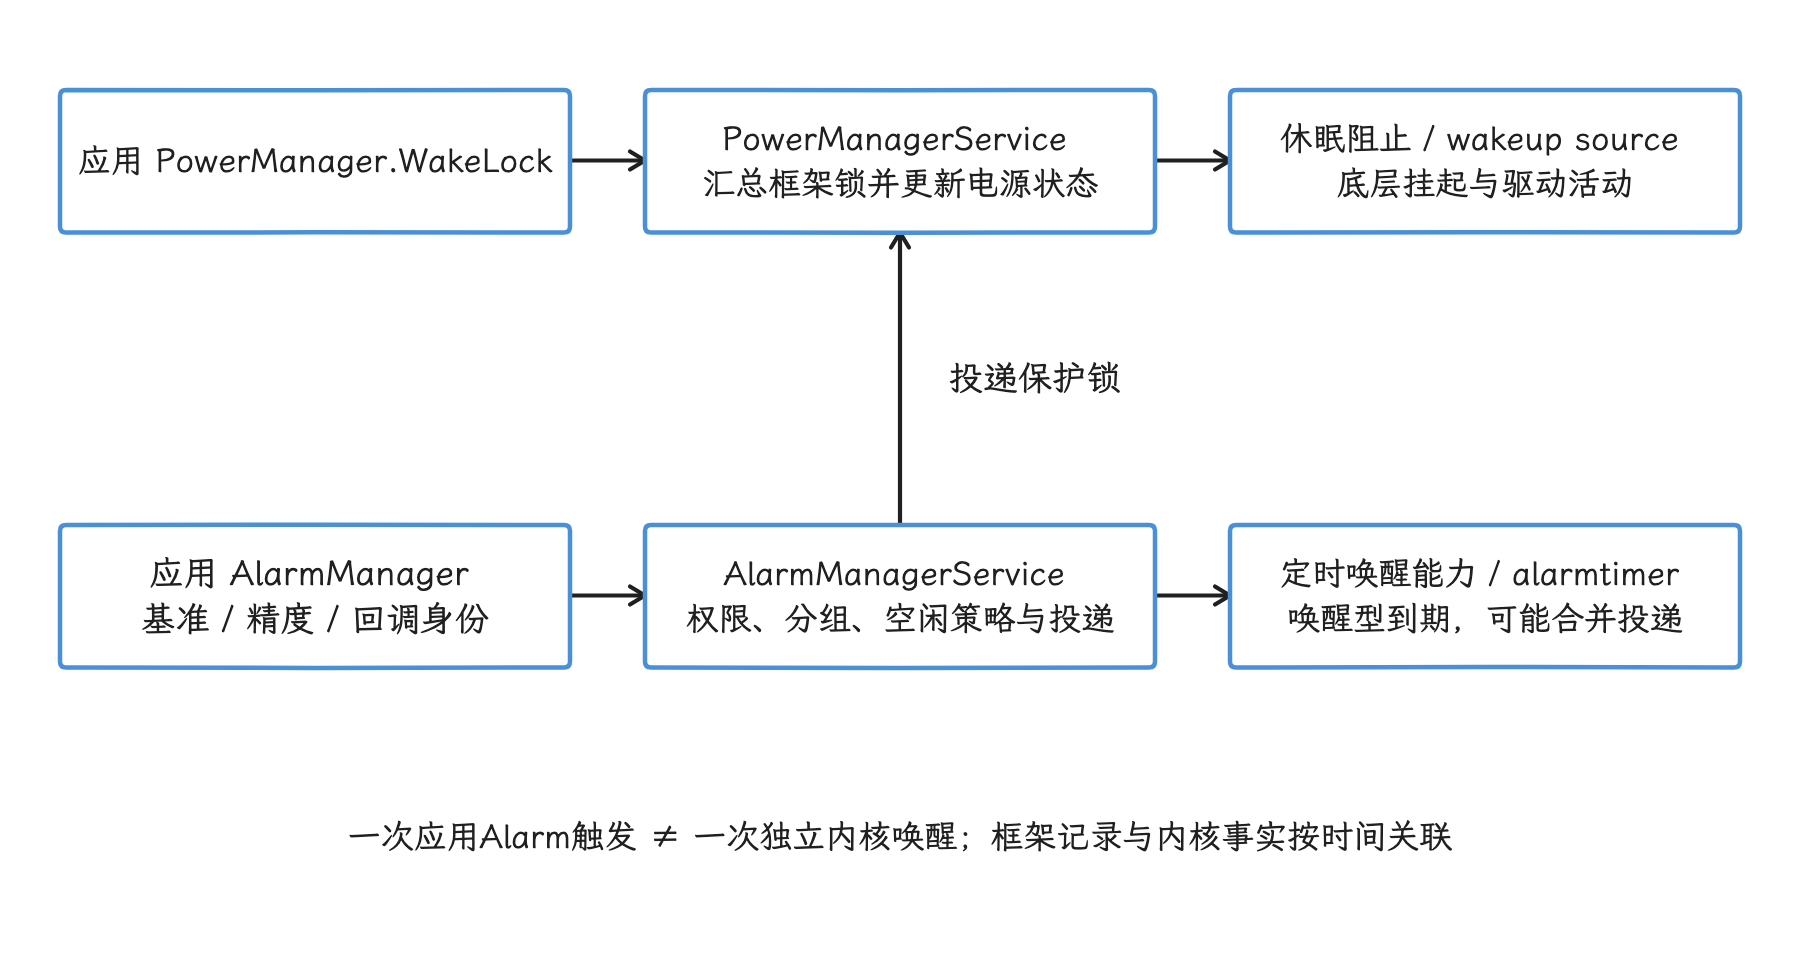
图:系统在投递前持锁,按完成或超时减少在途计数;最后一笔完成后才物理释放共享锁。
我们按这层分工往下看:PowerManagerService 汇总框架层的 WakeLock 并更新电源状态,AlarmManagerService 负责 Alarm 的分组、权限、空闲策略和分发。内核的 wakeup source(唤醒源)与 alarmtimer(定时唤醒机制)只提供阻止休眠和定时唤醒这两种底层能力,看不到 PendingIntent(由系统在未来代应用执行操作的凭据)、精确 Alarm 权限或应用业务。也正因为系统可以合并多个 Alarm、设备可能因其他来源已经处于唤醒状态,一次 Alarm 触发未必对应一次内核唤醒。
源码可从三个入口核对:
PowerManager.java与PowerManagerService.javaAlarmManager.java与AlarmManagerService.javadrivers/base/power/wakeup.c与kernel/time/alarmtimer.c
WakeLock 类型与使用规范
常规应用要评估的 CPU(中央处理器) 锁是 PARTIAL_WAKE_LOCK,它允许屏幕关闭,同时让 CPU 保持运行。SCREEN_DIM_WAKE_LOCK、SCREEN_BRIGHT_WAKE_LOCK 和 FULL_WAKE_LOCK 已废弃;页面需要保持亮屏时,使用 FLAG_KEEP_SCREEN_ON 或 View 的 keepScreenOn。申请 WakeLock 还需要在清单中声明 android.permission.WAKE_LOCK。
手动持锁之前,我们先检查平台接口是否已经管理了唤醒周期:WorkManager 和 JobScheduler(Android 系统任务调度器) 会在任务执行期间处理所需的 WakeLock,媒体、位置和部分传感器接口也有自己的电源行为。在这之上再叠加一把手动锁,通常只会扩大持锁范围。
WakeLock 官方实践可归纳为五项约束:
- 范围小:只覆盖必须在设备清醒时完成的同步代码。
- 超时明确:
acquire(timeoutMillis)的超时是故障保护,业务仍应在工作结束时主动释放。 - 标签稳定:标签包含包、类或方法的固定名称,不含用户信息、随机数、业务 ID 或计数器。
- 释放集中:获取与释放写在同一个所有权范围内,异常和取消都经过
finally。 - 用户可感知:需要长时间持锁的工作通常还需要合适类型的前台服务(Foreground Service,FGS);如果 FGS 也不适合,应重新选择任务接口。
| 场景 | 推荐做法 | 不建议的做法 |
|---|---|---|
| 屏幕保持常亮 | WindowManager.LayoutParams.FLAG_KEEP_SCREEN_ON 或 View 的 keepScreenOn | 用屏幕类 WakeLock 控制亮屏 |
| 用户触发且必须连续完成的短任务 | PARTIAL_WAKE_LOCK + 业务超时 + try/finally | 获取后分散到多个回调释放 |
| 可延后的后台同步 | WorkManager / JobScheduler | 用 WakeLock 保持线程池常驻 |
| 到时提醒 | AlarmManager,默认使用非精确 Alarm | 持锁等待目标时间 |
| 长时间用户可感知任务 | 合适类型的 FGS + 通知 + 取消入口 | 静默持锁运行 |
按这五项约束,我们把一段同步代码的持锁封装成下面这样:超时时间由调用场景传入,WakeLock 标签保持固定。
private const val SYNC_WAKELOCK_TAG = "com.example.app:SyncWorker"

inline fun <T> Context.withPartialWakeLock(
    timeoutMillis: Long,
    block: () -> T,
): T {
    require(timeoutMillis > 0L)

    val powerManager = getSystemService(PowerManager::class.java)
    val wakeLock = powerManager.newWakeLock(
        PowerManager.PARTIAL_WAKE_LOCK,
        SYNC_WAKELOCK_TAG,
    ).apply {
        setReferenceCounted(false)
        acquire(timeoutMillis)
    }

    return try {
        block()
    } finally {
        if (wakeLock.isHeld) {
            wakeLock.release()
        }
    }
}
使用这个封装的前提,是 block() 在函数返回前完成。如果它只负责启动协程、提交线程池任务或发起异步请求,函数返回时 WakeLock 就会释放。反过来,把释放分散到异步回调,会增加遗漏异常、取消和超时分支的风险。可延后的工作交给 WorkManager,长时间且用户可感知的工作使用符合类型与权限要求的 FGS。
WakeLock 默认使用引用计数:每次 acquire() 增加一次计数,每次 release() 减少一次,计数归零后才释放。示例将它关闭,是因为每次调用都创建独立对象,并且只有当前函数拥有这把锁。共享对象不适合这样处理:非引用计数模式下一次 release() 就会撤销此前所有 acquire() 的效果。
超时到达后 block() 仍可能继续运行,所以超时只兜住持锁时长,业务取消和任务成功的判断都要另行处理。
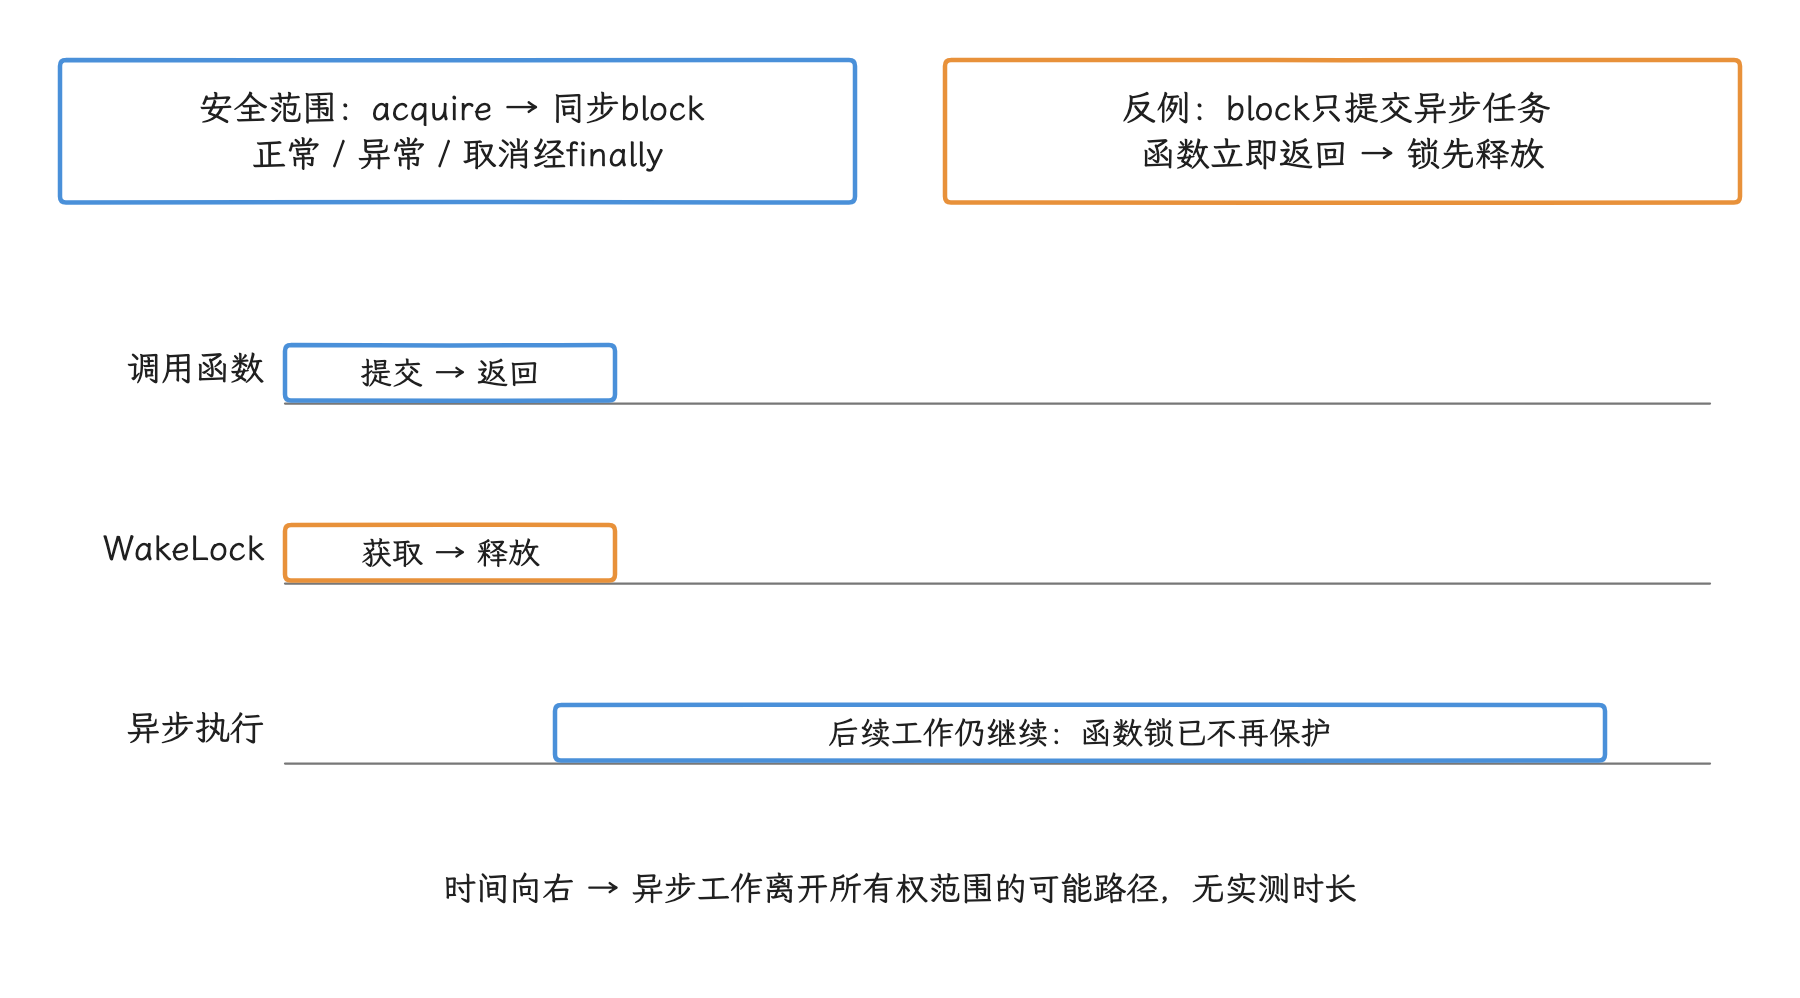
图:超时释放只兜住锁,不会取消block;业务deadline与底层取消需要另行设计。
WakeLock 泄漏检测与治理
线上出现持锁过长或锁泄漏时,我们优先查所有权:异常提前返回、回调没有到达、取消路径遗漏,或者异步工作已经换到其他执行器,原调用方却仍持有锁。定位要靠三份信息一起看:当前状态、历史时序和线上分布。
| 工具 | 观察对象 | 用法 |
|---|---|---|
adb shell dumpsys power | 当前仍活跃的 WakeLock | 查看标签(tag)、应用 UID、进程 PID 和持有状态,适合复现场景后立刻确认 |
adb shell dumpsys batterystats --history | BatteryStats(系统电量归因统计)记录的持锁与唤醒事件 | 对照测试起止时间检查异常长区间,必要时结合 bugreport(Android 系统诊断报告) |
| Perfetto(Android 系统追踪工具) | 系统挂起与恢复、CPU 调度和应用工作时序 | 判断锁是否阻止休眠,并与 Alarm 或任务触发时间对齐 |
| Play Console Android Vitals(Google Play 线上质量指标) | 线上非豁免 partial WakeLock 分布 | 按版本、设备和 WakeLock 名称查受影响会话 |
排查时还会遇到另一种情况:应用从未直接调用 PowerManager.newWakeLock(),却看到归因到自身的锁——AlarmManager、JobScheduler、WorkManager、位置、FCM(Firebase Cloud Messaging,云消息推送)和媒体接口都可能在系统或库内部持锁。官方的WakeLock 来源对照会随平台和库版本更新,诊断时应以当前系统显示的名称为起点。
AlarmManager 分发广播时会持有名为 *alarm* 的 WakeLock,并将它归因给设置 Alarm 的应用。对普通同步接收器,onReceive() 返回会完成该次接收;源码实际通过 onSendFinished()、in-flight 计数及最后一笔投递完成来释放共享锁。使用 goAsync() 时,广播完成改由有界异步处理后的 PendingResult.finish() 表达,不能简单按方法返回时刻判断;它仍受广播超时约束,不是长任务窗口。耗时工作应先持久化输入,再交给 WorkManager 等接口,不依赖接收器外的任意线程继续受保护。
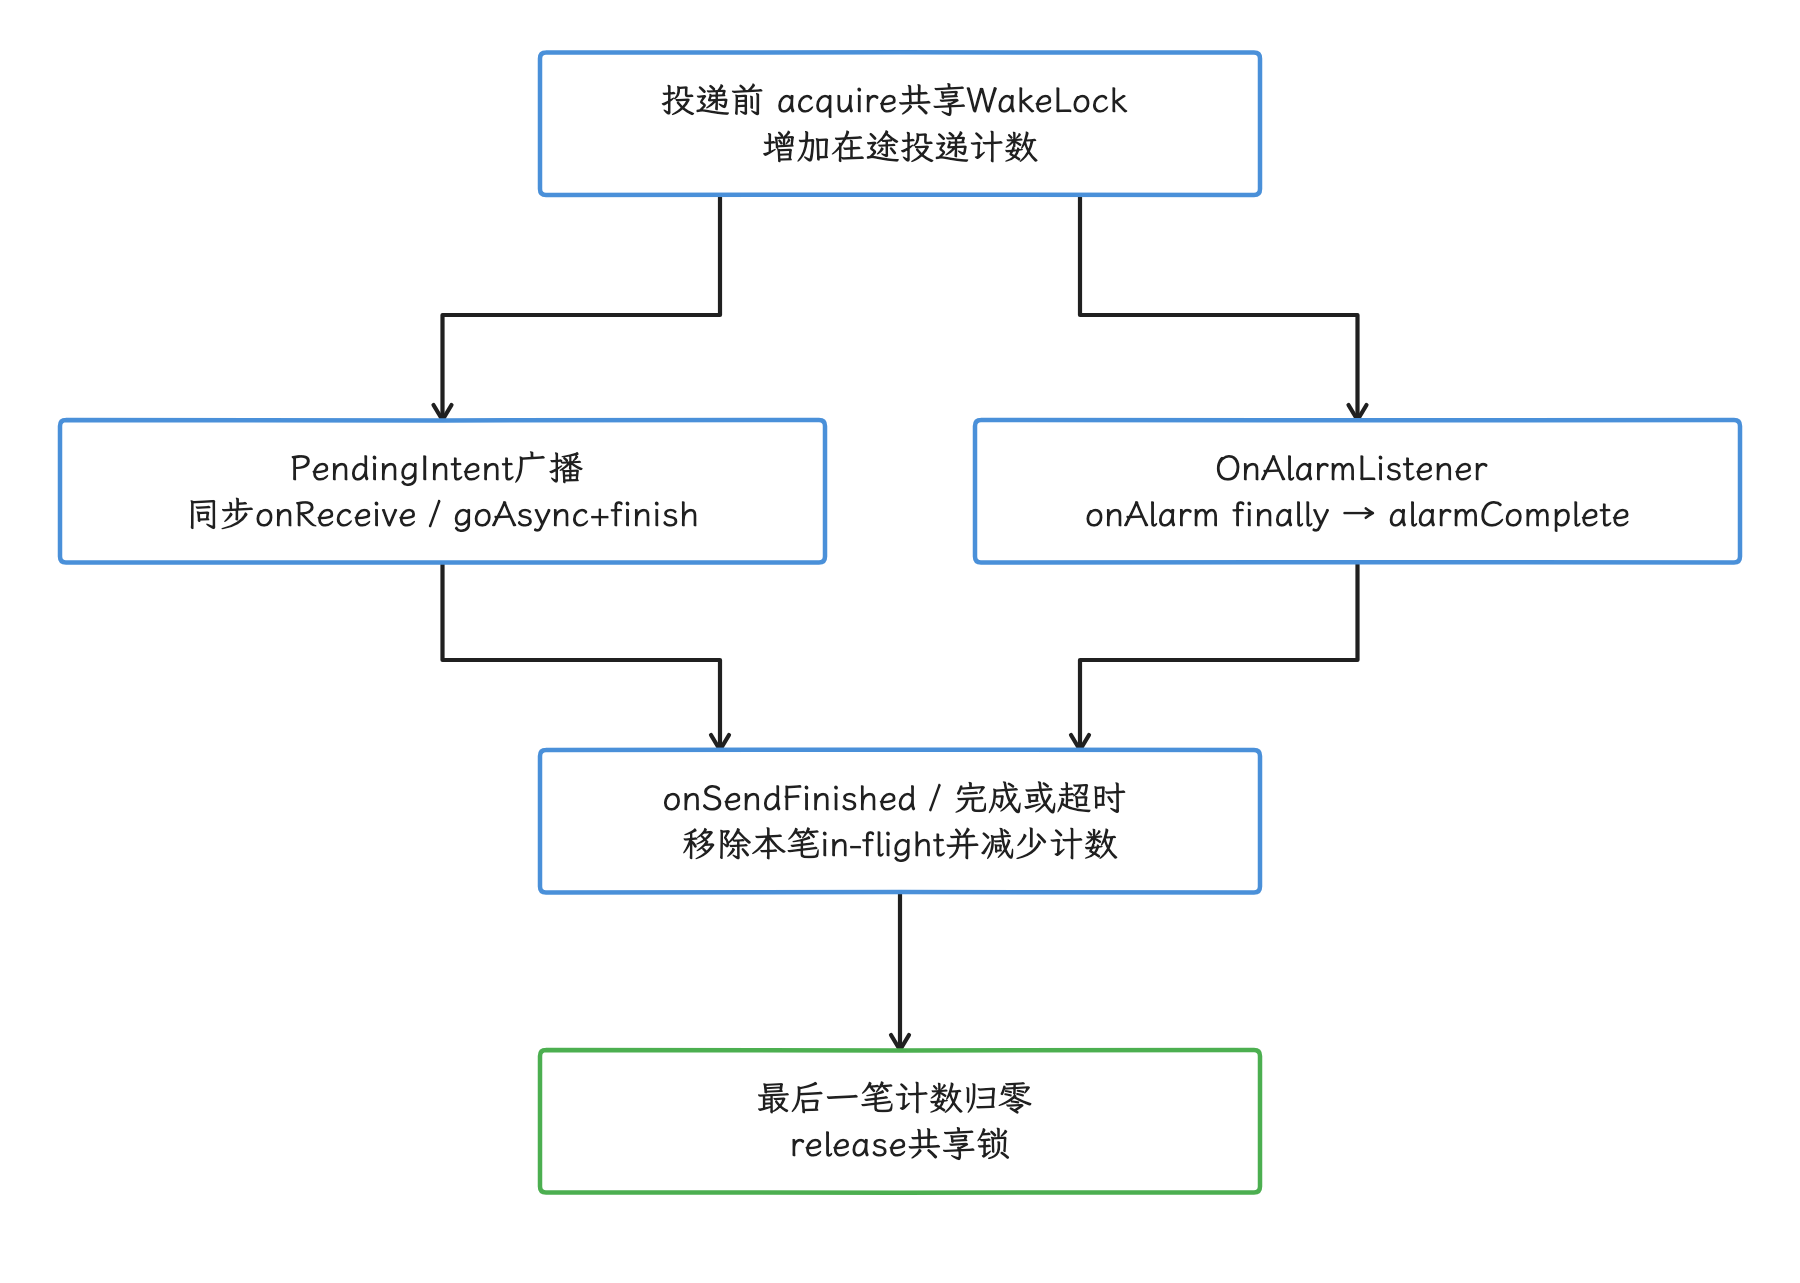
图:goAsync只延后有界广播完成,不是长任务通道;任意接收器外线程不自动继承保护。
Android Vitals 的判定门槛和豁免规则决定线上哪些锁会被记为过度使用,具体判定规则见「WakeLock 与 Alarm 功耗回归守门」。
应用自己的审计记录不要只保存标签:
| 字段 | 用途 |
|---|---|
wakelock_tag | 对应系统统计和 dumpsys power 输出 |
source_module | 区分业务来源,避免同一标签被多个模块复用 |
trigger_source | 记录来自用户动作、推送、Alarm、WorkManager 还是重试 |
acquire_elapsed_realtime_ms / release_elapsed_realtime_ms | 计算经过时间,包含深度睡眠且不受墙钟调整影响;另记 uptime 可分析实际清醒区间 |
timeout_ms | 判断是否依赖超时兜底释放 |
visible_to_user | 区分用户感知任务和静默后台任务 |
failure_reason | 记录异常、取消、超时、进程退出等释放路径 |
新增 WakeLock 应通过统一封装:标签固定且可定位,超时来自业务上限,每一条退出路径都能释放。单次时长和累计时长阈值应从具体场景的稳定版本与服务目标推导——下载、媒体、导航和短同步各有各的数字。
AlarmManager 最佳实践
AlarmManager 解决的是跨越应用生命周期的时间通知。应用还在运行时的界面计时、动画或请求超时,用 Handler(进程内消息调度器)、协程这类进程内工具就够了;允许延后的持久化工作交给 WorkManager。用户指定的闹钟、日历事件和到时提醒,才需要评估 AlarmManager。参见 Schedule alarms。
Doze 指设备空闲时的低功耗模式。选择接口时,要同时判断是否要唤醒设备、允许多大时间偏差,以及进程结束后是否仍然触发。
| API | 系统行为 | 适用边界 |
|---|---|---|
set() | 不早于目标时间的单次非精确 Alarm;Android 12 及以上在没有额外省电限制时通常会在目标时间后一小时内分发 | 到点附近执行即可 |
setWindow() | 在给定窗口内分发,便于系统合并唤醒 | 业务明确给出可接受窗口 |
setInexactRepeating() | 非精确重复 Alarm,连续两次到达间隔可以变化 | 必须使用 Alarm 的粗略重复提醒;普通周期工作仍优先 WorkManager |
setAndAllowWhileIdle() | Doze 中允许分发的非精确 Alarm,仍受频率限制 | 空闲状态下也要到达、但允许偏差 |
setExact() | 精确单次 Alarm,受精确 Alarm 权限约束 | 用户对时刻有明确要求,但无需穿过 Doze |
setExactAndAllowWhileIdle() | Doze 中允许分发的精确 Alarm,受权限和频率限制 | 闹钟、日历提醒等强时效场景 |
setAlarmClock() | 用户可见的闹钟;系统必要时离开低功耗模式 | 闹钟应用的核心功能 |
选窗口宽度时我们先记住一条平台规则:目标版本 31 及以上调用 setWindow() 时,小于十分钟的窗口可能被系统扩展到十分钟。这十分钟是平台下限,业务窗口仍应来自产品对延迟的接受范围,照抄十分钟没有意义。
也正因为精确 Alarm 难以和其他应用的唤醒合并,我们把它留给非精确接口满足不了的用户需求。
先选时间基准,再选是否唤醒
RTC/RTC_WAKEUP使用基于 Unix epoch 的墙钟毫秒,可能受用户改时间或系统校时影响。时区与夏令时不会直接改写 epoch 数值,但会改变“当地几点”的换算;按当地时间提醒时,要在时间、时区或相关规则变化后重新计算下一次触发。ELAPSED_REALTIME/ELAPSED_REALTIME_WAKEUP使用SystemClock.elapsedRealtime()表示开机后持续递增的单调时间,不受墙上时钟调整影响,适合同一次开机内的延迟。- 带
WAKEUP的类型可以唤醒休眠设备;不带WAKEUP的类型会等设备下次清醒后分发。业务允许等待时,选择不唤醒设备的类型。
这个示例把允许在目标时间附近到达的提醒安排成窗口 Alarm,提醒 ID 写入 Intent.data,让 PendingIntent 身份稳定,且不依赖 Long.hashCode()。
fun scheduleReminderWindow(
    context: Context,
    triggerAtMillis: Long,
    windowLengthMillis: Long,
    reminderId: Long,
) {
    require(windowLengthMillis > 0L)

    val alarmManager = context.getSystemService(AlarmManager::class.java)
    val intent = Intent(context, ReminderReceiver::class.java).apply {
        action = "com.example.app.ACTION_REMINDER"
        data = Uri.Builder()
            .scheme(context.packageName)
            .authority("reminder")
            .appendPath(reminderId.toString())
            .build()
        putExtra("reminder_id", reminderId)
    }
    val pendingIntent = PendingIntent.getBroadcast(
        context,
        0,
        intent,
        PendingIntent.FLAG_UPDATE_CURRENT or PendingIntent.FLAG_IMMUTABLE,
    )

    alarmManager.setWindow(
        AlarmManager.RTC_WAKEUP,
        triggerAtMillis,
        windowLengthMillis,
        pendingIntent,
    )
}
Intent 的附加字段不参与 PendingIntent 等价判断;只改变 reminder_id,可能覆盖已有 Alarm。示例使用唯一的 data URI(统一资源标识符) 区分提醒,取消时必须重建等价的 action、data、组件、requestCode 和标志位。这段代码用 RTC_WAKEUP 表示按用户墙上时钟提醒;若设备无需被唤醒,应改用 RTC。
接收器只做输入校验、状态确认和短小的本地处理。下载、数据库批处理或多轮网络请求需要入队;同一提醒已删除、账号已退出或状态已过期时,应直接结束。
设备关机后 Alarm 会被清除。需要跨重启保留的提醒,应先将业务记录持久化,再在 BOOT_COMPLETED 后重建。每天按当地时间重复的提醒还要处理时区和夏令时变化,通常按下一次日历时间安排单次 Alarm,比固定毫秒间隔更可靠。
Android 17:允许空闲分发的 Listener Alarm
Android 17 / API 37 给 setExactAndAllowWhileIdle() 新增了接受 OnAlarmListener(Alarm 回调监听器) 与 Executor(回调执行器) 的重载,适合这样的场景:组件仍在运行,我们只是不想为等待下一次时机而一直持有 WakeLock。这个示例按开机后的单调时间安排一次回调。
@RequiresApi(37)
fun scheduleProcessLocalIdleAlarm(
    alarmManager: AlarmManager,
    triggerElapsedRealtime: Long,
    executor: Executor,
    listener: AlarmManager.OnAlarmListener,
) {
    alarmManager.setExactAndAllowWhileIdle(
        AlarmManager.ELAPSED_REALTIME_WAKEUP,
        triggerElapsedRealtime,
        "com.example.app:socket-maintenance",
        executor,
        listener,
    )
}
OnAlarmListener 版本不要求 SCHEDULE_EXACT_ALARM,只在当前进程内有效。调用进程没有活动的 Activity、Service 或 ContentProvider 后,系统可以取消它;组件结束时也应调用 alarmManager.cancel(listener)。它仍受允许空闲分发的频率限制,不适合循环安排高频回调。需要在进程死亡或组件结束后仍然触发时,使用 PendingIntent 版本并满足精确 Alarm 权限。示例中的 @RequiresApi 来自 androidx.annotation.RequiresApi。
使用这个重载需同时满足四个条件:活跃组件仍在、设备空闲时需要唤醒、回调能快速同步完成、回调丢失后能够恢复。Android 17 的 AlarmManager 会在投递前获取共享 WakeLock;ListenerWrapper 在 onAlarm() 返回后的 finally 中报告完成,系统再按 in-flight 计数释放。但保护有上限:r1 的 listener_timeout 默认 5 秒且可配置,从系统投递起计,Executor 排队也会占用;超时后即使回调尚未结束,系统仍可完成这笔投递的持锁统计。因此回调必须短小,不能把保护理解为覆盖任意长回调,更不能另起线程后立即返回并假定仍受保护。
OnAlarmListener 通过进程内 Binder(Android 进程间通信机制) 回调交付。应用进程进入 cached(缓存进程) 或 frozen(冻结) 状态、监听器对应的 Binder 失效,或者拥有该监听器的组件结束时,系统都可以移除 Alarm;进程死亡后仍需交付的提醒,应使用 PendingIntent。
Android 17 为这类 Listener 型 Alarm 单独维护允许空闲分发的配额(quota)。AOSP 里的默认值只能当作理解当前实现的参考;业务承诺固定心跳间隔,要以自己的实测为准。每次回调完成后,再按当前协议状态安排下一次一次性 Alarm,并记录请求时间、实际触发时间和回调完成时间,避免形成来路不明的周期唤醒。
Exact Alarm 权限变化(Android 12+)
精确 Alarm 权限经历了三次关键变化:
| 版本 | 权限规则 |
|---|---|
| Android 12 / API 31 | 目标版本 31 及以上的应用使用基于 PendingIntent 的精确 Alarm,需要闹钟和提醒特殊访问权限或符合系统豁免 |
| Android 13 / API 33 | 目标版本 33 及以上可在 SCHEDULE_EXACT_ALARM 与 USE_EXACT_ALARM 中选择 |
| Android 14 / API 34 | 目标版本 33 及以上的新安装应用通常不会预先获得 SCHEDULE_EXACT_ALARM;备份恢复到 Android 14 的权限也会被拒绝 |
USE_EXACT_ALARM 会自动授予,用户也撤不掉,但用途受限,并受 Google Play 政策约束,适合核心功能就是闹钟或日历的应用。SCHEDULE_EXACT_ALARM 是用户可授予和撤销的特殊访问权限,适用范围更广。两者都不该为普通同步任务声明。
用户请求的操作所触发的精确 Alarm,才属于官方列举的 FGS 后台启动豁免场景,但 FGS 类型、类型权限和使用中权限(while-in-use permission)三项检查照样要过——它们一般只在应用可见或对应 FGS 满足条件时放行。普通后台任务想靠精确 Alarm 拿到启动资格,这条路是堵死的。
使用基于 PendingIntent 的 setExact()、setExactAndAllowWhileIdle() 或 setAlarmClock() 前,应通过 canScheduleExactAlarms() 检查资格。这个示例只负责安排 Alarm,并向调用层返回需要权限的结果;它不会从后台突然打开系统设置页。
enum class ExactAlarmScheduleResult {
    SCHEDULED,
    PERMISSION_REQUIRED,
}

fun scheduleExactReminder(
    context: Context,
    triggerAtMillis: Long,
    reminderId: Long,
): ExactAlarmScheduleResult {
    val alarmManager = context.getSystemService(AlarmManager::class.java)

    if (Build.VERSION.SDK_INT >= Build.VERSION_CODES.S &&
        !alarmManager.canScheduleExactAlarms()
    ) {
        return ExactAlarmScheduleResult.PERMISSION_REQUIRED
    }

    val intent = Intent(context, ReminderReceiver::class.java).apply {
        action = "com.example.app.ACTION_EXACT_REMINDER"
        data = Uri.Builder()
            .scheme(context.packageName)
            .authority("exact-reminder")
            .appendPath(reminderId.toString())
            .build()
        putExtra("reminder_id", reminderId)
    }
    val pendingIntent = PendingIntent.getBroadcast(
        context,
        0,
        intent,
        PendingIntent.FLAG_UPDATE_CURRENT or PendingIntent.FLAG_IMMUTABLE,
    )

    try {
        alarmManager.setExactAndAllowWhileIdle(
            AlarmManager.RTC_WAKEUP,
            triggerAtMillis,
            pendingIntent,
        )
    } catch (e: SecurityException) {
        // 查询与安排之间资格可能变化;只将确认的权限缺失转成降级结果。
        if (Build.VERSION.SDK_INT >= Build.VERSION_CODES.S &&
            !alarmManager.canScheduleExactAlarms()
        ) {
            return ExactAlarmScheduleResult.PERMISSION_REQUIRED
        }
        throw e
    }
    return ExactAlarmScheduleResult.SCHEDULED
}
UI 层收到 PERMISSION_REQUIRED 后,应先解释用户功能为何需要精确时刻,再由用户动作打开 Settings.ACTION_REQUEST_SCHEDULE_EXACT_ALARM。用户拒绝时,根据业务改用 setWindow()、WorkManager 或下次进入应用时补偿;前置资格检查决定正常权限分支;查询与安排之间仍可能变化,调用处按示例捕获后重查。只有确认资格缺失时才降级,其他 SecurityException 应保留给诊断,不把所有安全异常一概当成未授权。
权限状态还影响已安排的 Alarm:
SCHEDULE_EXACT_ALARM被撤销时,系统会停止应用进程并删除该应用未来的精确 Alarm。- 权限被授予时,系统发送
ACTION_SCHEDULE_EXACT_ALARM_PERMISSION_STATE_CHANGED。接收后仍要再次调用canScheduleExactAlarms(),确认资格仍有效,再根据持久化记录重建必要 Alarm。 - 该广播只表示授予,不会在撤销时发送。应用启动、进入相关页面和安排 Alarm 前都要重新检查。
- 设备重启也会清除 Alarm,因此重建逻辑应与
BOOT_COMPLETED共用同一份持久化业务数据。
我们审查精确 Alarm 时,逐项确认:
- 用户是否明确指定精确时间;后台同步和日志上传不属于此类。
- 时间窗口是否可以接受;可以接受就使用非精确 Alarm。
- 权限声明是否符合功能和商店政策。
- 调用前是否检查资格,拒绝后是否有可理解的降级行为。
- 提醒记录是否持久化,取消、重启、时间变化和权限变化能否得到一致结果。
- 相邻提醒是否可以合并,接收器是否只做短小工作。
WakeLock 与 Alarm 功耗回归守门
Android Vitals 的 excessive 与 stuck 判定
先看 Google Play 怎么判定。它的 WakeLock 指标只统计特定状态下的非豁免 partial WakeLock,也就是屏幕关闭且应用处于后台或运行 FGS 时持有的锁。Excessive(过度使用)指一个应用会话在 24 小时内累计持锁达到两小时,最近 28 天内出现该问题的应用会话超过 5% 时,可能影响应用在 Google Play 的可见性;stuck(长时间未释放)指 24 小时内至少出现一次在后台连续持锁一小时。一个未达到 stuck 阈值的高频短锁,累计后仍可能达到 excessive 阈值。这组门槛用来识别严重问题,应用的耗电预算要另定。参见 Excessive partial wake locks 与 Stuck partial wake locks。
我们的内部监控至少要同时保存单次最长时长、窗口累计时长、次数和重叠区间。
Vitals 判断豁免看创建锁的平台 API,与手动标签的名称无关。音频、定位或 JobScheduler 用户发起任务(user-initiated job)的系统锁可能在指标中豁免;业务自行调用 newWakeLock(),标签哪怕写成 Audio 或 Location,也换不来自动豁免。前台服务持有的锁同样计入统计。
Play Console 给出标签、受影响会话和持续时间分布,端侧还要补充调用现场。
手动锁应使用稳定、低基数(标签取值种类少)且不含用户信息的标签,例如 com.example.sync:message-refresh;应用日志再关联任务类型、版本、获取和释放时的调用栈哈希、前后台与充电状态。
WorkManager 或 JobScheduler 生成的 *job* 标签可能随系统和库版本变化。遇到这类系统标签时,要回查 Worker(工作执行单元)、Job、约束、重试和停止原因;源码中不一定存在完整的运行时标签。
我们的本地复现要落在同一组条件下:屏幕关闭、应用在后台或运行 FGS、设备由电池供电。dumpsys power 显示当前持锁者,BatteryStats 和 bugreport 还原累计区间,Perfetto 的 power 轨道把 WakeLock、Alarm、Job、屏幕状态与线程工作按时间对齐。Play 指标未计入的耗电也可能不合理;国内渠道和企业分发仍应保留相同的内部发布门禁。
我们设计 WakeLock 和 Alarm 的回归用例时,要覆盖安排、触发、取消和失败恢复。测试周期应包含业务完整的提醒或重试过程,不照抄固定息屏时长;场景上还要覆盖用户取消提醒、修改时间或时区、重启设备,以及授予和撤销精确 Alarm 权限。
这些命令用于测试机上观察当前 WakeLock、Alarm 队列和 BatteryStats 历史,并验证 Doze 条件下的到达行为。
adb shell dumpsys batterystats --reset
adb shell dumpsys battery unplug
adb shell dumpsys deviceidle force-idle

adb shell dumpsys power
adb shell dumpsys alarm
adb shell dumpsys batterystats --history

adb shell dumpsys deviceidle unforce
adb shell dumpsys battery reset
dumpsys power 显示此刻仍在持锁的对象,dumpsys alarm 显示等待中的 Alarm 及其分组,BatteryStats 历史用于对照测试时间。结束时必须解除强制 Doze 并恢复电池服务。
| 守门项 | 检查方式 | 失败处理 |
|---|---|---|
| 新增 WakeLock | 静态扫描 newWakeLock() 和封装入口 | 没有固定标签、超时、释放路径时退回修改 |
| Exact Alarm 新增 | 扫描 setExact* / setAlarmClock() | 没有用户精确时间需求说明和权限降级方案时退回修改 |
| 持锁配对 | 单元测试异常与取消路径,设备测试核对获取和释放 | 出现超时释放或场景结束后仍持锁时阻止发布 |
| Alarm 身份 | 安排、更新、取消多个提醒,检查 PendingIntent 是否互相覆盖 | 修正 action、data、组件、request code 或 flags |
| Doze 到达 | 在强制 Doze 下验证非精确、允许空闲和精确接口的差异 | 接口语义与业务时效不匹配时重新选型 |
| 线上分布 | Android Vitals 与应用任务记录按版本、设备、入口关联 | 超过场景基线时定位 WakeLock 名称和触发来源 |
| 权限状态 | 覆盖未授予、已授予、撤销、升级与备份恢复 | 任一状态导致崩溃、静默丢提醒或重复提醒时阻止发布 |
任一守门项失败,都应先修正任务接口、生命周期或权限处理,再重新运行对应场景;修复要落在这几处,扩大超时或放宽阈值都算绕过。
WakeLock 与 Alarm 小结
一段工作已经开始,用 WakeLock 保护它;一件工作尚未开始,用 Alarm 安排它的时刻。前者要交代所有权、超时和释放,后者要交代时间基准、精度、唤醒类型、回调身份和权限。
Android 17 的 Listener 版 setExactAndAllowWhileIdle() 可以在进程内组件仍存活时替代持续持锁等待,作用范围也止于进程存活期间。需要持久到达的用户提醒仍使用 PendingIntent,并遵守精确 Alarm 权限。诊断时,框架源码解释调度与归因,android17-6.18-2026-06_r6 内核源码解释休眠阻止和定时唤醒,我们要把两边放在同一条时间线上对照。
约束任务、重试与执行窗口
必须精确定时的事件才使用 Alarm,可延迟工作交给 WorkManager。交出去之后我们要盯住的,是约束怎么表达、执行时机由谁决定、重试怎么退避,以及 Worker 内部的 WakeLock、网络和重试总量。
平台源码基线:Android 17 / API 37 /
android-17.0.0_r1;WorkManager 示例固定为 2.11.2(2026-03-25 发布的稳定版)。截至 2026-10-25,官方当前稳定版已是 2.12.0(2026-09-23),其 minSdk 升至 24;下文保留 2.11.x 的 API 23 兼容说明,不把它外推到 2.12。
WorkManager 2.11.x 的 minSdk(库支持的最低 Android API 级别) 是 23,因此本文不再讨论旧版本库在 API 14–22 上使用 AlarmManager 的兼容路径;它还要求 compileSdk(编译时使用的 Android API 级别) 至少为 33。
WorkManager 是 Jetpack 的持久后台任务调度库,适合应用进程退出后仍应继续、允许系统选择执行时机的工作,例如日志上传、云端同步和可恢复的数据处理。四类需求应交给其他 API:
| 需求 | 合适的机制 | 原因 |
|---|---|---|
| 页面存在期间的异步计算 | 协程、线程池 | 页面退出后可以取消,不需要持久化调度 |
| 精确到时刻的提醒 | AlarmManager 的适用接口 | WorkManager 只保证满足条件后获得执行机会,不保证准点 |
| 持续提供用户可感知能力 | 前台服务(Foreground Service,FGS) | 任务生命周期和通知由应用明确管理 |
| 用户发起、需要进度通知的大文件传输 | 用户发起的数据传输任务(User-Initiated Data Transfer,UIDT)或直接前台服务 | Android 16 以后,长时 Worker 仍会消耗系统任务调度器 JobScheduler 的配额 |
对持久化调度,我们的预期要放准。普通进程退出不会自动删除持久工作;force-stop 会阻止执行,用户再次启动应用后才可能恢复调度,这与卸载清除数据、业务取消工作不同。依赖的网络、账户或权限长期不可用时,也不能保证任务最终完成。
依赖与版本
这些依赖分别支持普通 Worker、Kotlin 协程 Worker 和多进程 Worker:
dependencies {
    implementation("androidx.work:work-runtime-ktx:2.11.2")
    implementation("androidx.work:work-multiprocess:2.11.2") // 只有多进程场景才需要
}
只有用到多进程 Worker 的应用才需要引入 work-multiprocess。work-runtime 与 work-multiprocess 使用相同版本,可避免两个模块的内部协议不一致。
WorkManager 基础架构
一次工作从入队到执行会经过三层:
WorkRequest描述 Worker 类型、输入、约束、延迟、重试和标签。- WorkManager 将
WorkSpec(任务配置的内部数据库记录)、依赖关系和状态保存在自己的数据库中,并把符合调度条件的工作交给系统。 - 在 API 23–37 上,跨进程、跨重启的系统调度由
JobScheduler负责;应用进程已经存活时,GreedyScheduler(WorkManager 的进程内机会调度器)还可以就地运行满足条件的工作。
WorkManager 向 JobScheduler 注册的服务是 androidx.work.impl.background.systemjob.SystemJobService。系统侧由 JobSchedulerService 和一组约束控制器决定 Job 何时具备运行资格,配额由 QuotaController 等组件参与计算。WorkManager 能把业务意图转换成 Job 约束,但 Doze、App Standby(应用待机)、后台限制和系统负载的决策权仍在系统手里。
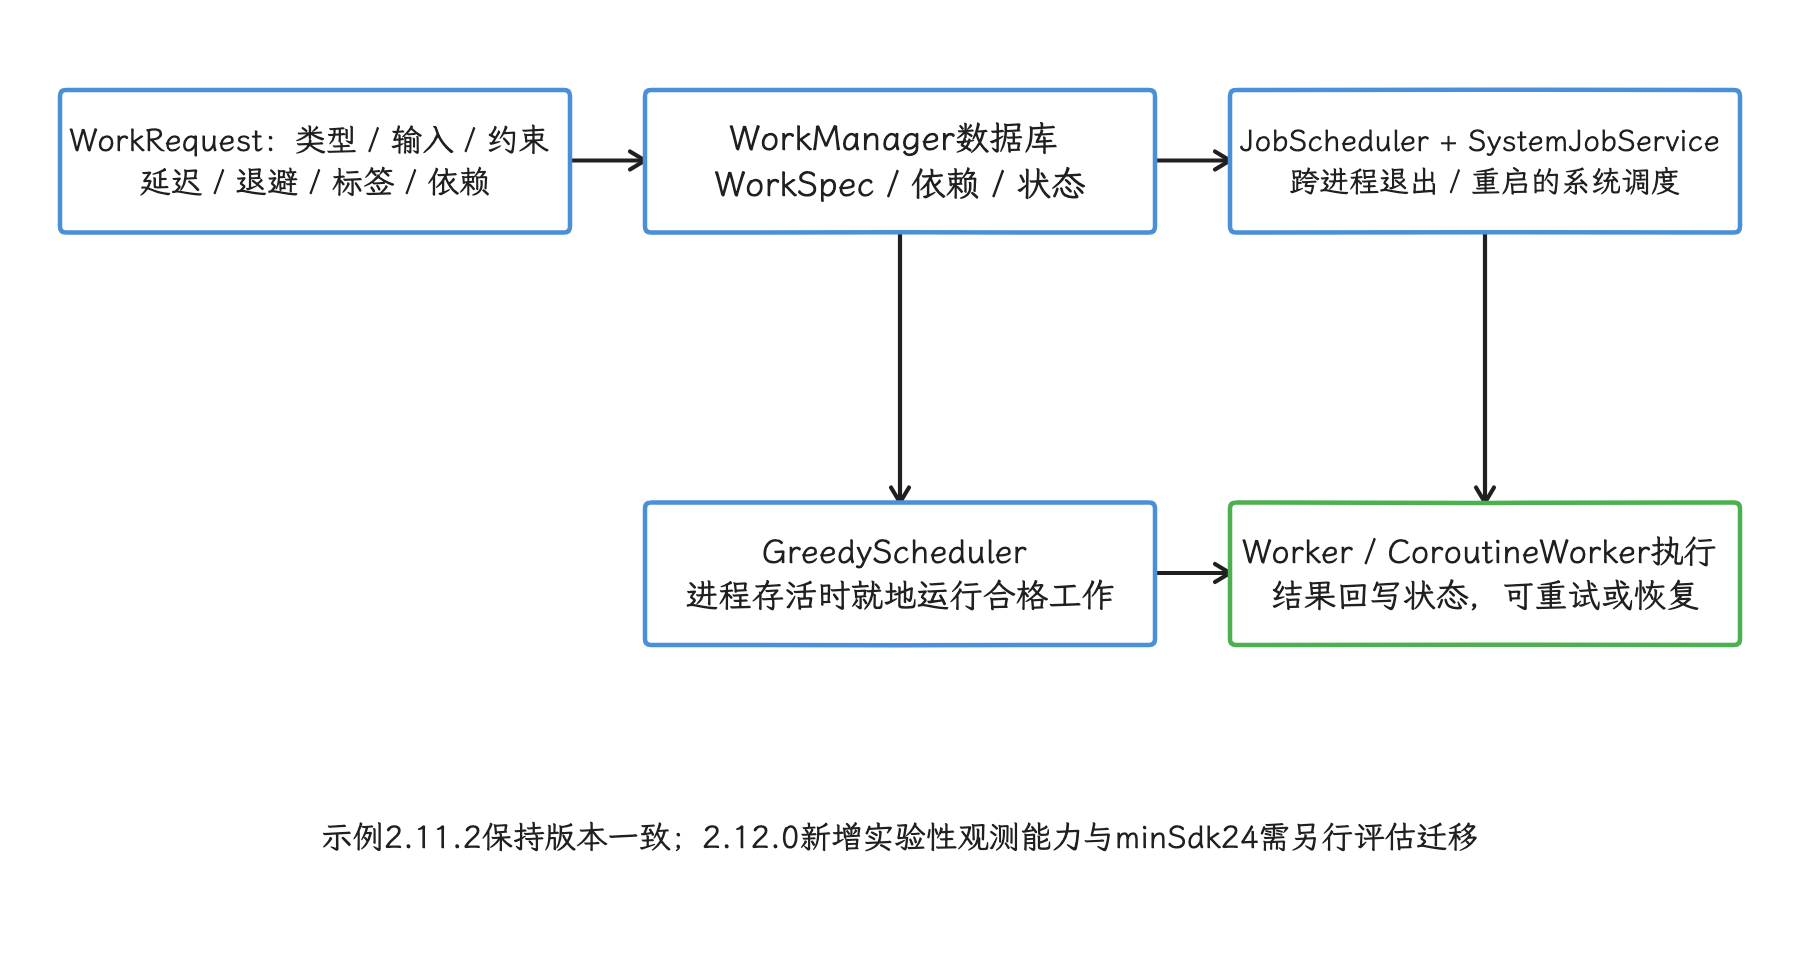
图:进程退出不自动删工作;force-stop阻止调度直到用户再次启动,卸载和取消则有不同后果。
Worker 类型与线程语义
Worker.doWork() 跑在 WorkManager 配置的后台 Executor(线程任务执行器) 上,适合同步阻塞接口;CoroutineWorker.doWork() 是挂起函数,没有自定义 Configuration.workerCoroutineContext 时默认使用 Dispatchers.Default(Kotlin 协程的默认计算调度器)。网络、文件和数据库操作仍应切换到相应的调度器——挂起函数里做阻塞 I/O(输入输出),照样占着线程。
这个 Worker 展示可取消的协程工作以及三种结果语义:
class ProfileSyncWorker(
    appContext: Context,
    params: WorkerParameters,
) : CoroutineWorker(appContext, params) {

    override suspend fun doWork(): Result = withContext(Dispatchers.IO) {
        val accountId = inputData.getString(KEY_ACCOUNT_ID)
            ?: return@withContext Result.failure()

        try {
            val operation = profileRepository.loadPendingSyncOperation(accountId)
                ?: return@withContext Result.success()
            profileRepository.sync(
                accountId = accountId,
                idempotencyKey = operation.id,
            )
            profileRepository.markSyncOperationComplete(operation.id)
            Result.success()
        } catch (e: AuthenticationRequiredException) {
            Result.failure()
        } catch (e: IOException) {
            if (runAttemptCount < MAX_ATTEMPTS - 1) Result.retry() else Result.failure()
        }
    }

    private companion object {
        const val KEY_ACCOUNT_ID = "account_id"
        const val MAX_ATTEMPTS = 5
    }
}
三种返回值对应三条出路:success() 进入成功终态,failure() 进入失败终态,retry() 让同一个 WorkSpec 按退避策略再次运行——退避就是失败后逐步延长重试间隔。profileRepository 是应用自有接口骨架:业务先持久化待同步操作和唯一 ID,loadPendingSyncOperation() 读取同一未确认操作;sync() 使用该 ID 向服务端去重,确认后才标记完成。下轮新的业务操作分配新 ID。尤其是周期任务,WorkRequest UUID 跨轮次不变,不能把 id.toString() 当成所有轮次共用的业务幂等键。代码只捕获可分类异常;CancellationException 继续传播,底层阻塞 I/O 仍需支持取消。
一次性任务与周期任务
一次性任务适合在条件满足后执行一次,周期任务适合长期重复检查。周期任务的最小间隔是 15 分钟,这只是最小周期,不保证每 15 分钟准点触发。
这段代码注册一个唯一的周期同步任务:
val syncConstraints = Constraints.Builder()
    .setRequiredNetworkType(NetworkType.CONNECTED)
    .setRequiresBatteryNotLow(true)
    .build()

val periodicSync = PeriodicWorkRequestBuilder<ProfileSyncWorker>(
    repeatInterval = 6,
    repeatIntervalTimeUnit = TimeUnit.HOURS,
)
    .setConstraints(syncConstraints)
    .setInputData(workDataOf("account_id" to accountId))
    .addTag("profile-sync")
    .build()

WorkManager.getInstance(context).enqueueUniquePeriodicWork(
    "profile-sync:$accountId",
    ExistingPeriodicWorkPolicy.UPDATE,
    periodicSync,
)
UPDATE 保留已有周期工作的入队时间,并让后续轮次采用新的约束和输入;如果旧的一轮正在执行,它不会被中断。只想保留旧配置时使用 KEEP,需要取消旧任务并重新计算周期时才使用 CANCEL_AND_REENQUEUE。
任务约束与系统适配
运行条件与执行时机
Constraints 中的条件采用 AND 关系,一个任务同时要求不计费网络、充电和存储空间充足时,三项都满足才有资格运行。我们把「有资格运行」和「此刻会执行」分开看:资格成立后,系统仍可以因为 Doze、应用待机分组、配额或负载把执行往后推。
六项常用约束分别表示:
setRequiredNetworkType()表达基础网络条件,包括CONNECTED、UNMETERED、NOT_ROAMING、METERED和TEMPORARILY_UNMETERED。setRequiresCharging(true)要求系统报告设备正在充电。setRequiresBatteryNotLow(true)要求系统报告电量处于非低电量状态。setRequiresStorageNotLow(true)要求系统报告存储处于非低存储状态。setRequiresDeviceIdle(true)要求平台 Job 的设备空闲约束成立。设备空闲包含的条件多于息屏,也不等同于只判断 Doze 的某一个状态。- API 24 及以上可用
addContentUriTrigger()监听本机content:URI 的变化。
电量和存储的判定阈值是系统实现细节,不在 WorkManager 公共契约里。我们想做「电池健康度低于某值才运行」「剩余空间低于某个百分比才运行」或「只在 Wi-Fi 6 上运行」这类精细控制时,就会发现这些布尔约束不够用。
精确网络能力
WorkManager 2.10.0 增加了 setRequiredNetworkRequest()。它在 API 28 及以上把 NetworkRequest(Android 网络能力请求) 交给 JobScheduler,第二个 NetworkType 参数用于在较低平台上表达同类约束。
这项约束要求网络已通过系统联网验证且不计费:
val requiredNetwork = NetworkRequest.Builder()
    .addCapability(NetworkCapabilities.NET_CAPABILITY_INTERNET)
    .addCapability(NetworkCapabilities.NET_CAPABILITY_VALIDATED)
    .addCapability(NetworkCapabilities.NET_CAPABILITY_NOT_METERED)
    .build()

val constraints = Constraints.Builder()
    .setRequiredNetworkRequest(
        requiredNetwork,
        NetworkType.UNMETERED,
    )
    .build()
在 API 28 以上,Worker 应使用 WorkerParameters.network 对应的网络执行请求,否则客户端库可能继续走默认网络,失去精确约束的意义。这个 API 描述传输类型和网络能力,不承诺吞吐、时延或信号强度。
约束在运行期间也会变化
工作开始后,网络断开、电量转低或存储状态变化都可能使约束失效,WorkManager 会停止 Worker,并在条件重新满足后重新调度。因此业务代码必须允许同一项工作从检查点再次进入——任务开始只是第一步,能否执行完成,还要看约束是否一直满足。
加急任务与配额
加急任务的语义
WorkManager 没有 setPriority(Int)。普通任务的相对顺序受入队、依赖、约束和系统调度共同影响,先入队不保证先执行。需要严格顺序时,用任务链或数据库状态机。
setExpedited() 面向短小、对用户重要且需要尽快开始的一次性工作;周期任务被排除在适用范围之外,加急换来的是尽快开始的机会,还谈不上立即执行。Android 12(API 31)及以上会申请 expedited job(加急系统任务);API 23–30 的兼容实现可能启动前台服务,因此支持这些平台的 Worker 需要提供有效的 ForegroundInfo(通知与前台服务信息)。
这个请求在加急配额不足时退回普通任务:
val expeditedSync = OneTimeWorkRequestBuilder<ProfileSyncWorker>()
    .setInputData(workDataOf("account_id" to accountId))
    .setConstraints(
        Constraints.Builder()
            .setRequiredNetworkType(NetworkType.CONNECTED)
            .build(),
    )
    .setExpedited(OutOfQuotaPolicy.RUN_AS_NON_EXPEDITED_WORK_REQUEST)
    .build()

WorkManager.getInstance(context).enqueue(expeditedSync)
该策略优先保证配额不足时任务仍被保留,但执行时间可能退化为普通 Job。加急配额与应用待机分组、进程重要性和近期使用情况有关,Android API 没有给应用一个固定可查询的分钟数。
支持 API 23–30 时,CoroutineWorker 还要实现前台信息入口 getForegroundInfo():
override suspend fun getForegroundInfo(): ForegroundInfo {
    return createForegroundInfo()
}
WorkManager 在需要以前台服务承载加急工作时调用它。返回的 ForegroundInfo 封装通知及前台服务类型;通知渠道必须已经创建,通知内容要让用户能够理解正在进行的操作。
三类工作的时长与配额
普通 Worker 的一次执行通常有十分钟上限,超时后会收到停止信号。加急工作面向短任务,官方建议控制在数分钟内;「数分钟」是量级描述,没有固定的三分钟承诺。
需要超过普通上限时,WorkManager 支持长时 Worker:调用 setForeground() 后,由 WorkManager 管理前台服务和通知。目标版本为 API 34 及以上时,必须声明与工作内容相符的前台服务类型和权限,并在 ForegroundInfo 中传入类型。
长时 Worker 也要面对平台上限:在 Android 15 及以上系统中,目标版本 35 及以上应用的 dataSync 与 mediaProcessing 前台服务各自在后台的 24 小时额度窗口内共享六小时运行时间(用户回到前台会重置;固定源码也有窗口重置规则);同一应用内相同类型的服务共同消耗对应额度。参见 Foreground service timeouts 与 §25.2。
这个清单为数据同步型长时 Worker 补充服务类型:
<manifest
    xmlns:android="http://schemas.android.com/apk/res/android"
    xmlns:tools="http://schemas.android.com/tools">

    <uses-permission android:name="android.permission.FOREGROUND_SERVICE" />
    <uses-permission android:name="android.permission.FOREGROUND_SERVICE_DATA_SYNC" />

    <application>
        <service
            android:name="androidx.work.impl.foreground.SystemForegroundService"
            android:foregroundServiceType="dataSync"
            tools:node="merge" />
    </application>
</manifest>
这段声明修改的是 WorkManager 已合并进应用清单的 SystemForegroundService。如果任务属于位置、媒体播放等其他类型,还要满足对应类型的权限和启动前置条件。
这个 Worker 在执行长下载前进入前台:
class ExportWorker(
    appContext: Context,
    params: WorkerParameters,
) : CoroutineWorker(appContext, params) {

    override suspend fun doWork(): Result {
        setForeground(createForegroundInfo())
        return exportRepository.export()
    }

    private fun createForegroundInfo(): ForegroundInfo {
        val notification = buildExportNotification(applicationContext)
        return ForegroundInfo(
            EXPORT_NOTIFICATION_ID,
            notification,
            ServiceInfo.FOREGROUND_SERVICE_TYPE_DATA_SYNC,
        )
    }
}
setForeground() 应在耗时操作之前调用。前台服务类型只是声明业务类别,JobScheduler 的配额检查照常进行;Android 16、17 上,长时 Worker 仍使用 JobScheduler,可能耗尽应用的 Job 配额。用户主动发起的大文件下载更适合用户发起的数据传输任务或直接前台服务。
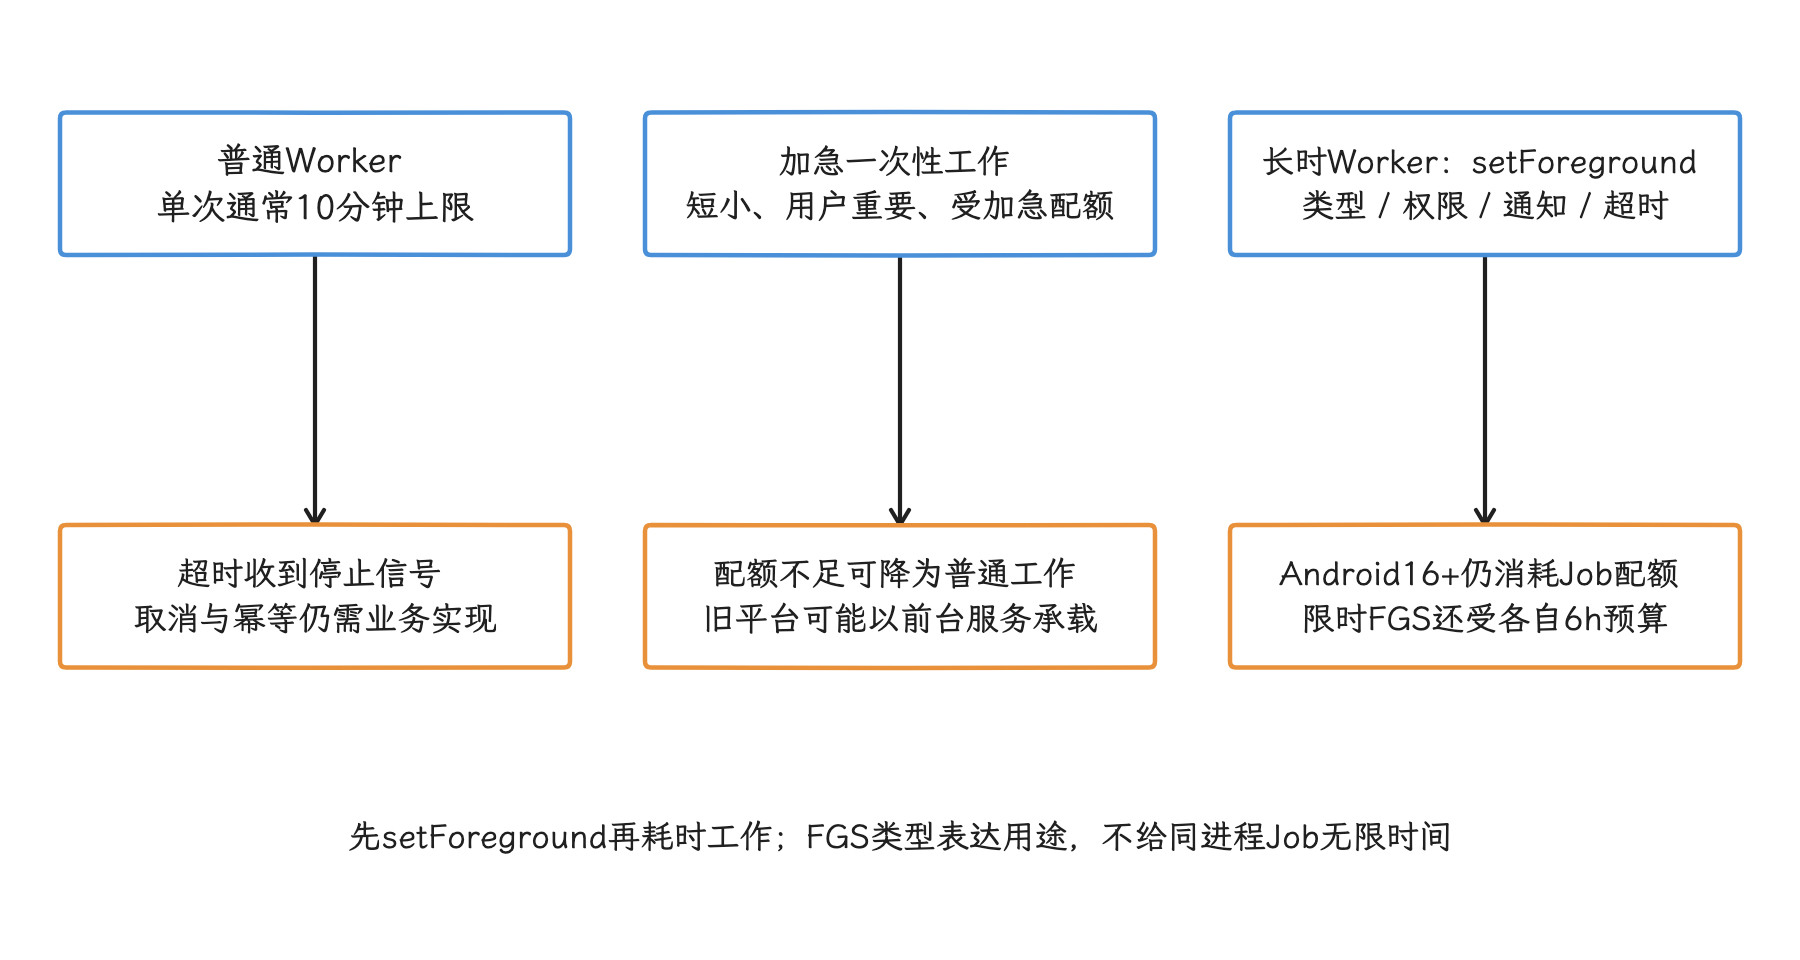
图:用户大文件传输可评估UIDT或直接FGS;可延后任务按约束与恢复语义选择。
重试、取消与幂等
幂等指同一业务操作重复执行时,不会产生重复扣款、重复写入等额外副作用。
退避与错误分类
这个请求使用 30 秒指数退避:
val upload = OneTimeWorkRequestBuilder<UploadWorker>()
    .setBackoffCriteria(
        BackoffPolicy.EXPONENTIAL,
        30,
        TimeUnit.SECONDS,
    )
    .build()
普通主动重试在 Worker 返回 Result.retry() 后使用这项配置;2.11.0 起的实验性 setBackoffForSystemInterruptions() 显式启用后,也会将同一策略应用于系统中断。setBackoffCriteria() 会把输入限制在 WorkRequest.MIN_BACKOFF_MILLIS 与 MAX_BACKOFF_MILLIS 支持的范围内;业务应使用这两个公开常量,不要依赖内部的 WorkSpec 常量。认证失效、参数非法等永久错误应返回 failure(),避免无意义地消耗后台配额。
重试次数没有自动的业务上限。应结合 runAttemptCount、HTTP 状态、服务器 Retry-After 和业务截止时间决定何时结束。周期工作的某一轮返回 failure() 也不会取消整个周期任务,后续周期仍可运行。
停止语义与外部副作用
WorkManager 可能因为取消、约束失效、超时或系统抢占停止 Worker。CoroutineWorker 会收到协程取消;Worker 应定期检查 isStopped,并可在 onStopped() 中释放本进程资源。
这里要认清一个现实:WorkManager 数据库中的状态变化与服务端写入、文件替换、支付请求等外部副作用分属两边,中间不存在共同的事务。一个上传可能已被服务器接受,但本地还没来得及返回 success()。所以可靠实现通常需要:
- 以 WorkRequest ID(标识) 或业务操作 ID 作为幂等键;
- 大任务记录可恢复检查点;
- 文件先写临时文件,再用原子重命名发布,使其他读取者只能看到完整旧文件或完整新文件;
- 服务端返回的操作结果先持久化,再向 WorkManager 返回成功。
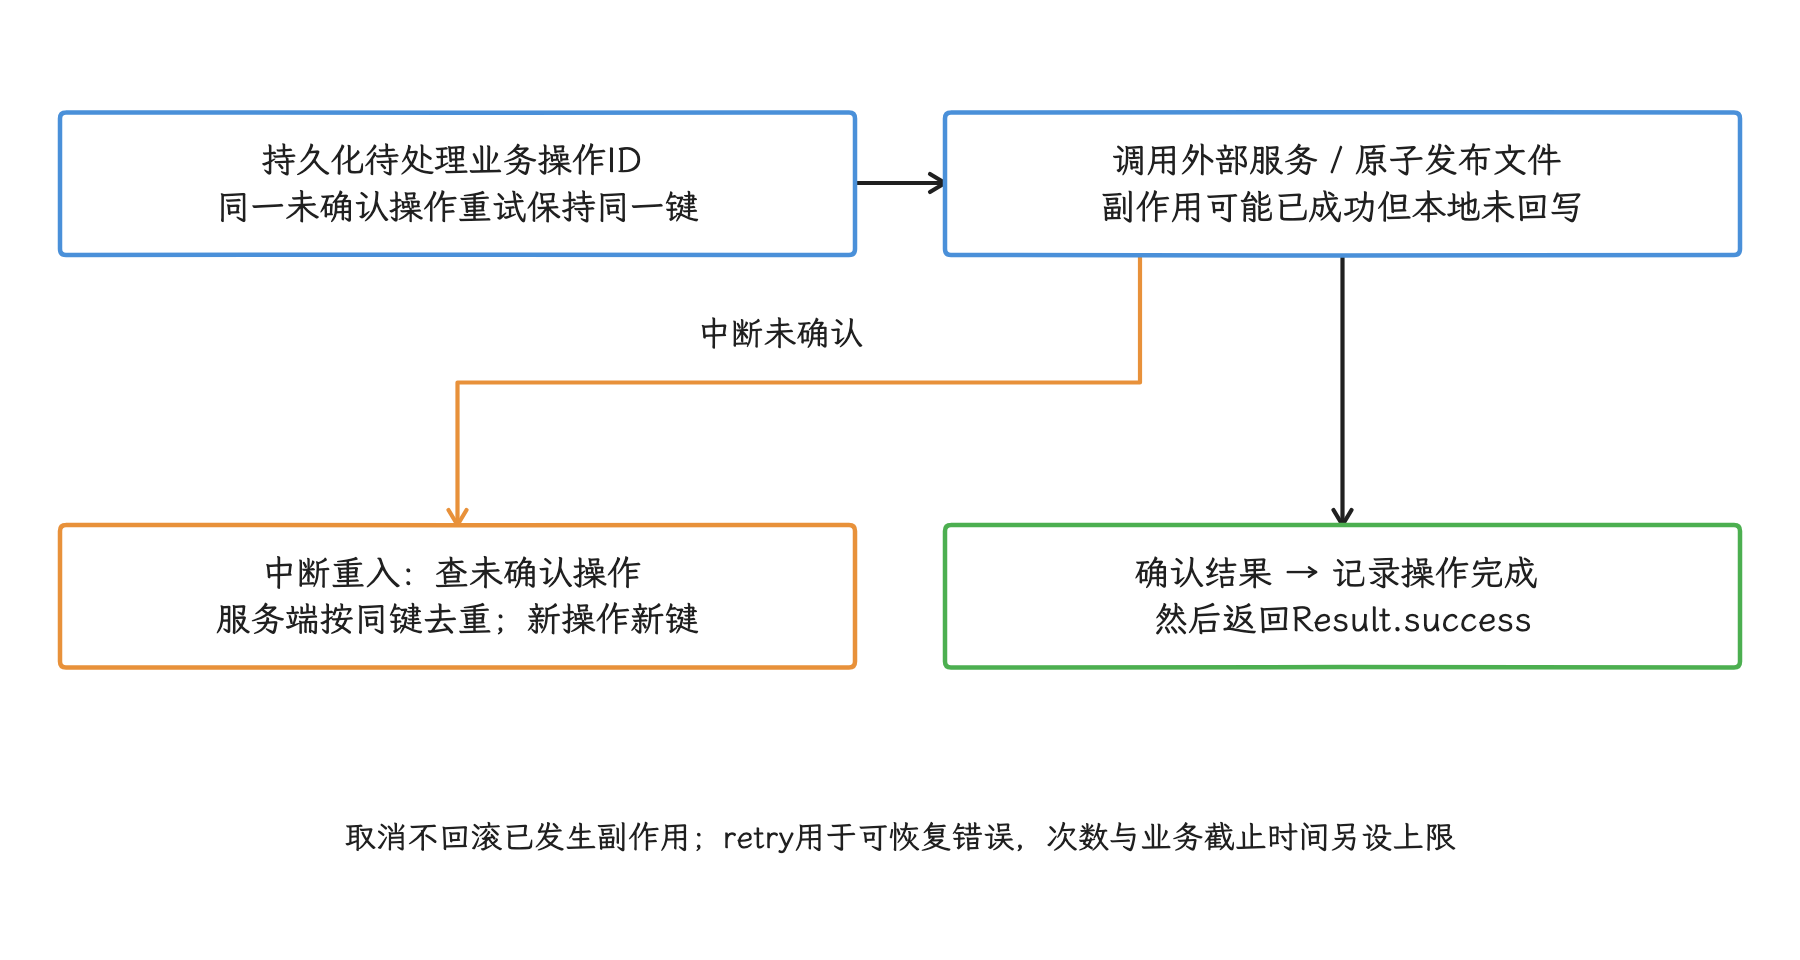
图:周期WorkRequest跨轮次UUID不变;固定UUID作为每轮新同步的永久幂等键会压掉后续业务。
任务链与依赖管理
串行、并行和汇聚
这个任务图先并行下载两份数据,待两项都成功后再合并和上传:
val downloadProfile = OneTimeWorkRequestBuilder<DownloadProfileWorker>().build()
val downloadMessages = OneTimeWorkRequestBuilder<DownloadMessagesWorker>().build()
val merge = OneTimeWorkRequestBuilder<MergeWorker>().build()
val upload = OneTimeWorkRequestBuilder<UploadWorker>().build()

WorkManager.getInstance(context)
    .beginWith(listOf(downloadProfile, downloadMessages))
    .then(merge)
    .then(upload)
    .enqueue()
enqueue() 才会把整张有向无环图(依赖方向明确且不存在环的任务图)写入 WorkManager。merge 只有在两个下载都成功后才会运行;任一前置工作失败,依赖项会进入失败状态;任一前置工作被取消,依赖项会被取消。
上游失败时,下游 Worker 不会开始,也就轮不到下游去检查上游的失败并执行备用任务。想继续执行备用路径,可以让上游把可接受的业务降级结果作为 success(Data) 返回;不可接受的失败则在链外观察终态,再明确入队另一条工作。
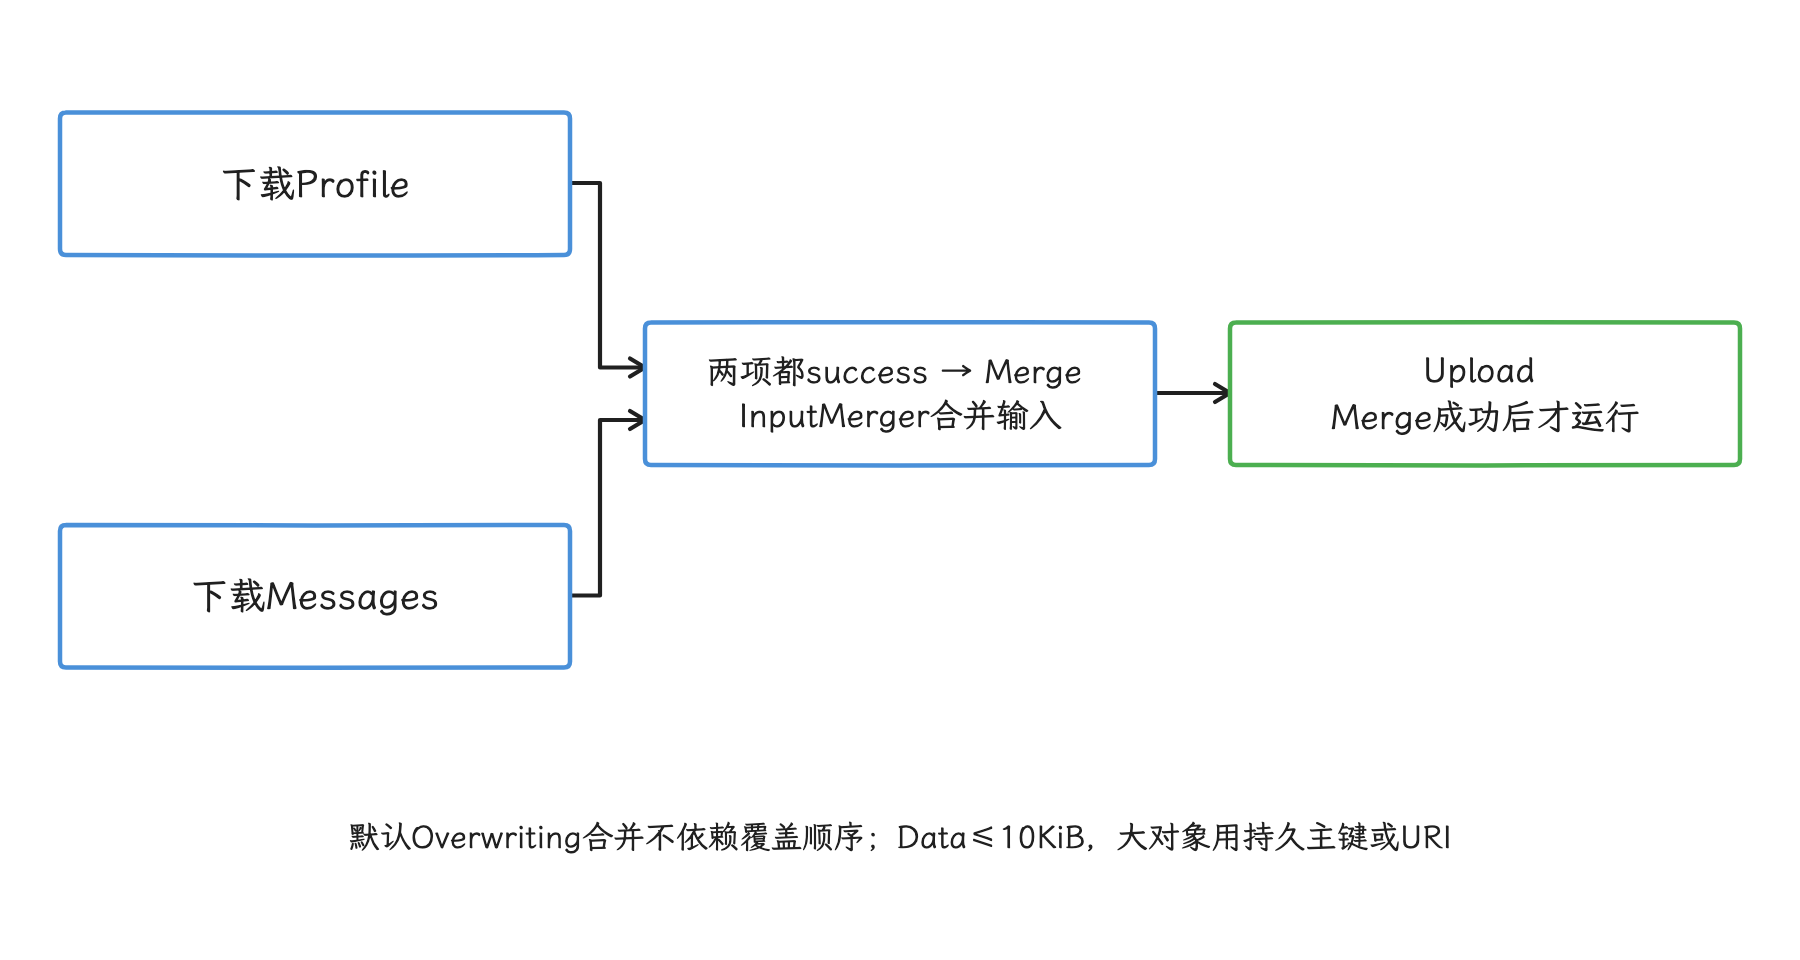
图:任一前置failure使依赖失败,任一前置cancel使依赖取消;下游不会开始后再判断前置失败。
输入合并与 Data 限制
单个上游的 Result.success(outputData) 会成为下游输入的一部分。多个前置 Worker 汇聚时,由 InputMerger(输入数据合并器) 负责合并:
- 默认的
OverwritingInputMerger遇到同名键时只保留一个值,业务逻辑要避免依赖覆盖顺序; ArrayCreatingInputMerger会把同名值组成数组,适合收集多个并行结果;- 自定义
InputMerger适合有明确合并规则的结构。
这个汇聚任务显式选择数组合并:
val merge = OneTimeWorkRequestBuilder<MergeWorker>()
    .setInputMerger(ArrayCreatingInputMerger::class)
    .build()
MergeWorker 读取的是合并后的输入。Data 只支持字符串、基本类型及其数组,序列化后的大小以 Data.MAX_DATA_BYTES(10 KiB,即 10,240 字节)为上限。大对象应存入数据库或文件,Data 只传主键、内容摘要或持久化 URI;跨重启使用 URI 时还要确保权限仍然有效。
唯一工作策略
enqueueUniqueWork() 用唯一名称解决重复入队,不负责业务去重本身:
KEEP:已有未完成同名链时忽略新请求;REPLACE:取消并删除现有链,再插入新请求;APPEND:把新请求附加到现有链的叶子节点;旧链已经失败或取消时,新请求会继承该终态;APPEND_OR_REPLACE:旧链可继续时追加,旧链失败或取消时新建链。
这个写法用 KEEP 保证同一账户同一时间只保留一条同步链:
WorkManager.getInstance(context).enqueueUniqueWork(
    "account-sync:$accountId",
    ExistingWorkPolicy.KEEP,
    syncRequest,
)
唯一名称应包含业务作用域。所有账户共用 "sync" 会把互不相关的请求误判为同一项工作;反过来,为每次点击生成随机名称则失去去重作用。
任务生命周期监控
WorkInfo.State 包含 ENQUEUED、RUNNING、BLOCKED、SUCCEEDED、FAILED 和 CANCELLED,前三项仍会变化,后三项是终态。BLOCKED 表示依赖尚未满足,跟设备约束未满足是两回事。
WorkManager 2.9.0 起提供 Kotlin Flow(异步数据流) 查询。这段观察代码绑定到页面可见生命周期,避免 observeForever() 留下释放不掉的观察者:
lifecycleScope.launch {
    repeatOnLifecycle(Lifecycle.State.STARTED) {
        WorkManager.getInstance(requireContext())
            .getWorkInfoByIdFlow(requestId)
            .filterNotNull()
            .collect { info ->
                renderState(
                    state = info.state,
                    progress = info.progress,
                    stopReason = info.stopReason,
                )
            }
    }
}
progress 只适合做界面提示,业务提交记录要另找地方。stopReason 用于诊断本次停止原因;Worker 后续仍可能重新调度,看到一次停止就标成永久失败会误判。
从三层排查未运行原因
排查时我们按 WorkManager、系统 Job、Worker 业务三层收集信息:
- WorkManager 层确认 WorkSpec 状态、约束、依赖和入队时间。
- JobScheduler 层确认对应
SystemJobServiceJob 是否仍在等待,以及受哪项约束或配额限制。 - Worker 层确认是否进入
doWork()、返回了什么结果、是否收到停止信号。
这项自定义配置在调试构建中开启详细日志:
class App : Application(), Configuration.Provider {
    override val workManagerConfiguration: Configuration
        get() = Configuration.Builder()
            .setMinimumLoggingLevel(
                if (BuildConfig.DEBUG) Log.DEBUG else Log.INFO,
            )
            .build()
}
WorkManager 日志标签通常以 WM- 开头。发布版本不宜长期启用过细日志,以免增加 I/O 和暴露业务参数。
下面两条命令分别检查系统 Job 和请求 WorkManager 输出诊断信息:
adb shell dumpsys jobscheduler
adb shell am broadcast \
  -a androidx.work.diagnostics.REQUEST_DIAGNOSTICS \
  -p com.example.app
诊断广播会在 logcat(Android 系统日志缓冲区) 中输出最近完成、正在运行和已调度的工作。执行前把命令里的包名替换为被测应用。WorkManager 2.10.0 起为交给 JobScheduler 的 Job 增加 Worker trace tag(追踪标签),dumpsys jobscheduler 的输出因此更容易关联到具体 Worker,但输出文本格式未经承诺,解析脚本要按「随时会变」来设计。
Perfetto 适合分析 Worker 运行时占用的线程和 CPU 时间;至于任务为什么还没获得调度,Perfetto 单独给不出答案。Trace 区段名称属于库实现细节,升级 WorkManager 后可能改变。
Pending Reasons(待执行原因) 与 JobDebugInfo
Android 17 功能页把一组待执行原因能力称为 JobDebugInfo,但公开 SDK 中没有同名类。应用调用的入口仍在 JobScheduler,历史元素类型是 PendingJobReasonsInfo:
| API | 起始版本 | 回答的问题 |
|---|---|---|
getPendingJobReason(jobId) | 34 | 返回一个主要等待原因,适合快速提示 |
getPendingJobReasons(jobId) | 36 | 当前有哪些原因同时阻止执行 |
getPendingJobReasonsHistory(jobId) | 36 | 网络、电量、Doze、配额等原因怎样变化 |
getPendingJobReasonStats(jobId) | 37 | 每种原因累计等待多久 |
这些方法的返回类型、异常和版本范围以 JobScheduler API 为准。
多个原因可以同时计时,所以各项累计时长之和可能大于 Job 的实际等待时间。这些历史和统计不会跨设备重启保存;Job 成功完成或取消后,统计也会清空。
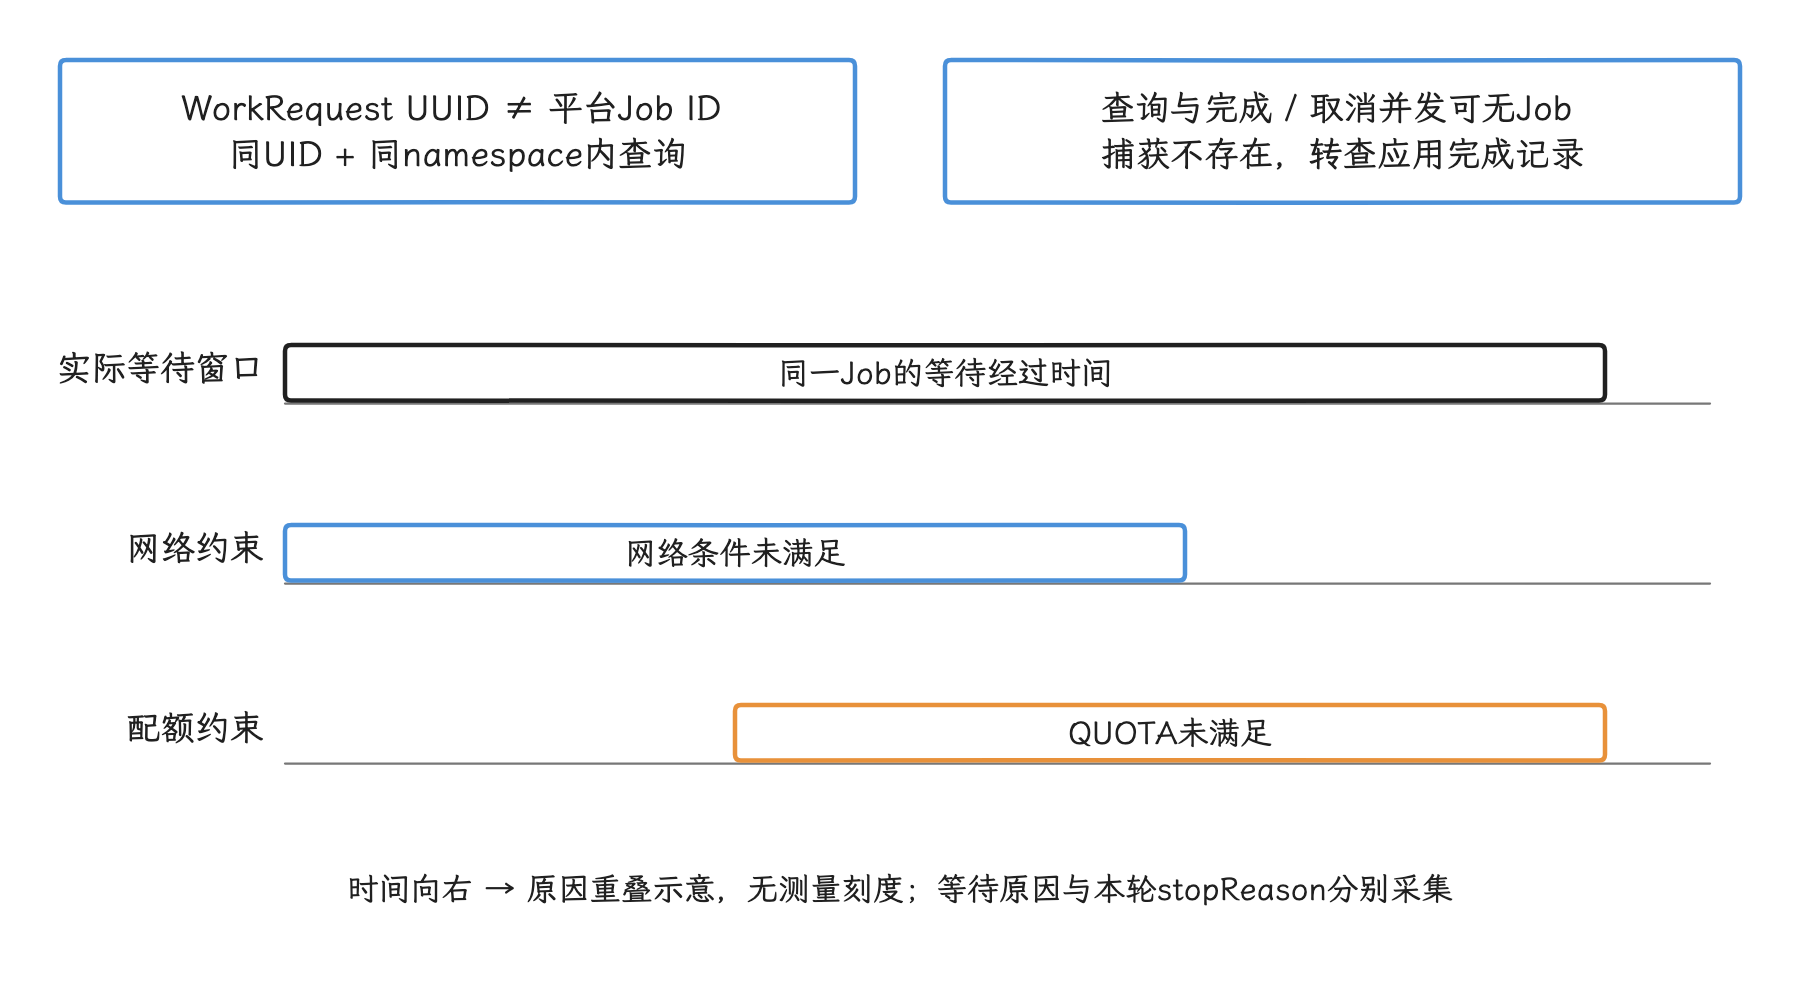
图:多个原因重叠累计不能相加当总等待;调度器没有Job后,应用自己的完成记录仍须保留。
采集查询若正好与 Job 完成或取消同时发生,可能因对象已不存在而抛出 IllegalArgumentException,此时应转查应用自己的完成记录。查询范围还受应用 UID(系统分配的应用身份) 与 JobScheduler namespace(命名空间) 限制,用 forNamespace() 调度的 Job 必须从同一命名空间查询。
原因常量只给出排查方向,我们把它们当索引用:CONSTRAINT_* 指向显式约束,QUOTA 指向待机分组或运行额度,BACKGROUND_RESTRICTION / APP_STANDBY 指向应用状态,DEVICE_STATE 还可能包含 Doze、热状态、内存压力或并发槽位。它们必须与 WorkInfo、停止原因、dumpsys jobscheduler 和业务阶段日志一起解释。
WorkManager 使用自己的 WorkRequest UUID(通用唯一标识符),系统 API 查询的是平台 Job ID;两套 ID 的映射属于内部实现,应用侧各自查询自己那一份。量产采集只保留取值种类少且稳定的字段,例如任务类型、API level、当前原因集合、累计等待最久的少量原因、停止原因、重试次数与按范围归类的等待时长。不要上传原始 Job ID、WorkRequest UUID、URL、文件名或完整 dumpsys。
发布门禁要把等待分成两类看:合理等待和设计错误。低优先级同步等待充电或未计费网络,通常说明约束在生效;用户发起任务长期等待 QUOTA、任务反复入队却不完成,或重试放大配额消耗时,需要改用 UIDT、前台入口、唯一任务、分片与更合理的退避。
初始化与执行资源
默认情况下,AndroidX Startup(Jetpack 组件自动初始化库)会通过 WorkManagerInitializer 初始化 WorkManager。需要自定义线程池、日志级别、WorkerFactory(Worker 实例创建工厂) 或默认进程时,应先移除 WorkManager 的默认初始化项,再让 Application 实现 Configuration.Provider;仅实现 Provider 而保留默认 WorkManagerInitializer,自定义配置不会生效。也不要在自动初始化仍启用时再次调用 WorkManager.initialize()。
这项配置把同步 Worker 和 CoroutineWorker 的执行资源都设为应用级固定线程池:
class App : Application(), Configuration.Provider {
    private val workerExecutor = Executors.newFixedThreadPool(4)
    private val workerDispatcher = workerExecutor.asCoroutineDispatcher()

    override val workManagerConfiguration: Configuration
        get() = Configuration.Builder()
            .setExecutor(workerExecutor)
            .setWorkerCoroutineContext(workerDispatcher)
            .setMinimumLoggingLevel(Log.INFO)
            .build()
}
数字 4 只是示例,本身没有推荐含义。我们定线程数的依据是:Worker 是否阻塞、同一时间的网络连接数、数据库写竞争、CPU 核心数和实测队列等待。setExecutor() 只配置执行资源,系统调度与 WorkManager 内部状态还会进一步限制同时运行的 Worker 数量。
采用这里的 Configuration.Provider 自定义/按需初始化时,必须从清单中移除 AndroidX Startup 下的 WorkManager 初始化项。这条合并规则只移除 WorkManager,不影响其他 Startup initializer(初始化器):
<provider
    android:name="androidx.startup.InitializationProvider"
    android:authorities="${applicationId}.androidx-startup"
    tools:node="merge">
    <meta-data
        android:name="androidx.work.WorkManagerInitializer"
        android:value="androidx.startup"
        tools:node="remove" />
</provider>
完成移除后,由 Configuration.Provider 提供配置并在首次获取 WorkManager 时初始化。直接调用 WorkManager.initialize() 只保留给用不上 Provider 的特殊启动架构,且整个应用生命周期只能初始化一次。
并发的多层限制
自定义 Configuration.executor 只改变 Worker 和部分内部任务用的线程资源,系统级并发和任务优先级由系统侧决定。可运行数还受约束、依赖、WorkManager 调度器、JobScheduler 配额、进程状态和业务资源限制影响;盲目扩大线程池,换来的是数据库、网络和 CPU 上更多的竞争。
多进程任务调度
多进程支持解决两个不同问题:
RemoteWorkManager把非默认进程中的入队、查询和取消请求转发到指定的 WorkManager 默认进程,减少多进程同时访问内部数据库造成的竞争;RemoteListenableWorker/RemoteCoroutineWorker把某个 Worker 的执行委托给指定进程中的RemoteWorkerService。
两者都需要 androidx.work:work-multiprocess:2.11.2。加进程的代价要先算清:额外进程会增加内存、Binder 通信、初始化和状态一致性成本;普通应用缺少内存隔离、原生库隔离或现有多进程架构需求时,单为后台任务加进程通常得不偿失。
指定 WorkManager 默认进程
这项配置明确把应用默认进程设为 WorkManager 的主调度进程:
override val workManagerConfiguration: Configuration
    get() = Configuration.Builder()
        .setDefaultProcessName(packageName)
        .build()
进程名必须是完整名称,并与清单中的实际进程一致。如果选择 "$packageName:work" 这样的专用进程,还要把 RemoteWorkManagerService 配置到同一进程;只调用 setDefaultProcessName() 不会改写清单中的 Service 进程。
这个调用可从非默认进程把请求转发到主调度进程:
RemoteWorkManager.getInstance(context).enqueue(request)
它返回 ListenableFuture(可监听完成状态的异步结果),供调用方观察入队操作是否完成。非默认进程要把自己当客户端看待——WorkManager 的内部数据库只在默认进程里维护一份。
在指定进程执行 RemoteCoroutineWorker
这个清单把官方 RemoteWorkerService 放入 :worker_process:
<service
    android:name="androidx.work.multiprocess.RemoteWorkerService"
    android:exported="false"
    android:process=":worker_process" />
exported="false" 限制其他应用绑定该服务。android:process 决定执行进程,Worker 类本身不通过清单声明进程。
这个 Worker 的逻辑会在服务所在进程执行:
class ThumbnailRemoteWorker(
    appContext: Context,
    params: WorkerParameters,
) : RemoteCoroutineWorker(appContext, params) {

    override suspend fun doRemoteWork(): Result {
        return thumbnailRepository.generate(inputData)
    }
}
doRemoteWork() 是远端执行入口。构造函数仍由 WorkManager 按 WorkerFactory 规则创建,因此自定义依赖注入(由框架提供 Worker 所需对象)要同时验证远端进程的初始化路径。
这个请求通过两个保留键指定要绑定的 Service 组件:
val service = ComponentName(
    context.packageName,
    RemoteWorkerService::class.java.name,
)

val remoteInput = workDataOf(
    RemoteListenableWorker.ARGUMENT_PACKAGE_NAME to service.packageName,
    RemoteListenableWorker.ARGUMENT_CLASS_NAME to service.className,
    "source_uri" to sourceUri.toString(),
)

val request = OneTimeWorkRequestBuilder<ThumbnailRemoteWorker>()
    .setInputData(remoteInput)
    .build()
ARGUMENT_PACKAGE_NAME 与 ARGUMENT_CLASS_NAME 描述的是 RemoteWorkerService 的 ComponentName,不是 ThumbnailRemoteWorker 的类名。Worker 类型已经由 OneTimeWorkRequestBuilder<ThumbnailRemoteWorker>() 记录。若有多个远端进程,可以为 RemoteWorkerService 建立不同子类,并分别在清单中指定进程。
远端执行并不会自动带来业务数据的多进程一致性。Room 数据库、文件和进程内单例仍要按各自的多进程规则设计;进程内互斥锁罩不住另一个进程的写入,跨进程的同步要另找机制。
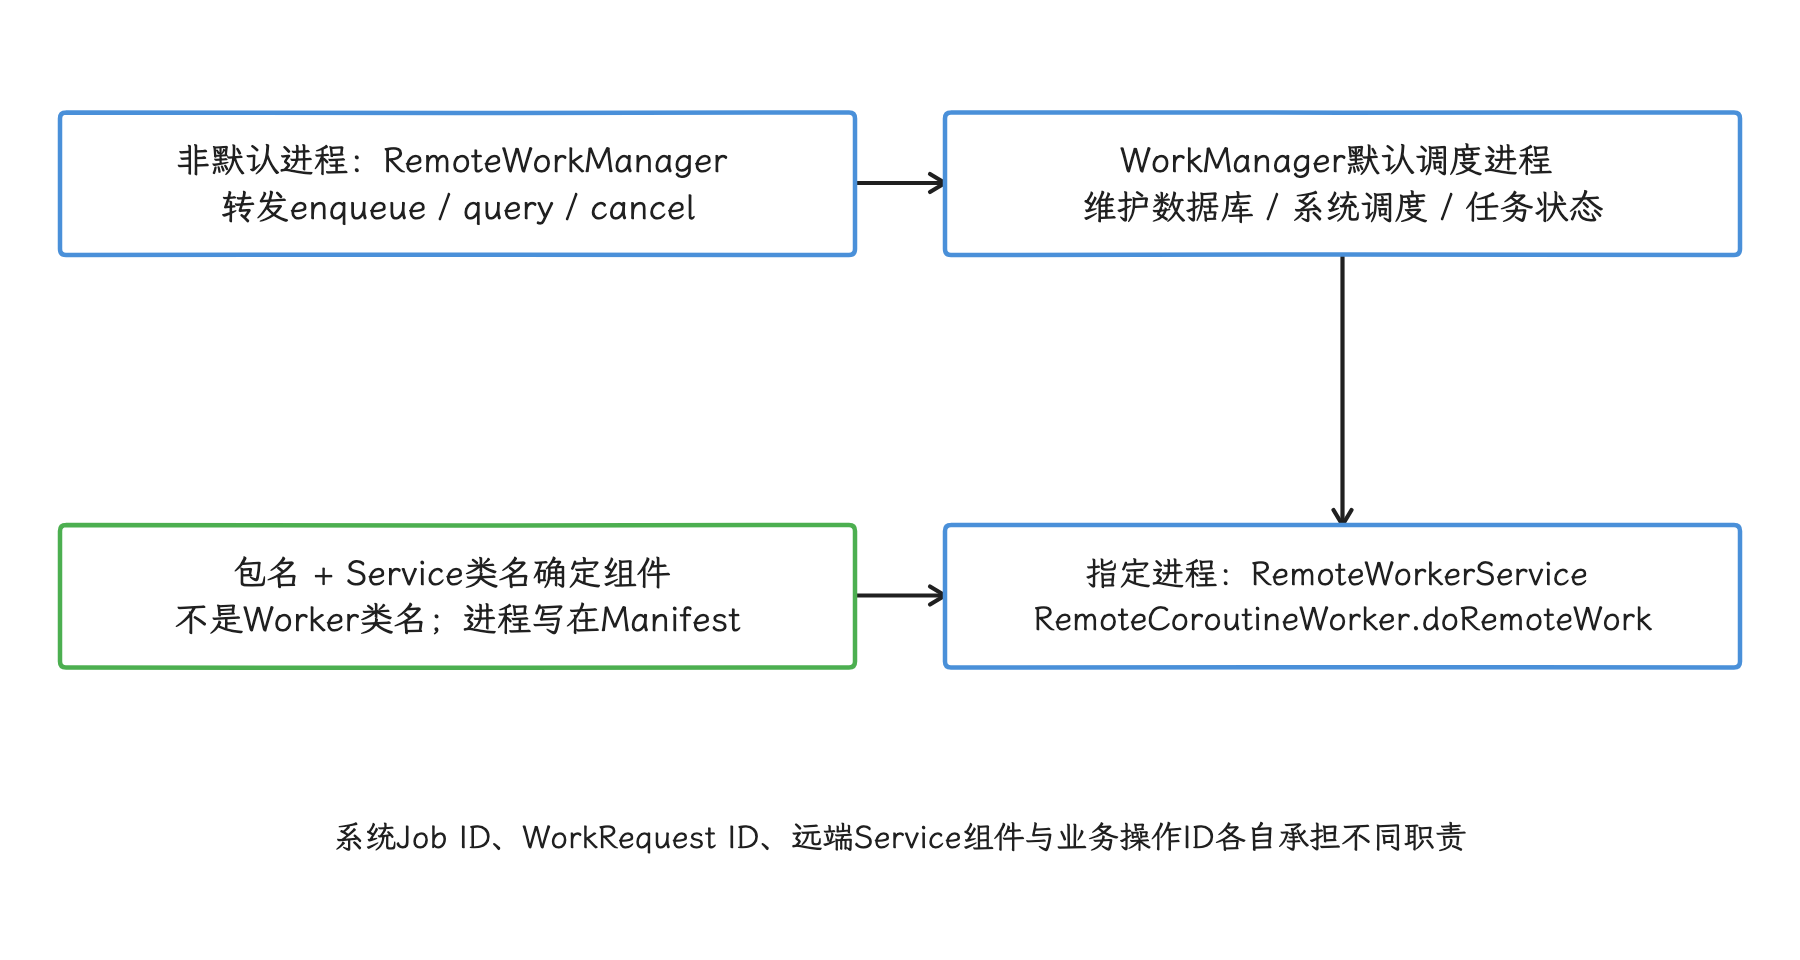
图:setDefaultProcessName不改Manifest;远端依赖注入与业务数据库、文件一致性都需单独验证。
设计检查表
我们提交一个 Worker 前,逐项回答这些问题:
- 工作是否需要跨进程退出或设备重启继续?如果不需要,普通协程更简单。
- 执行时间是否允许由系统决定?要求准点的任务应回到 AlarmManager。
- 每项约束是否对应业务必需条件?只为省电叠加多个约束可能让任务长期等待。
- 网络或系统中断后能否安全重入?外部副作用是否有幂等键或检查点?
retry()是否只用于可恢复错误,并且有业务结束条件?- 周期工作是否使用稳定唯一名称,更新策略是否符合预期?
Data是否只传轻量标识,而非业务对象或文件内容?- 长时工作是否声明正确的前台服务类型,并评估 Android 16–17 的 Job 配额?
- 多进程是否来自明确的隔离需求,远端 Service、默认进程和数据一致性是否一起验证?
全文小结
WakeLock 保护已经开始的短暂工作,Alarm 安排未来的时间通知,WorkManager 在系统约束下执行可延迟且需要持久化的任务。三者各管一段,互相代替不了:持锁要有明确所有权与释放,Alarm 要从时间基准、精度和是否唤醒出发,Worker 要接受执行时机与中断由系统决定。
可靠调度还需要我们把精确 Alarm 权限、Listener Alarm 的进程存活条件、Worker 约束、加急/长时配额、重试、唯一工作、任务链和多进程职责分别建模。系统停止只结束本轮执行,不会回滚外部副作用;幂等键、检查点、取消传播和分层诊断才是恢复的基础。