端侧大模型推理的内存管理
我们做端侧大模型,内存风险很少只来自模型文件本身。权重、KV 缓存(Key/Value Cache,保留注意力计算的历史键和值)、prefill(预填充) 阶段的临时张量、运行时编译产物、GPU/NPU 缓冲区,再加上应用自身的 Java 与 native 内存,会在不同阶段叠加出不同的峰值。所以模型能加载,还只是第一步:长上下文生成、并发会话、后台切换能否稳住,要分开验证。
源码基线:AOSP
android-17.0.0_r1,内核android17-6.18-2026-06_r6;平台为 Android 17 / API 37。
LiteRT、LiteRT-LM 和 MediaPipe LLM Inference 是独立发布的库,能力要按项目锁定的库版本和目标设备验证,Android API 级别推不出这些库的能力。2026-10-25 复核时,LiteRT CompiledModel Kotlin 文档示例依赖为 2.3.0,MediaPipe LLM Inference 已进入维护模式。虚拟地址与物理内存指标的区别可参阅 23.3 Native 与虚拟内存管理优化。设备可能使用其他内核分支。
1. 先把内存分项记清楚
1.1 六类常驻或阶段性内存
动手测内存之前,我们先把几个术语约定好。模型把文本切成离散单元来处理,这个单元叫 token;输入、中间值和输出保存在多维数组 tensor(张量) 里;delegate 是把部分计算图交给 GPU、NPU 等后端执行的运行时插件。prefill 一次处理完输入提示词并建立 KV 缓存(Key/Value Cache,保存每层注意力历史键和值的会话缓存),decode(解码) 随后逐个生成输出 token。
| 类别 | 典型内容 | 容易出现峰值的阶段 | 主要控制量 |
|---|---|---|---|
| 模型权重 | embedding(把 token 转成向量)、attention(组合上下文信息)、FFN(逐位置前馈网络)、量化元数据 | 文件映射、运行时初始化、delegate 准备 | 参数量、位宽、混合精度、是否重排或复制 |
| KV 缓存 | 每层历史 token 的 Key/Value | prefill 结束、持续 decode | 上下文长度、批大小、KV 头数、元素类型 |
| 临时张量 | attention 分数、FFN 中间值、prefill 工作区 | 首次运行、长提示词的 prefill | 分块大小、算子实现、缓冲区复用 |
| 编译与后端资源 | 计算图、着色器、NPU 编译产物、命令缓冲区 | delegate 初始化、首次运行 | 后端、AOT(提前编译)/JIT(设备运行时编译)、驱动实现 |
| 输入与输出 | tokenizer(把文本切成 token 的分词器)缓冲区、Bitmap、音频、输出 token | 多模态预处理、流式输出 | 输入尺寸、并发请求、对象生命周期 |
| 应用基线 | ART 托管堆、native heap、线程栈、代码与 UI | 进程整个生命周期 | 依赖、缓存、线程和页面状态 |
排查时我们要按阶段记录。一次 dumpsys meminfo 只反映采样那一刻的状态:至少要区分未加载模型、模型文件打开、运行时和 delegate 初始化完成、首次运行、prefill 峰值、稳定 decode、取消生成、关闭会话、关闭模型这几个点。表中六类内存的峰值时刻各不相同,中间峰值要靠这些分阶段的采样点才抓得到,加载完成或生成结束后的单点快照看不到它们。
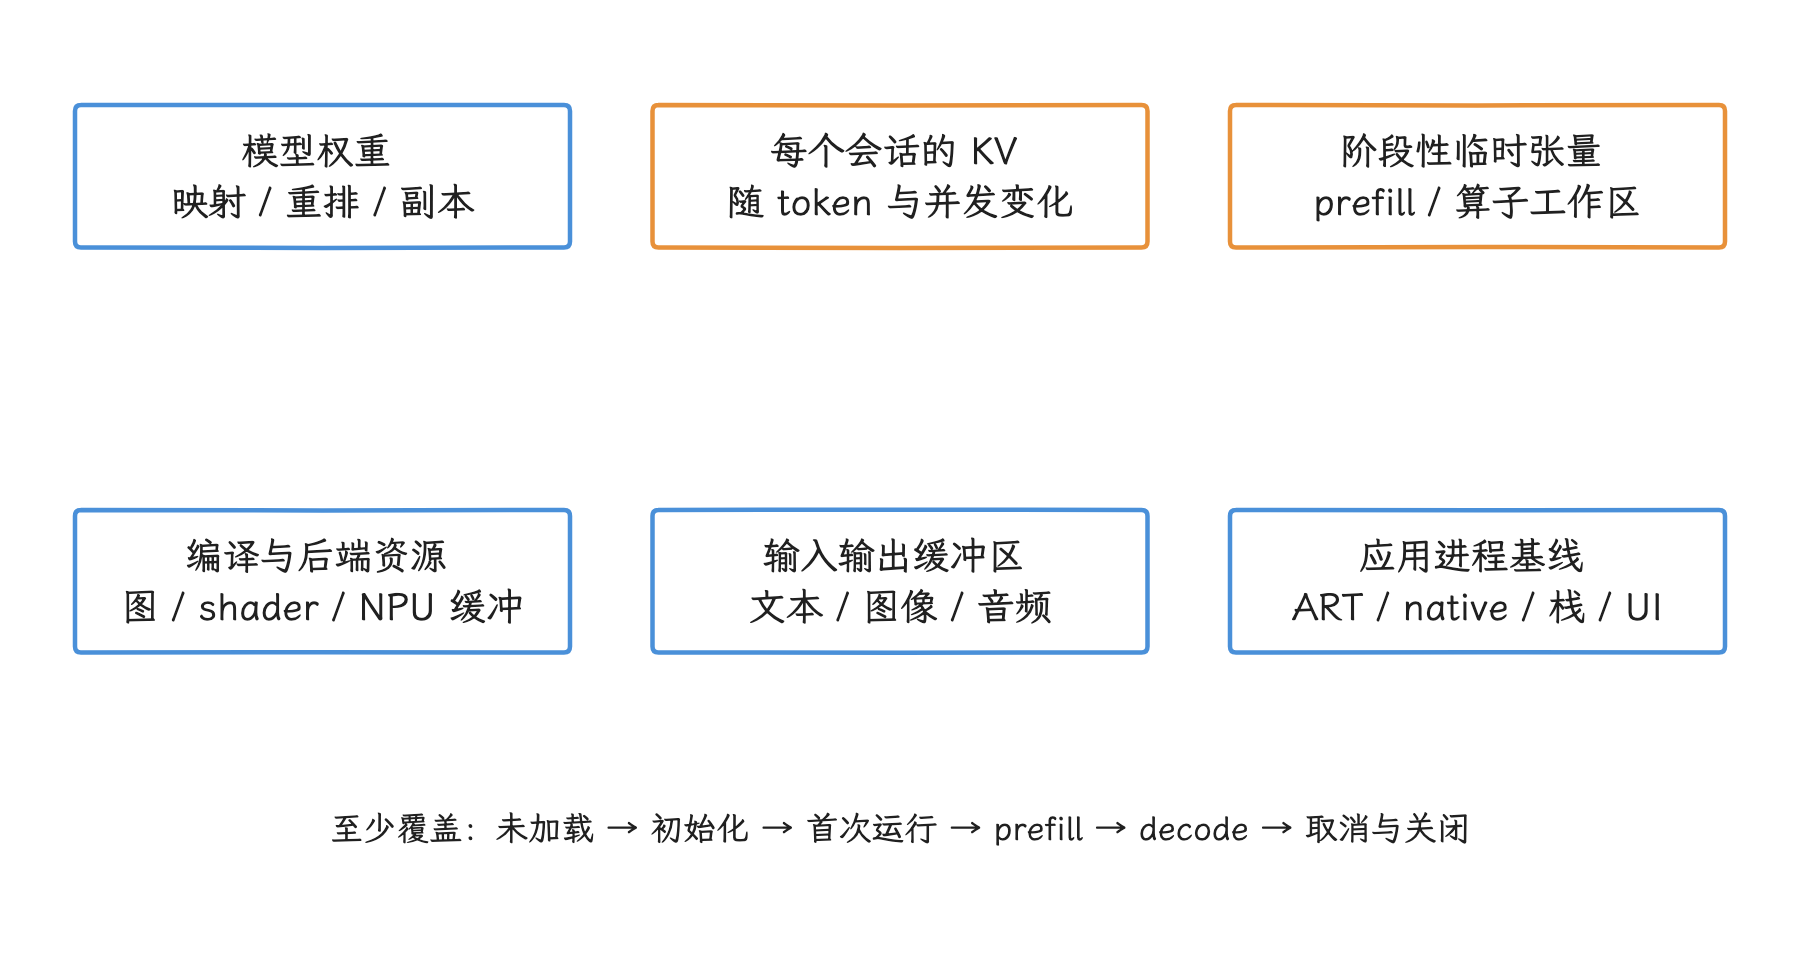
图:按分配归属和推理阶段分别采样:权重只是预算的一项,初始化、prefill 与多会话都可能形成峰值。
1.2 权重大小的理论下限
如果参数量为 (P),平均权重位宽为 (b),仅权重数据的理论下限是:
weight_min_bytes = P × b ÷ 8
下表按十进制参数量计算,再换算成 GiB,覆盖的只有权重数据本身;scale(量化缩放因子)、zero-point(非对称量化的零点偏移)、分组索引、padding(对齐填充)、分词器词表元数据、运行时副本和编译产物都要另算(embedding 权重若已计入参数量 P,不应再作为额外权重重复计数):
| 参数量 | FP16 下限 | 8-bit 下限 | 4-bit 下限 |
|---|---|---|---|
| 2B | 3.73 GiB | 1.86 GiB | 0.93 GiB |
| 7B | 13.04 GiB | 6.52 GiB | 3.26 GiB |
| 13B | 24.21 GiB | 12.11 GiB | 6.05 GiB |
不过,“4-bit 模型”也可能保留 FP16/FP32 的归一化层、embedding 或输出层。分组量化要为每组保存 scale (把量化整数还原到数值范围的缩放因子),非对称方案通常还需要 zero-point。所以表中数字只是权重位数的换算结果;模型文件比它们大时,先对照上面这些附加项,再判断打包有没有问题。
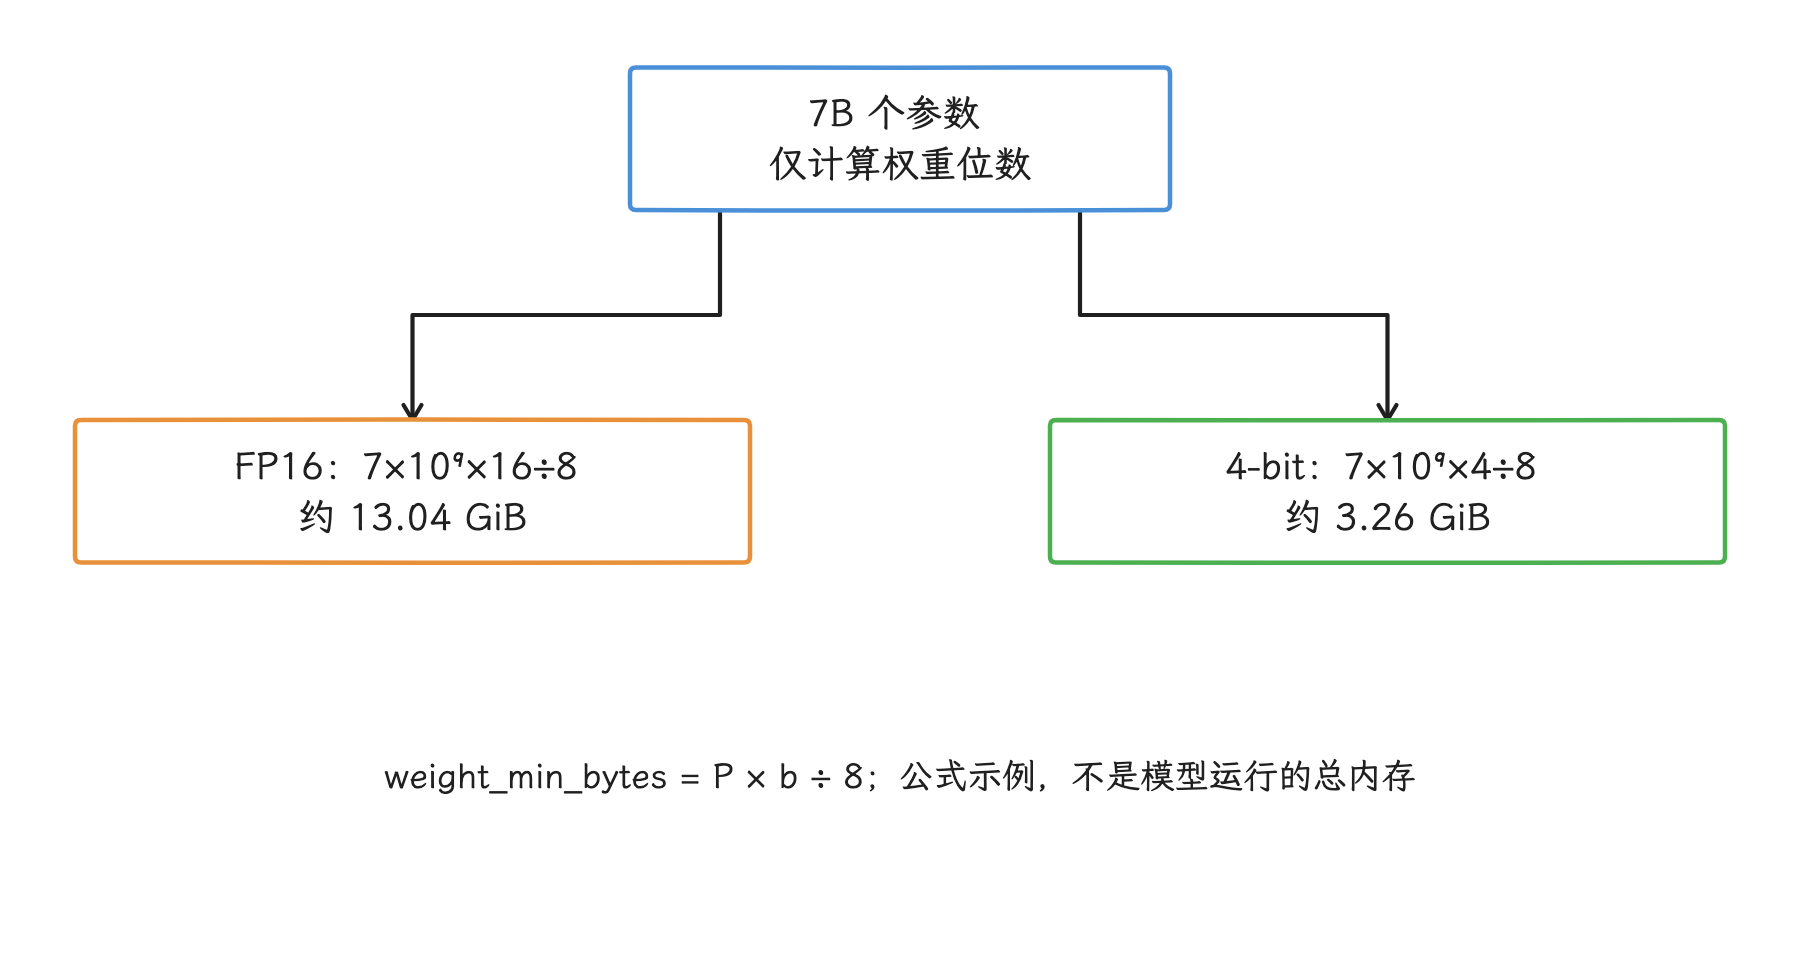
图:权重位宽给出理论数据量;量化元数据、混合精度、运行时副本、KV 和工作区仍需另算。
选量化方案时,压缩率只是其中一个输入:算子是否被目标后端支持、是否触发 CPU 回退、加载时是否反量化或重排,都会改变运行时内存。精度变化还依赖模型、校准集、量化算法和任务,通用的 MMLU(多学科问答基准)降幅只能当参考,验收要回到应用自己的任务上。
1.3 KV 缓存要按模型配置计算
我们拿一个每层都保留完整 K/V、没有滑动窗口、逐 token 自回归生成的 decoder(自回归生成部分) 来算,KV 缓存的估算公式是:
kv_bytes = 2 × batch × layers × kv_heads × head_dim × cached_tokens × element_bytes
系数 2 对应 Key 和 Value 两份。这里要用 kv_heads:一个 attention head(注意力头) 就是一组并行处理注意力投影的单元。GQA(Grouped-Query Attention)让一组查询头共享 KV 头,MQA(Multi-Query Attention)则让更多查询头共用同一组 K/V,所以 KV 头数可能比 query 头数少,估算时以 kv_heads 为准,query head 数先放到一边。
举个有量级的例子:批大小 1、32 层、8 个 KV 头、每个头的维度(head dimension) 128、缓存 4096 个 token、每个元素 2 字节,结果是 512 MiB;只把 KV 头数改成 32,结果就变成 2 GiB。这两个数是公式演示,不对应某个产品模型。
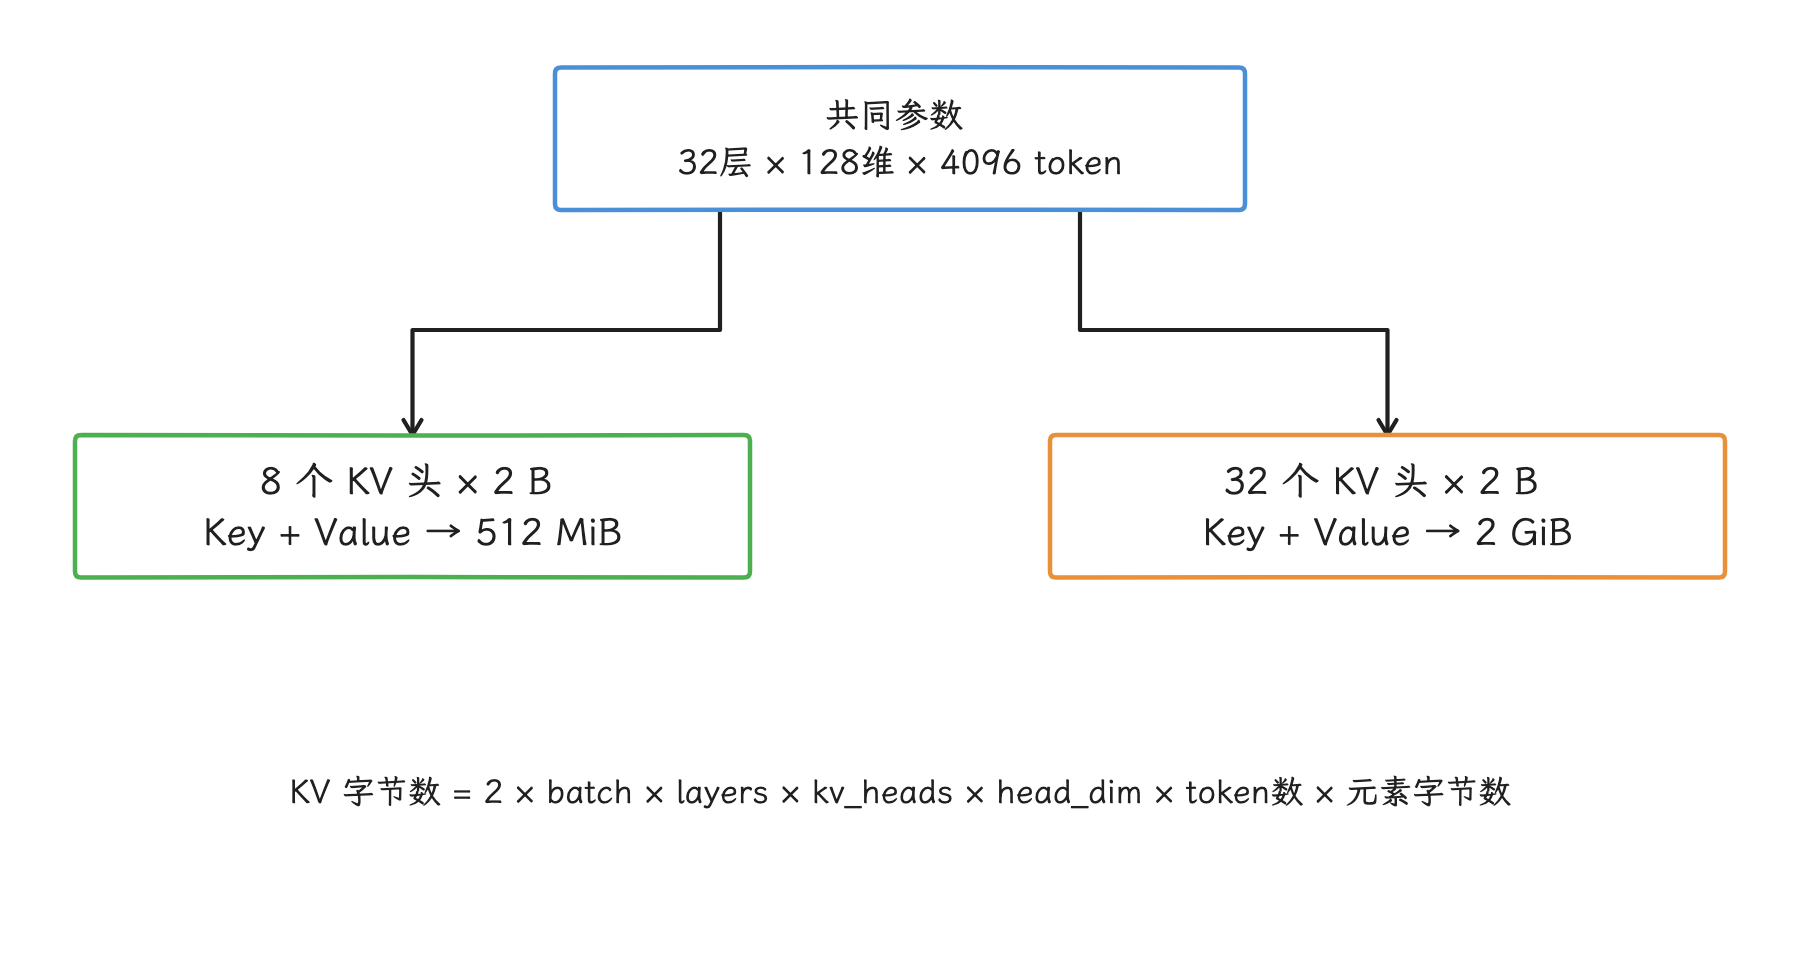
图:查询头共享 KV 头时,应使用 kv_heads 预算。权重量化不会自动降低 KV 元素的字节数。
在这条公式之上,还要处理几项修正:
- 部分层采用滑动窗口 attention 时,这些层保留的 token 数只能限制到窗口大小,global attention(全局注意力) 层仍可能保留完整上下文。
- KV 量化只有在引擎明确支持时才会减少缓存;权重量化不会自动改变 KV 的元素类型。
- 并发会话通常各自拥有 KV 缓存,共享同一份权重不代表共享会话状态。
- 推测解码(speculative decoding)会增加草稿模型的权重和会话状态,内存收益要单独评估,速度收益只是速度收益。
- 前缀缓存、分页 KV 或会话状态导出/导入都属于引擎能力,Android 端是否具备,要按所用引擎逐项确认。
引擎侧也有现实约束。MediaPipe LLM Inference 目前处于维护模式,官方建议新 Android 项目迁移到 LiteRT-LM Android Kotlin API。存量项目使用的 MediaPipe LlmInferenceOptions.maxTokens() 源码注释把 maxTokens 定义为输入与输出 token 的总上限,会话上下文的上界就由这个参数决定;具体内存仍要由模型结构和后端实测,迁移到 LiteRT-LM 之后,还要按新的模型格式与会话配置重新算一遍。
1.4 文件映射与运行时缓冲区
权重以只读文件映射加载时,VSS(虚拟地址映射总量) 先增加,RSS(当前驻留物理页) 和 PSS(按共享比例分摊的物理内存) 随后随缺页和回收变化,三者的区别可以回看开头的 23.3 一节。文件页可以被内核回收,也可以与其他进程共享页缓存;但后端仍可能为了对齐、布局转换、量化解码或设备私有格式,另外分配一份缓冲区。
所以我们观察内存时要分开记账,逐项看:模型文件映射的 VSS、RSS/PSS;native heap 与匿名映射;图形统计、DMA-BUF(跨设备共享缓冲区的内核对象) 或 memtrack(硬件内存记账)能看到的设备缓冲区;delegate 初始化前后的增量;第一次推理前后的增量。
还有一点容易算错:把模型文件大小、native heap 和 GPU 缓冲区直接相加,可能重复计算同一物理页。比较应用多进程总成本时,可用同一口径的 PSS 加总来分摊共享驻留页;PSS 可能不能完整覆盖 GPU/NPU 私有缓冲,仍须结合驱动、memtrack/DMA-BUF 与运行时统计,各分类用于归因而不机械相加。
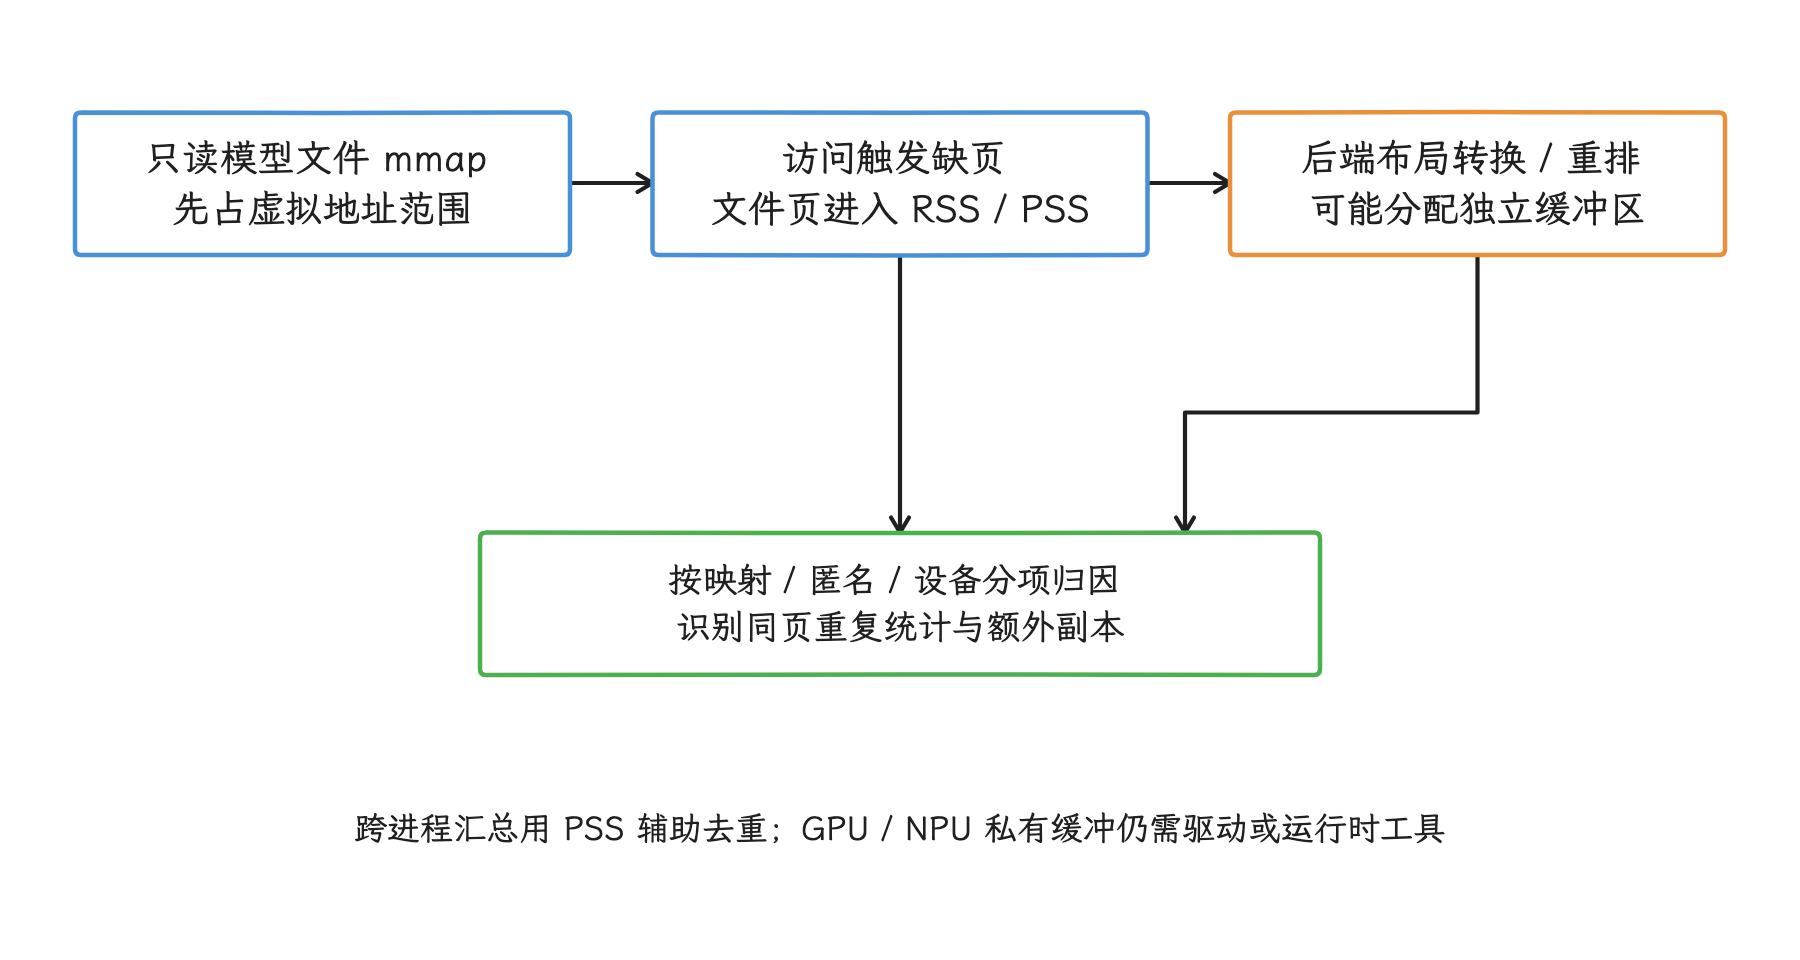
图:文件体积、native heap 和设备缓冲不能直接相加;先确认是否描述同一物理页,再记录独立后端副本。
1.5 16 KiB 页与数据搬运的峰值
16 KiB 页设备会改变模型文件映射、原生分配器区域和小映射的页面粒度:自研加载器要避免写死 4096 字节对齐,文件 mmap() 的 offset(文件偏移) 必须遵守运行时页大小,APK/ELF 也要按官方 16 KiB 兼容要求构建。页变大并不会自动让每个 tensor 各占一个 16 KiB 页,变化的是内部碎片和驻留页的观察结果。
跨进程或跨硬件后端传递大 tensor 时,Binder(Android 进程间通信机制) 只传控制信息、句柄和小型元数据,数据本体优先走运行时张量缓冲区、SharedMemory、文件描述符,或满足消费端约束的 AHardwareBuffer。Java direct ByteBuffer 通常没有可访问的 Java 数组,native 地址要另外确认,arrayOffset() 给不出答案。即便共享缓冲区能被后端导入,我们也要用跟踪数据验证有没有发生 CPU staging copy(先复制到过渡缓冲区)、后端重排或额外设备副本。
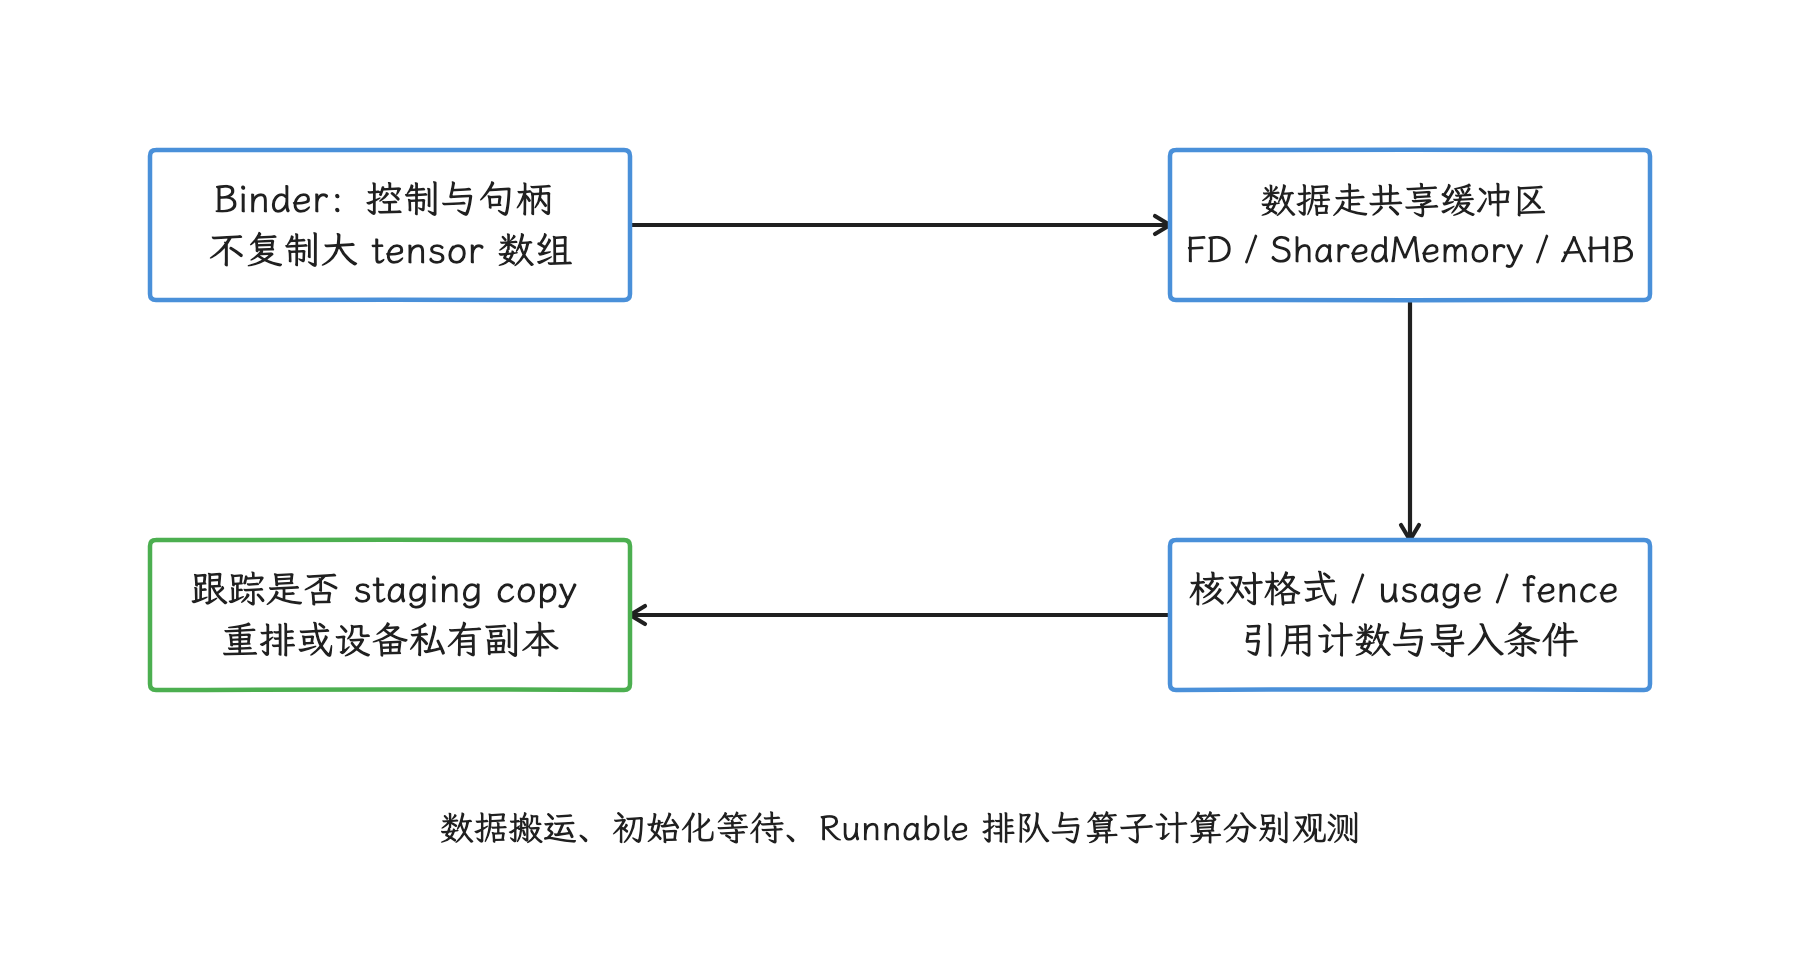
图:句柄减少 Binder 数据量;共享缓冲能否直用,取决于消费端的格式、同步与导入能力。
最后是线程问题:模型加载、delegate 初始化和首次编译不要放在主线程。在 Perfetto 里,除了计算 slice(一段带起止时间的跟踪事件),我们还要看 Binder 等待、Runnable 排队、page fault(缺页事件)、大块 memcpy 和后端返回码——数据搬运与初始化等待很容易被误判成“算子计算慢”。
2. 设备 RAM 与应用预算的关系
2.1 三种上限回答不同问题
我们向系统要预算时,先要分清三个上限各自回答的问题。ActivityManager.getMemoryClass() 与 getLargeMemoryClass() 描述的是应用 Java 托管堆容量的近似档位,native heap、线程栈、文件映射和图形缓冲区都在这个档位之外;系统在内存压力下还会根据进程重要性和整体压力回收或终止进程。
availMem是系统层面的可用内存估算,源码注释明确说明它只是参考值;threshold是系统开始清理后台服务和其他进程时参考的阈值;lowMemory表示系统当前是否处于低内存状态。
这三个字段说的都是系统整体状态,应用自己能分到多少额度,它们回答不了。availMem >= model_file_size × 1.5 这类固定公式也会漏掉应用基线、KV 缓存、后端副本、进程优先级和并发工作集,做上线准入条件是不够的。
系统侧的控制在 system_server 与系统守护进程内:MemoryLimiter.java 和 LMKD/OOM-adj 控制都在那里,LMKD 是低内存终止守护进程,OOM-adj 是系统衡量进程可终止优先级的分值。普通应用没有公共 API 为自己设置 memory.high、memory.swap.max 或 OOM-adj,也不要通过反射或 shell 权限绕过系统策略。
2.2 为每个模型变体建立设备档案
可执行的预算来自目标设备测试。我们为每个模型变体建立设备档案,每条档案至少包含:
- 模型与量化格式的不可变版本,以及运行时、delegate 与驱动版本;
- ABI、Android 版本、页大小、SoC(片上系统) 和物理 RAM 档位;
- 后端与回退结果;
- 上下文上限、并发会话数、输入模态与尺寸;
- 各阶段 PSS、RSS、
VmHWM、native heap 和可见的图形/DMA 数据; - 冷加载、热加载、取消、释放和重新加载结果;
- 发生 delegate 编译失败、
mmap/allocator(内存分配器) 失败、Java OOM 或 LMK 的现场。
即便同一个模型,在两台 RAM 相同的设备上也可能是不同结果:驱动是否复制权重、NPU 编译策略、GPU 共享内存核算、厂商后台进程,都会影响可用余量。
2.3 降级项的独立配置
降级项建议分开配置,只留“完整模型”和“拒绝运行”两个状态是不够的:
| 维度 | 可选动作 | 需要重新验证的内容 |
|---|---|---|
| 模型 | 参数更少或量化更强的变体 | 精度、算子覆盖、加载峰值 |
| 上下文 | 降低输入与输出 token 总上限 | 业务可用性、KV 缓存峰值 |
| 会话 | 限制并发、关闭闲置会话 | 排队时延、取消语义 |
| 模态 | 降低图像尺寸、限制图像/音频数量 | 任务质量、预处理峰值 |
| 后端 | NPU/GPU 失败后按设备档案选择 GPU/CPU | 回退路径的内存与延迟 |
| 预热 | 关闭后台预加载或 JIT 预热 | 首次请求时延 |
每个组合都要有实测档案。量化更强的模型如果触发 CPU 回退,内存和时延都可能比原方案更差。
3. 运行时生命周期决定峰值
3.1 一个资源管理器负责模型、会话和缓冲区
实践中最容易出问题的,是模型、delegate、会话、KV 缓存、输入/输出缓冲区由不同代码路径各自关闭。我们应把它们交给同一个生命周期组件管理,释放顺序遵守运行时的所有权关系:
- 停止接收新请求;
- 请求取消正在生成的任务;
- 等待回调和后端工作结束;
- 关闭会话,释放 KV 缓存;
- 关闭 I/O、图像、音频和共享缓冲区;
- 关闭模型、delegate 与运行时;
- 清除只为该模型服务的分词器和业务缓存。
这里有一条硬约束:异步回调仍可能访问对象时,先等它结束,再关闭它持有的 native 资源句柄。框架实现 AutoCloseable 时,用 try-with-resources、Kotlin use 或显式 finally。处于维护模式的 MediaPipe LLM Inference 示例也把 LlmInference 与 LlmInferenceSession 放进受控的关闭范围;迁移到 LiteRT-LM 后,再按新 API 的所有权约定确认一遍关闭顺序。
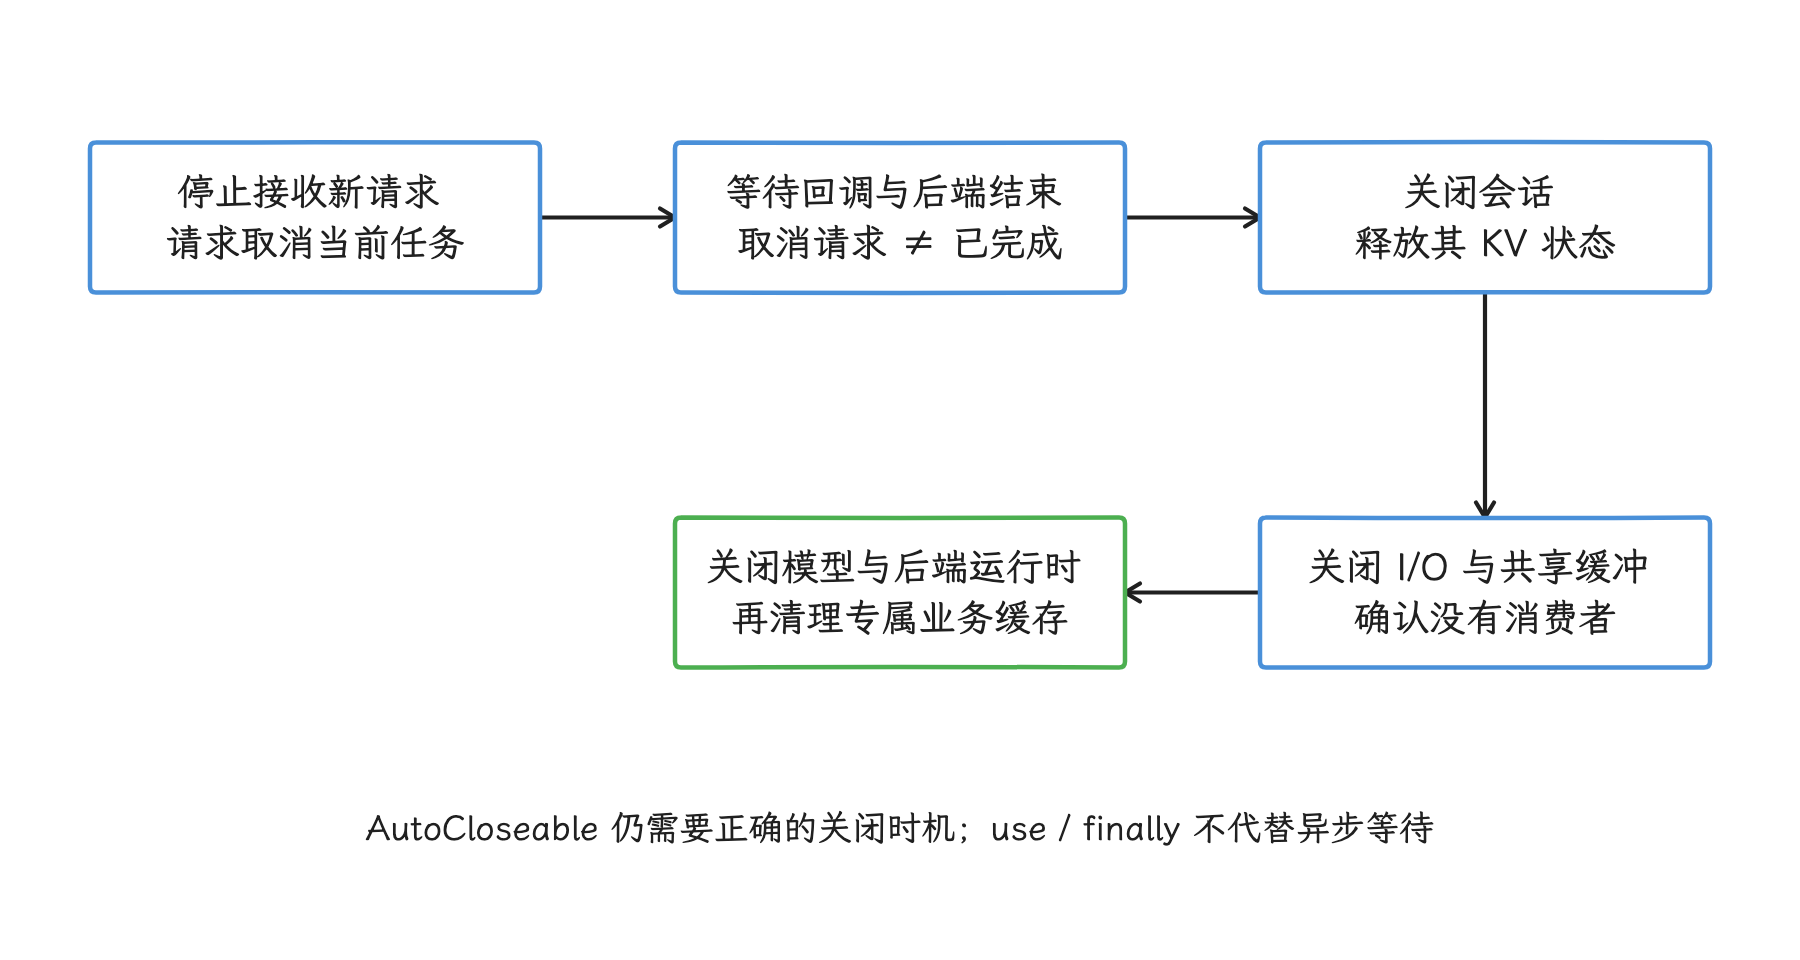
图:先等待异步消费者结束,再按所有权逆序关闭资源;不能在后端仍执行时直接 munmap 权重。
3.2 模型切换时的双份驻留
模型切换是另一个容易漏算的峰值。“先加载新模型,成功后再释放旧模型”确实能降低切换失败的风险,但代价是双模型同时驻留。内存紧张的设备应采用以下过程:
- 保存可重建的会话文本和业务状态;
- 停止旧会话;
- 关闭旧模型,并记录释放后的资源对象数量、PSS/RSS 与 native 分配快照;
- 加载目标变体;
- 加载失败时进入更小变体或云端路径。
判断“旧资源已经关干净”也要小心:内存分配器、驱动缓存或文件页可能让数值延迟回落,要多看几份快照再下结论。若产品要求无缝切换,双模型窗口就必须作为独立场景进入预算,归入正常单模型峰值会低估它。
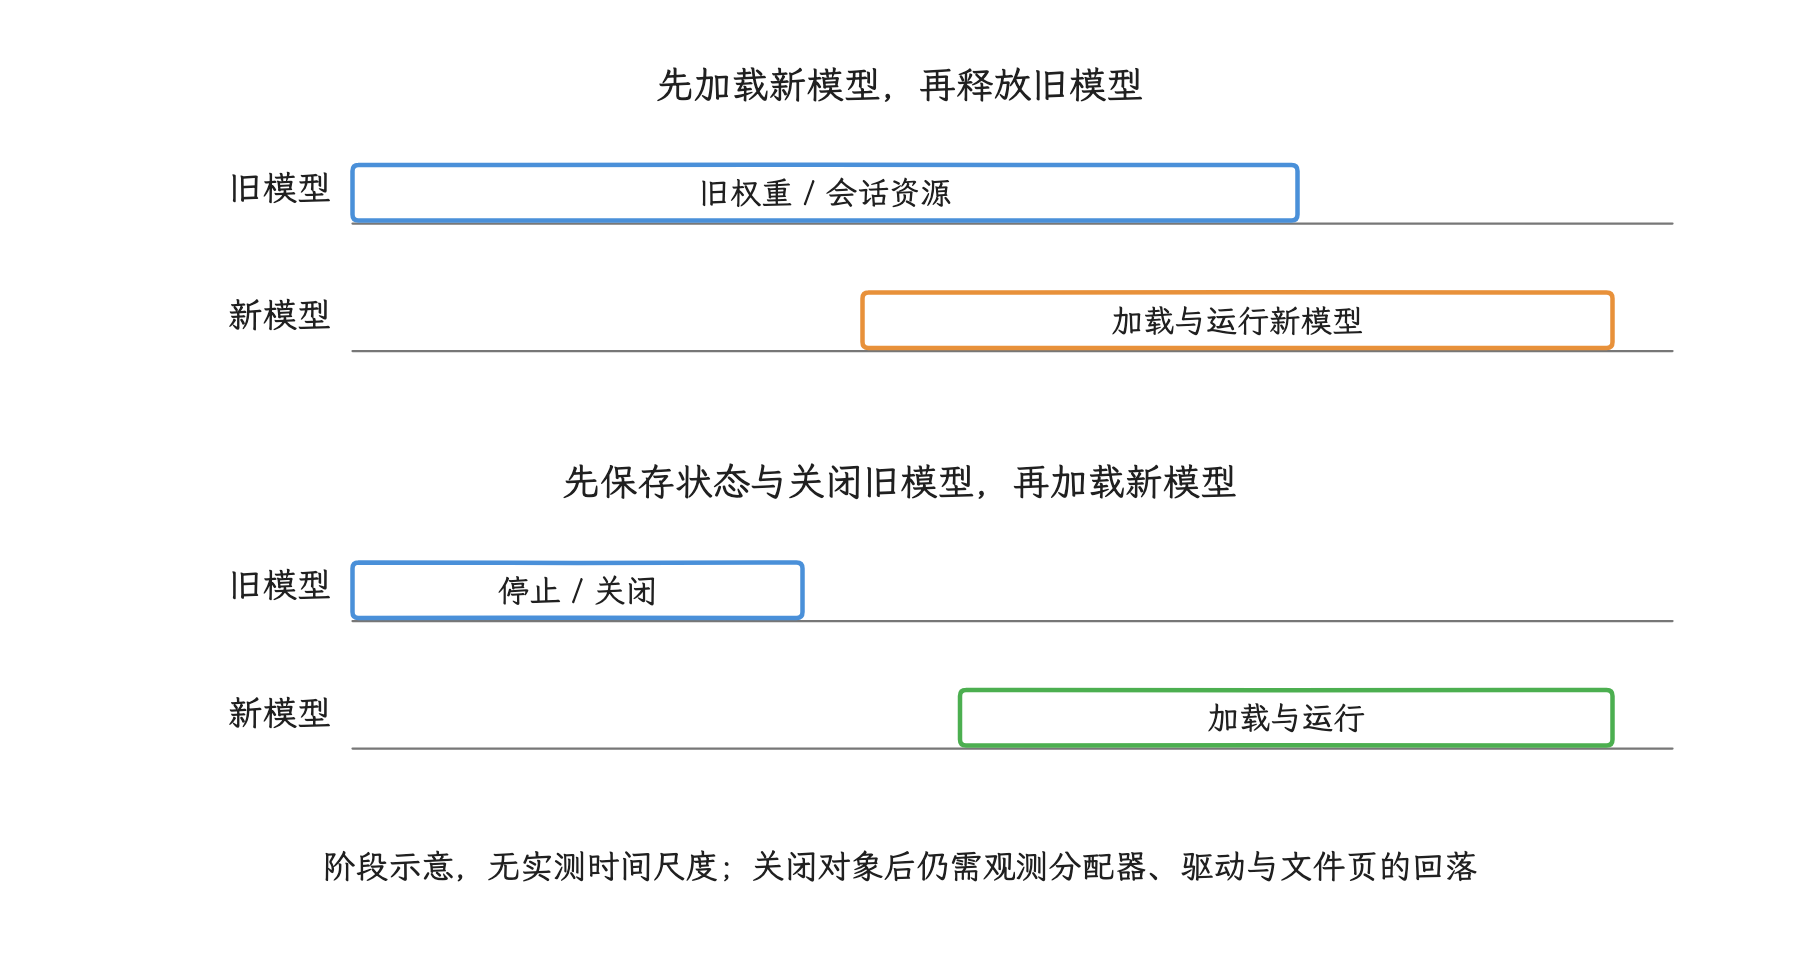
图:无缝切换需要预算双模型重叠窗口;内存紧张时先保存状态、停止旧会话并关闭旧模型,再加载目标变体。
3.3 多会话与多模型的统一调度
同一进程中的推理入口应统一限制模型数、会话数、上下文 token 总量和多模态输入总量。并发是否可行要由后端文档和测试决定;“NPU 同一时刻只能运行一个任务”不是 Android 平台契约,不同 SoC、驱动和 delegate 可能采用排队、并发或回退。
闲置会话的处理也要明确:
- 能快速从文本重建时,关闭会话通常比长期保存 KV 更稳妥;
- 只有引擎提供稳定的状态导出/导入时,才考虑把 KV 或会话状态写入存储;
- 会话状态可能含用户敏感内容,持久化需要加密、失效和删除规则;
- 预热模型与预热会话分开配置,保留权重不要求保留全部 KV。
4. 平台提供的压力信号
4.1 Memory Advice 的弃用状态
挑选平台压力信号时,先排掉一个已经过时的选项。官方内存管理概述已将 Memory Advice API beta 标记为 deprecated(已弃用),不再推荐使用;它属于 AGDK(Android Game Development Kit)的实验性 native 库,也不是 Android 17 新增的平台内存接口。现有项目可以在迁移期保留观测;新推理管线的准入与降级信号,应建立在平台维护的接口上。接口状态与迁移去向详见 内存监控与线上治理。
4.2 onTrimMemory() 的释放语义
onTrimMemory() 只负责机会性释放。Android 14 起,系统不再发送大部分旧的 running trim level(运行中进程的压力级别);Android 15 将这些常量正式标记为已弃用。当前官方建议集中处理 TRIM_MEMORY_UI_HIDDEN 和 TRIM_MEMORY_BACKGROUND。
这段代码在回调中只派发释放任务,不在回调线程执行模型关闭或等待后端:
override fun onTrimMemory(level: Int) {
    when {
        level >= ComponentCallbacks2.TRIM_MEMORY_BACKGROUND -> {
            inferenceExecutor.execute {
                inferenceController.cancelAndReleaseRebuildableState()
            }
        }
        level >= ComponentCallbacks2.TRIM_MEMORY_UI_HIDDEN -> {
            inferenceExecutor.execute {
                inferenceController.releaseUiInputs()
            }
        }
    }
}
inferenceController 是应用自己的生命周期组件,不是平台类。这些释放任务还要去重,避免连续回调排队执行多次关闭。还要认清这个回调的性质:TRIM_MEMORY_UI_HIDDEN 表示 UI 已不可见,给的是释放 UI 输入与预览缓存的时机;系统是否已经出现内存压力、杀进程前会不会先通知,它都回答不了,所以会话文本和用户操作进度应在正常业务流程中持续保存。
4.3 MemoryInfo 的用途与局限
MemoryInfo 适合做信号,不适合做容量承诺。加载前可以读取 lowMemory、availMem 和当前进程状态,结合已经测得的设备档案决定是否禁用预热、选择较小模型或延后任务;但不要高频轮询,ActivityManager.getMemoryInfo() 的文档也建议优先使用 onTrimMemory() 回调。
Android 17 的 ProfilingTrigger 增加了 TRIGGER_TYPE_OOM 与 TRIGGER_TYPE_ANOMALY 等触发器。OOM 触发器请求系统生成 Java 堆转储,并要求自定义 UncaughtExceptionHandler 继续调用默认处理器;anomaly(异常) 触发器返回何种产物取决于异常类型。系统触发的分析不保证一定生成结果,结果只能交给通过 registerForAllProfilingResults() 注册的全局监听器。它们适合生产问题取证,不是同步查询“还剩多少字节”的接口;配置细节参阅 Android 17 ProfilingManager 文档。
5. CPU、GPU 与 NPU 的边界
5.1 NNAPI 的现状与迁移
后端选择上,NNAPI 已不再是新方案。NNAPI 在 Android 15 / API 35 已 deprecated,Android 17 仍保留接口用于兼容,但官方说明未来设备可能更多回到 CPU 后端,并建议迁移到可独立更新的高层运行时。新项目要避免通过 NNAPI 枚举设备来设计长期 NPU 调度。
当前 LiteRT CompiledModel API 提供 CPU、GPU 和 NPU 路径,2026-10-25 复核时文档中的 Maven 示例版本为 2.3.0;具体 NPU 支持仍依赖 SoC、运行时包、delegate、模型算子和分发方式。选择 Accelerator.NPU 之后,我们要记录子图分区、回退、初始化峰值和首轮峰值,整张计算图是否都在 NPU 上运行,就靠这些记录来回答。
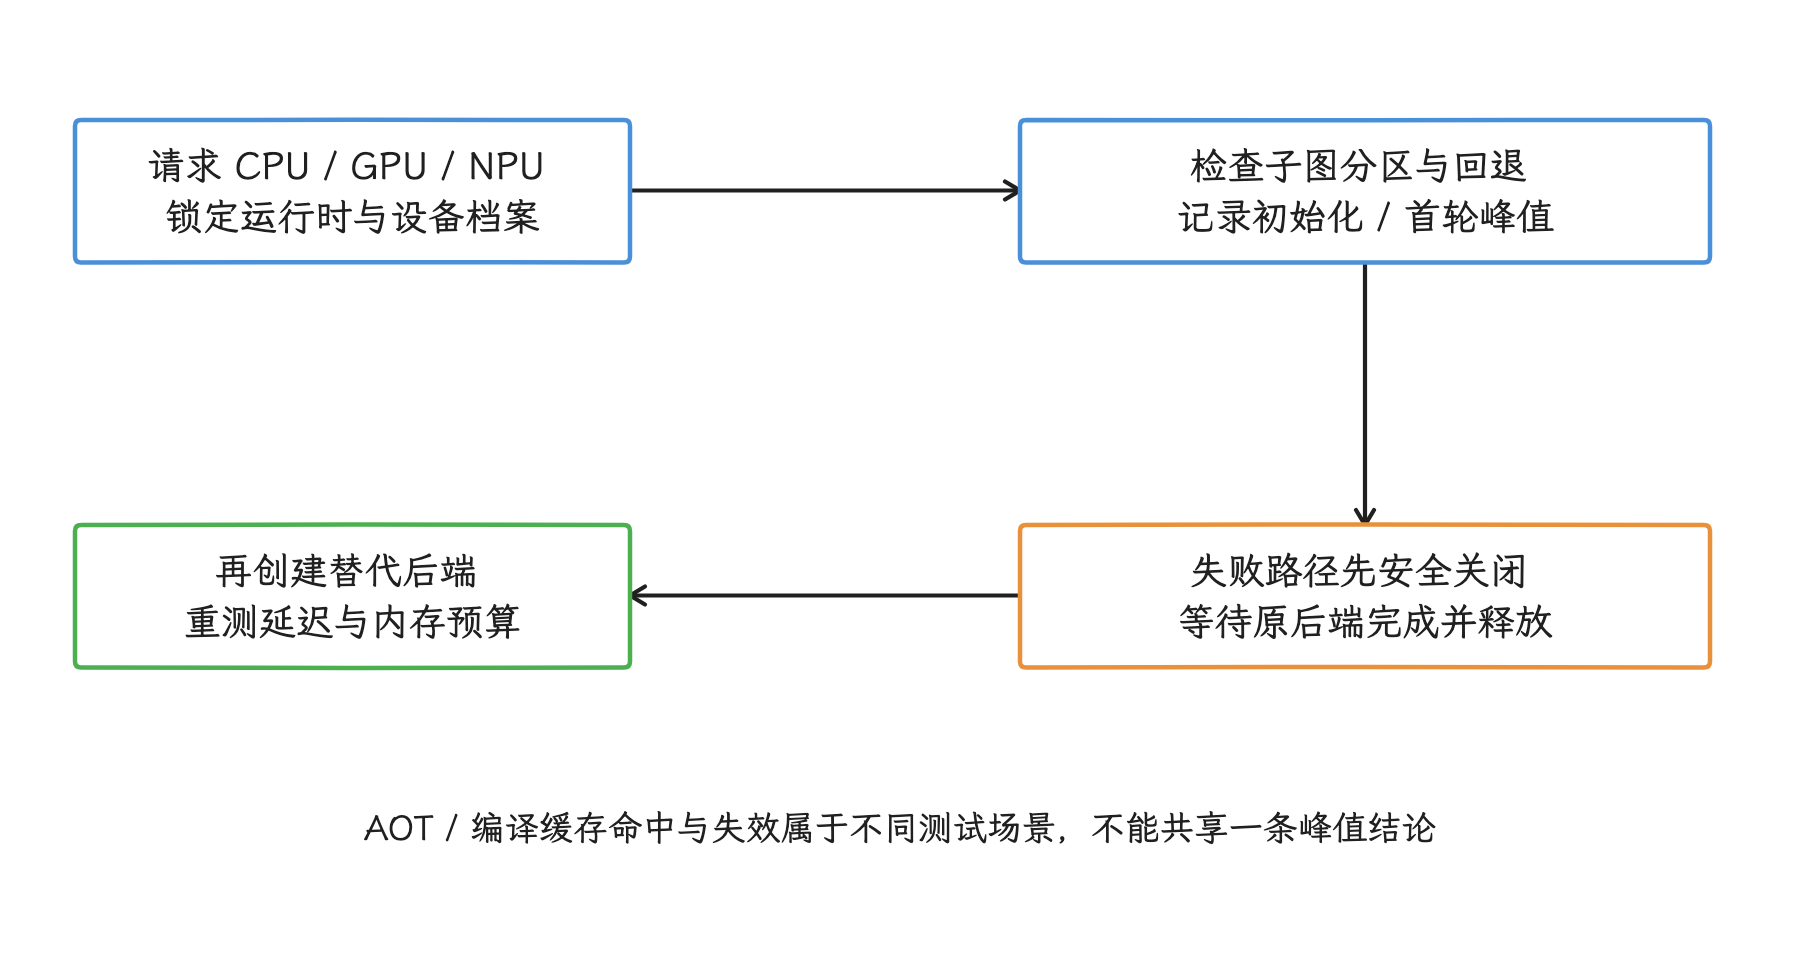
图:选择 NPU 不证明整图都在 NPU 执行;失败回退要避免旧后端与新后端资源同时驻留。
对较大且目标 SoC 已知的模型,部分 LiteRT NPU 路径 与当前 LiteRT NPU 编译和分发文档 都提供 AOT 方案,用来减少设备侧初始化编译。当前路径还支持设备侧编译及编译缓存,缓存是否命中会显著改变初始化时间和内存。另外,AOT 产物、原始模型、AI Pack(按设备投递的 Play 资产包)和厂商运行时库可能在安装或加载阶段同时存在,这一阶段的峰值仍要按对应 SoC 与运行时版本测量。
5.2 共享缓冲区的导入条件
AHardwareBuffer 从 API 26 起提供跨进程和图形 API 可共享的缓冲区。格式、usage flags(使用方式标志)、尺寸和设备实现共同决定它能否分配或被某个消费者导入;API 29 起可先用 AHardwareBuffer_isSupported() 检查给定描述。
AHardwareBuffer 没有“所有 NPU 都可访问”的平台保证。即使 GPU 或 delegate 接受它,我们也要逐项核对:
- CPU 锁定访问是否允许,是否会等待 fence(表示异步硬件操作完成的同步对象);
- GPU/NPU 导入缓冲区时是否产生额外副本;
- CPU 与设备缓存同步、访问权如何转换;
- 缓冲区的引用计数和关闭时机;
- memtrack (硬件内存记账接口)、DMA-BUF 与进程 PSS 分别如何核算。
OpenCL 同样要小心:Android NDK 并未把它纳入面向所有设备的稳定公共计算 API。某个推理库要求声明厂商 OpenCL 原生库,只说明该库在指定设备路径上的依赖,够不上 Android 17 的通用接口。
5.3 CPU 路径仍有映射和工作区
回到 CPU 路径:它可以直接访问进程地址空间中的权重和 tensor,通常不需要设备私有显存,但仍会占用文件映射、native arena(分配器批量管理的内存区)、线程栈、权重打包缓冲区和算子工作区。线程数加上去,栈地址空间预留和每线程临时缓冲区可能同时增加,所以并行度要按吞吐、峰值 PSS、温度和尾延迟共同确定。
6. 怎样测到可解释的峰值
6.1 VmRSS 与 VmHWM 的含义
测量峰值时最容易混用的两个值是 VmRSS 与 VmHWM。Debug.getRss() 在 r1 源码中有无参数的当前进程查询,以及 @hide 的 getRss(int pid, long[] outMemtrack) 重载,并不是带 flags 参数的接口;它不返回历史峰值;/proc/self/status 中 VmRSS 是当前 RSS,VmHWM 是进程生命周期内的 RSS high-water mark(历史峰值)。推理前后各读一次当前 RSS 再取差值,区间内冲上去又落回来的峰值会整段漏掉。
这个 Kotlin 函数用于低频读取关键的 /proc/self/status 字段。内存字段的单位是 KiB,Threads 表示线程数量:
import java.io.File

private val memoryStatusKeys = setOf(
    "VmSize", "VmRSS", "VmHWM", "RssAnon",
    "RssFile", "RssShmem", "VmSwap", "Threads"
)

fun readProcessStatus(): Map<String, Long> =
    File("/proc/self/status").useLines { lines ->
        lines.mapNotNull { line ->
            val separator = line.indexOf(':')
            if (separator <= 0) return@mapNotNull null

            val key = line.substring(0, separator)
            if (key !in memoryStatusKeys) return@mapNotNull null

            val value = line.substring(separator + 1)
                .trim()
                .substringBefore(' ')
                .toLongOrNull()
                ?: return@mapNotNull null
            key to value
        }.toMap()
    }
该函数适合在阶段交界处或异常触发时采样,不要在每生成一个 token 时调用。VmHWM 默认累计历史峰值,不会在每次推理时自动清零。固定内核的 proc.rst 也提供向 /proc/<pid>/clear_refs 写 5,把高水位重设为当前 RSS 的能力;实际可用性取决于内核配置、权限与 SELinux,不能假定所有应用设备都允许。比较单阶段峰值时,可用独立测试进程,或有明确阶段标记的 RSS/PSS 采样配合 Perfetto;若使用重置,需记录操作与重置时的基线。
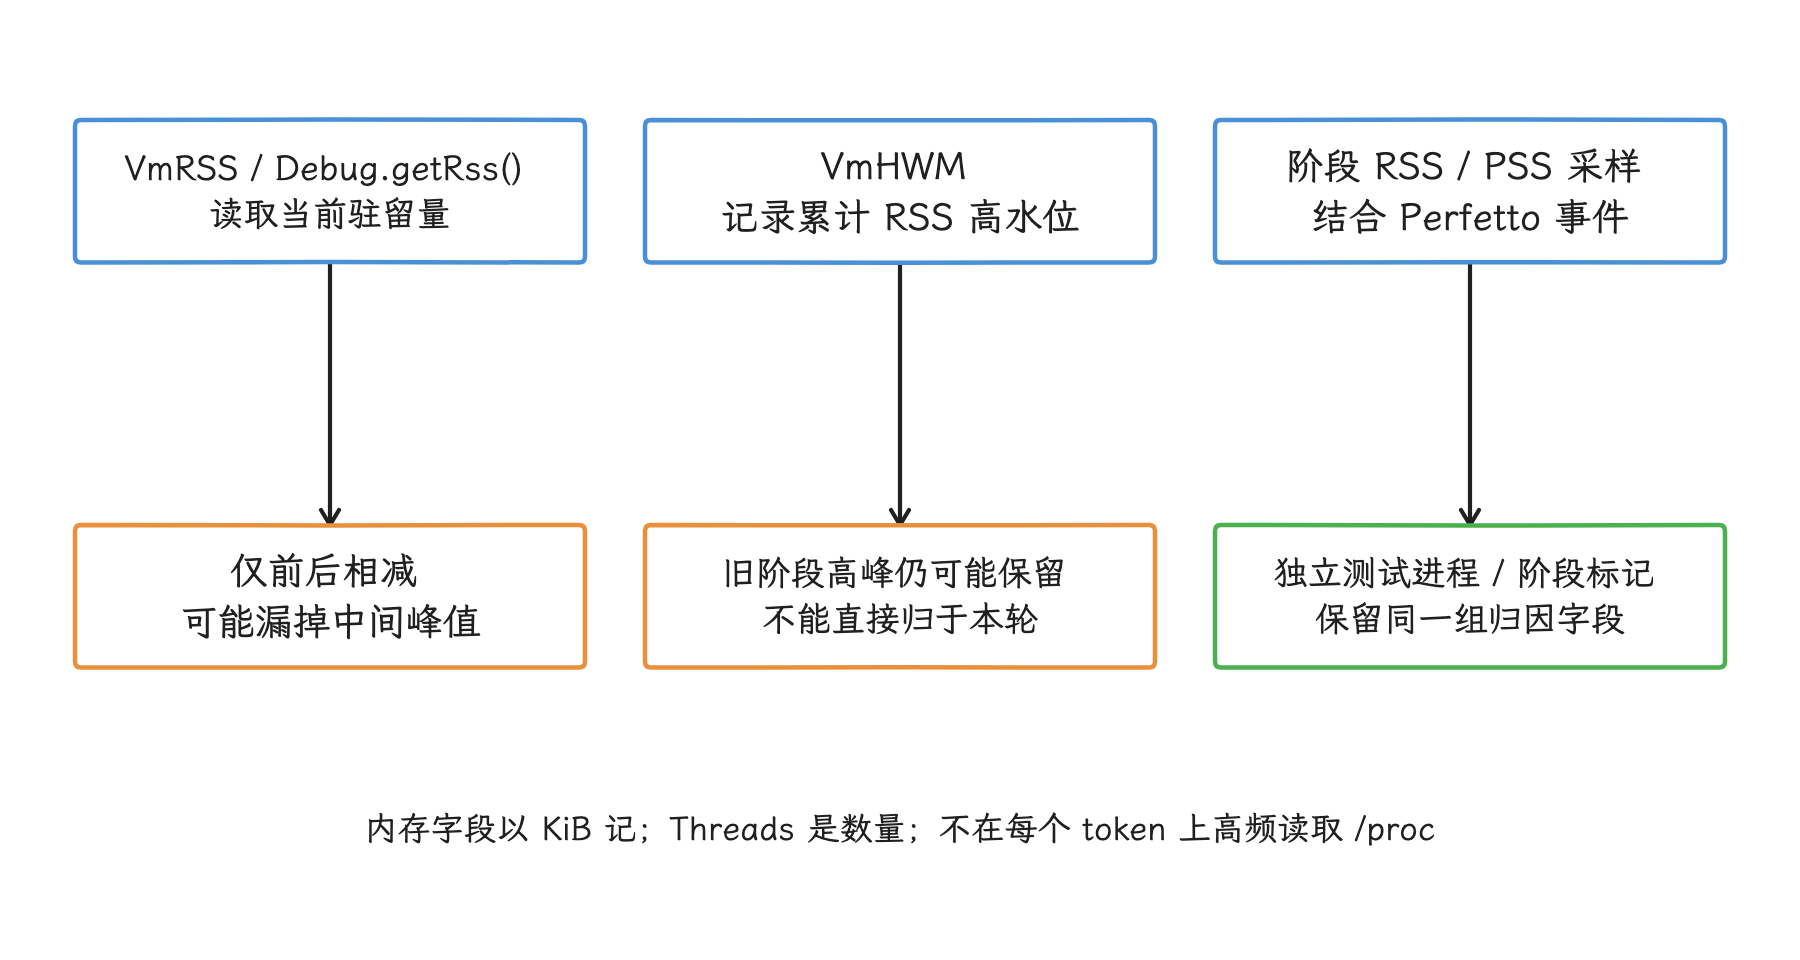
图:RSS 是当前值,HWM 默认是累计峰值;对比单阶段峰值需独立进程或有阶段标记的采样,并确认重置能力。
6.2 每个采样点保存同一组字段
建议统一保存:
- 时间、场景、模型/会话 ID、上下文 token 数和输入尺寸;
- 后端、delegate、回退结果与线程数;
VmSize、VmRSS、VmHWM、RssAnon、RssFile、RssShmem、VmSwap;- PSS 分类、native heap、Java heap、图形与代码;
- 当前模型、会话、KV 缓存和 I/O 缓冲区数量;
- 最近一次加载、编译、取消、关闭、内存分配器或 delegate 错误。
这组字段的语义,/proc 部分以 android17-6.18-2026-06_r6 的 proc.rst 为准。PSS 会按共享比例分摊,比 RSS 更适合比较多进程总成本;诊断单个分配来源时仍要看 maps(进程内存映射清单)、native 分配分析和运行时日志。
6.3 GPU 与 native 内存需要外部工具
到了 GPU 与 native 内存,我们要靠外部工具。Debug.java 中的 getGpuTotalUsageKb() 和 getGpuPrivateMemoryKb() 是 @hide(未纳入公开 SDK) 的系统接口,普通应用没有对应的 SDK 调用面,dumpsys gfxinfo 也算不上通用的 LLM GPU 内存计数器。测试环境可以组合:
adb shell dumpsys meminfo <package>的 Graphics、GL、DMA/memtrack 分类;- Perfetto 的进程、内存和可用 GPU 计数器;
- heapprofd(native 堆采样器)定位 native 分配调用栈;
- delegate 或运行时自带的 profiler;
- SoC 厂商工具,用于只在对应设备上解释驱动内存。
Native heap 统计与 Scudo 分配器的职责划分详见 23.3 Native 与虚拟内存管理优化。同一场景应保留完整工具版本和设备 build fingerprint(能够标识系统构建版本的字符串),避免直接横向比较厂商字段。
7. 内存压力下的动作顺序
7.1 按原因选择动作
| 现场 | 可能原因 | 优先动作 |
|---|---|---|
| 加载阶段 PSS 翻倍 | 权重重排、delegate 编译、旧模型未关闭 | 对比分阶段快照,检查双模型窗口与后端副本 |
| prefill 峰值过高 | 长提示词、临时 attention/FFN 工作区 | 限制上下文、评估 chunked prefill(分块预填充)或更小模型 |
| decode 随 token 线性增长 | KV 缓存持续扩张 | 限制总 token、关闭闲置会话、验证 KV 量化支持 |
| 取消后内存不回落 | 回调仍在运行、会话/模型未关闭、分配器保留 | 核对资源所有者、等待后端、区分泄漏与可复用 arena |
| GPU delegate 失败后峰值更高 | 回退时旧资源未释放或产生双后端资源 | 记录回退顺序,关闭失败后端后再创建替代路径 |
| 无 Java OOM 但进程消失 | LMK、原生代码主动终止、驱动崩溃或系统限制 | 查 ApplicationExitInfo(进程退出原因记录)、logcat、Vitals 与系统事件 |
表中各类峰值对应不同的资源,一个综合压力等级触发同一套降级,照顾不到这些不同的原因。压力信号到达后,控制器的动作顺序是:先阻止新任务,再取消或完成当前临界操作,然后释放可重建资源。安全底线是:不要在 native 后端执行中途随意 munmap() 权重或缓冲区,这会造成 use-after-free(资源释放后仍被访问) 或驱动错误。
7.2 保存可恢复状态
端侧对话的可恢复状态,通常是结构化消息、采样参数、模型版本和已提交的业务结果;KV 缓存只用于加速运行时生成。进程可能在没有回调的情况下被 LMKD 终止,因此重要状态应随交互增量保存,进程重建后再根据策略恢复模型和上下文。
8. 多进程的隔离收益与总账
把推理引擎放入私有子进程,收益是两个:推理子进程中的用户态原生崩溃通常可以隔离于 UI 进程;进程退出时会释放它拥有的运行时与映射。GPU/NPU 驱动故障、系统服务故障或整机资源压力仍可能跨进程影响 UI,进程边界并非对此的保证。代价则包括第二套 ART 与 native 内存基线、Binder 调用与序列化成本、模型可能重复映射,以及更复杂的恢复协议。进程隔离的通用取舍可参阅 23.5 大内存与多进程策略。
评估多进程时,我们要盯住总账:把所有应用进程的 PSS 加总起来看,主进程的下降往往只是内存发生了转移,总成本要靠这套加总数字说话。模型只在需要的进程初始化;大输入优先传文件描述符、SharedMemory 或受控的 HardwareBuffer,避免 Binder 内复制大数组。子进程死亡、任务幂等(同一请求重复执行不会产生额外副作用)、结果去重和版本不匹配,都要预先定义处理方式;用前台服务或频繁绑定服务提高进程存活率、来掩盖过高的内存,这条路也不要走。
另外,ProcessList.batchSetOomAdj() 和 LMKD 的私有控制包都留在系统自己手里——进程重要性由可见组件、服务状态和系统策略决定,伪造高优先级会挤压整机内存。
9. 测试覆盖与通过条件
9.1 设备与软件维度
设备与软件范围至少覆盖:
- Android 14、15、16、17 中产品支持的版本;
- 32/64 位 ABI,以及产品实际支持的 4 KiB/16 KiB 页设备;
- 不同 RAM 档位、SoC 和 GPU/NPU 驱动;
- 运行时和 delegate 的发布版本;
- CPU、GPU、NPU 与每条允许的回退路径;
- 冷启动、热启动和进程被系统重建。
9.2 场景维度
每个模型变体都要覆盖:
- 最短、常用和允许的最大上下文;
- 最大输出 token;
- 单会话与允许的最大并发;
- 多模态最大输入尺寸和数量;
- 首次设备侧编译、AOT 产物、编译缓存命中与失效;
- 生成中取消、前后台切换、旋转/配置变化;
- 模型切换、后端失败与降级;
- 多轮加载/关闭,直到 PSS/RSS 与 native 分配进入稳定区间;
- 受控系统内存压力和 LMK 恢复。
循环次数由“是否进入稳定区间”和泄漏检测灵敏度决定,不使用统一的 10 次或 1000 次。模拟 onTrimMemory() 回调只能测试处理代码,代替不了真实内存压力、页回收、swap 和 LMKD 场景。
9.3 通过条件
通过条件来自每个设备档案,至少包含:
- 所有阶段峰值未触发 Java/native OOM、系统内存限制或前台 LMK;
- 最大上下文下没有未声明的后端回退;
- 取消与关闭后,应释放的模型、会话和缓冲区实例归零,内存回到可解释的稳定区间;
- 后台释放后能够恢复,用户输入和已确认结果不丢失;
- 模型切换的双份窗口已被消除或明确计入预算;
- 线上能够通过 Android Vitals、
ApplicationExitInfo和 Android 17 分析触发器追踪失败。
全文小结
回到整篇文章的主线:运行时、驱动和模型结构的差异,装不进一个全设备通用的安全系数里。我们要做的是把权重、KV 缓存、工作区、后端资源和应用基线分别量化,再用阶段化数据限定模型、上下文、会话和后端组合。Android 17 新增了 OOM 与 anomaly 分析触发器,但推理资源的所有权和恢复协议,仍要应用自己管理。
参考资料
- Android 17
ActivityManager.java - Android 17
Debug.java - Android 17
MemoryLimiter.java - Android 17 LMKD
- Android 17 common kernel
/procdocumentation - Manage your app's memory
- About memory management(含 Memory Advice 弃用说明)
- NNAPI migration guide
- LiteRT
CompiledModelKotlin API - MediaPipe
LlmInferenceOptions.maxTokens()(固定提交源码) - Android NDK
AHardwareBuffer - Perfetto native heap profiler
- LiteRT-LM Android Kotlin API
- LiteRT NPU compilation and deployment
- Android 17 ProfilingTrigger
- Support 16 KB page sizes