SoC 平台差异
SoC 型号只是硬件拓扑的起点,最终性能还要看设备散热、内存配置、内核和厂商策略。做跨平台分析时,我们要把 CPU、GPU、加速器、内存与调度的数据分别对齐,让结论落在实测上;品牌和核心名称可以缩小排查范围,代替不了实测。
源码基线:Android 17(API 37)、AOSP
android-17.0.0_r1、Android common kernelandroid17-6.18-2026-06_r6;历史型号用于解释演进,涉及具体量产设备时,仍以该设备的内核、驱动和运行状态为准。
从 SoC 型号到设备证据
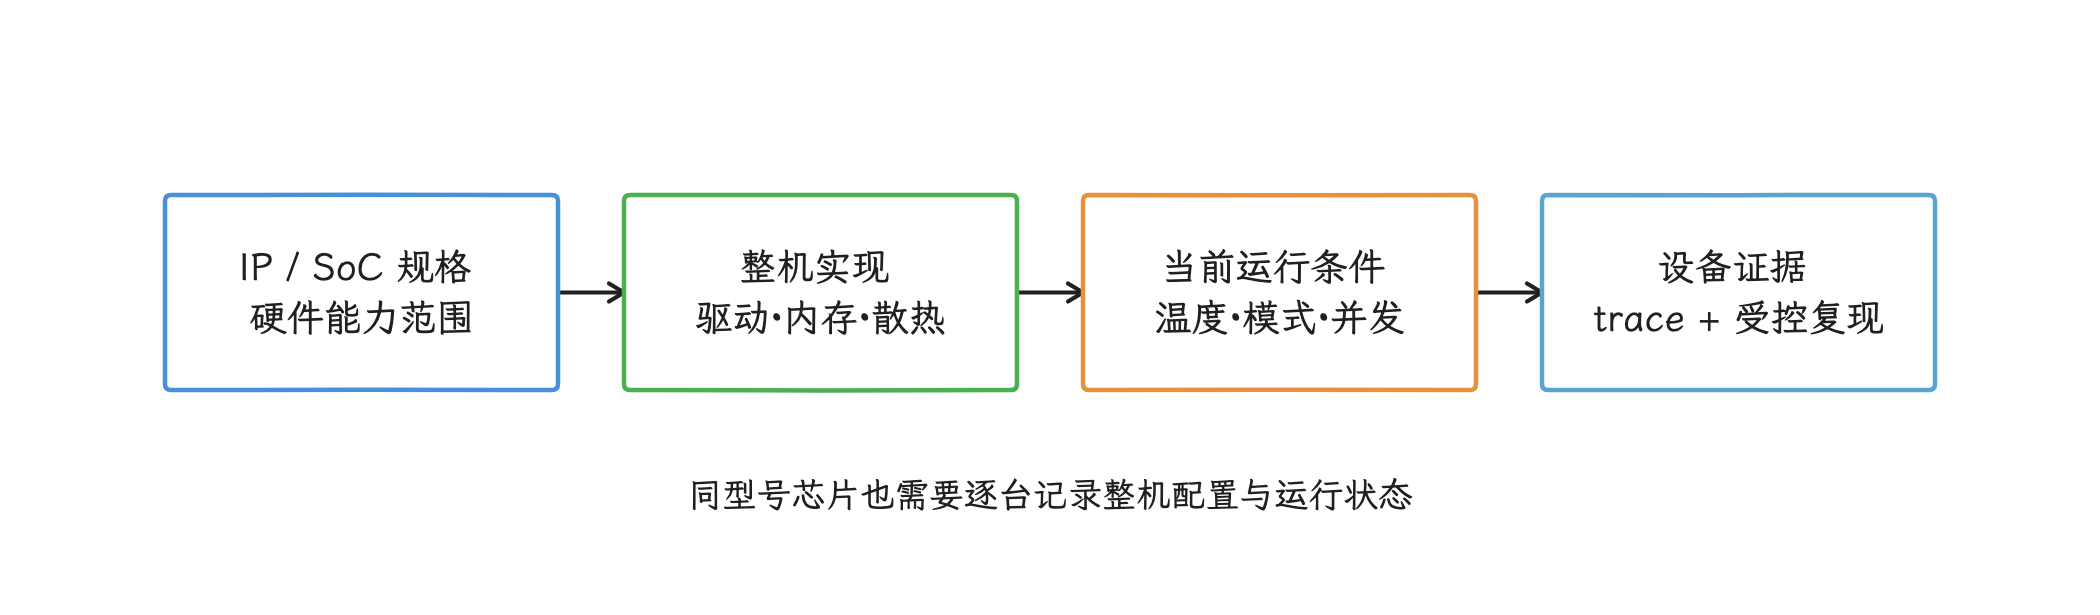
图:规格限定能力范围;整机实现与当前状态共同决定这次测量能支持的结论。
拿到两台设备上差异明显的数据时,我们首先要弄清差异来自哪一层。SoC(System on Chip,片上系统)把 CPU、GPU、内存控制器和专用加速器集成在同一颗芯片里,但同一款应用在两台手机上帧时间不同,原因可能在 CPU 拓扑、GPU 或内存系统,也可能在内核配置、驱动版本、散热结构、屏幕分辨率或 OEM 策略。芯片型号能缩小排查范围,结论还要从设备本身来。
分析时可以把问题拆成三层:
- IP 与 SoC 规格:这里的 IP 指可复用的硬件设计模块。芯片厂商公开的 CPU、GPU、NPU(神经网络处理器)、ISP(图像信号处理器)和内存能力,回答硬件提供了什么。
- 整机实现:OEM 选择的内存颗粒、频率表、散热方案、内核配置和驱动,决定这些能力在一台量产设备上如何工作。
- 当前负载:温度、电量模式、刷新率、前后台状态和并发任务,决定一次 trace(性能跟踪记录) 捕获到的是什么。
这三层各回答各的问题:要回答某台手机持续运行时的频率,得看整机实现和实测;单次 Perfetto 只是当时状态的一个样本,说明不了 SoC 的架构上限。
四类代表性平台
在我们核对过的资料范围内,四家厂商公开的新一代移动平台可以这样描述:
下表会用到几个术语:L3 是三级缓存,SLC(System Level Cache)是多个处理单元共享的系统级缓存,GAA(Gate-All-Around)是全环绕栅极晶体管结构;VPS(Visual Perception System)与 DVNR(Deep learning Video Noise Reduction)分别是视觉感知系统和深度学习视频降噪。
| 平台 | 官方公开的 CPU / GPU | 专用计算单元 | 分析边界 |
|---|---|---|---|
| Snapdragon 8 Elite Gen 5 | 第三代 Oryon CPU,最高 4.74 GHz;Adreno GPU | Hexagon NPU、三路 20-bit Spectra ISP | Qualcomm 另有 4.6 GHz 和七核版本;产品页的 API 列表不等于每台整机的驱动能力 |
| Dimensity 9500 | 1× C1-Ultra、3× C1-Premium、4× C1-Pro;Mali-G1 Ultra MC12(12 核配置) | NPU 990、Imagiq 1190 ISP | 官方还公开 16 MB L3、10 MB SLC 和 LPDDR5X 10667;整机频率表与内存配置由 OEM 决定 |
| Exynos 2600 | 1× C1-Ultra、3× 性能调优 C1-Pro、6× 能效调优 C1-Pro;Xclipse 960 | NPU、带 VPS / DVNR 的 ISP | Samsung 将其描述为 2 nm GAA、Armv9.3 平台;不要从 Xclipse 940 的 RDNA 3 资料推导 Xclipse 960 的未公开代际 |
| Tensor G5 | Google 官方材料公开 TSMC 3 nm,但未在该材料中列出完整 CPU 拓扑和 GPU 型号 | 新一代 TPU(张量处理器)、定制 ISP | 官方的 CPU 与 TPU 提升比例都是相对 Tensor G4 的代际数据,不能横向换算成其他厂商的性能 |
这张表帮我们把平台归入架构家族,排序还要靠实测:即使两台设备使用同一款 SoC,内存容量、散热空间和软件版本也可能让持续性能出现明显差异。
CPU:分别看指令集、微架构、拓扑和策略
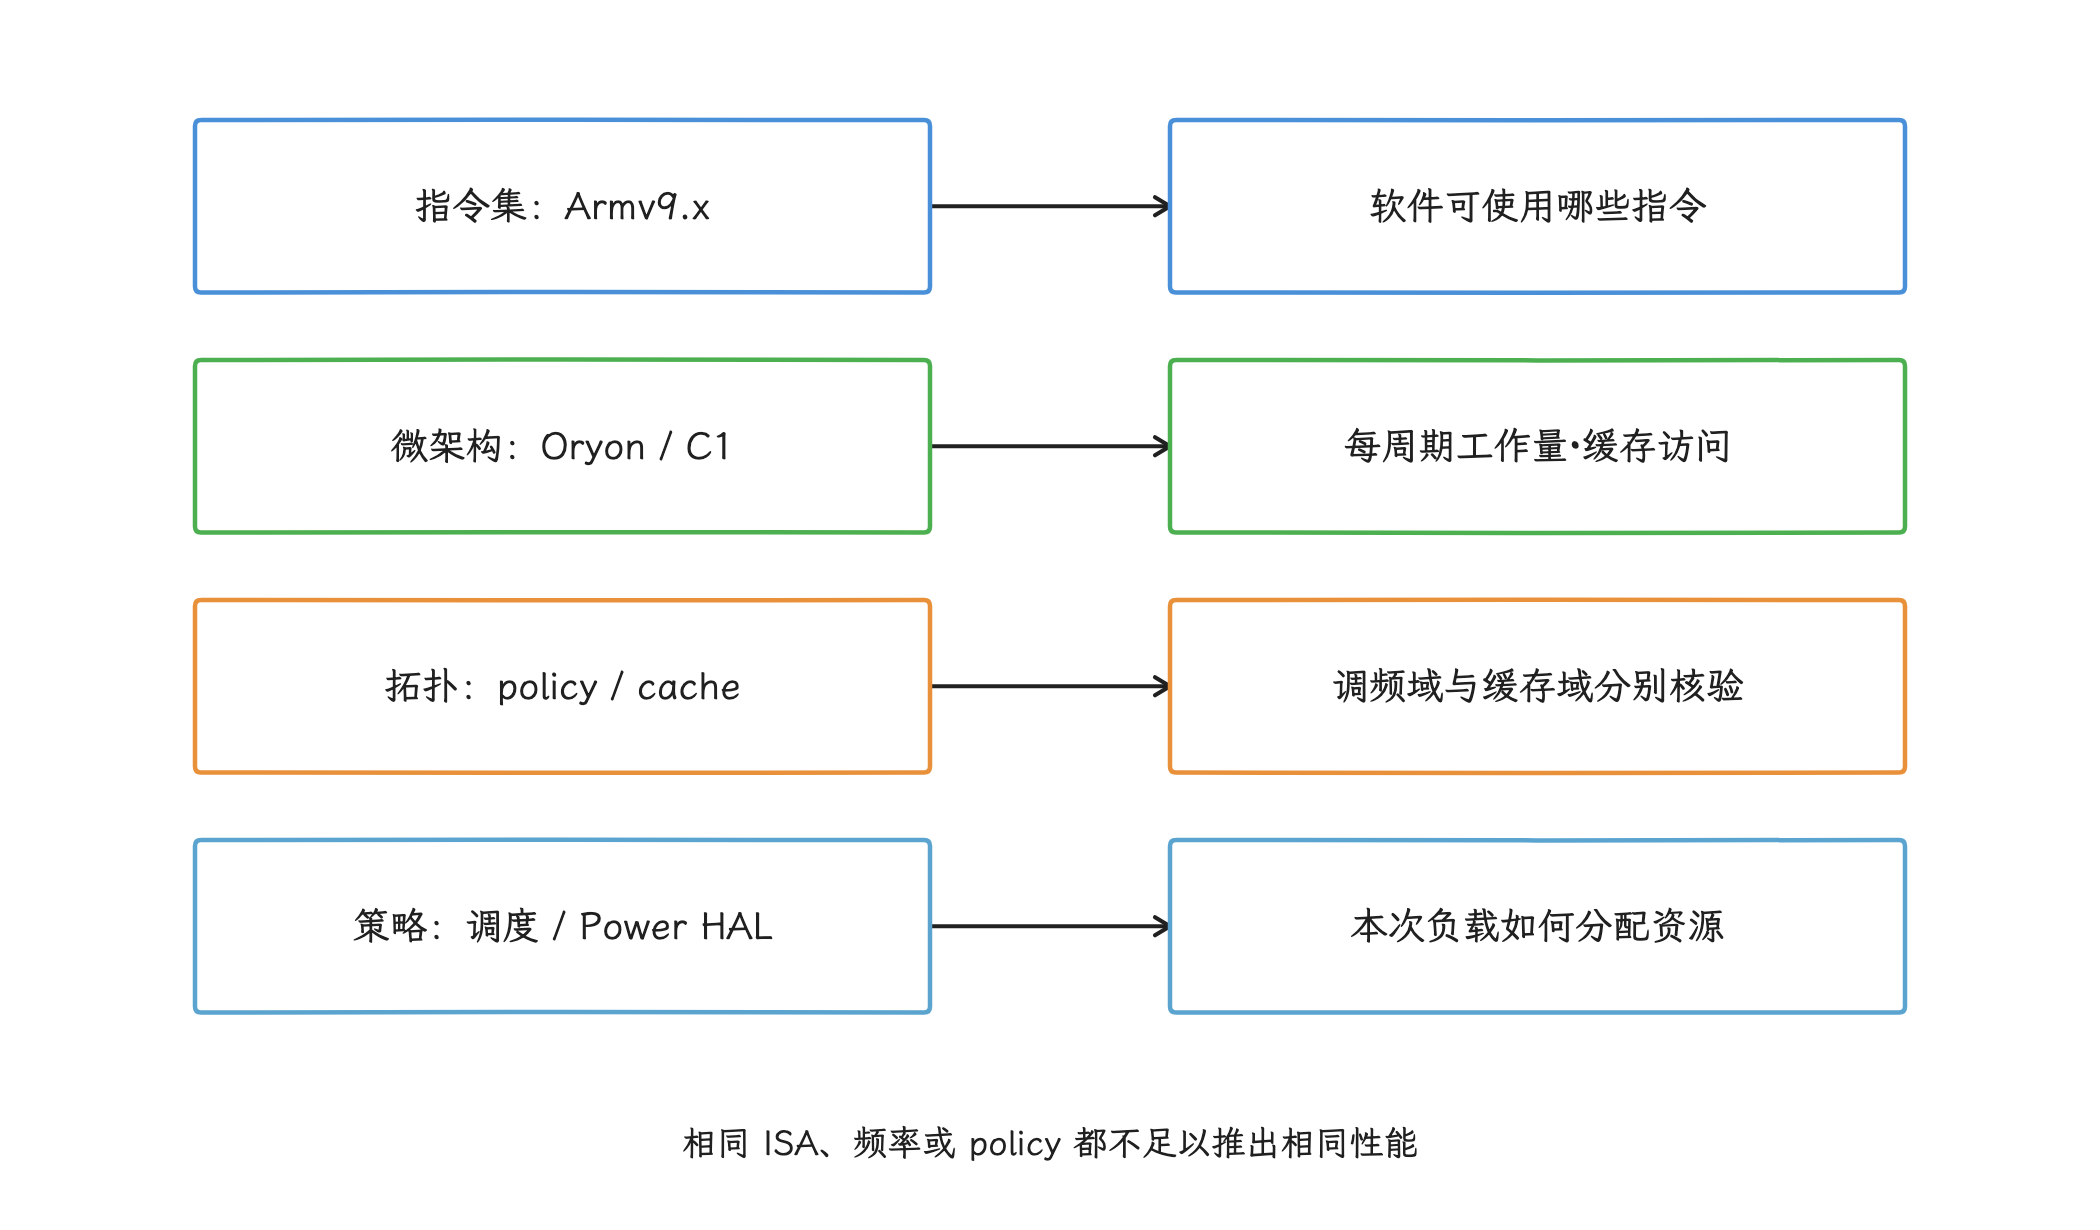
图:四个维度分别回答软件兼容、执行能力、硬件组织和运行策略;共享调频控制不能证明共享缓存。
聊 CPU 平台差异时,经常有四个概念被混在一起,我们一个个拆开:
- 指令集描述软件能够使用哪些指令,例如 Armv9.x。
- 微架构描述核心如何取指、乱序执行和访问缓存,例如 Oryon、C1-Ultra、C1-Pro。
- 拓扑描述核心数量、共享缓存和调频策略域(cpufreq policy,即共享一套调频控制的 CPU 集合)的组织方式。
- 策略描述调度器、调频器、Power HAL(负责传递系统性能与功耗策略的硬件抽象层)和 OEM 服务如何使用这些硬件。
两个核心都标注 Armv9,仍可能支持不同的指令扩展。Android 应用可用 getauxval(AT_HWCAP) 和 getauxval(AT_HWCAP2) 查询系统公开的 CPU 特性;官方文档也提醒,部分旧设备曾错误上报能力,兼容性问题还需结合设备验证。IPC(instructions per cycle,每周期完成的指令数)、缓存或能耗也可能相差很大。同样,两个核心落在同一个调频策略域,也说明不了它们共享某一级缓存。
从目标设备读取拓扑
做跨平台对比前,我们可以先用下面这组只读命令,把设备的 CPU 调频策略域、图形驱动和内核版本记录下来,随性能实验的设备信息一起归档:
adb shell cat /sys/devices/system/cpu/possible
adb shell 'for p in /sys/devices/system/cpu/cpufreq/policy*; do
  echo "$p"
  cat "$p/related_cpus" "$p/scaling_driver" "$p/scaling_governor"
done'
adb shell getprop ro.hardware.egl
adb shell 'dumpsys SurfaceFlinger | grep -m 1 GLES'
adb shell 'pm list features | grep -E "vulkan|opengles"'
adb shell uname -a
读的时候有两点要留意:policy* 展示的是调频策略域,和物理核心簇 cluster 是两回事;单独看 related_cpus,也证明不了缓存共享关系。部分 user build 会隐藏节点,SurfaceFlinger 的输出格式也可能随版本变化。缺项就记为“设备未公开”,不要凭 SoC 名称补值。
Android 17 的公平调度与 EAS
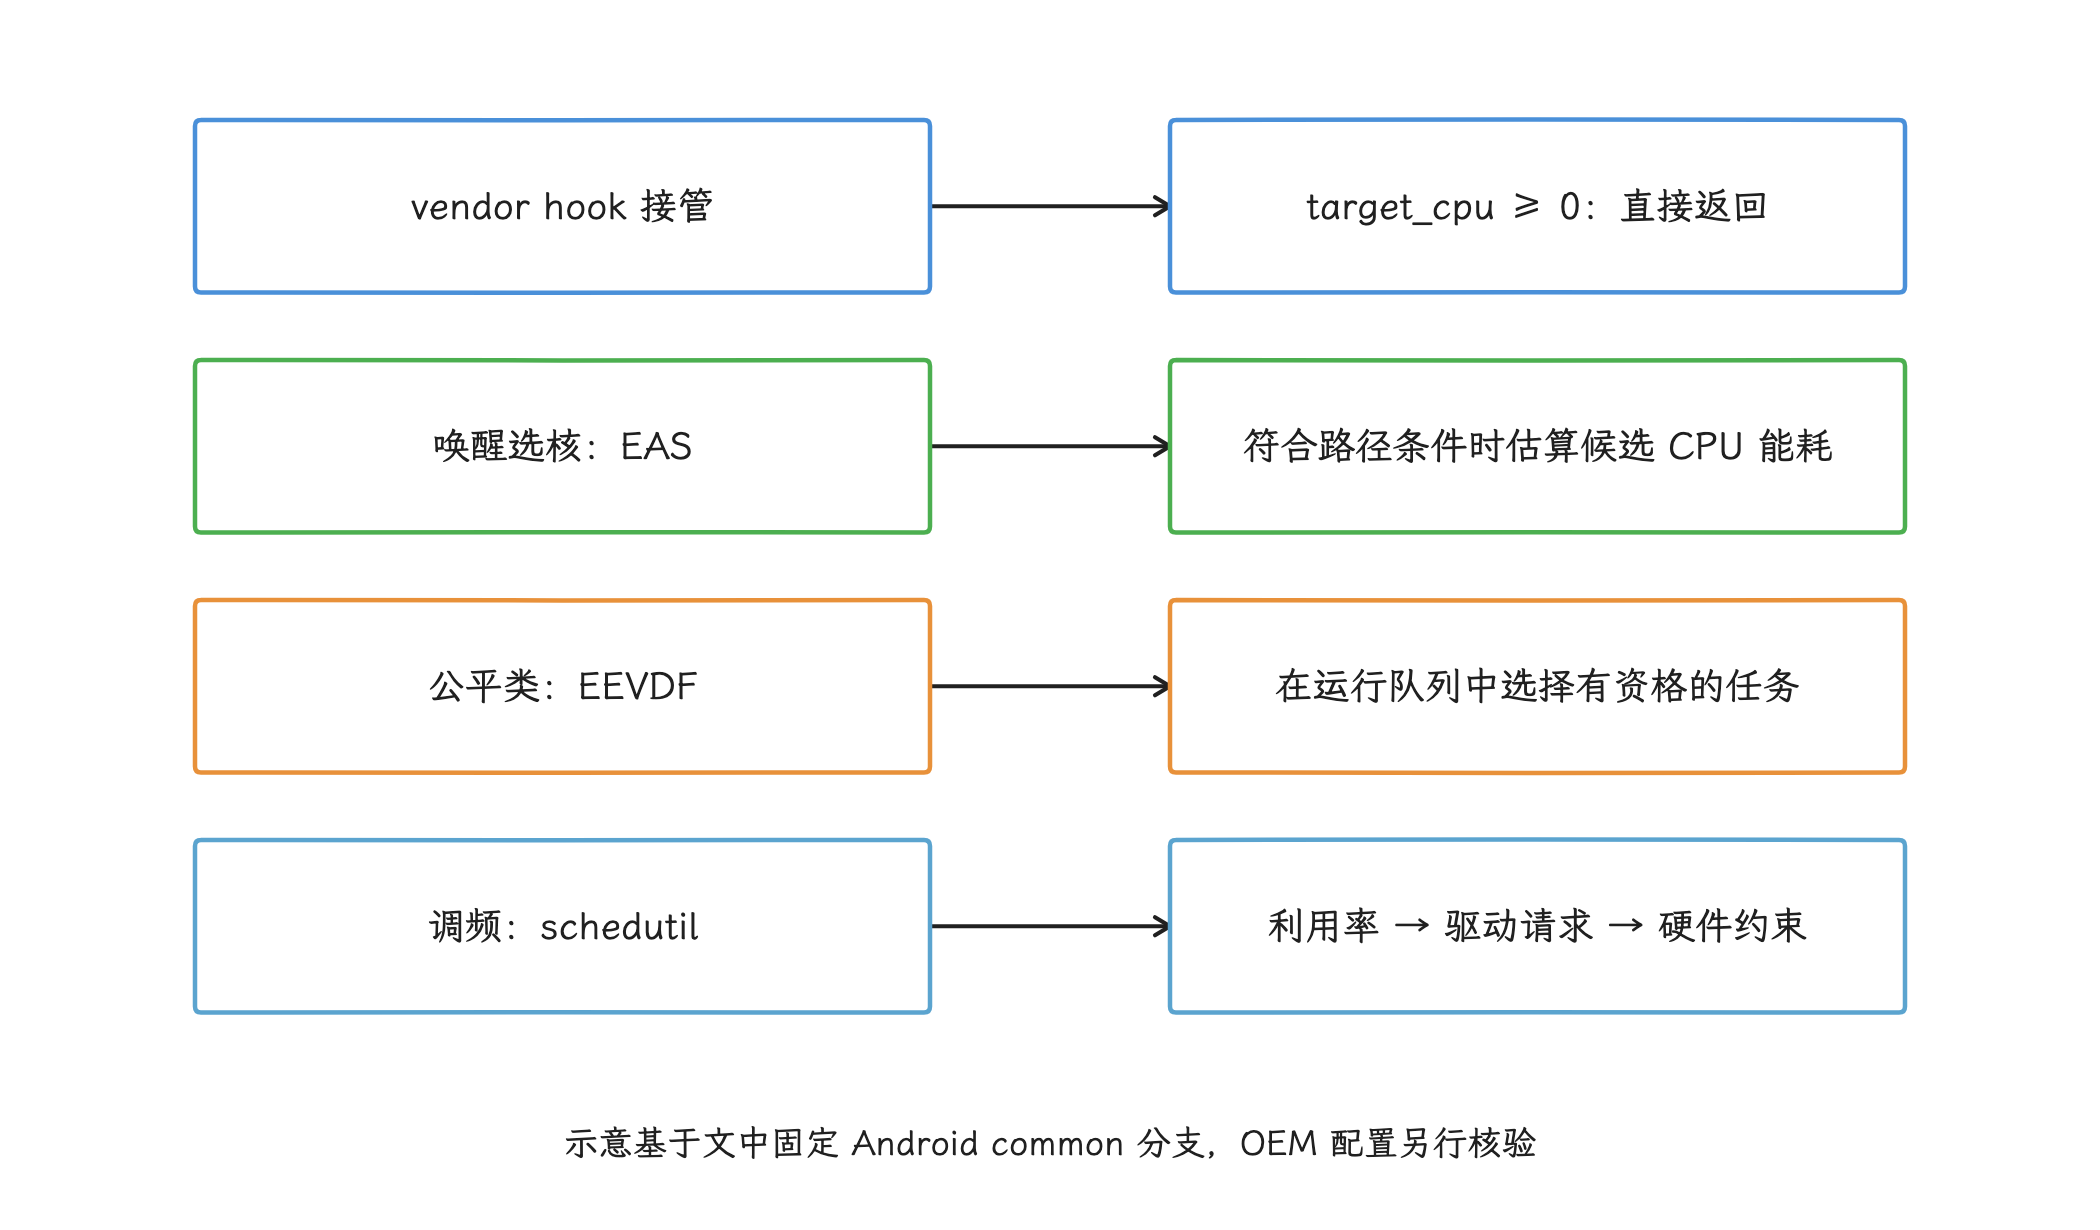
图:vendor hook 可提前返回;EAS 负责唤醒选核,EEVDF 负责公平类任务选择,schedutil 请求频率。
android17-6.18-2026-06_r6 的公平调度类使用 EEVDF(Earliest Eligible Virtual Deadline First):根据运行资格和虚拟截止时间,从公平调度类中挑选任务。EAS(Energy Aware Scheduling,能效感知调度)回答的是另一个问题——唤醒的任务放到异构 CPU 中的哪一个,判断依据是 Energy Model(能耗模型) 给出的能耗数据。两套机制处在不同的决策层次。
后面会用到两个内核概念:根调度域(root domain)指共享一套负载均衡状态的 CPU 范围;overutilized 表示这个范围的整体利用率已经超出 EAS 的适用条件。
在这条 Android common 分支里,select_task_rq_fair() 会先经过 Android vendor hook(厂商钩子,即内核预留的扩展回调点),厂商可以在这里接管选核。hook 给出非负 CPU 时,函数直接采用该目标;hook 没有接管、且根调度域未进入 overutilized 状态时,唤醒选核路径才会调用 find_energy_efficient_cpu()。
下面的摘录只保留 hook 返回和 EAS 判断相关的控制流:
trace_android_rvh_select_task_rq_fair(p, prev_cpu, sd_flag,
		wake_flags, &target_cpu);
if (target_cpu >= 0)
	return target_cpu;

if (!is_rd_overutilized(this_rq()->rd)) {
	new_cpu = find_energy_efficient_cpu(p, prev_cpu, sync);
	if (new_cpu >= 0)
		return new_cpu;
	new_cpu = prev_cpu;
}
EAS 的 compute_energy() 调用 em_cpu_energy(),为候选的 performance domain(性能域,即共享一组性能状态的 CPU 集合)估算活动能耗。Energy Model 里没有记录任务迁移造成的私有 L1/L2 缓存局部性损失,所以读到“EAS 选中了某个 CPU”时,合理理解是内核按能耗模型选了核,缓存迁移成本没有进入这份计算。
频率方面还要认识两个词:OPP(Operating Performance Point,工作频点)是一组配套的频率与电压;uclamp(utilization clamp,利用率钳制),用来限制调度器采用的利用率范围。schedutil 依据调度器利用率请求频率,而最终结果还要经过 cpufreq 驱动、OPP 表、调频间隔限制、温控约束、uclamp 和 Power HAL。所以一次频率抬升,可能来自负载,也可能来自性能提示、任务分组或厂商服务;把调用链、调度信息与频率轨迹对齐之后,我们才有条件判断来源。
内核侧还有一条新路径:这条 6.18 common 分支含有 sched_ext,一个允许用 BPF 程序定义调度策略的 Linux 可扩展调度框架。设备需要启用 CONFIG_SCHED_CLASS_EXT,再加载相应的 BPF 调度器,任务才会受这个扩展调度类影响。源码里能找到 kernel/sched/ext.c,至于某台量产设备是否启用了 OEM BPF 调度器,要以设备自身为准。
从观测结果识别厂商策略
Snapdragon、Dimensity、Exynos 和 Tensor 设备都可能在 AOSP 调度机制之上叠加自己的机制:厂商钩子、Power HAL 性能提示、uclamp、任务配置档(task profile)、cpufreq 服务质量约束(QoS)、私有守护进程。这些私有接口在 AOSP 里看不到,还会随产品线与版本变化;要判断某家厂商“更激进”还是“更保守”,只能看每台设备上的可观测结果。
在 trace 里遇到一段突发提频时,我们可以按下面的顺序查证:
- 用
sched和thread_state表判断线程处于运行态、可运行态还是阻塞态。 - 对齐 CPU 频率、空闲状态、温控状态与电源模式。
- 检查关键线程所在的 cgroup、任务配置档和 uclamp。
- 在可用的 userdebug(带调试能力的系统构建) 构建或厂商调试环境中追踪 Power HAL 性能提示与厂商事件。
- 用固定脚本重复实验,比较冷机、热机和不同电源模式。
访问厂商服务受限时,我们就把结论停在“观测到频率与负载不成比例”这一层,私有机制的名称留给有权限的环境去确认。
用 Perfetto 统计运行片段之间的 CPU 变化
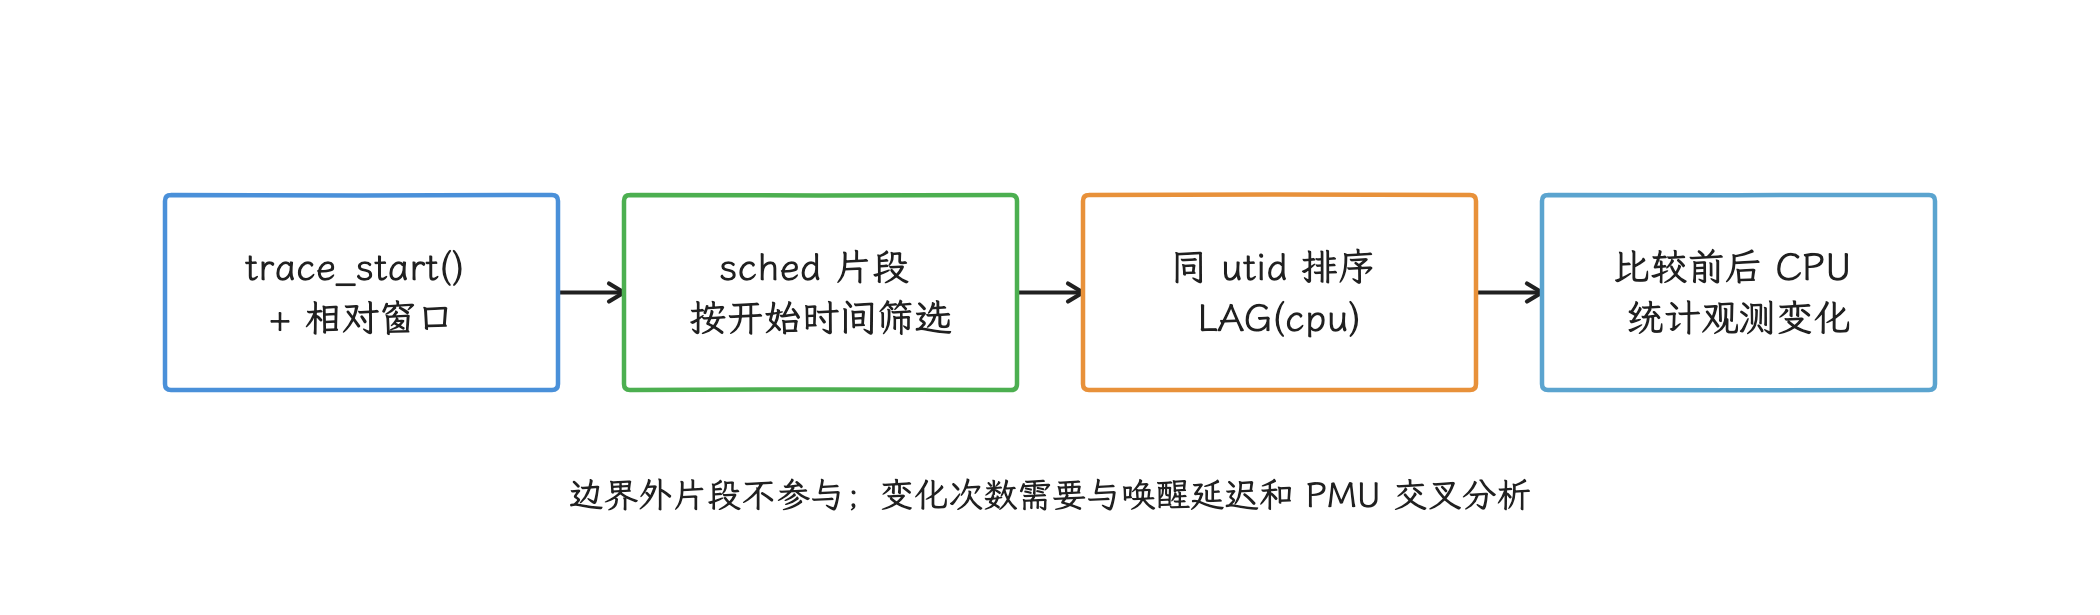
图:查询按线程排列窗口内的运行片段,再比较相邻 CPU;该计数不等于 sched_migrate_task 事件数量,也不直接衡量缓存代价。
我们可以用下面的 PerfettoSQL,统计指定时间窗内、同一线程相邻运行片段之间观察到的 CPU 编号变化:
WITH ordered_runs AS (
  SELECT
    s.utid,
    s.ts,
    s.cpu,
    LAG(s.cpu) OVER (
      PARTITION BY s.utid
      ORDER BY s.ts
    ) AS previous_cpu
  FROM sched s
  WHERE s.ts >= trace_start() + 1000000000
    AND s.ts < trace_start() + 11000000000
)
SELECT
  t.tid,
  t.name,
  COUNT(*) AS observed_cpu_changes
FROM ordered_runs r
JOIN thread t USING (utid)
WHERE COALESCE(t.is_idle, 0) = 0
  AND r.previous_cpu IS NOT NULL
  AND r.previous_cpu != r.cpu
GROUP BY r.utid, t.tid, t.name
ORDER BY observed_cpu_changes DESC;
示例窗口为 [trace_start() + 1 秒, trace_start() + 11 秒),按运行片段的开始时间筛选;跨越窗口起点但开始于窗口外的片段不在此计数内。使用时要替换成目标交互区间。
⚠️ 时间基准校勘:
sched.ts不是默认从零开始的相对时间;直接写 1~11 秒的常量不能表示 trace 起点后的窗口。来源:Perfetto trace bounds 源码查询排除 idle 线程,避免把多 CPU 的空闲片段当成同一业务线程的迁移。这个计数只描述相邻运行片段的 CPU 编号变化,和sched_migrate_task事件数量是两回事,也不能直接拿来衡量迁移代价;要判断代价,还要结合运行片段时长、唤醒延迟、PMU(Performance Monitoring Unit,性能监控单元)记录的缓存未命中与业务阶段。
GPU:架构名称与驱动能力
Adreno、Mali / Immortalis 与 Xclipse
Qualcomm 的 Adreno 是自研 GPU 系列。官方资料把 Snapdragon 8 Elite 引入的设计称为 sliced architecture(分片式架构);Adreno 开发文档还说明 FlexRender 可以在分块渲染与直接渲染路径之间选择。TBR(tile-based rendering),先按屏幕分块再处理图元的渲染方式;具体负载走哪条路径,我们以实机的驱动行为为准,一条固定的 TBR 流程,是概括不了所有 Adreno 工作负载的。
Arm 的 Mali 与 Immortalis 是可配置 GPU IP,也就是可以由 SoC 厂商选择规模并集成的 GPU 设计。同一代 IP 可以有不同的 shader core 数量、缓存和频率;Mali-G1 Ultra 的公开范围是 10~24 个着色器核心(shader core),Dimensity 9500 采用 MC12 的 12 核配置。所以看到 “Mali-G1 Ultra” 时,仍要落到具体核心数、驱动和整机功耗限制上。
Samsung 的 Xclipse 系列使用 AMD RDNA 技术。Samsung 明确说明 Xclipse 940 基于 RDNA 3;Exynos 2600 产品页列出 Xclipse 960,但没有在该页给出可供核验的 RDNA 代际。分析 Xclipse 960 时,应读取实机 Vulkan、OpenGL ES 和驱动信息。
Google 的 Tensor G5 官方介绍强调 TPU、ISP 与 3 nm 工艺,没有在该文中公开 GPU 型号。文档缺少规格时,设备查询结果比第三方参数表更可靠。
API 支持与整机驱动
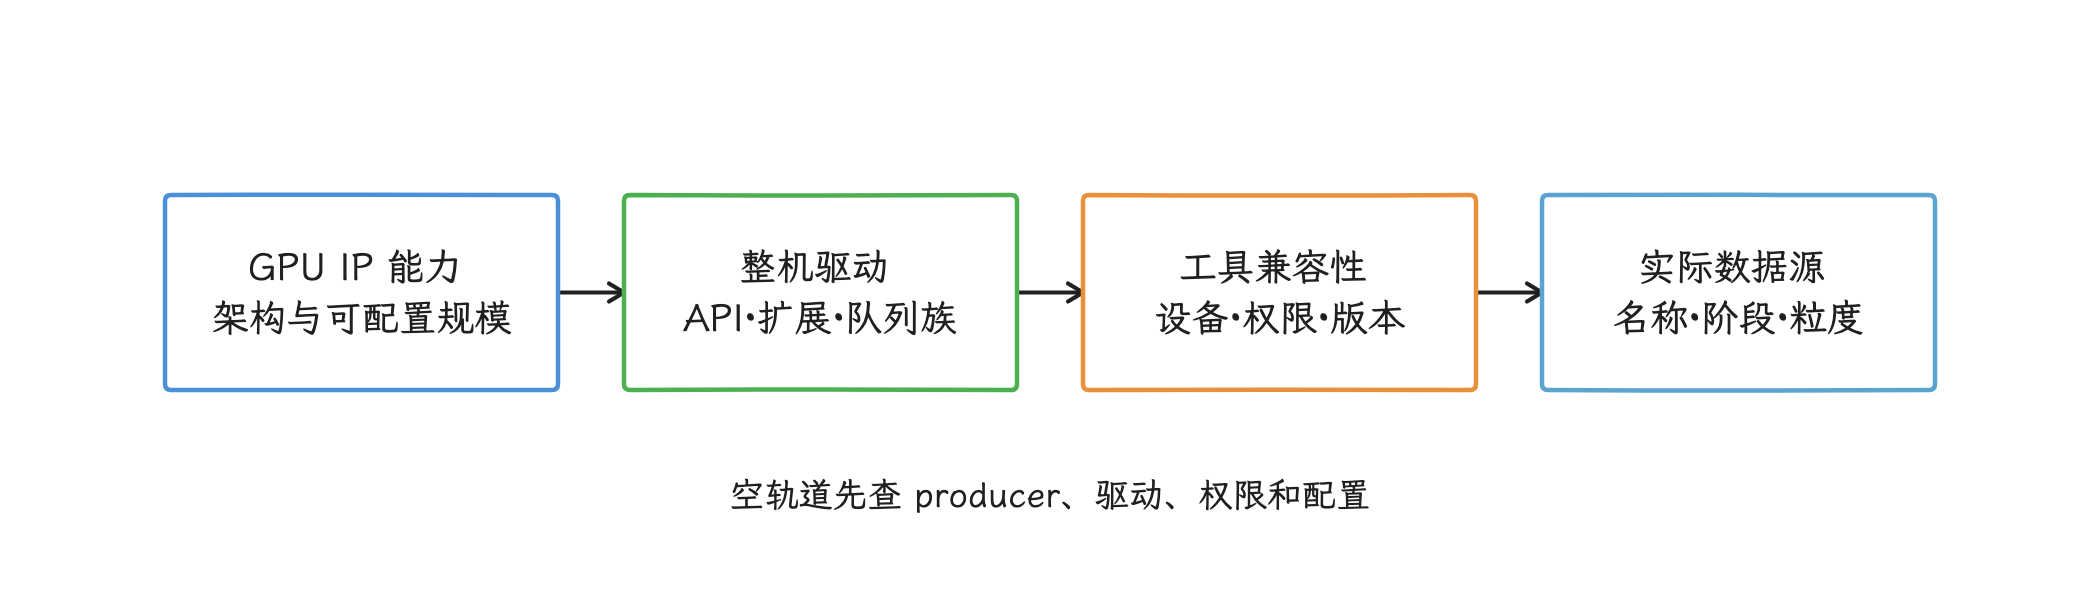
图:IP 规格、设备 API、工具支持与实际数据源是逐层核验的条件;跨厂商阶段标签并不保证等价。
SoC 产品页、GPU IP 页面和 Android 设备报告回答的是不同问题:产品页可能列出 IP 支持的 OpenGL ES / Vulkan 上限,应用能使用哪些扩展,要看量产设备的驱动、系统镜像和功能级别(feature level)。做跨设备记录时,至少要收集:
- GPU 的 vendor、renderer 字符串、驱动版本与系统构建指纹(build fingerprint);
- Vulkan API 版本、扩展和队列族(queue family,即具备同类操作能力的一组 Vulkan 队列);
- OpenGL ES 版本与扩展;
- 显示分辨率、刷新率、色彩格式和渲染比例;
- 图形 API、着色器变体、纹理格式与帧率上限。
Android GPU Inspector(AGI)的文档列出 Qualcomm Adreno、Arm Mali 和 Imagination PowerVR;快速入门还要求设备在支持列表中、运行 Android 11 或更高版本,并通过兼容 GPU 驱动的校验。文档没有列出 Xclipse,Xclipse 的 AGI 支持状态就要留到实机校验去确认。
Perfetto GPU 数据与数据生产端
Perfetto 定义了 gpu.counters、gpu.renderstages、vulkan.memory_tracker、gpu.log 等数据源,也能通过 ftrace(Linux 内核跟踪机制) 采集部分 GPU 频率与内存事件。
这里的 producer(数据生产端) 指向 Perfetto 跟踪服务注册并写入数据的组件,它可能把硬件后缀写进数据源名称,例如 gpu.renderstages.mali。下面的配置用于请求渲染阶段,以及内核提供的 GPU 频率和分配量事件:
data_sources {
  config {
    name: "gpu.renderstages"
  }
}
data_sources {
  config {
    name: "linux.ftrace"
    ftrace_config {
      ftrace_events: "power/gpu_frequency"
      ftrace_events: "gpu_mem/gpu_mem_total"
    }
  }
}
采集前先查询设备公布的数据源,配置里使用完全匹配的名称。缺少 gpu.renderstages 或某个 ftrace 事件时,删去该项并记录缺口;空轨道(Track) 只说明这一路没有数据,说明不了 GPU 没有工作。gpu_mem_total 表示内存分配量,DRAM 带宽是另一个量。
不同数据生产端给出的阶段标签和粒度,跨厂商并无等价保证。跨设备比较时,先固定画面、分辨率、刷新率、API、着色器、驱动版本、温度与功耗模式,再比较端到端帧时间、错过帧截止时间的次数和持续稳态;单独比较两个厂商阶段名称下的绝对耗时,容易得出错误结论。
NPU、DSP 与 ISP 的运行证据
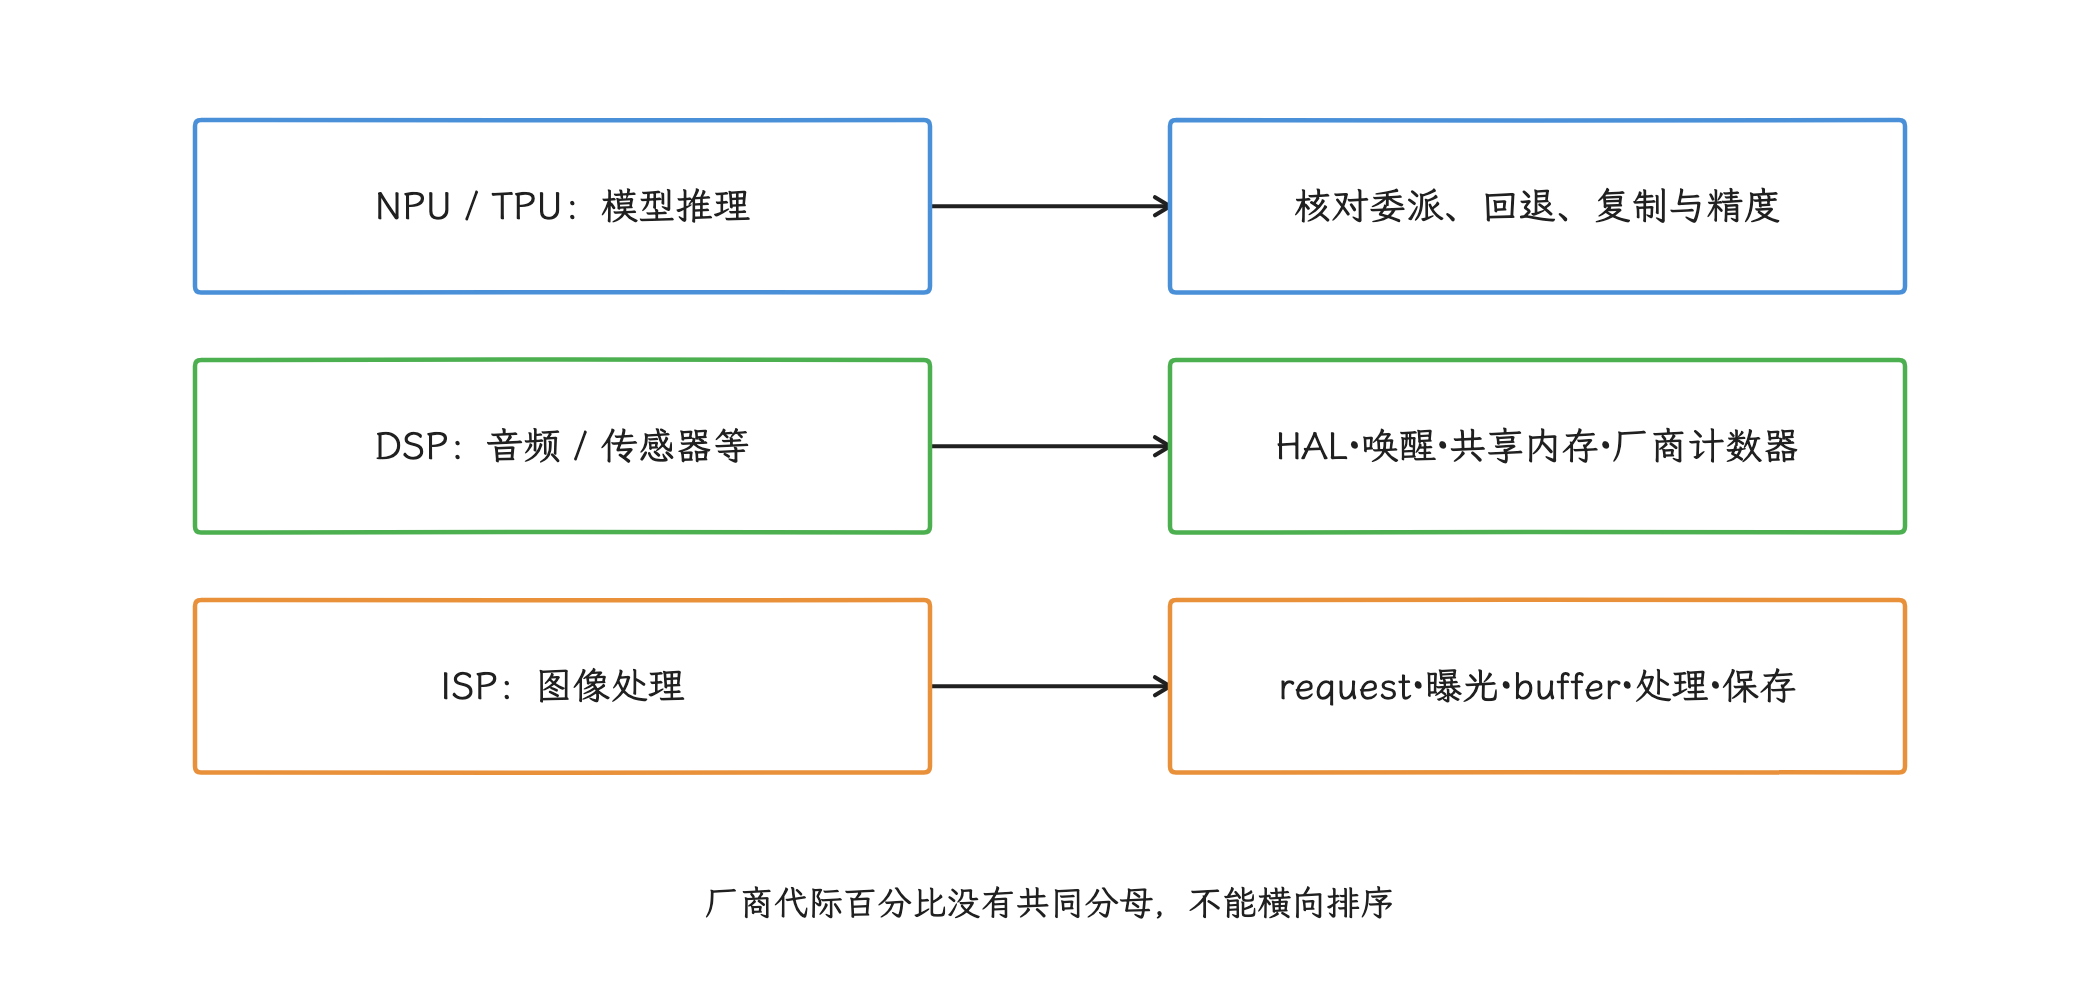
图:专用单元的活动可能不出现在 CPU sched 轨道;执行路径需结合运行时日志、HAL trace 和可用硬件计数器确认。
NPU / TPU
Hexagon、MediaTek NPU、Samsung NPU 和 Google TPU 面向端侧推理,也就是直接在设备上执行机器学习模型。厂商公布的代际百分比通常各自使用自己的模型、数值精度、功耗模式和上一代基线,直接横向拼成排行榜并不可靠。
我们评估一个模型在目标平台上的表现时,更有解释力的指标包括:
- 算子、数据类型与动态形状(dynamic shape) 是否受硬件加速器支持;
- 计算图被切成多少个子图(partition),哪些算子回退到 CPU 或 GPU;
- 编译和缓存耗时,输入输出复制与布局转换耗时;
- 冷启动、预热后延迟、吞吐、尾延迟和持续功耗;
- 模型精度、量化误差,以及不同 runtime 和 delegate 后端的版本。
NNAPI 的 NDK 接口从 Android 15 起已弃用。Android 17 应用应根据模型格式和目标硬件选择仍受支持的推理运行时与委派后端,并通过分析器或运行时日志确认委派结果。Neural Networks HAL 仍可作为系统框架与设备驱动之间的接口;至于整张模型会不会都落在 NPU 上跑,要看实际委派结果,设备标称有 NPU 还不够。
DSP
DSP(Digital Signal Processor,数字信号处理器)常处理音频、传感器、计算机视觉或推理子图。它的工作未必出现在 CPU sched 轨道中,却可能通过共享内存、DMA(Direct Memory Access,直接内存访问)、唤醒和功耗轨迹影响系统。排查常驻语音或传感器场景时,我们可以组合观察 wakelock、Binder、HAL 线程、内存分配、厂商 DSP 计数器和电源测量。
CPU 利用率低,离系统整体低功耗还有距离;看到某个 Hexagon 名称,也要先分清这条执行路径上跑的是 NPU 负载还是传统 DSP 负载。
ISP
ISP 负责传感器数据处理、去噪、HDR、对焦和部分计算摄影。相机流水线还会经过相机系统服务、HAL、BufferQueue、GPU、NPU / DSP 与编码器。拍照延迟需要按 request 下发、传感器曝光(sensor exposure)、buffer 就绪、处理与保存这些阶段分别统计。
ISP 通常缺少跨厂商通用的 Perfetto 计数器,我们能用的数据包括相机框架与 HAL 的 trace、BufferQueue、CPU / GPU 运行片段、厂商 ISP 计数器、内存互连计数器和外部功耗测量。相机运行时 UI 掉帧,第一步只能说明两个现象在时间上相关;要证明带宽争用,还需要计数器或受控扰动实验。
LPDDR5 / LPDDR5X:标称速率与有效带宽
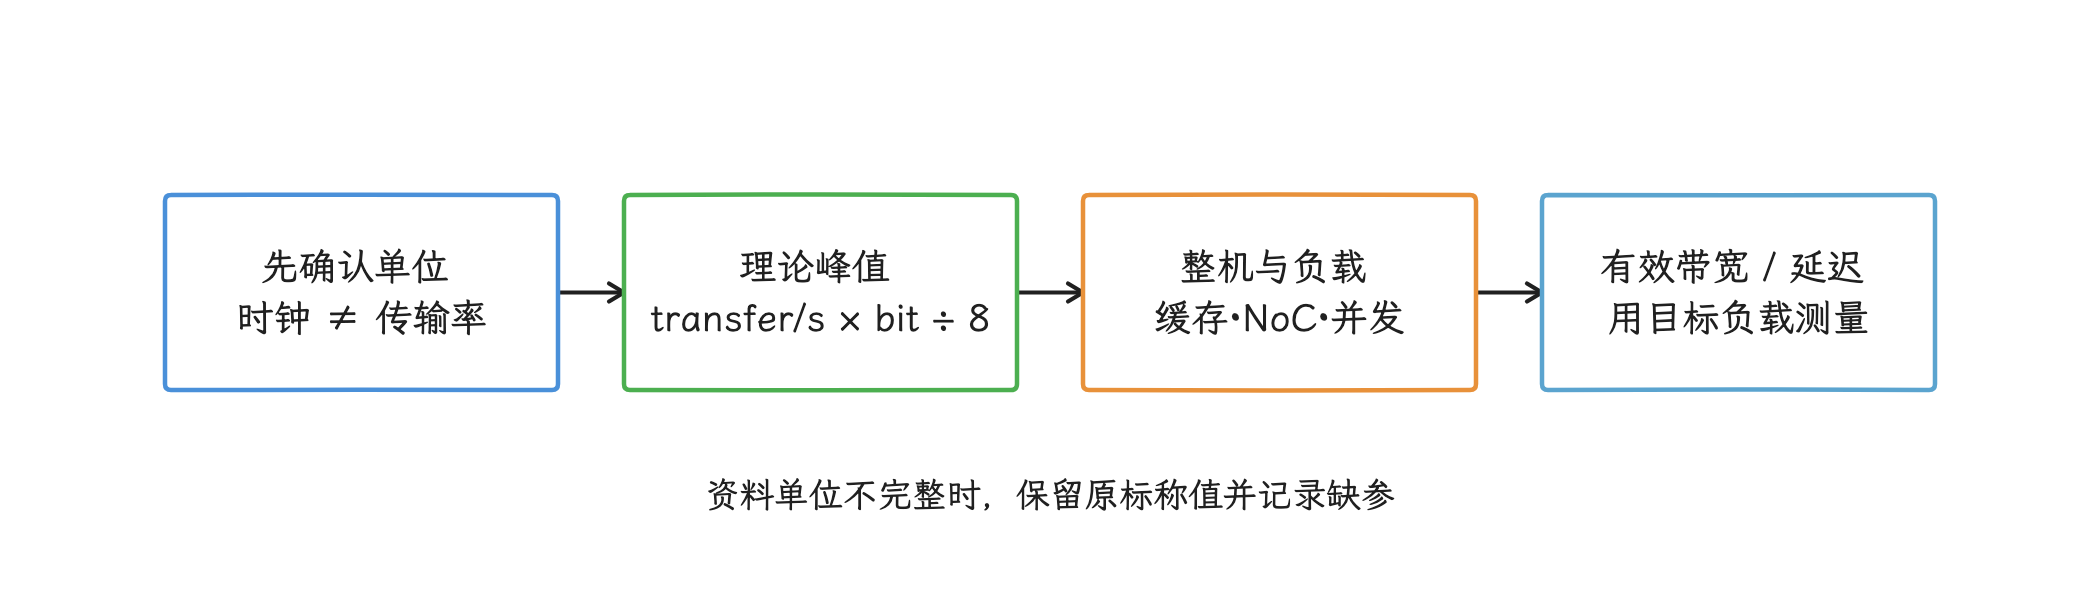
图:理论峰值需要明确传输率与总数据位宽;缓存、互连、并发和温控会改变实际工作负载的有效带宽。
一款 SoC “支持 LPDDR5X”,只说明内存控制器的能力范围。OEM 仍会选择颗粒、容量、速率、总线组织和固件策略。
Snapdragon 8 Elite Gen 5 产品简报写的是 “LP-DDR5x, up to 5300 MHz”,Dimensity 9500 页面只写 LPDDR5X 10667,没有注明单位。这两个数字采用的是时钟频率、每引脚数据率还是内存速率等级,资料都没有说明,直接把 5300 和 10667 当成同单位数字比较会出错。
当厂商给出可核验的总传输率与总数据位宽时,理论峰值可按下式估算:
理论带宽(Byte/s) = 每秒传输次数(transfer/s) × 总数据位宽(bit) ÷ 8
若资料只写内存通道(channel) 数量,不写每个通道的数据位宽,公式仍缺参数。MT/s 表示每秒百万次传输,Gb/s 表示每秒十亿比特;这两个单位要和时钟频率分开理解,双倍数据率已经算在定义里,不必再乘二。
应用最终拿到的是有效带宽和访问延迟。LLC(Last Level Cache)是末级缓存;NoC(Network on Chip)是连接芯片内部模块的片上网络。内存控制器调度、DRAM 时序、SLC / LLC 命中、压缩、NoC、内存互连、CPU / GPU / ISP 并发与温控,都会把理论值和测量值拉开。顺序读写微基准(microbenchmark) 同样代表不了游戏纹理采样或相机流水线。
Perfetto 没有所有 Android 设备都提供的通用 “DRAM bandwidth” 轨道。设备若公开内存互连、devfreq(内核设备调频框架)、PMU 或厂商内存计数器,可以在时间轴上对齐。
没有计数器时,可用固定负载做受控扰动,例如保持 GPU 场景不变,逐档增加 CPU 内存流量并记录帧时间、频率和功耗。相关性只能支持提出假设,因果判断还需要可重复的负载变化。
工具选择与数据缺口
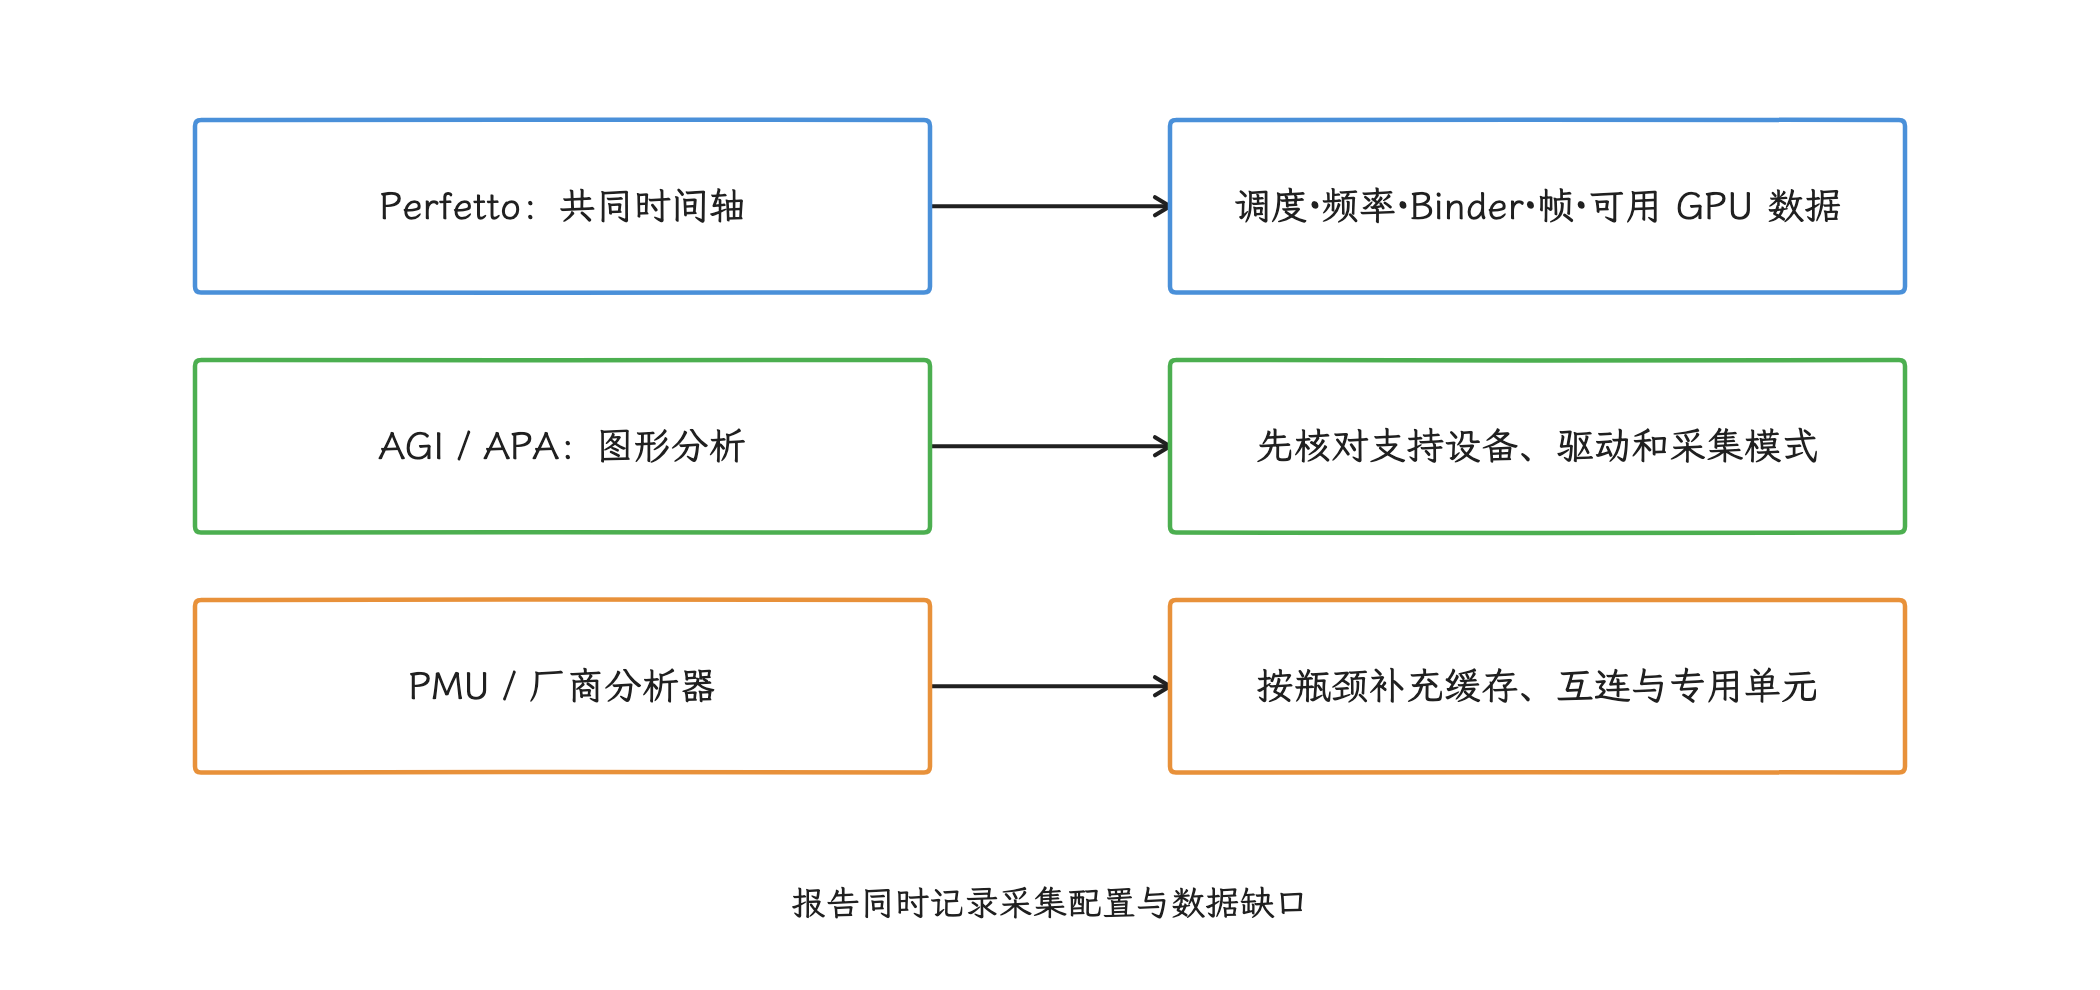
图:公共时间轴定位问题,再按瓶颈补充计数器;工具能力依赖设备、权限、驱动与版本。
Perfetto
做跨平台对比时,Perfetto 适合当公共基线:CPU 调度、频率、空闲状态、进程与线程、Binder、帧时间线、部分温控与 GPU 数据可以放在同一时钟域里。至于每条轨道存不存在,取决于内核跟踪点(tracepoint)、数据生产端、权限和配置。报告里要同时附上采集配置和缺失的数据——工具没采到,说明不了硬件没有活动。
CPU 频率可能按调频策略域变化,也可能由每核事件上报;温度传感器的名字、位置与采样周期也不相同。跨设备报告应把这些统计方式上的差异写清楚。
Android GPU Inspector 与 Android Performance Analyzer
AGI 可在受支持设备上采集 GPU 计数器,执行系统分析与单帧分析,适合检查绘制调用(draw call)、着色器、流水线停顿和 GPU 计数器;使用前要核对设备、GPU 和驱动是否在当前支持范围内。
Google 在 AGI 文档中推荐用 Android Performance Analyzer(APA)分析游戏,并将下载入口标为公开测试版。APA 当前面向游戏与基于 Vulkan 的图形分析,系统分析的最低要求是 Android 12,且设备须受支持并通过校验。其他应用按 APA 首页指引使用 Android Studio 分析器。AGI 的单帧分析与现有系统分析功能仍有独立用途。
Arm Streamline
Streamline 可分析 Arm CPU,以及目标系统支持的 Mali / Immortalis GPU 计数器。能采到哪些 PMU、GPU 与系统计数器,取决于目标内核、驱动、gator 数据采集模块或 agent 代理程序的配置和权限;就算设备使用 Arm CPU,也不能就此期待零售 user build 会自动开放全部计数器。
Snapdragon Profiler 与厂商工具
Snapdragon Profiler 面向受支持的 Snapdragon 平台,可提供 Adreno、CPU、DSP 等平台数据。具体采集模式、计数器数量、操作系统版本和设备兼容性,都以当前工具包文档为准;旧版本的功能表会过时,照抄成长期固定能力容易出错。
Samsung、MediaTek、Google 或 OEM 也可能提供内部或合作伙伴工具。拿不到这些工具时,Perfetto、simpleperf、AGI、应用埋点和外部功耗设备仍能组成一套可复现的基础数据。结论范围要与可见数据一致。
一套可复用的跨 SoC 分析流程
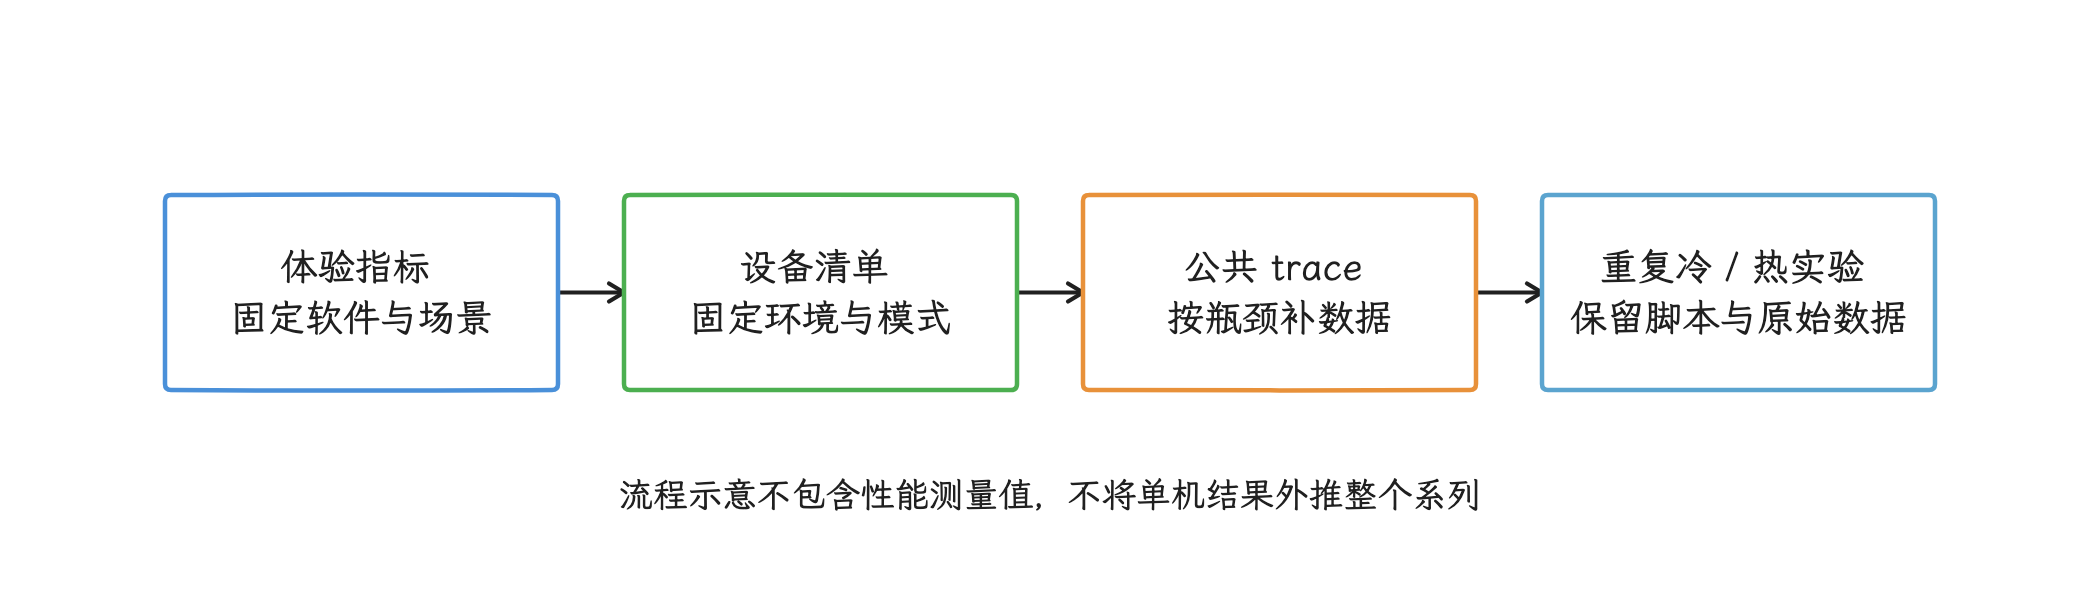
图:对齐输入条件,记录设备实现与数据缺口,再比较瞬态和持续稳态;结论仅覆盖已验证的软件、设备和运行条件。
把前面这些工具和数据缺口串起来,一次跨 SoC 对比可以按下面七步组织:
- 定义体验指标:例如启动首帧、交互帧错过截止时间的次数、推理 P95(第 95 百分位延迟)或拍照保存完成时间。
- 固定变量:相同应用构建版本、数据、屏幕参数、网络、环境温度、电量模式和预热轮次。
- 记录设备清单:SoC、RAM、系统构建指纹、内核、GPU 驱动、分辨率和刷新率。
- 采集公共证据:Perfetto 配置一致,并明确每台设备缺少哪些数据源。
- 按瓶颈补充数据:CPU 用 simpleperf / PMU,GPU 用 AGI 或厂商工具,内存用互连计数器,推理用运行时分析器。
- 区分瞬态与稳态:同时看冷启动、短时突发和热平衡后的持续运行。
- 复现实验:每个结论至少能由固定步骤重复触发,并保留原始 trace、配置和统计脚本。
这套流程得到的是“某个软件版本在某台设备、某种状态下”的结论。扩大到整个 SoC 系列前,需要增加机型、系统版本和运行条件。
常见误判
用芯片品牌预测流畅度
峰值算力不会自动转换成帧稳定性。OEM 策略、散热、内存、显示负载和应用路径都会影响结果。报告应描述可测量的错过帧截止时间次数、CPU 可运行态等待时延、GPU 完成时间和降频,不给品牌贴“流畅”或“保守”的标签。
用 CPU 主频跨架构比较性能
主频只表示每秒时钟周期数(cycles)。IPC、缓存、内存延迟和向量指令都会改变每个周期完成的工作。跨架构比较应使用相同工作负载的完成时间、指令数、周期数、缓存未命中次数与功耗。
把调频策略域当成物理核心簇
调频策略域表示共享调频控制的 CPU 集合,不保证共享 L2,也不保证核心微架构相同。缓存与 DSU(DynamIQ Shared Unit,共享单元)拓扑需要 TRM(Technical Reference Manual,技术参考手册)、设备树、内核日志或经过验证的硬件资料。
把频率同时升高归因于私有提频机制
线程并发、共享调频策略域、温控恢复、Power HAL 性能提示和厂商服务都可能形成相似曲线。没有调用链或厂商事件时,只记录现象和触发条件。
把 GPU 轨道缺失当成 GPU 空闲
数据生产端、驱动、权限或采集配置缺失都会造成空轨道。应用帧时间、同步 fence、SurfaceFlinger、GPU 频率和厂商分析器可以交叉核对。
直接比较厂商 AI 百分比
“提升 40%”必须连同上一代基线、模型、精度、批量大小(batch size)、功耗模式和软件栈一起读取。不同厂商的百分比缺少共同分母,也就谈不上相加、相减或排序。
从时间相关性推断内存带宽争用
CPU 与 GPU 同时变慢只是线索。可靠判断需要 DRAM 或内存互连计数器,也可以改变一方的内存流量,再用受控实验观察另一方是否按预期响应。
小结
跨 SoC 分析的最后一步,是把微架构、设备拓扑、驱动能力、整机约束和运行数据放进同一套实验条件里;芯片品牌排序只是起点。只有在工作负载、环境和数据生产端可比时,CPU、GPU、加速器与内存差异才具有可复查的解释力。
与相关章节的分工
- §5.1 说明公平调度、DynamIQ、异构核心、唤醒与可运行态等待时延;这里讨论 SoC 拓扑和厂商扩展怎样改变观测条件,设备拓扑仍须从目标机核验。
- §5.2 说明 DVFS;这里补充调频策略域、Power HAL 和整机散热的差异。
- §2.7 说明 Android GPU 渲染分析;这里补充 GPU IP、驱动与数据生产端的跨平台边界。
- §19.1 说明 OEM 优化的公共框架;这里提供 SoC 侧的证据分层。
参考资料
SoC 与 GPU 官方资料
- Snapdragon 8 Elite Gen 5
- Snapdragon 8 Elite Gen 5 产品简报
- Qualcomm Adreno
- Qualcomm Adreno FlexRender 开发指南
- MediaTek Dimensity 9500
- Samsung Exynos 2600
- Samsung Xclipse GPU 技术
- Google Tensor G5
- Arm Mali-G1 Ultra
- Arm C1 CPU 平台
- Arm C1 CPU cluster
Android、内核与分析工具
- Android 17 common kernel:fair.c
- Android 17 common kernel:schedutil
- Android 17 common kernel:sched_ext
- Android 17 common kernel:sched_ext Kconfig
- Linux Energy Aware Scheduling 文档(Android 17 kernel 锚点)
- Perfetto CPU scheduling 数据源
- Perfetto SQL tables
- Perfetto GPU 数据源
- Android GPU Inspector
- Android GPU Inspector 快速入门与设备校验
- Android Performance Analyzer
- Android Performance Analyzer 快速入门与设备校验
- Android NDK CPU 特性查询
- Arm Streamline 安装指南
- Snapdragon Profiler
- NNAPI 迁移指南
- Android Neural Networks HAL