千万级 DAU(Daily Active Users,日活跃用户数) 的 APM 端侧架构
DAU 到千万级之后,APM SDK(应用性能监控软件开发包) 在单台设备上要做的还是那几件事,但极小比例的缺陷也会落在大量用户头上。SDK 的压力峰值往往与宿主故障同时出现:卡顿会增加慢帧事件,网络失败会积压待传批次,内存异常可能触发更高采样率或更重的诊断采集,进程退出又要求保住故障前的少量上下文。端侧架构要按这个峰值设计,平稳期的平均流量只能作参考。
源码基线:Android 17 / API 37 / AOSP
android-17.0.0_r1;内核android17-6.18-2026-06_r6。
Android 8—17 的应用都能采用以下队列、分片和上传模型;ApplicationExitInfo、ProfilingManager 等能力再按 API level 分支。
“千万级 DAU”改变的是发布风险:一个只在 0.1% 设备出现的采集器回归,也会覆盖大量用户;重试一旦缺少随机错峰,就会在同一时刻形成请求峰值;目标范围过宽的远程指令会迅速消耗系统预算和用户流量。端侧因此要同时控制三样东西:单进程开销、跨进程一致性,以及一次配置或版本发布能影响的设备范围。
1. 端侧引擎的职责与不可破坏约束
我们先划清端和云的分工:端侧负责采集、准入、短期存储、受控上传和远程配置执行,聚合、长期检索、因果分析和告警留给服务端。设备上可以承担低成本过滤与摘要,复杂分析要放到业务线程之外。
一个可维护的 SDK 至少包含以下层:
| 层 | 主要职责 | 必须限制的风险 |
|---|---|---|
| 采集 API | 读取已有事实,填最小事件 | 主线程分配、锁等待、字符串处理 |
| 准入与缓冲 | 有界队列、优先级、丢弃计数 | 无界增长、低价值事件挤掉故障事件 |
| 编码 | schema 校验、批量序列化、压缩 | 大对象、GC、压缩 CPU 峰值 |
| 本地 spool | 分片、提交、恢复、配额 | 尾部损坏、磁盘满、跨进程并发写 |
| 上传调度 | 幂等、约束、退避、删除确认 | 后台唤醒、重试风暴、误删未确认文件 |
| 指令控制 | 验签、能力检查、TTL、预算 | 越权采集、过期指令、重样本失控 |
| 自我保护 | 成本计数、断路器、分批发布开关 | 监控逻辑递归、服务端失联时无法降级 |
这张表里有三个词后文会一直用到:schema 约定事件的字段、类型和兼容规则;spool 指尚未上传、暂存在 App 私有目录中的分片文件;TTL(Time To Live) 限定一条指令允许存活的时间。
全链条共享三条硬约束:
- 业务线程不等待编码、文件、压缩、加密和网络。
- 所有内存、文件、重试和重样本都有上限。
- 高优先级故障证据有独立容量,普通指标再多也挤不进去。
“业务线程不等待”指的是不在编码、文件这类慢操作上阻塞;至于每次调用的耗时,对象分配、CAS(Compare-And-Set,并发代码常用的原子比较后更新) 竞争、缺页(访问尚未驻留内存的页面)和线程调度都可能带来少量高延迟调用。所以我们要在目标低端机上实测入口 P50/P95/P99.9——分别对应 50%、95% 和 99.9% 的样本不高于该耗时——并给主线程路径配上自动降级。
2. 线程模型
线程模型围绕两件事展开:事件如何无阻塞地进入 SDK,以及写入如何保持单写者。我们先看入口。
2.1 trySend() 的非挂起契约
kotlinx.coroutines 1.11.0 的 Channel.trySend() 非挂起发送,返回 ChannelResult。我们固定使用正容量、BufferOverflow.SUSPEND 的 Channel:队列满就立刻失败,已关闭也立刻失败。若换成 DROP_OLDEST、DROP_LATEST 或 CONFLATED,事件可能已被悄悄丢掉而返回值仍是成功,光看成功结果证明不了“没有丢样”;UNLIMITED 则满足不了有界内存。所以准入策略与容量要由 SDK 自己持有,注入另一种 Channel 后,原来的统计含义就得重新定义。
拿到“立即返回”这个性质,还要把它和 lock-free 分开:lock-free 指系统整体总有线程能前进,wait-free 更进一步,要求每个操作在有限步骤内完成。这两条进度保证,连同固定的纳秒上限,Channel 文档都没有承诺;我们手里拿到的契约,只有“非挂起、失败可观测”一条。
如果项目选择自研 MPSC(Multi-Producer, Single-Consumer,多生产者单消费者)RingBuffer(首尾相接、循环复用槽位的缓冲区),就要用每个 slot(队列槽位) 的 sequence(代次序号) 证明发布顺序,并处理槽位值循环后被误认成旧状态的 ABA 问题。这样的实现要通过并发测试、长时间 soak test(持续压力测试) 和线性化检查才算数;直接把一个循环数组叫作无锁队列,是过不了这几关的。
下面的示例只展示准入语义。事件使用预先分配的 sceneId,避免在入口处理 URL、路由名和动态标签。
import android.os.SystemClock
import kotlinx.coroutines.channels.BufferOverflow
import kotlinx.coroutines.channels.Channel
import kotlinx.coroutines.channels.ReceiveChannel

private const val APM_QUEUE_CAPACITY = 4096

enum class Admission {
    ACCEPTED,
    FULL,
    CLOSED
}

class ApmIngress(
    private val selfMetrics: ApmSelfMetrics,
    private val clock: () -> Long = {
        SystemClock.elapsedRealtimeNanos()
    }
) {
    private val queue = Channel<ApmEvent>(
        capacity = APM_QUEUE_CAPACITY,
        onBufferOverflow = BufferOverflow.SUSPEND
    )

    // Only the SDK writer receives; the business side cannot change policy.
    internal val events: ReceiveChannel<ApmEvent> get() = queue

    // Buffered events remain receivable after graceful close.
    fun closeForSend(): Boolean = queue.close()

    fun recordFrameJank(
        sceneId: Int,
        frameCostNs: Long
    ): Admission {
        val result = queue.trySend(
            ApmEvent.FrameJank(
                sceneId = sceneId,
                frameCostNs = frameCostNs,
                observedElapsedNs = clock()
            )
        )

        return when {
            result.isSuccess -> Admission.ACCEPTED
            result.isClosed -> {
                selfMetrics.incrementClosed(EventKind.FRAME_JANK)
                Admission.CLOSED
            }
            else -> {
                selfMetrics.incrementDropped(
                    EventKind.FRAME_JANK,
                    DropReason.QUEUE_FULL
                )
                Admission.FULL
            }
        }
    }
}
ACCEPTED 只表示本次进入队列或直接交付等待中的接收者,到落盘、持久化和服务端确认还有整条链路要走。capacity = 4096 管住的只有 buffer 中驻留的元素;已被 worker 取走的批次、并发生产者刚构造的对象、对象引用的数组,都在这个容量之外。生产实现还要限制单事件大小、worker 批次与并发生产者开销,把队列节点、对象、编码和压缩工作区一起纳入内存预算。
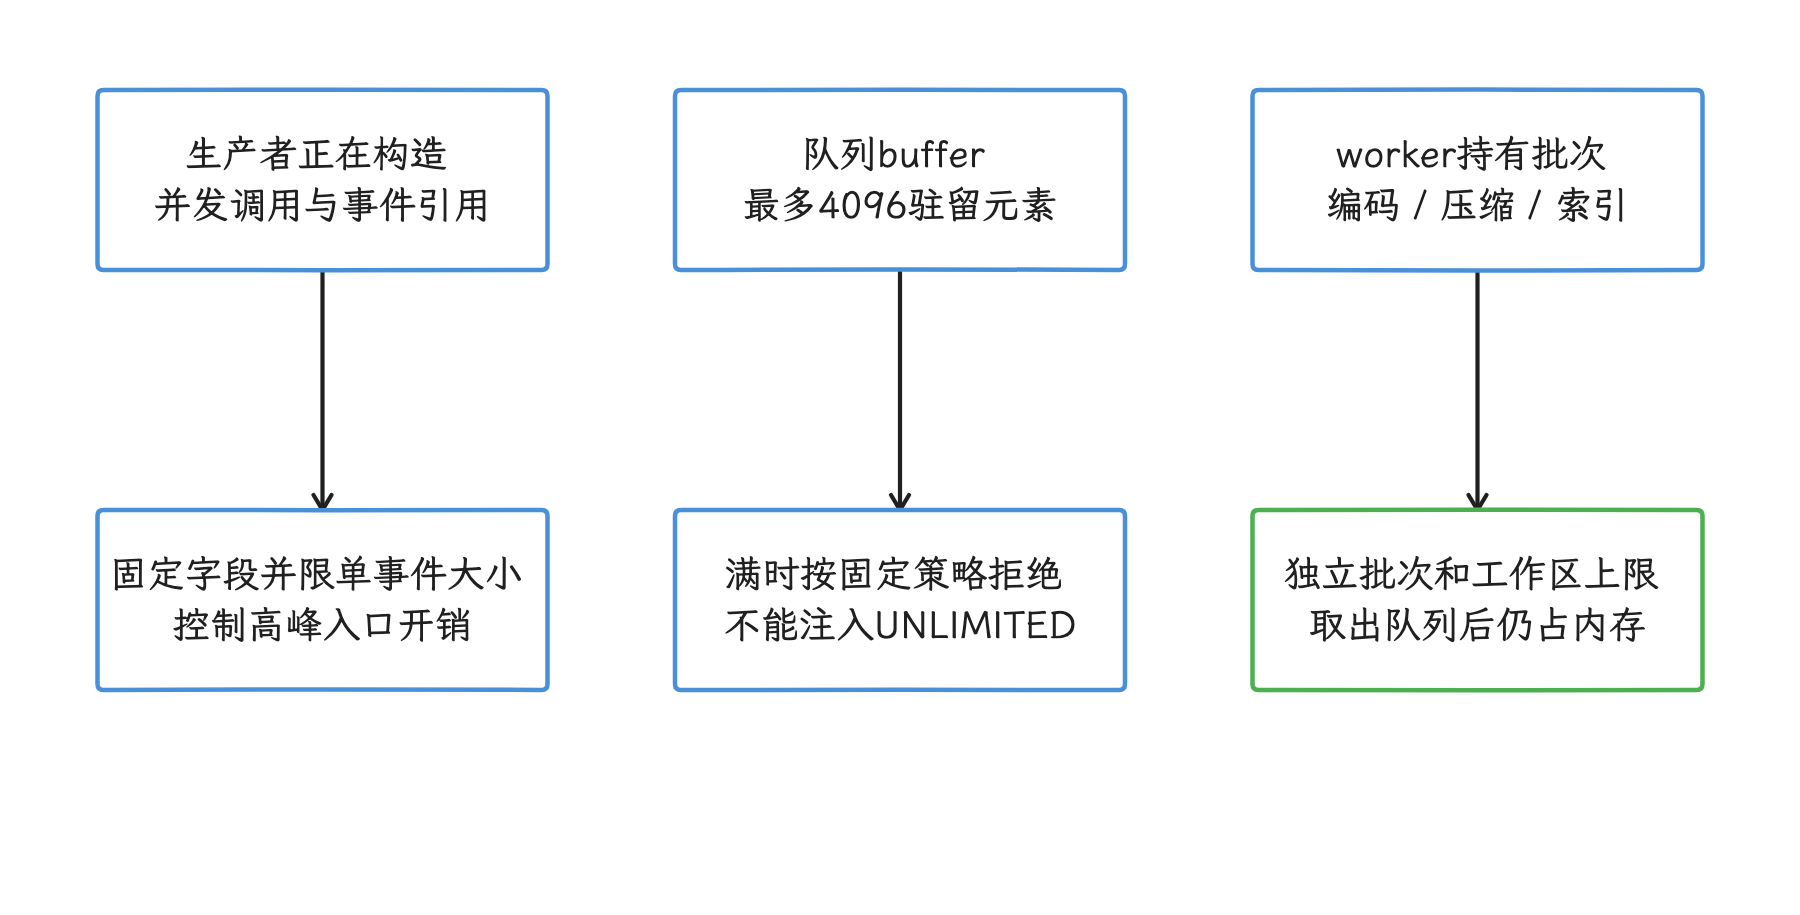
图:驻留 buffer、并发构造对象、在途批次和编码工作区分别计入内存。 4096 是 buffer 元素数上限,不是总事件数、对象字节数或持久化承诺。
失败计数同样在 hot path(调用频繁、对耗时敏感的路径):计数器预先创建、按固定枚举索引,只做有界自增。示例要求 clock 与 ApmSelfMetrics 的实现线程安全、不阻塞且不抛异常;这层保证要自己实现,Channel 的非挂起契约替它们兜不了底。队列关闭与容量满分开统计;计数失败不再递归投递普通 event。
closeForSend() 拒绝新发送,但已有 buffer 仍可被 writer 排空;取消 Channel 会丢掉尚未消费的事件。生产生命周期要区分优雅关闭与立即取消,并为取消后的未交付元素另作有限计数。若安装 onUndeliveredElement,它可能同步运行在取消、发送或接收方的调用上下文中,必须快速、无阻塞、不抛异常。示例只实现准入与优雅关闭,没有实现完整取消计数。
在本例 SUSPEND 策略下,trySend() 因满或关闭返回失败时,元素未交付,onUndeliveredElement 不替这个失败分支计数。事件不携带必须依赖该回调释放的复杂资源。这条规则只对本例成立,推不成“任何 overflow 策略都能仅凭 isSuccess 统计丢样”的通用结论。
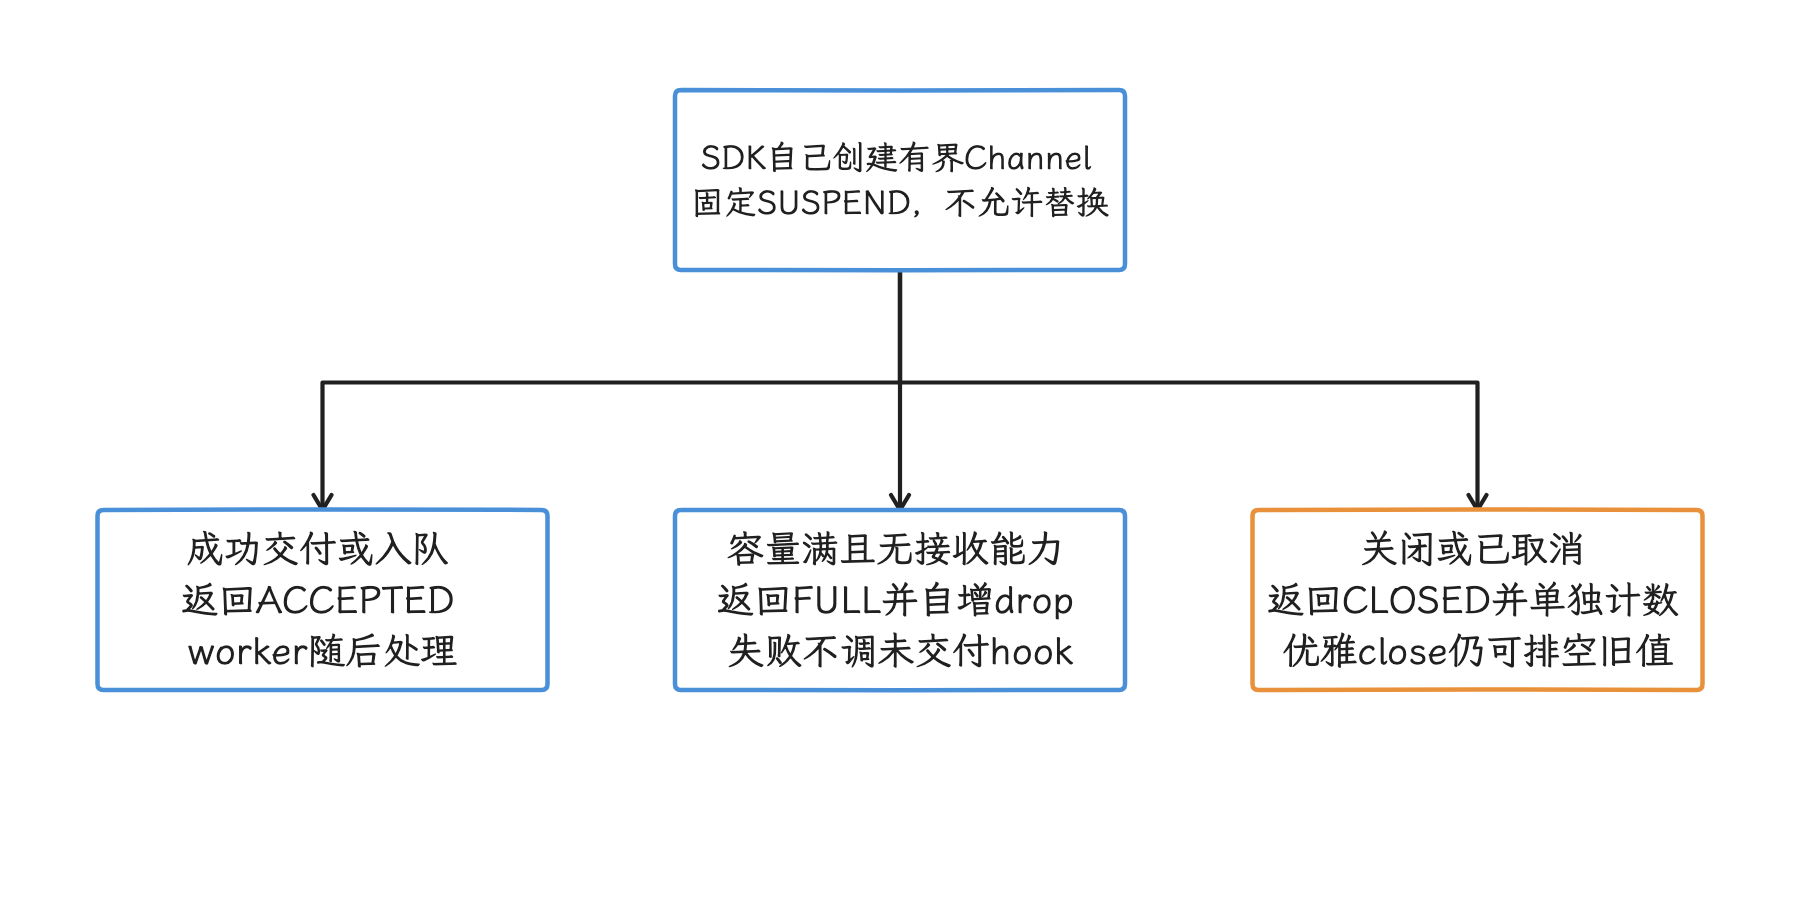
图:固定4096容量与 SUSPEND 后,trySend 的成功、满和关闭分别统计。 ACCEPTED 只表示交付或入队;换成自定义丢弃策略,可能一边返回成功一边丢样,持久化与否要看后续链路。
2.2 三级优先级准入
单个 FIFO(First In, First Out,先进先出) 队列满载时,普通帧样本可能先占满所有 slot,随后到达的 crash breadcrumb(崩溃前留下的少量事件线索)就无处可放。更稳妥的准入模型把事件分成三级:
| 级别 | 例子 | 队列满时的策略 |
|---|---|---|
| P0 故障证据 | crash/ANR 摘要、renderer gone、存储损坏 | 独立保留槽或直接写预分配故障区 |
| P1 异常样本 | 确认白屏、严重慢帧、超时网络 | 丢弃同类旧样本或限频保留 |
| P2 普通样本 | 正常帧、正常网络、Debug/Info | 按采样率丢弃 |
P0 的容量同样要有上限:常见做法是很小的独立 ring,每类只保留最近 N 条,或覆盖最旧 breadcrumb。覆盖发生时把 dropped/overwritten count(丢弃数和覆盖数)记下来,服务端才能识别样本不完整。
2.3 单写者简化文件一致性
多个业务线程可以并发投递,而编码、分片、游标提交和文件轮转尽量由一个 spool writer(待上传文件的单写入线程)串行执行。active 分片仍在写入,sealed 分片已提交并停止修改,上传 worker 只读 sealed 文件。这样我们能把“记录发布”“文件提交”“上传删除”拆成清晰的状态:
IN_MEMORY -> ACTIVE -> SEALED -> UPLOADING -> ACKED -> DELETED
                         \-> EXPIRED / CORRUPT
状态迁移由持久索引或同文件系统的原子 rename 表达;rename 只保证名称切换原子性,不自动保证掉电后的目录项持久性。若承诺掉电恢复,还要完成文件数据/元数据同步、rename 与父目录同步,并验证目标文件系统及错误处理。ACKED 必须绑定同一 batch ID、完整内容 hash 与服务端提交确认;启动恢复修复 ACTIVE、重新发现 SEALED,并按持久 claim/租约恢复中断的 UPLOADING。
3. 多进程与进程退出
进程一多,“谁来写、谁来传”要单独回答。App 自己声明的组件进程分别初始化 SDK;WebView sandboxed renderer 是隔离的 provider 进程,不会因为宿主启用了多进程就自动运行同一 SDK,需通过宿主回调和受控 Bridge 观察。每个 SDK 进程实例生成新的 process_instance_id,另记 process name、PID、启动 elapsed 与 App 版本;PID 会重用,持久身份认的是实例 ID。
我们推荐每个进程使用自己的 active queue、worker 和 spool 目录:
noBackupFilesDir/apm/spool/<process-name-hash>/<process-instance-id>/
上传协调者固定在主进程或专用诊断进程,负责扫描其他进程的 sealed 文件;其他进程只做 seal 和轻量 IPC(Inter-Process Communication,进程间通信) 通知,通知丢失时由下次扫描补上。需要从多个进程安全地提交 WorkManager 请求时,显式接入 androidx.work.multiprocess.RemoteWorkManager,每个进程各自初始化一套未验证调度器的做法要避开。
同一个 mmap(memory-mapped file) active file 也只能有一个写进程:Java/Kotlin 的进程内锁只覆盖本进程,文件锁只提供互斥,记录何时算完整提交要靠 record commit protocol(记录何时算完整提交的协议) 自己约定。Mars xLog 的接入文档同样是这个要求:多进程各用独立日志文件。
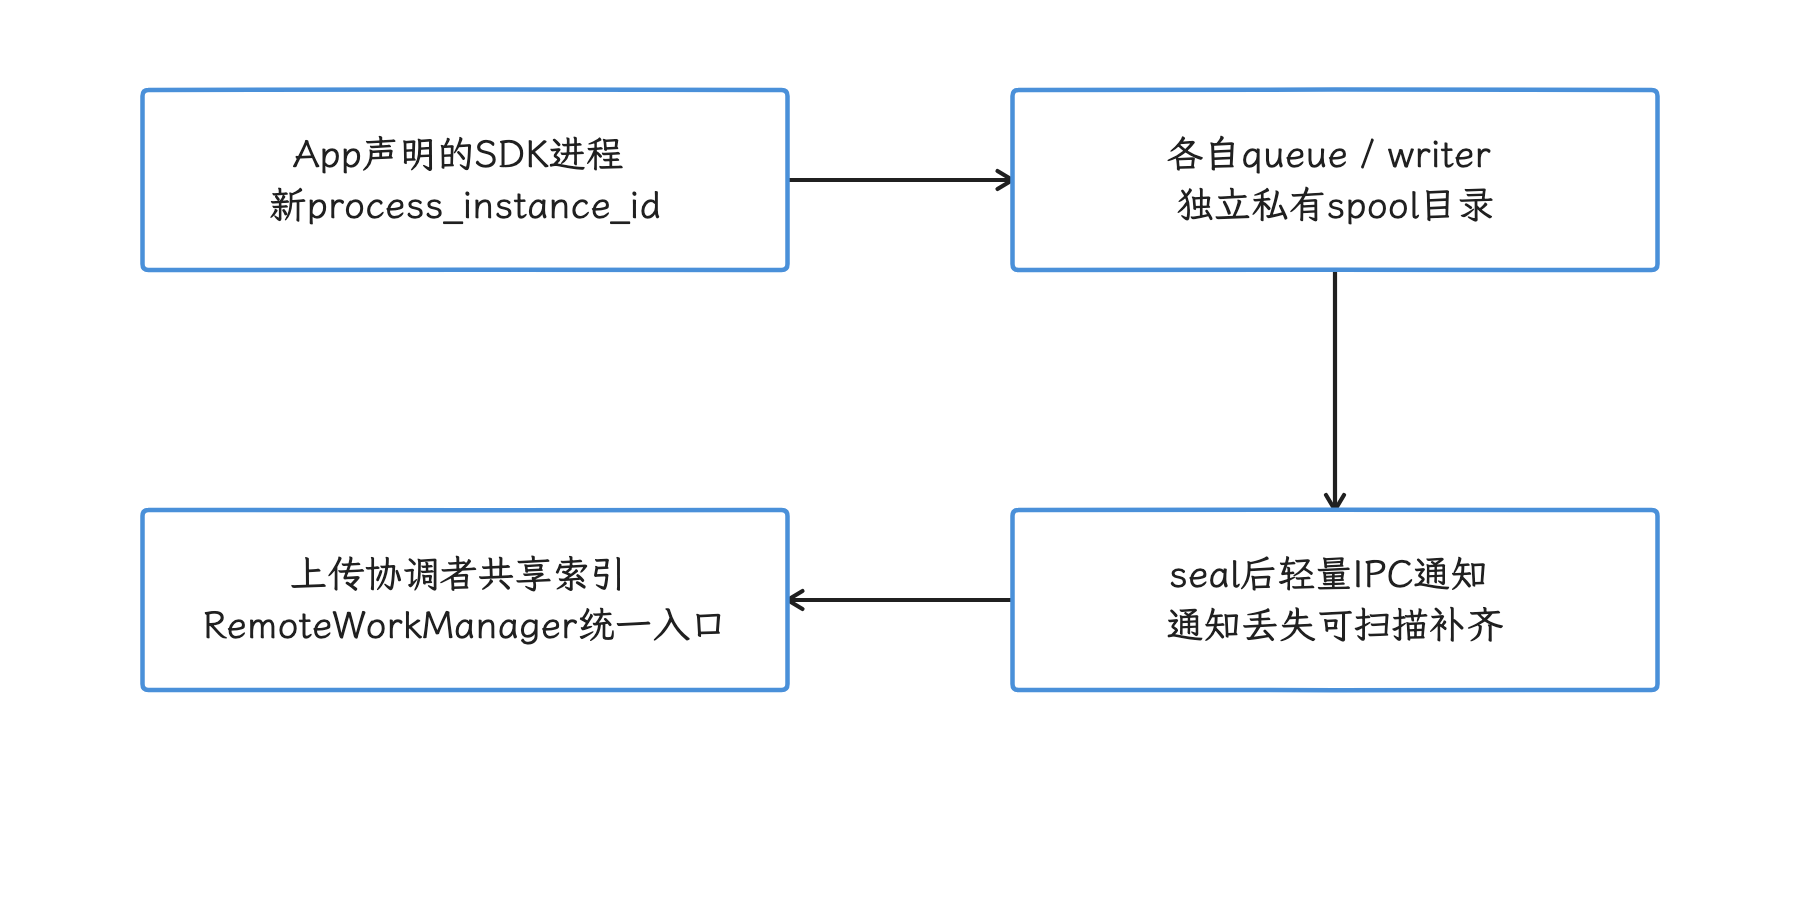
图:每个 SDK 进程实例拥有独立队列与 active 分片,协调者扫描 sealed 文件并统一调度。 PID 会重用;WebView 隔离 renderer 不自动运行宿主 SDK,文件锁也不提供记录提交协议。
3.1 crash handler 的最小职责
Java 未捕获异常、native signal、OOM(Out of Memory,内存耗尽) 和系统结束进程,这几种场景下能安全执行的操作各不相同:
- Java uncaught handler 仍在故障进程内,锁、堆和线程状态可能已损坏;
- native fatal signal handler 里只能调用 async-signal-safe(POSIX 明确允许在信号处理器中调用) 函数,也就是那个极小的函数集合;Java、malloc、常规日志和复杂文件 API 都不安全;
- OOM 后再创建大 event、压缩或 dump heap 很容易触发二次失败;
- LMK(Low Memory Killer,系统因内存压力终止进程)、force-stop、设备掉电与
SIGKILL没有应用清理回调。
因此 crash 前的 breadcrumb 要持续写入预分配区域。handler 只追加固定大小、无敏感正文的最小头,或设置预留的 crash marker(表示进程异常终止的固定标记),然后交还默认终止链。不要在 handler 中等待 Channel drain(排空队列)、执行全量 MappedByteBuffer.force()、上传网络或遍历所有线程。
3.2 下次启动补系统退出原因
crash 现场自己留下的信息有限,系统那边还有一份记录可查:API 30 起可以通过 ActivityManager.getHistoricalProcessExitReasons() 读取 ApplicationExitInfo。它能补充 reason、status、importance、timestamp,以及某些 ANR/native crash 的 trace stream(系统保存的诊断数据流)。
RSS 是进程当时驻留在物理内存中的页面总量,PSS 会按共享比例分摊共享页面;两者都取自系统最近一次采样,不是死亡瞬间的精确值。trace 也可能因系统循环缓冲被后续记录覆盖而返回 null。
SDK 常在下次启动扫描系统记录,按 process name、PID、时间窗口与本地实例记录谨慎匹配;同 App 的其他存活进程也可能在目标退出后查询,API 并不要求整个 App 重启。固定 Android 17 r1 的 NativeTombstoneManager 还可能从非致命 tombstone 合成 REASON_CRASH_NATIVE 记录,所以单凭 reason 宣布不了进程已死,判断要回到记录来源和完整材料上。幂等标记在有限读取并成功持久化摘要之后提交;trace 缺失或截断要另记状态。
4. mmap 的收益与代价
4.1 缺页、脏页与回写
事件落盘这一层,Mars、Logan 这些日志库共同的选择是 mmap:它把文件页面映射到进程虚拟地址空间,代码可以像访问内存一样读写它。
我们先看它省掉了什么:已经驻留内存的热页可省掉逐条 write() syscall,但首次访问和被回收后再次访问仍可能 page fault;dirty page 仍经 file cache 与 writeback 回写。本文用固定内核 tag 核查这条路径,目标设备仍须另记实际 kernel/build。内存回收、存储拥塞与显式同步都可能让访问变慢,入口耗时上限 mmap 给不出来。
Java MappedByteBuffer.force() 会把 read/write mapping 的修改强制写到本地存储设备:调用成功,即代表数据已提交到本地设备,我们由此拿到一条明确的持久化边界。它也可能执行同步 I/O,所以要放在 spool worker 上按批调用;FileChannel.force() 不保证替代 mapped buffer 自己的 force()。
要先定义允许丢失的窗口:
| 数据 | 同步策略 | 进程 crash 后的承诺 |
|---|---|---|
| 普通性能样本 | 按字节或时间批量 force() | 允许丢最近一个未提交窗口 |
| 关键 breadcrumb | 小分片、更短提交周期 | 尽量保留最近上下文,仍不承诺设备掉电零丢失 |
| sealed 上传分片 | 完成 header/index 后同步并原子 rename | 上传器只读取已提交文件 |
force() 之前,脏页何时写入由实现和内核决定;进程 crash 后内核仍在运行,这一点并不构成 Java API 的持久性契约。需要承诺的记录,必须有显式提交点。
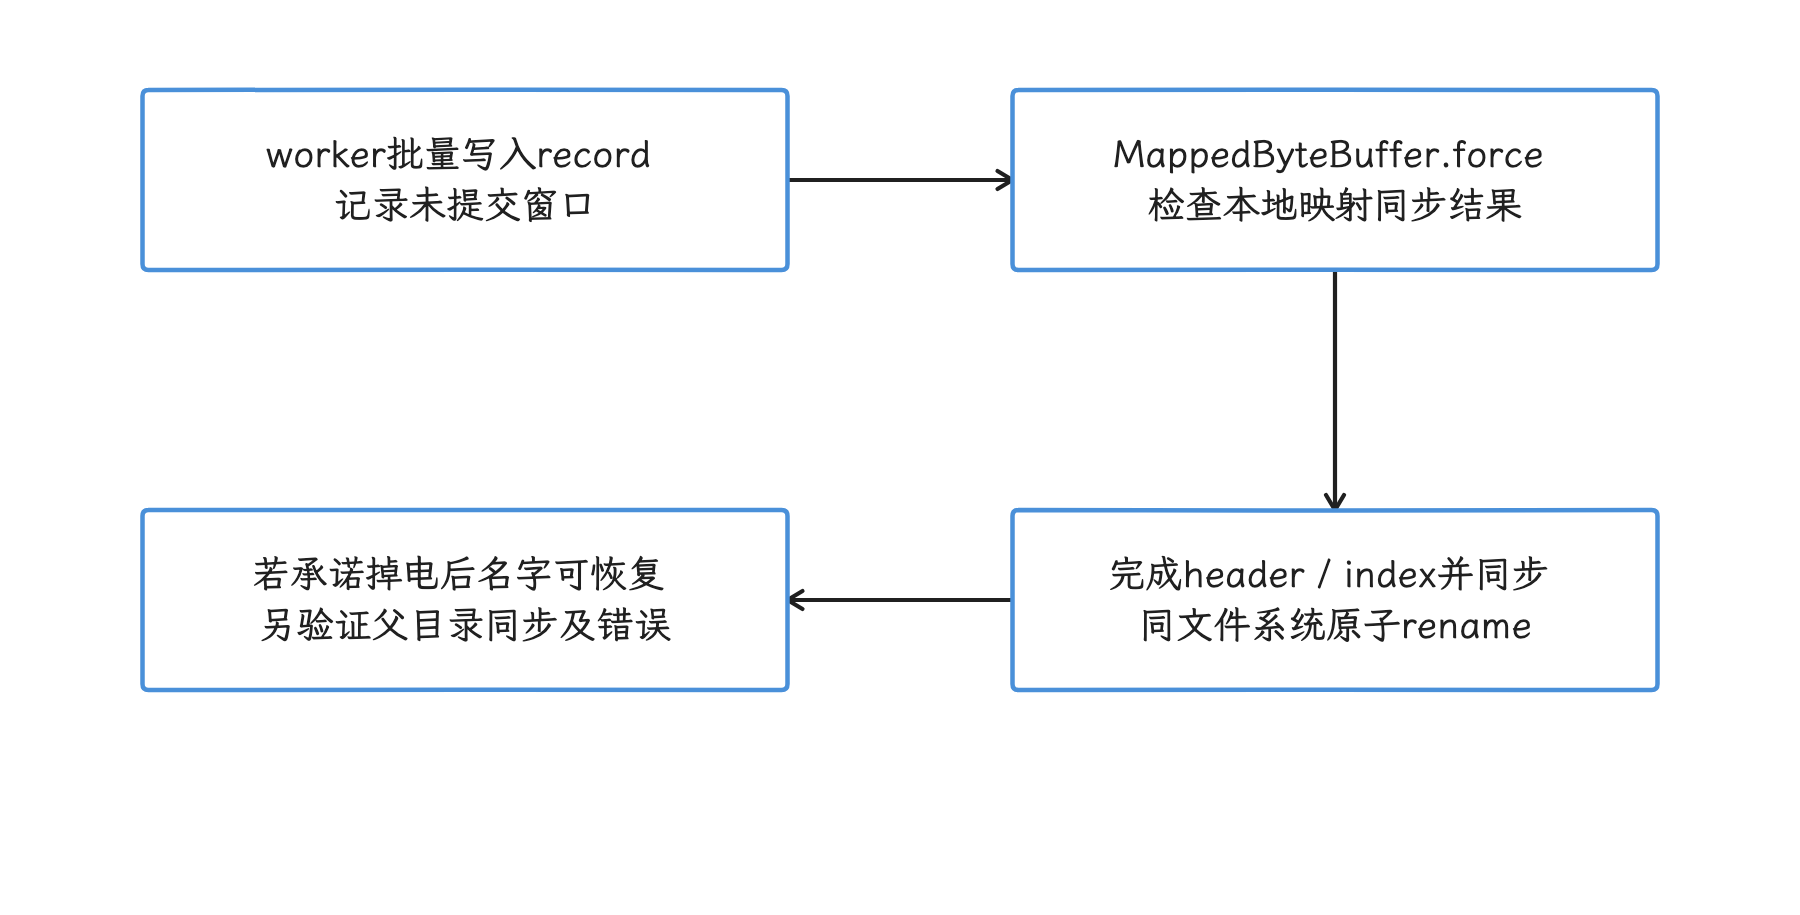
图:先定义允许丢失窗口,再分别完成映射数据同步、封口与名称提交。 MappedByteBuffer.force 与 FileChannel.force 作用不同,rename 的原子性也顶替不了父目录同步。
4.2 可恢复分片的文件格式
一个可恢复分片至少包含两类结构:superblock 是记录格式版本和已提交位置的元数据头,record 是单条事件的完整记录。
superblock A/B:
  magic, format_version, generation, committed_offset, checksum

record:
  length, type, flags, sequence, elapsed_ns, payload, checksum
先看字段含义:magic 是识别文件格式的固定值,generation 是 superblock 的更新代次,committed_offset 指向最后一个确认提交的位置,checksum 用于检查内容是否损坏。
单写者先写完整 record/checksum,批量强制同步这些数据,再写下一代 superblock 并同步提交元数据。恢复器在 A/B 中选 generation 与 checksum 有效且能通过记录校验的提交;扫描不得越过该副本的 committed_offset,较新副本的尾部失败时回退较旧有效提交。长度、类型、offset 与 payload 均先做上限和越界检查;提交点之后即使有完整字节,也不自动升格为已提交。CRC 检测意外损坏,可信来源与防篡改另靠认证机制。
跨 crash 的 4 字节游标更新并不是一个 transaction(要么全部成功、要么全部撤销的事务):文件系统、设备写入粒度和回写顺序都可能影响结果,所以恢复器必须能接受“数据写了但游标没写”“游标较新但尾部校验失败”这类组合。
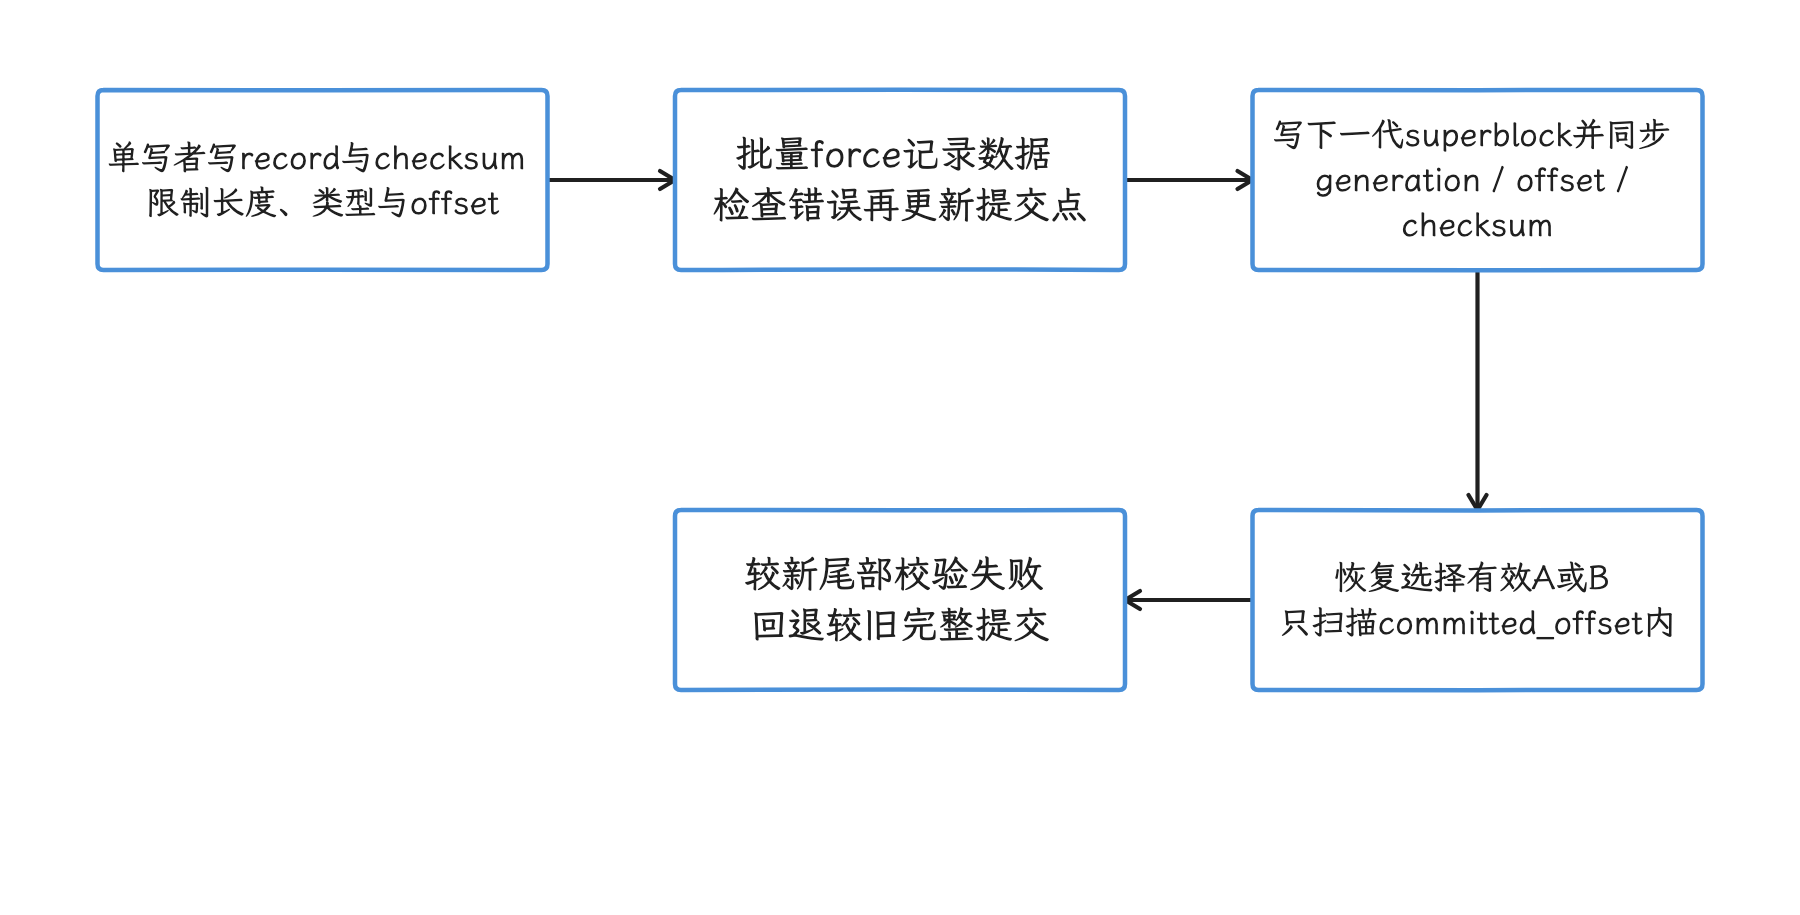
图:记录数据先同步,再提交下一代 A/B 元数据,恢复只接受校验完整的已提交前缀。 checksum 正确只说明内容未损坏,来源可信与否另看认证;提交点之外的完整字节也不会自动算作已提交记录。
4.3 预分配、磁盘满与 SIGBUS
ftruncate() 可以把文件的逻辑长度扩到指定值,但文件系统可能只创建 sparse region(尚未分配所有物理块的稀疏区),每个映射页未必都有 backing block。后续写 MAP_SHARED(修改会回到文件的共享映射)页面时,若空间耗尽,native 进程就可能收到 SIGBUS,即访问映射对象失败时触发的总线错误信号。
固定 Mars mmap_util.cc 在新文件扩容后尝试写零填充 backing store,README 提醒 cache path 与 SIGBUS;固定 Logan 则在映射前检查/填充长度,失败回退有限内存。它们是实现参考:换一个文件系统,或遇到 CoW、配额和延迟分配,分配失败仍可能发生,这类承诺要在自己的目标环境里验证过才算数。预分配本身也可能失败,须检查返回值并停止后续映射写入。
生产实现上,我们要做这几件事:
- 在 worker 上检查可用空间并完整预分配小而固定的 active file;
- active mapping 存续期间禁止其他线程/进程 truncate 或按同一路径重建/复用文件,清理遵守文件身份与代次协议;
- Java I/O/force 失败与初始 mmap 失败要停止当前提交,受控回退有限 buffer 或普通追加写;已建立映射后发生的 SIGBUS 不是一个可统一依赖普通 Java catch 恢复的 I/O 异常;
- 对 ENOSPC(设备无剩余空间)、只读文件系统、权限、checksum 失败分别计数;
- 清理器只删除 sealed/expired 文件,跳过当前正在写入的 active generation(正在写入的文件代次);
- 轮转前关闭旧 writer,再把分片标记为 sealed。
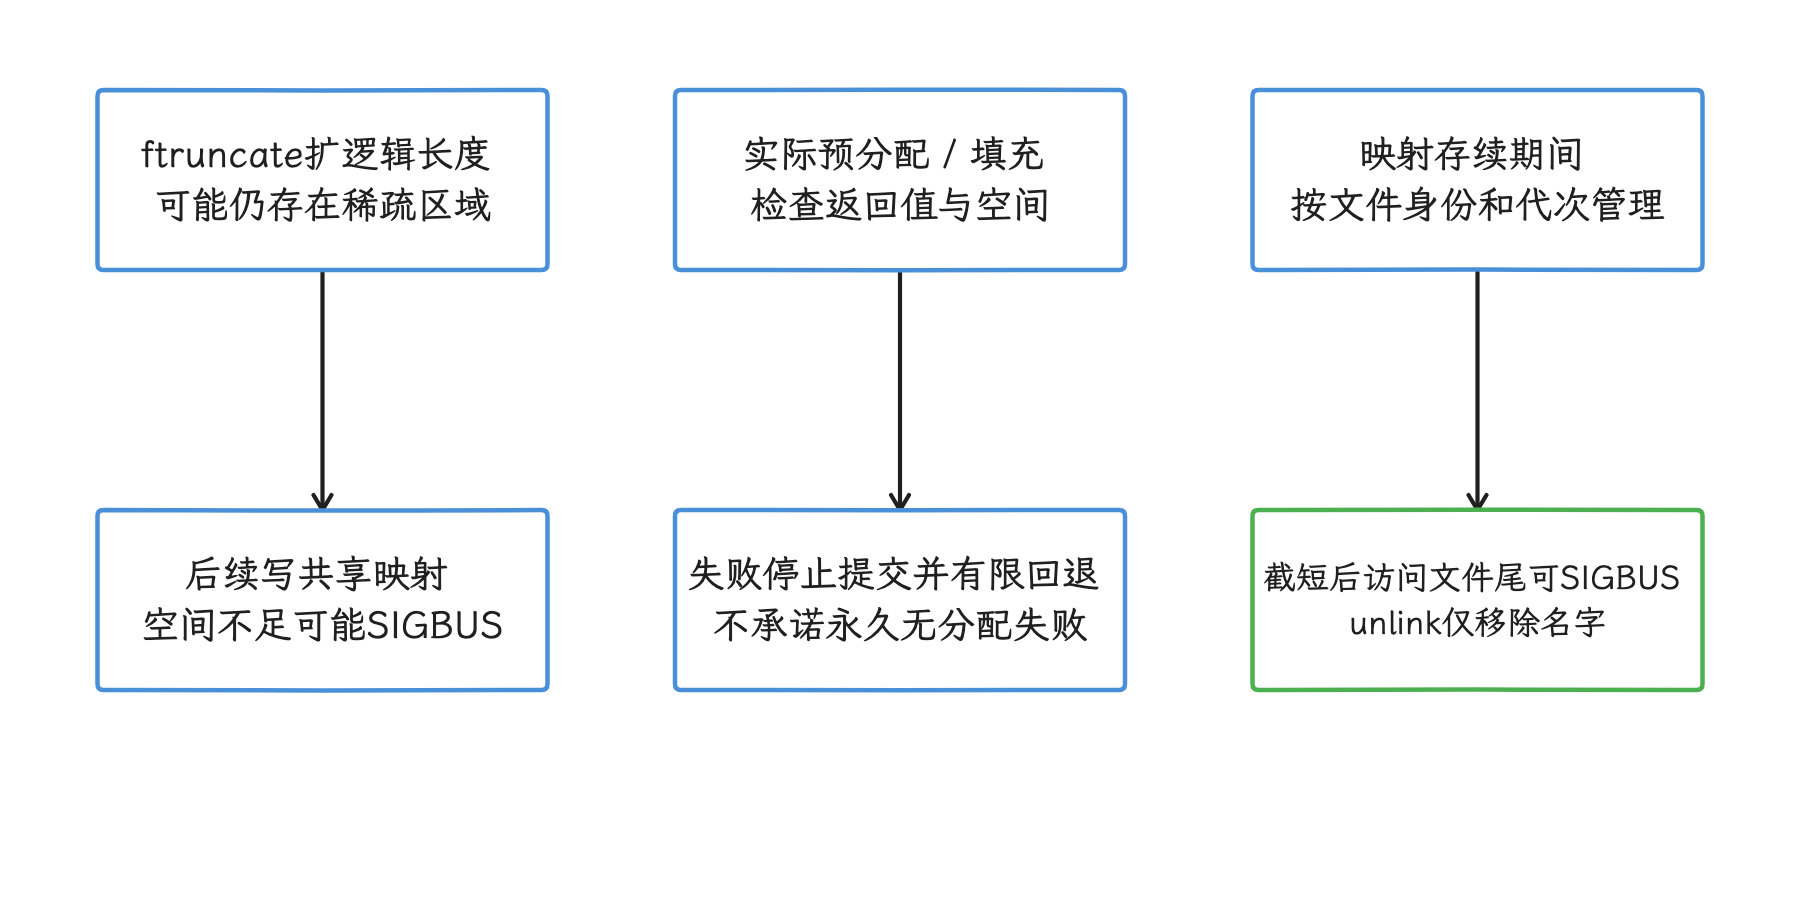
图:在 worker 上准备有限文件,初始失败受控回退,活跃映射禁止截短和路径复用。 预分配也会失败;已建立映射后的 SIGBUS 统一靠 Java catch 恢复是行不通的,unlink 与 truncate 不同。
纯 Java 还要注意 mapping 生命周期:关闭 FileChannel 不会让 MappedByteBuffer 立即失效,Android 17 的这组公开 API 没有可依赖的同步 unmap。Linux unlink 只移除路径名,已有映射不会仅因名字被删除就立即失效;但会破坏基于路径的发现、上传和配额管理,空间也可能等最后引用消失才释放。truncate 后访问文件尾以外则可能 SIGBUS,这是两件事,要分开处理。
可控的做法是长期复用一块很小的 active journal(按提交顺序追加的日志区),在 worker 上把已提交 block 复制成普通 sealed 文件后再复用 journal;若采用每分片 mapping,就限制同时存在的 mapping 数量,所有引用释放前不复用、不截断底层文件。
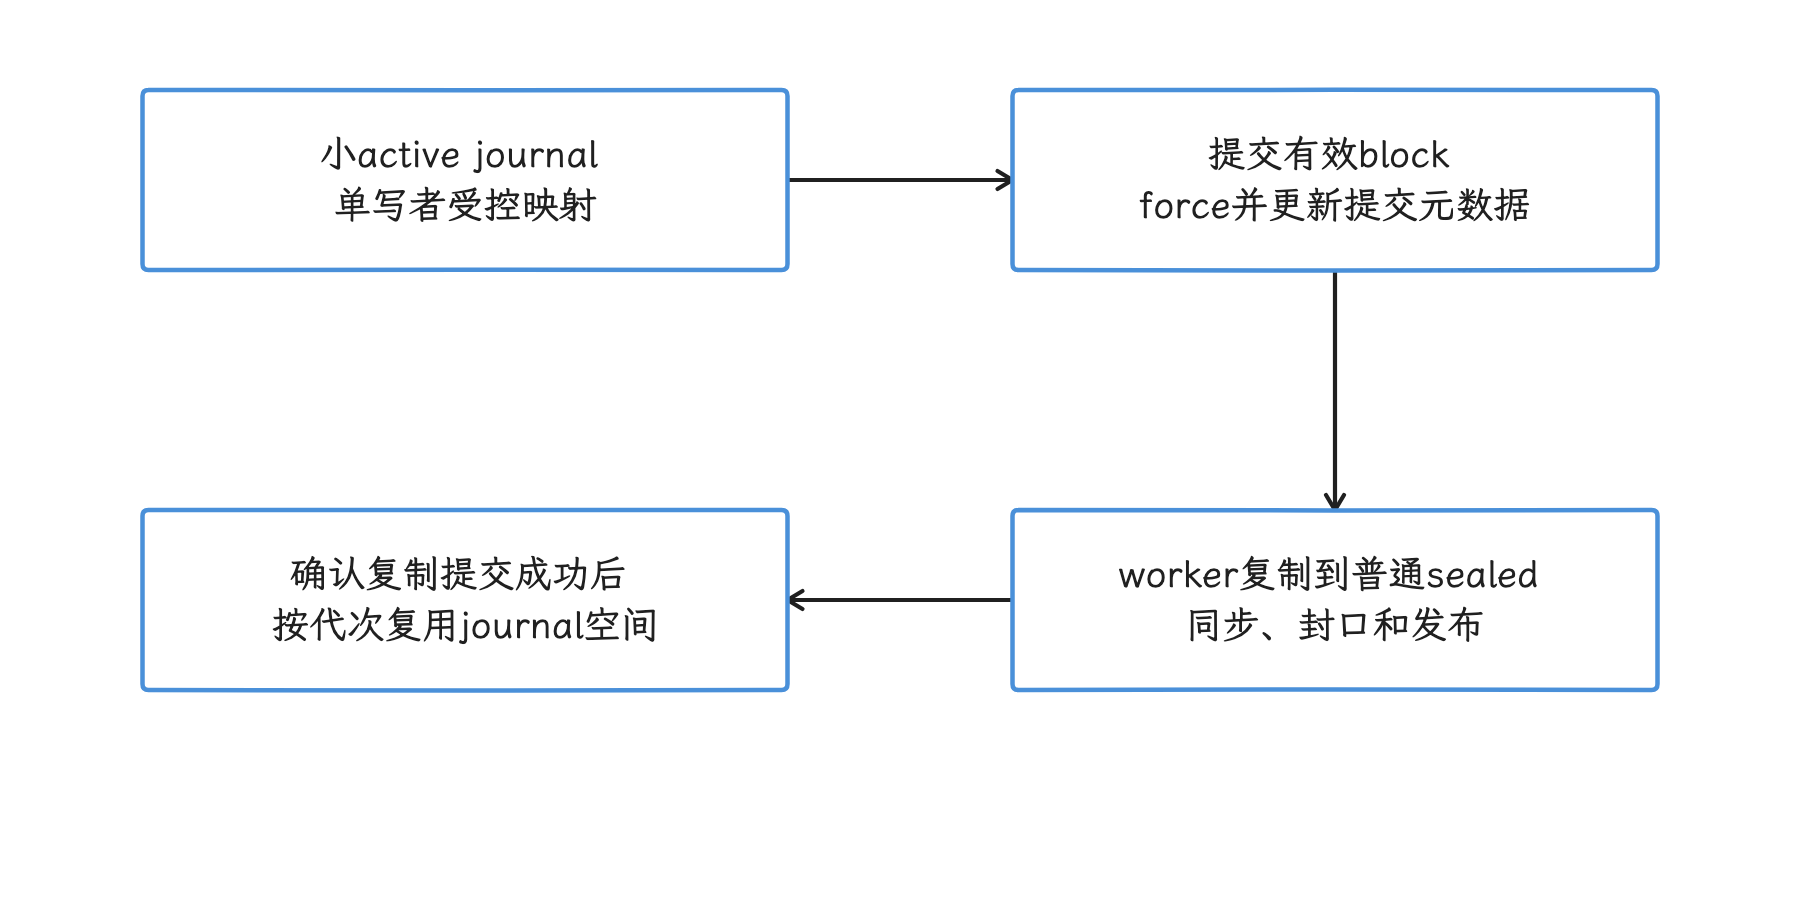
图:长期小 journal 可在 worker 复制已提交块为普通 sealed 文件,再受控复用。 关闭 FileChannel 不使已有 mapping 立即失效;纯 Java 不依赖同步 unmap 或提前截短复用。
mmap 本身只是缓冲与访问方式。crash-safe(进程异常终止后仍可判定并恢复有效记录)这个性质,要靠文件格式和恢复逻辑自己实现。Mars、Logan 的源码适合学习预分配、fallback(主路径失败后的受限备用方案) 和恢复思路;只复制一个 mmap() 调用,是学不到这些的。
5. 编码与文件 envelope 的选型
选编码格式之前,我们先看数据形状:APM event 通常字段稳定、数值多、批量频繁,事件内容集中在 payload(实际事件或附件字节)上。二进制协议常能减少字段名重复和临时字符串,但“二进制一定更快”这句话,要放到真实 payload 上验证过才成立。
| 方案 | 适用位置 | 优点 | 需要付出的成本 |
|---|---|---|---|
| JSON | 本地 debug、人工导出、小流量兼容接口 | 可读、工具普遍 | UTF-8 字符串与对象分配,字段名重复 |
| Protobuf Lite | 默认事件 schema 与网络批次 | 小 runtime、未知字段兼容、跨语言成熟 | 生成代码、schema 演进、对象构造 |
| FlatBuffers | 读取路径很热、希望直接访问 buffer | 不必 unpack 到第二份对象图 | builder 与随机访问模式不同,buffer 生命周期和 schema 约束更强 |
| 自定义定长记录 | 极少数超高频固定事件 | 可精确控制 slot 与文件格式 | 兼容、工具、安全审计全部自建 |
runtime 在这里指随 App 一起运行的协议支持库。Protobuf Lite 适合资源受限设备,但 schema 规则照样要执行:线上 field number 不改、不复用,删除字段后标记 reserved,enum 保留对 unknown value(新值未被旧客户端识别)的处理,批次大小设上限。
Lite runtime 没有 full runtime 那种能在运行时读取消息结构、按字段动态访问的 descriptor/reflection(运行时读取消息结构并按字段动态访问) 能力,服务端工具要按“端侧没有完整描述信息”来设计。
FlatBuffers 的“直接访问”指读取时无需先 unpack(展开) 成第二份对象表示;写入侧照样有成本,遍历快慢也要看具体访问模式。APM 多数场景是“写一次、服务端读一次”,值不值得引入,由写入成本、APK 体积、服务端生态和 schema 维护共同决定。
一个常见的存储结构是外层 block envelope 加内部 event;envelope 包住一批事件,描述编码和安全参数:
block envelope:
  format_version
  codec
  compression
  aead_algorithm
  server_key_id
  server_wrapped_dek
  nonce
  uncompressed_length
  ciphertext_length
  sequence_range
  authenticated_ciphertext
内部可放多个 length-delimited Protobuf event,先写长度再写字节。示例选 AES-GCM 这类 AEAD:先压缩,再加密并认证;同一 key 下 IV/nonce 只用一次,进程重启也不得把同一密钥的计数器简单归零。重传复用原密文,不重新用相同 nonce 加密变化的明文。版本、算法、长度、序号及 key ID 纳入规范化 AAD;密钥建立与服务端如何得到解密材料见第7节。
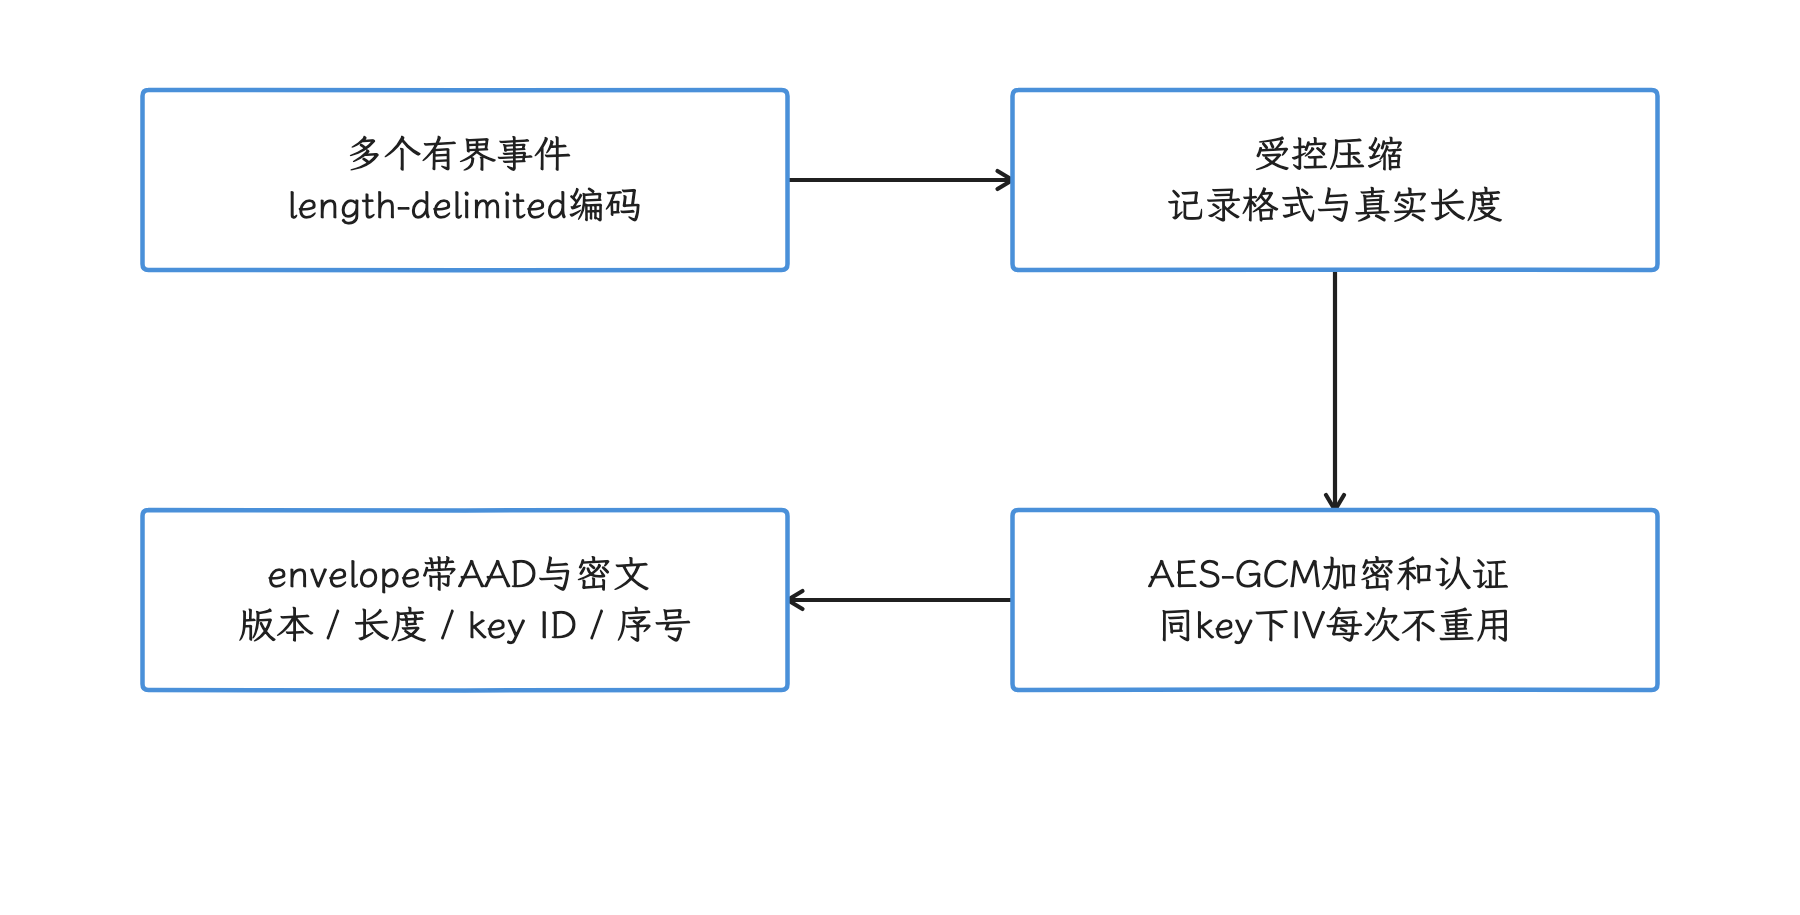
图:把有界事件批次压缩后用 AES-GCM 加密,规范化头字段作为 AAD。 同 key 下 IV 不重用,跨重启不从0重置;重传复用原密文,密钥建立另有协议。
解码前先限制文件/批次/记录长度、事件数和工作区;密文认证通过后再解压,并对真实解压输出逐块计数、到限中止。未认证的 uncompressed_length 只能当受限候选,直接照它申请大数组要避免;认证成功也不免除解压上限。
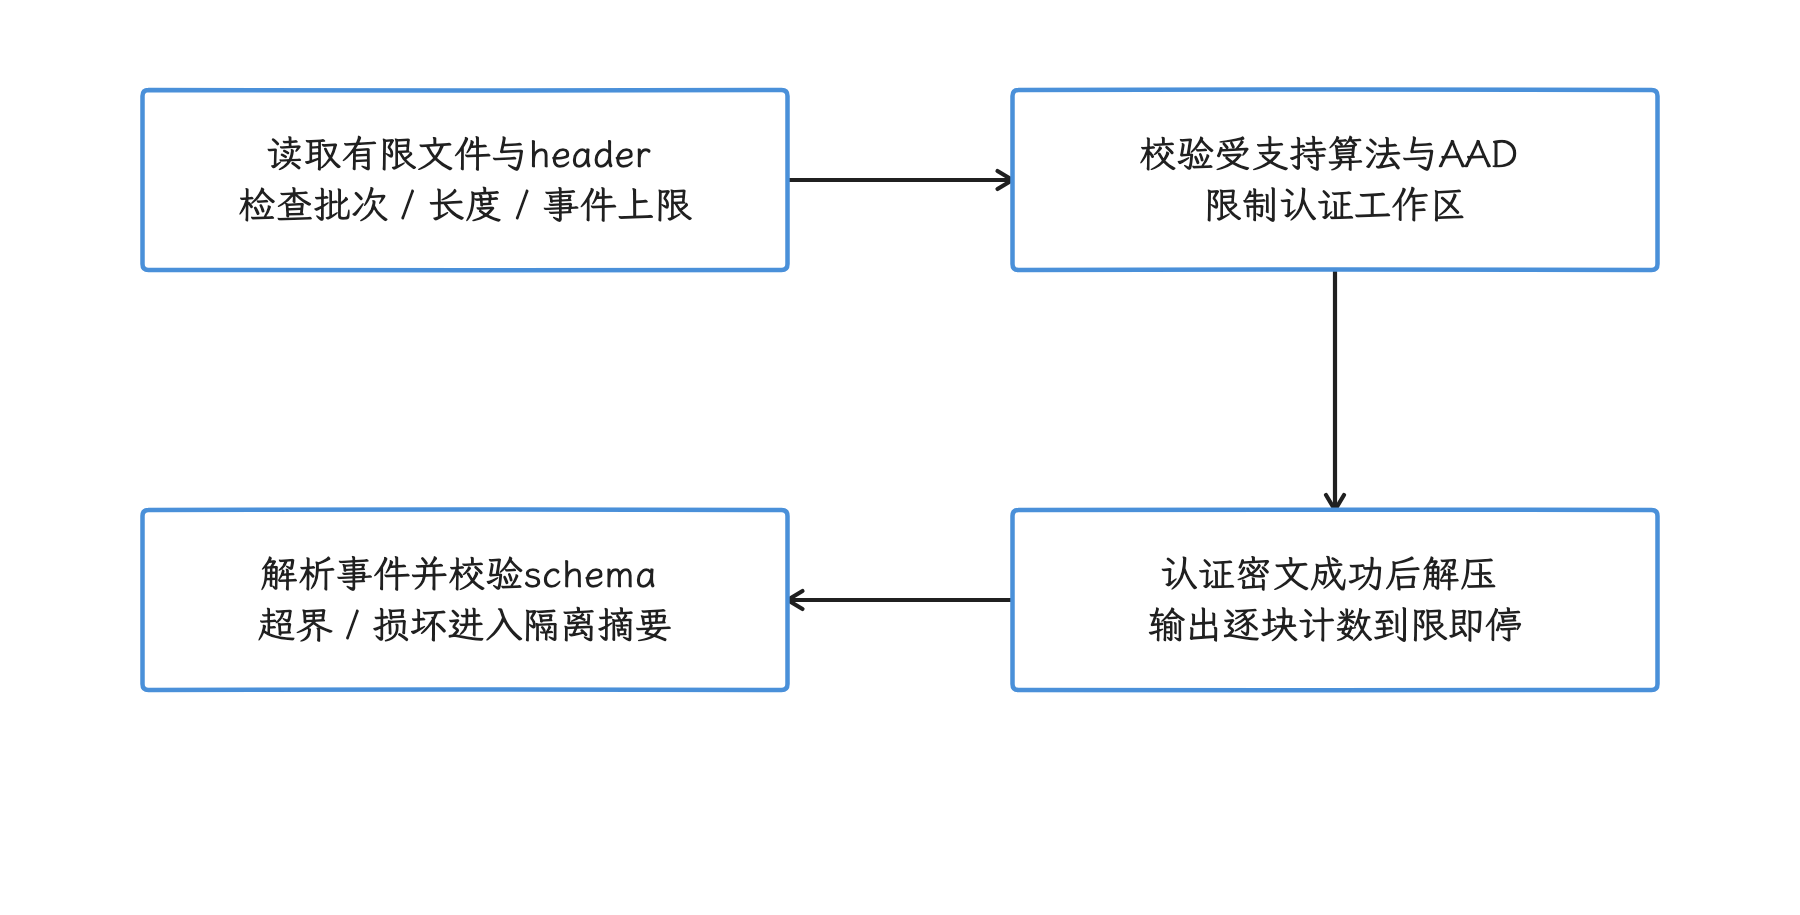
图:先限制格式、字段和工作区,认证成功后再解压并按真实输出持续计数。 未认证的长度字段先当受限候选,直接照它分配大数组要避免;认证成功也不免除资源上限。
选型 benchmark 使用 App 的真实字段分布,在低端32/64位与当前主力设备分别跑1000、10000条事件,记录:
- 编码/解码 wall time 与 thread CPU time;
- payload 与压缩后字节数;
- Java/native 分配量和 GC(Garbage Collection) 次数;
- 峰值工作区与大对象数量;
- 版本兼容、损坏输入和超大字段的行为。
测试结果按事件类型保存;只有三个整数的 microbenchmark(针对极小代码路径的微型基准测试),推不出包含 stack trace、URL 或 header 的真实批次。
6. 动态指令的能力与验签
当我们需要追线上少数设备的问题时,远程指令的价值是让这些设备从低成本指标切换到重取证,也就是 trace、heap dump 等成本较高的诊断采集。App 权限不会因远程指令增加;命令到达时内存、磁盘、网络和系统预算是否满足,也要客户端自己再查一遍。
6.1 Android 8—17 可用的采集能力
| 能力 | 普通发布 App | 版本与限制 |
|---|---|---|
android.os.Trace marker | 可写本进程 section/counter | 只有 trace session 正在采集时才形成可分析材料 |
| Perfetto SDK in-process | 可由 App 自己启停并写 .pftrace | 只含 App 自定义 data source,不含 sched/ftrace 等系统事件 |
ProfilingManager app-driven | 普通 App 可请求受控 system trace、Java heap dump、heap profile、stack sample | API 35+;平台脱敏、限流并把结果放入 App 私有目录 |
ProfilingManager system-triggered | App 登记 trigger,系统决定是否采集 | API 36、36.1、API 37 能力不同;Android 17 增加冷启动、OOM 等 trigger |
Debug.dumpHprofData() | 可 dump 自身进程,可能触发 GC,可能失败 | API 3+;高内存/停顿/敏感数据风险,不适合静默大范围开启 |
| 自有日志回捞 | 只能回捞 SDK 自己持久化且获准采集的日志 | 普通 App 无权读取全设备 logcat |
| 自由控制完整系统采集 / 任意读取其他进程 Hprof | 普通 App 不具备这种不受限能力 | adb/测试或系统权限另论;受控 ProfilingManager 结果不等于拥有全系统采集权限 |
我们先把表里的几个词展开。Trace marker 是写进 trace 时间线的区间或计数标记,只有采集会话开启时才会进入结果。Perfetto 的 data source 是向 trace 提供某类事件的数据生产者;in-process mode 下服务和 App 自定义 data source 都在当前进程内,所以看不到 sched/ftrace(内核调度等系统事件)。Hprof 是 Java heap dump 的文件格式,包含进程内对象及引用关系;至于全设备 logcat,普通发布 App 拿不到 READ_LOGS 特权。
重取证优先复用 15.7 ProfilingManager 已定义的两类流程:app-driven(App 主动请求)和 system-triggered(App 登记条件、系统决定是否采集)。系统会限流,请求也未必被满足,所以客户端要另设更低的本地预算。Perfetto SDK 的 system mode 适合 adb/lab 场景;in-process mode 无需特权,覆盖范围就是上面说的进程内事件。
Android 17 的 OOM system trigger 还有一个容易遗漏的前提:App 安装了自定义 uncaught exception handler 时,处理结束后必须继续调用系统默认 handler,这类 OOM 触发采集才能由平台完成。远程指令在执行前应把该接入条件也算入 capability(平台能力) 检查。
Java heap dump 可能包含 token(访问凭据)、会话、地址、订单和密钥材料。普通用户设备上,只放行有明确数据用途、可审计授权和严格人群范围的方案;端侧类计数或摘要能回答的问题,就让原始 heap 留在端侧。内部 build 与用户支持场景也要设置文件上限、加密、访问审计和短保留期。
6.2 指令字段与验签顺序
一个可执行指令至少包含:
command_id、schema_version、generation;issued_at、expires_at、max_duration_ms;- app version、Android version、设备/实验 cohort 与随机采样条件;
required_capability、required_consent(用户授权);- 单设备触发次数、CPU、内存、文件和上传字节预算;
key_id、规范化 payload 的数字签名;- server kill switch 与客户端不可放宽的 hard limit。
我们先约定字段里的几个词。cohort 是符合某组版本、设备或实验条件的目标设备集合;规范化 payload 要求字段顺序和字节编码都有唯一结果,验签才稳定。key_id 指明验证签名所用的公钥版本;server kill switch 是服务端紧急停用开关,hard limit 则是写在客户端、远端配置无权放宽的成本上限。
TLS 保护网络传输,应用层数字签名继续保护配置经过 CDN、代理或存储后的完整性。端侧内置公钥并支持 key rotation(逐步切换到新公钥);generation 倒退造成的 rollback(回滚攻击)要直接拒绝。
验签、schema、generation、TTL、cohort、consent、capability 和预算全部通过后,指令才能持久化为 VERIFIED。未知字段可能改变安全含义时采用 fail-closed,也就是拒绝执行,等客户端理解该字段后再放行。
wall clock 可能被用户修改,数字签名管不到设备现在的时间。取得配置时要保存有认证的新鲜 server time 与本机 elapsed 锚点、往返不确定性;同一开机周期用单调增量估算剩余 TTL,并持久化 generation、command ID 与已消耗预算。普通进程重启要保持 TTL 原值,设备重启则要重新建立 elapsed 起点。一旦拿不准新鲜度、发现回拨或确认不了同一 boot,先拒绝/挂起重取证并重新取可信配置;仅比较签名 expires_at 与可改墙钟,再加一个每次启动重置的最大存活期,挡不住反复续命。
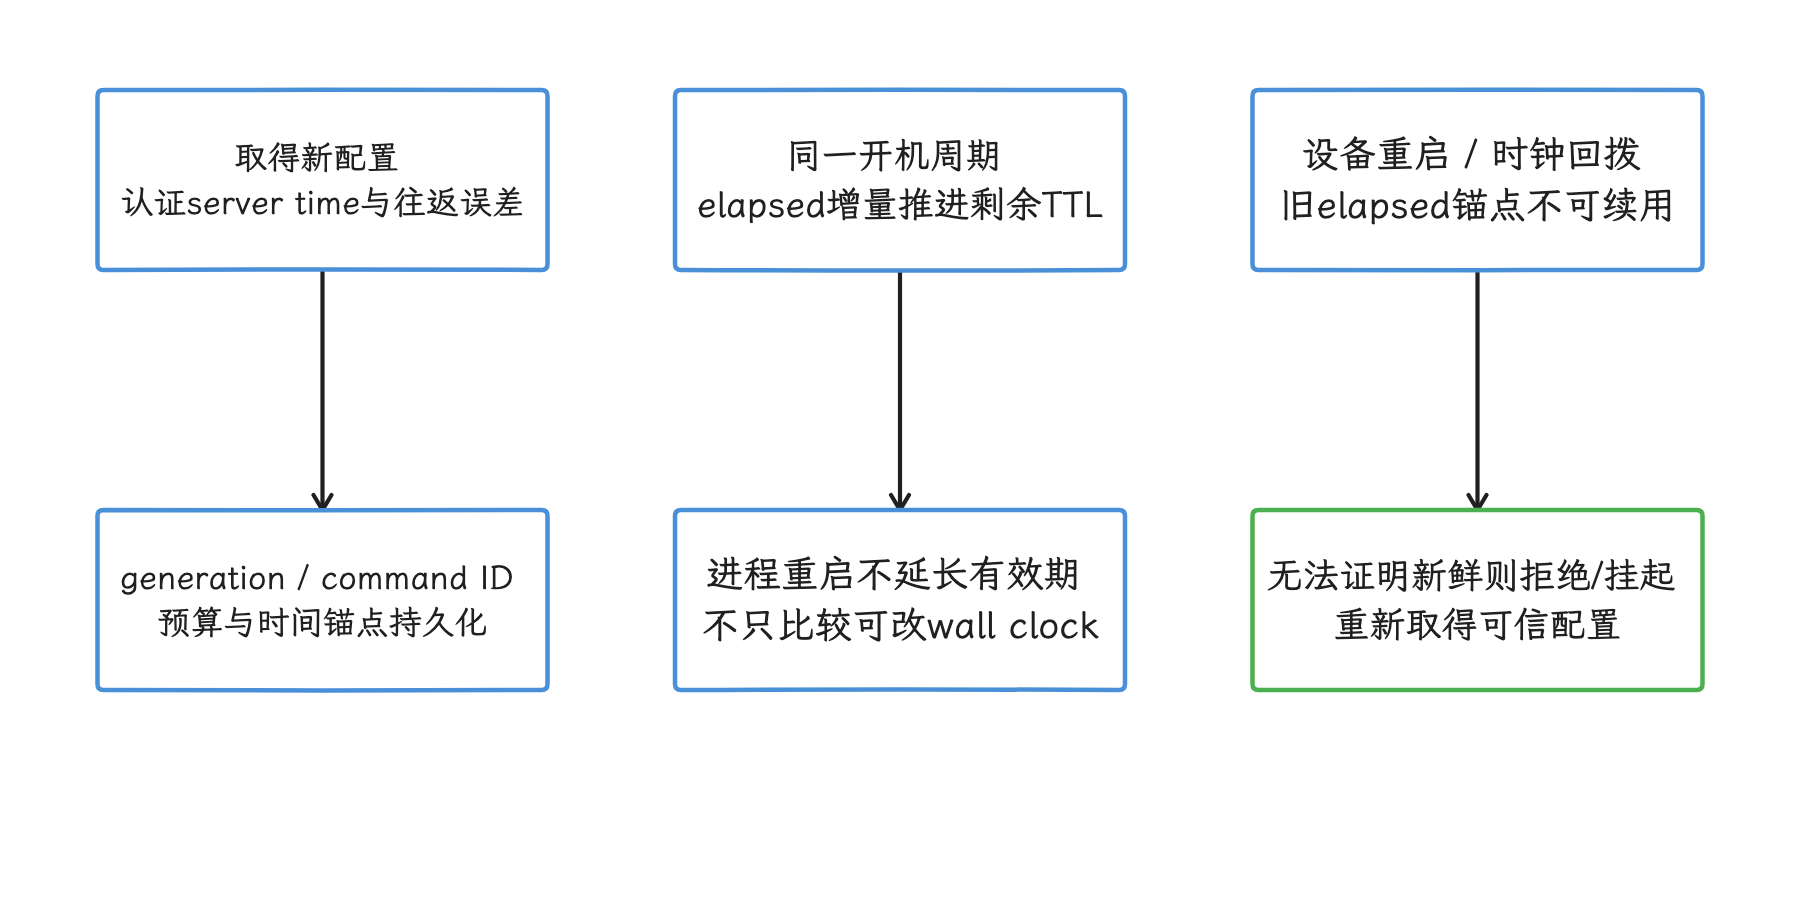
图:用认证 server time 与 elapsed 锚点推进 TTL,进程重启不重置到期和已用预算。 签名 expires_at 证明不了现在的时间;确认不了 boot 或可信时间时,先挂起重取证并重新获取配置。
服务端 kill switch 依赖网络,端侧 hard limit 仍然要自己兜底。
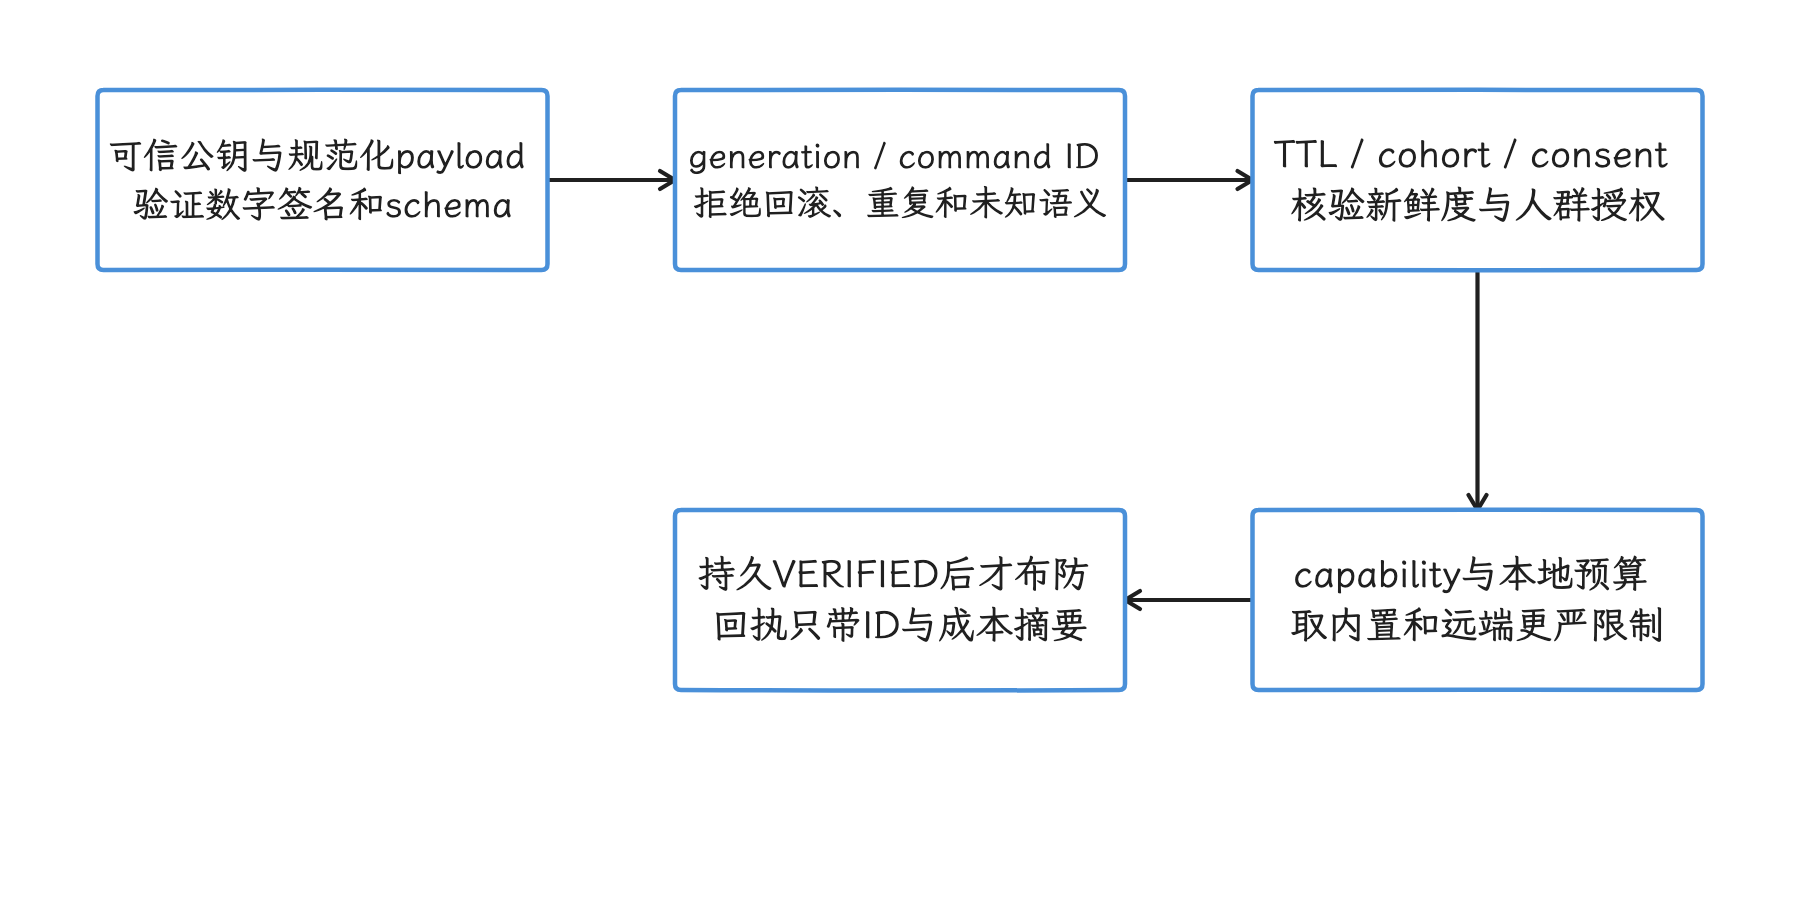
图:指令通过签名、版本、新鲜度、人群、授权、能力与预算核验,远端放宽不了本地硬上限。 TLS 与数字签名各有职责;网络失联时本地预算和拒绝规则仍需独立工作。
“特定 UserID”类指令要把原始账号挡在配置和 APM 文件之外。服务端应生成短期、仅限当前 App 使用的 App scoped(只能在当前 App 范围使用) opaque cohort token(不携带可读账号信息的目标令牌);也可在获得相应授权的支持流程中使用一次性 case ID。指令回执只带 command/case ID、结果码和预算消耗。
6.3 指令的执行状态机
落到执行侧,指令按以下状态运行:
RECEIVED -> VERIFIED -> ARMED -> RUNNING -> SEALED -> UPLOAD_PENDING
    \-> REJECTED
VERIFIED / ARMED / RUNNING -> EXPIRED / BUDGET_EXHAUSTED
进入 RUNNING 前持久化触发次数与预算预留,防止进程在写计数前被杀而反复执行。启动恢复时清理半成品,归还能够安全归还的预算,并产生一条固定大小的 command result。
crash loop 是 App 启动后很快再次崩溃并反复重启的循环;重取证请求在这种循环里要受触发次数约束,避免每次启动都跑一遍。
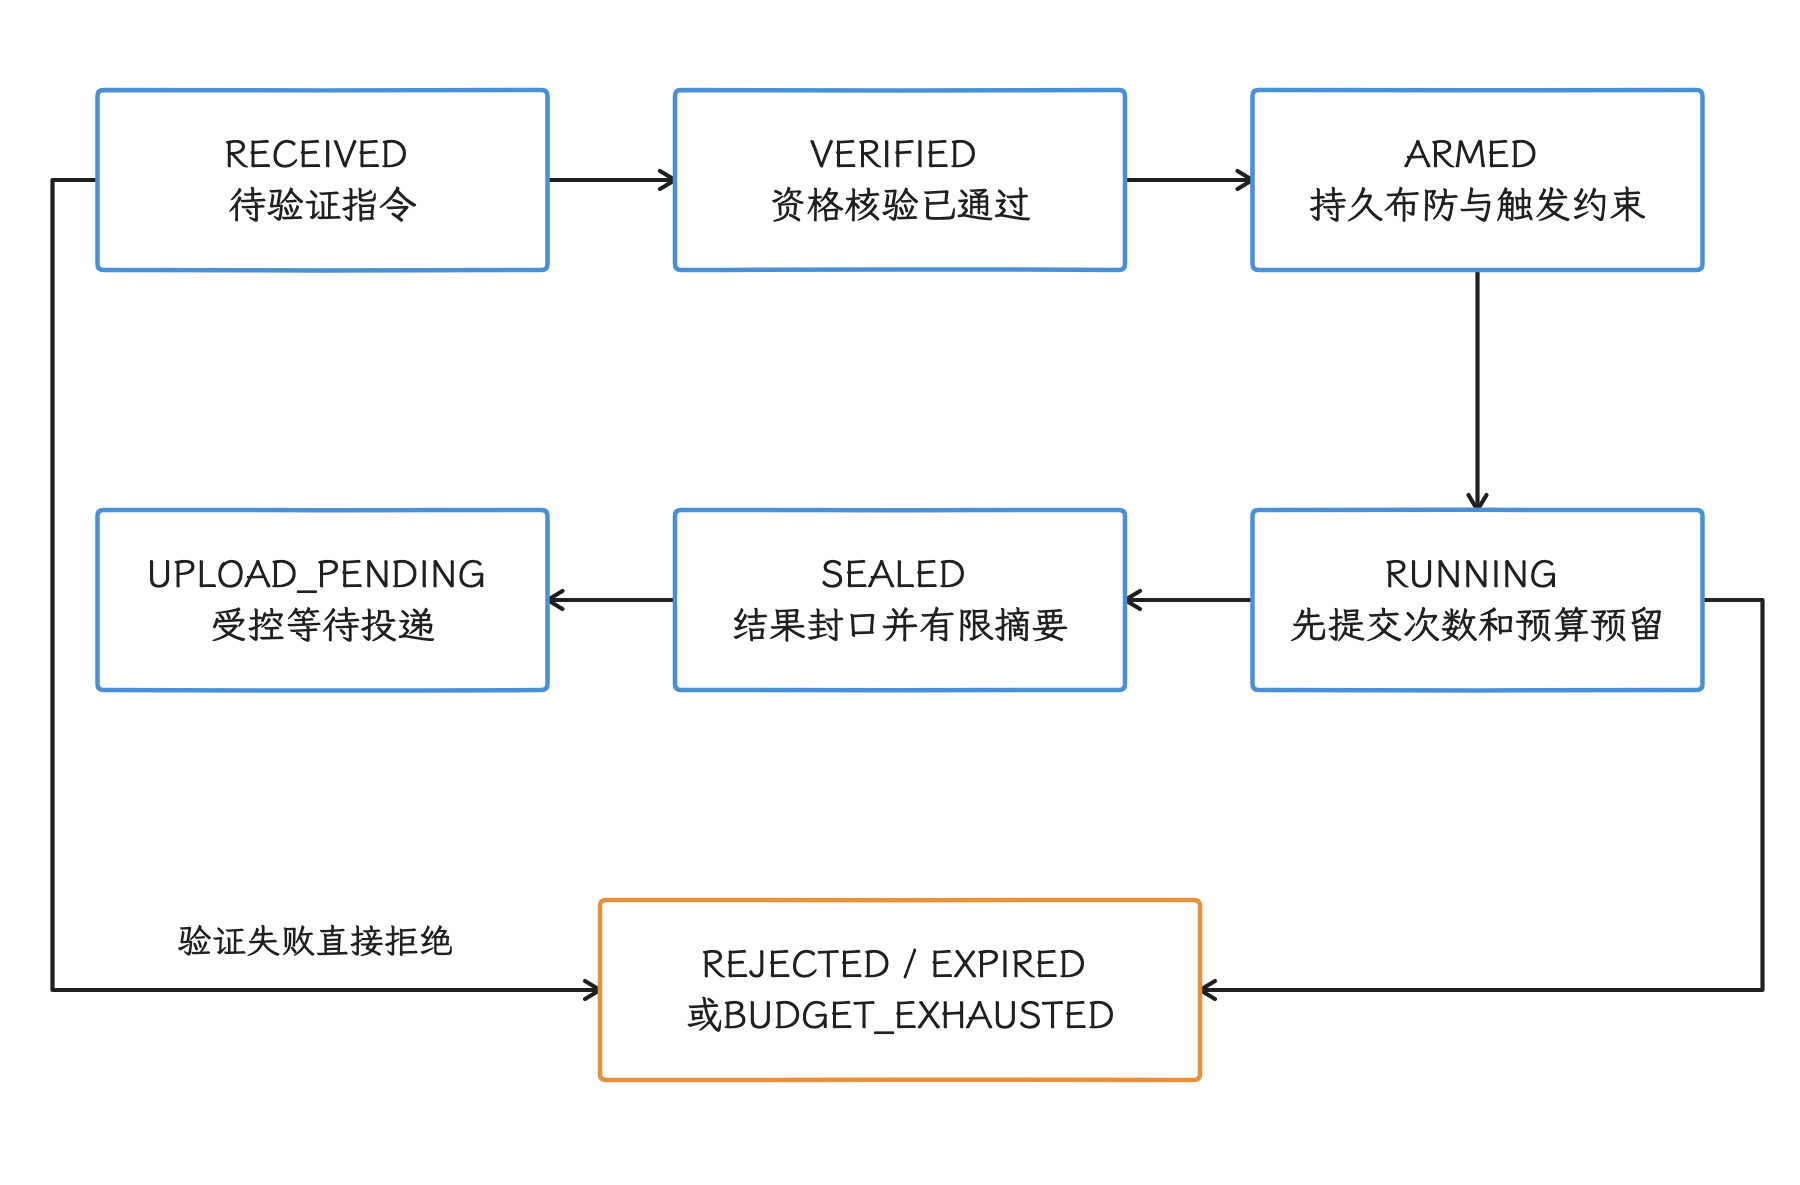
图:指令先验证再布防,进入 RUNNING 前持久预留预算,异常恢复不反复执行。 拒绝可发生在验证阶段,过期或预算耗尽可中止后续阶段;回收只归还能安全归还的预算。
7. 网络投递的两条路径
采集侧写好 sealed 分片之后,剩下的是怎么把它们送出去。我们把上传分成两层:
- App 仍在前台且已有合适网络时,上传器直接发送 sealed 小批次。这条 opportunistic fast path 只在现有进程和网络条件都合适时使用,是进程内快路径;
- 需要跨进程退出、重启或系统调度继续的任务交给 WorkManager。
WorkManager 是持久、可延迟后台任务的推荐 API:工作状态会被持久化,进程退出或设备重启后仍可由系统重新调度。它支持网络、电量、充电和存储约束,执行时刻则听系统调度。普通 worker 通常有约 10 分钟执行窗口;大 trace/Hprof 应切块和续传,每次都在窗口内收尾。
long-running worker 借助 foreground service 继续执行,并按要求显示用户可见通知。Android16起它仍通过 JobScheduler 调度,可能耗尽 App 的 job quota;提升为 foreground 并不自动获得无限执行额度。直接启动前台服务还受启动条件、服务类型和权限限制,用户真正发起的数据传输则另核对 user-initiated data transfer 的适用条件。APM 大附件默认分块、限量和续传。
上传使用 unique work 合并持久调度入口,输入只放 batch ID,实际字节留在 spool。合并的只是调度入口,foreground fast path 的文件锁、多进程之间的互斥,都要另靠同一套机制解决:两条上传路径通过同一持久索引原子 claim 批次,记录 owner/attempt 和可恢复租约,仅 owner 能推进状态;中断后重新确认归属再重试。事件上行整体按至少一次投递设计,重复的业务效果由服务端幂等 batch ID 消除;“网络只发一次”这样的宣称,我们给不了。worker 执行:
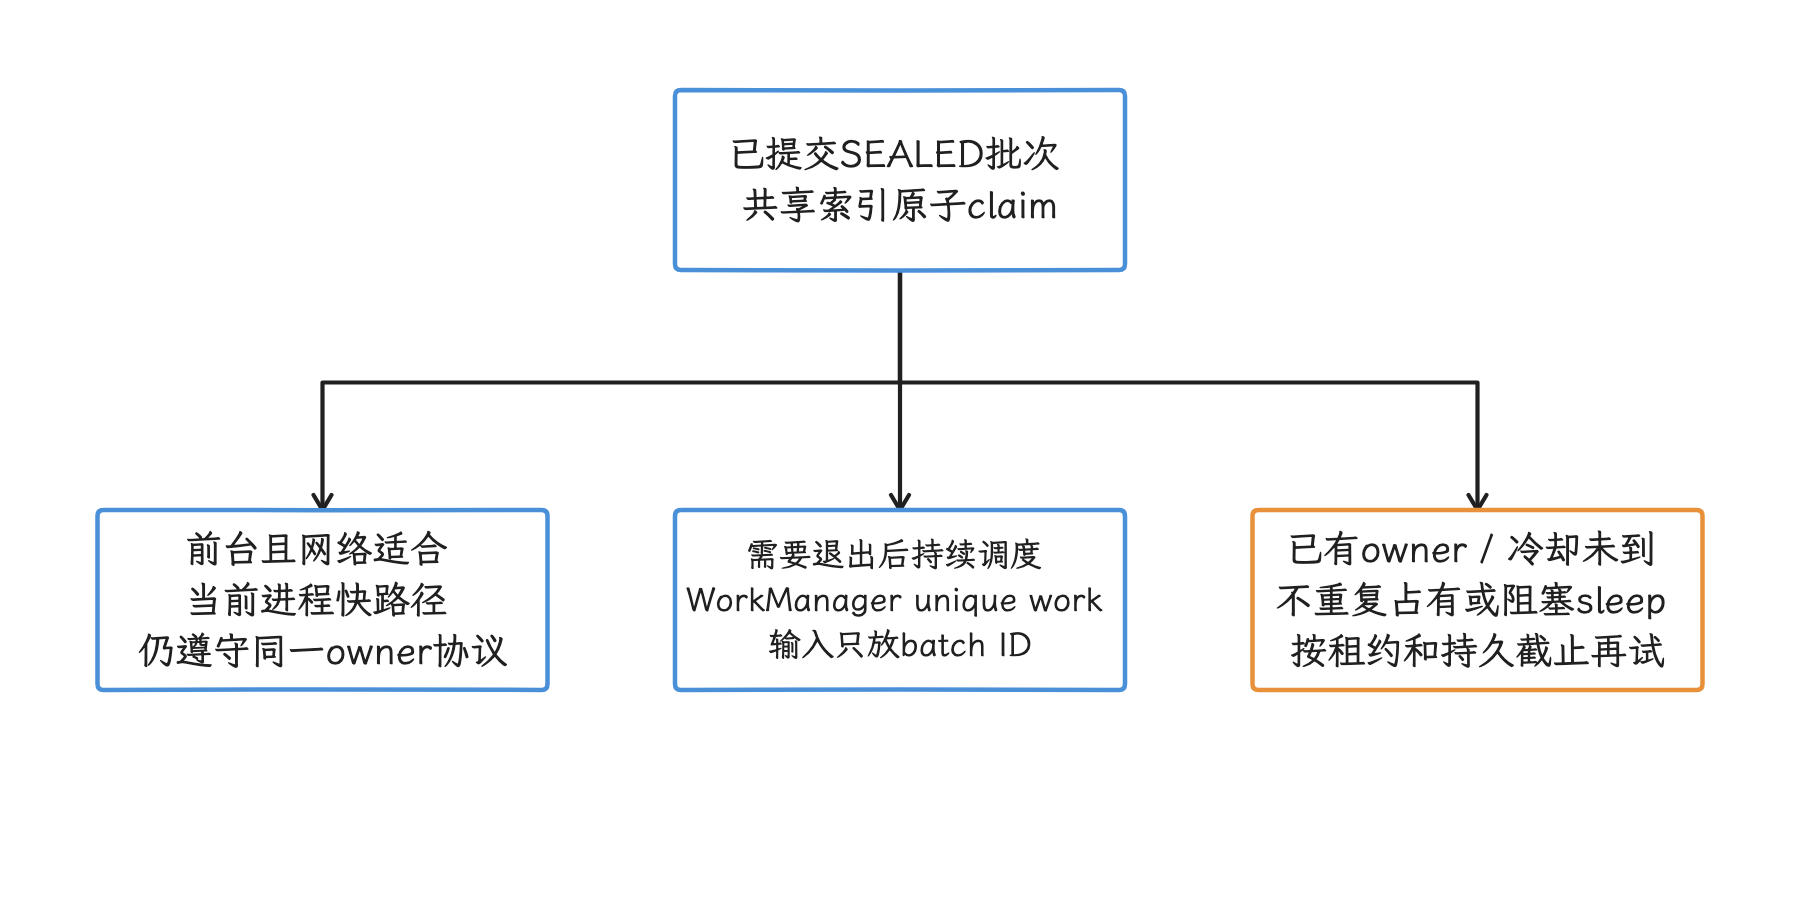
图:前台上传与持久 worker 共用同一索引的原子 claim,按 owner/attempt 协调。 unique work 合并的是调度入口,另一条快路径和其他进程的文件互斥要靠共享索引。
select SEALED
  -> mark UPLOADING with attempt_id
  -> upload chunks with content hash
  -> server confirms batch_id + complete content hash
  -> durably mark ACKED
  -> delete file and index entry
这里的幂等指:同一 batch_id 即使因超时被提交多次,服务端也只确认一个批次。content hash 是内容摘要,用来检查分块重传后字节是否一致;鉴权和数字签名要另走各自的机制。
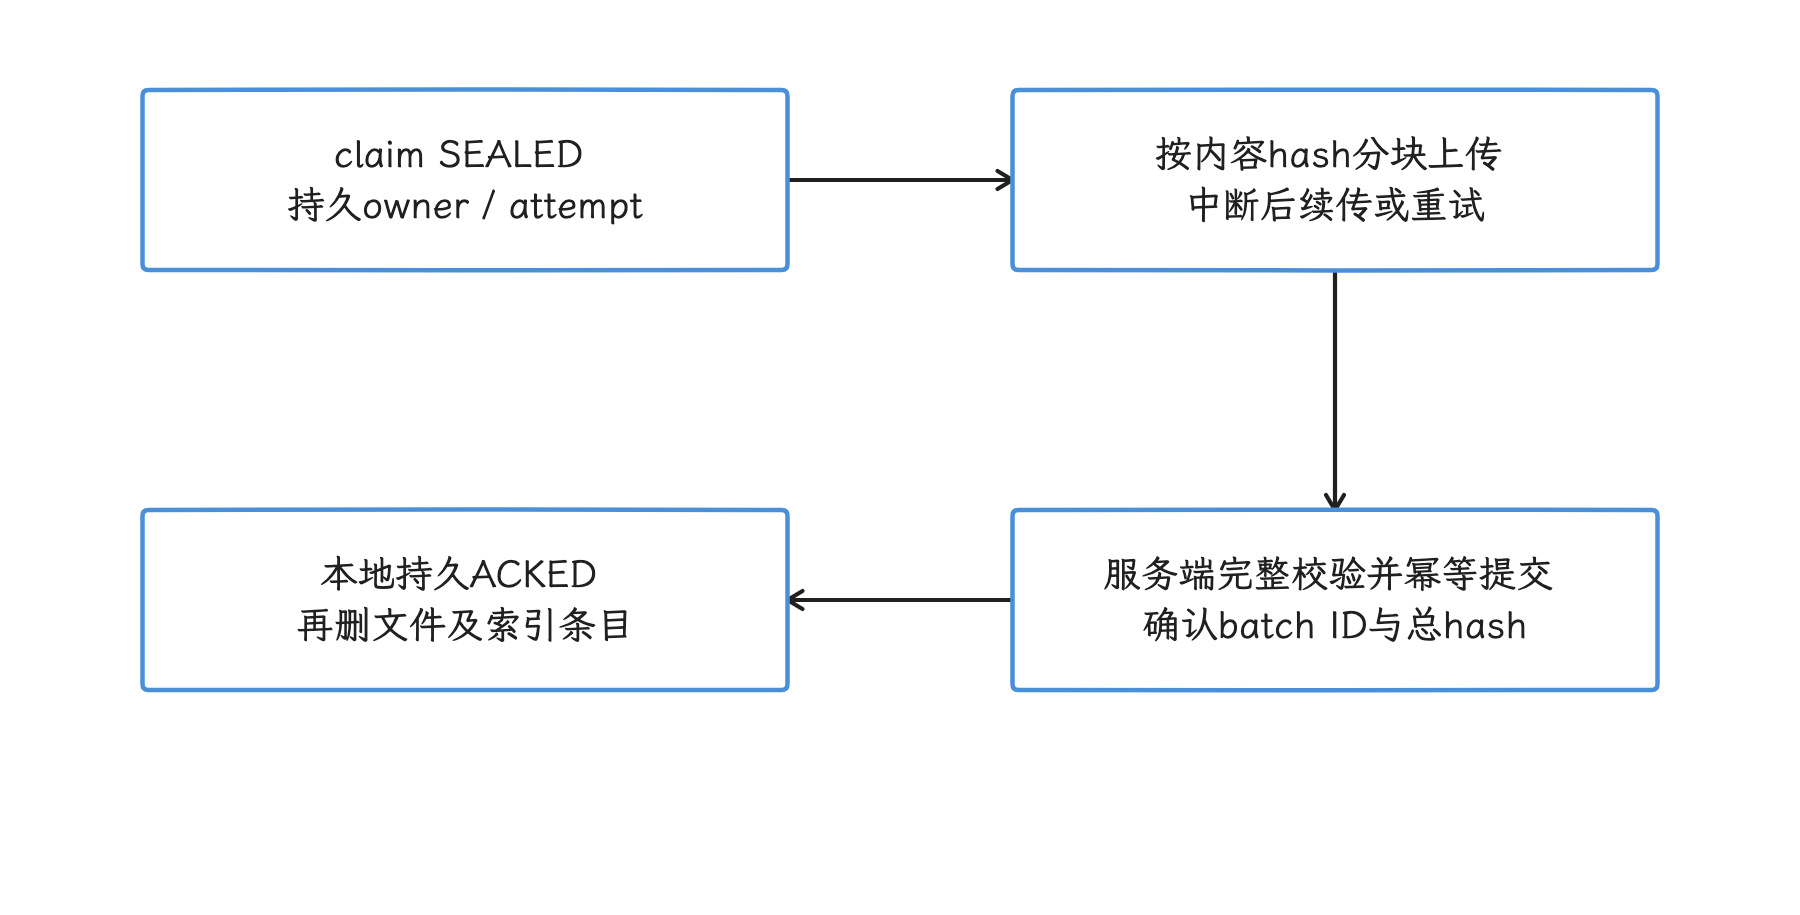
图:上传可重复发送,服务端按 batch ID 与完整 hash 幂等提交,本地持久 ACKED 后再清理。 content hash 管的是内容一致,鉴权与签名另走机制;块级接收或任意 HTTP 响应都顶替不了完整提交确认。
重试策略区分响应:
- 网络断开、timeout(超时)、408、429 和多数 5xx:指数退避加 full jitter(随机抖动);指数退避逐次增大等待上限,full jitter 则在
0到该上限之间重新随机取一个等待时间; - 429/503 带
Retry-After响应头:至少等待服务端指定的时间,并叠加本地随机偏移; - 认证或 key 失效:刷新一次凭据,仍失败则停止该批次;
- schema/4xx 永久错误:隔离批次并上报摘要,不无限重试;
- 文件 hash 不一致:停止上传,进入
CORRUPT,保住唯一证据。
WorkManager 公开 backoff 只有 LINEAR/EXPONENTIAL,最小10秒;它的调度精度有限,业务要的 full jitter 或 Retry-After 还得自己实现。把持久的 next_attempt_at 与服务端冷却先记入索引,worker 被调度时再核对到期、约束和 owner;未到期则安排后续工作并退出,别占着线程 sleep。Retry-After 与 WorkManager 自身退避取更晚的允许时刻,重启也清不掉已记下的冷却。
除了重试节奏,上传的时间点也要管:固定每15分钟整点上传会形成设备群请求洪峰。我们让每设备在允许窗口内选一个随机偏移,并在配置周期内保持稳定;这与按分钟精确执行是两回事。
Crash/ANR 先传小摘要,等 unmetered(非按流量计费网络)、battery-not-low(电量不低)、storage-not-low(可用存储不低) 等约束满足后再传大附件。
压缩、加密和网络放 worker,已压缩的 Perfetto/归档文件避免再次压缩。TLS 保护传输;本地加密与服务端解密分别设计:设备 Keystore 的不可导出密钥适合保护本机文件,服务端并不因拿到相同 key_id 就拥有它。
需要端到端密文上送时,可按批生成数据密钥 DEK,用服务端公钥封装给服务端持有对应私钥解封;本地若要重启后继续加密/解密,再用设备 Keystore 包装本地 DEK 副本。两种 wrapped key 的用途、ID 和生命周期分别记录,原始 DEK 不落盘;短暂进程内 DEK 仍可能暴露于进程内存。Keystore 是否由安全硬件保护取决于设备与配置,轮换后旧批次仍须有可解密和过期删除策略。
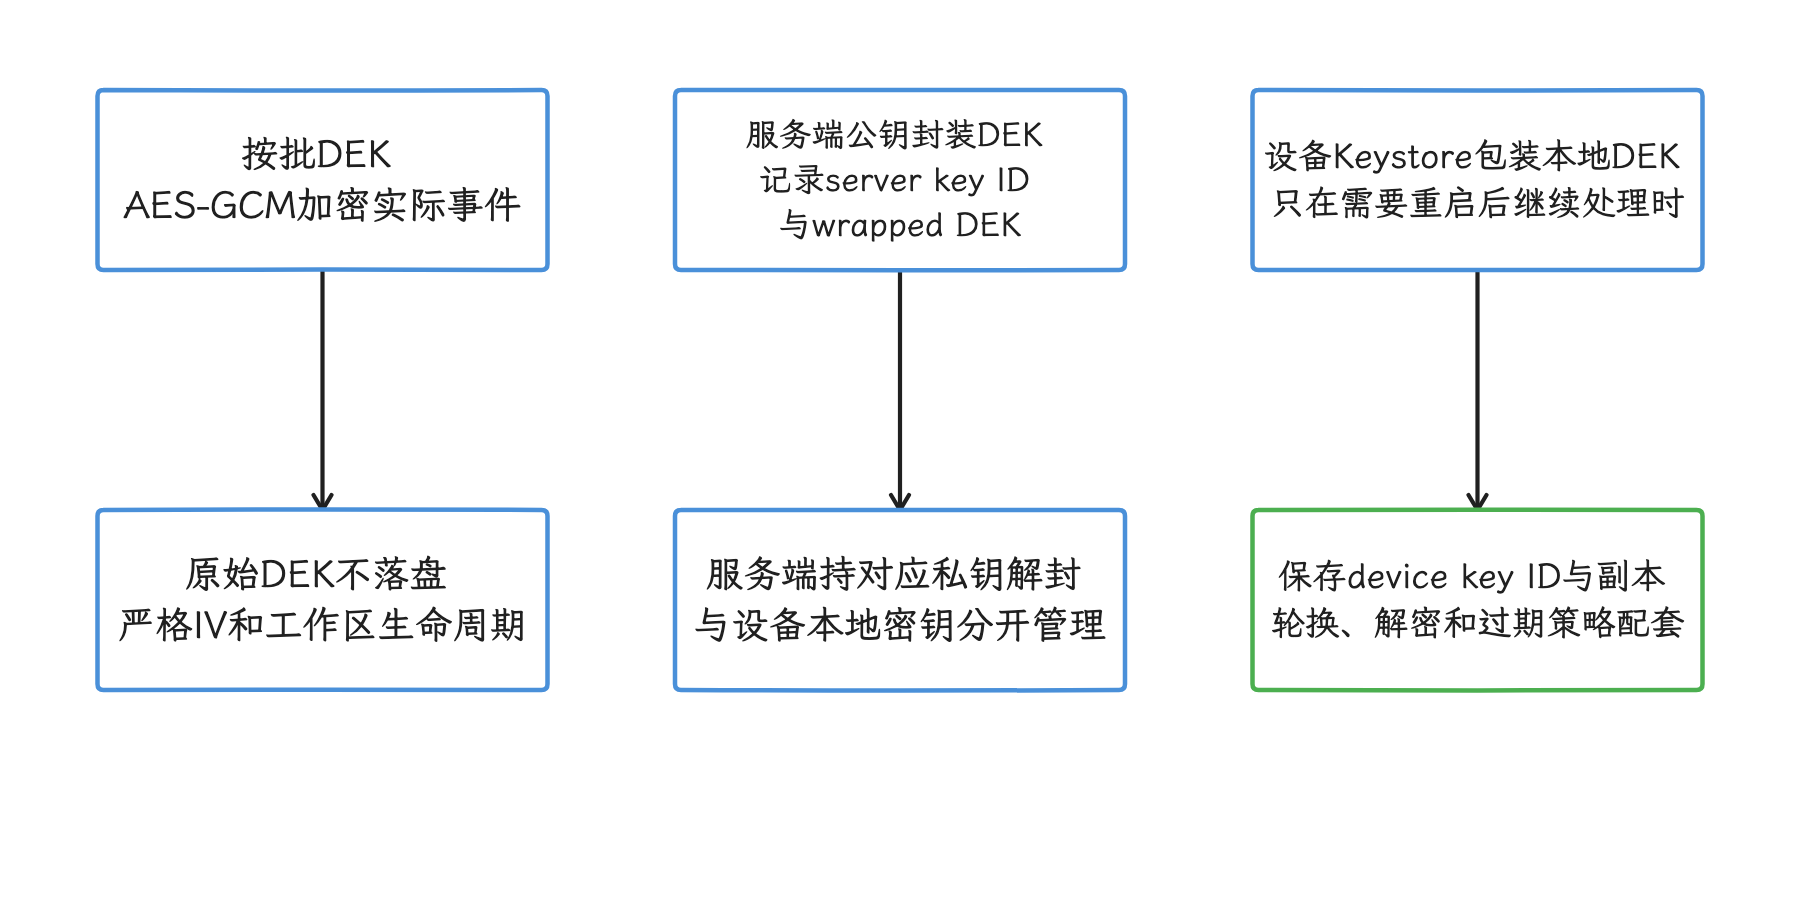
图:按批数据密钥加密内容,服务端公钥封装给服务端,设备 Keystore 另保护本地副本。 key_id 只标识密钥,不可导出的设备密钥交不到服务端手上;临时 DEK 仍可能出现在进程内存。
8. 断路器与自我保护
采集链路里的每个模块都可能出问题,SDK 需要一层自保。断路器就是这样的自保状态机:某类操作持续超预算或失败时,暂时拒绝对应的低优先级工作,冷却后再放少量请求探测是否恢复。
阈值必须来自设备实验和发布数据,下表只演示规则形态:
| 信号 | 示例判定 | 动作 |
|---|---|---|
| queue 拥塞 | 连续多个窗口占用接近容量上限且 drop 上升 | 关闭 P2,降低 P1 采样,保留 P0 槽 |
| writer 长尾 | force/write P99 超预算 | 增大普通提交窗口,暂停压缩,限制 active 文件的在用字节数 |
| SDK 内存 | queue、buffer 和文件索引合计超预算 | 释放工作区,停止重采样,不申请 Hprof |
| 存储不足 | 预分配/force 失败或 storage-not-low 不满足 | 停止新大文件,按优先级过期 sealed 批次 |
| 上传失败 | 429/5xx/timeout 持续 | 打开网络断路器,延长带 jitter 的冷却 |
| 模块故障 | writer/codec 连续捕获可恢复异常 | 禁用该模块,切到最小 breadcrumb 路径 |
| 上次异常退出 | ApplicationExitInfo 显示 OOM/资源异常且 SDK 队列或内存峰值异常 | 下次启动使用更低本地配置,不自动执行重指令 |
Android 14 / API 34 起不会再向 App 发送 TRIM_MEMORY_RUNNING_MODERATE/LOW/CRITICAL,这些常量又在 API 35 标记 deprecated,仅靠旧 low-memory callback 已经不够了。SDK 应以自己的已知字节预算、Runtime heap headroom、固定窗口内的队列最大占用、文件配额和系统可用空间为主;TRIM_MEMORY_UI_HIDDEN 等仍有效的 callback 只作为附加信号。
Runtime heap headroom 指 Java heap 当前占用距离运行时上限还剩多少空间;队列峰值则是固定测量窗口内出现过的最大占用。我们要盯的这两个量都来自 SDK 可观测数据,与系统还能提供多少内存是两回事。
断路器至少有 CLOSED、OPEN、HALF_OPEN:
CLOSED是正常放行状态;OPEN使用持久的冷却截止时间,拒绝对应低优先级工作;- 冷却后
HALF_OPEN只放少量探测请求; - 探测成功且成本恢复后才回到
CLOSED; - 连续失败增加冷却,但设置最大值,避免永久失去诊断能力。
自保规则由 SDK 内置上限与已验签配置共同计算:远端最多把规则继续收紧,硬上限永远以客户端内置值为准。服务端失联、DNS(域名解析) 故障或 App 离线时,本地规则照常工作。
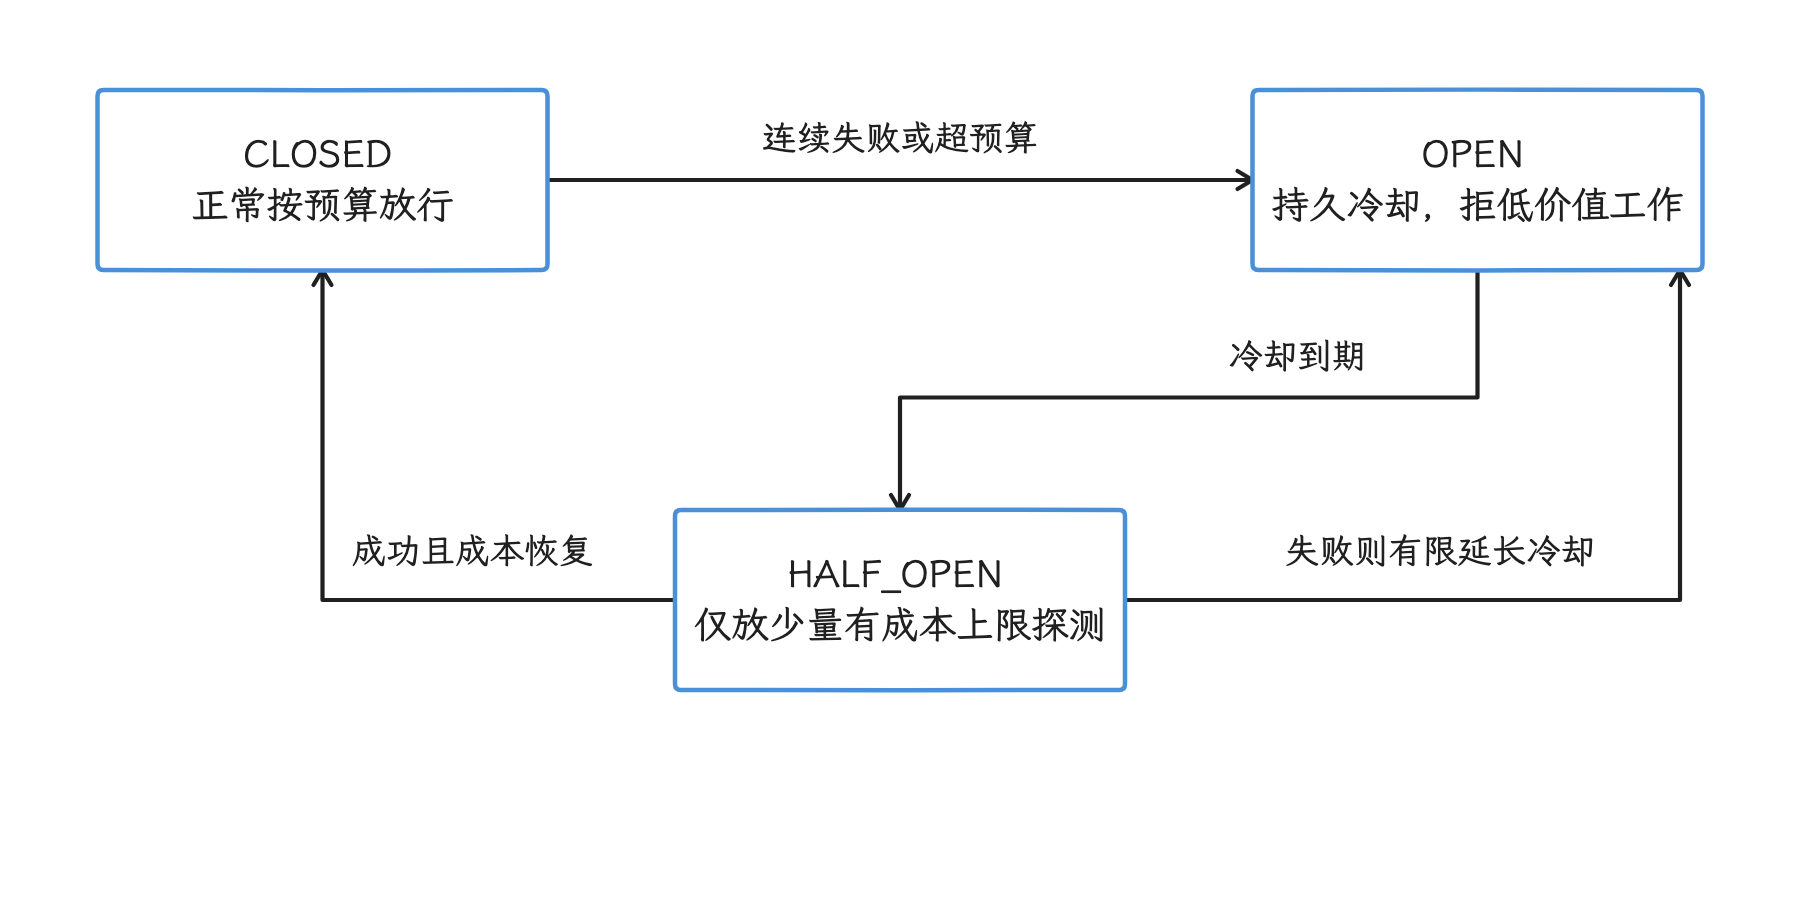
图:持续超成本或失败后熔断,冷却到期只放少量探测,成功后恢复。 冷却有上限且跨重启保存;服务端失联不解除本地硬限制,P0保留容量仍有限。
9. APM 监控 APM 的指标口径
“SDK CPU 占比 1%”这句话,要在分子、分母和覆盖线程都写清楚之后才有意义:分子可以是全部 SDK 线程消耗的 CPU 时间,分母可以是同一窗口的进程 CPU 时间。少写任何一项,两个“1%”就没法比较。我们建议随批次上传以下自监控窗口:
| 指标 | 可行测法 | 不能声称的内容 |
|---|---|---|
ingress_ | 抽样测入口 elapsedRealtimeNanos 差值;ns 表示纳秒 | 未抽样调用的精确分位数 |
worker_ | worker 任务前后读取 Debug.threadCpuTimeNanos(),得到当前线程消耗的 CPU 时间 | 整个 SDK 的 CPU,除非覆盖所有 SDK 线程 |
codec_ | codec(编码/压缩模块)自己的输入输出计数 | 文件系统实际物理写放大 |
mapped_ | writer 已修改范围的逻辑计数 | 已持久化字节,除非 force 成功 |
force_ / failure | force 周期与结果 | 设备内部 FTL 的完整物理写入行为 |
queue_ | 固定窗口内的最大队列占用 | 未记录时刻的瞬时峰值 |
drop_ | 固定枚举计数器 | 缺失样本的内容分布 |
upload_ | SDK 请求次数与明确计数层的请求体字节;重试分别累计 | TLS/TCP/IP、重传、HTTP 头或同 UID 其他流量的全部线上字节 |
repair/ | 启动修复、损坏批次和过期批次的状态计数 | 用户无故障 |
command_ | 每个 command 的 CPU/bytes/count | 未获授权的用户画像 |
FTL(Flash Translation Layer)负责闪存逻辑地址到物理页的映射。SDK 的逻辑写入与 force 计数覆盖不到设备内部的全部物理写入与写放大。
公开 API 里找不到低开销又精确的“某个 Java SDK 分配字节数”。我们可以按已知 event/buffer 大小估算,或在内部/profileable build 中用 allocation profiler(对象分配分析器)校准;估算字段要标记 estimated 和版本。
profileable build 是清单允许性能分析工具附加、但区别于 debuggable 的构建。进程级 ART 统计把宿主 App 和其他库都算在内,直接当作 APM 自身开销会高估。
自监控计数器走独立的固定结构;每次 drop 若再投递成一条普通 event,queue 一满就会递归放大。每个窗口只生成一份摘要;摘要也发送失败时覆盖旧摘要并保留累计计数。
发布策略从 0.01%/内部设备开始,按 Android 版本、RAM 档位(设备物理内存分组)、ABI(如 arm64-v8a)、厂商和 App 进程分别统计成本分布。
入口耗时、ANR/crash、OOM、耗电、流量、storage repair(存储启动修复) 都稳定,且目标样本中成功产出有效数据的比例没有下降后,才扩大发布比例。
10. App 私有存储、备份与隐私
Scoped storage(分区存储)限制的是 shared/external storage,即多个 App 或用户可见的共享/外部存储空间。filesDir、cacheDir 和 noBackupFilesDir 是 App 私有内部目录,读写免存储权限;APM 的内部 spool 本来就住在这里,我们不需要为了“兼容 scoped storage”把它搬到公共目录。
目录按“能否被系统清理”和“能否进入备份”选择:
| 数据 | 位置 | 处理原则 |
|---|---|---|
| 可丢普通批次 | cacheDir/apm/ | 系统可在低空间时删除;读取前接受文件消失 |
| 未上传故障摘要/可靠 spool | noBackupFilesDir/apm/ 或已排除备份的 filesDir | SDK 自己做配额、过期与删除 |
ProfilingManager 结果 | 平台的 files/profiling/ | 登记路径、限制大小、排除 cloud backup/device transfer |
| 临时 Hprof/trace | 专用私有目录 | 与普通日志分开权限、配额、上传和保留 |
| 用户导出诊断包 | 私有源文件 + FileProvider/SAF | 用户明确触发,授予短期 URI 权限 |
FileProvider 通过 content:// URI(统一资源标识符) 临时分享 App 私有文件;SAF(Storage Access Framework,存储访问框架)让用户通过系统选择器决定导出位置。两者都只授予本次操作需要的读写权限,并在使用结束后撤销或让权限自然失效。
cacheDir 可在上传前被系统删除,故障摘要选择受控可靠 spool。noBackupFilesDir 默认排除备份,卸载、清数据和文件系统故障仍会丢失;若用 filesDir 或平台 files/profiling,按 target/系统版本分别验证 cloud backup 与 device transfer 排除规则。仅凭 allowBackup=false 就认定所有OEM都禁用了设备迁移,是靠不住的。私有存储隔离之外,服务端访问控制和敏感文件加密仍有各自职责。
采集层执行数据最小化:
- URL 只保留模板化 path key,例如把
/users/123/orders/456规整为/users/{id}/orders/{id};不保留?后的 query、#后的 fragment 和用户输入; - HTTP header 采用允许列表,
Authorization、Cookie和 token 一律不进 event; - stack trace 做路径与动态值清理,并限制帧数和字节;
- 设备与账号使用短期、仅限当前 App 的随机标识;
- heap dump、trace 和日志正文分别设置授权、访问人群与保留期;
- 上传确认、过期、撤回授权和 command 结束都触发可审计删除。
多进程清理器与上传器共享 owner/claim 状态,只清理未被 active writer 或上传任务占用、已经过期或已确认的分片;不要求创建该 sealed 分片的进程先退出。判断不了 owner 是否仍活跃时先延迟清理,并在后续恢复中依据实例代次、锁/租约和状态重新核验。仅凭PID存在、文件年龄或“已经冷启动”,都证明不了其他进程已停止使用;清理不 truncate 活跃映射。
11. 完整架构与排查入口
最后我们把优先级准入、单写者 spool、重启恢复、持久上传和远程指令放到同一张图里。单写者指只有一个 writer 修改 active 文件,其他线程只向有界队列提交事件。
完整链路按数据流、控制流与恢复流组织:各进程 producer 只进入有界准入,单写者编码并提交分片;sealed 分片经共享 claim 交给前台快路径或 WorkManager。签名指令经能力、TTL 和预算验证后收紧本地策略;固定自监控计数器驱动断路器,启动恢复则修复提交与上传状态。
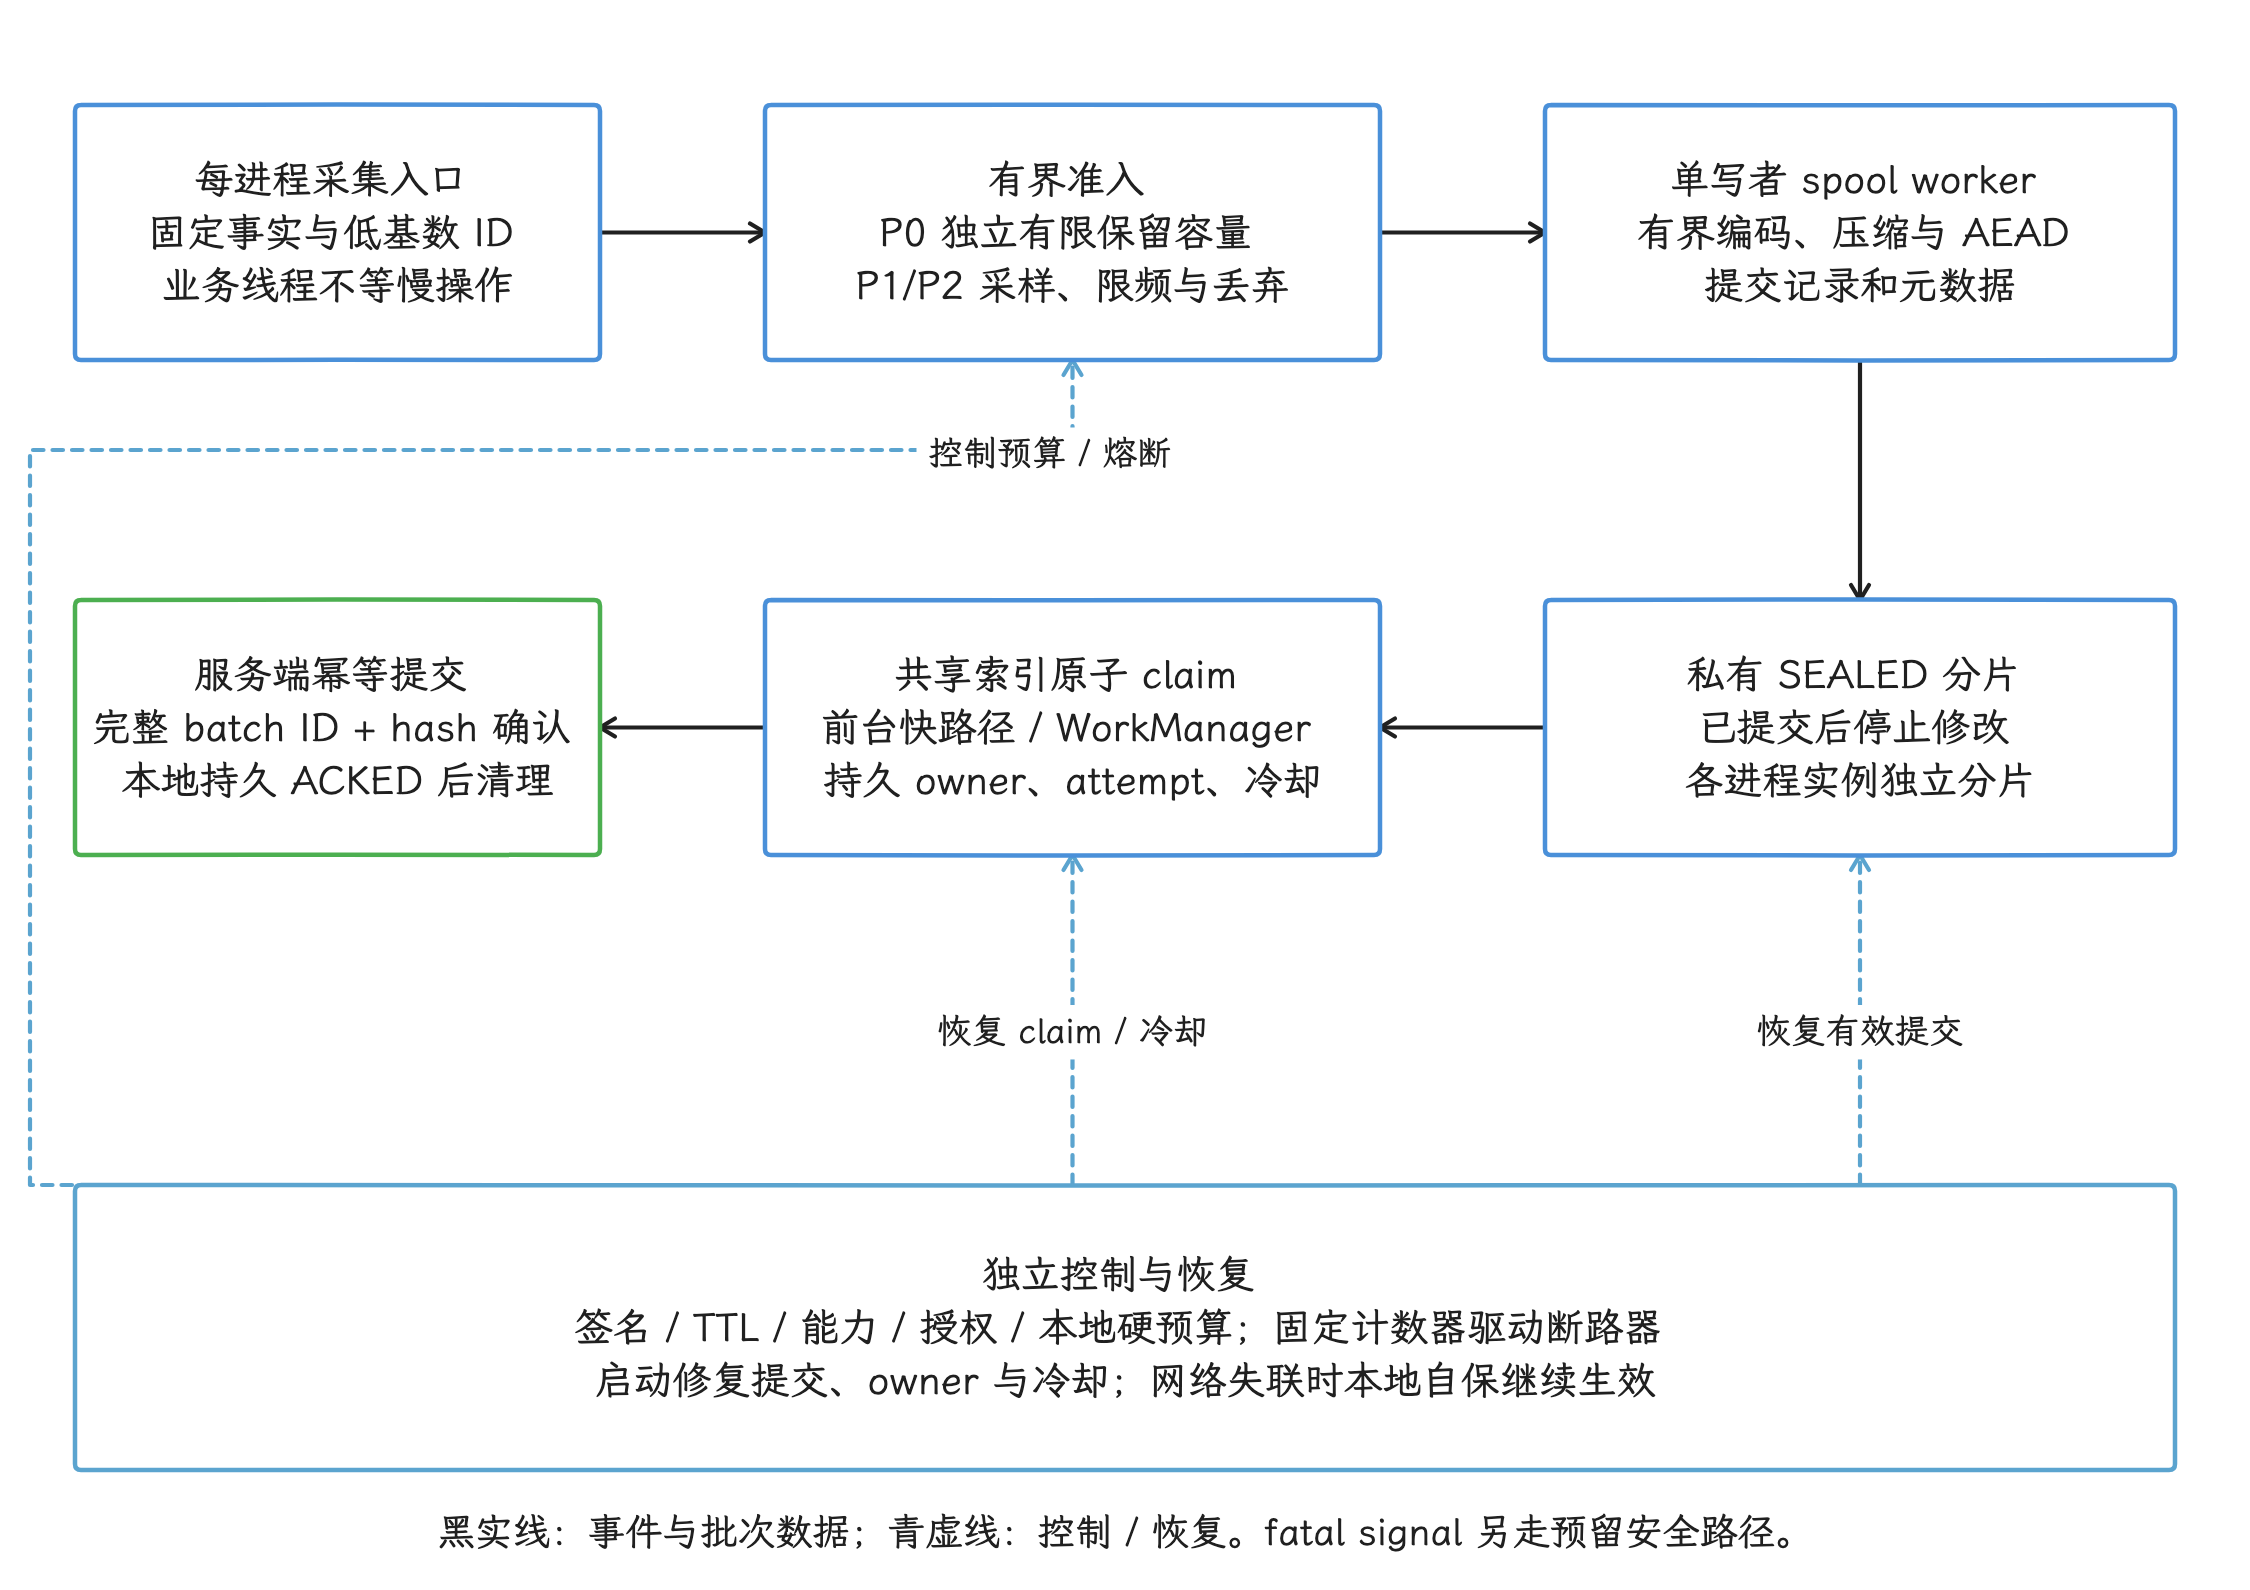
图:各进程有界准入与单写者提交,上传共享 claim 并在完整确认后清理。 本地预算、固定计数器与启动恢复独立作用于链路;fatal signal 走预留安全路径,持久性和实际成本另验。
从图上看,业务线程到文件、网络之间没有直连边,副作用都要经过队列和 writer。P0 走保留容量,仍受硬上限;P1/P2 可按成本丢弃。active mmap 只有单写者,上传只读 sealed 文件;断路器读固定计数器,与普通事件队列分开。
具体采集与诊断入口分别见:
- 17.2 Matrix、btrace 与 Tracing SDK
- 15.7 ProfilingManager
- 17.8 网络 APM 底层捕获原理
- 17.9 崩溃与 ANR 捕获机制
- 17.10 耗电与发热监控 (Battery & Thermal)
- 17.11 混合栈与跨平台 APM (WebView / Flutter)
参考资料
Android 17 / Linux 6.18
- AOSP
ApplicationExitInfo.java(android-17.0.0_r1) - AOSP
Debug.java(android-17.0.0_r1) - AOSP
ProfilingManager.java(android-17.0.0_r1) - ProfilingTrigger API reference
- libcore
MappedByteBuffer.java(android-17.0.0_r1) - Linux
mm/mmap.c(android17-6.18-2026-06_r6) - Linux
mm/filemap.c(android17-6.18-2026-06_r6) - Linux
mm/page-writeback.c(android17-6.18-2026-06_r6) - Android Keystore:不可导出密钥与硬件保护
- Cipher:GCM IV 唯一性与 AAD
- Linux mmap / SIGBUS
- Linux unlink
- Linux fsync:文件与目录持久化
- Auto Backup 与设备迁移
- MappedByteBuffer API reference
- FileChannel API reference
- ApplicationExitInfo API reference
- ComponentCallbacks2 / memory trim API
- App-specific storage
- Android background task scheduling
- WorkManager work constraints
- Long-running WorkManager 与 Android 16+ job quota
- RemoteWorkManager 多进程 API
- Manifest.permission.READ_LOGS
协议、Trace 与开源实现
- Perfetto Tracing SDK:in-process 与 system mode
Channel.trySend()contractChannelcapacity 与 overflow- Protocol Buffers Java generated code / Lite runtime
- Protocol Buffers proto3 schema evolution
- FlatBuffers documentation
- Mars xLog
appender.cc - Mars
mmap_util.cc - Mars Android README:多进程文件与 SIGBUS 提示
- Logan
mmap_util.c - Logan
clogan_core.c