崩溃与 ANR(Application Not Responding,应用无响应) 捕获机制
稳定性 APM(Application Performance Monitoring,应用性能监控)要处理的“崩溃”不止一种:Java 未捕获异常、Native(C/C++ 等本地代码)致命信号、系统判定的 ANR、lmkd(low memory killer daemon,Android 用户态低内存终止服务) 杀进程和资源耗尽。这几类现场发生时,进程的线程状态、权限和剩余执行时间各不相同。我们做采集器,第一件事是回答“现在还能安全做什么”,再决定采哪些数据。
源码基线:AOSP
android-17.0.0_r1;内核android17-6.18-2026-06_r6。
Android 8—10 的兼容路径会保留;厂商权限、root 或旧系统上可读的文件,本文按它们各自的适用范围描述,与普通应用的通用能力分开。
1. 四类现场,四种证据强度
拿到一份崩溃样本,我们第一步是判断它属于哪类现场——Java Crash、Native Crash、系统 ANR,还是资源耗尽与 LMK,四类现场的入口、进程状态和最可信的证据各不相同:
| 现场 | 主要入口 | 进程状态 | 最可信的证据 |
|---|---|---|---|
| Java Crash | Thread.、Android RuntimeInit 默认处理器 | VM(这里是 ART 运行时)仍在运行,资源可能已耗尽 | Throwable、崩溃线程、预存 breadcrumb、系统退出记录 |
| Native Crash | debuggerd/Crashpad signal path | 堆、锁或栈可能已经损坏 | siginfo_t、ucontext_t、tombstone/minidump、ELF build id |
| ANR | system_server 判定、ART SignalCatcher、Application | 进程可能仍存活,也可能稍后被杀 | 系统 ANR trace、触发类型、同一时间窗的 Perfetto/ProfilingTrigger |
| 资源耗尽与 LMK | 周期资源采样、lmkd、退出历史 | 临界点可能无法执行用户代码 | 预采样趋势、系统 reason、RSS/PSS、FD/线程/VMA 使用量 |
表中几个名词先交代清楚。breadcrumb 是应用预先记录的轻量事件轨迹;到了 Native 现场,证据换成了另一组:siginfo_t 保存信号原因和 fault address(出错地址),ucontext_t 保存寄存器等 CPU 上下文;tombstone 是 Android 系统生成的 Native 崩溃报告,minidump 是便于跨平台处理的紧凑转储文件,ELF build id 用来唯一匹配二进制与符号。
资源指标用的是另一套词汇:RSS 是实际驻留在内存中的页,PSS 按共享比例分摊内存,FD 是 file descriptor(文件描述符),VMA 是 virtual memory area(虚拟内存区域)。后面的取证会反复用到 Perfetto 和 ProfilingTrigger:Perfetto 是 Android 系统跟踪工具,ProfilingTrigger 是由系统事件触发性能采集的公开 API。
读这张表时还要区分“应用侧的怀疑”和“系统的结论”。应用端 watchdog(检查线程是否响应的监视器)报出“主线程卡了 5 秒”,这是应用侧的观察;系统判定的 ANR 是另一个层级的结论。同理,收到 SIGKILL 和被 LMK 终止,也要分开记录。
所以我们在每条稳定性样本里保存 evidence_source(证据来源)与 confidence(结论可信度),防止服务端把应用推测写成系统结论。
2. Java Crash:代理默认处理器与系统终止链
2.1 默认处理路径
先看系统自己怎么处理 Java 未捕获异常:RuntimeInit.commonInit() 安装两层处理器,下文的 handler 指异常或信号到达后执行的处理回调:
LoggingHandler是 VM 内部的 uncaught-exception pre-handler(前置处理器),负责输出 fatal exception 日志。KillApplicationHandler是Thread的 default handler(默认处理器),向 ActivityManager 报告崩溃并终止进程。
应用调用 Thread.setDefaultUncaughtExceptionHandler() 替换的是默认处理器,内部 pre-handler 仍由 VM 掌握。实际分派先执行 pre-handler,再找线程显式 handler;未设置时才经 ThreadGroup 回退到 default handler。线程或线程组自行处理且不转交时,全局默认代理可能就收不到这次异常。所以 APM(Application Performance Monitoring,这里指应用性能与稳定性监控) 安装前必须保存当前 default handler,采集结束后把异常交回给它。ProfilingTrigger.TRIGGER_TYPE_OOM 也明确要求自定义 handler 继续调用 default handler——少了这一步,OutOfMemoryError(OOM,内存不足异常) 路径上的触发式 Java heap(Java 对象堆) dump(堆快照)就产不出来。
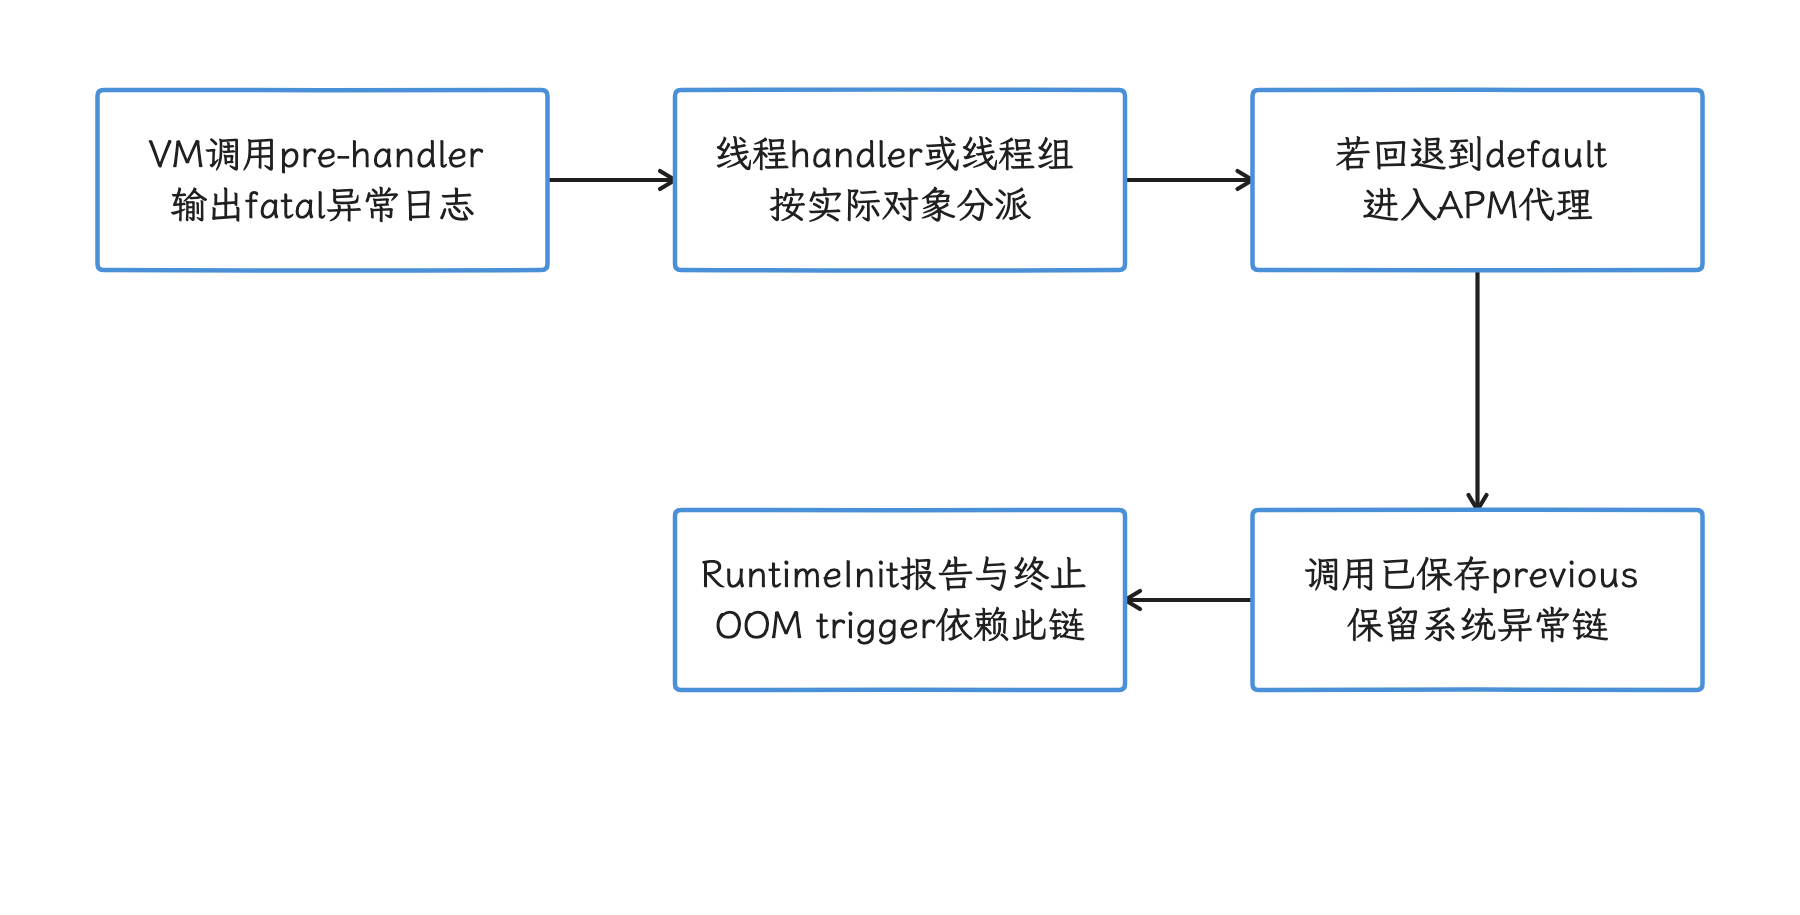
图:运行时先调用 pre-handler,再按线程和线程组分派,只有转交 default 时全局代理才参与。 显式线程 handler 或线程组不转交时,默认代理可能覆盖不到。
下面的代码展示 Java 层代理的最小骨架。CrashEnvelopeStore.tryWriteBounded() 表示项目预先初始化的有界存储;崩溃当下它只完成这次有界写入,开数据库、创建线程、等待网络都留给正常运行期。
class ChainedCrashHandler private constructor(
    private val previous: Thread.UncaughtExceptionHandler?,
    private val store: CrashEnvelopeStore,
) : Thread.UncaughtExceptionHandler {
    private val handling = AtomicBoolean(false)

    override fun uncaughtException(thread: Thread, throwable: Throwable) {
        if (!handling.compareAndSet(false, true)) {
            // 同时崩溃或 previous 链成环时,立即结束,避免递归和死锁。
            hardTerminate()
        }

        try {
            store.tryWriteBounded(
                threadId = thread.id,
                threadName = thread.name,
                throwable = throwable,
            )
        } catch (_: Throwable) {
            // 采集失败不能替换原始崩溃。
        }

        try {
            previous?.uncaughtException(thread, throwable)
        } catch (_: Throwable) {
            hardTerminate()
        }

        // 正常的 RuntimeInit handler 不会返回;空 handler 或第三方返回都在这里终止。
        hardTerminate()
    }

    private fun hardTerminate(): Nothing {
        Process.killProcess(Process.myPid())
        exitProcess(10)
    }

    companion object {
        @Synchronized
        fun install(store: CrashEnvelopeStore) {
            val previous = Thread.getDefaultUncaughtExceptionHandler()
            if (previous is ChainedCrashHandler) return
            val handler = ChainedCrashHandler(previous, store)
            Thread.setDefaultUncaughtExceptionHandler(handler)
        }
    }
}
这段代理把系统默认 handler 保留在链上,并用 CAS(compare-and-set,原子比较并设置)阻止采集器重复进入。previous 自身若返回,代码才执行防御性终止;正常的 Android 路径会在系统 handler 里结束进程。示例已避免在顶层重复安装自身;@Synchronized 只协调这个安装入口,其他 SDK 仍可能同时覆盖全局 handler。跨 SDK 循环仍需统一接管与集成测试,并覆盖 Java exception、Java heap OOM、后台线程崩溃和多个 SDK 的安装顺序。
2.2 崩溃当下的轻量记录 envelope
这里的 envelope 是一条字段受限、字节数有上限的崩溃记录。Java handler 比 Native signal(信号) handler 宽裕一些,但堆和锁这时未必可用:Throwable.printStackTrace()、JSON 序列化、数据库事务和压缩都会分配对象,遇到 OOM 或运行时已经损坏时可能再次失败。
我们把采集分工按时机拆开:
- 正常运行期维护固定容量的 breadcrumb ring buffer(环形缓冲区),并周期写入版本、进程、前后台、资源使用量等已脱敏快照。
- crash handler 只写 magic(识别文件格式的固定标记)、schema version、时间、线程 id、异常类型和预存 breadcrumb 的序号;栈序列化要限制深度、cause(异常原因链)数量和总字节数。
- 冷启动后校验 checksum(发现内容损坏的校验值)与完整标记,再补齐符号化所需字段,随后压缩、去重和上传。
- crash store(崩溃记录存储区)用独立小文件或预分配区域,和业务数据库分开锁与事务。
“立即发网络请求确保上报”成功率低,还会拉长系统崩溃处理。存储接口要在正常期设计为有限操作、非阻塞锁和有界写入;给同步函数外包一层计时,量得到耗时,中断不了已阻塞的 I/O 或锁等待——超时只决定愿意等多久,决定不了调用何时返回。队列满或采集失败时丢掉 APM 附件,尽快进入系统终止链。
3. Native Crash:signal handler 只负责交接
3.1 debuggerd(Native 崩溃诊断服务)、tombstone 与 Crashpad
Native 崩溃的入口是信号。signal 是操作系统通知进程发生事件的机制,Native 崩溃可能来自同步硬件故障、abort() 主动终止或异步送达等路径。常见致命信号包括 SIGSEGV、SIGABRT、SIGBUS、SIGILL、SIGFPE 和 SIGTRAP。系统的处理路径由 Bionic(Android 的 C 标准库)和 debuggerd 构成:debuggerd 是 Native 崩溃诊断服务,负责采集寄存器、线程、maps(进程内存映射)、backtrace(调用栈) 和 abort message(主动终止说明),再由 tombstoned 服务保存 tombstone。
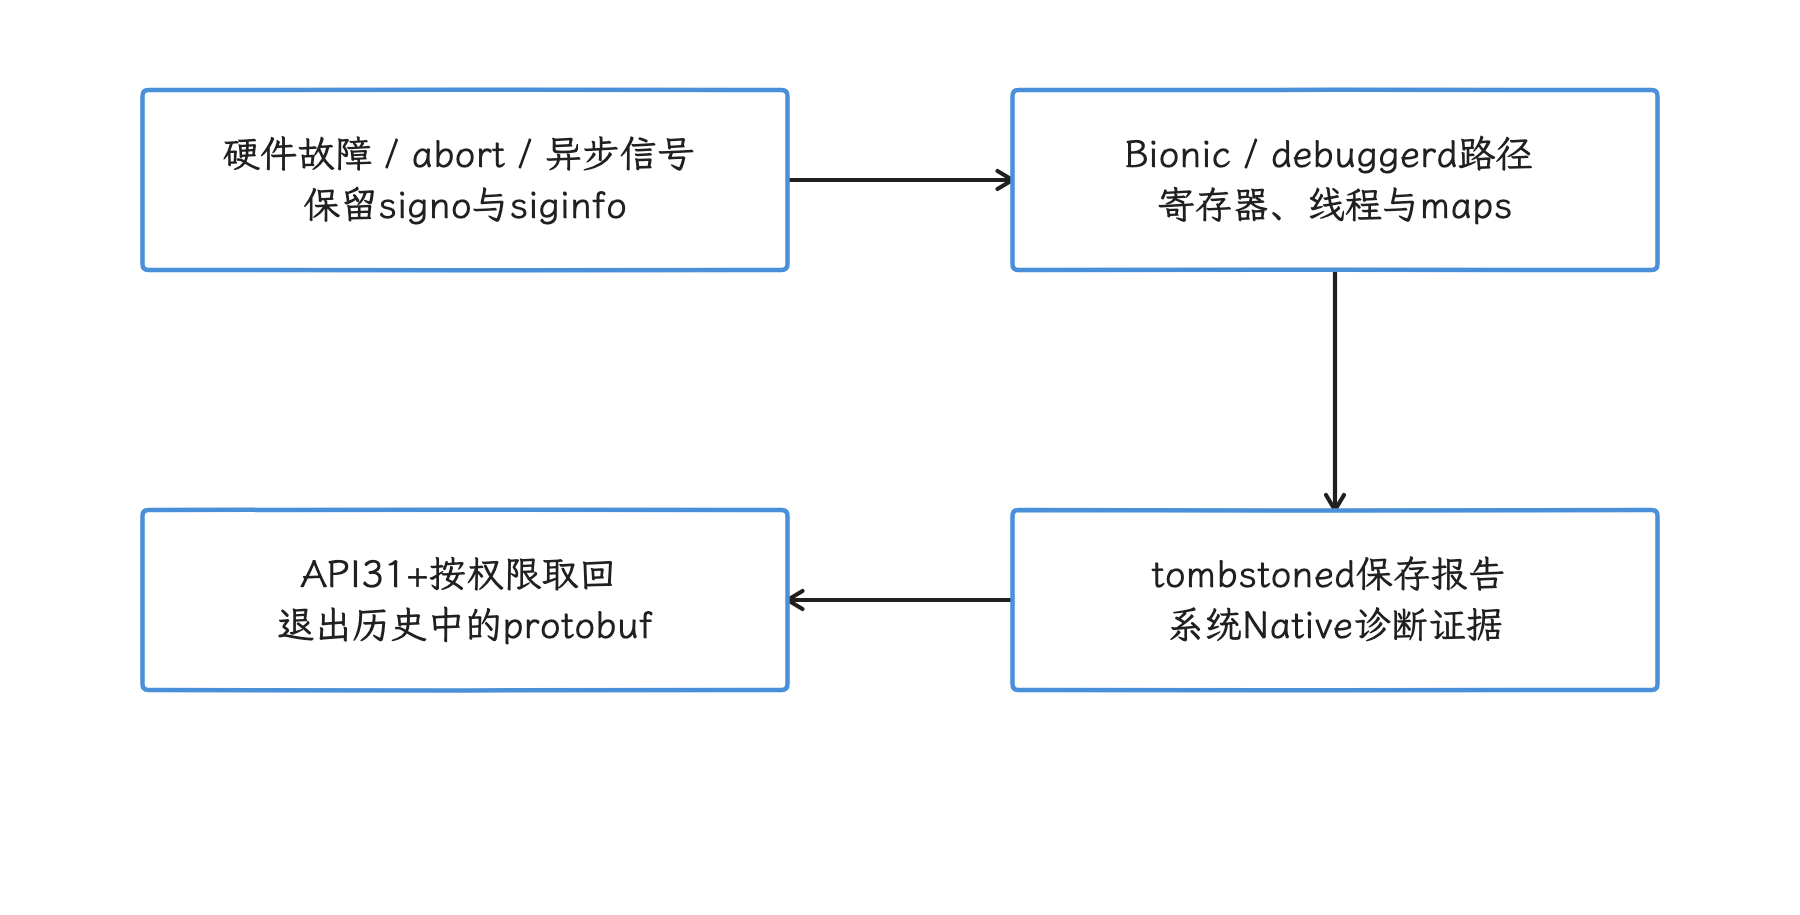
图:Native 故障可来自同步硬件异常、主动 abort 或异步信号,交由系统采集诊断。 信号编号本身说明不了触发方式;普通应用也读不到系统 tombstone 目录。
/data/tombstones 普通应用读不到;Android 12 / API 31 起,我们改从 ApplicationExitInfo.REASON_CRASH_NATIVE 的 getTraceInputStream() 里取对应的 tombstone protobuf。protobuf 指 Protocol Buffers 二进制编码;这份记录也可能在我们读取前,就被系统环形存储里的新记录覆盖。
Breakpad 常由进程内 handler 生成 minidump;Crashpad 的 Linux/Android 设计将客户端与独立 handler 进程分开:预启动路径中,客户端注册通信端点,崩溃时通知 handler 读取目标进程并写 dump。库还提供崩溃时启动 handler 的路径,初始化、权限和开销的边界各不相同,必须固定所用版本及配置验证。这种 out-of-process(进程外)设计减少了对损坏堆和锁的依赖;崩溃路径剩下的风险和开销,则要按所选启动策略、注册、权限与生命周期在正常运行期配置和验收。
下面三类文件各有用途:
- tombstone 是 Android 系统生成的 Native 诊断报告,protobuf schema 位于 debuggerd。
- minidump 是 Breakpad/Crashpad 使用的跨平台紧凑转储格式,适合 APM 上传和服务端解析。
- symbol file(符号文件)、未剥离 ELF 或符号服务器负责把 PC(program counter,程序计数器)里的指令地址还原成函数名和源码行。每个
.so共享库必须保存 build id;只按 version name 选符号,遇到热修复或重打包会匹配到错误版本。
把地址还原为函数和源码行的过程叫符号化。符号化结果错误时,调用栈看起来仍然完整,所以 build id 比文件名或版本号更可靠。
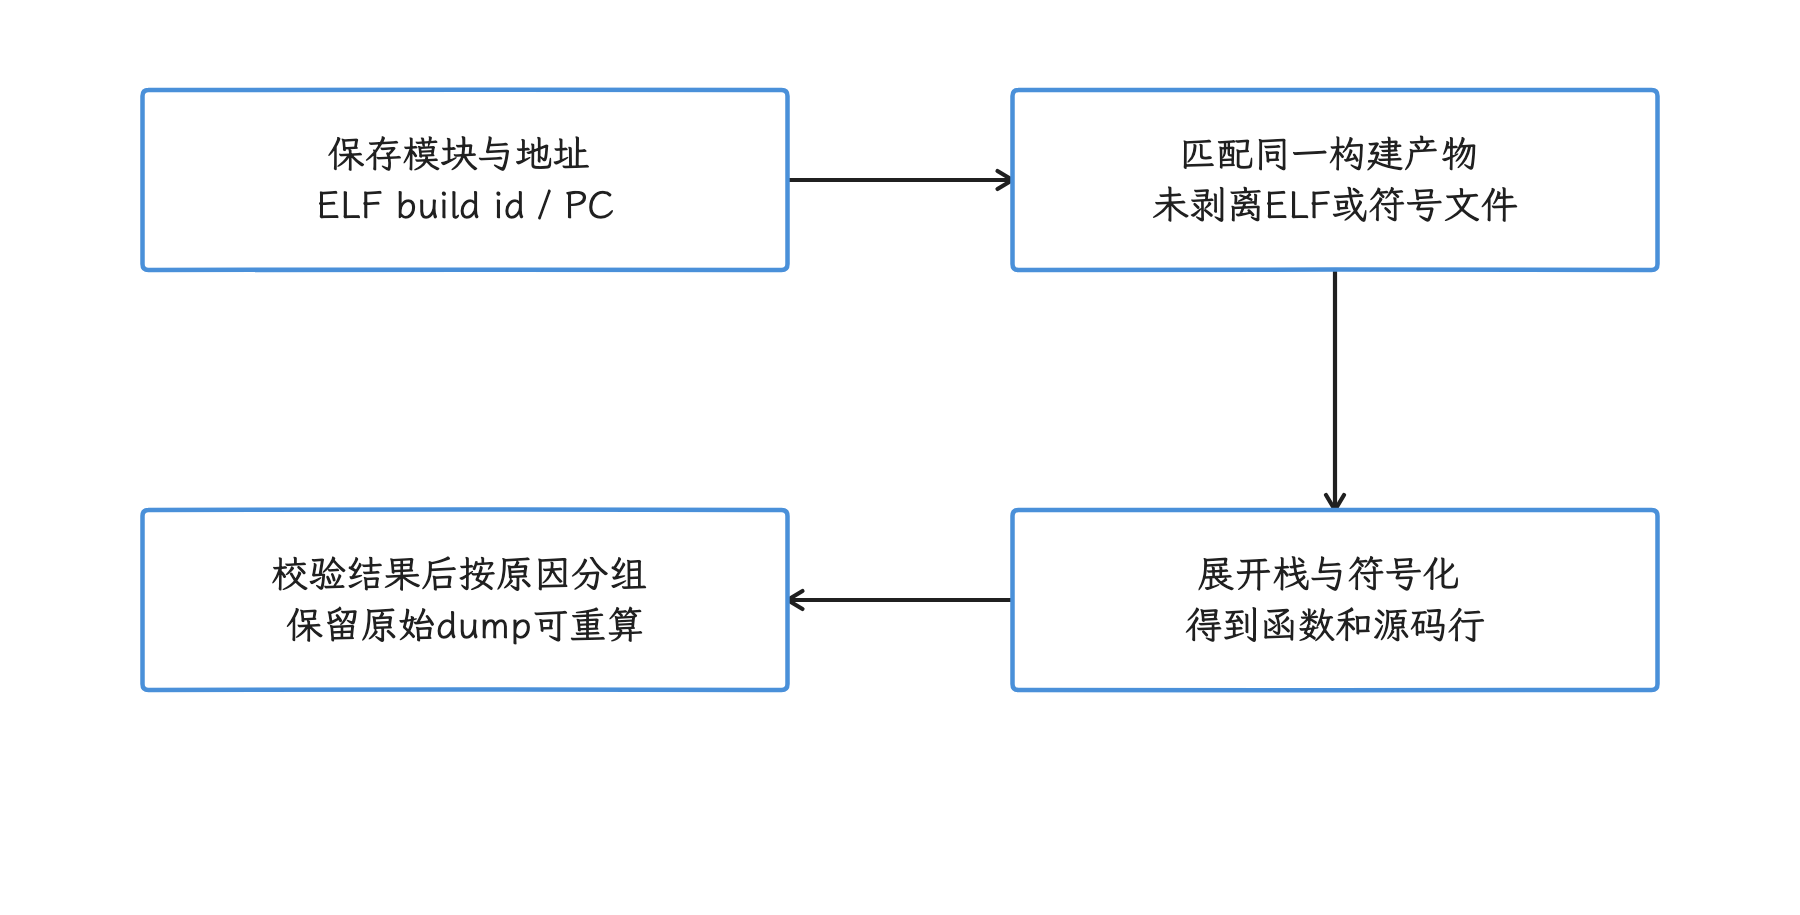
图:每个模块记录 build id,服务端用对应二进制与符号还原地址后再分组。 文件名或 version name 相同不保证产物相同,错误符号也可能得到貌似完整的栈。
3.2 signal 上下文的硬边界
致命 signal handler 里只能依赖 async-signal-safe 操作,即 POSIX 规范明确允许在异步信号上下文调用的那部分接口;我们所需的内存、FD 和 alternate signal stack(备用信号栈)也要提前备好。具体来说,下面这些动作要留在 signal handler 之外:
malloc/new/free、STL(C++ 标准模板库) 容器扩容、普通日志与 JSON。pthread_mutex、Java/JNI(Java 与 Native 代码的调用接口) 回调、数据库与线程池。- 在未知栈状态下调用通用 libunwind,并假设它不会分配内存或加锁。
- 直接上传网络、解析
/proc大文件或遍历所有线程。
handler 可以读 siginfo_t、ucontext_t 与当前 tid(thread id,线程 ID),把定长结构写入预先打开的 pipe/socket,或通知 Crashpad handler。完整的 unwind(逐层还原调用栈)、maps 读取和 minidump 生成,交给受控的外部 handler 或系统 debuggerd。
如果自研 reporter(崩溃报告器) 必须与前一个 handler 共存,还有一串 POSIX 细节要处理:SA_SIGINFO 回调签名、SIG_DFL(默认动作)、SIG_IGN(忽略信号)、SA_RESETHAND(处理一次后恢复默认动作)、signal mask(信号屏蔽集合)、备用栈和重入。POSIX 把忽略非 kill/sigqueue/raise 产生的 SIGFPE/SIGILL/SIGSEGV/SIGBUS 定义为未定义行为,SIG_IGN 也就当不了恢复策略。库的恢复与重发还要区分会再次触发的同步故障和异步信号,并保留原始 siginfo。几行没经过系统版本与 ABI(application binary interface,应用二进制接口) 测试的 sigaction() 链式代码,谈不上生产可靠性。
3.3 从 fault 到上报的顺序
我们按预启动 handler 的 Crashpad 路径走一遍;崩溃时启动的模式需要另行核对实现:
- 应用正常运行时启动并注册 handler,准备通信端点、备用栈与 annotation(随 dump 保存的注解);异常上下文的位置按所用实现传递,不把共享内存写成必需条件。
- 崩溃线程收到致命信号,客户端 handler 读取 signal、fault address 与寄存器上下文。
- 客户端通过预建 IPC(inter-process communication,进程间通信) 通知外部 handler,崩溃线程停在可被读取的状态。
- 外部 handler 读取线程、内存映射、模块与内存片段,写入 minidump。
- 客户端恢复或转交系统 signal 处理语义,让 debuggerd/tombstoned 继续生成系统证据并终止进程。
- 正常运行期或下次启动校验完整 dump,按隐私与重试策略上传;通常由服务端按模块 build id 取符号、展开调用栈、符号化和分组,避免把完整符号及高成本处理强加给客户端。
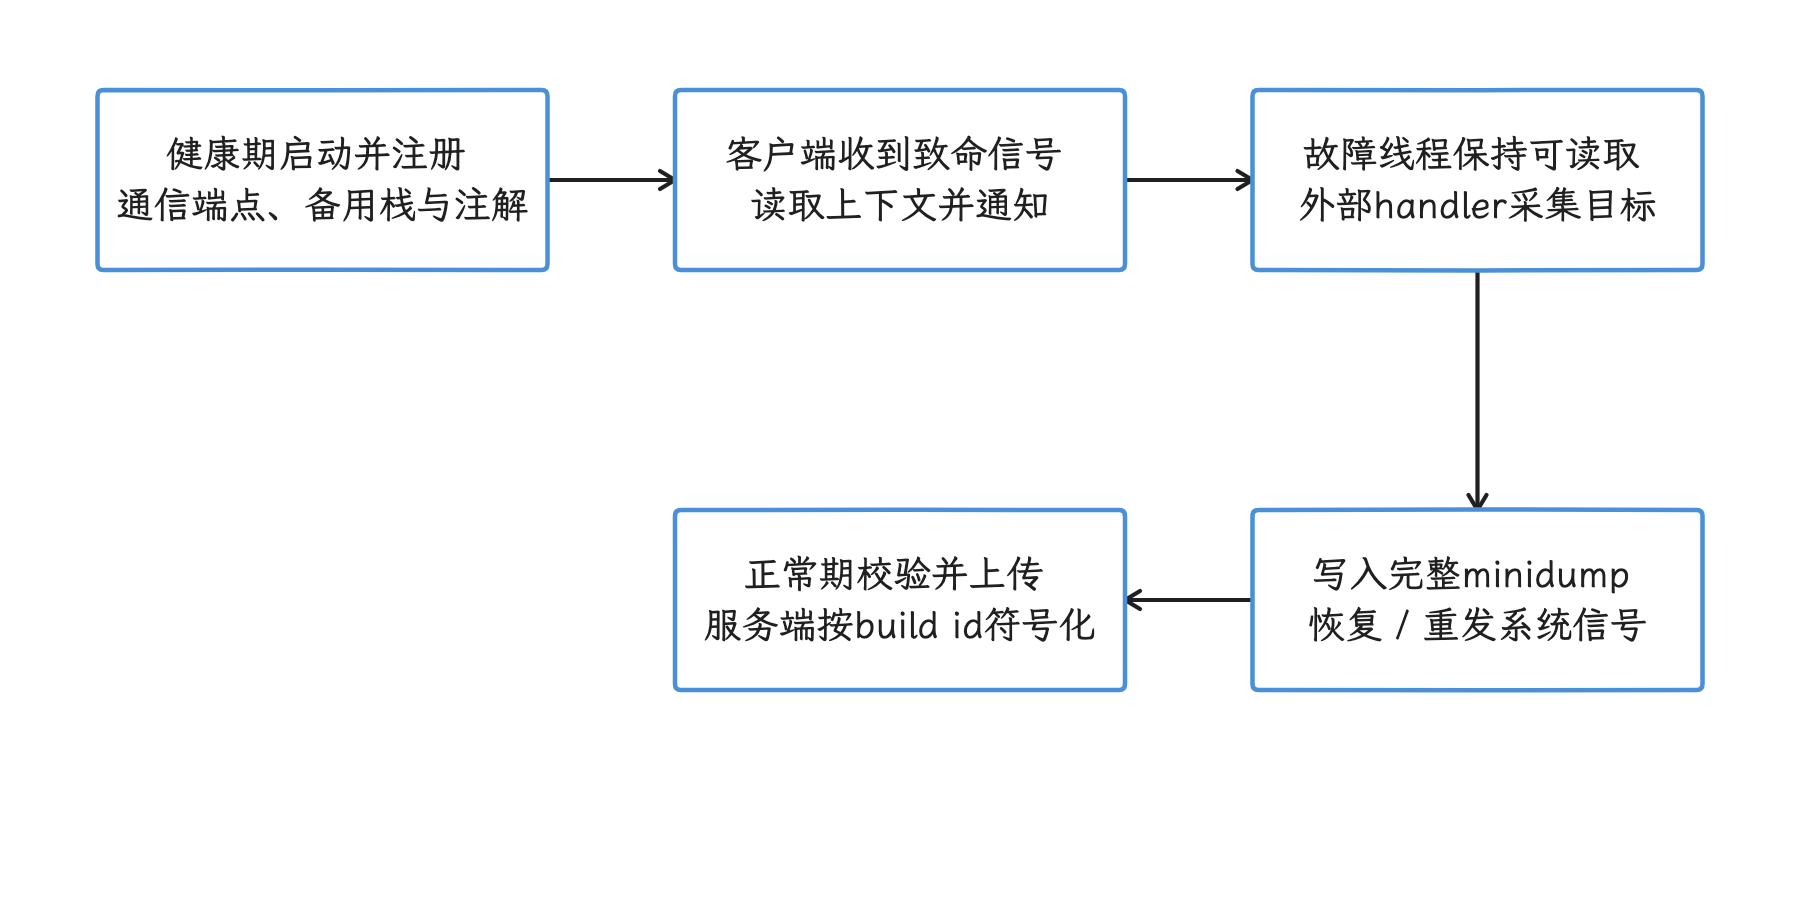
图:预启动路径先完成注册,故障时通知外部 handler,再恢复系统处理链并延后上传。 这里只描述所选启动策略,恢复系统报告与终止行为要用故障测试确认。
第 5 步要按所用 Crashpad/Breakpad 版本的官方实现逐一验证。自研 handler 吞掉 signal,会同时损失系统 tombstone、Android Vitals 的原因分类和后续 SDK 的处理机会。
4. ANR 取证:权限与入口的演进
4.1 /data/anr 的访问权限
ANR 的系统证据放在哪里、谁能读,先从目录说起。旧版调试资料常拿 /data/anr/traces.txt 当入口,较新的系统则是在 /data/anr/ 下保存独立的 trace 文件。init.rc 以 0775 system system 创建目录,但具体 trace 仍由系统侧控制:目录权限位只说明目录本身的开放范围,普通应用能读到哪些内部文件,还要过 SELinux 强制访问控制、文件 owner/mode(属主与权限位)和系统服务检查这三道限制。
取证入口因此分成两档:adb/bugreport、root 权限、userdebug 系统镜像或厂商系统组件在系统侧,可以直接取证;三方生产应用手里的轮询、inotify(Linux 文件变化通知)和反射调用系统服务,撑不起一个稳定方案。文件名、压缩方式和保留数量都属于实现细节,端侧协议要避开对这些细节的依赖。
4.2 SIGQUIT 与 ART(Android Runtime) SignalCatcher
我们先看系统怎么收集 Java 线程 dump:向目标进程发送 SIGQUIT,由 ART 专门的 SignalCatcher 线程接收。这条线程先屏蔽该信号,再经 SignalSet.Wait(info) 调用 sigwaitinfo64() 同步等待并取得 siginfo;signal_catcher.cc 的注释仍笼统称 sigwait(),具体调用以 signal_set.h 为准。
这就解释了一个看似矛盾的现象:ANR 取证路径在用 SIGQUIT,但应用自己再注册一个 SIGQUIT handler,未必接得到系统的 dump 信号——这条等待路径上,普通 sigaction handler 没有执行机会。
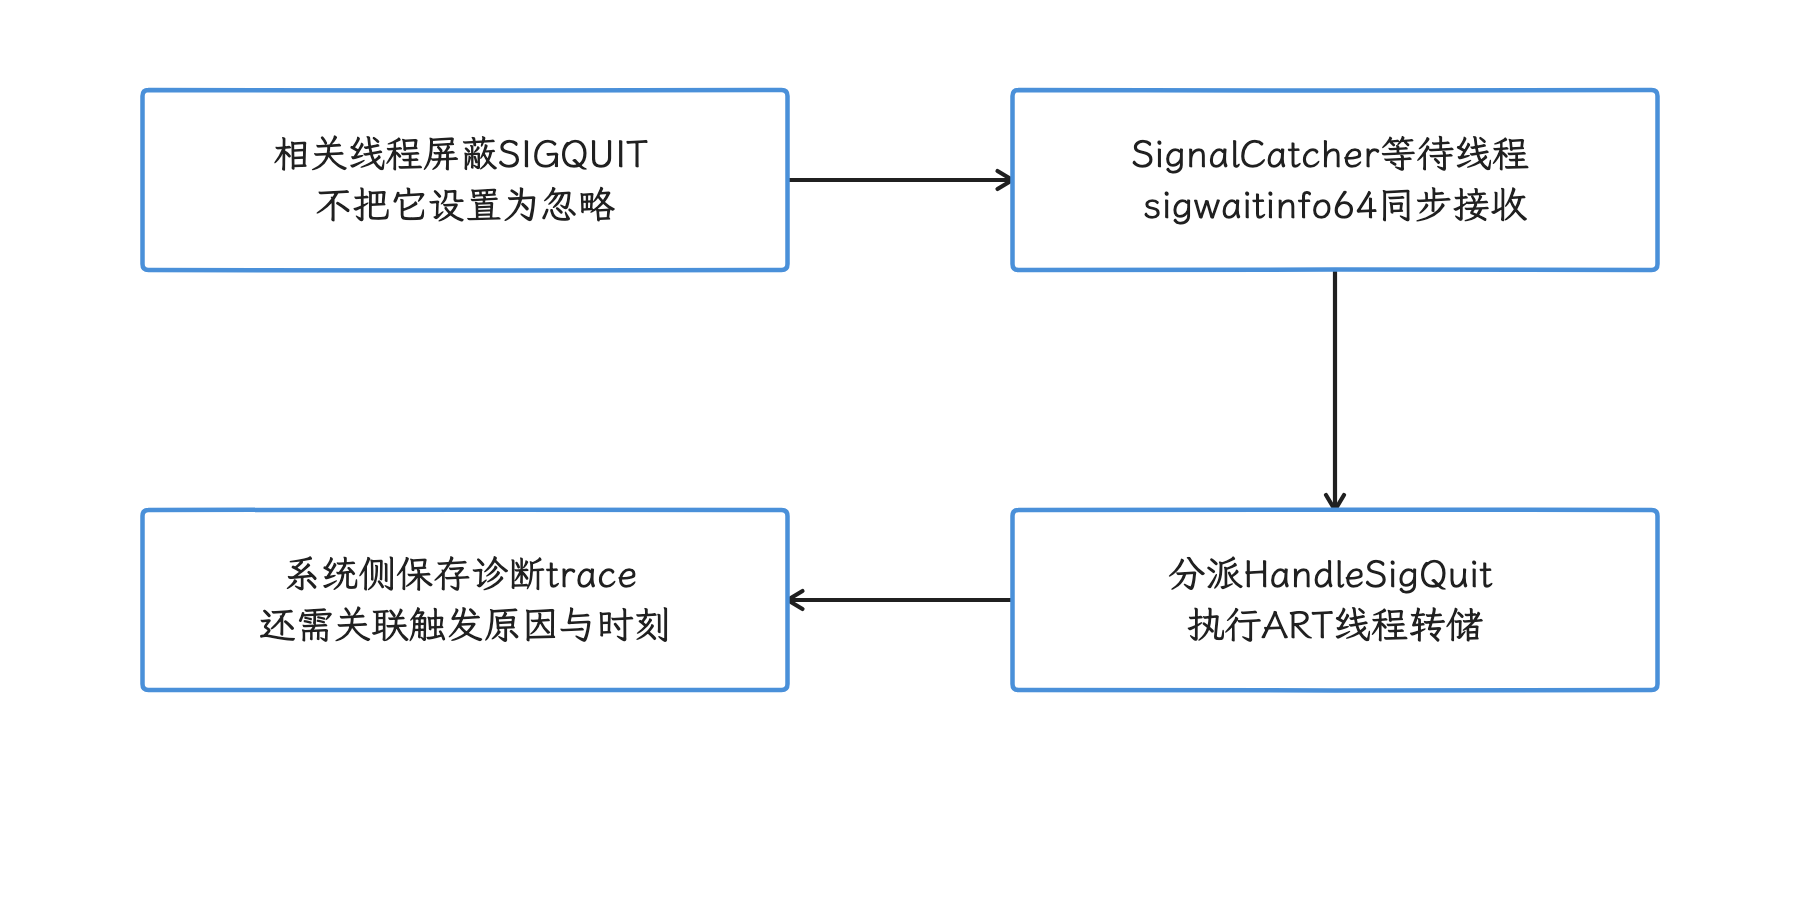
图:ART 屏蔽相关信号后由等待线程调用 sigwaitinfo64 同步接收,再执行线程转储。 再次安装普通 SIGQUIT handler 接不稳系统 dump 路径,dump 本身也说明不了已判定 ANR。
所谓 Signal Catcher Hook,是通过拦截或改写 ART 内部调用路径来取得线程 dump。它往往要改信号掩码、拦截 ART 内部符号、修改 libsigchain 或参与系统 ANR 流程,与 Android 版本、ART 实现和其他 SDK 强耦合。这类手段适合厂商 ROM、root/userdebug 诊断或可回滚实验;普通应用的默认能力,应放在应用端自己的 watchdog(定时检查线程是否响应的监视器) 上。
main-looper watchdog 定时检查主线程消息循环是否还能响应,可以在卡顿期间多次采主线程栈,提前发现耗时消息、锁等待和 Binder(Android 跨进程调用机制) 阻塞。它拿不到 system_server(承载核心 Android 系统服务的进程) 掌握的输入分发、广播、service、content provider 等超时上下文,所以只能标记 suspected_anr;系统 ANR 结论,仍以后续 ApplicationExitInfo、Vitals 或系统 trace 为准。
4.3 Android 11+ 的 ApplicationExitInfo
系统目录和信号路径都受限之后,普通应用能拿到的官方入口是退出历史。API 30 起,ActivityManager.getHistoricalProcessExitReasons() 提供当前 UID(Android 为应用或隔离进程分配的用户标识)/包的历史退出记录。常用字段包括 reason、status、importance、process name、timestamp、description、PSS/RSS 和 process state summary(应用退出前主动保存的少量状态摘要)。
读取时我们要记住几件事:
REASON_ANR的 trace 通常是系统 ANR 文本流;流可能为空。- API 31 起,
REASON_CRASH_NATIVE可返回按tombstone.proto编码的 protobuf,按二进制处理即可,按 UTF-8 文本解析会出错。 - trace 位于独立的全局环形存储,容量用完后会覆盖较旧记录;其他应用产生的新记录也会占用这份容量。
- 一个进程曾发生 ANR、随后恢复并因其他原因退出时,该退出记录仍可能带 ANR trace;退出原因以 reason 字段为准,看到 trace 就断定
reason == REASON_ANR是误读。 - PSS/RSS 记录的是系统最近一次采样,离死亡时刻可能还有距离;0 也可能只是没来得及采样。
description是给人看的说明,格式跨设备、跨版本都可能变,解析逻辑要避开字符串切片。- 缺少 LMK report 支持的设备会把低内存 kill 记为
REASON_SIGNALED + SIGKILL;这个组合只够标成“可能 LMK”,要再写成确定的 LMK,证据就不够了。
API 37 的 NativeTombstoneManager 还能把没有匹配到真实退出记录的 tombstone 合成为 REASON_CRASH_NATIVE 条目;合成条目的 status、PSS/RSS 可为 0,importance 也只是填入值。Recoverable GWP-ASan 报告可以在进程继续运行时出现。因此本章把这类入口先记为 NATIVE_REPORT,保留系统 reason,是否真的发生致命退出,另行确认后再计数。
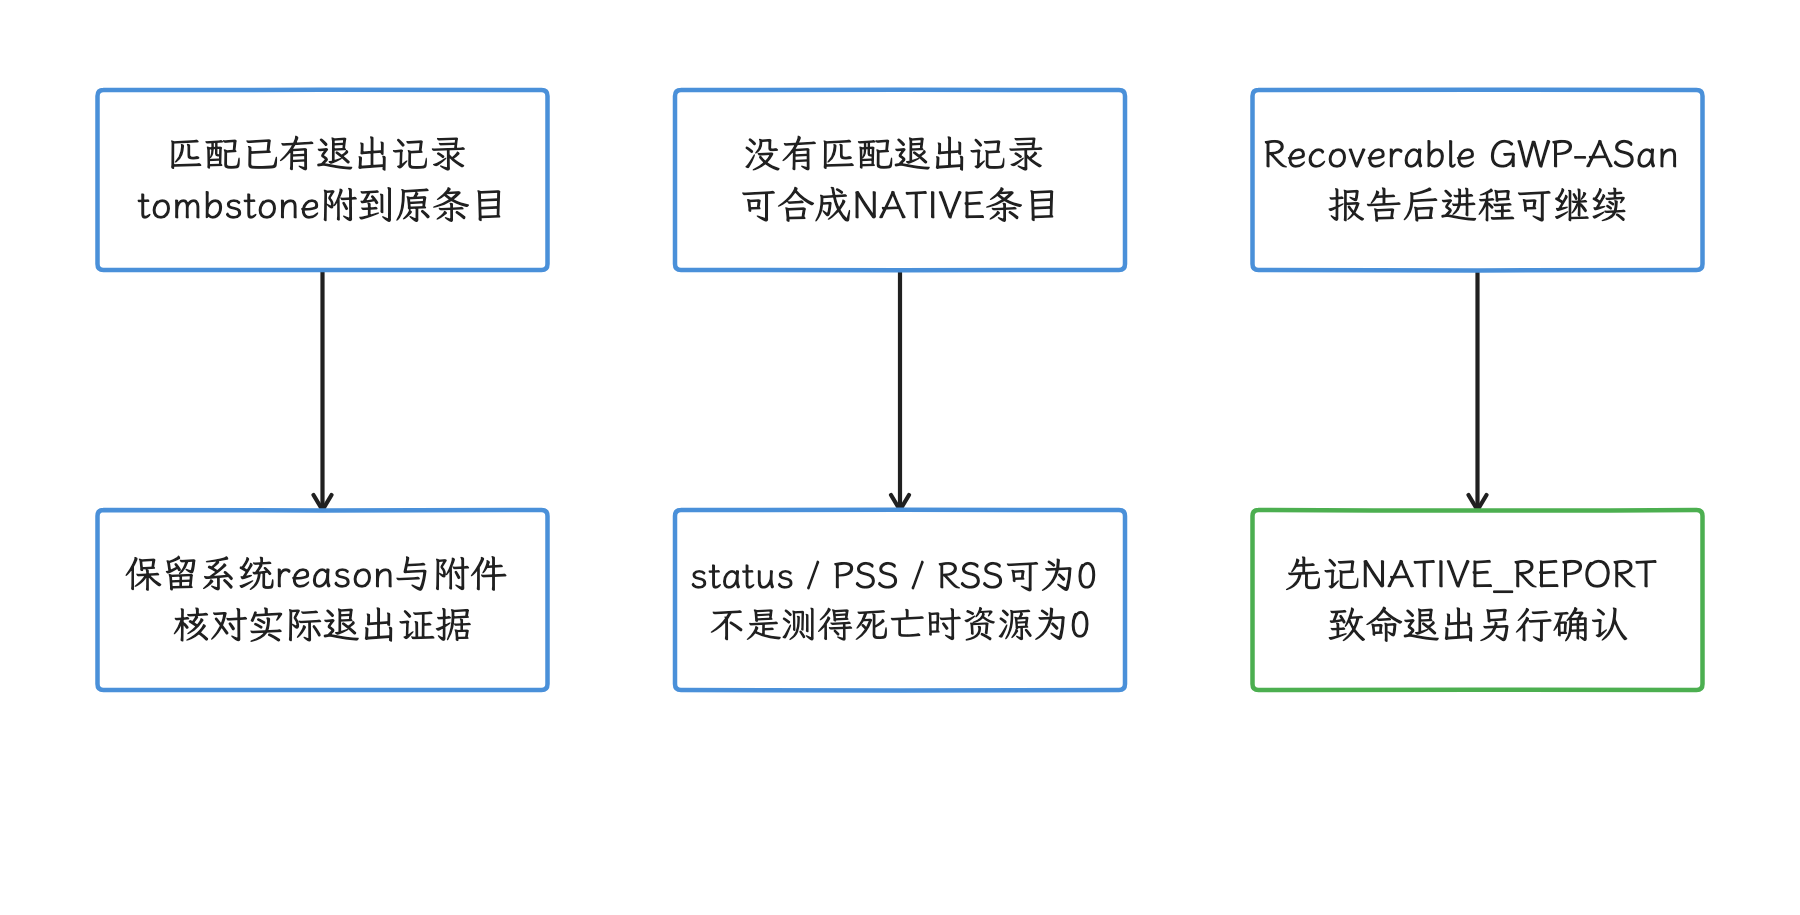
图:NativeTombstoneManager 可合成报告条目,Recoverable 故障还能在进程存续时产生报告。 status、PSS/RSS 为0和填入 GONE 都不证明真实退出现场,先保留报告来源。
API 37 新增 ApplicationExitInfo.getAnrInfo(),只在 reason == REASON_ANR 时有值。从中我们可以读到 getAnrType()(输入分发、广播、service、content provider、job 或应用启动等类型)、getAnrId()、getTimeoutMillis()(系统等待到判定 ANR 的总时长),以及 isUserPerceptible()(是否向用户显示 ANR 对话框)。getAnrId() 只保证在同一种 ANR 类型内唯一,全局去重键要配合其他字段构造;其他退出原因调用 getAnrInfo() 会得到 null。
下面的代码展示 API 30+ 通用路径里的启动后拉取、去重和有界读取。ExitEnvelope 与 ExitKind 是项目自己的上传 DTO(data transfer object,数据传输对象)和枚举;trace 保持原始字节前缀并显式记录是否截断;未截断也要由解析器校验格式和 schema,traceFormatHint 只是预期类型。应用端不把 tombstone protobuf 直接转为字符串。API 37 的生产实现可以在这份兼容基线上另行读取 getAnrInfo()。
@RequiresApi(30)
fun readRecentExits(
    context: Context,
    seen: Set<String>,
    traceLimitBytes: Int = 2 * 1024 * 1024,
    totalTraceLimitBytes: Int = 4 * 1024 * 1024,
): List<ExitEnvelope> {
    require(traceLimitBytes in 1..(2 * 1024 * 1024))
    require(totalTraceLimitBytes in 0..(4 * 1024 * 1024))
    val am = context.getSystemService(ActivityManager::class.java) ?: return emptyList()
    val supportsLmkReason = ActivityManager.isLowMemoryKillReportSupported()
    val emitted = seen.toMutableSet()
    var remainingTotal = totalTraceLimitBytes

    return am.getHistoricalProcessExitReasons(context.packageName, 0, 20).mapNotNull { info ->
        val key = listOf(
            info.processName, info.pid, info.timestamp, info.reason, info.status,
        ).joinToString(":")
        if (!emitted.add(key)) return@mapNotNull null

        val kind = when (info.reason) {
            ApplicationExitInfo.REASON_ANR -> ExitKind.ANR
            ApplicationExitInfo.REASON_CRASH -> ExitKind.JAVA_CRASH
            ApplicationExitInfo.REASON_CRASH_NATIVE -> ExitKind.NATIVE_REPORT
            ApplicationExitInfo.REASON_LOW_MEMORY -> ExitKind.LMK
            ApplicationExitInfo.REASON_SIGNALED ->
                if (!supportsLmkReason && info.status == OsConstants.SIGKILL) {
                    ExitKind.POSSIBLE_LMK
                } else {
                    ExitKind.SIGNAL
                }
            else -> ExitKind.OTHER
        }

        var trace: TraceReadResult? = null
        var traceReadError: String? = null
        if (remainingTotal > 0) {
            try {
                trace = info.traceInputStream?.use {
                    it.readBounded(minOf(traceLimitBytes, remainingTotal))
                }
                remainingTotal -= trace?.bytes?.size ?: 0
            } catch (_: IOException) {
                traceReadError = "io_error"
            }
        } else {
            traceReadError = "retained_byte_budget_exhausted"
        }

        ExitEnvelope(
            dedupKey = key,
            kind = kind,
            systemReason = info.reason,
            processName = info.processName,
            timestampMs = info.timestamp,
            status = info.status,
            pssKb = info.pss,
            rssKb = info.rss,
            traceBytes = trace?.bytes,
            traceTruncated = trace?.truncated,
            traceReadError = traceReadError,
            traceFormatHint = when {
                trace == null -> null
                Build.VERSION.SDK_INT >= 31 &&
                    info.reason == ApplicationExitInfo.REASON_CRASH_NATIVE ->
                    "tombstone-protobuf-expected"
                else -> "anr-text-expected"
            },
        )
    }
}

private data class TraceReadResult(val bytes: ByteArray, val truncated: Boolean)

private fun InputStream.readBounded(limit: Int): TraceReadResult {
    require(limit > 0)
    val output = ByteArrayOutputStream(minOf(limit, 32 * 1024))
    val buffer = ByteArray(minOf(limit, 8 * 1024))
    var remaining = limit
    while (remaining > 0) {
        val count = read(buffer, 0, minOf(buffer.size, remaining))
        if (count < 0) return TraceReadResult(output.toByteArray(), false)
        if (count == 0) {
            // 某些包装流可能暂时返回0;用单字节读取保证进展或识别EOF。
            val next = read()
            if (next < 0) return TraceReadResult(output.toByteArray(), false)
            output.write(next)
            remaining--
        } else {
            output.write(buffer, 0, count)
            remaining -= count
        }
    }
    // 多探测1字节区分刚好读完与被截断,不把该字节加入保留样本。
    return TraceReadResult(output.toByteArray(), read() != -1)
}
这段代码仍会分配内存,并执行 Binder 调用和文件 I/O,所以仅在 SDK_INT >= 30 时放到后台任务执行。示例限制请求记录数、单条与总保留字节;为判断截断,每条流还可能额外读 1 字节。它没有强制中断同步 Binder/I/O 的能力,任务时长需另外按可取消、可观测的执行机制控制。seen 只保存已成功持久化的记录;批内 key 去重算不上系统承诺的全局故障 ID,补拉到信息更完整的同一事件还需按证据合并。生产实现要限制总记录数、单条 trace 大小、单次任务时长和本地磁盘占用;解析失败时保存 schema/version 与少量摘要,避免反复上传同一条损坏记录。
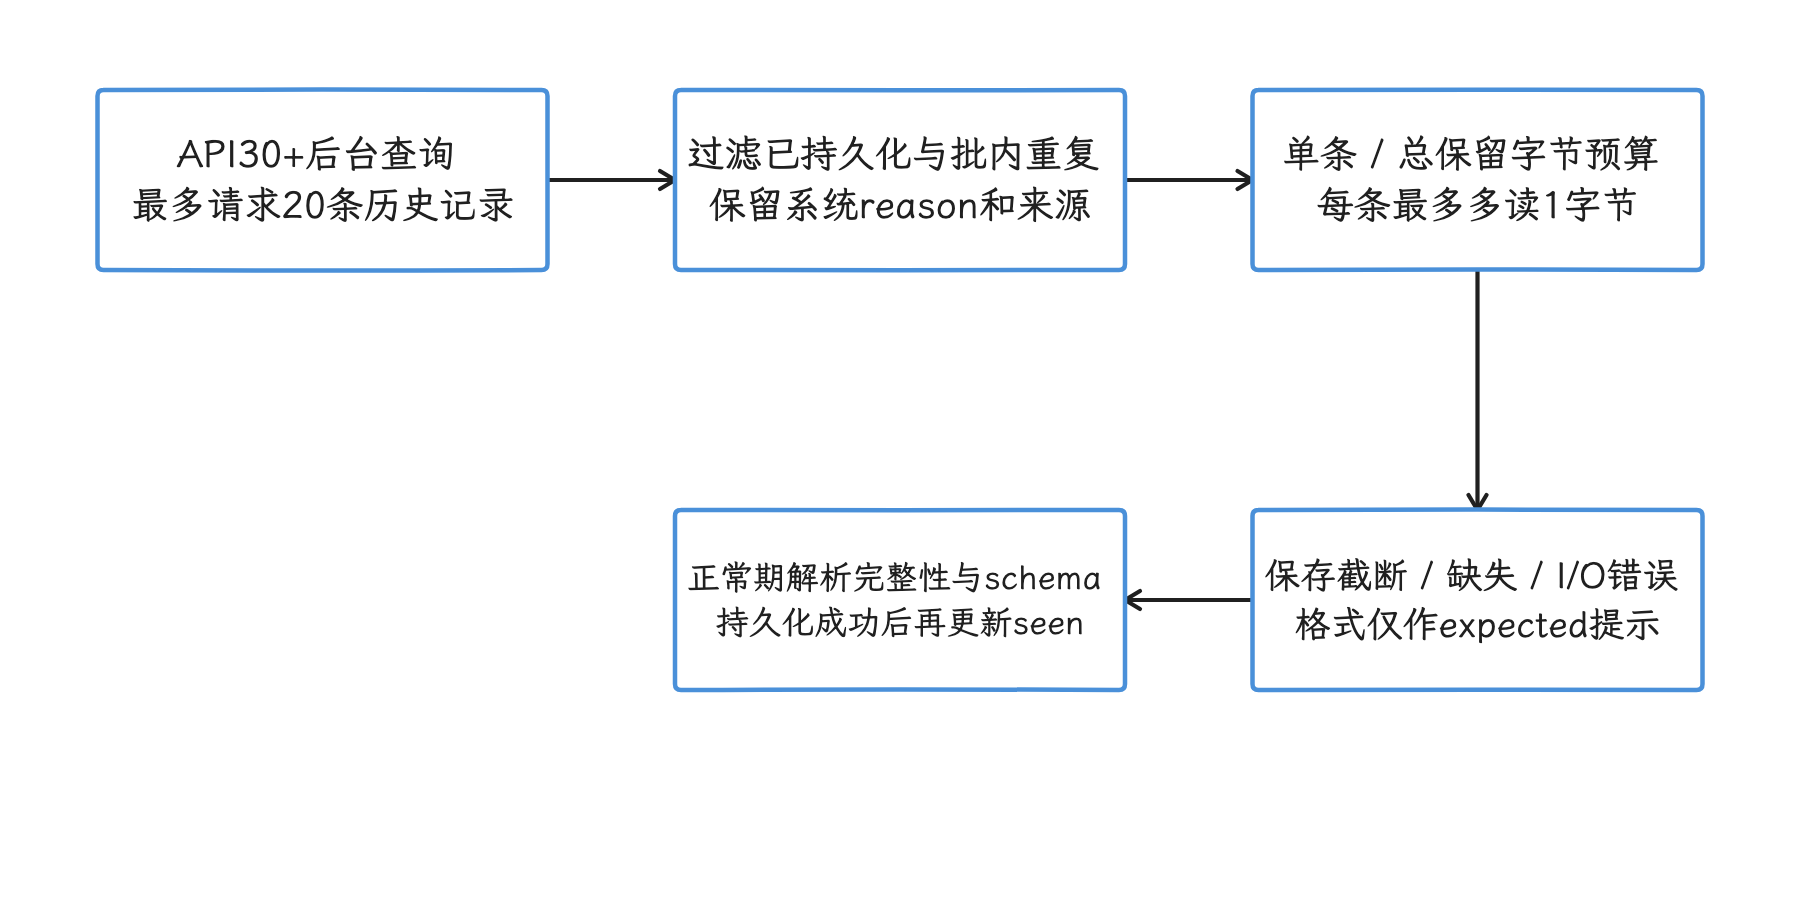
图:后台读取先查重,再限制每条与总保留字节,明确记录截断、缺失和读取失败。 格式提示只是预期,截断 protobuf 按截断样本处理,同步 I/O 的时长要靠任务机制控制。
5. 资源耗尽与多种 OOM
5.1 Java heap、Native RSS、FD、线程和 VMA
OOM 常被理解成 Java heap 装不下新对象,但进程还可能耗尽的是 Native 内存、文件描述符、线程或虚拟地址空间。先把失败的资源区分开,我们才知道该采哪类证据。
| 资源 | 常见失败 | 应用可观测信号 | 容易误判的地方 |
|---|---|---|---|
| Java heap | Out、GC thrash(频繁 GC 却回收很少) | heap used/max、GC、对象增长 | Java heap 正常不能排除 Native/graphics 增长 |
| Native/graphics | RSS/PSS 上升、分配失败 | Debug.、/、模块计数 | RSS 上升不自动等于泄漏 |
| FD table | open/ 返回 EMFILE | /proc/self/fd 数、RLIMIT_NOFILE、失败 errno | 扫目录本身也会短暂占用 FD |
| 线程 | pthread_ 返回 EAGAIN、Java 创建线程失败 | Threads、线程创建率、线程池活跃数/排队数 | 线程数只是一个维度,还要看 stack、地址空间和调度 |
| VMA/地址空间 | mmap 返回 ENOMEM | / 条目、VmSize、ABI、映射来源 | 64 位 VmSize 含大块预留地址,不能单独作为内存压力 |
| 系统低内存 kill | 进程无回调地消失 | Application、Vitals、预存资源使用量 | SIGKILL 还可能来自 force-stop、shell 或其他系统策略 |
表中的 errno 是 Native 系统调用失败时的错误码:EMFILE 表示当前进程打开的 FD 过多,ENOMEM 表示没有足够内存或虚拟地址空间。
这几类资源里,我们先看 FD。FD 泄漏最先破坏的是 socket、文件、eventfd(内核事件计数器)、pipe 和 Binder 辅助资源这些创建路径。RLIMIT_NOFILE 是进程可打开 FD 数量的上限,预警阈值应按当前使用量与该上限的比例计算,并保留 FD 类型分布;固定写死“超过 1024”,适配不了不同设备和进程配置。
线程这边,耗尽常由无界 executor(任务执行器)、每个请求新建线程、阻塞任务堆积或 Native 库自行建线程引起;每个线程还要占用用户栈映射、内核 task(调度实体) 资源与 CPU 调度时间。Android/内核最终可能返回 EAGAIN(资源暂时不可用)或内存失败,把这类失败一律标成 Java heap OOM,会盖住线程、栈和调度上的线索。
VMA 风险在 32 位进程暴露得更早:有限的地址空间要同时装下 .so、JIT(just-in-time,即时编译) 代码、线程栈、ashmem(Android 匿名共享内存)、图形内存映射和碎片。64 位进程也可能碰到异常映射增长,或撞上 vm.max_map_count(单进程可拥有的 VMA 数量上限) 这样的限制;很大的 VmSize 可能只是预留了地址范围,对应的物理内存未必真的驻留。
现代设备的低内存处置,主要由用户态 lmkd 结合 PSI(Pressure Stall Information,内核压力停顿指标)、内存压力、swap(交换空间) 状态和 oom_score_adj 来选择目标。早期 kernel lowmemorykiller 那套固定 minfree 阈值的模型,只能解释一部分现代设备的行为。oom_score_adj 也只是选择终止目标时的优先级输入之一,把它读成“达到该值就立即杀进程”,等于丢掉了同一决策里的其他输入。
5.2 预警靠正常运行期采样
我们建议按前后台与业务阶段做低频、错峰采样:
- 读取
/proc/self/status的VmRSS、VmSize、Threads,结合Debug.MemoryInfo。 - 统计
/proc/self/fd,并在诊断抽样中解析 symlink(符号链接) 指向的资源类型;接近 FD 上限时停止高成本分类。 - 统计 maps 行数与主要映射类别,高频任务里不上传完整
/proc/self/maps。 - 记录线程创建速率、pool size(线程池大小)、queue depth(排队任务数) 和任务最长等待时间;线程总数只作参考维度之一。
- 给 WebView、图片、数据库、音视频、模型与图形资源建立模块计数。
- 使用分位数和增长斜率设告警,同时保留设备 RAM、ABI、前后台和进程类型。
资源使用量接近限制后,采样器要主动降频、停掉高成本分类:继续频繁扫描 /proc、抓 heap dump 或拼接大日志,反而可能成为进程的额外负担。
5.3 Android 8—10 没有退出历史时
API 26—29 没有 ApplicationExitInfo。Java crash、Native crash 仍可由 handler/reporting library 捕获;系统 ANR 与 LMK 对普通应用没有等价的官方本地查询 API。
低版本上我们能用的方案与各自的证据强度如下:
- main-looper watchdog 和周期主线程栈用来标
suspected_anr,冒充不了 system_server ANR。 - 上次运行的 heartbeat(周期存活时间戳)、clean-shutdown marker(正常退出标记) 与资源使用量可以识别“非正常消失”;force-stop、系统更新、重启、LMK 和外部
SIGKILL又都可能留下相同结果,这类样本记为 unknown(原因未知) 或 possible LMK(可能由低内存终止)就好。 - Play Console Android Vitals 或厂商服务端数据可以补上系统 ANR/LMK 的视角,只是它们不属于端侧即时 API。
- bugreport、root、userdebug 和厂商合作能提供系统 trace;这些能力要按部署环境单列。
- KOOM 一类 fork-dump 会先用
fork()创建当前进程的副本,再由子进程写 heap dump,减少原进程的暂停时间。它是版本敏感的工程方案,Android 平台层面没有兼容性保证;适用版本、ART suspend(暂停运行时线程)和 fork 后行为,以项目实测及第 17.3 章为准。
“低版本下次启动继续补拉 ANR/LMK”的通用端侧接口并不存在。把未知退出硬归为 LMK,稳定性率看起来完整了,诊断可信度也丢了。
6. 现场快照:把高成本信息提前准备
6.1 按四种时机采集
采集时机不同,能安全做的事也不同:
| 时机 | 可做的事 | 不应做的事 |
|---|---|---|
| 正常运行期 | breadcrumb、资源使用量、network/UI 摘要、预先打开的存储区、模块表 | 持续抓全量 logcat 或保存敏感内容 |
| Java crash handler | 有界异常 envelope、已有 ring buffer 序号、继续调用系统 handler | 数据库、压缩、网络、无限栈展开 |
| Native signal handler | signal、fault address、tid、ucontext_t 位置、通知外部 handler | malloc、锁、JNI、通用日志、进程内复杂 unwind |
| 下次启动 | ApplicationExitInfo、trace/minidump 校验、补设备/版本、上传 | 在主线程解析大 trace |
寄存器来自 ucontext_t 或系统 tombstone,让 Java handler 伪造寄存器没有意义。RSS/PSS、FD、线程数适合用崩溃前最近一次采样;在 signal handler 里临时扫描 /proc,风险很高。
6.2 Breadcrumb 与日志
breadcrumb 应记录低基数事件,即事件类型数量有限、便于分组统计;原始输入不要记录:
- 页面/组件 id、生命周期和前后台切换。
- 点击 action id,控件文本、账号或输入内容不保存。
- 网络 route pattern(去掉具体参数的路由模板)、结果类别和 request id;URL query/header/body 不保存。
- 关键开关、实验枚举、权限或配置版本。
Logcat 当不了稳定的私有 crash store:权限、ring buffer 覆盖和设备策略都会影响可用性,读取过程本身也有成本。我们在应用内部维护容量受限且已脱敏的日志 ring buffer;crash envelope 只引用最近序号,冷启动后再读取已经写入磁盘的片段。
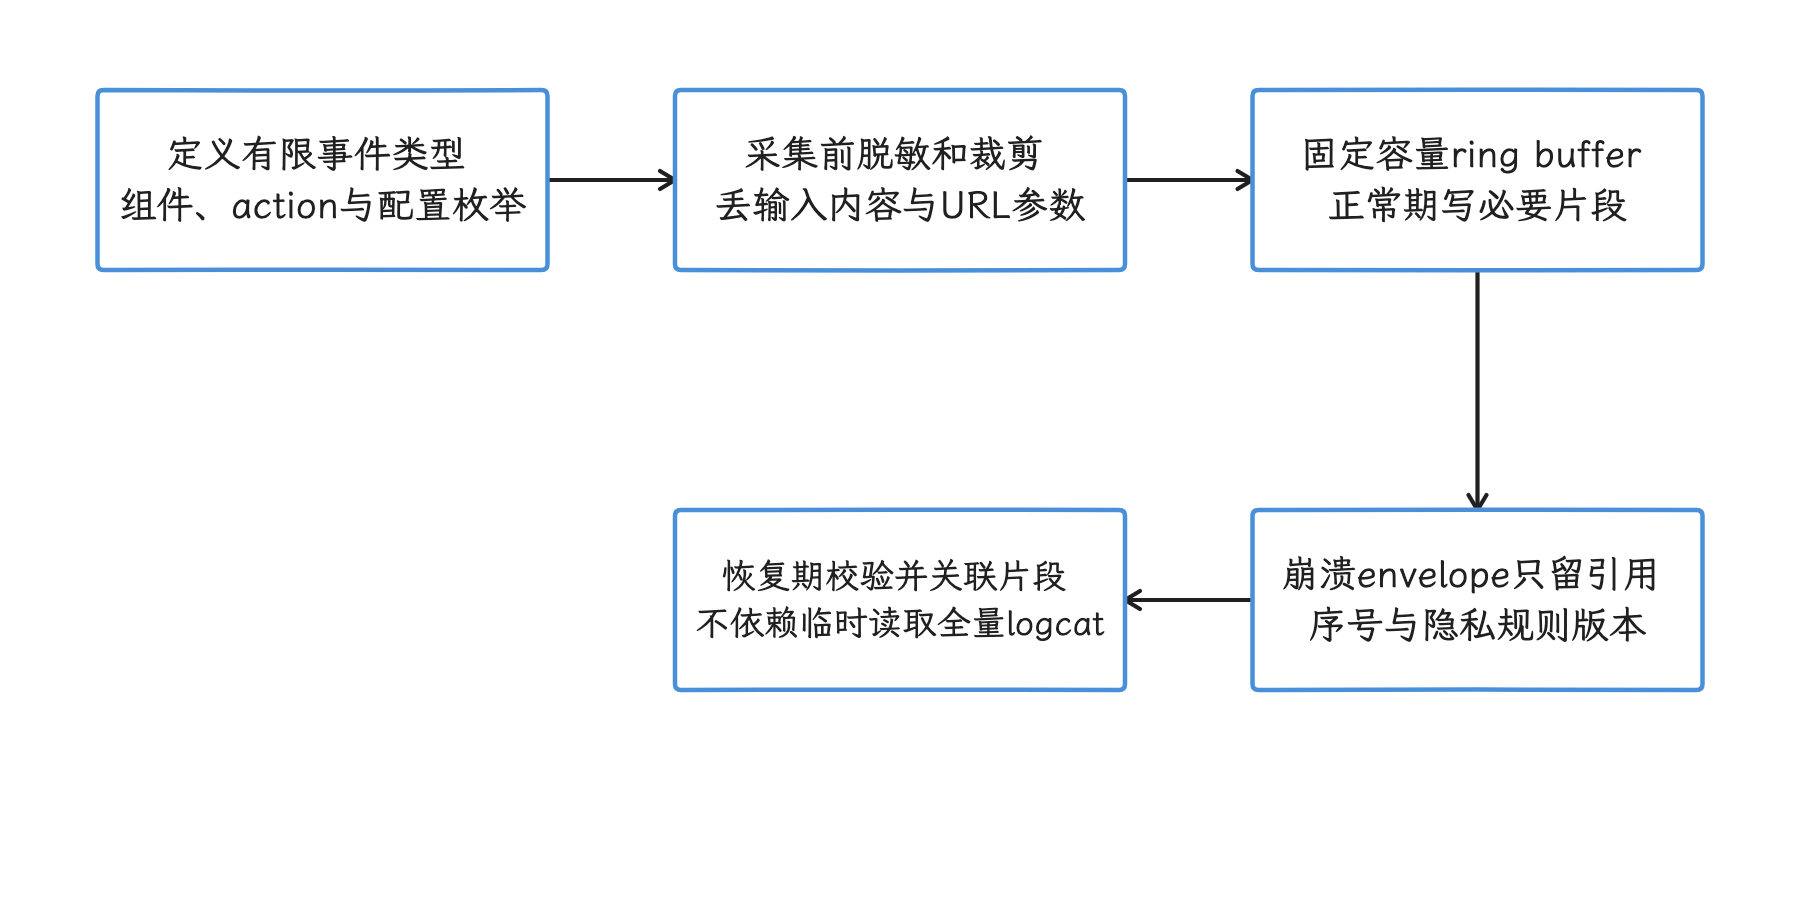
图:按低基数事件与隐私规则维护应用内有限日志,崩溃记录引用已存片段的序号。 logcat 受权限、覆盖与设备策略限制,输入文本、账号和网络内容不进入默认样本。
每条附件要有 schema(字段结构版本)、长度、checksum(用于发现内容损坏的校验值)、complete flag(写入完成标记)和隐私规则版本。payload → checksum → complete flag 是逻辑格式顺序;进程崩溃或掉电时的原子性与持久性,还要靠存储协议来保证——校验长度、代次及提交状态,并按实际文件系统验证发布、同步和恢复。冷启动跳过校验失败或未提交的记录。高成本同步安排在正常期,致命 signal handler 里只留有限写入。
7. 多 SDK 的 handler 冲突
7.1 Java default handler
我们先看 Java default handler 上的冲突:后安装的 SDK 会覆盖先安装者。即使每家都保存 previous,链上仍可能出现:
- A → B → A 的循环链。
- 多个 handler 依次等待 I/O,超过系统容忍时间。
- 某个 handler 捕获异常后返回,截断
RuntimeInit默认终止与 OOM ProfilingTrigger。 - SDK 延迟初始化,应用在
Application.onCreate()后检查时正常,稍后又被覆盖。
工程上的解法是指定一个统一负责者:
- 由应用 stability hub(集中管理稳定性采集的模块)安装唯一代理,并保存系统 default handler。
- 自研 sink(接收并保存事件的下游模块)只读取内存事件或有界 store,不各自安装 default handler。
- 第三方 SDK 优先使用“不接管 handler”或 callback(仅接收回调) 模式。
- 接管关不掉时,固定初始化顺序,并在启动后和首个 Activity 创建后校验当前 handler 的对象身份。
- 测试崩溃进程是否按预期退出、系统退出历史是否存在、各 SDK 是否各收到一次。
多个 Java crash sink 要串行调用:它们可能访问同一日志锁、数据库或 executor。崩溃线程只调用事先验证为非阻塞且有限操作的 sink,在调用之间检查剩余预算并跳过非必需附件;已经卡住的同步 sink,计时也拉不回来。原始异常最终交给保存的系统链,这一前提在正常期用集成测试验证。
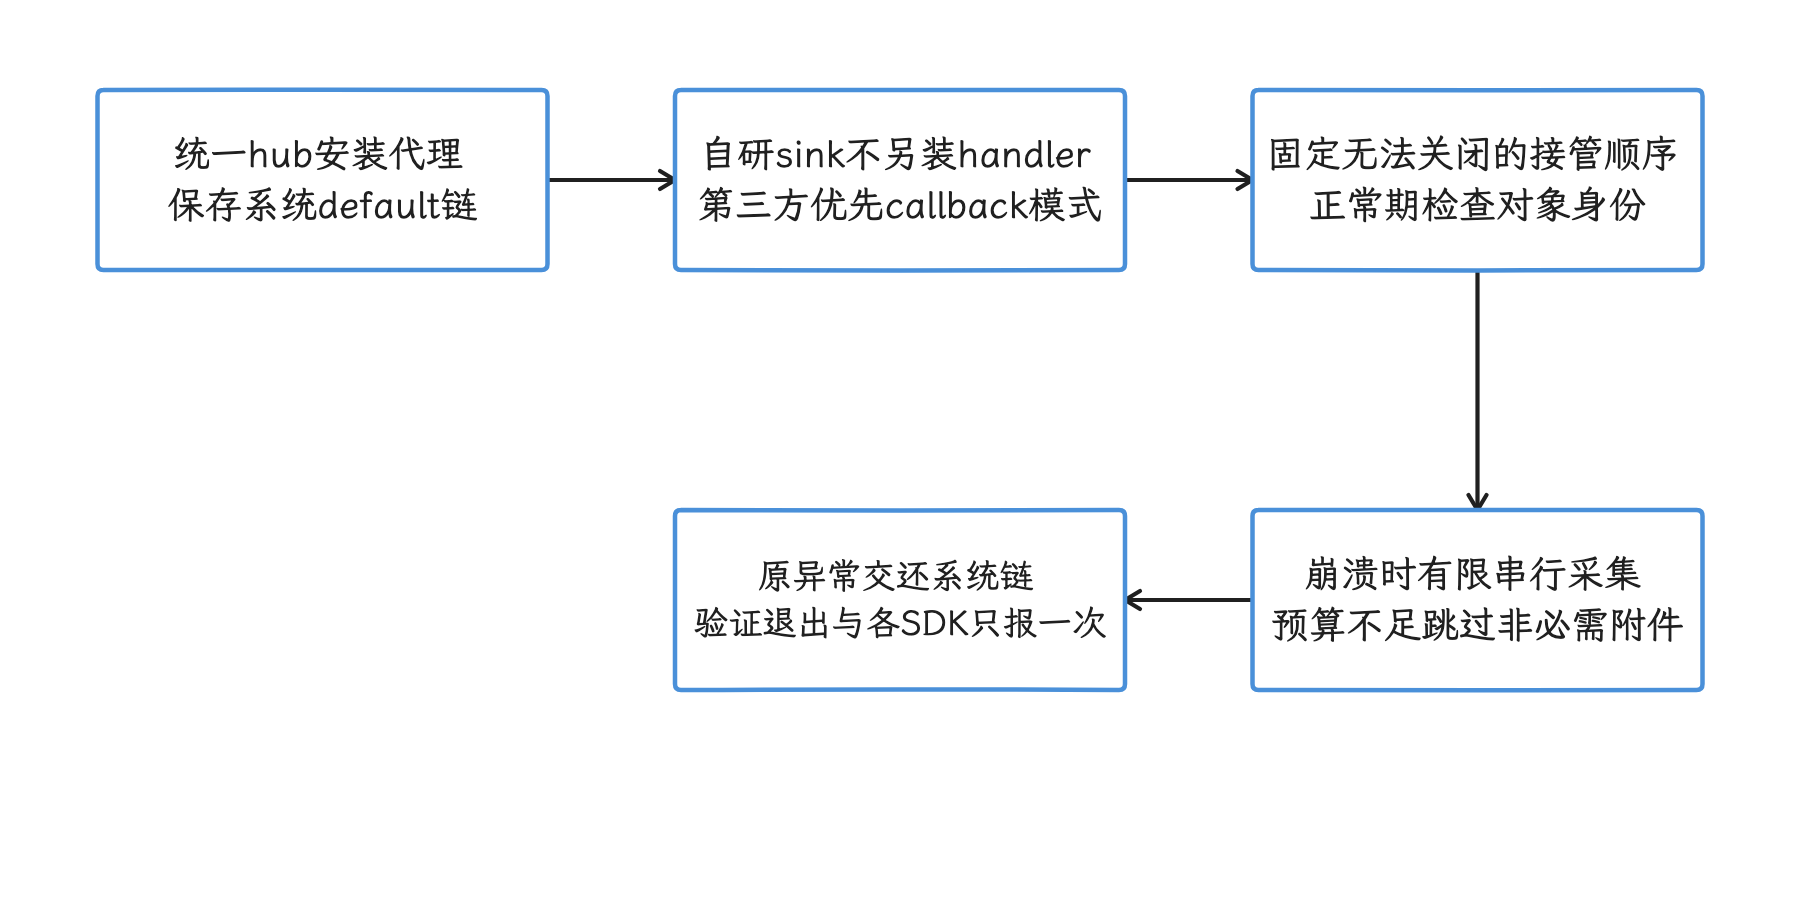
图:统一代理协调 SDK,正常期确认 handler 身份与初始化顺序,崩溃时只调用有限 sink。 时间预算中断不了已阻塞的同步 sink,循环和后来覆盖必须靠集成验证发现。
7.2 Native signal handler
Native 冲突更难靠安装顺序解决:
- 库可能拦截
sigaction,或通过 libsigchain(Android 用来串接多个信号处理者的内部库)与 ART/system handler 交互。 SA_SIGINFO和单参数 handler 混调会直接二次崩溃。- handler 可能使用同一备用栈、修改 signal mask,或在重入时覆盖静态缓冲。
- Crashpad、GWP-ASan、MTE(Memory Tagging Extension,ARM 内存标记扩展)与系统 debuggerd 对特定 fault 有各自的处理语义。
所以“万能 signal hub”这种同步回调所有 SDK 的设计要放弃:我们选定一个经过 Android 版本验证的 Native reporter,其他 SDK 改为导入它生成的 tombstone/minidump,或只做启动后处理。第三方库控制不住时,至少在 CI(continuous integration,持续集成) 测试里枚举已安装的 signal action、制造各类 fault,验证系统 tombstone 和 build-id 符号化没有丢失。
8. GWP-ASan:Android 17 默认走 Recoverable 抽样
GWP-ASan 是 Native 堆内存错误抽样检测器:随机挑选少量 allocation(内存分配),放进由 guard page(禁止访问的保护页)隔开的区域,从而捕获两类错误——heap use-after-free(释放后仍被访问,简称 UAF),以及 heap-buffer-overflow(读写越过堆缓冲区边界)。
启用后,每个受影响进程当前约占用 70 KiB 固定内存,CPU 开销也设计得很低,而且不需要重编译第三方 Native 库。它用于在线上取得真实错误现场,本身没有内存安全防护作用。
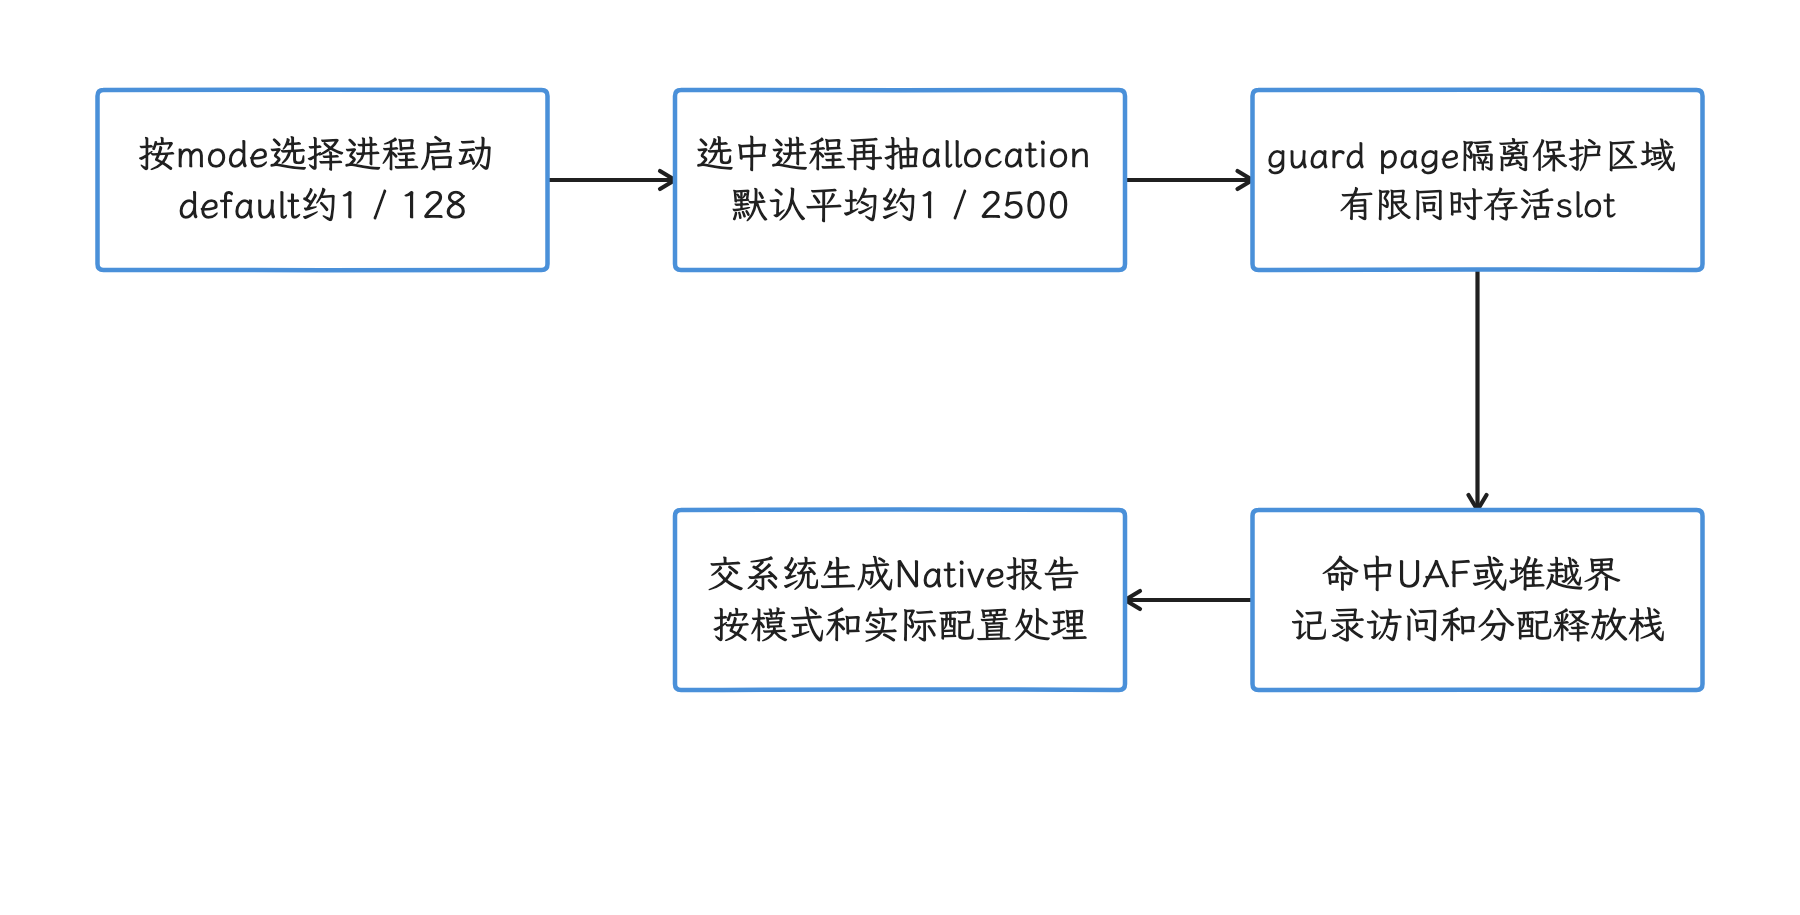
图:选中进程后仍只把少量 allocation 放入受保护区域,再记录命中的真实内存错误。 免重编译仍是抽样覆盖,抽样检测也提供不了内存安全防护。
公开配置应使用 manifest:
android:gwpAsanMode | Android 17 行为 | 使用建议 |
|---|---|---|
未设置 / default | Recoverable GWP-ASan,约 1% 进程启动被选中 | 常规生产默认 |
always | 每次启动启用 Recoverable GWP-ASan,仍只抽样 allocation;默认不因该报告终止进程 | 专项诊断,单独评估覆盖与开销 |
never | 按 manifest 禁用;系统属性或环境的受控覆写仍可能强制启用 | 仅在兼容故障明确且有替代诊断时使用 |
这里要区分指南与固定版本源码:官方指南的 always 段落仍写命中后终止,但 Android 17 Bionic 模式定义 明确说明,Android 15 起 always 默认也是 recoverable,只是不做进程启动抽样。同一版本的 wrapper 同样默认 Recoverable=true;系统属性和环境覆写另行核对。本表按该固定实现且无覆写解释,“always”读作“必然崩溃”就偏了。
Recoverable 模式命中后会生成 Native crash report(tombstone),然后允许进程继续;此时内存已经损坏,后续行为没有保证,进程可能稍后以另一个症状崩溃。一次进程生命周期只生成一份 Recoverable 报告。官方文档还明确指出:代表 Recoverable GWP-ASan fault 的 SIGSEGV 全程绕开应用自定义 signal handler。所以“自己的 SIGSEGV handler 先判断并放行”这条路走不通;我们在这里要做的是收下报告、保留现场,进程的存续交给系统的 Recoverable 语义。
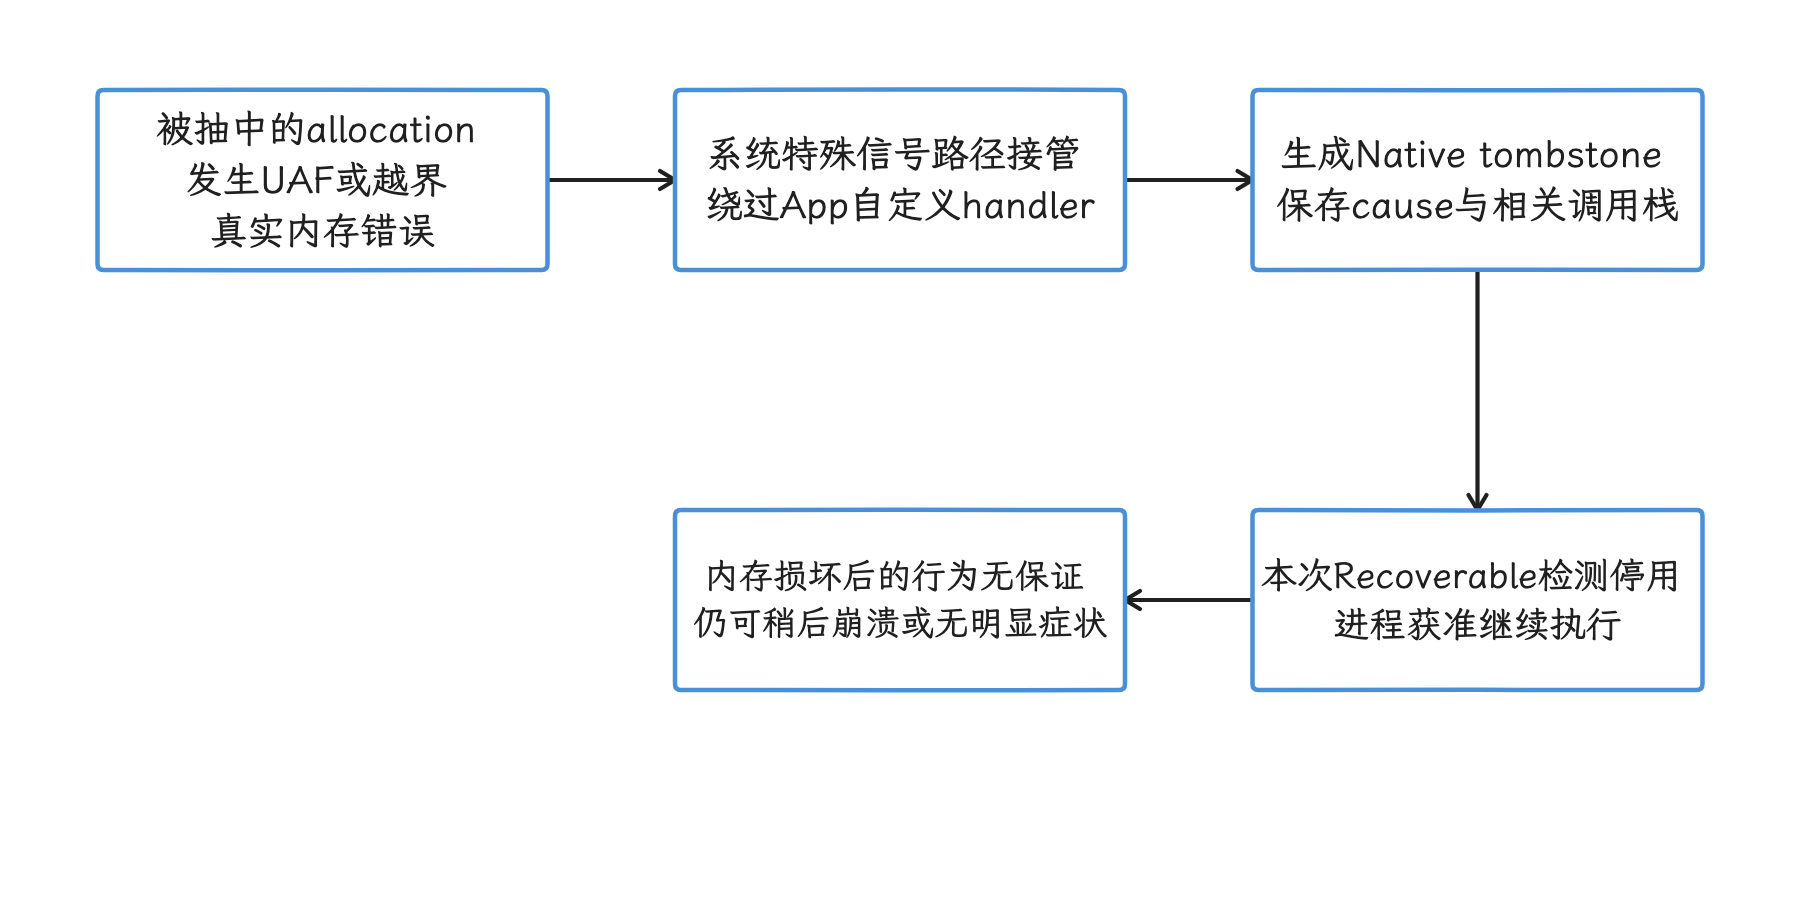
图:Recoverable 命中时生成一份报告并允许继续,仍需尽快修复真实内存损坏。 每次进程启动最多一份 Recoverable 报告,自定义 SIGSEGV handler 不会接到该特殊故障。
源码中的默认内部参数如下:
| 参数 | android-17.0.0_r1 默认值 | 含义 |
|---|---|---|
SampleRate | 2500 | 被选中进程平均每 2500 次 allocation 抽取一次 |
ProcessSampling | default/system app 模式为 128,always 等模式为 1 | 进程启动抽样的分母;128 表示约每 128 个候选进程选中一个 |
MaxSimultaneousAllocations | 32 | 保护区内可同时保留的 allocation 数量上限 |
Recoverable | true 的内部默认 | 具体是否使用还受 manifest mode 与初始化路径控制 |
这些数值来自 Bionic 实现,是内部默认值,应用不宜长期依赖;libc.debug.gwp_asan.* 系统属性或环境变量,也不要当成线上配置去写。SetDefaultGwpAsanOptions() 还把 InstallSignalHandlers 设为 false,报告由 Android debuggerd/Bionic 的既有路径协作完成。
源码中的 recoverable path 会在 fault 前后调用 GWP-ASan 的 pre/post crash hook,并通过 recoverable_crash 标记避免按普通致命 signal 再次发送。Permissive MTE(允许记录内存标记错误后继续运行的 MTE 模式)也走 recoverable 出口,但 fault 识别和恢复逻辑独立。APM 要保留的是系统 tombstone、GWP-ASan cause(错误类型)、模块 build id,以及 allocation/deallocation/access trace(分配、释放和非法访问调用栈);系统 handler 的内部实现,不要复制进应用 signal handler。
9. ProfilingTrigger 提供的补充证据
ProfilingManager 从 API 35 起提供 app-driven profiling,即由应用请求 system trace、Java heap dump、heap profile 或 stack sample 等性能文件。ProfilingTrigger 从 API 36 起支持预先注册系统事件,到事件发生时由系统采集。36.1 指 Android 16 QPR2 的 minor SDK release(次版本 SDK),编译包为 Android SDK Platform 36.1,与 SDK Extensions 的版本号是两回事。与稳定性相关的主要能力如下:
| 版本 | trigger | 返回文件与边界 |
|---|---|---|
| API 36 | TRIGGER_ | 系统识别 ANR 后、可能杀进程前截取运行中的 system trace;触发不代表进程必然被杀 |
| API 36.1 | TRIGGER_、TRIGGER_、TRIGGER_、TRIGGER_ | 返回正在运行的 system trace 快照,可帮助解释应用主动请求或用户终止,不能代替 crash handler |
| API 37 | TRIGGER_ | 发生 Out 时返回 Java heap dump;自定义异常 handler 必须继续调用 default handler |
| API 37 | TRIGGER_、TRIGGER_ | 返回文件随异常或兼容性问题变化,Profiling 提供类型说明;同一 UID 属于多个包时,部分异常可能没有文件 |
| API 37 | TRIGGER_ | 因 CPU 使用过高且退出原因是 REASON_ 时,返回运行中 system trace 的快照 |
| API 37 | TRIGGER_ | 冷启动时新建 system trace,并周期抽取线程调用栈(stack sampling);持续到 report,未调用时默认 5 秒,缓冲区满后保留最早事件 |
触发器要先注册好,并同时受应用设置与系统 rate limit(频率限制)约束。getRateLimitingPeriodHours() 表示同一种 trigger 再次返回结果前,系统至少应等待多少小时;实际间隔可能更长,系统还会额外限流。我们拿触发器提高“事故前后有 trace”的概率;Java handler、Native tombstone 和 ApplicationExitInfo 仍是基础,触发器是补充。
API 37 的 OOM trigger 有一条容易被多 SDK 破坏的前置条件:自定义 UncaughtExceptionHandler 必须调用 default handler。稳定性 SDK 一旦吞掉 OutOfMemoryError,系统 trigger 就会失效;应用只能在资源尚可时自行调用 requestProfiling(),crash 当下再请求通常太晚。
Profiling API 的完整请求、回调、36.1 minor SDK 判断与 rate-limit 处理见第 15.7 章;本章只把 Profiling 结果作为稳定性证据源,关联到同一个 incident id(一次故障的关联标识)。判断 36.1 API 可用性时,使用 SDK_INT_FULL/VERSION_CODES_FULL.BAKLAVA_1 或对应 minor SDK API;只检查 SDK_INT >= 36 是不够的。
10. 版本化接入建议
把前面各节的入口按系统版本排开,接入策略如下:
| 版本 | Java / Native Crash | ANR | LMK / 资源耗尽 |
|---|---|---|---|
| Android 8—10 / API 26—29 | chained Java handler + Crashpad/系统 tombstone | watchdog 只做疑似事件;系统证据依赖 Vitals/bugreport/OEM(设备厂商) | 周期预采样;未知退出保持 unknown |
| Android 11 / API 30 | 沿用 API 26—29 方案 | ApplicationExitInfo ANR text trace | REASON_LOW_MEMORY 或受限条件下 possible LMK |
| Android 12—14 / API 31—34 | native tombstone protobuf 可经退出历史取得 | 沿用 API 30 方案 | 沿用 API 30 方案;Android 14+ 默认 Recoverable GWP-ASan |
| Android 15 / API 35 | 加入 app-driven ProfilingManager | 可主动采 profile,但不能据此判定 ANR | 资源接近限制时可按预算主动 profiling |
| Android 16 / API 36、36.1 minor SDK | 沿用 API 35 方案 | 预注册 ANR ProfilingTrigger | 36.1 增加用户终止类 trigger |
| Android 17 / API 37 | 保持系统 handler 链,使用 API 37 trigger | ANR trigger、getAnrInfo() 与退出历史互相校验 | OOM/anomaly/excessive CPU trigger + 资源趋势 |
上线前,我们要准备一张故障用例表:Java exception、Java OOM、Native UAF/abort/SEGV、后台与前台 ANR、FD 上限、线程创建失败、mmap 失败、LMK、force-stop,以及多个 SDK 的不同初始化顺序。每个用例同时核对进程是否按预期终止、系统 reason、trace/dump、APM envelope、重复上报和隐私裁剪。
11. Android 17 与 6.18 r6 源码锚点
Java Crash、ANR 与退出历史
- Android 17
RuntimeInit.java:LoggingHandler、KillApplicationHandler与默认终止链。 - Android 17
ApplicationExitInfo.java:reason、PSS/RSS、ANR trace、API 31+ tombstone protobuf 与环形存储边界。 - ApplicationExitInfo.AnrInfo API 参考:API 37 的 ANR 类型、ID、系统等待时长与用户可感知标记。
- Android 17 ART
signal_catcher.cc与signal_set.h:SIGQUIT被屏蔽后,等待线程通过sigwaitinfo64()同步接收的实际实现。 - Android 17
init.rc:/data/anr与 tombstone 目录的系统侧创建。 - Android 17 tombstone schema:Native tombstone protobuf 解析依据。
Native reporter、GWP-ASan 与系统能力
- Crashpad Overview Design:客户端、外部 handler、注册与 crash capture。
- Android 17 Bionic signal header:
sigaction、SA_SIGINFO与 signal 类型定义。 - Android 17 debuggerd handler:致命 signal、GWP-ASan/MTE recoverable path 与系统报告交接。
- Android 17 GWP-ASan wrapper:
2500/128/32默认参数与 pre/post crash hook。 - Android GWP-ASan 官方指南:manifest mode、Recoverable 行为、开销与自定义 signal handler 边界。
- Android 17 ProfilingTrigger:API 37 trigger 类型与返回文件说明。
- ProfilingTrigger API 参考:API 36、36.1 与 37 的公开版本边界。
- Android 16 QPR2 SDK 设置:36.1 minor SDK 与
compileSdk配置。 - Android 17 lmkd:PSI(Pressure Stall Information,资源压力导致任务停顿的内核指标)、内存压力与
oom_score_adj选择被终止进程的用户态实现。
android17-6.18-2026-06_r6
-
FD table:
fs/file.c:进程 FD table 的分配与扩展。 -
线程/进程创建:
kernel/fork.c:task、clone/fork 与资源失败路径。 -
VMA:
mm/mmap.c:mmap 与 VMA 管理的核心实现。 -
Android 17 Thread 分派 与 ThreadGroup 回退:pre-handler、线程显式 handler 与全局 default 的顺序。
-
Android 17 NativeTombstoneManager:tombstone 与已有退出条目的匹配、合成报告与未知字段。
-
固定 Crashpad Linux 客户端 与 POSIX 信号恢复:启动策略、重入等待、恢复与重发语义。
-
POSIX Issue 8 信号与函数规则 和
abort():异步信号安全、忽略硬件故障的未定义行为与主动终止。