App 内存优化与诊断
内存问题落到应用上,往往是泄漏、峰值、持续增长、频繁分配或系统压力下的存活能力中的某一种,各有各的确认方式和治理手段。我们先统一统计口径和复现场景,再沿对象所有权、分配调用栈与回收行为逐层定位。某一时刻的低 PSS(Proportional Set Size,按共享比例分摊后的驻留内存)只是快照,问题是否解决,要靠同一场景下的前后对照来回答。
先确定优化对象
应用内存分散在几个不同的地方:Java/Kotlin 对象主要位于 ART 管理的堆中,malloc、Bitmap 像素和部分运行时数据在原生侧;GraphicBuffer、硬件 Bitmap、Surface 等还可能计入图形内存、memtrack 或 DMA-BUF 统计。查问题之前,先要弄清自己盯的是哪一块。
源码基线:AOSP
android-17.0.0_r1,Android 17 / API 37;文中兼顾 Android 8~16 的行为差异。
其中 DMA-BUF 是内核在设备和进程间共享缓冲区的机制,常用于图形、相机和视频数据。文件描述符则在堆之外,同样可能耗尽进程资源,排查时也要一并纳入。
所以,Java 堆离上限还远,只说明 ART 管理的那一块有余量,其他几处照样可能先出问题。动手前,我们至少要回答四个问题:
- 哪一类内存在增长:Java、原生堆、图形内存、共享页、交换空间(swap),还是文件描述符?
- 增长发生在哪个业务场景,退出场景后能否回落?
- 增长来自仍在使用的对象、缓存、延迟释放,还是业务已不再需要却仍从 GC Root 可达的对象?
- 问题表现为 OOM、系统低内存终止、GC 干扰帧执行,还是后台驻留能力下降?
这四个问题的答案直接决定工具选择:PSS(Proportional Set Size)按共享比例分摊驻留内存,适合观察进程总体占用;定位具体的引用或分配调用栈,一张总 PSS 曲线通常帮不上忙。
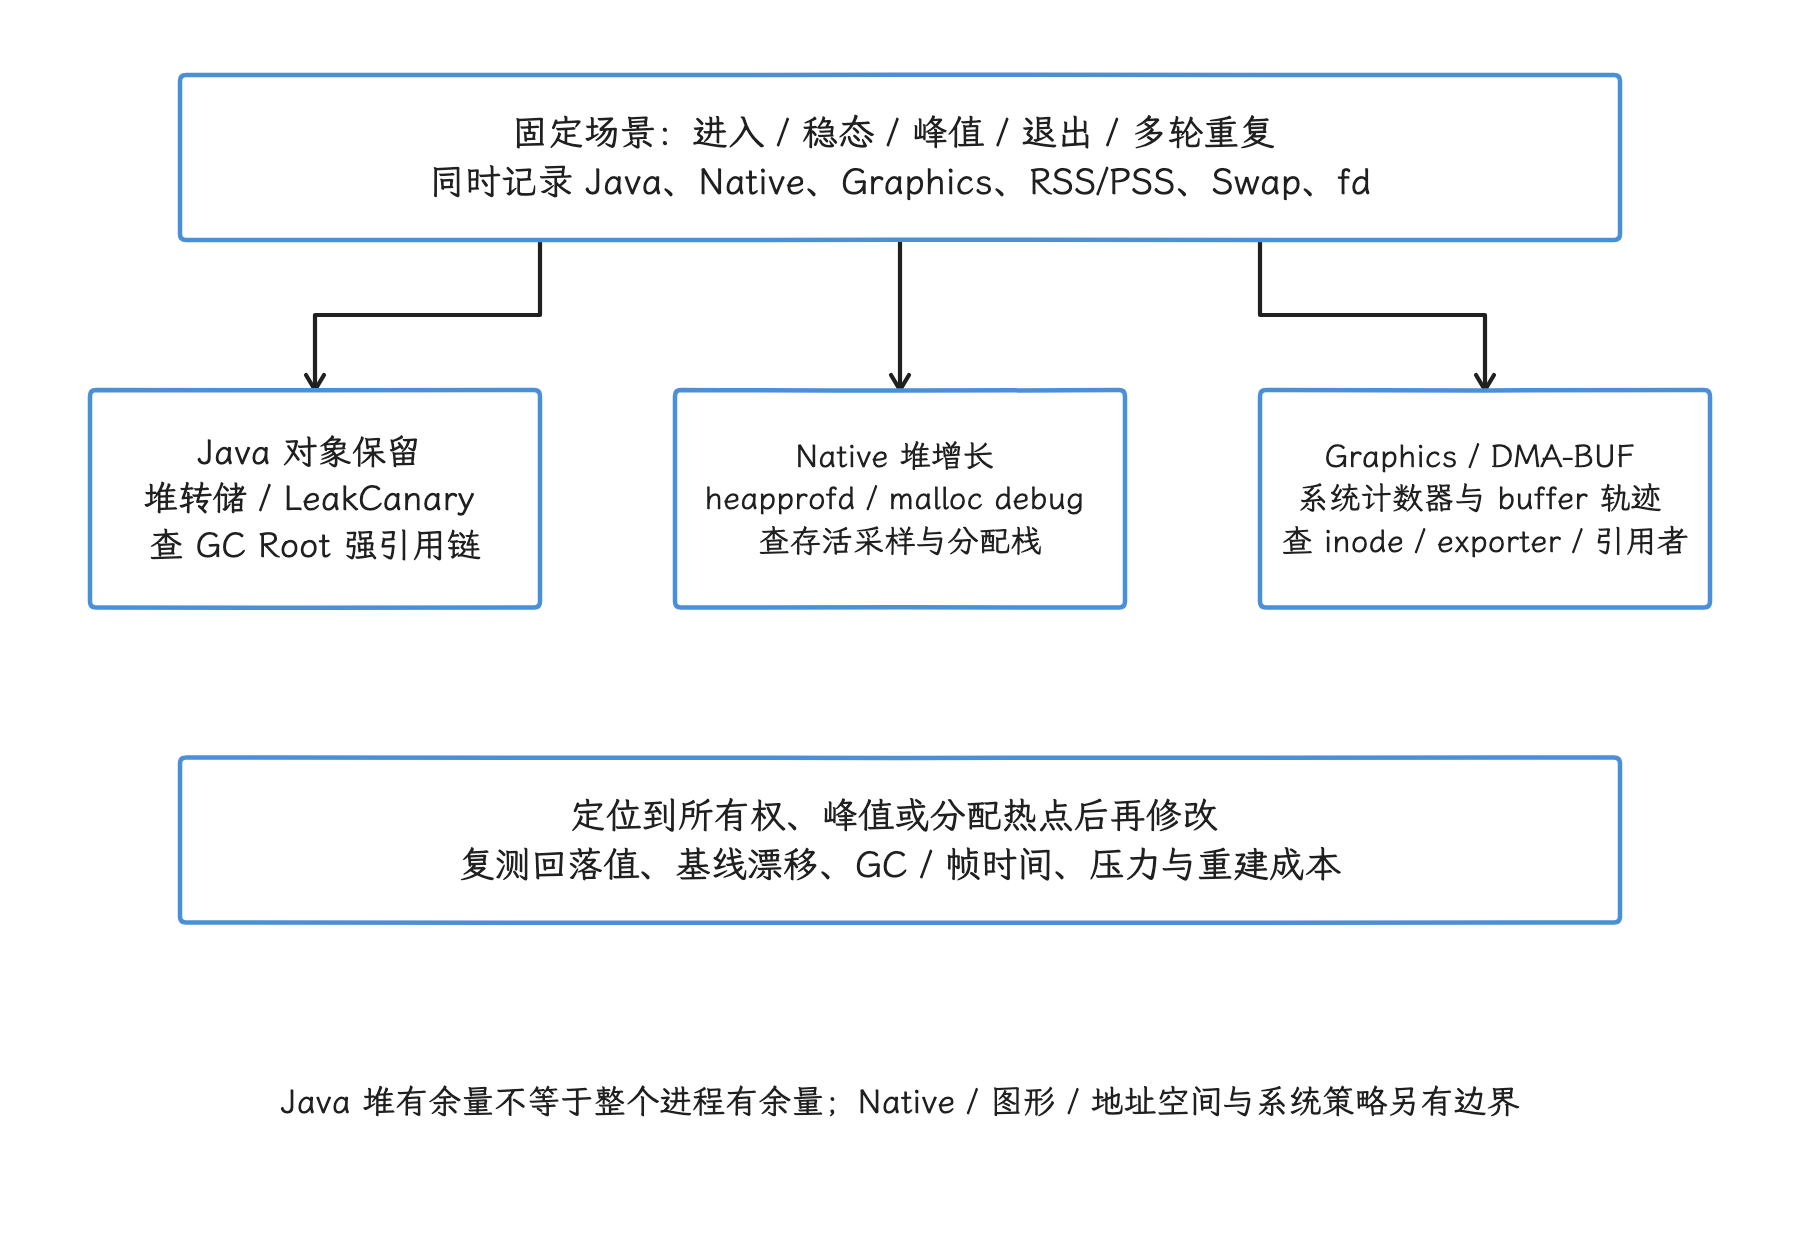
图:先固定设备、构建和重复场景,用分类指标确认增长发生在 Java、Native、图形共享资源或其他映射。Java 保留问题查引用图,Native 未释放分配查采样调用栈,DMA-BUF 查 inode、导出方与持有者。总 PSS 是归因快照,不能单独指出具体泄漏对象或分配函数。
四步优化顺序
应用侧的优化可以按“减少分配 → 缩短持有时间 → 消除泄漏 → 监控和回归”的顺序推进。我们把这条排查路径拆成四层来看,四层先后衔接,合起来是一条完整的路径。
第一层:减少无效分配
高频路径中的临时对象会增加分配速率,也可能增加 GC、线程停顿和内存带宽开销。优先检查:
onDraw()、动画回调和触摸处理中的Paint、Path、数组与临时集合;onBindViewHolder()和 Compose 重组中的排序、映射、字符串格式化;- 循环内不必要的装箱、复制和中间集合;
- 先解码原图、再缩放成缩略图的图片链路;
- 每次请求都新建的大缓冲区、编解码器或解析器。
优化前先用分配记录或 trace 证明这里确实是热点,再动手。同时留意两个副作用:把偶发的小对象改成成员变量,可能延长对象存活时间;为了“零分配”长期保留大缓冲区,也会抬高常驻内存。
第二层:缩短持有时间
对象离开业务场景后,应尽快断开强引用并释放其拥有的外部资源。典型动作包括:
- 页面销毁时取消任务、移除回调和监听器;
- 对有容量的缓存设置上限,并根据场景主动缩容;
Closeable、游标、文件、ParcelFileDescriptor和原生资源句柄使用明确的关闭路径;- Fragment 在
onDestroyView()清除 View Binding,而非等到 Fragment 销毁; - 图片请求离开目标 View 后交还给图片库,不继续由业务对象持有。
这里的“及时”要按所有权判断:仍在被 View、Canvas、解码任务或跨线程工作使用的资源,提前释放会把内存问题变成崩溃或数据竞争。
第三层:消除泄漏
所谓泄漏,就是业务已经不再需要某个对象,而从 GC Root 到它仍留着一条强引用路径。GC Root 是垃圾回收器判断对象可达性的起点,静态字段、活动线程和 JNI 全局引用都是典型例子。常见信号则是:页面反复进入退出后,Activity、Fragment View、Bitmap 或监听器的实例数量持续增加。
弱引用改变的只是引用强度:取消工作、注销观察者、关闭资源,仍然要靠业务代码自己完成。所以首选方案是让任务和注册行为服从生命周期,再根据 API 合约决定是否需要弱引用。
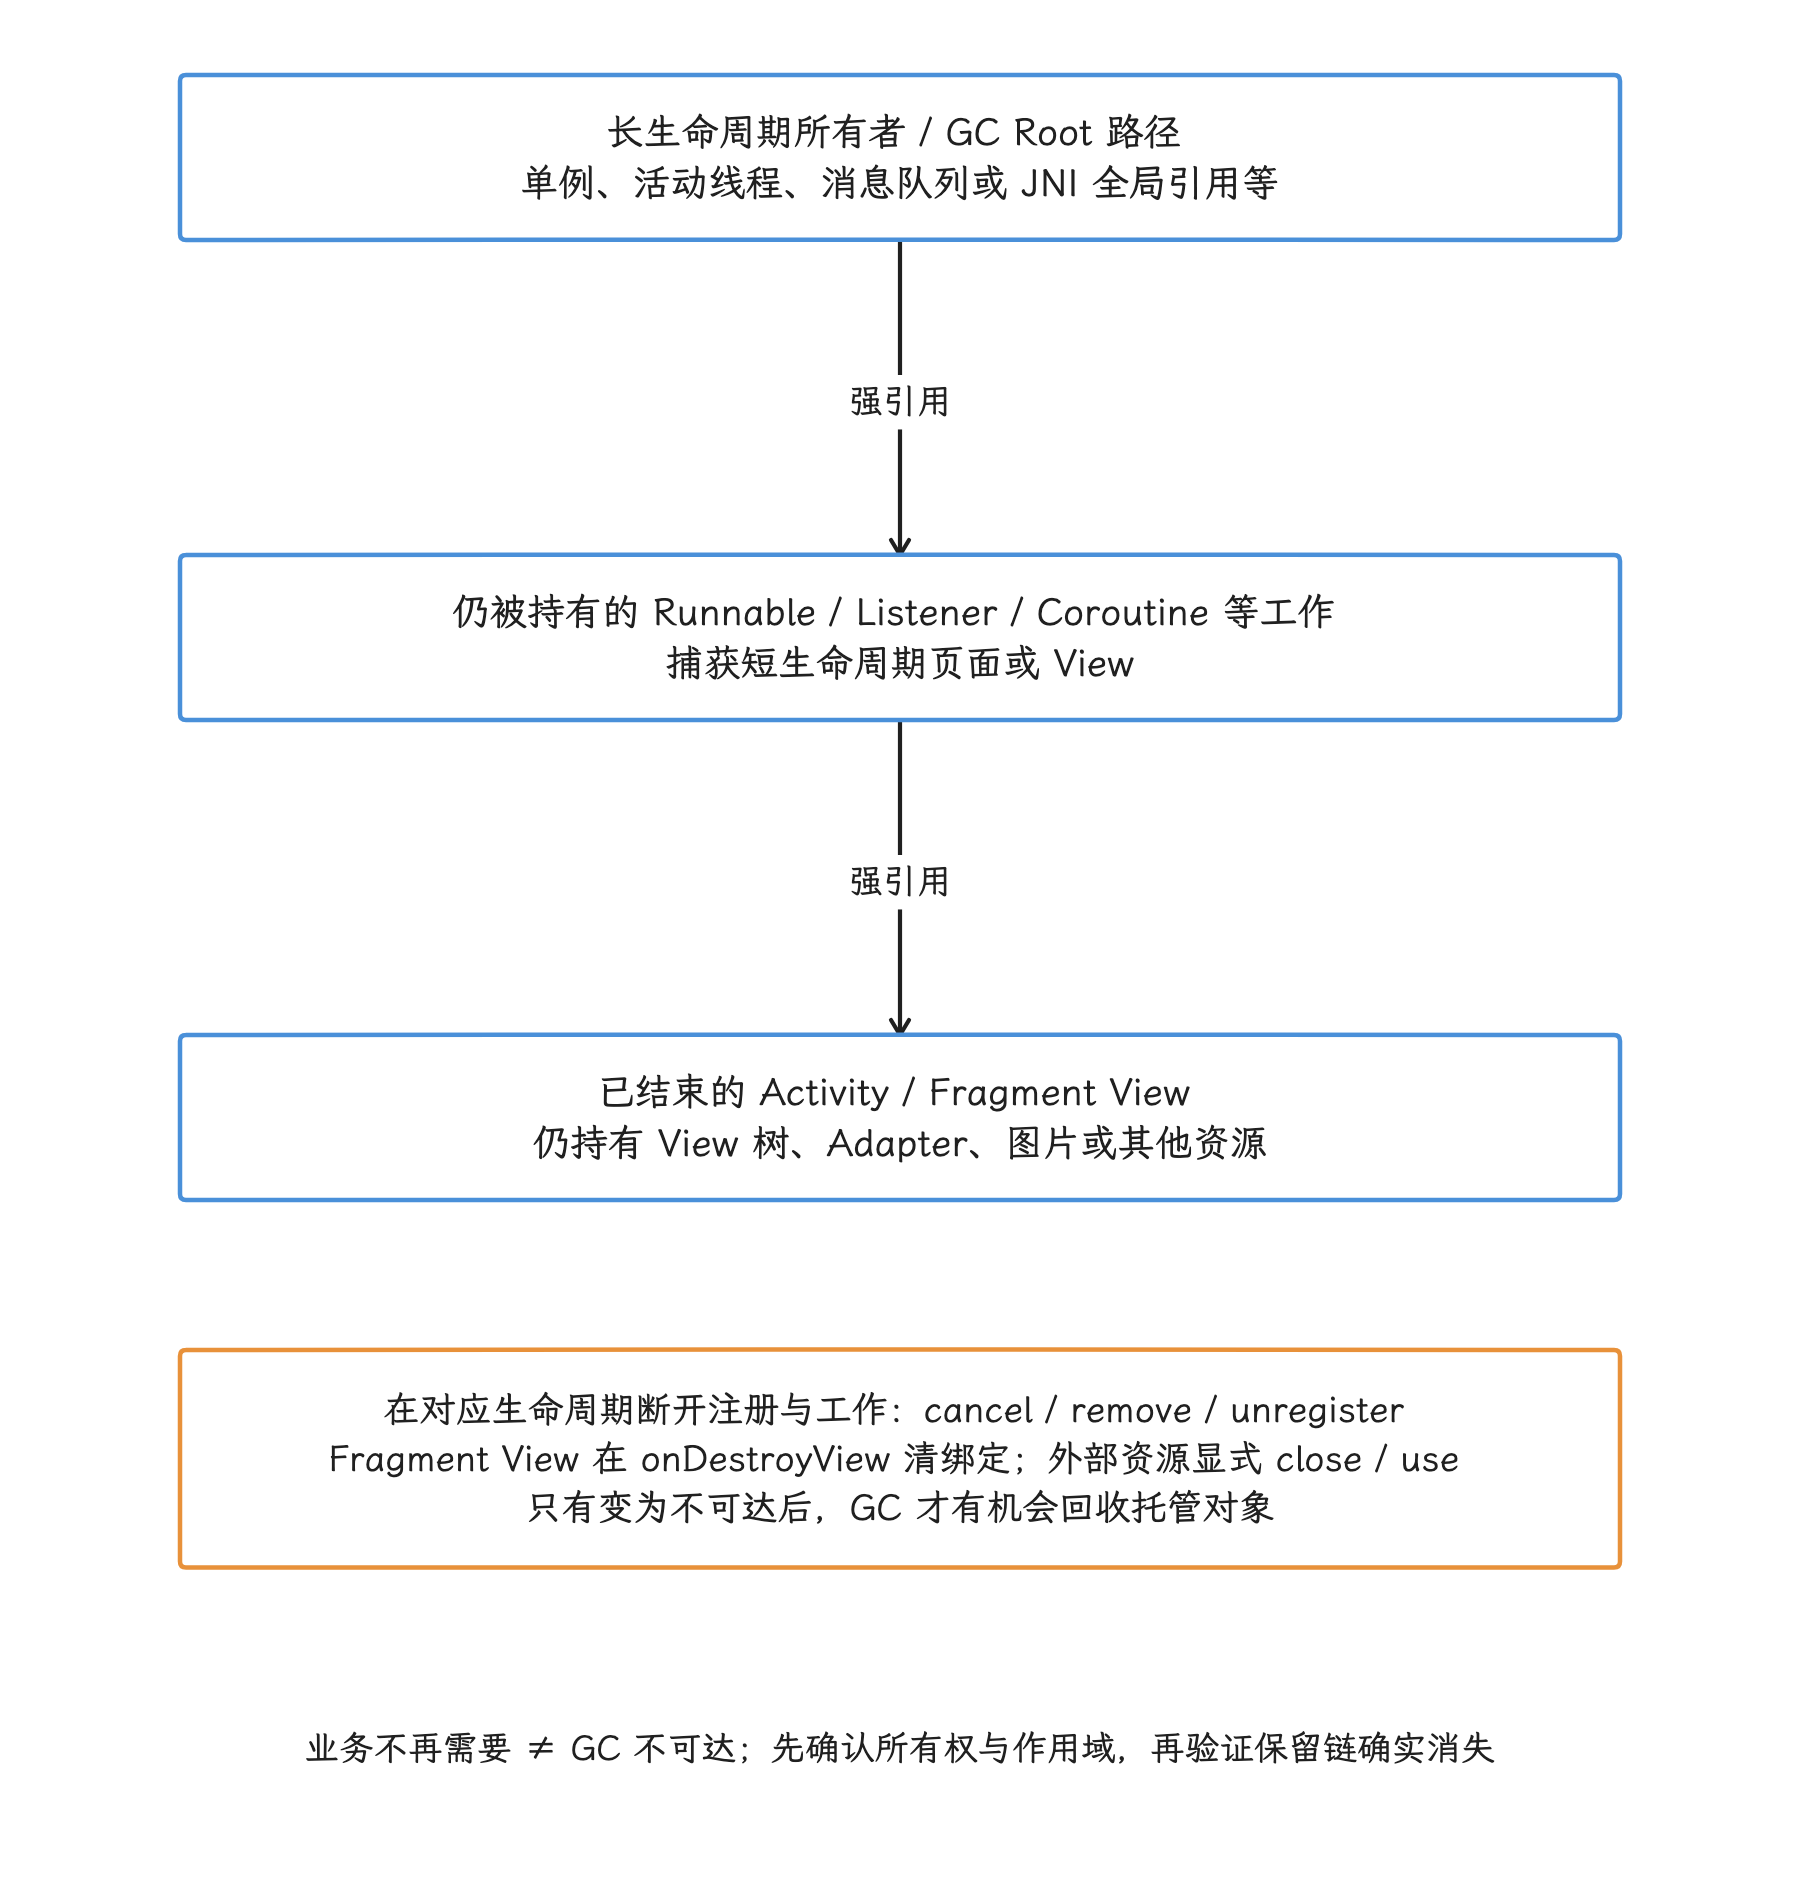
图:示例中,进程级单例、活动线程或消息队列持有回调,回调捕获已结束的页面,页面继续持有 View 与业务资源。对象仍从 GC Root 可达,所以 GC 不会替业务解除这条所有权。修复应在对应作用域取消任务、移除回调或注销监听;外部句柄再按 close / use 协议释放。
第四层:监控和回归
开发期可用 LeakCanary 和堆转储(Heap Dump)查引用链,用 Android Studio Memory Profiler 看分配热点;性能测试可用 Perfetto、heapprofd、dumpsys meminfo 和 /proc 指标;线上则关注退出原因、用户可感知的低内存终止率,以及不同设备档位的内存水位。
每次优化都要留下可复现的场景、设备、构建类型和前后数据。内存值受 GC 时机、共享页归属、系统服务和设备实现影响,结论要建立在同一场景的多次对照上。
内存抖动与帧预算
内存抖动指的是短时间内大量分配对象,这些对象又很快失去引用。它在性能分析器里常见的表现是锯齿曲线:分配使曲线上升,回收使曲线下降。锯齿本身只是表象;要不要治理,要看分配速率、回收频率和停顿有没有干扰用户操作路径。
ART 的垃圾收集器和代际策略随版本、设备配置与运行状态变化;动手前先弄清当前进程用的是哪一种收集器,停顿时长也要放在具体设备与负载里解读。诊断时,我们在同一台设备上同时观察:
- 主线程与 RenderThread 的 FrameTimeline,后者记录一帧从应用到显示链路的关键时序;
- GC 持续区间(slice)、线程调度和安全点(safepoint);安全点是运行时可以暂停线程并检查对象状态的位置;
- 分配速率、存活对象数量与回收后基线;
- 60 Hz、90 Hz、120 Hz 等目标刷新率下的业务负载。
120 Hz 的帧间隔约为 8.33 ms,60 Hz 约为 16.67 ms;刷新率越高,每帧可用时间越短,同样时长的暂停占的比例就越大。是否掉帧,还取决于该帧的其他工作、线程调度和设备性能。所以固定的“3 ms GC 黄金线”缺少跨设备依据;判断 GC 是否真的伤到了帧,应先用 FrameTimeline 找问题帧,再检查主线程暂停、分配等待与 CPU 调度;GC 时间重叠只是调查入口,不能单独证明因果。
对象池的取舍
Android 提供了 Message.obtain()、MotionEvent.obtain() 等具有明确获取/归还合约的复用 API。业务自建对象池需要额外评估:
- 加锁或并发容器可能比重新分配更贵;
- 归还前必须清理所有状态,遗漏会造成脏数据或引用泄漏;
- 池中的对象保持可达,会抬高存活集和常驻内存;
- 池大小和对象尺寸如果随输入增长,池会成为无界缓存。
Android 官方内存指南也提醒,对象池可能因同步、状态清理和存活集扩大而降低性能。自建池的门槛因此很高:先有 trace 证明这类对象的分配确实是热点,并且所有权清晰、容量有界,再谈引入。
Bitmap 内存
处理 Bitmap 内存,我们先算清楚解码后的账:压缩文件的大小和解码后的内存是两回事。一张 1080 × 1920 的 ARGB_8888 图片,仅像素数据就约为:
1080 × 1920 × 4 = 8,294,400 字节,约 7.91 MiB。
JPEG 或 WebP 在磁盘上可能只有几百 KiB,解码后的内存仍由宽、高、像素格式和每行实际占用的字节数决定。
像素数据的版本变化
Bitmap 像素数据所在位置经历过三段变化:
| Android 版本 | 像素数据主要位置 | 管理要点 |
|---|---|---|
| Android 2.3.3 / API 10 及更早 | 原生内存 | Java 对象与原生像素数据的释放时机需要特别谨慎 |
| Android 3.0~7.1 / API 11~25 | Dalvik/ART 堆 | 像素数据计入受管理堆 |
| Android 8.0 / API 26 及以后 | 原生内存 | 平台通过 NativeAllocationRegistry 把原生分配压力反馈给运行时 |
API 26+ 的像素数据离开了 Java 堆,但仍在进程内存限制之内:Bitmap 照样增加物理内存压力,原生分配注册也会影响 ART 的回收决策,分配失败仍可能表现为 OutOfMemoryError。所以排查时,Java、原生堆、图形内存、memtrack 和 DMA-BUF 要一起看。
inSampleSize 与解码尺寸
只需要显示 200 × 200 缩略图时,先完整解码 4000 × 3000 原图再缩小,多解出来的像素全是浪费。BitmapFactory.Options.inSampleSize 在解码阶段就把像素数降下来,平台规则是:
- 小于或等于 1 的值按 1 处理;
- 最终使用 2 的幂;非 2 的幂会向下取最近的 2 的幂;
- 值为
n时,解码宽高约为原图的1/n,像素数约为1/n²。
调用方先读取图片边界,下面的函数再据此计算不会小于目标尺寸的采样值:
fun calculateInSampleSize(
    outWidth: Int,
    outHeight: Int,
    requiredWidth: Int,
    requiredHeight: Int
): Int {
    var sample = 1
    while (
        outWidth / (sample * 2) >= requiredWidth &&
        outHeight / (sample * 2) >= requiredHeight
    ) {
        sample *= 2
    }
    return sample
}
这个结果只做粗粒度下采样。后续还要结合 EXIF 方向、目标密度、裁剪方式和图片库的尺寸解析,避免把尺寸刚好的图片又放大一截。
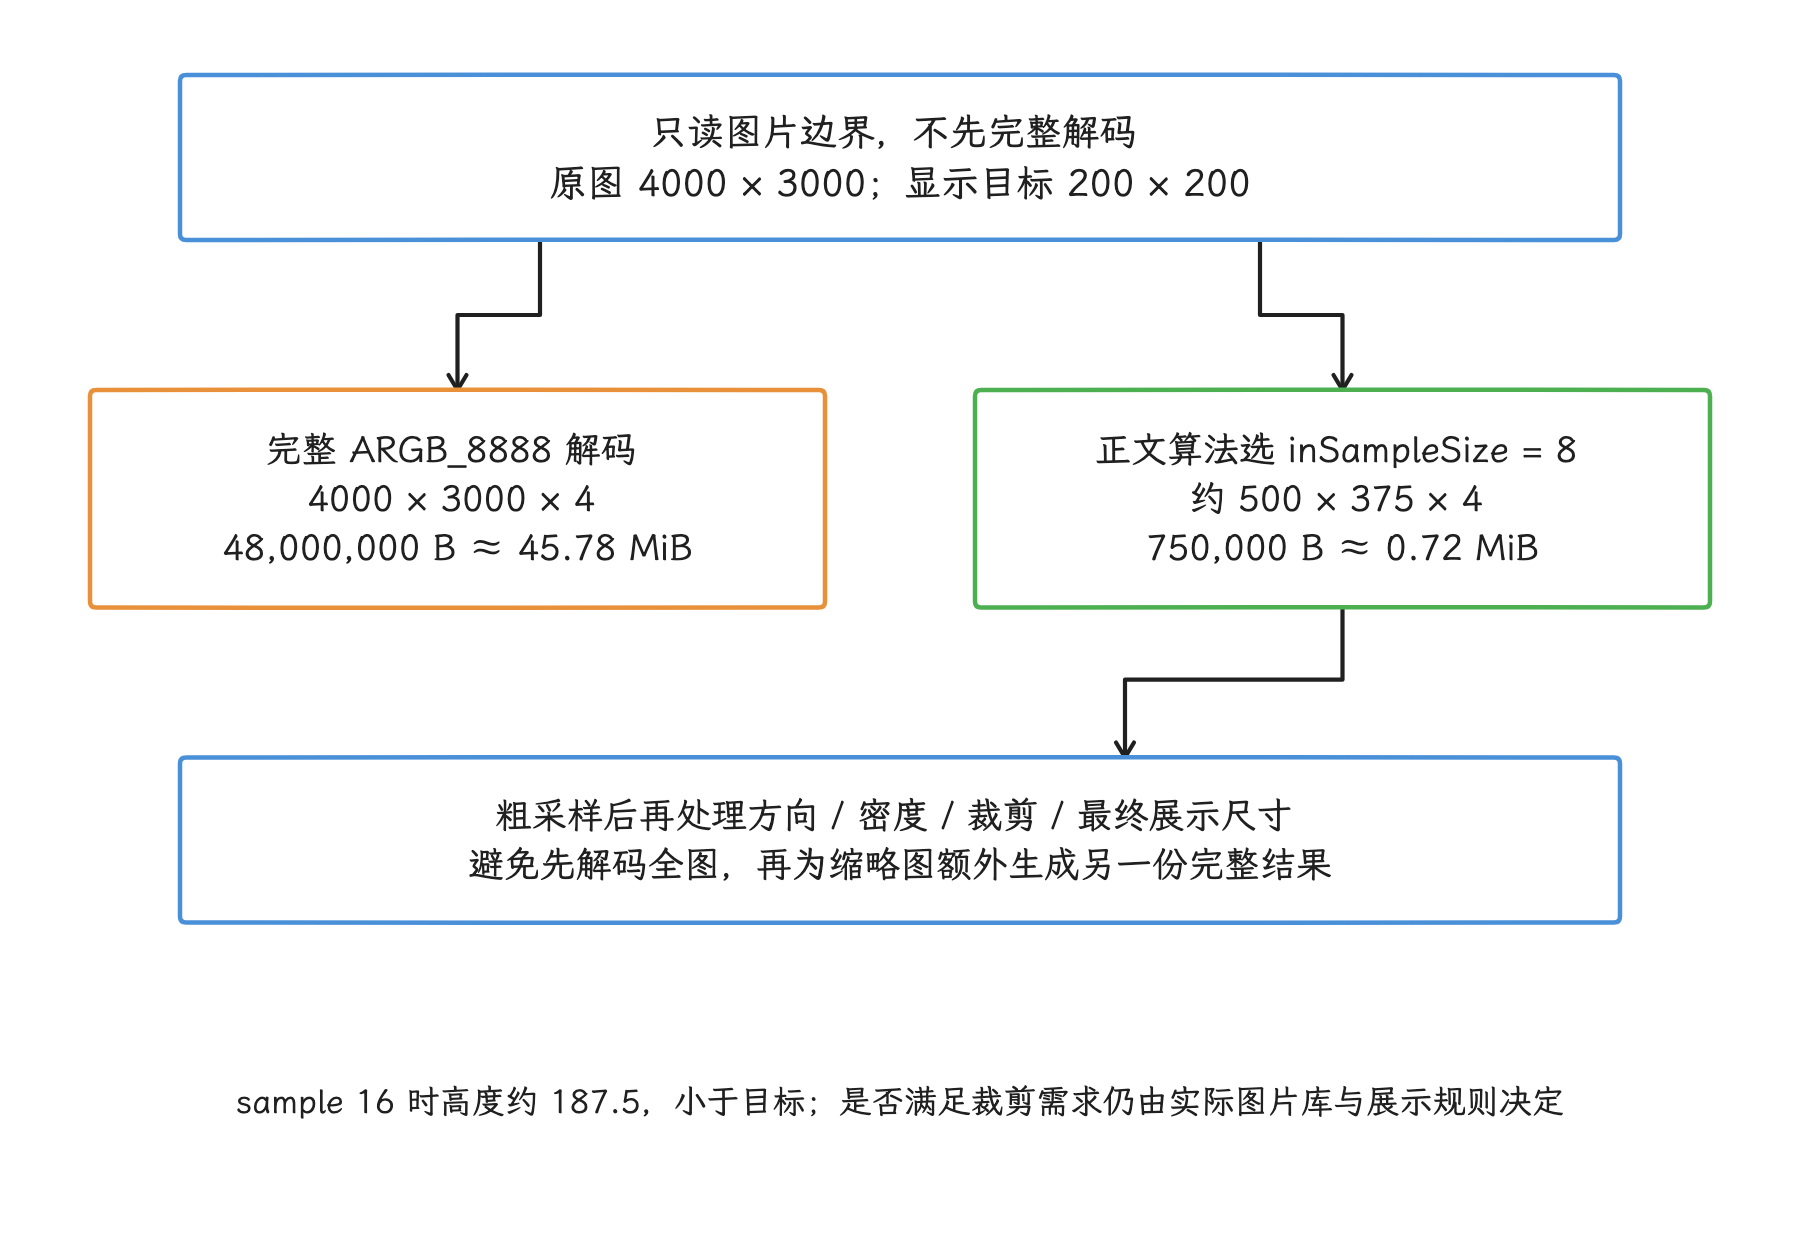
图:按正文算法,4000×3000 原图要覆盖 200×200 目标时可选 inSampleSize=8,粗采样约 500×375;继续取 16 会使高度不足 200。ARGB_8888 的紧密像素估算由 48,000,000 B 降到 750,000 B,后续仍需处理 EXIF、密度与裁剪。实际分配还看 rowBytes、格式、解码器和临时缓冲区。
像素格式
Bitmap.Config | 常见字节数/像素 | 适用边界 |
|---|---|---|
ARGB_8888 | 4 | 常用格式,支持透明度和较完整的颜色精度 |
RGB_565 | 2 | 无 Alpha,颜色精度下降,渐变可能出现色带 |
ALPHA_8 | 1 | 只保存 Alpha,适合遮罩 |
RGBA_F16 | 8 | 宽色域或高精度处理,内存成本高 |
RGBA_1010102 | 4 | 更高 RGB 精度,Alpha 只有 2 bit |
HARDWARE | 由图形后端决定 | 只读、面向硬件渲染,不能按固定字节数估算 |
RGB_565 可不可接受,交给视觉验收决定。文字截图、渐变和需要后处理的图片最容易暴露精度损失,“照片没有透明度”这一条理由覆盖不了这些场景。
硬件 Bitmap
Android 8.0 引入的 Bitmap.Config.HARDWARE 把像素交给图形缓冲区管理,可减少绘制时向 GPU 上传纹理的成本。不过 Android 设备通常是 CPU/GPU 共享统一物理内存,像素挪进图形缓冲区后照样占用物理内存,把它叫作“不占系统 RAM”会误导内存分析。
硬件 Bitmap 的限制主要在:
- 对象不可变,
getPixel()、copyPixelsToBuffer()等 CPU 像素访问会失败; - 既做不了软件 Canvas 的绘制目标,也画不到软件 Canvas 上;
- 适合解码后直接在硬件加速 UI 中展示;
- 需要像素编辑、软件渲染或某些截图链路时,应请求软件 Bitmap;
- 内存可能显示在图形内存、
memtrack、DMA-BUF 或设备特定分类中。
源码里,Bitmap 仍实现 Parcelable,对硬件 Bitmap 也有对应的 Parcel 处理,反序列化时像素格式还可能变化——所以“硬件 Bitmap 过不了 Binder”的说法站不住。跨进程传大图要掂量的成本仍在:同步、缓冲区所有权、接收端的格式变化;很多场景更适合传 URI、文件描述符或共享缓冲区协议。
inBitmap 复用
inBitmap 允许 BitmapFactory 尝试复用已有 Bitmap 的像素分配,约束可以归纳为:
- 候选 Bitmap 必须可变,
Bitmap.Config.HARDWARE一律排除; - API 19+ 要求解码所需字节数不超过候选对象的
getAllocationByteCount(); - API 11~18 只支持 JPEG/PNG、尺寸相同且
inSampleSize == 1的严格复用; - 候选对象不符合要求时,解码会抛出
IllegalArgumentException; - 调用方必须使用
decode*()的返回值——返回的未必就是传入的那个候选对象。
下面的示例展示最小的防御式写法,候选池本身仍需负责容量和并发:
val options = BitmapFactory.Options().apply {
    inMutable = true
    inBitmap = candidate
    inSampleSize = sampleSize
}

val decoded = try {
    BitmapFactory.decodeFile(path, options)
} catch (_: IllegalArgumentException) {
    options.inBitmap = null
    BitmapFactory.decodeFile(path, options)
} ?: error("Bitmap decode failed: $path")
失败后移除候选再解码,可以避免把尺寸不匹配当成图片损坏。成熟图片库通常已经实现了更完整的候选筛选、引用计数和并发保护,业务代码无需重复造池。
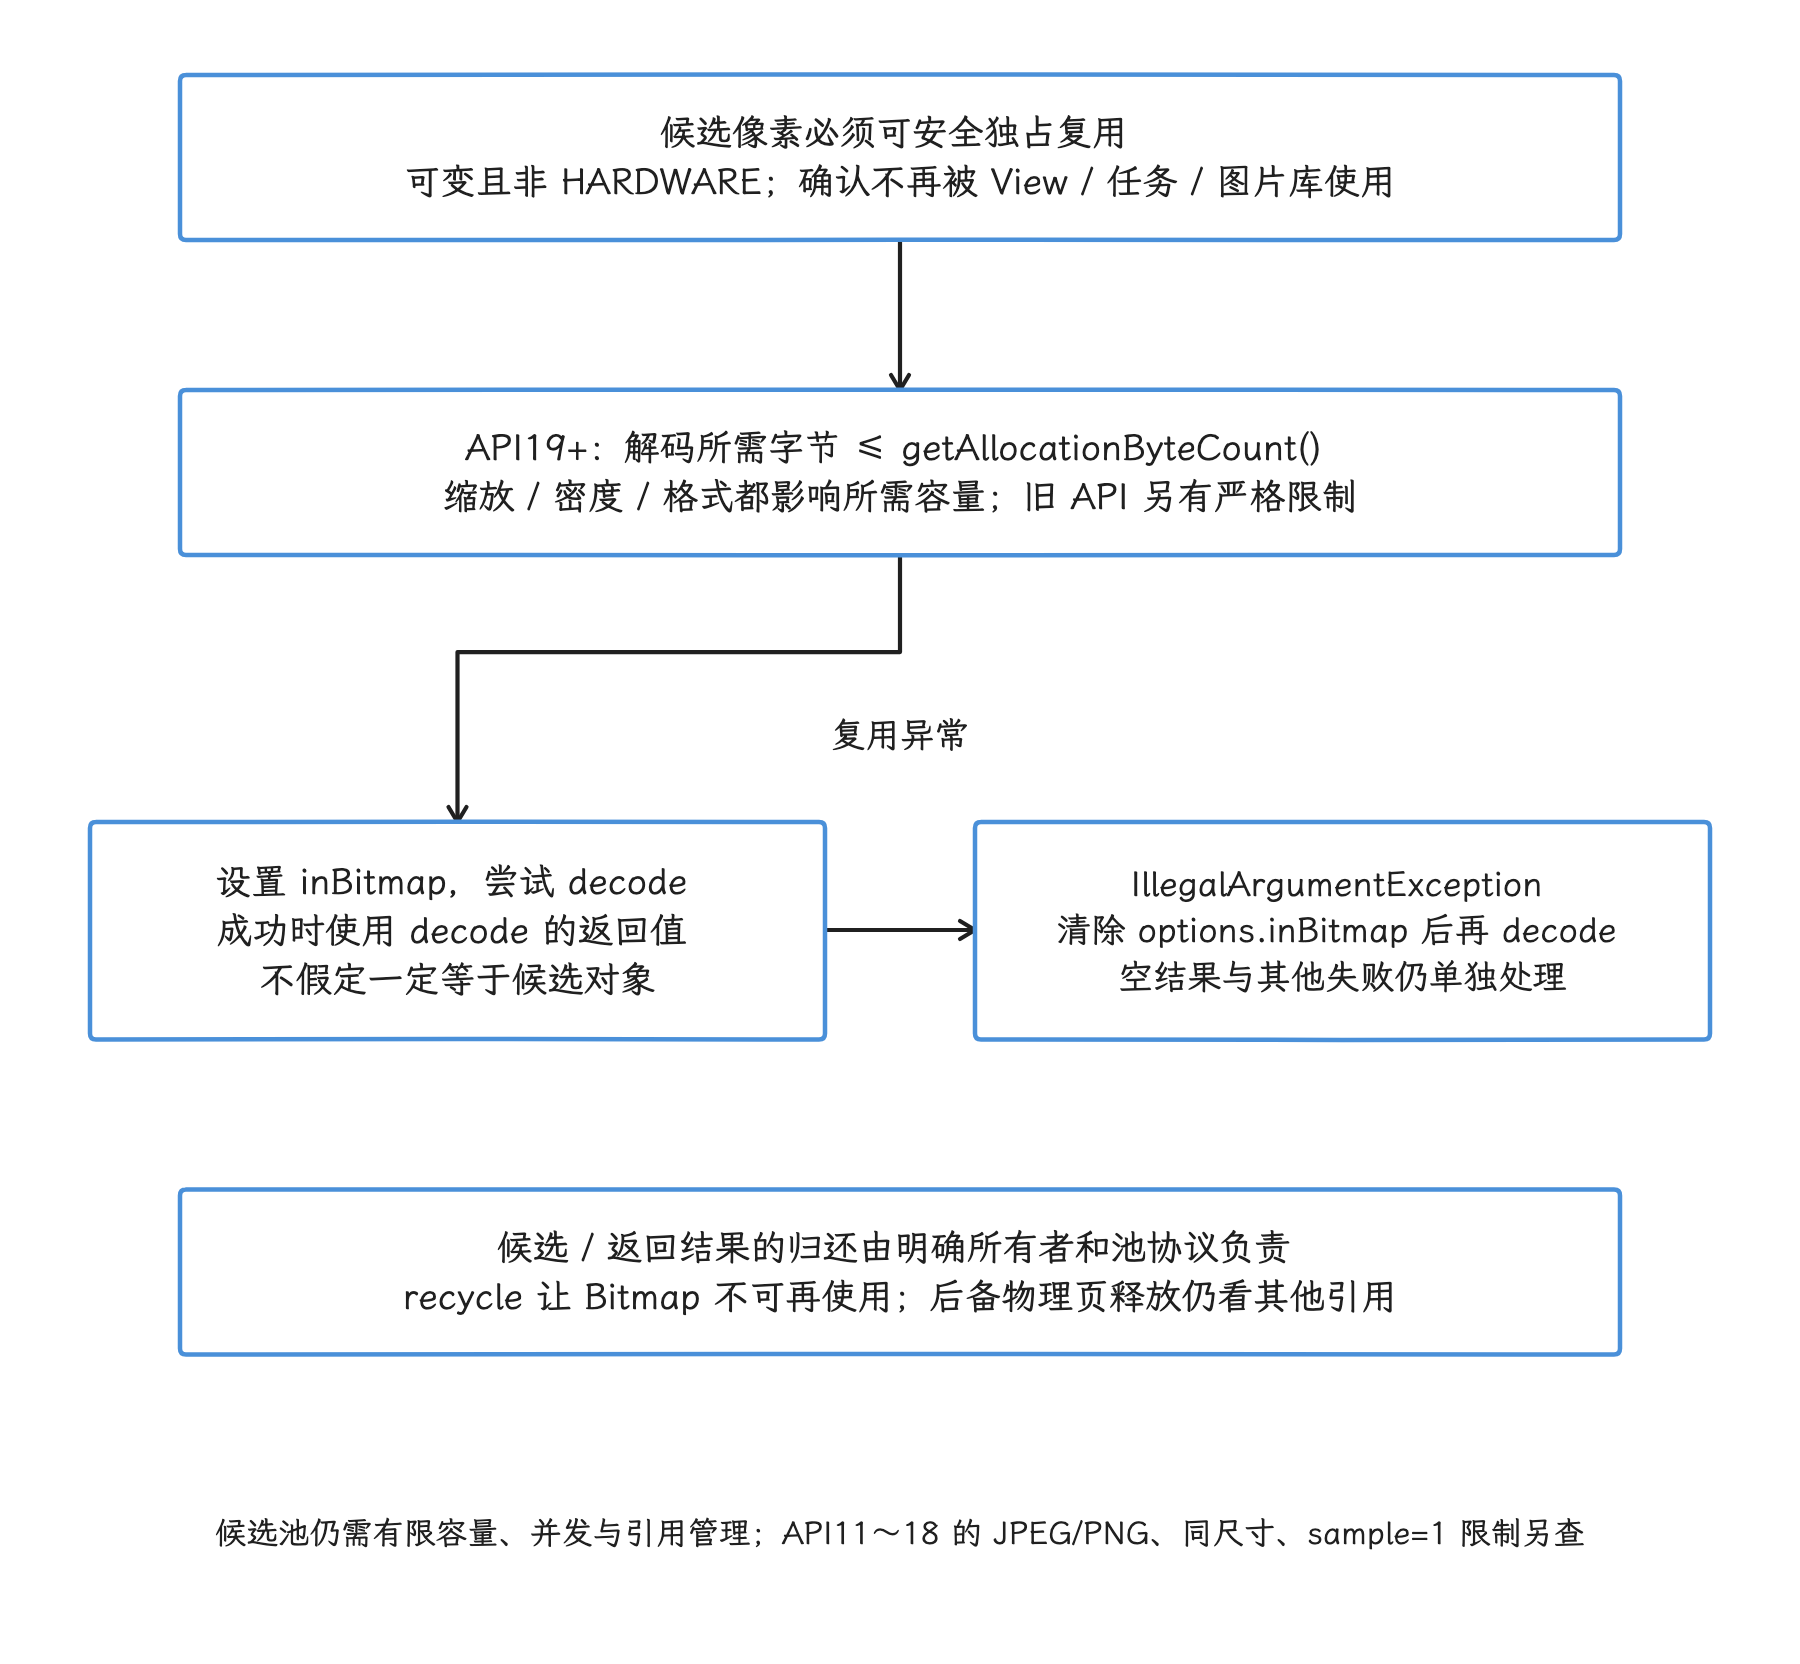
图:先确认候选可变、非 HARDWARE 且没有其他使用者,再按目标格式与缩放结果判断容量。API19+ 比较解码所需字节与 AllocationByteCount;不匹配时可捕获 IllegalArgumentException,清除 inBitmap 后重试。最终使用 decode 返回值,候选池负责归还与容量管理,业务不能擅自 recycle 图片库仍在使用的对象。
recycle() 与所有权
Bitmap.recycle() 会把该 Bitmap 标为不可再使用,并释放它持有的原生像素对象引用;若渲染端或其他原生对象仍持有后备,底层存储的最终释放还受引用与渲染生命周期约束,不能保证此刻 RSS 立即下降。调用它的前提,是调用方能证明这块 Bitmap 此后不会再被 View、Drawable、Canvas、图片库、后台任务或其他线程使用,否则后续访问会失败。
官方 Bitmap 内存指南把手动 recycle() 的重点放在 Android 2.3.3 / API 10 及更早版本;现代应用通常让清晰的所有权、GC 和图片库来管生命周期。图片变换产生的中间 Bitmap,若由当前函数独占、下游也已拿到新结果,可以及时回收;由 Glide 等库管理的 Bitmap,回收交给库自己。
Glide、Coil 与 Fresco
三类图片库都提供内存缓存,但实现和所有权合约不同:
- Glide:使用内存缓存和
LruBitmapPool,并通过ComponentCallbacks2调整缓存。默认容量由屏幕尺寸、密度、memory class 和低内存设备状态共同计算,不是固定的maxMemory / 8。资源仍受 Glide 管理时,业务代码不要调用recycle()。 - Coil 3:推荐进程内共享一个
ImageLoader,统一管理内存缓存、磁盘缓存和请求生命周期。硬件 Bitmap、解码器和缓存策略取决于版本、平台与单次请求配置。 - Fresco:区分已解码、已编码和磁盘缓存,并以
CloseableReference管理引用。早期 Android 版本曾使用 ashmem 等方案,现代版本怎么存,以所用版本的文档为准。
库升级可能修改默认缓存和硬件 Bitmap 策略。应用应查阅所用版本的官方文档,并用相同图片集和滚动场景测量峰值、回落值与命中率。
常见泄漏
泄漏的修法几乎都落在生命周期和所有权这两件事上。我们按高发位置逐个看过去。
Activity 与异步工作
匿名内部类、回调、线程或协程一旦比 Activity 存活得更久,就可能连带保留整棵 View 树。修复重点是让工作在对应生命周期结束时取消:
- UI 相关协程放进
lifecycleScope,使其随生命周期所有者销毁而取消; - 需要按可见状态收集 Flow 时使用
repeatOnLifecycle,在离开指定状态后停止收集; - 网络、定位、传感器和播放器任务在对应生命周期取消;
- ViewModel 不保存 Activity、Fragment、View 或其 Drawable;
- 进程级工作只保存完成工作所需的数据,不保存页面对象。
WeakReference<Activity> 能去掉一条强引用,但后台工作仍会继续,竞态条件也仍在:线程读出弱引用后,Activity 可能马上就进入销毁流程。生命周期取消加主线程状态检查,比弱引用可靠。
Handler 与延迟回调
消息队列会持有尚未执行的 Message 和 Runnable。页面退出时应移除由该页面发布的任务。下面的写法保留显式 Runnable,便于精确移除:
class DetailActivity : AppCompatActivity() {
    private val handler = Handler(Looper.getMainLooper())
    private val refreshTask = Runnable { renderLatestState() }

    override fun onStart() {
        super.onStart()
        handler.postDelayed(refreshTask, 5_000)
    }

    override fun onStop() {
        handler.removeCallbacks(refreshTask)
        super.onStop()
    }
}
清理点要与任务含义匹配:只应在页面可见时运行的任务放在 onStop() 清理;可以覆盖整个 Activity 生命周期的任务可在 onDestroy() 清理。Java 匿名 Handler 还会隐式持有外部类,静态内部类能去掉这条引用,但仍需取消消息。
单例持有 Context
进程级组件可以保存 context.applicationContext,前提是它执行的工作适合 Application Context。主题、窗口、对话框、页面导航和部分资源解析依赖 Activity 或带主题的 Context,盲目替换会产生功能错误。
判断时比较两端生命周期:
- 进程级缓存、数据库、网络客户端可使用 Application Context;
- UI 控制器只在页面作用域内持有 Activity Context;
- 静态字段和单例不保存 View、Activity、Fragment 或以它们创建的短生命周期对象。
Fragment View、监听器与观察者
Fragment 的生命周期可能长于它创建的 View。View Binding 应在 onDestroyView() 清空:
private var _binding: DetailBinding? = null
private val binding get() = requireNotNull(_binding)

override fun onCreateView(
    inflater: LayoutInflater,
    container: ViewGroup?,
    savedInstanceState: Bundle?
): View {
    _binding = DetailBinding.inflate(inflater, container, false)
    return binding.root
}

override fun onDestroyView() {
    adapter.onItemClick = null
    recyclerView.adapter = null
    _binding = null
    super.onDestroyView()
}
这里同时断开 Adapter 回调,以及 RecyclerView 对 Adapter 的引用。广播接收器、ContentObserver、传感器监听器、WebView 回调及第三方 SDK 监听器,也要在与注册时机对应的生命周期节点注销。
LeakCanary 与堆转储
LeakCanary 适合在 debug 构建中自动观察已销毁组件和保留对象。依赖版本应从其官方安装页获取,避免把文档中的固定版本长期复制到项目。
发现泄漏后需要阅读引用链:
- 确认对象已经离开业务生命周期;
- 找到引用链上最靠近 GC Root 的业务强引用;
- 判断它属于未取消任务、未注销注册、无界缓存,还是错误所有权;
- 修复后重复同一路径,比较实例数和保留大小(retained size)。保留大小表示某对象不可达后可连带释放的内存估算值。
强制 GC 是测试工具的手段,帮工具确认对象是否仍可达;业务修复方案里没有它的位置。
原生内存
原生侧没有 Java GC 代为调用 free() 或 close(),申请和释放的配对全靠代码自己维护。常见问题包括:
malloc/new与free/delete不配对,错误分支提前返回;NewGlobalRef()缺少DeleteGlobalRef(),连带的 Java 对象也跟着回收不了;GetStringUTFChars()、数组固定或复制 API 缺少相应的Release*();open()、套接字、AHardwareBuffer、编解码器或图形资源句柄缺少关闭;DirectByteBuffer的 Java 包装对象与底层内存所有权不明确;- 跨线程回调在所有者销毁后仍使用原生指针。
C++ 代码优先用 RAII(资源获取即初始化):对象析构时自动释放资源,异常和提前返回的路径也覆盖到。std::unique_ptr、容器、带自定义删除器(deleter)的智能指针和作用域封装都遵循这一思路。JNI 封装则还要明确线程附着方式、局部引用容量和全局引用的所有者。
malloc debug
bionic 的 malloc debug 可以记录原生内存分配回溯,适合已取得 root 权限的设备、userdebug 构建或平台开发环境。以下命令为目标进程设置包装属性,然后重启进程:
adb shell setprop wrap.com.example.app \
  '"LIBC_DEBUG_MALLOC_OPTIONS=backtrace logwrapper"'
adb shell am force-stop com.example.app
adb shell monkey -p com.example.app 1
复现问题后,可以让 dumpsys meminfo 搜出从已知根引用不到的原生内存块:
adb shell dumpsys meminfo --unreachable "$(adb shell pidof com.example.app)"
启用调用栈记录(backtrace)后,dumpsys meminfo 的报告能给出更多分配来源。它开销显著,定位角色是短期复现,长期线上监控要换工具;非 root 设备上的普通第三方应用,改用可调试构建的 wrap.sh、Sanitizer 或 heapprofd。测试完成后清除 wrap.<APP> 属性并重启进程。
HWASan、ASan 与 GWP-ASan
原生代码的越界访问和释放后使用(use-after-free)测试可优先考虑 HWAddressSanitizer(HWASan)。它从 NDK r21、Android 10 / API 29 起支持 arm64,其他 64 位 ABI 不在支持范围内。Android 14 / API 34+ 的可调试应用可通过 wrap.sh 运行;更早的系统需要 HWASan 系统镜像。
AddressSanitizer(ASan)从 API 27 起可用,但 Android NDK 已自 2023 年起停止支持,官方提醒继续使用可能遇到工具自身的缺陷。受限环境若仍采用 ASan,需要接受这一维护状态;使用 C++ 异常时,还要避开与 libc++_static 的已知不兼容组合。两者都更适合测试构建,单次测试没报错,说明不了内存错误不存在。
CMake 目标需要同时添加编译和链接选项。下面以 HWASan 为例:
target_compile_options(native-lib PRIVATE
    -fsanitize=hwaddress
    -fno-omit-frame-pointer)
target_link_options(native-lib PRIVATE
    -fsanitize=hwaddress)
使用 libc++ 时,HWASan 还要求共享 STL(c++_shared);wrap.sh 路径与 android:useAppZygote 不兼容,需要保留后者时,应按官方指南配置 HWASan 系统镜像。运行时库、系统镜像和最低 API 要求仍要按所用 NDK 的官方指南配置;doNotStrip 只影响符号保留,启用 Sanitizer 靠的是编译和链接选项。
GWP-ASan 用抽样方式检测部分堆内存错误,开销更适合生产环境。Android 14 / API 34 起,可恢复的 GWP-ASan 默认覆盖所有应用;它抽查的只是部分分配,一次未命中说明不了什么;职责也划得很清楚——发现越界和释放后使用,长期原生内存泄漏的统计归别的工具管。
heapprofd
Perfetto 的 heapprofd 采样原生内存的分配和释放,并聚合调用栈,适合回答“哪条原生代码路径仍保留最多字节”。Android 10+ 起可用;用户版系统通常要求目标应用可调试,或声明允许性能剖析。
主机侧快速采集可使用当前 heap_profile 子命令:
tools/heap_profile android \
  -n com.example.app \
  --interval=16000
默认采样间隔为 4096 字节;增大间隔会降低开销,也会降低小分配的可见性。看采集结果时,尚未释放的采样大小(outstanding size)、分配次数和调用栈要放在一起读,只按累计分配量排序会得出误导性的热点。
需要把采样结果放进系统性能轨迹时,可配置 android.heapprofd 数据源:
data_sources {
  config {
    name: "android.heapprofd"
    heapprofd_config {
      process_cmdline: "com.example.app"
      sampling_interval_bytes: 16384
    }
  }
}
Android 12+ 还可用 heaps: "com.android.art" 采样 Java 堆分配。它与完整堆转储的目标不同:采样更适合观察分配来源和趋势,堆转储更适合追踪具体对象引用。
onTrimMemory
回调级别的版本变化
ComponentCallbacks2 的内存整理级别(trim level)历经多次版本变化。Android 14 / API 34 起,平台不再向应用发送这些已废弃级别:
TRIM_MEMORY_RUNNING_MODERATE(5)TRIM_MEMORY_RUNNING_LOW(10)TRIM_MEMORY_RUNNING_CRITICAL(15)TRIM_MEMORY_MODERATE(60)TRIM_MEMORY_COMPLETE(80)
仍会发送的公开级别是:
TRIM_MEMORY_UI_HIDDEN(20):进程的 UI 已不可见,适合释放只服务于可见界面的资源;TRIM_MEMORY_BACKGROUND(40):进程处于后台 LRU,适合缩减可重建缓存。
TRIM_MEMORY_COMPLETE 在现代 Android 上已失去“即将被终止”通知的作用:系统可以在没有先发送高等级整理回调的情况下终止缓存进程,关键状态要按正常生命周期及时持久化。
应用侧分发
ActivityThread.ApplicationThread.scheduleTrimMemory() 接到 Binder 调用后,会优先把处理安排到主线程的 Choreographer.CALLBACK_COMMIT 阶段,让回调位于一帧绘制提交之后,以降低卡顿风险;没有可用的 Choreographer 时,改由 Handler 投递。
随后私有方法 ActivityThread.handleTrimMemory() 收集进程内的 ComponentCallbacks2 并分发,最终通知 WindowManager;通过 Application.registerComponentCallbacks() 注册的对象由 Application 的 callback controller 继续分发。各回调之间的相对顺序没有保证,业务代码不要依赖它。
系统侧还有两条相关行为:
- 配置标志
skipBgMemTrimOnFgApp可以让重要前台进程跳过BACKGROUND或更高等级的整理回调; CachedAppOptimizer在部分缓存进程进入冻结调度前发送TRIM_MEMORY_BACKGROUND,该回调是异步的,系统不会等待应用完成清理。
回调在主线程执行,我们在这里只做快速、可预测的操作。耗时压缩、磁盘写入或遍历超大缓存会把内存响应变成卡顿。
推荐响应策略
以下实现只依赖 Android 14+ 仍投递的级别:
override fun onTrimMemory(level: Int) {
    when {
        level >= ComponentCallbacks2.TRIM_MEMORY_BACKGROUND -> {
            imageCache.trimTo(backgroundLimitBytes)
            decodedDocumentCache.clear()
        }
        level >= ComponentCallbacks2.TRIM_MEMORY_UI_HIDDEN -> {
            prefetchQueue.cancelAll()
            visibleOnlyCache.clear()
        }
    }
}
UI_HIDDEN 只说明 UI 不可见,和内存压力没有必然联系;响应动作要快速完成,释放的内容也必须能重建。支持 Android 8~13 的应用仍可能收到旧级别,可以在兼容分支中逐步缩减缓存;核心状态的保存,走正常生命周期更可靠。
进程级缓存可以在 Application 实现 ComponentCallbacks2,短生命周期组件也可以注册独立回调。后者离开作用域时必须调用 unregisterComponentCallbacks(),避免注册表继续持有它。
16 KB 页大小
Android 15 起,AOSP 支持 16 KB 页大小。Google Play 当前要求,面向 Android 15 / API 35 及更高版本的应用都必须在 64 位设备上支持 16 KB 页大小;自 2027 年 2 月 1 日起,不满足该要求的更新会失去发布资格。
纯 Java/Kotlin 应用在所有依赖都不包含原生代码时,通常无需修改源码;即便如此,仍应在 16 KiB 环境测试。包含 .so 的应用需要同时检查:
- 自有原生库;
- AAR、SDK、游戏引擎和预编译库中的
.so; - APK/AAB 打包时的未压缩库对齐;
- 代码中硬编码的
4096、页对齐和内存映射(mmap)假设。
AGP 8.5.1+、NDK r28+ 和兼容的预编译依赖可提供默认支持。NDK r27 及更早版本需要按构建链配置兼容选项;直接控制链接器时,至少同时设置以下参数:
target_link_options(native-lib PRIVATE
    "-Wl,-z,max-page-size=16384"
    "-Wl,-z,common-page-size=16384")
代码应在运行时获取页大小:
long page_size = sysconf(_SC_PAGESIZE);
if (page_size <= 0) {
    /* 处理查询失败,不能回退到未经验证的 4096 假设 */
}
在目标设备和构建产物上分别验证:
adb shell getconf PAGE_SIZE
zipalign -c -P 16 -v 4 app-release.apk
16 KiB 页可能减少 TLB 未命中和部分启动开销。TLB 是 CPU 里缓存虚拟地址到物理地址转换结果的结构,页更大时,同样数量的条目能覆盖更多内存;另一方面,更大的页也可能增加小映射或页内碎片带来的内存消耗。收益取决于工作负载,快慢要靠同一设备上的 4 KiB/16 KiB 对照实验说话:Bitmap、GraphicBuffer 和内存分配器的变化都应这样测量。
Jetpack Compose 的内存
Compose 改变了 UI 对象的组织方式,但生命周期和所有权原则没有改变:
remember的值在对应可组合函数仍留在组合树(Composition)且 key 不变时保留;节点被移除或 key 变化后,该值会被遗忘;rememberSaveable的状态要写入Bundle,Bitmap、大数组或复杂对象图都不适合放进来;DisposableEffect适合成对注册和注销监听器、观察者及其他外部资源;- Flow 和生命周期数据应使用生命周期感知的收集方式;
- Lazy 列表应提供稳定键,避免项目位置变化后丢失状态,或把状态错误地用于其他项目;
- 排序、解析和大集合转换应移出高频重组路径,必要时使用
derivedStateOf等工具,但先测量重组与分配。
通用缓存这个角色,remember 担不起来:把 Activity Context、大 Bitmap 或播放器长期放在高层组合节点,它们就会跟随该节点长期存活;资源已有 ViewModel、图片库或进程级所有者时,可组合函数只保存轻量句柄和展示状态。
大型应用的内存预算
固定的“核心 30%、业务 40%、缓存 20%、预留 10%”缺少设备和场景依据。更可用的预算来自重复测试。
建立设备与场景分组
先按总内存、低内存设备标志、API、ABI、屏幕尺寸和页大小选择代表设备,再固定场景:
- 冷启动、首页稳定、前后台切换;
- 长列表快速滚动并返回;
- 大图、视频、地图、相机或文档等峰值业务;
- 页面反复进入退出、旋转和多窗口;
- 低内存回调、后台冻结与恢复。
每个场景记录稳定值、峰值、退出后的回落值,以及多轮后的基线漂移。至少区分 Java、原生堆、图形内存、总 PSS/RSS(Resident Set Size,常驻内存集)、交换空间、文件描述符和关键对象数量,并观察 p50、p95、p99 分位数;平均值之外,分位数才能暴露少量高峰。以 p95 为例,它表示 95% 的样本不高于该值。
堆等级的含义
ActivityManager.getMemoryClass() 返回普通应用的近似受管理堆等级,getLargeMemoryClass() 对应声明 largeHeap 后的等级。这两个值只描述受管理堆:它们不是进程总 PSS 上限,原生、图形和共享内存也没有全部计入。
下面的计算只能估算 Java 堆当前已用量与可增长余量:
val runtime = Runtime.getRuntime()
val javaUsed = runtime.totalMemory() - runtime.freeMemory()
val javaHeadroom = runtime.maxMemory() - javaUsed
Bitmap、DMA-BUF 或原生堆还剩多少空间,这套计算看不到;缓存上限要同时参考设备档位、业务峰值和系统回收信号,并为突发分配留出经过压力测试的余量。
采样成本与指标解释
Debug.getPss() 从 API 14 可用,Debug.getRss() 从 API 35 可用。RSS(Resident Set Size)统计当前驻留在物理内存中的页面,不分摊共享页;PSS 则按共享者数量分摊共享页。PSS 统计要读取和归并内存映射,成本扛不住每帧轮询;生产采样应低频、限量,并在设备上评估成本。
Debug.MemoryInfo.nativePss 与 Bitmap 数量之间没有换算关系。要数 Bitmap 对象,看 dumpsys meminfo <package> 的对象区、堆转储,或图片库自身的请求与缓存指标;图形内存和 DMA-BUF 还需要对应的系统计数器。
业务缓存的容量与冷热分段
业务缓存利用时间局部性,它的 hit/miss 是数据结构层指标,和 CPU cache miss 属于两个层面。android.util.LruCache 用 access-order LinkedHashMap 保存条目:命中会把条目移到最近使用端,超出权重预算时从最久未使用端逐出。单个公开操作受内部锁保护;由多次 get、remove、put 组成的复合操作,原子性仍要调用方自己保证。
纯 LRU 的常见弱点是 scan pollution(扫描污染):分页浏览或大列表预取会连续加入一批只访问一次的新 key,把稍早访问过、之后仍会复用的热条目挤出去。先用 trace 和缓存指标确认确实存在这种访问模式,再考虑比 LRU 更复杂的策略。
SLRU(Segmented LRU,分段最近最少使用) 的两段设计
SLRU(Segmented LRU)把预算拆成两个 access-order 段:
- 新条目进入
probation观察段。 probation条目再次命中后晋升到protected保护段。protected超出预算时,把最久未访问条目降回probation。probation超出预算时,逐出最久未访问条目。
一次扫描因此主要竞争观察段预算,稳定复用的条目得到单独保护。两段比例没有通用答案,应由 key 分布、value 权重、重复访问间隔和内存预算共同决定。图片可以用实际字节数作为权重;普通对象只能采用团队能持续校准的近似值。
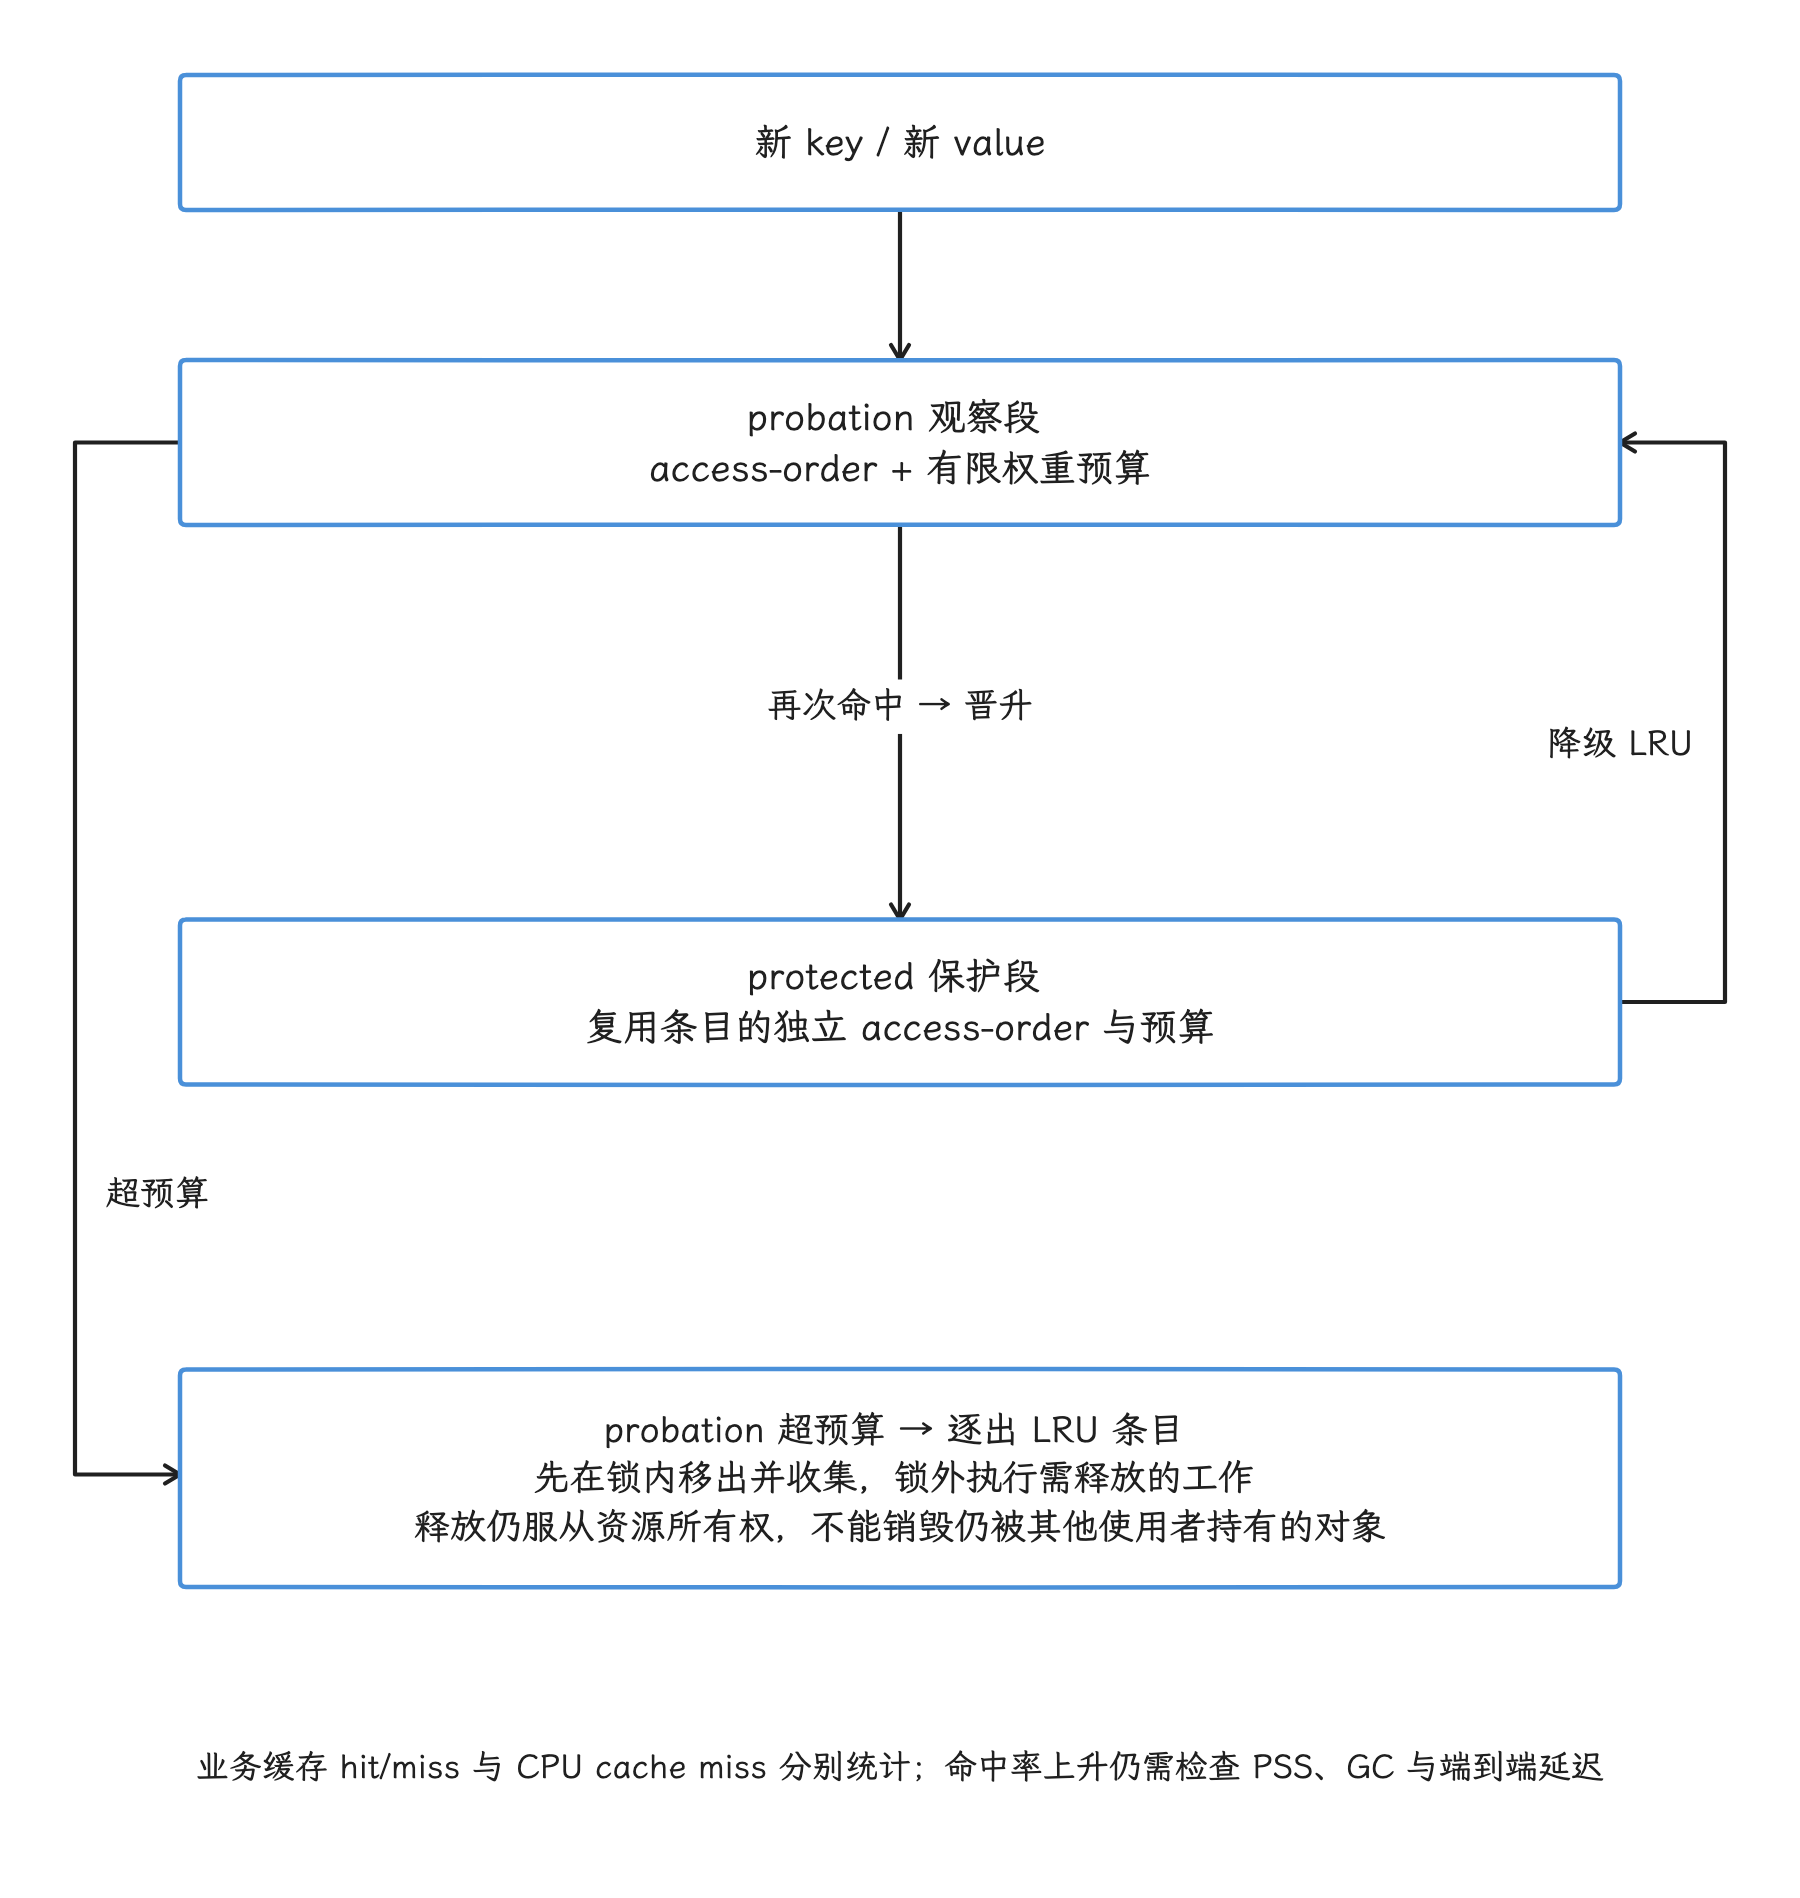
图:这是业务缓存的两段设计:新条目先进 probation;再次命中后晋升 protected;protected 超预算时将最久未使用者降回观察段;观察段超预算再逐出其最久未使用者。一次性扫描主要竞争观察段,稳定复用条目得到保护。两段都要有权重预算,分配比例需按实际访问模式验证。
并发加载与释放
LruCache.create() 在内部锁外计算 value。多个线程同时 miss 同一个 key 时,可能并行创建多个结果,缓存只保留其中一个。加载昂贵时,我们要在缓存外合并同 key 的在途请求,并定义失败是否缓存、多久后允许重试。磁盘、网络或解码工作要放在全局缓存锁之外,否则其他 key 的命中也会等待这次 I/O。
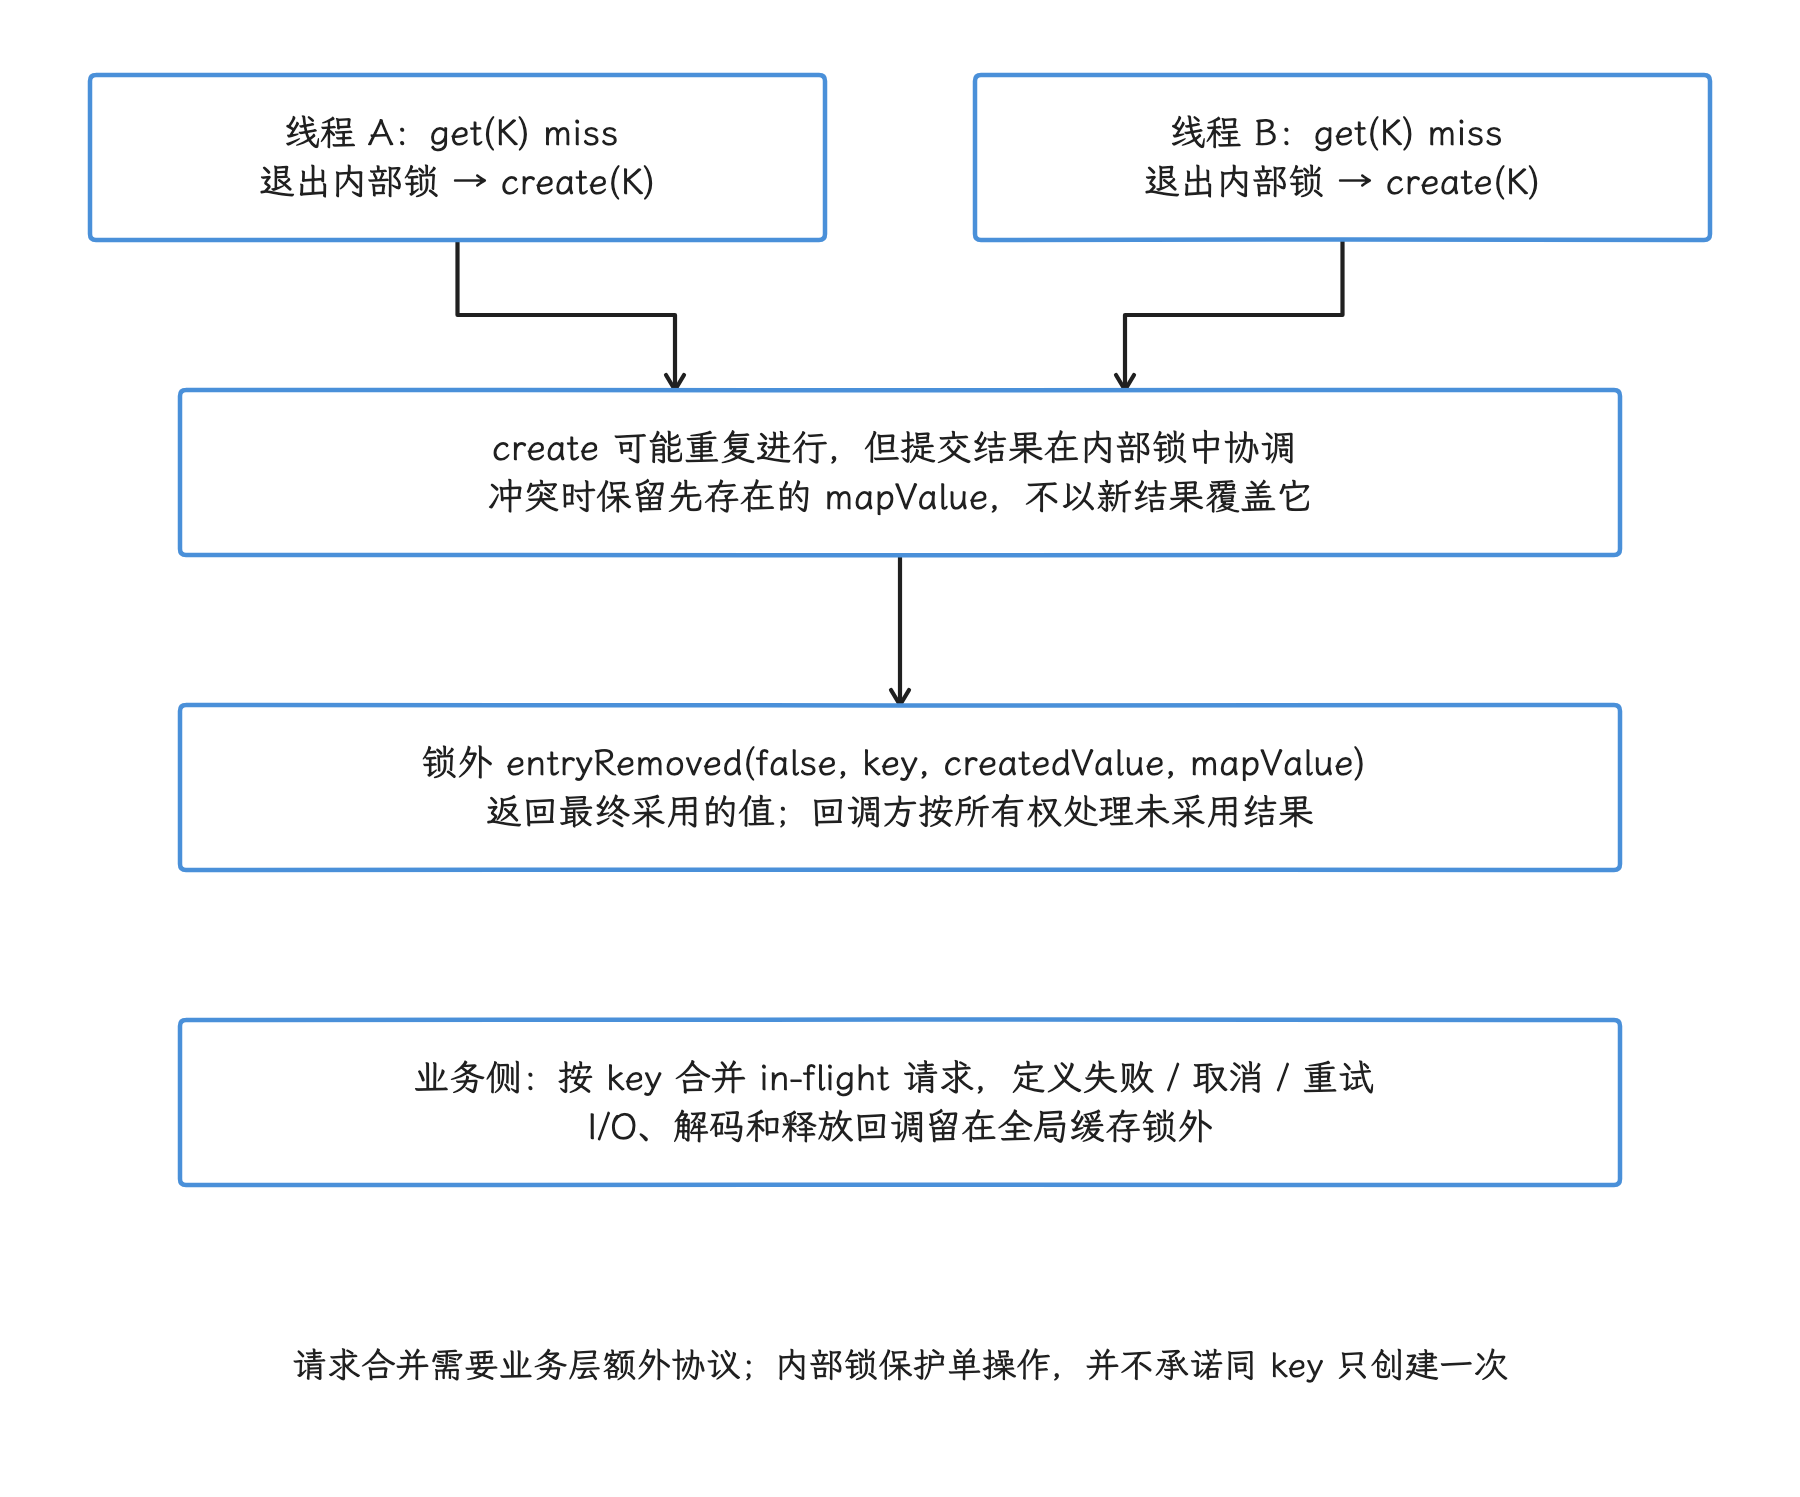
图:两个线程可在各自短暂加锁检查后都得到 miss,随后同时在锁外 create。提交时 LruCache 会在锁内协调冲突并保留已有值,锁外通知新建但未采用的结果。昂贵加载需额外合并同 key 的在途请求;不能为了去重把网络、磁盘或解码放到全局缓存锁里。
若 value 持有 Bitmap、文件句柄或其他需释放资源,应先在锁内收集逐出项,再在锁外执行释放回调,避免回调重入缓存或长时间占锁。上线 A/B 至少同时观察:
- 逻辑 hit、miss、逐出、晋升和降级;
- miss 后的解码、数据库、磁盘或网络成本;
- 缓存总权重、Java/native heap、PSS 和 GC;
- 锁等待、主线程耗时与端到端延迟。
命中率上去了,PSS、GC 或锁等待却恶化,缓存就没有带来净收益。分段 LRU 只解决明确的扫描污染;容量治理、内存压力响应和加载去重,各自还要单独做好。
线上诊断
ApplicationExitInfo
Android 11 / API 30 起,ActivityManager.getHistoricalProcessExitReasons() 可以回查进程退出记录。ApplicationExitInfo 通过 getReason()、getImportance() 和 getDescription() 提供退出原因、重要性和说明,通过 getPss()、getRss() 提供最后采样的内存值,单位为 kB。说明文本的格式不保证跨设备或版本稳定,程序判断应优先使用原因码。
诊断轨迹通过 getTraceInputStream() 读取,返回的流需要关闭,读取时要处理 IOException 和返回 null 的情况。它通常可用于 ANR;Android 12 / API 31 起,原生崩溃还可返回 tombstone 的 protobuf 数据。诊断轨迹存放在独立的全局环形缓冲区中,可能被后续记录覆盖,不能假定每条退出记录都有可读轨迹。
PSS/RSS 值可能为 0,也不保证等于死亡瞬间峰值。REASON_LOW_MEMORY 能说明系统按低内存原因记录了退出,仍需结合设备内存档位、业务场景和版本分布分析。
Android vitals 的用户可感知低内存终止率适合观察整体影响。它能指出问题规模;我们要定位具体个案,仍要依靠可复现路径、退出信息和内存采样。
ProfilingManager
Android 15 / API 35 引入 ProfilingManager,应用可以请求由系统管理的性能剖析采集。Android 17 / API 37 的 ProfilingTrigger 增加:
TRIGGER_TYPE_OOM:应用发生未捕获的OutOfMemoryError时触发 Java 堆转储;自定义UncaughtExceptionHandler必须继续调用默认处理器;TRIGGER_TYPE_ANOMALY:由系统检测异常并触发相应的诊断产物。
该能力受系统策略、速率限制和用户构建条件约束,产物能不能拿到,每次都要看当时的条件。接入时要记录请求结果、回调状态、文件上传策略和隐私方面的约束。
从现象选择工具
| 现象 | 首选证据 |
|---|---|
| 页面退出后 Java 对象不回落 | LeakCanary、堆转储引用链 |
| 滚动时分配率高并伴随卡顿 | 分配记录、Perfetto FrameTimeline 与 GC |
| 原生 PSS 持续上涨 | heapprofd、malloc debug、分配器与内存映射统计 |
| 图形内存或 DMA-BUF 上涨 | dumpsys meminfo、memtrack、DMA-BUF/Surface 相关性能轨迹 |
| 后台进程频繁消失 | ApplicationExitInfo、Android vitals、lmkd/系统内存压力 |
| 文件描述符持续增长 | /proc/self/fd、StrictMode、资源所有权审查 |
Perfetto 内存数据源与调查顺序
Perfetto 中常用的四个内存数据源回答不同问题:
| 数据源 | 回答的问题 | 主要限制 |
|---|---|---|
linux.process_stats | 进程 RSS、状态和 adj 如何变化 | 完整 PSS 需要显式启用 scan_smaps_rollup,且受 procfs/ptrace 权限限制 |
linux.sys_stats | meminfo、vmstat、PSI、buddyinfo 提供的系统背景 | 每类字段都需要在配置中显式开启 |
android.heapprofd | 哪些原生分配调用栈仍有存活采样 | 采样间隔、调用栈回溯(unwind)和数据传输会增加开销,且不覆盖所有内存映射和驱动内存 |
android.java_hprof | 哪些受管理对象被谁保留 | 重量级对象图快照,会暂停目标进程并增加其内存占用 |
linux.process_stats 的周期下限是 100 ms;下限只是能力所及,实际采集频率要按开销另选。heapprofd 的 sampling_interval_bytes 越小,调用栈与传输成本通常越高;all=true 会尝试覆盖大量符合条件的进程,这个选项留给专门的全量排查,常规诊断默认值里没有它的位置。block_client 会在采样数据来不及写出时阻塞分配方,因此还可能直接拖慢目标进程。
一轮可复现的调查,我们按下面的顺序加深:
- 固定用户可见问题、设备、构建版本和时间区间。
- 用进程与系统统计、线程调度、缺页与回收事件,以及少量
dumpsys meminfo,判断 Java、原生堆、图形内存、内存映射、交换空间或系统压力中哪一层异常。 - 只对命中的方向启用 Java HPROF、heapprofd、
memtrack/DMA-BUF、内存标签扩展(MTE)或内核内存规整采样。 - 保存完整 Perfetto 配置、采样间隔、目标 PID、是否允许性能剖析(profileable),以及分析器自身的 CPU 和内存开销。
- 用相同工作量比较优化前后;开启分析器和关闭分析器的两组数据都受工具开销影响,别直接当作产品收益。
收尾时,我们还要把“释放”拆成四个时刻:业务断开引用、GC 或内存分配器把空间标为空闲、运行时或分配器把页面归还内核、内核更新统计后 RSS/PSS 下降。四个时刻之间隔着时间差:对象不可达后 PSS 迟迟未降,可能只是释放链路还没走完,先别急着定性为泄漏;反过来,PSS 暂时下降,也证明不了所有权问题已经修复。
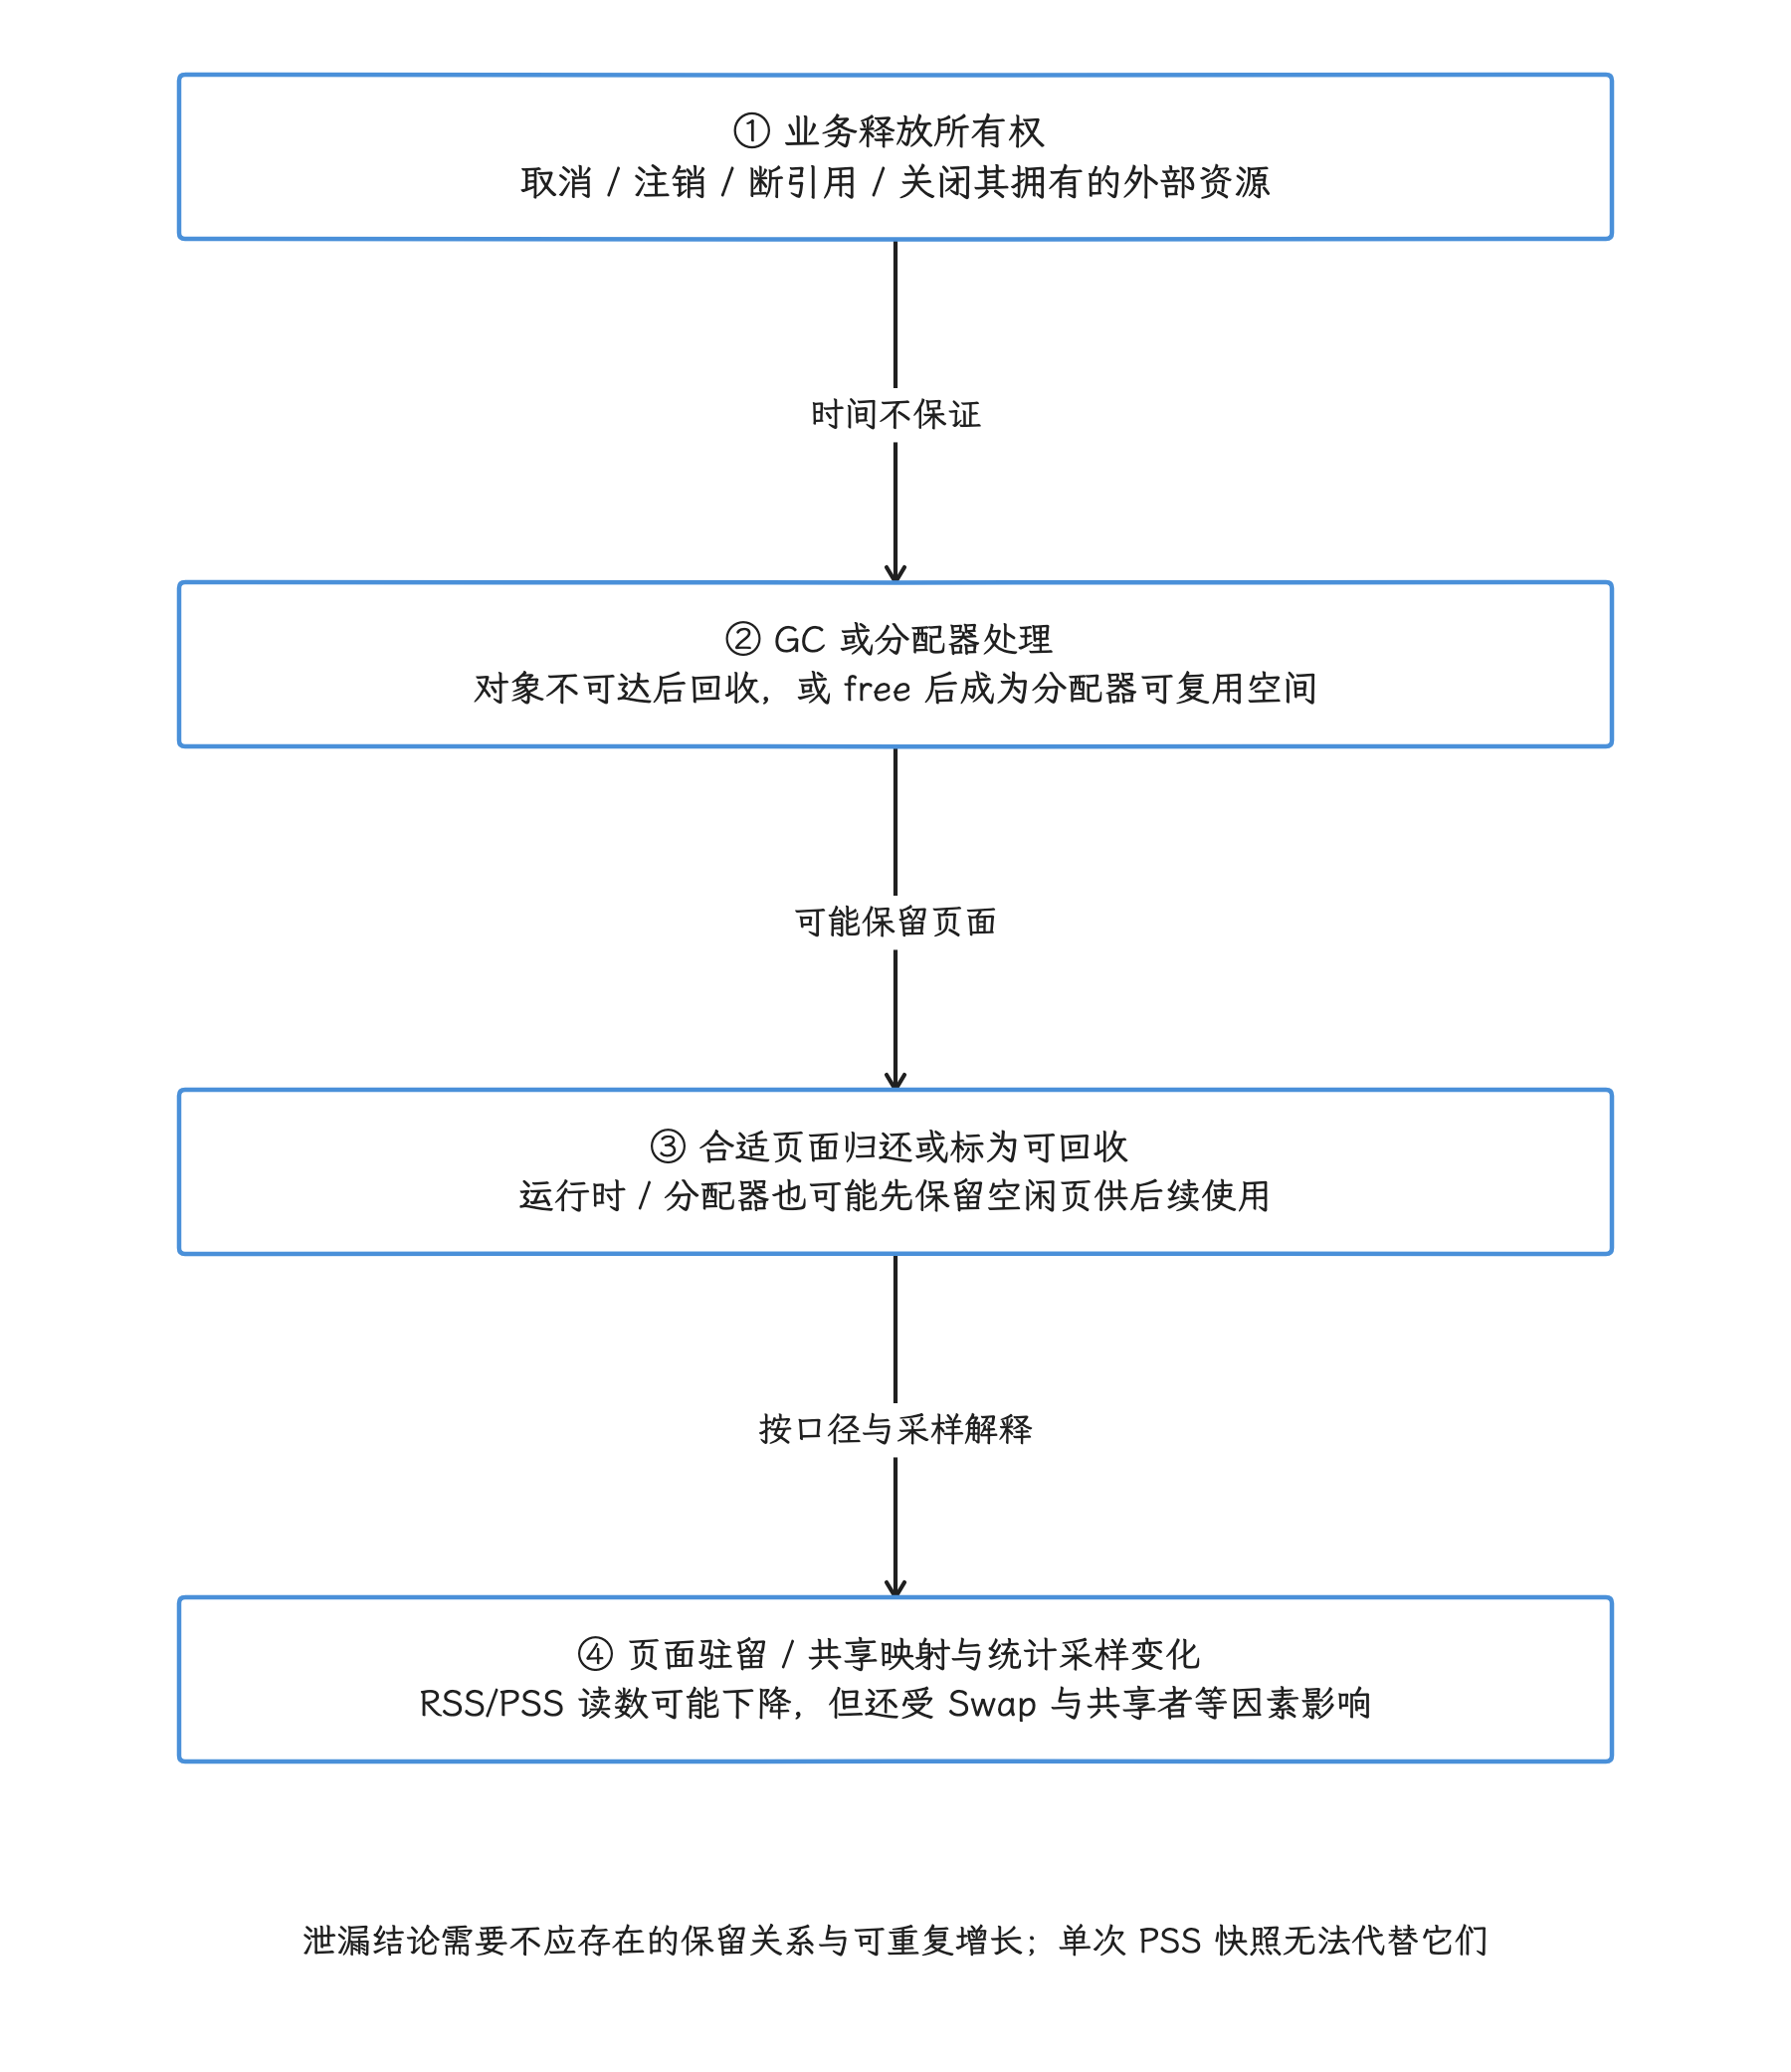
图:业务先断开不需要的引用,随后 GC 或分配器才把合适空间标为空闲;运行时或分配器可能继续保留空闲页,也可能归还或标为可回收。驻留与共享映射再影响 RSS/PSS 读数。四阶段可隔开,且比例归因还会受共享者变化影响;读数没立刻下降不直接等于泄漏,下降也不证明所有权已经正确。
PSS 与 CPU 缓存局部性
内存占用和访问效率可能同时改善或恶化,但测量对象不同:
| 粒度 | 典型大小与职责 | 主要证据 |
|---|---|---|
| CPU 缓存行 | 大小由目标 CPU 决定;是缓存传输和一致性维护的基本单位 | 性能监控单元(PMU)、simpleperf、调度与 CPU 拓扑 |
| 基础页 | 4 KiB 或 16 KiB;承载映射、缺页和 RSS/PSS 统计 | smaps、缺页、Perfetto 进程统计 |
| ART 卡表项 | Android 17 中对应 1024 B 地址范围;记录可能发生引用写入的区域 | ART GC 性能轨迹与源码 |
PSS 由内核按驻留页的映射次数(mapcount)分摊。Debug.MemoryInfo 的详细路径读取 smaps 并加入 memtrack,快速 Debug.getPss() 则由 libmeminfo 在汇总文件 smaps_rollup 与完整 smaps 之间选择。
伪共享是多个线程修改同一缓存行里的不同变量,导致缓存行频繁失效。这类 CPU 侧的现象影响内存指标要走一条间接路径:只有当换核、缓存未命中或伪共享改变了实际访问的页面、对象布局或工作集,驻留页才可能跟着变,PSS 的分摊算法始终只认映射次数。
优化局部性时,我们保持工作量、线程亲和性与设备状态一致,分别采集结构体或数组的布局和访问顺序、CPU/核心簇调度、目标设备支持的 PMU 缓存事件,以及相同时间窗内的 RSS/PSS。读数时把两套指标分开:缓存未命中要看 PMU 事件计数,内存占用要看 RSS/PSS;“PSS 下降”替代不了缓存未命中指标,单个未命中计数也证明不了内存占用已经改善。
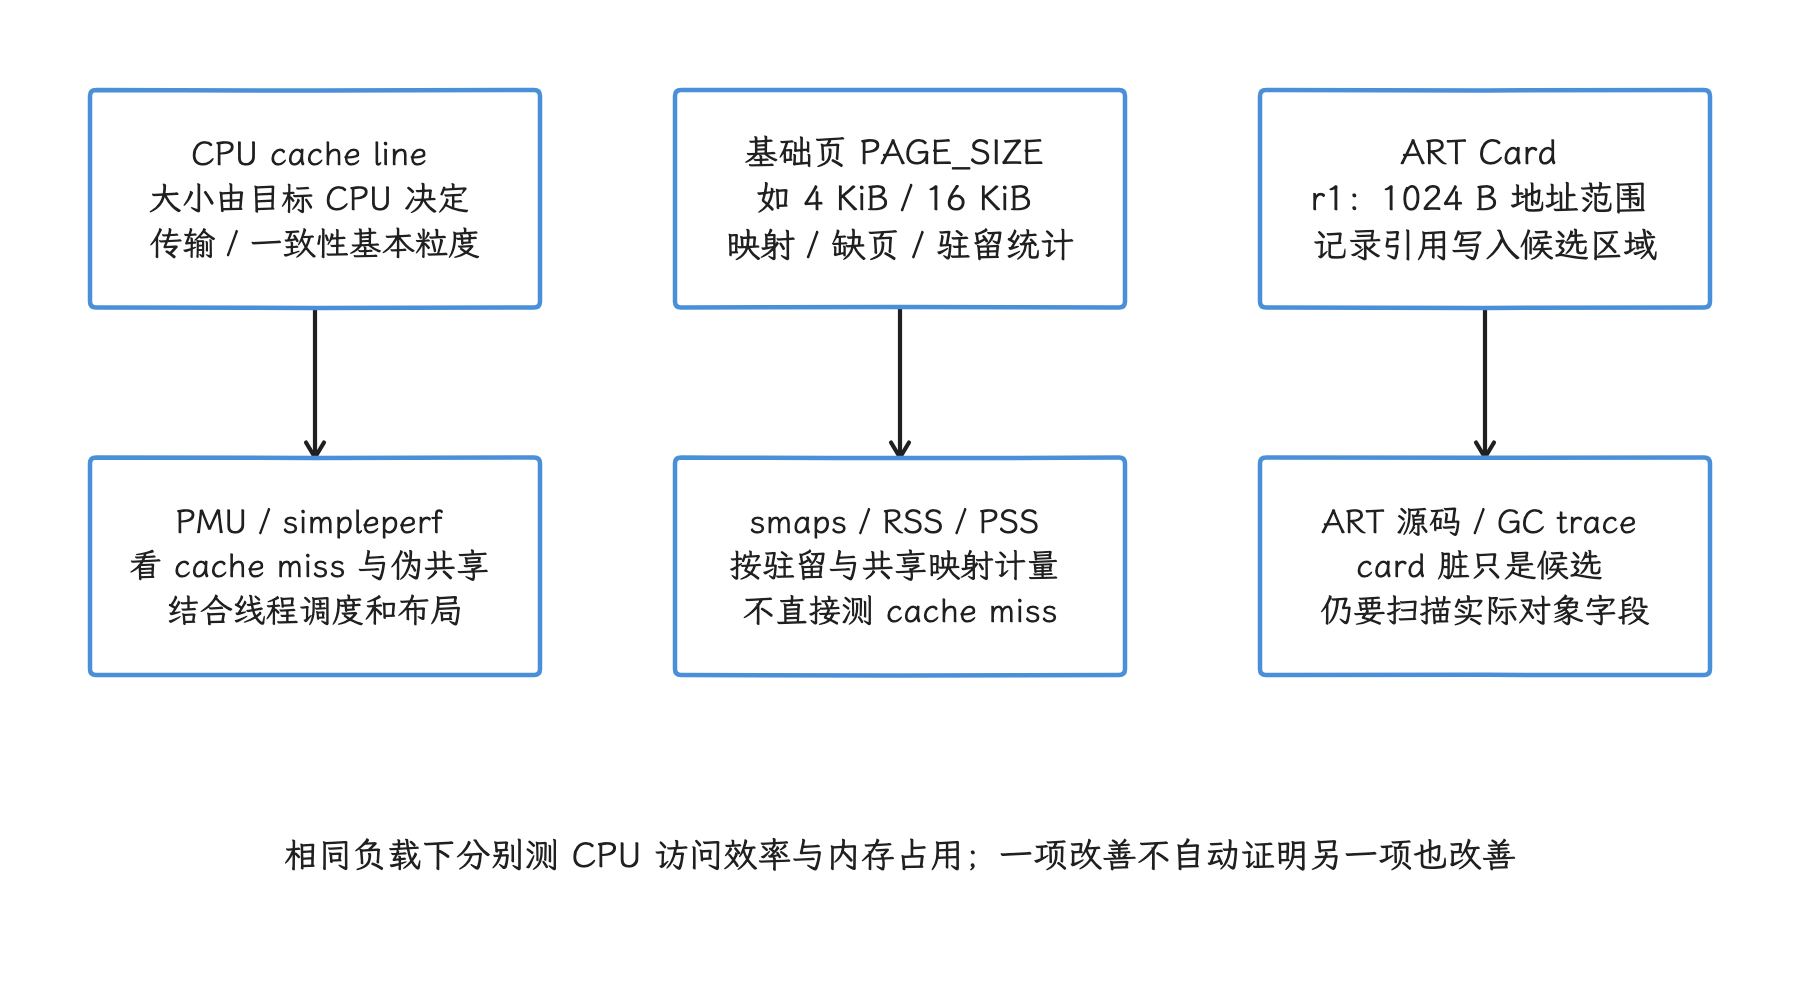
图:CPU cache line 是缓存传输和一致性的粒度,大小看目标 CPU;基础页承载映射、缺页与驻留统计,按设备 PAGE_SIZE;ART card 在 r1 覆盖 1024 B,用于记录引用写入候选。伪共享与 cache miss 查 PMU,RSS/PSS 查驻留页和共享比例,card 则帮助 GC 扫描。它们可能相互影响,但指标不能互相替代。
常见误区
System.gc() 的作用与局限
System.gc() 只是向运行时提出一次显式 GC 请求。它可能增加回收工作和暂停;泄漏对象仍可从 GC Root 到达,文件描述符它关不了,所有原生资源也未必都会因此释放。受控测试可以在断开引用后借它辅助验证,生产路径仍要回到引用、所有权和分配行为上修。
Bitmap 原生分配与 OOM 压力
API 26+ 的像素位于原生侧,平台仍会登记这部分分配,进程也仍受物理内存和系统策略约束。只盯 Runtime.maxMemory() 会漏掉 Bitmap、图形内存和 DMA-BUF 压力。
recycle() 的调用时机
recycle() 会立即让像素不可用。共享给 View、Drawable、异步任务或图片库的 Bitmap,回收权在所有者手里,局部代码不要擅自调用。现代应用优先使用清晰所有权和库提供的释放 API。
onTrimMemory 的通知语义
Android 14+ 只保留 UI_HIDDEN 和 BACKGROUND 两个公开投递级别,系统可以直接终止缓存进程。内存缩减回调只负责快速释放可重建资源,状态保存仍要遵守正常生命周期。
largeHeap 的适用条件
largeHeap 只改变设备为应用提供的受管理堆等级,具体大小由设备决定。它不修复泄漏,不扩大文件描述符上限,也不消除原生、图形内存或 Android 17 MemoryLimiter 带来的进程压力。只有业务确有大 Java 堆需求,并经过多档设备验证时才应使用。
设备档位与内存抖动
高端设备 CPU 更快,但高刷新率也缩短了帧间隔。结论必须来自目标设备的 FrameTimeline、GC 与分配数据。低端设备关注总量和回收压力,高刷设备还要关注暂停与帧工作的重叠。
复核清单
- 是否分别观察 Java、原生堆、图形内存/DMA-BUF、PSS/RSS、交换空间和文件描述符?
- 是否用可复现的性能轨迹证明高频分配或 GC 与帧问题有关?
-
Bitmap 是否按目标尺寸解码,并遵守
inBitmap、硬件 Bitmap 和recycle()的所有权? - Activity、Fragment View、Handler、监听器、观察者和协程是否在正确生命周期解绑?
- JNI 的内存、全局引用、字符或数组访问和文件描述符是否成对释放?
-
onTrimMemory是否只做快速、可重建的资源缩减,并兼容 API 34+ 行为? - 所有原生依赖是否通过 16 KB 页大小构建与设备验证?
- Compose 是否避免在 Composition 或 Bundle 中保存大对象?
- 内存预算是否来自设备×场景的 p50/p95/p99 与回落数据?
- 线上退出指标是否能关联版本、设备档位和业务场景?
参考资料
AOSP Android 17 源码
-
LruCache.java:访问顺序、权重预算、锁边界与缓存外创建。
-
frameworks/base/graphics/java/android/graphics/Bitmap.java:原生分配注册、硬件 Bitmap、Parcel 与recycle() -
frameworks/base/graphics/java/android/graphics/BitmapFactory.java:解码与inBitmap -
frameworks/base/core/java/android/app/ActivityThread.java:scheduleTrimMemory()与主线程分发 -
frameworks/base/core/java/android/app/Application.java:注册回调的分发 -
frameworks/base/core/java/android/content/ComponentCallbacks2.java:内存整理级别的公共契约 -
frameworks/base/services/core/java/com/android/server/am/CachedAppOptimizer.java:冻结前的后台 trim -
packages/modules/Profiling/framework/java/android/os/ProfilingManager.java、ProfilingTrigger.java:系统性能剖析与 API 37 触发器 -
external/perfetto/protos/perfetto/config/data_source_config.proto、external/perfetto/src/profiling/memory/heapprofd_producer.cc:android.heapprofd数据源名称与生产者常量
以上源码均按 android-17.0.0_r1 核查。
官方文档
- Memory overview
- Manage Bitmap memory
- BitmapFactory.Options.inBitmap
- Bitmap.Config.HARDWARE
- Support 16 KB page sizes
- Debug native Android platform code
- HWAddressSanitizer
- AddressSanitizer(已停止支持)
- GWP-ASan
- heapprofd
- ApplicationExitInfo
- ProfilingManager
- Glide configuration
- Coil ImageLoaders
- Fresco caches
- LeakCanary
交叉阅读
- 4.1 Android 与 Linux 内存管理全景:进程内存口径、页、回收与内核压力。
- 4.2 ART Heap、GC 与后台维护调度:分配、收集器与后台维护。
- 4.3 lmkd、Cached App Freezer 与内存压力治理:压力检测、优先级与进程终止。
- 4.5 16 KB Page Size 与 Android 性能:构建、加载与兼容性细节。
- 7.1、7.2、14.1:卡顿分类、归因方法与 Perfetto 分析。