Linux 调度、EAS 与大小核架构
异构 CPU 提供不同容量和能效的核心,Linux 调度器负责选择可运行任务与目标 CPU,能量感知调度(Energy Aware Scheduling,EAS)再把性能需求和能耗模型纳入放置决策。频率、温度和厂商策略会继续改变最终结果。
源码基线:AOSP
android-17.0.0_r1(Android 17 / API 37),内核android17-6.18-2026-06_r6。SoC(System on Chip,片上系统)的核心名称、编号、capacity(original capacity)与 cpufreq policy 属于设备实现,以目标设备内核或 sysfs 读到的数据为准。
异构 CPU 的容量、拓扑与能效
拿到一台异构 SoC 设备,我们要先弄清它的核心怎样分档、每档能力差多少,然后才谈得上解释任务为什么落在这一颗而不是那一颗。这一节先把容量、拓扑与能效的对应关系理清楚,再看任务在什么条件下迁移 CPU(migration)、换一次的代价怎么估。
先区分四个容易混用的概念
打开一段 Perfetto,我们会看到 CPU 编号、线程运行切片和频率计数器。要把这些数据解释对,先得把四个概念分开:
| 概念 | 回答的问题 | 可靠来源 |
|---|---|---|
| CPU 微架构(microarchitecture) | 同频下每周期大约能完成多少工作 | SoC/Arm 技术资料、目标设备测试 |
| 调度器 capacity | 内核认为 CPU 的最大相对算力与当前可用能力是多少 | arch_scale_cpu_capacity()、调度拓扑、温控或中断压力 |
| cpufreq policy | 哪些 CPU 共享一套频率控制,以及可选频点是什么 | /sys/devices/system/cpu/cpufreq/policy* |
| 能量模型性能域(Energy Model performance domain) | 哪组 CPU 共享活跃态功耗成本表 | 目标内核注册的 EM、调度器调试信息 |
这四者经常重合,却未必一一对应:两个 CPU 可以共享同一个 cpufreq policy 而 capacity 不同;宣传材料里的“中核”对应到哪个性能域,要以内核注册的能量模型为准。
CPU 编号更没有跨设备语义:CPU 7 可能是全机 capacity 最高的那颗,也可能只是某个同构簇里的普通成员。所以我们先识别拓扑,再谈“大核”“小核”。
从 big.LITTLE 到多档异构 CPU
早期 big.LITTLE 的软件模型
Arm big.LITTLE 把侧重单线程性能的 CPU 与侧重能效的 CPU 放进同一 SoC。早期实现经历过几种软件模型:
- 簇级迁移(Cluster migration):一个簇工作时,另一个对应簇整体关闭,切换粒度较粗。
- 内核切换器(In-kernel switcher):把一颗高性能 CPU 与一颗高能效 CPU 配成逻辑对,任一时刻只启用其中一颗。
- 全局任务调度(Global Task Scheduling)与 HMP(Heterogeneous Multi-Processing,异构多处理):所有 CPU 对内核可见,调度器按任务需求选择 CPU,也允许不同类型 CPU 采用不对称数量。
这些模型用来理解历史演进就够了。当前的公共调度路径以 capacity 感知调度(按 CPU 相对算力选择和均衡任务)、EAS、cpuset(限制任务可用 CPU 集合) 和利用率钳制(Utilization Clamping,UClamp)为主,早期“一次切换整个簇”的运行图已经不再适用。
历史资料常给迁移标注固定的微秒数,我们读的时候要记住一点:某个平台测得的数值只属于那个平台。迁移成本实际会随互连、缓存层级(cache hierarchy)、工作集、源 CPU 与目标 CPU 是否共享末级缓存(Last-Level Cache,LLC)、频率状态和内核路径变化。
DynamIQ 改变了 cluster 内组织方式
DynamIQ 允许不同 CPU 微架构在同一个 DynamIQ 簇中协作,并通过 DSU(DynamIQ Shared Unit)提供共享的系统级缓存与一致性支持。它降低了部分跨类型 CPU 共享数据的成本,也允许更灵活的核心组合。
分析时还要注意三点:
- 共享 LLC 不会复制源 CPU 私有的 L1/L2 内容,迁移后仍可能出现冷缓存未命中(cold miss);
- DynamIQ 具备每 CPU 动态电压与频率调节(Dynamic Voltage and Frequency Scaling,DVFS)的硬件能力,某款 SoC 实现到什么程度,要看它的 cpufreq policy;
- DSU 型号、缓存容量和互连拓扑由 SoC 决定,某款 Arm IP 的能力上限只描述那款 IP;
16 KB 页大小主要改变地址转换缓存(Translation Lookaside Buffer,TLB)的覆盖范围(TLB reach)、页表层级行为和内存管理成本。公开的通用 DSU 接口没有把“16 KB 页会降低监听过滤器(snoop filter)探测频率”定义为平台保证,互连层面的收益也就推导不出来,要靠目标设备实测。
当代 SoC 不止“大”和“小”
常见布局可以抽象为:
- 两档:高能效 CPU + 高性能 CPU;
- 三档:高能效 CPU + 高性能 CPU + 最高性能 CPU;
- 多颗 performance CPU + 少量 prime CPU;
- 市场上称为“全大核”的组合。
这些名称适合描述产品,不适合作为调度器输入。Linux 关心的是每颗 CPU 的 capacity、允许范围、当前压力、性能域和能量模型(Energy Model,EM)。即使两类 CPU 的 capacity 很接近,功耗成本仍可能不同;反过来也一样。
“某 CPU 的 capacity=837”这类数字,公开规格里推不出来;要做精确分析,就读目标设备的 capacity 数据或对应内核代码树。
Linux 怎样表达 CPU capacity
原始 capacity 与当前可用 capacity
Linux 6.18 的 Capacity Aware Scheduling 文档把 CPU 的最大能力近似写成:
capacity(cpu) = work_per_hz(cpu) × max_freq(cpu)
其中,work_per_hz 表示 CPU 每赫兹大约能完成的工作量,max_freq 表示最高频率。系统中最强 CPU 的原始 capacity 被归一化为 SCHED_CAPACITY_SCALE=1024,其他 CPU 按相对能力缩放。arch_scale_cpu_capacity(cpu) 返回原始 capacity。
运行时可用的 capacity 还要扣掉几类压力:硬件中断(IRQ)、温控压力(thermal pressure)和调频压力。对 EAS、不匹配任务迁移(misfit migration)或 util_fits_cpu() 来说,静态的 1024 或某个较小值只是计算起点。
单个 capacity 标量也有局限:两种微架构在整数、浮点、向量、分支和内存访问上的相对表现各不相同,一个数字装不下这些差异。capacity 适合调度器快速估算,性能结论还是要以微基准与业务测试为依据。
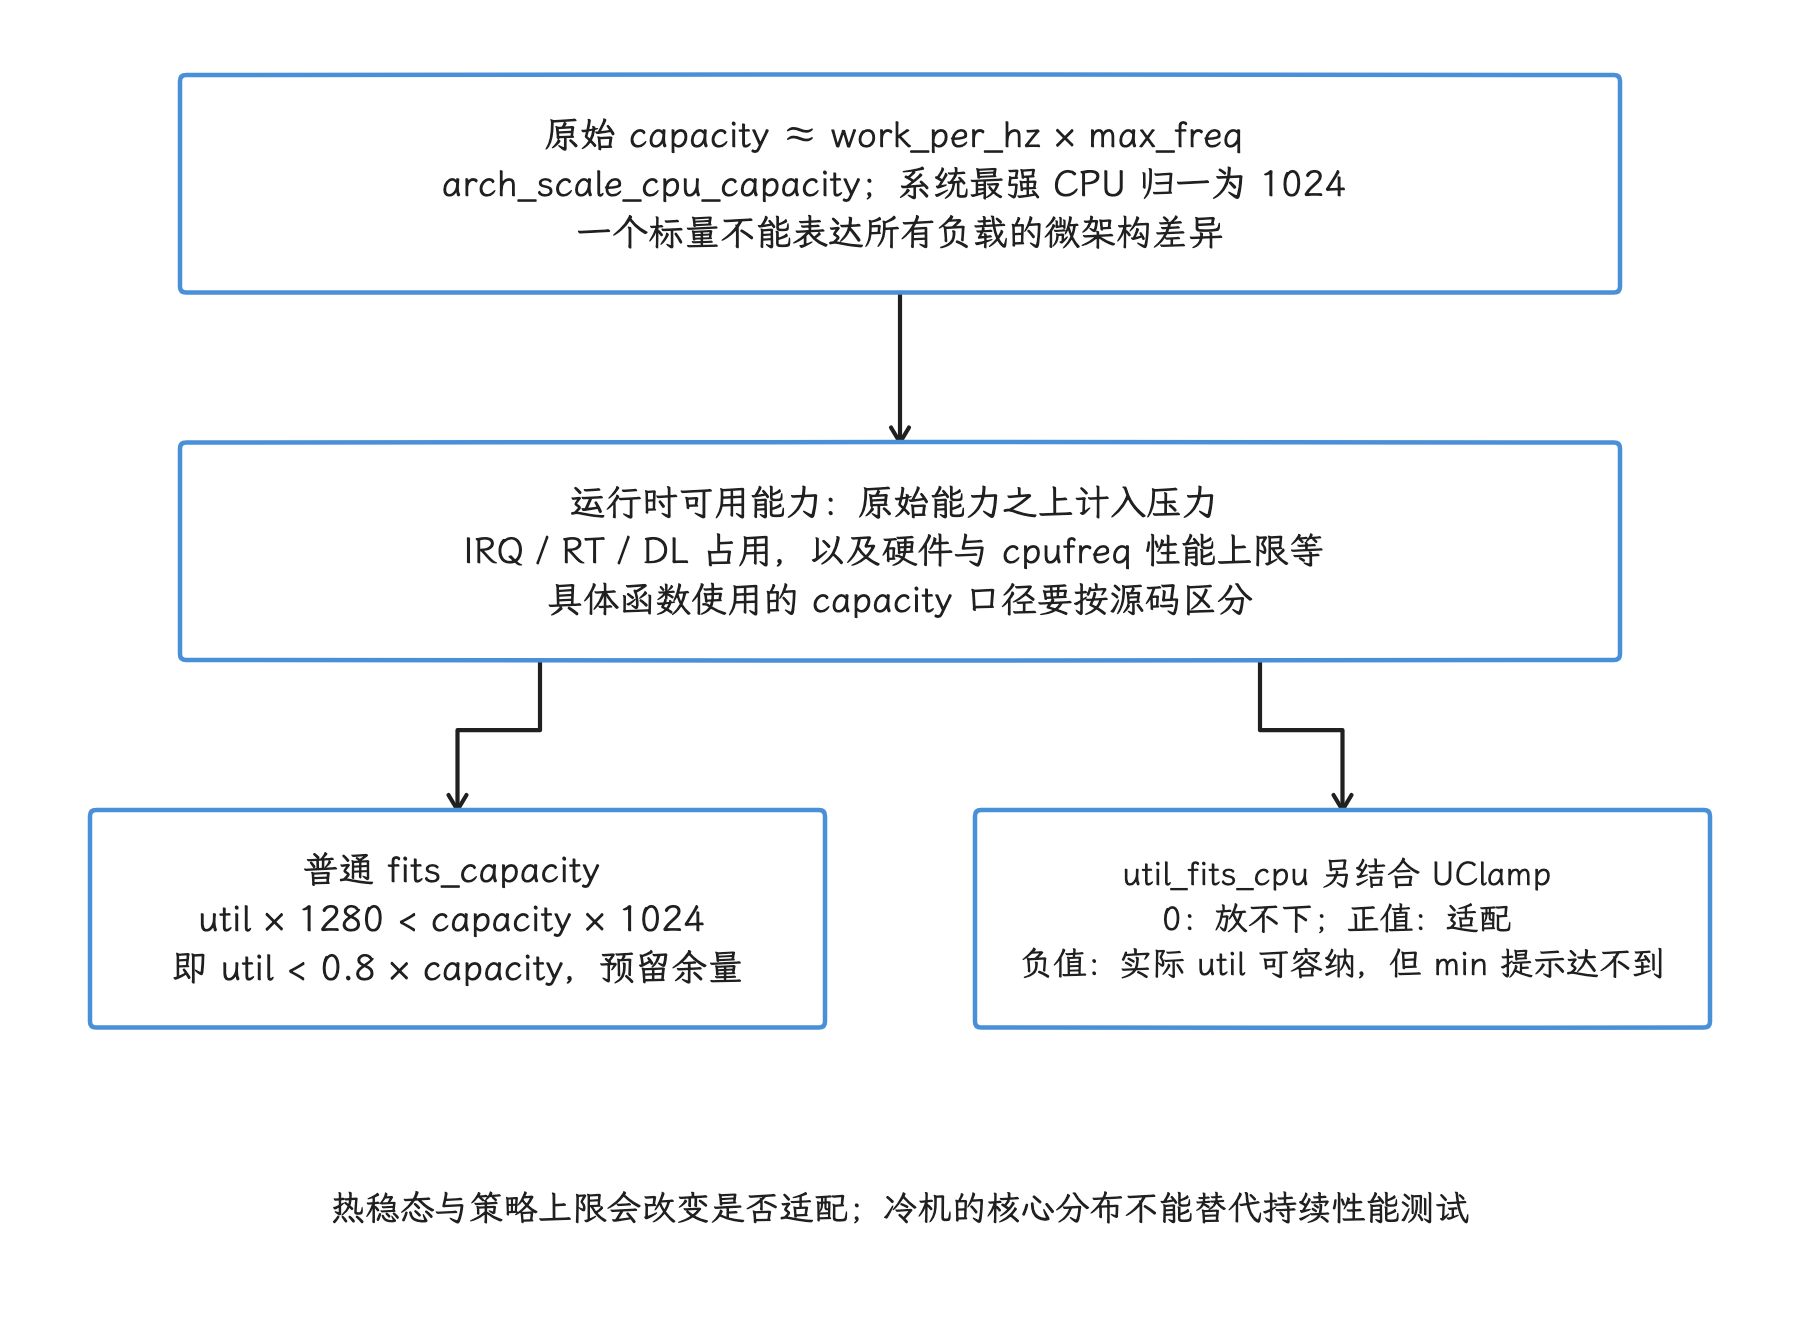
图:原始 capacity 近似由每赫兹工作量与最高频率相乘,系统最强 CPU 归一为 1024。实际可用能力受中断、其他调度类和外部性能压力影响。普通 fits_capacity 要求 util 小于 capacity 的约 80%;util_fits_cpu 还处理 UClamp,可能适配、拒绝或实际 util 装得下但无法满足最低性能提示。
利用率与 capacity 的比较带有余量(margin)
任务的 PELT(Per-Entity Load Tracking,每调度实体负载跟踪)利用率和短期利用率估计 util_est 经过频率不变性(Frequency Invariance)与 CPU 不变性(CPU Invariance)处理后,可以与 capacity 比较。Linux 6.18 的 fits_capacity(util, capacity) 会预留约 20% 的余量(headroom):
util × 1280 < capacity × 1024
因此 util=800 的任务放到 capacity=800 的 CPU 上,其实已经吃掉全部余量;这段余量是为了避免任务在临界位置反复迁移,也给突发负载(bursty workload)留出空间。
UClamp 会进一步影响 util_fits_cpu()。uclamp.min 可以表达较高的最低性能点,uclamp.max 可能让限制了性能上限的任务在较低 capacity CPU 上仍然算作适配。UClamp 本身不给 CPU 时间配额,也不单独决定目标 CPU。
温控压力会改变任务是否“装得下”
温控或 cpufreq 限制让 CPU 达不到原有最高性能时,内核会下调相应的可用 capacity。于是同一个任务在冷机时可能适合当前 CPU,进入热稳态后却可能变成不匹配任务(misfit),被负载均衡迁往其他 CPU。
这也是持续性能分析必须进入热稳态的原因:只比较冷机前几秒的核心分布,我们看到的只是短期行为,长期功耗预算下的行为要等热稳态才能说明。
如何理解不同 CPU 的性能
同频下的性能差距
capacity 文档把最大能力拆成每赫兹工作量与最高频率。高性能微架构往往有更宽的前端和后端、更大的乱序执行窗口,以及更多缓存和分支预测资源;相同频率下,它可能完成更多工作。
差距有多大,要看负载类型:
- 计算与分支密集代码更受执行宽度、预测和前端影响;
- 数据主要驻留在缓存里的负载更受 L1/L2 容量与延迟影响;
- 受内存限制的负载可能卡在 LLC、DRAM 和带宽争用上;
- 向量或加密代码还取决于具体执行单元。
因此,“大核一定快 2~3 倍”或“同频大核耗能更少”都需要目标工作负载的实测支撑。
单线程延迟
应用启动、UI 主线程和部分脚本任务都有单线程关键路径,高 capacity CPU 可能缩短其中受计算限制(CPU-bound)的阶段。但如果线程主要在等 Binder(Android 的跨进程调用机制)、锁、I/O 或 GPU,迁到 prime CPU 也消不掉这些等待。
判断是否需要更高 capacity CPU,我们先比较 wall time、CPU time、Runnable 等待时间和 deadline,再下结论。主线程没有运行在编号最大的 CPU 上,这本身是正常现象。
多线程吞吐与热稳态
图片处理、编译和软件编解码等吞吐任务可以利用多颗 CPU,但并行度还受任务划分、锁、内存带宽和散热预算(thermal budget)限制。短时间跑满全部 CPU,和长期维持最高频率是两回事。
进入热稳态后,系统可能降低多个 policy 的频率、调整任务放置,甚至下线部分 CPU。这时有效指标要覆盖每秒完成量、每项任务的能量、温度和尾延迟,高频 CPU 的数量只是表面数字。
在设备和 Perfetto 中识别拓扑
先读 sysfs,再看 Trace
sysfs 是 Linux 向用户空间暴露设备和内核对象状态的虚拟文件系统。我们先用下面的命令读取目标设备状态,建立 CPU、capacity 与 cpufreq policy 的对应关系,再和 Perfetto trace 对照:
adb shell 'for c in /sys/devices/system/cpu/cpu[0-9]*; do
  echo "$c"
  cat "$c/cpu_capacity" 2>/dev/null
  cat "$c/cpufreq/cpuinfo_max_freq" 2>/dev/null
  cat "$c/cpufreq/related_cpus" 2>/dev/null
done'

adb shell 'for p in /sys/devices/system/cpu/cpufreq/policy*; do
  echo "$p"
  cat "$p/related_cpus" 2>/dev/null
  cat "$p/scaling_available_frequencies" 2>/dev/null
  cat "$p/scaling_driver" 2>/dev/null
  cat "$p/scaling_governor" 2>/dev/null
done'
命令会逐个读取 CPU 的 capacity、最高频率与共享 policy,并列出各 policy 的可选频率、驱动和调频策略(governor)。有些量产设备会隐藏 cpu_capacity、可用频点或 governor 节点;读不到时转向设备内核配置、厂商源码或具备权限的调试接口,拿最高频率冒充 capacity 会引入误差。
Perfetto 标准库(stdlib)可以汇总 trace 期间观测到的频率。下面的查询用来查看各 CPU 的频率变化范围和采集覆盖时长:
INCLUDE PERFETTO MODULE linux.cpu.frequency;

SELECT
  cpu,
  MIN(freq) / 1000.0 AS observed_min_mhz,
  MAX(freq) / 1000.0 AS observed_max_mhz,
  ROUND(SUM(dur) / 1e9, 3) AS covered_s
FROM cpu_frequency_counters
WHERE dur > 0
GROUP BY cpu
ORDER BY cpu;
查询结果中,freq 的单位是 kHz。observed_max_mhz 只是采集窗口内出现过的最高频率;设备若没有运行到最高工作性能点(Operating Performance Point,OPP),该值会低于 cpuinfo_max_freq。两个 CPU 的频率同时变化只能提示它们可能共享 policy,还应通过 related_cpus 确认。
CPU 编号与最高频率的局限
最高频率较高的 CPU 往往 capacity 也较高,但每赫兹能完成的工作量可能不同。只看频率,下面这几种情况都区分不开:
- 同频但微架构不同;
- 不同频但最大 capacity 相近;
- policy 被温控或省电模式(battery saver)临时限制;
- 硬件自治 DVFS 让软件频率计数器和瞬时执行频率之间存在差异。
可靠的判断要结合 capacity、cpufreq policy、频率、线程运行时长和业务 deadline。
任务为什么会换 CPU
唤醒时放置
对于 fair 调度类任务,select_task_rq_fair() 处理唤醒,也处理 fork、exec 等场景下的任务放置(placement)。我们看唤醒这条路径:内核只在普通唤醒标志 WF_TTWU 路径、且根调度域(root domain)没有进入过载状态(overutilized)时调用 find_energy_efficient_cpu()。
EAS 并不遍历所有 CPU 后挑“最省电的一颗”:它在每个 EM 性能域里选出仍有剩余 capacity(spare capacity)的候选,再与任务上次运行的 CPU(prev_cpu)比较适配程度和能量增量(energy delta),同步唤醒满足条件时还可能直接复用当前 CPU。候选筛选与能量比较的完整流程,见后文「任务放置」。
root domain 进入 overutilized 状态后,这次唤醒会跳过能量估算,转到基于负载和空闲(idle)同级 CPU 的选择路径。看到线程在某颗 CPU 上运行,先别急着归因于 EAS。
运行时负载均衡与不匹配任务迁移
任务开始运行后,周期负载均衡(load balance)、CPU 即将空闲时的 newidle balance、主动均衡(active balance)和 misfit migration 仍可继续迁移它。常见原因包括:
- 原 CPU 的运行队列(runqueue)过载;
- 任务需求超出了低 capacity CPU 的能力;
- 其他 CPU 进入空闲状态(idle state),可以拉取任务;
- 调度域(sched domain)的不均衡超过阈值;
- thermal pressure 改变了 CPU 的可用 capacity。
这些路径不会为每次迁移调用 EM。唤醒选核与运行时迁移属于不同问题,在 Perfetto 中要结合迁移前的线程状态判断。
CPU 亲和性(affinity)、cpuset、热插拔与隔离
线程最终可用的 CPU,是在线 CPU、CPU 亲和性掩码(affinity mask)与 cpuset 允许范围的交集。系统切换前后台任务配置、下线 CPU、设置隔离 CPU 或应用厂商策略时,就算线程负载不变,也可能被迫迁移。
下面的命令用来确认某个线程当时可以在哪些 CPU 上运行:
adb shell 'cat /proc/<pid>/task/<tid>/status | grep Cpus_allowed_list'
adb shell 'cat /proc/<pid>/task/<tid>/cgroup'
第一条命令显示 CPU 亲和性允许列表,第二条显示线程所属的 cgroup。CPU 亲和性只能缩小候选范围,挡不住调度器在允许的 CPU 之间迁移线程;把 RenderThread 固定到某一颗高 capacity CPU,该 CPU 上的竞争或温控限制它就得照单全收。
RTG 属于厂商实现
RTG(Related Thread Group,相关线程组)、同位增强(colocation boost)和首选 CPU 簇等机制常见于部分厂商内核。它们可以按相关线程组聚合需求、偏好某个簇或影响频率提示。
这些符号不属于 Android 17 公共内核(Android common kernel)的通用接口,不同厂商、不同代际的 RTG 数据结构和策略也可能变化。若 trace 疑似受 RTG 影响,应到目标内核代码树、厂商钩子(vendor hook)和 Power HAL 里去核对;仅凭线程名,推断不出 RTG 的影响。
迁移成本怎样判断
缓存局部性
迁移不会复制源 CPU 私有缓存中的 L1/L2 内容,目标 CPU 要从共享 LLC、系统缓存或内存重新取数据。实际成本取决于工作集、缓存层级的共享方式、写共享、NUMA 等内存拓扑,以及迁移间隔。
DynamIQ 的共享缓存能降低部分数据获取成本,但消不掉私有缓存的冷未命中。固定的“迁移需要 30 μs”或“新架构只需几微秒”都不适合作为跨设备结论。
频率与 cpufreq policy 状态
任务迁入新的 cpufreq policy 后,该 policy 可能还处于低频。schedutil、I/O 等待增强(I/O-wait boost)、UClamp、Power HAL 和硬件 DVFS 会共同决定频率提升速度。若多个 CPU 共享 policy,另一个 CPU 的负载也可能已经使频率升高。
因此,“迁到大核后仍慢”至少要同时检查:
- 迁移前后的 Running 和 Runnable 时长;
- 源 CPU 与目标 CPU 的 capacity 和频率;
- 是否跨 LLC 或 cpufreq policy;
- 温控或省电模式设置的上限;
- 工作集的缓存未命中(cache miss)次数是否增加。
用 Perfetto 统计分布与迁移
第一条查询统计目标线程在各 CPU 上的运行时长与运行切片数量:
SELECT
  s.cpu,
  COUNT(*) AS slice_count,
  ROUND(SUM(s.dur) / 1e6, 3) AS running_ms
FROM sched_slice AS s
JOIN thread AS t USING (utid)
JOIN process AS p USING (upid)
WHERE p.name = 'your.package.name'
  AND t.name = 'RenderThread'
  AND s.dur > 0
GROUP BY s.cpu
ORDER BY s.cpu;
这张表只说明运行分布。要统计相邻运行切片(Running slice)之间的 CPU 变化,可以用窗口函数:
WITH target_slices AS (
  SELECT
    s.ts,
    s.cpu,
    LAG(s.cpu) OVER (PARTITION BY s.utid ORDER BY s.ts) AS previous_cpu
  FROM sched_slice AS s
  JOIN thread AS t USING (utid)
  JOIN process AS p USING (upid)
  WHERE p.name = 'your.package.name'
    AND t.name = 'RenderThread'
    AND s.dur > 0
)
SELECT
  previous_cpu,
  cpu,
  COUNT(*) AS transitions
FROM target_slices
WHERE previous_cpu IS NOT NULL
  AND previous_cpu != cpu
GROUP BY previous_cpu, cpu
ORDER BY transitions DESC;
相邻切片跨 CPU,只说明两次运行之间目标 CPU 变了,中间可能隔着睡眠、唤醒和排队。缓存迁移是不是延迟根因,还要把结果与业务切片、频率、缓存和性能监控单元(Performance Monitoring Unit,PMU)数据对齐之后再判断。
schedutil 怎样选频
当前源码路径
schedutil 使用调度器的利用率信号决定 cpufreq policy 的目标性能点。android17-6.18-2026-06_r6 中 sugov_get_util() 的处理过程可概括为:
util = sched_ext CPU perf target
if 尚未完全切换到 sched_ext(scx_switched_all() 为 false):
    util += boosted CFS util

util, min, max = effective_cpu_util(CFS + RT + DL + IRQ, UClamp)
util = max(util, I/O-wait boost)
target_perf = sugov_effective_cpu_perf(util, min, max)
其中,perf target 是 sched_ext 提供的性能目标,boosted CFS util 是调整后的 fair 类利用率。完全公平调度器(Completely Fair Scheduler,CFS)表示 fair 调度类任务,RT 表示实时调度类,DL 表示截止时间调度类(deadline),IRQ 表示硬件中断;sched_ext 是 Linux 的可扩展调度器框架。sugov_effective_cpu_perf() 先用 map_util_perf() 增加约 25% 的 DVFS 余量,再应用最低与最高性能约束。这种线性映射只是一种估算,和硬件的实际性能曲线还有距离。
如果一个 cpufreq policy 覆盖多个 CPU,sugov_next_freq_shared() 会遍历该 policy 中的 CPU,并采用其中最高的目标性能需求来选频。因此,Perfetto 中同一 policy 内 CPU 的频率联动符合源码预期。
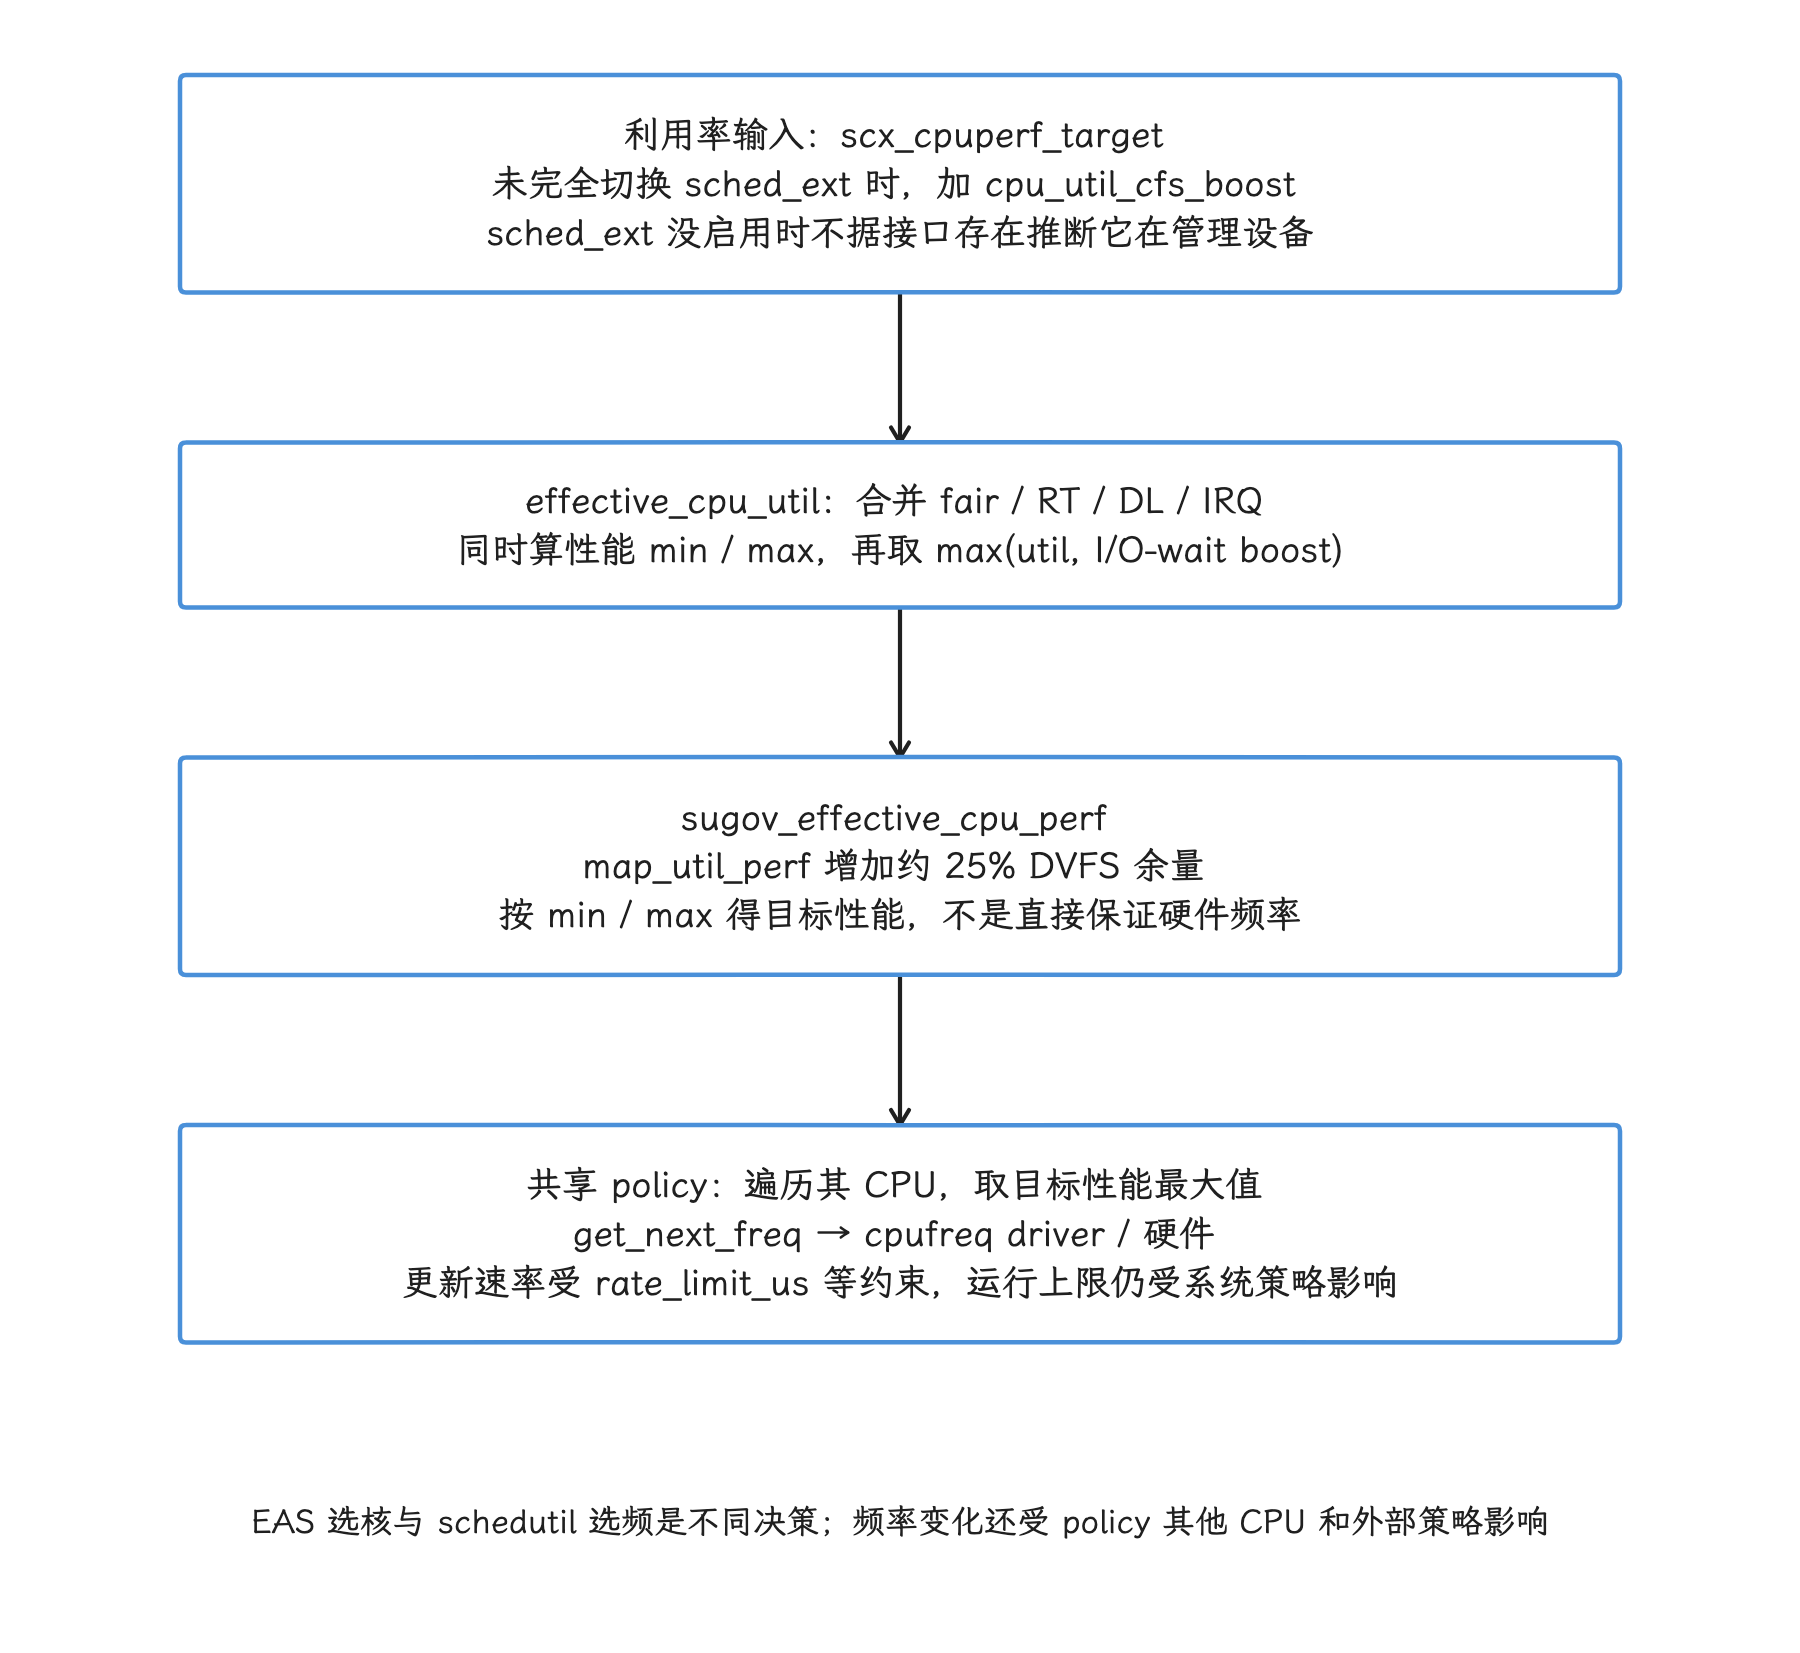
图:r6 的 sugov_get_util 从 sched_ext target 加未完全切换时的 CFS util 起步,经 effective_cpu_util 合并 RT、DL、IRQ 与 UClamp 上下界,再取 I/O-wait boost。map_util_perf 添加 DVFS 余量后应用性能约束;共享 policy 取各 CPU 目标的最大值,再由驱动解析频点。温控、Power HAL 与硬件仍可限制实际性能。
调频速率限制的取值来源
rate_limit_us 限制调频请求的更新频率。Linux 6.18 初始化时采用 cpufreq_policy_transition_delay_us(policy),之后可以由 governor 的可调参数(tunable)改写。该值取决于驱动与 policy,Android 并没有一个固定的 1 ms 或 2 ms。
I/O-wait boost 的适用范围
Linux 6.18 针对带有 SCHED_CPUFREQ_IOWAIT 标志的唤醒维护 I/O-wait boost。连续、频繁的 I/O 完成唤醒(completion wakeup)会逐步抬高这一增强值;超过一个调度时钟周期(tick)没有新请求时,增强值会重置或衰减。它服务的是 I/O 完成后那段处理的延迟;频率抬多高、抬多久,由后续请求的节奏决定,别按“文件一读就把频率拉满”去理解它。
RT、DL、UClamp 与 sched_ext
effective_cpu_util() 合并 CFS、RT、DL 与 IRQ 的影响,并向 schedutil 返回性能上下界。RT 或 DL 任务出现后频率怎么走,还要看截止时间带宽(deadline bandwidth)、默认 RT UClamp 和设备配置,“只要出现就永久锁定最高频率”是把机制简化了。
Android 公共内核的 schedutil 还接受 scx_cpuperf_target()。只有 sched_ext 实际管理 CPU 或提供性能目标(perf target)时,这项输入才有意义;源码里有这个接口,和量产设备默认启用 sched_ext 调度器是两回事。
Power HAL 和省电/温控是外部约束
Power HAL 可以应用任务配置、UClamp、cpuset、devfreq 或厂商节点,也可能调整 cpufreq 的最低与最高限制(floor/ceiling)。Android 平台并没有保证每个 LAUNCH / INTERACTION 性能提示(hint)都通过 scaling_min_freq 实现。
温控和省电模式可以限制最高 OPP,硬件 DVFS 也可能在软件请求之外自行选择。Perfetto 显示的是最终可观测频率,解释时应同时检查:
scaling_driver与scaling_governor;- policy 的最低值、最高值与温控(thermal)上限(thermal cap);
- UClamp 与任务配置;
- Power HAL 或 Android 动态性能框架(ADPF)会话;
- 硬件计数器是否提供频率不变性(Frequency Invariance)所需的信息。
一套可复现的分析顺序
这套顺序用来收敛容量与放置问题;可运行等待和调度延迟的排查顺序见后文「一套可复现的诊断顺序」。
- 建立设备拓扑:记录 capacity、cpufreq policy、在线 CPU、CPU 亲和性与 cpuset。
- 对齐运行结果:统计各 CPU 的运行时间、迁移、频率和空闲状态。
- 检查外部约束:温控、省电模式、Power HAL、UClamp、ADPF 和 vendor hook。
- 提出单一假设:例如“低 capacity CPU 赶不上 CPU-bound 段的截止时间”。
- 做 A/B 验证:比较延迟分位数、功耗与热稳态,不只看一次 Trace。
正常现象
- 短任务留在低 capacity CPU 且按时完成;
- 唤醒后保留
prev_cpu,减少不必要迁移; - 高利用率任务在温控允许时进入更高 capacity 性能域;
- 同一 cpufreq policy 的 CPU 共享频率变化;
- 任务发生运行时迁移,但没有对应的截止时间违约或缓存指标下降。
需要继续排查的现象
- CPU-bound 关键阶段持续超时,同时只能在低 capacity CPU 上运行;
- 存在空闲且允许使用的高 capacity CPU,目标线程却长时间处于 Runnable 状态;
- 迁移点与缓存未命中、wall time 尖峰稳定相关;
- policy 频率长期受限,且与温控或省电状态一致;
- 前后台状态变化后,cpuset、UClamp 或任务配置没有按预期更新。
这些现象是调查入口,单凭一条还定不了责。
GPU、NPU 与 CPU 调度的分工
EAS、最早合格虚拟截止时间优先算法(Earliest Eligible Virtual Deadline First,EEVDF)和 schedutil 分别负责 CPU 任务放置、CPU 运行队列(per-CPU runqueue)调度与 CPU 频率选择。GPU 和 NPU 走的是各自的队列、驱动、devfreq 或固件调度与功耗域,CPU EAS 的决策范围到不了那里,谈不上“协同调度”。
任务卸载仍会在 CPU 上产生准备、Binder 或 HAL 调用、命令提交(command submission)和 fence 同步,然后才是结果处理。分析异构计算时,可以按下面的执行依赖检查:
CPU 准备与提交
    → GPU/NPU 队列等待与执行
    → fence / callback 唤醒 CPU
    → CPU 后处理
如果 CPU 长时间睡眠并等待 fence,加速器执行时间就不在 CPU 调度的控制范围里,调整 CPU 亲和性帮不上忙;如果提交线程长时间处于 Runnable 状态或受 CPU 计算限制,则要回到 CPU 调度这条线继续排查。GPU/NPU 的频率、队列和利用率应使用各自的数据源分析。
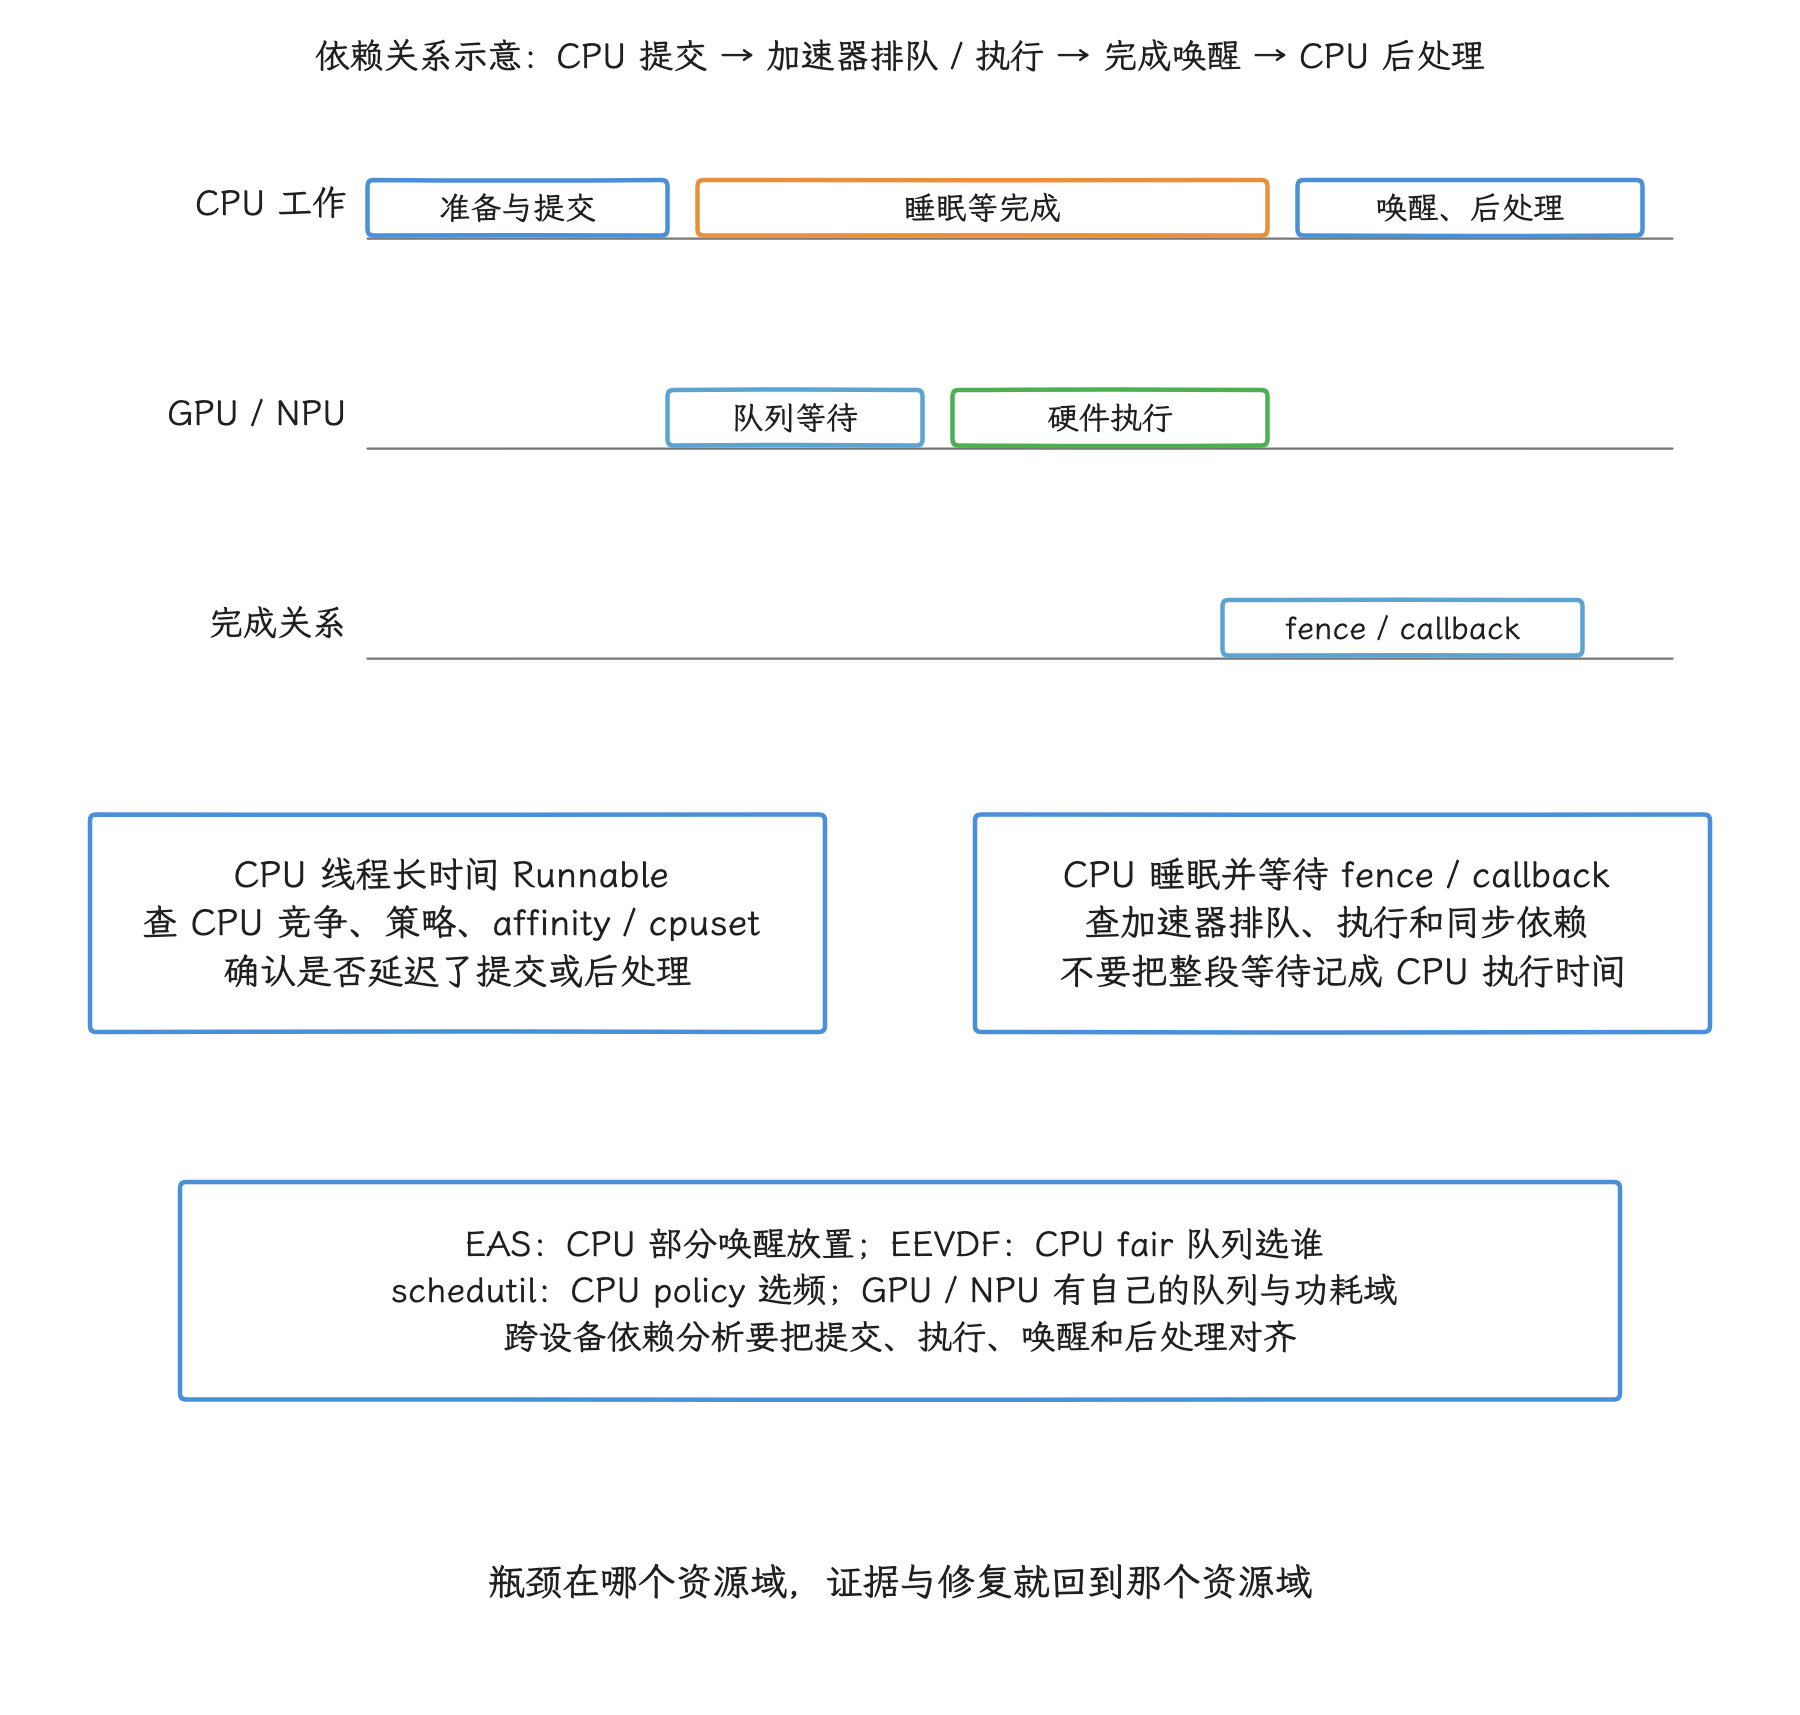
图:CPU 准备与提交后,GPU/NPU 可在各自队列等待并执行,fence 或回调再唤醒 CPU 做后处理。CPU 等 fence 时,增加 CPU 优先级不能消掉加速器本身的执行;若提交或后处理线程在 Runnable 排队,才回到 CPU 策略与约束分析。各硬件频率和利用率需要对应驱动或固件数据。
版本演进与适用范围
| 时期 | 变化 | 分析用途 |
|---|---|---|
| 2011 起 | Arm big.LITTLE 与早期簇级迁移或切换器模型 | 解释异构 CPU 的由来 |
| Linux 4.7 起 | schedutil 进入主线 | 解释调度器利用率驱动 DVFS |
| Linux 5.0 起 | EAS 进入主线 | 解释异构 CPU 的唤醒选核 |
| Android 9 起 | Android 设备广泛采用 EAS 和 schedutil,但厂商实现各异 | 只作历史范围,不假定所有设备一致 |
| Android 17 / API 37 | Android 开源项目(AOSP)android-17.0.0_r1 | 任务配置、UClamp、Power HAL 和 ADPF 控制面 |
| Android 17 内核 | android17-6.18-2026-06_r6 | capacity 感知调度、EAS、schedutil、thermal pressure 与 sched_ext 接口 |
常见误区
“CPU 编号越大,性能越高”
编号由固件和设备拓扑决定。用 capacity、policy 与实测识别 CPU 类型。
“降低 nice 值会让线程自动去大核”
nice 值主要改变 fair 类任务获得 CPU 时间的相对权重。选核还要看利用率、capacity、EAS、UClamp、cpuset 和当前负载;权重更高换来的是更高份额,落到哪颗 CPU 仍由选核过程决定。
“最高频率越高,CPU 就越快”
最高频率没有反映每赫兹工作量、缓存、内存与温控信息,只能描述 CPU 性能的一个维度。
“迁移次数多,调度一定有问题”
迁移是负载均衡和异构调度的正常手段。只有迁移与截止时间违约、缓存指标恶化或能耗增加稳定相关时,才有优化依据。
“绑核可以修复所有选核问题”
CPU 亲和性会缩小调度器的选择范围,也可能把线程留在拥塞或降频的 CPU 上。应先验证根因,再用可回滚的实验评估绑核效果。
“全大核 SoC 不需要 EAS”
内核拓扑才是判断依据:若仍有非对称 CPU capacity、可用 EM,并满足 EAS 的其他前提,能量感知的任务放置仍有分析价值;只有成本不同而拓扑完全对称,并不满足当前 EAS 的启用条件。
运行队列、优先级与任务选择
线程长时间停在 Runnable、或者一直停在小核上时,我们要回答的问题是:谁挡住了它,或者谁把它放错了地方。硬件拓扑给出可选核心,调度器再根据任务状态、优先级、负载和亲和性决定谁在何处运行。
[!info] 源码锚点 正文按 Android 17 / API 37 /
android-17.0.0_r1与 Linux 内核android17-6.18-2026-06_r6复核。文中提到旧 CFS、SchedTune 或早期 Android 行为时,会明确标为历史背景,避免与当前实现混用。
调度决策链
Perfetto 的 CPU 轨道只展示最终结果:某个线程在某个 CPU 上运行。要解释这个结果,需要把调度决策拆成五个问题:
- 线程是否已经被唤醒,进入可运行(runnable)状态?
- 它属于哪种调度策略,优先级和 nice 值是多少?
- 在公平调度类(fair class)中,它是否已经取得运行资格,虚拟截止时间(virtual deadline)是否足够早?
- CPU 亲和性、cpuset 和 CPU 在线状态允许它去哪些核心?
- UClamp 利用率约束(Utilization Clamping,UClamp)、CPU capacity、当前负载和能耗模型,会让内核倾向于哪个核心与频点?
这五层解决的问题各不相同。线程长期处于 Runnable,可能是同一 CPU 上有更高调度类的线程,也可能是公平调度竞争者太多;线程只在小核运行,也可能是 cpuset 限制所致,先别急着怀疑 EEVDF 选错了任务。分析时我们按 trace 里的线索逐层排除,别看到一段很长的等待就直接修改 nice 或绑定 CPU。
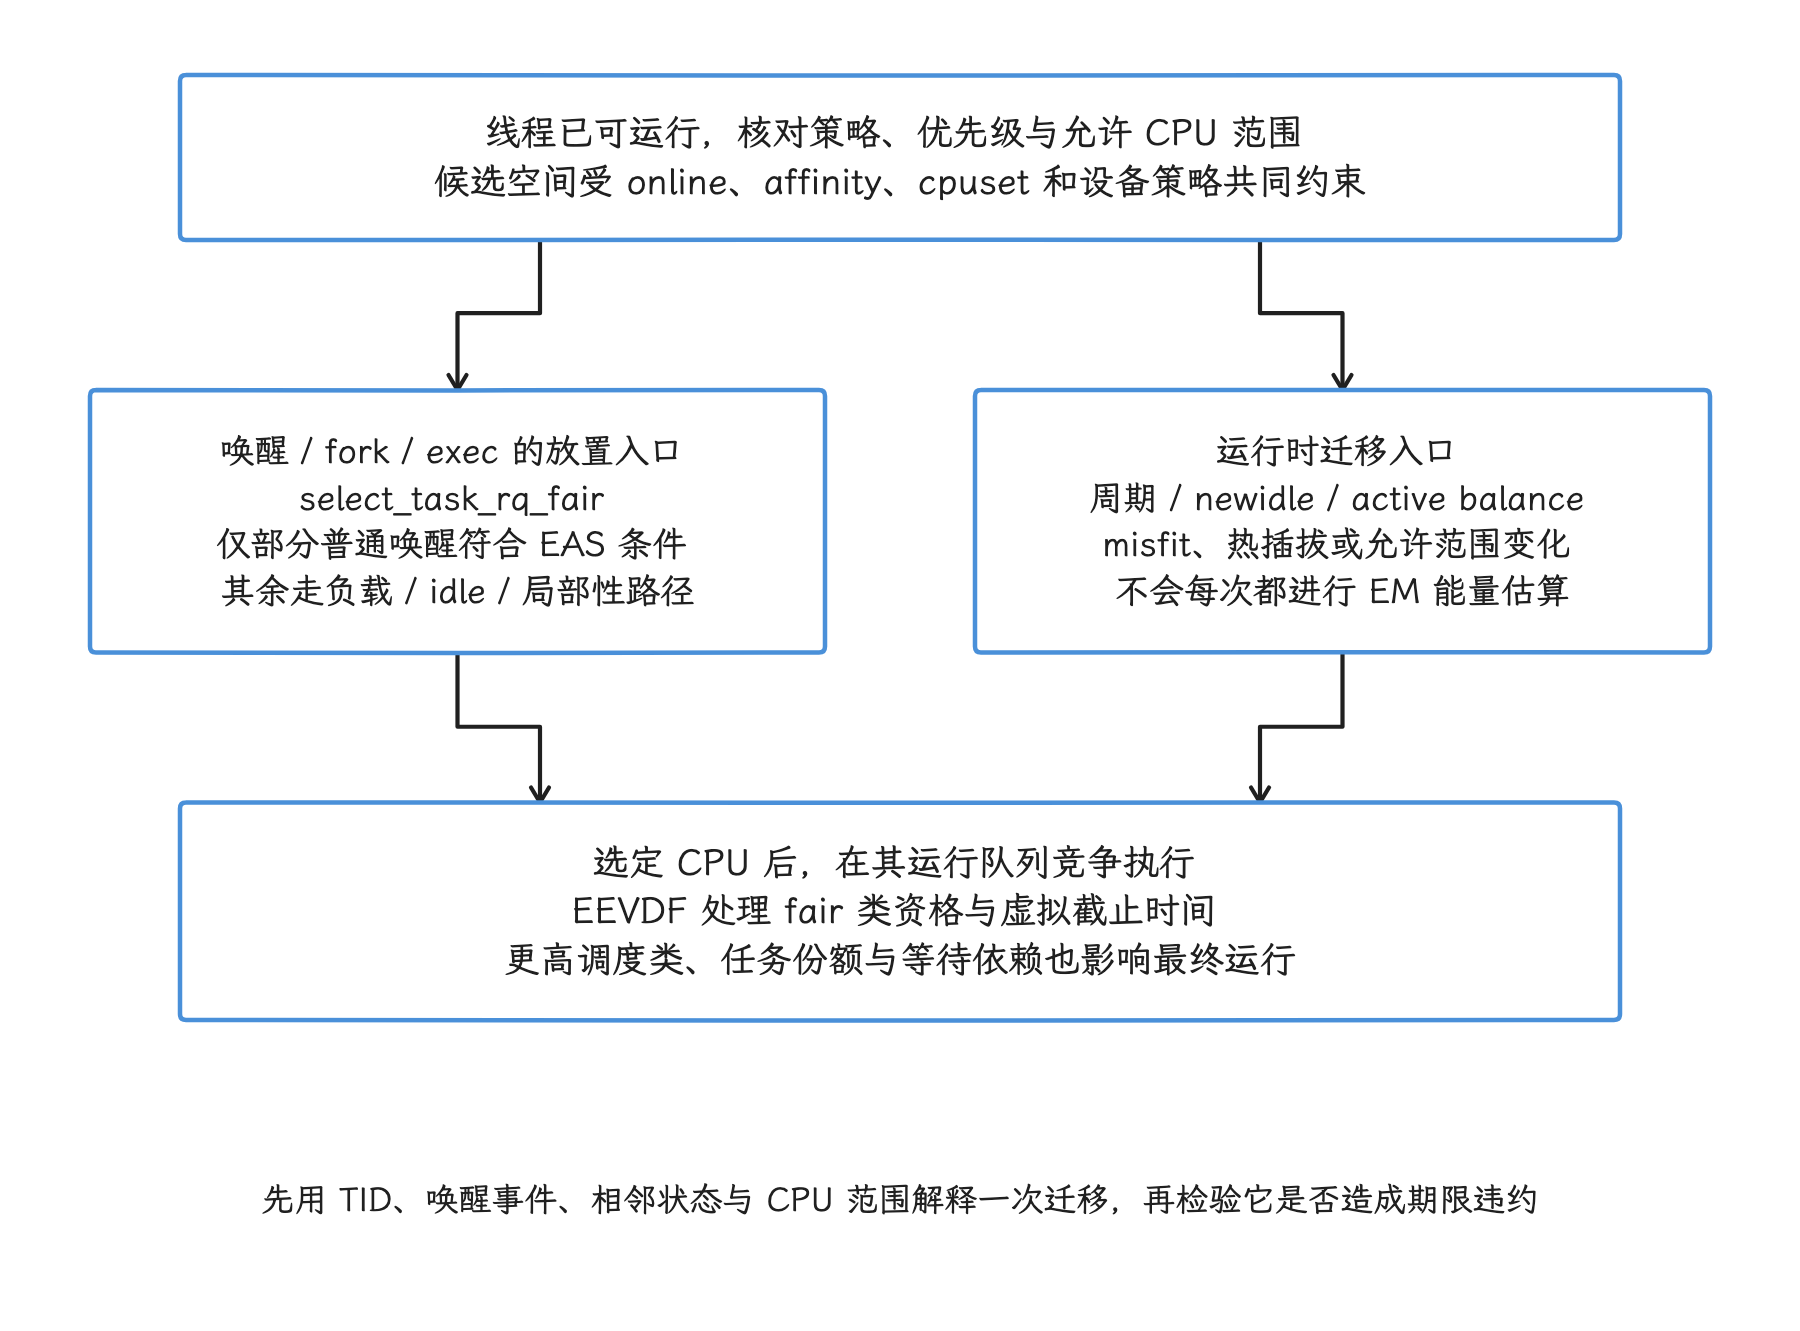
图:线程先要具备运行条件,再由策略和 CPU 约束决定何处竞争。普通唤醒可能走 EAS 放置;周期负载均衡、newidle、主动均衡、misfit 及 CPU 范围变化则可在运行过程中迁移任务。EEVDF 决定 fair 队列内选谁,不能单独解释所有选核;迁移次数也不是延迟根因的直接证据。
线程从睡眠到获得 CPU 的简化路径如下:
Sleeping / blocked
    │  sched_waking / sched_wakeup
    ▼
Runnable:已具备运行条件,在 runqueue 等待
    │  策略、资格、优先级、CPU 约束共同参与选择
    ▼
Running:出现在 sched_slice
    │
    ├─ 主动睡眠、等待锁或 I/O → S / D 等状态
    └─ 仍可运行但被切出         → R 或 R+
诊断时先确认线程是否具备运行条件,再检查调度资格和 CPU 约束,最后才考虑调参。
从 CFS 公平性到 EEVDF
vruntime 仍是公平记账的基础
CFS 从 Linux 2.6.23 开始用虚拟运行时间(vruntime)描述任务已经消耗的 CPU 份额。对于公平调度类里的一个调度实体,vruntime 增量可以用下面的关系理解:
delta_vruntime ≈ delta_exec × NICE_0_LOAD / weight
delta_exec 是实际运行时间,weight 是由 nice 值决定的权重。nice 越小,权重越大,相同实际运行时间产生的 vruntime 增量越少;长期竞争时,这类任务能获得更高的 CPU 份额。
Linux 6.18 的 kernel/sched/fair.c 仍通过 update_curr() 记账,并在 calc_delta_fair() 中按权重换算。变化主要在“下一次选择谁”:早期 CFS 偏向 vruntime 最小的实体,当前公平调度路径则使用 EEVDF 的运行资格(eligibility)和虚拟截止时间(virtual deadline)。
旧 CFS 的“最左节点”只用于理解历史实现
旧 CFS 把可运行的调度实体放入按 vruntime 排序的红黑树,并缓存最左节点,从中选择最缺 CPU 时间的实体。这个模型适合解释两件事:
- vruntime 为什么可以表达长期公平;
- nice 为什么影响 CPU 份额,而不会直接承诺某次唤醒的固定延迟。
在 Linux 6.18 中,如果继续把红黑树描述成“按 vruntime 排序并永远取最左节点”,就会得出错误结论。__enqueue_entity() 仍使用带额外统计信息的增广红黑树,但比较关系由虚拟截止时间决定;每个子树还维护 min_vruntime,供 __pick_eevdf() 快速跳过没有合格调度实体的分支。
EEVDF 的两个选择条件
Linux 从 6.6 开始迁移到 EEVDF。我们把 Linux 6.18 里 pick_eevdf() 选择任务的条件概括成两步:
- 具备资格(Eligible):任务的滞后量(lag)大于等于 0,表示按公平份额计算,系统仍欠它 CPU 时间。
- 最早虚拟截止时间:只在具备资格的实体中,选择虚拟截止时间最早的一个。
Linux 6.18 用加权平均虚拟时间与实体 vruntime 的差值表示 lag。理解正负方向即可:
lag > 0:任务尚未获得应有份额,具备被补偿的理由
lag < 0:任务已经超出当前公平份额
虚拟截止时间由本次请求的运行长度和权重共同决定。update_deadline() 的主要关系是:
virtual_deadline = vruntime + weighted(slice)
默认请求长度来自 sysctl_sched_base_slice。如果调用者通过 sched_setattr() 为公平调度类设置自定义时间片,Linux 6.18 的 __setparam_fair() 会把 sched_runtime 限制在 0.1 ms 到 100 ms。这个接口受内核版本、权限和调用方式约束,对普通 Android 应用来说算不上通用性能开关。
base_slice 的含义与有效值
在 android17-6.18-2026-06_r6 中,normalized_sysctl_sched_base_slice 的源码初值是 700,000 ns,也就是 0.70 ms。默认的 SCHED_TUNABLESCALING_LOG 会根据在线 CPU 数量做对数缩放,设备上的有效值还要以实际读取为准。
启用 CONFIG_SCHED_DEBUG 的内核,可以从下面的 debugfs 调试文件系统节点观察该值:
adb shell cat /sys/kernel/debug/sched/base_slice_ns
量产设备可能没有挂载 debugfs,也可能禁止 shell 读取。节点不可见只说明观测条件不足,判断调度器有没有用 EEVDF 还得靠其他观测手段。
sched_ext 的入口与默认状态
android17-6.18-2026-06_r6 已包含 sched_ext 和 BPF 调度类。BPF 允许在受控环境中把程序加载进内核;sched_ext 借此让具备系统权限的组件加载替代调度策略,并可通过 scx_bpf_cpuperf_set() 向 CPU 性能控制传递目标。内核包含这些接口是一回事,量产设备有没有启用某个 BPF 调度器,要另外验证。
验证时,我们至少要同时检查内核配置、/sys/kernel/sched_ext/state(节点存在且可读时)、已加载的 BPF 程序/链接,以及跟踪中是否出现相应的 sched_ext 事件。状态为 disabled 时,普通任务仍由本文描述的公平调度/EEVDF 路径选择。即使 sched_ext 已启用,它也不会直接写入 CPUFreq 驱动;性能目标仍要经过 schedutil、调频策略、驱动、固件与温控上限,详见 5.2。
Linux 6.18 还包含时间片保护(slice protection)、RUN_TO_PARITY(运行到公平收支平衡)、PREEMPT_SHORT(短请求抢占)和延迟出队(deferred dequeue)等细节。它们会影响一次请求何时允许被抢占、短请求怎样参与竞争,以及睡眠任务的 lag 如何衰减。分析跟踪时,记住下面三点更有用:
- EEVDF 仍以公平份额为目标,没有取消 nice 权重;
- 运行资格解决“当前是否欠它 CPU”,虚拟截止时间解决“欠 CPU 的任务中先选谁”;
- 单个 Running 切片的长度未必是
base_slice,唤醒、阻塞、抢占、层级调度与调度器 tick 都可能让切片提前结束或继续运行。
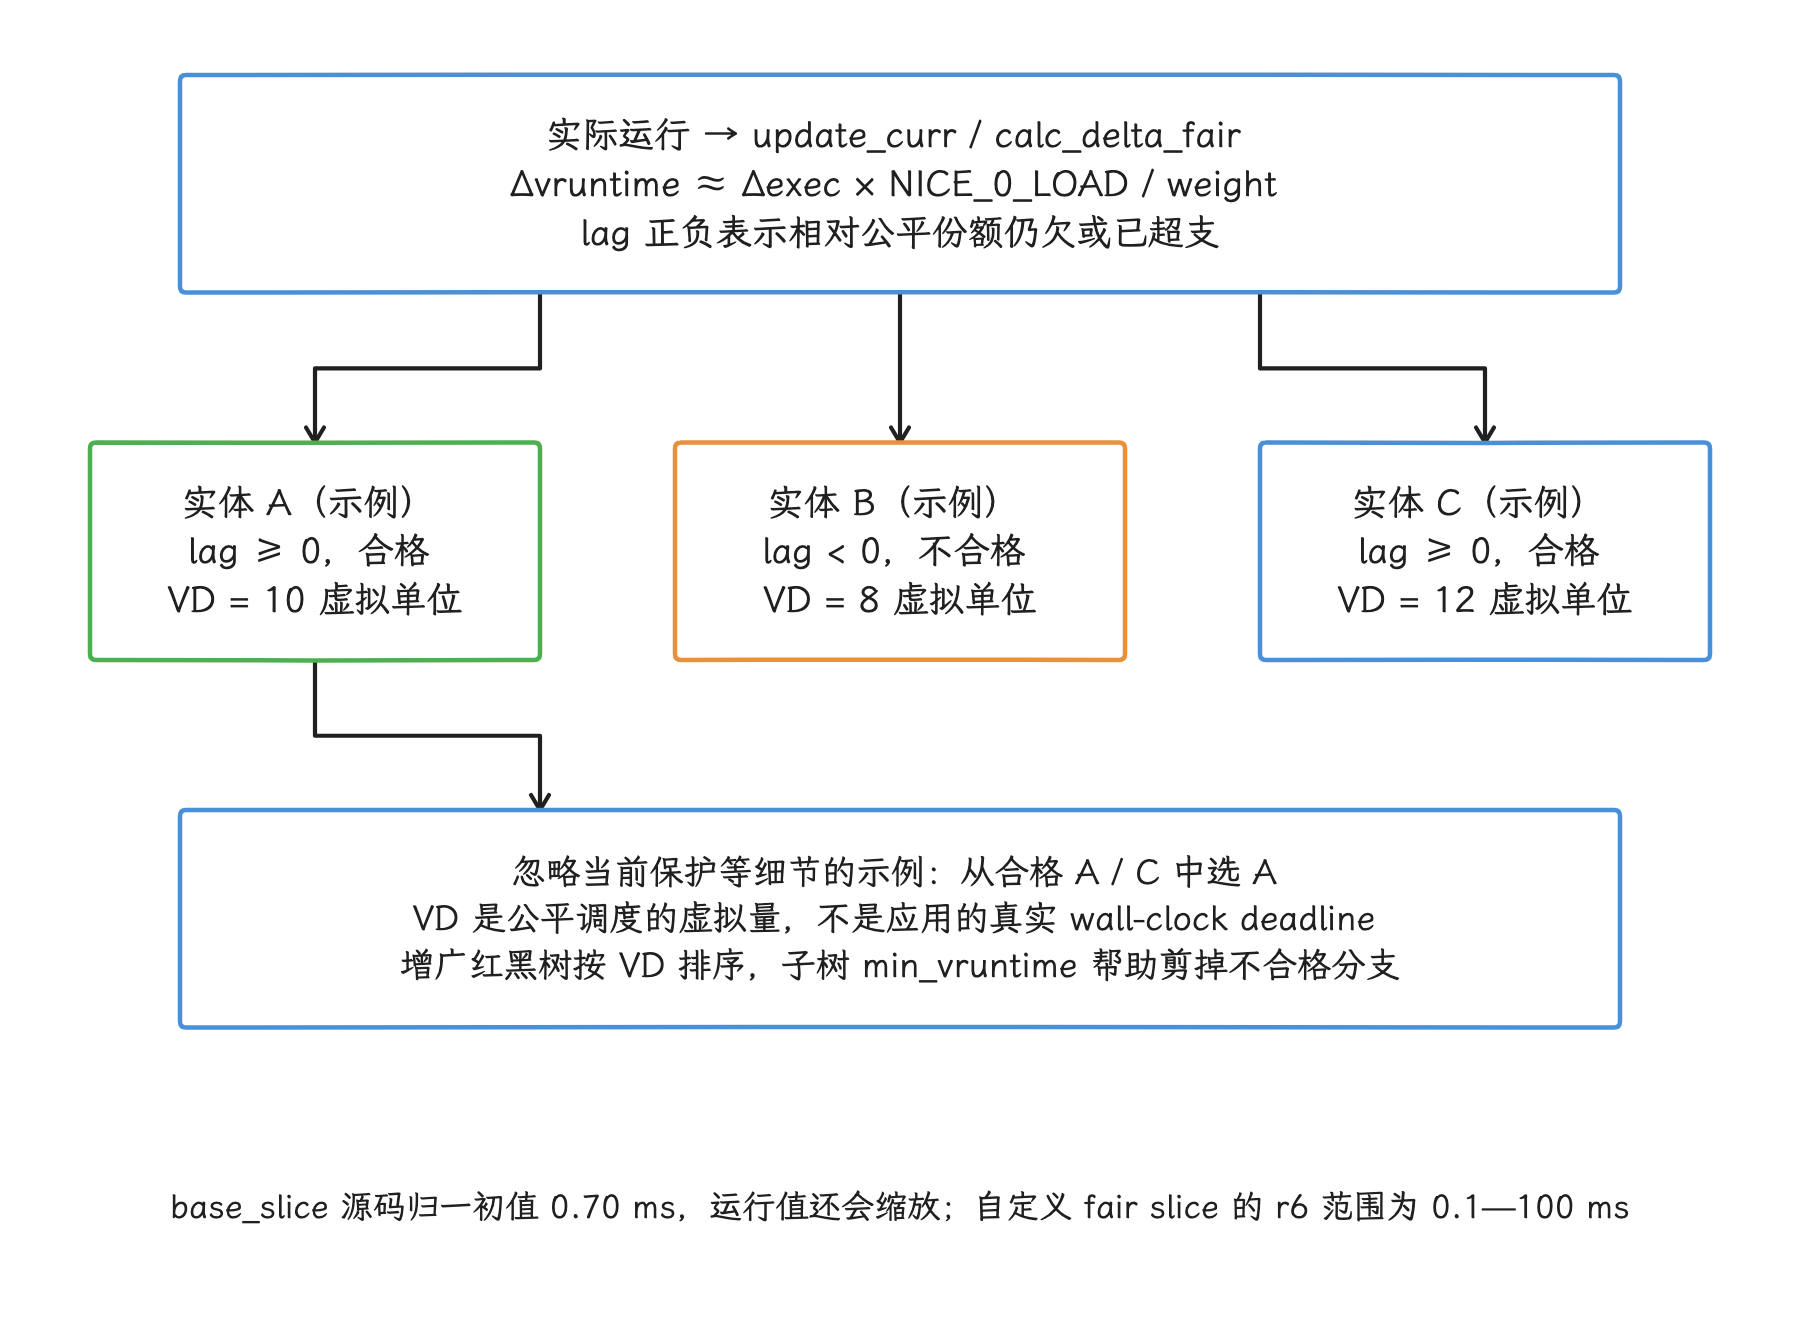
图:核心选择先看 lag 是否非负,再比较合格实体的虚拟截止时间。教学例子中 B 的 VD 最早但 lag 为负,A 与 C 合格,选 VD 更早的 A。nice 仍通过权重影响 vruntime 与虚拟请求长度。实际 r6 还处理当前实体的时间片保护、层级调度与延迟出队,单段 Running 长度不能直接当成 base_slice。
调度策略、调度类与优先级
用户可见策略的顺序
常见用户态策略的优先关系如下(内核内部的停止调度类 stop class、配置相关的 sched_ext 不计入):
SCHED_DEADLINE
    > SCHED_FIFO / SCHED_RR
    > SCHED_OTHER / SCHED_BATCH / SCHED_IDLE
用户态 SCHED_IDLE 由 kernel/sched/fair.c 实现,仍属于公平调度模块,不要与每个 CPU 的空闲任务所属的 idle_sched_class 混为一谈。SCHED_IDLE 比 nice 19 更弱,但线程仍是普通的可运行任务。
各策略的参数含义如下:
| 策略 | 用户态参数 | 关键语义 |
|---|---|---|
SCHED_DEADLINE | sched_runtime、sched_deadline、sched_period | 采用截止时间调度类,启用前受带宽准入控制 |
SCHED_FIFO | sched_priority 1..99 | 同优先级任务不会按轮转时间片自动切换 |
SCHED_RR | sched_priority 1..99 | 同优先级任务按轮转时间片(RR quantum)切换 |
SCHED_OTHER | sched_priority = 0,使用 nice | Android 普通线程的主要策略 |
SCHED_BATCH | sched_priority = 0,使用 nice | 偏向吞吐,交互性较弱 |
SCHED_IDLE | sched_priority = 0 | 公平调度模块中的极低权重策略 |
实时(RT)线程先比较 sched_priority,数值越大,用户态实时优先级越高。两个 RT 线程只有在优先级相同时,FIFO 与 RR 的队列语义才决定轮转方式。
对于公平调度线程,内核静态优先级通常可以按 120 + nice 理解:nice -20 对应 100,nice 0 对应 120,nice 19 对应 139。在 Perfetto 的 sched_slice.priority 中看到这些数字时,数值越小表示权重越高。不要把这套内核编号方向与 RT 用户态 sched_priority 的方向混在一起。
nice 调整的是份额
Linux 的 nice 范围是 -20 到 19。权重表近似按每一级 1.25 倍变化,几个常用点如下:
| nice | weight |
|---|---|
| -20 | 88761 |
| -10 | 9548 |
| 0 | 1024 |
| 10 | 110 |
| 19 | 15 |
两个始终可运行、处于同一公平调度层级并竞争同一个 CPU 的线程,CPU 份额大致与权重成比例。实际设备还会受到 cgroup 层级、负载均衡、CPU 算力(capacity)、UClamp、温控限制和睡眠/唤醒模式影响。
nice 不会让一段代码里的每条指令执行得更快,它改变的是 CPU 竞争结果。提高 nice 数值会降低权重;降低 nice 数值会提高权重,而且通常需要相应权限。如果线程大部分时间在等待 Binder、锁、I/O 或 GPU,修改 nice 很可能没有收益。
Android framework 的 android.os.Process 定义了一组常用线程优先级,例如:
| 常量 | nice 值 |
|---|---|
THREAD_PRIORITY_DEFAULT | 0 |
THREAD_PRIORITY_BACKGROUND | 10 |
THREAD_PRIORITY_FOREGROUND | -2 |
THREAD_PRIORITY_DISPLAY | -4 |
THREAD_PRIORITY_URGENT_DISPLAY | -8 |
THREAD_PRIORITY_AUDIO | -16 |
THREAD_PRIORITY_URGENT_AUDIO | -19 |
这些常量描述请求值,不表示任意应用都能把线程设置为所有负 nice 值。内核权限、Android 服务端检查和 SELinux 策略仍会限制调用。
进程进入后台时,系统可能同时改变 cpuset、CPU cgroup、UClamp、定时器松弛时间(timer slack)、I/O 优先级和 oom_score_adj。把这些变化概括成“系统一定把进程 nice 调高”是误读,CPU 调度优先级和低内存终止优先级也是两套独立的状态。
Android 的 CPU 约束与任务配置文件
亲和性、cpuset 与在线 CPU 共同决定可运行范围
一个线程能够运行的 CPU 范围,可以用下面的交集来理解:
effective CPUs
  = online CPUs
  ∩ sched affinity mask
  ∩ cpuset / cgroup 允许范围
sched_setaffinity() 为线程设置 CPU 亲和性掩码。在 Linux 接口中传入线程 ID(TID),即可控制单个线程。Android Bionic 也提供 sched_setaffinity() / sched_getaffinity();pthread_setaffinity_np() / pthread_getaffinity_np() 从 API 36 起公开。
CPU 亲和性只能进一步缩小允许范围,改不了 cpuset 划定的范围。之后系统调整 cpuset、下线 CPU,或温控策略缩小可用范围时,线程仍可能被迁移。直接把 RenderThread 固定在某个“大核编号”上,会压缩调度器的迁移空间,可能带来排队、温升或能耗回归,所以它只适合作为受控实验,别当成默认优化。
“cpu >= 4 就是大核”这类编号规则换一颗 SoC 未必还成立;判断 CPU 类型要结合 sysfs 拓扑、最高频率,或跟踪中的 CPU 频率/算力信息。
任务配置文件是 Android 用户空间的命名控制层
libprocessgroup 使用任务配置文件(task profile),把用户空间名称映射到 cgroup 和属性操作。system/core/libprocessgroup/profiles/task_profiles.json 中定义了:
HighEnergySaving加入 CPUbackgroundcgroup;HighPerformance加入 CPUforegroundcgroup;HighPerformanceWI加入foreground_window;MaxPerformance加入top-app;ProcessCapacityLow、ProcessCapacityHigh、ProcessCapacityMax分别加入相应 cpuset;UClampMin、UClampMax和UClampLatencySensitive映射到 CPU 控制器属性。
聚合配置可以组合多个操作。例如,CPUSET_SP_BACKGROUND 同时引用 HighEnergySaving、ProcessCapacityLow、低 I/O 优先级和较高的定时器松弛时间;CPUSET_SP_TOP_APP 则组合 MaxPerformance、ProcessCapacityMax、最高 I/O 优先级和普通定时器松弛时间。
因此,“前台/后台调度组”包含多种资源策略,一个目录名撑不起全部效果。设备还可能通过 system_ext 或厂商配置覆盖默认任务配置。诊断具体设备时,应从运行时配置和进程成员关系反查,避免硬编码某个 /dev/cpuset 或 /dev/cgroot 路径。
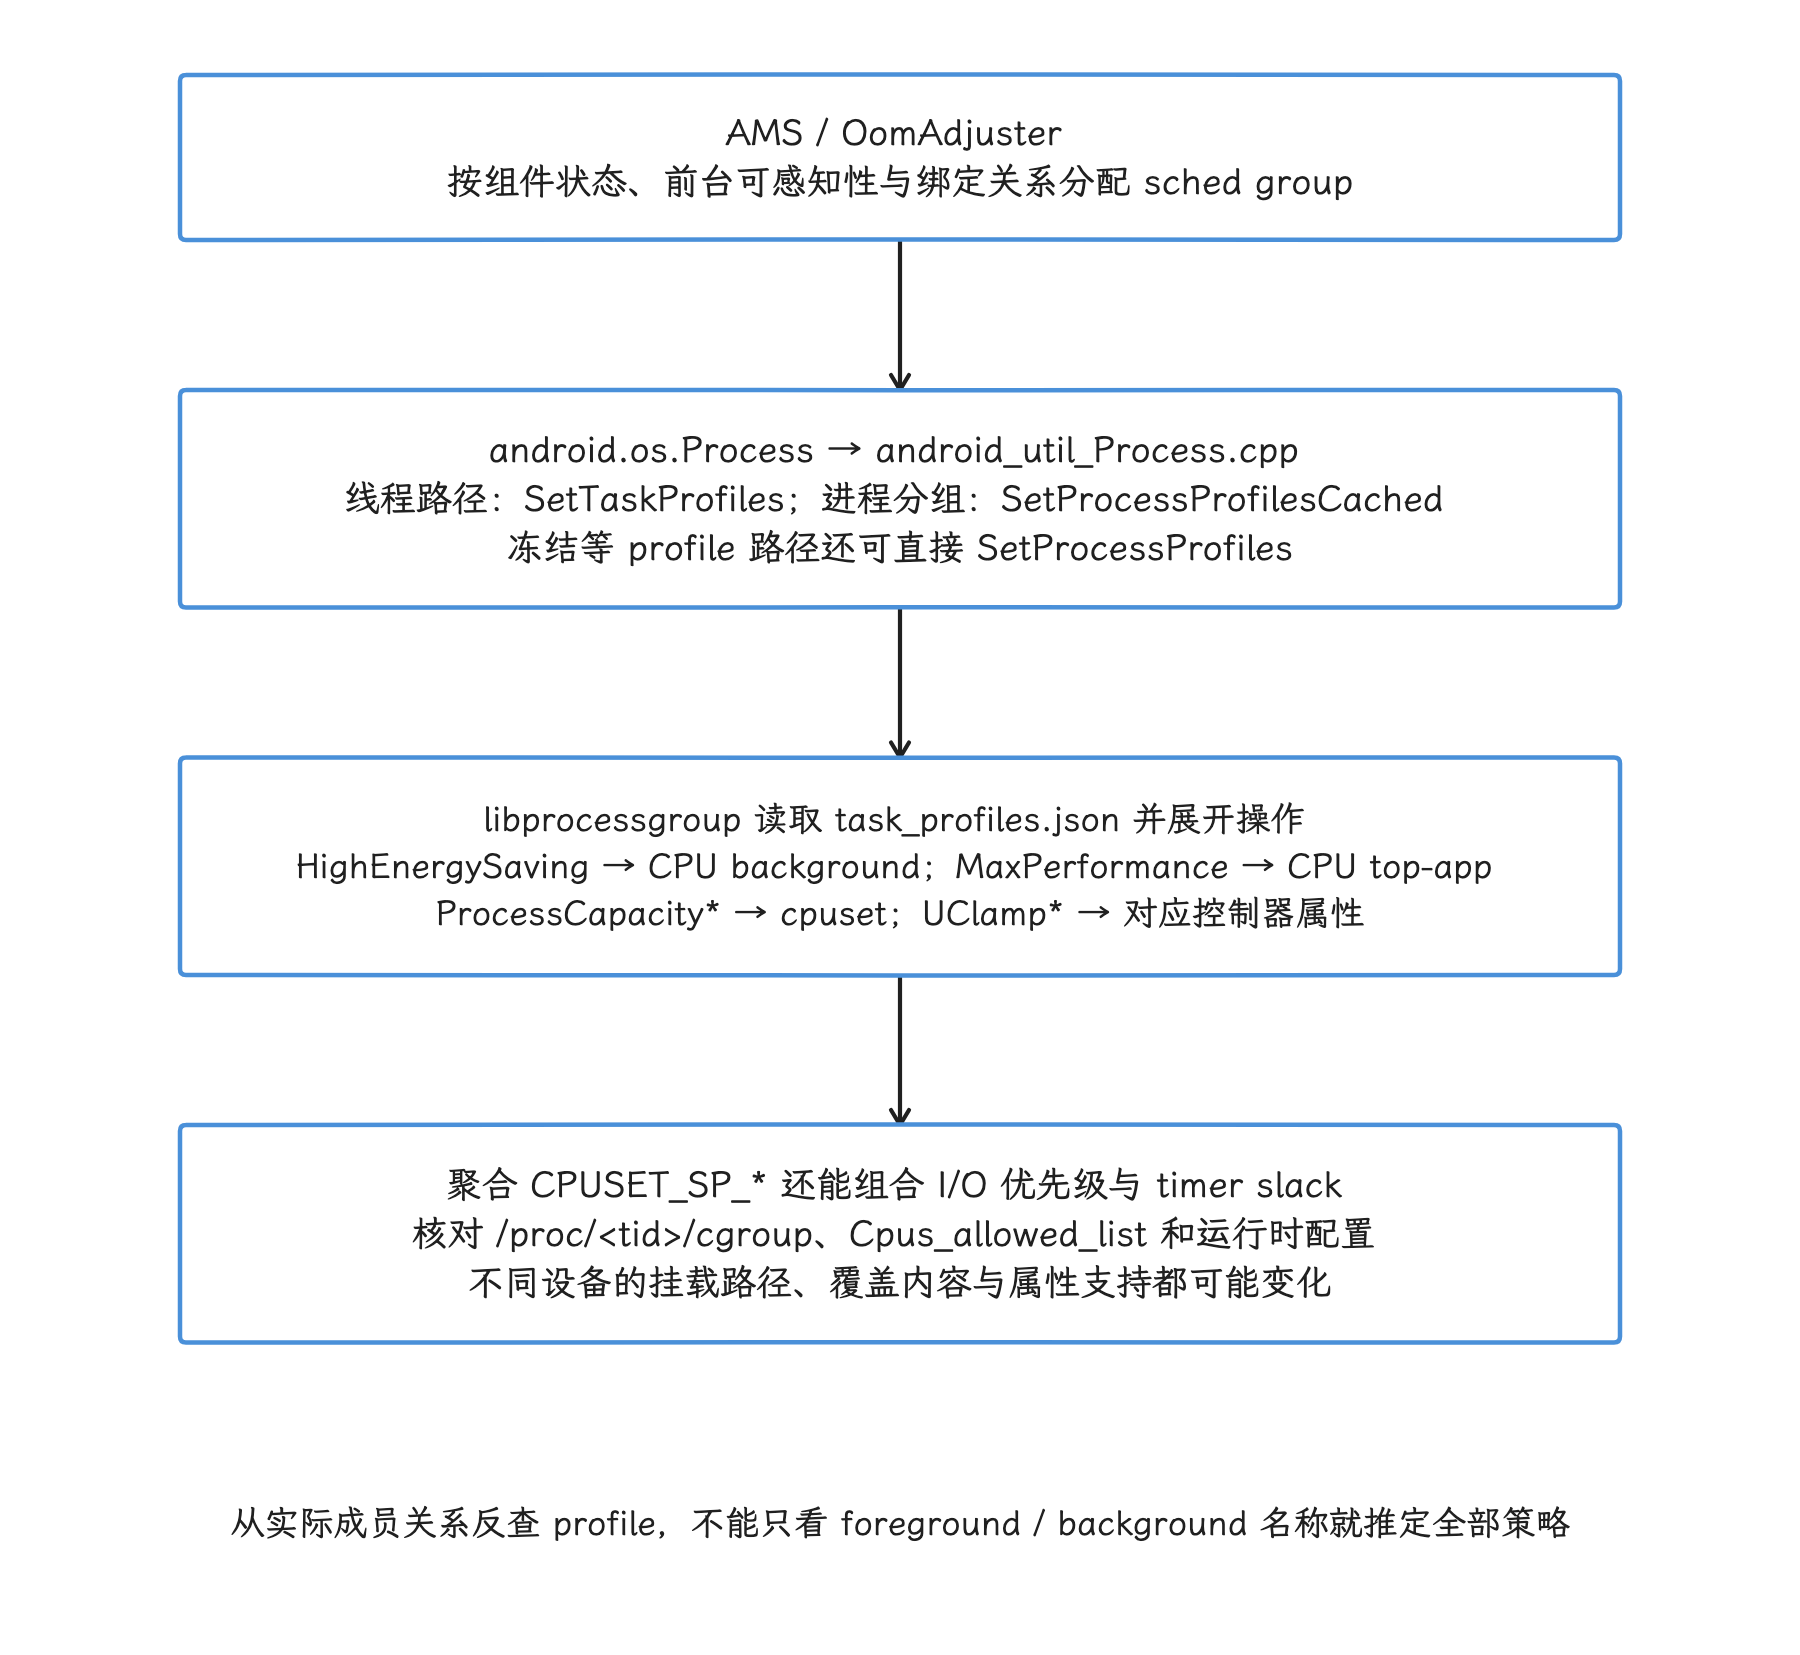
图:AMS 根据组件状态与依赖计算调度组,Process JNI 再调用 libprocessgroup 的任务或进程 profile 接口。命名 profile 展开为加入 CPU/cpuset cgroup、UClamp 属性和 I/O、timer slack 等操作;聚合 profile 可以组合多项。前后台变化不能简单等同于统一调高 nice,运行时配置还可能被厂商覆盖。
下面这组只读命令用于确认某个线程的有效 CPU 范围和 cgroup 成员关系:
adb shell 'cat /proc/<pid>/task/<tid>/status | grep Cpus_allowed_list'
adb shell 'cat /proc/<pid>/task/<tid>/cgroup'
adb shell 'cat /proc/mounts | grep cgroup'
把 <pid> 和 <tid> 替换成目标值。第一条给出经过亲和性/cpuset 共同约束后的当前允许列表,第二、三条帮助定位设备实际使用的控制器与挂载路径。
UClamp 的作用层面
UClamp 为任务或 cgroup 提供利用率上下界:
uclamp.min向调度器提供最低利用率提示,可能影响 CPU 选核和调频;uclamp.max限制可采用的最高利用率,有助于约束性能与功耗;- Android 配置中的
cpu.uclamp.latency_sensitive还依赖设备内核对该属性的支持。
UClamp 与 EEVDF 处理的层面不同。EEVDF 在公平调度运行队列中处理运行资格和虚拟截止时间;UClamp 参与算力适配、能量感知选核和频率决策。提高 uclamp.min 不保证线程会立刻得到 CPU,也不会越过实时线程或截止时间调度线程。
SchedTune 的 schedtune.boost 常见于旧版 Android 或厂商内核。阅读历史跟踪或旧设备配置时仍可能遇到它;对于 Android 17 / Linux 6.18 这套基线,应先检查 cgroup v2 与 cpu.uclamp.*,再根据设备源码判断是否保留了厂商扩展。
在 Perfetto 中读调度延迟
区分正在运行、可运行与被抢占
看 sched_slice 之前,我们先区分线程的几种状态。Perfetto 的 sched_slice 每一行描述某个线程在某个 CPU 上的一段正在运行(Running)时间,end_state 表示切片结束后线程进入的状态:
R:切出后仍然处于可运行状态;R+:Runnable (Preempted),Perfetto 明确标记为被抢占;S:可中断睡眠;D:不可中断睡眠;I:内核空闲线程状态;NULL且dur = -1:跟踪结束时切片尚未闭合等未完成情况。
thread_state 把正在运行、可运行和睡眠状态放在同一张时间表中。统计运行队列等待时间时,应同时纳入 R 与 R+;只查询 R 会漏掉被抢占后继续等待的区间。
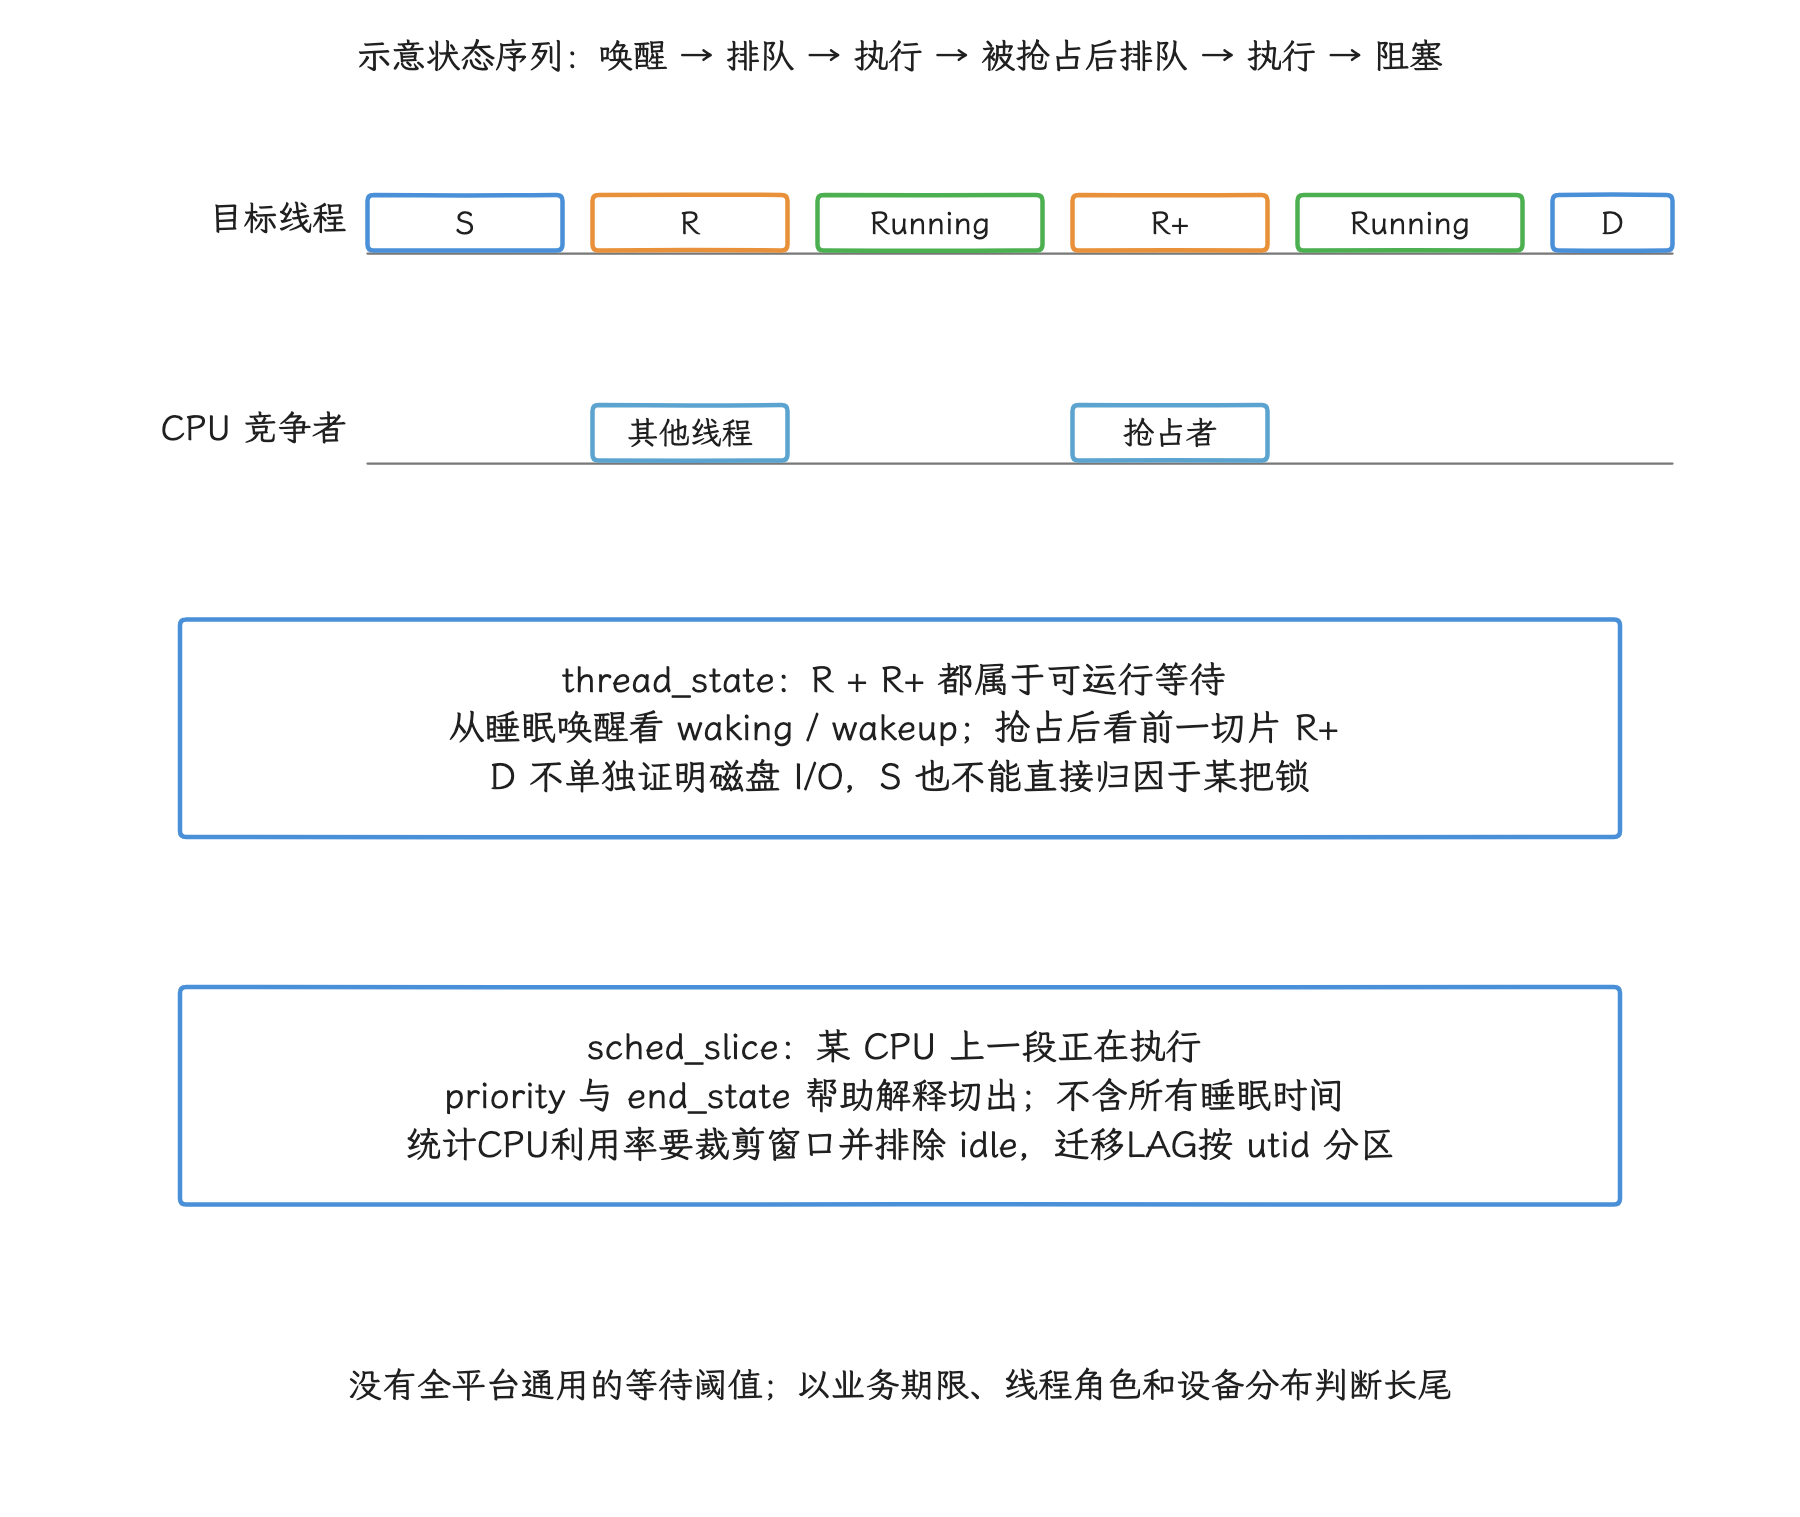
图:唤醒后到首次 Running 是一段可运行等待,Running 被抢占后仍可进入 R+ 继续排队。thread_state 用来量状态区间,sched_slice 量 CPU 上执行;S、D 则需栈与唤醒依赖解释。统计调度等待应同时看 R 与 R+,而迁移应按真实 utid 分区,不能把同名线程的不同生命周期连起来。
下面的查询用于找出目标进程中可运行等待时间最多的线程:
SELECT
  t.name AS thread_name,
  ts.state,
  COUNT(*) AS wait_count,
  ROUND(SUM(ts.dur) / 1e6, 3) AS total_wait_ms,
  ROUND(MAX(ts.dur) / 1e6, 3) AS max_wait_ms
FROM thread_state AS ts
JOIN thread AS t USING (utid)
JOIN process AS p USING (upid)
WHERE p.name = 'your.package.name'
  AND ts.state IN ('R', 'R+')
  AND ts.dur > 0
GROUP BY t.utid, t.name, ts.state
ORDER BY total_wait_ms DESC;
这里的 dur 是每段状态的持续时间,单位为纳秒。先看最大值判断是否存在少数尖峰,再看总量判断是否持续竞争;不要只用平均值掩盖长尾。
若要直接观察哪些运行切片以抢占结束,可以使用下面的查询:
SELECT
  s.ts,
  ROUND(s.dur / 1e6, 3) AS running_ms,
  s.cpu,
  t.name AS thread_name,
  s.priority
FROM sched_slice AS s
JOIN thread AS t USING (utid)
JOIN process AS p USING (upid)
WHERE p.name = 'your.package.name'
  AND s.end_state = 'R+'
  AND s.dur > 0
ORDER BY s.dur DESC
LIMIT 100;
R+ 能证明这次切出被 Perfetto 编码为抢占,抢占者是谁则要看同一 CPU 上紧接着开始的 sched_slice、其调度类/优先级,以及唤醒事件。
从运行时长到利用率
下面的查询只统计各 CPU 在跟踪中记录到的运行时长,适合快速查看工作分布:
SELECT
  cpu,
  ROUND(SUM(dur) / 1e6, 3) AS running_ms
FROM sched_slice
WHERE dur > 0
GROUP BY cpu
ORDER BY cpu;
这个查询不会直接给出利用率百分比。若要计算利用率,需要先确定分析窗口,把跨越窗口的切片裁剪到窗口边界,再用“该 CPU 的非空闲运行时长 / 窗口长度”计算。多个 CPU 的时长相加再除以单个窗口长度,结果会超过 100%,要按每颗 CPU 分别算。
从唤醒到运行要结合唤醒事件
可运行等待时长可以粗略写成:
scheduling latency = first_running_ts - runnable_ts
但进入可运行状态的时间来源需要区分:
- 从睡眠被唤醒:关注
sched_waking/sched_wakeup; - Running 后被抢占:前一个
sched_slice.end_state = 'R+'; - 主动让出 CPU、迁移或其他调度路径:需要结合相邻状态和内核事件判断。
采集 CPU 调度延迟时,Perfetto 官方文档建议关注 sched_switch、sched_waking,必要时再加入 sched_wakeup。sched_waking 由发起唤醒的一侧记录,通常足以还原唤醒关系;若要继续分析唤醒路径,或跨 CPU 的处理器间中断(IPI)延迟,再核对 sched_wakeup。
不存在跨设备通用的“可运行等待超过帧周期 10% 就算异常”阈值。阈值应来自业务完成时限、线程角色和设备分布。例如,主线程在一次 8.33 ms 帧预算内等待 2 ms 可能影响明显,后台编译线程等待同样时长通常无需处理。
Android 中的实时线程
音频、显示合成、相机等系统路径可能使用实时调度策略来降低调度抖动,但是否启用、使用哪个优先级以及由谁授权,取决于 AOSP 服务、设备配置和厂商实现;单看线程名,断定不了它是否使用 SCHED_FIFO。
普通应用直接设置实时策略,通常会受到 CAP_SYS_NICE 能力、rlimit、服务端授权与 SELinux 的限制。Android 音频路径存在由系统服务协调优先级的机制;这也不表示任意应用线程都能自由选择实时优先级。
实时调度的风险来自无界运行:高优先级 FIFO 线程如果长时间不阻塞,会压制较低优先级的实时线程和全部公平调度线程。审查实时调度问题时,我们至少要确认:
- 线程的调度策略和优先级;
- 每次连续运行的最长时间;
- 是否存在稳定的阻塞点;
- 是否造成关键公平调度线程长时间处于可运行等待;
- 设备是否配置实时调度带宽限制或厂商保护机制。
SurfaceFlinger、AudioFlinger 或 HAL 线程的策略,应根据目标设备的跟踪和源码确认。把某款设备上的实时调度配置写成 Android 平台固定行为,会让结论失去版本和设备的适用范围。
一套可复现的诊断顺序
1. 先确认关键区间和完成时限
从输入、动画、Binder 请求或业务跟踪切片中找到问题窗口,写清楚线程必须在什么时间前完成。没有完成时限,可运行等待时长就只是一项观测值。
2. 分解线程时间
把目标线程的区间拆成正在运行、R/R+、S、D 和 Binder/锁等待:
- 正在运行时间很长:优先检查代码量、热点与 CPU 频率;
R/R+很长:继续检查 CPU 竞争、调度策略、优先级与 CPU 约束;S很长:找唤醒者、锁、futex、Binder 或定时器;D很长:检查阻塞函数与 I/O/内核路径。
“墙上时间接近 CPU 时间”只能作为 CPU-bound 问题的初步筛查。多线程并行、抢占、CPU 迁移和采样误差都会破坏这个近似。
3. 解释竞争者
在较长的可运行等待区间内,我们查看同一 CPU 上正在运行的线程:
- 如果是截止时间/实时线程,先检查其运行是否有界;
- 如果是权重更高的公平调度线程,核对 nice、cgroup 层级和业务必要性;
- 如果 CPU 处于空闲状态,检查目标线程是否受 CPU 亲和性/cpuset 限制,或跟踪是否缺少事件;
- 如果目标线程频繁跨核,要结合缓存未命中、频率与迁移事件评估影响,迁移次数本身说明不了多少问题。
4. 检查 Android 控制面
读取目标 TID 的 Cpus_allowed_list、cgroup 成员关系、调度策略/nice,并对照运行时任务配置。还要区分应用自己的设置、framework 生命周期调整和厂商配置。
5. 每次只验证一个改动
可选措施包括减少关键路径工作、拆分后台任务、修正错误优先级、调整任务配置、修正过窄的 cpuset,或在拥有平台权限的系统组件中修改 UClamp/实时调度参数。先证明 CPU 迁移或选核确实造成了问题,再实验性调整 CPU 亲和性。
验证至少覆盖:
- 目标延迟的 P50/P90/P99;
- 可运行等待长尾;
- CPU 频率、温度与功耗;
- 相邻关键线程是否退化;
- 冷机、热稳态和持续负载。
调度优化常把延迟从一个线程转移到另一个线程。只看目标线程变快,还不足以证明系统收益。
版本基线与源码索引
| 主题 | 当前锚点 | 历史内容的用途 |
|---|---|---|
| Android 平台 | android-17.0.0_r1 / API 37 | 说明 API 引入与旧设备差异 |
| Linux 内核 | android17-6.18-2026-06_r6 | 旧 CFS 用于解释 vruntime 与演进 |
| 公平调度选择任务 | EEVDF:运行资格 + 最早虚拟截止时间 | “最小 vruntime 最左节点”仅用于说明旧 CFS 模型 |
| Android CPU 控制 | libprocessgroup 任务配置、cpuset、cgroup v2 UClamp | SchedTune 用于识别旧版/厂商内核 |
| Perfetto | Android 17 对应源码与 CPU 调度文档 | 旧 Systrace 术语只用于兼容阅读 |
相关结论可从以下源码入口复核:
- Linux 内核
Documentation/scheduler/sched-design-CFS.rst、Documentation/scheduler/sched-eevdf.rst; - Linux 内核
kernel/sched/fair.c:update_curr()、entity_eligible()、__pick_eevdf()、update_deadline()、__setparam_fair(); - Android
system/core/libprocessgroup/profiles/task_profiles.json; - Android bionic
libc/include/sched.h与libc/include/pthread.h; - Perfetto
docs/data-sources/cpu-scheduling.md、thread_state与sched_slice表定义。
常见误区
“优先级高,代码会执行得更快”
优先级改变竞争顺序或 CPU 份额。代码在相同核心、相同频率下的指令执行成本不会因此下降。
“绑到大核一定更快”
过窄的 CPU 亲和性会减少可选 CPU,让线程在繁忙核心上排队,也会限制 EAS 根据温度与负载迁移任务。应先用跟踪证明选核或迁移是瓶颈,再做 A/B 对照。
“大量 Runnable 说明调度器有 bug”
可运行状态只说明线程具备运行条件、但尚未获得 CPU。CPU 过载、实时线程干扰、错误的线程优先级、cpuset 限制和应用自身制造的并发,都可能产生相同现象。
“UClamp、nice、cpuset 可以互相替代”
三者分别约束利用率提示、公平权重和可用 CPU 集合。它们会相互影响,但修改对象和副作用不同。
“oom_score_adj 低,线程就会先获得 CPU”
oom_score_adj 服务于低内存终止选择;CPU 调度由调度策略、优先级、nice、cgroup、cpuset、UClamp 等机制决定。两者可能由同一个生命周期事件一起更新,但含义仍然独立。
EAS 的能量模型与任务放置
看到主线程落在低 capacity CPU 上、或在性能域之间来回迁移时,我们最终要解释的是 EAS 的放置决策。基础调度保证公平和实时约束,EAS 在候选 CPU 之间估算能耗;容量、利用率和能量模型不准确时,放置结果也会偏离预期。
[!info] 源码锚点 正文按 Android 17 / API 37 /
android-17.0.0_r1与 Linux 内核分支android17-6.18-2026-06_r6复核。Linux 5.x、6.6、6.12 和 Android 10—16 只用于说明演进,不代表当前实现。
EAS 要解决的问题
上一节讲了公平调度器怎样用 vruntime、lag 和虚拟截止时间分配 CPU 时间。移动设备还有另一个目标:在不明显损害吞吐和响应的前提下降低能耗。在大小核混合的 SoC 上,这个目标就落到了选核问题上。
我们以四小核加四大核的八核处理器为例:安排任务时要判断任务该放小核还是大核。小核更省电,但性能可能不足;大核性能更高,功耗也更高。调度器只看当前空闲程度时,轻任务(利用率较低)就可能被放到大核上,抬高频率和电压,并在前台交互阶段产生更多功耗与热量。
EAS 在 Linux 5.0 合入主线:任务唤醒时,它先在每个性能域(performance domain)中找出有代表性的候选 CPU,再借助能量模型(Energy Model,EM)估算放置前后的活跃态能量差值;最终选择仍要满足 CPU 亲和性、cpuset、capacity 和 UClamp 等约束。
在 Perfetto trace 里看到主线程运行在低 capacity CPU 上,或在性能域之间迁移时,可以分别追查唤醒选核(wake-up placement)、负载均衡、UClamp 与温控各自的贡献。
EAS 如何选择 CPU
从“找最快的核”到“找更省电的核”
不使用 EAS 时,fair 类任务的唤醒选核主要依据负载、空闲状态与缓存局部性(cache locality)。异构系统里只比空闲程度,轻任务就可能被送进 capacity 较高、功耗成本也较高的性能域。
EAS 接管 fair 类任务的部分唤醒负载均衡。Linux 6.18 的 select_task_rq_fair() 仅在带有普通任务唤醒标志 WF_TTWU、且根调度域未标记为过载(overutilized)时调用 find_energy_efficient_cpu();fork/exec、无可用 EM 等情况会走其他路径。同步唤醒仍会进入该函数,但满足快速路径条件时可在 EM 估算前直接返回当前 CPU。EM 用来比较数个可接受候选的能量影响,目标是在尽量降低能耗的同时,减少对吞吐的影响。
例如,一个 util 为 120 的轻量级任务需要被唤醒,系统中有两种核心:
- 小核:capacity 为 200,当前空闲;
- 大核:capacity 为 1024,当前空闲。
若小核的候选 CPU 通过 fits_capacity(120, 200),EAS 会继续比较它与大核候选、任务上次运行的 CPU 的能量增量。小核往往更合适,但结果仍取决于该性能域内其他 CPU 的利用率、UClamp、温控压力和 EM 成本,光凭 120 与 200 两个数断言不了目标 CPU。
EAS 的前提条件
EAS 要在一台设备上生效,需要先满足这些条件:
- 异构 CPU 拓扑:调度域需要具备
SD_ASYM_CPUCAPACITY_FULL。当前 EAS 不支持对称 CPU 拓扑。 - 能量模型可用:root domain 需要关联已注册的性能域与功耗成本表(power cost table)。
- 可缩放的利用率信号:平台要实现 PELT 频率不变性和 CPU 不变性所需的架构回调。
- schedutil 调频策略:EAS 假设 OPP 会跟随利用率变化。官方文档把 schedutil 视为符合这一假设的 governor;不推荐搭配其他 governor。
是否满足这些条件要以目标设备为准。Android 公共内核提供的是框架,SoC 的 capacity、EM、cpufreq 和调度域仍由设备内核与固件数据决定。
能量模型(Energy Model)
OPP:频率-电压对的集合
EAS 的能耗预测依赖 OPP 提供的数据。
CPU 可以在多个频率、电压工作点之间切换,每个有效组合就是一个 OPP。下面的数字只用于展示表的形态,不对应任何量产 SoC:
| OPP | 频率 (MHz) | 电压 (mV) | 功耗 (mW) |
|---|---|---|---|
| 0 | 300 | 600 | 15 |
| 1 | 600 | 650 | 30 |
| 2 | 900 | 720 | 60 |
| 3 | 1200 | 820 | 120 |
| 4 | 1500 | 950 | 200 |
| 5 | 1800 | 1100 | 380 |
表中的活跃态功耗成本(active power cost)随频率上升得很快。动态功耗常用 P_dynamic ∝ C × V² × f 解释,但整颗 CPU 的功耗还包含漏电、互连和平台相关成本,把它叫作“指数增长”并不准确。EAS 读取的是注册到 EM 的成本表(cost table),调度热路径里直接查表。
OPP 可以来自设备树(Device Tree)的 operating-points-v2,也可以由平台驱动提供。EM 的性能域通常对应共享性能状态(performance state)的 CPU 集合;它和“外观上的 CPU 簇”经常重合,最终以 cpufreq policy 和已注册的 EM 为准。
能量模型框架
Linux 内核的 EM 是一个独立于调度器的子系统。它给每个性能域维护一张活跃态功耗成本表,表项对应不同的性能状态或 OPP。调度器通过 em_cpu_energy() 接口估算“把任务放进这个簇后,活跃运行态(Running)大概要消耗多少能量”。调用链为 kernel/sched/fair.c::compute_energy() → em_cpu_energy() → EM 性能状态与功耗表。
EM 只描述活跃运行态的功耗成本,不负责 CPU 空闲状态。进入多深的 C-State(CPU 空闲低功耗状态)、停留多久,属于 CPUIdle governor(状态选择策略) 和驱动的职责;观测时看 cpu_idle 轨道、平台空闲态统计或内核空闲态数据。把 EM 和 CPUIdle 写成一张表,等于把“频率点功耗”和“空闲驻留功耗”混成同一层概念。
EAS、温控 IPA(Intelligent Power Allocation,智能功率分配)和功耗上限控制子系统 powercap,都能复用 EM 提供的活跃态功耗基线。EAS 负责把任务放到合适的簇,CPUIdle 负责在空闲时选择 C-State;两者都会影响整机功耗,读取的接口各不相同。
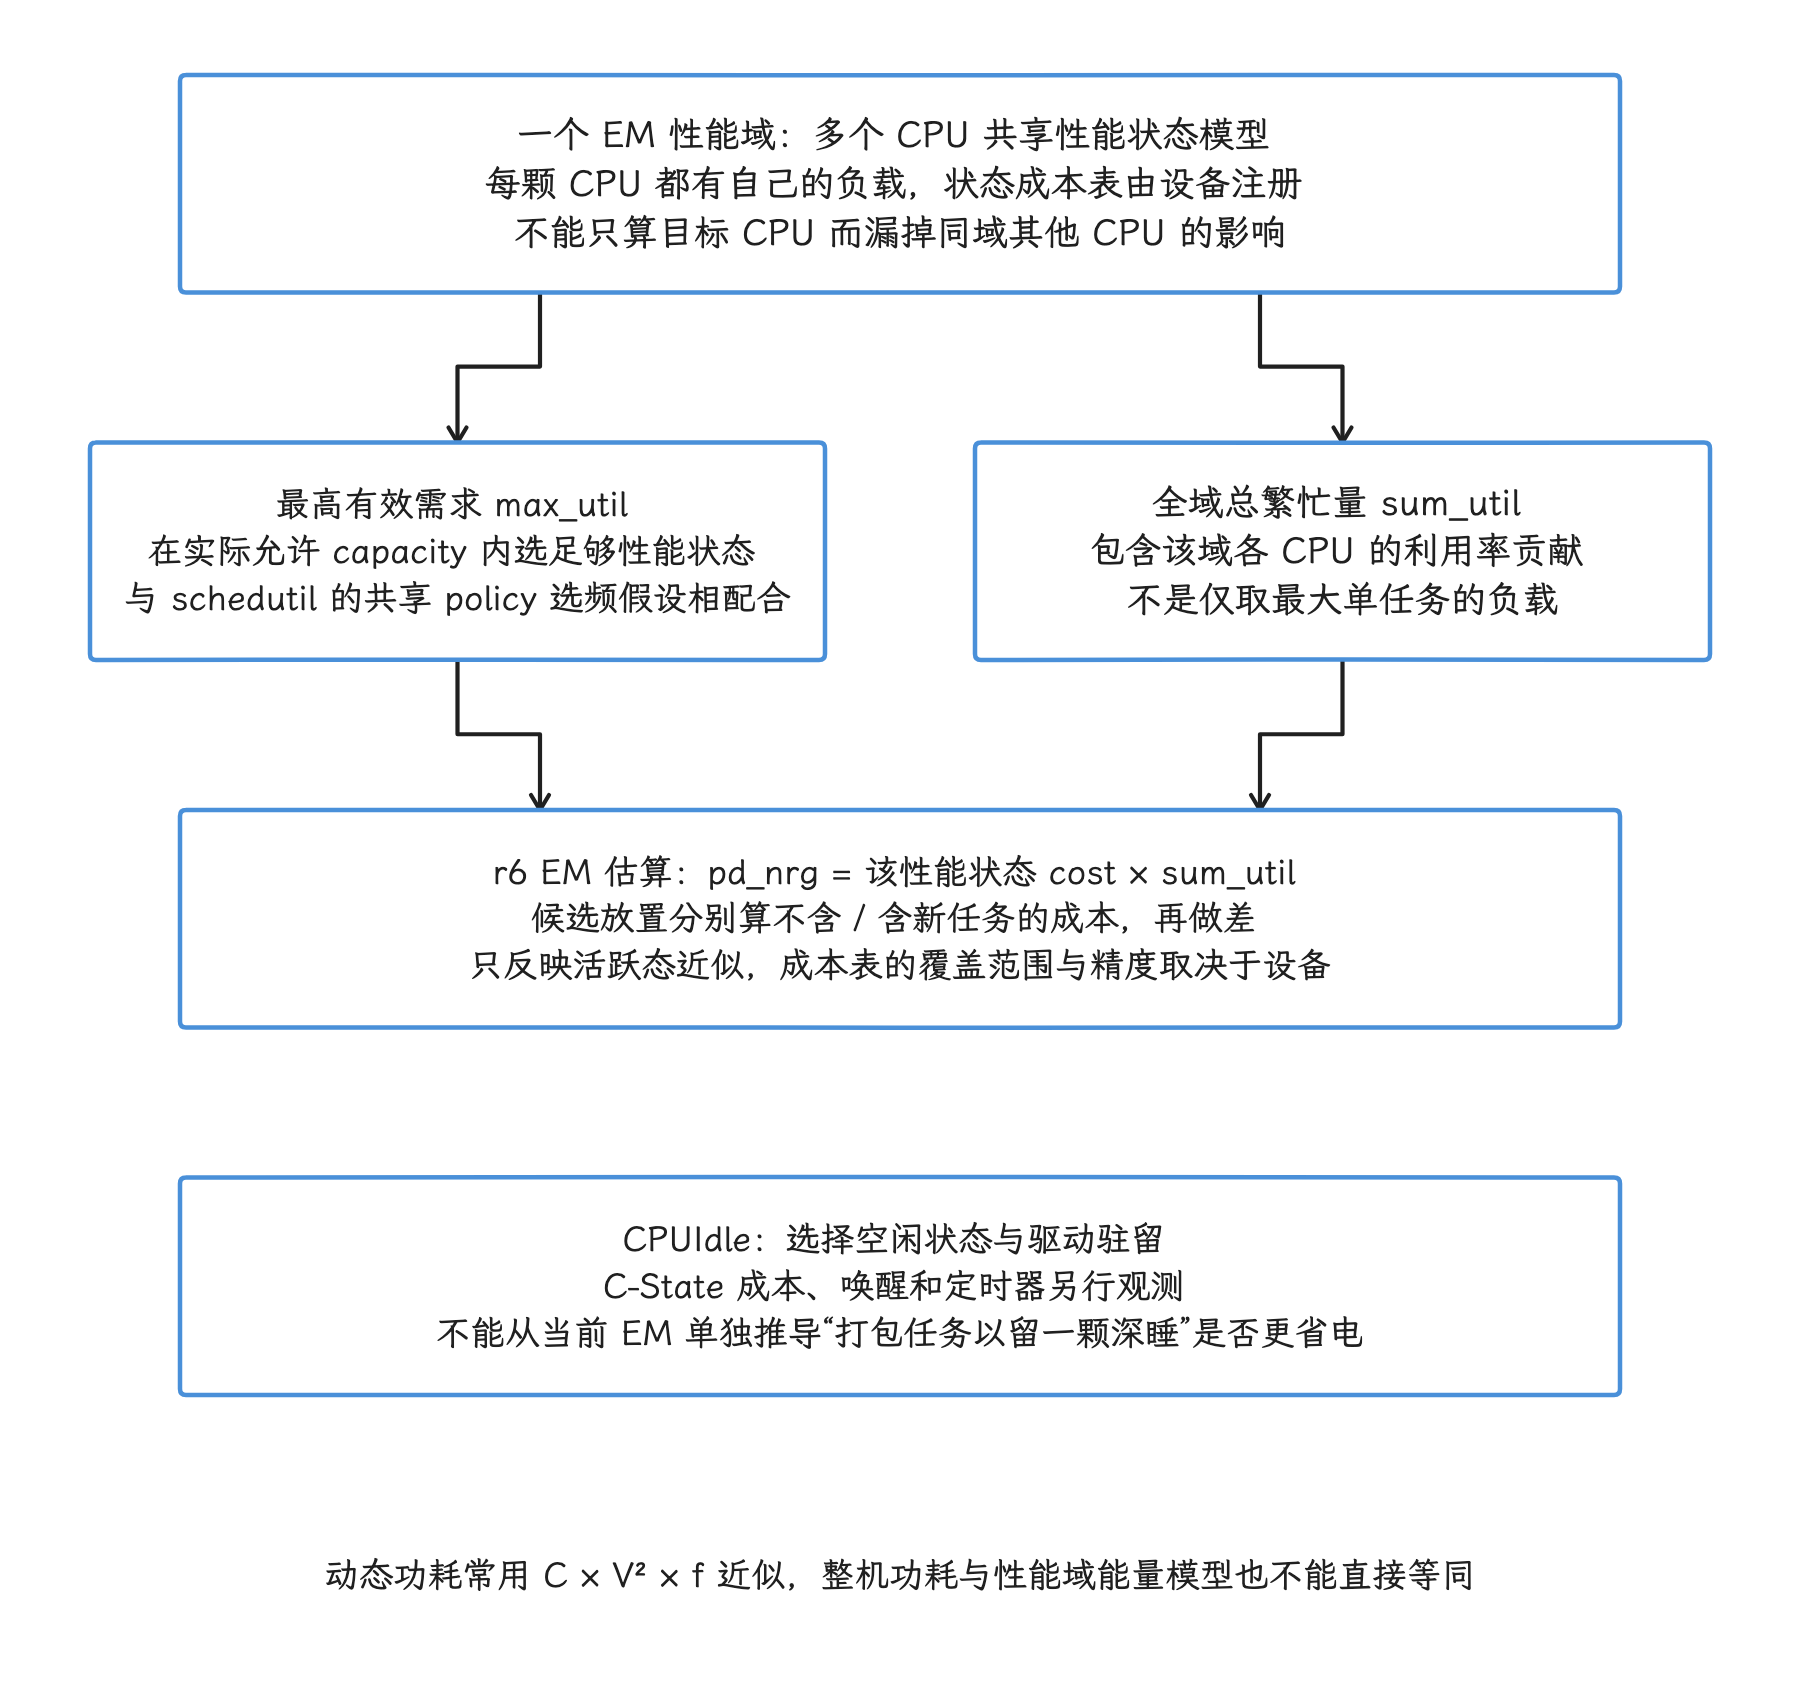
图:EM 以性能域为单位建活跃态成本表。最高有效需求决定需要的性能状态,域内各 CPU 的总繁忙量决定成本规模;共享频点变化会影响同域其他 CPU。compute_energy 使用该模型比较放置增量,结果是归一化的估算,不是设备实测焦耳数。CPUIdle 的空闲状态成本与驻留另算,当前 EM 不包含它。
能耗计算的主要关系
EAS 会为每个候选 CPU 计算能量增量(energy delta):
energy_delta = 放置任务后的系统总能耗 - 当前的系统总能耗
EAS 在适配程度相同的可接受候选中比较 energy_delta,不能只按某一 CPU 的功耗排序。计算过程是:
- 模拟把任务放到候选 CPU 后的利用率(utilization);
- 取性能域内最高有效需求,结合实际 capacity,在 EM 中选择性能状态;
- 用该性能状态的成本与整个性能域所有 CPU 的利用率 / 繁忙时间,估算活跃态能量成本;共享性能状态会影响域内其他 CPU;
- 比较候选与
prev_cpu的适配等级和能量增量;都满足不了uclamp.min时,还要比较可用 capacity。
这是一种近似计算:它假设频率请求会跟随利用率选择相应 OPP。固定频率,或改用其他输入信号的 governor,都会降低预测的可信度。
PELT:跟踪每个任务的“繁忙程度”
为什么需要利用率信号
EAS 的决策依赖任务利用率,这个信号由 PELT 提供。这里的“调度实体”既可以是单个任务,也可以是任务组或 CPU 运行队列。
在 PELT 出现之前,内核靠每个 CPU 运行队列的负载估算繁忙程度,但这种方式只反映 CPU 的整体负载,分不清“一个 CPU 上跑了三个轻任务”和“一个 CPU 上跑了一个重任务(利用率接近或超过低 capacity CPU 的能力)”。EAS 要知道每个任务需要多少计算能力,才能合理选核。
PELT 从 Linux 3.8 开始引入,它为每个调度实体维护独立的利用率信号 util_avg。
PELT 的计算方式
PELT 使用指数衰减累计利用率,常说的 32 ms 指半衰期;该信号没有到点清空的固定窗口。持续满载任务的信号会逐步逼近上限,停止运行后也会逐步衰减。具体表现为:
- 突发负载的
util_avg不会在第一个周期内立即达到真实需求; - 任务停止运行后,历史贡献仍会保留一段时间;
util_est与 UClamp 分别补充短期需求预测和用户空间性能提示。
PELT 的 util_avg 被归一化到 0~1024,其中 1024 代表“一个最大 capacity 的 CPU 满负荷运行”。归一化之后,util_avg 可以直接与 CPU 的 capacity 比较:任务的 util_avg 是 300、小核的 capacity 是 400 时,两者比较就能说明这个任务在小核上仍有余量。
频率不变性与 CPU 不变性
PELT 的利用率信号要能在大小核之间准确比较,需要满足两种“不变性”:
-
频率不变性:同一工作负载在较低频率下运行、占用更长的 wall time 时,算出来的负载不该更重。架构通过
arch_scale_freq_capacity()提供当前频率的相对能力。 -
CPU 不变性:同一工作负载迁到不同 capacity 的 CPU 后,利用率信号仍要表达可比较的计算需求。
arch_scale_cpu_capacity()提供各 CPU 相对于系统最强 CPU 的 capacity。
这两个缩放量参与 PELT 更新和 capacity 比较。它们缺失或不准确时,同一工作负载在不同频率、不同 CPU 上形成的信号将不可比,EAS 的能量预测也会失去基础。
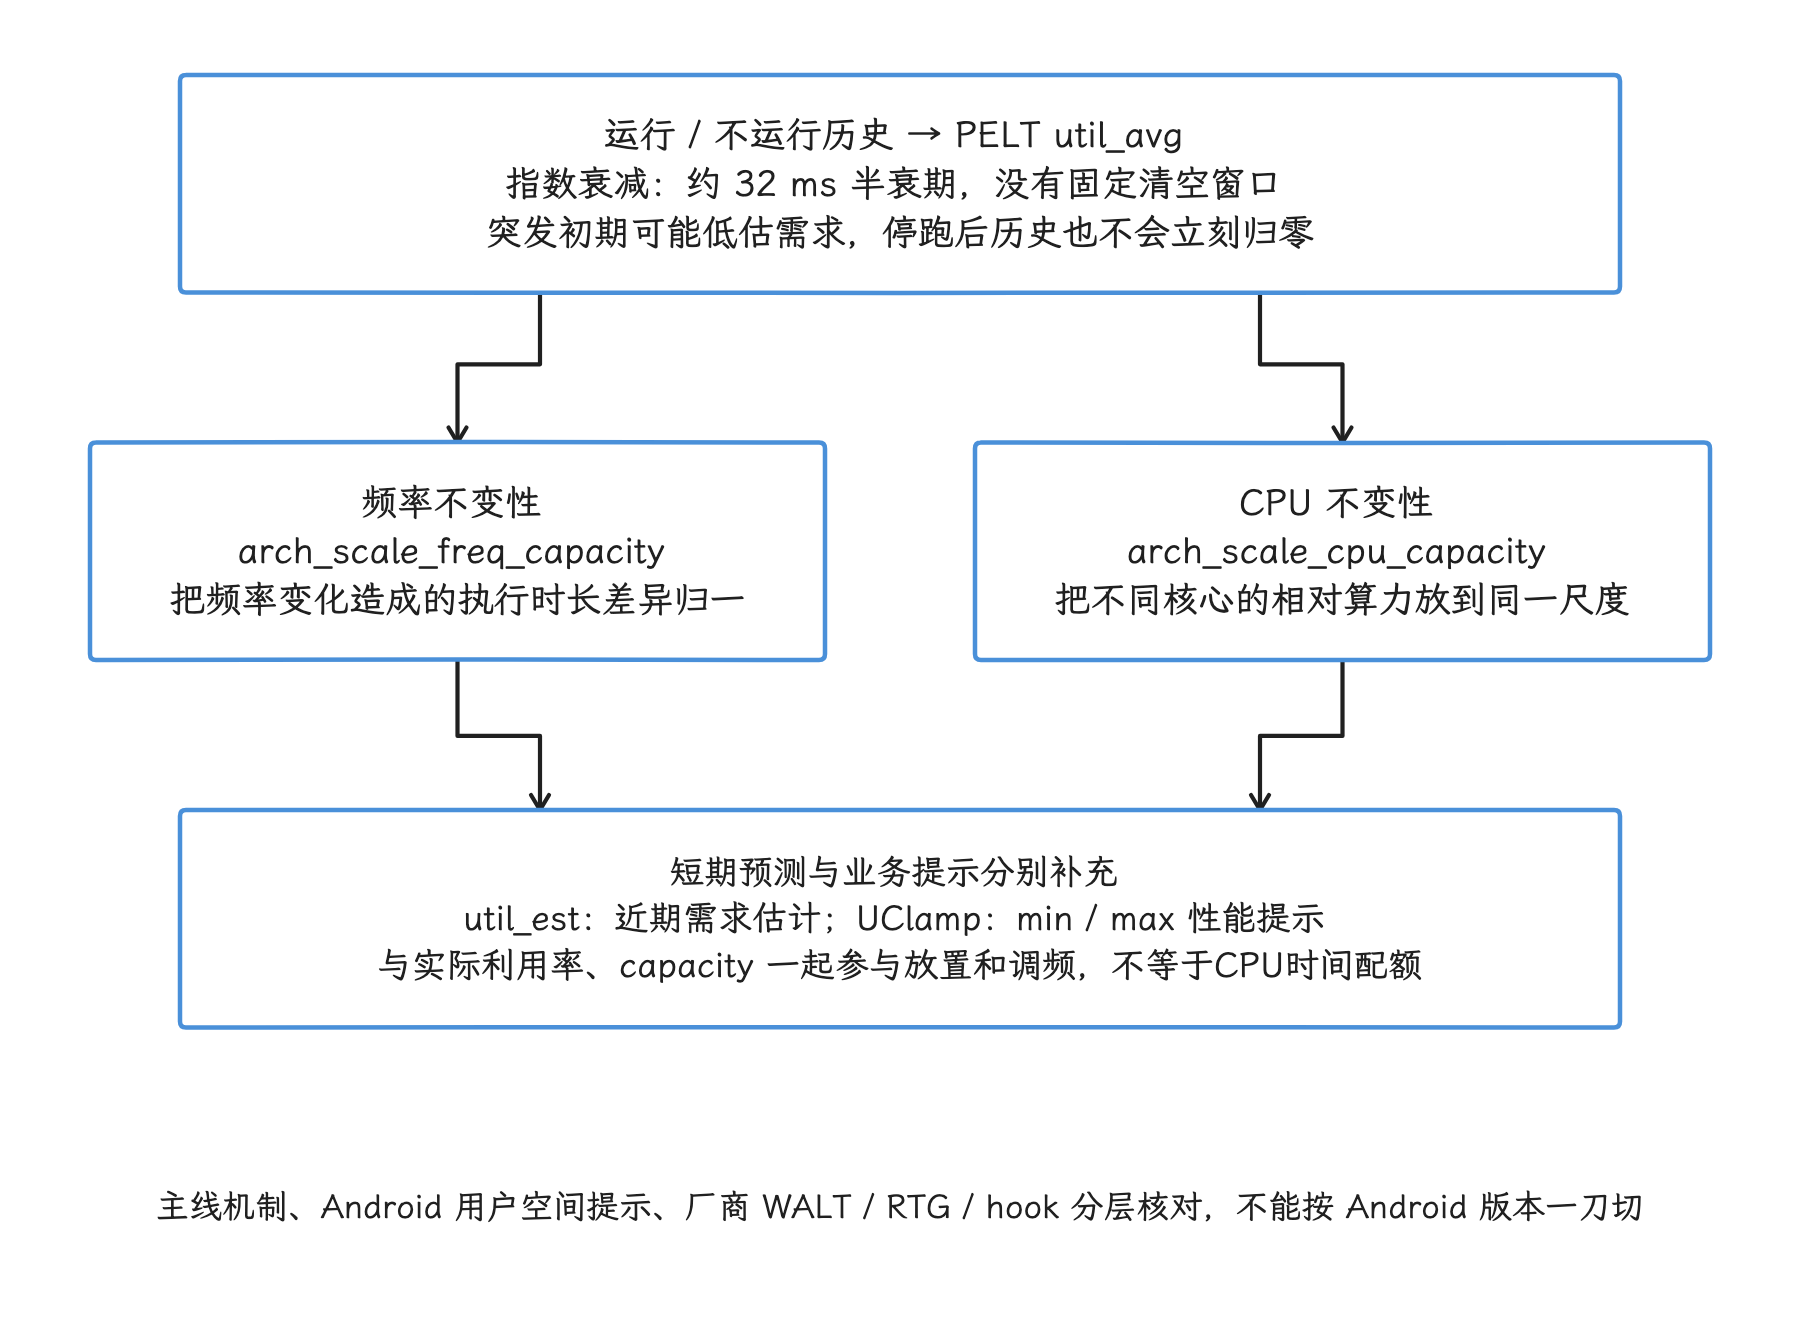
图:PELT 累积运行历史并指数衰减,常说的约 32 ms 是半衰期,信号不会到点清空。util_est 补近期需求估计,UClamp 补用户空间性能提示。频率与 CPU 不变性用架构缩放把不同核心、不同频点的利用率放到可比尺度;缺失或错误的缩放会影响 capacity 适配和能量预测。
WALT 与设备差异
Linux 主线的 EAS 文档建立在 PELT 及其频率不变性和 CPU 不变性之上,并没有把 WALT 当成前提。WALT(Window Assisted Load Tracking,窗口辅助负载跟踪)是部分 Android 公共内核或厂商内核使用过的负载跟踪扩展,常见于追求更快突发响应的设备内核。它会改变利用率信号的形成方式,但不会改变 EAS 依据利用率、capacity 和 EM 选核的基本逻辑。
分析具体设备时,我们可以分三层来看。Linux 主线内核这一层是 PELT → EAS → UClamp;AOSP 用户空间这一层是任务配置(task profile)、cgroup 和 Power HAL 怎样把提示送进调度器;厂商设备层才涉及 WALT、性能增强钩子(boost hook)和额外迁核策略。把三层概括成“Android 12 统一回归 PELT”,容易混淆 Linux 主线、AOSP 和厂商内核;排查时应根据内核版本和厂商代码树确认实际使用的负载跟踪方式。
任务放置(Task Placement):EAS 的选核策略
find_energy_efficient_cpu() 的决策流程
当一个 fair 类任务通过 WF_TTWU 被唤醒,且 root domain 未标记为 overutilized 时,select_task_rq_fair() 才会尝试调用 find_energy_efficient_cpu()。该函数只负责唤醒选核;fork/exec 时的任务放置、周期负载均衡、CPU 即将空闲时的 newidle balance,以及任务与 CPU capacity 不匹配时的迁移,各有自己的入口,不会在这里进行 EM 估算。Linux 6.18 的主要流程如下:
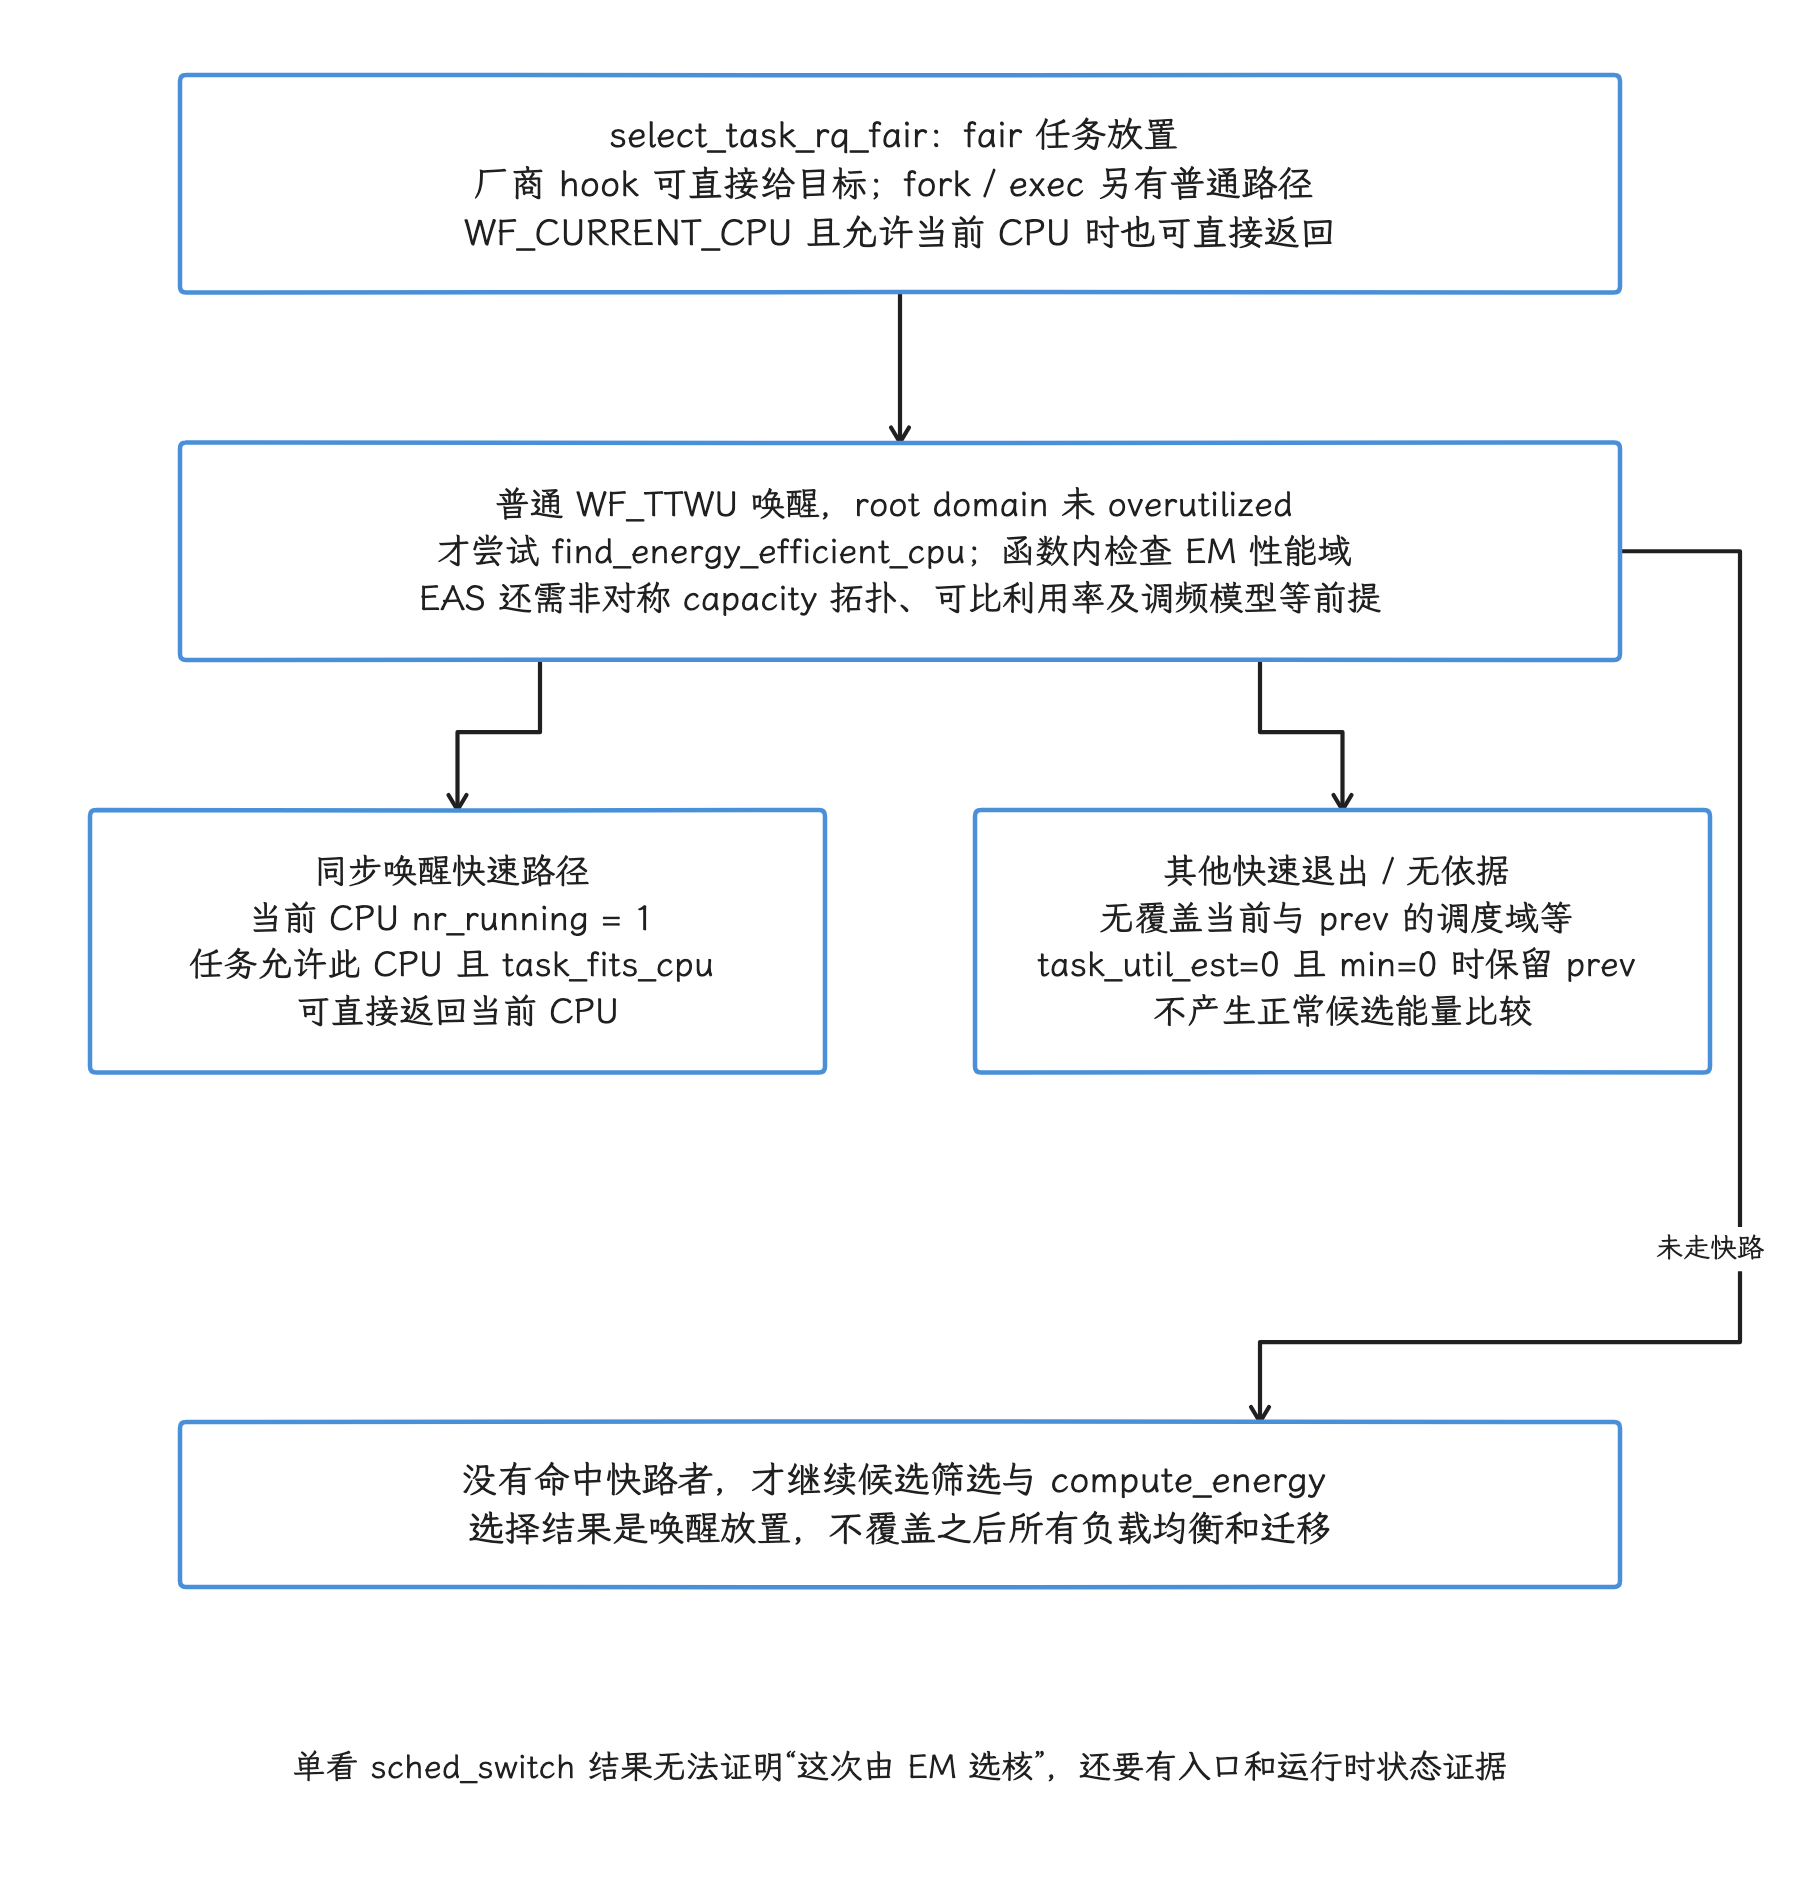
图:fair 唤醒入口先受厂商钩子与普通唤醒条件影响,WF_CURRENT_CPU 等分支可直接返回。root domain 处于 overutilized 时跳过 EAS;函数内部还需有 EM 性能域。同步唤醒满足当前 CPU 条件可快速返回,缺少 task_util_est 且 min=0 也不做能量预测。后续才进入性能域候选与 EM 比较。
第一步:处理快速路径。 同步唤醒时,如果当前 CPU 只有当前任务运行、目标线程允许在该 CPU 运行,且 task_fits_cpu() 成立,函数可直接返回当前 CPU。任务的 task_util_est() 为 0 且 uclamp.min 也为 0 时,则保留上次运行的 prev_cpu,不做缺少利用率依据的能量预测。
第二步:筛选候选。 对每个性能域,代码过滤离线 CPU、调度域外 CPU、任务 CPU 亲和性掩码 p->cpus_ptr 不允许的 CPU,以及 util_fits_cpu() 返回 0 的 CPU。返回负值表示实际利用率能放下,但 CPU 无法满足 uclamp.min;这类 CPU 会保留到后续 capacity 比较。每个性能域最终留下适配等级更好、剩余 capacity 更大的候选,并把可用的 prev_cpu 纳入比较。
第三步:计算能量增量。 compute_energy() 先计算不含被唤醒任务的基准能量 base_energy,再模拟把任务放到 prev_cpu 或候选 CPU。计算会使用该性能域的繁忙时间(busy time)、最大有效利用率、UClamp 和实际 capacity,经 em_cpu_energy() 得到活跃态能量成本。
第四步:比较适配程度与能量增量。 候选能满足性能提示时,优先选择能量增量更低者;若所有候选都满足不了 uclamp.min,代码还会比较可用 capacity。没有更优候选时保留 prev_cpu。Linux 6.18 的判断没有“能量差低于固定百分比就强制上大核”这类通用阈值。
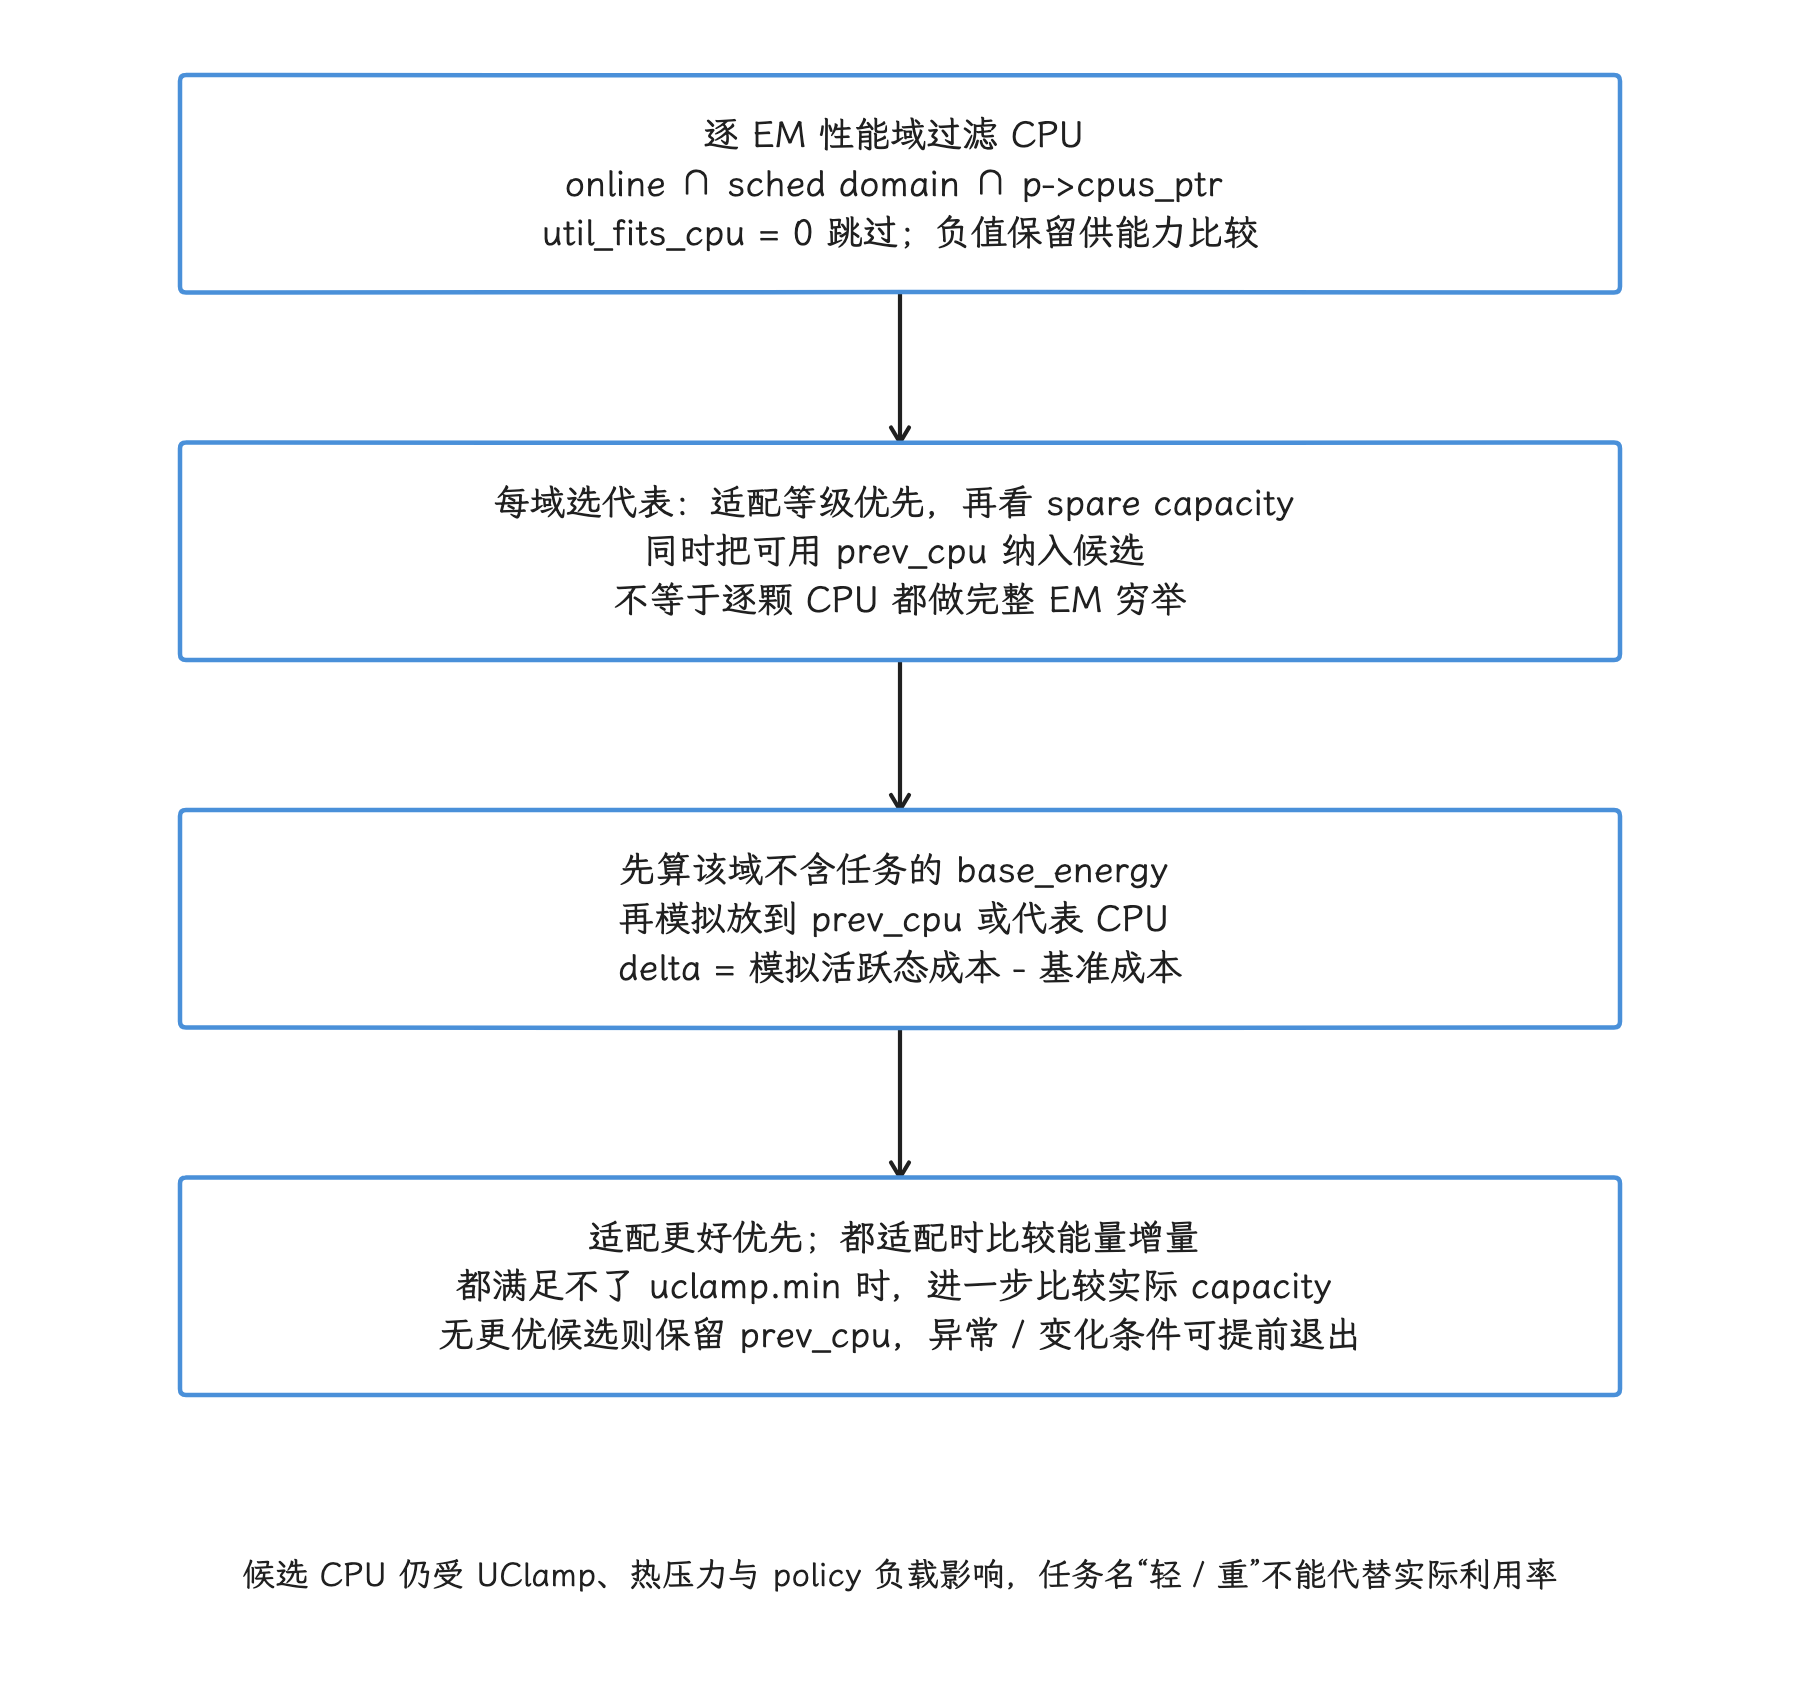
图:每个 EM 性能域先按在线、调度域与任务 CPU 掩码过滤,util_fits_cpu=0 的 CPU 被跳过;负值候选表示最低性能提示无法满足。每域留下适配更好、剩余能力更大的代表,并保留可用 prev_cpu。随后模拟域内基准与新增任务成本;最终按适配、能量增量及必要的实际 capacity 比较决定是否换目标。
轻任务与重任务的策略差异
EAS 对轻任务和重任务有不同的处理方式:
轻任务:利用率较低。若低 capacity 性能域装得下任务、能量增量又更低,EAS 常会选择该性能域。后台任务、心跳检测和短 UI 回调算不算“轻任务”,仍要看目标设备上的 PELT、util_est 与 UClamp,线程名说明不了问题。
重任务:利用率接近或超过低 capacity CPU 的能力。低 capacity 候选可能过不了 util_fits_cpu(),capacity 更高的性能域因而成为候选。视频编解码、游戏渲染和应用启动主线程也可能包含等待阶段,整条线程生命周期未必都是重负载。
全大核架构下的 EAS
部分新 SoC 不再采用传统“四小核 + 四大核”命名,市场上常把这类设计称为“全大核”。这类设备的 capacity 差距往往更小,但功耗成本差距不一定同步缩小;只要调度拓扑仍存在不同 capacity,且注册了对应 EM,EAS 的判断框架就没有变化。分析时仍要读取调度器 capacity、cpufreq policy、EM 和 thermal pressure,某个 CPU 的 capacity 数字来自具体内核代码树、频率上限与架构缩放,产品名称推不出来,“全大核”标签也推导不出能效空间或迁移代价。
负载均衡与任务迁移
运行中的任务迁移仍由周期负载均衡、newidle balance、主动均衡和 misfit 等路径处理,依据是调度域、负载、capacity 与 CPU 亲和性,不会为每次迁移调用 compute_energy()。
EAS 与基于负载的均衡以 root domain 的 overutilized 标志 为分界。r6 的 cpu_overutilized() 使用 !util_fits_cpu(cpu_util_cfs(cpu), rq_uclamp_min, rq_uclamp_max, cpu):没有特殊 UClamp 适配条件时,fits_capacity() 的约 20% 余量可帮助理解临界点;启用 UClamp 后,尤其 uclamp.max 的强制适配分支,会改变判定,不能只按单一的“利用率超过 80%”公式还原所有情况。capacity 还受 RT、deadline、IRQ 和外部压力等影响。root domain 被标记 overutilized 后,普通唤醒路径跳过 EAS 能量估算,转向基于负载和局部性的选择。
overutilized 对 EAS 的影响随内核版本有差异:
- Linux 6.6 及更早版本:
find_energy_efficient_cpu()在入口处检查rd->overutilized。系统已过载时,它直接跳过能量估算,回到传统选核路径。 android16-6.12公共内核分支:overutilized 的短路检查从find_energy_efficient_cpu()函数入口移到调用点select_task_rq_fair()。行为不变:系统过载时,唤醒路径跳过能量估算,重新使用基于负载的选择与均衡。该分支的find_energy_efficient_cpu()已接收sync参数,并在同步唤醒快速路径满足条件时直接返回当前 CPU。- Android 17 /
android17-6.18-2026-06_r6:调用点仍通过is_rd_overutilized(this_rq()->rd)保护find_energy_efficient_cpu();该函数沿用sync参数与同步唤醒快速路径。
因此,无论 Linux 6.6、android16-6.12 还是 Linux 6.18,root domain 过载时都不会执行 EAS 能量估算。这时“EM 选择了这个 CPU”的解释就不再成立。
UClamp:用户空间性能提示
UClamp 的作用
EAS 以 PELT、util_est、capacity 和 EM 为基础。用户空间还可以用 UClamp 描述任务期望的最低或最高性能点。
用户空间掌握业务截止时间(deadline)和进程状态,能够补充历史利用率暂时表达不了的信息。例如,突发帧任务的 PELT 尚未升高时,系统可能已经知道它需要较快响应。
UClamp 允许用户空间为每个任务设置有效利用率的上下限:
-
UCLAMP_MIN:设置有效利用率的下限。
UCLAMP_MIN=512会让选核与 schedutil 至少考虑这一性能提示,但目标 CPU 和实际频率仍受 capacity、其他任务、cpufreq、温控与厂商策略影响。 -
UCLAMP_MAX:设置有效利用率的上限,可限制调频与按 capacity 选核时采用的性能提示。它管的是性能提示这一层:任务照常运行,线程也仍可能出现在高 capacity CPU 上。
Android 中的 UClamp 使用
Android 平台通常由 Framework 和进程组管理库 libprocessgroup 应用调度提示,普通应用无须直接写 cgroup 文件。AMS(ActivityManagerService)中的 OomAdjuster 先根据进程状态给进程或线程分配调度组(sched group),随后由 android.os.Process.setThreadGroup()、setThreadGroupAndCpuset() 或 setProcessGroup() 进入 JNI。
Android 17 的 android_util_Process.cpp 中,线程分组路径调用 SetTaskProfiles(),进程分组路径调用 SetProcessProfilesCached();冻结、解冻等 profile 路径会直接调用 SetProcessProfiles()。libprocessgroup 读取 system/core/libprocessgroup/profiles/task_profiles.json,把任务配置展开为加入 cgroup 和设置属性两类动作。
UClamp 聚合方式的演进
Linux 主线内核以及 Android 17 android17-6.18-2026-06_r6 的 UClamp 请求采用最大值与分桶(max/bucket)聚合策略。运行队列分别维护 UCLAMP_MIN 与 UCLAMP_MAX 的 bucket,并取已入队任务中最高的有效请求。这里聚合的是 UClamp 上下界,不会取代 PELT 对运行队列实际利用率的求和。
例如,三个任务的 uclamp.min 都是 200,uclamp.max 都保持默认 1024,而 PELT 总利用率已达 300,运行队列聚合得到的下界为 200、上界为 1024;下界不会把实际利用率 300 降到 200。最大值聚合的局限主要体现在多个 UClamp 请求怎样合并,尤其会影响 UCLAMP_MAX 的节能语义;聚合的对象是 UClamp 上下界,与多任务真实负载的求和是两回事。厂商若改变聚合方式,应以对应内核代码树为准。
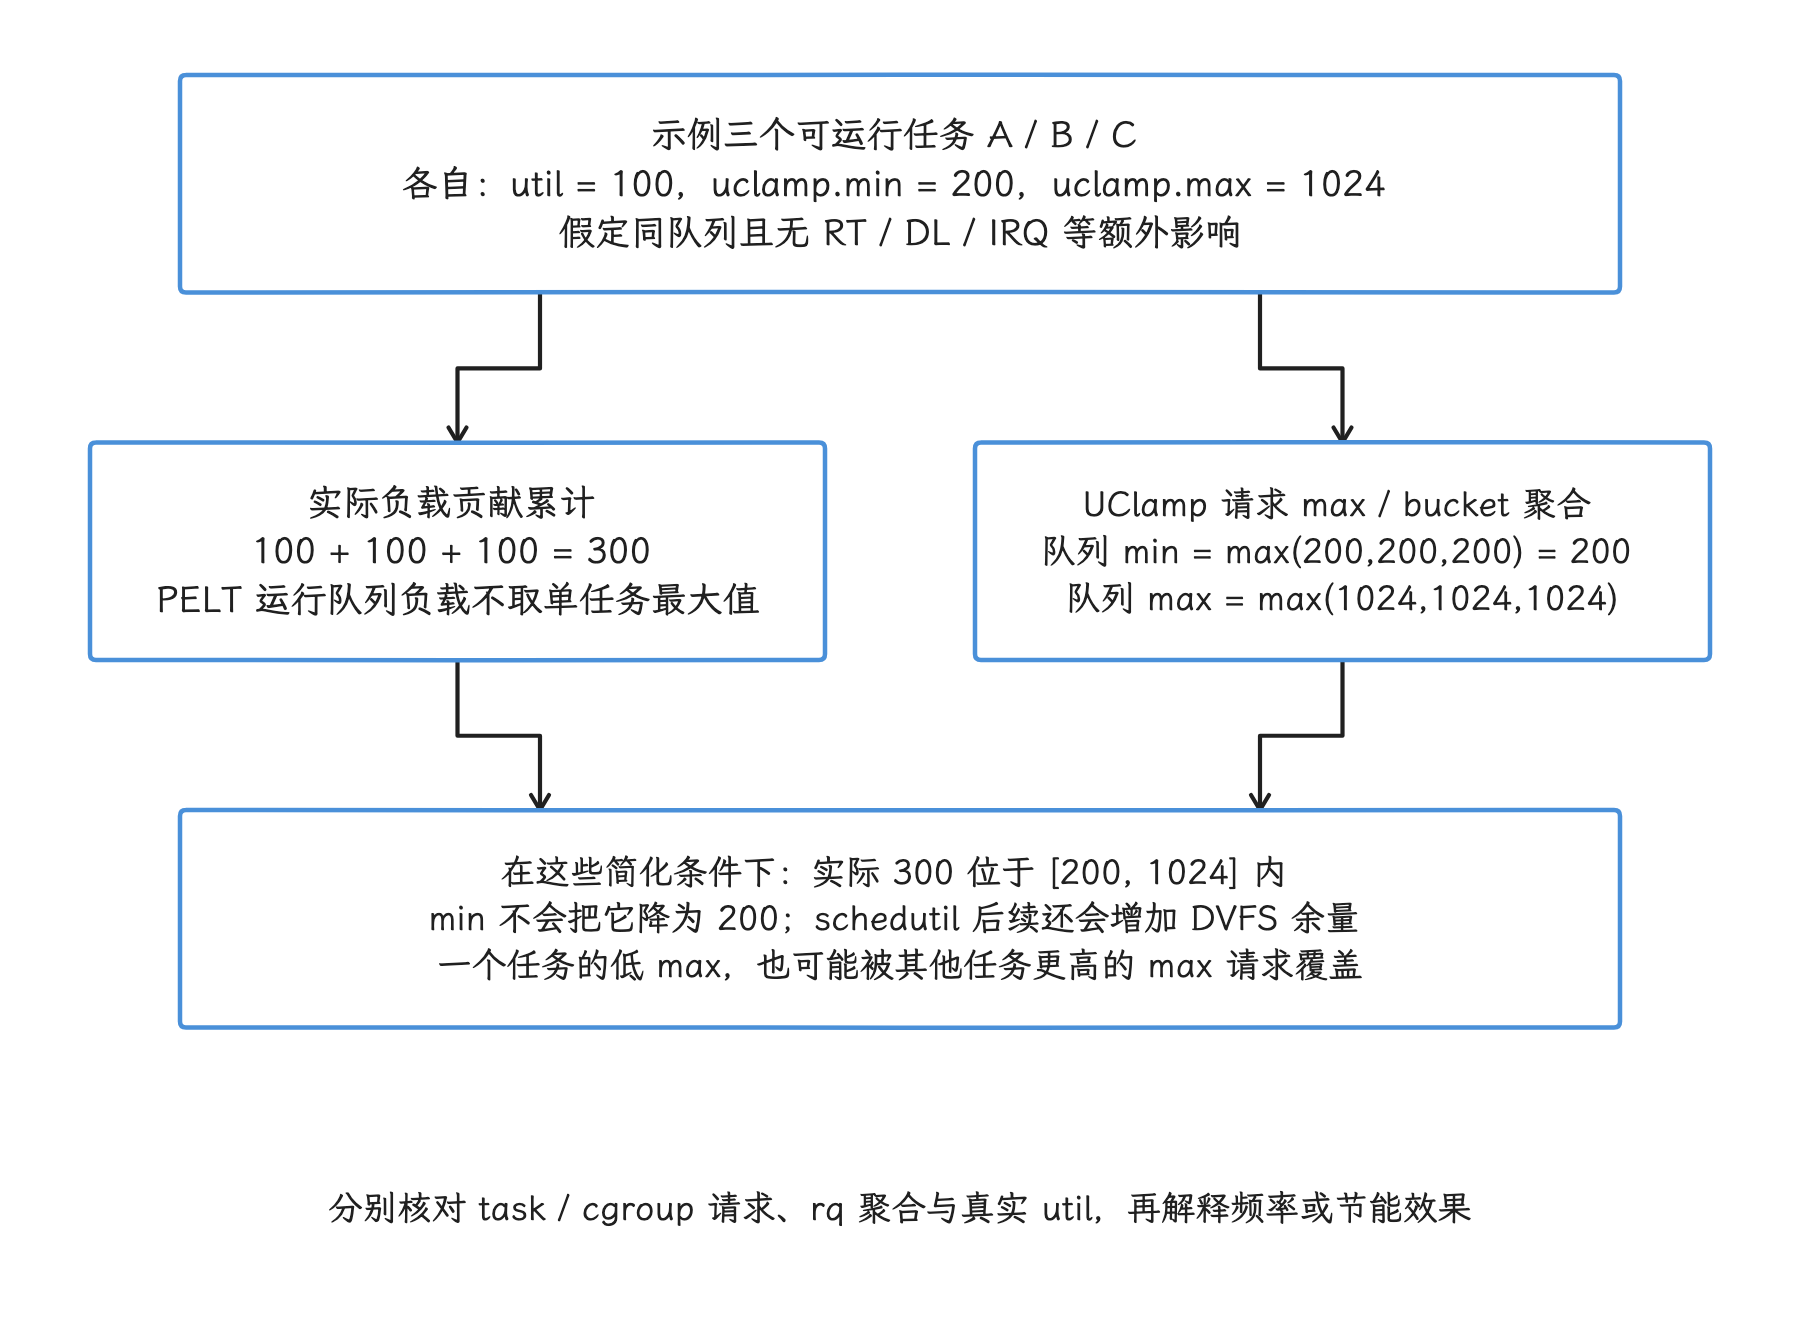
图:简化例子假定三任务各 util=100、min=200、max=1024,且没有 RT、DL、IRQ 等额外影响。运行队列 min 聚合为 200、max 为 1024,PELT 总 util 仍为 300;下界不把它降到 200。不同任务的 UCLAMP_MAX 也采用最大请求,较低 max 不会独自约束整个忙碌队列的性能。
在 Android 10、11、12 各版本中,排查路径应分层检查:
- Android 10:任务配置已经能操作
cpu.util.min/cpu.util.max,但默认性能档位仍大量依赖/dev/stune/{background,foreground,top-app}和schedtune.boost/schedtune.prefer_idle;cpuset 单独决定线程允许在哪组 CPU 上运行。 - Android 11:AOSP 把 CPU 控制器的接口名改为
cpu.uclamp.min/cpu.uclamp.max,默认配置仍保留schedtune分组。此时 UClamp 文件名已经就位,但默认性能档位还没有完全离开 SchedTune。 - Android 12 及以后:AOSP 默认的
HighEnergySaving/HighPerformance/MaxPerformance直接加入cpu/{background,foreground,top-app},cpuset继续负责 CPU 集合约束,冻结控制器(freezer)迁到 cgroup v2。至此,top-app、foreground 和 background 三档把 UClamp 提示纳入默认用户空间路径。
排查具体设备时,至少检查三处:
- 查看
/proc/<tid>/cgroup,确认线程位于哪个cpu、cpuset或schedtune分组; - 查看相应 cgroup 目录中的
cpu.uclamp.min和cpu.uclamp.max,旧设备还要检查cpu.util.min/cpu.util.max与/dev/stune/*/schedtune.boost; - 查看
/proc/<tid>/sched,核对该线程最终暴露给调度器的利用率和 UClamp 相关字段。字段名会随内核版本变化,通常要连同schedutil、频率轨道和 CPU 迁移一起分析。
这条控制链可以解释同一个 RenderThread 为什么在 top-app 状态更容易被选到大核,切到后台后又回到小核。
EAS 在 Perfetto 中的观察
三条关键轨道
Perfetto 不会直接标明“这次由 find_energy_efficient_cpu() 选核”,它给的是调度、频率和空闲态结果,我们还要结合 overutilized、UClamp、thermal 与设备内核来分析。主要关注三条轨道:
1. CPU 频率轨道(CPU Frequency Track)
CPU 频率轨道记录 cpufreq 变化。频率请求可能来自 schedutil 对 PELT 和 UClamp 的计算,也可能受 cpufreq policy 的共享范围、Power HAL、温控上限和硬件自治调频影响,每次变化都归因于 EAS 就过头了。
重点关注:
- 频率上限是否突然降低,例如
scaling_max_freq被调低;这可能来自温控、省电或其他频率上限策略,需要结合设备状态确认,详见 5.2 节; - 同簇 CPU 的频率是否同步变化;移动 SoC 通常以簇为单位调频;
- 任务运行期间的频率是否合理。如果高负载任务运行时频率被限制在低位,性能瓶颈可能来自系统策略,而非任务代码。
2. CPU 调度轨道(CPU Scheduling Track,sched_switch)
CPU 调度轨道显示每个时刻哪个线程在哪个 CPU 上运行,是观察 EAS 选核和迁移结果的直接窗口。
重点观察:
- 目标 CPU 是否满足截止时间:主线程和 RenderThread 无须默认常驻大核;能否满足帧预算,取决于运行时 capacity、频率和排队时间;
- 迁移是否与性能下降相关:迁移会影响缓存局部性,但负载均衡和温控迁移也属于正常行为。要把迁移点和 Runnable 等待、CPU 周期数(CPU cycles)、缓存未命中、wall time 对齐再下判断;
- 唤醒关系是否完整:采集
sched_waking后,才能从唤醒关系解释目标 CPU;只看sched_switch,还原不出完整的唤醒选核过程。
3. CPU 空闲状态轨道(CPU Idle States Track)
这条轨道显示 CPU 的空闲状态变化。Linux 6.18 的 EAS 能量模型只描述活跃态功耗,不计算空闲状态成本;find_energy_efficient_cpu() 的注释也明确说明,它仅凭当前 EM 判断不了“把小任务集中到一个 CPU、让另一个 CPU 深度休眠”是否更省电。
空闲态驻留仍是分析整机功耗的重要线索,但它反映的是 EAS、CPUIdle governor、定时器、IRQ、后台唤醒和设备驱动的共同结果。大核频繁退出深度空闲态(deep idle),说明要继续找唤醒源,还证明不了 EAS 配置错误。
使用 SQL 分析 EAS 行为
用 Perfetto,我们主要回答三个问题:线程在哪些 CPU 上运行、这些 CPU 当时运行在什么频率,以及连续的空闲态驻留是否被频繁唤醒打断。SQL 最好同时带上进程名和线程名,避免在多进程 Trace 中只按线程名查询而取得错误的 utid。
统计目标线程在各 CPU 上的运行时间:
WITH target_thread AS (
  SELECT t.utid, t.tid
  FROM thread t
  JOIN process p USING (upid)
  WHERE p.name = 'com.example.app'
    AND t.name = 'RenderThread'
  LIMIT 1
)
SELECT
  cpu,
  round(sum(dur) / 1e6, 2) AS running_ms
FROM sched_slice
WHERE utid = (SELECT utid FROM target_thread)
GROUP BY cpu
ORDER BY cpu;
如果 RenderThread 大部分时间位于低 capacity CPU,应把运行时长与帧截止时间对齐,再检查当时的 UClamp、进程组、overutilized 和 thermal pressure。
统计各 CPU 的频率驻留时间:
INCLUDE PERFETTO MODULE linux.cpu.frequency;

SELECT
  cpu,
  freq / 1000.0 AS freq_mhz,
  round(sum(dur) / 1e9, 3) AS time_s
FROM cpu_frequency_counters
GROUP BY cpu, freq
ORDER BY cpu, freq;
cpu_frequency_counters 是 Perfetto 标准库中的表,列名为 freq、cpu 和 dur。当前环境没有加载 stdlib 时,再使用原始的 counter / counter_track 查询方案。
统计 CPU 空闲态驻留时间:
INCLUDE PERFETTO MODULE linux.cpu.idle;

SELECT
  cpu,
  idle,
  round(sum(dur) / 1e9, 3) AS time_s
FROM cpu_idle_counters
GROUP BY cpu, idle
ORDER BY cpu, idle;
idle = -1 表示 CPU 处于活跃状态;非负编号如何对应具体 C-State,要对照目标设备的 cpuidle 状态表。较大编号通常表示更深的空闲状态,但这些编号在不同设备上并不对应统一的状态名称。
怎样判断系统是否 overutilized
官方文档把 overutilized 的临界条件描述为 CPU 利用率超过其计算能力(compute capacity)的 80%。Perfetto 没有统一的 sched_overutilized 轨道,SQL 只能提供排查线索,“小核几乎没有空闲时间”本身还不是结论。我们要看小核的运行时间占比(running ratio)是否持续偏高、同簇频率是否长期接近上限、关键线程是否转移到大核,再用设备内核导出的调度器调试信息确认。
与其他机制的关系
EAS 与 fair 调度器
EAS 只处理 fair 类任务的部分唤醒选核;Linux 6.18 仍由 EEVDF 决定 CPU 运行队列中接下来执行哪个任务。root domain 处于 overutilized 状态时,select_task_rq_fair() 会跳过能量估算;同步唤醒还可能进入 find_energy_efficient_cpu() 内部的快速路径。一份 Trace 中可以同时看到 EAS 唤醒选核、EEVDF 运行队列竞争和后续负载均衡的结果。
EAS 与大小核架构
EAS 的收益取决于 capacity 的不对称程度和各性能域的 EM 成本。传统的小核、大核命名便于理解,但源码仍根据调度拓扑与 EM 作判断。
EAS 与 DVFS(5.2 节)
EAS 的能耗预测依赖 schedutil governor 的 DVFS 行为。5.2 节会详细介绍 DVFS 机制,以及 Power HAL 的场景策略如何影响 CPU 频率;这些因素会直接影响 EAS 的预测准确性。
EAS 与温控管理(5.2 节)
温控可以通过 cpufreq cooling(以限制 CPU 频率进行散热)等机制降低频率上限,并以 thermal pressure 扣减可用 capacity。Linux 6.18 的 EAS 候选筛选与能量环境会读取实际 capacity,因此温控既可能改变频率,也可能改变任务是否适合某个 CPU 以及最终放置位置。
EAS 与 UClamp/SchedTune
SchedTune 到 UClamp 的替换分几步完成:Linux 主线在 5.3 引入 UClamp,5.4 提供 cgroup 接口,AOSP 到 Android 12 的默认配置才直接用 cpu/{background,foreground,top-app},Android 10 和 11 仍大量依赖 schedtune 分组。厂商设备是否继续保留 WALT 钩子、性能增强路径(boost path)或自定义 SchedTune 行为,需要根据设备内核代码树和任务配置核实。
EAS 使用有效利用率、capacity 与 EM。SchedTune 或 UClamp 会改变部分输入,让 top-app 组更容易获得较高性能点,并约束 background 组的性能提示;最终结果还受 CPU 亲和性、cpuset、负载、overutilized 和温控影响。
常见误区
“EAS 是为了让系统变慢来省电”
EAS 的目标是降低完成单位工作所需的能量,并把吞吐影响控制在较小范围。低利用率任务可能进入低成本性能域;高利用率任务或 uclamp.min 较高的任务可能需要高 capacity 性能域。
“任务应该尽量放在大核上以保证性能”
高 capacity CPU 能缩短部分计算时间,也可能提高该性能域的活跃态功耗。选核应综合考虑截止时间、利用率、capacity 与 EM 成本;“固定在大核”会绕过 EAS 的候选范围,还可能增加排队时间和热压力。
“看到任务在小核上就是 EAS 有问题”
先确认该 CPU 的实际 capacity,以及任务当时的利用率、util_est、UClamp 与截止时间。低 capacity CPU 若能按时完成工作,这次放置就可能合理;若任务已经错过截止时间,再继续排查 cpuset、thermal pressure、overutilized、EM、利用率信号和厂商钩子(vendor hook)。
“厂商的定制调度器比原版 EAS 好”
厂商定制可能加入 WALT、游戏或启动性能提示(hint)、vendor hook 和额外迁移策略。效果必须通过目标设备的延迟、能耗与热稳态数据判断。分析 Perfetto 前,应先确认内核代码树、Power HAL 和任务配置,避免把公共内核行为直接套用到厂商分支。
版本与实现差异
| 维度 | 时间节点 | 变化 | 排查要点 |
|---|---|---|---|
| Linux 主线内核 | Linux 3.8 | 引入 PELT | 为 EAS 提供每个调度实体的利用率信号 |
| Linux 主线内核 | Linux 5.0 | EAS 合入主线 | find_energy_efficient_cpu() 基于 EM 进行唤醒选核 |
| Linux 主线内核 | Linux 5.3 | UClamp 合入主线 | 任务可以声明最低和最高性能点 |
| Linux 主线内核 | Linux 5.4 | UClamp cgroup 接口合入 | 用户空间可以通过 cgroup 统一设置 UClamp |
| AOSP 用户空间 | Android 10 | task_profiles 机制成型;CPU 控制器暴露 cpu.util.min/max,默认性能档位仍大量依赖 schedtune 与 cpuset | 检查 /dev/stune/* 和 /dev/cpuset/* |
| AOSP 用户空间 | Android 11 | 使用 cpu.uclamp.min/max 命名,默认配置仍保留 schedtune 分组 | 同时核对 schedtune 与 cpu.uclamp.* |
| AOSP 用户空间 | Android 12+ | 默认的 HighEnergySaving / HighPerformance / MaxPerformance 直接进入 cpu/{background,foreground,top-app},cpuset 继续控制可运行 CPU 集合 | 检查 top-app、foreground 和 background 的默认提示路径 |
| Android 公共内核 | android16-6.12 分支 | overutilized 短路位置从 find_energy_efficient_cpu() 内部移到 select_task_rq_fair() 调用点;行为不变 | Linux 6.6 和 6.12 的检查位置不同,短路行为一致 |
| Android 公共内核 | Android 17 / android17-6.18-2026-06_r6 | find_energy_efficient_cpu() 沿用 sync 参数;同步唤醒且当前 CPU 只有当前任务运行、任务 CPU 掩码允许并通过 task_fits_cpu() 时,可直接返回当前 CPU | 排查 Android 16/17 公共内核的唤醒选核时,还要检查同步唤醒快速路径 |
| Android 公共内核 | Android 17 / android17-6.18-2026-06_r6 | UClamp 请求仍按 max/bucket 聚合,PELT 运行队列利用率仍按任务贡献累计 | 不要把 UClamp 最大值聚合误写成“CPU 总利用率取最大单任务值” |
| 设备实现 | 厂商分支 | WALT、Power HAL 性能增强和额外迁核策略随 SoC 与内核代码树变化 | Trace 结论必须结合具体设备 |
小结
- CPU capacity、调度拓扑与能量模型比“大核/小核”产品名称更适合描述异构处理器;CPU 编号和最高频率都替代不了实机能力测量。
- 线程从唤醒到运行要同时经过调度类、优先级、EEVDF 资格、亲和性/cpuset、UClamp 与 CPU 放置。Runnable 等待和已经 Running 但执行慢是两类问题。
- EAS 只在满足条件的候选 CPU 间比较任务放置的能量影响,DVFS 决定性能域频率,温控再改变频率上限和可用 capacity;三者必须在同一时间线上解释。
- 调度优化应以目标线程的期限、系统吞吐、能耗和热稳态共同验收;迁移次数、单次选核或绑核实验,都代替不了因果证据。
参考资料
相关公共源码结论可从以下入口复核:
- Linux 内核
Documentation/scheduler/sched-capacity.rst; - Linux 内核
Documentation/scheduler/sched-energy.rst; - Linux 内核
Documentation/scheduler/schedutil.rst; - Linux 内核
kernel/sched/fair.c:util_fits_cpu()、find_energy_efficient_cpu()、misfit 与负载均衡路径; - Linux 内核
kernel/sched/cpufreq_schedutil.c:sugov_get_util()、sugov_effective_cpu_perf()、I/O-wait boost; - Android
system/core/libprocessgroup/profiles/task_profiles.json; - Perfetto
linux.cpu.frequency、sched_slice与thread_state。
参考链接:
-
Linux 内核文档:Energy Aware Scheduling
-
Linux 内核文档:Utilization Clamping
-
Linux 内核文档:Energy Model framework
-
Linux 内核文档:CPU Idle Time Management
-
Linux 内核文档:Operating Performance Points (OPP)
-
Perfetto 官方文档:CPU Scheduling
-
Perfetto 官方文档:Perfetto stdlib docs
-
AOSP 源码:
platform/system/core/libprocessgroup/profiles/task_profiles.json(android-17.0.0_r1;历史对比:android10/11/12-release) -
AOSP 源码:
frameworks/base/core/jni/android_util_Process.cpp(android-17.0.0_r1,SetTaskProfiles()/SetProcessProfilesCached()调用链) -
Android common kernel:
kernel/sched/fair.c(android16-6.12-2026-06_r6与android17-6.18-2026-06_r6,find_energy_efficient_cpu()/ overutilized / 同步唤醒快速路径) -
Android common kernel:
kernel/power/energy_model.c(android17-6.18-2026-06_r6,EM 框架) -
ARM 社区:EAS 设计与实现