Android 分层架构、进程模型与线程协作
Android 的“五层架构”按职责划分系统组件,并不对应五个严格套叠的进程。我们从一个应用进程说起:它同时装着应用代码、Framework 客户端代码、ART 和原生库;system_server 既运行 Java 系统服务,也加载 JNI 庂;SurfaceFlinger 是独立的显示合成服务进程;HAL 既可能通过 Binder 提供跨进程服务,也可能在旧实现中作为共享库加载到调用方进程。
这种分层仍适合用来确定排查方向。面对一次卡顿、启动慢或硬件访问延迟,我们先确定工作发生在哪个进程,再确认它通过 Binder、JNI、系统调用还是 HAL 接口进入下一个模块。进程、接口和调度状态共同构成证据,单看“属于哪一层”不足以定位问题。
定位架构问题时,先确认调用跨越了哪些系统层,再沿进程生命周期和线程调度寻找等待、抢占或回收发生的位置。三条线共同决定一次系统行为最终落在哪个进程、哪条线程以及哪个资源边界。
源码基线:AOSP
android-17.0.0_r1;内核 Android Common Kernel(ACK)android17-6.18-2026-06_r6。量产设备通常还会在 ACK 之上叠加片上系统(SoC)驱动、通用内核镜像(Generic Kernel Image,GKI)厂商模块与厂商调度策略,公共内核源码标签替代不了设备自己的内核提交版本与配置。
系统分层、进程边界与跨层接口
这一节先回答三个问题:五层各自解决什么,启动过程怎样把它们连成一个系统,跨层接口有哪几类。后面两节讨论进程与线程时,坐标仍从这里出发。
五层分别解决什么问题
Android 通常从上到下分为应用、应用框架(Framework)、原生库与 ART、HAL、Linux 内核五层:
flowchart TB
    Apps["应用:业务代码与系统应用"]
    Framework["应用框架:SDK 客户端与 system_server 服务"]
    Native["原生库与 ART:运行时、Bionic、Skia、媒体与原生服务"]
    HAL["HAL:Stable AIDL、存量 HIDL 与厂商实现"]
    Kernel["Linux 内核:调度、内存、Binder、网络与驱动"]

    Apps -->|"SDK 调用 / Binder"| Framework
    Framework -->|"JNI / Native Binder"| Native
    Framework -->|"Stable AIDL / HIDL"| HAL
    Native -->|"系统调用 / ioctl / mmap"| Kernel
    HAL -->|"系统调用 / 驱动接口"| Kernel
图中的箭头表示常见接口,请求也常走捷径:应用可以直接通过 Bionic 发起文件系统调用,SurfaceFlinger 可以直接与 Composer HAL 和 Linux DRM 显示子系统或显示驱动交互,媒体数据则常通过共享缓冲区传递。
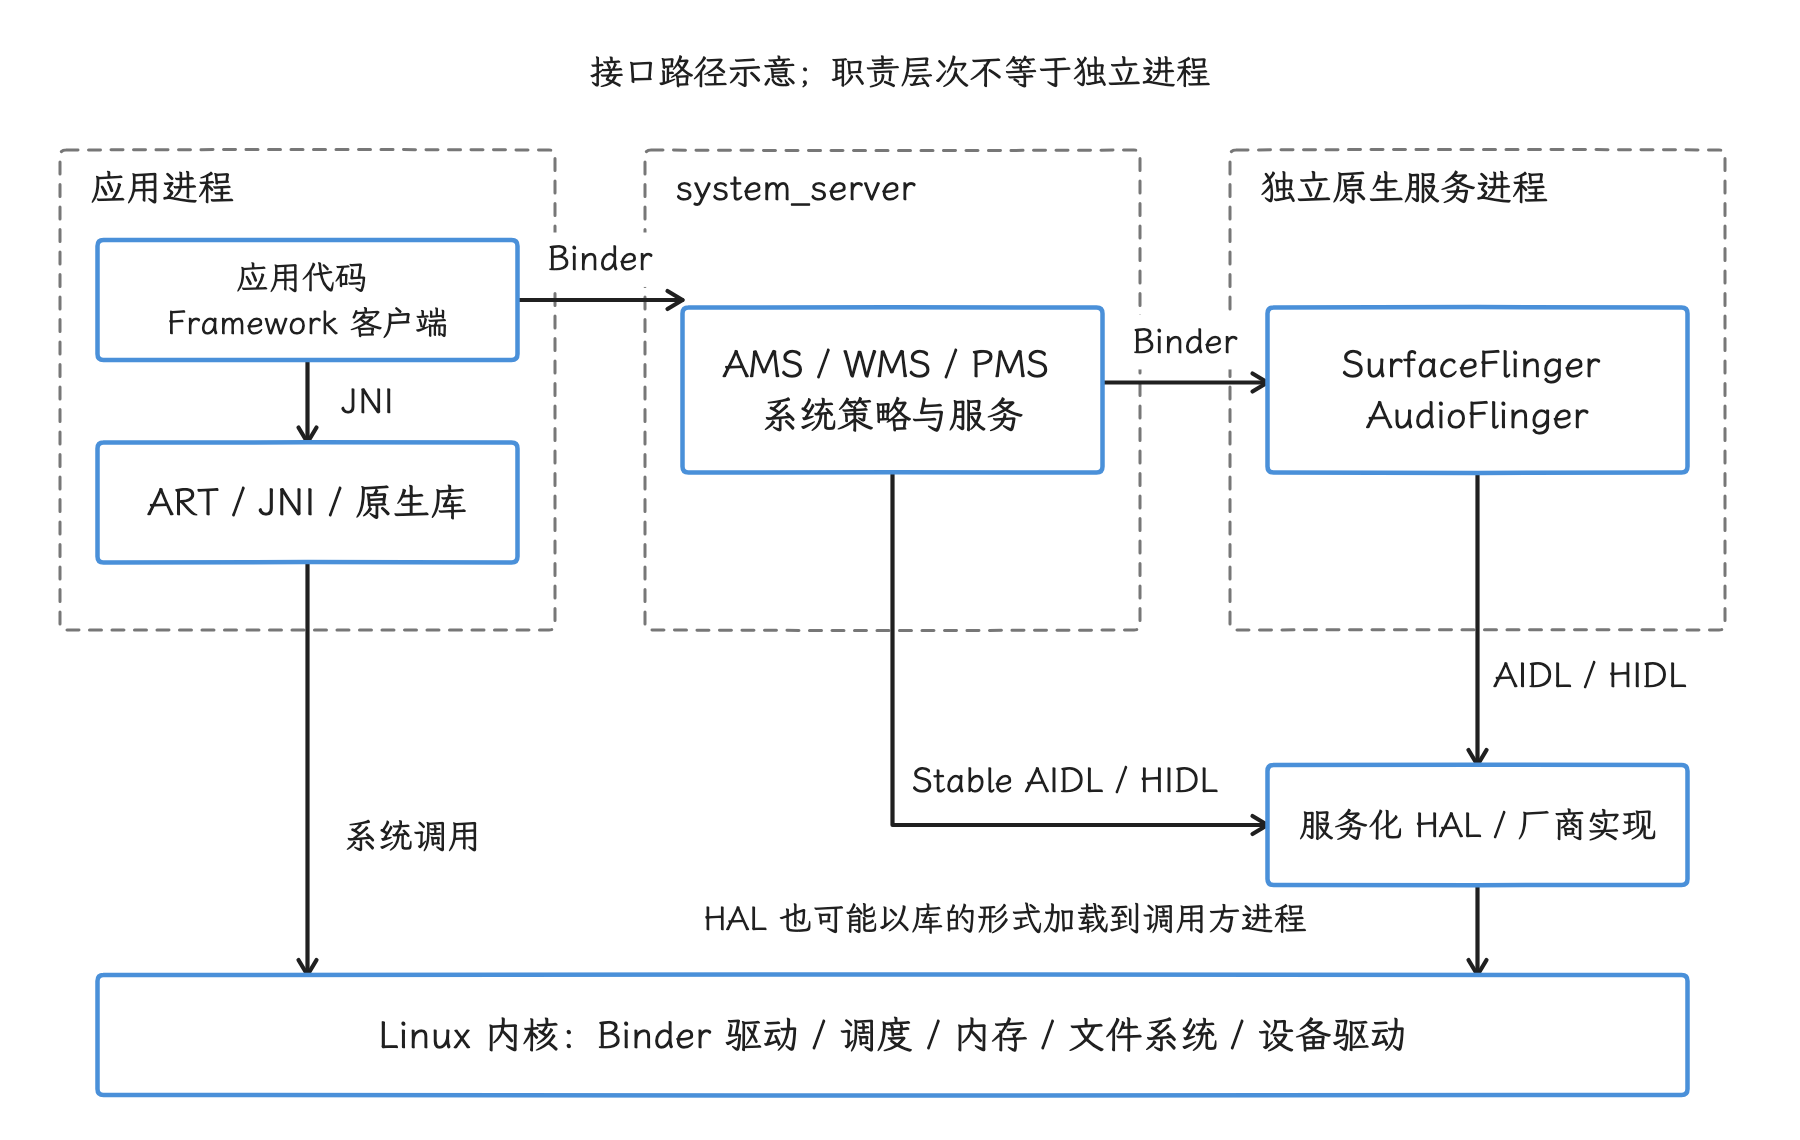
图:应用代码、Framework 客户端、ART 与原生库可以处在同一个进程;WMS 与 SurfaceFlinger 分属不同进程。箭头列出常见接口,HAL 的直通式实现另见正文。
| 层次 | Android 17 中的典型对象 | 主要边界 | 性能分析入口 |
|---|---|---|---|
| 应用 | Activity、Compose/View、业务线程、RenderThread | SDK、Binder、JNI、文件与网络 API | 应用主线程、RenderThread、自定义跟踪事件(trace)、FrameTimeline |
| 应用框架 | ActivityTaskManagerService、WindowManagerService、PackageManagerService 等 system_server 服务 | Java Binder、原生 Binder、系统服务内部锁 | system_server Binder 线程、服务跟踪时间片(slice)、锁与调度状态 |
| 原生库与 ART | ART、Android C 标准库 Bionic、Skia、SQLite、SurfaceFlinger、AudioFlinger、媒体服务 | JNI、原生 Binder、共享内存、系统调用 | ART 垃圾回收(GC)/即时编译(JIT)、原生代码时间片、调用栈、原生堆与系统调用 |
| HAL | Stable AIDL HAL、存量 HIDL HAL、厂商服务或同进程实现 | Binder、hwbinder、快速消息队列(FMQ)、共享缓冲区、设备节点 | HAL 服务进程、Binder 事务、锁、输入输出(I/O)与硬件同步栅栏(fence) |
| Linux 内核 | 调度器、内存管理、Binder 驱动、网络栈、文件系统、DMA-BUF 与设备驱动 | 系统调用、ioctl、mmap、中断 | ftrace 内核跟踪、线程状态、CPU 频率、I/O、Binder 与驱动事件 |
启动过程把这些层连在一起
init 进程仍按 first stage、SELinux 访问控制初始化、second stage 三步执行。第二阶段的 init 解析 .rc 配置并启动 Zygote(预加载 Android 运行环境、用于派生应用进程的模板进程)、SurfaceFlinger 等服务;Zygote(用于派生应用进程的模板进程) 随后预加载常用类和资源,通过 fork 创建 system_server,再进入 socket 循环,等待创建应用进程的请求。
frameworks/base/core/java/com/android/internal/os/ZygoteInit.java 的 main() 给出了这条顺序:
- 未启用延迟预加载(lazy preload)时调用
preload()。 - 创建
ZygoteServer。 - 主 Zygote 调用
forkSystemServer()。 - 父进程进入
zygoteServer.runSelectLoop()接收后续进程创建(fork)请求。
这一步里要分清两个层级的关系:“init 管理 Zygote”和“Zygote 创建 system_server”。init.zygote64.rc 把 zygote 服务定义为 /system/bin/app_process64 ... --zygote --start-system-server --socket-name=zygote,init.rc 的 zygote-start 再执行 start zygote——init 直接管理的是 Zygote 进程。[来源: https://juejin.cn/post/7679264879620374568;已验证: system/core/rootdir/init.zygote64.rc 与 init.rc @ android-17.0.0_r1] 而 system_server 的直接创建点在 Zygote:ZygoteInit.main() 完成预加载和 new ZygoteServer(...) 后,在进入 zygoteServer.runSelectLoop() 前执行 forkSystemServer(),并不走普通应用冷启动时由 system_server 请求 Zygote socket 的后续 fork 路径。[已验证: frameworks/base/core/java/com/android/internal/os/ZygoteInit.java @ android-17.0.0_r1]
system_server 子进程最终进入 SystemServer.main()。下面的 Android 17 服务启动骨架比旧资料常列的三组多出第四个 startApexServices(),对应 APEX 可更新系统模块的服务阶段。
进入 SystemServer.main() 之前,子进程路径会先把 Zygote 模板进程改造成 system_server 身份。nativeForkSystemServer() 在 pid == 0 分支调用 SpecializeCommon(..., is_system_server=true, ...),处理系统服务的控制组与 task profile、补充组和资源限制、seccomp、setresgid()/setresuid()、capabilities、SELinux context 和 post-fork hooks;handleSystemServerProcess() 随后经 ZygoteInit.zygoteInit()、RuntimeInit.applicationInit() 找到 com.android.server.SystemServer.main()。[来源: https://juejin.cn/post/7679264879620374568;已验证: frameworks/base/core/jni/com_android_internal_os_Zygote.cpp、ZygoteInit.java 与 RuntimeInit.java @ android-17.0.0_r1]
还有一个容易忽略的顺序:zygoteInit() 会先调用 nativeZygoteInit(),而 app_process/app_main.cpp 的 AppRuntime::onZygoteInit() 在该回调中执行 ProcessState::self()->startThreadPool(),所以 system_server 接收 Binder 事务的线程池早于 SystemServer.main() 启动。[已验证: frameworks/base/cmds/app_process/app_main.cpp @ android-17.0.0_r1]
SystemServer.main() 之后补齐服务容器
到达 SystemServer.main() 时,system_server 已经带着一部分能力:Zygote 子进程身份 specialize 已完成,ART、Framework JNI、预加载页面和 Binder IPC 线程池都在。但 System Context、主 Looper 的长期循环、SystemServiceManager 以及 AMS/PMS/WMS 等服务对象还要由 SystemServer.run() 组织建立。[来源: https://juejin.cn/post/7681897078311108623;已验证: frameworks/base/core/jni/com_android_internal_os_Zygote.cpp、frameworks/base/cmds/app_process/app_main.cpp 与 frameworks/base/services/java/com/android/server/SystemServer.java @ android-17.0.0_r1]
SystemServer.main() 本身只是 new SystemServer().run()。SystemServer 是 Java 装配总控,容易和三个名字混淆:system_server 是进程,AMS 是其中的系统服务,向全局 ServiceManager 发布的是 Binder 服务端对象;SystemServer 只负责装配。[来源: https://juejin.cn/post/7681897078311108623;已验证: frameworks/base/services/java/com/android/server/SystemServer.java @ android-17.0.0_r1]
我们可以按四段读 run() 的骨架:先设置系统进程规则,例如 Binder 阻塞告警、SQLite/Parcel 策略、Binder 后台调度与最大线程数;再准备主线程 Looper 与 SystemServerInitThreadPool;随后加载 android_servers、建立 System Context/System UI Context 并执行每进程 Mainline 模块初始化;最后创建 SystemServiceManager,进入 startBootstrapServices()、startCoreServices()、startOtherServices()、startApexServices()。[来源: https://juejin.cn/post/7681897078311108623;已验证: frameworks/base/services/java/com/android/server/SystemServer.java @ android-17.0.0_r1]
SystemServiceManager 建立后,只是 system_server 内部的 Java 管理对象和 LocalServices 条目。它的 startService(Class<T>) 用 Context 构造 SystemService、记录到 mServices,再调用该服务的 onStart();它管的是已纳管 SystemService 的启动和 Boot Phase/User 生命周期分发,创建顺序仍由 SystemServer.run() 的调用序列决定,遗留服务的创建也未必经过它。[来源: https://juejin.cn/post/7681897078311108623;已验证: frameworks/base/services/core/java/com/android/server/SystemServiceManager.java @ android-17.0.0_r1]
排查 system_server 启动卡顿时,我们先分清三条执行路径:主线程按 SystemServer.run() 控制总体顺序,末尾进入 Looper.loop();Binder 线程池接收远端 transaction,各自独立于主 Looper 的顺序;SystemServerInitThreadPool 和各服务自有线程承载允许并行或服务内部的工作。[来源: https://juejin.cn/post/7681897078311108623;已验证: frameworks/base/services/java/com/android/server/SystemServer.java 与 frameworks/base/services/core/java/com/android/server/SystemServiceManager.java @ android-17.0.0_r1]
所以 Looper.loop() 只说明主启动控制流进入了长期消息循环;要判断“Framework 全部 ready”,我们还要结合 SystemServerTiming/trace tag、具体服务的 StartService ... 片段、Binder 线程状态和 Boot Phase/systemReady() 事件,单看某个线程是否活跃判断不了。[来源: https://juejin.cn/post/7681897078311108623;已验证: frameworks/base/services/java/com/android/server/SystemServer.java 与 frameworks/base/services/core/java/com/android/server/SystemServiceManager.java @ android-17.0.0_r1]
排查时可以把进程树、socket 和死亡重启分开取证:ps -A -o PID,PPID,NAME,ARGS(或 /proc/<pid>/status 的 PPid)用于确认 system_server 的父进程是否指向 Zygote;Zygote socket 只解释后续应用进程 fork 请求;若 system_server 退出,Zygote 的 SIGCHLD 处理路径会 waitpid() 匹配 gSystemServerPid 并杀死 Zygote,让 init 的 Zygote 服务监督链路接管后续重启。[已验证: frameworks/base/core/jni/com_android_internal_os_Zygote.cpp 与 system/core/rootdir/init.zygote64.rc @ android-17.0.0_r1]
// AOSP android-17.0.0_r1
// frameworks/base/services/java/com/android/server/SystemServer.java
startBootstrapServices(t);
startCoreServices(t);
startOtherServices(t);
startApexServices(t);
这段代码证明的是启动分组和调用顺序;各组内部允许并行的工作可以交给专门线程或 SystemServerInitThreadPool。排查开机耗时时,我们从 SystemServerTiming、init 服务事件和具体线程的时间片还原实际执行。
应用冷启动还会经过另一个方向:应用或 Launcher 通过 Binder 请求 system_server 中的 Activity/Task 管理服务,系统服务通过 Zygote socket 请求创建进程,子进程进入 ActivityThread.main(),再通过 Binder 向 system_server 完成 attach。这条路径同时用了 Binder 和本地 socket,整条统称为“Binder 调用”并不准确。
三类跨边界接口
Binder:跨进程传递控制命令
Binder 由用户态 libbinder 与内核 Binder 驱动共同完成。frameworks/native/libs/binder/ProcessState.cpp 定义了接收 Binder 事务的映射区,以及通过 BINDER_SET_MAX_THREADS 写入驱动的动态线程上限:
// AOSP android-17.0.0_r1
#define BINDER_VM_SIZE ((1 * 1024 * 1024) - sysconf(_SC_PAGE_SIZE) * 2)
#define DEFAULT_MAX_BINDER_THREADS 15
DEFAULT_MAX_BINDER_THREADS = 15 限的是驱动允许动态请求的最大增线程数;进程内 Binder 线程总数要另算——ProcessState::startThreadPool() 启动的池中首个线程,以及手工调用 IPCThreadState::joinThreadPool() 的线程,都排在 15 个名额之外。默认路径下,内核通过 BR_SPAWN_LOOPER 请求用户态增加线程,前提是同时满足:没有等待线程、没有尚未完成的增线程请求、驱动已请求启动的线程数低于 max_threads,且当前线程已进入 Binder looper。ACK 还提供 trace_android_vh_binder_spawn_new_thread() 钩子;钩子设置 force_spawn 后,可以绕过这组默认判断,设备上的实际行为还要核对厂商实现。另外,setThreadPoolMaxThreadCount() 用 BINDER_SET_MAX_THREADS 配置驱动,线程池启动后,这个上限便失去了下调的空间。
“应用用 4 到 8 个、系统服务用 30 到 50 个”这类通用建议,这两个常量给不出来:线程数太少会让长事务阻塞后续请求,太多又会推高并发、锁竞争和内存成本。动手调整前,我们先用 Perfetto 系统跟踪和服务日志确认:
- 调用方是否在同步等待 Binder 回复;
- 目标进程是否没有空闲 Binder 线程;
- 处理线程是在运行、等待 CPU、等锁还是等 I/O;
- 长事务来自少数异常请求,还是稳定的并发容量不足。
Binder 事务数据由驱动从发送方用户空间复制到接收方可映射的 Binder 缓冲区,常被概括为“一次拷贝”。但端到端延迟由整条请求决定:文件描述符转换、对象解析、权限检查、线程调度和目标服务执行,都在“一次拷贝”之外各自产生开销。
SELinux 也在 Binder 事务路径上参与授权。ACK android17-6.18-2026-06_r6 的 security/selinux/hooks.c 中,selinux_binder_transaction() 会检查 BINDER__CALL;当前线程的 SELinux 安全标识符(SID)与事务发起方凭据的 SID 不同时,还会先检查 BINDER__IMPERSONATE,通过后再检查 BINDER__CALL。这里比较的就是 SID,结论也就到 SID 为止,推广到任意凭据字段差异并不成立。源码能证明的,是这些检查与条件存在;要写出固定的纳秒开销,需要同设备、同策略与同负载的测量(measure)。
在启用 A/B 系统更新服务的设备上,android.os.UpdateEngine 是 Framework 客户端:它通过 ServiceManager 获取 android.os.UpdateEngineService,再经 Binder 转发请求。服务端由 init 启动为 /system/bin/update_engine 原生进程,并在 DaemonAndroid::OnInit() 中注册 Binder 服务,执行升级的服务端不在 system_server。该 Java 类带有 @SystemApi 和 @hide,不能按普通 SDK 公开 API 使用。排查时,先在设备进程列表中确认 update_engine,再沿 Binder 事务查看调用方和服务端线程;Java 包名不能代替进程证据。[来源: 2026-11-03-77028958-AOSP 14 OTA 升级指导(三):.md;已验证: frameworks/base/core/java/android/os/UpdateEngine.java、system/update_engine/update_engine.rc 与 system/update_engine/aosp/daemon_android.cc @ android-17.0.0_r1]
JNI:同一进程里的托管代码与原生代码边界
JNI 是同一进程内从 ART 托管执行环境进入原生函数的应用二进制接口(ABI)边界——跨过这条边界,进程还是原来那个,Binder 与内核态切换也都不会自动发生。它的成本来自调用约定、线程状态转换、引用管理、参数转换、数组或字符串的复制或固定,以及原生函数自身的工作。
优化 JNI 时优先减少跨边界次数和数据转换:
- 循环中的细粒度调用可以改成一次批量调用,但要同时评估额外内存与延迟。
- 大块二进制数据可以评估直接缓冲区(direct buffer)或其他共享表示,避免反复构造 Java 对象。
@FastNative与@CriticalNative从 Android 14(API 34)起是经 CTS 测试的公开 API,满足约束的应用代码可以使用;能省多少要靠目标设备实测,固定倍数估不出来。
两种注解互斥,同一个方法只选其一。@CriticalNative 只适用于没有托管对象参数、返回值或隐式 this 的原生方法,并改变 JNI ABI:原生实现的签名不带 JNIEnv 和 jclass。注解执行期间,GC 失去了按普通 JNI 路径挂起该线程的手段,可能因此受阻;所以方法要短小、耗时有界,大量 I/O 和可能长期持有的原生锁都要避开。
兼容旧设备时还要区分 Android 系统版本:Android 8–13 已有相关实现,但没有 Android 14 起的 CTS 保证;Android 8–11 必须通过 RegisterNatives 显式注册,Android 12 起才支持动态查找,官方仍建议显式注册。Android 7 及以下会忽略这些注解,@CriticalNative 的 ABI 不匹配可能导致参数传递错误和崩溃。JNI tips 给出了这些限制。
是否值得调整,要用目标设备上的基准和调用栈判断:空 JNI 基准测出的纳秒数,代表不了包含字符串、数组、锁和 I/O 的业务调用。
系统调用与共享缓冲区:大量数据通常走另一条路径
高吞吐数据不适合反复塞进 Binder Parcel。图形、相机和音频通常用 Binder 传递控制命令,再用 BufferQueue、DMA-BUF、共享内存、FMQ 或硬件缓冲区传递数据和同步信息。
这类问题要把控制命令、缓冲区生命周期和同步栅栏分开观察。一次相机请求可以很快完成 Binder 往返,却仍然长时间等待传感器、ISP 或缓冲区同步栅栏;一次显示提交也可能在 SurfaceFlinger 侧很短,而 GPU 或 HWC 的完成时间更晚。
Treble、HIDL 与 Stable AIDL
HIDL 与 AIDL 都用于定义跨进程或 HAL 接口,但生成的传输代码与兼容规则不同。Project Treble 从 Android 8.0 开始约束系统框架与厂商实现之间的接口。VINTF 清单描述一方提供的接口,兼容性矩阵描述另一方要求的接口:设备清单要匹配框架兼容性矩阵,框架清单要匹配设备兼容性矩阵。两组匹配共同约束 system 与 vendor 分区的组合。Treble 提供只更新系统框架所需的稳定接口,但不保证任意系统框架与任意厂商实现都能组合,具体组合仍要通过 VINTF 与兼容性测试。
HIDL 时代需要区分两种传输:
- 服务化(binderized)HIDL HAL 以服务进程运行,常使用
/dev/hwbinder。 - 直通式(passthrough)HIDL HAL 以共享库加载到调用方进程,调用路径中没有独立 HAL 服务进程。
在 Android 17 基线下,HIDL 已废弃,既有实现仍受支持;新 HAL 接口应优先使用 Stable AIDL,上游接口仍为 HIDL 时则按该接口实现。用于 system/vendor 边界的 AIDL HAL 以 Binder 服务运行,需要在类型上声明 @VintfStability,在 aidl_interface 中设置 stability: "vintf",加入 VINTF 清单并满足接口冻结等 VTS 检查。旧 HIDL HAL 仍可能为了兼容已有 vendor 镜像而保留;即便在 Android 17 设备上,仅凭系统版本也判断不了全部 HAL 是否都已迁移。
Stable AIDL 还约束接口所用的语言后端。vendor 原生代码应使用 NDK 后端并链接 libbinder_ndk,通过 /dev/binder 通信;不稳定的 libbinder C++ 接口只对 system/system_ext 开放。Java 后端从 vendor 分区连不到 ServiceManager;API 34 之后,新增的 System API 也对 vendor 分区关闭。这些分区与后端限制,接口稳定性声明替代不了。
排查 HAL 延迟时,我们按实际传输模式走:
- 从应用框架或原生客户端找到接口调用与目标服务。
- 服务化实现沿 Binder 调用进入 HAL 进程,检查服务线程、锁、系统调用与同步栅栏。
- 直通式实现留在调用方进程,检查原生调用栈和共享库内部等待。
- 涉及大量数据传输的请求继续追踪缓冲区、FMQ、DMA-BUF 与驱动事件,控制命令的回复只是中途站。
Android 15 到 Android 17 的三个架构边界
16 KB 页大小
从 Android 15 开始,AOSP 支持配置为 16 KB 页大小的设备。应用及其全部库、SDK 都只包含 Java/Kotlin 代码时,不需要为 ELF(Android 原生可执行文件和共享库使用的二进制格式) 对齐做改造,但仍应在 16 KB 环境中回归测试;包含 NDK 编译的库或通过 SDK 间接引入 .so 时,需要检查 ELF 的 LOAD 段,以及 APK 内未压缩原生库的 ZIP 对齐。
设备运行时页大小可直接读取:
adb shell getconf PAGE_SIZE
4096 表示 4 KB,16384 表示 16 KB。Android Developers 文档公布的启动、功耗和系统启动收益来自 Google 的初始测试,并明确说明实际设备结果会不同。我们把这些数字当测试方向就好,具体收益以自己的应用和设备实测为准。
Google Play 当前要求目标版本为 Android 15 / API 35 或更高的应用支持 64 位设备上的 16 KB 页;从 2027 年 2 月 1 日起,未支持的应用更新将失去发布资格。这是应用分发兼容要求,落实到具体设备,Android 15、16 或 17 也未必都运行在 16 KB 模式。
Mainline 模块
Mainline 把一部分系统组件封装为 APEX 或 APK,使它们可以通过 Google Play 系统更新或合作伙伴 OTA 独立更新。SystemServer.run() 也明确执行每个进程所需的 Mainline 模块初始化,并在常规服务组之后调用 startApexServices()。
官方文档注明,Android 11 及以下版本的 Mainline 支持已于 2025 年第四季度结束。分析旧设备时,还要核对其模块更新支持状态。Mainline 支持说明
分析问题时,单看 Android 版本号确定不了 ART、Media、Wi-Fi、Bluetooth 等模块的实现,报告应同时记录构建指纹(build fingerprint)、相关 APEX/APK 版本和复现时间。模块更新可能改变实现,但仍受稳定 SDK/System API、稳定 C API 或 Stable AIDL 的约束。
VNDK 废弃与动态链接器命名空间
VNDK 用于约束 system 与 vendor 分区之间可使用的原生库,从 Android 15 开始废弃。新的 vendor 或 product 分区不再声明 ro.vndk.version,原 VNDK 库按厂商分区可用库(vendor-available library)的方式安装到 vendor 或 product 镜像;为旧厂商镜像提供兼容性的 VNDK APEX 仍可能存在。
VNDK 废弃没有删除动态链接器命名空间。bionic/linker/linker_namespaces.cpp 中,隔离命名空间仍通过 android_namespace_t::is_accessible() 检查 allowed_libs_、库搜索路径和 permitted_paths_。这段源码能支持的结论是“加载前存在可访问性校验”;要谈固定的启动耗时比例,得结合加载库数量、搜索路径、文件系统缓存、重定位、RELRO 只读重定位保护和构造函数,一起测量 dlopen() 成本。
SurfaceFlinger 与系统服务的进程分工
WindowManagerService 运行在 system_server,负责窗口容器、层级、焦点、配置和策略。SurfaceFlinger 是 init 启动的独立原生服务,负责接收 layer 状态与缓冲区,借助 CompositionEngine、RenderEngine 和 Composer HAL 生成显示输出。两者协作,但分属两个进程,归入同一个“应用框架进程”会丢掉这层区别。
frameworks/native/services/surfaceflinger/SurfaceFlinger.cpp 的主刷新路径包含:
SurfaceFlinger::commit(...):提交本轮状态并决定是否需要合成。SurfaceFlinger::composite(...):进入各显示设备的合成与显示提交(present)路径。postComposition跟踪事件:记录合成后的处理阶段。
历史跟踪数据中的搜索词会变化:
| 版本范围 | 建议先查的 SurfaceFlinger 入口 | 使用范围 |
|---|---|---|
| Android 17 | commit <vsyncId>、composite <vsyncId>、postComposition | 以 android-17.0.0_r1 为当前核对版本 |
| Android 15-16 | commit <vsyncId>、composite <vsyncId>;再按源码标签确认 post-composition 标记 | 不把 Android 17 的跟踪宏与名称直接套到旧源码标签 |
| Android 13-14 | commit、composite 与对应的 post-composition 路径 | 名称是否带 VSync ID 要以设备跟踪数据为准 |
| Android 11-12 | onMessageInvalidate、onMessageRefresh、CompositionEngine 显示提交路径 | 仍是消息驱动入口 |
| Android 10 及以前 | onMessageReceived、handleMessageRefresh、doComposition | 只用于历史设备与版本演进 |
composite 变长只是一条线索;GPU 是否过载,我们还要结合 HWC 合成决策、present fence、RenderEngine、显示模式、图层数量和驱动等待来判断。
在 Perfetto 中按因果关系定位
Perfetto 数据源与五层架构没有一一对应关系:
linux.ftrace可以提供调度、频率、I/O、Binder 驱动和部分驱动事件。它来自内核,但描述的线程可能属于应用、系统服务或 HAL。- ATrace/TrackEvent 允许用户态代码主动记录跟踪事件。应用、应用框架、原生服务和 HAL 都可以产生 slice;category 是采集开关,不是架构层名称。
- 进程统计、堆分析、FrameTimeline、功耗计数器等数据源各自回答特定问题,合并成一个“上层数据源”只会抹掉差别。
一次跨进程等待可以按下面的顺序读:
- 在调用方找到同步 Binder 时间片,确认发起线程和事务。
- 沿流向关联(flow)找到目标进程的处理线程。
- 检查目标线程处于 Running、Runnable、Sleeping 还是 Uninterruptible Sleep。
- Running 表示线程正在 CPU 上执行,仍需用时间片或调用栈判断执行内容。
- Runnable 表示已经可运行但尚未获得 CPU,结合优先级、CPU 利用率、频率和温控信息判断调度延迟。
- Sleeping 可能是 Binder 回复、
futex锁等待、epoll事件等待或定时等待;Uninterruptible Sleep 常见于不可中断的内核等待,但仍要用wchan记录的内核等待位置、I/O 与驱动事件确认对象。
Binder flow 只说明事务关系;调用方时间片的持续时间、目标线程的排队时间和服务执行时间要分别计算,读图时别拿箭头的视觉长度当比例。
三个常见排障场景
| 现象 | 第一组证据 | 向下追踪 | 不应直接得出的结论 |
|---|---|---|---|
| 应用主线程同步 Binder 很长 | 调用方 Binder 时间片、目标进程与目标线程 | 目标线程调度、锁、I/O、服务代码与下游 Binder | “Binder 驱动慢” |
surfaceflinger 的 composite 变长 | SurfaceFlinger 主线程、CompositionEngine、HWC/RenderEngine 事件 | 合成类型(composition type)、同步栅栏、GPU/HWC、显示模式与图层变化 | “一定是应用绘制慢” |
| Camera 请求返回慢 | 应用框架、CameraService 与 HAL 之间的事务及请求 ID | HAL 线程、FMQ/缓冲区、同步栅栏、驱动与传感器时间 | “HAL 只是接口,不会产生延迟” |
定位时我们会继续往下找:从调用 API 的进程,到接收进程、执行线程和内核等待对象。每多跨一层边界,都保存事务 ID、线程 ID、时间范围或源码符号,避免只凭相邻事件建立因果关系。
源码入口
以下路径都在固定源码标签下,用于复核上述结论;平台路径取 AOSP android-17.0.0_r1,内核路径取 ACK android17-6.18-2026-06_r6:
- init 三阶段入口:
system/core/init/main.cpp。 - Zygote 预加载、创建 SystemServer 与套接字循环:
frameworks/base/core/java/com/android/internal/os/ZygoteInit.java。 - SystemServer 服务分组:
frameworks/base/services/java/com/android/server/SystemServer.java。 - SurfaceFlinger 的
commit()/composite():frameworks/native/services/surfaceflinger/SurfaceFlinger.cpp。 - Binder 用户态线程池:
frameworks/native/libs/binder/ProcessState.cpp与IPCThreadState.cpp。 - 动态链接器命名空间:
bionic/linker/linker_namespaces.cpp。 - Binder 驱动:
drivers/android/binder.c。 - Binder 的 SELinux 安全检查钩子:
security/selinux/hooks.c。
固定源码标签、项目路径和符号一起使用,才能把架构图中的箭头还原成可验证的运行路径。
常见误区
- SurfaceFlinger 不在
system_server。 它是独立原生服务;WMS 与 SurfaceFlinger 通过明确接口协作。 - Zygote fork 不会立即复制全部物理内存。 写时复制(Copy-on-Write)让父子进程共享未修改页面;后续写入、ART 运行和应用初始化会逐步产生私有页。
- HAL 未必是独立进程。 Stable AIDL HAL 是 Binder 服务,存量 HIDL 还要区分服务化与直通式实现。
- JNI 与 IPC 是两回事。 JNI 在同一进程内跨托管/原生边界;原生函数随后是否发起系统调用或 Binder 是另一件事。
- Binder 一次拷贝推不出端到端低延迟。 排队、调度、权限检查、对象解析、目标服务和下游依赖都会进入总耗时。
- 应用现象不保证根因位于应用层。
system_server、SurfaceFlinger、HAL、驱动与硬件等待都可能把延迟传回应用。
应用进程的创建、状态与回收
分层描述解决组件归属问题,运行时故障还要落实到具体进程。应用进程从 Zygote 创建后,AMS、OomAdjuster、lmkd 与 Freezer 共同改变它的状态和可运行性。组件调度、adj 计算和 system_server 锁模型由 1.12 展开,具体 cgroup 落点由 1.13 展开,Binder Freezer 的事务语义由 1.10 展开。
Android 应用可以创建线程,却不能自行决定进程能活多久。系统根据进程中正在运行的组件、组件与其他进程的依赖关系、用户能否感知这些工作以及整机内存压力,持续计算进程重要性。内存紧张时,重要性较低的进程先成为回收候选。
这个模型解释了三类常见问题:
- 进程不存在时,启动组件要先由 Zygote(模板进程)创建进程,再经过应用绑定和组件调度,冷启动路径因此更长。
- 缓存进程能缩短应用切回时间,但会占用内存;系统必须在切回速度与前台可用内存之间取舍。
- 一个线程即使还在运行,如果所属进程中没有系统认可的活跃组件,进程仍可能进入缓存态(cached)并被终止。
分析这类问题时,我们把四件事分开看:应用代码是否还有工作、AMS 认为进程处于什么状态、内核是否允许它获得 CPU、低内存策略是否把它列为候选。
应用进程从哪里来
默认情况下,每个应用使用自己的 Linux 用户 ID(UID)和进程,Activity、Service、BroadcastReceiver、ContentProvider 等组件运行在默认进程中。fork 瞬间,子进程只保留执行 fork 的线程;但在普通应用进入 ActivityThread.main() 前,ZygoteInit.zygoteInit() 已经经 nativeZygoteInit() 启动 Binder 线程池——业务入口处的进程,从一开始就不止主线程一条。组件生命周期回调通常由主线程分发,但组件的方法也会落到其他线程上,例如远程 Binder 方法和来自其他进程的 ContentProvider 调用可以落在 Binder 线程池,相关实现仍要满足线程安全要求。
AndroidManifest.xml 可以改变进程边界:
<application android:process="...">为应用组件指定默认进程。<activity>、<service>、<receiver>、<provider>可以覆盖该值。- 以冒号开头的名字,例如
:player,表示应用私有进程,实际名字会带上包名前缀。 - 不以冒号开头的全局进程名只在共享 Linux UID 且签名匹配时才可能跨应用共用。
android:sharedUserId从 API 29 起已经废弃,新应用要绕开这种设计。已安装的应用想靠直接删除该属性迁出共享 UID,这条路走不通;官方建议旧应用设置android:sharedUserMaxSdkVersion="32",让新用户的安装不再进入共享 UID。
android.os.Process.start() 仍把 UID、GID、ABI、targetSdk、数据目录和运行时参数交给 ZygoteProcess.start()。fork 发生在 Zygote 一侧,Process.start() 只是应用框架的请求入口,并不直接调用 Linux fork()。应用进程创建后再经 Binder 向 system_server 回连,AMS 才能继续 bindApplication 和组件调度。
普通应用创建请求为什么走 Zygote socket
普通应用冷启动时,system_server 负责决定是否需要目标进程、整理启动参数,fork 本身交给 Zygote。ProcessList 会把 UID/GID、运行时标志、目标 SDK、SELinux seInfo、ABI、数据目录、包名和入口类 android.app.ActivityThread 传给 Process.start();Process.start() 再进入 ZygoteProcess.startViaZygote(),由后者把参数编码成换行分隔的 Zygote 命令并写入本地 LocalSocket。[来源: https://juejin.cn/post/7681511201547255842;已验证: frameworks/base/services/core/java/com/android/server/am/ProcessList.java、frameworks/base/core/java/android/os/Process.java 与 ZygoteProcess.java @ android-17.0.0_r1]
服务端端点也不是 Zygote 临时绑定的 TCP 端口:init.zygote64.rc 为主 Zygote 声明 socket zygote stream 660 root system 和 socket usap_pool_primary stream 660 root system。Zygote 继承这些受 init 管理的 Unix domain socket 后,由 ZygoteServer.runSelectLoop() 轮询服务端和会话文件描述符;连接进入 ZygoteConnection.processCommand(),读取 peer credentials、解析 ZygoteArguments、执行参数/身份策略检查,再走 Zygote 侧的 fork 与 specialize 路径。[来源: https://juejin.cn/post/7681511201547255842;已验证: system/core/rootdir/init.zygote64.rc、frameworks/base/core/java/com/android/internal/os/ZygoteServer.java、ZygoteConnection.java 与 Zygote.java @ android-17.0.0_r1]
USAP(Unspecialized App Process)池复用 Zygote 预先 fork、尚未完成应用身份专化(specialize)的进程。ZygoteProcess.startViaZygote() 先通过 openZygoteSocketIfNeeded(abi) 选择支持目标 ABI 的主或次 Zygote;所选 ZygoteState 同时保存常规 socket 和对应的 USAP pool socket。只有池受支持、已启用、策略允许且命令形态受支持时,才尝试 USAP。
未满足条件时,请求直接走所选 Zygote 的常规 socket;尝试 USAP 时,zygoteSendArgsAndGetResult() 只在捕获 IOException 后沿该连接状态回退。USAP 返回负 PID 会抛出 ZygoteStartFailedEx("USAP specialization failed") 并向上传播,不经过这条回退分支。排查时应区分通信 I/O 异常与身份专化失败,并核对目标 ABI 和对应的 Zygote,不能把回退目标固定为主 Zygote。[已验证: frameworks/base/core/java/android/os/ZygoteProcess.java 的 startViaZygote()、openZygoteSocketIfNeeded()、zygoteSendArgsAndGetResult() 与 attemptUsapSendArgsAndGetResult() @ android-17.0.0_r1]
无论走常规 Zygote socket 还是 USAP pool socket,AMS 仍要维护 ProcessRecord、启动序号和 PID 映射;客户端读到 PID,说明 Zygote/USAP 侧返回了创建结果;至于 Application 是否已绑定、组件是否已启动、首帧是否完成,这份结果里还没有答案。[来源: https://juejin.cn/post/7681511201547255842;已验证: frameworks/base/core/java/android/os/ZygoteProcess.java 与 frameworks/base/services/core/java/com/android/server/am/ProcessList.java @ android-17.0.0_r1]
这条源码路径能证明的是:AOSP Android 17 的普通应用创建请求走 Zygote/USAP 本地 socket,Zygote 没有被暴露成一个普通 Binder 服务。至于“Binder 从原理上承载不了创建进程命令”,源码推不出这个结论;“启动更早”“socket 天然更安全”这类说法,同样缺少能立为唯一官方原因的依据。
当前方案的安全性质来自 init socket 权限、SELinux 策略、peer credentials、Zygote 参数校验和 native specialize 的共同作用;Binder 本身也提供调用方身份并经过 Binder 驱动与 SELinux 检查。[来源: https://juejin.cn/post/7681511201547255842;已验证: frameworks/base/core/java/com/android/internal/os/ZygoteConnection.java、frameworks/base/cmds/app_process/app_main.cpp @ android-17.0.0_r1;drivers/android/binder.c 与 security/selinux/hooks.c @ android17-6.18-2026-06_r6]
排查应用“出生点”时,我们把三个时间点分开:ProcessList 发起进程启动、Zygote/USAP 返回 PID、应用进程进入 ActivityThread.main() 并通过 Binder attach 到 AMS。ps -A -o PID,PPID,NAME,ARGS 可以先确认新进程父子关系,dumpsys activity processes 可以核对 AMS 视角的进程记录;只看到 PID 返回时,bindApplication、组件生命周期和首帧都还没有着落。[来源: https://juejin.cn/post/7681511201547255842;已验证: frameworks/base/services/core/java/com/android/server/am/ProcessList.java 与 frameworks/base/core/java/android/app/ActivityThread.java @ android-17.0.0_r1]
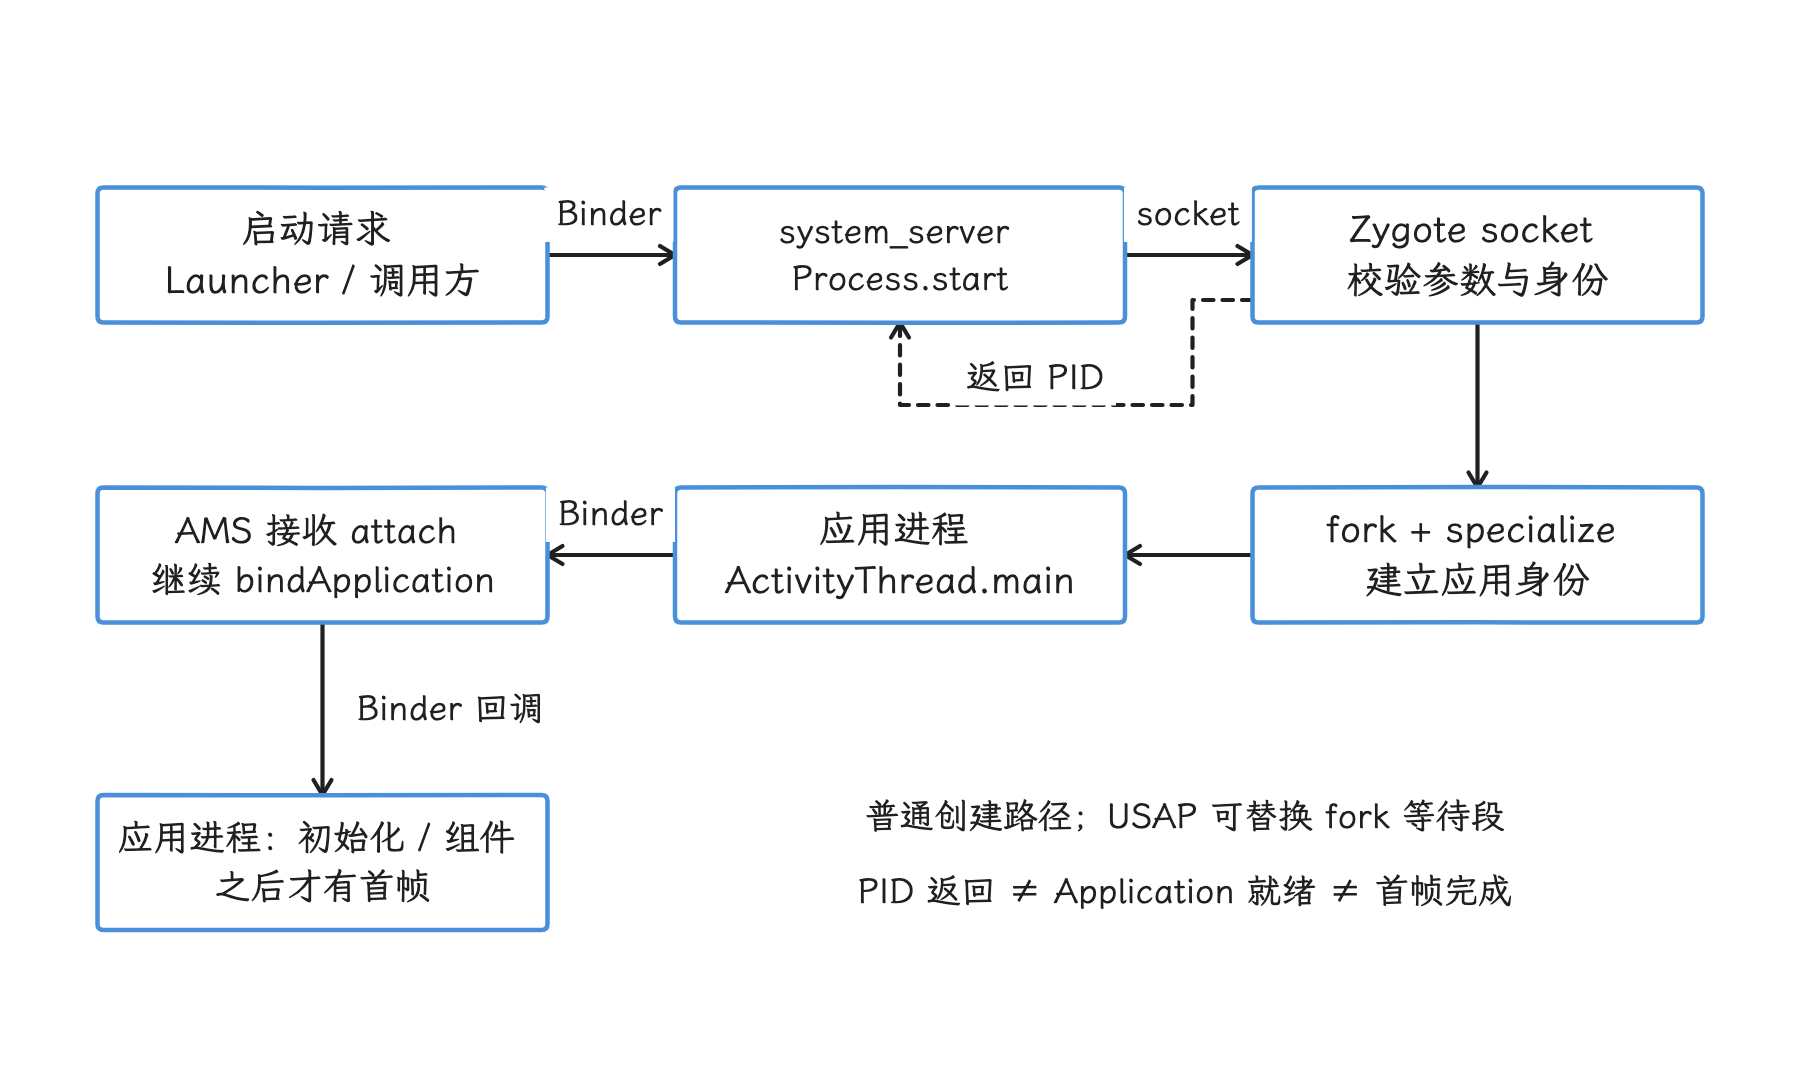
图:以常规 Zygote 创建路径为主线。USAP 满足条件时可复用预先 fork 的进程;返回 PID、attach、应用绑定和首帧完成是不同边界。
多进程会带来额外的隔离成本。一个 android:process=":remote" 至少增加一套进程地址空间、ART 运行时状态、Java 与原生堆、线程栈、主线程消息循环和 Application 初始化;原来的进程内调用也可能变成 Binder IPC。
普通 android:process=":remote" 默认仍使用应用的 UID 和权限,分开的只是地址空间以及一部分崩溃、内存故障;不可信代码的权限沙箱,它单独承担不了。若需要让服务不继承应用自身的权限,应评估 <service android:isolatedProcess="true"> 等系统支持的隔离进程模型,并按该组件允许的 Service 接口交互。传给隔离服务的数据、文件描述符和 Binder 接口仍需限制,宿主权限不得经由接口重新开放给它。
适合普通分进程的场景通常有明确的故障或内存边界,例如:
- 崩溃影响需要圈在自己进程内、避免拖垮主界面的独立模块;
- 生命周期清楚、结束后希望通过终止整个进程释放大块原生或图形内存的模块。
系统明确提供隔离进程模型的组件,应遵守对应的 UID、权限与通信限制;普通分进程配置顶替不了这套模型。
如果两个模块高频同步调用、共享大量可变状态,拆进程往往只会增加序列化、Binder 线程池、锁和状态同步成本。
组件状态决定进程重要性
我们先把分级看清楚。开发者文档把应用进程概括为前台(foreground)、可见(visible)、服务(service)和缓存(cached)四类。AOSP 的执行策略还使用更细的 adj 回收优先级分数,数值越小,进程在低内存时越不容易成为终止候选。Android 17 的常量已经从旧版 ProcessList 移到 com.android.server.am.psc.Constants:
| 典型状态 | Android 17 基准 adj | 含义 |
|---|---|---|
| 顶层/前台(top/foreground) | FOREGROUND_APP_ADJ = 0 | 用户正在交互,或进程正在执行广播接收器、服务回调等受保护工作 |
| 可见(visible) | VISIBLE_APP_ADJ = 100 起 | 内容仍可见;部分策略可以在可见区间内进一步分层 |
| 可感知(perceptible) | PERCEPTIBLE_APP_ADJ = 200 起 | 用户能感知中断,例如受认可的媒体播放或前台服务场景 |
| 服务(service) | SERVICE_ADJ = 500 | 持有已启动服务(started service),但没有更重要组件 |
| 桌面(home) | HOME_APP_ADJ = 600 | 当前桌面进程 |
| 上一个应用(previous) | PREVIOUS_APP_ADJ = 700 起 | 最近离开的应用;Android 17 可按开关对该区间分层 |
| B 类服务(service B) | SERVICE_B_ADJ = 800 | 重要性进一步降低的老化服务 |
| 缓存(cached) | CACHED_APP_MIN_ADJ = 900 到 CACHED_APP_MAX_ADJ = 999 | 当前没有用户可感知工作,可按系统需要回收 |
这些数值适合解释 AOSP 的相对顺序,各设备实际的“保活等级”还要看具体配置:可见、上一个应用和缓存区间都存在更细的排序策略与功能开关,厂商还可以调整进程上限、冻结阈值和 lmkd 参数。
分类遵循三条规则。
第一,进程按其中最重要的活跃组件定级。一个进程同时拥有可见 Activity 和已启动服务时,不会因为服务的重要性较低就降到服务级别。
第二,重要性会沿依赖关系传播。高优先级进程绑定另一个进程的 Service,或正在使用另一个进程的 ContentProvider 时,被依赖进程需要获得足以完成请求的保护。绑定标志(flag)、依赖类型和能力传播规则都会影响最终结果,只看服务端自身的组件会漏掉这部分。
第三,组件工作结束就可能撤销保护。没有调用 goAsync() 时,BroadcastReceiver.onReceive() 返回后,广播接收器通常不再被视为活跃;普通线程继续工作并不能保证进程存活。调用 goAsync() 可以在返回后暂时维持广播活跃,但必须在处理完成后调用 PendingResult.finish(),且整个异步区间仍受广播执行超时约束。这种有限延期不提供持久后台执行保证;需要可靠完成的任务应交给 JobScheduler、WorkManager 或其他与系统调度约束相匹配的接口。
从 Android 13 开始,缓存进程在重新进入活跃生命周期状态前,可能只得到有限的执行时间,甚至得不到执行时间。应用必须把缓存态视为“可以立即停止”的状态,按低优先级后台运行模式来设计是靠不住的。
Android 17 如何计算进程状态
进程状态相关实现已经进入 com.android.server.am.psc,还用“AMS 调用一个旧版 OomAdjuster.java”来概括就过时了:
- Activity、Service、Broadcast 等管理模块把组件和依赖变化交给
ProcessStateController。 ProcessStateController提交待处理事件,并触发局部或全量的 OOM 优先级调整(adjustment)。OomAdjusterImpl.computeOomAdjLSP()从最重要条件开始计算adj、procState、schedGroup和能力标志(capability)。- 依赖遍历继续修正服务端、Provider 端及其他可达进程的结果。
- 计算值提交后,回调更新调度组、缓存进程冻结器(freezer)、统计信息,并把 OOM 优先级同步给
lmkd。
下面按分支简化的源码片段显示,top app、正在接收广播和正在执行 Service 回调会得到不同的 procState 与调度组;片段省略了中间的远程动画、instrumentation 分支及日志,不是完整优先级算法。后续还会处理 Activity、前台服务和进程依赖。
// frameworks/base/services/core/java/com/android/server/am/psc/OomAdjusterImpl.java
// @ android-17.0.0_r1,按分支简化
if (app == topApp && PROCESS_STATE_CUR_TOP == PROCESS_STATE_TOP) {
    adj = FOREGROUND_APP_ADJ;
    schedGroup = useTopSchedGroupForTopProcess()
            ? SCHED_GROUP_TOP_APP : SCHED_GROUP_DEFAULT;
    procState = PROCESS_STATE_TOP;
    // 此处省略后续 else-if 中的远程动画、instrumentation 分支及日志。
} else if (isReceivingBroadcast(app)) {
    adj = FOREGROUND_APP_ADJ;
    schedGroup = app.getReceivers().getBroadcastReceiverSchedGroup();
    procState = ActivityManager.PROCESS_STATE_RECEIVER;
} else if (psr.hasExecutingServices()) {
    adj = FOREGROUND_APP_ADJ;
    schedGroup = psr.isExecServicesFg()
            ? SCHED_GROUP_DEFAULT : SCHED_GROUP_BACKGROUND;
    procState = PROCESS_STATE_SERVICE;
}
四组结果负责不同职责:
adj是 Android 的进程回收优先级,提交后与/proc/<pid>/oom_score_adj、lmkd进程表相关。procState描述更细的运行状态,供后台限制、统计、内存采样和其他策略使用。schedGroup决定进程应进入哪类 CPU 调度资源组。- 能力标志描述进程当前可以继承或使用的特定能力。冻结策略会直接检查 CPU 时间能力标志。
所以排查时我们要同时记录这几组值:oom_score_adj 较低,只说明回收保护强,进程是否落在 top-app CPU 集合(cpuset)要看 schedGroup;前台服务也换不来顶层 Activity 的完整待遇,是否等同要看 procState 与组件状态。
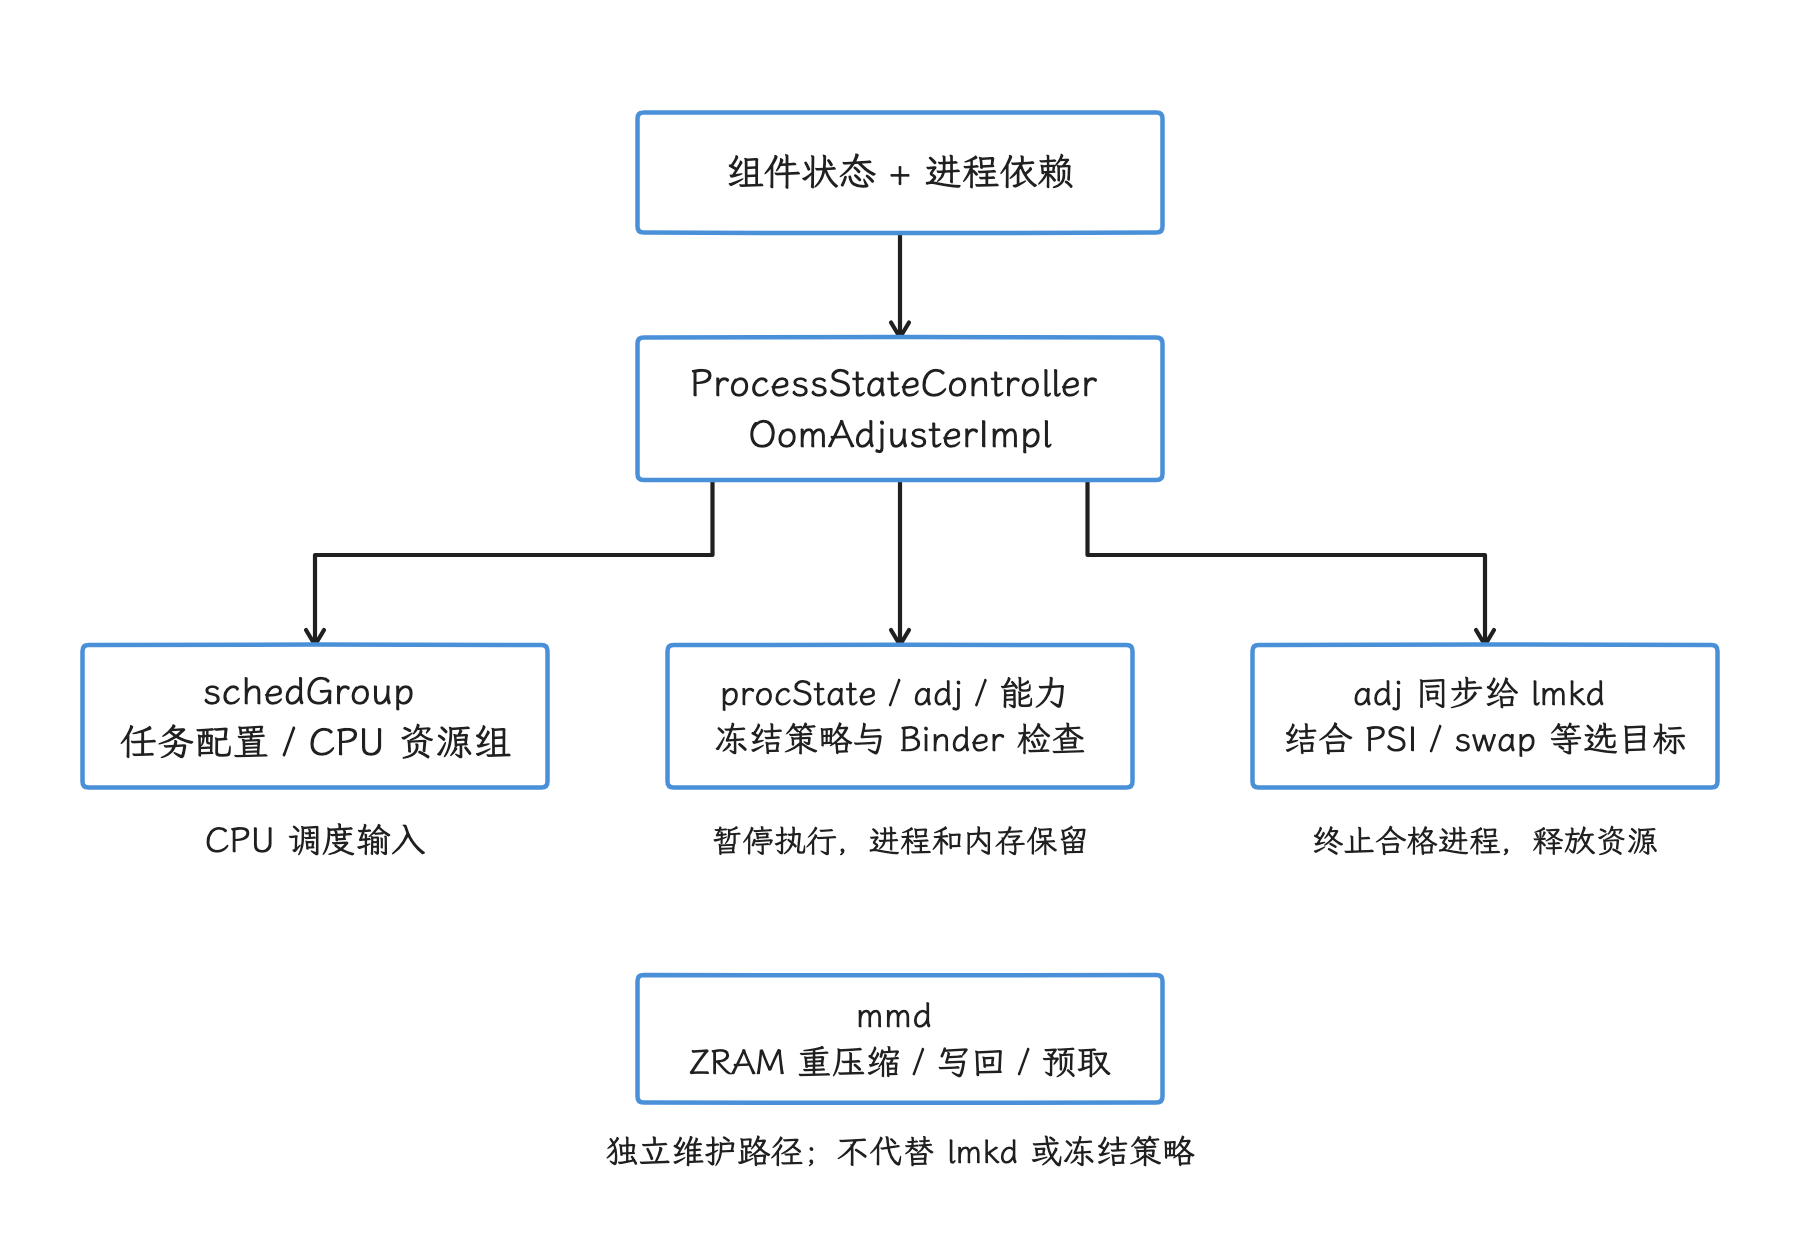
图:组件及依赖关系参与进程状态计算;CPU 分组、冻结和低内存终止各有条件。mmd 负责 ZRAM 维护,冻结不会释放进程的全部内存。
lmkd 决定何时杀、杀谁
Android 使用用户态守护进程 lmkd 监控内存压力。Android 10 及以上支持 PSI(Pressure Stall Information,资源压力停顿信息)模式:内核统计任务因 CPU、内存或 I/O 争用而停顿的时间,lmkd 订阅内存压力阈值。通用官方文档仍列出历史配置项 ro.lmk.use_psi=true;在本文固定的 android-17.0.0_r1 中,lmkd.cpp 已不读取该属性,init_monitors() 直接初始化 PSI 监视器,失败时返回 false,没有在这里回退到 vmpressure。排查 Android 17 设备时,我们应核对 PSI 内核支持、监视器初始化日志和产品源码;这个旧属性本身说明不了生效路径。
这条路径可以在固定平台与内核源码版本下核对:
ProcessList.setOomAdj()向lmkd发送LMK_PROCPRIO,包含 pid、uid、adj、进程类型等字段。system/memory/lmkd/lmkd.cpp保存进程的oomadj,读取 PSI、swap、页面缓存抖动(thrashing)、workingset refault 等信号后选择合格目标。- ACK
android17-6.18-2026-06_r6的kernel/sched/psi.c实现 PSI 触发器(trigger)的创建与轮询。
下面这段代码只是在同步优先级,不表示进程会立即被杀:
// frameworks/base/services/core/java/com/android/server/am/ProcessList.java
// @ android-17.0.0_r1
ByteBuffer buf = ByteBuffer.allocate(4 * 6);
buf.putInt(LMK_PROCPRIO);
buf.putInt(pid);
buf.putInt(uid);
buf.putInt(amt);
buf.putInt(0); // PROC_TYPE_APP
buf.putInt(forLmkdOnly ? 1 : 0);
writeLmkd(buf, null);
lmkd 终止谁,是综合下面这些信息选出来的,常驻内存集(RSS)最大的进程也只是候选之一:
- 当前内存压力及 PSI 记录的停顿时间;
- 进程是否达到本轮允许回收的最小
oom_score_adj; - swap 剩余量、页面缓存抖动和工作集页面淘汰后的再次访问;
- 是否启用“杀最大合格进程”等策略;
- 低内存设备与高性能设备的不同配置;
- 厂商在产品属性与内存控制组(cgroup)上的调整。
官方文档列出的 ro.lmk.medium=800、ro.lmk.critical=0 是特定模式下的默认配置说明,跨设备、跨压力级别套不成固定公式。应用侧要放弃“靠某个数值承诺存活时间”的指望。
ApplicationExitInfo.REASON_LOW_MEMORY 可用于分析一部分低内存退出,但官方 API 也说明,设备未必能把所有低内存终止都准确归为这一原因;某些情况可能表现为 REASON_SIGNALED 和 SIGKILL。退出原因要和 lmkd 日志、系统跟踪数据、当时的 oom_score_adj 一起判断。
缓存进程冻结器(Freezer)
缓存应用冻结器(Cached App Freezer)与 lmkd 执行两种不同操作:
lmkd终止进程,释放其资源。- 冻结器通过 cgroup v2 控制组的
cgroup.freeze暂停进程中的任务,进程和内存仍然存在。
CachedAppOptimizer.DEFAULT_USE_FREEZER 为 true,但设备实际启用还要同时满足 DeviceConfig(可动态调整的系统参数)配置、内核和 libprocessgroup 对冻结功能的支持。task_profiles.json 中的 Frozen/Unfrozen 配置最终写入 FreezerState,ACK 的 kernel/cgroup/freezer.c 与 kernel/cgroup/cgroup.c 实现并暴露 cgroup.freeze。
冻结与否也不只看 adj >= 900。常规默认冻结阈值来自 ActivityManagerConstants.DEFAULT_FREEZER_CUTOFF_ADJ:未启用 Flags.prototypeAggressiveFreezing() 时为 CACHED_APP_MIN_ADJ,启用该实验开关时可前移到 HOME_APP_ADJ;freezer_cutoff_adj 还允许产品配置调整。
此外,OomAdjuster.getFreezePolicy() 还会检查进程是否持有显式或隐式 CPU 时间能力标志。AMS 只有在冻结功能已启用、进程达到阈值且策略认为可冻结时,才安排异步冻结;中间还存在为避免频繁切换状态而设置的 debounce 延迟、待处理消息、Binder 事务和解冻原因。
同步 Binder 调用同样概括不成“自动解冻后一切正常”:系统会冻结 Binder 接口并处理待处理事务;如果应用通过持续 Binder 事务规避冻结,或者冻结状态下异步 Binder 缓冲区耗尽,系统可以终止进程。ApplicationExitInfo.REASON_FREEZER 表示进程因为冻结相关错误被终止,例如 Binder ioctl、同步事务或异步缓冲区问题;它既不表示一次普通冻结事件,也不是“解冻失败”的通用标签。
在 Perfetto 里,进程存在、线程长时间没有 sched_switch 记录,只能作为“可能被冻结”的线索;线程也可能只是睡眠、等待锁、等待 Binder 或没有任务。要确认冻结状态,我们组合检查:
dumpsys activity processes中的已冻结/待冻结状态(frozen/pending freeze)、adj、procState;- 目标进程实际 cgroup 的
cgroup.freeze/cgroup.events; - ActivityManager 的冻结跟踪事件与调度轨迹;
dumpsys activity exit-info中的退出原因(reason)与子原因(subreason);- Binder 和
lmkd日志。
同样,Perfetto 上的进程轨迹结束,要先排查崩溃、强制停止(force-stop)、用户停止、升级和其他信号,lmkd 只是其中一种可能。
mmd 与 lmkd 的分工
Android 17 新增 mmd,用来集中处理 ZRAM 的配置、参数和持续维护任务。它与 lmkd 的分工不同:
lmkd在内存压力下选择并终止较不重要的进程。mmd处理 ZRAM 重压缩、写回、按进程写回和预取等维护任务。
系统启动完成后,mmd_setup 尝试配置 ZRAM,随后启动 mmd 服务。system_server 中的 ZramMaintenance 通过 JobScheduler 安排全局维护,默认要求设备空闲且电量不低,这两个条件可由产品属性调整;任务执行时调用 IMmd.doZramMaintenanceAsync()。
启用 mmd.zram.enabled 管理 ZRAM 后,swapon_all 中原有的 ZRAM 配置步骤不再执行,config.xml 的 config_zramWriteback 和 ro.zram.* 写回属性也会被忽略。迁移设备配置时应先确认由哪套实现管理 ZRAM,避免修改已经失效的旧参数。
CachedAppOptimizer 还可以在缓存进程压缩后,经进程文件描述符(pidfd)请求 mmd.asyncWritebackProcessZramMemory();用户重新启动已写回的缓存进程时,可以调用 asyncPrefetchProcessZramMemory(),减少从后备存储恢复页面造成的主要缺页(major fault,即需要存储 I/O 才能补回页面)。是否启用、是否有后备块设备以及具体参数都属于产品配置,按进程写回不是每台设备都有。
这条新路径改变的是缓存进程的内存驻留和再次启动代价,并没有取消 OOM 优先级调整、冻结器或 lmkd。
调度组与任务配置(task profile)
进程重要性还会影响 CPU 和 I/O 资源。OomAdjusterImpl 计算 schedGroup 后,libprocessgroup 把抽象组映射为任务配置。task_profiles.json 仍包含这些典型映射:
SCHED_SP_BACKGROUND组合节能、低 I/O 优先级和更大的定时器容许延迟(timer slack);SCHED_SP_FOREGROUND组合较高性能、较高 I/O 优先级和正常的定时器容许延迟;SCHED_SP_TOP_APP组合MaxPerformance、MaxIoPriority和TimerSlackNormal,分别设置最大性能、最大 I/O 优先级与正常的定时器容许延迟。
任务配置只是平台默认策略的名字,应用时可能涉及 cpuset、uclamp、I/O 优先级或其他控制器。实际 cgroup 层级和文件路径由内核版本、init 配置与厂商产品配置共同决定;我们在某台设备上读到的 /dev/cpuset/... 路径,换台设备未必照样成立。
最小诊断方法
先记录同一时刻的 pid、uid 和进程名,再把 AMS、/proc、cgroup、退出记录和系统跟踪数据按时间对应起来。
# 找到精确进程;同一包可能有多个 processName
adb shell ps -A -o PID,UID,NAME | grep '<package-or-process>'

# AMS 视角:adj、procState、schedGroup、组件和冻结状态
adb shell dumpsys activity processes

# 内核 / lmkd 使用的当前优先级
adb shell cat /proc/<pid>/oom_score_adj

# 先找进程实际所属 cgroup,再读取相应 controller 文件
adb shell cat /proc/<pid>/cgroup

# 历史退出原因;需要结合日志和 trace 解释
adb shell dumpsys activity exit-info <package>

# 低内存和进程事件。不同产品的日志 tag、可见级别会有差异
adb logcat -b events -b system | grep -Ei 'lmkd|lowmemory|freez'
抓 Perfetto 时,应至少覆盖问题发生前后的调度、进程生命周期、ActivityManager 事件、内存计数器和 PSI。按以下顺序分析:
- 进程的重要组件何时消失,
procState与adj何时改变; - 调度组和冻结状态是否随后改变;
- PSI、交换空间(swap)与页面淘汰后的再次访问(refault)是否显示持续内存压力;
- 进程是被冻结、被
lmkd终止,还是因其他原因退出; - 下次返回应用时,是原进程解冻、ZRAM 页面预取,还是创建了新进程。
只存最终一张 dumpsys 快照,通常还原不了这条时序。
版本与实现边界
- Android 10:
lmkd支持 PSI 模式,默认配置为ro.lmk.use_psi=true,内核需启用CONFIG_PSI=y。 - Android 11:AOSP 引入缓存应用冻结器代码路径,并改进基于 PSI、交换空间和页面缓存抖动的
lmkd策略。 - Android 12:AOSP 冻结器的默认值改为启用,但设备仍需满足配置和内核能力。
- Android 13:缓存进程可能只有有限或没有执行时间;
ApplicationExitInfo增加冻结相关退出原因。 - Android 17:进程状态计算代码位于
com.android.server.am.psc,常量与实现的引用要和 Android 16 的旧路径脱钩;平台新增mmd,负责 ZRAM 与交换空间维护,但保留lmkd作为低内存终止决策者。
具体设备的功能开关、DeviceConfig、产品属性、cgroup 挂载和厂商内存策略,仍要在目标构建上实测。
常见误区
“进程还在,后台任务就可靠”
缓存进程可以被冻结或终止。普通线程、线程池、协程不会自行提升进程重要性;需要可靠完成的任务必须使用系统能识别和调度的组件。
“前台服务就是前台应用”
前台服务能让用户感知持续工作,也能提高进程重要性,但顶层 Activity、可见 Activity、前台服务在 adj、procState、调度组和后台能力上仍是不同状态。
“oom_score_adj 就是全部优先级”
它主要服务于内存回收。CPU 资源要看 schedGroup 与任务配置,后台权限和能力还要看 procState、能力标志、应用待机分组(App Standby Bucket)及相应子系统策略。
“线程轨迹空白就是进程被冻结”
睡眠、锁等待、Binder 等待和没有任务都可能导致线程没有 CPU 时间片。必须读取冻结状态或 ActivityManager 冻结事件来确认。
“低内存退出只看 RSS 最大者”
RSS 只是候选选择的一部分。进程重要性、PSI、交换空间、页面缓存抖动、页面再次访问和产品配置都会影响 lmkd 决策。
“多进程总能提高稳定性”
多进程可以隔离一部分崩溃与内存峰值,但会增加启动、常驻内存、Binder 和一致性成本。只有边界稳定、通信较少且失败可以隔离时,这笔成本才合理。
线程协作、调度与性能诊断
进程状态划出资源和调度的框架,实际执行延迟最终体现在线程上。我们按依赖关系来分析主线程、RenderThread、Binder 线程与后台执行器。
Android 应用的线程模型远比“主线程加几个后台线程”复杂。一次点击可能依次经过主线程的输入分发、业务代码、Binder 调用和渲染提交;其中任何线程因锁等待、I/O 或调度延迟而阻塞,都可能让这一帧错过按时显示的截止时间。
理解线程模型,是为了建立三种判断能力:
- 这段工作为什么运行在当前线程?
- 当前线程是在执行、等待 CPU,还是等待另一个线程或内核事件?
- 这段工作应该留在当前线程,还是交给其他执行机制?
主线程负责什么
应用进程由 Zygote 通过 fork() 创建后,ActivityThread.main() 在进程初始线程上完成主消息循环的初始化。ActivityThread 是应用进程的调度中枢,本身并不是一个 Thread 对象。
关键顺序如下,代码省略了参数解析、日志和调试初始化:
// frameworks/base/core/java/android/app/ActivityThread.java
// @ android-17.0.0_r1,节选
public static void main(String[] args) {
    // 参数解析可在此前处理 --use-deliqueue。
    Looper.prepareMainLooper();

    ActivityThread thread = new ActivityThread();
    thread.attach(false, startSeq);

    if (sMainThreadHandler == null) {
        sMainThreadHandler = thread.getHandler();
    }
    Looper.loop();

    throw new RuntimeException("Main thread loop unexpectedly exited");
}
Looper.loop() 正常情况下不会返回。主线程持续处理消息,直到进程退出。
应用组件和 View 体系的大部分回调都在主线程运行,包括:
- Activity、Service 和 BroadcastReceiver 的主要生命周期回调;
- 输入事件分发;
- View 的 measure、layout,以及记录待执行渲染命令的显示列表;
Choreographer驱动的动画与帧回调;- 主线程
Handler、主线程Executor和Dispatchers.Main上的任务; - 直接在主线程发起的同步 Binder 调用。
“Binder 回调都在主线程”是常见误判。远程 AIDL 调用默认由进程的 Binder 线程池接收;服务代码是否再切回主线程,取决于组件和实现。反过来,主线程主动发起同步 Binder 调用时要等远端返回,卡顿照样可能出在主线程。
UpdateEngine.bind(callback, handler) 接收远端回调后,若传入非空 Handler,客户端 Binder Stub 会用 handler.post() 投递状态与完成回调,业务回调在该 Handler 的 Looper 线程执行。bind(callback) 等价于 bind(callback, null),此时业务回调直接在接收 Binder 事务的线程上执行,不会自动切到主线程。排查进度界面卡顿时,应记录回调线程名、核对 Handler 绑定的 Looper,再查看对应线程上的回调耗时。[已验证: frameworks/base/core/java/android/os/UpdateEngine.java 的 bind() 两个重载与 IUpdateEngineCallback.Stub @ android-17.0.0_r1]
Looper、MessageQueue 与 Handler
一个已经调用 Looper.prepare() 的线程拥有一个 Looper 和一个 MessageQueue,也可以有多个绑定到这个 Looper 的 Handler。
Handler负责投递消息或Runnable任务,并在消息被取出时分发回调;MessageQueue保存尚未处理的消息,并计算下一次唤醒时间;Looper循环取出到期消息,调用消息对应Handler的dispatchMessage()。
Looper 通过线程局部变量 ThreadLocal 与当前线程关联。它不会自己创建线程,也不会自动改用后台线程。回调在哪个线程执行,只取决于 Handler 绑定的 Looper。
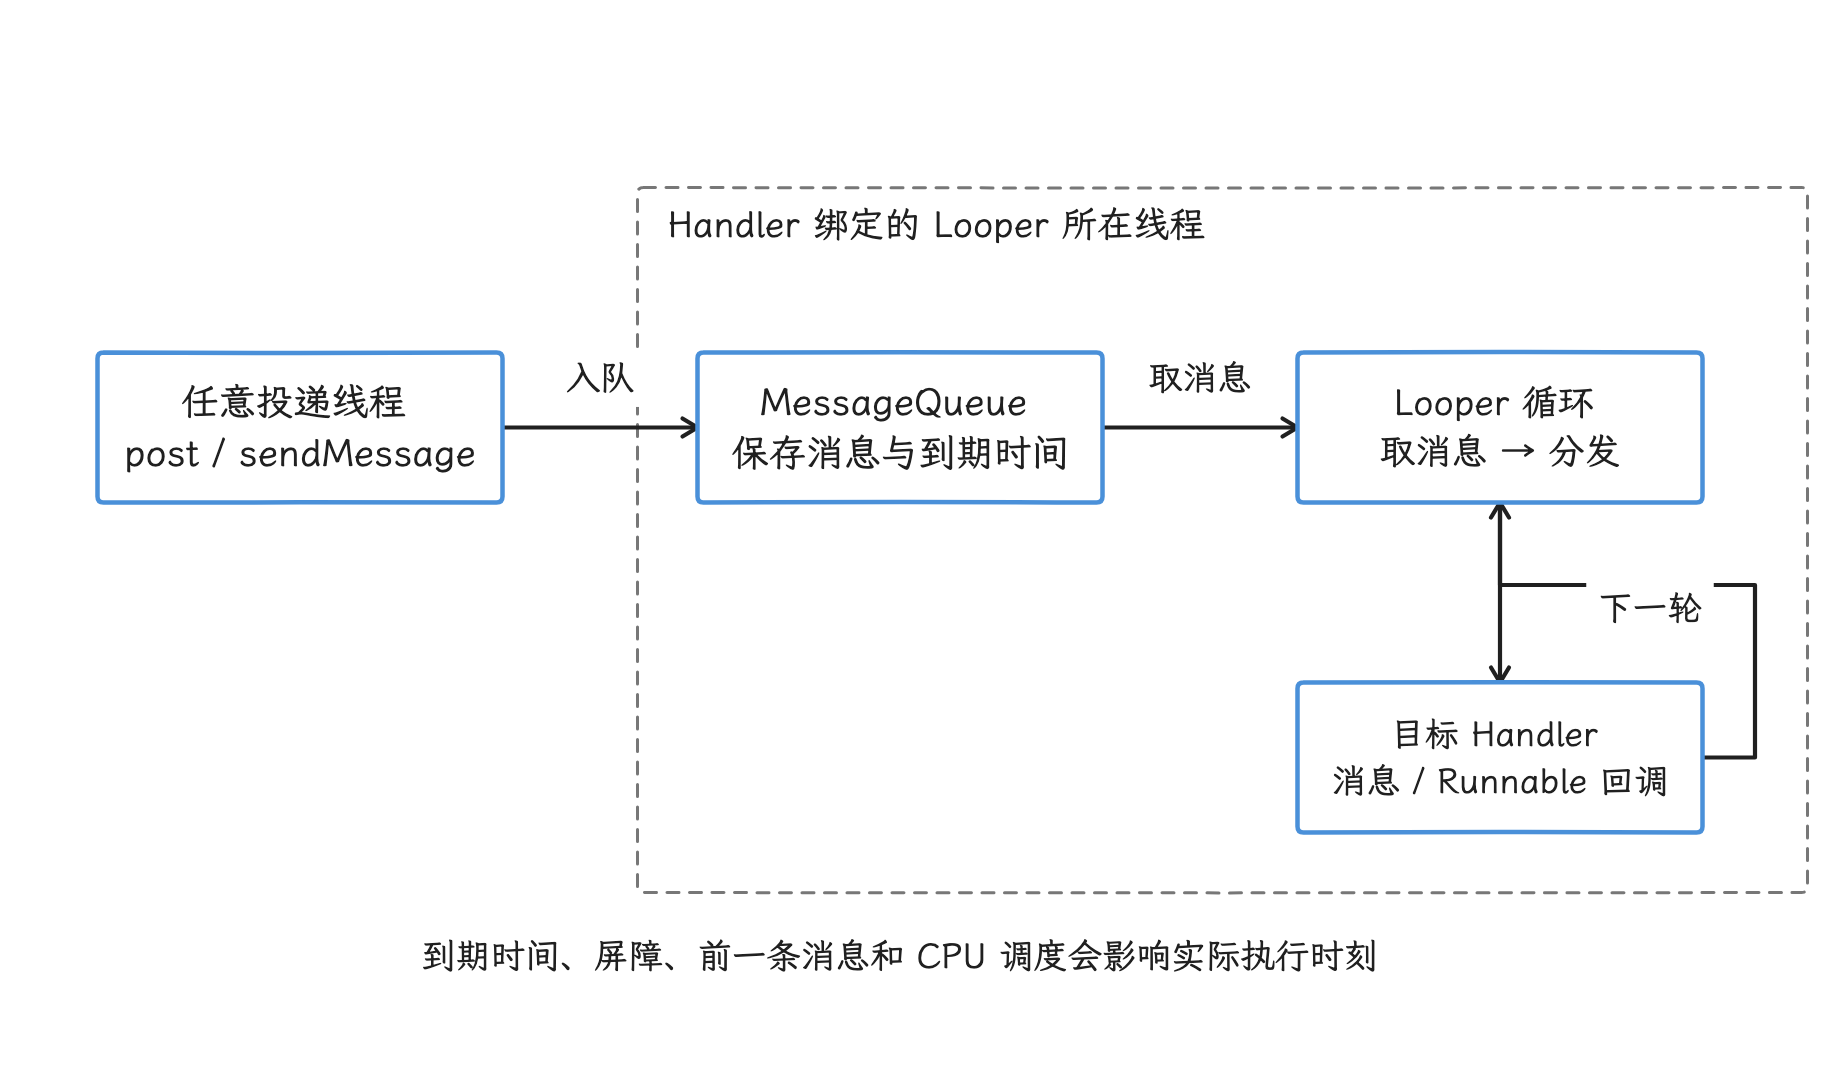
图:多个线程可以向同一个 Handler 投递工作;取消息和执行回调发生在该 Handler 绑定的 Looper 所在线程。到期只代表具备被选择的条件。
循环主体仍可以概括为:
// frameworks/base/core/java/android/os/Looper.java
// @ android-17.0.0_r1,按调用关系简化
for (;;) {
    if (!loopOnce(me, ident, thresholdOverride)) {
        return;
    }
}

// loopOnce() 内部取得消息后执行:
msg.target.dispatchMessage(msg);
msg.recycleUnchecked();
创建 Handler 时应显式指定 Looper,或者使用能够明确执行线程的 Executor。无参 Handler() 和隐式绑定当前线程的构造方式已经废弃,因为调用点一旦换到没有 Looper 的线程,或者意外绑定到错误的 Looper,问题通常要到运行时才暴露。
private val mainHandler = Handler(Looper.getMainLooper())

fun updateUiLater() {
    mainHandler.post {
        // 这里明确运行在主线程。
    }
}
构造点已经把执行目标固定为主线程 Looper,因此调用方位于哪条线程都不会改变消息归属。它只解决投递位置问题,不保证任务能在某个固定时限内执行。
Android 17 的 MessageQueue 分层实现
经典 LegacyMessageQueue 以 mMessages 为头结点,维护按执行时间排序的单向链表。这个模型适合解释旧版本的插入、同步屏障(只放行异步消息)和 next(),但覆盖不了 Android 17 的全部实现。
Android 17 有两层选择:
- 构建时选择源码实现。
frameworks/base/core/java/Android.bp排除各个 MessageQueue 实现目录,再由messagequeue-gen选择一套源码生成最终的android.os.MessageQueue。默认配置和产品变量可以选择不同实现。 - 运行时选择兼容模式。
CombinedMessageQueue和CombinedDeliMessageQueue还会按兼容性变更(以目标 SDK 版本等条件控制行为)、平台进程身份与功能开关,在 legacy 路径和新路径之间选择。
因此,源树里存在多个同名源码文件,最终装进应用进程的公开类仍然只有一个 android.os.MessageQueue。
Android 17 对以 API 37 为目标版本的应用启用新的并发 MessageQueue 路径。依赖 mMessages 等私有字段的反射代码可能失效。测试代码应使用公开或测试框架提供的同步机制,例如用于告知测试框架何时空闲的 IdlingResource;不要通过遍历私有链表判断“队列已空”。具体数据结构和兼容路径见 §1.8。
Looper 空闲时为什么不消耗 CPU
没有到期消息时,Java MessageQueue 会进入原生层的 native poll。system/core/libutils/Looper.cpp 创建 epoll 实例和用于唤醒通知的 eventfd,等待时调用 epoll_wait()。
新消息改变下一次到期时间时,投递消息的线程写入 eventfd 来唤醒 Looper。通过原生 Looper 或 MessageQueue 文件描述符监听接口注册的文件描述符(fd),也可以由同一轮 epoll 等待发现。线程此时处于阻塞睡眠,不会在 Java 层不断检查队列。
Binder 线程池使用另一条等待路径:Binder 工作线程通过 Binder 驱动的 ioctl 等待事务,默认不依赖主线程 Looper 的 epoll。所以在 Perfetto 里看到主线程睡在 epoll_wait,说明不了 Binder 线程的等待方式。
延迟消息的执行时机
postDelayed() 和 sendMessageAtTime() 表达的是“到这个时刻后才有资格执行”,不是“保证在这个时刻执行”。消息到期后仍可能受以下因素影响:
- 队列前方正在执行的长消息;
- 同步屏障(暂时阻止普通同步消息,只允许异步消息越过)对同步消息的阻挡;
- 线程处于可运行(Runnable)状态,但仍在等待 CPU;
- 进程冻结、省电策略或系统负载;
SystemClock.uptimeMillis()使用的时间基准:深度睡眠不计入该时钟,会给实际执行增加额外延迟。
postDelayed() 返回 true 只说明消息成功入队;如果所属 Looper 在分发前退出,消息仍可能被丢弃。若业务要求持久化、在进程重建后继续执行或由系统在约束满足后调度,应选择 AlarmManager、JobScheduler 或 WorkManager 等相应机制,避免用主线程 Handler 保存长期任务。[已验证: frameworks/base/core/java/android/os/Handler.java 的 postDelayed()、sendMessageDelayed() 与 sendMessageAtTime() @ android-17.0.0_r1]
IdleHandler 的适用范围
MessageQueue.IdleHandler 由所属 Looper 线程在消息队列满足空闲条件时调用。legacy 路径要求队列为空,或队首消息尚未到期;Android 17 的 CombinedDeliMessageQueue 还会分别检查同步与异步队列头。已到期的同步屏障可以使这些空闲检查失败,因此“暂时没有可分发消息”不足以保证回调运行。[已验证: frameworks/base/core/java/android/os/LegacyMessageQueue/MessageQueue.java 的 next()、CombinedMessageQueue/MessageQueue.java 的 next() 与 CombinedDeliMessageQueue/MessageQueue.java 的 looperCheckIsIdle() @ android-17.0.0_r1]
系统不会为 IdleHandler 预留一段保证可用的“空闲时间”。回调运行期间新消息可以入队,但当前回调返回前,所属线程不会开始分发这些消息。
IdleHandler 只适合执行时间可控的短任务;一次性初始化也需满足这个条件。磁盘扫描、网络访问、大对象反序列化和不可控循环都应移出主线程。返回 false 会在本次调用后移除该 IdleHandler;返回 true 表示以后队列进入空闲状态时仍可调用。
主线程与 RenderThread 如何分工
硬件加速窗口的一帧,由主线程与 RenderThread 接力完成。
主线程主要负责:
- 执行动画和 View 回调;
- 测量与布局(layout);
- 遍历 View 树并记录显示列表;
- 把本帧状态同步给渲染管线。
RenderThread 主要负责:
- 消费已记录的渲染节点和显示列表;
- 准备、批处理并提交 GPU 工作;
- 管理 HWUI 的渲染上下文;
- 执行一部分可以脱离主线程推进的属性动画。
RenderThread::getInstance() 按需创建名为 RenderThread 的线程。threadLoop() 把线程的 Linux 调度优先级(nice 值)调整为 PRIORITY_DISPLAY,然后初始化原生 Looper、Choreographer 及图形后端。把普通应用的 RenderThread 说成使用 SCHED_FIFO 策略的实时线程,与这里的 nice 值设置对不上。
syncAndDrawFrame() 是主线程与 RenderThread 的交接点
主线程经过 ThreadedRenderer、HardwareRenderer 和 RenderProxy,最终调用 DrawFrameTask::drawFrame()。后者把任务投递给 RenderThread,并等待渲染线程完成允许主线程继续的同步阶段:
// frameworks/base/libs/hwui/renderthread/DrawFrameTask.cpp
// @ android-17.0.0_r1,节选
int DrawFrameTask::drawFrame() {
    mSyncResult = SyncResult::OK;
    mSyncQueued = systemTime(SYSTEM_TIME_MONOTONIC);
    postAndWait();
    return mSyncResult;
}

void DrawFrameTask::postAndWait() {
    AutoMutex _lock(mLock);
    mRenderThread->queue().post([this]() { run(); });
    mSignal.wait(mLock);
}
RenderThread 执行 run() 时先同步帧状态。满足条件时,它可以在提交绘制前解除主线程等待;如果纹理准备等工作要求继续保持同步,则会在稍后解除。“主线程提交后立即自由运行”和“主线程必须等 GPU 完成整帧”这两个极端,都简化过头了。
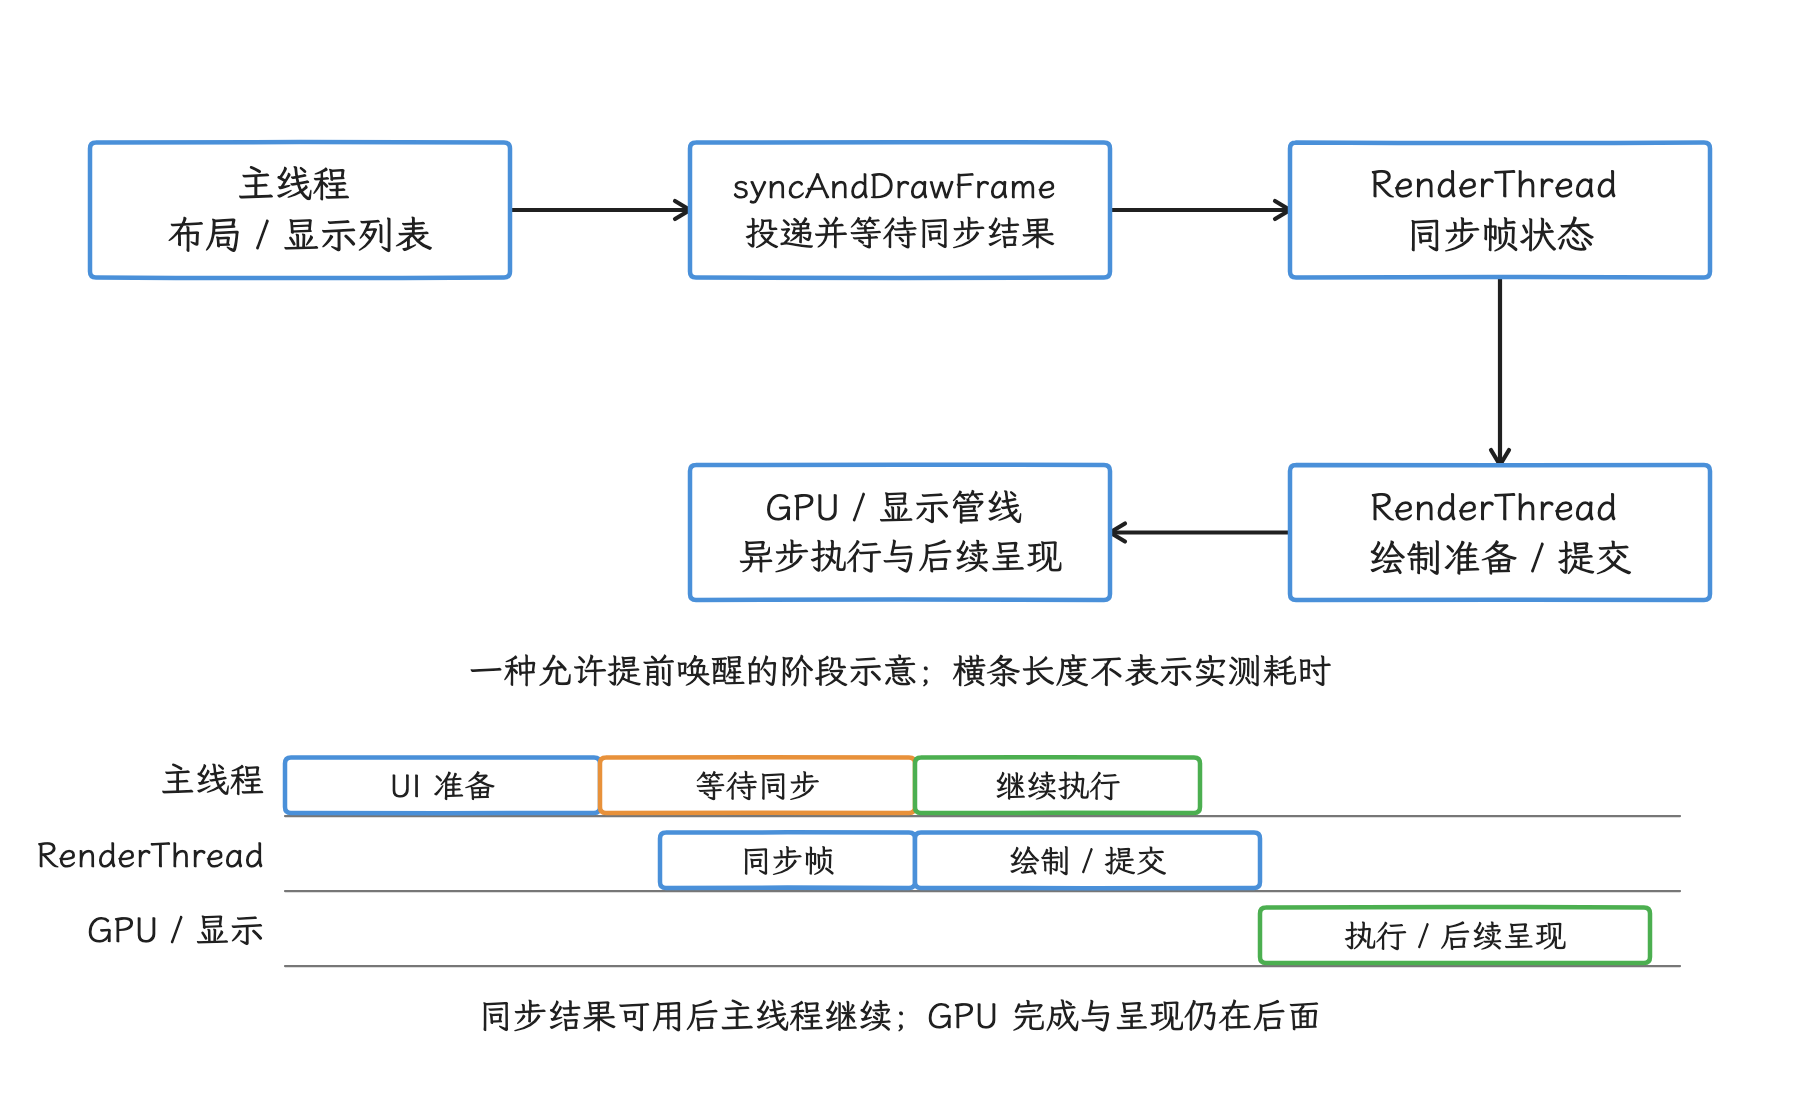
图:这里画出允许提前唤醒主线程的一种路径。真实唤醒位置取决于帧状态和纹理准备;主线程解除等待不代表 GPU 已完成。横条仅表示阶段关系。
Perfetto 中常见三种情况:
- 主线程长:输入、业务、布局或显示列表记录成为瓶颈;
RenderThread长:渲染准备、图形驱动或 GPU 侧压力更可疑;- 主线程在同步点等待
RenderThread:需要沿唤醒关系继续看RenderThread当时是在运行、等 CPU、等锁,还是等图形资源。
软件渲染窗口走的是 ThreadedRenderer 之外的渲染路径;不过同一进程中其他硬件加速窗口仍可能创建 RenderThread,进程里到底有没有它,取决于窗口构成。
如何选择后台执行机制
我们先判断任务是否需要立即完成、是否必须持久化、是否要求串行和线程亲和性,再选择工具。
| 需求 | 首选工具 | 关键边界 |
|---|---|---|
| 很短的 UI 更新 | 主线程 Handler、主线程 Executor、Dispatchers.Main | 不做阻塞 I/O 或长计算 |
| 与生命周期绑定的异步任务 | Kotlin 协程 + lifecycleScope/viewModelScope | 父任务取消时,子任务也应随之取消 |
| CPU 密集型并行计算 | Dispatchers.Default 或有界 Executor | 控制并行度,避免超过设备承受能力 |
| 阻塞式磁盘或网络调用 | Dispatchers.IO 或专用有界 Executor | 线程池不能消除底层阻塞,只是把它移出主线程 |
必须在一个带 Looper 的专用线程串行执行 | HandlerThread | 明确所有权,并安全退出 |
| 必须在约束满足后可靠执行的持久任务 | WorkManager | 调度时刻不精确,普通 Worker 有运行时长限制 |
| 需要立即运行且用户可感知的长任务 | 前台服务及相应任务 API | 遵守后台启动和通知限制 |
HandlerThread:仅在需要 Looper 时使用
HandlerThread 适合任务必须固定在同一线程执行(线程亲和)、要求顺序处理,且依赖 Handler/Looper API 的组件。只为了“开一个后台线程”时,Executor 或协程通常更容易管理并发、返回值和取消。
class SerialWorker : Closeable {
    private val thread = HandlerThread(
        "serial-worker",
        Process.THREAD_PRIORITY_BACKGROUND
    ).apply { start() }

    private val handler = Handler(thread.looper)

    fun submit(block: () -> Unit) {
        check(handler.post(block)) { "worker is shutting down" }
    }

    override fun close() {
        thread.quitSafely()
        thread.join()
    }
}
quitSafely() 会处理已经到期的消息,再丢弃未来消息并退出;quit() 会更直接地终止队列。调用方还要避免在该线程自身执行 join(),并保证关闭后不再投递。
协程与任务结构
协程可以用较少线程表达大量挂起任务,但实际的阻塞调用仍会占用承载它的线程。协程调度器(CoroutineDispatcher)的选择需要与工作类型相符:
class UserRepository(
    private val api: UserApi,
    private val db: UserDatabase,
) {
    suspend fun refresh(id: String): User = withContext(Dispatchers.IO) {
        val user = api.load(id)   // 阻塞式接口会占用 IO worker
        db.users().upsert(user)
        user
    }
}
Dispatchers.Main用于短小的 UI 工作;Dispatchers.Default用于 CPU 密集工作;Dispatchers.IO用于阻塞式 I/O;- 专用调度器用于线程亲和、资源隔离或严格并发上限。
不要依赖 Dispatchers.Default 或 Dispatchers.IO 当前的具体线程数。它们会随 Kotlin 版本、系统属性和运行环境调整。协程在挂起后也可能由另一个工作线程继续执行,因此跨挂起点保留 ThreadLocal 上下文,要靠协程上下文或 ThreadLocal.asContextElement() 显式完成。
结构化并发要求每项任务都有明确的作用域(scope),由页面、ViewModel、服务或应用级组件持有;生命周期结束时,取消操作才能从父任务传播到子任务。任务运行在哪条线程,和哪个组件负责管理、取消它,是两回事。
WorkManager 用于持久任务调度
WorkManager 面向需要在应用退出、进程重建后仍应继续安排的持久后台任务。它会根据系统版本使用 JobScheduler 等调度设施,并在约束满足后尽力执行,但不保证精确启动时间,也不保证业务操作只生效一次。
Worker(WorkManager 的任务执行单元)可能因为约束变化、进程终止或重试策略重复运行。上传、扣减、写入远端等操作应设计为重复执行也不改变最终结果的幂等操作,或者由服务端提供去重键。普通 Worker 单次最多运行 10 分钟,超过后会收到停止信号——可以无限阻塞的线程,它顶替不了。
需要超过普通运行时限时,WorkManager 的长任务可通过 setForegroundAsync() 或 CoroutineWorker.setForeground() 由前台服务承载并展示通知,但仍依赖 JobScheduler 调度。从 Android 16 起,这类长任务可能耗尽应用的作业配额。符合条件的用户发起数据传输可评估相应 JobScheduler 任务;选择直接启动前台服务时,仍须遵守后台启动、通知、服务类型和权限限制。
以 Android 14(API 34)及以上为目标版本时,所有长任务都必须声明前台服务类型,并在 ForegroundInfo 中指定运行时类型;Android 14 起还会按类型检查相应前置条件。更早的目标版本也有专项要求:目标 API 29 起使用位置的长任务要声明 location,目标 API 30 起使用相机或麦克风的长任务要声明 camera 或 microphone。具体声明和迁移方法见 WorkManager 长任务文档。
立即发生、只需随当前页面存活的任务,交给 WorkManager 反而增加调度开销,也更难看清哪个组件负责管理和取消任务。
AsyncTask 与 IntentService 的版本位置
AsyncTask 在 API 30 已废弃。它把线程池、生命周期和主线程回调包装在一个类里,但容易造成 Android Context 对象泄漏、配置变更后回调错位、取消语义不完整和异常处理不一致。新代码应按任务性质选择协程或 java.util.concurrent。
IntentService 同样在 API 30 废弃,原因是 Android 8.0 以后后台执行限制可能中断其工作。替代方案不是固定的:
- 需要持久、可延迟的工作,使用 WorkManager;
- 需要立即执行且用户可感知的长工作,评估前台服务;
- 仅在进程内短时串行执行,使用协程、
Executor,或确有Looper需求时使用HandlerThread。
线程优先级、调度类与任务配置
Android Java 层的 Process.setThreadPriority() 调整的是 Linux 的 nice 值,也就是普通线程参与 CPU 调度时的优先级输入。常见常量包括:
THREAD_PRIORITY_DEFAULT = 0;THREAD_PRIORITY_BACKGROUND = 10;THREAD_PRIORITY_FOREGROUND = -2;THREAD_PRIORITY_DISPLAY = -4;THREAD_PRIORITY_URGENT_DISPLAY = -8;THREAD_PRIORITY_AUDIO = -16。
数值越小,nice 优先级越高;但它换不来固定比例的 CPU,也换不来立即运行。对普通应用线程,Process.setThreadPriority() 比 Thread.setPriority() 更能准确表达 Android/Linux 层的调度意图。
在 ACK android17-6.18-2026-06_r6 中,普通 SCHED_NORMAL/SCHED_BATCH 线程进入公平调度类。kernel/sched/fair.c 使用 EEVDF,根据任务何时具备调度资格和虚拟截止时间来选择下一个可运行任务。nice 值会改变调度权重和虚拟时间推进方式,不会把 CPU 简单切成固定份额。
Android 还通过任务配置(task profile)、cgroup 和 cpuset 管理进程或线程。task_profiles.json 为后台、前台、顶层应用(top app)等组设置不同的性能、I/O、timer slack 和 CPU 容量配置;设备厂商可以覆盖这些配置。所以“前台组必定运行在某几颗大核”并不是跨设备成立的结论。
实时调度与 CPU 亲和性的适用场景
SCHED_FIFO/SCHED_RR 会绕过普通公平调度,配置不当可能让主线程、系统服务甚至关键内核工作长期得不到 CPU。设置实时策略通常还需要系统权限和经过约束的系统组件,不是第三方应用的通用性能开关。
手动把 RenderThread 或业务线程绑定到所谓“大核”也不可移植:SoC 的 CPU 拓扑、能效模型、温控状态和厂商调度策略各不相同,固定亲和性可能降低性能或增加功耗。普通应用应先缩短关键路径、控制并行度,再通过系统调度器和 Android 动态性能框架(ADPF)等公开机制表达性能需求。
线程数与吞吐量
增加线程只有在任务能并行、资源没有成为瓶颈且调度成本可接受时才可能提高吞吐量。过度线程化会带来:
- 每个线程的原生层元数据与栈地址空间开销;
- 更多上下文切换,也会让 CPU 缓存中的工作集更频繁地被替换;
- 更多可运行线程争抢有限 CPU;
- 锁竞争、队列竞争,以及高优先级线程等待低优先级线程的优先级反转;
- 不受控的并行 I/O,使存储或服务端更拥塞。
线程栈大小和实际物理内存占用会随运行时、架构、线程创建方式及实际访问过的内存页而变化,任何固定数值都代表不了所有 Android 设备的成本。
CPU 密集型任务应使用有界并行度,并以目标设备上的吞吐量、最慢一批请求的延迟、功耗和温度为依据。I/O 密集型线程池可以比 CPU 核数大,但仍需限制并发,避免耗尽文件描述符、连接池、数据库和远端服务容量。
用 Perfetto 判断线程为什么慢
看到一个很长的 slice,只说明某段逻辑从开始到结束经历了很长时间。下一步我们区分这段时间内的线程状态:
- 运行(Running):线程正在 CPU 上执行;
- 可运行(Runnable):线程可以运行,但仍在等待 CPU;
- 睡眠/可中断睡眠(Sleeping/Interruptible sleep):常见于等待消息、Binder、futex、I/O 或条件变量;
- 不可中断睡眠(Uninterruptible sleep):通常需要继续检查内核 I/O、驱动或等待链。
排查一帧卡顿时,可以按以下顺序推进:
- 从 Perfetto FrameTimeline 或对应帧事件确认错过的是应用期限还是显示合成期限;
- 同时查看主线程和
RenderThread,不要只盯doFrame; - 对长区间展开线程状态(thread state),区分线程正在使用 CPU(on-CPU)、等待 CPU 还是阻塞;
- 可运行状态持续很久时,查看 CPU 是否被更高优先级或大量线程占用;
- 阻塞时沿唤醒事件(wakeup)、futex、Binder、I/O 或锁持有者寻找真正负责唤醒它的线程或事件;
- 回到源码确认时间片段(slice)对应的执行边界,再决定优化业务、并行度还是跨线程协议。
主线程睡在 Looper 的轮询等待(native poll)中,通常表示“当前没有到期消息”,本身不是卡顿证据。相反,如果关键消息已到期而主线程仍被前一条消息占用,才需要缩短那条消息的执行路径。
Android 17 的虚拟线程边界
Android 17 的 libcore/api/current.txt 包含 Thread.ofVirtual()、Thread.startVirtualThread() 和 Executors.newVirtualThreadPerTaskExecutor(),这些工厂接口带有 com.android.libcore.virtual_thread_api_v1 发布开关;同一文件中的 Thread.isVirtual() 没有这个 @FlaggedApi 标记。两组接口的公开条件要分开看。
API 是否公开与运行时是否支持可挂起、恢复的 continuation 是两层条件。ContinuationSupport 检查 ART 的 virtualThreadImplV1();ThreadBuilders.newVirtualThread() 在支持时创建 VirtualThread,不支持且未指定自定义调度器时则退回由平台线程承载的 BoundVirtualThread。因此,工厂接口存在或 isVirtual() 返回 true,都不足以证明大量任务能复用少量操作系统线程。
应用要以实际 SDK 公开的接口、构建开关和目标设备行为为准,并准备兼容路径;评估资源成本时还应观察操作系统线程数和阻塞行为。具备相应运行时支持的虚拟线程适合表达大量阻塞式并发任务,但不会让 CPU 密集计算突破处理器上限,也不会替代主线程、Looper、生命周期作用域或 WorkManager 的持久调度语义。面向多个 Android 版本的应用,协程和有界 Executor 仍是更稳定的基础工具。
版本与实现边界
| 版本 | 与线程模型相关的变化 |
|---|---|
| Android 5.0 | 硬件加速渲染管线进一步采用独立 RenderThread,主线程与渲染提交的分工成为常见分析对象 |
| Android 8.0 | 后台执行限制趋严,后台 Service 不再适合承载任意长任务 |
| Android 11 / API 30 | AsyncTask 与 IntentService 废弃 |
| Android 12 以后 | 前台服务启动和后台工作的限制持续增加,任务类型必须与系统 API 语义匹配 |
| Android 17 / API 37 | 以 API 37 为目标的应用启用新的并发 MessageQueue 路径;私有字段反射存在兼容风险 |
| Android 17 / API 37 | 虚拟线程工厂 API 的发布开关与 ART continuation 支持分开控制;isVirtual() 没有同一发布标记,不能据此推断线程复用能力 |
分析线程问题时,先确认平台版本、应用 targetSdk、设备构建与实际调度配置,再解释系统跟踪数据。只凭线程名称、某个 nice 值或旧版 MessageQueue 字段,得不出可靠结论。
常见误区
“只要不在主线程就不会卡”
后台线程过多会抢占 CPU;后台线程持锁、占满 Binder 线程池或制造大量 I/O,也会间接拖慢主线程。
“RenderThread 会接管所有绘制”
主线程仍要执行布局、显示列表记录和帧状态同步。主线程上的长业务、复杂布局或错误的同步等待,RenderThread 补救不了。
“线程优先级设得越高越快”
优先级只是调度输入,还受控制组、CPU 容量、温控和其他实时负载约束。滥用高优先级会导致其他关键线程变慢。
“Handler 延迟时间到了就会准时执行”
到期只表示消息可以被选择。队列前方工作、同步屏障和 CPU 调度都可能继续推迟执行。
“协程等于后台线程”
协程是可挂起任务的结构。它在哪个线程运行由调度器和上下文决定;Dispatchers.Main 上的协程仍会占用主线程。
参考资料
- 系统分层与 HAL:Android 平台架构、HAL 总览、HIDL 概述与废弃警告、AIDL HAL 与后端限制、VINTF 清单和兼容性矩阵。
- 启动与进程入口:ZygoteInit.java、ZygoteProcess.java:ABI 选择与 USAP 回退、app_main.cpp、SystemServer.java。
- Binder 线程池与权限检查:ProcessState.cpp、ACK binder.c、SELinux hooks.c。
- 系统更新客户端与原生服务边界:OTA 调用路径材料(Android 14)、Android 17 UpdateEngine.java、update_engine.rc、daemon_android.cc。
- 进程与权限边界:进程和线程、应用沙箱、isolatedProcess、进程生命周期、BroadcastReceiver.goAsync()。
- 原生调用与兼容性:JNI tips、16 KB 页大小、Mainline、VNDK 废弃说明。
- 内存和调度策略:Android 17 lmkd.cpp、mmd 配置与迁移、task_profiles.json。
- 持久后台任务:Worker 运行时限、长任务、配额与前台服务类型。
- 消息延迟与空闲条件:Handler.java、LegacyMessageQueue、CombinedMessageQueue、CombinedDeliMessageQueue。
- Android 17 线程实现:目标 API 37 的 MessageQueue 变更、libcore API 文本、ThreadBuilders.java、ContinuationSupport.java。