线上存储、I/O(input/output,输入与输出) 与 SQLite 可观测性
存储故障很少只有一个症状。一次“打开页面卡住”的背后,可能同时有主线程读文件、SQLite 连接等待和目录扫描;一次“数据丢了”,可能来自磁盘空间不足、损坏恢复策略,也可能只是写入尚未持久化。我们在这篇文章里要解决的,是留下哪些线上证据,才能把这些路径区分开。文件 I/O 和 SQLite 的优化方法分别见 24.1、24.2,通用采集预算见 26.1。
源码基线:AOSP
android-17.0.0_r1;内核android17-6.18-2026-06_r6。
AndroidX SQLite、Room 和 Matrix(腾讯开源的性能诊断工具集)是独立发版的库,与应用所在的 API 37 没有绑定;所以应用使用的 driver(承接 SQL 执行与连接管理的数据库驱动)、库版本和 Hook(运行时拦截目标函数调用) 实现,必须作为事件字段保存下来。
观测对象分层
存储指标要先按失败层次拆开。单一的 storage_slow 只说明耗时上升;要分清该查文件调用、数据库并发还是设备空间,靠的是一组分层事件。表中 wall time 是操作从开始到结束经过的自然时间,CPU time 是线程实际占用处理器的时间,scope 标明计时的起止范围。
| 问题 | 建议事件 | 最小字段 | 诊断目的 |
|---|---|---|---|
| 文件调用慢 | storage_io_operation | 操作类别、路径类别、线程、wall time、CPU time、字节数、调用点、场景 | 区分调用方耗时、线程被抢占和疑似 I/O 等待 |
| 不良访问形态 | storage_io_pattern | 规则、窗口内次数、累计字节、累计耗时、文件指纹、调用点 | 找到主线程访问、细碎调用、重复读取和大目录遍历 |
| SQLite 执行慢 | sqlite_operation | scope、SQL 指纹、操作类型、线程、事务状态、wall time、driver | 区分查询本身、排队、事务和连接等待 |
| SQLite 错误 | sqlite_error | 异常类、主错误码/扩展码(若可得)、数据库别名、事务状态、恢复动作 | 分开处理 busy/locked、I/O error、full、corrupt 和约束错误 |
| 空间增长 | storage_snapshot | 目录类别、总字节数、文件数、年龄桶、扫描覆盖率 | 找出增长来源,并判断快照是否完整 |
| 业务文件损坏 | file_validation_failure | 格式版本、校验阶段、校验类型、文件类别、最近写入状态、恢复结果 | 区分下载不完整、写入中断、版本不兼容和内容损坏 |
| 资源未关闭 | resource_leak_signal | 资源类型、创建调用点、进程 fd(file descriptor,文件描述符)数量、发现方式 | 定位 Cursor、stream、ParcelFileDescriptor 等生命周期问题 |
两种时间分开记:区间耗时用同一单调时钟,不用可校准的日历时间;并记录是否包含设备深睡。只有同步操作的首尾位于同一OS线程时,当前线程CPU时间差才可与该区间比较。DAO协程跨线程或把工作交给其他线程时,首尾当前线程CPU差不代表整个操作;应另采分线程运行片段或明确范围的进程CPU指标。在线程范围成立时,wall高而CPU低可能来自调度、锁或I/O等待,仍不能单独证明磁盘慢,需trace补证据。
事件还要标清观测范围。围绕 DAO(data access object,数据访问对象) 方法计时,得到的是调用端到端时长,其中可能含协程调度和连接等待;在 driver 执行处计时,更接近 SQLite 操作本身;Native(本地 C/C++ 层) read()/write() Hook 看到的是系统调用,页缓存回写有一部分在它的视野之外。字段里只写 duration 的话,聚合端会把不同 scope 的数据混到一起。
路径、SQL 和文件内容都可能带用户数据。默认只采集稳定类别、用于聚合同类对象的受控指纹和应用调用点;需要原始证据时走 26.3 的受限诊断流程,常规事件维持较低的敏感数据采集范围。
I/O 采集路径选择
采集路径既决定覆盖面,也决定升级风险。我们先走公开 API 和应用自己封装的调用层,确认缺口值得承担额外兼容成本时,再上 Hook。
| 路径 | 能看到什么 | 看不到什么 | 建议使用范围 |
|---|---|---|---|
| 应用封装或库提供的回调 | 自有文件组件、Okio/FileSystem、缓存组件、导入导出任务 | 绕过封装的三方库和系统内部调用 | 生产环境长期采集的主路径 |
| 编译期插桩(构建时在字节码中加入观测代码) | 被选中并实际转换的文件入口、DAO和事务字节码;应用变体用AGP InstrumentationScope.ALL还可含库依赖 | Native、系统内部I/O、未转换或运行时生成的代码;反射是否可见取决于目标方法/调用点是否被插桩 | PROJECT仅本项目;ALL含依赖但不适用于library项目;记录实际scope/排除项并回归AGP与打包 |
| StrictMode / BlockGuard | 经 libcore(Android Java 核心库)OS 层上报的线程磁盘读写,以及未缓冲 I/O、SQLite/Closable 泄漏信号 | 三方 Native 代码直接调用 libc 的全部 I/O;精确字节数和设备耗时 | debug(调试版)、自动化测试、dogfood(团队内测);生产仅在评估成本后受控开启 |
| Native interposition(函数替换)/ Hook | 命中的 libc(C 运行库接口)或目标库 I/O 符号,可覆盖部分 Java 与 Native 路径 | 内联调用、直接 syscall(系统调用)、未命中符号、mmap(内存映射)后缺页、异步回写 | 只向少量用户启用的专项灰度;必须按 API、ABI(应用二进制接口)、加载顺序和目标库验证 |
| Android Debug Bridge(adb)+ Perfetto | 调度状态、频率、应用 trace、database atrace(数据库追踪事件),以及设备允许的 ftrace(内核追踪框架)、block(块设备请求)和 filemap(文件页缓存)数据 | 没有启用或无权限的数据源;一次 trace 之外的长期分布 | 实验室复现和开发设备诊断 |
ProfilingManager system trace(系统性能轨迹) | Android 15+ 受系统限流的应用请求采集;Android 17 还可结合部分系统 trigger(触发条件) | 不保证每次请求成功,也不等同于任意 adb Perfetto 配置 | 线上小范围诊断,版本细节见 26.6 |
StrictMode 能证明什么
StrictMode 擅长回答的问题是“这个受监控线程是否触发磁盘操作”。BlockGuardOs 在 open、read、write、fsync、stat、rename 等 libcore OS 操作之前,会调用当前线程策略的 onReadFromDisk() 或 onWriteToDisk();它记录的是“是否发生”,存储设备完成一次请求要多久,并不在它的测量范围内。
这份配置用在 debug 或 dogfood 包,把主线程磁盘访问、未缓冲 I/O 和资源未关闭打进日志。它只是发现问题的入口,生产策略另行评估。
StrictMode.setThreadPolicy(
    StrictMode.ThreadPolicy.Builder()
        .detectDiskReads()
        .detectDiskWrites()
        .detectUnbufferedIo()
        .penaltyLog()
        .build()
)

StrictMode.setVmPolicy(
    StrictMode.VmPolicy.Builder()
        .detectLeakedSqlLiteObjects()
        .detectLeakedClosableObjects()
        .penaltyLog()
        .build()
)
setThreadPolicy() 作用于调用它的线程;只在主线程安装时,各工作线程的覆盖情况要单独确认。detectUnbufferedIo() 从 API 26 提供,detectLeakedSqlLiteObjects() 从 API 9 提供。detectResourceMismatches() 从 API 23 起检查资源类型与读取方法是否匹配,文件句柄泄漏不在它的检查范围内;Android 17 也没有为它新增行为。
CloseGuard.setReporter() 在 Android 17 仍标记为隐藏/System API,普通应用拿不到稳定的公开调用契约。反射替换 reporter 会同时引入 non-SDK 限制和版本兼容风险;长期监控我们优先用公开的 StrictMode VM policy,并把使用范围限制在测试与受控诊断场景。
Native Hook 的验证清单
Native Hook 不在 Android 平台的兼容性保证范围内。就算某个版本拦住了 open、read、write 和 close,这些也要逐项验证:
- 已加载和延迟加载的共享库是否都进入 Hook。
- 32/64 位 ABI、不同 Android 版本和厂商链接器行为是否一致。
pread/pwrite、readv/writev、mmap、sendfile、直接 syscall 是否在覆盖清单中。- Hook 内部是否有递归保护,采集和上报自身的 I/O 是否会再次触发 Hook。
- 路径、fd 生命周期和调用栈采集是否线程安全,卸载或失败时能否回到原函数。
- 远程关闭、采样和崩溃隔离是否在 Hook 初始化前可用。
Hook 覆盖不完整,数据照样有用,前提是事件带上 collector 和 coverage_version(本次覆盖范围的版本):靠这两个字段,才能把业务回归和采集器升级造成的数量变化区分开。
不良 I/O 规则模板
通用规则可以固定,阈值则要按设备和场景分别标定。闪存、文件系统、加密层、温控、后台压力和数据规模都会改变耗时,所以规则至少按设备档、前后台、业务场景和 App 版本各建一套基线。
| 规则 | 判断信号 | 必要现场信息 | 容易误判的情况 |
|---|---|---|---|
| 主线程 I/O | StrictMode violation,或主线程文件调用与交互卡顿时间重叠 | 生命周期阶段、调用点、操作类型、wall/CPU time | 启动框架内部一次性访问、采集器本身写日志 |
| 细碎 I/O | 单位字节对应的系统调用数偏高,连续窗口内多次短 read/write | 总字节数、调用数、buffer(缓冲区)、文件类型、调用点 | 协议要求的小记录、设备已在页缓存中 |
| 重复读取 | 同一文件版本和调用点在短业务窗口内重复读取,期间没有有效写入 | 文件指纹、mtime(文件修改时间)/业务版本、调用点、场景 | 文件被外部进程或 ContentProvider 更新 |
| 大目录遍历 | 扫描耗时、访问文件数或主线程阻塞相对基线异常 | 已扫描/总量估计、深度、剪枝原因、目录类别 | 首次迁移、媒体导入、用户主动全量扫描 |
| fd 数量持续增长 | /proc/self/fd 数量在稳定场景中持续上升,离开场景后不回落 | 进程、场景、资源类型、StrictMode/CloseGuard 信号 | 网络连接池、动态加载和诊断采集临时占用 |
| 同步写入放大 | 单次业务提交对应多次 write/fsync,且交互时延同步升高 | 事务、文件协议、WAL(write-ahead logging,预写式日志)状态、调用点 | 明确要求持久性的关键数据 |
我们不用 StatFs.getBlockSizeLong() 给 Java buffer 推导统一的最小值:文件系统块大小、存储设备页、内核合并粒度和应用最佳 buffer 是几个不同的量。小 buffer 有没有问题,要看调用次数、总字节数、CPU 开销和目标设备上的实验。
阈值的制定与维护可以遵循同一流程:在无回归版本采集分布,固定事件 scope 和分母;按设备档与场景建立基线;用对照版本差值和置信区间触发告警;检查样本量、采集覆盖与上报缺口;修复后验证同一分组是否恢复。业务有明确体验预算时,可以增加绝对上限,但要记录预算来源。
主线程磁盘访问在 debug 阶段可以“发生即检查”;到了线上告警,每次访问和用户卡顿要分开看。调用发生时数据可能已在页缓存,耗时也可能短于一次帧预算;我们把 FrameTimeline(帧时间线)、主线程 slice(带起止时间的轨迹片段) 和用户操作关联起来,再定优先级。
SQLite 耗时、损坏与查询计划
SQLite 可观测性要把执行、事务、连接等待、错误和恢复分开看。一个 DAO 方法慢,SQL 计划未必是原因:时间可能花在等 writer(写连接) 连接、被调度到数据库线程,也可能花在把查询行转成业务对象的结果映射上。
| 事件 scope | 起止位置 | 可以解释什么 | 不能直接解释什么 |
|---|---|---|---|
| DAO end-to-end | 调用 DAO 到结果返回 | 用户路径中的总等待 | SQLite 内部执行占比 |
| transaction | begin 到 commit/rollback 返回 | 锁持有窗口、批量写范围 | 每条语句成本 |
| driver statement | prepare/step(预编译与逐步执行)到完成 | 接近 SQL 执行和取数成本 | 调用前排队与结果业务处理 |
| query callback | Room 在查询执行时通知 SQL 与 bind 参数 | SQL 文本、bind(绑定)参数和调用频率 | 精确耗时;回调可能在另一个 Executor(任务执行器)上 |
| exception/recovery | 捕获异常到恢复动作结束 | 错误类别、数据可用性和恢复结果 | 错误发生前所有磁盘状态 |
Room QueryCallback 能测到什么
RoomDatabase.QueryCallback#onQuery() 在查询执行时提供 SQL 和可用的绑定参数。官方文档明确提示它有少量额外成本,应按需启用,避免在生产包中长期全量使用。回调本身没有开始时间和结束时间;在回调的 Executor 里计时,量到的只是处理这次回调所花的时间。
下面的lambda对当前fun interface有效,示例采用未配置SQLiteDriver的SupportSQLiteOpenHelper路径。固定Room2.8.5源码在配置SQLiteDriver后会拒绝QueryCallback,不能直接把该回调接到BundledSQLiteDriver;需要在自有driver/DAO封装上观测。拦截器会复制或缓存bind参数,并在调用delegate前派发协程:回调到达不表示SQL执行成功,也不保证早于SQL完成。只记录参数类型并不消除Room内部暂时持有原始SQL/参数的事实。
示例依赖项目提供的normalizer、queryObserver和queryCallbackExecutor。生产实现应让归一化/记录失败止于诊断路径,记录丢弃原因;限制上游启用范围和派发积压并测量参数保留成本。仅在回调内采样,不能避免此前拦截、复制和派发成本。
val callback = RoomDatabase.QueryCallback { sql, bindArgs ->
    queryObserver.record(
        sqlFingerprint = normalizer.fingerprint(sql),
        bindTypes = bindArgs.map { value -> value?.javaClass?.simpleName ?: "null" }
    )
}

Room.databaseBuilder(context, AppDatabase::class.java, "main.db")
    .setQueryCallback(callback, queryCallbackExecutor)
    .build()
SQL 文本本身也可能通过字符串拼接带上账号、搜索词或 URL,光丢弃 bindArgs 还不够。normalizer应使用与目标SQLite语法匹配的词法/解析器,先去除可能带数据的注释,并替换字符串、数值和BLOB字面量,再做受控归一化指纹;不能靠简单正则覆盖引号与转义。解析失败时只记unknown/错误类别,不回退上传原始SQL。用 DAO 外围计时的话,字段名明确写成 dao_end_to_end,免得与 driver 执行耗时混在一起。
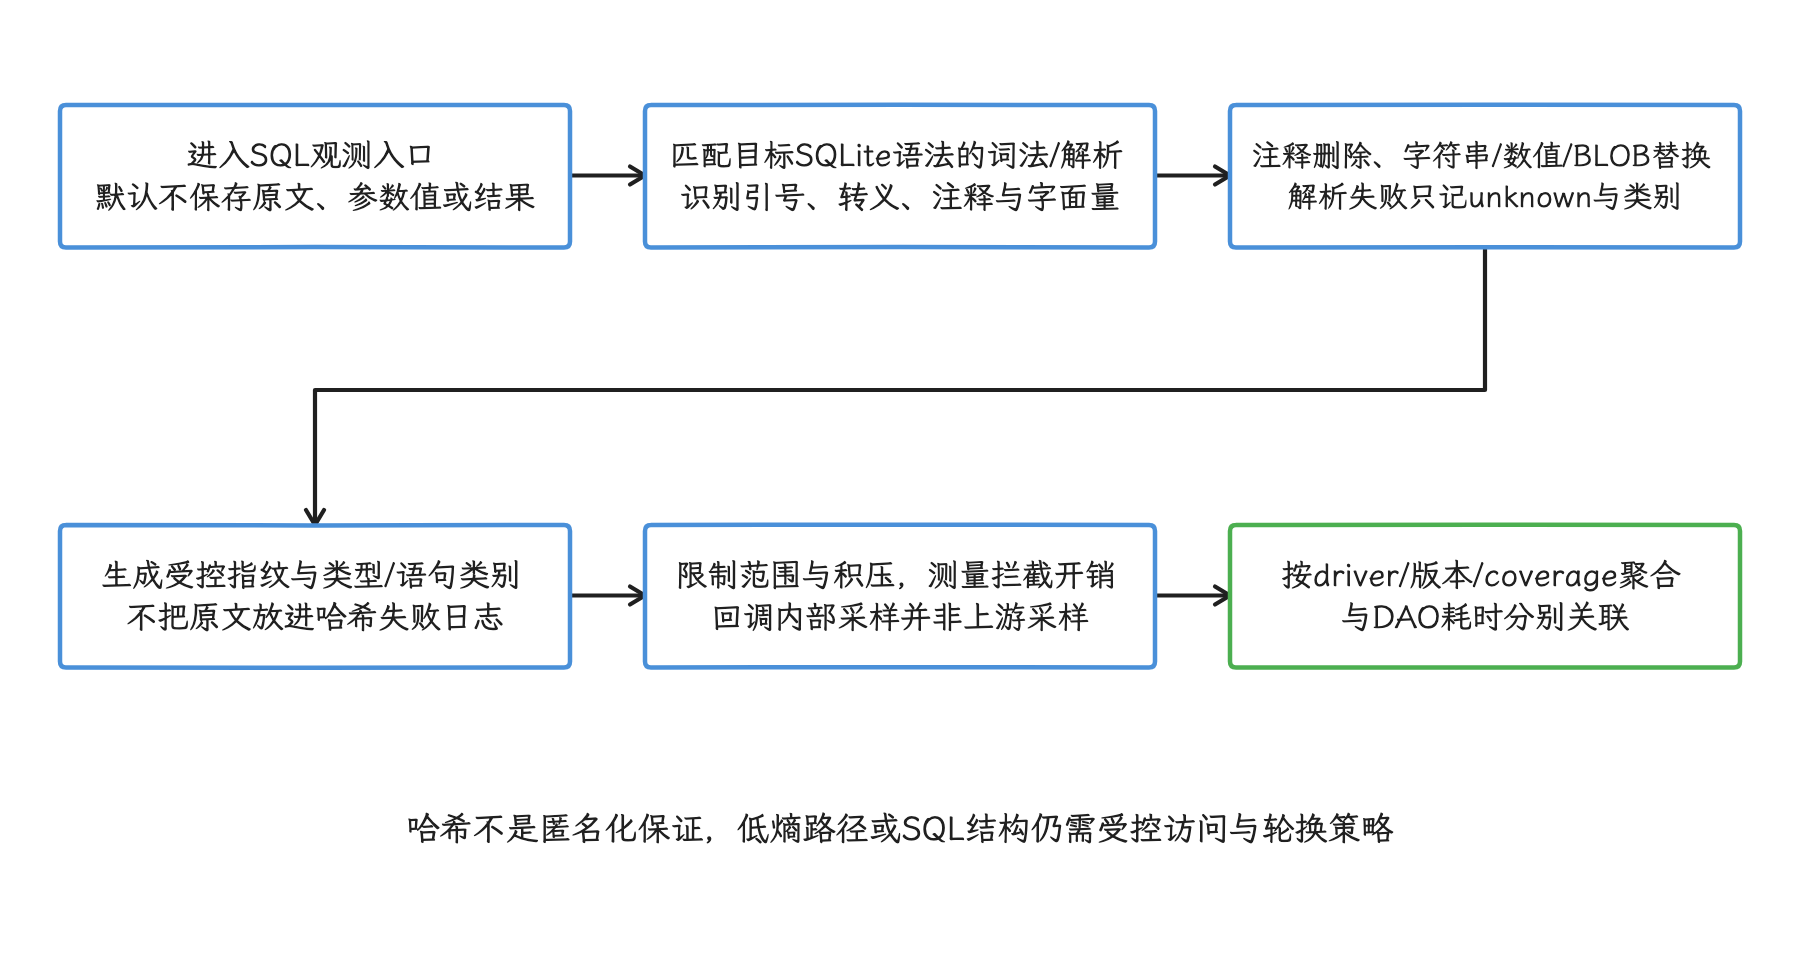
图:注释同样可能携带用户数据;简单正则或原文回退不足以构成可靠脱敏。
系统框架内部的诊断信息
SQLiteConnection.OperationLog 是系统框架的私有内部类,它的两项常量说明:保留 20 条最近操作,严格超过 2 秒的操作另放入一组长操作记录。
private static final int MAX_RECENT_OPERATIONS = 20;
private static final long LONG_OPERATION_THRESHOLD_MS = 2_000;
这段实现只服务于 framework 调试和 dump(诊断信息输出),普通 App 没有对应的采集接口。那个 2 秒是 framework 内部的“long operation”分类值,业务慢查询门槛要另行制定。源码还保存最近 10 条长操作,并对相关日志做限速;“20 条最近操作”“10 条长操作”和累计长操作数是三个不同的概念。
SQLiteConnectionPool#getStatementCacheMissRate() 从各可用连接的 prepared statement cache(预编译语句缓存) 命中与未命中次数算出miss rate(未命中率),但该方法带 @hide。SQLiteDatabaseConfiguration 里,每个 framework connection 的默认 cache size 是 25,公开的 SQLiteDatabase#setMaxSqlCacheSize() 允许上限 100。对应用来说,有两件事要避开:通过隐藏方法读取 miss rate,以及在缺少内存与命中率证据时把 cache 直接调到上限。
开发设备上用 adb shell dumpsys meminfo <package> 能看到 SQLite 的 cache hit、miss、cache size 和部分连接统计,Android 官方 SQLite 性能文档给出了这条命令的输出。Android 17 的 POOL STATS cache size 表示缓存中的预编译语句总数;较早版本的同名字段等于 hit 与 miss 之和,按缓存容量解读会读错。这条命令适合复现时观察,普通应用没有对应的免权限生产 API。
SQLiteDebug.shouldLogSlowQuery() 读取 db.log.slow_query_threshold 及按 UID(应用进程的用户标识) 加后缀的系统属性,相关日志还受 SQLiteSlowQueries 日志标签控制。它是隐藏的 adb/系统调试开关,普通 App 要动态下发慢查询阈值,得另找方案。官方另有 log.tag.SQLiteTime 的开发设备查询计时日志,两条机制别混成一个开关。
Android 17 仍提供 lookaside(小对象内存复用区)和空闲连接超时配置,但“可配置”和“生产上该调”之间还差一层论证。SQLiteDatabase.OpenParams.Builder#setIdleConnectionTimeout() 已废弃,文档明确警告重建连接会清除 per-connection PRAGMA,也就是每条连接各自的 SQLite 运行时配置;系统又没有供 App 恢复这些状态的回调。setLookasideConfig(0, 0) 可以请求禁用 lookaside(SQLite 的小对象内存复用区),但系统可能按设备选择不同值;等目标 driver、内存和查询基准都证明有收益,我们再考虑修改。
查询计划的验证环境
我们用这条 SQL 检查筛选与排序是否拿到合适的访问计划。占位符应在同一SQLite实现、同一schema且有代表性数据与统计信息的一致副本上绑定。使用引擎支持的备份/受控快照流程;WAL数据库不能只复制正在写入的.db而漏掉已提交的WAL内容。
EXPLAIN QUERY PLAN
SELECT id, name
FROM message
WHERE conversation_id = ?
  AND create_time >= ?
ORDER BY create_time DESC
LIMIT 50;
输出里的 SCAN 是扫描,SEARCH ... USING INDEX 是走索引,USE TEMP B-TREE 说明排序、分组或去重可能要建临时的 B-tree(平衡树结构)。这些计划节点只是线索:小表扫描可能合理,索引会增加写入和空间成本,复合索引的列顺序还要结合过滤、排序和选择性来判断。
Android 官方建议用目标设备上的 adb shell sqlite3,因为不同 Android 版本带的 SQLite revision(源码修订版) 不一样。用BundledSQLiteDriver时,应用携带自己的 SQLite 实现,设备自带的 sqlite3 可能对应另一个实现;这时要在同一 driver、同一 schema 的测试工具里跑执行计划。
SQLite 错误分类与恢复
busy/locked 指向并发或锁状态,full 指向写入空间不足,IOERR 指向 I/O 路径,CORRUPT/NOTADB 才更接近数据库内容或格式问题。我们按错误码分类;只搜异常 message(消息文本) 里的 “corrupt”,容易把不同的错误并到一起。
事件至少记录数据库别名、driver、库版本、异常类、driver可提供的主/扩展错误码、事务状态、WAL/SHM 是否存在及大小、剩余空间、恢复动作和恢复结果;SHM 是 WAL 模式下供进程协调访问的共享内存文件。异常 message 也可能带 SQL 或路径,进日志前先脱敏。
完整 PRAGMA integrity_check 会读取大量页面,不适合在前台或每次启动执行。要验证时,放在维护窗口、数据库副本或用户明确发起的诊断流程里运行,并记录检查覆盖了哪些部分。恢复策略先分清三类数据:可再生缓存、可从服务器重建的数据、唯一用户数据;默认删除数据库的做法,会让“恢复成功”盖住数据丢失。
存储容量与文件损坏指标
目录总大小只能说明空间被占用。要诊断增长来源,我们还需要文件数、年龄、类别和扫描覆盖率。
| 指标 | 采集方式 | 需要记录的边界 |
|---|---|---|
| 空间余量 | StatFs 获取目标卷可用字节和总字节 | 记录卷与采集时间;不要只看全局百分比 |
| 私有目录大小 | 对 files、cache、databases、no_backup 等受控类别分别扫描 | 记录扫描是否完成、忽略项和符号链接策略 |
| 文件数与深度 | 有预算的增量遍历 | 记录已访问节点、下次继续扫描的位置和耗时,避免把部分结果当全量 |
| 大文件/目录 | 只保留受控类别与 Top-K(数值最大的 K 项)统计 | K 由上报预算决定,不上传原始文件名 |
| 年龄分布 | 按业务允许的时间区间分组(分桶) | mtime 可能被迁移、恢复或外部写入改变 |
| 文件格式校验 | magic(固定文件头标识)、版本、长度、CRC(循环冗余校验)/hash(哈希摘要)或业务结构校验 | 校验算法必须属于文件格式协议,不能给所有文件统一加 CRC |
| 清理效果 | 规则版本、候选字节、删除字节、失败原因、再次扫描结果 | 只操作明确可再生且在 allowlist(允许清理的固定名单)内的文件 |
全量目录扫描本身就会产生 I/O 和 CPU 开销。大目录要保存扫描游标、分批扫描,前台交互、低电量或系统压力大时先停下来。事件里 coverage、visited_count(已访问节点数)、complete(扫描是否完整) 这三个字段与大小值同等重要,分别说明本次覆盖范围、已访问节点数和扫描是否完整。
上传前先做“目录树剪枝”,跳过不需要继续深入的分支,再配上受控样本,比上传完整路径更安全。每层保留聚合后的最大目录类别,其他节点归入 other;业务必须关联同一对象时,可以用服务端持有密钥的 keyed digest(带密钥摘要),并设置密钥轮换周期。对可枚举的短路径,普通 SHA-256 截断达不到可靠匿名化。
业务文件的损坏检测要和写入协议一起设计。每种格式定义好 magic、版本、长度和校验范围;事件记录写入阶段、临时文件状态和恢复来源。应用私有可替换文件可按AtomicFile的startWrite/finishWrite/failWrite协议处理;finishWrite会关闭、sync并提交,但AtomicFile不提供线程或进程间锁,调用者须串行化访问。自行实现临时文件+rename时,rename只提供命名替换边界,不能单独承诺断电持久化;按需求处理写入/同步失败、文件fsync和父目录fsync,并验证目标文件系统。数据库交给SQLite事务与journal/WAL,不自行拼装或远程删除.db、-wal、-shm。
远程清理是破坏性能力,要有固定 allowlist、规则版本、dry-run(只统计而不执行删除)、幂等执行(重复运行结果一致)和远程关闭这几道约束。未知文件、唯一用户数据、正在打开的数据库文件,以及现有规则识别不了的目录,都要排除在“疑似缓存”之外。
上报、采样与隐私
I/O 和 SQL 都是高频事件,采集器必须在设计阶段设定 CPU、内存、磁盘、网络和隐私预算。
| 数据 | 默认保留 | 默认丢弃 | 放大条件 |
|---|---|---|---|
| 文件操作 | 类别、调用点、scope、耗时、字节、采集器版本 | 原始绝对路径、文件内容 | 同调用点持续回归,且远程策略仍满足预算 |
| SQL | 归一化指纹、语句类别、表集合、参数类型、driver | bind 值、未处理字面量、完整结果 | 受限诊断会话;仍不得上传业务数据 |
| 目录快照 | 分类大小、文件数、年龄桶、coverage | 完整目录树和文件名 | 用户授权的问题诊断 |
| 错误 | 类型、错误码、恢复状态、受控 message 指纹 | 数据库内容、原始 SQL、账号路径 | 严重数据不可用事件,按事件限速 |
| 调用栈 | 应用帧指纹、mapping(混淆符号映射表)版本 | 全量系统帧、线程局部变量 | 调用点无法归因的专项灰度 |
采样单位要写清楚。按事件采样会偏向高频调用点;按 session(一次使用会话) 或按设备采样,更适合估算用户影响;触发后采样适合收集异常现场信息。三种采样的分母不同,后台聚合时分开处理。
上报组件还需自监控:采集耗时、被采集事件数、采样后保留数、队列深度、本地缓存字节、压缩后大小、上传结果和丢弃原因。文件 Hook 与日志写入之间必须有递归保护;空间不足时,我们先丢诊断缓存,把剩余空间留给业务数据。
隐私处理要尽量贴近数据源。Room callback 收到 bind 参数后立即转成类型并丢弃值;路径在离开调用线程前转成类别;URL、账号、搜索词或 token(身份或访问凭据) 都不要进入标签、文件名和 SQL 指纹。哈希只减少明文暴露,本身还不构成匿名化。
与现有章节的分工
- 24.1 负责文件 I/O、SharedPreferences、线程与持久化策略的优化。
- 24.2 负责 WAL、事务、索引、连接并发和 Room 使用方式。
- 24.4 负责 MediaStore、分区存储(Scoped Storage)、用户态文件系统(FUSE)与媒体扫描成本。
- 26.1 负责指标分位数、采样、上报预算和劣化检测。
- 26.3 负责远程证据包、受限诊断、灰度隔离和问题单流程。
- 26.6 负责
ProfilingManager与 trigger 的系统版本边界。
这些事件字段负责把问题定位到对应章节,本文不重复给出另一套优化规则。
扩展:Matrix(腾讯开源的 Android 性能诊断工具集) I/O Canary 与 SQLiteLint
Matrix 中的 I/O Canary 和 SQLiteLint 仍适合作为规则设计参考,但历史文档只代表当年的实现,Android 17 上的兼容性要重新验证。
| 模块 | 可借鉴内容 | 现代工程必须重验的部分 |
|---|---|---|
| I/O Canary | 从文件调用重建主线程 I/O、细碎访问、重复读和泄漏规则 | Hook 符号、链接器/ABI、mmap 缺口、采集递归、当前 AGP 与打包流程 |
| SQLiteLint | 基于运行时 SQL、schema 和 EXPLAIN QUERY PLAN 检查索引及临时 B-tree 等问题 | 2019 wiki 所述 sqlite3_profile Hook、Room/SQLiteDriver 覆盖、SQLite 新版计划文本和误报 |
SQLiteLint 的 wiki 明确说明,其系统 SQLite 路径通过 Hook 向 C 层 sqlite3_profile 注册回调;这份说明上次编辑在 2019 年。它在 API 37、所有 driver、所有 ABI 上是否仍有相同覆盖,要当作待验证项重新确认。使用 BundledSQLiteDriver、WCDB(腾讯的移动数据库框架)或应用自带 SQLite 时,目标库还可能与系统 framework 打开的 SQLite 实现不同。
接入评审至少要求:固定 Matrix revision(源码修订号);列出支持的 API/ABI/driver;在目标构建工具中运行启动、查询、并发、进程退出和崩溃测试;验证关闭开关;对采集前后 CPU、内存、I/O 与崩溃率做对照。达不到这些条件时,可以复用规则思想,在应用封装或 Room/driver 回调上重新实现。
自动分析 EXPLAIN QUERY PLAN 也要允许例外。小表的 SCAN、联接的外层扫描和一次性迁移未必需要索引;看到 SEARCH,我们仍要单独看结果集、排序和回表(按索引记录再查一次原表)的成本。EQP输出格式不是稳定的机器接口,SQLite官方明确警告其可能随版本改变;自动规则应固定SQLite版本、维护解析兼容性,未知格式输出unknown,不能当“无问题”。规则还应保留schema版本、表行数范围、计划文本和人工处置状态。
扩展:AndroidX SQLite/Room 新版本诊断能力
截至2026年10月25日,AndroidX SQLite 稳定版是 2.7.1,Room 稳定版是 2.8.5。这两个版本号独立于 Android 17 / API 37:Room 主版本与系统版本、AndroidX SQLite 版本各自独立演进。这里讨论与存储可观测性直接相关的稳定版能力:Room 2.8.4 引入连接池 prepared statement cache,Room 2.8.5 仍在同一 2.8 稳定线上;SQLite 2.7.1 只表示 SQLite 库版本,别当成 Room 版本。
与观测直接相关的变化包括:
- AndroidX SQLite 2.6.2 为
BundledSQLiteDriver创建的连接启用 extended error codes(扩展错误码),并用@FastNative降低部分 JNI(Java 与本地代码调用接口) 成本。 - AndroidX SQLite 2.7.1 是当前稳定版,修复了 web 和 suspending drivers 在事务中取消协程后、数据库和连接可能就此不可用的问题。Android App 是否升级,按发布说明、目标平台和回归测试决定;版本更新本身不构成替换生产环境 driver 的理由。
- Room 2.8.4 为 Room 连接池增加 prepared statement cache,适用于
SQLiteDriver内部没有连接池的场景,例如BundledSQLiteDriver;Room 2.8.5 调整了数据库关闭后的挂起查询和 invalidation tracker(失效追踪器)操作,数据库关闭后这类操作会抛出IllegalStateException。Room 的连接池 cache 与 Android 17 framework connection 自带的 cache 分属两层。 - Room2.8.5的QueryCallback用于SupportSQLiteOpenHelper路径,不能与已配置的SQLiteDriver组合;它通知SQL调用,不提供成功状态或执行区间。官方仍提示成本,启用前应核对版本、覆盖、派发积压与参数保留。
线上事件建议保留 room_version、androidx_sqlite_version、driver 类型、SQLite 是否随应用打包、journal mode(日志模式) 和 schema version(数据库结构版本)。从系统 AndroidSQLiteDriver 换到 BundledSQLiteDriver 或其他实现后,性能基线和错误码能力都可能变化,时间序列上应标记切换点。
扩展:Perfetto 文件系统 trace 与线上指标对照
Android 官方 SQLite 性能文档给出的 Perfetto 配置,是在 linux.ftrace 数据源中加入 atrace_categories: "database",启用 database 追踪类别来显示单条查询轨迹。应用还应在业务入口放置受控 Trace slice,把 DAO、事务和页面场景与 database track(数据库轨迹) 在时间轴上对齐。
| 线上信号 | 开发设备 trace 证据 | 可以排除或确认什么 |
|---|---|---|
| 主线程文件调用 wall time 高 | 应用 slice、sched 调度状态、CPU freq(处理器频率)、相关 syscall/ftrace | 线程是在运行、runnable(可运行但等待调度)、锁等待还是疑似 I/O 阻塞 |
| SQLite end-to-end 高 | DAO/transaction slice、database atrace、连接等待附近线程 | SQL 执行、调度和事务等待各占多少 |
| write/fsync 集中 | 文件调用 slice、writeback(页缓存回写)与 block(块设备)事件、设备状态 | 写入是否到达 block 层,是否伴随较长设备请求 |
| 读取慢但 block 事件少 | filemap/page fault(文件页缺页)、sched、CPU 和应用处理 | 数据可能来自页缓存,或耗时发生在应用代码/锁等待 |
| 目录扫描影响交互 | 扫描 slice、主线程、Binder 跨进程调用、GC(垃圾回收)、文件系统事件 | 遍历、对象分配和系统调用哪个阶段占主导 |
可核对的内核源码 block.h 定义了 block_rq_issue、block_rq_complete 等块设备请求事件;filemap.h 和 writeback.h 提供缺页与回写相关事件。这些事件是否开放取决于内核配置、trace 配置和权限,量产机上未必都能采到。
应用调用与 block request(块设备请求) 之间没有一一对应关系:页缓存可能直接满足 read,延迟回写会让 write 与 block I/O 分离,多个请求还可能合并;文件系统、dm-crypt(Linux 块设备加密层)和存储驱动又各加一层。我们用 trace 建立时序上的对应关系,无需按相同时间戳强行配对每个 Java 调用和每个 block event。
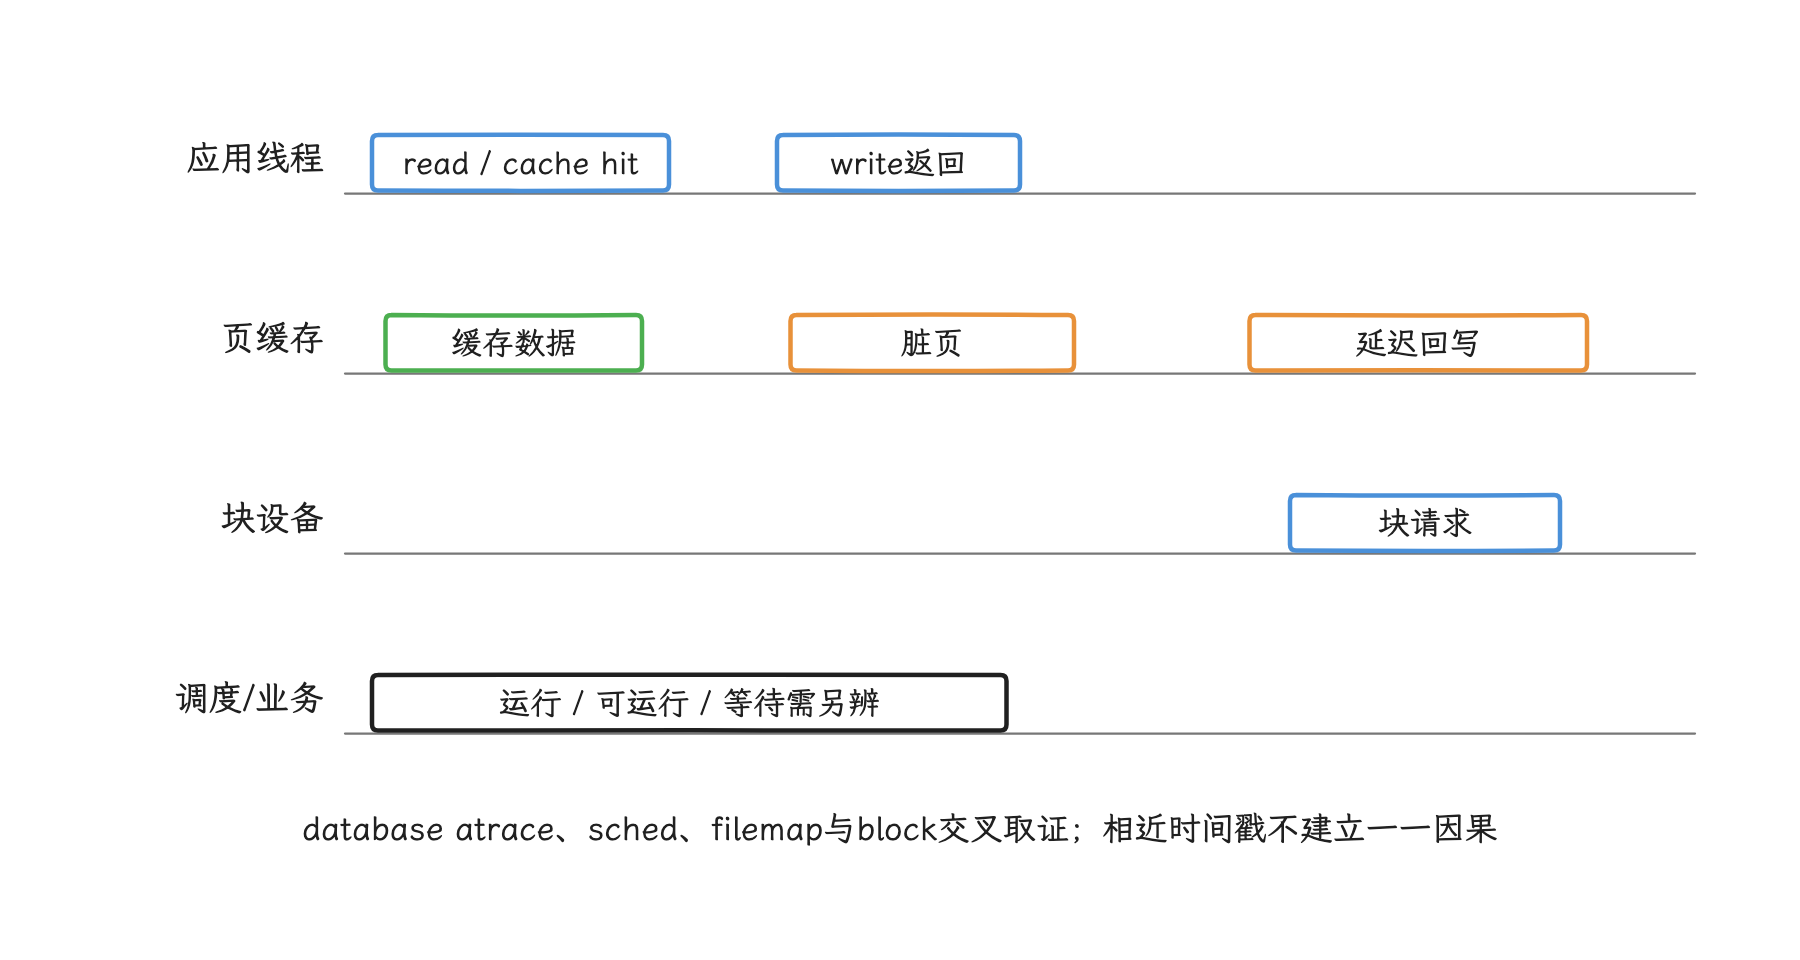
图:示意时间轴没有测量单位;read可由缓存满足,write返回后也可能稍后才触发回写。
Android 15+ 的 ProfilingManager 可以请求受控 system trace,Android 17 的 trigger 能覆盖更多系统事件,但请求受系统限流,且可能没有产物。线上应上传采集请求、结果状态和 trace 关联 ID;原始 trace 的合规、保留和访问控制沿用 26.6 的约定,存储事件里不额外保存一份。
全文小结
存储可观测性的产物应是一组定义清楚的证据:文件调用 scope、SQLite 执行层次、空间快照覆盖率、文件格式校验、资源生命周期和采集器自身成本。framework 内部的 OperationLog、cache 统计和慢查询属性能帮我们理解平台如何诊断,但其中多项是 private 或 @hide,普通 App 拿不到稳定的调用方式。
线上用公开接口和低成本字段发现分布,开发设备再用同一 SQLite 实现、EXPLAIN QUERY PLAN、dumpsys meminfo 和 Perfetto 验证原因。这样既保留源码依据,诊断工具也不会押在未经平台保证的实现细节上。
参考资料
- SQLite performance best practices
- SQLite
EXPLAIN QUERY PLAN - StrictMode API reference
- RoomDatabase.QueryCallback
- RoomDatabase.Builder#setQueryCallback
- AndroidX SQLite release notes
- Room release notes
- SQLiteConnection.java(android-17.0.0_r1)
- SQLiteConnectionPool.java(android-17.0.0_r1)
- SQLiteDatabase.java(android-17.0.0_r1)
- SQLiteDebug.java(android-17.0.0_r1)
- BlockGuardOs.java(android-17.0.0_r1)
- CloseGuard.java(android-17.0.0_r1)
- Matrix I/O Canary source
- Matrix SQLiteLint wiki