OOM(Out of Memory)、进程资源治理与 WebView Renderer 恢复
OOM 通常指内存不足,但在线上做稳定性统计时,线程、文件描述符和虚拟地址空间耗尽也常被归进同一类资源问题,本文把它们放在一起讨论。其中 OOME 专指 Java 的 OutOfMemoryError 异常,只是资源失败诸多表现中的一种。
源码基线:framework(Android 系统框架) 按 AOSP
android-17.0.0_r1、Android 17 / API 37 核对;Linux 资源限制按android17-6.18-2026-06_r6内核源码核对。
同样是“资源不够”,暴露形式随所在层面各不相同。走到 Java 这一层,Java heap 达到 ART 的 growth limit、由 native 层提供存储的 Java API 分配失败、线程创建失败,都可能抛出 OOME。留在 native 层,普通 malloc() / mmap() 失败往往只返回错误——FD(文件描述符)耗尽通常表现为 EMFILE,把高编号 FD(file descriptor,文件描述符) 误交给 select() 还可能触发 FORTIFY(Bionic 运行时边界检查)并 abort()。最极端的情况是 LMKD(低内存终止守护进程)结束进程:进程连抛 Java 异常的机会都没有。
面对这张错误清单,我们治理的第一步是保留原始错误、退出原因和进程资源快照,再按资源类型和内存区域选择排查入口——先弄清败在哪类资源上,再谈优化。
OOM 可能来自 Java Heap、Native、图形内存、地址空间或系统低内存终止。WebView Renderer 是其中一个特殊角色:它位于独立进程,退出时页面可能白屏,应用也可以通过回调重建页面。
OOM 类型、现场证据与恢复边界
这一节按资源类型展开:我们先看各类失败分别怎样暴露自己,再逐项过 Java heap、native、线程、FD 和虚拟地址空间,最后讨论 OOM 前的降级与资源预算。排查的主线只有一条——先定位败在哪类资源上,采集和治理才有方向。
OOM 与 OOME 如何出现
同一个“内存不足”告警,可能来自完全不同的系统层。我们先把事件放进正确的类别,再决定采集什么现场:
| 事件 | 常见表现 | 主要证据 | 是否经过 Java OutOfMemoryError |
|---|---|---|---|
| ART Java heap(托管对象堆)分配失败 | Failed to allocate ... growth limit ... | OOME 错误文本、Java 栈、heap dump、GC(garbage collection,垃圾回收)/heap 指标 | 是 |
| 由 native 层提供存储的 Java API 分配失败 | native alloc、Bitmap OOM、特定 JNI 错误 | Java 栈、native allocation 栈、PSS/RSS | 由 API 决定 |
| Java platform thread(传统 Java 线程)创建失败 | Could not allocate JNI Env 或 pthread_create (...) failed | OOME 错误文本、线程数、线程栈、VmSize、进程限制 | ART 会抛出 OOME |
| 普通 native(C/C++ 层)分配失败 | malloc/calloc/mmap 返回空指针或 ENOMEM,也可能被调用方转换为异常或 abort() | native 栈、heapprofd、maps/smaps、errno(系统错误编号) | 不一定 |
| 低内存结束进程 | 进程被系统终止;Android 11 / API 30+ 的支持设备可记录 ApplicationExitInfo.REASON_LOW_MEMORY | ApplicationExitInfo(API 30+)、LMKD/系统日志、内存压力 | 否 |
| FD 耗尽或高编号 FD 误用 | EMFILE、创建 socket/pipe/Looper 失败,或 FORTIFY abort | /proc/self/fd、rlimit、FD 创建与关闭记录 | 通常否 |
| 虚拟地址空间或 VMA(virtual memory area,虚拟内存区域)耗尽 | mmap 返回 ENOMEM,后续表现取决于调用方 | /proc/self/maps、VmSize、映射数、失败栈 | 不一定 |
类别放对之后,该用什么工具采集也就清楚了,而且这几样工具的视野要拼起来看:Heap dump 记录 Java 对象与引用关系,覆盖不到全部 native 映射;heapprofd 采样 native 分配调用栈,覆盖不到 Java 对象引用;LMKD(Low Memory Killer Daemon,低内存终止守护进程) 则是直接终止进程,崩溃捕获 SDK 连执行收尾代码的机会都没有。
ART 如何抛出 OOME
ART 内部有多条 native 失败路径,最终都汇到 Thread::ThrowOutOfMemoryError() 这个出口。它先尝试构造带错误文本的 java.lang.OutOfMemoryError;如果构造 OOME 时内存再次耗尽,线程就改用 Runtime 启动阶段预先准备好的 OOME 对象。
下面是 art/runtime/thread.cc 的关键分支,我们省略了日志和无关代码。
void Thread::ThrowOutOfMemoryError(const char* msg) {
  if (!tls32_.throwing_OutOfMemoryError) {
    tls32_.throwing_OutOfMemoryError = true;
    ThrowNewException("Ljava/lang/OutOfMemoryError;", msg);
    tls32_.throwing_OutOfMemoryError = false;
  } else {
    Dump(LOG_STREAM(WARNING));
    SetException(
        Runtime::Current()->GetPreAllocatedOutOfMemoryErrorWhenThrowingOOME());
  }
}
预分配对象保证线程至少还能设置异常状态,代价是错误文本和 Java 栈可能残缺;递归分支还会输出当前线程信息,帮助我们诊断。Heap::ThrowOutOfMemoryError() 另有 native stack overflow(C/C++ 调用栈耗尽)分支,使用 GetPreAllocatedOutOfMemoryErrorWhenHandlingStackOverflow()。
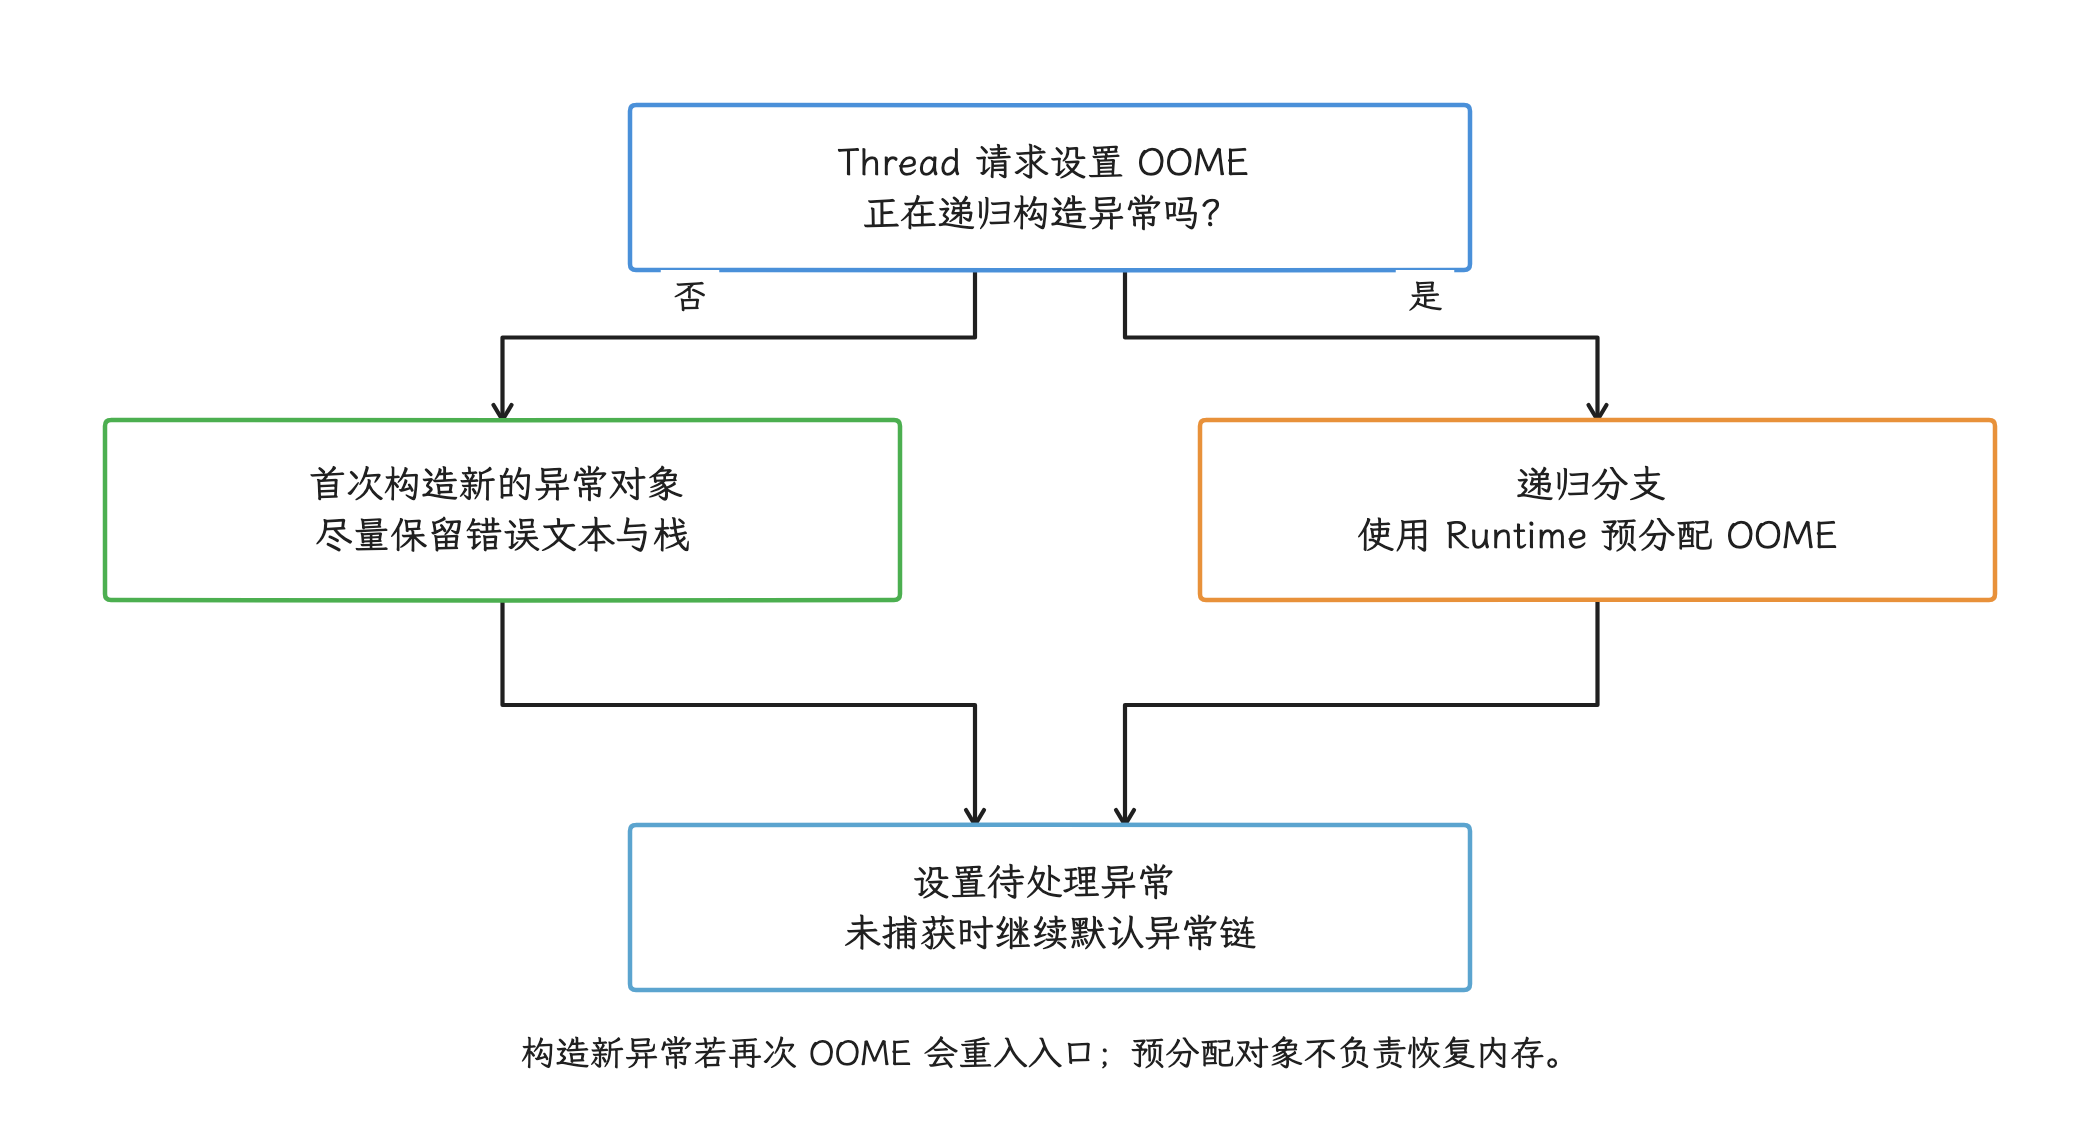
图:正常分支构造带文本的OOME;递归分支记录线程信息并使用预分配对象,栈与消息可能不完整。
OOME 成为 ART 的待处理异常后,控制流回到由 ART 执行的 Java/Kotlin 代码。业务没有捕获时,它交给 Thread.UncaughtExceptionHandler(未捕获异常的最终处理器),Android 默认处理器随后结束进程。所以自定义处理器必须继续调用安装前保存的默认处理器——API 37 的 ProfilingTrigger.TRIGGER_TYPE_OOM 也把这条调用路径作为自动生成 Java heap dump 的前提之一。
OOME 错误文本用于诊断,格式会随分配器和平台版本变化。监控平台可以提取 allocation size、growth limit 等已知字段做辅助分组;原始文本和栈必须保留,正则结果只当临时分组依据,别当长期接口。
Java Heap OOM 分类与治理
处理 Java heap OOM,我们要回答三个问题:本次请求多大、GC 后还活着多少对象、到 growth limit 之前还剩多少可用空间。只看“当前 free bytes(空闲字节)”很容易误判。
从错误信息定位
定位从错误信息本身开始。典型 heap OOME 可能包含以下信息:
java.lang.OutOfMemoryError: Failed to allocate a 48 byte allocation with
3610680 free bytes and 3526KB until OOM, target footprint 536870912,
growth limit 536870912; giving up on allocation because <1% of heap free after GC.
下面保留错误文本中的英文字段,便于直接检索日志;括号内给出含义:
- allocation size:本次请求大小。请求很小仍失败,通常说明堆已接近限制;一次超大请求则要检查输入尺寸和乘法溢出。
- free bytes(空闲字节数):ART 统计的 heap 空闲总量。它大于请求值还说明不了分配能成功:目标 heap 区域是否有足够大的连续块、分配后能否保留最小空闲比例,都会参与判断。
- until OOM(到 OOME 还可增长的空间):
GetFreeMemoryUntilOOME()给出的剩余增长空间,受当前 footprint 和 growth limit 约束。 - target footprint(目标堆占用):GC 用来调节 heap 增长的目标值,不等同于硬上限。
- growth limit(增长上限):应用 Java heap 的增长限制。设备通过
dalvik.vm.heapgrowthlimit、dalvik.vm.heapsize等属性配置 Runtime;android:largeHeap="true"会让ActivityThread调用VMRuntime.clearGrowthLimit(),普通应用走clampGrowthLimit()。 - fragmentation(碎片)文本:当空闲总量不小于请求且目标 allocator(内存分配器)支持碎片诊断时,
LogFragmentationAllocFailure()会报告最大连续块。LOS(Large Object Space,大对象空间)分支没有这段碎片详情。 <1% of heap free after GC:分配后保留不住 ART 要求的最小空闲比例。它描述的是 ART 对 heap 占用比例的限制;要下引用泄漏的结论,还得看 heap dump 里的引用关系。
ART 分配失败路径
Heap::AllocateInternalWithGc() 会先尝试分配,再执行适用的 GC 并在满足条件时重试,都拿不到对象才调用 Heap::ThrowOutOfMemoryError()。
下面的节选展示生成错误文本和选择碎片诊断的条件。
void Heap::ThrowOutOfMemoryError(
    Thread* self,
    size_t byte_count,
    AllocatorType allocator_type) {
  size_t total_bytes_free = GetFreeMemory();
  oss << "Failed to allocate a " << byte_count
      << " byte allocation with " << total_bytes_free
      << " free bytes and " << PrettySize(GetFreeMemoryUntilOOME())
      << " until OOM, target footprint "
      << target_footprint_.load(std::memory_order_relaxed)
      << ", growth limit " << growth_limit_;

  if (total_bytes_free >= byte_count &&
      allocator_type != kAllocatorTypeLOS) {
    // 省略按 allocator_type 选择 AllocSpace 的代码。
    if (!space->LogFragmentationAllocFailure(oss, byte_count)) {
      oss << "; giving up on allocation because <"
          << kMinFreeHeapAfterGcForAlloc * 100
          << "% of heap free after GC.";
    }
  }
  self->ThrowOutOfMemoryError(oss.str().c_str());
}
这段代码说明两点:碎片诊断只在“空闲总量足够”且分配目标不是 LOS(Large Object Space,ART 存放大对象的堆区域) 时才会尝试;错误文本记录的是失败瞬间的状态,对象引用关系仍要靠 heap dump。
四类 Java heap 问题
| 类型 | 证据特征 | 治理方向 |
|---|---|---|
| 引用泄漏 | 同一类对象和 GC Root(GC 认为始终存活的引用起点)路径跨场景持续增长 | 修复生命周期、监听器、线程本地变量、静态集合或错误缓存所有权 |
| 设计性常驻过大 | 对象都有合法持有者,但场景完成并短暂稳定后的存活集已接近预算 | 缩小模型、分页、按需加载、限制缓存和减少多份表示 |
| 分配抖动 | 存活集不高,短时间内频繁创建临时对象,分配速率与 GC 频率很高 | 复用缓冲区、减少中间对象、流式解析、避免热路径装箱 |
| 单次大对象或尺寸错误 | OOME 栈集中在数组、Bitmap、解压或反序列化入口 | 校验输入上限、分块处理、目标尺寸解码、检查宽高与字节数乘法 |
抓 heap dump 的时机同样有讲究:它更适合在资源接近内部告警线、进程还健康时采集。等到 OOME 发生后再做完整 dump,要额外申请内存和 I/O,成功率低,还可能延长用户可见的停顿。线上我们可以先用趋势采样找到内存上升的场景,再在可控设备、受控小流量版本或实验室里复现并抓取 HPROF(Java heap dump 文件格式)。
还有一个容易混淆的量:Runtime.totalMemory() - Runtime.freeMemory() 统计的是当前已提交 heap 里尚未空闲的部分,与 GC 后存活集是两个概念。判断泄漏,我们要比较同一场景、同一 GC 状态下的对象数量和 retained size(回收时可一并释放的内存);单次 Runtime 采样只覆盖其中一个维度。
largeHeap 的适用条件
largeHeap 只改变应用可用的 Java heap 上限:设备的物理内存没有变多,native、图形缓冲、线程栈和其他进程的压力也没有减轻。更大的 heap 反而会容纳更多存活对象,让系统更早进入内存竞争。
只有少数有大内存工作集的产品才值得评估 largeHeap,前提是低内存设备、后台切换、进程重建和系统压力测试都有数据;泄漏、无界缓存和错误尺寸分配要另想办法。至于修改 ART 私有字段、反射调用隐藏接口或动态“扩堆”,这类做法依赖内部实现,还可能破坏 GC 假设,生产方案里要避开。
Native 内存 OOM
到了 native 这边,我们查不到统一的“native heap 上限”:malloc() 可能因为地址空间用尽、系统拿不出更多内存、allocator 元数据不足或系统策略而失败;mmap()、图形缓冲和线程栈又各自走不同的分配路径。有时进程还会在分配函数返回失败之前,就被 LMKD 结束。
哪些路径会转换为 OOME
平台里有明确的转换点:
jdk_internal_misc_Unsafe.cc的Unsafe_allocateMemory()调用malloc();空指针时通过Thread::ThrowOutOfMemoryError("native alloc")抛出 OOME。libs/hwui/hwui/Bitmap.cpp的allocateHeapBitmap()使用calloc()分配普通 Bitmap 像素;返回空指针后,libs/hwui/jni/Bitmap.cpp的 JNI(Java Native Interface,Java/Kotlin 与 C/C++ 代码交互的接口) 入口调用doThrowOOME()。- JNI(Java Native Interface)的某些 API 会在输入超出可表示范围或分配失败时抛出 OOME,例如超长
NewStringUTF。具体结果由 JNI 入口实现决定。 - 应用或第三方 native 库直接调用
malloc/calloc/realloc/mmap时,失败结果属于调用方契约。其中malloc/calloc/realloc通常用空指针表示失败,mmap则返回MAP_FAILED(不是空指针)并设置errno;误用这些失败结果可能转成 SIGSEGV(非法内存访问)信号,主动abort()会产生 SIGABRT(主动终止)信号,只有显式调用 JNI/ART 异常接口才会变成 Java OOME。
根据 Android Bitmap 内存说明,普通 Bitmap 自 Android 8.0 起由 native heap 持有像素;Bitmap.Config.HARDWARE 使用 GraphicBuffer / AHardwareBuffer(供图形栈使用的硬件缓冲区)。两者都可能增加进程或系统内存压力,只是采集方式和归属不同。所以评估 Bitmap 成本时,我们要看像素和图形缓冲本身;Java heap dump 里那个体积很小的 Bitmap 包装对象,与真实成本相去甚远。
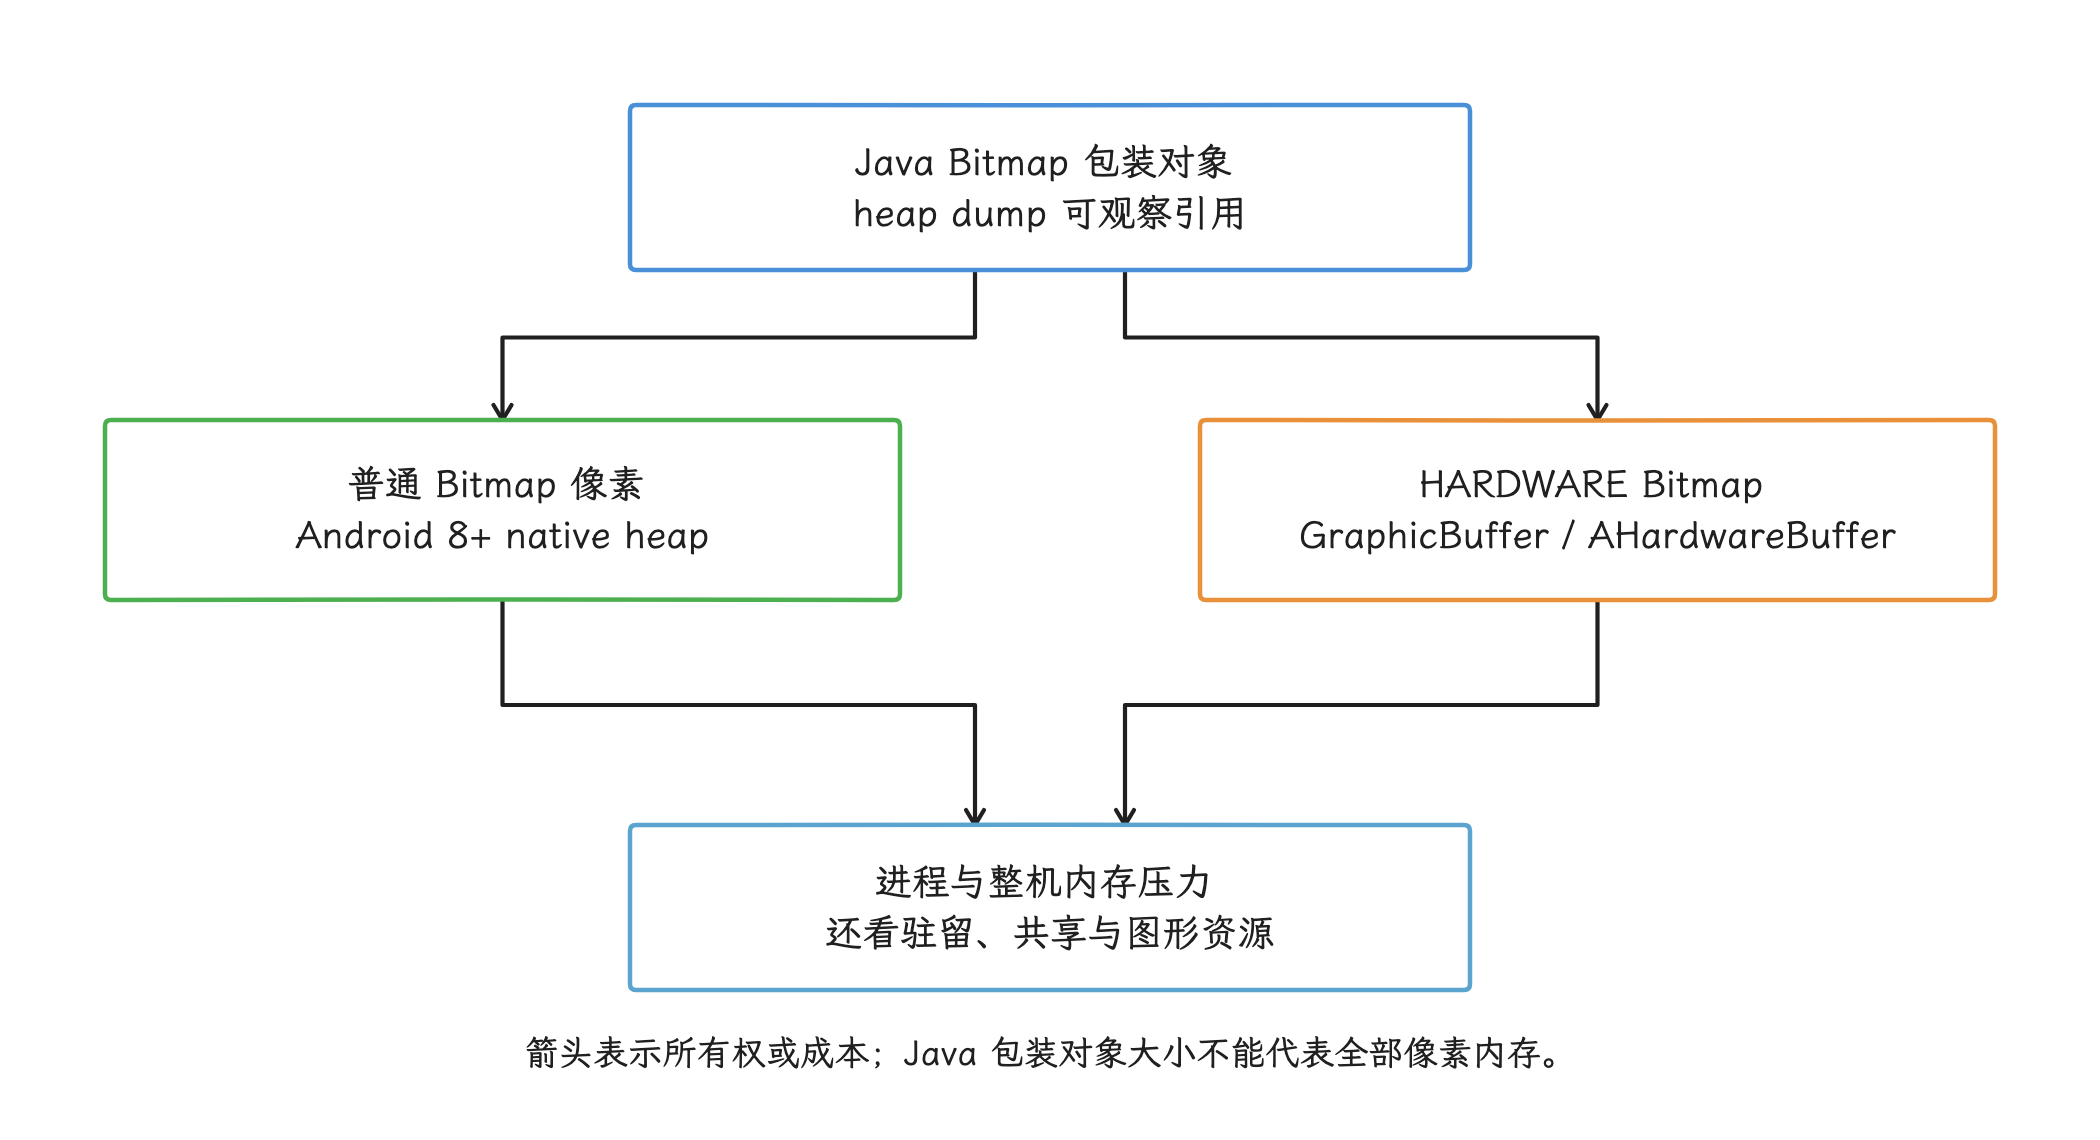
图:普通像素与硬件图形缓冲属于不同资源域;Java引用分析仍用于找到所有者,但大小要结合native与图形证据。
先区分虚拟地址、驻留页和比例分摊
| 指标 | 回答的问题 | 不能回答的问题 |
|---|---|---|
VmSize(Virtual Memory Size)/ /proc/self/maps | 进程保留和映射了多少虚拟地址区间 | 这些页是否常驻、是否独占 |
VmRSS / smaps_rollup RSS(Resident Set Size,驻留集大小) | 当前有多少页位于物理内存 | 共享页应由哪个进程负责 |
| PSS(Proportional Set Size,比例分摊集大小) | 独占页全额计入、共享页按映射进程数分摊后的进程成本 | 单个 native allocation 的调用栈 |
Debug.getNativeHeapAllocatedSize() | bionic(Android C 标准库)malloc 管理的已分配字节趋势 | mmap()、线程栈、GraphicBuffer 等全部 native 成本 |
| heapprofd | 被采样的 malloc/free 调用栈、大小和存活情况 | 未经过受支持 allocator 的所有映射与图形内存 |
所以单看一个总量容易误判:native heap 指标平稳,mmap、线程栈或图形缓冲仍可能在增长;VmSize 很大,也只是虚拟地址保留得多,物理内存泄漏的结论还要靠驻留页指标。
诊断顺序
我们按下面的顺序推进:
- Android 11 / API 30 及以上,先用
ActivityManager.getHistoricalProcessExitReasons()读取ApplicationExitInfo(系统保存的历史进程退出记录),把 OOME crash、native crash 和REASON_LOW_MEMORY分开;Android 10 / API 29 没有这组历史退出 API,只能靠 LMKD/系统日志、崩溃记录和重启前的轻量本地标记。API 30+ 还要先调用ActivityManager.isLowMemoryKillReportSupported()确认设备支持低内存退出原因;设备不支持时,低内存终止可能记录成REASON_SIGNALED与SIGKILL,此时就算记录里没有REASON_LOW_MEMORY,系统内存压力也仍然可能存在。系统直接终止进程时,也没有可依赖的未捕获异常回调。 - 对比同场景的 PSS(Proportional Set Size)/RSS(Resident Set Size)、Java heap、native malloc、图形内存、线程和映射数,先确定哪一类内存在增长。
malloc分配使用 heapprofd 或 Android Studio native allocation profiler,保留分配调用栈及释放/存活记录;其中 heapprofd 的聚合栈只标记分配发生的位置,读不到每次free()的调用栈。接入条件受构建类型、profileable(允许性能工具连接)配置、设备和系统策略影响。mmap()映射解析/proc/self/maps与smaps(逐映射的内存统计),按文件路径、匿名映射名称和权限汇总。- 图形与媒体对象结合 Perfetto(系统性能时间线工具)、
dumpsys meminfo、dma-buf(内核共享缓冲区)/GraphicBuffer 工具和对象生命周期检查。 - 对 JNI 资源建立明确的所有权与释放协议:
close()、RAII(作用域结束自动释放资源)、引用计数和失败路径都要覆盖;Cleaner(GC 触发、时机不确定的清理机制)只宜当作补充,释放要以明确的所有权协议为主。
采样本身就会带来内存与 CPU 开销,线上要限制时长、采样率和目标进程。资源接近内部告警线时,我们优先保存轻量计数与场景,详细分析放到受控小流量版本或可复现设备上做。
线程数 OOM(pthread_create 失败)
线程数 OOM 的错误文本我们在前面的表格里已经见过:Could not allocate JNI Env 或 pthread_create (...) failed。这类失败的根源,是每个线程都要占住一串资源:pthread_create() 是 POSIX 线程创建接口,每个已经启动的 Java platform thread 都对应一个 native thread,占用线程栈、guard 区(栈边缘的越界检测保护页)、ART Thread、JNI 环境和内核 task(可调度执行单元)等资源。线程数一涨,虚拟地址空间、native 内存和调度能力就同时被消耗;协程或排队任务的数量,与操作系统线程数之间也没有直接的换算关系。
线程创建的失败分支
Thread::CreateNativeThread() 先创建 ART Thread 和扩展 JNI 环境 JNIEnvExt,设置 pthread 栈大小,再调用 pthread_create()。失败后的错误文本由下面这段关键代码生成。
std::string msg(
    child_jni_env_ext.get() == nullptr
        ? StringPrintf("Could not allocate JNI Env: %s",
                       error_msg.c_str())
        : StringPrintf("pthread_create (%s stack) failed: %s",
                       PrettySize(stack_size).c_str(),
                       strerror(pthread_create_result)));
soa.Self()->ThrowOutOfMemoryError(msg.c_str());
Could not allocate JNI Env 说明失败发生在 pthread 启动之前;pthread_create ... failed 则要继续看 strerror() 给出的原因。Bionic 在 stack/TLS(线程局部存储)映射失败时返回 EAGAIN,含义是当前资源不足、稍后重试可能成功。内核 clone 还可能因为 task 数、RLIMIT_NPROC(每用户可创建的线程数上限)或其他资源不足而失败。android17-6.18-2026-06_r6/kernel/fork.c 的 copy_process() 会在相关限制失败时返回 -EAGAIN。
所以诊断时务必保留设备上的原始 errno(系统错误编号及文本);把所有 EAGAIN 记成同一个原因,会丢掉最关键的区分信息。
栈大小由 ART 的 FixStackSize() 和线程请求共同决定,“每线程固定 1 MB”换一台设备或架构就不成立。诊断时我们从 OOME 错误文本里的栈大小、/proc/self/task 数量和 maps 中的 stack/guard 映射出发。
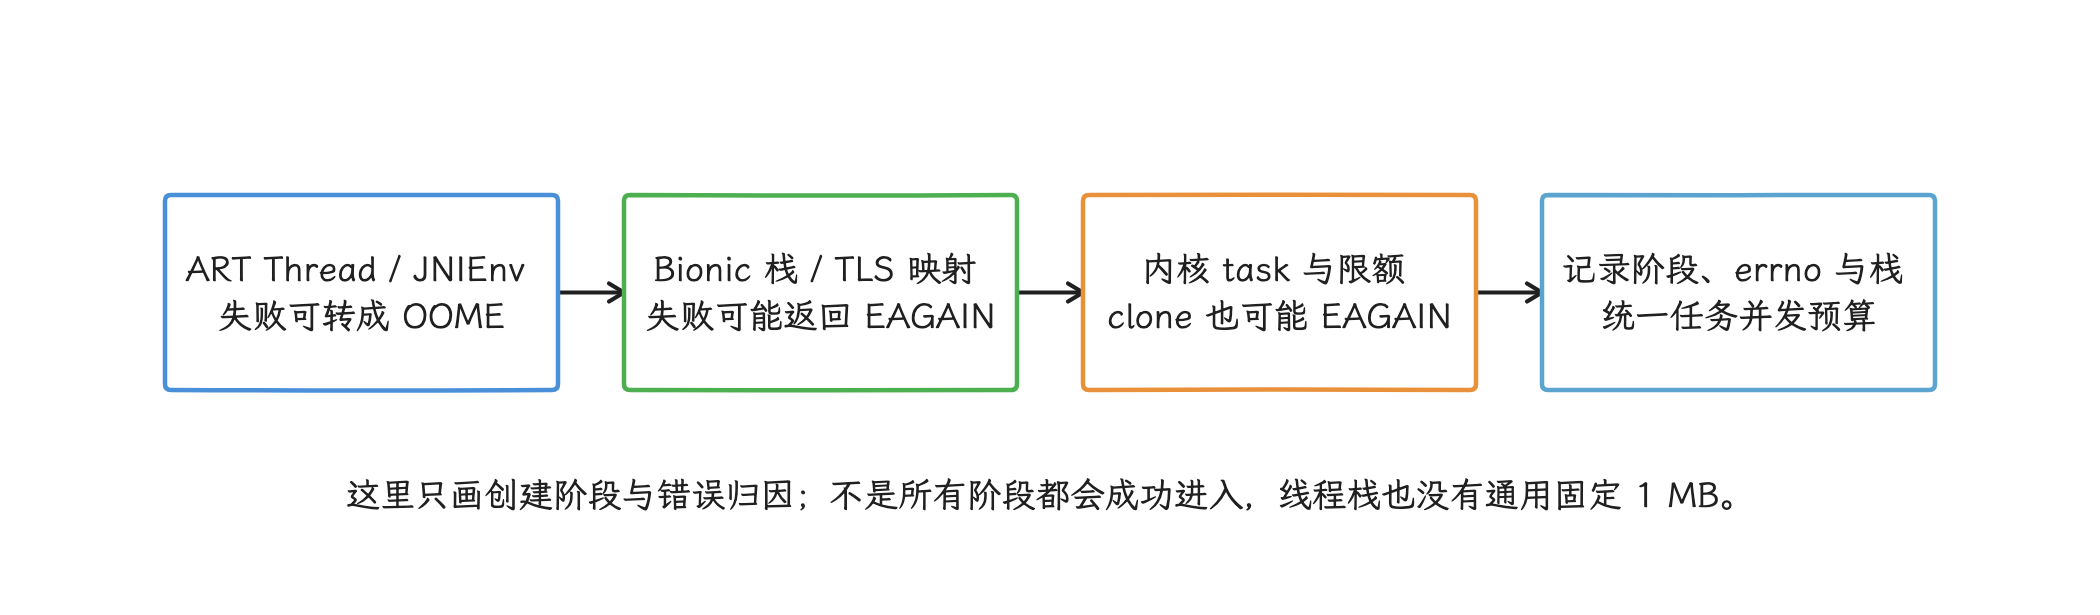
图:线程请求消耗地址区间、native资源与内核task;相同EAGAIN文本不足以区分栈映射和内核限额等原因。
线程治理与监控
- 对自有任务使用队列长度受限的 executor、结构化协程和统一调度入口,记录线程池大小、正在执行的任务数、排队任务数、拒绝次数和取消次数。
- 审计 SDK、WebView、媒体、数据库和网络库的线程池。多个库各自“合理”的池相加后仍可能过量。
Dispatchers.IO适合阻塞 I/O,但它不是全应用线程总额控制器;多个limitedParallelism(限制并行任务数的调度器视图)也需要共享一份产品级并发预算。- 在线程创建点记录责任模块、名称和创建场景。优先使用自有
ThreadFactory/ executor 观察;拦截 native 线程创建入口的 Hook 只用于受控诊断,需处理递归调用、性能和兼容性。 - 周期读取
/proc/self/status的Threads,并统计/proc/self/task。两者是采样值,线程快速创建与退出时可能不同。 - 告警阈值来自设备和场景基线,例如场景完成并短暂稳定后的线程数分布、增长速度和剩余地址空间。固定 400 或 500 对不同进程没有通用意义。
- 线程数超过内部告警线时不要立即调用
Thread.getAllStackTraces()抓取所有栈;它会创建大量对象。平时保留线程名、责任模块和采样栈,超过告警线后只补充少量线程现场。
反过来,线程数下降也要看任务是否仍能完成:把线程改成一个无界队列,可能把资源 OOM 改成排队延迟或 ANR(Application Not Responding,应用无响应)。
FD 泄漏导致的资源型崩溃
FD 是内核分配给文件、socket、pipe 等已打开资源的整数句柄。新分配 FD 的编号上界由 RLIMIT_NOFILE 的软限制规定:正常分配要找到小于该值的空闲编号,光看 FD 总数说明不了问题。找不到可用编号时,open()、socket()、pipe()、eventfd() 或 epoll_create1() 可能返回 EMFILE;系统级打开文件表耗尽还可能表现为 ENFILE。android17-6.18-2026-06_r6/fs/file.c 的 FD 分配路径,就是按当前进程的 files table 和限制返回 -EMFILE 的。
FD 耗尽一般不走 ART OOME 这条路,但治理上我们仍应把内存、线程、FD 和地址空间放进同一套进程资源看板,事件类型各自分开统计。
FORTIFY(Bionic 的运行时边界检查) 与真实上限
FORTIFY 是 Bionic 的运行时边界检查机制。下面的日志表示代码把过大的 FD 编号交给基于 fd_set 位集合的 select() 接口:
FORTIFY: FD_SET: file descriptor >= FD_SETSIZE
FD_SETSIZE 是 select() 数据结构能表示的 FD 编号上限,和 RLIMIT_NOFILE(可分配 FD 编号范围的软/硬限制)不是同一个值。只要代码把小于 0 或大于等于 FD_SETSIZE 的编号交给受检查的 FD_SET 等宏,FORTIFY 就可能调用 abort() 结束进程;此时 FD 总数仍可能低于进程上限。修复既要找 FD 增长源,也要检查库是否错误地用 select() 处理高编号 FD。
采集一份可解释的 FD 快照
一份有效快照至少包含:
getrlimit(RLIMIT_NOFILE)的软限制(当前生效值)、硬限制(进程可把软限制提高到的最大值)和当前 FD 数。/proc/self/fd/<n>的readlink()结果,也就是每个 FD 指向的资源;按 socket、pipe、anon_inode(没有普通文件路径的内核对象)、文件、设备和未知类型分组。- 持续增长类别的创建方、创建栈、创建时间和可用的业务 ID。
close()结果、重复关闭、dup*产生的多个 FD 指向同一底层资源的关系,以及对象生命周期。- 快照时的线程数、网络连接、页面或任务场景。
遍历 /proc/self/fd 本身会短暂打开目录 FD,其他线程也可能同时关闭或复制 FD,因此结果只代表采集过程附近的状态。readlink() 失败可能只是资源恰好被其他线程关闭,先别急着记成泄漏。
常见泄漏点包括未关闭的 ParcelFileDescriptor、Cursor、AssetFileDescriptor、InputStream、socket、Image、MediaExtractor 和重复注册的 pipe/eventfd。Kotlin use {}、Java try-with-resources 和 C++ RAII(对象离开作用域时由析构函数释放资源) 应覆盖成功、异常、取消与超时路径。
何时记录 native FD 创建点
数量统计给不出创建方时,可以在受控版本记录 open/openat、socket/accept、pipe/pipe2、dup*、eventfd、epoll_create* 与 close。实现要处理可变参数、同一函数的不同符号名、递归调用、采样和 FD 编号复用;漏掉 dup 或 accept,创建与关闭的记录就对不上。
不要在每次 open/close 时采集完整调用栈和全局映射表。先找持续增长的类别,再对目标模块采样;FD 数接近内部告警线时输出已有轻量记录,避免监控组件自己申请更多 FD 或大块内存。
虚拟内存空间耗尽(32 位进程)
32 位进程的地址空间较窄,.so 动态库、Java heap、native heap、线程栈和 mmap() 映射更容易互相挤压。如今主线设备与应用以 64 位为主要形态,但兼容 32 位 ABI(应用二进制接口)的设备仍可能运行 32 位进程;排查时我们用 Process.is64Bit() 记录当前进程架构,设备 CPU 只能作参考。
“32 位用户空间固定为 3 GB、内核固定占 1 GB”这样的说法,换个设备就不成立。可用范围由内核配置、架构、ASLR(地址空间布局随机化)、保留区和进程映射共同决定,可分配的最大连续区间还会小于剩余总地址空间。
地址空间由哪些映射构成
| 区域 | 观察方式 | 边界 |
|---|---|---|
| ART heap spaces | maps/smaps 中的 dalvik/ART 匿名区 | Java heap footprint 与 growth limit 相关,但保留量和已提交量要区分 |
| native allocator arenas(分配器管理的内存池) | libc malloc 匿名映射 | Debug.getNativeHeapAllocatedSize() 只覆盖 allocator 统计,不等于全部映射 |
.so、dex、oat、vdex 等 native 库和应用/运行时代码文件 | 带文件路径的映射 | 同一文件可有多个权限区段,共享页不能按 VmSize 当作独占物理成本 |
| 线程栈与 guard | stack/匿名映射、线程创建记录 | 大量线程会消耗地址区间,即使栈页尚未全部驻留 |
| Bitmap、媒体和共享内存 | 匿名映射、memfd(以内存为后端的匿名文件)、dma-buf 或设备映射 | 是否计入进程 RSS/PSS 取决于映射与统计方式 |
| 保留地址区间 | PROT_NONE(禁止读写执行的页保护)或 allocator/Runtime 保留区 | VmSize 会增长,但页可能尚未常驻 |
64 位进程也可能因无界映射、VMA 数量、异常地址保留或超大连续映射而收到 ENOMEM。android17-6.18-2026-06_r6/mm/mmap.c 的 do_mmap() 会在长度、地址或 map_count(当前进程的 VMA 数量)超过系统约束等条件下返回 -ENOMEM;64 位进程仍要管理映射生命周期。
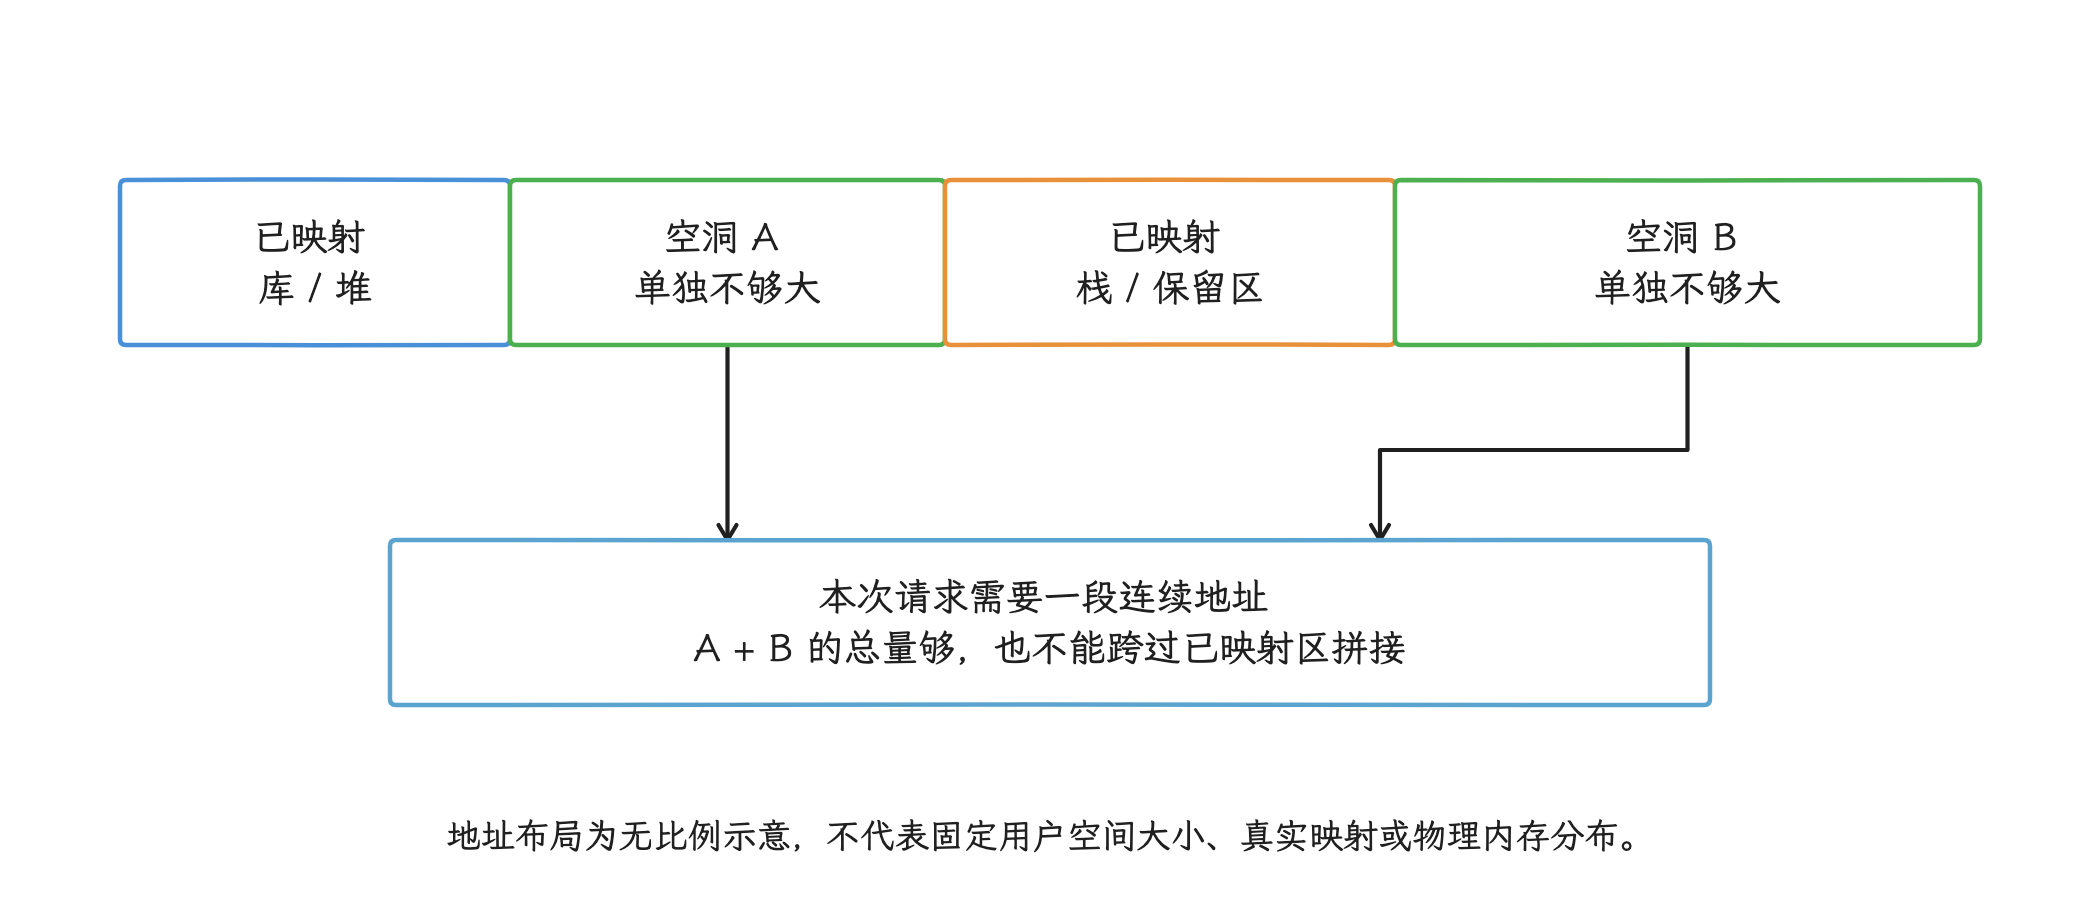
图:32位地址范围较窄,更容易因连续区间不足失败;64位仍受映射数、保留区和请求长度约束。
排查顺序
地址空间问题的排查顺序:
- 保存进程位数、失败 errno、请求长度、调用栈和连续性要求。
- 读取
/proc/self/status的 VmSize/VmPeak(当前/历史峰值虚拟地址空间)和/proc/self/maps区间数量,和同设备同场景健康样本比较。 - 按映射名称、权限和责任模块聚合 maps/smaps(进程的虚拟内存区间及逐区间统计),区分持续增长与单次巨型请求。
- 同时检查线程、Java growth limit、native allocator、文件映射和图形/媒体资源,避免只盯一个总量。
- 对 32 位进程检查最大空洞(尚未映射的最大连续地址区间)和碎片;总剩余地址空间够,未必存在满足本次请求的连续区间。
- 对 64 位异常 VmSize 先识别 Runtime 保留区。较大的保留区可以是正常实现,判断时还是要回到失败栈和映射增长上。
Debug.MemoryInfo.getTotalPrivateDirty() 统计的是进程独占、内容已被修改的驻留页,属于物理内存指标;要看虚拟地址空间是否接近限制,还是得回到 VmSize 和映射区间数量上。
治理方向
- 能迁移时提供完整 64 位 ABI(Application Binary Interface,应用二进制接口),并验证 64 位指针变大带来的 native heap 增量和第三方
.so兼容。 - 限制线程、映射和内存映射文件的数量与生命周期,及时
munmap()或关闭资源所有者。 - 大对象采用分块、流式或尺寸上限,避免要求巨型连续区域。
mallopt(M_PURGE, 0)请求 allocator 归还可清理的空闲物理页;它不会自动释放所有保留地址区间,也修复不了映射泄漏。- 拆进程会获得独立地址空间,却会复制 Runtime、
.so、线程和缓存,增加整机内存与 IPC(进程间通信) 成本;采用前要让隔离目标和测量数据同时成立。
OOM 前降级、自动取证与资源预算
OOM 前的降级与失败处理
OOME 发生后,当前线程连创建异常对象都可能失败,观测和降级因此要提前到资源接近预算时完成;异常一旦交给 UncaughtExceptionHandler,就只保留最小记录,沿默认处理路径结束进程。
在 OOM 前释放可重建资源
降级动作按风险排序:
- 对图片、页面模型、预取、媒体缓冲和离线队列设置硬上限与缓存淘汰规则,控制时机由应用自己掌握,等系统回调就晚了。
- 当页面退出、UI 隐藏或任务取消时释放资源所有者;
close()和协程取消路径都要测试。 - 内存占用持续上升时停止非必要预取、降低目标图片尺寸、缩小并发,并保留用户当前操作所需数据。
- 后台阶段释放可快速重建的 UI 缓存,避免同步序列化或磁盘写入阻塞主线程。
- 重任务保存阶段性进度,重试时允许同一步骤安全执行多次,让进程被系统结束后能够恢复,不依赖 OOM 处理器抢救。
API 34 及以上 不再向应用发送旧的 TRIM_MEMORY_RUNNING_*、TRIM_MEMORY_MODERATE 和 TRIM_MEMORY_COMPLETE。代码因此聚焦 TRIM_MEMORY_UI_HIDDEN(界面已不可见)与 TRIM_MEMORY_BACKGROUND(进程已在后台、可能为释放整机内存而被终止);需要兼容旧系统时,再为旧常量保留分支。
下面的示例让项目自定义缓存根据仍会送达的两个级别缩容;回调运行在主线程,trimTo() 只能释放引用和完成有界操作。
override fun onTrimMemory(level: Int) {
    when {
        level >= ComponentCallbacks2.TRIM_MEMORY_BACKGROUND -> {
            memoryCaches.trimTo(CacheProfile.BACKGROUND)
        }
        level >= ComponentCallbacks2.TRIM_MEMORY_UI_HIDDEN -> {
            memoryCaches.trimTo(CacheProfile.UI_HIDDEN)
        }
    }
}
释放引用后由 Runtime 决定 GC 时机,不要在生产路径主动调用 System.gc()。需要关闭文件或 native 资源时,关闭动作必须快速;耗时清理由后台任务处理,但别再让任务引用本应释放的大对象。
UncaughtExceptionHandler 与 API 37 OOM 触发器
全局 UncaughtExceptionHandler 不适合执行 Debug.getMemoryInfo()、heap dump、JSON 序列化或网络上报,这些动作会继续申请内存。若产品需要 OOM 标记,应预先准备固定大小的记录和写入量受限的路径,失败时立即放弃。
自定义处理器必须保存安装前的处理器,并对所有 Throwable 调用它——API 37 的 ProfilingTrigger.TRIGGER_TYPE_OOM 可以在 OOME crash 时生成 Java heap dump,官方明确要求这条调用路径,否则自动触发器不可用。
触发器还受系统资源和频率限制,每次都产生结果是没有保证的。已生成的结果要等应用后续启动、注册 registerForAllProfilingResults 回调后再读取,它不是崩溃线程上的同步恢复机制。
在可控的可选分配点捕获 OOME,只适用于输入尺寸已知、没有共享状态写到一半、可以返回低分辨率或失败结果的操作。全局吞掉 OOME 后继续运行,进程的资源使用可能仍接近上限,其他线程也可能已失败。
sigsetjmp / siglongjmp 可以从 SIGSEGV、SIGABRT 信号处理位置跳回预先保存的 native 执行点,只适合受控的 crash 隔离实验。它既处理不了 Java heap OOME,也修复不了 native allocator 失败;这种跳转可能绕过被跨越栈帧的正常返回、锁释放和 JNI 清理;若跨过本应执行非平凡 C++ 析构的自动对象,还会落入 C++ 非局部跳转的未定义行为限制,不要把它当作 OOM 降级方案。
大型 App 的内存预算管理
制定预算时,我们要同时覆盖 Java、native、图形/媒体缓冲、线程、FD 和地址空间;只看 Java maxMemory() 会漏掉大量进程成本。
预算维度与测量方式
| 维度 | 实验室/CI 证据 | 线上轻量指标 |
|---|---|---|
| Java live heap | HPROF、对象数、retained size、场景前后差值 | Runtime heap 已用量、GC 次数/时间、接近预算事件 |
| native malloc | heapprofd、Android Studio native allocations | getNativeHeapAllocatedSize() 趋势 |
| 进程物理成本 | dumpsys meminfo、PSS/RSS、smaps_rollup 汇总 | 低频 PSS/RSS 或平台允许的 MemoryInfo |
| 图形/媒体 | Perfetto、dma-buf/GraphicBuffer 与媒体工具 | 自有缓冲区数量、尺寸、格式和生命周期 |
| 线程与调度 | /proc/self/task、线程栈、executor 指标 | 线程数、线程池正在执行/排队/拒绝任务数 |
| FD | rlimit、/proc/self/fd 分类、创建方 | FD 总数、主要类别和增长率 |
| 虚拟地址 | maps/smaps、映射数、最大空洞 | VmSize、映射数、进程位数 |
所有指标都要绑定场景和时间点。冷启动后固定等待 5 秒,代表不了首页完成加载后的内存状态:网络、图片、延迟初始化和 GC 时机都可能不同。更可靠的采样点是“场景完成条件满足 + 短暂稳定窗口”,并记录测试数据、账户、网络、设备温度和进程冷热状态。
从产品预算到模块责任
预算制定可以按以下步骤执行:
- 选择低内存、主流和高配置设备组,记录
ActivityManager.getMemoryClass()、getLargeMemoryClass()、isLowRamDevice()与进程位数。 - 为冷启动、首页完成加载后的短暂稳定窗口、重页面峰值、后台驻留和多次往返分别建立基线,至少重复多轮并报告分布。
- 把内存增量对应到可以修改的责任模块:缓存、图片、模型、线程池、native 句柄、图形缓冲或映射文件。依据不足时保留“进程共享”项,模块归属等有数据再定。
- 模块预算同时规定场景完成后的常驻量、峰值、回落时间和失败策略。只规定“不得超过 N MB”,容易把内存使用推迟到另一个阶段。
- CI(持续集成)比较同设备同数据的分布与基线,门槛要考虑测量噪声、反复测量得到的波动范围和产品余量,“增加 5 MB 就阻断”这样的固定门槛并不合适。
- 发布后按设备、系统、ABI(应用二进制接口,也就是 32/64 位和指令集)、版本和场景观察受 OOME 影响的活跃用户占比、
REASON_LOW_MEMORY、PSS 高百分位、线程数与 FD 数。 - 发生回归时同时检查计算比例所用的用户总数和场景覆盖,避免测试样本减少后误判为优化。
模块预算直接加总,得到的还当不了进程预算:Runtime、共享库、allocator、系统组件和模块共享对象都需要单独余量。进程预算也要给整机留出余地,前后台切换、相机、WebView、媒体与系统更新都会改变整机竞争。
验证降级是否有效
每个降级动作都要验证三类结果:
- 资源结果:目标指标是否下降,下降发生在多长时间内,是否只是从 Java 转移到 native 或磁盘。
- 功能结果:当前操作是否有明确失败提示、低规格结果或可重试状态,进程重建后数据是否一致。
- 性能结果:缓存缩小后是否引入启动、网络、解码、功耗或 ANR 回归。
OOM 治理达到可发布状态时,每个接近资源预算的事件都有责任模块,系统终止与 OOME 分开统计,慢设备和 32 位兼容进程都有覆盖,任何 UncaughtExceptionHandler 都保留平台默认处理路径。
Renderer 退出、回调与页面重建
应用进程的 OOM 之外,还有一类退出要单独讨论:WebView Renderer。它与应用自身的 OOM 分属两类问题,归因要分开;页面能否安全恢复,则取决于 WebView 状态、业务导航和资源释放怎么处理。
我们常见的现场是:WebView 页面突然变白,宿主 Activity 还能响应,导航栏和原生按钮也都正常。如果这时收到 onRenderProcessGone(),就可以确认关联的 Renderer(负责网页解析、脚本执行与绘制的渲染进程)已经退出。旧 WebView 随之失效,reload()、goBack()、evaluateJavascript() 和 JS Bridge(JavaScript 与原生代码的通信接口)都救不回它。
本节主要讨论系统在内存压力下结束 Renderer 这一类情况;单次白屏或单个 didCrash=false 只能算线索,归因到 OOM 还需要后面几节的其他现场。
下文把一次 onRenderProcessGone() 回调简称为 gone 事件。WebView provider(向 framework 提供 WebView 实现的可更新系统包) 可以独立于系统版本更新,可能来自 Chromium,也可能由厂商定制;排查时要记录设备上的 provider 包名与版本。
文中涉及内核内存压力的源码名词时,以 Android common kernel(公共内核仓库)为参照,标签见文首基线;这个参照只用来固定源码版本,设备实际运行的内核可能不同。
平台、Provider 与进程
标准 android.webkit.WebView 同时跨越两条版本线:
- Android 平台提供
WebView、WebViewClient、Renderer 优先级和终止处理 API; - WebView provider 包提供 Chromium/Blink、页面合成、沙箱 Renderer 和大部分实现,并可独立于系统版本更新。
平台侧固定的是公开 API 与 framework 注释;设备实际使用的 Chromium 源码版本(revision)要靠 provider 信息确定。复盘时至少记录 Android build(系统构建号)、provider 包名、versionName、versionCode、ABI、设备型号,以及应用用的是系统 WebView、定制 Chromium 还是第三方内核。
我们可以把现代标准 WebView 拆成三个执行域来理解:
- 宿主进程保存
WebViewJava 对象、Activity/Fragment 状态、业务 Bridge,以及 provider 的 browser-side 代码;browser-side 指导航、网络、权限这类浏览器控制逻辑,都运行在宿主进程里,与设备上的浏览器应用无关; - 沙箱 Renderer 运行 Blink 排版引擎、JavaScript,以及样式计算、布局、绘制和部分页面合成工作;
- 宿主的 HWUI RenderThread(Android UI 硬件加速渲染线程) 通过 WebView functor 接收 provider 的绘制回调。functor 是 provider 与 HWUI 之间的原生绘制桥,结果通常先合入应用窗口,再交给 SurfaceFlinger(Android 的系统画面合成服务) 和 HWC(Hardware Composer,硬件合成器) 完成合成上屏。
视频、受保护内容或 provider overlay(由 provider 单独提交的叠加画面)可能增加独立的 SurfaceControl 图层。Renderer 退出后,已提交的旧帧可能短暂保留,也可能变成空白或静止画面。宿主窗口还在,只说明应用进程尚未退出;网页是否仍可交互,要等后面的恢复流程走完才知道。
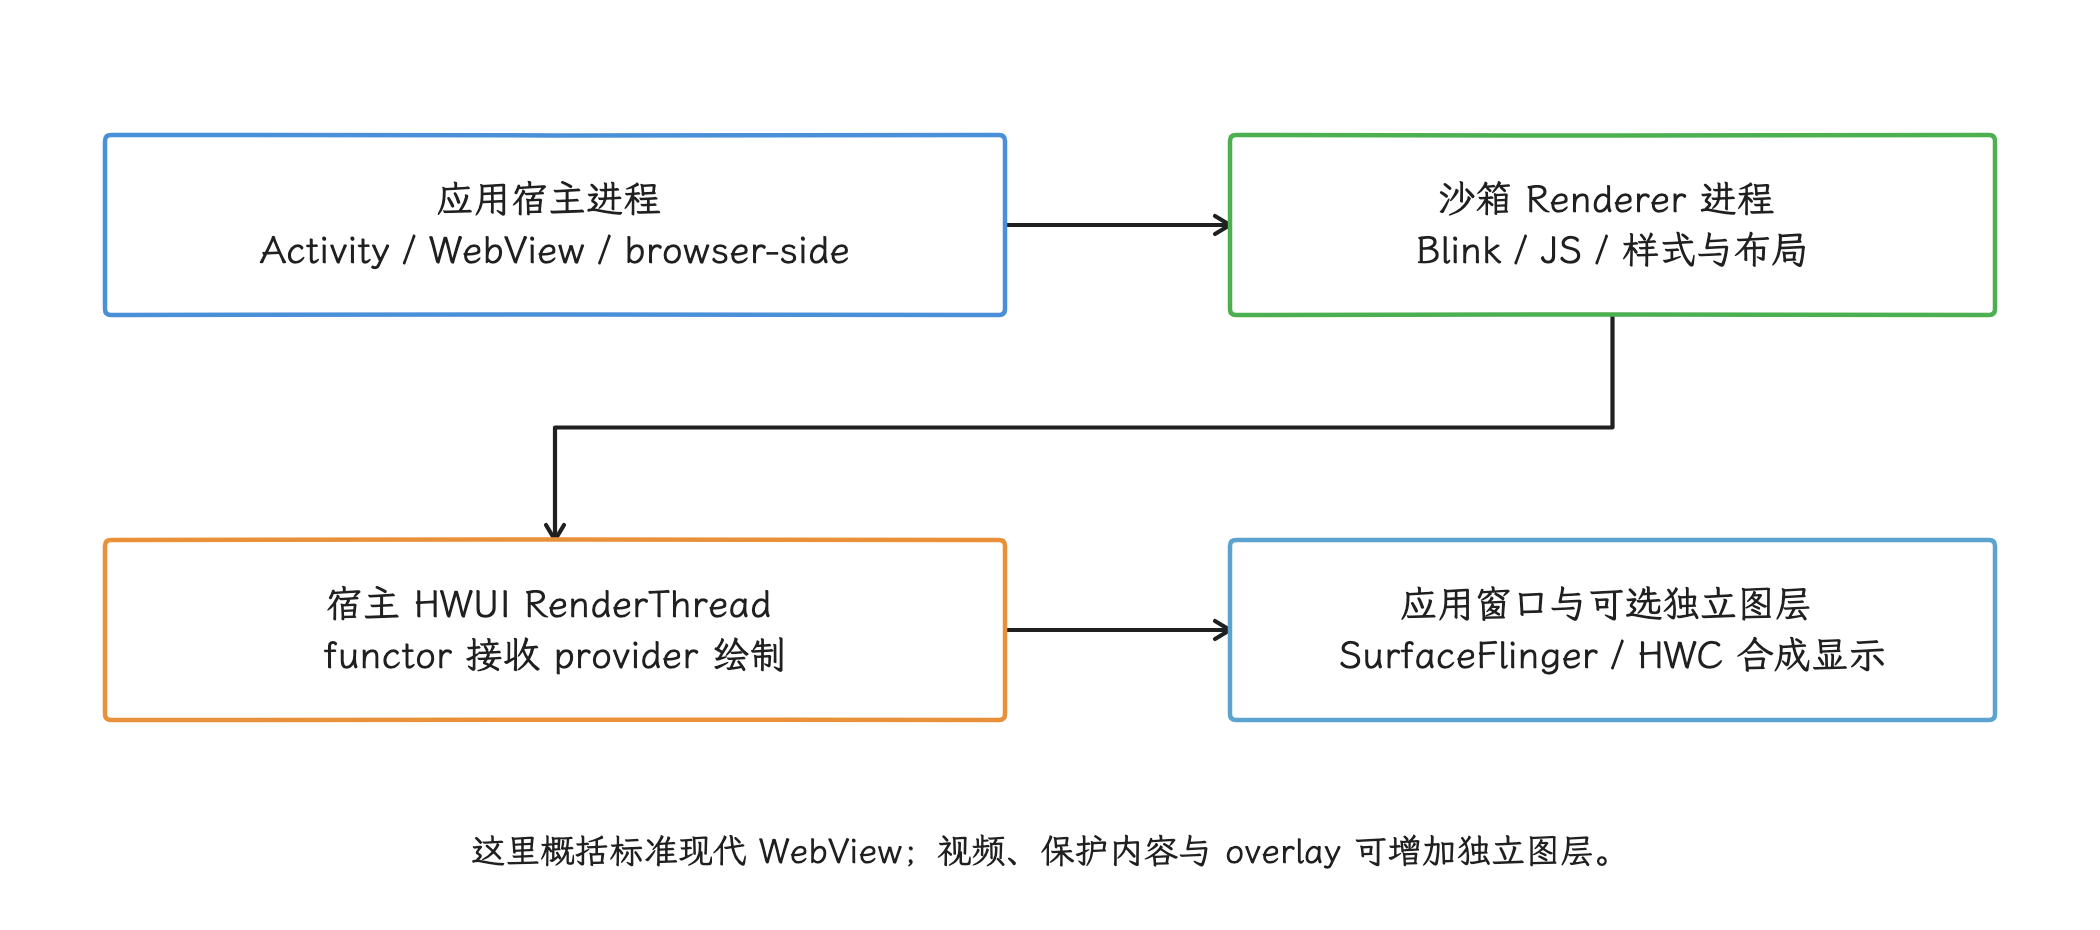
图:平台固定API契约,provider独立更新Chromium实现;宿主对象、沙箱页面和系统显示资源需分别取证。
onRenderProcessGone() 回调契约
Android 8 / API 26 起,WebViewClient.onRenderProcessGone(view, detail) 是 Renderer 退出后的公开入口。WebViewClient.java 给出四条硬约束:
- 多个 WebView 可能关联同一个 Renderer;
- 每个受影响的 WebView 都会收到回调;
- 当前回调只清理参数中的
view,其余实例是否退出,要看它们各自的回调; - 传入的 WebView 已经失效,必须从 View 层级移除并清理引用。
返回值决定宿主是否继续运行:
| 返回值 | Android 17 契约 | 工程含义 |
|---|---|---|
true | 应用声明已处理退出 | 当前旧实例已被移除、销毁,业务开始恢复或展示原生错误页 |
false | Renderer 崩溃时宿主随之崩溃;Renderer 被系统结束时宿主也被结束 | 应用没有能力安全处理,保留默认终止语义 |
默认实现返回 false。只有在清理动作已完成、后续代码不会再触碰旧实例时,才应返回 true。返回 true 却仍在访问旧对象,会把一次清晰的 Renderer 退出变成随机异常或长期白屏。
didCrash() 的二分类含义
RenderProcessGoneDetail.didCrash() 返回:
true:Renderer 被观察到发生崩溃;false:Renderer 被系统结束,AOSP 注释说明最常见背景是低内存。
要把 false 读成“页面 OOM”,先得排除两个干扰:应用在 API 29 及以上可能主动调用 WebViewRenderProcess.terminate();设备实现和系统资源管理也会影响进程寿命。另外,provider 更新通常会结束已经加载 WebView 的整个应用进程,这类进程重启要单独记录,别指望它一定留下 renderer-only 的 gone 事件。
若应用会主动终止 Renderer,应在调用前生成一条短时有效的“预期终止标记”(下文简称 termination token),至少包含会话、调用时间、有效期和关联的 WebView 实例。随后到达且命中这条标记的 gone 事件,才归为预期终止。未命中时,再结合设备内存档位、前后台状态、Renderer 优先级、系统内存压力和问题页面是否反复出现来判断。
rendererPriorityAtExit() 返回退出时的最终 Renderer 优先级。一个 Renderer 可被多个 WebView 共享;WebView.java 规定,最终优先级取所有关联实例请求值中的最高值,实例销毁后不再参与计算。RenderProcessGoneDetail.java 也提醒,退出值可能高于某个单独实例请求的值。这个字段适合描述现场;要反推是哪个 WebView 提高了优先级、解释它为何被回收,还得靠其他现场信息。
RenderProcessGoneDetail 里读不到 Renderer PID(进程号)、页面内存、JavaScript 堆、Native 代码调用栈或最近网络请求。公开 API 给不出精确的 Renderer 内存读数,宿主进程的 PSS 也替代不了它;PSS 的准确含义见“怎样判断内存诱因”一节。
恢复是一段状态迁移
可靠的容器应把 Renderer gone 处理成一组有先后顺序的状态。下面的大写名称可以直接作为容器内部的状态枚举:
ACTIVE
  -> GONE_CALLBACK
  -> DETACHED_AND_DESTROYED
  -> RECOVERY_UI
  -> NEW_WEBVIEW_LOADING
  -> VISUAL_COMMITTED
  -> BUSINESS_READY
任一步失败都进入原生错误页。VISUAL_COMMITTED 对应 onPageCommitVisible():旧导航的内容不会再被绘制,响应正文已经进入 DOM,后续绘制可以出现新页面内容,但 CSS、图片等资源此时可能尚未完成。支付、编辑、登录等页面还需要 H5(WebView 里运行的前端页面)主动发出可校验的 BUSINESS_READY,表示业务接口和关键交互已经可用;宿主还要为这次握手设置超时。
恢复前我们先回答三个问题:
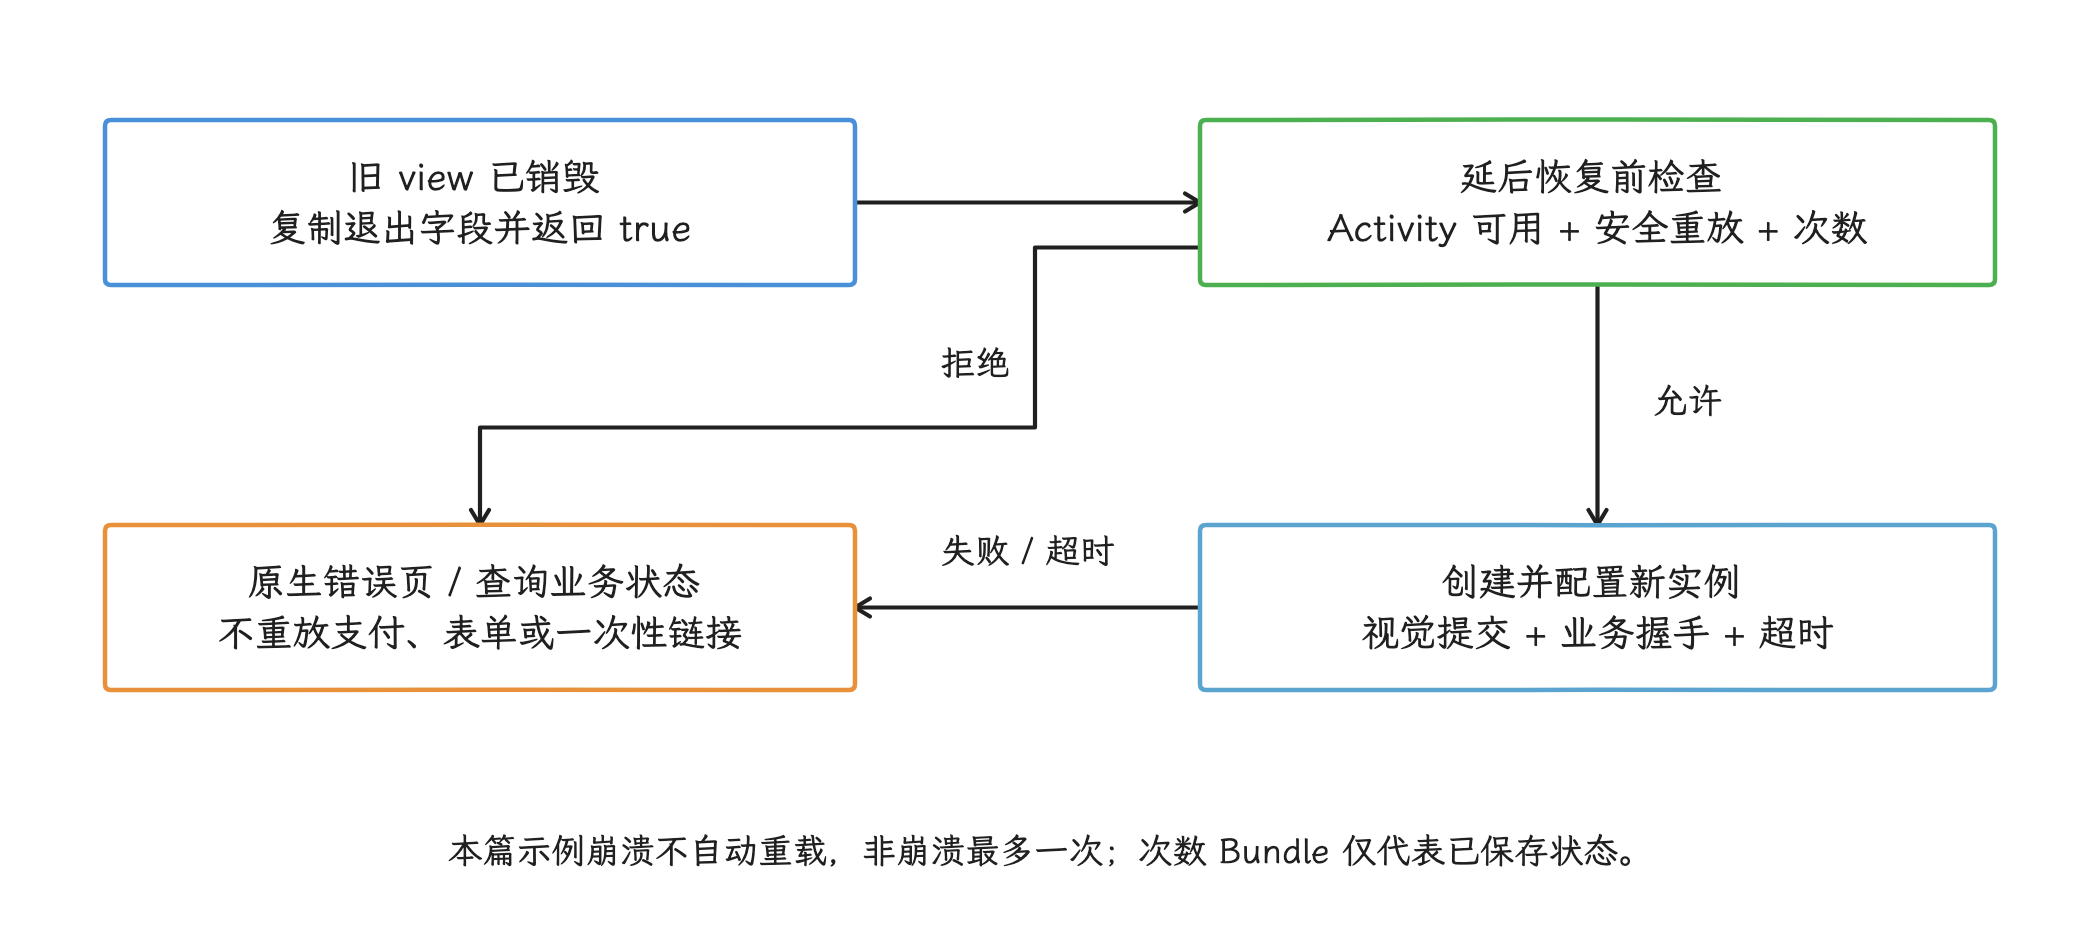
图:新实例沿统一安全配置加载去敏业务检查点;不可重放页查询服务端状态或进入原生错误页。
- 当前页面能否安全重放?
- 是否已有一次自动恢复尝试?
- Activity 是否仍处于可展示状态?
资讯详情、帮助页这类幂等页面(重复加载不改变业务结果)可以自动恢复。支付提交、表单编辑、身份验证和一次性 URL 则跳转到服务端状态查询或原生错误页,恢复检查点里保存的是去敏后的地址。原始 URL 可能含登录凭证、订单号和查询参数,上报时同样要按业务规则去掉敏感信息。
一个可控的 Activity 恢复骨架
下面的示例展示单 WebView Activity 的最小恢复状态。WebCheckpoint 是业务自定义的恢复检查点,只保存去敏后的安全重载地址、页面类型和是否允许自动重载。业务方法留作接口,重点是旧实例清理、延后重建、自动恢复次数上限和页面可用信号:
class H5Activity : AppCompatActivity() {
    private lateinit var container: ViewGroup
    private var webView: WebView? = null
    private var checkpoint: WebCheckpoint? = null
    private var autoRecoveryUsed = false

    override fun onCreate(savedInstanceState: Bundle?) {
        super.onCreate(savedInstanceState)
        setContentView(R.layout.h5_activity)
        container = findViewById(R.id.webview_container)

        checkpoint = restoreCheckpoint(savedInstanceState)
        autoRecoveryUsed =
            savedInstanceState?.getBoolean("auto_recovery_used") == true
        installWebView(checkpoint)
    }

    private fun installWebView(target: WebCheckpoint?) {
        check(webView == null)

        val next = WebView(this)
        configureWebView(next)
        next.webViewClient = object : WebViewClient() {
            override fun onPageStarted(
                view: WebView,
                url: String,
                favicon: Bitmap?,
            ) {
                if (view === webView) {
                    checkpoint = checkpointFor(url)
                }
            }

            override fun onPageCommitVisible(view: WebView, url: String) {
                if (view === webView) {
                    reportVisualCommit(checkpoint)
                }
            }

            override fun onRenderProcessGone(
                view: WebView,
                detail: RenderProcessGoneDetail,
            ): Boolean {
                val targetAtExit = checkpoint
                val didCrash = detail.didCrash()
                val priorityAtExit = detail.rendererPriorityAtExit()

                detachAndDestroy(view)
                reportRendererGoneSafely(
                    didCrash = didCrash,
                    priorityAtExit = priorityAtExit,
                    target = targetAtExit,
                )
                showRecoveringUi()

                container.post {
                    if (!isFinishing && !isDestroyed) {
                        recoverAfterRendererExit(targetAtExit, didCrash)
                    }
                }
                return true
            }
        }

        webView = next
        container.addView(
            next,
            ViewGroup.LayoutParams.MATCH_PARENT,
            ViewGroup.LayoutParams.MATCH_PARENT,
        )

        if (target == null) {
            next.loadUrl(homeUrl())
        } else {
            next.loadUrl(target.safeReloadUrl)
        }
    }

    private fun detachAndDestroy(target: WebView) {
        (target.parent as? ViewGroup)?.removeView(target)
        if (webView === target) {
            webView = null
        }
        target.destroy()
    }

    private fun recoverAfterRendererExit(
        target: WebCheckpoint?,
        didCrash: Boolean,
    ) {
        val mayAutoReload =
            !didCrash &&
                !autoRecoveryUsed &&
                target?.autoReloadAllowed == true

        if (mayAutoReload) {
            autoRecoveryUsed = true
            installWebView(target)
        } else {
            showFallbackPage(target)
        }
    }

    override fun onSaveInstanceState(outState: Bundle) {
        saveCheckpoint(outState, checkpoint)
        outState.putBoolean("auto_recovery_used", autoRecoveryUsed)
        super.onSaveInstanceState(outState)
    }

    override fun onDestroy() {
        webView?.let(::detachAndDestroy)
        super.onDestroy()
    }
}
旧实例按官方要求从视图树移除、清除引用并调用 destroy(),之后不再设置 client、停止加载或执行 JavaScript。代码先把 RenderProcessGoneDetail 中需要的字段复制成普通值,避免延后任务继续持有回调对象;事件上报函数也必须自行处理异常,别让异常从回调里抛出去。
重建通过 container.post 放入主线程消息队列,等回调返回后再执行,避免尚未退出回调又开始创建 WebView。任务执行前还会检查 Activity 是否正在结束或已经销毁。自动恢复次数写入 savedInstanceState(Activity 重建时由系统传回的状态 Bundle),可保留最近一次已保存的次数。Bundle 只是保存时刻的快照,保存之后发生的恢复尝试或未及保存的进程退出仍可能丢失;若要求会话级严格次数上限,还需要独立且可恢复的业务状态。
示例对崩溃采取保守策略:同一页面可能稳定复现 Chromium 或页面内容触发的问题,所以崩溃后不自动重载;被系统结束的页面也只有一次自动恢复机会。WebCheckpoint 保存去敏后的业务路由和重放规则,完整浏览历史、POST 数据和 JavaScript 运行时状态都留在恢复范围之外。
configureWebView() 要统一安全与功能配置,包括允许访问的 origin(协议、主机与端口)、Safe Browsing、Cookie 策略、文件访问、混合内容、WebChromeClient 和 JS Bridge(JavaScript 与原生代码之间的通信接口)。只有可信页面需要的 Bridge 才能重新注册。若每个业务页面都直接创建 WebView,恢复出的实例很容易漏掉安全配置。
多 WebView 容器
共享 Renderer 时,同一次退出会触发多个回调。每个回调只销毁参数中的 view 并返回 true;容器管理器再按页面栈决定统一展示错误页,还是等所有实例完成清理。第一个回调到达时,其余 WebView 未必已失效;后台、缓存池和 ViewHolder 里的实例也要逐个走到。
引用清理至少覆盖:
- Activity、Fragment 与自定义 View 字段;
- Adapter、ViewHolder 和页面栈;
- WebView 缓存池;
- JS Bridge、ValueCallback、下载与文件选择回调;
- 延迟 Runnable、协程和业务观察者。
回调完成后仍持有旧 WebView 的任务要被取消。另一种做法是给每次新建的实例分配递增代号,任务执行前比对代号,不匹配就放弃,避免旧任务操作新实例。
Renderer 优先级与低内存策略
WebView.setRendererPriorityPolicy(priority, waivedWhenNotVisible) 只影响多进程模式下 Renderer 在系统内存不足时被选为回收对象的可能性,它最多能用多少内存与此无关。优先级共三个级别:
| 级别 | 含义 |
|---|---|
RENDERER_PRIORITY_IMPORTANT | 默认值,Renderer 绑定优先级与宿主主进程相近 |
RENDERER_PRIORITY_BOUND | 中等,内存紧张时更容易成为回收目标 |
RENDERER_PRIORITY_WAIVED | 最低,系统低内存时会更积极回收 |
下面的设置请求可见时使用 BOUND,不可见时按 WAIVED 处理:
webView.setRendererPriorityPolicy(
    WebView.RENDERER_PRIORITY_BOUND,
    true,
)
降低优先级只是让系统在内存紧张时更容易选中 Renderer,页面内存并不会因此立即释放。只有当容器能处理全部关联 WebView 的 onRenderProcessGone()、能识别不可重放页面、也允许后台页面重建时,才适合调整这项策略;可见交易页通常别只为节省内存去降优先级。
多个 WebView 共享 Renderer 时,最终优先级取关联实例请求值的最大值;销毁某个 WebView 后,它不再参与计算。只修改一个后台实例,未必改变共享 Renderer 的最终优先级。
怎样判断内存诱因
判断内存诱因之前,我们先看 WebView 页面的资源分布在哪几个域:
- Renderer:DOM(页面的文档对象树)、JavaScript 堆、Blink 对象、已解码图片和部分光栅化资源;
- 宿主/provider:导航与网络等 browser-side 状态、Bridge、缓存与 WebView 对象;
- GPU/图形:纹理、分块渲染数据、图形缓冲区与驱动分配;
- 系统:其他进程的竞争、zram 压缩交换空间、内存回收活动和设备内存档位。
宿主 Java 堆正常,Renderer 或图形内存仍可能有压力;反过来,Renderer 被系统结束,也定不到某个 JavaScript 对象泄漏上。
一次有效的 gone 事件至少记录:
| 维度 | 字段 |
|---|---|
| 页面 | 去敏后的业务路由、H5 构建版本、页面类型、停留时长、是否允许重复加载 |
| 容器 | WebView 数量、是否来自缓存池、可见性、自动恢复次数 |
| 退出 | didCrash、rendererPriorityAtExit、预期 termination token 是否命中 |
| Provider | 包名、versionName、versionCode、系统 WebView / 定制 Chromium / 第三方内核 |
| 宿主 | 进程前后台、PSS/RSS、最近 onTrimMemory()、进程存活时长 |
| 设备 | Android build、API、ABI、内存档位、设备型号 |
| 恢复 | 销毁完成、新实例创建、视觉提交、H5 就绪、进入原生错误页的原因 |
PSS 把共享内存按比例计入进程,适合估算进程对物理内存的贡献;RSS 会把当前驻留的共享页全部计入,跨进程相加可能重复。这里记录二者只是为了补充宿主现场,别把它们当成 Renderer 的内存值。
在 Android 8 及以上,WebView.getCurrentWebViewPackage() 可在 WebView 加载前后调用。已经加载时,它返回当前进程实际使用的 provider;尚未加载时,它返回“此刻加载将会使用”的 provider,这个结果随后可能过期。设备不支持 WebView 或配置异常时,返回值也可能为 null。AndroidX WebKit 环境可使用对应的兼容 API。
provider versionName 常能帮助定位 Chromium 版本,但厂商格式不统一;从版本号解析 milestone(Chromium 主版本号,如 M140)只对特定 provider 成立。
实验室里我们可以用 Perfetto(系统跟踪工具)、bugreport(系统诊断包)、Chrome DevTools(网页调试工具)和 provider 对应的 Chromium 符号文件调查 Renderer、GPU 与系统内存压力;符号文件负责把原生地址还原成函数名和调用栈。
查看内核侧记录时,reclaim 对应内存回收活动,PSI(内存压力停顿指标)memory 对应任务因内存压力停顿的时间比例,page fault 对应缺页事件,dma-buf 常用来追踪跨进程共享的图形缓冲区;zram 的含义见上文。
线上公开 API 通常拿不到 Renderer 的精确 PSS,不要依赖反射、读取其他进程 /proc 或私有 Chromium 接口。
ApplicationExitInfo 记录的是应用进程的退出信息,适合补充宿主进程为何结束。Renderer 被回收而宿主继续运行时,未必有应用可查询的对应记录;它替代不了 onRenderProcessGone() 事件,在没有时间和进程依据时,也别与某次 Renderer gone 强行一一配对。
WebViewRenderProcessClient 的卡死检测与终止决策
Android 10 / API 29 起,WebViewRenderProcessClient 提供:
onRenderProcessUnresponsive():Renderer 因长阻塞任务等原因,迟迟未能处理输入或导航;onRenderProcessResponsive():同一 Renderer 恢复响应后回调一次。
源码说明,无响应期间会重复回调,相邻回调最短间隔 5 秒;WebView 自己不会采取动作。一次 unresponsive 回调的含义,就是 Renderer 没有及时处理输入或导航;要判断应用是否已经 ANR、这个 Renderer 是否值得结束,我们还要结合持续时间、页面阶段、用户是否可退出,以及 H5(运行在 WebView 中的 Web 前端页面) 是否正在执行预期的耗时任务。
当产品允许用户放弃当前页面,且所有共享 WebView 都已实现终止处理时,才考虑调用 renderer?.terminate()。调用前要:
- 写入前文定义的短时 termination token;
- 切断新的 JS 注入和导航;
- 展示不会依赖旧 WebView 的原生 UI;
- 限制一次会话中的终止次数;
- 等待随后的
onRenderProcessGone()完成清理。
WebViewRenderProcess 是不透明句柄:调用方可以请求终止,但拿不到稳定的 PID 这类实现细节。回调参数在单进程模式下还可能为 null。terminate() 返回 true 只表示当前可以终止这个 Renderer,返回 false 表示终止不了;返回值既说明不了 gone 回调已经到达,更说明不了新页面已经恢复。
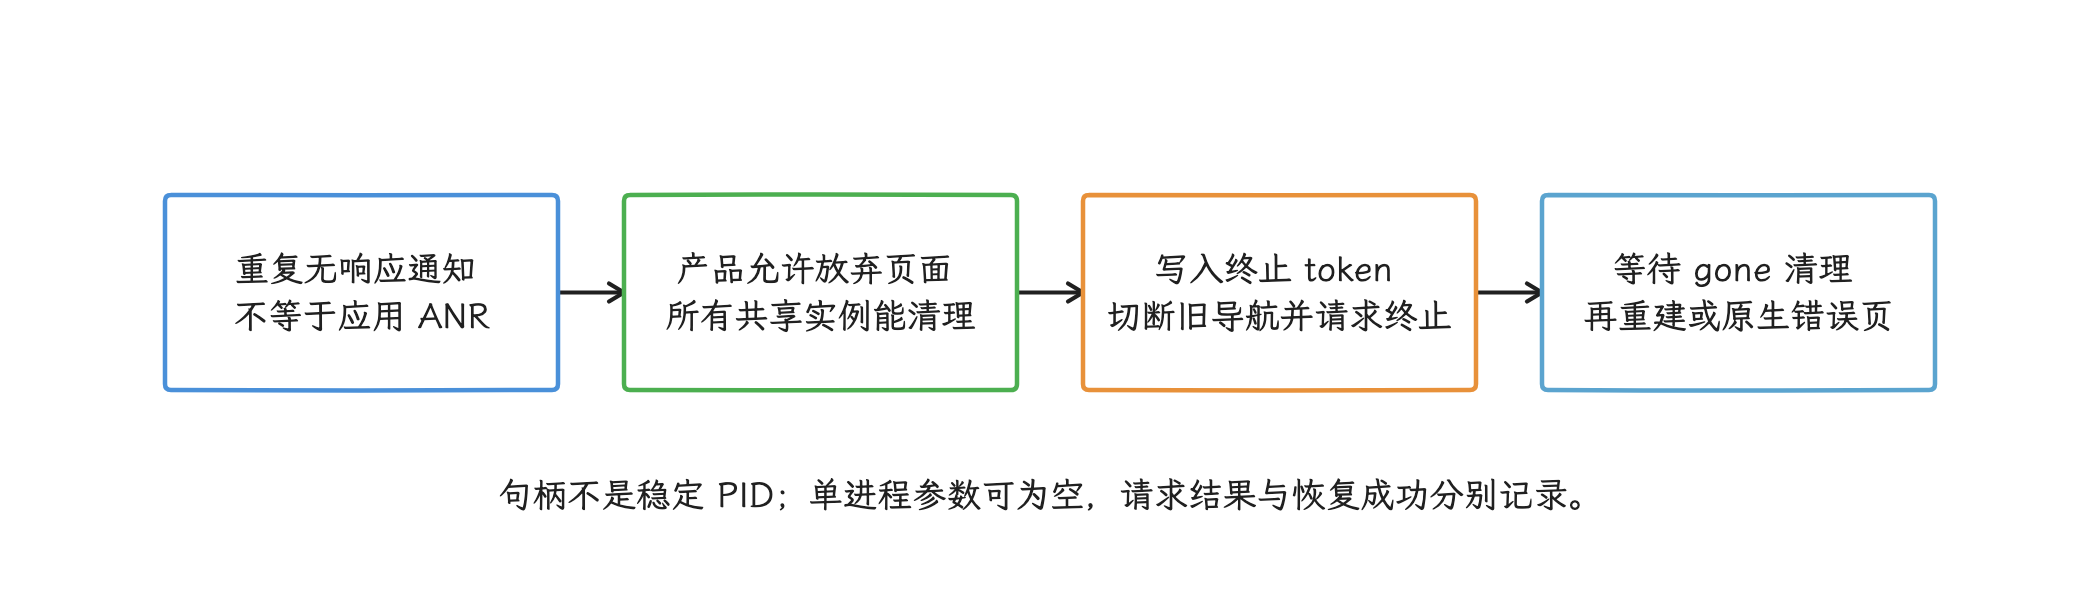
图:API29+回调描述Renderer输入或导航处理迟缓;terminate返回true不表示gone已经到达或页面恢复。
恢复过程的状态指标
应用崩溃率看不见那些已返回 true 的 Renderer gone,所以我们要按状态记录一次恢复过程:
| 状态 | 判定 |
|---|---|
gone_received | 回调到达,按崩溃、系统结束、预期终止分类 |
old_view_destroyed | 参数 View 已移除、引用已释放并调用 destroy() |
new_view_created | 尚未达到自动恢复次数上限,且新实例已加入容器 |
visual_committed | 新实例收到 onPageCommitVisible() |
business_ready | H5 业务握手完成,关键接口可用 |
fallback_shown | 进入原生错误页,并记录原因 |
repeat_gone | 同一会话或短窗口内再次退出 |
核心指标必须有分母:
- Renderer gone 用户率、会话率和页面访问率;
- 崩溃、系统结束、预期终止的占比;
- 从 gone 到视觉提交、业务就绪的成功率和耗时分布;
- 自动恢复后的 repeat gone 率;
- 不可重放页面进入原生错误页的比例与业务完成率;
- 按 provider 版本、业务路由、设备内存档位和前后台状态分组后的差异。
“新 WebView 已创建”离恢复成功还有距离,onPageFinished() 也保证不了用户已经看到可操作内容。更接近用户体验的是视觉提交加业务握手:两者都要设超时,并比对前文所说的实例代号,防止旧回调把新实例误报为成功。不过这个组合仍是应用侧的间接信号;某一帧是否已由 SurfaceFlinger 提交到屏幕,要逐帧诊断才能确认,那时我们再看宿主窗口的 FrameTimeline(帧的渲染时间线)和实际显示时间。
分批启用、紧急停用和自动恢复次数
远程配置应位于容器层,常用控制项包括:
- 是否允许 killed 场景自动恢复;
- 哪些业务路由只展示原生错误页;
- 每个会话的自动恢复次数;
- 是否启用 WebView 缓存池;
- 后台 WebView 是否请求较低 Renderer 优先级;
- 哪些 provider 版本暂停自动重载。
远程开关要赶在 WebView 退出前拿到:配置在进入 H5 容器前缓存,并为离线状态准备保守默认值。
自动重载或后台降优先级应先对少量设备和用户启用,观察 gone 率、重复退出率和业务完成率后再扩大范围。异常上升时,远程配置应能立即停用对应策略。
若某个 provider 版本集中发生 Renderer 崩溃,应立即停用同一页面的自动重载,并保留 provider、H5 构建版本和去敏后的业务路由。provider 是独立更新组件,同一 Android 版本可能出现不同结果;统计时必须单独按 provider 版本分组。
故障演练
设计演练用例时,我们要覆盖不同退出方式,以及回调与 Activity 生命周期同时变化时可能出现的先后顺序问题:
| 用例 | 需要确认 |
|---|---|
chrome://crash | 崩溃被识别,所有共享实例清理,宿主不退出 |
WebViewRenderProcess.terminate() | 预期 token 命中,gone 回调完成,终止次数受限 |
| 内存压力下 Renderer 被回收 | 系统结束分支、后台延迟恢复、前台重建策略 |
| 两个 WebView 共享 Renderer | 每个受影响实例都返回 true,没有漏清理 |
| 回调后 Activity 立即销毁 | container.post 排队的恢复任务不会创建泄漏实例 |
| 敏感页面退出 | 不重放 POST、一次性 URL 或未确认交易 |
| 新页面再次 gone | 自动恢复次数上限生效并进入原生错误页 |
| provider 更新或切换 | 进程重启后记录的新版本正确 |
chrome://crash 只能放在调试或测试工具中,并且可能影响共享 Renderer 的多个 WebView。它验证的是崩溃处理,覆盖不了低内存回收。内存压力测试要在可控设备上结合 Perfetto 或 bugreport 确认系统背景;一次手工白屏,证明不了 OOM。
API 26 以下没有 onRenderProcessGone()。若产品仍支持更低版本,需要单独定义进程级隔离、原生错误页和 provider 升级策略;不要把 API 26 的恢复契约套到旧系统。
常见误判
| 误判 | 更严谨的结论 |
|---|---|
| 白屏就是 Renderer OOM | 只有 gone 回调能确认 Renderer 已退出;网络、HTTP、SSL、页面脚本和绘制停滞也会白屏 |
didCrash=false 就是页面 OOM | 它表示 Renderer 并非因崩溃退出;还要排除应用主动终止,并补系统内存压力证据 |
返回 true 就完成恢复 | 旧实例清理、新实例重建、视觉提交和业务就绪都要验证 |
在旧实例上 reload() 能救回页面 | gone 后旧 WebView 不可复用,只能移除、销毁和新建 |
| 恢复时原样加载完整 URL | URL 可能敏感或不可重放,应使用去敏后的业务恢复检查点 |
| 一个 WebView 收到回调就能批量销毁 | 当前回调只处理参数实例,共享 Renderer 会逐个通知 |
| 宿主 PSS 就是 Renderer 内存 | 两者属于不同进程/执行域,公开 API 没有精确 Renderer PSS |
| Android 17 决定 Chromium 行为 | 还要记录设备 provider 包版本与对应的 Chromium 源码版本 |
| Renderer 准备好一帧就代表恢复可用 | 还需确认宿主能够绘制、收到视觉提交回调并完成业务握手 |
Renderer 恢复小结
Renderer gone 的恢复原则可以压缩成五句话:
- Android 17 固定 framework 契约,设备 provider 版本用于定位具体 Chromium 实现;
- 回调中的旧 WebView 只能移除、销毁和清引用;
- 每个受影响实例都要处理到,共享 Renderer 的实例要逐个确认;
- 自动恢复必须受页面可否重复加载、Activity 状态和次数上限约束;
- 视觉提交与业务就绪都成功,才能计为用户已恢复。
把 gone 事件、旧实例清理、新实例状态和 provider 版本放在同一条事件记录中,才能区分系统回收、Renderer 崩溃、主动终止和恢复代码自身的缺陷。
源码与官方资料
- Android 17
WebViewClient.java - Android 17
RenderProcessGoneDetail.java - Android 17
WebView.java - Android 17
WebViewRenderProcessClient.java - Android 17
WebViewRenderProcess.java - Android 17 HWUI
WebViewFunctor.h - Android 17
WebViewFunctorManager.cpp - Android Developers:处理 WebView Renderer 终止
- Android Developers:管理 WebView 对象
- Android Developers:
WebViewClientAPI - Android Developers:
WebViewAPI - Chromium WebView architecture
- AndroidX WebKit
WebViewCompat ApplicationExitInfoActivityManager.getHistoricalProcessExitReasons()- Android 17 kernel
mm/vmscan.c
小结
OOM 治理先把 Java Heap、Native Heap、线程、FD、虚拟地址空间和 LMK 这几类失败分开,在资源趋势接近预算时就由明确的 owner 降级或释放;等到 OOME 已经发生再做高开销抢救,成功率有限。WebView Renderer 退出则是另一个进程的问题:宿主销毁旧 WebView、受控重建,并用视觉与业务就绪共同验证恢复。
参考资料
- Android Developers:Prioritizing memory efficiency for Android 17
- Android Developers:ComponentCallbacks2
- Android Developers:ProfilingTrigger.TRIGGER_TYPE_OOM
- Android Developers:ApplicationExitInfo
- Android Developers:ActivityManager
- Android Developers:Record native allocations
- Android Developers:Managing Bitmap Memory
- Android Developers:Memory allocation among processes
- Android Developers:
<application>/android:largeHeap - AOSP Android 17:ART Heap
- AOSP Android 17:ART Heap declarations
- AOSP Android 17:ART Heap inline allocation
- AOSP Android 17:ART Thread
- AOSP Android 17:Unsafe native allocation
- AOSP Android 17:HWUI Bitmap allocation
- AOSP Android 17:Bitmap JNI
- AOSP Android 17:ActivityThread largeHeap handling
- AOSP Android 17:Bionic pthread creation
- AOSP Android 17:Bionic malloc controls
- AOSP Kernel
android17-6.18-2026-06_r6:FD allocation - AOSP Kernel
android17-6.18-2026-06_r6:Process/thread creation - AOSP Kernel
android17-6.18-2026-06_r6:Memory mapping