性能指标体系与线上监控
我们先把指标本身定义清楚——量什么对象、从哪到哪、用什么单位、分母是谁、窗口多长——然后才谈线上采集。采集系统同样要回答一组工程问题:采样怎么定、设备怎么分层、版本怎么归因、隐私怎么处理、告警怎么压过噪声。
指标定义、分位数与场景基线
一个数字要能跟另一个数字比较,前提是两个指标的定义对得上。这一节先把量什么对象、怎么算、跟谁比定下来,再谈分位数与场景基线。
指标合同
“启动耗时”“掉帧率”“OOM(Out of Memory,内存分配失败) 率”都只是名字;名字相同、定义不同,两块看板上的数字可能根本是两回事。团队要拿到可比较的数据,就得把事件、分母、统计窗口和排除条件一并定义。
每个长期指标至少包含以下字段:
| 字段 | 需要写清楚的内容 |
|---|---|
| 用户场景 | 哪个 CUJ(Critical User Journey,关键用户旅程)、页面或业务动作 |
| 起点/终点 | 由哪个事件或时间戳定义 |
| 观测单位 | frame(单帧)、launch(一次启动)、operation(一次业务操作)、session(一次使用会话)、user-device-day(同一用户在同一设备上的一个活跃日)等 |
| 数值单位 | ns(纳秒)、ms(毫秒)、byte(字节)、uWs(微瓦秒)、次数或比例 |
| 分子/分母 | 哪些事件进入计算,哪些事件被排除 |
| 统计窗口 | 单次运行、小时、天、发布周期或 28 天 |
| 聚合方法 | count(计数)、sum(总和)、mean(均值)、P50/P90/P99(分位数)、比例、直方图或 sketch(可合并的近似分布摘要) |
| 维度 | App/Android 版本、设备、刷新率、场景、启动类型、网络等 |
| 采样方法 | 采样概率、稳定抽样键、丢弃规则和权重 |
| 数据源版本 | Android、SDK、Benchmark/Perfetto、schema(字段结构)与采集配置 |
| 负责人 | 谁解释异常、谁维护埋点、谁批准口径变化 |
这里的“合同”指一份可审查、可复现的指标定义。合同一旦改变,我们就新建 schema/version(字段结构及口径版本) 版本,让新旧两套定义分开累计,避免拼进同一条趋势线。
指标的四种职责
| 类型 | 用途 | 示例 |
|---|---|---|
| 用户结果指标 | 描述用户是否顺利完成操作 | TTFD、click-to-display、播放首帧、搜索结果可见时间 |
| 健康指标 | 观察线上影响范围 | user-perceived ANR/crash、slow startup、excessive wake lock |
| 门禁指标 | 判断候选版本是否允许发布 | 固定 CUJ 的 Macrobenchmark 分布、内存峰值、功耗区间 |
| 诊断指标 | 解释为何回退 | thread state、frame overrun、Binder latency、RSS/heap、energy consumer |
先看用户结果指标:TTFD(Time to Full Display)由 App 报告主要内容完成,click-to-display 量的是从选定点击边界到选定显示边界的延迟。是否可交互还要写成可验证的业务条件。健康指标里的 user-perceived 是具体平台算法的分类,不是所有故障的同义词;ANR、slow startup 和 excessive wake lock 分别有自己的事件与分母。
门禁指标用的 Macrobenchmark(跨进程测量完整用户流程的 Jetpack 基准测试库) 在真实设备上跑完整用户流程,产出用于发布判断的分布。诊断指标负责解释为什么回退,保留 thread state(线程运行或等待状态)、frame overrun(帧超出时限的时间)、Binder(Android 跨进程调用机制) latency(跨进程调用延迟)、RSS/heap(进程驻留内存/堆内存) 和 energy consumer(逻辑耗能单元) 这类归因线索——线程当时处于什么状态、一次跨进程调用延迟多少、内存落在哪、耗能算到哪个单元。
同一数值可以承担不同职责,但合同通常不同。Play 的 bad-behavior threshold(平台定义的不良行为阈值) 是平台画的一条外部健康线;App 团队仍要另定更严、更贴合自身用户场景的发布目标。
流畅性指标
FPS(Frames Per Second,每秒帧数)
FPS 表示单位时间内实际呈现或生成的帧数。我们定义这个指标时,先注明量的是哪一层:
- App 生产帧;
- SurfaceFlinger(负责合成图层并把画面送往显示设备的系统服务) 呈现帧;
- 游戏 session 的实际 frame rate;
- 采样窗口内的平均值。
高 FPS 说明这段时间产出帧多;每一帧稳不稳,要另看分布:少量长帧会被较长窗口的平均值稀释,静止页面主动少出帧也可能是正确的节能行为。所以我们把 FPS 留给持续动画和游戏吞吐;普通 UI 的回归,更适合结合 frame deadline(平台分配给该帧的完成时限)、jank 比例(错过显示节奏的卡顿帧占比)和场景状态一起看。
Android Vitals 的 slow/frozen rendering
当前 Android Vitals 对使用 View/Canvas UI Toolkit(Android 传统 View/Canvas 界面渲染体系) 的应用记录:
- slow frame:官方当前页面定义为渲染时间超过 16 ms;
- frozen frame:渲染时间超过 700 ms。
这组数字是 Play 的报表阈值,逐帧判断要看目标设备自己的实时 deadline。冻结帧属于极慢的渲染现象,两类计数合并前要先去重。统计范围限于该 View/Canvas 渲染体系;Vulkan、Unity、Unreal、OpenGL 等自绘主画面落在范围之外,游戏另看 Slow Sessions。
16 ms 同样是这组报表定义里的数字;90 Hz、120 Hz 与可变刷新率设备要判断有没有错过平台预测的帧窗口,应结合 FrameTimeline 或 frame overrun,并核对目标 Layer、token、prediction 与实际完成范围。
FrameMetrics
FrameMetrics 从 API 24 起提供窗口帧耗时。TOTAL_DURATION 在 API 24 可用,GPU_DURATION 与 DEADLINE 在 API 31 加入;FRAME_TIMELINE_VSYNC_ID 要按字段自己的 API/flag 逐个核对,当成 API 24 字段用会出错。源码把 TOTAL_DURATION < DEADLINE 作为 App 命中 intended deadline(预定完成时限)的条件,判的是 App 这一侧;SurfaceFlinger、HWC 或面板是否按时完成,要另外核对。
使用 Window.OnFrameMetricsAvailableListener 时,我们要跟着记录:
dropCountSinceLastInvocation,也就是两次监听回调之间丢掉的样本数;不记录它会掩盖回调拥塞造成的选择性丢帧;- first draw(窗口第一次绘制)与普通交互帧的区分;
- 页面/CUJ 与刷新率;
- API level,因为部分字段在较新版本才存在;
- 指标对应哪个
Window;SurfaceView、独立渲染 surface(独立的图形缓冲区目标) 或游戏引擎的输出需另核对。
TOTAL_DURATION - DEADLINE 可表达窗口预算的带符号超出量:正数超出、负数尚有余量,严格按前述规则时 0 也不算命中。前提是字段有效;缺失、无效值或字段不可用要按无效样本处理,补成 0 会改变命中统计。
Macrobenchmark FrameTimingMetric
下面按固定 Macrobenchmark 1.4.1 的 FrameTimingMetric 实现解释字段;当前官方 API 页仅作对照。1.4.1 不是当前稳定版,升级后应重新核对查询和匹配规则:
frameOverrunMs:API 31+ 可用;正值表示错过 deadline,负值表示仍有余量;frameDurationCpuMs:固定 1.4.1 查询为匹配的 RenderThread slice 结束减去 UIdoFrameslice 开始,是跨 UI/RT 生产路径的经过时间,可能包含等待;它不是两线程 Running 区间之和,也不是线程 CPU 计时器;frameCount:满足该版本查询与帧匹配条件的帧数;窗口内全部实际呈现帧的计数要另外做。
官方文档建议在可用时优先用 frameOverrunMs 检测回归,因为它更适合高刷和可变刷新率。frameCount 也要一起观察:移除大量无意义的轻量帧后,剩余帧的分位数可能变差,但总工作量和功耗已经改善。
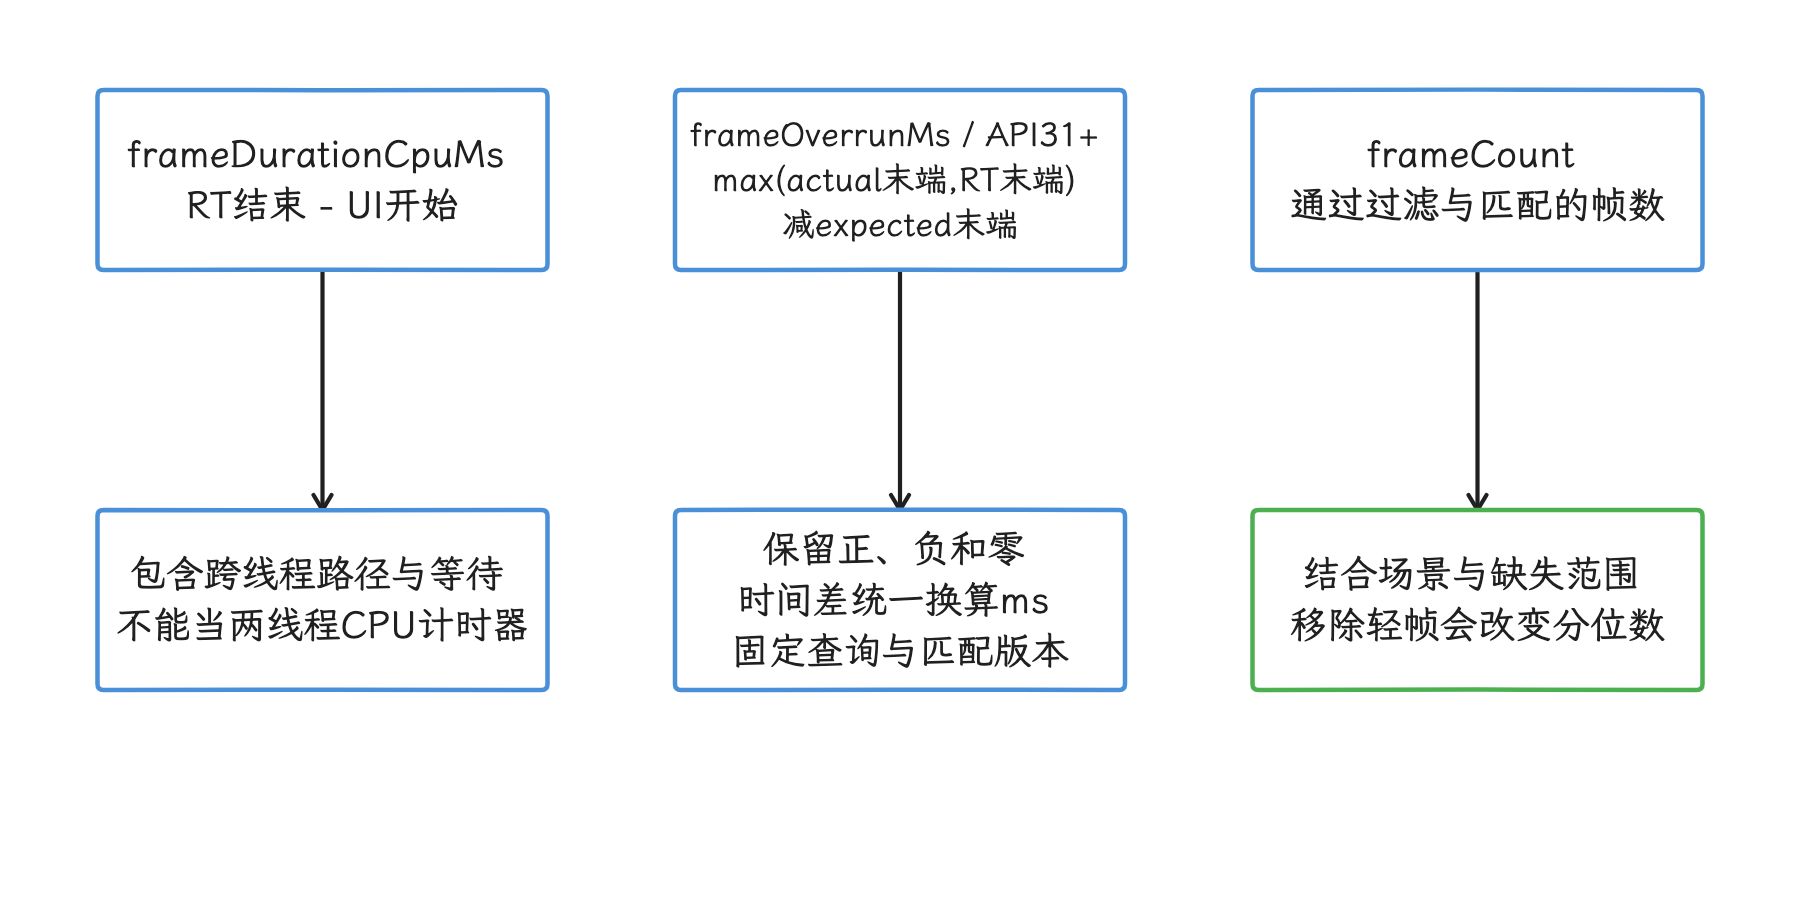
图:固定1.4.1用UI/RT匹配区间计算生产时间,并结合expected/actual判断overrun。 frameDurationCpuMs是经过时间,不是sched Running之和;frameCount只计通过该版匹配条件的帧。
Frame Time 分位数与 jank rate
P50、P90、P99 分别表示 50%、90%、99% 的样本不高于该值,P50 即中位数。用分位数之前,我们先确认样本来自同一份合同:
- 同一 CUJ 与页面状态;
- 相同刷新率或按刷新率分桶,也就是分组后分别统计;
- 相同 App/Android 版本和设备档位;
- 相同 first draw、动画、滚动或静止帧类型;
- 相同丢帧与采样规则。
“P99 高”说明的是尾部分布拉长了;要定位根因,我们还得回到样本本身。高分位需要足够样本支撑,样本很少时直接保留全部观测值反而更诚实。
jank rate 的分子必须写清楚:可以是 frameOverrunMs > 0 的帧数、JankStats 按帧时序和界面状态启发式判定(根据可用信号推断)的帧数、FrameTimeline 里某一组 jank type(平台标注的卡顿原因类型),也可以是业务自定阈值。分子不同的几个“卡顿率”,名称也要分开。
响应速度指标
TTID(Time to Initial Display,首次画面显示时间)
TTID 量的是从系统收到启动请求到 App 第一帧显示的时间。
Cold 启动从头创建进程和 Activity;Warm 启动只走 Cold 启动的一部分,可能复用进程并重建 Activity,也可能借助 saved instance state(已保存的界面状态)重建进程和 Activity;Hot 启动把仍驻留内存的 Activity 带回前台,内存被回收后也可能重建少量对象。所以 TTID 的起点要按启动类型写清楚,一律写成“进程创建到首帧”会出错。
Android Framework 自动报告 TTID。Play 当前使用 TTID 判断 slow startup,并按启动类型区分:
| Play slow startup 口径(核对日期:2026-10-26) | TTID |
|---|---|
| Cold | ≥ 5 s |
| Warm | ≥ 2 s |
| Hot | ≥ 1.5 s |
这些值用于解释 Play Console。项目内部预算应更严格,并绑定设备档位、构建、编译模式和分位数。
TTFD
TTFD 覆盖 TTID 以及首帧之后异步加载的主要内容,终点由 App 调用 reportFullyDrawn() 标记;App 不调用这个 API,就没有可用的 TTFD。
标记位置应对应“主要内容完成且用户可交互”的业务状态。调用过早会把空壳页面记作完成;调用过晚会把非首屏工作混入启动。埋点评审应把 fully drawn 条件写进合同,并在 UI/导航改版后复核。
TTID 与 TTFD 要分开看:TTID 适合观察系统启动、Application/Activity 创建和首帧,TTFD 则能覆盖首帧之后的首屏数据、图片与业务准备。
Click-to-Display
Click-to-display(点击到画面可见的延迟) 是自定义的端到端指标,两端都必须写明:
- 起点可选 input reader(系统从触摸设备读取输入)、input dispatch(系统把输入分发给目标窗口)、App 收到事件或业务点击回调;
- 终点可选 App 提交帧、SurfaceFlinger(负责图层合成与呈现的系统服务) present(系统实际呈现该帧) 或外部光学传感器检测到屏幕变化;
软件 Trace 通常盖不住触控控制器之前和面板 scanout(逐行扫描点亮像素)之后的物理延迟。跨版本比较时应固定起止层级:“点击回调到 App 提交帧”和“手指接触到屏幕发光”是两项指标。没有公开依据时,我们不为它写统一的 100 ms/200 ms 阈值。
稳定性指标
Android Vitals 的分母
Play Console 的 ANR/crash rate 按 daily active users(每日活跃用户) 归一化:一个单位表示某一天在某台设备上使用 App 的独立用户,可跨多个 session。同一用户当天用了两台设备,贡献两个单位;同一设备当天换了多个用户,Play 仍只计一个单位。次数、受影响用户比例、受影响 session 比例是三种不同的分母。
截至 2026-10-26,下面只列 Play 手机应用的两项稳定性 core-vital bad-behavior thresholds(不良行为阈值);Wear OS 的按表型阈值不同,partial wake lock、内存等其他项目另有口径:
| 手机稳定性指标 | Overall | Per phone model |
|---|---|---|
| User-perceived ANR rate | ≥ 0.47% | ≥ 8% |
| User-perceived crash rate | ≥ 1.09% | ≥ 8% |
Play 当前说明中,user-perceived ANR rate 只计入 input dispatching timed out 类别。Service、Broadcast 等其他系统 ANR 仍要监控;前台服务故障要先区分 shortService ANR 与启动转前台等异常/崩溃再归类,把全部 FGS 超时都算进 ANR 会混入不同性质的问题。Play 的总体 ANR 与内部 watchdog 候选同样要分开统计。
Play 用最近 28 天数据评估 core vitals。数据只来自允许共享 usage and diagnostics(使用情况和诊断数据) 的用户、认证设备以及通过 Google Play 安装的 App;为保护隐私,样本量不足时报告不展示。所以这组数字只代表这部分用户。
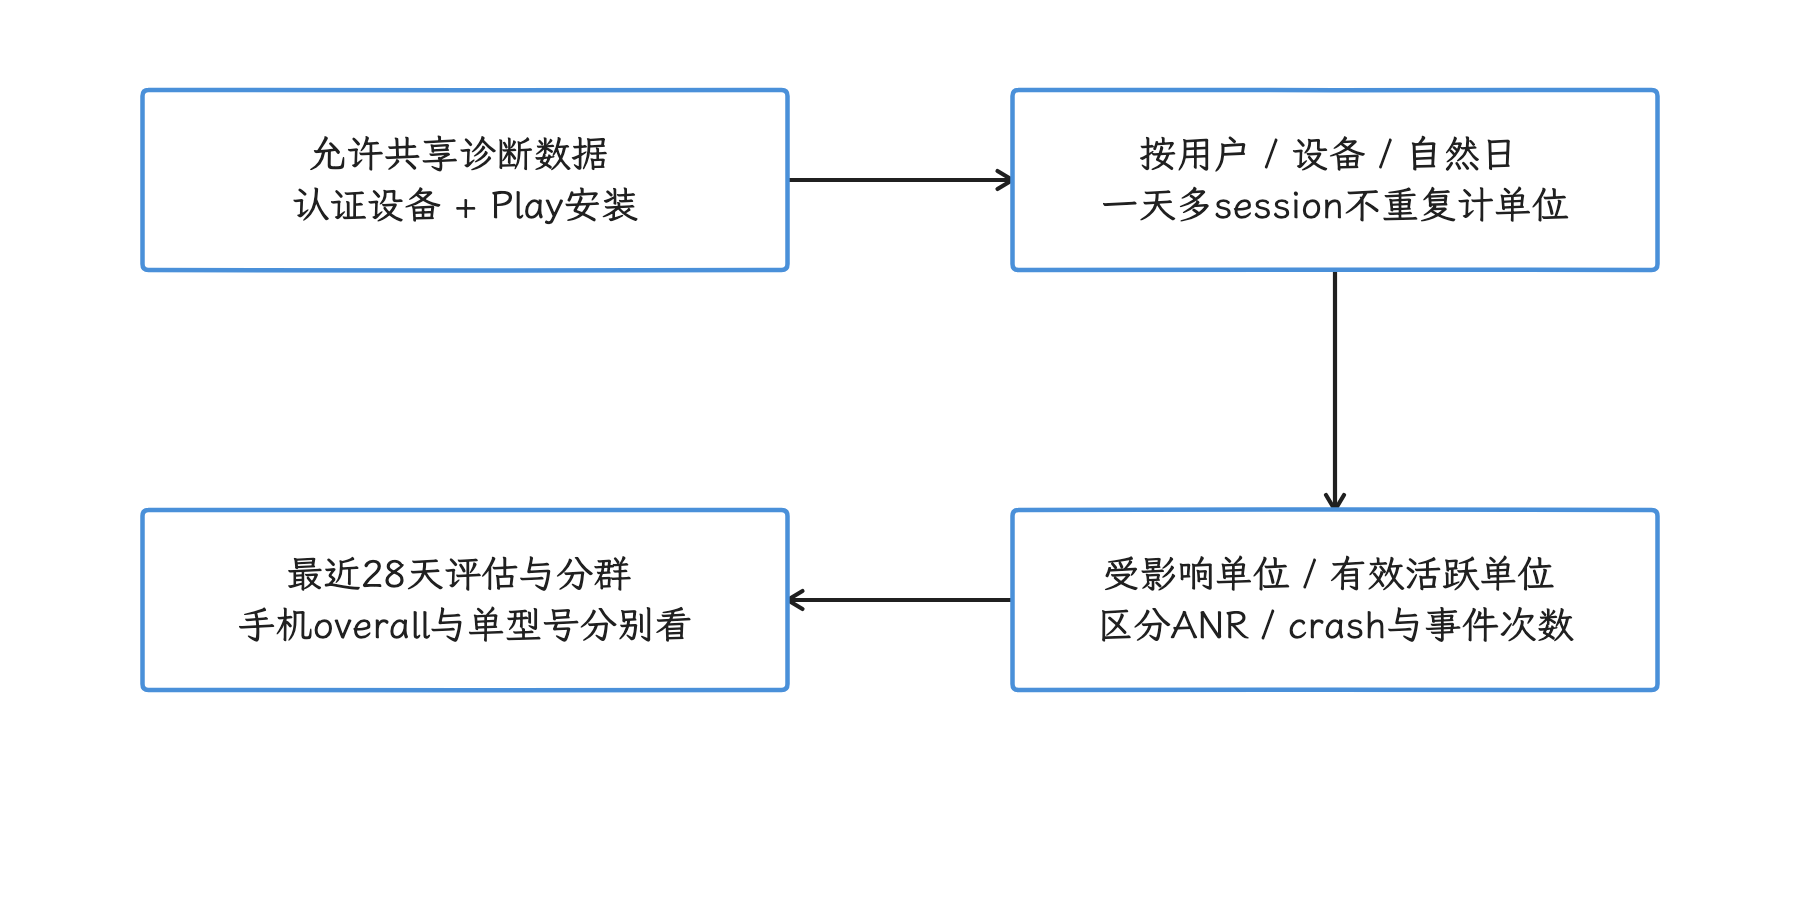
图:Play先限定可观测人群,再按日活用户设备单位计算稳定性,并用滚动窗口评估。 user-perceived ANR当前只计输入分发超时;手机阈值与手表不同,退出事件率不能直接替换它。
Crash/ANR 内部指标
内部看板应同时保留:
- 受影响 user-device-day 比例;
- 受影响 session 比例;
- 事件次数与重复事件用户;
- error/ANR cluster(按相似堆栈或特征聚合的问题组);
- App/Android 版本、设备型号、进程与前后台状态;
- 采样率和缺失率。
Crash 与 ANR 的分母必须分别记录。一次 session 发生多次同类错误时,事件率会上升,受影响 session 率只记一次;两者回答的问题不同。
ApplicationExitInfo
API 30+ 的 ActivityManager.getHistoricalProcessExitReasons() 可以在后续启动时读取系统保留的近期进程退出记录。ApplicationExitInfo 每条记录带 reason(退出原因)、timestamp(退出时间)、status(退出码或信号)、importance(退出前的进程重要级)、PSS/RSS(按比例分摊的内存/驻留内存) 采样和可选 trace(ANR 线程转储、native tombstone 等诊断制品):
REASON_LOW_MEMORY的支持度要用ActivityManager.isLowMemoryKillReportSupported()检查;getPss()/getRss()是系统最后一次采样值,不保证等于死亡瞬间峰值;来不及采样时会返回 0;getTraceInputStream()只在系统保存了对应 trace 或 tombstone(native crash 的系统诊断记录)时可用;trace 位于独立的全局环形缓冲区,可能被其他 App 的新记录覆盖;- 历史记录本身也由环形缓冲区保留,只适合当补充诊断,而非无损事件日志;
内部可把 exit reason 率分成 ANR、Java/native crash、low memory、excessive resource、user requested 等类别。LMK(Low Memory Kill,系统在内存压力下结束进程)、OOM 和 crash 的成因不同,合并成一个“内存崩溃率”会掩盖差异。
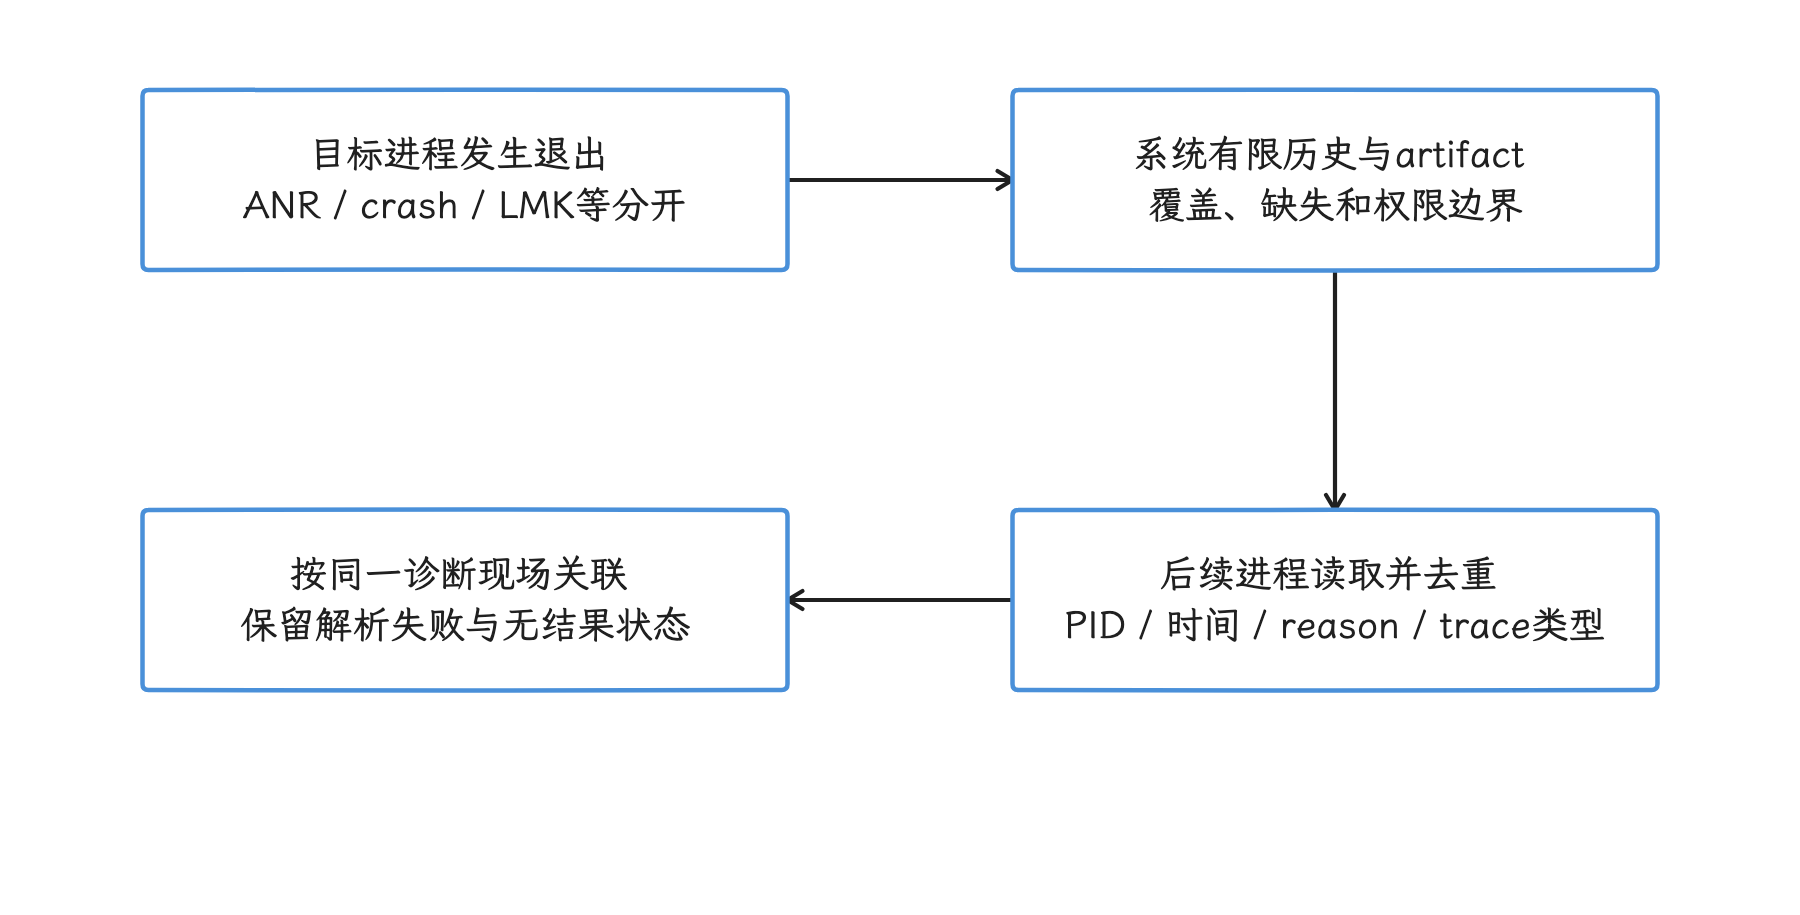
图:下次运行读取保留的退出记录,按reason、现场时间和可用artifact补充诊断。 历史记录和artifact都会被覆盖;内存值是最近采样,不能当死亡瞬间峰值,恢复后的ANR也可能附在其他退出记录上。
内存指标
PSS 与 RSS
| 指标 | 含义 | 适合用途 | 限制 |
|---|---|---|---|
| PSS | 私有驻留页 + 按共享者比例分摊的共享驻留页 | 进程占用归因、场景前后快照 | 采集有成本;受共享页和采样时点影响 |
| RSS | 进程全部 resident page(当前驻留在物理内存中的页),共享页按完整大小计入 | 时间趋势、reclaim/LMK 前后对照 | 跨进程相加会重复计算共享页 |
| Java heap | ART(Android Runtime)管理的对象堆 | 分配速率、GC(Garbage Collection,垃圾回收)、存活对象与 heap 趋势 | 不包含完整 native、graphics、mmap 与共享内存 |
| Native heap | native allocator(C/C++ 内存分配器)管理的分配 | JNI(Java 与 native 代码的调用接口)/C++ 分配与泄漏诊断 | 不等同于进程所有 native、mmap(内存映射)、GPU 内存 |
PSS/RSS 是占用指标,只是 lmkd(low memory killer daemon,低内存终止守护进程) 杀进程排序的依据之一;Android 17 lmkd.cpp 还会结合 PSI、内存状态、oom_score_adj(内核的进程 OOM 优先级修正值)与设备策略选择候选进程。
Play 的匿名内存与 Bitmap 指标
当前 Play 还单列 Memory usage(Anonymous RSS + Swap)与 Bitmap memory usage:前者把匿名驻留页与已换出的匿名页合并观察,量的是匿名内存这一块,总 RSS、PSS 或 Java heap 要另外看;后者是另一项 Bitmap 占用指标。它们需按进程状态区分,匿名内存还按设备 RAM 档位和 App/游戏类别解释,MB 预算也按同样的分层制定。
截至本次核对,官方说明这些内存项目越线可能从 2027 年 2 月起影响商店可见度。指标、阈值和生效时间分别维护;不要把未来的可见度处理写成当前已经实施。具体表格以当前 Play 指标页为准,内部场景预算仍由项目制定。
PSI 与系统压力
Android common kernel android17-6.18-2026-06_r6 的 PSI(Pressure Stall Information,资源压力停顿信息)文档定义了 CPU、memory、I/O 的 some/full 两类停顿:
some表示至少部分任务因该资源停顿;full表示所有非 idle 任务同时停顿;system-level CPU 不定义full。
PSI 描述任务因资源不足而停顿的比例和累计时间;既可读系统级 /proc/pressure/*,也可读 cgroup2 范围的 pressure 文件,必须记录作用域。单个 App 占了多少内存,是 PSS/RSS 这类占用指标回答的问题。我们可以把 App 占用、对应范围 PSI、reclaim 和 lmkd 事件放到同一时间轴上对照;对照给出的是相关性线索,因果结论还需要单独验证。
Java heap 与 GC
Runtime.totalMemory() - Runtime.freeMemory() 只能估算当前 Java heap 内已用空间,离进程总内存还差得远。heap 上限还受设备、ART、getMemoryClass()、largeHeap 与运行状态影响;固定写成某个 MB 范围会误导跨设备门禁。
GC 次数本身说明不了性能好坏,要结合暂停时间、分配速率、帧/响应窗口和存活对象看。大量并发 GC 可能对主线程影响很小,一次短的 stop-the-world(暂停相关 App 线程)也可能恰好跨过 frame deadline。
OOM、native allocation(分配)failure 与 LMK
建议拆为三类:
| 类别 | 典型证据 | 推荐分母 |
|---|---|---|
| Java OOM | Out crash cluster | session 或 user-device-day |
| Native allocation failure | tombstone、abort message(进程主动终止时留下的原因)、allocator/driver 日志 | session 或进程启动 |
| LMK/low-memory exit | Application、lmkd 事件 | session、进程启动或返回前台次数 |
分母要与产品问题对应。若关注“切回 App 后被重启”,返回前台次数可能比总 session 更有解释力。
功耗指标
Battery drain rate
电量百分比每小时适合长时场景的粗粒度观察,但电池曲线受充放电状态、温度、电池健康度和系统平滑算法影响。短时实验应优先用可用的能量类计数:energy counter(累计能量计数器)、Power Rails(硬件电源轨测量)、ODPM(On-Device Power Monitor,设备内功耗监测)、Energy Consumer(硬件抽象层提供的逻辑耗能单元),或外部功耗仪。
若能读取累计能量,平均功率可由同一 counter(随时间变化的数值) 的窗口差分计算:
average power = Δenergy / Δtime
当 Δenergy 使用 uWs、Δtime 使用秒时,结果单位就是微瓦,记作 uW;若时间差用毫秒,则 average power (uW) = Δenergy (uWs) × 1000 / Δtime (ms)。
Android 17 Power Stats 的 AIDL(Android Interface Definition Language,Android 接口定义语言) 中,EnergyMeasurement 记录 durationMs 时段内累积的 energyUWs,并带 timestampMs;EnergyConsumerResult 记录从开机起累计的 energyUWs,另有 timestampMs 与可选的 UID attribution(按 UID 归因),没有 durationMs。时间戳来自 CLOCK_BOOTTIME;能量单位为 microwatt-seconds(uWs,微瓦秒)。
对 EnergyConsumerResult 这类累计 counter,我们要先取同一设备、同次开机、同一 consumer ID 的差值,再用同源时间换算功率;counter reset(重置)、wrap(回绕)、缺失和设备不支持都要显式处理。Power Rails 与 Energy Consumer 可描述重叠的能量,存在重叠时直接相加会重复计量;整机或逻辑单元能量里能算给 App 的部分,按 UID attribution 核对覆盖范围后再定。
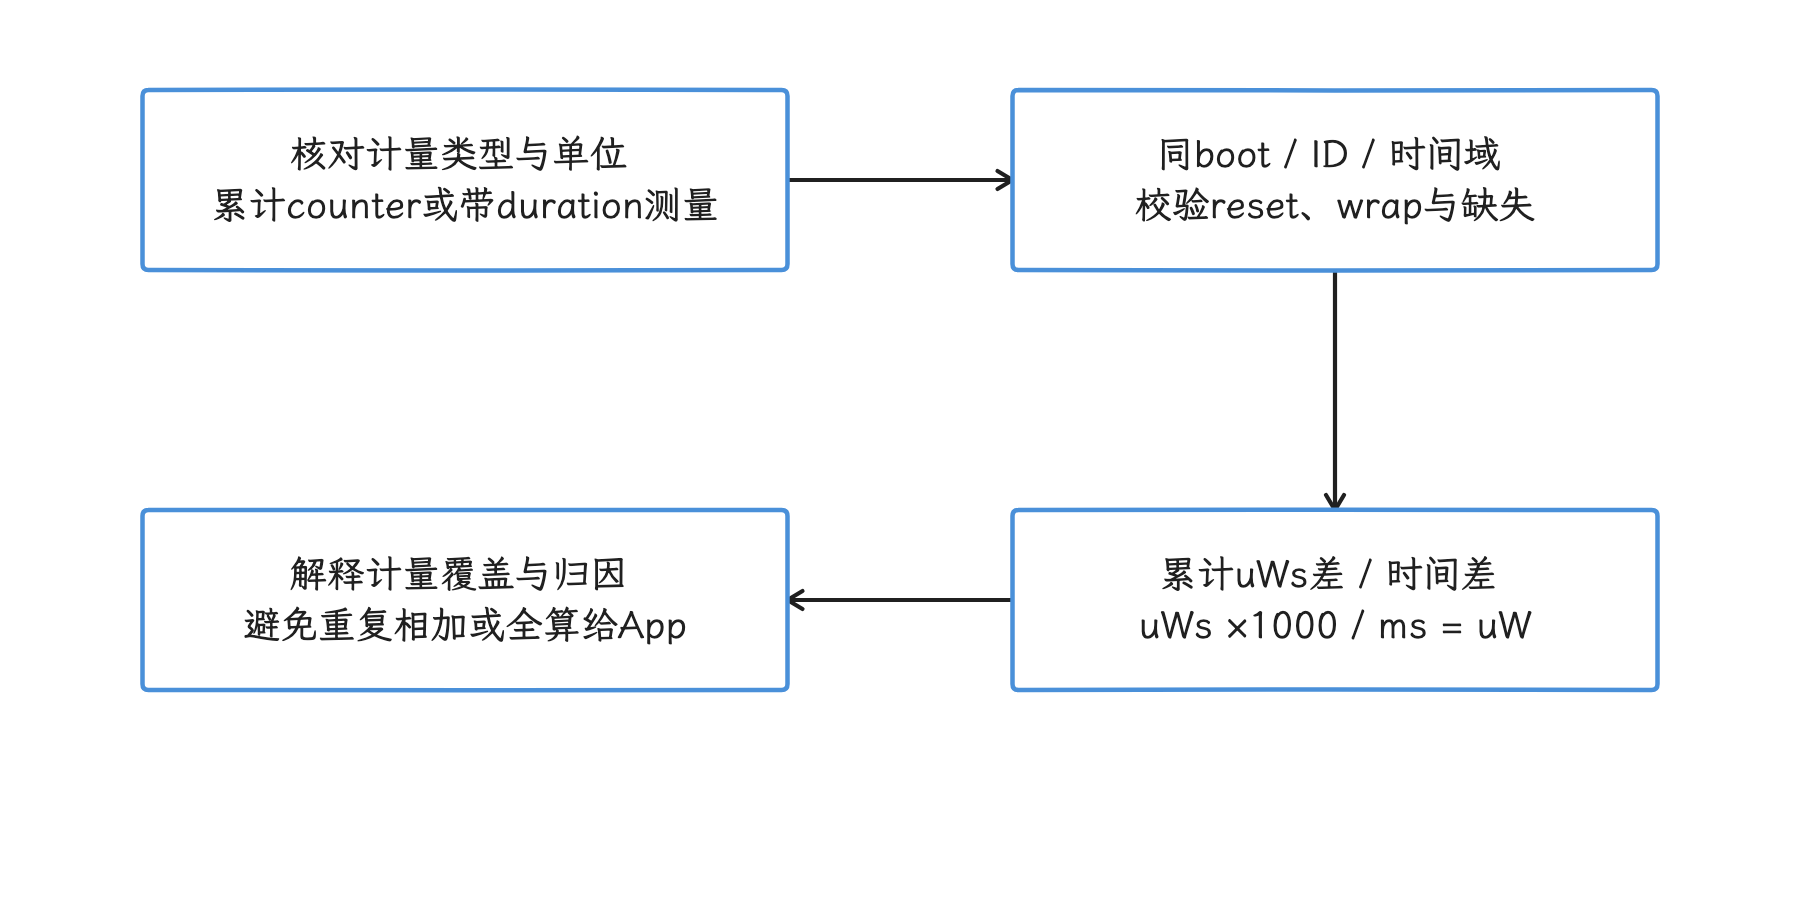
图:同设备、同次开机和同ID取累计能量与同源时间差,处理计数异常后再换算平均功率。 uWs除秒为uW;rail与consumer可重叠,整机能量不等于App能量,UID归因覆盖需另查。
Active/Idle power
Active 与 Idle 要由项目定义场景:前台静止、后台同步、息屏待机、音频播放和导航各有各的 idle 基线。实验至少固定:
- 屏幕亮度、刷新率和显示内容;
- 网络类型与信号;
- 充电状态、电池温度和 thermal state(系统热状态);
- 设备/App 版本与后台进程;
- 场景时长、预热和统计窗口。
Power Rails 与 Energy Consumer 的可用项、命名和精度取决于设备硬件与 HAL(Hardware Abstraction Layer,硬件抽象层) 实现。CPU frequency 只能提供活动背景,换算不出 App 的精确功耗。
Excessive partial wake locks
Partial wake lock(局部唤醒锁)使系统在屏幕可关闭时仍保持 CPU 可运行、避免进入 suspend;不表示 CPU 始终在执行 App 指令。Android Vitals 当前把 App 位于后台或运行前台服务期间的非豁免 partial wake lock 累计时长纳入统计:
- 24 小时内合计达到 2 小时或更多,session 被标记为 excessive;
- 最近 28 天内超过 5% 的 App sessions 命中时,可能影响 Play 可见度;
- audio(音频播放)、location、JobScheduler user-initiated(用户主动发起的任务) 等场景有官方豁免。
这是一项 Play 健康指标。内部功耗目标还应记录 wake lock 名称、持有区间、调用方和是否存在更合适的调度 API。
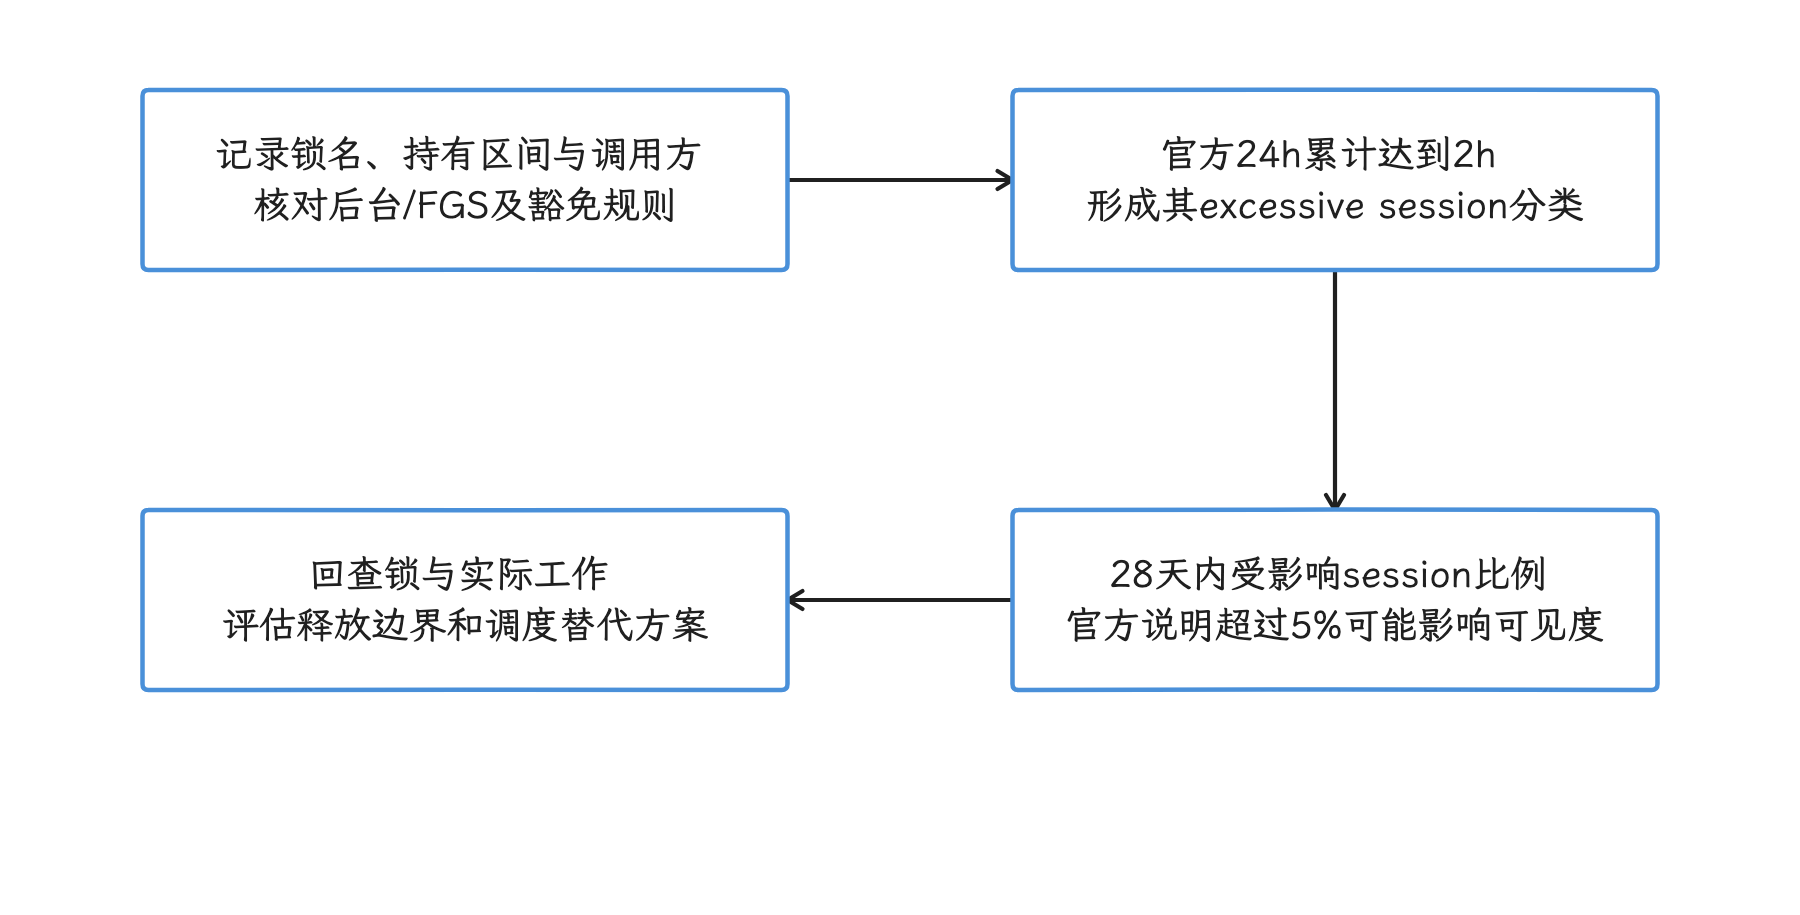
图:先按官方规则累计非豁免partial wake lock,再按其session分母与28天窗口解释过量比例。 后台或FGS持有、官方豁免与session口径都要保留;保持CPU可运行不等于CPU一直执行App工作。
线上与线下怎样配合
| 维度 | 线下实验 | 线上监控 |
|---|---|---|
| 目标 | 复现、归因、验证改动 | 发现趋势、影响范围和设备长尾 |
| 条件 | 可控制设备、构建、thermal、网络 | 环境复杂,存在采样与选择偏差 |
| 数据 | Trace(系统时间线记录)、调用栈、逐次观测 | 聚合分布、cluster、少量上下文 |
| 优势 | 因果验证能力强 | 覆盖版本与设备群 |
| 限制 | 样本小,代表性有限 | 难以直接给出代码根因 |
线上异常应生成可复现的分群:版本、设备、Android、场景、网络和状态。线下按该分群搭建实验;修复后用相同实验与线上分群共同验证。
聚合规则
跨分片的分位数合并
把机型 A 的 P90 与机型 B 的 P90 直接平均,只得到分位数的均值;每日 P99 的平均值也不是周期 P99。总体分位数应重算原始样本,合并桶边界和单位一致的计数直方图,或按同一兼容算法合并 t-digest/DDSketch 等分布摘要;采样概率不同时还要保留对应权重。
看板应标明分位数基于 frame、launch、session 还是 user 聚合。高频用户产生更多事件,event-level(按事件) P99 会因此偏向高频用户;user-level(按用户) 指标要先在用户内聚合,再在用户间聚合。
均值仍有用途
均值适合可加总的成本指标,例如 CPU time、energy、bytes 和基础设施成本。对长尾敏感的交互延迟,应同时提供分位数、超阈值比例和样本量。不要把“永远不用均值”写成规则。
采样率由误差预算决定
“高频事件采 1%—10%、启动 100%”这类固定建议缺少业务、样本量和隐私背景。采样设计本身应记录:
- 稳定抽样键,例如对经过隐私审查的用户或设备固定标识做哈希,避免一次 session 内忽采忽不采;
- 每条数据的采样概率或权重;
- 分层抽样策略,也就是为低端机、低版本和小流量场景单独保留样本;
- 客户端丢弃、限流和上传失败;
- 指标要求的最小样本与误差范围。
异常触发采样会改变分布。若慢事件更容易被上传,合同里必须注明,也不要与均匀采样数据直接合并。
维度与基数
维度基数指一个字段可能出现的不同取值数量。常用维度包括 App/Android 版本、设备型号、SoC(System on Chip,系统级芯片)、内存档位、刷新率、页面、CUJ、启动类型和网络。用户 ID、完整 URL、自由文本和堆栈的取值数量过大,当不了时序标签,可进入受控日志或 cluster 系统。
Android Vitals 的位置
Android Vitals 由系统采集,App 无需为此再集成一个监控 SDK;数据仍只来自允许共享 usage/diagnostics(使用情况和诊断数据) 的用户、认证设备和通过 Google Play 安装的 App。它提供:
- core vitals 与 bad-behavior thresholds;
- 版本、Android、设备、形态和地区等分群;
- slow startup、rendering、battery、crash/ANR 等数据;
- Play Developer Reporting API。
团队还需要自建业务 CUJ、非 Play 渠道、特定设备实验和详细上下文。两套数据应通过版本与场景关联,避免把分母不同的比例放进同一图表。
自定义业务指标
定义“信息流刷新完成”“视频首帧”“搜索结果可见”等指标时,逐项回答:
- 用户动作从哪个事件开始?
- 终点是数据返回、UI 提交、屏幕 present,还是可交互?
- 取消、失败、缓存命中、后台恢复怎样计入?
- 超时样本是否保留?若只记录成功,会产生幸存者偏差,也就是失败样本消失后,留下的数据显得过于乐观。
- 跨进程/跨设备时钟怎样对齐?
- 一个 session 多次操作如何聚合?
- 采样和隐私规则是什么?
- 指标变化后由谁启动 Trace、日志或回滚流程?
自定义指标应尽量落到用户可见终点,同时保留网络、解析、业务、UI、present 等诊断阶段。用户结果与内部阶段分开命名。
指标定义常见误区
FPS 高就代表流畅
平均 FPS 会隐藏长帧;静止页面低 FPS 也可能符合设计。结合 deadline、jank 比例、分位数和 CUJ。
TTID 快就代表启动完成
TTID 只到首帧。主要内容和交互准备要由 TTFD 或业务指标覆盖。
Play 阈值可以直接当门禁
Play 阈值用于平台健康评估,且可能更新。内部预算需要绑定用户旅程、设备、构建和统计分布。
PSS、RSS、Java heap 可以互换
三者的页分摊、覆盖范围和采集时点不同。趋势图和预算必须标明具体指标。
P99 可以跨天求平均
要还原总体分位数,得回到原始样本或兼容的分布摘要,并保留样本量和采样权重。
只记录成功操作
失败和超时被排除后,延迟看板会虚假改善。成功率与延迟应成对观察。
采样、聚合、告警与版本归因
指标定义稳定之后,线上系统才能决定采什么、采多少、怎么比较版本。不同人群和不同窗口的数字,直接横向比较没有意义。
线下测试与线上监控的分工
Perfetto(Android 系统时间线分析工具)、Macrobenchmark 和稳定的实验环境适合回答“某条路径为什么慢”;线上监控回答另一组问题:问题出现在哪些版本、机型和业务场景,波及多少用户,修复后是否回到基线。两类工作用的材料不同,在排障流程里的位置也不同。
实验室很难完整复制线上设备的组合:SoC、GPU 驱动、内存容量、温控状态、刷新率、厂商调度策略、网络质量和用户数据规模都会改变结果。测试用例还受预设路径约束;线上用户可能从通知、分享链接、桌面小组件或恢复任务进入应用,启动和渲染路径随之改变。
一套可维护的监控系统需要完成四件事:
- 用有明确语义的事件记录现象;
- 为事件附上页面、交互、版本和设备上下文;
- 用稳定分母与采样概率计算总体指标;
- 把异常样本关联到 trace、退出记录或实验复现。
帧回调、启动埋点或 ANR watchdog(定期探测主线程是否响应的监视线程) 只能提供局部信号。这些信号未经统一定义时,容易被误称为“掉帧”“冷启动”或“系统 ANR”,统计结果也就失去了可比性。
监控系统的三个层次
| 层次 | 产物 | 适合的实现 |
|---|---|---|
| 信号层 | 帧、启动、主线程停顿、进程退出等事件 | JankStats、FrameMetrics、Application、Application、业务埋点 |
| 证据层 | 异常前后的栈、trace、breadcrumb(按时间保留的近期关键事件)和资源状态 | 本地环形缓冲区、Profiling、Perfetto SDK、受控实验 |
| 分析层 | 分位数、比率、分群、回归检测和样本回查 | Android Vitals、第三方 APM(Application Performance Monitoring,应用性能监控)、自建数据系统 |
信号层应保持低开销,证据层按预算触发,分析层负责分母、采样校正和数据完整性。本地环形缓冲区只保留固定容量的最新记录,写满后覆盖最旧内容,适合保存异常前的有限上下文。
三层分开之后,客户端可以独立调整采样,服务端也能识别每条记录来自系统判定、库的启发式判定,还是业务规则。
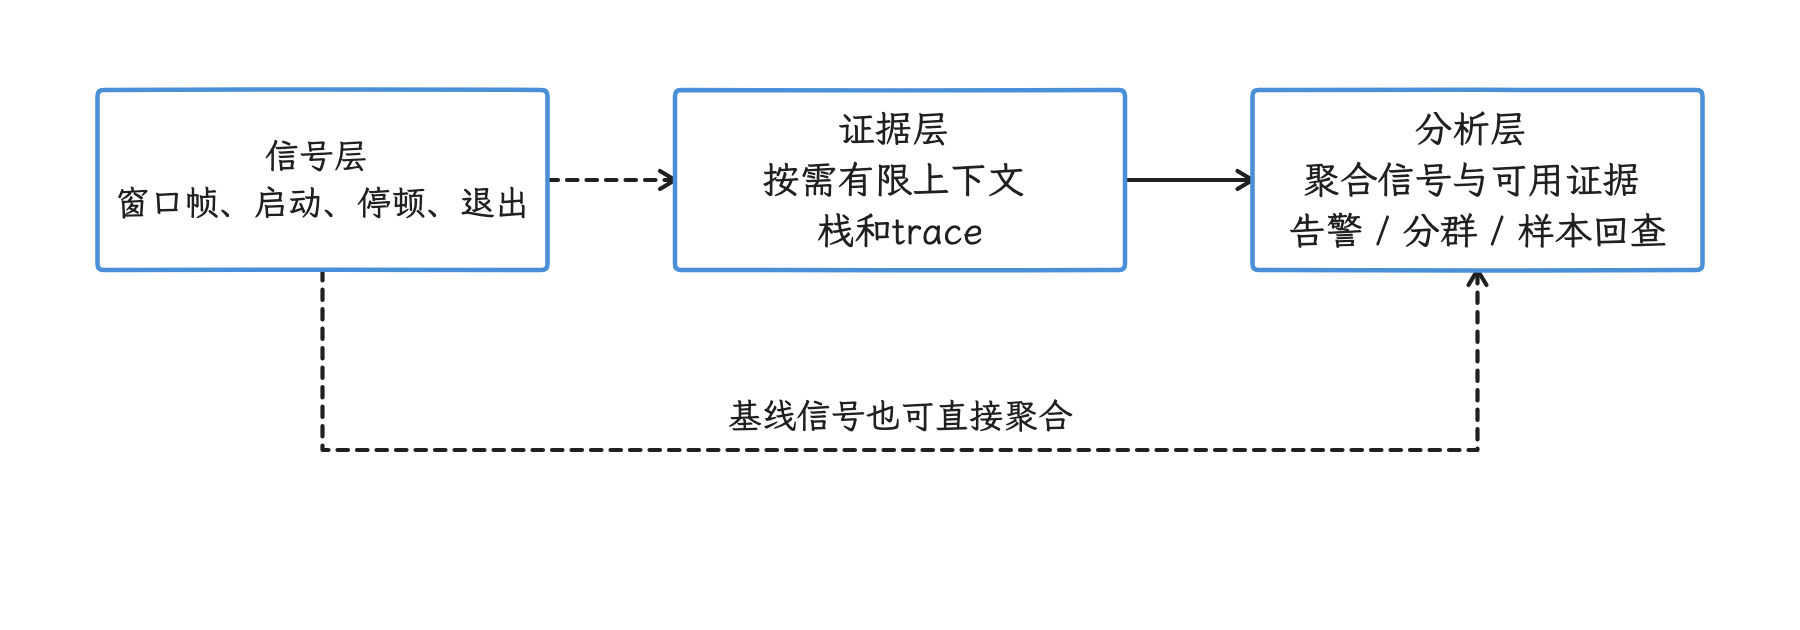
图:轻量信号记录事件,有限证据解释异常,分析层负责分母、分群与版本比较。 信号来源要区分系统、库启发式和业务规则;聚合曲线不能独自恢复完整现场。
事件协议与字段设计
这里的 schema 指事件字段结构及其版本约定。每类事件至少携带以下字段:
| 字段 | 作用 |
|---|---|
event_ | 标记字段结构与算法版本,支持协议演进 |
app_version、build_id | 定位发布回归 |
session_id、process_ | 区分会话与进程 |
scene、interaction | 关联页面和用户操作 |
source、classification | 标明系统结果或启发式结果 |
timebase、timestamp、duration | 防止混用 wall clock(日历时间)、uptime(不含深度休眠的开机时长)与 elapsed realtime(包含深度休眠的开机时长) |
sample_ | 服务端计算抽样权重 |
device、os、display_mode | 支持机型、版本和刷新率分群 |
同一时长的起点与终点必须来自同一时间域,或先有可验证的转换。记录单调时钟是否包含深度休眠;ApplicationStartInfo 的时间戳为 CLOCK_MONOTONIC 纳秒,与 elapsedRealtime() 的 CLOCK_BOOTTIME 值分属不同时间域,直接相减得到的是错值。自然日和发布时间用 wall clock,跨设备即使用 UTC 也要计入校时误差;各自的本地单调时间戳仅在本设备内有序,跨设备排序要先完成时钟换算。
帧监控的观测对象
“FPS”“慢帧”“错过 deadline”描述的是不同现象,我们先分清楚:
- FPS 是一段时间内呈现帧数量与时间的比值;
- 慢帧是应用或系统定义的帧耗时分类;
- deadline miss 表示一帧没有在系统给定的完成时限内完成;
- 用户可见卡顿还受缓冲、SurfaceFlinger 和重复呈现影响。
应用侧 API 能看到窗口或 View 渲染的一部分信息。要判断一帧是否按期呈现、卡在 App、RenderThread(承担部分渲染工作的线程)、GPU 还是合成阶段,就要回到 FrameTimeline 和渲染流水线分析,参见 §2.3、§7.1 和 §8.1。
Choreographer.FrameCallback:VSync(显示垂直同步) 邻近信号
Choreographer 负责按显示刷新节奏组织界面工作。FrameCallback.doFrame(frameTimeNanos) 提供该帧使用的调整后帧时间;这个参数用于观察帧节奏,回调实际进入 CPU 的时刻、原始硬件 VSync 到达时间是另外的量,这里读不到。在主线程取得 Choreographer 并持续注册回调后,可观察这个 Looper 的帧回调节奏:
Choreographer.FrameCallback callback = new Choreographer.FrameCallback() {
    private long previousVsyncNanos;

    @Override
    public void doFrame(long frameTimeNanos) {
        if (previousVsyncNanos != 0L) {
            vsyncIntervalHistogram.record(frameTimeNanos - previousVsyncNanos);
        }
        previousVsyncNanos = frameTimeNanos;
        Choreographer.getInstance().postFrameCallback(this);
    }
};

Choreographer.getInstance().postFrameCallback(callback);
这段代码记录相邻回调参数的时间差;回调是一次性的,因此在 doFrame() 中重新注册。示例假设 vsyncIntervalHistogram.record() 有界且轻量;停止监控或页面退出时,在同一 Choreographer 上调用 removeFrameCallback(callback),避免无意义地持续调度。除必要采样和计数外的工作放到后台线程。
这个信号有三条限制:
- 回调持续到达,应用未必持续产出新 buffer(图形缓冲区);没有 UI 更新时,回调仍可按 VSync 执行;
- 相邻
frameTimeNanos的差值,读不出某一帧的 CPU、GPU 或端到端呈现耗时; - 固定用 16.67 ms 判断卡顿会忽略 90 Hz、120 Hz、动态刷新率和 App 向系统提交的期望帧率。
因此 FrameCallback 适合当主线程节奏探针或低版本兼容信号,单独把它当“用户实际 FPS”的权威来源是不可靠的。
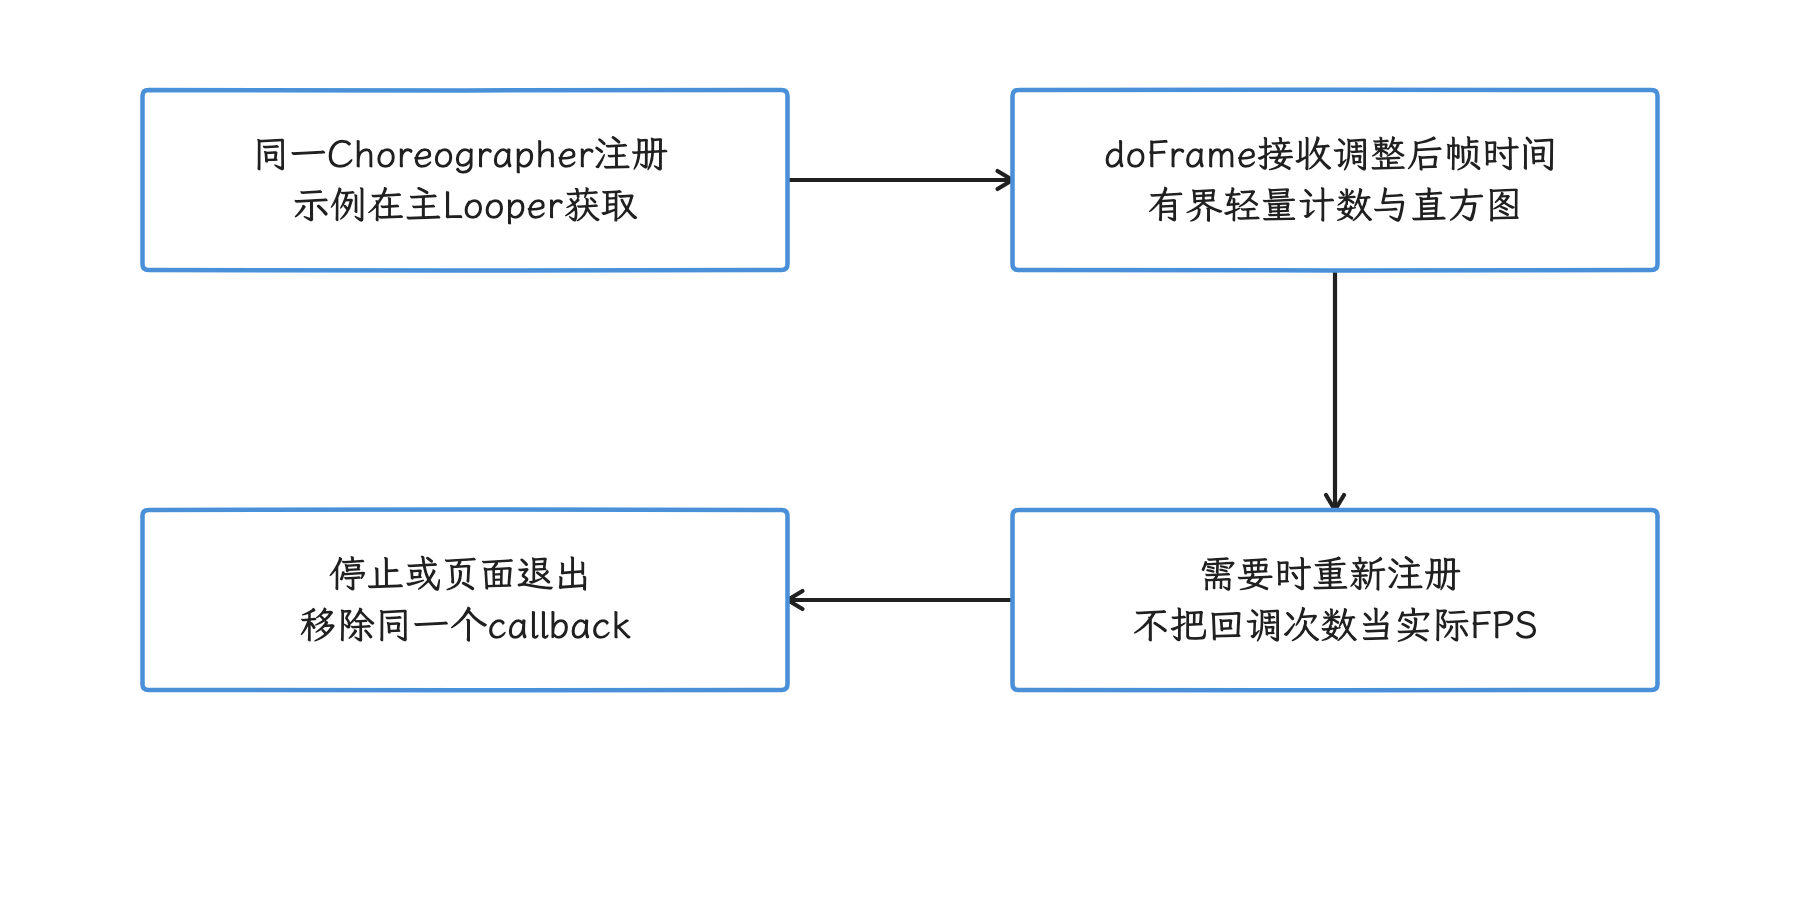
图:在正确Looper上注册一次性回调,记录调整后的帧时间差,按需续订并在停止监控时移除。 回调到达不证明新buffer或实际present;时间参数不等于回调上CPU时刻,也不能直接推出GPU耗时。
FrameMetrics:窗口内的帧耗时分项
Android 7(API 24)加入 Window.OnFrameMetricsAvailableListener。硬件加速窗口完成一帧后,监听器可以读取公开的 FrameMetrics 指标:
| 指标 | 解释 | 版本边界 |
|---|---|---|
UNKNOWN_ | 已知阶段之外、开始处理前后的未归类延迟 | API 24+ |
INPUT_ | 输入处理阶段 | API 24+ |
ANIMATION_ | 动画回调阶段 | API 24+ |
LAYOUT_ | measure/layout 阶段 | API 24+ |
DRAW_DURATION | UI 线程记录绘制命令阶段 | API 24+ |
SYNC_DURATION | UI 线程与 RenderThread 同步阶段 | API 24+ |
COMMAND_ | RenderThread 向图形驱动提交命令的阶段 | API 24+ |
SWAP_ | 交换图形缓冲区的阶段 | API 24+ |
TOTAL_ | 从 intended VSync 到 frame completed 的经过时间,分项可能重叠 | API 24+ |
FIRST_ | 是否为窗口首次绘制 | API 24+ |
GPU_DURATION | GPU 完成该帧工作的时长 | API 31+ |
DEADLINE | 系统分配给该帧的完成预算 | API 31+ |
COMMAND_ISSUE_DURATION 长表示该阶段的经过时间较长,要拆开线程执行和阻塞再看;它按经过时间计量,纯 CPU 指令时间只是其中一部分。TOTAL_DURATION 由帧边界时间戳求差,部分分项并行,表内 duration 直接相加会重复计入重叠部分。API 31+ 再结合 GPU_DURATION;这些窗口指标覆盖的是应用窗口这一段,SurfaceFlinger、HWC 与光学显示的完整链路要另行核对。
API 31 起,可用如下关系判断应用是否在预算内完成:
hit_deadline = TOTAL_DURATION < DEADLINE
miss_deadline = TOTAL_DURATION >= DEADLINE
这里用严格小于:FrameMetrics 文档把 TOTAL_DURATION < DEADLINE 定义为按期完成,等于 deadline 的帧要记到超期一边。
API 24—30 没有公开 DEADLINE,用 1 / display.refreshRate 只能得到当前显示模式的名义周期,既还原不出系统给某帧的精确预算,也盖不住刷新率切换与不同流水线深度。低版本可以保留“超过名义周期”这个独立指标,字段名里写清它是估算值。
监听器的回调跑在注册时传入的 Handler(把任务投递到指定线程消息队列的对象) 上。回调里应复制必需字段,做不随历史样本数增长的轻量聚合;序列化、压缩、落盘和网络发送都放到工作线程。dropCountSinceLastInvocation——两次回调之间丢掉的样本数——也要记,否则回调积压会让样本看起来比现场更平稳。
JankStats:启发式分类加 UI 状态
JankStats 是 Jetpack 的界面卡顿监控库,以窗口为监控单元。API 24+ 使用 FrameMetrics,API 23 及以下使用 OnPreDrawListener。它增加了两项工程能力:
- 根据平台可用信息进行可配置的 jank 判定;
- 通过
PerformanceMetricsState把页面和交互状态附到帧记录中。
下面的示例只在回调里复制当前帧,随后交给有界缓冲区。FrameData 会被 JankStats 重用,原对象不要交给异步任务:
private val jankStats = JankStats.createAndTrack(window) { frame ->
    val sample = FrameSample(
        startNanos = frame.frameStartNanos,
        uiDurationNanos = frame.frameDurationUiNanos,
        isJank = frame.isJank,
        states = frame.states.map { StateSample(it.key, it.value) }
    )
    frameBuffer.tryAdd(sample)
}

private val stateHolder =
    PerformanceMetricsState.getHolderForHierarchy(window.decorView)

fun onFeedScrollStarted() {
    stateHolder.state?.putState("scene", "home_feed")
    stateHolder.state?.putState("interaction", "scroll")
}
FrameSample、StateSample 和 frameBuffer 是项目内的数据结构,不是 JankStats API。缓冲区要有容量上限和丢弃计数;状态值用低基数枚举,也就是只允许少量固定取值,商品 ID、URL 或用户输入都不要放进聚合维度。
JankStats 的回调线程有版本差异:API 23 及以下在主线程,API 24+ 在 FrameMetrics 使用的线程。两个分支都要尽快返回;示例中的对象构造和 map 仍有分配成本,需按状态数量、采样和缓存预算实测。创建时要求有效的 Window/decorView;代码放在 Activity 里时,要等 Window 就绪后再创建和注册。
固定 JankStats 1.0.0 在 API 31+ 以 TOTAL_DURATION - DEADLINE 形成 frameOverrunNanos,以 TOTAL_DURATION - GPU_DURATION + SWAP_BUFFERS_DURATION 形成 frameDurationCpuNanos;API 24 分支的后者直接来自 TOTAL_DURATION。两者都按窗口字段差值计算,与 sched Running 求和是两种量。其 isJank 比较 UI duration 与乘上 jankHeuristicMultiplier 的预期时长,默认倍数为 2;这一分类和 frameOverrunNanos > 0 各归各,看板命名也应区分。
JankStats 的 isJank 属于库的启发式分类,FrameMetrics 的 duration 属于平台观测值。服务端应保留原始时长、算法版本和阈值配置,避免库升级后把分类规则变化误读为性能变化。
View 渲染与游戏渲染
FrameMetrics、JankStats 以及 Android Vitals 的慢帧/冻结帧统计,面向的都是使用 View/Canvas UI Toolkit 的窗口;直接用 OpenGL、Vulkan、Unity 或 Unreal 渲染的主画面不在该套 Vitals 渲染统计范围内,要另看为游戏提供的 Slow Sessions。
Google Play 为游戏提供 Slow Sessions(慢会话) 指标,从 SurfaceFlinger 所见的 App surface(应用提交图形内容的渲染目标) 估算相邻呈现帧率,覆盖 OpenGL、Vulkan 与 Android UI Toolkit,当前只面向游戏。Play 会在游戏运行满一分钟后开始监控;当前 20 FPS 口径下,一次 session 中超过 25% 的帧呈现间隔达到 50 ms 或更长,就算 slow session,另有 34 ms/30 FPS 口径。
应用若同时包含普通 View 页面和游戏 surface,要分别定义两套指标与分母;View 帧时长和游戏 session FPS 各看各的趋势图。
启动监控:TTID、TTFD 与业务可用时间
我们先把区间定义清楚,TTID 与 TTFD 的定义见前文“响应速度指标”一节:
| 指标 | 起点 | 终点 | 回答的问题 |
|---|---|---|---|
| TTID | 系统启动请求 | 第一帧完成 | 用户何时看到初始画面 |
| TTFD | 系统启动请求 | report | 应用声明何时完成延后加载 |
| 业务可用时间 | 已定义的启动入口 | 业务状态满足条件 | 某个页面何时可操作或展示目标内容 |
系统 SplashScreen(启动画面)先于 App 首帧出现,TTID 仍以 App 首帧为终点——这一帧可能是 App 自己的过渡页,也可能是内容还不完整的页面。TTFD 依赖 App 在合适时机调用 reportFullyDrawn();业务可用时间由产品语义决定,平台推断不了。三者可以同时采集,字段名与终点语义必须分开。
冷、温、热启动也应保存系统返回的分类(cold/warm/hot 的定义见前文“响应速度指标 > TTID”)。三类启动各有各的分布,不放在同一个分布里比较。
API 35+:ApplicationStartInfo 是系统启动记录
Android 15(API 35)加入 ApplicationStartInfo,它是系统保存的应用启动记录,一条记录对应一次启动,未必对应一次新进程创建。App 可通过 ActivityManager.addApplicationStartInfoCompletionListener() 在首帧绘制完成时收到记录,或用 getHistoricalProcessStartReasons() 查近期记录。完成监听器最多触发一次后自动移除;若当前启动早已完成,注册后会在指定 executor 上尽快交付已有记录,所以回调到达时间只反映交付时机,启动时刻要从记录的时间字段里读。
getStartupTimestamps() 返回单调时钟下的纳秒时间戳。记录可包含:
START_TIMESTAMP_LAUNCH;START_TIMESTAMP_FORK;START_TIMESTAMP_APPLICATION_ONCREATE;START_TIMESTAMP_BIND_APPLICATION;START_TIMESTAMP_FIRST_FRAME;START_TIMESTAMP_FULLY_DRAWN;- 初始 RenderThread 帧和 SurfaceFlinger 完成合成的时间戳。
各字段是否存在取决于启动状态和路径。完成监听器在第一帧时触发,不会等待 reportFullyDrawn();需要 TTFD 时,应在调用 reportFullyDrawn() 后再查历史记录。getStartType() 在首帧完成状态下给出 cold、warm 或 hot。getReason() 能区分 launcher、push、service、broadcast 等启动原因;API 36 加入的 getStartComponent() 则区分 Activity、Service、BroadcastReceiver 和 ContentProvider 组件类型。
计算时只对同一条 ApplicationStartInfo 记录做差:
TTID = START_TIMESTAMP_FIRST_FRAME - START_TIMESTAMP_LAUNCH
TTFD = START_TIMESTAMP_FULLY_DRAWN - START_TIMESTAMP_LAUNCH
缺少终点字段时记录为“未观测到”,不要补零,也不要用客户端 wall clock 拼接。官方文档说明 Android 16(Baklava)及以下的 service start 可能给出不准确的 START_TIMESTAMP_LAUNCH;面向 Activity 的启动面板应按 startComponent 或启动 reason 过滤。
API 24—34:手动埋点的区间拆分
Process.getStartUptimeMillis() 从 API 24 可用,可以当进程启动的单调时钟起算点。它早于 App 代码,但标记的是进程启动时间,替代不了系统收到 Activity launch 请求的时刻;Application.attachBaseContext() 更晚,只能说明 App 代码已经开始执行。
Activity.onWindowFocusChanged() 同样当不了 TTID:窗口可能多次获得焦点,焦点到达与首帧呈现也没有固定的先后关系。拿它定义某项业务交互指标可以,事件名不要写成 TTID。
低版本线上数据可以拆成以下区间:
- process start →
Application.onCreate(); Application.onCreate()→ 首个 Activity 的onCreate();- 页面创建 → 首个内容绘制回调;
- 页面创建 → 业务可用条件;
- 入口 →
reportFullyDrawn()。
这些区间有助于把问题定位到初始化、数据或 UI 阶段,但完整复制不出系统定义的 TTID。跨版本看板应标明 source,避免把 API 35+ 系统时间戳与低版本客户端近似值放进同一条序列。
Jetpack App Startup 的职责
Jetpack App Startup 用单个 InitializationProvider(基于 ContentProvider 的统一入口)发现并运行各个 Initializer(组件初始化器),还能声明初始化依赖与手动延迟初始化。它提供的是组织初始化的方式,不会自动产生 TTID、TTFD 或 initializer 耗时指标。
接入 App Startup 后,可以围绕每个 initializer 增加 android.os.Trace 切片和轻量计时,再用 Macrobenchmark 与线上启动记录核对收益。初始化顺序、主线程约束和依赖关系仍要按库文档处理;把多个 provider 迁移到 App Startup 能省多少毫秒,要测了才知道。
ANR 监控:区分预警、系统判定与退出证据
系统 ANR 的判定覆盖输入分发、Broadcast、Service 执行、JobService、ContentProvider 等路径,各自的起点、预算和完成条件不同;FGS 的 shortService ANR 与启动转前台等异常/崩溃也应先分类。“主线程连续数秒没有处理消息”描述的是 Looper stall(消息循环停顿)这一现象,系统有没有判定 ANR,以系统记录为准。
我们建议线上事件至少分成三类:
| 分类 | 来源 | 能说明什么 |
|---|---|---|
main_ | watchdog | 主线程探针在预算内未执行 |
anr_warning | API 37 Anr | 系统认为当前路径接近 ANR timeout |
process_ | Application | 历史记录显示进程因 ANR 被终止 |
Android Vitals 另有一套统计分母与用户感知口径。客户端记录、进程退出历史和 Play 指标要并列展示,谁也替换不了谁。
Watchdog:主 Looper 停顿候选
watchdog 在后台线程中向主 Handler 投递序号,等待主线程确认。超过项目定义的预算后,它可以保存:
- 连续未确认时长;
- 主线程栈;
- 当前页面和交互;
- 最近消息、锁等待或业务 breadcrumb;
- CPU、内存和前后台状态的轻量快照。
预算使用 SystemClock.uptimeMillis() 或 elapsedRealtime(),起点与终点保持同源。探针间隔、判定预算、重复事件合并窗口和设备休眠时如何计时都要进入 schema。系统冻结、调试器暂停、设备休眠和严重 CPU 饥饿(主线程长期抢不到运行时间)都会影响结果,所以服务端分类名称应保留 candidate(候选事件)。
watchdog 在 API 30 以下仍有诊断价值,高版本也能捕获应用恢复且未退出的长停顿。它给的是应用侧现场,与系统 ANR 之间没有一一对应关系。
API 30+:ApplicationExitInfo 在后续进程读取退出历史
进程重新启动后,可调用 ActivityManager.getHistoricalProcessExitReasons() 读取 ApplicationExitInfo。REASON_ANR 表示该进程因 ANR 被系统终止;记录还带时间、PID(进程 ID)、importance、PSS/RSS、description 等上下文。
getTraceInputStream() 需要按可空结果处理。系统维护的退出记录和 artifact(系统生成的诊断文件)都受环形缓冲区容量限制,旧内容可能被覆盖。ANR 后 App 若恢复运行,后续又因其他原因退出,该条退出记录仍可能附带早先的 ANR trace,因此读取 artifact 时应同时保存退出 reason、trace 类型和时间,避免只在 REASON_ANR 分支读取。
API 31+ 的 native crash artifact 可能是 protobuf(二进制结构化格式)编码的 tombstone(native crash 系统诊断记录),别总按文本 ANR trace 去解析。上传前还要限制大小、清理敏感路径与业务 tag,并记录解析失败。
ApplicationExitInfo 只描述退出历史:用户关闭 ANR 对话框、系统终止进程或 App 自行恢复,结果各不相同;它也做不到实时通知当前进程“刚刚发生了所有类型的 ANR”。Android Vitals 的用户感知 ANR 率只统计同意共享诊断数据的 Play 用户,以日活用户为分母,与本地退出记录的事件率是两回事。
API 37:ANR 预警与结构化 AnrInfo
Android 17(API 37)新增 ActivityManager.registerAnrWarningListener()。系统在 App 接近某条 ANR timeout(判定超时点) 时,以尽力而为的方式调用监听器——回调可能没执行,也可能来不及完成工作;官方要求 executor(执行回调的线程调度器)避开主线程。
下面的接入只复制结构化字段与内存中的最近状态。监听器对象需要由组件长期持有,注销时传回同一个对象:
@RequiresApi(37)
fun registerAnrWarning(
    activityManager: ActivityManager,
    executor: Executor
): Consumer<AnrWarningResult> {
    val listener = Consumer<AnrWarningResult> { warning ->
        anrWarningBuffer.tryAdd(
            AnrWarningSample(
                type = warning.anrType,
                id = warning.anrId,
                consumedMillis = warning.consumedMillis,
                timeoutMillis = warning.timeoutMillis,
                description = warning.description,
                breadcrumbs = breadcrumbRing.snapshot()
            )
        )
    }
    activityManager.registerAnrWarningListener(executor, listener)
    return listener
}
回调里不要做网络请求、压缩、大范围线程遍历或同步磁盘 IO。description 是面向调试的非稳定字符串,拿来辅助聚类可以,不要解析成长期兼容协议。
如果进程随后以 REASON_ANR 退出,API 37 的 getAnrInfo() 可提供结构化 AnrInfo,但仍按可空结果处理。字段包括 ANR type、ID、timeout 与 isUserPerceptible();后者按该 API 语义表示是否展示 ANR 对话框,与 Play 的 user-perceived ANR 分类是两套定义。warning 与 exit 在同一设备、系统运行期和目标 App/进程语境内用 type + ID 关联;这个组合只在同一语境内成立。预警后没有退出记录,可能是恢复、未退出或记录尚未读取,报表里如实标注这一状态即可。
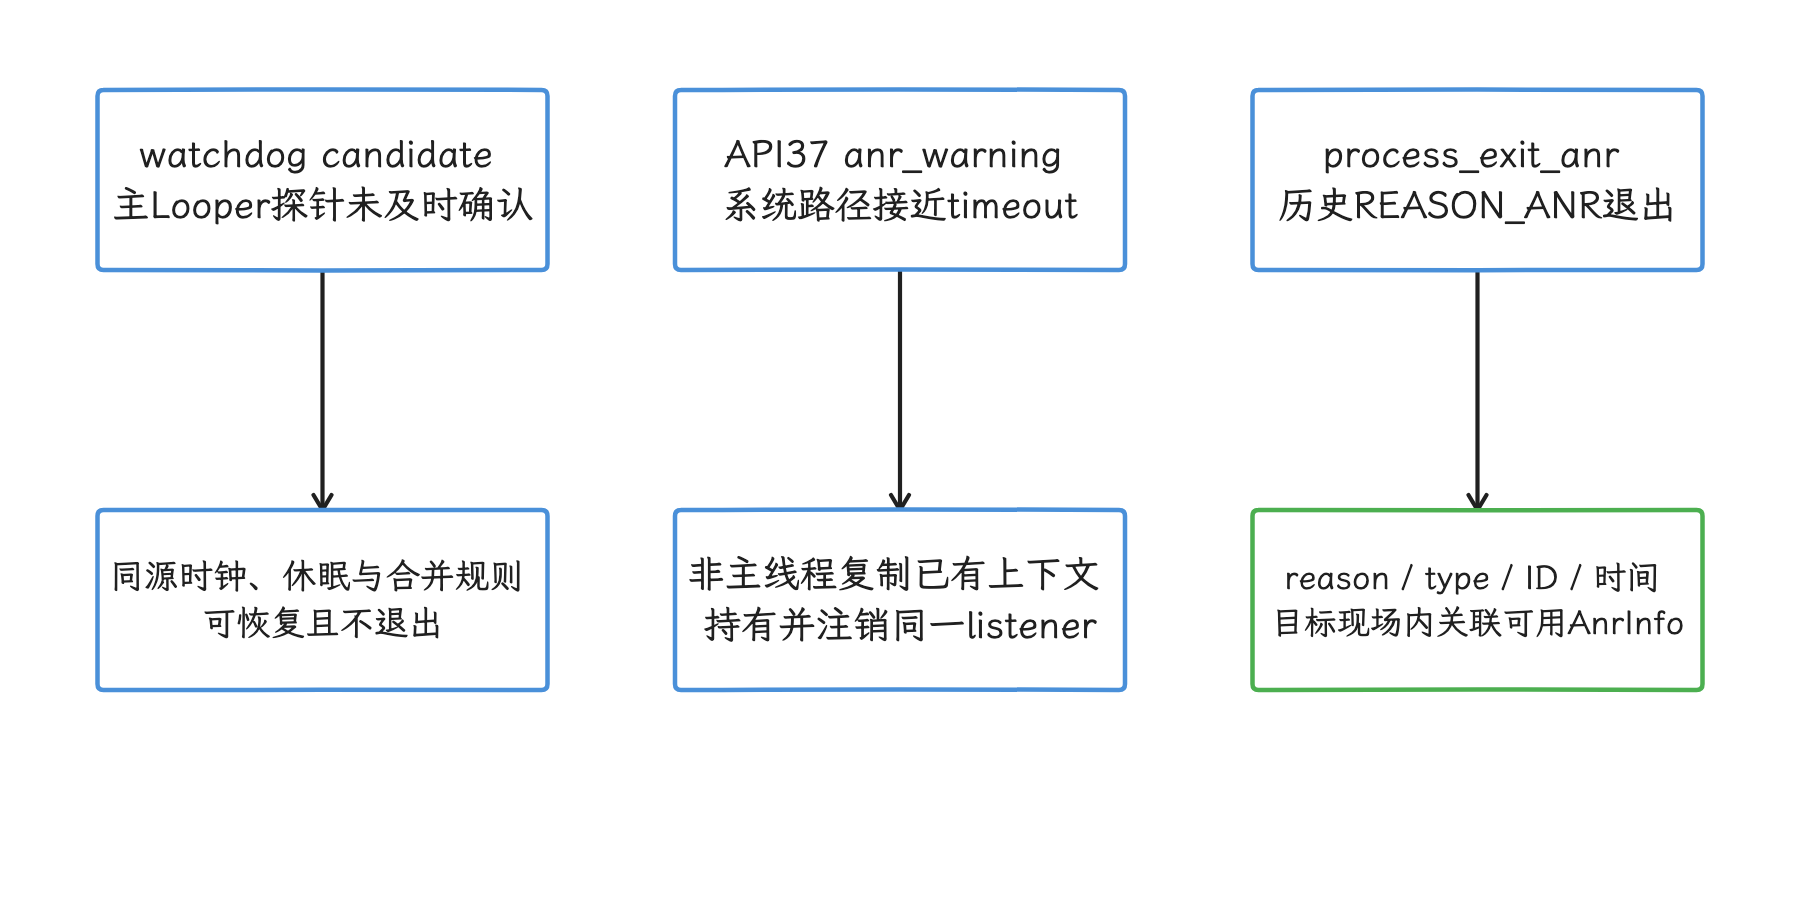
图:watchdog、API37预警与退出历史分别描述停顿、接近超时和最终退出,按现场键关联。 三者没有一一对应;warning尽力而为,getAnrInfo可空,对话框字段不等于Play用户感知分类。
FileObserver 监听 traces.txt 的历史方案
早期方案常监听 /data/anr/traces.txt。Android 17 的 AOSP 已经不用单一固定文件:StackTracesDumpHelper 把目录定义为 /data/anr,文件带 anr_ 与 temp_anr_ 前缀。普通第三方 App 受文件权限与 SELinux(Android 强制访问控制机制) 限制,把该目录当稳定、可读的公开接口是行不通的。
因此:
- 普通应用停用
FileObserver("/data/anr/traces.txt")接入; - 平台签名应用或系统镜像工具若读取
/data/anr,也要按当前文件命名、权限和清理逻辑验证; - API 30+ 使用
ApplicationExitInfo读取系统公开的退出 artifact; - API 37 可增加 ANR warning,低版本以 watchdog 记录停顿候选。
这项历史方案写在这里,是为了说清该从哪里迁移走;它在 Android 17 上已经算不上可行的应用 API。
SIGQUIT 与 ART SignalCatcher 的信号归属
系统的 ANR 路径会在需要进程自行输出线程栈时发送 SIGQUIT,ART 的 SignalCatcher 线程通过 sigwait 接收信号并生成 Java 线程 dump。普通 sigaction(SIGQUIT, ...) 抢在 ART 前面收到信号并没有保证;修改线程信号掩码、hook(拦截或替换)SignalCatcher 或吞掉 SIGQUIT,还可能破坏系统取栈。
量产应用应把这条路径当作平台实现细节看待,不把 signal hook 当公开 ANR API。强控制环境里的系统组件若要扩展信号采集,需在目标 Android 版本、ART 实现、ABI 与厂商改动上单独验证,并保证原有 dump 流程照常执行。
采样:基线样本与诊断样本
高频信号若全部上传,CPU、存储、网络和后端成本都会上去,所以我们要采样;采样设计要同时解决覆盖率与可估计性。
稳定的头部采样
头部采样(head-based sampling)在会话或进程开始时决定是否采集,并在整个采样单元内保持稳定。可对经过隐私审查的匿名 install ID、app version 和采样配置版本做哈希,获得可复现的选择结果。这样能避免同一会话中只留下少量孤立帧,也便于分批调整采样比例。
每条基线记录保存入选概率 p。在入选概率已知且大于 0、目标单位可被随机抽中的前提下,可用 1 / p 权重估计总体计数;例如 10% 入选概率对应权重 10。会话级抽样按会话入选概率解释其中事件;不同机型或版本有不同概率时分别加权。选择性丢弃、上传失败或未知入选概率影响的是覆盖,这个权重修正不了,报告里要单独给出覆盖与缺失情况。
采样决定要在看到性能值之前做出。只采“启动很慢”的会话估计不出慢启动率——正常会话根本没进分母。
异常触发的诊断样本
ANR warning、严重主线程停顿、极端启动或用户反馈,都可以触发额外上下文与 artifact 保存。这类按结果触发的诊断样本常称为尾部采样(tail-based sampling),适合定位根因;但它的入选概率依赖事件结果,拿来估计总体发生率或分位数,结果会带偏。
建议保留两条逻辑通道:
baseline_sample:稳定概率、可加权,用于趋势和 SLO(Service Level Objective,服务质量目标);diagnostic_sample:事件触发,用于聚类、栈与 trace 回查。
服务端展示诊断样本时,应标明“条件样本”,避免把异常集合中的机型占比解释成全体用户占比。
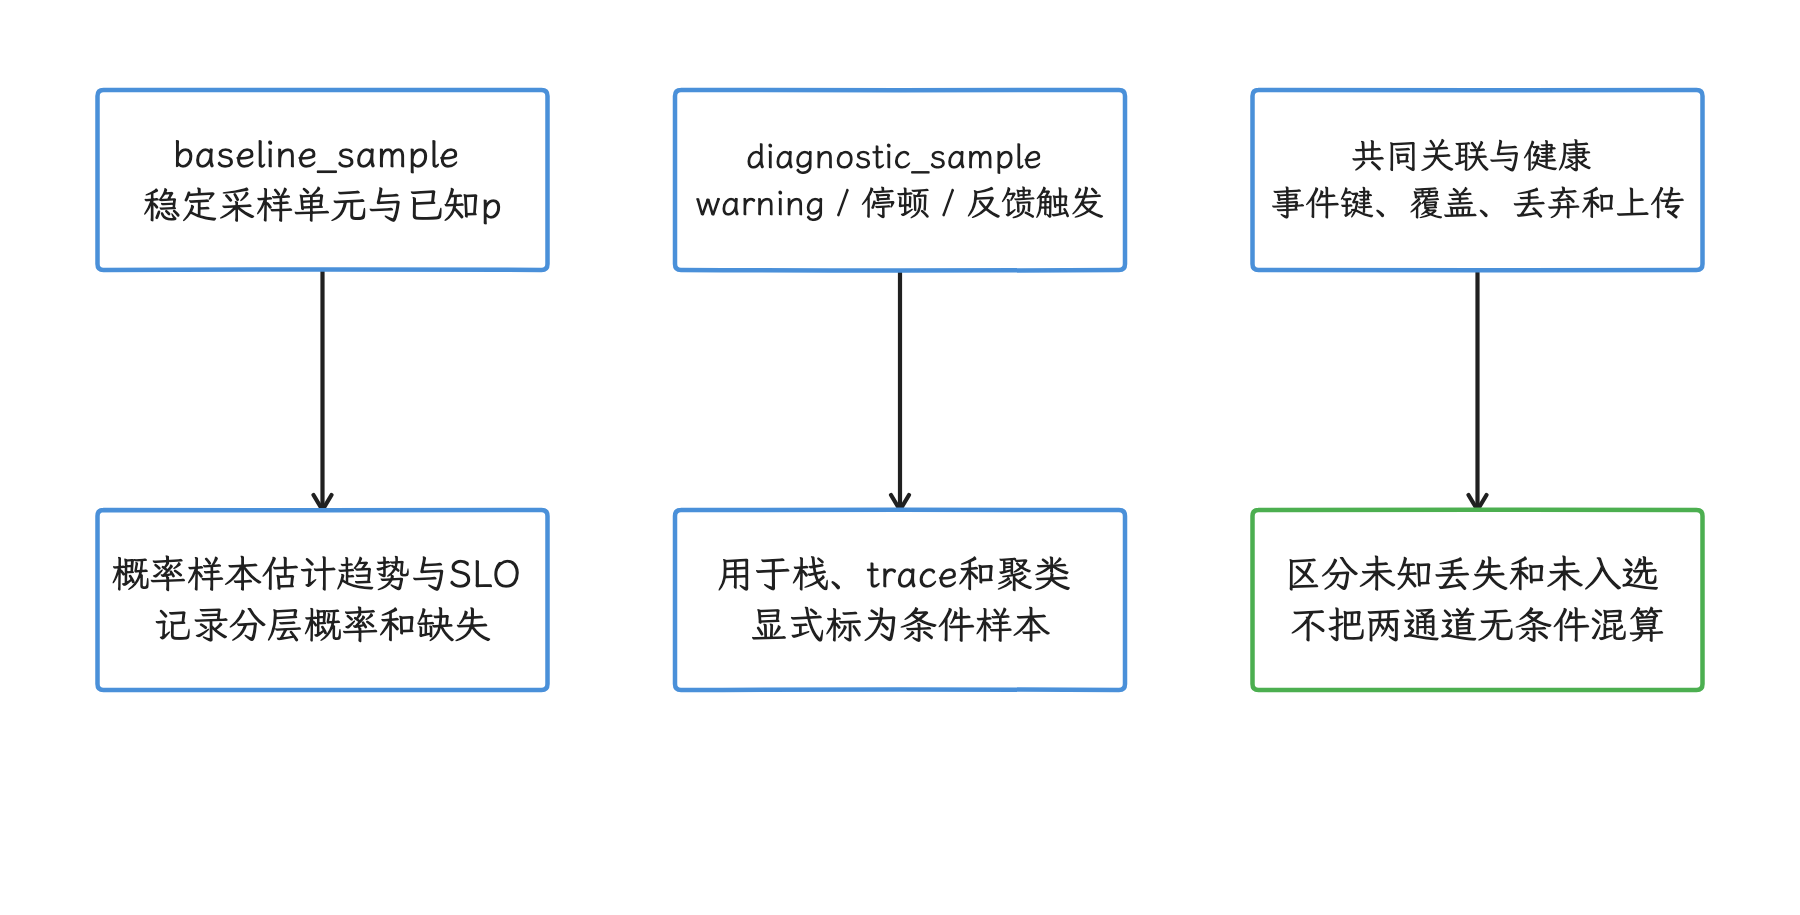
图:基线在看到结果之前做概率入选,异常通道额外保存条件证据,两者分别计算和展示。 已知非零p才支持概率加权;异常集合的机型占比不是全体占比,重复进入两通道的事件还需去重。
设备端聚合
逐帧原始事件通常无须全部发送。设备端可按 session、window、scene 和 display mode(显示模式,如刷新率与分辨率组合)聚合:
- 总帧数、JankStats jank 数、deadline miss 数;
- 帧时长或 overrun(超出 deadline 的时间)的固定桶直方图;
- TTID、TTFD 与业务阶段时长;
- watchdog 候选次数与最长持续时间;
- 本地缓冲、FrameMetrics 回调和上传队列的丢弃计数。
直方图把数值按固定区间计数,桶边界和算法版本属于 schema。修改桶边界后要升级版本,旧数据未经说明不与新数据合并。高基数字段会产生大量不同取值,应放在诊断样本中,不宜作为常规聚合标签。
聚合:分母、分群与延迟
每项指标要写清分母。常见口径包括:
| 指标 | 示例分子 | 示例分母 |
|---|---|---|
| Play 用户感知 ANR 率 | 当日发生至少一次目标 ANR 的用户设备日单位 | 当日满足统计条件的活跃用户设备日单位 |
| 会话 ANR 率 | 含目标 ANR 的会话 | 满足统计条件的会话 |
| 帧 deadline miss 率 | miss 的观测帧 | 同一渲染栈下满足统计条件的帧 |
| 慢启动会话率 | 超出目标的启动会话 | 同类型、同入口的启动会话 |
| TTFD 分位数 | 有效 TTFD 样本 | 已调用并观测到 report 的启动 |
事件率、用户率和会话率各答各的问题。一次会话中重复发生十次 ANR,事件率会涨,用户率只记一次。TTFD 缺失率也应单独展示,否则漏调用 reportFullyDrawn() 可能让曲线显得更好。
分群是按版本、设备或场景把总体样本分组。应从可行动维度开始:app version、Android version、device model/SoC、RAM 档位、启动类型、入口、scene、渲染栈和前后台状态。分群样本低于最小有效量时,不触发自动结论。
P50、P90、P95、P99 用于观察分布;均值能算某些可加总成本,单独描述长尾就不够了。任何分位数都要附上样本量、覆盖率和采样口径。数据到达可能延迟,Play Vitals 也按日更新,跨系统对比时要等各自窗口稳定。
报警:SLO、回归与数据质量
SLO 把团队承诺维持的性能要求写成可检查的数值。可执行的报警通常组合四类条件:
- 绝对目标:指标超过团队或外部平台定义的 SLO;
- 相对回归:新版本相对稳定版本、灰度对照或历史同周期恶化;
- 最小数据量:满足统计条件的用户、会话或帧达到统计要求;
- 数据健康:覆盖率、延迟、schema 分布和丢弃率正常。
多窗口 burn-rate(错误预算消耗速度)适用于已经定义 good/bad 事件、分母和允许失败比例的 SLI:比较实际坏事件比例与允许比例,同时观察短、长窗口。它不是直接把 P99 除以延迟目标。发布告警还需关联 rollout 比例、同分群对照和数据健康;阈值来自指标合同、当前平台口径或团队 SLO,不另设通用 P0/P1 数字。
报警事件应附带:
- 指标定义与当前值、基线值;
- 时间窗、样本量、覆盖率和采样概率;
- 受影响最大的可行动分群;
- 对应发布版本、变更记录与负责人;
- 可回查的诊断样本、trace 或 ANR cluster(按相似堆栈或特征聚合的问题组);
- 数据延迟与完整性状态。
趋势告警不带可回查的样本链接,只会换来一次次人工查询;不做数据健康检查的告警,容易把 SDK 关闭、字段缺失或上传故障误判成性能改善。
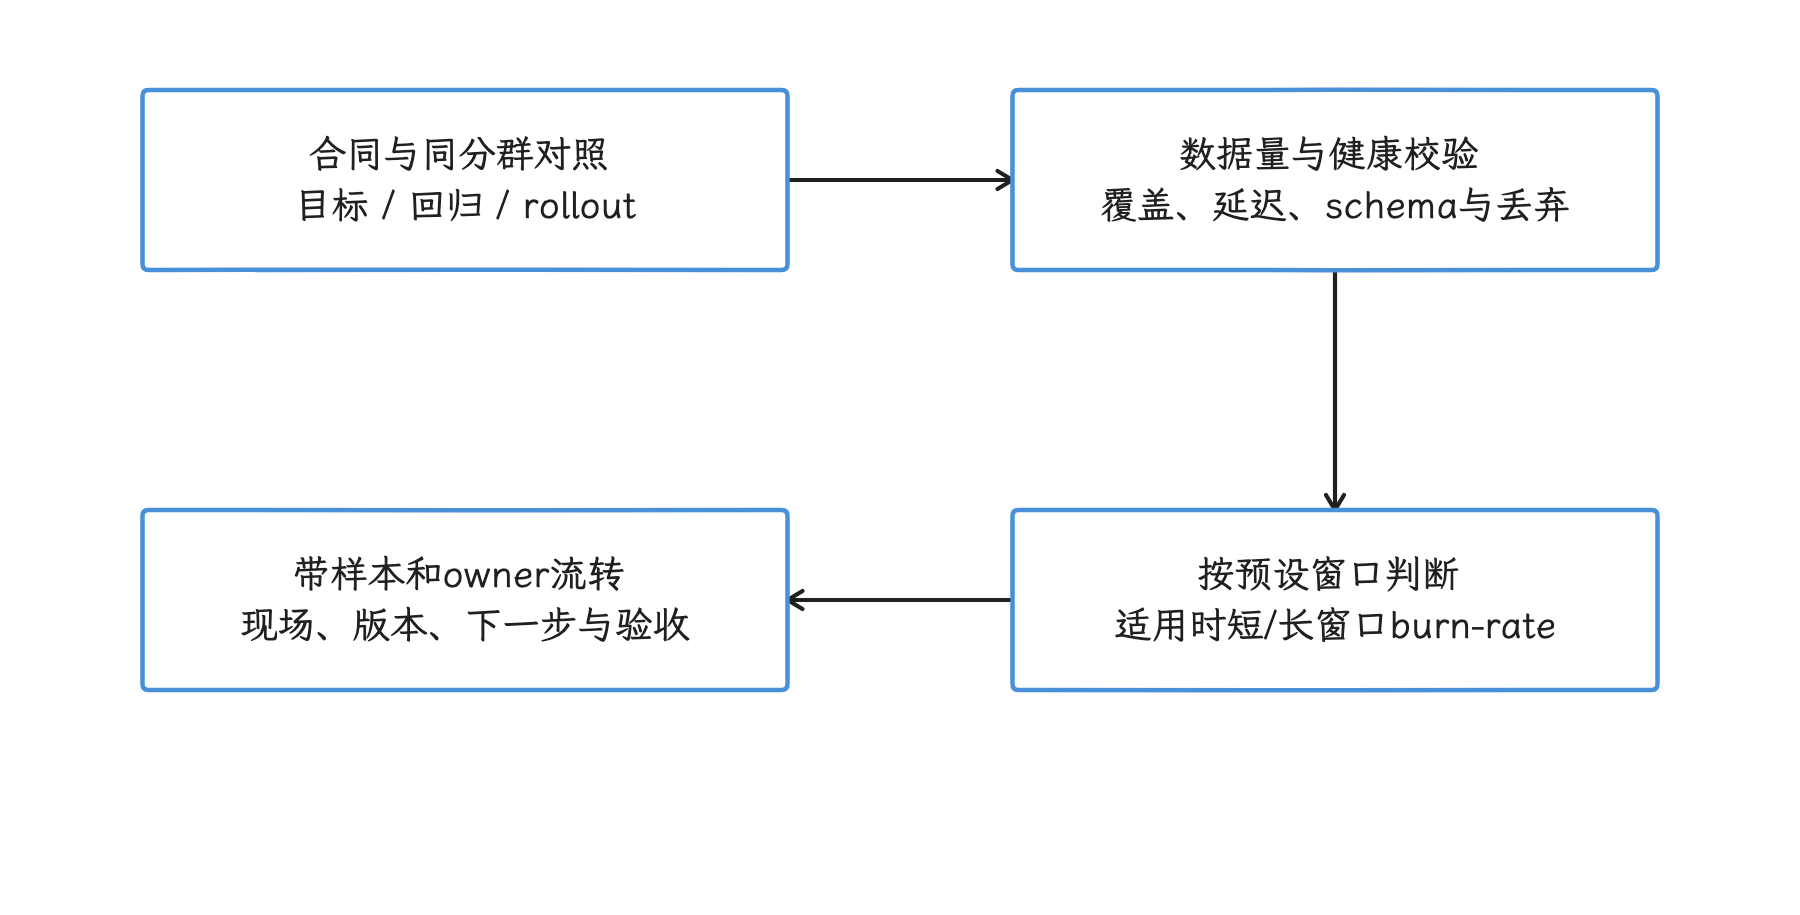
图:目标或回归判据结合有效样本、覆盖与发布对照后形成告警,并附带诊断样本和负责人。 burn-rate基于坏事件比例和允许失败比例;不能把P99直接除以延迟目标,也不能把SDK关闭当作性能改善。
ProfilingManager:由系统提供重型证据
Android 15(API 35)加入 ProfilingManager,App 可请求 Java heap dump、heap profile、stack sampling 与 system trace。主动请求需设置对应 executor/listener 或已有全局监听器;系统 trigger 的结果则需通过 registerForAllProfilingResults() 的全局监听器接收。结果异步返回并受资源、并发和速率限制,登记成功或提交请求都不保证生成 artifact。
Android 16(API 36)加入 ProfilingTrigger,App 可以登记关注的系统事件,由系统在事件发生时尝试生成诊断结果。到 Android 17 / API 37,触发类型包括:
| 类型 | 行为摘要 |
|---|---|
APP_ | 冷启动调用 report 后触发 |
ANR | 系统识别 ANR 后、可能终止 App 前,返回运行中 system trace 的 snapshot(当时快照) |
APP_ | 应用请求当前运行中的 system trace |
KILL_、KILL_RECENTS、KILL_ | 对应系统终止路径 |
OOM | 对应 OOM 条件,返回 Java heap dump |
ANOMALY、APP_COMPAT | 系统异常或未来兼容性条件,artifact 随具体事件变化 |
KILL_ | 因 CPU 资源使用过量被终止 |
COLD_START | 冷启动尽早开启新 system trace 与 stack sampling |
COLD_START 触发会持续到 reportFullyDrawn(),未调用时默认在 5 秒后停止;它使用 discard buffer(写满后丢弃新事件的缓冲区),因此优先保留启动早期的 Trace。ANR 触发表示系统已识别 ANR,但不保证进程随后被终止。
Android 17 源码位于 packages/modules/Profiling。该能力由可通过 Google Play 系统更新独立演进的 Mainline Profiling 模块提供:主动 requestProfiling() 从 API 35 可用,trigger 注册从 API 36 可用;部分后续方法属于 Android 16 的 minor SDK version(次版本 SDK 号)36.1,例如 requestRunningSystemTrace() 和 addAllProfilingTriggers();更多 trigger 类型在 API 37 加入。
接入时按调用的方法或 trigger 检查 API level、可表达次版本的 SDK_INT_FULL、flag 与运行时支持,并处理错误或无结果;只看 SDK_INT 会看漏次版本差异。低版本无需无条件读取新字段:访问 SDK_INT_FULL 本身也要有对应版本保护。addAllProfilingTriggers() 仍受系统限制、客户端采样和本地预算约束。
线上使用还需设定:
- 每类 trigger 的允许版本、场景与采样率;
- artifact 最大尺寸、保留期限和上传条件;
- 用户数据、路径、线程名、trace tag 与对象内容的隐私审查;
- 无结果、被限流、功能关闭和解析失败的可观测状态;
- 与轻量事件关联的 session、process、ANR ID 或 startup ID。
扩展:Perfetto SDK 的线上边界
Perfetto Tracing SDK 是 C++17 库,用 Track Event(按时间记录的事件) 或自定义 data source(Trace 数据源) 记录 App 事件。它有两种 backend(数据写入后端):
| 模式 | 能力 | 适用场景 |
|---|---|---|
| in-process | 只采当前进程,应用控制 session 和 trace 数据 | 受采样与隐私约束的应用内诊断 |
| system | 连接 traced(Perfetto 系统守护进程),将 App 事件与调度、syscall(系统调用)等系统事件放到同一时间线 | 本地调试、实验室和受控测试 |
in-process backend 不需要特殊 OS 权限,适合保存 App 自己的短窗口 trace。system backend 的 session 必须从进程外部控制;写入事件的数据 producer 也读不回包含其他进程信息的 system trace,以免信息泄露和侧信道风险(从时间或资源差异间接推断敏感信息)。所以“线上远程让普通 App 自行抓取完整 system trace 并上传”,并不是 SDK system mode 的通用工作方式。
Android 侧若只需要 slice(有起止时间的区间)、async slice(可跨线程结束的区间) 或随时间变化的 counter,Perfetto 官方建议继续用 android.os.Trace 或 NDK ATrace_*:这些事件同样能进 Perfetto,接入成本也低于引入完整 C++ SDK。等已有 native 子系统、需要自定义 protobuf data source 或独立 in-process session 时,再评估 Perfetto SDK。
无论使用哪种方式,都要限制时长、buffer、类别与触发频率。trace tag 不记录账号、URL 参数、文本内容和其他敏感数据。
可视化与归因平台
Android Vitals
Android Vitals 的覆盖范围前文说过:同意共享使用与诊断数据的用户、认证设备、Play 安装的 App,样本量不足时不展示报告。看它的数字时,要记得这层筛选。
它适合提供统一的外部口径:
- 用户感知 ANR 率、ANR 率与 cluster;
- 冷、温、热启动 TTID;
- UI Toolkit 应用的慢帧与冻结帧;
- 游戏的 Slow Sessions;
- crash、LMK 和部分电量指标。
当前 Play 的 user-perceived ANR 只计入 Input dispatching timed out,分母按日活用户定义。这个口径可能演进,数据字典里要保存外部文档的版本号。bad behavior threshold 统一在前文的指标合同里维护,避免多处复制后出现不一致。
Vitals 的 UI Toolkit 渲染统计不覆盖直接 OpenGL/Vulkan 主画面;游戏应看由 SurfaceFlinger 数据计算的 Slow Sessions。数据按日更新且可能晚到,发布当天的早期结论需要结合覆盖率。
第三方 APM 与自建系统
选择平台时,单看图表数量说明不了什么,我们要核对的是:
- Android 17、动态刷新率与多窗口支持;
- 帧、启动和 ANR 的采集源及算法版本;
- 原始事件、聚合结果和 artifact 的导出能力;
- 国内外网络、离线队列、失败后逐步延长重试间隔的退避策略与流量预算;
- 数据驻留位置、加密、删除和访问审计;
- 自定义 scene、interaction 与发布维度;
- 与 issue、发布灰度和负责人系统的关联。
自建系统通常由客户端 SDK、消息接收、实时流式或定时批量聚合、指标存储、artifact 存储、查询与报警组成。技术选型随组织基础设施变化,本文不绑定固定消息队列或数据库;比起组件名称,schema、分母、采样权重、数据保留和访问权限才是要先固定下来的。
平台与客户端的职责
| 客户端 | 平台 |
|---|---|
| 采集平台信号和业务上下文 | 维护指标定义、分母与算法版本 |
| 控制采样、缓冲和上传预算 | 做采样校正、分群与发布对照 |
| 在异常前后保存有限证据 | 管理 SLO、报警、聚类与样本回查 |
| 上报丢弃、限流和功能状态 | 监控覆盖率、延迟与数据完整性 |
| 执行隐私最小化 | 执行访问、保留与删除策略 |
客户端凭一条回调做不了总体判断,平台从缺少现场的聚合曲线也还原不出线程栈。两侧靠版本化事件协议协作,才能把趋势定位到可复现样本。
在 Perfetto 中核对线上结论
线上事件要能对应到可打开的线下记录:
- 帧异常:在 FrameTimeline 里对照
actual_frame_timeline_slice(实际帧时间线) 和expected_frame_timeline_slice(预期帧时间线),再关联主线程、RenderThread、GPU 与 SurfaceFlinger; - 启动异常:从启动请求、进程创建、
bindApplication(系统把 App 绑定到新进程)、首帧到reportFullyDrawn()对齐系统与 App 切片; - ANR:查看主线程运行/睡眠状态、锁等待、Binder 调用、调度延迟以及
am_anr等系统事件; - 业务阶段:用
android.os.Trace或 ATrace tag(写入系统 Trace 的业务标签)把线上 scene 与 trace slice 对应起来。
我们把这几类材料配合起来看:单看一条客户端帧时长,断言不了 GPU 或 SurfaceFlinger 是瓶颈;单看一条 watchdog 记录,也断言不了系统已经判定 ANR。Perfetto、ANR trace、ApplicationExitInfo 和版本对照各自提供自己范围内的材料。
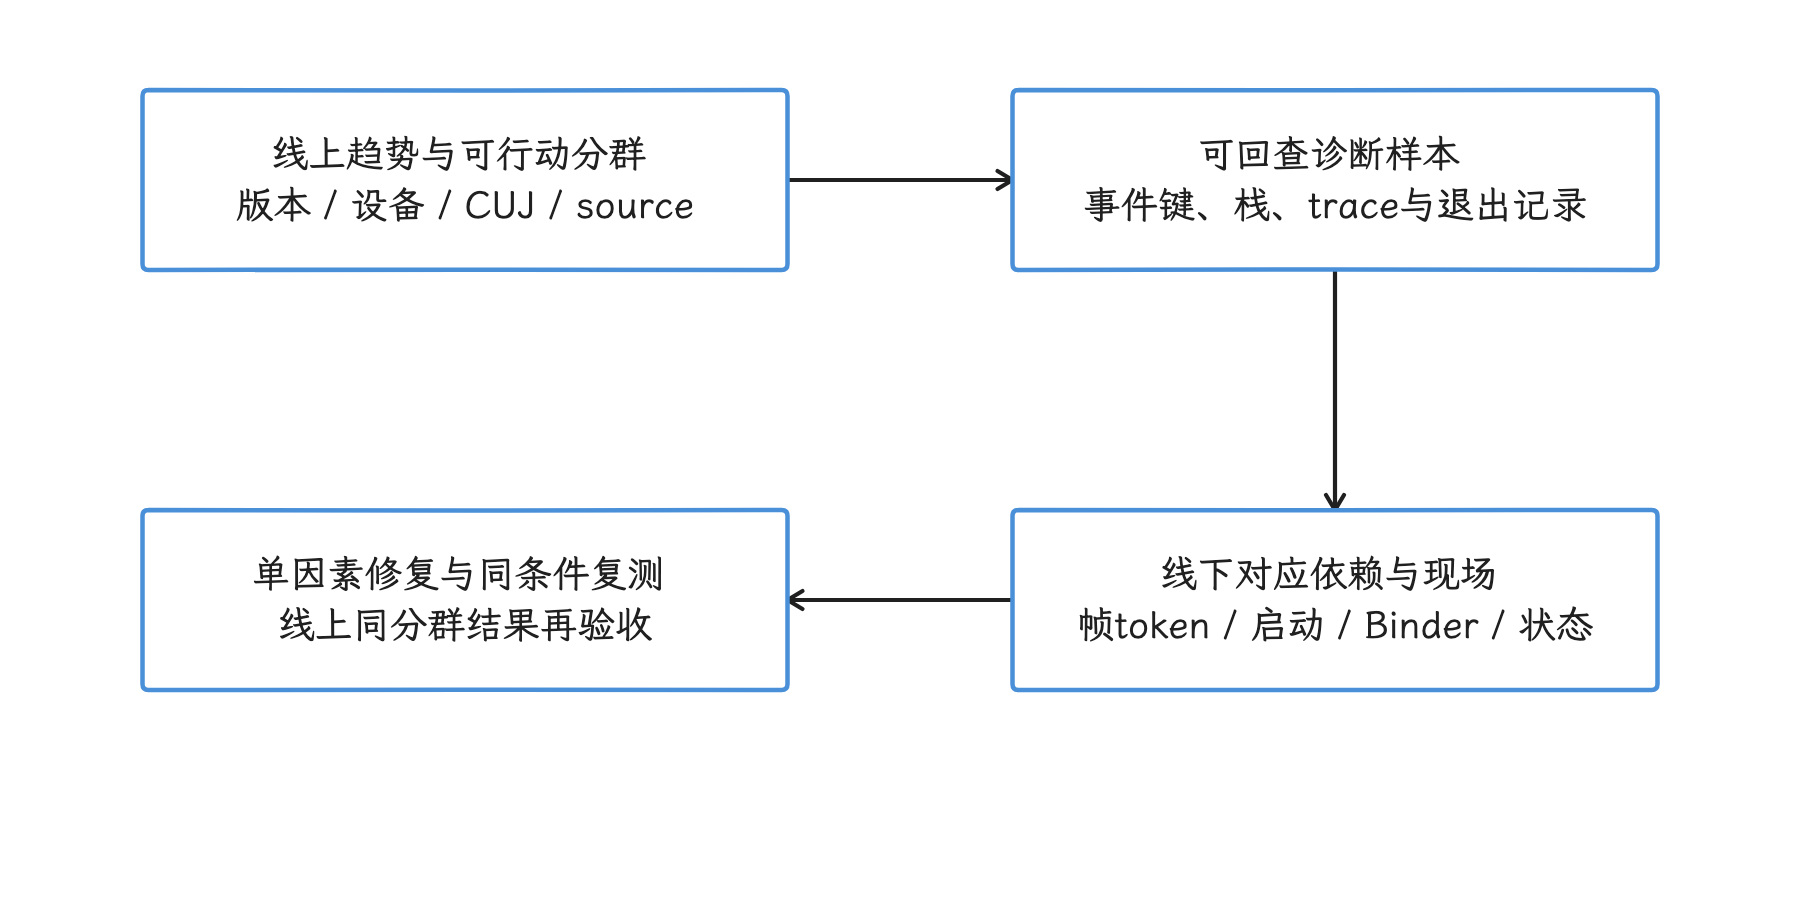
图:用版本化关联键把线上分群、诊断artifact、Perfetto现场和同条件复测连接起来。 单条帧时长不能定位GPU/SF,watchdog不能证明系统ANR;聚合和现场证据各自保留覆盖范围。
接入顺序
- 写出指标合同,也就是区间、分母、时钟、source、版本和隐私等级组成的可审查定义。
- 接入低开销基线:JankStats/FrameMetrics、启动记录、退出历史与 watchdog 候选。
- 建立 scene、interaction、session 和 process 关联。
- 增加稳定头部采样、设备端聚合、丢弃计数和离线上传。
- 建立覆盖率、延迟、schema 与采样概率的数据健康面板。
- 将 SLO、发布对照、最小样本量和多窗口规则接入报警。
- 为异常样本配置
ProfilingManager、in-process trace 或受控复现。 - 定期用 Perfetto、Macrobenchmark、ANR trace 和 Android Vitals 交叉核对。
与其他章节的关系
- §2.3、§7.1、§8.1 解释 Choreographer、FrameTimeline 与图形流水线。
- §7.2 提供卡顿归因步骤。
- §9.2 解释系统 ANR 类型、超时与 trace 分析。
- §15.6 说明自动化测试与 Macrobenchmark 回归门禁。
- §16.6 讨论跨应用测量时的可比性。
- §16.1 将监控、实验、修复、团队责任和发布验收组织成持续流程。
FAQ
帧监控会不会制造新的卡顿?
开销取决于回调中的工作量和采样覆盖。回调只复制少量字段、更新固定桶并写入有容量上限的内存队列时,风险可控;逐帧分配大对象、输出日志、序列化或同步写盘会改变被测性能。上线前要用 Macrobenchmark、Perfetto 和功耗测试比较开启/关闭监控的差异。
API 30+ 还有必要保留 watchdog 吗?
两者记录的事件不同。ApplicationExitInfo 在后续进程提供退出记录,watchdog 能在当前进程记录主 Looper 长停顿,包括恢复且未退出的样本。可以同时保留,但字段和看板要区分 candidate 与 REASON_ANR。
API 37 的 ANR warning 能阻止 ANR 吗?
不保证能阻止。回调按尽力而为执行,可能没被调用,也可能来不及完成。它适合复制已经在内存里的诊断上下文;业务修复还是要消除主线程阻塞、超时组件或资源争用。
采样率提高后,指标一定更可信么?
更大的随机样本通常降低抽样误差,但修不好选择偏差、错误分母、字段缺失和算法变化。采样概率、覆盖分群与数据健康,比单一百分比更能说明数据可不可信。
第三方 APM 能否覆盖业务指标?
它能提供通用信号和平台能力。首屏目标内容可用、下单链路某阶段完成等业务终点仍需应用定义。自定义指标也要沿用同一套时钟、采样、schema 和隐私规则。
常见误区
- 用 FrameCallback 次数计算“实际呈现 FPS”,忽略窗口是否产出新 buffer。
- 在 API 24—30 用名义刷新周期冒充 FrameMetrics 的精确
DEADLINE。 - 异步持有 JankStats 的
FrameData,忽略对象会被下一帧重用。 - 用
onWindowFocusChanged()作为 TTID,或把attachBaseContext()当作系统 launch 起点。 - 把 App Startup 描述成启动监控库。
- 把 watchdog 的主线程停顿候选计入系统 ANR 率。
- 在 Android 17 的普通应用中监听
/data/anr/traces.txt。 - hook SIGQUIT 后影响 ART SignalCatcher 的系统取栈。
- 用异常触发样本计算总体发生率。
- 改变采样率、jank 算法或桶边界,却不升级 schema。
- 把 View 渲染指标用于 OpenGL/Vulkan 游戏主画面。
- 报警只有阈值,没有样本量、覆盖率和发布对照。
参考资料
指标与平台计量
Android 17 源码索引
frameworks/base/core/java/android/view/Choreographer.javaframeworks/base/core/java/android/view/Window.javaframeworks/base/services/core/java/com/android/server/am/ProcessErrorStateRecord.javaframeworks/base/services/core/java/com/android/server/am/StackTracesDumpHelper.javaart/runtime/signal_catcher.ccpackages/modules/Profiling/framework/java/android/os/ProfilingManager.javapackages/modules/Profiling/framework/java/android/os/ProfilingTrigger.java