R8 Configuration Analyzer 与 keep 规则体积归因
R8 体积问题常由多条 keep 规则叠加造成,只看最终 APK,回答不了是哪条配置留下了哪些符号。Configuration Analyzer 把每条规则和它保留的类、字段、方法对上,方便按功能正确性和体积收益逐条收窄。
为什么需要单独看 R8 Configuration Analyzer
做 APK(Android 应用安装包)体积排查 时,我们通常先用 APK Analyzer 看 classes.dex(DEX,Android 运行时执行的字节码格式)、resources.arsc、res/、lib/ 哪一块在增长,再判断该调整 R8、资源、图片还是 native(C/C++ 本地代码)库。这一步回答的是“结果变大在哪里”。
至于哪条 keep 规则让 R8 放弃了哪些处理,APK Analyzer 给不出答案,这正好交给 Configuration Analyzer 来回答。R8 是 Android 构建中的代码缩减与优化器,keep 规则用于声明哪些类或成员必须保留,以及能否删除、改写或重命名。Configuration Analyzer 把最终合并后的配置映射到类、字段和方法,给出 shrinking(删除不可达代码)、optimization(内联、类合并等代码改写)、obfuscation(缩短名称)三类分数,并列出影响最大的规则和被其它规则覆盖的规则。
还有一层现实:最终生效的配置是多份文件合并的结果——AGP(Android Gradle Plugin,Android 构建插件)默认规则、App 自定义规则、AAR(Android Library 的发布包)携带的 consumer rules(交给使用方 App 的规则),以及部分工具生成的规则都会合并进来,proguard-rules.pro 只是其中之一。各来源分别留下了什么,要在合并结果里找。
拿到报告之前,先把它的统计范围说清楚:score(分数)与 rule impact(规则影响范围)统计的是哪些类、字段、方法仍允许被处理;单条规则对应多少 DEX 字节、启动耗时会不会变,要靠别的证据回答。跑分析的独立任务(standalone task)也不产出 APK 或 AAB(Android App Bundle,供应用商店生成设备 APK 的发布包)。所以归因体积时,我们要把报告与同一次完整构建的 APK Analyzer 结果、mapping(混淆映射)和 benchmark(基准测试)配对。
Android 17 与构建工具版本边界
R8 和 Configuration Analyzer 运行在构建主机,发布周期独立于 Android 平台。android-17.0.0_r1 不包含这个 AGP 分析工具,android17-6.18-2026-06_r6 也不参与 keep rule 合并、whole-program analysis(把 App 与依赖放进同一程序图分析)或分数计算。
Android 17 / API 37 在这里有两个作用:
compileSdk=37时,R8 把 API 37 的android.jar作为 platform library(平台库输入),再结合minSdk(最低运行 API)、程序类和依赖建立分析图;- 优化后的 release artifact(发布制品)要在 Android 17 实机或模拟器上覆盖反射、JNI(Java Native Interface,Java/Kotlin 与 C/C++ 的调用边界)、序列化、组件启动和动态加载路径。
所以报告要同时记录 AGP、R8、JDK、Gradle、compileSdk=37、minSdk、variant(构建变体,如 release)、依赖锁和代码提交;只写“已在 Android 17 验证”,别人复现不出你的 Analyzer 结果,升级 R8 后分数的统计实现也可能变化。
三条报告生成路径
拿到报告有三条路径:AGP 9.3.0 及以上的独立任务、完整 release 构建的自动报告,以及旧 AGP 配合替换版 R8 的系统属性。三条路径的前提相同,官方只给出两种准入方式:用 AGP 9.3.0 及以上,或把旧 AGP 内置的 R8 替换为 9.3.7-dev 及以上。Configuration Analyzer 最早随 AGP 9.3.0-alpha05 预览,当前文档按 AGP 9.3.0 正式版本描述。
AGP 9.3.0 及以上提供一个独立任务,适合本地迭代 keep 规则:
./gradlew :app:analyzeReleaseR8Config
这个任务跳过 APK/AAB 生成,供人查看的报告写入 app/build/reports/r8/r8-config-analyzer-release.html。当前官方 r8-analyzer 工作流还引用同目录的 r8-config-analyzer-release.pb,把 Protocol Buffers(protobuf,二进制结构化数据)转换成 JSON 后做定量汇总;这是该工作流描述的处理路径,转换入口和 schema 仍需版本核验。HTML 和这份 JSON 都只反映规则影响;最终包体和运行时验证,要靠完整构建补上。
启用 R8 的完整 release 构建会自动生成报告:
./gradlew :app:assembleRelease
默认路径是 app/build/outputs/mapping/release/configanalyzer.html;模块名和 variant 改变时,路径中的 app、release 也随之改变。若确有需要,可以用 android.experimental.r8.enableR8ConfigurationAnalyzer=false 关闭完整构建的自动报告。
AGP 9.2 及更早版本把内置 R8 替换为 9.3.7-dev 或更新版后,用下面的系统属性生成 HTML。系统属性只负责请求报告,不会升级 R8,替换步骤仍要按 R8 官方说明做:
mkdir -p /tmp/r8analysis

./gradlew :app:assembleRelease \
  -Dcom.android.tools.r8.dumpkeepradiushtmltodirectory=/tmp/r8analysis
dumpkeepradiushtmltodirectory 是 R8 的系统属性,和 AGP 9.3 那个独立任务是两个入口。CI(Continuous Integration,持续集成)里使用前,先固定替换版 R8 的下载来源和校验值,避免 -dev 制品在版本字符串不变时被换成另一次构建。
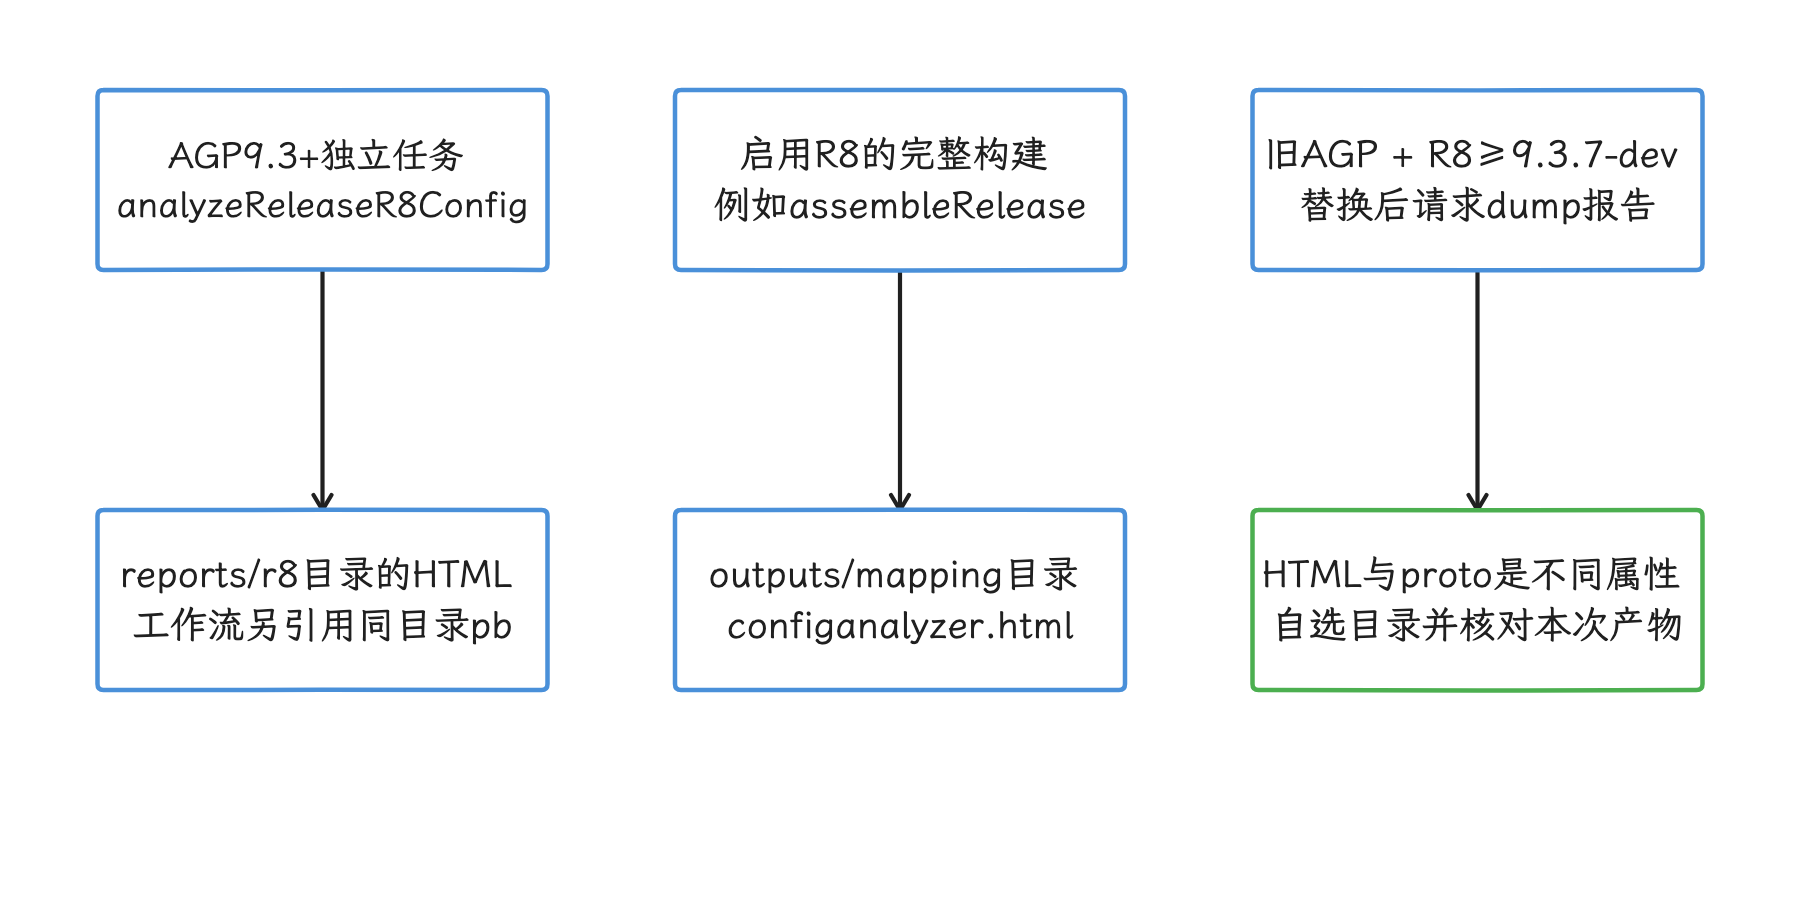
图:AGP独立任务、完整R8构建和旧AGP替换编译器使用不同入口与输出路径。 系统属性只请求报告,不负责升级R8;独立任务不生成APK/AAB,报告不能替代release回归。
AGP 9.3 的 optimization DSL
AGP 9.3 及以上改了优化开关和 App keep 规则的存放位置:用 optimization.enable 同时开启代码和资源优化,App keep 规则放在 src/<variant>/keepRules/ source set(按构建变体组织的源码目录)下,文件名以 .keep 结尾。下面的 Kotlin DSL(构建配置语法)用于 release variant:
android {
    buildTypes {
        release {
            optimization {
                enable = true
            }
        }
    }
}
例如公共规则可以放在 src/main/keepRules/app.keep。AGP 9.3 默认规则等价于 proguard-android-optimize.txt。旧版 AGP 继续使用 isMinifyEnabled=true、isShrinkResources=true 和 proguardFiles(...)。AGP 9.3 仍支持这套旧 DSL,keepRules source set 也能与旧 DSL 配合使用;采用新 optimization DSL 时,App 规则必须放在上述 .keep source set 中。
报告里哪些字段该看
报告首页的三类分数,衡量的是“仍允许 R8 处理的类、字段和方法占比”。读数时我们先记住两点:它衡量的是剩余处理空间,已经获得的字节或性能收益要另行测量;跨 R8 版本直接比较绝对值也靠不住。以本次核对的 R8 9.4.14 HTML 为例,overall 的分母是分析时的 live class、field、method 个数之和,每项权重均为 1;一个元素只要被任一规则施加了对应限制,就计入受限数,多条规则约束同一个元素时只算一次。分数按 100 × (1 - 受限元素数 / live元素数) 解释,前提是分母大于 0;全局 -dont* 选项会把对应能力的分数置为 0。所以,它统计的是分析图中的元素数量,最终 DEX 字节和已删除代码的比例要另外换算。
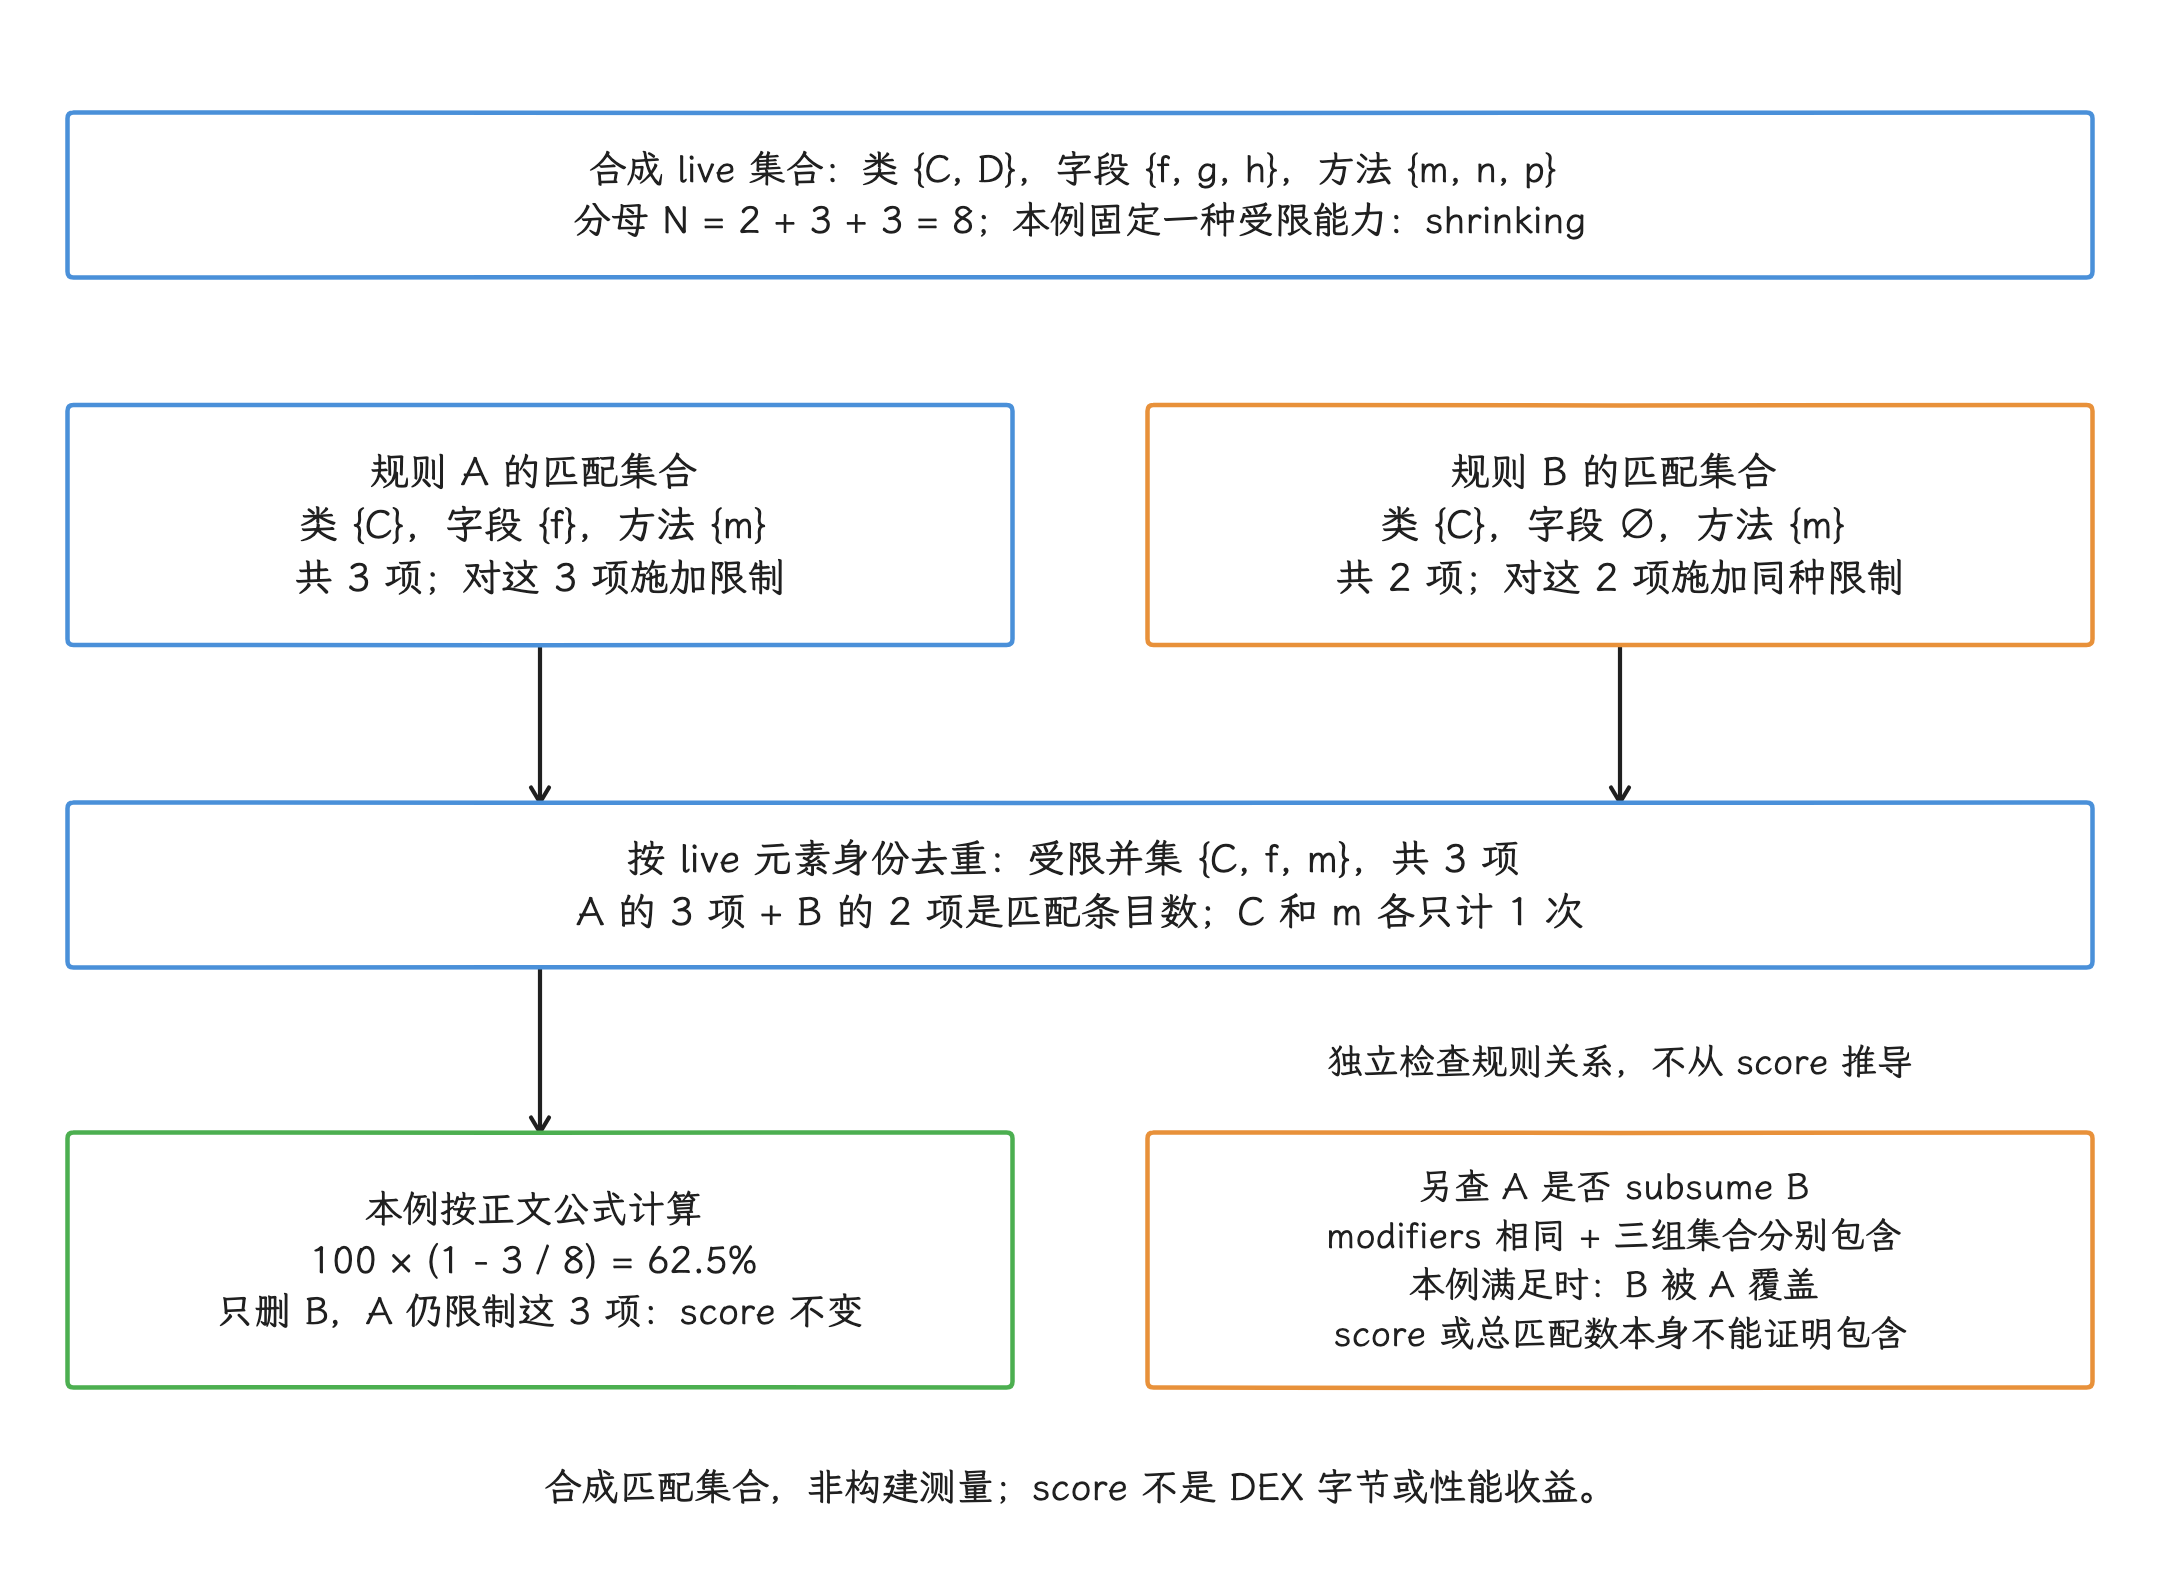
图:固定正文所述R8 9.4.14口径的合成匹配集合,非实际构建报告。只看一个能力(本例shrinking),A/B均施加该限制,无全局dont选项;live类2、字段3、方法3共8项,每项权重1。A命中C/f/m,B命中C/m,受限并集3项,按正文公式得到62.5%,不是把5条匹配重复相加。B被A subsume还须两者modifiers相同且类/字段/方法三组分别包含;不能从score或总数直接推出包含。只删冗余B仍有A限制这3项,本例score不变;要收窄A先确认真实运行时契约。分数不表示节省DEX字节或运行收益,UI显示取整未在本图复刻。
表格里的 full mode 指 R8 full mode(完整模式):AGP 8.0 起默认启用的优化模式,它允许 R8 做更积极的全程序分析与代码改写。
| 指标 | 它衡量什么 | 分数下降时先看哪里 |
|---|---|---|
| Shrinking score | 类、字段、方法中仍允许被删除的比例 | 包级 keep、-dontshrink、过宽的 -keep class ** { *; } |
| Optimization score | 仍允许被内联、类合并、访问级别调整等优化处理的比例 | -dontoptimize、未加 allowoptimization 的宽规则、为兼容 full mode 添加的临时宽规则 |
| Obfuscation score | 仍允许被重命名的比例 | -dontobfuscate、协议字段名和反射类名被整包固定 |
这三个分数要结合规则列表一起读。shrinking score 下降了,可能是 App 新增了一条宽规则,也可能是第三方 SDK 更新后扩大了 consumer rules 的匹配范围;报告里的来源文件和依赖信息,可以帮我们把 App 规则、library consumer rules 和 AGP 默认规则区分开。读来源时留意:序列化数据的 source 保存的是规则原文,在已核对的 R8 9.4.14 中,来源要经 origin、文件表和 Maven 信息关联,把它直接当文件或 Maven 坐标会读错。处理顺序上,App 规则我们直接改;库规则优先升级 SDK 或反馈库作者;AGP 默认规则只做识别,保持原样。规则是否真正生效也要分辨:AGP 9.0+ 会过滤 library consumer rules 中的全局选项,例如 -dontobfuscate;排查优化受限时,先查 App 自己声明的全局规则,库中已被过滤的声明可以先放到一边。
还要记住多条 keep 规则的限制会叠加:AAR 已经带入的宽规则,App 再加一条窄规则也抵消不掉。必须临时验证潜在收益时,AGP 8.4 及以上可以用 optimization.keepRules.ignoreFrom("group:artifact") 过滤指定 Maven 坐标的依赖规则,再由 App 补回确有运行时需要的部分;AGP 7.3~8.3 的旧接口名是 ignoreExternalDependencies()。过滤会改变库作者声明的运行时契约(反射、JNI 等路径依赖的名称、成员和元数据约束),我们把它留给隔离实验和有完整回归覆盖的受控构建。
impactful rules(高影响规则)按每条 keep 规则涉及的类、字段和方法数量聚合,用来排优先级。我们先看影响范围最大的规则,再确认它是否对应真实的反射、JNI 或动态加载入口。
subsumed rules 要结合当前工具的比较条件来读。已复核的 R8 9.4.14 的判定条件相当严格:两条规则的 modifiers(例如 allowoptimization)相同,且类、字段、方法三组匹配集合都分别被包含,才报告对应的 subsumed 关系;所以包名模式更宽、匹配数量更多,都推不出“一定会标成 subsumed”。典型例子是同一个包里同时存在下面两条声明:
# 规则 A:保留整个包
-keep class com.example.package.** { *; }

# 规则 B:保留包内一个类
-keep class com.example.package.MyClass
规则 A 已经覆盖了规则 B,报告会把这种重叠关系暴露出来。我们处理时先确认 A 是否过宽:只有 MyClass 需要保留,就收窄 A;整包都要保留,再看 B 是否冗余。
报告还会列出两类配置噪声:
- unused rule:当前构建没有匹配任何类、字段或方法;删除前要确认它是否用于其它 flavor(产品变体)、dynamic feature(按需交付模块)或可选依赖;
- identical rule:同一文件或多个配置来源中存在相同声明;移除副本不会改变当前匹配集合,但仍应通过完整构建确认。
unused、identical 和 subsumed 描述的都是当前 variant 的配置关系;要把它们变成删除动作,先在其它构建变体上重新确认一遍。
keep 规则的代价分级
评估一条 keep 规则的代价,我们得看得比“删不删”更细。同一条规则可能同时影响四件事:是否允许删除、是否允许重命名、是否允许优化、是否保留 class file attribute;规则越宽,R8 能处理的空间就越小。
| 规则影响 | 常见触发方式 | 典型后果 | 修正方向 |
|---|---|---|---|
| 阻止 shrinking | -keep class com.、-dontshrink | 未使用类和成员留在 DEX 中 | 改成精确类、接口实现、注解匹配或成员级规则 |
| 阻止 obfuscation | 直接 -keep 类名或字段名 | DEX 字符串池保留较长名称,短名压缩空间减少 | 确认运行时是否依赖名字;不依赖就加 allowobfuscation |
| 阻止 optimization | 宽规则未放开 optimization、-dontoptimize | 方法内联、类合并、访问级别调整受限 | 不用全局禁用;对安全范围加 allowoptimization |
| attribute 保留不足 | full mode 下只写 -keepattributes Signature | 反射框架读不到泛型、内部类或注解等 class file attribute(类文件元数据) | 同时 keep 关联类、字段或方法,并尽量放开混淆和优化 |
allowshrinking、allowobfuscation、allowoptimization 分别允许 R8 删除、重命名或改写匹配项。是否能加这些修饰符,取决于运行时契约依赖什么:
- 框架拿到的是
Class对象、用不到字符串类名时,类名通常允许混淆。 - 如果对象只在某个功能路径使用,功能不用时允许删除,规则可以加
allowshrinking。 - 反射只要求成员存在、调用点形状和访问级别允许变化时,可以考虑
allowoptimization,用 release 包跑覆盖测试确认。 - JSON 协议、JNI 查找或服务端下发类名依赖原始名字时,对应的 obfuscation 保持原样。
下面的规则展示怎样缩小 JNI 保护范围:只保留 native 方法和 C/C++ 回调需要的 Java/Kotlin 成员,避免固定整个包。
# 默认优化规则已覆盖 Java/Kotlin 调 native 的 downcall 场景。
-keepclasseswithmembernames,includedescriptorclasses class * {
    native <methods>;
}

# native 层按固定签名回调 Java/Kotlin 时,保留成员及描述符类型。
-keepclassmembers,includedescriptorclasses class com.example.bridge.NativeBridge {
    public void onNativeEvent(com.example.bridge.NativePayload);
}
第一条是默认优化规则中的 JNI downcall(Java/Kotlin 调 C/C++)保护。-keepclasseswithmembernames 仍允许 shrinking,完全未被使用的 native 类或方法靠它保不住;它保护的是最终仍存活的匹配类、成员及相关描述符类型的命名契约,未添加 allowoptimization 时还会限制对应优化。第二条面向 upcall(C/C++ 回调 Java/Kotlin),前提是 NativeBridge 已由 Java/Kotlin 代码实例化并在该构建中保留。-keepclassmembers 单独保不住桥接类;桥接类本身也只从 native 侧访问时,还要单独保留该类,并保护 native 按名查找的构造函数或成员。
includedescriptorclasses 会把方法 descriptor(参数与返回值组成的 JVM 签名)中的应用类型一并纳入保护。native 代码若还按名字访问 NativePayload 的构造函数或字段,这些成员要单独写规则。漏掉 native 查找的类或成员,可能导致 UnsatisfiedLinkError 或 NoSuchMethodError,所以要用启用 R8 的 release 包覆盖这些调用。这两条都比 -keep class com.example.bridge.** { *; } 窄。
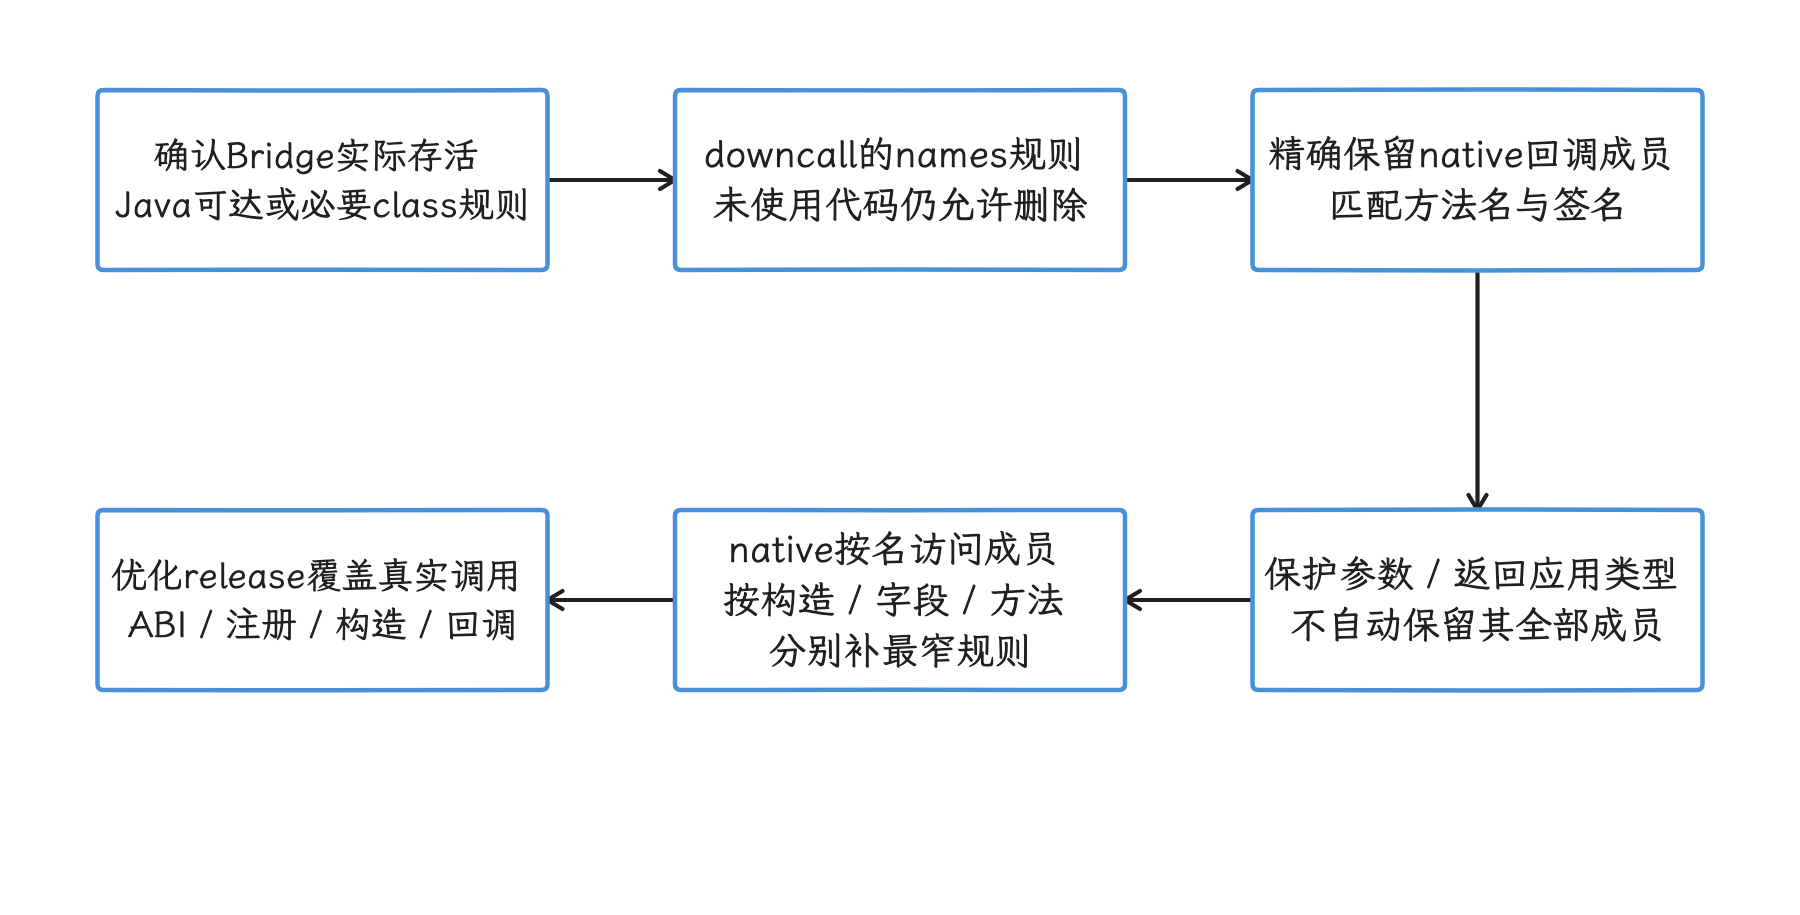
图:先证明Bridge存活,再精确保留upcall成员、描述符类型和native实际访问的成员。 keepclassmembers不独自保活Bridge;保护描述符类不等于保留其构造函数或全部字段。
高风险规则的排查顺序
排查 keep 规则,先别急着删。更稳的顺序是:先根据 APK Analyzer 或 DEX size diff(体积差异)找增长包,再用 Configuration Analyzer 找规则影响范围,随后回到代码确认运行时入口,下面按风险从高到低过一遍常见来源。
- 包级宽规则:优先处理
-keep class ** { *; }、-keep class com.company.** { *; }、-keep class * { *; }。这类规则会同时压低三类分数,常见来源是迁移 R8 full mode 时添加的临时兼容配置。 - 反射框架规则:Gson、Moshi、Jackson、反射式路由、插件化框架要区分“依赖类名”“依赖字段名”“依赖泛型签名”三种契约。只读字段名就保字段,读泛型就保
Signature和相关类型,整个数据模型包则无需全保。 - 代码生成与自带规则的库:Room、Hilt、Moshi codegen(代码生成)通过注解处理器或 KSP(Kotlin Symbol Processing)让 R8 看见静态引用;Gson 2.11.0+、Retrofit 2.10.0+ 自带关键 consumer rules。App 新增大范围临时规则前,先看库版本、AAR 内容和最终
configuration.txt。 - JNI 入口:Java/Kotlin 调 native 的
native <methods>通常由默认优化规则覆盖;native 回调 Java/Kotlin 的 upcall 才需要项目补规则。规则要精确到 bridge(桥接)类或方法签名。 - ServiceLoader 和可选依赖:先判断 R8 能否识别并改写服务加载路径。固定 R8 9.4.14 的 rewriter 支持受限的双参数形式,例如
ServiceLoader.load(Service.class, Service.class.getClassLoader()),并结合打包的META-INF/services/建立 provider 引用;可见的标准路径不一定需要额外 keep;动态 class loader、外部 provider、动态 feature 等路径另查。只有 R8 推导不出的加载契约,才按实际需求保留 provider、构造函数和名称;看到 ServiceLoader 就整包保留,保护范围远超实际需要。 - 注解和泛型签名:R8 full mode 下,attribute 是否保留与被 keep 的类、字段、方法有关。只写
-keepattributes可能不够,接着要确认读取 attribute 的对象也被规则匹配到。
排查时我们同步查看 build/outputs/mapping/<variant>/ 下的四个文件:configuration.txt 是最终合并配置,mapping.txt 记录改名前后的对应关系,seeds.txt 列出被规则阻止删除的元素,usage.txt 列出被删除的元素。要判断规则收窄之后包体有没有变小,四个文件和 Analyzer 报告得来自同一次构建。
与 R8 full mode 迁移的配合
full mode 下,R8 会做更积极的类合并、方法内联、属性裁剪和访问级别调整。迁移失败时的补救动作往往很直接:往 proguard-rules.pro 里加宽规则,甚至在 gradle.properties 里保留 android.enableR8.fullMode=false。这能让崩溃暂时消失,但会长期限制优化空间。
Configuration Analyzer 适合放在 full mode 迁移后的第二轮:第一轮先让 release 包跑完 smoke test(关键路径的基础冒烟测试),第二轮再检查临时宽规则的影响。报告里排名靠前的规则,常来自迁移期间为了先恢复功能而添加的配置。处理时我们把运行时契约拆成可以单独验证的单元:
- Gson
TypeToken依赖Signature与关联类型;Gson 2.11.0+ 已内置这部分 full mode consumer rules。模型字段还要符合规则的匹配条件,例如使用@SerializedName;升级库之后,未注解模型、构造与自定义反射路径未必都自动受保护,App 特有契约仍要自己补。 - 反射构造只需要无参构造函数时,保构造函数即可,整个类的所有字段和方法无需一起保。
- 注解扫描只需要运行时注解时,保
RuntimeVisibleAnnotations和被扫描成员即可,包内其余的类可以放开。 - native upcall 只需要固定被 native 查找的方法签名时,保 bridge 方法就够,整包的混淆和优化照常进行。
如果必须临时关闭 full mode,就把它当定位开关用,并给恢复 full mode 设一个截止时间。长期方案是用 Analyzer 找出压低分数的宽规则,再用 release 回归覆盖序列化、登录、支付、推送、deep link(深链)、插件加载和 JNI 路径。
CI 与回归治理
R8 Configuration Analyzer 更适合做趋势门禁,也就是比较同一项目相邻构建是否变差;绝对分数则只在本项目内有意义。不同 App 的反射、动态加载和 SDK 结构差异很大,同样 80% 的 optimization score,在纯 Compose App 和插件化 App 中含义不同,拿来当所有项目通用的红线会误伤。
基线与候选构建要使用相同的 AGP、R8、JDK、Gradle、variant、依赖图和 Analyzer 生成路径。升级编译器时先建立新基线,避免把编译器带来的分数变化算到业务 keep rule 头上。
CI 里至少归档这些产物:
| 产物 | 建议路径 | 用途 |
|---|---|---|
| analyzer HTML | build/、build/ 或手动输出目录 | 查看三类分数及 impactful、subsumed、unused、identical rules |
configuration. | build/ | 追踪最终合并后的规则来源 |
mapping. | build/ | 判断 obfuscation 是否生效,支持 crash 还原 |
seeds. | build/ | 查看被 keep 的类、字段、方法 |
usage. | build/ | 查看被删除的类、字段、方法 |
| APK / AAB size diff | CI artifact(持续集成归档制品) | 对照 DEX、resources、native 体积变化 |
独立任务本身不产出 APK、AAB、mapping、seeds 或 usage;表中的编译产物来自完整 R8 build,并且要和被比较的 APK/AAB 属于同一次构建。mapping 会被后续构建覆盖,发布时按制品校验值归档。
标准开发者工作流把 HTML 作为供人阅读的报告;最新官方 r8-analyzer skill 还会读取 protobuf:AGP 9.3 路径使用独立任务生成的 .pb,旧 AGP + R8 9.3.7-dev 及以上路径使用 dumpkeepradiustodirectory,随后转换成 JSON。这套流程服务于 skill 自己的分析脚本,其中的 protobuf/JSON schema(字段结构契约)官方并未承诺为稳定的外部 CI API。团队要复用这些数据,就固定 R8 与 skill 版本,给转换和解析脚本加上契约测试,格式变化时先停门禁、转人工检查。
门禁规则建议按“变宽”定义,避免把低分本身当作失败。可执行的评审条件包括:
- 新增或修改的 keep 规则进入团队基线定义的高影响集合。
- shrinking、optimization、obfuscation 任一分数相比主干基线下降超过团队约定阈值。
configuration.txt出现新的包级-keep class xxx.** { *; }或全局-dontshrink、-dontobfuscate、-dontoptimize。- DEX 体积增长和 Analyzer 分数下降同时出现,且增长集中在同一个业务包或 SDK 包。
- 新版 SDK 带入 consumer rules 后,subsumed rules 数量明显增加。
当前仓库的官方 r8-analyzer 文档元数据为 2026-09-22,它分成三条路径:AGP 9.3.0 及以上运行独立任务;旧 AGP 搭配 R8 9.3.7-dev 及以上生成定量数据;更旧 R8 只做启发式规则审查。该工作流的定位是生成摘要和候选清单,keep 规则由人来改。要注意当前仓库只有 SKILL.md 和 references/,文档引用的 scripts/convert_pb_to_json.py 与 scripts/analyze.py 未随目录提供,这些命令能否直接跑起来要先验证。参考文件里的内嵌转换和统计示例同样要小心:转换入口存在缩进问题,自动选择 proto 只是按文件名排序,作为“最新构建”的判据并不可靠。复用时从已固定版本的明确输入文件开始,先校验转换器、schema 与统计输出,再接入 CI。规则背后是运行时契约,反射、JNI、序列化和插件化路径最终由工程师确认覆盖。
与 APK Analyzer / apkanalyzer 的边界
体积排查可以固定成两步:APK Analyzer 或命令行 apkanalyzer 看产物结果,R8 Configuration Analyzer 看 keep 规则原因。
APK Analyzer 适合回答:
classes.dex、resources.arsc、res/、lib/哪一类变大。- 哪个包、哪个资源目录、哪个 ABI 贡献了主要体积。
- 两个 APK / AAB 构建之间有哪些文件级差异。
R8 Configuration Analyzer 适合回答:
- 哪条 keep 规则阻止了最多类、字段、方法被 shrink、optimize 或 obfuscate。
- App 规则、consumer rules、默认 AGP 规则各自贡献了哪些影响。
- 哪些规则互相覆盖,哪些宽规则可以收窄。
- full mode 迁移后,哪些临时宽规则仍在限制优化。
两者合用时,先用 APK Analyzer 确认 DEX 体积异常,再用 Analyzer 找规则原因;异常出在图片、字体或 native 库时,R8 报告里找不到直接答案,这部分回到 25.10 应用体积分析与优化:DEX、Native SO 与资源。
框架规则评审表
通用“框架 keep 模板”很容易随库升级失效。评审时先识别运行时契约,再选择规则:
| 运行时契约 | 需要保护的内容 | 可以尝试放开的能力 | 验证重点 |
|---|---|---|---|
无法被 R8 静态识别的 Class. 名称 | 按实际契约保护类名、类及反射调用的成员 | 能被 R8 解析的字面量调用可能被改写,不必一概固定名字 | 外部下发名称、动态注册、插件入口、可选实现 |
代码直接传递 Class 对象 | 被反射调用的构造函数或成员 | allowobfuscation;未使用实现可 allowshrinking | 每个实现类与低频分支 |
| 按字段名序列化 | 对应字段名和字段 | 未被协议读取的成员仍可 shrink/optimize | 旧数据、缺省值、混淆后协议兼容 |
| 读取泛型或注解 | Signature、运行时注解及其关联类/成员 | 不依赖名字的对象可 obfuscate | 泛型返回值、匿名 Type、suspend 接口 |
| Room、Hilt、Moshi codegen | 生成代码和静态引用 | 通常不需要 App 侧保留整个包 | 生成器版本、增量构建、consumer rules |
| JNI upcall | 被回调成员、descriptor 中的应用类型、native 按名访问的成员 | 只放开 native 不依赖的名称和成员 | ABI(二进制接口)、注册方式、构造函数、回调签名 |
Gson 2.11.0+ 与 Retrofit 2.10.0+ 已携带关键 consumer rules。官方示例的价值在解释语法;落到自己项目里,我们先检查依赖版本和 AAR 中的规则,再补 App 特有的数据模型或接口契约,示例照抄意义不大。
Agent 评审的安全边界
R8 Analyzer skill 可以汇总分数、影响较大的规则和重叠关系,也可以标出全局 -dont* 选项。它适合生成候选清单;删除 keep rule 的决定,留给人来做。建议把 agent 工作限制为以下步骤:
- 读取 Gradle、AGP、R8、variant 和依赖锁;
- 生成或读取 Analyzer 报告,不修改规则;
- 把候选规则映射到 source file、依赖坐标和受影响元素;
- 提出更窄规则与必须覆盖的运行时路径;
- 由工程师批准变更并运行 release 构建、功能回归、体积对比和性能测试;
- 把失败样本、mapping 和最终规则归档。
第三方登录回调、支付、push receiver(推送接收组件)、dynamic feature、JNI crash 上报和旧数据反序列化,这些路径日常 smoke test 往往覆盖不到。手头没有这些路径的用例时,先保留规则,同时把证据缺口记录下来。
参考资料
- R8 Configuration Analyzer
- Enable app optimization with R8
- Use R8 in full mode
- Add keep rules
- Keep rule use cases and examples
- Choose libraries wisely
- Troubleshoot R8 optimization
- Analyze a build with APK Analyzer
- R8 source and AGP replacement instructions
- R8 9.4.14 subsumption 实现:相同 modifiers 与三组集合包含
- R8 9.4.14 ServiceLoader 改写条件
- R8 9.4.14 可解析反射的改写
- R8 9.4.14 官方预构建制品
- Official r8-analyzer skill
- Configuration Analyzer data generation
- Android 17 platform manifest
- Android 17 common kernel 6.18 Makefile