Android Performance Analyzer 与 GAPS:性能追踪与目标可达性
性能调查既要复现目标路径,也要测量路径执行时的行为。Android Performance Analyzer(APA)用系统 trace 观察线程、帧和资源;GAPS 通过静态路径重建与动态执行验证目标方法是否可达。两者解决不同问题:触达目标方法只是测量的前提,它是否就是性能瓶颈,要靠后面的测量来回答。
源码基线:设备侧 Android 17 / API 37 / AOSP
android-17.0.0_r1;内核android17-6.18-2026-06_r6。
APA 是 Google 独立分发的性能分析工具;截至本轮复核,当前首页明确主要面向游戏与 Vulkan 图形,其他 App 优先使用 Android Studio Profiler;2026 年 5 月的发布文还说明,其 System Trace viewer 已进入 Android Studio Panda 4 Canary 及后续版本。本文的 APA 操作流程以独立版 System Profiler 为准。它支持 Android 12 及以上的受支持设备,发布周期独立于 Android 平台,Android 17 新增的 framework API 与它是两条线。
System Profiler 在 2026 年 5 月 19 日以 open beta 发布。当前应按 APA 自己的发布说明区分版本与通道:0.10.0-canary(2026 年 9 月)已加入实验性 Frame Profiler。旧交叉链接里的 Beta 字样不能代替当前发布记录;本文后续操作仍聚焦独立版 System Profiler。
System Profiler 负责录制 system trace(系统追踪)、在 Project(组织多份 trace 的项目容器)中保存多份 trace、查看 CPU/GPU/内存/功耗与 SurfaceFlinger 事件,并运行 PerfettoSQL。APA canary 的 Frame Profiler 则走 GFXR 捕获与逐 render pass 重放测量,还可导出 .rdc 交给 RenderDoc;兼容范围与预热、重复测量条件见 15.11。两条流程分别记录版本和测量条件。
统一性能检查与系统证据
这一大节回答的问题很实际:拿到一个卡顿、变慢或耗电的现场,怎样用 APA 把系统证据采全、读对。我们从前到后走一遍:先确认 APA 在工具链中的位置,再装好环境、选对构建、走完录制流程,最后在 Trace View 里把线程、帧、内存三类线索对上。
1. APA 在工具链中的位置
APA 的 System Profiler 依赖 Perfetto 采集 system trace。我们先分清设备侧和桌面侧各自的职责:设备侧的 tracing service 协调录制,producer 注册并写入数据,data source 表示可采集的数据类型,trace buffer 暂存生成的 trace packet(追踪数据包);桌面端 APA 负责配置录制、取回 trace、展示时间轨道和执行查询。AGI 文档仍把 APA 列为 system profiling 的推荐工具。逐帧问题还要区分 APA canary Frame Profiler 的 GFXR 性能测量、AGI Frame Profiler 的 .gfxtrace 命令/资源分析,以及 RenderDoc 图形调试;它们不是同一种捕获文件或重放引擎。
| 层次 | 组件 | 职责 |
|---|---|---|
| Android App / 游戏 | Java、Kotlin、C/C++、Vulkan、应用 trace marker(自定义时间标记) | 产生业务工作和可读标记 |
| Android framework | ART(Android Runtime)、Binder IPC(Android 跨进程通信)、HWUI(UI 硬件加速渲染库)、FrameTimeline(预期/实际帧时间线)、SurfaceFlinger | 产生线程、帧、buffer 与系统服务事件 |
| Linux kernel | ftrace(内核事件追踪)、scheduler(调度器)、frequency(频率)、idle(空闲状态)、IRQ(硬件中断请求) | 记录线程何时被唤醒、运行、抢占或阻塞 |
| Perfetto | tracing service、producer、data source、Trace(录制配置)、trace packet | 统一配置、时间轴和二进制 trace |
| APA System Profiler | Project、Record Trace、Trace View、PerfettoSQL | 交互录制、项目化管理和人工分析 |
自定义录制配置的协议定义在 external/perfetto/protos/perfetto/config/trace_config.proto,tracing service 的源码位于 external/perfetto/src/traced/service/;调度 tracepoint(内核事件记录点)如 sched_switch、sched_wakeup(线程唤醒事件) 则由内核 android17-6.18-2026-06_r6/include/trace/events/sched.h 定义。这些数据在设备侧是什么语义,APA 就显示什么——语义由设备侧决定,桌面工具只负责呈现。
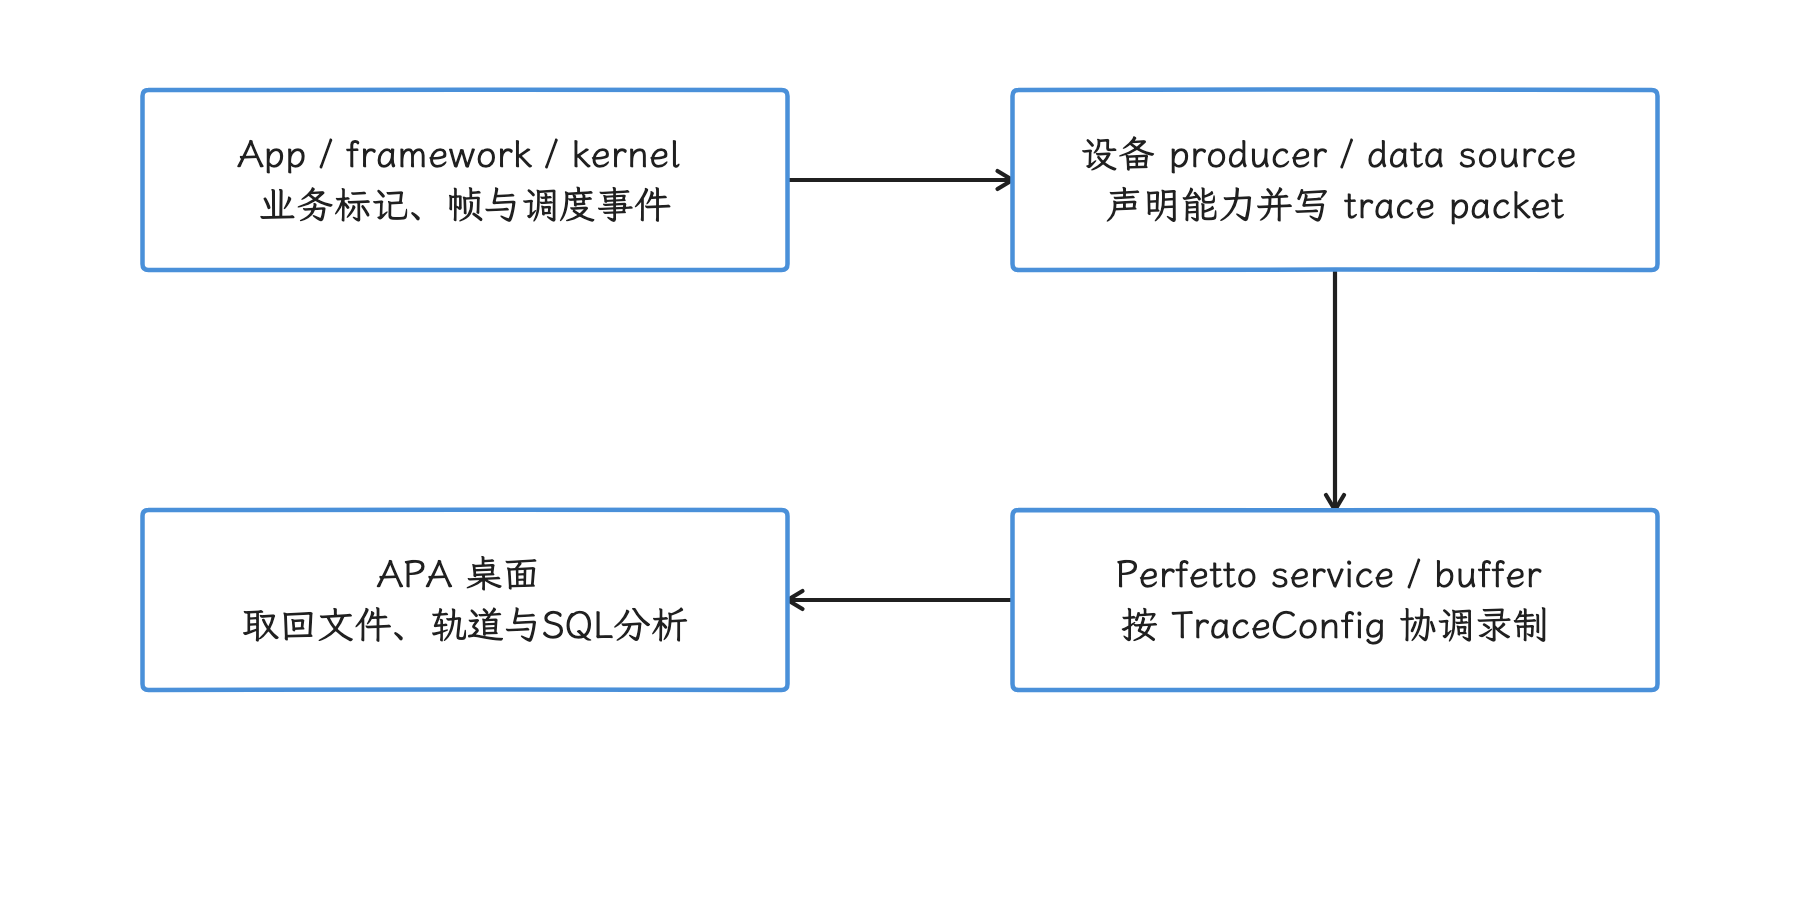
图:App、framework与内核提供事件,设备Perfetto协调并保存,APA取回展示和查询。 同一时间轴不能自动补齐未采集数据或把相邻事件变成因果。
这也划定了 APA 能证明什么:时间上相邻的两个事件,我们先当相关线索看;要写成因果结论,还要核对线程状态、flow(跨时间轨道的事件关联)、fence(GPU 或 buffer 的异步完成信号)、调用栈、源码或可重复实验。
2. 安装与设备要求
APA 首页提供 Windows、macOS 和 Linux 安装包。Quickstart 给出的主机要求如下:
- Windows:64 位 Windows 10 或更高版本;
- macOS:macOS 12 或更高版本,并且只支持 Apple Silicon;
- Linux:64 位环境需要相应的 64 位运行库;
- 所有平台都要安装 Android SDK Platform-Tools(包含
adb等设备工具),并把ANDROID_HOME指向 Android SDK 根目录。
设备侧的要求是“受支持的 Android 设备 + Android 12 或更高版本 + USB + 可用 adb debugging(通过 Android Debug Bridge 调试)”。Android 版本达标只是入场条件,过不过支持检查要看具体机型。首次连接新设备时,APA 会跑一次 device validation(设备兼容性检查),期间先把设备放在一边;通过后,Configure a Recording 的设备项旁会出现绿色标记。
不同设备、GPU 与驱动暴露的数据各不相同。GPU counter(周期采样的硬件指标)、GPU queue(GPU 硬件执行队列) 或 Vulkan 信息缺失时,先检查设备支持、驱动、App 构建和录制配置;轨道空着只说明这条数据没采到,要下“GPU 没有工作”的结论,光靠一条空轨道还不够。
3. 被测 App 应该用哪种构建
官方 Quickstart 对 managed-code App(以 Java/Kotlin 为主的应用)与 Vulkan App 给了不同的构建建议;这些建议服务于测量准确性,APA 启动时并不强制:
- Java/Kotlin 性能测量建议使用 release 版本或开启编译、打包优化的性能构建,并设置
debuggable=false,让 ART 运行在接近发布环境的优化状态; - Vulkan App 或游戏若要采集 Vulkan-specific data(Vulkan 专属数据),建议设置
debuggable=true,以便 APA 注入或启用对应的 Vulkan 调试能力; - 纯 C/C++ 或 native game loop(原生游戏循环) 受 ART debug 状态的影响较小,但编译优化、符号、引擎配置和资源包仍要固定。
如果一个 App 同时包含大量 Java/Kotlin 代码和 Vulkan 渲染,单次录制很难兼顾两种目标。我们保留两种实验:
- 接近发布配置(release-like)、不可调试(non-debuggable)的构建,用来测启动、UI、调度和整体帧表现;
- 原生代码优化保持一致、但
debuggable=true的 Vulkan 诊断构建,用来采集 API timing(CPU 侧 API 调用耗时)、render pass(渲染阶段及其附件处理范围) name 或 screenshot(捕获画面)。
这两种构建各测各的目标,绝对时间上的结论别直接互换;构建类型一旦变过,我们就要把 APK(Android 安装包)、代码提交、编译选项和 manifest(应用清单) 状态一并记录下来。
4. 从 Project 到一份可分析的 trace
APA 的基本工作流是:
- 创建或打开 Project;
- 点击 Record Trace;
- 选择 Device 与 launch mode;
- 配置 start/end trigger 和数据源;
- 执行固定的用户操作;
- 手工 Stop,或等待 Duration 到期;
- APA 拉取 trace 并自动打开 Trace View。
Project 适合保存同一问题的多份 trace,不过文件进了同一个 Project,采集条件也未必一致;所以每次录制,我们都要记下设备、build fingerprint(系统构建的唯一标识)、GPU driver、App 版本、刷新率、温度、亮度、电量和测试脚本。
4.1 Launch mode 与 trigger
launch mode 决定 APA 是否负责启动 App,trigger 决定录制何时开始或结束。Configure a Recording 提供两种 launch mode:
- Launch app and record:APA 启动目标 App;
- Record a running app:对已经运行的进程录制,Application 相关选项不可用,start trigger 只能选择 Manual。
启动触发器包括 Manual、On Startup、On Startup with Delay;结束触发器包括 Manual 和 Duration。分析启动问题时用 On Startup,并确认录制的开始时间盖住进程创建和首帧。滑动或游戏这类稳态场景(启动和预热影响已经消退),可以先把数据、账号和页面准备好,再用 Manual 进入目标窗口。
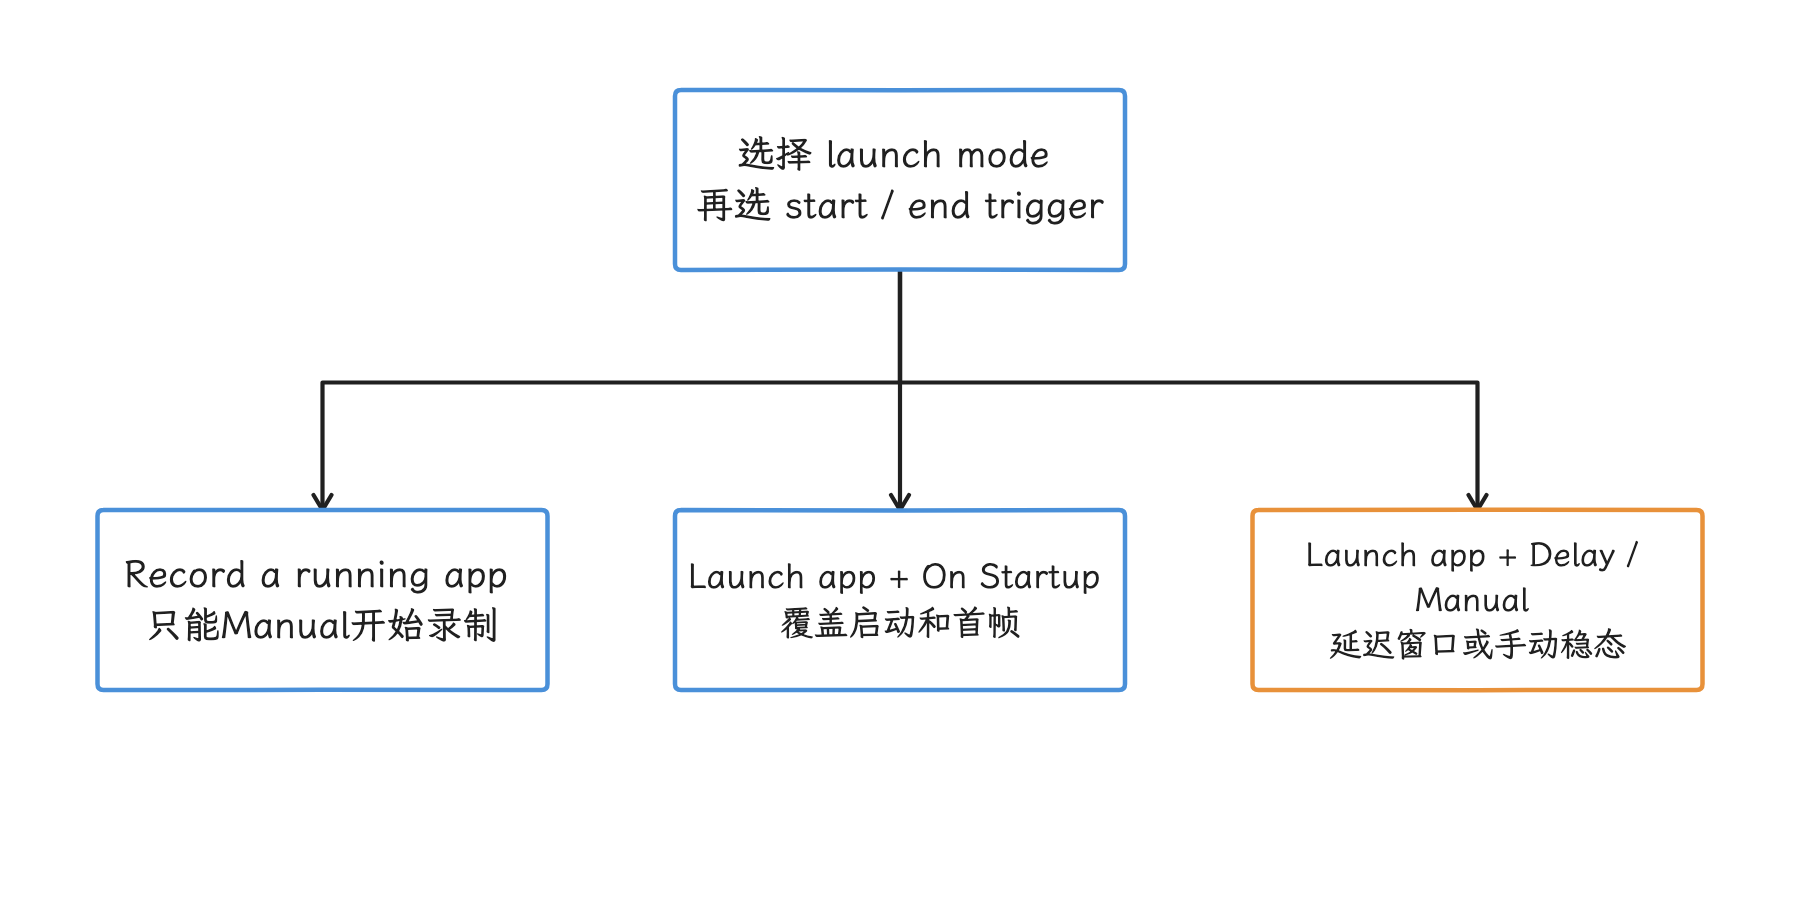
图:先选是否由APA启动App,再按启动或稳态问题选择录制触发。 Record a running app只允许Manual起始;结束触发另选Manual或Duration。
4.2 默认配置与自定义 TraceConfig
System Profiler 默认采集一组 CPU/GPU 指标,也可以在界面上按需勾选。官方建议一分钟以上的 trace 少选 data source,一分钟以内可以多选一些;只是“影响较小”说的是扰动小一些,还没小到可以忽略,仍要用相同配置做对照。
Use custom trace configuration 会把界面当前设置自动展开成 Perfetto TraceConfig textproto(Protocol Buffers 的文本格式)。可以在此基础上勾选或添加数据源。自定义配置要同时检查:
- data source 在目标设备上是否注册;
- buffer 大小与 fill policy(buffer 满后的覆盖或停止策略)是否适合录制时长;
- ftrace event(内核事件)、atrace(应用自定义 trace 事件) category(Android 用户态追踪类别)和 App marker 是否真的产生数据;
- 采样频率是否改变被测负载;
- trace 是否因 buffer 覆盖、flush(把暂存数据写出)或 stop 时机而丢掉目标窗口。
本轮核对的 System Profiler 录制指南使用 GUI 与自定义 TraceConfig,没有将 /system/etc/perfetto-configs/apa-config.textproto、--custom-cpu-freq、--custom-gpu 或 adb shell apa 定义为本流程的入口;本章不依赖这些未在所引指南公开的字符串。本文的 APA 操作步骤以独立桌面 GUI 为准;2026 年 5 月发布文还描述了 Android Studio 集成,两种界面都属于交互式工具,脚本化采集交给 Perfetto CLI、Macrobenchmark(Jetpack 性能基准测试框架)或相应测试工具。
5. Vulkan Layers:能力与扰动
APA 可以在录制时注入 Vulkan layers,也就是加载能拦截 Vulkan API 调用、写入额外调试数据的模块,当前文档列出三类选项。这些 layer 产出的是 trace 增强信息:render pass 名称和截图帮我们认出阶段与画面;逐 draw 的单帧 capture/replay 在这三类 System Profiler layer 的范围之外;APA canary 另有 Frame Profiler,这个范围限制不能外推成整个 APA 不提供逐帧能力。
5.1 CPU Timing
CPU Timing 把 Vulkan API 调用耗时显示为调用线程上的 slice(带开始时间和持续时间的事件)。APA 有意排除 vkCmdDraw 一类高频函数,因为逐次追踪会造成明显开销并扭曲结果。该轨道适合找 API 提交侧的长调用;GPU 执行时间要回到 GPU 侧轨道去看。
5.2 Render Pass Debug Names
Render Pass Debug Names 目前标为 Experimental。它把代码里设置的 Vulkan render pass debug annotation(调试标注)带进 Trace View,方便把 GPU 工作对应到 Shadow、Lighting、PostProcess 等引擎阶段。名字缺失时,依次检查 App 是否 debuggable、对象是否设置 debug name、录制选项是否开启,以及驱动是否提供所需数据。
5.3 Screenshots
Screenshots 也处于 Experimental。它依赖拦截标准 VK_KHR_swapchain(管理待显示图像的 Vulkan 扩展);走其他 present(把图像提交到显示路径) 机制时拿不到截图。截图可以帮我们辨认捕获时对应的应用画面;画面有没有交给显示端,要以 present fence 或 FrameTimeline(帧预期与实际时间线) 为准,图片时间戳说明不了这一点。
启用 Vulkan layer 会改变运行环境。需要对外报告性能数字时,我们要另录一份未启用 layer 的基线 trace:诊断 trace 用来查找可疑阶段,基线 trace 用来确认修改后的真实收益。
6. Trace View 中能看到什么
APA 把每条时间轨道(track)上的 trace event 分为三类;我们先把这三类记住,后面每条轨道都能对上号:
- slice 有开始时间与持续时间,例如函数、阶段或 render pass;
- counter 是时点数值,例如频率、内存或电流;
- flow 连接不同 track 上有关联的 slice,用来表示一次工作如何跨线程或子系统传递。
进下表之前先把几个词认全:command buffer 是提交给 GPU 的命令列表;render pass 定义一组渲染附件及其处理范围;framebuffer 是本次渲染使用的颜色、深度等图像附件集合;submission 是一次 GPU 队列提交。stall 是硬件单元在等数据或资源时的停顿,async event 则是起止可能落在不同时间或线程上的异步事件。
当前官方文档列出的主要区域包括:
| 区域 | 数据 | 常见用途 |
|---|---|---|
| CPU Scheduling / Utilization / Frequency | 每核调度 slice、利用率、频率 | 区分 Running、Runnable delay(可运行但尚未获得 CPU)、抢占和频率变化 |
| Battery | current、charge、capacity | 观察趋势;USB 连接会持续充电,不能直接当作脱机功耗 |
| GPU Memory | GPU 内存及全 trace 的 min/max/average | 找资源增长或场景峰值 |
| GPU Queues | 硬件队列工作;Vulkan 场景可含 command buffer、render pass、framebuffer | 估算 GPU 阶段与 submission 关系 |
| Vulkan Events | vk 与 submission_ | 关联 CPU submit 和 GPU queue slice |
| GPU Counters | 设备支持的周期采样 counter | 分析利用率、stall、纹理/顶点带宽;具体含义以 GPU 厂商文档为准 |
| SurfaceFlinger Events | 各 layer 的 On Display、active buffer 与生命周期 | 关联 buffer 到显示阶段 |
| Processes / Threads | 进程、线程、counter、async event | 回到主线程、RenderThread 与工作线程 |
| Actual Timeline | janky frame(卡顿帧)的严重程度与详情 | 从问题帧进入跨层分析 |
USB 充电对 Battery Usage track 有直接影响:APA Quickstart 要求 USB 连接,官方数据说明也提醒设备会在测试期间充电。所以能量类结论要转到规范化功耗测试、Batterystats(Android 电池用量统计)、power rail(硬件电源域计量)或实验室仪器上。
7. 浏览、对照与 SQL
Trace View 支持按名称过滤 track、缩放和平移、pin track(把轨道固定在顶部)、添加 bookmark(时间书签)、选择时间范围,以及用 box selection 一次框选多条轨道中的事件。关闭 trace 后,APA 会保存 pinned tracks、bookmark、zoom 与 scroll position。多份 trace 可以用 tab、window 或 split view(分栏视图) 同时打开;视觉对齐适合复盘,定量比较还是要回到相同的 SQL 或 benchmark metric(固定定义的基准指标)。
SQL 标签页执行 PerfettoSQL,并保存跨 trace、跨 Project 共享的 query history(历史查询)。下面的查询用于查找 com.android.systemui 中持续至少 8 ms 的 Runnable 区间。
SELECT
  p.name AS process_name,
  t.name AS thread_name,
  ts.ts / 1e9 AS start_s,
  ts.dur / 1e6 AS runnable_ms
FROM thread_state AS ts
JOIN thread AS t USING (utid)
JOIN process AS p USING (upid)
WHERE ts.state IN ('R', 'R+')
  AND p.name = 'com.android.systemui'
  AND ts.dur >= 8e6
ORDER BY ts.dur DESC;
查出来的每一行都在说同一件事:线程已经可运行,但在该区间内没有执行。R 与 R+ 都纳入查询,后者表示被抢占后仍可运行;两类的来源可继续分开分析。原因可能在 CPU 竞争、优先级、调度约束或更高优先级工作上,仅凭一行结果还定不了根因。下一步我们回到对应时间窗,检查 CPU Scheduling、wakeup、当前运行线程、频率与相关 slice。更多查询模式见 14.7 的 Perfetto SQL 查询手册。
当前 Android 工具页列出 perfetto-sql 与 perfetto-trace-analyzer 两个可安装 skill;文档中的工作流标题也可能使用 Perfetto Trace Analysis,供 AI agent 生成查询或给出分析起点。用之前要装好对应 skill;生成结果仍要对着当前 trace 核一遍表、字段、单位和进程范围,AI 给出的自然语言解释当起点就好,最终以 trace 为准。
8. 三类常用分析
8.1 帧耗时
分析一帧时,我们先区分 CPU total time(两次帧提交之间包含等待的总时长)、CPU active time(CPU 实际运行该 App 代码的时长)、GPU time 与最终 present 结果。
- Vulkan 场景可用相邻
vkQueuePresentKHR之间的区间估算 CPU total frame time;其中包含等待 GPU 或 buffer 的时间; - CPU active time 要统计该帧窗口内相关主线程、render thread 和 worker 的 Running 区间;先裁剪到目标帧窗口,再注明如何聚合。跨线程求和得到 CPU 工作量,线程并行时可大于窗口墙钟时长,不能直接当作端到端关键路径;
- GPU slice 可用时,它比 counter 更适合估算 GPU frame time;
- GPU slice 缺失时,可以用 GPU utilization(利用率)、instruction(指令活动) 或 queue counter 的周期模式估算边界,但精度较低;
- 一帧可能包含多次 Vulkan submission,应使用 Vulkan Events 与
submission_id关联同一帧的 GPU 工作; - Actual Timeline 的 jank(卡顿帧) slice(卡顿帧区间)、SurfaceFlinger On Display 和 expected/actual present(预期/实际显示时间)用来确认用户是否晚看到这一帧。
CPU submit 返回、GPU producer completion fence、SurfaceFlinger latch、display present fence 和 layer release fence 是五个不同的时序边界,我们逐个对齐:completion fence 表示 producer 已完成 buffer 写入,consumer 可以安全读取;latch 表示 SurfaceFlinger 选中该 buffer 参与本轮合成;present fence 是本轮 display present 的系统时间基准;release fence 则通知 producer 何时可以复用旧 buffer。把这五个边界对齐之后再回到 APA:vkQueuePresentKHR 调用完成、GPU queue slice 结束,都还证明不了一帧已经显示;接下来要沿 submission ID、buffer/layer、fence 与 FrameTimeline 继续对齐。队列中存在多帧 in flight(已提交、尚未显示)时,FPS 稳定也可能伴随较高的输入到显示延迟。
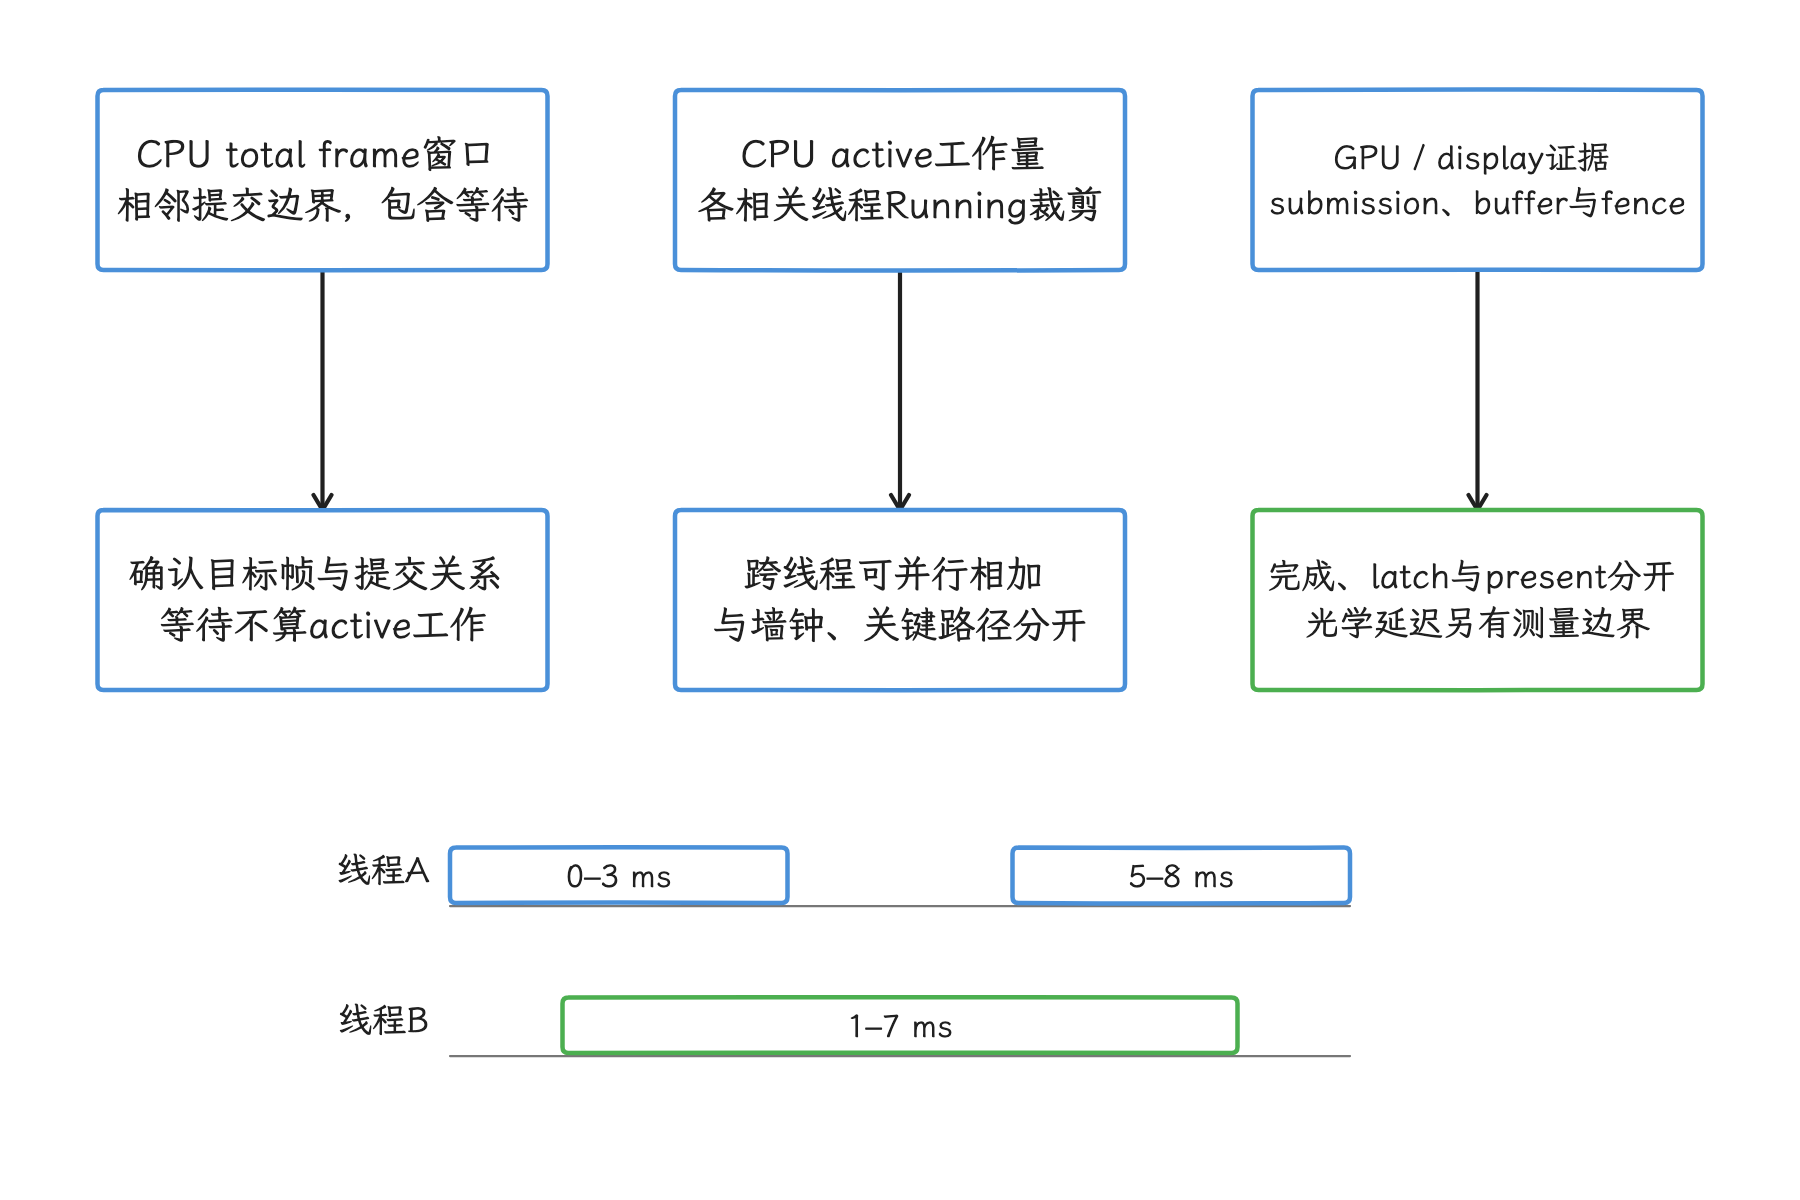
图:CPU窗口、跨线程工作量、GPU完成与显示反馈分别统计和关联。 下方为合成示意:8ms窗口内两线程各运行6ms,CPU总工作量12ms不能当作端到端12ms。
8.2 GPU 内存效率与带宽
APA 官方的 Memory Efficiency 分析主要讨论 GPU counter 与 memory bandwidth(单位时间通过内存总线的数据量);Java heap allocation(堆对象分配) 与泄漏分析属于另一套方法,都不在这条主线上。我们按以下顺序读取:
- 用 counter 周期确定单帧窗口,避免把独立采集的 GPU slice 边界直接套到 counter;
- 查看总 read/write bandwidth;
- 再区分 texture(纹理)、vertex(顶点)、cache(缓存) 与 fetch stall(取数等待);
- 将峰值与 render pass、GPU queue 和帧耗时对齐;
- 到 AGI Frame Profiler 或引擎资源统计中检查纹理格式、mipmap(多级缩小纹理)、vertex layout(顶点数据布局)、render target(渲染输出图像) 和 draw submission(绘制提交批次)。
Adreno 与 Mali 的 counter 名称和计算方法不同,阈值还依赖 GPU、总线、分辨率与工作负载。团队看板要把 GPU 型号、driver、counter 名称和单位绑定在一起;一台设备的数值,换到其他 SoC(System on Chip,片上系统) 上就没有直接可比性。
Java/Kotlin 对象增长、GC(垃圾回收) 与调用栈,交给 Android Studio Memory Profiler、heap dump(堆转储)或 LeakCanary;native heap 则可以结合 heapprofd(Perfetto 原生堆采样器)来分析。APA 提供的是系统时间线上下文。
8.3 线程调度
线程调度分析要区分三类时间:
- Running:线程占用 CPU;
- Runnable:线程具备运行条件,但尚未获得 CPU;
- Sleeping/Blocked:线程等待 timer(定时器)、futex(用户态同步原语的内核等待)、Binder IPC、I/O 或其他依赖。
长 Running 指向工作量,长 Runnable 指向调度延迟,长 Blocked 指向依赖等待,我们靠这三类先把排查方向定下来。若线程频繁迁核或落在不合适的 CPU 上,先检查线程优先级、任务划分、负载和 ADPF(Android Dynamic Performance Framework)的 Performance Hint。官方 APA 调度指南建议用 Performance Hint API 向系统表达性能需求;手工 affinity(把线程绑定到指定 CPU)留作个案处理,别当成通用修复。
调度 tracepoint 的语义由内核决定,APA 展示的 sched_switch、sched_wakeup 反映的是内核调度事实;再往下的 CPU topology(核心层级与大小核布局)、uclamp(调度利用率上下限)、cpuset(任务可使用的 CPU 集合)、thermal(温控限制) 和厂商 scheduler 策略,要结合设备源码与 Perfetto 轨道解释。
9. APA 与其它工具如何分工
| 问题 | 首选工具 | APA 的角色 |
|---|---|---|
| 系统级卡顿、线程调度、CPU/GPU/帧关联 | APA 或 Perfetto UI | Project 化录制、Trace View、SQL、A/B 对照 trace |
| Java/Kotlin 方法热点 | Android Studio CPU Profiler | 提供系统上下文与目标时间窗 |
| Java/Kotlin 分配、GC、对象泄漏 | Memory Profiler、heap dump、LeakCanary | 关联场景、进程内存与帧变化 |
| Vulkan 逐 render pass 成本或单帧资源问题 | APA canary Frame Profiler(性能)、AGI Frame Profiler、RenderDoc | System Profiler 先确定异常窗口;逐帧工具再按文件、设备兼容与调试目的选择 |
| WindowManager、SurfaceFlinger 状态机和跨窗口问题 | Winscope | 提供 buffer、layer 和帧时间线线索 |
| 可重复启动、滚动和帧指标 | Macrobenchmark | 对异常样本做人工 trace 复盘 |
| CI 批量指标 | Trace Processor、PerfettoSQL | 人工打开回归 trace |
| 线上真实用户 trace | Profiling + Perfetto UI | APA 不提供线上采集 API;导出的脱敏 trace 能否完整显示,要按 APA 版本验证 |
| 长时间耗电与后台行为 | Batterystats、Battery Historian、statsd | 在短时 trace 中关联 CPU/GPU/电流变化 |
表中几个工具先认一下:Winscope 用来看 WindowManager 与 SurfaceFlinger 状态;Macrobenchmark(Jetpack 的可重复性能测试框架)负责可重复的基准测试;CI(Continuous Integration) 是持续集成流水线;ProfilingManager 是面向真实用户设备采集脱敏 profile 的 Android API;statsd 是 Android 系统统计守护进程。它们各管一段,APA 主要承担本地 system trace 的交互分析。
官方仍推荐 APA 做 system profiling;AGI Frame Profiler、Android Studio Profiler、Perfetto CLI、Trace Processor 也都还没有停用的说法。
10. Android 17 平台边界
评审 APA 结论时,版本要分三层记录:
- APA 桌面版本:决定 GUI、默认配置、Vulkan layer、SQL 与文件管理能力;
- Android build fingerprint(系统构建指纹) /
android-17.0.0_r1:决定 framework trace event、Perfetto producer、FrameTimeline 和系统服务行为; - kernel
android17-6.18-2026-06_r6与 vendor driver:决定 scheduler/ftrace 语义、GPU counter、render stage 和设备能力。
APA 安装包不属于 android-17.0.0_r1 framework 源码,在平台 tag 里翻不到它的可执行文件属于正常现象,也不影响这个桌面产品本身的定位。反过来说,APA 文档里出现某项 UI 能力,只代表桌面工具有这个界面;具体某台 Android 17 设备配有哪些 data source,要回到 build fingerprint 与 vendor driver 那两层确认。
11. 一轮可复查的 APA 实验
建议把一次分析记录成以下结构:
- 固定设备、build fingerprint、GPU/driver、刷新率、亮度、电量和温度;
- 固定 App APK、代码提交、构建类型、
debuggable与引擎配置; - 固定 APA 版本与 Project;
- 切换到 Use custom trace configuration,复制并保存界面生成的
TraceConfig; - 固定 launch mode、trigger、duration、测试数据和操作脚本;
- 录制基线 trace,标记异常帧和时间窗;
- 用 track、flow、详情面板与 SQL 形成一个能被后续证据验证或推翻的原因假设;
- 修改后用同一配置、同一场景重录;
- 并排打开两份 trace,再用同一 SQL 或 Macrobenchmark metric 做 A/B 对照;
- 保存 trace、查询、截图、结论、反例和仍未验证的部分。
短 trace 适合定位一轮交互,长时间功耗、温升和降频需要专门实验。为了 Trace View 更丰富而把数据源全开,换来的主要是更多扰动;等记录不到目标事件,再按缺口增加 data source。
动态目标可达性与路径重建
系统性能检查定位出异常区域后,接下来我们要回答另一个问题:目标函数或状态怎样被实际执行路径触达。一条路径在静态分析里存在,离它在运行时真正可达还有一段距离,GAPS 类方法补的就是这一段。
方法可达性有两个判定阶段
“静态找到路径”和“设备上执行到目标方法”是两个不同的事件,我们把它们分开判断。这里的 Android 入口指外部可启动的组件或框架回调,和 Java main() 是两回事:
| 阶段 | 成功条件 | 不能推出的结论 |
|---|---|---|
| 静态路径重建 | 至少生成一条包含目标方法的路径 | 路径在当前账号、权限和 UI 状态下一定可执行 |
| 动态目标触达 | AndroLog 日志插桩或 Frida 动态 Hook 观察到目标方法调用 | 该方法造成卡顿、ANR(应用无响应)、耗电或安全影响 |
论文使用 AndroTest 自动交互基准中的 56 个开源应用,每个应用随机选取 50 个目标方法,并让各工具针对同一组目标运行。只有 34.39% 的目标位于 Activity(Android 界面组件) 中,多数目标靠浅层页面遍历是够不到的。
v3 报告的结果如下:
静态路径重建
| 工具 | 生成至少一条路径的目标占比 | 平均分析时间/应用 |
|---|---|---|
| DroidReach | 9.48% | 23.46 秒 |
| FlowDroid | 58.81% | 35.06 秒 |
| GAPS | 88.24% | 12.67 秒 |
这里的 88.24% 只统计“至少生成一条路径”的目标;路径本身的精确率、设备上的真实执行,都还在它的统计范围之外。
动态目标触达
| 工具 | 动态触达率 | 论文表中的平均运行时间 |
|---|---|---|
| GoalExplorer | 4.75% | 30 分钟超时 |
| APE | 11.12% | 30 分钟超时 |
| Guardian | 34% | 30 分钟超时 |
| GAPS(关闭 PHIL) | 23.24% | 2 分 26 秒 |
| GAPS(启用 PHIL) | 56.93% | 3 分 15 秒 |
动态基线均运行三轮,每轮上限 30 分钟。GAPS 在这些实验中没有超过 5 分钟,表中的 3 分 15 秒是平均运行时间,据此写成“所有工具统一使用 5 分钟超时”就对不上了。PHIL 从 23.24% 提升到 56.93% 的消融实验(关闭一个模块后比较结果)也说明,v3 的完整动态结果包含 agent fallback(确定性步骤失败后的代理补救);LLM(Large Language Model,大型语言模型) 已是论文实验的一部分。
GAPS 的处理链
GAPS 把一次查询分成静态分析与动态执行两半,处理链如下。call graph(调用图)记录方法之间的调用关系,GUI 触发点就是需要点击或输入的界面元素:
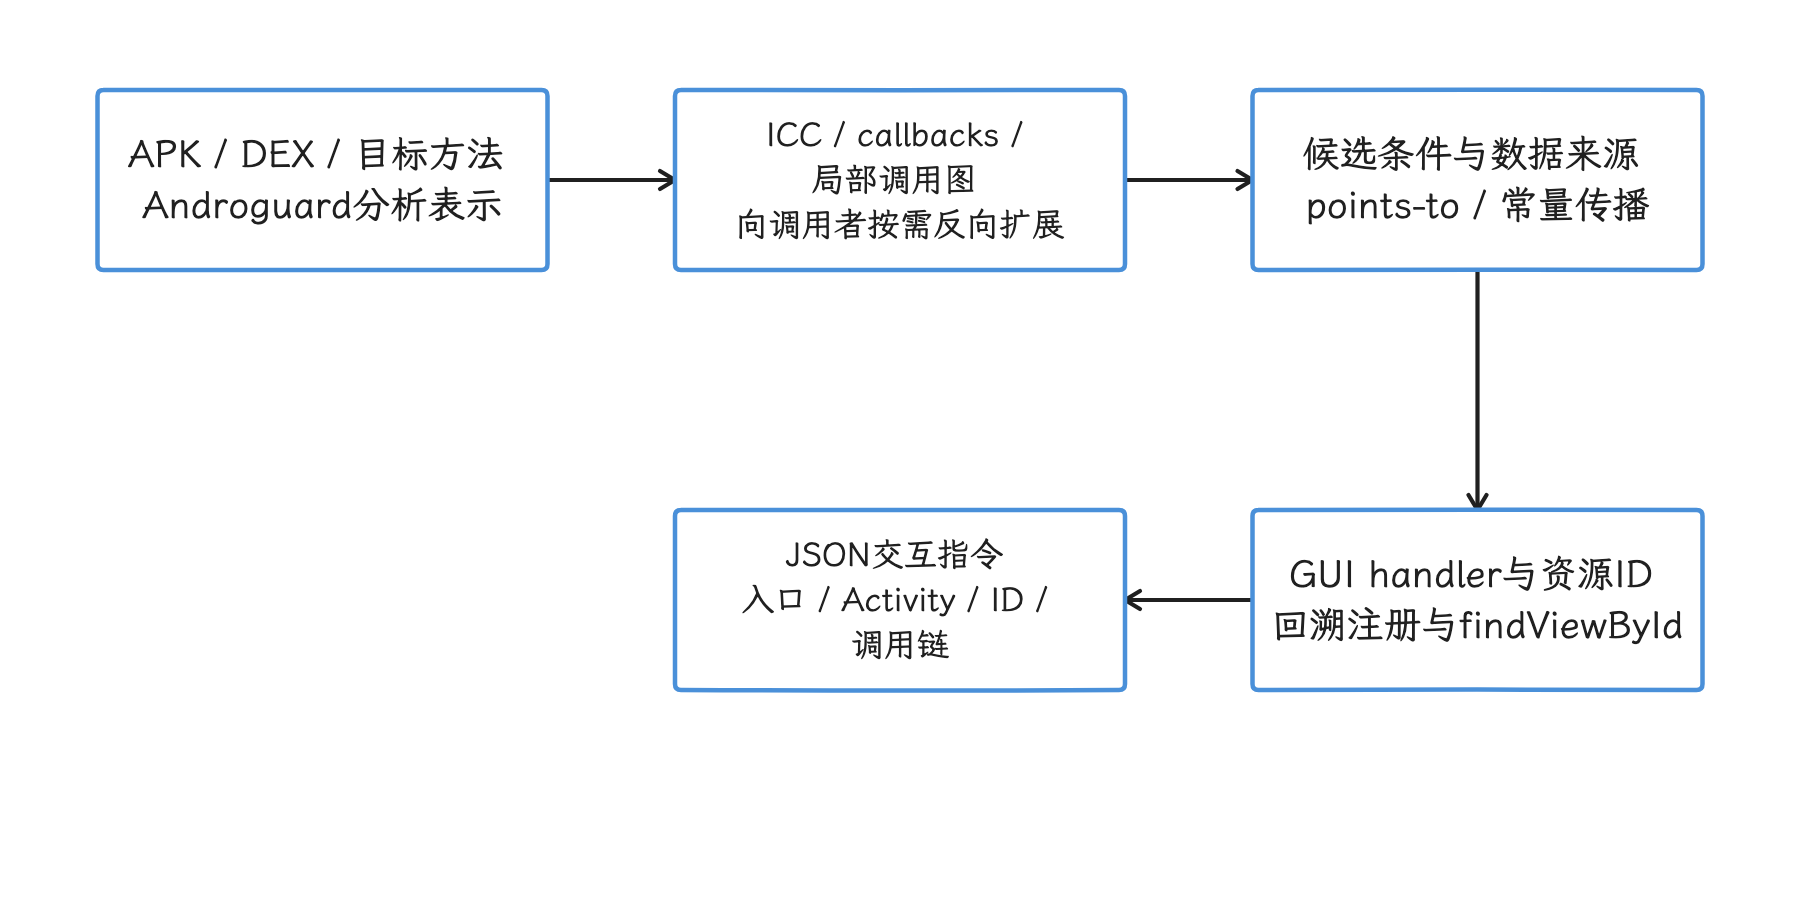
图:从APK/DEX反向恢复候选入口、条件和GUI触发,再生成可执行交互指令。 分析受字节码、回调映射、资源ID与运行时状态限制,不要求源码也不自动恢复全部语义。
目标方法 → 目标导向的反向调用图 → 入口、条件和 GUI 触发点 → JSON 交互指令 → 设备执行 → 运行时触达证据
1. 从 APK/DEX(Android 字节码) 建立分析表示
静态阶段使用 Androguard 的 AnalyzeAPK/AnalyzeDex 读取 APK、DEX、基本块和 smali(DEX 的汇编式文本表示)指令,并用 Python 图算法库 NetworkX 表示局部调用图。Apktool 负责反编译资源表,后续可把 smali 中的整型资源值映射为 public.xml 里的字面量资源 ID。
这条路线直接分析编译产物,不要求应用源码。代价是信息上限受 DEX、资源表、混淆和框架建模能力约束;源码中的类型语义、生成过程和运行期状态不会自动恢复。
2. 识别 Android 入口与 ICC
Android 应用没有单一 main() 入口。ICC(Inter-Component Communication,组件间通信)通过 Intent 连接 Activity、Service、BroadcastReceiver 等组件。GAPS 会检查 manifest 中导出的组件和 intent filter(Intent 匹配规则),也会分析动态注册的 receiver(广播接收器) 及其注册路径。ICC 映射保存组件类名、action(动作字符串) 或关联路径,供反向遍历在合法入口处停止。
论文也交代了这一步的能力范围:带权限的入口、只能由系统发送的广播,以及要求额外 data 参数的 Intent,可能有静态路径,却构造不出可自动执行的输入。当前实现离“完整求解 action、category(分类)、URI(数据地址)和 extras(附加键值参数)”还有距离。本轮执行器还会过滤掉首项第一字段为 intent 的候选路径;静态识别到这类入口,不表示该快照会自动执行相应 Intent。
3. 按目标反向生成局部调用图
GAPS 从目标方法向调用者反向扩展,按需构建 CHA(Class Hierarchy Analysis,类层次分析)图,对运行时才确定实现的虚调用保守列出潜在调用者;遇到已识别入口时停止该分支;完整的整应用调用图并不预先构建,用到哪段建哪段。
v3 的 Algorithm 2 把路径提取写成深度优先遍历 dfs_visit;同一论文的实现说明与本轮复核的 path_generation.py 则使用自定义 all_shortest_paths() 枚举最短路径。它的生成器在 n_paths > max_paths 时才停止,单次调用可多产一条;调用方还按入口分配预算并在合并后检查数量。因此 path_limit 是配置预算,不能当作该快照严格满足的总路径硬上限。复现实验应固定快照文件,只凭伪代码名称去推枚举策略,是靠不住的。
论文将整体分析描述为 target-oriented(围绕目标)、demand-driven(按需扩展)、inter-procedural(跨方法)、context-sensitive(区分调用上下文)。EdgeMiner 与 Soot virtual edges(框架隐式回调边)提供回调映射;不过,未被跟踪的 implicit flow(由框架隐式触发、源码中没有直接调用语句的执行流程)仍会让调用图漏边。
4. 补足条件路径
候选路径中的条件会进入两类分析:points-to analysis(指向分析,追踪引用可能指向哪些对象) 与 constant propagation(常量传播,推导变量可能取到的常量)。v3 明确覆盖三类操作数:
int、String、float等变量和基本类型;- 与
null比较的对象; - 方法返回值。
分析器回溯左右操作数的来源,传播候选常量,再合并能满足条件的赋值路径。这里得到的是静态推导的候选满足路径;它不构成完整运行时可达性证明。账号态、网络返回、随机数、服务端配置等输入仍可能让设备执行停住。
5. 找到 GUI 事件和资源 ID
GAPS 识别 onClick()、onItemSelected() 等 handler(事件处理方法),沿 listener(监听器) 注册和对象来源回溯到 findViewById(),再解析其资源参数。生成的 JSON 指令包含:
- 可执行入口;
Activity名称;- 需要交互的图形元素 ID 序列;
- 对应 call sequence(方法调用序列)。
XML View 体系能提供稳定资源 ID,正好适合这套分析。Jetpack Compose 通过 Kotlin lambda(匿名函数) 挂接事件,界面节点还会随 recomposition(状态变化后的重组)改变;v3 的 Limitations 明确说明当前不支持 Compose。
动态执行:确定性指令加受限 PHIL
动态阶段安装应用,并用 AndroidViewClient 的 findViewById() 与 touch() 执行静态指令。论文 Algorithm 5 在每条候选路径开始前调用 restart_app(),执行器持续轮询 runtime monitor(运行时触达监视器);方法被观察到后返回 REACHED,当前路径走不下去时转试下一条。公开快照的具体重启范围与这段伪代码不同,见下文的重启范围说明。
确定性操作(同一输入按既定指令执行)遇到权限弹窗、广告或动态布局时,v3 会调用 PHIL(Predictive Handler for Interface Limitations,界面障碍预测处理器)。它接收经过筛选的当前 GUI 层级、目标方法和静态路径,输出 click、type 等结构化动作。论文实验写的是 GPT-5.4、temperature(采样随机度)0.7;本轮取回的复现文件 phil.py 则配置 gpt-5.4-mini、temperature 0.7。PHIL 是 LLM 组件,可关闭也可换模型,模型名必须随实验记录,算不上 GAPS 的稳定接口。
PHIL 的调用受到两层约束:
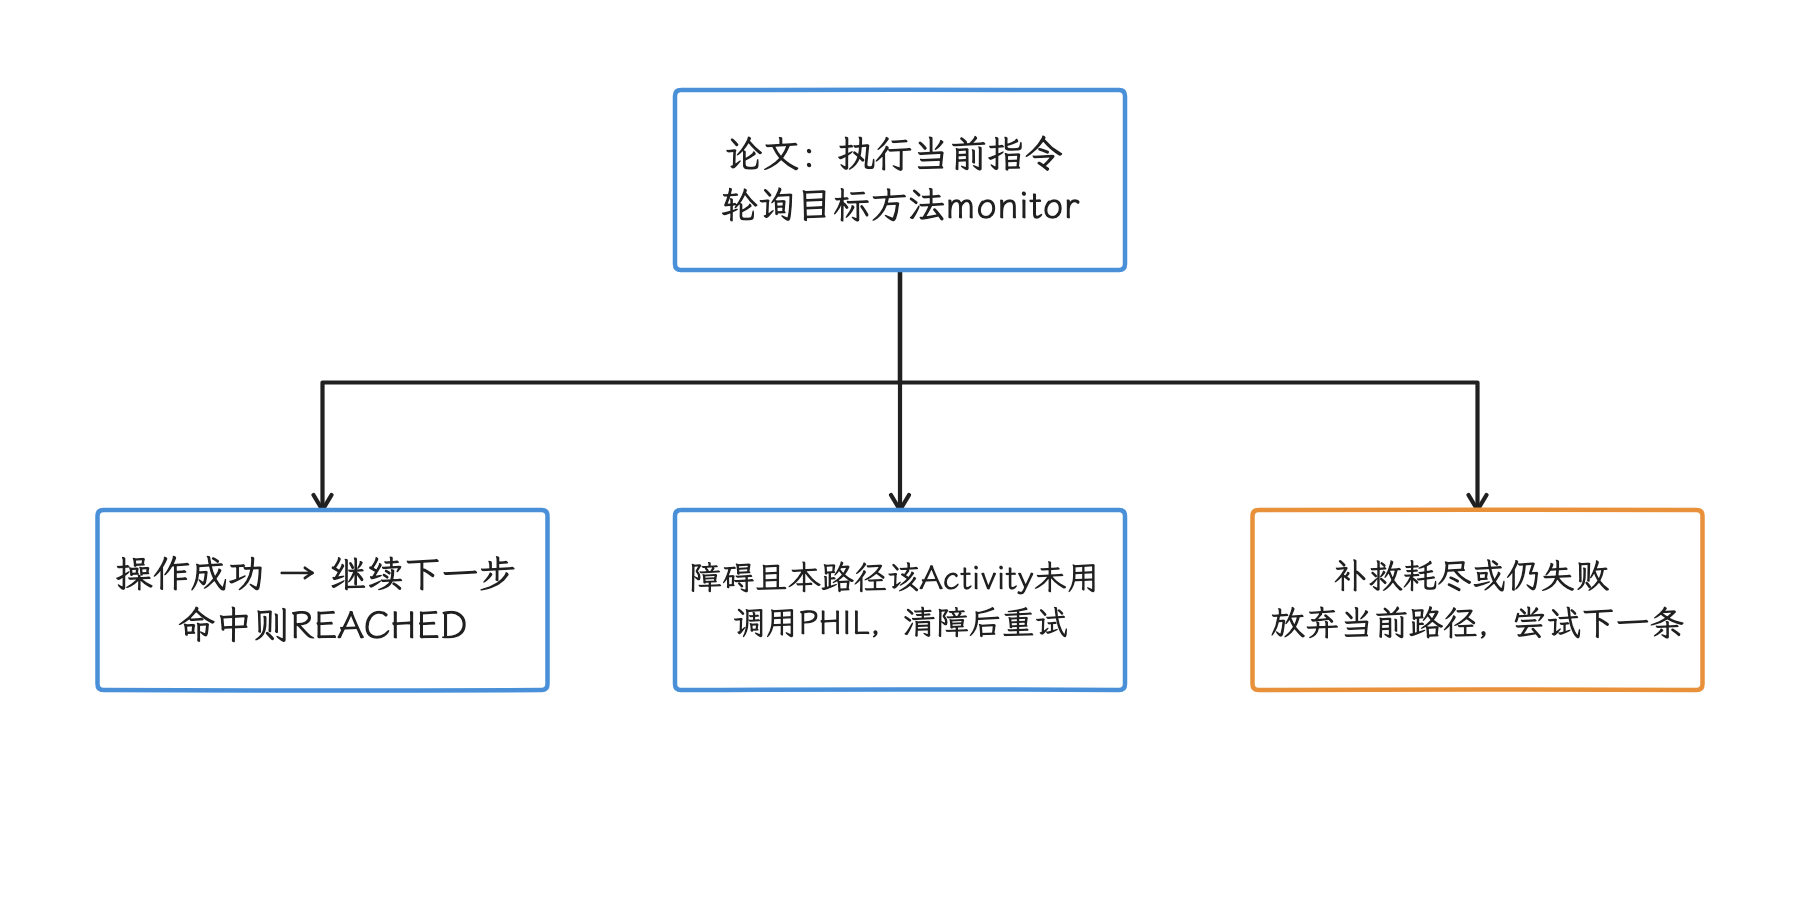
图:论文以静态指令为主,障碍时按每路径每Activity预算补救,并持续检查目标命中。 这是论文控制流;本轮代码的预算作用域和失败后的跳步行为见下一图。
- 每条路径中的同一个
Activity最多介入一次; - 障碍仍未清除,或该
Activity已用过 PHIL 时,当前路径会终止。
以上是论文 Algorithm 5 的语义。本轮复核的 gaps_run.py(内容 SHA-256 前缀 47b7b00773a261b2)把 llm_used 保存在 GAPSRUN 实例上,没有在每条候选路径或每个目标方法开始时清空。若某 Activity 的补救已经用过且动作仍失败,当前代码走 i += 1 跳到后续指令,并不按论文 Algorithm 5 立即放弃该路径。PHIL 线程最多15轮尝试,其中可能只有焦点/层级检查而没有动作;单轮模型请求另有最多3次重试,所以15轮不等于15个成功动作或15次API请求,也不是5分钟硬超时。工程复现时,“每路径每 Activity 一次”这套语义套不到该快照上,实际预算要以固定代码和运行日志确认。
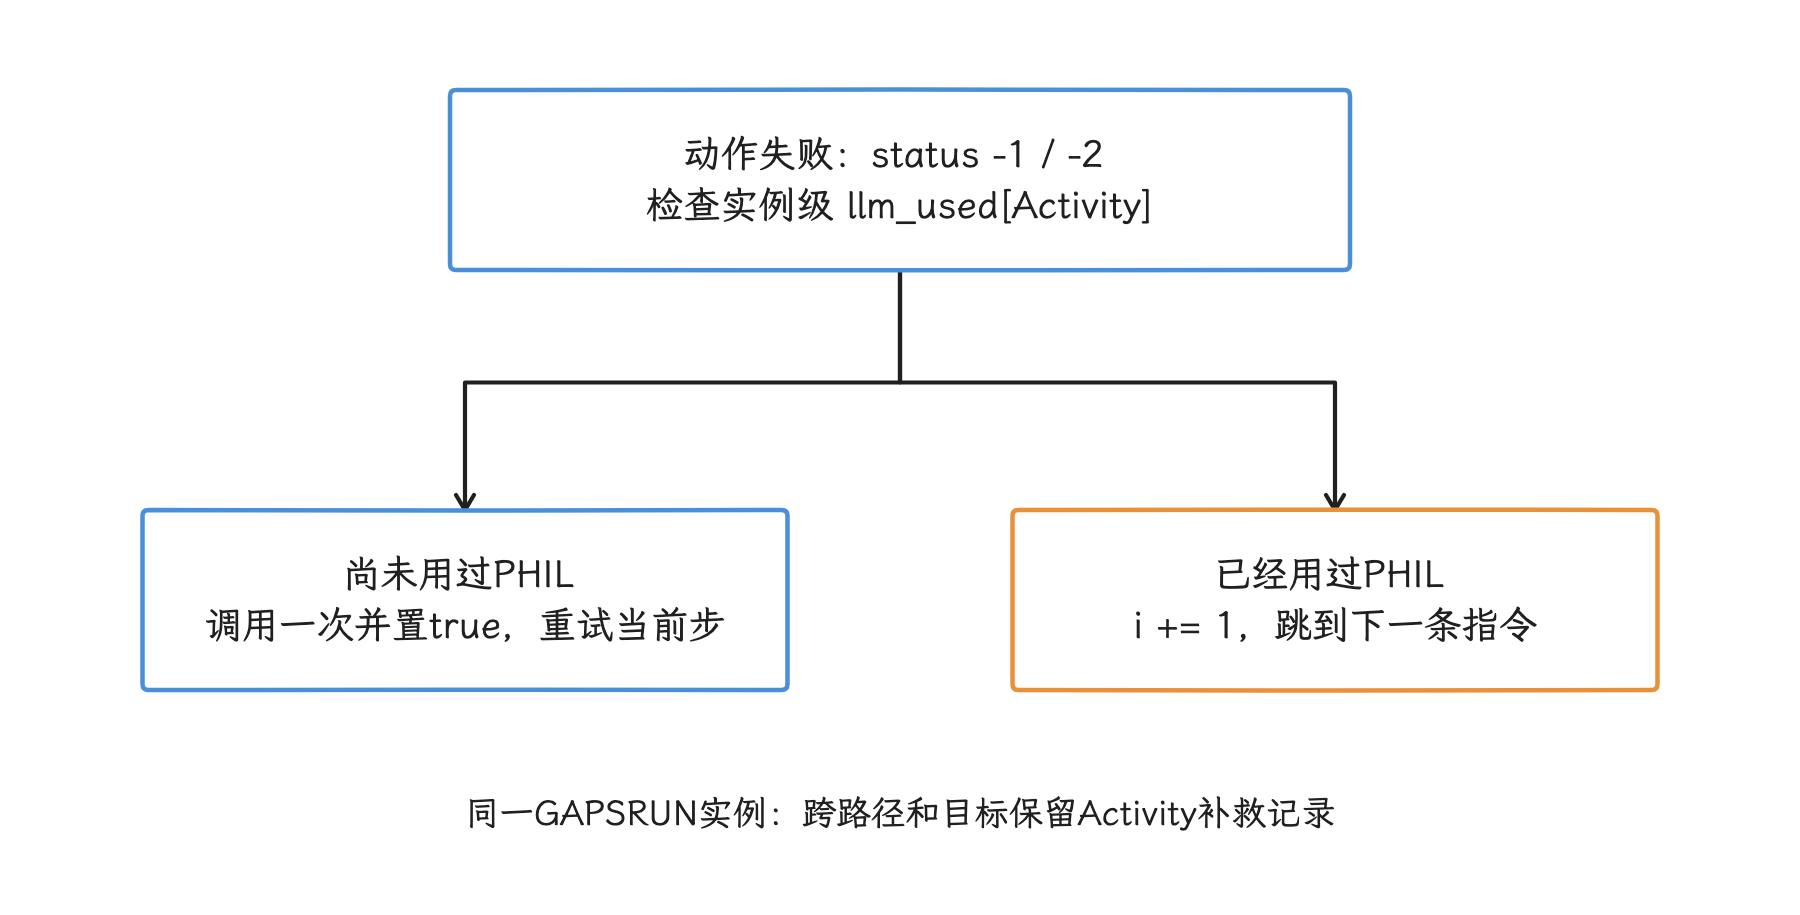
图:当前代码按GAPSRUN实例保存Activity补救记录;用过补救后仍失败会跳到后续指令。 PHIL最多15轮尝试、每轮模型请求最多3次重试;它们不是成功动作数或5分钟总时限。
论文的这两条约束把 agent(自动决策代理)的探索限制在有限范围内,并保留静态路径的主导地位。PHIL 仍带有非确定性,论文通过每个应用运行三轮并报告平均值来反映部分波动。
当前仓库命令的含义
下面的命令展示 4open.science 复现快照中的两阶段入口。uv 是 Python 环境与依赖管理工具,uv.lock 锁定具体依赖版本;实际使用时还应保存快照文件哈希:
#!/usr/bin/env bash
set -euo pipefail
apk_path=app-under-test.apk
output_dir=gaps-output
[[ -f "$apk_path" ]] || { printf '%s\n' '找不到目标 APK' >&2; exit 1; }
uv sync

uv run gaps static \
  -i "$apk_path" \
  -sig 'Lcom/example/Target;->work(Ljava/lang/String;)V' \
  -cond \
  -o "$output_dir"

apk_stem=${apk_path##*/}
apk_stem=${apk_stem%.*}
instructions="$output_dir/$apk_stem/$apk_stem-instr.json"
[[ -f "$instructions" ]] || { printf '%s\n' '未生成指令 JSON,停止动态阶段' >&2; exit 1; }
uv run gaps run \
  -i "$apk_path" \
  -instr "$instructions" \
  -frida
static 生成路径和高层指令,-sig 接收 smali 格式的方法签名;run 才会操作设备。示例按实际输出规则构造 <输出目录>/<APK 基名>/<APK 基名>-instr.json,检查文件存在后才执行动态阶段。命令需在已取回的 GAPS 项目目录中运行,并把 APK 与签名改为实际目标。-frida 需要具有 root 权限且运行 frida-server 的设备或模拟器;PHIL 所用模型还可能要求通过环境变量提供 API 凭据。自动化环境里只记一句“使用最新版”是不够的。
Runtime monitor 的触达判定
论文使用了两种目标方法触达证据:
- AndroTest 应用可重新打包,使用 AndroLog 在方法中插入日志;
- 真实应用无法稳定通过 AndroLog 重新打包时,使用 GAPS 的 Frida integration(Frida 集成模块) 动态 Hook 目标方法。
这两种证据都比“页面已经打开”严格——页面完成未必意味着特定方法执行。它们回答的只是“到没到”:一次 hook 命中说明方法执行过;至于耗时多少、调用是否落在 missed frame、ANR 前兆或功耗尖峰内,还在它们的回答范围之外。
Frida Hook 本身会改变执行时间,短方法、锁竞争、JIT(运行时即时编译)/AOT(预先编译) 边界和高频调用尤其容易受探针开销干扰。所以做性能实验时,我们把“无 Hook 的基线 trace”和“带 Hook 的定位 trace”分开录,必要时改用应用源码中的 Trace.beginSection() 或 Perfetto SDK 埋点做低扰动复测。
GAPS 与 Perfetto 的组合
GAPS 论文没有把 Perfetto 纳入路径生成、动态执行或 reachability(目标方法触达)判定。我们自己把二者组合时,先把职责分开:
| 工具 | 在组合流程中的问题 |
|---|---|
| GAPS 静态阶段 | 怎样从入口走到目标方法 |
| GAPS 动态阶段 | 这套交互能否执行并命中方法 |
| Frida/AndroLog/应用 marker(时间标记) | 目标方法在什么时间被观察到 |
| Perfetto | 同一时间窗内哪些线程、帧、调度、I/O(文件或网络输入输出)或 fence(图形同步栅栏)出现异常 |
| simpleperf | CPU 样本主要落在哪些调用栈 |
一套可复现的接入顺序
- 记录 APK SHA-256、包名、
versionCode、完整 smali 方法签名与 GAPS 快照文件哈希。 - 运行静态阶段,人工检查 entry point(入口)、条件和 GUI ID 是否符合目标应用。
- 准备独立测试账号、权限、网络响应与初始数据库;记录哪些状态无法由 GAPS 生成。
- 在交互前启动 Perfetto,配置容量足够的 ring buffer(写满后覆盖最旧数据的环形缓冲区),并包含目标应用的 atrace、FrameTimeline、调度、CPU 频率及场景所需数据源。
- 安装 runtime monitor,再运行 GAPS 动态阶段。每轮同时记录
REACHED/FAILED、采用的候选路径、PHIL 是否介入和 marker 时间。 - 只在
REACHED样本内对齐目标 marker 与性能异常;FAILED样本用来分析自动化可靠性,要和 P50/P95 等性能分位数分开算。 - 移除 Frida hook 后复测可疑场景,确认异常不由探针、重打包或调试环境引入。
论文 Algorithm 5 的每路径重启会改变进程冷启动/热启动、JIT、页面缓存、数据库连接和图片缓存;本轮代码在单目标分支或遍历所有目标之前调用一次 restart_app();随后每个 _process_method() 可创建 Frida spawn/attach,或通过 monkey 启动应用,处理方法结束后会 force-stop。候选路径之间主要重新启动主 Activity,没有逐路径完整 force-stop。缺包时的安装使用 adb install -r -g,也会影响运行时权限初始状态。若待测问题只在长会话、后台恢复或热缓存条件下出现,需要先确认所用版本的重置范围,再修改执行器或使用 --manual-setup 准备状态,统一的 clean-state(干净初始状态)策略在这里立不住。
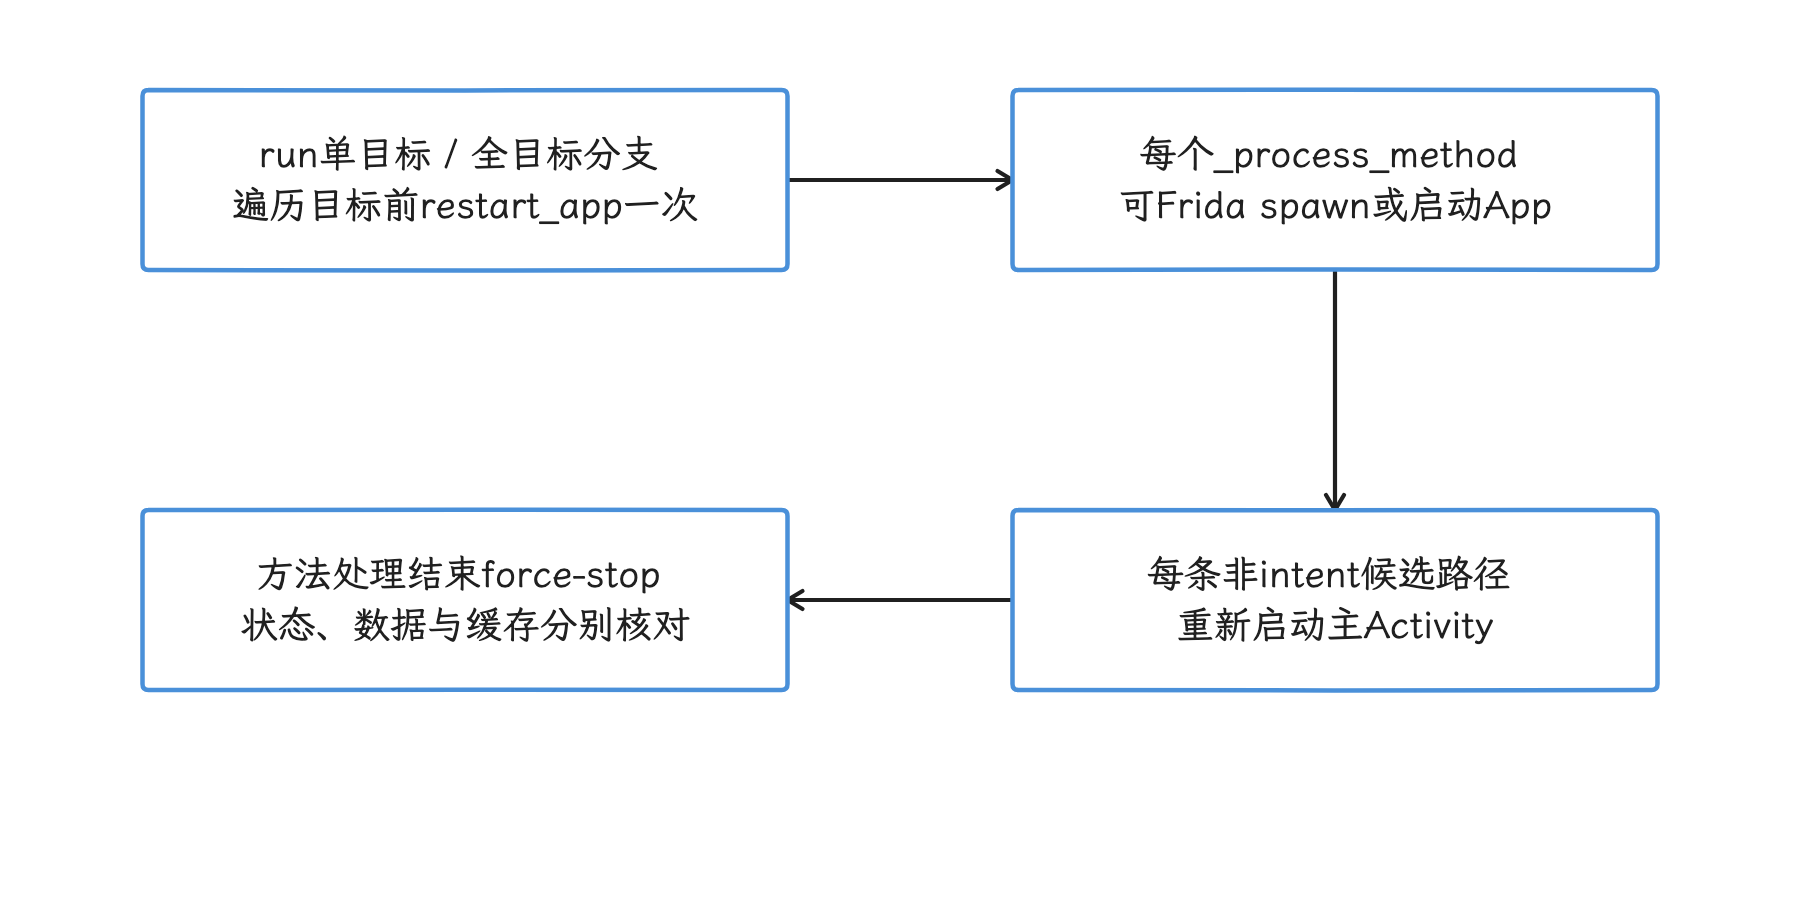
图:按run起始、方法处理和候选路径三个层次记录生命周期与初始状态。 候选路径间启动主Activity不等于完整冷启动;缺包安装的-r -g也会改变权限条件。
用 Frida 注入时间锚点
下面的示例用于测试设备:它在目标 Java 方法的同一线程上包一层 android.os.Trace section,Perfetto 必须在 GAPS 执行前启动并采集该应用的 atrace。
Java.perform(() => {
  const Trace = Java.use("android.os.Trace");
  const Target = Java.use("com.example.Target");
  const work = Target.work.overload("java.lang.String");

  work.implementation = function (arg) {
    Trace.beginSection("gaps_target:Target.work");
    try {
      return work.call(this, arg);
    } finally {
      Trace.endSection();
    }
  };
});
这个 Trace section(同步时间片)包住 Hook 调用期间的方法执行,在应用线程轨道上给出一个时间标记;beginSection() 与 endSection() 必须在同一线程成对调用。它的职责到打点为止:Perfetto 的启停交给录制流程,帧时间线的判断交给 FrameTimeline。目标方法若被内联、位于 C/C++ 等 native 库、存在多个 overload(同名重载),或进程在 Hook 安装前已执行该方法,需要调整探针并单独验证。
jank、ANR 与功耗各看什么
- jank:从 missed
DisplayFrame(最终显示帧)与对应SurfaceFrame(应用或图层提交帧)出发,检查 marker 是否落在相关帧的生产区间;只在时间重叠且调用链合理时继续归因。 - ANR:确认目标方法与主线程、Binder 跨进程调用、锁等待或 input timeout(输入分发超时) 的时序。方法命中早于 ANR 数十秒,通常还缺中间证据。
- 功耗/发热:按同设备、同热状态、同网络条件做多轮对照;单次目标触达无法区分方法成本、Frida 与屏幕操作开销;PHIL 的模型请求由主机代码发出,其网络等待还可能延长手机亮屏与应用活跃窗口,不能直接当作目标方法自身耗电。
- native 热点:GAPS 的 DEX 路径可触达 Java/Kotlin 包装层,native 内部成本仍需 simpleperf、Perfetto native heap/CPU 数据或库内 marker。
v3 的真实应用实验
论文还在 2026 年 6 月收集的 Google Play 下载量前 50 应用上做了实验,目标是 SPECK(按 Google 安全与隐私规则识别潜在违规的静态分析器) 报告的方法。只有 5.55% 的目标位于 Activity 中,场景比 AndroTest 更偏向深层代码。
| 指标 | v3 结果 |
|---|---|
| 静态路径生成率 | 62.03% |
| 平均静态分析时间/应用 | 278.9 秒 |
| 生成的 call sequence | 219 条 |
| call sequence 长度 | 1—41,均值 12.42,中位数 4 |
| 三轮动态触达率均值 | 54.80% |
| 动态执行平均时间 | 4 分 48 秒 |
真实应用实验用 Frida 作为触达证据。62.03% 与 54.80% 之间的差值另有解释,我们先别急着叫“静态误报率”:有些静态路径成立,但运行期需要登录、支付、特定文本、动态内容、权限或 Intent 参数,执行器没能构造出对应状态。
把这些数字直接外推成 Android 17 应用的成功率是要冒险的:样本、目标选择、应用版本、设备、模型和时间预算都会改变结果;Compose 在现代应用中的占比还会进一步影响 GUI ID 提取。
GAPS 与相关工具
| 工具 | 主要目标 | 输出/执行方式 | 与 GAPS 的差别 |
|---|---|---|---|
| FlowDroid | Android 污点与数据流分析 | 全程序抽象、dummy main(合成入口)、数据流结果 | 不生成面向目标方法的可执行 GUI 指令 |
| DroidReach | 静态路径重建 | 基于完整 call graph 输出路径 | 没有 GAPS 的动态执行、条件解析和 GUI trigger 链 |
| APE | 覆盖率导向 GUI 探索 | 模型驱动事件生成 | 不掌握目标方法的静态路径 |
| Guardian | 用户任务导向 LLM 交互 | 根据界面语义规划动作 | v3 中作为独立动态基线;不是 GAPS 内部 fallback |
| GoalExplorer | screen/activity 导向探索 | Screen Transition Graph(页面转换图)+ 动态探索 | 引导单位偏页面和 Activity,不以方法级 backward slice(从目标反推相关语句的切片)为起点 |
| PHIL | GAPS 内部受限 agent | 只在确定性步骤失败时处理 UI 障碍 | 它是 GAPS v3 的 fallback,不是 Guardian 的别名 |
比较百分比时还要核对预算和分母。FlowDroid/DroidReach 的百分比属于静态路径生成,APE/Guardian/GoalExplorer/GAPS Dynamic 的属于动态方法触达;这两列统计的是两件不同的事,直接按高低排在一起,得不出统计意义。
已验证的限制与工程外推
论文 v3 直接列出的限制包括:
- Flutter/React Native 的主要逻辑不在传统 Dalvik/DEX 字节码中;
- 混淆会引发 path explosion(候选路径数量快速膨胀)并增加分析时间;
- 库中的 dead code(不可达但仍留在输入中的代码) 会拖慢路径重建;
- callback mapping(回调映射) 未覆盖的 implicit flow 会造成 call graph unsoundness(调用图漏掉真实运行时边);
- 当前不支持 Jetpack Compose;
- 游戏胜利、账号、支付等复杂状态可能阻断动态执行;
- intent filter 入口可能要求权限、系统身份或额外 data 参数;
- 动态布局和 WebView 会干扰静态 GUI 提取;
- PHIL 引入非确定性。
反射、动态代理、Dagger/Hilt 依赖注入和 JNI 是 Android 程序分析中常见的额外风险,但论文没有提供这些类别的 GAPS 分项命中率。工程报告可以把它们列为待验证条件;这些场景的专项能力要单独实验,88.24% 或 56.93% 覆盖不到。
把流程落到 Android 17 的工程扩展上,还要额外核对:
- 目标应用是否主要采用 Compose;
- entry component(入口组件) 是否可从测试环境启动,权限和导出属性是否允许;
- Frida 所需 root、SELinux 与进程架构条件是否满足;
- split APK(拆分安装包)、dynamic feature(按需交付模块)和运行期代码加载是否都进入分析输入;
- 目标方法签名是否因 R8、版本更新或 multi-dex(多个 DEX 文件) 布局改变。
复现实验检查清单
静态阶段:
- 固定论文版本、4open.science 文件哈希、Python/
uv.lock、Androguard 与 Apktool 版本。 - 固定 APK hash、目标签名、path limit(每次查询的路径数量上限)、
-cond与其他 CLI 参数。 - 保存生成的 JSON、call sequence、分析时长和失败原因。
动态阶段:
- 记录设备型号、Android 版本、ABI(二进制接口/处理器架构)、root/Frida 版本、分辨率和导航模式。
- 固定应用初始状态、账号、权限、locale(语言与地区)、网络响应和广告策略。
- 保存每轮候选路径、PHIL 调用、动作序列、runtime monitor 与执行时间。
- 至少重复三轮,分开报告确定性路径与 PHIL 路径。
性能扩展:
- Android 17 测试写明 API 37 与具体 build fingerprint。
- trace 在自动交互前启动,避免丢失入口和首帧。
- reachability 结果与性能指标使用不同字段。
- hook、重打包和 release 原包分别建基线。
- 结论同时给出目标 marker、线程/帧证据和无探针复测。
版本与实现边界
GAPS(Graph-based Automated Path Synthesizer,基于图的自动路径合成器)解决一个方法级问题:给定 APK/DEX 与目标方法,能否找出从 Android 入口到该方法的调用路径,并自动执行对应交互。衡量一帧是否卡顿是另一回事,那要看 Perfetto 系统 trace、simpleperf CPU 采样或应用埋点。
以下说明依据 2026 年 7 月 17 日发布的论文 v3 与论文公开的 4open.science 复现快照。v3 已更名为 GAPS: Targeted Execution of Android Apps via Static Path Reconstruction,作者也从 v1 的 2 人扩展为 5 人;实验环境、动态基线、运行时间和 PHIL 代理模块数据均有更新。57.44%、Guardian 17.12%、静态分析 4.27 秒及 Android 13 模拟器等数字来自 v1,描述不了 v3 的表现。
平台集成部分以 Android 17 / API 37 / android-17.0.0_r1 为知识库基线。论文自身的动态实验使用 Android 16 x86-64 模拟器;需要 ARM 架构时使用 Pixel 2 / Android 11。论文没有报告过 Android 17 实验;文中的 Android 17 + Perfetto 流程属于工程扩展,写作时应与论文已验证结论区分开。
小结
APA 和 GAPS 的共同点,是帮自动化工作流拿到“实际发生了什么”的证据,但两者要证明的东西不同。APA 用 system trace 定位线程、帧、内存和功耗异常;GAPS 用静态路径重建加动态触达,验证目标方法是否可达。“已触达方法”离“方法造成性能问题”还差一整段因果链,两类结果要用不同字段、版本范围和复现记录分开存放。
参考资料
Android Performance Analyzer
- Android Performance Analyzer
- APA Quickstart
- Record a system trace
- View a system trace
- Understand trace data
- Analyze frame processing times
- Analyze memory efficiency
- Analyze thread scheduling
- Android Developers Blog: Introducing APA
- AGI System Profiler: APA recommendation
- Perfetto documentation
- Android 17
TraceConfig - Android 17 Perfetto tracing service
- Android 17 common kernel scheduler tracepoints
GAPS 与目标可达性
- GAPS 论文 v3:GAPS: Targeted Execution of Android Apps via Static Path Reconstruction
- 旧数字对照:GAPS 论文 v1
- GAPS 公开复现快照:GAPS README
- 动态交互库:AndroidViewClient
- 动态插桩:Frida
- 资源反编译:Apktool
- DEX 静态分析:Androguard
- 方法日志插桩:AndroLog
- Android trace API:
android.os.Trace - Perfetto Android tracing:System tracing tutorial
- Perfetto 应用事件:ATrace data source
- Perfetto 帧判定:FrameTimeline
- Perfetto 缓冲区语义:Trace configuration