Simpleperf 与 ARM Topdown 微架构分析
我们做 CPU 优化时,第一批问题通常是“CPU 时间集中在哪些函数”“某段代码执行了多少条指令”“热点由哪条调用路径进入”。回答它们的主力工具就是 Simpleperf:它通过 Linux perf_events 子系统采集事件计数、PC(Program Counter,当前执行指令的地址) 和调用栈,把结果写入 perf.data。
源码基线:AOSP
android-17.0.0_r1;内核android17-6.18-2026-06_r6。下文以“A17”简称这份平台源码;设备可能使用其他内核分支,较早版本只用于说明兼容范围,旧设备行为以当时的版本为准。
堆内存泄漏、Java 对象分配、完整系统调用时序和整机功耗归因各有专门工具:Heap Dump/LeakCanary、Allocation Tracking、Perfetto ftrace 和 Power Profiler。Simpleperf 也能读 PMU(Performance Monitoring Unit,处理器性能监控单元) 的硬件计数器,但这些计数单独换算不出可靠的能耗。在这些计数与采样能力之上,Topdown 用 CPU 专属公式描述四类流水线 slot:前端(Frontend Bound)、后端(Backend Bound)、错误推测(Bad Speculation)和退休(Retiring)。Topdown 结论要落在设备 PMU 支持和可复现负载上,这是全篇的前提。
采样、调用图与硬件事件基础
采样模型
一次采样从内核事件开始,在主机报告结束。下面的图用于定位每一层负责的数据。
采集链路从 Simpleperf 配置目标并调用 perf_event_open() 开始,目标应用线程是被观测对象。内核记录事件后,Simpleperf 保存样本和元数据,主机报告再解析符号。
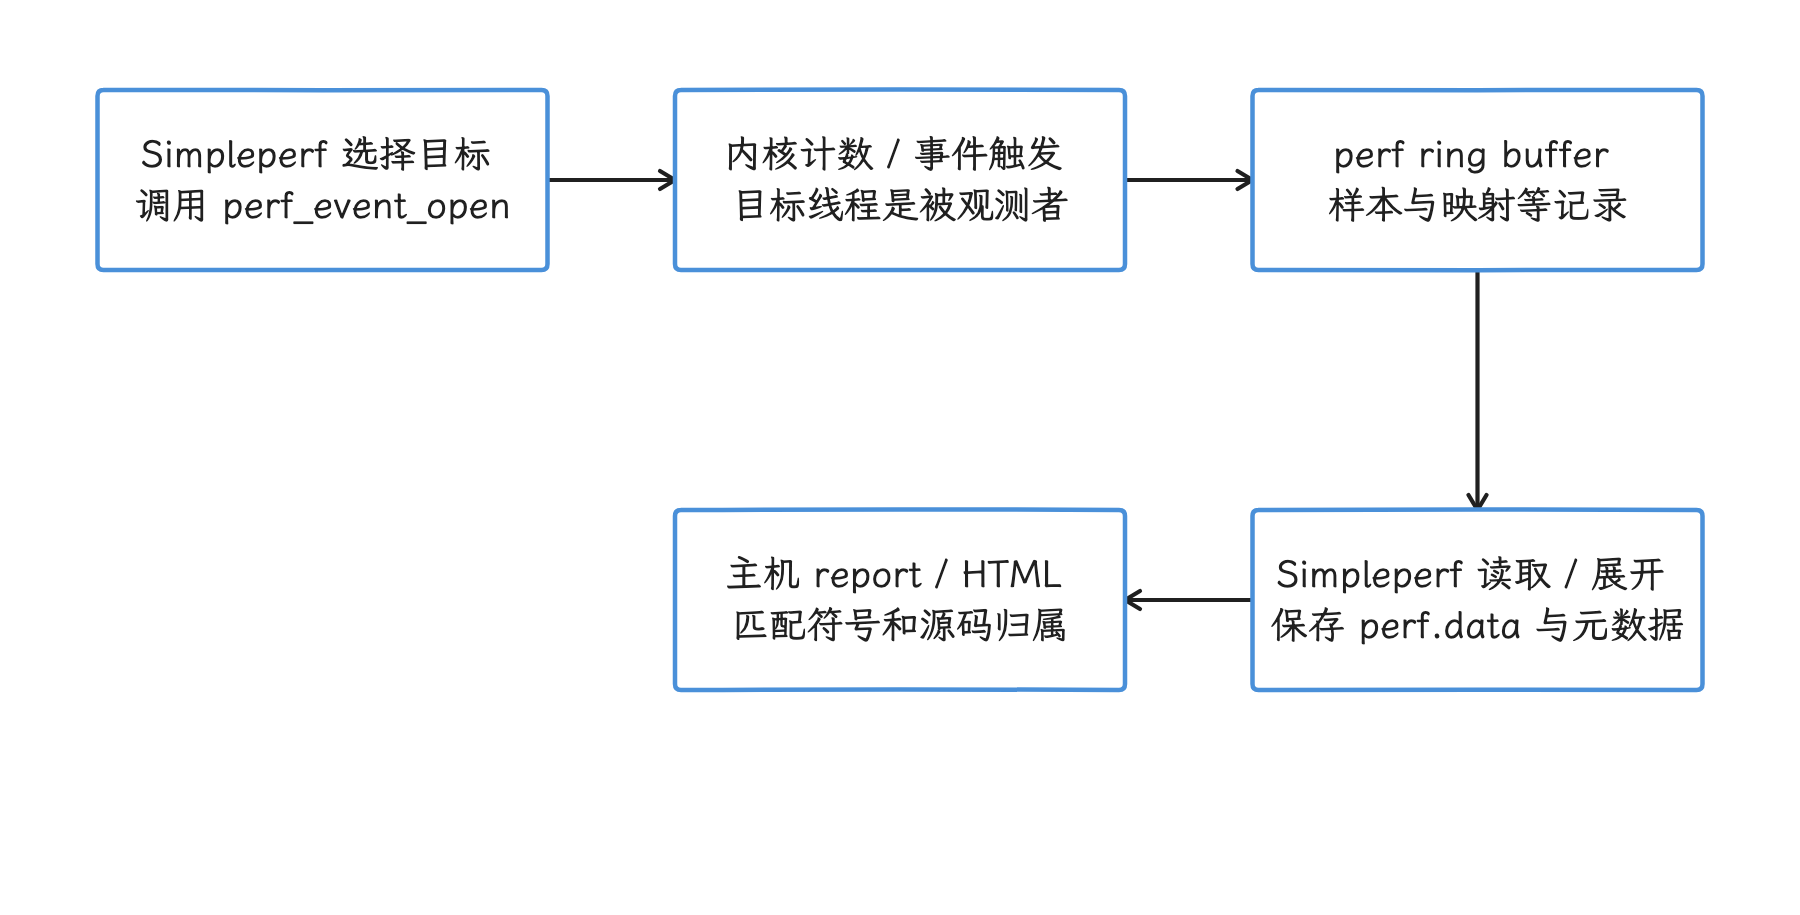
图:Simpleperf 配置事件并观测目标线程,内核产出记录,主机报告解析地址与符号。 样本是离散事件位置;报告 Overhead 取决于所选事件权重,不等于每次调用或墙钟时长。
内核决定事件能否打开、何时产生样本,以及样本进入哪个 perf ring buffer(环形缓冲区,一块循环复用的内存队列);Simpleperf 负责配置事件、持续读取记录、处理调用栈并保存分析所需的元数据;报告工具再把地址映射到库、函数和源码行。三段分工读报告时都要用到。
这套模型决定了我们读报告时怎么看三个数字:
record产生的是离散样本,函数每被调用一次并不会记一条。两个条目占比接近,只说明它们占所选事件的权重接近;要比较调用次数,得另想办法。cpu-cycles、instructions、task-clock衡量的量不同。报告里的Overhead是某条目占所选事件总权重的比例,要换算成墙钟时间再比较,两边必须先统一口径。- 函数地址要配上 build ID 匹配的符号文件才能还原名称;build ID 是写在 ELF(Executable and Linkable Format,Android 原生二进制格式) 二进制中的构建标识。采样本身完整而符号缺失时,报告里仍会出现大量
[unknown]。
内核实现入口可从 kernel/events/core.c 和 include/uapi/linux/perf_event.h 查看。实际能打开哪些事件,还要看产品内核配置、SELinux 强制访问控制策略、PMU 型号和厂商限制,源码标签替代不了在目标设备上探测。
版本与权限边界
版本能力
| Android 版本 | Simpleperf 能力边界 |
|---|---|
| Android 5.0(API 21)起 | 设备端 simpleperf 可执行文件受支持 |
| Android 7.0(API 24)起 | 官方 Python 采集与报告脚本受支持;Java 仅能识别已编译为本地指令的代码 |
| Android 8.x(API 26–27) | Java 仍以已编译代码为主;系统库从 Android 8.0 起携带 .gnu_debugdata |
| Android 9(API 28)起 | 可为解释执行、JIT(运行时编译)和 AOT(提前编译)Java/Kotlin 代码生成调用栈 |
| Android 10(API 29)起 | 发布应用可声明 profileable,由 shell 使用预装分析工具采样 |
| Android 16(API 36)起 | 应用采样优先由 simpleperf_app_runner 启动设备内置 Simpleperf;侧载二进制不再拥有获取内核样本所需的权限 |
| Android 17(API 37) | 沿用 simpleperf_app_runner 路径;以 android-17.0.0_r1 的实现为准 |
另外要分清 Java 支持和 ART method tracing:method tracing 记录方法进入和退出,这里比较的 Simpleperf 普通 CPU 采样模式则按所选事件抽样,两边的“热点”含义不同。Android 9 起,解释器、JIT 与 AOT 代码都能进入采样调用栈。
三种常见授权场景
profileable发布应用:Android 10 起可允许 shell 使用设备预装的分析工具采样,这种构建的运行形态更接近 release。debuggable应用:允许调试器和更多开发期检查,代价是 debug 构建会改变 Java、JNI 和编译优化行为。Android 12 及更高版本上,A17 的app_profiler.py默认拒绝这类构建;接受该偏差后,需显式传入--unrepresentative_profile_debug_app。- root 或 AOSP 调试设备:可分析普通发布应用、原生系统进程或全系统目标。userdebug/eng 构建开放更多诊断能力,最终能力仍由内核和安全策略决定。
发布包若要接受本机 shell 采样,应在 <application> 中加入下面的声明。它只开放本机性能分析能力,应用保持原来的构建形态,不会因此变成 debuggable。
<manifest xmlns:android="http://schemas.android.com/apk/res/android">
    <application>
        <profileable android:shell="true" />
    </application>
</manifest>
android:shell="true" 允许 shell 通过 Simpleperf、Perfetto 等预装工具执行受控分析。任意读取进程内存、接入调试器都不在它的授权范围内;Perfetto 的原生堆、Java 堆和 CPU profiler 仍各自执行权限检查并只返回规定的分析结果。具体限制见 <profileable> 官方说明。
还有一个容易搞混的开关:adb shell am set-debug-app 只影响调试器附加,改不了 APK 的 debuggable 或 profileable 属性,更当不成发布包的采样授权。真正的应用内授权走系统属性 persist.simpleperf.profile_app_uid,它记录被临时授权的应用 UID(Android 用于隔离应用的数字身份);Android 13 起,api_profiler.py prepare --days 可为这项授权设置有效天数。常规外部采样交给 app_profiler.py 处理。
工具位置与环境检查
NDK 发行包把设备端程序、主机端程序和 Python 脚本放在顶层 simpleperf/ 目录,而不是 LLVM 工具链的 bin/ 目录。路径中的 ${arch} 表示目标 CPU 架构,${host} 表示运行报告工具的桌面系统:
simpleperf/bin/android/${arch}/simpleperf:设备端静态可执行文件。simpleperf/bin/${host}/${arch}/simpleperf:主机端报告程序。simpleperf/*.py:app_profiler.py、report.py、report_html.py等脚本。
进入 NDK 的 simpleperf/ 目录后,我们先让工具自查设备功能——应用运行器、调用栈、离开 CPU 采样等能力,以及设备接受的事件名,都在这份输出里。
./run_simpleperf_on_device.py list --show-features
./run_simpleperf_on_device.py list
这份输出才是当前设备的能力清单。事件名列在里面,只代表工具认识它,当前 UID 未必有权打开;采集时报的 permission denied、not supported 和 event not found 分别指向权限、内核或硬件支持、事件名称三类问题。
Android 16/17 上应保持主机采集与报告脚本来自同一套 NDK,并单独记录设备内置 Simpleperf 的版本。应用采样入口在这些系统上优先选择 simpleperf_app_runner,由它在受控应用上下文中启动设备内置程序;升级 NDK 不会同时升级设备上的这个程序。A17 源码指出侧载程序获取内核态样本的权限受限,不能把“二进制可执行”当成目标事件可采集的证明;最终仍以运行器、当前 UID 与事件打开结果为准。
一条可靠的应用采样路径
下面以 profileable 发布应用为例,记录十秒用户态 CPU 时间和 DWARF 调用栈;“用户态”只统计 App 等普通进程执行的部分,不含内核态。命令从环境变量读取真实包名和未剥离原生库目录,缺少输入时会立即退出。
: "${PACKAGE_NAME:?请先设置目标应用的 PACKAGE_NAME}"
: "${UNSTRIPPED_LIB_DIR:?请先设置未剥离原生库目录 UNSTRIPPED_LIB_DIR}"

./app_profiler.py \
  -p "${PACKAGE_NAME}" \
  -r "-e task-clock:u -f 1000 --duration 10 -g" \
  -lib "${UNSTRIPPED_LIB_DIR}"

./report_html.py
这组记录参数与 A17 app_profiler.py 的默认值一致,显式写出是为了便于复现实验。脚本在当前目录生成 perf.data,再用 UNSTRIPPED_LIB_DIR 中未删除调试信息的库准备 binary_cache/ 符号缓存,report_html.py 读取两者并生成 report.html。采样窗口内要记得操作目标功能,否则报告只反映空闲或启动状态。
若要从 Activity 启动前开始采样,可把真实 Activity 名交给脚本。下面的命令要求三个环境变量均已设置。
: "${PACKAGE_NAME:?请先设置目标应用的 PACKAGE_NAME}"
: "${ACTIVITY_NAME:?请先设置要启动的 ACTIVITY_NAME}"
: "${UNSTRIPPED_LIB_DIR:?请先设置未剥离原生库目录 UNSTRIPPED_LIB_DIR}"

./app_profiler.py \
  -p "${PACKAGE_NAME}" \
  -a "${ACTIVITY_NAME}" \
  -r "-e task-clock:u -f 1000 --duration 5 -g" \
  -lib "${UNSTRIPPED_LIB_DIR}"
脚本会先结束目标进程、布置采样,再启动 Activity。这里的“从启动前采样”保证的是覆盖进程与 Activity 启动;应用数据和系统文件缓存要靠实验自己控制,所以比较冷启动结果时,应固定应用数据、ART 编译状态、存储状态和业务输入。
调用栈开销从低频开始校准
设备端 simpleperf record 的默认事件是 cpu-cycles,默认频率是每个运行中线程每秒约 4000 个样本。A17 的 app_profiler.py 已把应用采样默认值降为 task-clock:u、1000 Hz、DWARF 调用栈和十秒窗口。混合 Java/原生应用可从脚本默认值开始,再根据样本数、丢失记录、截断栈和业务扰动调低频率或缩短窗口。
采样开销受事件类型、频率、线程数、CPU 型号、栈展开方式和符号处理影响,给不出一个固定的百分比。稳妥的做法是在同一设备上比较“未采样”和“采样”两组的业务指标,并把采样频率当作实验变量来对待。
stat、record 与 report
stat:回答“消耗了多少”
stat 汇总事件计数,不保存每个热点位置。下面的命令用于观察目标进程在十秒内的 CPU 时间、周期数和指令数。
: "${APP_PID:?请先设置目标进程的 APP_PID}"

simpleperf stat \
  -e task-clock,cpu-cycles,instructions \
  -p "${APP_PID}" \
  --duration 10
硬件事件打不开时,可以保留 task-clock 单独测量。instructions / cpu-cycles 常被称为 IPC(Instructions Per Cycle,每周期退休指令数)。不过异构 CPU 的各类核心微架构不同,PMU 约束和线程迁核也会影响聚合结果,跨设备比较时先想想这个分母是否可比。
record:回答“消耗发生在哪”
record 以指定事件触发样本,并把程序计数器、线程、映射及可选调用栈写入 perf.data。下面的命令适用于已经具备权限的设备端环境。
: "${APP_PID:?请先设置目标进程的 APP_PID}"

simpleperf record \
  -e task-clock:u \
  -f 1000 \
  -p "${APP_PID}" \
  --duration 10 \
  -g \
  -o perf.data
-f 1000 表示线程处于运行态时每秒约采样 1000 次。线程一秒只运行 200 ms 时,样本量约为 200 个。-c 则按事件累计值指定采样周期,例如 -c 100000 表示每累计十万个所选事件产生一个样本。
report:回答“样本如何归属”
下面的命令用于读取同一个 perf.data,显示调用图并按进程、线程、库和函数分组。
simpleperf report \
  -i perf.data \
  -g \
  --sort comm,pid,tid,dso,symbol
默认报告的主要维度已经包含 comm,pid,tid,dso,symbol:comm 是进程或线程名,PID(Process ID,进程编号) 和 TID 分别是进程 ID 与线程 ID,DSO(Dynamic Shared Object)是动态共享库,symbol 是函数符号。显式写出排序字段有助于团队保存可复现命令;需要缩小范围时,用 --comms、--pids、--tids 或 --dsos。
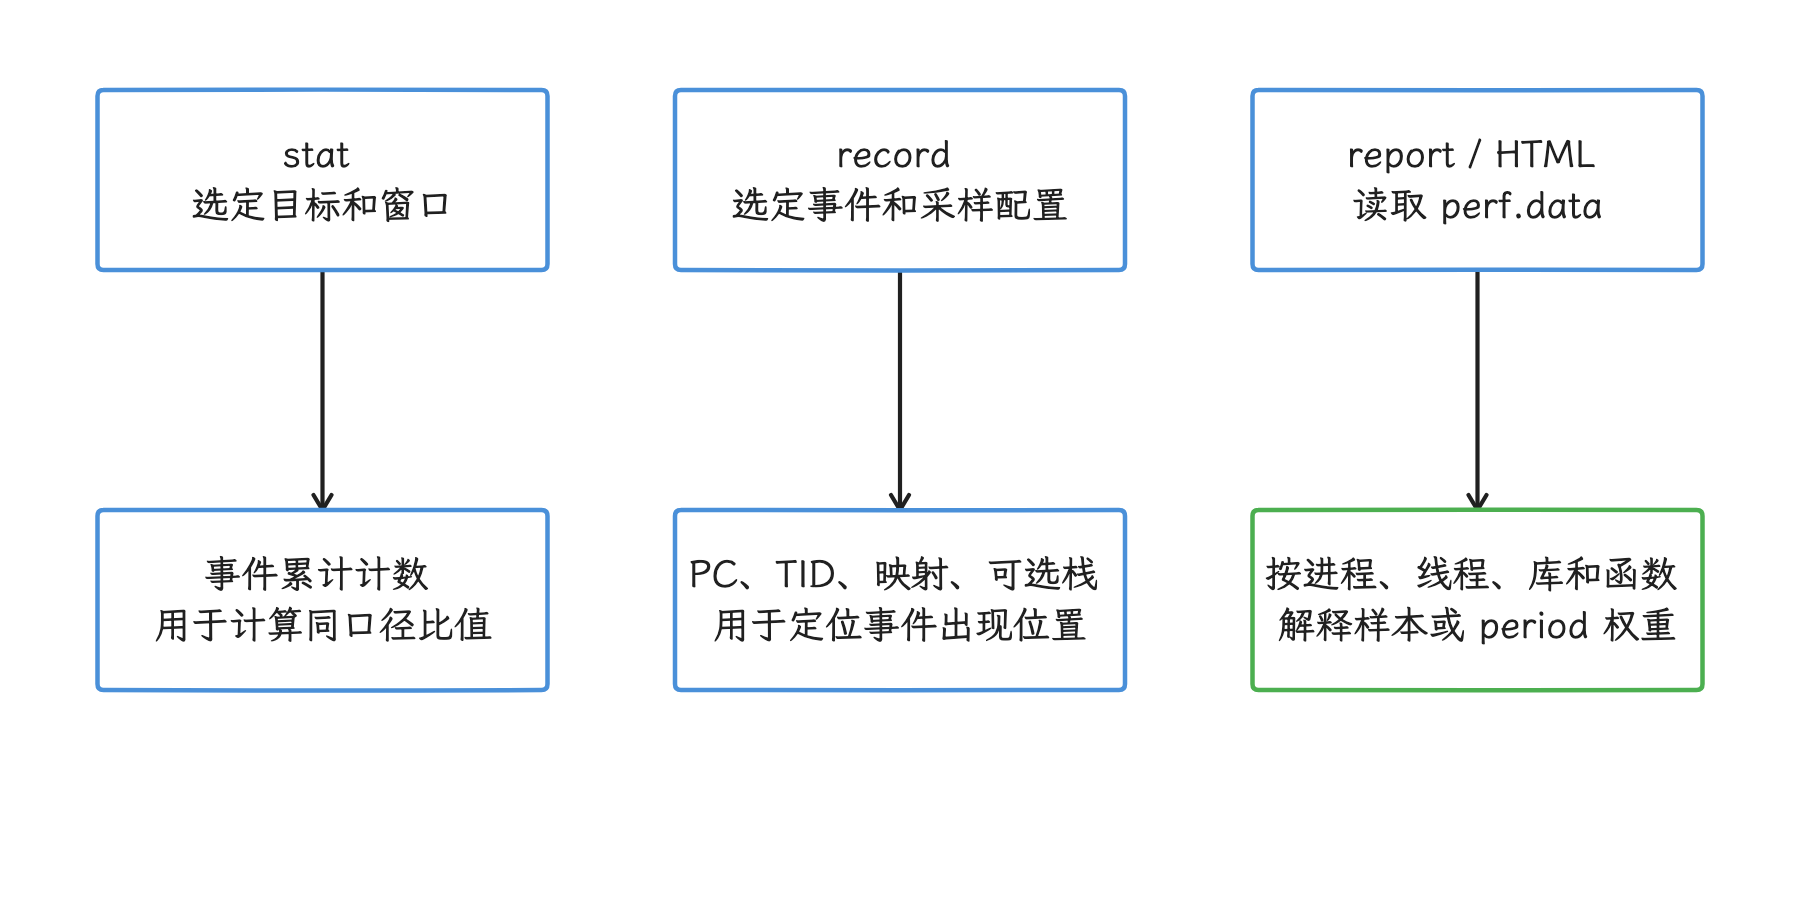
图:stat 给事件总量,record 保存抽样位置,report 按已记录身份和调用链聚合。 计数、样本数和 period 权重分别解释;未记录调用栈或身份的输入不能由报告补齐。
事件选择与解释
时间类事件
task-clock:线程在 CPU 上运行的时间,适合用作 CPU 热点的直观权重。cpu-clock:软件 CPU 时钟事件,也可用于--trace-offcpu。cpu-cycles:硬件周期计数;CPU 频率、微架构和迁核会改变它与时间的关系。
工作量与缓存类事件
instructions:退休指令数,也就是完成执行并提交结果的指令;观察执行工作量用它,评估算法改动时常与cpu-cycles一起看。cache-references、cache-misses:通用缓存事件,但映射到哪级缓存、是否支持以及权限条件由 PMU 驱动决定。raw-*:平台专用原始事件。事件编码与 CPU 型号绑定,把一台设备的命令复制到另一种 SoC(System on Chip,片上系统) 上直接比较是行不通的。
并发采集的硬件事件超过可用 PMU 计数器时,内核可能对计数器做 multiplex(分时复用),再按启用时间缩放结果,误差随负载和调度变化。工程分析可以分两步走:
- 用
task-clock和调用栈找出热点函数。 - 围绕同一稳定负载,分组采集少量 PMU 事件验证瓶颈类型。
用户态后缀 :u 会排除内核态样本。分析应用代码时,它能减少无符号内核帧和权限干扰;轮到分析系统调用成本时,就应保留内核态并准备匹配的内核符号。
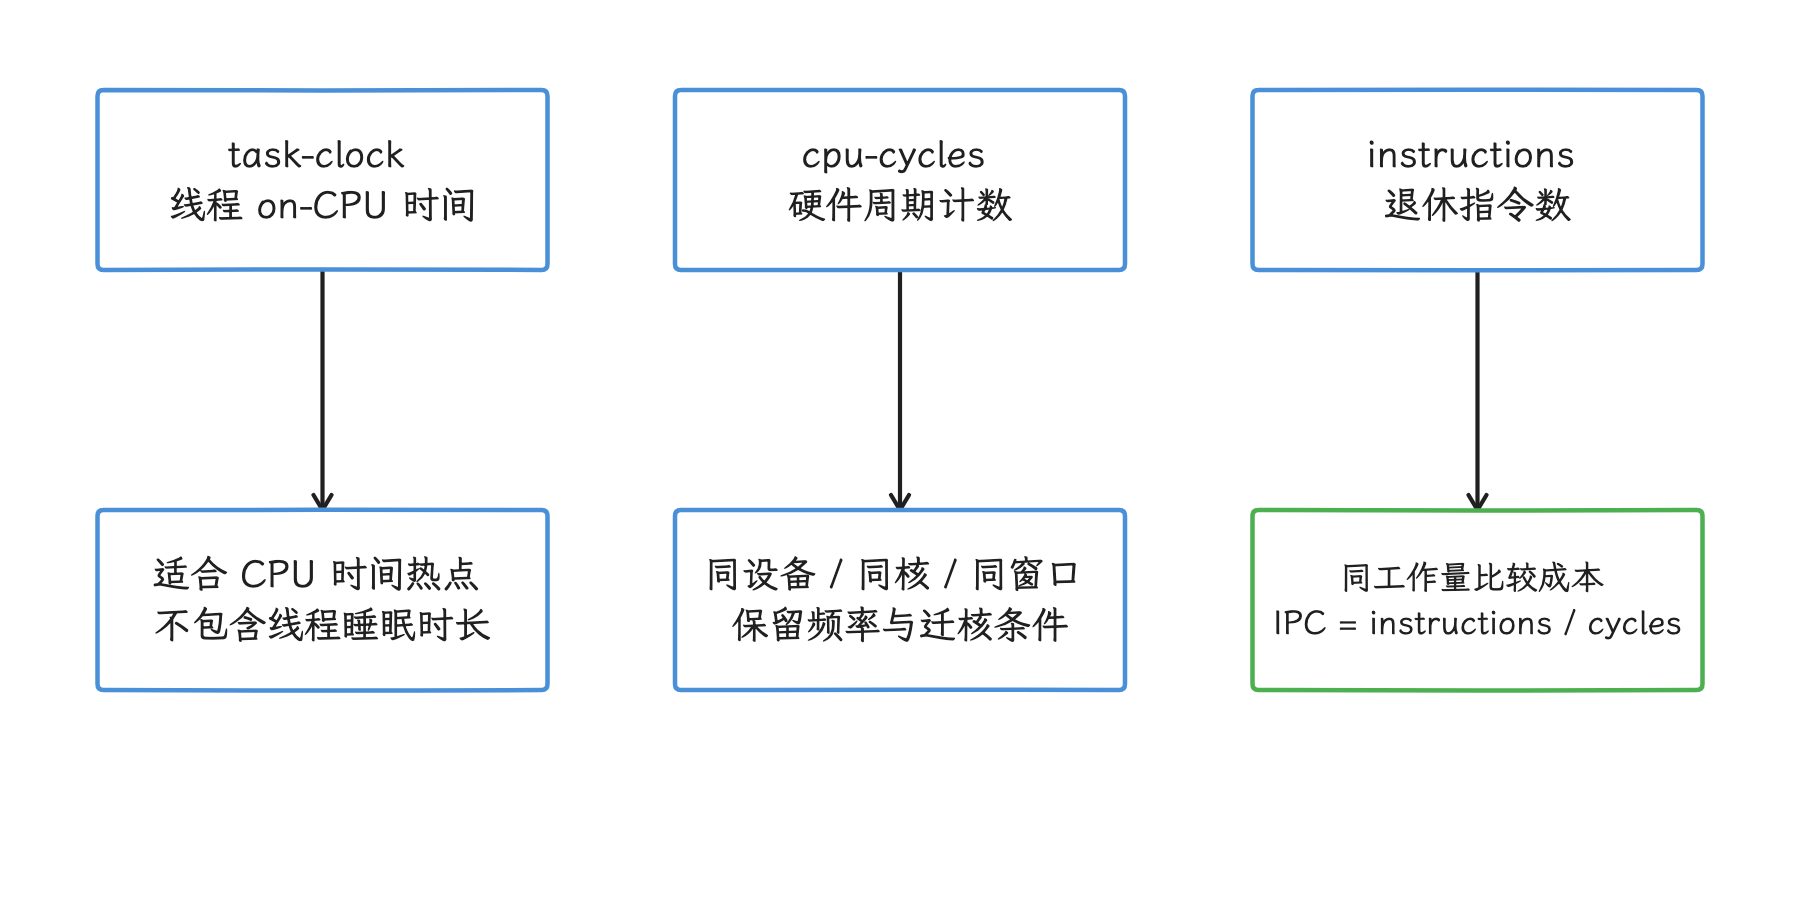
图:先确认 CPU 时间、周期和退休指令的单位,再解释热点占比或计算 IPC。 周期受频率与微架构影响;:u 排除内核态,跨簇汇总不能直接套单一 CPU 公式。
调用栈与符号
DWARF 与帧指针(FP)
-g 默认选择 DWARF 调用栈:内核为样本保存寄存器和用户栈数据,Simpleperf 再用 Android 的 libunwindstack 库离线还原栈帧。展开依赖 ELF 中的 .eh_frame、.debug_frame、.ARM.exidx 或 .gnu_debugdata。A17 的默认单样本栈数据上限是 65,528 字节,再深的栈可能在到达线程入口前就断掉。
--call-graph fp 让内核沿帧指针获取调用链,在保留帧指针的 ARM64 原生代码上开销较低。但 ART 不保证为 Java 代码保留合适的帧指针,32 位 ARM/Thumb 混合代码也容易断栈,所以选择 FP 前应确认编译参数和目标代码形态。
下面的两条采集命令读取同一组真实输入,用于在相同负载上比较 DWARF 与 FP 的栈完整度。
: "${PACKAGE_NAME:?请先设置目标应用的 PACKAGE_NAME}"
: "${UNSTRIPPED_LIB_DIR:?请先设置未剥离原生库目录 UNSTRIPPED_LIB_DIR}"

./app_profiler.py -p "${PACKAGE_NAME}" \
  -r "-e task-clock:u -f 1000 --duration 10 -g" \
  -lib "${UNSTRIPPED_LIB_DIR}"

./app_profiler.py -p "${PACKAGE_NAME}" \
  -r "-e task-clock:u -f 1000 --duration 10 --call-graph fp" \
  -lib "${UNSTRIPPED_LIB_DIR}" \
  -o perf-fp.data
比较时我们检查 [unknown] 比例、栈深、热点归属和被测指标扰动。FP 报告更短时,先怀疑代码没有保留帧指针,这与业务调用路径的深浅无关。
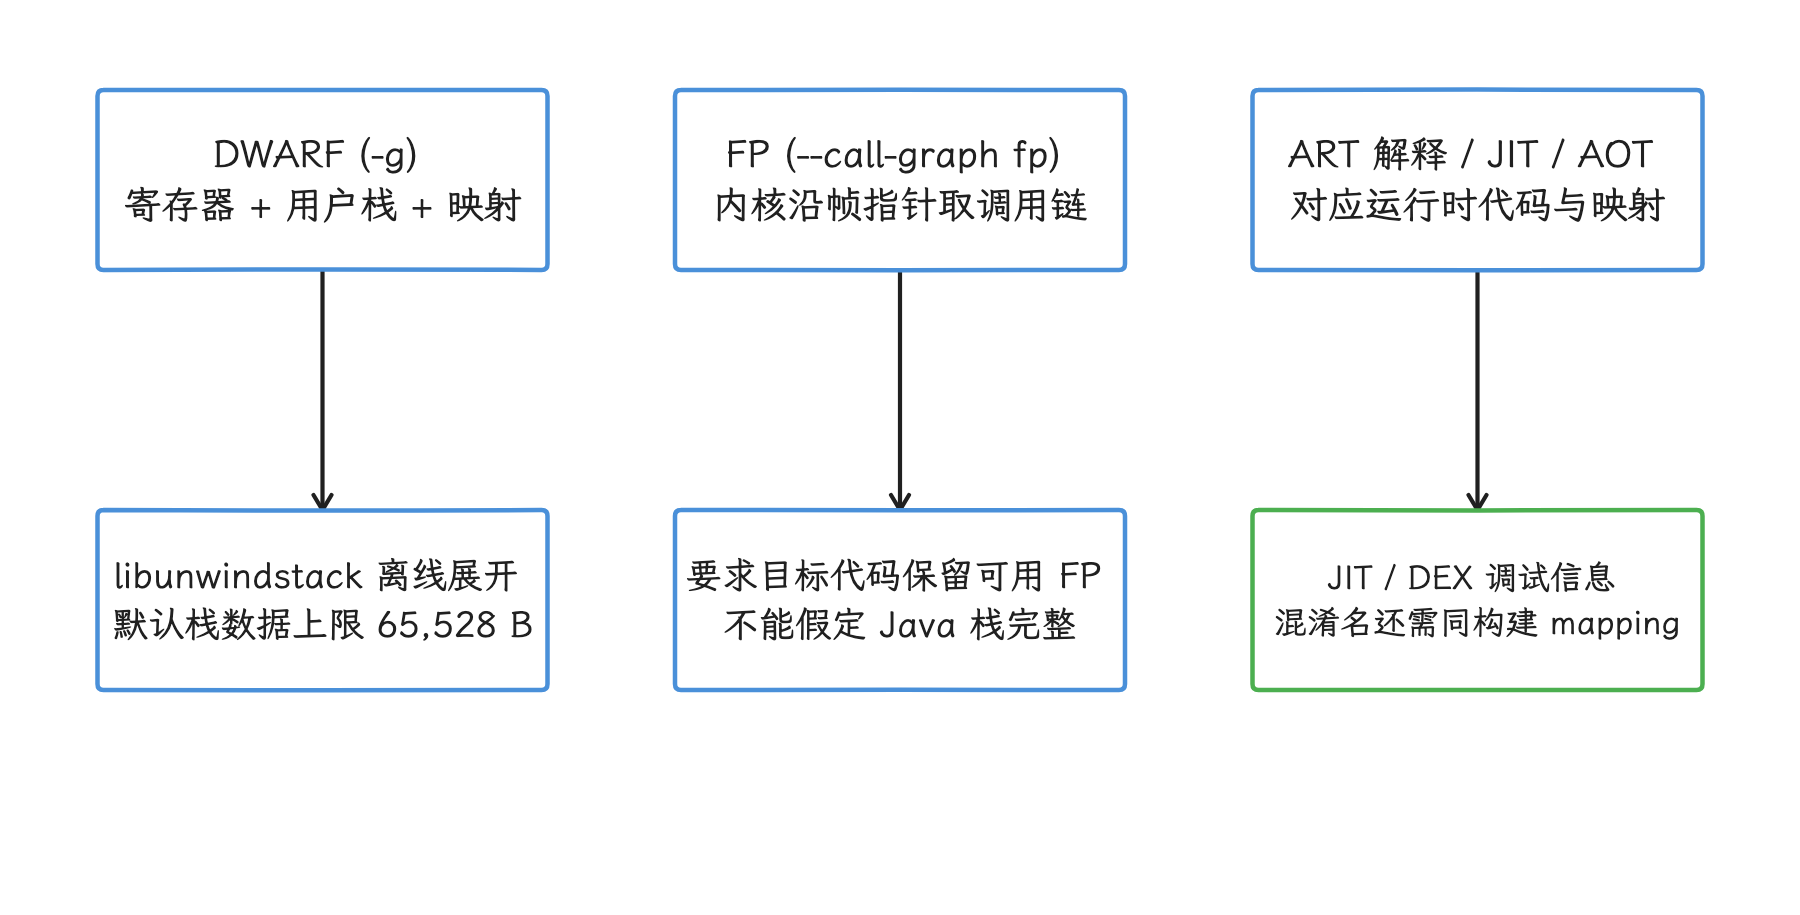
图:调用栈能否还原,取决于采样寄存器、栈数据、编译约定与运行时元数据。 FP 栈更短可能来自断链;Java 解释/JIT/AOT 与原生符号的恢复条件分别核对。
Java/Kotlin 符号
Android 9 起,Simpleperf 可处理 ART 解释器、JIT 和 AOT 代码。Android 17 源码中的 JITDebugReader 负责读取 JIT 与 DEX 调试描述;DEX 是 Android 运行时使用的字节码格式。样本仍由 perf 事件触发,读取调试信息并不会把采样变成方法追踪。
经过 R8/ProGuard 混淆的 Java/Kotlin 符号需要映射文件。下面的报告命令从环境变量读取与 APK 同构建的文件。
: "${R8_MAPPING_FILE:?请先设置与 APK 同构建的 R8_MAPPING_FILE}"

./report_html.py \
  --proguard-mapping-file "${R8_MAPPING_FILE}"
映射文件必须来自与 APK 相同的构建产物——版本不匹配时,方法名可能无法恢复,也可能被错误的同名映射替换,后者更危险。
原生符号
APK 内的 .so 动态库通常已经剥离调试信息。app_profiler.py -lib 应指向同一构建的未剥离库,脚本据此创建 binary_cache/;判断是否匹配以 ELF build ID 为准,只看文件名容易上当。
已有 perf.data 且设备仍可连接时,可补建符号缓存。下面的命令用于从设备和本地目录收集样本涉及的二进制。
: "${PERF_DATA_FILE:?请先设置已有记录文件 PERF_DATA_FILE}"
: "${UNSTRIPPED_LIB_DIR:?请先设置未剥离原生库目录 UNSTRIPPED_LIB_DIR}"

./binary_cache_builder.py \
  -i "${PERF_DATA_FILE}" \
  -lib "${UNSTRIPPED_LIB_DIR}"
生成缓存后重新运行报告。若 [unknown] 仍集中在应用库,依次检查 build ID、ABI(Application Binary Interface,二进制接口约定)、拆分 APK,以及被采样进程实际加载的路径。
多进程、线程与离开 CPU 时间
目标选择
下面每条命令都是独立的目标选择方式,执行时只选与问题相符的一条。PID、线程 ID、进程名正则和包名都从真实环境变量读取;正则表达式用于按文本模式匹配一个或多个进程名。
# 一个或多个 PID
simpleperf record \
  -p "${PID_LIST:?请设置逗号分隔的 PID_LIST}" \
  --duration 10

# 进程名匹配给定正则
simpleperf record \
  -p "${PROCESS_NAME_REGEX:?请设置 PROCESS_NAME_REGEX}" \
  --duration 10

# 指定线程
simpleperf record \
  -t "${THREAD_ID_LIST:?请设置逗号分隔的 THREAD_ID_LIST}" \
  --duration 10

# debuggable 或 profileable 应用
simpleperf record \
  --app "${PACKAGE_NAME:?请设置 PACKAGE_NAME}" \
  --duration 10

# 全系统目标;常规产品设备通常需要 root 权限
simpleperf record -a --duration 10
--app 以包名准备应用采样,并可等待应用进程出现。多进程应用要记得在报告中保留 pid、tid 和 comm,否则相同库中的同名函数会被汇总,主进程与 :remote 进程的成本就分不开了。
-p 接受 PID 列表或进程名正则。按名称选目标前,应保存 adb shell ps -A -o PID,NAME 的输出,确认没有同名测试进程进入样本。
离开 CPU 采样的边界
普通 CPU 采样只在线程运行时产生样本,这段时间称为 on-CPU;线程因抢占、锁、I/O 或其他等待而未在 CPU 上执行时处于 off-CPU。--trace-offcpu 额外记录 sched:sched_switch 调度切换样本和上下文切换记录,用相邻时间戳估算线程离开 CPU 后停留在哪条调用路径。
使用前先探测内核支持。下面的命令用于确认 trace-offcpu,再以 task-clock 记录线程在 CPU 和离开 CPU 的数据。
: "${PACKAGE_NAME:?请先设置目标应用的 PACKAGE_NAME}"

./run_simpleperf_on_device.py list --show-features

./app_profiler.py \
  -p "${PACKAGE_NAME}" \
  -r "-e task-clock:u -f 1000 --duration 10 -g --trace-offcpu"

./report_html.py --trace-offcpu on-off-cpu
--trace-offcpu 要求整次记录只选择 cpu-clock 或 task-clock 中的一个事件。on-off-cpu 报告模式会把两类权重分开显示;离开 CPU 的权重来自调度时间戳,丢失样本或切换记录都会降低精度。问题一旦涉及可运行队列等待、线程唤醒者、Binder(Android 进程间通信机制) 对端或 CPU 频率,我们再换 Perfetto System Trace,它的时间上下文更完整。
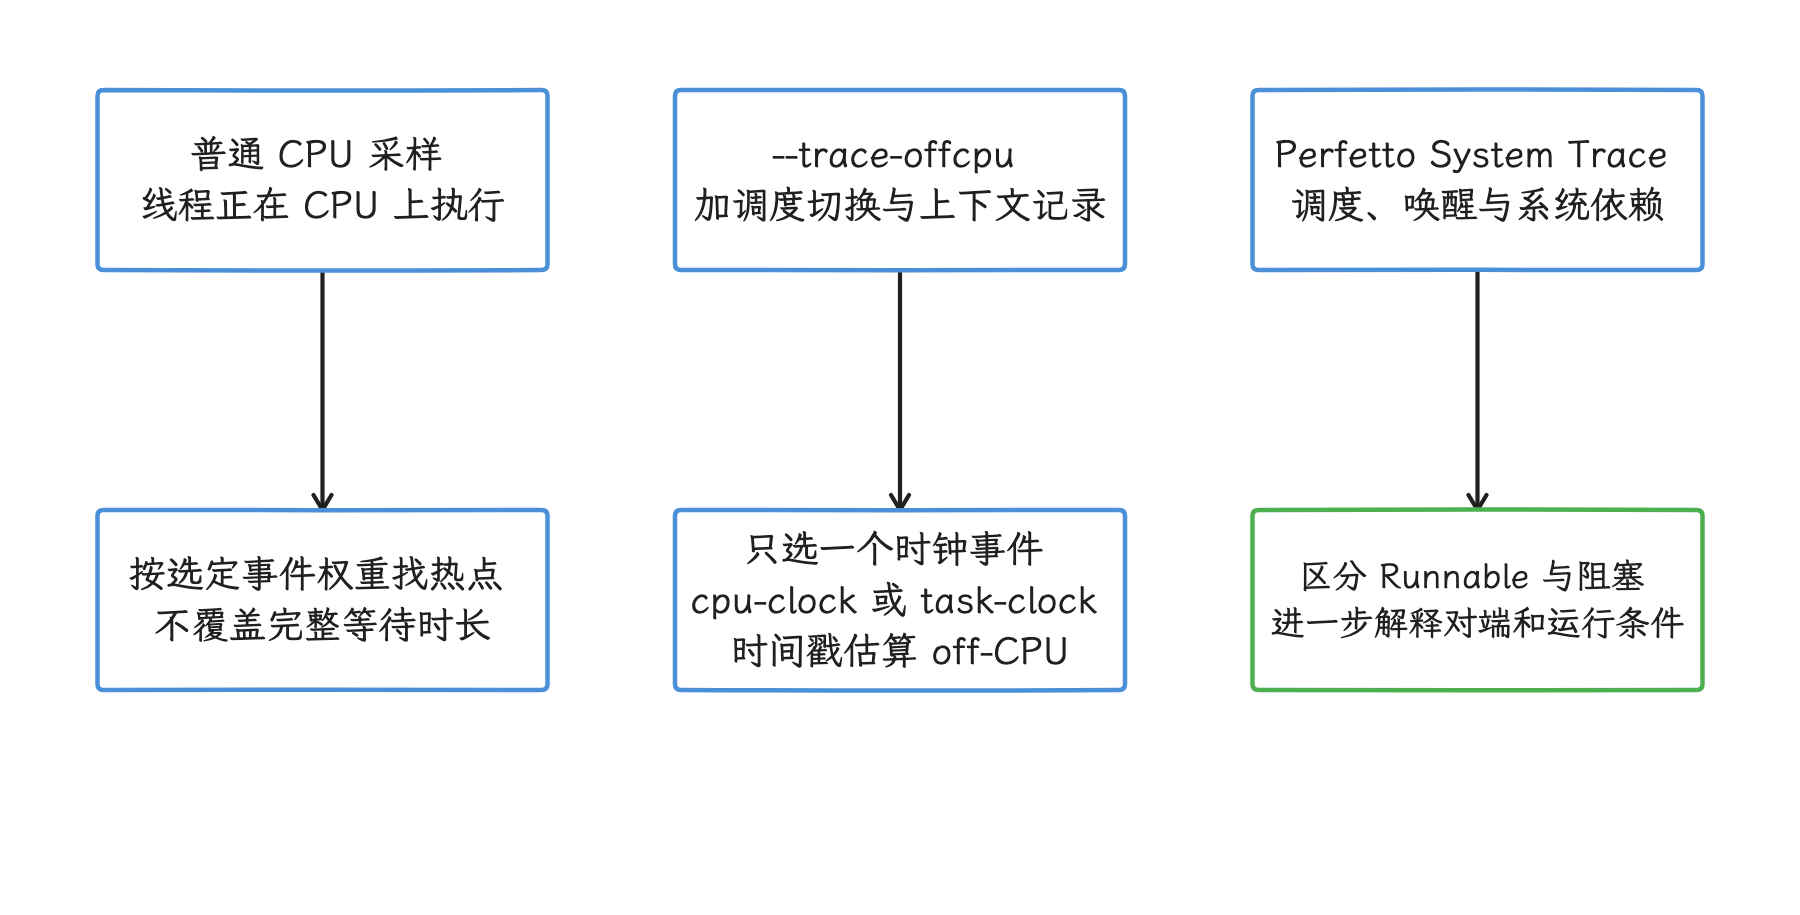
图:CPU 事件样本说明执行位置,调度切换记录补充离开 CPU 的时间权重。 off-CPU 包含排队、抢占和等待;要区分唤醒者、Binder 对端或频率,仍需系统时间线。
丢样、截断栈与缓冲区
采样数据要经过内核 perf 环形缓冲区和 Simpleperf 用户态记录缓冲区两级。内核缓冲区溢出会增加 kernelspace 丢失记录;当配置的单样本用户栈容量大于 1 KiB 时,A17 会在用户态缓冲区低水位把保存的有效栈上限缩至 1 KiB,低于临界水位则直接丢弃此类 sample 记录,把容量留给 mmap(内存映射)和 fork(创建子进程)这些还原地址空间必需的记录。
看到丢样不要同时增大所有参数,按下列顺序定位:
- 降低
-f,确认丢样是否随采样率下降。 - 只出现内核丢样时,逐步增大
-m。该参数表示每个 CPU 的内核缓冲页数,必须是 2 的幂;未指定时,A17 会尝试不超过 1024 页的最大可用值。 - 用户态缓冲区不足或栈被截断时,增大
--user-buffer-size。 - 缩短采样时长、减少目标线程或改用 FP,检查数据量是否回到可控范围。
- 每次只改一个变量,并记录工具结束时的
Samples recorded、Samples lost和truncated stacks统计。
A17 的非全系统记录默认使用 64 MiB 或 256 MiB 用户态缓冲区:设备报告内存不超过 3 GiB 时取 64 MiB,否则取 256 MiB;全系统记录固定为 256 MiB。这只是 GetDefaultRecordBufferSize() 的实现分支,某台设备到底需要多大缓冲区,还是要由本轮丢样情况决定。
确认用户态丢样或截断栈后,可从环境变量传入本轮实验值。下面的命令不预设设备通用数值。
: "${PACKAGE_NAME:?请先设置目标应用的 PACKAGE_NAME}"
: "${USER_BUFFER_SIZE:?请设置带单位的 USER_BUFFER_SIZE,例如按实验选择 MiB 值}"

./app_profiler.py \
  -p "${PACKAGE_NAME}" \
  -r "-e task-clock:u -f 1000 --duration 10 -g --user-buffer-size ${USER_BUFFER_SIZE}"
缓冲区增大是有代价的:分析进程的内存占用随之上涨。系统内存紧张、采样目标很多或栈很深时,要同时观察被测业务是否受到了分析工具的干扰。对于配置用户栈容量大于 1 KiB 的样本,A17 在低水位时把保存的有效栈上限缩至 1 KiB;低于临界水位时,在检查实际有效栈长度前就丢弃该 sample 记录——结束日志能区分这两种结果。
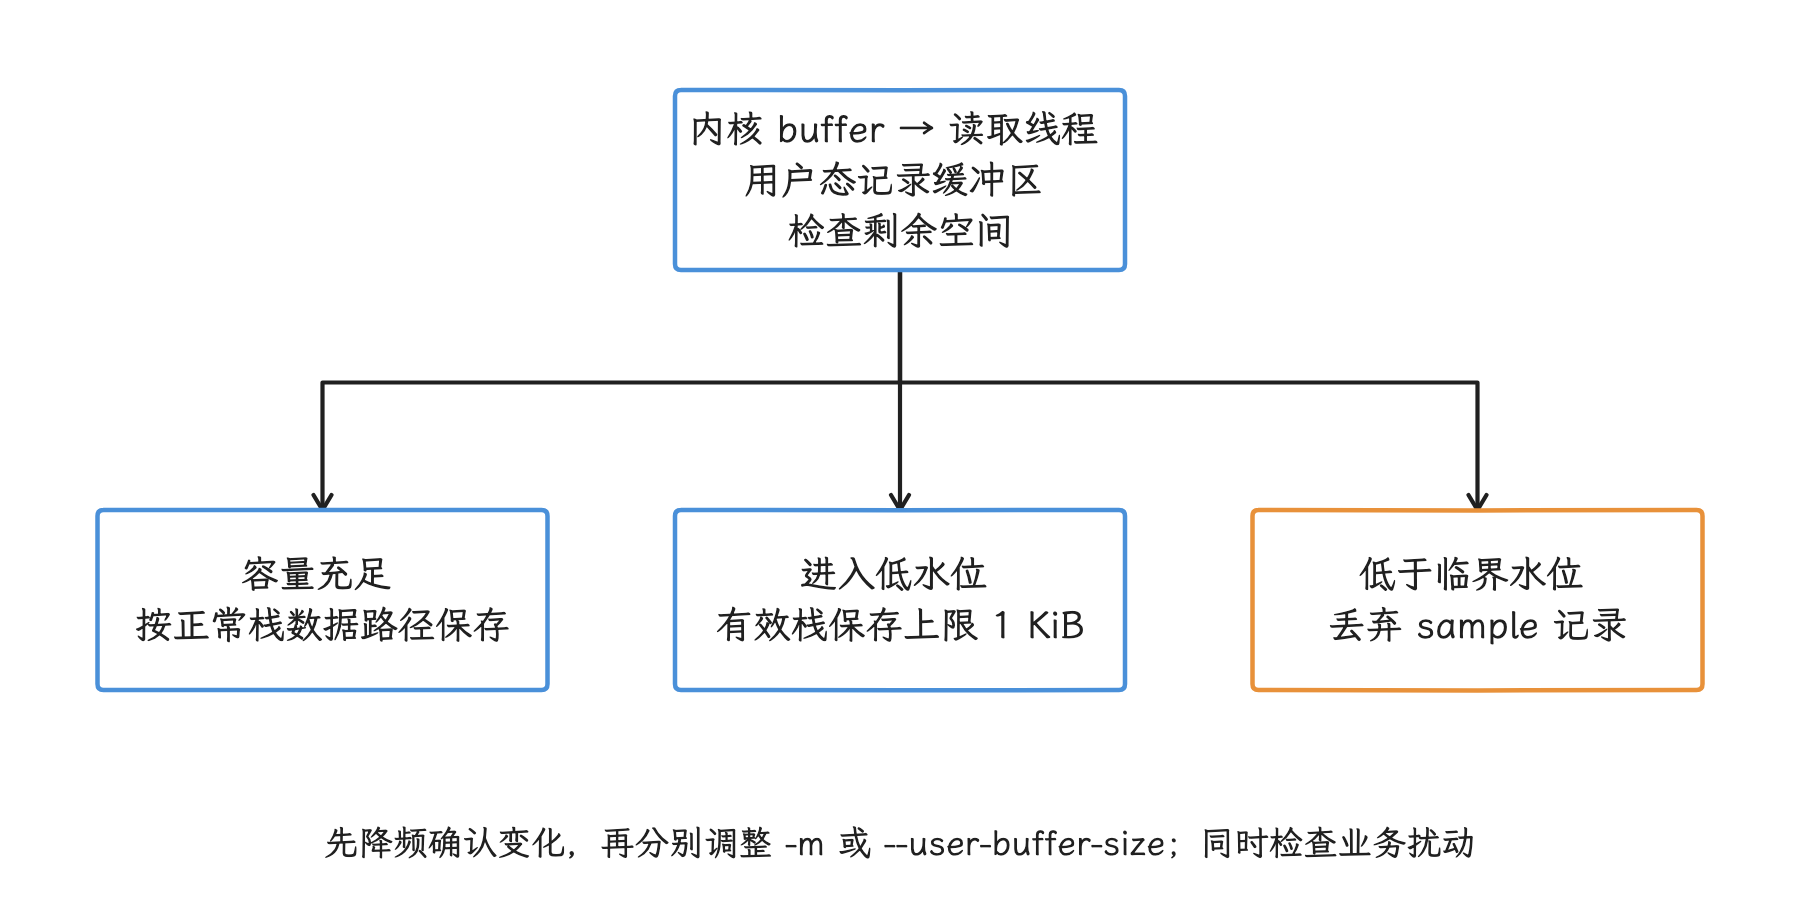
图:分别定位内核丢记录与用户态容量压力,再按日志区分栈裁剪和样本丢弃。 图中为配置用户栈容量大于 1 KiB 的分支;其他预留失败也可能丢记录,阈值按源码与配置计算。
Android 17 的 RecordReadThread 用独立读取线程把内核缓冲区读取与主线程处理分开,以降低 DWARF 采样的丢失概率。它解决的是排队时间;过高频率、权限限制或硬件事件溢出还要单独处理。
报告与时间线工具
文本和 HTML 报告
文本报告适合自动化对比。下面的命令从环境变量读取真实库名,显示调用图并限制到该原生库。
: "${TARGET_DSO:?请先设置要分析的 TARGET_DSO}"

./report.py \
  -g \
  --dsos "${TARGET_DSO}"
--dsos 只保留匹配库的样本;调用图要成立,采集阶段就得先记录调用栈。
HTML 报告适合交互检查。下面的命令从环境变量读取与二进制同提交的源码树,并加入源码与反汇编视图。
: "${SOURCE_ROOT:?请先设置与二进制同提交的 SOURCE_ROOT}"

./report_html.py \
  --add_source_code \
  --source_dirs "${SOURCE_ROOT}" \
  --add_disassembly
源码注释依赖调试行号信息、源码路径和当前文件内容。构建机路径在本机解析不了时,把 --source_dirs 指向对应提交的源码树即可。
转为 Perfetto/Android Studio 可读格式
Simpleperf 的 perf.data 可由 report-sample 转成 protobuf,也就是按协议定义编码的二进制消息;Android Studio CPU Profiler 官方支持这种格式,Android 17 的 Perfetto Trace Processor 也包含 Simpleperf protobuf 解析器。下面的命令保留调用链并生成 perf.trace。
simpleperf report-sample \
  --protobuf \
  --show-callchain \
  -i perf.data \
  -o perf.trace
生成的文件可在 Android Studio CPU Profiler 中打开,Android 17 对应版本的 Perfetto UI 和 Trace Processor 也能解析。转换入口是 report-sample,--show-callchain 决定输出中是否包含调用链;要兼容其他版本的 Perfetto UI,AOSP 当前还提供 gecko_profile_generator.py 和 report_sample.py 两条转换路径。
Perfetto Trace Processor 会把这种 protobuf 中的样本导入 cpu_profile_stack_sample 和栈分析表。要注意 Android 17 导入器会忽略 Simpleperf 的 ContextSwitch 记录,也没有把 event_type 与丢样信息完整映射成时间线语义,所以它适合查看样本火焰图,要看调度数据还是得回到系统跟踪。
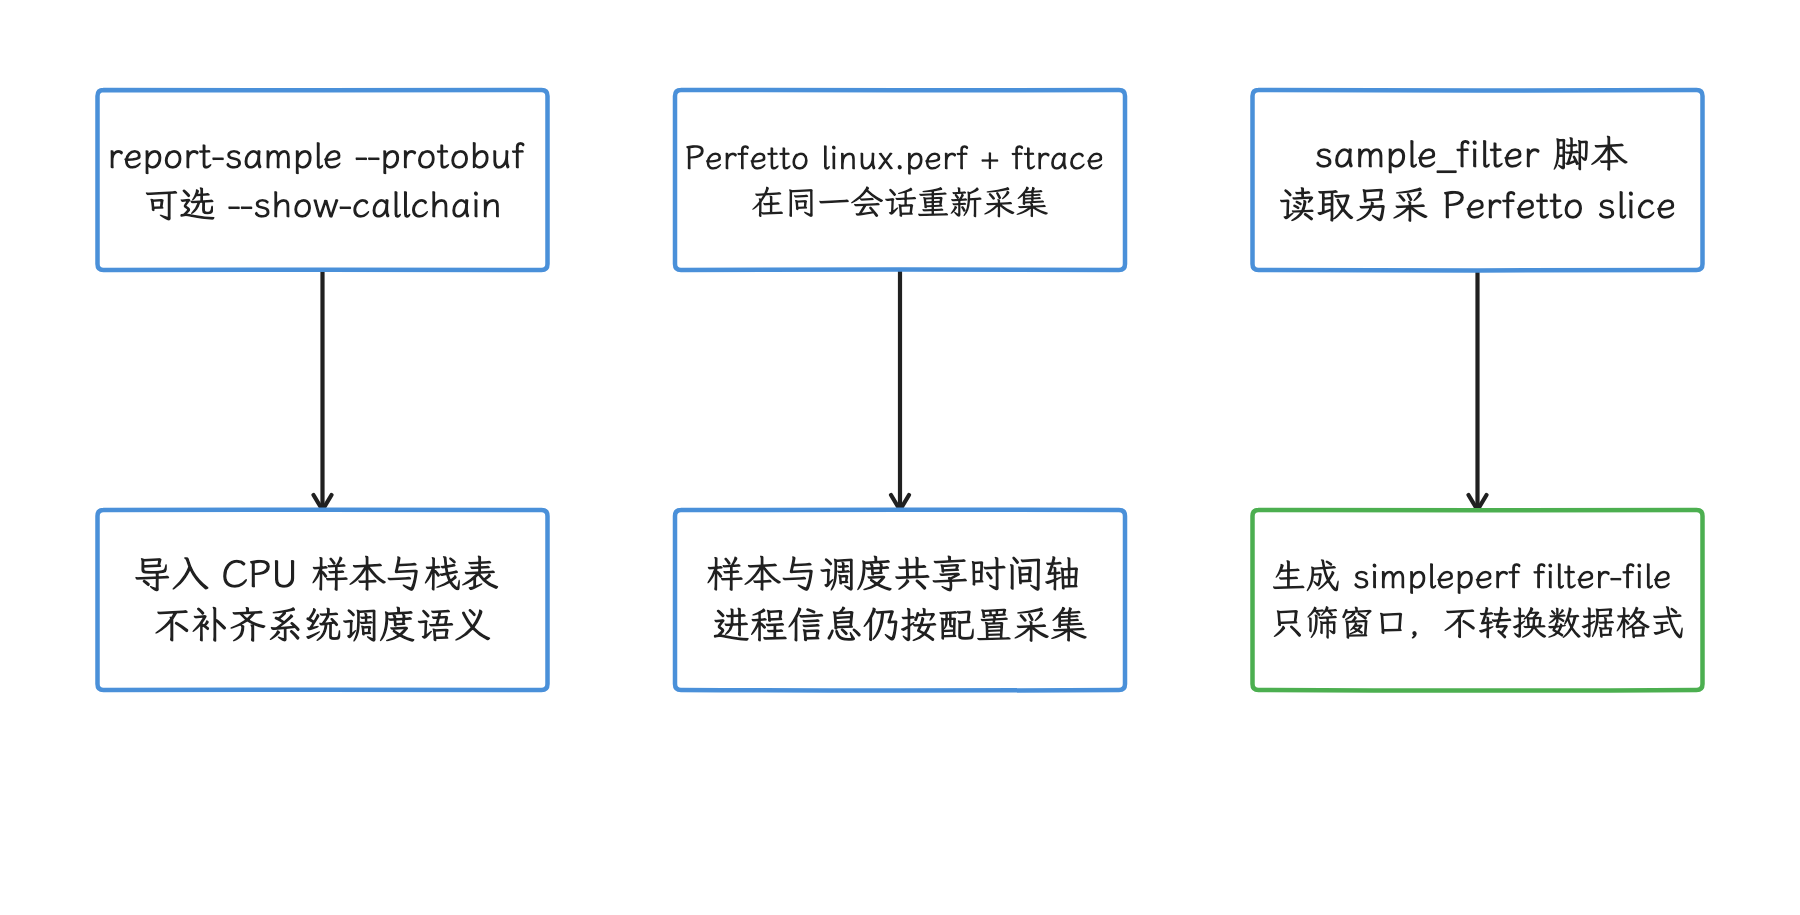
图:导出 Simpleperf 样本、在 Perfetto 会话采样和按已有 slice 筛选样本是不同入口。 A17 Simpleperf 导入器不恢复完整 ContextSwitch/event_type/丢样语义,不能视为系统调度 trace。
Perfetto 的 linux.perf 是另一套采集入口,由 traced_perf 组件调用 perf_event_open 并直接向 Perfetto 会话写入调用栈样本,这样采到的样本能与 ftrace 数据共享时间轴。已经生成的 Simpleperf perf.data 属于另一场采集,我们要另行发起会话,它不会自动并入。
下面的 A17 配置以真实系统进程 surfaceflinger 为目标,按 100 Hz 采集用户态调用栈,并在同一会话加入调度和进程信息。SurfaceFlinger 是 Android 负责合成屏幕图层的系统服务;采样这类系统进程通常需要 userdebug/eng 构建或等价权限。
duration_ms: 10000

buffers {
  size_kb: 40960
  fill_policy: DISCARD
}

data_sources {
  config {
    name: "linux.perf"
    perf_event_config {
      timebase {
        counter: SW_CPU_CLOCK
        frequency: 100
        timestamp_clock: PERF_CLOCK_BOOTTIME
      }
      callstack_sampling {
        scope {
          target_cmdline: "surfaceflinger"
        }
      }
    }
  }
}

data_sources {
  config {
    name: "linux.ftrace"
    ftrace_config {
      ftrace_events: "sched/sched_switch"
      ftrace_events: "sched/sched_waking"
    }
  }
}

data_sources {
  config {
    name: "linux.process_stats"
    process_stats_config {
      scan_all_processes_on_start: true
    }
  }
}
SW_CPU_CLOCK 是触发采样的软件 CPU 时钟,PERF_CLOCK_BOOTTIME 让样本时间戳采用包含休眠时间的系统启动时钟,便于与 Android system trace 对齐。callstack_sampling 未显式配置 kernel_frames,所以示例只保留默认的 DWARF 用户态栈;linux.ftrace 补充切换与唤醒事件,linux.process_stats 补充进程元数据。字段定义可在 Android 17 的 perf_event_config.proto 和 perf_events.proto 中核对。
一句话分工:函数热点和源码归属优先用 Simpleperf;要把调用栈与调度、Binder、频率、帧时间放在同一时间轴上,就换 Perfetto linux.perf 加 ftrace。
Android 17 源码实现要点
应用运行器的版本分支
下面的摘录用于说明 Android 16/17 为什么优先使用设备内置 Simpleperf,代码来自 android-17.0.0_r1 的 environment.cpp。
// Before Android 16, we prefer using run-as, which can use the latest sideloaded simpleperf.
// After Android 16, sideloaded simpleperf has no permission to get kernel samples. So prefer
// using simpleperf_app_runner to run simpleperf shipped on device.
bool prefer_simpleperf_app_runner = GetAndroidVersion() >= kAndroidVersion16;
后续分支在 Android 16/17 上先尝试 simpleperf_app_runner,旧版本先尝试 run-as。因此,A17 应用采样应由 app_profiler.py 协调设备内置程序,完整上下文见 environment.cpp。
采集与展开模块
| 模块 | Android 17 中的职责 |
|---|---|
event_selection_set.cpp | 组织事件、CPU、线程和 perf 事件文件描述符(内核对象句柄),启动记录读取线程 |
RecordReadThread.cpp | 从内核缓冲区读取记录,管理用户态缓冲、栈裁剪和数据通知 |
OfflineUnwinder.h | 用采样寄存器、栈和映射执行离线 DWARF 展开 |
JITDebugReader.h | 读取 ART JIT/DEX 调试描述,维护 JIT 代码符号 |
cmd_record.cpp | 解析 record 参数,协调记录、映射、展开和文件写入 |
record_file_writer.cpp | 写入 perf.data 及其特性段 |
scripts/app_profiler.py | 配置应用目标、默认采样参数、Activity 启动和二进制缓存收集 |
这些模块解释了两个常见现象:采样期间看到的栈可能在写盘前经过离线展开;JIT 方法名依赖运行时调试信息,光靠 APK 内静态符号是恢复不出来的。
温度、频率与异构 CPU
还要记住 Simpleperf 记录的是设备当时执行出来的数据:温控降频、任务迁核和后台负载都会改变同一业务路径的 task-clock、cpu-cycles 与样本分布。
分析 big.LITTLE 或更多 CPU 簇时,应保存以下实验条件。big.LITTLE 泛指由高性能核与高能效核组成的异构 CPU 架构:
- 设备型号、系统构建号、内核版本和电量状态;
- 前台/后台状态、屏幕亮度、网络与充电状态;
- 测试前温度区间和每轮冷却策略;
- 业务输入、迭代次数、编译模式与应用版本;
- Simpleperf 事件、频率、调用栈模式和权限路径。
“修复”采样的名义下,关闭温控服务、修改 sysctl 内核运行参数、解除厂商 PMU 限制或强制锁频都不可取——这些修改会改变调度和功耗环境,也可能损害设备。需要解释频率和调度时,可另采 Perfetto 的 power/cpu_frequency、调度与温控数据;目标设备是否开放对应跟踪点,仍由产品配置决定。
跨 CPU 簇聚合 cpu-cycles 时要小心:一个周期在不同微架构上的含义并不相同。可先用 task-clock 排热点,再用 simpleperf report --cpu 为各 CPU 簇分别过滤样本。report 不支持按 CPU 作为排序列,CPU 簇列表也必须来自目标设备拓扑;优化前后的线程一旦落在不同 CPU 簇,单个全局 IPC 数字很容易掩盖迁核造成的变化。
结果复核清单
采集完成后,按以下问题检查报告:
- 目标包、PID、进程名和采样时段是否正确?
- 业务操作是否完整覆盖采样窗口?
- 事件是否在目标设备成功打开?是否发生 PMU 复用?
- 结束日志里是否出现
Samples lost或truncated stacks? [unknown]是否集中在应用库?build ID 与映射文件是否匹配?- Java、JIT、AOT 和原生帧是否符合系统版本能力?
Overhead表示哪一种事件权重?是否被误写成墙钟耗时?- 优化前后是否使用相同设备状态、输入、频率和调用栈方式?
- 热、频率、迁核或后台任务能否解释差异?
- 结论能否由另一轮采样、微基准或 Perfetto 时间线交叉验证?
这份清单能拦住两类误判:把采样噪声当成业务变化,以及把符号或权限缺失当成“代码没有执行”。
Android 17 采集能力与微架构工作流
基础采样回答“热点在哪里”;要进一步确认缓存、分支和流水线的瓶颈,就要动用 Android 17 新加入的这批能力。
前文的 PMU 采样是基础,Android 17 在这之上加入了 SPE(Statistical Profiling Extension,统计分析扩展)的采集与解码,并改进后台采集、应用进程跟踪和 ETM profile(性能数据)转换。这里的“微架构”指缓存、地址转换和分支预测等处理器内部行为。我们讨论的范围限于已经进入 android-17.0.0_r1 的实现;某台设备用不用得上这些能力,由 SoC、内核配置和权限共同决定。
先分清 PMU、SPE 和 ETM
三种机制都可以由 Simpleperf 驱动,但它们回答的问题不同。
| 机制 | 输入数据 | 适合回答的问题 | 主要代价 |
|---|---|---|---|
| PMU 计数与溢出采样 | cycles、instructions、cache miss 等事件 | 哪些函数消耗 CPU,事件率是否异常 | 计数器数量有限;采样依赖溢出中断 |
| SPE 统计采样 | CPU 生成的 SPE packet | 哪些指令与访存、TLB、分支事件相关 | 依赖可选硬件和 AUX 缓冲;当前解码器只使用部分字段 |
| ETM/ETE 指令 trace | 控制流 trace | 执行过哪些分支路径,如何生成 AutoFDO profile | 数据量大,容易因 sink 与缓冲压力丢失 trace |
几个词先说清:SPE packet 是硬件输出流中的一个编码单元,一条采样 record 可由事件、地址、上下文、结束标记等多个 packet 组成;TLB(Translation Lookaside Buffer)是缓存虚拟地址到物理地址转换结果的结构;AUX 是 Linux perf 为大体积硬件 trace 准备的辅助缓冲区。SPE 从 Armv8.2-A 起成为可选扩展,运行在 AArch64(64 位 Arm 执行状态)中,不以 Armv9 为前提。
ETM(Embedded Trace Macrocell)和 ETE(Embedded Trace Extension)是 CoreSight 中的指令控制流 trace 源;CoreSight 是 Arm 的片上硬件跟踪框架,sink 指接收并保存 trace 的终点。TRBE(Trace Buffer Extension)是每 CPU 的内存 sink,ETR(Embedded Trace Router)则可把 trace 写入系统内存——后两者都不负责生成 SPE 微架构样本。
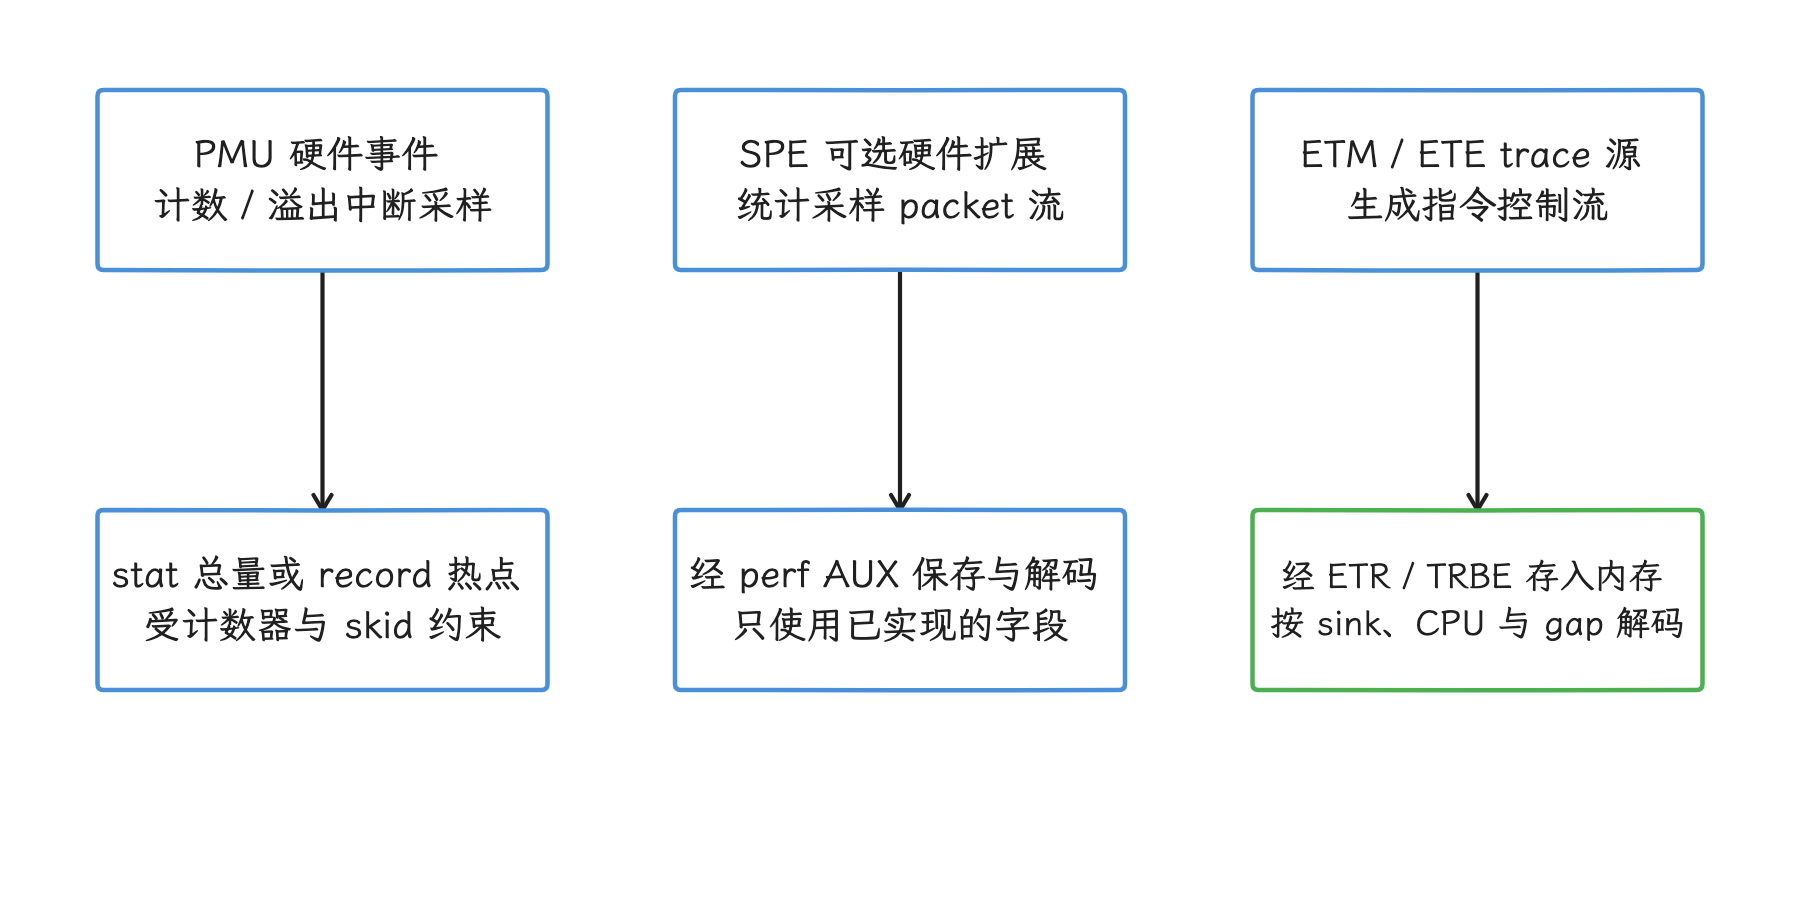
图:PMU 计数和溢出样本、SPE 统计 record 与 ETM/ETE 控制流各有不同证据粒度。 SPE packet 是编码单元;TRBE/ETR 是 CoreSight sink,不产生 SPE 样本,也不保证无缺口。
Android 16 与 Android 17 的差异需要分开看:
| 能力 | Android 16 | Android 17 |
|---|---|---|
| Arm SPE | Simpleperf 尚无 SPERecorder / SPEDecoder | 新增 SPE 发现、采集和 report 解码 |
| CoreSight TRBE | ETMRecorder 已能识别 ETR 与 TRBE,发现 TRBE 时已把 sink 选择交给内核 | 列出多个 ETR 名称、记录 TRBE 支持的 CPU,并按 CPU 判断通用事件是否实际使用 TRBE |
record --background | 无此选项 | 新增单次 fork() 的后台模式 |
--app | record、stat 已支持 | stat --monitor-new-thread 可继续发现同一包名的新进程 |
devfreq / pmu_lib | --use-devfreq-counters 已能临时切换并恢复 mem_latency governor | 保留原流程,并在未找到该 governor 时增加 pmu_lib 后备路径与恢复动作 |
| 内核模块 ETM AutoFDO | 已识别模块 DSO,但 branch-list 未保存运行时模块信息,.ko 也缺少可供转换器使用的 program header | 保存模块内存范围与首个符号,并从 .text section 建立 AutoFDO 偏移映射 |
表格之外再补几个名词:DSO 在 Simpleperf 中是被分析二进制的对象抽象,范围也包括内核与内核模块;branch-list 是序列化保存已解码分支路径的中间文件;ELF program header 描述运行时装载段,.text section 保存机器指令。AutoFDO 是基于实际执行数据的反馈优化格式,编译器用其中的指令范围和分支计数调整代码布局。生成 profile 只是准备好了优化输入,编译产物是否变快还要另测。
Android 17 的 SPE 采集链路
从 sysfs 事件到 AUX 数据
Android 17 的 SPETypeFinder 会扫描 /sys/bus/event_source/devices/arm_spe*(sysfs 是内核把设备属性暴露给用户空间的虚拟文件系统)。发现逻辑从中读取 PMU 数字类型 type 和 format/* 配置位,并把 arm_spe 作为默认设备 arm_spe_0 的别名。SPERecorder 还会读取:
caps/min_interval:CPU 建议的最小采样间隔,属建议值而非硬件强制下限;读取失败时,Simpleperf 把采样周期设为 4096。- 每个在线 CPU 的 MIDR(Main ID Register,处理器型号与版本标识):解码时据此判断 SPE 版本和 CPU 型号。
- PMU
type:交给perf_event_open()创建使用 AUX 缓冲的性能事件。
一次 record 命令只能选择一个 SPE 设备。带配置的事件名采用 sysfs 暴露的字段,例如 arm_spe_0/<field>=<value>/;字段名称以本机 sysfs 为准,别从其他芯片照搬。
开始采集前,先用下面的命令核对目标设备实际暴露的事件——它的用途是阻止脚本把“不支持 SPE”和“权限不足”混成一类错误:
adb shell su root simpleperf list | grep arm_spe
adb shell 'ls -d /sys/bus/event_source/devices/arm_spe* 2>/dev/null'
su root 表示切换为超级用户。先确认命令本身执行成功,且 sysfs 路径可见;确认没有匹配节点后,才能判断本次可见的内核设备列表未注册 SPE PMU。没有输出也可能来自 su 不可用、权限错误或命令失败。sysfs 存在而 record 失败时,再检查 root、SELinux 强制访问控制策略、perf 权限和事件配置。
目标设备支持通用 arm_spe 事件后,可以用以下流程采集一个已经运行的应用进程:
target_pid=$(adb shell pidof -s com.example.app)
test -n "$target_pid" || { printf 'target process not found\n' >&2; exit 1; }
adb shell su root simpleperf record \
  -e arm_spe -p "$target_pid" --duration 10 \
  -o /data/local/tmp/spe.data
adb shell su root simpleperf report \
  -i /data/local/tmp/spe.data
pidof -s 只取一个匹配进程的 PID。record 把原始 SPE packet 写入 perf AUX 数据,report 再调用 SPEDecoder 生成可聚合的 sample。示例之所以用 root,是因为量产设备通常不允许 shell 任意分析其他进程;可调试应用还可以按前文的 run-as 流程操作。
当前解码器能给出什么
SPEDecoder 会从 packet 中提取采样指令虚拟地址(也称 IP)、数据虚拟地址、上下文线程 ID 和事件位。Android 17 能据此生成的事件包括:
- architecturally retired;
- L1 data cache access / refill;
- TLB access / walk;
- branch condition not taken / branch mispredicted;
- LLC access / miss;
- remote access、misalignment;
- SPE 新版本提供的 L2 access / miss 等事件。
这些名称来自 decoder 的事件表;LLC 指 last-level cache(处理器缓存层级中的末级缓存),实际事件集合还受 CPU 所实现 SPE 版本的约束。报告中的地址能帮助定位关联指令或数据访问,不过“被采样到”是统计结果,想拿到每一次 load/store(内存读写)的完整记录,SPE 给不了。
Android 17 的 decoder 没有把以下 packet 信息转换成 perf sample 字段:
| 尚未输出的字段 | 对分析结论的限制 |
|---|---|
PERF_SAMPLE_DATA_SRC | 该 perf 标准字段没有写入,因此无法直接给出 L1、L2、LLC、内存构成的逐级访问来源 |
| operation type | 不能仅凭报告稳定区分 load、store 或其他操作 |
| branch target / previous branch | 不能从 SPE 报告还原完整分支路径 |
| physical address | 报告只使用虚拟地址 |
latency counter / PERF_SAMPLE_WEIGHT | 不能报告 issue 到完成的周期数 |
| timestamp | 当前生成的 sample 时间为 0,不能用它与其他 trace 做逐样本时间对齐 |
所以 simpleperf report --spe-cache-miss 在 Android 17 上还只是一条无效命令,固定的“缓存延迟链”和“TLB walk 深度”同样要等 decoder 实现。我们需要这些字段时,先查后续平台版本是否已经支持,再决定分析方案。
SPE 采样事件的多个视图
一条 SPE record 可以同时携带多个事件位,Android 17 的 report 会为这些事件分别建立视图,于是同一条 record 可能同时计入 L1 refill、TLB walk 和 remote access。各类 sample 数量拿来分别排序热点是合适的,相加之后当成互斥事件总数就错了。
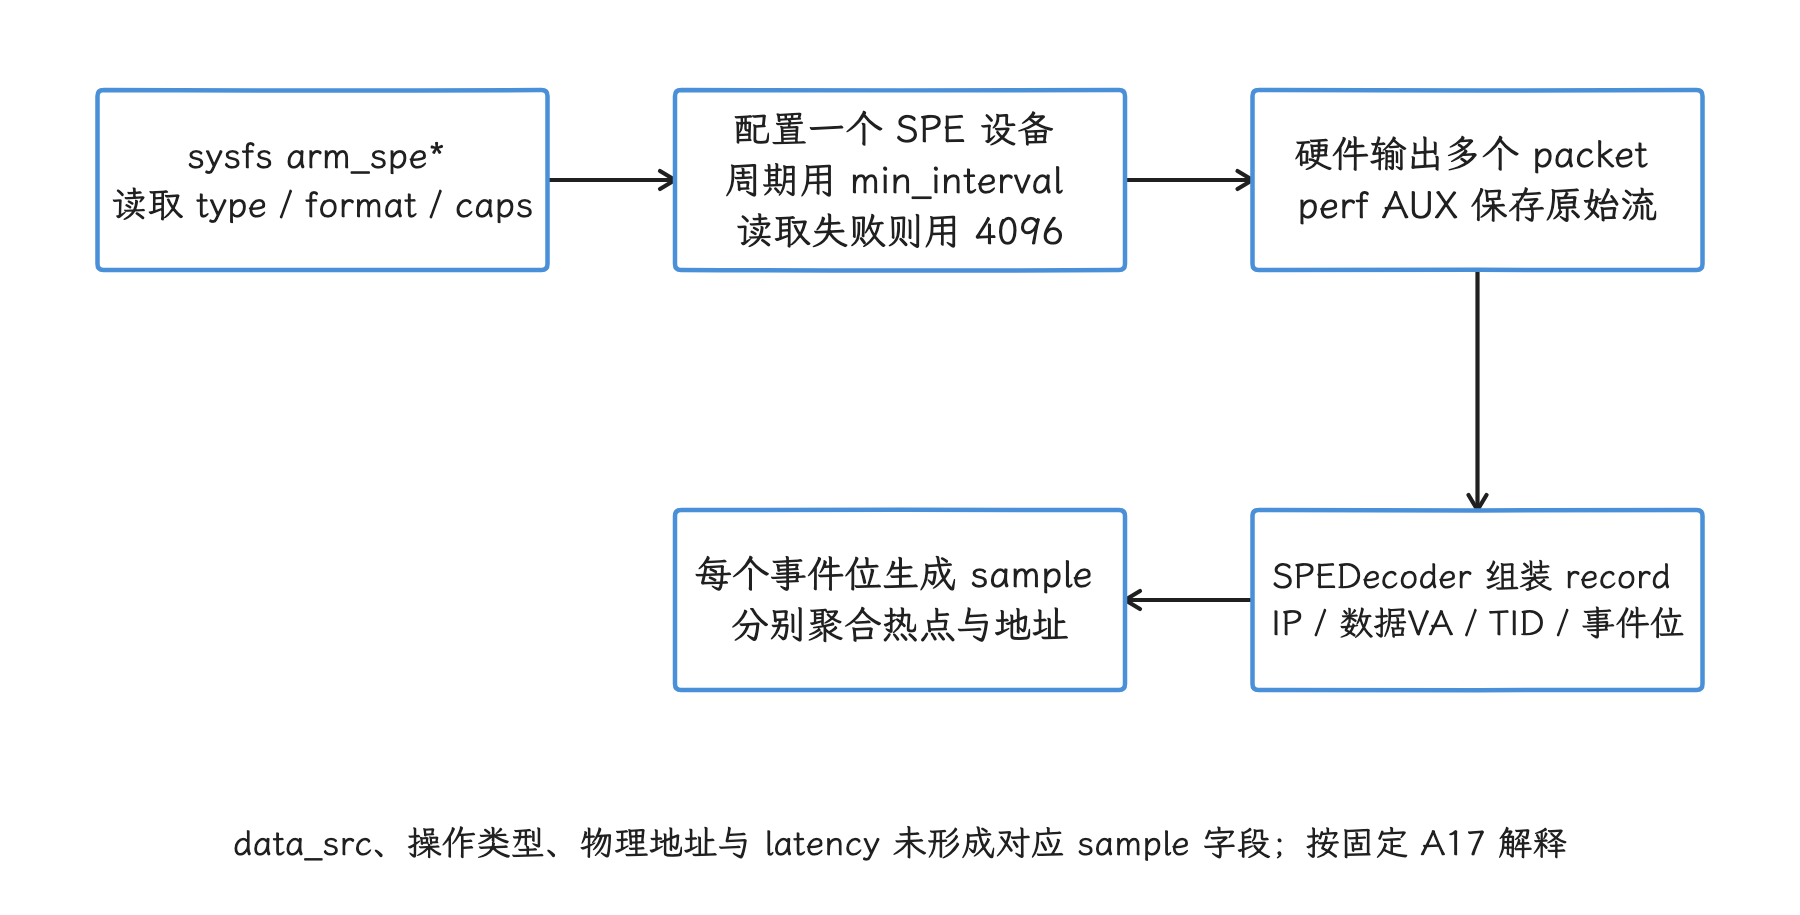
图:读取 sysfs 类型与格式,保存 AUX packet 流,再由 decoder 按事件位形成报告视图。 一条 record 可命中多个事件,视图计数不能相加当互斥总数;A17 样本时间为 0,未输出延迟权重。
SPE 的 packet 由硬件写入 profiling buffer,不需要每个样本触发一次 PMU 溢出中断。但 Linux SPE 驱动仍要处理 AUX 缓冲区装填、截断、碰撞和 IRQ(Interrupt Request,硬件中断请求),采样间隔过小或缓冲消费不及时都会产生丢失记录。开销与丢失率得在目标设备和目标负载上测量,套用固定百分比没有意义。
TRBE 是 CoreSight sink
CoreSight 链路可以概括为:
CPU 上的 ETM/ETE 生成控制流 trace → CoreSight 选择 sink → ETR 或每 CPU 的 TRBE 把 trace 保存到内存
TRBE 是每 CPU 的 trace sink,对应 CPU 的 ETE 可以把 trace 写入该 CPU 的内存缓冲。缓冲到达边界时,内核驱动通过 maintenance IRQ(维护中断)更新 AUX 状态;wrap(写指针绕回)、碰撞、截断和硬件 erratum(已知设计缺陷)都可能造成 trace gap(控制流记录缺口)。所以“独立带宽必然无丢包”“固定低延迟”这类说法推不出来。
Android 17 的选择逻辑
Android 16 的 ETMRecorder::FindSinkConfig() 已能识别 ETR 和 TRBE,并在发现 TRBE 时把 config2 设为 0,让内核选择合适的 sink。config2 是 perf_event_attr 中用于传递 CoreSight sink 配置的字段。Android 17 的变化集中在更细的 sink 建模:
CheckSinkSupport()收集所有可用 ETR 配置,并保存支持 TRBE 的 CPU ID。- 事件列表除通用
cs-etm外,还可以列出cs-etm/@tmc_etr0/这类显式 ETR 事件。 - 通用
cs-etm在存在可用 TRBE 时令config2为 0,交给内核按 CPU 选择 TRBE;没有 TRBE 时选择可用的 ETR。 - 显式 ETR 事件把对应 sink 配置写入
config2。 IsUsingTRBE()同时检查config2和目标 CPU 是否支持 TRBE。
目标设备的 sink 名称由内核提供,下面的命令用于查看 Simpleperf 已经识别出的实际事件:
adb shell su root simpleperf list | grep cs-etm
只有列表中出现显式 ETR 事件时,才能指定它与默认 cs-etm 做对照。默认事件是否使用 TRBE,还取决于采集 CPU 的支持集合,产品宣传材料说了不算。
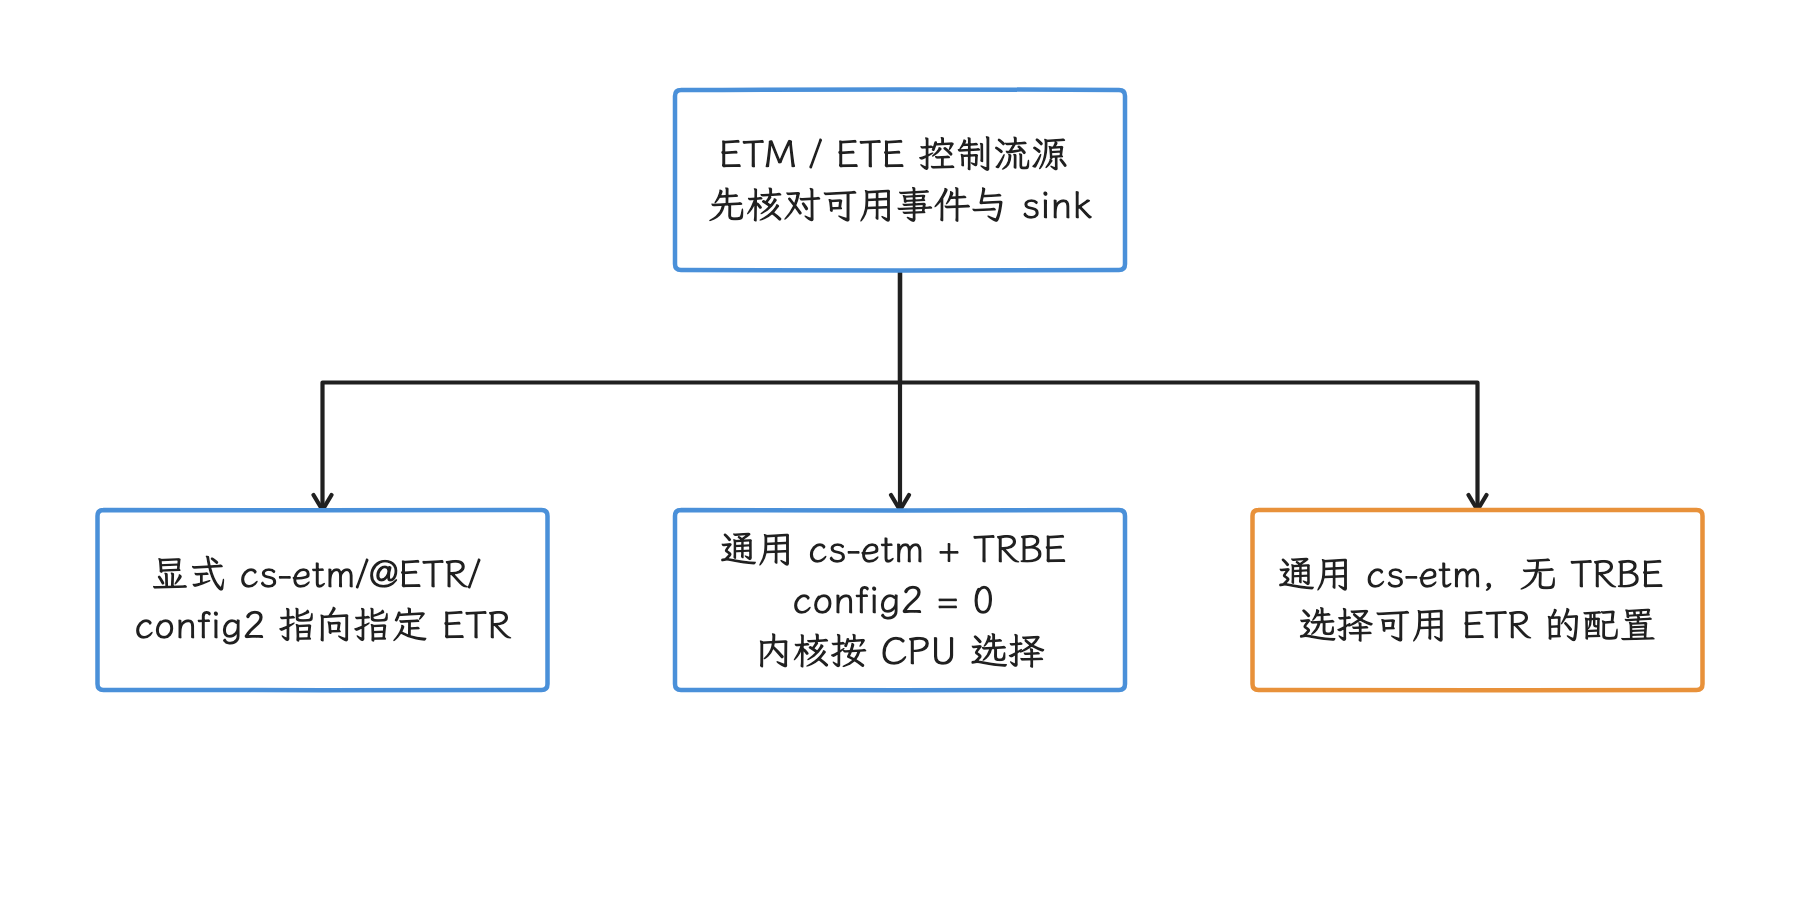
图:先发现可用 sink,再区分显式 ETR 配置与通用事件的按 CPU 选择。 config2 为 0 还要核对该 CPU 的 TRBE 支持集合;不存在可用 sink 或权限不足时采集仍会失败。
下面的命令用于做一次短时的系统级内核指令 trace,以便先检查权限、sink 和数据丢失情况:
adb shell su root simpleperf record \
  -a -e cs-etm:k --duration 5 \
  -o /data/local/tmp/kernel-etm.data
:k 将事件限制在内核态。系统级 ETM 通常要求 root;Simpleperf 也会阻止应用 UID 采集内核 ETM,以免泄露受 KASLR(Kernel Address Space Layout Randomization,内核地址空间布局随机化)保护的地址。
record --background 的进程语义
Android 17 新增的 --background 适合脚本启动有限时长的采集。实现只调用一次 fork(),也就是从当前进程复制出一个子进程:
- 父进程打印子进程 PID,然后成功返回。
- 子进程忽略终端断开时常见的
SIGHUP信号,并调用setsid()脱离原会话、创建新会话。 - 子进程把标准输入、标准输出和标准错误重定向到
/dev/null空设备,随后执行采集。
这里没有第二次 fork()。命令行解析发生在分叉前,输出文件准备和正式采集发生在子进程中,分叉后的报错也就不会出现在当前终端——所以后台采集应使用绝对输出路径,并在长任务前先做一次短时前台预检。
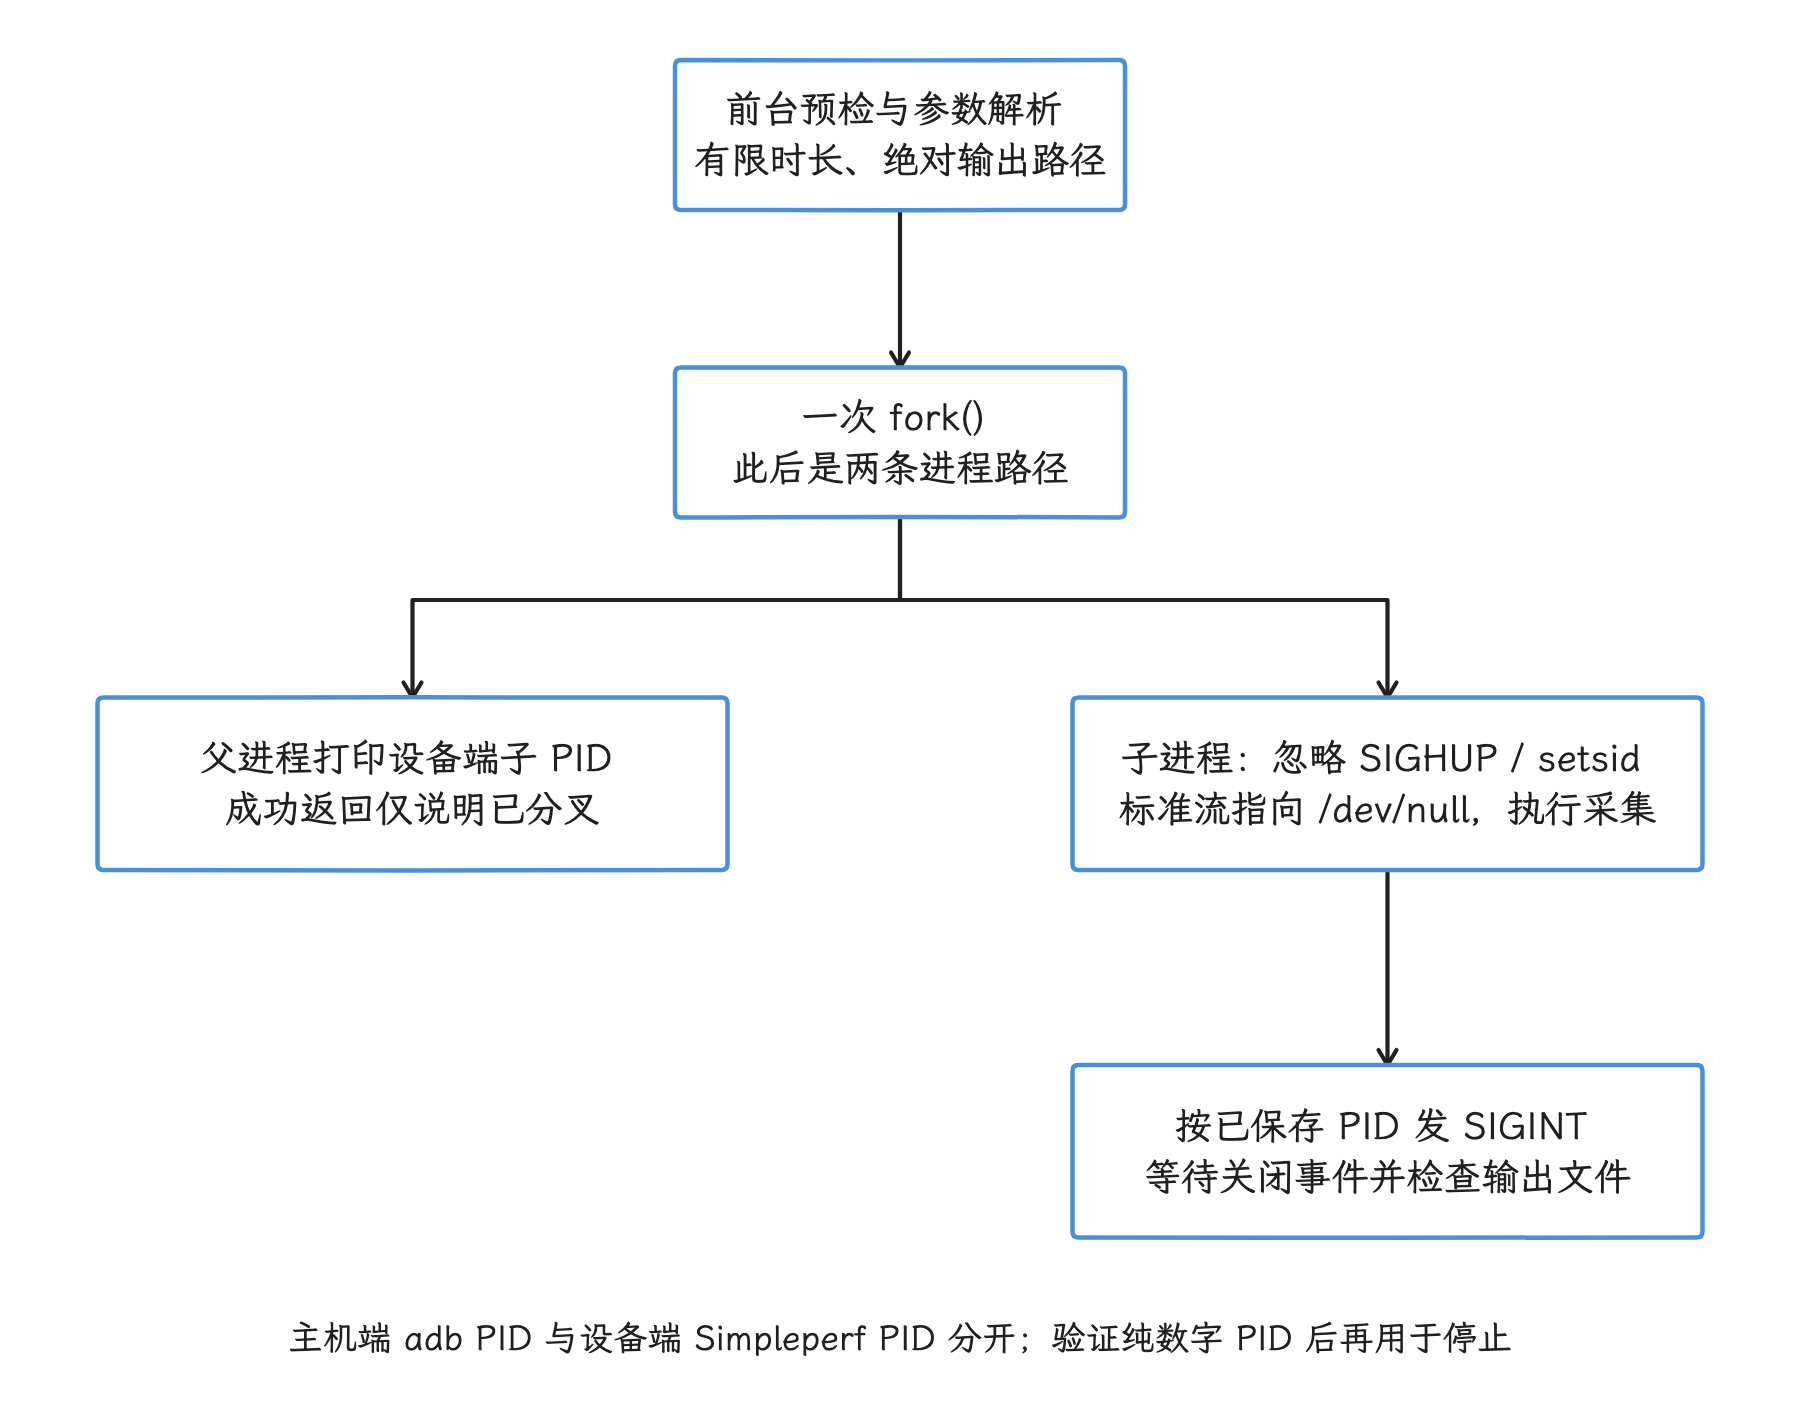
图:父进程返回 PID,子进程独立采集并在正常停止后写完记录。 父进程成功返回不证明采集成功;分叉后错误可能静默,SIGKILL 无法保证完整文件。
下面的脚本在设备端定位目标进程、启动 60 秒采集,并在主机端保存 Simpleperf 返回的后台 PID。它假设当前设备端 simpleperf 已有采样目标的权限;--background 不会绕过 profileable、root、SELinux 或内核权限:
background_pid=$(adb shell '
  target_pid=$(pidof -s com.example.app) &&
  simpleperf record --background \
    -p "$target_pid" --duration 60 \
    -o /data/local/tmp/app-perf.data
')
case "$background_pid" in
  ''|*[!0-9]*) printf 'invalid simpleperf background pid\n' >&2; exit 1 ;;
esac
printf 'simpleperf background pid: %s\n' "$background_pid"
父进程输出的是纯 PID,便于脚本保存。若 background_pid 为空,应立即检查包进程、权限和前台预检结果,别等输出文件自己出现。
需要提前结束采集时,向这个 PID 发送 SIGINT 中断信号,让 Simpleperf 关闭事件并写完 perf.data:
adb shell kill -INT "$background_pid"
adb shell ls -l /data/local/tmp/app-perf.data
SIGKILL 会强制终止进程,不给清理逻辑执行机会,可能留下不完整数据,别把它当常规停止方式。后台模式也远不是无人值守的全天采集:文件增长、设备温度、丢样和静默失败,仍需要外部监控盯着。
--app 与新进程跟踪
--app <package> 在 Android 16 已经存在。它让 Simpleperf 等待包对应的初始进程;非 root 场景通过 RunInAppContext() 选择受控运行器,目标可为 debuggable 或获准由 shell 分析的 profileable App。A17 帮助文本仍保留“必须 debuggable,因为使用 run-as”的旧描述,这里按 environment.cpp 的实际分支解释。Android 16 的 NewThreadMonitor 已能扫描初始 PID 集合中的新线程。Android 17 的增量是让 stat 在 --app 场景继续发现同包名进程:
- 只有启用
--monitor-new-thread时才持续扫描新进程与线程。 - 扫描器遍历
/proc进程信息,读取进程对应的应用包名,把新出现且包名匹配的进程加入监控。 - 新进程加入后,它的现有线程和随后创建的线程都可以成为统计目标。
- 帮助文本要求把该选项与
--per-thread --no-inherit配合使用。
下面的命令用于观察应用冷启动期间出现的同包名进程和线程。先停止旧进程,再让第一条 adb 在主机后台等待,随后启动应用:
adb shell am force-stop com.example.app

adb shell simpleperf stat \
  --app com.example.app \
  --per-thread --no-inherit --monitor-new-thread \
  --duration 10 &
stat_adb_pid=$!

adb shell am start -n com.example.app/.MainActivity
wait "$stat_adb_pid"
这里的 stat_adb_pid 是主机端 adb 进程,不是设备上的 Simpleperf PID。--app 单独使用时,别指望它持续纳入全部后续子进程;要动态纳入,得靠 --monitor-new-thread。
--use-devfreq-counters 与 pmu_lib
devfreq 是 Linux 为内存控制器等非 CPU 设备提供的动态频率框架,governor 是它选择频率的策略。--use-devfreq-counters 在 Android 16 已存在;Android 17 新增的是 pmu_lib 供应商驱动后备路径。相关处理位于 DevfreqCounters::Use(),只在显式传入该选项时运行,而且要求 root。
处理顺序如下:
- 扫描
/sys/class/devfreq/*/governor。 - 读取各节点的 governor;值恰好为
mem_latency时记录文件路径,并临时写入performance。 - 只有未找到这类节点时,才检查
/sys/devices/system/cpu/pmu_lib/enable_counters。 - 文件当前值为
1时写入DEADBEEF,对象析构时写入BEEFDEAD。
这两个 magic value(约定好的特殊常量)来自供应商驱动,推广成通用 PMU 控制接口是不成立的;路径不存在时,Simpleperf 跳过该后备路径。
下面的命令只适合受控、已 root 的实验设备,用于在需要 devfreq 计数器的统计任务中触发这套流程:
adb shell su root simpleperf stat \
  --use-devfreq-counters \
  -e cpu-cycles,instructions \
  --duration 10 -a
该选项会改变内存延迟相关 governor 或暂时停用供应商计数器,测量结果也会受到状态切换影响。正常退出时,DevfreqCounters 对象的析构逻辑负责恢复;进程被 SIGKILL 或崩溃时,恢复逻辑没有机会运行。所以实验脚本应在运行前后记录 governor 和 enable_counters,发现状态未恢复时按设备内核文档处理。
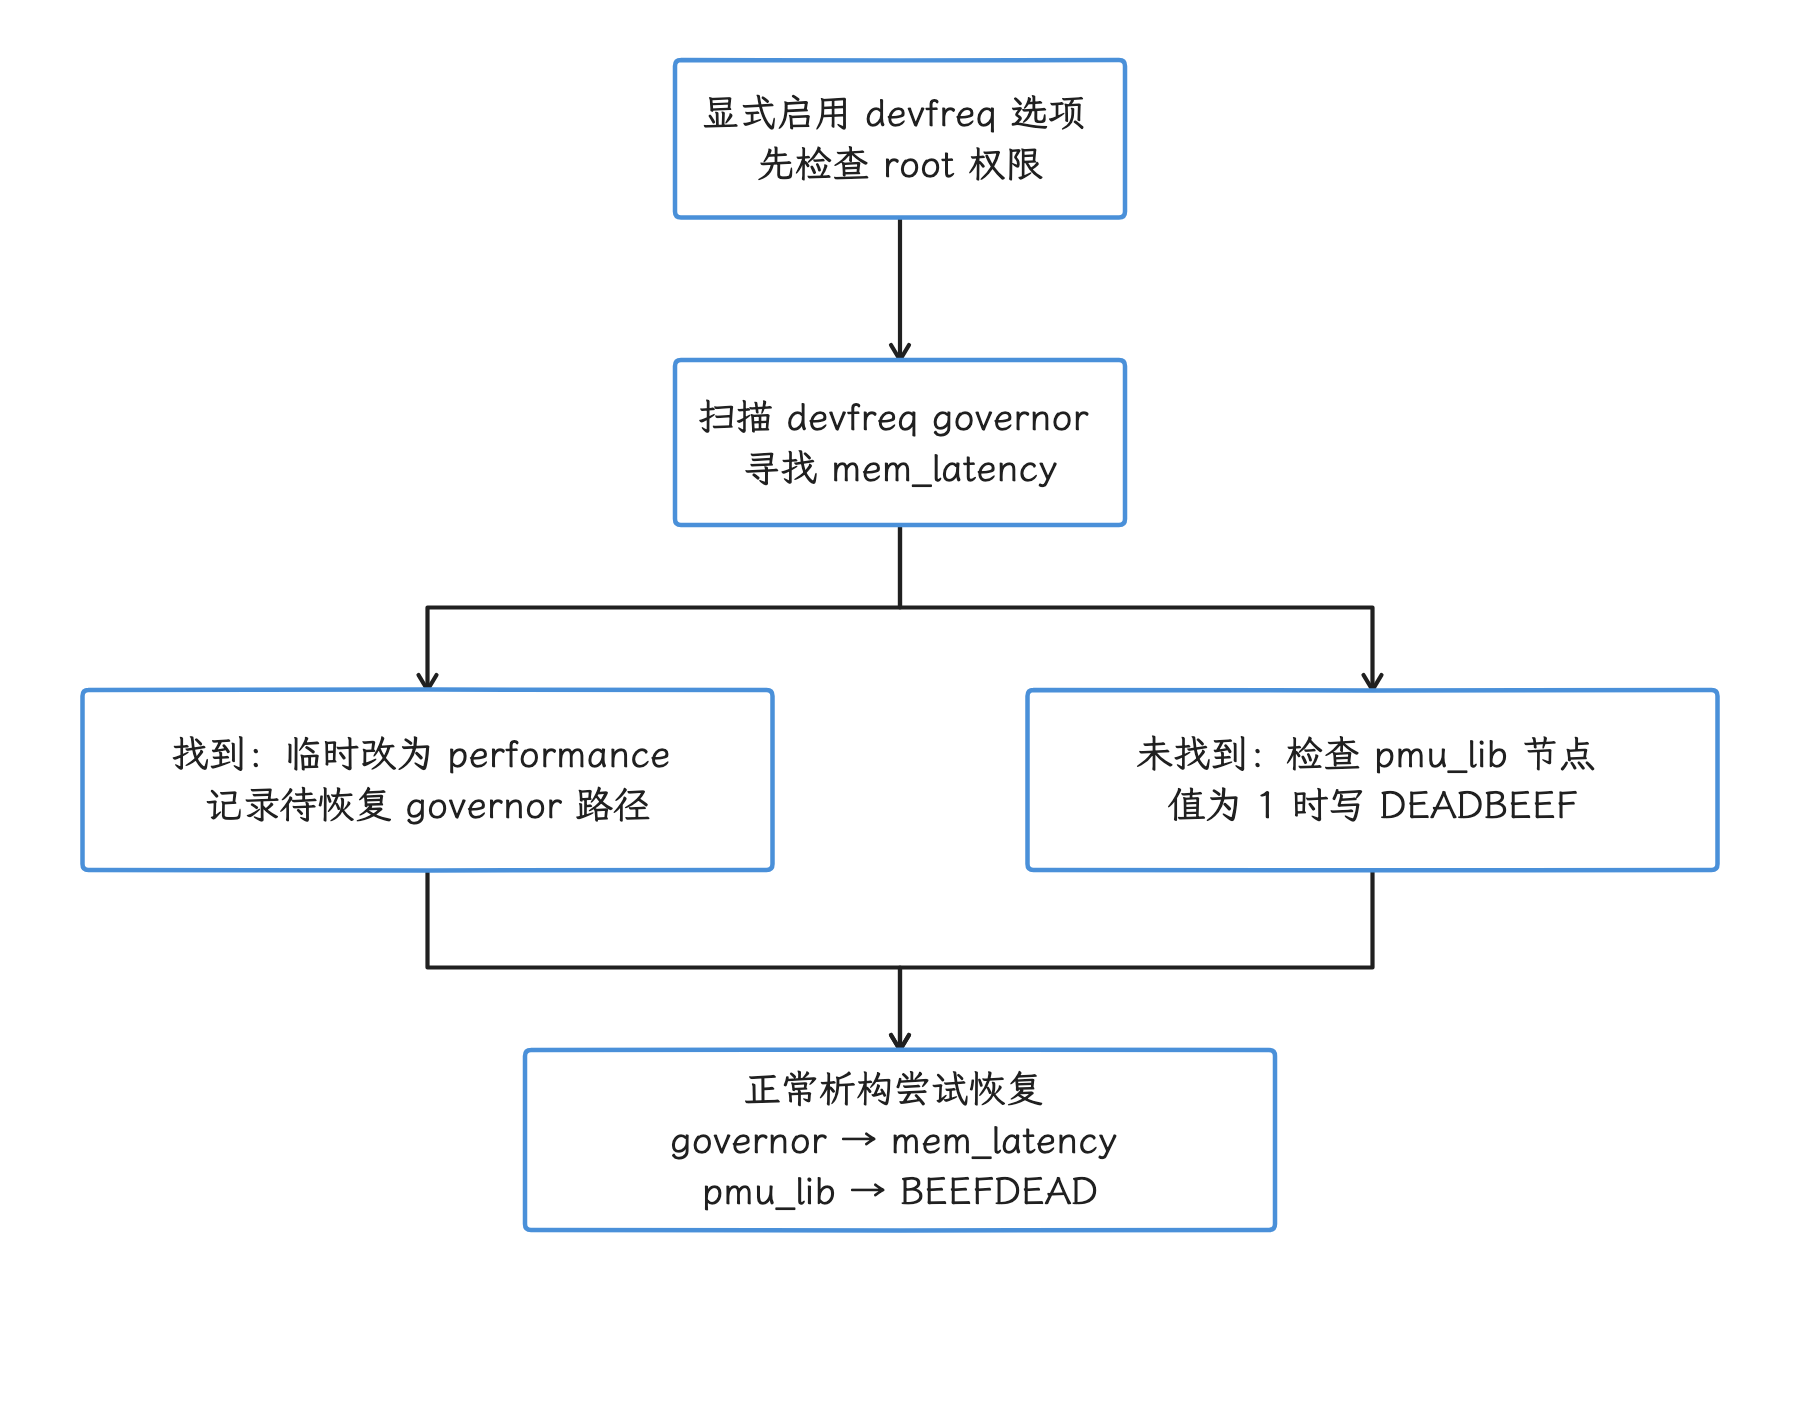
图:按源码条件临时切换 governor,未找到时才尝试供应商 pmu_lib 后备路径。 这些 magic 值不是通用 PMU API;SIGKILL/崩溃可能跳过恢复,正常退出后也应核对实际状态。
从内核模块 ETM trace 生成 AutoFDO profile
内核模块 .ko 是可动态装载的 ELF 目标文件,通常没有描述运行时装载段的 program header。KernelModuleDso 在 Android 16 已存在,但当时 inject 的通用转换路径没有携带足够的模块运行时信息,也拿不到 AutoFDO 所需的可执行范围。Android 17 补齐了两段链路:
- 生成 branch-list 时保存模块的内存起止地址和首个符号;转换时据此重建
KernelModuleDso,把 trace 内存地址对齐到.ko文件地址。 - 从存放机器指令的
.textsection 构造一个只用于文件偏移换算的伪可执行 segment。 - 支持从 ETM
perf.data直接生成 AutoFDO,也支持先转成 branch-list 再生成。
源码测试用 zram 模块数据覆盖了这两条转换路径;zram 是把压缩数据保存在内存中的块设备内核模块。测试证明的是地址映射和格式转换能力,至于 zram 或其他模块能拿到多少性能提升,还要按负载另测。
采集阶段可以使用前文的内核 ETM 命令。把数据拉到构建主机后,先把 module_symdir 设为匹配设备构建产物中存放未剥离符号模块的目录。下面的命令会拒绝未设置的变量,并把输出限定到 zram 模块:
adb pull /data/local/tmp/kernel-etm.data ./kernel-etm.data

: "${module_symdir:?set module_symdir to the matching unstripped module directory}"
simpleperf inject \
  -i kernel-etm.data \
  --symdir "$module_symdir" \
  --binary 'zram\.ko$' \
  --output autofdo \
  -o zram.afdo
--symdir 会递归查找调试二进制和模块,Android 17 没有 --kernel-module-dir 选项。输入的 perf.data 或 branch-list 要包含模块 map(运行时地址区间记录),地址对齐还依赖采集时保存的 kallsyms(内核符号表)首符号信息;主机上的 .ko 也要与设备运行版本和 build ID 对应。一个 AutoFDO 文件包含多个二进制时,Simpleperf 会提示拆分;--binary 可在转换时把范围限定到单个模块。
生成 zram.afdo 只算完成了 profile 制备:能否用于内核模块构建、编译器接受哪种 profile,以及优化后是否改善目标负载,要由对应 Android 17 内核构建规则和基准测试确认。
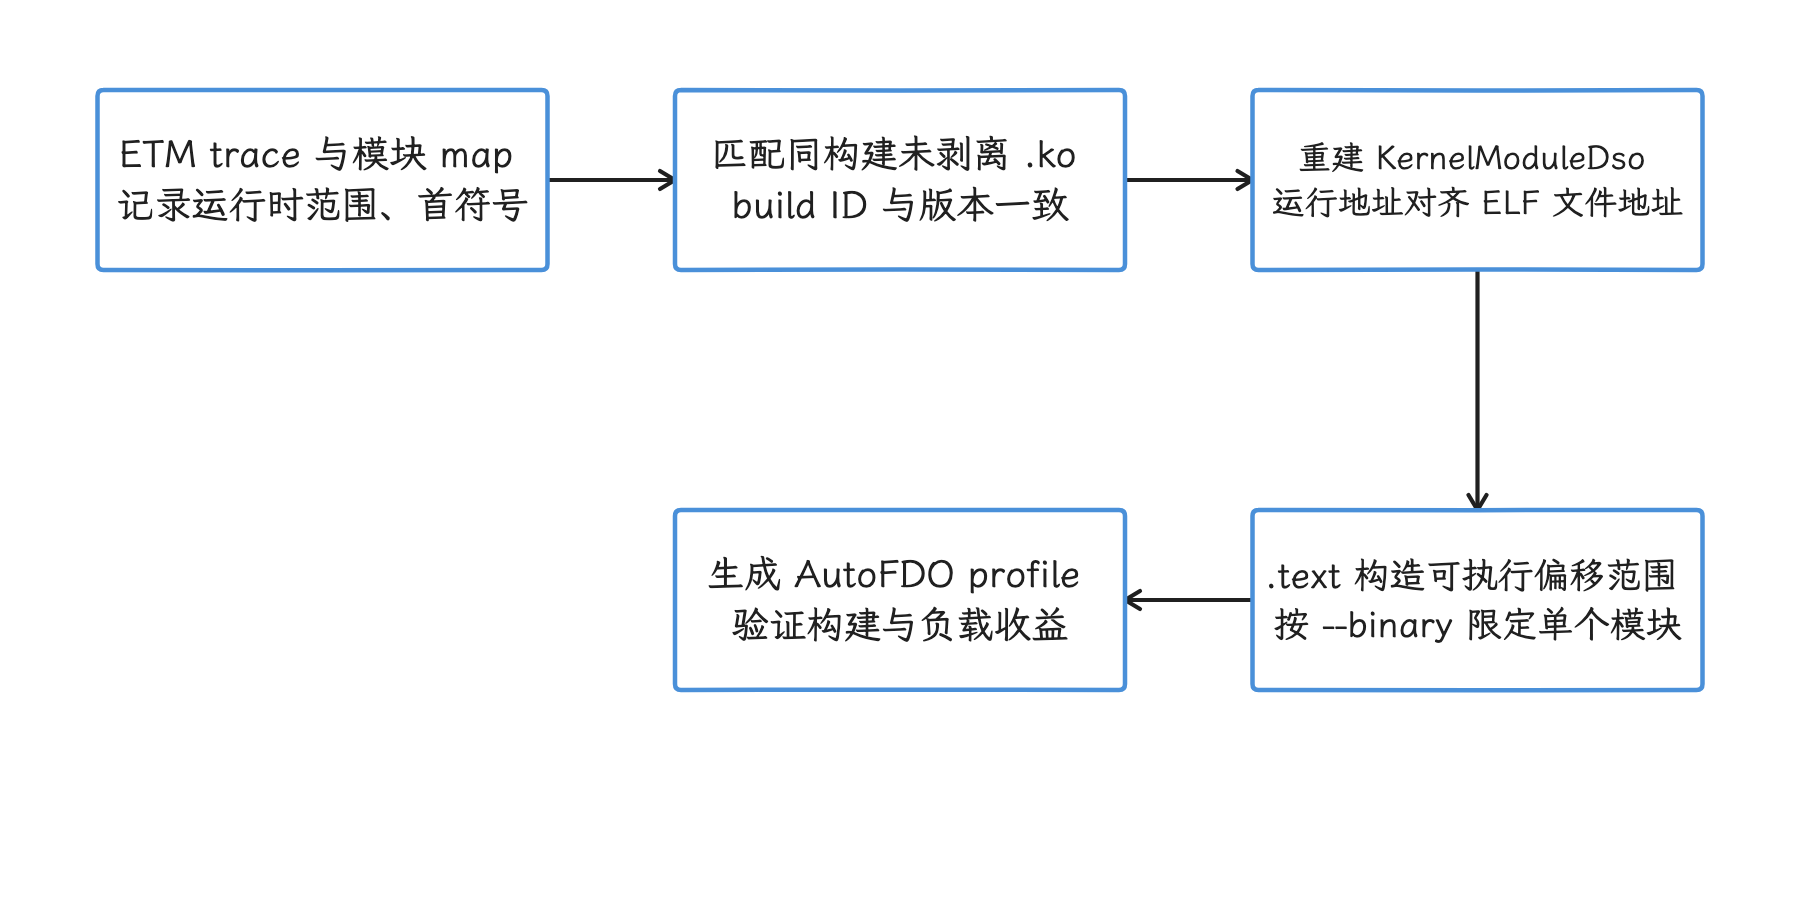
图:保存模块运行区间和首符号,匹配未剥离 .ko,再建立可执行范围与文件偏移映射。 可直接由 ETM perf.data 转换或先生成 branch-list;输出 profile 不证明构建可用或性能提升。
选择分析手段
| 现象 | 优先工具 | 原因 |
|---|---|---|
| 不清楚 CPU 时间消耗在哪些函数 | PMU cpu-cycles 采样 | 覆盖面广,调用栈和符号工作流成熟 |
| 怀疑访存、TLB 或分支事件集中在少量指令 | SPE | 可按采样 IP、数据地址和事件位聚合 |
| 需要完整控制流或生成 AutoFDO profile | ETM/ETE | 提供可解码的分支路径 |
| 需要调度、Binder 进程间通信、频率和帧时序上下文 | Perfetto | 提供系统时间线;SPE 报告当前不能逐样本时间对齐 |
稳妥的调查顺序是:我们先用 Perfetto 或常规 PMU 缩小问题范围,再按问题类型选择 SPE 或 ETM。SPE 和 ETM 都可能增加数据量与系统负载,所以先做短时预检,再记录同一设备、同一负载下的对照基线,并检查丢失记录。
核验清单
simpleperf list中确认目标 SPE 或cs-etm事件存在。- 从 sysfs 核对 SPE 配置字段,不复制其他 SoC 的事件字符串。
- SPE 报告不宣称 Android 17 decoder 尚未输出的 latency、
data_src、物理地址或时间戳。 - 多个 SPE 事件视图不相加为互斥总数。
- TRBE 按 sink 理解,并检查 CPU 支持集合与 trace 丢失。
- 后台采集先做前台预检,保存 PID,使用绝对路径和有限
--duration。 - 应用动态进程统计显式启用
--per-thread --no-inherit --monitor-new-thread。 --use-devfreq-counters只在 root 实验设备使用,并核对状态恢复。- 内核模块 AutoFDO 使用匹配设备且未剥离符号的
.ko和 build ID,并用--binary限定单个模块。 - 所有性能收益都由目标工作负载的前后对照测量给出,不引用与当前设备无关的固定比例。
源码索引
- SPERecorder.cpp:SPE PMU 发现、配置与 AUX 元数据
- SPEDecoder.cpp:packet 解码、事件映射与当前未实现字段
- event_selection_set.cpp:SPE min_interval 与 AUX 缓冲配置
- ETMRecorder.cpp:TRBE / ETR sink 发现与选择
- cmd_record.cpp:
--background进程模型 - cmd_stat.cpp:应用新线程监控与 devfreq / pmu_lib 保护
- cmd_inject.cpp:内核模块 DSO 地址映射与 AutoFDO 输出
- arm_spe_pmu.c:Android 17 内核 SPE AUX 缓冲与 IRQ 处理
- coresight-trbe.c:Android 17 内核 TRBE per-CPU sink 驱动
ARM Topdown 分类与反证
拿到一堆硬件事件计数之后,Topdown 帮我们回答“瓶颈在流水线哪一层”:它把 pipeline slot(一个周期内的执行机会)归入前端、后端、错误推测和退休四类。要让结论可复查,事件可用性、复用比例和 SoC 定义必须随结果一起记录。
Topdown 能回答什么
排查 CPU 性能时,通常会遇到两个不同的问题:
- 处理器把可用的执行机会消耗在了哪里;
- 哪段代码、哪条指令或哪类数据访问造成了这些消耗。
Topdown(自顶向下微架构分析)处理的是前一个问题。处理器流水线重叠执行取指、解码、发射和退休等阶段,其中“退休”表示把指令结果正式提交为程序可见状态;Topdown 把这些阶段可用的执行机会归入少量类别,帮我们决定下一轮该查取指、分支、数据访问,还是执行单元。至于后一个问题——哪段代码、哪条指令造成的消耗——仍要交给采样工具,用函数热点、调用栈、指令地址和内存地址定位。
所以 Topdown 给出的是诊断顺序,优化处方还得靠中间的归因证据:看到 Backend Bound 偏高就直接加预取,或看到 Frontend Bound 偏高就直接改链接布局,都是在跳步。
示例公式取自 Arm Telemetry Solution 支持的具体 CPU 数据库,公式按 CPU 型号给出;直接套到任意 Android SoC(System on Chip,片上系统) 上是行不通的。
结论只覆盖参考资料列出的版本:AOSP simpleperf、Android common kernel 的 perf 权限说明,以及 Arm 对 Topdown/Telemetry Solution 的公开文档。厂商内核补丁、后续平台版本的 simpleperf 变化、SoC 私有 PMU 扩展和商业性能工具链都在讨论范围之外。
Intel TMAM 与 Arm Topdown 的关系
这套方法的源头,是 Ahmad Yasin 在 2014 年 ISPASS 论文中面向 Intel 乱序处理器提出的 Top-Down 分析:乱序处理器会在保持程序可见结果不变的前提下调整内部操作的执行顺序,论文用 pipeline slot(流水线执行机会) 统计 Retiring、Bad Speculation、Frontend Bound 和 Backend Bound,后来 Intel 把它扩展成多级 TMAM(Top-Down Microarchitecture Analysis Method)。
Arm 这边也有官方 Topdown Methodology,事件定义、CPU 数据库和 topdown-tool 由 Arm Telemetry Solution 提供;telemetry specification 指某款 CPU 对 PMU 事件、指标公式和分析分组的定义。Arm 官方的跨平台说明保留了相同的四个一级名称,同时明确指出 Arm 与 Intel 使用不同的 PMU 事件、计算公式和工具。
| 项目 | Intel TMAM | Arm Topdown |
|---|---|---|
| 一级分类 | Retiring、Bad Speculation、Frontend Bound、Backend Bound | 同名四类 |
| 计数事件 | Intel 型号专属事件与 perf metric | Arm CPU 对应的 PMU 事件 |
| 公式参数 | 由 Intel 微架构定义 | 由 Arm CPU telemetry specification 定义 |
| 官方工具 | Linux perf 的 Topdown/metric 支持及 Intel 工具 | Arm Telemetry Solution 的 topdown-tool |
| Android 17 现成入口 | 没有通用入口 | simpleperf 可采集设备支持的事件,但不计算四类指标 |
四个名称相同,分母、流水线宽度、错误分支恢复代价却未必相同;把 Intel 的公式直接换成 Arm 事件名,算出的数通常没有物理含义。
Slot 与 CPU cycle 的区别
Slot 表示一个周期内处理器理论上可以接收或处理的一次操作机会;超标量处理器同一周期能处理多个操作,因此每周期有多个 slot。公式若采用 8 slots/cycle,分母就可能写成 8 × CPU_CYCLES。
这个 8 属于具体 CPU 的定义,从 Armv8、Armv9 或 Android API 级别推导不出来,从 IPC 也反推不出;Retiring 指标统计的是公式定义下的退休 slot 占比,与 IPC 是两个量。
四个一级类别
| 类别 | 计量含义 | 下一轮常查方向 | 常见误读 |
|---|---|---|---|
| Frontend Bound | 前端没有及时向后端提供操作所损失的 slot | I-cache、I-TLB、取指、解码、分支预测与代码布局 | 一律归因于 I-cache miss |
| Backend Bound | 后端资源约束导致无法发射操作所损失的 slot | 数据 cache、D-TLB、内存延迟、依赖链、执行端口 | 一律归因于 DRAM |
| Bad Speculation | 已推测执行但未退休的操作,以及公式计入的流水线恢复开销 | 错误分支、机器清空、输入相关的分支行为 | 等同于 branch-misses 计数 |
| Retiring | 公式认定为已退休操作的 slot | 指令组合、向量化、冗余工作、算法成本 | 数值越高,代码就一定没有优化空间 |
表里的几个词:I-cache 与 D-cache 分别保存指令和数据,I-TLB 与 D-TLB 分别缓存两类地址转换,DRAM 指主内存;“发射”表示把操作送往后端执行资源,“执行端口”是操作进入具体执行单元的通道。
同一次、同一 CPU 上取得的有效计数,代入匹配公式后,四类之和通常应接近 100%。看到负值、明显超过 100% 或相加大幅偏离 100%,先检查 CPU 公式、事件支持、计数复用、线程迁移和采集时段。
公式按 CPU 型号定义
Arm Telemetry Solution 把公式放在每款 CPU 的 telemetry 数据中。以仓库中的 Neoverse V1 r1p2 定义为例,一级公式包含以下参数:
| 指标 | Neoverse V1 r1p2 示例公式 |
|---|---|
| Backend Bound | 100 × STALL_SLOT_BACKEND / (8 × CPU_CYCLES) |
| Frontend Bound | 100 × (STALL_SLOT_FRONTEND / (8 × CPU_CYCLES) - 4 × BR_MIS_PRED / CPU_CYCLES) |
| Retiring | 100 × (1 - STALL_SLOT / (8 × CPU_CYCLES)) × OP_RETIRED / OP_SPEC |
| Bad Speculation | 100 × ((1 - OP_RETIRED / OP_SPEC) × (1 - STALL_SLOT / (8 × CPU_CYCLES)) + 4 × BR_MIS_PRED / CPU_CYCLES) |
表里的 8 和 4 都来自 Neoverse V1 定义。把它们复制到 Cortex、C1、Kryo、Oryon、Tensor 自研核或其他厂商核上,是没有依据的——即使两个 CPU 都能计数 STALL_SLOT_FRONTEND,各自的公式也可能不同。
AOSP Android 17 的 simpleperf/event_table.json 收录了 Arm64 架构事件定义,也为若干已知 CPU 型号维护了事件支持表:生成器把 STALL_SLOT_BACKEND 这类名称转换成 raw-stall-slot-backend,simpleperf 再结合 MIDR 和实际 perf_event_open() 探测结果过滤事件。这个数据库只说明工具认识某个事件,替代不了 CPU 自己的 telemetry specification。
分析前我们先过四道门:
- 精确识别采集落在哪种 CPU 核上;
- 目标核暴露了公式需要的全部事件;
- 手里有这款核对应的官方或厂商公式;
- 这些事件在一致的 workload(可重复执行的测试负载)时段内得到可信计数。
任何一道门没有通过,就把结果降级为普通 PMU 线索,先别标成完整的 Arm Topdown 百分比。
Android 17 各工具的分工
simpleperf stat:计数
simpleperf stat 通过 Linux perf_event_open() 读取事件计数。Android 17 的命令支持:
simpleperf list raw:列出当前设备可用的 Arm CPU PMU 原始事件;--group:让一组事件同时调度和退出调度;--print-hw-counter:探测每个 CPU 可用的硬件计数器数量;--per-core:按 CPU 输出计数;--cpu:选择在哪些 CPU 上监控后续事件;--csv:输出便于脚本解析的结果。
--cpu 只限制监控哪些 CPU,线程的 affinity(CPU 亲和性,即允许运行的 CPU 集合)并不受它影响。需要固定线程时,应在测试程序中调用 sched_setaffinity(),或对独立 native benchmark 使用 taskset;给线上 App 强行绑核会改变调度行为,测出的结果只代表该实验条件。
simpleperf record/report:采样归因
record 周期性记录样本,report 按 DSO、函数、线程或调用栈聚合,回答“热点在哪”。DSO 是 Simpleperf 对被分析二进制的对象抽象,也用于表示内核和内核模块。读数时把事件计数与样本数分开:
stat输出某段时间内累计发生多少次事件;record输出抽样位置,样本还会受采样周期、skid(采样地址相对真实触发指令的偏移)和调用栈质量影响。
record 配合 report --raw-period 可以让聚合结果显示各样本 period 字段的累计值,而非 period percentage,但离 Topdown 四类占比还差一步。android-17.0.0_r1 没有 report --print-sample-period 这个选项。
Arm topdown-tool:Linux perf 上的公式引擎
Arm 官方 topdown-tool 自动选择 CPU telemetry 数据,调用 Linux perf 采集事件,再计算指标;metric 是由若干事件计算出的指标,group 是一组相关指标,工具可按两者组织采集。用 --max-events 限制同时采集的事件数后,超出的部分要靠多次运行 workload 补齐,各轮负载差异因此仍要考虑。
官方安装与用法面向 Arm Linux 系统,采集后端是 Linux perf。当前文档既没有承诺它能读取 simpleperf 的 perf.data,也没有 simpleperf .data 转 Streamline .apc 的标准步骤;想在 Android 上复用该工具,Python 运行环境、perf 兼容性、CPU 数据库、权限和采集接口都要单独验证。
Perfetto:系统时序上下文
Perfetto 擅长记录调度、CPU 频率、idle(CPU 空闲状态)、热状态、线程状态和应用 trace marker(业务代码写入的时间标记),用它解释某个计数窗口里是否发生迁核、降频或长时间阻塞最合适。
simpleperf 不会自动产出 .perfetto-trace,Topdown 百分比也不会自动变成 Perfetto counter track(随时间展示数值的计数器轨道)。常用做法是并行采集,用同一 workload marker 对齐窗口,再分别读取 PMU 结果与系统时序;项目若需要把派生指标写入 Perfetto,应显式实现 counter track 生产端,并记录公式、CPU 型号和采集窗口。
Android 17 simpleperf 还提供 sample_filter_for_perfetto_trace.py:脚本读取一份单独采集的 Perfetto trace,按 slice(带开始和结束时间的区间事件)名称正则提取时间范围,再生成 simpleperf --filter-file 可用的样本过滤文件。它解决的是对齐分析窗口;把 perf.data 转成 Perfetto trace、计算 Topdown 指标,都不在它的职责内。
Arm SPE:可选的归因来源
Android 17 simpleperf 源码包含 SPERecorder 与 SPEDecoder,simpleperf list arm_spe 会检查内核是否暴露 SPE PMU。该版本解码器会输出采样指令虚拟地址(也称 IP,Instruction Pointer)、数据虚拟地址、线程 ID 和事件位,却不会输出 operation type(操作类型)、PERF_SAMPLE_DATA_SRC、latency weight(延迟权重)或可用于逐样本对齐的时间戳。因此,它能按事件位定位热点指令或地址;读写类型、逐级数据来源和访问延迟,还得另想办法。
SPE 也顶替不了一级 Topdown 公式;它的位置是在 Backend Bound 已由计数确认后,帮忙定位延迟落在哪些指令或地址。另外,Android 17 该版本源码中没有名为 brbe 的 simpleperf 后端,把 BRBE(Branch Record Buffer Extension,分支记录扩展)写成通用可用的采集选项是不成立的。
一套可复现的 Android 工作流
下面把前面这些工具串成一条流程,每一步的输出都是下一步的输入。
步骤一:固定问题和 workload
先写清 workload,也就是可重复执行的测试负载:
- 业务阶段,例如图片解码的第 20 至 120 帧;
- 目标进程与线程;
- 输入数据;
- 冷启动、热启动或稳态;
- 设备温度、供电方式与后台负载;
- 是否允许绑核;
- 每组至少重复多少次。
预热轮次应丢弃,每轮耗时要保存:耗时本身波动很大时,PMU 百分比的差异也很难解释。大核与小核上的计数要分开保存、分别解释,相加后套单一公式会把不同微架构的量混在一起。
步骤二:在设备上发现能力
下面三条命令分别列举原始事件、探测硬件计数器数量和检查 SPE 设备。--print-hw-counter 会尝试打开性能事件来探测可用计数器,仍受权限和 PMU 占用约束;这些命令不启动本文的长时间 workload 录制。
adb shell simpleperf list raw
adb shell simpleperf stat --print-hw-counter
adb shell simpleperf list arm_spe
输出里凑不齐 raw-stall-slot-backend、raw-stall-slot-frontend、raw-stall-slot、raw-op-retired、raw-op-spec 这五个事件时,先别构造完整的一级 Topdown。list raw 还可能按 CPU 标出支持范围,异构 SoC 应逐簇核对。
步骤三:用通用事件建立基线
下面的示例针对可由 shell profile 的 App 采集 10 秒,并按 CPU 输出 CSV。事件仍要以本机 simpleperf list 的结果为准。
adb shell simpleperf stat \
  --app com.example.app \
  -e cpu-cycles,instructions,branch-misses,cache-misses \
  --duration 10 \
  --per-core \
  --csv
这组数据够我们计算 IPC、分支错误的相对变化和 cache miss 的相对变化,但 Arm Topdown 四类还生成不了。Android 17 会为 --app 优先使用设备内置 simpleperf_app_runner;非 root 设备上的 App 通常需要声明 debuggable,或通过 <profileable android:shell="true"> 允许 shell profiling。系统范围 -a 采集通常需要 root。
基线至少回答这些问题:
- workload 是否运行在预期 CPU 簇;
- 每轮 CPU cycles 与 instructions 是否稳定;
- 目标线程是否频繁迁核;
- 分支或 cache 指标是否随回归同步变化;
- 内核态是否应该计入。只看用户态时可给事件加
:u修饰符。
步骤四:只在完整支持时采集一级事件
若设备列出了全部事件,并且目标 CPU 公式要求它们在同一窗口计数,可以尝试把七个事件放进一个 group。下面的命令会在 group 无法同时调度时暴露问题。
adb shell simpleperf stat \
  --app com.example.app \
  --group raw-cpu-cycles,raw-stall-slot-backend,raw-stall-slot-frontend,raw-stall-slot,raw-br-mis-pred,raw-op-retired,raw-op-spec \
  --duration 10 \
  --per-core \
  --csv
group 所需的计数器超过硬件能力时,内核可能直接拒绝调度;普通非 group 采集则可能发生 multiplexing(分时复用)。simpleperf 文档明确提醒:复用时各事件只在部分时间内计数,彼此甚至可能不在相同时段运行——看到警告还照常计算比例,结果就靠不住了。
若完整 group 放不下,应按 CPU 公式所需事件拆分:
| 诊断项 | Neoverse V1 示例所需事件 |
|---|---|
| Backend Bound | CPU_CYCLES、STALL_SLOT_BACKEND |
| Frontend Bound | CPU_CYCLES、STALL_SLOT_FRONTEND、BR_MIS_PRED |
| Retiring | CPU_CYCLES、STALL_SLOT、OP_RETIRED、OP_SPEC |
| Bad Speculation | CPU_CYCLES、STALL_SLOT、OP_RETIRED、OP_SPEC、BR_MIS_PRED |
每组要在可重复的 workload 上独立运行,且每组内部同时计数。跨轮拼接会引入输入、调度、温度和 DVFS 差异,重复次数与离散程度应一并报告;Arm topdown-tool 的 --max-events 与按 metric 采集同样要为事件拆分重复运行 workload,跨轮误差藏不住。
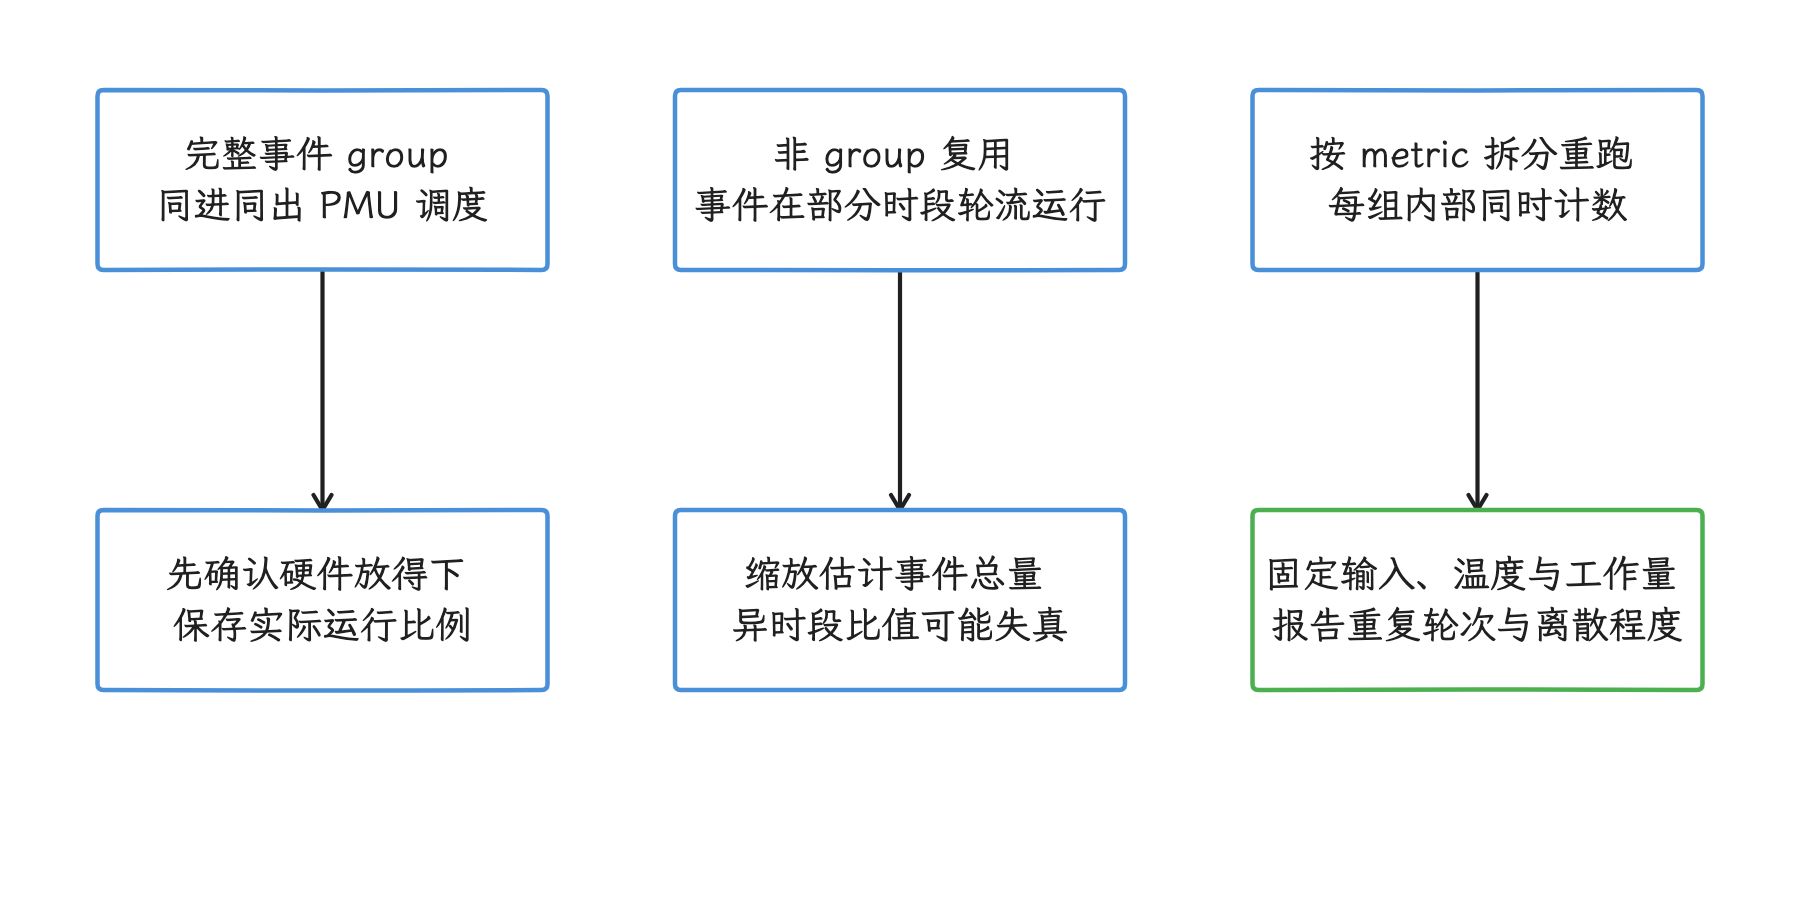
图:多个事件的比值先要求可信的时间对应,计数器不足时应显式处理调度与跨轮差异。 group 放不下可能无法调度;缩放计数不能恢复各事件在同一时段同时发生的关系。
步骤五:用 CPU 专属定义计算
计算脚本应把这些信息一并写入结果:
- SoC、CPU MIDR、CPU 编号与簇;
- Android build 与内核版本;
- 事件名、原始编码和用户态/内核态修饰符;
- enabled time、running time 与是否 multiplex;前者是事件启用的总时长,后者是事件实际占用 PMU 计数器的时长;
- 公式来源及版本;
- workload 标记和持续时间;
- 原始计数、派生值与重复轮次。
公式里任何分母为零都应返回无效值,派生值保留未裁剪的结果——直接把负值裁成 0、超过 100% 的裁成 100%,采集或公式错误就被盖住了。
步骤六:按方向做二级归因
Topdown 只给调查方向。下一轮要选择能区分原因的证据。表中的 LL cache 即 last-level cache(末级缓存),refill 表示发生未命中后从下一层取回内容,TLB walk 表示遍历页表完成地址转换;依赖链则表示后一个操作必须等待前一个操作的结果:
| 一级结果 | 可继续采集的证据 | 要验证的假设 |
|---|---|---|
| Frontend Bound 高 | L1I/LL cache refill、I-TLB walk、branch miss、代码地址样本 | 取指、翻译、分支恢复或代码体积谁占主导 |
| Backend Bound 高 | L1D/L2/LL cache refill、D-TLB walk、内存延迟、SPE 样本、依赖链 | 内存子系统或执行资源谁在限制发射 |
| Bad Speculation 高 | branch miss、分支地址样本、输入分布、机器清空相关事件 | 哪类分支和哪组输入造成浪费 |
| Retiring 高但耗时仍长 | 指令数、操作混合、向量化报告、算法工作量 | 是否退休了过多但可省掉的工作 |
下面的 simpleperf 采样示例用 CPU cycles 定位热点函数。它用于归因,不参与一级百分比计算。示例假设 shell 已有附加到该 PID 的权限;受限发布包应改用 --app 对应的受控入口或主机端 app_profiler.py。
app_id=com.example.app
pid=$(adb shell pidof -s "$app_id")
test -n "$pid" || { printf 'target process not found\n' >&2; exit 1; }

adb shell simpleperf record \
  -p "$pid" \
  -e cpu-cycles:u \
  -g \
  --duration 10 \
  -o /data/local/tmp/topdown-hot.data

adb shell simpleperf report \
  -i /data/local/tmp/topdown-hot.data \
  --sort dso,symbol
调用栈质量取决于 unwind(栈展开)信息、帧指针和运行时;硬件事件采样还可能发生 skid,也就是记录到的 PC 落在真正触发事件的指令之后。归因到源码行时,应保留未剥离符号与匹配 build ID。Android 17 这版 Simpleperf 的 SPE 解码器可辅助定位带特定事件位的指令或数据虚拟地址,延迟字段它不输出。
步骤七:用 Perfetto 解释运行环境
与 simpleperf 同步采集的 Perfetto trace 至少应覆盖:
sched_switch与线程状态;- CPU frequency 与 idle;
- thermal 或 power 相关轨道;
- 业务阶段的应用 trace marker。
如果 Backend Bound 上升的那轮同时发生了迁到小核、热降频或 workload 窗口错位,先修正实验再谈结论。频率降低会同时改变 cycles、耗时和内存等待的相对表现,把它归给某一个 Topdown 类别是说不通的。
从指标到修改:保持假设可证伪
“可证伪”的意思是修改前先写出可观察的预测,比如“若主要原因是 I-cache miss,调整布局后耗时与 L1I refill 应同时下降”;结果不符合预测时,就放弃或修改原假设。
Frontend Bound
调查顺序可采用:
- 用 I-cache、I-TLB 和 branch 相关计数区分取指与预测;
- 用热点地址确认问题集中在哪个二进制和函数;
- 查看函数布局、内联膨胀、异常冷路径和间接分支;
- 只改一个变量,再复测耗时、一级指标与二级事件。
PGO(Profile-Guided Optimization,基于运行 profile 的编译优化)、函数重排和 BOLT(二进制级代码布局优化工具)可能改善代码局部性,但 Android NDK 默认工作流并不自带 BOLT。-fno-jump-tables、强制函数对齐或扩大内联也可能增加指令数与代码体积,别把它们当固定模板套。
Backend Bound
Backend Bound 接下来要分清 memory-bound(受内存层级限制)与 core-bound(受执行单元或依赖限制)。cache miss 偏高还证明不了 DRAM 就是限制项,我们还要看 miss 层级、每千指令 miss、TLB、内存延迟和并行未决请求。
SoA(Structure of Arrays,把同类字段连续存放)、预取、对齐、restrict、向量化和软件流水都有适用条件。restrict 是 C 中关于指针不别名的承诺,C++ 通常使用编译器提供的扩展写法,违反这项承诺会触发未定义行为;固定 64 字节对齐可能浪费空间,错误预取也会抢带宽和 cache。动手前先备好事件或指令级证据,改完同时检查耗时与副作用。
Bad Speculation
分支无关写法并不保证更快,它可能引入更多指令、额外 load,或阻碍编译器生成目标核更合适的代码。稳妥的路径是先找到高错误率分支,再用真实输入分布比较分支版、查表版或条件选择版。
Retiring
Retiring 占比高,说明流水线大部分可计量 slot 在退休操作,至于这些操作是否都值得执行,它说了不算:解码同一数据两次、复制多余缓冲区或使用标量循环,都可能产生很高的 Retiring。这时我们把 instructions、业务工作量与耗时放在一起看。
常见失真来源
四类百分比到手之后,还要当心下面这些失真来源。
异构 CPU 聚合
Android SoC 常有多种 CPU 核,不同簇的事件支持、流水线宽度和公式可能都不同。按 SoC 汇总原始计数(raw count)后套一个公式,等于把不同物理含义的计数混在一起;用 --per-core 保存原始结果,再按同构簇分别解释。
计数器复用
事件数超过 PMU 可用计数器后,内核会做时间复用。缩放计数可以估计总量,事件间完全同步的关系却恢复不了;Topdown 公式依赖多个事件的比值,group 和可重复 workload 因此很重要。
调度、DVFS 与热状态
DVFS(Dynamic Voltage and Frequency Scaling)动态调整电压与频率。线程迁核更换 PMU 语义,频率变化改变周期分母,热节流改变 workload 进度——所以 Perfetto 的调度与频率轨道应和 PMU 结果一起归档。
统计口径
:u 只统计用户态,:k 只统计内核态。App 的系统调用、缺页和驱动等待可能落在内核态或睡眠时间里,所以报告要说明统计范围,用户态 PMU 百分比代表不了端到端的耗时分解。
样本与计数混淆
一个函数占 30% 的采样样本(samples),离“它制造了 30% 的全部 cache miss”“它占 30% 的 Backend Bound”都还很远;采样周期、事件精度、skid、调用栈丢失和符号解析都会影响归因。
只看百分比
优化后 Backend Bound 百分比可能上升,同时总 cycles 大幅下降——这也可能是其他类别下降得更快。所以每轮都要同时保存墙钟耗时、cycles、instructions、绝对事件数和派生百分比。
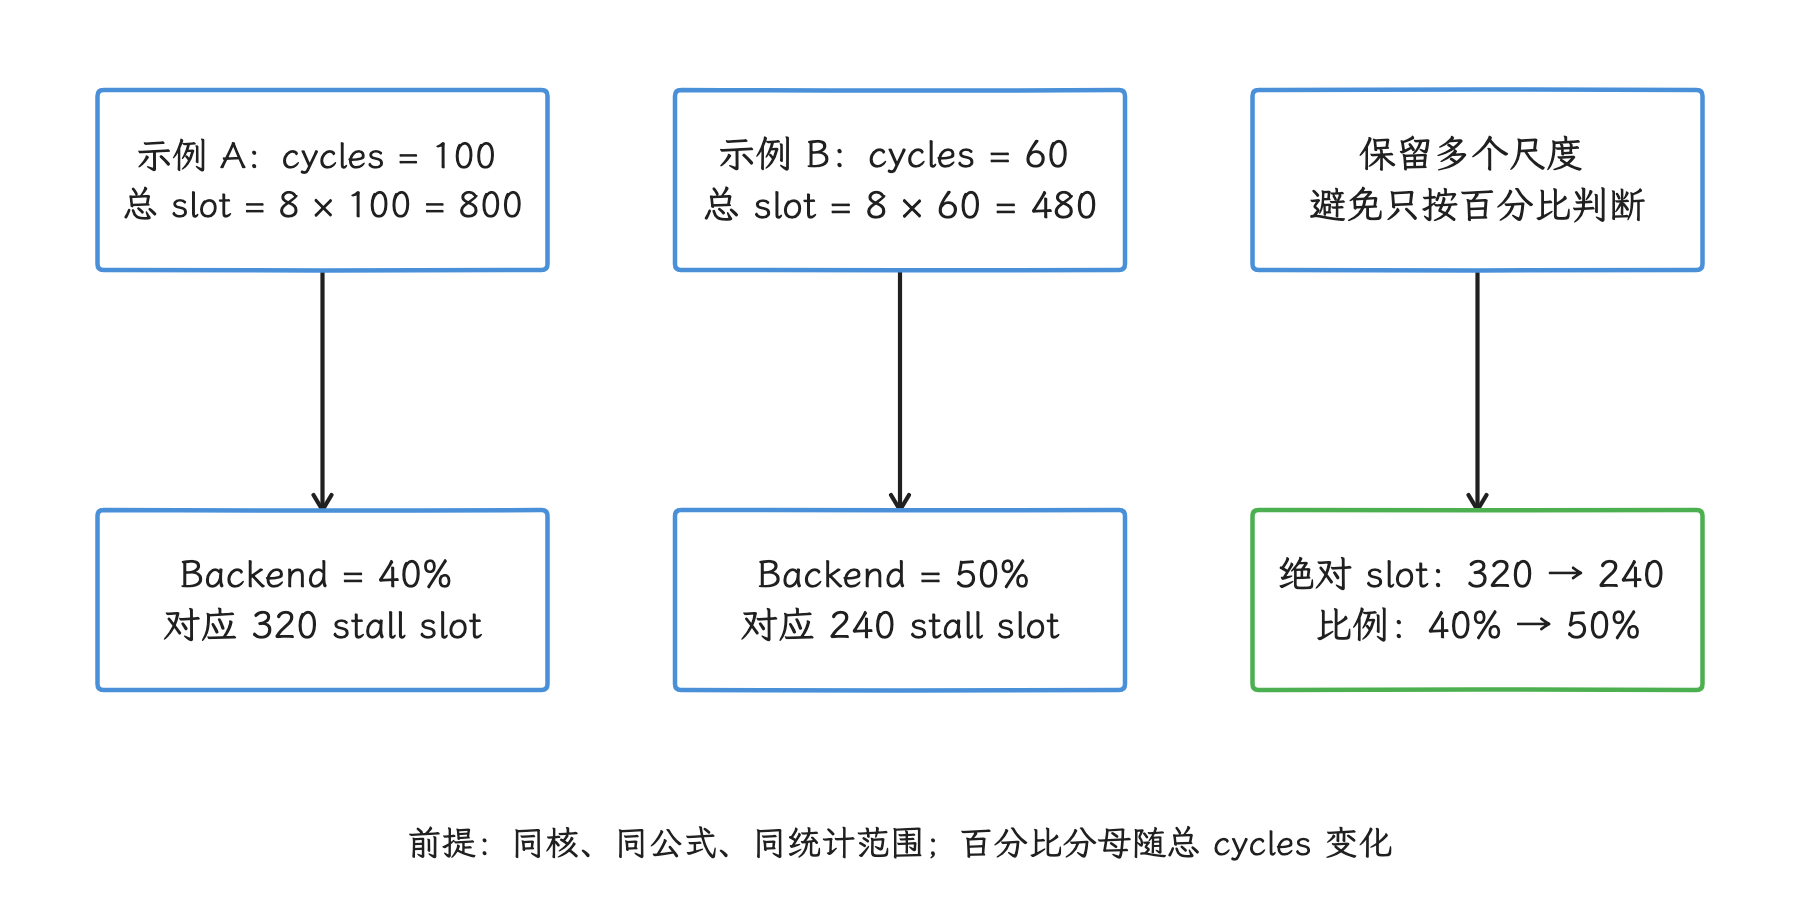
图:同一 CPU 的 Backend Bound 比例升高时,绝对 stall slot 仍可能减少。 归一化数字只作公式示意,非设备测量;实际验收还要比较相同工作量的墙钟时延。
结论
Android 17 上可执行的可靠路径是:
- 用
simpleperf list raw识别目标 CPU 暴露的事件; - 用
simpleperf stat取得按核、同窗口的计数; - 只采用目标 CPU telemetry specification 中的公式;
- 用
record/report或 SPE 把方向定位到代码与数据访问; - 用 Perfetto 核对调度、频率、idle、热状态和业务窗口;
- 每次修改后复测端到端耗时、绝对计数与派生指标。
缺少 CPU 专属公式时,保留“前端 stall 事件升高”“分支错误增加”这类可核验的描述,比硬凑出四个看似完整的百分比更可靠。
本节的依据都已在参考资料列出。拿到具体手机 SoC 时,还要补入对应 CPU 的 telemetry specification、设备 simpleperf list raw 输出和同窗口计数原始记录;这些依据缺位时,示例公式只能当示范看,通用 Android 结论写不得。
参考资料
Simpleperf 与 Android 采样
- Simpleperf 总览(AOSP
android-17.0.0_r1) - Android 应用采样(AOSP
android-17.0.0_r1) - 命令参考(AOSP
android-17.0.0_r1) - 脚本参考(AOSP
android-17.0.0_r1) cmd_record.cpp(AOSPandroid-17.0.0_r1)RecordReadThread.cpp(AOSPandroid-17.0.0_r1)app_profiler.py(AOSPandroid-17.0.0_r1)<profileable>Manifest 元素(Android Developers)- Android Studio Callstack Sample(Android Developers)
- Perfetto 调用栈采样
- Perfetto 导入 Simpleperf 数据
- Perfetto
PerfEventConfig(AOSPandroid-17.0.0_r1) - Perfetto perf 事件枚举(AOSP
android-17.0.0_r1) - Linux perf events 核心实现(
android17-6.18-2026-06_r6) - perf_event UAPI(
android17-6.18-2026-06_r6)
ARM Topdown 与微架构
- A Top-Down Method for Performance Analysis and Counters Architecture(ISPASS 2014)
- AOSP android-17.0.0_r1:simpleperf
- AOSP android-17.0.0_r1:simpleperf 命令参考
- AOSP android-17.0.0_r1:cmd_stat.cpp
- AOSP android-17.0.0_r1:cmd_list.cpp
- AOSP android-17.0.0_r1:Arm64 PMU 事件表
- AOSP android-17.0.0_r1:raw event 名称生成规则
- AOSP android-17.0.0_r1:SPERecorder.cpp
- AOSP android-17.0.0_r1:SPEDecoder.cpp
- AOSP android-17.0.0_r1:Perfetto 时间窗转 simpleperf sample filter
- AOSP android-17.0.0_r1:simpleperf sample filter 文档
- Android common kernel android17-6.18-2026-06_r6:perf security
- Android Developers:Simpleperf
- Arm:Topdown Methodology L1 Events
- Arm:Telemetry Solution / topdown-tool
- Arm:Neoverse V1 Top-down Methodology
- Arm:Arm 与 Intel Topdown 对照
- Arm Telemetry Solution 6d4f550d053c:Neoverse V1 r1p2 指标定义
- Perfetto:TraceConfig