Jetpack Compose 渲染管线:Composition、Layout 与 RenderNode
Compose 改变了 UI 的声明方式、状态追踪和节点更新,却仍使用 Android 的 App Window 渲染管线。App Window 指应用主窗口及其图形 buffer。对于开启硬件加速且没有额外独立 Surface 的普通 Compose 页面,像素仍依次经过 ViewRootImpl、HWUI、RenderThread、BLAST BufferQueue(协调窗口 buffer 与 SurfaceControl transaction 提交的队列机制)、SurfaceFlinger 和 HWC(Hardware Composer,硬件合成器)到达屏幕。
排查 Compose 卡顿,先要分清两层职责。Composition 根据 composable 调用生成和更新 UI 结构,Layout 负责测量与放置,Drawing 负责记录绘制内容,这三阶段属于 Compose;窗口 buffer 的生产、系统合成与 present(提交到显示设备)属于 Android 图形栈。只看 recomposition 次数,无法解释 RenderThread、GPU 或 SurfaceFlinger 导致的慢帧。
复核基线与阅读边界
本次图文复核日期为 2026-10-24,仍固定使用下列 Compose 1.11.4 与 Android 17 源码基线;这不是“当前最新版”的声明。Android 平台、Jetpack Compose、Kotlin 编译器与内核版本分别记录;Android 版本不能代替 Compose 依赖版本。
| 层级 | 基线 | 说明 |
|---|---|---|
| Android 平台 | Android 17 / API 37 / android-17.0.0_r1 | Choreographer、ViewRootImpl、ThreadedRenderer、HardwareRenderer、HWUI、SurfaceFlinger |
| Jetpack Compose | Compose BOM 2026.06.01,Runtime/UI/Foundation 1.11.4 | Compose 独立发布,不属于 android-17.0.0_r1 源码标签 |
| Android 内核 | android17-6.18-2026-06_r6 | 调度、cpuset、cpufreq、dma-buf 与 fence 等机制;内核不包含 Composition 或 LayoutNode |
讨论范围限定为 Android 12 至 Android 17 上采用硬件加速的 App Window。软件 Canvas、截图或离屏捕获、Preview,以及 SurfaceView、TextureView、视频或相机等独立 Producer(buffer 生产方)都会改变局部路径,不能沿用单一窗口 buffer 的结论。
Compose 改了什么,复用了什么
Compose 主要提供四组机制:
Snapshot为状态读写提供版本化视图,并通知读取过相应状态的观察者;Recomposer对失效的 restart scope(编译器标出的可单独重新执行范围)执行 recomposition,再通过applyChanges把结果写入现有 UI 结构;LayoutNode树承载 Compose UI 节点,执行测量、放置、绘制和语义处理;OwnedLayer/GraphicsLayer保存可复用的绘制内容与 layer 属性。
窗口侧仍由 Android 平台负责:
AndroidComposeView作为ViewGroup接入 View 树;ViewRootImpl安排 traversal,即窗口的 measure、layout、draw 遍历;- UI 线程把 View/Compose 的绘制操作录入 RenderNode display list,即可复用的绘制指令列表;
- RenderThread 同步 RenderNode 树,通过 Skia 构建并提交 GPU 工作;
- App Window Producer 提交 buffer 及生产完成 fence;queue 时 GPU 写入可以尚未完成;
- SurfaceFlinger latch buffer,即选定本轮合成要使用的 buffer,再把合成状态交给 HWC 或 RenderEngine;
- 显示系统以选定 frame timeline 为目标安排 present;是否按时显示须看实际反馈,不能由目标时间保证。
“Compose 有独立渲染引擎”容易把职责说得过宽。Compose 拥有自己的 UI runtime 和节点系统;在 Android 的常规硬件加速窗口中,实际图形后端仍是 HWUI。
两条帧驱动在同一主线程会合
Compose 与 View traversal 都使用 Choreographer,即主线程上的帧回调调度器,但两类回调承担不同工作:
Recomposer有帧级工作时等待 parent frame clock;Android 默认接到AndroidUiFrameClock,通常经AndroidUiDispatcher排入 Choreographer 帧回调。它先向 composition 的 BroadcastFrameClock 等待者分发帧时间,再处理本轮失效、recomposition 与变更应用。单个动画等待者并不一定各自注册一个平台回调。ViewRootImpl的 traversal callback 驱动窗口 measure、layout、draw 与 HWUI 提交。
下面的时序图标出两类回调的调用边界:
sequenceDiagram
    participant V as "Choreographer / Main"
    participant F as "AndroidUiDispatcher / FrameClock"
    participant R as "Recomposer"
    participant W as "ViewRootImpl"
    participant A as "AndroidComposeView"
    participant H as "ThreadedRenderer / HWUI"
    participant T as "RenderThread"

    opt 有等待帧的工作且回调到期
        V->>F: "animation phase / FrameCallback"
        F->>R: "parent withFrameNanos 的 onFrame"
        R->>R: "BroadcastFrameClock 分发时间;收集失效"
        opt 有需要执行和应用的变更
            R->>R: "recompose + applyChanges"
            R-->>W: "按变更请求 invalidate / requestLayout"
        end
    end
    opt 已安排窗口 traversal
        V->>W: "traversal phase / TraversalRunnable"
        W->>A: "onMeasure / onLayout(按需)"
        W->>H: "draw(root View),有 draw 工作时"
        H->>A: "按失效更新 display list / dispatchDraw"
        A->>A: "待办 measureAndLayout;root.draw;dirty layer 更新"
        H->>T: "syncAndDrawFrame"
    end
默认主线程 Choreographer 按 animation、traversal 等阶段处理到期 callback,因此及时安排的变更可以赶上同一 doFrame 的 traversal;晚到、被推迟或没有请求 traversal 时则不能保证。Recomposer 的 frame work 与窗口 traversal 各自按需执行,不能把图读成每个 vsync 都完整重组、测量和重录。这里讨论默认窗口接入,不排除 SubcomposeLayout 在测量时创建子 composition。
Compose 1.11.4 的 AndroidUiFrameClock 使用一次性回调。下面只摘出“未匹配 AndroidUiDispatcher”的直接注册分支,不能代表默认 dispatcher 路径的完整实现:
override suspend fun <R> withFrameNanos(onFrame: (Long) -> R): R =
    suspendCancellableCoroutine { continuation ->
        val callback = Choreographer.FrameCallback { frameTimeNanos ->
            continuation.resumeWith(runCatching { onFrame(frameTimeNanos) })
        }
        choreographer.postFrameCallback(callback)
        continuation.invokeOnCancellation {
            choreographer.removeFrameCallback(callback)
        }
    }
完整实现会优先使用同一 Choreographer 的 AndroidUiDispatcher.postFrameCallback(),取消时也从对应 dispatcher 移除。Dispatcher 先清理 trampolined tasks,再执行本批帧回调,并交换待执行队列,避免连续的 withFrameNanos 在同一帧反复立即恢复。一次调用不构成永久自循环;后续请求取决于新的等待者或工作。
Recomposer 默认帧内顺序是:分发 BroadcastFrameClock 时间 → 发送待处理 Snapshot apply 通知 → 记录 composition 失效 → 按需 recompose → applyChanges / late changes / changesApplied。无动画等待者时可跳过前两步;有帧等待者也不保证发生重组。
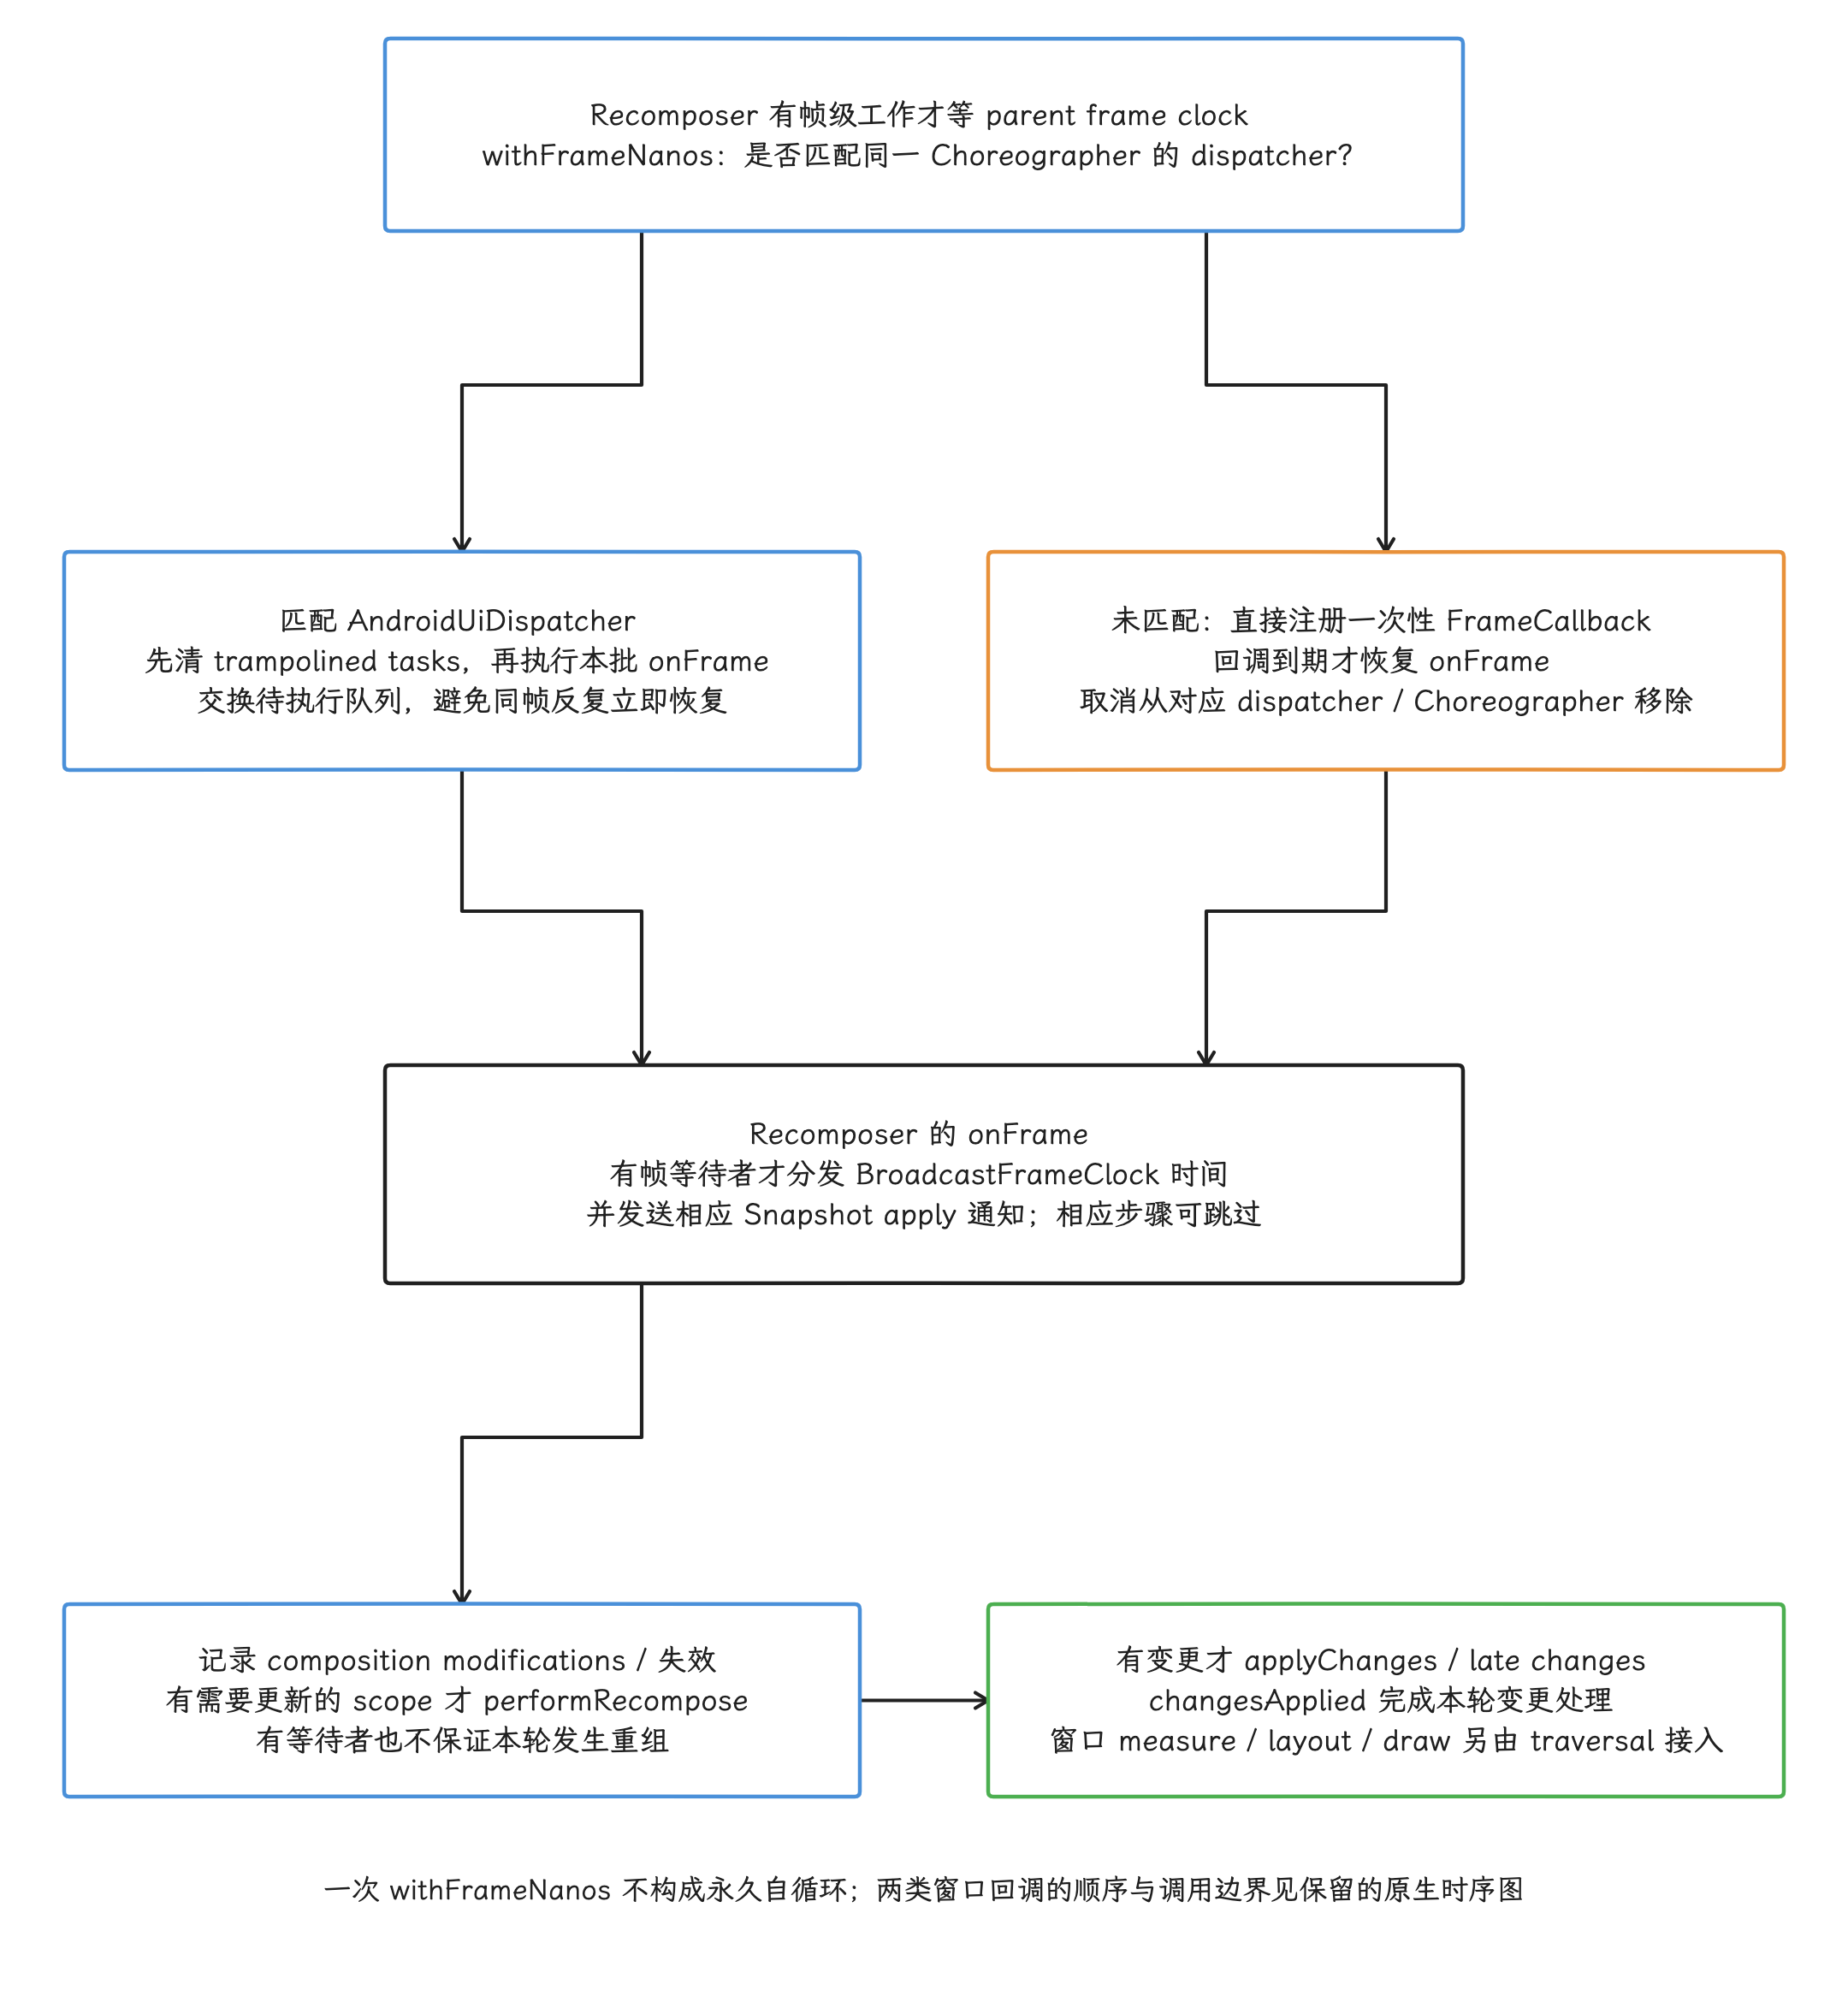
图:固定Compose1.11.4默认Android接入:Recomposer有帧级工作才等parent clock;匹配同一Choreographer的AndroidUiDispatcher时聚合回调,trampoline后执行本批并换队列,否则直接注册一次性FrameCallback。取消从对应队列移除。onFrame有等待者才BroadcastFrameClock分发时间及发送相应Snapshot通知,随后收集失效、按需重组/apply/late/changesApplied;无工作可跳相应步骤,不直接完成整个窗口draw。
AndroidComposeView:Compose 与 ViewRoot 的连接点
ComposeView / AbstractComposeView 负责创建 composition,即一棵 composable 内容的运行实例;真正承载 Compose 节点树的是内部 AndroidComposeView。后者继承 ViewGroup,普通 Compose 子节点却不会各自变成 Android View。
Compose 1.11.4 的三个入口各有明确职责:
| Android 入口 | Compose 工作 | 需要注意的边界 |
|---|---|---|
onMeasure() | 把 View 的 MeasureSpec 转成 Compose Constraints,更新根节点约束并执行所需测量 | 仍受父 View 的测量契约约束 |
onLayout() | 调用 MeasureAndLayoutDelegate.measureAndLayout(),完成待处理测量/放置并更新根边界 | Layout 不在 AndroidUiFrameClock 回调里直接完成 |
dispatchDraw() | 再执行一次 measureAndLayout() 检查,调用 root.draw(),更新标记为 dirty、等待重录的 OwnedLayer | draw 前仍可完成刚产生的布局请求 |
硬件加速 draw 的调用顺序如下:Android 17 的 ViewRootImpl.performDraw() 进入 ThreadedRenderer.draw(),后者先通过 updateRootDisplayList() 更新 View 树的 display list(期间调用 AndroidComposeView.dispatchDraw()),随后执行 syncAndDrawFrame()。
上述宿主 draw 路径中,UI 线程录制 Compose 的 RenderNode display list,RenderThread 同步节点状态、准备目标并提交 Skia/GPU 工作。树、内容和 layer 属性可独立复用;一次 draw 入口不表示每个 Compose 节点都要重录。RenderThread 还可处理自身的渲染动画,不能把“Compose 内容在 Main 录制”扩大成全部图形工作都只在 Main。
Composition、Layout、Drawing 可以分别失效
Composable 函数的一次执行不会直接包办 Composition、Layout、Drawing 三阶段。状态在哪个阶段读取,决定哪些观察范围收到失效通知;同一状态可同时被多个范围读取,所以这些分支可以同时触发。按 mutation policy 等价的写入未必产生有效变化;普通对象内部字段的变化也不会自动变成 Snapshot state 通知。
| 状态读取位置 | 变更后的主要工作 | 可能跳过的阶段 |
|---|---|---|
| Composable 函数体 | Recomposition,随后按变更结果请求 Layout 或 Drawing | 无法预先保证 |
| 测量 lambda | 重新测量受影响节点和必要祖先/子树 | 可跳过 Recomposition |
| 放置 lambda | 重新放置相关节点 | 可跳过 Recomposition,常可跳过测量 |
| draw lambda | 重录所属 layer 的绘制内容 | 可跳过 Recomposition 和 Layout |
graphicsLayer {} 属性 lambda | 更新 layer 属性 | 内容未变时可复用 display list |
下面的例子把状态读取放进布局和 layer 属性 lambda,使高频位置变化不必从 composable 函数体重新开始:
@Composable
fun MovingBadge(offsetPx: State<Int>) {
    Box(
        Modifier
            .offset { IntOffset(offsetPx.value, 0) }
            .graphicsLayer {
                alpha = if (offsetPx.value > 0) 1f else 0.6f
            }
    )
}
本例的 offset {} 在 placement block 读取状态,位置变化通常只请求重新放置;固定实现用 placeRelativeWithLayer() / placeWithLayer() 放置,避免简单移动必须重录子内容。graphicsLayer {} 则有独立的 layer 参数观察器,更新 alpha 等属性时可复用内部 display list。同一 offsetPx 建立两组观察关系;若它还被其他 composable 读取,那些 scope 仍可重组。是否更快需要在相同画面下用 trace / benchmark 验证。
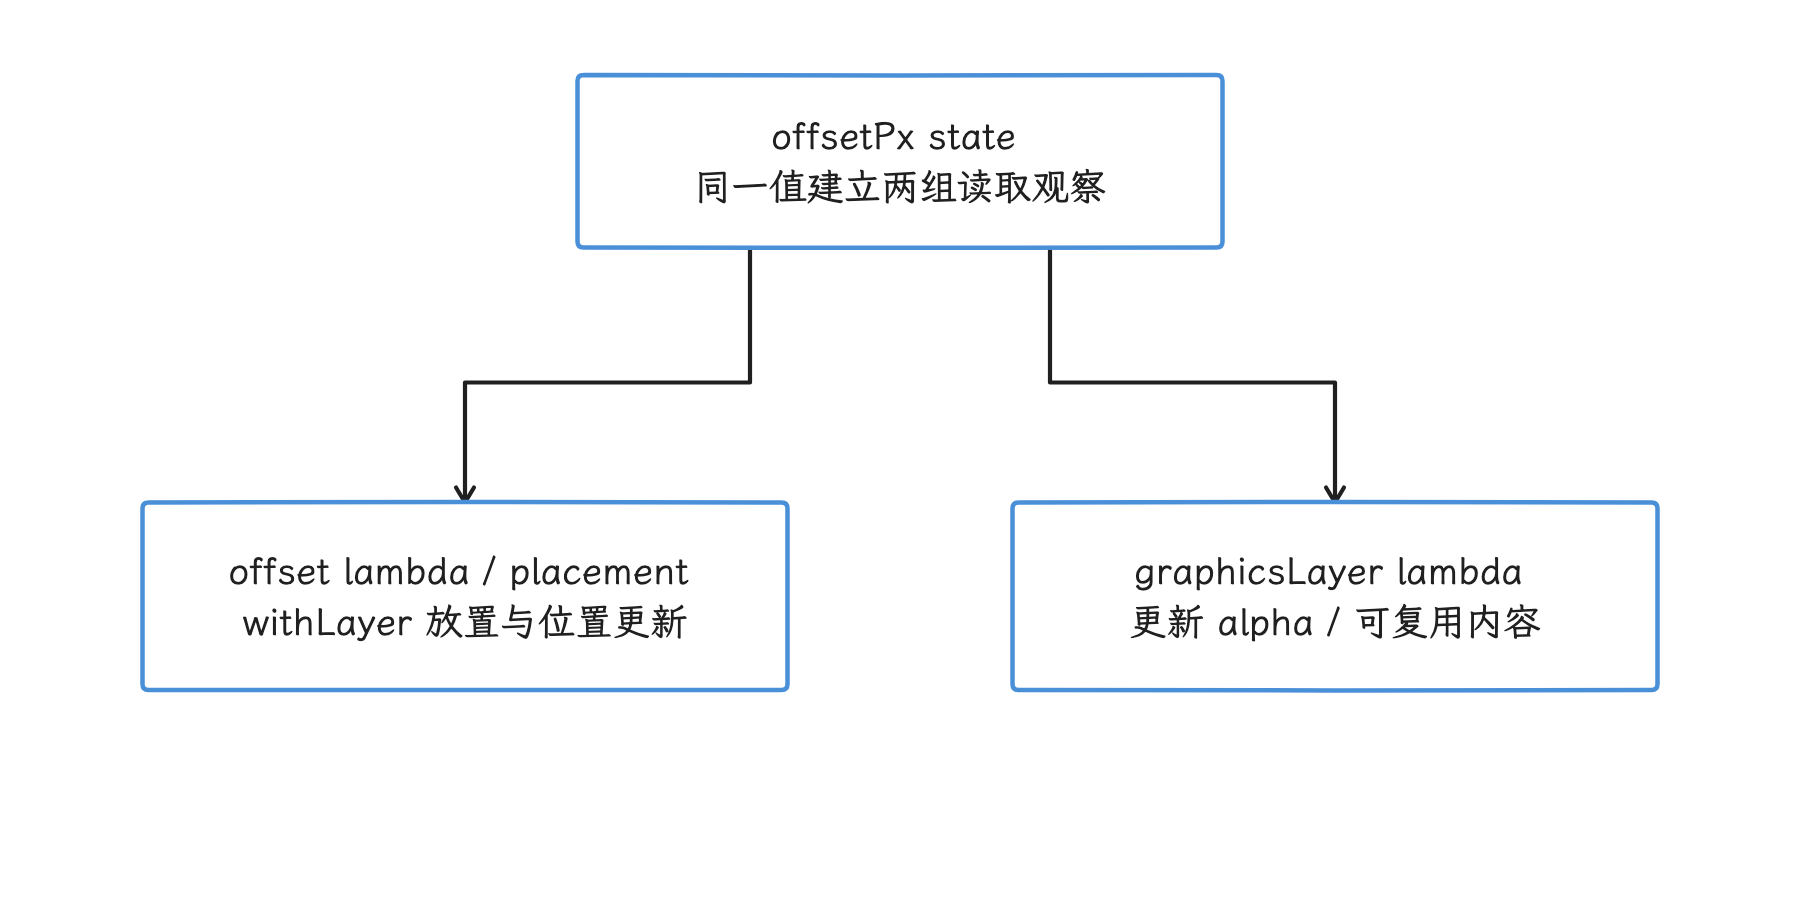
图:offset 在 placement 读取位置,graphicsLayer 在参数观察中读取 alpha。 额外的 composable 读者仍可能重组;示例只解释边界,不保证性能收益。
Recomposition 不等于重绘
Recomposition 重新执行需要更新的 composable scope,并计算对现有 UI 结构的变更。父 scope 执行时,满足跳过规则的未失效子调用可以复用;但子 scope 自己读取的 state 已失效时,参数相同不构成跳过它的充分条件。变更若只影响副作用或无障碍语义,也可能不产生新的绘制内容。
没有 Recomposition 也能更新画面:Canvas / drawWithContent 内的 state 变化会使所属绘制范围失效,重录相关 draw 内容;graphicsLayer {} 的 state 变化则可只更新 layer 参数并触发 repaint。后者不能一概称为再次执行 draw lambda。
Strong Skipping 属于 Compose Compiler / Kotlin 工具链,从 Kotlin 2.0.20 起默认启用,与 Android 17 平台版本无关。启用后 restartable composable 通常可被编译为 skippable;稳定参数按 equals、不稳定参数按实例相等比较。是否实际跳过仍要结合 scope 的失效状态、参数变化以及 @NonSkippableComposable 等条件,不能仅看 stable 标签或重组计数。
LayoutNode 的测量与放置
LayoutNode 是 Compose UI 树的布局节点。父节点通过 Constraints(minWidth, maxWidth, minHeight, maxHeight) 给出允许的尺寸范围,子节点测量后返回 Placeable(带测量尺寸、可被放置的结果),父节点再在 MeasureResult 的 placement block 中确定它的位置。
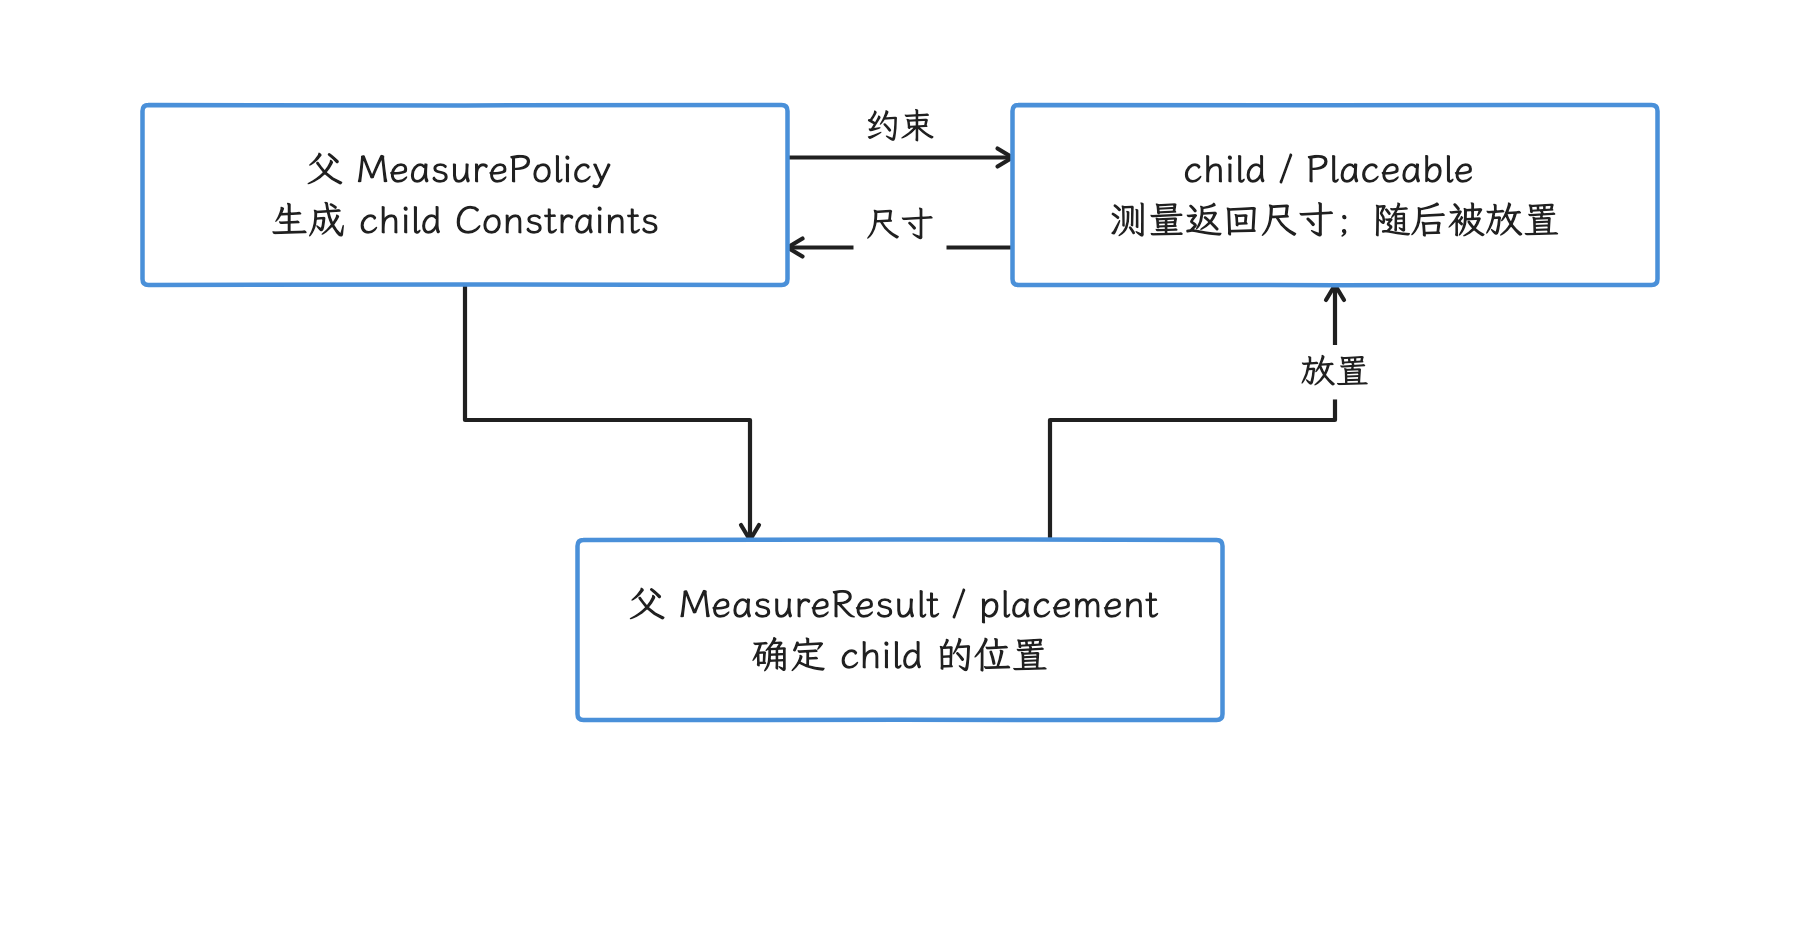
图:父向子传约束,子向父交尺寸,随后 placement 决定位置。 一次常规父测量调用中同一 child 只测一次;图不表示每帧只走一遍树。
Compose 的常规布局协议要求同一父测量调用中的一个 child 只测量一次;违反时默认抛错。约束从父向子传递,尺寸结果向父返回,placement 再向子确定位置。它不是“整棵树每帧只遍历一遍”的保证;intrinsic 查询、lookahead 与实际 measure 是不同边界,SubcomposeLayout/Lazy 也可在 measure 中创建所需子内容。下列机制各有额外工作,不能据此允许同一普通 measure pass 任意重复测量 child:
- Intrinsic measurement 会先查询内容在给定条件下需要的最小或最大固有尺寸;
SubcomposeLayout可以在测量过程中根据约束再生成需要测量的内容;- Lazy 容器会根据可见视口、缓存窗口与预取策略组合和测量 item;
- Lookahead 会保存目标布局的预测结果,为后续动画或位置变化提供参考;
- 约束、内容或依赖状态在 traversal 中变化时,可能产生新的测量请求;
dispatchDraw()仍会处理尚未完成的 measure/layout 请求。
单凭“每个 child 在一次 measure pass 中只测量一次”这一条,推不出 Compose 一定比 View 更快。差距往往在测量范围被扩大,具体节点、布局策略和状态变化要在 Perfetto 里逐一核对。
Drawing、GraphicsLayer 与 RenderNode
LayoutNode 与 RenderNode 不是一一对应
Composable 函数调用、composition group、LayoutNode 与绘图 layer 是不同对象,没有一一对应关系。Text、Row、Column 通常不因各自出现就创建独立 Android RenderNode;无独立 layer 的绘制会录入最近的所属 layer,Compose root 自身也有 layer。这里的 layer / RenderNode 只是 App 内的绘制复用边界,不等于 SurfaceFlinger 的独立 Layer 或独立 BufferQueue。
绘制失效的粒度不能按 LayoutNode 来概括。display list 的复用单位是 OwnedLayer / GraphicsLayer 等绘制边界;普通 LayoutNode 的 draw 内容变化时,可能要重录包含它的最近所属 layer。
Android 17 上的 graphicsLayer 主路径
在 Android 12 至 Android 17 上,Compose 1.11.4 的 AndroidComposeView.createLayer() 主路径会创建 GraphicsLayerOwnerLayer。Android 17 使用的图形实现是 GraphicsLayerV29,其内部调用公开的 android.graphics.RenderNode:
GraphicsLayerOwnerLayer.updateDisplayList()只在 dirty 时调用graphicsLayer.record(...);GraphicsLayerV29通过RenderNode.beginRecording()/endRecording()保存绘制操作;- 绘制时通过
Canvas.drawRenderNode()引用该节点; - translation、scale、rotation、alpha 等 layer 属性可以在绘制内容不变时单独更新,避免重录内部 draw commands。
RenderNodeLayer 仍保留在兼容代码中,但 Android 17 + Compose 1.11.4 的主路径不是它。
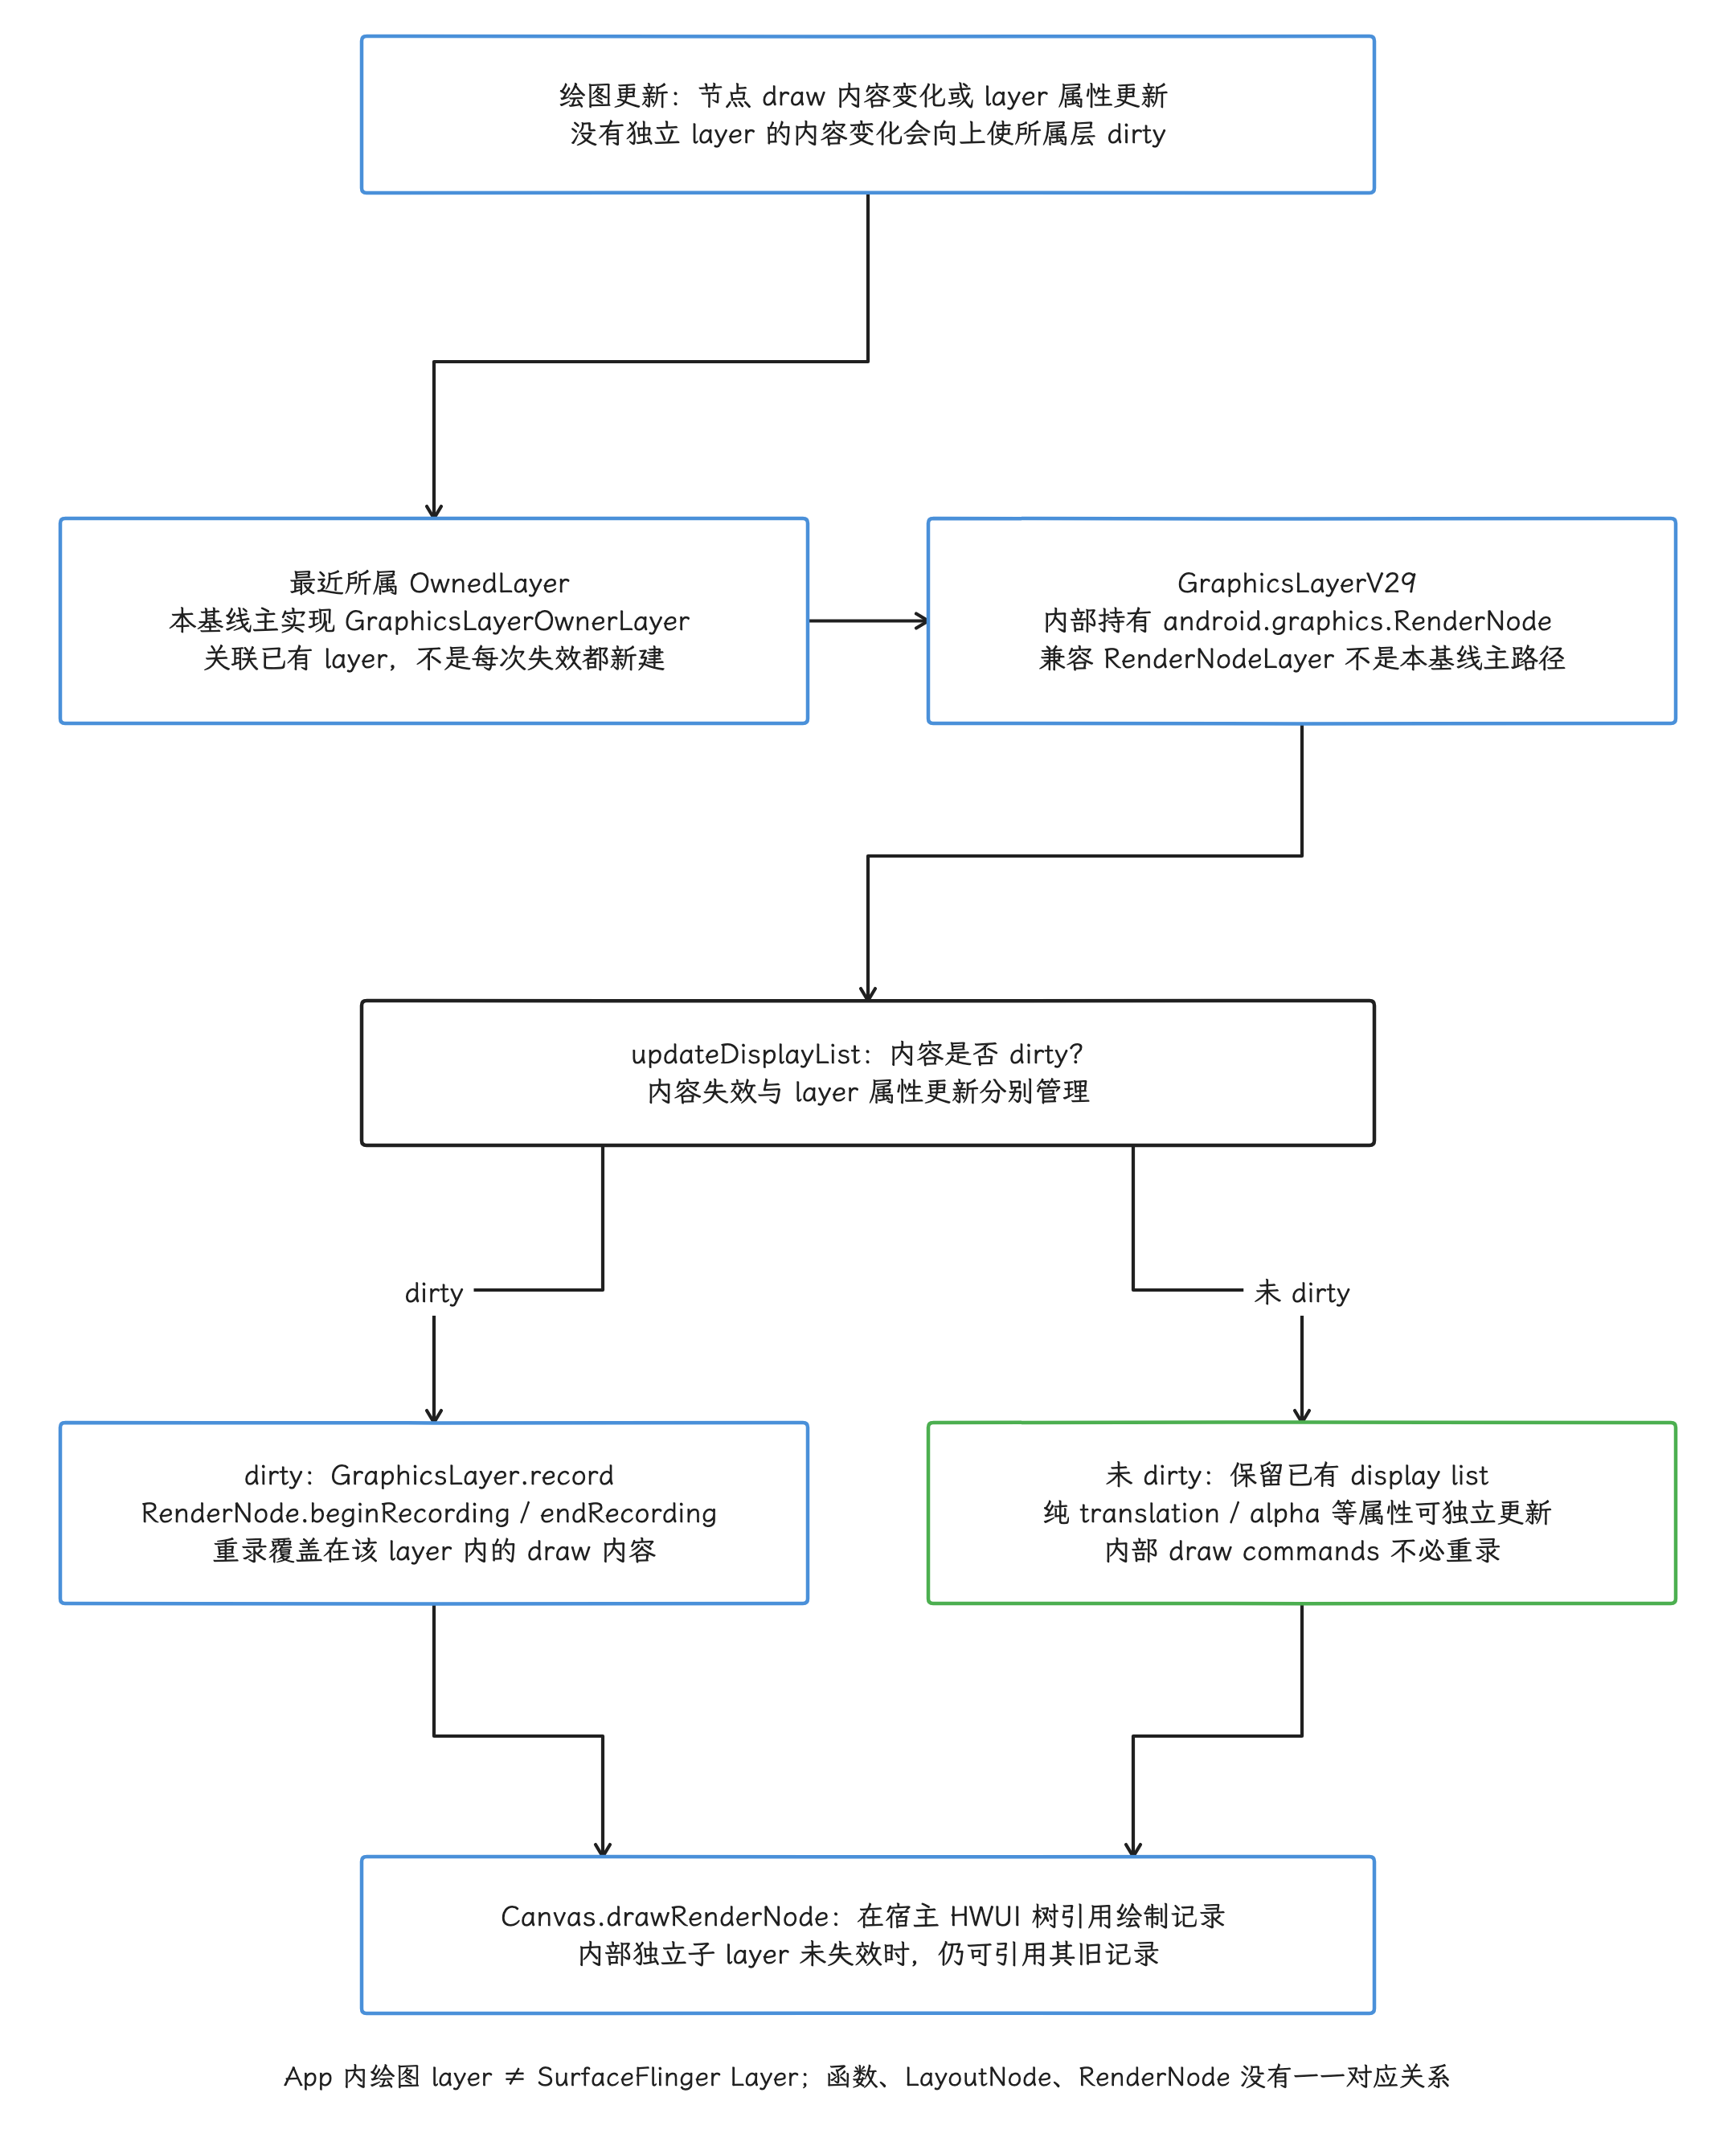
图:无独立layer的普通LayoutNode draw变化先使最近所属layer内容dirty;普通函数/group/LayoutNode与RenderNode不一一对应。固定Android12–17/Compose1.11.4主路径为GraphicsLayerOwnerLayer→GraphicsLayerV29→公开RenderNode。内容dirty才record begin/endRecording;内容未变可保留displaylist并独立改属性,Canvas.drawRenderNode引用进宿主HWUI。未失效的独立子layer可继续引用旧记录。App内layer不是独立Surface/系统Layer,复用也不等零GPU成本。
layer 边界不一定产生离屏 buffer
Modifier.graphicsLayer 会建立图形 layer 隔离边界。offscreen buffer 是先把内容画进中间纹理、再参与最终合成的缓冲区;是否需要它由合成策略和效果共同决定。
| 条件 | RenderNode / layer 边界 | offscreen buffer |
|---|---|---|
| 普通 LayoutNode,无显式 layer | 通常并入最近所属 layer | 无额外 offscreen |
graphicsLayer + 平移/缩放/旋转 | 有 | 通常不需要 |
CompositingStrategy.Auto + alpha < 1 | 有 | 按整层 alpha 语义自动采用中间层;并非先检测实际内容重叠再决定 |
RenderEffect | 有 | 需要中间结果 |
非默认 SrcOver 的 BlendMode 或非空 ColorFilter | 有 | Compose 1.11.4 强制按 Offscreen 处理 |
CompositingStrategy.Offscreen | 有 | 始终启用 |
CompositingStrategy.ModulateAlpha | 有 | 仅避免为 alpha 单独建离屏层;RenderEffect、BlendMode、ColorFilter 等仍可要求 Offscreen;重叠时结果可不同 |
离屏渲染可能增加中间纹理、像素填充、内存带宽与 GPU 内存压力,成本取决于中间区域、复用和效果。ModulateAlpha 仅应在逐指令 alpha 满足视觉要求时采用;它不会保证所有效果都没有离屏分配,也不会把 RenderNode 变成独立窗口 Surface。
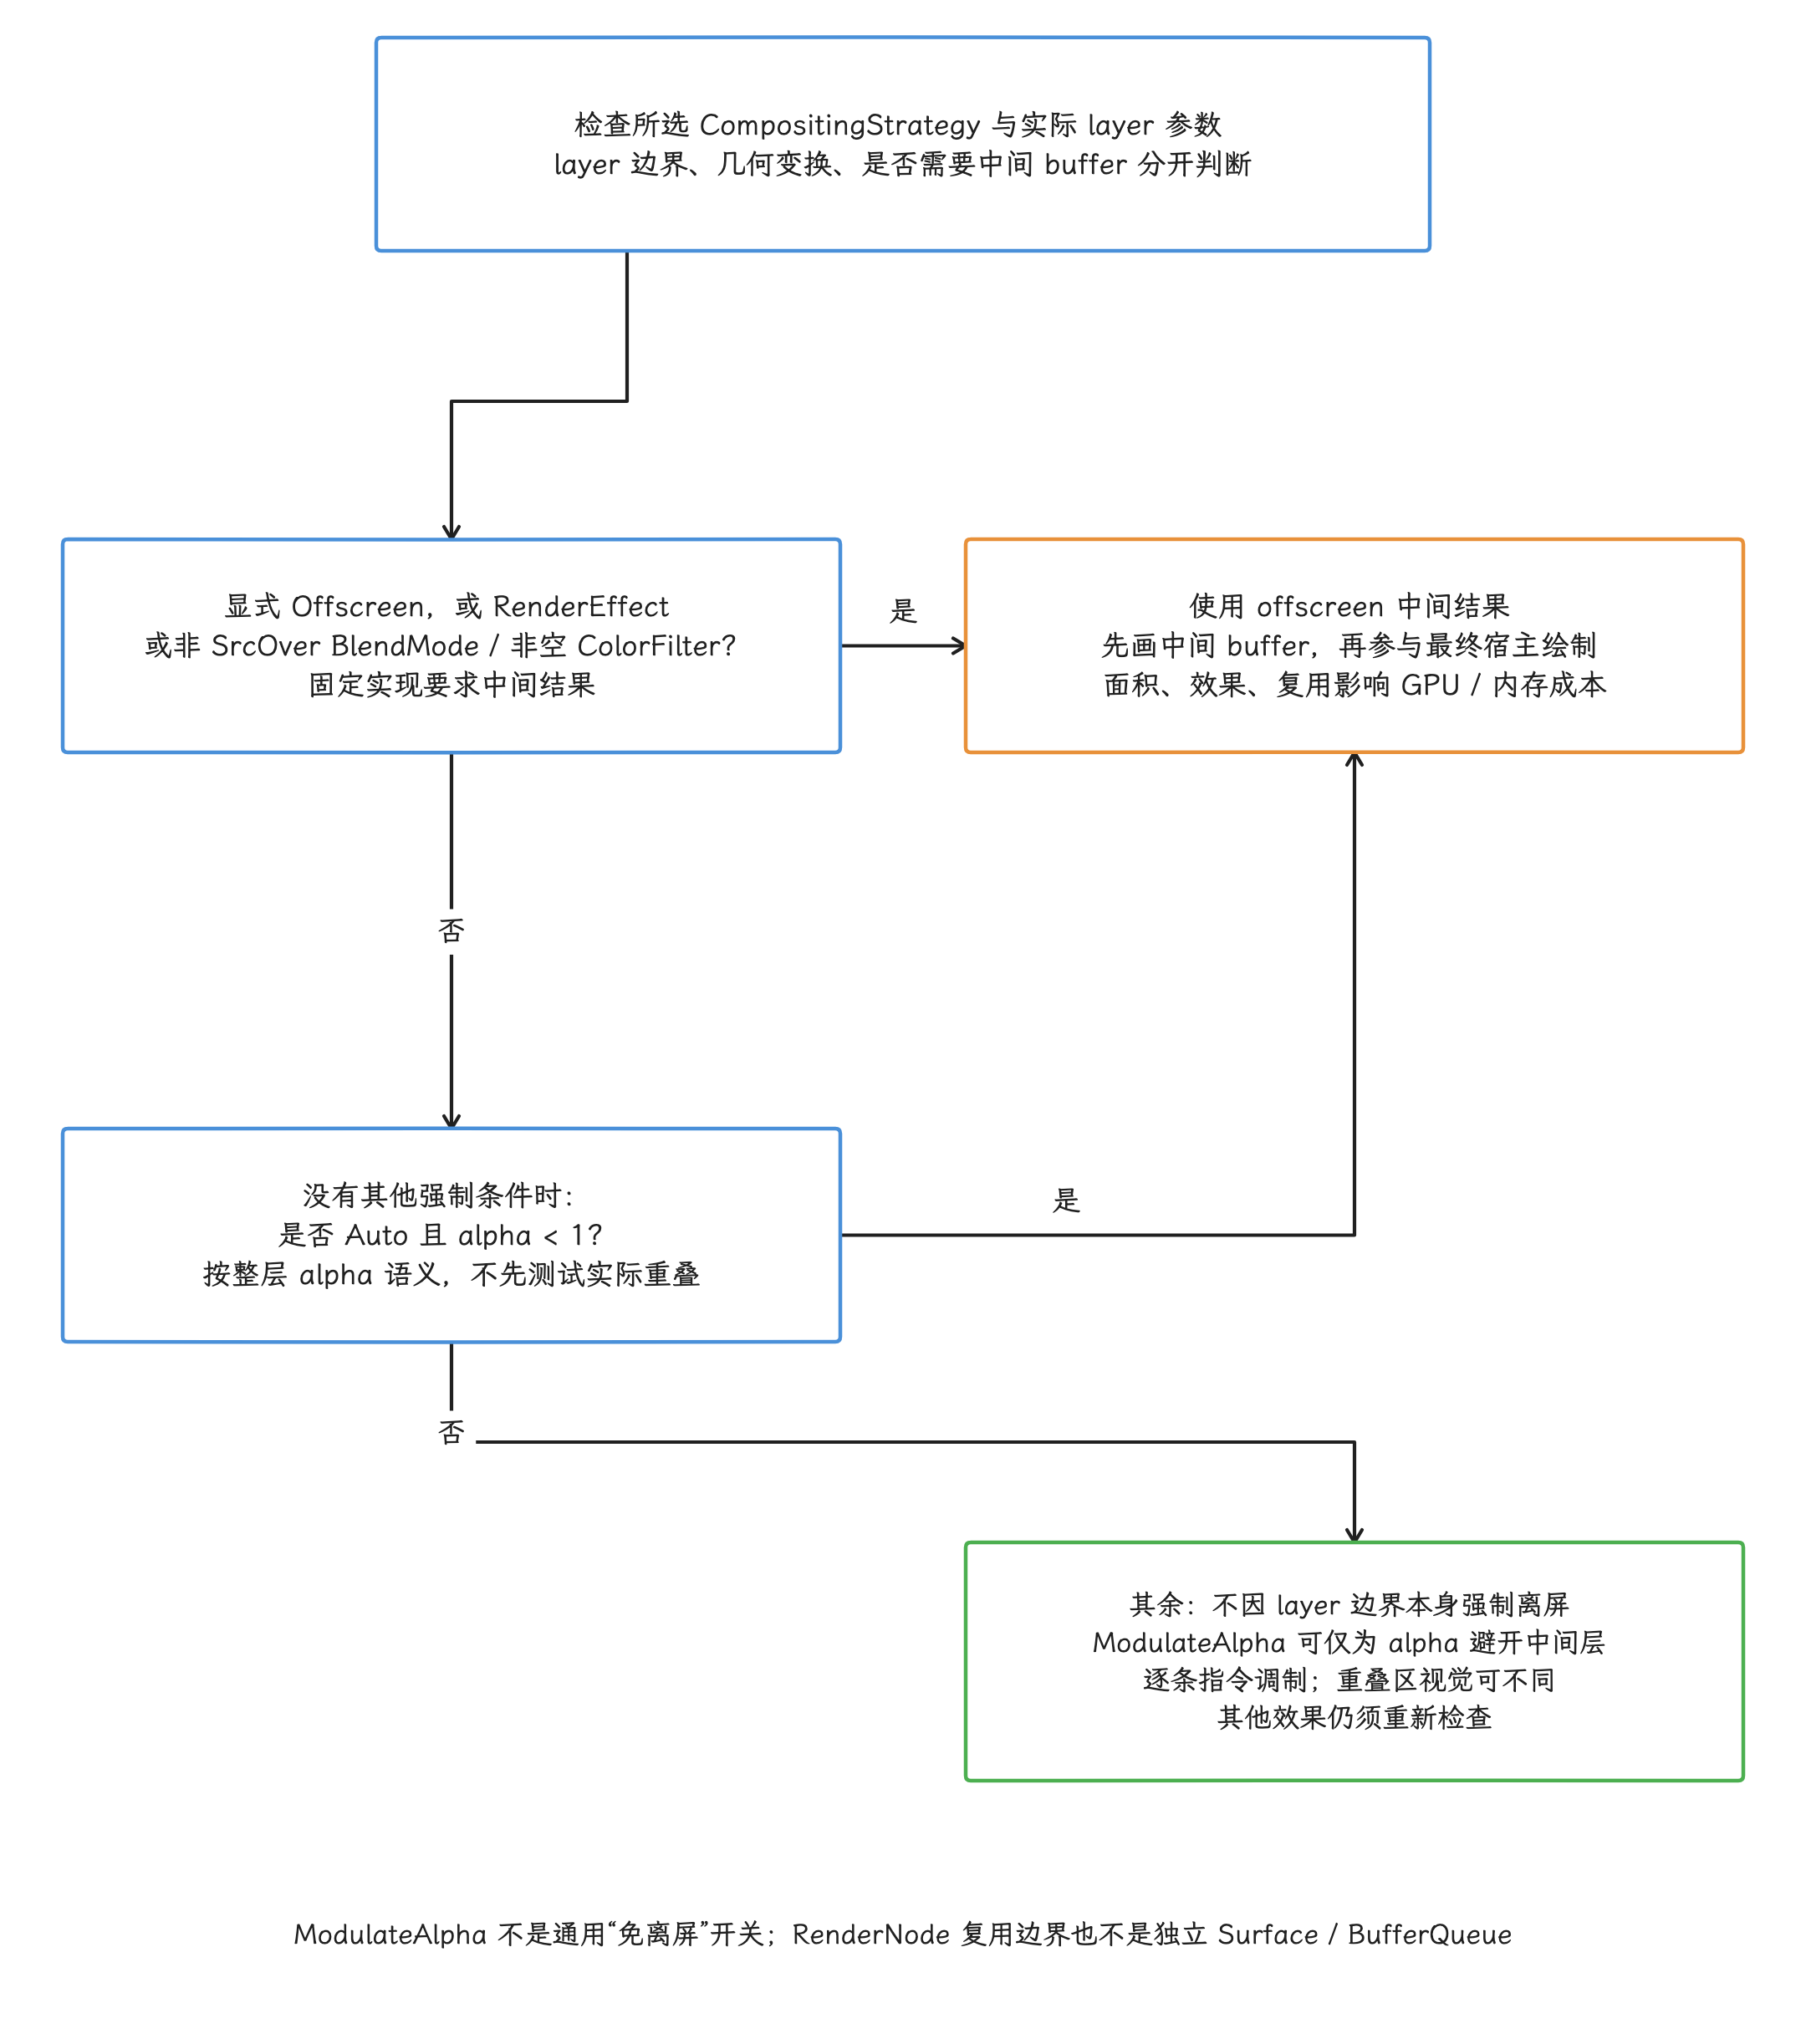
图:固定Compose1.11.4:Offscreen显式策略、RenderEffect、非SrcOver BlendMode或非空ColorFilter等会要求中间结果;这些条件也适用于ModulateAlpha。无其他强制条件时,Auto+alpha<1按整层语义使用中间层,不先检测内容是否实际重叠。ModulateAlpha只避免为alpha单独离屏,逐指令调制在重叠时可改变视觉结果。平移/缩放/旋转或建立layer边界本身不等创建离屏buffer,更不等独立窗口Surface。
从状态写入到 present
下面的流程图把 Compose、HWUI、窗口队列和 SurfaceFlinger 串成一条可按时间核对的证据链:
flowchart TD
    A["有效 Snapshot state 变更 / apply 通知"] --> B["通知已记录的读者集合;可命中多个分支"]
    B --> C["Composition 读者:Recomposer 按需重组 / apply"]
    B --> D["Measure / placement 读者:请求对应布局工作"]
    B --> E["Draw 读者:使所属 layer 内容 dirty"]
    B --> F["Layer 参数读者:更新属性并 repaint"]
    C -.->|"仅当结果需要"| D
    C -.->|"仅当结果需要"| E
    D --> G["Android owner 安排窗口更新"]
    E --> G
    F --> G
    G --> H["窗口 traversal / 按需 measure、layout、display-list 更新"]
    H --> I["UI syncAndDrawFrame → RenderThread tree sync / target / GPU submit"]
    I --> J["queueBuffer + Producer 完成 fence,经 BLAST 提交 buffer TX"]
    I --> K["GPU 异步执行并发出完成信号"]
    J --> L["SF readiness / latch / 确定各 Layer 合成类型"]
    L --> M["实际读取前满足 acquire 依赖"]
    K --> M
    M --> N["HWC DEVICE;需要 CLIENT 时 RenderEngine 生成 client target"]
    N --> O["display present 反馈"]
在这条链路中,成功 queueBuffer 表示 Producer 向队列交付 buffer 与完成依赖;它不保证该 buffer 后来一定被选中显示。Producer completion fence 在 Consumer 侧称为 acquire fence,约束读取前的写完成;readiness / latch 的采纳时点不必一律等同于 fence 已 signal。定位用户实际看到的帧时,还要对齐 BufferTX、目标 Layer、FrameTimeline、合成与 present;present fence 是显示栈反馈,不能独立测出像素发光的光学延迟。
UI 线程与 RenderThread 的分工
UI 线程主要完成:
- Snapshot 通知、recomposition 与
applyChanges; - Compose 测量和放置;
- 录制 View/Compose display list;
- 调用
syncAndDrawFrame()并参与 HWUI 同步。
RenderThread 主要完成:
- 同步 RenderNode tree 和渲染属性;
dequeueBuffer取得窗口 buffer 及复用依赖;对上次 Consumer release fence 的等待可在 CPU 或 GPU 侧处理,写入前必须满足复用约束;不能只凭 dequeue 返回认定旧读者已完成;- 让 Skia 构建/提交 GLES 或 Vulkan GPU 工作;
- 完成 swap/queue,并把 producer completion fence 随 buffer 提交。
RenderThread trace slice 的长度不能直接当作 GPU 执行时长。GPU 可能在 RenderThread 提交返回后继续工作,需要 GPU completion、fence 或 GPU counter 才能判断设备侧执行时间。syncAndDrawFrame() 返回通常也早于 present 完成;显示结果要结合 present fence 或 FrameTimeline 判断。
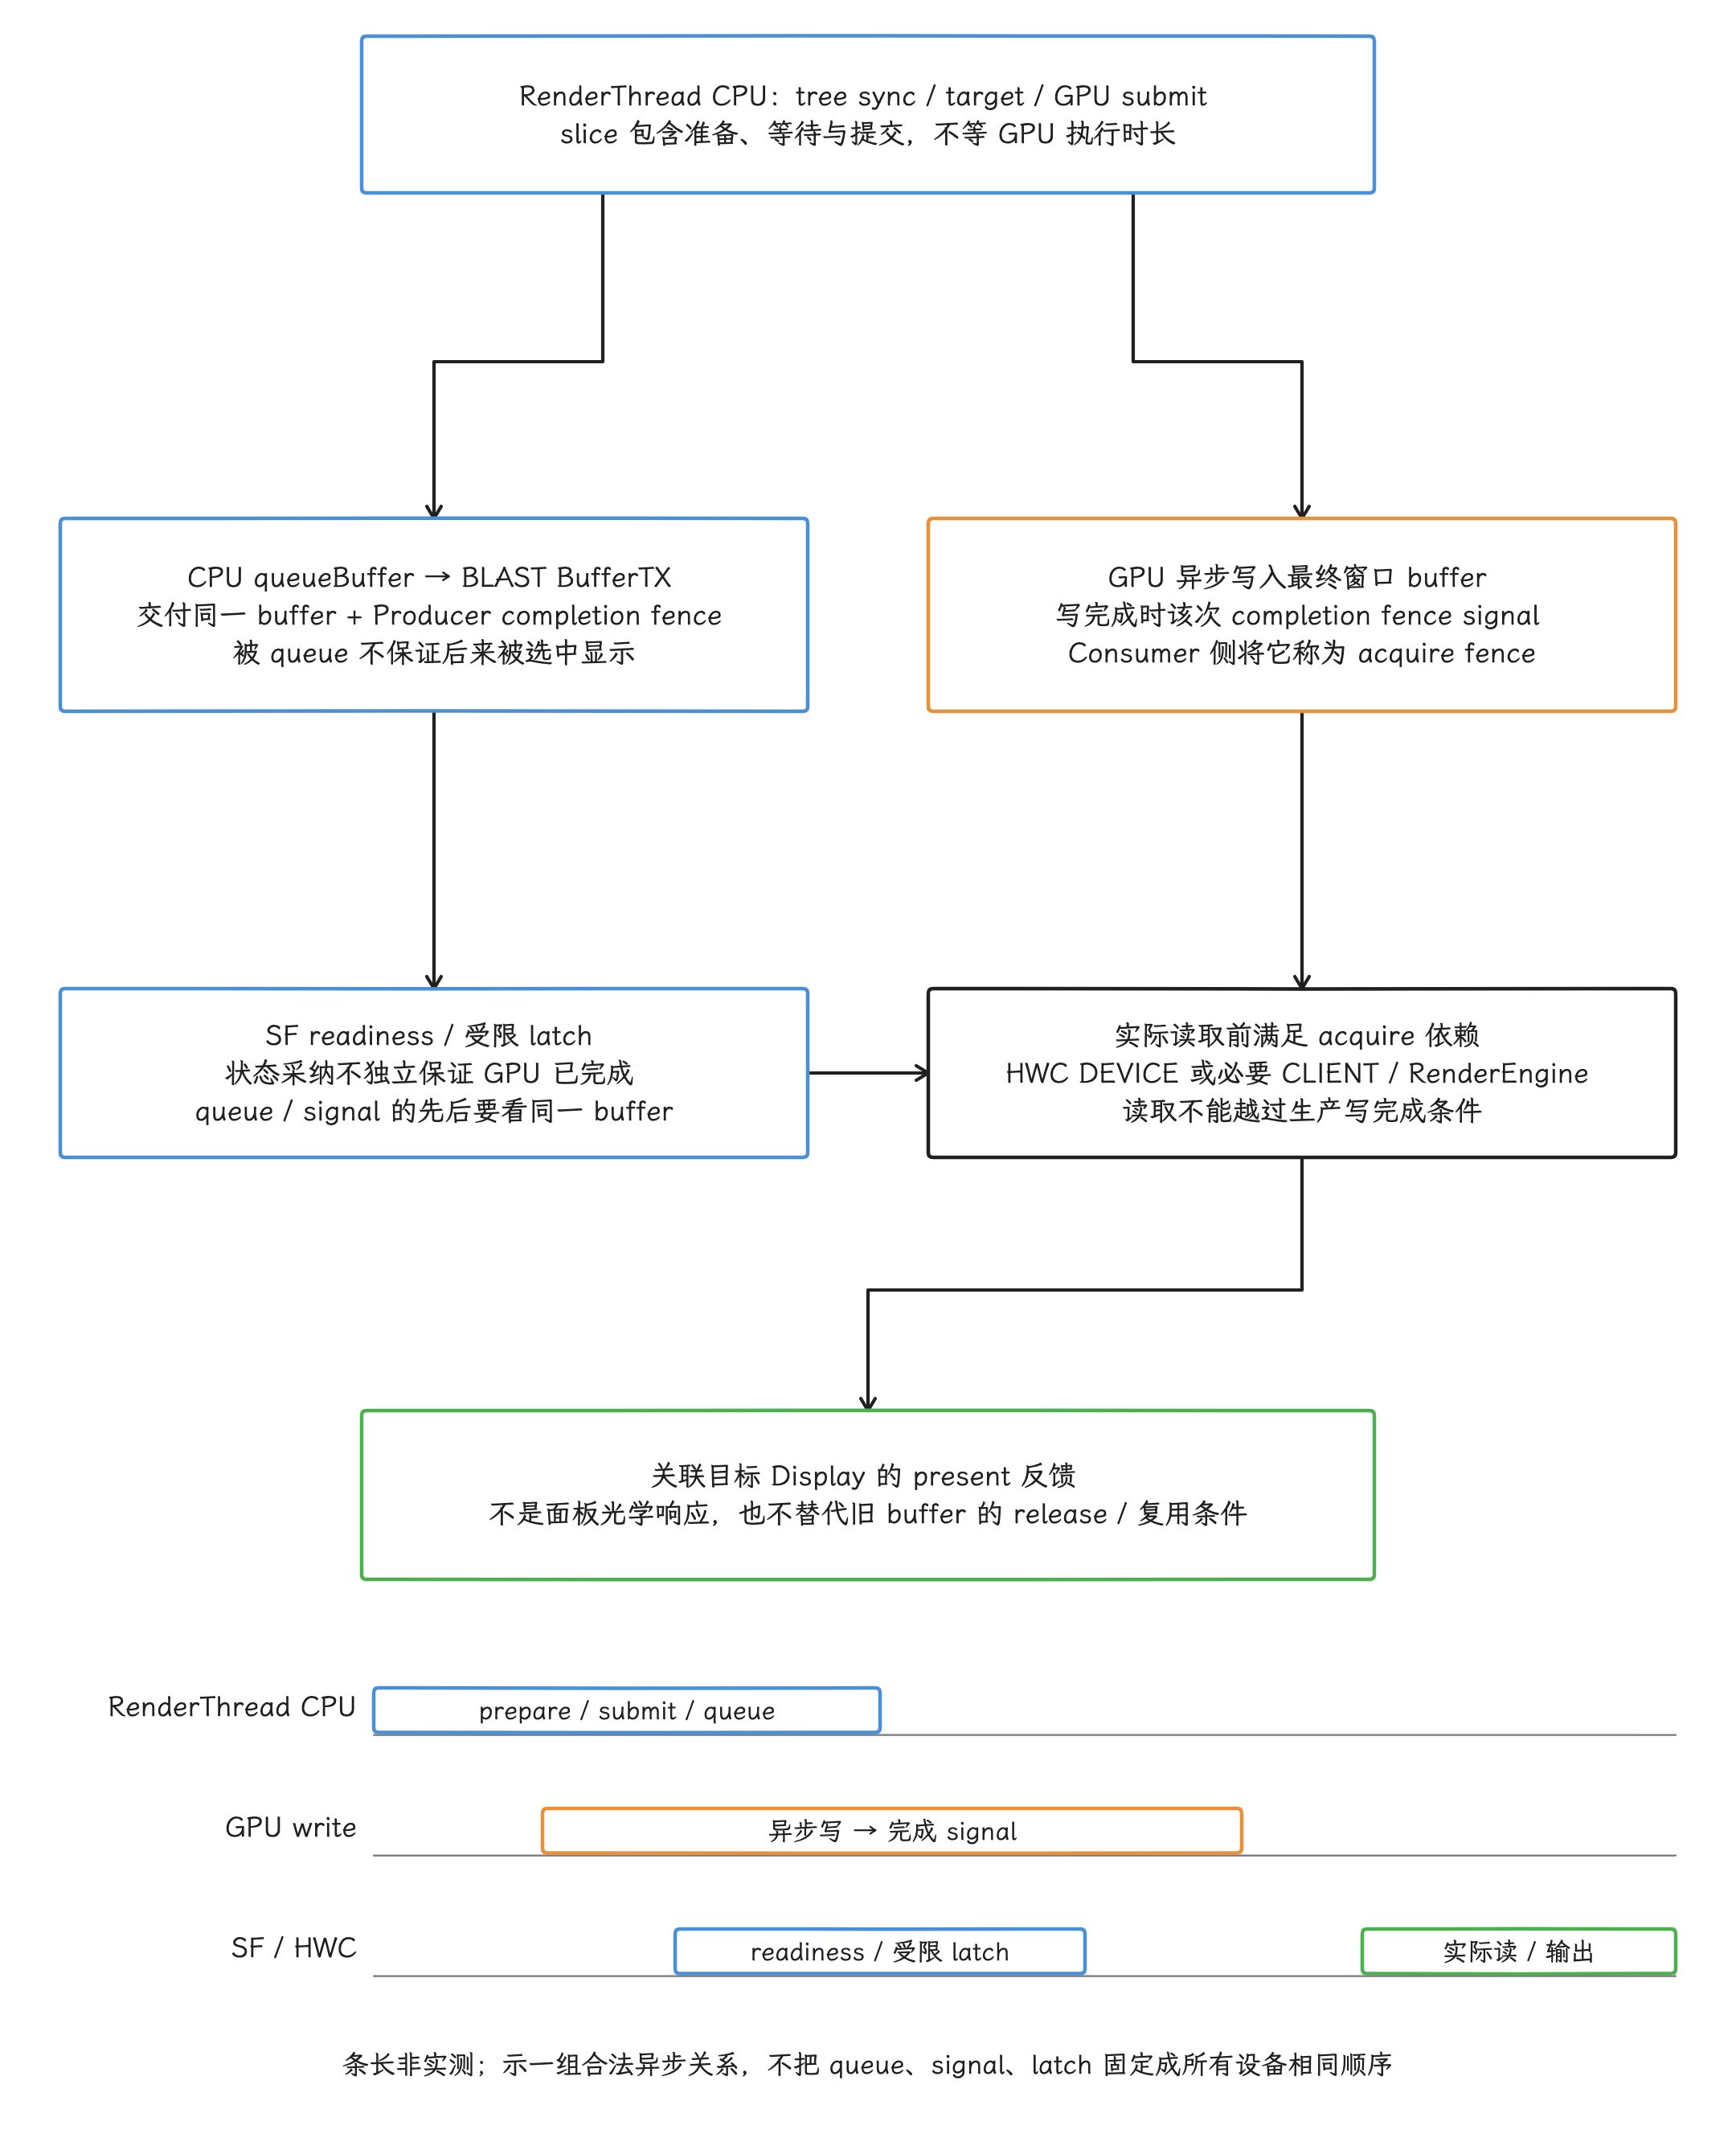
图:同一窗口buffer由RenderThread/Skia准备并提交;CPU slice可含等待,不等GPU busy。CPU queue交付buffer与Producer completion fence,Consumer侧称acquire;GPU异步写入完成另发signal,queue与signal无固定先后,受限readiness/latch也可先于signal。实际读取前满足acquire,DEVICE或必要CLIENT合成后追目标displaypresent。queue不保证该buffer后来被选中;present反馈不等像素光学响应,旧buffer复用另受release依赖约束。
Snapshot 与 Recomposer 的并发边界
Snapshot 为状态保存可见的版本记录,读观察器追踪依赖,写入和 apply 通知再让相应 observer 处理变更。全局 state 写入的通知还会由 Android 的 GlobalSnapshotManager 调度并合并发送;因此“setter 返回”不等于所有 UI reader 已同步执行。版本化不承诺完全无锁,也不让同一个 composition 自动并行重组。
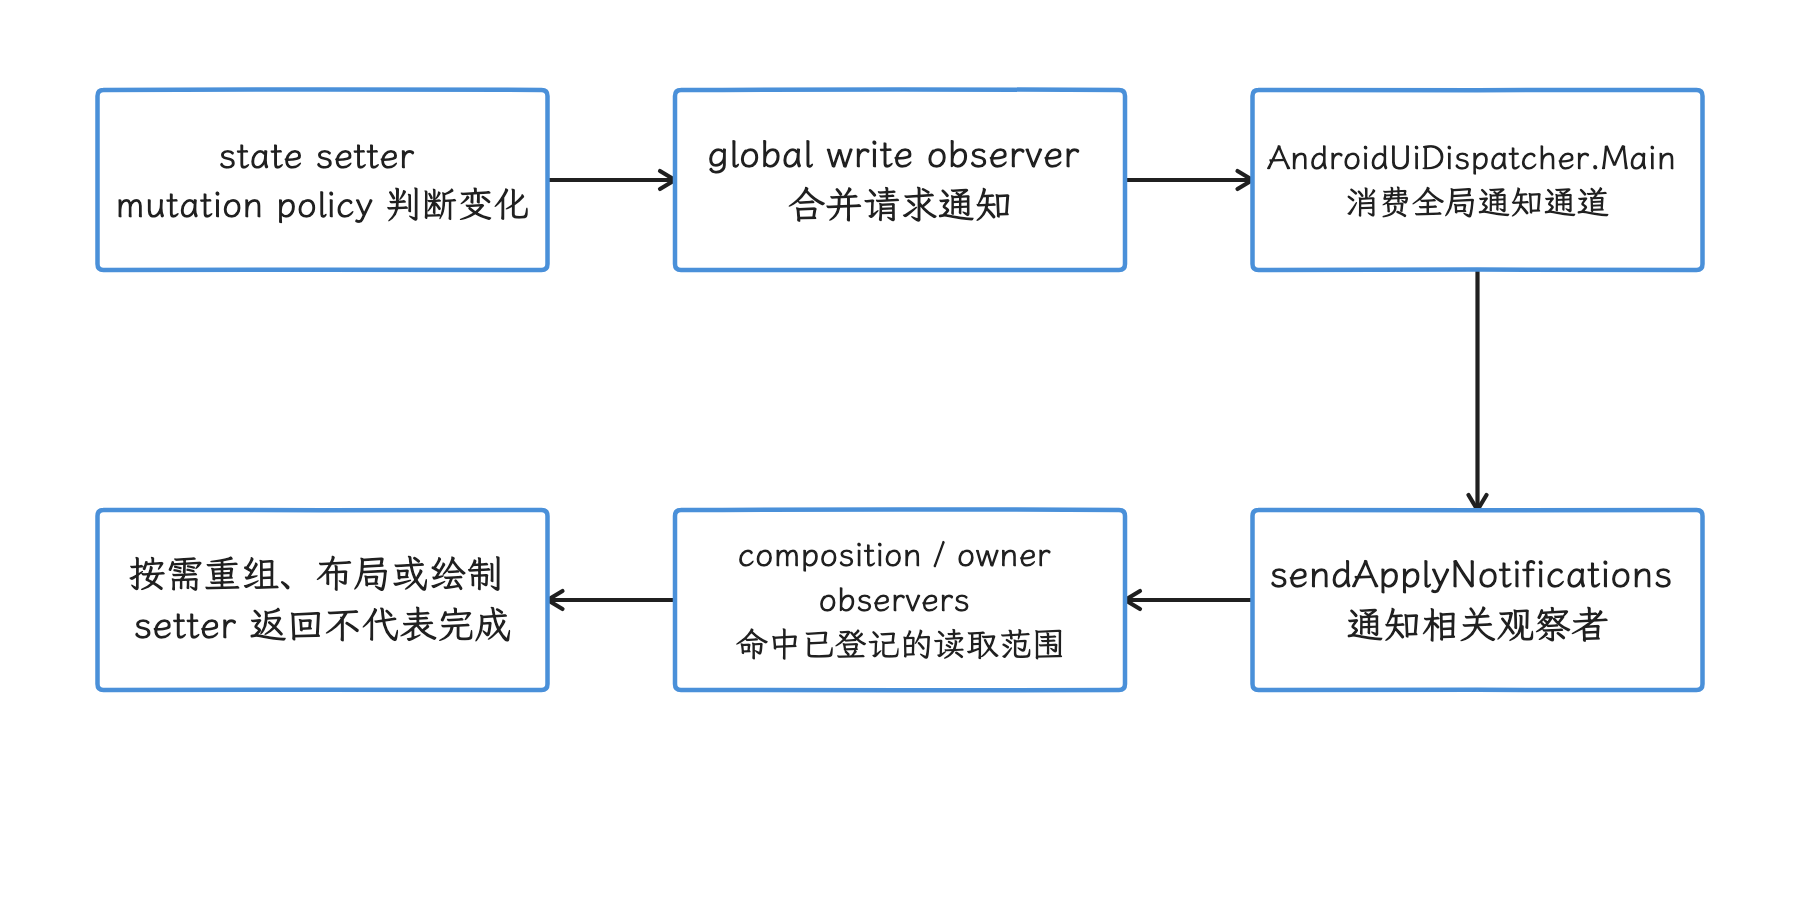
图:全局写观察器请求通知,主线程合并派发后由读者决定后续工作。 这是默认 Android 全局通知入口;mutable snapshot apply 与重组内通知另有调用路径。
Android UI 性能分析可以依赖以下边界:
- 同一个 composition 不会被 Recomposer 同时执行两次 recomposition;
- Runtime 1.11.0-alpha01 已移除曾经的实验性 concurrent recomposition API,旧版本的字段不能证明当前版本仍支持并发 composition;
- 多个
ComposeView各有 composition root(各自的组合根),但可以共享 window Recomposer、parent composition context,也可以显式共享同一份 state; - 后台线程可用 Snapshot state;若多个值要一起可见,用明确的 mutable snapshot 并处理 apply 结果。快照事务只覆盖 Snapshot state,不自动覆盖普通字段、I/O 或 Android View 操作;
apply()可能遇到并发修改冲突,业务代码不应把 Snapshot 当作任意跨线程数据结构的替代品;- Android
View、AndroidComposeView、绘制对象与副作用仍受各自线程约束。state 可以跨线程更新,不表示 UI 对象可以跨线程访问。
Runtime 内部的锁与字段会随 Compose 版本调整;应用应依赖 composition 单实例串行、状态冲突处理和 Android UI 线程约束这些公开边界,而非某一版本的锁实现行号。
PausableComposition 与 Lazy 预取
分段处理哪类工作
PausableComposition 可以分段执行尚未投入使用的子 composition。典型场景是 Lazy 容器预先准备可能进入视口的 item:当前空闲时间不足时请求暂停,后续再调用 resume() 继续。只有 isComplete 为真并完成 apply() 后,结果才能加入布局树。
Lazy 的这一预取用途不是把当前可见页面的常规 recomposition 任意切成多帧;使用普通 setContent / setContentWithReuse 也不会自动获得暂停语义。它调整尚未使用的子 composition 的准备时机,不能据此推出 draw、GPU 或 SurfaceFlinger 工作量下降。取消后必须丢弃相应 composition,而非把未完成节点交给可见布局。
API 与暂停语义
Compose 1.11.4 的关键 API 是:
PausableComposition.setPausableContent()/setPausableContentWithReuse()返回PausedComposition;- 调用方反复执行
resume(shouldPause); shouldPause返回true表示请求暂停,执行并不保证在任意函数边界立即停止;resume()返回后仍要检查isComplete,完成时再同步调用apply();- 暂停期间读过的 state 若发生变化,原本已完成的结果可能再次需要处理;
- 放弃预取时调用
cancel(),并按 API 契约丢弃状态不再确定的 composition。
1.11.4 的默认预取路径
PausableComposition 最初在 Runtime 1.8.0-alpha02 加入,并非 Compose 1.7 的稳定特性。Foundation 的 Lazy 预取开关后来经历过调整:
- Foundation 1.10.6 因稳定性考虑把
isPausableCompositionInPrefetchEnabled设为false; - Foundation 1.11.4 源码中的该 flag 为
true; LazyLayoutPrefetchState在 flag 开启时调用 paused precomposition,并分别记录 resume、pause、apply 与 measure 的历史耗时。
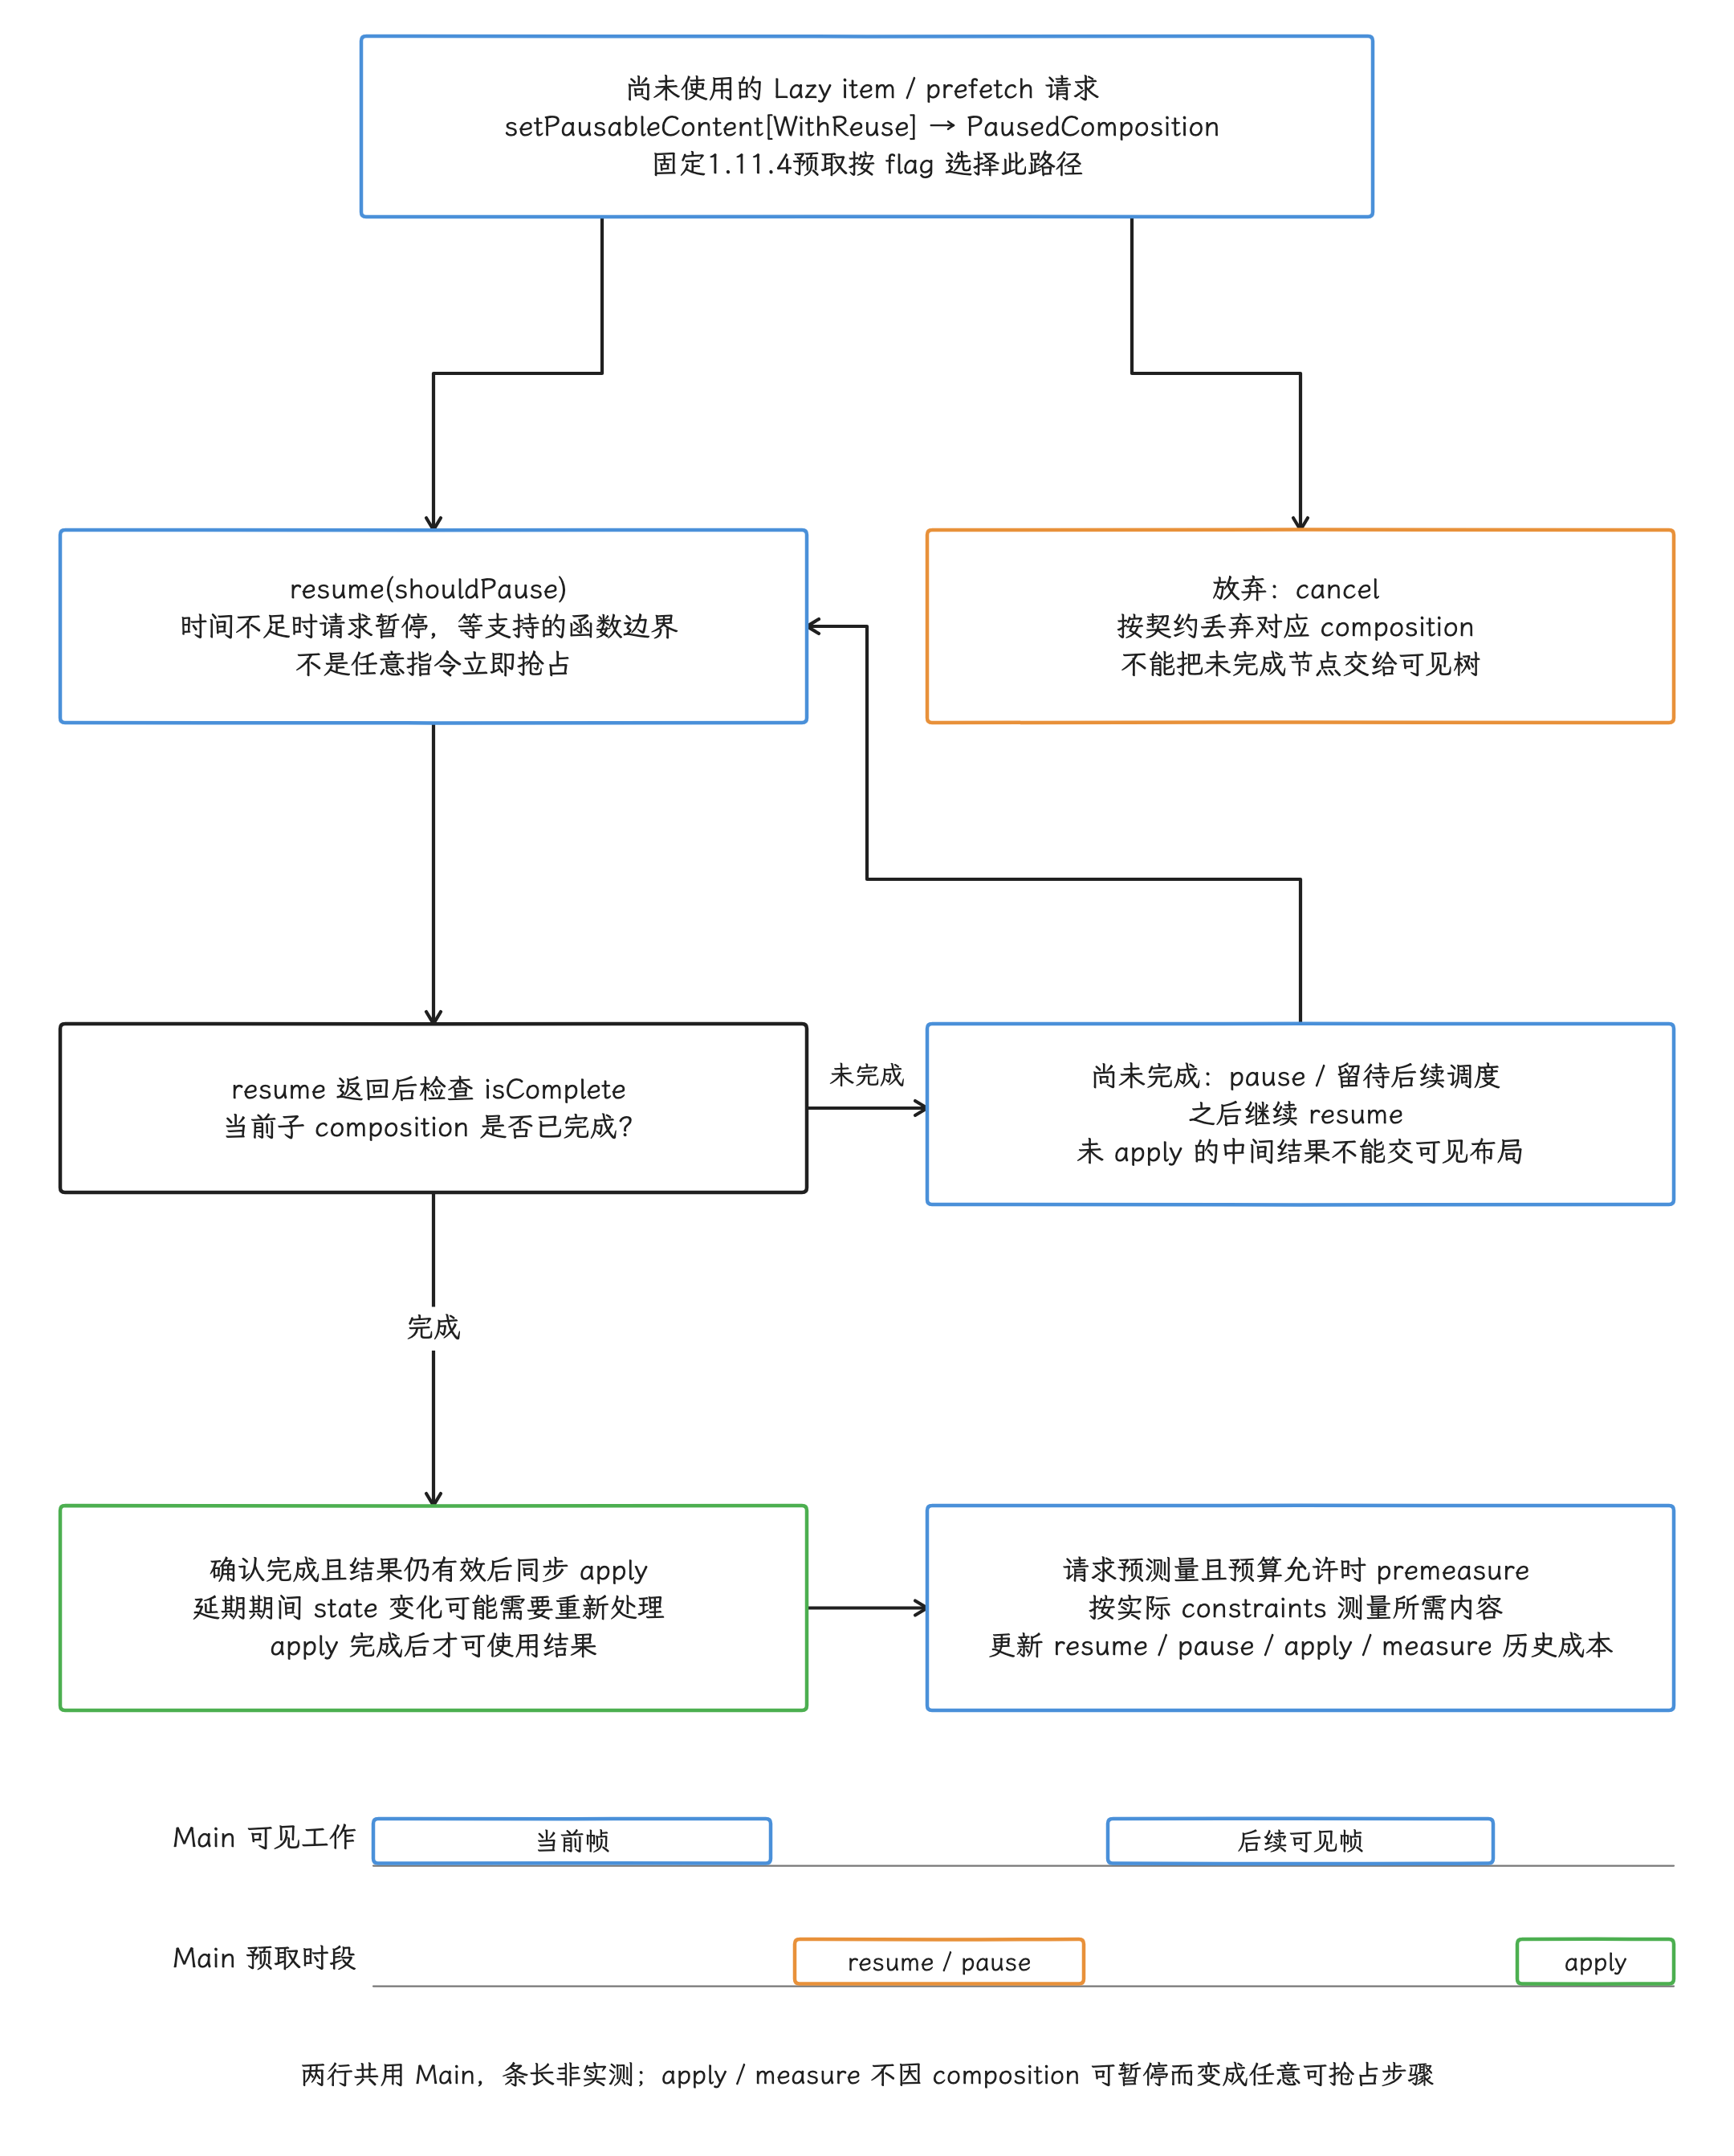
图:PausableComposition只安排尚未使用的子composition,典型为Lazy预取;普通setContent不自动可暂停,可见页面常规重组不因此任意分多帧。反复resume(shouldPause)到完成,pause在支持边界生效,apply同步且完成有效后结果才可使用;完成后延迟apply期间state变化可能需要重新处理。预取后续apply/预测量分别按请求和预算评估并更新步骤成本,非任意可抢占。放弃则cancel并丢弃composition;预取与可见帧共享Main,图不保证GPU工作下降。
默认 Android 预取调度器在主线程用 View.display.refreshRate 估算并静态缓存 frameIntervalNs,不是逐帧读取实时刷新率。普通预算是 max(0, max(frameStartTimeNanos, viewDrawTimeNanos) + frameIntervalNs - now)。距上次 draw 超过两个缓存帧间隔时,首个请求可进入 idle 处理,把可用时间视为 Long.MAX_VALUE;处理一个请求后会重置 idle 状态。
Lazy 请求还会把剩余时间与该步骤的历史平均成本比较;urgent 请求只要求剩余时间为正,可绕开平均成本阈值。resume / pause 的停止点也受可暂停函数边界限制,所以这是一种启发式安排,不是对主线程占用的硬时限。
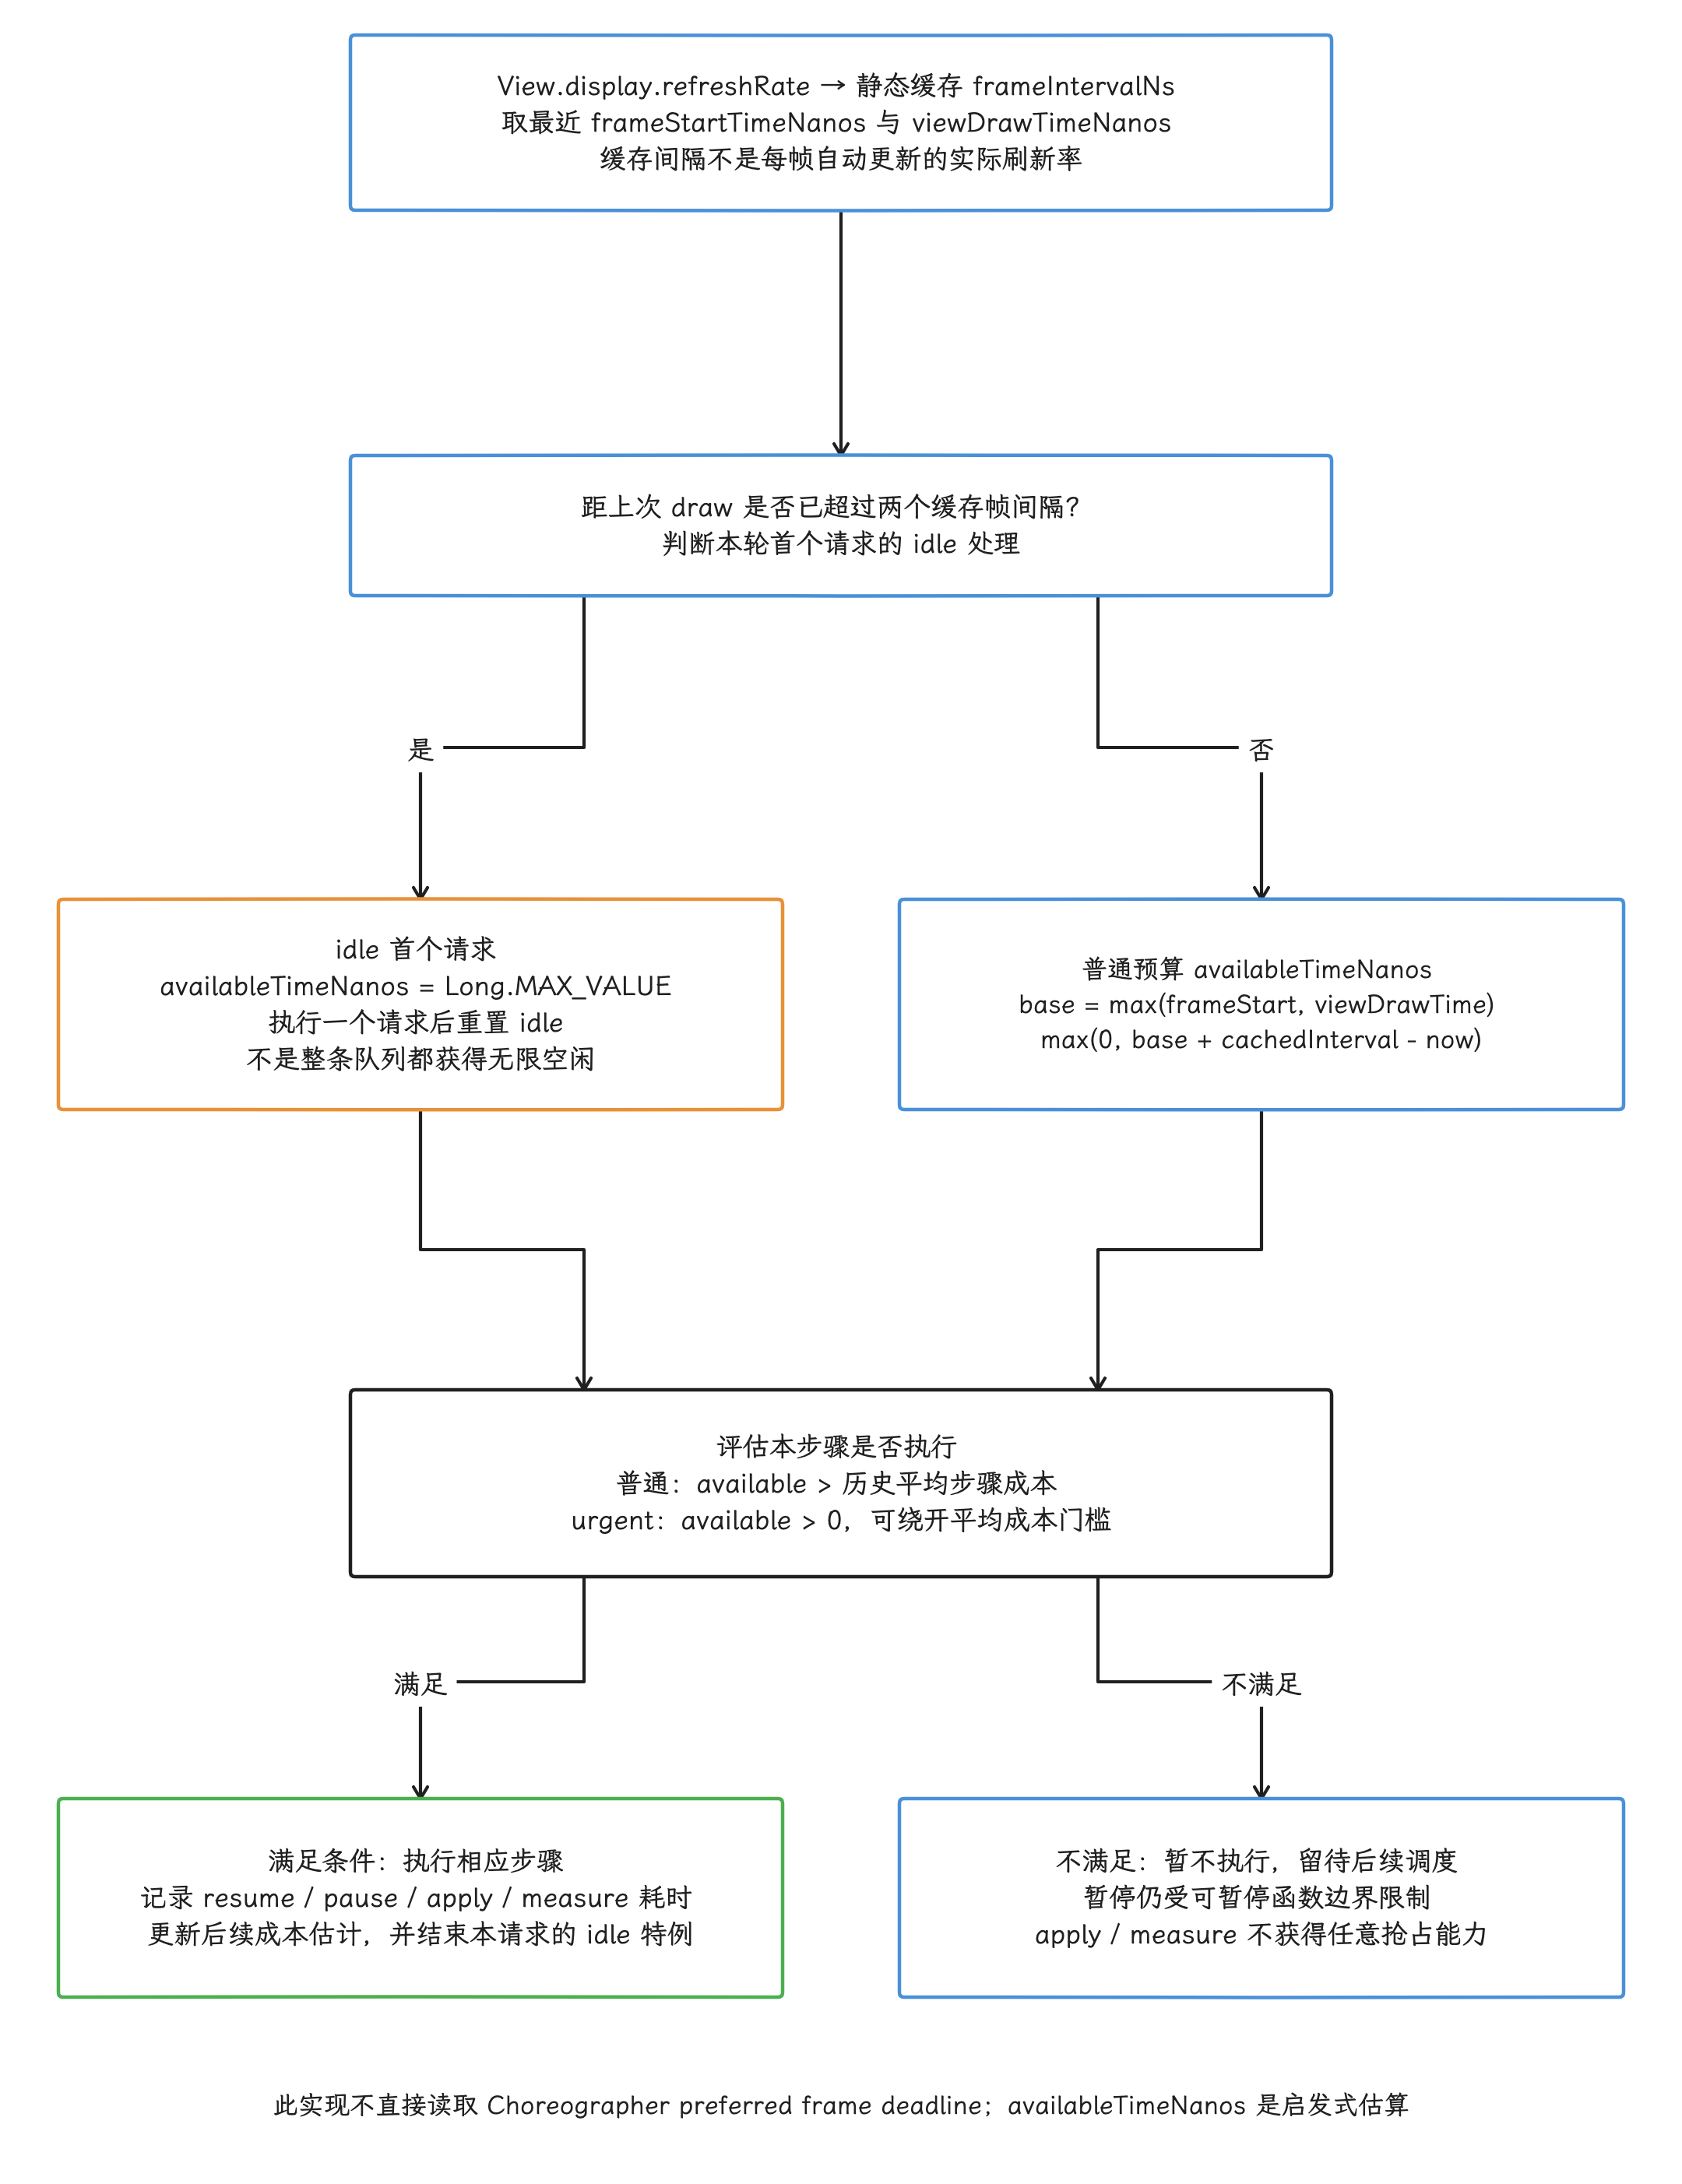
图:固定Foundation默认Android预取调度器:View.display.refreshRate估算并静态缓存frameIntervalNs,普通available=max(0,max(frameStartTimeNanos,viewDrawTimeNanos)+frameIntervalNs-now)。距上次draw超过两个缓存间隔时首个请求可按idle Long.MAX_VALUE,执行一个请求后重置idle。普通步骤要求可用时间超过历史平均成本,urgent只需正值。暂停边界与非分段步骤仍可超估算;这里不直接读取preferred frame deadline,也不是实时刷新率逐帧预算或硬时限。
这套调度没有直接读取 Choreographer.FrameData.getPreferredFrameTimeline().getDeadlineNanos()。因此,availableTimeNanos() 只是 Compose Foundation 当前实现对剩余时间的估算,不能当作 Android 12+ 提供的精确 frame deadline。
互操作:按 Surface 拓扑分类
AndroidView 或 ComposeView 只能说明 UI 框架如何嵌套,不能直接确定图形管线。还要确认四件事:谁生产 buffer、谁消费 buffer、是否新建 Surface,以及 SurfaceFlinger 中是否出现独立 layer。
| 场景 | 常见 Producer / Surface | 管线判断 |
|---|---|---|
Compose 中嵌普通 TextView、ImageView | 仍由 App Window HWUI Producer 生成窗口 buffer | 单一标准 App Window 路径 |
View 树中嵌普通 ComposeView | 仍由 App Window HWUI Producer 生成窗口 buffer | 单一标准 App Window 路径 |
AndroidView 内含 SurfaceView | 子内容通常有独立 BufferQueue / SurfaceControl layer | 多 Surface 混合路径 |
AndroidView 内含 TextureView | 独立 Producer 先写 SurfaceTexture,再作为纹理进入 App Window | Producer 独立,但常回到 App Window 合成 |
| 视频、相机、WebView 或厂商组件 | 取决于内部采用 SurfaceView、TextureView、SurfaceTexture 或软件绘制 | 必须用 dumpsys/trace 验证 |
AndroidView 的边界
AndroidViewHolder 把 Compose Constraints 转成 View MeasureSpec,按其适配规则测量传统 View,并在 Compose placement 中调用 View layout。普通 View invalidation 经 holder 传播到 Compose 绘制范围;内容会在宿主 draw 链中绘制。它不会天然创建独立 Surface,实际成本和显示对象仍取决于内部 View;嵌入 SurfaceView / TextureView 时要另查其 Producer。
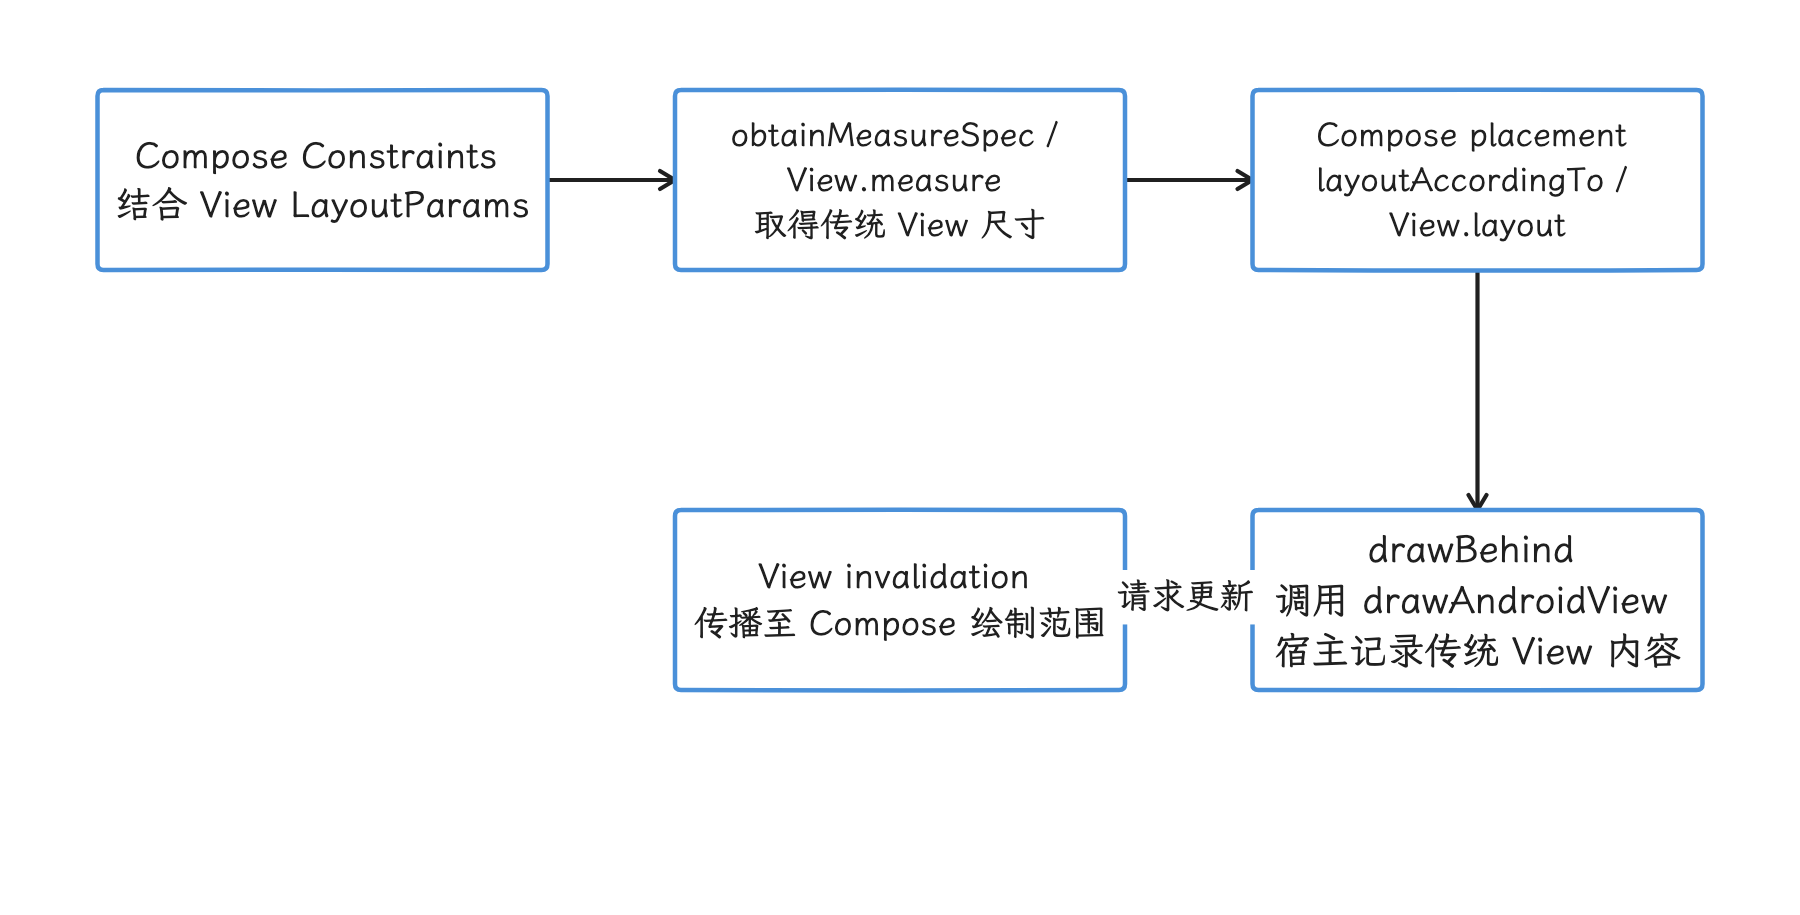
图:holder 连接两套布局协议,并把普通 View 的内容放回宿主 draw 链。 包装不天然创建 Surface;内部若含独立 Producer,需另查其生命周期和同步。
ComposeView 的边界
每个已创建内容的 ComposeView 都有自己的 composition root 与 AndroidComposeView 宿主,但 state 的所有权由应用决定。未显式指定 parent context 时,宿主会查找 View tree composition context,或取得可共享的 window Recomposer;重挂载、销毁和生命周期策略仍各自管理。多个 root 不等于多个隔离状态容器,也不保证每个 root 独占 Recomposer。
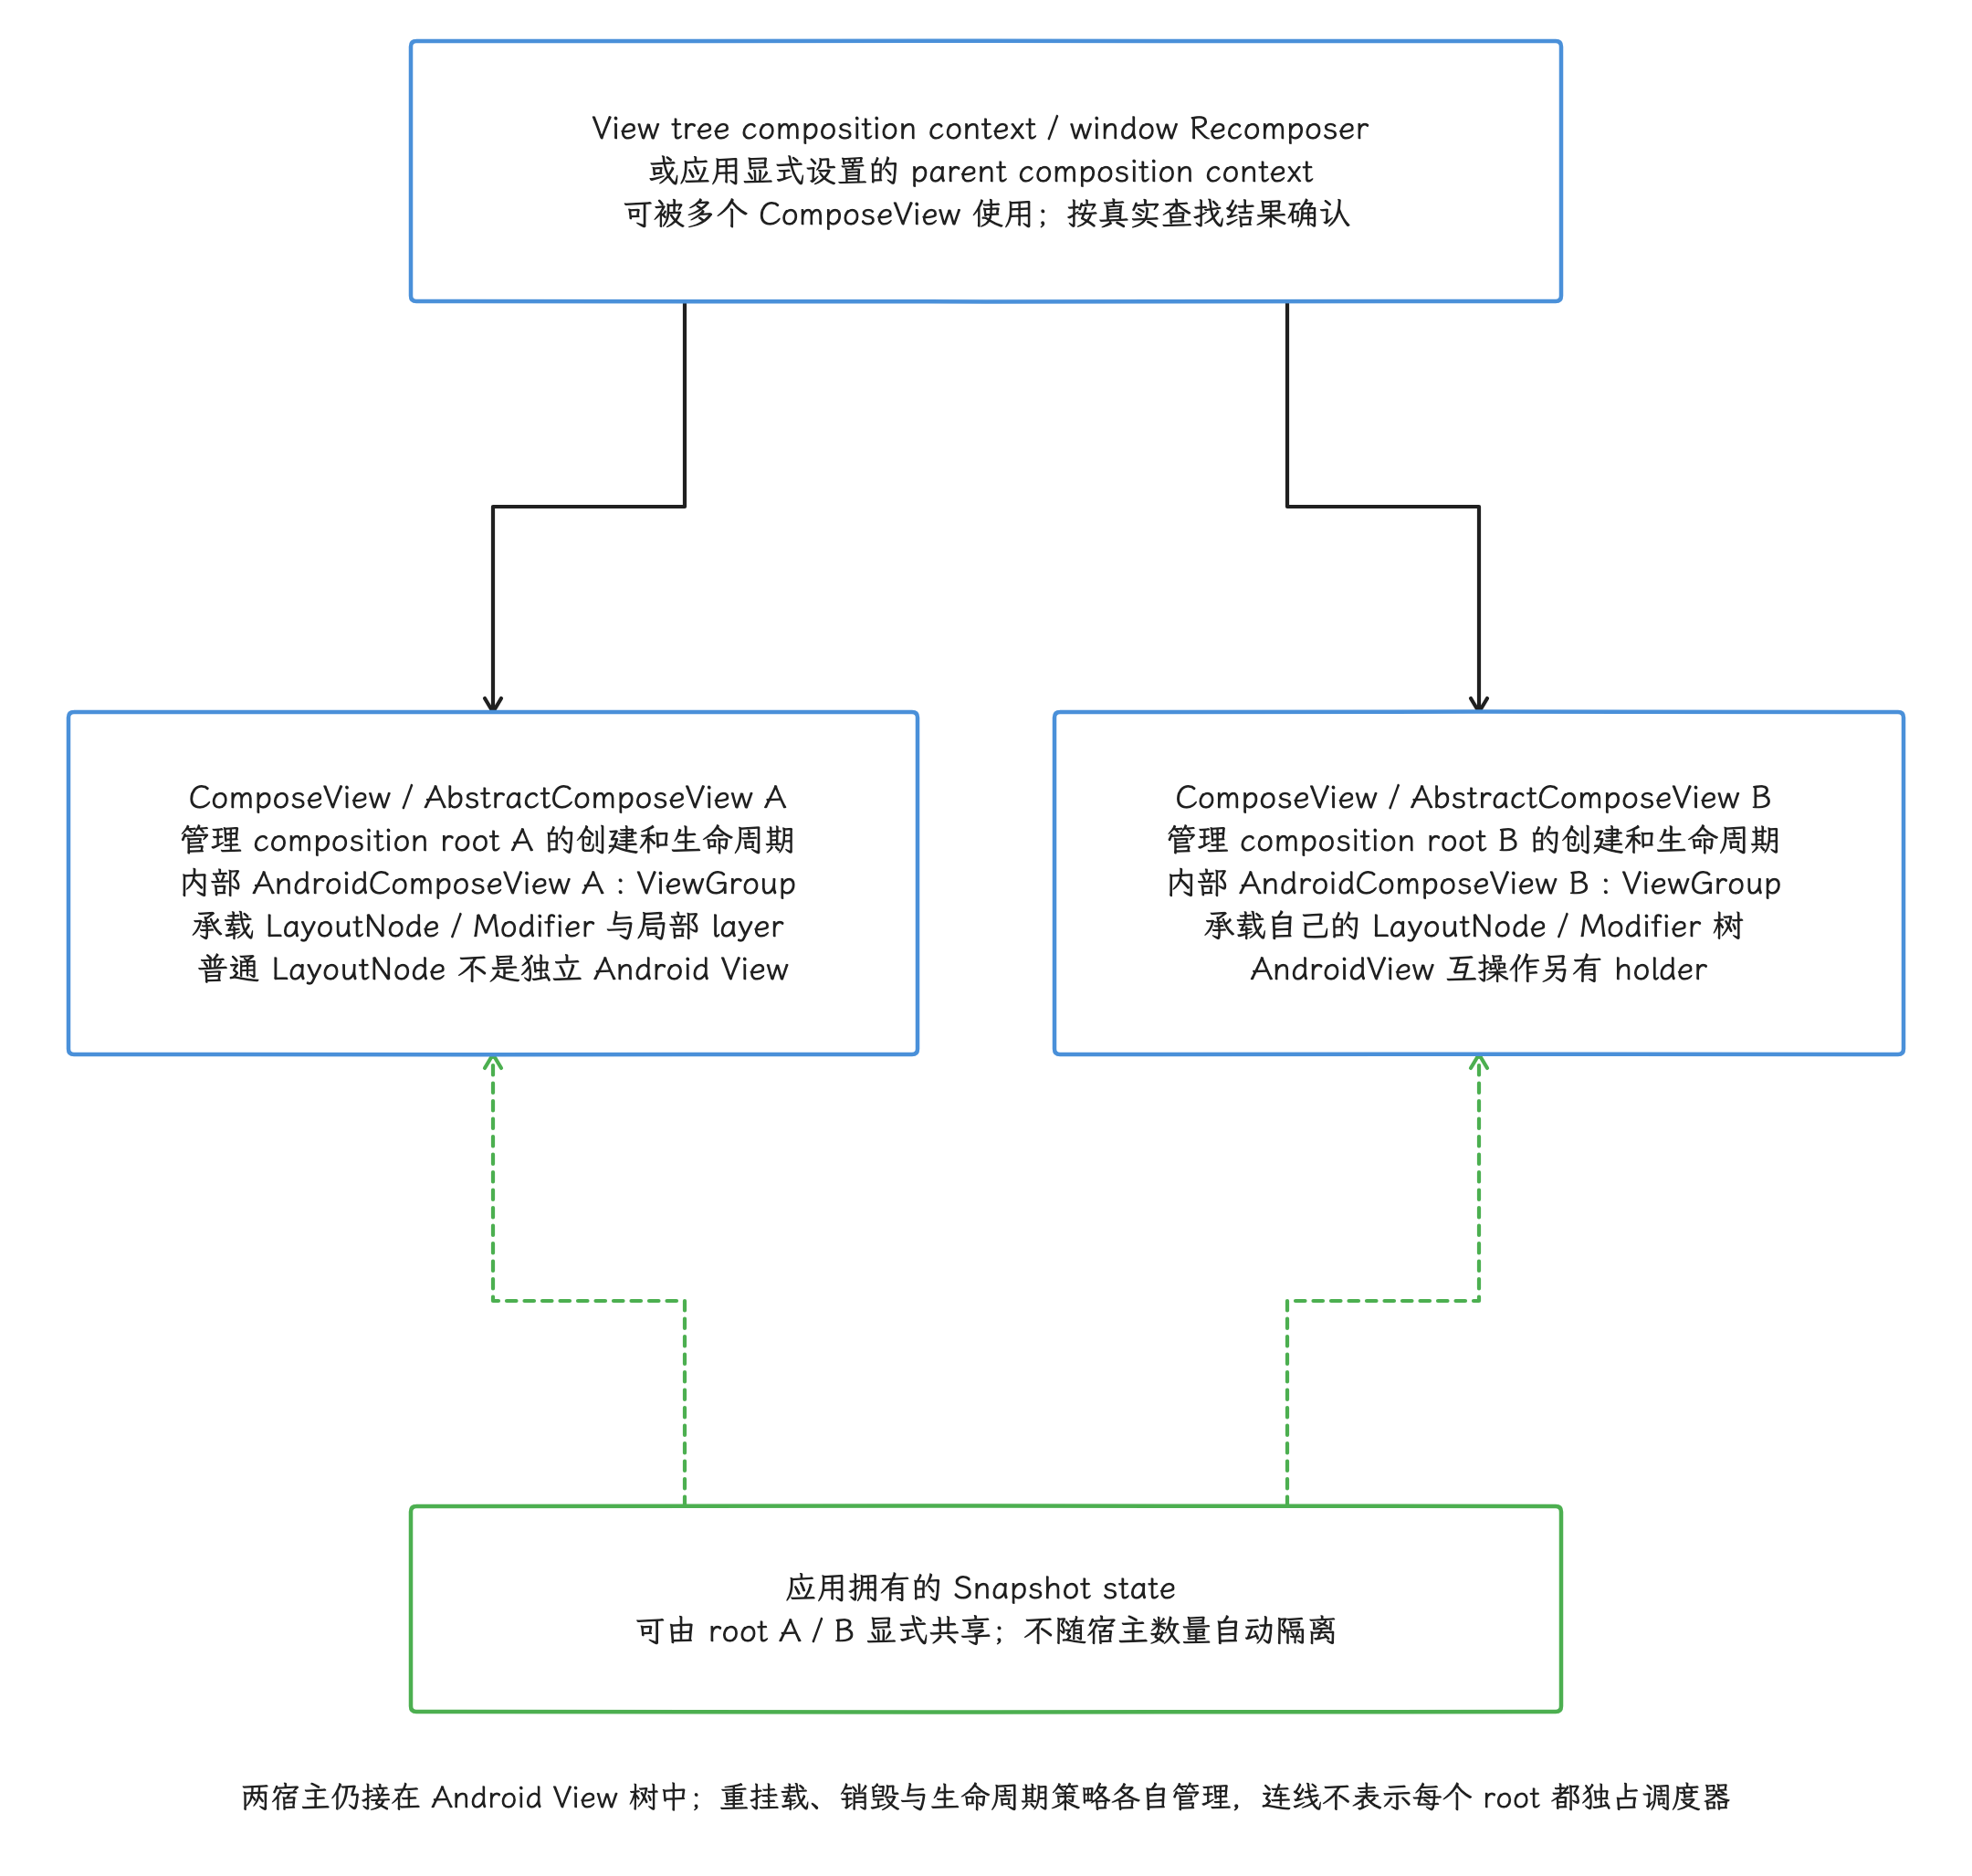
图:ComposeView/AbstractComposeView管理composition,内部AndroidComposeView作为ViewGroup承载LayoutNode/Modifier树,普通LayoutNode不是逐一AndroidView。不同ComposeView各有root/owner与生命周期;可查找View tree composition context或共享window Recomposer,也可显式设置parent context。应用state可被多个root显式共享;context/root数量不证明状态隔离或Recomposer独占。
混合动画不自动同步
Compose 与普通 View 往往共享主线程 Choreographer 和窗口 traversal,这只代表二者受同一窗口调度。内部若存在 SurfaceView、视频解码器或其他独立 Producer,各 Producer 的 dequeue、render、queue、fence 与 SurfaceFlinger latch 时序仍可能不同。必须逐个对象对齐 frame timeline,不能仅凭共用 Choreographer 就认定画面同步。
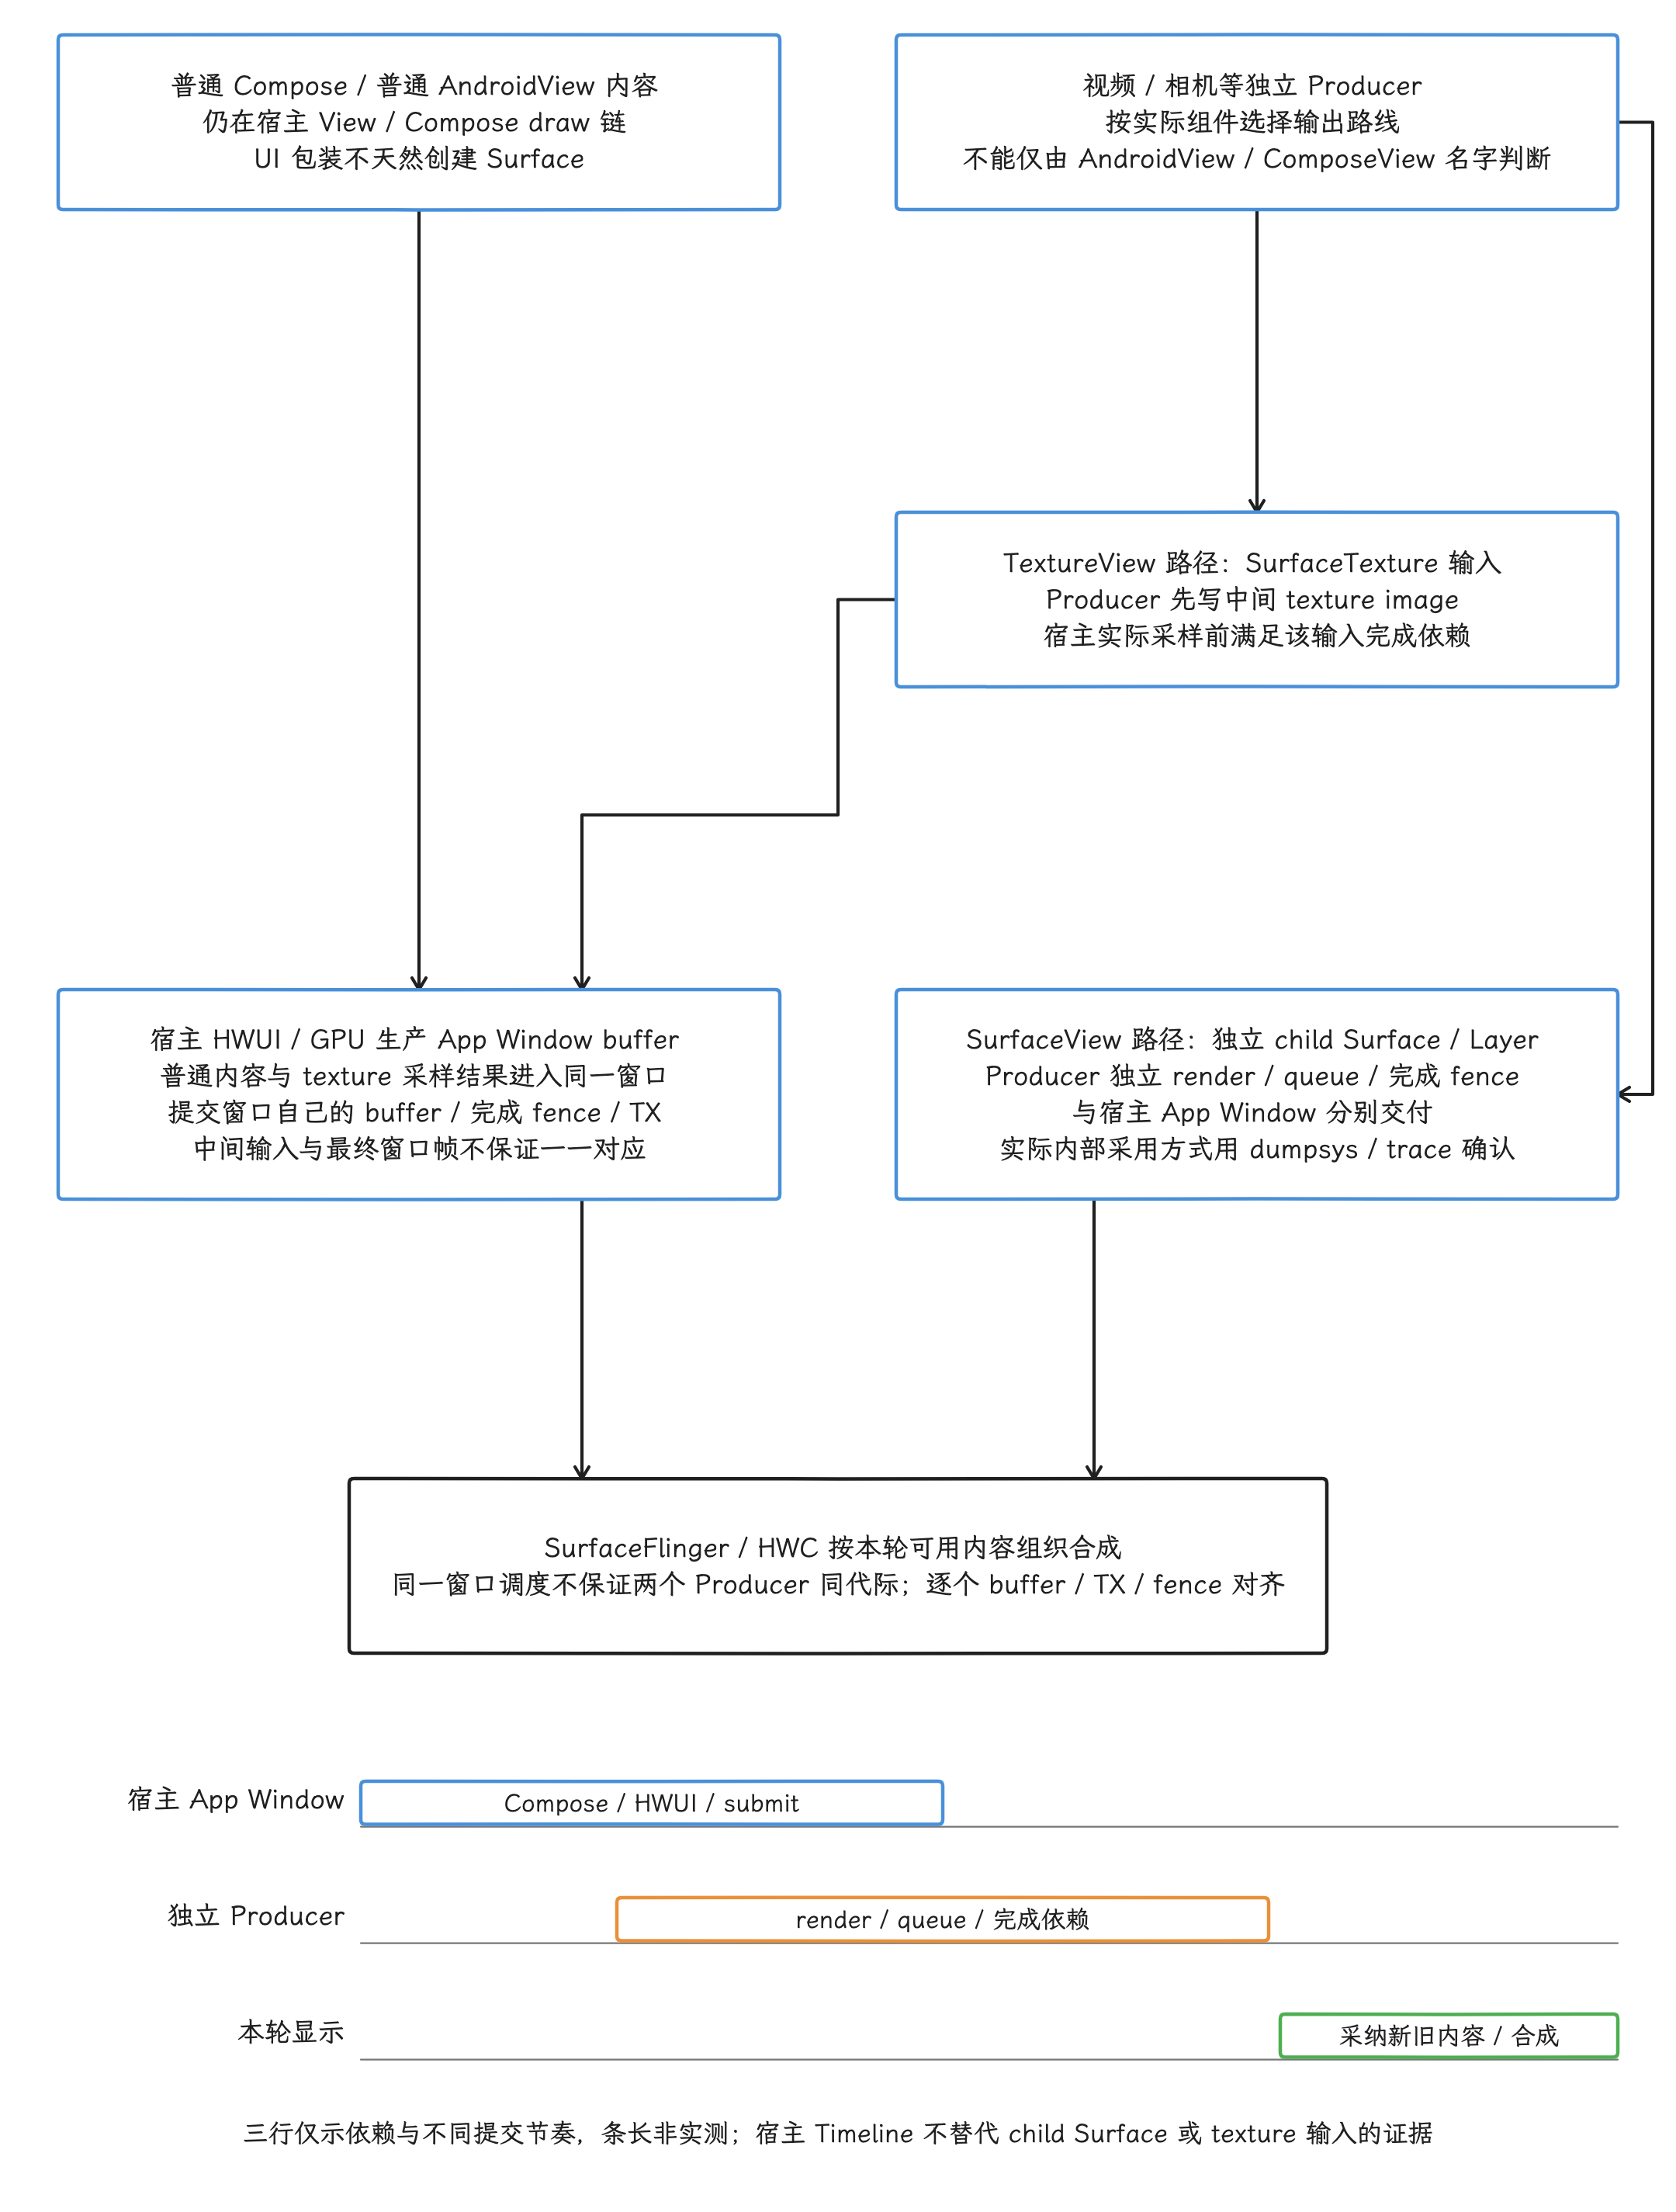
图:普通View/Compose通常由宿主HWUI共同生产App Window;AndroidView包装本身不新建Surface。独立Producer若用TextureView/SurfaceTexture,宿主满足输入依赖后采样并另产窗口buffer,输入通常不是独立显示Layer;若用SurfaceView,子内容有独立Surface/Layer与宿主分别提交。两条是按实际组件选择的路线,不表示同一输入自动双投递。即使共用Main/Choreographer,SF仍按本轮readiness与依赖选各Layer新旧内容,须用buffer/TX/fence取证,不能推画面自动同步。
FrameTimeline 中 SurfaceFrame 关联一个 Surface 的帧交付,DisplayFrame 关联显示侧合成与 present。先确认目标对象确实接入采集:官方 Perfetto 文档仍明确列出 SurfaceView 不在该页面描述的支持范围,不能把宿主 App Window 的 App Timeline 当作它的独立时间线;SurfaceTexture 输入同样需要单独取证。分析混合页面时,从异常 DisplayFrame 反向找宿主 BufferTX、独立 layer 的新旧 buffer 与 Texture 输入的采样依赖,覆盖不足就用 buffer / transaction / fence 补齐。
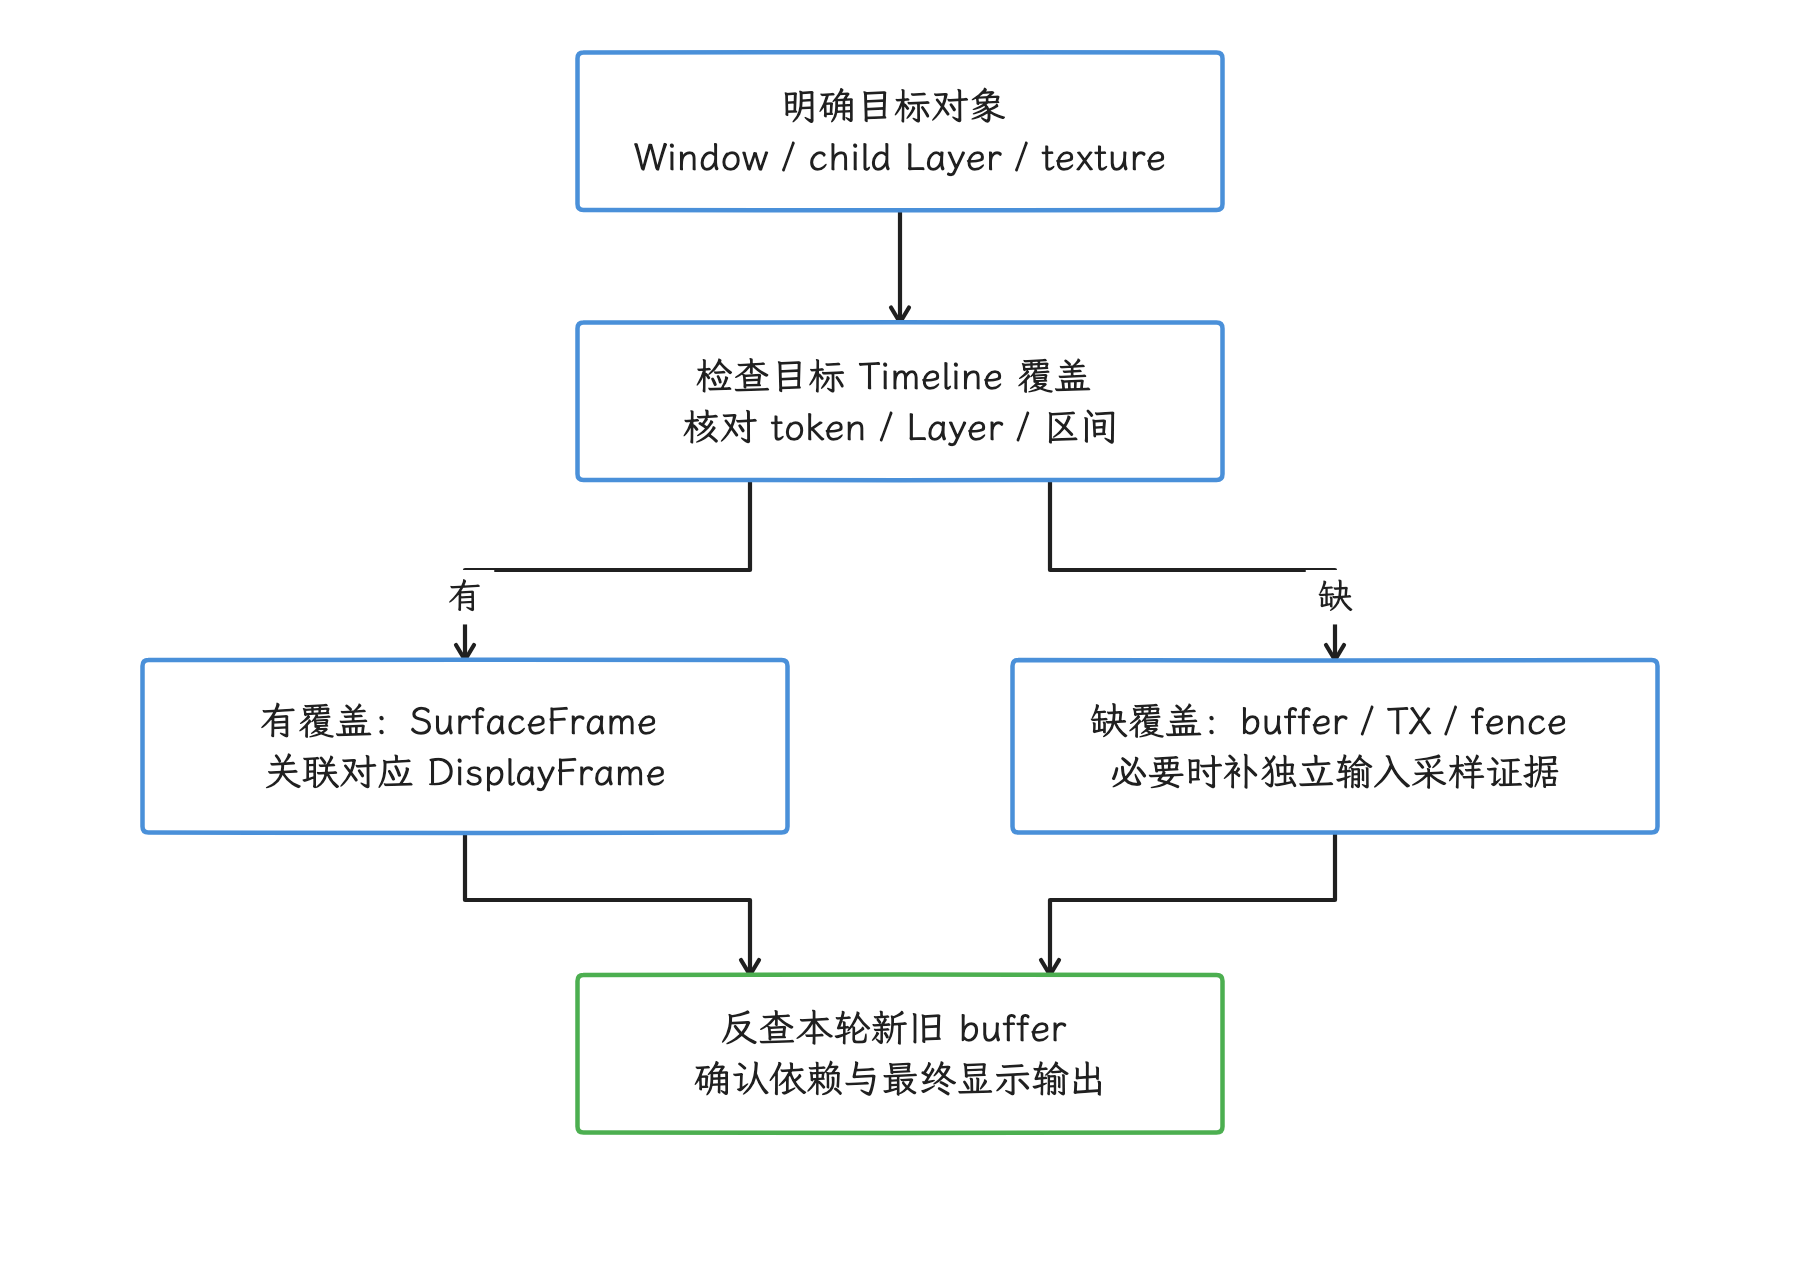
图:先确认目标 Surface 的采集覆盖,再按缺失部分补齐证据。 官方文档所述 FrameTimeline 暂不支持 SurfaceView;宿主 App Timeline 不能代替独立输入流。
用 Perfetto 定位慢帧
先确认看到的是哪一帧
从 FrameTimeline 的 expected/actual slice(期望帧与实际帧时间片)或目标 jank 帧出发,记录 frame token(关联同一帧的标识)、时间区间和刷新率。60 Hz 的名义间隔约为 16.67 ms,120 Hz 约为 8.33 ms,但应用实际可用的预算还受回调相位、deadline、buffer 压力与系统调度影响。不能把名义帧间隔机械分配成固定的 composition 5 ms、layout 8 ms、draw 3 ms。
再沿线程和队列取证
建议按下面顺序检查:
- Main thread:检查目标
Choreographer#doFrame内是否出现 composition、snapshot apply、measure/layout、display-list recording、GC、Binder 或业务代码。 - Compose scope:trace 若没有 composition 细节,确认匹配依赖基线的 runtime-tracing、编译器支持与采集配置。正式性能比较使用 non-debuggable / profileable 构建;终端采集还需配置相应 track_event 数据源。缺少 slice 只能说明未采到该事件,不能证明没有重组。
- RenderThread:检查
DrawFrame、tree sync、dequeueBuffer等等待,以及线程处于 runnable 却未获得 CPU 的调度空档。整段 RenderThread slice 不能都记为 GPU 时间。 - GPU / fences:有 GPU counters、GPU completion 或 fence 时,再判断复杂绘制 path、过度离屏、像素填充、纹理上传或频率限制。
- BufferQueue / SurfaceFlinger:对齐 queue、BufferTX、latch、composition 和 present,确认 App Window 是否错过目标 timeline。
- HWC:检查 layer 集合与 DEVICE/CLIENT 选择。DEVICE 表示 HWC 直接处理该 layer,CLIENT 表示先由 RenderEngine 合成。独立 Surface 过多、效果或格式限制都可能增加 CLIENT 合成。
- 内核:在
android17-6.18-2026-06_r6边界内查看 sched、cpuset、cpufreq、dma-buf 与 fence 等机制;这里能解释线程为何没运行或 fence 为何没到,不能解释哪个 composable 被重组。
按阶段选择优化手段
| 证据 | 优先检查 | 常见改法 |
|---|---|---|
| Recomposition 范围大 | 状态读取位置、参数稳定性、无效派生状态 | 缩小 state reader scope;只在输出变化频率低于输入时使用 derivedStateOf |
| 高频状态把 Composition 拉进来 | 动画/滚动值在函数体读取 | 能满足语义时,把读取移到 placement、draw 或 layer property lambda |
| Measure/Layout 重 | Intrinsics、Subcompose、Lazy 嵌套、自定义 MeasurePolicy | 减少重复 intrinsic 查询;降低布局层级;让 constraints 稳定;用 benchmark 验证 |
| Display-list recording 重 | 大范围 draw invalidation、复杂 path/text、所属 layer 过大 | 缩小绘制失效范围;缓存可复用计算;选择合适 layer 边界 |
| GPU 重 | Offscreen、blur、blend、overdraw(同一像素被重复绘制)、大纹理 | 降低中间 buffer 面积;减少高成本 effect;核对色彩/格式和纹理上传 |
| dequeue / queue 阻塞 | buffer 压力、消费者落后、独立 Producer 时序 | 沿 BufferQueue 和 fence 找等待方,避免只改 Compose 代码 |
| SurfaceFlinger / HWC 重 | Layer 数量、CLIENT 合成、显示侧 deadline | 调整 Surface 拓扑或效果;与设备合成能力一起验证 |
derivedStateOf 观察输入并缓存派生计算;下游读者最终按派生结果及其相等策略处理失效,本身仍有观察与计算成本。它适合输入高频变化、读者关心的输出低频变化的场景,例如由滚动位置得到“是否显示返回顶部”。它不会降低源 state 的写入频率;创建时通常还应 remember 合适实例,并用 benchmark 验证收益。
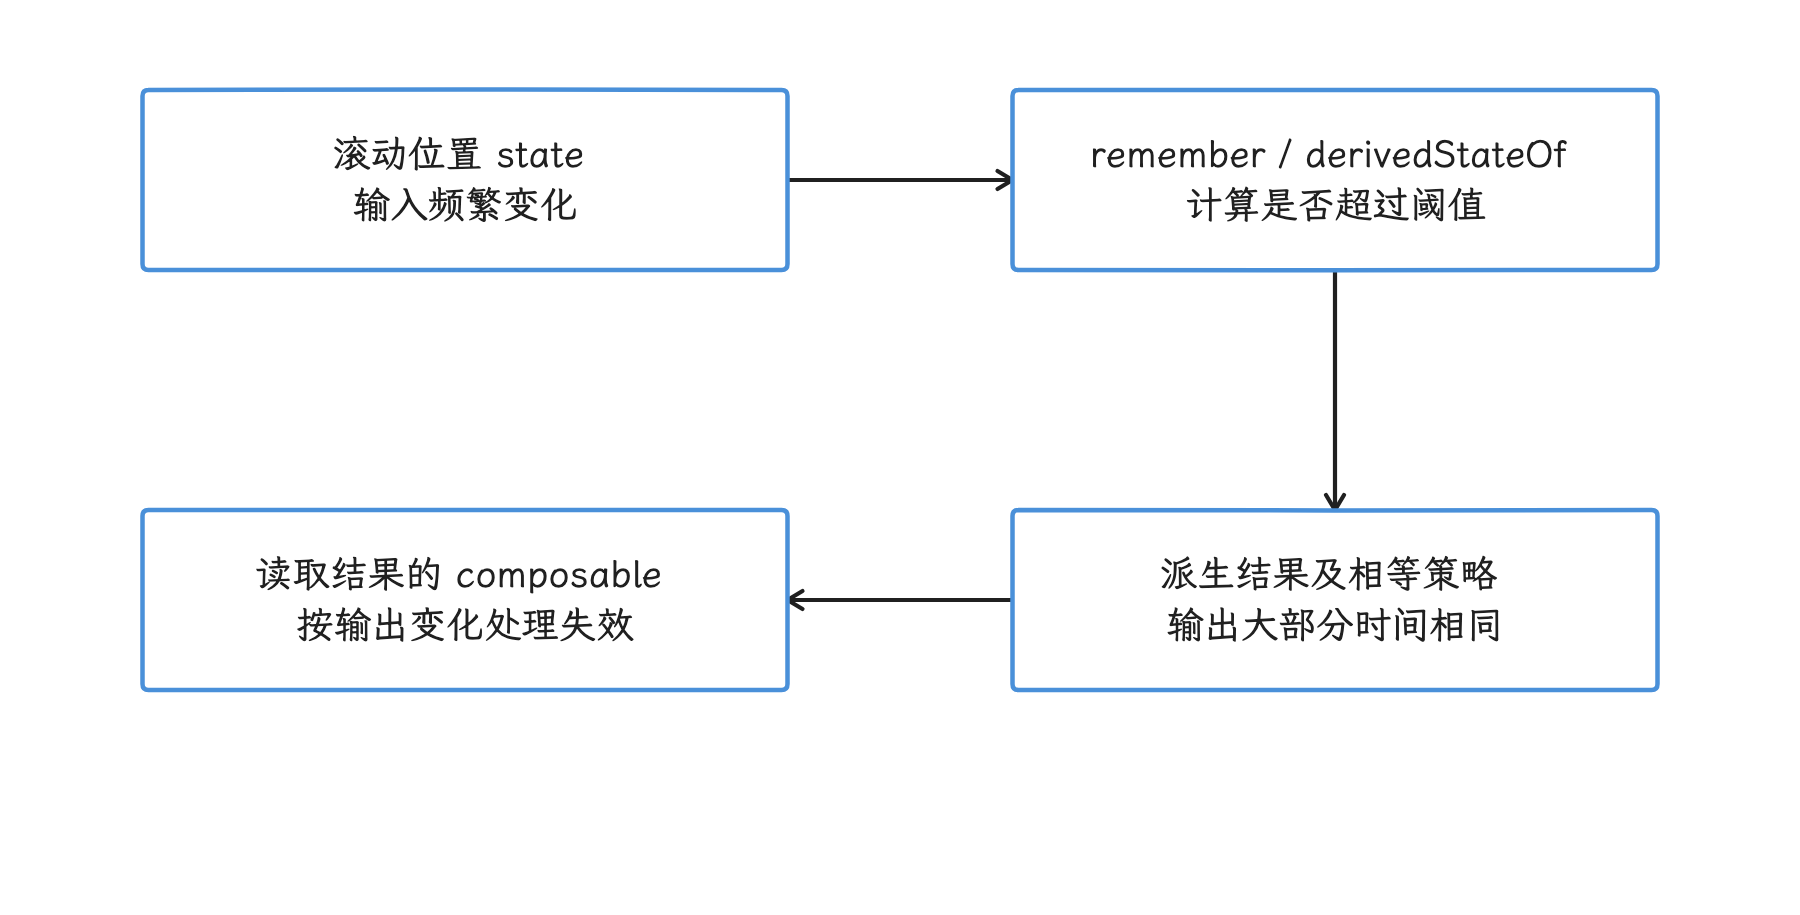
图:高频输入映射到低频派生结果,读者只关心输出语义的变化。 源 state 仍照常写入;派生观察和计算有成本,实例与相等策略要匹配用途。
版本演进:平台与 Compose 分开记
| 时间/版本 | 相关变化 |
|---|---|
| Compose 1.0(2021) | AndroidComposeView、LayoutNode、Snapshot 与基础硬件加速接入进入稳定版 |
| Runtime 1.8.0-alpha02(2024-09) | 加入实验性 PausableComposition,供可暂停的子 composition 使用 |
| Kotlin 2.0.20 | Strong Skipping 默认启用;这是编译器边界 |
| Foundation 1.10.6 | Lazy 预取的 PausableComposition flag 因稳定性问题暂时默认关闭 |
| Runtime 1.11.0 | 用于保存 composition group 与节点关联的新 SlotTable/link-buffer 内部实现仍处于实验阶段且默认关闭;旧实验性 concurrent recomposition API 已移除 |
| Compose 1.11.4 / BOM 2026.06.01 | Jetpack 基线;Foundation 源码中 Lazy PausableComposition 预取 flag 为 true |
| Android 17 / API 37 | 平台上限;标准 App Window 仍走 ViewRoot/HWUI/RenderThread/SurfaceFlinger |
Android 17 同期可用的 Compose 版本不是系统内置版本。Compose Runtime/UI/Foundation 由应用依赖决定,同一台 Android 17 设备可以运行由不同 Compose 版本构建的应用。
常见误区
“每个 Composable 都对应一个 RenderNode”
Composable 对应函数调用与 composition group,LayoutNode 是 UI 节点,RenderNode/GraphicsLayer 是绘制复用边界,三者没有一一对应关系。普通 LayoutNode 的绘制内容通常录入最近的所属 layer。
“Compose 的 FrameCallback 会直接 measure、layout、draw”
AndroidUiFrameClock / AndroidUiDispatcher 执行等待帧的 onFrame,默认窗口布局与绘制由 traversal 接入:按需 onMeasure / onLayout,接着 ThreadedRenderer.draw 更新 display list(期间可能进入 dispatchDraw),最后 syncAndDrawFrame。并非先完成 dispatchDraw 再进入 ThreadedRenderer.draw;SubcomposeLayout 的 measure-time composition 也须另看。
“graphicsLayer 一定创建离屏纹理”
graphicsLayer 建立 layer 边界。平移、缩放、旋转等属性通常可以由 RenderNode 处理;Offscreen 策略、特定 alpha 语义、RenderEffect、BlendMode 或 ColorFilter 才可能需要中间 buffer。
“RenderThread slice 就是 GPU 时长”
RenderThread 负责准备和提交 GPU 工作,也可能等待 buffer 或 fence。GPU 可以异步执行,实际执行时长必须结合 GPU completion、counter 或 fence 判断。
“queueBuffer 代表已经上屏”
queue 之后仍有 SurfaceFlinger latch、合成决策、HWC/RenderEngine 工作与 present。看到 queue 只能证明 Producer 已交付 buffer。
“多个 ComposeView 的状态天然隔离”
不同 composition root 仍可显式共享 state,也可能使用同一个 Recomposer。判断隔离边界时,需要查看 parent composition context、window Recomposer 和业务状态所有权。
“PausableComposition 会降低 GPU 工作量”
它主要安排 Lazy 预取子 composition 的执行时机。draw 和 GPU 工作是否减少,取决于最终进入屏幕的内容与绘制方式。
源码核对索引
下表列出关键结论及其固定版本源码。新增的观察与调度细节同时可查:AndroidUiDispatcher、Recomposer、NodeCoordinator、SnapshotStateObserver 与 DerivedState。
| 结论 | 基线源码 |
|---|---|
| 一次性 frame callback | Compose UI 1.11.4 AndroidUiFrameClock.android.kt |
| AndroidComposeView 的 measure/layout/draw 接缝 | Compose UI 1.11.4 AndroidComposeView.android.kt |
| Android 17 主 graphics layer | Compose UI 1.11.4 GraphicsLayerOwnerLayer.android.kt;UI Graphics 1.11.4 GraphicsLayerV29.android.kt |
| offscreen 策略 | Compose UI Graphics 1.11.4 GraphicsLayer.kt 与 CompositingStrategy.kt |
| PausableComposition 契约 | Compose Runtime 1.11.4 PausableComposition.kt |
| Lazy 预取 flag 与分段执行 | Compose Foundation 1.11.4 ComposeFoundationFlags.kt、LazyLayoutPrefetchState.kt 与 PrefetchScheduler.android.kt |
| ViewRoot 到 HWUI 提交 | AOSP Android 17 ViewRootImpl.java、ThreadedRenderer.java 与 HardwareRenderer.java |
| RenderThread 到窗口 buffer | AOSP Android 17 DrawFrameTask.cpp、CanvasContext.cpp 与 BLASTBufferQueue.cpp |
| SurfaceFlinger 与 HWC | AOSP Android 17 SurfaceFlinger FrontEnd 与 HWComposer.cpp |
| 内核机制边界 | ACK android17-6.18-2026-06_r6 sched/core.c、dma-buf.c 与 sync_file.c |
Compose 版本可在 Android Developers 的 Compose BOM 页面、BOM 映射表 与 Compose Runtime release notes 交叉核对。平台源码以 android-17.0.0_r1 固定标签为准,不使用持续变化的开发分支代替。
总结
Compose 渲染性能的排查先分成两块职责:Compose 负责内容生成,Android 图形栈负责窗口合成;落到具体动作,再拆成三层:
- Compose 层:Snapshot 失效范围、Recomposition、Layout、Drawing、GraphicsLayer 与 Lazy 预取;
- App Window 层:ViewRoot traversal、UI display-list recording、RenderThread、Skia/GPU 与 BLAST BufferQueue;
- 系统合成层:SurfaceFlinger latch、LayerSnapshot、HWC/RenderEngine 和 present。
普通 Compose 页面仍通过标准 App Window 生产 buffer。Compose 决定窗口内容如何生成;独立 Surface、GPU fence、SurfaceFlinger 合成与显示时序则要沿 Android 图形栈取证。只有把阶段、线程、buffer 和 present timeline 放在同一时间轴上,才能判断慢帧发生在 recomposition、布局、display-list recording、GPU、队列还是系统合成。