ANR 与 Kernel Trace 联合诊断
ANR trace(线程转储) 记录超时附近的线程栈,Kernel Trace 补充 CPU 调度、锁、I/O 和内存压力。两类证据要对齐到同一个时间窗口,我们才能区分线程主动执行、可运行未调度和不可中断等待。
源码基线:AOSP
android-17.0.0_r1;Android Common Kernelandroid17-6.18-2026-06_r6。
现场保护、线程栈与责任链
先建立证据模型
ANR 的判定信息本身很薄:系统认定某项关键响应超过了期限,仅此而已。超时发生在哪一行代码、保存下来的线程栈还停在出事的路径上吗,都要靠我们把多个时间点、多个系统层级的证据拼起来,还原整个超时窗口内发生的事情。
历史设备仍可能生成名为 traces.txt 的文件;StackTracesDumpHelper 则在 /data/anr/ 下创建以 anr_ 开头的文件。下文用“ANR trace”统称这些 thread dump(线程转储)文件。
一份可靠结论通常要回答五个问题:
- 哪个检测器判定了超时:输入、广播、Service、ContentProvider、Job 等类型的期限和触发点不同。
- 目标进程在采样时停在哪里:ANR trace 提供线程栈、锁等待和部分进程状态。
- 主线程在期限内经历了什么:Perfetto、系统事件和业务埋点提供连续时间线。
- 系统当时能否及时调度它:CPU 调度、频率、内存和 I/O 压力会影响代码从开始到结束的 wall time(墙上时钟时间)。
- 采集晚了多久、缺了哪些进程:采样延迟和 dump 范围决定结论能有多大把握。
nativePollOnce、高 Load、某个 D 状态,每一条都只是线索。我们把这些线索和调用链、时间线、资源证据对应起来之后,责任才能落定;所以报告先记事实,再写这些事实支持或排除哪些解释,最后才把某项解释升级成根因。
ANR trace 是怎样生成的
“系统向进程发送 SIGQUIT,ART 写出 traces.txt”——这句流传很广的描述来自旧版本。当前主路径由 system_server 创建 ANR 文件,再通过 Debug.dumpJavaBacktraceToFileTimeout() 或 native backtrace 接口,请求 tombstoned/debuggerd(负责进程转储的系统组件) 写入;ProcessErrorStateRecord 直接向目标进程发送 SIGQUIT 信号的路径,只在 trace 文件创建失败等降级场景才会走到。
StackTracesDumpHelper 为正式多进程 dump 设置默认 20 秒的共享预算,native dump 默认上限为 2 秒;这些值都会乘以 HW timeout multiplier(硬件超时倍数)。它是控制采集成本的预算,不是整条 ANR 处理严格不超过 20 秒的保证:独立 early dump 默认最多 10 秒;Java dump 失败后补做 native dump 还可能额外消耗时间,CPU/DropBox 等处理也在这笔预算之外。文件可能按顺序包含:
Subject、超时起止时间、额外诊断头和 CriticalEventLog;firstPids中优先采集的各进程线程栈;- 条件允许时的
nativePids; ProcessCpuTracker根据 CPU 活动选出的extraPids;- 目标进程第一段 dump 之后附加的
AnrLatencyTracker延迟数据。
所以拿到文件后,我们要逐段确认:文件头之后未必紧跟 PID 段;超时、进程退出、权限问题或整轮预算耗尽,都可能留下失败标记或截断结果,文件读到结尾,也还要确认每个候选进程是否都成功完成了 dump。
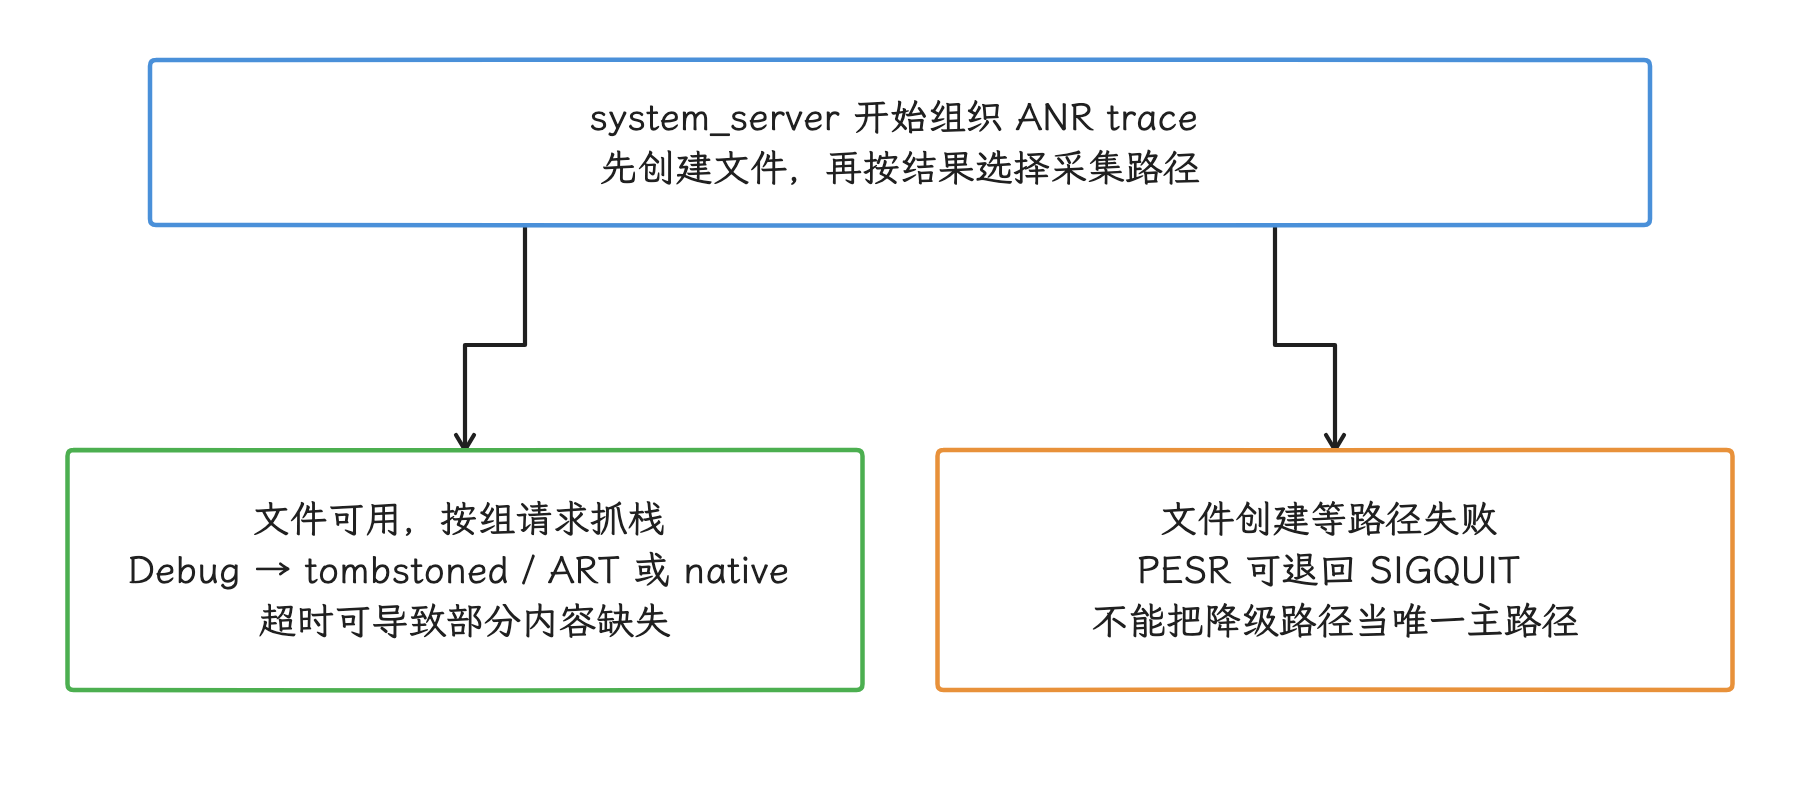
图:正式循环有共享预算,early dump 与 fallback 另有成本;文件存在,也说明不了全部候选进程都抓取成功。
dump 的进程范围
ProcessErrorStateRecord.appNotResponding() 会构造三组候选:
firstPids以 ANR 目标进程开头,还可以包含其 parent(父进程)、system_server、persistent(常驻) 进程,以及服务状态被标为treatLikeActivity的进程(源码注释把它视作可能的输入法);lastPids收集剩余的 LRU(最近最少使用顺序) Java 进程,随后由ProcessCpuTracker根据本轮 CPU 活动挑选额外进程;nativePids来自NATIVE_STACKS_OF_INTEREST(系统关心的原生进程清单),并受调用方、进程类型和系统配置限制。
这份清单按本轮采集候选规则圈定,某个进程出现在文件里,说明的也只是它符合规则。要确认 Binder 因果关系,我们还要用事务 flow(因果连线)、双方调用栈、transaction log 或对端业务日志。
后台 silent ANR(不显示对话框的后台 ANR)、系统启动早期和报告排队过久等场景都会缩小采集范围:AnrHelper 在 ANR 报告进入处理队列后等待超过 10 秒时,会把报告视为已经积压,启用 onlyDumpSelf(只转储目标进程),只采集被归因进程;系统启动后的前 10 分钟也使用相同策略。这个 10 秒度量的是“报告在 system_server 队列中等了多久”,线程栈是否可信要另行判断。
应用能回捞到哪一段
AppExitInfoTracker 保存 ANR trace 时,只复制从文件开头到目标进程第一段结束位置的区间,再压缩。应用经 ApplicationExitInfo.getTraceInputStream() 读到的就是这个子集,system_server、native daemon(原生守护进程) 和额外热点进程可能已经被截掉;文件也可能已被覆盖、清理或没有保存成功,所以 API 允许返回 null。
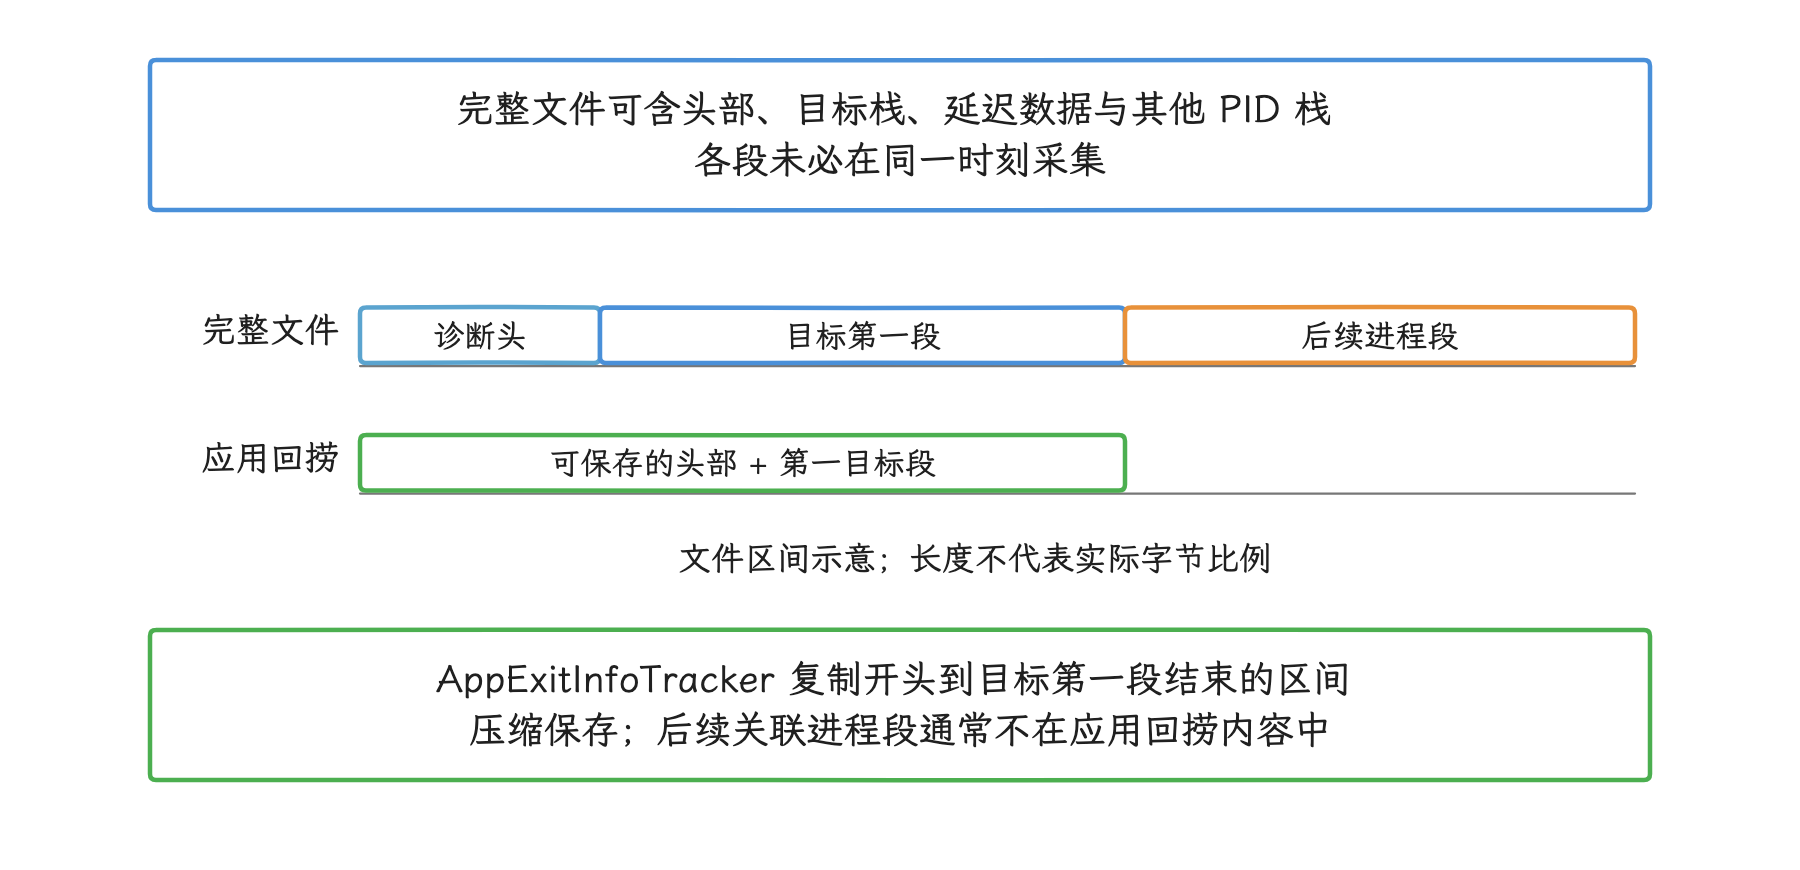
图:这是文件区间示意;保存失败、清理或覆盖会导致 getTraceInputStream 返回 null。
阅读 ANR trace
从文件头部定位问题
拿到文件先看头部。我们把 Subject、Reason、Timeout、进程名、PID、时间戳和触发组件记下来:输入分发与广播超时即使留下相似的主线程栈,分析窗口和责任链也不同。头部若包含 TimeoutStart,它在这条 timer 路径上是 MONOTONIC/uptime 系的毫秒起点;需要先换算单位,并按 trace 的 clock snapshot 处理与 Trace Processor 时间基准的偏移,跨休眠时尤其要先换算、后相减,再用它辅助定位受监控窗口;目标构建缺少该字段时,就改用 am_anr、bugreport 时间戳和业务日志,建立带误差范围的时间区间。
随后我们确认文件是否完整:
- 目标 PID 的
----- pid ... at ... -----与----- end ... -----是否成对; - 是否出现 dump timeout、process exited、copy failed 等错误;
- 目标进程是不是第一段;
- 多个进程段落是否属于同一次 ANR,避免把追加内容或相邻事件误合并成一组。
主线程栈与采样瞬间
下面的片段展示 Looper 在采样时正通过 epoll 等待下一条消息的典型堆栈:
"main" prio=5 tid=1 Native
  | sysTid=5991 nice=-10 cgrp=default sched=0/0
  | state=S schedstat=( 807053249 267562324 1494 )
  native: #00 pc ... libc.so (__epoll_pwait+...)
  native: #01 pc ... libutils.so (Looper::pollInner+...)
  native: #02 pc ... libutils.so (Looper::pollOnce+...)
  at android.os.MessageQueue.nativePollOnce(Native method)
  at android.os.MessageQueue.next(MessageQueue.java:...)
  at android.os.Looper.loopOnce(Looper.java:...)
  at android.os.Looper.loop(Looper.java:...)
  at android.app.ActivityThread.main(ActivityThread.java:...)
这份栈说明的只是 dump 那一刻主线程在等下一条消息。超时窗口里发生过什么,要回到时间线上看:上一条消息可能刚刚执行完,ANR 检测器等的也可能是窗口焦点、广播的异步完成信号、Service 工作或另一个进程。这时我们在 Perfetto 里找到采样点,再向前看完整超时窗口。
反过来,主线程停在业务方法里,同样是采样瞬间的一幕。要认定责任,还要知道这次调用何时进入、持续多久、是否覆盖了对应 ANR 的期限。
区分三类“状态”
同一线程段落里可能同时出现 ART 状态、Linux 调度状态和 Java 栈语义:
| 证据 | 示例 | 可得出的结论 |
|---|---|---|
| ART 线程状态 | Blocked、Waiting、TimedWaiting、Native、Runnable | ART 维护的运行时状态;它与 Linux 是否正在使用 CPU 是不同维度 |
| Linux 状态 | state=R/S/D | 内核在采样点看到的 task state(任务状态) |
| Java/native 栈 | Object.wait、futex_wait、nativePollOnce | 当前调用路径或正在使用的等待机制 |
ART 状态 Native 表示线程正在原生代码中,至于有没有在消耗 CPU,要回到调度轨迹上确认——主线程在 epoll 中等待消息时,显示的同样是 Native。sCount 度量的是当前挂起的 suspend count(暂停请求计数);线程历史上被 GC 或调试器暂停过几次,这个字段里查不到。
6.18 内核里,D 对应 TASK_UNINTERRUPTIBLE 一类不可中断等待,I/O、direct reclaim(线程同步参与内存回收)、驱动 completion、内核锁等待等路径都可能落到这一状态;状态字母本身不带等待原因,归因要靠后面的内核轨迹。
普通 futex(快速用户态互斥锁) 等待在该内核源码中设置为 TASK_INTERRUPTIBLE|TASK_FREEZABLE,通常按 S 等待分析。所以要把 D-state 归到用户态锁头上,光有 futex_wait 还不够。
Freezer 还有独立的 TASK_FROZEN 状态;cgroup v2 通过 cgroup.freeze 请求冻结,并在完成后将 cgroup.events 中的 frozen 更新为 1。只有冻结控制状态、freeze/unfreeze 事件和调度证据能够相互对应时,才能把停顿归因给 freezer。
沿锁地址建立等待图
下面的片段展示怎样通过同一个对象地址,将 Java monitor(synchronized 使用的对象锁)的等待者与持有者关联起来:
"main" prio=5 tid=1 Blocked
  at com.example.cache.DiskCache.read(DiskCache.kt:84)
  - waiting to lock <0x0e57c91f> (a java.lang.Object)
    held by thread 89

"CacheWriter" prio=5 tid=89 Native
  at java.io.FileDescriptor.sync(Native method)
  at com.example.cache.DiskCache.flush(DiskCache.kt:146)
  - locked <0x0e57c91f> (a java.lang.Object)
对象地址 <0x0e57c91f> 把两段栈连成一条等待边:主线程在等 CacheWriter,后者持着锁做同步写盘。我们顺着这条边往下追:若 CacheWriter 又在等主线程手里的另一把锁,并在同一时段确认双方互持、互等、没有可打破等待的路径,这类 monitor 死锁就坐实了;等待环没有闭合时,先把当前已观察到的等待边确认下来——可能是锁竞争、长临界区,也可能只是其他线程或进程的栈还缺着。修复方向也随之清楚:缩短持锁范围、把 I/O 移出临界区,或统一多把锁的获取顺序。
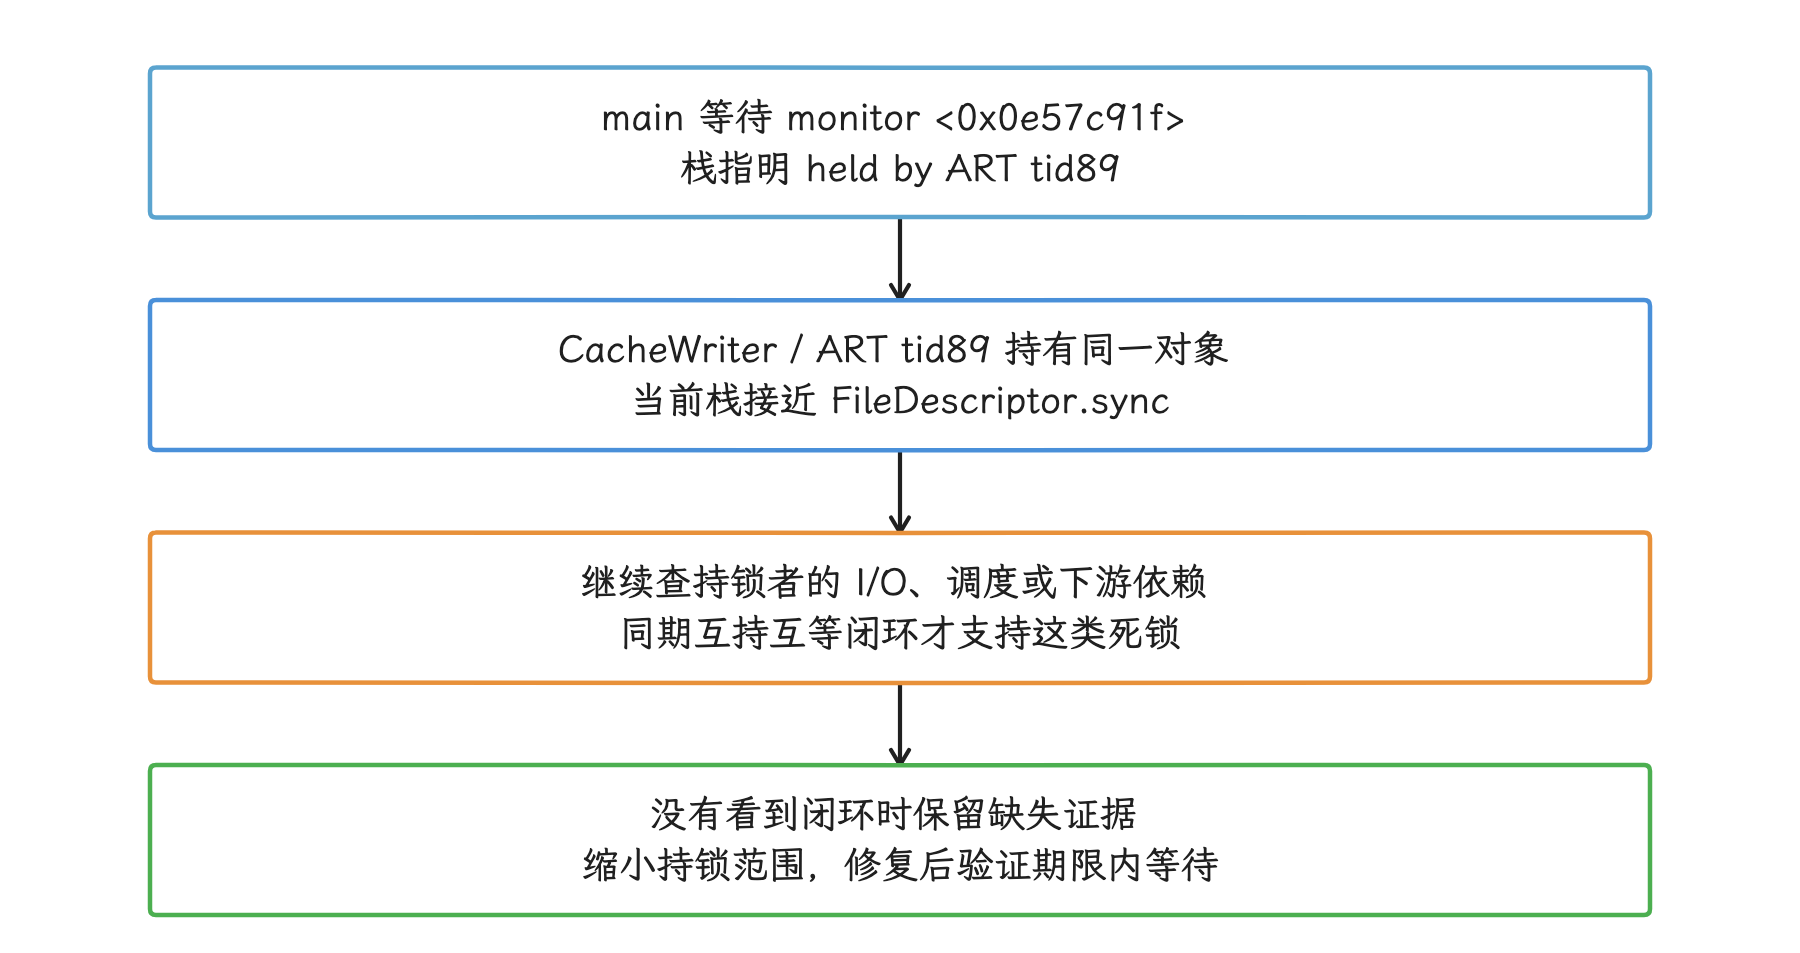
图:地址只用于同一转储的关联;单向等待也可能是未采完整的等待链,死锁、漏唤醒此时还排除不掉。
tid=89 这类编号只在所属工具内有效:ART 的 tid 是 ART 内部线程编号,Linux 的 sysTid 是内核线程 ID,Perfetto 的 TID 对应 Linux 线程;在 ANR trace 内按 ART tid 找持锁者,切换到 Perfetto 时要使用 sysTid。
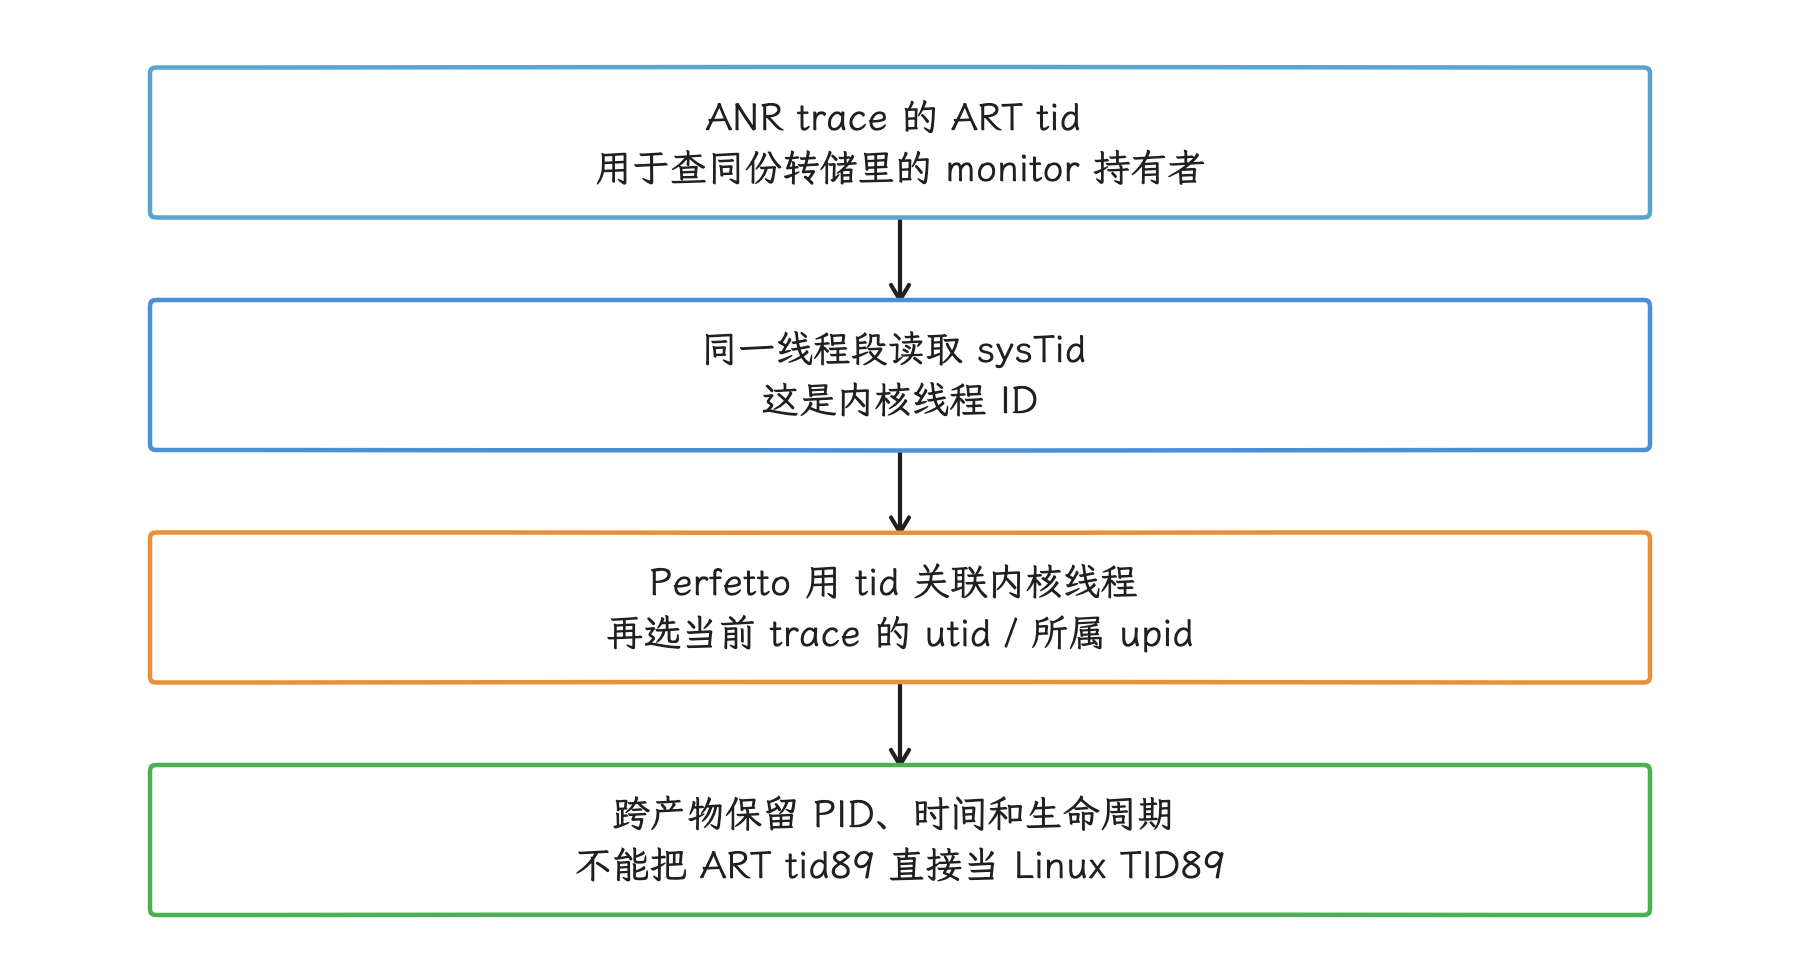
图:utid/upid 只在当前 trace 内有效;同名线程与 PID/TID 复用要分别处理。
识别 Binder 等待
主线程执行同步 Binder 调用时,堆栈常落在 android.os.BinderProxy.transactNative()、IPCThreadState::transact() 或 IPCThreadState::waitForResponse() 附近。binder_thread_read 则常见于 Binder 工作线程等待新事务;单看这个函数,还定不了线程是否在等某个已发出调用的返回,要结合调用方的栈和时间线确认。
Binder 分析应闭合四段证据:
- 调用方主线程的 Java 接口和 transaction code(AIDL 方法对应的事务编号);
- Binder transaction 的来源/目标 TID、PID 和时序;
- 对端 Binder 线程从收到事务到发送回复的运行、等待和嵌套调用;
- 回复到达后调用方何时重新获得 CPU。
对端耗时可能来自 Binder 线程池排队、对端锁竞争、磁盘 I/O,或再次同步调用第三方进程;也可能服务端已经回复,但调用方长期处于 Runnable,迟迟没有重新运行。这几种原因对应不同的修复方向,报告里要逐一拆开,“Binder 慢”三个字只够当现象记。
用采集延迟校准线程栈
栈是采样来的,采样和触发之间隔了多久,直接决定栈里还剩多少现场——AnrLatencyTracker 就是量化这个间隔的。它为 ANR 处理过程写入 Perfetto slice/counter(区间和数值轨道),并在目标进程第一段后附加 DurationsV5 延迟数据,常见名称包括:
anrRecordPlacedOnQueue与anrRecordsQueueSize;anrProcessing;dumpStackTraces();dumpingPid#<pid>;dumpingFirstPids、dumpingNativePids、dumpingExtraPids。
这些字段回答报告何时排队、何时开始处理、各组 dump 花了多久。AOSP 也没有“采样延迟低于 500 ms 就可信”一类通用阈值;栈还对应不对应触发现场,看的是应用执行路径在触发时刻和采样时刻之间有没有变过。
推荐给每份证据标记以下时间:
| 时间点 | 用途 |
|---|---|
T_deadline | 监视器判定超时的时刻 |
T_queue | ANR 记录进入 system_server 处理队列 |
T_process | ANR 消费者开始处理 |
T_dump_main | 目标进程线程栈完成采样 |
T_log | ANR in 等报告写入日志 |
若 T_dump_main 时主线程已经进入 nativePollOnce,但 Perfetto 显示它在 T_deadline(完成期限) 前连续执行同一条耗时消息,时间线就补回了栈中已经消失的现场。若采样时主线程仍停在同一路径,点状快照与连续时间线会互相印证。若两者冲突且采集窗口不完整,我们就把结论降级为“疑似”,并列出缺失证据。
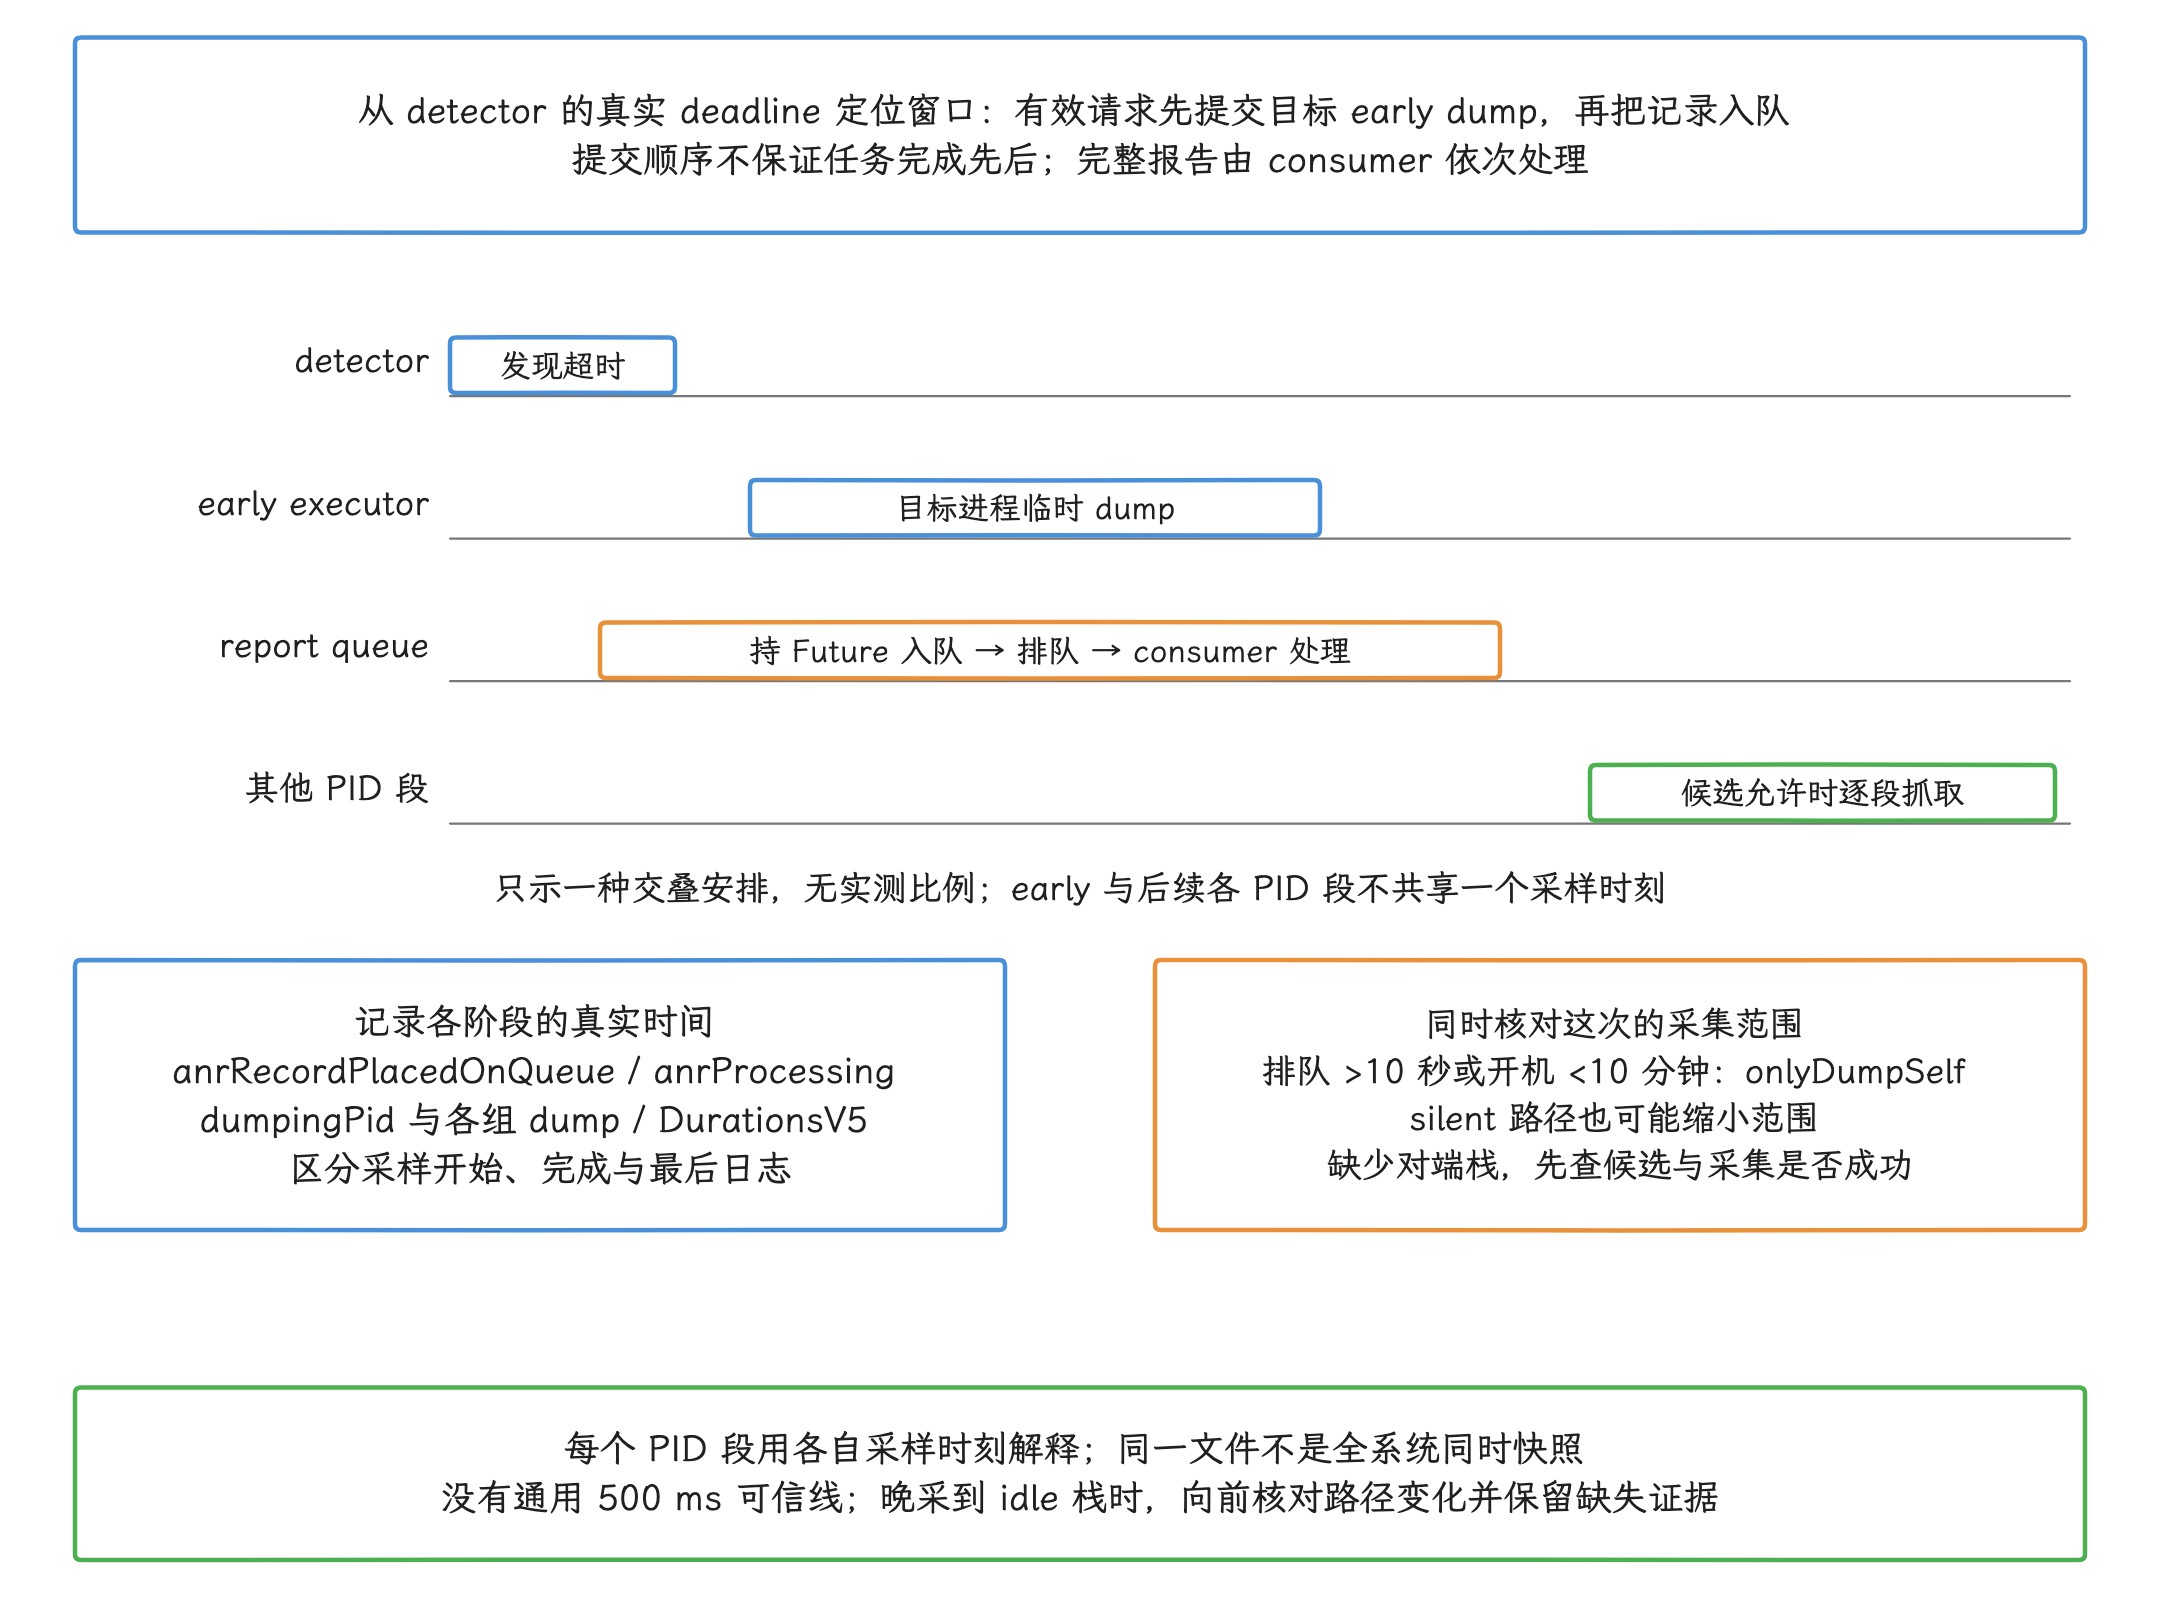
图:有效请求先提交early任务再入队;图仅示目标early采样先于完整consumer处理完成的一种交叠,不承诺实际任务完成顺序,也无实测比例。记录各PID真实采样开始/完成、入队/处理和最后日志时刻,结合AnrLatencyTracker的anrRecordPlacedOnQueue、anrProcessing、dumpingPid/各组dump及DurationsV5解释延迟。排队超过10秒或开机不足10分钟启用onlyDumpSelf,silent路径也可能缩范围;缺对端栈要核对候选与成功情况。同文件各PID段不是同时快照,无500ms通用可信线,晚采idle栈需回看完整超时窗口的路径变化。
从 Perfetto 还原超时窗口
数据源的覆盖范围
我们在 Perfetto 里搜不到 am_anr 时,先检查 trace 是否包含 Android log/EventLog 数据源;采集期间有没有发生 ANR,要另外核实。ANR 分析常用的配置要覆盖:
linux.ftrace:线程调度、CPU 频率、idle、Binder 等内核事件;track_event:采用 Perfetto SDK/Track Event 发出的事件,例如系统debug.anr标记;应用android.os.Trace/atrace 的 section 则经 ftraceprint/trace_marker 导入,需要相应 atrace category 与应用过滤配置;android.log:需要用am_anr对时的 EventLog/logcat;linux.process_stats:进程、线程和部分计数器;- 设备支持时的内存、I/O、thermal(温控)与 power 数据源。
system_server 在相应功能开关启用时,还会发出名为 ANR Detected 的 Perfetto SDK instant(瞬时事件),并携带 anrId、errorId。这个信号取决于系统构建和开关,各设备未必有固定的对应轨道。
离线复现时,下面三条命令分别采集 Perfetto、生成 bugreport,并在有权限时列出原始 ANR trace:
adb shell perfetto --txt -c /data/local/tmp/anr.cfg \
  -o /data/misc/perfetto-traces/anr.perfetto-trace
adb bugreport bugreport-anr.zip
adb shell ls -lt /data/anr
Perfetto 配置决定 trace 包含哪些数据;bugreport 补充 ANR 报告、EventLog、进程和系统快照。直接遍历或拉取 /data/anr 通常需要可用的 root/adbd 调试权限;userdebug/eng 也要看实际权限。量产 user 构建可使用授权的 adb bugreport 收集系统选择导出的内容;直接读取该目录的权限,普通应用或 shell 不会因为这次授权就拿到。
选对时间窗
我们以 T_deadline 为中心,向前至少覆盖该 ANR 类型的完整响应期限,再向后覆盖目标进程 dump。输入超时需要回看事件进入、窗口焦点和分发;广播超时需要回看 receiver 调度、onReceive()、goAsync() 和 finish();Service 与 Job 则要对齐对应的生命周期回调。
时间窗的原点应选在检测器超时处:对话框、系统通知、ANR in 日志和线程 dump 都可能明显晚于检测器超时,从对话框出现时刻向前固定截取几秒可能错过窗口。
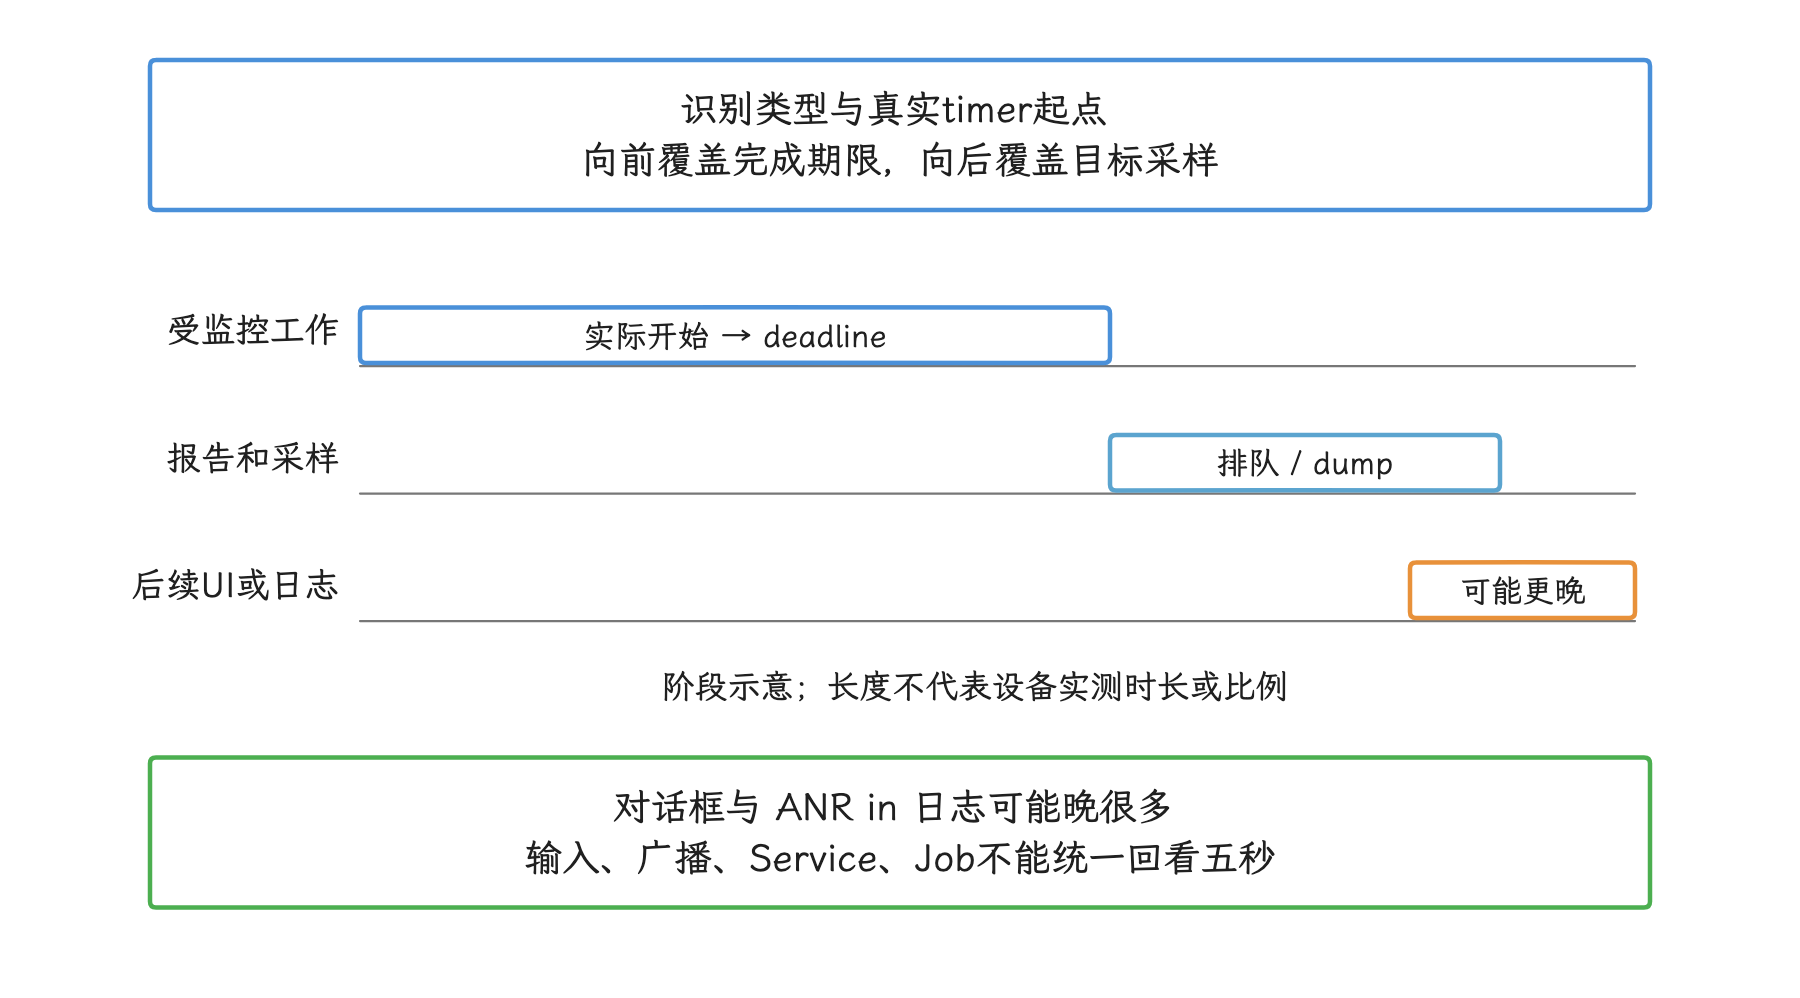
图:Android17默认finish-attach可能把初始化放在广播/服务执行timer之前;先确认设备实际计时起点。
阅读主线程调度轨迹
| 时间线形态 | 解释方向 | 仍需确认 |
|---|---|---|
| 长时间 Running | 主线程持续执行 CPU 工作 | 调用栈、方法 trace、是否降频 |
| 长时间 Runnable,Running 很少 | 线程已可运行,却没有及时得到 CPU | 每次唤醒延迟、优先级、cpuset、uclamp、竞争任务 |
S 睡眠 | 等待可中断事件 | 等待原语、唤醒源、消息或 Binder 回复 |
D 等待 | 不可中断内核等待 | kernel callstack(内核调用栈)、I/O/驱动事件、等待对象 |
| Blocked monitor | Java 锁未取得 | 持锁线程、锁序、持锁区工作 |
CPU 饥饿要用“Runnable 区间远大于 Running 区间”和显著的 wakeup-to-run(线程被唤醒到真正运行) 延迟来证明。
整机 CPU 百分比高只能提供环境背景。大小核调度、cpuset(允许线程运行的 CPU 集合) 限制、uclamp(调度器利用率约束)、温控降频或一个高优先级线程,都可能让主线程得不到 CPU,即使整机仍有空闲核。
跟踪同步 Binder
在 Perfetto 中沿调用方 Binder transaction 的 flow 跳到服务端线程,检查以下阶段:
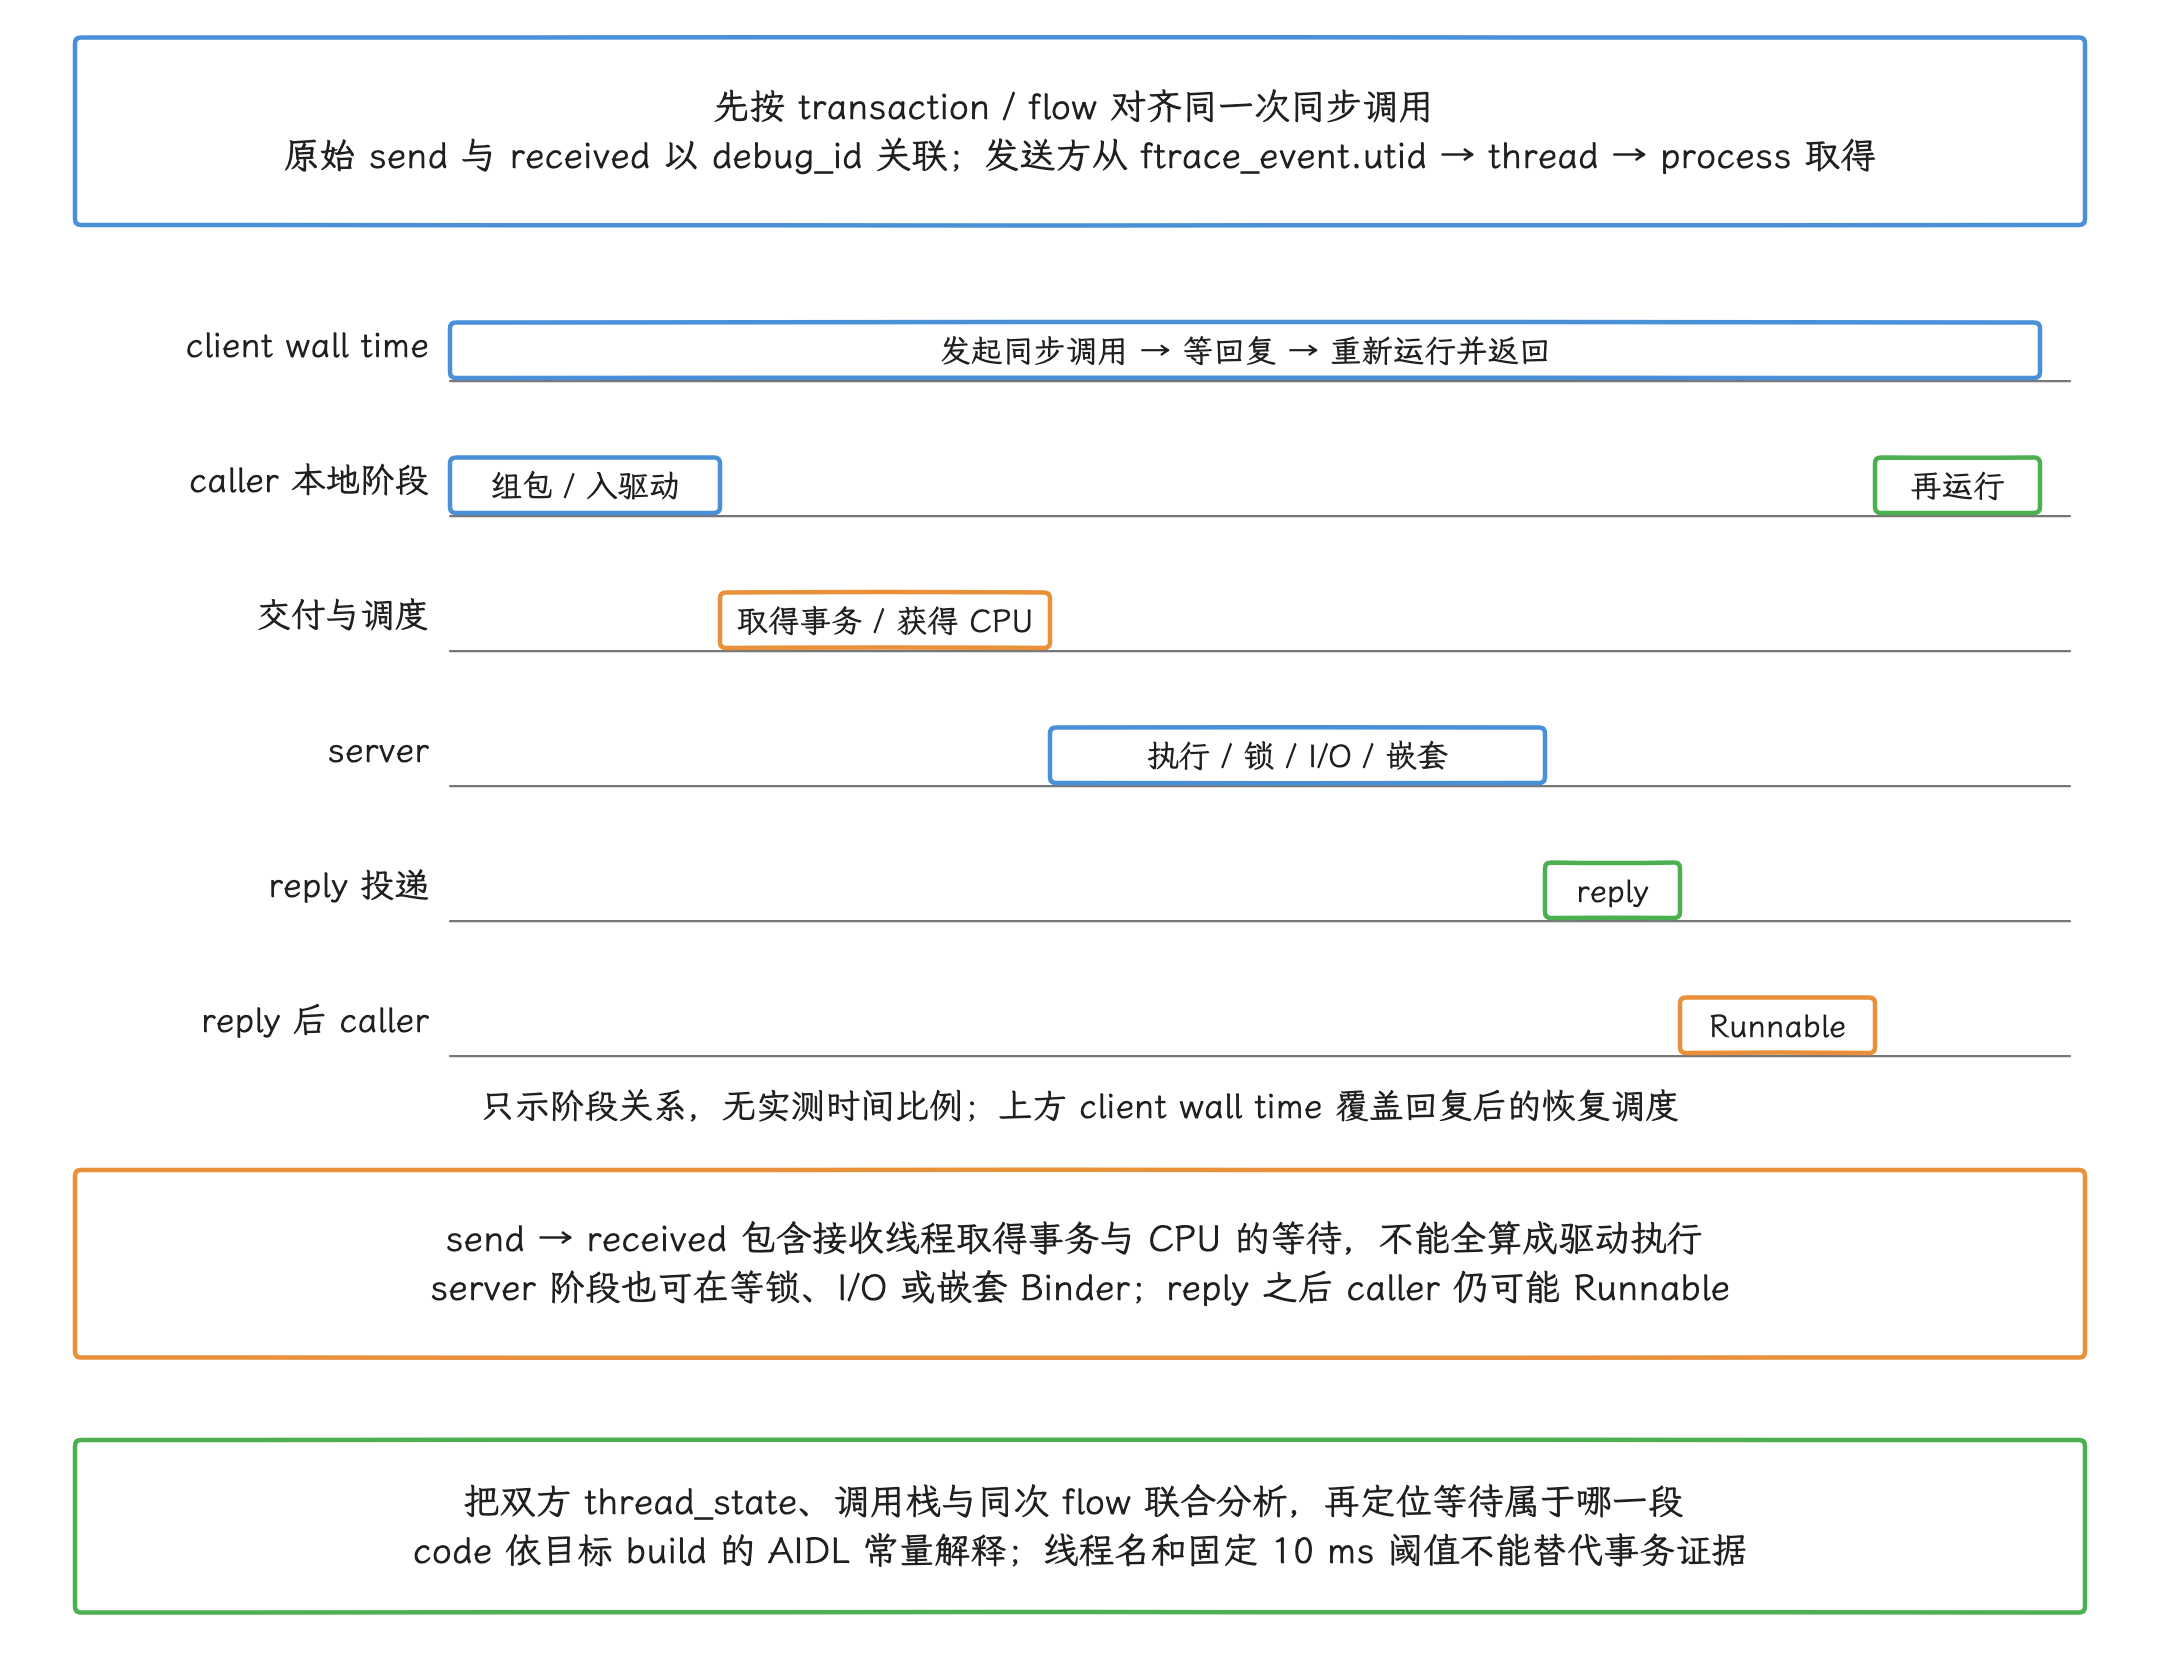
图:这是同一次可关联同步Binder调用的一种阶段安排,无实测时长比例。client wall time一直覆盖到reply后的重新运行与返回;取得事务/CPU、服务端执行或等待、reply投递与caller再次Runnable分别核对,组包/入驱动阶段也不预设全程在CPU上。原始send与received用debug_id关联,发送方由ftrace_event.utid关联thread/process;code需匹配目标build的AIDL。send→received包含接收与调度,不是纯驱动执行,没有统一10ms竞争阈值;结合双方thread_state、栈和flow定位实际等待。
- 调用方发起事务前是否已经在主线程执行了耗时工作;
- 事务是否排队等待对端 Binder 线程;
- 服务端处理期间是否被锁、I/O 或嵌套 Binder 卡住;
- reply 产生后,调用方何时被唤醒并运行;
- oneway 调用是否因异步队列拥塞而间接占满服务端资源。
接口名和 transaction code 可以帮助定位 AIDL Stub 方法,但不同系统构建的 EventLog tag(事件标签)定义或采样格式不一定相同。我们优先依赖 Binder flow 和双方调用栈,日志字段则按照目标设备的 event-log-tags 定义解释。
用 Perfetto SQL 批量抽取线程状态
下面的查询先导出同名进程各生命周期的主线程状态与 upid/utid,供后续选定事件所属实例。线程名可以修改,所以用 is_main_thread,不把名称必须等于 main 当条件:
SELECT
  process.upid, process.pid, process.name AS process_name,
  thread.utid, thread.tid, thread.name AS thread_name,
  thread_state.ts, thread_state.dur,
  thread_state.state, thread_state.cpu
FROM thread_state
JOIN thread USING (utid)
JOIN process USING (upid)
WHERE process.name = 'com.example.app'
  AND thread.is_main_thread = 1
ORDER BY process.upid, thread_state.ts;
ts 和 dur 使用 Trace Processor 的纳秒时间基准。不同 Perfetto 版本的状态字符串和可选列可能有差异,批处理前先通过 .schema thread_state 查当前表结构,再按 T_deadline 的时间范围过滤和聚合。SQL 结果给出的是状态时长;至于原因,我们还要回到调用栈、flow 和系统计数器上解释。
常见根因的证据链
前面几节讲的是证据怎么读、怎么对齐,这一节把它们落到常见根因上:每一类根因有各自的证据形态和修复方向。
主线程执行过久
典型特征是主线程在期限内持续 Running,调用栈落在布局、序列化、图片处理、正则、大集合遍历或业务循环。采样点可能只命中耗时路径的尾部,因此我们还要结合 method trace、应用自定义 trace section 和多个样本确认热点。
修复时把工作拆成两部分:
- 必须在主线程完成的 UI 状态读取与 View 更新留在主线程,并限制单次执行时间;
- 可并行的计算、解析、解码移到后台,并在回主线程前处理取消、过期结果和生命周期。
把一个长任务切成大量主线程消息,缩短的只是每条消息的占用时间;总工作量降不下来,消息积压仍可能拖过 deadline,所以整体完成时间也要量。
主线程 I/O
Java 栈可能出现 FileInputStream.read()、FileOutputStream.write()、SQLite、fsync()、资源解压或类加载;native 栈和 Perfetto 则可能显示 page fault(缺页)、block(块设备) I/O 或 D 等待。即使代码量很少,冷页、存储抖动和同步落盘也可能产生很长的 wall time(从开始到结束的实际经过时间)。
SharedPreferences.apply() 会把数据写入异步排队,但组件停止阶段可能通过 QueuedWork.waitToFinish() 等待此前未完成的工作。分析时要检查累计写入量、生命周期时点和 fsync();即使 apply() 本身返回很快,它对后续等待的影响也要查。
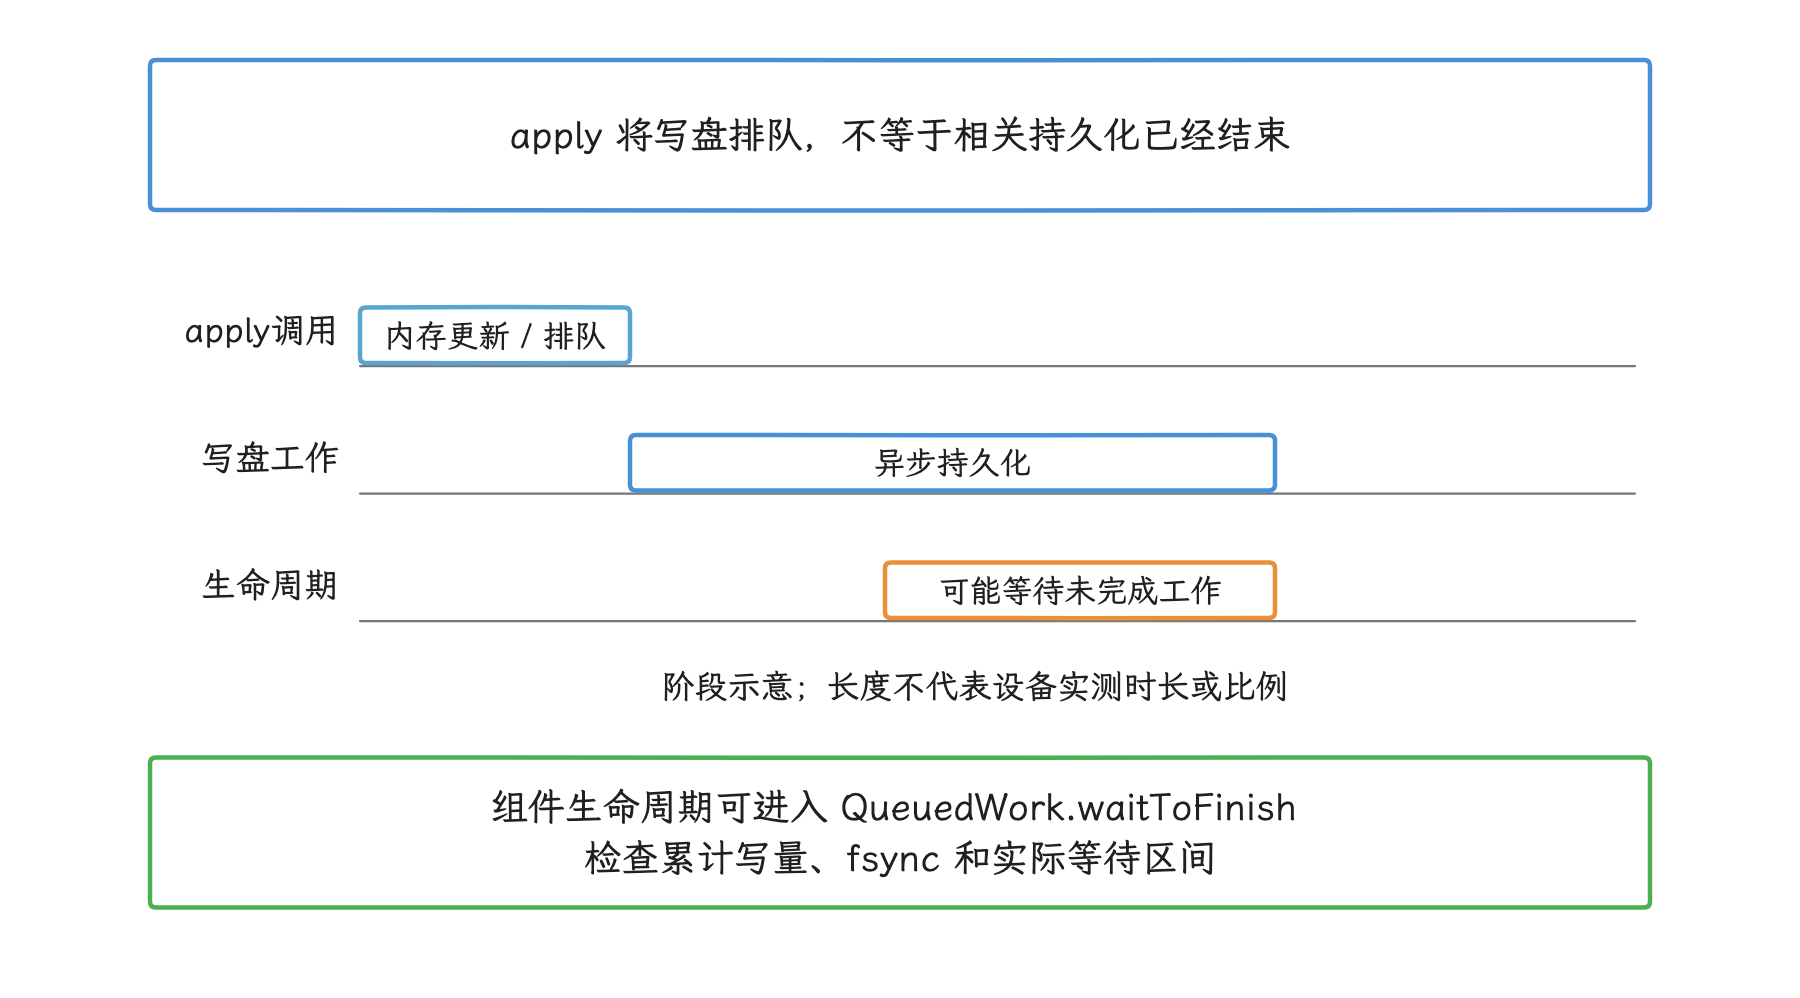
图:这是可能的等待关系;后台I/O仍需恢复语义,异步返回时磁盘还没保证安全落盘。
修复方向包括将 I/O 移到后台、合并批量提交、减少同步持久化、提前加载必要缓存,以及减少超时期限内的工作。涉及用户可见状态时,还要定义进程被杀后怎样恢复——推迟写入只解决写入本身的耗时,恢复要另行设计。
锁竞争与死锁
对这里的互斥锁案例,确证死锁要凑齐一个闭合且推进不下去的等待环;只观察到单向等待时,可以先从竞争或长临界区入手,缺失的等待边、漏唤醒或其他无限等待仍有可能。常见的恶化因素包括:
- 持锁执行磁盘或 Binder 调用;
- 主线程与工作线程使用相反锁序;
- 回调在持锁状态下调用未知代码;
- 大对象复制、遍历或清理放进临界区;
- 读写锁中的写线程长期拿不到锁。
线程栈显示的是采样点上的等待图。对反复出现、每次持续较短的竞争,我们还可以结合 monitor contention、dvm_lock_sample、Perfetto slice 或应用埋点统计持锁时长。
同步 Binder 卡住
调用方主线程等待同步回复时,耗时原因往往位于调用链更深处。我们先找到服务端执行线程,再判断时间花在线程池排队、服务代码、服务端锁、服务端 I/O、嵌套调用,还是回复后调用方的调度延迟。
对于自有接口,应避免让主线程发起没有截止时间的同步工作,并考虑将耗时操作改为异步协议。系统服务接口改不动时,可以减少调用次数、缓存稳定结果、把允许异步的查询移出 UI 响应期限,并处理服务死亡与超时后的备用路径。移动调用线程前必须确认 API 的线程安全和生命周期约束。
CPU 饥饿与系统负载
CPU 饥饿的直接证据是目标线程已经可以运行,却迟迟没有进入 Running 状态。我们通常按以下顺序追查:
- 同一个 CPU 或 cpuset 上有哪些竞争线程;
- 目标线程的 nice(普通调度优先级) 值、调度组、uclamp(CPU 性能需求上下限) 和优先级是否异常;
- CPU 频率、idle 和 thermal 状态是否降低可用算力;
- GC、JIT、编解码、system_server 或厂商守护进程是否制造突发负载;
- 唤醒路径是否存在调度器或驱动异常。
“系统负载高”描述的是运行环境,责任划分要看主线程在做什么:若还有可以移除的同步 I/O 或长计算,高负载会让这些工作更容易超过期限;若主线程长期 Runnable、应用路径里又挑不出超过预算的工作,问题才更可能落在调度或系统资源侧。写报告时,我们把外部触发条件和应用能够修复的因素分别列清。
内存回收、GC 与 page fault(缺页异常)
判断 GC 影响时,要同时看 pause slice(暂停区间)、并发阶段、对象分配速率和主线程停顿。minor faults 表示无需从块设备读取就能处理的缺页;major fault(需要从存储载入页面的缺页)s 通常需要读入后备页。fault 计数要放回采样区间、进程工作集和 I/O 时间线里解释,单个 major fault 计数推不出“ANR 来自磁盘”的结论。
若 kswapd(内核后台回收线程)、direct reclaim(由申请内存的线程直接回收内存页)、频繁 major fault、memory PSI 和 lmkd 事件出现在同一窗口,内存压力解释会更可信。还要区分应用工作集增长、系统全局压力和厂商内存策略。
解读 ANR 报告里的 CPU 与压力信息
CPU 百分比
ANR 报告附带的 CPU 统计来自 ProcessCpuTracker:ActivityManager 用它输出某个采样区间内各进程在 user、kernel(内核态) 和两者合计上的 CPU 占比。多核设备上单进程超过 100% 是合法结果,表示它在区间内并行使用了超过一个 CPU 核的时间。
下面的示例说明多核百分比、user/kernel 拆分和 fault 计数怎样同时出现:
CPU usage from 0ms to 13135ms later:
  191% 1948/system_server: 72% user + 119% kernel
      / faults: 78816 minor 9 major
  30% 5991/com.example.app: 23% user + 6.4% kernel
      / faults: 118172 minor 2 major
这份快照给出的事实是:system_server 在该区间消耗了约 1.91 个 CPU 核的时间,其中内核态占比较高。内核时间究竟花在 Binder、文件系统、内存管理还是驱动,要交给 Perfetto callstack、系统计数器或更细的 profile(性能剖析)继续区分。
分析时我们同时看:
- 统计区间是否覆盖
T_deadline; - 目标进程、system_server 与全局总量;
- user/kernel 占比的相对变化;
- 短区间和长区间是否呈现同一热点;
- 进程 CPU 低时,主线程是 Sleeping、Blocked、
D还是长期 Runnable。
Load Average
Load: 15.29 / 5.19 / 1.87 是 1、5、15 分钟的指数移动平均,统计的对象是可运行任务加不可中断等待任务的数量,和 CPU 利用率属于两类指标。8 核设备的 Load 为 8,可能表示八个任务持续使用 CPU,也可能混着等待 I/O 的 D 状态任务;持续很短的 ANR 还可能被 1 分钟平均值稀释。
Load 适合提示系统近期有多少任务正在争用 CPU 或不可中断地等待;要确认 CPU 是否满载,还要用 Perfetto 的 sched、CPU frequency(CPU 频率)/idle 和 I/O 轨迹区分来源。
PSI
6.18 内核通过 /proc/pressure/{cpu,memory,io} 暴露 PSI(Pressure Stall Information,资源压力停顿信息):
some:至少有一部分任务因该资源不足而停顿的时间占比;full:所有 non-idle(非空闲) 任务同时因该资源不足而停顿的时间占比;avg10、avg60、avg300:以 10、60、300 秒为时间尺度的指数衰减趋势百分比,不是精确滑动窗口内的算术平均;total:自启动以来累计停顿微秒数。
系统级 cpu.pressure 的 full 没有可用语义,为兼容始终保持为 0。memory 或 I/O 的 full 非零,说明采样窗口内出现过所有 non-idle 工作同时停顿。判断相关性时,我们计算 ANR 窗口内 total 的增量,再结合 avg 趋势、reclaim、block I/O 和目标线程状态;很短的尖峰可能和当前 ANR 无关。
下面的样例展示 PSI 中趋势值和累计值的格式:
----- Output from /proc/pressure/memory -----
some avg10=1.35 avg60=0.31 avg300=0.06 total=346727
full avg10=0.00 avg60=0.00 avg300=0.00 total=34803
----- End output from /proc/pressure/memory -----
这里的 full avg10=0.00 只表示这项指数趋势按两位小数显示为 0.00,可能是低于显示精度的非零值,过去十秒是否完全没有 full stall,从它断定不了;累计 total 仍可能包含更早的 full stall(所有任务同时停顿)。判断当前事件时,要比较相邻两次采样的 total 增量;系统启动以来的累计值只提供背景。
CPU 摘要的两种采样窗口
ANR 路径可能输出两套 ProcessCpuTracker 结果,两者采样起止时间不同,合并成同一窗口会引入错误:
| 结果 | 采样器 | 内容 | 时间边界 |
|---|---|---|---|
| 全局进程榜 | AppProfiler.mProcessCpuTracker | 最多十个活跃进程,不含线程明细 | 长期复用;两次更新至少间隔 5 秒,区间可能跨越 ANR 前后 |
| 临时进程榜 | new ProcessCpuTracker(true) | 活跃进程及其活跃线程 | init() 后等待约 200 ms 再 update();用于挑选最多两个额外抓栈进程,静默后台 ANR 可能跳过 |
ProcessErrorStateRecord 记录的 anrTime 位于 ANR 处理开始附近。临时榜通常在它之后采样,因此标题可能出现 ms later;长期榜则可能覆盖 deadline 之前、之后或两侧。解析每个 CPU 块时,要保存 sample_start、sample_end、duration、它位于 anrTime 之前还是之后、采样器类型,以及与超时窗口的重叠关系。只覆盖转储阶段的数据,支撑的结论止于“抓栈时仍观察到该现象”。
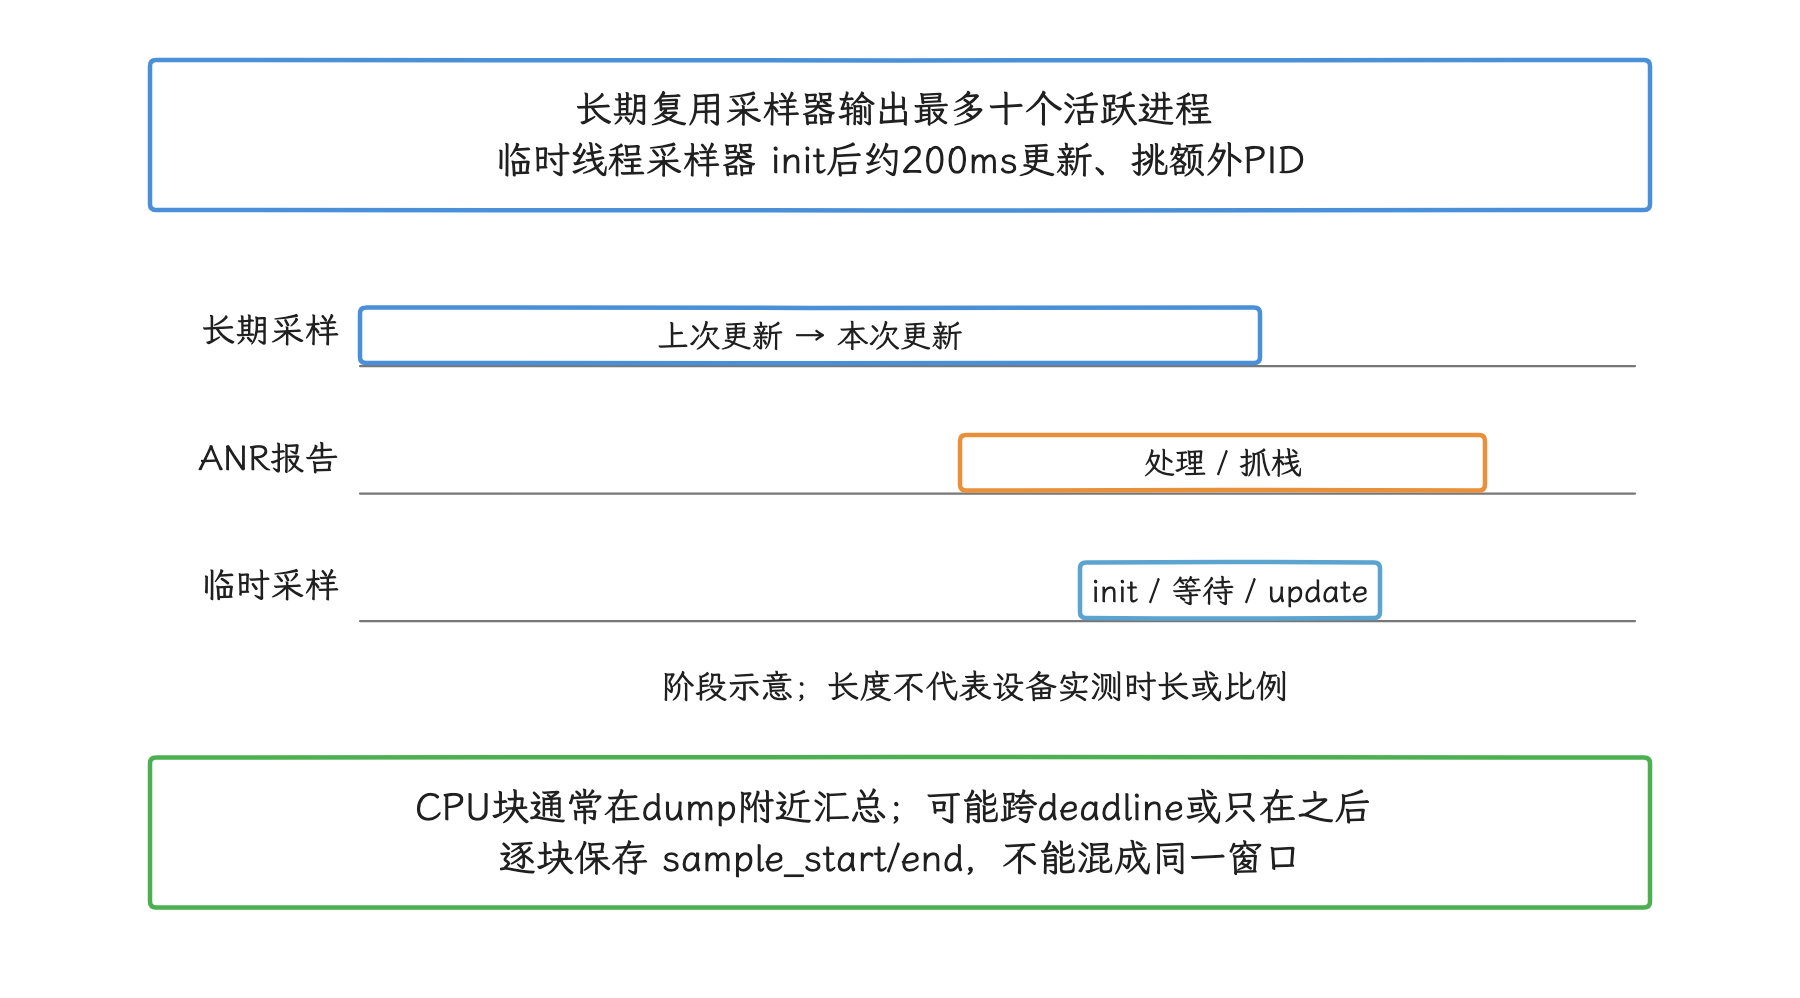
图:轨道为一种可能相对位置,不保证每次deadline都落在采样范围;silent路径还可能跳过临时榜。
进程和线程行以各自两个采样点之间的 uptime 为分母,因此多线程进程超过 100% 合法。TOTAL 行的分母则是该实现从所有 CPU 汇总的 /proc/stat user(含 nice)、system、idle、iowait、irq、softirq 六类增量之和,并不是读取全部可能字段;其非 idle 百分比包含 iowait(CPU 等待 I/O 的记账时间),把它当纯执行利用率,或与进程行直接相减,都会得出错误数字。
AOSP ProcessCpuTracker 的标准输出不附带 R/S/D,若报告中带有状态字符,应按厂商扩展或其他采集器解释,并保留来源名称。
minor、major fault 统计的是两个采样点之间发生的缺页事件数,内存分配量和 I/O 字节数要另找依据。页大小可能是 4 KB、16 KB 或其他值,major fault 的后备介质也可能是 zram(压缩内存交换设备)。只有 fault 增量与 D 状态、reclaim、文件系统或 block I/O 在同一时间窗口相互印证,存储或内存压力解释才更可信。
自动解析器应把输出严格分为三层:
- 事实字段:原始时间窗、进程/线程的 user 与 kernel、fault delta(增量)、
TOTAL、Load 和 PSI; - 派生观察:跨核执行、全机繁忙、资源压力,以及采样与 deadline 是否重叠;
- 候选解释:每项同时列出支持证据、反证、缺失材料和规则版本。
自动解析器要避免内置跨设备的固定结论,例如“iowait 超过 5% 就是 I/O 瓶颈”或“major fault 超过 100 次就是磁盘问题”。阈值应来自同机型、同场景、同采样窗口的基线;若时间不重叠、字段缺失或 OEM 格式未知,解析器要降低置信度并保留原文。
一套可复用的分析流程
1. 固定事件身份
我们先记录 build fingerprint(系统构建指纹)、Android 版本、进程、PID/UID、ANR 类型、anrId/errorId(若有)、组件、T_deadline 和用户动作。一个 bugreport 可能包含多次 ANR,PID 也会被新进程复用,因此时间与事件 ID 必须一起使用。
2. 检查采集完整性
接着确认目标进程段是否完整、采样延迟多长、是否启用 onlyDumpSelf、ApplicationExitInfo 是否只包含第一进程段,以及 Perfetto 数据源是否覆盖 sched/Binder/log。缺失项要写进结论,避免把“没有采集到”表述为“没有发生”。
3. 按 ANR 类型划定期限
从相应检测器的开始事件向后追到 deadline:
- 输入:输入事件、焦点窗口、目标连接、主线程分发;
- 广播:receiver 调度、
onReceive()、异步PendingResult完成; - Service:创建、启动、绑定或前台服务晋升所对应的检查点;
- ContentProvider:先区分发布失败保护与显式的远程调用探测;发布保护到期走的是初始化失败移除进程,与 Provider 调用 ANR 要分开记;
- Job:区分绑定失败、回调超时、运行期限与所需通知;绑定或正常运行期限耗尽要按各自的期限问题记录,别并进回调 ANR。
类型划分和各类期限见 §9.1 ANR 类型与触发条件。
4. 为主线程分类
把期限内主线程的状态分为 Running、Runnable、Sleeping、monitor blocked、Binder wait 和 I/O/D wait。我们先找持续时间最长的区间,再阅读该区间的调用栈、锁和 flow。采样栈与时间线一致时可以提高结论置信度;不一致时要说明线程状态在超时与采样之间如何变化。
5. 沿等待边追到资源拥有者
锁等待要找到持锁线程,Binder 等待要找到服务端线程,I/O 等待要追到文件系统或块设备,Runnable 则要找 CPU 竞争者。每向下一层追踪,都记录 PID/TID、开始时间、结束时间和出处。
6. 检查系统放大因素
检查 CPU 竞争与频率、thermal、GC、reclaim(内存回收)、PSI、lmkd(低内存终止守护进程)、I/O 和 freezer。系统异常与应用慢路径可以同时存在,报告中要分别列出主因、触发条件和让超时更容易发生的因素。
7. 用反事实验证修复
一条能够指导修复的根因,应能回答:移除某段同步工作、缩短某个持锁区、改变某个 Binder 协议或解除某项资源限制后,为什么 deadline 就能满足。修复后要在相同场景下比较期限内的主线程状态、P95/P99 耗时和 ANR Rate,避免只让采样时的栈顶换了位置。
线上工具链
开发阶段的证据链搭好之后,线上还要拿得到数据。这一节我们看应用侧可以自建的几类入口:系统回捞、Watchdog 探针、触发式采集,以及 SIGQUIT hook(挂接系统行为) 能覆盖到哪里。
ApplicationExitInfo 回捞
Android 11(API 30)起,应用可以查询自身历史退出记录,并读取系统仍然保留的 ANR trace。下面的代码应在后台执行器中运行,找到最近一条 ANR 退出记录,并将可读的 trace 以流式复制方式保存到应用私有目录。它是采集顺序示例:生产实现需要处理打开/复制时的 IOException、限制实际复制字节数,并用临时文件完成后原子替换,避免异常留下半份报告;固定 64 KB 缓冲只限制每次复制块的大小,不限制总文件大小:
if (Build.VERSION.SDK_INT >= 30) {
    val activityManager =
        context.getSystemService(ActivityManager::class.java)
    val exit = activityManager
        .getHistoricalProcessExitReasons(null, 0, 20)
        .firstOrNull {
            it.reason == ApplicationExitInfo.REASON_ANR
        }

    exit?.traceInputStream?.use { input ->
        val destination = File(
            context.noBackupFilesDir,
            "anr-${exit.timestamp}.txt"
        )
        destination.outputStream().buffered().use { output ->
            input.copyTo(output, bufferSize = 64 * 1024)
        }
    }
}
traceInputStream 允许为 null,代码必须分别处理“退出记录存在”和“trace 仍可读取”。保存的内容是目标进程第一段及其前置头部,内容范围小于完整 bugreport。上线后还要限制文件保留数量、大小和上传网络条件,并按隐私规范清洗用户数据。
Watchdog 与业务埋点
应用自建的 Watchdog 线程会定期向主线程投递探针任务,可以在系统判定 ANR 前保存消息队列、页面、业务阶段和自定义栈。它直接测量的是“探针没有按期执行”;GC、调度饥饿、debugger 和设备休眠都可能造成这种现象,因此它代替不了系统 ANR 统计,两者要一起看。
高价值埋点通常包括:
- 主线程长消息的开始/结束与业务标签;
- 关键同步 Binder 的接口、对端和 wall time;
- 主线程 I/O 与锁持有时间;
- 页面、输入动作、广播/Service/Job 生命周期;
- build、设备、thermal 状态、内存等级和采样延迟。
探针阈值要按业务场景和设备能力分组设置;线上上报还需要采样、限制频率和去重,避免监控本身造成负担。
ProfilingManager 触发式采集
ProfilingManager 在 Android 15(API 35)加入公开 API;Android 16(API 36)的 ProfilingTrigger 提供 TRIGGER_TYPE_ANR。系统可在 ANR 触发后,从当时正在后台运行的系统 trace 环形缓冲区中截取快照;后台 trace 是周期性随机采样,间歇运行,平时并不常开。它不会等到 ANR 发生才开始录 trace,所以产物能否覆盖超时之前的过程,取决于 system trace 是否已经在运行、缓冲区还保留多少内容、系统规则和设备配置。触发之后应用未必被杀,也不保证每次都产生文件,rate limit(频率限制) 也会拦住一部分请求。
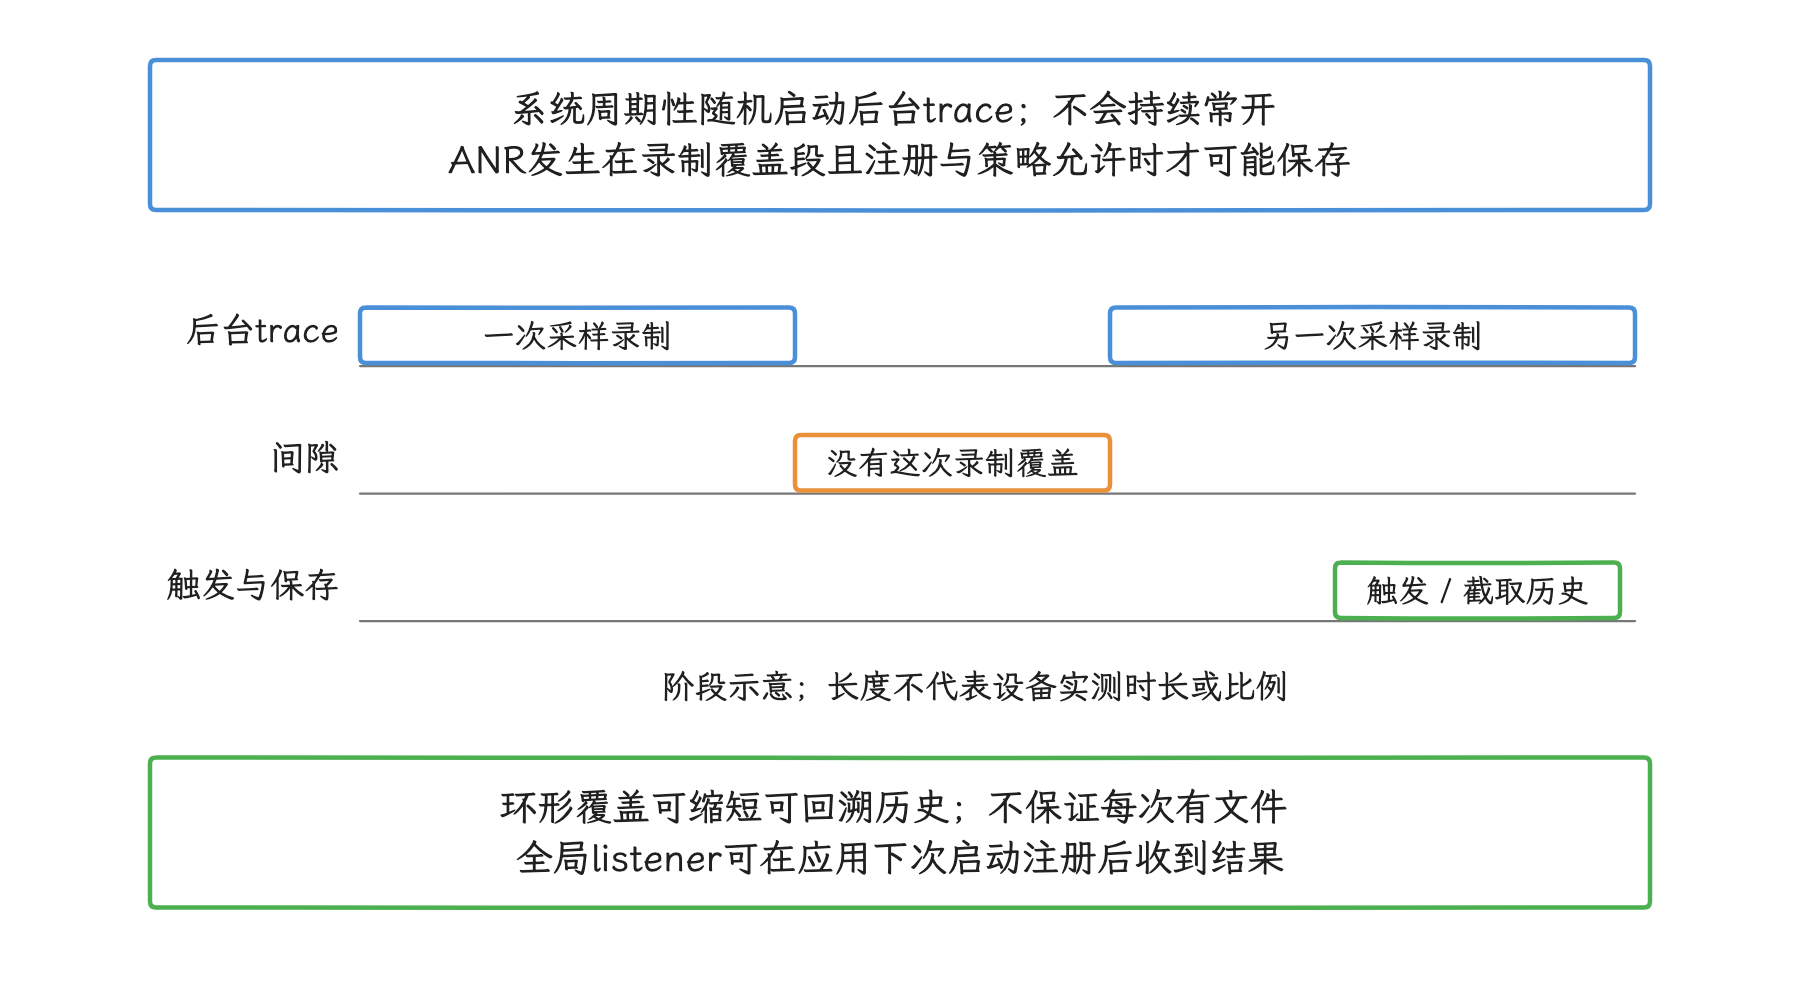
图:API35主动采集、API36 ANR trigger;图不保证trigger先于进程终止,r1报告路径与公开注释存在已标明差异。
下面的代码在 API 36 及以上注册 ANR trigger,并通过全局结果 listener(监听器) 接收系统返回的 profiling 文件:
if (Build.VERSION.SDK_INT >= 36) {
    val profilingManager =
        context.getSystemService(ProfilingManager::class.java)

    profilingManager.registerForAllProfilingResults(
        context.mainExecutor
    ) { result ->
        val resultPath = result.resultFilePath
        // 在回调外执行校验、压缩与合规上传。
    }

    profilingManager.addProfilingTriggers(
        listOf(
            ProfilingTrigger.Builder(
                ProfilingTrigger.TRIGGER_TYPE_ANR
            )
                .setRateLimitingPeriodHours(24)
                .build()
        )
    )
}
⚠️ 矛盾:ProfilingTrigger 的公开注释 描述 ANR trigger 发生在系统尝试杀应用之前;但 Android 17 r1 AnrHelper 在 r.appNotResponding() 返回后发送 trigger,而该调用中的 ProcessErrorStateRecord 已可能执行 killLocked()。因此不要把 trigger 当作“应用尚未被杀”或“原现场仍保留”的保证;结果回调可能要等应用下次启动并注册监听器。
触发式结果只会投递给通过 registerForAllProfilingResults() 注册的全局 listener。生产代码还要检查 ProfilingResult 的 error code(错误码)、文件生命周期,并避免重复注册,同时按隐私规范处理产物。Android 17(API 37)新增的 TRIGGER_TYPE_ANOMALY 面向系统检测到的通用异常,产物类型取决于 anomaly tag;ANR 采集应继续使用含义明确的 TRIGGER_TYPE_ANR。
公开 SDK 中没有 android.os.PerfettoManager:开发调试用 Perfetto CLI,普通应用的系统触发入口是 ProfilingManager。
SIGQUIT hook 的适用范围
部分 APM 会拦截或旁路观察 SIGQUIT,再自行采集线程栈。这类 hook 依赖 ART、信号处理、tombstoned 路径和厂商改动,可能与系统 dump 竞争,也可能在目标版本失效;在 Android 17 的 ANR 主路径上,第三方也未必总能收到可供 hook 的 SIGQUIT。经过版本验证后,它可以作为 ApplicationExitInfo、Perfetto 和系统事件之外的补充信号。
线上指标与聚类
进入线上之后,我们先把指标怎么算统一住,再谈把原因相近的 ANR 合并成组。自建监控可以同时保留三种统计口径,并明确各自的分子、分母和去重周期:
- 事件率:ANR 事件数 / 会话数,能反映同一会话反复发生的情况;
- 受影响会话率:发生过至少一次 ANR 的会话数 / 会话数;
- 受影响用户率:发生过至少一次 ANR 的用户数 / 活跃用户数。
Google Play Android vitals 按每日活跃用户与设备组合计数(同一用户同一天使用多台设备会分别贡献活跃数):ANR rate 的分子是当天至少遇到一次任意 ANR 的用户;user-perceived ANR rate 的分子是当天至少遇到一次用户感知 ANR 的用户。当前公开定义把 Input dispatching timed out 计入用户感知 ANR。厂商平台和自建 APM 可能使用会话、事件或设备作为分母,因此报表必须标注去重周期、前后台过滤条件和分母。只按事件总量排序会掩盖低频但影响面大的问题,也会让单个高频触发用户放大计数。
聚类是把原因相近的 ANR 合并为一组。聚类键可以按稳定程度分层:
- ANR 类型、组件与规范化主线程栈;
- 第一条应用帧、等待对象或 Binder 接口;
- build、设备 SoC(片上系统)、Android 版本和厂商;
- 前台页面、业务动作与系统压力标签;
- 采样延迟、trace 完整度和证据等级。
代码行号、混淆方法名和对象地址会随构建变化,不适合直接作为长期 fingerprint(特征签名)。修复验收应同时观察该聚类的发生率、影响用户数、P95/P99 超时路径耗时,以及新旧 build 的样本分布。P95/P99 表示 95%/99% 的样本不超过该耗时,用来观察长尾是否改善。
系统日志信号速查
| 信号 | 能说明什么 | 不能直接说明什么 |
|---|---|---|
am_anr / ANR in | event log 与 logcat 中的 ANR 事件及报告信息 | 二者的时间差不能单独证明系统负载高 |
Slow dispatch / Slow delivery | Handler 回调执行过久,或从消息计划执行时间 when 到真正开始执行之间的延迟过长 | 必须结合日志所属进程、Looper 线程和消息内容定位责任方 |
dvm_lock_sample | ART 采样到了 monitor(synchronized 使用的对象锁)竞争 | 阈值和采样策略会随构建配置变化 |
binder_sample | 当前构建的采样机制记录到慢 Binder 调用 | 字段顺序和阈值并非跨版本固定协议 |
binder thread pool starved | 某进程的 Binder 线程池长期没有空闲线程 | 仍需查明各线程被哪些事务、锁或 I/O 占用 |
am_kill / am_proc_died | 进程退出或被系统终止 | 还要读取 reason/subreason(主原因与细分原因)判断成因 |
lmkd / reclaim / PSI | lmkd(低内存终止守护进程)活动、内存页回收和资源压力 | 单条事件不能证明它导致了当前 ANR |
| freeze / unfreeze | 进程或 cgroup(控制组)的冻结状态发生变化 | 需要与目标 PID 和超时窗口对齐 |
日志中的固定毫秒阈值往往来自设备配置、采样策略或厂商修改。分析报告应保留原始字段并注明构建版本,避免把某台设备的阈值写成 Android 平台保证。
已验证的公开 API 演进
- Android 11(API 30):加入
ActivityManager.getHistoricalProcessExitReasons()与ApplicationExitInfo,应用可查询REASON_ANR并尝试读取保留 trace。 - Android 15(API 35):加入
ProfilingManager,应用可以请求 profiling(性能剖析)并注册接收结果的全局 listener。 - Android 16(API 36):加入
ProfilingTrigger、TRIGGER_TYPE_ANR与触发式 profiling 注册,系统检测到 ANR 后可以自动采集指定产物。 - Android 17(API 37):加入通用
TRIGGER_TYPE_ANOMALY,用于系统检测到的多类异常;ANR 仍有专用的TRIGGER_TYPE_ANR。
文件名、dump 进程范围和日志格式属于实现细节,应以目标构建源码为准。
调度、锁、I/O 与内核等待
Java 或 Native 栈给出线程停留位置,内核轨迹解释它为什么长时间没有推进。ANR trace 回答“取样时各线程停在哪里”,Perfetto 回答“超时窗口内发生过什么”;两者处在两个时间尺度上,联合诊断要做的是把线程转储中的等待点放回调度、Binder、文件系统和块设备的时间线上。
nativePollOnce、BinderProxy.transactNative 和 D 状态都只是现象:
- 主线程停在
nativePollOnce,可能只是消息队列在正常休眠;若超时消息仍未执行,还要检查输入焦点、消息投递和取样延迟。 - 主线程等待同步 Binder,瓶颈可能在调用方、对端用户空间代码、对端调度、嵌套 Binder 调用或驱动路径。
- 线程处于
D状态,说明它在不可中断睡眠中;块 I/O、direct reclaim(申请内存的线程同步回收页)、驱动等待都可能产生这种状态。
所以,看到 native 帧就断言“内核故障”为时尚早;版本演进信息只用来解释旧设备差异。
1. ANR trace 能回答什么
StackTracesDumpHelper 对 Java 进程调用 tombstoned/ART 的 Java backtrace(调用栈) 接口,Java 转储失败时才回退到 native backtrace。一份转储可以包含线程状态、Java 帧、进入 native 的位置和调度统计,但它仍然是某个时间点附近的样本:等待从什么时候开始、由谁唤醒、在 run queue(CPU 运行队列) 里排了多久、此前经历过哪些 Binder 事务,都不在文件里。
一份 ANR trace 可以可靠提供:
- 取样时的线程栈与 Java monitor 关系;
- 主线程当时停在用户态还是 native;
- 同一份转储中已采集进程的瞬时状态;
- trace header(文件头)、ANR reason(超时原因) 和进程调度摘要。
单凭一份转储,我们还回答不了下面这些问题:
- 某个栈帧是否持续了整个超时窗口;
RUNNABLE线程一直占用 CPU;Java/ART 栈中的该状态区分不了线程正在运行还是等待调度,也给不出整个窗口的 CPU 占用;D状态由哪一个块请求导致;- 同步 Binder 的耗时属于驱动、对端排队还是对端业务代码;
- 转储时看到的状态是否就是触发超时那一刻的状态。
当栈已经给出完整证据链,例如主线程持锁做长计算且业务日志覆盖整个窗口,无需为每个 ANR 补抓内核事件。下面这些情况更适合引入 Perfetto:
- 主线程栈与超时原因对不上,怀疑 dump 到达时现场已经变化;
- 主线程在同步 Binder、
fsync、page fault、direct reclaim 或驱动等待附近; - 主线程长时间处于
R/R+,但 CPU 运行片段很少; - 多个进程同时卡顿,需要区分全局资源压力与单进程缺陷;
- 问题只在特定 SoC、存储介质、thermal 状态或厂商内核上出现。
2. 采集前先定义问题
内核 trace 事件量很大,采集前我们至少记录以下信息:
- ANR 类型和 timeout reason(超时原因);
- 目标包名、进程 PID、主线程 TID,以及 trace 内用于区分生命周期的
upid/utid; - 需要覆盖的时间窗;
- 想验证的假设,例如“主线程等 system_server 的同步 Binder”;
- 目标 build fingerprint(系统构建标识)、平台 tag 与 kernel release(内核版本)。
不同 ANR 的 deadline 并不相同,窗口不该固定向前看 5 秒。输入超时、广播、Service、ContentProvider 和 Job 的计时起点各不相同;窗口应从对应 timeout record(超时记录) 或业务事件起点向后覆盖到系统识别 ANR。若起点未知,可以先抓取更宽的环形窗口,再靠到手的数据缩小范围。
3. Android 17 中可用的数据源
3.1 atrace category(事件类别) 与 ftrace event
atrace.cpp 定义了 category 到 tracepoint(内核埋设的事件记录点) 的对应关系。诊断时应区分“category 名称”和“内核 event 名称”。
| 目标 | Android 17 配置 | Perfetto 侧主要入口 | 能回答的问题 |
|---|---|---|---|
| ActivityManager 标记 | atrace am;Track Event debug.anr | slice(带起止时间的事件片段)、Track Event(自定义时间标记) | ANR instant、系统侧阶段与 error id(事件标识) |
| 调度 | atrace sched | sched、thread_state | 运行、Runnable、Sleep、D-state 各持续多久 |
| CPU 频率 | atrace freq,按需加 idle | CPU frequency/idle counters(计数器) | 当时的频点、idle 和频率上限 |
| Binder | atrace binder_driver | Binder slices、flow(跨线程关联线)、android.binder stdlib(标准查询库) | 调用方、对端、事务与回复的 wall time(实际经过时间) |
| 文件系统与 bio | atrace disk | raw ftrace(原始内核事件)、filesystem slices | sync、writeback(脏页写回)、bio queue/complete |
| 块请求 | 显式启用 block/block_rq_* | ftrace_event 与 args | request 的 insert(入队)、issue(下发)、complete(完成)阶段 |
| 内存回收 | atrace memreclaim | reclaim slices/raw ftrace | 主线程或系统是否进入 direct reclaim |
这里有三条容易混淆的实现细节:
- 磁盘 category 叫
disk,没有名为block的 atrace category。 binder_driver只要求 transaction、received 和 alloc-buffer 事件。binder_lock是另一个可选 category;android17-6.18-2026-06_r6的 common kernelbinder_trace.h没有这些旧式全局锁事件。ftrace_event的事件字段存放在args(参数) 表中,debug_id、to_proc、sector都要到args里取。
3.2 先检查设备暴露了哪些 tracepoint
下面的命令用于检查目标设备是否暴露分析所需的 event,避免采集结束后才发现数据源缺失:
adb shell '
for event in \
  sched/sched_switch \
  sched/sched_waking \
  sched/sched_blocked_reason \
  binder/binder_transaction \
  binder/binder_transaction_received \
  block/block_rq_insert \
  block/block_rq_issue \
  block/block_rq_complete \
  power/cpu_frequency; do
  if [ -e "/sys/kernel/tracing/events/$event/enable" ]; then
    echo "yes $event"
  else
    echo "no  $event"
  fi
done'
no 可能来自内核配置、厂商裁剪、权限或 tracefs(内核追踪文件系统)挂载路径差异。它的含义止于“这台设备按当前方式采不到”,与“事件没有发生”是两回事。
3.3 推荐的 Perfetto 配置
下面的 textproto(Perfetto 文本配置格式)用于实验室复现。它保留调度、Binder、块请求、频率、idle 和 reclaim 事件,并抓取进程与线程的对应关系:
buffers {
  size_kb: 65536
  fill_policy: RING_BUFFER
}
duration_ms: 30000

data_sources {
  config {
    name: "linux.ftrace"
    target_buffer: 0
    ftrace_config {
      atrace_categories: "am"
      atrace_apps: "com.example.app"

      ftrace_events: "sched/sched_switch"
      ftrace_events: "sched/sched_waking"
      ftrace_events: "sched/sched_blocked_reason"

      ftrace_events: "binder/binder_transaction"
      ftrace_events: "binder/binder_transaction_received"
      ftrace_events: "binder/binder_transaction_alloc_buf"

      ftrace_events: "block/block_rq_insert"
      ftrace_events: "block/block_rq_issue"
      ftrace_events: "block/block_rq_complete"
      ftrace_events: "block/block_bio_queue"
      ftrace_events: "block/block_bio_complete"

      ftrace_events: "power/cpu_frequency"
      ftrace_events: "power/cpu_frequency_limits"
      ftrace_events: "power/cpu_idle"

      ftrace_events: "vmscan/mm_vmscan_direct_reclaim_begin"
      ftrace_events: "vmscan/mm_vmscan_direct_reclaim_end"
    }
  }
}

data_sources {
  config {
    name: "linux.process_stats"
    target_buffer: 0
    process_stats_config {
      scan_all_processes_on_start: true
    }
  }
}

data_sources {
  config {
    name: "track_event"
    target_buffer: 0
    track_event_config {
      enabled_categories: "debug.anr"
    }
  }
}
若需要在同一 trace 内解析 EventLog/logcat,再增加下面的数据源;前面的配置没有自动包含 android.log。atrace_apps 也要换成目标包名。
data_sources {
  config {
    name: "android.log"
    android_log_config {
      log_ids: LID_EVENTS
      log_ids: LID_SYSTEM
      log_ids: LID_DEFAULT
    }
  }
}
debug.anr 是 PerfettoCategories.ANR_CATEGORY 的 category 名。64 MB 环形缓冲和 30 秒时长只是复现起点。应根据设备事件速率、丢事件统计、问题周期和内存预算调整,这组数值不宜直接照搬到线上。
临时复现也可以用 atrace 快速抓取。下面的命令会在设备上抓 30 秒并把输出保存到主机:
adb shell atrace -z -b 32768 -t 30 \
  sched freq idle binder_driver disk memreclaim am \
  > anr-repro.atrace
-b 32768 的单位是 KB。atrace 对各 category 的覆盖由目标版本 atrace.cpp 决定;若要拿到 block_rq_insert/issue/complete,应使用前面的显式 Perfetto 配置。
4. 建立可靠的时间参照
ProcessErrorStateRecord 在 ANR 处理中写入 AM_ANR EventLog,并通过 Perfetto SDK 发出名为 ANR Detected 的 instant(没有持续时间的瞬时事件),参数可以包含 anrId、errorId、timeout、PID。这个 instant 比“猜一个 am_anr slice 名”可靠,但它仍可能受 feature flag(功能开关)、ANR 路径和 trace category 影响。
我们建议按下面的优先级定位:
- 在 Perfetto 中搜索
ANR Detected,核对 PID、ANR id 或 error id; - 用
AM_ANR、stats atom(系统统计事件)、系统日志和 timeout reason 交叉确认; - 用 ANR 文件 header 辅助对齐,不把文件写入时间当成检测时刻;
- 缺少系统 instant 时,用应用自定义 Track Event 标记输入、生命周期或任务起点。
Perfetto SQL 的 ts 使用 trace 内部时钟,EventLog 和日志文件常带 wall clock(日期时间)。手工对齐不同产物时,应使用 trace 中的 clock snapshot(时钟对应关系快照) 或同一个业务标记做换算;“纳秒 ts”和日期字符串直接相减得不出有效结果。
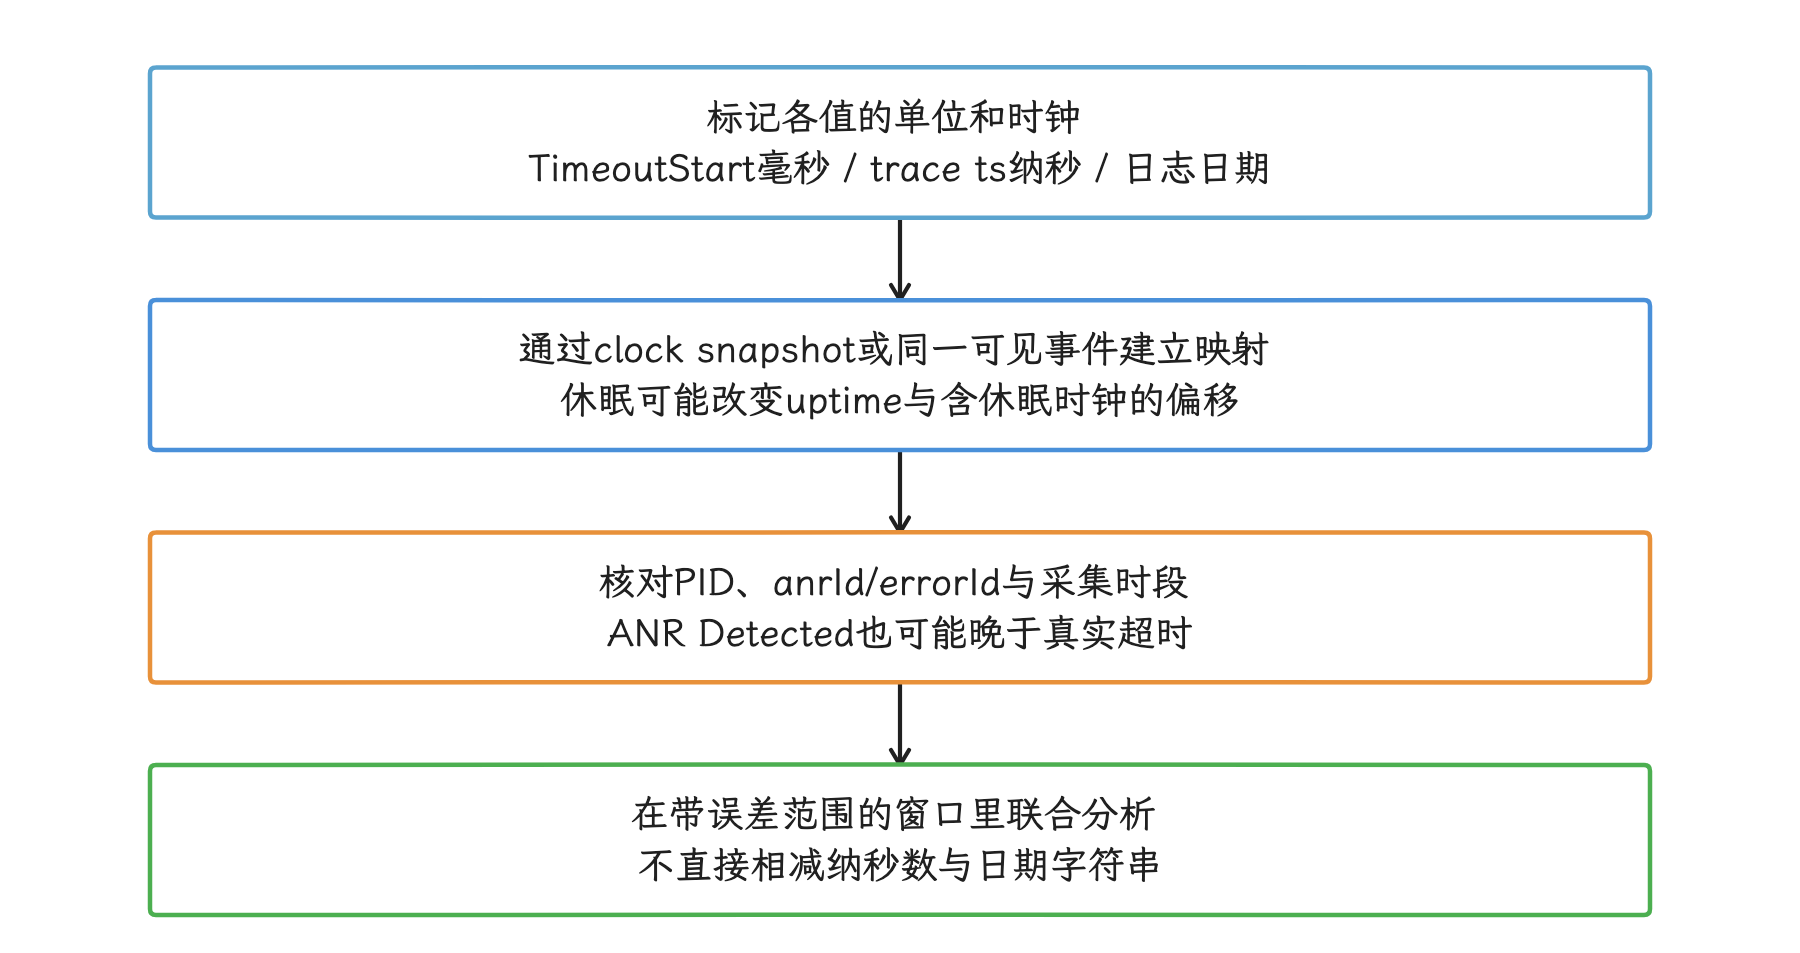
图:没有系统instant时,用业务起点和日志建立带误差范围的时间参照;应用标记不等于系统detector到期记录。
5. 从主线程状态开始
5.1 sched 与 thread_state 各自表示什么
sched 的每一行表示某线程在 CPU 上运行的一段时间,线程键 utid 是 Perfetto 在本次 trace 内分配的线程标识。end_state 表示该运行片段结束后进入的状态:
| 值 | 含义 |
|---|---|
R / R+ | 离开 CPU 后仍可运行,常见于抢占或时间片结束 |
S | 可中断睡眠,等待唤醒 |
D | 不可中断睡眠 |
X / Z | 退出或 zombie(进程已结束但退出状态尚未被父进程回收) |
NULL | 没有解析到运行片段的结束状态,常见于 trace 截止时仍未闭合 |
end_state 不会用 Running 表示当前片段;行本身就是 Running 区间。要统计等待时间,我们查询 thread_state,它会给出 Running、R、S、D 等状态区间。
下面的 SQL 用于列出目标进程主线程在分析窗口内的状态,并把跨出窗口的 slice 裁剪到窗口以内:
WITH params AS (
  SELECT
    42 AS target_utid,
    123000000000 AS window_start,
    133000000000 AS window_end
), observed AS (
  SELECT
    MAX(s.ts, params.window_start) AS ts,
    MIN(
      CASE WHEN s.dur = -1 THEN trace_bounds.end_ts
           ELSE s.ts + s.dur END,
      params.window_end
    ) AS end_ts,
    s.state, s.io_wait, s.blocked_function,
    s.dur = -1 AS observed_open
  FROM thread_state s
  CROSS JOIN params
  CROSS JOIN trace_bounds
  WHERE s.utid = params.target_utid
    AND (s.dur > 0 OR s.dur = -1)
    AND s.ts < params.window_end
)
SELECT ts, end_ts - ts AS dur, state,
       io_wait, blocked_function, observed_open
FROM observed
WHERE end_ts > ts
ORDER BY ts;
先从前面的结果选出事件所属进程的主线程 utid,再替换 target_utid 和两个时间端点;utid/upid 只在当前 trace 内有效。这里 dur=-1 表示缺少闭合终点,查询仅把它统计到 trace_bounds.end_ts 与窗口终点中较早者,并用 observed_open 标记;线程是否在该处恢复,从这里看不出来。未采到的时间、丢事件和数据源晚启动仍可能留下空洞,要比较状态时长之和与窗口长度,空洞保持未知就好,别补成 Sleeping。结果先描述“线程经历了什么状态”,根因仍需与栈、Binder flow、reclaim、I/O 和 CPU 负载在时间上对齐。
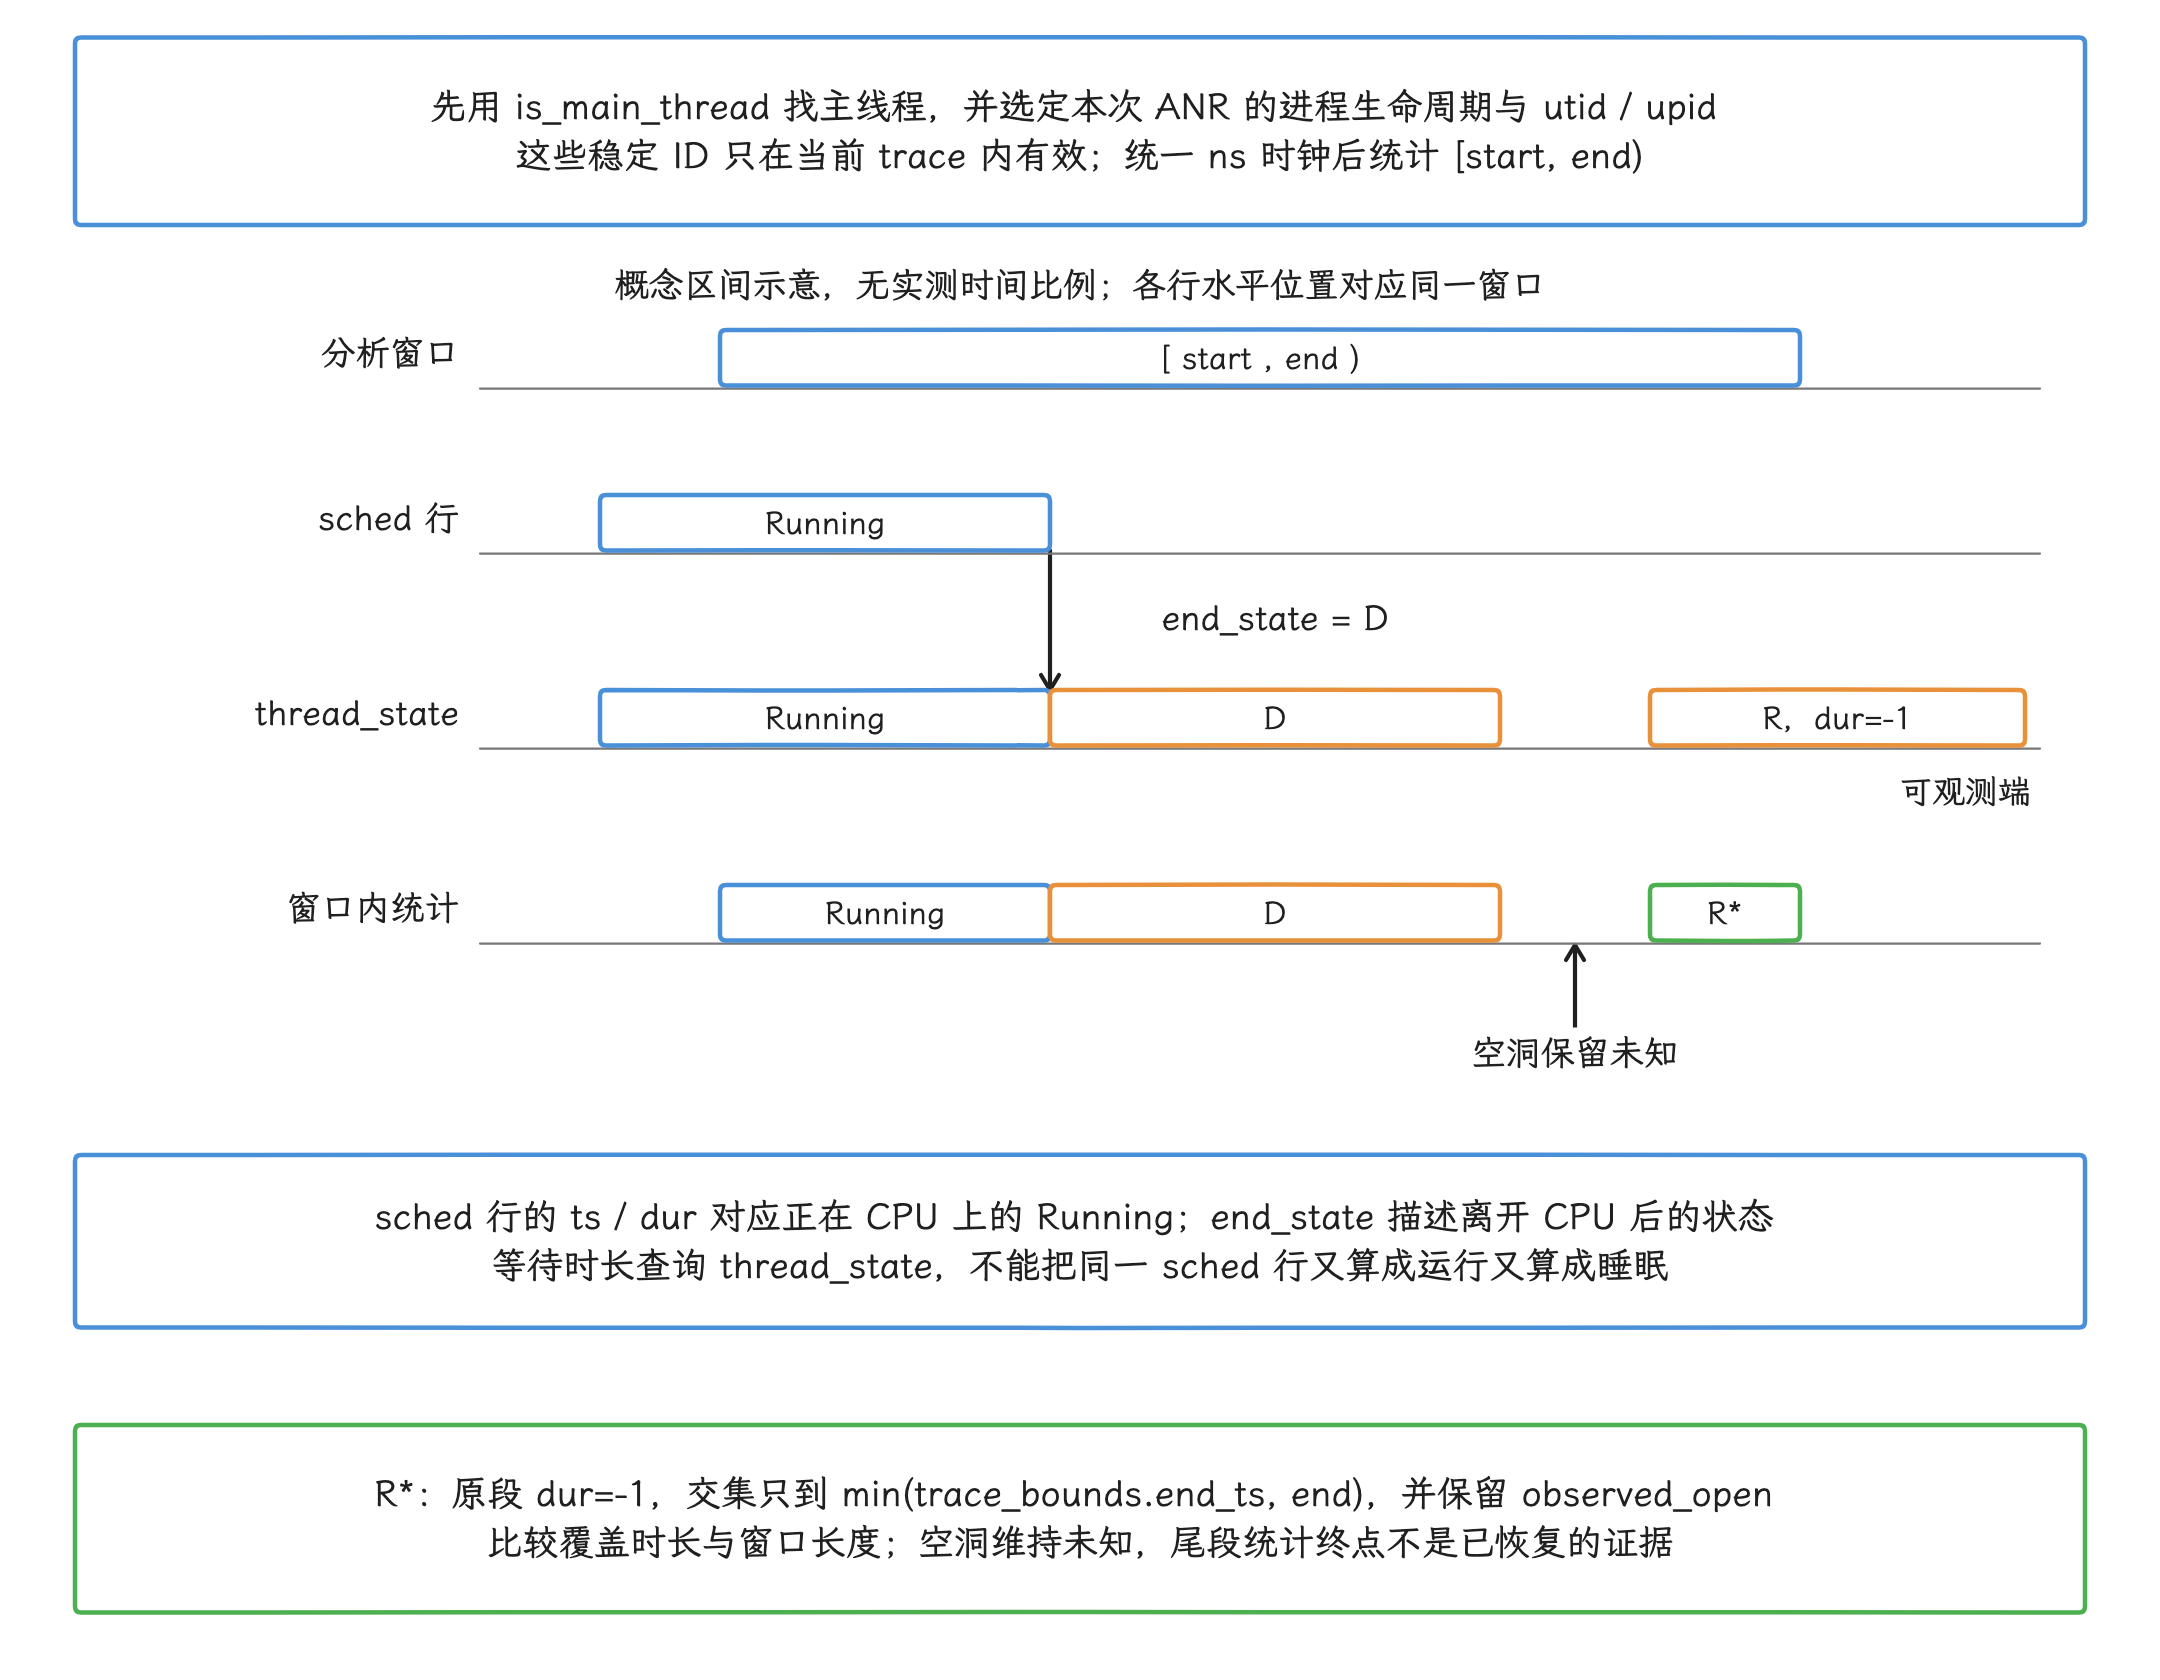
图:区间为概念示意,不是测量结果。先用is_main_thread选本次生命周期及当前trace的utid/upid,统一ns时钟,再与[start,end)取交集。sched行本身是Running,示例end_state=D说明离开CPU后进入的状态;D的等待时长来自thread_state。原段dur=-1仅统计到min(trace_bounds.end_ts,window_end),保留observed_open,图中的R*只表示区间在此截断,线程是否已恢复未知。覆盖空洞始终未知,别把它补成Sleeping;统计总覆盖需与窗口长度核对,状态分布本身不直接证明根因。
下面的聚合查询用于计算窗口内各状态的时长分布:
WITH params AS (
  SELECT
    42 AS target_utid,
    123000000000 AS window_start,
    133000000000 AS window_end
), observed AS (
  SELECT
    MAX(s.ts, params.window_start) AS ts,
    MIN(
      CASE WHEN s.dur = -1 THEN trace_bounds.end_ts
           ELSE s.ts + s.dur END,
      params.window_end
    ) AS end_ts,
    s.state, s.io_wait, s.blocked_function,
    s.dur = -1 AS observed_open
  FROM thread_state s
  CROSS JOIN params
  CROSS JOIN trace_bounds
  WHERE s.utid = params.target_utid
    AND (s.dur > 0 OR s.dur = -1)
    AND s.ts < params.window_end
)
SELECT state,
       SUM(end_ts - ts) / 1e6 AS duration_ms,
       SUM(observed_open) AS open_intervals
FROM observed
WHERE end_ts > ts
GROUP BY state
ORDER BY duration_ms DESC;
运行占比没有通用的 30% 分界线。10 秒窗口里主线程只运行 50 ms,可能是在等待一个正常的异步结果,也可能遭遇调度饥饿;我们还要看它在等待什么、何时被唤醒,以及完成期限是否已经到期。
5.2 Runnable 时间
thread_state.state 为 R 或 R+ 时,线程具备运行条件却没有占用 CPU。遇到长 Runnable 区间,我们继续检查:
- 同期哪些进程消耗了 CPU;
- 目标线程的 nice、cgroup(控制组)、uclamp 和调度策略;
- 是否有实时线程、长 IRQ(硬件中断) 或 vendor(厂商) driver activity(厂商驱动活动);
- CPU 是否 online(已启用),频率上限是否受 thermal/power policy(温控或功耗策略) 约束;
- 唤醒发生在哪个 CPU,线程迁移是否频繁。
下面的查询用于列出窗口内 CPU 时间最高的进程:
WITH params AS (
  SELECT
    123000000000 AS window_start,
    133000000000 AS window_end
), observed AS (
  SELECT
    p.upid, p.pid,
    COALESCE(p.name, '[unresolved process]') AS process_name,
    MAX(s.ts, params.window_start) AS ts,
    MIN(
      CASE WHEN s.dur = -1 THEN trace_bounds.end_ts
           ELSE s.ts + s.dur END,
      params.window_end
    ) AS end_ts,
    s.dur = -1 AS observed_open
  FROM sched s
  JOIN thread t USING (utid)
  LEFT JOIN process p USING (upid)
  CROSS JOIN params
  CROSS JOIN trace_bounds
  WHERE COALESCE(t.is_idle, 0) = 0
    AND (s.dur > 0 OR s.dur = -1)
    AND s.ts < params.window_end
)
SELECT upid, pid, process_name,
       SUM(end_ts - ts) / 1e6 AS cpu_ms,
       SUM(observed_open) AS open_intervals
FROM observed
WHERE end_ts > ts
GROUP BY upid, pid, process_name
ORDER BY cpu_ms DESC
LIMIT 20;
这里按 upid 区分同名进程的不同生命周期,并排除 idle 线程;无进程元数据的线程归入 unresolved,仅凭 NULL 还认定不了它是内核线程。open_intervals 标记统计到可观测末尾的未闭合运行。各 CPU 上运行时间相加后,多核设备的 cpu_ms 可以高于实际经过的窗口时长。排名只能说明同期有哪些 CPU 竞争者;指认“谁抢走了主线程的 CPU”,光靠 sched_switch.next_pid 一项还不够。
5.3 sched_blocked_reason
在 android17-6.18-2026-06_r6 中,sched_blocked_reason 的注释和事件定义都限定为 uninterruptible sleep(不可中断睡眠)。事件字段为:
pid:被记录的线程;caller:__get_wchan()得到的内核等待位置;io_wait:该 task(内核任务) 当时的in_iowait标记。
Perfetto 会把可解析结果放入 thread_state.blocked_function 和 io_wait。它不为普通的 S 状态 futex 等待提供通用调用栈,futex_wait_queue_me 也不算 D-state 的固定模式。
blocked_function 只是等待位置线索。io_schedule、文件系统 wait、driver completion(驱动完成回调)或 reclaim 函数,都要结合相邻事件和符号化质量(地址能否正确解析为函数名)解释。io_wait=1 能增强 I/O 假设,却标识不了某个具体 request(请求)。
5.4 CPU 频率与 thermal
低频本身证明不了 thermal throttling(温控限频):线程休眠或负载很低时,DVFS(动态电压频率调节)主动降频是正常行为。我们认定 thermal 影响,至少要同时满足:
- 目标线程存在持续 Runnable 等待或业务工作量;
cpu_frequency与cpu_frequency_limits显示可用上限下降;- thermal zone(温度区域)、cooling device(限频或散热控制设备)或厂商 power/thermal track 在同一时间变化;
- 高频竞争、CPU hotplug(CPU 核动态上下线)和 idle 解释得并不比 thermal 更好。
如果 trace 只采到了 cpu_frequency,结论应写成“低频与延迟时间重合,thermal 原因待补证”。
6. Binder:拆开客户端等待与服务端处理
同步 Binder 的客户端 wall time(从调用开始到返回的实际经过时间)包含多段:
- 客户端组包和进入驱动;
- 事务投递及服务端 Binder 线程获得运行机会;
- 服务端方法执行,期间还可能发起嵌套 Binder;
- reply 投递;
- 客户端线程重新被调度。
binder_transaction 在发送事务的线程上下文触发,common kernel 字段包括 debug_id、target_node、to_proc、to_thread、reply、code 和 flags。发送方 PID 不在 payload(事件携带的数据字段)中,应通过 ftrace_event.utid 关联 thread、process。binder_transaction_received 只带相同的 debug_id。
从 send 到 received 的间隔,除了驱动执行还包含接收线程取得事务、获得 CPU,并运行到 received tracepoint 之前的等待。固定用 10 ms 判定“驱动竞争”,会把调度和线程池排队时间误算到驱动。
6.1 优先使用 Perfetto Binder 标准库
Perfetto 会根据 Binder tracepoint 生成 transaction slice 和 flow。下面的查询用于查看目标进程在窗口内发起的 Binder 调用:
INCLUDE PERFETTO MODULE android.binder;

WITH params AS (
  SELECT 7 AS client_upid,
         123000000000 AS window_start,
         133000000000 AS window_end
)
SELECT
  txn.binder_txn_id, txn.client_ts,
  txn.client_upid, txn.client_utid,
  txn.client_dur / 1e6 AS client_wall_ms,
  txn.client_process, txn.client_thread,
  txn.server_upid, txn.server_utid,
  txn.server_process, txn.server_thread,
  CASE WHEN txn.server_dur >= 0 THEN txn.server_dur / 1e6 END
    AS server_wall_ms,
  txn.aidl_name, txn.interface, txn.method_name
FROM android_binder_txns txn
CROSS JOIN params
WHERE txn.client_upid = params.client_upid
  AND txn.is_sync = 1
  AND txn.client_dur > 0
  AND txn.client_ts < params.window_end
  AND txn.client_ts + txn.client_dur > params.window_start
ORDER BY txn.client_dur DESC;
这条查询只保留已能关联且客户端区间已闭合的同步事务。先替换 client_upid;筛选采用与窗口相交的条件,输出的 client_wall_ms/server_wall_ms 仍是整次事务的时长,窗口内贡献要另行折算。oneway 已单独排除;客户端尚未闭合或缺少配对事件的事务仍要回到原始 slice/flow 检查,查询无结果时 Binder 等待照样可能存在。server_wall_ms 为 NULL 时按“未知”处理,零时延是误读。二者还需与双方 thread_state 联合分析:服务端长时间处于 R,更可能存在调度延迟;长时间 Running 表示执行量较大;S 则可能在等待锁或嵌套调用。
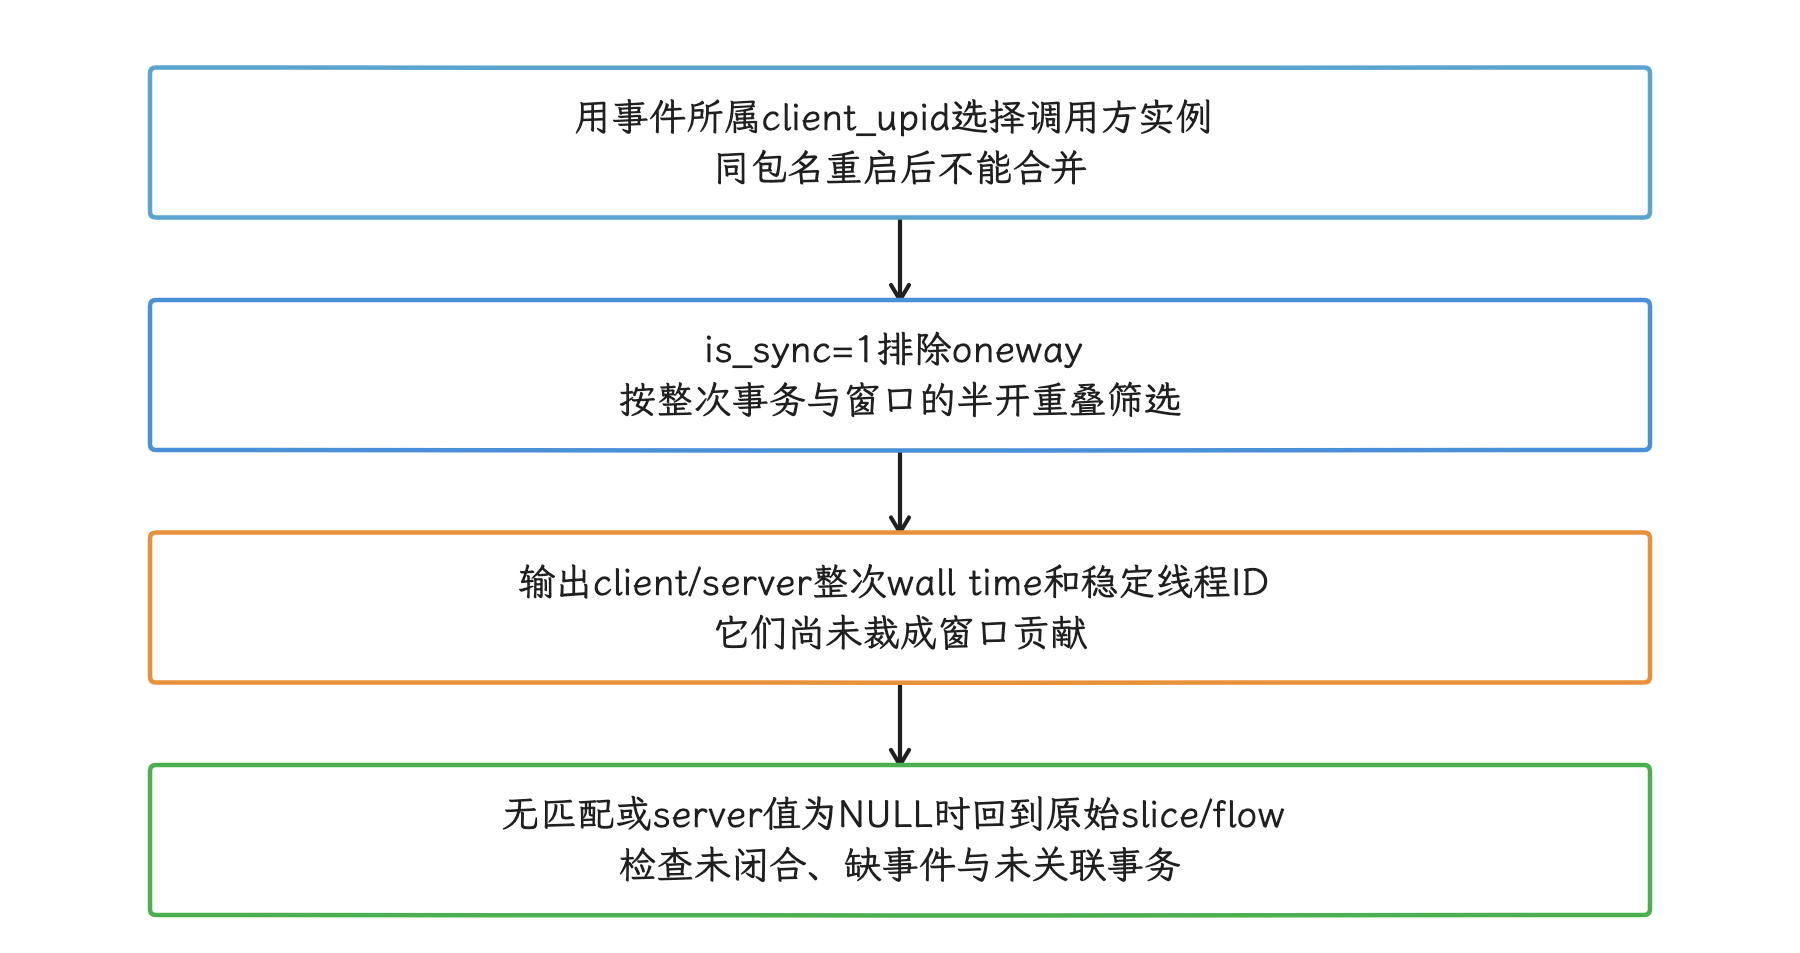
图:查询只覆盖可关联且客户端已闭合的同步事务;没有行,也证明不了没有Binder等待。
主机侧 Perfetto 工具支持较新的标准库时,可以加载 android.binder_breakdown,查看同一事务的延迟主要发生在 client 侧还是 server 侧:
INCLUDE PERFETTO MODULE android.binder;
INCLUDE PERFETTO MODULE android.binder_breakdown;

WITH params AS (
  SELECT 7 AS client_upid,
         123000000000 AS window_start,
         133000000000 AS window_end
)
SELECT
  txn.binder_txn_id, txn.client_ts,
  txn.client_process, txn.server_process, txn.aidl_name,
  breakdown.reason_type, breakdown.reason,
  SUM(
    MIN(breakdown.ts + breakdown.dur, params.window_end)
      - MAX(breakdown.ts, params.window_start)
  ) / 1e6 AS duration_ms
FROM android_binder_txns txn
JOIN android_binder_client_server_breakdown breakdown
  USING (binder_txn_id)
CROSS JOIN params
WHERE txn.client_upid = params.client_upid
  AND txn.is_sync = 1
  AND breakdown.dur > 0
  AND breakdown.ts < params.window_end
  AND breakdown.ts + breakdown.dur > params.window_start
GROUP BY txn.binder_txn_id, txn.client_ts,
  txn.client_process, txn.server_process, txn.aidl_name,
  breakdown.reason_type, breakdown.reason
ORDER BY duration_ms DESC;
标准库会随 trace processor(Perfetto trace 解析器)演进。查询报“module/table 不存在”时,先核对模块名、工具版本和字段,可升级主机侧工具重试,或用兼容的原始表查询。升级只解决解析能力;如果原 trace 没采 Binder、调度或所需字段,仍需要重新采集,缺失的事件事后补不出来。
6.2 用原始事件核对字段
下面的查询用于确认 Binder 原始事件有哪些参数:
SELECT
  event.ts,
  event.name,
  thread.tid,
  process.pid,
  process.name AS process_name,
  args.key,
  args.int_value,
  args.string_value
FROM ftrace_event event
LEFT JOIN thread USING (utid)
LEFT JOIN process USING (upid)
JOIN args USING (arg_set_id)
WHERE event.name IN (
  'binder_transaction',
  'binder_transaction_received'
)
ORDER BY event.ts, args.key;
字段键名受 trace processor 版本影响,我们先查看 args.key,再编写 EXTRACT_ARG() 查询更稳妥。要把 code 解释为具体方法,还需结合正确的 AIDL interface(接口) 和该 build 生成的 transaction 常量。
6.3 判断路径
- 客户端长等待,服务端很晚才开始:检查服务端 Binder 线程可运行时间、线程池占用和调度压力。
- 服务端及时开始但执行很久:展开服务端 slice、嵌套 Binder、锁、I/O 和 CPU 栈。
- 服务端很快回复,客户端晚恢复:检查客户端 Runnable 时间、freezer(进程冻结机制)和优先级。
- 多个调用方同时等待同一服务:检查服务端共享锁、全局队列和资源依赖。
- trace 没有对应 transaction:核对采集窗口、PID/TID 复用、oneway(异步 Binder 事务)语义和 event 是否启用。
Binder 线程名随 Java/native 实现和进程而变化,只用 Binder:<N> 过滤会漏掉目标。应以 flow、PID/TID 和事务 slice 为主。
7. I/O:区分调用点、文件系统和设备阶段
Java 栈停在 FileDescriptor.sync()、SQLite checkpoint 或资源读取附近,只能说明取样点接近 I/O。完整路径还可能经过 page cache(文件页缓存)、writeback、文件系统 journal(日记账)、dm-crypt/dm-default-key(块设备加密层)、device mapper(设备映射层)、blk-mq(多队列块层) 和 UFS 存储驱动。
7.1 write() 之后的等待位置
普通 buffered write(2)(缓冲写)往往把数据复制进 page cache 后返回。线程更容易在以下位置产生长等待:
- page fault 或内存分配进入 direct reclaim;
- dirty page throttling(脏页过多时限制继续写入);
fsync/fdatasync等待数据和 metadata(元数据) 持久化;- SQLite transaction、WAL sync 或 checkpoint;
- direct I/O(绕过页缓存的直接读写);
- 文件系统、device mapper 或驱动 completion。
因此,把每次 write() 都描述成“主线程进入 D,直到 block_rq_complete”并不成立。
7.2 Android 17 / kernel 6.18 的块事件
块层用 request 表示送往设备的请求,用 bio 表示块 I/O 操作。android17-6.18-2026-06_r6 中的事件含义如下:
block_rq_insert:request 即将插入队列;block_rq_issue:request 发送给 device driver;block_rq_complete:驱动报告 request 的一部分完成,可能仍有尚未完成的 bio;block_bio_queue/block_bio_complete:bio 进入块层及全部工作完成。
insert→issue 可以反映 request 在块队列中的一段等待,issue→complete 覆盖驱动可见的服务阶段。文件系统准备、page cache、reclaim、request merge(请求合并)、device mapper 和完成后的线程唤醒,都在这两个区间之外。
这些 raw event 都没有可以稳定跨事件使用的 request id。仅用 dev + sector(设备号与扇区号) 配对,会在并发、merge、split(请求拆分)、重复访问同一扇区和 partial completion(部分完成) 时发生错配。完成事件也常在 IRQ 或 kworker(内核工作线程)上下文触发,按 ftrace_event.utid 归属到最初发起 I/O 的应用会张冠李戴。
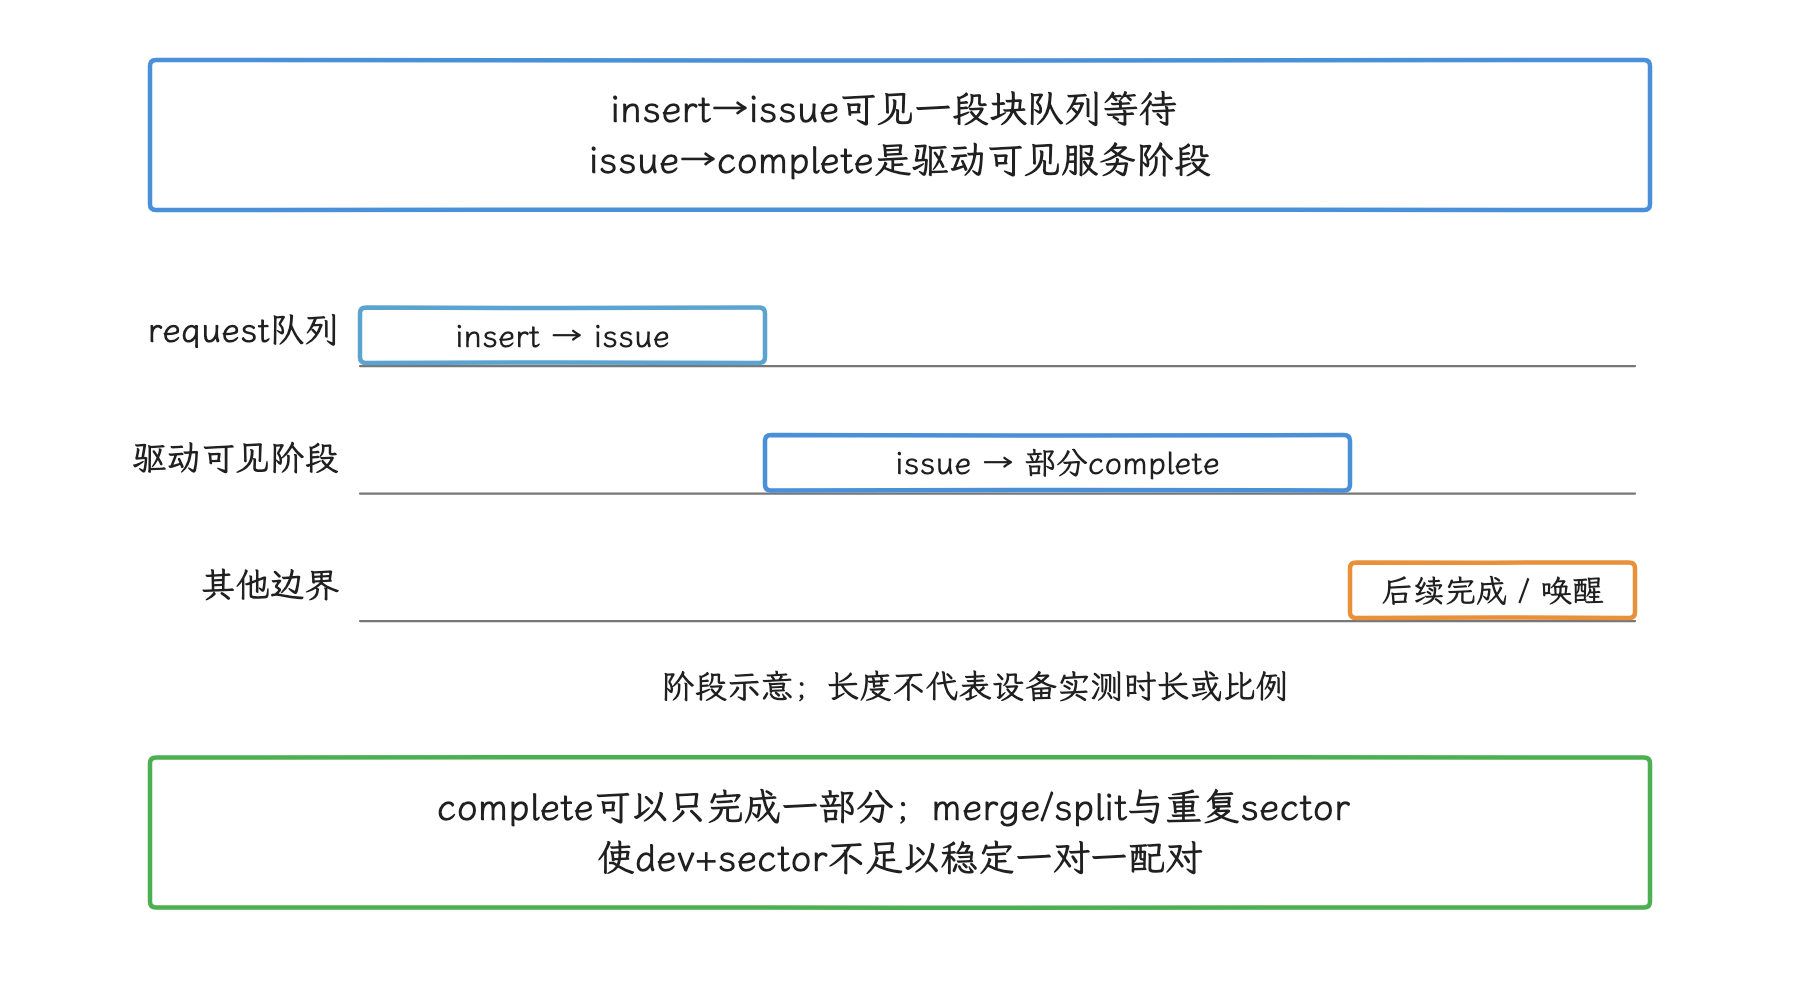
图:原始事件通常不带稳定request ID;完成事件的发射线程可能是IRQ或kworker,别记到原始应用头上。
下面的查询用于查看目标窗口内块事件的真实参数,避免进行依据不足的一对一配对:
SELECT
  event.ts,
  event.name,
  thread.name AS emitter_thread,
  process.name AS emitter_process,
  args.key,
  args.int_value,
  args.string_value
FROM ftrace_event event
LEFT JOIN thread USING (utid)
LEFT JOIN process USING (upid)
JOIN args USING (arg_set_id)
WHERE event.name IN (
  'block_rq_insert',
  'block_rq_issue',
  'block_rq_complete',
  'block_bio_queue',
  'block_bio_complete'
)
  AND event.ts >= 123000000000
  AND event.ts < 133000000000
ORDER BY event.ts, event.name, args.key;
拿到 dev、sector、nr_sector、rwbs、comm 和 error 等键后,可以按目标内核字段制作局部分析脚本。结论中要保留 merge 与 partial completion 带来的不确定性。
7.3 联合判断
一条可信的 I/O 归因通常包含四组证据:
- 应用栈或用户空间 slice 指向同步 I/O;
- 主线程
thread_state在同一时间进入 D、reclaim 或同步等待; - 文件系统/bio/request 事件在窗口内出现异常长尾或排队;
- request 完成、reclaim 结束或锁释放后,主线程被唤醒并继续执行。
若只有“主线程 D + 全机有慢 block request”,结论只能写到相关性。要证明因果,还需要 syscall(系统调用)或内核栈采样、文件系统 trace、device mapper 路径或可控复现实验。
固定的 4 KB/50 ms、1 MB/100 ms 阈值不适用于所有设备。判断设备是否变慢,要与同机型、同温度、同队列深度、同 request 类型的正常数据比较,并分开观察耗时分位数和明显偏离主体分布的样本。
8. 内存回收和全局压力
主线程 D-state 或耗时较长的 syscall 也可能来自 direct reclaim。采集 mm_vmscan_direct_reclaim_begin/end 后,我们检查:
- reclaim 是否发生在目标线程上下文;
- 回收区间是否与主线程等待重合;
- PSI memory(资源压力导致任务停顿的时间)、major fault、kswapd(后台内存回收线程)、compaction(内存规整) 和 swap/zram(交换区或压缩内存) 是否同时上升;
- 多个前台进程是否一起变慢;
- 触发点是一次大分配、缺页,还是全局内存压力。
应用发起大分配与系统内存紧张可以同时成立,没必要把责任强行二分为“应用侧”或“系统侧”。修复可能包括降低内存峰值、把工作移出完成期限、避免同步触发缺页,也可能需要调整系统内存参数和 vendor 策略。
9. AnrHelper 与取样偏差
ANR 处理走异步队列:目标进程的转储先提交,完整 ANR 处理可能排队。检测路径把记录交给 AnrHelper.appNotResponding();AnrHelper 先把目标进程的临时转储提交给 early-dump executor(执行器),再由 AnrConsumer 依次处理队列并调用 ProcessErrorStateRecord.appNotResponding()。后者设置 notResponding 状态、写入 AM_ANR EventLog、发出 Perfetto ANR instant(瞬时事件),随后组织目标进程、parent、system_server、persistent(常驻系统进程) 及 native interest(系统关注的 native 进程) 进程转储。
AnrHelper 还会对同一 PID 的 predump(预转储)、queued ANR(已排队记录) 和正在处理的 ANR 去重,由 consumer(队列消费者) 串行处理记录。因此文件里各段栈来自不同时刻:
- 目标进程的 early dump 更接近超时现场,后续进程的栈可能晚数秒。
- 排队超过 10 秒或开机 10 分钟内的记录会走
onlyDumpSelf,从“文件里没有对端栈”推导不出“系统没有尝试采集对端”;这样处理的目的是避免已经失去时效的大范围采集继续增加系统压力。
排障时我们记录:
- ANR 检测时刻;
- early dump 的时刻;
- 完整 trace 中各 PID 段落的时间;
reportLatency、dump duration(转储耗时)、超时或 fallback(回退路径) 日志;- 是否处于
onlyDumpSelf,或 silent/background ANR(不弹出前台 ANR 对话框的后台处理) 路径。
这组时间能解释“ANR 时主线程被卡住,trace 却已经回到 nativePollOnce”一类矛盾。线程可能在 dump 到达前恢复,栈没有错,只是样本晚了。
10. eBPF 的适用范围
Android 的 eBPF 基础设施早于 Android 14。内核配置、SELinux、BPF loader(加载器) 和稳定性评估允许时,系统组件可以用 BPF 在内核事件发生时做过滤和聚合。这份能力留在系统侧:第三方应用没有随意加载 BPF 程序的权限,BPF 在应用侧也扮演不了通用 ANR SDK 的角色。
BPF 程序仍会在事件路径上执行,事件频率、map(BPF 键值存储)操作、栈采样和上报都会产生开销。若系统团队采用它辅助 ANR,需在目标内核与 SoC 上测量 CPU、内存、功耗、丢事件情况和 verifier(内核安全校验器)限制,并提供停用开关。BPF 的校验和权限只说明程序满足加载约束,零开销、绝不扰动事件时序,这些它都保证不了。
11. 从证据生成分类
自动分类可以按下面的顺序产出“候选原因”:
- 用 ANR instant、reason 和 PID 定义窗口;
- 计算主线程
thread_state分布; - 对长
S检查 monitor、Binder flow 和嵌套调用; - 对长
R检查 CPU 竞争、优先级、频率上限与 thermal 状态; - 对长
D检查blocked_function、reclaim、文件系统和 block 事件; - 对长 Running 检查用户态 slice、CPU sampling(定期采样调用栈)、GC 和业务阶段;
- 输出证据、反证、置信度及仍缺的数据。
分类结果止步于“Binder ANR”“I/O ANR”这样的标签,指导修复的力度有限。更便于采取行动的描述是:“主线程在输入期限的 4.2 秒内等待同步 Binder;server 线程晚 3.6 秒开始运行;同一窗口 server 的全部 Binder 线程持续处理请求;未发现客户端长 Runnable。”这样的结论能指向服务端线程池、共享锁或请求合并策略,也保留后续验证空间。
12. 生产采集策略
不同 SoC、kernel config(内核配置)、trace processor 和业务负载下的事件采集成本差异很大,固定百分比套不到所有组合。上线前应覆盖目标设备组合并测量:
- tracing 开关前后的 CPU、功耗、帧时延和 Binder/I/O P95/P99(95%/99% 样本不超过的分位值);
- 每秒 trace 字节数、buffer wrap(环形缓冲覆盖一轮)周期与
ftrace丢事件数量; - ANR 快照成功率、覆盖时长、文件大小和限流命中率;
- 低内存、thermal、存储压力下的额外扰动;
- 脱敏、保留期、上传网络与用户授权。
实践上可分三层:
- 开发复现:按假设显式开启完整事件,保留 CPU sampling 和用户空间业务标记;
- 灰度诊断:只在一部分设备上启用,并限制时长和触发频率,验证数据质量及开销;
- 线上快照:优先使用系统提供的 trigger-based capture(按系统事件触发采集),只解析已经采到的类别,不声称 ANR 后能补回未采集的历史事件。
每次修改 category 都应重新测量。设备提供某个 tracepoint,未必适合持续开启;低频测试结果也外推不到 Binder 或 I/O 请求集中出现的场景。
13. 一份联合诊断报告应包含什么
交付给应用、Framework 或内核团队时,报告至少包含:
- build fingerprint(系统构建标识)、它与
android-17.0.0_r1的对应关系,以及内核与android17-6.18-2026-06_r6的对应关系; - ANR 类型、reason、检测时刻、目标 PID/TID;
- ANR trace 中主线程栈及该段转储时间;
- Perfetto 分析窗口和时钟对齐方法;
- 主线程 Running/R/S/D 时长;
- Binder、reclaim、filesystem(文件系统)、block、frequency、thermal 的相关证据;
- 能排除的假设;
- 结论置信度、缺失事件与下一次复现要增加的数据源。
联合诊断靠的是时间一致性:线程栈说明取样位置,scheduler(调度器) 说明线程何时能运行,Binder flow 说明跨进程依赖,filesystem/block 说明 I/O 经过了哪些阶段。只有这些证据在同一个窗口互相支持时,才适合把“相关”写成“根因”。
常见误区
ANR 分析里有几个反复出现的误判,把它们集中列出来,方便对照检查。
看到 nativePollOnce 就排除应用责任
nativePollOnce 表示 Looper 在采样时正通过 native poll 等待新事件,只能证明该采样点空闲。回看 T_deadline 前的主线程消息、输入流和 ANR 类型,才能判断耗尽期限的工作是否已经结束。
应用 CPU 占比最高就直接优化 CPU
前台计算、渲染和启动都可能让应用成为采样区间内的 CPU 热点。先确认主线程是否长期处于 Running、热点是否位于超时路径,以及移除热点能否降低 wall time,再决定优化对象。
D 状态等于磁盘慢或被冻结
D 只表示线程处于不可中断等待。要判断具体原因,我们需要结合 kernel callstack(内核调用栈)、block I/O(块设备读写)、驱动事件或 cgroup 冻结证据。
高 Load 足以证明系统问题
Load 同时统计可运行任务和不可中断等待任务,常见的 1、5、15 分钟数值还是衰减平均值,几秒钟的 ANR 窗口装不进这个尺度。要判断目标线程受到的影响,还是回到该窗口内的 sched 调度事件、CPU 频率、I/O 和 PSI 上看。
trace 中的附加进程都是 Binder 对端
系统还会收集 parent、system_server、persistent、可能的输入法、native interest 和 CPU 活跃进程。只有 Binder transaction flow(事务流) 或调用双方的栈能够证明对端关系。
一份 ANR trace 足够覆盖全程
线程转储只记录一个采样点,ApplicationExitInfo 保存的又只是目标进程的第一段 trace。疑难问题需要结合 Perfetto、系统日志、业务事件和多次同类样本,补齐超时前后的执行过程。
相关章节
- 9.1 ANR 机制、类型与触发条件:监视器、deadline 与报告路径。
- 9.3 特殊与跨边界 ANR:冻结、焦点和厂商场景。
- 9.4 ANR 诊断案例集:把证据流程用于完整案例。
- 1.9 Android IPC 全景与 Binder 性能:同步事务、线程池与调用链。
- 14.6 Android Tracing 基础设施与自定义 Trace:ftrace、atrace 与 trace_marker。
- 26.2 崩溃与 ANR 监控:线上聚合与监控体系。
参考资料
-
Android Common Kernel android17-6.18-2026-06_r6:futex wait/wake
-
Android Common Kernel android17-6.18-2026-06_r6:cgroup v2 freezer
-
Android Common Kernel android17-6.18-2026-06_r6:sched trace events
-
Android Common Kernel android17-6.18-2026-06_r6:Binder trace events
-
Android Common Kernel android17-6.18-2026-06_r6:block trace events