Kotlin Coroutine、Flow 与线程调度实践
协程可以在等待期间释放线程,也可能把大量细小任务集中到同一条调度路径。分析性能时,我们要区分四件事:协程何时挂起、保存后续执行状态的 continuation 是否需要 dispatch(提交给调度器)、目标线程何时拿到 CPU,以及业务代码实际运行了多久。这四个阶段常被笼统称作“协程切换”,混在一起就看不清延迟出在哪一层;下面我们按阶段把它们拆开。
源码基线:kotlinx.coroutines 1.11.0 公开 API;平台 AOSP
android-17.0.0_r1;内核android17-6.18-2026-06_r6。协程库随应用独立升级,Dispatcher 的内部实现跟着协程库版本走,Android API 级别说明不了它。
⚠️ 校勘(2026-10-23):旧文把出队画在取得 CPU 之前,将 limitedParallelism 的片段串行近似为整个任务串行,并把回调恢复 / yield 固定计为调度;这里按 1.11.0 源码与 API 修正。另更新 Tracing 2.0 稳定状态、热流无订阅者行为及 SQL 的线程身份 / 窗口边界。
从挂起到恢复的七个阶段
以下七项是分析阶段,不是每次都会发生的固定七步。挂起调用也可能立即返回;只有实际挂起时,才会把后续执行交回恢复路径:
- 业务到达可能挂起的位置;编译生成的状态机与 continuation 保留后续执行所需状态。
- I/O、计时器、锁或其他等待条件满足,恢复方提交结果。
- 恢复路径依据目标上下文、
isDispatchNeeded及取消状态决定是否 dispatch。 - 可直接恢复时走当前调用栈或事件循环;需要 dispatch 时才将
Runnable提交到目标队列。 - 排队路径需要目标线程执行;若线程需唤醒或正等待 CPU,内核先让它进入 Running。
- 已在运行的目标线程从队列取出任务,并执行恢复与取消检查。
- 协程继续业务代码,或以取消 / 失败结束。
直接恢复可以跳过排队阶段;已经在运行的 worker 直接复用即可,无须为每个任务重新唤醒。线程必须已经取得 CPU,才能执行出队代码,把“出队后才取得 CPU”画成固定顺序,方向就反了。
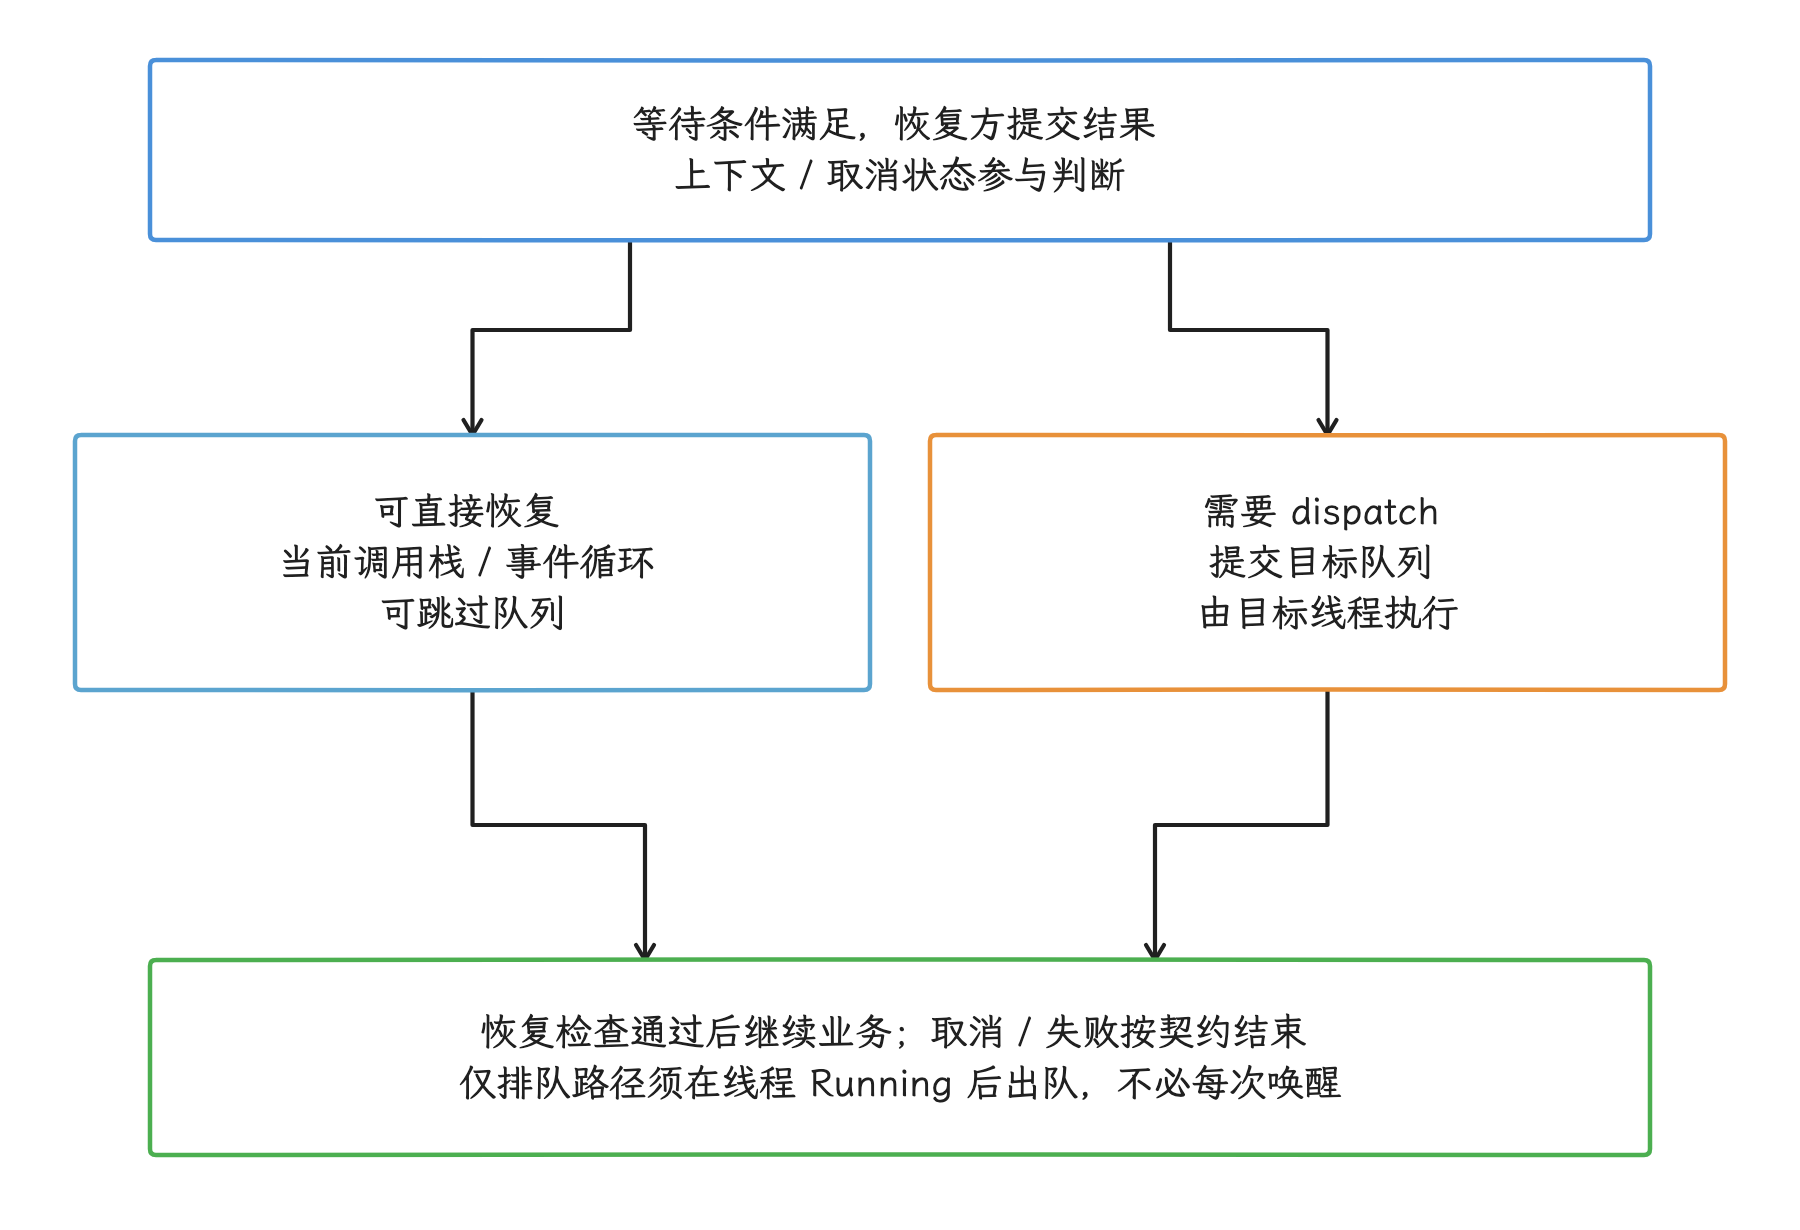
图:直接恢复与排队恢复有不同路径;worker 必须已在运行,才能执行出队和恢复代码。
这些阶段里,状态机由编译器生成,恢复与 dispatch 由协程库和上下文协调;第 5 项描述线程调度条件,第 6 项才是线程池或 Android Looper 上的执行。Perfetto 里的 Runnable 表示线程已经具备运行条件、正在等 CPU;continuation 还停在 Dispatcher 队列里的等待,则不会直接显示成该线程的 Runnable。业务方法消耗 CPU 的时间落在第 7 步。所以只统计 suspend 函数从开始到结束的墙钟时间,我们还是分不清慢在哪一层;要看清,就把这几段分别量出来。
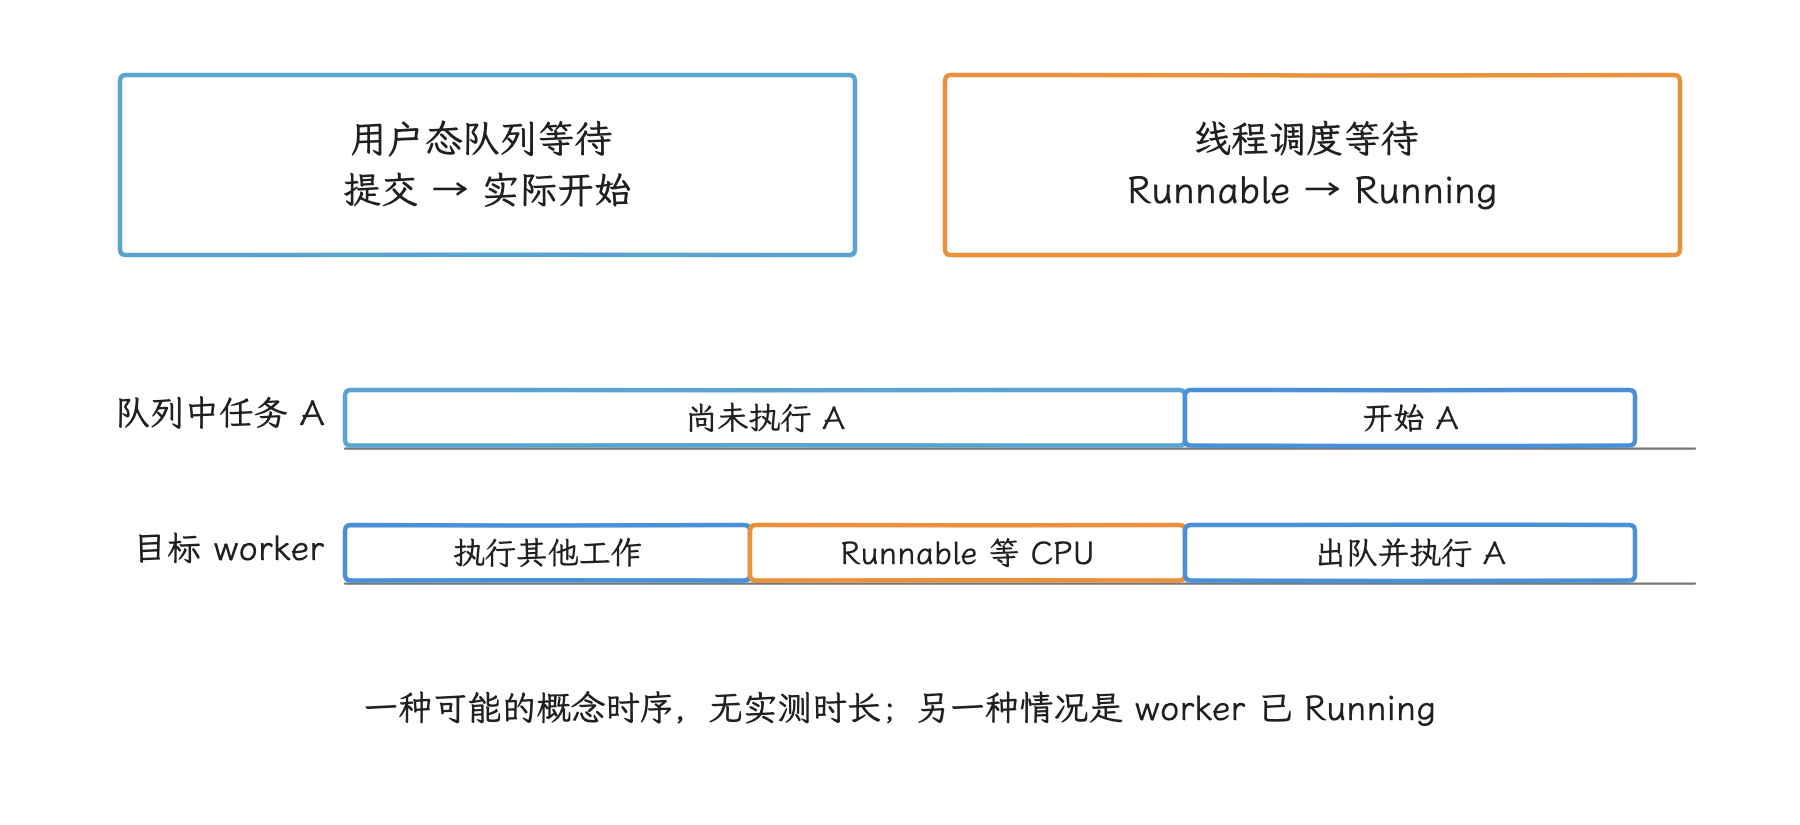
图:continuation 等队列不自动等于线程 Runnable;线程可能正执行其他工作,也可能尚未拿到 CPU。
Dispatcher 选择:选执行约束,不按“前台/后台”命名
四个标准 Dispatcher
| Dispatcher | 执行模型 | 适合的工作 | 容易写错的地方 |
|---|---|---|---|
Dispatchers.Main | Android 主 Looper 对应的单线程 Dispatcher | UI 状态读取与更新、很短的主线程工作 | suspend 函数仍可能阻塞;队列拥塞不会消失 |
Dispatchers.Default | 共享后台调度器,面向 CPU 任务;worker 有本地队列,并可通过 work stealing 从其他队列取任务 | 排序、解析、压缩、纯计算 | 阻塞 I/O 会占住计算并行度 |
Dispatchers.IO | 面向阻塞 I/O 的弹性视图,与 Default 共享线程和资源 | 阻塞文件、阻塞 socket、旧数据库或 SDK API | suspend 网络 API 往往已经自行调度;IO 不适合所有后台代码 |
Dispatchers.Unconfined | 调用帧内启动,挂起后在恢复方所在线程继续 | 少数框架、测试和高级控制场景 | 没有线程约束,嵌套执行顺序也不应依赖 |
Main:Handler、Looper 与队列延迟
Android 上的 Main Dispatcher 由 kotlinx-coroutines-android 提供:1.11.0 的 AndroidDispatcherFactory 用主 Looper 请求创建 async Handler(API 28+ 使用公开创建接口,较低版本反射失败时可回退到普通 Handler),HandlerContext.dispatch() 再调用 handler.post(block)。async message 可以越过 MessageQueue 的同步屏障,但仍要排队等主线程当前的回调,以及排在前面的其他可执行消息。协程路径上还有 Job、continuation、取消检查和上下文元素要处理,把这些环节都算上,再拿一次普通方法调用当参照就不合适了。
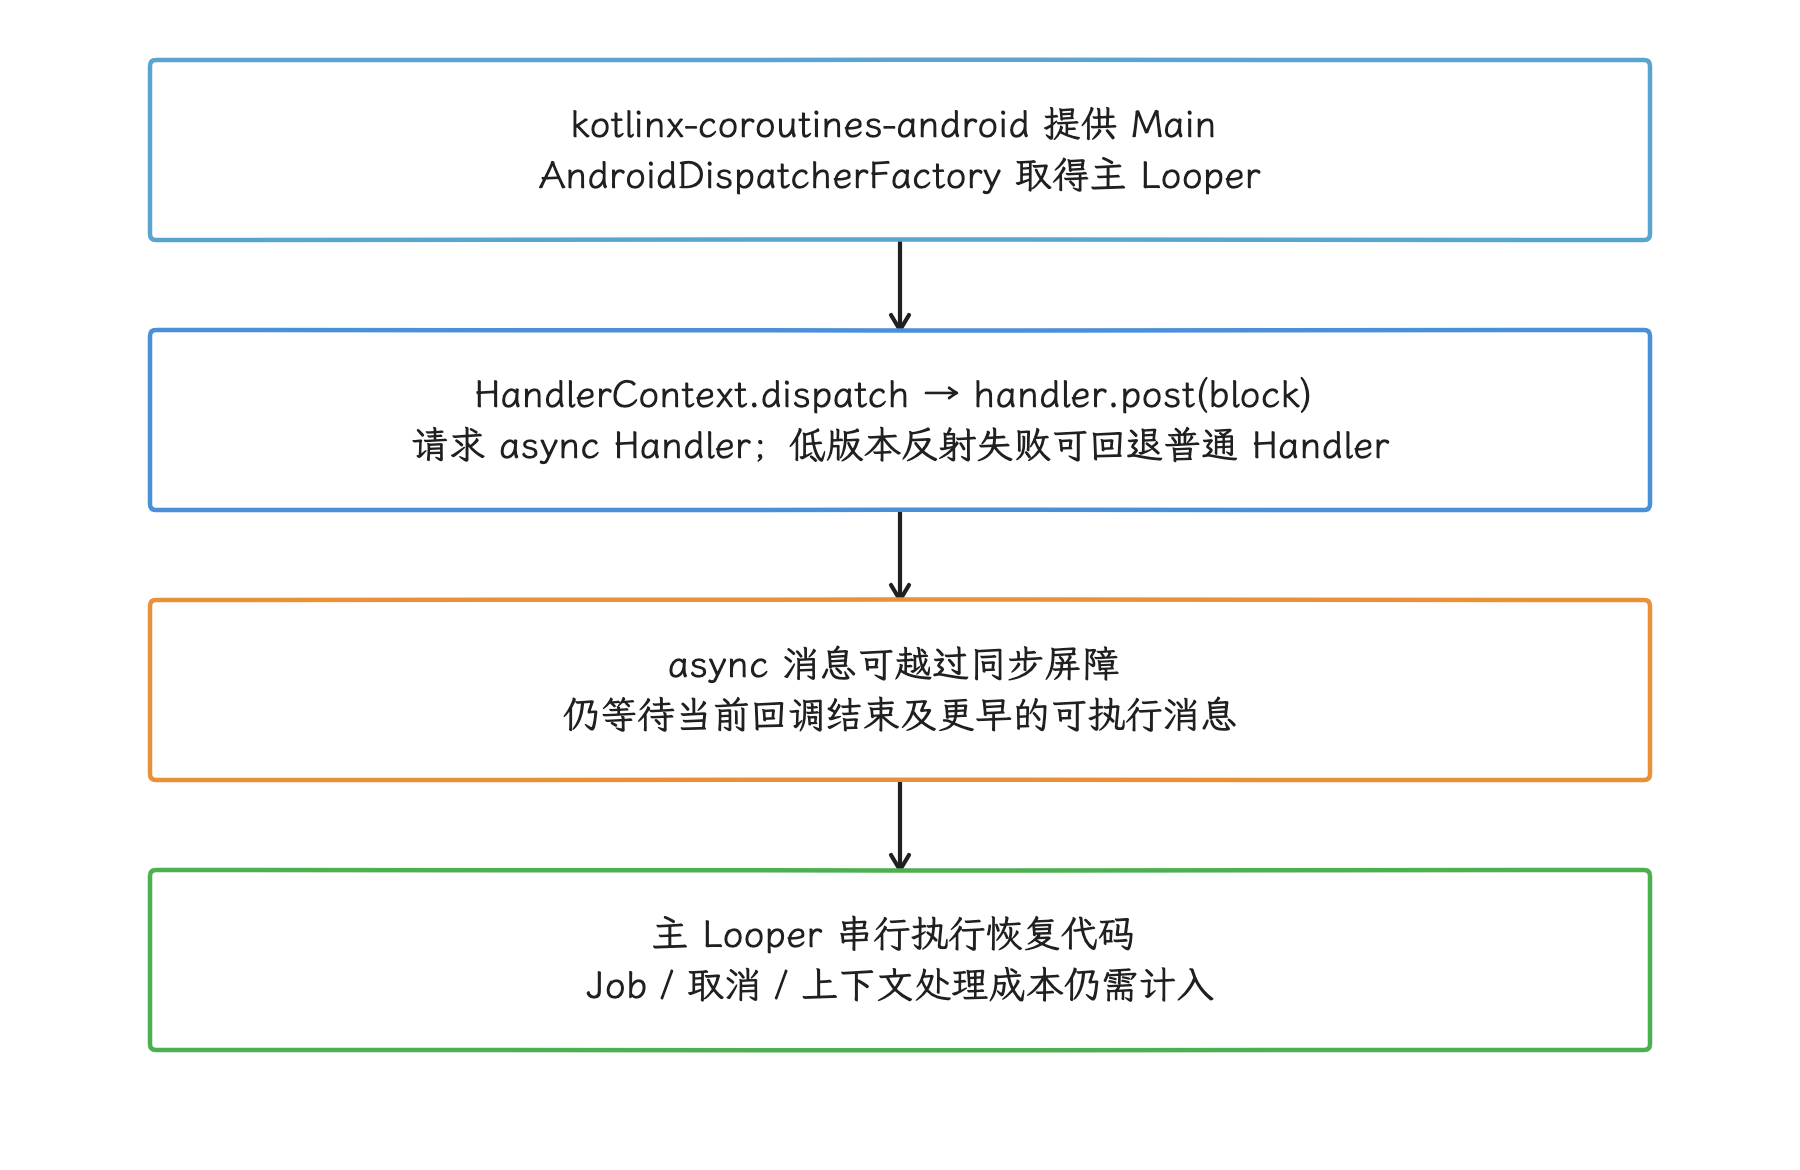
图:Android Main 经 async Handler 投递;绕过同步屏障不等于抢占当前回调或绕过所有消息。
Dispatchers.Main.immediate 在当前线程已经是目标 Looper 时,可以跳过一次重新投递;从其他线程进入时仍会 dispatch。直接执行会改变事件先后顺序,也可能发生同步重入,也就是当前调用尚未退出、就再次进入同一段状态逻辑。要不要用它,先看业务能否接受这两种行为;省一次 post 只是附带的好处,还够不上选择它的理由。
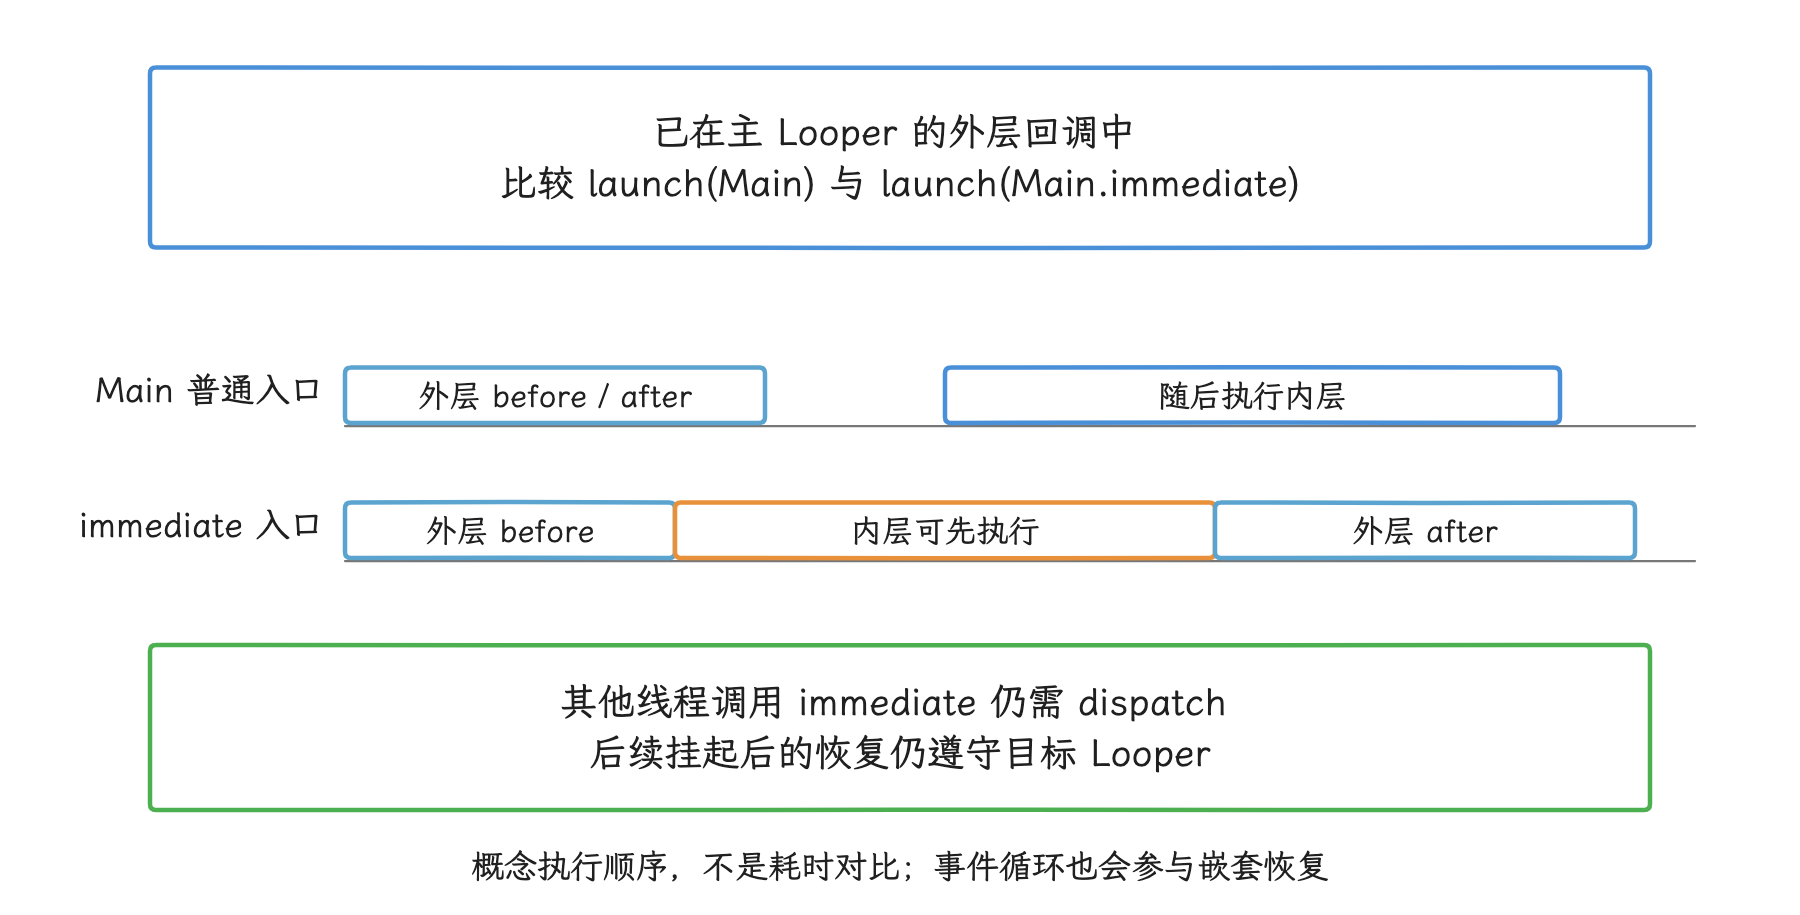
图:已在目标 Looper 时入口可跳过 post;嵌套执行顺序与同步重入须由状态逻辑承受。
Android 17 为 target API 37+ 的应用默认启用新的无全局队列锁 MessageQueue(兼容开关和设备实现仍须核对),减少了一类入队和队列管理竞争;但主线程仍然一次只执行一个回调,前面的长消息、其他 async message、帧回调和 Binder 返回照样造成队列延迟。
Default:CPU 并行度与阻塞补偿
Default 面向持续占用 CPU 的任务。当前 JVM 调度器使用共享 worker、本地队列、全局队列和 work stealing(空闲 worker 从其他队列窃取任务);CPU 任务的有效并行度接近可用处理器数量,并保留最低并行度。这些内部实现可能随 kotlinx.coroutines 版本变化,我们写业务代码时,要把具体的 worker 数量、队列顺序和线程名当成会变的细节。
CPU 任务数量超过并行度后,新增任务排队属于预期行为。把阻塞调用放进 Default,会一直占住 worker。调度器的补偿线程只面向被正确标记为 blocking 的内部任务,普通业务代码需要自己安排,所以我们要主动把阻塞调用放到 IO 或专用的受限 Dispatcher。
IO:默认限制与弹性视图
Dispatchers.IO 默认允许并行执行的阻塞任务数,是 64 与处理器数量二者中的较大值,可以通过 kotlinx.coroutines.io.parallelism 调整。这个数管的是默认 IO 视图中同时执行的阻塞任务;进程里能同时存在多少协程或线程,是另一回事。
Dispatchers.IO 之所以容易出现更多 worker,有两层原因。一层是默认 IO 并行度较大;另一层在 1.11.0 的实现里:DefaultScheduler.dispatch() 默认用 NonBlockingContext,Dispatchers.IO 则通过 UnlimitedIoScheduler 把 Runnable 以 BlockingContext 交给同一个 CoroutineScheduler。TaskContext 只是一个 blocking / non-blocking 标记,至于 Runnable 是不是真的在等 I/O,调度器并不查看;同一段代码放到 Default 或 IO,在它眼里就是两种任务类型。来源:固定版本的调度器与任务标记源码。
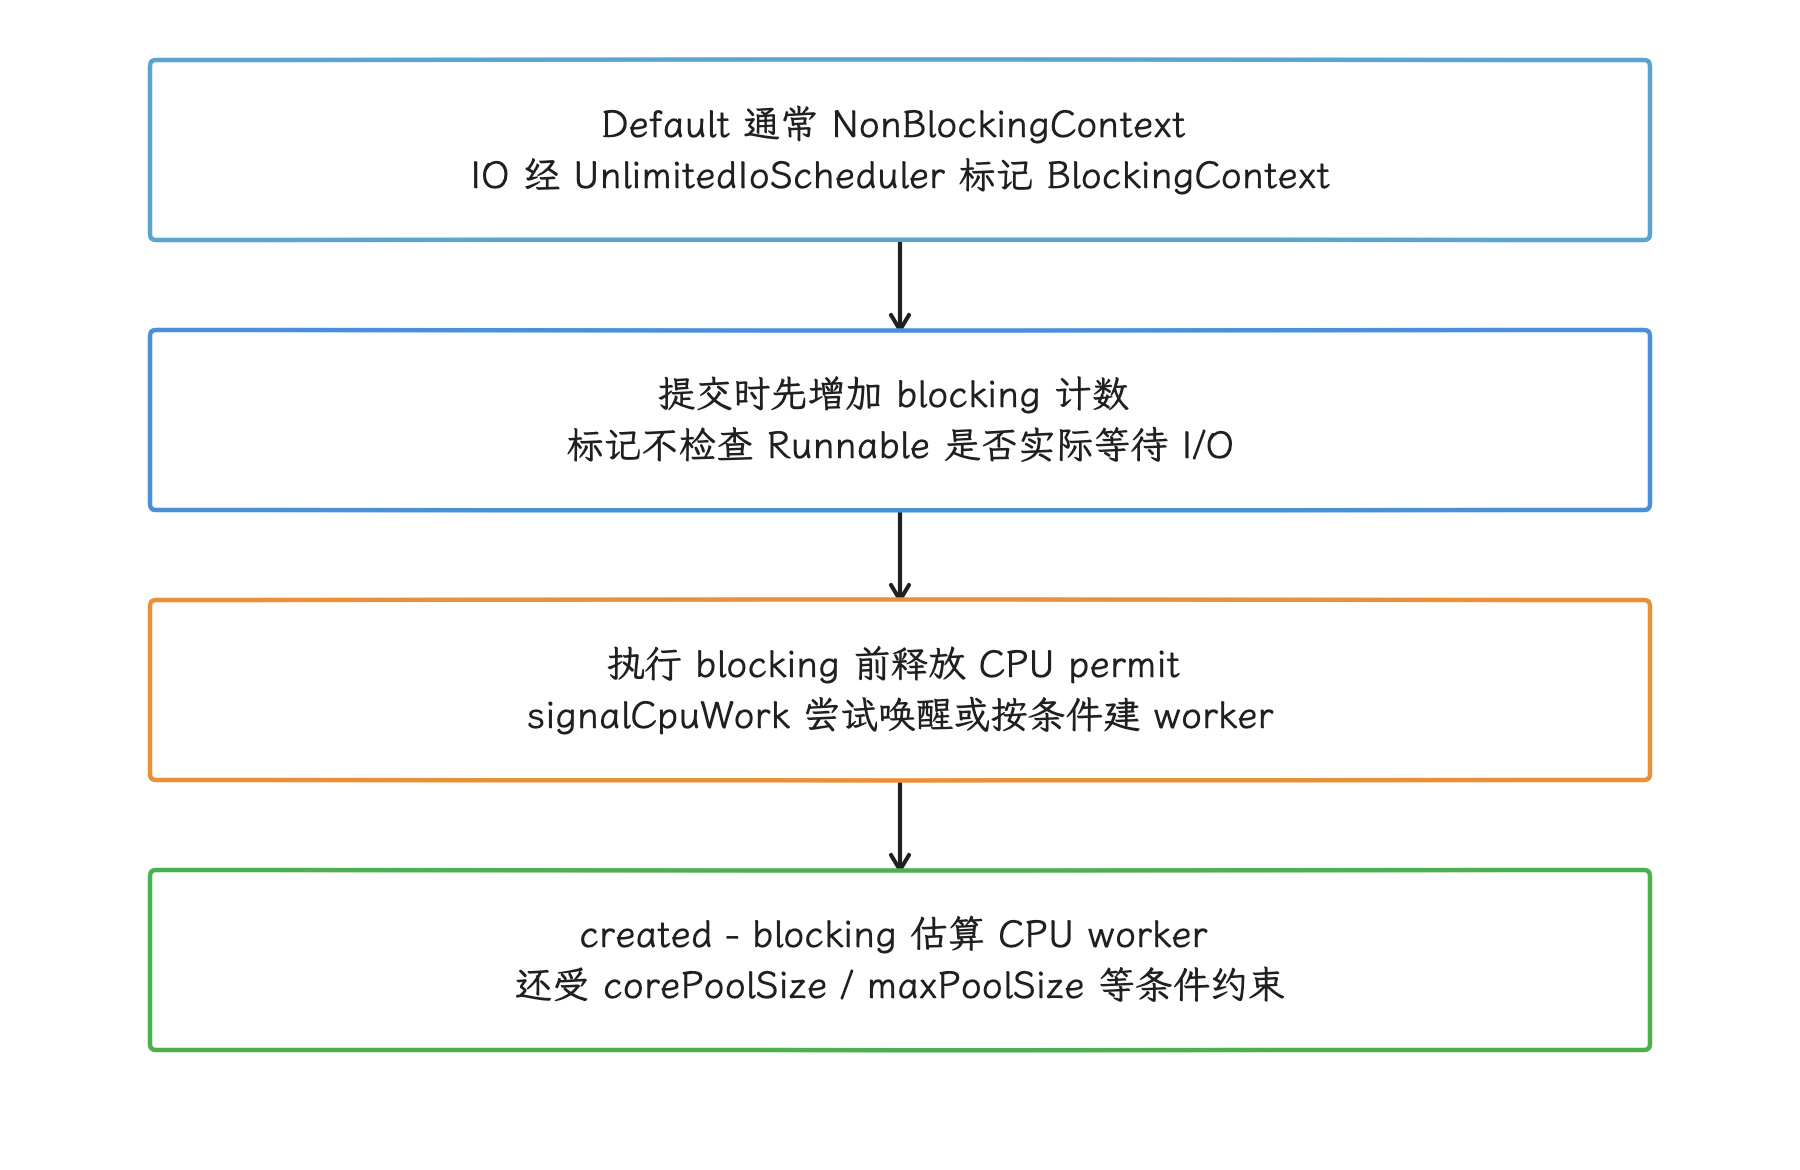
图:TaskContext 是库方标记;释放 CPU permit 与条件性唤醒 / 建 worker 解释线程增加,不能凭线程数认定真实 I/O。
调度器处理 blocking task 时,会先增加 blocking 计数;worker 执行 blocking task 前会进入 BLOCKING 状态并释放 CPU permit,随后 signalCpuWork() 可以唤醒或创建 worker 来保留 CPU 任务并行度。tryCreateWorker() 估算 created - blocking 后,如果可处理 CPU work 的 worker 少于 corePoolSize,且尚未达到 maxPoolSize,才会创建新 worker。这就解释了 IO 场景 worker 数可能超过 Default 并行度的原因。我们排查时除了数线程,还要同时看 IO 并行度、各个 limitedParallelism 视图、blocking 调用数量,以及 worker 是否真的处在 Sleep / I/O wait。来源:固定版本的调度器与任务标记源码。
Dispatchers.IO.limitedParallelism(n) 创建的是弹性视图:每个视图不受默认 IO 并行度上限约束,但仍共享底层线程和资源。如果同时创建并行度为 100 和 60 的两个视图,峰值阻塞并行度就可能叠加。它适合表达两个外部系统各自的并发预算,但我们要同时算清进程总并发量。
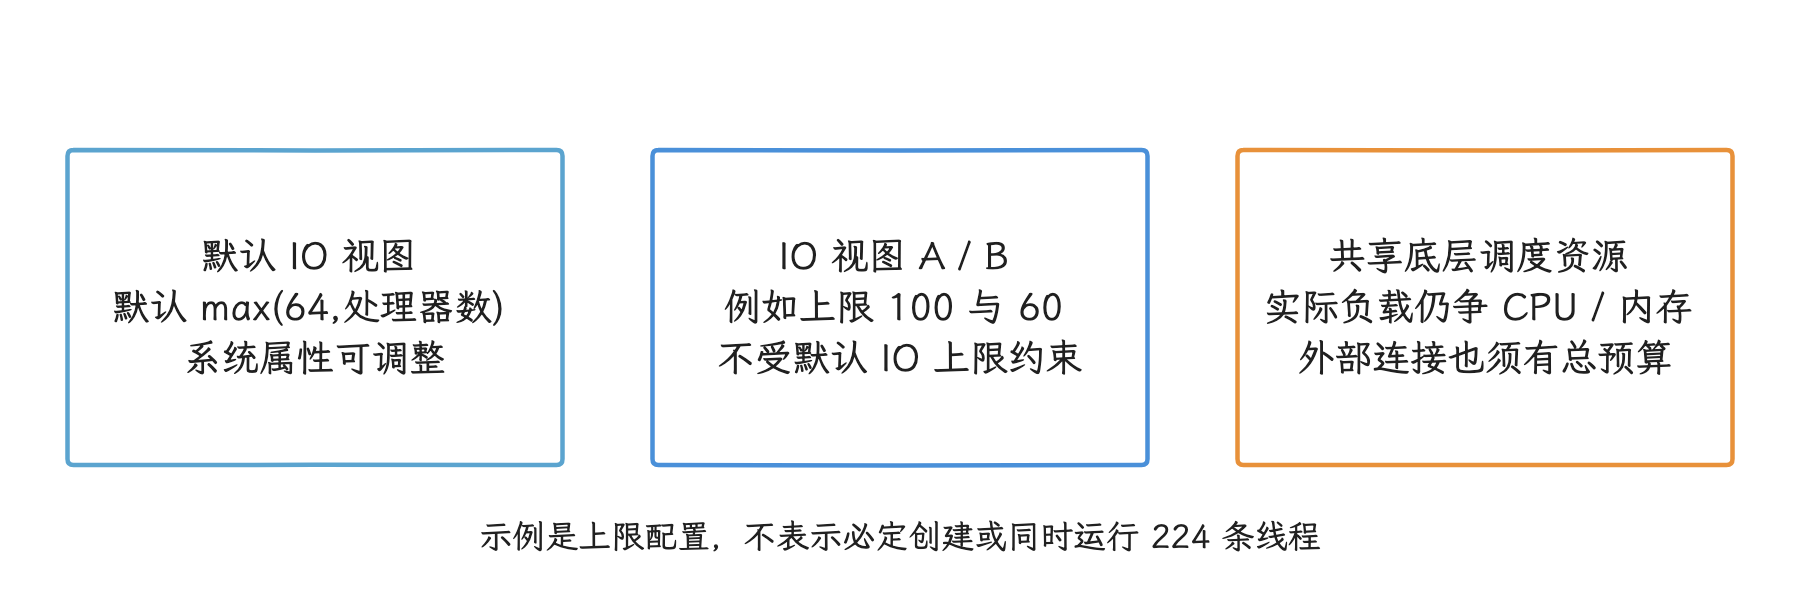
图:每个 IO 视图有自己的执行上限;100 与 60 可叠加,默认 IO 的限制不是进程总线程或在途请求上限。
Default 与 IO 共享底层线程:协程当前已经在 Default worker 上时,切换到 IO 后可能用的还是同一条线程。官方把这种复用描述为 best effort(尽力而为):线程可能保持一致,也可能随时换掉,业务代码要按“随时可能换线程”来设计。
Unconfined:线程不受约束,结构仍可存在
Unconfined 会在调用者当前调用栈中开始执行,第一次挂起后的恢复线程则由挂起函数决定。嵌套的 Unconfined 协程靠内部事件循环避免栈溢出;执行顺序没有稳定保证,写代码时以实际调用为准。
线程约束和 Job 父子关系是两个独立维度。Unconfined 保留了结构化并发的父子关系,代价是代码究竟在哪个线程运行变得难以推断。需要“在当前调用栈执行到首次挂起,后续仍回到指定 Dispatcher”时,可以评估 CoroutineStart.UNDISPATCHED;普通 UI 和数据层代码,我们优先选线程约束明确的 Dispatcher。
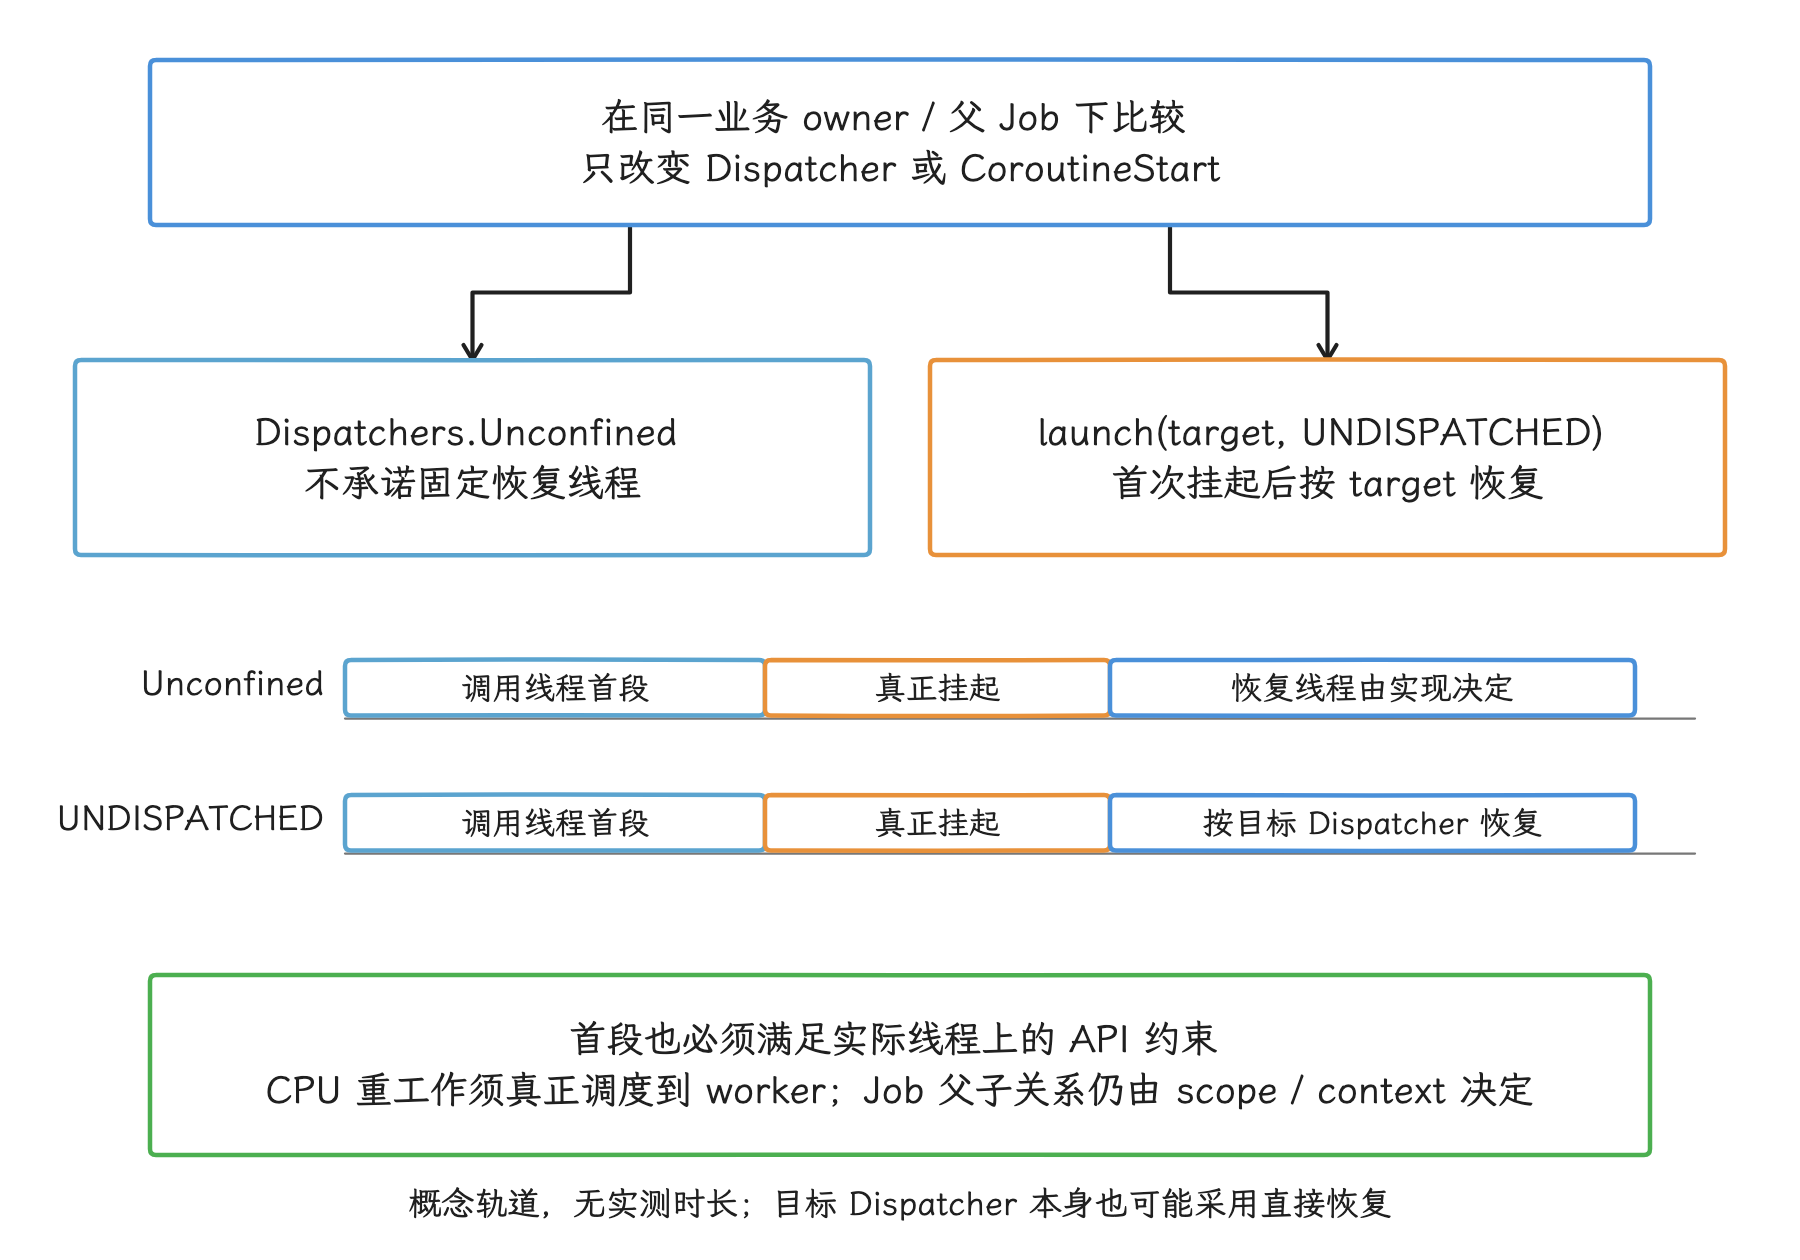
图:两者都可从调用帧开始;Unconfined 的恢复线程取决于挂起函数,UNDISPATCHED 后续按目标 Dispatcher 恢复。仅改变这两项不会自动脱离 Job 树。
让 suspend API 对主线程安全
下面的代码将阻塞文件读取和 CPU 解码的线程选择封装在 Repository 内部,同时允许测试替换 Dispatcher:
class ThumbnailRepository(
    private val ioDispatcher: CoroutineDispatcher = Dispatchers.IO,
    private val cpuDispatcher: CoroutineDispatcher = Dispatchers.Default,
) {
    suspend fun load(file: File): Bitmap {
        val bytes = withContext(ioDispatcher) {
            file.readBytes() // 阻塞文件 I/O
        }
        return withContext(cpuDispatcher) {
            requireNotNull(
                BitmapFactory.decodeByteArray(bytes, 0, bytes.size)
            )
        }
    }
}
这样一来,调用者从 Main 调用 load(),文件读取和解码仍会分别在指定 Dispatcher 上执行,这就是 main-safe:API 可以安全地从主线程调用。示例假设缩略图文件大小可控,任意大小的文件应改为流式读取;注入 Dispatcher 还允许测试替换为 TestDispatcher。如果阻塞 API 支持 Thread.interrupt(),可以评估 runInterruptible(ioDispatcher)——取消普通的 withContext(IO),并不会强制中断所有 Java 或 native 阻塞调用。
limitedParallelism 的执行并行预算与线程亲和
Dispatchers.Default.limitedParallelism(2) 表示同一时刻最多有两个任务在这个视图中执行。并行度为 1 时,两次挂起之间的执行片段串行,并建立 happens-before 关系;但某个协程挂起后,其他协程仍可进入这个视图,跨挂起的临界区要另用 Mutex,在途操作数量用 Semaphore 等协议限制。片段还可能落到不同 worker,固定 TID、JNI 会话或 Looper 亲和须选择相应线程设施;仅需传播 ThreadLocal 值时,也可用 asContextElement(),无需仅为这一点新建线程。
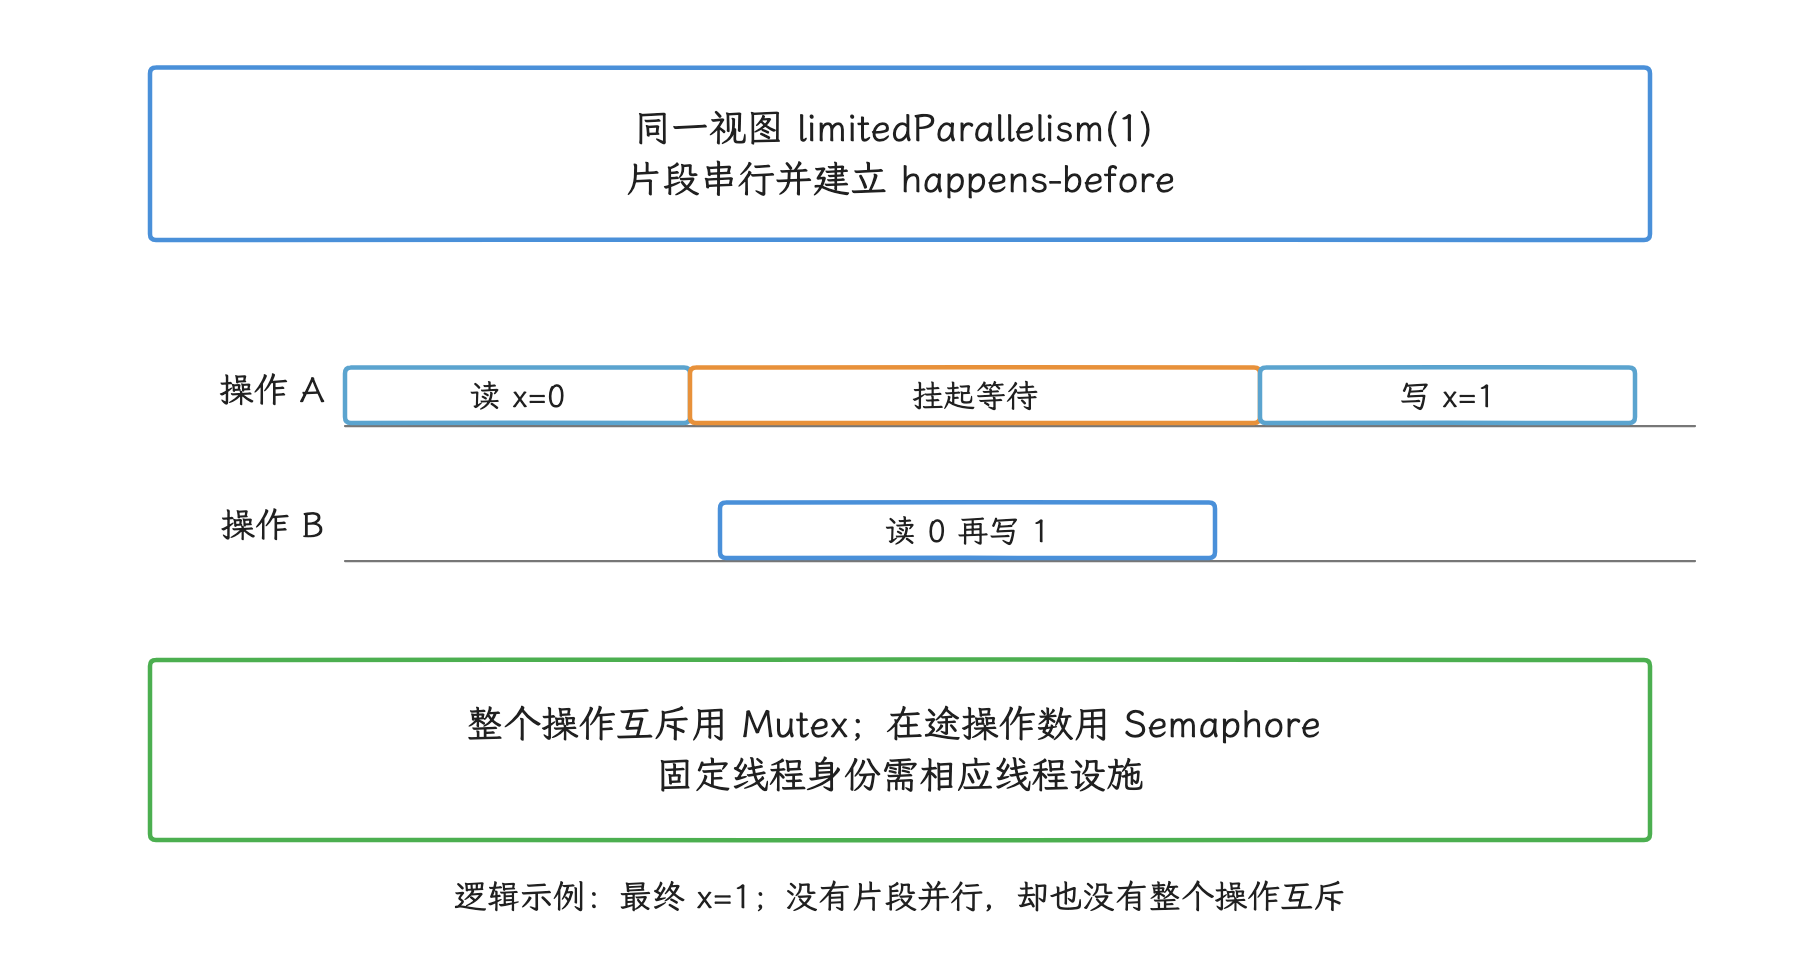
图:同一 limitedParallelism(1) 视图中,A 挂起时 B 可以进入;跨挂起的读改写仍可产生逻辑丢更新。
协程切换与线程切换:用事件数量和分位量化
三类事件:挂起恢复、dispatch 与内核切换
- 挂起 / 恢复:continuation 状态发生变化,但不一定更换 Dispatcher。
- dispatch:Dispatcher 决定直接执行还是把任务放入队列。
- 内核上下文切换:CPU 从一个线程切换到另一个线程,可以通过
sched_switch观察。
一次协程恢复可能在当前调用栈内完成,也可能先排队,并在等待期间经历多次线程调度。一次 Linux 线程切换也可能由 GC、Binder、RenderThread 或其他进程抢占触发,和协程毫无关系。至于“协程几十到几百纳秒、线程 1–10 微秒”这类固定范围,它们缺少硬件、ART、协程版本、CPU 频率和队列状态等条件;在 Android 项目里下结论,我们要用自己设备上测出的数字。
dispatch 次数取决于执行路径
| 调用形态 | 协程层面的 dispatch | 强制线程迁移 |
|---|---|---|
同一 Dispatcher 的 withContext | 进入 / 返回通常不必重新 dispatch;block 内挂起另计 | 边界本身不强制迁移,挂起后仍可能换 worker |
已在主线程进入 Main.immediate | 入口可跳过 post;后续挂起另计 | 入口无需迁移,后续仍受目标 Looper 约束 |
Default worker 调用 withContext(Main) | 进入 Main 一次,返回原 Dispatcher 一次 | 至少有两个执行线程参与 |
Default 调用 withContext(IO) | 语义上进入和返回两个边界 | 可能为 0;共享线程只提供 best effort |
yield() | 检查取消并给其他任务执行机会;可能不真正挂起 | 不保证迁移,也不保证其他任务已完成 |
| I/O 回调恢复 continuation | 可能直接恢复,也可能入队;完成早于挂起时也可立即返回 | 取决于 continuation、Dispatcher 和回调时机 |
表中“至少有两个线程参与”说的是执行线程的数量;sched_switch 记下多少次,要看等待期间发生了什么——抢占、GC 和其他任务都可能发生,内核记录的次数可以更多。
在目标设备上测四个数
量化时应使用 release / profileable 构建,固定设备温度和电源状态,并分别记录:
| 指标 | 回答的问题 |
|---|---|
| wall time P50 / P95 / P99 | 从逻辑开始到结果可用,用户等待了多久? |
| thread running time | 业务和运行时用了多少 CPU? |
| Runnable time | 线程已就绪却等了多久? |
| scheduled slices / operation | 每次操作被分成多少段 Running 区间? |
对照组应保留相同的业务工作,只移除 Dispatcher 切换。空 block 测到的主要是框架、循环和计时器噪声;block 过重又会掩盖调度成本。所以我们至少准备“空对照、短任务、真实任务”三档,报告时给出分位数——平均值回答不了尾部的问题。
我们拿一帧预算做个换算:120 Hz 屏幕的一帧约为 8.33 ms。若一次实际测得的操作串行发生 10 次往返,每次都耗时 0.20 ms,那么合计为 2 ms。这只是算术示例:排队相关性和分布会改变结果,“单次 P95 乘 10”给不出整条路径的 P95,应直接测量完整操作的分位数。
结构化并发:控制寿命、失败和取消
Job 树的规则
coroutineScope 和普通父 Job 遵循以下规则:
- 父 Job 取消时,子 Job 会被取消。
- 父 Job 进入 completing(自身代码结束、等待子任务)状态后,会等待所有子 Job 结束。
- 普通子协程以非 CancellationException 失败时,会取消父 Job;父的其他子任务随后也会取消。
supervisorScope或SupervisorJob隔离其直接子任务之间的失败;若supervisorScope自身的 block 抛异常,或父 owner 被取消,其子任务仍会取消。- 取消是协作式的。挂起函数通常会检查取消;长 CPU 循环和不响应中断的阻塞 API 需要主动配合。
Android 的 viewModelScope 和生命周期 scope 使用 SupervisorJob 风格的根作用域,一个顶层 launch 失败,兄弟任务可以继续运行。进入普通 coroutineScope 后,内部又回到普通父子 Job 规则,失败照常传播。所以设计异常策略时,我们要把这两层分开对待。监督只规定 Job 传播这一层,异常要另行处理:顶层 launch 的未捕获异常仍可能交给 Android 的未捕获异常处理链并导致进程崩溃,需要显式捕获或配置合适的 CoroutineExceptionHandler。async 的异常在 await() 处重新抛出,调用方也要决定怎样处理。
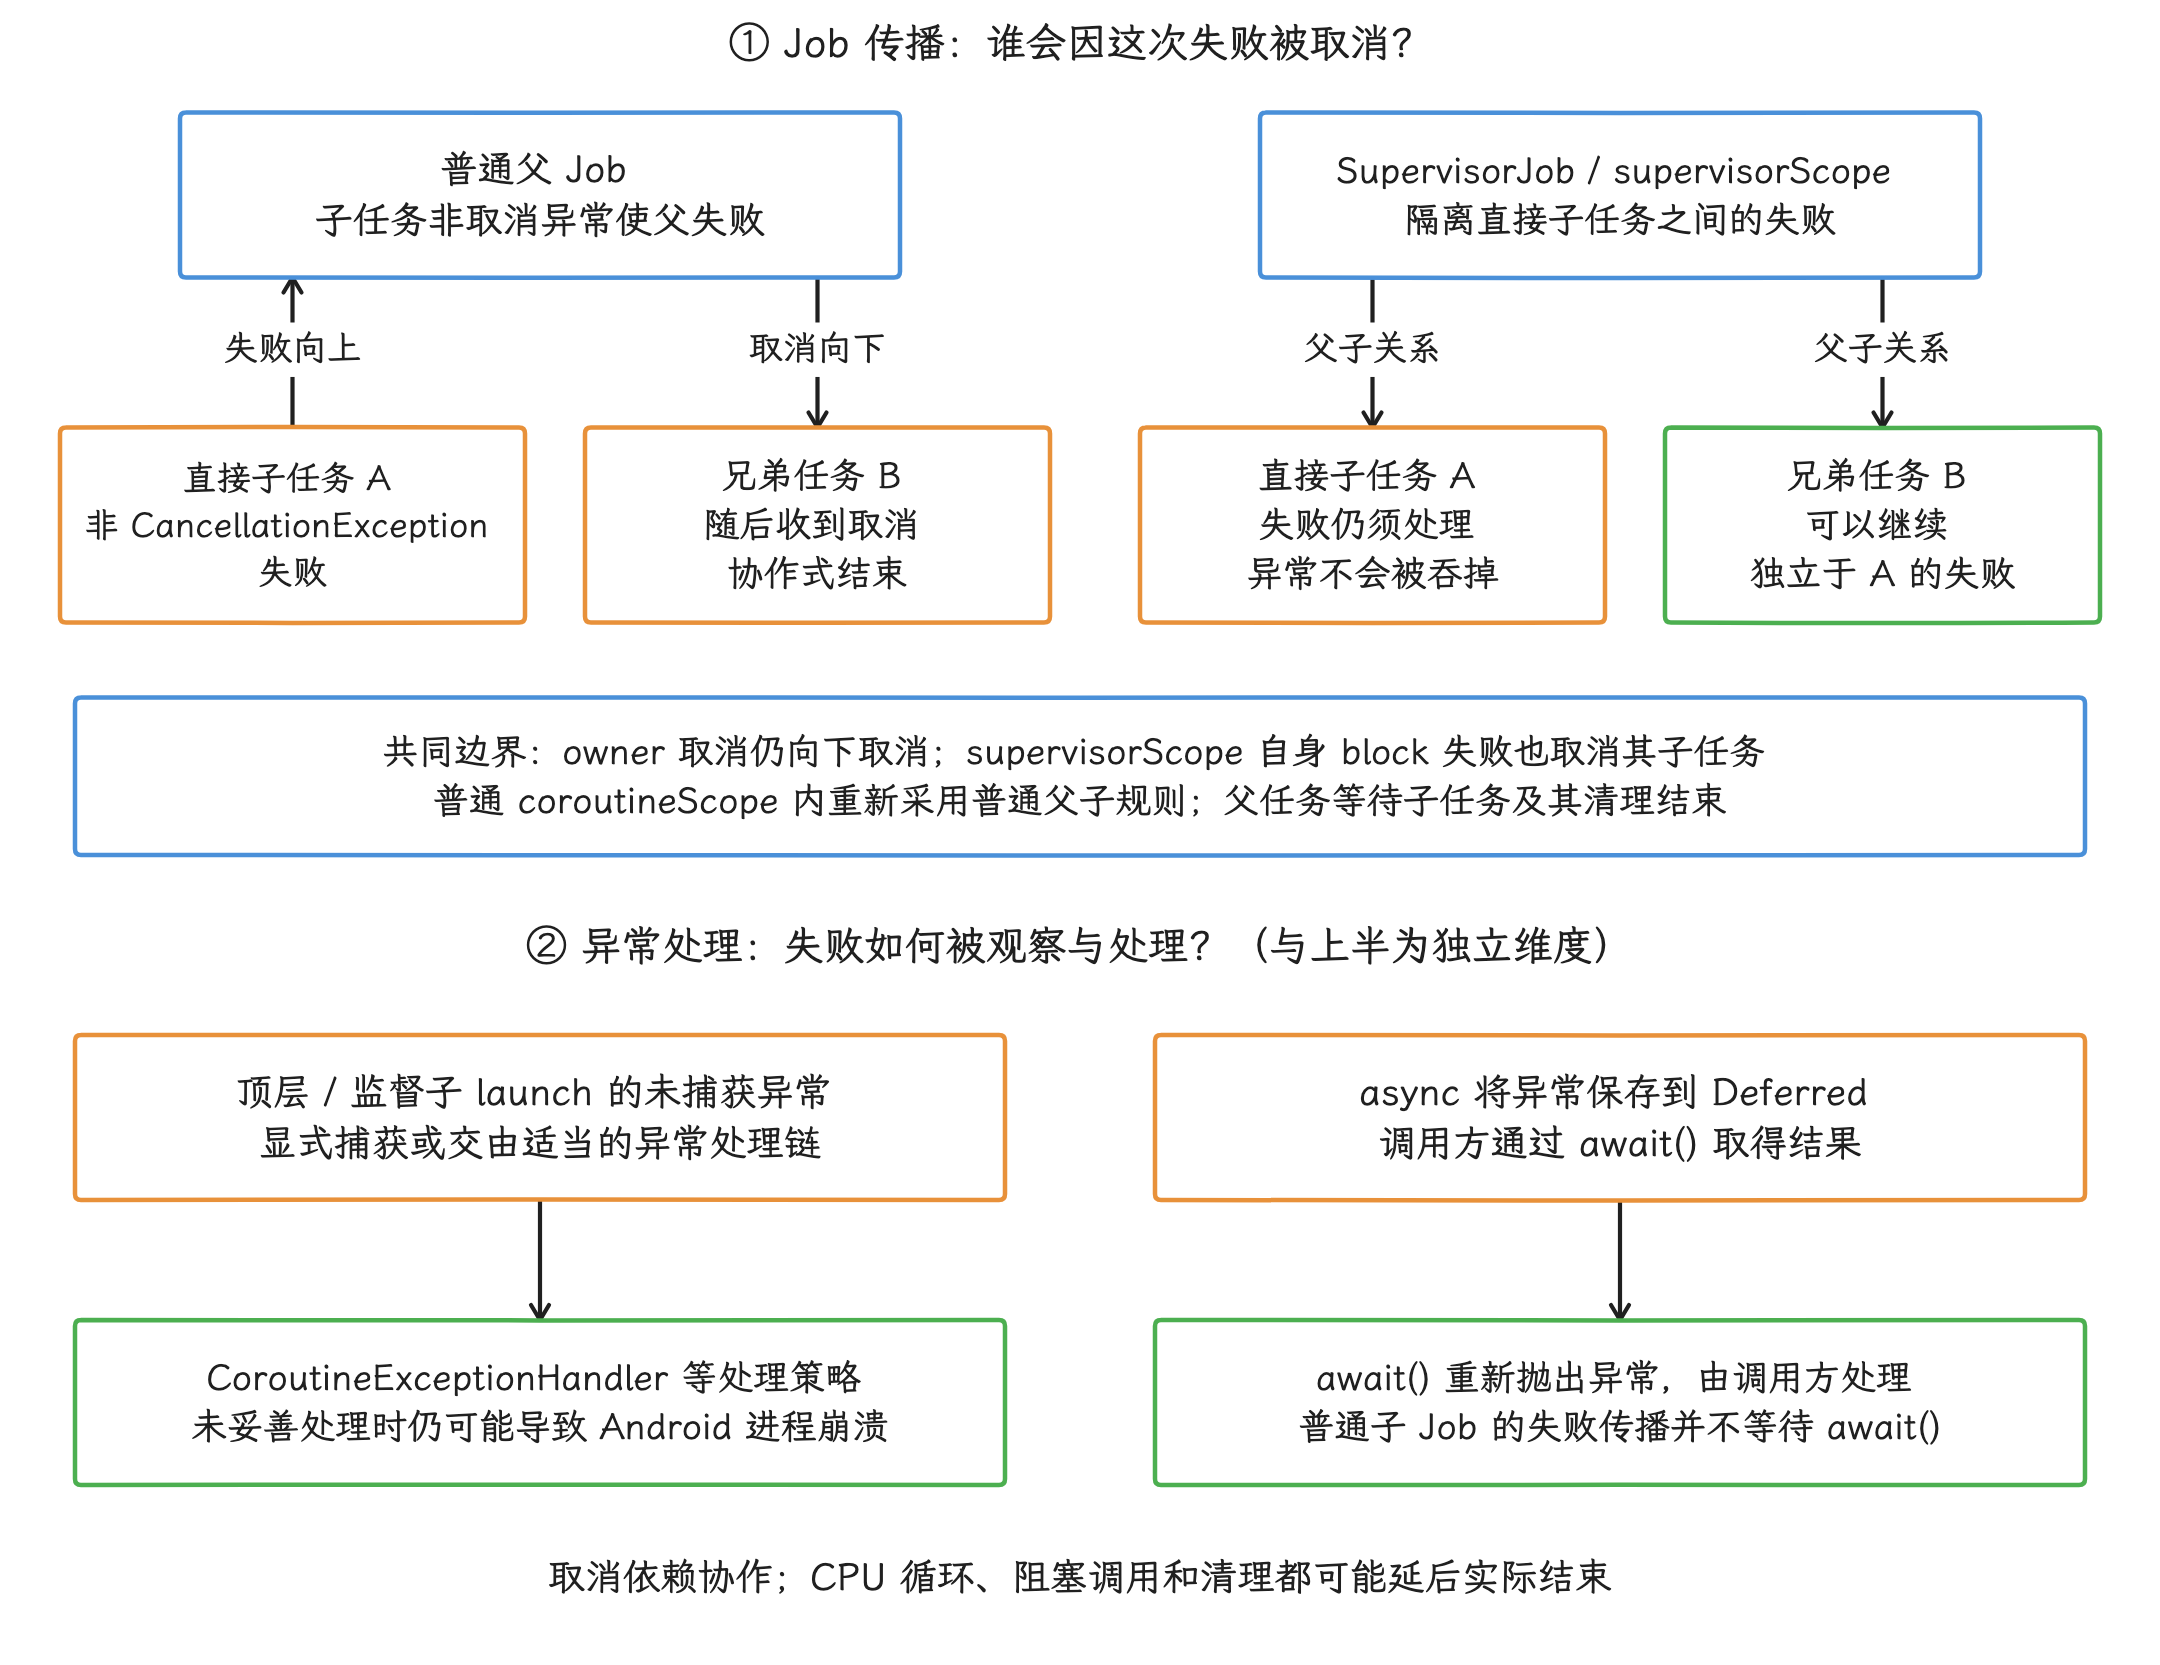
图:上半比较Job传播:普通子任务的非CancellationException失败会取消父和兄弟,监督只隔离直接子任务;owner取消或supervisorScope自身block失败仍向下取消,普通coroutineScope内采用普通规则。下半单独比较异常处理:顶层或监督子launch仍需要异常策略,async异常由await重新抛出,普通子Job的失败传播不等await。取消与清理依赖协作,两层不是同一流水线。
生命周期取消要覆盖“不可见”状态
lifecycleScope 会在 Lifecycle 销毁时取消,而页面进入 STOPPED 后它仍可能长期存在;只等 DESTROYED 的话,不可见页面可能还在继续收集热流。下面的代码让两个 Flow 只在视图至少处于 STARTED 状态时并行收集:
viewLifecycleOwner.lifecycleScope.launch {
    viewLifecycleOwner.repeatOnLifecycle(Lifecycle.State.STARTED) {
        launch { viewModel.uiState.collect(::renderState) }
        launch { viewModel.effects.collect(::handleEffect) }
    }
}
repeatOnLifecycle 会在 STOPPED 时取消内部子协程,回到 STARTED 时再重新创建。这里假定两条流长期收集;各用一个子协程,才能并发观察而不被前一个 collect 阻挡。重新进入 STARTED 时,停订期间的事件能否补回,取决于流本身的配置:effects 若来自 replay=0 的 SharedFlow,无订阅者期间的事件可能已经直接丢失,关键事件须另有持久化或确认协议。Fragment 里我们用 viewLifecycleOwner,避免 View 已销毁后仍更新旧视图。
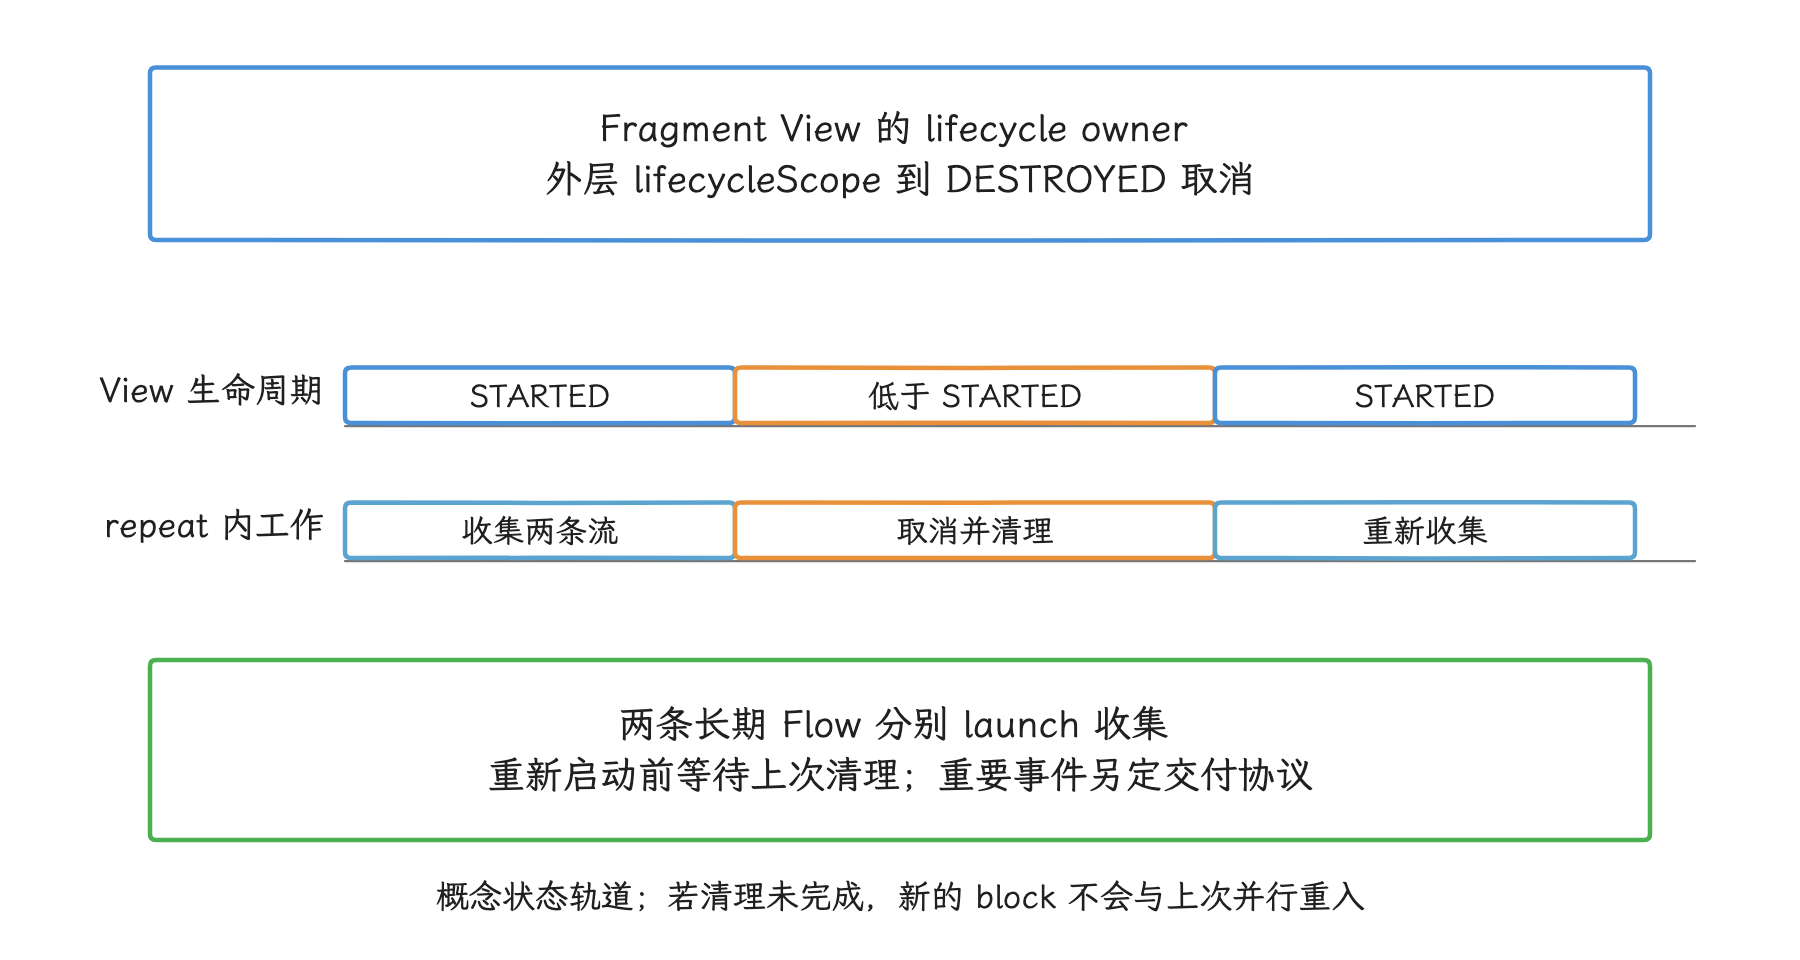
图:viewLifecycleOwner 管理旧 View;repeatOnLifecycle 在低于门槛时取消,再达到门槛时重建,不能补回无 replay 事件。
结构化并发与并发上限
在同一个 scope 中启动一万个子协程,队列、内存和取消开销照样可能堆积:生命周期正确只说明这些任务有共同所有者,并发度是否合理还要另行约束。需要分别限制执行并行度、在途业务操作数和等待队列:limitedParallelism 约束执行片段,Semaphore.withPermit 可覆盖整个挂起操作,有界 Channel 配合固定消费者可限制待办。若先 launch 一万个协程再抢许可,等待者和内存仍已创建;背压还须在生产 / 接单处生效。
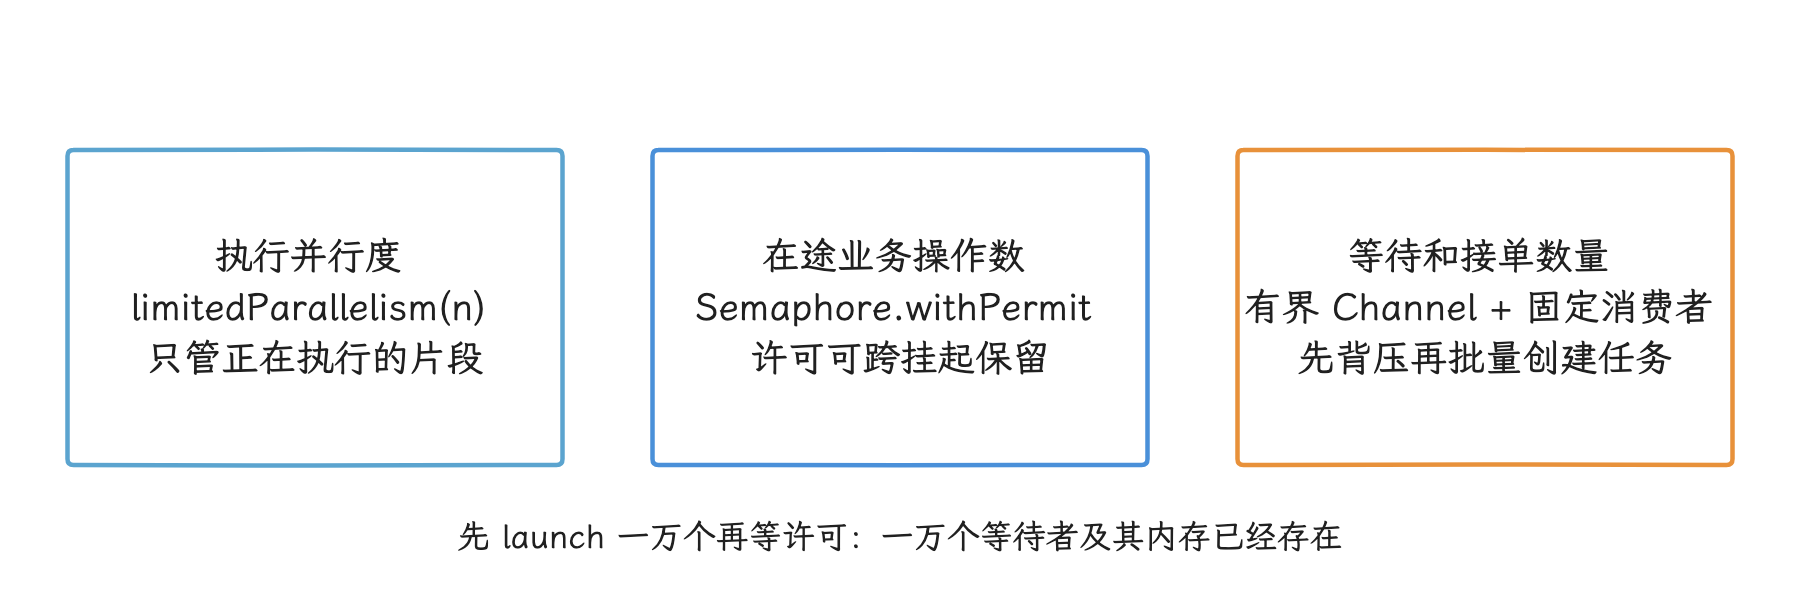
图:同一 owner 不限制任务数量;执行片段、在途操作和接单队列有各自预算。
另一个常见情况是调用 async 后忘记 await:子协程仍在父 Job 之下,父任务也会等它结束,只是返回结果被忽略,异常处理也更难理解。没有返回值需求时我们用 launch,需要并行结果时则显式调用 await 或 awaitAll。
常见的脱离结构路径
GlobalScope没有业务生命周期所有者,属于 delicate API(需要谨慎使用的 API)。它既不为进程保活,也不随页面退出而取消。- 手动创建
CoroutineScope(Job() + dispatcher)后未在 owner 结束时调用cancel()。 - 向
withContext传入新的 Job,会切断它与调用者 Job 的关系。当前官方 API 明确不支持这种模式。 - 使用
suspendCoroutine包装回调却不注销监听;支持取消的回调应使用suspendCancellableCoroutine,并在取消处理器中注销监听。 - CPU 循环没有
ensureActive()、yield()或可控分块,收到取消后仍占用 worker。 - 在
NonCancellable中启动长期子任务。NonCancellable只适合时长明确且有限的清理工作。
Flow 背压:选择是否允许丢值、并发和取消
默认 Flow 是顺序执行
收集 Flow 时,我们最先要回答的问题是:生产快、消费慢时,多出来的值放到哪、要不要丢。普通冷 Flow 的答案是顺序执行:上游、中间操作和 collector 默认跑在同一个协程里,emit() 会按调用链执行下游 collector,处理完当前值才返回;只有下游实际挂起时,调用链才随之挂起。顺序路径没有额外队列,也不会主动丢中间值——多出来的值留在生产侧,靠调用链挂起形成天然背压,代价是每项串行处理成本会相加。交付仍可能被失败、取消或数据源本身丢值中止;事务和审计记录要的持久化或恰好一次保证,得由 collect 之外的机制提供。
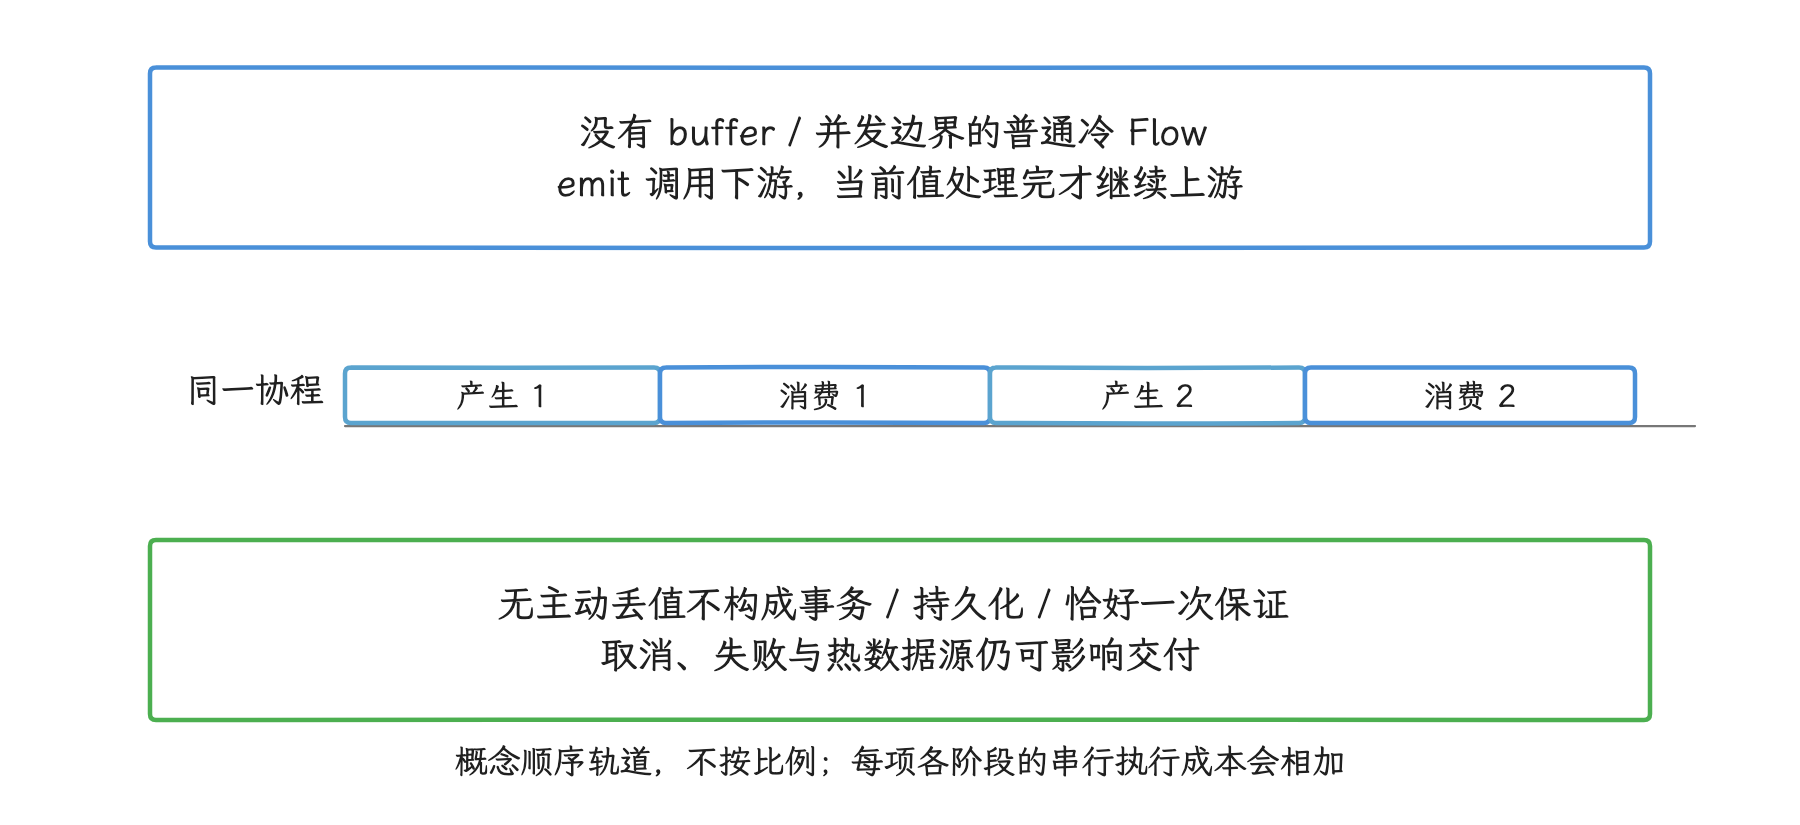
图:普通冷流的上游与 collector 默认在同一协程依次执行;同步 collector 可直接返回,实际挂起才释放线程。
buffer、conflate、channelFlow、flatMapMerge 等操作会引入并发,或让值多经过一道 Channel。选它们之前,我们先分清冷流和热流:冷 Flow 通常在每次收集时开始执行;StateFlow 和 SharedFlow 这类热流的数据源独立于 collector,收集开始之前就已经存在。
三个操作符的语义表
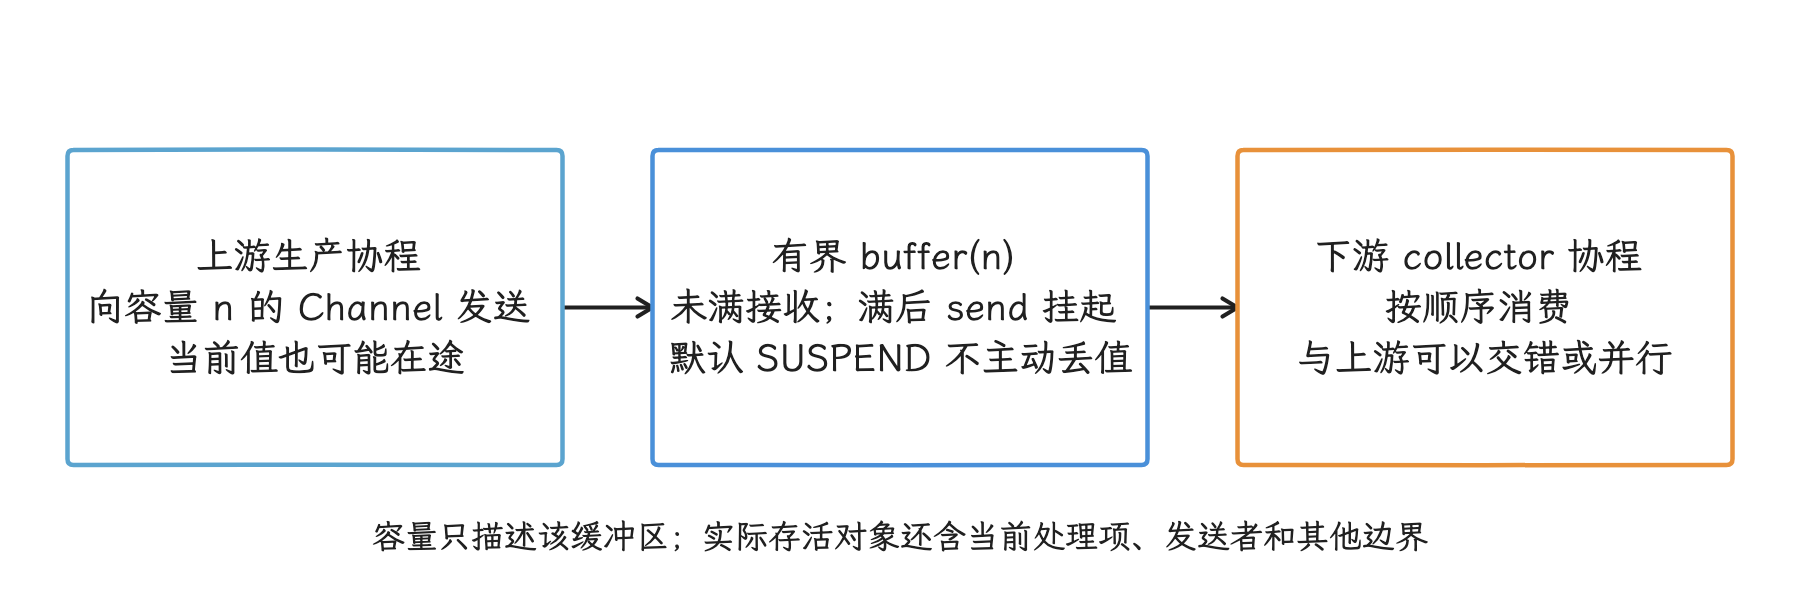
图:buffer 引入协程和 Channel;默认 SUSPEND 在容量满时让生产者等待,不自动选择后台线程。
| 方案 | 是否丢值 | 是否增加并发 | 慢消费者时的行为 | 适用数据 |
|---|---|---|---|---|
默认 collect | 否 | 否 | 上游挂起 | 顺序事件、事务、审计记录 |
buffer(n) + 默认 SUSPEND | 否 | 是,上游在独立协程中运行 | 容量满后上游挂起 | 可流水处理且每项都要保留 |
conflate() | 是,只保留较新值 | 是 | emitter(发送方)不因慢 collector 挂起 | 可跳过中间状态的 UI 快照 |
collectLatest | 取消旧 action | action 可反复重启 | 新值到来时取消前一个 action | 搜索、预览、最新选择驱动的工作 |
conflate() 等价于容量 0、溢出策略为 DROP_OLDEST 的 buffer 语义。StateFlow 已经根据 Any.equals 合并相同状态,在它之上再调 conflate() 是多余的一步。
buffer() 的默认容量是 Channel.BUFFERED,由库方约定。相邻的 channelFlow、flowOn、buffer 和 produceIn 可能发生操作符融合,共享底层 Channel;所以最终容量和溢出策略,我们要按操作符顺序推导。还要当心 Channel.UNLIMITED:它会把生产与消费之间长期存在的速率差,转化成没有上限的内存增长。
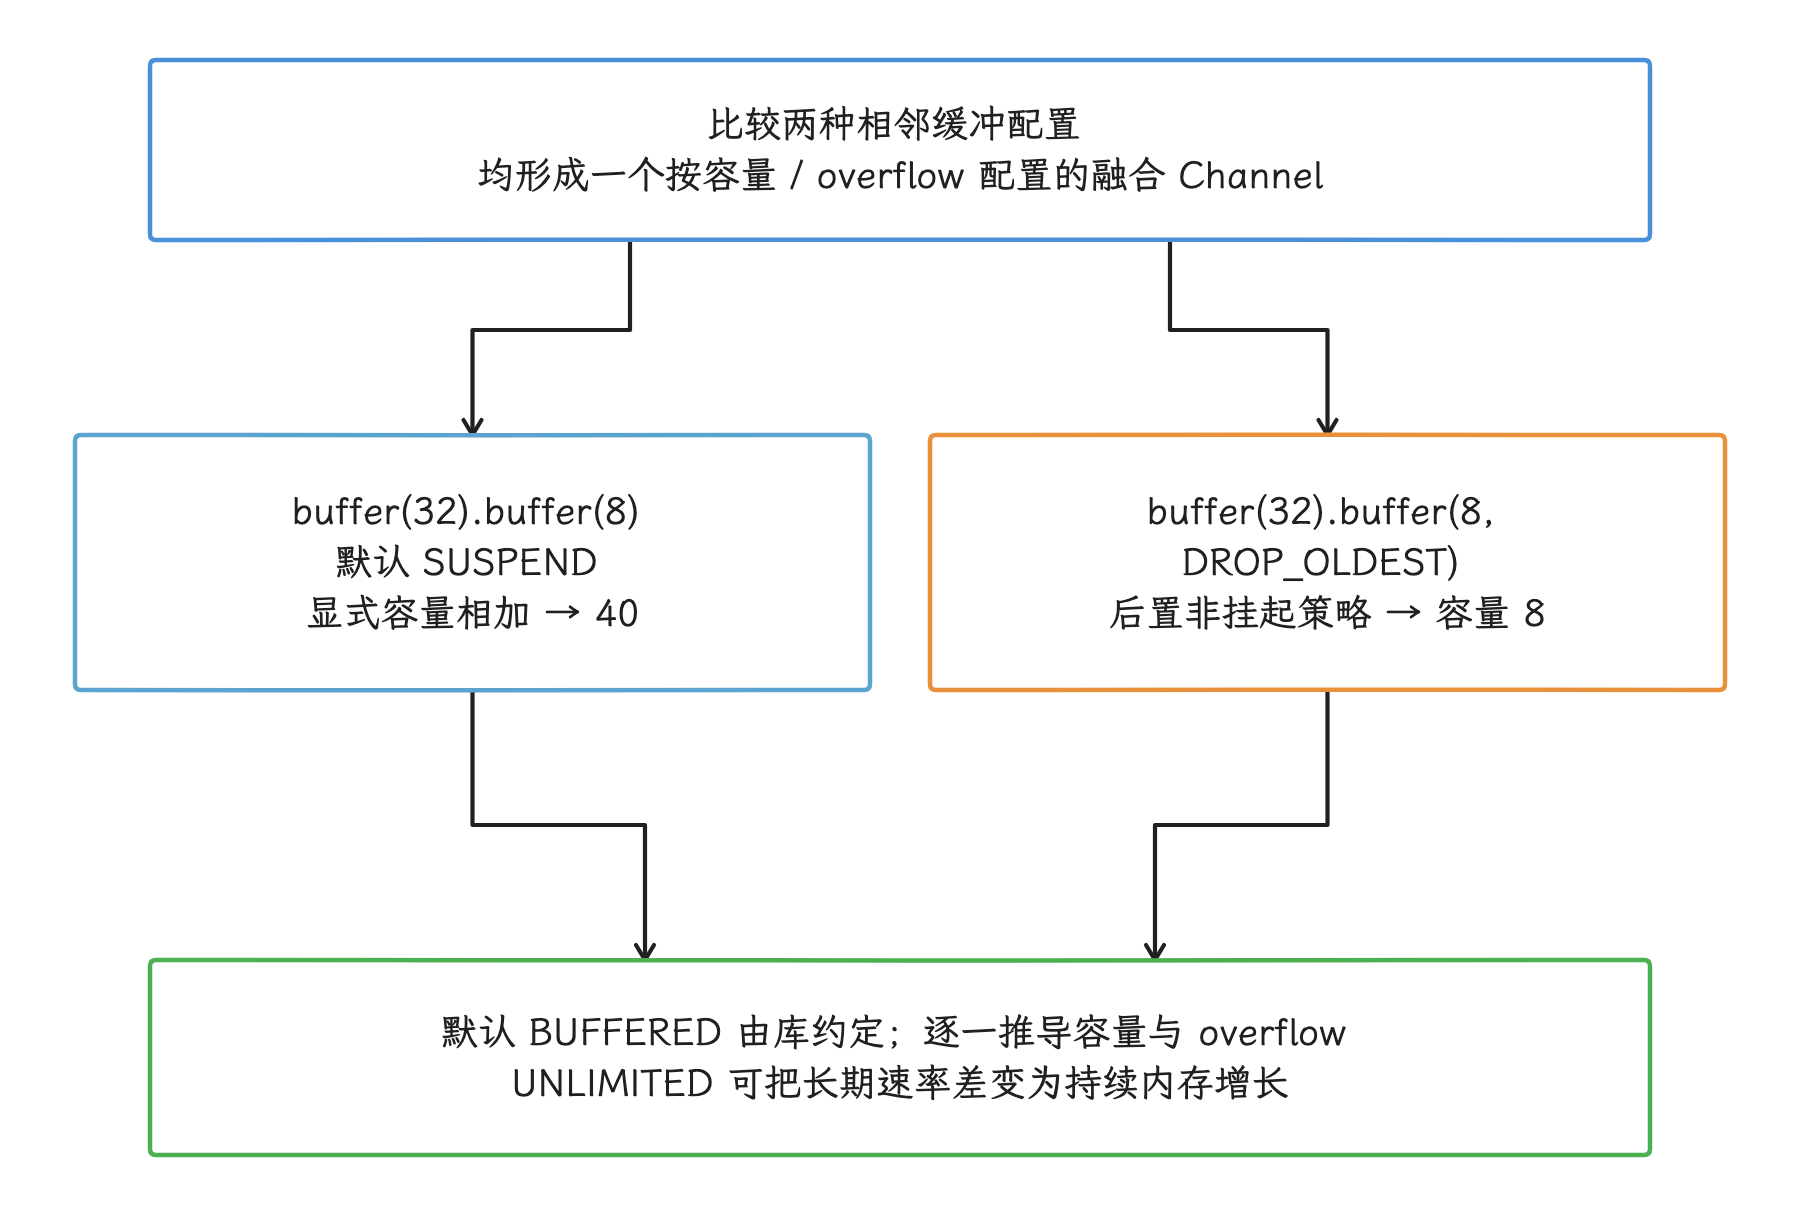
图:相邻边界可能共享一个 Channel;显式容量可相加,后置非 SUSPEND 策略会覆盖前面的等待缓冲。
按数据语义选择
下面的代码对比三种数据语义:必须全部保留的事件、允许跳过中间值的 UI 状态,以及新查询到来时可以取消的旧搜索:
suspend fun collectPipelines(
    events: Flow<Event>,
    uiSnapshots: Flow<UiState>,
    queries: Flow<String>,
) = coroutineScope {
    launch {
        events
            .buffer(capacity = 64)
            .collect { event -> persist(event) }
    }

    launch {
        uiSnapshots
            .conflate()
            .collect { state -> render(state) }
    }

    launch {
        queries
            .collectLatest { query ->
                render(repository.search(query))
            }
    }
}
三条路径对应三种语义。事件这一路:缓冲区满后让上游挂起,buffer 自身不主动丢值,但取消、失败及热上游仍可能影响交付。UI 快照这一路允许跳过中间值,新查询这一路则取消旧的 collector action。示例假定函数从 Main scope 调用,persist() 和 repository.search() 自己满足 main-safe 契约;buffer() 会增加协程和 Channel,后台 Dispatcher 要另行指定。第三条路能多快停下来,取决于搜索是否支持协作式取消:遇到不可中断的阻塞 SDK,即使放在 IO 中,也可能一直执行到调用返回。
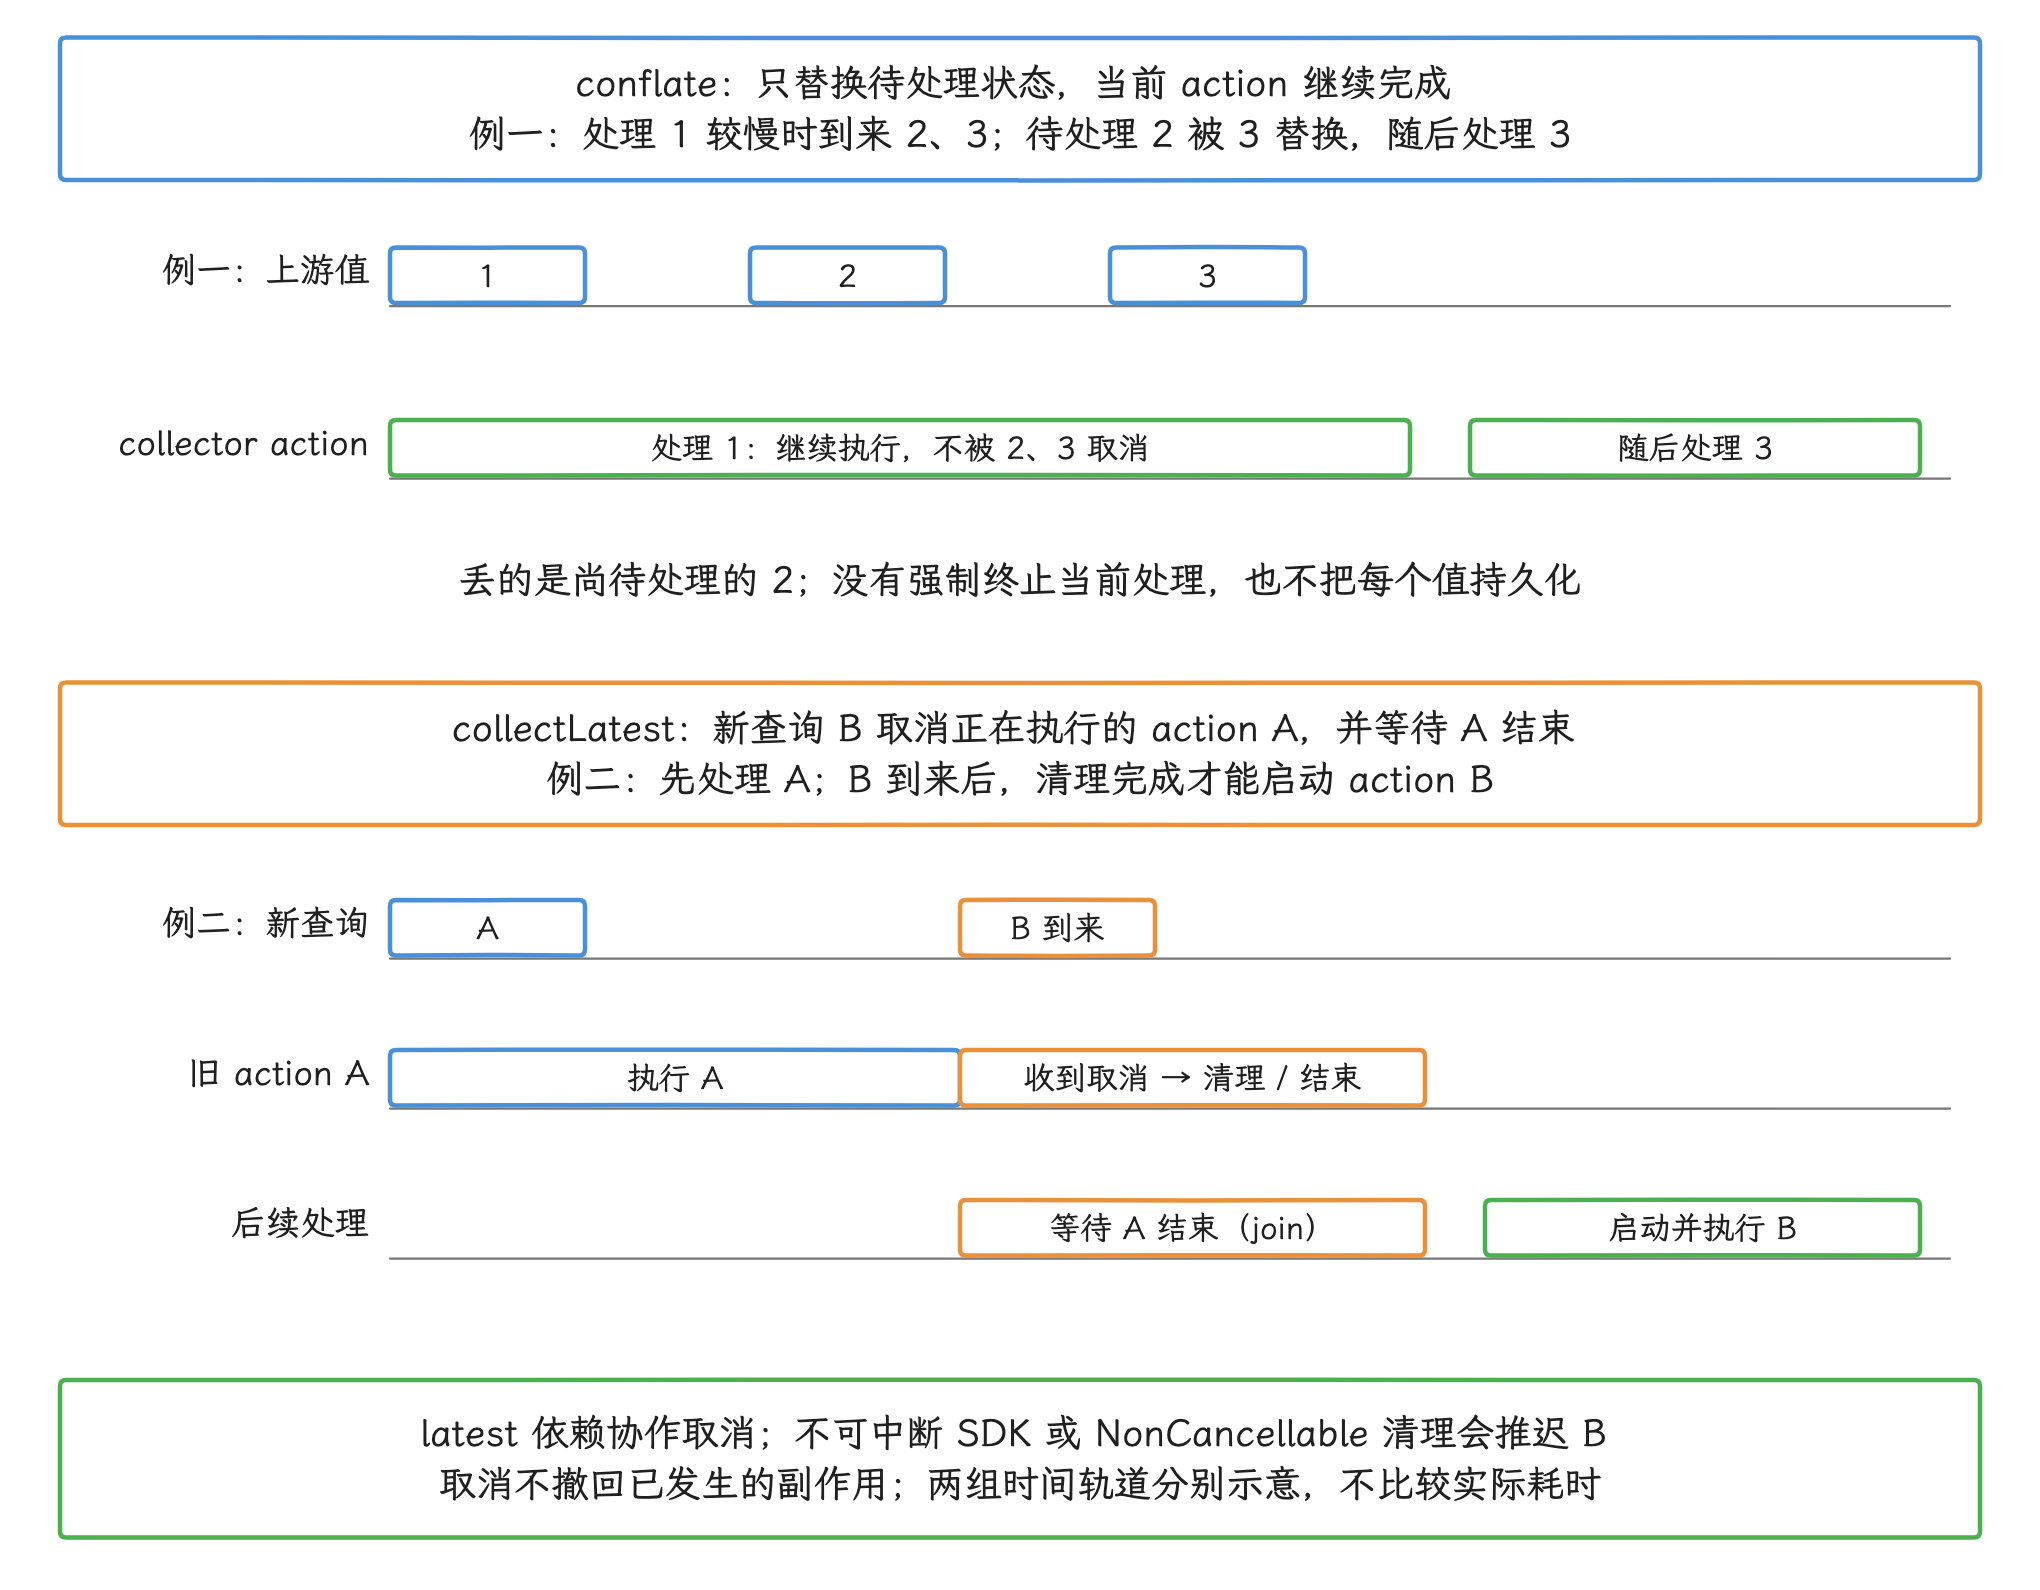
图:两组轨道分别示意,不共用发射时刻或实测比例。conflate让当前值1的action继续完成,仅把待处理2替换为3;collectLatest在B到来时取消旧action A并等待其结束后启动B。非协作SDK和清理可能推迟B,取消不能撤回既有副作用;等待轨道表示后续处理等待,并非B的action已启动。
StateFlow、SharedFlow 与 flatten 的资源语义
StateFlow 是只保存一个当前值的状态容器,按照 Any.equals 合并相同值。有效状态更新的官方复杂度为 O(N),N 为活跃订阅者数量;写入 equals 相同的值可直接返回,遍历只发生在值有变化的时候。订阅者翻倍时墙钟时间是否随之翻倍,要以实际测量为准。
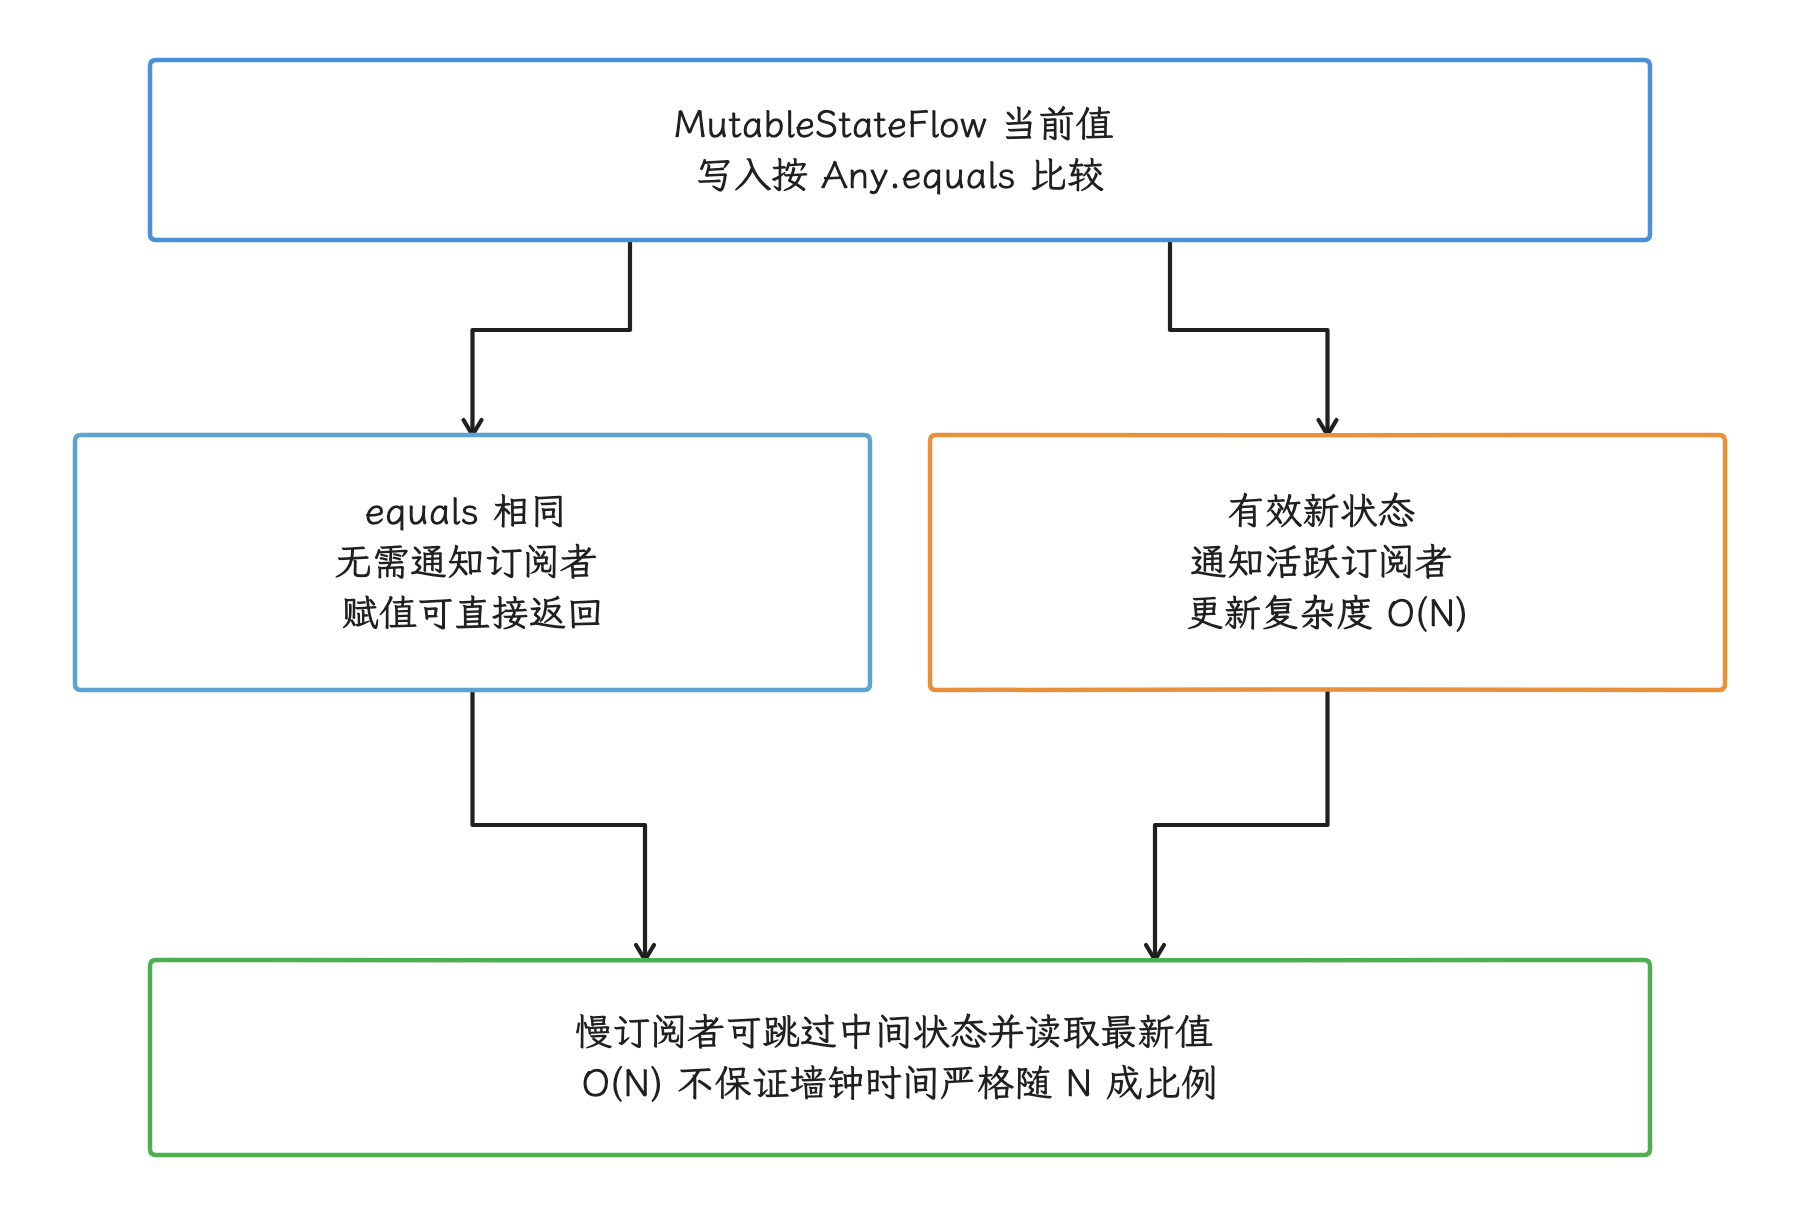
图:StateFlow 是状态容器;equals 相同值可早退,慢订阅者可跳过快速更新,不是逐事件队列。
SharedFlow 是广播流,replay(为新订阅者重放的值数量)、extraBufferCapacity 和 onBufferOverflow 共同决定慢订阅者如何影响 emitter。只有通过 shareIn / stateIn 从其他 Flow 共享而来时,上游运行才由相应 scope 和 SharingStarted 控制;直接构造 MutableStateFlow / MutableSharedFlow 时,生产者寿命由调用方自己管理。SharedFlow 没有订阅者时只保留 replay 个值,extraBufferCapacity 在这一阶段闲置,emit 也没有 SUSPEND 策略意义上的等待对象——它约束的是已经在收听的慢订阅者。
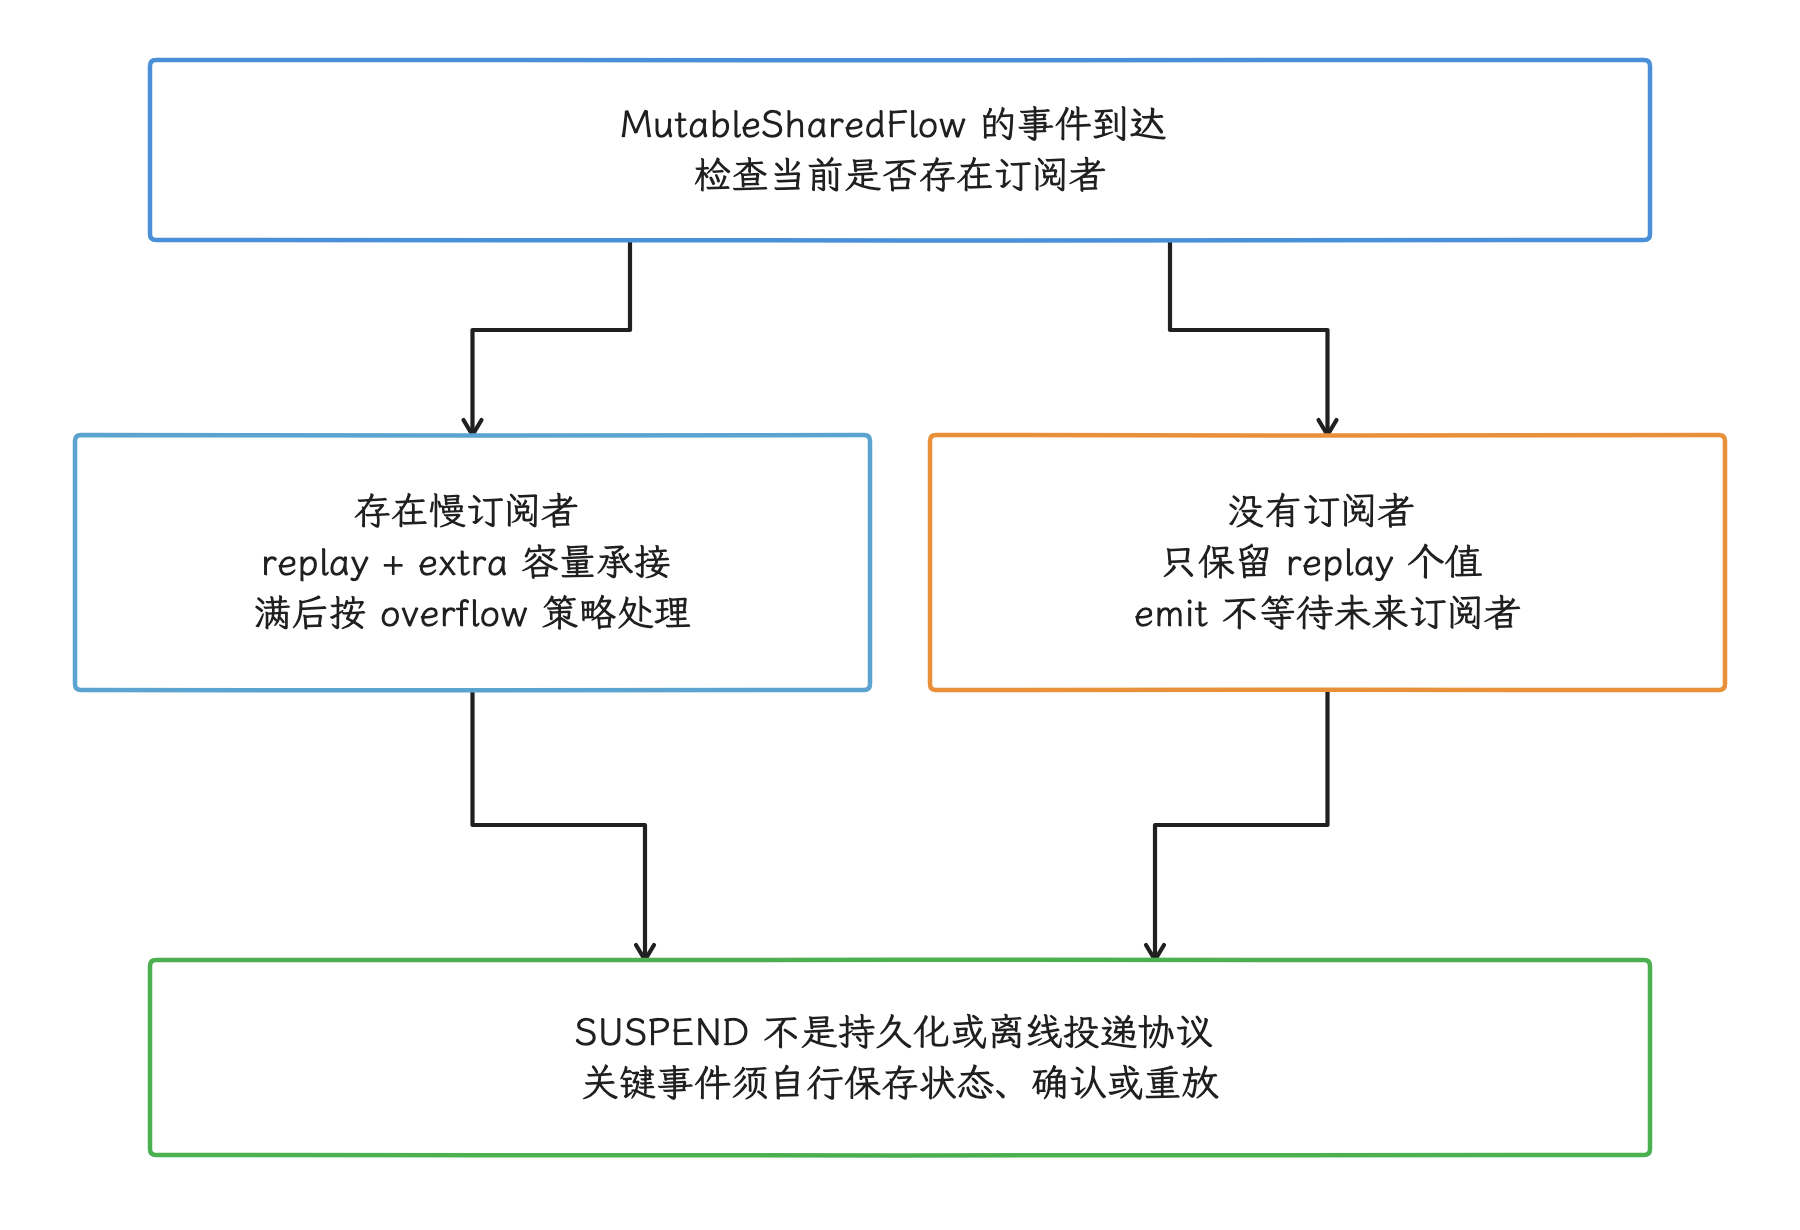
图:有慢订阅者时才讨论溢出;无订阅者仅存 replay,默认 replay=0 的事件可直接消失。
再看 flatten 这一层:flatMapConcat 按顺序处理内层流,flatMapMerge(concurrency) 允许多条内层流并发,flatMapLatest 则在新值到来时取消旧内层流。并发上限必须符合数据库连接数、HTTP client、文件描述符和内存预算。
取消要及时生效,前提是内层操作支持协作取消。操作符链不会为每一级都创建 Job,但 buffer、flowOn、channelFlow 和并发 flatten(将内层流合并回外层)会让取消跨越额外的协程或 Channel。
flowOn 只改变上游
flowOn(dispatcher) 只改变它前方上游操作符的执行上下文,下游 collector 原样不动。跨 Dispatcher 时通常会加入 Channel 和额外协程,所以执行位置变了,缓冲和取消的传播也跟着变。只改变非 Dispatcher 上下文时不一定增加协程;相邻边界还会融合。跨 Dispatcher 的取消可能丢弃已经发出但尚未交给下游的在途元素,这个 Channel 当不了可靠的消息存储。数据层已经提供 main-safe suspend API 时,flowOn(IO) 留在数据层一处就够了,我们无须在每一层重复叠加。
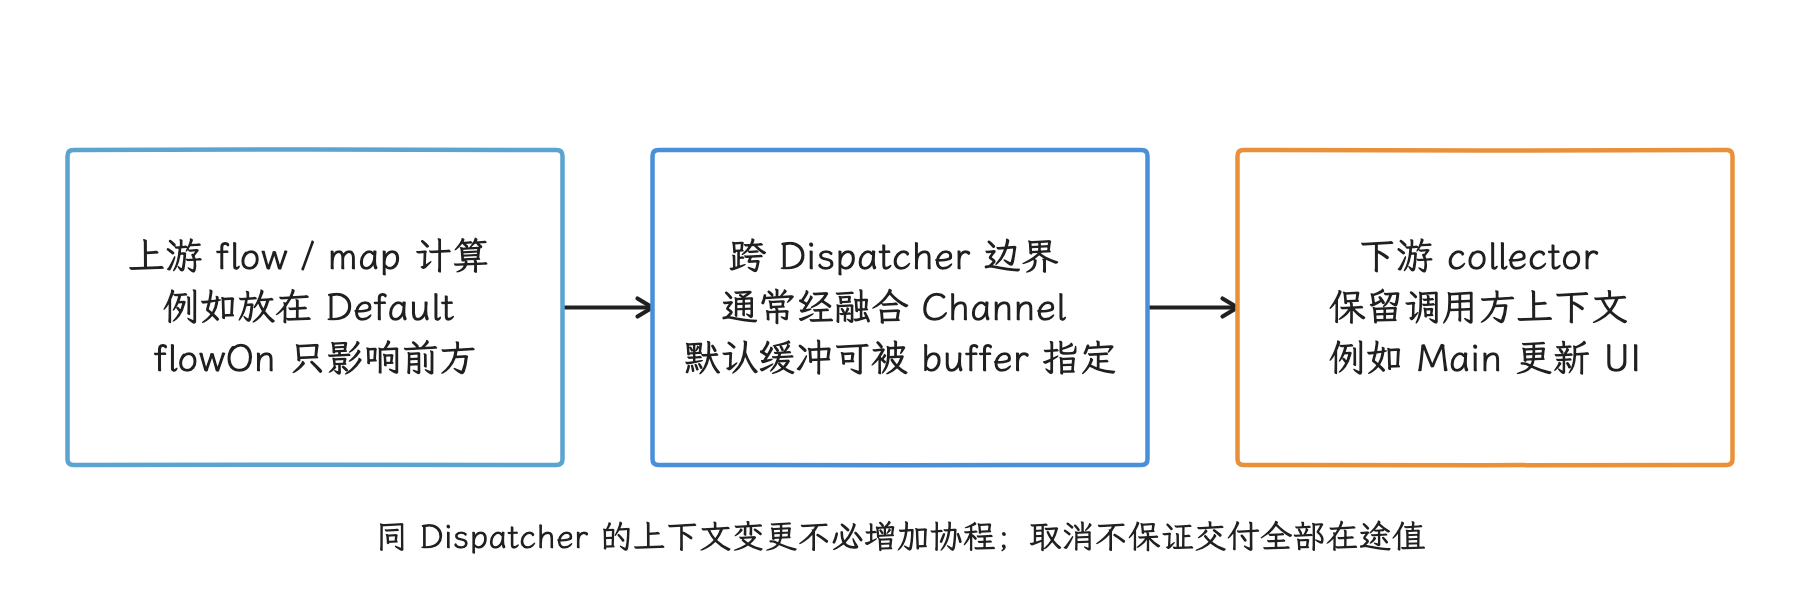
图:flowOn 改变尚未自带上下文的前方操作符;collector 上下文保留,跨 Dispatcher 的在途值可因取消而丢弃。
UI 收集与共享上游的生命周期
StateFlow 和 SharedFlow 是热流,页面停止显示后,共享上游仍可能继续运行;repeatOnLifecycle 只控制当前 UI collector,共享上游在它管辖之外。所以排查后台耗电时,我们还要检查共享上游的 owner、停止超时和订阅数量。
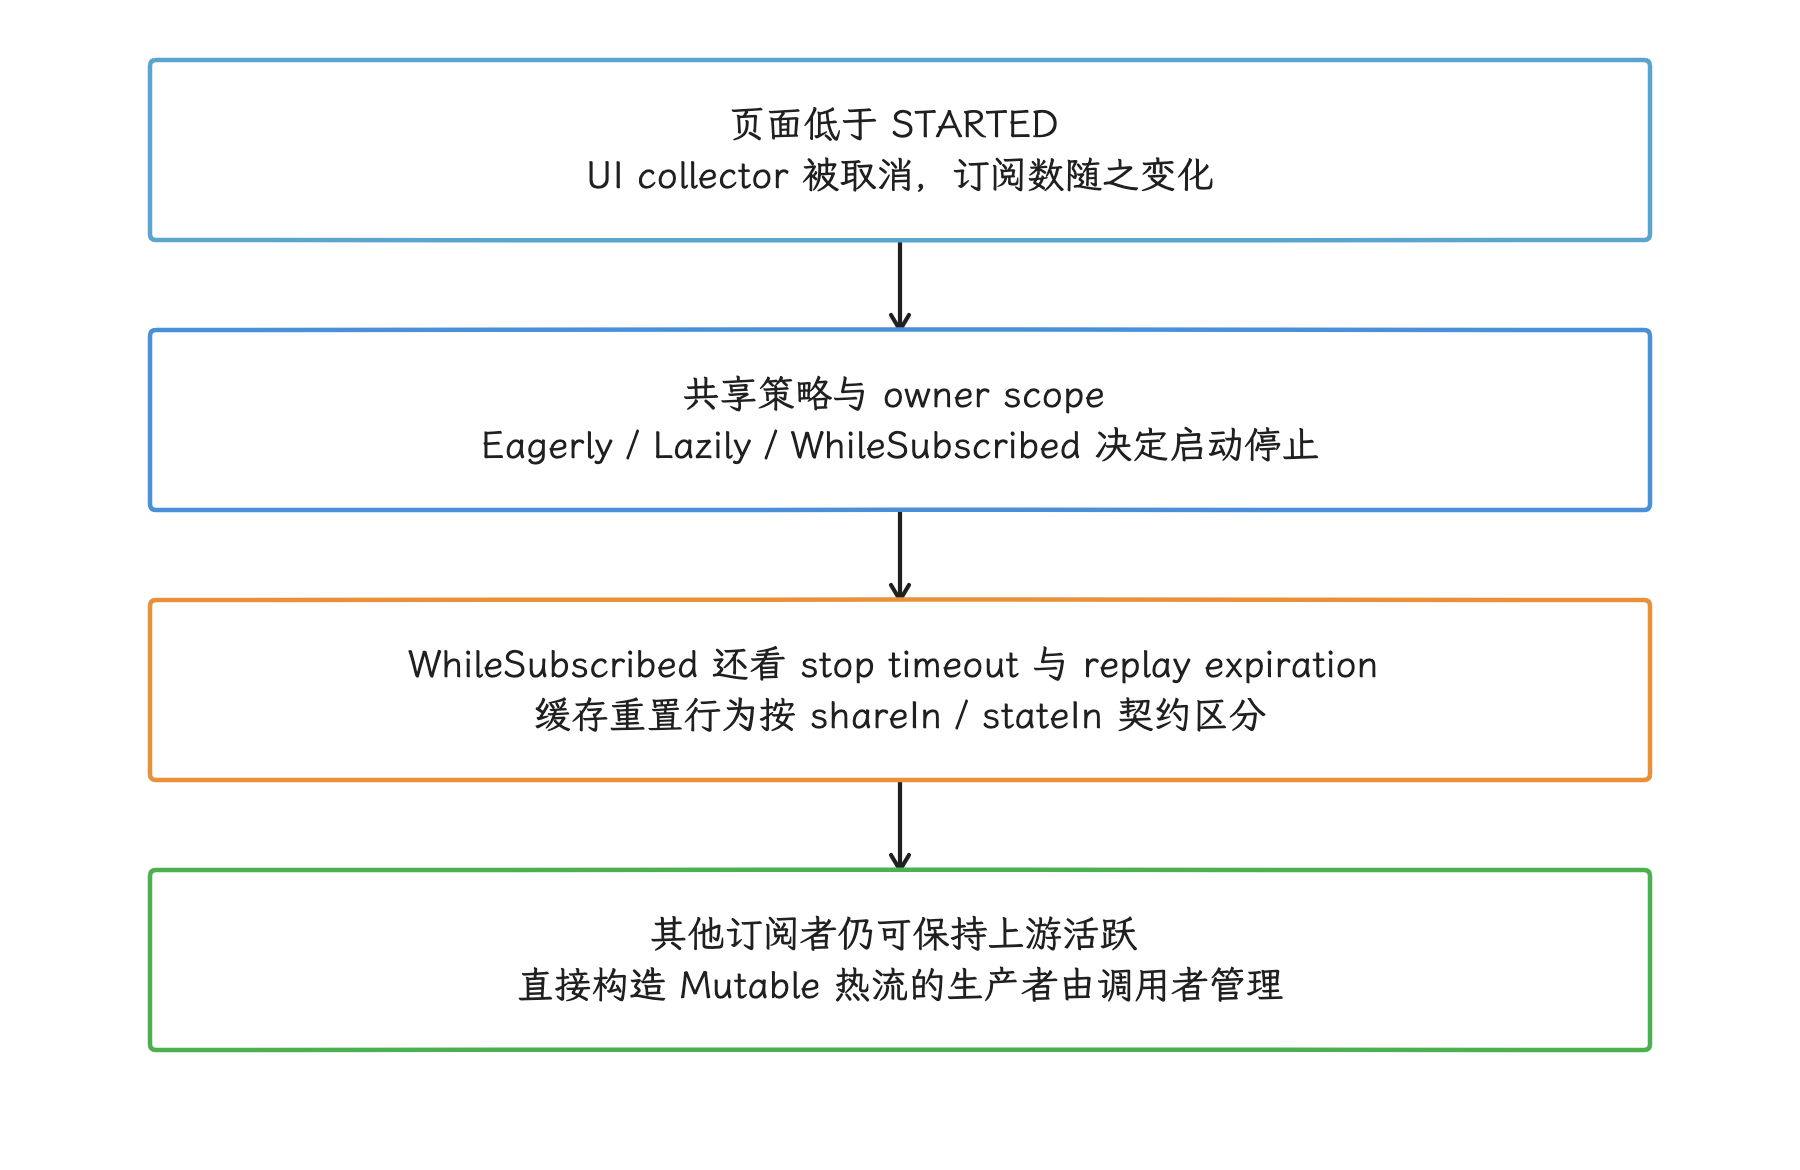
图:repeatOnLifecycle 只控制本 UI collector;共享上游由 shareIn/stateIn 的 owner 与 SharingStarted 控制。
在 Perfetto、调试器和 CPU Profiler 中定位协程
三类工具回答不同问题
| 工具 | 擅长回答 | 不能单独证明 |
|---|---|---|
| Perfetto / System Trace | 线程何时 Running、Runnable、Sleep;帧、Binder、频率和自定义 trace 之间的时间关系 | 某段 worker CPU 一定属于哪个 CoroutineName |
| Coroutine Debugger | Job 层级、状态、Dispatcher、挂起栈和创建栈 | release 构建中的真实耗时 |
| CPU Profiler 采样 | 哪些 Java / Kotlin / native 调用栈消耗 CPU | 等待队列、跨线程墙钟路径和完整因果关系 |
调试器暂停和 debug 构建都会扰动线程时序,所以性能结论要取自 profileable / release 构建;调试器留给解释 Job 状态用,暂停之后的时间线就别拿来当延迟基准了。
CoroutineName 有助于阅读调试器和日志,但 Perfetto 不会自动为它生成同名 slice;要把业务操作稳定地映射到 trace,我们应显式添加跟踪标记。
跨 suspend 边界使用 async trace
同步的 beginSection / endSection 必须在同一线程上正确嵌套,不适合包住可能切换线程的 suspend block。下面的辅助函数为每次操作分配唯一 cookie,用 async section 记录跨线程、跨挂起的完整逻辑区间;cookie 须在相同 name 的并发活动区间内保持唯一,并与同名结束事件配对。下面的进程内计数器适合常规短操作,长寿命或极高吞吐场景需处理 Int 回绕及其他埋点共用编号的问题:
private val nextTraceCookie = AtomicInteger(1)

private suspend inline fun <T> traceAsync(
    name: String,
    crossinline block: suspend () -> T,
): T {
    val cookie = nextTraceCookie.getAndIncrement()
    Trace.beginAsyncSection(name, cookie)
    return try {
        block()
    } finally {
        Trace.endAsyncSection(name, cookie)
    }
}
这里的 Trace 可以使用 androidx.tracing.Trace。async section 表示业务操作从开始到结束的墙钟区间,其中的等待时间不会混进任何线程的 CPU 时间;不会挂起的短函数再用同步 section。这样 Perfetto 才能同时显示整条操作经过了多久,以及各线程实际执行了多久。
AndroidX Tracing 2.0.0 已于 2026-08-12 稳定发布;截至本次核对,官方最新稳定版为 2.0.5(2026-10-21)。新进程内 API 支持协程上下文传播,写入进程管理的 Perfetto 数据;应用配置 tracing-wire 时还要核对自动初始化、文件位置、flush / close 与容量策略。它不自动等同于 Studio 系统 trace 中已有同名事件,需要导出并按支持流程合并。既有同步 / 异步系统 trace API 仍可用于低频标记。来源:版本发布与进程内追踪说明。
用 sched 表量化 worker 运行片段
下面的 PerfettoSQL 统计选定 trace 中,每个协程 worker 获得了多少段 CPU 运行时间,以及累计运行了多久:
SELECT
  t.upid,
  p.name AS process_name,
  t.utid,
  t.tid,
  t.name AS thread_name,
  COUNT(*) AS scheduled_slices,
  ROUND(SUM(s.dur) / 1e6, 3) AS running_ms
FROM sched AS s
JOIN thread AS t USING (utid)
LEFT JOIN process AS p ON p.upid = t.upid
WHERE t.name GLOB 'DefaultDispatcher-worker-*'
  AND s.dur > 0
GROUP BY t.upid, t.utid, t.tid, t.name, p.name
ORDER BY running_ms DESC;
sched 的每一行记录线程的一段 Running 时间,所以 scheduled_slices 数的是调度片段,不是 coroutine resume 次数。这里按 trace 内部身份 upid / utid 分组;tid 可复用,名字也可重复或被平台截断,应先检查真实线程名,必要时调整过滤条件。dur=-1 等未闭合片段已排除,此查询覆盖的是 trace 边界之内的运行时间。要看一次业务操作,先选择正确进程和 async slice,取得半开窗口 [t0,t1);对相交 Running 片段按 min(ts+dur,t1)-max(ts,t0) 裁剪后求和——只筛选起点会漏掉从窗口前开始、仍在窗口内运行的片段,把跨窗片段的整段 dur 直接相加又会算进窗口之外的时间。同一 worker 可能交替执行多个协程,时间重叠本身说明不了因果归属。
识别常见 trace 形态
- worker 长时间 Running:可能在执行大型 CPU block;使用采样栈定位方法,并检查取消点。
- worker 长时间处于不可中断睡眠或 I/O:检查阻塞 API、存储与内核路径。
- worker 出现大量短 Running slice:可能是细粒度任务,也可能来自 profiler 或其他运行时活动;加入业务 trace 后再归因。
- Main 上的 async 操作很长,但 Running 时间很短:大部分时间可能在等待队列、I/O、锁或其他线程,这部分墙钟时间要和主线程 CPU 分开记。
- Default 任务长期 Runnable:CPU 已饱和或线程优先级/系统负载影响调度;继续查看各核心、频率和竞争进程。
Android Studio 的 Java / Kotlin 方法 instrumentation(插桩跟踪)会引入额外开销,高频短协程尤其容易被放大。确认方法热点时我们优先用采样;只有需要精确调用次数时再上 instrumentation,并注明这类数字不可当作生产环境延迟。
kotlinx-coroutines-debug 的适用范围
kotlinx-coroutines-debug 的动态 agent 和 DebugProbes 主要面向标准 JVM;Android 设备上的协程调试,靠的是 Android Studio / IDE 集成和打包在 coroutines-core 里的调试元数据,JVM Instrument agent 这类标准 JVM 工具在设备侧 Perfetto 分析里派不上用场。调试设施本身会增加开销,线上长期开启并不合适。
Coroutine 与 RxJava:比较相同语义
判断 Coroutine 和 RxJava 的性能,前提是先统一工作负载与数据语义,谁更快要测了才知道:
| 维度 | Flow / Coroutine | RxJava |
|---|---|---|
| 单值异步 | suspend 函数、Job 取消 | Single/Maybe、Disposable |
| 默认流控制 | 冷 Flow 顺序执行,emit 挂起 | Observable 无背压;Flowable 使用 request 协议 |
| 并发边界 | buffer、flowOn、channelFlow 等 | subscribeOn、observeOn、各类 Scheduler |
| 生命周期 | Job 树与 scope | Disposable/CompositeDisposable |
| 融合优化 | 相邻 Flow 通道操作会融合 | 部分操作符支持 queue fusion |
基准必须统一热流 / 冷流、缓冲容量、丢值策略、错误处理、调度方式和消费者工作量。只比较“启动一百万个空任务”,说明的只是空任务的开销,网络、数据库或 UI 路径的表现还得另行测量。已有 RxJava 项目考虑整体迁移时,光凭微基准还不够,我们先测量高频路径和维护成本,再做决定。
自定义 Dispatcher:优先复用线程,再考虑专用线程
执行并行度优先使用视图
下面的代码复用标准 Dispatcher,分别限制图片解码和旧 SDK 的并发量,不创建新的线程池:
private val imageDecodeDispatcher =
    Dispatchers.Default.limitedParallelism(2)

private val legacySdkDispatcher =
    Dispatchers.IO.limitedParallelism(4)
前者最多并行执行两个 CPU 解码片段。Default 的实际计算并行度大于 2 时,它可以限制这组工作对预算的占用,独占或保留特定 worker / CPU 则超出了它的承诺范围;后者限制实际占线程执行的旧阻塞 SDK 调用,若 API 会挂起或只是提交异步请求,限制整个在途操作仍需 Semaphore 等协议。IO 弹性视图的并发量会与其他 IO 视图叠加,因此我们仍要检查整个进程中的阻塞任务总数。
线程亲和与专用 Executor
下面的代码为必须固定在同一个 Java 线程上的 native 会话创建专用 Dispatcher,并通过 owner 的 close() 释放线程:
class NativeSessionExecutor : Closeable {
    private val dispatcher =
        Executors.newSingleThreadExecutor { task ->
            Thread(task, "native-session")
        }.asCoroutineDispatcher()

    suspend fun <T> call(block: () -> T): T =
        withContext(dispatcher) { block() }

    override fun close() {
        dispatcher.close()
    }
}
这个 Executor 默认按需启动单个 Java worker,首次提交后通常保留到关闭;它不提供 Looper,也不自动完成 JNI attach/detach 或 native 会话销毁。示例只封装同步调用的执行位置,完整 owner 仍须实现停止接单、等待 / 取消在途操作、在规定线程释放 native 会话、最后关闭 Dispatcher 的协议。worker 若被替换,还须重建依赖线程身份的资源。线程创建和销毁都有开销,所以它应由 Application 级服务、Repository 或其他明确的 owner 复用,并在 owner 生命周期结束时关闭。按请求新建 Executor、用 Java 的 Thread.MAX_PRIORITY 顶替 Android 线程优先级配置和负载测量,这两种做法都要避开。
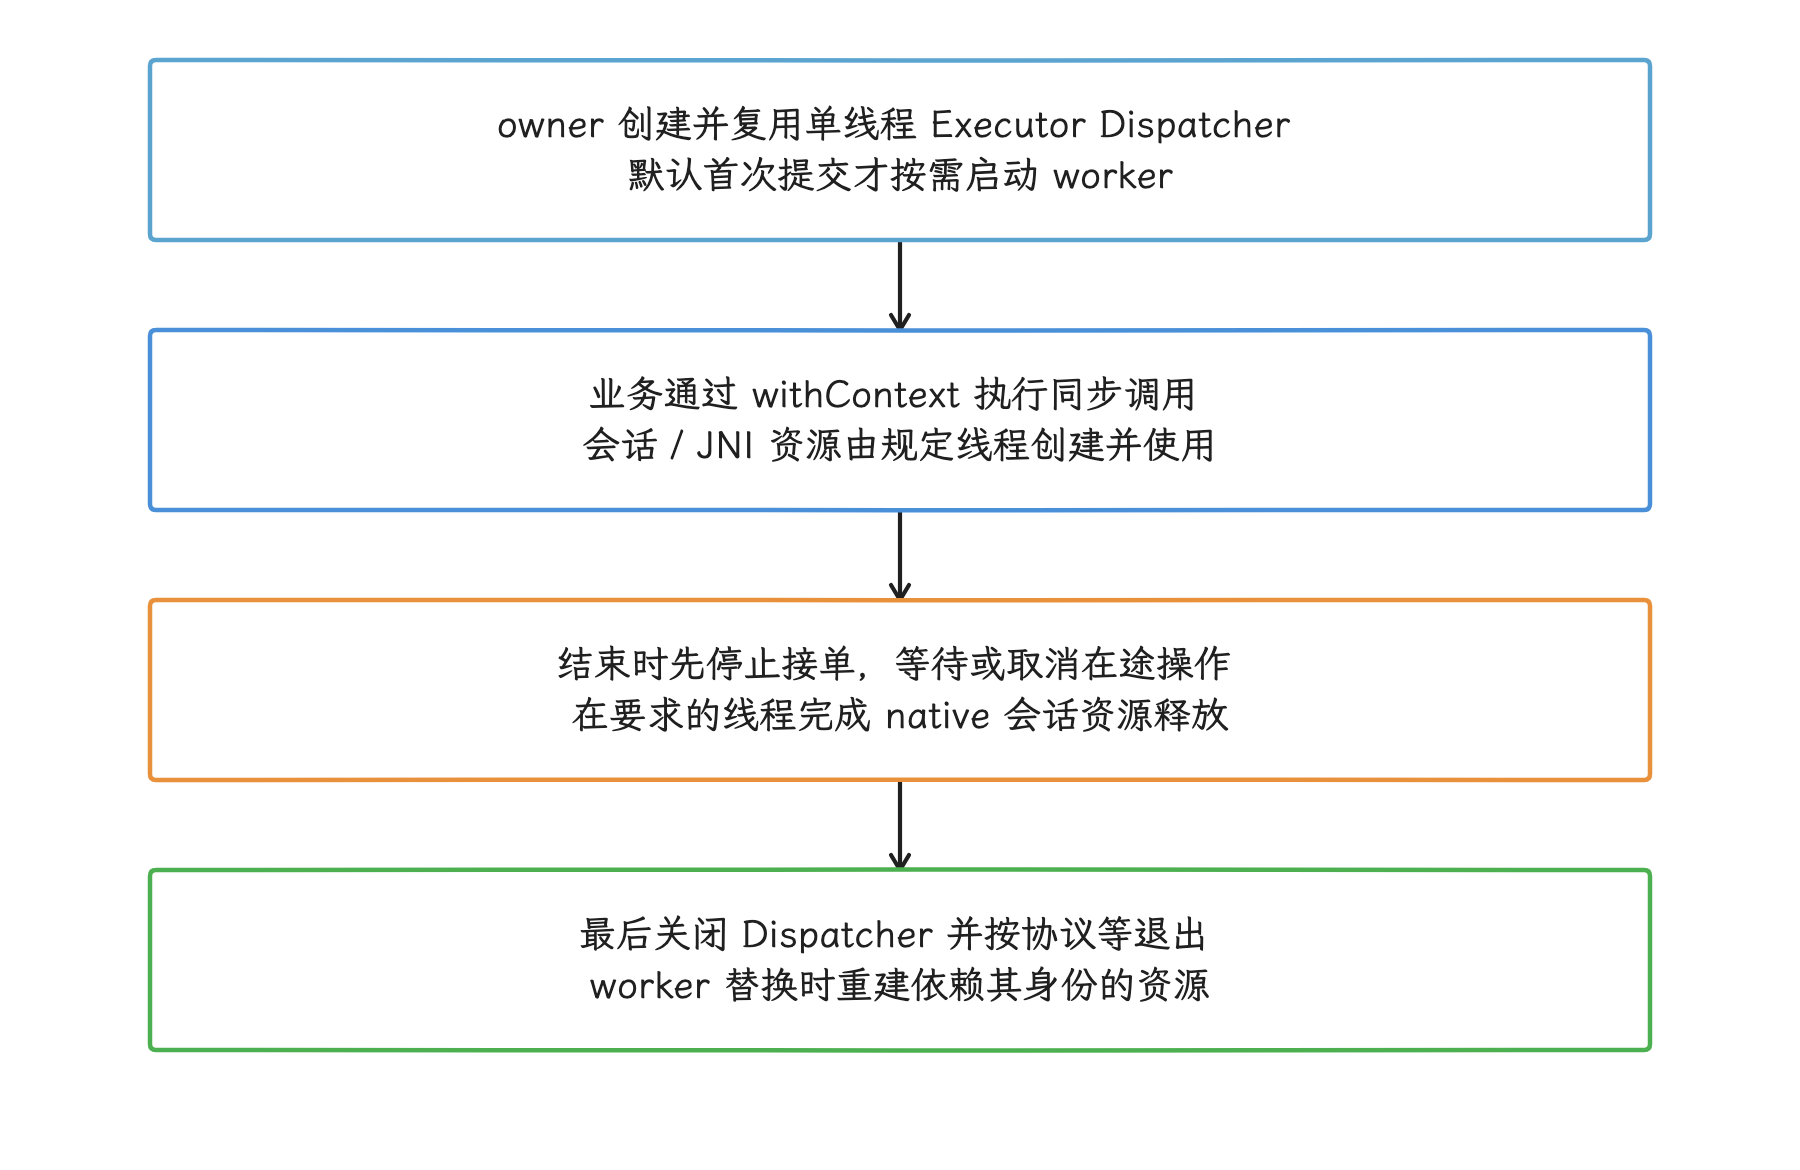
图:单线程 Executor 提供串行线程位置,没有 Looper 或自动 JNI 会话管理;释放须安排在关闭之前。
Executor、HandlerThread 与队列所有权
自定义 ExecutorCoroutineDispatcher 的 owner 还要定义队列(queue)、拒绝新任务的策略(rejection)、停止接单、关闭超时(shutdown timeout)和未完成任务的处理方式。Executors.newFixedThreadPool() 使用无界队列,线程数固定不表示提交方会受到背压。需要限制队列容量时,应显式构造 ThreadPoolExecutor,并让 rejection 对应明确的业务失败或降级结果。通过 asCoroutineDispatcher() 提交而被 Executor 拒绝时,协程库会取消相应 Job,并把恢复任务转交 IO 以执行取消清理;到了关闭或队列拒绝之后,“finally 必定运行于原来的专用线程”这个假设就靠不住了。
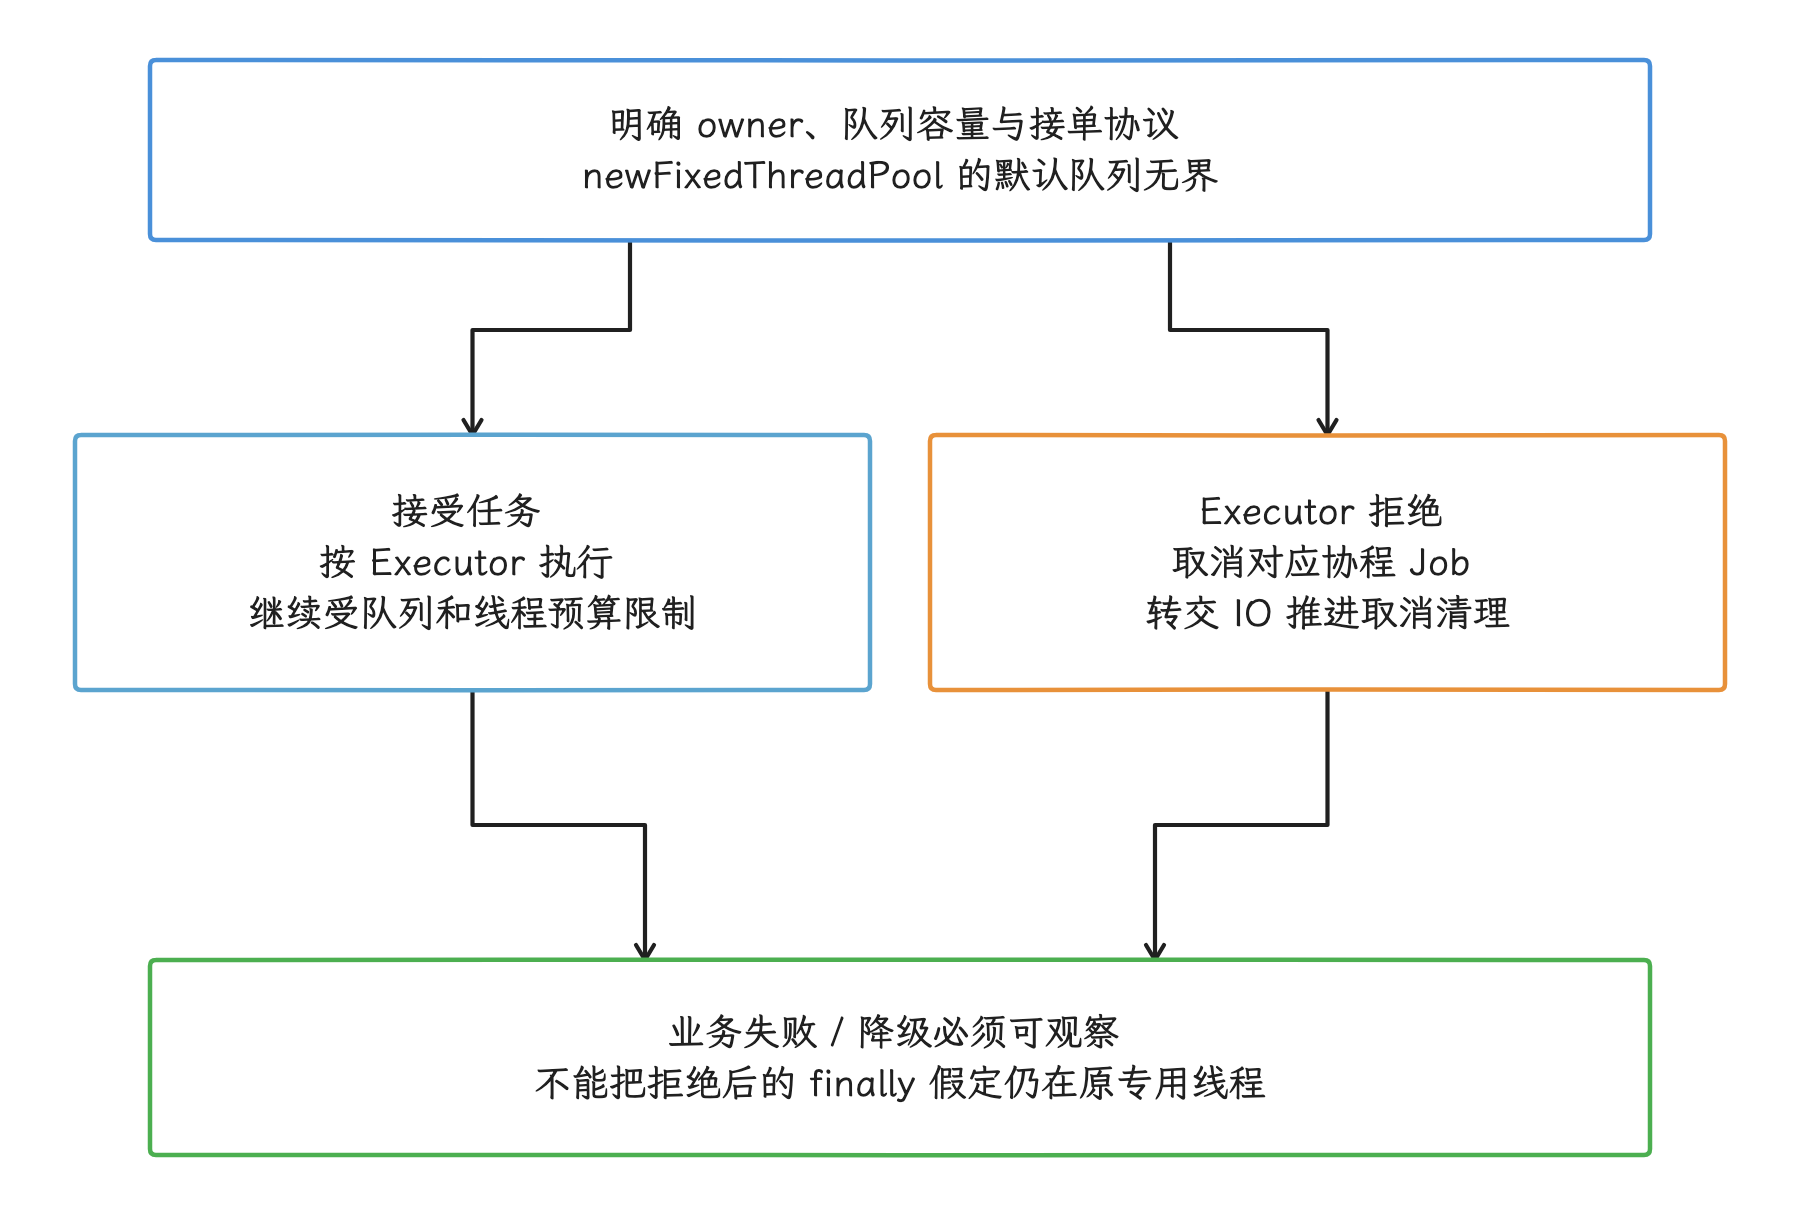
图:固定线程数不限制无界待办;Executor 拒绝时协程取消并回退 IO 清理,原线程亲和不再保证。
API 明确要求 Looper / Handler 或 MessageQueue 语义时,可以使用 HandlerThread;仅要求固定 Java 线程而不依赖 Looper 时,单线程 Executor 也是候选。HandlerThread 包含一个常驻线程和一条串行队列,长 callback 会阻塞所有后续消息;owner 结束时先停止接单并释放线程资源,再调用 quitSafely();它处理当时已到期的消息,未来的延迟消息会被丢弃,不保证所有队列任务都执行。必要时从其他线程使用带超时的 join() 等待退出。
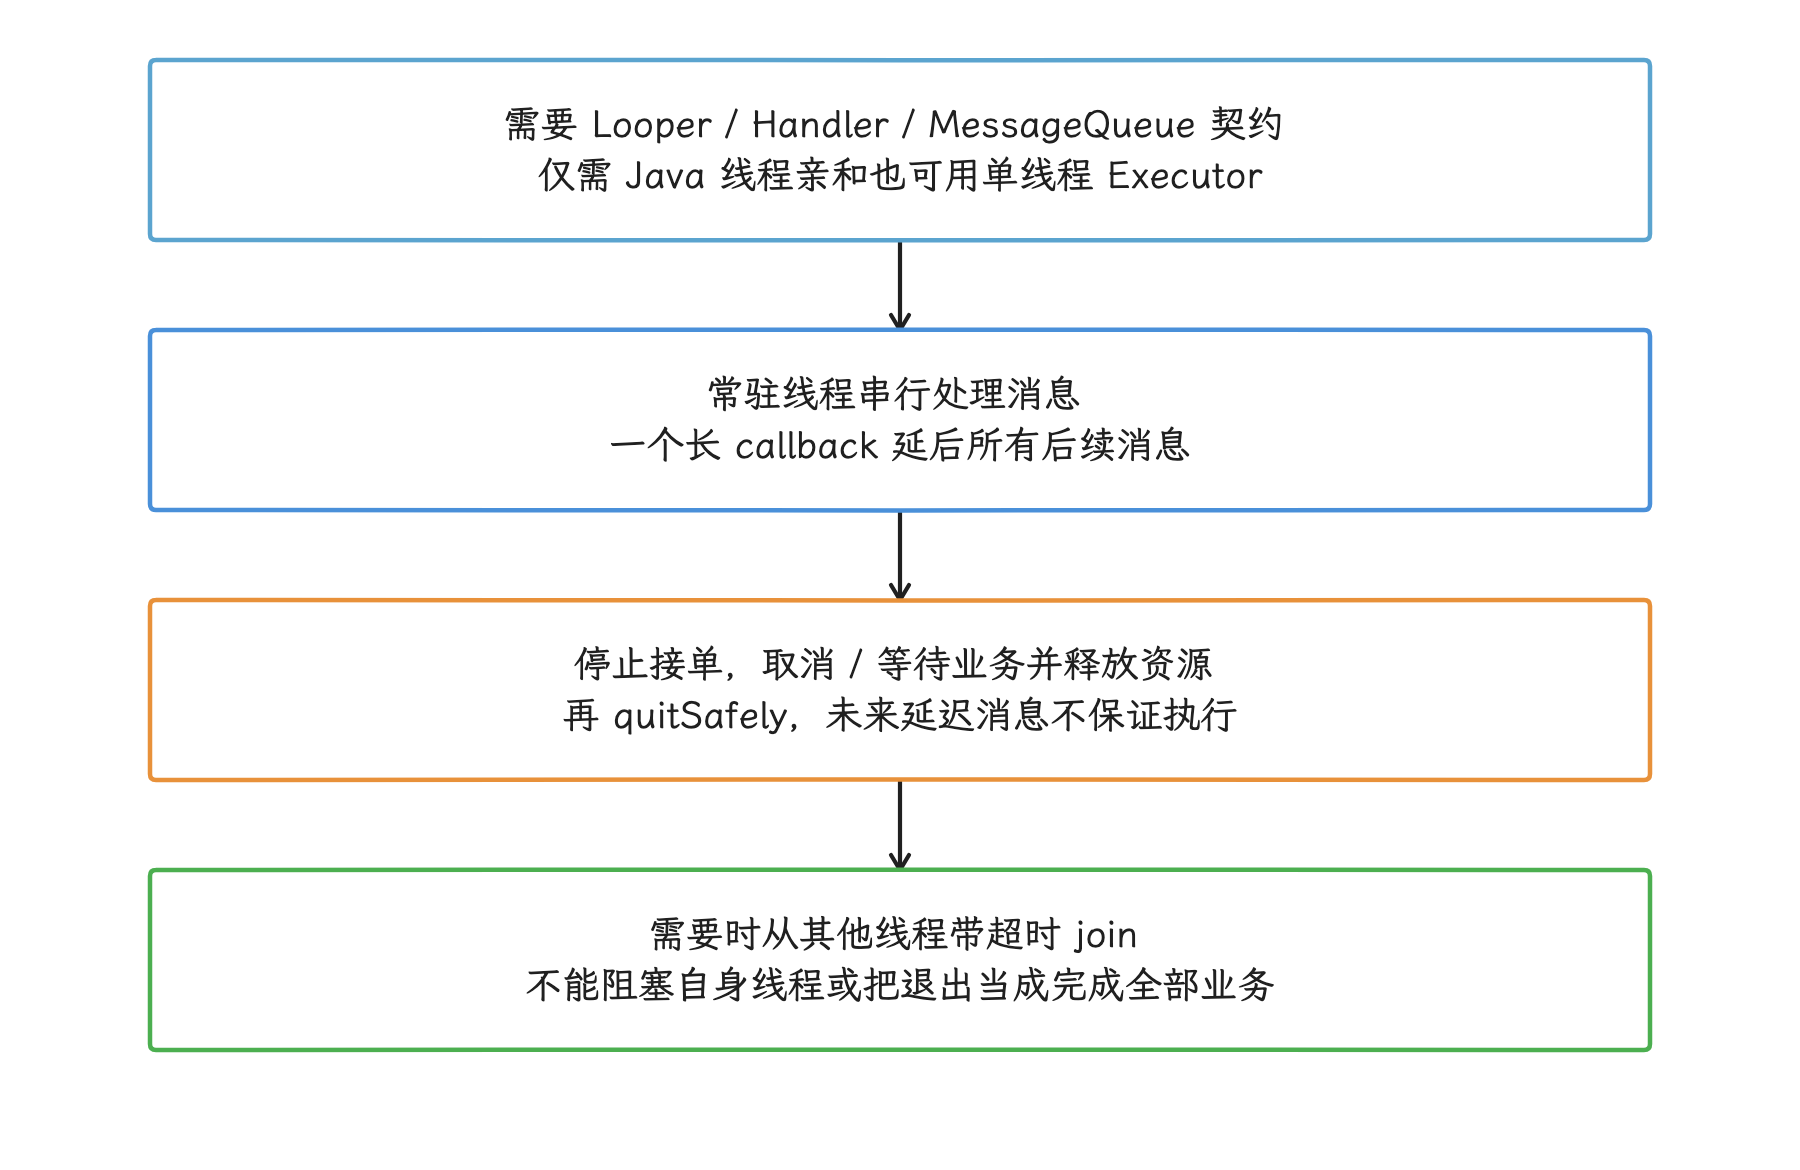
图:要求 Looper 时才选择 HandlerThread;quitSafely 不是执行全部历史待办,关闭前先处理 owner 与资源。
对于普通串行状态操作,可以优先比较 limitedParallelism(1)、Mutex、actor / Channel 和单线程 Executor。选 limitedParallelism(1) 时注意,固定 TID 和跨 suspension 的整个业务操作互斥,都超出它的保证范围。
Channel 的 send / receive 在需要等待时通过挂起释放线程,条件已满足时可直接完成;BlockingQueue.put / take 则会阻塞调用线程。两者都可以实现有界背压,也都需要明确关闭、取消和异常协议;笼统地说 BlockingQueue“没有背压”,并不成立。
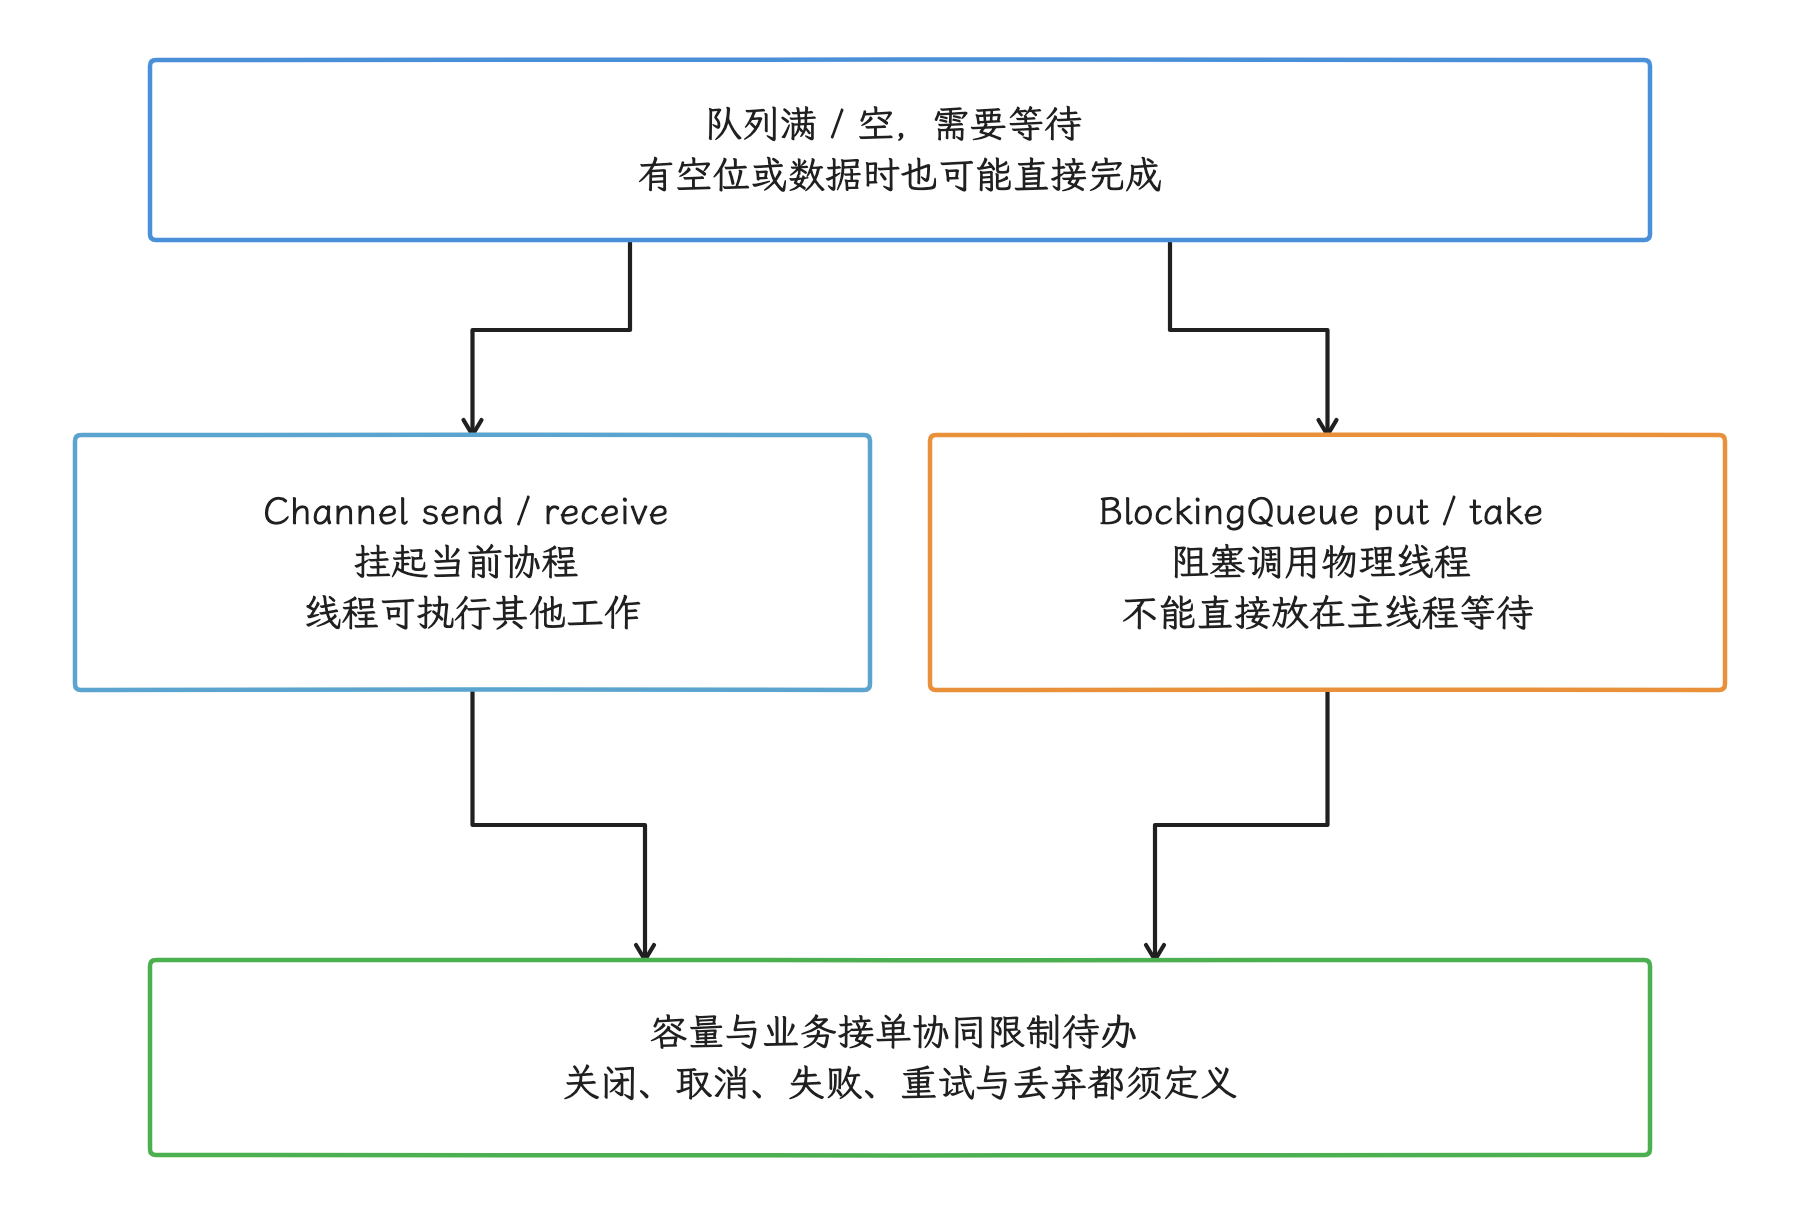
图:Channel 等待时挂起协程,BlockingQueue.put/take 等待时阻塞调用线程;二者都需要关闭和失败协议。
线程优先级与 ADPF 的归属
Process.setThreadPriority() 设置 Linux nice 值,Thread.setPriority() 维护 Java priority 语义;二者的数值范围、继承关系和运行时行为都不同。在此之上,Android 的 task profile、cpuset(允许线程运行的 CPU 集合)、uclamp(调度利用率上下限)、进程状态、thermal 和 OEM 策略,仍会改变线程实际获得的 CPU。所以要设置 Android nice,就在目标线程入口设置并测量;内核优先级要看目标线程本身,创建者线程和 CoroutineName 都给不出答案。
Linux 6.18 的 EEVDF 调度器会在 runnable fair entity(可运行的普通调度实体)中,根据 eligibility(是否具备运行资格)和 virtual deadline(虚拟截止时间)选择任务。这里我们要区分两种等待:协程 continuation 还停在用户态 scheduler 队列中是一种,worker 已经 Runnable 却还没拿到 CPU 是另一种。前者的线索是提交 / 开始标记和 worker 队列压力,后者看 Perfetto sched / thread_state、频率、cgroup 和 uclamp。
ADPF(Android Dynamic Performance Framework)session 绑定一组长期存在的 TID(线程 ID),与 coroutine ID 无关。周期性渲染、音视频或稳定计算确实需要 ADPF 时,应由 owner 明确的长期 worker 承担,按照完整工作周期上报 wall duration,并在 worker 被替换时更新 TID;session 按 owner 粒度创建,避免随每次 launch、suspend 或 resume 各开一个。
Android 17 与内核 6.18 下的边界
Dispatchers.Main仍受单线程 Looper 约束。Android 17 target API 37+ 默认新队列减少了队列竞争,但没有消除长消息或改变帧预算。- Default / IO 的队列和 work stealing 位于用户态,Linux 6.18 调度器只能看到 worker 线程。协程优先级不会自动转换成内核调度优先级。
- Perfetto 中
Runnable表示线程可运行却未获得 CPU;它与协程在 Dispatcher 队列中尚未出队是不同状态。 - ADPF
PerformanceHintManager.Session绑定 TID,不绑定 coroutine ID。Default worker 之间可以迁移任务,因此一个静态 TID 列表不适合长期代表某条协程。 - ADPF 适合持续、可度量的渲染或计算 work cycle(工作周期)。不要为每次 suspend / resume 发送 hint,也不要假设 hint 会让任务固定到某一类 CPU 核心。
- 发现系统调度或 Binder 等待时,平台源码按 android-17.0.0_r1 核对,内核行为按 android17-6.18-2026-06_r6 核对;历史版本的 trace 不可直接代替。
排查清单
主线程
- suspend 函数内部是否仍有阻塞 I/O、锁或大量计算?
- 是否连续嵌套多个
withContext(Main/Default/IO)? Main.immediate是否改变了事件顺序或触发重入?- UI collector 是否用
repeatOnLifecycle跟随可见状态?
worker
- Default 上是否存在阻塞调用?
- IO 和各个
limitedParallelism视图的总并发量是多少? - CPU 循环是否定期检查取消?
- 任务粒度是否小到调度和对象分配占主要比例?
- 自定义 Executor 是否复用并正确关闭?
Flow
- 中间值能否丢弃?
- buffer 满时应挂起、丢旧值还是丢新值?
- collectLatest 的 action 能否协作取消?
flowOn放在了哪段上游,是否无意中增加了 Channel 边界?- StateFlow / SharedFlow 的共享 scope 在页面不可见时是否仍在工作?
Trace
- 业务墙钟区间是否有 async trace?
- 同步 section 是否跨过 suspend 或线程迁移?
- 是否同时查看 Running、Runnable、Sleep 和 CPU 频率?
- 方法热点来自采样还是高开销 instrumentation?
- 调试器观察到的 Job 状态是否与 release trace 分开记录?
版本演进
- Kotlin 1.3 稳定了语言层协程支持,kotlinx.coroutines 继续独立演进。
- AndroidX Lifecycle 后续提供了
viewModelScope、lifecycleScope和repeatOnLifecycle,将常见 Android owner 接入 Job 生命周期。 - kotlinx.coroutines 的 Default / IO 调度器、Flow 融合和调试支持仍在持续变化;本文以 1.11.0 公开 API 为准,不假设内部线程数量和队列实现长期不变。
- Android 12 / API 31 引入
PerformanceHintManager,Android 14 / API 34 公开Session.setThreads()。它们是线程级性能提示接口,不属于协程调度器。 - Android 17 对 target API 37+ 默认启用新无全局队列锁 MessageQueue;兼容开关可影响实现选择,Main Dispatcher 仍执行在 Android 主线程。
参考资料
- kotlinx.coroutines 1.11.0 API 总览
- kotlinx-coroutines-android 1.11.0 HandlerDispatcher 源码
- kotlinx.coroutines 1.11.0 CoroutineScheduler 源码
- CoroutineScheduler 设计解析(上)—— 为什么 Dispatchers.IO 会创建更多线程?
- CoroutineDispatcher 公开契约
- Dispatchers.IO 的并行度、弹性与共享线程说明
- Dispatchers.Unconfined 的恢复线程与事件循环
- Main.immediate 的内联执行条件
- withContext 的 dispatch 与取消契约
- Android 协程最佳实践
- Lifecycle-aware coroutine 与 repeatOnLifecycle
- Flow 公开契约
- buffer 的容量、溢出与操作符融合
- conflate 的丢值语义
- collectLatest 的取消语义
- StateFlow 的融合与复杂度说明
- Android 自定义 trace 事件
- AndroidX Tracing 2.0 进程内追踪与协程上下文传播
- Android Studio System Trace
- Android Studio / IntelliJ Coroutine Debugger
- PerformanceHintManager.Session API
- Android 17 无全局锁 MessageQueue
- android-17.0.0_r1 Combined MessageQueue 源码
- android-17.0.0_r1 PerformanceHintManager 源码