App 冷启动链路与 Binder Trace 分析
我们从一次冷启动的 trace 切入:总时长只有先拆开,才知道往哪里查。前半篇把启动拆成进程创建、绑定应用、组件启动和首帧,后半篇用 Binder 事务,把跨进程等待接回具体的服务端线程。
从启动请求到首帧
启动性能要回答的三个问题
一次应用启动要穿过 Launcher、system_server、Zygote、应用进程、SurfaceFlinger 和显示设备。总耗时只回答“慢不慢”;要找到能下手修的位置,我们要依次回答三个问题:
- 本次样本属于冷启动、温启动还是热启动?
- 测量目标是首帧可见的 TTID,还是主内容可交互的 TTFD?
- 时间消耗发生在系统调度、进程创建、应用初始化、Activity/UI 创建,还是首帧渲染与合成?
源码基线:AOSP
android-17.0.0_r1(Android 17 / API 37);内核android17-6.18-2026-06_r6;Binder 部分另核对frameworks/native与external/perfetto,设备也可能使用其他内核分支。文中 SDK 初始化、Zygote preload(预加载) 等优化手段的收益,都要在目标设备和实际启动样本上测量。
冷启动、温启动与热启动
冷、温、热三种启动类型描述启动前的进程和 Activity 状态,也决定系统需要重新执行哪些工作。
| 类型 | 启动前状态 | 主要工作 | 可复现实验口径 |
|---|---|---|---|
| 冷启动 | 应用进程不存在 | 创建进程、绑定 Application、创建 Activity、生成首帧 | Macrobenchmark StartupMode.COLD |
| 温启动 | 常见口径是进程存活、Activity 需要重建 | 复用进程和 Application,重建 Activity / UI | Macrobenchmark StartupMode.WARM |
| 热启动 | 进程和目标 Activity 仍存在 | 将已有 Activity 带回前台,恢复必要状态并更新画面 | Macrobenchmark StartupMode.HOT |
官方启动文档对温启动的描述较宽,还包括“进程重建,但可以使用 saved instance state(已保存实例状态)”的情况。Macrobenchmark 为基准测试提供了更窄、可重复的定义:WARM 保留进程并重建 Activity。所以比较线上数据和实验室数据时,应记录各自采用的是哪种定义。
按 Home、按返回键、从 Recents(最近任务) 恢复和点击通知,会产生不同的任务栈状态。生命周期日志可以辅助判断,但单凭出现 onCreate() 或 onResume() 还定不下启动类型;更可靠的依据是 Perfetto 的 Android App Startups、am start -W 输出、Macrobenchmark 配置,以及 API 35 及以上版本的 ApplicationStartInfo.getStartType()。
冷启动时序
下面的时序图省略了权限校验、任务复用、窗口转场和错误分支,只保留影响启动性能的主要步骤:
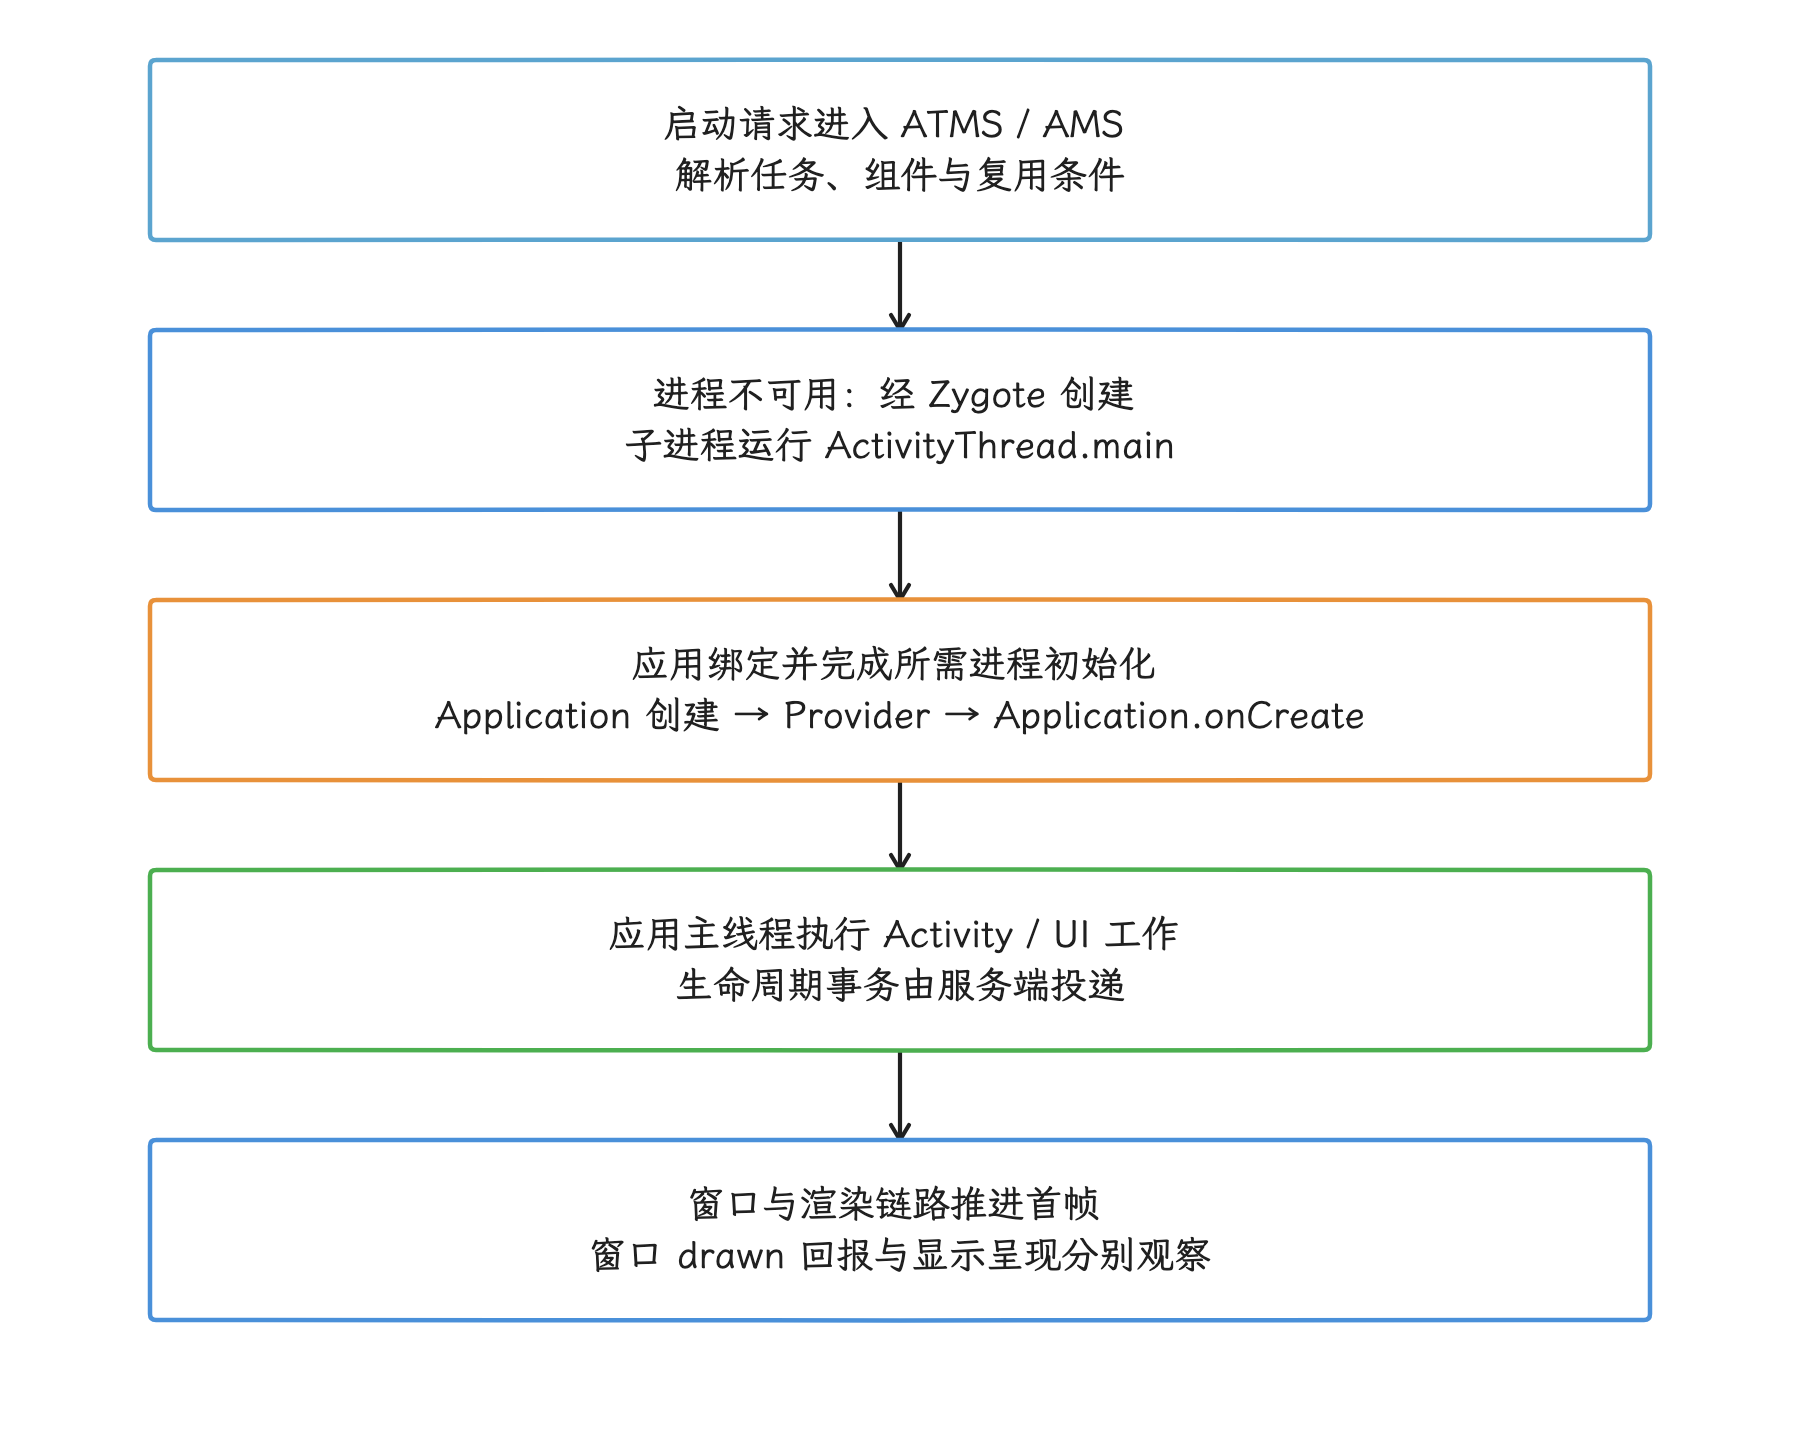
图:主线描述必要依赖;事务可提前投递,绘制回报与实际显示另有交叠,细节见下文分图。
查看 Mermaid 源码
sequenceDiagram
    participant L as Launcher
    participant A as ATMS / AMS
    participant W as WMS
    participant Z as Zygote
    participant P as App process
    participant S as SurfaceFlinger / HWC

    L->>A: startActivity
    A->>A: resolve Activity and task
    A->>W: create starting window
    A->>Z: Process.start request
    Z-->>P: fork and specialize
    P->>A: attachApplication
    A-->>P: bindApplication
    P->>P: create Application
    P->>P: install providers
    P->>P: Application.onCreate
    P->>A: finishAttachApplication(常规等待分支)
    A-->>P: 生命周期事务(也可受开关提前投递)
    P->>P: Activity lifecycle and UI creation
    P->>W: add app window
    P->>P: Choreographer traversal and DrawFrame
    par 绘制上报与系统计时
        P-->>W: finishDrawing / 窗口绘制同步
        W->>A: app windows drawn
        A->>A: record Framework TTID
    and buffer 与显示链路
        P->>S: submit buffer / transaction + fence
        S->>S: compose and present
    end
图中的“app windows drawn”是窗口绘制上报触发 Framework 计时的回调点,到这里为止的都还是软件侧的绘制回报,GPU 完成、HWC present 和面板发光各有各的时刻;它和实际 present 谁先谁后,受提交、IPC 和调度影响,要按同一 buffer 的 trace 核对,事先假定它必定早于面板点亮会出错。
启动请求、任务解析与 starting window
Launcher 通过 Activity API 发起启动,Binder 请求随后进入 ActivityTaskManagerService(ATMS)。系统解析 Intent、权限、后台启动限制,以及 Task 与 Activity 的复用关系,并为本次启动建立计时记录。
冷启动期间,WindowManager 可以先显示 starting window(启动占位窗口)。从 Android 12(API 31)开始,标准路径由 SplashScreen API 统一。starting window 是系统在目标应用首帧之前显示的过渡画面,TTID 的终点仍是目标 Activity 自己的首帧。若再使用专门的 trampoline Activity(只负责跳转的中间 Activity)充当启动页,还会额外增加一次 Activity 创建和窗口转场。
进程选择与 Zygote fork
ActivityTaskSupervisor.startSpecificActivity() 会先检查目标进程是否存在、是否已经注册了可用的应用线程:
WindowProcessController.hasThread()为真时,系统可进入realStartActivityLocked();- 进程不可用时,系统走
startProcessAsync()。
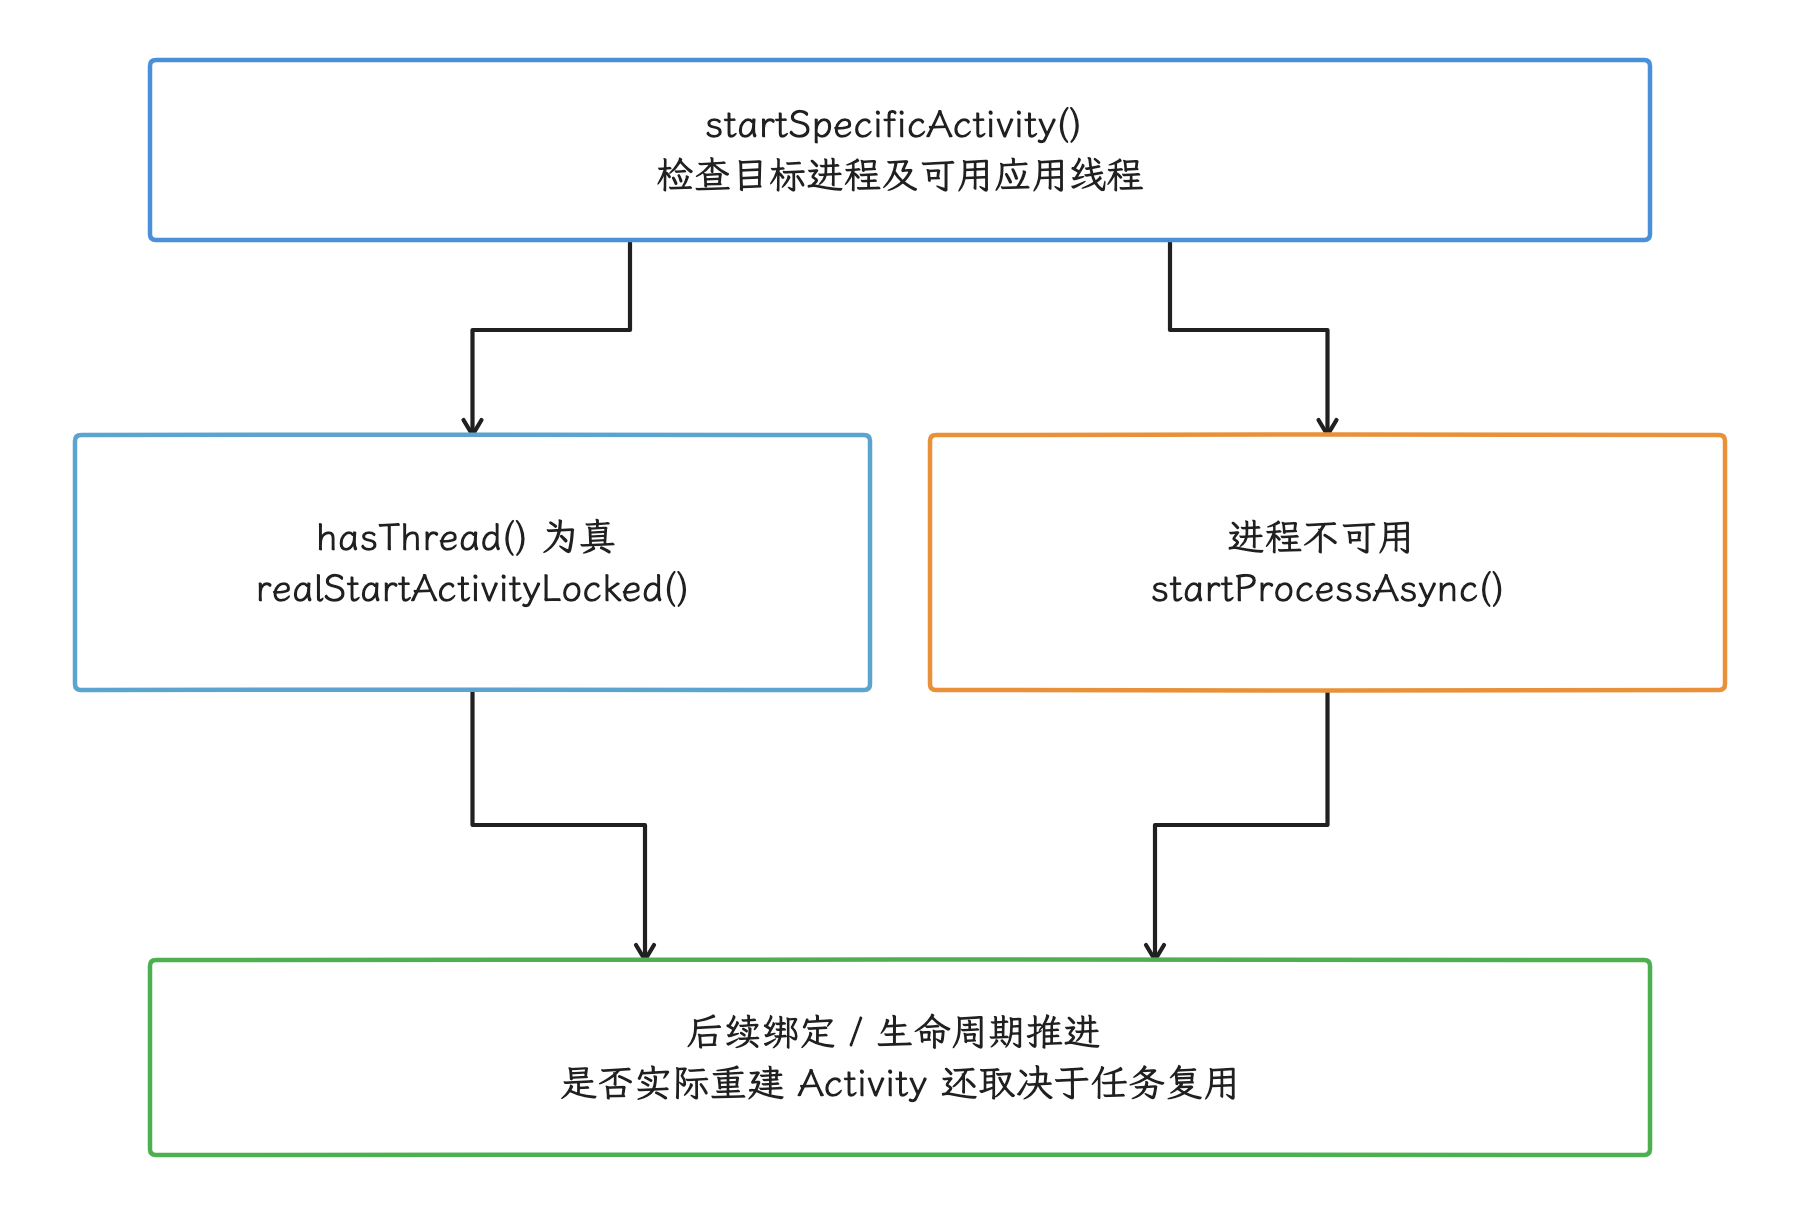
图:已注册应用线程可复用;否则异步请求创建进程。
需要创建进程时,调用会继续进入 ProcessList.startProcessLocked(),再到 Process.start() 和 ZygoteProcess。ZygoteProcess 通过本地 socket 向匹配目标 ABI 的 Zygote 发送参数。Zygote 通过 fork 复制出子进程,再为它设置 UID、GID、SELinux、运行时参数和入口类;这个过程称为 specialize(专门化)。应用入口通常是 ActivityThread.main()。
Zygote 已加载的 Framework 类、资源和部分 native 映射,可以由子进程通过 Copy-on-Write(写时复制)共享:只读时多个进程使用同一物理页,发生写入时才复制。共享页能减少重复加载和内存占用;至于应用代码的类加载是否完成、共享页是否驻留在内存里,共享机制本身说明不了。preload 的收益取决于系统版本、厂商列表、内存压力和启动路径,具体设备上的覆盖比例,我们实测了才有数。
ActivityThread 与 attachApplication
ActivityThread.main() 创建应用主线程环境和主 Looper(消息循环)。ActivityThread.attach() 通过 ActivityManagerService.attachApplication() 告知系统应用线程已经可用。系统随后向应用侧的 ApplicationThread 发送 bindApplication,应用主线程处理 BIND_APPLICATION 消息并进入 handleBindApplication()。
这一阶段在 r1 主线程 trace 中通常标为 bindApplication,其中包含的工作远多于 Application.onCreate():
- 建立
LoadedApk、Context、ClassLoader 和运行时配置; - 创建并
attach()Application; - 安装系统下发的 ContentProvider;
- 初始化 Instrumentation;
- 调用
Application.onCreate(); - 处理字体、网络安全和图形环境等进程级配置。
ActivityThread.handleBindApplication() 按照以下顺序执行:先调用 makeApplicationInner(),再调用 installContentProviders(),最后由 Instrumentation.callApplicationOnCreate() 进入应用回调。所以 SDK 用于自动初始化的 Provider 会在 Application.onCreate() 之前运行;测量启动时要把这段也圈进来,单看 Application 回调会漏掉它。
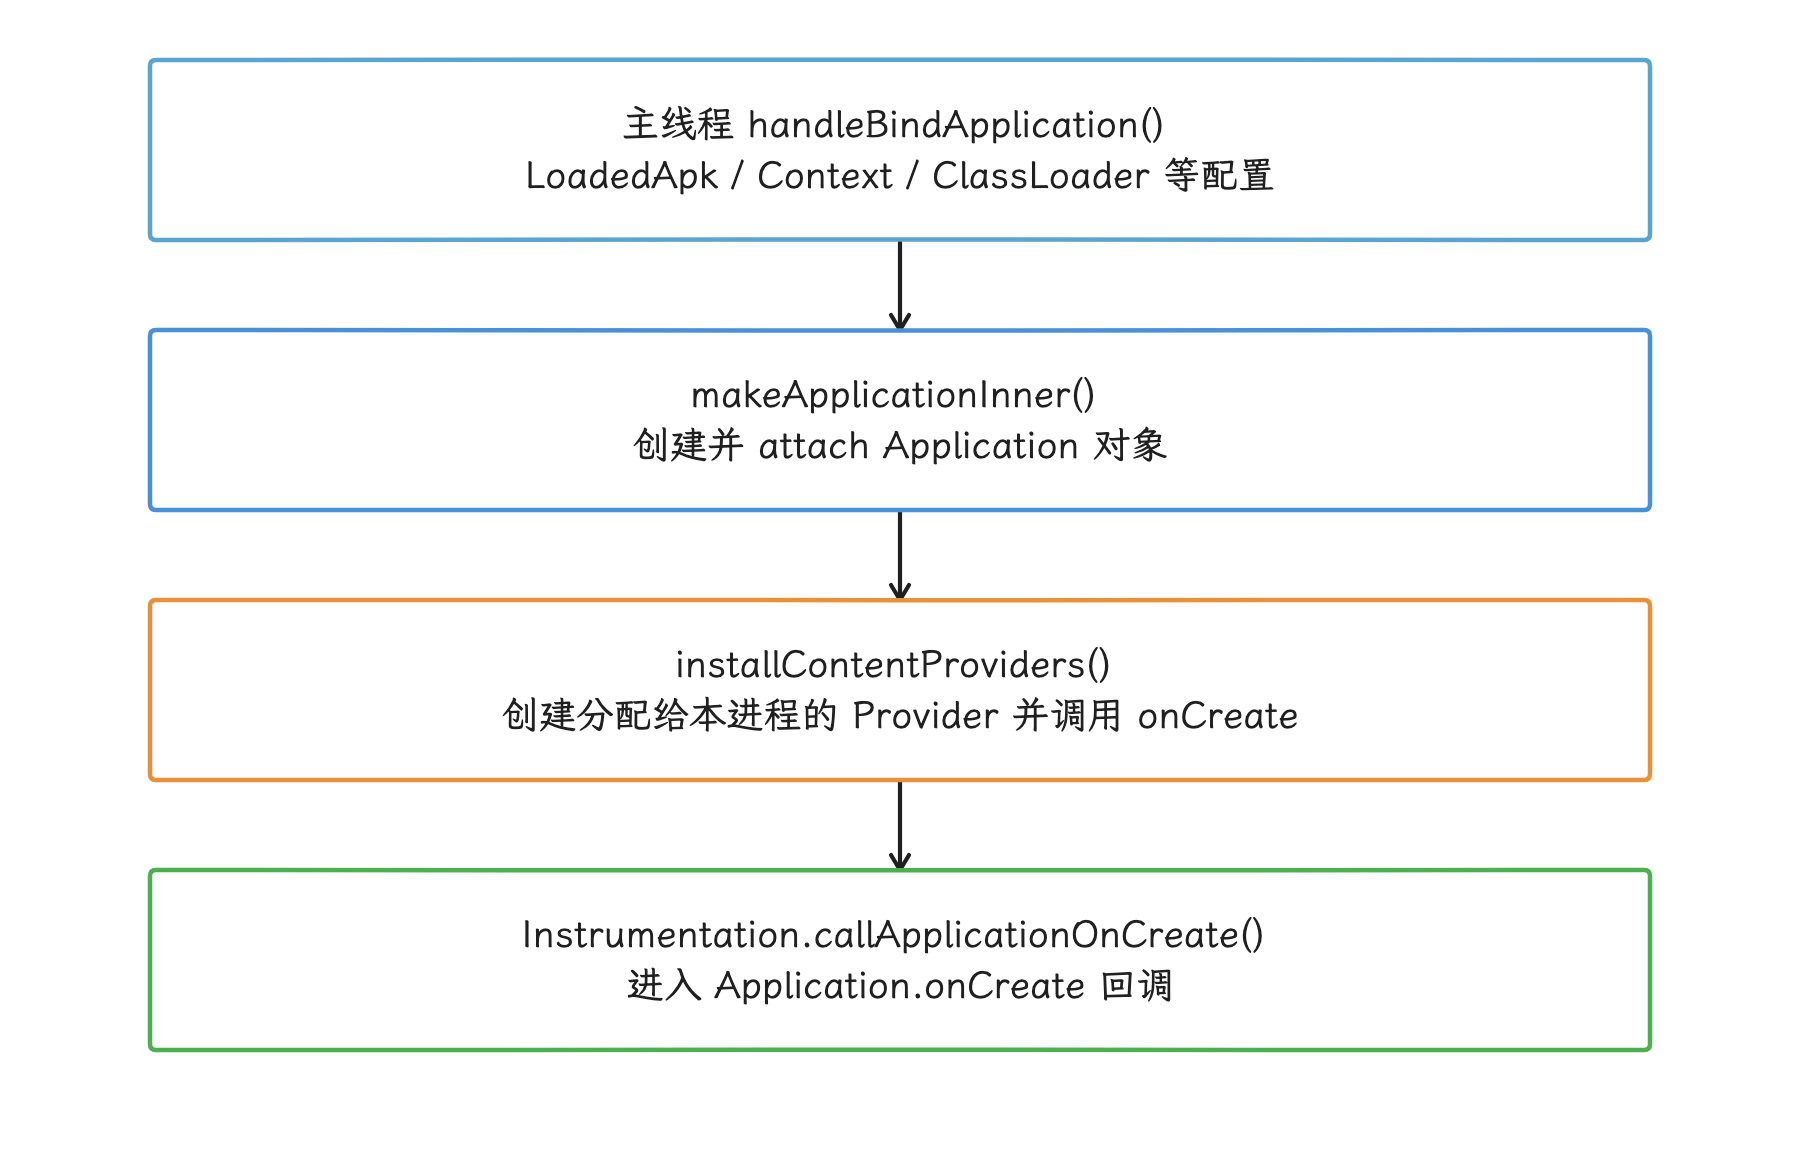
图:Application 对象已创建和 attach 后才安装 Provider;Application.onCreate 在其后。
ClientTransaction 与 Activity 生命周期
r1 中,handleBindApplication() 结束时会调用同步的 finishAttachApplication(startSeq, onCreateEntryNs)。AMS 的常规等待分支随后推进待启动 Activity;expediteActivityLaunchOnColdStart 等开关也可让服务端更早投递事务。投递到 Binder 的时刻与 App 主线程实际执行生命周期的时刻应分开看。ActivityTaskSupervisor 为新建 Activity 构造 LaunchActivityItem;如果 Activity 还需要进入前台,则同时附带 ResumeActivityItem。这些对象属于 ClientTransaction,用于把服务端决定的生命周期操作发送给应用。LaunchActivityItem.execute() 调用应用侧的 handleLaunchActivity(),随后进入 performLaunchActivity()。
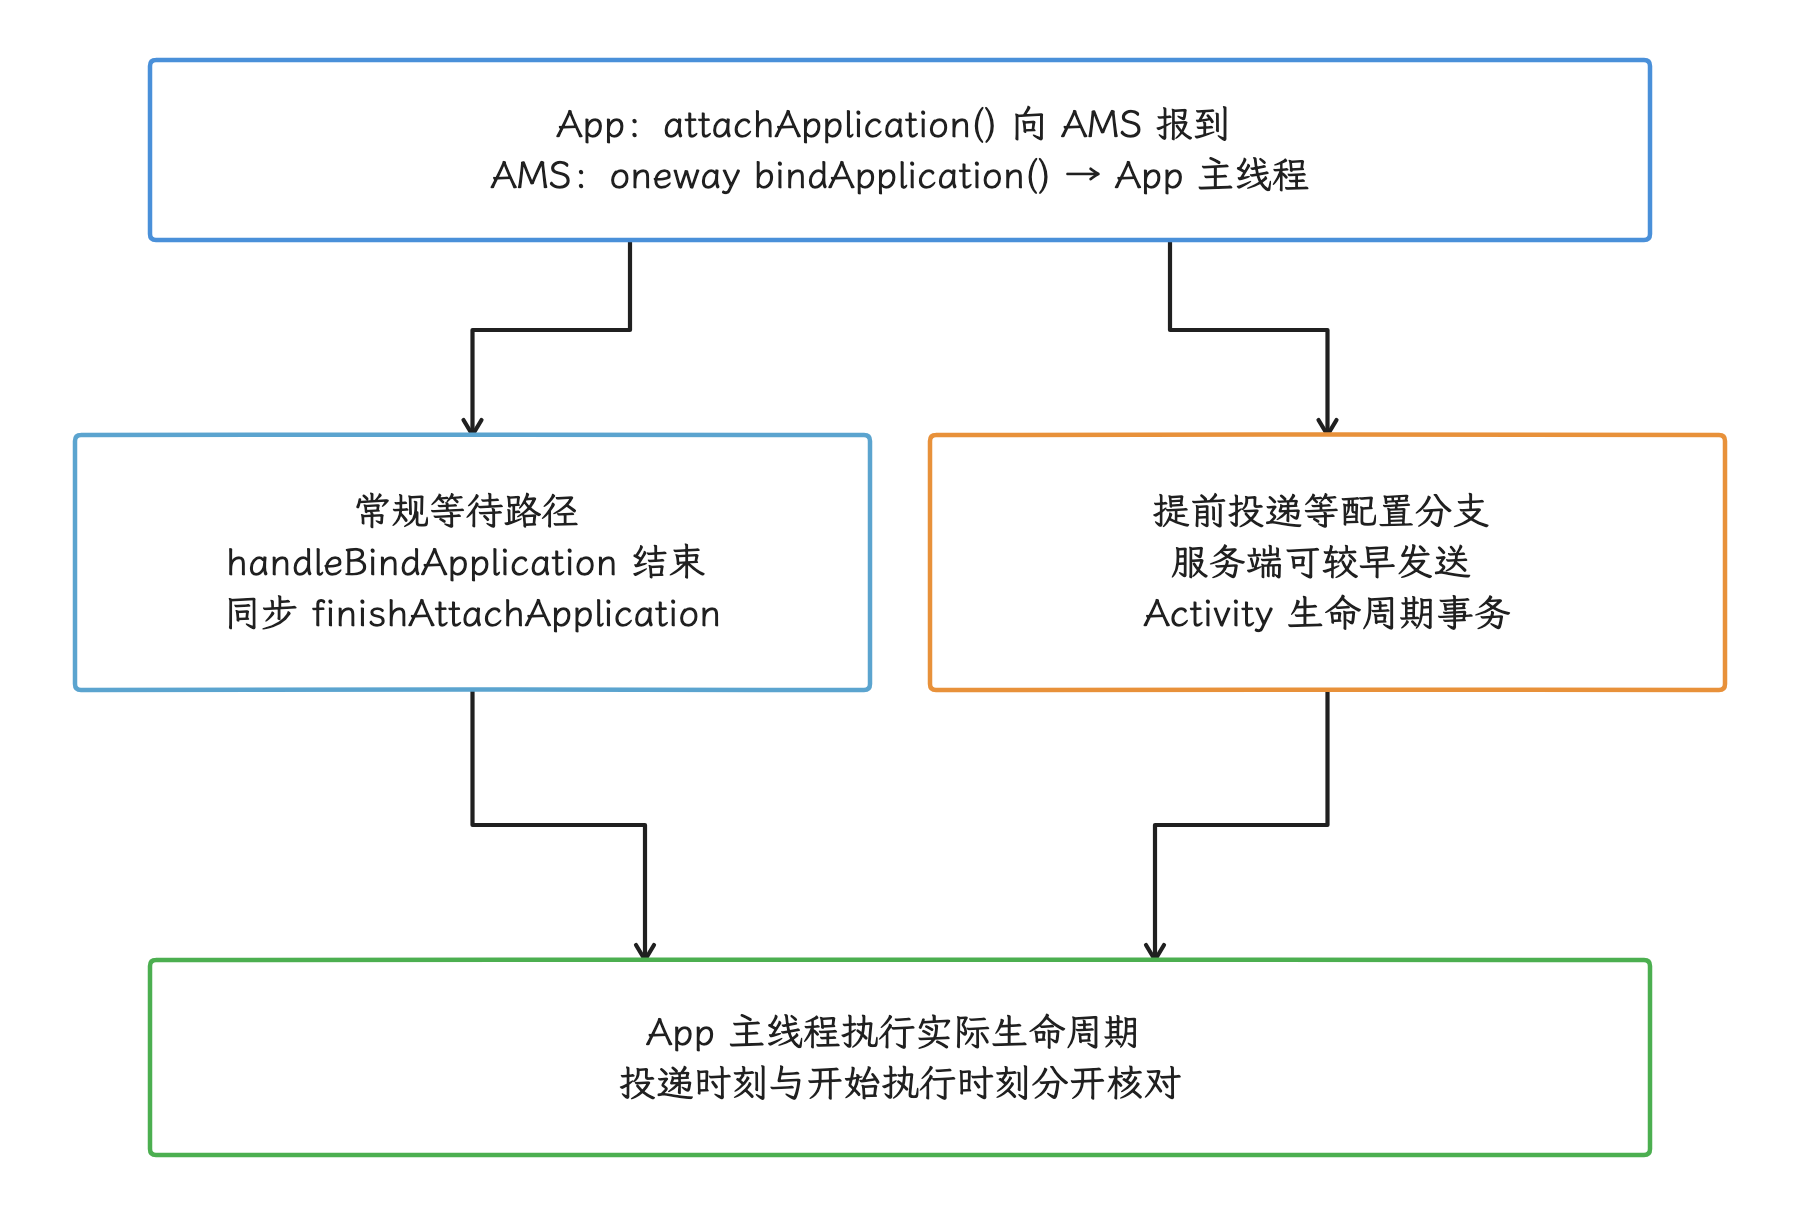
图:常规等待分支由 finishAttach 推进 Activity;开关也可提前投递,但 App 主线程按实际消息与依赖执行。
performLaunchActivity() 创建 Activity 实例和对应的 Activity Context,执行 Activity.attach(),再调用 onCreate()。TransactionExecutor 根据目标生命周期继续执行 onStart() 和 onResume()。启动 Activity 中常见的首屏工作包括:
setContentView()中的 XML inflate(解析并创建 View),或 ComposesetContent {}后的初始 composition(组合);- ViewModel、依赖注入和 saved state 恢复;
- 同步资源解析、主题和 drawable 创建;
- 首屏数据读取与 UI 状态构建。
“Activity 启动必然 inflate XML”只适用于典型的 View 页面;无界面、透明、跳板或延迟安装内容的 Activity 可能走其他路径,系统对 setContentView() 也没有强制要求。
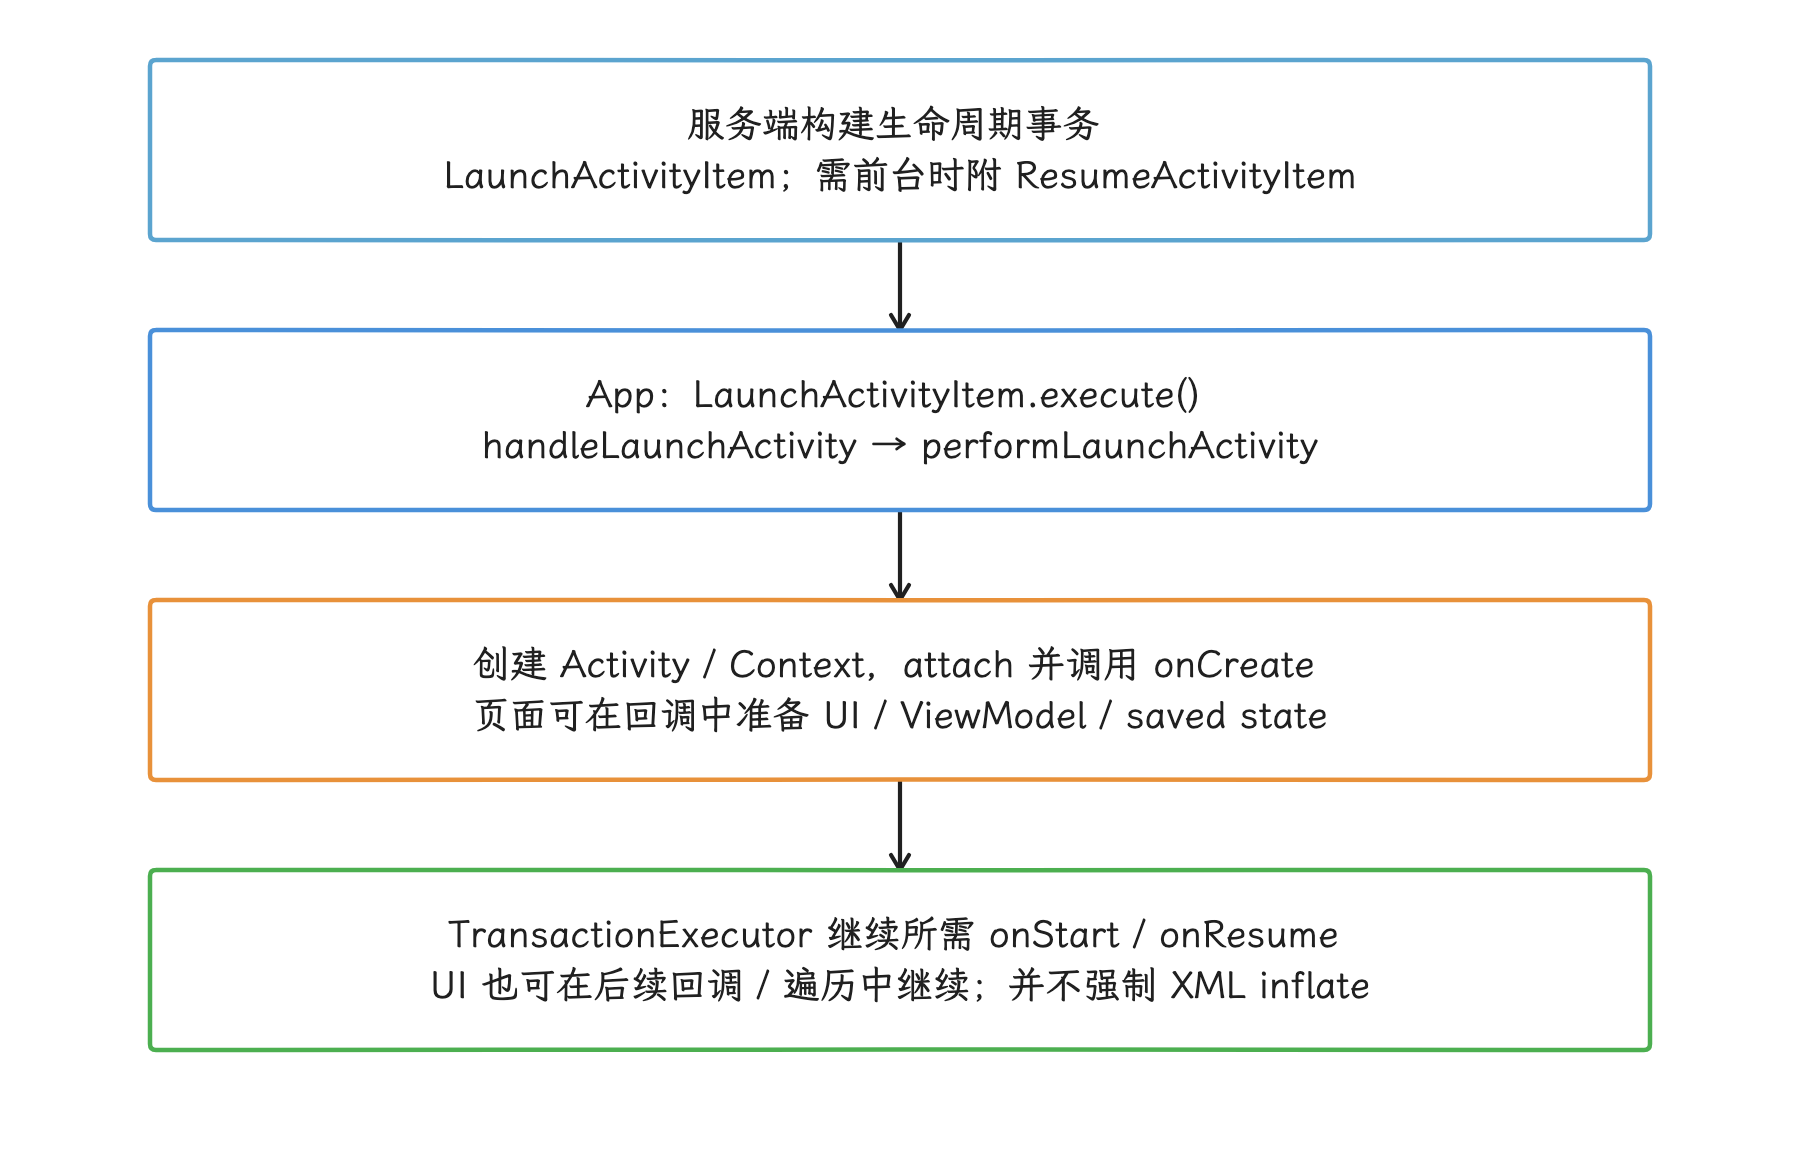
图:LaunchActivityItem 驱动创建;前台目标按事务执行后续生命周期,XML inflate 只是一种 UI 路径。
窗口、遍历与首帧
Activity 进入 resume 阶段后,DecorView 会被加入 WindowManager;应用进程创建 ViewRootImpl,并向 WMS 注册窗口。首帧的应用侧路径通常包括:
ViewRootImpl.scheduleTraversals()向 Choreographer 请求一次 traversal(界面遍历);- VSync 到来后执行
performTraversals(); - View 页面完成 measure、layout 和 draw,Compose 页面完成相应的 composition、layout 和 draw;
- UI Thread 更新渲染节点,RenderThread 执行
DrawFrame并提交 GPU 工作; - buffer 提交给 SurfaceFlinger;
- SurfaceFlinger 选择 buffer、完成合成,并交给 HWC present(提交显示)。
ActivityRecord.onWindowsDrawn() 会调用 ActivityMetricsLogger.notifyWindowsDrawn()。这是窗口绘制路径的系统观测点,不是 HWC 的实际呈现时间。Framework 在这里通过 SystemClock.uptimeNanos() 记录 START_TIMESTAMP_FIRST_FRAME,并结束 Framework 统计的窗口绘制启动区间——平台对 TTID 的统计就到这一刻为止。SurfaceFlinger 合成、HWC present 和面板扫描仍可能发生在这个时间点之后。
TTID 与 TTFD
TTID:目标 Activity 的首帧
TTID(Time to Initial Display,首帧显示时间)统计从系统收到启动请求,到目标 Activity 首帧完成所用的时间。冷启动包含进程创建、Application 和 Activity 初始化;温启动会跳过部分进程工作;热启动主要反映 Activity 恢复和重新显示。
Logcat 中的 Displayed 行和 Android Vitals 的启动时间以 TTID 为主要口径。Android Vitals 把以下 TTID 归为 excessive startup:
- 冷启动达到 5 秒;
- 温启动达到 2 秒;
- 热启动达到 1.5 秒。
这些数值是 Google Play 判定启动过长的告警线;要追求更好的体验,当前 Android 性能度量指南另有启动体验目标(入口操作到用户数据出现,不能无条件与窗口 drawn 口径视作同一指标):冷启动低于 500 ms、温启动低于 200 ms、热启动低于 150 ms。产品仍应结合设备档位和业务入口,设定 P50、P90、P95、P99 以及超过目标的样本占比。
首帧可能只包含 Splash 之后的页面外壳、骨架屏或空列表,所以 TTID 变短时页面内容可能还没就绪,判断内容可用要看 TTFD。
TTFD:应用声明的可用状态
TTFD(Time to Full Display,完整显示时间)使用与 TTID 相同的启动起点,终点是应用报告 fully drawn。应用应在主内容已经显示、主要交互已经可用时调用 reportFullyDrawn()。如果图片、列表或本地数据属于首屏可用条件,就应纳入这个状态;与首屏无关的预取、埋点上传和后台同步,则以不影响 TTFD 为前提。
ActivityMetricsLogger.notifyFullyDrawn() 会检查窗口是否已经 drawn(完成首帧绘制)。如果应用过早调用,Framework 会推迟报告,确保 TTFD 不早于 TTID。这项保护只保证时间顺序,业务是否可用仍由应用自己定义;就绪条件定义错误,TTFD 就会失真。
AndroidX ComponentActivity 中的 FullyDrawnReporter 可以汇总多个异步就绪条件。下面的示例在等待首屏数据期间增加一个 reporter 计数:
override fun onCreate(savedInstanceState: Bundle?) {
    super.onCreate(savedInstanceState)
    setContentView(R.layout.activity_home)

    fullyDrawnReporter.addReporter()
    lifecycleScope.launch {
        val result = try {
            Result.success(viewModel.awaitInitialContent())
        } catch (cancelled: CancellationException) {
            throw cancelled // 销毁/取消不把仍未就绪的页面报为 fully drawn
        } catch (error: Exception) {
            Result.failure(error)
        }
        // 应用自定义挂起函数:提交成功/可交互错误 UI,等待必要异步提交完成。
        renderInitialStateAndAwaitCommit(result)
        fullyDrawnReporter.removeReporter()
    }
}
所有 reporter 计数移除后,reporter 会经 executor 安排报告;ComponentActivity 的实现还与绘制回调配合。这仍不证明已经实际 present。业务必须先提交成功或可交互错误 UI;只在 finally 里减计数会把失败、取消但仍停在 loading 的页面误报为就绪。Activity 销毁导致的取消,这次 TTFD 缺席就让它缺席,报告成功只会污染数据;仍存活页面若用新任务替换旧任务,应正确交接 readiness 条件。异步 Diff、图片等必需 UI 提交也要等到约定条件完成后再移除 reporter。
Compose 页面可以使用 ReportDrawn、ReportDrawnWhen 或 ReportDrawnAfter 表达相同的就绪条件。判断依据应是用户能否使用页面,无须等待所有后台任务结束。
API 35+:ApplicationStartInfo
Android 15(API 35)引入了 ApplicationStartInfo,用于描述进程为何启动、由哪类组件触发、属于哪种启动类型、当前到达什么状态,以及各阶段的 monotonic(单调递增时钟)纳秒时间戳。一条记录可能由 Activity、Service、Provider、Broadcast 等入口产生,应先检查启动原因、状态和样本身份。getStartComponent() 从 API 36 才公开,API 35 不能直接调用;在 API 35 上,getReason() 也不是组件类型的一一映射,需结合入口与 trace 复核。
常用字段如下:
| 字段 | 含义 | 读取边界 |
|---|---|---|
getStartupState() | STARTED、ERROR 或 FIRST_FRAME_DRAWN | 返回时记录可能仍在收集中 |
getStartType() | COLD、WARM、HOT 或 UNSET | FIRST_FRAME_DRAWN 状态才保证已设置 |
getStartComponent()(API 36+) | 触发进程的组件类型 | API 35 无该公开 getter;Service start 不能当成 Activity TTID |
getReason() | Launcher、Job、Provider、Service 等具体原因 | 用于拆分入口 |
getStartupTimestamps() | 各阶段的 monotonic 纳秒时间戳 | 不同状态和启动类型对应不同的 key |
API 只保证部分状态下必定存在对应时间戳,读取时要按状态分开处理:
START_TIMESTAMP_LAUNCH在STARTED状态可用;FIRST_FRAME_DRAWN状态还保证 bindApplication、Application onCreate 调用点和 first frame 时间戳存在;FULLY_DRAWN依赖应用调用reportFullyDrawn();FORK、initial RenderThread frame 和 SurfaceFlinger composition complete 都应作为可选 key 读取。
先从 getHistoricalProcessStartReasons() 的结果中核对记录身份、状态与入口;最新一条可能仍未结束,也可能属于服务启动。下面的函数只对调用方已选好的记录计算阶段差值,不自动把“最新一条”命名为 Activity TTID:
@RequiresApi(35)
fun readStartPhases(info: ApplicationStartInfo): Map<String, Double?> {
    val timestamps = info.startupTimestamps

    fun deltaMs(startKey: Int, endKey: Int): Double? {
        val start = timestamps[startKey] ?: return null
        val end = timestamps[endKey] ?: return null
        if (end < start) return null // 异常样本另记,不夹成零耗时
        return (end - start) / 1_000_000.0
    }

    return mapOf(
        "launch_to_fork_ms" to deltaMs(
            ApplicationStartInfo.START_TIMESTAMP_LAUNCH,
            ApplicationStartInfo.START_TIMESTAMP_FORK,
        ),
        "bind_to_application_onCreate_entry_ms" to deltaMs(
            ApplicationStartInfo.START_TIMESTAMP_BIND_APPLICATION,
            ApplicationStartInfo.START_TIMESTAMP_APPLICATION_ONCREATE,
        ),
        "launch_to_first_frame_ms" to deltaMs(
            ApplicationStartInfo.START_TIMESTAMP_LAUNCH,
            ApplicationStartInfo.START_TIMESTAMP_FIRST_FRAME,
        ),
        "launch_to_sf_composition_ms" to deltaMs(
            ApplicationStartInfo.START_TIMESTAMP_LAUNCH,
            ApplicationStartInfo.START_TIMESTAMP_SURFACEFLINGER_COMPOSITION_COMPLETE,
        ),
    )
}
START_TIMESTAMP_APPLICATION_ONCREATE 记录回调开始点;START_TIMESTAMP_BIND_APPLICATION 是系统发送 bindApplication 时的时间点。因此差值里还混着 oneway 投递、接收和主线程排队,是一段混合耗时,和纯 handleBindApplication() CPU 时间要分开看;之后才是 Application 创建与 Provider 安装等回调前工作。Application.onCreate() 自身的执行时长要另外测:在回调里加自定义 trace section,或做方法级分析。
同一个 startupTimestamps map 中的时间戳可以直接相减。若要把 monotonic 时间戳叠加到 Perfetto,则应使用 trace clock snapshot(时钟快照) 转换时钟域,API 数值与 trace 主时间轴的零点未必一致。getHistoricalProcessStartReasons() 可能返回尚未完成的记录,缺少部分字段属于正常状态。文档还注明 Service 启动的 LAUNCH 时间戳在 Android 16(BAKLAVA)及更早版本可能不正确;异常样本要单独标记,相减得到的延迟按不可信处理。
四类测量工具
指标定义好了,剩下的是拿数据。四类工具各管一段,我们依次看:
adb shell am start -W
下面的命令会先停止目标应用,再发起启动并等待结果,适合快速检查单次冷启动和 Displayed 时间:
adb shell am start -S -W \
  -a android.intent.action.MAIN \
  -c android.intent.category.LAUNCHER \
  -n com.example.app/.MainActivity
-S 会在启动前停止目标应用,便于构造冷启动,但也会改变原有现场状态。旧版文档示例可能包含 ThisTime,但 r1 的 ActivityManagerShellCommand 实际打印 LaunchState、TotalTime 和 WaitTime,没有 ThisTime。应按设备输出与对应源码解释,不依赖已消失的字段;遇到 trampoline、重定向或多个 Activity 连续启动时,三者要分别确认。这条命令适合冒烟检查,也就是快速确认功能和大致耗时;正式的耗时对比还是要用受控的多轮基准测试。
Logcat
Displayed package/.Activity: +... 对应 Framework 记录的 TTID,调用 reportFullyDrawn() 后则会出现 Fully drawn ...。有些 Displayed 行还带有 total 字段,其统计范围包含在当前 Activity 之前已经启动但尚未显示的 Activity;分析跳板页时应保留这段信息。
Logcat 时间可以帮助定位样本,但记录日志本身会产生一定扰动,而且缺少线程调度、Binder、I/O 和渲染细节。
Macrobenchmark
Macrobenchmark 可以固定启动类型、编译模式、迭代次数和测试入口,并自动保存 Perfetto trace。下面的测试测量冷启动 TTID;如果应用正确报告 fully drawn,也会同时产生 TTFD:
@get:Rule
val benchmarkRule = MacrobenchmarkRule()

@Test
fun coldStartup() = benchmarkRule.measureRepeated(
    packageName = "com.example.app",
    metrics = listOf(StartupTimingMetric()),
    compilationMode = CompilationMode.Partial(),
    startupMode = StartupMode.COLD,
    iterations = 10,
    setupBlock = {
        pressHome()
    },
) {
    startActivityAndWait()
}
StartupMode.COLD 会在迭代间终止进程;本文核对的 AndroidX 实现还在 COLD setup 中尝试清 shader cache 与 kernel page cache,具体权限/平台条件和失败行为需核对所用库版本。WARM 和 HOT 按各自定义保留状态,所以手工 am start -S 不自动等价于这套完整协议。比较 Baseline Profile 前后结果时,需要固定 CompilationMode,否则编译状态差异可能被误认为代码优化收益。
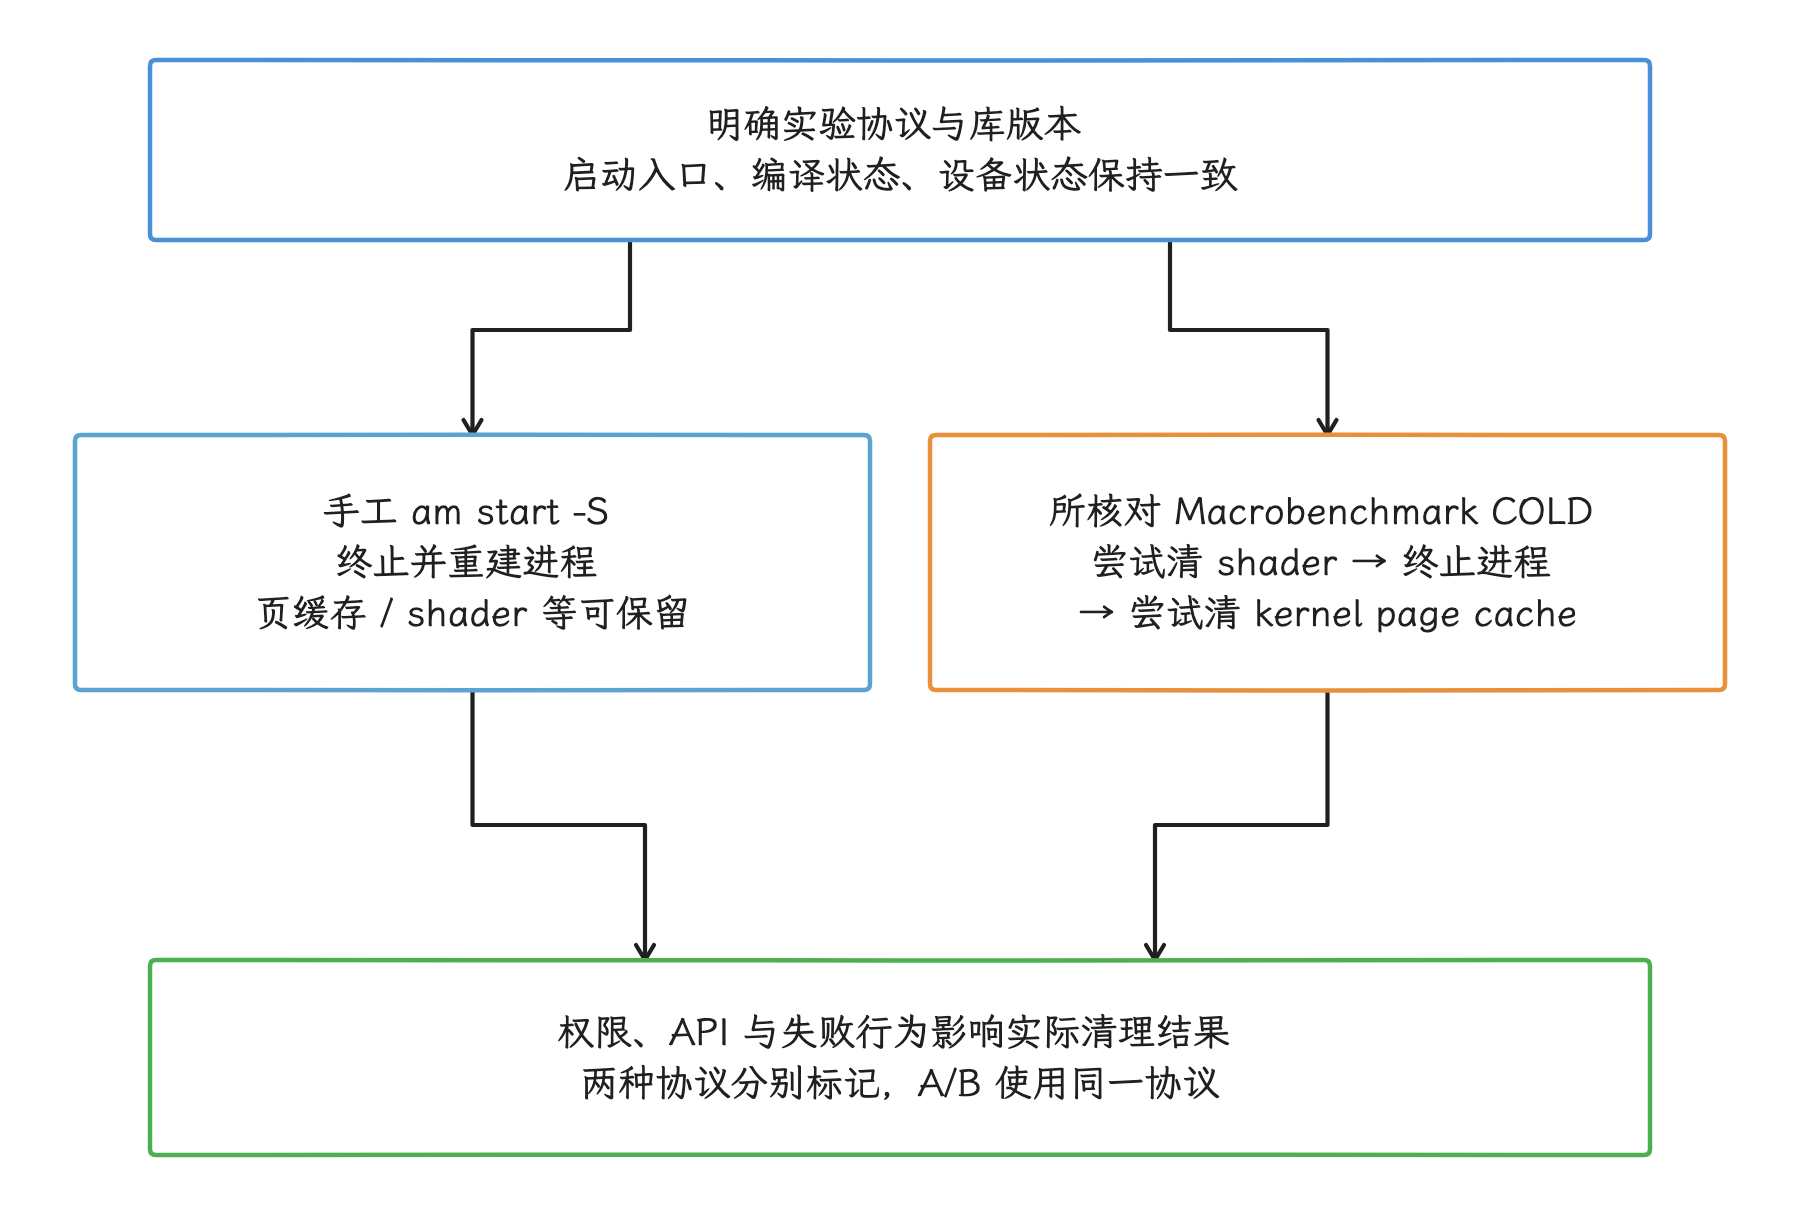
图:本文核对的 AndroidX COLD setup 还尝试清 shader / kernel page cache;记录版本与清理结果,只写“冷启动”三个字是不够的。
Perfetto
Perfetto 用于定位启动时间花在了哪个阶段。界面中的 Android App Startups derived metric(派生指标)会给出启动区间和类型,随后可以展开检查:
system_server的launchingActivity#...、进程创建和 Binder;- 应用主线程的
bindApplication、activityStart、class loading、ContentProvider 和自定义 trace; - View 的
performTraversals,Compose 的 composition/layout/draw; - RenderThread
DrawFrame、GPU、FrameTimeline; - SurfaceFlinger、HWC 和厂商 display trace。
较新的 trace processor 标准库可以直接查询启动类型、TTID 和 TTFD。下面的 SQL 会列出指定包的启动记录,并关联首帧和完整显示时间:
INCLUDE PERFETTO MODULE android.startup.startups;
INCLUDE PERFETTO MODULE android.startup.time_to_display;

SELECT
  s.startup_id,
  d.upid,
  s.startup_type,
  s.dur / 1e6 AS startup_slice_ms,
  d.time_to_initial_display / 1e6 AS ttid_ms,
  d.time_to_full_display / 1e6 AS ttfd_ms,
  d.ttid_frame_id,
  d.ttfd_frame_id
FROM android_startups AS s
LEFT JOIN android_startup_time_to_display AS d
  USING (startup_id)
WHERE s.package = 'com.example.app'
ORDER BY s.ts;
如果应用没有报告 TTFD,或 trace 未覆盖对应帧,ttfd_ms 可以为空。r1 time_to_display.sql 的端点取 RenderThread DrawFrame 切片结束:TTID 取选中的首帧,TTFD 取包含或晚于 fully-drawn 信号的候选帧。这与 Framework 窗口 drawn / Logcat 的计时端点、SF present 和面板发光均不同,是三个各有定义的数,记录时要分开写。
r1 的查询还要复核:以进程/时间推导关联,若多次启动、同包多个进程或缺少首帧,可能选到不属于该样本的后续帧;部分选帧使用 GROUP BY 搭配非聚合列,再在分组后 ORDER BY,组里选中的是否为最早帧,从这里看不出来,要另行核对。应核对 upid、frame id、目标窗口和样本边界,缺失时保留不确定性。
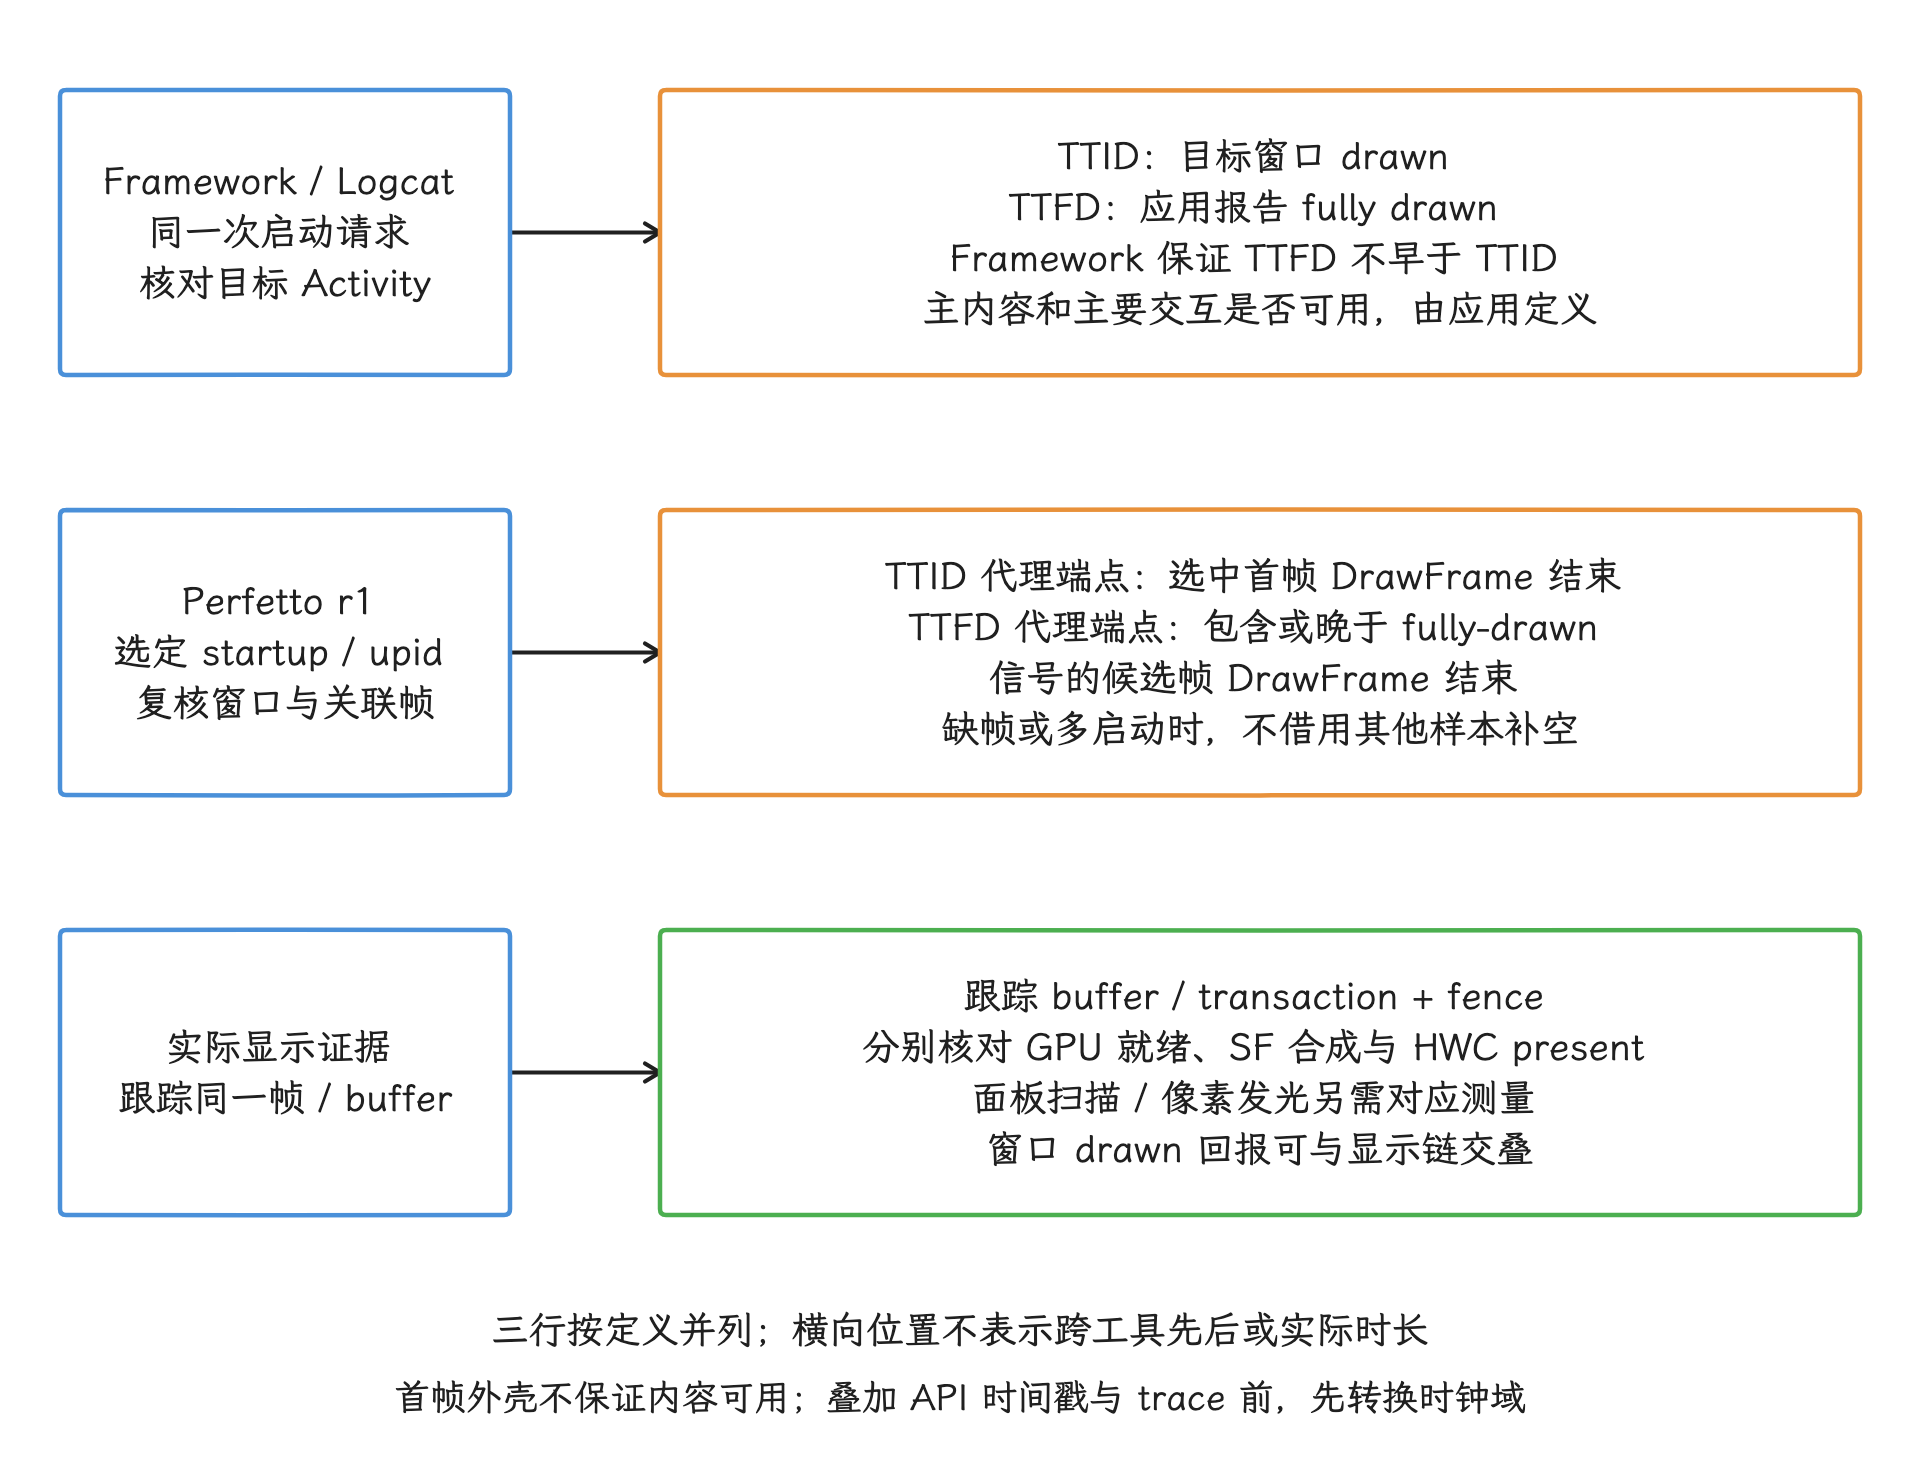
图:三行分别按工具定义观测:Framework / Logcat 以目标窗口 drawn 与 fully drawn 计时,应用负责业务就绪;本文 r1 Perfetto 指标取选定的 RenderThread DrawFrame 结束作为代理端点,并需复核 startup、进程、窗口与帧;GPU、SF、HWC present 和面板结果另按同一 buffer 追踪。跨行位置不表示固定先后或时长,行间换算没有固定的 VSync 偏移可用,跨时钟域叠加还需转换。
Application 与 Provider 的启动成本
ContentProvider 早于 Application.onCreate
排查从 Manifest 合并后的最终 Provider 列表开始:WorkManager、Firebase、图片库、APM(应用性能监控)、广告、推送和自定义 SDK 都可能通过 Provider 自动初始化。Provider 的 onCreate() 在应用主线程执行,并且早于 Application.onCreate();同步磁盘、数据库、Binder 或类加载都会延迟 Activity 创建。
检查时应同时查看:
- 应用源 Manifest 与依赖合并后的最终 Manifest;
bindApplication内 Provider 安装相关 slice;- SDK 是否提供关闭自动初始化或按需初始化的配置;
- 当前启动入口是否需要这项初始化,例如 Launcher 入口和 push / service 进程可能依赖不同组件。
Application.onCreate
Application 回调适合建立所有进程入口都需要、且耗时可控的进程级状态。常见风险包括:
- 同步读取 SharedPreferences、文件、数据库或 keystore;
- 主线程等待 Binder、锁、线程池
Future或网络; - 一次创建完整依赖图和大量单例;
- 初始化当前入口用不到的 SDK;
- 大量反射、序列化、类加载和 native library 加载;
- 为“异步化”同时启动过多任务,争抢启动线程需要的 CPU、I/O 和内存带宽。
将工作移到后台线程只改变了执行位置。如果后台任务占满高性能 CPU 核心、触发大量缺页,或持有主线程需要的锁,TTID 仍可能变差。每项延迟初始化都应明确触发条件、执行线程、依赖、完成时限和失败策略。
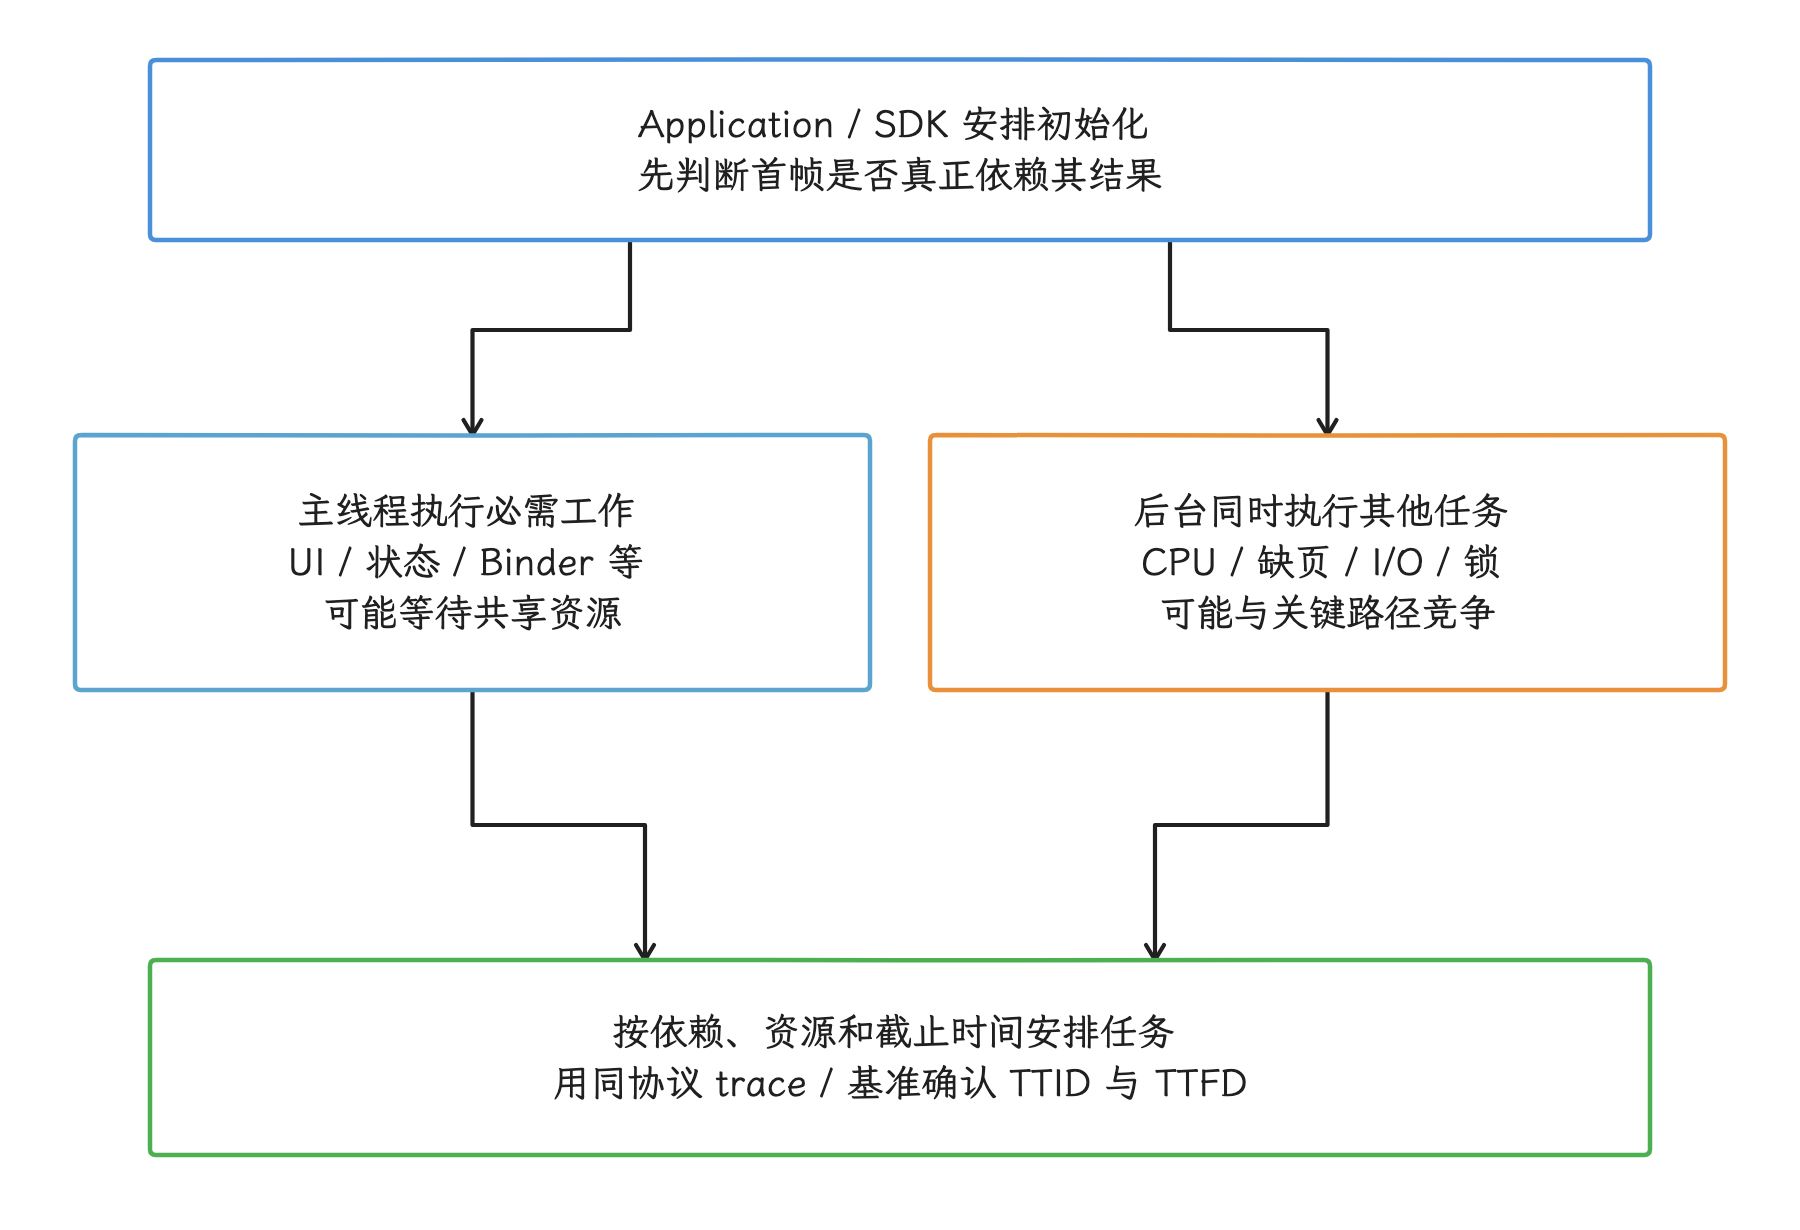
图:换线程只改变执行位置;后台竞争 CPU、I/O、内存带宽或锁仍能拉长首帧关键路径。
多 DEX 与 ART
Android 8.0 到 Android 17 的 ART 原生支持多 DEX。Android 5.0 以下版本中 MultiDex.install() 的解压和安装问题属于历史兼容路径,与本文的平台基线无关。
多 DEX 仍会影响现代 Android 的启动表现:类在 DEX 文件中的布局、页缓存、校验、类加载,以及解释执行、JIT(运行时即时编译)、AOT 等编译状态都会改变启动开销。我们应通过 class loading slice、文件 I/O、编译过滤器和 Macrobenchmark 的 compilation mode 验证具体原因,DEX 的开销来源也不止“方法数超过 65536”这一种。
AndroidX App Startup
AndroidX App Startup 让多个支持它的组件共享一个 InitializationProvider,并通过 Initializer.dependencies() 声明初始化顺序。这样可以减少多个独立 Provider 带来的框架开销,也更容易看清组件之间的依赖关系。
下面的 Initializer 表示 Telemetry 必须在配置组件完成初始化后才能创建:
class TelemetryInitializer : Initializer<Telemetry> {
    override fun create(context: Context): Telemetry =
        Telemetry.create(context)

    override fun dependencies(): List<Class<out Initializer<*>>> =
        listOf(ConfigInitializer::class.java)
}
App Startup 会先初始化 ConfigInitializer,再调用 TelemetryInitializer.create()。直接注册或被其他 eager Initializer 作为依赖发现的 Initializer 仍在 InitializationProvider.onCreate() 中执行,并且早于 Application.onCreate()。共享 Provider 不会自动把工作移到后台线程,也不会自动推迟初始化时间。
如果组件无须在首帧前运行,应从合并后的 manifest 中移除对应 metadata,并检查它是否仍被其他 eager Initializer 的依赖图引用;只删直接注册但仍有可达依赖,组件依然会自动初始化。真正脱离启动依赖图后,再按需调用 AppInitializer.initializeComponent();手动调用也在调用线程同步执行,不会自动切后台。尚未适配 App Startup 的第三方 Provider 不会被框架自动接管,需要使用 SDK 提供的关闭开关,或向供应方确认其他初始化入口。
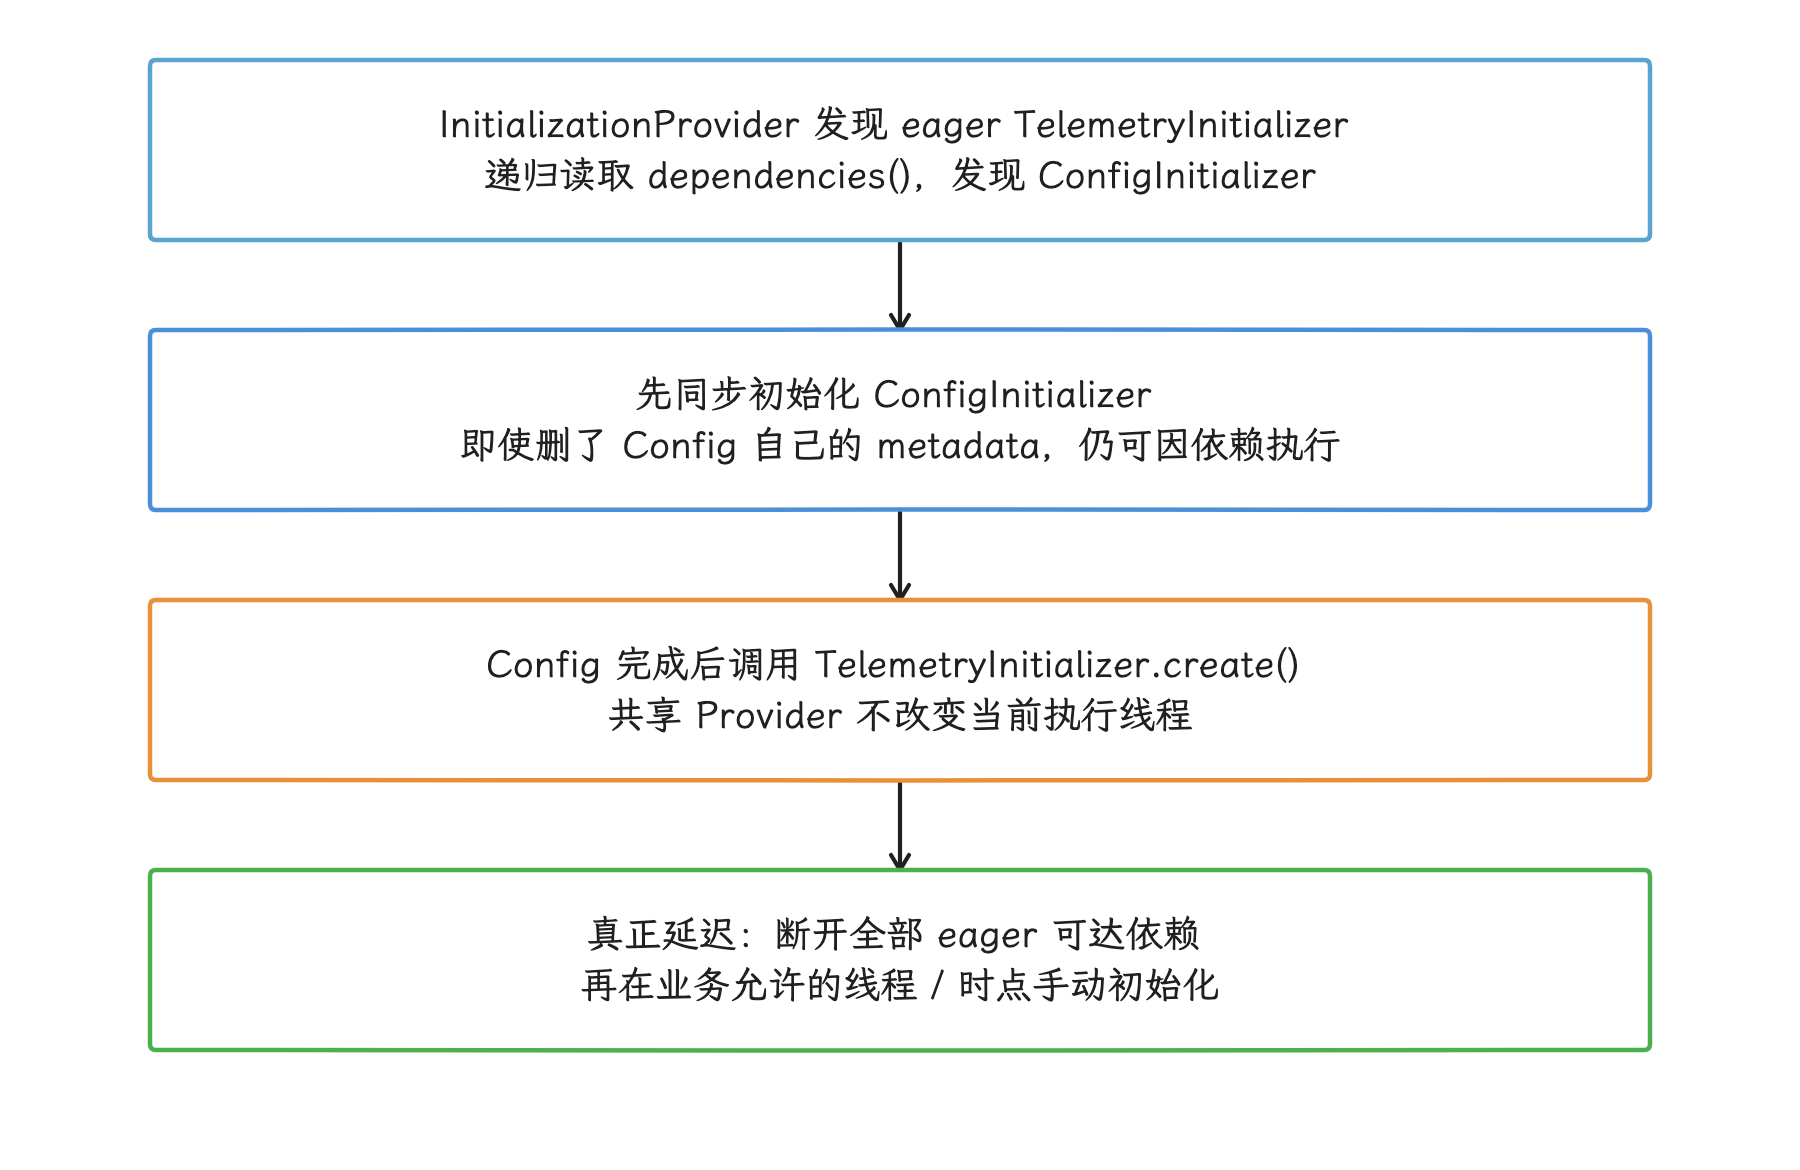
图:删除组件自己的 metadata 后,若仍是其他 eager Initializer 的依赖,仍会在 Provider 中执行。
首帧 UI 的成本
View 页面
XML 页面通常依次经历 inflate、measure、layout 和 draw。inflate 包括解析 XML 与主题属性、构造 View 和加载相关资源;measure / layout 的开销取决于树结构、自定义 View、约束和重复测量;draw 还可能触发 drawable 解析、文本布局、bitmap 解码或 GPU 上传。
减少层级只是可以尝试的手段之一。ConstraintLayout、嵌套容器和自定义布局中哪一种更快,应由首帧 trace 与基准测试判断。AsyncLayoutInflater 也受 View 线程安全限制;如果 Activity 必须等待异步 inflate 完成后才能显示,那么工作虽然换了线程,TTID 却未必缩短。
Compose 页面
Compose 首帧包含初始 composition、measure / place 和 draw。启动期间读取磁盘、执行复杂集合变换、同步创建图片,或一次组合大量不可见节点,都会延长主线程或 RenderThread 路径。可以根据可见状态进行条件组合,推迟次要 tab、错误详情和屏外内容,但要避免首帧之后立即出现一次耗时更长的重组。
图片与资源
首帧只应同步准备当前可见且必需的资源。图片解码、VectorDrawable rasterization(栅格化)、字体加载和主题资源解析都可能出现在 trace 中。使用占位内容时应预留真实内容的尺寸,避免资源到达后发生大范围重新布局。减少首帧工作的前提,是界面仍可交互、内容不闪烁。
Profile 优化的三层含义
Baseline Profile
Baseline Profile 会随应用或库一起交付热点类和方法规则,ART 可以对覆盖路径进行 AOT(运行前)编译,具体可能发生在安装或后台优化阶段。首次运行是否已获编译收益取决于系统版本、安装渠道和 profile 安装/编译状态;例如 API 26–27 常靠 ProfileInstaller 首次写入后再等待后台优化,首次启动是否已完成 AOT,要按当时的安装与编译状态确认。官方文档给出的“覆盖代码路径约有 30% 执行速度提升”是总体经验值;自己的 TTID 能缩短多少,要按应用实测。
生成 profile 后要确认:
- 启动、通知、深链等主要入口是否被覆盖;
- release 构建经过 R8 后,规则仍被正确重写和打包;
- 目标设备上的安装状态与编译过滤器符合预期;
CompilationMode.None、Partial与Full的 Macrobenchmark 差异符合解释。
Startup Profile
Startup Profile 是 Baseline Profile 中用于构建期 DEX layout(文件布局)的规则子集。R8 / D8 根据它安排启动相关类和方法,减少启动期间跨 DEX 读取和页面访问。它解决的是文件布局问题,与运行时 AOT 可以同时使用。规则过多、导致启动代码仍分散到多个 DEX 时,布局收益会下降。
Cloud Profile
Cloud Profile 由 Google Play 汇总真实用户设备上的热点,再提供给后续安装或更新应用的设备,支持 Android 9(API 28)及更高版本。它需要积累足够样本,可能在版本发布数小时到数天后才开始分发。离开 Google Play 渠道,Cloud Profile 就未必存在;APK 内的 Baseline Profile、ProfileInstaller 和设备本地 ART 优化仍可独立工作,具体安装行为需要按分发渠道验证。
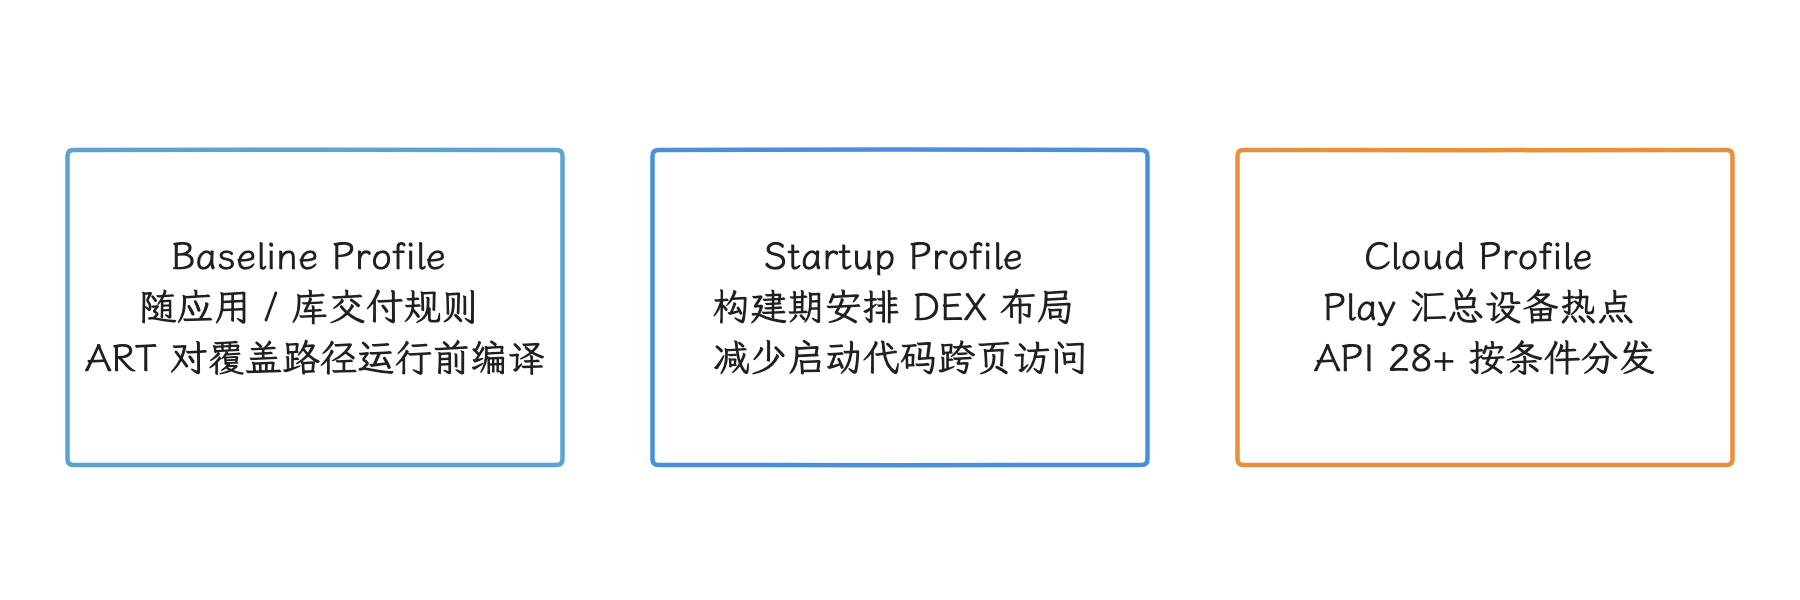
图:Baseline 用于覆盖代码的 ART 编译,Startup 用于构建期 DEX 布局,Cloud 从 Play 的用户样本分发。
16 KB page size 的边界
从 Android 15 开始,AOSP 支持使用 16 KB page size(内存页大小)的设备。包含 native library 的应用必须确保 APK zip alignment、ELF segment alignment(压缩包和 ELF 段对齐)、预编译依赖,以及代码中对 page size 的假设都兼容;纯 Java / Kotlin 应用也应在 16 KB 环境中进行回归测试。
Google 的初始测试显示,在系统存在内存压力时,样本中的应用启动时间平均降低 3.16%,部分样本改善更多;这只描述一组受控测试,换一个应用或设备要重新测。更大的页会同时改变页表、TLB(地址转换缓存)、页内空间浪费、缺页和 COW 粒度,从“页大小变为四倍”推不出“缺页次数减少四倍”。
比较 4 KB 和 16 KB 环境下的启动表现时,应使用同一设备或等价平台配置,固定 APK、编译状态、缓存、温度和内存压力,并分别查看缺页、I/O、CPU time(线程实际占用 CPU 的时间) 和 TTID;只看 bindApplication 之前那一段,会漏掉后面大半个启动过程。
诊断顺序
- 固定入口、账号状态、缓存、启动类型、编译模式和设备状态。
- 同时记录 TTID 与 TTFD,确认
reportFullyDrawn()语义。 - 从 Perfetto Android App Startups 区间定位最慢样本。
- 将时间分为进程启动、BindApplication、Provider、Application、Activity、UI Thread、RenderThread / GPU 和 SurfaceFlinger 等阶段。
- 对长片段检查线程状态、Binder 对端、锁、I/O、缺页、GC、CPU 频率和温控。
- 用自定义 trace 缩小应用代码的排查范围,再选择推迟、移除、缓存、并行或 Profile 优化。
- 在相同测试协议下复测多轮,报告分位数和回归样本。
性能采集本身也会产生额外开销。方法 trace 比系统 trace 更重,适合在排查范围已经缩小后使用。冷缓存、force-stop、重启设备和清除数据代表不同的实验条件,混在同一种“冷启动”标签下会让对比失真。
Android 17 源码锚点
ActivityTaskSupervisor.java:进程复用判断、startSpecificActivity()与LaunchActivityItem。ProcessList.java:startProcessLocked()与Process.start()。Process.java:应用进程启动入口。ZygoteProcess.java:Zygote socket 通信。ActivityThread.java:ActivityThread.main()、handleBindApplication()、Provider 安装和 Activity 生命周期。LaunchActivityItem.java:应用侧 Activity launch transaction。ViewRootImpl.java:窗口接入、遍历与首帧调度。ActivityRecord.java:窗口 drawn 回调。ActivityMetricsLogger.java:TTID、TTFD 与 ApplicationStartInfo 时间戳。ApplicationStartInfo.java:启动类型、状态、原因与 timestamp key。
启动链路的官方核对入口
- App startup time: TTID, TTFD and startup types
- App startup analysis and optimization
- Overview of measuring app performance
- Macrobenchmark overview
- Macrobenchmark metrics
ApplicationStartInfoAPI- PerfettoSQL Android startup modules
- Baseline Profiles overview
- Startup Profiles and DEX layout
- AndroidX App Startup
- Support 16 KB page sizes
用 Binder Trace 还原跨进程等待
前文把启动拆成了一段段能直接测的时间,但跨进程等待还悬着:一笔 Binder 调用迟迟不返回时,要去对面的服务进程找原因。后半部分用 Binder Trace 回答 system_server、PackageManager、WindowManager 或其他服务为什么延迟返回。
冷启动路径上的 Binder 瓶颈可以用 Perfetto 的 android.binder 标准库定位:一笔事务在客户端等待、服务端处理和返回调度上各花了多久,Binder 线程池是否饱和,目标进程冻结错误则需补查原始返回命令及进程状态;失败原因和线程池拥塞的认定,标准配对表独自给不出完整结论。Binder 机制原理见 §1.9 和 §1.10,冷启动阶段划分见前文「从启动请求到首帧」。
一、先把冷启动窗口和 Binder 范围分开
一次 Activity 冷启动会经过 Launcher、system_server、Zygote 和目标应用进程,Binder 只负责其中一部分跨进程通信。我们在时间线上看到的 slice 是一段有起止时间的执行区间,下面几类工作经常与 Binder slice 紧挨着,却要按各自的数据源分开分析:
system_server通过 Zygote command socket(命令套接字) 请求创建应用进程,这段通信不走 Binder;- 应用读取 dex、resources、SharedPreferences 或 DataStore 时产生文件 I/O;
- Choreographer 通过
DisplayEventReceiver接收 vsync(垂直同步信号); - 应用主线程执行类加载、View inflate(从布局资源创建 View)、Compose composition(组合计算) 和业务初始化。
因此,am start -W 的总时间只能当作整个启动的参考,Binder 等待要单独统计。分析时先确定 Activity startup 的起止区间,再统计与这个区间相交的事务。
1.1 冷启动中常见的 Binder 方向
我们从源码里能确认的主要方向如下:
| 方向 | 代表调用 | 与首帧的关系 |
|---|---|---|
Launcher → system_server | IActivityTaskManager.startActivity() | 启动入口,通常为同步调用 |
App → system_server | IActivityManager.attachApplication() | 新进程向 AMS(ActivityManagerService)报到 |
system_server → App | IApplicationThread.bindApplication() 及生命周期 ClientTransaction | 驱动应用绑定和 Activity 创建 |
| App → WMS | IWindowSession.addToDisplayAsUser()、relayout() | 向 WMS(WindowManagerService)注册窗口并取得 Surface/布局结果 |
| App → AMS | getContentProvider()、refContentProvider() | 获取远端 Provider 及管理引用 |
| App/SDK → PKMS | getPackageInfo()、getApplicationInfo() 等 | 访问 PKMS(PackageManagerService);是否出现取决于应用或 SDK 行为 |
bindApplication 携带应用信息和 Provider 列表。应用在 ActivityThread.handleBindApplication() 中安装本进程 Provider;Provider 初始化代码若访问系统服务、远端 Provider 或其他进程,还会产生相应 IPC(Inter-Process Communication,进程间通信)。观察到 ContentProvider.onCreate() 很慢时,我们应把本进程内的初始化和它发起的 Binder 调用分别计时,看清两类耗时各占多少。
1.2 先回答三个问题
拿到一笔慢事务,我们先问三个问题:
- 哪个线程发起,是否位于目标应用主线程?
- 事务与冷启动区间相交多少,是否位于首帧关键路径?
- 时间主要花在请求派发、服务端处理,还是 reply(回复) 传回后客户端重新获得 CPU 的阶段?
调用次数和单次时长要同时看。大量短事务可能累积成明显延迟;单笔长事务也可能与其他工作并行,未必等量增加首帧时间。多个嵌套事务的 client_dur 区间会互相包含,直接求和会重复计时,所以“事务总和”只适合用来排序排查对象,要估算可节省的启动时间,还得回到首帧关键路径逐笔确认。
二、采集 Binder Trace
范围划清了,先把 trace 采对,后面的 SQL 才有得查。
2.1 Android 17 r6 kernel 提供的 tracepoint
我们先看内核给了哪些观测点。tracepoint 是内核代码中预先埋设的事件观测点,android17-6.18-2026-06_r6/drivers/android/binder_trace.h 定义了这次分析所需的 Binder tracepoint:
| Tracepoint | 用途 |
|---|---|
binder_transaction | 记录发送、目标进程/线程、code、flags 和 reply 标志 |
binder_transaction_received | 标记目标线程收到事务 |
binder_transaction_alloc_buf | 记录驱动为事务数据分配 buffer 的情况 |
binder_command | 记录用户空间写给驱动的 BC_* 命令 |
binder_return | 记录驱动返回用户空间的 BR_* 命令 |
binder_set_priority | 观察目标 Binder 线程的优先级调整 |
binder_netlink_report | 观察 frozen(目标已冻结)、pending(事务待处理)等内核报告 |
旧内核中的 binder_lock、binder_locked、binder_unlock 已不在 r6 的 binder_trace.h 中。服务端锁竞争要结合服务端 slice、thread_state、ART monitor contention(Java 对象监视器竞争)或业务 trace 判断。
2.2 一份可复现的 Perfetto 配置
下面的配置覆盖 Binder 配对、线程状态、Activity/WMS/渲染 slice、包元数据和应用自定义 Trace。把包名替换为被测应用。android.surfaceflinger.frametimeline 适用于 API 31+;更早设备删除该 data source,且逐项确认设备暴露的 tracepoint / atrace 类别。
buffers {
  size_kb: 32768
  fill_policy: RING_BUFFER
}

duration_ms: 15000

data_sources {
  config {
    name: "linux.ftrace"
    ftrace_config {
      ftrace_events: "binder/binder_transaction"
      ftrace_events: "binder/binder_transaction_received"
      ftrace_events: "binder/binder_transaction_alloc_buf"
      ftrace_events: "binder/binder_command"
      ftrace_events: "binder/binder_return"
      ftrace_events: "binder/binder_set_priority"
      ftrace_events: "binder/binder_netlink_report"
      ftrace_events: "sched/sched_switch"
      ftrace_events: "sched/sched_waking"

      atrace_categories: "am"
      atrace_categories: "wm"
      atrace_categories: "view"
      atrace_categories: "gfx"
      atrace_categories: "dalvik"
      atrace_apps: "com.example.app"

      drain_period_ms: 250
    }
  }
}

data_sources {
  config {
    name: "linux.process_stats"
    process_stats_config {
      proc_stats_poll_ms: 1000
    }
  }
}

data_sources {
  config { name: "android.packages_list" }
}

# API 31+;较早设备删除此项。
data_sources {
  config { name: "android.surfaceflinger.frametimeline" }
}
这份配置同时采集 Binder 内核事件、线程调度、框架 atrace slice 和目标应用的自定义 slice。RING_BUFFER 表示空间用完后覆盖最旧数据,drain_period_ms 控制 ftrace 数据搬入 Perfetto buffer 的周期。
15 秒和 32 MiB 是便于手工分析的起点。高频设备或多轮连续启动需要根据丢事件统计调整 buffer;配置过大也会增加采集开销。android.binder 属于 Trace Processor 的分析侧标准库,能否通过 INCLUDE 加载取决于分析工具版本,与采集设备的 API 级别无直接对应关系。
2.3 正确制造一次应用冷启动
重启整个 Android framework 会改变系统缓存、服务状态和设备温度,普通应用的冷启动采集用不到这一步。我们手工采集时用两个终端:一个运行有限时长的 Perfetto,另一个强停并启动目标 Activity。
终端 A 使用下面的命令启动采集。
adb push binder-trace.pbtxt /data/local/tmp/
adb shell perfetto --txt \
  -c /data/local/tmp/binder-trace.pbtxt \
  -o /data/local/tmp/cold-start-binder.pftrace
该命令在配置的 15 秒结束后退出。保持终端 A 运行,再执行终端 B 的启动命令。
终端 B 用 am start -S 终止目标包的现有进程并启动指定 Activity。
adb shell am start -W -S \
  -n com.example.app/.MainActivity
采集结束后再执行 adb pull /data/local/tmp/cold-start-binder.pftrace .。
手工 am start -S 的“进程冷启动”只保证目标进程已终止并重建;文件页缓存、shader cache 和 ART 编译产物仍可能保留。本文核对的 Macrobenchmark COLD setup 已依次尝试清 shader cache、终止进程和 dropKernelPageCache(),描述这套协议时按实际动作写全,压缩成“只有终止进程”会误导复测。缓存清理是否成功取决于库版本、API、设备权限等条件,应记录实际结果;复测还需固定 CompilationMode、温度、动画和迭代次数。
2.4 atrace 只用于快速查看
只能使用 atrace 时,类别应作为位置参数传入,-c 表示 circular buffer:缓冲区写满后覆盖最旧事件。
adb shell atrace --async_start -c -b 20000 -a com.example.app \
  binder_driver sched am wm view gfx dalvik
adb shell am start -W -S -n com.example.app/.MainActivity
adb shell atrace --async_stop -z > cold-start.atrace
这份 trace 可用于在时间线上快速定位可疑区间。团队需要复用 SQL 分析流程时,Perfetto protobuf 配置更便于审查采集了哪些事件、buffer 多大、持续多久,也能避开不同 atrace 版本的类别差异。
2.5 应用代码标记业务边界
androidx.tracing.Trace 会通过 Android tracing API 写入应用 slice,用来标出某段业务代码从哪里开始、到哪里结束;它和 Perfetto Native SDK 是两套接入方式。同步代码要用 try/finally 保证区间闭合。
fun loadBookmarks(): List<Bookmark> {
    Trace.beginSection("startup.load_bookmarks")
    return try {
        bookmarkProvider.queryAll()
    } finally {
        Trace.endSection()
    }
}
这个 slice 反映同步函数从开始到结束的 wall time(墙上时钟时间),其中既包含实际运行时间,也包含等待和被调度出 CPU 的时间。跨线程、跨 suspend 点或回调式工作应使用 async trace,并用稳定 cookie(同一异步区间的配对 ID)关联开始与结束事件。section 名要保持低基数,也就是控制不同名称的数量,不要把用户 ID、URL 等动态内容拼进名称。
三、理解 android_binder_txns 的数据边界
3.1 标准表包含哪些列
我们先看这张表的来历:external/perfetto/.../android/binder.sql 定义了 android_binder_txns,它把客户端和服务端的 Binder slice 配成一对,是一张标准表。常用列包括:
binder_txn_id、binder_reply_id;client_process、client_thread、client_upid、client_utid;server_process、server_thread、server_upid、server_utid;client_ts、client_dur、server_ts、server_dur;is_main_thread、is_sync;aidl_name、interface、method_name;- client/server OOM score、package version code 和 debuggable 标志。
其中 upid 和 utid 分别是 Trace Processor 为进程和线程分配的内部 ID;client/server OOM score 表示进程在内存回收时的相对被杀优先级。
aidl_name 取自服务端的 AIDL/HIDL 插桩,HIDL 是较早用于 HAL 接口描述的一套机制;没有对应插桩时 aidl_name 可以为空,这时 Binder 调用仍然发生了,只是没有可用的名称。android_binder_metrics_by_process 只有 process_name、pid、slice_name 和 event_count,是一张计数视图,要看平均延迟还得回到配对表。
这个标准表通过 flow 关系把客户端 binder transaction slice 与服务端 binder reply 或 async receive 关联;在 Perfetto UI 中,flow 通常显示为连接两个 slice 的因果箭头。目标死亡、frozen rejection(因目标被冻结而被拒绝)或采集丢事件时,客户端和服务端可能配不上对,这些事务也就缺席于标准表——Freezer 的问题因此要另找入口查(见 6.4)。r1 的同步配对还排除 client/server 的未闭合时长 -1,并要求 client_dur >= server_dur;标准表不是全部发送尝试的台账。
3.2 四段时间怎样解释
对完成配对的同步事务,我们可以把耗时近似拆成下面四段:
| 分段 | 计算 | 包含内容 |
|---|---|---|
| 客户端总时长 | client_dur | Trace Processor 配对的客户端 slice wall time,不是整个公开 API 的总耗时 |
| 请求派发间隔 | server_ts - client_ts | 驱动传递、目标队列等待、目标线程被调度到并接收事务 |
| 服务端区间 | server_dur | 服务端收到事务到发出 reply,包含服务逻辑、嵌套调用、等待与调度 |
| reply 残差 | client_dur - (server_ts - client_ts) - server_dur | 无法归入前两段的剩余时间,包括 reply 传递、客户端重新运行及少量记账误差 |
“请求派发间隔”里除了排队,还包含驱动传递和调度,把它直接叫线程池排队时间会丢信息。要确认线程池饱和,我们再看目标进程 Binder 线程在同一窗口的状态、活跃数量,以及是否有多个客户端同时受影响。
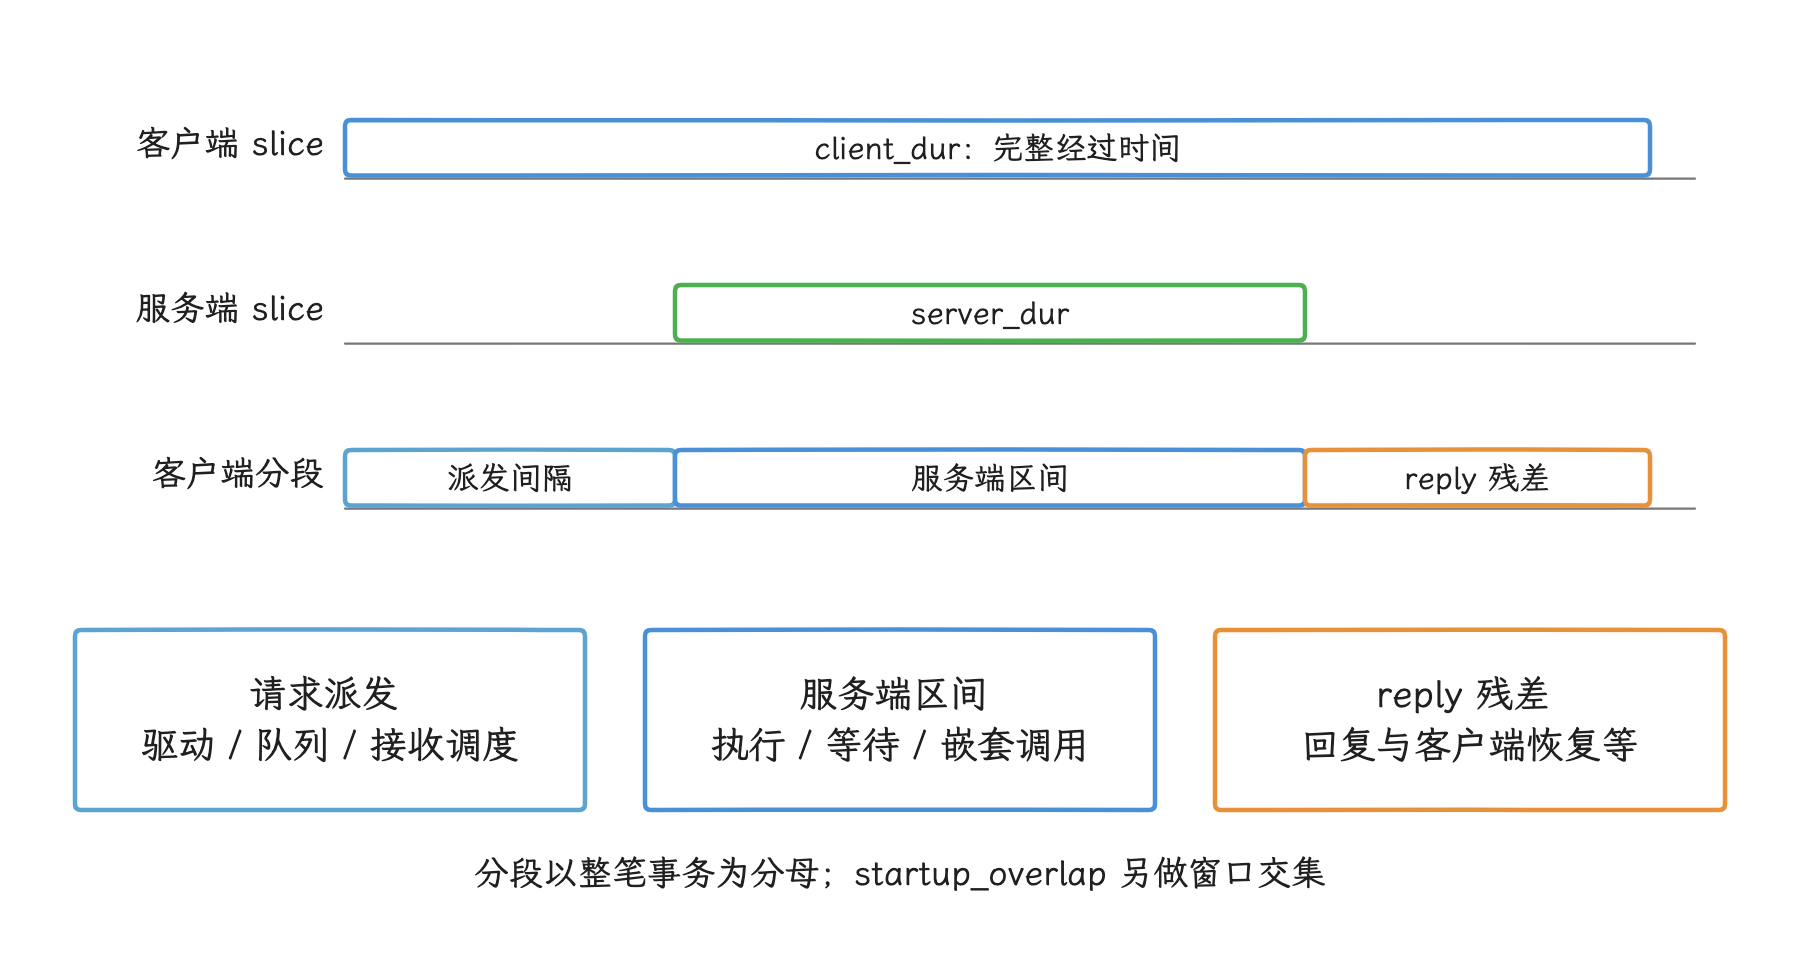
图:client_dur 是配对客户端 slice;请求派发、服务端区间和 reply 残差分解完整事务,与窗口裁剪值分开使用。
client_dur 与 server_dur 都是经过时间,把 Running、Runnable 和阻塞都算在里面,范围比“等待时间之和”更宽。CPU time 可由相同 utid 的 sched / thread_state Running 区间裁剪求和等方式计算,不必要求另有 CPU time 计数器。序列化、反序列化和调用前后工作可能在内核派生 slice 外,完整 API 耗时应另有业务/API 标记。服务端 CPU time 很少而 server_dur 很长时,常见原因是等待锁、I/O、嵌套同步 Binder,或线程在区间内被调度出 CPU。
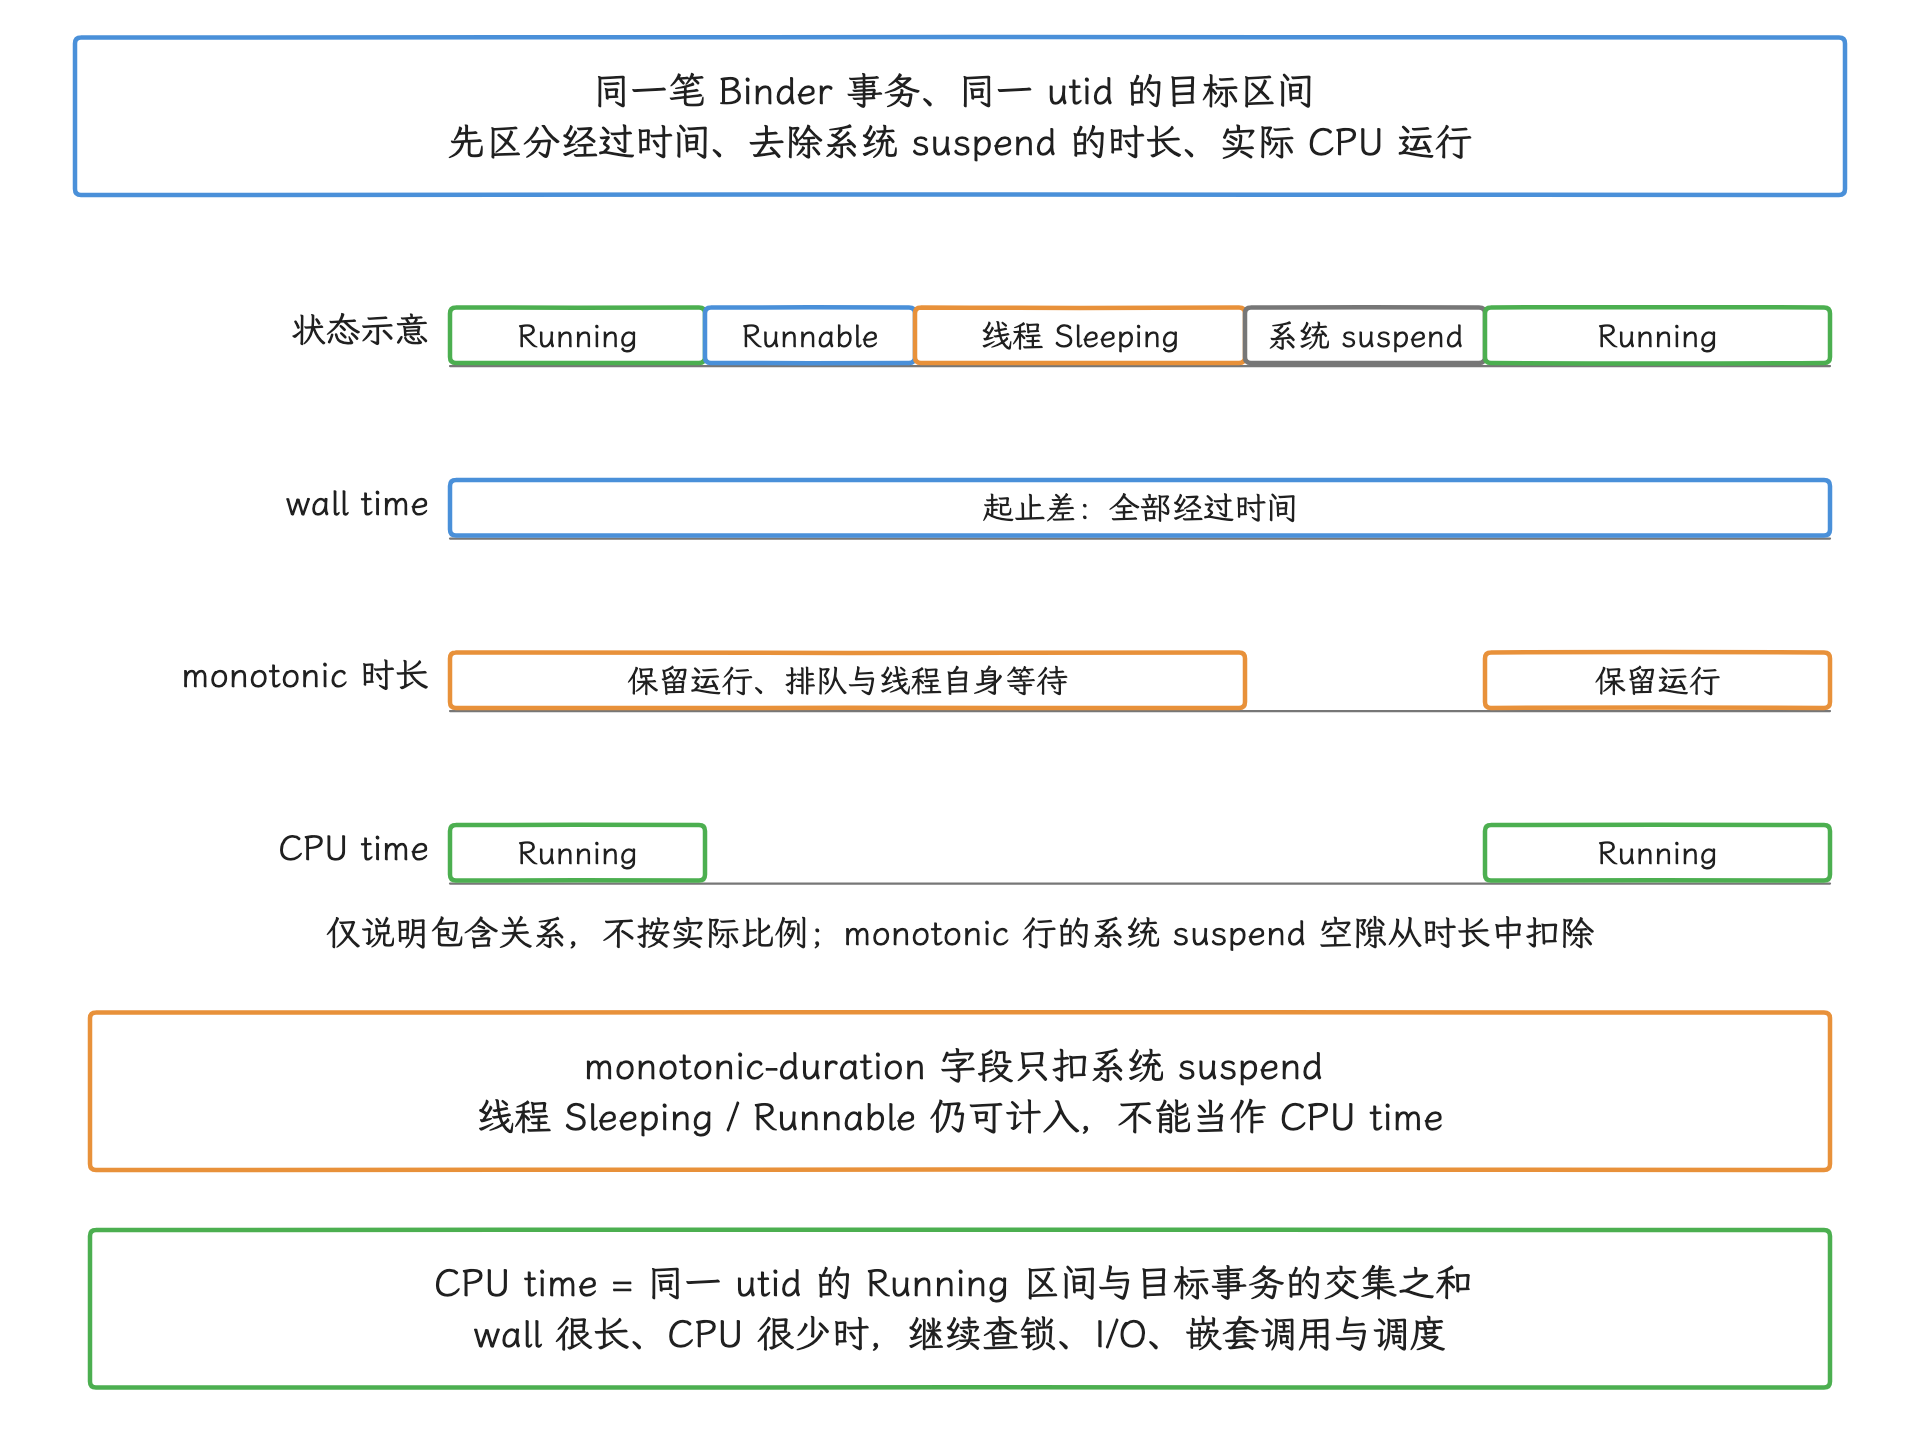
图:示意轨道只说明同一事务和同一 utid 的包含关系,没有实测比例。wall time 包含整个经过区间;monotonic-duration 字段扣掉系统 suspend,线程自身 Sleeping / Runnable 仍可计入;CPU time 只累计 Running 与目标区间的交集。事务内锁、I/O、嵌套调用和调度需继续按证据区分。
3.3 归因顺序
建议按下面的顺序查看一笔慢同步事务:
- 检查
is_main_thread和 startup 时间窗,确认它是否影响目标首帧。 - 比较请求派发间隔、
server_dur和 reply 残差。 - 用
android.binder_breakdown查看 client/server 区间里的 thread state、I/O、reclaim(内存回收)、monitor 竞争或 Binder 嵌套等待。 - 回到服务端线程 track(时间轨道),阅读该事务下的 AIDL 和业务子 slice。
- 若事务未进入标准表,检查未经标准库配对的原始
binder_return事件、采集丢失情况和目标进程状态。
队列增长、服务逻辑变慢和客户端抢占可能叠加,只依据耗时最大的一个字段下判断,容易错过复合瓶颈。
四、Perfetto SQL:从启动窗口到事务原因
4.1 找到目标启动
下面的查询列出 Trace Processor 在 trace 中识别到的 Activity startup。startup_id 用来区分多次启动,ts 和 ts_end 是以纳秒表示的起止时间;后续查询以这段时间为筛选窗口。
INCLUDE PERFETTO MODULE android.startup.startups;

SELECT
  s.startup_id, s.ts, s.ts_end,
  s.dur / 1e6 AS startup_slice_ms,
  s.package, s.startup_type,
  p.upid, p.pid, process.name AS process_name
FROM android_startups AS s
LEFT JOIN android_startup_processes AS p USING (startup_id)
LEFT JOIN process ON process.upid = p.upid
WHERE s.package = 'com.example.app'
ORDER BY s.ts, p.upid;
startup_slice_ms 是标准库所识别启动 slice 的时长,要当另一个工具的 TTID 使用,先核对两者的定义。先用包名、类型、时间和关联 upid 确认样本。r1 的进程匹配依赖包元数据与 bindApplication / Activity 等标记,缺包元数据时还有进程名前缀回退,故关联结果也要人工复核,身份以人工确认为准。若无结果,检查 am/wm、进程/包名数据和分析器版本;不要改用整条 trace 求和来代替目标窗口。
4.2 冷启动窗口内的 Top-N 同步事务
下面的查询以最新一次目标 cold startup 为窗口,通过 android_startup_processes 关联目标进程实例,列出主线程同步 Binder 调用;具体复盘可直接指定 startup_id。startup_overlap_ms 真正裁剪到 [ts, ts_end) 的交集,full_client_ms 保留整笔事务时长。AIDL 名称作为 endpoint,缺失时显示 <unresolved>。
INCLUDE PERFETTO MODULE android.startup.startups;
INCLUDE PERFETTO MODULE android.binder;

WITH target_startup AS (
  SELECT startup_id, ts, ts_end
  FROM android_startups
  WHERE package = 'com.example.app'
    AND startup_type = 'cold'
  ORDER BY ts DESC
  LIMIT 1
), target_processes AS (
  SELECT DISTINCT s.startup_id, s.ts, s.ts_end, p.upid
  FROM target_startup AS s
  JOIN android_startup_processes AS p USING (startup_id)
)
SELECT
  s.startup_id, b.client_upid, b.client_utid,
  b.binder_txn_id, b.binder_reply_id,
  coalesce(b.aidl_name, '<unresolved>') AS endpoint,
  b.server_upid, b.server_process,
  b.client_dur / 1e6 AS full_client_ms,
  (min(b.client_ts + b.client_dur, s.ts_end)
   - max(b.client_ts, s.ts)) / 1e6 AS startup_overlap_ms,
  (b.server_ts - b.client_ts) / 1e6 AS dispatch_ms,
  b.server_dur / 1e6 AS server_ms,
  (b.client_ts + b.client_dur
   - b.server_ts - b.server_dur) / 1e6 AS reply_residual_ms
FROM android_binder_txns AS b
JOIN target_processes AS s
  ON b.client_upid = s.upid
 AND b.client_ts < s.ts_end
 AND b.client_ts + b.client_dur > s.ts
WHERE b.is_sync = 1
  AND b.is_main_thread = 1
  AND b.client_dur >= 0
ORDER BY startup_overlap_ms DESC, full_client_ms DESC
LIMIT 30;
结果先按窗口交集排序。dispatch_ms、server_ms、reply_residual_ms 仍按整笔事务计算,三者只与 full_client_ms 对应,从裁剪后的 startup_overlap_ms 机械相减得到的并不是这三段。残差只是排查线索;出现负值应核对事件、区间包含关系与嵌套情况,负延迟按数据问题处理。
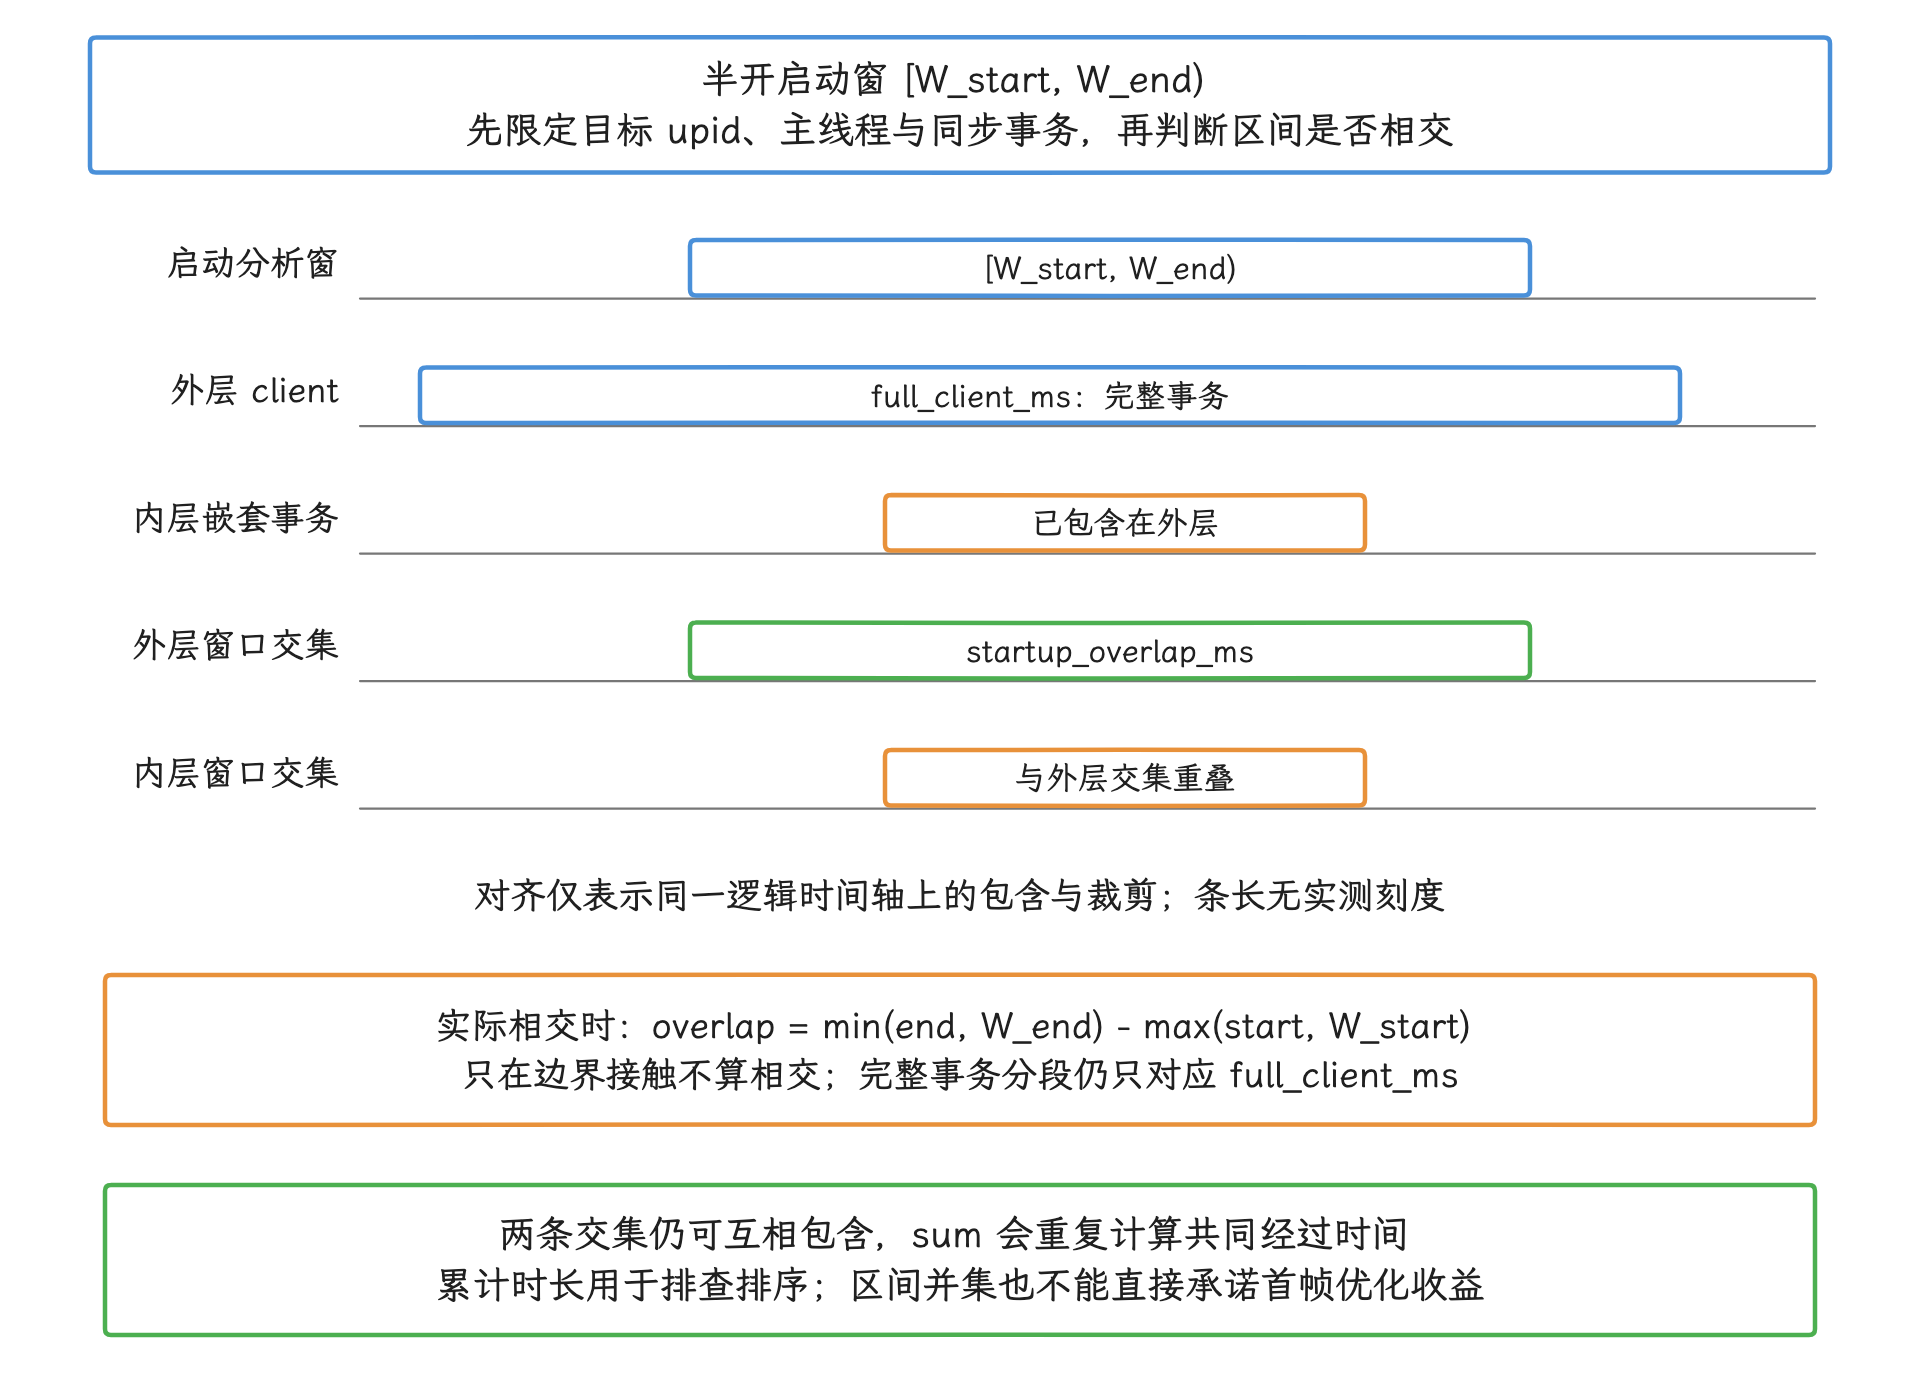
图:先限定目标进程和主线程同步事务,再与半开 startup 窗口求交集;只接触边界不算相交。full_client_ms 保留整笔事务分段,startup_overlap_ms 只表示窗口交集。嵌套事务的交集仍可重叠,累计值用于排查排序,区间并集离“首帧能省多少”还差一步关键路径确认;条长仅为示意。
4.3 按 endpoint 聚合调用压力
下面的查询按 endpoint 和服务端进程分组,统计同一 startup 窗口内的调用次数、累计时长、平均值和最大值,用来找出调用频繁或单次较慢的接口。
INCLUDE PERFETTO MODULE android.startup.startups;
INCLUDE PERFETTO MODULE android.binder;

WITH target_startup AS (
  SELECT startup_id, ts, ts_end
  FROM android_startups
  WHERE package = 'com.example.app'
    AND startup_type = 'cold'
  ORDER BY ts DESC
  LIMIT 1
), target_processes AS (
  SELECT DISTINCT s.startup_id, s.ts, s.ts_end, p.upid
  FROM target_startup AS s
  JOIN android_startup_processes AS p USING (startup_id)
)
SELECT
  s.startup_id, b.client_upid, b.server_upid,
  coalesce(b.aidl_name, '<unresolved>') AS endpoint,
  b.server_process,
  count(*) AS calls,
  sum(b.client_dur) / 1e6 AS summed_full_client_ms,
  sum(min(b.client_ts + b.client_dur, s.ts_end)
      - max(b.client_ts, s.ts)) / 1e6 AS summed_overlap_ms,
  avg(b.client_dur) / 1e6 AS avg_full_client_ms,
  max(b.client_dur) / 1e6 AS max_full_client_ms
FROM android_binder_txns AS b
JOIN target_processes AS s
  ON b.client_upid = s.upid
 AND b.client_ts < s.ts_end
 AND b.client_ts + b.client_dur > s.ts
WHERE b.is_sync = 1
  AND b.is_main_thread = 1
  AND b.client_dur >= 0
GROUP BY s.startup_id, b.client_upid, b.server_upid,
         endpoint, b.server_process
ORDER BY summed_overlap_ms DESC;
summed_full_client_ms 累计完整事务,summed_overlap_ms 累计与启动窗口的交集;两者都可能重复计算嵌套或重叠区间,只适合排序。要预测移除 IPC 能节省多少首帧时间,仍需计算区间并集并核对真实关键依赖;并集本身也不是收益保证。P50/P95 分别表示样本的第 50 和第 95 百分位,应从多轮同条件启动数据中计算;一条 trace 里的少量同名调用,代替不了启动耗时分布。
4.4 用标准 breakdown 查等待原因
breakdown 是把一笔 Binder 事务的时间按客户端或服务端、线程状态及等待原因进一步分类。下面的查询按事务和原因汇总这些分类区间,用来判断长耗时更接近锁竞争、I/O、嵌套 Binder,还是线程等待调度。
INCLUDE PERFETTO MODULE android.startup.startups;
INCLUDE PERFETTO MODULE android.binder;

INCLUDE PERFETTO MODULE android.binder_breakdown;

WITH target_startup AS (
  SELECT startup_id, ts, ts_end
  FROM android_startups
  WHERE package = 'com.example.app'
    AND startup_type = 'cold'
  ORDER BY ts DESC
  LIMIT 1
), target_processes AS (
  SELECT DISTINCT s.startup_id, s.ts, s.ts_end, p.upid
  FROM target_startup AS s
  JOIN android_startup_processes AS p USING (startup_id)
)
SELECT
  s.startup_id, b.client_upid, b.client_utid,
  b.binder_txn_id,
  coalesce(b.aidl_name, '<unresolved>') AS endpoint,
  x.reason_type, x.reason,
  sum(min(x.ts + x.dur, s.ts_end)
      - max(x.ts, s.ts)) / 1e6 AS startup_reason_ms
FROM android_binder_txns AS b
JOIN target_processes AS s ON b.client_upid = s.upid
JOIN android_binder_client_server_breakdown AS x USING (binder_txn_id)
WHERE b.is_sync = 1
  AND b.is_main_thread = 1
  AND x.dur > 0
  AND x.ts < s.ts_end
  AND x.ts + x.dur > s.ts
GROUP BY s.startup_id, b.client_upid, b.client_utid,
         b.binder_txn_id, endpoint, x.reason_type, x.reason
ORDER BY startup_reason_ms DESC;
reason 可能是 monitor_contention(Java monitor 竞争)、art_lock_contention(ART 内部锁竞争)、mutex_contention(原生互斥锁竞争)、io、binder 或某种线程状态。这里的 startup_reason_ms 只累计启动窗内的分类片段。合并表在重叠处优先采用非空 server reason,否则采用 client reason,reason_type 是这条归类规则的结果,不是独立证明了根因;事件/线程状态缺失也会影响覆盖。要判断哪段业务造成延迟,还需对照服务端业务 slice。
4.5 查询 Binder 计数画像
android_binder_metrics_by_process 可快速确认每个进程记录到了哪些 Binder slice,适合先检查有哪些 Binder 切片进入了分析;计数只够做第一步筛查,采集是否完整还要看 trace loss、覆盖和配不上的事件。
INCLUDE PERFETTO MODULE android.binder;

SELECT
  process_name,
  pid,
  slice_name,
  event_count
FROM android_binder_metrics_by_process
WHERE process_name = 'com.example.app'
   OR process_name GLOB 'com.example.app:*'
   OR process_name = 'system_server'
ORDER BY event_count DESC;
结果只包含各类 slice 的事件数,启动窗口和耗时都不在其中;性能归因仍要回到 android_binder_txns。
五、冷启动中常见的 Binder 瓶颈模式
单笔事务的分析方法到这里就齐了。我们把它套到冷启动里最常见的几类 Binder 瓶颈上:
5.1 PackageManager 查询重复
系统框架已经向新进程传递 ApplicationInfo 等启动数据,但应用代码和 SDK 仍可能重复调用 PackageManager。若查询确实进入远端 PackageManagerService,即使命中服务端 snapshot/cache,也仍有 Binder 往返等开销;部分 API / 参数组合还可能命中客户端缓存,直接避免本次 IPC。因此应按 trace 中实际事务计数;PackageManager API 调用数只是客户端视角,Binder 次数以 trace 里的事务为准。
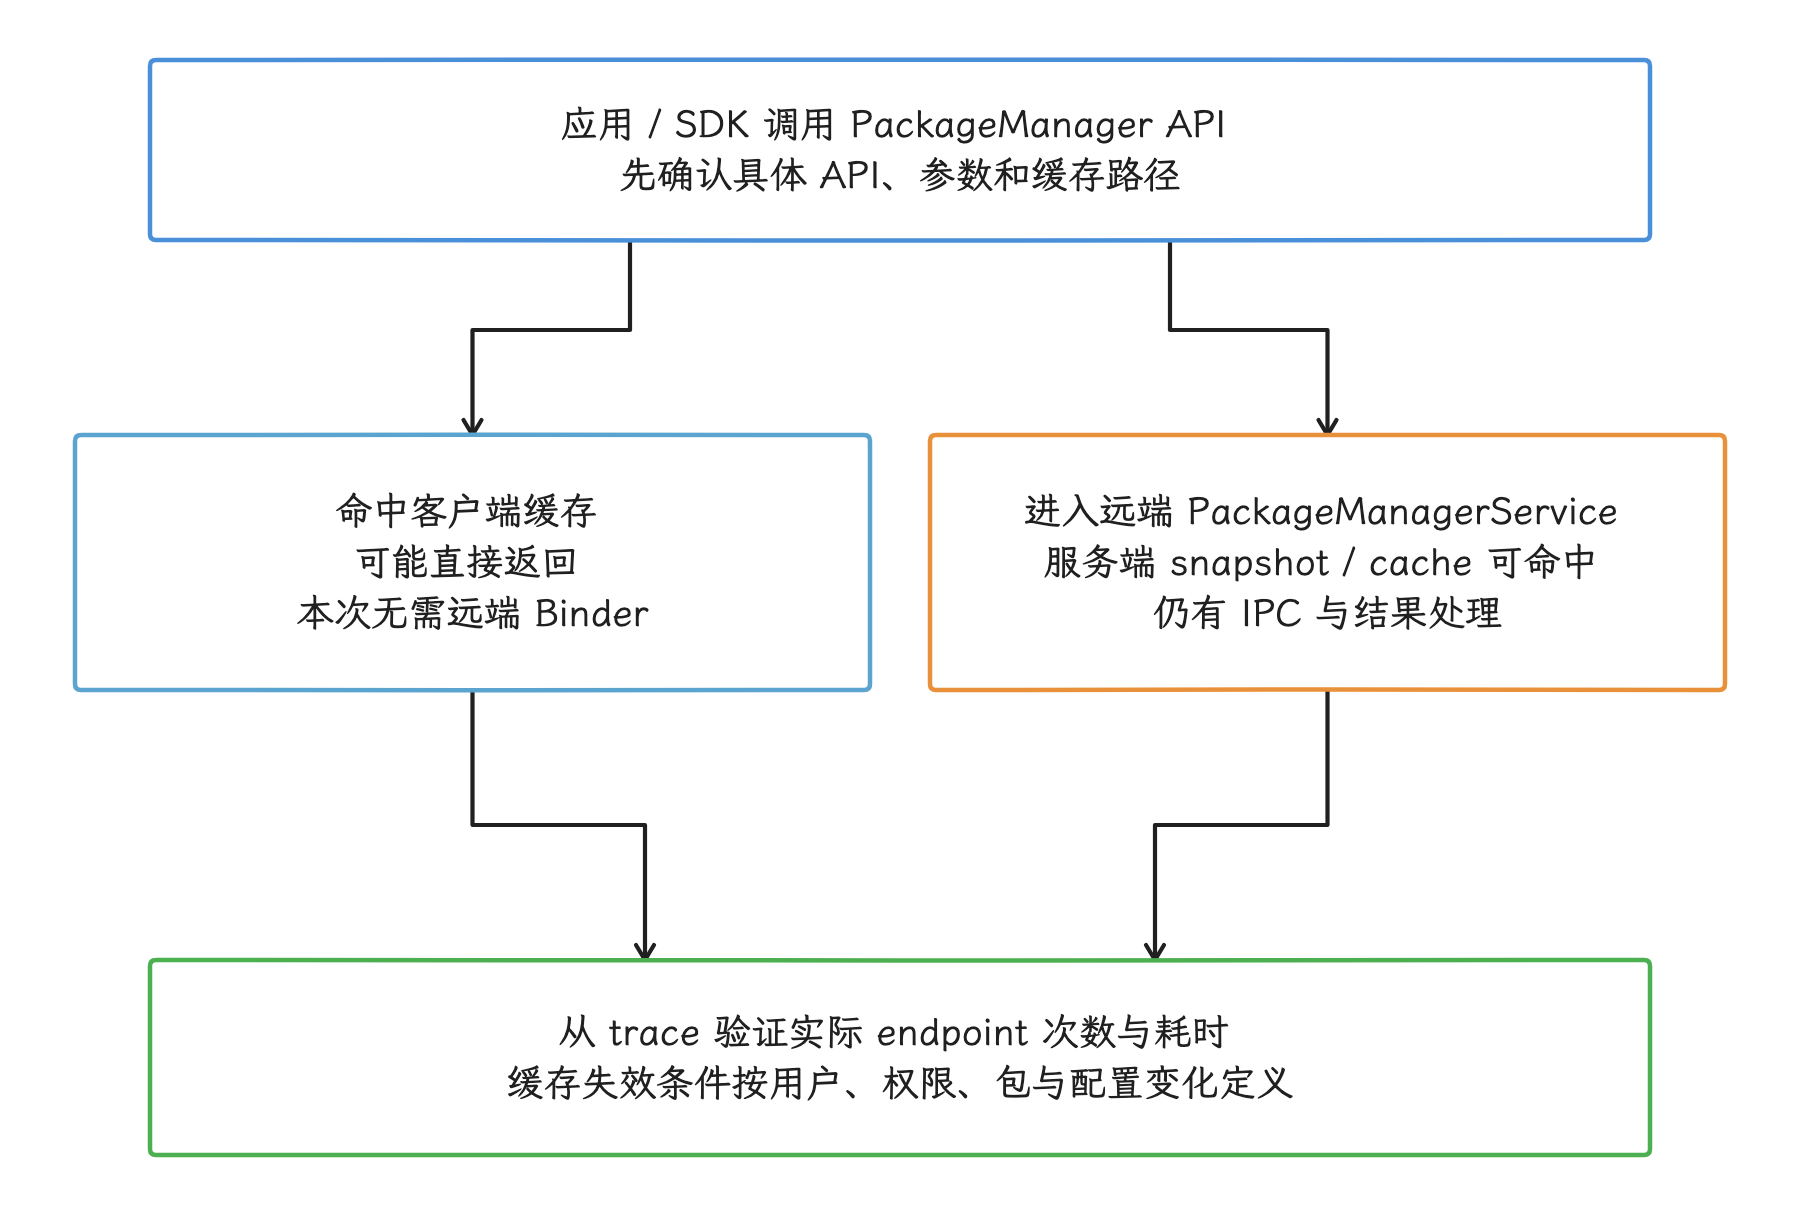
图:客户端命中可避免 IPC;服务端命中仍可能发生往返。优化依据实际事务与一致性条件。
处理步骤:
- 按
interface、method_name和调用方自定义 slice 统计来源; - 对稳定的包元数据使用进程内缓存,并明确版本升级、包变更和配置变化时怎样使旧缓存失效;
- 定位不到 SDK 来源时,在 SDK 初始化的入口加应用 slice,再用时间重叠缩小范围。
把多个公开的 PackageManager API 合并成一笔系统事务,这件事应用侧做不到。可控的优化包括减少重复请求、延后读取首帧不需要的数据,以及让 SDK 支持懒初始化,也就是在功能首次使用时再初始化。
5.2 WindowManager 的必要同步事务
ViewRootImpl.setView() 经 IWindowSession.addToDisplayAsUser() 注册窗口,后续 relayout() 获取布局和 Surface(图形缓冲区的载体)相关结果;finishDrawing() 在绘制完成后上报。其中 add 和需要结果的 relayout 路径为同步调用;r1 还存在 relayoutAsync 等 oneway 变体,finishDrawing() 本身也是 oneway。绘制完成上报不表示等待 WMS 处理结束,更不证明 present 已完成。排查时要减少它们之前的应用侧工作,并确认 WMS 服务端是否出现异常长的处理或派发间隔。
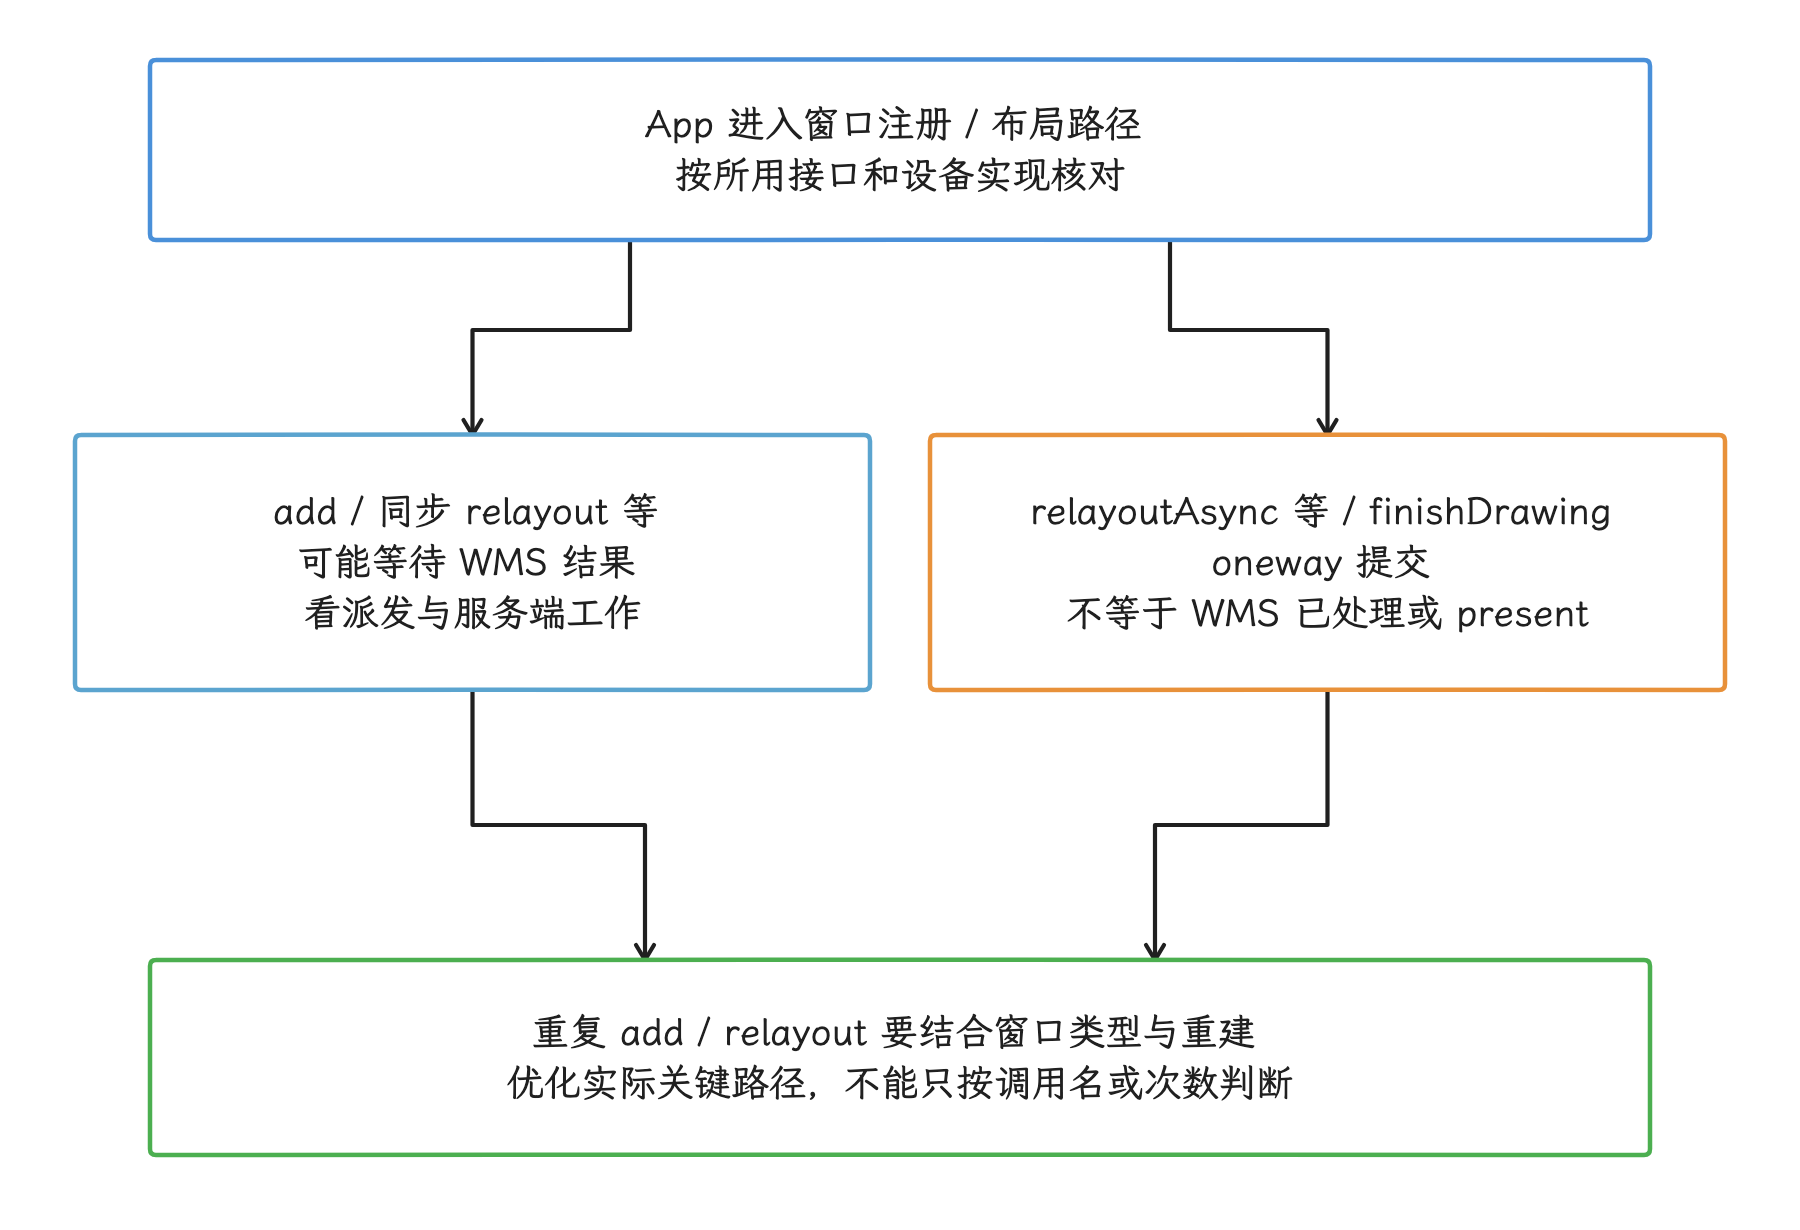
图:窗口注册、同步 relayout 与异步上报各有语义;finishDrawing 不表示客户端等 WMS 处理完。
单看出现次数,还判定不了正常的 addToDisplayAsUser 调用就是冗余。若同一次 startup 出现多组 add/relayout,应结合 Activity 重建、窗口类型、Dialog/Popup 和进程日志解释。
5.3 Provider 与 SDK 初始化
本进程 Provider 的对象创建和 onCreate() 属于应用主线程工作。获取远端 Provider 会调用 AMS;Provider 初始化内部还可能访问 PKMS、Settings、账号、网络或另一 Provider。
通过 manifest(应用清单)注册的 Initializer 仍会在启动阶段执行。需要延后时,应移除对应 metadata 并确认它不再是其他 eager Initializer 的可达依赖,再于业务允许的时点手动调用;AppInitializer.initializeComponent() 在调用线程同步执行(见前文「AndroidX App Startup」)。第三方 Provider 能否移除要遵循其文档。
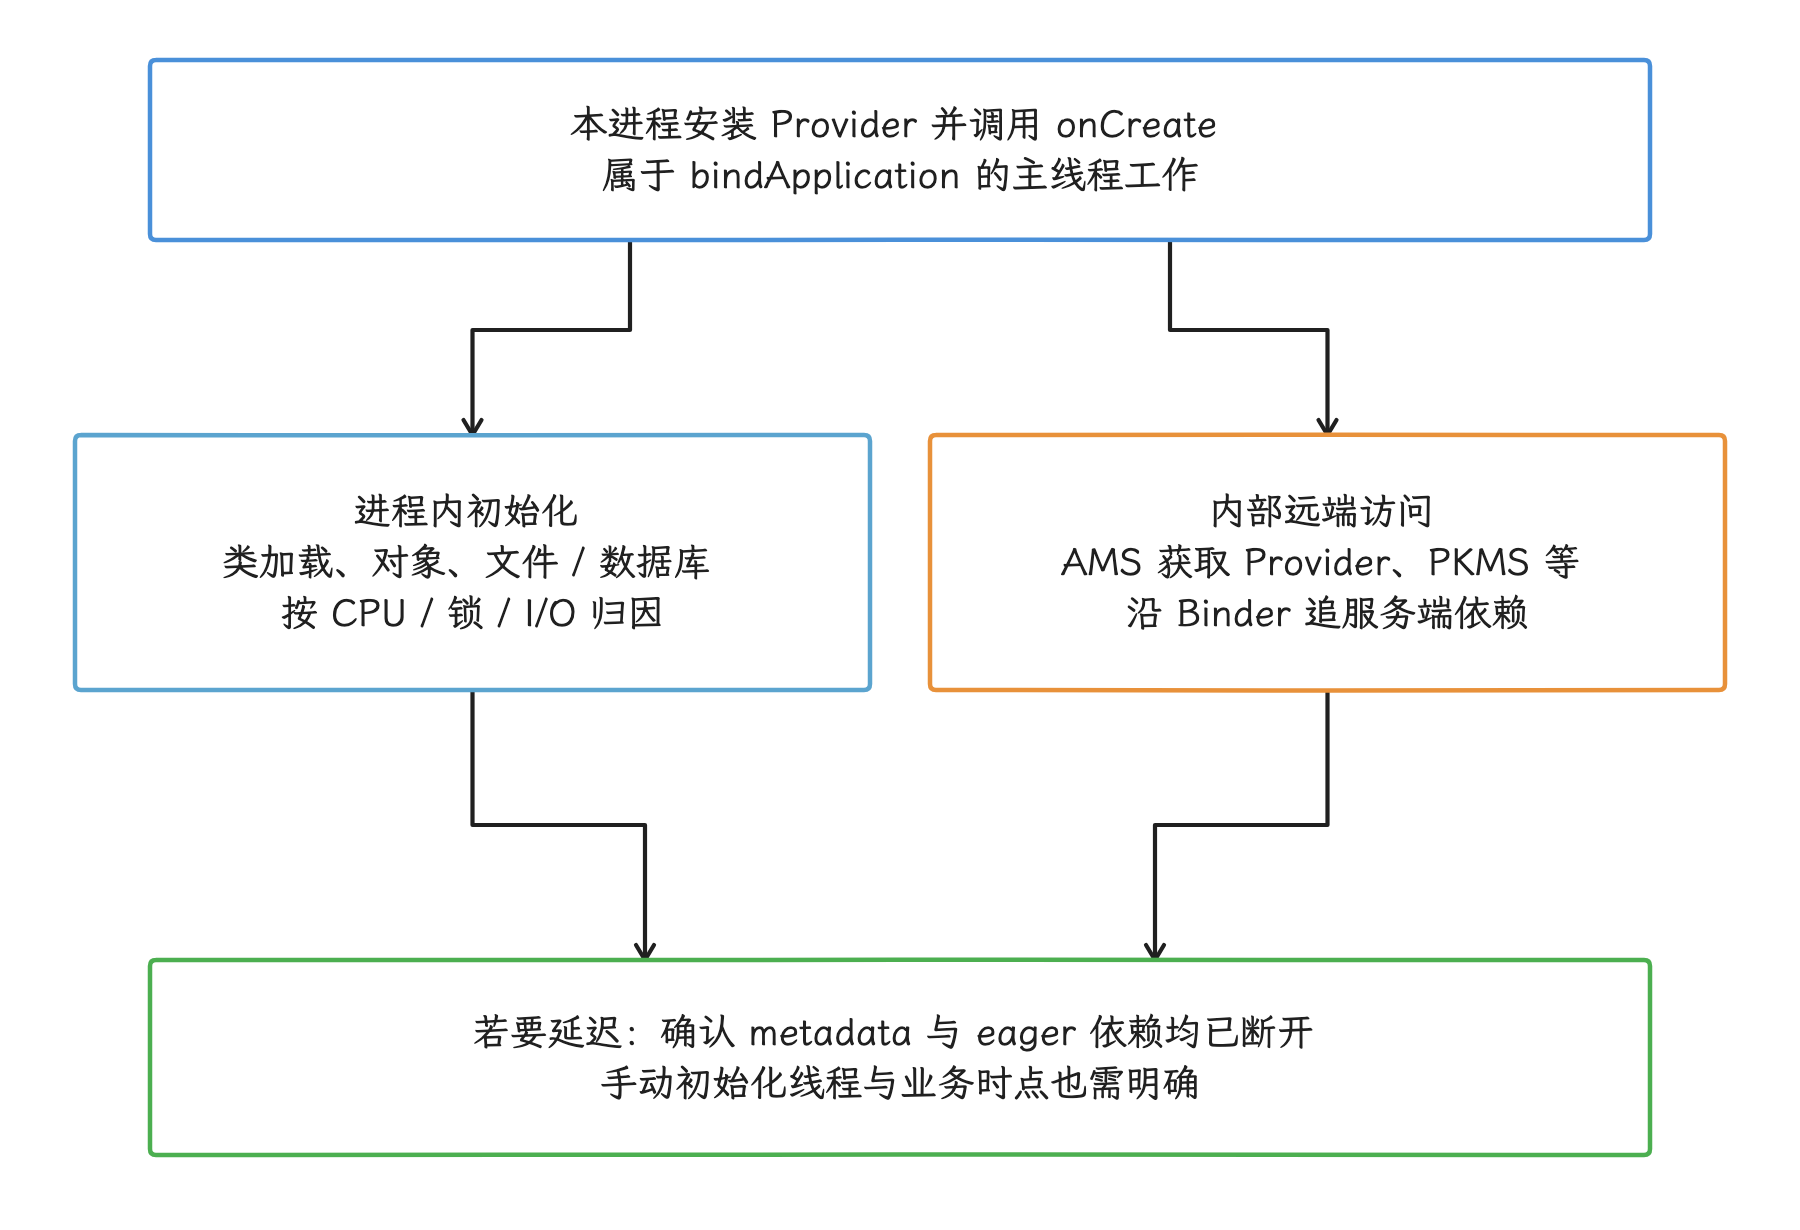
图:Provider.onCreate 是本进程主线程工作;内部远端获取与服务调用另形成 Binder 依赖。
5.4 Binder 线程池拥塞
SystemServer 把 Binder thread-pool max thread count(线程池最大线程数) 配置为 31,libbinder 普通进程的默认值是 15。31 / 15 是 libbinder 配给驱动扩池的 max 参数,不是整个进程 Binder 参与线程的绝对总数;startThreadPool() 首线程和主动 joinThreadPool() 等还影响计数。实际工作者、嵌套回入和空闲状态应从 trace 与所用实现核对。
Binder 线程池拥塞指的是可处理新事务的 worker(工作线程) 不够用,新事务只能排队等派发。判断它要凑齐多项观测:
- 同一服务进程收到的多笔事务同时出现较长请求派发间隔;
- 多个客户端在相近窗口受影响;
- 服务端 Binder 线程长时间运行,或集中阻塞在同一把锁、同一 I/O 等共同资源上;
- 服务端事务完成后,派发间隔随负载下降而恢复。
只看到一笔很长的 server_dur,更可能是该服务的业务逻辑、嵌套调用、锁或 I/O 导致;要认定线程池拥塞,我们还需要 android_binder_server_breakdown 和服务端子 slice 的佐证。
5.5 本地 I/O 与 Binder 等待混在一起
SharedPreferences、DataStore、数据库和文件读取可能在时间线上紧邻 Binder 调用。SharedPreferences.apply() 还会把待完成的磁盘写入登记到 QueuedWork,进而影响组件退出时的等待。它们不一定产生 Binder;但若服务端在同步事务内做本地 I/O,I/O 正是 Binder wall time 的组成部分。应区分“进程内独立工作”与“事务内部等待”:独立工作可以从 Binder 分析里分开看,服务端同步事务内的 I/O 则计入 wall time,一概扣掉会算错。
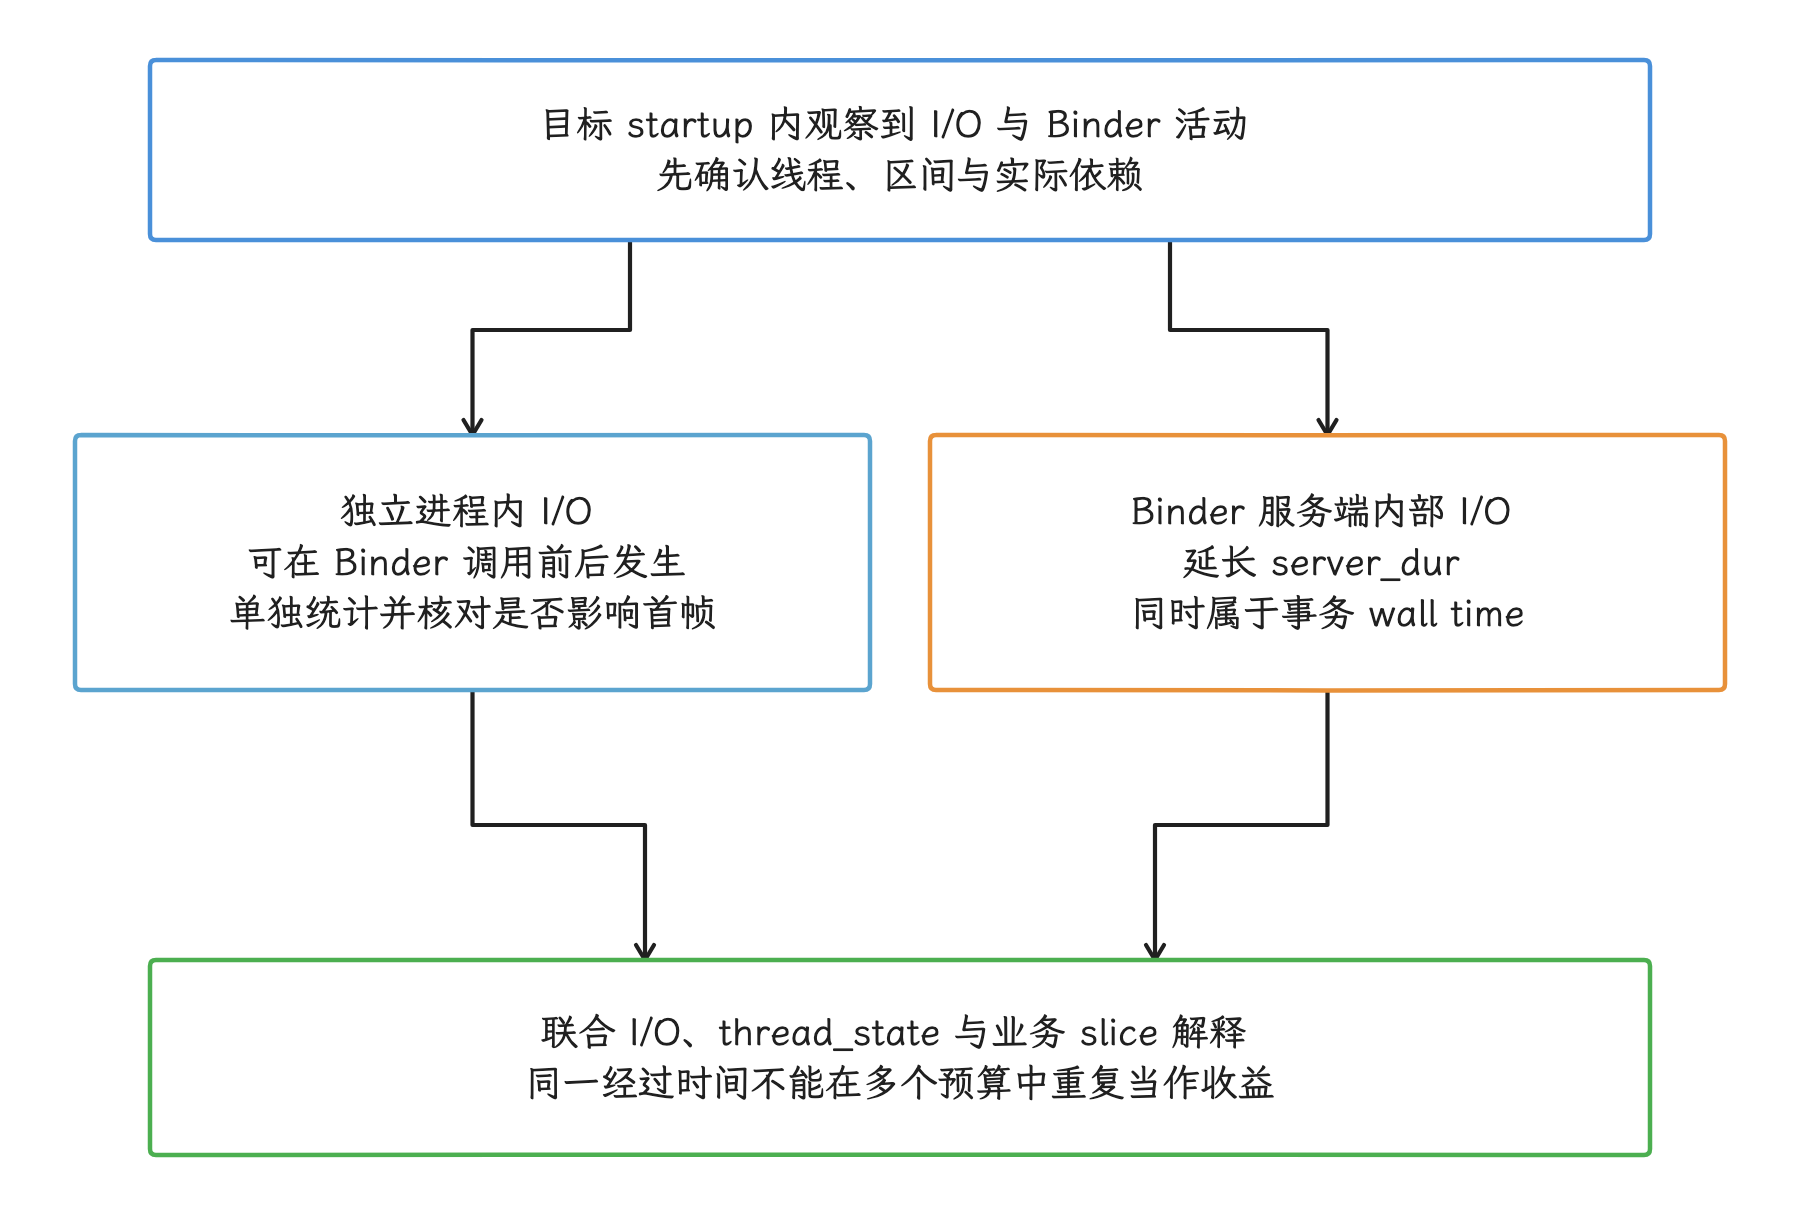
图:独立本地工作与事务内部等待必须区分;服务端同步事务内的 I/O 本来就属于该事务的经过时间。
同一 startup 内分别统计:
- Binder:
android_binder_txns与 binder breakdown; - 文件/块 I/O:I/O 数据源、
thread_state.io_wait和业务 slice; - Java 锁:monitor contention,即
synchronized等监视器锁的竞争; - coroutine:应用 trace,以及 Dispatcher 所在线程的 thread state。
六、主线程阻塞、优先级与 Freezer
6.1 从 client slice 走到服务端
主线程发起同步 Binder 后,libbinder(Binder 的原生用户空间库)会从 IPCThreadState::transact() 进入 waitForResponse()。等待期间 client slice 可保持打开,线程可能在 binder_thread_read 内睡眠,也可能处理嵌套回入事务;reply 到达后仍有线程调度和用户态结果处理。排查路径如下:
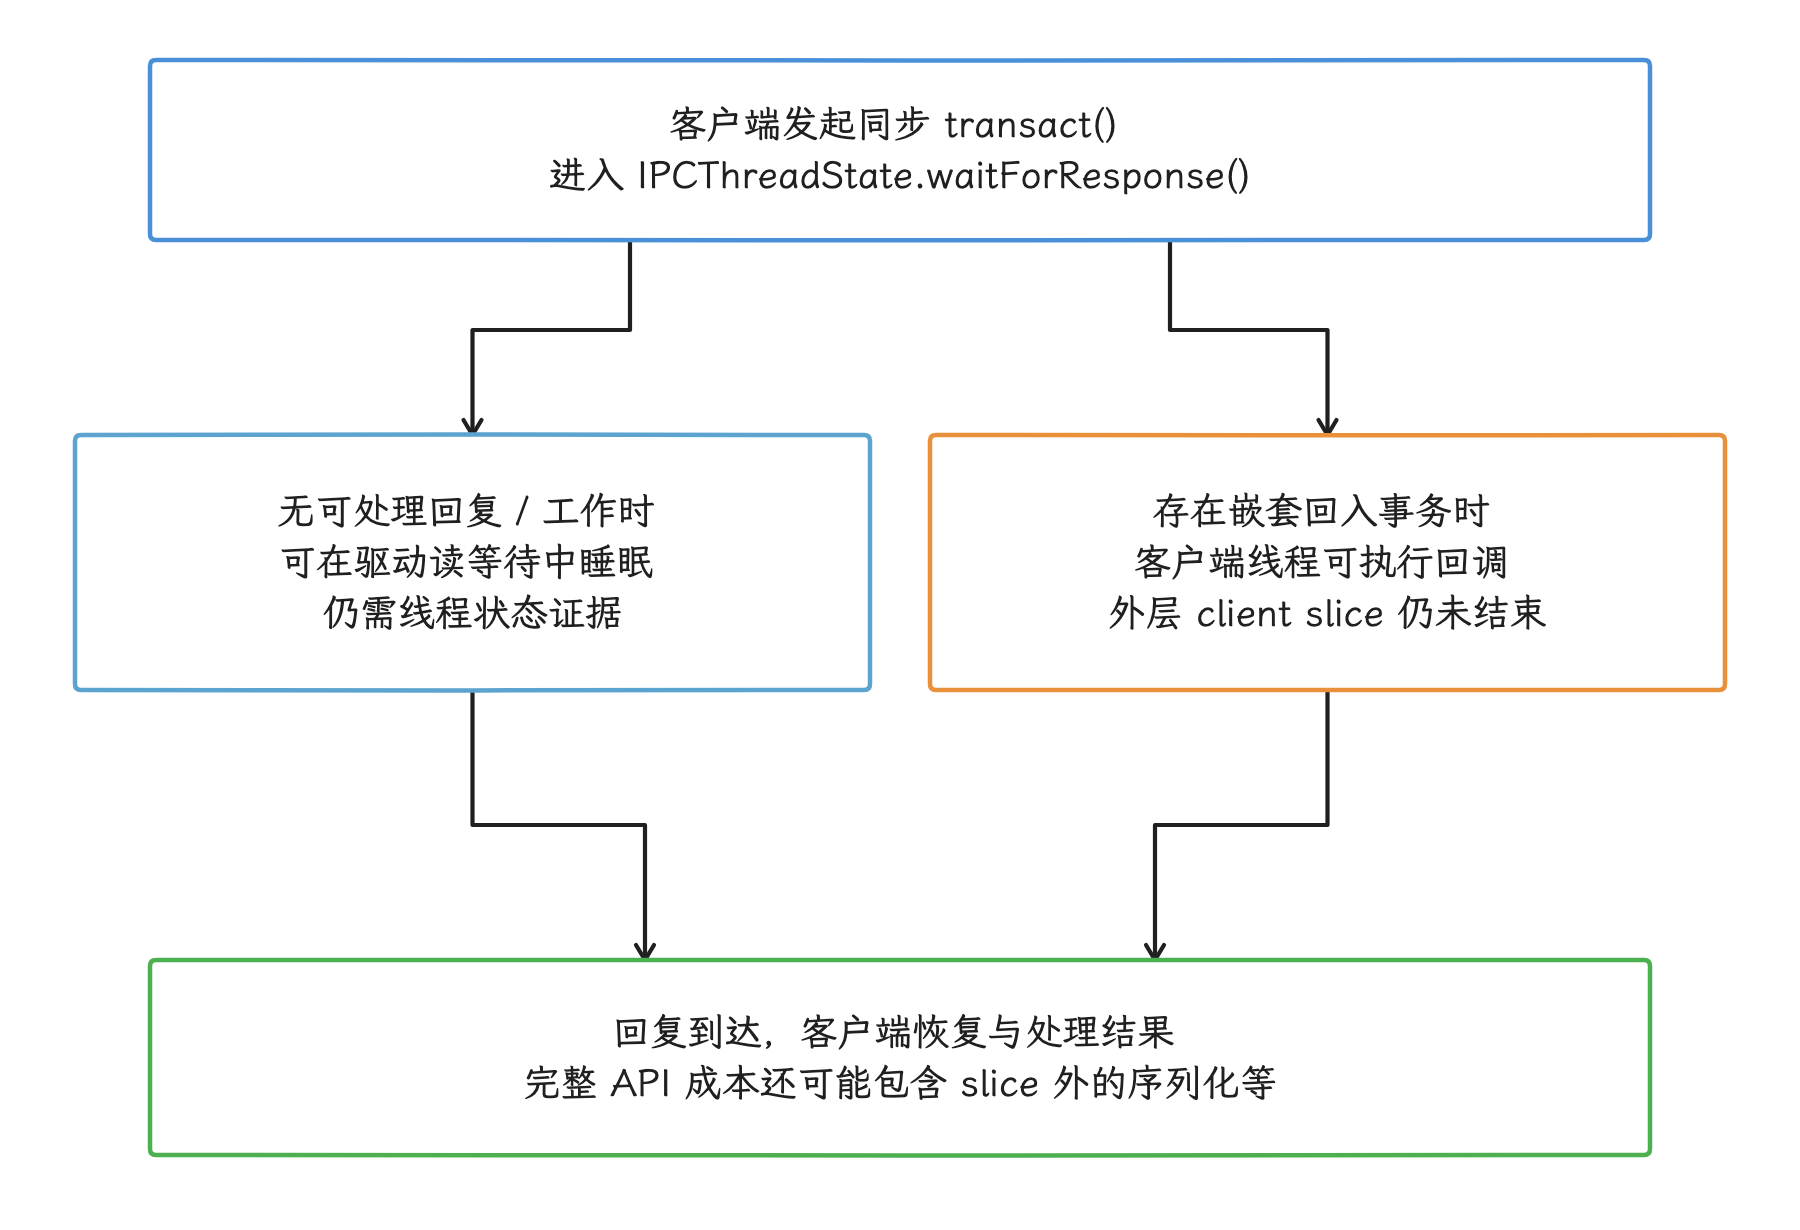
图:waitForResponse 既可能睡眠等待,也可能接收嵌套事务;回复到达后还要等待客户端调度与结果处理。
- 从主线程的
binder transactionslice 取得binder_txn_id。 - 在
android_binder_txns找到server_utid、server_ts和server_dur。 - 跳到服务端线程区间,阅读 AIDL 子 slice、嵌套 Binder、锁和 I/O。
- 用 client/server breakdown 解释 wall time 中线程没有占用 CPU 的部分。
UI 颜色会随主题和版本变化,我们识别 Binder 时依据的是 slice 名称、所属线程、flow 关系和 SQL ID,“红色或黄色 slice”只用来快速导航。
6.2 Binder 优先级继承的边界
r6 kernel 在选中目标 Binder 线程后调用 binder_transaction_priority()。同步事务可继承调用方受支持的调度策略/优先级,再与 node 最低优先级及 inherit_rt 等规则比较;oneway 则先用目标进程默认优先级,不继承发送方优先级。之后的调优仍受策略和权限限制。若目标事务还停留在进程或 node 的待处理队列中、尚未选择 worker,优先级调整就要等具体线程被选中后再做。
binder_set_priority 记录目标 proc / thread 及 old_prio、new_prio、desired_prio 数值,没有调度 policy 字段,也不能直接把内核优先级数字当作 nice。它可辅助观察优先级调整,但确认 RT policy 还须配合相应调度策略证据与源码。thread_state 能显示线程处于 Running(正在 CPU 上运行)、Runnable(可运行但正在等 CPU) 还是 Sleeping(睡眠等待),以及 blocked function(阻塞所在的内核函数),替我们回答不了优先级设置这层问题。优先级继承可以缓解一部分调度反转,即高优先级调用方等待低优先级服务线程的情况;长锁、I/O、线程池容量不足或服务端算法开销,还是要分别解决。
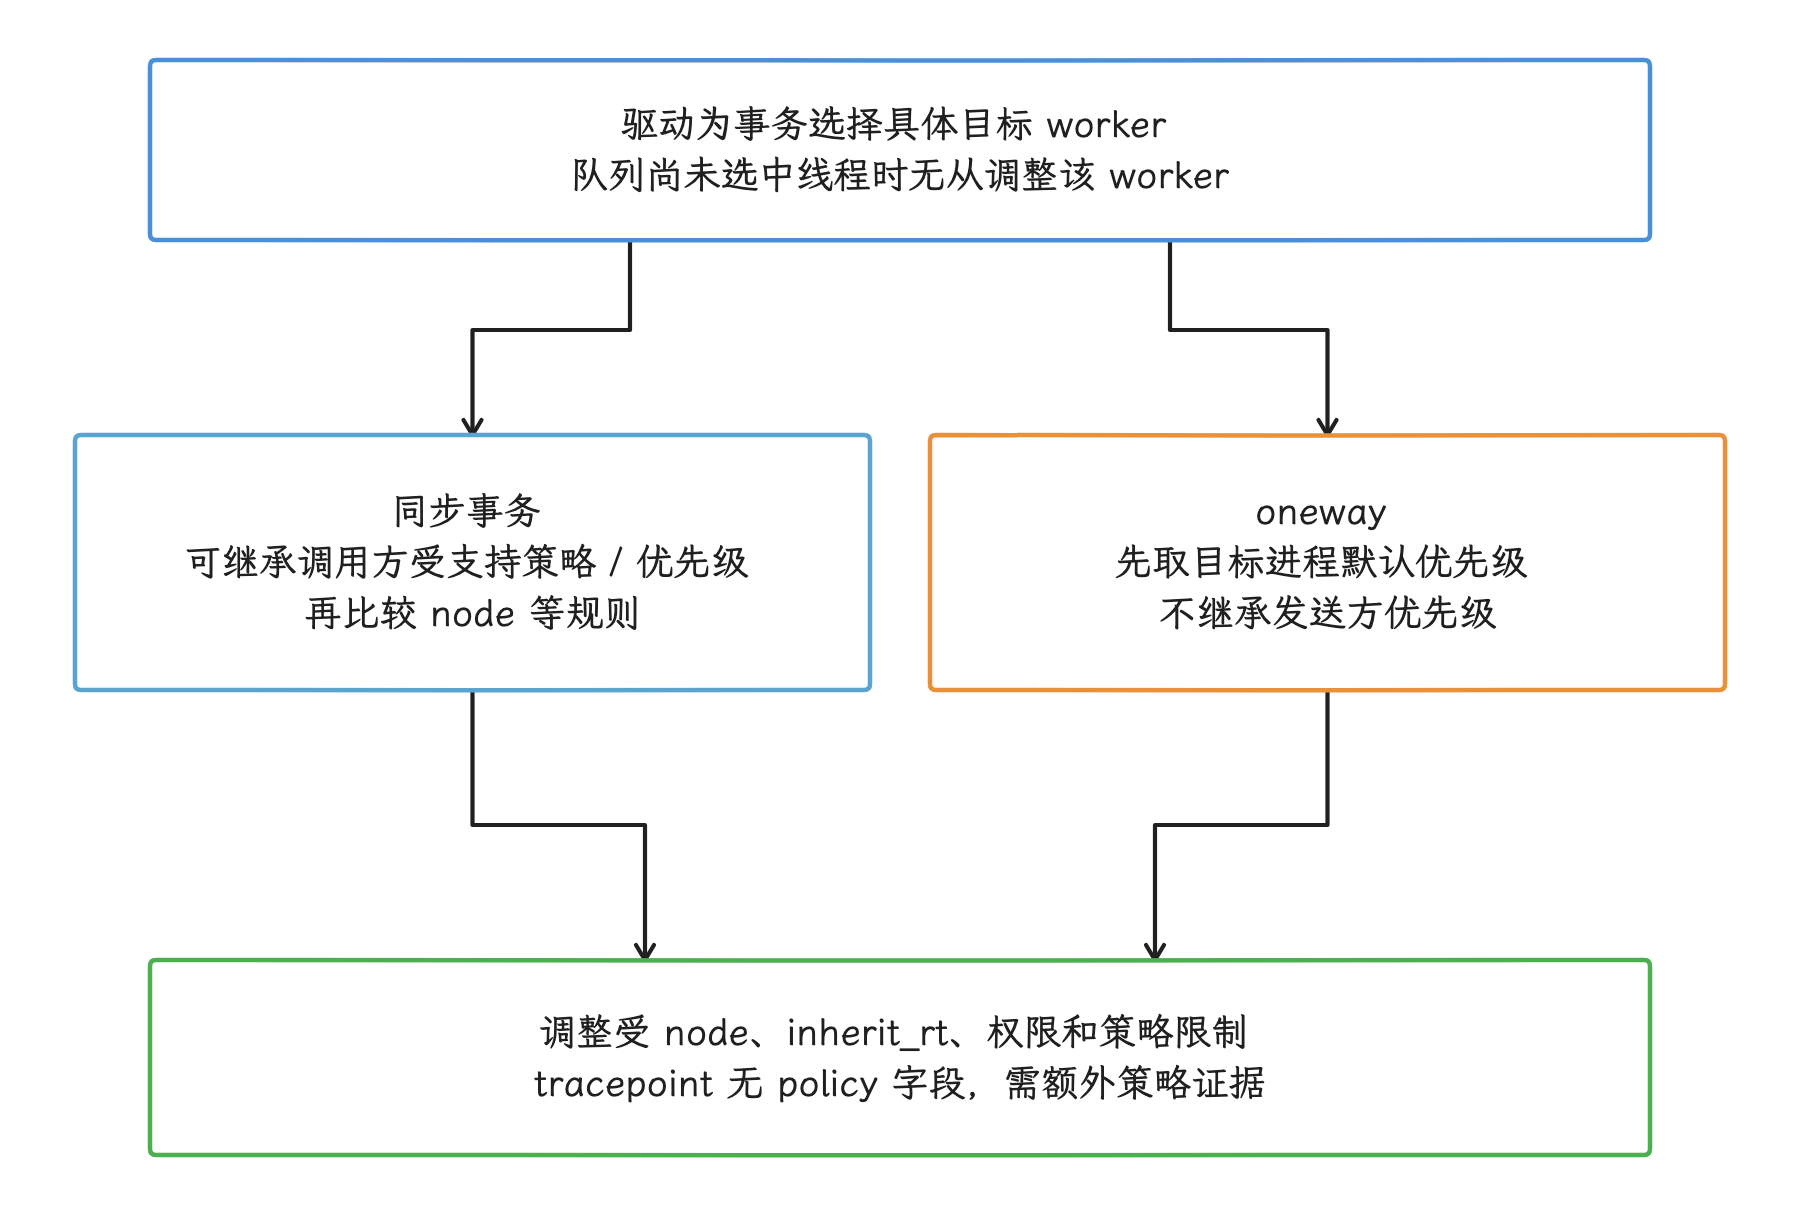
图:同步与 oneway 的优先级来源不同;binder_set_priority 只有优先级数值,不能单独证明 RT policy。
6.3 Android 17 r6 的 frozen transaction 语义
这里的 frozen 目标是被系统 Freezer 暂停执行的 cached process(缓存进程)。binder_proc_transaction() 会根据事务类型走两条不同路径:
| 事务类型 | r6 行为 |
|---|---|
| 同步事务 | 拒绝入队并向调用方返回 BR_FROZEN_REPLY |
| oneway | 允许进入 async(异步)队列,并向调用方报告 BR_TRANSACTION_PENDING_FROZEN |
libbinder 在 waitForResponse() 收到 BR_FROZEN_REPLY 后,会根据 frozen-object error code 开关返回 FROZEN_OBJECT,或返回用于兼容旧行为的 FAILED_TRANSACTION。前台应用调用 system_server 时,通常不会遇到 system_server 被冻结;更常见的方向是系统或前台进程访问 cached/frozen 的应用、Provider 或 Service。
6.4 为什么 server_dur = 0 查不到 frozen rejection
android_binder_txns 依赖客户端到服务端的 flow。同步事务在目标 frozen 时会被驱动直接拒绝,没有服务端 receive/reply slice,标准表通常也就没有这一行;因此在标准表里过滤 server_dur = 0、把 client_dur > 0 AND server_dur = 0 直接计成 frozen 次数,这两种推断都靠不住。我们诊断 frozen rejection 时要保留 binder_return 原始事件,下面的查询从 raw ftrace 表中列出返回命令、发生时间和调用线程,供进一步与目标进程状态、调用 slice 对齐。
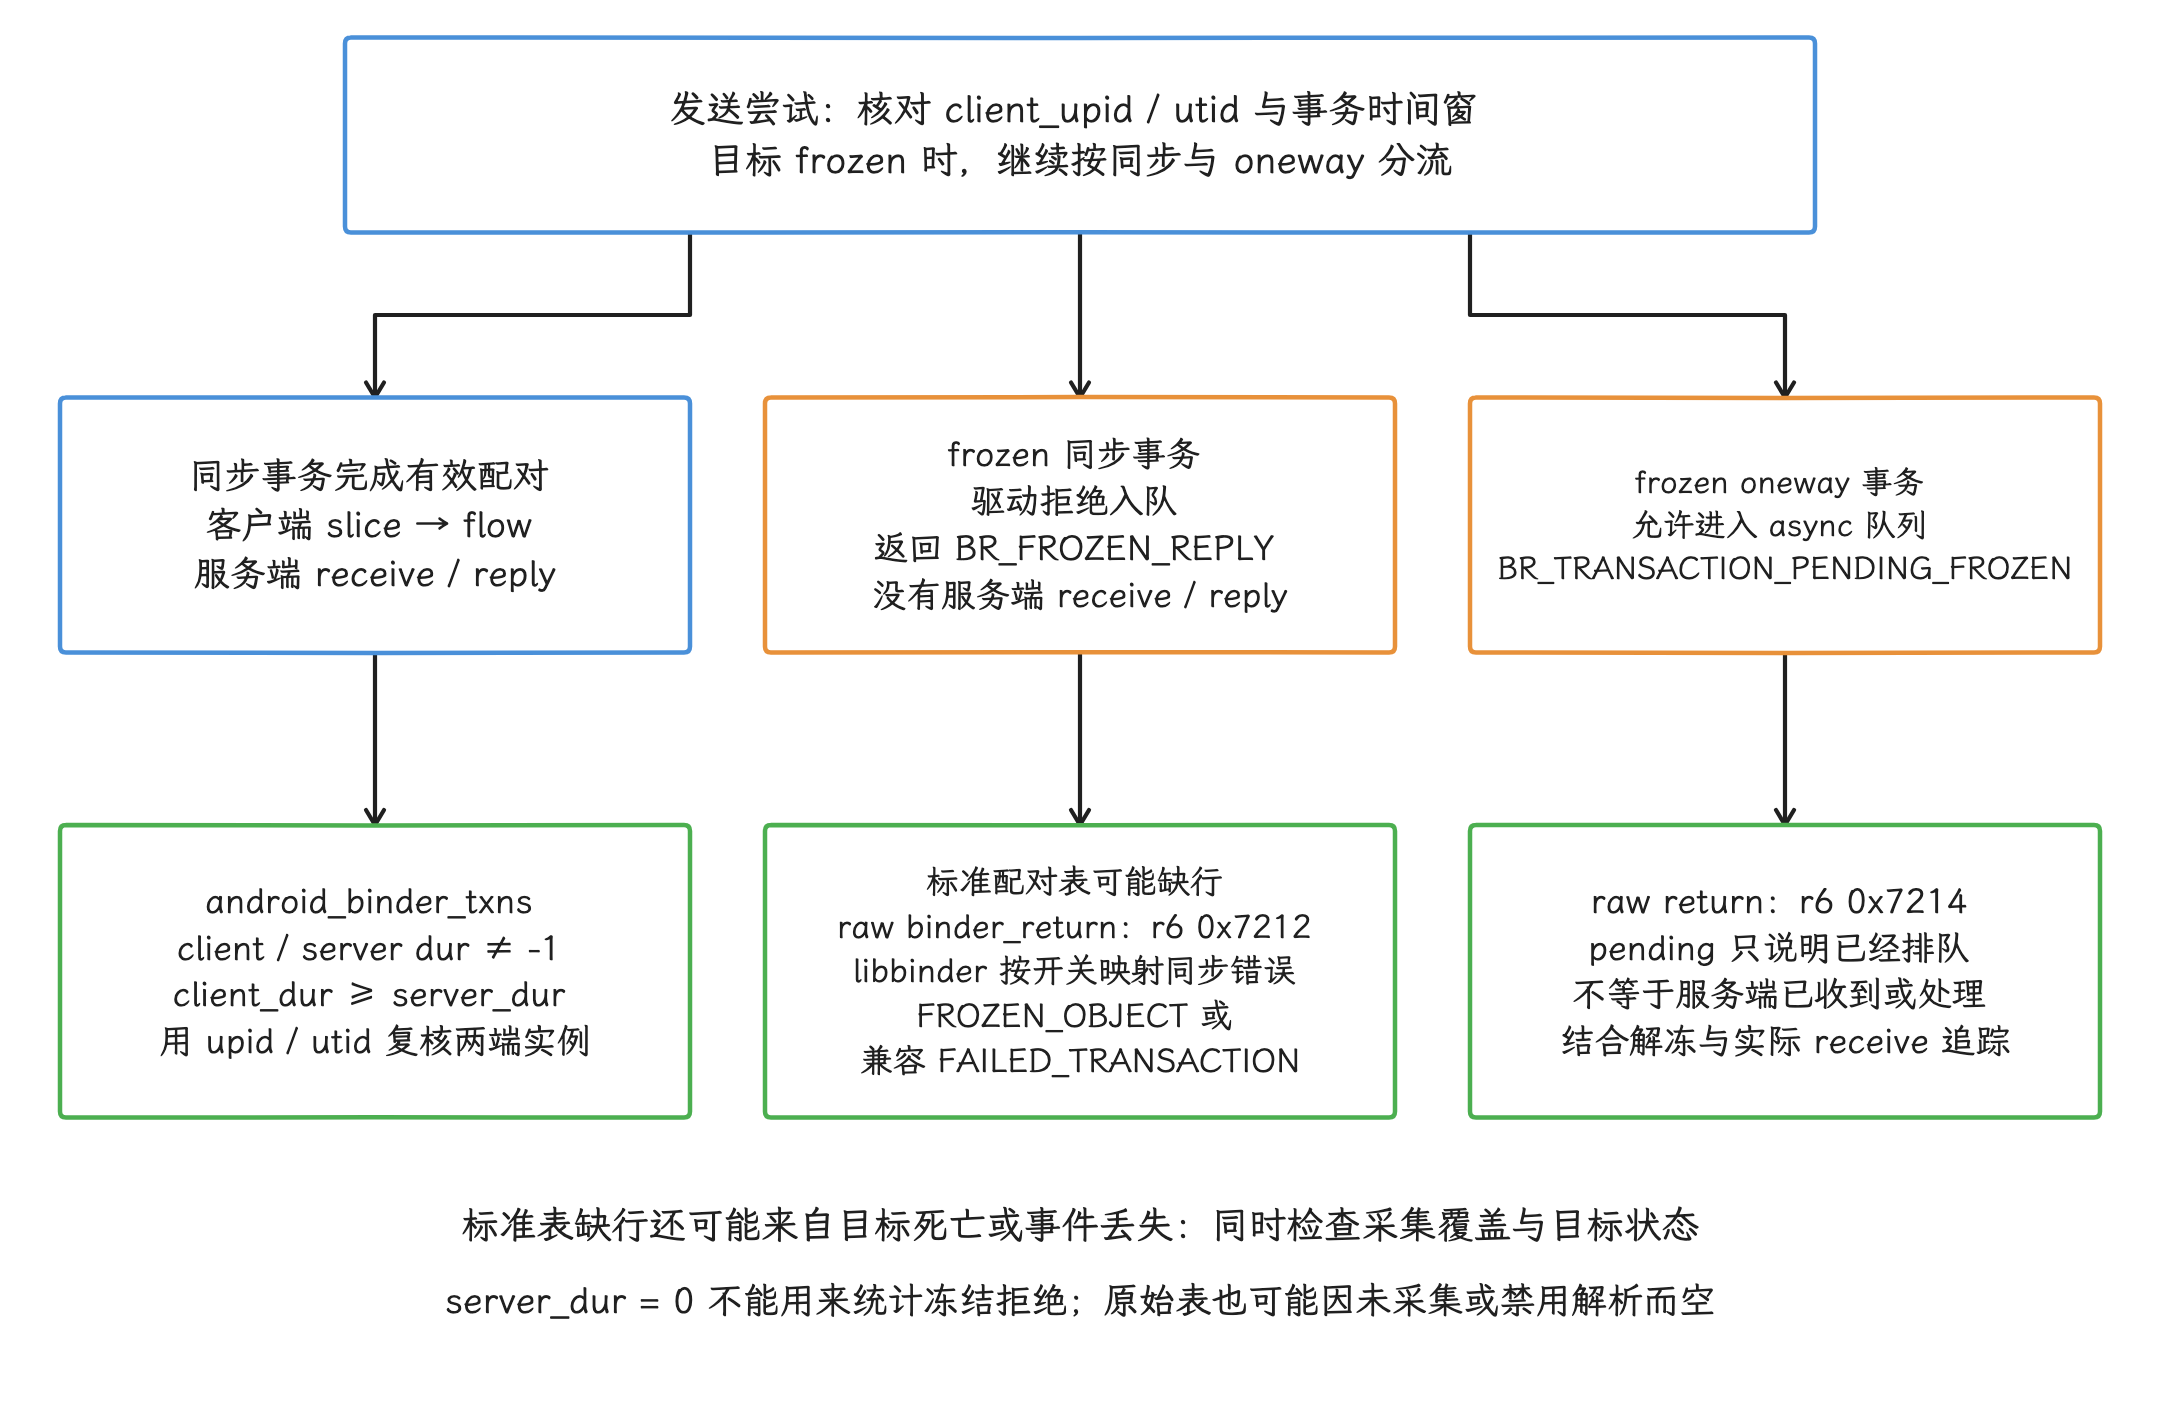
图:有效同步配对依赖 client / flow / server 及完整时长约束;r6 frozen 同步事务拒绝入队,可缺失服务端配对行,应查原始 binder_return 和目标状态;frozen oneway 可排队并报告 pending,这只代表进入队列,处理结果要看服务端后续状态。标准表缺行还可能来自死亡或采集丢失,冻结拒绝的统计要以原始 binder_return 为准,server_dur=0 给不出这个答案;原始表也依赖采集与解析。
SELECT
  f.ts,
  t.tid,
  t.name AS thread_name,
  printf(
    '0x%x',
    cast(EXTRACT_ARG(f.arg_set_id, 'cmd') AS int)
  ) AS binder_return_cmd
FROM ftrace_event AS f
LEFT JOIN thread AS t
  USING (utid)
WHERE f.name = 'binder_return'
ORDER BY f.ts;
r6 UAPI(用户空间与内核共享的接口定义)中,BR_FROZEN_REPLY = _IO('r', 18),BR_TRANSACTION_PENDING_FROZEN = _IO('r', 20)。查询结果中的十六进制值要按该版本的 UAPI 映射回命令名。
Trace Processor 的 ftrace_event 是调试表,关闭原始 ftrace 事件解析后可能为空。团队若要长期统计,应在采集端或自己的 Trace Processor metric(分析指标) 中明确解析这两个命令,并保留失败事务的客户端、目标和时间窗。
6.5 TF_UPDATE_TXN 只更新特定 pending oneway
目标进程 frozen,且同一 Binder node(驱动中代表一个 Binder 实体的对象) 已有 pending async transaction(待处理的异步事务)时,新事务只有满足以下条件才可能替换旧事务:
- 新旧事务都带
TF_ONE_WAY | TF_UPDATE_TXN; - 目标进程、transaction code、完整 flags 相同;
- 发送方 PID 相同;
- target node pointer(目标 node 的内核指针)和 cookie(与该 node 关联的用户空间标识) 相同。
这套替换只发生在满足上述条件的 oneway 之间:同步事务不参与合并,android_binder_txns 里也没有 is_merged、frozen_reply 或 parent_txn_id 这样的列。被更新的旧 oneway 不再由服务端消费,所以应用侧发送次数可能多于服务端实际处理次数。
七、优化策略与验证
7.1 减少首帧前可避免的调用
| 发现 | 优化方向 | 验证 |
|---|---|---|
| 重复 PackageManager 查询 | 进程内缓存、SDK 懒初始化 | endpoint 计数下降,缓存失效测试通过 |
| 非展示必需的 SDK 初始化 | 移到首帧后或按功能首次使用时执行 | startup 窗口内事务消失 |
| manifest 注册的非关键 Initializer | 移除注册并手动初始化 | Provider/Initializer slice 离开关键路径 |
| 自有远端服务逐项查询 | 设计批量读取或本地快照 | 调用次数下降,Parcel 数据大小仍受控 |
| 服务端长处理 | 优化锁、I/O、缓存或算法 | server_dur 与 breakdown 原因下降 |
缓存要说明一致性的判定条件:哪些变化发生后旧值不再可信。包升级、locale(语言与地区设置)、用户、权限、配置和进程重建都可能让旧结果失效;失效之后要以新值为准,别为了缩短 trace 而沿用过期数据。
7.2 只有自有 AIDL 才能选择 oneway
公开系统 API 的同步或 oneway 属性由平台 AIDL 固定,应用在调用点没有改写的余地。对于自有 AIDL,若业务不需要同步返回结果,可以选择 oneway(单向异步调用),但协议还要处理:
- 无同步返回值和服务端异常回传;
- 调用方撤销、超时、重试和幂等,也就是重复发送同一请求时避免额外副作用;
- 服务端消费速度低于发送速度时的排队;
- frozen 目标上的 pending 行为;
- 多 Binder node 或多线程下的顺序要求。
对远端 Binder,oneway 取消等待同步业务回复,但 Parcel 构造、提交驱动等发送成本仍在,队列、资源或错误也可能影响发送。服务端处理不会因此消失,目标 worker 需被选中后才有优先级调整。若 AIDL 对象位于同一进程,本地调用仍直接在调用线程同步执行,oneway 不会自动创建异步任务。
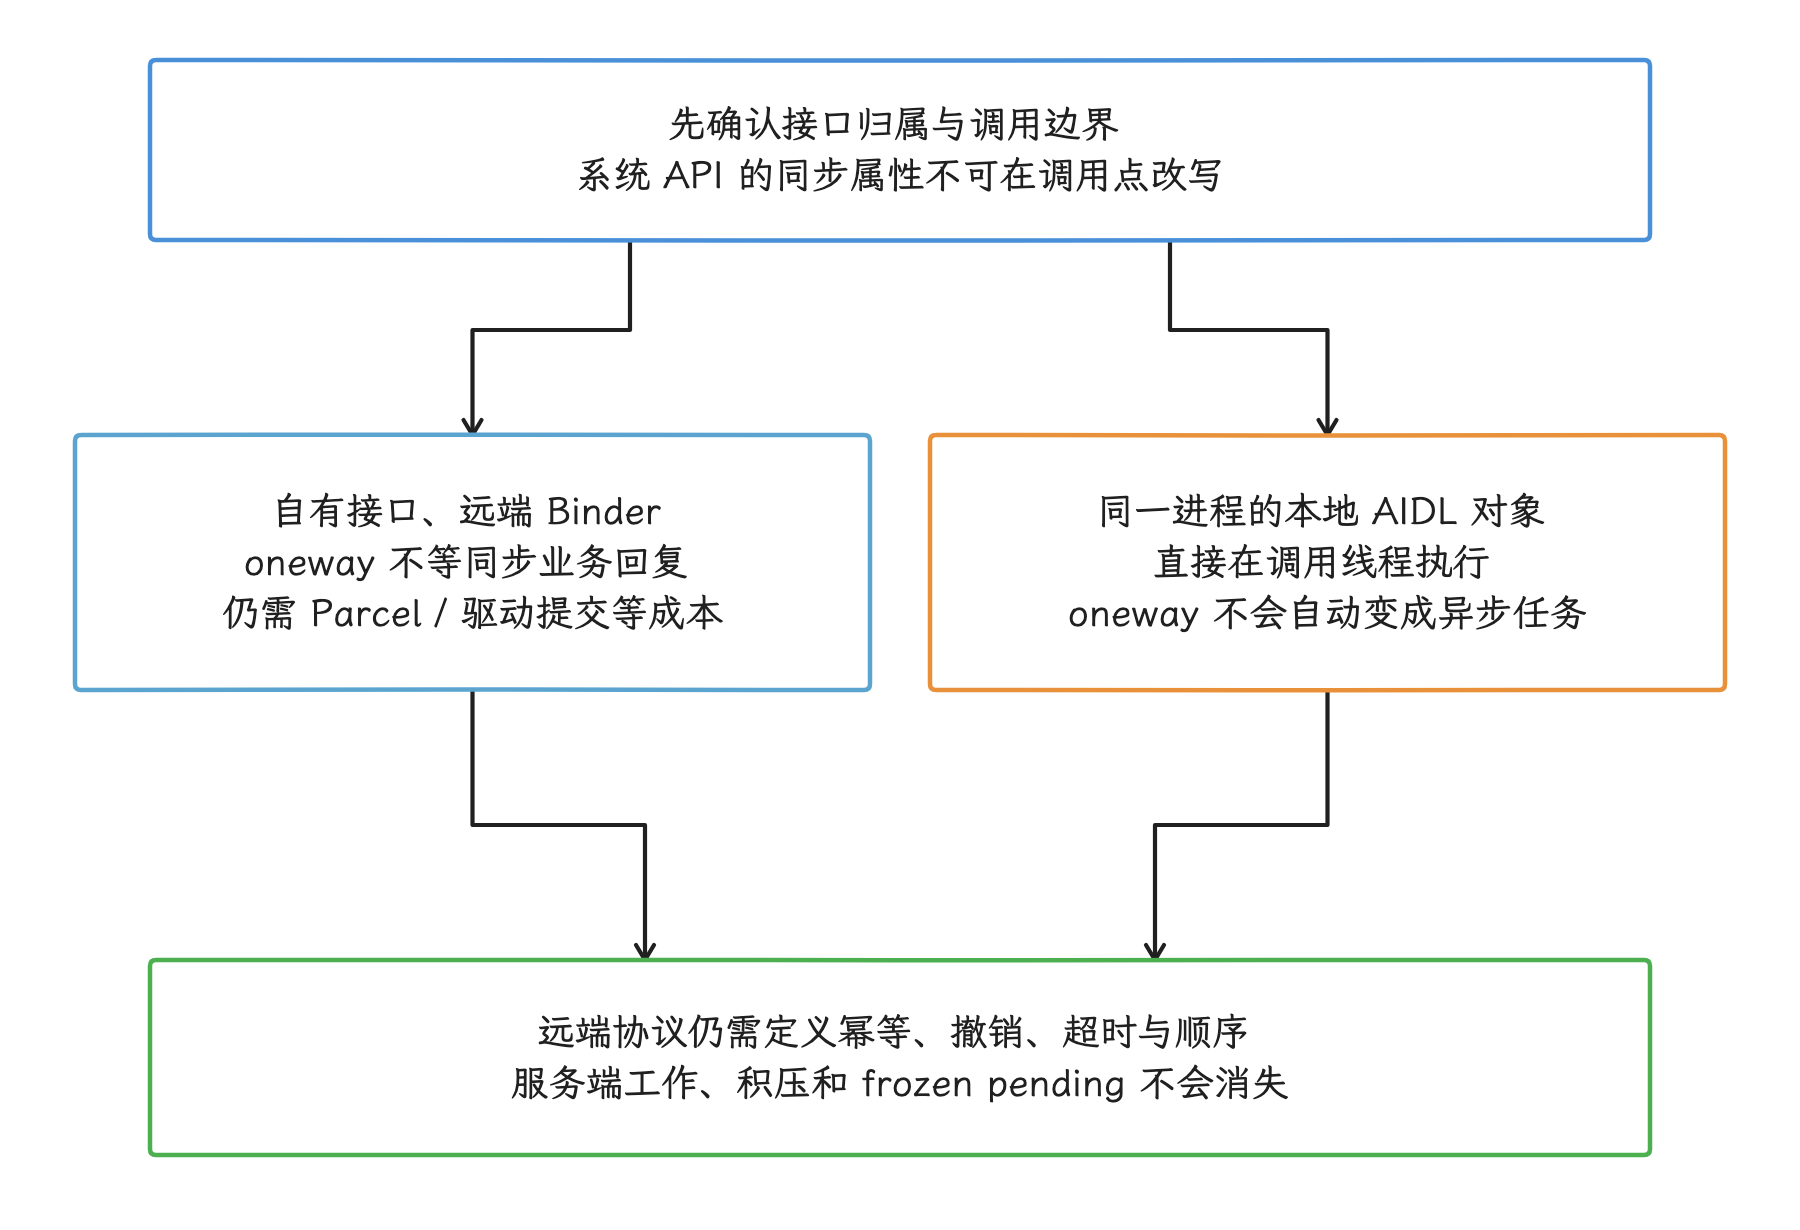
图:系统 AIDL 属性固定;自有接口的远端 oneway 仍有发送成本、排队和失败协议,本地调用继续同步。
7.3 用 Macrobenchmark 做 A/B
Macrobenchmark 是 AndroidX 提供的应用级基准测试工具,A/B 表示只改变一个待验证因素,对比修改前后两组结果。单条 Perfetto trace 适合解释原因,性能结论要来自多轮可控实验。推荐固定:
StartupMode.COLD;- CompilationMode(代码编译模式)与 Baseline Profile 安装状态;
- 构建类型、应用版本、账号与首屏数据;
- 电量、温度、充电状态和后台负载;
- 每组迭代数与异常值处理规则。
同时比较 TTID、TTFD、主线程同步事务计数、endpoint 分布、请求派发间隔、server_dur 和 breakdown。若 Binder 指标下降而启动指标不变,这笔事务可能不在首帧关键路径上,也可能有新的工作占用了节省出的时间。
扩展
🔸 Android 17 Binder Layer 追踪增强
这里的 Binder Layer 指从内核驱动事件到 Trace Processor 事务配对的整条观测链路。Android 17 源码里与之相关的能力有两类:
- r6 kernel 的
binder_command/binder_return让BinderTracker在失败、frozen 和 nested transaction(嵌套事务)场景中更可靠地维护事务栈; - Android 17 的 Perfetto
android.binder表提供 sync/async、client/server、AIDL 名称、OOM score、package metadata(包版本等元数据)与 monotonic-duration(扣除系统 suspend 区间)相关字段。这些字段描述事务自身的属性;线程 Running / Runnable 的时长和 CPU time,要按前文四段分解的方式另算。
因目标冻结而失败的事务,这些能力也补不进 android_binder_txns,替代查法见 6.4。分析工具版本升级后,应先阅读所用 tag(源码版本标签) 的表定义,再写 SQL;网页上最新版 stdlib 的列,在按 r1 源码构建或其他版本的 Trace Processor 中未必存在;设备 Android 版本不唯一决定离线分析器版本。
🔸 多进程应用冷启动 Binder 放大效应
普通应用新进程通常独立执行 attach、Application 与分配给该进程的组件初始化;并不是每个进程安装整个 APK 的全部 Provider。隔离入口、SDK sandbox 等特殊路径另查实现。子进程还可能重复初始化 SDK、查询包信息、获取 Provider 或绑定服务。风险会随进程数和依赖关系增加,但事务数不一定按固定的 N×N 关系增长。
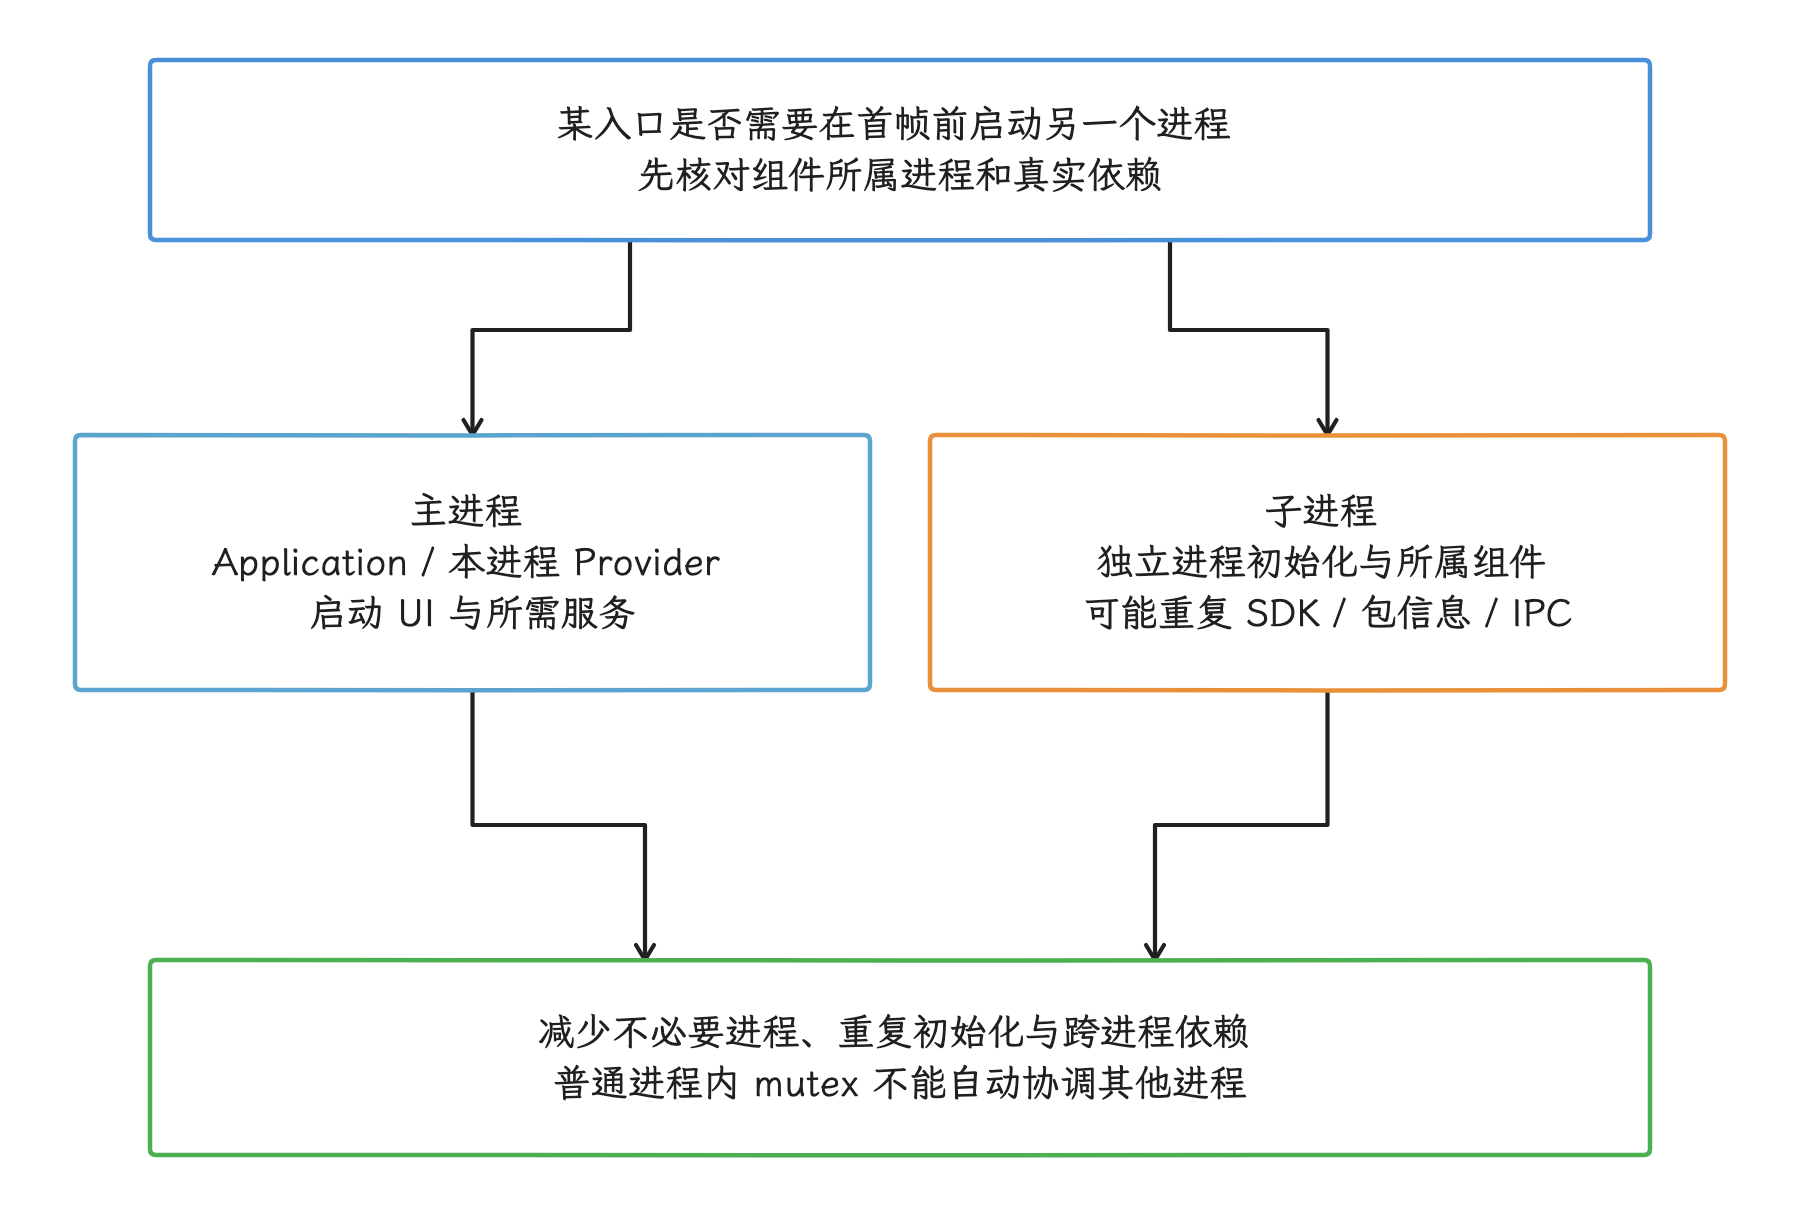
图:普通新进程各有 Application 与分配给它的组件;不是每个进程安装全部 Provider,也没有固定 N² 事务规律。
排查时按进程逐项检查:
- 该进程是否必须在首帧前创建;
Application和 ContentProvider 是否识别当前进程;- SDK 是否在所有进程重复初始化;
- 跨进程缓存的读取成本、一致性和故障模式;
- 多进程同时启动时,是否同时占用同一系统服务或自有 Binder pool(线程池)。
普通 mutex 管得住的只有同一进程内的线程,跨进程协调要走别的路。显式进程共享锁、文件锁或中心服务协议若把初始化串行化,才会形成跨进程等待;还要验证超时、崩溃恢复和死锁风险。应先减少不必要的进程、初始化和重复 IPC;确需协调时,协议要明确定义超时、崩溃恢复和进程死亡后的行为。
🔸 真实案例分析
一份经得起复盘的案例,除了“优化了多少毫秒”,还应保留原始 trace、采集配置、构建信息和 SQL。复盘顺序可以固定为:
- 用
android_startups锁定目标startup_id。 - 列出主线程 Top-N 同步事务,记录 txn ID(事务 ID)。
- 对每笔事务查看 server thread(服务端处理线程) 和 breakdown。
- 用应用 slice 定位调用模块或 SDK。
- 只改一个变量,记录代码差异。
- 以相同设备条件重复 Macrobenchmark。
- 将启动分布和 Binder 分段指标一起归档。
案例拿不出原始材料时,文中的毫秒数就只是示例;其他应用的预算和阈值,要按自己的实测来定。
与相关章节的边界
- 1.9 Binder IPC:驱动、libbinder、同步与 oneway 语义。
- 1.10 Binder 调度、Freezer 与线程池:cached process 冻结、线程池容量、嵌套调用与系统级排查。
- 14.7 Perfetto SQL 手册:通用 SQL、时间窗口和表关联。
版本与实现边界
- Android 8.0 到 Android 8.1(API 26–27)使用 ART profile-guided compilation,但那时还没有 Google Play Cloud Profile 的 API 28+ 分发渠道。
- Android 9(API 28)及更高版本可从 Google Play 获得 Cloud Profile,前提是渠道和样本满足条件。
- Android 12(API 31)统一 SplashScreen,并提供 FrameTimeline 诊断首帧。
- Android 15(API 35)加入
ApplicationStartInfo,AOSP 同期开始支持 16 KB page-size 设备。 - Android 17(API 37)是本文核对的平台上限。源码路径和时序以
android-17.0.0_r1为准,厂商私有的启动加速器不属于 AOSP 保证。
诊断与验证清单
- 是否使用 startup 时间窗裁剪 Binder 事务?
- 是否区分 wall time、CPU time、请求派发间隔和服务端区间?
- 是否确认
aidl_name为空的原因? - 是否避免对重叠或 nested
client_dur做 wall-time 推断? - 是否用 client/server breakdown 验证锁、I/O、reclaim 和嵌套 Binder?
- 是否用 raw
binder_return确认 frozen rejection? - 是否区分独立本地 I/O 与发生在 Binder 事务内部的 I/O,而非把全部 I/O 从事务 wall time 中扣掉?
- 是否只对自有 AIDL 讨论同步/oneway 改造?
- 是否用 Macrobenchmark 多轮验证,并固定编译、温度和数据条件?
- 正文平台源码是否锚定
android-17.0.0_r1,kernel 是否锚定android17-6.18-2026-06_r6?
常见误区
“冷启动优化等于缩短 Application.onCreate”
Provider、进程创建、类加载、Activity、首帧 UI、RenderThread 和系统合成都可能占据主要时间,Application.onCreate() 只是其中一段。
“Displayed 就是用户已经能操作”
Displayed 代表 TTID。首帧可能仍然是骨架屏、空数据或禁用状态,业务可用时间应通过 TTFD 或单独的交互指标表示。
“reportFullyDrawn 越早越好”
过早上报会让 TTFD 失去原有含义。Framework 只能保证它不早于窗口首帧,登录数据、列表内容或主要按钮是否可用,要靠应用自己定义。
“后台初始化不会影响启动”
后台线程仍会与启动路径共享 CPU、I/O、内存带宽、Binder 线程池和锁,需要验证二者是否发生资源竞争。
“Baseline Profile 能修复所有启动问题”
Baseline / Startup Profile 主要帮助覆盖路径的运行前编译、代码执行与 DEX 布局,实际也可能缩短这些路径中部分 UI / 初始化 CPU 工作。它们不保证消除同步等待或所有启动瓶颈。同步网络、慢 Binder、数据库锁、图片解码、复杂布局和 GPU / HWC 瓶颈仍需分别处理。
“TTID 再加固定的两个 VSync 就是触摸到像素”
启动请求之前的输入路径,以及之后的 SurfaceFlinger 调度、HWC present 和面板扫描,都会随设备与刷新相位变化。API 35 及以上版本的 SurfaceFlinger composition timestamp 可以补充软件侧时间点,面板级结果仍需外部测量。
结论
本文普通新进程 Activity 路径从启动请求开始,经 Zygote fork、ActivityThread 绑定、Provider 与 Application 初始化,再执行 Activity/UI 与首帧工作;系统绘制回报、GPU 和显示合成的时间可能交叠,应按各工具的端点和真实依赖解释。温启动与热启动复用的状态不同,测量前必须明确采用哪一种定义。
TTID 回答“首帧何时出现”,TTFD 回答“主内容何时可用”。我们手里的工具各管一段:am start -W 和 Logcat 适合快速检查,Macrobenchmark 用于可重复对比,ApplicationStartInfo 提供结构化时间点,Perfetto 用于逐阶段归因。把这些测量的统计口径统一之后,启动优化结果才能被复测和解释。
参考资料
- Perfetto
android.binder源码 - Perfetto
android.binder_breakdown源码 - Perfetto Activity startup 标准库
- Perfetto
BinderTracker状态机 - AOSP
IPCThreadState.cpp - AOSP
ProcessState.cpp - AOSP
SystemServer.java - AOSP
ActivityThread.java - AOSP
IWindowSession.aidl - r6 kernel
binder_trace.h - r6 kernel
binder.c - r6 kernel Binder UAPI
- PerfettoSQL 标准表与
ftrace_event - Android Macrobenchmark
- AndroidX
Trace