跨进程内存共享与端侧推理预算
把智能体和推理服务拆进多个进程之后,内存算在谁头上、数据怎么跨进程共享,Android 17 / API 37 没有为此新造机制:平台里没有名为“智能体进程”的内核对象,也没有智能体专用的内存命名空间。模型推理、工具调用和跨应用协作,仍由 Android 现有机制管着——应用身份 UID、进程地址空间、Binder、文件描述符 fd、SELinux、cgroup v2、AMS 的进程状态,以及低内存终止守护进程 lmkd。
源码基线:AOSP
android-17.0.0_r1;内核android17-6.18-2026-06_r6。
产品侧如果用了 AICore、私有推理服务或厂商 NPU 服务,它们的包名、进程优先级和缓存策略要当成设备实现来看,别套用 AOSP Android 17 的通用行为:com.google.android.aicore 不属于 AOSP android-17.0.0_r1,它在具体设备上的生命周期和内存策略,以该设备的实现为准。
平台层面能确认的结论如下:
- 进程 RSS/PSS 与 cgroup 内存控制器的记账口径不同;共享页的 cgroup 用量不会按映射者重复计入或按 PSS 分摊;
- 同一物理页可以出现在多个进程的 RSS 中,PSS 才会按映射者分摊;
- Binder 适合传递控制消息和小数据,大块内容走 fd、共享缓冲区或受控 URI;
android:process、隔离服务(isolated service)和系统推理服务提供的隔离强度不同;- MemoryLimiter 与 lmkd 仍依据进程状态、设备配置和内存压力工作,没有通用的“正在执行 AI”进程标签;设备配置可以单独豁免默认的沙箱推理服务包。
4.10.1 先确定内存属于哪个进程
看到“端侧推理”四个字,我们最先要回答的问题是:模型和上下文放在哪个进程里跑。常见四种部署方式:
| 方式 | UID / 进程 | 内存计入 | 隔离边界 |
|---|---|---|---|
| 应用进程内推理 | 应用 UID / 主进程 | 主进程的 Java 堆、原生内存、文件映射、dma-buf 等 | 无额外进程隔离 |
android:process=":inference" | 通常仍是应用 UID / 独立进程 | 独立 PID 的各类内存 | 隔离地址空间和进程故障;不构成跨 UID 安全沙箱 |
android:isolatedProcess="true" 服务 | 系统分配的隔离 UID / 独立进程 | 隔离进程 | 权限和数据访问明显收窄,只能通过获准的进程间通信(IPC)与句柄取得数据 |
| 系统或厂商推理服务 | 服务自己的 UID / 进程 | 服务进程及其 cgroup | 由系统映像、SELinux 和服务协议决定 |
独立进程的 oom_score_adj
AMS 会根据组件状态、绑定关系和前台可感知性等信息,持续计算每个进程的状态和 oom_score_adj;分值越高,内存紧张时通常越容易被选中终止。同一应用的主进程和 :inference 进程可以拿到不同分值;被前台组件绑定的服务,也可能因为依赖关系拿到更高的优先级。
所以“推理服务”的 oom_score_adj 没有可照抄的固定区间,oom_score_adj=500~800 这类写法靠不住,系统推理服务也未必比调用方更难被终止。实际分值要在目标设备和目标场景里读:
adb shell dumpsys activity processes
adb shell cat /proc/<pid>/oom_score_adj
第一条命令看 AMS 认定的进程状态和依赖关系,第二条确认该时刻写进内核的分值。测量要覆盖前台、转入后台、解绑、冻结和重新绑定这些状态变化。
反过来,进程内存变大并不会直接抬高它的 oom_score_adj:内存大小影响的是终止该进程能释放多少内存,还可能影响同一 adj 档位内的选择;进程重要性仍由 AMS 的状态模型决定。
android:process 的隔离范围
进程名以冒号开头时,组件通常运行在应用自己的另一个 Linux 进程里,用的仍是应用 UID。它适合:
- 把原生推理引擎的崩溃限制在单独的 PID;
- 让主界面与推理进程分别观测内存;
- 在组件不再使用时终止推理进程,回收其整个地址空间。
拿它当“不可信模型代码”的保密沙箱就错了位:同一应用身份的进程能访问该应用已经获准的数据和能力,具体范围还受 SELinux、文件权限模式和组件实现影响。
隔离服务的能力传入
Manifest 可以声明:
<service
    android:name=".InferenceService"
    android:isolatedProcess="true"
    android:exported="false" />
attrs_manifest.xml 对隔离进程的定义是“运行在与系统其余部分隔离的特殊进程”,通信入口是服务的启动与绑定 API。这个进程不以宿主应用的 UID 运行,宿主的运行时权限、私有文件访问权和任意系统服务访问能力,都别想当然地认为它有,需要什么就显式传入什么。
宿主要通过受约束的 Binder 接口,只传完成一次请求所需的内容:fd、只读共享区和最少的元数据。需要 GPU、编解码器或其他硬件服务时,还要确认设备为对应的隔离安全域(isolated domain)配置了哪些服务和设备权限——AOSP 给 isolated_compute_app 单独写了 SELinux 规则,普通 isolated_app 并不会因此获得相同能力。
4.10.2 RSS、PSS 与共享页怎样记账
跨进程复用内存时,我们最常撞见的误判是:“两个进程都显示 400 MiB RSS,所以系统用了 800 MiB。”错在 RSS 的记法:RSS(Resident Set Size,驻留集大小)把每个进程页表里当前驻留的共享页完整计入该进程,直接相加就会重复。PSS(Proportional Set Size)则按映射者数量把共享页分摊开。
对一页被 N 个进程映射的物理页,可以用下面的简化关系理解 PSS:
每个映射进程的 PSS 贡献 ≈ 页大小 / N
所有映射进程的 PSS 贡献之和 ≈ 页大小
这个简化关系只对“当时已经驻留、且由这些进程共同映射”的页面成立。一旦某个进程还没因首次访问调入页面(fault-in)、已经解除映射,或者私有写入触发写时复制(Copy-on-Write,COW),N 和对应的物理页集合都会变。
| 内存来源 | RSS 表现 | PSS / 共享语义 | 常见遗漏 |
|---|---|---|---|
| Java 堆、匿名原生堆 | 通常只计入一个进程 | 主要计入该进程 | 分配器缓存可能让 free() 后的 RSS 不会立即下降 |
只读文件 mmap | 每个进程计入驻留页 | 同一文件页可通过页缓存(page cache)分摊 | 解压、重排或写时复制会新增私有页 |
SharedMemory | 每个映射者计入驻留共享页 | PSS 按映射者分摊 | fd 已关闭时,已有映射仍可存活 |
HardwareBuffer / dma-buf | 可能无法完整归入普通匿名/文件分类 | 由导入者、驱动和统计接口决定 | CPU、GPU、显示系统和 NPU 可同时持有引用 |
| 加速器私有内存 | 依赖驱动 | 未必能归入调用进程的常规 PSS | 驱动复制、常驻缓存和固件内存 |
分析模型内存时,我们至少要分别记录 Java 堆、原生堆、文件映射、共享内存/dma-buf、交换空间和驱动侧内存。只看 Debug.MemoryInfo.getTotalPss(),解释不了每一类内存各自的生命周期。
cgroup v2 内存控制器管理的页面,用量归实际分配页面的 cgroup;已经记账的用量不会随进程迁移到新组。共享页可以被不同 cgroup 的进程使用,但不会按映射者重复计入或按 PSS 分摊。排查 MemoryLimiter 时,应从 /proc/<pid>/cgroup 确认归属,再对照该组的 memory.current、memory.stat,不能用进程 PSS 代替 cgroup 用量。归属规则见内核文档的 Memory Ownership。
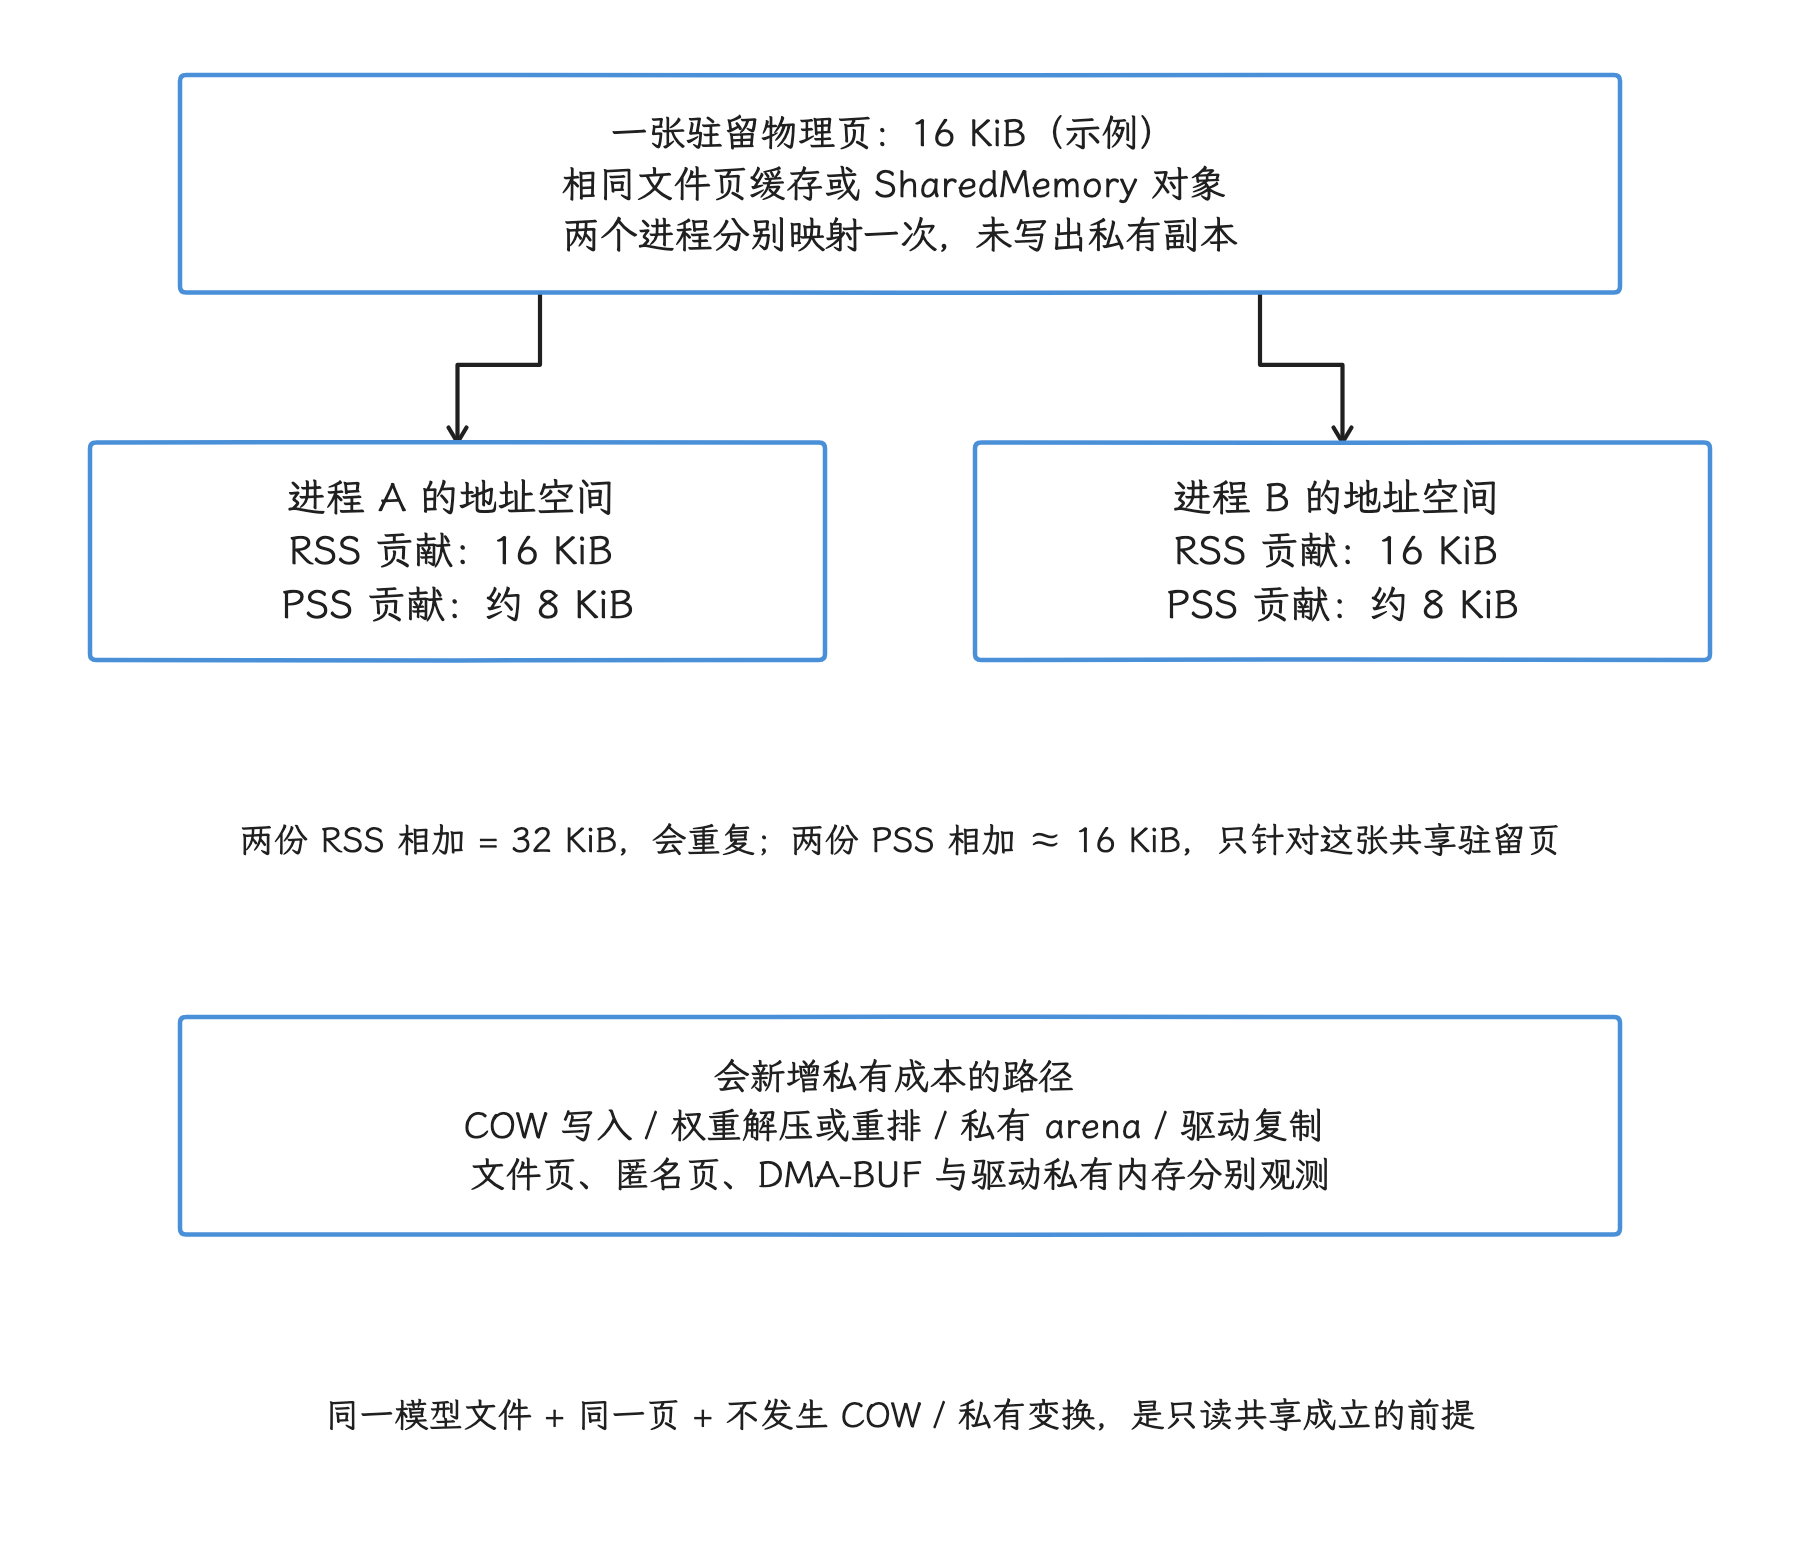
图:教学示例假定一张 16 KiB 驻留物理页分别被两个进程各映射一次:两边 RSS 都计 16 KiB,PSS 各计约 8 KiB,合计回到这一张页。只读模型文件可共享页缓存,但 COW、反量化、重排和驱动副本会新增私有存储。PSS 是归属分摊,也不能覆盖全部加速器私有成本。
4.10.3 IPC 先传控制信息,再传大块数据
Binder 这一侧的容量要从原生库看起:libbinder 在 ProcessState.cpp 里按下面的大小建立接收端映射:
#define BINDER_VM_SIZE ((1 * 1024 * 1024) - sysconf(_SC_PAGE_SIZE) * 2)
这块接收缓冲区由进程内所有 Binder 线程共享,多个并发事务一起挤在这里,要按“整个进程一块”来理解,别按“每个 Binder 线程各有 1 MiB”来理解。请求、返回值、对象偏移表和并发事务都从这块空间里出。
TransactionTooLargeException 的 Java 文档也强调,它只是大事务失败时抛出的启发式异常。调用方拿到它时,请求到底送没送到是判断不准的:也可能服务端已经处理完请求,只是返回值发送失败。所以接口要按“操作可能已经部分完成”设计幂等性,也就是让同一请求重复执行时不产生额外副作用。
公开 API IBinder.getSuggestedMaxIpcSizeBytes() 返回 64 KiB;它引用的 MAX_IPC_SIZE 常量在源码里带着 @hide,应用拿不到直接访问的入口。这个 64 KiB 是让事务安全低于接收缓冲区上限的建议值,不是驱动的硬上限。传输通道可以按下面的分工选择:
| 内容 | 优先方式 | 原因 |
|---|---|---|
| 命令、令牌、状态、小型结构体 | AIDL / Parcelable | 边界清楚,便于校验权限与版本 |
| 一次性大块字节数据 | SharedMemory + Binder fd | 数据载荷不占用大块 Binder 缓冲区 |
| 图像、视频帧、硬件可导入张量(tensor) | HardwareBuffer | 允许硬件组件共享同一个缓冲对象 |
| 持久内容或可分页记录 | ContentProvider + URI / fd | 有权限、生命周期和查询语义 |
| 跨应用受控动作 | App Functions | system_server 校验调用资格,目标应用执行业务逻辑 |
“通过 Binder 传 fd”仍会发送一个小型 Parcel。真正共享的是 fd 指向的对象,控制消息本身仍然存在。
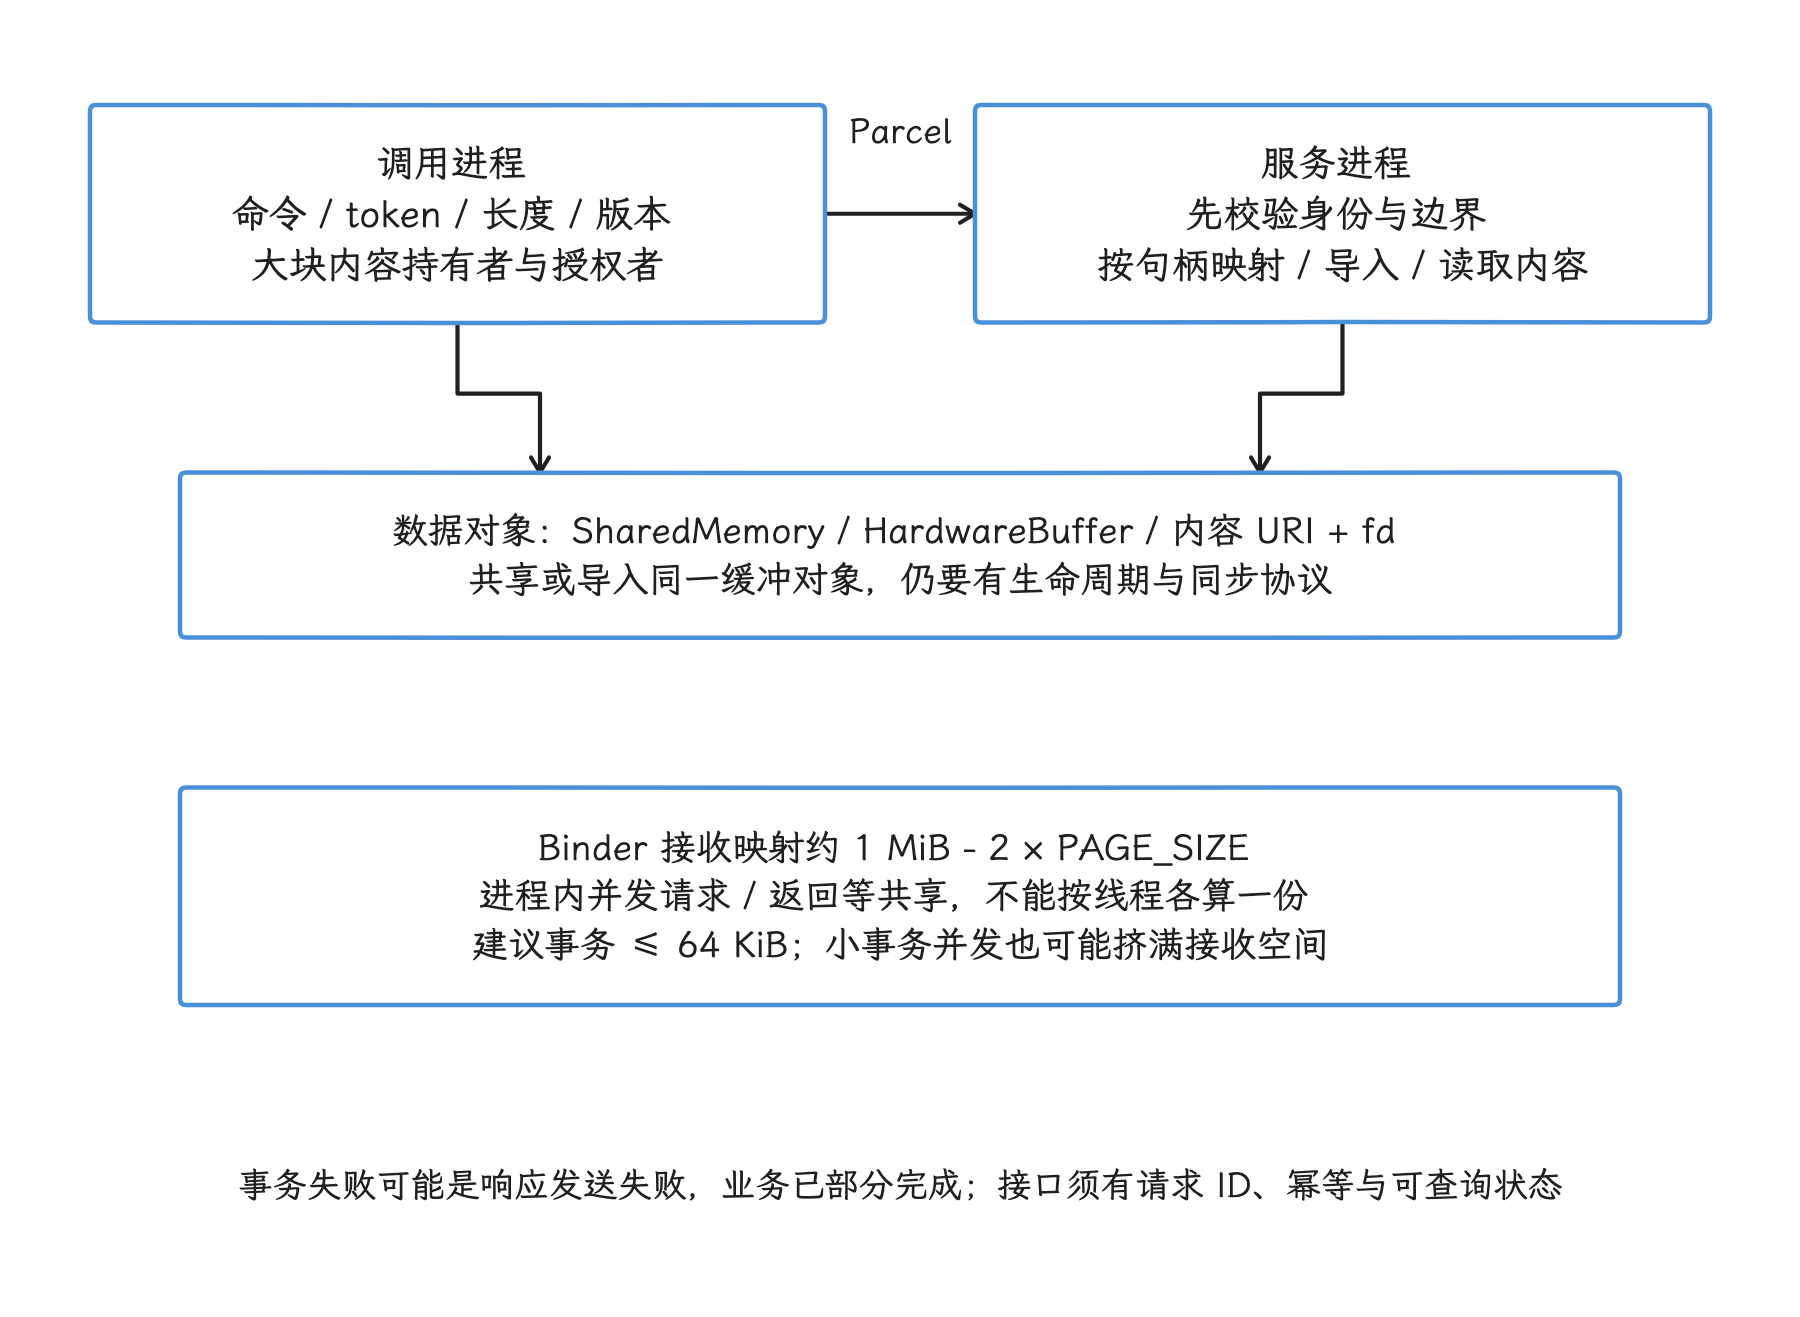
图:libbinder 接收映射约为 1 MiB 减两个基础页,由进程内并发事务共享,64 KiB 只是公开 API 的建议大小。控制 Parcel 传长度、版本和 fd 等句柄;载荷放在共享页、硬件缓冲或受控内容对象中。TransactionTooLargeException 不能证明服务未执行,重试还需要请求幂等和状态确认。
4.10.4 SharedMemory:共享页加上能力句柄
android.os.SharedMemory 实现了 Parcelable,所以对应句柄可以通过 Binder 传递。Java 实现通过原生函数 ashmem_create_region() 创建区域,映射时调用 mmap(..., MAP_SHARED, ...);设备上的 libcutils 有没有改用 memfd 兼容实现,光看 Java 类名是推断不出来的。
下面的示例传递一块写完后只读的数据。AIDL 接口可定义为 void consume(in SharedMemory region, int validBytes):
try (SharedMemory region = SharedMemory.create("inference-context", capacity)) {
    ByteBuffer writable = region.mapReadWrite();
    try {
        writable.put(payload);
    } finally {
        SharedMemory.unmap(writable);
    }

    if (!region.setProtect(OsConstants.PROT_READ)) {
        throw new IllegalStateException("Failed to make shared region read-only");
    }
    remote.consume(region, payload.length);
}
先解除发送方的可写映射,再调用 setProtect(PROT_READ),此后基于该区域创建的映射就可以是只读的。源码明确说明,setProtect() 只能移除权限,而且不会改变已经存在的映射。如果发送方还留着旧的可写映射,这块区域就谈不上不可变快照。
接收方读取完成后,要分别解除映射并关闭 fd:
try (SharedMemory received = region) {
    ByteBuffer readable = received.mapReadOnly();
    try {
        if (validBytes < 0 || validBytes > readable.capacity()) {
            throw new IllegalArgumentException("Invalid shared region length");
        }
        readable.limit(validBytes);
        consumeBytes(readable, validBytes);
    } finally {
        SharedMemory.unmap(readable);
    }
}
close() 只关闭当前 SharedMemory 对象持有的 fd;已经建立的映射仍然有效。只有等所有 fd 都已关闭、所有映射都已解除,相关物理页才具备释放条件。
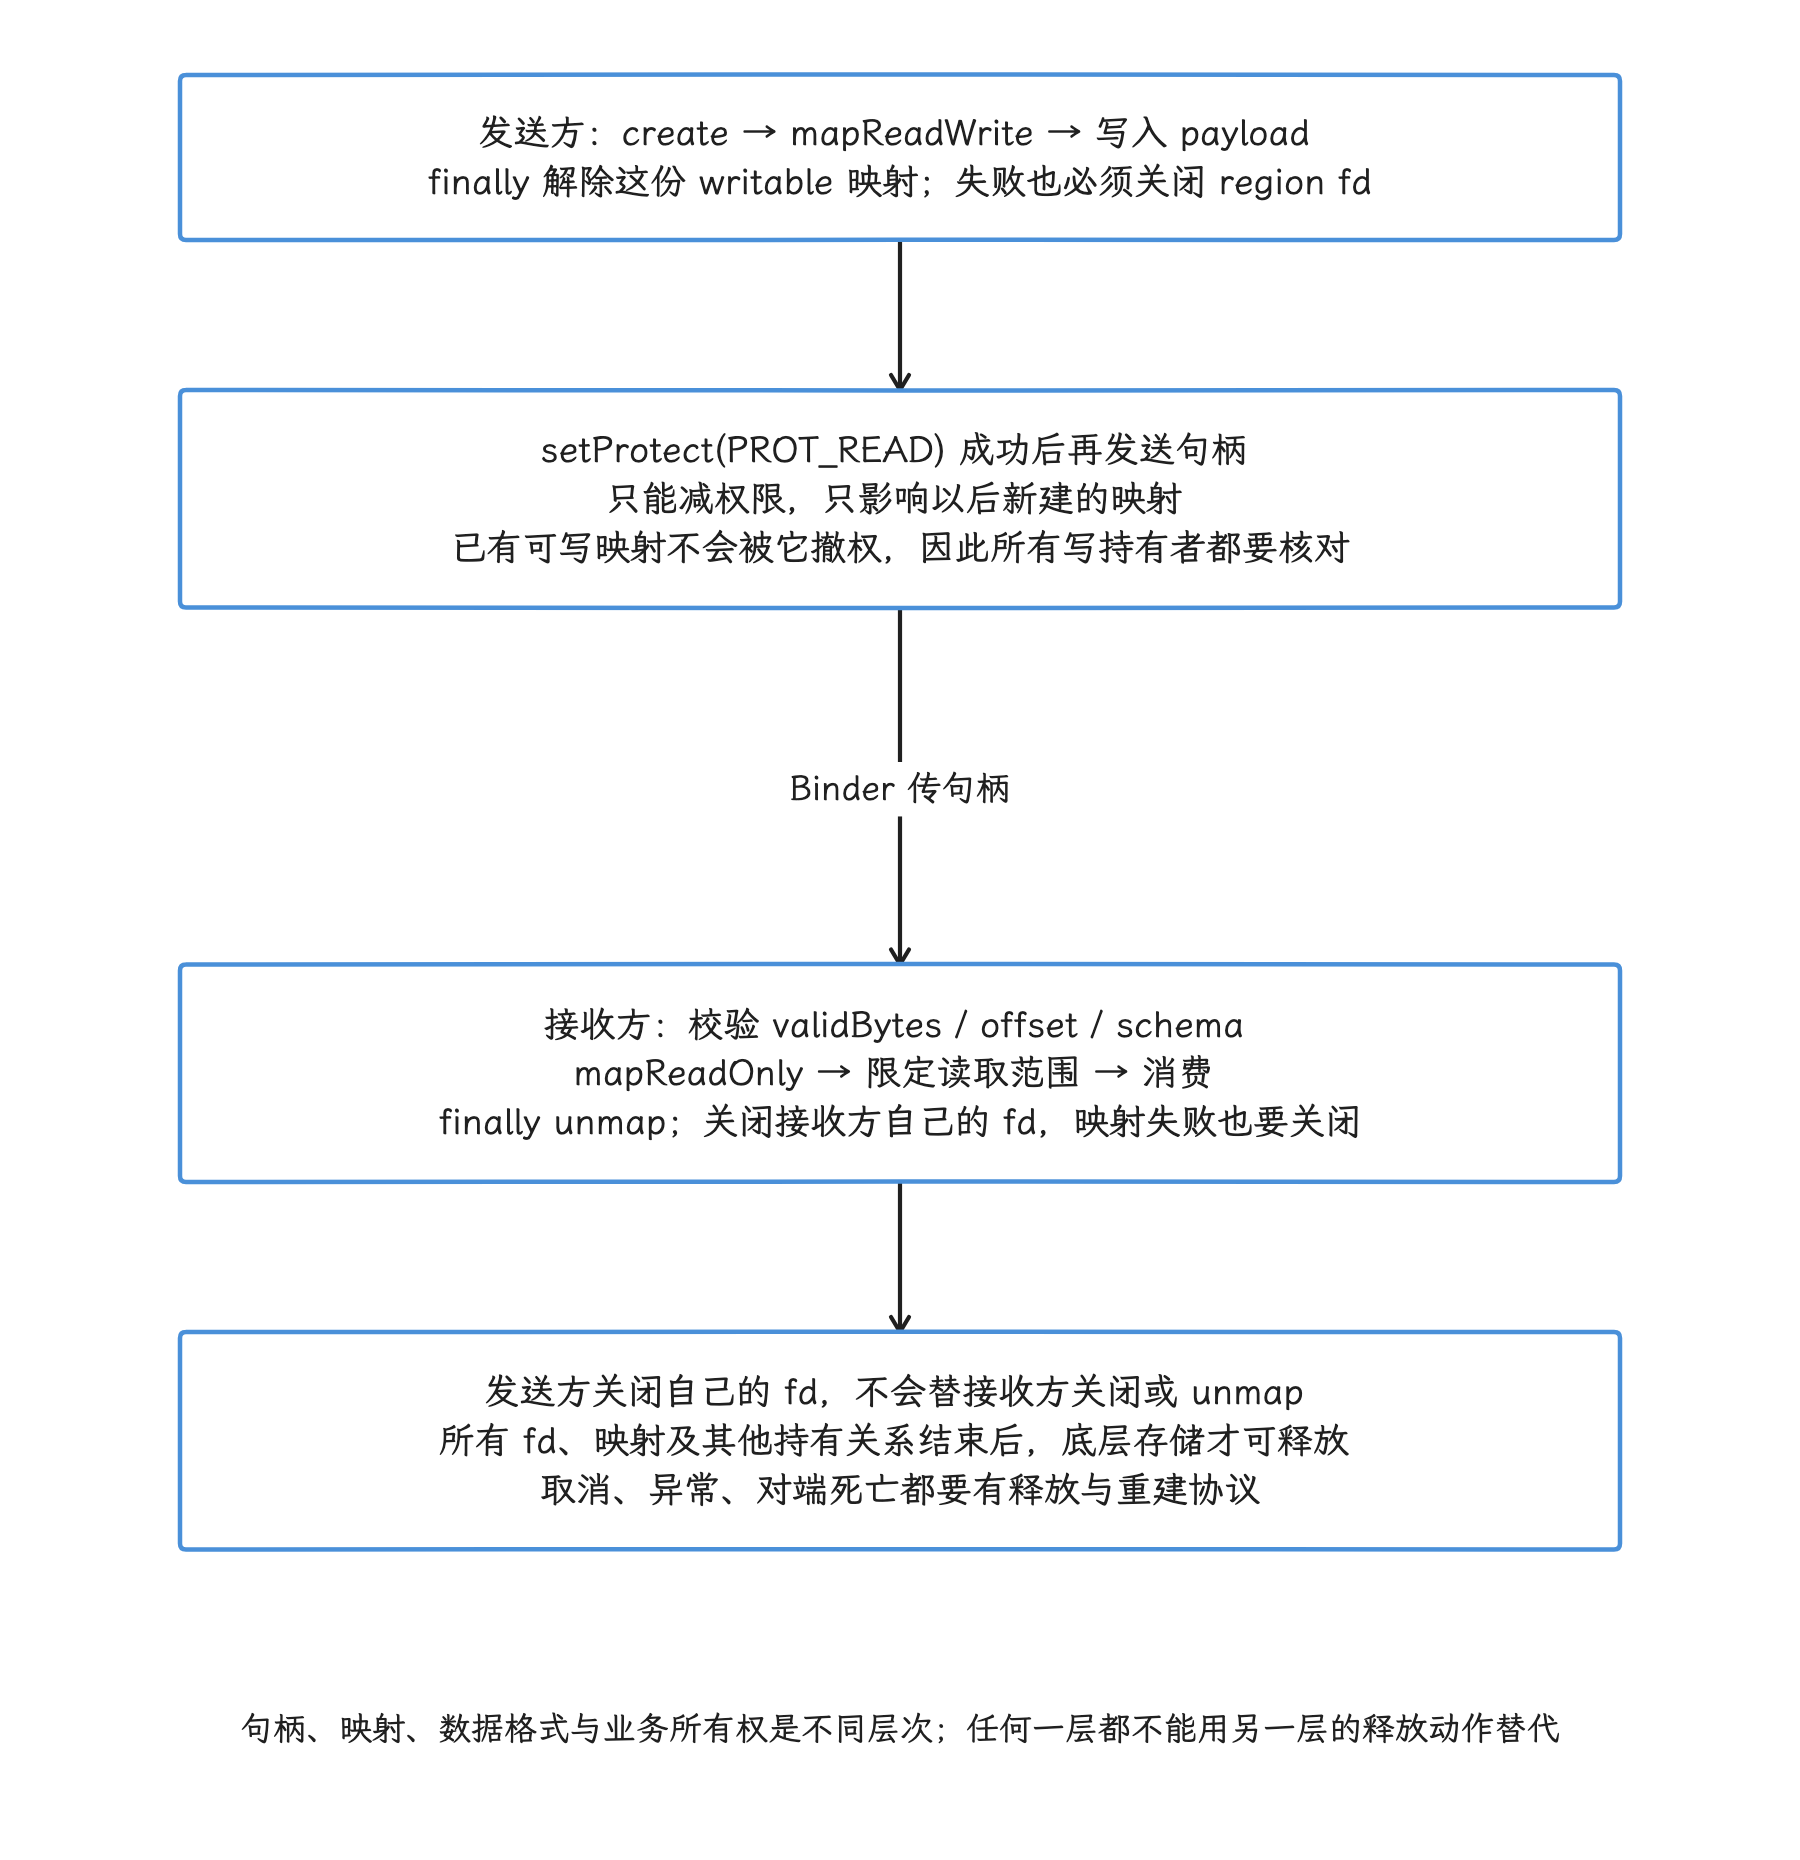
图:发送方创建区域并映射写入,解除可写映射后检查 setProtect(PROT_READ) 成功,再传 SharedMemory 句柄。接收方独立校验长度、建立只读映射并消费。close 只关当前 fd,unmap 只撤映射,两者必须分别处理;try-with-resources 与 finally 还要覆盖映射、写入或 IPC 抛异常的路径。
“零拷贝”的观察范围
把 SharedMemory 交给另一个进程,可以避免把整块数据序列化进 Binder,也不需要接收端为获得同一组页面再复制一次。以下操作仍会产生复制或额外物理页:
- 发送方先把源数组写入共享区;
- 接收方又调用
ByteBuffer.get(byte[]); - 推理运行时把数据重排到自己的内存区(arena);
- 加速器驱动导入失败后创建私有暂存缓冲区(staging buffer);
- 任一可写私有映射触发 COW。
所以更准确的说法是“两个进程可以共享同一组页面”。从输入到推理后端的完整路径有没有避开复制,我们要结合 PSS、缺页(page fault)和驱动统计来判断。
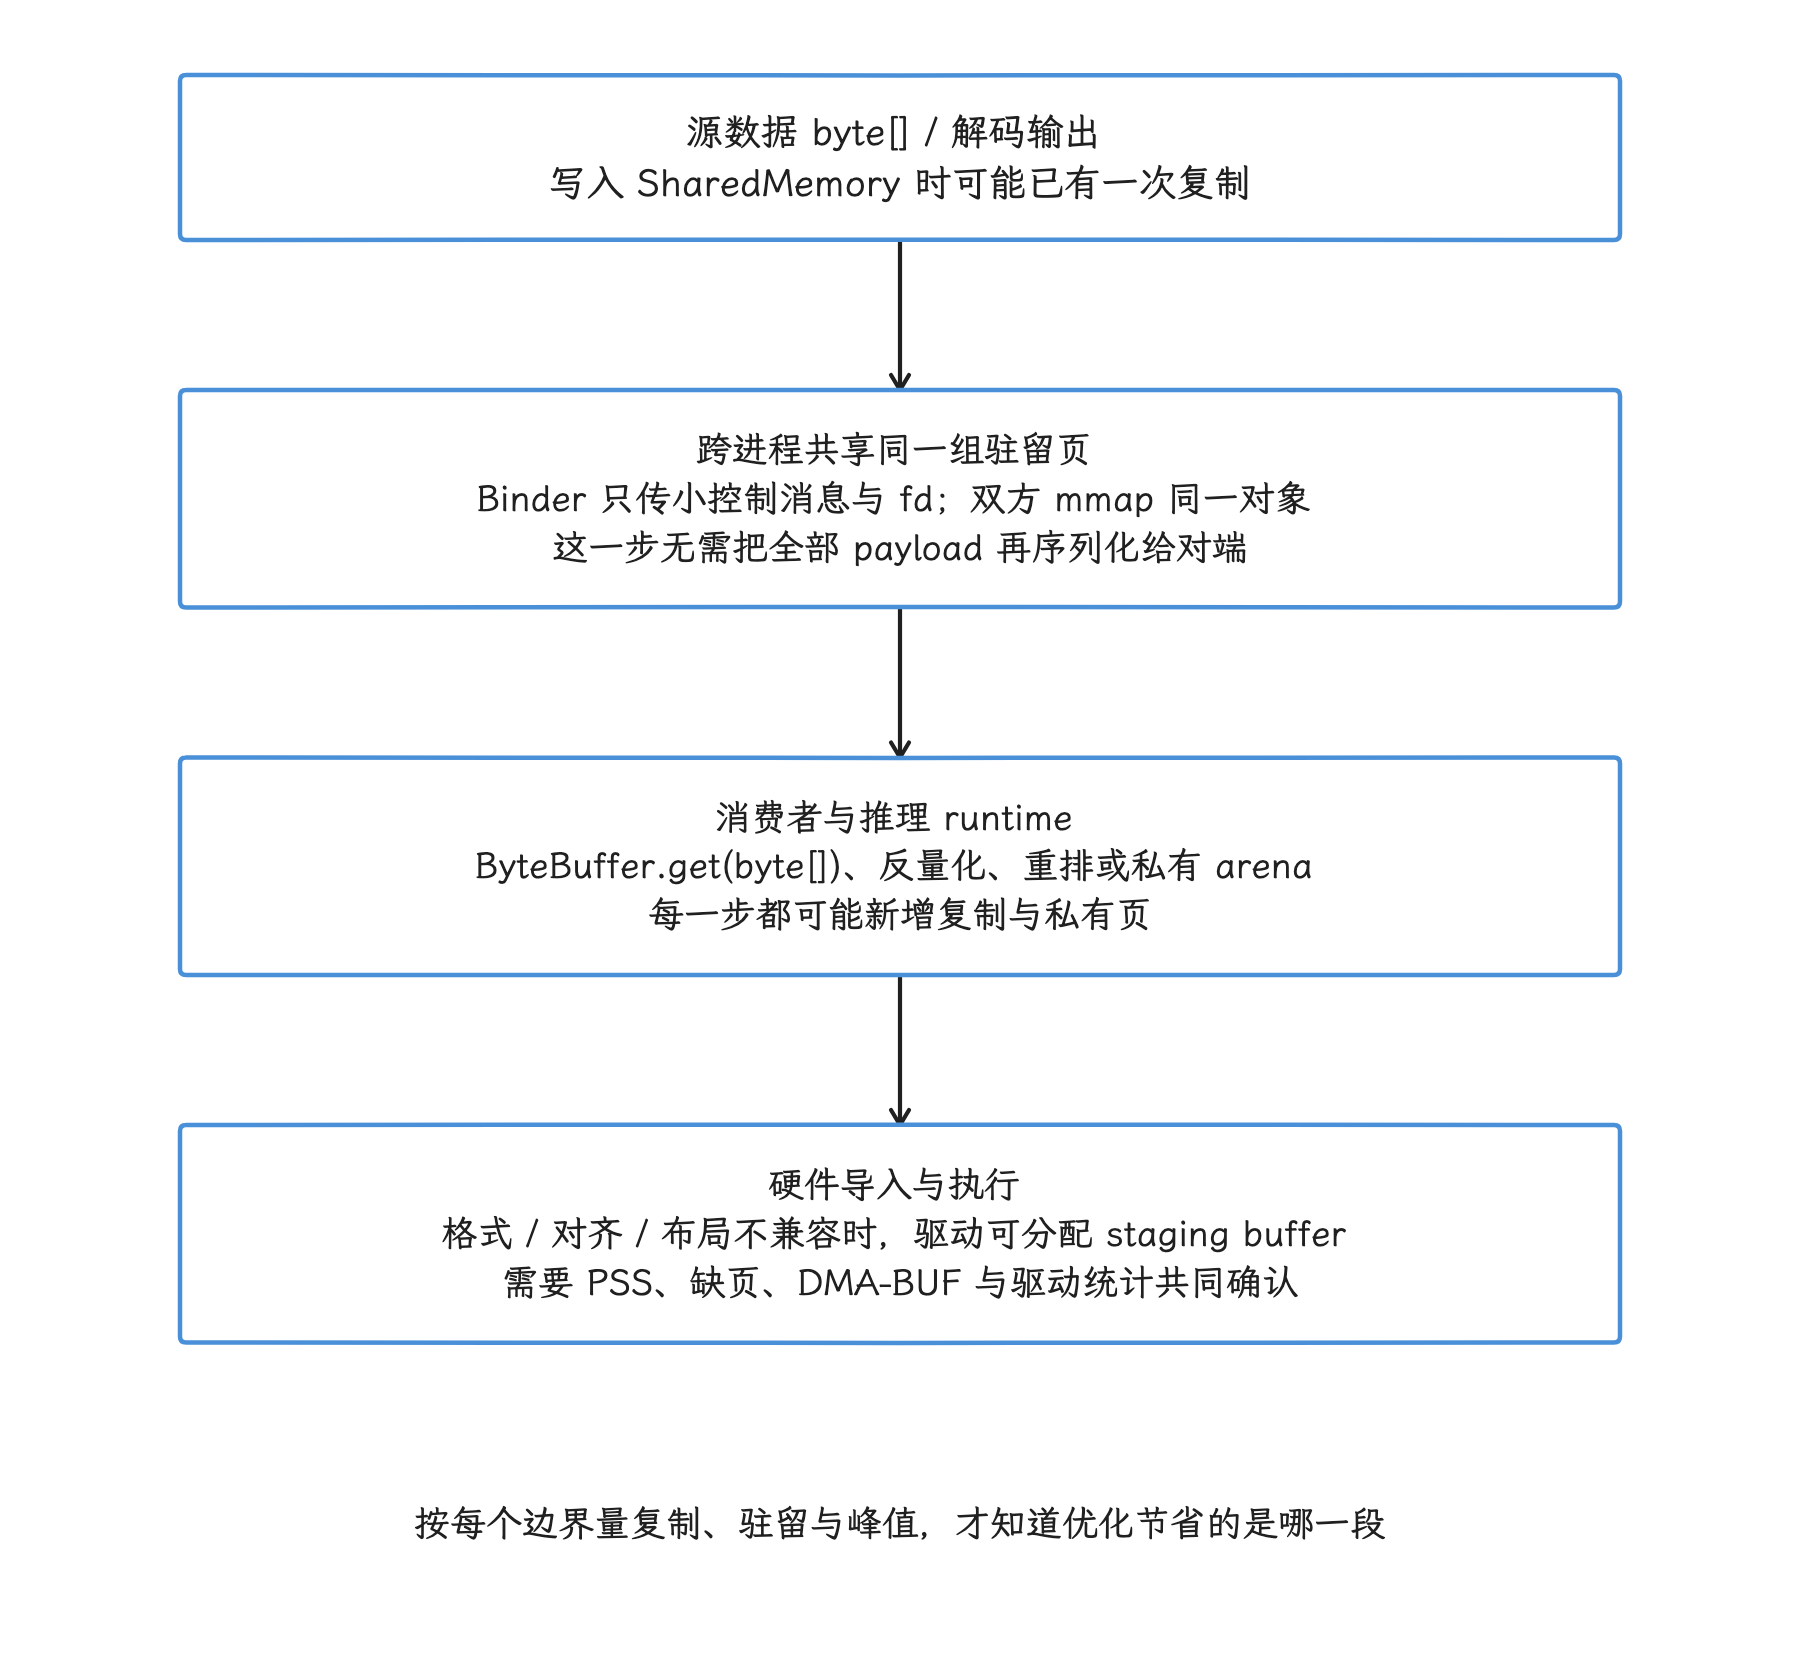
图:SharedMemory 可以让两进程访问同一组页,省掉整块 Binder 序列化及接收端为访问同页再复制的需求。源数组写入共享区、ByteBuffer.get、运行时张量重排及驱动 staging 仍可能复制。是否避开这些步骤要查实际后端和分配证据,不能由传 fd 这一步替整条管线下结论。
fd 的能力与身份校验
拿到有效 fd 的进程,就有了在该 fd 保护范围内映射数据的能力。所以发送前要校验 Binder 调用者身份、数据用途、长度和版本,发送后要限定句柄的生命周期。处理敏感上下文时,还应考虑:
- 发送只读快照,不复用长期可写区域;
- 每次请求使用新的区域,或使用带世代编号的槽位;
- 不在共享区留下上一位用户或上一会话内容;
- 对长度、偏移量(offset)、格式和校验值做边界检查;
- 取消请求时关闭不再需要的 fd,并让双方解除映射。
4.10.5 HardwareBuffer:硬件互操作能力由契约决定
HardwareBuffer 是可以通过 Parcelable 传递的硬件缓冲对象,格式与用途标志共同描述它的预期用法。GPU、传感器、编解码器或其他辅助处理单元都可以访问它,但“任意神经网络处理器(NPU)都能直接读取任意 HardwareBuffer”这件事并没有保证。用之前我们要逐项确认:
- 生产者(producer)与消费者(consumer)支持相同的格式、尺寸、层数和用途;
- HAL 或驱动能够导入该缓冲区;
- 接口能够正确处理缓存一致性和 fence 同步;
- 是否允许 CPU 映射,以及映射是否引入额外的缓存刷新/失效操作(flush/invalidate);
- 消费者是否会因布局、量化或对齐要求,再分配一块内存。
如果图像帧已经位于 gralloc 图形缓冲区中,而且推理服务明确接受同一格式的 HardwareBuffer,那么它通常比“读回 CPU 字节数组、写进 Binder、服务端再上传”更合适。模型权重和通用文本上下文没有相应的硬件导入协议时,SharedMemory 或只读文件映射更简单。
不要把 HardwareBuffer 统一称为“GPU 显存”。许多 Android 设备使用统一物理内存;缓冲区来自哪个分配堆、具有何种缓存属性、哪些硬件可以访问,都由 gralloc 与驱动决定。
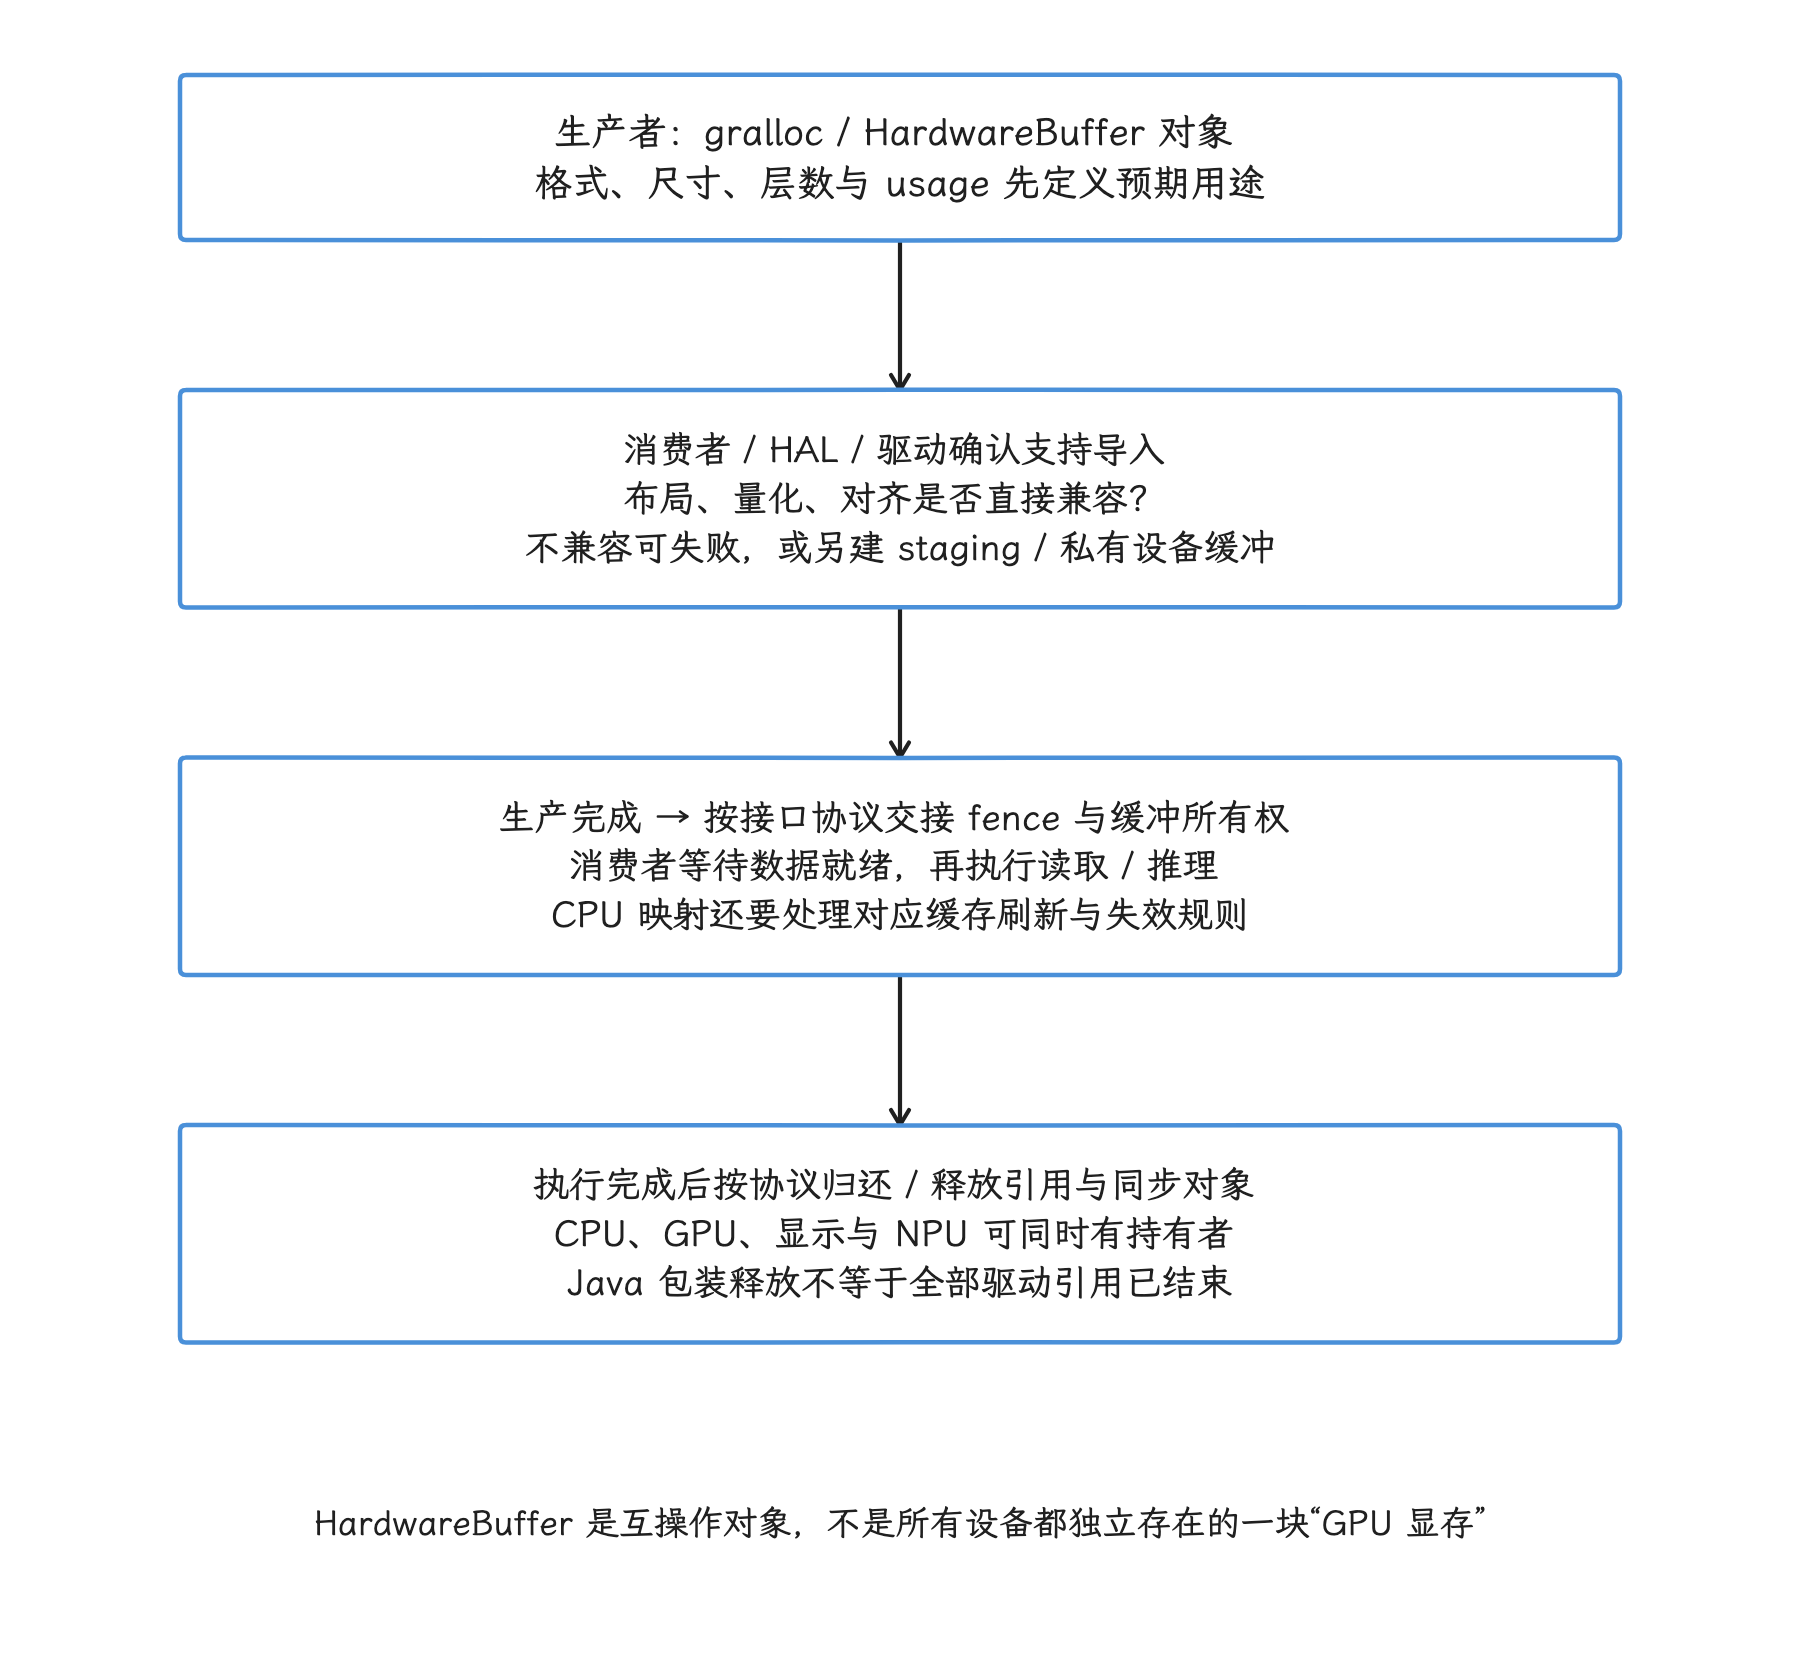
图:生产与消费双方要支持相同格式、尺寸、层数和 usage,目标 HAL/驱动还必须支持导入。数据可见性与所有权转移依赖缓存一致性和 fence 协议;CPU 映射也可能需要 flush/invalidate。布局、量化和对齐不匹配时仍可能复制。统一物理内存也不等于任意 NPU 都可使用任意缓冲对象。
4.10.6 ContentProvider:共享数据,不暴露进程内存
ContentProvider 适合让目标应用保留数据所有权,调用方按 URI、权限和查询条件读取。它提供的是访问控制与数据协议,另一个应用的地址空间并不会因此对智能体敞开。
结构化查询使用的 CursorWindow 初始可写;从 Parcel 还原的接收端窗口只读。android-17.0.0_r1 的原生实现会先创建最多 16 KiB 的进程内区域,写入空间不足时才扩展为 ashmem 共享内存区域;CursorWindow(String name, long windowSizeBytes) 中的 windowSizeBytes 是上限。未显式传入窗口大小的 CursorWindow(String name) 使用设备资源 config_cursorWindowSize,默认大小可能随设备配置变化。旧的 CursorWindow(boolean localWindow) 已弃用,参数也被忽略,应使用 CursorWindow(String name)。
内联窗口写入 Parcel 时会复制当前使用的数据,接收端再分配本地存储;已经扩展的窗口传递 fd,由接收端只读映射同一共享区域。接收端只读不代表查询结果总经共享内存传输。
处理大对象时:
- Cursor 只返回 id、类型、长度、版本和内容 URI;
- 用
openFileDescriptor()/openAssetFileDescriptor()流式读取二进制大对象(blob); - 通过 URI 授权(URI grant)限定接收方和有效期;
- 对查询结果分页,避免单次构造过大的 Cursor 或 Bundle;
- 及时关闭 Cursor、
ParcelFileDescriptor和输入流。
这样“小型索引”和“大型内容”就分开了,撤销、审计和按用户隔离也都能在 ContentProvider 一侧执行。
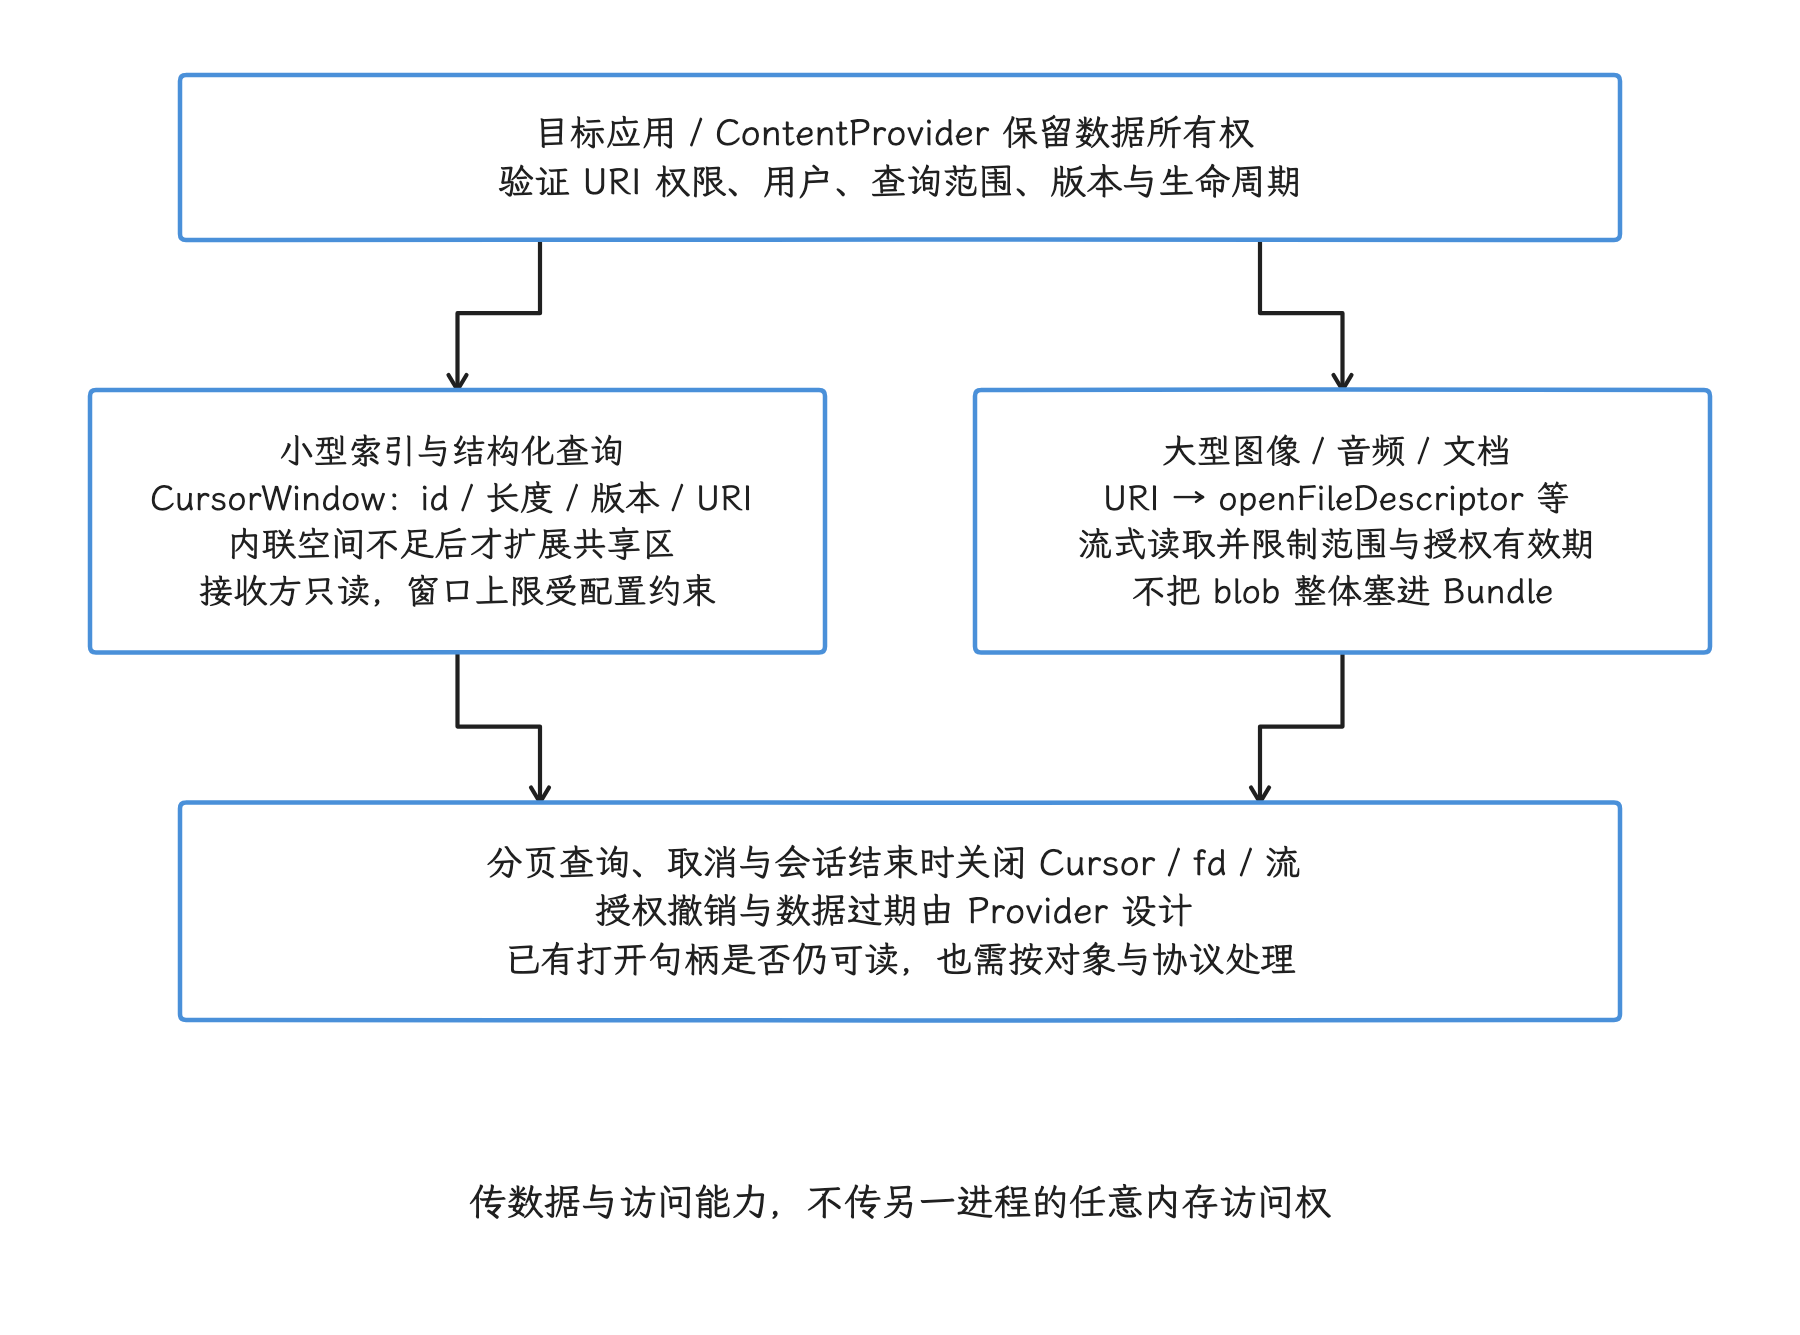
图:结构化查询用 CursorWindow 承载小型记录与内容 URI;r1 原生窗口可先用至多 16 KiB 内联空间,超出再膨胀为共享区域,接收端只读。大型 blob 通过受控 URI 打开 fd 或流。授权、分页和审计由 Provider 协议决定,传 URI 不会开放另一个进程的整个地址空间。
4.10.7 App Functions:受控函数调用,不是共享内存 API
AppFunctionManager.executeAppFunction() 和 AppFunctionService 从 Android 16 / API 36 开始提供,用来受控地调用另一个应用公开的函数。Android 17 / API 37 上,执行请求仍由 system_server 处理;v2 权限流程(permission-v2)在 AOSP 里的校验规则包括:
- 声明的调用包名必须与 Binder 记录的调用方 UID 匹配;
- permission-v2 开启时,普通调用方没有跨用户的路径,次要用户配置文件(secondary profile)里也发起不了执行;旧分支要求
INTERACT_ACROSS_USERS_FULL,两条路径还会检查 DevicePolicyManager 的 App Functions 策略; - 调用自身函数可以走同包规则,不要求跨包执行权限;
- 调用其他包时,普通调用方需要
EXECUTE_APP_FUNCTIONS;permission-v2 还要求“调用方—目标”组合命中允许列表(allowlist)。持有EXECUTE_APP_FUNCTIONS_SYSTEM的系统调用方不受该列表限制; - 目标服务必须要求
android.permission.BIND_APP_FUNCTION_SERVICE,外部应用没有绕开system_server直接绑定的路径。
目标应用通过 AppFunctionService.onExecuteFunction() 接收请求。该回调在主线程触发;模型推理、磁盘读取和网络访问必须切换到后台工作线程,完成后通过回调返回结果,并处理取消信号 CancellationSignal。permission-v2 路径会把 callingPackage 置为空字符串,把 callingPackageSigningInfo 置为 unknown,函数实现要放弃用这两个参数鉴权。
请求中的 GenericDocument、Bundle extras 和响应对象都实现了 Parcelable,仍受 Binder 事务空间限制。大图像、文档或音频就传受控 URI 或小型句柄描述;App Functions 管的是“谁可以调用哪个函数”,大块数据仍要走合适的内容接口。
Android 17 / API 37 新增了 AppFunctionUriGrant 和 ExecuteAppFunctionResponse.getUriGrants()。permission-v2 开启后,目标函数可以在响应中同时返回 URI 和对应授权。system_server 只处理 content:// URI,接收者固定为本次请求的调用包;目标函数能选的只有 URI 本身,以及读、写、前缀匹配和可持久化这些授权模式。ContentProvider 还必须允许 URI 授权。
临时授权通常持续到设备重启;可持久化标志只表示接收方可以调用 takePersistableUriPermission(),不会自动把授权持久化。需要更短的生命周期时,仍要由 ContentProvider 设计一次性 URI、过期检查或主动撤销。
App Functions 也不会自动拿到目标应用的全部数据:目标函数读的是目标应用自己有权访问的内容,返回哪些字段也由函数实现决定。
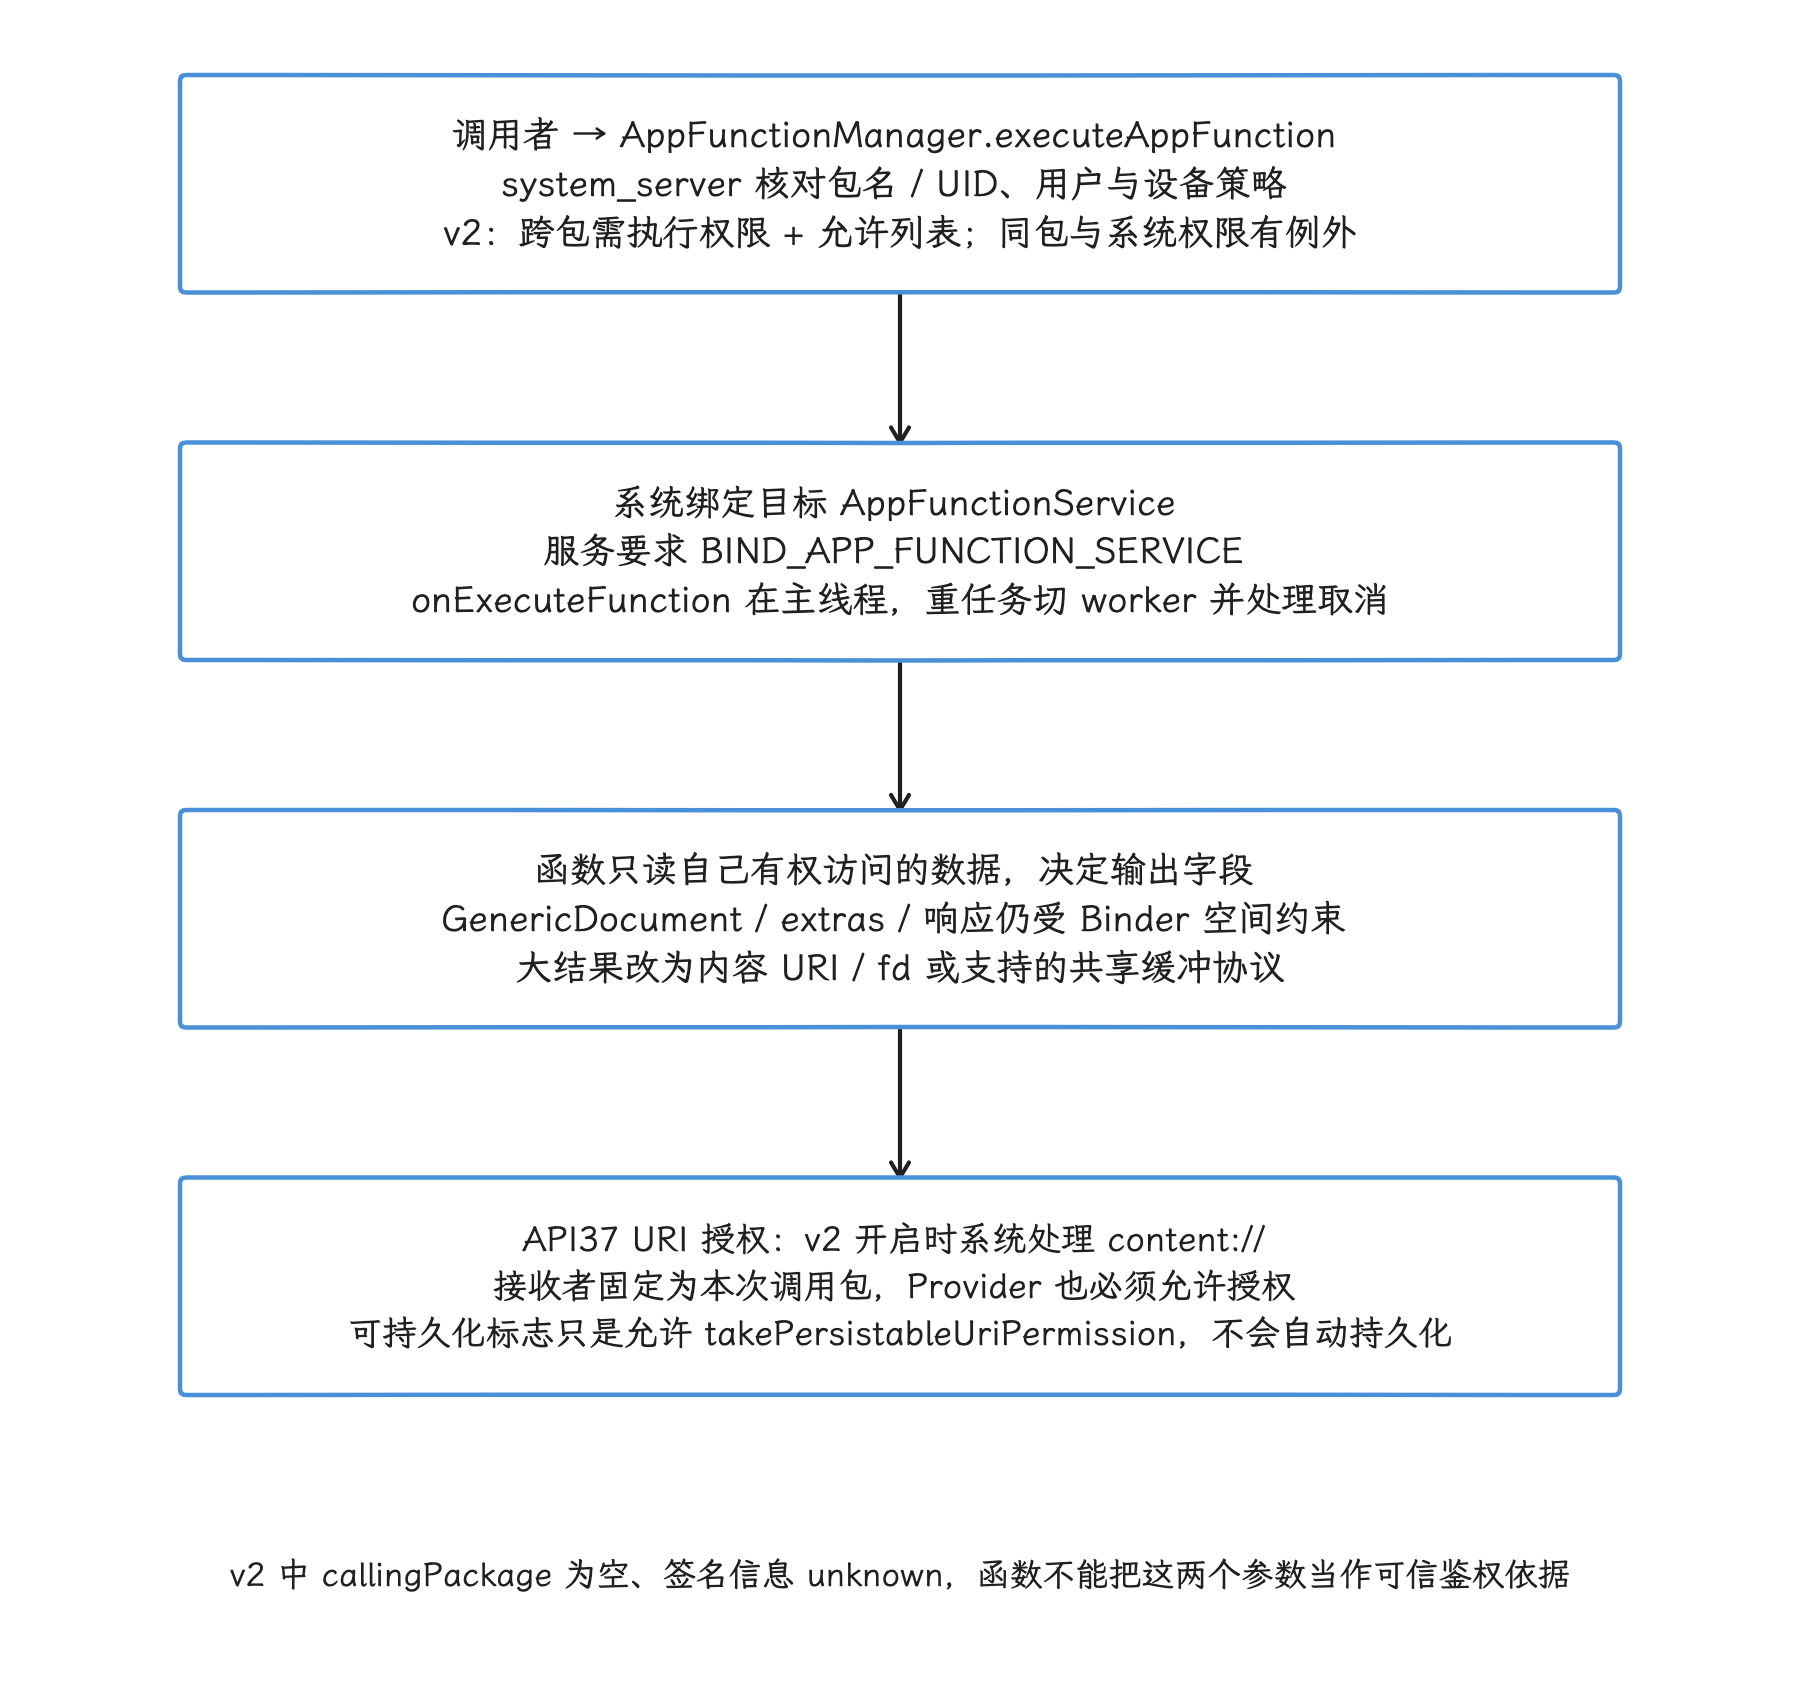
图:system_server 校验调用包与 UID、用户及设备策略,并在 permission-v2 下验证跨包权限和调用方—目标允许列表;同包与系统执行权限有对应例外。系统绑定受 BIND_APP_FUNCTION_SERVICE 保护的服务,主线程回调应把重任务转给 worker。响应可附 content URI 授权,系统只发给本次调用包;可持久化标志还需接收方主动领取。
生成式 UI 描述的物化与读取
Flutter A2UI 的 Async A2UI 示例把实时生成界面拆成两个生命周期:业务数据变化后由后台 Cloud Function 调用模型生成 A2UI 消息并写回 Firestore;用户打开 App 时,客户端读取已缓存的消息,把它们交给原来的 A2uiTransportAdapter、A2uiParserTransformer 和 SurfaceController 流程恢复 Flutter Widget,而不是再等待一次模型现场输出。[来源: https://juejin.cn/post/7675633667490267179]
我们把这类方案放回 Android 的内存记账里看,它更接近“把 UI 投影物化成数据”:跨边界流动的是字符串、JSON、URI 或 fd 这些数据对象,流动的不是另一个进程的地址空间。缓存命中改变的只是模型调用发生的时间和数据读取路径;客户端把描述读入、解析成 Widget,或交给智能体恢复 A2UI Surface 的上下文之后,相关字符串、对象、A2UI 状态和运行时缓存,仍按持有它们的进程、映射和驱动资源记账。[来源: https://juejin.cn/post/7675633667490267179][已验证: frameworks/base/services/core/java/com/android/server/am/MemoryLimiter.java @ android-17.0.0_r1; frameworks/native/libs/binder/ProcessState.cpp @ android-17.0.0_r1]
因此,把生成式 UI 作为 ContentProvider 或 App Functions 的载荷时,接口仍应传版本、schema、生成时业务数据版本和内容 URI,避免整段大描述塞进 Binder。A2UI 文章提到的乱序覆盖、Widget Catalog schema 演进和界面状态纳入智能体状态,都是这类“可回放 UI 数据”上线前必须解决的数据一致性问题;它们不构成 Android 17 平台对内存共享的新语义。[来源: https://juejin.cn/post/7675633667490267179][已验证: frameworks/base/core/java/android/os/IBinder.java @ android-17.0.0_r1]
4.10.8 模型推理内存要按阶段和后端计算
端侧生成式模型的内存,我们可以先拆成几块:
进程可见内存
  = 权重与常量
  + KV cache / recurrent state
  + 计算工作区
  + runtime、代码与普通业务对象
  + 输入输出缓冲
  + allocator 与驱动保留
其中任何一项都可能落在 Java 堆、原生堆、文件映射、共享内存或 dma-buf 上。只写一句“模型占 1.4 GB”,说明不了内存压力究竟来自哪里。
权重大小与位宽下限
参数量为 P、平均权重位宽为 q 时,纯权重的理论下限是:
weight_bytes = P × q / 8
对 2B(20 亿)参数、4 位权重的模型,理论值约为 1,000,000,000 字节,即约 0.93 GiB。文件与运行时还可能包含量化比例因子(scale)、零点(zero point)、张量元数据、词表、对齐填充和重排后的权重副本,所以单凭“INT4(4 位整数权重)”定不下文件或 RSS 到底是 1.0 GiB、1.1 GiB 还是 1.4 GiB。
如果推理运行时对同一只读模型文件使用 MAP_PRIVATE 映射,未修改的驻留文件页可以通过页缓存被多个进程共享。这个结论成立的前提是:
- 映射的是同一底层文件和相同页;
- 页保持只读,没有 COW;
- 推理运行时没有把权重解压、反量化或重排到私有缓冲区;
- 驱动没有为每个会话(session)复制一份设备侧权重。
KV 缓存的估算
KV 缓存保存注意力机制已经计算过的 Key/Value 状态,避免生成每个新 token(模型处理的文本单位)时重复计算全部历史。标准注意力实现中,KV 缓存的近似字节数为:
kv_bytes
  = 2 × layers × kv_heads × head_dim
    × tokens × batch × bytes_per_element
前面的 2 代表 K 和 V。假设模型有 26 层、4 个 KV 头、每个头 256 维、采用 16 位浮点数 FP16,且批大小 batch=1:
- 1024 个 token:约 104 MiB;
- 4096 个 token:约 416 MiB。
这只是示例。MHA、GQA、MQA 对 KV 头的共享方式不同:MHA 为各注意力头保留独立 KV,GQA 让一组查询头共享 KV,MQA 则让所有查询头共享 KV。分页 KV、滑动窗口、量化 KV、候选序列数(beam)和多会话并发也会改变结果。评估具体模型时,我们应从模型配置和推理运行时分配日志中取参数,单靠参数量或层数是估不准的。
工作区与内存峰值
推理运行时往往预先分配内存区,或复用计算缓冲区,以减少频繁调用 malloc/free。峰值仍可能来自:
- 首次编译或硬件后端委托器(delegate)初始化;
- 提示词预填充阶段使用的大型临时张量;
- CPU 与加速器之间的暂存缓冲区;
- 动态形状(dynamic shape)触发内存区重新规划;
- 多个会话同时执行;
- 分配器保留已经释放的内存块(span)。
会话结束后,就算 Java/原生对象已经不可达,RSS 也未必立刻降下来。这时我们要区分四种情况:对象仍被引用、分配器留存、干净文件页仍驻留、驱动仍持有缓冲区。
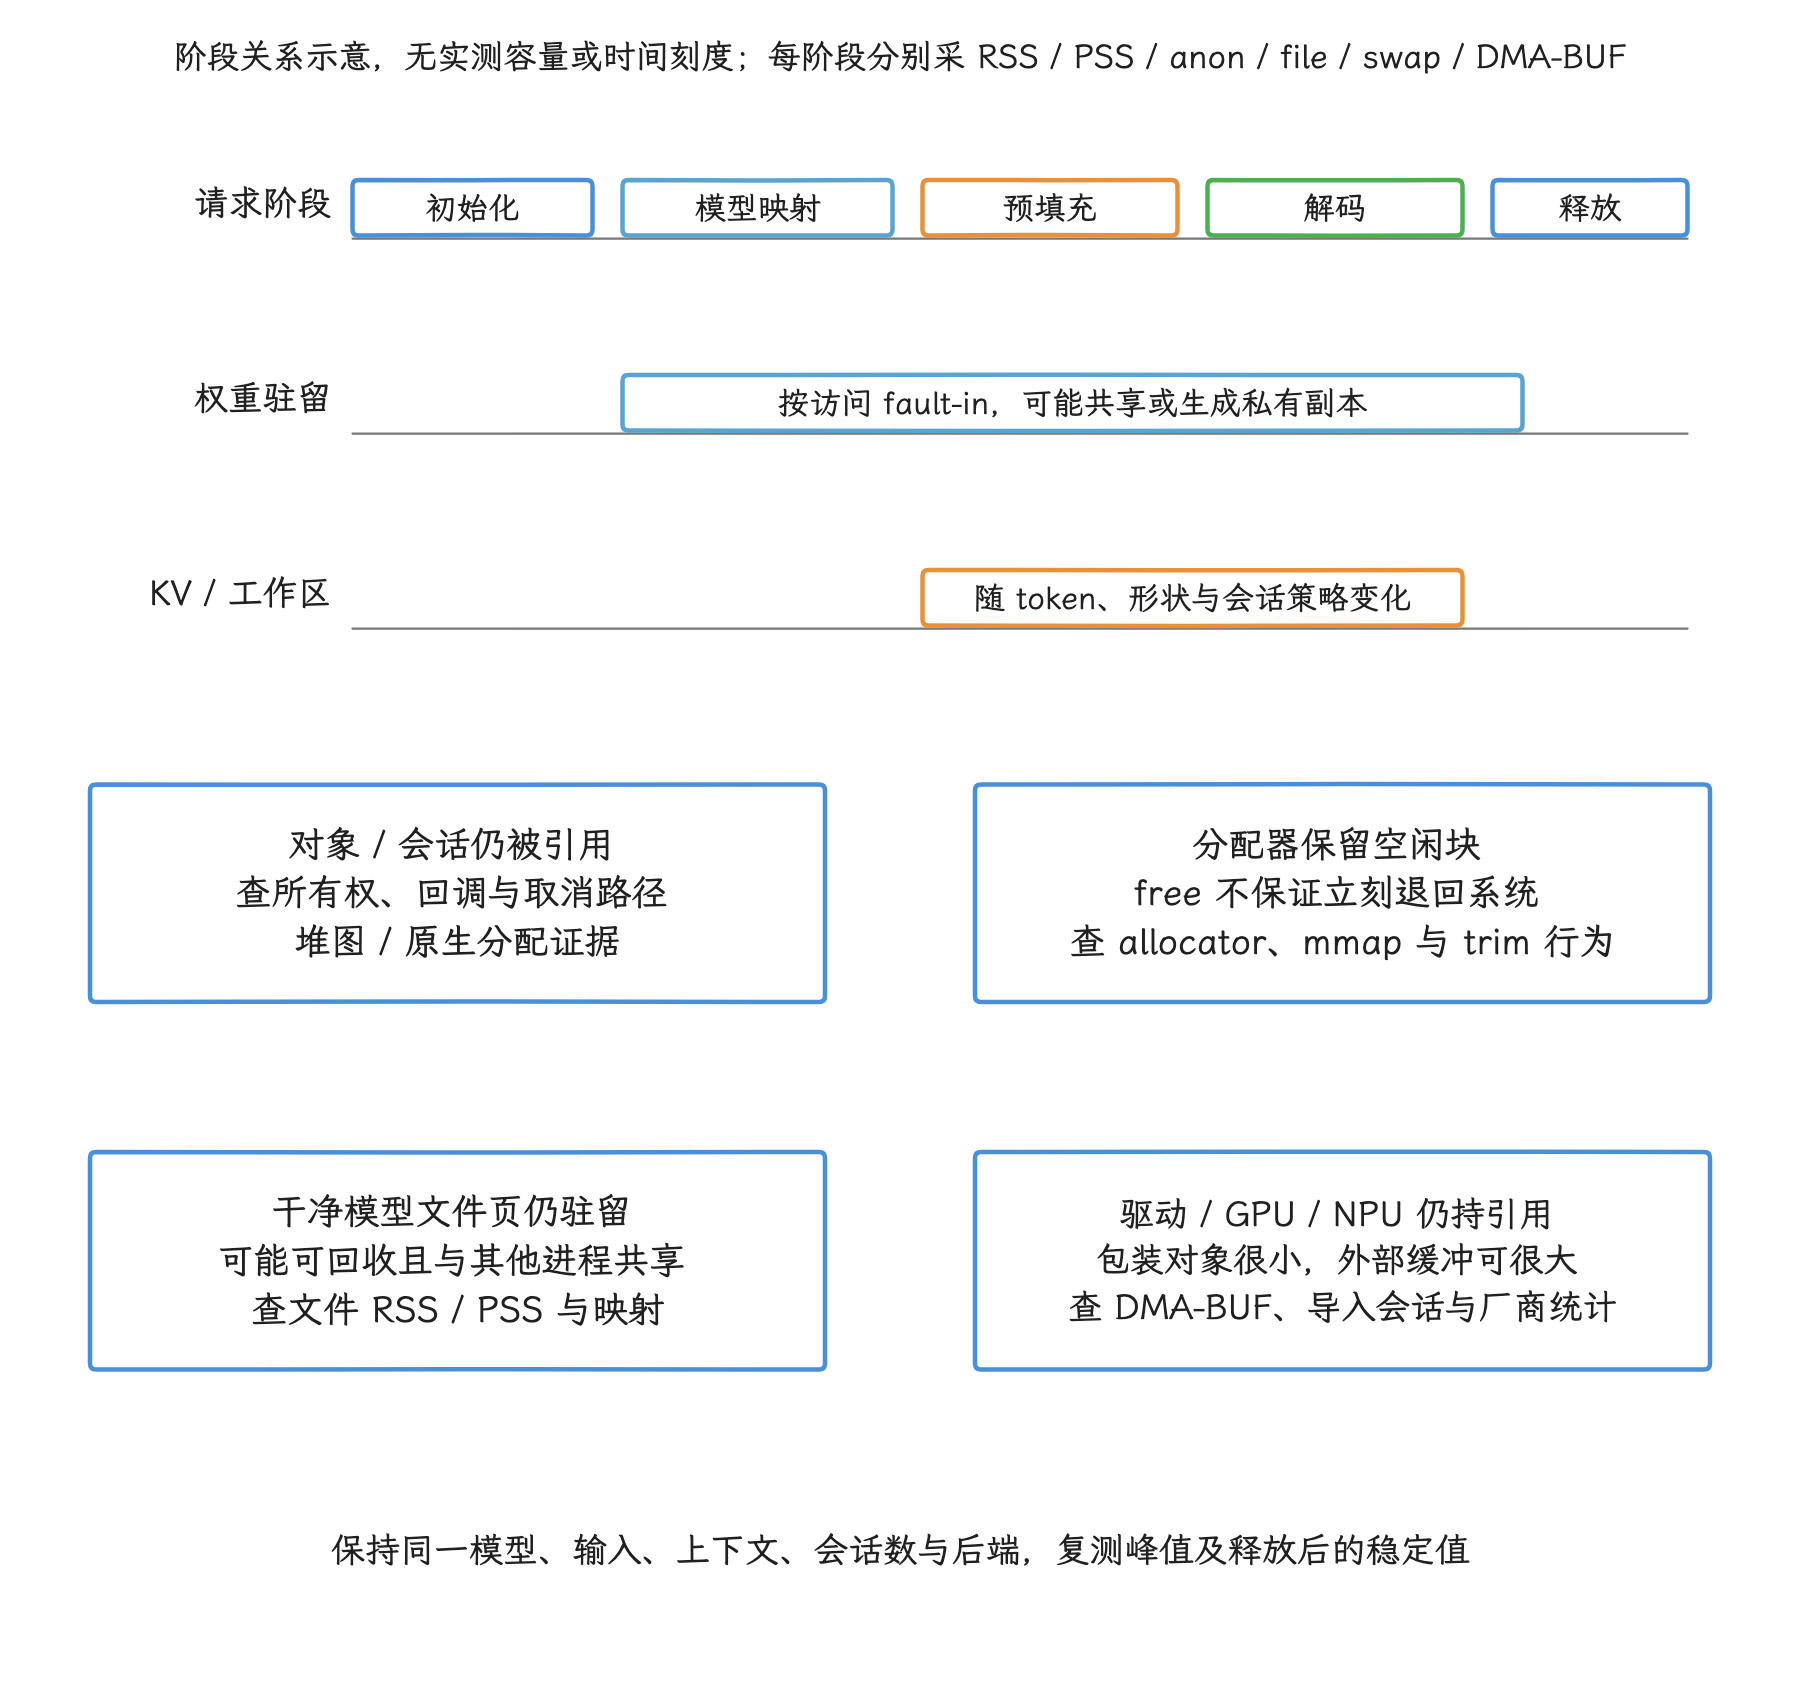
图:示意轨道标记初始化、模型映射、预填充、解码和释放;它们的内存分量并不都同步变化。模型页按访问驻留,KV 随缓存策略和 token 变化,临时工作区受后端与形状影响。会话结束后若 RSS 未下降,应分别查真实引用、allocator 留存、干净文件驻留与驱动引用,不能直接等同泄漏。
4.10.9 Android 17 MemoryLimiter 与 lmkd 的边界
MemoryLimiter 的生产配置
MemoryLimiter.java 里带着一份 sDefaultConfig:可见组(visible)内存为 4 GiB,不可见组(notVisible)内存为 2 GiB,两组的交换空间都是 2 GiB。源码注释明确说明这份配置用于测试,生产环境要先经过复核再用。生产系统从下面的文件读取配置:
/vendor/etc/memory-limiter-config.xml
系统会从中选择与设备总内存匹配的配置。该功能还受功能开关(feature flag)、配置文件是否存在和设备内存条件控制,所以某台 Android 17 设备完全可能没有启用 MemoryLimiter。
启用后,进程状态大致映射为:
| 类别 | Android 17 中的状态示例 | 限制来源 |
|---|---|---|
| 可见(visible) | TOP、BOUND_TOP、IMPORTANT_FOREGROUND、TOP_SLEEPING | 厂商配置的可见组内存/交换空间 |
| 不可见(notVisible) | FOREGROUND_SERVICE、SERVICE、RECEIVER、HOME 等 | 厂商配置的不可见组内存/交换空间 |
| 缓存(cached) | 各类缓存状态 | 忽略 memory.high,把 memory.swap.max 设为 max |
| 常驻(persistent) | PERSISTENT、PERSISTENT_UI | 两项均不限制 |
这里的 visible 是 MemoryLimiter 自己的分组,跟窗口可见性或某个应用组件名称没有直接对应。
还有一个与端侧推理直接相关的例外,我们要单独记下:initializeExemptList() 会读取 config_defaultOnDeviceSandboxedInferenceService,把配置的包加入豁免列表,设备默认的沙箱推理服务可能因此不受 MemoryLimiter 管理。第三方 :inference 进程并不会因为名字里带 inference 就自动拿到豁免。
memory.high 是 cgroup v2 的内存软限制,超过后会增加内存回收和执行节流压力;它不是“到值立即发生内存耗尽(OOM)”的硬上限。JNI 层实际写入的是 memory.swap.max,用来限制该 cgroup 可用的交换空间。具体的延迟变化取决于页面类型、工作集、交换空间、存储和内核回收,从阈值推不出固定的 P99(第 99 百分位)延迟倍数。
lmkd 的终止目标选择
lmkd 从较高 oom_score_adj 向较低档位搜索满足最低阈值的进程。kill_heaviest_task 属性以及是否进入用户可感知(perceptible)档位等条件,会影响系统是否在同一档位选择内存占用最大的进程;否则,系统可能按进程队列选择。
这带来三点结论:
- 推理内存增加会提高系统压力,但不会给进程创建“AI 保护”。
- 把推理拆到另一个进程后,两个 PID 的进程状态、
adj和内存都要分别观察。 - 系统推理服务占用大量内存时,被终止的可能是其他
adj更高的进程;具体结果取决于当时的进程集合和设备配置。
lmkd 终止日志还会读取 RSS、匿名 RSS、交换空间、dma-buf PSS 和 dma-buf RSS。排查硬件推理时,只截 Java 堆或匿名 RSS 是不够的。
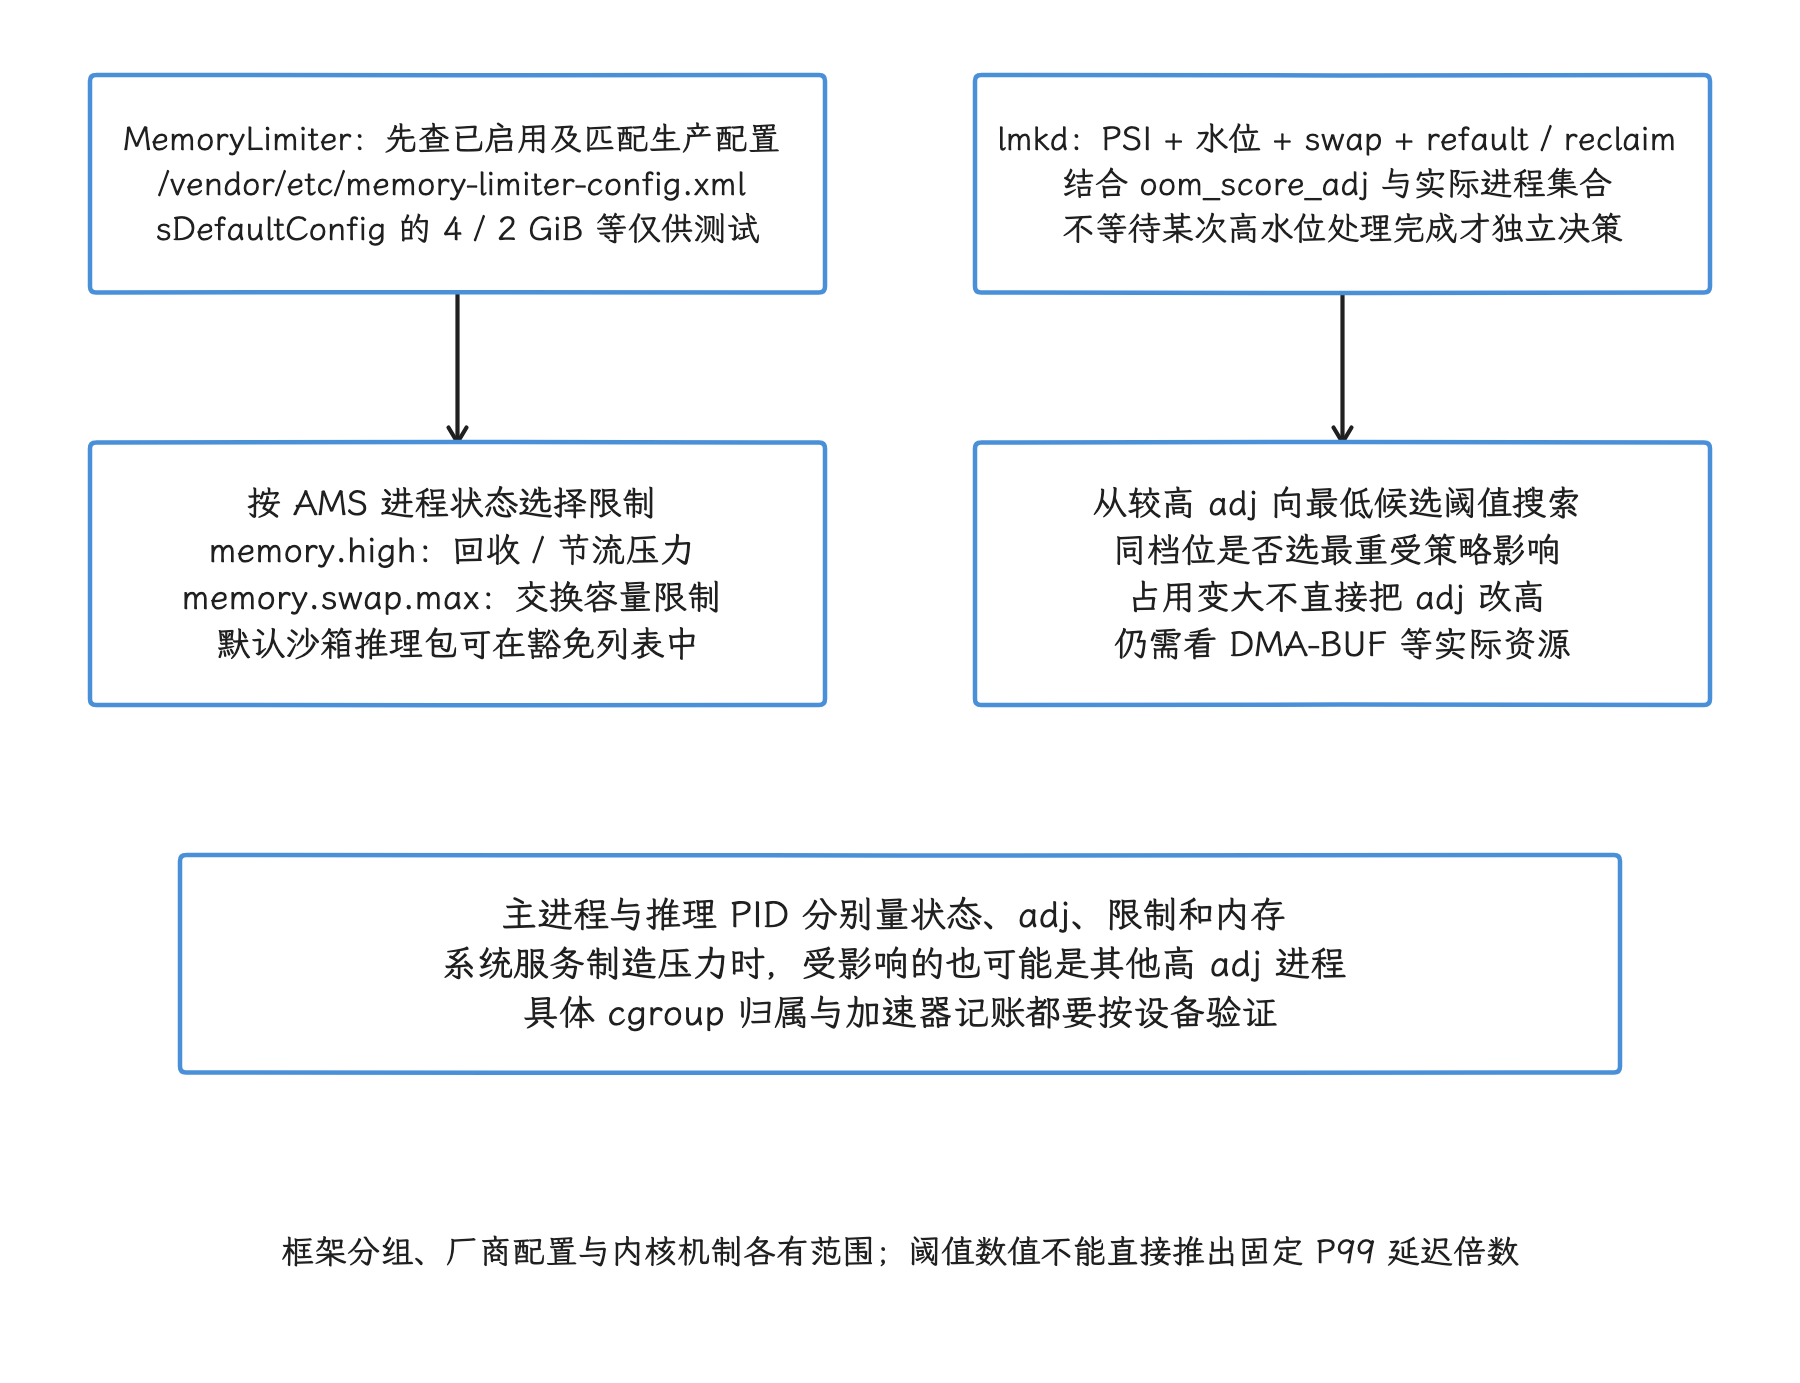
图:MemoryLimiter 启用后按状态与厂商 XML 配置 memory.high 和 memory.swap.max,前者增加回收与节流压力,后者限制该 cgroup 的交换容量;高水位并非立即 OOM。默认沙箱推理服务包可被显式豁免。lmkd 独立结合压力与 adj 搜索候选,同档位再按策略比较占用;推理命名、服务拆分和大模型大小都不产生通用 AI 保护。
4.10.10 一套可执行的测量方法
第一步:画出 PID、UID 与 fd 所有权
我们先把每个组件的以下信息记下来:
- 包名、PID、UID 和 SELinux 安全域;
- AMS 进程状态、
oom_score_adj和绑定关系; - 模型文件、SharedMemory、HardwareBuffer 的创建者与持有者;
- 会话结束后由谁关闭 fd、解除映射并释放会话。
多进程问题没有这张表,很容易把调用方内存、服务内存和共享页重复相加。
第二步:记录推理阶段
至少划分:
- 进程启动;
- 推理运行时与硬件后端委托器初始化;
- 模型打开与映射;
- 首次缺页或预热;
- 提示词预填充;
- 逐 token 解码与 KV 缓存增长;
- 会话释放;
- 进程退后台、冻结和解冻;
- 进程退出。
每个阶段都要记录延迟、RSS、PSS、匿名内存、文件映射、交换空间和 dma-buf,这样才能判断峰值来自权重驻留、KV 缓存、工作区还是驱动导入。
第三步:组合使用测量工具
可用的设备侧命令包括:
adb shell dumpsys meminfo <package-or-pid>
adb shell dumpsys activity processes
adb shell cat /proc/<pid>/status
adb shell cat /proc/<pid>/smaps_rollup
adb shell cat /proc/<pid>/oom_score_adj
/proc 的可见性受用户版本(user build)、adb 权限和 SELinux 限制,读取失败不表示指标不存在。cgroup 路径也由设备配置决定,应先从进程的 /proc/<pid>/cgroup 查找归属,别把路径硬编码成 /dev/memcg/<uid>。
Perfetto 中可启用:
linux.process_stats:采样各进程的统计值;linux.sys_stats:观察系统内存与虚拟内存计数;android.heapprofd:采样原生内存分配器的分配记录;- Binder、线程调度、缺页和 lmkd 相关的 ftrace/atrace 跟踪事件。
heapprofd 面向原生堆分配,覆盖不了只读模型文件映射的全部驻留页,也替代不了 dma-buf 和加速器驱动统计;Java 堆还要结合 ART 堆转储、内存分配采样或 dumpsys meminfo 分析。
4.10.11 设计评审清单
进程与隔离
- 推理代码需要故障隔离、权限隔离,还是只需要避免主进程出现 RSS 峰值?
:inference同 UID 是否满足威胁模型?- 隔离服务所需的文件、Binder 服务和硬件节点是否都经过明确授权?
- 调用方退出、服务被终止或进程被冻结后,会话能否安全取消或重建?
数据传递
- Binder Parcel 是否能稳定保持在建议的 64 KiB 以下?
- 大数据能否改为 SharedMemory、HardwareBuffer 或 URI?
- SharedMemory 发送前是否已经解除可写映射并降为只读?
- 谁负责 fd、映射、同步栅栏和会话的最终释放?
- 接收方是否会再复制、解压或重排,导致所谓共享失去效果?
内存预算
- 权重计算是否包含量化元数据与运行时副本?
- KV 缓存是否按
kv_heads、token、批大小和数据类型计算? - 预填充、逐 token 解码和多会话峰值是否分别测量?
- 文件页、匿名页、交换空间、dma-buf 和驱动内存是否分开记录?
- MemoryLimiter 是否启用,生产设备的厂商配置是什么,目标包是否被豁免?
安全
- 共享句柄发送前是否验证 Binder 调用身份与用户隔离?
- URI 授权、App Functions 权限和允许列表是否覆盖预期调用者?
- 可回放的生成式 UI 描述是否记录 schema、revision 和生成时业务版本,避免旧生成结果覆盖新状态或让智能体恢复到错误的 UI 上下文?[来源: https://juejin.cn/post/7675633667490267179]
- 共享区是否可能残留上一会话的敏感内容?
- 参数长度、偏移量、格式、版本和取消时序是否做了防御性校验?
4.10.12 源码索引
4.10.13 小结
- Android 17 没有通用的智能体进程类别;应先确认内存由哪个 PID、UID、cgroup 和驱动持有。
:inference提供地址空间与故障隔离,但通常仍使用应用 UID;敏感代码需要评估隔离服务。- Binder 的约 1 MiB 接收区由进程内并发事务共享,64 KiB 是平台建议的安全 IPC 大小。
- SharedMemory 通过 fd 共享同一组页面;
setProtect()、映射和 fd 必须分别管理。 - HardwareBuffer 能否避免复制,取决于双方格式、用途、HAL 导入和同步协议。
- ContentProvider 与 App Functions 提供访问控制和业务协议,大块数据仍应使用 URI、fd 或共享缓冲区。
- 预生成/缓存 A2UI 这类生成式 UI 描述属于应用层数据物化:它能把实时模型调用拆到后台生命周期,但读入、解析和智能体状态恢复后的内存仍按持有进程记账,别写成 Android 平台共享内存的新语义。[来源: https://juejin.cn/post/7675633667490267179]
- 权重、KV 缓存、工作区、文件映射、dma-buf 和驱动内存必须分开估算与测量。
- MemoryLimiter 的生产阈值来自厂商 XML;源码里的 4 GiB/2 GiB 内存阈值及 2 GiB/2 GiB 交换空间阈值只是测试配置。默认沙箱推理服务还可能被豁免。
- lmkd 不识别“AI”标签。进程状态、
oom_score_adj、设备策略、当时的进程集合与内存压力共同决定结果。