Android logd 日志系统性能与开销
普通 Log.d() 的参数先在调用方求值,随后经过 JNI 取字符串、liblog 级别判断、Unix Domain Socket(同一设备上进程间通信使用的本地套接字)发送和 logd 缓冲保存,最后由读取客户端取得。分析这条链路时,有三处容易混淆:应用写日志与 logd 保存日志是两段成本;logd 的服务端筛选与 logcat 的客户端筛选是两回事;EventLog 与 StatsD 原子事件(atom,即 StatsD 定义的一类结构化指标事件)走的是两条传输路径。
源码基线:AOSP
android-17.0.0_r1,本文结论均以它为准。
1. 日志写入链路
先把一条普通文本日志从 Java 层到 logd 缓冲区的路径完整走一遍,后面讨论开销和丢弃时都以它为参照。
1.1 从 Log.d() 到 logdw
普通 Java 文本日志的主路径如下:
android.util.Log.d(tag, message)
  -> Log.println_native(LOG_ID_MAIN, DEBUG, tag, message)
  -> frameworks/base/core/jni/android_util_Log.cpp
     GetStringUTFChars(tag / message)
  -> __android_log_buf_write()
     __android_log_is_loggable()
  -> liblog LogdWrite()
     writev(header, payload)
  -> /dev/socket/logdw (AF_UNIX, SOCK_DGRAM)
  -> logd LogListener
  -> LogBuffer::Log()
这条路径上有四个细节会影响开销判断:JNI 取字符串、native 侧的级别过滤、writev() 的提交方式,以及 socket 的凭据传递。
JNI 层用 GetStringUTFChars() 取到 tag 和 message 的表示,编码是 Modified UTF-8(JNI 使用的一种 UTF-8 变体),用完即释放。虚拟机会不会复制字符串,取决于具体实现和字符串内容,直接写成“一次堆分配”并不可靠;可以确定的是,取编码和跨一次 JNI 都有成本。
文本日志进入 __android_log_buf_write() 后执行 __android_log_is_loggable()。普通 Log.d(tag, message) 在 Java 层直接调用 native 方法,调用方若未显式检查级别,JNI 取字符串前没有这道过滤。此时参数也已求值,所以 liblog 的过滤能省去套接字写入,却省不掉字符串拼接、对象 toString()、JSON 序列化或 JNI 转换。
liblog 用 writev() 把头部和 payload(日志消息体) 一次提交。旧版内核 logger 的 /dev/log_main 等节点留在早期版本里,当前路径已经用不到它们。
/dev/socket/logdw 是 datagram socket,保留消息边界、无连接。logd 为它启用凭据传递,LogListener 从内核附带的 SCM_CREDENTIALS 取得发送方 PID、UID、GID,客户端伪造 payload 也冒充不了另一个进程。SELinux 和文件/socket 权限约束的是谁能连接与写入;至于日志本身,liblog 并不会在每条日志上重新执行一次 SELinux 判定。
对应源码:
frameworks/base/core/java/android/util/Log.javaframeworks/base/core/jni/android_util_Log.cppsystem/logging/liblog/logger_write.cppsystem/logging/liblog/logd_writer.cppsystem/logging/liblog/README.protocol.mdsystem/logging/logd/LogListener.cpp
1.2 过载时的丢弃行为
LogdWrite() 给普通日志用的 socket 带 SOCK_NONBLOCK:套接字暂时不可用时,写入立即返回。这里的普通日志覆盖 main、system、radio、events、stats、crash 等合法 buffer;security 是受权限控制的特殊二进制 buffer,liblog 为它单独准备了阻塞 socket。
logd 一旦来不及接收,socket 就返回 EAGAIN(表示“稍后再试”),liblog 记一次丢弃并直接返回;等后续写入恢复、liblog 内部日志允许输出时,它会尝试写入 event tag 1006(liblog),也就是 liblog 自己的事件,报告此前丢了多少条。这与旧版 chatty 行是两套机制。
所以应用日志风暴的代价主要落在四处:
- 调用方持续做格式化、JNI 转换和系统调用,消耗 CPU 与电量;
- socket 过载后新日志丢失,关键现场被噪声覆盖;
- logd 忙于接收、压缩、裁剪和服务读取客户端,增加系统负载;
- 日志对象和中间字符串增加分配压力。
在这套机制下,“socket 满后 write() 阻塞主线程并导致 ANR”的说法与 android-17.0.0_r1 的 liblog 实现不符。trace 里如果真有线程长期停在日志相关调用上,我们要查的是自建日志框架的锁、磁盘输出端(sink)、格式化、崩溃收集器或厂商改动;普通日志的非阻塞 logdw 过载分支会丢弃新记录,不会因为 socket 队列满而等待下游;前述 security 阻塞 socket 是另一条路径。
对 EAGAIN 也不要做无间隔重试——那等于把“允许丢日志”的保护机制变成 CPU 自旋。
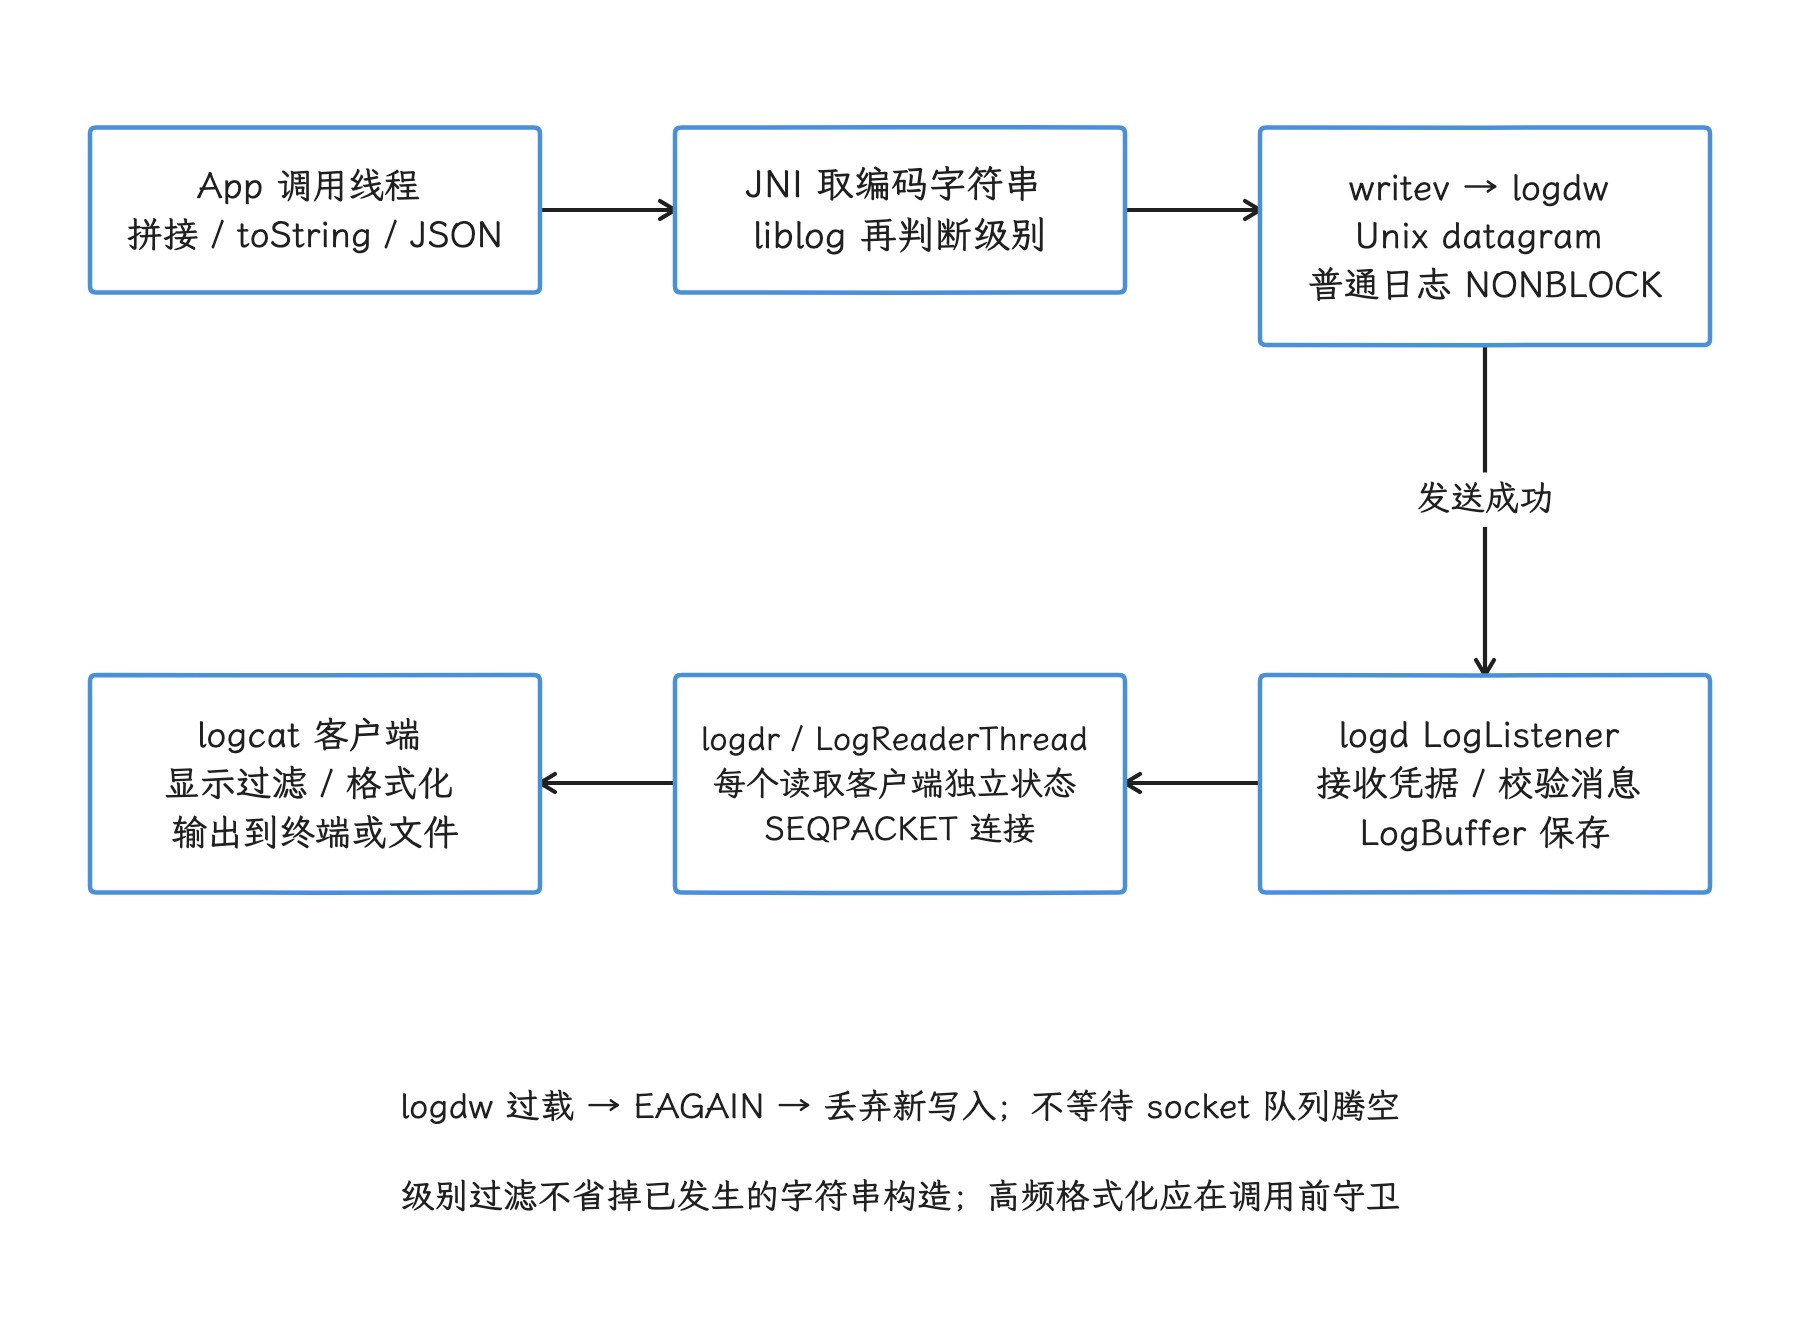
图:参数格式化先发生在应用调用线程,之后才经过 JNI、liblog 级别判断和普通非阻塞 logdw 写入。socket 过载可丢新日志,logd 保存后的日志则经独立的 logdr 连接读出;security 使用的阻塞写入路径另行处理。
1.3 payload 上限与长消息
LOGGER_ENTRY_MAX_PAYLOAD 为 4068 字节。LogdWrite() 会把超出上限的直接 payload 截到可发送范围。Java Log.printlns() 处理长文本和堆栈时,会按字符缓冲区容量和换行位置拆成多条,再逐条调用原生写入函数。缓冲区容量由 payload 上限减去 tag 长度、终止符和预留量估算;Log.java 明确接受 Modified UTF-8 编码差异带来的截断风险,没有逐条精确计算编码后的字节数。
这带来两个结果:
- 一条很长的异常堆栈可能对应多次 JNI 和
writev(); - 直接调用底层打印接口时,尾部信息可能被截断。
所以线上诊断信息要把稳定标识和错误类别放在前面,避免把唯一有用的字段留到长消息末尾;结构化数据写进 logcat 之前,也要先给它限好体积。
2. logd 如何接收和保存日志
日志写进 socket 之后,接收和保存就都是 logd 的事了。我们先看它怎么接。
2.1 LogListener 的两条接收实现
logd 从 init 继承 logdw socket。LogListener 有两条接收路径,其中一条依赖 io_uring(Linux 的异步 I/O 接口):
android.logd.flags.use_iouring开启且内核支持时,走IOUringSocketHandler的 multishotrecvmsg,一次提交接收请求,之后连续取得多个完成事件;- 条件不满足时,退回传统
recvmsg()循环。
两条路径都会校验包长度、读取发送方凭据,再调用 LogBuffer::Log()。至于一台设备实际走哪条,由 aconfig 功能开关和运行时支持共同决定,要以目标设备为准。
2.2 buffer 名称、容量与设备差异
logd 一共定义八个 log ID,每个对应一类独立的日志缓冲区:
| Buffer | 常见内容 |
|---|---|
main | 应用与通用 native 日志 |
radio | radio/telephony 相关日志 |
events | EventLog 二进制事件 |
system | framework/system 组件的文本日志 |
crash | 崩溃相关日志 |
stats | logd 协议中的 stats 二进制 buffer |
security | 受权限控制的安全事件 |
kernel | logd 收集的内核日志 |
system/logging/logd/LogSize.h 给出的通用默认值是每个 buffer 256 KiB,最小 64 KiB,最大 256 MiB。但 LogSize.cpp 里启动时读取 persist.logd.size* / ro.logd.size* 覆盖值的路径,只对 ro.debuggable=true、且设备类型为 automotive 或 ro.hardware=android-desktop 的设备生效;不可调试的低内存(low-RAM)设备会选择 64 KiB。再叠加产品配置和 logcat -G 运行时设置,实际容量因设备而异,一张固定容量表代表不了所有设备。
所以容量问题直接查目标设备:
adb logcat -g
输出会列出各 buffer 的环形缓冲区大小(ring buffer size)、已使用量、可读量以及单条上限。logcat -G 配合 -b 可以修改运行时大小,但通常需要相应权限。还要清楚一点:调大容量只能延长日志保留窗口,写入成本和 socket 丢包并不会因此消失。
2.3 默认实现使用序列化数据块
logd.buffer_type 的默认值是 serialized,即日志先编码、再按数据块保存;另一个可选值是 simple。所以默认实现并不是定长的 LogBufferEntry[] 数组。
SerializedLogBuffer 为每个 log ID 维护一份 SerializedLogChunk 列表,chunk 就是一批连续保存的序列化日志:当前的 chunk 保持可追加,写满或封存后的 chunk 用 Zstd 1 级压缩。计入容量的总大小一旦超过目标值,logd 就从较老的 chunk 开始裁剪。
访问封存块内的日志条目时,logd 在 SerializedLogChunk::IncReaderRefCount() 中按需解压;清理被裁剪块的统计信息也可能触发这一步。引用计数管理解压后的内容,裁剪时会通知关联读取状态放弃旧块,再回收数据,不会等待客户端读完。logcat 经 logdr 收到的是日志条目头和原始 payload,不承担 serialized chunk 的解压。
从外面看,这套设计仍表现为“只保留有限窗口,并淘汰旧数据”;内部的管理单位则换成了 chunk 和序列化条目。我们分析裁剪成本、内存占用或慢速读取客户端行为时,都要落到这套实现上看。
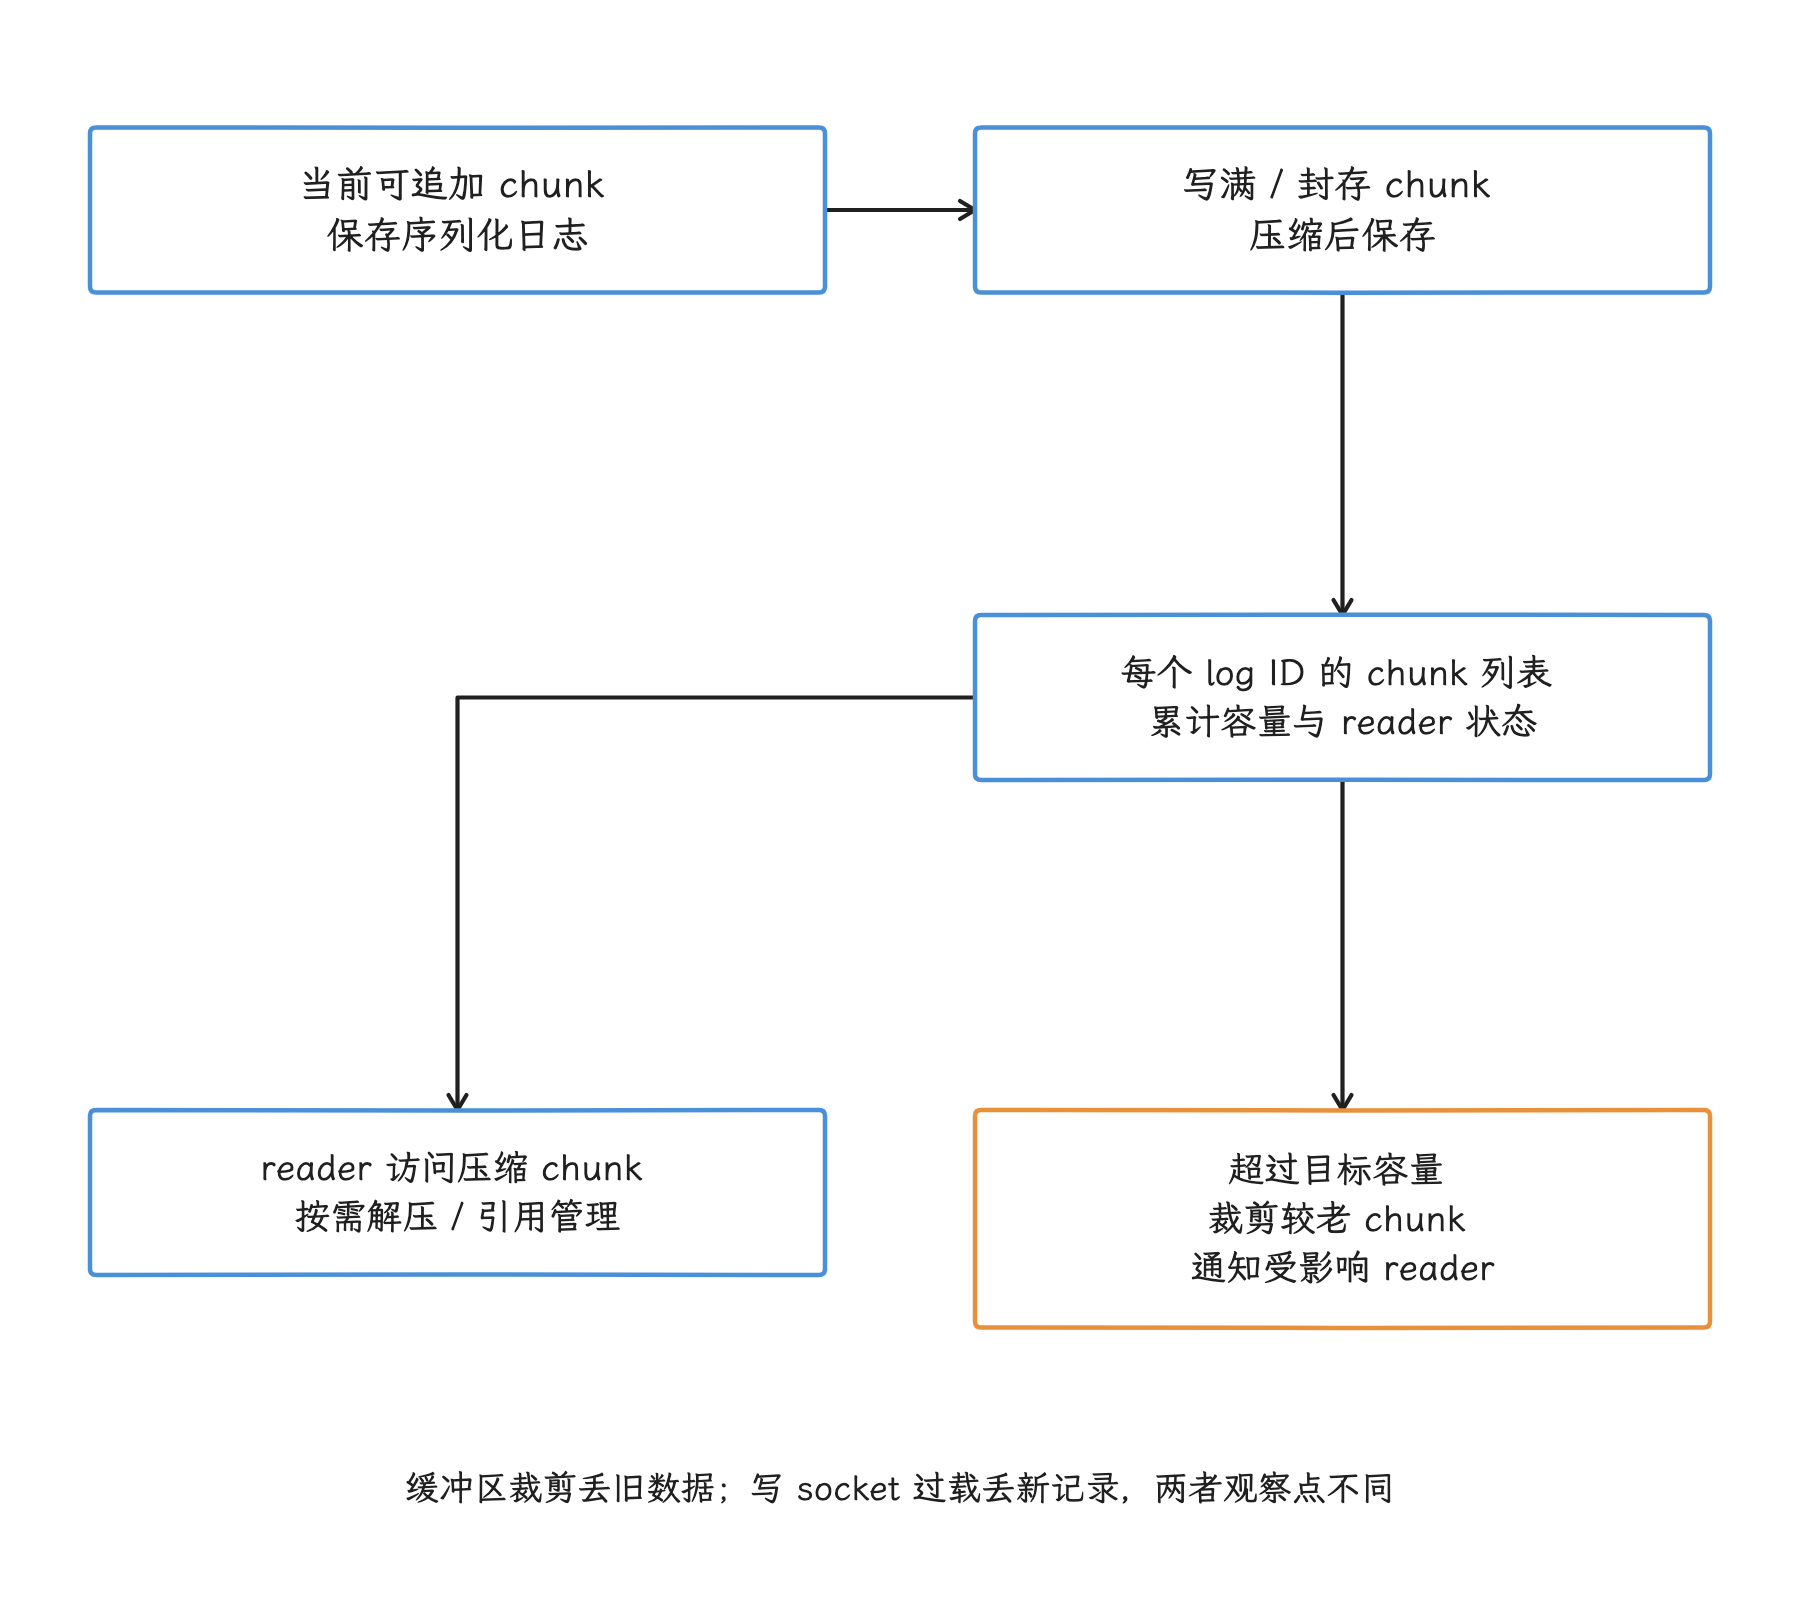
图:默认 serialized 路径把日志追加到当前 chunk,封存后压缩;容量超限时裁剪较老 chunk。按需解压在 logd 内完成,reader 状态也要随裁剪推进。增大容量不会消除调用方格式化或 socket 过载丢弃。
2.4 chatty 属于历史机制
system/logging/logd/README.compression.md 的标题就写着 Android S 的这次变化:用日志压缩取代 Chatty。到了 Android 17,logd 源码里已经没有当前默认路径所需的 ChattyLogBuffer.cpp,默认的 serialized buffer 也不会按旧说明插入 uid=... expired ... lines 来表示重复日志。
旧设备的日志中仍可能看到 chatty,AOSP 的事件 tag 表也保留了历史名称,但这只能说明历史,说明不了 Android 17 默认还在使用旧的重复行合并策略。当前版本有两个容易混在一起的现象:
- buffer 超限:logd 裁剪较老 chunk;
- writer socket 过载:liblog 遇到
EAGAIN丢弃新写入,并可能用 event tagliblog报告数量。
3. logcat 的读取与过滤
3.1 reader(读取客户端) socket 与每个客户端的线程
logcat 这边连接的是 /dev/socket/logdr。该 reader socket 使用 SOCK_SEQPACKET:可靠、面向连接,并保留每条消息的边界。logd 接受连接和读取命令后,会为每个客户端创建独立的 LogReaderThread。服务端命令支持的主要筛选条件包括:
- log ID mask;
- PID;
- 起始时间,由服务端换算成内部日志序号(sequence);
- tail 条数;
- 非阻塞读取,以及延迟读取(wrap)模式;后者等待裁剪或超时后再开始读取。
安全 buffer 和跨 UID 读取还受凭据与权限约束。面向普通应用的公开 NDK logging API 仅支持 main,应使用 __android_log_print() 或 __android_log_write();带 buffer 参数的接口不代表普通应用可写入其他 buffer。读取全局 logcat 所需的 READ_LOGS 也只授予受信任的特权组件。
3.2 tag 与正则表达式在 logcat 客户端执行
*:S MyApp:V 一类 tag/priority(标签/优先级) 规则,由 logcat 进程里的 android_log_shouldPrintLine() 判断;--regex 同样在 logcat 端交给 std::regex_search() 执行。这两类过滤都停在 logcat 进程里,不会作为标签表或正则表达式交给 logd。
这条客户端与服务端的分工直接影响性能判断:
--pid能直接交给 logd 执行,减少服务端发送的数据;-b能缩小服务端读取的 buffer 集合;- tag/priority 和
--regex主要减少终端输出,对 logd 到 logcat 的传输量帮助有限; - 复杂正则消耗的是 logcat 客户端的 CPU——把 logd CPU 升高归因于正则匹配,就找错了对象。
所以长期采集时,我们先用 -b 和 --pid 缩小服务端范围,再添加客户端显示过滤。例如:
adb logcat -b main --pid="$(adb shell pidof -s com.example.app)" \
  -v threadtime 'MyApp:V' '*:S'
这里 -b main 和 --pid 控制服务端数据范围,后面的过滤规则(filter spec)决定 logcat 打印哪些 tag。$(...) 命令替换应在主机 shell 中执行;多进程应用还要确认 pidof -s 选中的进程是不是我们要排查的那个。
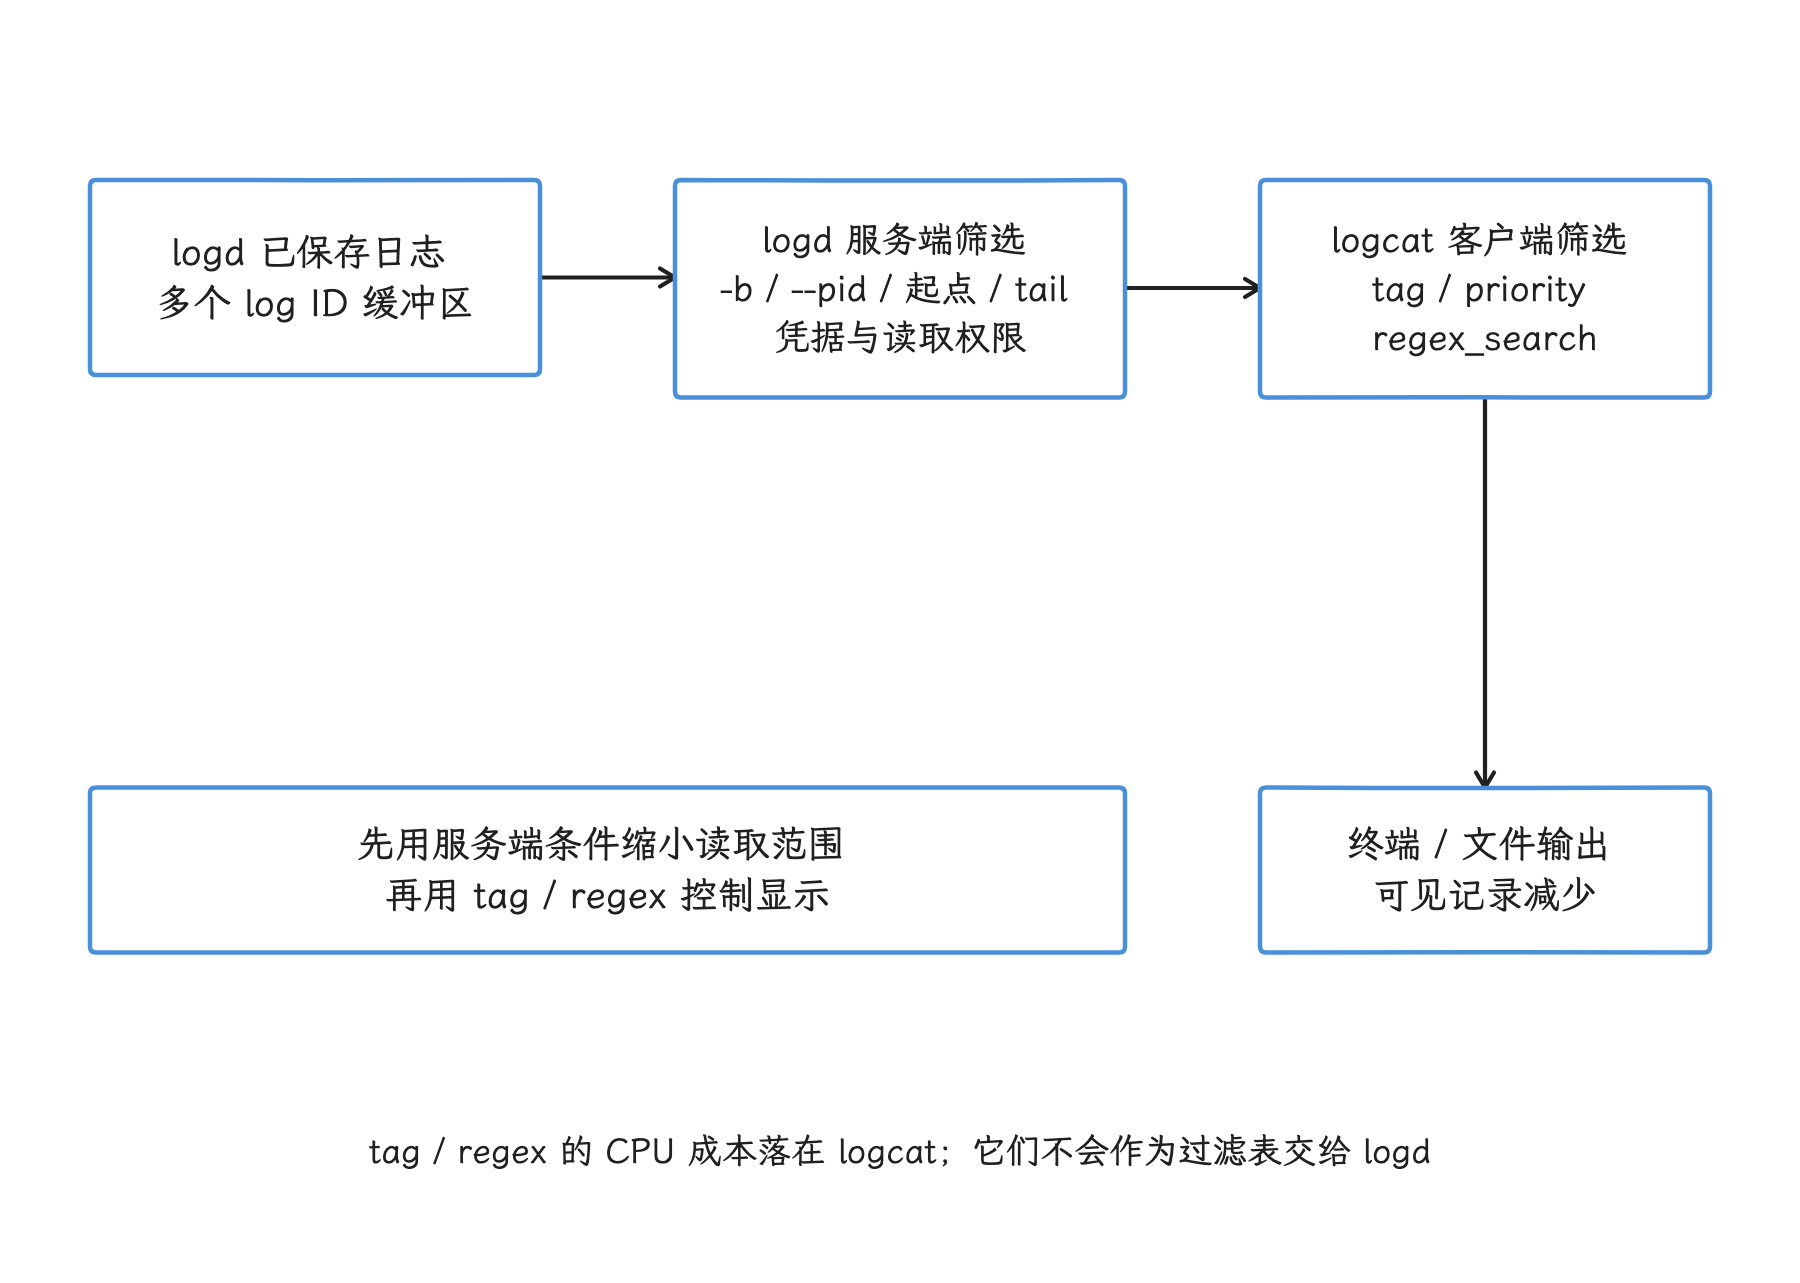
图:服务端按 buffer、PID、起点与 tail 等条件读取,再把记录传给 logcat;tag/priority 与正则匹配在 logcat 进程中执行。显示更少不意味着应用少写了日志,也不保证服务端少发同样多的记录。
3.3 慢速读取客户端与多个 reader
logd 为每个 reader 维护独立线程和读取状态。多开 logcat 会增加 logd 的线程、解压和 socket 发送工作量;不过 AOSP 并没有给出“每个客户端固定占用多少 KB”或“超过多少个必然变慢”的通用阈值。
reader 要读的位置一旦落在被裁剪的数据之后,serialized buffer 会让它跳过已回收的旧 chunk,并记一条警告;读 socket 也配置了发送超时,避免一个停止读取的客户端长期占住发送线程。是否达到瓶颈,取决于日志速率、buffer 容量、读取客户端数量、输出介质和设备性能,答案要以目标设备上的测量为准。
4. 容易被算进 logd 的两件事
排查 logd 开销时,有两个话题经常被算到它头上:StatsD atom 的传输路径,以及 system/logging 下的 Rust 代码。我们把它们摘出来。
4.1 EventLog 与 StatsD atom
LOG_ID_EVENTS 保存 EventLog 风格的二进制事件,其中的 tag 可由事件 tag 表解析。现代 StatsD atom(结构化指标事件)走的主要是另一条路:Android R 及以后,packages/modules/StatsD/lib/libstatssocket 通过独立的非阻塞 Unix datagram socket /dev/socket/statsdw 向 statsd 写入。
所以高频 StatsD atom 并不会“先写满 logd 的 events buffer”——StatsD 有自己的 socket、丢失报告和限流规则。logd 虽然仍定义 LOG_ID_STATS,但从名字推断“所有 atom 都经 logd 保存”并不可靠。追查 atom 丢失,我们要看 libstatssocket 与 statsd 的指标;只有分析 EventLog 的保留窗口时,才需要查看 events buffer。
对应源码:
packages/modules/StatsD/lib/libstatssocket/Android.bppackages/modules/StatsD/lib/libstatssocket/statsd_writer.cppsystem/logging/liblog/log_event_list.cpp
4.2 system/logging 中的 Rust 代码
system/logging/rust/ 包含的 Rust logging API、结构化日志和 liblog 绑定等都是客户端代码,这个目录的存在说明不了 logd 守护进程已经改写为 Rust。
android-17.0.0_r1 中,logd/Android.bp 构建的是 cc_binary,核心文件仍是 C++ 的 main.cpp、LogListener.cpp、SerializedLogBuffer.cpp、LogReader.cpp 和 LogReaderThread.cpp,logd/ 下找不到承担这些核心职责的 .rs 实现。基于 RwLock<VecDeque<...>>、mio 或“Rust 版吞吐提升比例”的描述在这个版本的源码里都没有依据,也就写不进 Android 17 的结论。
5. 应用侧怎样减少日志开销
5.1 消除无效的参数求值
即使这行日志最终会被 liblog 的级别过滤拦下,参数也已经在 Java/Kotlin 层构造完:
Log.d(TAG, "user=${user.name}, payload=${encodeLargePayload(data)}")
高频路径应在格式化前判断是否需要输出,并由构建类型(build type)或应用日志组件统一控制级别策略:
if (BuildConfig.DEBUG && Log.isLoggable(TAG, Log.DEBUG)) {
    Log.d(TAG, "user=${user.name}, payload=${encodeLargePayload(data)}")
}
这项条件判断可以跳过字符串插值和 encodeLargePayload()。反过来,如果只在调用外再包一层普通函数、传进去的仍是已经构造好的 String,就起不到同样的效果;自建 logger 若支持用 lambda 延迟求值,要确认 lambda 只在日志级别允许时执行。
5.2 用 R8 按级别删除 release 日志
当前 R8 文档提供了专门的 -maximumremovedandroidloglevel。例如,release 构建可以删除 verbose、debug 和 info 日志:
# INFO 对应数值 4;删除 INFO 及以下级别。
-maximumremovedandroidloglevel 4
R8 会处理匹配的 Log.* 与 Log.isLoggable() 调用。这条规则近年才进入正式文档,使用前要确认项目实际采用的 R8/AGP 版本支持它;规则应只进入 release 变体,并通过反编译、mapping/usage 输出和自动化测试确认结果。若只想作用于特定包或方法,可追加类规范(class specification)。
-assumenosideeffects 也能声明某些日志方法无副作用,但它属于强制优化假设:调用参数中具有可观察副作用的函数,并不保证随日志调用被删而连带消失。构建期删除仍应配合调用前的条件判断。
5.3 release 不会自动静音
debuggable=false 并不会自动删除所有 Log.d():liblog 会按 tag 属性和默认优先级判断是否写入,但调用点、参数求值和 JNI 入口仍可能发生。我们按信息价值逐类决定去留:
| 内容 | 发布版处理建议 |
|---|---|
| 高频调试轨迹 | 构建期删除 |
| 可恢复状态变化 | 聚合、限频,只保留诊断所需字段 |
| 警告与错误 | 保留稳定错误码和必要上下文 |
| 凭据、令牌、完整账号、原始请求体 | 禁止写入 |
采样率也别机械固定成“每 100 次一次”:故障可能正集中在被跳过的请求上,多线程共享计数器还会改变样本分布。需要采样时,要明确采样单位、时间窗口和紧急开关,还要选一个稳定的 key 决定同一对象是否入样——而且这个决定要在构造昂贵消息之前作出。
5.4 隐私与敏感数据
Android 4.1 以后,全局 READ_LOGS 读取能力受到特权权限限制,但预装特权组件、bugreport、工程构建和设备厂商诊断工具仍可能接触日志。敏感数据一旦写进系统日志,事后限制读取权限抵消不了这层风险。
发布版日志按字段白名单输出,令牌、密码和会话密钥必须完全删去;掩码只适合允许显示部分信息的字段。异常对象也要审查——服务端响应、URI 查询参数和用户输入都可能借异常文本进入日志。
官方依据:Log Info Disclosure 与 R8 Additional rule types。
6. 设备上如何定位日志开销
6.1 确认容量和丢失现象
以下命令分别观察容量和统计信息:
adb logcat -g
adb logcat -S
adb shell pidof logd
-S 输出 logd 统计,可结合 --pid 查看特定进程;具体字段和可见范围受构建与权限影响。/proc/<pid>/fdinfo 在这里帮不上忙——它反映不了 serialized chunks 的占用与裁剪状态,别拿它推断 logd 的逻辑 buffer 已用量。
6.2 区分调用方成本和守护进程成本
做一次有效的测量,我们至少要区分四组事件:
- 调用前消息格式化与对象分配;
- 应用进程的 JNI、
writev()次数及EAGAIN; - logd 的 CPU 调度、接收、压缩、解压和裁剪;
- logcat 客户端的条目解析、正则匹配、格式化与输出介质。
Perfetto 可同时观察应用与 logd 的线程调度、CPU 时间和频率变化。userdebug/eng 环境还可用 CPU 采样工具 simpleperf 分析应用或 logd 热点;用系统调用跟踪工具 strace 短时间跟踪,能验证应用是否频繁调用 writev()、调用是否返回 EAGAIN。
顺带一提,Android 的 bpfloader 只加载系统批准的 BPF 程序,普通应用并不能因此随意加载自定义 BPF 程序,排障手册也不该把它写成通用方案。
AOSP 自带 system/logging/liblog/tests/liblog_benchmark.cpp,其中有轻载写入和高压写入基准。结果取决于 SoC、内核、构建类型、buffer 和 logd 负载,跨设备固定的“单条若干微秒”给不出来。
比较优化前后的结果时,应固定消息长度、日志级别、CPU 状态和读取客户端配置,并同时记录丢失量;只统计成功循环次数,会把日志丢弃误判为吞吐提升。
6.3 一个实用的判断顺序
把前面这些工具串起来,遇到日志开销问题时可以按这个顺序排查:
- trace 中调用方在编码或字符串构造上耗时:减少参数工作;
- 应用
writev()很密集且出现EAGAIN:降低写入率,保留错误码和聚合结果; - logd CPU 高:检查全机日志源、buffer 裁剪与 reader 数量;
- 只有某个 logcat 进程 CPU 高:检查客户端正则、格式化和文件输出;
- 线上现场缺失:同时检查 liblog socket 的新日志丢弃和 logd 的旧数据裁剪。
7. 版本演进
| 版本阶段 | 相关变化 |
|---|---|
| Android 4.x 及更早 | 历史实现使用内核 logger 字符设备;只用于阅读旧源码和旧设备问题 |
| Android 5.0 起 | 用户态 logd 与 Unix socket 成为现代日志主路径 |
| Android S | serialized compression 取代旧 Chatty 方案,详见 README.compression.md |
| Android R 起 | StatsD 原生 atom 经独立 statsd socket 传输,应与 EventLog 路径分开分析 |
| Android 17 / API 37 | logd 核心仍为 C++;默认使用 serialized/Zstd buffer;接收端具备由功能开关控制的 io_uring 路径;Rust logging 代码位于客户端侧 |
这些旧路径保留下来,只用于分析历史 trace;判断当前行为,一律以文首的 android-17.0.0_r1 为准。现代应用日志链路不依赖 kernel 日志驱动实现,分析时用不着引入 android17-6.18-2026-06_r6 的额外假设。
8. 源码核查清单
复核或移植这些结论时,可从这些文件开始:
- Java/JNI:
frameworks/base/core/java/android/util/Log.java、frameworks/base/core/jni/android_util_Log.cpp - liblog 写端:
system/logging/liblog/logger_write.cpp、logd_writer.cpp、README.protocol.md - logd 接收:
system/logging/logd/LogListener.cpp、flags/logd_flags.aconfig - buffer:
system/logging/logd/LogSize.h、LogSize.cpp、SerializedLogBuffer.cpp、SerializedLogChunk.cpp、CompressionEngine.cpp - reader:
LogReader.cpp、LogReaderThread.cpp - logcat 客户端过滤:
system/logging/logcat/logcat.cpp - 历史 Chatty 边界:
system/logging/logd/README.compression.md - StatsD:
packages/modules/StatsD/lib/libstatssocket/statsd_writer.cpp
以上文件均按 android-17.0.0_r1 核查。产品分支若修改了 liblog socket flags、logd buffer type 或权限策略,应以设备对应源码和运行时命令输出为准。